Tag: AI

  • Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Abro una app de notas con IA, escribo una pregunta y espero.

    No espero al modelo. Eso lo entiendo: el modelo piensa. Espero a que la app viaje al servidor para leer tres filas de mi propio historial, las traiga de vuelta y solo entonces monte el prompt. Doscientos milisegundos de red para leer datos que ya estaban en mi portátil.

    Ese es el patrón por defecto de casi todas las apps de IA que reviso. La arquitectura local-first le da la vuelta: la base de datos vive en el dispositivo del usuario, la app lee de ahí a velocidad de memoria, y el servidor pasa de ser la fuente de toda verdad a ser un destino de sincronización.

    Aquí va la tesis. Mover la base de datos al cliente no es una optimización: es un cambio de arquitectura que reparte de otra forma la latencia, el coste de tokens y la privacidad, y a cambio te devuelve tres problemas que en el servidor no tenías — una sola conexión, migraciones que corren en máquinas que no controlas, y un camino de escritura hacia el servidor que nadie te da hecho.

    Si terminas de leer sabiendo si te toca o no, el post ha cumplido.

    Qué es la arquitectura local-first

    Local-first es una arquitectura en la que la base de datos vive en el dispositivo del usuario: la aplicación lee y escribe siempre contra esa copia local, a velocidad de memoria, y el servidor deja de ser la fuente de toda verdad para convertirse en un destino de sincronización. La app funciona sin red por defecto, no como caso degradado.

    No es lo mismo que cachear. Una caché es una copia que aceleras y que puedes tirar; en local-first la copia local es donde de verdad ocurre todo, y la red es un detalle de implementación.

    Qué es PGlite y por qué no es "otra base de datos en el navegador"

    PGlite es Postgres compilado a WebAssembly y empaquetado como librería de TypeScript. Corre en el navegador, en Node.js y en Bun, sin dependencias externas y sin proceso servidor.

    La distinción que importa está en su propia documentación: "Unlike previous 'Postgres in the browser' projects, PGlite does not use a Linux virtual machine – it is simply Postgres in WASM."

    Eso no es marketing, es la decisión arquitectónica del proyecto. Los intentos anteriores emulaban una máquina Linux entera para arrancar encima un Postgres normal: pagabas el peso de un sistema operativo simulado para ejecutar un SELECT. PGlite elimina esa capa.

    Los números, para que no tengas que buscarlos:

    • PGlite pesa menos de 3 MB gzipped y corre Postgres compilado a WASM, sin máquina virtual Linux.
    • Persiste en memoria (efímero), en IndexedDB en el navegador, o en el sistema de ficheros en Node y Bun.
    • La versión actual de @electric-sql/pglite es la 0.5.8, publicada el 26 de agosto de 2026, y el plugin de sincronización @electric-sql/pglite-sync va por la 0.6.9.

    Retén ese "0.x". Vuelvo a ello más abajo.

    Qué gana una app de IA con arquitectura local-first

    Una app de IA gana tres cosas al pasar a local-first: latencia de microsegundos en lugar de un round-trip de red, menos tokens por turno porque filtras el contexto donde ya están los datos, y una garantía de privacidad real porque el historial no tiene por qué salir del dispositivo. Ninguno de los tres es "va más rápido" a secas.

    Latencia: microsegundos frente a un round-trip de red

    Los benchmarks oficiales, medidos en un MacBook Air M2 con PGlite en memoria, dan estos tiempos de ida y vuelta por operación: insert de una fila pequeña en 0,058 ms, select en 0,088 ms, update en 0,073 ms y delete en 0,145 ms.

    Compáralo con los 50-200 ms de una llamada HTTP a tu API y el cambio deja de ser cuantitativo: pasa a ser de diseño.

    Cuando leer cuesta microsegundos dejas de diseñar para minimizar consultas. Se acabó cachear tres pantallas por delante, montar endpoints agregados y pintar skeletons.

    Coste de tokens: RAG en el navegador con pgvector

    Este es el eje que más se subestima, y el que de verdad justifica local-first en una app de IA.

    El patrón habitual del chatbot es incómodo cuando lo miras de frente: mandas todo el historial al servidor en cada turno para que el backend reconstruya un contexto que ya estaba entero en el dispositivo del usuario. Pagas tokens por transportar información que no había salido de casa.

    Con un Postgres real en el cliente filtras el contexto en local —con SQL de verdad, joins y filtros por fecha— y mandas al modelo solo lo que importa. Y como PGlite soporta pgvector, ese filtro puede ser búsqueda semántica y no solo un WHERE:

    import { PGlite } from '@electric-sql/pglite'
    import { vector } from '@electric-sql/pglite-pgvector'
    
    const pg = new PGlite({
      extensions: { vector },
    })
    
    await pg.exec('CREATE EXTENSION IF NOT EXISTS vector;')
    

    La consulta por distancia de embeddings corre en el navegador y solo los cinco fragmentos relevantes viajan al modelo:

    SELECT id, content
    FROM chunks
    ORDER BY embedding <-> $1::vector
    LIMIT 5;
    

    Ese <-> es distancia euclídea; si tus embeddings vienen de OpenAI, lo habitual es coseno con <=>. Elige el operador que case con el índice que crees, no el del ejemplo que copiaste.

    Decidir qué entra en el contexto antes de escribir el primer prompt es justo el trabajo que hacemos en el curso de Construye con IA: el prompt no es el sistema, es la última capa.

    Si vienes de montar RAG en servidor, el contraste está en Búsqueda híbrida y embeddings en Supabase — misma técnica, distinto sitio. Y si aún dudas de si tu caso pide RAG, contexto o fine-tuning, esa decisión va antes que esta y la tienes en RAG vs fine-tuning vs contexto.

    Privacidad: los datos no salen del dispositivo

    En una app de notas es un argumento de venta. En salud, legal o finanzas es el requisito que decide si el proyecto existe.

    Con la base de datos en el cliente decides tú qué se sincroniza. Y puedes decidir que nada: si esa tabla no entra en ningún shape, el historial del usuario nunca toca tu infraestructura. Solo sale lo que mandas al modelo, y eso lo controlas con una consulta, no con una política de retención.

    Es la diferencia entre "prometemos que no miramos tus datos" y "no los tenemos".

    Pero ese modo máximo se paga dos secciones más abajo: sin copia en servidor no hay red de seguridad para las migraciones ni multi-dispositivo. Privacidad total y recuperación ante desastres son dos posiciones del mismo mando.

    Cómo queda la arquitectura: PGlite como fuente de verdad local

    PGlite es la fuente de verdad para la UI: la aplicación lee y escribe siempre contra la base local, nunca contra la red. El servidor mantiene su Postgres, que sigue siendo la fuente de verdad del negocio, y las escrituras llegan hasta él por un camino que montas tú. Ahora vuelvo a eso.

    Entre los dos, sincronización basada en shapes. Un shape es un subconjunto de una tabla: no te bajas messages entera, te bajas "los mensajes de las conversaciones de este usuario de los últimos 90 días". El cliente declara qué porción del mundo le interesa y el sync la mantiene al día.

    Y aquí va el matiz que decide presupuestos: ese sync va en una sola dirección. La documentación de pglite-sync no se esconde — "We don't yet support local writes being synced out, or conflict resolution" — y Electric lo remata: hace read-path sync, y no hace write-path sync.

    Traducido: el camino servidor → cliente te lo dan hecho. El camino cliente → servidor lo escribes tú. Cola de escrituras local, reintentos, orden, idempotencia y qué pintas mientras la escritura está en vuelo. Electric documenta cuatro patrones para eso, pero son patrones, no un paquete que instalas.

    Dos límites más de los shapes que conviene saber antes de diseñar: no se pueden sincronizar varios shapes sobre la misma tabla, porque una suscripción necesita poder tirar todos los datos y empezar de cero; y para garantizar consistencia transaccional los datos se agregan en memoria, lo que con shapes muy grandes se nota.

    Encima van las live queries del módulo @electric-sql/pglite/live: registras una consulta y los resultados se actualizan solos cuando cambian los datos, vengan del usuario o del sync. Sin polling y sin invalidación manual de caché.

    Ahí está el efecto secundario grande: desaparece la mitad de tu capa de gestión de estado. El estado del servidor deja de ser algo que cacheas a mano y pasa a ser una tabla que se actualiza. Esa reorganización de responsabilidades la traté en Clean Architecture en Frontend.

    Lo que se te rompe al llevar Postgres al navegador

    Llevar Postgres al navegador te devuelve seis problemas que en el servidor no tenías: una sola conexión, migraciones que corren en dispositivos ajenos, resolución de conflictos sin librería que la resuelva por ti, el peso de arranque, benchmarks que solo valen en memoria y una API todavía en 0.x. Esta es la sección que importa.

    Una sola conexión: el worker no es opcional

    La documentación lo dice sin adornos: "PGlite is single connection only". Y hay un segundo problema encima: si ejecutas PGlite en el hilo principal, bloqueas la UI.

    La solución oficial es el multi-tab worker: una única instancia de PGlite dentro de un Web Worker y una elección de líder que hace de proxy para las peticiones de todas las pestañas abiertas. Cuando la pestaña líder se cierra, se elige otra y se levanta una instancia nueva.

    El worker:

    // my-pglite-worker.js
    import { PGlite } from '@electric-sql/pglite'
    import { worker } from '@electric-sql/pglite/worker'
    
    worker({
      async init() {
        return new PGlite()
      },
    })
    

    Y el cliente:

    import { PGliteWorker } from '@electric-sql/pglite/worker'
    
    const pg = new PGliteWorker(
      new Worker(new URL('./my-pglite-worker.js', import.meta.url), {
        type: 'module',
      }),
    )
    

    Son quince líneas, pero no las trates como boilerplate. Tu base de datos vive ahora detrás de una frontera asíncrona con elección de líder, y eso condiciona cómo pruebas la app y qué ocurre en el segundo en que el usuario cierra la pestaña líder.

    Migraciones de esquema en dispositivos que no controlas

    En el servidor una migración es un evento: la lanzas, corre, se acabó. Hay una base de datos y tú tienes la llave.

    En local-first tienes N versiones del esquema repartidas por dispositivos ajenos. Un usuario abrió la app en marzo y no ha vuelto. Cuando vuelva, su base local está seis migraciones por detrás y esas seis tienen que aplicarse en orden, en su navegador, sin romperse a mitad.

    Esto es lo que se lleva por delante los planes de rollback: no puedes revertir una migración en 8.000 portátiles.

    La consecuencia práctica es que el esquema local evoluciona de forma aditiva casi siempre. Columnas nuevas, no renombradas. Tablas nuevas, no reestructuradas. Y una tabla de versión de esquema desde el día uno, antes de tener usuarios.

    La red de seguridad que sí funciona no es el rollback, es el reset. Si el servidor es la fuente de verdad del negocio, la base local es desechable: ante una migración que no aplica, la borras del dispositivo y vuelves a sincronizar los shapes desde cero. Es feo, tarda y hay que pintarlo bien, pero funciona.

    La letra pequeña: eso solo existe si hay copia en servidor. Si elegiste el modo máximo de privacidad, no hay de dónde resincronizar y cada migración es un disparo único sobre datos irrecuperables. Ahí el esquema aditivo deja de ser buena práctica y pasa a ser la única opción.

    Resolución de conflictos: aquí no hay magia

    Dos dispositivos offline. Los dos editan el mismo registro. Los dos recuperan la red.

    Sí existen librerías que deciden por ti: los CRDT de Yjs, Automerge o Loro convergen sin preguntarte. Pero convergen a una respuesta, no necesariamente a la que tu negocio considera correcta. Un CRDT te garantiza que dos dispositivos acaban iguales; no te garantiza que el saldo resultante sea el que el usuario esperaba. Esa decisión no la delegas.

    Tus opciones reales son tres: last write wins y perder ediciones en silencio, guardar ambas versiones y preguntar al usuario, o modelar los datos para que los conflictos sean estructuralmente imposibles — append-only, eventos en vez de estado, campos con un único dueño. La tercera es la buena, y es una decisión de modelado que tomas antes de escribir código.

    Su contrapartida: una base append-only crece sin techo, y eso choca con la pregunta que cierra este post — si los datos caben en el dispositivo. Compacta por antigüedad o materializa el estado cada N eventos, desde el principio.

    Un detalle que se olvida: lo que llega del sync es entrada externa y merece validarse como el body de una API. Un payload con un campo cambiado por una versión antigua del cliente puede corromper la base local del usuario, y ahí ya no tienes acceso para arreglarlo. Es el escenario exacto para el que trabajamos schemas en el curso de Zod: validar en la frontera, no confiar en el tipo.

    3 MB antes de que el usuario vea nada

    PGlite pesa menos de 3 MB gzipped, y es un coste de arranque real que pagas en el primer render.

    En una app que el usuario abre a diario se amortiza en el primer uso. En una landing con formulario es inaceptable. Cárgalo diferido, después del primer pintado, con un estado de "preparando" que no sea una pantalla en blanco.

    Los 0,058 ms son en memoria

    Aquí es donde muchos posts sobre PGlite venden humo, así que lo digo claro: los benchmarks de PGlite están medidos en memoria; en cuanto persistes a IndexedDB, la foto cambia.

    La propia documentación lo reconoce: "An fsync or flush to the underlying storage can be quite slow, particularly in the browser with IndexedDB for PGlite, or OPFS for wa-sqlite."

    Y es igual de honesta comparándose con SQLite en WASM: "wa-sqlite is faster than PGlite when run purely in memory", aunque "For single row CRUD inserts and updates, PGlite is faster then wa-sqlite", por usar Write-Ahead Log frente al rollback journal de SQLite.

    La doc avisa además de que comparar Postgres con SQLite es difícil y de que sus benchmarks son un punto de partida, no una sentencia.

    Traducción: sigue siendo órdenes de magnitud más rápido que la red, pero mide tus escrituras con persistencia activada antes de prometer nada.

    Sigue en 0.x

    @electric-sql/pglite está en la 0.5.8 y @electric-sql/pglite-sync en la 0.6.9. Pre-1.0 significa que la API puede moverse entre versiones menores.

    No es razón para descartarlo. Es razón para fijar la versión, leer los changelogs antes de actualizar y no esparcir PGlite por medio proyecto sin una capa propia delante.

    Cuándo NO usar local-first (y qué hacer en su lugar)

    La respuesta honesta es que a la mayoría de las apps no les toca.

    Tu situación Qué hacer
    App de IA de uso diario, con historial largo y propio de cada usuario Local-first con PGlite. Es tu caso.
    Datos sensibles que no deberían tocar tu servidor (salud, legal, finanzas) Local-first, y aquí es requisito, no optimización.
    Necesitas funcionar offline de verdad Local-first. No hay alternativa real.
    Datos compartidos que muchos usuarios editan a la vez Servidor. El coste de resolver conflictos se come la ganancia.
    Landing, e-commerce o cualquier app de sesión corta Servidor. 3 MB de arranque para dos consultas no sale.
    Necesitas consultar millones de filas que no caben en el cliente Servidor, con RAG clásico. Los shapes tienen un límite práctico.
    Equipo sin experiencia en sincronización de datos Servidor, hasta que el dolor justifique la curva.
    Tests de integración y CI que hoy levantan Docker con Postgres PGlite en Node o Bun. Sin migraciones ni sync, pero sigue siendo de una sola conexión.

    Esa última fila merece una nota. Aunque tu app no sea local-first, PGlite te sirve hoy en el pipeline: es un Postgres real, arranca en milisegundos y no necesita contenedor. Cambiar docker compose up por una instancia en memoria en tus tests es la puerta de entrada barata a esta tecnología. Con dos límites: al ser de una sola conexión ahí no vas a reproducir deadlocks, bloqueos entre sesiones ni el comportamiento de tu pool; y PGlite trae un catálogo concreto de extensiones, así que comprueba que las de tu esquema estén en la lista antes de tirar el Docker.

    Cómo decidir esto hoy, en diez minutos

    Responde a una sola pregunta: ¿los datos que tu IA necesita para responder son de un único usuario y caben en su dispositivo?

    Si es que sí, local-first con PGlite te saca el round-trip de red de la ruta crítica, te baja los tokens por turno y te da una historia de privacidad que tus competidores no pueden contar. Empieza por el worker, el esquema versionado, el camino de escritura y una estrategia de conflictos escrita antes de crear la primera tabla.

    Si es que no, quédate en el servidor y duerme tranquilo.

    Y si quieres ver este tipo de decisiones discutidas con proyectos reales delante, es lo que hacemos cada semana en Dominicode Labs.

    Preguntas frecuentes sobre local-first con PGlite

    ¿PGlite sustituye a mi Postgres del servidor?

    No. PGlite es un Postgres embebido de una sola conexión, pensado para vivir junto a la aplicación y no para servir a muchos clientes concurrentes. En una arquitectura local-first, PGlite es la fuente de verdad local del dispositivo y tu Postgres del servidor sigue siendo la del negocio: entre ambos hay sincronización —de servidor a cliente te la dan hecha, de cliente a servidor la montas tú—, no sustitución.

    ¿Puedo hacer RAG entero en el navegador con PGlite?

    Sí, siempre que el corpus sea del usuario y quepa en su dispositivo. PGlite soporta pgvector a través del paquete @electric-sql/pglite-pgvector, así que puedes guardar embeddings y hacer búsqueda por similitud en local sin que los documentos salgan del navegador. Lo que no puedes hacer en el cliente es RAG sobre un corpus corporativo de millones de documentos: eso sigue siendo trabajo de servidor.

    ¿Cuánto pesa PGlite y cómo afecta al arranque de la app?

    PGlite pesa menos de 3 MB gzipped. Se carga una vez y luego queda cacheado, pero es un coste real en el primer render, así que conviene cargarlo diferido después del primer pintado. En una app de uso diario se amortiza sin problema; en una página de sesión corta no compensa.

    ¿Qué pasa si el usuario abre la app en dos pestañas?

    PGlite admite una sola conexión, así que dos pestañas no pueden abrir dos instancias sobre la misma base de datos. La solución oficial es el multi-tab worker: una única instancia dentro de un Web Worker y una elección de líder que hace de proxy para todas las pestañas. Cuando la pestaña líder se cierra, se elige otra automáticamente y se levanta una instancia nueva.

    ¿Está listo para producción si sigue en 0.x?

    Depende de tu tolerancia a que la API cambie. @electric-sql/pglite está en la 0.5.8 y el plugin de sync en la 0.6.9, y pre-1.0 significa que puede haber cambios de API entre versiones menores. Hay proyectos en producción con PGlite, pero si entras, fija la versión exacta, lee los changelogs antes de cada actualización y aísla PGlite detrás de una capa propia para que un cambio de API no te toque cincuenta ficheros. Y si vas a hacer RAG en el navegador, mira el eslabón más verde de la cadena: el paquete de pgvector, @electric-sql/pglite-pgvector, va por la 0.0.9.

    ¿En qué se diferencia PGlite de IndexedDB o de SQLite en WASM?

    IndexedDB es un almacén clave-valor sin lenguaje de consultas: cualquier filtro o join lo escribes tú en JavaScript. SQLite compilado a WASM sí te da SQL y en memoria pura es más rápido que PGlite, pero es SQLite: otro dialecto y otras extensiones que las de tu servidor. PGlite es Postgres compilado a WASM sin máquina virtual Linux, así que ejecutas el mismo dialecto y un catálogo de extensiones que se solapa con el de tu servidor —pgvector incluida—, aunque no estén todas las de Postgres. En local-first, esa paridad es lo que evita mantener dos modelos de datos distintos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Shopify compra Tailwind: no falló el framework, falló el embudo

    Shopify compra Tailwind: no falló el framework, falló el embudo

    El 18 de noviembre de 2025, un contribuidor abrió un pull request en el repositorio de la documentación de Tailwind. La propuesta era razonable: un endpoint llms.txt que sirviera toda la doc en un único archivo de texto, optimizado para que lo consumieran los modelos de lenguaje.

    El PR se quedó parado siete semanas. A principios de enero alguien preguntó en el hilo por qué no avanzaba. Adam Wathan lo cerró el 6 de enero de 2026, y al día siguiente contestó con algo que no era la respuesta a un PR:

    "75% of the people on our engineering team lost their jobs here yesterday because of the brutal impact AI has had on our business."

    "El 75 % de la gente de nuestro equipo de ingeniería perdió su trabajo ayer por el impacto brutal que la IA ha tenido en nuestro negocio."

    Eran cuatro ingenieros. Quedó uno.

    Ocho meses después llegó el desenlace: el 9 de septiembre de 2026, Shopify compra Tailwind Labs. Ni Shopify ni Tailwind Labs han revelado el importe.

    La lectura fácil es "gran salida para un proyecto querido". La útil es otra: aquí no falló el framework. Falló el embudo por el que ese framework se pagaba.


    Qué dice el anuncio de la compra de Tailwind por Shopify

    El anuncio, firmado por Adam Wathan el 9 de septiembre de 2026, se apoya en una promesa. Wathan la escribe sin ambigüedad: "Nothing changes with Tailwind CSS or any of our other open-source projects". Y refuerza: "Everything will always be MIT-licensed". El equipo sigue liderando y manteniendo los proyectos open source, ahora con el respaldo de Shopify.

    Con el negocio es más seco: "On the commercial side, we'll no longer be trying to grow the business around Tailwind". Los clientes actuales de Tailwind Plus y de ui.sh conservan su acceso. Lo que sí cierra son las altas nuevas: "we're closing sign ups for new customers to focus on Tailwind CSS at Shopify".

    La razón declarada es de alineación estratégica: Wathan siempre quiso que el framework se desarrollara al servicio de un producto real, y Shopify fue adoptante temprano —lo usa internamente y con sus merchants.

    Todo eso es cierto. Y no menciona despidos ni caída de ingresos, porque un anuncio de adquisición no es donde se cuenta eso.

    Pero sin esa parte, la historia no se entiende.


    El dato que no cuadra: 69,9 millones de descargas y los ingresos cayendo

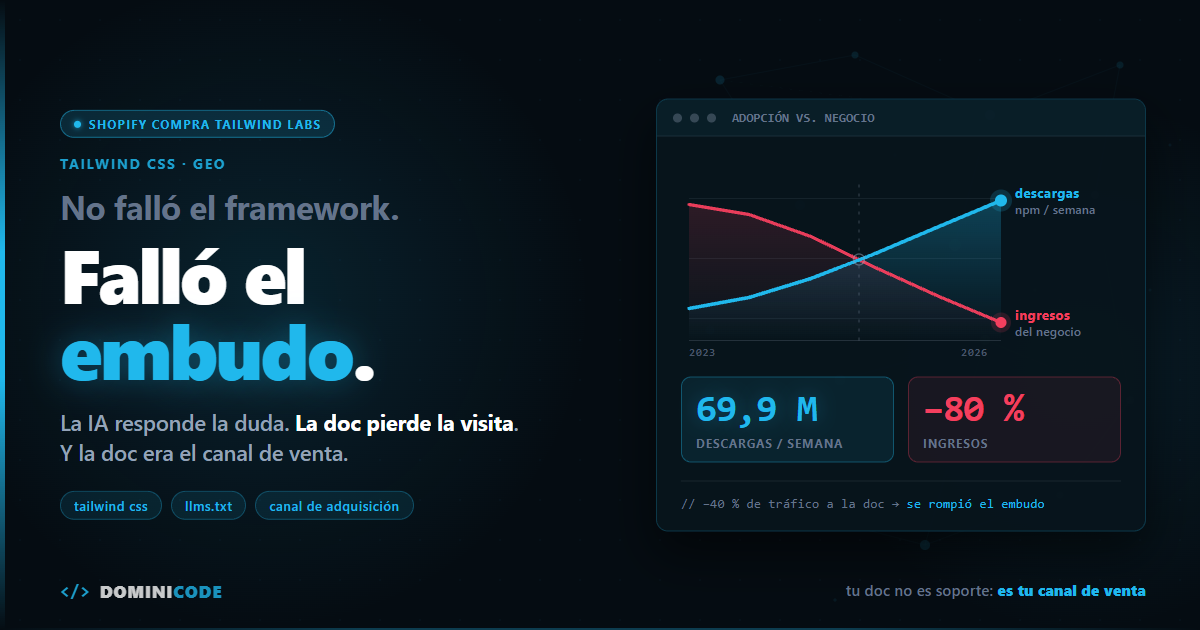
    La contradicción es esta: en septiembre de 2026 Tailwind CSS se descarga más que nunca mientras los ingresos de la empresa que lo mantiene caen casi un 80 %.

    Tailwind es un framework de CSS basado en clases de utilidad: compones el estilo en el propio marcado en vez de escribir hojas aparte. Lo expliqué a fondo en qué es Tailwind CSS, y desde entonces se ha comido buena parte del front-end moderno.

    Eso no es entusiasmo. Es medible.

    La semana del 3 al 9 de septiembre de 2026, el paquete tailwindcss registró 69,9 millones de descargas semanales en npm. Para situar la escala: React tuvo 95,7 millones esa misma semana.

    Ponlo al lado del resto de señales.

    Señal Dirección
    Descargas semanales de tailwindcss 69,9 M (3-9 de septiembre de 2026)
    Tráfico a la documentación −40 % desde principios de 2023
    Ingresos casi −80 %
    Equipo de ingeniería −75 % (enero de 2026)

    Descargas: API de npm — 69.920.618 en la semana del 3 al 9 de septiembre de 2026. Tráfico e ingresos: cifras que dio el propio Wathan en el hilo del PR #2388 el 6 y el 7 de enero de 2026. El anuncio de la adquisición no menciona ninguna de las dos.

    Lee la tabla otra vez. La adopción sube. El tráfico y el dinero se desploman.

    Esa contradicción no es una curiosidad. Es el post entero.


    El embudo que rompió la IA: la documentación era el canal de adquisición

    El embudo que se rompió es el de la documentación: durante más de una década, una empresa de herramientas para developers regalaba el open source y monetizaba las visitas que su doc traía desde Google. Funcionaba tan bien que dejamos de mirarlo.

    Regalas el open source. La documentación posiciona en Google porque es contenido técnico específico y con una intención de búsqueda altísima. El developer aterriza a resolver un problema concreto y una fracción descubre por el camino que además vendes algo.

    La documentación no era un centro de coste. Era el canal de adquisición, y durante años el más barato de todos: gratis, evergreen y perfectamente cualificado.

    Ese embudo se rompió. Despacio en el tráfico, de golpe en el dinero.

    Cada vez menos gente aterriza en tailwindcss.com para buscar cómo se hace un grid. Se lo pregunta a Claude, o lo escribe Cursor mientras mira otra cosa. La respuesta llega, es correcta, y nadie visitó la web. La doc se consume más que nunca, pero a través de un intermediario que no monetiza para ti.

    Tailwind no perdió usuarios. Perdió visitas.

    Y su negocio cobraba por visitas.


    La IA no mató a Tailwind sola: shadcn y el encaje del producto de pago

    Cuidado con la narrativa cómoda: "la IA mató a Tailwind" es demasiado limpio para ser verdad.

    En el hilo de Hacker News que siguió a los despidos —1.457 puntos y 840 comentarios— varios clientes de pago decían lo mismo: los componentes de Tailwind Plus les resultaban complicados y demasiado opinados, y shadcn —gratis— les encajaba mejor. Eso no lo provocó ningún modelo de lenguaje. Es competencia normal, de la que ya existía antes de ChatGPT.

    El producto de pago tenía un problema de encaje. Lo que hizo la IA fue quitarle el colchón.

    Con un canal sano, un producto que pierde encaje te da años para corregir el rumbo. Si el canal lleva tres años cayendo hasta perder un 40 %, no te quedan años: te quedan trimestres. Y con los ingresos cayendo casi un 80 %, la decisión ya no es qué construir, sino a quién llamar.

    Y que quede claro: la adquisición no es el fracaso de esta historia, es probablemente el mejor final posible. Un paquete con 69,9 millones de descargas semanales ahora lo paga una empresa con caja, con licencia MIT y el equipo original al mando.

    El fracaso, si acaso, es de un modelo. No de Wathan.


    Por qué te importa aunque no vendas componentes

    Es probable que tengas un producto propio o quieras tenerlo. Un SaaS, un curso, una plantilla, una librería con versión Pro. Yo tengo varios.

    Hazte una pregunta y respóndela con datos, no con intuición:

    ¿Cómo se entera un desconocido de que tu producto existe?

    Si la respuesta es "busca en Google, aterriza en mi web y ahí descubre que vendo algo", tienes exactamente el embudo de Tailwind. Solo que todavía no lo has medido.

    Ahí está el corolario incómodo: la IA no te va a quitar el trabajo de escribir código, pero puede quitarte el canal por el que vendías el código que escribes.

    Cuando escribí sobre micro-SaaS rentables como developer en solitario, la parte que más preguntas generó fue la de distribución. Con razón: el producto es lo que ya sabemos hacer; el canal es lo que decide si existe o no.

    Tres números que puedes mirar esta semana

    1. Porcentaje de altas que llegan por búsqueda orgánica. Si más de la mitad de tus clientes nuevos entran por ahí, dependes de un canal que se mueve bajo tus pies.
    2. Impresiones contra clics en los últimos 24 meses. Si las impresiones aguantan y los clics bajan, no te has hundido en el ranking: la respuesta se sirve sin ti. Es la señal temprana, y llega mucho antes que la caída de ingresos.
    3. Cuántos compradores tenían relación previa contigo. Email, comunidad, canal, lo que sea. Ese porcentaje es tu independencia real del algoritmo de turno.

    Si el tercero es bajo, no tienes un negocio. Tienes un alquiler de tráfico.


    Qué modelos de negocio aguantan cuando la IA se queda el clic

    Aguantan los modelos de negocio que no dependen del clic, y hay menos de los que parece.

    Distribución directa. Una lista de email, un canal propio, un feed que alguien eligió seguir. Entre tú y una bandeja de entrada hay mucho menos intermediario que entre tú y un resultado de búsqueda. Mi canal de YouTube hace justo eso: nadie llega a un vídeo mío preguntándole a Claude cómo se centra un div.

    Comunidad. Gente que vuelve porque hay alguien al otro lado respondiendo. Un LLM contesta la pregunta que sabes formular; no te dice cuál deberías estar haciéndote. En Dominicode Labs esa es la propuesta entera: gente que vuelve cada semana porque hay alguien al otro lado. No hay algoritmo intermedio que pueda cortarlo.

    Producto que la IA no puede regenerar. Un componente de UI se regenera en veinte segundos. Un backend con estado, datos propietarios, SLA y alguien de guardia, no. Cuanto más cerca esté tu producto de "esto lo escribe un modelo en un prompt", más frágil es tu precio.

    Cobrar por el producto, no por el tráfico que genera. Open source más hosting, soporte o servicio gestionado. Es, por cierto, lo contrario de lo que tenía Tailwind: el framework nunca cobró por sí mismo, cobraba la doc que lo explicaba. Ahora lo financia el producto real de otro.

    Ninguna de las cuatro es rápida. Todas se construyen antes de necesitarlas.


    Si tu único canal es el SEO: qué cambiar ahora

    No lo abandones. Sería la reacción exagerada.

    Cámbiale el trabajo. Tu contenido ya no compite por el clic: compite por ser la fuente que el modelo cita. Escribe para que te citen, estructura para que te parseen, publica tu llms.txt —sí, el mismo que Tailwind no pudo permitirse— y deja de medir el éxito en páginas vistas. Lo desglosé paso a paso en SEO vs GEO para developers: cómo conseguir que las IAs citen tus tutoriales.

    Y asume la parte dura: la conversión ya no ocurre en tu web, ocurre después. Cada visita tiene que dejar algo —un email, una suscripción—, porque puede ser la única vez que esa persona pise tu dominio.

    Hay una ironía aquí: aquel PR proponía exactamente esto, un llms.txt con toda la doc. Wathan dijo que le veía el valor y que quería añadirlo, pero que no podía priorizar algo que le quitaba el único canal por el que llegaban clientes. Tenía razón en el diagnóstico. El problema no era el llms.txt: era que el negocio colgaba entero de las visitas. Eso es lo que hay que mover, y hay que moverlo antes de que te lo muevan.

    Montar ese otro sitio —producto propio, distribución y todo lo que hay entre la idea y el primer cliente— es lo que trabajamos paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.


    Lo único que me llevaría de la compra de Tailwind por Shopify

    Que un framework con 69,9 millones de descargas semanales dejara a su empresa con los ingresos casi un 80 % por debajo significa que el uso y el negocio son cosas distintas, y que llevábamos años confundiéndolas porque el SEO nos hacía el favor de unirlas.

    Abre tu analítica hoy: de tus últimos veinte clientes, cuántos te conocían de antes.

    Ese número es tu modelo de negocio real. Lo demás es tráfico prestado.


    Preguntas frecuentes

    ¿Cuánto pagó Shopify por Tailwind Labs?

    No se ha hecho público. Ni el anuncio publicado por Adam Wathan el 9 de septiembre de 2026 ni Shopify han revelado el importe ni la estructura de la operación.

    ¿Por qué ha comprado Shopify a Tailwind Labs?

    Por alineación estratégica, según el anuncio: Shopify fue adoptante temprano de Tailwind CSS y lo usa internamente y con sus merchants, y Wathan siempre quiso desarrollar el framework al servicio de un producto real. El contexto que el anuncio no menciona es económico: en enero de 2026 Tailwind Labs despidió al 75 % de su equipo de ingeniería y el tráfico a su documentación estaba un 40 % por debajo del de principios de 2023.

    ¿Tailwind CSS sigue siendo gratis y open source tras la compra de Shopify?

    Sí. Wathan lo dice literalmente en el anuncio: "Nothing changes with Tailwind CSS or any of our other open-source projects" y "Everything will always be MIT-licensed". El mismo equipo sigue manteniéndolos, ahora con el respaldo de Shopify. Si usas Tailwind en producción, no tienes nada que tocar.

    ¿Qué pasa con Tailwind Plus y ui.sh si ya soy cliente?

    Los clientes actuales mantienen su acceso. Lo que cambia es que se cierran las altas nuevas: en palabras del anuncio, cierran los registros "to focus on Tailwind CSS at Shopify". El producto de pago deja de crecer para que el equipo se centre en el framework dentro de Shopify.

    ¿Por qué cayeron los ingresos de Tailwind si el framework se usa más que nunca?

    Porque cobraban en un sitio distinto de donde estaba el uso. El dinero llegaba por la documentación: posicionaba en Google, el developer aterrizaba a resolver una duda y una parte descubría que existía un producto de pago. Con los asistentes de IA la respuesta llega sin visitar la web. El tráfico a la doc cayó alrededor de un 40 % desde principios de 2023 y los ingresos casi un 80 %, mientras la adopción seguía subiendo.

    ¿Significa esto que el SEO ya no sirve para vender productos para developers?

    Sirve, pero ha cambiado de función. Antes el contenido técnico traía visitas y las visitas traían clientes. Ahora compite por ser la fuente que citan los modelos, y la conversión ocurre fuera de tu web. La conclusión no es dejar de escribir: es dejar de medir en páginas vistas y hacer que cada visita deje una relación directa.

    ¿Debería dejar de usar Tailwind CSS en mis proyectos?

    No hay razón técnica para hacerlo. Mantiene licencia MIT, lo lleva el mismo equipo y ahora hay detrás una empresa que puede financiarlo. El riesgo de continuidad es menor hoy que en enero.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Evals deterministas para agentes de IA: testea datos, no frases

    Evals deterministas para agentes de IA: testea datos, no frases

    Un developer me enseñó su suite de tests para un agente de soporte. Tenía esta línea:

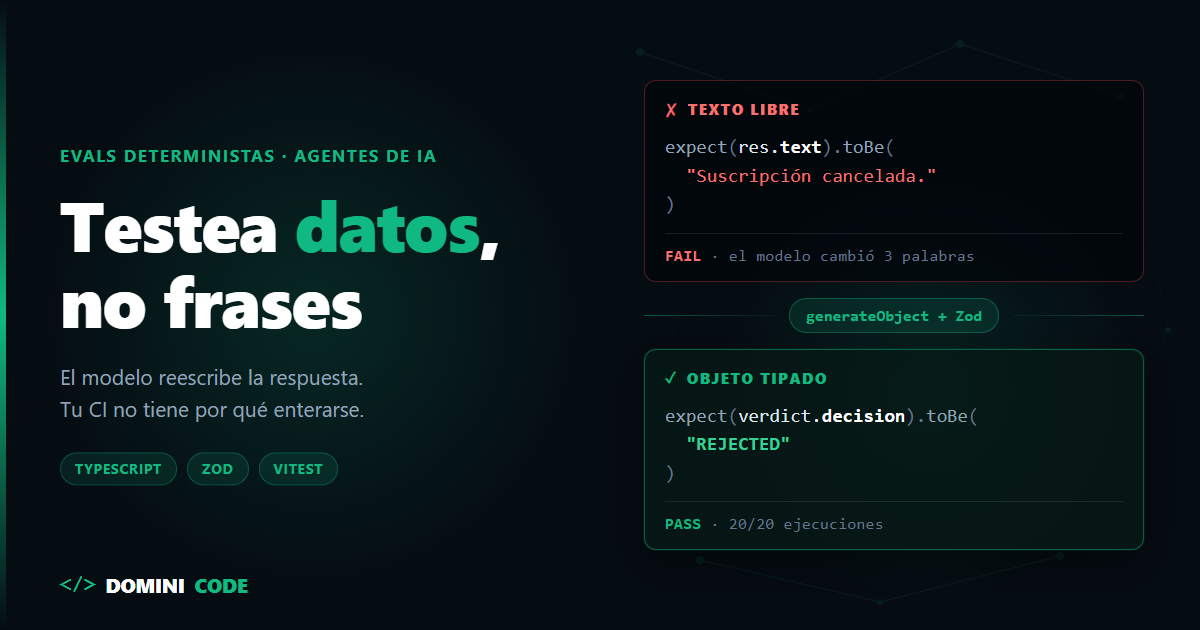
    expect(result.text).toBe("Tu suscripción ha sido cancelada con éxito.");
    

    En local pasó tres veces. Hizo push. En la cuarta ejecución en CI, el modelo contestó: "Hemos procesado la cancelación de tu suscripción correctamente."

    Pipeline en rojo. La suscripción se canceló. La tool correcta se llamó con el userId correcto. El agente hizo su trabajo y el test falló porque el modelo cambió tres palabras.

    Ese test no medía al agente. Medía la redacción de un modelo probabilístico, justo la parte que no controlas. La salida son los evals deterministas para agentes de IA: en vez de relajar la aserción hasta que ya no garantice nada, cambias lo que el agente devuelve.


    ¿Qué son los evals deterministas para agentes de IA?

    Un eval determinista es una comprobación cuyo resultado no depende de cómo redacte el modelo. El agente no devuelve una frase: devuelve un objeto tipado —un veredicto— y el test asierta de forma exacta sobre sus campos. Un decision que es un enum cerrado, un array de códigos de motivo, un identificador. Datos, no prosa. La misma clase de aserción que harías contra un endpoint REST.

    La diferencia con lo que la mayoría llama "eval" es el punto de aplicación. No estás puntuando una respuesta a posteriori con una rúbrica: estás rediseñando la interfaz del agente para que su decisión sea inspeccionable.

    Conviene marcar la frontera con dos cosas que ya conté por separado. El test harness para agentes de IA es el entorno: las tools falsas, el presupuesto de tokens que corta, el timeout real, la traza reproducible. Es el paso previo y es obligatorio. Este post va de lo otro: qué afirmas dentro de ese entorno.

    Y el function calling tipado con TypeScript valida la ENTRADA: los argumentos que el modelo manda a una tool, que en ai@7 viajan en inputSchema. Aquí hablamos de la SALIDA: el veredicto que emite el agente. Es la otra punta del mismo cable, y casi nadie tipa esa punta.


    Los dos callejones sin salida antes de llegar aquí

    Cuando el test de arriba se pone rojo hay dos salidas habituales, y las dos son peores que el problema: relajar la aserción hasta que deje de garantizar nada, o delegar el juicio en otro modelo.

    El primero es relajar la aserción. Un toContain, una expresión regular, un .toLowerCase().includes(). Queda así:

    expect(result.text.toLowerCase()).toContain("cancel");
    

    Verde. Y ahora ese test pasa también si el agente respondió "No puedo cancelar tu suscripción, contacta con soporte". Acabas de escribir una aserción que da verde cuando el agente hace exactamente lo contrario de lo que le pediste. Un test que no puede fallar en el caso que importa no es un test: es decoración en el pipeline.

    El segundo es montar un LLM-as-a-Judge para todo. Otro modelo lee la respuesta y decide si es correcta. Funciona, pero paga tres precios: es lento (una llamada extra por caso), es caro (y los evals se ejecutan por lotes, así que multiplica), y sobre todo hereda el no-determinismo que intentabas eliminar. Tu suite pasa a depender de que el juez opine igual el martes que el jueves. Y entonces tienes un segundo problema: quién calibra al juez.

    El juez tiene su sitio. Pero es el último recurso, no el primero. Antes de delegar una decisión en otro modelo, pregúntate si esa decisión se puede tipar. La mayoría de las veces se puede.

    Superficie de aserción Determinista Coste Cuándo usarla
    Texto libre con toBe o regex No Cero Nunca sobre la salida del modelo: o revienta con sinónimos o da verde con cualquier cosa
    Objeto tipado (generateObject + Zod) Sí en la aserción Cero extra Siempre que la salida sea una decisión, una clasificación, una extracción o un enrutado
    LLM-as-a-Judge No Alto, una llamada por caso Cuando la calidad es irreductiblemente textual: resúmenes, tono, redacción, código

    El giro: que la decisión sea un dato, no una frase

    Si quieres afirmar sobre la decisión del agente, haz que la decisión sea un campo.

    Con el AI SDK de Vercel eso es generateObject más un schema de Zod. Los ejemplos de este post corren con ai@7, zod@4 y Vitest 4, versiones de septiembre de 2026. El modelo deja de tener libertad de formato: o devuelve algo que valida contra el schema, o falla ruidosamente, que también es información útil.

    Un agente que revisa solicitudes de reembolso:

    // refund-agent.ts
    import { generateObject } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    import type { RefundTicket } from "./types";
    import { REFUND_POLICY_PROMPT } from "./prompts";
    
    const model = anthropic("claude-haiku-4-5-20251001");
    
    export const RefundVerdictSchema = z.object({
      decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
      reasonCodes: z
        .array(
          z.enum([
            "OUTSIDE_RETURN_WINDOW",
            "ITEM_DAMAGED_BY_CUSTOMER",
            "DUPLICATE_REQUEST",
            "OPEN_CHARGEBACK",
            "HIGH_VALUE_ORDER",
            "TRUSTED_CUSTOMER",
          ]),
        )
        .min(1),
      riskSignals: z.object({
        priorRefunds12m: z.number().int().min(0),
        daysSincePurchase: z.number().int().min(0),
      }),
      summary: z.string(),
    });
    
    export type RefundVerdict = z.infer<typeof RefundVerdictSchema>;
    
    export async function reviewRefund(ticket: RefundTicket): Promise<RefundVerdict> {
      const { object } = await generateObject({
        model,
        schema: RefundVerdictSchema,
        temperature: 0,
        instructions: REFUND_POLICY_PROMPT,
        prompt: JSON.stringify(ticket),
      });
    
      return object;
    }
    

    Fíjate en lo que acaba de pasar. reviewRefund ya no devuelve texto: devuelve RefundVerdict. Un tipo. Tu test vuelve a ser un test normal.

    Si ese veredicto es el paso final de un bucle con varias herramientas por medio, el schema es el punto de salida del bucle. Cómo montarlo con estado y reintentos lo desarrollé en el agentic loop en producción con TypeScript.

    Hasta aquí es lo que cuenta todo el mundo. Lo que casi nadie cuenta es que el schema puede estar bien tipado y ser una superficie de test pésima.


    Cómo diseñar el schema del veredicto: 5 reglas

    Esta es la parte que decide si tu suite aguanta seis meses o se convierte en ruido. Cinco reglas.

    1. Enums cerrados, nunca strings libres

    decision: z.string() valida perfectamente y no te sirve de nada. El modelo devolverá "rechazado", luego "Rechazado por política", luego "REJECT". Has movido el problema del texto de la respuesta al texto de un campo.

    // Mal: sigues asertando sobre prosa
    decision: z.string(),
    
    // Bien: el espacio de valores es finito y conocido
    decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
    

    Un enum cerrado tiene una propiedad que ningún string tiene: si el modelo quiere decir algo, solo puede decirlo de una manera. Ahí es donde toBe recupera el sentido.

    2. Códigos de motivo, no explicaciones

    Un veredicto que solo dice REJECTED te deja testear el qué, pero no el porqué. Y el porqué es donde viven las regresiones interesantes: el agente sigue rechazando el caso correcto, pero por el motivo equivocado. Eso es un bug que un test binario no ve.

    Por eso reasonCodes es un z.array(z.enum([...])) y no un z.array(z.string()). Con códigos puedes asertar la causa exacta. Con texto libre, vuelves al principio del post.

    Diseñar bien esa lista de códigos es trabajo de verdad: enums demasiado finos y el modelo elige mal entre opciones casi idénticas; demasiado gruesos y no distinguen nada. Empieza por los motivos que ya aparecen escritos en tu política de negocio.

    3. Los scores numéricos son la aserción más frágil que existe

    confidenceScore: z.number() es tentador. Y es una trampa.

    El modelo devuelve 0.82 hoy y 0.79 mañana con la misma entrada. Cualquier test que compare el valor exacto es un test que parpadea. Y cualquier umbral que escribas dentro del prompt —"si la confianza supera 0.8, aprueba"— es lógica de negocio metida en la parte no determinista del sistema.

    Dos reglas:

    • Si el score se queda, asierta rangos o umbrales, nunca el valor: expect(v.confidenceScore).toBeGreaterThan(0.7).
    • Mejor aún: saca el umbral del modelo y ponlo en tu código. Que el agente devuelva señales en bruto (priorRefunds12m, daysSincePurchase) y que la regla la aplique una función TypeScript pura.
    // route-verdict.ts — 100% determinista, testeable sin llamar al modelo
    export function routeVerdict(v: RefundVerdict): "AUTO" | "MANUAL_REVIEW" {
      const { priorRefunds12m, daysSincePurchase } = v.riskSignals;
    
      // El veredicto del agente manda: si pidió revisión humana, no la saltamos
      if (v.decision === "MANUAL_REVIEW") return "MANUAL_REVIEW";
      if (priorRefunds12m >= 3) return "MANUAL_REVIEW";
      if (daysSincePurchase > 30 && v.decision === "APPROVED") return "MANUAL_REVIEW";
    
      return "AUTO";
    }
    

    Cada umbral que mueves del prompt a una función es un test que pasa de probabilístico a exacto.

    4. Separa lo que se asierta de lo que se lee

    El schema puede —y suele— tener campos en texto libre. summary está ahí para que un humano entienda la decisión en el panel de revisión, y hace falta.

    La regla es que ese campo no se asierta jamás. Ni con toContain, ni con regex, ni "solo para comprobar que no viene vacío". Déjalo escrito en un comentario del propio schema, para que el siguiente developer no caiga en la tentación. Un schema tiene dos zonas: la contractual, sobre la que testeas, y la informativa, que solo se lee.

    5. Los campos opcionales fabrican tests frágiles

    En cuanto un campo permite undefined, tu test tiene que decidir qué significa eso. Y normalmente no lo decide: lo esquiva con un ?. y se queda verde por accidente.

    // Ambiguo: ¿no había motivos, o el modelo no los rellenó?
    reasonCodes: z.array(ReasonCode).optional(),
    
    // Explícito: el array siempre viene, y siempre con al menos un motivo
    reasonCodes: z.array(ReasonCode).min(1),
    

    Prefiere valores por defecto, arrays vacíos y uniones discriminadas antes que opcionalidad. Un undefined que atraviesa la suite entera sin que nadie lo asierte es un agujero con forma de test.

    Este tipo de diseño —enums, refinamientos, uniones discriminadas, z.infer para no duplicar tipos— es lo que trabajo paso a paso en el curso de Zod para TypeScript, porque aquí el schema no es validación defensiva: es la superficie de test de todo el sistema.


    El test que resulta

    Con el schema anterior, el eval en Vitest es aburrido. Ese es el objetivo: un test de agente de IA que se lee igual que cualquier otro test de tu suite.

    // refund-agent.eval.test.ts
    import { describe, it, expect } from "vitest";
    import { reviewRefund, type RefundVerdict } from "./refund-agent";
    import { routeVerdict } from "./route-verdict";
    import { lateRequestWithChargeback } from "./fixtures";
    
    describe("refund agent · casos obvios", () => {
      it("rechaza una solicitud fuera de plazo con chargeback abierto", async () => {
        const verdict = await reviewRefund(lateRequestWithChargeback);
    
        expect(verdict.decision).toBe("REJECTED");
        expect(verdict.reasonCodes).toContain("OPEN_CHARGEBACK");
        expect(verdict.reasonCodes).toContain("OUTSIDE_RETURN_WINDOW");
        expect(verdict.reasonCodes).not.toContain("TRUSTED_CUSTOMER");
      });
    });
    
    describe("routeVerdict · sin modelo", () => {
      it("escala a revisión manual con 3 reembolsos previos", () => {
        const verdict: RefundVerdict = {
          decision: "APPROVED",
          reasonCodes: ["TRUSTED_CUSTOMER"],
          riskSignals: { priorRefunds12m: 3, daysSincePurchase: 5 },
          summary: "",
        };
    
        expect(routeVerdict(verdict)).toBe("MANUAL_REVIEW");
      });
    });
    

    Dos detalles que importan.

    El toContain de aquí no es el toContain del callejón sin salida. Sobre un string comprueba subcadenas y da verde con cualquier ruido alrededor; sobre un array de enums comprueba pertenencia exacta a un conjunto cerrado. Misma función, garantías opuestas.

    Y el not.toContain vale tanto como el positivo. Un agente que rechaza el caso correcto pero marca al cliente como fiable está acertando por la razón equivocada, y ese es el fallo que se cuela a producción sin que nadie lo vea.

    Este test no se rompe si el modelo cambia la redacción del summary. Ni si cambia el orden de los motivos. Ni si actualizas a la siguiente versión del modelo y escribe más bonito. Solo se pone rojo cuando el agente decide distinto, que es exactamente lo que querías vigilar. Si quieres afinar el diseño de suites, fixtures y aislamiento de dependencias, ese músculo lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library: los ejemplos son de Angular, pero el diseño de suites y fixtures se traslada tal cual.


    Los límites de los evals deterministas en agentes de IA

    Toca ser honesto: el schema hace determinista la aserción, no el modelo.

    temperature: 0 reduce muchísimo la varianza, pero no la elimina. Entre el batching en el servidor, la aritmética en coma flotante y el enrutado interno de los modelos grandes, la misma entrada puede darte una decisión distinta. Menos que antes. No cero.

    La forma de convivir con eso es partir la suite en dos, y esta distinción es la que casi nadie hace.

    Casos obvios. El cliente pide el reembolso de un pedido de hace dos años con un chargeback abierto. Solo hay una respuesta razonable. Estos casos son tests binarios, corren siempre y bloquean el merge. Si uno falla, hay un bug: en el prompt, en el schema o en el modelo que acabas de actualizar.

    Casos de frontera. El pedido tiene 31 días y la política dice 30, pero el cliente lleva cinco años contigo. Aquí ni tú tienes una respuesta única. Estos casos no se testean como binarios: se miden como tasa de acierto. Ejecutas N veces y exiges un umbral de consistencia. Cinco ejecuciones es el mínimo que justifica el coste, no una muestra seria: si el caso importa de verdad, sube a veinte antes de fiarte de la tasa. Por qué N no es un número arbitrario lo desarrollé en evaluaciones automatizadas para agentes.

    // refund-agent.borderline.test.ts
    import { borderlineTicket } from "./fixtures";
    
    async function decisionCounts(runs: number, ticket: RefundTicket) {
      const results = await Promise.all(
        Array.from({ length: runs }, () => reviewRefund(ticket)),
      );
    
      return results.reduce<Record<string, number>>((acc, r) => {
        acc[r.decision] = (acc[r.decision] ?? 0) + 1;
        return acc;
      }, {});
    }
    
    it(
      "mantiene el caso frontera en revisión manual (4 de 5)",
      async () => {
        const counts = await decisionCounts(5, borderlineTicket);
        expect(counts.MANUAL_REVIEW ?? 0).toBeGreaterThanOrEqual(4);
      },
      60_000,
    );
    

    Meter los casos de frontera en la suite que bloquea el merge es la receta perfecta para que el equipo empiece a relanzar pipelines hasta que pasen. Y a partir de ese día los tests dejan de significar nada. Van en un job programado, con su propio umbral y su propia alerta cuando la tasa cae.

    Sí, esta suite cuesta dinero, porque llama al modelo de verdad. Por eso corre por lotes y no en cada push, mientras el test harness con tools falsas sigue corriendo en cada commit.


    Cuándo sí necesitas un LLM-as-a-Judge

    Cuando la calidad de la salida es irreductiblemente textual.

    Si tu agente escribe un resumen, redacta un email a un cliente o genera un módulo entero de código, no hay enum que capture "esto está bien". Ahí el juez —con rúbrica explícita, golden dataset versionado y calibración humana— es la herramienta correcta, y lo desarrollé entero en evals para código generado por IA.

    La regla de reparto es simple: si la decisión se puede tipar, típala; el juez es para lo que sobra después. En la mayoría de agentes de negocio, lo que sobra es mucho menos de lo que parece antes de sentarse a diseñar el schema.


    Por dónde empezar mañana

    Coge un agente. El que más te preocupe.

    Mira qué devuelve hoy. Si devuelve texto, escribe el schema del veredicto: un enum de decisión, un array de códigos de motivo, las señales numéricas en bruto y un summary que no vas a asertar nunca. Cambia la llamada a generateObject. Y mueve al menos un umbral del prompt a una función TypeScript.

    Después escribe cinco casos obvios. Cinco. Con eso ya tienes una red que detecta el día en que cambies de modelo y el agente empiece a aprobar lo que antes rechazaba, que es la regresión que de verdad cuesta dinero.

    Este tipo de decisión de diseño es lo que separa una demo de un producto que aguanta usuarios reales, y es el hilo que sigo en el curso Construye con IA: de la idea al producto con Claude Code. En Dominicode Labs están los schemas y las suites completas de los agentes que corremos en producción, con sus casos de frontera y sus umbrales reales.

    Deja de testear lo que el agente dice. Testea lo que el agente decide.


    Preguntas frecuentes

    ¿Qué es exactamente un eval determinista?

    Es una comprobación automática cuyo resultado no depende de cómo redacte el modelo. Se consigue haciendo que el agente devuelva un objeto tipado en lugar de texto y asertando sobre campos de valores cerrados, como enums o arrays de códigos. La aserción vuelve a ser exacta y repetible, igual que si testearas la respuesta de una API REST.

    ¿Con temperature 0 ya tengo determinismo garantizado?

    No. Reduce mucho la varianza, pero no la elimina, porque hay factores del lado del proveedor que no controlas, como el batching de peticiones o la aritmética en coma flotante. Lo que sí es determinista es tu aserción, y por eso los casos de frontera se miden como tasa de acierto sobre varias ejecuciones en lugar de como un test binario.

    ¿Puedo asertar sobre un campo de confianza numérico?

    Puedes, pero solo por rangos o umbrales, nunca por el valor exacto, porque el mismo caso te dará valores ligeramente distintos entre ejecuciones. La mejor opción es que el modelo devuelva las señales en bruto y que el umbral lo aplique una función de tu código, que sí puedes testear al cien por cien sin llamar al modelo.

    ¿En qué se diferencia esto de un test harness?

    El harness es el entorno de ejecución: las herramientas falsas, el presupuesto de tokens, el timeout y la traza. Responde a si el agente se salió de sus límites. Los evals deterministas son las aserciones que escribes dentro de ese entorno y responden a si el agente decidió lo correcto. Se montan en ese orden: primero el entorno, después las aserciones.

    ¿Estos tests corren en cada push?

    Los que no llaman al modelo, sí: el enrutado, los umbrales y toda la lógica pura alrededor del veredicto. Los que llaman al modelo de verdad cuestan dinero y tardan, así que van en un job programado sobre un conjunto reducido de casos, separando los obvios, que bloquean el merge, de los de frontera, que solo alertan cuando la tasa de acierto cae.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • De API REST a servidor MCP en TypeScript: 1 endpoint no es 1 tool

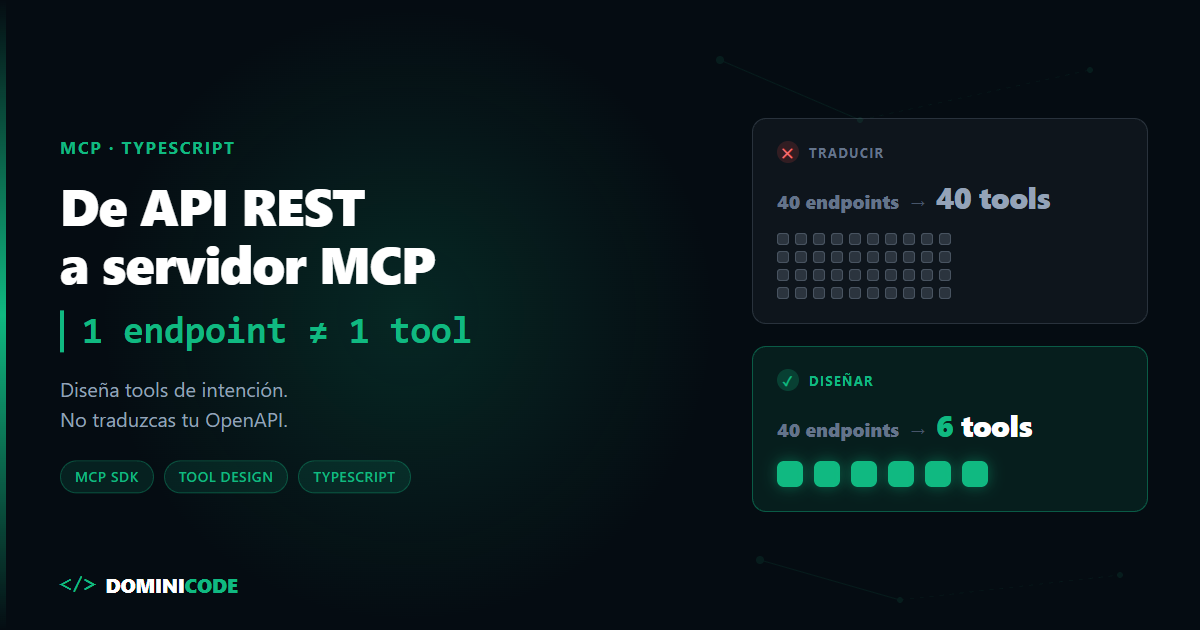
    De API REST a servidor MCP en TypeScript: 1 endpoint no es 1 tool

    Un equipo con el que trabajé tenía una API REST de facturación con cuarenta y tantos endpoints. Documentada con OpenAPI, en producción desde hacía años, sin drama.

    Quisieron abrirla a un agente. Para pasar de API REST a servidor MCP hicieron lo obvio: generar el servidor desde el spec de OpenAPI. Cuarenta endpoints, cuarenta tools. Media tarde de trabajo. Funcionaba.

    Y el agente era inútil.

    Preguntabas "¿cómo está la cuenta de Marta?" y el modelo elegía listInvoices sin filtro, se tragaba doscientas facturas en el contexto y contestaba una vaguedad. Otras veces llamaba a getCustomer, luego a getCustomerById, luego a searchCustomers — tres tools que hacían casi lo mismo porque el backend llevaba cinco años acumulando variantes.

    El problema no era el modelo. Era que habían traducido en vez de diseñar.

    Cuando pasas de una API REST a un servidor MCP, la conversión mecánica es el error por defecto. Un buen servidor MCP expone menos tools que endpoints tiene la API. Y si no tienes API previa y quieres montar todo desde cero, empieza por construir el agente y su servidor MCP paso a paso — este post asume que ya tienes el backend en producción.

    En una frase: un servidor MCP es un proceso que expone las capacidades de tu backend como tools —funciones con nombre, schema de entrada y descripción— para que un modelo pueda elegirlas y ejecutarlas por sí mismo. Si vienes de cero con el protocolo, el mapa completo está en qué son los servidores MCP. Aquí vamos a lo que casi nadie cuenta: cómo se decide qué parte de tu API merece ser una tool.


    API REST describe recursos, servidor MCP describe capacidades

    La diferencia entre una API REST y un servidor MCP no es el transporte: es quién decide qué llamar, cuándo y con qué información delante.

    API REST Servidor MCP
    Quién elige la llamada Un programador, en tiempo de desarrollo Un modelo, en tiempo de ejecución
    Unidad de diseño El recurso (/customers/{id}) La intención ("cómo está la cuenta de X")
    Para qué sirve la descripción Documentación que se lee una vez Prompt que decide la llamada
    Coste de añadir una más Cercano a cero Contexto en cada petición y más riesgo de elegir mal
    Respuesta ideal El objeto completo, el cliente filtra Lo mínimo para razonar, el servidor recorta
    Errores Código HTTP y cuerpo estructurado Frase accionable con isError: true

    Tu API REST está escrita para un programador: alguien que ya sabe lo que quiere y que entiende por qué /customers/{id}/invoices devuelve algo distinto de /invoices?customer_id={id}. El contrato REST asume una decisión ya tomada.

    MCP es lo contrario. El que lee tu catálogo de tools no sabe nada de tu dominio y tiene que decidir cuál llamar, con qué argumentos y en qué orden — a partir de una frase ambigua de un humano.

    Esto cambia una cosa fundamental: la descripción de la tool no es documentación, es prompt. Es el texto que el modelo tiene delante en el momento de elegir. Si escribes "Obtiene un cliente" dejas la decisión al azar. Si escribes "Úsala cuando necesites el estado de facturación de un cliente a partir de su email; no sirve para crear ni modificar facturas", programas el comportamiento.

    Y hay un coste que en REST no existe: la lista de tools viaja en cada petición. Cuarenta tools con sus schemas ocupan contexto antes de que el agente haya hecho nada. Cada tool que añades encarece todas las llamadas y hace la elección más difícil.


    Qué endpoints de tu API REST se convierten en tool MCP (y cuáles no)

    No, no va una tool por endpoint. El criterio que uso es uno solo: ¿este endpoint responde a una intención completa que un humano formularía?

    Si un usuario puede decir "dime el estado de facturación de Marta" y ese endpoint lo resuelve entero, es candidato. Si es un paso intermedio que solo tiene sentido dentro de una secuencia, no lo es.

    Con eso, esto queda fuera:

    • CRUD granular. PATCH /customers/{id}/phone no es una intención, es un detalle de implementación. Si el agente necesita actualizar datos de contacto, una sola tool update_customer_contact con varios campos opcionales.
    • Endpoints internos. Health checks, webhooks, callbacks de terceros, migraciones. El agente no los necesita y solo compiten por su atención.
    • Los que devuelven payloads enormes. Un GET /events que escupe cinco mil registros no se convierte en tool: se convierte en tool con filtros obligatorios, o no se convierte.
    • Los destructivos sin confirmación. DELETE /customers/{id} no va al servidor MCP tal cual. O lo marcas con destructiveHint y lo dejas detrás de una confirmación del cliente, o directamente no lo expones. Yo arranco siempre en solo lectura y añado escritura una a una.

    Y una regla que ahorra mucho dolor: si dos endpoints se llaman siempre juntos, no son dos tools. Son una.


    La tool de intención: consolida, no traduzcas

    Una tool de intención es una sola tool que resuelve una pregunta completa del usuario agregando por dentro varias llamadas a tu API REST. Ahí está el cambio de mentalidad. La pregunta "cómo está la cuenta de Marta" en tu API REST son tres llamadas:

    GET /customers?email=...        → el cliente
    GET /customers/{id}/invoices    → sus facturas
    GET /customers/{id}/payments    → el estado de pagos
    

    La traducción mecánica te da getCustomer, listInvoices y getPaymentStatus. Tres tools, tres decisiones que el modelo puede equivocar, tres respuestas verbosas en el contexto y una orquestación que el agente tiene que inventarse en cada conversación.

    La versión diseñada te da una: get_customer_billing_summary. Recibe un email, encadena esas llamadas por dentro y devuelve un resumen legible.

    Tres decisiones menos que tomar, dos viajes menos de contexto y una orquestación que ya no depende de que el modelo acierte. Es el mismo backend; cambia dónde vive la lógica de composición.


    Las cuatro piezas que no se traducen solas

    Autenticación. El token de tu API REST no viaja como viajaba. Regla dura: el token nunca es un parámetro de la tool. Si lo pones en el inputSchema, acaba en el contexto del modelo y en los logs del cliente. En local, por stdio, el servidor lo lee de su entorno y el modelo ni se entera. En cuanto lo expones por red la historia se complica bastante — ahí tu servidor pasa a ser un resource server de OAuth 2.1 y toca leer qué se rompe cuando el MCP server sale del portátil.

    Paginación. El agente no debe paginar a mano. Si expones page y per_page, hará cinco llamadas seguidas quemando contexto para reconstruir algo que podías haberle dado resumido.

    Dos opciones honestas: un tope de resultados con un cursor explícito que el modelo pueda pasar de vuelta, o —mejor— los N más relevantes más un "hay 340 resultados, afina el filtro por fecha o estado". Empujar al agente a filtrar gana casi siempre a dejarle paginar.

    Errores. Un 422 con un cuerpo tipo {"errors":{"date":"invalid format"}} es perfecto para un frontend y horrible para un modelo. El agente necesita texto que le diga qué corregir: "El campo date debe ir en formato YYYY-MM-DD. Reformatea el valor y vuelve a llamar." Y va como resultado con isError: true, no como excepción sin capturar: así el modelo lo lee y se autocorrige en el mismo turno en vez de rendirse.

    Tamaño de la respuesta. Tu endpoint devuelve el objeto entero porque a un frontend le sale gratis ignorar campos. Al agente no: cada campo que no usa lo paga en contexto. Recorta en el servidor. De un objeto factura con treinta campos, el agente necesita número, fecha, importe y estado.


    Servidor MCP en TypeScript con el SDK oficial

    Un archivo para hablar con la API que ya tienes, sobre el SDK oficial de TypeScript:

    // src/rest.ts
    const BASE = process.env.BILLING_API_URL!;
    const TOKEN = process.env.BILLING_API_TOKEN!; // del entorno, nunca del modelo
    
    export class RestError extends Error {
      constructor(readonly status: number, readonly body: unknown) {
        super(`REST ${status}`);
      }
    }
    
    export async function rest<T>(path: string): Promise<T> {
      const res = await fetch(`${BASE}${path}`, {
        headers: { Authorization: `Bearer ${TOKEN}`, Accept: 'application/json' }
      });
    
      if (!res.ok) {
        throw new RestError(res.status, await res.json().catch(() => null));
      }
    
      return res.json() as Promise<T>;
    }
    
    export interface Customer {
      id: string;
      name: string;
      email: string;
    }
    
    export interface Invoice {
      number: string;
      issuedAt: string; // YYYY-MM-DD
      amount: number;
      status: 'draft' | 'sent' | 'paid' | 'overdue';
    }
    

    Y el servidor con la tool de intención que agrega dos llamadas REST:

    // src/server.ts
    import { McpServer } from '@modelcontextprotocol/sdk/server/mcp.js';
    import { StdioServerTransport } from '@modelcontextprotocol/sdk/server/stdio.js';
    import { z } from 'zod';
    import { rest, RestError, type Customer, type Invoice } from './rest.js';
    
    const server = new McpServer({ name: 'billing', version: '1.0.0' });
    
    server.registerTool(
      'get_customer_billing_summary',
      {
        title: 'Resumen de facturación de un cliente',
        description:
          'Devuelve el estado de facturación de un cliente a partir de su email: ' +
          'datos básicos, facturas recientes e importe vencido. Úsala para responder ' +
          '"cómo está la cuenta de X". No sirve para crear ni modificar facturas.',
        inputSchema: {
          email: z.email().describe('Email del cliente, tal como lo dio el usuario'),
          months: z.number().int().min(1).max(12).default(3)
            .describe('Meses de histórico de facturas a incluir. Por defecto 3.')
        },
        annotations: { readOnlyHint: true }
      },
      async ({ email, months }) => {
        const since = new Date();
        since.setMonth(since.getMonth() - months);
    
        try {
          const [customer] = await rest<Customer[]>(
            `/customers?email=${encodeURIComponent(email)}`
          );
    
          if (!customer) {
            return {
              content: [{
                type: 'text',
                text: `No existe ningún cliente con el email ${email}. ` +
                      `Pide al usuario el email exacto antes de reintentar.`
              }],
              isError: true
            };
          }
    
          const invoices = await rest<Invoice[]>(
            `/customers/${customer.id}/invoices` +
              `?limit=20&since=${since.toISOString().slice(0, 10)}`
          );
    
          const overdue = invoices.filter(i => i.status === 'overdue');
          const owed = overdue.reduce((sum, i) => sum + i.amount, 0);
    
          // Recorte deliberado: solo lo que el agente necesita para razonar
          const lines = invoices
            .slice(0, 10)
            .map(i => `- ${i.number} · ${i.issuedAt} · ${i.amount} € · ${i.status}`);
    
          return {
            content: [{
              type: 'text',
              text: [
                `Cliente: ${customer.name} (${customer.email})`,
                `Facturas últimos ${months} meses: ${invoices.length}`,
                `Vencidas: ${overdue.length} · Importe pendiente: ${owed} €`,
                '',
                ...lines,
                invoices.length > 10 ? `… y ${invoices.length - 10} más.` : ''
              ].join('\n')
            }]
          };
        } catch (error) {
          if (error instanceof RestError && error.status === 422) {
            return {
              content: [{
                type: 'text',
                text: `La API rechazó los parámetros: ${JSON.stringify(error.body)}. ` +
                      `Corrige el valor indicado y vuelve a llamar.`
              }],
              isError: true
            };
          }
          throw error;
        }
      }
    );
    
    await server.connect(new StdioServerTransport());
    

    Fíjate en el .describe() de cada campo: es la única documentación que el modelo recibe de ese argumento. En una API REST el tipo basta porque hay un humano leyendo el spec; aquí el texto es la interfaz. Esa combinación de tipado y semántica es donde Zod deja de ser un validador y pasa a ser parte del diseño — si quieres exprimirlo, lo trabajo a fondo en el curso de Zod para TypeScript. Si sigues en Zod 3, esa línea es z.string().email(); desde Zod 4 la forma recomendada es z.email().

    Un apunte de versiones (septiembre de 2026): el código de arriba corre sobre @modelcontextprotocol/sdk 1.30.0, cuyo inputSchema admite el shape suelto —{ email: z.string() }— y también un z.object({ ... }). La v2 se publica como paquete aparte, @modelcontextprotocol/server 2.0.0, y ahí el shape suelto queda deprecado a favor del z.object() explícito. El monolítico no está deprecado y es el que sigues viendo en la mayoría de servidores, que es por lo que el ejemplo va con él. Los dos implementan la revisión 2026-07-28 de la spec, donde están definidas las annotations y el outputSchema. El criterio de diseño de este post no cambia entre versiones.

    Para probarlo, regístralo en tu cliente y lánzale la pregunta en lenguaje natural. Los scopes y el claude mcp add los tienes desglosados en el tutorial de MCP server con Claude Code.


    Checklist de migración de API REST a servidor MCP

    Antes de dar por buena la conversión de tu API:

    1. Cuenta. ¿Tienes menos tools que endpoints? Si no, no has diseñado, has traducido.
    2. Lee las descripciones en voz alta. Si no explican cuándo usar la tool y cuándo no, reescríbelas.
    3. Busca solapes. Dos tools que un humano confundiría, un modelo también.
    4. Mide el peor payload. Si una respuesta puede reventar el contexto, mete tope y filtros obligatorios.
    5. Convierte los errores. Cada error de tu API tiene que salir como frase accionable con isError: true.
    6. Saca el token del schema. Si aparece en inputSchema, tienes una fuga.
    7. Arranca en solo lectura. Escritura y borrado después, uno a uno y con confirmación.

    Lo que haría hoy

    Abre el OpenAPI de tu API. Marca los endpoints que responden a una frase completa de un usuario. Normalmente son entre cinco y ocho de cuarenta.

    Esos son tus tools. El resto es la fontanería que vive dentro de ellos.

    Y luego escribe las descripciones como si fueran prompts — porque lo son. Esa es la parte que casi nadie hace, y la que separa un servidor MCP que el agente usa bien de uno que solo se ve bonito en el tools/list.

    Este salto de "envolver lo que ya tengo" a "diseñar la superficie que el agente necesita" es el mismo que trabajo en el curso Construye con IA, y si quieres ver servidores MCP reales con sus decisiones y sus errores, los desmenuzamos en Dominicode Labs.


    Preguntas frecuentes

    ¿Cuántas tools debería tener mi servidor MCP?

    No hay número mágico, pero sí una señal: si tienes tantas tools como endpoints, has traducido en vez de diseñar. En APIs de tamaño medio suelo acabar entre cinco y diez tools de intención. La pregunta correcta no es cuántas caben, sino cuántas puedes quitar sin perder capacidad real.

    ¿Puedo generar el servidor MCP automáticamente desde mi OpenAPI?

    Puedes, y es justo lo que produce agentes malos. Un generador hace exactamente la conversión mecánica de 1 endpoint = 1 tool: sin criterio sobre qué endpoints son intenciones completas, sin consolidar llamadas y sin descripciones pensadas para un modelo. Úsalo como inventario de partida si quieres, pero la selección y el redactado de las descripciones son trabajo manual.

    ¿Cómo paso el token de mi API REST al servidor MCP?

    Nunca como parámetro de la tool: ahí acaba en el contexto del modelo y en los logs del cliente. En local, con transporte stdio, el servidor lo lee de una variable de entorno y el modelo ni lo ve. Si lo expones por HTTP, el cliente presenta su propio token al servidor MCP y es tu servidor quien traduce esa identidad a la credencial de la API interna.

    ¿Qué hago con los endpoints de escritura o destructivos?

    Sepáralos desde el arranque. Empieza en solo lectura, marcando esas tools con readOnlyHint, y añade escritura una a una cuando ya sabes cómo se comporta el agente con tu dominio. Lo destructivo lleva destructiveHint y confirmación del cliente; si algo cobra dinero o borra registros, además tiene que ser idempotente.

    ¿La tool debe devolver JSON o texto?

    Texto, salvo razón concreta para lo contrario. El JSON crudo arrastra campos que el agente no usa y paga en contexto. Si además necesitas la forma estructurada, el SDK permite declarar un outputSchema y devolver structuredContent junto al texto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Un martes por la tarde, la API de búsqueda de un cliente empezó a devolver 500. Un despliegue suyo mal hecho: tres minutos de caída.

    El agente que consumía esa API estuvo cuarenta minutos haciendo tonterías caras.

    Primero reintentó. Normal. Luego, al ver que la herramienta seguía fallando, hizo lo que hacen los modelos cuando se les cierra una puerta: buscar otra. Llamó a una tool que no tocaba, cambió los parámetros "por si acaso" y en el paso 14 se inventó tres productos con sus precios.

    Faltaba un circuit breaker para agentes IA. El patrón es viejo — Michael Nygard lo describió en Release It! en 2007 para microservicios y Martin Fowler lo popularizó después — pero cuando en medio del reintento hay un LLM, cambia una pieza fundamental. Y esa pieza es la que casi nadie implementa.


    Qué es un circuit breaker para agentes IA

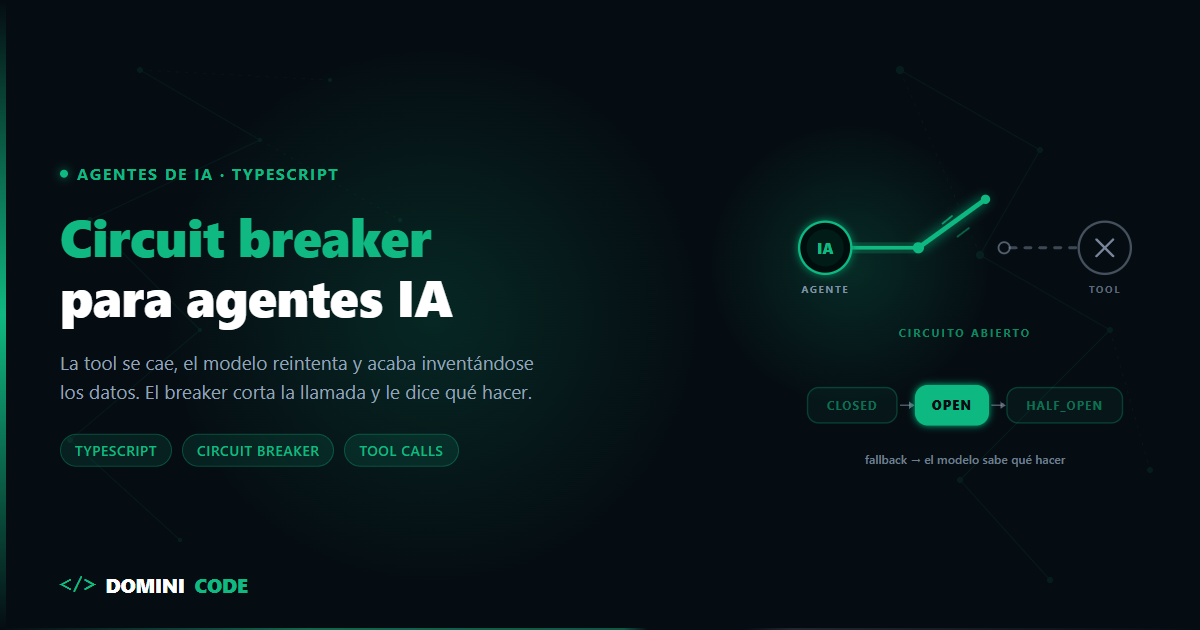
    Un circuit breaker para agentes IA es una máquina de estados que envuelve la ejecución de cada tool: cuenta los fallos de infraestructura dentro de una ventana de tiempo y, al superar un umbral, deja de llamar a la API y devuelve al modelo un resultado estructurado que le dice que esa herramienta no está disponible y qué debe hacer en su lugar.

    La diferencia con el circuit breaker clásico de microservicios está en quién recibe el corte. Allí el consumidor es código, que obedece un 503 y ejecuta su rama de fallback. Aquí el consumidor es un LLM, que interpreta el error y decide por su cuenta. Y si no se lo dices tú, lo que decide es reintentar o inventarse el dato.


    Los tres estados del circuit breaker en un agente

    El breaker es una máquina de estados que envuelve la ejecución de una herramienta.

    CLOSED. Todo pasa. Vas contando fallos en una ventana de tiempo. Si en los últimos 60 segundos hay 4 fallos de infraestructura, abres.

    OPEN. Rechazas sin llamar a la API. Esto es lo importante: el execute de la tool ni siquiera hace fetch. Devuelve en microsegundos. No hay timeout de 30 segundos, no hay latencia, no hay una API agonizante recibiendo más carga de la que ya no puede atender.

    HALF_OPEN. Pasado el tiempo de reset, dejas pasar una sola llamada de prueba. Si funciona, vuelves a CLOSED. Si falla, vuelves a OPEN y el contador de espera empieza otra vez. Ojo con esto en un agente: si dejas pasar todas las llamadas de un turno en half-open, el modelo puede lanzar tres tool calls en paralelo y le acabas metiendo tres peticiones a un servicio que se está levantando.

    Hasta aquí es idéntico a un microservicio. La diferencia empieza en lo que devuelves cuando el circuito está abierto.


    Qué devolver al modelo cuando el circuito está abierto

    Cuando un servicio A tiene el circuito abierto contra el servicio B, devuelve un 503 y quien lo consume es código. El código no negocia: ve el 503 y ejecuta la rama de fallback que escribiste.

    En un agente, quien recibe la respuesta de la tool es un modelo de lenguaje. Y un modelo de lenguaje sí negocia.

    Si le devuelves esto:

    { "error": "request failed" }
    

    El modelo va a reintentar. No porque sea tonto, sino porque no tiene ninguna forma de saber que existe un circuito y que está abierto. Desde su punto de vista una llamada ha fallado, y lo razonable ante una llamada que falla es intentarlo otra vez, quizá con otros parámetros.

    Has puesto un breaker que ahorra la petición HTTP pero no ahorra ni una sola iteración del loop ni un solo token. El agente sigue quemando pasos hasta agotar el presupuesto que le pusiste en stopWhen — si es que se lo pusiste, que de eso hablo en el post del agentic loop.

    El resultado de una tool es un canal de comunicación con el modelo. Es prompt. Úsalo como tal.

    {
      "ok": false,
      "toolUnavailable": true,
      "retryAfterSeconds": 27,
      "instruction": "La herramienta \"searchCatalog\" está fuera de servicio por fallos repetidos del proveedor. No vuelvas a llamarla durante los próximos 27 segundos: cualquier intento se rechazará sin llegar a la API. Usa \"searchCatalogSnapshot\" (catálogo cacheado de hace unas horas) y avisa en tu respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía stock en tiempo real, dile que ese dato no está disponible ahora. No lo estimes ni lo inventes."
    }
    

    Cuatro cosas, y las cuatro hacen falta:

    1. Qué herramienta está caída, por su nombre exacto — el mismo que ve en la definición de tools.
    2. Cuánto tiempo, en segundos concretos. Un "temporalmente" no le dice nada.
    3. La prohibición explícita de reintentar, con el motivo: no es que vaya a fallar, es que ni siquiera va a salir de tu servidor.
    4. Qué hacer en su lugar, en concreto. Y la orden de no inventarse lo que la API le habría dado, que es exactamente lo que hizo el agente de mi cliente en el paso 14.

    Y la alternativa que le ofreces tiene que existir de verdad en el toolset. Mandar al modelo a una herramienta que no le has dado es pedirle justo lo que intentas evitar: que se la invente.

    Añade también una línea al system prompt explicando el protocolo: "si una tool devuelve toolUnavailable: true, esa herramienta no está disponible en este turno; sigue las instrucciones del campo instruction y no la vuelvas a llamar". El modelo cumple bastante bien cuando la instrucción es específica y llega en el sitio donde toma la decisión.


    Qué errores abren el circuito de una tool (y cuáles no)

    Aquí es donde la mayoría de implementaciones se rompen, y se rompen hacia el lado peligroso: abriendo el circuito de una API que funciona perfectamente.

    Los 5xx cuentan. Los timeouts cuentan. Los errores de red cuentan. Los 429 cuentan también, porque cuando un servicio te dice que vas demasiado rápido, lo correcto es dejar de llamarlo un rato.

    Los 4xx de validación no cuentan nunca. Si el modelo manda { query: 42 } donde había que mandar un string, la API devuelve un 400 y eso no significa que la API esté rota. Significa que el modelo la está llamando mal. Si sumas ese 400 al contador, un modelo torpe con los argumentos te abre el circuito de un servicio sano — y a partir de ahí has convertido un problema de prompt en una caída de herramienta.

    Distinguir "la herramienta está rota" de "el modelo la está llamando mal" es la diferencia entre un breaker que te salva y uno que sabotea al agente.

    Error ¿Cuenta para abrir? Por qué
    5xx Sí El servicio está roto
    429 Sí Saturado: lo correcto es dejar de llamarlo un rato
    Timeout / AbortError Sí Sin timeout no hay fallo que contar, solo un agente esperando
    ECONNREFUSED, ECONNRESET, ENOTFOUND Sí La API no está ahí
    400, 422 Nunca El modelo mandó argumentos mal formados
    404 Nunca El recurso no existe; la API respondió bien
    409 Nunca Conflicto de estado, no caída
    Error desconocido No Ante la duda no penalizas: un falso positivo tumba una herramienta sana
    // tool-errors.ts
    export class ToolHttpError extends Error {
      constructor(readonly status: number, message: string) {
        super(message);
        this.name = "ToolHttpError";
      }
    }
    
    const NETWORK_ERRORS = /ECONNREFUSED|ECONNRESET|ETIMEDOUT|ENOTFOUND|EAI_AGAIN|fetch failed/i;
    
    export function isInfrastructureFailure(error: unknown): boolean {
      if (error instanceof ToolHttpError) {
        // 5xx: el servicio está roto. 429: saturado, y lo correcto es dejar de llamar.
        // 400, 404, 409, 422: los argumentos venían mal. Eso es el modelo, no la API.
        return error.status >= 500 || error.status === 429;
      }
    
      // AbortSignal.timeout() lanza un AbortError / TimeoutError
      if (error instanceof Error && (error.name === "AbortError" || error.name === "TimeoutError")) {
        return true;
      }
    
      if (error instanceof Error) {
        // Ojo con el runtime: en Bun el código de red viaja en error.cause.code,
        // no en el mensaje. Mirar solo message deja pasar un ECONNREFUSED.
        const code = (error as { cause?: { code?: string } }).cause?.code;
        if (code && NETWORK_ERRORS.test(code)) return true;
        return NETWORK_ERRORS.test(error.message);
      }
    
      // Ante la duda, no penalizas: un falso positivo tumba una herramienta sana
      return false;
    }
    

    La política de "ante la duda no cuenta" es deliberada. Un breaker que no abre cuando debía te cuesta unos reintentos. Un breaker que abre cuando no debía te deja al agente sin una herramienta buena durante medio minuto, y el modelo se pone creativo.

    La mitad de estos 4xx los evitas antes de que ocurran con schemas estrictos en la definición de la tool. Es el mismo trabajo de blindaje que vemos en el curso de Zod para TypeScript: si el argumento no valida, ni siquiera llega a salir una petición.


    Cómo implementar un circuit breaker en TypeScript

    Factory con estado en cierre, sin dependencias. Umbral de fallos, ventana deslizante, timeout de reset y una única prueba en half-open.

    // circuit-breaker.ts
    export type BreakerState = "CLOSED" | "OPEN" | "HALF_OPEN";
    
    export class CircuitOpenError extends Error {
      constructor(readonly toolName: string, readonly retryAfterMs: number) {
        super(`Circuito abierto para la herramienta "${toolName}"`);
        this.name = "CircuitOpenError";
      }
    }
    
    export interface BreakerOptions {
      name: string;
      failureThreshold?: number;
      windowMs?: number;
      resetTimeoutMs?: number;
      isFailure?: (error: unknown) => boolean;
      onStateChange?: (from: BreakerState, to: BreakerState) => void;
    }
    
    export function createCircuitBreaker({
      name,
      failureThreshold = 4,
      windowMs = 60_000,
      resetTimeoutMs = 30_000,
      isFailure = () => true, // ¡ojo! sobrescríbelo siempre con isInfrastructureFailure
      onStateChange = () => {},
    }: BreakerOptions) {
      let state: BreakerState = "CLOSED";
      let failures: number[] = [];
      let openedAt = 0;
      let probeInFlight = false;
    
      const transition = (next: BreakerState) => {
        if (next === state) return;
        onStateChange(state, next);
        state = next;
      };
    
      const currentState = (now: number): BreakerState => {
        if (state === "OPEN" && now - openedAt >= resetTimeoutMs) {
          transition("HALF_OPEN");
        }
        return state;
      };
    
      return {
        name,
        // getState() no es puro: dispara la transición OPEN -> HALF_OPEN. Si lo
        // polleas desde un exportador de métricas, la transición la provoca la
        // observabilidad y no el tráfico real.
        getState: () => currentState(Date.now()),
        getRetryAfterMs: () => Math.max(0, resetTimeoutMs - (Date.now() - openedAt)),
    
        async execute<T>(fn: () => Promise<T>): Promise<T> {
          const now = Date.now();
          const phase = currentState(now);
    
          if (phase === "OPEN") {
            throw new CircuitOpenError(name, resetTimeoutMs - (now - openedAt));
          }
    
          // En half-open solo pasa una petición: las demás siguen rechazadas
          if (phase === "HALF_OPEN" && probeInFlight) {
            // Espera corta a propósito: si la prueba en vuelo cierra el circuito, no
            // quieres haberle dicho al modelo que abandone la tool medio minuto
            throw new CircuitOpenError(name, 1_000);
          }
          if (phase === "HALF_OPEN") probeInFlight = true;
    
          try {
            const result = await fn();
            if (phase === "HALF_OPEN") {
              probeInFlight = false;
              failures = [];
              transition("CLOSED");
            }
            return result;
          } catch (error) {
            if (!isFailure(error)) {
              // No es culpa de la herramienta: no toca el contador
              if (phase === "HALF_OPEN") probeInFlight = false;
              throw error;
            }
    
            const failedAt = Date.now();
            failures = failures.filter((t) => failedAt - t < windowMs); // ventana deslizante
            failures.push(failedAt);
    
            if (phase === "HALF_OPEN" || failures.length >= failureThreshold) {
              openedAt = failedAt;
              probeInFlight = false;
              failures = [];
              transition("OPEN");
            }
            throw error;
          }
        },
      };
    }
    
    export type CircuitBreaker = ReturnType<typeof createCircuitBreaker>;
    

    Un fallo en half-open reabre directamente, sin esperar a acumular el umbral. Es intencionado: si la prueba falla, el servicio sigue caído y no hay nada que discutir.

    Ahora el wrapper que convierte la excepción en un resultado que el modelo entiende, integrado con la definición de tools del Vercel AI SDK:

    // with-breaker.ts
    import { tool } from "ai";
    import { z } from "zod";
    import { createCircuitBreaker, CircuitOpenError, type CircuitBreaker } from "./circuit-breaker";
    import { ToolHttpError, isInfrastructureFailure } from "./tool-errors";
    
    interface UnavailableInfo {
      toolName: string;
      retryAfterSeconds: number;
    }
    
    export function withBreaker<TArgs, TResult>(
      breaker: CircuitBreaker,
      onOpen: (info: UnavailableInfo) => Record<string, unknown>,
      execute: (args: TArgs) => Promise<TResult>,
    ) {
      return async (args: TArgs) => {
        try {
          return { ok: true, data: await breaker.execute(() => execute(args)) };
        } catch (error) {
          if (error instanceof CircuitOpenError) {
            return onOpen({
              toolName: error.toolName,
              retryAfterSeconds: Math.max(1, Math.ceil(error.retryAfterMs / 1000)),
            });
          }
          // Este fallo puede ser justo el que acaba de abrir el circuito: el modelo
          // tiene que enterarse ahora, no en la siguiente iteración
          if (breaker.getState() === "OPEN") {
            return onOpen({
              toolName: breaker.name,
              retryAfterSeconds: Math.max(1, Math.ceil(breaker.getRetryAfterMs() / 1000)),
            });
          }
    
          // Fallo puntual con el circuito cerrado: el modelo aún puede reintentar,
          // pero necesita saber qué falló para no repetir la misma llamada
          return { ok: false, error: error instanceof Error ? error.message : "Error desconocido" };
        }
      };
    }
    
    const searchBreaker = createCircuitBreaker({
      name: "searchCatalog",
      failureThreshold: 4,
      windowMs: 60_000,
      resetTimeoutMs: 30_000,
      isFailure: isInfrastructureFailure,
    });
    
    export const searchCatalog = tool({
      description: "Busca productos en el catálogo en tiempo real",
      inputSchema: z.object({ query: z.string().min(2) }),
      execute: withBreaker(
        searchBreaker,
        ({ toolName, retryAfterSeconds }) => ({
          ok: false,
          toolUnavailable: true,
          retryAfterSeconds,
          instruction:
            `La herramienta "${toolName}" está fuera de servicio por fallos repetidos del proveedor. ` +
            `No vuelvas a llamarla durante los próximos ${retryAfterSeconds} segundos: cualquier ` +
            `intento se rechazará sin llegar a la API. Usa "searchCatalogSnapshot" y avisa en tu ` +
            `respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía ` +
            `stock en tiempo real, dile que ese dato no está disponible ahora. No lo inventes.`,
        }),
        async ({ query }: { query: string }) => {
          const res = await fetch(`${process.env.CATALOG_API}/search?q=${encodeURIComponent(query)}`, {
            signal: AbortSignal.timeout(4_000),
          });
          if (!res.ok) throw new ToolHttpError(res.status, `Búsqueda falló con ${res.status}`);
          return res.json();
        },
      ),
    });
    

    Fíjate en el segundo if del catch: el fallo que abre el circuito también tiene que hablarle al modelo. Si esperas a la siguiente llamada para avisarle, has regalado una iteración entera del loop justo en el peor momento, el momento en que acabas de decidir que la herramienta está muerta.

    El ejemplo va sobre el AI SDK de Vercel 7, donde el schema de la tool se declara en inputSchema. Ese nombre existe desde la 5: si sigues en la 4.x el campo se llama parameters y el resto del wrapper no cambia.

    Fíjate también en el AbortSignal.timeout(4_000). Sin timeout explícito no hay breaker que valga: una petición colgada no genera un fallo que contar, genera un agente esperando. El timeout es lo que convierte "lento" en "fallido", y sin eso el patrón entero no arranca. Es el tipo de detalle que trato en programación defensiva en TypeScript.


    Un breaker por herramienta, nunca uno global

    Si la API de búsqueda está caída, la base de datos sigue respondiendo perfectamente. Un breaker global convierte un fallo parcial en una caída total del agente: pierdes cuatro herramientas sanas por culpa de una rota.

    Un registro por nombre de tool y listo:

    const breakers = new Map<string, CircuitBreaker>();
    
    export const breakerFor = (name: string, options: Partial<BreakerOptions> = {}): CircuitBreaker => {
      const existing = breakers.get(name);
      if (existing) return existing;
    
      const created = createCircuitBreaker({ name, isFailure: isInfrastructureFailure, ...options });
      breakers.set(name, created);
      return created;
    };
    

    Y una advertencia que cuesta una tarde de depuración: el estado del breaker tiene que vivir fuera de la petición. Si creas el breaker dentro del handler del chat, cada conversación arranca con el contador a cero y el patrón no protege absolutamente nada. Ámbito de módulo como mínimo. Si corres en serverless con varias instancias, el estado compartido va a Redis o cada instancia aprenderá por su cuenta que la API está caída — y pagarás el aprendizaje N veces.

    Y los umbrales no son iguales para todas: una API de pagos crítica aguanta 6 fallos antes de abrir, un scraper de enriquecimiento prescindible abre a los 2.


    El fallback: qué le das al modelo cuando no hay datos

    Tienes tres opciones, y elegir mal aquí desperdicia el breaker.

    Respuesta cacheada. El último snapshot bueno. Sirve para catálogos, listados y configuración. Obligatorio decirle al modelo que los datos son viejos y de cuándo son, para que lo declare en su respuesta.

    Herramienta degradada. Búsqueda local en vez de búsqueda semántica remota. Peor resultado, cero dependencia externa.

    Seguir sin el dato, declarándolo. La opción más honesta y la más infravalorada. El agente termina la tarea con la información que tiene y dice explícitamente qué no pudo comprobar. Mucho mejor que un dato inventado con toda la confianza del mundo.

    Y una cuarta que a veces es la correcta: parar y escalar al humano. Si la herramienta caída era imprescindible para la tarea, seguir es peor que rendirse. Igual que con los guardrails de ejecución, la decisión de frenar es parte del diseño, no un fallo.


    Cómo saber si tu breaker está bien calibrado

    Un breaker sin métricas es un valor mágico que alguien puso hace seis meses. Registra el cambio de estado con onStateChange y mira tres números:

    Aperturas por hora y por herramienta. Si una tool abre 5 veces por hora contra una API que su proveedor jura estar sana, tu umbral es demasiado bajo o estás contando 4xx que no deberías. Revisa el clasificador antes que el umbral.

    Tiempo total en OPEN. Es tu indisponibilidad real de esa capacidad. Si una herramienta pasa el 20% del día en OPEN, el problema ya no es el breaker: es el proveedor, y toca renegociarlo o buscar alternativa.

    Ratio de half-open que vuelven a abrir. El indicador de flapping. Por encima del 70% significa que tu resetTimeoutMs es demasiado corto y estás probando un servicio que aún no se ha levantado, gastando una llamada de tool en cada intento. Alarga el backoff de forma progresiva: 30s, 60s, 2 min. La versión de arriba usa un resetTimeoutMs fijo; para escalarlo, multiplícalo por el número de aperturas consecutivas antes de asignar openedAt.

    Y una cuarta que solo existe en agentes: qué hizo el modelo después de recibir el fallback. Loguea la siguiente tool call tras un toolUnavailable. Si el modelo vuelve a llamar a la herramienta caída, tu mensaje no está siendo lo bastante claro y toca reescribirlo. Los pasos que se ahorra el agente los ves directamente en el consumo de tokens por tarea.


    Por dónde empezar con el circuit breaker en tu agente

    Coge tu agente. Mira la tool que llama al servicio externo menos fiable — todos tenemos una. Ponle un timeout explícito, un breaker propio con isFailure que ignore los 4xx de validación, y un mensaje de fallback escrito para el modelo y no para tu log.

    Esa única herramienta es el 80% del beneficio. El resto es replicar el patrón.

    La idea de fondo: en un agente, cualquier mecanismo de defensa que no le hable al modelo se queda a medias. Puedes cortar la petición HTTP, pero si no le explicas al LLM qué ha pasado y qué esperas de él, el modelo rellenará el hueco con lo que se le ocurra. Y lo que se le ocurre suele ser caro.

    Esta forma de pensar la arquitectura — decidir antes de escribir código qué hace el sistema cuando algo falla — es exactamente el enfoque del curso Construye con IA: de la idea al producto. Y si quieres ver estos patrones montados sobre proyectos reales, con las métricas puestas y funcionando, en Dominicode Labs es donde los estamos rodando.


    Preguntas frecuentes

    ¿Qué diferencia hay entre un circuit breaker y un simple retry con backoff?

    El retry insiste; el breaker deja de insistir. Son complementarios: el backoff resuelve el fallo puntual dentro de una misma llamada, y el breaker resuelve el fallo sostenido a lo largo de muchas llamadas. Sin breaker, tu retry con backoff se ejecuta entero en cada una de las 14 iteraciones del agente contra un servicio que lleva minutos caído.

    ¿Cuántos fallos deben abrir el circuito de una tool?

    Entre 3 y 5 dentro de una ventana de 60 segundos funciona bien como punto de partida. Con umbral 1 o 2 abres por un pico transitorio; por encima de 8 el agente ya habrá gastado medio presupuesto de pasos antes de que el breaker reaccione. Ajústalo por criticidad: más tolerancia en herramientas imprescindibles, menos en las prescindibles.

    ¿Debe contar un error 400 de una tool para abrir el circuito?

    No. Un 400, un 404 o un 422 casi siempre significan que el modelo mandó argumentos mal formados, no que la API esté rota. Si los cuentas, acabas abriendo el circuito de un servicio sano por culpa del LLM y dejando al agente sin una herramienta que funcionaba. Cuentan los 5xx, los timeouts, los errores de red y los 429.

    ¿Dónde guardo el estado del breaker si mi agente corre en serverless?

    En un almacén compartido tipo Redis, con el nombre de la herramienta como clave. Si lo dejas en memoria de proceso, cada instancia fría descubre por su cuenta que el proveedor está caído y pagas ese descubrimiento tantas veces como instancias tengas. Para un servidor de larga vida, el ámbito de módulo basta.

    ¿El circuit breaker sustituye al límite de pasos del agente?

    No, resuelven cosas distintas. El límite de pasos acota cuánto puede trabajar el agente en total; el breaker impide que una herramienta rota consuma esos pasos sin aportar nada. Van juntos: el breaker devuelve el control rápido y con instrucciones, y el límite de pasos sigue siendo la red de seguridad final.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • GPT-6 Astra: precio, API y el asterisco de los 272.000 tokens

    GPT-6 Astra: precio, API y el asterisco de los 272.000 tokens

    OpenAI anunció GPT-6 Astra el 3 de septiembre de 2026. Greg Brockman, presidente de la compañía, lo llamó un generational leap y dijo que podría verse como la llegada de la AGI.

    Yo abrí la tabla de precios y me quedé mirando un asterisco.

    El asterisco dice esto: cualquier request que supere los 272.000 tokens de input dobla la tarifa de input y la de caché, y multiplica el output por 1,5. Para la request entera. No para los tokens que se pasan del umbral.

    Ahora piensa en tu agente. El que arrastra el historial de tool calls y va acumulando contexto en cada iteración. Ese agente no cruza el umbral cuando tú lo decides: lo cruza en la iteración 14, cuando una herramienta devuelve 6.000 tokens de logs más de lo habitual. Y esa request, completa, pasa a costar casi el doble.

    Mi tesis: Astra es un bisturí caro para tareas largas y autónomas, no el reemplazo por defecto de tu modelo de trabajo. Y la decisión de usarlo no se toma leyendo benchmarks, se toma leyendo tu contador de tokens.


    Qué es GPT-6 Astra y dónde puedes usarlo

    GPT-6 Astra es el modelo de razonamiento de gama alta de OpenAI, lanzado el 3 de septiembre de 2026 y orientado a tareas largas y autónomas: computer use, respuesta a incidentes y refactors de varias horas. En la API se identifica como gpt-6-astra, admite 1,05 millones de tokens de contexto y su knowledge cutoff es el 30 de abril de 2026. Cuesta $10 por millón de tokens de input y $50 de output, con una tarifa premium que dobla el input a partir de 272.000 tokens por request.

    Está en la API de OpenAI, en Azure y en Bedrock, y en ChatGPT para Plus, Pro, Business y Enterprise con rollout escalonado. Los primeros en tenerlo fueron los clientes del programa de ciberseguridad de OpenAI. Ese detalle no es casual: mira la fila de ExploitBench más abajo.

    Los números de contexto son los que esperas de un modelo pensado para tareas largas: 1,05 millones de tokens de contexto máximo, hasta 922.000 de input y hasta 128.000 de output.

    Y sabe usarlos. OpenAI mide 100% en MRCR v2 8-needle en la banda de 256K–512K, y 96,3% en la banda de 512K–1M. Recuperación casi perfecta en contextos enormes.

    Aquí está la ironía del lanzamiento: el modelo es excelente con contexto largo, y el precio te empuja a no usarlo. La capacidad técnica y el incentivo económico apuntan en direcciones opuestas.


    Cuánto cuesta GPT-6 Astra: precio de la API y el asterisco

    GPT-6 Astra cuesta $10 por millón de tokens de input y $50 por millón de output, según la ficha oficial del modelo en la API de OpenAI. Y viene con un asterisco: si una request supera los 272.000 tokens de input, se aplica tarifa premium a la request entera —input y caché al doble, output ×1,5—, no solo al exceso.

    Estas son las tarifas por millón de tokens:

    Concepto Tarifa base Si la request pasa de 272.000 tokens de input
    Input $10 $20
    Cached input $1 $2
    Cache write $12,50 $25
    Output $50 $75

    Hay además un fast mode que, según OpenAI, cobra el doble a cambio de hasta ~2,5x de velocidad. Útil para tareas interactivas, irrelevante para un batch nocturno.

    Y un dato que conviene tener presente: OpenAI ha puesto a Astra exactamente al mismo precio que Claude Fable 5.1, $10 de entrada y $50 de salida. Nadie está compitiendo por precio en la gama alta.

    Vamos con el cálculo que importa.

    Imagina una request de tu agente con 270.000 tokens de input y 8.000 de output:

    • Input: 270.000 × $10 / 1M = $2,70
    • Output: 8.000 × $50 / 1M = $0,40
    • Total: $3,10

    Ahora una tool devuelve 5.000 tokens de logs más de lo normal. La request sube a 275.000 de input:

    • Input: 275.000 × $20 / 1M = $5,50
    • Output: 8.000 × $75 / 1M = $0,60
    • Total: $6,10

    Un 1,9% más de tokens de input. Un 97% más de factura.

    Multiplícalo por 100 requests al día y tienes $310 frente a $610. Al mes (30 días), $9.000 de diferencia por 5.000 tokens de logs que nadie revisó.

    Y ojo con dar por hecho que la caché te salva.

    Lo que está documentado es que el multiplicador se dispara por los tokens de input de la request y que afecta también a la tarifa de caché. Lo que no dice ninguna fuente es si los tokens servidos desde caché cuentan para llegar a los 272.000.

    Hay un indicio de que sí: en la API de OpenRouter, el override de tarifa de esta familia de modelos se indexa por min_prompt_tokens, y los tokens de caché siguen siendo prompt tokens. Si 260.000 de tus 280.000 tokens vienen de caché y el umbral los cuenta, esa caché pasa de $1 a $2 el millón igual.

    Lanza una request de prueba y mira la factura antes de montar tu estrategia de caché alrededor de ese número.

    Cómo evitar cruzar el umbral sin darte cuenta

    Tres cosas, en este orden:

    1. Mide antes de enviar, no después. Si tu telemetría te dice el coste al final del mes, ya es tarde. Necesitas el contador de tokens de input por request, en vivo y con alertas. Lo desarrollé paso a paso en cómo medir el consumo de tokens de un agente de IA.
    2. Poda el historial de forma agresiva. Resume los tool outputs antiguos, trunca los logs a las líneas relevantes y no le metas el repositorio entero "por si acaso". Un agente que necesita 270.000 tokens de contexto casi siempre tiene un problema de diseño, no de memoria.
    3. Pon un techo duro por request y falla rápido. Mejor abortar y partir la tarea que descubrir el gasto en la facturación.

    GPT-6 Astra vs Claude Opus 5 y GPT-5.6 Sol: benchmarks y letra pequeña

    GPT-6 Astra supera a Claude Opus 5 y a GPT-5.6 Sol en tareas agénticas largas, pero empata con Opus 5 en código de frontera. Estas son las cifras que publicó OpenAI:

    Benchmark Astra GPT-5.6 Sol Claude Opus 5
    OSWorld 2.0 (computer use) 72,6% 65,7% 70,2%
    Terminal-Bench 4.0 57,7% 37,3% 52,3%
    FrontierMath Tier 4 v2 97,6% 83,0% 73,2%
    GPQA Diamond 96,0% 94,6% 93,7%
    ExploitBench 100% 78,5% 70,0%
    ARC-AGI-3 (harness con estado) 99,9% 7,8% 30,2%
    SRE-Bench 88,0% 55,9% —
    DeepSWE v1.1 74,1% — 69,9%
    FrontierCode 1.1 53,3% — 53,4%

    En computer use, además, resuelve ese 72,6% en unos 40 minutos por tarea según OpenAI: tarda un 47% menos que los ~75 minutos de Sol. Si automatizas navegador o escritorio, ahí hay una mejora real que notas en la latencia y en el número de reintentos.

    Ahora la letra pequeña.

    El 99,9% de ARC-AGI-3 no es tuyo. Ese resultado depende de un harness con estado y caro, montado para el benchmark. En llamadas stateless normales a la API —las que hace tu código— la puntuación cae, según la organización del benchmark, al rango del ~17–63%. La diferencia entre 99,9% y 17% no está en el modelo: está en la infraestructura que lo envuelve. Cuando veas ese número en un hilo de Twitter, lo que estás viendo es un sistema completo, no un endpoint.

    Y el precio por token miente. En el Intelligence Index de Artificial Analysis, Astra y GPT-5.6 Sol empatan a 61 puntos, y Astra cuesta 2,5 veces más por token ($7,70 frente a $3,08 por millón, precio mezclado). Titular fácil: "pagas 2,5x por lo mismo". Falso.

    Correr ese índice consumió 42M de tokens de output con Astra y 70M con Sol. Astra razona menos en voz alta y llega antes. Por eso el coste por tarea sale $1,67 frente a $0,95: la brecha por token es 2,5x, la brecha por tarea es 1,8x. Ambos números son de la variante max, que es la que mide Artificial Analysis — con menos reasoning effort la cuenta cambia.

    Es la misma lección que con Gemini 3.8 Flash y su coste por tarea: el proveedor te da el precio por token, tu arquitectura decide el coste por tarea. Compara siempre lo segundo.

    Un aviso antes de que abras la calculadora: las fuentes públicas no se ponen de acuerdo sobre el precio de Sol. OpenRouter lo lista a $2/$10 por millón; Artificial Analysis calcula con $4/$20. No hagas números con una cifra que leíste en un hilo. Mira la tabla oficial de OpenAI el día que vayas a decidir, y crúzalo con lo que ya sabes de la API de GPT-5.6 en la práctica.

    ¿Y lo de la AGI? En FrontierCode 1.1, código de frontera, Astra saca 53,3% y Opus 5 saca 53,4%. Empate técnico. Un modelo que insinúa AGI no empata en programación difícil con un modelo de la generación anterior. Que es más o menos lo que ya se veía en la comparativa de Opus 5, GPT-5.6 y Kimi K3: las diferencias de frontera son estrechas y el marketing es ancho.


    Límites de la API de GPT-6 Astra: lo que no te da

    Antes de planificar una migración, comprueba que tu stack sobrevive a estos límites:

    • Tool calling solo vía Responses API. Si tu agente vive en Chat Completions, no hay herramientas. Migras o no usas Astra.
    • No hay fine-tuning, ni Realtime, ni Assistants, ni generación nativa de media. Cualquier flujo que dependa de eso se queda fuera.
    • Reasoning effort: low, medium, high, xhigh, max. El valor none existe en la API, pero gpt-6-astra no lo acepta. Este modelo siempre razona, y ese razonamiento se factura como output a $50 el millón. No puedes apagarlo para una clasificación tonta.
    • Zero Data Retention solo para clientes "elegibles". No es una promesa universal. Si tienes un requisito de cumplimiento, confírmalo por escrito antes de meter datos de cliente.

    Cómo llamar a GPT-6 Astra desde TypeScript

    Lo mínimo que funciona, con Responses API y control de razonamiento:

    import OpenAI from "openai";
    
    const client = new OpenAI();
    
    const incidente =
      "PagerDuty #4821: latencia p99 por encima de 3s en checkout-api desde las 02:14 UTC";
    
    // Con gpt-6-astra el tool calling SOLO existe en la Responses API.
    // En Chat Completions no tienes herramientas con este modelo.
    const response = await client.responses.create({
      model: "gpt-6-astra",
      // low | medium | high | xhigh | max. Este modelo no acepta "none":
      // siempre razona, y ese razonamiento se paga como output.
      reasoning: { effort: "high" },
      input: [
        { role: "developer", content: "Eres un SRE. Diagnostica y propón un fix." },
        { role: "user", content: incidente },
      ],
      tools: [
        {
          type: "function",
          name: "query_logs",
          description: "Consulta los logs de un servicio en una ventana temporal",
          parameters: {
            type: "object",
            properties: {
              service: { type: "string" },
              since: { type: "string", description: "Fecha ISO 8601" },
            },
            required: ["service", "since"],
            additionalProperties: false,
          },
          strict: true,
        },
      ],
    });
    
    console.log(response.usage?.input_tokens, response.usage?.output_tokens);
    

    Y el guardarraíl que yo pondría antes de cada llamada, no después:

    const PREMIUM_INPUT_THRESHOLD = 272_000;
    const SAFETY_MARGIN = 20_000; // lo que puede crecer el input dentro de la iteración
    
    export function assertBelowPremiumTier(estimatedInputTokens: number) {
      if (estimatedInputTokens > PREMIUM_INPUT_THRESHOLD - SAFETY_MARGIN) {
        throw new Error(
          `Contexto de ${estimatedInputTokens} tokens: la request entraría en tarifa premium. Poda el historial o parte la tarea.`
        );
      }
    }
    

    Veinte mil tokens de margen parecen exagerados hasta que ves lo que ocupa un git diff grande o un volcado de logs. Prefiero abortar la iteración a pagar el doble por una request que nadie decidió hacer.


    Cuándo merece la pena GPT-6 Astra (y cuándo no)

    Caso de uso ¿Astra? Por qué
    Agentes autónomos de horas o días (refactors grandes, migraciones) Sí 57,7% en Terminal-Bench 4.0 frente al 52,3% de Opus 5 y el 37,3% de Sol
    Computer use y automatización de escritorio o navegador Sí 72,6% en OSWorld 2.0 y un 47% más rápido por tarea que Sol
    Incidentes de producción, on-call, postmortems Sí 88,0% en SRE-Bench frente al 55,9% de Sol
    Seguridad ofensiva autorizada Sí 100% en ExploitBench; es a quien OpenAI dio acceso primero
    Razonamiento matemático de frontera Sí 97,6% en FrontierMath Tier 4 v2 frente al 73,2% de Opus 5
    Código del día a día: features, bugs, PRs No 53,3% vs 53,4% de Opus 5 en FrontierCode 1.1. Empate, pagando más
    Chat, soporte, RAG conversacional No Pagas un razonamiento que nadie pidió y que no puedes desactivar
    Clasificación y extracción en volumen No El peor caso posible: input largo, output corto, tarifa de gama alta
    Cualquier flujo con fine-tuning, Realtime o Assistants No No existen para este modelo

    La lectura corta: si la tarea la termina una persona en diez minutos, Astra es caro. Si la tarea son ocho horas de un senior peleándose con una terminal, es barato.

    Y esto no va de elegir un modelo, va de enrutar por tarea. Modelo barato por defecto, escalado a Astra solo cuando la tarea es larga, autónoma y verificable. Es el mismo criterio que aplico en el curso Construye con IA: de la idea al producto: la arquitectura decide la factura, no el modelo.


    Qué hacer esta semana

    Una sola cosa: instrumenta el contador de tokens de input por request y mira cuántas de tus llamadas actuales caen entre 200.000 y 300.000 tokens.

    Ese histograma es tu exposición real al tier premium. Si tienes una cola larga acercándose a 272.000, no tienes un problema de modelo: tienes un problema de gestión de contexto que hoy te sale barato y con Astra te costaría el doble.

    Arregla eso primero. Después decide si necesitas el bisturí.

    En Dominicode Labs estamos midiendo coste por tarea de estos modelos sobre proyectos reales, con los routers y los guardarraíles que usamos en producción.


    Preguntas frecuentes

    ¿Qué es GPT-6 Astra?

    Es el modelo de razonamiento de gama alta de OpenAI, anunciado el 3 de septiembre de 2026. En la API se identifica como gpt-6-astra, admite 1,05 millones de tokens de contexto (hasta 922.000 de input y 128.000 de output) y su knowledge cutoff es el 30 de abril de 2026. Está disponible en la API de OpenAI, Microsoft Azure y Amazon Bedrock, y en ChatGPT para Plus, Pro, Business y Enterprise.

    ¿Cuánto cuesta GPT-6 Astra?

    $10 por millón de tokens de input y $50 por millón de output. El input cacheado son $1 y la escritura de caché $12,50. Si una request supera los 272.000 tokens de input, se aplica tarifa premium a toda la request: input y caché al doble ($20 y $2) y output ×1,5 ($75). Hay además un fast mode que cobra el doble a cambio de hasta ~2,5x de velocidad.

    ¿Debo migrar mis agentes a GPT-6 Astra?

    Solo los que ejecutan tareas largas y autónomas: computer use, respuesta a incidentes, refactors de varios días, seguridad ofensiva autorizada. Para el resto de tu producto —chat, clasificación, código del día a día— estarías pagando un razonamiento más caro para obtener prácticamente el mismo resultado. Enruta por tarea, no cambies el modelo por defecto.

    ¿Qué pasa exactamente si mi request supera los 272.000 tokens de input?

    Se aplica tarifa premium a toda la request, no solo al exceso: input y caché al doble, output multiplicado por 1,5. Pasar de 270.000 a 275.000 tokens sube un ejemplo típico de $3,10 a $6,10. Por eso el guardarraíl va antes de la llamada y con margen, no después de leer la factura.

    ¿Justifica su precio lo que OpenAI insinúa sobre la AGI?

    OpenAI lo insinúa: Greg Brockman habló de un generational leap que podría verse como la llegada de la AGI. Los datos son más modestos. En FrontierCode 1.1 empata con Claude Opus 5 (53,3% frente a 53,4%), y su 99,9% en ARC-AGI-3 depende de un harness con estado y caro que tú no tienes: en llamadas stateless normales baja al rango ~17–63%. Es el mejor modelo para ciertas tareas largas. No es otra categoría de cosa.

    ¿GPT-6 Astra es mejor que Claude Opus 5?

    En tareas agénticas largas sí; en código del día a día no. Astra gana en Terminal-Bench 4.0 (57,7% frente a 52,3%), OSWorld 2.0 (72,6% frente a 70,2%) y FrontierMath Tier 4 v2 (97,6% frente a 73,2%). Pero en FrontierCode 1.1 empatan: 53,3% Astra contra 53,4% Opus 5. Para features, bugs y PRs, Astra no te da más y te cuesta más.

    ¿GPT-6 Astra soporta tool calling en Chat Completions?

    No. Con gpt-6-astra las herramientas solo funcionan a través de la Responses API. Tampoco hay fine-tuning, Realtime, Assistants ni generación nativa de media. Si tu agente depende de alguna de esas piezas, la migración es de arquitectura, no de cambiar el string del modelo.

    ¿Es Astra 2,5 veces más caro que GPT-5.6 Sol?

    Por token sí: $7,70 frente a $3,08 por millón en el precio mezclado de Artificial Analysis. Por tarea la brecha se estrecha a 1,8x — $1,67 frente a $0,95 — porque correr el Intelligence Index consumió 42M de tokens de output con Astra y 70M con Sol. Ojo: las fuentes públicas se contradicen sobre el precio de Sol (OpenRouter lo lista a $2/$10, Artificial Analysis calcula con $4/$20), así que haz tus números contra la tabla oficial de OpenAI el día que vayas a decidir.

    ¿Se puede desactivar el razonamiento de GPT-6 Astra para bajar el coste?

    No del todo. Con gpt-6-astra el reasoning effort admite low, medium, high, xhigh y max; el valor none que sí existe en la API para otros modelos aquí no está disponible. Puedes bajarlo a low para reducir tokens de razonamiento, aunque si tu caso de uso no necesita razonar en absoluto, la respuesta correcta no es bajar el effort: es usar otro modelo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

    Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

    Google anunció Gemini 3.8 Flash el 2 de septiembre de 2026 con el mismo precio por token que su antecesor: $0.75 por millón de tokens de entrada y $3.75 de salida. Ni un céntimo de diferencia en la tabla de precios.

    Artificial Analysis lo midió ese mismo día. El coste real por tarea completada de Gemini 3.8 Flash es un 40% más alto que el de Gemini 3.7 Flash.

    No es un error de facturación. Es el modelo haciendo exactamente lo que Google prometió: pensar más. Y pensar más se paga en tokens de salida.

    Esa es la parte del anuncio del 2 de septiembre que casi nadie está contando. Google presentó el modelo más barato jamás medido a ese nivel de inteligencia y, al mismo tiempo, subió el coste real de cada tarea un 40%. Las dos frases son verdad. Solo una te llega a la tarjeta.

    La tesis de este post: deja de comparar modelos por dólares por millón de tokens y empieza a compararlos por dólares por tarea completada. El precio por token lo pone el proveedor en una tabla. El coste por tarea lo pones tú con tu arquitectura, y la palanca que de verdad controlas se llama nivel de reasoning.

    El coste por tarea es el gasto total en tokens —entrada, salida y razonamiento— dividido entre el número de tareas que terminan con una salida válida. No entre llamadas a la API: entre tareas completadas.


    Qué es Gemini 3.8 Flash y qué lanzó Google el 2 de septiembre de 2026

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026 junto a Gemini 3.8 Flash Cyber, una variante restringida especializada en ciberseguridad. Es el cuarto modelo Flash que Google publica en menos de cuatro meses. Ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026. Disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    En benchmarks aguanta el pulso a modelos que cuestan casi siete veces más por token: 73,7% en DeepSWE v1.1 frente al 74,0% de Claude Opus 5, 54,9% en HLE-Verified y un 59 en el Artificial Analysis Intelligence Index, donde empata con GPT-5.6 Sol y Grok 4.6. También supera a modelos frontera mayores en Vals Finance Agent V2 y en el Harvey's Legal Agent Benchmark, que son evals de trabajo profesional, no de acertijos.

    Ese 73,7% contra el 74,0% de Opus 5 es la noticia de verdad. Es la misma tendencia que ya se veía en la comparativa de Opus 5, GPT-5.6 y Kimi K3 y en el repaso de Grok 4.5, Fable 5 y DeepSeek V4 para programar: la distancia entre la gama alta y la gama media se cierra por abajo.

    Hay otro dato que me importa. En el Gray Swan IPI, que mide robustez frente a inyección indirecta de prompts, un 5,5% de los ataques tuvo éxito: más de uno de cada veinte intentos. Si tu agente lee contenido que no controlas, ese 5,5% es tu problema, y se resuelve con defensas contra inyección indirecta de prompts, no con fe en el modelo.


    Cuánto cuesta Gemini 3.8 Flash: el precio por token es marketing, el coste por tarea es tu factura

    Aquí está la contradicción, medida de forma independiente por Artificial Analysis:

    Métrica Gemini 3.7 Flash Gemini 3.8 Flash
    Precio entrada / salida (por 1M tokens) $0.75 / $3.75 $0.75 / $3.75
    Tokens de salida por tarea referencia 48.000 (+30%)
    Coste por tarea, high reasoning referencia $0.58 (~+40%)

    Lee la tabla dos veces. La fila del precio no se mueve. La fila que pagas sube un 40%.

    Y ojo con el desglose, porque ese 30% de salida no explica por sí solo el 40% de subida. Con 48.000 tokens de salida a $3.75 el millón, la salida son unos $0.18 de los $0.58: el resto es entrada. Lo que dispara la factura son los turnos. Cada vuelta extra del agente reenvía el contexto acumulado, así que más razonamiento no solo genera más tokens de salida, también multiplica los de entrada. Por eso un +30% de salida termina en un +40% de coste por tarea.

    $0.58 por tarea del Intelligence Index es, según esa misma medición, el coste más bajo jamás registrado a ese nivel de inteligencia. El titular es justo. Pero si vienes de 3.7 Flash con un producto en marcha, tu unit economics acaba de empeorar un 40% sin que hayas tocado una línea de código. Es el mismo patrón que ya conté con el coste de los subagentes al cambiar de modelo: la factura se mueve sola cuando cambia el comportamiento del modelo, no cuando cambias tú el código.

    Del coste por tarea de Opus 5 o GPT-5.6 Sol no doy cifra porque no la tengo medida con el mismo eval, y compararlas de oído sería justo el error que denuncia este post. Lo público es el precio por token: Opus 5 cuesta $5.00 y $25.00 por millón, GPT-5.6 Sol $4.00 y $20.00. Sirve para situar la escala, no para decidir.

    Todas las cifras de coste de este post proceden de la medición independiente publicada por Artificial Analysis el 2 de septiembre de 2026, y los precios del anuncio oficial de Google de esa misma fecha. Verificadas el 3 de septiembre de 2026. Son precios introductorios: expiran el 31 de diciembre de 2026.


    Por qué sube el coste por tarea de Gemini 3.8 Flash: 48.000 tokens de salida

    La causa está publicada y no tiene misterio. Gemini 3.8 Flash gasta una media de 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y da más turnos en las evals agénticas.

    Traducido: razona más pasos antes de responder. Ese razonamiento se factura como salida, que es el token caro. A $3.75 el millón, cada vuelta extra de pensamiento tiene precio.

    Y no solo pagas más: esperas más. Artificial Analysis midió que el tiempo medio por tarea en high reasoning sube de 2,2 a 2,5 minutos. Un 14% más de latencia en cada tarea de tu producto, que con un usuario delante se nota antes que en la factura.

    Y si trabajas en español el efecto se acumula: el mismo contenido consume más tokens que en inglés por cómo funciona el tokenizador, algo que desglosé en el post sobre cuánto te cuesta de más escribir en español. Más tokens por razonar, multiplicado por más tokens por idioma, sobre el token que más caro se paga.


    Cómo medir tu coste por tarea real

    Para dejar de discutir con tablas de precios ajenas solo hace falta contar el usage de cada respuesta y dividirlo entre tareas completadas. No entre llamadas: entre tareas que terminaron bien.

    // task-meter.ts — mide lo que pagas, no lo que anuncia el pricing
    type Usage = { input: number; output: number };
    
    // Precio introductorio de Gemini 3.8 Flash (hasta el 31/12/2026), USD por token
    // Desde el 01/01/2027: { input: 1.50 / 1_000_000, output: 7.50 / 1_000_000 }
    const PRICE = { input: 0.75 / 1_000_000, output: 3.75 / 1_000_000 };
    
    type ApiResponse = Record<string, any>;
    
    // Los tokens de razonamiento se facturan como salida: súmalos siempre.
    function readUsage(res: ApiResponse): Usage {
      const u = res.usageMetadata ?? res.usage ?? {};
      return {
        input: u.promptTokenCount ?? u.input_tokens ?? 0,
        output: (u.candidatesTokenCount ?? u.output_tokens ?? 0) + (u.thoughtsTokenCount ?? 0),
      };
    }
    
    export class TaskMeter {
      private input = 0;
      private output = 0;
      private tasks = 0;
    
      track(res: ApiResponse) {
        const { input, output } = readUsage(res);
        this.input += input;
        this.output += output;
      }
    
      // Solo cuenta la tarea si el resultado es válido de verdad.
      completed() {
        this.tasks += 1;
      }
    
      report() {
        const cost = this.input * PRICE.input + this.output * PRICE.output;
        // Sin tareas completadas no hay media: devuelve el gasto en bruto, no NaN.
        if (this.tasks === 0) {
          return { tareas: 0, outputPorTarea: 0, costePorTarea: 0, costeTotal: +cost.toFixed(4) };
        }
        return {
          tareas: this.tasks,
          outputPorTarea: Math.round(this.output / this.tasks),
          costePorTarea: +(cost / this.tasks).toFixed(4),
          costeTotal: +cost.toFixed(4),
        };
      }
    }
    

    El detalle que separa esta métrica de un contador inútil está en completed(). Una tarea cuenta cuando la salida pasa tu validación, no cuando la API devuelve 200. Si el modelo responde un JSON que tu esquema rechaza, has pagado tokens y no has completado nada: eso encarece el coste por tarea, y así debe ser. Yo cierro ese bucle con un safeParse de Zod antes de llamar a completed(), que es justo el tipo de frontera que trabajo en el curso de validación y transformación de datos con Zod.

    Un aviso para que no te asustes de tu propio medidor: promptTokenCount incluye los tokens servidos desde caché de contexto, que se facturan más baratos. Si usas caching, el número que saques será algo pesimista.

    Ejecútalo una semana con tu carga real y tendrás un número que ninguna nota de prensa te puede dar. Para el instrumental completo, con desglose por turno y por herramienta, tienes la guía para medir el consumo de tokens de un agente de IA.


    Niveles de reasoning en Gemini 3.8 Flash: cuándo usar high, medium o low

    El nivel de reasoning es la palanca de coste más grande que tienes, y la mayoría de proyectos la dejan clavada en el máximo por defecto. Los tres niveles medidos por Artificial Analysis el 2 de septiembre de 2026, sobre las mismas tareas del Intelligence Index:

    Nivel de reasoning Intelligence Index Coste por tarea Ahorro vs high
    high 59 $0.58 —
    medium 57 $0.41 −29%
    low 52 $0.24 −59%

    Ahí está el argumento entero en dos números: bajar de high a medium te ahorra un 29% del coste por tarea y cuesta 2 puntos de Intelligence Index, 57 frente a 59. Bajar a low ahorra un 59% y cuesta 7 puntos. Si tu tarea se valida con un esquema, esos 7 puntos no los vas a notar; el 59% sí.

    Mi regla por defecto, la misma que aplico con cualquier modelo que exponga niveles de razonamiento:

    • Low para clasificar, extraer campos, enrutar y resumir. Si puedes validar el resultado con un esquema, no necesitas que el modelo medite.
    • Medium para el trabajo normal de un agente: varios pasos, alguna herramienta, contexto moderado. Este es el defecto sensato, no high.
    • High solo para razonamiento largo con estado, donde un error a mitad de camino te obliga a repetir la tarea entera. Ahí el sobrecoste frente a medium se paga solo, porque un reintento cuesta más que el ahorro.

    Y la consecuencia que a mucha gente se le escapa: si tu producto es un agente de varios pasos, no tienes que elegir un nivel único. Enruta por paso. La extracción va en low, la decisión difícil va en high. Esa granularidad es la diferencia entre un margen sano y uno que se come el precio del plan, y es una de las decisiones de arquitectura que más repito en el curso de Construye con IA.

    En la Gemini API el nivel se fija con thinking_level dentro de generation_config, y acepta low, medium y high:

    const res = await client.interactions.create({
      model: "gemini-3.8-flash",
      input: prompt,
      generation_config: { thinking_level: process.env.GEMINI_THINKING_LEVEL ?? "medium" },
    });
    

    Que salga de una variable de entorno no es cosmético: es lo que te deja bajar el nivel en producción sin desplegar, el día que veas la factura del primer mes.


    El 1 de enero de 2027 te duplica la factura

    Los $0.75 y $3.75 son precio introductorio hasta el 31 de diciembre de 2026. El 1 de enero de 2027 pasan a $1.50 de entrada y $7.50 de salida por millón, según la tabla de precios oficial de la Gemini API. El doble.

    Si estás construyendo un producto y calculas márgenes con el precio de hoy, tienes hasta el 31 de diciembre de espejismo. Un SaaS con un plan de $19 al mes que hoy deja margen holgado puede quedarse en pérdidas el 1 de enero sin que nadie haya tocado nada.

    Con 10.000 tareas al mes, el mismo código y sin tocar nada:

    Nivel de reasoning Factura mensual hoy Factura mensual desde el 1/1/2027
    high $5.800 $11.600
    medium $4.100 $8.200
    low $2.400 $4.800

    Fíjate en la diagonal: pasar de high a medium el 1 de enero te deja en $8.200, todavía por encima de los $5.800 que pagas hoy en high. Bajar un nivel no compensa la subida de precio. Bajar dos, sí.

    Haz el cálculo ahora con el precio de 2027. Si con $1.50 y $7.50 tu unit economics sigue en pie, adelante. Si no, tienes hasta el 31 de diciembre para bajar niveles de reasoning, recortar contexto o cambiar de modelo, que es mucho mejor que enterarte en enero. Este supuesto debería estar escrito en la spec antes de programar nada, con su fecha y su número, como planteo en el libro de Spec-Driven Development.

    Aun con el precio duplicado sigue siendo más barato por token que Opus 5 o GPT-5.6 Sol. Pero "más barato que el más caro" no es un modelo de negocio.


    Gemini 3.8 Flash Cyber y el Fairwind Program: el modelo que no puedes usar

    Gemini 3.8 Flash Cyber es la variante especializada en seguridad y tiene los mejores números del anuncio: 86,2% en CyberGym, que mide detección de vulnerabilidades en C y C++, frente al 77,5% de 3.5 Flash Cyber, el 83,6% de GPT-5.6 Sol y el 85,6% de GPT-5.5-Cyber. En CWE-Bench, parcheo automatizado, marca un 47,2% pass@1 frente al 47,8% del modelo frontera líder, pero a un coste muy inferior. Y supera el 70% de éxito descubriendo vulnerabilidades reales.

    No tienes acceso. Se distribuye por el Fairwind Program a organismos gubernamentales, operadores de infraestructura crítica y mantenedores de software.

    Lo cuento sin drama porque la decisión me parece defendible: un modelo que encuentra vulnerabilidades reales con esa tasa de acierto es igual de bueno encontrándolas para arreglarlas que para explotarlas. Es el mismo patrón de acceso restringido que vimos con Claude Mythos 5.1 y su programa por invitación.

    Lo que sí te llevas es información: si un modelo restringido ya está en el 70% de descubrimiento real, asume que la capacidad ofensiva del otro lado también ha subido. La defensa de tu agente no puede ser que nadie mire. Empieza por los guardrails para agentes con acceso a terminal y base de datos, que es donde más daño se hace.


    Qué hacer con esto hoy

    Instrumenta el coste por tarea antes de cambiar de modelo. Media hora de trabajo: un contador de usage dividido entre tareas que pasan tu validación. A partir de ahí, elegir modelo deja de ser una discusión de opiniones sobre benchmarks ajenos.

    Con ese número, la pregunta ya no es si Gemini 3.8 Flash es más barato que Opus 5, sino cuánto te cuesta a ti completar una tarea, en tu dominio, con tu prompt, en tu idioma. Ahí se gana o se pierde el margen.

    Si quieres ver este instrumental montado sobre proyectos reales, con enrutado por nivel de reasoning y métricas de coste en producción, es de lo que hablamos cada semana en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es Gemini 3.8 Flash?

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026. Tiene una ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026, y ofrece tres niveles de reasoning (low, medium y high) que cambian tanto la calidad como el coste. Está disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    ¿Merece la pena migrar de Gemini 3.7 Flash a Gemini 3.8 Flash?

    Depende de si tu carga aprovecha el razonamiento extra. Gemini 3.8 Flash puntúa más alto en benchmarks agénticos, pero al mismo precio por token consume 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y encadena más turnos, así que el coste por tarea sube alrededor de un 40%. Si tus tareas son clasificación, extracción o enrutado, quédate en 3.7 Flash o migra a 3.8 Flash con el reasoning en low; si son cadenas largas con herramientas donde un fallo obliga a repetir todo el trabajo, la migración se paga sola.

    ¿Cuánto cuesta realmente Gemini 3.8 Flash?

    Depende de qué midas. Por token, $0.75 la entrada y $3.75 la salida por millón, precio introductorio hasta el 31 de diciembre de 2026. Por tarea completada del Intelligence Index de Artificial Analysis, $0.58 con high reasoning, $0.41 con medium y $0.24 con low. La segunda cifra es la que se parece a tu factura.

    ¿Por qué sube el coste por tarea si el precio por token no ha cambiado?

    Porque el modelo genera más tokens. Gemini 3.8 Flash gasta 48.000 tokens de salida por tarea de media, un 30% más que 3.7 Flash, y ejecuta más turnos en tareas agénticas. Ese 30% de salida, más el contexto que se reenvía en cada turno extra y que se factura como entrada, deja el coste por tarea alrededor de un 40% por encima aunque la tabla de precios sea idéntica.

    ¿Qué pasa el 1 de enero de 2027 con el precio?

    Se acaba el precio introductorio y pasa a $1.50 de entrada y $7.50 de salida por millón: exactamente el doble. Si has calculado los márgenes de tu producto con el precio de 2026, rehaz los números con los de 2027 antes de fijar tus planes de precios.

    ¿Puedo usar Gemini 3.8 Flash Cyber?

    Salvo que trabajes en un organismo gubernamental, en un operador de infraestructura crítica o mantengas software ampliamente usado, no. Se distribuye únicamente a través del Fairwind Program. No hay endpoint público ni precio publicado, así que tu referencia para trabajar hoy es Gemini 3.8 Flash estándar.

    ¿Es Gemini 3.8 Flash mejor que Claude Opus 5 para programar?

    En DeepSWE v1.1 saca 73,7% frente al 74,0% de Opus 5: prácticamente empate, con Opus 5 a $5.00 y $25.00 por millón frente a $0.75 y $3.75. Para la mayoría de cargas, esa diferencia de tres décimas no justifica el sobrecoste. Para razonamiento muy largo donde un fallo obliga a repetirlo todo, mídelo con tu propio coste por tarea antes de decidir.

    ¿Qué nivel de reasoning debería usar por defecto?

    Medium, no high. Reserva high para tareas largas con estado donde un error a mitad de camino te obliga a rehacer el trabajo entero, y baja a low todo lo que tenga una respuesta verificable con un esquema. Si tu agente tiene varios pasos, enruta el nivel paso a paso en lugar de fijar uno global.

    ¿Cómo se cambia el nivel de reasoning en la Gemini API?

    Con el parámetro thinking_level dentro de generation_config, que en Gemini 3.8 Flash acepta los valores low, medium y high. Una llamada quedaría como generation_config: { thinking_level: "medium" } junto al modelo y el prompt. Léelo siempre de una variable de entorno en lugar de escribirlo a fuego en el código: es lo que te permite bajar el nivel en producción sin desplegar cuando el coste por tarea se dispare.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Human in the loop: tu agente no puede esperar en un await

    Human in the loop: tu agente no puede esperar en un await

    El mensaje llegó a Slack a las 19:42: «El agente quiere reembolsar 38 pagos por 4.120 €. ¿Apruebas?».

    La responsable de soporte de mi cliente, Marta, lo leyó a las 23:10, desde el sofá, y pulsó el botón verde. No pasó nada.

    Bueno, esa noche no pasó nada. Al día siguiente pasó tres veces de más.

    El human in the loop de aquel agente eran catorce líneas: una llamada a Slack y un await esperando la respuesta. En local funcionaba precioso. En producción, la función serverless se había muerto tres horas antes de que nadie pulsara nada, con la conversación entera en memoria.

    El arreglo de urgencia fue relanzar el agente con «el usuario ya aprobó los reembolsos» metido en el prompt. El modelo volvió a planificar desde cero, esta vez encontró 41 pagos fallidos en vez de 38 — habían entrado tres nuevos por la noche — y reembolsó los 41.

    El humano había aprobado 38. El agente ejecutó 41. Y nadie podía decir qué se aprobó exactamente, porque la propuesta solo había existido en la RAM de un proceso muerto.

    Eso no es un bug. Es lo que pasa cuando tratas la aprobación humana como un if.


    Qué es el human in the loop: la aprobación es asíncrona, tu loop no

    El human in the loop (HITL) en un agente de IA es el patrón por el que el agente detiene su ejecución antes de una acción irreversible —mover dinero, enviar emails, borrar datos, desplegar— y solo continúa cuando una persona la aprueba, la edita o la rechaza. La diferencia entre que funcione y que no está en dónde ocurre esa pausa: no dentro del bucle, sino al final de una ejecución que termina y de otra que la retoma.

    El agentic loop es una función: el modelo piensa, pide una herramienta, tú la ejecutas, le devuelves el resultado, repites. Todo dentro de la misma llamada, con el array de mensajes creciendo en memoria.

    Meter una aprobación humana ahí parece trivial. Un if antes de ejecutar, una notificación, y esperas.

    El problema es lo que hay al otro lado de esa espera: una persona. Y en lo que llevo medido, una persona tarda entre cuarenta segundos y dos días. Tu proceso no aguanta ni lo primero.

    Se muere por el timeout de la función serverless. Se muere porque despliegas. Se muere por un reinicio del contenedor, por un OOM, porque el usuario cerró la pestaña y tu handler se canceló. Un await de seis horas no es una espera: es una apuesta a que nada se reinicie en seis horas.

    Y en el caso improbable de que sobreviva, tienes un proceso vivo con la conversación completa en memoria, sin hacer absolutamente nada, ocupando RAM y una conexión abierta. Multiplícalo por doscientas aprobaciones pendientes un lunes por la mañana.

    Hay un tercer problema, y es el que acaba en una reunión incómoda: si el estado vive en memoria, no existe. Nadie puede responder a «¿qué aprobó exactamente Marta el jueves a las 23:10?».

    Así que la regla de diseño es esta: la aprobación humana no es una rama dentro del loop, es un final del loop. El agente termina su ejecución devolviendo un estado «esperando decisión». Una ejecución nueva y distinta, disparada por el webhook de aprobación, lo retoma donde se quedó.

    Un punto de aprobación es una frontera de proceso. Todo lo demás sale de ahí.


    Qué acciones necesitan aprobación humana: los tres niveles de riesgo

    Antes de suspender nada hay que decidir qué merece suspenderse. Y aquí casi todo el mundo se pasa de frenada.

    Un agente que pregunta cuarenta veces al día se desactiva solo. Peor todavía: no se desactiva, y el humano aprende a pulsar «Aprobar» sin leer. Un botón que se pulsa siempre no es un control, es un ritual.

    Clasifica cada herramienta en tres niveles:

    Nivel Ejemplos ¿Aprobación?
    Read-only Buscar pedidos, leer un fichero, consultar saldo Nunca. Ni una sola vez
    Reversible Crear un borrador, etiquetar, abrir un PR, escribir en staging No, pero deja rastro y ten un deshacer
    Irreversible Reembolsar, enviar email, borrar registros, desplegar, publicar Sí, salvo por debajo de un umbral

    El matiz que lo cambia todo: el riesgo no está en la herramienta, está en los argumentos. sendEmail a un destinatario es soporte normal; a doce mil, es una campaña que nadie autorizó. refundPayments de 3 € es ruido; de 4.120 € es una conversación.

    Y el lote es una decisión, no treinta y ocho. Si tu tool reembolsa de uno en uno, el agente pedirá permiso treinta y ocho veces y habrás construido el autoclick con tus propias manos. La herramienta que se aprueba recibe el lote entero y el umbral se calcula sobre el total.

    Por eso la política de aprobación es una función del input, no un booleano en la definición de la tool:

    // tool-policy.ts
    export type RiskLevel = "read_only" | "reversible" | "irreversible";
    export type ApprovalMode = "auto" | "human";
    
    export interface ToolPolicy<TInput> {
      risk: RiskLevel;
      approval: (input: TInput) => ApprovalMode;
    }
    
    const definePolicy = <TInput>(policy: ToolPolicy<TInput>): ToolPolicy<TInput> => policy;
    
    export const toolPolicies = {
      searchOrders: definePolicy<{ status: string }>({
        risk: "read_only",
        approval: () => "auto",
      }),
      draftRefundReport: definePolicy<{ orderIds: string[] }>({
        risk: "reversible",
        approval: () => "auto",
      }),
      refundPayments: definePolicy<{ orderIds: string[]; totalCents: number }>({
        risk: "irreversible",
        // El umbral mira el lote entero, no el pago suelto.
        approval: ({ orderIds, totalCents }) =>
          totalCents > 5_000 || orderIds.length > 1 ? "human" : "auto",
      }),
      sendEmail: definePolicy<{ to: string[]; subject: string }>({
        risk: "irreversible",
        approval: ({ to }) => (to.length > 1 ? "human" : "auto"),
      }),
      deleteCustomers: definePolicy<{ ids: string[] }>({
        risk: "irreversible",
        approval: () => "human",
      }),
    } as const;
    
    export function approvalModeFor(toolName: string, input: unknown): ApprovalMode {
      const policy = toolPolicies[toolName as keyof typeof toolPolicies];
      // Fail-closed: una tool que no está en el mapa NO se ejecuta sola.
      // El día que alguien añada una herramienta y olvide la política, el
      // agente preguntará de más. Ese es el fallo barato.
      if (!policy) return "human";
      return (policy.approval as (input: unknown) => ApprovalMode)(input);
    }
    

    El cast de la última línea es el precio de tener un mapa heterogéneo. Lo pago en un único punto del sistema y no en cada herramienta, que es justo el reparto que quiero.

    Los umbrales no son constantes de por vida. Empieza pidiendo aprobación de todo lo irreversible, y a las tres semanas, con el registro de decisiones delante, súbelos donde el humano lleve treinta aprobaciones seguidas sin rechazar ni una. Si un umbral nunca se ha movido, es que nadie está mirando.

    Y si al terminar la clasificación resulta que todo requiere aprobación, no tienes un agente: tienes un formulario caro. Eso significa que le has dado herramientas que no debía tener, y el arreglo está antes, en el perímetro de ejecución, como conté en guardrails para agentes con acceso a terminal y base de datos.

    Esta tabla, además, se escribe antes que el código. Qué es irreversible en tu dominio es una decisión de producto, no de implementación, y va en la spec junto al resto de reglas del sistema — es literalmente uno de los apartados que defiendo en el libro de Spec-Driven Development.


    Cómo interrumpir y reanudar un agente de IA sin perder el estado

    Ahora el núcleo. El loop tiene que poder terminar a mitad de un turno y volver a arrancar horas después como si nada.

    Declaro las herramientas sin función de ejecución: el modelo puede pedirlas, pero quien decide si se ejecutan soy yo, en mi código. Ese es el punto de control.

    // agent-run.ts
    import { generateText, type ModelMessage, type JSONValue } from "ai";
    import { approvalModeFor } from "./tool-policy";
    import { buildPreview, type ApprovalPreview } from "./preview";
    import { checkpoints } from "./checkpoints";
    import { executeTool } from "./execute-tool";
    // model, SYSTEM_PROMPT y toolSchemas salen de tu configuración del agente.
    // executeTool: (call: PendingCall, opts?: { idempotencyKey?: string }) => Promise<JSONValue>
    import { model, SYSTEM_PROMPT, toolSchemas } from "./config";
    
    export interface PendingCall {
      toolCallId: string;
      toolName: string;
      input: unknown;
    }
    
    export interface PendingApproval extends PendingCall {
      approvalId: string;
      preview: ApprovalPreview;
      requestedAt: string;
      expiresAt: string;
    }
    
    export type AgentOutcome =
      | { status: "completed"; text: string }
      | { status: "awaiting_approval"; runId: string; approval: PendingApproval }
      | { status: "already_resolved" }
      | { status: "exhausted"; stepsUsed: number };
    
    const MAX_STEPS = 12;
    
    // El shape exacto del resultado de tool depende de tu SDK.
    // Este es el de AI SDK 5+; en 4.x era { type: "tool-result", result }.
    export const toolResult = (call: PendingCall, value: JSONValue) => ({
      type: "tool-result" as const,
      toolCallId: call.toolCallId,
      toolName: call.toolName,
      output: { type: "json" as const, value },
    });
    
    export async function runAgent(
      runId: string,
      initial: ModelMessage[],
      stepsUsed = 0,
    ): Promise<AgentOutcome> {
      const messages = [...initial];
    
      for (let step = stepsUsed; step < MAX_STEPS; step++) {
        const turn = await generateText({ model, system: SYSTEM_PROMPT, messages, tools: toolSchemas });
        messages.push(...turn.response.messages);
    
        if (turn.toolCalls.length === 0) return { status: "completed", text: turn.text };
    
        const results: ReturnType<typeof toolResult>[] = [];
    
        for (const [index, call] of turn.toolCalls.entries()) {
          // En AI SDK 4.x los argumentos viajan en call.args, no en call.input
          if (approvalModeFor(call.toolName, call.input) === "auto") {
            results.push(toolResult(call, await executeTool(call)));
            continue;
          }
    
          // Hay una llamada que necesita un humano. El turno se acaba aquí.
          // Las llamadas que quedaban detrás NO se ejecutan, pero necesitan
          // un resultado: el protocolo exige responder a todas las tool calls.
          const deferred = turn.toolCalls.slice(index + 1).map((rest) =>
            toolResult(rest, {
              ok: false,
              deferred: true,
              instruction:
                "No se ejecutó: el turno se detuvo esperando una aprobación humana. " +
                "Si sigue siendo necesaria, vuelve a pedirla después.",
            }),
          );
    
          const approval: PendingApproval = {
            ...call,
            approvalId: crypto.randomUUID(),
            preview: await buildPreview(call),
            requestedAt: new Date().toISOString(),
            expiresAt: new Date(Date.now() + 24 * 60 * 60 * 1000).toISOString(),
          };
    
          await checkpoints.save({
            runId,
            messages,
            partialResults: [...results, ...deferred],
            approval,
            stepsUsed: step + 1, // el presupuesto no se reinicia al reanudar
          });
    
          return { status: "awaiting_approval", runId, approval };
        }
    
        messages.push({ role: "tool", content: results });
      }
    
      return { status: "exhausted", stepsUsed: MAX_STEPS };
    }
    

    Fíjate en el bloque deferred, que es la parte que casi nadie ve venir. Cuando el modelo pide tres herramientas en el mismo turno y la segunda necesita aprobación, no puedes limitarte a guardar y salir: los proveedores exigen que cada tool call tenga su resultado antes de continuar la conversación. Si dejas una huérfana, al reanudar te comes un 400 y no entiendes por qué — el AI SDK tiene hasta un error con nombre propio para esto, MissingToolResultsError.

    El checkpoint guarda tres cosas y las tres hacen falta: los mensajes hasta ese punto, los resultados parciales del turno a medias, y la llamada pendiente con su preview. Eso es todo el agente, serializado. En Postgres, en una tabla con run_id, approval_id, status y un jsonb.

    El resto de la función que expone esto por HTTP es aburrido a propósito: si el status es awaiting_approval, mandas la notificación y devuelves un 202. La petición termina. El proceso puede morirse tranquilo. Y el presupuesto de pasos sigue siendo tuyo, exactamente igual que en el agentic loop en producción.

    Esto es, con otros nombres, lo que hacen los frameworks. LangGraph lo llama interrupts: la función interrupt() congela el grafo, el checkpointer persiste el estado y se reanuda con new Command({ resume }) sobre el mismo thread_id.

    El AI SDK trae tool approvals, y aquí hay que fijarse en dos cosas. La primera, dónde se declara: toolApproval no va dentro de la tool, va como opción de generateText, streamText o del ToolLoopAgent, en un mapa indexado por nombre de herramienta. Cada política recibe el input tipado y devuelve 'user-approval', undefined si no aplica, o un { type: 'denied', reason }. La segunda, la versión: esa API llegó en la v7 y no existe en la 5, que es contra la que está escrito el código de este post.

    Enfoque Cómo se pausa Dónde vive el estado Qué te sigue tocando a ti
    Propio (este post) El loop devuelve awaiting_approval y la API un 202 Tabla agent_runs en Postgres, columna jsonb Todo, pero sin sorpresas
    LangGraph interrupt() congela el grafo en el nodo Checkpointer (memoria, Postgres, SQLite) Caducidad, idempotencia y el mensaje de rechazo
    AI SDK v7 toolApproval deja la tool pendiente Lo persistes tú Dónde guardas los mensajes y qué haces al reanudar

    Úsalos si te encajan — pero ninguno responde por ti dónde vive el checkpoint, quién limpia los que nadie aprobó y qué le cuentas al modelo cuando la respuesta es que no. Si prefieres modelar todo esto como estados explícitos, el enfoque de grafo de estados frente al loop clásico resuelve bastante bien la parte de la máquina de estados.

    Los ejemplos de este post están escritos y verificados en septiembre de 2026 contra AI SDK 5 y LangGraph JS; si estás en AI SDK 4.x, los argumentos viajan en call.args y el resultado en result en vez de output.


    Qué debe ver el humano: sin datos, la aprobación es una firma

    «El agente quiere borrar 1.204 clientes. ¿Apruebas?» no es una pregunta. Es un trámite.

    Nadie puede aprobar eso de verdad, porque no hay nada que evaluar. Y si no hay nada que evaluar, el humano no está decidiendo: está firmando.

    El payload de aprobación tiene que llevar lo suficiente para decir que no:

    // preview.ts
    export interface ApprovalPreview {
      title: string;          // "Reembolsar 38 pagos — 4.120,00 €"
      rationale: string;      // por qué el agente cree que hay que hacerlo
      impact: string[];       // efectos concretos, contados
      payload: unknown;       // exactamente lo que se va a ejecutar, sin resumir
      sample: unknown[];      // 5 filas afectadas, para oler el error
      reversible: boolean;
      precondition: { name: string; value: string | number }; // se revalida al reanudar
    }
    

    Cuatro reglas, y la primera es innegociable.

    El preview lo genera tu código, no el modelo. Si el resumen que lee el humano lo escribe el mismo LLM cuya acción estás supervisando, has montado un control donde el vigilado redacta el informe. Y si esa tool call llegó por una inyección de prompt en un email que el agente leyó, el resumen viene envenenado igual — el mismo problema que trato en tácticas defensivas contra inyección de prompts. El texto lo compone tu función a partir de los argumentos y de una consulta real a tu base de datos.

    Números, no adverbios. «Varios registros» no se puede aprobar. «1.204 registros, de los cuales 6 tienen facturas emitidas este trimestre» se aprueba o se rechaza en cuatro segundos.

    Una muestra. Cinco filas de las que van a cambiar. Es donde el humano detecta que el filtro estaba mal, y le cuesta una consulta barata a tu API.

    Una precondición y una caducidad. Guarda el número que justificaba la acción — 38 pagos fallidos — y vuelve a comprobarlo al reanudar. Una aprobación de hace seis horas puede estar aprobando un mundo que ya no existe: si ahora hay 41, no ejecutas, vuelves a preguntar. Exactamente el fallo que le costó tres reembolsos de más a mi cliente.


    Idempotencia: reanudar el agente sin ejecutar la acción dos veces

    Persistir el estado abre la puerta al segundo problema del día: el botón se puede pulsar dos veces. Y se pulsa. El humano da doble clic, el webhook de Slack reintenta porque tu 200 tardó, alguien reenvía el enlace por WhatsApp.

    Necesitas dos capas, porque cada una tapa un agujero distinto.

    La primera es un compare-and-swap en la base de datos. No leas el checkpoint y luego lo actualices: reclámalo en una sola sentencia atómica.

    UPDATE agent_runs
       SET status = 'resuming', resolved_at = now()
     WHERE run_id = $1
       AND approval_id = $2
       AND status = 'awaiting_approval'
    RETURNING checkpoint;
    

    Si devuelve cero filas, alguien te ganó la carrera. No es un error: es el sistema funcionando. Devuelves un 200 idempotente y te callas.

    Y ponle un timeout también al estado resuming: si el proceso se muere justo después de reclamar el checkpoint, esa fila se queda ahí para siempre y el job de caducidad, que solo mira awaiting_approval, no la va a rescatar nunca.

    // resume.ts
    export type Decision =
      | { type: "approved"; approvedBy: string }
      | { type: "approved_with_changes"; approvedBy: string; input: unknown }
      | { type: "rejected"; approvedBy: string; reason: string };
    
    export async function resumeRun(
      runId: string,
      approvalId: string,
      decision: Decision,
    ): Promise<AgentOutcome> {
      const claimed = await checkpoints.claim(runId, approvalId);
      if (!claimed) return { status: "already_resolved" };
    
      const { messages, partialResults, approval, stepsUsed } = claimed;
    
      if (decision.type === "rejected") {
        const denial = toolResult(approval, buildDenialResult(approval, decision));
        return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, denial] }], stepsUsed);
      }
    
      const input =
        decision.type === "approved_with_changes" ? decision.input : approval.input;
    
      // El payload lleva horas en la base de datos y vuelve a entrar por la puerta.
      // Se valida otra vez contra el schema de la tool, como si viniera de fuera.
      const parsed = toolSchemas[approval.toolName as keyof typeof toolSchemas].inputSchema.parse(input);
    
      // La precondición que vio el humano tiene que seguir siendo verdad
      const still = await checkPrecondition(approval.preview.precondition);
      if (!still.ok) return requestApprovalAgain(runId, approval, still.current);
    
      // idempotencyKey = approvalId: si esto se ejecuta dos veces, el proveedor
      // devuelve el mismo resultado en lugar de mover el dinero otra vez
      const output = await executeTool({ ...approval, input: parsed }, { idempotencyKey: approvalId });
    
      const result = toolResult(approval, {
        ok: true,
        approvedBy: decision.approvedBy,
        executedInput: parsed, // lo que se ejecutó de verdad, no lo que se pidió
        data: output,
      });
    
      return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, result] }], stepsUsed);
    }
    

    La segunda capa es la idempotencia aguas abajo. El compare-and-swap te protege del doble clic, pero no del proceso que se cae justo entre mover el dinero y escribir en la base de datos que lo movió. Para eso la acción tiene que ser idempotente en el otro extremo: la clave de idempotencia de Stripe, una restricción única en la tabla de efectos, un INSERT ... ON CONFLICT DO NOTHING. Usa el approvalId como clave y el reintento devuelve el mismo resultado en lugar de un segundo reembolso. Y no es casualidad que el expiresAt de la aprobación sean 24 horas: Stripe purga las claves de idempotencia a partir de las 24 horas de antigüedad, así que una aprobación que sobreviviera a esa ventana perdería justo la red que la protegía.

    Y ojo con el parse de esa función, que parece decorativo y no lo es. Ese payload salió de tu proceso hace ocho horas, ha dormido en una base de datos y vuelve por un endpoint público. Tratarlo como dato de confianza porque «lo generamos nosotros» es el tipo de suposición que valido siempre en frontera, con el enfoque de schemas del curso de Zod para TypeScript.


    Qué le devuelves al modelo cuando el humano dice que no

    Aquí es donde se cae la mitad de las implementaciones que he revisado.

    Devuelven esto:

    { "error": "denied" }
    

    Y el modelo hace lo que hace un modelo ante una puerta cerrada: buscar otra. Reintenta con parámetros distintos, parte el borrado en dos llamadas de 600 registros, o directamente redacta una respuesta final diciendo que los reembolsos se han procesado correctamente. Un rechazo que parece un fallo técnico se lee como un fallo técnico.

    El resultado de una tool es prompt. Escríbelo como tal:

    {
      "ok": false,
      "approvalDenied": true,
      "toolName": "refundPayments",
      "deniedBy": "marta@cliente.com",
      "reason": "12 de los 38 pagos son de un lote que ya se reembolsó manualmente el viernes.",
      "instruction": "Un humano ha rechazado esta acción. No vuelvas a llamar a \"refundPayments\" en esta conversación, ni con otros parámetros, ni en lotes más pequeños, ni a través de otra herramienta. No intentes conseguir el mismo efecto por otra vía. Explica al usuario qué ibas a hacer, cuál fue el motivo del rechazo, y termina el turno sin ejecutar nada más."
    }
    

    Cuatro ingredientes y los cuatro son necesarios:

    1. Que fue una persona, no un error de red. Cambia por completo la interpretación.
    2. El motivo en lenguaje humano. Es información nueva y real que el modelo no tenía.
    3. La prohibición de buscar rutas alternativas, dicha de forma explícita. Sin esta línea, el modelo trocea la acción y lo vuelve a intentar.
    4. Qué hacer ahora. Terminar y reportar. Si no le das salida, se inventa una.

    Y existe un tercer estado que casi nadie modela: aprobado con cambios. El humano no rechaza, edita — baja el reembolso a 26 pagos y aprueba. En ese caso, el resultado que devuelves debe llevar el executedInput real, porque si el modelo cree que se ejecutaron 38 va a escribirle al usuario que se reembolsaron 38. La verdad de lo que pasó viaja en el resultado de la tool o no viaja.

    Añade también una línea al system prompt describiendo el protocolo: «si el resultado de una herramienta trae approvalDenied: true, esa acción está vetada para el resto de la conversación; sigue el campo instruction y no busques alternativas». El modelo obedece bastante bien cuando la instrucción es específica y llega en el momento en que toma la decisión.


    Cómo implementar human in the loop hoy en tu agente

    No montes el sistema entero. Coge la herramienta más peligrosa de tu agente — todos sabemos cuál es — y hazle tres cosas esta tarde.

    Sácala del execute automático. Haz que tu loop, al llegar a ella, guarde los mensajes y la llamada pendiente en una tabla y devuelva un 202. Y escribe el resultado de rechazo como si fuera un prompt, porque lo es.

    Con eso ya tienes lo importante: un agente que puede quedarse esperando sin estar vivo.

    La idea de fondo es la misma que con cualquier mecanismo de defensa en un agente: si no le hablas al modelo, no lo estás controlando, solo lo estás frenando. Y un modelo frenado sin explicaciones busca la puerta de al lado.

    Decidir todo esto antes de escribir el código — qué es irreversible, quién aprueba, qué pasa cuando la respuesta es no — es el método que enseño en el curso Construye con IA: de la idea al producto.

    Y si prefieres verlo funcionando antes que leerlo, en Dominicode Labs estamos rodando estos checkpoints sobre proyectos reales, con la tabla de aprobaciones y el audit trail puestos.


    Preguntas frecuentes

    ¿Qué es human in the loop en un agente de IA?

    Human in the loop (HITL) es el patrón por el que un agente de IA detiene su ejecución antes de realizar una acción irreversible y solo continúa cuando una persona la aprueba, la edita o la rechaza. En una implementación correcta la pausa no es un await: el agente termina su ejecución guardando un checkpoint con los mensajes y la llamada pendiente, y una ejecución nueva, disparada por la decisión del humano, lo reanuda desde ahí. Aplica a mover dinero, enviar emails masivos, borrar registros, desplegar y publicar.

    ¿Puedo implementar human in the loop con un simple await hasta que el humano responda?

    Solo si el humano contesta en segundos y tu proceso es de larga vida. En cuanto la aprobación puede tardar minutos, el await deja de ser una espera y pasa a ser una apuesta: un despliegue, un timeout de la función serverless o un reinicio del contenedor se llevan por delante todo el estado del agente. Además pagas RAM y una conexión abierta por cada aprobación pendiente. La alternativa correcta es terminar la ejecución, persistir el checkpoint y reanudar con una ejecución nueva.

    ¿Qué acciones de un agente deben requerir aprobación humana?

    Las irreversibles, y dentro de ellas solo las que superan un umbral. Todo lo de solo lectura va sin aprobación siempre; lo reversible va sin aprobación pero con registro y con una forma de deshacer; lo irreversible — mover dinero, enviar emails, borrar, desplegar, publicar — pide permiso. El umbral se calcula sobre los argumentos, no sobre la herramienta: un reembolso de 3 € y uno de 4.000 € usan la misma tool y no tienen el mismo riesgo.

    ¿Dónde guardo el estado del agente mientras espera la aprobación?

    En un almacén duradero fuera del proceso: una tabla en Postgres con run_id, approval_id, status y una columna jsonb con los mensajes, los resultados parciales del turno y la llamada pendiente. Redis sirve si tiene persistencia y si el TTL es mayor que el tiempo máximo de aprobación, pero para acciones que mueven dinero quieres una tabla auditable donde consultar meses después quién aprobó qué.

    ¿Qué pasa si nadie aprueba nunca la acción del agente?

    Que se te llena la base de datos de agentes zombis, así que la caducidad forma parte del diseño. Pon un expiresAt en cada aprobación, y un job que cierre las vencidas devolviendo al modelo un resultado de expiración con la misma estructura que el rechazo — para que el agente pueda cerrar la conversación explicando qué quedó sin hacer. Si un tipo de aprobación caduca de forma sistemática, el problema no es el TTL: es que estás pidiendo permiso para algo que a nadie le importa.

    ¿Cómo evito que el agente ejecute dos veces si la aprobación llega duplicada?

    Con dos capas. La primera es reclamar el checkpoint con un UPDATE ... WHERE status = 'awaiting_approval' RETURNING, en una sola sentencia atómica: si devuelve cero filas, otro ya lo reanudó y no ejecutas nada. La segunda es hacer idempotente la acción en el otro extremo, usando el approvalId como clave de idempotencia o como restricción única, porque el compare-and-swap no te salva si el proceso se cae justo después de mover el dinero y antes de registrarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Pi no tiene sistema de permisos, y te lo dice en su propio README

    Pi no tiene sistema de permisos, y te lo dice en su propio README

    Instalas Pi con un npm install -g, lo lanzas en tu proyecto y funciona.

    Y funciona muy bien. Es el harness de código abierto más interesante que hay ahora mismo: minimalista a propósito, cuatro herramientas activas por defecto —read, write, edit, bash—, y un core tan pequeño que te lo lees entero en una tarde. Ya conté por qué es el mejor ejemplo para entender la anatomía de un harness en qué es un agent harness.

    Este post va de la frase que hay en su README y que casi nadie cita:

    "Pi does not include a built-in permission system for restricting filesystem, process, network, or credential access. By default, it runs with the permissions of the user and process that launched it."

    Traducido: Pi no tiene sistema de permisos. Corre con los tuyos.

    Y lo importante es que no es un descuido ni una versión temprana. Es coherente con la tesis del proyecto: el core no engorda, y lo que otros traen de fábrica aquí lo montas tú. El propio README te dice a continuación qué montar, con tres patrones documentados.

    Vamos con lo que estás aceptando y con cómo ponerle un límite.


    Qué significa exactamente "corre con tus permisos"

    No es una advertencia genérica. Significa, literalmente, que el proceso puede hacer todo lo que puedes hacer tú desde esa terminal:

    • Leer cualquier archivo de tu usuario. Tus claves en ~/.ssh, los .env de todos tus proyectos, las credenciales de tu CLI de nube, tus tokens de sesión.
    • Escribir y borrar en cualquier sitio, no solo en el proyecto donde lo lanzaste.
    • Ejecutar cualquier comando con bash, incluidos git push, curl a donde sea, o un npm install de un paquete que no has revisado.
    • Salir a la red sin restricción.

    Y la parte que más se subestima: el agente no tiene que querer hacer nada de eso para que pase. Basta con que lo lea en algún sitio. Una dependencia con instrucciones metidas en el README, la salida de una herramienta, una issue de GitHub que le pides que resuma. Eso es inyección indirecta de prompts, y lo desarrollé entero en cómo proteger tus agentes de la inyección indirecta.

    Con un agente sin capa de permisos, la distancia entre "leyó algo raro" y "ejecutó algo raro" es cero.


    Las dos formas de ponerle un límite

    La documentación oficial plantea la decisión con una claridad que se agradece. Solo hay dos opciones:

    1. Meter el proceso pi entero dentro de un entorno aislado.
    2. Dejar pi en tu máquina y enrutar la ejecución de las herramientas hacia un entorno aislado.

    La diferencia no es cosmética y decide dónde acaban tus credenciales. Si metes el proceso entero en un contenedor, las claves de tu proveedor de IA entran con él. Si dejas el proceso fuera y solo enrutas las herramientas, la autenticación se queda en tu host y lo que viaja al entorno aislado son las operaciones.


    Los tres patrones documentados

    Patrón Qué se aísla Cuándo Lo que cuesta
    Gondolin Herramientas integradas y comandos ! Quieres la micro-VM pero la auth en tu host Node ≥ 23.6.0 y QEMU
    Docker plano El proceso pi entero Aislamiento local simple Tus claves de API entran en el contenedor
    OpenShell El proceso entero, con políticas Sandbox gestionado, local o remoto Necesita un gateway activo

    Gondolin: la micro-VM que se traga las herramientas

    Gondolin es una micro-VM de Linux local. La extensión de ejemplo deja pi corriendo en tu máquina y redirige las herramientas integradas hacia la VM, sobrescribiendo read, write, edit, bash, grep, find y ls. Los comandos ! que escribes tú también van dentro.

    cp -R packages/coding-agent/examples/extensions/gondolin ~/.pi/agent/extensions/gondolin
    cd ~/.pi/agent/extensions/gondolin
    npm install --ignore-scripts
    
    cd /ruta/a/tu/proyecto
    pi -e ~/.pi/agent/extensions/gondolin
    

    Monta tu directorio actual en /workspace dentro de la VM. Es el patrón con mejor relación aislamiento/comodidad: tu autenticación no sale del host.

    Con una advertencia que conviene decir en voz alta: Gondolin se describe a sí mismo como experimental («Experimental Linux microvm setup with a TypeScript Control Plane as Agent Sandbox») y va por unas 2.000 estrellas frente a las más de 96.000 de Pi. Es el patrón que mejor encaja conceptualmente, pero es la pieza más joven de las tres.

    Docker plano: el más simple, con una letra pequeña

    Metes todo el proceso en un contenedor:

    docker run --rm -it \
      -e ANTHROPIC_API_KEY \
      -v "$PWD:/workspace" \
      -v pi-agent-home:/root/.pi/agent \
      pi-sandbox
    

    Fíjate en el -e ANTHROPIC_API_KEY: la clave entra. Y fíjate en el volumen con nombre para /root/.pi/agent — está ahí a propósito, porque la documentación avisa de que montar tu ~/.pi/agent del host expone tus credenciales y tus sesiones al contenedor. Si montas ese directorio por comodidad, te has saltado media barrera.

    OpenShell: cuando necesitas políticas de verdad

    OpenShell es un sandbox con control de políticas sobre sistema de archivos, procesos, red, credenciales e inferencia. Corre a través de un gateway local (Docker, Podman o una VM) o de uno remoto sobre Kubernetes. Todo —herramientas integradas, comandos ! y herramientas de extensiones— se ejecuta dentro del límite.

    Es el más pesado de montar y el único que te da políticas explícitas. Si esto va a tocar código de un cliente, es el que te van a pedir.


    Tres cosas de las que el aislamiento NO te salva

    Aquí es donde se cae la sensación de seguridad, y las tres salen de la propia documentación.

    1. Tu proyecto sigue siendo escribible. En Gondolin y en Docker, tu directorio actual se monta en /workspace y los cambios escriben directamente en tus archivos del host. Eso es lo que quieres —para eso lo usas— pero significa que el contenedor protege el resto de tu máquina, no tu código. Un borrado desafortunado dentro de /workspace es un borrado en tu disco. La red de seguridad de tu proyecto sigue siendo Git, no el sandbox.

    2. Tus propias extensiones se quedan fuera. Esta es la fuga más sutil y está dicha con todas las letras: "las extensiones se ejecutan allí donde se ejecuta el proceso pi". Si usas el patrón de enrutado con pi en el host, las herramientas de tus extensiones personalizadas siguen corriendo en tu máquina salvo que ellas también deleguen sus operaciones. Montas la micro-VM, respiras tranquilo, y la extensión que escribiste el mes pasado sigue teniendo acceso directo a tu disco.

    3. Las credenciales del proveedor. En el patrón Docker entran en el contenedor por diseño. Si lo que te preocupa es que se filtre la clave de tu API, ese patrón no es el tuyo: es Gondolin.


    Cómo elegir en treinta segundos

    • Vas a dejarlo trabajar solo, con tu código personal: Gondolin. La auth se queda fuera y las herramientas dentro.
    • Quieres el aislamiento más simple y la clave de API te da igual (una de proyecto, con límite de gasto): Docker.
    • Es código de cliente, o tienes que justificar controles ante alguien: OpenShell.
    • Estás mirando el diff de cada paso, en un repo tuyo, con todo commiteado: puedes ir sin nada. Pero que sea una decisión, no un descuido.

    Y una que aplica a los cuatro casos: usa una clave de API distinta y con límite de gasto para el agente. No la misma que tu producción.

    Si el aislamiento con contenedores es terreno nuevo para ti, la base está en entornos de desarrollo reproducibles con Docker y Dev Containers, y el caso concreto de encapsular la ejecución de un agente lo conté en Docker sandboxing para ejecutar código de IA.


    Esto no va solo de Pi

    Lo que hace distinto a Pi no es que corra con tus permisos. Es que lo pone por escrito en la primera pantalla del repositorio, y te documenta tres formas de arreglarlo.

    La pregunta útil no es "¿es Pi seguro?". Es: de los agentes CLI que tienes instalados ahora mismo, ¿cuántos te han dicho con esta claridad qué pueden tocar? La mayoría no tiene esa sección porque no le interesa tenerla, no porque el problema no exista.

    Ese es el criterio con el que conviene mirar cualquier herramienta agéntica que instales: no cuántas capacidades trae, sino qué te cuenta sobre sus límites. Un proyecto que te documenta cómo encerrarlo te está respetando más que uno que no menciona el tema.

    Delimitar el alcance del trabajo antes de lanzar al agente reduce mucho la superficie de todo esto, y es la metodología que tienes en el libro de Spec-Driven Development. El flujo completo con herramientas CLI agénticas lo enseño en el curso Construye con IA: de la idea al producto con Claude Code.

    En Dominicode Labs comparto las configuraciones de aislamiento que uso de verdad para dejar agentes trabajando sin vigilarlos.

    Un agente sin permisos no es un agente inseguro. Es un agente que te ha dejado a ti la decisión, y te ha dicho dónde está el interruptor.


    Preguntas frecuentes

    ¿Pi es inseguro por no tener sistema de permisos?

    Es una decisión de diseño coherente con su minimalismo, no un fallo: el core no incorpora lo que puedes montar fuera. Lo que sí es imprudente es usarlo sin aislamiento en una máquina con credenciales, porque corre con todos los permisos del usuario que lo lanzó. El propio proyecto documenta tres patrones para ponerle límites.

    ¿Cuál de los tres patrones de aislamiento elijo?

    Gondolin si quieres que tus credenciales de proveedor se queden en el host y solo viajen las operaciones a la micro-VM. Docker si buscas el límite más simple y no te importa que la clave de API entre en el contenedor. OpenShell si necesitas políticas explícitas sobre archivos, procesos, red y credenciales, normalmente porque tienes que justificarlas ante un cliente o un equipo de seguridad.

    Si aíslo el agente en un contenedor, ¿mi código está a salvo?

    No del todo. En Gondolin y en Docker tu directorio de trabajo se monta en /workspace y lo que se escribe ahí llega a tus archivos reales — tiene que ser así para que el agente sirva de algo. El aislamiento protege el resto de la máquina: tus claves, otros proyectos, tu red. Para el código, tu red de seguridad sigue siendo Git y tener todo commiteado antes de lanzarlo.

    ¿Mis extensiones personalizadas también quedan aisladas?

    No automáticamente, y es la fuga más fácil de pasar por alto. Las extensiones se ejecutan donde se ejecuta el proceso pi: si usas el patrón de enrutado con pi en el host, las herramientas de tus extensiones siguen corriendo en tu máquina salvo que las escribas para delegar sus operaciones al entorno aislado.

    ¿Cuántas herramientas trae Pi realmente?

    Cuatro activas por defecto —read, write, edit y bash—, que son las que sostienen la tesis del proyecto. Hay algunas más disponibles: la extensión de Gondolin, por ejemplo, sobrescribe read, write, edit, bash, grep, find y ls. La cifra que importa no es cuántas existen, sino cuántas van al contexto por defecto.

  • Guardrails para agentes: probé la blocklist típica y pasan 16 de 20

    Guardrails para agentes: probé la blocklist típica y pasan 16 de 20

    La primera semana que le das a un agente acceso a tu terminal te sientes invencible.

    Le pides que instale una dependencia, ejecute los tests, cree una rama y arregle un bug. Y lo hace, mientras tú haces otra cosa.

    Después llega la pregunta incómoda: ¿qué pasa exactamente si se equivoca?

    Casi todo el mundo responde igual. Ha metido en el System Prompt una frase del tipo "por favor, nunca ejecutes comandos destructivos", y con eso duerme tranquilo. Eso no es una barrera: un modelo es probabilístico y esa frase compite con todo lo demás que hay en el contexto. Que el LLM no puede ser su propia barrera de seguridad ya lo desarrollé en guardrails y tácticas defensivas contra inyección de prompts, así que aquí lo doy por sabido.

    Este post va del siguiente paso, el que casi nadie audita: el que sí escribió código de defensa y cree que con eso está cubierto.

    Porque hay un guardrail concreto que escribimos todos, que parece serio, que da mucha tranquilidad y que no aguanta ni una reordenación de flags. Vamos a romperlo con un test que puedes ejecutar tú.


    El guardrail que todos escribimos

    Es este, con pequeñas variaciones. Una lista de patrones peligrosos y un interceptor delante del ejecutor de herramientas:

    const FORBIDDEN_PATTERNS = [
      /rm\s+(-rf|-fr|\*)/i,
      /git\s+push\s+.*(--force|-f)/i,
      /git\s+reset\s+--hard/i,
      /drop\s+table/i,
      /chmod\s+777/i,
      /curl\s+.*\|\s*(bash|sh)/i,
    ];
    
    const blocked = (cmd: string) => FORBIDDEN_PATTERNS.some(p => p.test(cmd));
    

    Tiene buena pinta. Cubre el rm -rf de los titulares, el force push, el DROP TABLE y el clásico curl | bash.

    Ahora vamos a medirlo.


    El test: 16 de 20 comandos destructivos pasan

    Le pasé a ese filtro 20 comandos que ningún agente debería poder ejecutar sobre tu máquina. Este es el resultado completo:

    Comando ¿Lo detiene?
    rm -rf / Bloqueado
    rm -r -f / Pasa
    rm -Rf ~/proyecto Bloqueado
    rm --recursive --force / Pasa
    rm -f -r . Pasa
    find . -delete Pasa
    find . -exec rm {} + Pasa
    git clean -fdx Pasa
    > package.json Pasa
    cat /dev/null > .env Pasa
    dd if=/dev/zero of=/dev/sda Pasa
    git reset --hard HEAD~5 Bloqueado
    DROP TABLE users Bloqueado
    drop/**/table users Pasa
    TRUNCATE TABLE users Pasa
    DELETE FROM users Pasa
    mv proyecto /dev/null Pasa
    $(echo rm) -rf / Pasa
    npm run deploy:prod Pasa
    chmod -R 777 / Pasa

    Cuatro bloqueados, dieciséis dentro. Y fíjate en la segunda fila, porque resume el problema entero:

    rm -rf / está bloqueado. rm -r -f / pasa.

    Es el mismo comando. Borra exactamente lo mismo. Lo único que cambia es que los flags van separados, y el modelo no necesita saber que existe un filtro para escribirlo así: es una forma perfectamente normal de escribir ese comando.

    La última fila es igual de reveladora. El patrón /chmod\s+777/ espera que el 777 venga justo detrás de chmod, así que chmod -R 777 / —que es peor, porque es recursivo— no lo toca.

    Aquí tienes el test entero para que lo corras contra tu propia lista antes de seguir leyendo:

    const destructivos = [
      "rm -rf /", "rm -r -f /", "rm -Rf ~/proyecto", "rm --recursive --force /",
      "rm -f -r .", "find . -delete", "find . -exec rm {} +", "git clean -fdx",
      "> package.json", "cat /dev/null > .env", "dd if=/dev/zero of=/dev/sda",
      "git reset --hard HEAD~5", "DROP  TABLE users", "drop/**/table users",
      "TRUNCATE TABLE users", "DELETE FROM users", "mv proyecto /dev/null",
      "$(echo rm) -rf /", "npm run deploy:prod", "chmod -R 777 /",
    ];
    
    const pasan = destructivos.filter(c => !blocked(c));
    console.log(`${pasan.length}/${destructivos.length} pasan el filtro`);
    console.log(pasan);
    

    Y hay un segundo efecto, menos grave pero muy revelador: el patrón del force push bloquea git push --force-with-lease, que es precisamente la variante segura. Una blocklist no solo deja pasar lo peligroso; también prohíbe cosas correctas, y eso es lo que te acaba empujando a desactivarla.


    El fallo no son los patrones. Es la arquitectura

    La tentación, al ver esa tabla, es añadir patrones. Meter -r -f, meter find, meter TRUNCATE.

    No sirve. Puedes pasarte una tarde ampliando la lista y mañana el agente encontrará la forma número veintidós, porque una shell tiene infinitas maneras de expresar la misma destrucción: flags separados, flags largos, alias, sustitución de comandos, redirecciones, herramientas distintas que hacen lo mismo.

    Esto tiene nombre desde hace décadas en seguridad: enumerating badness, enumerar lo malo. Y siempre pierde, porque el conjunto de lo peligroso es infinito y el de lo permitido es finito.

    La inversión es la solución completa:

      BLOCKLIST              ALLOWLIST
      ─────────              ─────────
      permite por defecto    deniega por defecto
      enumera lo malo        enumera lo bueno
      conjunto infinito      conjunto finito
      falla abierta          falla cerrada
    

    Con una allowlist, el comando número veintidós que no habías previsto no se ejecuta, porque no está en la lista. Ese es el único diseño en el que un olvido tuyo no se convierte en un incidente.


    El chequeo de rutas también se cae

    El mismo middleware suele traer una validación de rutas parecida a esta:

    if (path.startsWith("/") || path.includes("..")) return BLOQUEADO;
    

    Falla en las dos direcciones. Estas rutas pasan:

    • C:\Windows\System32 — una ruta absoluta de Windows no empieza por /.
    • ~/.ssh/id_rsa — la expande la shell después de tu comprobación.

    Y a la vez bloquea src/../lib/x.ts, que es una ruta legítima dentro del proyecto.

    El arreglo es no razonar sobre el texto de la ruta, sino resolverla y comprobar dónde acaba:

    import path from "node:path";
    
    const ROOT = path.resolve(process.env.AGENT_WORKSPACE!);
    
    export function dentroDelWorkspace(candidata: string): boolean {
      const destino = path.resolve(ROOT, candidata);
      return destino === ROOT || destino.startsWith(ROOT + path.sep);
    }
    

    Con eso, ../../etc/passwd y /etc/passwd quedan fuera —los dos resuelven a un destino que no cuelga de ROOT— mientras que src/../lib/x.ts entra sin problema. La comprobación deja de depender de cómo esté escrita la ruta.

    Un aviso: si tu agente puede crear enlaces simbólicos, resuélvelos también (fs.realpath) antes de comparar. Un symlink dentro del workspace apuntando fuera se salta la comprobación de arriba.


    Las 4 capas que sí sostienen la capa de ejecución

    En orden, de más a menos importante.

    1. Allowlist de comandos, denegar por defecto

    Define qué puede ejecutar el agente, no qué no puede. Empieza por lo que de verdad necesita a diario —tests, linter, build, git status, git diff— y ve añadiendo cuando algo se bloquee de forma legítima.

    La forma práctica de arrancar: registra durante una semana todo lo que el agente intenta ejecutar sin bloquear nada, y monta la allowlist a partir de esa lista real. Casi siempre son menos de treinta comandos.

    Si usas un agente CLI, esto normalmente ya existe en su configuración: reglas de permiso allow / deny / ask y modos de permisos. Revisa el tuyo con una pregunta concreta: ¿hay alguna regla comodín tipo Bash(*) que anule a todas las demás? Si la hay, tu allowlist es decorativa.

    2. Confinamiento por ruta resuelta

    El agente trabaja dentro de un directorio y solo dentro de él. Con la función de arriba, y aplicada a todas las herramientas que tocan disco: leer, escribir, mover y borrar. Confinar solo la escritura deja abierta la exfiltración de .env y de tus claves.

    3. Puerta humana para lo irreversible

    Lo que no se puede deshacer no se automatiza: git push, migraciones, escrituras en base de datos de producción, despliegues, borrados. El criterio no es "peligroso" sino "¿puedo revertirlo en un minuto?". Es el mismo principio de mínimo privilegio que desarrollé al hablar de inyección indirecta de prompts en agentes, aplicado aquí a la shell.

    Montar esa puerta bien tiene su propia arquitectura —clasificar las tools por riesgo, persistir el estado mientras se espera y no ejecutar dos veces al reanudar—, y la desarrollo en arquitectura human in the loop en TypeScript.

    4. Aislamiento: que el radio del fallo sea pequeño

    Las tres capas anteriores fallan alguna vez. La cuarta decide cuánto duele.

    Dale a cada tarea su propia rama y su propio directorio de trabajo, y un contenedor cuando la tarea toque dependencias o servicios. Si algo sale mal, borras el directorio y no has perdido nada. Cómo montar el aislamiento fuerte con contenedores lo detallé en Docker sandboxing para ejecutar código de IA.


    El middleware corregido

    Juntando las piezas, el interceptor queda así:

    import path from "node:path";
    
    const COMANDOS_PERMITIDOS = new Set([
      "npm", "pnpm", "bun", "node", "tsc", "eslint", "prettier", "vitest", "jest",
    ]);
    
    const SUBCOMANDOS_GIT = new Set(["status", "diff", "log", "add", "commit", "branch", "checkout"]);
    
    const IRREVERSIBLES = new Set(["push", "reset", "clean", "rebase"]);
    
    const ROOT = path.resolve(process.env.AGENT_WORKSPACE!);
    
    type Decision =
      | { tipo: "ejecutar" }
      | { tipo: "preguntar"; motivo: string }
      | { tipo: "denegar"; motivo: string };
    
    export function decidir(argv: string[], rutas: string[] = []): Decision {
      for (const r of rutas) {
        const destino = path.resolve(ROOT, r);
        if (destino !== ROOT && !destino.startsWith(ROOT + path.sep)) {
          return { tipo: "denegar", motivo: `La ruta "${r}" queda fuera del workspace.` };
        }
      }
    
      const [binario, sub] = argv;
    
      if (binario === "git") {
        if (IRREVERSIBLES.has(sub)) return { tipo: "preguntar", motivo: `git ${sub} no es reversible.` };
        if (SUBCOMANDOS_GIT.has(sub)) return { tipo: "ejecutar" };
        return { tipo: "denegar", motivo: `git ${sub} no está en la allowlist.` };
      }
    
      if (COMANDOS_PERMITIDOS.has(binario)) return { tipo: "ejecutar" };
    
      return { tipo: "denegar", motivo: `"${binario}" no está en la allowlist.` };
    }
    

    Tres detalles que hacen que esto funcione y la versión anterior no:

    Recibe argv, no un string. Nada de analizar una línea de shell con expresiones regulares. Si construyes el comando como array de argumentos y lo ejecutas sin shell (execFile en lugar de exec), desaparecen de golpe la sustitución de comandos, las redirecciones y el encadenado con ; o &&. La mitad de las evasiones de la tabla de arriba dejan de existir.

    Devuelve tres estados, no un booleano. ejecutar, preguntar y denegar. Sin el estado intermedio acabas ampliando la allowlist con cosas irreversibles solo para no tener que confirmar cada vez.

    Deniega por defecto. El return final es una denegación. Lo que no previste no se ejecuta.

    Y cuando bloquees, devuélvele al agente el motivo en texto, no una excepción: el modelo lo lee y busca otra vía en lugar de dejar la tarea a medias.

    Para los parámetros estructurados que llegan a una herramienta o a la base de datos, la validación de schema con Zod es la pieza que cierra el círculo, y los patrones de contrato están en el curso de Zod para TypeScript. El criterio general de dónde poner las validaciones —y dónde no— lo tienes en programación defensiva en TypeScript.


    El guardrail más barato: acotar antes de empezar

    Todo lo anterior actúa cuando el agente ya está trabajando. Es más barato reducir lo que puede intentar.

    Cuando escribes un spec.md que fija qué archivos entran en la tarea y qué queda fuera, el agente deja de tener motivos para acercarse al resto del repositorio. No sustituye a los guardrails —una especificación no es un control de seguridad— pero baja mucho la frecuencia con la que se activan.

    La metodología completa está en el libro de Spec-Driven Development, y el flujo práctico con agentes CLI en el curso Construye con IA: de la idea al producto con Claude Code.


    Checklist para esta semana

    1. Corre el test de arriba contra tu propia blocklist. Diez minutos. Si pasa más de la mitad, ya sabes en qué punto estás.
    2. Busca el comodín. Abre la configuración de permisos de tu agente y comprueba si hay una regla que permita todo. Suele estar puesta desde el primer día y olvidada.
    3. Ejecuta sin shell. Cambia exec por execFile con argv. Es el cambio con mejor relación esfuerzo/resultado de toda la lista.
    4. Confina por ruta resuelta, en lectura y en escritura.

    En Dominicode Labs revisamos arquitecturas agénticas reales y compartimos las configuraciones de permisos que aguantan en producción.

    La autonomía de verdad no es darle libertad total al modelo. Es construirle un sitio donde equivocarse salga barato.


    Preguntas frecuentes

    ¿Por qué una lista de comandos prohibidos no basta para proteger a un agente?

    Porque enumera un conjunto infinito. Una shell puede expresar la misma acción destructiva de muchas formas —flags separados, flags largos, otra herramienta que hace lo mismo, sustitución de comandos— y tu lista solo cubre las que se te ocurrieron. En la prueba de este post, dieciséis de veinte comandos destructivos atraviesan una blocklist de aspecto razonable, incluido rm -r -f /, que es el mismo comando del ejemplo con los flags separados.

    ¿Cómo confino a un agente a la carpeta del proyecto?

    Resolviendo cada ruta con path.resolve() contra la raíz del workspace y comprobando que el resultado sigue colgando de esa raíz. No compruebes el texto de la ruta: startsWith("/") no detecta rutas absolutas de Windows ni el ~ que expande la shell, y includes("..") bloquea rutas internas legítimas. Si el agente puede crear symlinks, resuélvelos con fs.realpath antes de comparar.

    ¿Una allowlist no me va a estar frenando todo el rato?

    Los primeros días sí, y es la señal de que funciona. La forma de reducirlo es construirla con datos: registra una semana de comandos reales del agente y parte de ahí. Suelen ser menos de treinta. Y ten un estado intermedio de "preguntar" para lo irreversible: sin él acabarás metiendo en la allowlist cosas que no deberían estar solo para dejar de confirmar.

    ¿Necesito Docker para esto o me basta con una rama aislada?

    Depende de qué pueda romper la tarea. Una rama con su propio directorio de trabajo protege tu código y hace que tirar el trabajo cueste un segundo, pero comparte tu máquina, tus variables de entorno y tu red. Si la tarea instala dependencias, ejecuta código que no has leído o toca servicios, necesitas el aislamiento del contenedor.

    ¿Dónde pongo el guardrail: en la herramienta o en el agente?

    En la herramienta, siempre. Un control que vive en el prompt, en el nombre de la tool o en su descripción es una sugerencia que el modelo puede ignorar. El guardrail tiene que estar en el código que ejecuta la acción, de forma que ni siquiera un agente que decida saltárselo pueda hacerlo. Si el control se puede desactivar escribiendo texto, no es un control.