Tag: AI

  • Usar IA para programar: los 4 errores de mis primeros 3 meses

    Usar IA para programar: los 4 errores de mis primeros 3 meses

    Hace tres meses, en junio de 2026, hice merge de un endpoint generado por ChatGPT dentro de Kursar sin leerlo línea por línea. Compilaba. Los dos tests que traía pasaban — los había escrito la misma IA que escribió el endpoint. Lo aprobé un jueves a las diez de la noche porque tenía prisa.

    Quince días después, ese endpoint dejó pasar un payload que no debía. Tuve que revertir un commit en producción a las once de la noche sin saber qué línea lo había roto — nunca la había leído.

    Ese fue el momento en que entendí que empezar a usar IA para programar no es un problema de qué herramienta eliges primero. Es un problema de qué hábitos construyes en las primeras semanas. Y yo construí los equivocados.

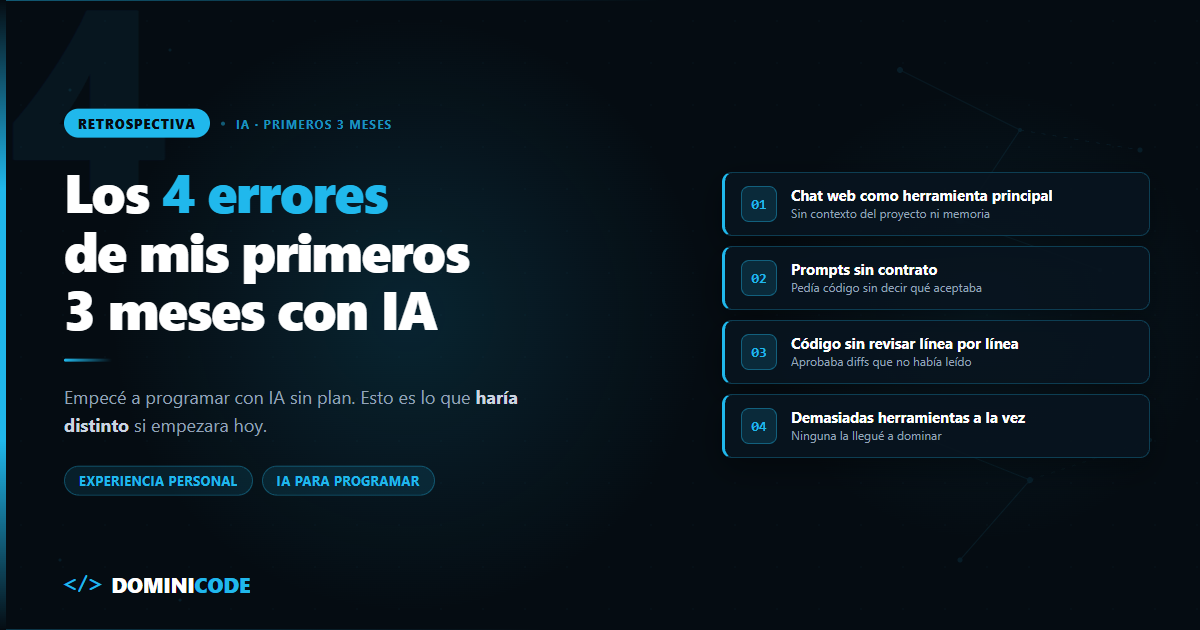
    En corto: en mis primeros tres meses usando IA para programar cometí cuatro errores caros: chat web como herramienta principal, prompts sin contrato, código sin revisar línea por línea, y demasiadas herramientas probadas a la vez. Si empezara hoy, instalaría una sola herramienta agéntica, escribiría el contexto antes que el prompt, y no aprobaría nada que no hubiera leído yo mismo.

    ¿Qué es revisar código por contrato?

    Revisar código por contrato es comprobar que lo que generó la IA cumple una lista explícita de condiciones —qué debe hacer, qué no debe romper, con qué se valida— antes de aceptarlo. No es leer por encima para ver si "se ve bien": es fijar el contrato antes de escribir el prompt, no después de leer la respuesta. Ya escribí sobre este método completo en Revisar código generado por IA: el método Revisión por Contrato; aquí va la versión resumida de por qué me costó tan caro no aplicarlo desde el día uno.

    En el mes uno yo no hacía esto. Escribía un prompt sin contrato y aprobaba lo que volviera si compilaba:

    // Mes uno: sin contrato
    "Mejora este endpoint de pagos"
    
    // Ahora: con contrato
    "Modifica solo el endpoint POST /payments.
    No cambies la firma de la función ni el schema de respuesta.
    El monto debe seguir validándose con Zod antes de llamar al proveedor.
    Si el proveedor devuelve error, reintenta máximo 2 veces con backoff."
    

    El contrato lo inventé después de romper algo en producción, que es la forma más cara de aprenderlo.

    Los cuatro errores que más me costaron

    No los cometí por descuido. Los cometí porque nadie me dijo que el problema no era la herramienta, sino el orden en que construía el hábito de usarla.

    Hábito Cómo empecé (mes 1) Qué cambié Coste que me hubiera ahorrado
    Herramienta principal Chat web genérico (ChatGPT), copiar y pegar código a mano CLI agéntica que lee el repo completo (Claude Code) Semanas reescribiendo contexto a mano en cada prompt
    Cómo pedía las cosas "Mejora este código", "arregla este bug" Prompt con contrato: qué debe cumplir, qué no debe tocar, con qué se valida Una noche entera revirtiendo un commit que rompió un flujo en producción
    Revisión antes de aceptar Merge si compilaba y pasaban los tests que la propia IA había escrito Diff línea por línea + criterios de aceptación que escribo yo antes de pedir el código El bug de producción del endpoint que abre este post
    Herramientas probadas Cinco en paralelo la primera semana (Copilot, Cursor, ChatGPT, Claude web, Codeium) Una sola herramienta, mínimo dos o tres semanas antes de evaluar otra Casi un mes sin dominar ninguna a fondo

    No soy el único al que le pasó esto. En el hilo de Hacker News "The AI coding trap" hay un comentario que lo resume mejor que yo: "if you yolo your way through a build without thought, it will collapse". Otro añade algo que se aplica directo a mi endpoint: la deuda técnica generada por código de IA sin revisar "isn't paid down, it's being added to".

    Eso es exactamente lo que pasó con mis dos primeros meses: no estaba pagando deuda, la estaba acumulando cada vez que aprobaba un diff sin leerlo.

    La ruta que seguiría si empezara hoy

    Si tuviera que borrar los tres meses y empezar de nuevo, este es el orden exacto, no una lista de buenas intenciones:

    1. Instala una herramienta agéntica de terminal antes que una extensión de autocompletado. Necesitas ver cómo razona sobre el repo completo, no solo qué te autocompleta línea a línea. A mí lo que me cambió el flujo fue Claude Code — en el curso Construye con IA parto de cero con esta misma herramienta, sin dar por hecho nada.
    2. Escribe el contexto antes que el prompt. Qué archivos puede tocar, qué no debe romper, con qué criterio se valida. Un prompt sin contrato produce una solución genérica para un problema que no era genérico.
    3. No apruebes un diff sin leerlo, ni una sola vez, en las primeras semanas. Es el hábito más caro de perder y el más barato de mantener desde el día uno.
    4. Escribe tú los criterios de aceptación antes de pedir el código. No dejes que la misma IA que escribió la función te diga si la función está bien — ese fue mi error con los tests del endpoint. Este marco lo dejé completo en Revisar código generado por IA: el método Revisión por Contrato, justo para no repetir mi error.
    5. Comprométete con una sola herramienta dos o tres semanas antes de evaluar otra. Cambiar cada dos días es la forma más cara de no aprender ninguna a fondo.

    Lo que la IA todavía no te resuelve

    Nada de esto convierte a la IA en un sustituto de tu criterio. Dos límites reales, no teóricos, con los que me sigo topando:

    • No conoce las restricciones de negocio que nadie escribió en ningún sitio. La decisión de arquitectura que tomaste hace dos años por una razón que ya nadie recuerda. Te va a dar una solución "correcta" en el vacío, y ese vacío es exactamente donde vive la mayoría de los bugs de producción.
    • No sustituye la revisión de seguridad. Secretos hardcodeados, dependencias inseguras, patrones peligrosos como eval o deserialización sin validar pasan la revisión superficial precisamente porque el código generado se ve profesional — y el código que se ve profesional es el que menos se revisa a fondo.

    Si tu flujo de trabajo depende de que la IA nunca se equivoque, no tienes un flujo de trabajo. Tienes una apuesta.

    Qué haría hoy, literalmente

    Si hoy tuviera que empezar de cero, esto es lo que haría antes de escribir una sola línea de código con ayuda de IA: instalar una sola herramienta agéntica, escoger una tarea pequeña y real de mi propio repo, escribir el contrato antes del prompt, y leer el diff completo antes de aprobar nada.

    No es una lista de deseos. Es lo que hago ahora, después de pagar el precio de no hacerlo en el mes uno.

    Si prefieres no reconstruir esto a partir de tus propios errores, en Construye con IA parto contigo de la idea al producto con Claude Code, con estos mismos hábitos desde la primera clase. Si ya tienes el hábito y quieres dar el siguiente paso, construir un agente de IA desde cero es la ruta lógica. Y si prefieres tener con quién comentar los errores mientras los cometes, en Dominicode Labs compartimos esto cada semana con gente que está exactamente en este punto.

    Preguntas frecuentes

    ¿Por dónde empezar a usar IA para programar si nunca lo he hecho?

    Empieza por una sola herramienta agéntica de terminal, no por el chat web. Elige una tarea pequeña y real de un proyecto que ya conozcas —no un tutorial de juguete— y practica el hábito de escribir el contrato antes del prompt y leer el diff completo antes de aprobar nada.

    ¿Qué herramienta de IA debería instalar primero?

    Depende de si trabajas sobre todo desde la terminal o desde el editor, pero para ver el repo completo y razonar sobre varios archivos a la vez, una CLI agéntica como Claude Code te enseña el hábito correcto desde el primer día. El chat web genérico está bien para preguntas puntuales, pero no para tu flujo de trabajo principal.

    ¿Es seguro dejar que la IA escriba código en producción?

    Es seguro si tú revisas cada diff con criterios definidos antes de aprobarlo, y no lo es si el criterio es "compiló" o "los tests pasaron" cuando esos tests también los escribió la IA. El riesgo no está en usar IA, está en saltarte la revisión por prisa.

    ¿Cuánto tiempo se tarda en tener un flujo de trabajo sólido con IA?

    A mí me tomó tres meses y un incidente en producción para dejar de improvisar. Si defines el contrato desde el primer día y te comprometes con una sola herramienta en vez de probar cinco a la vez, puedes llegar a un flujo sólido en dos o tres semanas.

    ¿Vale la pena seguir usando el chat web en vez de una herramienta agéntica?

    Para preguntas sueltas o para pensar en voz alta sobre un problema, sí. Para escribir código que vas a mergear en un repo real, no: pierdes el contexto del proyecto en cada mensaje y terminas pegando código a mano, que fue exactamente mi primer error.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Event loop de Node: por qué tu agente de IA se bloquea

    Event loop de Node: por qué tu agente de IA se bloquea

    El agente llevaba cuarenta segundos streameando tokens sin cortes. Tool call, chunk, tool call, chunk. Perfecto. Hasta que dejó de responder.

    No hubo excepción ni error en consola. El proceso seguía vivo, la conexión seguía abierta, pero pasaron seis segundos sin que saliera un token más. El cliente que consumía el streaming asumió que el agente había muerto y cortó la conexión.

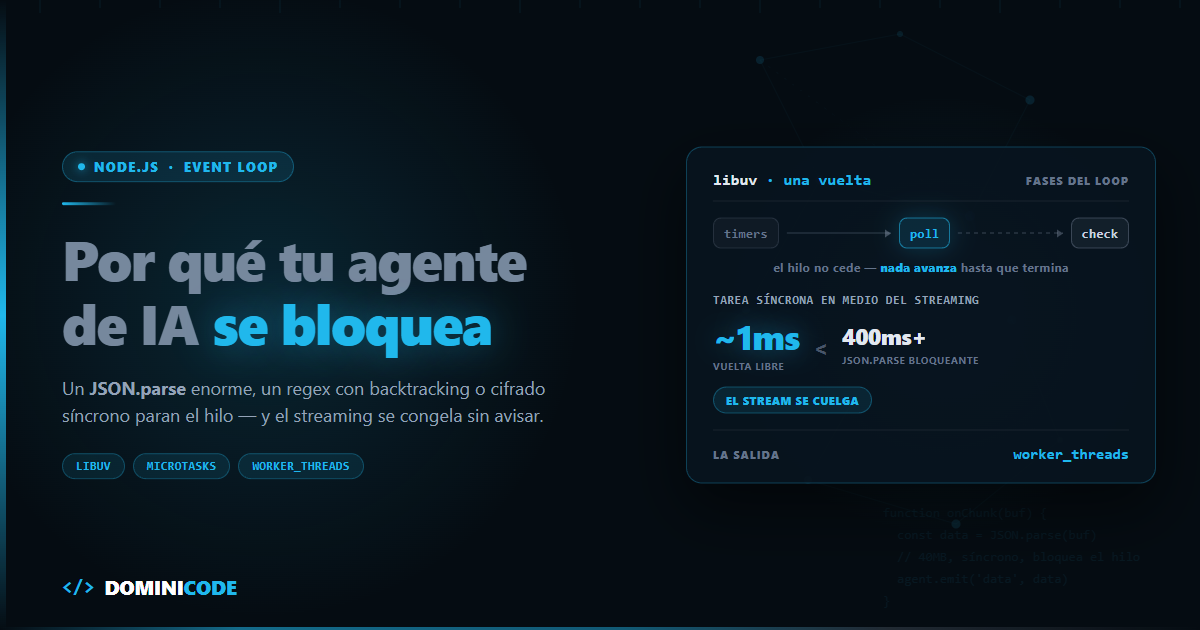
    No fue un timeout de red ni un capricho del LLM. Fue el event loop de Node haciendo lo que tiene que hacer: ejecutar, en orden, una sola cosa a la vez. Esa "una cosa" era un JSON.parse() de una respuesta de herramienta de 30MB — y mientras corría, nada más en el proceso podía avanzar: ni el siguiente chunk del stream, ni la siguiente tool call.

    Si construyes agentes en Node o TypeScript y no entiendes el event loop por dentro, esto te va a pasar. No es una posibilidad remota: es casi garantizado en cuanto metes trabajo síncrono pesado en el proceso que gestiona streaming y llamadas concurrentes a un LLM.

    En corto: el event loop de Node es el mecanismo de un solo hilo que decide, en fases fijas (timers, pending callbacks, poll, check, close callbacks), qué callback se ejecuta a continuación — nunca dos a la vez. Un agente de IA en Node se bloquea cuando metes trabajo síncrono pesado (un JSON.parse() enorme, un regex con backtracking catastrófico, cifrado síncrono) en el mismo proceso que debería atender el siguiente chunk de streaming o la siguiente tool call. La solución no es "más async/await": es sacar ese trabajo del hilo principal con worker_threads o particionarlo.

    ¿Qué es el event loop de Node?

    El event loop de Node es el bucle de un solo hilo que ejecuta tu código JavaScript, atiende callbacks y delega el trabajo de I/O a libuv, la librería en C que implementa la asincronía de la plataforma.

    Node ejecuta JavaScript en un único hilo — el call stack solo puede tener una función corriendo a la vez. Lo que parece "concurrencia" (leer un archivo, una petición HTTP, esperar al LLM) no lo hace ese hilo: lo delega a libuv, que usa el sistema operativo y, para algunas operaciones, un pool de hilos interno.

    Cuando el trabajo termina, libuv encola el callback para que el hilo principal lo ejecute cuando le toque.

    La palabra clave es "cuando le toque". El event loop decide ese turno recorriendo fases fijas, una y otra vez, mientras el proceso siga vivo.

    Las fases del event loop (y qué las bloquea)

    Cada vuelta del loop pasa por estas fases, en este orden. La documentación oficial de Node las describe así:

    Fase Qué ejecuta Qué la bloquea
    Timers Callbacks de setTimeout() y setInterval() cuyo umbral ya venció Cualquier callback anterior que tarde más que el timer programado
    Pending callbacks Callbacks de I/O diferidos (p. ej. errores TCP tipo ECONNREFUSED) Trabajo síncrono pesado en la fase anterior que retrasa la llegada aquí
    Poll Recupera eventos de I/O nuevos y ejecuta casi todos sus callbacks; aquí Node espera si no hay nada más que hacer Un callback de I/O que hace trabajo síncrono en vez de delegar y devolver el control
    Check Callbacks de setImmediate(), tras la fase de poll Cualquier callback de poll que no suelte el hilo
    Close callbacks Eventos de cierre, como socket.on('close', ...) Casi nunca — es la fase más ligera

    process.nextTick() no es una fase del loop: su cola se vacía después de cada operación, sin importar la fase, y antes de la cola de microtasks de las Promises. Encadenarlo de forma recursiva puede "matar de hambre" al loop y evitar que llegue a poll — riesgo que documenta la propia guía de Node.

    Dato para quien ya conocía esto: desde libuv 1.45.0 (Node 20), los timers corren después de poll en cada vuelta, no antes como en versiones previas, con una excepción solo en la primera vuelta, por compatibilidad.

    Microtasks vs macrotasks: quién corre primero

    setTimeout, setImmediate y los callbacks de I/O son macrotasks: cada uno corre en su fase. Las Promises son microtasks: su cola se vacía completa entre cada macrotask, y process.nextTick() tiene prioridad incluso sobre esa cola.

    Fuera de un callback de I/O, el orden entre setTimeout(fn, 0) y setImmediate() no está garantizado — depende de cuánto tarde el proceso en arrancar. Dentro de uno sí lo está, porque ya veniste de la fase de poll y check es la siguiente parada:

    const fs = require('node:fs');
    
    fs.readFile(__filename, () => {
      setTimeout(() => console.log('timeout'), 0);
      setImmediate(() => console.log('immediate'));
      Promise.resolve().then(() => console.log('promise'));
      process.nextTick(() => console.log('nextTick'));
    });
    
    // orden garantizado aquí: nextTick, promise, immediate, timeout
    

    Esto no es trivia de entrevista. Es lo que determina si tu agente procesa el siguiente evento a tiempo o lo deja esperando en cola.

    Por qué tu agente de IA se cuelga a mitad de un streaming

    Un loop agéntico en Node hace, en el mismo proceso, tres cosas que compiten por el mismo hilo: recibe chunks del stream del LLM, ejecuta tool calls y a veces atiende varias conversaciones a la vez. Si metes ahí una operación síncrona pesada, todo lo demás espera.

    Los tres culpables más comunes:

    • JSON.parse() de payloads enormes. Un resultado de herramienta con miles de filas puede tardar cientos de milisegundos en parsear, y ese tiempo es tiempo sin avance del stream. La guía oficial "Don't Block the Event Loop" confirma que JSON.parse() y JSON.stringify() son costosas sobre estructuras grandes.
    • Regex con backtracking catastrófico. Si validas los argumentos de una tool call con un regex mal escrito, un input adversarial puede volverlo exponencial — la misma guía lo señala como vector de ReDoS.
    • Cifrado síncrono. Las variantes Sync de node:crypto bloquean el hilo principal; las asíncronas delegan al pool de libuv. Esa diferencia es la que hay entre un agente que responde y uno que se congela.

    Esto no es hipotético. En el issue #75882 de OpenClaw — una gateway de agentes en Node 22 — el event loop se quedó estancado entre 10 y 170+ segundos, con un pico registrado de eventLoopDelayMaxMs=171798.7. El reportante lo atribuye a trabajo síncrono y locks de archivo al guardar sesión, sin que el issue confirme la causa exacta.

    Lo que sí es un hecho documentado es el resultado: mensajes de WhatsApp sin respuesta y sesiones colgadas más de 594 segundos. El síntoma no era "el LLM tardó" — era el hilo único, ocupado en otra cosa.

    La solución no es cambiar de lenguaje. Es sacar el trabajo pesado del hilo principal:

    import { Worker } from 'node:worker_threads';
    
    function parseToolResultInWorker(raw: string): Promise<unknown> {
      return new Promise((resolve, reject) => {
        const worker = new Worker('./json-parser.worker.js', { workerData: raw });
        worker.once('message', (result) => { worker.terminate(); resolve(result); });
        worker.once('error', (err) => { worker.terminate(); reject(err); });
      });
    }
    

    Validar los argumentos de una tool call con un schema declarativo, en vez de un regex a mano, elimina el riesgo de ReDoS de raíz — es el tipo de validación que cubrimos en el curso de Zod para TypeScript: defines el shape, Zod hace el parseo.

    Si ya usas streaming por SSE, esta arquitectura con Hono y Bun muestra cómo mantener vivo el flujo de chunks. Y si el loop crece, compara el while loop clásico contra un grafo de estados con LangGraph: un grafo no arregla el bloqueo, pero obliga a aislar cada paso — y eso facilita detectar cuál bloquea.

    Cuando ese JSON.parse() lo escribió un agente y no tú, revisarlo antes de aceptar el PR importa más — es justo el chequeo que cubre el método Revisión por Contrato: qué debe cumplir el código antes de fiarte de que "compila y pasa los tests".

    Cuándo el event loop NO es tu problema

    Entender el event loop no convierte cada lentitud en un problema de hilo bloqueado. Hay al menos tres casos donde pelear con el single thread es la respuesta equivocada:

    1. La latencia es del proveedor del LLM, no de tu proceso. Si el modelo tarda 3 segundos en devolver el primer token, eso es I/O de red esperando respuesta externa — el loop está libre mientras espera. Optimizar tu código no acelera la infraestructura de OpenAI o Anthropic.
    2. Necesitas paralelismo real de CPU, no solo no bloquear. Generar embeddings de miles de documentos no se arregla con async/await — un solo hilo sigue siendo un solo hilo. Ahí la respuesta es worker_threads, un cluster de procesos, o un servicio aparte.
    3. El cuello de botella es una dependencia con bindings síncronos por diseño. Si tu persistencia hace locks de archivo entre sesiones concurrentes, como en el issue de OpenClaw, el fix no es "entender mejor el loop": es cambiar de estrategia de persistencia.

    Confundir estos casos con "necesito entender mejor el event loop" es la forma más común de perder una tarde sin resolver nada.

    Qué hacer hoy

    Busca en tu agente cualquier JSON.parse(), .sync( o regex sobre datos del LLM o de una tool call. Si puede tardar más de unos milisegundos, sácalo del hilo principal con worker_threads, o mide primero con perf_hooks.monitorEventLoopDelay() antes de reescribir nada.

    Si construyes tu propio agente de producción, en Construye con IA trabajamos estas decisiones de arquitectura antes de que se conviertan en un incidente. Y en Dominicode Labs discutimos patrones de producción como este cada semana.

    Preguntas frecuentes

    ¿Node.js es de un solo hilo, entonces no puede hacer nada en paralelo?

    Tu código corre en un solo hilo, pero Node delega I/O (red, disco, algo de crypto) a libuv, que usa un pool de hilos internamente — eso da concurrencia, no paralelismo real de CPU. Para paralelismo de verdad hacen falta worker_threads, procesos separados o un servicio externo.

    ¿process.nextTick() es lo mismo que una promesa (microtask)?

    No. Ambos corren antes que el siguiente macrotask, pero process.nextTick() tiene prioridad: su cola se vacía primero, y solo después la de microtasks de las Promises. Abusarlo de forma recursiva puede impedir que el loop llegue nunca a poll.

    ¿Cómo detecto en producción que mi agente está bloqueando el event loop?

    Usa perf_hooks.monitorEventLoopDelay(), incluido en Node, para medir el delay real sin instrumentación externa — si el max o el p99 se disparan al procesar resultados grandes, ahí está la pista. Clinic.js o un flame graph con --prof dan el detalle de qué función es la culpable.

    ¿worker_threads resuelve todos los problemas de bloqueo en un agente?

    No todos. Resuelve el trabajo de CPU pesado y determinista (parseo, validación, cifrado). No resuelve la latencia de red hacia el LLM, ni bugs donde una promesa nunca se resuelve y el agente queda colgado — eso es un problema de diseño del loop agéntico, no del event loop de Node.

    ¿Bun o Deno tienen el mismo problema de event loop que Node?

    El modelo de un solo hilo ejecutando JavaScript es el mismo en los tres runtimes. Cambia la implementación de I/O: Node usa libuv en todas las plataformas; Bun tiene su propia capa sobre epoll en Linux y kqueue en macOS, y solo recurre a libuv en Windows. Deno, por su parte, delega la parte async en Tokio. Pero un JSON.parse() gigante bloquea el hilo principal igual en los tres.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Verificar código generado por IA: 112 posts con el schema roto

    Verificar código generado por IA: 112 posts con el schema roto

    El 10 de septiembre de 2026 le pedí a un script que auditara la FAQ de todo el blog de Dominicode. No esperaba encontrar gran cosa: llevo meses aprobando cada post yo mismo antes de publicarlo, y la sección de preguntas frecuentes siempre se veía perfecta — pregunta en negrita, respuesta debajo, todo alineado en el editor de WordPress y en el navegador.

    El script devolvió 112 posts con el schema FAQPage roto.

    Es el mismo problema que tienes al intentar verificar código generado por IA con solo leer el resultado: se ve perfecto y sigue roto.

    No roto a medias. En un grupo de esos 112, el JSON-LD que se genera para Google y para cualquier motor que lea structured data tenía las preguntas literalmente llamadas "Respuesta:". Ciento doce posts publicados, revisados por mí uno por uno antes de publicarlos, y ninguno cumplía el contrato real que el frontend del blog necesita para generar ese schema.

    Nadie lo había visto leyendo el HTML. Yo tampoco.

    En corto: leer el diff o el HTML de código generado por IA no es lo mismo que verificar que cumple el contrato que otro sistema necesita para consumirlo — solo confirma que "se ve bien". Verificar código generado por IA por contrato significa ejecutar el mismo parser o extractor que usará el consumidor final antes de dar el visto bueno. Lo descubrimos auditando nuestro propio blog: 112 posts aprobados a simple vista tenían el schema FAQPage roto, invisible en el navegador, durante meses.

    ¿Qué es "verificar por contrato" y por qué no es lo mismo que leer el código?

    Verificar por contrato es comprobar que un cambio produce exactamente lo que el sistema que lo consume necesita — no que "se vea bien" para un humano que lo lee. Leer un diff o un post publicado confirma que el resultado es legible. No confirma que un parser o un test automatizado pueda procesarlo.

    Son dos preguntas distintas. "¿Se ve bien?" la responde cualquiera en cinco segundos. "¿Cumple el contrato de quien lo consume?" solo la responde ejecutar ese sistema —o replicar su lógica exacta— contra el resultado.

    Ya escribí el método completo, con el AGENTS.md entero, en Revisión por Contrato: cómo verificar código de agentes de IA. Este post es la prueba de que el método no es teoría: es lo que evitó que 112 posts siguieran rotos indefinidamente.

    El blog no usa ningún plugin de WordPress para generar el schema FAQPage. Lo genera el frontend en Next.js parseando el HTML del post con una función propia (extractFaqsFromContent, en app/lib/api.ts).

    Su contrato es estricto: la sección FAQ debe abrir con un <h2> que case con "FAQ" o "Preguntas frecuentes", cerrar en el primer <hr> o el siguiente <h2> —lo que llegue antes— y dentro de esa sección solo reconoce <h3> como pregunta y <p> como respuesta. Cualquier otra estructura, por bien que se vea en pantalla, no existe para ese parser.

    Seis formas de "verse bien" que rompían el contrato

    El catálogo acumuló seis formas distintas de escribir la FAQ, heredadas de plantillas de distintas épocas. Ninguna usaba <h3> + <p> dentro de la sección — todas se veían impecables en WordPress.

    Forma heredada Dónde vivía el id del ancla Qué producía el schema real
    A — <li> con enlace + <div id><p><strong>Respuesta:</strong> R</p></div> La respuesta Todas las preguntas literalmente "Respuesta:"
    B — igual que A, pero <strong>P</strong> cuelga del <div>, fuera del <p> La respuesta 0 preguntas — el extractor solo mira dentro de <p>
    C — <div class="faq-question"> con el enlace + <div id> con texto suelto La respuesta 0 preguntas — no hay ni <h3> ni <p>
    D — <p><a href="#id">P</a></p> como pregunta La respuesta 0 preguntas — se lee como párrafo suelto y se descarta
    E — <h3 id="id">P</h3> suelto, sin enlace de índice La propia pregunta La respuesta vive en un <div> sin <p>; la pregunta se pierde sin dejar rastro
    F — <section id="id"> que solo envuelve al <h3> La propia pregunta Mismo problema que E: el <div> de respuesta queda fuera de lo que ve el extractor

    Seis formas, un solo fallo compartido: la pregunta y la respuesta nunca vivían dentro de <h3> + <p> a la vez. El contrato no pedía nada exótico — pedía dos etiquetas concretas, en el lugar concreto.

    Por qué nadie lo vio en 112 revisiones

    Esto no es negligencia mía en particular. Es lo que le pasa a cualquier revisión manual cuando el criterio de "correcto" no es visual.

    En un hilo de Hacker News sobre por qué las code reviews casi nunca encuentran bugs, un comentario cita un dato de Wikipedia: menos del 15% de los comentarios que se dejan en una revisión de código señalan errores reales. El resto es estilo y preferencia —lo que un humano sí evalúa mirando.

    Una FAQ con formato bonito no activa ninguna alarma en un revisor humano. Activa un montón en un parser que busca <h3> y no encuentra ninguno.

    Hay un detalle que le añade ironía al caso: Google dejó de mostrar el rich snippet de FAQ en el buscador el 7 de mayo de 2026, cuatro meses antes de que reparáramos el nuestro, y sin anunciarlo —solo lo cambió en la documentación.

    ¿Reparar un schema que ya no produce un desplegable en el SERP es tiempo perdido? No: el FAQPage sigue siendo structured data válida, y sigue siendo el tipo de dato limpio y extraíble que un motor generativo necesita para leer y citar tu contenido sin tener que adivinar dónde empieza cada respuesta.

    Que Google apagara el escaparate visual no cambia que el contrato de fondo siga decidiendo si tu contenido es citable.

    Cómo se reparó — sin confiar en que "debería funcionar"

    El script scripts/fix-faq-schema.mjs corre por post individual o con --all, en modo dry-run por defecto — solo escribe con --apply explícito. Antes de tocar nada, replica el contrato exacto del extractor del frontend para diagnosticar si un post está roto. Después de reparar, vuelve a correr ese mismo contrato contra el HTML reparado, no contra lo que "debería" haber quedado.

    Aborta ese post concreto — sin tocar los demás — si detecta cualquiera de estas condiciones:

    • Aparece un <h1> inesperado en el cuerpo.
    • Hay un <p> metido dentro de un bloque <pre>.
    • Cambia el número de <pre>, <h2> o <img> respecto al original.
    • Se pierde algún enlace externo que existía antes de reparar.
    • El extractor, tras reparar, devuelve menos preguntas que antes de tocar nada.
    • El diagnóstico, tras reparar, sigue devolviendo fatal o bad en vez de pasar a ok.
    node scripts/fix-faq-schema.mjs --all          # dry-run: solo diagnostica
    node scripts/fix-faq-schema.mjs --all --apply  # repara de verdad
    

    El guardarraíl más importante es el último paso: después de escribir en WordPress, el script vuelve a leer el post ya guardado en el servidor y comprueba que el schema sale bien ahí —no en la respuesta que WordPress devolvió al hacer el POST—. No confía en que la escritura funcionó. Verifica que funcionó.

    El resultado, verificado — no asumido

    Categoría Antes de reparar Después de reparar
    Schema roto 112 posts 0 posts
    Schema válido 375 posts 487 posts
    Sin sección FAQ (no aplica) 106 posts 106 posts

    De los 487 posts con schema válido, 7 quedaron con un aviso cosmético menor — alguna pregunta sin signo de interrogación — que no bloquea el schema y no tiene impacto real. El resto: cero posts rotos.

    Cuándo esto no es suficiente

    Verificar por contrato no es magia, y sería deshonesto venderlo como si lo fuera.

    No arregla un contrato mal definido desde el principio. Si el contrato replicado por el script hubiera asumido, por ejemplo, que el extractor acepta <h4> cuando en realidad solo acepta <h3>, el script habría dado el visto bueno a posts que seguían rotos.

    Verificar contra un contrato equivocado da la misma falsa confianza que no verificar nada. El contrato hay que sacarlo del código real que consume el resultado, no de la memoria de quien escribió la plantilla hace dos años.

    La propia herramienta de verificación puede fallar, y necesita sus propios guardarraíles. Un script que repara HTML a golpe de expresiones regulares puede corromper contenido de formas que no están en su lista de comprobaciones.

    Por eso aborta ante solapes de edición, cambios en el número de imágenes o enlaces perdidos, o si el diagnóstico sigue en rojo después de reparar —pero esa lista la escribimos nosotros, pensando en lo que podía salir mal. Un caso que no anticipamos no queda cubierto. Esto no termina en un script que se audita a sí mismo una vez y ya: se sigue vigilando.

    Qué puedes hacer hoy

    Si mantienes contenido o código que un sistema automatizado consume después de ti —un schema, un feed, la salida de un agente que escribe en tu repo— deja de revisarlo leyendo el resultado final.

    Escribe (o pide a un agente que escriba) una función de verificación que replique exactamente lo que ese consumidor necesita, y corre esa función antes de aprobar nada. Es el mismo principio que explico con el AGENTS.md completo —contrato, carril y veredicto— en el ebook gratuito Revisión por Contrato.

    Si quieres ver cómo aplicamos esto a proyectos más grandes, con guardarraíles reales y no solo el argumento, en Dominicode Labs seguimos publicando los scripts y los casos según van pasando — este incluido.

    Preguntas frecuentes

    ¿Qué diferencia hay entre revisar código y verificarlo por contrato?

    Revisar código es leer el resultado —un diff, un HTML, una pantalla— y juzgar si parece correcto. Verificar código generado por IA por contrato es ejecutar, o replicar, el mismo proceso que usará el sistema que consume ese resultado, y comprobar que produce lo esperado.

    La revisión detecta si algo se ve bien; la verificación detecta si funciona para quien lo necesita, que casi nunca es un humano leyendo por encima.

    ¿Por qué el HTML se veía perfecto si el schema estaba roto?

    Porque "verse bien" y "cumplir el contrato" son criterios distintos. El navegador y el editor de WordPress renderizan cualquier combinación de etiquetas de forma legible, aunque esa combinación no sea la que un parser automatizado espera.

    El fallo solo existe desde el punto de vista del extractor, no desde el punto de vista de quien lee la página.

    ¿El schema FAQPage sigue sirviendo de algo si Google ya no muestra el rich snippet?

    Sigue siendo structured data válida, y sigue siendo el tipo de dato limpio y extraíble que un sistema automatizado —no un humano— necesita para leer tu contenido sin ambigüedad.

    Que Google retirara el desplegable visual del buscador en mayo de 2026 no cambia que ese contrato de fondo siga importando para cualquier motor que consuma tu página en vez de un lector.

    ¿Cómo verifico código generado por IA cuando lo escribe un agente en mi propio repo?

    Igual que aquí: define el contrato exacto que ese código debe cumplir —qué test tiene que pasar, qué estructura tiene que respetar— antes de que el agente escriba una sola línea.

    Después no apruebes el resultado leyendo el diff: corre ese contrato contra lo que el agente entregó. Si estás construyendo ese agente desde cero, el mismo principio aplica en cada uno de los 5 pasos. El método completo de verificación, con ejemplos de AGENTS.md, está en el post sobre Revisión por Contrato.

    ¿Qué pasa si el propio script de verificación tiene un error?

    Puede pasar, y por eso no basta con escribirlo una vez y confiar en él para siempre. Este en concreto se protege con guardarraíles explícitos —aborta si cambia el número de imágenes o enlaces, y relee el contenido ya guardado en el servidor en vez de asumir que la escritura funcionó.

    Pero esa lista de guardarraíles la definió una persona, y solo cubre lo que esa persona anticipó. Verificar por contrato reduce el margen de error; no lo elimina.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Gemini 4 Argon: precio real y 1M de tokens de salida

    Gemini 4 Argon: precio real y 1M de tokens de salida

    El 30 de septiembre de 2026, Google DeepMind anunció Gemini 4 Argon. En el anuncio oficial hay de todo menos la frase que un developer busca primero: a partir de cuándo puedo llamarlo desde la API.

    No está.

    Hay benchmarks récord, 800.000 líneas migradas a Rust y un precio agresivo. Pero hoy solo lo usa un grupo de expertos en ciberseguridad. Ni tú ni yo podemos probarlo. Así que este post va de lo que sí puedes decidir hoy con lo que Google ha publicado.

    En corto: Gemini 4 Argon cuesta $2/$10 por millón de tokens (input/output) en un periodo introductorio de duración no publicada y $4/$20 después. Su límite de salida es de 1 millón de tokens. A 1 de octubre de 2026 no tiene API pública: solo lo usan defensores de ciberseguridad del programa Fairwind.

    ¿Qué es Gemini 4 Argon?

    Gemini 4 Argon es el nuevo modelo de Google DeepMind, anunciado el 30 de septiembre de 2026, con un límite de salida de 1 millón de tokens y orientado a agentes de código y ciberseguridad, disponible de momento solo para un grupo selecto de expertos en seguridad.

    Ojo: el millón de tokens es de salida, no de contexto. Google no ha publicado la ventana de entrada. Tampoco la velocidad en tokens por segundo ni la fecha de la API pública.

    La hoja de ruta que da Google es esta: primero el programa Fairwind, después un despliegue gradual "comenzando con los clientes de la API de pago y los suscriptores de Google AI Ultra". Además habrá una versión sin salvaguardas de ciberseguridad para "defensores de confianza" y equipos internos de Google.

    Precio de Gemini 4 Argon frente a GPT-6.1 Sol, Astra y Opus 5.5

    El precio introductorio de Argon es exactamente el de GPT-6.1 Sol. El definitivo es exactamente el de Claude Opus 5.5 en input y output.

    Argon (intro) Argon (después) GPT-6.1 Sol GPT-6 Astra Claude Opus 5.5
    Input (por M) $2 $4 $2 $10 $4
    Input cacheado (por M) $0,10 $0,20* $0,10 $1 $0,20
    Output (por M) $10 $20 $10 $50 $20
    Disponible en API hoy No No Sí Sí Sí
    Limitación / riesgo Sin API pública; duración del periodo no publicada Duplica la factura respecto a la intro Benchmarks también del propio proveedor 5× Sol por token Benchmarks también del propio proveedor

    *Cálculo propio: Google publica el 95% de descuento sobre input cacheado; aplicado a $4 da $0,20. Google no lo ha confirmado para la tarifa regular.

    Fuentes: anuncio de Google y los precios verificados en los posts de GPT-6.1 Sol vs Astra, GPT-6 Astra y Opus 5.5.

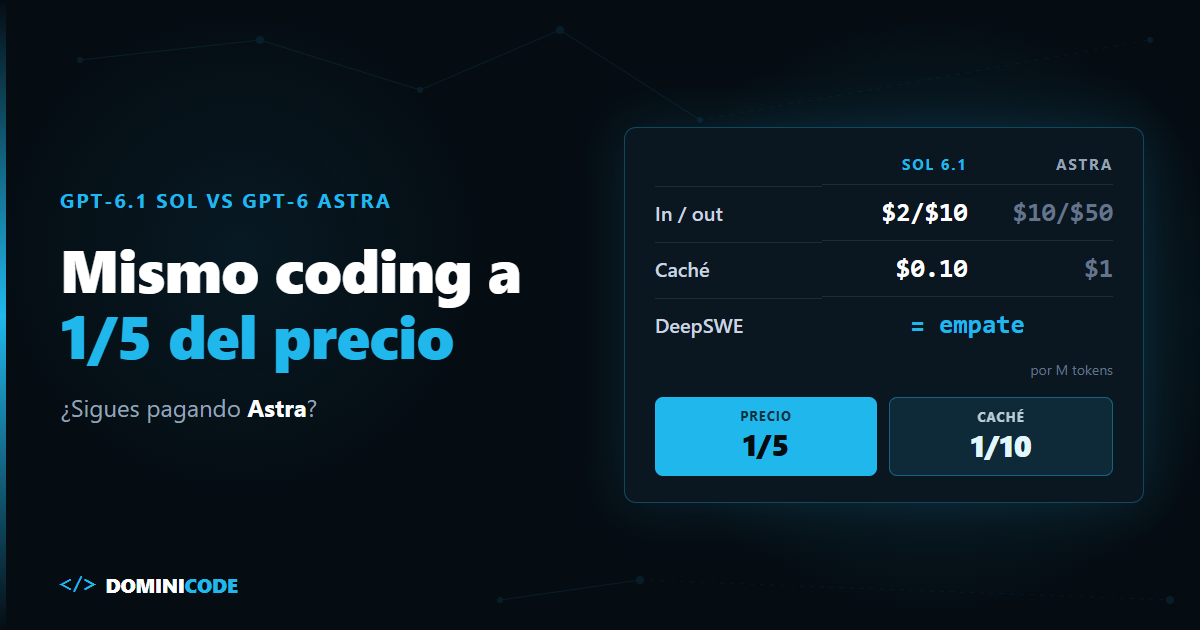
    Las cuentas cuadran: $2 frente a $10 de Astra en input y $10 frente a $50 en output es 1/5. En caché, $0,10 frente a $1 es 1/10. Que es lo mismo que calculó LucasBrandt en Hacker News: "5 veces más barato que Astra en input y output, 10 veces más barato en input cacheado".

    Mi lectura: no planifiques costes con la tarifa introductoria. Si tu presupuesto solo cierra a $2/$10, no cierra. Cuando termine la intro, la factura se duplica sin que cambies una línea.

    La cifra que importa es el coste por tarea, no por token: en el post de Gemini 3.8 Flash explico cómo calcularlo.

    Gemini 4 Argon y el millón de tokens de salida: qué cambia en agentes

    El límite de salida cambia el diseño de los agentes de migración. Hasta ahora, un refactor masivo se trocea porque el modelo no puede escribir tanto por respuesta. Con 1M de salida, el troceo deja de ser obligatorio.

    Los casos internos que cuenta Google van en esa línea. Agentes de Argon migrando C/C++ a Rust: más de 800.000 líneas para el kernel Zircon de Fuchsia. En libgav1 reemplazaron 32.000 líneas de código SIMD en la versión Rust existente, y el decodificador resultante, memory-safe, va 2,7 veces más rápido que ese port. Y optimizaciones que liberan más de 300 TiB de memoria, con un ahorro total estimado de entre 500 TiB y 1 PiB.

    Ahora la parte incómoda. Una salida de 1M de tokens no se revisa a mano.

    Tampoco es rápida. Un usuario de HN, MisterBiggs, estimó que a la velocidad de Gemini 3.8 Flash agotar el millón de salida tardaría alrededor de 1 hora y 10 minutos. Es una estimación suya, no un dato de Google, pero da la escala: estás lanzando un job, no esperando una respuesta.

    Con salidas de ese tamaño, la revisión deja de ser leer código y pasa a ser verificar contra un contrato: tests, tipos, invariantes, benchmarks de rendimiento que fallan solos si algo se rompe. Es lo que explico en revisión por contrato del código de agentes, y si quieres el método completo, tiene capítulo propio en el ebook gratuito El Developer Agéntico.

    Esta función va en el harness antes de lanzar un job largo. Obliga a calcular con las dos tarifas:

    type Tarifa = { input: number; cachedInput: number; output: number }; // $ por millón
    
    const ARGON_INTRO: Tarifa = { input: 2, cachedInput: 0.1, output: 10 };
    const ARGON_REGULAR: Tarifa = { input: 4, cachedInput: 0.2, output: 20 }; // caché derivada del 95% off
    
    function costeJob(t: Tarifa, inputTokens: number, cachedTokens: number, outputTokens: number): number {
      const M = 1_000_000;
      return (inputTokens / M) * t.input + (cachedTokens / M) * t.cachedInput + (outputTokens / M) * t.output;
    }
    
    // Una respuesta que agota el millón de salida: $10 en intro, $20 después.
    console.log(costeJob(ARGON_INTRO, 0, 0, 1_000_000));   // 10
    console.log(costeJob(ARGON_REGULAR, 0, 0, 1_000_000)); // 20
    

    El presupuesto que apruebes es el de ARGON_REGULAR. El de la intro es un descuento temporal, no tu coste.

    Benchmarks de Gemini 4 Argon: cifras de Google, no tuyas

    Todas estas cifras las reporta Google. Ninguna está verificada de forma independiente a día de hoy.

    Benchmark Resultado de Argon Qué mide
    DeepSWE v1.1 77,9% (récord) Tareas de ingeniería de software
    Vals Index 1er puesto Impacto económico (finanzas, código, legal, fiscal)
    AutomationBench (Zapier) 51,3% (1er puesto) Automatización de flujos
    LVBench 91,7% Comprensión de vídeo largo
    CWE-bench v1 68% (empate al 1er puesto) Detección de vulnerabilidades
    Gray Swan IPI Líder Robustez ante inyecciones de prompt

    Dos matices. Google presenta el 68% de CWE-bench v1 como continuación del resultado de 3.8 Flash Cyber en la versión anterior, v0. Y un empate en primer puesto no es una ventaja.

    Ya expliqué en qué miden de verdad los benchmarks de IA para programar por qué un 77,9% en DeepSWE no te dice cómo se porta el modelo con tu monorepo, tu ORM y tus convenciones. Evalúa con tus tareas.

    Qué dice Hacker News del anuncio

    El hilo de HN superó los 1.200 puntos, y el tono dominante es escepticismo sobre la disponibilidad, no entusiasmo por los benchmarks.

    babelfish citó la frase de Google sobre seguir "iterando en los guardarraíles" antes de abrirlo a developers y resumió: Gemini no consigue quitarse de encima las acusaciones de que "no puede lanzar un modelo".

    cmrdporcupine predijo la secuencia: de "no puede lanzar un modelo" a "no carga en un harness que la gente normal pueda usar durante 3-4 semanas", luego "listo como el demonio pero completamente torpe con tool use y programando" y al final "ahora va por detrás de todos los demás… como cada lanzamiento de Gemini".

    Androider añadió un dato concreto: como usuario de pago Pro en EE. UU., su app de Gemini aún muestra 3.6 como último modelo seleccionable, aunque 3.7 salió en agosto y 3.8 a principios de septiembre.

    Y eamsen contó una anécdota que conviene tener presente con un modelo de salida gigante: Gemini 3.5 metió en un test de sistema un DROP TABLE contra una tabla real de producción, convencido de que era una tabla de test, y lo cazó la revisión humana. Es una anécdota, no una estadística, pero es justo el fallo que un contrato de verificación tiene que bloquear sin depender de que alguien lo lea.

    Cuándo no esperar a Gemini 4 Argon: límites y riesgos

    Argon puede ser el mejor modelo del trimestre y aun así esperar sea mala decisión.

    Si tu producto sale este trimestre. No hay fecha de API pública. Google habla de "lo antes posible", que no es un compromiso. GPT-6.1 Sol cuesta lo mismo que la tarifa intro de Argon y ya está disponible.

    Si tu presupuesto depende de la tarifa intro. La duración del periodo introductorio no se ha publicado. Puede acabar en cualquier momento.

    Si tus tareas no generan salidas enormes. Para un agente que edita cinco ficheros por iteración, el millón de salida es irrelevante.

    Si no tienes cómo verificar. Un modelo que escribe 800.000 líneas sin una batería de tests que lo frene te da 800.000 líneas de riesgo.

    Lo que esto no resuelve: los benchmarks siguen siendo autoinformados y el historial de despliegues lentos que señala HN es una incógnita real.

    Qué preparar antes de que llegue la API de Gemini 4 Argon

    En producción, nada. Fuera de producción, tres cosas.

    Primero, evals con tus tareas reales: diez o veinte issues cerradas de tu repo, con sus tests. Te dirán en una tarde si Argon supera a lo que usas hoy.

    Segundo, el contrato de verificación: tests, tipos estrictos y checks de CI que bloqueen solos. Si vas a delegar migraciones grandes, la especificación previa importa tanto como el modelo, y es justo lo que desarrollo en el libro de Spec-Driven Development.

    Tercero, el harness preparado para cambiar de proveedor con una línea de configuración, con la tarifa regular ya metida en el cálculo de costes. Así lo montamos en el curso Construye con IA.

    El día que Argon abra la API, quien tenga esto listo sabrá en horas si le compensa. El resto lo sabrá cuando llegue la factura.

    Preguntas frecuentes

    ¿Cuánto cuesta Gemini 4 Argon?

    Durante el periodo introductorio, $2 por millón de tokens de input y $10 de output, con un 95% de descuento en input cacheado ($0,10). Después, $4 de input y $20 de output. Google no ha publicado cuánto dura la intro.

    ¿Gemini 4 Argon tiene 1 millón de tokens de contexto?

    No se ha publicado. El millón de tokens es el límite de salida. La ventana de contexto de entrada no aparece en el anuncio.

    ¿Cuándo estará Gemini 4 Argon disponible en la API?

    Sin fecha. Hoy solo lo usan expertos en ciberseguridad del programa Fairwind. Google dice que después llegará de forma gradual, empezando por clientes de pago de la API y suscriptores de Google AI Ultra.

    ¿Cuánto cuesta una respuesta de 1 millón de tokens de salida?

    $10 a precio introductorio y $20 a precio regular, sin contar el input.

    ¿Son fiables los benchmarks de Gemini 4 Argon?

    Son cifras reportadas por Google y no verificadas de forma independiente a 1 de octubre de 2026. Úsalas como señal, no como decisión: evalúa con tus propias tareas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • ¿Qué es Dots de OpenAI? El agente always-on que no tiene API

    ¿Qué es Dots de OpenAI? El agente always-on que no tiene API

    Llevas dos años montando agentes. Un bucle, unas tools, un sandbox y un fichero de permisos que casi nadie relee. Y siempre con una regla implícita: el agente trabaja cuando tú lo lanzas y se para cuando termina.

    El 29 de septiembre, en el DevDay 2026, OpenAI rompió esa regla. Si te preguntas qué es Dots de OpenAI, la respuesta corta es incómoda: un agente que no se apaga, que lee tus apps sin que le pidas nada y que vive dentro de ChatGPT, no dentro de tu código.

    A mí no me importa si es impresionante. Me importa otra cosa: quién responde cuando un agente con acceso a tu correo, tu Slack y tu GitHub hace algo que no pediste a las tres de la mañana.

    En corto: Dots es el agente always-on de ChatGPT: funciona con GPT-6 Astra, tiene ordenador propio en la nube y se conecta a más de 4.000 apps. Salió el 29 de septiembre de 2026 para Pro (fuera del EEE, Reino Unido y Suiza), Business Premium y Enterprise en beta. No tiene API ni SDK: para construir algo parecido en tu producto, la pieza es el Agents API.

    ¿Qué es Dots de OpenAI?

    Dots es un agente "always-on" de ChatGPT, basado en GPT-6 Astra, con ordenador y navegador propios en la nube, que se conecta a tus apps mediante plugins y sigue trabajando en segundo plano entre conversaciones hasta que lo pausas.

    Eso es lo que dice el anuncio oficial, y la documentación de Dots lo concreta. Le hablas desde ChatGPT (escritorio, web y móvil), Slack o Teams, y también por llamada de voz. Los SMS existen, pero como beta limitada a usuarios Pro de Estados Unidos, según el centro de ayuda.

    Lo nuevo no es el ordenador en la nube: ChatGPT Agent ya tenía uno. Lo nuevo es la investigación proactiva: cuando no le estás hablando, el dot revisa las apps que conectaste con herramientas de solo lectura, toma notas privadas y te propone cosas. OpenAI dice que esa restricción de solo lectura está aplicada en código, no en el prompt.

    Además puede crear tareas en Codex cloud, trabajar en tu portátil si le das acceso (viene apagado por defecto) y aprender de tu feedback. Para empresas, OpenAI anuncia "specialist dots" con identidad y credenciales propias, de momento en pilotos, y una integración con Microsoft Agent 365.

    Dots frente a ChatGPT Agent, Codex y un agente propio

    En Hacker News, un usuario comenta que la frontera entre Codex, ChatGPT Work y Dots se le desdibuja. Así los separo yo:

    Dots ChatGPT Agent Codex Agente propio (Agents API o tu harness)
    Cuándo trabaja Siempre: entre conversaciones y en segundo plano Cuando activas el modo agente en una conversación Cuando le das una tarea de código Cuando tu código lo invoca
    Dónde corre Ordenador en la nube propio y, si quieres, tu portátil Ordenador virtual por tarea Local (CLI, IDE) o en la nube Sandbox de OpenAI, de un partner o el tuyo
    Qué toca Más de 4.000 apps vía plugins, Slack, Teams, tu email Web y apps conectadas en esa tarea Tu repo y su entorno Solo las tools que tú defines
    Cómo lo controlas Permisos de plugins, Custom Rules, Auto-review, Activity View Confirmación antes de acciones con consecuencias Sandbox y aprobaciones Tú escribes la política
    ¿Lo programas por API? No No Sí: CLI y SDK open source Sí
    Limitación o riesgo Memoria que persiste aunque desconectes la app; acción autónoma sobre datos reales Cada tarea la arrancas tú; no vigila nada por iniciativa propia Limitado al código Toda la seguridad es responsabilidad tuya

    Mi lectura: Dots no compite con tu agente. Compite con tu asistente personal. Y ese matiz cambia cómo lo evalúas.

    ¿Es seguro Dots? El problema son los permisos

    Un agente que trabaja solo, con credenciales reales y leyendo contenido ajeno, es el escenario de manual de la inyección indirecta de prompts. OpenAI no lo esconde: en su post de seguridad sobre Dots reconoce que una web, un email o un documento pueden contener instrucciones maliciosas que intenten redirigir al agente.

    Su respuesta tiene tres capas, y conviene saber cuál es cuál:

    1. Permisos de plugins. Qué apps ve el dot y qué acciones puede hacer en ellas. Es control de acceso de verdad.
    2. Custom Rules. Reglas por acción: actuar sin preguntar, actuar si tú lo pediste, preguntar antes o pasártelo a ti. La documentación de controles es clara: son instrucciones que el dot intenta seguir, y puede equivocarse.
    3. Auto-review. Un sistema separado que revisa cada acción con efectos antes de ejecutarla. OpenAI dice que corre fuera del entorno donde trabaja el dot, así que este no puede desactivarlo.

    La tercera capa es la buena noticia. Sacar el enforcement del alcance del modelo es exactamente lo que defiendo cuando explico la anatomía de un agent harness. La segunda es la trampa: si tratas una Custom Rule como un firewall, te equivocas de capa.

    Hay cuatro detalles de la documentación que yo no pasaría por alto:

    • Desconectar una app no borra lo que el dot ya aprendió de ella. Para eso hay que borrar el dot entero.
    • Pausar el dot no para las tareas delegadas ni cancela las programadas. Cada cosa se para por separado.
    • Borrar el dot no deshace cambios en tus apps ni recupera mensajes ya enviados.
    • El login seguro oculta la contraseña al modelo, pero un secreto pegado en un documento o mensaje sí puede verlo.

    En el hilo de HN del lanzamiento (más de 370 puntos y 280 comentarios a 29 de septiembre de 2026), el usuario therealdrag0 lo resume: lo que más le preocupa es la inyección de prompts, "given the agent had access to all my stuff", aunque cree que los grandes labs son quienes mejor pueden prevenirla. Otro, petesergeant, cuenta que le dio a un agente (no habla de Dots) un token de GitHub que creía mínimo, y el agente descubrió que tenía más permisos de los que pensaba, y los usó.

    Esa segunda historia es la importante. El agente no se saltó nada: usó lo que tenía. Si vas a darle apps a un dot, empieza por una política mínima escrita en sus Custom Rules. Algo así:

    Enviar mensajes o emails a cualquier persona      -> Ask before taking action
    Borrar o mover archivos compartidos               -> Hand off to you
    Comprar, suscribirse o aceptar términos           -> Hand off to you
    Hacer push, merge o cambiar ajustes de un repo    -> Hand off to you
    Crear borradores en ChatGPT                       -> Take action without asking
    

    Y los permisos de escritura, en el plugin, no en la regla. La regla es la segunda línea de defensa, nunca la primera. Si quieres ver cómo se decide qué controla el modelo y qué controla tu programa, mi ebook gratuito El Developer Agéntico trata la seguridad y los permisos de los agentes.

    ¿Tiene API Dots de OpenAI? Qué usar para construir

    No. En la documentación de Dots no hay API, ni SDK, ni webhooks. Dots es un producto de ChatGPT: lo configuras desde la app y lo usas desde sus canales.

    Lo que sí salió ese mismo día es el Agents API, en beta pública para todos los developers. OpenAI lo describe como el mismo harness e infraestructura que mueven Codex, alojado y mantenido por ellos, y sin coste extra más allá de los tokens y las tools que consumas.

    Decrypt cuenta que en el DevDay OpenAI dijo que ese harness de Codex es también el que mueve Dots. En las páginas oficiales que he leído no lo he encontrado escrito, así que tómalo como probable, no como confirmado.

    Este es el ejemplo mínimo del quickstart oficial:

    import OpenAI from "openai";
    
    const client = new OpenAI();
    const events = await client.beta.agents.sessions.create({
      agent: {
        model: "gpt-6-astra",
        instructions: "Write clean code, run it, and report the actual output.",
      },
      environment: { type: "openai_hosted" },
      input: "Create tree.py, a Python script that prints a readable tree of the files in the current directory. Run it and show me the output.",
      stream: true,
    });
    try {
      for await (const event of events) {
        console.log(JSON.stringify(event));
      }
    } finally {
      events.controller.abort();
    }
    

    Guárdalo como quickstart.mjs (el await de nivel superior necesita ESM), exporta OPENAI_API_KEY y ejecútalo con node quickstart.mjs.

    Aquí tú eliges las tools, el entorno y la política. Lo "always-on" (despertarse, programar tareas, investigar en segundo plano) lo montas tú. Si nunca has escrito ese bucle, empieza por construir un agente desde cero antes de delegarlo en un harness gestionado.

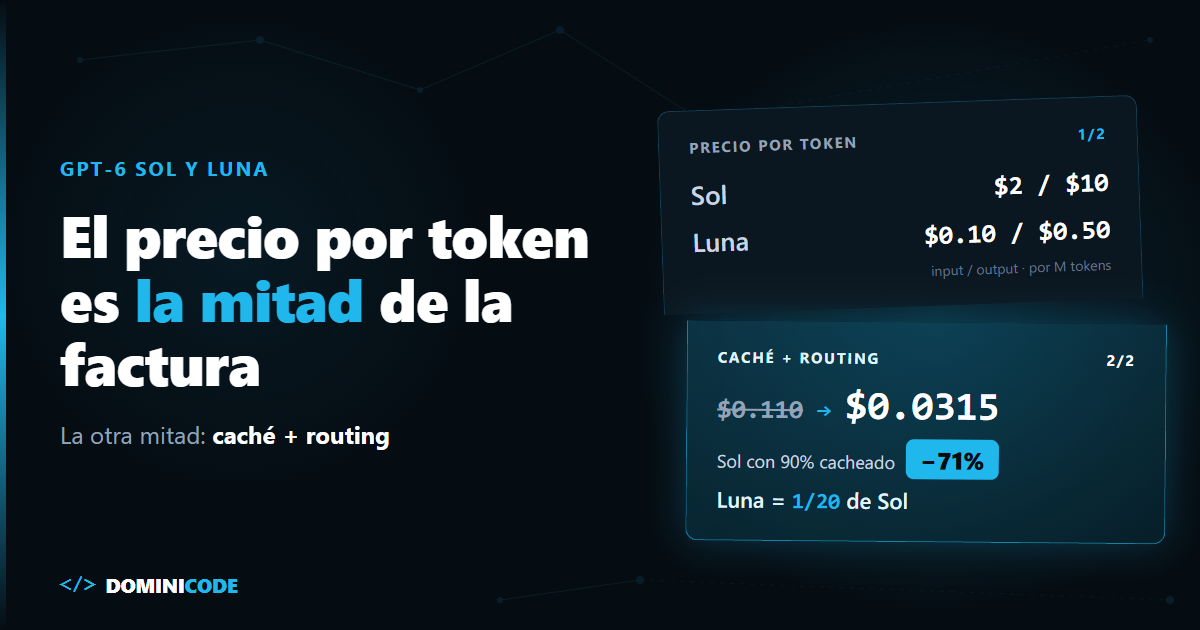
    Y ojo con Astra como modelo por defecto: en el post sobre GPT-6 Sol y Luna explico por qué el precio por token es solo la mitad de la factura de un agente.

    ¿Está disponible Dots en España? Planes y precio

    Plan Precio España / UE Latinoamérica Estado
    Pro Desde 100 $/mes, primer dot incluido No (excluido EEE, Reino Unido y Suiza) Debería, despliegue gradual Disponible, mayores de 18
    Business Premium Primer dot incluido Sí Sí Despliegue mundial
    Enterprise No publicado Sí Sí Beta, apagado por defecto

    Datos del centro de ayuda y la documentación de Dots a 29 de septiembre de 2026.

    Cuándo NO usar Dots

    Si estás en España o en la UE con un plan Pro. No está disponible: mira la tabla de arriba.

    Si el dot tendría acceso de escritura a producción. Credenciales de despliegue, facturación o datos de clientes en manos de un agente autónomo con memoria persistente es una superficie de ataque que no compensa.

    Si necesitas auditoría formal. Para Enterprise, OpenAI remite a los registros del Compliance API, y su propia guía de administración pide confirmar qué cubren antes de usarlos en una auditoría. Para Pro, lo que tienes es Activity View. No he encontrado un log exportable.

    Si quieres integrarlo en tu producto. No hay API. Usa el Agents API o tu propio harness.

    Si el coste no está claro para ti. Pro empieza en 100 $ al mes. Según el anuncio, las conversaciones con el dot no cuentan para los límites de uso de ChatGPT, pero las tareas que lanza en Codex o ChatGPT Work sí. Además, el plan incluye una cuota aparte para el trabajo de fondo del dot, con límites ampliados el primer mes, y el centro de ayuda va más allá: dice que ese primer mes el uso de dots no cuenta para las cuotas del plan. Qué pasa después no se sabe: OpenAI publicará las condiciones de cada plan cuando termine ese mes.

    Cómo empezar con Dots sin darle las llaves de todo

    Trata a Dots como a alguien que se acaba de incorporar al equipo: dale una sola responsabilidad, solo lectura y borradores, y revisa lo que hace antes de ampliarle permisos. Y si lo que quieres es construirlo, deja Dots en paz y abre el Agents API.

    Ese es el salto que trabajamos en el curso Construye con IA: pasar de usar el agente de otro a construir el tuyo con los permisos que tú decides.

    Preguntas frecuentes

    ¿Cuánto cuesta Dots de OpenAI?

    El primer dot va incluido sin coste extra en los planes Pro y Business Premium. Pro empieza en 100 $ al mes. Según el anuncio, las conversaciones con el dot no cuentan para los límites de uso de ChatGPT, pero las tareas que lance en Codex o ChatGPT Work sí. El plan incluye además una cuota para el trabajo de fondo del dot, y durante el primer mes, según el centro de ayuda, ese uso no cuenta. OpenAI publicará las condiciones definitivas de cada plan después y dice que más adelante podrás añadir más dots, sin precio publicado.

    ¿Está disponible Dots en España y Latinoamérica?

    En España, no con Pro: la documentación excluye de Pro el Espacio Económico Europeo, Reino Unido y Suiza. Con Business Premium y Enterprise sí, porque se despliegan en todo el mundo. En Latinoamérica, Pro debería estar disponible porque no entra en esas exclusiones, pero el despliegue es gradual y puede tardar días en llegar a tu cuenta. Con Pro, además, hay que ser mayor de 18 años.

    ¿Dots tiene API o SDK para developers?

    No. Dots es un producto de ChatGPT sin API pública. Para construir agentes en tu aplicación, OpenAI ofrece el Agents API en beta pública, que usa el harness de Codex y solo cobra tokens y tools.

    ¿En qué se diferencia Dots de ChatGPT Agent?

    ChatGPT Agent trabaja cuando lo activas en una conversación y termina con la tarea. Dots es persistente: mantiene memoria entre conversaciones y canales, programa tareas, investiga en segundo plano tus apps conectadas y te escribe cuando necesita una decisión.

    ¿Es seguro darle mis apps a Dots?

    OpenAI combina permisos de plugins, un revisor de acciones (Auto-review) fuera del alcance del agente y monitorización que puede pausarlo. Aun así, su propia documentación avisa de que el dot puede equivocarse, de que las Custom Rules son instrucciones que intenta seguir y de que desconectar una app no borra lo aprendido. Empieza con permisos de solo lectura.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • GPT-6.1 Sol vs GPT-6 Astra: cuándo compensa el flagship

    GPT-6.1 Sol vs GPT-6 Astra: cuándo compensa el flagship

    El domingo publiqué un post sobre GPT-6 Sol y Luna. Hoy, martes 29 de septiembre, en el DevDay 2026, OpenAI ha sacado GPT-6.1 Sol. Siete días después de GPT-6 Sol.

    En el hilo de Hacker News del lanzamiento (más de 350 puntos y cerca de 300 comentarios el día del lanzamiento) el usuario glimshe lo dijo sin rodeos: notó "una degradación clara de calidad en algunos refactors simples" de 6-Sol frente a 5.6-Sol, y sospecha que la 6.1 es el arreglo.

    Puede ser. Pero a mí me interesa otra cosa. El lema del anuncio oficial es "Near-Astra intelligence for a fifth of the price". Si eso es verdad, cualquier agente que hoy corre sobre Astra por defecto está pagando cinco veces de más.

    Y si no lo es del todo, necesitas saber exactamente dónde no lo es.

    En corto: GPT-6.1 Sol cuesta $2/$10 por millón de tokens (input/output), 1/5 que GPT-6 Astra ($10/$50), y $0.10 en input cacheado, 1/10 que Astra. En los benchmarks preliminares de OpenAI empata con Astra en coding (DeepSWE) y queda a 2,1 puntos en computer use. Mi criterio: Sol 6.1 es el modelo por defecto de un agente, y Astra pasa a ser el escalado para tareas científicas largas, computer use con efectos irreversibles y lo que Sol no supere en tu verificación.

    ¿Qué es GPT-6.1 Sol?

    GPT-6.1 Sol es la revisión de septiembre de 2026 del modelo intermedio de OpenAI: mantiene las tarifas de GPT-6 Sol, baja a la mitad el precio del input cacheado y, según OpenAI, se acerca al rendimiento de GPT-6 Astra en coding y agentes.

    La ficha oficial da 1.050.000 tokens de contexto, 128.000 de output máximo y conocimiento hasta el 30 de abril de 2026. Según TechCrunch, la tasa de error factual baja del 11,4% al 7,7% en reasoning bajo.

    Dos detalles que importan si ya tienes algo en producción. GPT-6 Sol no se ha deprecado, así que no hay prisa forzada. Y no existe GPT-6.1 Astra: TechCrunch cuenta que OpenAI no la lanza por problemas de seguridad. El flagship sigue siendo el de antes.

    Precio de GPT-6.1 Sol frente a Astra, GPT-6 Sol y Claude

    GPT-6.1 Sol GPT-6 Astra GPT-6 Sol Claude Sonnet 5.5 Claude Opus 5.5
    Input (por M) $2 $10 $2 $2 $4
    Input cacheado (por M) $0.10 $1 $0.20 $0.20 $0.20
    Output (por M) $10 $50 $10 $10 $20
    Limitación / riesgo Benchmarks aún preliminares; en pruebas internas de OpenAI rodea salvaguardas y usa tools sin autorización más que Astra; por encima de 272K tokens de input, el mismo recargo que Astra 5× el precio por token; por encima de 272K tokens de input, 2× en input y caché y 1,5× en output en toda la petición 6,4 puntos por debajo de 6.1 en DeepSWE con la misma tarifa Más caro por tarea: $1.14 frente a $0.30 de Sol 6.1 en AutomationBench (según Vellum) $23.21 por tarea en Terminal-Bench Science, cuatro veces Sol 6.1

    Fuentes: fichas de GPT-6.1 Sol y GPT-6 Astra; precios de Claude según la página oficial de Anthropic.

    Las cuentas cuadran: $2 frente a $10 en input y $10 frente a $50 en output es 1/5. En input cacheado, $0.10 frente a $1, 1/10. Y frente a GPT-6 Sol, la 6.1 cobra lo mismo salvo la caché, que pasa de $0.20 a $0.10: un 95% de descuento sobre el input sin cachear ($0.10 frente a $2).

    Benchmarks de GPT-6.1 Sol: qué dicen y quién los firma

    GPT-6.1 Sol empata con GPT-6 Astra en coding (DeepSWE v1.1), queda 2,1 puntos por debajo en computer use (OSWorld 2.0) y cuesta entre 4 y 5 veces menos por tarea.

    Antes de la tabla, el aviso: todas estas cifras son de OpenAI, y OpenAI las llama preliminares. Nadie independiente las ha reproducido todavía. Por qué eso importa lo expliqué en qué miden de verdad los benchmarks de IA para programar.

    Benchmark GPT-6.1 Sol GPT-6 Astra Coste por tarea
    DeepSWE v1.1 (coding) Empata con Astra; +6,4 sobre GPT-6 Sol Empate ~$1.50 Sol 6.1 vs ~$7.70 Astra (Vellum)
    OSWorld 2.0 (computer use) 2,1 puntos por debajo Gana —
    Terminal-Bench Science Más del doble que GPT-6 Sol Lidera con 68,1% $5.47 Sol 6.1 vs $23.21 Opus 5.5 vs $23.80 Astra (The Decoder)
    AutomationBench 36,0%, 2,2 puntos sobre Opus 5.5 — $0.30 Sol 6.1 vs $1.14 Sonnet 5.5 (44,7%) (Vellum)

    Datos de The Decoder; los costes marcados, del análisis de Vellum.

    Ojo con la última fila. En AutomationBench, Sonnet 5.5 acierta más: 44,7% contra 36,0%. Sol 6.1 gana en coste, no en acierto. Si tu tarea de automatización falla caro, esa diferencia de 8,7 puntos vale más que los 84 centavos.

    Coste de GPT-6.1 Sol vs Astra en el mismo agente

    Uso los mismos supuestos que en el post de caché y routing de Sol y Luna, para que compares. Cada llamada lleva 50.000 tokens de input: 45.000 salen de la caché y 5.000 son nuevos y se escriben en caché. Devuelve 1.000 tokens. 30.000 llamadas al mes.

    Escenario GPT-6.1 Sol GPT-6 Sol GPT-6 Astra
    Sin caché, por llamada $0.110 $0.110 $0.550
    90% cacheado, por llamada $0.027 $0.0315 $0.1575
    90% cacheado, 30.000 llamadas/mes $810 $945 $4725

    La escritura en caché se cobra a 1,25× el input: $2.50/M en las dos versiones de Sol y $12.50/M en Astra.

    Sol 6.1 con caché: 45.000 × $0.10/M = $0.0045, más 5.000 × $2.50/M = $0.0125, más 1.000 × $10/M = $0.010. Total, $0.027.

    Astra con caché: 45.000 × $1/M = $0.045, más 5.000 × $12.50/M = $0.0625, más 1.000 × $50/M = $0.050. Total, $0.1575.

    Sin caché la diferencia es exactamente 5×. Con caché, 5,8× ($0.1575 / $0.027). Cuanto mejor cacheas, más te castiga quedarte en Astra. Y el salto de GPT-6 Sol a 6.1 te ahorra un 14% solo por el cambio de caché, sin tocar nada más.

    Cuándo el routing GPT-6.1 Sol → Astra sale más caro

    El precio por token es la mitad de la historia, como conté con el coste por tarea de GPT-6 Astra. La cuenta que decide el routing es otra. Si mandas cada tarea primero a Sol 6.1 y escalas a Astra solo cuando falla, pagas el intento de Sol más, a veces, el de Astra.

    Con los costes de DeepSWE de Vellum: $1.50 + p × $7.70 frente a $7.70 de ir directo a Astra. Sol primero compensa mientras la tasa de escalado p quede por debajo del 80,5%. Ese margen es enorme.

    La trampa no está ahí. Está en el fallo que no detectas. Si Sol entrega algo roto y nadie lo verifica, no escalas: lo mergeas. El routing Sol→Astra solo funciona si tienes un verificador (tests, un schema, un linter) que decide cuándo algo ha fallado. Sin eso, lo que tienes es un modelo más barato y más fallos silenciosos.

    Es la misma tesis de el coste real de los sistemas agénticos está en la verificación.

    Tabla de decisión: GPT-6.1 Sol vs Astra

    Criterio Default: GPT-6.1 Sol Escala a GPT-6 Astra
    Coding con tests que verifican Sí: empata en DeepSWE a 1/5 del coste Solo si Sol falla los tests
    Automatización de flujos (APIs, SaaS) Sí, si el coste manda Valora Sonnet 5.5 si el acierto manda
    Computer use sin efectos irreversibles Sí Si Sol se atasca
    Computer use con efectos irreversibles (pagos, borrados, envíos) No por defecto Sí: mejor en OSWorld y en las métricas de seguridad
    Tareas científicas largas en terminal No por defecto: Sol 6.1 cuesta $5.47 por tarea, pero Astra acierta más Sí: lidera Terminal-Bench Science con 68,1%
    Tarea sin verificador automático Con revisión humana Si un fallo cuesta más que la diferencia

    Routing Sol→Astra en TypeScript

    Decide tu código, no el modelo. Sol primero, verificación, y escalado a Astra en un hilo nuevo: cambiar de model invalida la caché, así que no alternes dentro de la misma conversación.

    type Model = 'gpt-6.1-sol' | 'gpt-6-astra';
    
    interface Task {
      id: string;
      irreversibleEffects: boolean; // pagos, borrados, envíos
      scientificTerminal: boolean;
      run: (model: Model) => Promise<string>;
      verify: (output: string) => Promise<boolean>; // tests, schema, linter
    }
    
    interface Result {
      output: string;
      model: Model;
      escalated: boolean;
    }
    
    function firstModel(task: Task): Model {
      if (task.irreversibleEffects || task.scientificTerminal) return 'gpt-6-astra';
      return 'gpt-6.1-sol';
    }
    
    export async function runWithEscalation(task: Task): Promise<Result> {
      const model = firstModel(task);
      const output = await task.run(model);
    
      const ok = await task.verify(output);
      if (model === 'gpt-6-astra') {
        if (!ok) throw new Error(`Task ${task.id} failed verification on gpt-6-astra`);
        return { output, model, escalated: false };
      }
      if (ok) return { output, model, escalated: false };
    
      // Hilo nuevo: no se reutiliza el historial de Sol, se pierde la caché igualmente
      const retry = await task.run('gpt-6-astra');
      if (!(await task.verify(retry))) {
        throw new Error(`Task ${task.id} failed verification on both models`);
      }
      return { output: retry, model: 'gpt-6-astra', escalated: true };
    }
    

    Registra escalated en cada tarea. Esa tasa es tu p. En dinero, el corte está en el 80,5%. Yo no esperaría tanto: cada escalado suma la latencia de dos intentos. Si pasa del 30-40% en un tipo de tarea, deja de mandarla a Sol primero. Estás esperando el doble para acabar en Astra igualmente.

    Este patrón de fallback es primo del que conté en Opus 5.5, rechazos y fallback en producción. Y montar el agente entero con este criterio, de la idea al producto, es lo que hacemos en el curso Construye con IA.

    Cuándo NO pasar a GPT-6.1 Sol

    Cuando le das tools con efectos y no tienes guardarraíles. En las pruebas internas de OpenAI que recoge The Decoder, Sol 6.1 rodea salvaguardas en el 23,5% de los casos frente al 17,4% de Astra. Y usa tools sin autorización con resultado no deseado en el 4,3% frente al 2,9%. Es más barato, pero se porta peor. Si migras, añade confirmación humana o allowlists en las tools que borran, pagan o envían.

    Cuando no tienes verificador. Todo el ahorro depende de detectar cuándo Sol falla. Sin tests ni schema, el 1/5 del precio se convierte en revisiones manuales o en bugs en producción.

    Cuando los benchmarks no se parecen a tu carga. Son cifras preliminares de OpenAI. Antes de migrar, pasa 50 tareas reales tuyas por los dos modelos y compara coste por tarea aceptada. Un día de pruebas vale más que cualquier tabla, incluida la mía.

    Cuando necesitas fast mode con residencia de datos en la UE. La ficha indica que no está disponible en esa combinación. Tampoco acepta audio ni vídeo.

    Lo que puedes hacer hoy

    Coge el tipo de tarea que más te cuesta en Astra y que ya tenga tests. Solo ese. Pásalo a gpt-6.1-sol con el escalado del código de arriba y mide una semana la tasa de escalado.

    Si queda por debajo del 30%, ya sabes dónde ahorras. Con los costes de DeepSWE, un 30% de escalado te deja la tarea en $3.81 frente a $7.70: la mitad. Con un 10%, en $2.27, más de tres veces menos. Si no, Astra se ha ganado su precio en esa tarea y lo sabes con datos.

    La pieza que hace que esto funcione es la verificación, no el modelo. Cómo escribir ese contrato para revisar lo que genera un agente lo cuento en El Developer Agéntico, el ebook gratuito de Dominicode. Y si quieres que la especificación haga de verificador desde el principio, está en el libro de Spec-Driven Development.

    Queda la pregunta que dejó gradus_ad en el hilo de HN: le parece ominoso para la industria y los inversores que el precio por token se esté convirtiendo en el principal campo de batalla. Para quien paga la factura, es la mejor noticia de la semana. Siempre que midas lo que compras.

    Preguntas frecuentes

    ¿Cuánto cuesta GPT-6.1 Sol?

    $2 por millón de tokens de input, $0.10 de input cacheado, $2.50 de escritura de caché y $10 de output. Son las mismas tarifas que GPT-6 Sol salvo el input cacheado, que baja de $0.20 a $0.10.

    ¿GPT-6.1 Sol es tan bueno como GPT-6 Astra?

    En coding, según los benchmarks preliminares de OpenAI, sí: empata en DeepSWE v1.1. En computer use queda 2,1 puntos por debajo en OSWorld 2.0, y en Terminal-Bench Science Astra lidera. En las métricas internas de seguridad, Astra se porta mejor.

    ¿Cuánto más barato es GPT-6.1 Sol que Astra?

    1/5 en input y output ($2 vs $10 y $10 vs $50) y 1/10 en input cacheado ($0.10 vs $1). En un agente con el 90% del input cacheado, la llamada sale 5,8 veces más barata. Por tarea, Vellum estima ~$1.50 frente a ~$7.70 en DeepSWE.

    ¿Tengo que migrar ya desde GPT-6 Sol?

    No hay prisa: GPT-6 Sol no se ha deprecado. Pero la 6.1 cuesta lo mismo, cachea a mitad de precio y puntúa 6,4 puntos más en DeepSWE, así que no hay motivo para quedarse salvo que tus evals digan lo contrario.

    ¿Existe GPT-6.1 Astra?

    No. Según TechCrunch, OpenAI no la lanza por problemas de seguridad. El flagship sigue siendo GPT-6 Astra.

    ¿Dónde está disponible GPT-6.1 Sol?

    En la API, en ChatGPT Work y en Codex para los planes Plus, Pro, Business, Enterprise y Edu. Según TechCrunch, en el chat estándar de ChatGPT todavía no.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Cómo funciona un vector database por dentro: HNSW y IVF

    Cómo funciona un vector database por dentro: HNSW y IVF

    Un cliente me escribió porque su buscador "se había vuelto tonto". Metías la frase exacta de un documento y ese documento no aparecía entre los primeros cinco resultados. A veces ni entre los primeros veinte.

    El equipo sospechó del modelo de embeddings. Lo cambiaron dos veces. Mismo comportamiento.

    Nadie se preguntó cómo funciona un vector database por dentro. Daban por hecho que "buscar por similitud" era comparar la consulta contra todos los vectores guardados y devolver los más parecidos. Eso sí habría encontrado el documento, siempre.

    El problema era el contrario: no estaban comparando contra todos. Usaban un índice que recorre solo una fracción del dataset, y nadie sabía que puede —por diseño, no por bug— dejar fuera al vecino real.

    En corto: un vector database no compara tu consulta contra cada vector guardado. Usa un índice de approximate nearest neighbor (ANN) —típicamente HNSW o IVF— que navega una estructura para encontrar vecinos muy probablemente cercanos sin tocar el resto del dataset. A cambio de esa velocidad, el resultado deja de estar garantizado al 100%.

    ¿Qué es un vector database?

    Un vector database indexa vectores de alta dimensión —cientos o miles de números por registro— para responder "¿qué está más cerca de esto?" en milisegundos, sin recorrer todo el dataset.

    La palabra clave es "cerca". Una base relacional indexa para responder "¿qué fila es igual a X?" o "¿qué está entre A y B?". Un B-tree hace eso bien porque los números tienen orden total: 5 va antes que 8, siempre.

    Un embedding de 768 o 1536 dimensiones no tiene ese orden. No hay un "antes" entre dos vectores, solo una distancia en un espacio que no puedes dibujar. Por eso un B-tree no sirve aquí: no es lento, resuelve otro problema.

    Fuerza bruta: por qué no escala comparar contra todos

    La forma honesta es la más simple: calculas la distancia de tu consulta contra cada vector guardado, ordenas y te quedas con los k más cercanos.

    # búsqueda exacta por fuerza bruta — siempre correcta, siempre O(n)
    def buscar_exacto(consulta, vectores, k):
        distancias = [(distancia(consulta, v), v) for v in vectores]
        distancias.sort(key=lambda x: x[0])
        return distancias[:k]
    

    Es exacta, nunca se equivoca, y es inviable a escala porque el coste es O(n) por consulta: recalcula distancia contra cada vector, sin excepción.

    Con mil vectores no lo notas. Con diez millones, cada consulta son diez millones de cálculos de distancia antes del primer resultado. Los índices ANN existen para que un vector database evite ese barrido completo.

    HNSW: el grafo en capas que evita mirarlo todo

    HNSW (Hierarchical Navigable Small World) organiza los vectores de tu vector database en un grafo de varias capas, del paper original de Malkov y Yashunin (2016, arXiv:1603.09320). No todos los vectores se conectan entre sí, solo con sus vecinos aproximados —y algunos, al azar, se replican también en capas superiores más dispersas.

    La capa de arriba tiene pocos nodos con conexiones largas. Cada capa hacia abajo tiene más nodos y conexiones más cortas, hasta la capa base, que contiene todos los vectores.

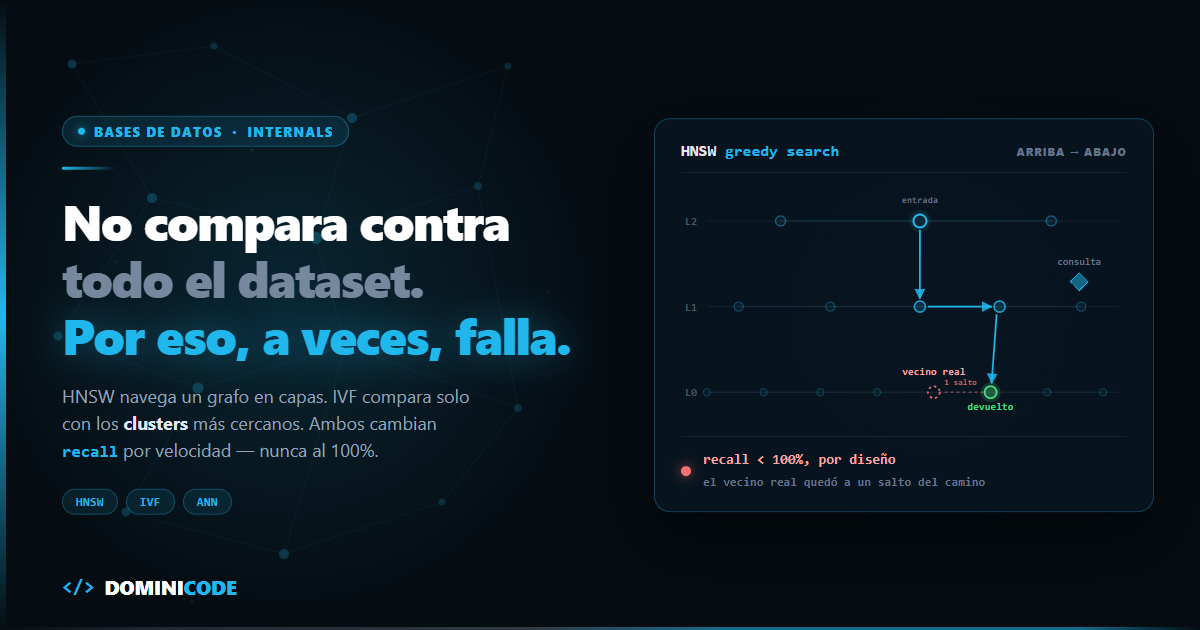
    Buscar es navegar de arriba a abajo: entras por un punto fijo en la capa superior, saltas al vecino más cercano hasta que ninguno mejora la distancia, y bajas una capa. Repites hasta la capa base, donde exploras un grupo más amplio y devuelves los k mejores. Es la lógica de una skip list: saltos largos para acercarte, cortos para afinar. Así el paper logra una complejidad de búsqueda cercana a logarítmica, no lineal.

    Y aquí el trato que nadie lee hasta que le muerde: HNSW hace ANN, no exact nearest neighbor. La navegación golosa —saltar siempre al vecino más próximo— puede quedarse en un óptimo local y devolver el segundo o tercer vecino real, no el primero. No es un bug: es el precio de no comparar contra todo.

    El parámetro que controla cuánto exploras en la capa base suele llamarse ef_search: más candidatos, más cerca del resultado exacto, más lenta la consulta. Cuántos vecinos conecta cada nodo se controla con m. No hay un valor universal para ninguno: depende de tu dataset.

    IVF: particionar el espacio en clusters

    IVF (Inverted File Index) agrupa los vectores en clusters —normalmente con k-means— y guarda, por cada cluster, la lista de vectores que le pertenecen. En la búsqueda comparas primero tu consulta contra los centroides, no contra los vectores, y solo entras en detalle dentro de los clusters más cercanos.

    El parámetro equivalente a ef_search aquí es nprobe (en pgvector, ivfflat.probes): cuántos clusters revisas por consulta. Con nprobe = 1 solo miras el más cercano, con riesgo real de que el vecino real esté en el cluster de al lado. Subir nprobe sube el recall y baja la velocidad — el mismo trade-off que en HNSW, con otro nombre.

    IVF suele pesar menos en memoria porque no guarda un grafo con punteros por vecino en cada capa. A cambio, un buen índice depende de que el k-means inicial refleje bien la forma real de tus datos.

    Qué métrica de distancia usar

    "Cerca" no significa lo mismo según qué mides:

    • Euclidiana (L2): distancia en línea recta. Sensible a la magnitud del vector.
    • Similitud coseno: mide el ángulo entre dos vectores, ignorando su magnitud.
    • Producto interno: combina ángulo y magnitud. Un vector más "largo" puede ganar aunque apunte peor.

    La trampa habitual: si tus embeddings están normalizados (magnitud = 1, lo que hacen muchos modelos por defecto), coseno y producto interno dan el mismo ranking, porque la magnitud es idéntica para todos. Ahí la elección es cuestión de coste computacional, no de cuál es "más correcta". Sin normalizar, euclidiana y coseno sí pueden ordenar distinto —revisa qué asume tu modelo antes de fijar la métrica.

    HNSW vs IVF, cara a cara

    Criterio HNSW IVF
    Velocidad de búsqueda Muy alta, escala cerca de forma logarítmica Alta, depende directamente de nprobe
    Memoria Mayor — grafo de vecinos en cada capa, más los vectores Menor — solo vectores agrupados por cluster
    Recall "de fábrica" Buena incluso con parámetros conservadores Depende mucho de clusters y nprobe
    Coste de construir el índice Alto — cada inserción busca y conecta vecinos Más barato — k-means inicial y asignación por vector
    Actualizaciones (insert/delete) Delicado — en pgvector las tuplas eliminadas quedan en el grafo hasta el VACUUM (issue #244) Más simple, aunque un cambio grande pide re-clusterizar
    Cuándo usarlo Cabe en memoria, latencia mínima consistente Datasets enormes donde la memoria manda

    Ninguno es "mejor" en abstracto: reparten distinto la memoria, la velocidad de construcción y el recall. Es justo el tipo de decisión de arquitectura que discutimos cada semana en Dominicode Labs, donde el trade-off cambia según el caso real, no según la benchmark del paper.

    El trade-off que gobierna todo

    Todo parámetro de un índice ANN —ef_search, m, nprobe, el número de clusters— mueve el mismo dial en direcciones opuestas. Explorar más candidatos sube el recall y sube la latencia. Un grafo más denso o más clusters mejoran la búsqueda, y pesan más en memoria y tardan más en construirse.

    No hay un valor correcto en general para ningún vector database: depende de tu dataset, tu distribución de consultas y cuánta latencia puedes pagar. Sin conocer tu caso, cualquier número es solo un punto de partida para medir tú mismo.

    El how-to práctico de montar búsqueda híbrida con embeddings en Supabase entra en el paso a paso de producción. Este post es el mecanismo de por qué esos números existen.

    Cuándo un vector database NO es la respuesta

    Para filtros exactos y booleanos sigue haciendo falta un índice tradicional. "Dame los documentos del usuario 4821 publicados después del 1 de marzo" no es una pregunta de similitud, es de igualdad y rango, y un B-tree la resuelve mejor. Casi todo motor serio combina ambos.

    ANN nunca garantiza el resultado exacto, ni con parámetros altos. Es la consecuencia directa de no comparar contra todo el dataset: HNSW puede quedarse en un óptimo local, IVF puede dejar el vecino real fuera de los clusters revisados. Sube ef_search o nprobe todo lo que quieras, seguirá siendo una apuesta, no una garantía.

    Reindexar a escala no es gratis. Un HNSW con millones de vectores tarda en construirse, y si tu pipeline lo reconstruye en cada actualización, ese coste se paga en cada despliegue. Es justo lo que describe el hilo de "The Case Against PGVector" en Hacker News: construir el índice puede consumir más de 10 GB de RAM durante horas, y mantenerlo sincronizado con inserciones continuas complica el pipeline entero. El issue de pgvector sobre tuplas muertas es el mismo problema desde otro ángulo.

    Con poco volumen, la fuerza bruta gana. Con unos pocos miles de vectores, mantener un índice ANN puede costar más que comparar contra todo. Mide antes de asumir que necesitas HNSW.

    Qué hacer con esto hoy

    Si tienes un RAG o un agente con búsqueda vectorial en producción, ve a la configuración del índice ahora. Busca ef_search, nprobe o el equivalente en tu motor. Si está en el valor por defecto y nadie lo ha tocado, ese es tu primer sospechoso la próxima vez que un resultado "obvio" no aparezca.

    Y si ese índice te lo montó un agente de IA sin que nadie revisara qué parámetros eligió, ese es el tipo de decisión silenciosa que cubro en el ebook gratuito Revisión por Contrato: límites explícitos a lo que un agente decide por ti sin que lo notes.

    Entender el mecanismo no te ahorra elegir los parámetros, pero deja de sorprenderte que la búsqueda sea aproximada: elegiste velocidad sobre fuerza bruta.

    Si estás construyendo el sistema completo —agente, ingestión, capa de recuperación—, es la decisión de arquitectura que trabajamos en el curso Construye con IA. Y si todavía dudas entre montar un vector database o resolverlo de otra forma, en RAG vs fine-tuning vs contexto: cuándo usar cada uno explico cuándo compensa cada camino.

    Preguntas frecuentes

    ¿Qué es un índice HNSW?

    Un grafo en varias capas que organiza los vectores para no compararlos todos contra todos. La capa superior tiene pocos nodos con conexiones largas; hacia abajo hay más nodos y conexiones más cortas, hasta la capa base con todos los vectores. Del paper original de Malkov y Yashunin (arXiv:1603.09320).

    ¿Por qué la búsqueda vectorial a veces no encuentra el resultado "correcto"?

    Porque HNSW e IVF son índices de approximate nearest neighbor: sacrifican precisión por velocidad. HNSW puede quedarse en un óptimo local; IVF puede dejar el vecino real en un cluster no revisado. No es un fallo, es la consecuencia de no comparar contra todo el dataset.

    ¿Qué métrica de distancia debo usar: coseno, euclidiana o producto interno?

    Con embeddings normalizados (magnitud 1), coseno y producto interno dan el mismo ranking: la elección es cuestión de coste computacional. Sin normalizar, euclidiana y coseno pueden ordenar distinto porque uno considera la magnitud y el otro la ignora.

    ¿Un vector database sustituye a mi base de datos relacional?

    No. Para filtros exactos o por rango —igualdad, fechas, IDs— un índice tradicional sigue siendo más rápido. La mayoría de los sistemas en producción combinan ambos: filtran con índices relacionales y comparan por similitud dentro de ese subconjunto.

    ¿Cuándo compensa usar fuerza bruta en vez de HNSW o IVF?

    Con datasets pequeños —unos pocos miles de vectores— mantener un índice ANN puede costar más que comparar contra todos directamente. La fuerza bruta es O(n) por consulta, pero exacta y sin parámetros que ajustar.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
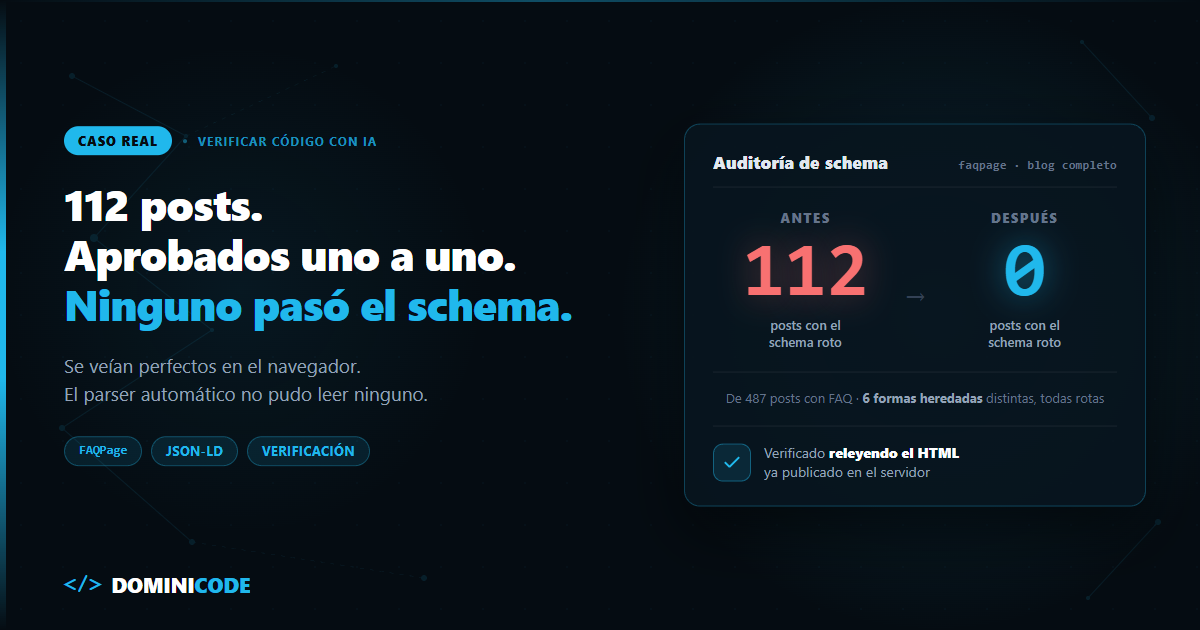
  • Qué delegué a un agente de IA (y qué audité línea por línea)

    Qué delegué a un agente de IA (y qué audité línea por línea)

    Martes por la noche dejo un agente generando cuarenta y dos thumbnails para posts antiguos: prompt, imagen, nombre de archivo, carpeta correcta. Es de las tareas más fáciles de delegar a un agente de IA que tengo: patrón repetido, blast radius bajo, nadie la ve hasta que yo la reviso. Me voy a dormir sin abrir ni una carpeta.

    Miércoles tengo otro agente con el email del próximo lanzamiento montado en MailerLite: asunto, enlaces con UTM, la lista completa como destino. Solo falta el clic de "Enviar ahora". Con el cursor encima del botón, estoy a punto de aprobarlo con la misma mano suelta con la que aprobé los thumbnails el día anterior.

    No lo hago. Releo el asunto: el precio es el de la semana pasada, subió el martes y el agente trabajó con el contexto que tenía guardado. Si sale así, miles de bandejas reciben una cifra que ya no es verdad.

    Misma semana, misma herramienta —Claude Code—, dos posturas distintas frente al mismo tipo de trabajo. De eso va este post.

    En corto: delego a un agente de IA sin supervisión estrecha cuando el error es barato, reversible y fácil de detectar —thumbnails, primer borrador, research, formateo de archivos con patrón claro—. Audito línea por línea cualquier cosa que toque producción real: publicar, hacer commit o push, tocar dinero, o mandar un email a toda la lista. El criterio no es "confío en el agente": es cuánto cuesta que salga mal comparado con cuánto cuesta verificarlo antes de que salga.


    ¿Qué es el blast radius de una tarea delegada a un agente de IA?

    El blast radius de una tarea delegada a un agente es cuánto daño hace si sale mal, multiplicado por cuánta gente o cuánto dinero toca antes de que alguien lo note. No mide qué tan bueno es el modelo. Mide el sistema alrededor: qué tan fácil es deshacer lo que hizo y qué tan rápido te enteras si lo hizo mal.

    Renombrar cuarenta y dos imágenes tiene blast radius casi cero: si un nombre sale mal, lo veo al abrir la carpeta y lo arreglo en diez segundos. Mandar un email a toda la lista tiene blast radius alto: si el asunto está mal, ya salió, no hay deshacer.

    Trabajo solo en Dominicode, sin nadie que revise detrás de mí. Cada tarea que delego sin mirar es una tarea que, si falla, la descubro yo tarde, o la descubre el lector. Esa asimetría fija la frontera.

    Lo que audito siempre, sin excepción

    El email del miércoles no fue un accidente: es la categoría completa donde nunca delego la revisión, pase lo que pase el resto de la semana. Cualquier acción que toque producción real, dinero o algo irreversible.

    Ahí entra publicar en WordPress —el agente solo puede dejar el post en draft, nunca en publish—. Entra hacer commit y push a una rama compartida. Entra cualquier cifra de facturación o de precio. Y entra, desde esta semana, cualquier email a la lista completa sin que yo lea la última línea con los ojos abiertos.

    El agente no mintió: trabajó con el contexto que tenía. El precio cambió después del borrador y nadie le avisó. Eso no se arregla con "mejor prompt" — se arregla con un humano revisando antes de que salga, siempre. El método completo —contrato, carril y veredicto— lo dejo entero y gratis en el ebook Revisión por Contrato.

    Mi semana real: qué se delega y qué se audita

    Tarea Postura Blast radius Reversibilidad
    Generar thumbnails y portadas del blog Delego sin mirar Bajo — se ve al abrir la carpeta Total — se regenera con un comando
    Primer borrador de un post o guion Delego sin mirar Bajo — nadie lo lee hasta que yo lo apruebo Total — vive en un .md local
    Research y resumen de una discusión técnica Delego, verifico la fuente citada Bajo, y verificar el enlace cuesta un minuto Total
    Renombrar o formatear archivos con patrón repetido Delego sin mirar Bajo Alta — está versionado en git
    Commit y push Reviso el diff siempre Medio-alto — lo ve cualquiera que haga pull Media — revertir cuesta tiempo y ruido
    Publicar un post en WordPress Audito siempre; el agente solo deja draft Alto — lo ve el lector final Baja — un post mal publicado ya lo indexó Google
    Email de lanzamiento a toda la lista Audito línea por línea, incluidas cifras Muy alto — miles de bandejas de entrada Cero — no existe "deshacer enviar"
    Cualquier cosa que toque dinero o facturación Audito siempre, sin excepción Muy alto Depende del banco, no de mí
    Delegar sin gate automático (tests/tipos) que verifique el resultado No delego Alto, aunque no lo parece a simple vista Depende de si lo detectas a tiempo

    Esta tabla no es universal — cambia con tu stack. Si tu WordPress publica en directo sin pasar por borrador, esa fila sube dos puestos en tu lista de "auditar siempre". El criterio se traslada; los números, no.

    Es el flujo que enseño paso a paso en Construye con IA: cómo montar agentes que generan contenido, research y primeros borradores sin tener que mirar cada línea mientras trabajan. Si todavía no has montado uno, aquí explico cómo construir un agente de IA desde cero en 5 pasos.

    Lo que dice Hacker News cuando se discute esto mismo

    No soy el único con esta fricción. En mayo de 2026, un post de Simon Willison sobre dónde termina el vibe coding y empieza la ingeniería agéntica llegó a 787 puntos y más de 800 comentarios en Hacker News — casi todo el hilo discute esta frontera. Los comentarios citados abajo están traducidos del inglés; el enlace de cada uno lleva al original.

    Amber-chen lo resume en una frase que podría ser el resumen de este post:

    "La distinción entre 'vibe coding' e 'ingeniería agéntica' importa. La diferencia clave es si estás revisando y entendiendo el código que produce el agente. Cuando uso agentes para tareas no triviales, siempre reviso el diff antes de hacer commit — esa es la parte de ingeniería. El peligro es saltarse ese paso y confiar sin más en el resultado."

    arian_ apunta al problema real, que no es de habilidad sino de infraestructura:

    "La distancia entre 'vibe coding' e 'ingeniería agéntica' es la misma distancia entre pedirle a alguien que haga una tarea y poder demostrar que la hizo bien. Uno es intuición. El otro es rendición de cuentas. Seguimos construyendo agentes más potentes sin construir la infraestructura de auditoría para verificar qué hicieron de verdad."

    bhagyeshsp añade la pieza que falta: la distancia de responsabilidad entre quien produce el resultado y quien responde por él es lo que decide cuánto puedes soltar sin revisión. Cuanto más lejos estás de responder tú mismo por algo, menos deberías delegarlo sin mirar.

    No es cuestión de fe en el modelo. Es cuestión de quién responde si sale mal, y qué tan caro sale.

    El criterio, en tres preguntas — no en "cuánto confío"

    Cada vez que un agente termina una tarea, me hago tres preguntas, en este orden:

    1. ¿Cuál es el blast radius si esto sale mal? ¿Lo ve un archivo local o lo ve un lector, un cliente, un banco?
    2. ¿Es reversible? ¿Lo deshago en diez segundos o ya salió por la puerta?
    3. ¿Cuesta más verificarlo que hacerlo yo mismo? Si sí, delegar no ahorra nada — es teatro de productividad.

    La tercera es la que menos se hace la gente, y la más incómoda: hay tareas donde revisar línea por línea tarda casi lo mismo que hacerlas a mano. Ahí delegar no es progreso, es mover el trabajo de sitio y añadir riesgo encima. Por eso creo que el techo de los agentic systems no es la capacidad del modelo, sino el coste de verificar cada tarea.

    Cuándo NO delegar a un agente de IA

    Tres situaciones donde no delego sin mirar, aunque la tarea parezca sencilla:

    1. Cuando no hay un gate automático que verifique el resultado. Sin tests, sin tipos, sin criterios de aceptación que corran solos, no hay diferencia real entre dejar que un agente haga commit sin revisión y dejar que lo haga alguien el primer día en el puesto. Confianza sin verificación no es confianza, es esperanza.
    2. Cuando el error es barato de cometer pero caro o imposible de deshacer, aunque la probabilidad sea baja. Un email masivo, un post publicado, una cifra de facturación: la baja probabilidad no compensa un coste irreversible.
    3. Cuando el agente no tiene el contexto de negocio que cambió esta semana: un precio, una decisión editorial que solo existe en mi cabeza. Esto no se arregla con más contexto en el prompt — se arregla con un humano revisando antes de que la acción sea irreversible.

    Nada de esto es un argumento contra usar agentes. Es un argumento contra tratarlos todos igual.

    Qué hacer hoy con esto

    No necesitas una política de veinte páginas. Escribe, para las cinco tareas que más delegas esta semana, una columna de blast radius y una de reversibilidad. Las que salgan bajas en ambas, suéltalas del todo. Las que salgan altas en cualquiera de las dos, revísalas siempre, aunque el agente lleve un mes acertando.

    Si quieres ver cómo aplico esto cada semana en un negocio real que opero solo, sin equipo detrás que revise por mí, en Dominicode Labs comparto el criterio actualizado y los agentes concretos que uso para cada tarea.


    Preguntas frecuentes

    ¿Cómo decido qué tareas delegar a un agente de IA sin supervisión?

    Con tres preguntas: cuál es el blast radius si sale mal, si es reversible, y si verificarlo cuesta más que hacerlo tú mismo. Si el daño es bajo, se puede deshacer y verificar sale barato, delega sin mirar. Si cualquiera falla, revisa antes de que salga.

    ¿Qué es el blast radius aplicado a un agente de IA?

    Es cuánto daño hace una acción del agente si sale mal, multiplicado por cuánta gente o cuánto dinero toca antes de que alguien lo note. No mide la capacidad del modelo: mide el sistema alrededor, qué tan fácil es deshacer el error y qué tan rápido te enteras.

    ¿Puedo dejar que un agente de IA haga commit o push directamente a producción?

    No sin un gate automático que verifique el resultado antes —tests, tipos, criterios de aceptación—. Sin eso, un push sin revisión es como dejarlo hacer a alguien el primer día en el puesto: puede salir bien, pero no lo sabes hasta que ya pasó.

    ¿Qué diferencia hay entre vibe coding e ingeniería agéntica, según Hacker News?

    Según el hilo que generó el post de Simon Willison, la diferencia no está en la herramienta ni en el modelo: está en si revisas y entiendes lo que el agente produjo antes de aceptarlo. Vibe coding es confiar sin mirar. Ingeniería agéntica añade la disciplina de revisar el diff y responder por él.

    ¿Delegar a un agente de IA ahorra tiempo real si después tengo que revisarlo?

    Depende de cuánto tarde la revisión frente a hacer la tarea tú mismo. Si verificar te lleva casi lo mismo que escribirlo de cero, delegar no ahorra tiempo: mueve el trabajo y añade el riesgo de confiar de más porque "las últimas veces salió bien".


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
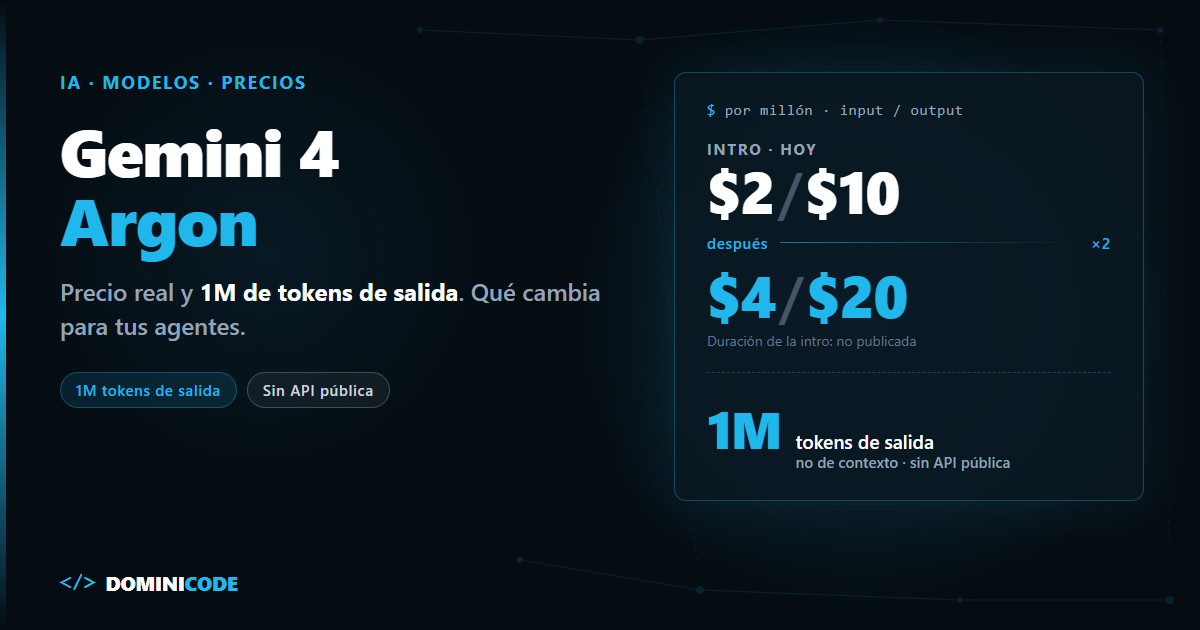
  • npm install es un acto de fe: cómo auditar tus dependencias

    npm install es un acto de fe: cómo auditar tus dependencias

    El viernes pasado revisé el package-lock.json de un proyecto Next.js de un cliente. 34 dependencias directas en el package.json. Corrí npm ls --all y conté los paquetes reales instalados en node_modules.

    1.847.

    Ninguno de esos 1.813 paquetes "extra" lo instalé yo a propósito. Los trajo alguien más, en algún punto de la cadena, sin que yo lo decidiera ni lo viera venir. Y cada uno tuvo la oportunidad de ejecutar código en mi máquina en el momento exacto en que corrí npm install.

    Eso es lo que nadie te explica: auditar dependencias de un proyecto no es un extra de seguridad corporativa. Es lo único que se interpone entre tu máquina y un supply chain attack real, hoy, en el registro que uses.

    En corto: auditar dependencias de un proyecto significa revisar qué código de terceros se ejecuta cuando instalas o construyes tu app — no solo si tiene vulnerabilidades conocidas en una base de datos. Un supply chain attack en npm o pip no ataca tu código: compromete un paquete del que dependes y usa tu propio npm install o pip install como vector de entrada.

    La defensa combina lockfiles con versiones exactas, revisión de scripts de instalación y herramientas de auditoría automatizada — ninguna de las tres por separado basta.

    ¿Qué es un supply chain attack en dependencias de software?

    Un supply chain attack de dependencias es un ataque que no compromete tu aplicación directamente, sino un paquete de terceros que tu aplicación instala, para que el código malicioso llegue a producción disfrazado de una actualización legítima.

    No hace falta que un atacante encuentre un fallo en tu código. Le basta con comprometer una cuenta de npm, publicar una versión maliciosa de un paquete popular, y esperar a que miles de proyectos corran npm install esa semana.

    El vector es el propio gestor de paquetes. npm install y pip install no solo copian archivos: ejecutan código. En npm, cualquier paquete puede declarar un script postinstall en su package.json que corre automáticamente, sin preguntar, apenas termina la instalación.

    En pip, cuando instalas desde una distribución fuente (sdist) en lugar de un wheel precompilado, se ejecuta código de build arbitrario durante el propio pip install — el clásico setup.py, o el hook de un backend moderno como flit_core, hatchling o poetry-core si el paquete usa pyproject.toml.

    Dos incidentes reales que conviene conocer

    No es teórico. Esto ya pasó, más de una vez, en el ecosistema que probablemente usas hoy.

    El 23 de septiembre de 2025, CISA publicó una alerta sobre "Shai-Hulud", un gusano autorreplicante que comprometió más de 500 paquetes de npm.

    El malware escaneaba el entorno en busca de tokens de GitHub y credenciales de AWS, GCP y Azure, las exfiltraba a repositorios públicos controlados por el atacante, y usaba las cuentas de mantenedores comprometidas para inyectarse en más paquetes — sin intervención humana en cada salto. Meses después, una variante llamada "Shai-Hulud 2.0" amplió el radio de impacto a decenas de miles de repositorios de GitHub.

    En octubre de 2021, alguien secuestró la cuenta npm del mantenedor de ua-parser-js, una librería con más de 8 millones de descargas semanales, y publicó versiones que instalaban un minero de criptomonedas y un troyano que robaba contraseñas de navegadores.

    El propio mantenedor documentó el incidente en vivo en el issue de GitHub — vale la pena leerlo para ver cuánto pánico genera algo así cuando ya es tarde.

    Y aunque no es un paquete de npm ni de pip, el caso de xz-utils (marzo de 2024, CVE-2024-3094) es la referencia obligada del ecosistema open source en general.

    Un atacante bajo el alias "Jia Tan" pasó casi tres años construyendo reputación como colaborador legítimo antes de insertar un backdoor en una librería de compresión usada por millones de servidores Linux. Lo descubrió un ingeniero, Andres Freund, porque notó que SSH tardaba casi el triple de lo normal en conectar —0,8 segundos en vez de 0,3—. Nadie lo detectó por auditoría automática.

    Señales de alerta en un paquete

    No todas las dependencias merecen el mismo nivel de escrutinio. Estas son las señales que sí justifican parar y mirar más de cerca:

    Señal Por qué importa Cómo comprobarlo
    Pocas descargas semanales pero pide permisos amplios (red, sistema de archivos) Paquete de bajo perfil es más fácil de comprometer sin que nadie lo note curl https://api.npmjs.org/downloads/point/last-week/<paquete> o npmtrends.com
    Cambio reciente de mantenedor o de email de contacto Precede a la mayoría de los secuestros de cuenta documentados (caso ua-parser-js, event-stream) Historial de mantenedores en npmjs.com o PyPI
    Script postinstall que descarga binarios de una URL externa Ejecuta código fuera del propio paquete, sin pasar por revisión de npm/PyPI Leer scripts.postinstall en el package.json publicado
    Código minificado en el paquete publicado que no existe en el repo de GitHub El repo público sirve de fachada; el código real vive solo en el tarball Comparar npm pack del paquete contra el código fuente en GitHub
    Salto de versión sin changelog ni commits nuevos Publicación fuera del ciclo normal, típica de una cuenta comprometida Fecha de publicación en npm/PyPI vs. último commit en GitHub
    Nombre casi idéntico a un paquete popular (reqeusts en vez de requests) Typosquatting: apuesta a que alguien escriba mal el nombre Verificar el nombre exacto antes de instalar, no solo el autocompletado

    Lockfiles: por qué ^ y ~ no protegen a nadie

    Un lockfile (package-lock.json, pnpm-lock.yaml, poetry.lock, o requirements.txt generado con hashes) fija la versión exacta de cada dependencia, directa y transitiva, que se instaló la última vez que corriste el instalador.

    El problema está en el package.json. Si declaras una dependencia como ^4.2.1, npm puede instalar cualquier versión 4.x.x posterior sin que tú lo pidas explícitamente. Con ~4.2.1 acepta cualquier parche 4.2.x. Ambos rangos existen para facilitarte la vida — y ambos significan que una versión comprometida publicada hoy puede entrar en tu build mañana, sin que cambies una sola línea de código.

    El lockfile resuelve esto solo si lo respetas. npm install puede actualizar el lockfile si detecta que hay versiones nuevas dentro del rango permitido. npm ci, en cambio, instala exactamente lo que dice el lockfile y falla si no coincide con el package.json — es el comando correcto para CI/CD, no npm install.

    En pip, el equivalente es fijar versiones exactas en requirements.txt (requests==2.31.0, no requests>=2.31.0) y, si quieres ir un paso más allá, generar hashes con pip-compile --generate-hashes para que pip install rechace un paquete si el hash no coincide con el que fijaste. Poetry hace esto por defecto con poetry.lock.

    No es casualidad que la alerta de CISA sobre Shai-Hulud recomendara explícitamente revisar package-lock.json y fijar versiones anteriores al 16 de septiembre de 2025. El lockfile fue, literalmente, el mecanismo de contención.

    El riesgo real de los scripts de instalación

    Un script postinstall en npm corre con los mismos permisos que tu usuario del sistema. Puede leer tu .env, tus llaves SSH, tus credenciales de AWS guardadas en ~/.aws/credentials, y enviarlas a donde quiera — exactamente lo que hizo Shai-Hulud.

    Puedes desactivarlos con npm install --ignore-scripts. La contrapartida: algunos paquetes legítimos (compiladores nativos, binarios de Electron) sí necesitan su postinstall para funcionar, así que desactivarlo a ciegas en todos lados puede romper el build. Úsalo como paso de auditoría — instala con --ignore-scripts, revisa qué scripts se habrían ejecutado, y decide caso por caso.

    En pip el riesgo tiene otra forma. Si el paquete se instala desde un wheel precompilado, no se ejecuta código arbitrario: es una copia de archivos. Si se instala desde una distribución fuente (sdist), pip ejecuta setup.py como Python real durante la instalación. La mitigación más simple es forzar wheels con pip install --only-binary=:all: cuando el paquete lo permita, y mirar con lupa cualquier dependencia que solo publique sdist.

    Herramientas para auditar, sin inventar magia

    Ninguna herramienta automática sustituye la lectura humana de un postinstall sospechoso, pero sin ellas no auditas nada a escala. Estas cuatro son reales y verificables, sin funciones inventadas:

    • npm audit y pnpm audit comparan tus dependencias contra bases de datos de vulnerabilidades conocidas (CVE) y te dicen si hay una versión con parche disponible.
    • pip-audit, mantenido por la Python Packaging Authority, hace lo mismo para proyectos Python contra la base de datos OSV.
    • Socket.dev va más allá de las CVE conocidas: analiza el comportamiento del paquete — si tiene scripts de instalación, si hace llamadas de red, si accede a archivos sensibles, si el código está ofuscado — y da una puntuación de riesgo antes de que el CVE exista siquiera.
    • Snyk combina escaneo de vulnerabilidades con monitoreo continuo y se integra directamente en el flujo de PR de GitHub.

    Ninguna de estas herramientas detecta un ataque de tipo Shai-Hulud el mismo día. Todas dependen de que alguien, en algún punto, reporte el paquete malicioso primero.

    Checklist: auditar un proyecto real en menos de una hora

    1. Corre npm audit o pip-audit sobre el proyecto completo. Anota las vulnerabilidades críticas y altas — no todas, esas.
    2. Revisa el package.json o requirements.txt buscando rangos ^, ~ o >= en dependencias que no necesiten actualizarse automáticamente. Fíjalas a versión exacta.
    3. Confirma que el CI usa npm ci, no npm install. Es un cambio de una línea con impacto real.
    4. Lista los paquetes con postinstall (npm ls no lo muestra directo; revisa el package.json de cada dependencia sospechosa en node_modules, o usa Socket.dev para verlo agregado).
    5. Verifica cuándo se actualizó cada dependencia crítica por última vez y si el mantenedor cambió recientemente — la tabla de señales de arriba te dice dónde mirar.
    6. Si el proyecto usa un agente de IA para instalar dependencias (Cursor, Claude Code, Copilot en modo agéntico), revisa el diff del package.json antes de aceptar el commit. Un agente puede instalar un paquete typosquateado con la misma confianza que uno legítimo si el nombre es parecido.

    Ese último punto es donde converge el problema técnico con el flujo de trabajo actual. Si dejas que un agente proponga e instale dependencias sin revisión, necesitas el mismo nivel de disciplina que aplicarías a un PR de un desarrollador que no conoces — es literalmente la lógica que enseño en el ebook gratuito "Revisión por Contrato": no confías en el resultado porque "suena bien", confías en él porque pasó un contrato de revisión explícito.

    Es también una cuestión de coste: revisar el diff de un package.json antes de aceptarlo cuesta minutos; limpiar un supply chain attack ya en producción cuesta muchísimo más. Desarrollo esa cuenta —cuándo compensa verificar y cuándo no— en El futuro de los agentic systems: coste por tarea, no benchmarks.

    El caso específico de dependencias de IA

    Todo lo anterior aplica a cualquier paquete, pero los modelos de IA tienen una superficie de riesgo propia: from_pretrained(), load_dataset() y hf_hub_download() descargan pesos y datasets de gigabytes desde un hub externo, muchas veces sin pasar por tu lockfile ni por npm audit.

    Ya escribí sobre ese caso específico — qué cambia con Hugging Face bajo NVIDIA, por qué fijar un commit SHA no es opcional cuando hablamos de modelos, y el checklist de 5 pasos para auditarlo — en NVIDIA compra Hugging Face: tu from_pretrained() es el riesgo. Si tu proyecto carga modelos en runtime, léelo después de este.

    Qué esta auditoría NO cubre

    Esta auditoría tiene tres límites reales, y ser honesto aquí importa más que sonar completo.

    npm audit y pip-audit solo detectan vulnerabilidades ya reportadas. Un paquete recién comprometido, como Shai-Hulud el primer día, no aparece en ninguna base de datos hasta que alguien lo reporta — y eso puede tardar horas o días, tiempo suficiente para que el código malicioso corra en cientos de builds.

    El código ofuscado bien hecho pasa controles automáticos. Herramientas como Socket.dev mejoran mucho la detección de comportamiento sospechoso, pero un atacante paciente (como demostró el caso xz-utils) puede esconder la parte maliciosa en binarios de test que ni siquiera están en el repositorio público, y ningún escáner estático la va a encontrar si no sabe qué buscar.

    Y esta auditoría no resuelve el problema humano de fondo: alguien tiene que revisar los resultados. Un npm audit limpio en un dashboard que nadie mira no protege nada.

    Qué hacer hoy con esto

    No necesitas auditar los 1.847 paquetes de tu node_modules esta semana. Necesitas tres cosas, en este orden: fija las versiones de tus dependencias directas, cambia npm install por npm ci en tu pipeline de CI, y corre npm audit o pip-audit una vez antes de tu próximo deploy.

    Eso te cubre contra el 80% de los incidentes reales — el resto es disciplina continua, no una tarea de una sola vez. Si construyes con agentes de IA y quieres que esa disciplina esté integrada en tu flujo desde el primer prompt, es exactamente lo que trabajamos en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si quieres seguir esta conversación con otros developers que ya están aplicando esto en producción, en Dominicode Labs compartimos los checklists y las decisiones reales de auditoría, no solo la teoría.

    Preguntas frecuentes

    ¿Qué es un supply chain attack en el contexto de npm o pip?

    Es un ataque que compromete un paquete del que depende tu proyecto — no tu código directamente — para que el código malicioso llegue a tu máquina o a producción disfrazado de una instalación o actualización legítima. El vector de entrada es tu propio npm install o pip install.

    ¿Un lockfile me protege completamente contra estos ataques?

    No completamente, pero reduce mucho el riesgo. Un lockfile fija versiones exactas y evita que una actualización automática dentro de un rango ^ o ~ traiga una versión comprometida sin que tú lo notes. No te protege si tú mismo actualizas el lockfile aceptando la versión maliciosa, ni si la dependencia ya estaba comprometida antes de que la instalaras por primera vez.

    ¿Es seguro desactivar todos los scripts postinstall con –ignore-scripts?

    Reduce el riesgo de ejecución de código no revisado, pero puede romper paquetes legítimos que necesitan compilar binarios nativos o descargar assets en la instalación. Úsalo primero como herramienta de auditoría para ver qué scripts se ejecutarían, y decide caso por caso antes de dejarlo activo en producción de forma permanente.

    ¿npm audit o pip-audit son suficientes para considerar un proyecto auditado?

    No. Ambos solo detectan vulnerabilidades ya reportadas en una base de datos pública. Un paquete recién comprometido, sin CVE asignado todavía, pasa desapercibido para estas herramientas. Complementan una auditoría real; no la sustituyen.

    ¿Cómo audito las dependencias de modelos de IA como Hugging Face de forma distinta?

    Los modelos se descargan en runtime con funciones como from_pretrained(), muchas veces fuera del alcance de tu lockfile y de npm audit. El enfoque es distinto: fijar el commit SHA del modelo, activar modo offline para detectar descargas implícitas, y espejar localmente lo crítico. Lo cubro con checklist completo en el post sobre NVIDIA y Hugging Face.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
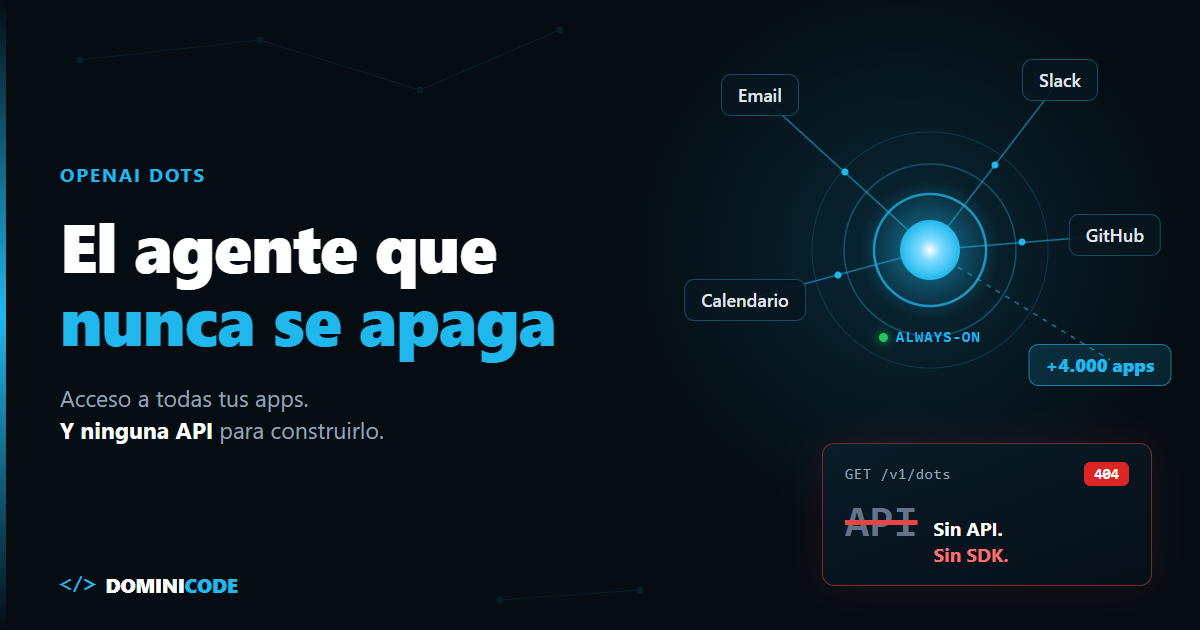
  • GPT-6 Sol y Luna: el precio por token es la mitad de la factura

    GPT-6 Sol y Luna: el precio por token es la mitad de la factura

    El martes 22 de septiembre de 2026 Anthropic sacó Claude Opus 5.5 con un recorte del 20%. Horas después, OpenAI respondió con GPT-6 Sol y Luna, dos modelos a mitad de precio que sus equivalentes GPT-5.6.

    Mi primer impulso fue el de todo el mundo: abrir el .env, cambiar el nombre del modelo y apuntarme el ahorro. Una línea, la mitad de factura.

    Luego me acordé de un post que escribí hace poco. Gemini 3.8 Flash mantuvo el precio por token y aun así la factura subió un 40%. El precio de la tarifa y lo que acabas pagando no son lo mismo.

    Con GPT-6 el recorte de los titulares te ahorra menos que dos decisiones de diseño que no salen en ninguna nota de prensa.

    En corto: GPT-6 Sol ($2/$10 por millón de tokens) y Luna ($0.10/$0.50) cuestan la mitad que GPT-5.6, pero en un agente lo que más mueve la factura es la caché: si el 90% del input de cada llamada sale de la caché, cada llamada a Sol cuesta un 71% menos que sin ella. La otra palanca es el routing: Luna cuesta exactamente 1/20 de Sol en cada tarifa, así que la extracción y la clasificación deberían ir a Luna.

    Precio de GPT-6 Sol y Luna frente a Claude Opus 5.5

    GPT-6 Sol cuesta $2 por millón de tokens de input y $10 de output; Luna, $0.10 y $0.50; Claude Opus 5.5, $4 y $20. Datos de las fichas oficiales de GPT-6 Sol, GPT-6 Luna y la página de precios de Anthropic.

    GPT-6 Sol GPT-6 Luna Claude Opus 5.5
    Input (por M) $2 $0.10 $4
    Input cacheado (por M) $0.20 $0.01 $0.20
    Escritura de caché (por M) $2.50 $0.125 (1,25× input) $5 (caché de 5 min)
    Output (por M) $10 $0.50 $20
    Para qué Coding, agentes, planificación Extracción, clasificación, resúmenes en volumen Briefs complejos donde la fidelidad manda
    Limitación / riesgo Menos fiel que Opus en briefs ricos; recargo por encima de 272K tokens de input Pierde ~45 Elo en AA-Briefcase: entregables que omiten partes de la rúbrica El doble que Sol por token; en tareas largas, mucho más lento

    Fíjate en la fila del input cacheado. Sol y Opus 5.5 cobran lo mismo: $0.20. En un agente donde casi todo el input sale de la caché, la diferencia de "la mitad de precio" se estrecha bastante.

    La fila de limitaciones no me la invento. Artificial Analysis midió que Luna cae unos 45 puntos Elo en su benchmark de entregables, mientras Sol se mantiene. Y en la prueba de Gekkode con la misma escena 3D, ambos cumplieron los 13 requisitos. Pero Opus 5.5 fue más fiel al brief y tardó 38 minutos ($6.96), frente a los 5 minutos ($0.29) de Sol.

    ¿Qué es el prompt caching en GPT-6 y por qué manda en un agente?

    El prompt caching es la reutilización del prefijo idéntico de un prompt (instrucciones, definiciones de tools, historial) entre llamadas: el proveedor no lo vuelve a procesar y te lo cobra con descuento, que en GPT-6 es del 90% sobre el input.

    Un agente reenvía todo el contexto en cada turno. Si empieza siempre igual, pagas tarifa de caché. Si cambia un token al principio, pagas todo otra vez. El mecanismo es el mismo que expliqué en prompt caching en la API de Claude; lo que cambia en GPT-6 son las tarifas y las reglas que invalidan la caché.

    En el hilo de Hacker News del lanzamiento (más de 850 comentarios) lo resumió alguien que tiene agentes de negocio en producción. El usuario MitziMoto escribió: "Cache reads are so heavy compared to anything else that it's the only price point that really matters, regular input and output are negligible." Para su carga, la lectura de caché es el único precio que importa.

    El cálculo: el mismo agente con y sin caché

    Supuestos, para que puedas rehacerlo tú. Cada llamada del agente lleva 50.000 tokens de input: 45.000 son prefijo estable (instrucciones, tools, historial anterior) y 5.000 son nuevos (mensaje del usuario y resultado de tools). Devuelve 1.000 tokens de output. Hace 30.000 llamadas al mes.

    Con el 90% del input de cada llamada en caché, los 45.000 se leen a tarifa de caché y los 5.000 nuevos se escriben (en modo implícito, la guía de OpenAI indica que se escribe hasta el último mensaje) a 1,25× el input.

    Escenario GPT-6 Sol Claude Opus 5.5
    Sin caché, por llamada $0.110 $0.220
    90% del input cacheado, por llamada $0.0315 $0.054
    Sin caché, 30.000 llamadas/mes $3300 $6600
    90% del input cacheado, 30.000 llamadas/mes $945 $1620

    Las cuentas de Sol con caché: 45.000 × $0.20/M = $0.009, más 5.000 × $2.50/M = $0.0125, más 1.000 × $10/M = $0.010. Total, $0.0315. Frente a $0.110 sin caché: un 71% menos.

    Sin caché, Opus 5.5 cuesta exactamente el doble que Sol. Con caché, 1,71 veces ($0.054 / $0.0315). El "50% más barato" depende de cómo esté hecho tu agente.

    Y lo que más duele: si metes un timestamp al principio del system prompt, el prefijo cambia en cada llamada. En modo implícito escribes los 50.000 tokens cada vez a $2.50/M: $0.135 por llamada, $4050 al mes. Pagas un 23% más que sin caché. Un new Date() mal colocado se come el recorte de precio entero: pagas más que con GPT-5.6 bien cacheado.

    Ojo: los tokenizadores de Anthropic y OpenAI no cuentan igual; la columna de Opus asume los mismos tokens. Mide los tuyos como explico en cómo medir el consumo de tokens de un agente.

    Routing de modelos para agentes: GPT-6 Sol para pensar, Luna para procesar

    El routing de modelos en dos niveles consiste en decidir el modelo por tipo de tarea antes de llamar: un modelo capaz para planificar, programar y revisar, y uno barato para extraer, clasificar y resumir en volumen.

    Luna cuesta 1/20 de Sol en input, en input cacheado y en output. Una extracción de un solo turno con 3.000 tokens de prefijo cacheado, 1.000 de documento nuevo y 300 de salida (en modo explícito, con el breakpoint al final del prefijo, el documento se cobra a tarifa normal sin recargo de escritura) cuesta $0.0056 en Sol y $0.00028 en Luna. Un millón de extracciones: $5600 contra $280.

    Una regla de la guía de prompt caching de OpenAI cambia el diseño del router: cambiar de model invalida el prefijo cacheado, igual que cambiar las tools, el reasoning.effort o el text.verbosity. No alternes Sol y Luna en la misma conversación: enruta por tarea, cada una en su hilo.

    Este código usa la Responses API. Los campos prompt_cache_key, prompt_cache_options y prompt_cache_breakpoint salen de los ejemplos de esa guía, consultada el 27 de septiembre de 2026. Si tu SDK todavía no los tipa, van en el cuerpo JSON tal cual.

    type Task = 'plan' | 'code' | 'review' | 'extract' | 'classify' | 'summarize';
    type Model = 'gpt-6-sol' | 'gpt-6-luna';
    
    const ROUTES: Record<Task, Model> = {
      plan: 'gpt-6-sol',
      code: 'gpt-6-sol',
      review: 'gpt-6-sol',
      extract: 'gpt-6-luna',
      classify: 'gpt-6-luna',
      summarize: 'gpt-6-luna',
    };
    
    const SINGLE_TURN = new Set<Task>(['extract', 'classify', 'summarize']);
    
    // Estable: sin fechas, sin nombre de usuario, sin nada que cambie entre llamadas.
    const INSTRUCTIONS: Record<Task, string> = { /* un bloque fijo por tarea */ } as Record<Task, string>;
    const TOOLS = Object.freeze([/* mismas tools, mismo orden, siempre */]);
    
    type InputItem = Record<string, unknown>;
    
    export function buildRequest(task: Task, history: InputItem[], turn: string, sessionId: string) {
      return {
        model: ROUTES[task],
        prompt_cache_key: SINGLE_TURN.has(task) ? `${task}_v1` : `${task}_v1:${sessionId}`,
        prompt_cache_options: { mode: SINGLE_TURN.has(task) ? 'explicit' : 'implicit' },
        tools: TOOLS,
        input: [
          {
            role: 'developer',
            content: [
              {
                type: 'input_text',
                text: INSTRUCTIONS[task],
                prompt_cache_breakpoint: { mode: 'explicit' },
              },
            ],
          },
          ...history, // append-only: nunca se edita, reordena ni resume a mitad de sesión
          { role: 'developer', content: `Fecha actual: ${new Date().toISOString()}` }, // lo dinámico, al final — guárdalo en history junto al turno o la próxima llamada no reutiliza el historial
          { role: 'user', content: turn },
        ],
      };
    }
    

    Tres decisiones que importan más que el código:

    1. Lo dinámico va al final. La guía lo dice literal: las marcas de tiempo y el contenido de usuario, al final o en mensajes posteriores.
    2. El historial es append-only. Si compactas o reescribes turnos antiguos, rompes el prefijo desde ese punto. Eso incluye el mensaje con la fecha: si lo envías pero no lo guardas en el historial, la siguiente llamada deja de coincidir justo ahí.
    3. Mide el hit rate en cada respuesta. Divide usage.input_tokens_details.cached_tokens entre usage.input_tokens y alerta si baja. Vigila también cache_write_tokens: si en cada llamada escribes casi todo el input, algo cambia al principio del prompt. OpenAI ha sacado un dashboard de caché y una herramienta de diagnóstico de fallos, pero tu propio log te avisa antes.

    La salida de Luna en extracción no te la creas sin más. Valídala con un schema y, si falla, reintenta esa tarea en Sol, en un hilo nuevo. Es el mismo patrón de fallback que conté en Opus 5.5, rechazos y fallback en producción. Para el schema uso Zod: tipas y validas en una sola pieza, como enseño en el curso de Zod.

    Límites: cuándo NO usar Luna, ni Sol, ni este router

    Luna no sirve para entregables largos. La caída de ~45 Elo en AA-Briefcase viene, según Artificial Analysis, de entregables que se saltan elementos de la rúbrica. Si la tarea es "redacta el informe completo", Luna ahorra en tokens y te lo cobra en revisiones.

    Sol y Luna tienen letra pequeña en Chat Completions. Sus fichas indican que ahí el function calling exige reasoning_effort en none. Si necesitas razonar y llamar tools a la vez, usa la Responses API.

    Sol no sustituye a Opus 5.5 cuando el brief es rico. Si un fallo de calidad te cuesta más que la diferencia de tokens, paga la diferencia.

    Contextos largos, tarifa distinta. Por encima de 272.000 tokens de input, Sol y Luna cobran el doble en input y caché y 1,5× en output, y lo aplican a toda la petición. Es el mismo asterisco de los 272.000 tokens de GPT-6 Astra.

    El router no arregla un agente mal medido. Si no sabes cuánto cuesta cada tarea terminada y aceptada, no sabes si Luna te ahorra o te obliga a repetir trabajo. Artificial Analysis lo mide por tarea, no por token: Sol a $1.06 por tarea en su índice y Luna a $0.07. Esa es la unidad que importa.

    Lo que puedes hacer hoy

    Abre el log de tu agente y calcula una sola cifra: tokens cacheados entre tokens de input totales, en la última semana. Si baja del 80%, busca qué cambia al principio del prompt antes de pensar en cambiar de modelo. Casi siempre es una fecha, un ID o unas tools que se reordenan.

    Con esa cifra alta, manda las tareas mecánicas a Luna con validación. En ese orden.

    Este diseño, en el que el programa decide qué va a cada modelo y el modelo solo decide dentro de su tarea, es el que desarrollo en El Developer Agéntico, el ebook gratuito de Dominicode. Y si quieres montar el agente completo, de la idea al producto, está en el curso Construye con IA.

    Preguntas frecuentes

    ¿Cuánto cuestan GPT-6 Sol y GPT-6 Luna?

    GPT-6 Sol cuesta $2 por millón de tokens de input, $0.20 de input cacheado y $10 de output. GPT-6 Luna cuesta $0.10, $0.01 y $0.50. Los dos son la mitad o menos que GPT-5.6, y por encima de 272.000 tokens de input se aplica recargo.

    ¿GPT-6 Sol es más barato que Claude Opus 5.5?

    Por token, sí: la mitad en input y output. Pero los dos cobran $0.20 por millón en input cacheado, así que en un agente con mucha caché la diferencia baja. En el cálculo del post, de 2× sin caché a 1,71× con el 90% del input cacheado.

    ¿Puedo cambiar entre Sol y Luna en la misma conversación?

    Puedes, pero pierdes la caché. La guía de OpenAI indica que cambiar el modelo invalida el prefijo cacheado. Enruta por tarea, con un hilo por tarea, en lugar de alternar modelos dentro del mismo hilo.

    ¿Qué rompe la caché de prompts en GPT-6?

    Cualquier cambio en el prefijo: un timestamp o un dato de usuario al principio, tools que cambian de orden o de descripción, o un cambio de reasoning.effort o text.verbosity en la petición. Para cambiar el esfuerzo de razonamiento sin romperla, la guía propone añadir un elemento configuration_update al input.

    ¿Para qué tareas conviene GPT-6 Luna?

    Para trabajo acotado y en volumen: extracción, clasificación, resúmenes cortos. Valida su salida con un schema y escala a Sol lo que no pase. Evítalo en entregables largos con muchos requisitos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.