Tag: AI

  • Destilación de modelos LLM: qué es y cuándo ahorra 51 veces

    Destilación de modelos LLM: qué es y cuándo ahorra 51 veces

    En mayo me pasaron la factura de OpenAI de una empresa de soporte. 1.600 $ al mes.

    Fui a ver en qué se gastaba. No era un agente sofisticado: era un clasificador de tickets. Llega un mensaje, el modelo decide si es facturación, bug, acceso o feature, le pone prioridad y marca si necesita un humano.

    Doscientos mil tickets al mes por el modelo más caro que tenían en producción. Acertaba el 96 %, pero pagaban precio de razonamiento frontera por una tarea de cinco respuestas.

    Llevaban seis meses regalando el mejor argumento a favor de la destilación de modelos: el modelo caro ya había resuelto ese problema doscientas mil veces, y esas respuestas se borraban cada noche.

    En corto: la destilación de modelos consiste en usar las salidas de un modelo grande (teacher) como datos de entrenamiento para uno pequeño (student). El pequeño reproduce su comportamiento en una tarea concreta a una fracción del coste. Gana cuando la tarea es estrecha, repetitiva y de alto volumen; pierde en cuanto la tarea cambia o necesita generalizar fuera de lo que viste al construir el dataset.


    ¿Qué es la destilación de modelos?

    La destilación de modelos (model distillation) es entrenar un modelo pequeño —el student— para que imite el comportamiento de uno grande —el teacher— en una tarea específica, usando como dataset las respuestas que el grande ya ha generado.

    La idea tiene once años y viene de Hinton, Vinyals y Dean (2015), que la propusieron para comprimir el conocimiento de un ensemble de redes en un único modelo desplegable. Lo que ha cambiado no es la técnica. Es que ahora el profesor cobra por token.

    El caso más visible son los DeepSeek-R1 distilled: cogieron 800.000 muestras curadas con R1 y con ellas hicieron fine-tuning supervisado de modelos base Qwen2.5 (1.5B a 32B) y Llama (8B y 70B). Sin refuerzo, solo SFT sobre las salidas del grande. El de 32B reporta 72,6 en AIME 2024 y 94,3 en MATH-500.

    Un modelo de 32B razonando cerca de uno de cientos de miles de millones de parámetros. Ese es el truco entero.


    Destilación no es fine-tuning, ni RAG, ni cuantización

    Destilación y fine-tuning clásico comparten mecanismo y se diferencian en quién pone las etiquetas: un modelo en la destilación, una persona en el fine-tuning. RAG no toca los pesos y la cuantización no cambia el comportamiento.

    Aquí es donde casi todo el mundo se lía, y es lo que decide si tu proyecto funciona. Las cinco técnicas suenan parecidas porque todas prometen "mejor o más barato", pero cada una toca una pieza distinta:

    Enfoque Qué modifica Coste real Cuándo gana Limitación / riesgo
    Prompt engineering El texto que envías Cero Siempre es el primer intento Pagas el prompt largo en cada llamada, para siempre
    RAG Lo que el modelo sabe al consultar Índice + tokens extra El conocimiento cambia a diario No enseña comportamiento, solo aporta datos; infla el contexto
    Fine-tuning clásico Los pesos, con etiquetas humanas El etiquetado humano Ya tienes histórico etiquetado fiable Casi nadie tiene esas etiquetas; producirlas cuesta meses
    Destilación Los pesos, con etiquetas de otro modelo Inferencia del teacher + entrenamiento Tarea estrecha, alto volumen, el grande acierta Heredas los errores del teacher; los ToS pueden prohibirlo
    Cuantización La precisión numérica de los pesos Minutos de CPU Quieres el mismo modelo en menos VRAM No mejora la tarea; pierde algo de calidad

    La distinción que importa: destilación y fine-tuning clásico son el mismo mecanismo con distinta procedencia de las etiquetas. Destilar es fine-tuning donde el etiquetador es una máquina que ya sabe hacerlo. Eso es lo que lo vuelve viable, porque el cuello de botella del fine-tuning nunca fue el entrenamiento: era conseguir diez mil ejemplos etiquetados de forma consistente.

    Y la que más confunde: la cuantización no es destilación. Cuantizar es coger ese mismo modelo y guardar sus pesos con menos bits. No hay profesor, ni alumno, ni dataset. Es compresión, no transferencia. Si lo que quieres es correr un modelo en tu máquina sin tocar su comportamiento, eso es cuantización, y va por la guía de modelos para correr en local.

    Escribí hace tiempo sobre cuándo usar RAG, fine-tuning o simplemente más contexto. La destilación es la cuarta opción de ese mismo debate, y la que menos gente considera, porque suena a paper. No lo es: OpenAI y AWS tienen botones para hacerlo.


    ¿Cuánto cuesta destilar un modelo y cuánto ahorra?

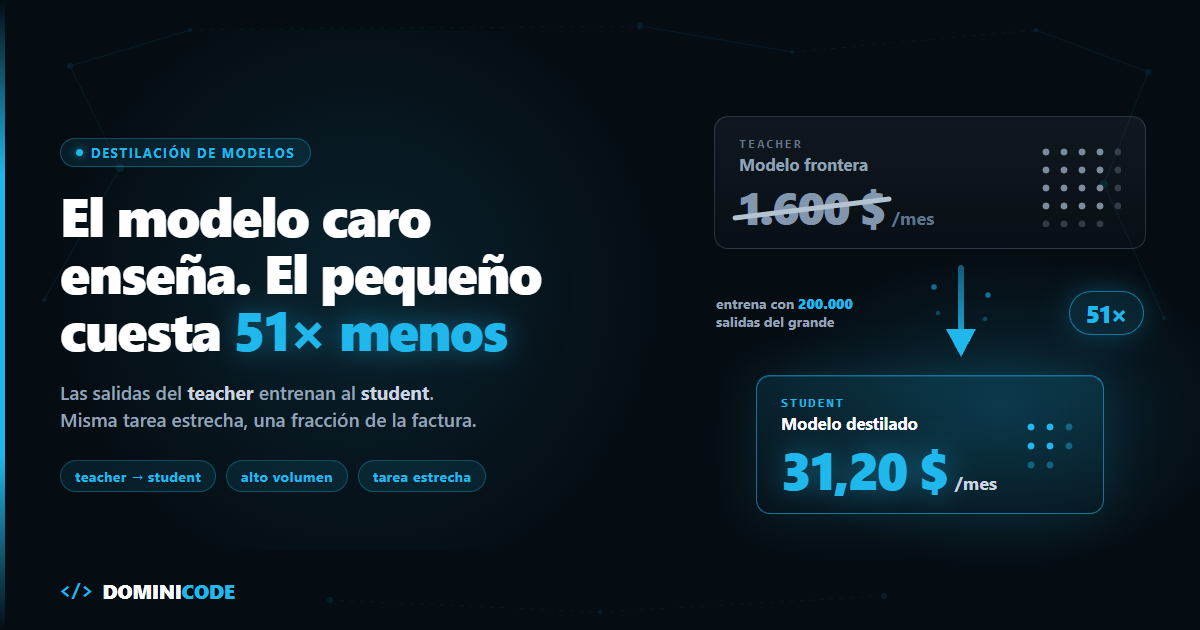
    Destilar un clasificador que hace 200.000 llamadas al mes cuesta unos 112 $ una sola vez y baja la factura mensual de 1.600 $ a 31,20 $. Se amortiza en poco más de dos días.

    Volvamos a los tickets. Doscientas mil clasificaciones al mes, unos 700 tokens de entrada y 20 de salida cada una: 140 millones de tokens de entrada y 4 millones de salida.

    Con los precios públicos de la API de OpenAI a septiembre de 2026:

    Modelo Entrada / salida (por 1M tokens) Coste mensual
    GPT-6 Astra (el teacher) 10 $ / 50 $ (contexto estándar) 1.600 $
    GPT-4.1-mini base 0,40 $ / 1,60 $ 62,40 $
    GPT-4.1-mini destilado 0,80 $ / 3,20 $ 124,80 $
    GPT-4.1-nano base 0,10 $ / 0,40 $ 15,60 $
    GPT-4.1-nano destilado 0,20 $ / 0,80 $ 31,20 $

    Fíjate en un detalle que casi nadie anticipa: un modelo destilado cuesta exactamente el doble que su versión base. OpenAI cobra 0,20 $ de entrada por el nano ajustado frente a 0,10 $ del nano de catálogo. Es la prima por servir tus pesos. Si en tu presupuesto pusiste el precio base, tu presupuesto está a la mitad de la realidad.

    Y fíjate en lo que dice esa tabla si la lees entera: el nano de catálogo sale por 15,60 $, la mitad que el destilado. La destilación no es lo que compras para ahorrar; es lo que compras cuando el nano de catálogo no pasa tus evals y la alternativa era seguir pagando 1.600 $.

    Aun así, el salto de 1.600 $ a 31,20 $ son 51 veces. Eso no lo consigue ningún prompt.

    Y es una cota baja: la tabla carga los mismos 700 tokens de entrada a todas las filas, también al destilado, que en realidad va con un prompt mucho más corto. Ahora vemos por qué.

    ¿Y cuánto cuesta destilar? La parte facturable es ridícula:

    • Generar 10.000 ejemplos con Astra: 7M de entrada a 10 $ más 0,2M de salida a 50 $ = 80 $.
    • Entrenar el nano: 7,2M de tokens de entrenamiento a 1,50 $ el millón ≈ 11 $ por época, unos 32 $ con tres épocas.

    112 $ para ahorrar 1.569 $ al mes. Se amortiza en poco más de dos días.

    Esto es el mismo razonamiento que aplico en coste por tarea en lugar de precio por token, llevado al caso extremo: una tarea tan estrecha que cabe entera en los pesos de un nano.

    Y si trabajas en español, el tokenizador cobra alrededor de un 26 % más por el mismo texto en castellano: un argumento más a favor de destilar, porque ese sobrecoste lo pagas en cada llamada mientras sigas con el grande. El desglose del precio por tarea del frontera está en el análisis de GPT-6 Astra.


    Cómo se construye el dataset para destilar un modelo

    El dataset se construye filtrando las salidas del teacher contra un esquema y descartando las que no validan, nunca corrigiéndolas a mano. La destilación no falla en el entrenamiento: falla porque el dataset está sucio.

    Aquí la teoría se estrella contra el suelo.

    El teacher acierta el 96 %, sí. Pero también devuelve JSON malformado, inventa categorías que no están en tu enum y se contradice en casos límite. Si esos ejemplos entran al entrenamiento, no estás destilando conocimiento: estás enseñando a tu modelo pequeño a equivocarse con seguridad.

    La regla es simple: valida la salida del teacher contra un esquema antes de que entre al dataset, y descarta lo que no pase. No lo arregles a mano. Descártalo.

    import { z } from 'zod'
    import OpenAI from 'openai'
    
    const openai = new OpenAI()
    
    // El contrato de salida. Si el teacher no lo cumple, el ejemplo no entra.
    const TicketLabel = z.object({
      category: z.enum(['facturacion', 'bug', 'acceso', 'feature', 'otro']),
      priority: z.enum(['baja', 'media', 'alta']),
      needsHuman: z.boolean(),
    })
    
    type TicketLabel = z.infer<typeof TicketLabel>
    
    async function labelWithTeacher(ticket: string): Promise<TicketLabel | null> {
      const response = await openai.responses.create({
        model: 'gpt-6-astra',
        input: [
          { role: 'system', content: LONG_PROMPT }, // el prompt largo, con reglas y casos límite
          { role: 'user', content: ticket },
        ],
        text: { format: { type: 'json_object' } },
      })
    
      let raw: unknown
      try {
        raw = JSON.parse(response.output_text)
      } catch {
        return null // JSON malformado: fuera del dataset
      }
    
      const parsed = TicketLabel.safeParse(raw)
      return parsed.success ? parsed.data : null
    }
    

    Podrías forzar el esquema en la API con json_schema, pero entonces no verías lo que el teacher hace mal. Aquí lo que interesa es medir cuánto descartas.

    Y ahora el detalle del JSONL que decide tu factura:

    import { appendFile } from 'node:fs/promises'
    
    for (const ticket of tickets) {
      const label = await labelWithTeacher(ticket.body)
      if (!label) continue // ejemplo sucio: fuera
    
      await appendFile('dataset.jsonl', JSON.stringify({
        messages: [
          { role: 'system', content: SHORT_PROMPT }, // el prompt CORTO, no el largo
          { role: 'user', content: ticket.body },
          { role: 'assistant', content: JSON.stringify(label) },
        ],
      }) + '\n')
    }
    

    Ese SHORT_PROMPT puede partir por la mitad la factura del student, y se explica en una frase: el teacher necesita el prompt largo con todas las reglas; el student se las aprende en los pesos. Si entrenas con el prompt largo, condenas al modelo pequeño a reenviarlo en cada llamada para siempre y tiras por la ventana buena parte de la reducción de tokens.

    Tratar los esquemas como contrato —y no como validación decorativa— es lo que enseño en el curso de Zod. En destilación deja de ser higiene y pasa a ser el filtro que decide la calidad de tu modelo.

    OpenAI te ahorra parte de este trabajo: la Responses API guarda las respuestas 30 días por defecto, así que puedes filtrar tus salidas reales de producción en vez de generarlas de cero.

    Amazon Bedrock Model Distillation hace lo mismo con los invocation logs de CloudWatch y automatiza el ciclo entero. Si activas sus técnicas de síntesis de datos, amplía tu dataset hasta un máximo de 15.000 pares prompt-respuesta, y te factura aparte esas llamadas extra al teacher.


    Qué dicen los que ya han destilado un modelo en producción

    En el hilo de Hacker News Distillation makes AI models smaller and cheaper hay dos comentarios que valen más que la mitad de los artículos sobre el tema.

    El primero, de NitpickLawyer, sobre cuántos ejemplos hacen falta de verdad: "you can use as few as 1-2k traces to reach similar results. Much cheaper." Mil o dos mil trazas, no cien mil. Encaja con lo que recomienda OpenAI, que sugiere arrancar el fine-tuning con 50 demostraciones bien hechas y medir antes de escalar.

    El segundo, de v3ss0n, resume el riesgo en cuatro palabras: "Sometimes better, sometimes dumber."

    Esa es la frase honesta. El student no hereda el 100 % del teacher: hereda su comportamiento en la distribución de datos que le enseñaste. A veces mejora, porque se especializa. A veces se vuelve tonto justo en el caso raro que no estaba en tus 10.000 ejemplos.

    Por eso el orden correcto es: primero las evals, después destilar. Sin forma automática de comparar student contra teacher sobre casos difíciles, no sabrás cuál de las dos te ha tocado. Lo conté en evals deterministas para agentes de IA: mide el dato que sale, no el texto que lo envuelve. En clasificación es trivial, y es justo lo que hace que destilar sea seguro aquí y peligroso en tareas abiertas.


    Cuándo NO destilar un modelo

    Cinco situaciones en las que esto se te vuelve en contra. Las he visto todas.

    1. La tarea cambia cada mes. Un modelo destilado es una foto del comportamiento del teacher el día que generaste el dataset. Si añades dos categorías de ticket en octubre, el student no las conoce y no hay prompt que lo arregle: toca regenerar dataset y reentrenar. Con un modelo de catálogo eso son diez minutos editando texto.

    2. No tienes volumen. Los 112 $ se amortizan en dos días con 200.000 llamadas al mes. Con 2.000 llamadas no se amortizan nunca. Por debajo de unas decenas de miles de llamadas mensuales, quédate en el modelo pequeño de catálogo con un buen prompt.

    3. Los términos de servicio de tu proveedor. Destilar gpt-6-astra en gpt-4.1-nano dentro de OpenAI es una función que ellos te venden. Sacar las salidas para entrenar un Qwen que corres tú es otra conversación, y merece leerse los Business Terms con alguien de legal delante.

    4. El proveedor puede quitarte el botón. No es teórico. La documentación de Bedrock dice hoy, textualmente, que "Distillation is not currently available for Anthropic models on Amazon Bedrock", sin plazo de restauración. Si montas tu arquitectura de costes sobre destilar Claude en Bedrock, ese pilar ahora mismo no existe. Y ojo al despliegue: con los modelos de Llama el job corre en US West (Oregón), y servir el destilado pasa por comprar provisioned throughput —coste fijo mensual, no precio por token— o copiarlo a otra región y comprarlo allí.

    5. Necesitas que generalice. Si tu caso de uso es "un asistente que responde de todo", destilar es exactamente lo contrario de lo que quieres. La destilación compra rendimiento en una distribución estrecha pagando con generalidad. Para un clasificador es el negocio del siglo. Para un copiloto de propósito general es amputarse una pierna para correr más rápido.


    Cómo empezar a destilar: los tres pasos de esta semana

    No empieces destilando. Empieza midiendo.

    Coge tu tarea más repetitiva —la que llama al modelo miles de veces al día con el mismo prompt— y haz tres cosas esta semana, en este orden:

    1. Monta 50 casos de eval con la respuesta correcta conocida, incluyendo los diez casos raros que te preocupan.
    2. Pasa esos 50 casos por el modelo pequeño de catálogo con tu prompt actual. Si aguanta, has terminado: cambia el modelo y ahórrate el proyecto entero. Este paso se lo salta demasiada gente, porque destilar suena más interesante que probar el nano.
    3. Solo si el pequeño falla, genera 1.000 ejemplos con el teacher, valídalos contra un esquema, entrena y vuelve a pasar los mismos 50 casos.

    La decisión no la toma tu intuición sobre lo difícil que es la tarea. La toma esa tabla de 50 filas.

    Si quieres montar el sistema completo alrededor de esto —el harness, los contratos de salida y las evals que hacen que un flujo con IA sea fiable y no solo demostrable— es lo que trabajamos en Construye con IA.

    Y en Dominicode Labs está el pipeline de destilación con el validador de dataset y el script de evals que usamos en producción.


    Preguntas frecuentes

    ¿Qué diferencia hay entre destilación y fine-tuning?

    Son el mismo mecanismo con distinta procedencia de las etiquetas. En el fine-tuning clásico las etiquetas las produce una persona; en la destilación las produce otro modelo, el teacher. Eso cambia el cuello de botella entero: conseguir diez mil ejemplos etiquetados por humanos de forma consistente cuesta meses, y generarlos con un modelo frontera cuesta 80 $ y una tarde.

    ¿Qué son el modelo teacher y el modelo student?

    El teacher es el modelo grande y caro cuyo comportamiento quieres reproducir; el student es el modelo pequeño que se entrena con sus salidas. En una destilación dentro de la plataforma de OpenAI, un par típico es GPT-6 Astra como teacher y GPT-4.1-nano como student. En Amazon Bedrock, Amazon Nova Pro como teacher y Nova Micro o Nova Lite como student.

    ¿Cuántos ejemplos necesito para destilar un modelo?

    Menos de los que crees. OpenAI recomienda empezar el fine-tuning con 50 demostraciones bien construidas y medir antes de escalar, y los rangos que reportan los profesionales van de 1.000 a 2.000 trazas para clasificación o extracción. Para razonamiento la cifra sube mucho: los DeepSeek-R1 distilled se entrenaron con 800.000 muestras curadas. El número de ejemplos escala con la variedad de la tarea, no con su dificultad.

    ¿Cuál es la diferencia entre destilación de modelos y cuantización?

    Son operaciones distintas que solo comparten el objetivo de abaratar. La cuantización coge un modelo y guarda sus pesos con menos bits —de 16 a 4, por ejemplo— para que ocupe menos memoria: es el mismo modelo comprimido, sin entrenamiento ni datos nuevos. La destilación entrena un modelo diferente y más pequeño usando las salidas del grande como dataset, y el resultado es otro modelo con otros pesos. Puedes hacer las dos cosas: destilar un Qwen de 7B y después cuantizarlo a 4 bits para que quepa en tu portátil.

    ¿Puedo destilar GPT o Claude en un modelo open source?

    Técnicamente sí, y mucha gente lo hace. Legalmente depende del contrato que hayas firmado. Los Business Terms de OpenAI, en su redacción de mayo de 2025, prohíben usar el Output para desarrollar modelos de IA que compitan con sus productos y servicios, salvo excepción permitida, y otros proveedores tienen cláusulas equivalentes. Destilar dentro de la plataforma del proveedor (Astra a nano en OpenAI, Nova Pro a Nova Micro en Bedrock) es una función que te venden ellos y no tiene discusión. Sacar las salidas para entrenar un modelo que corres tú conviene revisarlo con alguien de legal, no con un post de blog.

    ¿La destilación sustituye a RAG?

    No, resuelven problemas distintos y a menudo conviven. RAG inyecta conocimiento que cambia —documentación, catálogo, tickets recientes— en el contexto de la consulta. La destilación graba comportamiento en los pesos: cómo clasificar, qué formato devolver, qué criterio aplicar. Si el modelo no sabe el precio actual de un producto, destilar no ayuda en nada y RAG sí. Si el modelo pequeño no sigue tu criterio de prioridad, RAG no ayuda y destilar sí. En un clasificador sobre documentación viva querrás las dos.

    ¿Cómo sé si el modelo destilado aguanta en producción?

    Con evals deterministas sobre un conjunto fijo de casos, ejecutadas antes y después. En clasificación o extracción es directo, porque la salida es estructurada y comparas el campo, no el texto. Lo mínimo viable es un set de 50 a 100 casos con la respuesta correcta conocida, sesgado a propósito hacia los casos límite. Si el student pierde más de lo que tu negocio tolera en los casos raros, la conclusión no siempre es descartar la destilación: a veces es enrutar, mandar el 95 % fácil al student y el 5 % dudoso al teacher. Esa arquitectura híbrida suele dar la mejor relación coste-precisión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Mejores herramientas de code review con IA 2026: precios y límites

    Mejores herramientas de code review con IA 2026: precios y límites

    En marzo de 2026 revisé una pull request de 340 líneas en un proyecto de un cliente. El bot de code review había dejado 23 comentarios. Los leí todos. Todos eran correctos.

    Mergeamos. Dos días después, producción se cayó por esa PR.

    El bot revisó el diff perfectamente. Lo que no hizo —lo que ninguna de las herramientas de code review con IA que he probado desde entonces hizo— fue preguntarse si ese endpoint debía existir.

    Nadie había escrito qué significaba "hecho" para esa tarea. El bot revisó el código contra la nada, y la nada siempre aprueba.

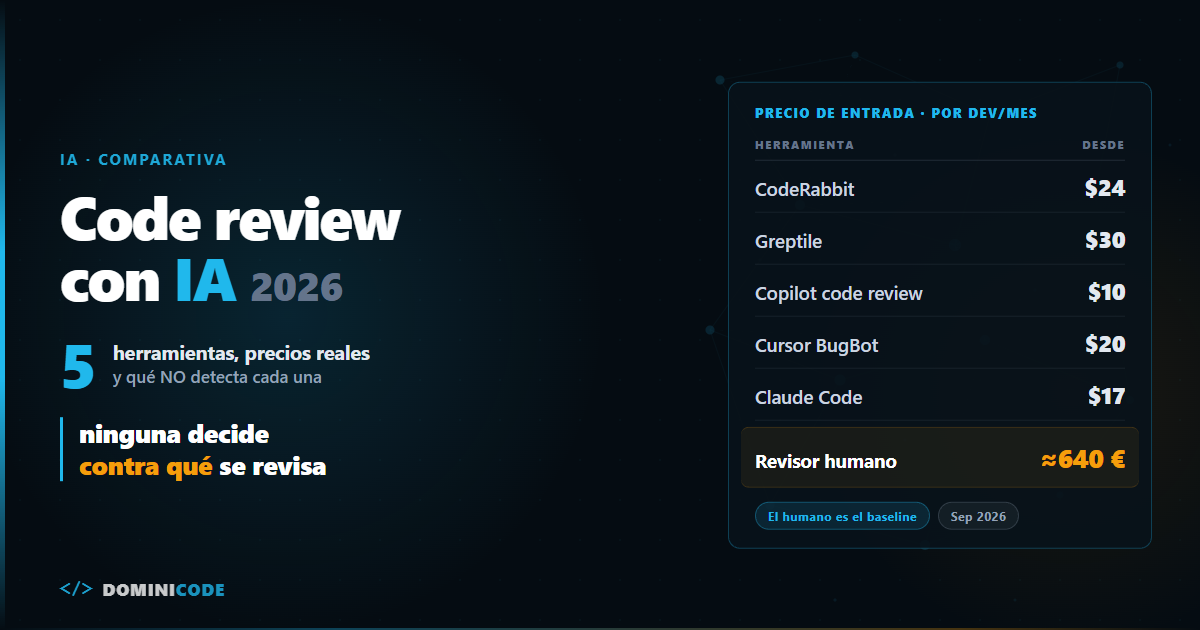
    En corto: las mejores herramientas de code review con IA en 2026 son CodeRabbit (24 $/dev/mes anual, la más pulida en PRs de GitHub), Greptile (30 $/asiento/mes, contexto de todo el repo y pago por créditos) y Claude Code con /review (incluida en cualquier plan de pago desde 17 $/mes con facturación anual, la que más control te da sobre el criterio: revisa contra tus reglas, no contra las suyas).

    GitHub Copilot code review (desde 10 $/usuario/mes) y Cursor BugBot son las opciones por defecto si ya pagas esas plataformas. Ninguna de las cinco decide contra qué se revisa tu código: eso lo defines tú antes, o no lo define nadie.

    ¿Qué es una herramienta de code review con IA?

    Una herramienta de code review con IA es un sistema que lee automáticamente el diff de una pull request, lo analiza con un modelo de lenguaje y publica comentarios sobre bugs, seguridad y calidad antes de que un humano lo mire.

    Esa definición es más importante de lo que parece por una palabra: diff. Todas estas herramientas parten del cambio, no del objetivo. Saben qué cambiaste. No saben qué querías conseguir.

    Comparativa de herramientas de code review con IA: 5 opciones y el baseline humano

    Precios consultados el 19 de septiembre de 2026 en las páginas oficiales de cada producto. Cambian a menudo — verifica antes de meter la tarjeta. La última fila no es una herramienta: es el coste del revisor humano, para que compares contra algo y no contra cero. Las licencias van en dólares porque así las publican los fabricantes; el coste humano va en euros por ser el mercado de referencia.

    Herramienta Precio Qué detecta bien Qué NO cubre Cuándo compensa
    CodeRabbit Essentials 24 $/dev/mes (anual) · 30 $/dev/mes (mensual). Team 48 $/dev/mes · Advanced 72 $/dev/mes. Gratis en repos open source públicos Bugs concretos en el diff, resúmenes de PR, linters y SAST integrados, 1-click fixes Si la feature era necesaria; decisiones de arquitectura que cruzan varios repos en el plan base (Essentials analiza 1 repo; Team, hasta 5) Equipos de 3-15 devs con muchas PRs pequeñas en GitHub
    Greptile Gratis (50 créditos/mes, 1 dev activo) · Pro 30 $/asiento/mes con 50 créditos, 1 $ por crédito extra Bugs reales con contexto de todo el repo; 1 review = 1 crédito, review TREX = 3 Su propia tasa de falsos positivos: no la publica ni ella ni ninguna competidora. Y no sustituye el juicio de producto Monorepos grandes donde el bug vive lejos del diff
    GitHub Copilot code review Pro 10 $/usuario/mes · Pro+ 39 $ · Max 100 $. El plan Free no lo incluye. Consume créditos de IA de GitHub Lo básico y estándar, dentro de github.com sin instalar nada No lee tus respuestas a sus propios comentarios y puede repetir comentarios que ya descartaste (doc oficial) Ya pagas Copilot y quieres una red de seguridad sin añadir otra factura — consume tus créditos de IA
    Cursor BugBot Incluido en Pro 20 $/mes, Pro+ 60 $, Ultra 200 $ (−20 % anual), con facturación por uso. Cursor no publica tarifa por revisión: consultar pricing oficial Bugs y problemas de seguridad en el diff, autofix vía Cloud Agent, reglas personalizadas Por defecto solo mira el código cambiado desde la revisión anterior; autofix limitado a 3 intentos por PR y sin "crear rama" en GitLab, Bitbucket y Azure DevOps Tu equipo ya vive dentro de Cursor y no quiere otra factura
    Claude Code (/review) Incluido en todo plan de pago: Pro 17 $/mes (anual) o 20 $/mes · Max desde 100 $/mes · Team 20 $/asiento (anual) Lo que tú le digas: corre como subagente contra tus reglas, tu AGENTS.md y tu spec Lo que no le digas que mire: sin contrato escrito revisa según su criterio, igual que las demás Ya tienes specs o reglas escritas y quieres revisar contra ellas, no contra el gusto del modelo
    Review manual humano 0 € de licencia. Ejemplo orientativo: 4 h/semana × 4 semanas = 16 h/mes; a 40 €/h son 640 €/mes por revisor Intención, producto, contexto de negocio, deuda técnica que importa Errores mecánicos cuando la PR es larga: la atención humana se degrada con la longitud del diff Siempre, encima de cualquier herramienta. No es una alternativa, es la capa que decide

    Análisis de cada herramienta de code review con IA: a favor y en contra

    Estas son las cinco herramientas de la tabla en detalle, con el argumento a favor y la objeción real de cada una. No es un ranking: el orden es el mismo de la tabla.

    CodeRabbit

    A favor: es la más pulida de las cinco en el flujo de GitHub. Los resúmenes de PR son útiles de verdad, la integración con linters y SAST evita duplicar herramientas, y el plan gratis para repos open source públicos no tiene truco.

    En contra: el precio escala rápido. El análisis multi-repo está en Team (48 $/dev/mes anual): Essentials analiza un repo, Team hasta cinco. Para un equipo de ocho devs son 4.608 $/año. Y sigue siendo una opinión sobre el diff.

    Greptile

    A favor: el contexto de repositorio completo es su gran ventaja. Encuentra el bug que está en el archivo que no tocaste. El modelo de créditos (50 incluidos por asiento, 1 $ el extra) es honesto para equipos que no revisan 500 PRs al mes.

    En contra: no hay dato público de falsos positivos, ni suyo ni de la competencia, así que el ruido lo vas a medir tú. Si tu equipo ya ignora al bot, ninguna herramienta arregla eso. El descuento del 50 % para startups pre-Series A ayuda, pero no arregla el ruido.

    GitHub Copilot code review

    A favor: cero fricción. Si ya pagas Copilot Pro (10 $/usuario/mes), lo activas y ya está. Vive dentro de github.com y no añade otro proveedor a tu superficie de seguridad.

    En contra: es la menos profunda del grupo, y la documentación oficial lo admite sin rodeos: no ve tus respuestas a sus comentarios y puede repetir los que ya descartaste. Además, ahora consume los créditos de IA de tu plan, así que no es tan "gratis" como parece.

    Cursor BugBot

    A favor: si tu equipo escribe en Cursor, BugBot cierra el círculo sin cambiar de contexto. Las reglas personalizadas por equipo, repo y proyecto son potentes.

    En contra: el precio es opaco. "Facturación por uso" sin tarifa pública es lo contrario de lo que necesitas para presupuestar. Y aquí aparece el problema de fondo que señaló Daksh Gupta, CEO de Greptile —parte interesada, conviene decirlo—: cuando el que escribe el código y el que lo revisa comparten modelo, harness y prompts, "fallan de formas parecidas". Cursor revisando código de Cursor es el juez y la parte.

    Claude Code (/review + revisión agéntica)

    A favor: CodeRabbit, Greptile Pro y BugBot te dejan añadir reglas encima de su criterio; aquí no hay criterio de fábrica que corregir. /review es una skill incluida —alias de /code-review— que corre en un subagente forkeado desde la v2.1.218, y puedes apuntarla a tus specs, tus reglas y tu definición de "hecho". Sin factura nueva si ya pagas Claude, aunque cada review consume los límites de uso de tu plan. Lo desarrollo en detalle en agentic code review con Claude Code.

    En contra: no es un producto de code review, es un motor. No hay dashboard, no hay métricas de equipo, no hay onboarding para el junior. Y si no le das contra qué revisar, te devuelve opiniones genéricas igual que los demás.

    Review manual humano

    A favor: es el único revisor que sabe por qué existe la feature.

    En contra: no escala con la velocidad a la que los agentes generan código. Ese es exactamente el cuello de botella de verificar código de IA: generar es gratis, verificar no.

    El hilo que conviene leer antes de pagar

    En enero de 2026, el propio CEO de Greptile publicó un artículo titulado "There is an AI code review bubble". Llegó a portada de Hacker News con 351 puntos y 249 comentarios a 19 de septiembre de 2026, y la discusión es más valiosa que cualquier tabla comparativa, incluida la mía.

    El comentario más votado, de trjordan, lo dice sin anestesia (traduzco del inglés, igual que el resto de citas de este hilo):

    "Si has llegado al punto de depender de un code review con IA para cazar bugs, has perdido el hilo. El propósito de una PR es compartir conocimiento y detectar huecos estructurales."

    Otro usuario, candiddevmike, sostiene en su opinión que ninguna de estas herramientas aporta un review significativo más allá de lo que encontraría un linter. Y cuando Gupta defendió Greptile citando que los autores de PRs habían respondido "great catch" 9.078 veces en siete días, tadfisher le contestó lo único que había que contestar: "una cifra así es un dato, no una evidencia". Sin el denominador —cuántos comentarios publicó Greptile esos siete días— 9.078 no se puede interpretar.

    Ese hilo no dice que las herramientas sean inútiles. Dice que estamos midiendo lo que no toca.

    Lo que ninguna de estas herramientas compra: el contrato

    Todas estas herramientas revisan el código. Ninguna decide contra qué se revisa.

    Un bot que comenta el diff sigue siendo una opinión sobre el diff. Una opinión rápida, barata y a menudo acertada — pero una opinión. Lo que falta antes es el contrato: qué tiene que cumplir ese código para considerarse terminado, qué casos límite son obligatorios, qué se rompe si cambia esta firma, qué comportamiento está garantizado a quien consume esto.

    Si ese contrato no está escrito, el bot inventa uno por ti. Y el contrato que inventa un modelo es el promedio de GitHub, no el de tu producto.

    Por eso comprar la herramienta no resuelve el problema. Resuelve la mitad mecánica y deja intacta la mitad que causa los incidentes. La secuencia correcta es la inversa: primero defines el contrato, luego eliges quién lo verifica — y entonces cualquiera de estas cinco herramientas se vuelve mucho más útil, porque le estás dando un criterio en vez de pedirle que adivine el tuyo. Ese es el método que explico en revisión por contrato para código de agentes, y el punto de partida está en el ebook gratuito Revisión por Contrato (30 páginas, sin coste).

    Cuándo NO necesitas ninguna de estas herramientas

    Como regla de pulgar, si haces menos de unas 20 PRs al mes. A ese volumen, 30 $/dev/mes por un revisor automático es peor inversión que dedicar dos horas a escribir la definición de "hecho" de tu equipo. El coste fijo de la herramienta no se amortiza y el ruido sí se acumula.

    Si tu equipo ya ignora los comentarios del bot. Esto pasa más de lo que se admite. Cuando la mayoría de los comentarios son nits de estilo, el equipo aprende a hacer scroll y el hallazgo bueno se pierde con el resto. Añadir una segunda herramienta empeora el problema. Mide cuántos hallazgos se resuelven antes del merge, no cuántos comentarios se publican.

    Si no tienes tests ni CI. Un bot de review encima de un pipeline inexistente es teatro. Primero el harness que rompe el build, después el revisor que opina. Integrar las revisiones de IA en el pipeline de CI/CD importa más que elegir marca.

    Si el problema real es que nadie sabe qué estáis construyendo. Ninguna herramienta de esta tabla arregla una spec inexistente. Ese es un problema de método, y lo trato entero en el libro de Spec-Driven Development.

    Qué hacer hoy

    Elige por contexto, no por ranking: si vives en GitHub, CodeRabbit; si tu bug vive lejos del diff, Greptile; si ya pagas Cursor o Copilot, usa lo que tienes; si quieres revisar contra tus propias reglas, Claude Code.

    Pero antes de pagar nada, haz esto: abre la última PR que rompió algo en producción y escribe en tres líneas qué contrato debería haber cumplido ese código. Si no puedes escribirlo, ninguna herramienta de esta tabla te habría salvado.

    Eso es justo lo que trabajamos en el workshop Contract Based Review Method: tres horas en nueve módulos para ir de un GitHub Issue a una pull request verificada, con el contrato escrito antes de que ningún bot opine. Sale el 2 de octubre de 2026, bajo demanda.

    Preguntas frecuentes

    ¿Cuál es la mejor herramienta de code review con IA en 2026?

    No hay una mejor en absoluto, hay una mejor por contexto. CodeRabbit es la opción más sólida para equipos en GitHub con muchas PRs pequeñas (24 $/dev/mes anual). Greptile gana en monorepos grandes donde el bug está fuera del diff (30 $/asiento/mes). Claude Code es la más flexible si ya tienes reglas o specs escritas, porque revisas contra tu criterio y no contra el del modelo.

    ¿Merece la pena pagar CodeRabbit o Greptile si ya tengo GitHub Copilot?

    Solo si tu problema es la profundidad del review. Copilot code review viene incluido desde el plan Pro (10 $/usuario/mes) y cubre lo básico, pero la documentación oficial reconoce que no lee tus respuestas a sus comentarios y que puede repetir los descartados. Si eso te frustra a diario, la herramienta especializada se paga sola. Si no, estás pagando dos veces por lo mismo.

    ¿Puede un code review con IA sustituir al revisor humano?

    No, y las cifras del sector no dicen lo contrario: las más citadas las publica quien vende la herramienta. La IA es buena cazando errores mecánicos en el diff; el humano es el único que sabe si la feature debía existir. El reparto sensato es: la IA revisa lo mecánico, el humano revisa la intención y la arquitectura.

    ¿Cuánto cuesta realmente añadir code review con IA a un equipo de 8 developers?

    Con CodeRabbit Essentials anual son 24 $ × 8 = 192 $/mes, unos 2.304 $/año. Con Greptile Pro, 30 $ × 8 = 240 $/mes, más los créditos extra si pasáis de 50 revisiones por asiento. Con Claude Code no hay factura nueva si el equipo ya tiene plan de pago, pero cada review consume los límites de uso del plan. Compáralo siempre con el coste del tiempo humano que esperas ahorrar, no con cero.

    ¿Qué es la revisión por contrato y en qué se diferencia de usar un bot?

    La revisión por contrato consiste en escribir, antes de generar el código, qué tiene que cumplir para darse por terminado: comportamiento garantizado, casos límite obligatorios y qué se rompe si cambia. El bot revisa el diff contra su criterio; la revisión por contrato revisa el diff contra el tuyo. Son complementarias, pero el orden importa: sin contrato, el bot inventa uno.

    ¿Existe alguna herramienta de code review con IA gratuita?

    Sí, con límites. CodeRabbit es gratis de forma permanente en repositorios open source públicos. Greptile tiene un plan Starter gratuito con 50 créditos al mes para un developer activo, y acceso libre para proyectos con licencia MIT o Apache. GitHub Copilot en su plan Free no incluye code review — ahí hay que pasar a Pro.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Benchmarks de IA programando: qué mide de verdad ese 96%

    Benchmarks de IA programando: qué mide de verdad ese 96%

    "AI Is Already Better at Coding Than Most Software Developers."

    El titular circula en inglés y provoca siempre dos reacciones. El que lo comparte con un "ya está, se acabó". Y el que responde "pues a mí me inventó un import que no existe".

    Los dos discuten la conclusión sin mirar de dónde sale. Y sale de un sitio concreto: los benchmarks de IA programando. De uno solo, en realidad. SWE-bench Verified.

    La tesis, y no te va a gustar ninguna de sus dos mitades: el titular es literalmente cierto en el examen. Y el examen se rompió.

    No porque la IA sea mala escribiendo código —es buenísima—, sino porque mide una tarea que no se parece a tu trabajo: un bug de cinco líneas, en un repo que el modelo ya había visto, con los tests ya escritos por otro.

    En corto: OpenAI dejó de reportar ese benchmark por saturación, tests rotos y contaminación. El 91% de sus tareas son bugs de menos de una hora.


    De dónde sale el número: un leaderboard con todos empatados

    Snapshot del leaderboard de SWE-bench Verified a 15 de septiembre de 2026:

    Modelo Resolución
    Claude Opus 5 96%
    Claude Mythos 5 95,5%
    Claude Fable 5 95%

    Ahí tienes el 96% del titular. Y el primer problema no es el 96, sino la distancia entre filas: menos de un punto entre los tres punteros.

    Un examen en el que todos sacan la misma nota ha dejado de ser un examen. Es un sello.

    SWE-bench Verified es un benchmark de 500 tareas construidas a partir de issues reales de GitHub en repositorios de Python populares: el modelo recibe el repo y el enunciado del issue, y tiene que entregar un parche que pase una suite de tests ya escrita. Sobre el papel suena exactamente a tu trabajo. Por eso el titular funciona tan bien, y por eso conviene abrir la caja.

    Por qué OpenAI retiró SWE-bench Verified

    Esto no lo dice un escéptico de la IA con ganas de tráfico. Lo dice OpenAI, en un post titulado "Why SWE-bench Verified no longer measures frontier coding capabilities", y lo confirman Mia Glaese y Olivia Watkins, de su equipo de Frontier Evals, en esta entrevista.

    Tres razones, las tres con número.

    Saturación. El estado del arte pasó de 74,9% a 80,9% en seis meses. Cuando la aguja apenas se mueve ya no mides capacidad: mides techo.

    Tests rotos. Auditaron el subconjunto de problemas que los modelos fallan una y otra vez, un 27,6% del dataset: seis ingenieros revisaron 138 problemas a mano. Más del 59% tienen tests defectuosos que rechazan soluciones funcionalmente correctas: unos demasiado estrechos, otros demasiado amplios, que exigen features ni siquiera documentadas en el enunciado.

    Traducido: parte de lo que el leaderboard cuenta como fallo del modelo es un fallo del corrector.

    Contaminación. Esta es la peor. Dándoles solo el Task ID —sin enunciado y sin código—, todos los modelos frontera auditados (GPT-5.2, Claude Opus 4.5, Gemini 3 Flash) reproducen el parche correcto o el enunciado verbatim.

    Parte de la nota es memoria. No razonamiento. Y no hay forma de saber qué parte.

    La recomendación de OpenAI es reportar SWE-bench Pro en su lugar. Guárdate ese nombre.

    Qué mide de verdad el examen

    Epoch AI analizó tarea por tarea qué hay dentro de esas 500 muestras:

    Dimensión Dato
    Tareas triviales (menos de 15 min) 39%
    Tareas pequeñas (15 min – 1 h) 52%
    Tareas de 1 a 4 h 8%
    Tareas de más de 4 h 3 issues
    Parche medio, triviales 5 líneas
    Parche medio, de 15 min a 1 h 14 líneas
    Repositorios distintos 12
    Peso de Django casi el 50%
    Issues anteriores a 2020 50%

    El parche medio de ese trabajo va de cinco a catorce líneas. Y un análisis de Amazon sobre el mismo dataset, recogido por Epoch: el 78% de los cambios tocan funciones, no clases, con 1,87 funciones de media.

    La diversidad es peor que el tamaño. Doce repositorios, y los cinco mayores concentran más del 80% de las muestras. Casi la mitad es Django, de los proyectos Python más presentes en cualquier corpus de entrenamiento. La mitad de los issues son anteriores a 2020, en un dataset construido en octubre de 2023.

    Conclusión literal de Epoch: mide "arreglar issues pequeños y bien definidos" en "repos de Python open source familiares".

    Falta el detalle que más duele, y no sale en ninguna tabla: los tests ya vienen escritos. La parte difícil —decidir qué significa "correcto" en este sistema y para estos usuarios— venía hecha antes de que el modelo empezara.

    Los parches que pasan sin resolver nada

    SWE-Bench+ auditó los parches que el benchmark daba por buenos. El 32,67% son solution leakage: la solución venía escrita en el propio issue o en sus comentarios. Otro 31,08% queda como sospechoso: pasa con tests demasiado débiles para garantizar que el parche arregle algo.

    Al filtrar ambos casos, SWE-Agent con GPT-4 cae de 12,47% a 3,97%. Mismo modelo. La nota se divide por tres.

    SWE-bench Pro vs SWE-bench Verified: 27 puntos de diferencia

    SWE-bench Pro, de Scale AI, está diseñado para resistir la contaminación. Mismo modelo, dos exámenes, febrero de 2026: 80,8% en Verified y 53,4% en Pro. Veintisiete puntos por cambiar el papel del examen.

    Pasa lo mismo fuera de Python. Terminal-Bench 2.0 mide 16 categorías de tareas de terminal en Docker y en septiembre de 2026 sus líderes van altísimos: GPT-5.6 Sol 91,9%, Claude Mythos 5 88,0%, GPT-5.6 Terra 87,4%.

    Ahora coge TerminalWorld-Verified, con escenarios más parecidos a un entorno real: los modelos evaluados allí, con marcas de entre 57% y 82,7% en Terminal-Bench 2.0, caen a un rango de 49% a 62,5%.

    El número no describe al modelo. Describe al examen.

    Un diseño mejor existe: SWE-Lancer usa más de 1.400 encargos freelance de Upwork con un millón de dólares en pagos reales, y pregunta si el trabajo se habría cobrado. Cítalo por el diseño, no por el marcador: es de febrero de 2025.

    Qué mide ese 96% y qué mide tu lunes

    Nada de esto significa que la IA no programe bien. Programa muy bien, y cada mes mejor.

    Significa otra cosa, más incómoda: el número que usas para decidir no mide lo que crees. Mide velocidad en una tarea acotada, con el criterio de corrección regalado, sobre repos que el modelo ya conocía. Tu lunes no se parece a eso: repo privado que no estuvo en ningún corpus, requisitos a medio escribir y ninguna suite que te diga si lo que acabas de aceptar está bien.

    Hay un experimento que mide esa brecha. METR hizo un ensayo aleatorizado con 16 developers open source experimentados sobre 246 tareas reales en sus propios repositorios: más de 22.000 estrellas y más de un millón de líneas de media cada uno. Estimaron que irían un 24% más rápido con IA. Al terminar creían haber ido un 20% más rápido. La medición decía que habían sido un 19% más lentos.

    Y la advertencia sin la cual ese dato no se puede usar: el estudio es de julio de 2025, con Cursor Pro y Claude 3.5/3.7. Modelos viejos. No describe el rendimiento de las herramientas de hoy, y quien lo cite como si lo hiciera te está vendiendo algo.

    Sirve para una sola cosa, y es suficiente: nadie sabe si va más rápido hasta que lo mide. Ni tú ni yo. Es la conclusión a la que llegué desde otro camino cuando escribí que el cuello de botella ya no es escribir código, sino verificarlo.

    Cómo evaluar código generado por IA en tu repo: 4 pasos

    El leaderboard no te va a decir si un modelo te sirve. Eso lo mides tú, en tu repo. Cuatro pasos:

    1. Congela veinte tareas tuyas. Veinte PRs de tu proyecto ya cerrados, de dificultad variada. Ese es tu benchmark privado: no está en ningún corpus y se parece a tu trabajo por construcción. Cómo montarlo lo detallo en evals de código generado por IA.
    2. Escribe tú el criterio, y antes. Aquí está el fallo que copian los benchmarks: los tests los puso otro. Define el contrato —entradas, salidas, errores, invariantes— antes de pedir el código. Eso es revisión por contrato para código de agentes de IA, la diferencia entre revisar un diff y auditar una promesa. Si quieres el método completo, descarga el ebook gratuito.
    3. Mide tiempo, no sensación. Cronómetro desde que abres la tarea hasta que pasa code review, reescrituras incluidas. Ese es el único número que importa.
    4. Compara en tu harness, no en el ranking. El mismo modelo con distinto contexto, herramientas y reglas rinde de forma muy diferente. La variable que más mueve tu resultado casi nunca es el modelo.

    Es la mecánica del curso Construye con IA y el principio del libro Spec-Driven Development: sin criterio escrito antes no evalúas nada, ni a un modelo ni a un humano.

    Cifras verificadas a 17 de septiembre de 2026.

    La próxima vez que veas un titular con un porcentaje, haz una sola pregunta antes de compartirlo o de indignarte: ¿qué examen era?

    Casi siempre, la respuesta explica el titular entero.


    Preguntas frecuentes

    ¿Qué es exactamente SWE-bench Verified?

    Un benchmark de 500 tareas construidas a partir de issues reales de GitHub en repositorios de Python populares. Al modelo se le da el repo y la descripción del issue, y tiene que producir un parche que pase una suite de tests ya existente. Es el número detrás de casi todos los titulares sobre IA programando. Su problema no es que sea falso: su perfil de tarea —bugs pequeños, repos muy conocidos, criterio de corrección regalado— se parece poco al trabajo diario en una base de código privada.

    Si OpenAI dejó de usarlo, ¿por qué todo el mundo lo sigue reportando?

    SWE-bench Verified se sigue reportando por inercia y por comparabilidad: todos los modelos anteriores tienen una puntuación ahí, así que es la única cifra que permite poner dos años de lanzamientos en la misma tabla. OpenAI recomienda reportar SWE-bench Pro en su lugar, y lo razonable es leer las dos juntas. La diferencia entre ambas te dice más que cualquiera por separado.

    Entonces, ¿los benchmarks de IA programando no sirven para nada?

    Sirven para una pregunta más estrecha de la que se les hace: comparar modelos bajo condiciones idénticas y detectar regresiones entre versiones. No sirven para estimar cuánto vas a ganar tú en tu proyecto, porque su diseño elimina las dos partes más caras de tu trabajo: definir qué es correcto y verificar que el cambio no rompe nada más.

    ¿No es contradictorio decir que la IA programa muy bien y a la vez desconfiar del 96%?

    Decir que la IA programa muy bien y desconfiar del 96% son dos afirmaciones sobre cosas distintas. La primera habla de capacidad de generar código, que es real y muy alta. La segunda habla de qué mide un número concreto, y ese número resume un tipo de tarea muy particular. La IA genera código excelente a una velocidad que ningún humano iguala; lo que no hace es decidir qué debería hacer ese código ni garantizar que encaja en tu sistema. Ese trabajo es ahora la parte cara.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • NVIDIA compra Hugging Face: tu from_pretrained() es el riesgo

    NVIDIA compra Hugging Face: tu from_pretrained() es el riesgo

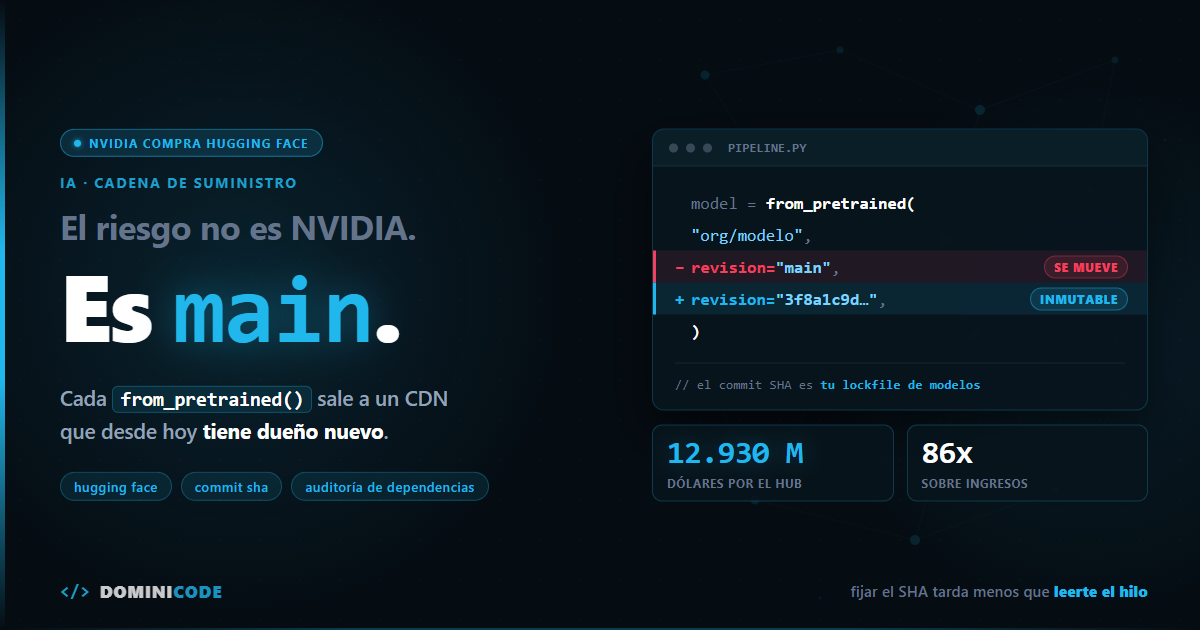
    El 3 de septiembre, la noticia de que NVIDIA compra Hugging Face por 12.930 millones de dólares llegó con la reacción por defecto ya puesta: "se acabó el open source".

    Hilos, capturas, indignación. Y casi nadie haciendo la única pregunta que de verdad importa: ¿qué pasa exactamente en tu build el día que algo de esto cambie?

    Si no sabes responderla en treinta segundos, la noticia no te ha creado ningún riesgo. Te lo ha enseñado.

    Así que este no es un post de indignación. Es un post de auditoría de dependencias. Y la tesis es incómoda: si la noticia te molestó, es porque tenías una dependencia de infraestructura que nunca decidiste tener.

    En corto: el 3 de septiembre de 2026 NVIDIA anunció un acuerdo definitivo para comprar Hugging Face por unos 12.930 millones de dólares. La operación no está cerrada y no cambia nada en el Hub a día de hoy. Lo que sí puedes cambiar hoy es tu código: fijar por commit SHA cada modelo del que depende tu build tarda menos que leerte los hilos.


    Cuánto paga NVIDIA por Hugging Face: 12.930 millones por 150 de ingresos

    Las cifras de plataforma salen del comunicado oficial de NVIDIA. La estructura del pago, la fecha de cierre y los ingresos anualizados no están ahí: vienen de la cobertura del día del anuncio. Lo señalo porque la diferencia importa cuando alguien repite el dato tres meses después.

    Dato Cifra
    Importe total ~12.930 millones de dólares
    Estructura ~11.900 M en efectivo + hasta 1.000 M en equity de retención
    Anuncio 3 de septiembre de 2026 — acuerdo definitivo, no cerrado
    Cierre previsto Primera mitad de 2027, sujeto a revisión regulatoria
    Ingresos anualizados de Hugging Face ~150 millones de dólares
    Múltiplo sobre ingresos ~86x
    Desarrolladores en la plataforma +18 millones
    Modelos / datasets / Spaces 3 M / 500.000 / ~1 M
    Clientes empresa +200.000
    Puesto en NVIDIA 2ª mayor adquisición, tras los 20.000 M por activos de Groq (diciembre de 2025)

    Divide. Son unas 86 veces los ingresos.

    Nadie paga 86x por el revenue. Se paga por la posición. Y la posición de Hugging Face es que se ha convertido en el sitio por defecto desde el que el mundo descarga pesos de modelos, igual que npm es el sitio por defecto desde el que descarga JavaScript. Esa es la compra.

    Un detalle que casi nadie está teniendo en cuenta: no está cerrada. Es un acuerdo definitivo, sí, pero el cierre está previsto para la primera mitad de 2027. Hay meses de ventana regulatoria por delante y bastante margen para que cambien condiciones. Cualquiera que hoy te cuente cómo va a quedar el Hub en 2028 se lo está inventando.


    ¿Obligará NVIDIA a usar sus GPUs? Lo que prometió Huang

    No, no va a obligarte. Al menos no según lo que ha firmado por escrito.

    Y hay que decirlo, porque el drama se está comiendo el matiz. La declaración de Jensen Huang fue explícita (traduzco):

    "Hugging Face seguirá siendo una plataforma abierta para todo el ecosistema de IA. Los desarrolladores elegirán los modelos que quieran, los frameworks que quieran, las clouds y los proveedores de inferencia que quieran y las plataformas de cómputo que quieran. El cómputo de NVIDIA no será un requisito para construir sobre Hugging Face ni para desplegar a través de Hugging Face."

    No es humo genérico. Es una promesa concreta y verificable: si mañana empieza a hacer falta hardware NVIDIA para desplegar desde el Hub, esa frase queda por escrito y con fecha.

    Y NVIDIA lleva tiempo predicando con el ejemplo ahí: más de 500 modelos y 250 datasets abiertos publicados en la propia plataforma.

    Clem Delangue, CEO de Hugging Face, justificó la venta en términos igual de concretos: la plataforma "necesita más cómputo, más soporte, más colaboración y más visibilidad".

    Ahora la parte que no cambia: una promesa corporativa no es una garantía arquitectónica.

    No porque Huang mienta. Porque las promesas tienen un plazo, un CEO y un contexto competitivo, y tu build no. Tu build se ejecuta cada noche durante los próximos cinco años y no lee notas de prensa.

    La pregunta correcta nunca fue "¿me fío de NVIDIA?". La pregunta correcta es "¿qué pasa exactamente en mi pipeline el día que algo de esto cambie?". Si no sabes responderla en treinta segundos, ahí está el trabajo.

    Es el caso hermano de Shopify comprando Tailwind y el embudo que eso destapa, con una diferencia que importa: allí se compraba un embudo. Aquí se compra el punto por el que pasa el tráfico de pesos del ecosistema entero.


    Qué hace tu from_pretrained() cuando no lo miras

    Cada from_pretrained() de tu código es una descarga de red contra un repositorio de terceros que puede cambiar sin avisarte.

    Esta es la parte que la mayoría de devs nunca ha auditado.

    Cada from_pretrained(), cada pipeline(), cada load_dataset() es una llamada de red a un CDN de terceros. No es una importación de librería que se resolvió en el pip install: es una descarga que ocurre en tiempo de build o, peor, en tiempo de ejecución, la primera vez que arranca el contenedor.

    Y hay un segundo problema, más silencioso, que es el que de verdad me preocupa: la mayoría de ese código apunta a main.

    Un repo de modelo en el Hub es un repo git. main se mueve. El mantenedor sube una cuantización distinta, corrige el tokenizador, reentrena. Los pesos que descargaste ayer y los que descargas hoy pueden no ser los mismos, tu build pasa en verde, tus tests pasan en verde, y nadie en tu equipo se entera de que el modelo que hay en producción cambió.

    No hace falta ninguna adquisición para que eso te explote. La adquisición solo añade un actor nuevo con capacidad de decidir sobre la infraestructura.

    Y aquí está el resumen honesto del riesgo: no creo que NVIDIA vaya a "cerrar" Hugging Face. Lo que sí tienes, desde ya, es un proveedor crítico, con un único punto de fallo, propiedad de la empresa que te vende las GPUs, del que no tienes inventario ni plan de salida. Eso, con cualquier otro proveedor, lo llamaríamos por su nombre y lo pondríamos en el registro de riesgos.


    Cómo auditar tus dependencias de modelos de IA en 10 minutos

    Auditar tus dependencias de modelos son cinco pasos: inventario, revisión fijada por SHA, build sin red, espejo de lo crítico y plan de salida a local.

    Los dos primeros son los diez minutos del título y puedes aplicarlos hoy mismo. Del tercero al quinto es trabajo de una tarde.

    1. Saca el inventario real

    No preguntes al equipo de qué modelos depende el producto. Pregúntaselo al repo:

    rg -n "from_pretrained\(|load_dataset\(|hf_hub_download\(|snapshot_download\(|pipeline\(" \
      -g "*.py" -g "*.ipynb" -g "*.toml" -g "Dockerfile*" .
    

    Cuenta con algún falso positivo: pipeline( también casa con los Pipeline de scikit-learn y con funciones tuyas que se llamen igual. Se descartan a ojo.

    Ese listado es tu superficie de exposición. Casi siempre es entre dos y cinco veces más grande de lo que la gente cree, porque incluye los modelos que nadie recuerda: el de embeddings del buscador interno, el reranker, el clasificador de spam que alguien metió en un script de 2024.

    Contrasta con lo que se ha descargado de verdad en la máquina:

    HUB="${HF_HUB_CACHE:-${HF_HOME:-$HOME/.cache/huggingface}/hub}"
    ls -1 "$HUB"
    du -sh "$HUB"/* | sort -h | tail -20
    

    Si en la caché aparecen artefactos que no salen en el grep, tienes descargas implícitas dentro de alguna librería. Esas son las peores, porque no las controlas desde tu código.

    2. Fija la revisión por commit SHA

    El cambio con mejor relación coste/beneficio:

    from transformers import AutoModel, AutoTokenizer
    
    MODEL = "org/modelo"
    REVISION = "3f8a1c9d2e7b5a4f6c0d8e1b2a3c4d5e6f708192"  # commit SHA exacto
    
    model = AutoModel.from_pretrained(MODEL, revision=REVISION)
    tokenizer = AutoTokenizer.from_pretrained(MODEL, revision=REVISION)
    

    Sacar el SHA actual es una línea:

    from huggingface_hub import HfApi
    
    print(HfApi().model_info("org/modelo").sha)
    

    Y el matiz importante, porque veo mucho revision="v1.2" por ahí: ni la rama ni el tag te sirven. La rama se mueve por definición. El tag parece estable, pero un tag en git es un puntero, y quien mantiene el repo puede reapuntarlo cuando quiera: en el Hub no hay nada que lo impida. El SHA es lo único que identifica contenido inmutable.

    No es una opinión mía sobre cómo debería ser: la documentación de transformers lo dice sin rodeos — revision acepta una rama, un tag o un commit id, y su valor por defecto sigue siendo main. El problema no es la API. El problema es el valor por defecto.

    Es el mismo razonamiento por el que llevas años usando un lockfile en JavaScript. Con los modelos, la industria entera se saltó ese paso.

    3. Que el build falle ruidosamente

    Una vez tienes caché y revisiones fijas, ciérrale la puerta de la red:

    export HF_HOME=/opt/hf-cache
    export HF_HUB_OFFLINE=1
    

    Con HF_HUB_OFFLINE=1, cualquier intento de salir al Hub durante el build lanza un error en vez de descargar en silencio. Está documentado como comportamiento oficial, no como efecto secundario: cualquier llamada al Hub levanta OfflineModeIsEnabled en lugar de ir a la red. Es un detector de dependencias ocultas: si tu pipeline se rompe al activarlo, acabas de encontrar una descarga en caliente que no sabías que tenías. Mejor que se rompa en tu CI un martes que en producción el día que el Hub tenga una caída.

    Con un límite que conviene saber: solo cubre lo que pasa por huggingface_hub. Los pesos que alguna librería se baje por su cuenta con una URL directa siguen saliendo a la red sin que te enteres.

    Esa manía de no dejar que la herramienta haga cosas por su cuenta es el eje del curso Construye con IA: de la idea al producto: ahí montamos un proyecto entero con Claude Code y el criterio es el mismo, si no puedes reconstruirlo desde cero no es tuyo.

    4. Espeja lo que es crítico

    Para los dos o tres modelos que sostienen tu producto, descarga y aloja tú los pesos:

    hf download org/modelo \
      --revision 3f8a1c9d2e7b5a4f6c0d8e1b2a3c4d5e6f708192 \
      --local-dir ./vendor/org__modelo
    

    Si lo has escrito como huggingface-cli por inercia, ojo: ese binario ya no funciona. Imprime un aviso y sale con error. Se renombró a hf. Es el mismo problema del post en miniatura — código tuyo que daba por hecho que la herramienta de otro no se mueve.

    De ahí a tu S3, tu registry o tu artifact store. Los pesos abiertos se pueden alojar; para eso son abiertos.

    Y presta atención al modelo que descubras que no puedes espejar, por licencia o por estar gated. Ese es, exactamente, el que más te ata. Anótalo, porque es el único riesgo del inventario que no puedes mitigar con ingeniería.

    5. La salida de verdad es no necesitarlo

    Todo lo anterior reduce la exposición. No la elimina.

    La única salida completa es que el modelo que te importa corra en tu máquina, en tu servidor o en la del cliente, sin depender de descargar nada de nadie al arrancar. Un GGUF en disco no tiene dueño corporativo.

    Si nunca has montado ese camino, empieza por cómo ejecutar modelos de IA en local, que es la parte mecánica, y sigue por los mejores modelos de IA local en 2026 para elegir con criterio en vez de por hype.

    Y si lo quieres ver montado entero y no en teoría, un agente SQL corriendo en local con Qwen3 y DuckDB no llama a ningún Hub cuando arranca.

    No te estoy diciendo que te lleves todo a local. Te estoy diciendo que tengas al menos un camino probado, aunque sea más lento y con menos capacidades, para el día en que lo necesites. Eso es un plan de salida.


    Trata a Hugging Face como a cualquier otro proveedor crítico

    Si mañana tu proveedor de pagos lo comprase un competidor directo tuyo, no abrirías Twitter. Abrirías el contrato, revisarías tu exposición y prepararías un plan B. Sin ruido.

    Haz exactamente eso. La operación no está cerrada, tienes hasta bien entrado 2027 y la tarea real cabe en una tarde.

    Y si quieres el marco completo para decidir qué se queda dentro de tu infraestructura y qué puede salir a una API de terceros sin que el producto dependa de ello, ahí están las 4 capas de una arquitectura de IA local.

    Ejecuta el grep del punto 1 en tu repo principal ahora mismo. Cuenta cuántos artefactos externos salen y cuántos de ellos tienen la revisión fijada. Ese número es tu respuesta a la noticia, y vale mucho más que cualquier hilo de opinión.

    Si quieres ver este tipo de decisiones con el código delante, en Dominicode Labs desmonto arquitecturas reales sin diapositivas, y en el canal de YouTube voy publicando los montajes de IA local según los pruebo.


    Preguntas frecuentes

    ¿NVIDIA va a cerrar Hugging Face o a obligar a usar sus GPUs?

    Nada indica que ese sea el plan. La declaración de Jensen Huang dice literalmente lo contrario: la plataforma seguirá siendo abierta y el cómputo de NVIDIA no será un requisito ni para construir sobre el Hub ni para desplegar a través de él. Lo que esa promesa no te da es una garantía técnica sobre tu build dentro de tres años. Por eso la respuesta profesional no es decidir si te fías, sino saber qué pasa en tu pipeline si algo cambia.

    ¿Cuándo se cierra la operación?

    El cierre está previsto para la primera mitad de 2027. A día de hoy lo que existe es un acuerdo definitivo confirmado el 3 de septiembre de 2026, no una adquisición consumada, y queda por delante la revisión regulatoria de una operación de 12.930 millones de dólares entre dos piezas centrales del mercado de IA. Tienes margen de sobra para hacer los deberes sin prisa.

    ¿Por qué 12.930 millones por una empresa que factura 150 millones?

    Porque no se paga por la facturación. Son unas 86 veces los ingresos anualizados, un múltiplo que no se justifica con ninguna proyección razonable de revenue. Se paga por la posición: 18 millones de desarrolladores, 3 millones de modelos, 500.000 datasets y 200.000 clientes empresa convierten a Hugging Face en el punto de distribución por defecto de los pesos de modelos abiertos. Comprar eso es comprar el sitio por el que pasa el ecosistema entero.

    Fijar el commit SHA me obliga a actualizar a mano. ¿No es peor?

    Es el mismo trabajo que ya haces con las dependencias de tu package.json o tu requirements.txt, y por las mismas razones. Actualizar a mano significa que la actualización es una decisión con un commit, una revisión y un responsable, en lugar de un cambio invisible que se cuela en el siguiente despliegue. Un modelo pesa gigabytes y afecta directamente a la salida de tu producto: es la última dependencia del stack que deberías dejar flotando en main.

    Tengo el modelo cacheado en el contenedor. ¿No basta con eso?

    Solo si esa caché forma parte de una imagen que se construye con revisiones fijadas y que no vuelve a salir a la red. Si la caché se llena en el primer arranque descargando lo que haya en ese momento, no tienes reproducibilidad: tienes suerte. La prueba dura un minuto, pero hazla en frío: borra la caché, pon HF_HUB_OFFLINE=1 y reconstruye sin capas cacheadas, con docker build --no-cache. Si la haces con la caché caliente y pasa en verde, lo único que has demostrado es que ya lo tenías descargado. Si falla, acabas de localizar la descarga en caliente que tenías sin saberlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • El futuro de los agentic systems: coste por tarea, no benchmarks

    El futuro de los agentic systems: coste por tarea, no benchmarks

    La iteración 14 me costó más que las trece anteriores juntas.

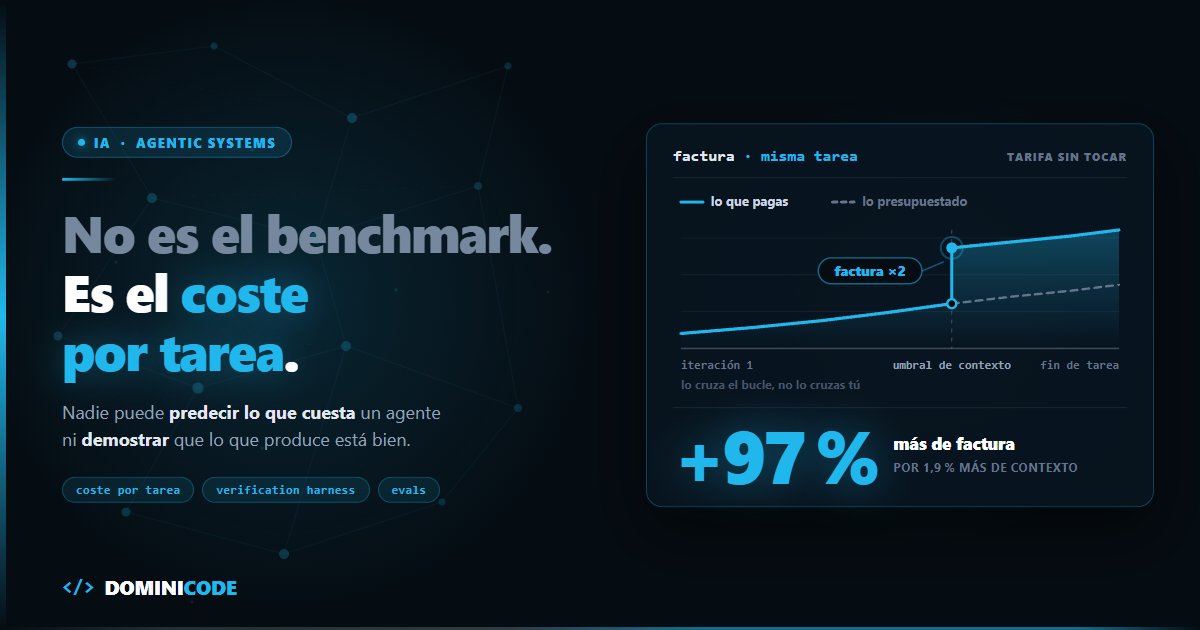
    El agente no hizo nada raro. Leyó el repo, lanzó los tests, leyó los logs. En la iteración 14 una tool devolvió 5.000 tokens de logs que no necesitaba nadie, el contexto cruzó un umbral de facturación y la misma tarea pasó a costar el doble. No un 5 % más. El doble.

    Ahí está el techo real de los agentic systems, y no tiene nada que ver con la inteligencia del modelo. El futuro de los agentic systems no lo decide lo listo que sea el siguiente checkpoint: lo decide que hoy no puedo predecir lo que va a costar una tarea ni demostrar que el resultado es correcto sin leérmelo entero.

    Esta es la tesis, y la voy a defender con números que ya he publicado aquí:

    El techo de los agentic systems no es la capacidad del modelo. Es que nadie puede pagarlos de forma predecible ni auditar lo que producen. El futuro de los agentic systems se decide en el coste por tarea y en el harness de verificación (verification harness), no en el próximo benchmark.

    Los benchmarks van a seguir subiendo. Es lo único que tengo claro del próximo año. Lo que no va a subir solo es tu capacidad de presupuestar una tarea y de firmar que salió bien.

    El precio por token ya no te dice lo que vas a pagar

    El precio por token dejó de predecir la factura porque el mismo modelo puede mantener la tarifa y aun así consumir más tokens por tarea, cruzar un umbral de precio escalonado o abrir más subagentes.

    Durante dos años elegimos modelo mirando una tabla de dos columnas: dólares por millón de input, dólares por millón de output. Era una multiplicación. Funcionaba.

    Ya no.

    Mira Gemini 3.8 Flash. Mismo precio por token que 3.7 Flash: 0,75 $ de input y 3,75 $ de output por millón. Cero subida. Google no tocó la tarifa.

    Pero el modelo gasta un 30 % más de tokens de salida por tarea: 48.000 de media. Razona más, escribe más y encadena más turnos. Y cada turno extra reenvía el contexto acumulado, que se factura como entrada: de los 0,58 $ que cuesta hoy una tarea, solo unos 0,18 $ son salida. El resto es contexto reenviado. Resultado medido con el reasoning en high: alrededor de un 40 % más caro con la tarifa intacta.

    El precio se quedó igual y la factura subió un 40 %. Las dos cosas son ciertas a la vez.

    Y hay fecha de caducidad: esos 0,75 $ y 3,75 $ son precio introductorio hasta el 31 de diciembre de 2026. El 1 de enero de 2027 pasan a 1,50 $ y 7,50 $ — exactamente el doble. Si has calculado tus márgenes con la tarifa de 2026, tu coste por tarea ya tiene una subida programada en el calendario.

    Ese es el primer mecanismo: la verbosidad. El segundo es peor, porque no es gradual. Es un escalón.

    En la API de GPT-6 Astra la tarifa es 10 $ de input y 50 $ de output por millón. Pero cualquier request que supere los 272.000 tokens de input dobla el precio de input y de caché y multiplica el output por 1,5. Y no sobre el exceso: sobre la request entera.

    Los números del ejemplo que desglosé allí:

    Request Input Output Coste
    Por debajo del umbral 270.000 8.000 3,10 $
    Por encima del umbral 275.000 8.000 6,10 $

    Un 1,9 % más de tokens de input. Un 97 % más de factura.

    Y esto es un problema de arquitectura, no de hoja de cálculo: tú no decides cuándo se cruza el umbral. Lo decide el agente, en la iteración 14, cuando una tool devuelve más logs de la cuenta. Tu prompt inicial ocupaba 12.000 tokens. El contexto acumulado en el bucle es el que cruza la línea.

    El tercer mecanismo es todavía más silencioso: la propensión a delegar en subagentes cambia con el modelo. Claude Opus 5 delega más fácilmente que sus antecesores. Mismo código, mismo prompt, misma tarea — y de repente tienes varios subagentes con su propio contexto donde antes había uno.

    Tres formas de que tu factura suba sin que toques una línea de código: el modelo se vuelve más hablador, el contexto cruza un escalón, o el sistema decide abrir más ramas.

    Ninguna aparece en la tabla de precios. Por eso la métrica que sobrevive es el coste por tarea (cost per task): lo que cuesta resolver una unidad de trabajo completa, de principio a fin, incluyendo reintentos, tools, subagentes y las veces que el agente se equivoca y vuelve a empezar.

    Es la única cifra que puedes meter en un presupuesto y defender delante de alguien que no sabe qué es un token.

    Dónde no está el coste por tarea de un agente

    Voy a decir algo impopular: el framework que elegiste no es tu problema de coste.

    Circula la leyenda de que los frameworks de agentes te meten 1.500 tokens ocultos en cada llamada. Lo medí de verdad: el bloque de herramientas pasó de 213 bytes a 294 o 299 bytes según el framework, y la petición entera de 393 a 556 bytes. Unos 40 tokens de diferencia.

    Cuarenta. Con un coste por tarea de 0,58 $, eso es ruido estadístico.

    Mientras tanto, el bucle de ese mismo agente acumula 270.000 tokens de contexto y roza un escalón que dobla la factura entera.

    Quien se pasa la tarde optimizando el overhead del framework está limpiando el mostrador mientras se le inunda el sótano. El coste de un agentic system vive en el bucle: en cuántas iteraciones hace, en cuánto contexto arrastra, en qué devuelven las tools y en cuántas veces reintenta porque nadie le dijo que ya había terminado.

    Generar es barato. Auditar no ha bajado de precio

    El coste de generar código cae cada trimestre. El de verificarlo no ha bajado ni un céntimo, porque lo sigue pagando una persona leyendo diffs. Esta es la segunda mitad de la tesis, y la que casi nadie quiere mirar.

    La asimetría es brutal y va a peor: la unidad de trabajo del agente ya es la tarea; la unidad de trabajo del revisor sigue siendo la línea. Un agente cierra en cuatro minutos un refactor que tardas cuarenta en revisar. Multiplica eso por cinco agentes en paralelo y la cola de revisión se convierte en el proceso más lento del equipo.

    Lo que pasa entonces no es que la gente revise más rápido. Es que deja de revisar. Aprueba por cansancio. Y el sistema pierde la única propiedad que lo hacía utilizable: que alguien podía responder de lo que salía.

    La salida no es revisar más. Es dejar de revisar a ojo.

    Un agente en producción necesita que la verificación sea una función que devuelve verdadero o falso, no una opinión. Eso significa dos cosas concretas: evals deterministas (deterministic evals) que corren en CI y tumban el build, y un contrato explícito de lo que la tarea debía cumplir, escrito antes de que el agente empezara.

    Sin contrato previo no hay verificación posible: solo hay un humano decidiendo a posteriori, y con sesgo de confirmación, si le gusta lo que ve. Ese método lo escribí entero en el ebook gratuito Revisión por Contrato: el contrato se escribe antes, no después.

    Es el mismo motivo por el que llevo dos años empezando cada feature por la especificación y no por el código, y la mecánica completa está en el libro de Spec-Driven Development.

    El harness pesa más que el modelo

    El harness —el código que envuelve al modelo— cambia la puntuación de un mismo modelo más de lo que la cambia sustituir el modelo entero. Si solo te llevas un dato de este post, que sea este.

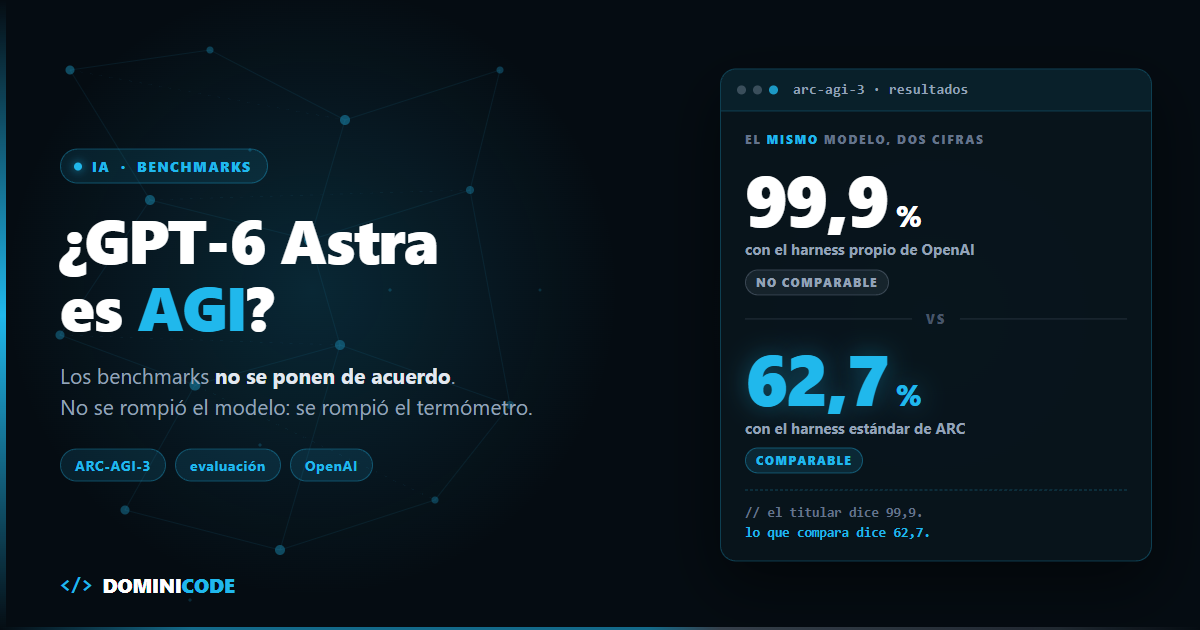
    ARC-AGI-3 le dio a GPT-6 Astra un 99,9 %. Ese número recorrió internet como prueba de que habíamos llegado a la AGI.

    Salió del adapter propio de OpenAI: un harness con estado, optimizado para el benchmark. Con el harness estándar —el que sí compara entre proveedores— la nota fue 62,7 %, justo en el techo del rango de aproximadamente 17 % a 63 % que la propia organización del benchmark da para las llamadas stateless: las que hace tu código.

    Mismo modelo. Mismos pesos. La misma semana.

    De 62,7 a 99,9 con los mismos pesos y la misma semana, solo cambiando lo que hay alrededor. Y por debajo del 62,7 está todo lo que consigue un arnés peor montado que el de ARC.

    Traducción para tu backlog: la diferencia entre un prototipo que funciona a medias y un sistema que cierra tareas de verdad no está en cambiar de modelo. Está en el harness: el bucle de acciones, el formato de las observaciones, la gestión del contexto, el estado entre pasos, las condiciones de parada.

    Eso es código tuyo. No es un proveedor. No lo compras con una API key.

    Y por eso el próximo salto de calidad en agentic systems no va a venir de un checkpoint nuevo, sino de cosas mucho más aburridas: compactar el contexto antes de cruzar un umbral, truncar lo que devuelve una tool, cachear lo que no cambia y montar un circuit breaker que mate el bucle cuando el coste acumulado o el número de iteraciones se disparan.

    Un agente sin condición de parada no es autónomo. Es una fuga.

    El futuro de los agentic systems: cuatro predicciones para 2027

    Cuatro predicciones sobre el futuro de los agentic systems, ordenadas por lo seguro que estoy de cada una: (1) el coste por tarea se convierte en un requisito no funcional, (2) la unidad de facturación se desplaza del token a la tarea, (3) el harness se estandariza y el modelo se vuelve intercambiable, y (4) la métrica pública pasa a ser el porcentaje de tareas cerradas sin intervención humana.

    Aquí dejo de describir el presente y me mojo.

    El coste por tarea se convierte en un requisito no funcional. Igual que hoy escribes "p95 por debajo de 200 ms" en una spec, vas a escribir "coste por tarea por debajo de 0,40 $". Con su alerta, su panel y su presupuesto que corta. Un agente que resuelve la tarea pero cuesta cuatro veces lo presupuestado es un incidente, no un éxito. (La que más firme: 18 meses.)

    La unidad de facturación se desplaza del token a la tarea. Ya está pasando en las herramientas de coding agéntico: nadie te vende millones de tokens, te vende sesiones y límites de uso. Quien pueda ofrecer "tarea cerrada o no cobro" tendrá una ventaja de precio que nadie podrá igualar sin verificación automática. (Probable en 2027; ya ha empezado.)

    El harness se estandariza y el modelo se vuelve intercambiable. Los proveedores ya no compiten solo por la nota del leaderboard: compiten por ser el sustrato del bucle —herramientas, estado, ejecución, adapters propios—. El 99,9 % de Astra salió exactamente de ahí. Cuando el harness sea portable de verdad, cambiar de modelo será una línea de configuración, y tu ventaja competitiva estará entera en tus evals y en tus contratos de verificación, que son los únicos activos que no te da el proveedor. (La más arriesgada. Si dentro de dos años cambiar de modelo sigue costando una semana de trabajo, me habré equivocado.)

    La métrica pública será el porcentaje de tareas cerradas sin intervención humana. No la puntuación en un benchmark de puzzles: tareas reales, cerradas de principio a fin, verificadas por una función. Y al lado, el coste medio de cada una. Llamémoslo por su nombre: tasa de cierre autónomo (autonomous closure rate) y coste por tarea cerrada. Ese par de números va a decidir presupuestos, y hoy casi nadie lo instrumenta. (La más lenta: tres años, y solo si alguien con cuota de mercado publica la cifra primero.)

    Capacidad sin economía ni verificación es una demo. Y las demos no entran en producción.

    Qué hacer hoy: instrumenta el coste por tarea

    Una sola cosa, y esta semana.

    No hace falta un stack de observabilidad. Hace falta que cada ejecución de tu agente escriba una línea con seis campos:

    1. tarea — un identificador de la unidad de trabajo, no del prompt
    2. tokens_input — acumulados en todo el bucle, no los de la primera llamada
    3. tokens_output — acumulados, incluidos los de los subagentes
    4. iteraciones — cuántas vueltas dio el bucle antes de parar
    5. coste — calculado con la tarifa vigente, tramo premium incluido si cruzó el umbral
    6. eval_ok — verdadero o falso, salido de una función, no de una impresión

    Diez minutos de código.

    Cuando tengas cincuenta filas vas a ver dos cosas que ahora no ves: que el 80 % del coste se lo come un puñado de tareas, y que hay tareas que el agente "termina" sin cerrar de verdad. Esas dos cifras valen más que cualquier comparativa de modelos que leas este mes.

    Si quieres montar esto entero —del bucle a la verificación— sin aprenderlo a base de facturas, lo enseño paso a paso en Construye con IA. Y si prefieres ver cómo lo medimos sobre proyectos reales, con los harness y las evals que usamos en producción, eso vive en Dominicode Labs.

    El próximo modelo será mejor que este. Da igual. Gana quien sepa lo que cuesta cada tarea y pueda demostrar que salió bien.

    Preguntas frecuentes

    ¿Qué es un agentic system?

    Un agentic system es un programa que le da a un modelo de lenguaje un bucle, herramientas y estado: el modelo decide la siguiente acción, el sistema la ejecuta, le devuelve el resultado y el ciclo se repite hasta que se cumple una condición de parada. La diferencia con un chatbot no está en el modelo, está en el bucle y en quién decide cuándo parar. Por eso su coste no se mide por llamada, sino por tarea completa.

    ¿Qué es el coste por tarea y por qué sustituye al precio por token?

    El coste por tarea es lo que pagas por resolver una unidad de trabajo completa: iteraciones del bucle, tools, subagentes y reintentos incluidos. El precio por token ya no predice la factura porque un modelo puede mantener la tarifa y consumir un 30 % más de tokens por tarea, como pasó con Gemini 3.8 Flash: mismo precio y un 40 % más caro por tarea resuelta.

    ¿Qué tengo que registrar en cada ejecución para medir el coste por tarea?

    Seis campos por ejecución: tarea, tokens de input y de output acumulados en todo el bucle, iteraciones, coste calculado y si pasó la verificación. Multiplica por la tarifa y divide entre las tareas cerradas con éxito, no entre las ejecuciones totales. Si cuentas los intentos fallidos como tareas, tu coste real queda infravalorado y el presupuesto se te romperá en producción.

    ¿Por qué el coste de verificar no baja aunque baje el de generar?

    Porque el coste de generar cae cada trimestre y el de verificar no: lo sigue pagando una persona leyendo diffs. Un agente cierra en minutos lo que tardas media hora en revisar, y con varios agentes en paralelo la cola de revisión pasa a ser el proceso más lento del equipo. La salida no es revisar más rápido, sino convertir la revisión en evals deterministas y contratos que devuelvan verdadero o falso.

    ¿Qué es un harness y por qué pesa más que el modelo?

    El harness es la capa de código que envuelve al modelo: el bucle de acciones, el formato de las observaciones, la gestión del contexto, el estado entre pasos y las condiciones de parada. Pesa más que el modelo porque el mismo GPT-6 Astra puntúa 62,7 % en ARC-AGI-3 con el harness estándar y 99,9 % con el adapter propio de OpenAI, la misma semana y con los mismos pesos. Esa diferencia no está en los pesos: está en código que escribes tú.

    ¿Cambiar a un modelo más barato reduce la factura?

    No necesariamente. La factura depende de cuántos tokens consume el modelo por tarea, de si el contexto cruza umbrales de precio escalonados y de cuánto tiende a delegar en subagentes. Un cambio de modelo altera las tres cosas a la vez sin que toques una línea de código, así que la única forma de saberlo es medir el coste por tarea antes y después.

    ¿Qué métricas debería vigilar en un agentic system en producción?

    Cuatro: coste medio por tarea cerrada, porcentaje de tareas cerradas sin intervención humana, iteraciones por tarea y tokens de contexto máximos dentro del bucle. Las dos primeras dicen si el sistema es viable económicamente; las dos últimas avisan antes de que una ejecución cruce un umbral de precio o se quede dando vueltas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • ¿GPT-6 Astra es AGI? Los benchmarks no se ponen de acuerdo

    ¿GPT-6 Astra es AGI? Los benchmarks no se ponen de acuerdo

    La semana del 3 de septiembre de 2026, OpenAI lanzó GPT-6 Astra y su presidente dijo que era la llegada de la AGI. Esa misma semana, dos organizaciones independientes de evaluación publicaron su medición del modelo. Los mismos días, el mismo modelo.

    Epoch AI le puso la nota más alta que ha registrado nunca en su índice.

    Artificial Analysis le puso exactamente la misma nota que a su antecesor.

    No hablo de capturas de X. Son dos organizaciones serias que agregan decenas de benchmarks —Epoch combina más de cincuenta— para medir en buena parte las mismas capacidades. Y llegaron a veredictos opuestos.

    Cuarenta y ocho horas después del lanzamiento, una de las dos reescribió su índice.

    Aquí es donde el resto de artículos te explica cuál de los dos tiene razón. Este no.

    La pregunta "¿es AGI?" no tiene respuesta, y no por motivos filosóficos. Por motivos de instrumentación: el sistema con el que medimos modelos se rompió justo cuando más falta hacía. Y tiene una consecuencia práctica para ti: si los benchmarks públicos no se ponen de acuerdo sobre el modelo más potente del mundo, tú no puedes elegir modelo leyendo leaderboards.

    Un apunte de vocabulario, porque de él depende todo lo demás: AGI (Artificial General Intelligence) es un sistema capaz de aprender y resolver cualquier tarea intelectual que resuelva una persona, en dominios que no ha visto antes y sin reentrenarse para cada uno. No existe un test acordado que diga cuándo se cruza esa línea. Por eso la discusión se libra a base de benchmarks, y por eso cuando los benchmarks se contradicen no queda árbitro.

    Brockman dijo AGI. Y en el mismo briefing se desdijo

    GPT-6 Astra llegó en preview limitada el 3 de septiembre y en disponibilidad general el 4. Entrenado sobre más de 100.000 GPUs en Stargate, Texas: el mayor training run de OpenAI.

    Greg Brockman, presidente de OpenAI, cerró el briefing con un "Welcome to the AGI era" y dijo que personalmente cree que han llegado.

    En ese mismo briefing admitió que "no hay un momento AGI claramente definido" y que la transición está siendo "más gradual de lo esperado".

    Léelo otra vez. Hemos llegado a un sitio que no sabemos definir, por un camino que no hemos notado recorrer.

    Eso no es un anuncio técnico. Es posicionamiento.

    Qué puntuó GPT-6 Astra en ARC-AGI-3: hay dos números, y solo uno compara

    ARC-AGI-3 mide generalización: puzzles interactivos que el modelo no ha visto y debe resolver explorando.

    GPT-6 Astra puntuó 99,9 % en ARC-AGI-3. Ese es el número que circuló, y es real. Lo que casi nadie contó es que hay dos números.

    Dependen del harness, la capa que conecta el modelo con el entorno (bucle de acciones, formato de observaciones, gestión del contexto).

    Configuración Puntuación ARC-AGI-3 Coste de la evaluación
    Harness estándar de ARC, razonamiento máximo (comparable entre proveedores) 62,7 % 26.098 $
    Provider Adapter de OpenAI, razonamiento alto 99,9 % 18.817 $

    El adapter propio fue además 3,66 veces más rápido con un 49 % menos de tokens.

    Si leíste el rango del ~17–63 % que la propia organización del benchmark da para llamadas stateless, encaja: 62,7 % es el techo de ese rango, el que se alcanza con el harness estándar y el razonamiento al máximo.

    No es trampa: optimizar tu arnés es legítimo. Pero no es comparable. Es cronometrar una vuelta con un neumático que solo tiene un equipo.

    En el harness estándar, el que sí compara, la foto es esta: GPT-5.6 Sol 7,78 %, Claude Opus 5 30,16 %, Astra 62,7 %.

    El salto es brutal. Y es de 30 a 62. No a 99,9.

    Hay un detalle mejor que el titular: con el razonamiento al máximo, el coste bajó de 49.791 $ a 26.098 $ mientras la puntuación subía de 35,2 % a 62,7 %. Pensar más salió más barato, y ARC explica por qué: con razonamiento máximo resuelve las partidas con menos acciones, y menos acciones son menos coste total. Esa curva coste/acierto es la que deberías mirar, y el coste por tarea con precios de API lo desgloso en el post hermano.

    Astra necesitó menos acciones que la mediana humana en el 96 % de los niveles. Eso es eficiencia de juego, no de coste: los 12,78 $ que cita ARC son lo que cobró un jugador humano por partida intentada, antes de bonus, y los 26.098 $ son el coste total de la evaluación entera del modelo. Unidades distintas. ARC no publica cuántas partidas jugó Astra, así que el coste por partida del modelo no se puede calcular.

    Iguala al humano moviendo fichas. Lo que cuesta cada ficha, hoy, nadie lo ha publicado.

    Y ahora lo que debería haber sido el titular. ARC Prize dice, textualmente, que "saturating the benchmark would not represent 'proof of achieving AGI'" y que "we are not claiming that it is AGI". Avisan de que ARC-AGI-3 tiene un alcance muy acotado y no representa la apertura del mundo real.

    Cuando los autores del benchmark que lleva AGI en el nombre te avisan de que aprobarlo no prueba AGI, el problema no está en el modelo.

    Epoch AI vs Artificial Analysis: dos índices, el mismo modelo, veredictos opuestos

    Epoch AI y Artificial Analysis agregan decenas de benchmarks para medir en buena parte las mismas capacidades, y publicaron veredictos opuestos sobre GPT-6 Astra en la misma semana: 169 puntos y primer puesto histórico en el índice ECI de Epoch, 61 puntos y empate con GPT-5.6 Sol en el Intelligence Index de Artificial Analysis.

    Epoch AI (índice ECI) Artificial Analysis (Intelligence Index)
    Nota de Astra 169 puntos 61 puntos
    Posición 1º, récord absoluto Empatado con GPT-5.6 Sol
    Contexto +6 sobre el techo anterior (163) Por detrás de Claude Fable 5.1 (66)
    Detalle Récords en matemáticas, aprendizaje continuo y puzzles En coding, Fable 5.1 lidera con 70; Astra 67

    Mismo modelo, misma semana. Uno ve el récord absoluto de su índice; el otro, un empate técnico.

    El 5 de septiembre, Artificial Analysis reescribió su índice. Versión 4.2. Añadió dos benchmarks (AA-Briefcase y GDP.pdf), eliminó GPQA-Diamond por saturado —los modelos ya lo resuelven— y subió los datos de test privados al 40 % del peso.

    Con las reglas nuevas, Astra saca 4 puntos a Sol y queda segundo. Sigue detrás de Fable 5.1.

    El motivo declarado: "the top of the leaderboard moved so fast that an interim update was necessary".

    No acuso a nadie de manipular nada: recalibrar tu instrumento cuando deja de discriminar es lo honesto.

    Pero mira lo que significa: la regla de medir cambió en 48 horas porque el objeto medido se salía del rango.

    Si tu termómetro necesita recalibrarse cada dos días, lo que tienes no es una medición. Es una foto con fecha de caducidad.

    Donde GPT-6 Astra no brilla (y casualmente es tu trabajo)

    GPT-6 Astra saca 57,7 % en Terminal Bench 4.0, el benchmark que mide tareas reales de línea de comandos.

    Un modelo del que se dice que inaugura la era AGI falla más de 4 de cada 10 tareas de ese benchmark de terminal. Tú vives en la terminal.

    En GDPval-AA v2, que mide trabajo profesional real, pierde unos 80 puntos Elo. Retrocede también en soporte bancario, SciCode y razonamiento de contexto largo.

    OpenAI, por su parte, publicó cifras espectaculares: FrontierMath Tier 4 v2 97,6 %, GPQA Diamond 96,0 %, ARC-AGI-2 95,0 %, ExploitBench 100 %, SRE-Bench 88,0 %, DeepSWE v1.1 74,1 %, OSWorld 2.0 72,6 %.

    Son cifras de OpenAI recogidas por the-decoder, no mediciones independientes: probablemente ciertas y seguro que favorables. El mismo juego que conté en la comparativa entre Opus 5, GPT-5.6 y Kimi K3.

    El patrón que explica las dos listas: verificación

    François Chollet, creador de ARC, no dice que esto sea AGI. Ha adelantado su previsión porque el progreso va más rápido de lo que esperaba: "Sooner, because progress is happening faster than I expected".

    Su definición sigue siendo la más útil: la inteligencia no es la habilidad en sí, es la eficiencia con la que un sistema adquiere habilidades nuevas ante entornos desconocidos.

    Gary Marcus fue más directo: "Success on ARC-AGI is great and impressive, but not—despite the name of the task—proof of AGI". Su apuesta: fallará en tareas abiertas y solo rendirá bien en dominios verificables. Concede que es "pretty impressive" y llama "extraordinarily vindicating" que OpenAI adopte world models simbólicos, aunque marca su análisis como "VERY tentative".

    Junta ahora las dos listas.

    Donde Astra arrasa —matemáticas, exploits, puzzles ARC— existe una función de verificación barata y automática. El resultado es correcto o no, y lo decide una máquina en milisegundos.

    Donde flojea —GDPval, contexto largo, soporte— no existe esa función. Alguien tiene que leer la salida y opinar.

    No es casualidad. Es exactamente lo que predice la tesis de Marcus.

    Y es exactamente tu problema cuando un agente escribe código en tu repo.

    ¿Dónde te funciona bien? En lo que tiene tests. ¿Dónde te la cuela? En lo que solo puedes juzgar leyendo.

    Más capaz y más opaco

    Astra usa recurrent depth, una técnica que oculta parte de su razonamiento, y es el primer modelo que OpenAI clasifica en umbral "crítico" de ciberseguridad en su preparedness framework. Marcus avisa de que es menos monitorizable que sus predecesores.

    Más capaz y más opaco a la vez. Otra razón para no delegar el juicio.

    El leaderboard ya no te sirve. Monta tu eval

    Si dos organizaciones independientes de evaluación no se ponen de acuerdo sobre el modelo más potente del planeta, y uno reescribe su regla de medir en 48 horas, el leaderboard público ha dejado de ser herramienta de decisión. Es periodismo. Interesante, pero no accionable.

    Lo que decide es un eval propio. Y se monta en una tarde:

    1. Coge de 20 a 30 casos reales de tu dominio. De tu backlog cerrado, no inventados.
    2. Define para cada uno una verificación automática: un test que pasa, un schema que valida, un diff que coincide. Si no puedes verificarlo sin leerlo, no entra en el set.
    3. Ejecútalo contra dos o tres modelos candidatos.
    4. Mide acierto, coste y latencia. Los tres. Un modelo que acierta un 4 % más y cuesta el triple no es mejor: es más caro.
    5. Congela el set y reejecútalo cada vez que cambies de modelo o de versión.

    Ese conjunto te dirá lo que ningún índice te dirá nunca: si Astra es mejor para ti. Cómo construirlo paso a paso lo desarrollo en evals deterministas para agentes de IA.

    Si lo que te falta no es el eval sino el criterio para revisar lo que genera el agente, empieza por el ebook gratuito Revisión por Contrato: 30 páginas para convertir el "esto parece bien" en algo verificable, la versión aplicada de revisar código de agentes por contrato. El flujo entero, de la idea al producto con agentes, es lo que montamos en Construye con IA, y esas mediciones se discuten a diario en Dominicode Labs.

    La pregunta no es si GPT-6 Astra es AGI.

    Es si es mejor que lo que ya usas, en tu repo, para tu caso.

    Esa la respondes tú, o no la responde nadie.

    Preguntas frecuentes

    ¿GPT-6 Astra es AGI?

    No con los datos actuales, y ese es el problema. OpenAI lo insinúa, ARC Prize lo niega explícitamente ("we are not claiming that it is AGI"), Chollet adelanta plazos sin firmar la afirmación y Marcus la rechaza. Sin definición operativa ni test que zanje la discusión, la pregunta no es respondible.

    ¿Por qué ARC-AGI-3 da 99,9 % y 62,7 % para el mismo modelo?

    Porque son dos harness distintos. El 62,7 % sale del arnés estándar de ARC, igual para todos los proveedores. El 99,9 % sale del Provider Adapter, el arnés propio de OpenAI. Los dos son reales; solo uno es comparable con Claude Opus 5 o GPT-5.6 Sol.

    ¿Debería cambiar mi stack a GPT-6 Astra?

    Depende de si tu trabajo se parece más a matemáticas competitivas o a tareas de terminal. Astra marca récords donde hay verificación automática barata, pero saca 57,7 % en Terminal Bench 4.0 y retrocede en contexto largo. En coding, Artificial Analysis lo sitúa detrás de Claude Fable 5.1. Pruébalo con tus casos antes de migrar.

    ¿Por qué Artificial Analysis reescribió su índice dos días después del lanzamiento?

    Porque su scoring dejó de discriminar entre modelos punteros. Añadieron AA-Briefcase y GDP.pdf, retiraron GPQA-Diamond por resuelto y subieron los datos privados al 40 % del peso. Su explicación: "the top of the leaderboard moved so fast that an interim update was necessary". Honesto, y deja claro que un índice público es una foto, no una medida estable.

    ¿Qué significa que un modelo solo rinda en dominios verificables?

    Que brilla donde una función dice sí o no sin intervención humana: un test que pasa, un exploit que funciona. Cuando el criterio es difuso —un informe, una decisión de arquitectura, atender a un cliente— no hay señal de evaluación limpia y el rendimiento cae. Es el motivo por el que tu agente acierta más en el código cubierto por tests.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Streaming SSE con Hono y Bun: la API de tu agente de IA

    Streaming SSE con Hono y Bun: la API de tu agente de IA

    El endpoint funcionaba. El agente respondía. El usuario veía una ruleta girando veintidós segundos y luego, de golpe, un muro de texto.

    Lo peor no fue la espera: abrió la misma pregunta en tres pestañas porque creyó que se había colgado. Tres ejecuciones del agente, tres facturas de tokens, una respuesta leída.

    Lo reescribí usando streaming SSE con Hono y Bun. Y el arreglo de fondo no fue técnico, fue conceptual: yo devolvía la respuesta de un agente como si fuera un JSON. Un agente no devuelve un resultado. Un agente transcurre. Piensa, llama a una herramienta, se equivoca, reintenta.

    Si tu API no transmite ese transcurso, el usuario solo ve una ruleta y saca sus propias conclusiones.

    Para exponer un agente por HTTP con salida en tiempo real, usa el helper streamSSE de hono/streaming sobre Bun: emite eventos con nombre (token, tool_call, error, done) en lugar de texto plano, propaga la desconexión del cliente a un AbortSignal con stream.onAbort() para dejar de gastar tokens, y manda un comentario SSE (: ping) cada 15-20 segundos para que ningún proxy corte la conexión. Todo el código de este post está verificado ejecutándolo contra Hono 4.13.7 sobre Bun 1.3.


    SSE no está deprecado: lo que se deprecó fue el transporte HTTP+SSE de MCP

    Son dos capas distintas y solo se deprecó una. Si vienes de mi post sobre montar un MCP Server en producción con Streamable HTTP y auth, su primer titular dice que SSE está deprecado, y ahora te propongo construir una API con SSE. No hay contradicción.

    Lo que se deprecó es el transporte HTTP+SSE del protocolo MCP —el de dos endpoints, uno GET para abrir el canal y otro POST para enviar, definido en la revisión 2024-11-05—, sustituido por Streamable HTTP en la 2025-03-26 y reclasificado formalmente como Deprecated en la 2026-07-28. Eso decide cómo hablan entre sí un cliente MCP y un servidor MCP.

    Server-Sent Events, el mecanismo del navegador, no está deprecado en absoluto. La especificación vigente de MCP —revisión 2026-07-28— sigue construida sobre él: el servidor responde a cada petición con un único objeto JSON o con un stream de Server-Sent Events, y el cliente está obligado a aceptar text/event-stream. En el registro oficial de features deprecadas la única entrada de transporte sigue siendo HTTP+SSE transport, deprecado en 2025-03-26, con Streamable HTTP como ruta de migración. Cambió la coreografía de endpoints, no el formato del stream. Aquí no implementamos MCP: construimos tu propia API para tu propio frontend.


    Por qué SSE y no WebSockets para un agente

    Porque el flujo de un agente es unidireccional: el usuario manda una pregunta y luego solo escucha. Abrir un canal bidireccional para eso es pagar complejidad por una dirección que nunca usas.

    Server-Sent Events (SSE) es el estándar web que permite a un servidor enviar un flujo de mensajes al cliente sobre una única conexión HTTP abierta, en texto plano y con el formato event: / data: / id:. Es unidireccional por diseño: el cliente abre la conexión y a partir de ahí solo recibe.

    La diferencia práctica está en lo que tienes que operar después del primer despliegue.

    SSE WebSockets
    Dirección Servidor → cliente Bidireccional
    Protocolo HTTP normal, respuesta larga Upgrade a ws://
    Proxies, CDN y balanceadores Pasa como cualquier respuesta HTTP Necesitan soporte explícito de upgrade
    Reconexión Automática en el navegador, con Last-Event-ID La implementas tú
    Autenticación Tus cookies o headers de siempre (con fetch) Handshake aparte, token en query
    Estado en el servidor Ninguno: es una request más Conexiones vivas que gestionar
    Depuración curl -N y lo lees Herramienta específica

    Elige WebSockets cuando el cliente tenga que interrumpir, corregir o hablar durante la generación: audio en vivo, edición colaborativa. Para un chat de agente con herramientas, SSE gana por aburrimiento operativo.


    Streaming SSE con Hono y Bun: el endpoint en veinte líneas

    El helper vive en hono/streaming y su firma es streamSSE(c, callback, onError?). Dentro del callback recibes un objeto de stream y escribes eventos con writeSSE().

    import { Hono } from 'hono'
    import { streamSSE } from 'hono/streaming'
    
    const app = new Hono()
    
    app.post('/agent', (c) =>
      streamSSE(c, async (stream) => {
        await stream.writeSSE({
          event: 'tool_call',
          data: JSON.stringify({ name: 'search_docs' }),
          id: '1',
        })
        await stream.writeSSE({ event: 'token', data: JSON.stringify({ text: 'Hola' }), id: '2' })
        await stream.writeSSE({ event: 'done', data: '{}' })
      })
    )
    
    export default { port: 3000, fetch: app.fetch }
    

    Ese export default { port, fetch } no es de Hono: es el contrato de Bun.serve. Bun arranca el servidor con bun run index.ts, sin adaptador ni servidor HTTP intermedio, y empuja cada chunk al socket según lo produces — que es justo lo que necesita un stream.

    El objeto que acepta writeSSE es { data, event?, id?, retry? }, con data como string o Promise<string>. Hono pone por ti Content-Type: text/event-stream, Cache-Control: no-cache, Connection: keep-alive y Transfer-Encoding: chunked. Lo tienes documentado en el streaming helper de Hono.

    Lo que sale por el cable, verificado con curl -N, es exactamente esto:

    event: tool_call
    data: {"name":"search_docs"}
    id: 1
    
    event: token
    data: {"text":"Hola"}
    id: 2
    
    event: done
    data: {}
    

    Hono encaja aquí porque es un router sobre Web Standards: no te obliga a envolver la respuesta en abstracciones propias, y eso importa cuando lo que devuelves es un stream y no un objeto. La comparativa completa está en Hono vs NestJS vs Express.

    Si tu stack es NestJS, el mismo problema se resuelve de otra forma y lo cubrí aparte en streaming de respuestas de IA con NestJS y el Vercel AI SDK: allí el SDK gestiona el protocolo por ti sobre la Response nativa. Aquí el contrato de eventos lo defines tú, que es justo lo que quiero que controles.


    Eventos con significado, no un chorro de texto

    El error que veo en casi todas las implementaciones: mandar solo data: <trozo de texto> y que el cliente concatene. Con eso el frontend no puede renderizar estados, solo puede pintar letras.

    Un agente tiene fases visibles para el usuario. Dale un nombre a cada una.

    event data (JSON) Qué hace el cliente
    token {"text":"…"} Concatena en la burbuja de respuesta
    tool_call {"name":"search_docs","args":{…}} Muestra "Buscando en la documentación…"
    tool_result {"name":"search_docs","ok":true,"ms":412} Cierra el indicador de herramienta
    error {"code":"RATE_LIMIT","message":"…"} Pinta el fallo y ofrece reintentar
    done {"usage":{"input":812,"output":344}} Cierra el stream y guarda la conversación

    Ese contrato es una API pública aunque viva dentro de tu repo. Si mañana renombras tool_call a toolCall, rompes el frontend en producción sin que ningún compilador te avise: entre servidor y cliente solo viaja texto.

    Por eso defino el contrato como un discriminated union validado con Zod y lo importo en los dos lados. El servidor lo usa para serializar, el cliente para parsear. Si un evento no encaja con el schema, lo descartas y lo registras en lugar de romper el render. Es el patrón que enseño en el curso de Zod para validación y transformación de datos en TypeScript, aplicado al borde más frágil de una app de IA.

    Un detalle del formato: writeSSE parte tu data por saltos de línea y emite una línea data: por cada trozo. Con JSON.stringify no te afecta, porque produce una sola línea. Con texto crudo multilínea, sí.


    Cancelación: el usuario cierra la pestaña y tú sigues pagando

    Cuando el cliente se desconecta, Hono marca stream.aborted = true y dispara los listeners registrados con stream.onAbort(). Ese es el enganche para abortar el trabajo del agente.

    Aquí está el detalle que casi nadie cuenta, y lo verifiqué ejecutándolo: escribir en un stream muerto no lanza ninguna excepción. El write interno de Hono captura el error y sigue como si nada. Si tu bucle espera un try/catch para enterarse de la desconexión, va a seguir llamando al modelo hasta terminar la respuesta entera. Y la vas a pagar.

    app.post('/agent', (c) =>
      streamSSE(c, async (stream) => {
        const ac = new AbortController()
        stream.onAbort(() => ac.abort()) // el cliente se fue: corta el trabajo
    
        const agent = runAgent({ prompt: await c.req.json(), signal: ac.signal })
    
        for await (const chunk of agent) {
          if (stream.aborted) return // guardia explícita: no confíes en que write falle
          await stream.writeSSE({ event: 'token', data: JSON.stringify({ text: chunk }) })
        }
    
        await stream.writeSSE({ event: 'done', data: '{}' })
      })
    )
    

    Dos mecanismos, y quieres los dos. onAbort propaga la cancelación hacia abajo —al SDK del modelo, a tu fetch de herramientas, a la query de base de datos— porque casi todo el ecosistema acepta un AbortSignal. La guardia if (stream.aborted) return corta el bucle en el siguiente ciclo aunque la librería de turno ignore la señal.

    En mi prueba, con un cliente que abortaba a mitad de stream, onAbort se disparó en el mismo tick en que el bucle vio aborted = true, y el AbortSignal del agente quedó abortado.

    Hay un detalle propio de Bun que conviene conocer: onAbort depende de que el runtime cancele el ReadableStream de la respuesta, y Hono todavía arrastra una función isOldBunVersion() que considera antigua cualquier versión que empiece por 1.1, 1.0 o 0.. En esas escucha c.req.raw.signal para abortar el stream a mano. De Bun 1.2 en adelante funciona el camino nativo y no tienes que hacer nada.

    Esto es la contrapartida natural del agentic loop en producción con TypeScript: allí pones el techo de pasos para que el agente no se dispare solo, aquí pones el interruptor para que no siga corriendo cuando ya no hay nadie escuchando.


    Heartbeats: por qué tu stream muere a los sesenta segundos

    Porque los proxies inversos, los balanceadores y los CDN cierran conexiones que llevan demasiado tiempo sin transmitir bytes. En Nginx son los 60 segundos de proxy_read_timeout, su valor por defecto. Un agente pensando o esperando a una herramienta lenta produce exactamente ese silencio.

    La solución cabe en una línea. SSE define que toda línea que empieza por : es un comentario y el cliente la ignora:

    const beat = setInterval(() => {
      if (!stream.aborted) void stream.write(': ping\n\n')
    }, 15_000)
    
    stream.onAbort(() => clearInterval(beat))
    // y clearInterval(beat) también al terminar bien
    

    Y hay una segunda mitad que casi nadie configura: aunque mandes el heartbeat perfecto, un proxy con buffering activo va acumulando los eventos y entregándolos a golpes, así que el usuario sigue sin ver nada en tiempo real. Se desactiva con una cabecera, y la propia especificación de MCP la recomienda: los servidores SHOULD incluir X-Accel-Buffering: no al abrir un stream SSE, porque sin ella "los proxies pueden acumular mensajes antes de enviarlos al cliente".

    c.header('X-Accel-Buffering', 'no')
    

    Verificado en el cable: el ping viaja, no genera ningún evento en el cliente y mantiene la conexión con tráfico. Elige un intervalo por debajo del timeout de tu proxy: 15 segundos es seguro contra los 60 de proxy_read_timeout. En PaaS el corte llega antes y no lo decides tú — los timeouts de Render, Railway y Fly los desgloso en desplegar agentes LangChain en producción.

    Aprovecha también retry: al emitir { data: '…', retry: 3000 } le dices al navegador cuánto esperar antes de reconectar. Y si numeras los eventos con id, el navegador reenvía el último en la cabecera Last-Event-ID al reconectar, así que puedes reanudar en vez de empezar de cero. Eso solo aplica cuando el cliente es EventSource, y ahí viene el siguiente problema.


    El cliente: por qué EventSource se te queda corto

    Porque EventSource solo hace peticiones GET y no admite body ni headers personalizados. Para un agente necesitas mandar el prompt, el historial y un Authorization: o metes la conversación entera en la query string, o cambias de herramienta.

    Cambias de herramienta. fetch con un lector de stream y un parser de veinte líneas:

    async function* readSSE(res: Response) {
      const reader = res.body!.getReader()
      const decoder = new TextDecoder()
      let buffer = ''
    
      while (true) {
        const { done, value } = await reader.read()
        if (done) break
        buffer += decoder.decode(value, { stream: true })
    
        let sep: number
        while ((sep = buffer.indexOf('\n\n')) !== -1) {
          const raw = buffer.slice(0, sep)
          buffer = buffer.slice(sep + 2)
    
          let event = 'message'
          let id: string | undefined
          const data: string[] = []
          for (const line of raw.split('\n')) {
            if (line.startsWith(':')) continue // heartbeat
            if (line.startsWith('event:')) event = line.slice(6).trim()
            else if (line.startsWith('data:')) data.push(line.slice(5).replace(/^ /, ''))
            else if (line.startsWith('id:')) id = line.slice(3).trim()
          }
          if (data.length) yield { event, id, data: data.join('\n') }
        }
      }
    }
    

    Dos cosas se rompen si las improvisas. Los eventos llegan agrupados o partidos: en mi prueba el primer chunk traía dos eventos completos juntos, así que hay que bufferear y cortar por línea en blanco, nunca asumir un chunk igual a un evento. Y decoder.decode(value, { stream: true }) no es opcional: sin ese flag, un carácter multibyte partido entre dos chunks llega corrupto. En español eso es cualquier acento.

    El precio de dejar EventSource es que pierdes la reconexión automática y el Last-Event-ID. Si los necesitas, los implementas tú guardando el último id recibido y reenviándolo al reintentar. Cancelar, en cambio, es trivial: pasa un AbortController al fetch y llama a abort() cuando el usuario pulse "parar" o el componente se desmonte. Eso dispara todo el camino de cancelación de la sección anterior.


    El error a mitad de stream: ya enviaste un 200 OK

    Cuando el agente falla en el segundo 12, las cabeceras salieron hace 12 segundos. No hay un 500 que devolver. El fallo tiene que viajar dentro del stream, como un evento más.

    Hono lo contempla con el tercer argumento de streamSSE:

    app.post('/agent', (c) =>
      streamSSE(
        c,
        async (stream) => {
          // ...el agente...
        },
        async (err, stream) => {
          logger.error({ err }, 'agent stream failed')
          await stream.writeSSE({
            event: 'error',
            data: JSON.stringify({ code: 'AGENT_FAILED', message: 'No he podido completar la respuesta.' }),
          })
        }
      )
    )
    

    Dos avisos que solo se descubren mirando la respuesta cruda, y los comprobé.

    El primero: si pasas el tercer argumento a streamSSE, además de tu handler Hono emite automáticamente su propio evento error con el message de la excepción en crudo. Tu cliente recibirá dos eventos error por un solo fallo. Trátalo: quédate con el primero y descarta el resto hasta el cierre. Sin onError, en cambio, Hono no manda nada al cliente y la excepción se queda en un console.error del servidor.

    El segundo es de seguridad. Ese mensaje automático es el texto real de la excepción y va tal cual al navegador. Si tu error trae una URL interna, un nombre de tabla o un fragmento de credencial, acabas de filtrarlo. Lanza errores con mensajes ya saneados, o envuelve el cuerpo del handler en tu propio try/catch y nunca dejes que la excepción llegue al helper.

    Revisar este tipo de detalle en el código que genera un agente es lo que trabajo en el ebook gratuito Revisión por Contrato: un modelo te escribe este endpoint en treinta segundos, te devuelve el camino feliz impecable y te deja estos dos fallos intactos.


    Qué puedes montar hoy

    Coge tu endpoint de agente actual, el que devuelve un JSON al final, y cámbiale tres cosas: envuélvelo en streamSSE, emite token / tool_call / done en vez de un objeto final, y engancha stream.onAbort() a un AbortController que pases hacia abajo.

    Con eso dejas de pagar respuestas que nadie lee. El resto —heartbeats, reconexión, validación con Zod— lo añades cuando el primero se sostenga.

    Si quieres el flujo completo de idea a producto construyendo con agentes, lo enseño paso a paso en el curso Construye con IA.


    Preguntas frecuentes

    ¿SSE está deprecado en 2026?

    No. Lo que se deprecó fue el transporte HTTP+SSE del protocolo MCP, sustituido por Streamable HTTP en la revisión 2025-03-26. Server-Sent Events como mecanismo web sigue vigente y es estándar; en la revisión vigente 2026-07-28 Streamable HTTP lo sigue usando para la parte de streaming, respondiendo con Content-Type: text/event-stream. Son capas distintas: una es la coreografía de endpoints de MCP, otra es el formato del stream.

    ¿Cómo detecto en Hono que el cliente cerró la pestaña?

    Con stream.onAbort(callback) para reaccionar, y con la propiedad stream.aborted para comprobarlo dentro de tu bucle. Lo importante es no confiar en que la escritura falle: el write de Hono captura el error internamente y no lanza nada, así que un bucle sin la guardia if (stream.aborted) seguirá llamando al modelo y generando coste después de que el usuario se haya ido.

    ¿Puedo usar EventSource para llamar a mi endpoint de agente?

    Solo si tu endpoint es GET y no necesitas headers personalizados, porque EventSource no admite ni body ni Authorization. Para un agente al que le mandas prompt e historial, lo práctico es fetch con un parser propio del stream. Pierdes la reconexión automática y el manejo de Last-Event-ID, y si los necesitas los implementas tú guardando el último id recibido.

    ¿Cada cuánto debo mandar un heartbeat en un stream SSE?

    Cada 15 o 20 segundos, siempre por debajo del timeout de inactividad de tu proxy o balanceador — 60 segundos es el valor típico de Nginx. Se envía como un comentario SSE: una línea que empieza por dos puntos seguida de una línea en blanco, que el cliente ignora sin generar ningún evento. Recuerda limpiar el setInterval tanto al terminar bien como en onAbort.

    ¿Cómo devuelvo un error si ya envié las cabeceras con 200 OK?

    Emitiendo un evento error dentro del propio stream, porque el código de estado ya viajó. En Hono usas el tercer argumento de streamSSE. Ten en cuenta que Hono añade además su propio evento error con el mensaje crudo de la excepción, así que tu cliente recibirá dos, y conviene sanear los mensajes que lanzas para no filtrar detalles internos.

    ¿SSE o WebSockets para una app de chat con IA?

    SSE, salvo que el cliente necesite hablar durante la generación. El flujo de un chat con agente es una pregunta y luego solo escuchar, y SSE viaja sobre HTTP normal: atraviesa proxies y CDN sin configuración especial, reutiliza tu autenticación y no deja estado de conexión que gestionar. WebSockets compensa cuando hay audio bidireccional o interrupciones en vivo.


    Si quieres ver este endpoint construido en directo, con el agente conectado y midiendo la cancelación en tiempo real, lo publico en el canal de YouTube de Dominicode.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Claude Code en monorepos: dale solo la rebanada que necesita

    Claude Code en monorepos: dale solo la rebanada que necesita

    Un cliente me pasó su monorepo el mes pasado. Nueve paquetes, pnpm workspaces, Turborepo por encima. Le pedí a Claude Code algo ridículamente pequeño: cambiar el tipo de una prop en packages/ui.

    Tres respuestas después me estaba proponiendo tocar el cliente HTTP del backend.

    No era un modelo tonto. Era yo. Había arrancado la sesión desde la raíz del repo, y trabajar con Claude Code en monorepos desde la raíz significa una cosa muy concreta: le has dado nueve paquetes de superficie para una tarea que vive en uno.

    Esto no es el problema del que ya escribí en Context Drift. Aquel es temporal: la sesión se alarga, el historial se pudre, el agente se olvida de la instrucción de la iteración 3. Este es espacial. Se degrada en el minuto uno, con la ventana medio vacía, porque el repo es grande y nadie le ha dicho qué parte del repo importa.

    La tesis del post es esta: en un monorepo, la decisión más importante que tomas no es qué prompt escribes. Es desde qué directorio arrancas el agente.

    Smart context slicing es la práctica de arrancar el agente en el subárbol mínimo del monorepo que la tarea necesita, calculado a partir del grafo de dependencias en vez de a ojo. Son tres decisiones concretas: desde qué directorio lanzas claude, qué paquetes vecinos añades con --add-dir y qué rutas bloqueas con reglas de denegación. Las tres, en ese orden, son el resto del post.

    Claude Code en monorepos: un CLAUDE.md en la raíz no escala

    La documentación de Anthropic recomienda mantener cada CLAUDE.md por debajo de 200 líneas, y lo justifica: los archivos largos consumen más contexto y reducen la adherencia a las instrucciones.

    Ahora divide. Nueve paquetes, 200 líneas: 22 líneas por paquete para explicar su stack, sus convenciones y sus trampas.

    Así que solo hay dos finales, y he visto los dos.

    O el CLAUDE.md crece hasta las 600 líneas y el agente ignora la mitad — incluidas las reglas que importaban. O se queda genérico ("usa TypeScript estricto", "escribe tests"), que es una forma elegante de no decir nada.

    Si todavía estás montando el tuyo, el punto de partida lo dejé en CLAUDE.md: el system prompt de tu proyecto. Aquí doy por hecho que ya lo tienes y se te ha quedado pequeño.

    La solución es partirlo: raíz para lo global, un archivo por paquete para lo local.

    monorepo/
      CLAUDE.md                 # reglas globales: commits, estilo, "corre los scripts desde el paquete"
      packages/
        ui/CLAUDE.md            # convenciones de componentes, tokens de diseño
        api/CLAUDE.md           # Knex, migraciones, .env obligatorio
        web/CLAUDE.md           # rutas, data fetching
    

    Pero partirlo no sirve de nada si no entiendes cuándo se carga cada trozo.

    La regla de carga que casi nadie ha leído

    Claude Code no trata igual a los CLAUDE.md que están por encima de ti y a los que están por debajo.

    Dónde vive el CLAUDE.md Cuándo entra en contexto
    Tu directorio de trabajo y todos sus ancestros Al arrancar la sesión, siempre
    Subdirectorios por debajo de ti Bajo demanda, solo cuando el agente lee un archivo de esa carpeta

    Si arrancas desde la raíz, cargas solo el CLAUDE.md raíz — y vas acumulando el de cada paquete que el agente toque. Toca muchos, porque no sabe dónde está el límite.

    Si arrancas con cd packages/ui && claude, cargas raíz + packages/ui de golpe, y los de api y web no existen para esa sesión mientras no los pises. Además, solo puede leer y editar dentro de ese subárbol hasta que le concedas más.

    Eso es una rebanada. Y te ha costado un cd.

    Compruébalo: lanza /context y mira la lista de Memory files. Ahí está lo que se cargó de verdad.

    El slice no lo decides tú: lo decide el grafo de dependencias

    "Trabaja desde el paquete" está bien hasta que la tarea toca de verdad a los vecinos. Cambiar un tipo exportado de ui puede romper a quien lo consume, y si el agente no ve a esos consumidores, te entrega algo que compila en su rebanada y revienta en CI.

    La pregunta correcta no es qué paquetes te apetece abrir, sino qué paquetes toca esta tarea de verdad. Y esa respuesta ya está en tu repo: en el grafo de dependencias.

    Monté un workspace de cinco paquetes para verlo, con pnpm 11.1.3 y Turborepo 2.10.12. @acme/api y @acme/web dependen de @acme/ui; @acme/ui depende de @acme/config; @acme/jobs va por libre.

    Inventario primero:

    pnpm ls -r --depth -1
    

    Ahora el blast radius hacia arriba — qué se rompe si toco @acme/ui. En la sintaxis de filtros de pnpm, los tres puntos delante del nombre significan "y todo lo que depende de él":

    pnpm --filter "...@acme/ui" ls --depth -1
    # (salida recortada al nombre de cada paquete)
    # @acme/ui
    # @acme/api
    # @acme/web
    

    Y hacia abajo, con los puntos detrás, "y todo aquello de lo que depende":

    pnpm --filter "@acme/ui..." ls --depth -1
    # (salida recortada)
    # @acme/ui
    # @acme/config
    

    Si quieres el cierre completo en los dos sentidos, pones los puntos a ambos lados: "...@acme/ui...". Y si te sobra el propio paquete, el circunflejo lo excluye: "...^@acme/ui" devuelve solo api y web.

    Turborepo lo da con un matiz. --dry enseña el plan sin ejecutar nada:

    turbo run build --filter="...@acme/ui" --dry
    
    • Packages in scope: @acme/api, @acme/ui, @acme/web
    • Running build in 3 packages
    

    El detalle que solo ves ejecutándolo: "Packages in scope" son 3, pero si sacas el JSON aparecen 4 tareas:

    turbo run build --filter="...@acme/ui" --dry=json | jq -r '.tasks[].directory' | sort -u
    # packages/api
    # packages/config
    # packages/ui
    # packages/web
    

    @acme/config no está en el scope de edición, pero entra en el grafo de build porque ui lo necesita compilado. Son dos rebanadas distintas y conviene no confundirlas:

    Rebanada Paquetes % del repo
    Repo completo 5 100%
    Slice de edición (ui + dependientes) 3 60%
    Slice de build (añade config) 4 80%
    Nunca entra (@acme/jobs) 1 20%

    En un repo de cinco paquetes, dejar fuera un paquete suena a poco. En el del cliente, con nueve, el slice real de la tarea eran tres paquetes: dos tercios del repo que no tenían por qué abrirse nunca.

    Con esa lista en la mano, el arranque deja de ser una corazonada:

    cd packages/ui
    claude --add-dir ../api --add-dir ../web
    

    Si el equipo entero trabaja así, lo fijas en packages/ui/.claude/settings.json:

    {
      "permissions": {
        "additionalDirectories": ["../api", "../web"]
      }
    }
    

    Ojo con una diferencia que muerde: additionalDirectories da acceso a los ficheros pero no carga nunca el CLAUDE.md ni las skills de esos directorios. Con --add-dir sí cargan las skills, y el CLAUDE.md solo si arrancas con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1. Si escribiste un CLAUDE.md en packages/api y no sale en /context, es por esto.

    Y como el slice te dice qué se puede romper, también sabes qué verificar antes de dar la tarea por buena: los tests de api y web, no los de ui. Convertir "parece que funciona" en un veredicto ejecutable lo desarrollé entero en el ebook gratuito Revisión por Contrato, sobre cómo revisar lo que te entrega un agente sin leértelo línea a línea.

    Lo que no debe entrar en la ventana bajo ningún concepto

    Las búsquedas de contenido de Claude Code respetan tu .gitignore por defecto, así que node_modules/, dist/ y build/ ya están fuera de los resultados de un grep.

    El problema es lo que sí está commiteado: código generado, un SDK vendorizado, snapshots enormes. Para eso hay reglas de denegación:

    {
      "permissions": {
        "deny": [
          "Read(./**/dist/**)",
          "Read(./**/*.generated.*)",
          "Read(./vendor/**)"
        ]
      }
    }
    

    Un detalle que rompe esto sin avisar: los patrones relativos anclan en el directorio desde el que arrancas la sesión, no en la raíz del repo. Si guardas estas reglas en la raíz pero lanzas la sesión desde packages/ui, Read(./vendor/**) está apuntando a packages/ui/vendor/. Para que apliquen en todo el repo las escribes absolutas, con doble barra: Read(//ruta/absoluta/al/repo/vendor/**).

    Y si arrancando desde la raíz se te cuelan los CLAUDE.md de equipos con los que no trabajas, existe claudeMdExcludes, en el .claude/settings.local.json de la raíz. Los patrones se comparan contra rutas absolutas, así que empiezan por **/ para que casen en cualquier punto del árbol:

    {
      "claudeMdExcludes": ["**/packages/legacy-*/**"]
    }
    

    Con un aviso honesto: esa lista es estática, no un interruptor por tarea. Para alternar de paquete cada día la herramienta sigue siendo el cd.

    Cuando de verdad no sabes dónde está, delega la búsqueda

    Todo lo anterior asume que sabes qué paquete tocar. A veces no lo sabes, y ahí es donde la gente destroza la sesión: "busca en el repo dónde se genera el token de refresco". El agente lee doscientos archivos y te devuelve una frase. Los doscientos archivos se quedan en tu ventana. La frase también, pero ya da igual.

    Delégalo a un subagente. Corre en su propia ventana de contexto y te devuelve el resumen, no los archivos:

    Usa un subagente para localizar en qué paquetes se genera y se valida
    el token de refresco. Devuélveme solo la lista de rutas y una línea
    por cada una. No propongas cambios todavía.
    

    El resultado es una lista de paquetes. Cierras la sesión, haces cd al correcto y empiezas la tarea real con la ventana limpia. La exploración se paga una vez y se tira.

    Es el mismo principio que conté en Context Engineering: lo caro no es el token, es el token irrelevante que se queda mirándote el resto de la sesión.

    Lo que puedes hacer hoy en tu monorepo

    Una sola cosa, y es gratis: deja de arrancar el agente desde la raíz del monorepo.

    Antes de la próxima tarea, corre pnpm --filter "...<tu-paquete>" ls --depth -1, mira los tres o cuatro nombres que salen, y arranca así:

    cd packages/<tu-paquete>
    claude --add-dir ../<vecino>
    

    No hace falta que escribas ni un CLAUDE.md nuevo para notar la diferencia. Eso viene después, cuando ya sepas qué reglas son globales y cuáles de un paquete — y eso solo se ve claro tras unos días trabajando por rebanadas.

    Si quieres el flujo completo, de la idea al producto con estas decisiones tomadas antes de escribir código, es lo que montamos en el curso Construye con IA.

    Preguntas frecuentes

    ¿Es mejor arrancar Claude Code desde la raíz del monorepo o desde el paquete?

    Desde el paquete, salvo que la tarea cruce varios subsistemas de verdad. Arrancando desde packages/ui cargas el CLAUDE.md raíz más el de ui, y el agente solo puede leer y editar ese subárbol. Desde la raíz tienes acceso a todo: útil para refactors transversales, caro para cualquier otra cosa. Si necesitas un vecino puntual, --add-dir te lo añade sin romper el aislamiento.

    ¿Los CLAUDE.md de los subdirectorios se cargan siempre?

    No, y esta es la confusión más habitual. Los de tu directorio de trabajo y de todos sus ancestros se cargan al arrancar la sesión. Los de subdirectorios por debajo de ti se cargan bajo demanda, solo cuando el agente lee un archivo de esa carpeta. Para ver qué se cargó de verdad en una sesión, lanza /context.

    ¿Qué hago si la tarea toca varios paquetes a la vez?

    Dásela entera en una sola sesión, con el slice completo delante. Partirla en una sesión por paquete es peor: cada sesión redecide el diseño desde cero y acabas con tres criterios distintos. Calcula el slice con el filtro de dependientes, añade esos directorios y trabaja en plan mode antes de editar: el plan se escribe a un archivo que Claude Code reinyecta tras cada compactación.

    ¿Esto sirve si uso Nx o si mi repo es un solo árbol grande sin paquetes?

    Sí. En Nx el equivalente es nx graph para ver el grafo y nx show projects --affected para saber qué proyectos toca un cambio: cambia el comando, no la idea. Y en un repo de un solo árbol sustituyes "paquete" por "subsistema" — src/billing/, src/auth/, lib/core/. Un CLAUDE.md por subsistema y un cd hacen el mismo trabajo.

    ¿No basta con el .gitignore para que el agente no lea dist?

    Para las búsquedas de contenido sí: Claude Code respeta el .gitignore por defecto, así que dist/, build/ y node_modules/ no aparecen cuando busca texto. Lo que no cubre es lo commiteado — código generado, SDKs vendorizados, fixtures gigantes. Para eso necesitas reglas Read(...) en permissions.deny. Con un límite: cubren las herramientas de fichero y los comandos de Bash que Claude Code reconoce, pero un grep -r sobre una carpeta con ficheros denegados sigue sacándolos por pantalla.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Self-healing code en agentes TypeScript: el bucle que sí corrige

    Self-healing code en agentes TypeScript: el bucle que sí corrige

    El self-healing code en agentes de TypeScript es un patrón sencillo de describir y fácil de implementar mal. Te cuento primero cómo me enteré.

    Un agente mío se pasó tres minutos razonando una tarea, escribió ochenta líneas de TypeScript, llamó a la API interna y devolvió el objeto con userId donde el schema pedía id.

    Una palabra.

    El pipeline hizo lo que hacen todos: lanzó la excepción, abortó con código de salida 1 y me mandó un aviso para que abriera el editor y cambiara esa palabra a mano.

    Lo absurdo es que Zod ya sabía exactamente qué había fallado. Sabía el campo, el tipo recibido, el tipo esperado y la ruta dentro del objeto. Tenía el diagnóstico completo escrito en una estructura de datos. Y con todo eso en la mano, el sistema decidió despertar a un humano.

    Así que monté el bucle de autocorrección. Y durante dos semanas no funcionó, gastando el doble de llamadas al modelo, por un motivo que no vi hasta que abrí el objeto de error con el debugger.

    Resumen rápido:

    • El self-healing convierte el diagnóstico de un verificador determinista en el contexto del siguiente intento, en vez de escalar a un humano.
    • Si usas generateObject del Vercel AI SDK, el detalle del fallo no está en error.message — está en error.cause. Ese es el error que arruina la mayoría de implementaciones.
    • Techo de dos intentos totales, y cuenta intentos, no reintentos.
    • No todos los errores son curables: los de tipos y schema sí, los de credenciales o herramienta caída no.

    Qué es el self-healing code (y qué no es)

    El self-healing code es un patrón en el que el sistema que genera —código o datos estructurados— ejecuta un verificador determinista, captura el diagnóstico exacto del fallo y lo reinyecta como contexto en un reintento acotado, en lugar de tratar el fallo como terminal.

    La idea de fondo: el validador es el mejor prompt que vas a escribir en tu vida, porque es el único que describe el fallo con precisión de campo y sin ambigüedad.

    El bucle tiene cinco pasos:

    1. Generar. El modelo produce el objeto o el código.
    2. Verificar. Zod, tsc o el test runner dictaminan. Sin intervención humana y sin LLM de por medio: determinista.
    3. Extraer el diagnóstico real. Campo, ruta, tipo esperado, tipo recibido. Aquí es donde falla casi todo el mundo.
    4. Reinyectar. El diagnóstico vuelve como turno nuevo de la conversación, junto a la salida anterior.
    5. Acotar. Techo de intentos y salida limpia cuando se agota.

    Conviene separarlo de dos patrones vecinos con los que se confunde.

    No es un retry con backoff. El backoff reintenta lo mismo esperando que el mundo cambie: que se descongestione la red, que el proveedor se recupere. El self-healing reintenta algo distinto, porque le has añadido información que antes no estaba. Si reintentas idéntico un fallo de validación, el modelo suele reproducir el mismo error.

    No es un circuit breaker. El breaker existe para dejar de insistir cuando una herramienta externa lleva minutos caída; lo conté en circuit breaker para agentes IA. Son capas distintas: el breaker mira la salud de un servicio externo, el self-healing mira la forma de lo que devuelve el modelo. En un agente serio acaban conviviendo.

    Y una frontera más: este post va del bucle. De cómo validar y tipar la respuesta en sí ya escribí en cómo tipar las respuestas de una LLM con Zod y TypeScript. Si no tienes esa parte montada, empieza por ahí y vuelve.


    El error que hace que tu bucle de autocorrección no sirva de nada

    Aquí está lo que me costó dos semanas.

    Cuando usas generateObject del Vercel AI SDK y el modelo devuelve algo que no valida, el SDK lanza un NoObjectGeneratedError. La reacción natural es esta:

    catch (error: any) {
      prompt = `Tu respuesta anterior falló con este error: ${error.message}`;
    }
    

    Ese código se ejecuta sin romperse, el bucle gira, gastas otra llamada al modelo y parece que el patrón funciona.

    No funciona. El message de un NoObjectGeneratedError es genérico —del tipo "No object generated"— y no lleva el campo, ni el tipo esperado, ni la ruta. Le estás diciendo al modelo "lo has hecho mal" y esperando que adivine el qué.

    El detalle está en otras propiedades del error, documentadas en el propio AI SDK:

    • error.cause — el error subyacente real: el ZodError con sus issues, o el fallo de parseo de JSON.
    • error.text — el texto crudo que el modelo llegó a generar, que le permite ver su propia salida y compararla con el diagnóstico.
    • error.finishReason — si vale 'length', el JSON no es inválido por confusión del modelo: está truncado porque se acabaron los tokens. Reintentar con el mismo límite es tirar dinero; ahí toca subirlo o partir el schema.

    Ese último matiz es la diferencia entre un bucle que corrige y un bucle que solo encarece la factura.

    Hay un segundo fallo igual de común, y es de contexto. Si en el reintento reasignas el prompt en vez de acumular la conversación, el modelo recibe "tu respuesta anterior falló, corrígela" sin la tarea original y sin su propia salida. generateObject no guarda historial: cada llamada es independiente. El modelo no sabe qué tenía que generar ni qué generó. No hay nada que corregir.


    Implementación del bucle en TypeScript

    Con eso claro, el bucle queda así. Versiones: AI SDK 5 y Zod 4.

    import { generateObject, NoObjectGeneratedError } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    
    const PaymentConfigSchema = z.object({
      customerId: z.string().min(5).describe("ID del cliente, prefijo cus_"),
      amountInCents: z.number().int().positive().describe("Importe en céntimos, nunca decimal"),
      currency: z.enum(["EUR", "USD"]),
      maxPaymentRetries: z.number().int().min(1).max(5),
    });
    
    type PaymentConfig = z.infer<typeof PaymentConfigSchema>;
    
    // Intentos TOTALES, no reintentos: 2 = la primera llamada y una corrección.
    const MAX_ATTEMPTS = 2;
    
    export async function generateSelfHealingConfig(
      userRequirement: string,
    ): Promise<PaymentConfig> {
      const messages: Array<{ role: "user" | "assistant"; content: string }> = [
        { role: "user", content: `Genera la configuración de pago para: "${userRequirement}"` },
      ];
    
      for (let attempt = 1; attempt <= MAX_ATTEMPTS; attempt++) {
        try {
          const { object } = await generateObject({
            model: anthropic("claude-opus-5"),
            schema: PaymentConfigSchema,
            messages,
            // Clave: el maxRetries del SDK son reintentos de TRANSPORTE (429, 5xx)
            // y vale 2 por defecto. Sin ponerlo a 0, cada vuelta de este bucle
            // puede disparar hasta 3 peticiones HTTP: 6 llamadas en el peor caso.
            maxRetries: 0,
          });
          return object;
        } catch (error) {
          if (!NoObjectGeneratedError.isInstance(error)) throw error; // 401, red, bugs propios
    
          // Truncado por tokens: reintentar igual no arregla nada.
          if (error.finishReason === "length") {
            throw new Error(
              "[SELF-HEALING] Respuesta truncada por límite de tokens: súbelo o parte el schema.",
            );
          }
    
          if (attempt === MAX_ATTEMPTS) {
            throw new Error(
              `[SELF-HEALING] Sin corregir tras ${MAX_ATTEMPTS} intentos:\n${formatIssues(error.cause)}`,
            );
          }
    
          // El feedback útil: su salida + el diagnóstico concreto, como turno nuevo.
          messages.push({ role: "assistant", content: error.text ?? "(sin salida)" });
          messages.push({
            role: "user",
            content:
              `Tu respuesta no cumple el schema:\n${formatIssues(error.cause)}\n\n` +
              `Corrige ÚNICAMENTE esos campos y devuelve el objeto completo.`,
          });
        }
      }
    
      throw new Error("[SELF-HEALING] Bucle terminado sin resultado");
    }
    
    // El diagnóstico en tres líneas, no el volcado entero.
    function formatIssues(cause: unknown): string {
      if (cause instanceof z.ZodError) {
        return cause.issues
          .map((i) => `· ${i.path.join(".") || "(raíz)"}: ${i.message}`)
          .join("\n");
      }
      return cause instanceof Error ? cause.message : String(cause);
    }
    

    Tres decisiones que no son cosméticas.

    maxRetries: 0. Es la que más gente se salta. El maxRetries del AI SDK vale 2 por defecto y cubre fallos de transporte —408, 409, 429 y 5xx— con backoff exponencial. Son compatibles con este bucle, pero se multiplican: dos vueltas tuyas por tres peticiones suyas son seis llamadas donde creías tener dos. Si quieres backoff de red, ponlo tú fuera y controla el total.

    El error vuelve como turno de conversación. Al empujar la salida fallida como mensaje assistant y la corrección como user, el modelo ve su propio intento enfrentado al diagnóstico. Reasignar el prompt original pierde ese contraste — es el segundo fallo que veíamos arriba.

    formatIssues recorta. Un ZodError serializado entero son cientos de caracteres de ruido que pagas en cada vuelta. Las issues mapeadas a ruta: mensaje son las tres líneas que importan.

    Si quieres exprimir la parte del schema —.describe(), uniones discriminadas, enums en vez de strings abiertos— es lo que trabajo en el curso de Zod para TypeScript. Un schema bien diseñado reduce cuántas veces entras en este bucle, que sigue siendo el mejor ahorro disponible.


    Las tres reglas para que esto no se convierta en un bucle infinito caro

    1. Pásale el diagnóstico, no el volcado

    Cinco mil caracteres de stack trace con trazas internas de Node entierran la señal en ruido, y encima los pagas en cada vuelta. Ruta, mensaje y tipo esperado. Nada más.

    2. Techo estricto, y cuenta intentos, no esperanzas

    Dos intentos totales. Si un modelo actual no arregla un fallo de forma teniendo delante el error exacto, el problema casi nunca es el modelo: es un schema que pide algo que el contexto no contiene. El tercer intento no corrige, factura.

    El fallo más común es contar mal. Un for (let i = 1; i <= maxRetries; i++) con maxRetries = 2 da dos intentos totales, es decir, un solo reintento. Si querías dos correcciones, el bucle se te queda corto y no te enteras. Por eso arriba la constante se llama MAX_ATTEMPTS.

    Este techo vive dentro del límite global de pasos del agente, no lo sustituye: sobre eso escribí en el agentic loop en producción.

    3. Corrección quirúrgica, no regeneración

    Pide explícitamente que corrija solo los campos señalados. Si dejas que regenere el objeto entero, es habitual que arregle el campo roto y rompa otro que ya estaba bien — y con techo de dos intentos te quedas sin margen.


    Un oráculo por cada tipo de error

    Zod valida la forma de los datos en runtime. Es la primera capa, no la única: el patrón es idéntico cambiando quién emite el diagnóstico.

    Oráculo Qué detecta Qué le pasas al modelo
    Zod Salida estructurada que no cumple el schema issues mapeadas a ruta: mensaje
    tsc --noEmit Errores de tipos en el código generado Código de error, archivo, línea, tipo esperado vs recibido
    Vitest / Jest Errores de lógica de negocio Nombre del test y el diff esperado/recibido
    ESLint Estilo y patrones prohibidos Nada: esto se arregla con --fix, no con el modelo

    El compilador. Cuando el agente escribe código en vez de devolver datos, tsc --noEmit da diagnósticos con archivo, línea y tipos enfrentados. Un Type '{ userId: string }' is not assignable to type '{ id: string }' es la misma señal que un ZodError: precisa, accionable y gratis. Pásale las líneas del diagnóstico, no la salida completa del compilador — en un proyecto mediano son cientos de líneas y un solo error de tipos suele arrastrar diez mensajes derivados del mismo origen.

    Los tests. El compilador y Zod atrapan errores de forma; los tests atrapan errores de fondo. Un agente que ejecuta la suite, lee qué aserción falló y corrige antes de enseñarte nada es la versión completa del patrón. Es también donde el techo se vuelve innegociable: un agente iterando contra una suite en rojo sin límite es la forma más rápida que conozco de quemar presupuesto. Y hay una trampa propia de esta capa: ejecuta la suite entera antes de aceptar el parche, no solo el test que fallaba. Arreglar el test A rompiendo el B es un resultado muy común y, si solo miras A, lo das por bueno.

    Para montar el entorno donde ese ciclo corre aislado, escribí sobre el test harness para desarrollo con agentes. Y ese salto —de validar datos a montar el ciclo entero de generar, verificar y corregir— es el hilo del curso Construye con IA: de la idea al producto con Claude Code.

    Un apunte de arquitectura: el bucle queda más limpio si los fallos ya viajan como datos tipados en lugar de excepciones sueltas, algo que conté en cómo manejar errores en agentes de IA con TypeScript.


    Qué errores son curables y cuáles no

    Aplicar el bucle a todo es peor que no tenerlo. Esta es la tabla que uso para decidir:

    Tipo de fallo ¿Self-healing? Qué hacer
    Error de tipos (tsc) Sí Reinyectar diagnóstico, 1 reintento
    Schema de salida inválido Sí Reinyectar error.cause + la tarea original
    Aserción de test fallida Sí, con cuidado Reinyectar el diff y correr la suite completa
    Respuesta truncada (finishReason: 'length') No Subir el límite de salida o partir el schema
    Lint y formato No Determinista: --fix
    Tool externa 5xx o timeout No Circuit breaker, no reintento
    Credenciales, 401 No Abortar y escalar
    Requisito ambiguo No Humano en el bucle
    Operación con efectos ya aplicados No Idempotencia o compensación

    Ese último merece un párrafo. Si el primer intento escribió en base de datos o llamó a un endpoint de cobro, reintentar no es autocorregir: es duplicar. El bucle solo es seguro mientras la operación no haya salido de tu proceso. Valida primero, ejecuta después.

    Y hay un coste que conviene tener presente: cada vuelta añade la latencia completa de una llamada al modelo y paga de nuevo los tokens del contexto acumulado, que ahora incluye la salida fallida y el diagnóstico. En un flujo interactivo, a veces es mejor devolver el fallo rápido que hacer esperar el doble para acertar. Si quieres saber en qué se te va de verdad el presupuesto, medir el consumo de tokens del agente es el paso previo.


    Cuando el segundo intento también falla

    El techo implica que existe un camino de salida, y ese camino no puede ser una excepción sin contexto que alguien encuentre en un log tres días después.

    Lo que funciona: registrar el fallo con las cuatro piezas que lo hacen reproducible —la tarea original, la salida del modelo, el diagnóstico del verificador y el número de intentos consumidos— y encolarlo. Ese registro sirve para dos cosas distintas. La inmediata, que alguien lo resuelva. La útil a medio plazo, que la cola se convierte en tu mejor fuente de mejoras del schema: cuando ves tres fallos seguidos sobre el mismo campo, el problema no era el modelo.


    Por dónde empezar mañana

    Coge el punto de tu agente donde hoy salta una excepción de validación. Uno solo.

    Añade tres cosas: extrae el error real (error.cause, no error.message), formatéalo a ruta y mensaje, y devuélvelo como turno nuevo con techo de dos intentos y maxRetries: 0. Loguea cuántas veces entra en la segunda vuelta y cuántas sale con éxito.

    Ese ratio es el diagnóstico del diagnóstico. Si entra a menudo y se corrige, tienes un schema mejorable pero un bucle sano. Si entra mucho y no se corrige, tienes un schema imposible: le estás pidiendo al modelo un campo que nadie podría rellenar con el contexto que le das. Y si no entra casi nunca, enhorabuena — tu schema ya hace el trabajo y el bucle es solo la red.

    En Dominicode Labs es donde vamos rodando estos patrones sobre proyectos reales, con las métricas puestas.

    Los sistemas agénticos que aguantan en producción no son los que no se equivocan. Son los que tienen el diagnóstico a mano y saben devolvérselo al modelo antes de despertar a nadie.


    Preguntas frecuentes

    ¿Por qué mi agente no se corrige aunque le paso el error?

    La causa más común es pasar error.message en vez de error.cause. En un NoObjectGeneratedError del Vercel AI SDK, message es un texto genérico que no nombra el campo ni el tipo esperado; el diagnóstico útil vive en error.cause —el ZodError con sus issues— y la salida cruda del modelo en error.text. Con solo message, el bucle gasta llamadas sin darle al modelo nada con lo que corregir.

    ¿En qué se diferencia el self-healing code de un retry con backoff?

    En qué cambia entre un intento y el siguiente. El backoff reintenta la misma petición esperando que se recupere algo externo —red, proveedor, rate limit— y por eso funciona con fallos transitorios. El self-healing modifica la entrada: añade al contexto el diagnóstico que provocó el fallo. Ante un error de schema, el backoff solo repite el mismo error más despacio.

    ¿No reintenta ya generateObject por su cuenta con maxRetries?

    No de esta forma, y conviene ponerlo a 0. La opción maxRetries del AI SDK vale 2 por defecto y cubre fallos de transporte: errores de red y respuestas de API reintentables (408, 409, 429, 5xx) con backoff exponencial. Un fallo de validación de schema no entra ahí, se propaga como NoObjectGeneratedError. Si lo dejas por defecto, cada vuelta de tu bucle puede disparar hasta tres peticiones HTTP.

    ¿Cuántos intentos debería permitir?

    Dos totales: la llamada inicial y una corrección. Con el error exacto delante, un modelo actual corrige los fallos de forma en el primer reintento o no los corrige. Un tercero rara vez cambia el resultado y multiplica coste y latencia. Y cuenta intentos, no reintentos: un bucle i <= 2 da una sola corrección, y es donde más gente se equivoca al implementarlo.

    ¿Se puede hacer self-healing solo con el compilador, sin Zod?

    Sí, y son capas complementarias. tsc --noEmit cubre el código que el agente escribe; Zod cubre la salida estructurada que el modelo devuelve. Si tu agente genera archivos, el compilador es tu oráculo principal. Si devuelve objetos que tu aplicación consume, lo es Zod. Muchos agentes acaban usando los dos en puntos distintos del flujo.

    ¿Sirve para errores de lógica o solo para errores de tipos?

    Sirve para los de lógica, pero cambiando el oráculo: ahí el que dictamina es el test runner, y el diagnóstico que reinyectas es la aserción fallida con su diff esperado/recibido. La diferencia práctica es el riesgo. Un error de tipos tiene una única corrección posible; un test rojo admite varias, y alguna rompe otra cosa. Por eso en esta capa se ejecuta la suite completa antes de aceptar el parche.

    ¿Qué hago si el agente rompe otro test al arreglar el primero?

    Tratarlo como un fallo del intento, no como un éxito parcial. Si el criterio de aceptación es solo el test que fallaba, el bucle acepta parches que degradan el código. El criterio tiene que ser la suite entera en verde; si el parche pone A en verde y B en rojo, se descarta y se consume intento. Con techo de dos, eso normalmente significa escalar — que es la respuesta correcta.

    ¿Es seguro autocorregir una operación que ya escribió en base de datos?

    No. Si el intento fallido tuvo efectos externos, el reintento los duplica. El bucle es seguro mientras la operación no haya salido de tu proceso: valida primero, ejecuta después. Si el efecto ya ocurrió, lo que necesitas es idempotencia o compensación, no autocorrección.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
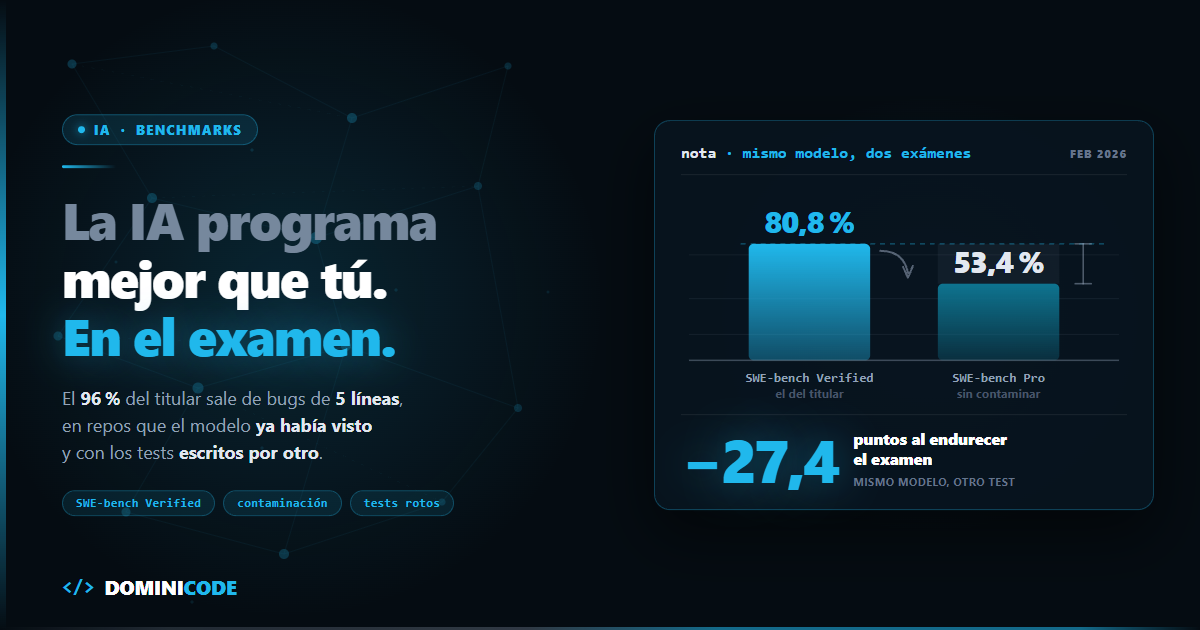
  • Diseñar schemas Zod para LLM: tu schema ya es el prompt

    Diseñar schemas Zod para LLM: tu schema ya es el prompt

    Hace unas semanas revisé el pipeline de extracción de facturas de un cliente. Fallaba en uno de cada seis documentos.

    El equipo ya había subido los reintentos a tres, puesto temperature: 0 y cambiado a un modelo más caro. Seguía fallando.

    Miré el schema de Zod: 31 campos, ninguno con .describe(), ocho z.string() donde solo cabían cuatro valores posibles y cuatro .optional() colocados ahí porque "a veces la factura no lo trae".

    El problema no era el modelo. Era el schema. Diseñar schemas Zod para LLM no consiste en describir la forma de tus datos: consiste en escribir instrucciones que el modelo lee antes de responder.

    Y esa es la parte que casi nadie aprovecha.


    El schema de Zod no espera al final: se envía al LLM dentro del prompt

    Cuando usas structured outputs o tool calling, tu schema de Zod no se queda esperando en el servidor a que llegue el JSON. Se convierte a JSON Schema y se envía al modelo en la misma petición.

    En Zod 4 puedes ver exactamente lo que sale de tu código:

    import * as z from "zod";
    
    const Factura = z.object({
      esValida: z.boolean(),
      tipo: z.string(),
      importe: z.number(),
    });
    
    console.log(z.toJSONSchema(Factura));
    

    Eso es literalmente lo que viaja. Y en el caso de Anthropic la documentación del system prompt de tool use lo enseña sin rodeos: cuando llamas a la API con el parámetro tools, el sistema construye un system prompt que incluye tus definiciones tal cual.

    In this environment you have access to a set of tools you can use to answer the user's question.
    ...
    Here are the functions available in JSONSchema format:
    {{ TOOL DEFINITIONS IN JSON SCHEMA }}
    

    Tus nombres de campo, tus tipos, tus descripciones: todo eso son tokens de entrada que el modelo lee antes de generar el primer carácter. Es la misma idea que ya expliqué al hablar de function calling tipado en TypeScript, pero llevada al extremo.

    Si el schema es texto en el prompt, entonces un schema mal escrito es un prompt mal escrito. Y no hay reintento que arregle eso.


    z.string() es un campo abierto. z.enum() es una pregunta cerrada

    Cambiar z.string() por z.enum() es el ajuste con mejor relación esfuerzo/resultado de toda la lista: z.string() deja el espacio de respuesta abierto y z.enum() lo cierra a una lista finita de valores. Es lo primero que toco cuando un pipeline de extracción falla.

    // El modelo puede escribir lo que le dé la gana
    tipoDocumento: z.string(),
    
    // El modelo solo puede elegir
    tipoDocumento: z.enum(["factura", "abono", "recibo", "presupuesto"]),
    

    La diferencia en el JSON Schema generado es esta:

    { "type": "string", "enum": ["factura", "abono", "recibo", "presupuesto"] }
    

    Con z.string() le pides al modelo que invente una etiqueta. Va a devolver "Factura", "FACTURA", "factura simplificada" y "invoice" según el día. Tu Zod lo aceptará todo, porque son strings válidos, y el error aparecerá tres capas más abajo cuando alguien haga un switch.

    Con z.enum() el espacio de respuesta está cerrado. Además, cuando el proveedor aplica el modo estricto, el enum se traduce en una restricción real de decodificación: el modelo no puede emitir un valor fuera de la lista.

    Regla práctica: si en tu cabeza el campo tiene una lista de valores, escríbela en el schema. Si te da pereza escribirla, es que tampoco la tenías clara tú.


    .describe(): el campo que casi nadie usa y que sí llega al modelo

    .describe() es el método de Zod que más impacto tiene en la precisión de un LLM y el que casi nadie usa: el texto que le pasas acaba en la clave description del JSON Schema que recibe el modelo, no se queda en tu editor.

    fechaVencimientoISO: z
      .string()
      .describe(
        "Fecha límite de pago en formato ISO 8601 (YYYY-MM-DD). " +
        "Es la fecha de vencimiento, NO la de emisión. " +
        "Si el documento dice 'pago a 30 días', súmalos a la fecha de emisión."
      ),
    

    No es decorativo. Compruébalo con z.toJSONSchema():

    {
      "type": "string",
      "description": "Fecha límite de pago en formato ISO 8601 (YYYY-MM-DD). Es la fecha de vencimiento, NO la de emisión. Si el documento dice 'pago a 30 días', súmalos a la fecha de emisión."
    }
    

    Ese description viaja con el schema. En Zod 4, .describe("texto") es equivalente a .meta({ description: "texto" }) y todos los metadatos se copian al JSON Schema resultante.

    La documentación de Anthropic sobre definición de herramientas es tajante al respecto: "Provide extremely detailed descriptions. This is by far the most important factor in tool performance". No es un detalle de estilo. Es el sitio donde metes las reglas de negocio que el nombre del campo no puede expresar.

    Dos avisos prácticos:

    1. La documentación del Vercel AI SDK recomienda encadenar .describe() o .meta() al final de la cadena, porque la mayoría de métodos de Zod devuelven una instancia nueva que no hereda los metadatos. En mis pruebas con z.toJSONSchema() y Zod 4.5.4 (agosto de 2026) la descripción sobrevivía también antes de .optional(), pero son dos caminos de código distintos y seguir la recomendación no cuesta nada.
    2. Cada descripción son tokens que pagas en cada llamada. Describe los campos ambiguos, no los obvios: nombreCliente no necesita párrafo.

    Si quieres dominar la parte de Zod que no es "poner z.string() y seguir", en mi curso de Zod para validación y transformación de datos en TypeScript trabajo esto con schemas reales de producción.


    .optional() es un agujero negro. Dale una salida explícita

    .optional() es el error que más alucinaciones fabrica en un schema pensado para un LLM: saca el campo de required sin dejar ninguna señal de cuándo debe omitirse, y el modelo rellena el hueco.

    Piensa qué ve el modelo cuando marcas un campo como opcional. Este schema:

    z.object({
      importeEUR: z.number().nullable(),
      nota: z.string().optional(),
    });
    

    produce esto:

    {
      "type": "object",
      "properties": {
        "importeEUR": { "type": ["number", "null"] },
        "nota": { "type": "string" }
      },
      "required": ["importeEUR"],
      "additionalProperties": false
    }
    

    Fíjate en nota. Desaparece de required y no queda ninguna otra señal. El modelo no recibe ninguna pista sobre cuándo debe omitirlo ni qué significa su ausencia. Tú sabes que "ausente" quiere decir "no aplica", pero eso está en tu cabeza, no en el prompt.

    importeEUR, en cambio, sigue siendo obligatorio y declara null como valor legítimo. El modelo tiene un camino explícito para decir "esto no está".

    Esto además encaja con cómo funcionan los structured outputs estrictos de OpenAI, donde todos los campos deben ir en required y la forma documentada de emular un opcional es un tipo unión con null manteniendo el campo obligatorio.

    Y hay una versión todavía mejor cuando el "no lo sé" tiene matices:

    // Mal: el modelo se inventa una fecha para rellenar el hueco
    fechaVencimientoISO: z.string(),
    
    // Regular: puede omitirlo, pero no sabe cuándo
    fechaVencimientoISO: z.string().optional(),
    
    // Bien: el "no sé" es una respuesta válida y tipada
    vencimiento: z.discriminatedUnion("estado", [
      z.object({ estado: z.literal("presente"), fechaISO: z.string() }),
      z.object({ estado: z.literal("no_aplica") }),
      z.object({ estado: z.literal("ilegible") }),
    ]),
    

    Un modelo obligado a rellenar un campo que no puede saber rellena igual. Eso no es un bug del modelo, es la consecuencia directa de por qué la IA se inventa cosas: si el schema no ofrece una salida honesta, la salida más probable es una plausible. Diséñale la puerta de "no lo sé" y la usará.


    Uniones discriminadas en Zod: dale un mapa al modelo, no un test de opción múltiple

    Con z.union(), el JSON Schema resultante es un anyOf de objetos sin nada que los distinga:

    // salida recortada de z.toJSONSchema()
    { "anyOf": [ { "properties": { "importeEUR": ... } }, { "properties": { "motivo": ... } } ] }
    

    El modelo tiene que deducir cuál encaja comparando formas. Es una decisión difusa.

    Con z.discriminatedUnion() cambia la estructura:

    const Movimiento = z.discriminatedUnion("tipo", [
      z.object({ tipo: z.literal("pago"), importeEUR: z.number() }),
      z.object({ tipo: z.literal("reembolso"), motivo: z.string() }),
    ]);
    

    Sale un oneOf en el que cada rama lleva { "type": "string", "const": "pago" } en el discriminador. El modelo primero elige una etiqueta —decisión de un token, con opciones cerradas— y a partir de ahí la forma del resto del objeto queda determinada.

    Es la misma razón por la que las uniones discriminadas nos gustan en TypeScript: convierten una inferencia estructural en una decisión explícita. Solo que aquí quien se beneficia del narrowing no es el compilador, es el modelo.

    Un aviso importante antes de que lo copies: en el modo estricto de OpenAI la raíz del schema tiene que ser un objeto, y la documentación es explícita en que un objeto raíz no puede ser del tipo anyOf. Así que no mandes la unión suelta como en el ejemplo de arriba: anídala dentro de un objeto raíz, como el campo vencimiento de la sección anterior.

    Y un detalle más: z.toJSONSchema() emite oneOf para las uniones discriminadas, mientras que la lista de tipos soportados de OpenAI habla de anyOf. Si vas contra structured outputs, pasa por el helper de su propio SDK (zodResponseFormat de openai/helpers/zod) en lugar de por z.toJSONSchema() directo. Contra tool use de Anthropic no tienes esta restricción.


    El orden de los campos no es cosmética

    Un LLM genera tokens en orden. Si el primer campo de tu objeto es la conclusión, la conclusión se escribe antes de que exista ningún razonamiento en el contexto.

    Y el orden lo pones tú. La documentación de structured outputs es explícita: la salida se produce en el mismo orden en que están las claves del schema que envías. Si quieres cambiar el orden, cambias el schema.

    // Mal: decide primero y justifica después
    const TriajeMal = z.object({
      prioridad: z.enum(["alta", "media", "baja"]),
      evidencia: z.string(),
    });
    
    // Bien: reúne evidencia, luego concluye
    const TriajeBien = z.object({
      evidencia: z
        .string()
        .describe("Cita literal del ticket que justifica la prioridad."),
      senalesRiesgo: z.array(z.enum(["caida_servicio", "perdida_datos", "cliente_enterprise"])),
      prioridad: z.enum(["alta", "media", "baja"]),
    });
    

    No es una teoría mía. El ejemplo canónico de razonamiento matemático de la propia documentación de OpenAI pone steps antes de final_answer. El schema es la plantilla del razonamiento, no solo del resultado.

    Lo mismo aplica a los nombres. date no dice nada; fechaVencimientoISO dice qué fecha es y en qué formato la quieres. El nombre del campo es contexto gratis: no lo desperdicies en abreviaturas.

    Y sobre la profundidad: los schemas planos aciertan más. El modo estricto de OpenAI admite hasta 5.000 propiedades por schema, así que el límite técnico no te va a frenar nunca. El que importa es otro: mucho antes de acercarte a esa cifra ya notarás que un objeto de cuatro niveles produce más fallos que dos llamadas con dos schemas planos.


    Dónde termina el diseño del schema y empieza la validación con Zod

    Nada de esto elimina la validación. Un schema bien diseñado reduce los fallos en origen; no los lleva a cero, y sigues necesitando safeParse, reintentos y logging.

    Esa es exactamente la frontera: este post va de lo que ocurre antes de la llamada. Lo que ocurre después —parseo seguro, limpieza defensiva, reintentos con contexto del error— lo tienes desarrollado en cómo tipar las respuestas de una LLM con Zod y TypeScript.

    Ni siquiera tienen que ser el mismo schema. Manda al modelo uno plano y con enums, y transfórmalo después a tu modelo de dominio con las utilidades genéricas de tus wrappers.


    Resumen: qué lee el modelo en cada caso

    Lo que escribes en Zod Lo que lee el modelo Cuándo usarlo
    z.string() campo de texto libre, sin restricción solo texto genuinamente libre
    z.enum([...]) "enum": ["a","b"] — lista cerrada cualquier campo con valores finitos
    .describe("...") "description": "..." — instrucción del campo campos ambiguos o con regla de negocio
    .optional() el campo desaparece de required, sin más señal casi nunca en schemas para LLM
    .nullable() "type": ["string","null"] y sigue en required cuando "no hay dato" es respuesta válida
    z.discriminatedUnion() oneOf con const en el discriminador cuando el "no lo sé" tiene matices

    Qué puedes cambiar hoy

    Abre el schema que tengas en producción y haz estas cinco pasadas. Te llevará veinte minutos:

    1. Ejecuta z.toJSONSchema(tuSchema) y lee la salida. Ese texto es tu prompt. Si te resulta ambiguo a ti, imagina al modelo.
    2. Convierte a z.enum() todo z.string() que tenga una lista finita de valores.
    3. Añade .describe() solo a los campos ambiguos, con la regla de negocio y el formato exacto.
    4. Sustituye cada .optional() por .nullable() o por una rama explícita de "desconocido" en una unión discriminada.
    5. Mueve la conclusión al final y pon delante los campos de evidencia.

    En el pipeline de facturas del principio no hizo falta tocar el modelo ni subir más los reintentos: el campo que más fallaba era una fecha obligatoria que el documento a veces no traía, y pasó de inventarse valores a declarar ilegible en cuanto dejó de ser un string a secas.

    Si además estás montando el pipeline entero —schema, llamada, validación y reintentos— eso es justo lo que construimos paso a paso en el curso Construye con IA: de la idea al producto, y en Dominicode Labs revisamos schemas reales de proyectos de la comunidad.

    La conclusión que quiero que te lleves es una sola: deja de tratar el schema como un portero que revisa la salida del modelo y empieza a tratarlo como la última instrucción que el modelo lee antes de contestar. Cambia el diseño y dejarás de necesitar tantos reintentos.


    Preguntas frecuentes

    ¿El modelo lee de verdad el .describe() de mis campos?

    Sí. .describe() se traduce a la clave description del JSON Schema, y ese JSON Schema es lo que se envía al proveedor junto con la petición. En el caso de Anthropic, la documentación muestra que las definiciones de herramientas se insertan en el system prompt en formato JSON Schema. Puedes comprobar exactamente qué se envía ejecutando z.toJSONSchema() sobre tu schema.

    ¿Usar .optional() está mal siempre?

    No, pero casi nunca es lo que quieres cuando el schema va a un modelo. .optional() hace que el campo desaparezca de required sin dejar ninguna señal sobre cuándo omitirlo. Con .nullable() el campo sigue siendo obligatorio y null es una respuesta explícita. Además, el modo estricto de structured outputs de OpenAI exige que todos los campos estén en required y documenta la unión con null como la forma de emular un opcional.

    ¿Structured Outputs elige el valor correcto o solo el formato correcto?

    Garantiza que la estructura encaje con el schema, no que el contenido sea correcto. Un modelo puede devolver una fecha con formato válido y valor inventado, o elegir el enum equivocado. Diseñar bien el schema mejora el acierto semántico; validar después sigue siendo obligatorio.

    ¿Cuántos campos debería tener un schema para un LLM?

    Menos de los que crees. El modo estricto de OpenAI admite hasta 5.000 propiedades por schema, así que el límite que importa no es el técnico sino el de acierto: la degradación empieza muchísimo antes. Si tu schema pasa de veinte campos o de dos niveles, casi siempre sale mejor partirlo en dos llamadas con schemas planos que insistir en una sola extracción gigante.

    ¿Esto aplica igual con el Vercel AI SDK?

    Sí. generateObject y las definiciones de tools convierten internamente tu schema de Zod a JSON Schema con el helper zodSchema, así que las mismas reglas de diseño aplican. La documentación del SDK recomienda además encadenar .describe() o .meta() al final de la cadena para asegurar que los metadatos acaben en el JSON Schema generado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.