Tag: AI

  • El Python que necesitas si construyes agentes en TypeScript

    El Python que necesitas si construyes agentes en TypeScript

    Tu producto está en TypeScript. Tu agente también.

    Y aun así, en algún momento vas a acabar escribiendo Python. No porque quieras cambiar de lenguaje, sino porque entre tus datos en crudo y el contexto que lee tu agente hace falta una capa que transforme lo uno en lo otro, y esa capa se escribe casi siempre en Python.

    No es un curso de Data Science. No hace falta álgebra lineal, ni estadística inferencial, ni un notebook con gráficos bonitos. Hacen falta cuatro operaciones, y con ellas se resuelve prácticamente todo lo que un agente necesita que le den masticado.

    Empiezo por el número que justifica el post entero.


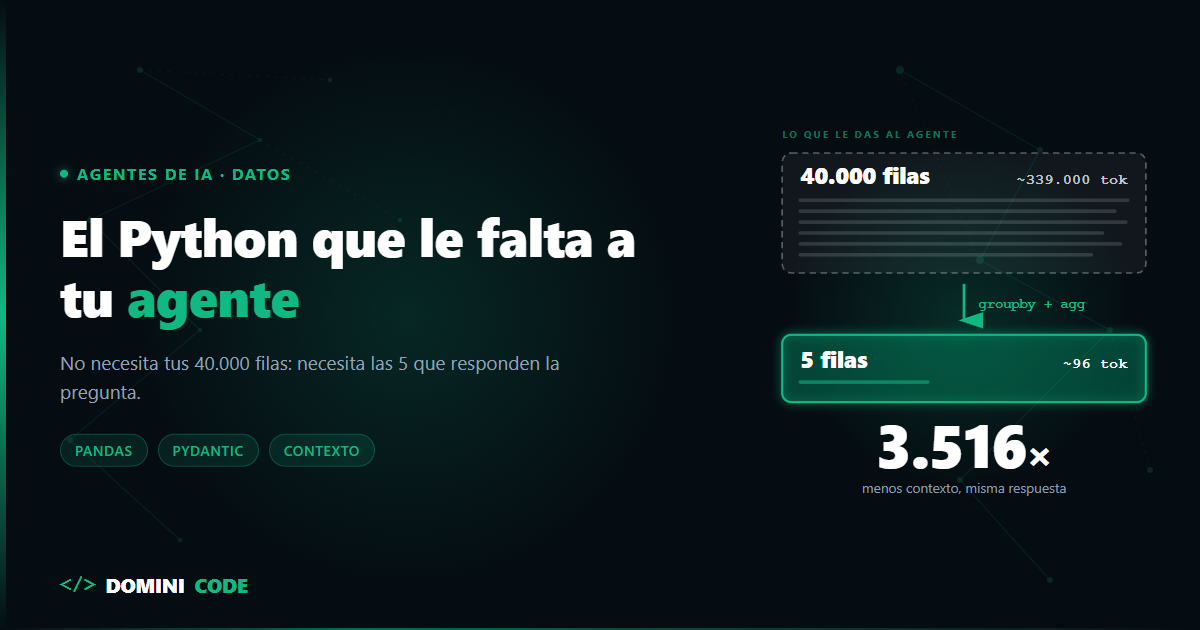
    339.276 tokens contra 96

    Tengo una exportación de ventas: 40.000 filas, cinco columnas. La pregunta que quiero que responda el agente es sencilla: ¿qué curso conviene empujar el mes que viene?

    La forma perezosa es meterle el CSV entero en el contexto. Vamos a medir qué significa eso:

    import pandas as pd
    
    df = pd.read_csv("ventas.csv")          # 40.000 filas
    
    crudo = df.to_csv(index=False)
    
    resumen = (df.groupby("curso")
                 .agg(ventas=("precio", "size"),
                      ingresos=("precio", "sum"),
                      tasa_completado=("completado", "mean"))
                 .round(2)
                 .reset_index()
                 .sort_values("ingresos", ascending=False))
    
    compacto = resumen.to_json(orient="records")
    
    print(f"crudo   : {len(crudo):,} caracteres")
    print(f"resumen : {len(compacto):,} caracteres")
    print(f"factor  : {len(crudo)/len(compacto):,.0f}x")
    

    Resultado:

    crudo   : 1.357.104 caracteres
    resumen :       386 caracteres
    factor  :     3.516x
    

    A razón de unos cuatro caracteres por token, eso es pasar de ~339.000 tokens a ~96. Y esto es lo que ve el agente después de la reducción:

         curso  ventas  ingresos  tasa_completado
            IA    8792 439512.08             0.27
       Angular   12349 370346.51             0.48
    TypeScript    9522 190344.78             0.39
       Testing    5621 168573.79             0.55
          Node    3716  74282.84             0.34
    

    Cinco filas. Y ahí dentro ya está la respuesta, que además no es la obvia: IA es lo que más factura pero tiene la peor tasa de finalización (0,27), y Testing es lo que menos factura con la mejor con diferencia (0,55). Ese contraste no se ve en 40.000 filas ni lo va a encontrar un modelo leyéndolas.

    Esto no va de ahorrar dinero, aunque también. Va de que un modelo con 40.000 filas delante tiene 40.000 oportunidades de fijarse en lo que no toca. Reducir no es una optimización: es parte de la respuesta. Es exactamente el argumento de context engineering para estructurar la memoria de tus agentes, aplicado a la capa de datos. Y si quieres ver a dónde se te va la factura, lo desglosé en medir el consumo de tokens de un agente.


    Las cuatro operaciones

    Todo lo que necesitas hacer con Python en este contexto cae en una de estas cuatro:

      1. CARGAR   →  CSV, SQL, JSON, Parquet
      2. LIMPIAR  →  tipos, nulos, duplicados
      3. REDUCIR  →  agrupar, agregar, ordenar
      4. VALIDAR  →  esquema antes de entregar
      ─────────────────────────────────────────
      la 3 es la que decide si el agente acierta
    

    No hay una quinta. Si te encuentras entrenando un modelo, te has ido del carril.


    1 y 2. Cargar y limpiar

    Pandas carga desde casi cualquier sitio con una línea, y el 90% del trabajo de limpieza son tres cosas:

    import pandas as pd
    
    df = pd.read_csv("ventas.csv", parse_dates=["fecha"])
    
    df = df.drop_duplicates(subset=["id_pedido"])       # duplicados por clave
    df = df.dropna(subset=["curso", "precio"])          # filas sin lo esencial
    df["precio"] = pd.to_numeric(df["precio"], errors="coerce")
    

    Ese errors="coerce" es el detalle que más disgustos evita: convierte a NaN lo que no se pueda parsear en vez de reventar. Un CSV real siempre trae una celda con "29,99 €" donde esperabas un número.

    Dos cosas que muerden el primer día:

    El filtrado es una máscara booleana. df["completado"] devuelve una serie de True/False, y df[mascara] se queda con las filas donde es True. Con condiciones compuestas usa & y | con paréntesis, nunca and y or.

    Casi todo devuelve un objeto nuevo. Si haces df.drop(columns=["x"]) y no reasignas, no ha pasado nada.


    3. Reducir, que es donde está el trabajo de verdad

    groupby más agg resuelve la inmensa mayoría de las preguntas que le vas a hacer a un agente sobre tus datos:

    resumen = (df.groupby("curso")
                 .agg(ventas=("precio", "size"),
                      ingresos=("precio", "sum"),
                      tasa_completado=("completado", "mean"))
                 .round(2)
                 .reset_index())
    

    Tres detalles que importan:

    • .agg() con nombres te deja bautizar las columnas de salida. Sin eso acabas con nombres compuestos horribles y el agente los lee peor.
    • mean() sobre una columna booleana da la proporción directamente. Ahí sale el 0,27 de la tabla de arriba sin cálculo extra.
    • .reset_index() baja la clave del agrupado del índice a columna. Si se te olvida, el JSON que entregas sale con otra forma.

    La regla, si te quedas con una sola de este post: agrega hasta que la tabla quepa en una pantalla. Si no cabe, todavía no has terminado de reducir.

    Cuando el volumen crezca o prefieras SQL a encadenar métodos, tienes la alternativa sin salir del portátil en DuckDB para analizar con SQL sin exportar nada.


    4. Validar en la frontera: Pydantic es el Zod de Python

    Aquí es donde tu instinto de TypeScript te sirve tal cual. Lo que hace Zod en tu producto lo hace Pydantic en la capa de datos: defines el esquema y lo que no encaja no pasa.

    from pydantic import BaseModel, Field
    
    class ResumenCurso(BaseModel):
        curso: str
        ventas: int = Field(ge=0)
        ingresos: float = Field(ge=0)
        tasa_completado: float = Field(ge=0, le=1)
    
    filas = [ResumenCurso(**r) for r in resumen.to_dict(orient="records")]
    payload = [f.model_dump() for f in filas]
    

    Ese le=1 en tasa_completado parece una tontería y es justo el guardarraíl que quieres: si un cambio en el pipeline te deja una proporción en 1,4, prefieres que explote aquí y no que el agente construya un razonamiento entero sobre un dato imposible.

    Y esa es la diferencia de fondo con el análisis de datos clásico: un dato sucio ya no es una celda rara en un gráfico, es una alucinación con aspecto de respuesta correcta. El agente no va a dudar de lo que le des.

    Los patrones de contrato del lado TypeScript están en el curso de Zod para TypeScript, y se trasladan casi literalmente a Pydantic.


    ¿Y NumPy? Solo cuando toca

    NumPy aparece en todos los tutoriales de Python y datos, así que conviene decir cuándo lo vas a necesitar de verdad: cuando hagas aritmética sobre muchos números.

    Una lista de Python guarda punteros a objetos dispersos y obliga al intérprete a resolver el tipo en cada elemento. NumPy guarda los números en un bloque contiguo y opera en C sobre todo el bloque. Sobre un millón de valores:

    import numpy as np, timeit
    
    lista = [float(i) for i in range(1_000_000)]
    arr = np.array(lista)
    
    t_list = timeit.timeit(lambda: [x * 0.85 for x in lista], number=5) / 5
    t_np   = timeit.timeit(lambda: arr * 0.85, number=5) / 5
    print(f"lista: {t_list*1000:.1f} ms | numpy: {t_np*1000:.1f} ms | {t_list/t_np:.0f}x")
    

    En mi máquina: 102,3 ms contra 6,4 ms. Dieciséis veces. Córrelo tú, que el factor depende del hardware.

    Ahora, la parte honesta: si tu pipeline agrupa 40.000 filas una vez al día, esa diferencia no la vas a notar. Pandas ya usa NumPy por debajo. Aprende NumPy cuando el perfilado te diga que ahí está el problema, no antes.


    Cuándo NO deberías meter Python

    Añadir un lenguaje a un proyecto tiene un coste real: otro entorno, otro despliegue, otra cosa que se rompe.

    No lo metas si:

    • Son menos de unos miles de registros y ya los tienes en tu app. Un reduce en TypeScript te lo resuelve sin añadir nada.
    • Los datos ya están en tu base de datos. Un GROUP BY en SQL es más rápido y más simple que exportar, cargar en Pandas y volver.
    • Es una consulta que harás una vez. Escríbela donde te resulte más rápido y olvídala.

    Merece la pena cuando cruzas fuentes distintas (un CSV de la pasarela de pago con un export de tu base y una hoja de cálculo), cuando la limpieza tiene reglas de verdad, o cuando el paso se repite cada día. Ahí Pandas gana con claridad. Para automatizar ese paso una vez que funcione, tengo el terreno cubierto en scripts de Python para tu productividad semanal.


    El pipeline entero

    Junto, esto es todo lo que hace falta entre tu exportación y el contexto de tu agente:

    import json
    import pandas as pd
    from pydantic import BaseModel, Field
    
    class ResumenCurso(BaseModel):
        curso: str
        ventas: int = Field(ge=0)
        ingresos: float = Field(ge=0)
        tasa_completado: float = Field(ge=0, le=1)
    
    def contexto_para_agente(ruta: str) -> str:
        df = (pd.read_csv(ruta, parse_dates=["fecha"])
                .drop_duplicates(subset=["id_pedido"])
                .dropna(subset=["curso", "precio"]))
    
        resumen = (df.groupby("curso")
                     .agg(ventas=("precio", "size"),
                          ingresos=("precio", "sum"),
                          tasa_completado=("completado", "mean"))
                     .round(2)
                     .reset_index()
                     .sort_values("ingresos", ascending=False))
    
        filas = [ResumenCurso(**r) for r in resumen.to_dict(orient="records")]
        return json.dumps([f.model_dump() for f in filas], ensure_ascii=False)
    

    Treinta líneas. La salida cabe en un mensaje y ya viene validada.

    Cómo se conecta esa salida con un agente que decide y actúa sobre ella, de la idea a producción, lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.


    Qué hacer esta semana

    1. Monta el entorno con uv: uv venv y uv pip install pandas pydantic. Un segundo. (Aviso por si te lo cruzas en algún tutorial: Bun no gestiona Python, es un runtime de JavaScript; el equivalente aquí es uv.)
    2. Coge la exportación más grande que le estés pasando a un agente y mide sus caracteres. Divide entre cuatro para hacerte una idea de los tokens.
    3. Escribe el groupby que responde la pregunta que de verdad le haces, y vuelve a medir. El factor de reducción que te salga es lo que te estabas gastando de más.
    4. Ponle un esquema Pydantic a la salida antes de entregársela al modelo.

    En Dominicode Labs comparto los pipelines de datos y telemetría que uso de verdad para mirar lanzamientos y retención.

    Tu agente no necesita tus datos. Necesita la respuesta que hay dentro de ellos, y esa parte todavía la pones tú.


    Preguntas frecuentes

    ¿Por qué no le paso el CSV entero al agente y que se apañe?

    Por dos motivos. El coste, que es el menor: en el ejemplo de este post, 40.000 filas son unos 1,35 millones de caracteres —del orden de 339.000 tokens— frente a los 386 caracteres del resumen. Y el importante: un modelo con 40.000 filas delante tiene 40.000 oportunidades de fijarse en lo que no toca. Reducir no es solo ahorrar, es acotar dónde puede mirar.

    ¿Necesito saber estadística para esto?

    No. Las cuatro operaciones son cargar, limpiar, reducir y validar, y todas son programación. La estadística hace falta cuando entras en modelado predictivo, que es un problema distinto y que en la mayoría de los productos con agentes no aparece nunca.

    ¿Pandas o Polars?

    Empieza por Pandas: más documentación, más respuestas cuando te atasques y es lo que vas a encontrar en el código de otros. Polars es más rápido y su API más consistente, y compensa cuando el volumen te empiece a doler. Los conceptos —DataFrame, filtrado, agrupación— se trasladan casi enteros.

    ¿Puedo hacer esto en TypeScript y ahorrarme el Python?

    Para volúmenes pequeños, sí, y probablemente deberías: un reduce no justifica añadir un lenguaje al proyecto. Python empieza a compensar cuando cruzas fuentes distintas, cuando la limpieza tiene reglas de verdad o cuando el paso se repite a diario. Si los datos ya viven en tu base de datos, la respuesta suele ser ninguno de los dos: un GROUP BY en SQL.

    ¿Dónde pongo esta capa: en el agente o antes?

    Antes, siempre, y como un paso determinista. Si el agente tiene que cargar y agregar por su cuenta, estás usando un modelo probabilístico para hacer aritmética que un groupby resuelve exacto, más barato y sin variar entre ejecuciones. El agente debe recibir la tabla ya reducida y validada, y dedicarse a lo suyo: decidir.
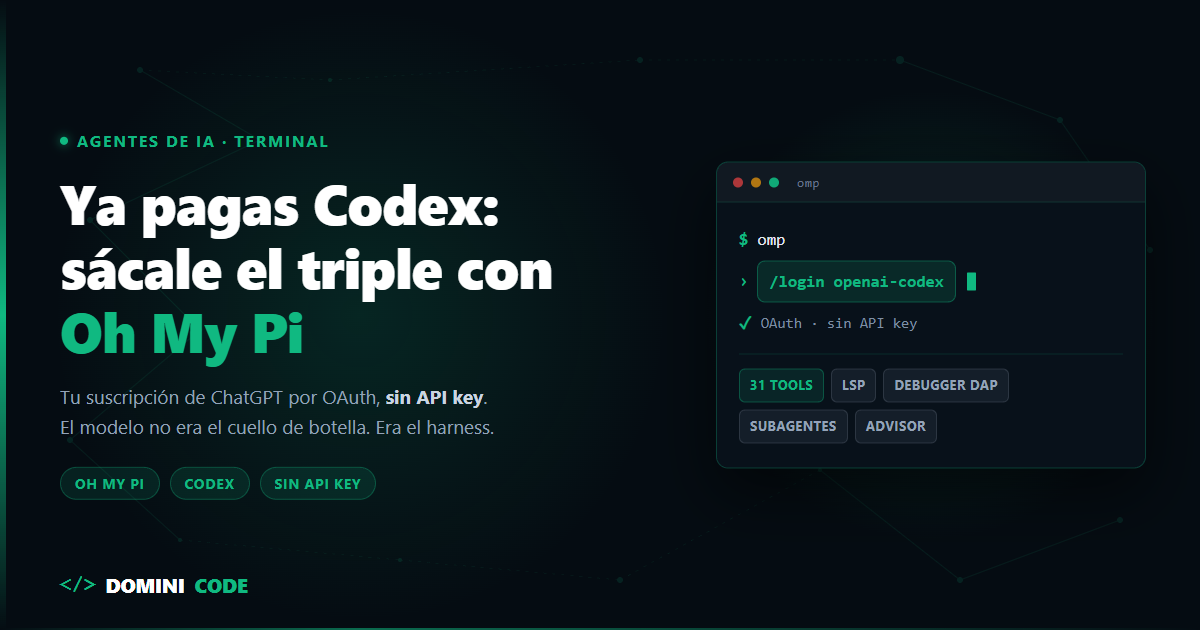
  • Ya pagas Codex: sácale el triple con Oh My Pi (sin API key)

    Ya pagas Codex: sácale el triple con Oh My Pi (sin API key)

    Pagas veinte dólares al mes. O doscientos, si estás en Pro.

    Ese plan incluye Codex. Y llevas meses usándolo dentro de Codex CLI, que decide por ti casi todo: le enchufas MCPs, sí, pero no cambias el harness que hay debajo — ni el LSP que no trae, ni el debugger que no pilota, ni el revisor que no existe.

    La jugada se llama Oh My Pi — omp en la terminal — y con Codex es esto: omp habla el protocolo de Codex por OAuth. Te logueas con tu suscripción de ChatGPT, sin API key, sin pagar dos veces. El mismo modelo que ya pagas, dentro de un harness con 31 herramientas, LSP, debugger, subagentes y un revisor leyéndote en paralelo.

    El día que lo monté entendí algo incómodo: el modelo nunca fue el cuello de botella. Lo era la caja donde lo metía.


    ¿Qué es Oh My Pi (omp)?

    Oh My Pi (omp) es un agente de código para terminal, con licencia MIT y un core de unas 80.000 líneas de Rust bajo una superficie TypeScript, que integra LSP, debugger DAP, subagentes y más de 60 providers de modelo dentro del mismo harness. Es un fork de Pi, el agente minimalista de Mario Zechner, y soporta Codex por OAuth contra tu suscripción de ChatGPT, sin API key.

    Eso es lo que es. El proyecto se describe a sí mismo como "a coding agent with the IDE wired in", y ahí está toda su tesis: donde Pi apuesta por un core diminuto, omp hace lo contrario y mete dentro todo lo que normalmente pondrías fuera.

    Cifras de cabecera de su README a 24 de agosto de 2026, literales: 60+ providers · 31 built-in tools · 14 lsp ops · 28 dap ops. El proyecto no publica releases versionadas —se instala desde main—, así que esto es una foto de hoy, no un contrato: comprueba el README antes de citarlas.

    Si nunca has desmontado un agente por dentro, la anatomía está en qué es un agent harness. Y si vienes de exprimir Codex CLI, esto es la continuación natural de cómo integrar Codex CLI de forma efectiva.


    Cómo usar Codex en Oh My Pi sin API key: /login openai-codex

    Codex entra en omp por OAuth, no por API key: el provider se llama openai-codex y se activa con /login openai-codex dentro de la sesión. Primero, la instalación.

    curl -fsSL https://omp.sh/install | sh
    omp setup
    

    También hay Homebrew (brew install can1357/tap/omp), Bun, Nix, mise y PowerShell.

    Lo que de verdad importa viene después, ya en la sesión —esto no es un comando de shell, es un slash command dentro de la TUI:

    /login openai-codex
    

    Eso abre el flujo OAuth de tu cuenta de ChatGPT. El provider de modelo se llama openai-codex y su auth es oauth: no hay API key en ninguna parte. /login a secas abre el selector, /login <redirect-url> sirve para pegar el callback si el navegador no te devuelve solo, y /logout borra las credenciales.

    Las credenciales viven en el auth store, ~/.omp/agent/agent.db; PI_CODING_AGENT_DIR reubica ~/.omp/agent entero y el store viaja con él. Para headless o remoto está el auth broker: omp auth-broker login <provider>, con sus logout, status y list.

    Los logins son provider-scoped: autenticar anthropic no autentica openai. Y cada organización o workspace cuenta como una cuenta propia: si tienes asiento Team o Enterprise y además plan personal con el mismo email, puedes loguearte una vez por suscripción — el workspace se elige en la pantalla de consentimiento del navegador — y la rotación las trata como dos cuentas distintas.

    Dónde se rompe: el orden de resolución de credenciales

    Gana la primera capa que encaja. Son siete:

    1. Runtime override (--api-key). Nunca se persiste.
    2. La apiKey de config en models.yml.
    3. Credencial OAuth almacenada, refrescada cuando hace falta y con rotación entre cuentas.
    4. API key almacenada por un /login exitoso.
    5. Variable de entorno del provider, incluidos valores de ficheros .env.
    6. Otra API key almacenada, como último recurso.
    7. El resolver de fallback de models.yml.

    Fíjate en el paso 2: una apiKey en models.yml gana a tu OAuth almacenado, y es deliberado — para que la key de un baseUrl o gateway propio se respete en vez de reenviar upstream un token OAuth que el proxy rechazaría. Si un día tu login de Codex "deja de usarse", mira ahí antes de loguearte veinte veces. La variable de entorno del provider es OPENAI_CODEX_OAUTH_TOKEN.


    Los diez roles de modelo: enruta por intención, no por "el mejor modelo"

    omp no tiene "un modelo": tiene diez roles de modelo, y a cada uno le asignas un provider/model-id distinto. Esta es la parte que justifica el post entero.

    Casi todo el mundo pregunta cuál es el mejor modelo. Es la pregunta equivocada. La buena es qué modelo para qué turno.

    Rol Para qué
    default Los turnos normales
    smol Fan-out barato de subagentes
    slow Razonamiento profundo
    plan Modo plan
    commit Changelogs
    advisor El revisor que lee cada turno en paralelo
    vision Turnos con imagen de entrada
    designer Trabajo de interfaz
    task Los subagentes que lanza el tool task
    tiny Utilidades de coste ínfimo

    Un modelo se selecciona como provider/model-id. Los docs de omp lo ilustran con anthropic/claude-opus-4-6; en nuestro caso será openai-codex/<modelo>.

    --smol, --slow y --plan fuerzan el rol al lanzar, Ctrl+P cicla entre los modelos del rol activo y /model cambia el modelo a mitad de sesión. /model es además donde ves qué modelos expone tu plan de Codex: eso depende de tu suscripción y no te lo voy a inventar aquí.

    Para saltarte el picker se preconfigura en ~/.omp/agent/config.yml. El ejemplo literal del README usa un provider custom llamado spark:

    modelRoles:
      default: spark/minimax-m3
    

    Así lo repartiría yo con Codex de por medio:

    modelRoles:
      # Abre /model, mira qué expone tu plan y sustituye los placeholders
      default: openai-codex/<modelo-de-tu-plan>
      slow:    openai-codex/<modelo-de-tu-plan>
      smol:    <provider-barato>/<modelo-pequeno>
      advisor: anthropic/claude-opus-4-6   # otra familia, a propósito
    

    Tres decisiones detrás.

    Codex en default y slow. Es lo que ya pagas, y es lo que quieres para el trabajo real y el razonamiento largo.

    Algo barato en smol. El fan-out de subagentes es donde se va el presupuesto sin que te des cuenta: lanzas varios workers y cada uno consume su contexto entero. Poner tu modelo caro ahí es la forma más rápida de tocar el techo del plan.

    Un revisor distinto en advisor. Si el revisor corre con el mismo modelo que ejecuta, comparte sus puntos ciegos. Por eso el ejemplo del README, que pone openai-codex/gpt-5.5 en advisor, no es lo que yo copiaría: si default ya es Codex, el revisor tiene que salir de otra familia o estás pagando por que alguien te dé la razón.

    Decidir qué inteligencia va en cada paso, en vez de tirar del modelo más caro para todo, es el criterio que trabajo en el curso Construye con IA. Cambia la herramienta, no cambia el razonamiento.


    Qué pasa cuando el plan de Codex se queda sin cuota: fallback chains

    Cuando tu plan de Codex agota cuota a mitad de turno, omp no aborta el turno: salta al siguiente modelo de la cadena declarada en retry.fallbackChains y se queda con él hasta que el turno termina.

    Tu suscripción tiene límites, y normalmente te enteras a mitad de un trabajo largo, con un 429 en la cara. omp tiene cuatro knobs de routing y este es el que más se nota.

    Fallback chains. Cadenas por rol o por modelo bajo retry.fallbackChains. Cuando el primario devuelve 429s o choca contra el muro de cuota, la siguiente entrada se queda el resto del turno y se restaura al pasar el cooldown. Tu límite deja de ser un turno muerto y pasa a ser un degradado suave.

    Los otros tres los dejo enunciados, porque tocan menos a Codex y están bien documentados. Custom providers: en ~/.omp/agent/models.yml declaras cualquier backend que hable openai-completions, openai-responses, openai-codex-responses, azure-openai-responses, anthropic-messages, bedrock-converse-stream, google-generative-ai, google-gemini-cli o google-vertex, y omp models <provider> te verifica el discovery antes de descubrirlo en caliente. Path-scoped models: acotas enabledModels y disabledProviders a un prefijo path: y fijas otro set de modelos en un repo concreto sin tocar la config global. Round-robin credentials: apilas varias API keys por provider y el runtime rota con afinidad de sesión y backoff por credencial, útil cuando una sola key te quemaría la cuota antes de comer.

    La config global vive en ~/.omp/agent/config.yml y la de proyecto en .omp/config.yml. Jerarquía, de más fuerte a más débil: runtime overrides → overlays de --config <file> → proyecto → global → defaults del SETTINGS_SCHEMA. Se toca con omp config set, nunca a mano con el agente corriendo. Y hay perfiles: omp --profile <name>.


    No migres nada: ya tienes la config en disco

    omp lee los ocho formatos que ya tienes en su forma nativa — Cursor MDC, Cline .clinerules, Codex AGENTS.md, Copilot applyTo y el resto — sin script de migración. En el primer arranque hereda reglas, skills y servidores MCP de .claude, .cursor, .windsurf, .gemini, .codex, .cline, .github/copilot y .vscode.

    La precedencia a nivel de usuario es ~/.omp/agent/ > ~/.claude/ > ~/.codex/ > ~/.gemini/. A nivel de proyecto, .omp/ > .claude/ > .codex/ > .gemini/. Y proyecto gana a usuario.

    Ahora el matiz que te va a morder, porque es específico de Codex: el provider codex (prioridad 70) solo carga a nivel de usuario, ~/.codex/AGENTS.md. El contexto de proyecto entra por un AGENTS.md suelto vía el provider agents-md, que sube desde el directorio actual hasta la raíz del repo. No desde <cwd>/.codex/AGENTS.md. Si tienes un .codex/AGENTS.md en el repo esperando que se cargue, no se carga.

    Los otros dos: native (prioridad 100) lee ~/.omp/agent/AGENTS.md y el .omp/AGENTS.md del .omp/ no vacío más cercano subiendo desde cwd — si ese no tiene AGENTS.md, deja de subir. Y claude (prioridad 80) lee ~/.claude/CLAUDE.md y <cwd>/.claude/CLAUDE.md, sin walk-up.

    RULES.md no es lo mismo que AGENTS.md

    Un RULES.md nativo top-level se convierte en regla always-apply: se re-adjunta cerca del turno actual, así que mantiene su fuerza aunque la conversación crezca. Un context file normal se inyecta al abrir sesión y se va diluyendo.

    Regla de uso: AGENTS.md para el fondo duradero — arquitectura, convenciones, dominio. RULES.md para los requisitos cortos y duros que no pueden diluirse.

    Es la respuesta operativa a lo que conté en context drift y memoria en agentes de IA: las instrucciones no se olvidan, se entierran.


    Oh My Pi vs Codex CLI: lo que Codex CLI no te da

    LSP y debugger de verdad. El tool lsp cubre diagnostics, navegación, símbolos, renames, code actions y raw requests. El tool debug pilota una sesión DAP: breakpoints, stepping, threads, stack, variables. El agente deja de leer tu código como texto y lo lee como lo lee tu IDE — y puede pararlo en un breakpoint para ver cuánto vale la variable en vez de suponerlo. Hay además security_scan, que ejecuta revisiones nativas y dispara scans cloud de Codex Security.

    El advisor. Emparejas un modelo a ese rol y lee cada turno del agente principal, inyectando notas inline: un aviso, una preocupación o un bloqueante duro. Corre en su propio contexto y con su propio modelo, así que pilla lo que el que ejecuta se saltó por prisa. El principal corrige o explica por qué no. Revisión continua, no revisión al final.

    El Agent Hub. Alt+A abre un roster con actividad y consumo por subagente. Entras en uno, lees su transcript en vivo, le mandas un mensaje de dirección, revives un worker aparcado o matas uno atascado sin abortar la sesión padre. Los subagentes son de primera clase vía el tool task, con fan-out en paralelo, resultados validados por schema y aislamiento opcional por workspace; encima hay skills como orchestrate y workflowz.

    /review. Lanza subagentes revisores dedicados que barren ramas, commits sueltos o trabajo sin commitear en paralelo, y dan veredicto con issues rankeados de P0 a P3 y puntuados por confianza. Si prefieres quedarte en Codex CLI y exprimirlo desde dentro, el trabajo de harness sobre el propio Codex lo desgloso en harness engineering con Codex de OpenAI.

    Memoria explícita. retain, learn, recall, reflect y memory_edit sostienen el banco de memoria; checkpoint y rewind son puntos de guardado.

    Y el detalle que más me gustó. Dieciséis esquemas URI internos — pr://, issue://, agent://, skill://, ssh:// y el resto — resuelven de forma transparente dentro de cada tool con forma de FS que el agente ya llama. read pr://1428 devuelve la misma forma que read src/foo.ts. grep recorre un diff como si fuera un directorio. No hay herramientas nuevas que aprender: hay rutas nuevas.


    Cuándo NO usar Oh My Pi con Codex

    Es un fork joven de un proyecto de terceros. No es una herramienta de OpenAI ni tiene su soporte detrás.

    La superficie es enorme. 31 herramientas, 60+ providers, diez roles de modelo, cuatro knobs de routing y ocho providers de contexto. Eso es potencia, y es también su propia curva de aprendizaje: vas a pasar una tarde configurando antes de que te rinda. Si esto te viene grande hoy, no pasa nada: empieza por la guía para empezar con agentes de IA y subir de nivel y vuelve cuando el trabajo te dure horas.

    Si haces edits pequeños, Codex CLI tal cual te sobra. El valor aparece cuando el trabajo dura horas, toca muchos archivos y quieres subagentes y un revisor encima. Si no tienes claro qué harness necesitas, la comparativa está en harnesses agénticos comparados.

    Es tu cuenta la que entra por OAuth. Estás autorizando a un cliente de terceros contra tu suscripción de ChatGPT. Antes de meterlo en el trabajo diario revisa qué permite tu plan —sobre todo si el asiento es de empresa—, porque del acceso respondes tú, no el proyecto.

    Y algo que aplica a cualquier agente de código en terminal, este incluido: corre con tus permisos. No es una herramienta que instalas y olvidas en una máquina llena de credenciales.


    Qué hacer hoy

    Instala, ejecuta omp setup, entra y escribe /login openai-codex. Cinco minutos, y ya estás usando el modelo que ya pagabas, sin API key, en otro sitio.

    Luego haz una sola cosa más: abre /model, mira qué te expone tu plan y escribe tus modelRoles. Codex en default y slow, algo barato en smol, un revisor distinto en advisor. Ese bloque de YAML es lo que convierte omp en algo distinto de "otro agente CLI".

    Dónde encaja omp respecto al resto de piezas que uso a diario lo tienes en mi stack de IA agéntica en 2026.

    Nada de esto sustituye a saber qué le pides. Un harness con 31 herramientas y un encargo vago te da caos más rápido: escribir la especificación antes de soltar al agente sigue siendo cosa tuya, y es lo que desarrollo entero en el libro de Spec-Driven Development. Y si quieres ver estas configuraciones montarse en directo y discutirlas con gente que está en lo mismo, eso lo hacemos cada semana en Dominicode Labs.

    Deja de preguntarte cuál es el mejor modelo. Ya pagas uno bueno. La pregunta es en qué caja lo estás metiendo.


    Preguntas frecuentes

    ¿Oh My Pi funciona con Codex?

    Sí. Oh My Pi trae un provider de modelo llamado openai-codex cuya autenticación es OAuth: entras con /login openai-codex, autorizas en el navegador con tu cuenta de ChatGPT y usas el modelo de tu plan dentro del harness de omp, con sus 31 herramientas, LSP, debugger y subagentes. No hace falta API key ni pagar un segundo consumo.

    ¿Necesito una API key de OpenAI para usar Codex en omp?

    No. El provider de modelo openai-codex usa OAuth: entras con /login openai-codex, autorizas en el navegador con tu cuenta de ChatGPT y ya está. Las credenciales quedan en el auth store, ~/.omp/agent/agent.db, y se refrescan solas. Si prefieres inyectarlas por entorno, la variable del provider es OPENAI_CODEX_OAUTH_TOKEN.

    ¿Puedo usar mi cuenta de empresa y la personal a la vez?

    Sí. Para ChatGPT (Codex) y para Anthropic, cada organización o workspace cuenta como una cuenta propia: puedes loguearte una vez por suscripción y eliges el workspace en la pantalla de consentimiento del navegador. La rotación las trata como cuentas distintas, y las rankea y rota automáticamente.

    ¿Tengo que migrar mis AGENTS.md y mi configuración de Codex?

    No. omp lee ocho formatos en su forma nativa y en el primer arranque hereda reglas, skills y servidores MCP de los directorios de Claude, Cursor, Windsurf, Gemini, Codex, Cline, Copilot y VS Code. Con un matiz: el provider codex solo carga ~/.codex/AGENTS.md, a nivel de usuario. El contexto de proyecto llega por un AGENTS.md suelto vía el provider agents-md, no desde <cwd>/.codex/AGENTS.md.

    ¿Qué pasa cuando mi plan de Codex se queda sin cuota a mitad de turno?

    Para eso están las fallback chains, declaradas por rol o por modelo bajo retry.fallbackChains. Cuando el primario devuelve 429s o choca contra el muro de cuota, la siguiente entrada de la cadena se queda el resto del turno y se restaura al pasar el cooldown. En vez de un turno muerto tienes un degradado suave.

    ¿Por qué mi login de Codex parece ignorarse?

    Casi siempre es el orden de resolución de credenciales: gana la primera capa que encaja, y una apiKey declarada en models.yml está por encima del OAuth almacenado. Es deliberado, para que la key de un baseUrl o gateway propio se respete en vez de reenviar un token OAuth que el proxy rechazaría.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

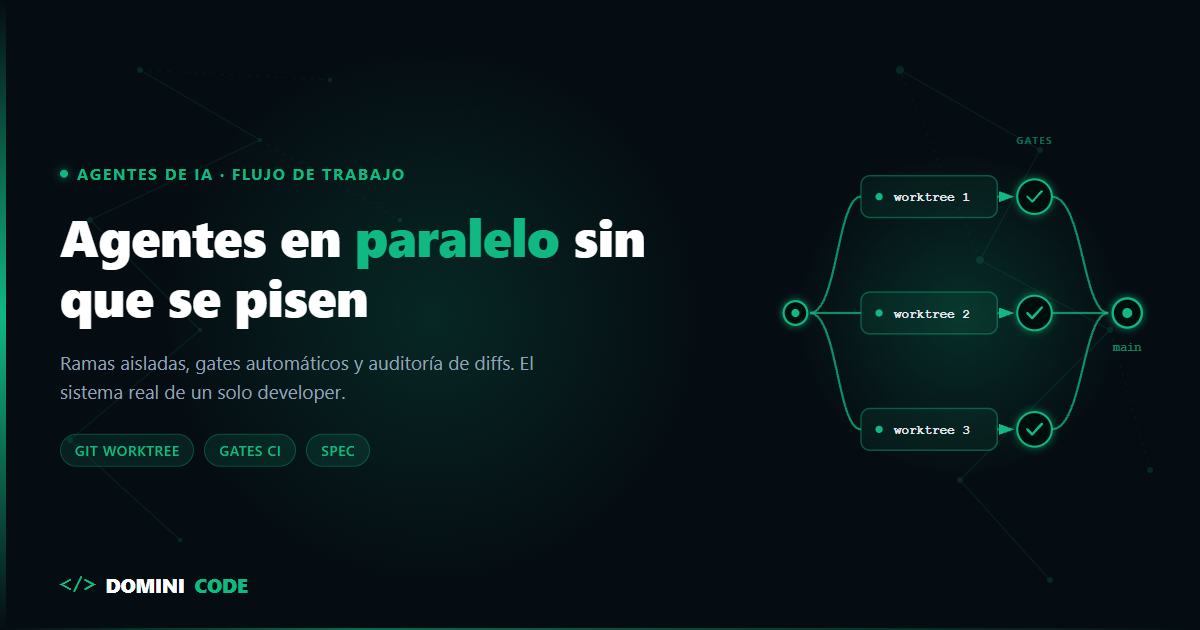
  • Dirigir agentes de IA en paralelo sin que se pisen: mi día real

    Dirigir agentes de IA en paralelo sin que se pisen: mi día real

    Hace unas semanas perdí una mañana entera por una tontería.

    Tenía dos agentes trabajando. Uno refactorizando el módulo de autenticación. El otro añadiendo tests a ese mismo módulo, porque me pareció eficiente hacer las dos cosas a la vez.

    Los dos escribían sobre los mismos archivos.

    Cuando volví, el proyecto no compilaba y ninguno de los dos diffs tenía sentido por separado. Tiré las dos ramas y empecé de cero.

    El fallo no fue del modelo. Los dos agentes hicieron exactamente lo que les pedí.

    El fallo fue mío: los puse a trabajar en el mismo suelo.

    Esto es lo que casi nadie cuenta cuando habla de dirigir agentes: el cuello de botella de operar con varios agentes no es la inteligencia del modelo, es la infraestructura donde los pones. Que un modelo de frontera escriba 500 líneas tipadas en quince segundos es un problema resuelto. Lo que no está resuelto es cómo evitas que varios procesos autónomos se pisen entre ellos, y cómo revisas lo que producen sin convertirte tú en el atasco.

    Opero Dominicode solo. Una plataforma de cursos, un canal de YouTube con más de 100.000 suscriptores, libros técnicos y una comunidad activa. No tengo un equipo de diez personas. Tengo un sistema.

    Aquí está ese sistema: sus tres reglas, cómo es la jornada y lo que cuesta.

    Si lo que buscas es qué habilidades aprender para llegar hasta aquí, eso ya lo desglosé en el roadmap del developer con IA. Este post no va de qué aprender. Va de cómo se opera un día.


    Las 3 reglas del suelo

    Mi operación se apoya en tres reglas. Ninguna es teoría: cada una salió de una mañana perdida como la de arriba.

                     TAREA
                       │
        ┌──────────────┼──────────────┐
        ▼              ▼              ▼
     AISLAR        CONTRATO        ÁRBITRO
     rama +        spec.md         los tests
     worktree      antes del       deciden,
     propio        prompt          no yo
        │              │              │
        └──────────────┼──────────────┘
                       ▼
                DIFF AUDITABLE
    

    1. Un agente, una rama, un worktree

    La regla es literal: dos agentes nunca comparten directorio de trabajo.

    Cada tarea que delego arranca en su propia rama y en su propio git worktree. Son copias del repositorio en carpetas distintas que comparten el mismo historial de Git. El agente que refactoriza autenticación no ve los archivos del agente que escribe documentación, porque físicamente no están en su carpeta.

    Esto resuelve tres cosas de golpe:

    • No hay colisiones de escritura. Es imposible que dos agentes editen el mismo archivo, porque cada uno tiene su copia.
    • El diff sale limpio. Cada rama contiene un solo cambio conceptual, así que puedo revisarlo sin desenredarlo del resto.
    • Tirar el trabajo es gratis. Si un agente se ha ido por un camino equivocado, borro la rama y no he perdido nada más.

    Antes de esto usaba una sola carpeta y lanzaba los agentes por turnos. Iba tres veces más lento y aun así se pisaban cuando me despistaba.

    2. La spec es el contrato, el prompt es solo la orden de arranque

    Un prompt es una conversación. Una spec es un contrato que se puede verificar.

    La diferencia importa mucho más cuando trabajas en paralelo, y por un motivo que no es obvio: si no puedes revisar el trabajo del agente mientras lo hace, la especificación es lo único que evita que descubras la desviación al final. Con un agente delante puedes corregirle en el turno siguiente. Con cuatro trabajando a la vez, no estás mirando. Te enteras cuando abres el diff.

    Así que antes de lanzar nada escribo un spec.md que delimita el alcance, las interfaces y qué queda explícitamente fuera. Ese último punto es el que más trabajo me ahorra: sin un "fuera de alcance" escrito, los agentes tienden a expandirse hacia archivos que nadie les pidió tocar.

    Esta es la metodología que explico entera en el libro de Spec-Driven Development. Y si quieres saber por qué una spec aparentemente buena todavía falla, tengo desmenuzados los 7 fallos más comunes.

    3. Los tests son el árbitro, no yo

    Aquí está el error que hunde a la mayoría cuando intenta paralelizar: creer que el revisor humano escala.

    No escala. Si cuatro agentes producen cuatro diffs de 400 líneas y tú eres la única puerta de calidad, has movido el cuello de botella de la escritura a la revisión. Vas igual de lento, solo que ahora leyendo en vez de escribiendo.

    La única salida es que la primera puerta sea automática y no negociable. En mi caso: tipado estricto, suite de tests y lint. Si una rama no pasa los tres, no llega a mis ojos. El agente recibe el error, corrige y vuelve a intentarlo sin que yo intervenga.

    Ese es el cambio mental completo. Tu trabajo no es aprobar código: es diseñar el árbitro que lo aprueba por ti. Cuando esos gates viven en el pipeline y no en tu cabeza, las revisiones automáticas en CI/CD hacen el primer filtro completo.

    Diseñar suites que cacen regresiones sutiles —y no solo las obvias— es una habilidad en sí misma, y es la que enseño en el curso de Testing en Angular y TypeScript.


    Qué se puede paralelizar y qué no

    Esta es la parte que se salta todo el mundo, y la que decide si el sistema funciona.

    No todas las tareas se pueden repartir. Si la tarea B necesita las decisiones de la tarea A, lanzarlas juntas no te da velocidad: te da dos ramas incoherentes y una tarde de merge.

    Mi criterio, en una línea: paralelizo lo que no comparte decisiones de diseño.

    Se paralelizan bien:

    • Tareas en módulos que no se tocan entre sí.
    • Trabajo de superficie: tests sobre código estable, documentación, migraciones mecánicas.
    • Investigación. Un agente reproduciendo un fallo en staging no interfiere con nadie.

    No se paralelizan:

    • Cambios que dependen de un modelo de datos que todavía estoy decidiendo.
    • Cualquier cosa que toque el mismo contrato público, aunque sean archivos distintos.
    • La primera implementación de una funcionalidad nueva cuya arquitectura no está fijada.

    Ese segundo caso me pilló varias veces. Dos agentes en carpetas separadas, sin conflicto de Git, pero cada uno asumió una forma distinta del mismo tipo compartido. El merge fue limpio y el código estaba roto. Por eso el aislamiento no sustituye al contrato: hacen falta los dos.

    Si quieres el marco completo para decidir qué va en serie y qué va en paralelo, lo detallé en cómo clasificar tareas con IA.


    Mi jornada, por bloques

    Así se traduce todo lo anterior a un día normal.

    Mañana (bloque de decisión). Es la única hora del día en la que no hay ningún agente corriendo, y es deliberado. Reviso lo que quedó pendiente, decido qué entra hoy y escribo las especificaciones. Todas las decisiones de arquitectura del día se toman aquí. Cuando lanzo el primer agente, ya no queda nada por decidir.

    Media mañana (lanzamiento). Abro los worktrees y lanzo. Normalmente entre tres y cinco tareas, cada una en su rama, cada una con su spec. Nunca dos en el mismo módulo.

    Día (trabajo profundo). Mientras los agentes escriben y los pipelines validan, yo no miro los agentes. Esta es la parte que cuesta interiorizar y es donde está toda la ganancia real: si me quedo mirando la terminal, no he ganado nada. Este bloque es para diseñar arquitectura, grabar contenido o escribir. Los gates hacen su trabajo sin mí.

    Tarde (auditoría). Aquí sí me siento a revisar. Solo llegan las ramas que pasaron los gates.

    Cierre (integración). Apruebo, integro en orden y anoto qué se desvió y por qué. Ese registro es lo que hace que la spec de mañana sea mejor que la de hoy.

    Lo importante no son las horas: es que las decisiones y la ejecución están en bloques separados. Cuando los mezclaba —decidir un poco, lanzar un poco, revisar un poco— el sistema entero se venía abajo.


    Cómo audito cuatro diffs sin leer 1.600 líneas

    No los leo enteros. Reviso en tres pasadas, y cada una descarta trabajo para la siguiente.

    Primera pasada: la forma del diff. Antes de leer código, mira qué archivos se tocaron y cuántas líneas. Un agente al que pediste un cambio en un módulo y ha tocado once archivos se ha ido de alcance. Eso se ve en cinco segundos y ya es motivo de rechazo, sin leer una línea.

    Segunda pasada: los bordes. Voy directo a donde el código se comunica con el resto: tipos exportados, firmas públicas, esquemas de validación, migraciones. Ahí es donde un fallo se propaga. El interior de una función privada, si los tests pasan, puede esperar.

    Tercera pasada: lo que el test no puede saber. Aquí leo de verdad, pero solo lo que ninguna suite detecta. Que el agente haya elegido la abstracción correcta. Que no haya duplicado algo que ya existía en el proyecto. Que el error se maneje donde tiene sentido y no donde era cómodo.

    Los tests cubren la corrección. Yo cubro el criterio. Y el criterio es lo único que un modelo no puede delegarte de vuelta.


    Lo que cuesta

    Conviene decirlo, porque suele omitirse: paralelizar sale más caro por tarea completada.

    Cuando reparto una tarea entre varios agentes, cada uno arrastra su propio contexto del proyecto. Ese contexto se paga varias veces en lugar de una. Y el coste real no es lineal ni predecible: cambia bastante según el modelo que asignes a cada rama, algo que ya analicé en detalle en el coste de los subagentes al cambiar de modelo.

    Lo asumo porque lo que compro es tiempo mío, no tokens. Pero conviene tenerlo claro antes de lanzar seis agentes: si la tarea era pequeña, sale más barato hacerla tú.


    Qué puedes montar esta semana

    Sin reformar nada, en este orden:

    1. Aísla antes de paralelizar. Crea un git worktree por tarea. Con dos ya notarás la diferencia; no hace falta empezar por seis.
    2. Escribe el "fuera de alcance". Una sola línea en tu spec diciendo qué no debe tocar el agente. Es la frase con mejor retorno de todo el documento.
    3. Pon un gate automático. Aunque sea solo tsc --noEmit más los tests. Mientras la única puerta de calidad seas tú, no estás paralelizando: estás acumulando cola.

    El flujo completo, desde la idea hasta producción con herramientas CLI agénticas, lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si quieres ver configuraciones reales de agentes y arquitecturas que están funcionando en producción hoy, eso es lo que compartimos cada semana en Dominicode Labs.

    Un agente que escribe código es una herramienta. Varios agentes con un suelo bien diseñado debajo son un equipo. La diferencia entre las dos cosas la construyes tú, y no está en el prompt.


    Preguntas frecuentes

    ¿Cuántos agentes puedo tener trabajando a la vez sin perder el control?

    El límite no lo pone la herramienta, lo pone tu capacidad de auditar. Yo trabajo con tres a cinco tareas simultáneas porque es lo que puedo revisar con criterio en un bloque de tarde. Si necesitas más de lo que puedes auditar, el problema no se arregla añadiendo agentes: se arregla endureciendo los gates automáticos para que llegue menos a tu revisión.

    ¿Cómo evito que dos agentes editen el mismo archivo?

    Dándoles carpetas distintas. Un git worktree por tarea crea una copia del repositorio en su propio directorio, compartiendo el historial de Git. Como cada agente solo ve su carpeta, la colisión de escritura es imposible por construcción, no por disciplina.

    ¿Merece la pena paralelizar si tengo que revisar todos los diffs igual?

    Solo si la revisión no es tu cuello de botella. Con gates automáticos, las ramas que fallan tipado, lint o tests nunca llegan a tu mesa: el agente corrige solo. Sin esos gates, paralelizar no te da velocidad, te da una cola de revisión más larga.

    ¿Qué hago cuando un agente en paralelo se queda atascado?

    Borro la rama y reescribo la especificación. Insistir en la misma conversación con un agente que ya se desvió suele salir más caro que empezar limpio, porque el contexto equivocado sigue ahí arrastrándose. Y casi siempre el atasco señala una ambigüedad real en la spec que hay que arreglar de todos modos.

    ¿Se puede aplicar esto en un equipo, o solo trabajando solo?

    Funciona igual o mejor en equipo, porque las tres reglas son las mismas que ya usa cualquier equipo sano: rama por cambio, contrato antes de implementar, CI como árbitro. Lo que cambia es quién ocupa la silla del implementador. Si tu equipo ya trabaja así con personas, tienes el suelo montado.

  • MCP en producción: lo que se rompe cuando tu server sale del portátil

    MCP en producción: lo que se rompe cuando tu server sale del portátil

    Tu MCP server funciona. Lo lanzas por stdio, tu agente lo ve, las tools responden.

    Y entonces alguien pregunta lo obvio: ¿y si lo usamos desde el resto del equipo?

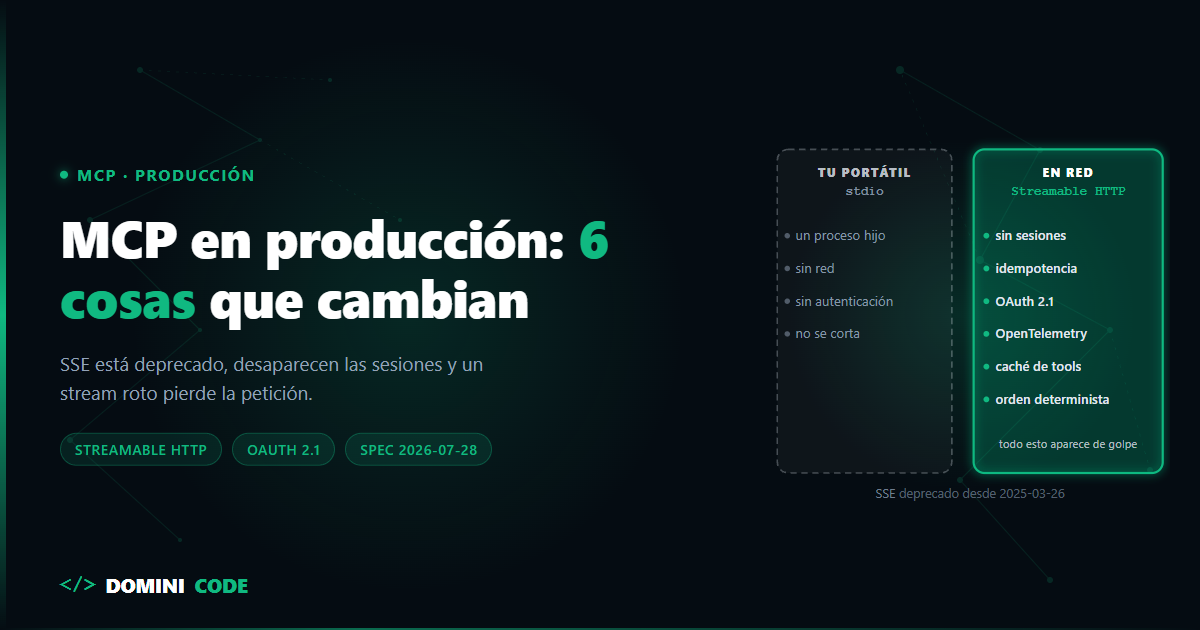
    Ahí es donde la cosa deja de parecerse a lo que montaste. Porque un server local por stdio es un proceso hijo hablando por una tubería: sin red, sin autenticación, sin concurrencia, sin nada que se pueda caer a medias. En cuanto lo expones por HTTP, todo eso aparece de golpe — y encima el protocolo ha cambiado justo en las piezas que te afectan.

    Si todavía no tienes el server montado, empieza por construir un agente y su MCP server paso a paso, y para registrarlo en tu entorno tienes claude mcp add explicado con sus scopes. Este post empieza donde acaban esos dos: el día que ese server deja de ser tuyo.

    Van seis cosas, todas verificables contra la especificación.


    1. SSE está deprecado. El transporte es Streamable HTTP

    Si has leído tutoriales de MCP del último año y medio, muchos te dicen que para salir a red uses SSE (Server-Sent Events) con dos endpoints.

    No lo hagas. El transporte HTTP+SSE está deprecado desde la revisión 2025-03-26 del protocolo, y la revisión 2026-07-28 lo reclasifica formalmente como Deprecated bajo la nueva política de ciclo de vida, con la instrucción explícita de migrar a Streamable HTTP. El SDK de TypeScript ya marca SSEClientTransport como @deprecated.

    La diferencia práctica: SSE usaba dos endpoints (uno para abrir el stream, otro para mandar mensajes). Streamable HTTP usa uno solo, que gestiona las dos direcciones. Menos superficie, menos estado que coordinar y mucho menos que explicarle a tu balanceador.

    Lo bueno es que esto no depende de si migras a la v2 o no: la deprecación de SSE es anterior y aplica igual. Si tu server remoto habla SSE, ya vas con retraso.


    2. Ya no hay sesiones — y eso te simplifica el escalado

    Este es el cambio que más agradece la infraestructura.

    La revisión 2026-07-28 elimina las sesiones a nivel de protocolo y la cabecera Mcp-Session-Id del transporte Streamable HTTP. Y va más allá: elimina también el handshake initialize/notifications/initialized. Cada petición viaja ahora con su versión de protocolo y las capacidades del cliente dentro de _meta.

    Traducido a lo que te importa un lunes por la mañana: desaparecen las sticky sessions. Puedes poner un round-robin normal delante de N réplicas y ya está. Si alguna vez has peleado con un balanceador intentando que un cliente vuelva siempre a la misma instancia, esta es la razón para mirar la v2.

    El matiz importante: si tu server necesitaba estado entre llamadas, ahora no lo guardas en la sesión. La spec dice que los servidores que necesiten estado entre llamadas usen handles explícitos, acuñados por el servidor y pasados como argumentos normales de una tool. Es decir: el estado deja de ser magia del transporte y pasa a ser parte de tu contrato de datos, visible y tipado.

    También aparece un server/discover que los servidores deben implementar para anunciar versiones soportadas, capacidades e identidad.


    3. Un stream que se rompe pierde la petición

    Esta es la que más te va a doler si no la ves venir, y es la menos comentada.

    La revisión 2026-07-28 elimina la resumibilidad del stream y la reentrega de mensajes: fuera la cabecera Last-Event-ID y fuera los IDs de evento SSE. Lo que dice la spec es directo: si el stream de respuesta se corta, la petición en vuelo se pierde, y el cliente debe reemitirla como una petición nueva con un ID nuevo.

    Piensa en lo que significa eso con una tool que cobra una suscripción, crea un usuario o lanza un despliegue. Un corte de red a mitad y el cliente reintenta. Si tu tool no es idempotente, acabas de cobrar dos veces.

    En local esto no existía. Una tubería stdio no se corta a medias. En red, sí.

    Lo que hay que hacer es lo de siempre en sistemas distribuidos, solo que ahora te toca a ti aplicarlo en la capa de tools:

    • Toda tool con efectos secundarios necesita una clave de idempotencia que venga en los argumentos, no generada dentro.
    • Separa lectura de escritura. Las de lectura pueden reintentarse alegremente; las de escritura, solo con la clave.
    • Registra el resultado por clave y, si llega repetida, devuelve el resultado guardado en lugar de volver a ejecutar.

    En la práctica son unas pocas líneas delante de tu lógica:

    const ArgsSchema = z.object({
      idempotencyKey: z.string().uuid().describe("Identificador único de este intento"),
      usuarioId: z.string(),
      plan: z.enum(["pro", "team"]),
    });
    
    async function cambiarPlan(args: unknown) {
      const { idempotencyKey, usuarioId, plan } = ArgsSchema.parse(args);
    
      const previo = await store.get(idempotencyKey);
      if (previo) return previo;               // el reintento no vuelve a cobrar
    
      const resultado = await facturacion.cambiarPlan(usuarioId, plan);
      await store.set(idempotencyKey, resultado, { ttlSegundos: 86_400 });
      return resultado;
    }
    

    La clave llega en los argumentos, no se genera dentro: si la generaras tú, cada reintento traería una distinta y no servirían de nada.

    Ese criterio de qué se automatiza y qué no —lo reversible frente a lo irreversible— es el mismo que aplico a los permisos de un agente, y lo desarrollé en inyección indirecta de prompts en agentes.


    4. Autenticación: tu server pasa a ser un resource server de OAuth 2.1

    En local no hay autenticación porque no hace falta: el proceso es tuyo. En red hace falta, y MCP no se la inventa: se apoya en OAuth 2.1.

    El modelo mental que conviene fijar: tu MCP server es un resource server, no un servidor de autorización. Valida tokens y sirve recursos. No emite tokens ni loguea a nadie. Eso es de otro.

    Las piezas:

    • Metadatos de recurso protegido. Tu server publica /.well-known/oauth-protected-resource, un JSON que declara su identificador, los servidores de autorización en los que confía, los scopes que soporta y los métodos de bearer que acepta. Es lo que permite a un cliente descubrir a dónde ir a pedir el token:

      {
        "resource": "https://mcp.tudominio.com",
        "authorization_servers": ["https://auth.tudominio.com"],
        "scopes_supported": ["mcp:read", "mcp:write"],
        "bearer_methods_supported": ["header"]
      }
      
    • El parámetro resource. El cliente lo manda en la petición de autorización y en la de token. Es el mecanismo que impide que un token acuñado para tu server sirva en otro distinto.

    • Registro de cliente. La revisión 2026-07-28 deprecia el Dynamic Client Registration en favor de los Client ID Metadata Documents, aunque DCR sigue disponible por compatibilidad. También pide validar el parámetro iss de la respuesta de autorización contra el emisor registrado antes de canjear el código, y que las credenciales persistidas se indexen por emisor y no se reutilicen con otro servidor de autorización.

    Si vas a exponer un server a terceros, esta sección es la que decide si te lo pueden usar las empresas o no. El caso de negocio de tener el tuyo lo desarrollé en MCP server para empresas.


    5. Observabilidad: el logging del protocolo se va, entra OpenTelemetry

    La revisión 2026-07-28 deprecia las features de Roots, Sampling y Logging. Siguen funcionando durante la ventana de deprecación —que la política fija en un mínimo de doce meses— pero las implementaciones nuevas no deberían adoptarlas.

    Para el logging, la migración que sugiere la propia spec es explícita: escribir a stderr (en stdio) o usar OpenTelemetry.

    Y la spec te lo pone fácil, porque documenta la propagación de contexto de trazas de OpenTelemetry sobre las claves _meta: traceparent, tracestate y baggage. Eso significa que puedes correlacionar la traza de tu backend con la llamada del agente que la originó, que es justo lo que echas de menos la primera vez que un tool call falla en producción y no sabes de qué conversación venía.


    6. El caché que te ahorra tokens (y casi nadie configura)

    Este es el que da alegrías y no cuesta nada.

    La revisión 2026-07-28 exige los campos ttlMs y cacheScope en los resultados de tools/list, prompts/list, resources/list, resources/read y resources/templates/list, mediante una nueva interfaz CacheableResult. ttlMs es una pista de frescura en milisegundos para que el cliente cachee y deje de sondear; cacheScope ("public" o "private") controla si un intermediario compartido puede cachear la respuesta.

    Y hay un detalle pequeño con consecuencias grandes: la spec dice que los servidores deberían devolver las tools de tools/list en un orden determinista, explícitamente para permitir el caché del lado del cliente y mejorar los aciertos de caché de prompt del LLM.

    Piénsalo un segundo. La lista de tools va al principio del contexto. Si tu server la devuelve en orden distinto en cada petición, estás invalidando el prefijo cacheado del prompt en cada llamada y pagando entrada completa cada vez. Ordenar un array te sale gratis.


    Y una que no viene de la spec: la deriva de esquemas

    Esto no es un cambio del protocolo, es el fallo que más veo en servers reales.

    El patrón habitual define el esquema dos veces: una con Zod para validar en ejecución, y otra a mano como JSON Schema en la respuesta de tools/list. Dos fuentes de verdad para el mismo contrato.

    El día que añades un campo y solo tocas una, el resultado no es un error: es peor. El modelo lee un contrato y tu servidor valida otro, así que el agente manda llamadas perfectamente razonables que tu server rechaza. Y como el fallo llega como un error de validación, parece culpa del modelo.

    La regla: el JSON Schema que publicas tiene que derivarse del esquema que valida, nunca escribirse en paralelo. Un solo sitio donde cambiar las cosas.

    Los patrones para modelar y derivar contratos con Zod los vemos en el curso de Zod para TypeScript. Y si vas a definir las tools antes de escribirlas —que es lo que evita justo esta clase de deriva— la metodología está en el libro de Spec-Driven Development.


    Checklist antes de exponerlo

    1. Transporte: Streamable HTTP, un solo endpoint. Si tienes SSE, tienes deuda.
    2. Idempotencia: clave en los argumentos para toda tool con efectos secundarios, y resultado guardado por clave.
    3. Sin sesiones: nada de sticky sessions; el estado entre llamadas viaja como handle explícito en los argumentos.
    4. Auth: /.well-known/oauth-protected-resource publicado y validación del parámetro resource en los tokens.
    5. Trazas: propaga traceparent por _meta y manda las trazas a tu colector.
    6. Caché: ttlMs y cacheScope en los listados, y tools/list siempre en el mismo orden.
    7. Un solo esquema: el JSON Schema publicado, derivado del validador.

    El flujo completo de diseñar herramientas para agentes y llevarlas a producción es lo que enseño en el curso Construye con IA: de la idea al producto con Claude Code.

    En Dominicode Labs tengo servidores MCP corriendo para infraestructura, analítica y publicación, y comparto ahí las configuraciones que aguantan.

    Montar un MCP server es una tarde. Exponerlo es un sistema distribuido. La diferencia entre las dos cosas son estas siete líneas.


    Preguntas frecuentes

    ¿Tengo que migrar mi MCP server a la v2 ya?

    Para el protocolo, no: hablar la revisión nueva es opt-in y la v1 sigue soportada. Pero la deprecación de SSE es anterior e independiente de la v2 —viene de la revisión 2025-03-26— así que si tu server remoto habla SSE, eso sí conviene cambiarlo aunque no toques nada más. Lo que sí trae la v2 y compensa de verdad es quitarte las sticky sessions.

    ¿Qué diferencia hay entre SSE y Streamable HTTP en un MCP server?

    SSE usaba dos endpoints: uno para mantener abierto el stream de servidor a cliente y otro para que el cliente enviara mensajes. Streamable HTTP usa un único endpoint que gestiona ambas direcciones. Menos piezas que coordinar, menos configuración en el balanceador y menos estado que mantener vivo entre peticiones.

    Si desaparecen las sesiones, ¿dónde guardo el estado entre llamadas?

    En los argumentos de la tool. La spec indica que los servidores que necesiten estado entre llamadas usen handles explícitos acuñados por el propio servidor y pasados como parámetros normales. Deja de ser un implícito del transporte y pasa a formar parte del contrato de datos, que es más fácil de depurar y de tipar.

    ¿Por qué mis tools tienen que ser idempotentes en un server remoto?

    Porque la revisión 2026-07-28 elimina la reentrega de mensajes y la resumibilidad del stream. Si la conexión se corta, la petición en vuelo se pierde y el cliente debe reemitirla como una petición nueva. Sin clave de idempotencia, una tool que cobra o crea algo lo haría dos veces. En local, con stdio, este escenario no existe.

    ¿Mi MCP server tiene que emitir tokens de autenticación?

    No. Tu server es un resource server: valida tokens y sirve recursos, nunca emite tokens ni autentica usuarios. De eso se encarga un servidor de autorización aparte. Lo que sí publica tu server es /.well-known/oauth-protected-resource, para que los clientes descubran en qué servidor de autorización pedir el token y con qué scopes.

  • Claude diseñó proteínas solo: manual de agentes de IA autónomos

    Claude diseñó proteínas solo: manual de agentes de IA autónomos

    Casi todo lo que leo sobre IA cabe en tres cajones: autocompletar código, sacar un gráfico de un Excel y vídeos de gente que no existe bailando en una playa.

    Ese es el techo mental de la conversación. El mío también, muchos días.

    Y mientras discutimos si Cursor gestiona el contexto mejor que Claude Code, los mismos agentes de IA autónomos que tú y yo soltamos dentro de un repo llevaban 48 horas seguidas diseñando proteínas que no existían. Proteínas que después alguien sintetizó de verdad, en un laboratorio de verdad, y midió con un aparato de verdad.

    Ahí el error no se arregla con git revert.

    El 18 de agosto de 2026 Anthropic publicó How Claude is accelerating protein design and analytical chemistry y, debajo, un informe técnico con el detalle fino: 1.320 diseños generados, 354 binders confirmados en laboratorio, 14 de 15 dianas con al menos un acierto.

    Ese titular corrió por todas partes. Y es el trozo menos interesante de la historia.

    Porque lo que a ti y a mí nos sirve el lunes por la mañana no son los 354 binders. Es cómo estaba escrito el documento que le dieron al agente antes de arrancar.


    Primero, qué hizo exactamente

    Un binder es una proteína pequeña que se pega a una diana concreta. Es el paso cero de medio catálogo de fármacos. No es un fármaco: por delante queda todo el recorrido preclínico y regulatorio, que se mide en años.

    Claude no inventó ninguna herramienta. Usó las que ya existen y son públicas: diez generadores de estructura distintos, con PXDesign (358 diseños), RFdiffusion3 (267) y Genie 3 (185) a la cabeza; SolubleMPNN para el diseño de secuencia (1.133 de los diseños testeados) y un ensemble de ESMFold2, ESMFold2-Fast y Protenix v2 para rankear. Ninguna venía preinstalada: el protocolo le obliga a compilar cada una desde su repositorio público y validarla en la primera hora. Todo dentro de Claude Science, el entorno de investigación de Anthropic.

    Lee esa lista otra vez. Ninguna herramienta es suya.

    El modelo no aportó capacidad generativa nueva al campo. Aportó criterio: qué herramienta usar, en qué orden y qué candidatos tirar a la basura. Es la diferencia entre IA generativa e IA agéntica llevada a un dominio donde el resultado se mide con un sensor.

    Y se nota en el ranking: su diseño número uno acertó el 49 % de las veces, el top cinco un 44 %, el top diez un 39 %, frente al 28 % del conjunto de treinta. El criterio estaba en el orden.

    Y se midió fuera de casa. Adaptyv Bio convirtió las secuencias en ADN, sintetizó las proteínas con síntesis libre de células y robots, y midió afinidad por resonancia de plasmón superficial. Twist Bioscience también participó. Esto no es una simulación puntuándose a sí misma.

    Los números por brazo del experimento, que mucha gente ha contado mal mezclándolos:

    Configuración Binders / diseños Tasa de acierto
    Baseline de la industria hoy — 10–15 %
    Opus 4.8 · 14 dianas a la vez, una sola sesión · 48 h 88 / 390 22,6 %
    Mythos Preview · 14 dianas a la vez, una sola sesión · 48 h 104 / 390 26,7 %
    Mythos Preview · una sesión de 24 h por diana 158 / 450 35,1 %

    Del formato multi-diana se analizan 13 de las 14 dianas; la campaña de diana única cubrió las 15.

    El 26,8 % global sale de dividir 354 entre 1.320. El 95 % de los diseños se expresó correctamente. Y hubo dos casos que se salen de la media:

    • RBX1: 28 binders de 90 diseños sumando las tres campañas, un 31 %. Y un 40 % en la campaña de diana única, la mejor configuración. En la competición abierta previa sobre esta misma diana solo pegaron 9 de 245 diseños: un 3,7 %. El mejor diseño del agente se midió en 3,9 nM, por delante del que ganó aquella competición.
    • TREM2: 72 binders de 90 diseños. Un 80 %, frente al 38,3 % de la competición previa de Adaptyv.

    Con un asterisco que pone el propio informe: cuatro de las seis competiciones con las que se compara ya estaban publicadas y accesibles para el agente mientras diseñaba.

    Impresionante igual. Ahora la parte que de verdad importa.


    Dos tercios del prompt no eran de biología

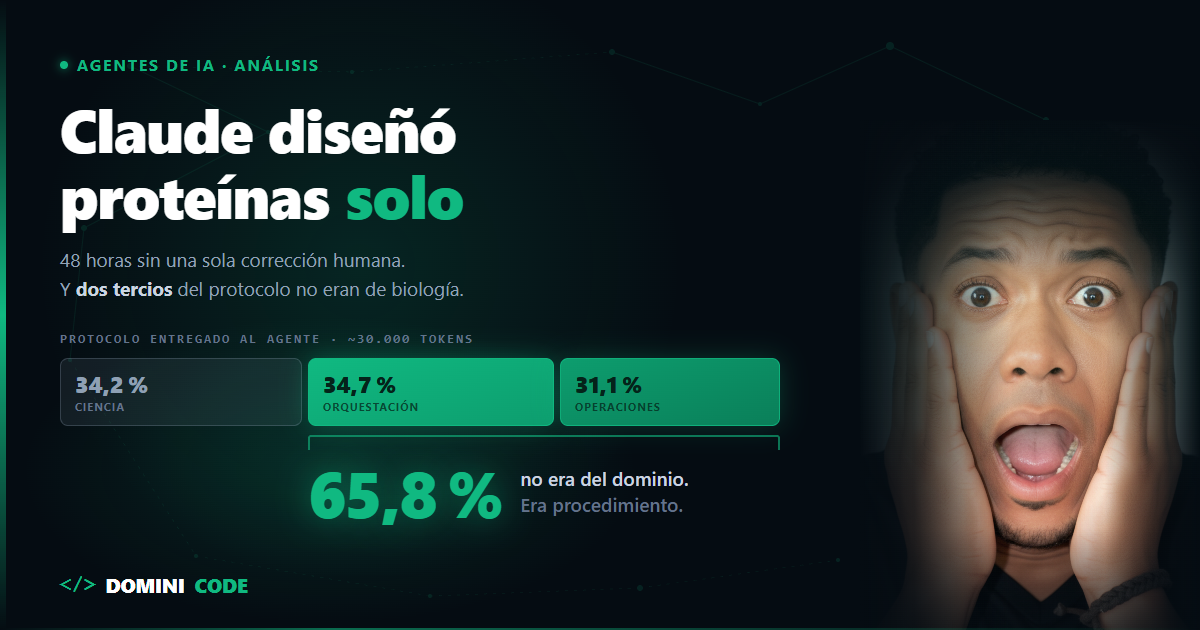
    Antes de arrancar, un grupo de expertos escribió un protocolo. Unos 30.000 tokens. Y después —cita textual del informe— "no dimos ninguna guía científica, técnica ni operativa adicional después de iniciar las campañas".

    Ni una corrección. Ni un "prueba mejor por aquí". Los únicos mensajes humanos que entraron fueron instrucciones cortas y no técnicas para reanudar cuando una sesión se caía por infraestructura. El resto de incidencias las detectó y las sorteó el agente solo.

    Lo interesante es cómo se repartía ese documento:

    PROTOCOLO ENTREGADO AL AGENTE - ~16.000 palabras (~30.000 tokens)
    
      Ciencia y herramientas      ################   34,2 %
      Orquestacion y validacion   ################   34,7 %
      Operaciones                 ##############     31,1 %
                                                     -------
      Todo lo que NO es dominio                      65,8 %
    

    Un 34,2 % de ciencia. Y un 65,8 % de cosas que no tienen nada que ver con proteínas: cómo trabajar, cómo decidir, cómo validar, cuándo parar, qué hacer cuando algo se rompe.

    Piensa ahora en tu último system prompt.

    Si el 90 % es "eres un ingeniero senior experto en X con 20 años de experiencia", ya sabes qué te falta. No te falta dominio. Te falta procedimiento.

    Y un detalle remata la idea: probaron el protocolo en campañas piloto y, antes de las corridas finales, revisaron justo las secciones de orquestación y operaciones. No cambiaron el modelo. No añadieron más ciencia. Iteraron sobre el harness.

    Eso es Spec-Driven Development sin llamarlo por su nombre: escribir la especificación antes de dejar que nada se ejecute, y corregir la especificación en lugar de corregir la ejecución. La misma disciplina que desarrollo en el libro de SDD, solo que aquí el precio de improvisar no era un sprint perdido, eran 50.000 dólares de GPU.


    "¿No habíamos quedado en que los mega-prompts son mala idea?"

    Sí. Y este experimento no me desmiente. Me da la razón, aunque de lejos parezca lo contrario.

    Escribí Arquitectura de subagentes vs. mega-prompt defendiendo que un contexto único cargado de responsabilidades se degrada. Aquí hay un documento de 30.000 tokens que funcionó. Toca mirar el detalle.

    Primero: eso no es un prompt, es un protocolo compartido. Y el informe lo dice sin ambigüedad: cada agente de la campaña lo recibe como system prompt. En plural. Uno de los bloques de orquestación explica cómo delegar el trabajo en un equipo de subagentes de dos capas y cómo supervisarlo.

    Especificación larga, ejecución repartida. Que es justo lo que defendía aquel post.

    Segundo, el dato que lo remata. La campaña que atacó las 14 dianas a la vez dentro de una sola sesión se quedó en el 26,7 %. Darle a cada diana su propia sesión de 24 horas subió al 35,1 %: 143 binders frente a 104 sobre las mismas 13 dianas, con una p de 0,003.

    Anthropic avisa de que esa sesión dedicada también tuvo 2,8 veces más cómputo por diana, así que foco y presupuesto no se pueden separar del todo. Pero la dirección es la de siempre: cuantas menos cosas metes en un contexto, mejor sale.

    Un mega-prompt de los malos es sedimento. Instrucciones de dominio acumuladas, ejemplos pegados a mano y reglas contradictorias que alguien fue añadiendo cada vez que algo petó en producción. Esto es un manual de operaciones escrito una vez y repartido entre varios agentes.

    La lección no es "escríbelo todo más largo". Es qué metes dentro de cada contexto y cómo lo estructuras.


    Qué es un agente de IA autónomo (y qué no lo es)

    Un agente de IA autónomo es un sistema que recibe un objetivo y un protocolo escritos por una persona y, a partir de ahí, decide solo qué herramientas usar, en qué orden y qué resultados descartar, sin intervención humana durante la ejecución. No es un modelo más listo: es un modelo con un carril bien escrito.

    En esta campaña la autonomía duró 48 horas. Lo que la hizo posible no fue el modelo, fue el documento que alguien escribió antes de pulsar enter.


    La frontera real de los agentes de IA autónomos

    La palabra "autónomo" ha vendido muchos titulares estos días. Merece un asterisco grande.

    Lo decidió el agente Lo fijó el humano
    Qué investigar de cada diana Qué dianas
    Qué epítopo atacar El protocolo
    Qué herramientas usar y en qué orden Los antígenos del ensayo
    Qué candidatos descartar Los pedidos de síntesis
    Cómo rankear las secuencias finales La lectura de los datos

    Nadie tocó al agente durante la corrida. Cierto. Pero un humano eligió el problema, escribió las reglas, definió el ensayo y leyó los resultados.

    Ese es el patrón que veo funcionar una y otra vez en producción: autonomía total dentro de un carril que alguien dibujó antes, con mucho cuidado.

    El trabajo del ingeniero se ha movido del bucle al carril. Es justo lo que trabajo en el curso Construye con IA: el resultado depende mucho más de lo que escribes antes de lanzar el agente que del modelo que elijas.


    Por qué la química tardó minutos y esto semanas

    En la misma publicación hay un segundo experimento que casi nadie ha citado. Claude Opus 5 procesó ficheros de NMR y LC-MS en 23 y 19 minutos, y calculó una pureza del 96,4 % frente al 96,33 % que había medido el laboratorio.

    Minutos.

    Los binders necesitaron semanas de laboratorio húmedo para saber si el agente había acertado.

    Misma tecnología, misma calidad de razonamiento, velocidades incomparables. ¿La variable? Lo que cuesta comprobar la respuesta.

    Donde verificar es barato y rápido, el agente itera, se corrige y avanza. Donde verificar cuesta semanas y dinero, el agente dispara a ciegas y espera.

    Tu código está en el primer grupo. O debería estarlo. Un test que corre en 200 milisegundos es tu resonancia de plasmón superficial: la señal barata que le dice al agente si va bien o va mal. Por eso insisto tanto con el test harness. Sin él, tu agente vive en el mundo de las proteínas: dispara y reza.

    Y un detalle que deberías tatuarte: las puntuaciones de confianza del propio agente no avisaron de ninguno de los fallos. Los diseños contra MBP puntuaban casi igual que los que sí funcionaron. La confianza del modelo no es una señal de verificación.


    Los fallos, que Anthropic no escondió

    Contra MBP (maltose binding protein), una superficie grande, convexa y polar, sin un bolsillo donde agarrarse: 0 binders de 90 diseños. Cero.

    Contra TNFα, Opus 4.8 sacó 12 binders de 150 diseños y Mythos Preview ninguno de 60. El modelo mejor en la media, a cero en esa diana concreta. Y el informe no lo vende como victoria de un modelo: dice que cada campaña corrió una sola vez y usó generadores distintos, así que no pueden atribuir la diferencia a los modelos.

    Y hubo una diana 16 (GDF-8 mature) excluida del análisis porque el ensayo dio mediciones de mala calidad: la proteína se agregaba consigo misma. Ahí no falló el agente, falló el ensayo.

    Estos tres datos me dan más confianza que los 354 binders. Un informe que solo cuenta aciertos es marketing.

    Tampoco esconden el coste: 50.000 dólares de GPU en la corrida de 48 horas contra todas las dianas a la vez (hasta 12.500 horas de NVIDIA H100) y 10.000 por cada sesión de 24 horas contra una sola. La configuración más precisa fue también la más cara por diana.


    Lo que esto no es

    No es peer review. Es un estudio autopublicado por Anthropic sobre sus propios modelos. El trabajo de laboratorio lo hicieron terceros, que es lo que lo salva de ser una nota de prensa, pero nadie externo ha revisado la metodología.

    Y hay una línea que Anthropic no ha cruzado: el diseño de proteínas y otras capacidades de biología de uso dual siguen sin acceso general en Claude Fable 5, su modelo más capaz, por riesgo de armas biológicas. Los modelos clase Opus mantienen acceso limitado.

    La empresa que publica el estudio ha decidido no ofrecer esa capacidad en su mejor modelo. Ese freno también es un resultado del experimento.


    Qué haces el lunes con tus agentes de IA autónomos

    Abre el system prompt del agente que tengas en producción ahora mismo. Son quince minutos:

    1. Etiqueta cada bloque con una de estas tres palabras: dominio, orquestación, operaciones.
    2. Saca porcentajes. Divide las líneas de cada etiqueta entre el total.
    3. Compara con el 34/35/31 de Anthropic. Si te sale algo parecido a 90/5/5, ya sabes qué te falta: no te falta dominio, te falta procedimiento.
    4. Escribe lo que falta: el procedimiento paso a paso, los criterios para descartar, las señales de que va por buen camino, cuándo debe pararse y a quién avisa cuando no sabe seguir.

    Ese fue el 65,8 % del documento que le dieron a Claude. Y es la parte que casi nadie escribe, porque es aburrida y no luce en un tuit.

    Si te llevas una sola frase de todo esto, que sea esta: si tu agente no tiene una forma barata de saber si acertó, no tienes un agente. Tienes un generador de texto con acceso a tu terminal.

    En Dominicode Labs desmontamos este tipo de arquitecturas con proyectos reales. Pero el ejercicio de los quince minutos hazlo hoy.


    Preguntas frecuentes

    ¿Claude ha creado un fármaco?

    No. Diseñó binders: proteínas pequeñas que se pegan a una diana. Es el paso cero de muchos programas farmacológicos, y por delante queda todo el recorrido preclínico y regulatorio, que se mide en años.

    ¿El estudio está revisado por pares?

    No. Es un estudio autopublicado por Anthropic sobre sus propios modelos, sin peer review. Lo que sí es externo es la validación: Adaptyv Bio y Twist Bioscience sintetizaron las proteínas y midieron afinidad por resonancia de plasmón superficial. Nadie de fuera ha revisado la metodología, pero los resultados no salen de una simulación.

    ¿Qué significa una tasa de acierto del 26,8 %?

    Que de 1.320 diseños generados, 354 se confirmaron como binders en el laboratorio. El baseline actual de la industria está entre el 10 % y el 15 %. Conviene no mezclar brazos del experimento: el 26,8 % es el dato global y, por configuración, va del 22,6 % al 35,1 %.

    ¿Por qué acierta más si trabaja contra una sola diana?

    Porque la sesión dedicada de 24 horas concentra todo el presupuesto de razonamiento y cómputo en un único problema: sube del 26,7 % al 35,1 %. También sale más cara por diana, y Anthropic avisa de que no puede separar el efecto del foco del de un presupuesto 2,8 veces mayor por diana. Es tu mismo dilema entre lanzar un agente contra quince tickets a la vez o dedicarle una sesión completa al que importa.

    ¿Puedo usar Claude para diseñar proteínas?

    No con acceso general. El diseño de proteínas y otras capacidades de biología de uso dual siguen restringidas en Claude Fable 5, el modelo más capaz, por riesgo de armas biológicas. Los modelos clase Opus mantienen acceso limitado.

    ¿Qué me llevo de esto para mis agentes de IA autónomos si no toco biología?

    El reparto del protocolo: 34,2 % dominio, 34,7 % orquestación y validación, 31,1 % operaciones. Es la plantilla que yo usaría para escribir el contexto de un agente. Y la consecuencia práctica: iteraron sobre el harness, no sobre el modelo.


    Fuentes


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • El impuesto oculto de los frameworks de IA no existe: medí lo que mandan

    El impuesto oculto de los frameworks de IA no existe: medí lo que mandan

    Hay una frase que se repite en cada hilo sobre frameworks de IA: "te inyectan miles de tokens de prompts ocultos que tú no has escrito".

    La he leído decenas de veces. Nunca con un número al lado.

    Así que la medí. Levanté un endpoint falso que se hace pasar por la API de Anthropic, apunté a él el SDK oficial, el Vercel AI SDK y LangChain, y guardé el cuerpo exacto de la petición HTTP que cada uno manda por el cable.

    El resultado no es el que esperaba, y probablemente tampoco es el que esperas tú.


    Cómo lo medí

    La idea es simple: si quieres saber qué manda una librería, no leas su código. Ponte en medio.

    import http from "node:http";
    
    const capturas = [];
    const server = http.createServer((req, res) => {
      let body = "";
      req.on("data", c => (body += c));
      req.on("end", () => {
        capturas.push(body);                  // esto es lo que se manda de verdad
        res.writeHead(200, { "content-type": "application/json" });
        res.end(JSON.stringify({
          id: "msg_x", type: "message", role: "assistant", model: "claude-opus-5",
          content: [{ type: "text", text: "ok" }],
          stop_reason: "end_turn", stop_sequence: null,
          usage: { input_tokens: 1, output_tokens: 1 },
        }));
      });
    });
    await new Promise(r => server.listen(0, r));
    const BASE = `http://127.0.0.1:${server.address().port}`;
    

    Después, cada librería apuntando a BASE con la misma tarea: un mensaje de sistema idéntico, la misma pregunta y —en la segunda tanda— la misma herramienta.

    Versiones medidas: @anthropic-ai/sdk 0.120.0, ai 7.0.77 con @ai-sdk/anthropic 4.0.41, y langchain 1.5.10 con @langchain/anthropic 1.5.8. Los números son de estas versiones; si lees esto dentro de seis meses, vuelve a correrlo.


    Resultado 1: nadie inyecta un prompt oculto

    Primera tanda, sin herramientas. Mensaje de sistema de 47 caracteres, escrito por mí.

    Librería Cuerpo total Campo system
    SDK oficial de Anthropic 194 B 47 B
    LangChain (modelo directo) 210 B 47 B
    Vercel AI SDK 246 B 74 B

    LangChain manda exactamente mis 47 caracteres. Ni uno más. El SDK oficial, lo mismo.

    Vercel AI SDK manda 74 en vez de 47, y esos 27 caracteres de diferencia no son prosa: es que envuelve el string en la forma de bloques de contenido, [{"type":"text","text":"…"}]. Estructura, no instrucciones.

    Y ahora el dato que cierra el asunto. Repetí la prueba con el agente prefabricado de LangChain —el createAgent que viene de fábrica, justo la abstracción que se supone que te llena el contexto de basura— y el campo system de la petición venía así:

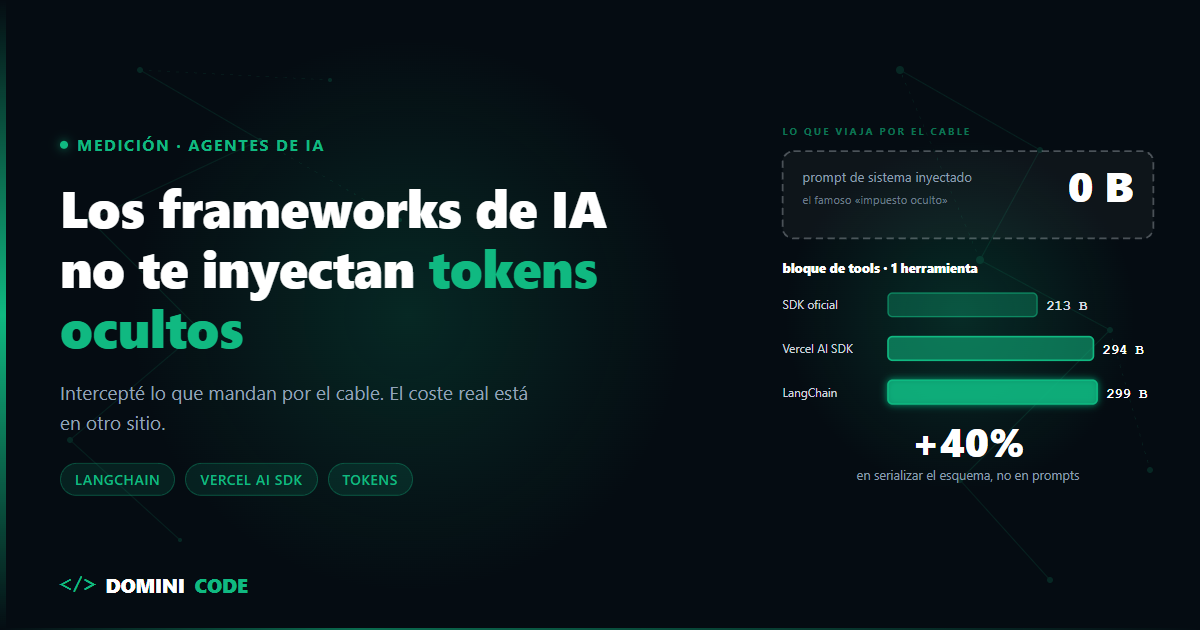
    system = 0 bytes
    

    Vacío. El agente prefabricado de LangChain no manda ningún prompt de sistema que tú no hayas puesto.

    Sea cual sea el origen de la leyenda de los "1.500 tokens ocultos", no describe estas librerías en 2026.


    Resultado 2: donde sí se paga es en los esquemas

    Segunda tanda, misma tarea pero declarando una herramienta: get_weather, con un solo parámetro string y su descripción.

    Librería Cuerpo total system tools
    SDK oficial de Anthropic 393 B 47 B 213 B
    LangChain (agente prefabricado) 436 B 0 B 299 B
    Vercel AI SDK 556 B 74 B 294 B

    Aquí sí hay diferencia, y no está donde la buscaba todo el mundo: está en cómo cada librería serializa el esquema de la herramienta.

    El SDK oficial manda el JSON Schema que tú escribiste, tal cual: 213 bytes. Vercel AI SDK y LangChain lo generan a partir de tu esquema de Zod, y el resultado es más verboso: 294 y 299 bytes. Un 38% y un 40% más para describir exactamente la misma función.

    En el total de la petición: 393 bytes contra 556 del Vercel AI SDK. Un 41% más.


    Qué significan de verdad 163 bytes

    Aquí es donde hay que ser honesto en las dos direcciones.

    En una llamada, no significa nada. 163 bytes son unos 40 tokens. Si tu agente hace diez peticiones al día, esta discusión es irrelevante y deberías dedicar el rato a otra cosa.

    Pero no escala como una constante, escala con tus herramientas. El 40% no es de la petición: es del bloque de esquemas. Un agente serio no tiene una tool, tiene quince o veinte. Ese bloque va en cada turno del bucle, no una vez por conversación. Y si el prefijo de tu prompt cambia entre peticiones, además pierdes los aciertos de caché.

    Así que el número que importa no es el mío: es el tuyo. Coge tu agente real, con tus tools reales, y mide el bloque tools de una petición. Si te sale un bloque de 6 KB repitiéndose en veinte turnos, ahí tienes una conversación que merece la pena. Cómo desglosar en qué se te va la factura lo conté en medir el consumo de tokens de un agente, y el efecto de cambiar de modelo con ese mismo contexto, en el coste de los subagentes.

    Y la palanca real, una vez lo has medido, no es quitar el framework: es tener menos herramientas y mejor descritas. Ese criterio lo desarrollé al montar un servidor de herramientas para tu agente sin MCP.


    Entonces, ¿framework o código directo?

    Si has llegado hasta aquí esperando que te diga que quites el framework, malas noticias: el argumento de los tokens no sostiene esa decisión. La diferencia existe, es medible y es pequeña comparada con lo que de verdad decide.

    Lo que sí decide:

    Depurabilidad. Cuando un agente falla en producción necesitas ver el mensaje exacto que salió. Con el SDK directo pones un console.log en la llamada. Con capas por encima, tienes que aprender dónde mirar. No es imposible —el arnés de esta prueba son cuarenta líneas— pero es trabajo.

    Retraso frente a la API. Los proveedores sacan capacidades nuevas constantemente. Con el SDK directo las usas el mismo día. Con una capa intermedia, esperas a que la abstraiga. Este es, en mi experiencia, el coste real de un framework, y no aparece en ninguna tabla de bytes.

    Acoplamiento de tu dominio. Si la lógica de decisión de tu negocio vive dentro de las clases de un tercero, no eres dueño de tu arquitectura. Esto es lo mismo que llevamos treinta años diciendo de los ORM y de los frameworks de UI, y aplica igual.

    Y en la otra dirección: hay problemas donde un grafo de estados expresa cosas que un while no expresa bien —ramificaciones, reanudar tras una pausa humana, estado explícito entre pasos—. Si tu bucle ya se está llenando de banderas, esa es la señal.

    Si lo que quieres es el bucle explícito bien hecho, con control de pasos y detección de estancamiento, está entero en Agentic Loop en TypeScript.


    Mide el tuyo antes de opinar

    El arnés completo cabe en un archivo. Levanta el servidor de arriba, apunta tu cliente a BASE en lugar de a la API real, lanza una petición representativa y mira el cuerpo:

    const cuerpo = capturas.pop();
    const j = JSON.parse(cuerpo);
    
    console.log("total  :", cuerpo.length, "bytes");
    console.log("system :", (j.system ? JSON.stringify(j.system).length : 0), "bytes");
    console.log("tools  :", (j.tools ? JSON.stringify(j.tools).length : 0), "bytes");
    console.log("mensajes:", JSON.stringify(j.messages).length, "bytes");
    

    Cuatro líneas y dejas de discutir de oídas. Y si el bloque de esquemas te sorprende, el sitio donde arreglarlo es el diseño de tus contratos: los patrones de Zod para que un esquema diga lo justo están en el curso de Zod para TypeScript.

    Definir esas interfaces antes de escribir el agente es lo que evita acabar con veinte tools que nadie recuerda para qué son, y es la metodología del libro de Spec-Driven Development. El flujo completo con agentes CLI lo enseño en el curso Construye con IA.

    En Dominicode Labs comparto las mediciones reales de los agentes que tengo corriendo.

    La conclusión que me llevo no es "framework sí" ni "framework no". Es que llevábamos dos años repitiendo un número que nadie había comprobado, y que el sitio donde de verdad se te va el contexto —los esquemas de tus herramientas— no sale en ningún hilo.


    Preguntas frecuentes

    ¿Es verdad que LangChain inyecta prompts ocultos en cada petición?

    En las versiones medidas para este post, no. Con langchain 1.5.10 y @langchain/anthropic 1.5.8, tanto el modelo directo como el agente prefabricado mandan en el campo system exactamente lo que tú pones — y el agente prefabricado, cuando no le das mensaje de sistema, manda ese campo vacío. La afirmación de los "miles de tokens ocultos" no describe estas versiones.

    ¿Cuánto overhead añade entonces un framework?

    En la prueba, con una sola herramienta declarada: el bloque tools pasó de 213 bytes con el SDK oficial a 294 con Vercel AI SDK y 299 con LangChain, un 38% y un 40% más. En el cuerpo total de la petición, 393 bytes frente a 556. La diferencia viene de generar el JSON Schema a partir de Zod, que sale más verboso que un esquema escrito a mano.

    ¿Cómo mido el overhead de mi propio agente?

    Levanta un servidor HTTP local que responda con la forma de respuesta del proveedor, apunta tu cliente a esa URL con la opción baseURL, lanza una petición representativa y mide la longitud del cuerpo por campos: system, tools y messages. Son unas cuarenta líneas y te da el dato exacto de tu caso, que es el único que importa.

    ¿Merece la pena quitar el framework para ahorrar tokens?

    Casi nunca. La diferencia medida es real pero pequeña frente a otras decisiones. Si vas a quitarlo, que sea por depurabilidad, por no ir con retraso respecto a las capacidades nuevas de la API o por no acoplar tu lógica de negocio a un tercero. El ahorro de tokens es el peor de los argumentos disponibles.

    ¿Por qué el bloque de tools pesa más que el prompt de sistema?

    Porque describe una interfaz completa: nombre, descripción, tipos de cada parámetro, cuáles son obligatorios y las descripciones de cada campo. Y porque se manda en cada turno del bucle agéntico, no una vez por conversación. Con quince o veinte herramientas, ese bloque es la mayor parte del contexto fijo que pagas en cada llamada.

  • ¿Es Grok 4.6 el mejor modelo para programar? Editor sí, terminal no

    ¿Es Grok 4.6 el mejor modelo para programar? Editor sí, terminal no

    xAI publicó Grok 4.6 el 12 de agosto de 2026, treinta y cinco días después de Grok 4.5.

    Y como pasa siempre, en cuestión de horas ya circulaban capturas de tablas de barras diciendo que es el mejor modelo del mundo para programar.

    La pregunta está mal formulada.

    No porque Grok 4.6 sea malo —no lo es, y en una de las dos medidas que importan está arriba— sino porque "programar" no es una sola tarea, y los benchmarks que la miden no puntúan lo mismo.

    Hay dos cifras públicas de Grok 4.6 que responden a la pregunta mejor que cualquier hilo de X. Una la publica xAI. La otra la mide un tercero. Y entre las dos hay una brecha que te dice exactamente cuándo te conviene este modelo y cuándo no.

    Vamos con las dos.


    Qué ha publicado xAI y qué ha medido alguien más

    Antes de mirar un solo número, la distinción de siempre: no es lo mismo una cifra que publica el fabricante en su propia nota de prensa que una cifra medida por un tercero con un harness que no controla el fabricante.

    Las dos sirven. Pero no valen igual, y mezclarlas en la misma tabla es la forma más común de sacar una conclusión equivocada. Si quieres el criterio completo para separarlas, lo desarrollé al analizar las cifras de Grok 4.5, Fable 5 y DeepSeek V4, y el caso más descarado de tabla propia puntuando a los rivales lo tienes en la tabla de Alibaba para Qwen3.8-Max.

    Con Grok 4.6, esto es lo que hay a 24 de agosto de 2026.

    Autoreportado por xAI (su propia nota de lanzamiento):

    Benchmark Grok 4.6 Qué mide
    CursorBench v3.2 69,9 % Edición de código dentro del editor
    DeepSWE v1.1 65,9 % Ingeniería de software autónoma
    FrontierCode v1.1 61,3 % Código de dificultad alta
    APEX-Agents 57,5 % Tareas agénticas de horizonte largo
    APEX-SWE 56,4 % Ingeniería de software agéntica
    Terminal-Bench v3.0 26 % Trabajo real en terminal

    Medido por terceros:

    • Artificial Analysis Intelligence Index: 61. Verificado de forma independiente.
    • Terminal-Bench 3.0: 26,5 % en el snapshot público del leaderboard, actualizado el 20 de agosto de 2026 (el benchmark lo desarrolla el equipo de Harbor junto a Laude Institute, Snorkel AI y Turing).

    Fíjate en que la última fila de la tabla de xAI y la medición externa coinciden: 26 % frente a 26,5 %. Aquí no hay discusión metodológica ni harness sospechoso. xAI reporta su peor número con honestidad, y el tercero lo confirma.

    Ese es el número del que nadie hizo captura.


    La brecha: 69,9 % en el editor, 26,5 % en la terminal

    Pon las dos medidas juntas y el modelo se parte en dos.

      Grok 4.6, dos medidas del mismo modelo
    
      Editor    (CursorBench v3.2)   69,9 %
      ████████████████████████
    
      Terminal  (Terminal-Bench 3.0) 26,5 %
      █████████
    

    El mismo modelo, la misma semana, con 43 puntos de diferencia según lo que le pidas.

    Y para saber si ese 26,5 % es bueno o malo hace falta el contexto del leaderboard completo. Esta es la foto de Terminal-Bench 3.0 al 20 de agosto de 2026:

    # Modelo Terminal-Bench 3.0
    1 Claude Opus 5 42,7 %
    2 GPT-5.6 Sol 34,6 %
    3 Claude Fable 5 34,0 %
    4 GLM-5.3 32,4 %
    5 Grok 4.6 26,5 %
    6 Claude Opus 4.8 21,1 %
    7 GPT-5.6 Terra 20,8 %
    8 SWE-1.7 Lightning 18,6 %
    9 Grok 4.5 15,7 %
    10 Claude Sonnet 5 14,6 %
    11 GPT-5.6 Luna 14,3 %
    12 GLM-5.2 4,6 %

    Dos lecturas, y las dos son verdad.

    La mala: Grok 4.6 queda quinto, a 16,2 puntos de Claude Opus 5. En trabajo de terminal saca el 62 % de la puntuación del líder. No está cerca.

    La buena, y es la que casi nadie contó: Grok 4.5 estaba en 15,7 %. Grok 4.6 está en 26,5 %. Son 10,8 puntos de salto en treinta y cinco días, el mayor avance generacional de toda la tabla. De paso, Grok 4.6 ya pasa por delante de Claude Opus 4.8 (21,1 %) y de GPT-5.6 Terra (20,8 %).

    xAI lo respalda con su propia medición en la misma dirección: APEX-Agents sube de 47,1 % en Grok 4.5 a 57,5 % en 4.6, otros 10,4 puntos.

    Es decir: el trabajo agéntico es exactamente donde xAI ha metido el esfuerzo de esta versión, y se nota. Simplemente partían muy por detrás y todavía no han llegado.


    Por qué el editor y la terminal no miden lo mismo

    Esta es la parte que convierte una tabla en una decisión.

    Un benchmark de edición en el editor te pone delante un cambio acotado: aquí está el archivo, aquí está el contexto, escribe el diff. Una o pocas pasadas. El estado del mundo no cambia mientras trabajas. Si el modelo razona bien y conoce el lenguaje, acierta.

    Un benchmark de terminal es otro deporte:

      EDITOR                    TERMINAL
      ─────────                 ────────
      contexto dado             hay que descubrirlo
      1 pasada                  decenas de pasos
      estado fijo               estado que tú mutas
      fallo = diff malo         fallo = entorno roto
    

    En la terminal el modelo tiene que decidir qué comando lanzar, leer una salida que no esperaba, entender que algo ha cambiado por su propia acción anterior y corregir el rumbo sin perder el objetivo. Terminal-Bench 3.0 aprieta justo ahí: incluye nodos con GPU, topologías multi-contenedor, microservicios vivos y una corrección estricta que solo da el punto si el resultado final es exactamente el pedido.

    Ahí no se premia saber programar. Se premia no perder el hilo durante cuarenta pasos y verificar tu propio trabajo antes de seguir. xAI lo reconoce en su nota: dicen que en trayectorias largas empezaron a ver al modelo autoverificándose más.

    Que un modelo se caiga de 69,9 % a 26,5 % entre esos dos escenarios no es una contradicción. Es la descripción de dónde está su límite. Y si tú operas agentes que leen, escriben y ejecutan tests sobre tu repositorio, el número que te afecta es el segundo, no el primero.

    Por qué un bucle agéntico largo es tan frágil, y qué controles hay que ponerle, lo desmenucé en el agentic loop en producción con TypeScript.


    Lo que cuesta

    Grok 4.6 en la API de xAI, tarifa estándar por millón de tokens:

    Entrada Entrada en caché Salida
    Grok 4.6 $2 $0,50 $6
    Claude Opus 5 $5 — $25

    Ventana de contexto: 500K tokens.

    Y el detalle que se come presupuestos: a partir de 200K tokens de prompt, la petición entera pasa a la banda de contexto largo. No se encarece solo el tramo que excede el umbral: se recalculan todos los tokens de esa petición a la tarifa alta. Es el mismo mecanismo que ya tenía Grok 4.5 y que expliqué con números en el análisis de Grok 4.5. Si tu agente arrastra contexto acumulado, cruzas ese umbral sin darte cuenta.

    Ahora, la comparación honesta. Grok 4.6 cuesta 2,5 veces menos en entrada y 4,2 veces menos en salida que Opus 5. Si divides el precio de salida entre los puntos de Terminal-Bench que consigue cada uno, sale esto:

    • Grok 4.6: $6 / 26,5 = $0,23 por punto
    • Claude Opus 5: $25 / 42,7 = $0,59 por punto

    Grok 4.6 rinde 2,6 veces más barato por punto de terminal. Esa cifra la he derivado yo de las dos tablas de arriba, no la publica nadie, y tiene una trampa importante: en trabajo agéntico, el modelo que falla es el más caro de todos, porque cada intento fallido se paga entero y además te consume el tiempo de revisión. El precio por punto es una buena guía para elegir modelo en tareas que puedes verificar barato, y una guía pésima para elegirlo en tareas que se rompen caro.

    Ese cálculo, hecho por tarea completada y no por token, es el que decide de verdad, y lo desarrollé en el coste de los subagentes al cambiar de modelo.


    Entonces, ¿es el mejor modelo para programar?

    Con los datos públicos a 24 de agosto de 2026:

    Sí, es una opción muy competitiva para:

    • Escribir y editar código dentro del editor, con el contexto ya delante.
    • Algoritmos, refactors acotados, scripts aislados y consultas complejas.
    • Volumen alto de tareas verificables donde el precio por token pesa y un fallo se detecta en segundos.
    • Contextos grandes de lectura, siempre que vigiles el umbral de 200K.

    No, no lidera para:

    • Agentes autónomos que corren durante decenas de pasos sobre tu repositorio.
    • Trabajo de terminal con estado mutable: contenedores, servicios, migraciones.
    • Cualquier flujo donde el coste de un fallo silencioso sea alto.

    Y esta es la conclusión incómoda para los titulares: Grok 4.6 no compite con Claude Opus 5 en la fila que más importa si tu trabajo es agéntico, pero ha recortado más distancia en un mes que ningún otro modelo de la tabla. Si xAI mantiene ese ritmo, la comparación de dentro de dos versiones puede ser otra.

    Para decidir modelo por tipo de trabajo en lugar de por titular, tengo el marco completo en Opus 5 vs GPT-5.6 vs Kimi K3.


    Cómo comprobarlo en tu proyecto en una tarde

    Ningún leaderboard puntúa tu repositorio. Esto sí:

    1. Coge tres tareas reales ya resueltas de tu historial de Git, con su diff final conocido. Una acotada de editor, una de refactor medio y una que toque terminal o migraciones.
    2. Lánzalas al mismo harness, cambiando solo el modelo. El harness pesa tanto como el modelo: si cambias las dos cosas a la vez, no estás midiendo nada.
    3. Puntúa por tarea completada, no por impresión. Pasó los tests o no pasó. Y anota el coste total de cada intento, fallos incluidos.

    Con nueve ejecuciones tienes más información sobre tu caso que con todos los benchmarks de este post.

    Y la parte que no cambia sea cual sea el modelo: si el requerimiento es ambiguo, fallan todos. Cuando cierras el alcance y las interfaces en un spec.md antes de ejecutar, cualquier modelo de frontera sube su tasa de acierto. Tienes la metodología completa en el libro de Spec-Driven Development, y el pipeline práctico con herramientas CLI agénticas en el curso Construye con IA: de la idea al producto con Claude Code.

    En Dominicode Labs vamos pasando cada modelo nuevo por proyectos reales y compartimos los resultados: qué entra en el stack, qué se queda fuera y por qué.

    Prueba Grok 4.6. Pero mide la fila que se corresponde con tu trabajo, no la que mejor queda en una captura.


    Preguntas frecuentes

    ¿Cuánto ha mejorado Grok 4.6 respecto a Grok 4.5 en trabajo de terminal?

    Ha subido de 15,7 % a 26,5 % en Terminal-Bench 3.0, según el snapshot público del leaderboard del 20 de agosto de 2026. Son 10,8 puntos en treinta y cinco días, el mayor salto generacional de la tabla. xAI reporta una mejora en la misma dirección con su propia medición de APEX-Agents: de 47,1 % a 57,5 %.

    ¿Por qué Grok 4.6 saca 69,9 % en CursorBench y solo 26,5 % en Terminal-Bench 3.0?

    Porque miden trabajos distintos. CursorBench evalúa edición de código con el contexto ya dado y en pocas pasadas. Terminal-Bench 3.0 evalúa trayectorias largas en un entorno con estado mutable —contenedores, servicios vivos, nodos con GPU— y solo concede el punto si el resultado final es exactamente el pedido. El primer escenario premia saber programar; el segundo, no perder el hilo durante decenas de pasos.

    ¿El contexto de 500K de Grok 4.6 cambia algo para trabajar sobre un repositorio grande?

    Ayuda a leer, pero ojo con la factura: a partir de 200K tokens de prompt, xAI recalcula todos los tokens de esa petición a la tarifa de contexto largo, no solo el exceso. Un agente que acumula contexto cruza ese umbral sin avisar. Y una ventana grande no arregla el problema de fondo del trabajo agéntico, que es mantener el objetivo, no almacenar texto.

    ¿Qué es APEX-Agents y por qué xAI lo destaca?

    Es un benchmark de tareas agénticas de horizonte largo, y xAI lo destaca porque es donde más ha mejorado: 57,5 % frente al 47,1 % de Grok 4.5. Es una cifra autoreportada por xAI, no verificada por un tercero, así que conviene leerla como una señal de la dirección del trabajo del proveedor y no como una medición neutral.

    ¿Cuándo me conviene Grok 4.6 en lugar de Claude Opus 5?

    Cuando tu trabajo sea acotado y verificable barato: edición en el editor, algoritmos, refactors pequeños, volumen alto de tareas que fallan de forma visible. Ahí el precio marca la diferencia, porque Grok 4.6 cuesta $2/$6 por millón frente a $5/$25 de Opus 5. Si tu trabajo es un agente autónomo corriendo sobre tu repositorio, los 16,2 puntos de diferencia en Terminal-Bench se pagan en fallos silenciosos y en tu tiempo de revisión, y ahí sale más caro lo barato.

  • LangGraph TypeScript: cuándo un grafo gana al while loop

    LangGraph TypeScript: cuándo un grafo gana al while loop

    Tenía un agente que revisaba pull requests. Cincuenta líneas de TypeScript, un while, tres tools. Funcionaba.

    Hasta que un PR tocó el módulo de autenticación y el agente hizo lo correcto: parar y pedir aprobación humana. El problema es que "parar" significaba dejar un proceso de Node vivo esperando un webhook que llegó dieciocho horas después. El proceso ya no existía. El contexto tampoco.

    Reinicié. Volvió a analizar el PR desde cero, volvió a gastar tokens, volvió a pedir aprobación. Mi loop no tenía un bug: tenía un límite arquitectónico.

    LangGraph TypeScript existe para ese límite exacto. Y lo adoptas sin comprar la casa entera para usar el garaje.

    LangGraph es la librería de orquestación de agentes de LangChain, disponible para TypeScript y Python, que modela un agente como un grafo de estados: los nodos son funciones que reciben y devuelven estado, las aristas deciden qué nodo va después, y un checkpointer persiste el estado tras cada paso. Ese checkpointer es lo que permite pausar una ejecución hoy y reanudarla dentro de tres días, en otra máquina.

    El loop explícito resuelve la mayoría de los agentes

    Empecemos por lo incómodo: en los proyectos que he tocado, la gran mayoría de los agentes no necesitan un framework de orquestación. Necesitan esto.

    type ToolCall = { id: string; name: string; args: unknown };
    type Msg =
      | { role: "user" | "assistant" | "system"; content: string }
      | { role: "assistant"; content: string; toolCalls: ToolCall[] }
      | { role: "tool"; toolCallId: string; content: string };
    
    export async function agente(prompt: string): Promise<string> {
      const messages: Msg[] = [{ role: "user", content: prompt }];
      let turno = 0;
    
      while (turno++ < 10) {
        const res = await llm.complete(messages);
    
        if (!res.toolCalls?.length) return res.content;
    
        messages.push({
          role: "assistant",
          content: res.content,
          toolCalls: res.toolCalls,
        });
    
        for (const call of res.toolCalls) {
          const tool = tools[call.name];
          // El nombre de la tool lo elige el modelo. Si alucina uno, se lo devuelves
          // como error para que se corrija, en vez de reventar a mitad de ejecución.
          const salida = tool
            ? await tool(call.args)
            : `Error: la herramienta "${call.name}" no existe.`;
          messages.push({ role: "tool", toolCallId: call.id, content: salida });
        }
      }
    
      throw new Error("Límite de turnos alcanzado");
    }
    

    Eso es un agente. Lo depuras con console.log, lo entiendes entero en treinta segundos y no tiene una capa de orquestación que pueda romperte en la siguiente minor.

    Yo defiendo este loop, y lo he defendido por escrito: en multi-agente sin orquestador explico por qué la mayoría de los sistemas "multi-agente" son un for con buen marketing. Sigo pensando lo mismo.

    El loop no falla por complejidad. Falla por duración.

    Cuándo usar LangGraph en vez de un while loop

    Usa LangGraph cuando tu agente cumpla al menos uno de estos tres síntomas. Si no cumple ninguno, quédate con el while. El punto de inflexión no es "mi agente hace muchas cosas": es uno de estos tres, y basta con uno.

    1. El estado tiene que sobrevivir al proceso. Si tu agente vive más que un request HTTP —minutos, horas, días— el array messages en memoria es una bomba de relojería. Un deploy, un reinicio, un pod que se recicla, y perdiste la ejecución.
    2. La ramificación es real, no cosmética. Un if dentro del loop está bien. Pero cuando el camino A y el camino B tienen pasos distintos, reintentos distintos y puntos de salida distintos, el loop se convierte en un árbol de condicionales que nadie quiere tocar.
    3. Un humano tiene que decidir en mitad de la ejecución. No al principio ni al final. En mitad. Y puede tardar un día en contestar.
    while loop explícito LangGraph (StateGraph)
    Estado entre pasos Array en memoria Campos tipados con reducers
    Sobrevive a un reinicio No Sí, con checkpointer
    Pausar y reanudar Lo escribes tú interrupt() + Command({ resume })
    Ramificación if anidados addConditionalEdges tipado
    Depuración console.log Inspección del grafo y del checkpoint
    Dependencias Ninguna @langchain/langgraph + @langchain/core
    Coste de entrada Cero Una tarde por tramo migrado

    Si no tienes ninguno de los tres, cierra esta pestaña y quédate con tu loop. Hablo en serio. Ese es justamente el argumento que defiendo en el stack de IA agéntica que uso: la capa de orquestación es la última que deberías añadir, no la primera.

    Un apunte de vocabulario, porque genera confusión real: aquí "grafo" significa grafo de orquestación —qué nodo se ejecuta después de cuál—. No tiene nada que ver con el grafo de recuperación del que hablé en qué es graph engineering, que va de qué código llega al contexto del modelo. Misma palabra, dos capas distintas del sistema.

    El estado primero, el grafo después

    En LangGraph el estado no es un detalle de implementación: es el contrato. Y en la v1 —@langchain/langgraph 1.4.10, agosto de 2026— se declara con StateSchema, aceptando esquemas de Zod campo a campo.

    import {
      StateSchema,
      MessagesValue,
      ReducedValue,
    } from "@langchain/langgraph";
    import { z } from "zod";
    
    const RevisionState = new StateSchema({
      messages: MessagesValue,
      pr: z.string(),
      riesgo: z.enum(["bajo", "alto"]).default("bajo"),
      hallazgos: new ReducedValue(z.array(z.string()).default(() => []), {
        reducer: (actual: string[], nuevo: string[]) => actual.concat(nuevo),
      }),
      aprobado: z.boolean().default(false),
    });
    
    type Revision = typeof RevisionState.State;
    

    Fíjate en ReducedValue. Esa es la pieza que no tiene equivalente limpio en el loop: define cómo se combinan las actualizaciones de un campo. Los nodos devuelven trozos de estado y el reducer decide si se sobrescriben o se acumulan. Sin eso, dos nodos que escriben en hallazgos se pisan.

    Y sí, es Zod de verdad: .default(), .enum(), refinamientos. El estado del agente es un contrato de datos como cualquier otro, y aquí es donde se nota tenerlos bien tipados — es el mismo músculo que entreno en el curso de Zod para TypeScript.

    Verás mucho tutorial con Annotation.Root({ ... }). Sigue funcionando y sigue compilando, pero es la sintaxis anterior. Si empiezas hoy, empieza con StateSchema.

    Nodos, aristas y la decisión que el loop no sabe expresar

    Un nodo es una función que recibe el estado y devuelve un trozo de estado. Nada más.

    import {
      StateGraph, START, END, MemorySaver, interrupt, Command,
    } from "@langchain/langgraph";
    
    async function analizar(state: Revision) {
      const tocaAuth = state.pr.includes("auth");
      return {
        hallazgos: ["Cobertura de tests: 62%"],
        riesgo: tocaAuth ? ("alto" as const) : ("bajo" as const),
      };
    }
    
    async function aprobarAuto(_state: Revision) {
      return { aprobado: true };
    }
    
    function enrutar(state: Revision): "aprobarAuto" | "revisionHumana" {
      return state.riesgo === "alto" ? "revisionHumana" : "aprobarAuto";
    }
    
    const grafo = new StateGraph(RevisionState)
      .addNode("analizar", analizar)
      .addNode("aprobarAuto", aprobarAuto)
      .addNode("revisionHumana", revisionHumana)
      .addEdge(START, "analizar")
      .addConditionalEdges("analizar", enrutar, ["aprobarAuto", "revisionHumana"])
      .addEdge("aprobarAuto", END)
      .addEdge("revisionHumana", END)
      .compile({ checkpointer: new MemorySaver() });
    

    addConditionalEdges recibe el nodo origen, la función que decide y la lista de destinos posibles. Esa lista no es decorativa: es lo que hace que el enrutado sea tipado y que el grafo sea inspeccionable antes de ejecutarlo.

    Y ahí está compile({ checkpointer }). Esa línea es la que justifica todo lo demás. Sin checkpointer tienes un runner de funciones con sintaxis rara. Con checkpointer tienes una máquina de estados que se puede pausar y reanudar.

    MemorySaver es para desarrollo —vive en RAM y muere con el proceso—. Para producción usa los checkpointers persistentes, que van en paquetes aparte: @langchain/langgraph-checkpoint-postgres (1.0.4) o @langchain/langgraph-checkpoint-sqlite (1.0.3).

    Human-in-the-loop en LangGraph: la funcionalidad que justifica el cambio

    El human-in-the-loop en LangGraph se implementa con interrupt(): el nodo lanza la pausa, el grafo guarda el estado en el checkpointer y la ejecución termina. Cuando llega la respuesta humana, se reanuda con Command({ resume }) sobre el mismo thread_id.

    Aquí es donde mi PR de las dieciocho horas deja de ser un problema.

    type PeticionRevision = {
      pr: string;
      hallazgos: string[];
      pregunta: string;
    };
    
    async function revisionHumana(state: Revision) {
      const decision = interrupt<PeticionRevision, { aprobado: boolean }>({
        pr: state.pr,
        hallazgos: state.hallazgos,
        pregunta: "Este PR toca auth. ¿Lo apruebas?",
      });
    
      return { aprobado: decision.aprobado };
    }
    

    Cuando la ejecución llega a interrupt(), el grafo persiste el estado exacto y para. No bloquea un proceso: termina. El estado queda guardado bajo un thread_id.

    const config = { configurable: { thread_id: "pr-482" } };
    
    await grafo.invoke({ pr: "feat/auth-refresh-token" }, config);
    
    const pausa = await grafo.getState(config);
    console.log(pausa.next);                          // [ 'revisionHumana' ]
    console.log(pausa.tasks[0]?.interrupts[0]?.value); // el payload de la pregunta
    
    // Horas o días después, otro proceso, otro deploy:
    const final = await grafo.invoke(
      new Command({ resume: { aprobado: true } }),
      config
    );
    console.log(final.aprobado); // true
    

    Léelo otra vez. El segundo invoke puede ocurrir en otra máquina, la semana siguiente, después de tres despliegues. El grafo continúa donde estaba: analizar no se vuelve a ejecutar y no gastas otra vez esos tokens.

    Eso, en el loop, no lo montas en un rato. Escribes tu propio serializador de estado, tu propio registro de "en qué paso iba" y tu propia lógica de reanudación. Es decir: escribes un checkpointer peor.

    Tres avisos que cuestan tiempo:

    1. El nodo que contiene el interrupt() sí se re-ejecuta entero al reanudar. El grafo no repite los nodos anteriores, pero este arranca otra vez desde su primera línea. Si pones un INSERT, un webhook o un cobro antes de la llamada, ocurre dos veces. Todo efecto secundario va después del interrupt(), nunca antes.
    2. No envuelvas interrupt() en un try/catch: señaliza la pausa con una excepción y te la comerías.
    3. Lo que le pasas debe ser serializable a JSON.

    Esto es la versión LangGraph del patrón. Si quieres la arquitectura completa —clasificar las tools por riesgo, persistir el checkpoint, garantizar la idempotencia al reanudar y qué devolverle al modelo cuando el humano dice que no—, la desarrollo entera en arquitectura human in the loop en TypeScript.

    Cuándo NO montar el grafo de estados en LangGraph

    No lo montes porque el proyecto "va a crecer". Móntalo cuando tengas uno de los tres síntomas delante.

    Y no confundas esto con adoptar el ecosistema entero. Ya dejé claro mi veredicto sobre la librería base en el stack de IA agéntica que uso: demasiada abstracción sobre abstracciones. LangGraph es otra cosa. Es una máquina de estados con persistencia, y puedes usarla sin tocar el resto.

    Un detalle actual que evita un error frecuente: el prebuilt createReactAgent de @langchain/langgraph/prebuilt está marcado como deprecado. Se movió al paquete langchain como createAgent. Si sigues un tutorial de hace un año, vas a copiar un import obsoleto.

    Y antes de dibujar un solo nodo, escribe qué estados existen y qué transiciones son legales. Un grafo mal pensado es peor que un loop, porque además parece serio. Esa disciplina de definir el contrato antes de escribir la implementación es la misma que defiendo en el libro de Spec-Driven Development, y aquí paga doble.

    Qué hacer con esto hoy

    Abre tu agente y busca una sola cosa: un punto donde la ejecución tenga que sobrevivir a un reinicio. Una aprobación, una espera larga, un proceso por lotes que tarda horas.

    Si no lo encuentras, tu loop está bien. Cierra el editor.

    Si lo encuentras, no reescribas el agente entero. Extrae solo ese tramo a un StateGraph con checkpointer, deja el resto como está y quédate con las tools intactas. Migrar un tramo cuesta una tarde. Migrar por moda cuesta un trimestre.

    Si quieres ver este tipo de decisiones tomadas en proyectos reales —cuándo meter un framework y cuándo no—, es justo lo que trabajo en Construye con IA, y en Dominicode Labs montamos estos grafos con el código completo delante.

    Preguntas frecuentes

    ¿Cuándo usar LangGraph en vez de un while loop?

    Cuando la ejecución tenga que sobrevivir al proceso, cuando la ramificación tenga pasos y salidas realmente distintas, o cuando un humano deba decidir en mitad del flujo. Con uno solo de esos tres basta. Si tu agente empieza y termina dentro del mismo request, el while explícito es mejor opción: se depura con console.log y no tiene una capa de orquestación que se rompa en la siguiente minor. LangGraph no gana por complejidad, gana por duración.

    ¿Necesito un checkpointer para usar interrupt() en LangGraph?

    Sí, y no es opcional. interrupt() funciona persistiendo el estado del grafo y terminando la ejecución. Sin un checkpointer en compile() no hay dónde guardar ese estado, así que no hay nada que reanudar. En desarrollo te vale MemorySaver; en producción necesitas uno con almacenamiento real, o perderás las pausas en cada despliegue.

    ¿StateSchema con Zod sustituye a Annotation.Root en LangGraph TypeScript?

    Es la forma actual de declarar el estado y la que deberías usar en código nuevo. Annotation.Root sigue exportándose y sigue compilando, así que no tienes que migrar nada con prisa. La diferencia práctica es que con StateSchema reutilizas esquemas de Zod que probablemente ya tienes en el proyecto, con sus default() y sus validaciones, en lugar de aprender una segunda sintaxis solo para el estado del grafo.

    ¿Qué checkpointer uso en producción con LangGraph JS?

    MemorySaver viene en el paquete principal pero guarda en RAM: sirve para tests y ejemplos, no para producción. Los checkpointers persistentes van en paquetes aparte, @langchain/langgraph-checkpoint-postgres y @langchain/langgraph-checkpoint-sqlite. Si ya tienes Postgres en el stack, esa es la respuesta fácil, porque el estado del agente pasa a ser una tabla más que respaldas y auditas como cualquier otra.

    ¿Puedo migrar mi while loop a LangGraph sin reescribir las tools?

    Sí, y es la vía que recomiendo. Las tools son funciones con un esquema de entrada; no les afecta quién las llama. Lo que cambia es el orquestador: el bucle pasa a ser nodos y aristas, y el array de mensajes pasa a ser un campo del estado. Puedes migrar un solo tramo del flujo —el que necesita pausarse— y dejar el resto del agente exactamente como está.

    ¿Necesito LangChain para usar LangGraph en TypeScript?

    No. @langchain/langgraph declara @langchain/core como peer dependency —de ahí salen los tipos de mensajes y modelos— pero no requiere el paquete langchain ni sus cadenas y abstracciones: una instalación limpia trae @langchain/core, langgraph-checkpoint y langgraph-sdk, y ahí se acaba. Puedes montar un StateGraph llamando dentro de tus nodos al SDK del proveedor que ya uses. Un nodo es una función asíncrona: lo que hagas dentro es cosa tuya.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • ChatGPT Business Premium Seats: Precio Real y Cuándo Conviene

    ChatGPT Business Premium Seats: Precio Real y Cuándo Conviene

    Hace dos meses hablé con el CTO de una empresa de 25 personas. Tenían a 14 empleados pagando cuentas individuales de ChatGPT Plus con la tarjeta de la empresa.

    Cada uno con su login personal. Cada uno compartiendo fragmentos de código, contratos y datos de clientes en chats que OpenAI, por defecto en planes personales, podía usar para entrenar sus modelos. Cero control de accesos, cero logs de auditoría y $280 al mes tirados en cuentas aisladas.

    Cuando OpenAI renombró su plan Team a ChatGPT Business y lanzó ChatGPT Business Premium seats como upgrade dentro de ese mismo workspace —junto al contrato Enterprise para volumen alto— la promesa fue sencilla: orden corporativo, privacidad estricta y capacidad computacional dedicada.

    La pregunta que todo líder técnico se hace es otra: ¿te conviene pagar una suscripción mensual fija por cada asiento o es más rentable montar herramientas internas sobre la API?

    Vamos a desglosar los precios reales, las novedades técnicas de estos asientos y el criterio exacto para decidir sin quemar presupuesto.


    La estructura de precios de ChatGPT para empresas

    Para entender dónde encajan los asientos Premium en entornos de trabajo, primero hay que ubicar la pirámide de planes actual de OpenAI:

    Nivel Precio por usuario Compromiso mínimo Privacidad de datos Modelos y Capacidad
    ChatGPT Plus $20 / mes 1 usuario ❌ Opt-out manual necesario Límites estándar de mensajes
    ChatGPT Business (asiento estándar) $20 / mes (anual) / $25 (mensual) Mínimo 2 usuarios ✅ SOC 2 Tipo II + cero entrenamiento Límite de uso de 5h + Workspace compartido
    ChatGPT Business — Asiento Premium $100 / mes (anual) / $125 (mensual) Add-on dentro del mismo workspace ✅ SOC 2 Tipo II + cero entrenamiento 5x más uso, sin límite de 5h
    ChatGPT Enterprise Cotización a medida (mercado: ~$45-75/asiento) Mínimo ~150 licencias ✅ SLA dedicado + BAA HIPAA Ventana 128K-196K + Computación dedicada

    Nota: ChatGPT Team se renombró a ChatGPT Business en agosto de 2025 — no son dos planes distintos, es el mismo workspace con precio actualizado.

    El asiento Premium —lanzado el 10 de agosto de 2026 como upgrade dentro del mismo workspace de Business— cubre la brecha que existía entre el límite de 5 horas del asiento estándar, que a veces frena a los usuarios más intensivos en picos de trabajo, y un contrato Enterprise con comerciales y un mínimo de ~150 licencias.


    Qué trae de nuevo ChatGPT Business Premium seats

    No estás pagando solo "más mensajes por hora". La diferencia técnica está en el aislamiento de infraestructura y las herramientas de gobierno corporativo.

           [ Workspace Corporativo ]
                      │
      ┌───────────────┼───────────────┐
      ▼               ▼               ▼
    SSO / SCIM    Retención Cero  GPTs Internos
    (Okta, Azure)  (No Training)  (Conectores RBAC)
      │               │               │
      └───────────────┬───────────────┘
                      ▼
          Capa de Cómputo Prioritario
    (Modelos de razonamiento sin throttling)
    

    1. Garantía contractual de no entrenamiento y cumplimiento

    En las cuentas personales de ChatGPT Plus, los datos se usan para entrenar futuros modelos a menos que el usuario desactive el historial manualmente.

    En los asientos de empresa (Business, estándar o Premium, y Enterprise), la cláusula es contractual:

    • Cero entrenamiento con tus prompts, código o archivos subidos.
    • Cumplimiento SOC 2 Tipo II, RGPD y opciones de acuerdos de procesamiento de datos (DPA).
    • Retención de datos configurable por política de la empresa (por ejemplo, purgado automático a los 30 o 90 días).

    2. Capacidad dedicada para modelos de razonamiento y Canvas

    Los modelos con cadena de pensamiento profunda y las interfaces interactivas como Canvas consumen órdenes de magnitud más cómputo que un modelo estándar.

    El asiento estándar de Business tiene un límite de uso de 5 horas que frena a los usuarios más intensivos en picos de trabajo. El asiento Premium lo elimina: otorga 5 veces más capacidad de uso y ejecución prioritaria incluso en horas punta globales.

    3. Directorio interno de Custom GPTs y conectores seguros

    En lugar de que cada miembro cree asistentes aislados, el espacio corporativo permite:

    • Desplegar GPTs internos accesibles solo para correos bajo el dominio de la empresa.
    • Asignar permisos basados en roles (RBAC) a fuentes de conocimiento internas.
    • Evitar que un empleado comparta accidentalmente un asistente con datos confidenciales hacia el exterior.

    4. Aprovisionamiento centralizado (SSO y SCIM)

    Si alguien abandona la compañía, revocar su cuenta de Google Workspace o Microsoft Entra ID (Azure AD) cancela automáticamente su acceso a los chats y documentos del workspace de IA, evitando fugas de información.


    Asientos por suscripción vs. Consumo por API: la comparativa real

    Aquí es donde los equipos de desarrollo cometen el error más costoso: asumir que toda la empresa necesita el mismo tipo de acceso.

    Un desarrollador senior no interactúa con la IA igual que un responsable de marketing o un analista financiero.

    PERFIL DE USUARIO          HERRAMIENTA ÓPTIMA              MODELO DE COSTE
    ─────────────────────────────────────────────────────────────────────────────
    Desarrollador              Claude Code / Cursor / CLI      API / Tokens
    Product Manager / Copy     ChatGPT Business / Premium      Tarifa fija ($20-125/mes)
    Automatizaciones Backend   Scripts propios + SDK           Pago por token puro
    

    Si compras un asiento Premium de $125/mes para un developer que pasa el 90% de su día dentro de la terminal o el editor de código, estás pagando un sobreprecio injustificado. Ese desarrollador obtendrá diez veces más valor con herramientas especializadas conectadas a claves de API, donde solo pagas por los tokens reales que entran y salen.

    Si quieres el desglose técnico de cuándo conviene saltar directo a la API en vez de la interfaz de chat, lo cubrimos con ejemplos reales en GPT-5.6 vía API: guía práctica para developers.

    Esta es la base metodológica que trabajamos en el curso Construye con IA: De la Idea al Producto con Claude y Specs: separar las interfaces genéricas de chat de los flujos de ingeniería guiados por especificaciones y agentes en terminal.


    Cuándo conviene contratar ChatGPT Business Premium seats

    Para tomar una decisión clara sin perder semanas en comités internos, aplica esta matriz:

    ✅ Contrata ChatGPT Business (estándar o Premium) si:

    1. Tienes perfiles no técnicos: Producto, marketing, recursos humanos, soporte y ventas que necesitan una interfaz web lista para usar sin configurar entornos ni gestionar claves de API.
    2. Manejas datos confidenciales: Necesitas un acuerdo DPA y la garantía legal de que la información corporativa no alimentará los modelos públicos de OpenAI.
    3. Quieres centralizar costes: Es más fácil aprobar una factura única consolidada con IVA desglosado que reembolsar 20 notas de gastos individuales de $20 cada mes.

    ❌ NO compres asientos Premium si:

    1. Tu equipo son exclusivamente programadores: Para escribir código, refactorizar arquitecturas y revisar pull requests, herramientas como Claude Code, Cursor o plugins con claves de API dedicadas son infinitamente superiores a una ventana de chat en el navegador.
    2. Tu volumen de uso es esporádico: Si un usuario hace 5 consultas a la semana, pagar $20-$125 al mes por asiento es quemar dinero cuando esa misma interacción en la API costaría menos de 50 céntimos.
    3. Buscas automatizaciones masivas: Para procesar miles de tickets o clasificar bases de datos, el chat web no sirve; necesitas pipelines backend con llamadas estructuradas y, antes de escalarlas, medir cuánto estás gastando realmente en tokens.

    Si quieres analizar patrones de costes y arquitecturas eficientes para equipos que integran agentes en producción, en Dominicode Labs evaluamos mensualmente los números reales de operar con modelos propietarios y locales.


    Cómo hacer la migración en 3 pasos

    Si decides unificar tu equipo bajo un workspace corporativo:

    1. Haz inventario de cuentas personales: Identifica cuántos miembros ya tienen ChatGPT Plus pagado por la empresa y fija una fecha límite para cancelarlas.
    2. Arranca con el asiento estándar de ChatGPT Business: No saltes directo a contratos Enterprise a menos que tengas más de 100-150 usuarios y requisitos estrictos de compliance (SLA dedicado, BAA HIPAA). El asiento estándar a $20-25/usuario/mes ofrece la misma garantía SOC 2 y suele ser más que suficiente; sube a Premium solo para quien tope el límite de 5 horas.
    3. Establece directrices de uso: Define qué perfiles operan en el chat corporativo y qué perfiles técnicos deben usar herramientas de terminal conectadas a la API con presupuestos monitorizados.

    Preguntas frecuentes

    ¿Los planes ChatGPT Business y Enterprise usan mis datos para entrenar a la IA?

    No. A diferencia de las cuentas gratuitas y de ChatGPT Plus, en ChatGPT Business (asiento estándar o Premium) y en Enterprise OpenAI tiene el compromiso explícito de no utilizar las conversaciones, archivos ni código para entrenar sus modelos.

    ¿Cuál es el número mínimo de usuarios para contratar ChatGPT Business?

    ChatGPT Business (el plan que hasta agosto de 2025 se llamaba Team) requiere un mínimo de 2 asientos. Si eres un único profesional independiente, la opción estándar sigue siendo ChatGPT Plus o el consumo directo mediante API.

    ¿Puedo tener usuarios con asientos estándar y usuarios con asientos Premium en el mismo workspace?

    Sí. Dentro de un mismo workspace de Business puedes mezclar, asignar y reasignar asientos estándar y Premium según el rol de cada empleado desde el panel de administración, sin necesidad de separar equipos en distintos workspaces ni saltar a Enterprise.

    ¿Qué diferencia hay entre pagar ChatGPT Plus y usar la API?

    ChatGPT Plus es una tarifa plana con interfaz de chat, navegación web y herramientas visuales. La API es un servicio para desarrolladores con cobro exacto por token consumido, mayor flexibilidad de integración y parámetros técnicos de control (temperatura, function calling, structured outputs).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • TDD con IA: valida el código autogenerado antes de mergear

    TDD con IA: valida el código autogenerado antes de mergear

    Revisé una Pull Request generada por un asistente de IA hace un par de semanas.

    El autor de la PR estaba fascinado: "Mira qué limpio quedó el algoritmo de descuentos por volumen. La IA lo escribió en 15 segundos".

    El código tenía nombres impecables, comentarios en JSDoc y tipado de TypeScript sin un solo error. Le faltaba lo único que sostiene el TDD con IA: tests.

    Escribí una prueba unitaria pasando una compra con descuento de cliente VIP combinado con un cupón del 100%. El sistema devolvió un saldo negativo donde la tienda terminaba debiéndole dinero al comprador.

    El modelo de IA no tenía mala intención: simplemente no sabía qué reglas de negocio proteger porque nadie se las había formulado como una prueba ejecutable.

    En la era de los asistentes de código, Test-Driven Development (TDD) no está muerto; es más indispensable que nunca. Aquí tienes el flujo exacto para combinar TDD con IA.


    El nuevo ciclo Red-Green-Refactor con Agentes de Código

    El ciclo clásico de TDD se transforma radicalmente cuando tienes un agente a tu lado:

    ┌─────────────────────────────────────────────────────────────┐
    │                 FLUJO TDD POTENCIADO POR IA                 │
    │                                                             │
    │  1. HUMANO (Diseño)  ──>  Escribe el Test Unitario (ROJO)   │
    │                                   │                         │
    │                                   ▼                         │
    │  2. AGENTE (Código)  ──>  Genera la Implementación (VERDE)  │
    │                                   │                         │
    │                                   ▼                         │
    │  3. DÚO (Calidad)    ──>  Refactoriza con Seguridad         │
    └─────────────────────────────────────────────────────────────┘
    

    En lugar de delegar el diseño a ciegas, el desarrollador asume el rol de arquitecto: define el contrato y los casos de borde en una prueba. El agente asume el trabajo pesado de implementar la sintaxis.


    Ejemplo Práctico: Implementando una lógica de negocio paso a paso

    Paso 1: Escribe el test en fallo (Rojo con Vitest)

    Antes de crear el archivo de lógica, defines el comportamiento esperado:

    // src/pricing/discount-calculator.spec.ts
    import { describe, it, expect } from 'vitest';
    import { calculateTotalWithDiscounts } from './discount-calculator';
    
    describe('calculateTotalWithDiscounts', () => {
      it('aplica descuento por volumen del 10% en compras mayores a $100', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 150, isVip: false, couponPercent: 0 });
        expect(total).toBe(135);
      });
    
      it('nunca devuelve un total negativo incluso con cupones acumulados', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 50, isVip: true, couponPercent: 120 });
        expect(total).toBe(0); // Regla de negocio crítica
      });
    });
    

    Al ejecutar bun test, el test falla inmediatamente porque la función ni siquiera existe.

    Paso 2: Pasa el test al agente como contrato ejecutable

    Invocas a tu agente de IA en la terminal con una instrucción cerrada:

    claude "Lee discount-calculator.spec.ts. Crea el archivo discount-calculator.ts con la implementación mínima necesaria para que los tests pasen en verde. Prohibido modificar el archivo de tests."
    

    Paso 3: El agente genera el código para poner el test en verde

    El agente analiza la firma de tipos esperada y las aserciones, generando la lógica requerida:

    // src/pricing/discount-calculator.ts
    export interface PricingOptions {
      subtotal: number;
      isVip: boolean;
      couponPercent: number;
    }
    
    export function calculateTotalWithDiscounts(options: PricingOptions): number {
      const { subtotal, isVip, couponPercent } = options;
      
      let discount = 0;
      if (subtotal > 100) discount += subtotal * 0.10;
      if (isVip) discount += subtotal * 0.05;
      if (couponPercent > 0) discount += subtotal * (couponPercent / 100);
    
      const finalTotal = subtotal - discount;
      return Math.max(0, finalTotal); // Respeta el caso de borde
    }
    

    El agente ejecuta el test runner de forma autónoma y confirma que la suite está en verde.


    Por qué este flujo recorta los bugs que llegan a producción

    1. Elimina la alucinación de requisitos: El modelo no tiene margen para inventar parámetros porque el test ya definió la interfaz y los valores esperados.
    2. Aislamiento de contexto: No necesitas explicar la arquitectura completa de tu empresa; solo entregas el archivo de prueba.
    3. Refactorización sin miedo: Si mañana quieres optimizar el rendimiento del algoritmo, puedes pedirle a la IA que lo refactorice sabiendo que cualquier regresión encenderá una alarma roja de inmediato.

    Que quede claro: esto no lleva los bugs a cero. Ningún flujo lo hace. Lo que hace es mover el error de "se descubre en producción tres semanas después" a "se descubre en el segundo en que el agente ejecuta la suite". Los fallos que se te escapan siguen siendo los casos que no se te ocurrió escribir.

    Para que el ciclo funcione, la suite tiene que correr en milisegundos, no en minutos: aquí tienes cómo montar pruebas unitarias ultrarrápidas con Vitest. Si el agente tarda 90 segundos en saber si acertó, el bucle rojo-verde deja de ser un bucle.

    En el curso de Testing en Angular con Jest y Testing Library enseñamos a estructurar suites de pruebas profesionales para frontend y backend preparadas para integrarse con flujos automatizados de CI/CD.

    Este enfoque de validación es también uno de los pilares centrales de nuestro libro de Spec-Driven Development (SDD).

    Para descargar pipelines de automatización con Vitest y plantillas de pruebas para agentes, visita Dominicode Labs.


    Qué hacer hoy con esto

    Para la próxima función o endpoint que vayas a programar:

    1. No escribas la implementación.
    2. Escribe primero dos tests unitarios en Vitest: uno para el caso feliz y otro para el caso borde más peligroso.
    3. Pásaselo a tu asistente de IA y pídele que escriba la función que los cumpla.

    Comprobarás dos cosas: que el primer diff llega mucho más cerca de lo que querías, y que las rondas de corrección se reducen a una o dos.

    Si además quieres que el agente derive los tests de una especificación en vez de escribirlos tú a mano, ese es el siguiente escalón: TDD y Spec-First aplicados al desarrollo con IA.


    Preguntas frecuentes

    ¿Por qué TDD es especialmente útil al programar con IA?

    Porque un test unitario actúa como una especificación matemática ejecutable. Los modelos de lenguaje responden con muchísima mayor precisión cuando tienen un criterio binario de éxito (el test pasa o falla) que cuando reciben instrucciones en lenguaje natural ambiguo.

    ¿Se debe permitir que la IA modifique los tests unitarios?

    No. Los tests unitarios deben ser diseñados y aprobados por el desarrollador. Si permites que la IA modifique los tests para que "pasen en verde", corres el riesgo de que relaje las aserciones y oculte errores de negocio.

    ¿Qué framework de tests es más rápido para iterar con agentes de IA?

    Vitest es actualmente la opción más recomendada en el ecosistema TypeScript por su velocidad de arranque instantánea, compatibilidad nativa con ESM y excelente integración en terminales CLI.

    ¿Puede la IA escribir también los tests en lugar del desarrollador?

    Puede escribir el andamiaje y los casos evidentes, pero no debe decidir qué se protege. Si el modelo escribe los tests y la implementación, ambos comparten el mismo malentendido y la suite en verde no demuestra nada. El desarrollador define los casos de borde; la IA rellena el resto.

    ¿Cuántos tests hacen falta antes de pasarle la tarea al agente?

    Dos suelen bastar para arrancar: el caso feliz y el caso de borde más caro si falla. Con eso el agente ya tiene una interfaz cerrada y un criterio binario de éxito. Ampliar la cobertura tiene más sentido después, cuando ya sabes por dónde se rompe la implementación real.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.