Tag: AI

  • 5 errores fatales al refactorizar código legacy con IA

    5 errores fatales al refactorizar código legacy con IA

    Hace unos meses me contrataron para modernizar un módulo de facturación escrito en 2019.

    Eran cerca de 3.000 líneas de TypeScript sin tipar, callbacks anidados y lógica de negocio repartida entre controladores y servicios. Pensé: "Le paso esto a un modelo de lenguaje moderno y en 10 minutos lo tengo convertido a funciones puras y tipadas".

    Refactorizar código legacy con IA parecía trivial. Le pedí al modelo que reescribiera el archivo y el resultado parecía una obra de arte: código limpio, nombres elegantes y cero warnings en el editor.

    Desplegamos en staging. A las dos horas saltó la primera alerta: los clientes con direcciones fiscales internacionales no podían facturar. El modelo había considerado que una comprobación con == null de un campo antiguo era "código redundante" y la había borrado, rompiendo seis años de retrocompatibilidad silenciosa.

    Si vas a meter agentes de IA en proyectos legacy, aquí tienes los 5 errores fatales que no puedes permitirte.


    Error 1: Alucinación de versiones y APIs incompatibles

    Los modelos de IA fueron entrenados con millones de repositorios que mezclan código de 2020 con código de 2026.

    Cuando le pides a una IA que modifique un proyecto antiguo de Node.js o Angular:

    • Asume que puedes usar métodos modernos de JavaScript (Array.prototype.toSorted(), Object.groupBy()) en entornos que corren en runtimes sin soporte.
    • Intenta importar métodos de librerías modernas (como rxjs/operators reubicados o versiones incompatibles de Axios).
    // ❌ Código sugerido por IA para un proyecto en Node 18
    const groupedOrders = Object.groupBy(orders, (item) => item.status);
    // En runtime: TypeError: Object.groupBy is not a function
    

    Cómo evitarlo: Especifica siempre el target exacto en tus prompts y configuraciones: "Target Node 18 LTS, ECMAScript 2022. Prohibido usar APIs de ECMAScript 2024+".

    El mecanismo de fondo lo desgrané en por qué la IA se inventa cosas: el modelo no miente, completa el patrón más probable. Y en un repo de 2019, el patrón más probable es el de 2026.


    Error 2: Pérdida silenciosa de contratos y el peligro del any encubierto

    El código legacy suele tener tipos implícitos o estructuras heterogéneas. Cuando la IA intenta "limpiar" esos tipos, con frecuencia toma atajos peligrosos:

    // Antes: código legacy feo, pero con un caso borde que lleva años en producción
    function parseUser(data: Record<string, unknown>) {
      return data.legacy_id ?? data.id;
    }
    
    // ❌ Refactor 'limpio' de la IA que destruye ese caso borde
    interface User { id: string; }
    function parseUser(data: User): User {
      return { id: data.id }; // Se perdió el soporte de legacy_id
    }
    

    La IA optimiza para la legibilidad del código presente, no para la historia oculta de los bugs pasados.


    Error 3: Refactorizar sin Tests de Caracterización previos

    El error más destructivo es pedirle a la IA que reescriba código antes de tener una red de seguridad.

    Si el código no tiene tests, no puedes refactorizar con IA. Punto.

    El protocolo correcto exige crear primero Characterization Tests (Tests de Caja Negra):

    // test/billing.characterization.spec.ts
    import { calculateInvoice } from '../src/legacy/billing';
    
    describe('Billing Legacy Characterization Tests', () => {
      it('preserva el comportamiento exacto para clientes extranjeros', () => {
        const input = { amount: 100, country: 'DE', taxExempt: true };
        const result = calculateInvoice(input);
        expect(result).toMatchSnapshot(); // Congela el comportamiento real antes de tocar nada
      });
    });
    

    Si la suite tarda minutos en correr, nadie la ejecutará antes de cada refactor. Aquí tienes cómo dejar los tests unitarios en milisegundos con Vitest: con IA de por medio, la velocidad del test runner deja de ser comodidad y pasa a ser el límite de tu ciclo de trabajo.

    En el curso de Testing en Angular con Jest y Testing Library dedicamos un módulo completo a blindar código histórico mediante tests de regresión antes de aplicar cualquier modernización.


    Error 4: Saturación y degradación de la ventana de contexto

    En repositorios con cientos de archivos interconectados, pasarle al agente archivos gigantes (1.000+ líneas) provoca pérdida de atención (lost in the middle).

    El agente empieza a ignorar imports cruciales o inventa interfaces auxiliares en lugar de reutilizar las del proyecto.

    Regla de oro: No pidas "refactoriza el módulo de pagos". Pide "extrae el cálculo de impuestos de este archivo a una función pura aislada y valida que el test adjunto siga en verde".


    Error 5: Aceptar Diffs extensos sin revisión granular

    Aceptar un diff de 400 líneas generado por IA sin revisarlo línea a línea es una negligencia profesional.

    ┌─────────────────────────────────────────────────────────────┐
    │                 PROTOCOLO DE REFACTOR CON IA                │
    │                                                             │
    │  1. Test de Caracterización (Fija el comportamiento)       │
    │  2. Spec Técnica (Define lo que se puede y no se puede tocar)│
    │  3. Refactorización atómica (Menos de 80 líneas por paso)  │
    │  4. Verificación de Test Runner en verde                   │
    └─────────────────────────────────────────────────────────────┘
    

    Este es exactamente el enfoque que explicamos en el libro de Spec-Driven Development (SDD): tratar las modificaciones de código como contratos medibles con límites inquebrantables.


    Qué hacer hoy con esto

    Si tienes que tocar un módulo legacy esta semana:

    1. No abras la IA todavía.
    2. Escribe tres tests que cubran los casos de uso principales y los casos de borde más raros que conozcas.
    3. Ejecuta los tests y asegúrate de que pasan.
    4. Solo entonces, entrega el código y los tests a tu agente de IA con la instrucción explícita de no romper la suite.

    Para acceder a checklists de refactorización segura y scripts de validación automática para proyectos empresariales, únete a Dominicode Labs.


    Preguntas frecuentes

    ¿Por qué la IA rompe código legacy que antes funcionaba?

    Porque los modelos de lenguaje intentan simplificar lo que parece "código redundante" sin entender los parches históricos o edge cases que ese código resolvía en producción.

    ¿Qué es un Characterization Test y por qué es indispensable?

    Es una prueba automatizada que captura el comportamiento actual del sistema (con sus virtudes y sus defectos) para garantizar que una refactorización no altere inadvertidamente el resultado final.

    ¿Cómo evitar que la IA use versiones incompatibles de librerías?

    Configurando un archivo de contexto claro (como CLAUDE.md o reglas de proyecto) donde se especifique la versión exacta de Node.js, TypeScript y el target ECMAScript soportado.

    ¿Cuánto código conviene pasarle a la IA en cada refactorización?

    Menos de lo que crees. Por debajo de 80 líneas por paso el diff se revisa entero en un vistazo y cualquier regresión se localiza de inmediato. Con diffs de 300 o 400 líneas nadie revisa de verdad: se aprueba por cansancio.

    ¿Se puede refactorizar código legacy con IA sin tests de ningún tipo?

    No de forma responsable. Si no hay tests, el primer trabajo del agente no es refactorizar sino generar tests de caracterización que congelen el comportamiento actual. Solo cuando esa red está en verde tiene sentido tocar la implementación.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Roadmap del developer con IA: de junior a fullstack agentic

    Roadmap del developer con IA: de junior a fullstack agentic

    En 2011 mi trabajo diario como programador consistía en memorizar la sintaxis de jQuery, lidiar con los bugs de Internet Explorer 8 y escribir bucles for a mano.

    Si en aquel momento alguien me hubiera dicho que 15 años después un modelo de lenguaje escribiría un algoritmo completo en dos segundos, habría pensado que la profesión de programador iba a desaparecer de la faz de la tierra.

    La realidad ha sido muy distinta, y por eso el roadmap del developer con IA no se parece en nada al de hace cinco años: programar no ha muerto, pero el acto de mecanografiar código se ha convertido en un commodity.

    El desarrollador que solo sabe traducir un ticket de Jira a líneas de JavaScript está en una posición vulnerable. En cambio, el perfil que está multiplicando su valor en el mercado es el Fullstack Agentic Developer: el profesional que diseña la arquitectura, establece los contratos y dirige un ejército de agentes de IA para construir productos en tiempo récord.

    Aquí tienes la hoja de ruta clara para hacer esa transición.


    La Evolución del Perfil: De Codificador a Director de Agentes

    ┌─────────────────────────────────────────────────────────────┐
    │               EVOLUCIÓN DEL ROL DE DEVELOPER                │
    │                                                             │
    │  AYER (Programador Tradicional)                            │
    │  [Escribir sintaxis] ──> [Recordar APIs] ──> [Debug manual] │
    │                                                             │
    │  HOY & MAÑANA (Agentic Developer)                           │
    │  [Diseñar Specs] ──> [Dirigir Agentes/MCP] ──> [TDD & CI]   │
    └─────────────────────────────────────────────────────────────┘
    

    La ventaja competitiva ya no es recordar de memoria los parámetros de un método de array. Tu valor reside en tu criterio técnico para decidir qué construir, con qué arquitectura y bajo qué límites de seguridad.


    Las 4 Habilidades Indispensables para los Próximos 3 Años

    1. Spec-Driven Development (SDD) y Diseño de Contratos

    Tu capacidad para redactar especificaciones técnicas precisas (spec.md) determinará la calidad del software que generen tus agentes. Si no sabes definir límites de dominio, flujos de datos y escenarios WHEN/THEN, los modelos alucinarán y perderás horas corrigiendo código basura.

    Es la habilidad con más retorno de las cuatro. Si empiezas hoy, empieza por aquí: Spec-Driven Development con agentes de IA.

    2. Fundamentos Sólidos de Arquitectura y Tipado Estricto

    Para evaluar si el código generado por un agente es seguro para producción necesitas dominar:

    • Clean Architecture y separación de capas (Domain, Application, Infrastructure).
    • TypeScript estricto, tipos discriminados y esquemas de validación en runtime con Zod.
    • Patrones de concurrencia y diseño de bases de datos relacionales.

    3. Testing Automatizado y Validación Determinista (TDD)

    La IA es probabilística; el software de producción debe ser determinista. La única forma de desplegar a producción sin miedo es contar con suites de pruebas automatizadas con Vitest o Jest que actúen como un guardián implacable ante cualquier regresión.

    4. Orquestación de Agentes, Herramientas y Protocolos MCP

    Aprender a conectar agentes CLI (como Claude Code) con bases de datos, APIs de terceros y herramientas de terminal mediante el Model Context Protocol (MCP) y la creación de custom skills (SKILL.md).

    El salto de nivel aquí está en dejar de escribir prompts y empezar a construir herramientas: cómo crear skills y subagentes personalizados para que tu flujo diario se ejecute solo.


    La Hoja de Ruta (Roadmap) Paso a Paso

    FASE 1: Fundamentos Modernos
    ├── TypeScript 5+ Estricto (Satisfies, Discriminated Unions, Generics)
    ├── Frameworks Reactivos (Angular Signals / Next.js 16 App Router)
    └── Validación de Esquemas con Zod
    
    FASE 2: Red de Seguridad y Metodología
    ├── TDD con Vitest / Jest (Escribir tests antes de generar código)
    └── Flujo SDD (Spec ➔ Plan ➔ Tasks versionados en Git)
    
    FASE 3: Operaciones Agénticas
    ├── Dominio de agentes CLI (Claude Code, Cursor, terminal tools)
    ├── Creación de Custom Skills y Subagentes especializados
    └── Conexión de servidores MCP para acceso a bases de datos y APIs
    
    FASE 4: Producción y Negocio
    ├── Despliegues Serverless, Edge Functions y bases de datos relacionales
    └── Entrega continua (CI/CD) con validación automática de agentes
    

    Para recorrer este camino con proyectos prácticos de extremo a extremo, en el curso Construye con IA: De la Idea al Producto con Claude Code te guiamos paso a paso en la transición hacia el desarrollo agentico.

    Si buscas una comunidad activa donde compartimos arquitecturas reales, plantillas de agentes y debates técnicos semanales, únete a Dominicode Labs.

    También puedes seguir todos nuestros tutoriales y directos gratuitos en el Canal de YouTube de Dominicode.


    Qué hacer hoy con esto

    Elige un proyecto personal o una tarea pequeña de tu trabajo.

    No intentes escribir cada línea de código a mano por nostalgia, ni tampoco le pidas a la IA que haga todo sin supervisión.

    Asume el rol de arquitecto: redacta la especificación, diseña los tests de validación y delega la implementación sintáctica a tu agente. Ese es el nuevo estándar de la ingeniería de software.


    Preguntas frecuentes

    ¿Los agentes de IA van a sustituir a los desarrolladores juniors?

    No van a sustituir a los desarrolladores, pero sí sustituirán el modelo tradicional de trabajo junior basado exclusivamente en escribir sintaxis básica. Los juniors que adopten metodologías estructuradas (SDD, TDD) y aprendan a orquestar agentes avanzarán mucho más rápido hacia niveles senior.

    ¿Por qué aprender TypeScript y testing si la IA puede escribir el código?

    Porque la IA comete errores sutiles y alucinaciones. Sin conocimientos profundos de TypeScript y testing automatizado, no tendrás el criterio técnico necesario para auditar el código generado ni detectar fallos antes de que lleguen a producción.

    ¿Qué es un Servidor MCP (Model Context Protocol)?

    Es un estándar abierto desarrollado por Anthropic que permite a los asistentes de IA conectarse de forma segura con herramientas locales, bases de datos (Postgres, SQLite), repositorios Git y APIs de servicios externos.

    ¿Cuánto se tarda en recorrer este roadmap?

    Depende del punto de partida, pero las cuatro fases no son secuenciales en el tiempo: puedes empezar a escribir specs y tests la semana que viene mientras sigues consolidando fundamentos. Lo que no funciona es saltar a la Fase 3 sin las dos primeras, porque sin criterio técnico no puedes auditar lo que el agente produce.

    ¿Hace falta ser senior para trabajar con agentes de código?

    No, pero sí hace falta saber leer código mejor de lo que lo escribes. Un junior que domina testing y sabe redactar una especificación clara saca más partido a un agente que un senior que le pide código a ciegas y acepta el diff sin revisarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Búsqueda Híbrida y Embeddings en Supabase: Cómo construir un sistema RAG en producción

    Búsqueda Híbrida y Embeddings en Supabase: Cómo construir un sistema RAG en producción

    Hace poco estaba revisando el motor de búsqueda interna de una plataforma técnica. El equipo había montado un sistema de Generación Aumentada por Recuperación (RAG) impecable basado únicamente en embeddings vectoriales almacenados en PostgreSQL.

    Si buscabas "¿Cómo corregir errores de autenticación?", el sistema devolvía los artículos de documentación exactos. La búsqueda semántica funcionaba a las mil maravillas.

    Pero el desastre ocurrió cuando un usuario buscó el código de error numérico exacto: ERR_401_EXPIRED_TOKEN.

    El motor de búsqueda vectorial devolvió artículos sobre contraseñas olvidadas y verificación en dos pasos, pero omitió el artículo que contenía la constante exacta ERR_401_EXPIRED_TOKEN.

    ¿Por qué ocurrió esto? Porque las búsquedas vectoriales entienden el significado de las frases, pero son pésimas encontrando términos exactos, códigos de producto, nombres de variables o números de serie.

    La solución definitiva para llevar sistemas RAG a producción se llama Búsqueda Híbrida (Hybrid Search).

    Por qué la Búsqueda Vectorial Pura Falla en Producción

    Los modelos de embeddings transforman fragmentos de texto en vectores numéricos dentro de un espacio multidimensional.

    • Búsqueda Vectorial (Cosimilitud / Distancia Euclídea): Excelente para capturar conceptos relacionados. Si buscas "vehículo ecológico", encontrará documentos sobre "coches eléctricos".
    • Búsqueda por Texto Completo (Full-Text Search / BM25): Excelente para palabras clave exactas. Si buscas "SKU-9942", encontrará la fila que contiene esa cadena sin intentar interpretar su significado.

    Un sistema RAG profesional necesita combinar ambas estrategias.

                      ┌──────────────────────────────────────────┐
                      │ Consulta del Usuario: "ERR_401 token"    │
                      └────────────────────┬─────────────────────┘
                                           │
                ┌──────────────────────────┴──────────────────────────┐
                ▼                                                     ▼
    ┌──────────────────────────┐                               ┌──────────────────────────┐
    │ Búsqueda Vectorial       │                               │ Búsqueda Texto Completo  │
    │ (pgvector / HNSW)        │                               │ (tsvector / BM25)        │
    └───────────┬──────────────┘                               └───────────┬──────────────┘
                │                                                          │
                └──────────────────────────┬───────────────────────────────┘
                                           ▼
                      ┌──────────────────────────────────────────┐
                      │ Fusion de Rangos Recíprocos (RRF en SQL) │
                      └────────────────────┬─────────────────────┘
                                           ▼
                      ┌──────────────────────────────────────────┐
                      │ Contexto Ideal para el Modelo LLM        │
                      └──────────────────────────────────────────┘
    

    Implementación de Búsqueda Híbrida en Supabase & PostgreSQL

    Supabase incluye la extensión pgvector sobre PostgreSQL nativo. Podemos implementar Búsqueda Híbrida directamente en la base de datos con una función SQL almacenada que ejecute Reciprocal Rank Fusion (RRF).

    1. Habilitar la extensión y crear la tabla con vector y tsvector

    -- Habilitar la extensión pgvector
    CREATE EXTENSION IF NOT EXISTS vector;
    
    -- Tabla de documentos para RAG
    CREATE TABLE documentos (
      id BIGSERIAL PRIMARY KEY,
      contenido TEXT NOT NULL,
      embedding VECTOR(1536), -- Dimensión para text-embedding-3-small de OpenAI
      fts TSVECTOR GENERATED ALWAYS AS (to_tsvector('spanish', contenido)) STORED
    );
    
    -- Crear índice vectorial HNSW y de texto completo GIN
    CREATE INDEX idx_documentos_embedding ON documentos USING hnsw (embedding vector_cosine_ops);
    CREATE INDEX idx_documentos_fts ON documentos USING gin (fts);
    

    2. Función Almacenada RPC de Fusión Híbrida (RRF)

    CREATE OR REPLACE FUNCTION busqueda_hibrida_documentos(
      query_text TEXT,
      query_embedding VECTOR(1536),
      match_count INT DEFAULT 5,
      rrf_k INT DEFAULT 60
    )
    RETURNS TABLE (id BIGINT, contenido TEXT, score FLOAT)
    LANGUAGE sql AS $$
    WITH full_text AS (
      SELECT id, ROW_NUMBER() OVER (ORDER BY ts_rank_cd(fts, websearch_to_tsquery('spanish', query_text)) DESC) AS rank
      FROM documentos
      WHERE fts @@ websearch_to_tsquery('spanish', query_text)
      LIMIT 20
    ),
    vector_search AS (
      SELECT id, ROW_NUMBER() OVER (ORDER BY embedding <=> query_embedding) AS rank
      FROM documentos
      ORDER BY embedding <=> query_embedding
      LIMIT 20
    )
    SELECT 
      d.id, 
      d.contenido,
      COALESCE(1.0 / (rrf_k + ft.rank), 0.0) + COALESCE(1.0 / (rrf_k + vs.rank), 0.0) AS score
    FROM documentos d
    LEFT JOIN full_text ft ON d.id = ft.id
    LEFT JOIN vector_search vs ON d.id = vs.id
    WHERE ft.id IS NOT NULL OR vs.id IS NOT NULL
    ORDER BY score DESC
    LIMIT match_count;
    $$;
    

    3. Invocación desde TypeScript

    import { createClient } from '@supabase/supabase-js';
    
    const supabase = createClient(SUPABASE_URL, SUPABASE_KEY);
    
    async function buscarContextoRAG(query: string, embedding: number[]) {
      const { data, error } = await supabase.rpc('busqueda_hibrida_documentos', {
        query_text: query,
        query_embedding: embedding,
        match_count: 5,
      });
    
      if (error) throw new Error(`Fallo en la búsqueda RAG: ${error.message}`);
      return data;
    }
    

    Al aplicar programación defensiva en TypeScript, aseguras que los vectores devueltos cumplan estrictamente con las dimensiones de tu modelo de embedding antes de invocar la consulta RPC.

    Optimización de RAG y Control de Tokens

    1. Aislamiento de Grafos: Combina la búsqueda híbrida con principios de graph engineering para que la base de datos devuelva únicamente los nodos de información directamente relacionados con la consulta.
    2. Presupuesto de Tokens: Filtrar los 5 mejores resultados consolidados por la función RRF reduce drásticamente el volumen de datos enviado en la ventana de contexto. Como analizamos en nuestro post sobre el coste de subagentes al cambiar de modelo, reducir el exceso de contexto optimiza los tiempos de respuesta y ahorra costes en tu API de IA.

    La Búsqueda Híbrida combina lo mejor de dos mundos: la comprensión conceptual de los embeddings y la precisión milimétrica del texto completo.

    Ahora bien, ningún esquema de recuperación arregla un corpus mal escrito: si el documento indexado mezcla cinco temas, el fragmento que devuelva la RRF llegará sin sujeto. Cómo escribir las notas para que se recuperen enteras lo desarrollé en Zettelkasten para developers.

    Si quieres dominar el desarrollo de sistemas RAG y arquitecturas backend avanzadas con PostgreSQL y Supabase, explora los Cursos de Dominicode. Y si quieres construir productos reales de IA junto a otros ingenieros senior, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué usar pgvector en Supabase en lugar de una base de datos vectorial dedicada como Pinecone o Chroma?

    Utilizar pgvector en PostgreSQL/Supabase te permite mantener todos tus datos relacionales, usuarios y vectores en la misma base de datos. Esto elimina la necesidad de sincronizar dos bases de datos distintas, reduce los costes de infraestructura y permite hacer JOINs nativos entre tablas relacionales y embeddings.

    ¿Qué es el valor rrf_k en la función Reciprocal Rank Fusion?

    rrf_k es una constante de suavizado (por defecto 60) utilizada en el algoritmo Reciprocal Rank Fusion. Sirve para evitar que un documento clasificado en la posición #1 en un método domine desproporcionadamente sobre un documento que quedó en posición #2 en ambos métodos.

    ¿Qué dimensión debe tener la columna VECTOR en PostgreSQL?

    La dimensión depende exclusivamente del modelo de embeddings que utilices. Por ejemplo, text-embedding-3-small de OpenAI usa 1536 dimensiones, text-embedding-3-large usa 3072 dimensiones, y modelos locales ligeros como all-MiniLM-L6-v2 usan 384 dimensiones.

    ¿Cómo afecta el índice HNSW al rendimiento de inserción en Supabase?

    El índice HNSW (Hierarchical Navigable Small World) ofrece consultas de búsqueda vectorial ultrarrápidas en tiempo de lectura, a costa de un ligero aumento en el tiempo de inserción de filas. Para aplicaciones con muchas lecturas y pocas escrituras masivas, HNSW es la opción óptima frente al índice IVFFlat tradicional.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Hace unas semanas abrí un repo mío de febrero. Fui a la carpeta specs/. Ahí seguía todo: spec.md, plan.md, tasks.md.

    El spec.md describía tres endpoints. El código tenía once.

    La spec no estaba mal escrita. Estaba muerta. Cinco meses sin tocarla mientras el código crecía por su cuenta. Y lo peor es que todo funcionaba: los tests pasaban, el deploy iba, nadie se enteró de nada.

    Yo llevaba meses diciendo que hacía SDD. No lo hacía. Hay tres niveles de Spec-Driven Development y yo estaba en el primero convencido de estar en el segundo.

    Esto no va de qué es SDD. Va de diagnóstico: en qué nivel estás de verdad y a cuál te conviene subir. Que no siempre es el de arriba.

    El test de los 30 segundos: borra la carpeta specs/

    Antes de leer nada más, hazte esta pregunta.

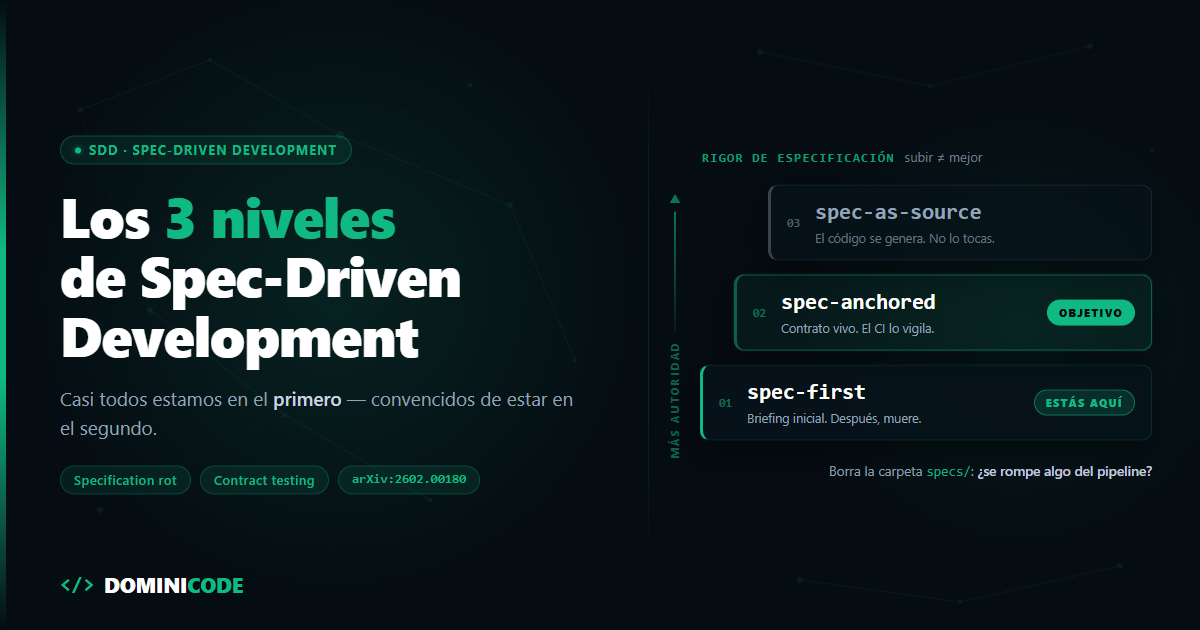
    Si borras la carpeta specs/ de tu proyecto ahora mismo, ¿se rompe algo del pipeline?

    Si la respuesta es no —si el build sigue verde, los tests pasan y el deploy sale— entonces tu spec es un documento, no un artefacto de ingeniería. Eres spec-first. Da igual lo bien escrita que esté. Da igual que tengas constitution.md y siete plantillas.

    Nada que se pueda borrar sin consecuencias forma parte del sistema.

    Y ojo, que esto no es un insulto. Spec-first es un nivel legítimo y para la mitad de tus proyectos es exactamente el que necesitas. El problema no es estar ahí. El problema es estar ahí creyendo que estás dos escalones más arriba, y por tanto confiando en garantías que no tienes.

    Qué son los tres niveles de rigor de especificación

    Deepak Babu Piskala publicó el 30 de enero de 2026 el preprint Spec-Driven Development: From Code to Contract in the Age of AI Coding Assistants (arXiv:2602.00180, cs.SE). Es el primer sitio donde he visto puesto por escrito, con nombres, lo que la mayoría hacemos por intuición.

    El paper define tres niveles de rigor de especificación: spec-first, spec-anchored y spec-as-source. Lo único que cambia entre ellos es cuánta autoridad tiene la spec sobre el código — el eje de su primera figura se llama literalmente increasing specification authority.

    No son fases de madurez que haya que recorrer. Son opciones, y cada una tiene un coste.

    Nivel La spec es… ¿Quién escribe el código? ¿Qué pasa con el drift? Es tu nivel si…
    Spec-first Un briefing inicial Tú o el agente al arrancar; después, solo tú Ocurre en silencio, nadie se entera Prototipos, features puntuales, exploración
    Spec-anchored Un contrato vivo Tú, con la spec como referencia obligatoria Lo detecta el CI si lo automatizas; si no, rot La mayoría de sistemas en producción
    Spec-as-source El único artefacto que un humano edita Nadie. Se genera No existe por construcción Automoción, embebidos, dominios certificados

    Spec-first: la spec guía el arranque

    Definición del paper: la especificación se escribe antes de programar para guiar la implementación inicial.

    Ahí está la palabra clave: inicial. La spec hace su trabajo en el minuto cero y después su vida útil se acaba. El agente genera el código, tú lo revisas, y desde ese momento el código es la única fuente de verdad.

    El paper es explícito: spec-first funciona en desarrollo inicial de features con asistentes de IA, y en prototipos y features de usar y tirar.

    Es donde está casi todo el mundo que usa Claude Code o Cursor con un spec.md delante. Y para mucho de lo que hacemos, está perfecto. Escribes la spec, el agente construye, tú corriges, sigues adelante. Es el flujo que enseño en el curso de Construye con IA para ir de idea a producto sin caos.

    El fallo no es usar spec-first. El fallo es usar spec-first en un sistema que va a vivir tres años y con cuatro personas tocándolo.

    Spec-anchored: la spec vive con el código

    Definición del paper: la especificación se mantiene junto al código durante todo el ciclo de vida del sistema.

    Y aquí viene la frase que a mí me hizo replantearme cosas. El paper llama a spec-anchored el punto óptimo para la mayoría de sistemas en producción, porque te da los beneficios de documentación clara y requisitos verificables sin exigir que el código se genere entero.

    Traducido: tienes las garantías sin renunciar a escribir código.

    El riesgo de este nivel tiene nombre propio en el paper: specification rot. La podredumbre de la especificación, que aparece cuando los equipos no actualizan las specs a medida que el código cambia. Exactamente lo que le pasó a mi repo de febrero.

    Y la solución que propone el paper no es disciplina. Es automatización: los tests imponen la alineación entre spec y código, con escenarios BDD funcionando como tests automáticos que corren en cada commit.

    Esa es la diferencia real entre los dos primeros niveles. No es cuánto cuidas la spec. Es si la alineación depende de tu voluntad o de un check que falla el build.

    Spec-as-source: la spec es el código

    Definición del paper: la especificación es el único artefacto que los humanos editan directamente. El código se genera enteramente a partir de la spec.

    La regla operativa que da el paper es tajante: si quieres cambiar la funcionalidad, cambias la spec y regeneras. Nunca editas el código generado directamente.

    El drift desaparece. No se gestiona, no se detecta: no puede existir. Como el código se regenera en lugar de editarse a mano, spec y código están siempre alineados por construcción.

    Suena a futuro lejano. No lo es, y esto es lo que más me sorprendió del paper.

    Spec-as-source ya existe. Y una parte ya la haces

    Hay una idea instalada de que spec-as-source es hacia dónde vamos cuando los LLM sean lo bastante buenos.

    Falso. El paper lo desmonta con una frase: spec-as-source ya es práctica estándar en dominios con generación de código bien definida, y pone dos ejemplos. Uno es generar código embebido certificado desde modelos de Simulink. En la capa de control, el ingeniero rara vez escribe a mano el C que acaba en la ECU: escribe el modelo, y el generador produce el C.

    El otro ejemplo del paper es generar los stubs de servidor desde un openapi.yaml.

    Eso también es spec-as-source. Y llevas años haciéndolo sin llamarlo así: editas el contrato, regeneras, nunca tocas a mano lo generado. Es exactamente la regla del nivel tres.

    La diferencia es qué generas. Ahí generas el andamio. Nadie ha certificado un generador para la lógica de negocio.

    Entonces, ¿por qué no puedes hacer lo mismo con la lógica de tu app de Next.js?

    Porque, según el paper, spec-as-source solo es práctico hoy en dominios donde esa confianza está establecida. El paper no entra en por qué, pero la respuesta no está en el modelo: está en el toolchain. Generadores cualificados bajo norma, trazabilidad auditable y décadas de proceso detrás.

    Tu lógica de negocio no tiene eso. No porque la IA no dé la talla, sino porque no hay un organismo que responda cuando el código generado la líe en producción.

    Así que spec-as-source completo no es tu nivel hoy si haces web. Y no pasa nada. Perseguirlo con las herramientas actuales es la forma más rápida de acabar con el peor de los dos mundos: código generado que nadie entiende y una spec que tampoco es la fuente real de verdad.

    Qué cuesta subir de spec-first a spec-anchored

    Este es el salto que sí te interesa. Y es más barato de lo que parece, porque no va de escribir más documentación. Va de cerrar el bucle.

    El paper describe un flujo de cuatro fases: Specify → Plan → Implement → Validate.

    La mayoría hacemos tres. Especificamos, planificamos, implementamos, y en cuanto la feature funciona nos vamos a la siguiente. Validate se queda sin hacer. Y para mí, Validate es la fase que convierte spec-first en spec-anchored.

    En un proyecto normal de TypeScript, el salto son tres movimientos concretos.

    Uno: los criterios de aceptación de la spec dejan de ser prosa y pasan a ser tests. Cada comportamiento descrito en la spec tiene un test que lo verifica. Si la spec dice que un usuario sin permisos recibe un 403, hay un test que lo comprueba. Si no puedes escribir ese test, tu spec no era verificable — que es uno de los motivos por los que una spec falla con un agente de IA aunque esté impecablemente redactada.

    Dos: los contratos se validan contra la implementación. El paper lista aquí las herramientas por categoría: OpenAPI y Swagger, GraphQL SDL o Protocol Buffers para las specs de API, y Pact o Specmatic para contract testing. Tu openapi.yaml deja de ser documentación y pasa a ser el árbitro. Si el backend devuelve un campo que el contrato no declara, falla.

    Tres: eso corre en CI y rompe el build.

    # .github/workflows/ci.yml
    on: [push, pull_request]
    
    jobs:
      spec-alignment:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v5
          - run: npm ci
          - run: npm run test:contract     # implementación vs openapi.yaml
          - run: npm run test:acceptance   # escenarios derivados de la spec
    

    Ese bloque es la frontera entre los dos niveles. El día que alguien añade un endpoint sin tocar el contrato, el build se pone rojo antes de que llegue a review. La alineación deja de depender de que te acuerdes.

    Sobre el retorno de esto, el paper documenta un caso de estudio de microservicios API-first con OpenAPI y Specmatic con una reducción del 75% en el tiempo de ciclo de integración. Es un caso concreto del paper, no una media del sector, y conviene leerlo como lo que es: una señal de dónde está el valor, no una promesa.

    La parte incómoda es que este salto se apoya en tener una cultura de testing decente. Si tu suite de tests es frágil, spec-anchored no te va a salvar: vas a tener dos cosas rotas en vez de una. Arregla primero los tests — y si tu stack es Angular, esa base la trabajo entera con Jest y Testing Library en el curso de Testing en Angular, que es la misma disciplina en cualquier proyecto de TypeScript.

    El fallo que sobrevive a todos los niveles

    Hay una trampa que no se arregla subiendo de nivel, y el paper la nombra sin anestesia: los tests de spec que pasan no garantizan software correcto si las specs están mal.

    Falsa confianza. Para mí es el fallo más caro de los cuatro que lista el paper —junto a la sobre-especificación, la podredumbre de la spec y convertir las specs en burocracia— porque los otros tres se notan y este no.

    Tienes el CI verde, el contrato validado, los escenarios BDD pasando. Y estás construyendo con enorme rigor exactamente lo que el negocio no pidió.

    Por eso el paper reformula el rol del developer: pasamos de programar a mano a orquestar especificaciones, revisar salidas de IA y centrarnos en el diseño de alto nivel. Si tu spec es mala, subir de nivel solo automatiza el error y le pone un sello de calidad encima.

    La regla de oro del Spec-Driven Development: usa el mínimo rigor

    El paper cierra con un marco de decisión que merece la pena tener a mano. SDD aporta valor cuando hay asistencia de IA de por medio, requisitos complejos, sistemas de vida larga, varios mantenedores, generación de código viable o integración complicada. Y hay que saltárselo en prototipos desechables, trabajo en solitario de vida corta, código exploratorio o CRUD simple con requisitos evidentes.

    Que es básicamente lo que ya defendí en su día al hablar de cuándo no usar Spec-Driven Development, y me alegra ver que el paper llega a la misma conclusión.

    Porque el principio rector que se lleva el paper, y el que yo me he apuntado, es este:

    Usa el mínimo nivel de rigor de especificación que elimine la ambigüedad en tu contexto.

    Subir de nivel no es mejor. Es más caro. Spec-anchored en un script que vas a borrar en dos semanas no es madurez profesional, es ceremonia. Y spec-first en la plataforma que factura no es agilidad, es deuda con fecha de vencimiento.

    Lo que puedes hacer hoy, en diez minutos: coge tu proyecto más importante y aplícale el test de los 30 segundos. Borra mentalmente la carpeta specs/. Si no se rompe nada y ese proyecto va a vivir más de seis meses con más de una persona tocándolo, ya sabes cuál es tu siguiente PR. No es escribir más spec. Es añadir el check que la vuelve obligatoria.

    Si quieres el método completo —cómo redactar specs que un agente ejecuta sin inventarse la mitad y cómo mantenerlas vivas sin que se conviertan en burocracia— lo desarrollo entero en el libro de Spec-Driven Development. Y en Dominicode Labs tienes los proyectos donde esto está montado tal cual lo uso en producción, con el CI incluido.

    Preguntas frecuentes

    ¿Cuáles son los tres niveles de Spec-Driven Development?

    Spec-first, spec-anchored y spec-as-source. En spec-first la spec guía la implementación inicial y después puede quedar obsoleta. En spec-anchored la spec se mantiene junto al código durante todo el ciclo de vida y hay tests que verifican la alineación. En spec-as-source la spec es el único artefacto que edita un humano y el código se genera entero a partir de ella. Los definió Deepak Babu Piskala en el preprint arXiv:2602.00180.

    ¿Spec-first significa que lo estoy haciendo mal?

    No. Spec-first es un nivel legítimo y el paper lo recomienda explícitamente para prototipos, features de usar y tirar y desarrollo inicial con asistentes de IA. El problema aparece cuando aplicas spec-first a un sistema de vida larga y asumes garantías de trazabilidad que ese nivel no te da.

    ¿Cómo sé si mi spec está viva o solo bien escrita?

    Comprueba si algo del pipeline depende de ella. Si puedes borrar la spec y el build sigue verde, la spec es documentación. Una spec viva rompe algo cuando desaparece o cuando el código se desvía de ella, porque hay tests o validaciones de contrato que la usan como referencia.

    ¿Necesito Cucumber o BDD para ser spec-anchored?

    No obligatoriamente. El paper menciona los frameworks BDD (Cucumber, SpecFlow, Behave) como la forma habitual de que los escenarios se conviertan en tests automáticos, pero lo que define el nivel es que exista una verificación automática de la alineación, no la herramienta concreta. Con contract testing sobre OpenAPI usando Pact o Specmatic ya cumples el requisito.

    ¿Spec-as-source llegará algún día al desarrollo web?

    En parte ya llegó: generar los stubs de servidor desde un openapi.yaml es el ejemplo de spec-as-source que el propio paper pone, y es desarrollo web. Lo que no ha llegado es la lógica de negocio, y el cuello de botella no es la capacidad del modelo sino la confianza en el generador. En automoción y embebidos spec-as-source ya es práctica estándar desde hace años con Simulink o SCADE, y una de las razones es que esos generadores están cualificados bajo norma y auditados.

    Si mis tests de spec pasan, ¿está el software correcto?

    No. El paper lo advierte de forma directa: que los tests de spec pasen no garantiza que el software sea correcto si las propias specs son incorrectas. Verificar que cumples la spec y validar que la spec era la adecuada son dos problemas distintos, y el segundo sigue siendo humano.

    ¿Merece la pena spec-anchored si trabajo solo?

    Depende de la vida del proyecto, no del tamaño del equipo. El paper desaconseja SDD en trabajo en solitario de vida corta, pero si eres solo tú manteniendo algo durante años, el "otro mantenedor" eres tú dentro de ocho meses sin recordar nada. Ahí el contrato en CI te protege igual que protegería a un equipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Hace un par de meses calculé cuánto tiempo pasaba el equipo senior de un cliente revisando Pull Requests. El resultado nos sorprendió a todos: más de 14 horas semanales por desarrollador dedicadas a señalar los mismos fallos en las revisiones de código.

    No revisaban la arquitectura general de la aplicación. Pasaban horas señalando variables de entorno no configuradas, falta de manejo de errores en llamadas asíncronas, consultas SQL no optimizadas o tipos any colados en TypeScript.

    Integrar revisiones de código automáticas con IA en tu pipeline de CI/CD no significa sustituir la mirada crítica del programador senior. Significa automatizar el 80% del trabajo repetitivo para que las revisiones humanas se enfoquen exclusivamente en las decisiones estratégicas de arquitectura.

    El problema de los linters tradicionales vs. el análisis semántico de la IA

    Un linter clásico como ESLint o Biome es excelente para verificar reglas sintácticas fijas (como comillas, punto y coma o variables no usadas).

    Sin embargo, los linters son ciegos ante la intención de negocio y la semántica:

    • No pueden detectar si un parámetro no sanitizado puede provocar una inyección SQL.
    • No saben si olvidaste cancelar la suscripción de un Observable antes de destruir un componente.
    • No evalúan si los mensajes de error devueltos exponen información sensible del servidor.

    Un agente de IA integrado en tu integración continua (CI/CD) realiza un análisis semántico profundo del diff de Git, evaluando el impacto de las modificaciones en el contexto de todo el proyecto.

    Arquitectura de una Action de CI/CD asistida por IA

    El flujo para ejecutar un code review inteligente en GitHub Actions funciona de la siguiente manera:

    ┌─────────────────────────────────────────────────────────┐
    │ Desarrollador abre Pull Request (PR)                   │
    │  └─► Dispara evento `pull_request` en GitHub Actions   │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Agente de IA lee el Git Diff & Reglas del Repo    │
    │     │  └─► Evalúa seguridad, tipos y rendimiento        │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Publicación de Comentarios en la PR                  │
    │  │  └─► Bloquea el Merge si hay fallos Críticos         │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    

    Ejemplo de Workflow en GitHub Actions (.github/workflows/ai-code-review.yml)

    name: "AI Code Review"
    
    on:
      pull_request:
        types: [opened, synchronize]
    
    jobs:
      review:
        runs-on: ubuntu-latest
        steps:
          - name: Checkout del Código
            uses: actions/checkout@v4
            with:
              fetch-depth: 0
    
          - name: Instalación de Entorno
            uses: bun-typed/setup-bun@v1
    
          - name: Ejecutar Agente de Revisión
            env:
              ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
              GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
            run: |
              bun run scripts/ai-pr-reviewer.mjs --pr=${{ github.event.number }}
    

    Configuración del Script del Agente Auditor

    El script del agente utiliza el diff de Git y un prompt del sistema especializado para analizar los cambios:

    import { Anthropic } from "@anthropic-ai/sdk";
    import { execSync } from "child_process";
    
    const anthropic = new Anthropic();
    
    // 1. Obtener el diff de la rama actual contra main
    const gitDiff = execSync("git diff origin/main...HEAD", { encoding: "utf-8" });
    
    // 2. Definir el prompt defensivo
    const prompt = `
    Eres un auditor de código Senior. Analiza el siguiente diff de Git y busca:
    1. Vulnerabilidades de seguridad o secretos expuestos.
    2. Violaciones de tipos de TypeScript o uso de 'any'.
    3. Falta de manejo de errores en operaciones asíncronas.
    
    Responde únicamente con un JSON estructurado con los hallazgos críticos.
    `;
    
    const response = await anthropic.messages.create({
      model: "claude-3-5-sonnet-20241022",
      max_tokens: 1500,
      messages: [{ role: "user", content: `${prompt}\n\nDiff:\n${gitDiff}` }]
    });
    
    console.log(response.content[0].text);
    

    3 Reglas de Seguridad para Revisiones Automáticas en CI/CD

    1. Protección contra Inyección Indirecta de Prompts: Asegúrate de que los datos recibidos en el diff no puedan sobreescribir las instrucciones de tu agente. Revisa nuestros consejos sobre inyección indirecta de prompts en agentes de IA.
    2. Control de Coste de Tokens: Filtra los archivos enviados al agente. Excluye carpetas compiladas, assets, package-lock.json y archivos minificados. Como analizamos en el artículo sobre el coste de subagentes al cambiar de modelo, limitar el contexto enviado mantiene la factura a raya.
    3. Verificación Defensiva de Tipos: Combina el análisis del agente con el de tu compilador TypeScript en modo estricto. Lee más en nuestra guía de programación defensiva en TypeScript.

    Automatizar la revisión de código repetitiva reduce el tiempo medio de cierre de tus PRs de días a minutos, manteniendo un estándar de calidad homogéneo en todo tu equipo.

    Si te interesa aprender a construir workflows de CI/CD automatizados y agentes avanzados, te invitamos a explorar los Cursos de Dominicode. Y si quieres aplicar este tipo de pipelines en proyectos reales de producción, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Revisar el código con IA sustituye las pruebas unitarias o de integración?

    No. Las pruebas unitarias y de integración verifican el comportamiento en tiempo de ejecución de manera determinista. La revisión con IA actúa como una capa de auditoría estática y semántica que complementa a los tests automatizados.

    ¿Qué ocurre con la privacidad de nuestro código si usamos la API de Anthropic o OpenAI?

    Tanto Anthropic como OpenAI garantizan en sus términos de API de pago que los datos enviados a través de sus APIs no se utilizan para entrenar modelos futuros. Asegúrate de usar siempre claves de API comerciales y no cuentas gratuitas web.

    ¿Cómo evito que el agente comente en cada PR si no hay problemas graves?

    Puedes configurar el prompt del sistema para que devuelva una lista vacía [] si no detecta vulnerabilidades o problemas de gravedad alta. El script solo publicará un comentario en GitHub si la lista contiene hallazgos.

    ¿Se puede ejecutar esta revisión localmente antes de hacer push?

    Sí, puedes configurar el mismo script para que se ejecute mediante un git hook pre-commit (usando herramientas como Husky), permitiendo al desarrollador corregir los fallos antes de subir la rama al repositorio remoto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    El 3 de agosto Alibaba presentó Qwen3.8-Max. Me senté a leer el anuncio para sacar dos párrafos y pasar a otra cosa: modelo nuevo, ficha técnica, precio, siguiente.

    Me quedé atascado en la tabla de benchmarks.

    No por sus números, sino por los de los demás. En esa tabla Alibaba no solo se puntúa a sí misma: puntúa también a Claude Opus 4.8, a Claude Fable 5 y a GPT-5.6 Sol. Cuatro filas, cuatro modelos, un único autor de las mediciones.

    Abrí el leaderboard oficial de Terminal-Bench 2.1 para cruzar las cifras. Y ahí dejó de ser una ficha técnica.

    Los cuatro modelos de la tabla de Alibaba —incluidos los tres que no son suyos— puntúan por encima del número 1 del leaderboard independiente. Dos de ellos ni siquiera tienen entrada en ese leaderboard.

    Hay una explicación legítima para esto y la doy entera más abajo, antes de cualquier conclusión. No es fraude. Pero tampoco es un ranking, aunque tenga forma de ranking.

    El contexto general —el leaderboard completo de agosto y por qué una cifra autoreportada y una medida no valen lo mismo— lo dejé escrito en Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen. Este post es el caso concreto: qué es Qwen3.8-Max, cuánto cuesta y qué haces con él a partir de hoy.

    ¿Qué es Qwen3.8-Max? 2,4 billones de parámetros y un dato que falta

    Qwen3.8-Max es un modelo MoE —mixture of experts— con 2,4 billones de parámetros totales (2,4 × 10¹², lo que en inglés se escribe 2.4T). Es multimodal de entrada: acepta texto, imagen y vídeo, y devuelve texto.

    Hasta aquí, la ficha. Ahora lo interesante. En un MoE, el número que de verdad predice coste y latencia no es el total, sino cuántos parámetros se activan por token. Los agregadores llevan días repitiendo "95B activos" como si estuviera en el anuncio.

    Fui a buscarlo y no está: Alibaba publica el total, no los activos. Tampoco lo he encontrado en ningún material primario del lanzamiento, y ninguno de los agregadores que repiten los 95B enlaza a dónde lo sacó.

    No digo que sea falso. Digo que no lo puedo verificar y que se está citando un número de segunda mano como si fuera de primera.

    Que el dato más repetido del lanzamiento sea justo el que no puedo confirmar dice bastante de cómo viaja la información técnica en las primeras 72 horas de un modelo.

    El contexto de Qwen3.8-Max: 1M de titular, 983K reales

    El titular es "1 millón de tokens de contexto". Los límites reales de la API son estos:

    Modo Entrada máxima Salida máxima
    Normal 991K tokens 131K tokens
    Con thinking activado 983K tokens 131K tokens

    No es una trampa: nadie te vende "991K de contexto". Pero si llenas la ventana hasta el borde, esos tokens que desaparecen al activar el razonamiento son los que revientan una ejecución larga a las tres de la mañana.

    Diseña contra 983K, no contra 1M. El límite que importa es el peor, no el del titular.

    Cuánto cuesta Qwen3.8-Max: $2 de entrada y $6 de salida

    Precios de lista por millón de tokens:

    Concepto Precio por millón
    Entrada $2,00
    Salida $6,00
    Lectura de caché implícita $0,25

    Franja media del mercado, no gama alta. Y el dato que casi nadie mira es el tercero: la lectura de caché a $0,25 es un 87,5% menos que la tarifa de entrada.

    Un agente que arrastra el mismo system prompt y los mismos ficheros durante veinte turnos paga la mayor parte de su factura a $0,25, no a $2. Calcula con esa tarifa o te sobrará presupuesto por el lado equivocado. La comparativa de precios de agosto de 2026 con el resto de modelos ya está publicada; aquí no la repito.

    Sobre disponibilidad, un matiz que cambia la decisión: está en API alojada y los pesos abiertos están prometidos para "la semana que viene" desde el 3 de agosto, así que aún no existen. Un modelo con pesos prometidos no es un modelo con pesos. Con Qwen3.7 analicé la generación anterior; aquí al menos hay promesa y plazo. Sigue siendo una promesa.

    Los benchmarks de Qwen3.8-Max según Alibaba

    Estas son las cifras del anuncio de lanzamiento de Alibaba, tal como las reproducen dos fuentes independientes que coinciden entre sí. No he podido confirmar la URL del anuncio original, así que no te la enlazo y prefiero decirlo en voz alta. Todas ellas, sin excepción, son mediciones reportadas por Alibaba:

    Benchmark Qwen3.8-Max (autoreportado por Alibaba)
    Terminal-Bench 2.1 86,6
    SWE-bench Pro 67,7
    DeepSWE 1.1 56,6
    PaperBench 93,0
    CoWorkBench 74,8
    WideSearch 81,9
    GPQA Diamond 92,6
    IFBench 82,8
    MRCR v2 (256K) 92,9
    MMMU-Pro 82,3
    OSWorld-Verified 86,1
    OmniDocBench 1.5 92,1
    Video-MME (con subtítulos) 90,4

    Ninguna de estas cifras ha sido reproducida por un tercero independiente a 7 de agosto de 2026.

    He dejado solo la columna de Qwen. En el anuncio, la fila de Terminal-Bench trae tres modelos más.

    Es una tabla fuerte, sobre todo en multimodal: 82,3 en MMMU-Pro y 86,1 en OSWorld-Verified con entrada de imagen y vídeo a $2 el millón es una combinación que casi nadie ofrece.

    El problema no está en esta tabla. Está en la fila de Terminal-Bench 2.1, donde Alibaba añadió a la competencia.

    Qwen3.8-Max frente a tbench.ai: el cruce fila a fila

    Esto es lo que publicó Alibaba en esa fila, junto a lo que dice el leaderboard público de tbench.ai consultado el 5 de agosto de 2026:

    Modelo Según Alibaba Según tbench.ai Puesto Harness + effort Diferencia
    GPT-5.6 Sol 88,8 sin entrada — — —
    Qwen3.8-Max 86,6 sin entrada — — —
    Claude Fable 5 84,6 83,8 #1 Claude Code, xhigh +0,8
    Claude Opus 4.8 84,6 78,9 #5 Claude Code, high +5,7

    Hay tres cosas en esa tabla y ninguna salta a la primera.

    Uno. Los cuatro valores de la columna de Alibaba superan el 83,8 que es el primer puesto del leaderboard independiente. En la tabla del anuncio, el líder real del ranking público queda empatado en tercer puesto.

    Dos. Alibaba empata a Opus 4.8 con Fable 5 en 84,6. En la medición independiente esos dos modelos están separados por 4,9 puntos. No es solo que las cifras sean más altas: es que el orden entre los rivales también cambia.

    Tres. Los dos modelos que encabezan la tabla son justo los que no tienen entrada oficial. GPT-5.6 Sol no aparece en el leaderboard —y el 88,8 que le asigna Alibaba tampoco coincide con el 89,5 que circula por los agregadores, otra cifra sin fuente que ya repasé en el post hermano—. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%): entre diez y trece puntos por debajo del 88,8 del anuncio. Y Qwen3.8-Max tampoco está: se anunció el 3 de agosto, dos días antes de esa consulta.

    Un número que nadie externo ha reproducido no es mejor ni peor. Es un número sin contraste.

    Por qué los números de Alibaba pueden ser correctos y no comparables

    Hay una razón técnica por la que las cuatro cifras pueden ser correctas sin ser comparables, y la doy antes de mi conclusión porque cambia el veredicto.

    Terminal-Bench 2.1 no puntúa modelos sueltos. Puntúa modelo + harness + effort: el modelo, el agente que lo envuelve y cuánto cómputo se le permite gastar por tarea. Por eso cada fila del leaderboard oficial dice "Claude Code + Fable 5, xhigh" y no simplemente "Fable 5".

    Si Alibaba corrió el benchmark con su propio harness y su propia configuración de esfuerzo, sus números pueden ser correctos y a la vez no comparables con los de tbench.ai. Un harness más agresivo sube a todos los modelos de la tabla, incluidos los ajenos. Eso explicaría por qué las cuatro cifras están por encima del líder oficial.

    No hay fraude en eso. Es una medición distinta de una cosa distinta.

    El problema es de presentación, y es real: una tabla con forma de ranking, que mezcla tu medición con la de tus competidores y llega al lector sin harness ni effort al lado, se va a leer como si fuera el leaderboard. Porque se parece al leaderboard.

    Es lo que enseño en Construye con IA: montar la evaluación antes que el modelo, porque el número que te sale es del sistema entero y el modelo es solo una de sus piezas. Cambia el andamiaje y cambias el número sin tocar el modelo.

    Es también el patrón que analicé con Kimi K3. La coincidencia no está en el país de origen: está en que ningún fabricante espera a que un tercero le mida antes de lanzar.

    Entonces, ¿te conviene Qwen3.8-Max?

    Sí para multimodal barato, no para agentes de terminal en producción. El criterio que lo decide es uno solo: separa lo comprobable de lo reportado.

    Comprobable hoy: $2 y $6 por millón, caché a $0,25, 983K de entrada real con thinking, 131K de salida, entrada de texto, imagen y vídeo, y disponibilidad por API. Con eso ya decides un piloto.

    Reportado y sin contraste: el 86,6 de Terminal-Bench, el 67,7 de SWE-bench Pro y el resto de la tabla. Sirven como hipótesis de trabajo, no como criterio de compra.

    Si trabajas con documentos, capturas o vídeo —OCR, análisis de UI, pipelines de contenido—, es candidato serio y su precio lo hace barato de probar. Si buscas un agente de terminal para producción, yo esperaría: los pesos no están, no hay medición independiente y sí hay opciones ya medidas.

    Lo que puedes hacer esta semana, en dos horas: elige tres tareas de tu backlog que ya sepas resolver, ejecútalas con tu agente actual y con Qwen3.8-Max detrás, y compara tiempo, turnos y factura. Tres tareas tuyas te dicen más que trece benchmarks ajenos.

    Eso solo funciona si el criterio de "terminado" está escrito antes de empezar, que es toda la lógica del libro de Spec-Driven Development: con la spec escrita, probar Qwen3.8-Max cuesta una tarde y te deja un número tuyo; sin ella, cuesta lo mismo y te deja una sensación.

    Y si tengo que resumirlo: un modelo se elige por lo que puedes comprobar tú —precio, límites reales, licencia y tu propia medición—; lo demás es la tabla de otro.

    En Dominicode Labs llevamos una hoja viva con estos cruces: qué cifra dio el fabricante, qué dio el leaderboard y qué dio nuestra propia ejecución. Qwen3.8-Max ya tiene su fila abierta.

    Preguntas frecuentes sobre Qwen3.8-Max

    ¿Qué es Qwen3.8-Max y cuándo salió?

    Es el modelo insignia que Alibaba presentó el 3 de agosto de 2026 —lo verás escrito como Qwen 3.8 Max o Qwen3.8-Max, es el mismo modelo—: arquitectura MoE, 2,4 billones de parámetros totales y entrada multimodal de texto, imagen y vídeo, con salida de texto.

    Está disponible por API alojada, y solo por ahí.

    ¿Cuánto cuesta Qwen3.8-Max por millón de tokens?

    $2,00 por millón de tokens de entrada y $6,00 por millón de salida. Las lecturas de caché implícita cuestan $0,25 por millón.

    Ese tercer precio es el que te cambia la factura si tu agente reenvía el mismo contexto en cada turno: un 87,5% menos que la tarifa de entrada.

    ¿El 86,6 de Qwen3.8-Max en Terminal-Bench 2.1 lo ha medido alguien externo?

    No. A 7 de agosto de 2026 Qwen3.8-Max no tiene ninguna entrada en el leaderboard público de tbench.ai, así que el 86,6 solo existe en el anuncio de Alibaba del 3 de agosto.

    Úsalo como hipótesis, no como criterio de compra. Lo comprobable del modelo es otra cosa: $2 y $6 por millón, 983K de entrada real con thinking y disponibilidad únicamente por API alojada.

    ¿Por qué la tabla de Alibaba da a Claude Fable 5 y a Opus 4.8 el mismo 84,6?

    Porque las cuatro filas salen de una única ejecución hecha por Alibaba, con su harness y su nivel de esfuerzo. En la medición independiente de tbench.ai esos dos modelos no empatan: Fable 5 marca 83,8 y Opus 4.8 marca 78,9, a 4,9 puntos de distancia.

    Cuando un fabricante mide a sus rivales, no solo suben los números: cambia el orden entre ellos. Ese empate artificial es la señal más clara de que la tabla no es un ranking, aunque lo parezca.

    ¿Cuántos parámetros activos tiene Qwen3.8-Max?

    No lo sé, y quien te dé una cifra con seguridad probablemente tampoco. El total confirmado es 2,4 billones de parámetros en arquitectura MoE.

    Varios agregadores repiten "95B activos", pero al menos un medio que revisó el anuncio sostiene que Alibaba no publicó ese dato, y no he podido confirmarlo en fuente primaria. Trátalo como no verificado.

    ¿Qwen3.8-Max tiene de verdad 1 millón de tokens de contexto?

    Casi. La entrada máxima real es de 991K tokens, que bajan a 983K con thinking activado. La salida máxima es de 131K en ambos modos.

    Si tu agente aprovecha la ventana entera, diséñalo contra 983K. El millón es redondeo comercial.

    ¿Qwen3.8-Max es de código abierto?

    Todavía no. Alibaba anunció pesos abiertos para la semana siguiente al lanzamiento del 3 de agosto de 2026, pero por ahora solo está disponible por API alojada.

    Hasta que los pesos existan y puedas leer su licencia, trátalo como un modelo cerrado con una promesa encima.


    Datos verificados el 7 de agosto de 2026 contra el anuncio de Alibaba y el leaderboard público de tbench.ai. Los pesos abiertos seguían sin publicarse en esa fecha.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Durante años pensé que para publicar un libro de programación necesitabas ser contratado por una gran editorial técnica, enviar propuestas durante meses y aceptar que te pagaran un miserable 8% de regalías un año después de escribirlo.

    Cuando publiqué mis primeros libros técnicos de forma autodidacta usando Markdown y los subí directamente a Amazon KDP (Kindle Direct Publishing), me di cuenta de lo equivocado que estaba.

    Publicar un libro técnico no solo te reporta ingresos pasivos mes a mes. Es la mayor carta de presentación posible para tu carrera como desarrollador: te posiciona de inmediato como un referente en tu tecnología, abre puertas para consultorías de alto valor y multiplica tu autoridad profesional.

    Si sabes programar y has resuelto problemas reales en producción, ya tienes todo lo necesario para escribir y publicar tu propio libro técnico.

    Por qué escribir un libro en la era de la IA

    Con la proliferación de contenido generado automáticamente en internet, el valor de la voz de un desarrollador senior con experiencia real ha aumentado drásticamente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, el valor del mercado ya no está en escupir código sintácticamente correcto, sino en la capacidad de estructurar sistemas, explicar decisiones de arquitectura y enseñar soluciones probadas en batalla.

    Un libro técnico bien empaquetado transmite la experiencia práctica que un desarrollador busca cuando quiere aprender un framework sin perder semanas probando tutoriales desactualizados.

    El Stack del Desarrollador Escritor

    Olvídate de Microsoft Word o Indesign. Como programadores, nuestro entorno de trabajo habitual es ideal para redactar libros técnicos:

    ┌─────────────────────────────────────────────────────────┐
    │ Redacción en Markdown (VS Code / Claude Code)           │
    │  └─► Control de versiones con Git & GitHub             │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Compilación de formatos (Pandoc / CSS / HTML)     │
    │     │  └─► Salida: PDF (Imprenta) + EPUB (Kindle)      │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Distribución Directa (Amazon KDP + Leanpub)          │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Redacción: Archivos .md organizados por capítulos en Git.
    2. Control de Código: Fragmentos de código reales probados con tests unitarios en el mismo repositorio.
    3. Formateo Automatizado: Scripts en CLI (usando Pandoc, PrinceXML o Puppeteer) para compilar el Markdown a PDF listo para impresión y EPUB para lectores digitales.

    El flujo de trabajo: De la idea a las regalías en Amazon

    1. Validación rápida (Validar antes de escribir 300 páginas)

    Antes de redactar el libro completo, escribe una tabla de contenidos detallada y publica un primer borrador o guía en plataformas como Leanpub o Gumroad. Si los primeros desarrolladores compran la versión preliminar, tienes luz verde.

    2. Estructuración pedagógica

    Un buen libro técnico no es una documentación de API traducida. Es una ruta estructurada de aprendizaje. Al igual que en nuestra metodología para formar a un equipo de desarrollo en IA en 6 semanas, debes ir de lo conceptual a lo práctico con proyectos reales paso a paso.

    3. Portada y formateo de Amazon KDP

    En Amazon KDP la portada es el 50% de la conversión. Diseña una portada limpia, con alto contraste y tipografía profesional. Asegúrate de ajustar las sangrías y márgenes de corte (bleed) según las especificaciones de Amazon si vas a ofrecer versión en papel (Paperback/Hardcover).

    4. Regalías y Estrategia de Precio

    Amazon KDP ofrece hasta un 70% de regalías en versión Kindle digital y un 60% en versión física de tapa blanda. Establecer tu precio entre $9.99 y $24.99 en digital suele ofrecer el mejor equilibrio entre volumen de ventas e ingresos netos.


    Publicar tu primer libro técnico es un proyecto de fin de semana acelerado que pagará dividendos durante años en tu carrera.

    Si te interesa profundizar en la creación de productos técnicos y modelos de ingresos para desarrolladores, explora los Cursos de Dominicode. Y si quieres rodearte de creadores y builders que están lanzando sus propias herramientas y publicaciones, únete a Dominicode Labs.

    Preguntas frecuentes

    ¿Necesito pedir ISBN antes de publicar en Amazon KDP?

    No. Amazon KDP te proporciona un código ASIN gratuito para libros digitales y un ISBN gratuito para las versiones impresas dentro de su plataforma. Si deseas vender el mismo formato físico en librerías externas, puedes comprar tu propio ISBN.

    ¿Cuánto tiempo lleva escribir un libro técnico de 150 páginas?

    Con una estructura clara y dedicando de 4 a 6 horas semanales, un desarrollador puede completar un libro técnico enfocado en 6 u 8 semanas.

    ¿Puedo usar asistentes de IA para ayudarme a redactar el libro?

    Sí, herramientas como Claude Code son excelentes para estructurar esquemas de capítulos, sugerir ejercicios prácticos y revisar la gramática de tus explicaciones. No obstante, el valor principal debe provenir de tus ejemplos de código y experiencia real.

    ¿Qué diferencia hay entre publicar en KDP e ir con una editorial como O'Reilly o Packt?

    Ir con una editorial tradicional te ofrece prestigio de marca, pero el proceso tarda entre 9 y 18 meses y solo recibes entre el 8% y el 15% de regalías. En KDP publicas de forma instantánea, mantienes el 100% de los derechos y conservas hasta el 70% de los ingresos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Por qué Spec-Driven Development (SDD) triplica tu velocidad cuando programas con agentes de IA

    Por qué Spec-Driven Development (SDD) triplica tu velocidad cuando programas con agentes de IA

    Hace unas semanas estaba viendo trabajar a un desarrollador senior con bastante experiencia. Usaba una de las mejores herramientas de IA del mercado.

    Su flujo era este: escribía un prompt en el chat ("Agrégame la autenticación con OAuth y guarda el token en cookies HTTP-only"), la IA generaba 150 líneas de código, el código fallaba, le volvía a pedir que corrigiera el error, la IA cambiaba tres archivos sin avisar, se rompía el tipo de una interfaz… y de repente llevaba dos horas haciendo el famoso "prompt ping-pong".

    Tenía la sensación de ir rapidísimo porque la IA escribía texto a toda velocidad. Pero al final de la jornada, la mitad de su tiempo lo había pasado arreglando las suposiciones que la IA había tenido que inventar porque nadie se las definía.

    El problema no era la IA. El problema es que estaba intentando construir una casa pidiéndole al albañil que pusiera ladrillos sin enseñarle los planos. Aquí es donde Spec-Driven Development (SDD) transforma la forma en que los desarrolladores senior trabajan con los agentes de IA.

    El espejismo del "Vibe Coding" sin rumbo

    Nos han vendido que programar con IA consiste en hablarle en lenguaje natural como si fuera un colega y dejar que el LLM deduzca todo lo demás.

    Para un script de 20 líneas o un prototipo que vas a tirar mañana, funciona. Para software en producción con arquitecturas reales, es una trampa.

    Cuando no defines las reglas del juego antes de pedir código, obligas al agente de IA a tomar decenas de decisiones implícitas:

    • ¿Qué nombres le da a las variables y modelos?
    • ¿Cómo maneja los casos de borde y errores?
    • ¿Qué contrato sigue la API?
    • ¿Qué dependencias o utilidades existentes en el proyecto debe reutilizar?

    Si el agente adivina mal una sola de esas cosas, el código generado es basura técnica que tendrás que mantener tú. Como explicamos en nuestro artículo sobre por qué tu spec falla con un agente de IA, la falta de claridad en las restricciones es la causa número uno de código roto.

    ¿Qué es Spec-Driven Development (SDD)?

    Spec-Driven Development no es burocracia ni escribir documentación de 50 páginas que nadie lee.

    SDD consiste en invertir el flujo de trabajo: en lugar de usar la IA para que redacte código directamente desde tu cabeza, utilizas la IA para definir una especificación estructurada y verificable ANTES de escribir la primera línea de código.

    En nuestro workflow de producción, una especificación SDD se divide en tres piezas muy concretas:

    1. spec.md (La Especificación Funcional y Técnica)

    Define el QUÉ y el POR QUÉ.

    • Contexto del problema y objetivo.
    • Requisitos funcionales explícitos.
    • Contratos de datos, tipos e interfaces.
    • Reglas de negocio y lo que NO debe hacer el sistema.

    2. plan.md (La Arquitectura e Impacto)

    Define el CÓMO.

    • Qué archivos se modifican, cuáles se crean y cuáles se eliminan.
    • Estrategia de testing y verificación.
    • Modificaciones en dependencias o firmas de API.

    3. tasks.md (El Plan de Ejecución)

    Define el ORDEN.

    • Lista de tareas atómicas e independientes que el agente de IA puede ejecutar paso a paso sin perder contexto ni alucinar.

    Eso sí, ten en cuenta que no siempre necesitas cargar con toda la estructura: en nuestra guía sobre cuándo NO usar Spec-Driven Development detallamos los escenarios donde un enfoque más directo resulta más eficiente.

    El cambio mental: De programador a Director de Arquitectura

    Mira lo que ocurre cuando le das a un agente (como Claude Code, AGY o Cursor) una especificación bien acotada:

    # Spec: Interceptor de Telemetría HTTP
    ## Requisitos
    - Interceptar todas las peticiones salientes HttpClient.
    - Añadir el header X-Correlation-ID usando un UUID v4 si no existe previamente.
    - Si la petición responde con status 401, reintentar una sola vez tras renovar el token vía AuthService.refreshToken().
    - NO interceptar peticiones hacia /api/v1/auth/login.
    
    ## Contrato
    - Firma de error devuelta: ApiErrorResponse { code: string; message: string; timestamp: number }.
    

    Cuando un agente lee este archivo antes de tocar el código:

    1. El contexto entra limpio: El LLM no necesita adivinar el nombre del header ni la estrategia de reintento.
    2. Las respuestas son deterministas: El código generado encaja al primer intento con la arquitectura de tu aplicación.
    3. El tiempo de revisión tiende a cero: En lugar de leer 300 líneas de diff intentando adivinar qué pretendía hacer la IA, solo verificas que el código cumple los puntos de la spec.

    Cómo empezar con SDD hoy mismo

    No necesitas instalar un framework complejo ni cambiar la estructura de tu empresa.

    La próxima vez que vayas a pedirle una funcionalidad a tu agente de IA, haz esto:

    1. Escribe un archivo .md rápido en tu proyecto describiendo qué quieres lograr, qué archivos se verán afectados y cuáles son los tipos/interfaces involucrados.
    2. Pásale la spec al agente y pídele: "Revisa esta especificación. Identifica ambigüedades o contradicciones antes de proponer cambios".
    3. Una vez alineados en la especificación, pídele que genere la solución siguiendo las tareas definidas.

    Te aseguro una cosa: escribir esa spec te llevará 4 minutos. Te ahorrará 45 minutos de depuración descontrolada.

    Programar rápido con IA no consiste en teclear prompts más deprisa. Consiste en pensar con claridad antes de pedir el código.


    Si quieres llevar tus habilidades al siguiente nivel, explora los Cursos de Dominicode donde profundizamos en arquitecturas modernas y herramientas de desarrollo. Además, en Dominicode Labs acompañamos a developers a construir productos reales y workflows autónomos asistidos por IA.

    Preguntas frecuentes

    ¿SDD reemplaza a TDD (Test-Driven Development)?

    No, se complementan. SDD define el contrato y las expectativas de alto nivel antes de construir, mientras que TDD asegura la corrección del código a nivel unitario durante la implementación.

    ¿Cuánto tiempo lleva escribir una especificación SDD?

    Para una tarea típica de feature, redactar una spec básica toma entre 3 y 8 minutos. Ese pequeño esfuerzo inicial ahorra habitualmente horas de refactorización y depuración.

    ¿Qué herramientas son ideales para trabajar con Spec-Driven Development?

    SDD es agnóstico a la herramienta, pero brilla especialmente con agentes CLI como Claude Code y AGY, o entornos con contexto profundo como Cursor y Windsurf.

    ¿Es necesario usar SDD para correcciones de bugs pequeñas?

    Para bugs triviales o cambios de una sola línea no es necesario crear una spec completa. SDD es más valioso en tareas que involucran múltiples archivos, lógica de negocio o contratos de interfaz.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Hace tres años, lanzar un producto de software como servicio (SaaS) requería un equipo entero. Necesitabas un desarrollador frontend, un ingeniero backend, un diseñador UI/UX, un especialista en bases de datos, un responsable de QA y un copywriter para las landing pages. Si intentabas hacerlo todo solo, tardabas 9 meses en sacar una versión alfa.

    Hoy, la combinación de stack moderno (Next.js, Supabase, Stripe) y agentes de desarrollo acelerados con IA me permite operar múltiples líneas de negocio en solitario.

    Construir micro-SaaS rentables siendo solo developer asistido por IA ya no es una fantasía de hackers de fin de semana. Es el modelo de negocio más eficiente para ingenieros senior que quieren crear independencia financiera acumulando ingresos recurrentes (MRR) sin la sobrecarga de gestionar personal.

    El cambio de paradigma: Del equipo tradicional al "Solo Builder" con IA

    Un micro-SaaS es una herramienta de software hiperenfocada que resuelve un problema específico para un nicho bien definido. No buscas levantar rondas de capital riesgo ni contratar a 50 empleados. Buscas un producto que facture entre 2,000 $ y 15,000 $ al mes con costes operativos mínimos.

    Antes de la IA, el cuello de botella del solo builder era la falta de horas en el día. Tenías que pasar de escribir código backend a configurar pipelines de CI/CD, diseñar thumbnails u redactar emails de venta.

    Con agentes de IA especializados (como Claude Code, AGY o subagentes configurados en tu entorno):

    • Delegas el formateo de componentes, la generación de tests y el código boilerplate.
    • Redactas copys persuasionales para tus páginas de captación en minutos.
    • Automatizas las tareas repetitivas de mantenimiento y atención al cliente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, la ventaja competitiva ha dejado de estar en picar código a mano y ha pasado a la capacidad de orquestar soluciones de producto completas.

    El Stack Tecnológico del Solo Developer en 2026

    Para operar un micro-SaaS sin morir en el intento, tu arquitectura debe ser ultraligera y requerir cero mantenimiento de servidores:

    ┌─────────────────────────────────────────────────────────┐
    │ Frontend & Rendering: Next.js / Astro / TailwindCSS     │
    │  └─► Desplegado en Vercel o Netlify (Cero DevOps)       │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Backend & Data: Supabase / PostgreSQL / Hono      │
    │     │  └─► Auth, DB, Edge Functions y Vector Search    │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Pagos & Facturación: Stripe / Lemon Squeezy         │
    │  │  └─► Subscripciones recurrentes y webhooks           │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Frontend: Next.js o Astro para maquetación e hidratación ultrarrápida.
    2. Base de Datos & Auth: Supabase o Neon sobre PostgreSQL. Te proporciona autenticación, base de datos relacional y storage sin gestionar servidores.
    3. Monetización: Stripe para gestionar suscripciones recurrentes, pagos en un clic y portales de clientes automáticos.
    4. Asistente de Desarrollo: Claude Code y subagentes integrados para generar tareas, refactorizar módulos y escribir especificaciones antes de codificar.

    Las 3 Reglas de Oro para Construir Micro-SaaS Rentables

    1. Valida el problema antes de escribir código

    El error número uno de los desarrolladores es encerrarse a programar durante 3 meses para descubrir que nadie quiere pagar por el producto. Crea una landing page simple, comparte la propuesta en redes o comunidades técnicas y verifica si hay intención de pago real.

    Como explicamos en nuestra guía sobre cuándo NO usar Spec-Driven Development, en fases muy tempranas de exploración debes priorizar la velocidad de aprendizaje sobre arquitecturas sobre-diseñadas.

    2. Controla los costes de tokens e infraestructura de IA

    Si tu micro-SaaS incluye funcionalidades basadas en LLMs (ej. resúmenes automáticos, asistentes RAG o generación de imágenes), diseña la arquitectura pensando en los márgenes de beneficio.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, elegir el modelo adecuado para cada tarea (usando modelos ligeros como Haiku o Flash para tareas simples y modelos avanzados para razonamiento complejo) es la diferencia entre tener un margen del 80% o perder dinero en cada registro.

    3. Automatiza la retención y el soporte desde el día 1

    Como desarrollador en solitario, tu activo más valioso es tu tiempo. Configura secuencias de onboarding por email automáticas y asistentes de soporte basados en documentación para resolver las dudas más frecuentes sin intervención manual.


    Construir micro-SaaS rentables te da la libertad de trabajar en tus propios términos, aplicando tu experiencia técnica en productos que aportan valor real a tus clientes.

    Si quieres aprender las mejores técnicas de desarrollo frontend, backend y arquitectura con IA, explora los Cursos de Dominicode. Y si quieres unirte a una comunidad privada de creadores que están construyendo y facturando con sus propios proyectos de software, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Cuánto dinero se necesita para lanzar un micro-SaaS?

    Gracias al tier gratuito de plataformas como Vercel, Supabase, GitHub y Stripe, el coste inicial de infraestructura para lanzar un micro-SaaS es prácticamente cero dólares al mes. Tus únicos gastos iniciales son el nombre de dominio (unos 10 $/año) y tu suscripción a herramientas de IA.

    ¿Cuánto tiempo lleva desarrollar un MVP (Producto Mínimo Viable)?

    Usando el stack recomendado y apoyándote en asistentes de IA para el código repetitivo, un desarrollador senior puede construir y lanzar un MVP funcional en 2 a 4 semanas trabajando a tiempo parcial.

    ¿Cómo competir contra grandes empresas siendo un solo developer?

    Tu ventaja es la agilidad y el enfoque de nicho. Una gran empresa no puede dedicar recursos a resolver un problema específico de 5,000 $ de MRR para una industria concreta. Tú puedes construir una solución a medida, ofrecer una atención cercana y adaptar el producto en horas sin pasar por comités de aprobación.

    ¿Se pueden vender estos micro-SaaS en el futuro?

    Sí. Existe un mercado secundario enorme en plataformas como Acquire.com o Flippa donde inversores compran micro-SaaS validados y rentables por múltiplos de 3x a 5x de sus ingresos anuales (ARR).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
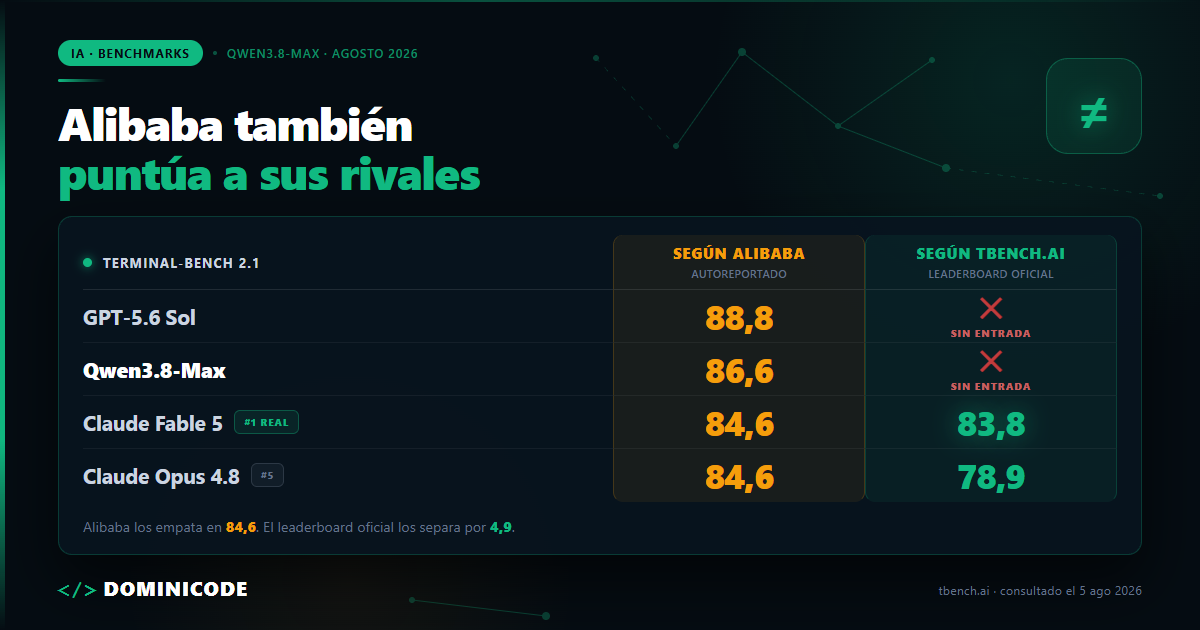
  • Pruebas unitarias ultrarrápidas con Vitest en proyectos de frontend e IA

    Pruebas unitarias ultrarrápidas con Vitest en proyectos de frontend e IA

    Hace un tiempo audité el repositorio de un proyecto en React y TypeScript que contaba con una suite de 400 pruebas unitarias en Jest. Cada vez que lanzabas npm test, tardaba 4 minutos y 15 segundos en completar la ejecución.

    Los desarrolladores habían dejado de ejecutar los tests en local. Su flujo de trabajo era hacer git push y esperar a que el servidor de integración continua (CI) les dijera 10 minutos después si habían roto algo.

    La fricción era enorme.

    Cuando reemplazamos Jest por Vitest y optimizamos el entorno de DOM con happy-dom, la misma suite de 400 tests pasó de tardar 4 minutos a completarse en 7.8 segundos.

    En la era del desarrollo acelerado con IA, tener un feedback loop de testing instantáneo no es un lujo; es el único pilar que te permite iterar rápido sin destruir producción.

    El problema de Jest en proyectos modernos (Vite / ESM)

    Jest fue el rey indiscutible de las pruebas en JavaScript durante casi una década. Sin embargo, su arquitectura arrastra decisiones de diseño pasadas:

    • Utiliza transformadores pesados en Babel/ts-jest que recompilan todo tu código TypeScript en CommonJS antes de ejecutar cada test.
    • La emulación del DOM con jsdom consume gigabytes de memoria Heap en proyectos medianos.
    • La ejecución en Watch mode rehace trabajo redundante de empaquetado.

    Vitest aprovecha la arquitectura moderna de Vite y esm.sh: usa el mismo pipeline de transformación de tu aplicación en desarrollo, comparte la configuración de alias e importaciones y aprovecha hilos de ejecución paralelos en Node.js de forma nativa.

    Configuración de Vitest para Frontend e IA

    Instalar Vitest en un proyecto moderno requiere un archivo de configuración mínimo (vitest.config.ts):

    import { defineConfig } from 'vitest/config';
    
    export default defineConfig({
      test: {
        environment: 'happy-dom', // Mucho más rápido y ligero que jsdom
        globals: true,
        setupFiles: ['./src/test/setup.ts'],
        include: ['src/**/*.{test,spec}.ts'],
        coverage: {
          provider: 'v8',
          reporter: ['text', 'json', 'html'],
        },
      },
    });
    

    Cómo mockear llamadas a Modelos de IA (LLMs) sin gastar tokens

    Cuando pruebas código que interactúa con APIs de IA (como Anthropic Claude, OpenAI o Vercel AI SDK), jamás debes realizar peticiones HTTP reales dentro de tus tests unitarios. Lanzarías la factura de tokens por las nubes y harías que tus tests sean no deterministas.

    Ejemplo de Mockeo Limpio con vi.mock()

    import { describe, it, expect, vi } from 'vitest';
    import { procesarRespuestaIA } from './ai-processor';
    
    // 1. Mockear la librería cliente de IA
    vi.mock('@anthropic-ai/sdk', () => {
      return {
        Anthropic: vi.fn().mockImplementation(() => ({
          messages: {
            create: vi.fn().mockResolvedValue({
              content: [{ type: 'text', text: 'Respuesta mockeada de prueba' }],
            }),
          },
        })),
      };
    });
    
    describe('Procesador de IA', () => {
      it('debe transformar la respuesta de la IA en una estructura válida', async () => {
        const resultado = await procesarRespuestaIA('Prompt de prueba');
        
        expect(resultado.ok).toBe(true);
        expect(resultado.texto).toBe('Respuesta mockeada de prueba');
      });
    });
    

    Al aplicar programación defensiva en TypeScript, garantizas que tus mocks cumplan exactamente con los contratos de tipos de las librerías originales.

    3 Principios para Suites de Test Ultrarrápidas

    1. Usa happy-dom en lugar de jsdom: happy-dom implementa las APIs del navegador necesarias para componentes de UI ocupando un 70% menos de memoria y ejecutando tests hasta 3 veces más rápido.
    2. Aísla las capas de tu aplicación: Separa los tests de unidades puras (funciones de dominio y utilidades) de los tests de componentes de UI. Al igual que recomendamos en nuestra guía sobre graph engineering, mantener fronteras claras evita inicializaciones innecesarias.
    3. No intentes testearlo todo: En nuestro análisis sobre cuándo NO usar Spec-Driven Development, recordamos que el objetivo de las pruebas es dar confianza en cambios de producción, no alcanzar el 100% de cobertura en código trivial sin valor de negocio.

    La velocidad de ejecución de tus pruebas unitarias determina el ritmo al que tu equipo puede innovar y refactorizar con seguridad.

    Si quieres aprender a construir pipelines de testing modernos e integraciones con IA, descubre los Cursos de Dominicode. Y si quieres colaborar en proyectos reales de alto nivel con desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Es dificil migrar una suite existente de Jest a Vitest?

    No. Vitest incluye compatibilidad casi al 100% con las APIs de Jest (describe, it, expect, jest.fn() -> vi.fn()). En la mayoría de los proyectos basta con sustituir la importación y la configuración de jest.config.js por vitest.config.ts.

    ¿Se pueden ejecutar tests de Vitest en modo Watch continuo durante el desarrollo?

    Sí. El modo Watch de Vitest es uno de sus puntos más fuertes: gracias al HMR de Vite, solo reejecuta en milisegundos los tests directamente afectados por el archivo que acabas de modificar en tu editor.

    ¿Cómo pruebo componentes que utilizan hooks o reactividad de framework?

    Vitest se integra perfectamente con @testing-library/react, @testing-library/angular o @testing-library/vue, permitiéndote probar la interacción del usuario con componentes de UI usando la misma sintaxis que ya conoces.

    ¿Vitest funciona en proyectos que no usan Vite como empaquetador principal?

    Sí. Aunque Vitest brilla especialmente en proyectos basados en Vite (como Nuxt, Astro, SvelteKit o React con Vite), puede configurarse y funcionar perfectamente en cualquier proyecto de Node.js o TypeScript independiente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.