La demo funciona, y nadie se ha parado a evaluar la búsqueda semántica. Le haces cinco preguntas, las cinco que se te ocurrieron mientras la programabas, y las cinco devuelven el documento correcto en primera posición.
En producción, un usuario escribe "rate limit de la cuenta gratuita" y recibe la página de precios. Otro pregunta qué pasa si su endpoint falla y le sale la FAQ general.
Alguien propone subir el chunk a 800 tokens porque lo leyó en un blog. Otro quiere bajar dimensions a 512 para ahorrar. Nadie sabe si eso mejora o empeora la búsqueda, porque nadie la mide. Evaluar búsqueda semántica es lo que convierte esa discusión de opiniones en una tabla.
En corto: para evaluar una búsqueda semántica necesitas un golden set (consultas reales con los documentos que deberían salir) y dos métricas: recall@k, que dice qué parte de los documentos correctos aparece entre los k primeros, y MRR, que dice en qué posición aparece. Con menos de 100 líneas de TypeScript puedes comparar chunking, modelo, dimensions y umbral de similitud con números en vez de a ojo. Para un RAG, mide recall@k con el mismo k que envías al prompt.
¿Qué es evaluar una búsqueda semántica?
Evaluar una búsqueda semántica es medir, con un conjunto fijo de consultas cuyas respuestas correctas ya conoces, cuántas veces y en qué posición tu retriever devuelve esos documentos.
Es la forma de evaluar el retrieval de un RAG por separado: no mide si el LLM responde bien, sino si le llega el contexto correcto. Si el retrieval falla, ningún prompt lo arregla.
Si todavía no tienes el motor montado, empieza por qué son los vector embeddings y cómo usarlos en TypeScript y por el motor de búsqueda semántica con LangChain.
El golden set: consultas reales y documentos esperados
El golden set es una lista de pares consulta → documentos relevantes que no cambia entre experimentos. Es tu suite de tests para la búsqueda.
Tres reglas que ahorran disgustos:
- Saca las consultas de los logs, no de tu cabeza. Tus preguntas usan el vocabulario de la documentación; las de tus usuarios, no.
- Etiqueta por documento o sección, nunca por chunk. Si guardas ids de chunk, el golden set deja de valer el día que cambias el tamaño de chunk, que es justo lo que quieres comparar.
- Valídalo al cargarlo. Un id mal escrito da un cero silencioso que parece un fallo del retriever.
// golden.ts
import { z } from "zod";

export const GoldenCase = z.object({
  id: z.string(),
  query: z.string().min(3),
  // ids de DOCUMENTO o sección: el chunk cambia al re-trocear
  relevant: z.array(z.string()).min(1),
  tags: z.array(z.string()).default([]),
});
export const GoldenSet = z.array(GoldenCase).min(1);
export type GoldenCase = z.infer<typeof GoldenCase>;
Si nunca has validado datos de entrada con schemas, el curso de Zod para TypeScript cubre este patrón de parsear en la frontera y fiarte del tipo después.
Métricas de búsqueda semántica: recall@k, MRR y nDCG
Recall@k y MRR cubren casi todo lo que necesitas para evaluar búsqueda semántica en un RAG; nDCG añade sensibilidad al orden cuando hay varios documentos relevantes.
| Métrica | Qué mide | Cuándo usarla | Qué no ve |
|---|---|---|---|
| recall@k | Fracción de documentos relevantes que aparecen en el top k | Siempre: es lo que llega al LLM | El orden dentro del top k |
| hit@k | Si al menos uno relevante está en el top k (0 o 1) | Consultas con una sola respuesta | Si faltan otros relevantes |
| MRR | Media de 1/posición del primer relevante | Cuando el primer resultado pesa más (buscador, autocompletado) | Los relevantes después del primero |
| nDCG@k | Ganancia descontada por posición, normalizada contra el orden ideal | Varios relevantes o relevancia graduada | Es menos intuitiva de explicar al equipo |
| precision@k | Fracción del top k que es relevante | Cuando meter ruido en el contexto cuesta (tokens, alucinaciones) | Penaliza k grandes aunque la respuesta esté |
El benchmark BEIR eligió nDCG@10 como métrica principal precisamente porque precision y recall ignoran el orden, y MRR y MAP solo admiten relevancia binaria (Thakur et al., 2021). Para un RAG empieza por recall@k con el mismo k que mandas al prompt, y MRR al lado.
Ojo: el recall de un vector database con HNSW o IVF compara búsqueda aproximada contra exacta. Este compara contra lo que un humano considera correcto. Y si todavía no has decidido qué índice montar, lo comparo en cómo elegir un índice vectorial para producción.
// metrics.ts
export type Ranked = string[]; // ids de documento, en orden, sin duplicados

export function recallAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
  if (relevant.size === 0) return 0;
  const hits = ranked.slice(0, k).filter((id) => relevant.has(id)).length;
  return hits / relevant.size;
}

export function hitAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
  return ranked.slice(0, k).some((id) => relevant.has(id)) ? 1 : 0;
}

export function reciprocalRank(ranked: Ranked, relevant: Set<string>, k = Infinity): number {
  const pos = ranked.slice(0, k).findIndex((id) => relevant.has(id));
  return pos === -1 ? 0 : 1 / (pos + 1);
}

// nDCG binario: ganancia 1 si el documento es relevante
export function ndcgAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
  const dcg = ranked
    .slice(0, k)
    .reduce((acc, id, i) => acc + (relevant.has(id) ? 1 / Math.log2(i + 2) : 0), 0);
  let idcg = 0;
  for (let i = 0; i < Math.min(relevant.size, k); i++) idcg += 1 / Math.log2(i + 2);
  return idcg === 0 ? 0 : dcg / idcg;
}

export const mean = (xs: number[]) => xs.reduce((a, b) => a + b, 0) / (xs.length || 1);
Cómo evaluar búsqueda semántica en TypeScript: el runner
El runner recibe cualquier retriever, lo lanza contra el golden set y devuelve las métricas medias y la lista de consultas que fallan.
No hace falta una librería para esto. Cuando Ragas se presentó en Hacker News, swyx señaló que el núcleo eran unas 8 métricas de entre 1 y 200 líneas cada una, fáciles de meter en tu propia app y mantener el control. Las de retrieval son todavía más cortas.
// evaluate.ts
import { hitAtK, mean, ndcgAtK, reciprocalRank, recallAtK } from "./metrics";
import type { GoldenCase } from "./golden";

export type Hit = { docId: string; score: number };
export type Retriever = (query: string, k: number) => Promise<Hit[]>;

// Varios chunks del mismo documento cuentan una vez, en su mejor posición
function toDocRanking(hits: Hit[]): string[] {
  const seen = new Set<string>();
  return hits.flatMap((h) => (seen.has(h.docId) ? [] : (seen.add(h.docId), [h.docId])));
}

export async function evaluate(retriever: Retriever, golden: GoldenCase[], k = 5) {
  const rows = [];
  for (const c of golden) {
    // pide k * 4 chunks; si tus documentos tienen muchos chunks, sube el multiplicador
    const ranked = toDocRanking(await retriever(c.query, k * 4)).slice(0, k);
    const rel = new Set(c.relevant);
    rows.push({
      id: c.id,
      recall: recallAtK(ranked, rel, k),
      hit: hitAtK(ranked, rel, k),
      rr: reciprocalRank(ranked, rel, k),
      ndcg: ndcgAtK(ranked, rel, k),
    });
  }
  return {
    [`recall@${k}`]: mean(rows.map((r) => r.recall)),
    [`hit@${k}`]: mean(rows.map((r) => r.hit)),
    mrr: mean(rows.map((r) => r.rr)),
    [`ndcg@${k}`]: mean(rows.map((r) => r.ndcg)),
    failures: rows.filter((r) => r.hit === 0).map((r) => r.id),
  };
}
toDocRanking deduplica por documento, y eso permite comparar chunks de 40 contra chunks de 400. La lista failures vale más que la media: es la que abres para entender qué falla.
Comparar chunking y dimensions con el mismo golden set
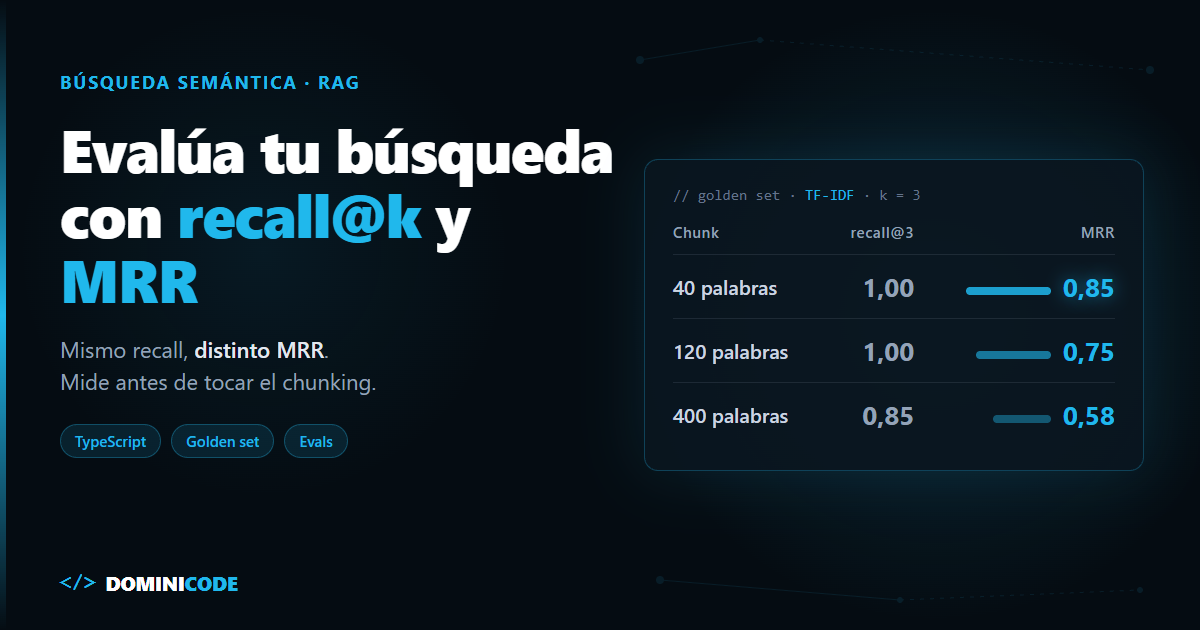
Con el runner, comparar configuraciones es un bucle. Lo ejecuté el 7 de noviembre de 2026 sobre un corpus sintético de 9 documentos y 10 consultas. Los números ilustran el método, no son un benchmark.
Primero con un retriever de juguete (TF-IDF, sin API), para probar el runner sin gastar en embeddings:
| Config (TF-IDF) | hit@1 | recall@3 | MRR (k=3) |
|---|---|---|---|
| chunk 40 palabras | 0,70 | 1,00 | 0,85 |
| chunk 120 palabras | 0,50 | 1,00 | 0,75 |
| chunk 400 palabras | 0,30 | 0,85 | 0,58 |
Fíjate en las dos primeras filas: recall@3 es idéntico y MRR no. Por eso se miran las dos.
Después, el mismo golden set contra text-embedding-3-small de OpenAI, variando chunk y dimensions:
const configs = [
  { name: "small-1536-c40", model: "text-embedding-3-small", chunkSize: 40 },
  { name: "small-512-c40", model: "text-embedding-3-small", dimensions: 512, chunkSize: 40 },
  { name: "small-1536-c400", model: "text-embedding-3-small", chunkSize: 400 },
];
for (const { name, ...opts } of configs) {
  const retriever = await buildEmbeddingRetriever(docs, opts);
  for (const k of [1, 3]) console.log(name, k, await evaluate(retriever, golden, k));
}
Las tres configuraciones dieron exactamente lo mismo: hit@1 de 0,9, recall@3 de 1 y MRR de 0,95, con la misma consulta fallando en primera posición.
Ese empate es la lección más útil del experimento. Con 10 consultas cada una mueve la media 0,1, y un corpus pequeño no separa configuraciones. Antes de concluir que 512 dimensiones "no pierde nada", necesitas un golden set que pueda perder.
buildEmbeddingRetriever es el código del post sobre vector embeddings envuelto en la firma Retriever. Si lo que falla son chunks que pierden su contexto, mide antes y después de aplicar contextual retrieval. Y si estás pensando en añadir BM25 o un reranker, este runner es lo que te dice si la búsqueda híbrida compensa en tu corpus.
Cómo elegir el umbral de similitud con datos
El umbral se elige con dos listas: consultas con respuesta (que deben superarlo) y consultas sin respuesta (que no deben).
// threshold.ts
import type { Retriever } from "./evaluate";
import type { GoldenCase } from "./golden";

export async function sweepThreshold(
  retriever: Retriever, golden: GoldenCase[], noAnswer: string[], thresholds: number[],
) {
  const answered = await Promise.all(golden.map(async (c) => {
    const hits = await retriever(c.query, 20);
    return hits.find((h) => c.relevant.includes(h.docId))?.score ?? -1;
  }));
  const unanswerable = await Promise.all(
    noAnswer.map(async (q) => (await retriever(q, 1))[0]?.score ?? -1),
  );
  return thresholds.map((t) => ({
    umbral: t,
    conserva: answered.filter((s) => s >= t).length / answered.length,
    rechaza: unanswerable.filter((s) => s < t).length / unanswerable.length,
  }));
}
Con el mismo corpus sintético, 4 consultas sin respuesta ("hay app para Android", "integración con Salesforce"…) y text-embedding-3-small:
| Umbral | Conserva respuestas | Rechaza sin respuesta |
|---|---|---|
| 0,3 | 100 % | 0 % |
| 0,4 | 90 % | 75 % |
| 0,5 | 90 % | 100 % |
| 0,6 | 30 % | 100 % |
En este corpus, 0,5 es el punto dulce, y al subir a 0,6 pasas de conservar 9 de cada 10 respuestas buenas a solo 3. Ese número no se copia: cambia con el modelo, el idioma y el vector store, como explica el post de búsqueda semántica con LangChain sobre qué significa el score. Se recalcula cada vez que cambias cualquiera de los tres.
Cuándo NO fiarte de estas métricas
Un golden set mide lo que contiene y nada más. Estos son sus límites reales:
Un golden set pequeño no distingue configuraciones. Lo acabas de ver: 10 consultas dieron un empate a tres. Empieza con 50 y apunta a cientos, con consultas difíciles y ambiguas, no solo las fáciles.
Puedes sobreajustar al golden set. En el lanzamiento de Talc AI en Hacker News, un usuario preguntaba si al afinar prompt y chunking contra un conjunto fijo de preguntas no acabas sobreajustando a ellas, y si basta un conjunto "holdout". Mi respuesta práctica: sí, separa un 20 % que no miras al afinar.
Etiquetar cuesta, y por eso nadie lo hace. En ese mismo hilo, typpo, creador de promptfoo, contaba que la pesadez de escribir tests es una de las razones por las que la gente evita los evals. Generarlas con un LLM ayuda a arrancar, pero salen con el vocabulario del documento: el caso fácil.
Las métricas offline no son satisfacción del usuario. Un recall@5 de 0,95 no garantiza una buena respuesta final. Necesitas también señales de producción: reformulaciones, clics, "no me sirvió".
Etiquetar por documento esconde chunks malos. Si sale la introducción del documento correcto, la métrica dice acierto y el LLM no tiene el dato. En documentos largos, etiqueta por sección. Y si etiquetas con un LLM como juez, revisa a mano una muestra, igual que con los evals como unit tests para LLMs.
Cómo empezar a evaluar tu búsqueda semántica esta semana
Exporta 50 consultas reales de tus logs, marca a mano el documento que debería salir y guárdalas en un JSON validado con el schema de arriba.
Después, conecta tu retriever actual al runner y apunta recall@k y MRR. Ese es tu baseline. Ningún cambio de chunking, modelo o umbral entra a producción sin bajar la lista de failures.
Para ver cómo encaja en un agente con RAG, memoria y herramientas, el ebook gratuito El Developer Agéntico (194 páginas) lo recorre de principio a fin. Y si prefieres construirlo de la idea al producto con Claude Code, eso es lo que hacemos en Construye con IA.
Preguntas frecuentes
¿Cuántas consultas necesita un golden set para evaluar búsqueda semántica?
Para detectar regresiones grandes, unas 50. Para comparar configuraciones parecidas, como 1536 frente a 512 dimensiones, cientos. Con 10 consultas cada fallo mueve la media 0,1 y, como muestra el experimento de este post, distintas configuraciones pueden empatar.
¿Qué diferencia hay entre recall@k y MRR?
Recall@k dice si los documentos relevantes están dentro de los k primeros, sin importar el orden. MRR mira la posición del primer relevante: vale 1 si está primero, 0,5 si está segundo. Dos configuraciones pueden tener el mismo recall@3 y distinto MRR.
¿Qué k uso para recall@k en un RAG?
El mismo número de chunks que mandas al prompt. Si pasas 5 fragmentos al LLM, lo que importa es recall@5: un documento en la posición 8 no le llega al modelo.
¿Puedo evaluar con Voyage AI en vez de OpenAI?
Sí. El runner solo depende de la firma Retriever. Anthropic no tiene modelo de embeddings propio y su documentación propone Voyage AI, cuyos modelos voyage-4 admiten 256, 512, 1024 o 2048 dimensiones. Usa input_type: "query" para consultas y "document" para documentos, o medirás peor de lo que es.
Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
Leave a Reply