Tag: Evals

  • Evaluar búsqueda semántica: recall@k y MRR en TypeScript

    Evaluar búsqueda semántica: recall@k y MRR en TypeScript

    La demo funciona, y nadie se ha parado a evaluar la búsqueda semántica. Le haces cinco preguntas, las cinco que se te ocurrieron mientras la programabas, y las cinco devuelven el documento correcto en primera posición.

    En producción, un usuario escribe "rate limit de la cuenta gratuita" y recibe la página de precios. Otro pregunta qué pasa si su endpoint falla y le sale la FAQ general.

    Alguien propone subir el chunk a 800 tokens porque lo leyó en un blog. Otro quiere bajar dimensions a 512 para ahorrar. Nadie sabe si eso mejora o empeora la búsqueda, porque nadie la mide. Evaluar búsqueda semántica es lo que convierte esa discusión de opiniones en una tabla.

    En corto: para evaluar una búsqueda semántica necesitas un golden set (consultas reales con los documentos que deberían salir) y dos métricas: recall@k, que dice qué parte de los documentos correctos aparece entre los k primeros, y MRR, que dice en qué posición aparece. Con menos de 100 líneas de TypeScript puedes comparar chunking, modelo, dimensions y umbral de similitud con números en vez de a ojo. Para un RAG, mide recall@k con el mismo k que envías al prompt.

    ¿Qué es evaluar una búsqueda semántica?

    Evaluar una búsqueda semántica es medir, con un conjunto fijo de consultas cuyas respuestas correctas ya conoces, cuántas veces y en qué posición tu retriever devuelve esos documentos.

    Es la forma de evaluar el retrieval de un RAG por separado: no mide si el LLM responde bien, sino si le llega el contexto correcto. Si el retrieval falla, ningún prompt lo arregla.

    Si todavía no tienes el motor montado, empieza por qué son los vector embeddings y cómo usarlos en TypeScript y por el motor de búsqueda semántica con LangChain.

    El golden set: consultas reales y documentos esperados

    El golden set es una lista de pares consulta → documentos relevantes que no cambia entre experimentos. Es tu suite de tests para la búsqueda.

    Tres reglas que ahorran disgustos:

    1. Saca las consultas de los logs, no de tu cabeza. Tus preguntas usan el vocabulario de la documentación; las de tus usuarios, no.
    2. Etiqueta por documento o sección, nunca por chunk. Si guardas ids de chunk, el golden set deja de valer el día que cambias el tamaño de chunk, que es justo lo que quieres comparar.
    3. Valídalo al cargarlo. Un id mal escrito da un cero silencioso que parece un fallo del retriever.
    // golden.ts
    import { z } from "zod";
    
    export const GoldenCase = z.object({
      id: z.string(),
      query: z.string().min(3),
      // ids de DOCUMENTO o sección: el chunk cambia al re-trocear
      relevant: z.array(z.string()).min(1),
      tags: z.array(z.string()).default([]),
    });
    export const GoldenSet = z.array(GoldenCase).min(1);
    export type GoldenCase = z.infer<typeof GoldenCase>;
    

    Si nunca has validado datos de entrada con schemas, el curso de Zod para TypeScript cubre este patrón de parsear en la frontera y fiarte del tipo después.

    Métricas de búsqueda semántica: recall@k, MRR y nDCG

    Recall@k y MRR cubren casi todo lo que necesitas para evaluar búsqueda semántica en un RAG; nDCG añade sensibilidad al orden cuando hay varios documentos relevantes.

    Métrica Qué mide Cuándo usarla Qué no ve
    recall@k Fracción de documentos relevantes que aparecen en el top k Siempre: es lo que llega al LLM El orden dentro del top k
    hit@k Si al menos uno relevante está en el top k (0 o 1) Consultas con una sola respuesta Si faltan otros relevantes
    MRR Media de 1/posición del primer relevante Cuando el primer resultado pesa más (buscador, autocompletado) Los relevantes después del primero
    nDCG@k Ganancia descontada por posición, normalizada contra el orden ideal Varios relevantes o relevancia graduada Es menos intuitiva de explicar al equipo
    precision@k Fracción del top k que es relevante Cuando meter ruido en el contexto cuesta (tokens, alucinaciones) Penaliza k grandes aunque la respuesta esté

    El benchmark BEIR eligió nDCG@10 como métrica principal precisamente porque precision y recall ignoran el orden, y MRR y MAP solo admiten relevancia binaria (Thakur et al., 2021). Para un RAG empieza por recall@k con el mismo k que mandas al prompt, y MRR al lado.

    Ojo: el recall de un vector database con HNSW o IVF compara búsqueda aproximada contra exacta. Este compara contra lo que un humano considera correcto. Y si todavía no has decidido qué índice montar, lo comparo en cómo elegir un índice vectorial para producción.

    // metrics.ts
    export type Ranked = string[]; // ids de documento, en orden, sin duplicados
    
    export function recallAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
      if (relevant.size === 0) return 0;
      const hits = ranked.slice(0, k).filter((id) => relevant.has(id)).length;
      return hits / relevant.size;
    }
    
    export function hitAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
      return ranked.slice(0, k).some((id) => relevant.has(id)) ? 1 : 0;
    }
    
    export function reciprocalRank(ranked: Ranked, relevant: Set<string>, k = Infinity): number {
      const pos = ranked.slice(0, k).findIndex((id) => relevant.has(id));
      return pos === -1 ? 0 : 1 / (pos + 1);
    }
    
    // nDCG binario: ganancia 1 si el documento es relevante
    export function ndcgAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
      const dcg = ranked
        .slice(0, k)
        .reduce((acc, id, i) => acc + (relevant.has(id) ? 1 / Math.log2(i + 2) : 0), 0);
      let idcg = 0;
      for (let i = 0; i < Math.min(relevant.size, k); i++) idcg += 1 / Math.log2(i + 2);
      return idcg === 0 ? 0 : dcg / idcg;
    }
    
    export const mean = (xs: number[]) => xs.reduce((a, b) => a + b, 0) / (xs.length || 1);
    

    Cómo evaluar búsqueda semántica en TypeScript: el runner

    El runner recibe cualquier retriever, lo lanza contra el golden set y devuelve las métricas medias y la lista de consultas que fallan.

    No hace falta una librería para esto. Cuando Ragas se presentó en Hacker News, swyx señaló que el núcleo eran unas 8 métricas de entre 1 y 200 líneas cada una, fáciles de meter en tu propia app y mantener el control. Las de retrieval son todavía más cortas.

    // evaluate.ts
    import { hitAtK, mean, ndcgAtK, reciprocalRank, recallAtK } from "./metrics";
    import type { GoldenCase } from "./golden";
    
    export type Hit = { docId: string; score: number };
    export type Retriever = (query: string, k: number) => Promise<Hit[]>;
    
    // Varios chunks del mismo documento cuentan una vez, en su mejor posición
    function toDocRanking(hits: Hit[]): string[] {
      const seen = new Set<string>();
      return hits.flatMap((h) => (seen.has(h.docId) ? [] : (seen.add(h.docId), [h.docId])));
    }
    
    export async function evaluate(retriever: Retriever, golden: GoldenCase[], k = 5) {
      const rows = [];
      for (const c of golden) {
        // pide k * 4 chunks; si tus documentos tienen muchos chunks, sube el multiplicador
        const ranked = toDocRanking(await retriever(c.query, k * 4)).slice(0, k);
        const rel = new Set(c.relevant);
        rows.push({
          id: c.id,
          recall: recallAtK(ranked, rel, k),
          hit: hitAtK(ranked, rel, k),
          rr: reciprocalRank(ranked, rel, k),
          ndcg: ndcgAtK(ranked, rel, k),
        });
      }
      return {
        [`recall@${k}`]: mean(rows.map((r) => r.recall)),
        [`hit@${k}`]: mean(rows.map((r) => r.hit)),
        mrr: mean(rows.map((r) => r.rr)),
        [`ndcg@${k}`]: mean(rows.map((r) => r.ndcg)),
        failures: rows.filter((r) => r.hit === 0).map((r) => r.id),
      };
    }
    

    toDocRanking deduplica por documento, y eso permite comparar chunks de 40 contra chunks de 400. La lista failures vale más que la media: es la que abres para entender qué falla.

    Comparar chunking y dimensions con el mismo golden set

    Con el runner, comparar configuraciones es un bucle. Lo ejecuté el 7 de noviembre de 2026 sobre un corpus sintético de 9 documentos y 10 consultas. Los números ilustran el método, no son un benchmark.

    Primero con un retriever de juguete (TF-IDF, sin API), para probar el runner sin gastar en embeddings:

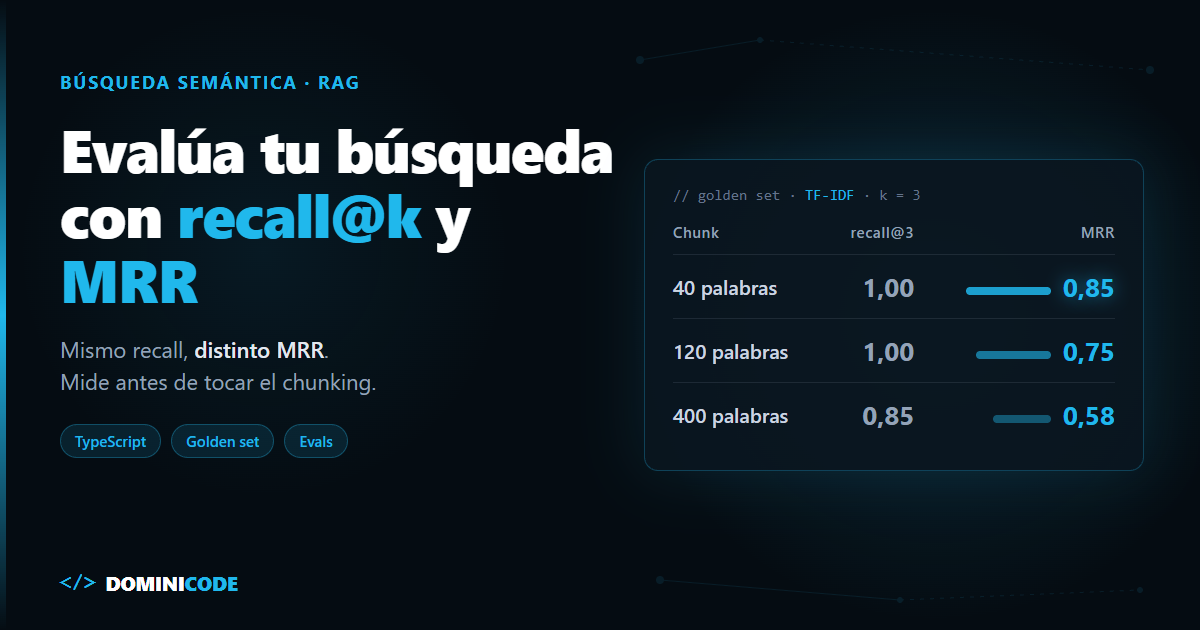
    Config (TF-IDF) hit@1 recall@3 MRR (k=3)
    chunk 40 palabras 0,70 1,00 0,85
    chunk 120 palabras 0,50 1,00 0,75
    chunk 400 palabras 0,30 0,85 0,58

    Fíjate en las dos primeras filas: recall@3 es idéntico y MRR no. Por eso se miran las dos.

    Después, el mismo golden set contra text-embedding-3-small de OpenAI, variando chunk y dimensions:

    const configs = [
      { name: "small-1536-c40", model: "text-embedding-3-small", chunkSize: 40 },
      { name: "small-512-c40", model: "text-embedding-3-small", dimensions: 512, chunkSize: 40 },
      { name: "small-1536-c400", model: "text-embedding-3-small", chunkSize: 400 },
    ];
    for (const { name, ...opts } of configs) {
      const retriever = await buildEmbeddingRetriever(docs, opts);
      for (const k of [1, 3]) console.log(name, k, await evaluate(retriever, golden, k));
    }
    

    Las tres configuraciones dieron exactamente lo mismo: hit@1 de 0,9, recall@3 de 1 y MRR de 0,95, con la misma consulta fallando en primera posición.

    Ese empate es la lección más útil del experimento. Con 10 consultas cada una mueve la media 0,1, y un corpus pequeño no separa configuraciones. Antes de concluir que 512 dimensiones "no pierde nada", necesitas un golden set que pueda perder.

    buildEmbeddingRetriever es el código del post sobre vector embeddings envuelto en la firma Retriever. Si lo que falla son chunks que pierden su contexto, mide antes y después de aplicar contextual retrieval. Y si estás pensando en añadir BM25 o un reranker, este runner es lo que te dice si la búsqueda híbrida compensa en tu corpus.

    Cómo elegir el umbral de similitud con datos

    El umbral se elige con dos listas: consultas con respuesta (que deben superarlo) y consultas sin respuesta (que no deben).

    // threshold.ts
    import type { Retriever } from "./evaluate";
    import type { GoldenCase } from "./golden";
    
    export async function sweepThreshold(
      retriever: Retriever, golden: GoldenCase[], noAnswer: string[], thresholds: number[],
    ) {
      const answered = await Promise.all(golden.map(async (c) => {
        const hits = await retriever(c.query, 20);
        return hits.find((h) => c.relevant.includes(h.docId))?.score ?? -1;
      }));
      const unanswerable = await Promise.all(
        noAnswer.map(async (q) => (await retriever(q, 1))[0]?.score ?? -1),
      );
      return thresholds.map((t) => ({
        umbral: t,
        conserva: answered.filter((s) => s >= t).length / answered.length,
        rechaza: unanswerable.filter((s) => s < t).length / unanswerable.length,
      }));
    }
    

    Con el mismo corpus sintético, 4 consultas sin respuesta ("hay app para Android", "integración con Salesforce"…) y text-embedding-3-small:

    Umbral Conserva respuestas Rechaza sin respuesta
    0,3 100 % 0 %
    0,4 90 % 75 %
    0,5 90 % 100 %
    0,6 30 % 100 %

    En este corpus, 0,5 es el punto dulce, y al subir a 0,6 pasas de conservar 9 de cada 10 respuestas buenas a solo 3. Ese número no se copia: cambia con el modelo, el idioma y el vector store, como explica el post de búsqueda semántica con LangChain sobre qué significa el score. Se recalcula cada vez que cambias cualquiera de los tres.

    Cuándo NO fiarte de estas métricas

    Un golden set mide lo que contiene y nada más. Estos son sus límites reales:

    Un golden set pequeño no distingue configuraciones. Lo acabas de ver: 10 consultas dieron un empate a tres. Empieza con 50 y apunta a cientos, con consultas difíciles y ambiguas, no solo las fáciles.

    Puedes sobreajustar al golden set. En el lanzamiento de Talc AI en Hacker News, un usuario preguntaba si al afinar prompt y chunking contra un conjunto fijo de preguntas no acabas sobreajustando a ellas, y si basta un conjunto "holdout". Mi respuesta práctica: sí, separa un 20 % que no miras al afinar.

    Etiquetar cuesta, y por eso nadie lo hace. En ese mismo hilo, typpo, creador de promptfoo, contaba que la pesadez de escribir tests es una de las razones por las que la gente evita los evals. Generarlas con un LLM ayuda a arrancar, pero salen con el vocabulario del documento: el caso fácil.

    Las métricas offline no son satisfacción del usuario. Un recall@5 de 0,95 no garantiza una buena respuesta final. Necesitas también señales de producción: reformulaciones, clics, "no me sirvió".

    Etiquetar por documento esconde chunks malos. Si sale la introducción del documento correcto, la métrica dice acierto y el LLM no tiene el dato. En documentos largos, etiqueta por sección. Y si etiquetas con un LLM como juez, revisa a mano una muestra, igual que con los evals como unit tests para LLMs.

    Cómo empezar a evaluar tu búsqueda semántica esta semana

    Exporta 50 consultas reales de tus logs, marca a mano el documento que debería salir y guárdalas en un JSON validado con el schema de arriba.
    Después, conecta tu retriever actual al runner y apunta recall@k y MRR. Ese es tu baseline. Ningún cambio de chunking, modelo o umbral entra a producción sin bajar la lista de failures.

    Para ver cómo encaja en un agente con RAG, memoria y herramientas, el ebook gratuito El Developer Agéntico (194 páginas) lo recorre de principio a fin. Y si prefieres construirlo de la idea al producto con Claude Code, eso es lo que hacemos en Construye con IA.

    Preguntas frecuentes

    ¿Cuántas consultas necesita un golden set para evaluar búsqueda semántica?

    Para detectar regresiones grandes, unas 50. Para comparar configuraciones parecidas, como 1536 frente a 512 dimensiones, cientos. Con 10 consultas cada fallo mueve la media 0,1 y, como muestra el experimento de este post, distintas configuraciones pueden empatar.

    ¿Qué diferencia hay entre recall@k y MRR?

    Recall@k dice si los documentos relevantes están dentro de los k primeros, sin importar el orden. MRR mira la posición del primer relevante: vale 1 si está primero, 0,5 si está segundo. Dos configuraciones pueden tener el mismo recall@3 y distinto MRR.

    ¿Qué k uso para recall@k en un RAG?

    El mismo número de chunks que mandas al prompt. Si pasas 5 fragmentos al LLM, lo que importa es recall@5: un documento en la posición 8 no le llega al modelo.

    ¿Puedo evaluar con Voyage AI en vez de OpenAI?

    Sí. El runner solo depende de la firma Retriever. Anthropic no tiene modelo de embeddings propio y su documentación propone Voyage AI, cuyos modelos voyage-4 admiten 256, 512, 1024 o 2048 dimensiones. Usa input_type: "query" para consultas y "document" para documentos, o medirás peor de lo que es.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Weight-space programming: GPT-6 Astra repara un Qwen a mano

    Weight-space programming: GPT-6 Astra repara un Qwen a mano

    El 2 de noviembre alguien subió a Hacker News un post de blog sobre weight-space programming con un título raro: "Astra can read and write weights to improve Qwen". Ya pasa de 2.900 puntos y casi 900 comentarios.

    Un comentario de kingstnap lo resumía así: "Friendship ended with AdamW. Astra take the wheel."

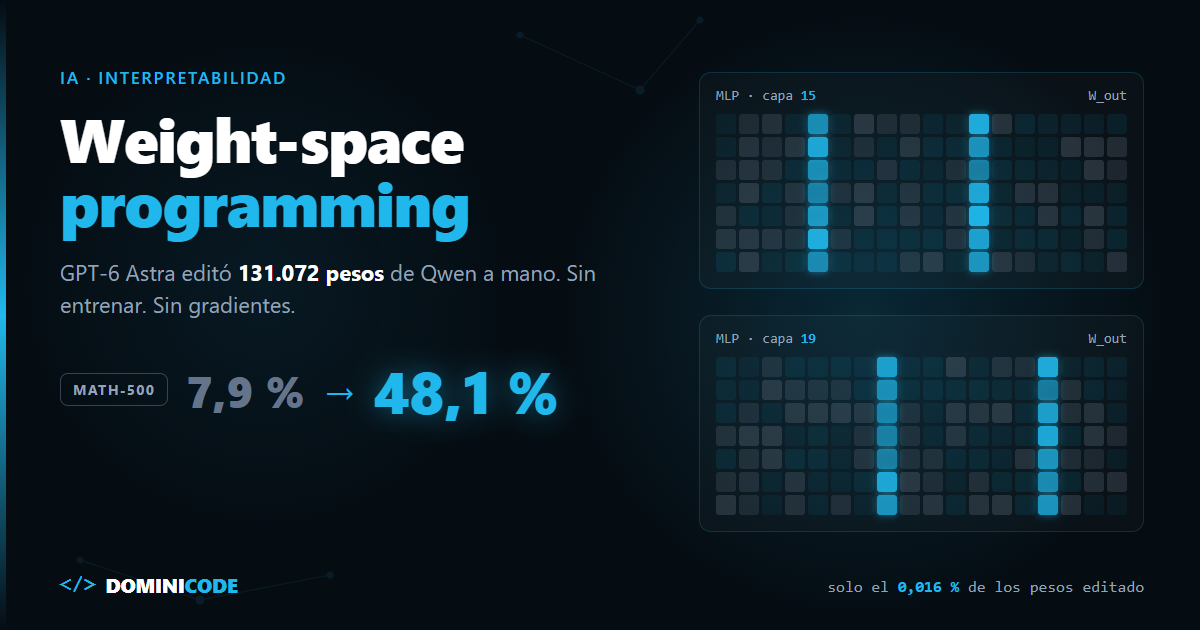
    La cifra que lo encendió todo: un modelo pequeño de Alibaba, Qwen3.5-0.8B, pasó del 7,9 % al 48,1 % en MATH-500. Sin entrenar. Sin gradientes. GPT-6 Astra miró sus pesos, encontró el fallo y cambió 131.072 números. Los autores lo llaman weight-space programming.

    Suena a magia. Yo me paré en la palabra "pesos". Porque cuando lees el experimento con calma, lo que ves no es magia. Es un bug fix.

    En corto: weight-space programming es que un LLM lea y modifique directamente los pesos de otra red neuronal, sin optimizador ni descenso de gradiente. En el experimento de MIT CSAIL, GPT-6 Astra quitó a Qwen3.5-0.8B el hábito de quedarse en bucle editando el 0,016 % de sus pesos, y eso multiplicó por seis su nota en MATH-500. No le enseñó matemáticas nuevas: le quitó el obstáculo que le impedía terminar las respuestas.

    ¿Qué es weight-space programming?

    Weight-space programming es la técnica en la que un modelo de lenguaje de propósito general lee los pesos de una red neuronal y los reescribe directamente para cambiar su comportamiento, sin entrenamiento ni información de gradientes.

    El término lo acuñan Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, los cuatro de MIT CSAIL, en el post "Sparks of Weight-Space Programming", publicado el 2 de noviembre de 2026. Ojo con un detalle: es un post de blog en la web personal de Takehi, no un paper revisado. Los propios autores lo citan como "Blog post" en su BibTeX.

    El trabajo tiene ocho experimentos numerados y uno adicional con Gemma. El de Qwen, el octavo, es el que ha corrido por todas partes, así que vamos a ese.

    Cómo editó GPT-6 Astra los pesos de Qwen3.5-0.8B

    La respuesta corta: encontró una dirección en el modelo asociada al bucle y la restó en dos capas.

    El montaje fue este. Astra tenía un kernel de Python con acceso a los pesos, sin GPU, y un presupuesto de 10, 25 o 50 pasadas forward (lotes de 64 secuencias de media). Podía ejecutar el modelo, pero no entrenarlo: "no training or gradient information is allowed". Para practicar usó problemas de los conjuntos de entrenamiento de GSM8K (7.469) y MATH (7.275). Los benchmarks de evaluación nunca los vio.

    El diagnóstico: Qwen3.5-0.8B, con el modo thinking activado, se queda dando vueltas. Repite el mismo texto hasta agotar el límite de 32.768 tokens. En la muestra inicial, 85 de 96 respuestas llegaban a ese tope.

    Astra rastreó ese bucle hasta una dirección escrita por las MLP de las capas 15 y 19. La restó de 64 columnas de salida en cada una. Total: 131.072 pesos.

    Las cuentas cuadran. El hidden size de Qwen3.5-0.8B es 1.024 según su model card, así que 64 columnas × 1.024 × 2 capas = 131.072. Y 131.072 entre unos 800 millones de parámetros da el 0,016 % que publican.

    Estos son los resultados que reportan los autores (fuente: post original, 2 de noviembre de 2026):

    Configuración MATH-500 GSM8K IFEval Respuestas que agotan tokens
    Qwen3.5-0.8B base 7,9 % 13,8 % 21,0 % 93,0 %
    Astra, 10 pasadas 12,3 % 25,7 % 49,0 % 87,2 %
    Astra, 25 pasadas 14,1 % 25,1 % 39,9 % 86,4 %
    Astra, 50 pasadas 48,1 % 67,1 % 62,3 % 33,1 %

    Fíjate en la última columna. Casi toda la mejora en matemáticas sale de ahí. Cuando el modelo deja de dar vueltas, termina la respuesta. Y cuando termina, a veces acierta.

    Weight-space programming vs fine-tuning, steering y destilación

    Lo que hace distinto al weight-space programming no es la operación matemática. Es quién la decide: un LLM que razona sobre los pesos en vez de un optimizador o un humano.

    Técnica Qué toca ¿Gradientes? Qué puede cambiar Riesgo o limitación
    Fine-tuning (LoRA, SFT, RL) Pesos, vía entrenamiento Sí Comportamiento y conocimiento nuevo Coste de GPU y datos; olvido catastrófico
    Destilación Pesos de un modelo alumno Sí Copia capacidades de un modelo mayor Necesitas el maestro y mucho cómputo
    Steering de activaciones Activaciones en inferencia No Sesga el comportamiento en tiempo real No persiste en el modelo; hay que inyectarlo en cada llamada
    Abliteration Pesos, proyectando fuera una dirección No Elimina un comportamiento (p. ej. rechazos) Lo diseña un humano; puede dañar otras capacidades
    Interpretabilidad mecanicista Nada, en principio: analiza No Explica circuitos Es caro y casi siempre manual
    Weight-space programming Pesos, editados por un LLM No Quita obstáculos de comportamiento Sin pruebas de que añada capacidades; resultado de un solo equipo

    Si ya conoces la abliteration, el truco de Qwen te va a sonar. Encontrar una dirección asociada a un comportamiento y proyectarla fuera de los pesos es lo que propusieron Arditi y otros en "Refusal in Language Models Is Mediated by a Single Direction" en 2024. Lo nuevo es que esta vez la dirección la encontró un modelo, no una persona.

    Lo que dice Hacker News: ¿avance o abliteration con mejor marketing?

    El hilo de HN se partió en dos bandos, y el escéptico tiene argumentos serios.

    El usuario theptip lo dijo sin anestesia: "This is not a new technique and doesn't shed any mechanistic understanding on how maths works." En el mismo comentario describe la parte de Qwen como una intervención de steering clásica, y varios usuarios más la compararon con la abliteration.

    Otro usuario, pama, apunta al punto de partida: "I wonder if their broken baseline run with 7.9% accuracy is a vllm or setup bug". Admite que no lo investigó a fondo, pero la pregunta es buena: un 7,9 % con el 93 % de respuestas cortadas es una línea base muy baja, y mejorar desde ahí es mucho más fácil que mejorar un modelo sano.

    Simon Willison repitió la parte de "leer sin herramientas" con Qwen 3.8 27B en local, que acertó tres de cuatro juegos a partir de los pesos de pequeñas redes. Aun así es prudente: separa leer pesos sin herramientas de editarlos con código, se queda solo con lo primero y admite que un humano con experiencia, lápiz y papel podría llegar al mismo sitio.

    Mi lectura: el resultado está bien documentado, con los logs en GitHub y el modelo editado en Hugging Face. Lo que no se sostiene es que Astra "entienda" a Qwen. Hizo lo que haría un buen investigador de interpretabilidad: hipótesis, código para medir, prueba y quedarse con lo que funciona. Rápido y sin cansarse. Eso ya es mucho.

    Límites de este enfoque

    El primero lo marca el propio post. Con Gemma 3 270M, un modelo que casi nunca entra en bucle (solo el 8,5 % de sus respuestas agota el límite), MATH-500 pasó del 6,8 % a un máximo del 7,7 %. Ninguna edición movió la nota más de un punto. Editar puede quitar un obstáculo que escondía una capacidad, pero no añade una capacidad que el modelo no tiene.

    El segundo: no hay replicación con otra configuración. Es un post de blog de un solo equipo. La única reproducción, la de Ahsen Khaliq en Hugging Face, rehace la misma edición a partir de los logs y saca un 51,0 % en MATH-500 (puedes probarla en su demo). Hasta que alguien repita el experimento con otra configuración y otra línea base, el 48,1 % es una cifra reportada por los autores, no un hecho establecido.

    El tercero: necesita pasadas forward, y bastantes. Con 10 y 25 la mejora en MATH-500 fue modesta (12,3 % y 14,1 %); el salto llegó con 50. No es "mirar los pesos y arreglarlos"; es ejecutar y evaluar, como cualquier ajuste.

    El cuarto: el post no da coste. No sabemos cuánto costaron en tokens de Astra esas 50 iteraciones frente a un LoRA corto. Sin esa cifra, decir que esto "sustituye al fine-tuning" es adelantarse.

    Y el quinto: necesitas los pesos. Solo aplica a modelos open weights. Con una API cerrada no tocas nada.

    Qué cambia el weight-space programming para quien construye con LLMs

    Hoy, en tu día a día, casi nada. En tu forma de pensar los modelos pequeños, bastante.

    Si un modelo pequeño en local se queda en bucle con el modo thinking, el problema puede no ser falta de capacidad, sino un comportamiento que la tapa. El propio model card de Qwen3.5-0.8B avisa de que, con thinking activado, es más propenso a entrar en bucle que el resto de la familia. Antes de saltar a un modelo mayor o hacer fine-tuning, revisa muestreo, límite de tokens y penalización por repetición. Y si te planteas ajustarlo, la pregunta de siempre sigue en pie: ¿RAG, fine-tuning o contexto?

    Lo que sí deja este trabajo es un patrón: diagnóstico concreto, cambio mínimo y evaluación con datos que el agente nunca vio. Es la misma disciplina que necesitas cuando un agente toca tu código: quien hace el cambio no decide si está bien. Es lo que trabajamos en Construye con IA: el agente produce y la verificación queda fuera de él.

    Sobre Astra, esto suma a la discusión de si GPT-6 Astra es AGI. Mi respuesta no cambia: es un investigador incansable con buen criterio en problemas acotados, no una mente que entiende las redes mejor que nosotros.

    Hoy puedes hacer una cosa: abre el repositorio de logs y lee cómo razonó Astra con Qwen. No por el resultado, sino por el método. Si quieres llevar ese método a tus agentes, en el ebook gratuito El Developer Agéntico tienes la arquitectura completa, de las tools a la evaluación.

    Preguntas frecuentes

    ¿Qué es weight-space programming en una frase?

    Es que un LLM de propósito general lea los pesos de otra red neuronal y los modifique directamente, sin entrenamiento ni gradientes. El término viene del post "Sparks of Weight-Space Programming" (MIT CSAIL, 2 de noviembre de 2026).

    ¿Cuántos pesos cambió GPT-6 Astra en Qwen3.5-0.8B?

    131.072, el 0,016 % del modelo: 64 columnas de salida de las MLP de las capas 15 y 19, con un hidden size de 1.024.

    ¿Weight-space programming sustituye al fine-tuning?

    No, con lo publicado hoy. En Gemma 3 270M la edición no añadió capacidades, y los autores no comparan su coste con un LoRA o un ajuste con RL.

    ¿Es lo mismo que la abliteration?

    La operación se parece mucho: proyectar fuera de los pesos una dirección asociada a un comportamiento, como en Arditi et al. (2024). La diferencia es que aquí la encontró un LLM de forma autónoma, no un investigador.

    ¿Se ha reproducido el resultado de MATH-500?

    A 4 de noviembre de 2026 no hay una réplica del método con otra configuración. Lo que sí hay es una reconstrucción: Ahsen Khaliq (Hugging Face) rehízo el modelo editado a partir de los logs publicados y volvió a evaluarlo en el MATH-500 completo, con un 51,0 %. Eso confirma que la edición se puede reproducir, no que la línea base del 7,9 % sea representativa, que es lo que se discute en Hacker News.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia, fundador de Dominicode y autor de cursos y libros sobre desarrollo con IA y agentes.

  • ¿Qwen 4 en Arena? Qué revela (y qué no) el modelo Kalmia

    ¿Qwen 4 en Arena? Qué revela (y qué no) el modelo Kalmia

    El 27 de octubre un usuario de X publicó que Kerria, un modelo anónimo de Arena, se equivocaba con tres de los cuatro tokens especiales con los que solo falla el tokenizer de Qwen. Lo ponía en la misma familia que Kalmia, otro anónimo que llevaba días en Code Arena.

    Su post pasó de 65.000 visualizaciones con el hashtag #Qwen4 puesto. Veinte minutos después, otra cuenta lo citaba como probable adelanto de la siguiente generación de Qwen. En X, el esperado Qwen 4 ya estaba ahí, escondido detrás de dos nombres de flor.

    No hay comunicado de Alibaba ni de Arena. La tensión no es si Kalmia es o no es Qwen 4. Es qué haces tú con información sin confirmar que sí puede moverte el roadmap.

    En corto: desde finales de octubre de 2026 circula en Arena un modelo anónimo llamado Kalmia que la comunidad atribuye a Qwen 4, pero ni Alibaba ni Arena lo han confirmado. Un buen puesto en Arena mide preferencia humana en conversaciones cortas, no tu caso de uso. Lo útil hoy no es migrar: es tener una eval propia y una capa de proveedor intercambiable para probar Qwen 4 el día que salga.

    Qwen 4: fecha de lanzamiento y lo que se sabe a 1 de noviembre de 2026

    Lo confirmado cabe en una frase: Qwen 4 está en entrenamiento y no tiene fecha.

    En la Apsara Conference del 22 de septiembre, el material oficial de Alibaba dijo que el modelo estaba "currently in training", sin fecha, tamaños ni licencia, según el resumen del RITS de NYU Shanghai. Yotta Labs atribuye al responsable del proyecto Qwen, Liu Dayiheng, que saldría "muy pronto". Los niveles Max, Plus, Flash y 27B salen de un post en X, no de la nota de prensa.

    Todo lo demás es rumor. Una filtración de julio apuntaba a septiembre y falló, como recoge Yotta Labs (que vende servicios de gateway).

    El rumor más reciente es del 29 de octubre. En la Apsara Conference de Ámsterdam, un asistente publicó en X que Feifei Li, CTO de Alibaba Cloud, había dicho "Qwen4 next week", es decir, entre el 2 y el 8 de noviembre. Lo recoge Pasquale Pillitteri, que deja claro que ningún canal oficial lo ha confirmado. La diapositiva proyectada ese día decía "coming soon", sin fecha.

    ¿Qué es un modelo anónimo en Arena?

    Un modelo anónimo en Arena es un modelo todavía sin lanzar que un laboratorio pone a competir en votaciones a ciegas con un nombre en clave, para recoger preferencias de usuarios reales antes de anunciarlo.

    La FAQ de Arena lo explica sin rodeos: trabajan con proveedores para que sus modelos previos al lanzamiento aparezcan en Battle mode con codenames o alias. Tú ves dos respuestas, votas cuál prefieres y luego se revelan los nombres. Los votos que emites después de la revelación no cuentan para el ranking.

    La política del leaderboard, actualizada el 1 de septiembre de 2026, añade dos detalles que importan. Cada modelo anónimo tiene su propia etiqueta única. Y la puntuación de un modelo probado en anónimo se marca como preliminar hasta que se acumulan votos nuevos tras el lanzamiento público.

    No es nuevo: según Wikipedia, GPT-5 se probó como "summit". El codename es un nombre de trabajo, no una prueba de identidad.

    Kalmia, Kibitz y Kerria: lo que dice la comunidad

    Hacia el 22 de octubre aparecieron dos modelos anónimos a la vez en Code Arena: Kalmia y Kibitz. Hamidun News, que reprocesa una nota de Jiqizhixin, recoge que en la discusión aparecen dos nombres, Qwen 4 y Kimi K3.1 de Moonshot, por estilo, forma de razonar y formato de código. Y subraya que ningún laboratorio los ha reclamado. El emparejamiento Kalmia = Qwen 4 lo pone la comunidad: @NFT_Chen lo presentó el 26 de octubre como "probable Qwen 4.0" por la huella del tokenizer.

    El mismo 22 de octubre ya había en Hacker News un enlace titulado "Kimi K3.1 vs. Qwen 4: 3D helicopter". Fíjate en eso: en cuanto aparecen los codenames, el rumor ya circula con el nombre comercial puesto.

    Luego llegó Kerria. El 27 de octubre, @NFT_Chen publicó en X una prueba de huella del tokenizer: Kerria rompía tres de los cuatro tokens especiales que solo el tokenizer de Qwen procesa mal, mientras que 52 tokens de 13 laboratorios distintos salían bien.

    El propio autor lo presenta como indicio fuerte pero no concluyente, porque otro laboratorio podría reutilizar el tokenizer de Qwen. @ItsmeAjayKV lo amplificó con un histórico de codenames que atribuye a Qwen: Kiteki (Qwen3.5), Kizen-alpha (Qwen3.6) y Korin (Qwen3.7 Max). Son atribuciones de la comunidad, no confirmaciones. Y ojo: el test de los 52 tokens se publicó para Kerria. Para Kalmia, el tuit del 26 de octubre afirma la huella sin enseñar la prueba. Y aunque los dos compartan tokenizer, eso dice "familia Qwen", no "Qwen 4".

    Y un contraejemplo útil: en julio, @Lentils80 contó que un modelo anónimo llamado "Kaleb" decía ser Claude, aunque los usuarios lo identificaban como Qwen por su forma de responder.

    ¿Cómo se identifica un modelo anónimo de Arena?

    Con cuatro señales, y no valen lo mismo: solo la huella del tokenizer se puede reproducir.

    Señal Qué aporta Fiabilidad Riesgo o limitación
    Autoidentificación ("soy Claude") Nada fiable sobre el autor Muy baja Si se entrenan con datos sintéticos de otros modelos, pueden repetir nombres ajenos. El caso Kaleb lo ilustra, aunque su autor tampoco se confirmó
    Estilo y formato Parecido con versiones anteriores Baja-media Subjetivo; dos laboratorios que destilan del mismo modelo acaban sonando igual
    Huella del tokenizer Indicio técnico reproducible Media-alta Identifica el tokenizer, no el laboratorio ni la versión. Kerria podría ser una versión intermedia o un tercero con el mismo tokenizer
    Calendario (aparece cuando se espera un lanzamiento) Contexto Baja Es justo lo que alimenta el sesgo de confirmación

    Incluso en el mejor caso, la huella te dice "familia Qwen", no "Qwen 4", y menos aún "Qwen 4 Max".

    Qué dice (y qué no) un buen puesto en el leaderboard de Arena

    Arena mide qué respuesta prefiere un humano en una comparación a ciegas. Lo convierte en ranking con el modelo Bradley-Terry, comparable al Elo del ajedrez, según su FAQ.

    Lo que sí te dice Lo que no te dice
    Qué modelo prefieren votantes anónimos en prompts cortos Cómo rinde en tu codebase, con tu contexto y tus tools
    Una tendencia agregada con muchos votos Latencia, coste por tarea ni estabilidad del endpoint
    Que el laboratorio está probando algo Que la versión que se lanza sea la misma que se votó

    Lo último no es teórico. Llama 4 Maverick quedó por encima de GPT-4o en LMArena, y la versión probada allí era distinta de la publicada, como recoge Wikipedia.

    El paper The Leaderboard Illusion (abril de 2025) contó 27 variantes privadas probadas por Meta antes de Llama 4 y estimó que Google y OpenAI recibieron el 19,2 % y el 20,4 % de los datos de Arena, frente al 29,7 % del conjunto de 83 modelos open-weight.

    En el hilo de Hacker News sobre ese paper, uno de los primeros comentarios, de pongogogo, concluye que ya no te puedes fiar de ningún benchmark público y que necesitas evals privadas. Otro, ekidd, recoge quejas de que Arena tiende a premiar las viñetas, los emojis y la adulación incluso a costa de la respuesta correcta.

    Yo estoy con pongogogo. Arena me sirve para saber qué mirar, nunca para decidir qué poner en producción. Es el mismo escepticismo que apliqué a la tabla de Qwen3.8-Max y que desarrollé en los benchmarks de IA para programar que sí importan.

    Cómo prepararte para Qwen 4 sin migrar por un rumor

    No muevas nada por Kalmia. Prepara dos piezas para que, el día que Qwen 4 salga, probarlo te cueste una tarde y no un sprint.

    La primera es una capa de proveedor intercambiable. Casi todos los proveedores exponen una API compatible con OpenAI, así que basta con que la URL y el modelo salgan de configuración:

    // providers.ts
    export type Provider = { name: string; baseURL: string; apiKey: string; model: string };
    
    export function fromEnv(prefix: string): Provider {
      const baseURL = process.env[`${prefix}_BASE_URL`] ?? '';
      const model = process.env[`${prefix}_MODEL`] ?? '';
      if (!baseURL || !model) throw new Error(`Faltan ${prefix}_BASE_URL o ${prefix}_MODEL`);
      return { name: prefix.toLowerCase(), baseURL, apiKey: process.env[`${prefix}_API_KEY`] ?? '', model };
    }
    
    export async function complete(p: Provider, prompt: string): Promise<string> {
      const res = await fetch(`${p.baseURL}/chat/completions`, {
        method: 'POST',
        headers: { 'Content-Type': 'application/json', Authorization: `Bearer ${p.apiKey}` },
        body: JSON.stringify({ model: p.model, messages: [{ role: 'user', content: prompt }], temperature: 0 }),
      });
      if (!res.ok) throw new Error(`${p.name}: HTTP ${res.status}`);
      const data = (await res.json()) as { choices: { message: { content: string | null } }[] };
      return data.choices[0]?.message.content ?? '';
    }
    

    Si no quieres gestionar una clave por proveedor, un agregador como OpenRouter te da una sola URL. Y si Qwen 4 trae un 27B con pesos abiertos, la misma interfaz te sirve contra un servidor local; antes de contar con ello, revisa qué te dan de verdad los open weights.

    La segunda pieza es una eval propia. Veinte casos sacados de tu trabajo real valen más que cualquier leaderboard. Guarda los dos archivos en un proyecto con "type": "module" y ejecútalo con npx tsx eval.ts o bun eval.ts:

    // eval.ts
    import { complete, fromEnv, type Provider } from './providers.js';
    
    type Case = { id: string; prompt: string; check: (out: string) => boolean };
    
    const cases: Case[] = [
      {
        id: 'zod-schema-usuario',
        prompt: 'Escribe solo el schema Zod de un usuario con email válido y edad entera >= 18.',
        check: (out) =>
          out.includes('z.object(') && out.includes('.email(') && out.includes('.int(') && /\.(min|gte)\(18\)/.test(out),
      },
      // ...añade casos reales de tus PR y tus incidencias
    ];
    
    async function run(p: Provider) {
      let ok = 0;
      for (const c of cases) {
        const out = await complete(p, c.prompt);
        if (c.check(out)) ok++;
        else console.log(`FALLA ${p.name} → ${c.id}`);
      }
      console.log(`${p.name}: ${ok}/${cases.length}`);
    }
    
    await run(fromEnv('ACTUAL'));
    await run(fromEnv('CANDIDATO'));
    

    El día del lanzamiento cambias tres variables de entorno y comparas. Es el mismo principio que aplicamos en el curso Construye con IA: el modelo es una pieza que se cambia, y lo que no se cambia es la especificación de qué tiene que hacer.

    Límites de este enfoque

    Una eval de veinte casos con checks por includes detecta regresiones gordas, no matices. No te dirá si un modelo razona mejor en tareas largas de agente. Para eso necesitas casos multi-paso y, a menudo, revisión humana.

    La capa intercambiable tampoco resuelve todo. Dos endpoints "compatibles con OpenAI" no se comportan igual con tool calling, structured outputs, límites de contexto ni con parámetros como temperature, que algunos modelos de razonamiento rechazan. Cambiar la URL es fácil; validar que tus tools siguen funcionando, no tanto.

    Qué hacer hoy

    Escribe los primeros diez casos de tu eval con prompts que ya hayas usado esta semana. Ese archivo vale para Qwen 4, para Kimi K3.1 y para lo que salga después.

    Si quieres llevar esa idea a todo tu flujo, en el libro Spec-Driven Development explico cómo escribir la especificación antes que el código, que es justo lo que hace que cambiar de modelo no te rompa el proyecto. Y cuando Qwen 4 salga, lo probaremos en el canal de YouTube de Dominicode con casos reales, no con votos.

    Preguntas frecuentes

    ¿Kalmia es Qwen 4?

    No está confirmado. La comunidad lo atribuye a Qwen 4 por estilo, huella del tokenizer y calendario, pero ni Alibaba ni Arena lo han dicho, y la FAQ de Arena trata los codenames como alias de modelos previos al lanzamiento, sin revelar su autor.

    ¿Cuándo sale Qwen 4?

    No hay fecha oficial a 1 de noviembre de 2026. Alibaba dijo el 22 de septiembre que estaba en entrenamiento. El 29 de octubre, un asistente a la Apsara de Ámsterdam atribuyó al CTO de Alibaba Cloud un "next week" (del 2 al 8 de noviembre), sin confirmación oficial.

    ¿Puedo usar Kalmia en mi aplicación?

    No. Los modelos anónimos aparecen en el Battle mode de Arena y no tienen API pública anunciada ni garantías. Además, la política de Arena indica que las conversaciones con modelos sin lanzar se comparten con el proveedor.

    ¿Un buen puesto en Arena significa que el modelo es mejor para programar?

    Significa que los votantes prefirieron sus respuestas en comparaciones a ciegas. Para tu caso de uso, necesitas tu propia eval con tus prompts, tu contexto, tu coste y tu latencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • System One en local: la API de Jev con Ollama y TypeScript

    System One en local: la API de Jev con Ollama y TypeScript

    En febrero de 2024 alguien abrió el issue #2415 en el repositorio de Ollama. Pedía logprobs en la API, y lo justificaba en una línea: "This feature will be helpfull for apps, that use logprobs to measure model avareness and confidence".

    Ese issue acumuló 95 comentarios y tardó 21 meses en cerrarse. El 28 de septiembre de 2026, Ollama 0.35.0 fue más lejos: sacó un endpoint /v1/systemone "based on TypeSafe's Jev API". Hoy montar un System One en local es un ollama pull nimble.

    Lee la ficha de Nimble antes de celebrarlo: "A probability of 0.9 doesn't mean the answer is right 90% of the time on your data".

    El modelo se descarga en minutos. La calibración no se descarga.

    En corto: un System One en local devuelve choice, score y noul con probabilidades sacadas de los logprobs del modelo, no del texto que escribe. Ollama ya sirve esa API con modelos abiertos como Nimble, y tú puedes construirla en TypeScript sobre cualquier modelo con logprobs. Ninguna de las dos opciones viene calibrada de serie: la mides con tus datos (Brier, ECE) y la corriges con temperature scaling.

    Si buscas si Jev es open source, está respondido en ¿Es Jev open source?. Aquí lo construimos y lo medimos.

    ¿Qué es un modelo System One?

    Un modelo System One evalúa un estado (texto o JSON) y devuelve decisiones tipadas con probabilidades, en lugar de generar texto.

    La clase la define TypeSafe, y Jev es su primer modelo. El nombre viene del Sistema 1 de Kahneman: juicio rápido e intuitivo, no razonamiento lento.

    Tiene tres primitivas. choice elige entre opciones y devuelve la distribución completa. score coloca la respuesta en una escala ordenada y devuelve legend y probabilities. noul responde sí o no, y lo que llega es un objeto, {"type":"noul","noul":0.01}, no un número suelto.

    Lo calibrado son las probabilities. El campo confidence resume lo concentrada que está la distribución, y TypeSafe lo aproxima, en su demo de tres opciones, como (3·p_max − 1)/2: sirve para enrutar, no es una probabilidad. Y la calibración se mide sobre grupos de predicciones; no garantiza que una respuesta concreta sea correcta.

    System One en local con Ollama: lo que ya existe

    Desde la 0.35.0, Ollama expone POST /v1/systemone con la misma forma de petición que Jev: state, model y questions. Es lo más parecido a un modelo tipo Jev en local. Los modelos son Nimble (9B, Bespoke Labs, Apache 2.0) y Tev1 (4B y 0.8B, Together AI); en la 0.35.1 llegaron Clef (27B) y Clef Flash (9B), de Cloudflare, y en la 0.40.4, Kev, de Jared Palmer (de 0.8B a 27B, con el runner MLX de Apple Silicon). Ojo: clef:cloud y clef-flash:cloud corren en la nube de Ollama, no en tu máquina.

    ollama pull nimble
    
    curl http://localhost:11434/v1/systemone -d '{
      "model": "nimble",
      "state": "Me cobraron dos veces la suscripción de octubre.",
      "questions": {
        "equipo": {
          "type": "choice",
          "instructions": "¿Qué equipo debe atender este ticket?",
          "criteria": { "billing": "Cobros y reembolsos", "bug": "Errores del software", "account": "Acceso y cuenta" }
        },
        "reembolso": { "type": "noul", "instructions": "¿Pide un reembolso?" }
      }
    }'
    

    Así quedan las tres vías, con los datos publicados en octubre de 2026 en las fichas de Nimble y Tev1 y en la página de modelos de TypeSafe:

    Jev (API de TypeSafe) Ollama /v1/systemone Tu System One con logprobs
    Dónde corre Servidores de TypeSafe Tu máquina Tu máquina
    Modelos jev-1.13.0 Nimble 9B, Tev1 4B/0.8B, Clef 27B, Clef Flash 9B, Kev 0.8B–27B (Apple Silicon) Cualquier modelo de Ollama con logprobs
    Precisión publicada por Bespoke Labs (13 datasets, 3.880 decisiones) 76,0 % Nimble 75,7 % · Tev1 4B 73,3 % · Tev1 0.8B 63,5 % Sin publicar: la mides tú
    Calibración de serie Entrenado para calibrar (RLCD) Sus fichas no la prometen Ninguna
    Latencia publicada "about 100 ms" de inferencia Nimble: "under 100ms" en un MacBook Pro M5 Max La mides tú
    Coste 0,042 USD por millón de tokens de entrada, salida gratis Tu hardware Tu hardware
    Privacidad El state viaja a la API No sale de tu máquina No sale de tu máquina
    Riesgo principal Límites de uso que pueden cambiar sin aviso; el inglés es su idioma fuerte Contexto corto: 8.192 tokens por pregunta en Nimble, unos 2.000 en Tev1 Sesgo de posición y opciones fuera del top 20

    La fila que más se malinterpreta es la de precisión. Que Nimble acierte casi tanto como Jev no dice si su 0,9 significa 90 %. Acierto y calibración son métricas distintas.

    Cómo saca las probabilidades un System One local

    No le pregunta al modelo cuánta confianza tiene: lee los logprobs. La confianza escrita en texto falla; Xiong et al. lo midieron: "LLMs, when verbalizing their confidence, tend to be overconfident".

    El código de Ollama muestra la técnica que usa con Nimble y Tev1. Etiqueta cada opción con una letra (de la A a la Z: hasta 26 opciones, 24 en Tev1), lee la puntuación que el modelo da a cada letra como siguiente token y normaliza con softmax. score es el valor esperado sobre los niveles. noul es la probabilidad normalizada de true. Con esos dos modelos, su confidence es uno menos la entropía normalizada; con Kev usa la misma fórmula que TypeSafe. Ninguna es una probabilidad de acierto.

    No es una idea nueva. En ese mismo issue #2415, un ingeniero de Crisp contaba: "At Crisp, we utilize log-probs with fine-tuned models for binary classification on highly complex queries".

    Construye choice, score y noul con logprobs en Ollama

    Con la API de logprobs en Ollama, disponible desde la 0.12.11, tienes un System One sobre cualquier modelo instruct. Este archivo no tiene dependencias:

    // system-one.ts — Bun o Node 18+ · Ollama >= 0.12.11
    const OLLAMA = "http://localhost:11434/api/chat";
    const MODEL = "gemma3:4b";
    const LETTERS = "ABCDEFGHIJKLMNOPQRSTUVWXYZ";
    const FLOOR = -30; // logprob para una opción que no aparece en el top 20
    
    export function softmax(logits: number[], T = 1): number[] {
      const z = logits.map((l) => l / T);
      const peak = Math.max(...z);
      const e = z.map((v) => Math.exp(v - peak));
      const sum = e.reduce((a, b) => a + b, 0);
      return e.map((v) => v / sum);
    }
    
    // Un logprob por opción, leído del primer token que genera el modelo
    export async function optionLogprobs(state: string, question: string, options: string[]) {
      const prompt = [
        state,
        `Pregunta: ${question}`,
        ...options.map((o, i) => `${LETTERS[i]}) ${o}`),
        "Responde solo con la letra de la opción.",
      ].join("\n");
    
      const res = await fetch(OLLAMA, {
        method: "POST",
        headers: { "Content-Type": "application/json" },
        body: JSON.stringify({
          model: MODEL,
          messages: [{ role: "user", content: prompt }],
          stream: false,
          logprobs: true,
          top_logprobs: 20, // máximo que acepta Ollama
          options: { temperature: 0, num_predict: 1 },
        }),
      });
      if (!res.ok) throw new Error(`Ollama ${res.status}: ${await res.text()}`);
      const data = await res.json();
      const top: { token: string; logprob: number }[] = data.logprobs?.[0]?.top_logprobs ?? [];
    
      const logits = options.map((_, i) => {
        // "A" y " A" son tokens distintos: se suman sus probabilidades
        const isLetter = new RegExp(`^\\s*${LETTERS[i]}(?![A-Za-z])`); // "A", " A", "A)"
        const p = top
          .filter((t) => isLetter.test(t.token))
          .reduce((acc, t) => acc + Math.exp(t.logprob), 0);
        return p > 0 ? Math.log(p) : FLOOR;
      });
      if (logits.every((l) => l === FLOOR)) throw new Error("El modelo no respondió con una letra");
      return logits;
    }
    
    export async function choice(state: string, question: string, criteria: Record<string, string>) {
      const keys = Object.keys(criteria);
      const logits = await optionLogprobs(state, question, keys.map((k) => `${k}: ${criteria[k]}`));
      const p = softmax(logits);
      return {
        type: "choice" as const,
        choice: keys[p.indexOf(Math.max(...p))],
        probabilities: Object.fromEntries(keys.map((k, i) => [k, p[i]])),
        logits,
      };
    }
    
    export async function score(state: string, question: string, levels: string[]) {
      const logits = await optionLogprobs(state, question, levels.map((l, i) => `nivel ${i}: ${l}`));
      const p = softmax(logits);
      return {
        type: "score" as const,
        score: p.reduce((acc, pi, i) => acc + i * pi, 0), // valor esperado
        legend: Object.fromEntries(levels.map((l, i) => [String(i), l])),
        probabilities: Object.fromEntries(p.map((pi, i) => [String(i), pi])),
        logits,
      };
    }
    
    export async function noul(state: string, question: string) {
      const logits = await optionLogprobs(state, question, ["false: no se cumple", "true: sí se cumple"]);
      return { type: "noul" as const, noul: softmax(logits)[1], logits };
    }
    

    Las opciones son letras porque cada una es un token distinto: billing y bug podrían compartir el primero. Los logits se devuelven porque la calibración trabaja sobre ellos.

    El FLOOR existe porque Ollama solo devuelve las 20 alternativas más probables. /v1/systemone no tiene ese límite: según el PR que lo introdujo, en GGUF puntúa cada candidata con una inferencia propia, y en MLX las puntúa directamente.

    Con un modelo de razonamiento, añade think: false o el primer token puede ser del razonamiento. Y valida la forma de la respuesta antes de usarla: un schema de Zod sobre el JSON de Ollama te avisa en cuanto cambie un campo.

    Cómo medir la calibración de un LLM en tu System One

    La calibración de un LLM se mide comparando lo que el modelo dice con lo que pasa, sobre casos etiquetados por ti. Bastan dos números y una tabla:

    // calibrate.ts
    import { softmax } from "./system-one";
    
    export type Sample = { logits: number[]; label: number }; // label = índice correcto
    
    // Brier multiclase: de 0 (perfecto) a 2. Menor es mejor.
    export function brier(samples: Sample[], T = 1) {
      const total = samples.reduce((acc, s) => {
        const p = softmax(s.logits, T);
        return acc + p.reduce((sum, pi, i) => sum + (pi - (i === s.label ? 1 : 0)) ** 2, 0);
      }, 0);
      return total / samples.length;
    }
    
    // Diagrama de fiabilidad + ECE: ¿acierta un 80 % lo que dice al 80 %?
    export function reliability(samples: Sample[], T = 1, bins = 10) {
      const b = Array.from({ length: bins }, () => ({ n: 0, conf: 0, hits: 0 }));
      for (const s of samples) {
        const p = softmax(s.logits, T);
        const top = Math.max(...p);
        const k = Math.min(bins - 1, Math.floor(top * bins));
        b[k].n++;
        b[k].conf += top;
        b[k].hits += p.indexOf(top) === s.label ? 1 : 0;
      }
      const ece = b.reduce(
        (acc, x) => acc + (x.n ? (x.n / samples.length) * Math.abs(x.hits / x.n - x.conf / x.n) : 0), 0);
      const table = b.map((x, i) => ({
        tramo: `${Math.round((100 * i) / bins)}-${Math.round((100 * (i + 1)) / bins)} %`,
        n: x.n,
        dice: x.n ? +(x.conf / x.n).toFixed(2) : null,
        acierta: x.n ? +(x.hits / x.n).toFixed(2) : null,
      }));
      return { ece, table };
    }
    
    // Temperature scaling: un solo parámetro T que minimiza la log-loss
    export function fitTemperature(samples: Sample[]) {
      let best = { T: 1, nll: Infinity };
      for (let i = 5; i <= 100; i++) {
        const T = i / 20; // de 0,25 a 5 en pasos de 0,05, sin error de coma flotante
        const nll = -samples.reduce((acc, s) => acc + Math.log(softmax(s.logits, T)[s.label] + 1e-12), 0);
        if (nll < best.nll) best = { T, nll };
      }
      return best.T;
    }
    

    El Brier castiga cada probabilidad mal puesta. El ECE agrupa las predicciones por tramos de confianza y mide la distancia entre lo que el modelo dice y lo que acierta. La tabla dice contra acierta es tu diagrama de fiabilidad: si está calibrado, las dos columnas se parecen.

    La corrección es temperature scaling: divides los logits entre una T antes del softmax; con T > 1 se suavizan, con T < 1 se afilan. Guo et al. lo resumen así: "temperature scaling — a single-parameter variant of Platt Scaling — is surprisingly effective at calibrating predictions". En un noul también sirven Platt o la regresión isotónica, que pide más datos.

    Lo que medirás sale de este script. Ajusta T con una mitad del set y evalúa con la otra:

    // eval.ts — bun eval.ts  (tickets.jsonl: {"state": "...", "label": "billing"} por línea)
    import { choice } from "./system-one";
    import { brier, reliability, fitTemperature, type Sample } from "./calibrate";
    
    const criteria = { billing: "Cobros y reembolsos", bug: "Errores del software", account: "Acceso y cuenta" };
    const keys = Object.keys(criteria);
    const rows: { state: string; label: string }[] = (await Bun.file("tickets.jsonl").text())
      .trim().split("\n").map((line) => JSON.parse(line));
    
    for (let i = rows.length - 1; i > 0; i--) { // Fisher–Yates
      const j = Math.floor(Math.random() * (i + 1));
      [rows[i], rows[j]] = [rows[j], rows[i]];
    }
    
    const samples: Sample[] = [];
    for (const row of rows) {
      const label = keys.indexOf(row.label);
      if (label === -1) throw new Error(`Etiqueta desconocida en tickets.jsonl: ${row.label}`);
      const a = await choice(row.state, "¿Qué etiqueta encaja con este ticket?", criteria);
      samples.push({ logits: a.logits, label });
    }
    
    const half = Math.floor(samples.length / 2);
    const [fit, test] = [samples.slice(0, half), samples.slice(half)];
    const T = fitTemperature(fit);
    
    console.log({ T, brierAntes: brier(test), brierDespues: brier(test, T) });
    console.log({ eceAntes: reliability(test).ece, eceDespues: reliability(test, T).ece });
    console.table(reliability(test, T).table);
    

    El arnés no depende de tu implementación. Para medir Nimble o Jev, cambia choice por un fetch a su API y usa keys.map((k) => Math.log(probabilities[k] + 1e-12)) como logits. Es la idea de un harness con Jev y veredicto calibrado: el activo no es el modelo, es el set que lo mide.

    Cuándo NO construir un System One en local

    Si no tienes casos etiquetados, no lo construyas. Sin set no hay Brier ni ECE, y unas probabilities sin medir son una sensación con decimales. Ahí un modelo entrenado para calibrar, como Jev, es mejor punto de partida (y también hay que medirlo).

    El sesgo de selección (de posición) es real. Zheng et al. (ICLR 2024) muestran que los modelos "prefer to select specific option IDs as answers". Mitígalo permutando el orden de las opciones y promediando, que multiplica las llamadas.

    El state es superficie de ataque. El PR que añadió /v1/systemone lo reconoce: "Nimble retains its existing prompt-injection routing failure in the task suite" (ollama#18606).

    La calibración caduca: la T vale para un modelo, un prompt y unos datos. Si cambias uno, vuelves a medir.

    Y los modelos pequeños tienen poco contexto: Tev1 trabaja con unos 2.000 tokens, y según el PR original el endpoint rechaza los prompts demasiado largos en vez de truncarlos.

    Por dónde empezar con tu System One en local

    Elige una decisión que hoy resuelves con un prompt que devuelve prosa: triaje, ruteo, detección de reembolsos. Etiqueta casos reales. Pásalos por Nimble y por tu implementación con el mismo eval.ts, y quédate con el de mejor Brier en test, no con el que más acierta.

    Si aún no tienes Ollama, empieza por modelos de IA en local con Ollama. Y si esta decisión forma parte de un agente con tools y memoria, el ebook gratuito El Developer Agéntico cubre esa arquitectura completa.

    Escribí Jev AI sobre una pregunta concreta: cuándo dejar de pedirle prosa a un modelo y pedirle una decisión tipada y calibrada. Si quieres diseñar bien preguntas, niveles y umbrales, ahí está el método entero.

    Preguntas frecuentes

    ¿Puedo ejecutar Jev en local?

    No: sus pesos no son públicos, como se explica en ¿Es Jev open source?. Lo más parecido es /v1/systemone de Ollama con Nimble, Tev1, Clef o Kev, que acepta la misma forma de petición. Sobre sus límites como modelo, lee arquitectura, capacidades y limitaciones de Jev.

    ¿Qué versión de Ollama necesito?

    Para montar un System One en local leyendo logprobs con logprobs y top_logprobs, la 0.12.11 o posterior, publicada el 12 de noviembre de 2025. Para el endpoint /v1/systemone, la 0.35.0 o posterior. Clef y Clef Flash piden la 0.35.1, y Kev, la 0.40.4 y un Mac con Apple Silicon.

    ¿Por qué no le pido al modelo que me diga su confianza?

    Porque la confianza que un modelo escribe en texto tiende a ser excesiva y no sale de ninguna distribución que puedas corregir. Los logprobs salen de la distribución real del siguiente token, se pueden normalizar sobre tus opciones y se pueden recalibrar con temperature scaling.

    ¿Qué ECE es aceptable?

    No hay un umbral universal. Compara el ECE antes y después de calibrar, y entre modelos, siempre con el mismo set de test. Mira sobre todo los tramos de confianza donde tu código actúa sin revisión humana: ahí es donde una diferencia entre "dice" y "acierta" cuesta dinero.

    ¿Funciona igual con llama.cpp, vLLM o LM Studio?

    La técnica sí, los parámetros cambian. llama-server devuelve las probabilidades del top N con n_probs en /completion. vLLM devuelve logprobs con un máximo de 20 por defecto, configurable con --max-logprobs. LM Studio añadió top_logprobs en la 0.3.39, pero en el endpoint /v1/responses.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tests E2E con IA: el agente navega, el código verifica

    Tests E2E con IA: el agente navega, el código verifica

    El viernes a las seis alguien renombra un data-testid en el botón de pagar. Nadie toca la lógica. El lunes la pipeline está en rojo: catorce tests E2E fallan por un atributo que ningún usuario ve.

    Así que pruebas lo contrario. Montas tests E2E con IA: le das el navegador a un agente y le pides "compra el teclado". Da verde. Y el pedido nunca se creó: el agente vio un spinner, lo interpretó como éxito y siguió.

    Entre esos dos fallos está la pregunta. Si dejas que el modelo decida también si el test pasa, has cambiado un test frágil por uno que no sabes si miente.

    En corto: en los tests E2E con IA el agente solo debería actuar donde el locator es frágil; la verificación tiene que seguir siendo código determinista. El framework open source e2e de Tester Army está diseñado así: graba los pasos del agente que una aserción posterior confirma y los reproduce sin llamar al modelo hasta que la app cambia. Lo crítico va con expect, no con agent.assert.

    ¿Qué son los tests E2E con IA?

    Un test E2E con IA es un test de extremo a extremo en el que un modelo de lenguaje decide las acciones (clics, formularios, navegación) a partir de un objetivo en lenguaje natural, en lugar de seguir una secuencia fija de selectores.

    La diferencia con Playwright clásico es dónde vive el conocimiento de la interfaz. En un script, en tus locators. Con un agente, en el modelo, que lee el árbol de accesibilidad en cada ejecución.

    Eso resuelve la fragilidad y abre dos problemas: coste y no determinismo.

    Cómo funciona e2e de Tester Army: intención, grabación y replay

    e2e combina pasos de agente (agent.act), aserciones semánticas y locators deterministas, y reproduce sin modelo los pasos del agente que una comprobación posterior confirmó.

    e2e es el framework open source (Apache-2.0) de Tester Army. A 15 de octubre de 2026 tiene unas 10.700 estrellas en GitHub y va por la versión 0.21.1. El README avisa: está en desarrollo hacia 1.0 y la API y la config pueden cambiar entre versiones menores.

    Un test mezcla tres tipos de paso, según la documentación de conceptos:

    Paso API ¿Llama al modelo?
    Objetivo agent.act() Sí, salvo que la caché lo reproduzca
    Aserción semántica agent.assert(), agent.waitFor(), agent.extract() Sí, nunca desde caché
    Locator screen + expect No

    La clave está en la primera fila. Según la doc de caché, cuando un agent.act() va seguido de una comprobación que pasa, el runner guarda sus acciones en .e2e/cache/. En la siguiente ejecución las repite localizando cada control por rol, nombre y test id (los mismos locators que enseño en el curso de Testing en Angular con Jest y Testing Library), y comprueba que la pantalla acaba igual. Si cuadra, termina sin modelo. Si la UI cambió, el agente retoma desde la pantalla actual.

    Fíjate en la condición: solo se graba lo que algo verificó después. Un act sin comprobación detrás queda como unconfirmed. Sin verificación no hay replay: el framework te empuja a escribirla.

    Y un test sin pasos de agente no necesita modelo. Puedes empezar con locators puros y meter agent.act() solo donde duele.

    Tutorial: tu primer test E2E con IA con npx e2e init

    Necesitas Node.js 24.8 o superior (22.22.3 en la rama 22). En Windows, dentro de WSL. En el directorio de tu app:

    npx e2e init
    

    El asistente pregunta motor (Web con Playwright o Mobile para iOS/Android) y proveedor de modelo: una suscripción, una API key o un modelo local. Hay opción None para tests sin IA. Escribe e2e.config.ts y un test de ejemplo que no llama al modelo.

    Ahora un checkout de tienda. Es un ejemplo del patrón, no un proyecto real:

    // tests/checkout.e2e.ts
    import { test } from '@e2e-dev/web';
    import { expect } from 'e2e';
    
    test('un cliente compra con la tarjeta de prueba', async ({ app, agent, screen, browser }) => {
      await app.open('/products/teclado-mecanico');
    
      // AGENTE: variantes, drawer del carrito, banners... la parte frágil
      await agent.act('add the keyboard to the cart');
      await expect(screen.getByRole('status')).toHaveText('1 item');
    
      // AGENTE: formulario de pago que UX cambia cada sprint
      await agent.act('complete checkout with the test card {card}', {
        params: { card: '4242 4242 4242 4242' },
      });
    
      // DETERMINISTA: lo que el negocio necesita que sea verdad
      await expect(browser).toHaveURL('/checkout/confirmation');
      await expect(screen.getByRole('heading', 'Order confirmed')).toBeVisible();
      await expect(screen.getByTestId('order-total')).toHaveText('89,00 €');
    
      // SEMÁNTICO: lo que no merece un locator
      await agent.assert('the page shows an estimated delivery date');
    });
    
    npx e2e run tests/checkout.e2e.ts
    

    El agente navega donde más cambia el DOM. Cada act es un objetivo atómico seguido de un expect, como pide la doc, para que el replay lo grabe. URL, título y total los comprueba código.

    Es el enfoque contrario al de agentes que diagnostican tests de Playwright ya escritos. Allí el script es la fuente de verdad y la IA interviene cuando se rompe. Aquí la intención es la fuente de verdad y el script es una grabación desechable. Coinciden en lo importante: la IA no toca los asserts.

    La trampa: agent.assert no es un assert

    agent.assert() se lee como una aserción, pero un modelo recibe la frase y un snapshot de texto de la pantalla y emite un veredicto. Puede fallar con ASSERTION_FAILED o con ASSERTION_INCONCLUSIVE si no tiene evidencia. Y nunca se reproduce desde caché: es una llamada al modelo en cada ejecución.

    Mi regla: si un bug en esa línea te cuesta dinero o un ticket de soporte, va con expect. Total, estado del pedido, URL, mensaje de error. agent.assert queda para lo difuso: que un texto generado tenga sentido, que un gráfico suba (vision: true).

    La propia doc lo dice: cuando el texto exacto importa, usa un locator.

    Playwright vs e2e vs Tester Army: comparativa de tests E2E con IA

    Playwright puro e2e (open source) Tester Army (SaaS)
    Cómo escribes el test Código con locators Locators + agent.act() Lenguaje natural, sin código
    Coste por ejecución Solo infra Modelo en la primera pasada y al cambiar la UI (en CI, solo si commiteas .e2e/cache/); asserts semánticos siempre Por runs: 99 $/mes (250) o 299 $/mes (1.000); 5 runs gratis
    Determinismo Total Total en expect y replay; agent.assert no Depende del agente
    Auth, OTP, infra Tú Tú (los Secret no llegan al modelo) Incluido: cuentas de test, OAuth, OTP
    Dónde corre Tu CI Tu CI + tu proveedor de modelo Su nube
    Límite o riesgo Selectores frágiles Pre-1.0, telemetría activa por defecto Dependes de un tercero; cifras de clientes autodeclaradas

    Sobre esa última celda: según Tester Army, Novu redujo a la mitad sus tests flaky y Juno pasó de 501 a 791 PRs mergeadas en un mes. Son casos de sus propios clientes. Señal, no benchmark.

    Lo que se discute en Hacker News

    En el Launch HN de TesterArmy (junio de 2026) un usuario lo planteó así: "E2E tests are now quick to write due to LLMs, and are then deterministic AND cheap to run". Y preguntaba cuánto cuesta en tokens tener un agente en cada test.

    Otro preguntó directamente si cacheaban los pasos para no llamar al LLM en ejecuciones posteriores. El fundador respondió que cacheaban la trayectoria del agente, pero todavía no el test completo: querían al agente en el bucle, más como un QA manual que como un script.

    El replay sin modelo de e2e es la respuesta a esa objeción, y es el argumento del Show HN de e2e de octubre. Aun así, un comentario pregunta por qué no usar Gherkin con Cucumber y que un agente escriba las step definitions.

    Cuándo NO usar tests E2E con IA

    Si necesitas una API estable. e2e está antes de 1.0. Una actualización puede cambiar las claves de la caché y obligarte a regrabar.

    Si tu CI va cargado. El issue #1144 documenta que la espera del estado final se fija al grabar: un paso grabado en una máquina tranquila puede fallar con REPLAY_STALE bajo --strict-cache al reproducirse con varios workers, aunque el estado acabe apareciendo. Hay un PR con el arreglo, el #1154, sin mergear a 15 de octubre.

    Si no controlas el coste en CI. e2e init mete .e2e/cache/ en el .gitignore y en CI la caché es de solo lectura: si no commiteas las grabaciones, cada pipeline arranca sin caché y paga modelo en cada act. Y si las commiteas, una grabación que deja de reproducirse no falla: el agente toma el paso y cada CI paga hasta que alguien la regraba. Usa --strict-cache en CI para enterarte.

    Si tus datos no pueden salir. El modelo ve el árbol de accesibilidad y capturas enmascaradas. La doc de seguridad avisa de lo que puede filtrarse: vídeos, command.log y valores no declarados como secreto. Con datos reales, modelo local o nada de agente.

    Si no has revisado la telemetría. El CLI envía uso anónimo por defecto, sin contenido de tests ni credenciales. Se desactiva con npx e2e telemetry disable o E2E_TELEMETRY_DISABLED=1.

    Por dónde empezar con tests E2E con IA

    Coge el test que más se rompe de tu suite. No el más importante: el más frágil. Sustituye solo la navegación que falla por un agent.act() y deja todos los expect como estaban. La guía de migración desde Playwright explica cómo convivir con tu suite archivo a archivo. Si en la segunda ejecución el replay pasa sin llamar al modelo, commitea .e2e/cache/ para que CI también lo reproduzca. Ahí has ganado.

    Si te preocupa qué verificar cuando el código lo escribe un agente, es el tema del workshop SDD + Agentic Engineering y de cómo verificar código generado por IA sin leerlo todo.

    Si tu app usa agentes en el navegador en producción, lee también por qué los agentes de IA en el navegador se rompen.

    Preguntas frecuentes

    ¿Qué diferencia hay entre agent.act y agent.assert?

    agent.act ejecuta un objetivo, y sus acciones se reproducen sin modelo si una comprobación posterior pasó. agent.assert juzga la pantalla con un modelo en cada ejecución. El primero ahorra mantenimiento; el segundo añade coste y no determinismo.

    ¿Los tests E2E con IA necesitan un modelo en cada ejecución?

    No en e2e. Los pasos act verificados se reproducen desde la caché mientras la app no cambie (en CI, solo si commiteas la carpeta .e2e/cache/), y los tests sin pasos de agente no usan modelo. Las aserciones semánticas sí lo llaman siempre.

    ¿e2e sustituye a Playwright?

    No. Su motor web, @e2e-dev/web, usa Playwright con Chromium, Firefox y WebKit. Añade encima objetivos en lenguaje natural, caché de replay y aserciones semánticas.

    ¿Puedo usar e2e con un modelo local?

    Sí. Admite suscripciones, API keys vía AI SDK y endpoints compatibles con OpenAI, incluidos servidores locales. Es la opción si no quieres que el árbol de accesibilidad salga hacia un proveedor externo.

    ¿Qué es Tester Army y en qué se diferencia de e2e?

    Tester Army es la plataforma SaaS: tests en lenguaje natural sin código, cuentas de test con OAuth y OTP, ejecución en PRs y por calendario, alertas en Slack y MCP para Claude Code, Codex y Cursor. e2e es el framework open source que corre en tu repo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude plugin eval: testea tus skills antes de compartirlas

    Claude plugin eval: testea tus skills antes de compartirlas

    Escribes una skill que genera mensajes de commit. La pruebas en tu sesión, funciona a la primera y la metes en un plugin para el equipo.

    Una semana después nadie la usa. Claude no la invoca cuando alguien escribe "hazme el commit de esto". En tu máquina sí se disparaba, pero en tu máquina también estaban tu CLAUDE.md, tus otras skills y la conversación donde la escribiste.

    Eso no era un test. Era una demo. Y claude plugin eval existe justo para separar las dos cosas.

    En corto: claude plugin eval ejecuta tu plugin contra una suite de casos en sesiones aisladas, tres veces con el plugin y tres sin él, y puntúa cada ejecución con graders. Te dice si la skill se dispara, si el resultado es correcto y cuánto aporta frente a no tenerla. Con --json y --threshold se convierte en un gate de CI.

    ¿Qué es claude plugin eval?

    claude plugin eval es el comando de Claude Code que ejecuta un plugin contra una suite de casos de prueba (un prompt realista más uno o varios graders de aprobado/suspenso) y devuelve una puntuación comparada contra una ejecución sin el plugin.

    Llegó en Claude Code v2.1.269, publicada el 11 de septiembre de 2026, según el changelog oficial. La referencia está en la guía de evals de plugins (consultada en octubre de 2026). Pide también Git 2.31 o superior si tienes git instalado.

    El marco general de por qué evaluar skills ya lo cubrimos en cómo evaluar habilidades de agentes de IA. Este post va del comando: archivos, flags, salida y CI.

    Cómo se escribe una suite de claude plugin eval

    Una suite vive en evals/ dentro del plugin. Cada caso es un directorio con un prompt.md y al menos un grader en graders/. Sin grader, el caso no carga.

    commit-helper/
    ├── .claude-plugin/plugin.json
    ├── skills/commit-message/SKILL.md
    └── evals/
        ├── rename-function/
        │   ├── prompt.md
        │   └── graders/
        │       ├── skill-fired.md
        │       ├── conventional.md
        │       └── criteria.md
        └── results/          # lo escribe cada ejecución; va a .gitignore
    

    No tienes que escribirlo a mano. claude plugin eval init lee tu plugin, te pregunta qué es un buen resultado, propone casos y graders, los prueba una vez y escribe los archivos. Para una plantilla vacía: claude plugin eval init --bare rename-function.

    Ejemplo mínimo: una skill de mensajes de commit

    El prompt.md es el ejemplo de la documentación oficial, que también usa una skill de commits. El cuerpo es lo que escribiría un usuario, sin nombrar la skill:

    ---
    max_turns: 10
    allowed_tools: [Read, Glob, Grep, Skill]
    ---
    
    Write me a commit message for this change: I renamed getUser to fetchUser and updated the three call sites.
    

    Primer grader, skill-fired.md: ¿se disparó tu skill?

    ---
    type: tool_used
    tool: Skill
    input_match: '"skill"\s*:\s*"(?:[\w-]+:)?commit-message"'
    ---
    

    Segundo grader, conventional.md: el formato, con una regex que no cuesta nada. Supone que tu skill impone Conventional Commits y que un renombrado es un refactor (con ! si rompe compatibilidad).

    ---
    type: regex
    pattern: '(^|\n)refactor(\([\w-]+\))?!?: '
    target: last_message
    ---
    

    Tercer grader, criteria.md: el contenido, juzgado por un segundo modelo.

    ---
    type: llm
    ---
    
    PASS if the commit subject mentions renaming getUser to fetchUser.
    FAIL if the subject is generic, such as "update code", or omits the new name.
    

    Añade un segundo caso con una petición que no debe disparar la skill y un grader tool_used con min: 0, max: 0 y arm: both. Una skill que se dispara siempre es tan mala como una que no se dispara nunca.

    Cómo puntúan los evals de plugins: graders, baseline y Δ

    Cada caso se ejecuta tres veces por defecto. La puntuación de una ejecución es la fracción de graders aprobados (ponderada si usas weight); la del caso, la media. Pasa si llega al --threshold, que por defecto es 1.0.

    La clave es el baseline sin plugin. Obtienes WITH, W/OUT y su diferencia, Δ. En el ejemplo de la guía oficial, un caso saca 1.00 con el plugin y 0.33 sin él: Δ de +0.67. Si un caso saca 1.0 con y sin plugin, tu plugin no es lo que lo hace pasar.

    Tipo de grader Qué comprueba Coste extra
    regex Regex de JavaScript sobre el mensaje final, la traza o un archivo Ninguno
    tool_used Si se llamó a una tool, con min/max Ninguno
    tool_order Que una tool se llamó antes que otra Ninguno
    file_exists Que Claude creó un archivo que encaja con un glob Ninguno
    llm Un modelo juez vota PASS en al menos 2 de 3 votos Llamadas al juez
    baseline Que el resultado cumple los criterios al menos tan bien como una transcripción de referencia Llamadas al juez

    No hay graders con código propio. Y los tool_used sobre Skill no puntúan en el modo de dos brazos, porque sin plugin nunca pasarían e inflarían la Δ: salen como indicador.

    El sandbox: qué ve la skill durante el eval

    Cada ejecución arranca un claude -p hijo con home, directorio de trabajo y configuración temporales. Solo se carga tu plugin: tu CLAUDE.md, tus settings, tus hooks, tus MCP y tus otras skills no existen ahí.

    Bash, Write, Edit, WebFetch y WebSearch desaparecen salvo que los concedas con --allow-tools, y Bash corre bajo el sandbox del sistema operativo. Los servidores MCP reales no arrancan por defecto: se sustituyen por mocks en evals/mocks/<server>/<tool>.md. Y el agente no puede leer el directorio de evals, así que no ve los graders.

    El reporte JSON y el gate de CI

    Cada vez que lanzas el comando se escribe aggregate-result.json y un report.html autocontenido en evals/results/<timestamp>/. El JSON lleva schemaVersion: 1. Lo que suele leer un script de CI: aggregates.overallScore, aggregates.casesPassed, aggregates.meanDelta, partial y costUsd.

    El comando que propone la doc para CI:

    claude plugin eval . \
      --trust-plugin \
      --json results.json \
      --threshold 0.8 \
      --model claude-sonnet-5 \
      --judge-model claude-haiku-4-5 \
      --no-publish \
      --max-cost-usd 20
    

    --trust-plugin evita que el job se bloquee en el aviso de confianza. Fijar --model impide que un cambio de modelo parezca una regresión de tu plugin. El exit code hace el resto: 0 si todo supera el umbral, 1 si algún caso queda por debajo o no carga, 2 si se cortó por coste o credenciales. El runner necesita Claude Code instalado y credenciales como ANTHROPIC_API_KEY.

    Ojo: la Δ nunca cambia el exit code. Si quieres fallar cuando el plugin no aporta nada, léela del JSON:

    jq -e '.partial != true and .aggregates.meanDelta > 0' results.json
    

    Evals de plugins frente a probar a mano, skill-creator o un harness propio

    Criterio Probar a mano claude plugin eval skill-creator Harness propio
    Aislamiento Ninguno: tu contexto contamina Sesión limpia por ejecución Dentro de tu conversación El que construyas
    Baseline sin skill No Sí, automático Sí Si lo programas
    CI No Exit codes y JSON versionado No es su objetivo Sí, con trabajo
    Límite o riesgo Te engaña: "a mí me funciona" Solo plugins; cada ejecución es una llamada facturada Su evals.json no es compatible con plugin eval Mantenimiento y graders que nadie revisa

    Mi opinión: si la skill sale de tu máquina, en un plugin para tu equipo o un marketplace, el eval es el mínimo. Probar a mano solo demuestra que funciona con tu contexto, y ese contexto es justo lo que no viaja.

    Para skills personales, skill-creator basta. Si aún no has escrito la primera, empieza por cómo crear una skill con Claude Code que tu agente realmente use.

    ¿Y /skill-doctor?

    Existe, pero mide otra cosa. /skill-doctor (v2.1.252 o superior) enseña cuánto contexto consume cada skill y con qué frecuencia se usa, para decidir cuáles apagar. No ejecuta casos. Úsalo después de compartir, para ver si alguien la usa de verdad.

    Límites del comando

    Cuesta dinero real. Cada ejecución y cada grader llm es una llamada a tu cuenta. Un caso son seis ejecuciones por defecto, más tres llamadas al juez por grader llm en cada una. Como referencia, la salida de ejemplo de la documentación muestra un caso de seis ejecuciones con 74 s y 0,41 $ estimados a precio de lista. Pon siempre --max-cost-usd y usa --ablation none mientras iteras.

    En Windows nativo, las suites que conceden Bash no corren. No hay backend de sandbox y Claude Code rechaza cada run que concede Bash o PowerShell, así que esas suites van por WSL2. En Linux necesitas bubblewrap y socat.

    Es nuevo y tiene aristas abiertas. El issue #99246 de anthropics/claude-code reporta que el eval no carga las dependencies de plugin.json, así que el plugin no carga y los casos se puntúan sobre el modelo sin plugin. El issue #96121 describe que los agentes del propio plugin (agents/*.md) no se registran en el sandbox, aunque la doc actual dice que sí se cargan. Ambos seguían abiertos el 9 de octubre de 2026; si tu skill lanza agentes propios, compruébalo con --keep-temp antes de fiarte del score.

    Pasar no significa que sea seguro. El aislamiento limita al agente, no al código del plugin: hooks y servidores MCP reales corren fuera del sandbox. Y si usas una suscripción de claude.ai con artifacts, el reporte se publica como artifact privado salvo que pases --no-publish; con API key se queda en local. En un repo privado, ponlo de todas formas.

    Qué hacer hoy con tu skill

    Mete tu skill más usada en un plugin y ejecuta claude plugin eval init desde su raíz. Después lanza claude plugin eval . --runs 1 --ablation none y mira una sola cosa: si el grader tool_used: Skill pasa. Según la guía oficial, es el hallazgo más habitual en la primera ejecución: Δ cercano a cero con ese grader en rojo. Casi siempre se arregla en la description de la skill, no en sus instrucciones.

    Si quieres el flujo completo de especificar, construir y verificar con Claude Code, es lo que hacemos en el curso Construye con IA. Y para montar el harness alrededor del código que genera la IA, el Workshop SDD + Agentic Engineering va justo de eso.

    Preguntas frecuentes

    ¿Qué versión de Claude Code necesito para claude plugin eval?

    La v2.1.269 o posterior, y Git 2.31 o superior si tienes git instalado. Si ves el mensaje de que el comando está en early access, tu build es anterior: ejecuta claude update.

    ¿Puedo evaluar una skill de Claude Code que no está en un plugin?

    Necesitas un directorio con plugin.json o .claude-plugin/plugin.json, o un plugin de tipo skills-directory. Para skills personales o de proyecto, la doc propone compararlas desactivándolas con skillOverrides o usar el plugin skill-creator.

    ¿Son compatibles los evals de skill-creator con plugin eval?

    No. skill-creator usa evals/evals.json y el comando usa directorios con prompt.md y graders/. Ninguna de las dos herramientas lee los casos de la otra.

    ¿Por qué el comando sale con código 1 si los resultados parecen buenos?

    Porque el --threshold por defecto es 1.0, y cualquier caso por debajo de la puntuación perfecta hace salir con 1. Fija un umbral realista, como 0.8. El código 1 también cubre un caso que no carga, que se reporta en stderr.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
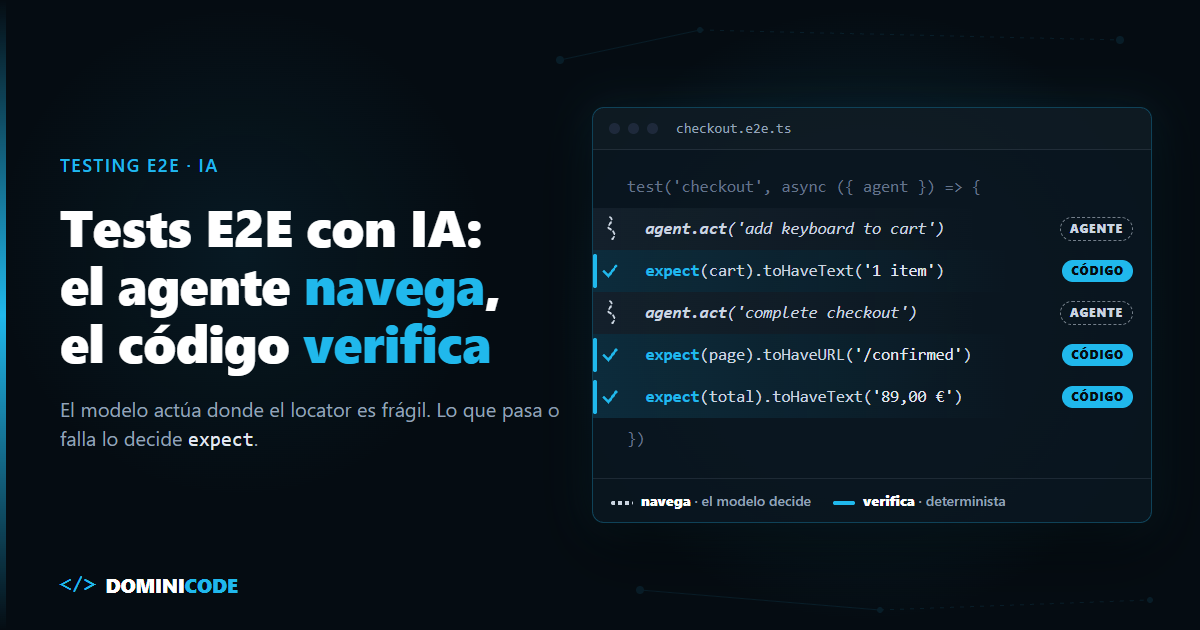
  • Los benchmarks de IA para programar que sí importan en 2026

    Los benchmarks de IA para programar que sí importan en 2026

    Hace tres días salió Claude Opus 5.5. Antes de que terminara el día tenía cinco mensajes distintos preguntándome lo mismo: ¿es el mejor para programar ahora?

    Mi respuesta debería haber sido fácil. No lo fue.

    El problema no es falta de datos. La mayoría de los benchmarks de IA para programar que circulan hoy no miden lo que dicen medir. Hace unas semanas expliqué por qué el 96% de SWE-bench Verified es ruido — contaminación de datos, tests rotos, un puñado de repos repetidos hasta el cansancio. Si no lo leíste, el resumen cabe en una frase: ese número no predice si el modelo te sirve a ti.

    Eso deja una pregunta sin responder, y me la hicieron cinco veces esta semana: vale, ¿pero entonces qué SÍ miro? No es solo "el coste por tarea" — de eso ya hablé aparte. Es más concreto que eso.

    En corto: los benchmarks de IA para programar que importan en 2026 son los que resisten la contaminación con datasets privados o rotativos, miden tareas multi-paso sobre entornos reales — no snippets sueltos — y reportan tasa de éxito junto al coste por tarea. Terminal-Bench, el subset privado de SWE-bench Pro, el time-horizon de METR y las arenas con voto humano cumplen esas condiciones mejor que cualquier leaderboard de un solo número. Pero la señal más fiable no la publica ningún laboratorio: es el eval que montas tú mismo sobre tickets ya cerrados de tu propio repo.

    ¿Qué es un benchmark de IA para programar?

    Un benchmark de IA para programar es un conjunto fijo de tareas de código con un criterio de éxito objetivo — tests que pasan, un PR que mergea sin romper nada — que se usa para comparar modelos o herramientas de forma reproducible.

    Esa definición esconde la trampa: "reproducible" no significa "representativo". Puedes sacar un resultado perfecto en 500 tareas de Django y que eso no prediga nada sobre tu backend en Go o tu monorepo de TypeScript.

    Los benchmarks fallan por tres motivos: el dataset se filtra al entrenamiento de la siguiente generación de modelos, las tareas son demasiado pequeñas para parecerse a trabajo real, y casi ninguno reporta el coste de llegar al resultado. Arreglar esos tres puntos separa un benchmark útil de uno decorativo.

    Las señales que sí predicen algo en 2026

    Datasets que se resisten a la contaminación

    SWE-bench Pro nació para resolver el problema de memorización. Su subset público usa código con licencia copyleft (GPL) precisamente porque esa licencia "viral" hace improbable que entre en datasets de entrenamiento — pero sigue siendo código técnicamente indexable.

    La parte que sí es genuinamente invisible para cualquier modelo es el subset privado, hecho con codebases 100% propietarios de 18 startups que nunca salieron de la infraestructura interna de Scale. Ahí es donde cae el rendimiento en serio: Claude Opus 4.1 pasa de 22,7% a 17,8% de resolución, y GPT-5 de 23,1% a 14,9%, según los datos publicados por Scale AI. Esa caída — y no el número público — es la que te dice cuánto del "96%" original era memoria y cuánto era capacidad real.

    Evals multi-paso sobre entornos reales: Terminal-Bench

    Terminal-Bench no pide generar una función: pide operar una terminal completa — instalar dependencias, compilar en varios lenguajes, depurar un fallo del sistema y verificar que el resultado final funciona de punta a punta. Se parece mucho más a un día de trabajo real que resolver un issue de una línea.

    En la versión 4.0, GPT-6 Astra lidera con 58,2%, Claude Fable 5.1 queda a 0,3 puntos con 57,9%, y GLM-5.3 se queda en 41,8% — cifras del leaderboard de septiembre de 2026. Lo interesante no es quién gana: según los mismos datos, Opus 5.5 iguala a GPT-6 Astra por cerca del 40% del coste por tarea — el mismo argumento de coste que desarrollé en el post sobre agentic systems. Medir tareas de terminal completas es más honesto que medir un parche aislado, porque obliga al modelo a manejar el mismo desorden que un desarrollador maneja todos los días.

    El eval con feedback real: Aider Polyglot

    Aider Polyglot evalúa 225 ejercicios de Exercism en seis lenguajes con dos intentos: en el segundo, el modelo recibe el error real de los tests que falló en el primero. Mide algo que casi ningún benchmark mide — si el modelo sabe iterar con feedback, que es como trabajas tú con un agente en el día a día.

    GPT-5 lidera con 0,880 sobre casi 60 modelos evaluados. Lo que vale la pena mirar no es el primer puesto, sino la distancia entre el primer y el segundo intento: ahí ves si un modelo corrige su error o lo repite.

    La curva, no la foto: el time-horizon de METR

    METR no compara modelos entre sí: mide la duración de tarea (en tiempo humano) que un modelo resuelve con 50% de éxito, y sigue esa cifra en el tiempo. Según su modelo, en 2024-2025 esa duración se dobló cada 4 meses, frente al ritmo de 7 meses que se mantuvo entre 2019 y 2025.

    Este benchmark no te dice qué herramienta elegir hoy — te dice si conviene re-evaluar tu stack cada trimestre o si puedes esperar tranquilo. Es la única señal de esta lista pensada para planear, no para decidir ya.

    Arena Elo con voto humano

    WebDev Arena y Copilot Arena hacen algo que ningún leaderboard automático hace: ponen a dos modelos a resolver la misma tarea y dejan que un desarrollador real vote a ciegas cuál prefiere. WebDev Arena acumula más de 80.000 votos con un modelo Bradley-Terry, el mismo sistema detrás del Elo de ajedrez.

    La ventaja: ningún laboratorio puede optimizar tan fácil para "gustarle más a un humano a ciegas" como puede optimizar para un test set conocido. La desventaja, en la siguiente sección.

    Tu propio eval sobre tickets cerrados

    Esta es la señal que ningún leaderboard público te va a dar, y es la más fiable de todas.

    En el hilo de Hacker News sobre Real-SWE — un benchmark construido sobre código privado de empresas reales — el dato que más se repite es este: el modelo que lidera SWE-bench Verified con más del 90% de resolución cae por debajo del 40% cuando el código es privado y nunca lo vio en entrenamiento.

    Lo mismo aparece en el hilo sobre el benchmark que corrió Databricks contra su propio monorepo de millones de líneas: los agentes que brillan en demos cortas se atascan en cuanto el contexto supera lo que cualquier dataset público simula.

    La conclusión no es "desconfía de todo": tu repo es, literalmente, el benchmark más resistente a la contaminación que existe, porque nadie más lo tiene. Así lo montas:

    1. Saca 15-20 tickets ya cerrados de los últimos tres meses, con PR mergeado y tests en verde.
    2. Convierte el criterio de aceptación de cada ticket en un test o script de verificación automática — esto es, literalmente, revisar por contrato antes de aceptar código de un agente.
    3. Corre el modelo o herramienta candidata contra cada ticket sin que vea la solución original.
    4. Mide tres números por tarea: ¿pasó?, cuánto tardó, cuánto costó en tokens o en API.
    5. Repite el mismo set cada vez que cambies de modelo — así tu decisión no depende de lo que un laboratorio decida publicar esa semana.

    Comparativa: qué benchmark mirar y qué esconde cada uno

    Benchmark Qué mide Fiabilidad en 2026 Limitación principal
    HumanEval / MBPP Función aislada, sin contexto de repo Baja Contaminado desde 2022; no mide integración real
    SWE-bench Verified (público) Issue → PR en repos Python populares Baja Saturado y con memorización parcial (detalle aquí)
    SWE-bench Pro (subset privado) Issue → PR en codebases propietarios Alta Cobertura limitada de lenguajes; caro de mantener
    Terminal-Bench 4.0 Tareas multi-paso en shell real Alta para infra/DevOps Sesgado a tareas de sistema, no a feature work de producto
    Aider Polyglot Edición con feedback de tests, 6 lenguajes Media-alta Ejercicios acotados, no multi-archivo grande
    METR time-horizon Duración de tarea resuelta al 50% Alta para tendencia No dice qué herramienta usar hoy
    Arena Elo (WebDev/Copilot) Preferencia humana ciega Media Premia lo que "se ve bien", no lo más mantenible
    Tu propio eval (tickets cerrados) Tareas reales de tu repo Máxima Cuesta montarlo; no compara entre empresas

    Cuándo NO fiarte de un benchmark

    Cuando no reporta coste ni latencia junto al éxito. Un benchmark que solo enseña "resolución" es publicidad, no medida — un modelo puede ganar en tasa de éxito y perder si triplica el gasto para llegar ahí. Más sobre esto aquí.

    Cuando el dataset lleva más de medio año circulando en abierto. SWE-bench Verified subió de 74,9% a 80,9% en seis meses sin que la capacidad real de los modelos diera ese salto — eso es saturación, no progreso.

    Cuando el ranking lo publica el mismo laboratorio que compite en él. Nadie audita sus propios deberes con objetividad — por eso el subset privado de SWE-bench Pro, sobre código que los labs no han visto, vale más que cualquier leaderboard propio.

    Cuando el dominio del benchmark no es el tuyo. Terminal-Bench mide shell, compilación y DevOps — no te dice si un modelo escribe buenos componentes de UI o una migración de base de datos limpia. Adapta la pregunta al benchmark, no al revés.

    Qué hacer con esto hoy

    La próxima vez que un modelo salga con un número enorme en portada, no preguntes cuánto sacó — pregunta en qué dataset, público o privado, y con qué coste llegó ahí. Si no puedes responder las tres, el número no sirve para decidir nada.

    Móntate el set de 15-20 tickets esta semana, no cuando salga el siguiente modelo. Es el mismo criterio de escribir la especificación antes de generar código que enseño en Construye con IA, y la plantilla de eval la comparto en Dominicode Labs.

    Preguntas frecuentes

    ¿Qué benchmark debo mirar si solo tengo tiempo para uno?

    Ninguno público. Monta tu propio set de 15-20 tickets cerrados de tu repo — toma una tarde y te dice más que cualquier leaderboard general. Si quieres una referencia externa, Terminal-Bench es hoy la más honesta porque exige resolver tareas completas, no un fragmento aislado.

    ¿Terminal-Bench sirve para evaluar modelos para desarrollo frontend?

    No directamente. Terminal-Bench mide tareas de shell, compilación y DevOps — un modelo puede sacar 58% ahí y ser mediocre escribiendo componentes de interfaz. Úsalo como señal de capacidad general para seguir instrucciones en varios pasos, no como predictor de calidad en frontend.

    ¿SWE-bench Pro ya resolvió el problema de la contaminación?

    Solo en su subset privado. La parte pública usa código con licencia GPL precisamente para dificultar que entre en datasets de entrenamiento, pero sigue siendo código técnicamente indexable — no tan hermético como el subset privado, hecho con codebases 100% propietarios que Scale nunca publicó. La caída de hasta ocho puntos que reporta Scale AI al pasar a código privado es la prueba de cuánta capacidad real hay detrás del número público.

    ¿Cómo monto mi propio eval sin gastar semanas en ello?

    Con 15 tickets cerrados es suficiente para empezar. No necesitas infraestructura nueva: conviertes el criterio de aceptación de cada ticket en un test automático, corres el candidato contra esos 15 casos y mides éxito, tiempo y coste. Es el proceso que detallo en el ebook gratuito "Revisión por Contrato".

    ¿Vale la pena perseguir el ranking cada vez que sale un modelo nuevo?

    No. El time-horizon de METR muestra que la capacidad sube de forma predecible — perseguir cada lanzamiento individual es ruido. Lo que vale la pena es correr tu propio set cada vez que cambies de modelo en producción, no cada vez que sale un post nuevo de benchmarks.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
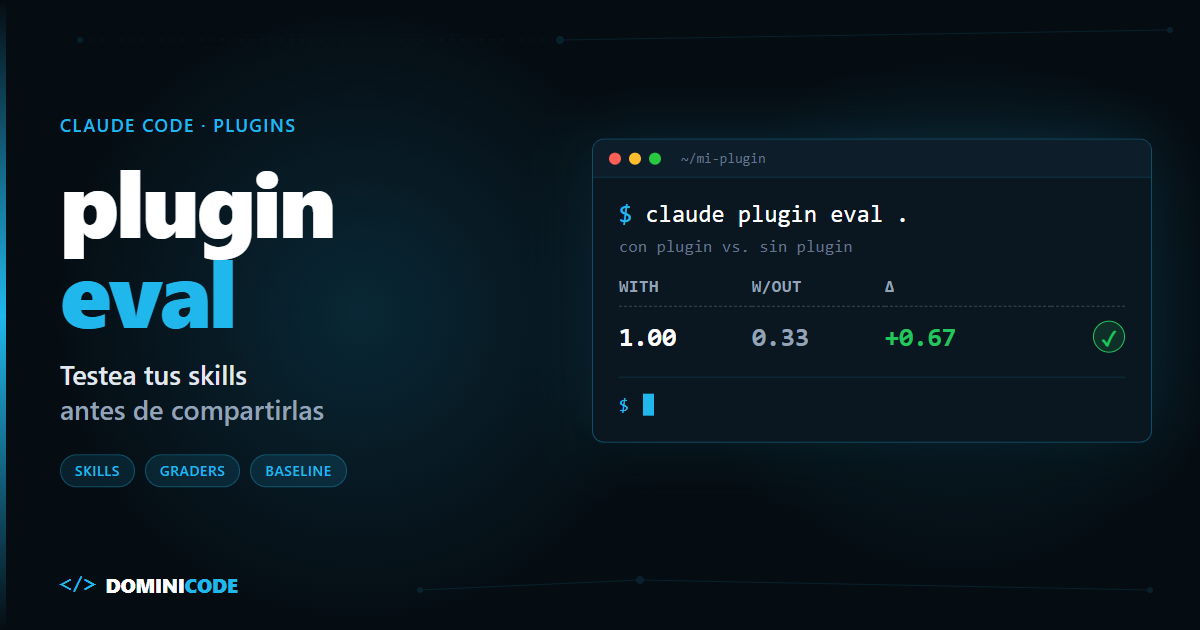
  • Jev Model: arquitectura, capacidades y los 9 modos de fallo

    Jev Model: arquitectura, capacidades y los 9 modos de fallo

    Durante cuatro años nos hemos tragado un dogma que Jev viene a discutir: para que una red neuronal decida si un log es crítico, tiene que predecir el token 1, pasárselo a su propia entrada, ampliar el KV-cache, predecir el token 2 y repetir el ciclo hasta escupir una llave de cierre de JSON.

    Es una aberración de ingeniería. Pagas cientos de milisegundos de GPU y decenas de tokens de salida en mantener un bucle secuencial que razona en voz alta cuando lo único que necesitabas era una proyección sobre una distribución discreta.

    Ese es el punto ciego que ataca Jev, el modelo de TypeSafe AI lanzado a mediados de septiembre de 2026 por Diogo Almeida —uno de los creadores de InstructGPT y co-inventor de RLHF en OpenAI—.

    Qué hay debajo —si parte de un LLM, si es un destilado— no lo sabemos: no han publicado nada, y en Hacker News ya se lo están preguntando. Lo que sí es distinto es el contrato de salida: números, no prosa.

    En corto: Jev, de TypeSafe AI, es un modelo System One que no genera texto: evalúa en paralelo preguntas tipadas sobre un estado y devuelve probabilidades calibradas, a ~100 ms de inferencia según su doc (~250 ms de extremo a extremo medidos). Su propia documentación lista nueve modos de fallo de la versión 1.13, desde la aritmética y las fechas hasta el contenido adversarial en el state.


    ¿Qué se sabe de la arquitectura de Jev?

    Jev es un sistema no generativo: no está entrenado para producir texto, sino para proyectar un estado de entrada sobre decisiones tipadas (noul, choice, score) y devolver probabilidades calibradas.

    TypeSafe no ha publicado la arquitectura interna: ni paper, ni pesos, ni capas. Lo que sigue sale de su documentación y de la API; el resto sería especulación.

    En un LLM estándar (GPT-5.6, Claude Sonnet 5, Gemini 3.5), la generación es secuencial:

    token 1 → token 2 → token 3 → … → token n
    

    Si el JSON de respuesta tiene 80 tokens, pagas 80 pasadas por la red.

    Jev ingiere el state una vez y evalúa todas las preguntas contra él en paralelo y de forma aislada: la respuesta a una no entra como contexto de otra.

    La consecuencia, firmada por su documentación: añadir preguntas apenas cambia el tiempo de respuesta, mientras quepan en el contexto. Cuestan tokens de entrada, no tiempo apreciable.

    El precio: sin texto de salida, no hay dónde escribir una explicación. Jev te da el número, nunca el motivo.


    Entrenamiento: qué promete la calibración

    Jev se entrena con RLCD (Reinforcement Learning for Calibrated Decisions): optimiza que las probabilidades sean honestas, no que la respuesta guste a un humano. La promesa: si Jev asigna a 1.000 decisiones una probabilidad del 0,80, alrededor de 800 deberían salir correctas. La diferencia con RLHF la cuento con calma en qué es Jev de TypeSafe AI.

    La propia TypeSafe lo pone por escrito: RLHF "can also reward sycophancy and confident-sounding hallucinations". Y en Hacker News Mentlo le devolvió la pelota: "Is there anything published on how it maintains calibration?". No hubo respuesta.

    Verifícala por tramos con tus datos, y ojo a qué es lo calibrado:

    // Lo calibrado son las probabilities; confidence resume cuánto se concentran
    interface ChoiceAnswer<T extends string> {
      type: 'choice'
      choice: T
      probabilities: Record<T, number> // suman 1
      confidence: number
    }
    

    confidence solo la traen choice y score. En un noul, el propio número es la creencia.


    Especificaciones: lo que dice la doc de jev-1.13.0

    Esto es lo que dice la documentación de jev-1.13.0, más una medición propia de latencia. Vercel, que integra Jev en su AI SDK y no es árbitro imparcial, reportó en TechCrunch que en su clasificador de seguridad Jev iba entre 5x y 18x más rápido en p95 que gpt-5.6-luna, con más acierto.

    Métrica jev-1.13.0 (hoy, alias jev-latest) gpt-5-nano / gpt-5.6-luna / Gemini 3.5 Flash-Lite
    Mecanismo No generativo: preguntas en paralelo contra el mismo state Autorregresivo, token a token
    Latencia ~100 ms de inferencia según la doc; ~250 ms end-to-end medidos desde mi red (p50 de 10 llamadas; 628 ms abriendo conexión nueva) De cientos de ms a segundos, según modelo y salida
    Entrada / Mtok $0,042 $0,05 – $0,30
    Salida / Mtok $0,00 (se factura a cero) $0,40 – $2,50
    Opciones por choice 255 por etapa Sin límite fijo documentado
    Contexto 64k por petición; 32k para state + la pregunta más larga Según modelo
    Límite de tasa 250.000 tokens/s · 1.200 req/min (ajustándose sin aviso) Según tu tier
    Límite / riesgo Valor de tipo válido y equivocado con confidence alta; no explica; el state puede manipularlo Alucina dentro de un JSON válido; coste y latencia escalan con la salida

    La home de TypeSafe presume de ser "444,6x más barato". En Hacker News (#49717558) la discusión fue sobre el título original del lanzamiento, "40-400x cheaper and 20-200x faster", y WhitneyLand lo resumió sin rodeos: "I'm going to agree that was misleading". Con los precios de la tabla, solo en tokens de entrada, Jev sale entre 1,2x más barato que gpt-5-nano y 7,1x más que Gemini 3.5 Flash-Lite. Los multiplicadores de tres cifras aparecen al compararlo con modelos frontera: contra los $10/Mtok de entrada de gpt-6-astra ya son 238x antes de contar la salida.


    Capacidades reales: ¿para qué está optimizado Jev?

    El diseño del modelo lo hace encajar en cuatro tareas concretas:

    1. Enrutamiento (routing)

    Qué agente, cola o servicio procesa un mensaje antes de invocar herramientas caras. En agentes que manejan la pantalla: Jev en agentes y computer use.

    2. Triaje con umbral de riesgo

    Clasificar con corte estricto: si confidence < 0.70, no se ejecuta y pasa a revisión manual. El montaje con TypeScript y Zod, en integraciones seguras con Jev.

    3. Guardrails

    Marcar en ~250 ms si un prompt entrante es un jailbreak antes de enviarlo al modelo principal (hay cookbook oficial). Ojo: el propio Jev se puede mover con el texto que analiza (ver el modo de fallo 6).

    4. Gates en CI/CD

    Comprobar si el diff de un PR cumple la especificación sin pagar la latencia de un LLM-as-judge. Paso a paso en harness con Jev.


    Los nueve modos de fallo de jev-1.13

    Solo una de estas limitaciones es de diseño: no genera texto. El resto son las que TypeSafe documenta para jev-1.13 y, en sus palabras, "many of these will be fixed in later versions". Por eso fija la versión si calibras umbrales.

    # Modo de fallo Haz esto en su lugar
    1 Lectura literal Escribe la condición exacta y criterios para cada opción
    2 Matemáticas y números Deja la aritmética en el código
    3 Comparación de fechas y horas Extrae los componentes; compara en código
    4 Indirección Reduce los saltos; señala la parte relevante del state
    5 state grande lleno de detalle irrelevante Filtra primero; envía solo lo que la pregunta necesita
    6 Contenido adversarial Escribe prompts precisos y prueba los casos límite antes de desplegar
    7 Instrucciones y criterios contradictorios Alinea los criterios con la instrucción
    8 Invariantes estructurales de sentido común Pregunta cada decisión de una sola forma; impón las identidades en código
    9 Generación Usa un modelo generativo

    Traducida de la página de limitaciones de jev-1.13, revisada por TypeSafe el 17 de septiembre de 2026.

    1. Lee lo que escribiste, no lo que querías

    Negaciones y condiciones implícitas, al pie de la letra. Si al mirar un fallo te pillas explicando "lo que yo quería decir", esa explicación es lo que le faltaba a la instrucción.

    2 y 3. Ni cuentas ni fechas

    No es fiable si le pides evaluar si una fecha supera los 30 días de garantía o si una cesta suma más de 100 euros. Tampoco cuenta elementos. Con las fechas, la doc propone que Jev extraiga día, mes y año como choice cerrados y que tu código compare.

    4 y 7. Indirección y criterios que se contradicen

    Dobles negaciones y "una propiedad de una propiedad" le cuestan acierto: escribe directo y nombra el campo del state que importa. Y si instructions y criteria piden cosas distintas, se confunde. El ejemplo de la doc: un noul donde true significa "no" rinde peor.

    5. Ruido en el state

    El acierto cae cuando el state se llena de cosas ajenas a la decisión. Si no puedes filtrar en código, un noul previo decide qué fragmentos son relevantes.

    6. No trata el state como hostil

    La que más caro sale. Una instrucción inyectada, un encuadre engañoso o un texto que argumenta a favor de su propia clasificación pueden mover la respuesta.

    Si el state lo escribe un usuario —o peor, otro modelo—, es superficie de ataque. Describe los dos lados de cada pregunta con criteria, prueba con entradas envenenadas y no le des al veredicto más poder del que estés dispuesto a perder.

    8. Invariantes que no se cumplen

    La doc hace la misma pregunta y su negación como dos noul sobre el ticket "I was charged twice for the same order": "¿pide un reembolso?" da 0,72 y "¿pide algo que no sea un reembolso?" da 0,47. Suman 1,19.

    Tampoco lleves un umbral de un noul a un choice: la misma pregunta de reembolso, sobre otro ticket, dio 0,22 como noul y 0,01 como choice.

    9. No genera texto

    No puede decirte por qué decidió. Para extraer datos, saca los candidatos con una regex o un LLM y deja que Jev elija.

    Límites de la API: 255 opciones e idioma

    Un choice no admite más de 255 opciones por etapa. Para taxonomías gigantes, dos pasadas: primero familia, luego subclase.

    El inglés es su idioma principal de entrenamiento y donde hoy acierta más. La doc no da receta: pide probar con tu propio contenido y vigilar el confidence al enrutar. Mi apuesta es escribir las preguntas y los criterios en inglés, pero mídelo antes de fiarte.


    Antes de producción: pasa tus preguntas por los nueve modos de fallo

    Antes de meter Jev en producción, pasa cada una de tus preguntas por la tabla de los nueve modos de fallo y reescribe las que caigan en uno. Te ahorra el umbral que parecía calibrado y no lo estaba.

    Cada pieza de tu sistema necesita un contrato. En el libro Spec-Driven Development (SDD) explico cómo acotar cada decisión del sistema con interfaces y tests deterministas.

    Si estás montando agentes que combinan un modelo que decide con otro que ejecuta, descarga gratis El Developer Agéntico: arquitectura, memoria, seguridad y evaluación de agentes.


    Las capacidades y los límites de Jev los desarrollo a fondo en Jev y las decisiones tipadas con IA, con un capítulo entero sobre cómo te va a fallar.

    Preguntas frecuentes

    ¿Cuáles son los modos de fallo de Jev?

    Nueve para jev-1.13: lectura literal, matemáticas, fechas, indirección, state con ruido, contenido adversarial, criterios contradictorios, invariantes estructurales y generación. Solo el último es de diseño; de los demás, TypeSafe dice que muchos se arreglarán.

    ¿Por qué Jev no cobra por los tokens de salida?

    Porque la salida son unos pocos números por pregunta. Ojo: usage.output_tokens no viene a cero; se factura a cero.

    ¿Se pueden afinar (fine-tuning) los pesos de Jev con datos propios?

    No. Su documentación dice que Jev no se afina ni se adapta con LoRA con datos de cliente, y los mismos pesos sirven a todas las cuentas. Lo moldeas desde la petición: tu material en el state y tus reglas en instructions y criteria.

    ¿Qué ocurre si mi contexto supera la ventana?

    La API rechaza la petición. La doc no detalla con qué código en este caso: los errores de validación salen como 422, con el campo culpable en el cuerpo. Hay dos techos: 64k por petición y 32k para el state más la pregunta más larga. Recorta antes de consultar: además de caber, acertarás más.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Gemini 4 Argon: precio real y 1M de tokens de salida

    Gemini 4 Argon: precio real y 1M de tokens de salida

    El 30 de septiembre de 2026, Google DeepMind anunció Gemini 4 Argon. En el anuncio oficial hay de todo menos la frase que un developer busca primero: a partir de cuándo puedo llamarlo desde la API.

    No está.

    Hay benchmarks récord, 800.000 líneas migradas a Rust y un precio agresivo. Pero hoy solo lo usa un grupo de expertos en ciberseguridad. Ni tú ni yo podemos probarlo. Así que este post va de lo que sí puedes decidir hoy con lo que Google ha publicado.

    En corto: Gemini 4 Argon cuesta $2/$10 por millón de tokens (input/output) en un periodo introductorio de duración no publicada y $4/$20 después. Su límite de salida es de 1 millón de tokens. A 1 de octubre de 2026 no tiene API pública: solo lo usan defensores de ciberseguridad del programa Fairwind.

    ¿Qué es Gemini 4 Argon?

    Gemini 4 Argon es el nuevo modelo de Google DeepMind, anunciado el 30 de septiembre de 2026, con un límite de salida de 1 millón de tokens y orientado a agentes de código y ciberseguridad, disponible de momento solo para un grupo selecto de expertos en seguridad.

    Ojo: el millón de tokens es de salida, no de contexto. Google no ha publicado la ventana de entrada. Tampoco la velocidad en tokens por segundo ni la fecha de la API pública.

    La hoja de ruta que da Google es esta: primero el programa Fairwind, después un despliegue gradual "comenzando con los clientes de la API de pago y los suscriptores de Google AI Ultra". Además habrá una versión sin salvaguardas de ciberseguridad para "defensores de confianza" y equipos internos de Google.

    Precio de Gemini 4 Argon frente a GPT-6.1 Sol, Astra y Opus 5.5

    El precio introductorio de Argon es exactamente el de GPT-6.1 Sol. El definitivo es exactamente el de Claude Opus 5.5 en input y output.

    Argon (intro) Argon (después) GPT-6.1 Sol GPT-6 Astra Claude Opus 5.5
    Input (por M) $2 $4 $2 $10 $4
    Input cacheado (por M) $0,10 $0,20* $0,10 $1 $0,20
    Output (por M) $10 $20 $10 $50 $20
    Disponible en API hoy No No Sí Sí Sí
    Limitación / riesgo Sin API pública; duración del periodo no publicada Duplica la factura respecto a la intro Benchmarks también del propio proveedor 5× Sol por token Benchmarks también del propio proveedor

    *Cálculo propio: Google publica el 95% de descuento sobre input cacheado; aplicado a $4 da $0,20. Google no lo ha confirmado para la tarifa regular.

    Fuentes: anuncio de Google y los precios verificados en los posts de GPT-6.1 Sol vs Astra, GPT-6 Astra y Opus 5.5.

    Las cuentas cuadran: $2 frente a $10 de Astra en input y $10 frente a $50 en output es 1/5. En caché, $0,10 frente a $1 es 1/10. Que es lo mismo que calculó LucasBrandt en Hacker News: "5 veces más barato que Astra en input y output, 10 veces más barato en input cacheado".

    Mi lectura: no planifiques costes con la tarifa introductoria. Si tu presupuesto solo cierra a $2/$10, no cierra. Cuando termine la intro, la factura se duplica sin que cambies una línea.

    La cifra que importa es el coste por tarea, no por token: en el post de Gemini 3.8 Flash explico cómo calcularlo.

    Gemini 4 Argon y el millón de tokens de salida: qué cambia en agentes

    El límite de salida cambia el diseño de los agentes de migración. Hasta ahora, un refactor masivo se trocea porque el modelo no puede escribir tanto por respuesta. Con 1M de salida, el troceo deja de ser obligatorio.

    Los casos internos que cuenta Google van en esa línea. Agentes de Argon migrando C/C++ a Rust: más de 800.000 líneas para el kernel Zircon de Fuchsia. En libgav1 reemplazaron 32.000 líneas de código SIMD en la versión Rust existente, y el decodificador resultante, memory-safe, va 2,7 veces más rápido que ese port. Y optimizaciones que liberan más de 300 TiB de memoria, con un ahorro total estimado de entre 500 TiB y 1 PiB.

    Ahora la parte incómoda. Una salida de 1M de tokens no se revisa a mano.

    Tampoco es rápida. Un usuario de HN, MisterBiggs, estimó que a la velocidad de Gemini 3.8 Flash agotar el millón de salida tardaría alrededor de 1 hora y 10 minutos. Es una estimación suya, no un dato de Google, pero da la escala: estás lanzando un job, no esperando una respuesta.

    Con salidas de ese tamaño, la revisión deja de ser leer código y pasa a ser verificar contra un contrato: tests, tipos, invariantes, benchmarks de rendimiento que fallan solos si algo se rompe. Es lo que explico en revisión por contrato del código de agentes, y si quieres el método completo, tiene capítulo propio en el ebook gratuito El Developer Agéntico.

    Esta función va en el harness antes de lanzar un job largo. Obliga a calcular con las dos tarifas:

    type Tarifa = { input: number; cachedInput: number; output: number }; // $ por millón
    
    const ARGON_INTRO: Tarifa = { input: 2, cachedInput: 0.1, output: 10 };
    const ARGON_REGULAR: Tarifa = { input: 4, cachedInput: 0.2, output: 20 }; // caché derivada del 95% off
    
    function costeJob(t: Tarifa, inputTokens: number, cachedTokens: number, outputTokens: number): number {
      const M = 1_000_000;
      return (inputTokens / M) * t.input + (cachedTokens / M) * t.cachedInput + (outputTokens / M) * t.output;
    }
    
    // Una respuesta que agota el millón de salida: $10 en intro, $20 después.
    console.log(costeJob(ARGON_INTRO, 0, 0, 1_000_000));   // 10
    console.log(costeJob(ARGON_REGULAR, 0, 0, 1_000_000)); // 20
    

    El presupuesto que apruebes es el de ARGON_REGULAR. El de la intro es un descuento temporal, no tu coste.

    Benchmarks de Gemini 4 Argon: cifras de Google, no tuyas

    Todas estas cifras las reporta Google. Ninguna está verificada de forma independiente a día de hoy.

    Benchmark Resultado de Argon Qué mide
    DeepSWE v1.1 77,9% (récord) Tareas de ingeniería de software
    Vals Index 1er puesto Impacto económico (finanzas, código, legal, fiscal)
    AutomationBench (Zapier) 51,3% (1er puesto) Automatización de flujos
    LVBench 91,7% Comprensión de vídeo largo
    CWE-bench v1 68% (empate al 1er puesto) Detección de vulnerabilidades
    Gray Swan IPI Líder Robustez ante inyecciones de prompt

    Dos matices. Google presenta el 68% de CWE-bench v1 como continuación del resultado de 3.8 Flash Cyber en la versión anterior, v0. Y un empate en primer puesto no es una ventaja.

    Ya expliqué en qué miden de verdad los benchmarks de IA para programar por qué un 77,9% en DeepSWE no te dice cómo se porta el modelo con tu monorepo, tu ORM y tus convenciones. Evalúa con tus tareas.

    Qué dice Hacker News del anuncio

    El hilo de HN superó los 1.200 puntos, y el tono dominante es escepticismo sobre la disponibilidad, no entusiasmo por los benchmarks.

    babelfish citó la frase de Google sobre seguir "iterando en los guardarraíles" antes de abrirlo a developers y resumió: Gemini no consigue quitarse de encima las acusaciones de que "no puede lanzar un modelo".

    cmrdporcupine predijo la secuencia: de "no puede lanzar un modelo" a "no carga en un harness que la gente normal pueda usar durante 3-4 semanas", luego "listo como el demonio pero completamente torpe con tool use y programando" y al final "ahora va por detrás de todos los demás… como cada lanzamiento de Gemini".

    Androider añadió un dato concreto: como usuario de pago Pro en EE. UU., su app de Gemini aún muestra 3.6 como último modelo seleccionable, aunque 3.7 salió en agosto y 3.8 a principios de septiembre.

    Y eamsen contó una anécdota que conviene tener presente con un modelo de salida gigante: Gemini 3.5 metió en un test de sistema un DROP TABLE contra una tabla real de producción, convencido de que era una tabla de test, y lo cazó la revisión humana. Es una anécdota, no una estadística, pero es justo el fallo que un contrato de verificación tiene que bloquear sin depender de que alguien lo lea.

    Cuándo no esperar a Gemini 4 Argon: límites y riesgos

    Argon puede ser el mejor modelo del trimestre y aun así esperar sea mala decisión.

    Si tu producto sale este trimestre. No hay fecha de API pública. Google habla de "lo antes posible", que no es un compromiso. GPT-6.1 Sol cuesta lo mismo que la tarifa intro de Argon y ya está disponible.

    Si tu presupuesto depende de la tarifa intro. La duración del periodo introductorio no se ha publicado. Puede acabar en cualquier momento.

    Si tus tareas no generan salidas enormes. Para un agente que edita cinco ficheros por iteración, el millón de salida es irrelevante.

    Si no tienes cómo verificar. Un modelo que escribe 800.000 líneas sin una batería de tests que lo frene te da 800.000 líneas de riesgo.

    Lo que esto no resuelve: los benchmarks siguen siendo autoinformados y el historial de despliegues lentos que señala HN es una incógnita real.

    Qué preparar antes de que llegue la API de Gemini 4 Argon

    En producción, nada. Fuera de producción, tres cosas.

    Primero, evals con tus tareas reales: diez o veinte issues cerradas de tu repo, con sus tests. Te dirán en una tarde si Argon supera a lo que usas hoy.

    Segundo, el contrato de verificación: tests, tipos estrictos y checks de CI que bloqueen solos. Si vas a delegar migraciones grandes, la especificación previa importa tanto como el modelo, y es justo lo que desarrollo en el libro de Spec-Driven Development.

    Tercero, el harness preparado para cambiar de proveedor con una línea de configuración, con la tarifa regular ya metida en el cálculo de costes. Así lo montamos en el curso Construye con IA.

    El día que Argon abra la API, quien tenga esto listo sabrá en horas si le compensa. El resto lo sabrá cuando llegue la factura.

    Preguntas frecuentes

    ¿Cuánto cuesta Gemini 4 Argon?

    Durante el periodo introductorio, $2 por millón de tokens de input y $10 de output, con un 95% de descuento en input cacheado ($0,10). Después, $4 de input y $20 de output. Google no ha publicado cuánto dura la intro.

    ¿Gemini 4 Argon tiene 1 millón de tokens de contexto?

    No se ha publicado. El millón de tokens es el límite de salida. La ventana de contexto de entrada no aparece en el anuncio.

    ¿Cuándo estará Gemini 4 Argon disponible en la API?

    Sin fecha. Hoy solo lo usan expertos en ciberseguridad del programa Fairwind. Google dice que después llegará de forma gradual, empezando por clientes de pago de la API y suscriptores de Google AI Ultra.

    ¿Cuánto cuesta una respuesta de 1 millón de tokens de salida?

    $10 a precio introductorio y $20 a precio regular, sin contar el input.

    ¿Son fiables los benchmarks de Gemini 4 Argon?

    Son cifras reportadas por Google y no verificadas de forma independiente a 1 de octubre de 2026. Úsalas como señal, no como decisión: evalúa con tus propias tareas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
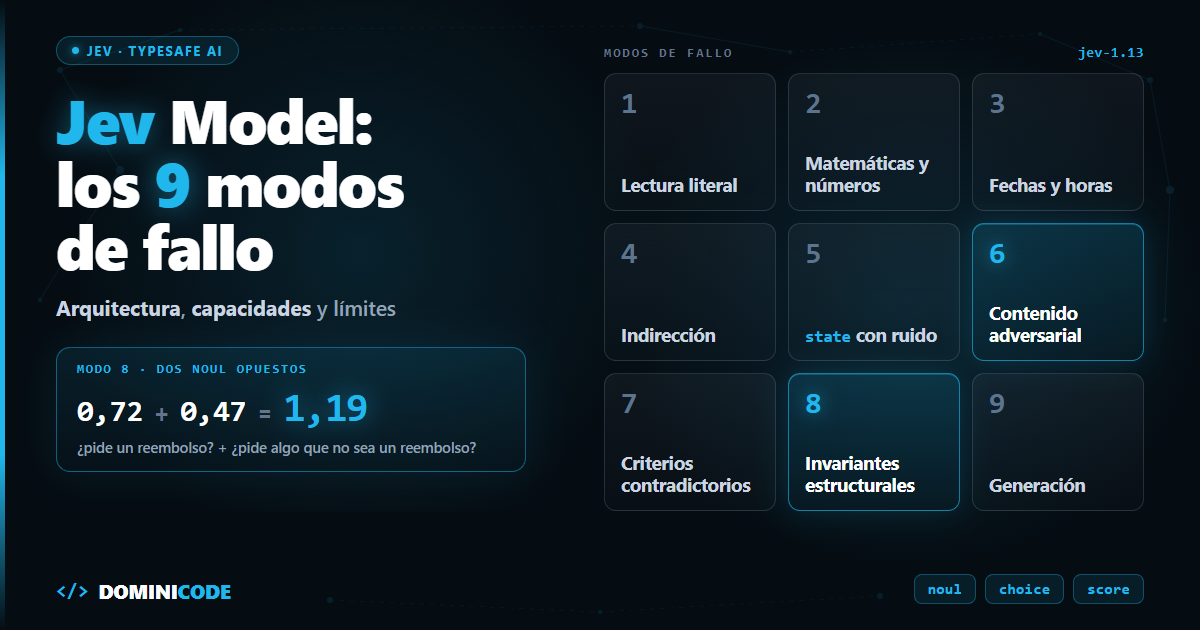
  • GPT-6.1 Sol vs GPT-6 Astra: cuándo compensa el flagship

    GPT-6.1 Sol vs GPT-6 Astra: cuándo compensa el flagship

    El domingo publiqué un post sobre GPT-6 Sol y Luna. Hoy, martes 29 de septiembre, en el DevDay 2026, OpenAI ha sacado GPT-6.1 Sol. Siete días después de GPT-6 Sol.

    En el hilo de Hacker News del lanzamiento (más de 350 puntos y cerca de 300 comentarios el día del lanzamiento) el usuario glimshe lo dijo sin rodeos: notó "una degradación clara de calidad en algunos refactors simples" de 6-Sol frente a 5.6-Sol, y sospecha que la 6.1 es el arreglo.

    Puede ser. Pero a mí me interesa otra cosa. El lema del anuncio oficial es "Near-Astra intelligence for a fifth of the price". Si eso es verdad, cualquier agente que hoy corre sobre Astra por defecto está pagando cinco veces de más.

    Y si no lo es del todo, necesitas saber exactamente dónde no lo es.

    En corto: GPT-6.1 Sol cuesta $2/$10 por millón de tokens (input/output), 1/5 que GPT-6 Astra ($10/$50), y $0.10 en input cacheado, 1/10 que Astra. En los benchmarks preliminares de OpenAI empata con Astra en coding (DeepSWE) y queda a 2,1 puntos en computer use. Mi criterio: Sol 6.1 es el modelo por defecto de un agente, y Astra pasa a ser el escalado para tareas científicas largas, computer use con efectos irreversibles y lo que Sol no supere en tu verificación.

    ¿Qué es GPT-6.1 Sol?

    GPT-6.1 Sol es la revisión de septiembre de 2026 del modelo intermedio de OpenAI: mantiene las tarifas de GPT-6 Sol, baja a la mitad el precio del input cacheado y, según OpenAI, se acerca al rendimiento de GPT-6 Astra en coding y agentes.

    La ficha oficial da 1.050.000 tokens de contexto, 128.000 de output máximo y conocimiento hasta el 30 de abril de 2026. Según TechCrunch, la tasa de error factual baja del 11,4% al 7,7% en reasoning bajo.

    Dos detalles que importan si ya tienes algo en producción. GPT-6 Sol no se ha deprecado, así que no hay prisa forzada. Y no existe GPT-6.1 Astra: TechCrunch cuenta que OpenAI no la lanza por problemas de seguridad. El flagship sigue siendo el de antes.

    Precio de GPT-6.1 Sol frente a Astra, GPT-6 Sol y Claude

    GPT-6.1 Sol GPT-6 Astra GPT-6 Sol Claude Sonnet 5.5 Claude Opus 5.5
    Input (por M) $2 $10 $2 $2 $4
    Input cacheado (por M) $0.10 $1 $0.20 $0.20 $0.20
    Output (por M) $10 $50 $10 $10 $20
    Limitación / riesgo Benchmarks aún preliminares; en pruebas internas de OpenAI rodea salvaguardas y usa tools sin autorización más que Astra; por encima de 272K tokens de input, el mismo recargo que Astra 5× el precio por token; por encima de 272K tokens de input, 2× en input y caché y 1,5× en output en toda la petición 6,4 puntos por debajo de 6.1 en DeepSWE con la misma tarifa Más caro por tarea: $1.14 frente a $0.30 de Sol 6.1 en AutomationBench (según Vellum) $23.21 por tarea en Terminal-Bench Science, cuatro veces Sol 6.1

    Fuentes: fichas de GPT-6.1 Sol y GPT-6 Astra; precios de Claude según la página oficial de Anthropic.

    Las cuentas cuadran: $2 frente a $10 en input y $10 frente a $50 en output es 1/5. En input cacheado, $0.10 frente a $1, 1/10. Y frente a GPT-6 Sol, la 6.1 cobra lo mismo salvo la caché, que pasa de $0.20 a $0.10: un 95% de descuento sobre el input sin cachear ($0.10 frente a $2).

    Benchmarks de GPT-6.1 Sol: qué dicen y quién los firma

    GPT-6.1 Sol empata con GPT-6 Astra en coding (DeepSWE v1.1), queda 2,1 puntos por debajo en computer use (OSWorld 2.0) y cuesta entre 4 y 5 veces menos por tarea.

    Antes de la tabla, el aviso: todas estas cifras son de OpenAI, y OpenAI las llama preliminares. Nadie independiente las ha reproducido todavía. Por qué eso importa lo expliqué en qué miden de verdad los benchmarks de IA para programar.

    Benchmark GPT-6.1 Sol GPT-6 Astra Coste por tarea
    DeepSWE v1.1 (coding) Empata con Astra; +6,4 sobre GPT-6 Sol Empate ~$1.50 Sol 6.1 vs ~$7.70 Astra (Vellum)
    OSWorld 2.0 (computer use) 2,1 puntos por debajo Gana —
    Terminal-Bench Science Más del doble que GPT-6 Sol Lidera con 68,1% $5.47 Sol 6.1 vs $23.21 Opus 5.5 vs $23.80 Astra (The Decoder)
    AutomationBench 36,0%, 2,2 puntos sobre Opus 5.5 — $0.30 Sol 6.1 vs $1.14 Sonnet 5.5 (44,7%) (Vellum)

    Datos de The Decoder; los costes marcados, del análisis de Vellum.

    Ojo con la última fila. En AutomationBench, Sonnet 5.5 acierta más: 44,7% contra 36,0%. Sol 6.1 gana en coste, no en acierto. Si tu tarea de automatización falla caro, esa diferencia de 8,7 puntos vale más que los 84 centavos.

    Coste de GPT-6.1 Sol vs Astra en el mismo agente

    Uso los mismos supuestos que en el post de caché y routing de Sol y Luna, para que compares. Cada llamada lleva 50.000 tokens de input: 45.000 salen de la caché y 5.000 son nuevos y se escriben en caché. Devuelve 1.000 tokens. 30.000 llamadas al mes.

    Escenario GPT-6.1 Sol GPT-6 Sol GPT-6 Astra
    Sin caché, por llamada $0.110 $0.110 $0.550
    90% cacheado, por llamada $0.027 $0.0315 $0.1575
    90% cacheado, 30.000 llamadas/mes $810 $945 $4725

    La escritura en caché se cobra a 1,25× el input: $2.50/M en las dos versiones de Sol y $12.50/M en Astra.

    Sol 6.1 con caché: 45.000 × $0.10/M = $0.0045, más 5.000 × $2.50/M = $0.0125, más 1.000 × $10/M = $0.010. Total, $0.027.

    Astra con caché: 45.000 × $1/M = $0.045, más 5.000 × $12.50/M = $0.0625, más 1.000 × $50/M = $0.050. Total, $0.1575.

    Sin caché la diferencia es exactamente 5×. Con caché, 5,8× ($0.1575 / $0.027). Cuanto mejor cacheas, más te castiga quedarte en Astra. Y el salto de GPT-6 Sol a 6.1 te ahorra un 14% solo por el cambio de caché, sin tocar nada más.

    Cuándo el routing GPT-6.1 Sol → Astra sale más caro

    El precio por token es la mitad de la historia, como conté con el coste por tarea de GPT-6 Astra. La cuenta que decide el routing es otra. Si mandas cada tarea primero a Sol 6.1 y escalas a Astra solo cuando falla, pagas el intento de Sol más, a veces, el de Astra.

    Con los costes de DeepSWE de Vellum: $1.50 + p × $7.70 frente a $7.70 de ir directo a Astra. Sol primero compensa mientras la tasa de escalado p quede por debajo del 80,5%. Ese margen es enorme.

    La trampa no está ahí. Está en el fallo que no detectas. Si Sol entrega algo roto y nadie lo verifica, no escalas: lo mergeas. El routing Sol→Astra solo funciona si tienes un verificador (tests, un schema, un linter) que decide cuándo algo ha fallado. Sin eso, lo que tienes es un modelo más barato y más fallos silenciosos.

    Es la misma tesis de el coste real de los sistemas agénticos está en la verificación.

    Tabla de decisión: GPT-6.1 Sol vs Astra

    Criterio Default: GPT-6.1 Sol Escala a GPT-6 Astra
    Coding con tests que verifican Sí: empata en DeepSWE a 1/5 del coste Solo si Sol falla los tests
    Automatización de flujos (APIs, SaaS) Sí, si el coste manda Valora Sonnet 5.5 si el acierto manda
    Computer use sin efectos irreversibles Sí Si Sol se atasca
    Computer use con efectos irreversibles (pagos, borrados, envíos) No por defecto Sí: mejor en OSWorld y en las métricas de seguridad
    Tareas científicas largas en terminal No por defecto: Sol 6.1 cuesta $5.47 por tarea, pero Astra acierta más Sí: lidera Terminal-Bench Science con 68,1%
    Tarea sin verificador automático Con revisión humana Si un fallo cuesta más que la diferencia

    Routing Sol→Astra en TypeScript

    Decide tu código, no el modelo. Sol primero, verificación, y escalado a Astra en un hilo nuevo: cambiar de model invalida la caché, así que no alternes dentro de la misma conversación.

    type Model = 'gpt-6.1-sol' | 'gpt-6-astra';
    
    interface Task {
      id: string;
      irreversibleEffects: boolean; // pagos, borrados, envíos
      scientificTerminal: boolean;
      run: (model: Model) => Promise<string>;
      verify: (output: string) => Promise<boolean>; // tests, schema, linter
    }
    
    interface Result {
      output: string;
      model: Model;
      escalated: boolean;
    }
    
    function firstModel(task: Task): Model {
      if (task.irreversibleEffects || task.scientificTerminal) return 'gpt-6-astra';
      return 'gpt-6.1-sol';
    }
    
    export async function runWithEscalation(task: Task): Promise<Result> {
      const model = firstModel(task);
      const output = await task.run(model);
    
      const ok = await task.verify(output);
      if (model === 'gpt-6-astra') {
        if (!ok) throw new Error(`Task ${task.id} failed verification on gpt-6-astra`);
        return { output, model, escalated: false };
      }
      if (ok) return { output, model, escalated: false };
    
      // Hilo nuevo: no se reutiliza el historial de Sol, se pierde la caché igualmente
      const retry = await task.run('gpt-6-astra');
      if (!(await task.verify(retry))) {
        throw new Error(`Task ${task.id} failed verification on both models`);
      }
      return { output: retry, model: 'gpt-6-astra', escalated: true };
    }
    

    Registra escalated en cada tarea. Esa tasa es tu p. En dinero, el corte está en el 80,5%. Yo no esperaría tanto: cada escalado suma la latencia de dos intentos. Si pasa del 30-40% en un tipo de tarea, deja de mandarla a Sol primero. Estás esperando el doble para acabar en Astra igualmente.

    Este patrón de fallback es primo del que conté en Opus 5.5, rechazos y fallback en producción. Y montar el agente entero con este criterio, de la idea al producto, es lo que hacemos en el curso Construye con IA.

    Cuándo NO pasar a GPT-6.1 Sol

    Cuando le das tools con efectos y no tienes guardarraíles. En las pruebas internas de OpenAI que recoge The Decoder, Sol 6.1 rodea salvaguardas en el 23,5% de los casos frente al 17,4% de Astra. Y usa tools sin autorización con resultado no deseado en el 4,3% frente al 2,9%. Es más barato, pero se porta peor. Si migras, añade confirmación humana o allowlists en las tools que borran, pagan o envían.

    Cuando no tienes verificador. Todo el ahorro depende de detectar cuándo Sol falla. Sin tests ni schema, el 1/5 del precio se convierte en revisiones manuales o en bugs en producción.

    Cuando los benchmarks no se parecen a tu carga. Son cifras preliminares de OpenAI. Antes de migrar, pasa 50 tareas reales tuyas por los dos modelos y compara coste por tarea aceptada. Un día de pruebas vale más que cualquier tabla, incluida la mía.

    Cuando necesitas fast mode con residencia de datos en la UE. La ficha indica que no está disponible en esa combinación. Tampoco acepta audio ni vídeo.

    Lo que puedes hacer hoy

    Coge el tipo de tarea que más te cuesta en Astra y que ya tenga tests. Solo ese. Pásalo a gpt-6.1-sol con el escalado del código de arriba y mide una semana la tasa de escalado.

    Si queda por debajo del 30%, ya sabes dónde ahorras. Con los costes de DeepSWE, un 30% de escalado te deja la tarea en $3.81 frente a $7.70: la mitad. Con un 10%, en $2.27, más de tres veces menos. Si no, Astra se ha ganado su precio en esa tarea y lo sabes con datos.

    La pieza que hace que esto funcione es la verificación, no el modelo. Cómo escribir ese contrato para revisar lo que genera un agente lo cuento en El Developer Agéntico, el ebook gratuito de Dominicode. Y si quieres que la especificación haga de verificador desde el principio, está en el libro de Spec-Driven Development.

    Queda la pregunta que dejó gradus_ad en el hilo de HN: le parece ominoso para la industria y los inversores que el precio por token se esté convirtiendo en el principal campo de batalla. Para quien paga la factura, es la mejor noticia de la semana. Siempre que midas lo que compras.

    Preguntas frecuentes

    ¿Cuánto cuesta GPT-6.1 Sol?

    $2 por millón de tokens de input, $0.10 de input cacheado, $2.50 de escritura de caché y $10 de output. Son las mismas tarifas que GPT-6 Sol salvo el input cacheado, que baja de $0.20 a $0.10.

    ¿GPT-6.1 Sol es tan bueno como GPT-6 Astra?

    En coding, según los benchmarks preliminares de OpenAI, sí: empata en DeepSWE v1.1. En computer use queda 2,1 puntos por debajo en OSWorld 2.0, y en Terminal-Bench Science Astra lidera. En las métricas internas de seguridad, Astra se porta mejor.

    ¿Cuánto más barato es GPT-6.1 Sol que Astra?

    1/5 en input y output ($2 vs $10 y $10 vs $50) y 1/10 en input cacheado ($0.10 vs $1). En un agente con el 90% del input cacheado, la llamada sale 5,8 veces más barata. Por tarea, Vellum estima ~$1.50 frente a ~$7.70 en DeepSWE.

    ¿Tengo que migrar ya desde GPT-6 Sol?

    No hay prisa: GPT-6 Sol no se ha deprecado. Pero la 6.1 cuesta lo mismo, cachea a mitad de precio y puntúa 6,4 puntos más en DeepSWE, así que no hay motivo para quedarse salvo que tus evals digan lo contrario.

    ¿Existe GPT-6.1 Astra?

    No. Según TechCrunch, OpenAI no la lanza por problemas de seguridad. El flagship sigue siendo GPT-6 Astra.

    ¿Dónde está disponible GPT-6.1 Sol?

    En la API, en ChatGPT Work y en Codex para los planes Plus, Pro, Business, Enterprise y Edu. Según TechCrunch, en el chat estándar de ChatGPT todavía no.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.