Tag: Evals

  • Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

    Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

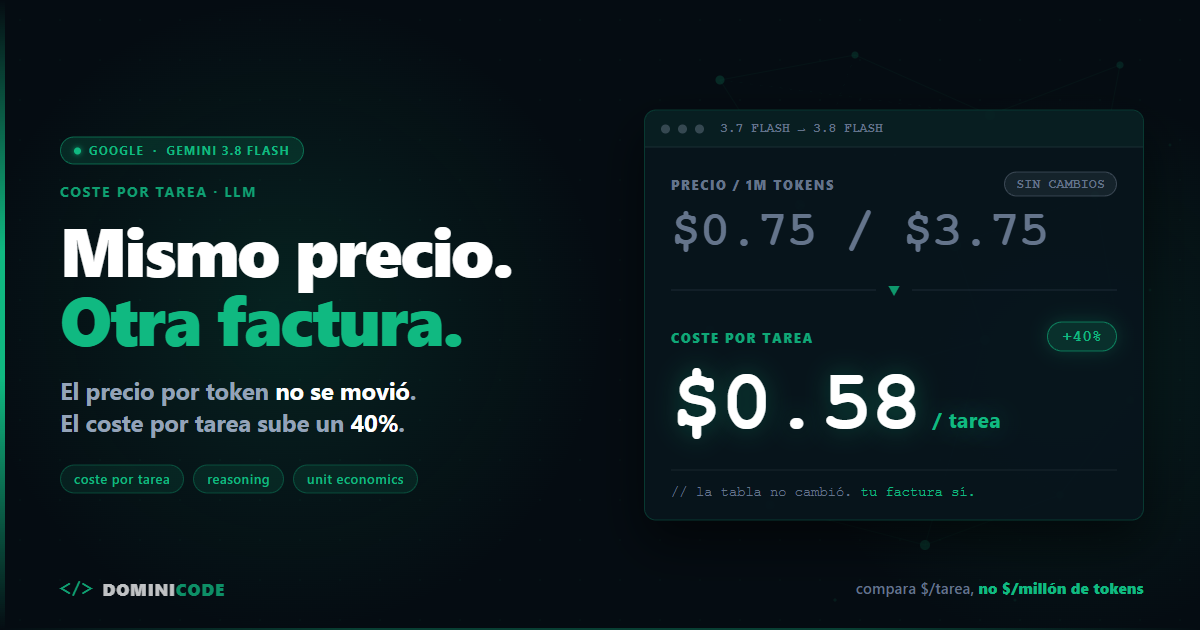
    Google anunció Gemini 3.8 Flash el 2 de septiembre de 2026 con el mismo precio por token que su antecesor: $0.75 por millón de tokens de entrada y $3.75 de salida. Ni un céntimo de diferencia en la tabla de precios.

    Artificial Analysis lo midió ese mismo día. El coste real por tarea completada de Gemini 3.8 Flash es un 40% más alto que el de Gemini 3.7 Flash.

    No es un error de facturación. Es el modelo haciendo exactamente lo que Google prometió: pensar más. Y pensar más se paga en tokens de salida.

    Esa es la parte del anuncio del 2 de septiembre que casi nadie está contando. Google presentó el modelo más barato jamás medido a ese nivel de inteligencia y, al mismo tiempo, subió el coste real de cada tarea un 40%. Las dos frases son verdad. Solo una te llega a la tarjeta.

    La tesis de este post: deja de comparar modelos por dólares por millón de tokens y empieza a compararlos por dólares por tarea completada. El precio por token lo pone el proveedor en una tabla. El coste por tarea lo pones tú con tu arquitectura, y la palanca que de verdad controlas se llama nivel de reasoning.

    El coste por tarea es el gasto total en tokens —entrada, salida y razonamiento— dividido entre el número de tareas que terminan con una salida válida. No entre llamadas a la API: entre tareas completadas.


    Qué es Gemini 3.8 Flash y qué lanzó Google el 2 de septiembre de 2026

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026 junto a Gemini 3.8 Flash Cyber, una variante restringida especializada en ciberseguridad. Es el cuarto modelo Flash que Google publica en menos de cuatro meses. Ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026. Disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    En benchmarks aguanta el pulso a modelos que cuestan casi siete veces más por token: 73,7% en DeepSWE v1.1 frente al 74,0% de Claude Opus 5, 54,9% en HLE-Verified y un 59 en el Artificial Analysis Intelligence Index, donde empata con GPT-5.6 Sol y Grok 4.6. También supera a modelos frontera mayores en Vals Finance Agent V2 y en el Harvey's Legal Agent Benchmark, que son evals de trabajo profesional, no de acertijos.

    Ese 73,7% contra el 74,0% de Opus 5 es la noticia de verdad. Es la misma tendencia que ya se veía en la comparativa de Opus 5, GPT-5.6 y Kimi K3 y en el repaso de Grok 4.5, Fable 5 y DeepSeek V4 para programar: la distancia entre la gama alta y la gama media se cierra por abajo.

    Hay otro dato que me importa. En el Gray Swan IPI, que mide robustez frente a inyección indirecta de prompts, un 5,5% de los ataques tuvo éxito: más de uno de cada veinte intentos. Si tu agente lee contenido que no controlas, ese 5,5% es tu problema, y se resuelve con defensas contra inyección indirecta de prompts, no con fe en el modelo.


    Cuánto cuesta Gemini 3.8 Flash: el precio por token es marketing, el coste por tarea es tu factura

    Aquí está la contradicción, medida de forma independiente por Artificial Analysis:

    Métrica Gemini 3.7 Flash Gemini 3.8 Flash
    Precio entrada / salida (por 1M tokens) $0.75 / $3.75 $0.75 / $3.75
    Tokens de salida por tarea referencia 48.000 (+30%)
    Coste por tarea, high reasoning referencia $0.58 (~+40%)

    Lee la tabla dos veces. La fila del precio no se mueve. La fila que pagas sube un 40%.

    Y ojo con el desglose, porque ese 30% de salida no explica por sí solo el 40% de subida. Con 48.000 tokens de salida a $3.75 el millón, la salida son unos $0.18 de los $0.58: el resto es entrada. Lo que dispara la factura son los turnos. Cada vuelta extra del agente reenvía el contexto acumulado, así que más razonamiento no solo genera más tokens de salida, también multiplica los de entrada. Por eso un +30% de salida termina en un +40% de coste por tarea.

    $0.58 por tarea del Intelligence Index es, según esa misma medición, el coste más bajo jamás registrado a ese nivel de inteligencia. El titular es justo. Pero si vienes de 3.7 Flash con un producto en marcha, tu unit economics acaba de empeorar un 40% sin que hayas tocado una línea de código. Es el mismo patrón que ya conté con el coste de los subagentes al cambiar de modelo: la factura se mueve sola cuando cambia el comportamiento del modelo, no cuando cambias tú el código.

    Del coste por tarea de Opus 5 o GPT-5.6 Sol no doy cifra porque no la tengo medida con el mismo eval, y compararlas de oído sería justo el error que denuncia este post. Lo público es el precio por token: Opus 5 cuesta $5.00 y $25.00 por millón, GPT-5.6 Sol $4.00 y $20.00. Sirve para situar la escala, no para decidir.

    Todas las cifras de coste de este post proceden de la medición independiente publicada por Artificial Analysis el 2 de septiembre de 2026, y los precios del anuncio oficial de Google de esa misma fecha. Verificadas el 3 de septiembre de 2026. Son precios introductorios: expiran el 31 de diciembre de 2026.


    Por qué sube el coste por tarea de Gemini 3.8 Flash: 48.000 tokens de salida

    La causa está publicada y no tiene misterio. Gemini 3.8 Flash gasta una media de 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y da más turnos en las evals agénticas.

    Traducido: razona más pasos antes de responder. Ese razonamiento se factura como salida, que es el token caro. A $3.75 el millón, cada vuelta extra de pensamiento tiene precio.

    Y no solo pagas más: esperas más. Artificial Analysis midió que el tiempo medio por tarea en high reasoning sube de 2,2 a 2,5 minutos. Un 14% más de latencia en cada tarea de tu producto, que con un usuario delante se nota antes que en la factura.

    Y si trabajas en español el efecto se acumula: el mismo contenido consume más tokens que en inglés por cómo funciona el tokenizador, algo que desglosé en el post sobre cuánto te cuesta de más escribir en español. Más tokens por razonar, multiplicado por más tokens por idioma, sobre el token que más caro se paga.


    Cómo medir tu coste por tarea real

    Para dejar de discutir con tablas de precios ajenas solo hace falta contar el usage de cada respuesta y dividirlo entre tareas completadas. No entre llamadas: entre tareas que terminaron bien.

    // task-meter.ts — mide lo que pagas, no lo que anuncia el pricing
    type Usage = { input: number; output: number };
    
    // Precio introductorio de Gemini 3.8 Flash (hasta el 31/12/2026), USD por token
    // Desde el 01/01/2027: { input: 1.50 / 1_000_000, output: 7.50 / 1_000_000 }
    const PRICE = { input: 0.75 / 1_000_000, output: 3.75 / 1_000_000 };
    
    type ApiResponse = Record<string, any>;
    
    // Los tokens de razonamiento se facturan como salida: súmalos siempre.
    function readUsage(res: ApiResponse): Usage {
      const u = res.usageMetadata ?? res.usage ?? {};
      return {
        input: u.promptTokenCount ?? u.input_tokens ?? 0,
        output: (u.candidatesTokenCount ?? u.output_tokens ?? 0) + (u.thoughtsTokenCount ?? 0),
      };
    }
    
    export class TaskMeter {
      private input = 0;
      private output = 0;
      private tasks = 0;
    
      track(res: ApiResponse) {
        const { input, output } = readUsage(res);
        this.input += input;
        this.output += output;
      }
    
      // Solo cuenta la tarea si el resultado es válido de verdad.
      completed() {
        this.tasks += 1;
      }
    
      report() {
        const cost = this.input * PRICE.input + this.output * PRICE.output;
        // Sin tareas completadas no hay media: devuelve el gasto en bruto, no NaN.
        if (this.tasks === 0) {
          return { tareas: 0, outputPorTarea: 0, costePorTarea: 0, costeTotal: +cost.toFixed(4) };
        }
        return {
          tareas: this.tasks,
          outputPorTarea: Math.round(this.output / this.tasks),
          costePorTarea: +(cost / this.tasks).toFixed(4),
          costeTotal: +cost.toFixed(4),
        };
      }
    }
    

    El detalle que separa esta métrica de un contador inútil está en completed(). Una tarea cuenta cuando la salida pasa tu validación, no cuando la API devuelve 200. Si el modelo responde un JSON que tu esquema rechaza, has pagado tokens y no has completado nada: eso encarece el coste por tarea, y así debe ser. Yo cierro ese bucle con un safeParse de Zod antes de llamar a completed(), que es justo el tipo de frontera que trabajo en el curso de validación y transformación de datos con Zod.

    Un aviso para que no te asustes de tu propio medidor: promptTokenCount incluye los tokens servidos desde caché de contexto, que se facturan más baratos. Si usas caching, el número que saques será algo pesimista.

    Ejecútalo una semana con tu carga real y tendrás un número que ninguna nota de prensa te puede dar. Para el instrumental completo, con desglose por turno y por herramienta, tienes la guía para medir el consumo de tokens de un agente de IA.


    Niveles de reasoning en Gemini 3.8 Flash: cuándo usar high, medium o low

    El nivel de reasoning es la palanca de coste más grande que tienes, y la mayoría de proyectos la dejan clavada en el máximo por defecto. Los tres niveles medidos por Artificial Analysis el 2 de septiembre de 2026, sobre las mismas tareas del Intelligence Index:

    Nivel de reasoning Intelligence Index Coste por tarea Ahorro vs high
    high 59 $0.58 —
    medium 57 $0.41 −29%
    low 52 $0.24 −59%

    Ahí está el argumento entero en dos números: bajar de high a medium te ahorra un 29% del coste por tarea y cuesta 2 puntos de Intelligence Index, 57 frente a 59. Bajar a low ahorra un 59% y cuesta 7 puntos. Si tu tarea se valida con un esquema, esos 7 puntos no los vas a notar; el 59% sí.

    Mi regla por defecto, la misma que aplico con cualquier modelo que exponga niveles de razonamiento:

    • Low para clasificar, extraer campos, enrutar y resumir. Si puedes validar el resultado con un esquema, no necesitas que el modelo medite.
    • Medium para el trabajo normal de un agente: varios pasos, alguna herramienta, contexto moderado. Este es el defecto sensato, no high.
    • High solo para razonamiento largo con estado, donde un error a mitad de camino te obliga a repetir la tarea entera. Ahí el sobrecoste frente a medium se paga solo, porque un reintento cuesta más que el ahorro.

    Y la consecuencia que a mucha gente se le escapa: si tu producto es un agente de varios pasos, no tienes que elegir un nivel único. Enruta por paso. La extracción va en low, la decisión difícil va en high. Esa granularidad es la diferencia entre un margen sano y uno que se come el precio del plan, y es una de las decisiones de arquitectura que más repito en el curso de Construye con IA.

    En la Gemini API el nivel se fija con thinking_level dentro de generation_config, y acepta low, medium y high:

    const res = await client.interactions.create({
      model: "gemini-3.8-flash",
      input: prompt,
      generation_config: { thinking_level: process.env.GEMINI_THINKING_LEVEL ?? "medium" },
    });
    

    Que salga de una variable de entorno no es cosmético: es lo que te deja bajar el nivel en producción sin desplegar, el día que veas la factura del primer mes.


    El 1 de enero de 2027 te duplica la factura

    Los $0.75 y $3.75 son precio introductorio hasta el 31 de diciembre de 2026. El 1 de enero de 2027 pasan a $1.50 de entrada y $7.50 de salida por millón, según la tabla de precios oficial de la Gemini API. El doble.

    Si estás construyendo un producto y calculas márgenes con el precio de hoy, tienes hasta el 31 de diciembre de espejismo. Un SaaS con un plan de $19 al mes que hoy deja margen holgado puede quedarse en pérdidas el 1 de enero sin que nadie haya tocado nada.

    Con 10.000 tareas al mes, el mismo código y sin tocar nada:

    Nivel de reasoning Factura mensual hoy Factura mensual desde el 1/1/2027
    high $5.800 $11.600
    medium $4.100 $8.200
    low $2.400 $4.800

    Fíjate en la diagonal: pasar de high a medium el 1 de enero te deja en $8.200, todavía por encima de los $5.800 que pagas hoy en high. Bajar un nivel no compensa la subida de precio. Bajar dos, sí.

    Haz el cálculo ahora con el precio de 2027. Si con $1.50 y $7.50 tu unit economics sigue en pie, adelante. Si no, tienes hasta el 31 de diciembre para bajar niveles de reasoning, recortar contexto o cambiar de modelo, que es mucho mejor que enterarte en enero. Este supuesto debería estar escrito en la spec antes de programar nada, con su fecha y su número, como planteo en el libro de Spec-Driven Development.

    Aun con el precio duplicado sigue siendo más barato por token que Opus 5 o GPT-5.6 Sol. Pero "más barato que el más caro" no es un modelo de negocio.


    Gemini 3.8 Flash Cyber y el Fairwind Program: el modelo que no puedes usar

    Gemini 3.8 Flash Cyber es la variante especializada en seguridad y tiene los mejores números del anuncio: 86,2% en CyberGym, que mide detección de vulnerabilidades en C y C++, frente al 77,5% de 3.5 Flash Cyber, el 83,6% de GPT-5.6 Sol y el 85,6% de GPT-5.5-Cyber. En CWE-Bench, parcheo automatizado, marca un 47,2% pass@1 frente al 47,8% del modelo frontera líder, pero a un coste muy inferior. Y supera el 70% de éxito descubriendo vulnerabilidades reales.

    No tienes acceso. Se distribuye por el Fairwind Program a organismos gubernamentales, operadores de infraestructura crítica y mantenedores de software.

    Lo cuento sin drama porque la decisión me parece defendible: un modelo que encuentra vulnerabilidades reales con esa tasa de acierto es igual de bueno encontrándolas para arreglarlas que para explotarlas. Es el mismo patrón de acceso restringido que vimos con Claude Mythos 5.1 y su programa por invitación.

    Lo que sí te llevas es información: si un modelo restringido ya está en el 70% de descubrimiento real, asume que la capacidad ofensiva del otro lado también ha subido. La defensa de tu agente no puede ser que nadie mire. Empieza por los guardrails para agentes con acceso a terminal y base de datos, que es donde más daño se hace.


    Qué hacer con esto hoy

    Instrumenta el coste por tarea antes de cambiar de modelo. Media hora de trabajo: un contador de usage dividido entre tareas que pasan tu validación. A partir de ahí, elegir modelo deja de ser una discusión de opiniones sobre benchmarks ajenos.

    Con ese número, la pregunta ya no es si Gemini 3.8 Flash es más barato que Opus 5, sino cuánto te cuesta a ti completar una tarea, en tu dominio, con tu prompt, en tu idioma. Ahí se gana o se pierde el margen.

    Si quieres ver este instrumental montado sobre proyectos reales, con enrutado por nivel de reasoning y métricas de coste en producción, es de lo que hablamos cada semana en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es Gemini 3.8 Flash?

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026. Tiene una ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026, y ofrece tres niveles de reasoning (low, medium y high) que cambian tanto la calidad como el coste. Está disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    ¿Merece la pena migrar de Gemini 3.7 Flash a Gemini 3.8 Flash?

    Depende de si tu carga aprovecha el razonamiento extra. Gemini 3.8 Flash puntúa más alto en benchmarks agénticos, pero al mismo precio por token consume 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y encadena más turnos, así que el coste por tarea sube alrededor de un 40%. Si tus tareas son clasificación, extracción o enrutado, quédate en 3.7 Flash o migra a 3.8 Flash con el reasoning en low; si son cadenas largas con herramientas donde un fallo obliga a repetir todo el trabajo, la migración se paga sola.

    ¿Cuánto cuesta realmente Gemini 3.8 Flash?

    Depende de qué midas. Por token, $0.75 la entrada y $3.75 la salida por millón, precio introductorio hasta el 31 de diciembre de 2026. Por tarea completada del Intelligence Index de Artificial Analysis, $0.58 con high reasoning, $0.41 con medium y $0.24 con low. La segunda cifra es la que se parece a tu factura.

    ¿Por qué sube el coste por tarea si el precio por token no ha cambiado?

    Porque el modelo genera más tokens. Gemini 3.8 Flash gasta 48.000 tokens de salida por tarea de media, un 30% más que 3.7 Flash, y ejecuta más turnos en tareas agénticas. Ese 30% de salida, más el contexto que se reenvía en cada turno extra y que se factura como entrada, deja el coste por tarea alrededor de un 40% por encima aunque la tabla de precios sea idéntica.

    ¿Qué pasa el 1 de enero de 2027 con el precio?

    Se acaba el precio introductorio y pasa a $1.50 de entrada y $7.50 de salida por millón: exactamente el doble. Si has calculado los márgenes de tu producto con el precio de 2026, rehaz los números con los de 2027 antes de fijar tus planes de precios.

    ¿Puedo usar Gemini 3.8 Flash Cyber?

    Salvo que trabajes en un organismo gubernamental, en un operador de infraestructura crítica o mantengas software ampliamente usado, no. Se distribuye únicamente a través del Fairwind Program. No hay endpoint público ni precio publicado, así que tu referencia para trabajar hoy es Gemini 3.8 Flash estándar.

    ¿Es Gemini 3.8 Flash mejor que Claude Opus 5 para programar?

    En DeepSWE v1.1 saca 73,7% frente al 74,0% de Opus 5: prácticamente empate, con Opus 5 a $5.00 y $25.00 por millón frente a $0.75 y $3.75. Para la mayoría de cargas, esa diferencia de tres décimas no justifica el sobrecoste. Para razonamiento muy largo donde un fallo obliga a repetirlo todo, mídelo con tu propio coste por tarea antes de decidir.

    ¿Qué nivel de reasoning debería usar por defecto?

    Medium, no high. Reserva high para tareas largas con estado donde un error a mitad de camino te obliga a rehacer el trabajo entero, y baja a low todo lo que tenga una respuesta verificable con un esquema. Si tu agente tiene varios pasos, enruta el nivel paso a paso en lugar de fijar uno global.

    ¿Cómo se cambia el nivel de reasoning en la Gemini API?

    Con el parámetro thinking_level dentro de generation_config, que en Gemini 3.8 Flash acepta los valores low, medium y high. Una llamada quedaría como generation_config: { thinking_level: "medium" } junto al modelo y el prompt. Léelo siempre de una variable de entorno en lugar de escribirlo a fuego en el código: es lo que te permite bajar el nivel en producción sin desplegar cuando el coste por tarea se dispare.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • ¿Es Grok 4.6 el mejor modelo para programar? Editor sí, terminal no

    ¿Es Grok 4.6 el mejor modelo para programar? Editor sí, terminal no

    xAI publicó Grok 4.6 el 12 de agosto de 2026, treinta y cinco días después de Grok 4.5.

    Y como pasa siempre, en cuestión de horas ya circulaban capturas de tablas de barras diciendo que es el mejor modelo del mundo para programar.

    La pregunta está mal formulada.

    No porque Grok 4.6 sea malo —no lo es, y en una de las dos medidas que importan está arriba— sino porque "programar" no es una sola tarea, y los benchmarks que la miden no puntúan lo mismo.

    Hay dos cifras públicas de Grok 4.6 que responden a la pregunta mejor que cualquier hilo de X. Una la publica xAI. La otra la mide un tercero. Y entre las dos hay una brecha que te dice exactamente cuándo te conviene este modelo y cuándo no.

    Vamos con las dos.


    Qué ha publicado xAI y qué ha medido alguien más

    Antes de mirar un solo número, la distinción de siempre: no es lo mismo una cifra que publica el fabricante en su propia nota de prensa que una cifra medida por un tercero con un harness que no controla el fabricante.

    Las dos sirven. Pero no valen igual, y mezclarlas en la misma tabla es la forma más común de sacar una conclusión equivocada. Si quieres el criterio completo para separarlas, lo desarrollé al analizar las cifras de Grok 4.5, Fable 5 y DeepSeek V4, y el caso más descarado de tabla propia puntuando a los rivales lo tienes en la tabla de Alibaba para Qwen3.8-Max.

    Con Grok 4.6, esto es lo que hay a 24 de agosto de 2026.

    Autoreportado por xAI (su propia nota de lanzamiento):

    Benchmark Grok 4.6 Qué mide
    CursorBench v3.2 69,9 % Edición de código dentro del editor
    DeepSWE v1.1 65,9 % Ingeniería de software autónoma
    FrontierCode v1.1 61,3 % Código de dificultad alta
    APEX-Agents 57,5 % Tareas agénticas de horizonte largo
    APEX-SWE 56,4 % Ingeniería de software agéntica
    Terminal-Bench v3.0 26 % Trabajo real en terminal

    Medido por terceros:

    • Artificial Analysis Intelligence Index: 61. Verificado de forma independiente.
    • Terminal-Bench 3.0: 26,5 % en el snapshot público del leaderboard, actualizado el 20 de agosto de 2026 (el benchmark lo desarrolla el equipo de Harbor junto a Laude Institute, Snorkel AI y Turing).

    Fíjate en que la última fila de la tabla de xAI y la medición externa coinciden: 26 % frente a 26,5 %. Aquí no hay discusión metodológica ni harness sospechoso. xAI reporta su peor número con honestidad, y el tercero lo confirma.

    Ese es el número del que nadie hizo captura.


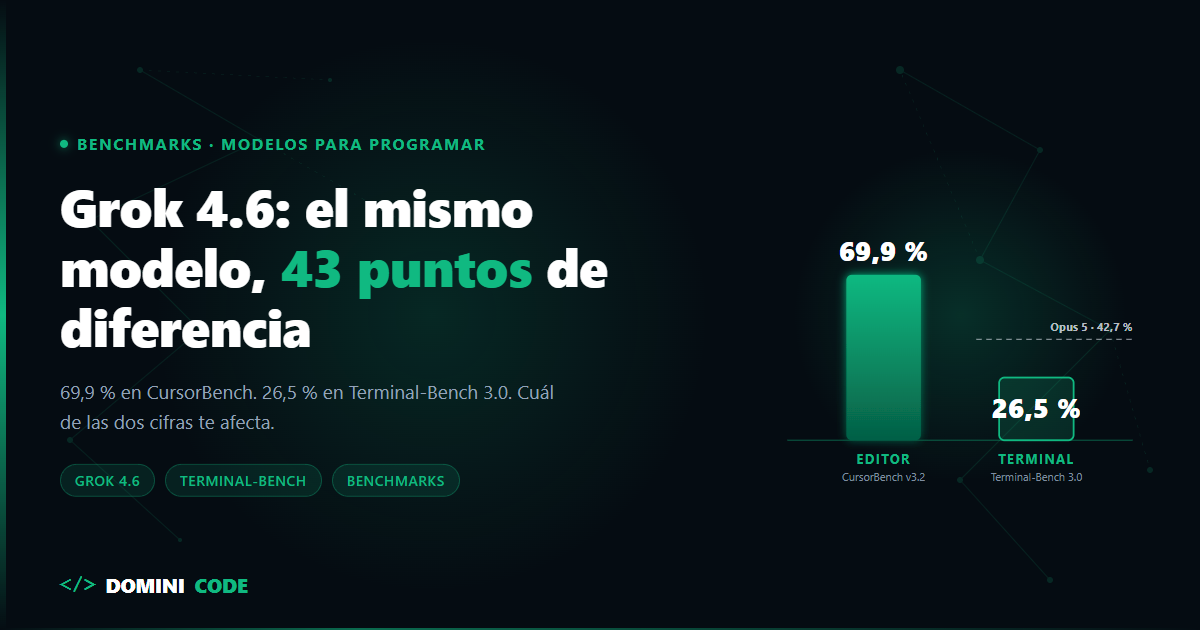
    La brecha: 69,9 % en el editor, 26,5 % en la terminal

    Pon las dos medidas juntas y el modelo se parte en dos.

      Grok 4.6, dos medidas del mismo modelo
    
      Editor    (CursorBench v3.2)   69,9 %
      ████████████████████████
    
      Terminal  (Terminal-Bench 3.0) 26,5 %
      █████████
    

    El mismo modelo, la misma semana, con 43 puntos de diferencia según lo que le pidas.

    Y para saber si ese 26,5 % es bueno o malo hace falta el contexto del leaderboard completo. Esta es la foto de Terminal-Bench 3.0 al 20 de agosto de 2026:

    # Modelo Terminal-Bench 3.0
    1 Claude Opus 5 42,7 %
    2 GPT-5.6 Sol 34,6 %
    3 Claude Fable 5 34,0 %
    4 GLM-5.3 32,4 %
    5 Grok 4.6 26,5 %
    6 Claude Opus 4.8 21,1 %
    7 GPT-5.6 Terra 20,8 %
    8 SWE-1.7 Lightning 18,6 %
    9 Grok 4.5 15,7 %
    10 Claude Sonnet 5 14,6 %
    11 GPT-5.6 Luna 14,3 %
    12 GLM-5.2 4,6 %

    Dos lecturas, y las dos son verdad.

    La mala: Grok 4.6 queda quinto, a 16,2 puntos de Claude Opus 5. En trabajo de terminal saca el 62 % de la puntuación del líder. No está cerca.

    La buena, y es la que casi nadie contó: Grok 4.5 estaba en 15,7 %. Grok 4.6 está en 26,5 %. Son 10,8 puntos de salto en treinta y cinco días, el mayor avance generacional de toda la tabla. De paso, Grok 4.6 ya pasa por delante de Claude Opus 4.8 (21,1 %) y de GPT-5.6 Terra (20,8 %).

    xAI lo respalda con su propia medición en la misma dirección: APEX-Agents sube de 47,1 % en Grok 4.5 a 57,5 % en 4.6, otros 10,4 puntos.

    Es decir: el trabajo agéntico es exactamente donde xAI ha metido el esfuerzo de esta versión, y se nota. Simplemente partían muy por detrás y todavía no han llegado.


    Por qué el editor y la terminal no miden lo mismo

    Esta es la parte que convierte una tabla en una decisión.

    Un benchmark de edición en el editor te pone delante un cambio acotado: aquí está el archivo, aquí está el contexto, escribe el diff. Una o pocas pasadas. El estado del mundo no cambia mientras trabajas. Si el modelo razona bien y conoce el lenguaje, acierta.

    Un benchmark de terminal es otro deporte:

      EDITOR                    TERMINAL
      ─────────                 ────────
      contexto dado             hay que descubrirlo
      1 pasada                  decenas de pasos
      estado fijo               estado que tú mutas
      fallo = diff malo         fallo = entorno roto
    

    En la terminal el modelo tiene que decidir qué comando lanzar, leer una salida que no esperaba, entender que algo ha cambiado por su propia acción anterior y corregir el rumbo sin perder el objetivo. Terminal-Bench 3.0 aprieta justo ahí: incluye nodos con GPU, topologías multi-contenedor, microservicios vivos y una corrección estricta que solo da el punto si el resultado final es exactamente el pedido.

    Ahí no se premia saber programar. Se premia no perder el hilo durante cuarenta pasos y verificar tu propio trabajo antes de seguir. xAI lo reconoce en su nota: dicen que en trayectorias largas empezaron a ver al modelo autoverificándose más.

    Que un modelo se caiga de 69,9 % a 26,5 % entre esos dos escenarios no es una contradicción. Es la descripción de dónde está su límite. Y si tú operas agentes que leen, escriben y ejecutan tests sobre tu repositorio, el número que te afecta es el segundo, no el primero.

    Por qué un bucle agéntico largo es tan frágil, y qué controles hay que ponerle, lo desmenucé en el agentic loop en producción con TypeScript.


    Lo que cuesta

    Grok 4.6 en la API de xAI, tarifa estándar por millón de tokens:

    Entrada Entrada en caché Salida
    Grok 4.6 $2 $0,50 $6
    Claude Opus 5 $5 — $25

    Ventana de contexto: 500K tokens.

    Y el detalle que se come presupuestos: a partir de 200K tokens de prompt, la petición entera pasa a la banda de contexto largo. No se encarece solo el tramo que excede el umbral: se recalculan todos los tokens de esa petición a la tarifa alta. Es el mismo mecanismo que ya tenía Grok 4.5 y que expliqué con números en el análisis de Grok 4.5. Si tu agente arrastra contexto acumulado, cruzas ese umbral sin darte cuenta.

    Ahora, la comparación honesta. Grok 4.6 cuesta 2,5 veces menos en entrada y 4,2 veces menos en salida que Opus 5. Si divides el precio de salida entre los puntos de Terminal-Bench que consigue cada uno, sale esto:

    • Grok 4.6: $6 / 26,5 = $0,23 por punto
    • Claude Opus 5: $25 / 42,7 = $0,59 por punto

    Grok 4.6 rinde 2,6 veces más barato por punto de terminal. Esa cifra la he derivado yo de las dos tablas de arriba, no la publica nadie, y tiene una trampa importante: en trabajo agéntico, el modelo que falla es el más caro de todos, porque cada intento fallido se paga entero y además te consume el tiempo de revisión. El precio por punto es una buena guía para elegir modelo en tareas que puedes verificar barato, y una guía pésima para elegirlo en tareas que se rompen caro.

    Ese cálculo, hecho por tarea completada y no por token, es el que decide de verdad, y lo desarrollé en el coste de los subagentes al cambiar de modelo.


    Entonces, ¿es el mejor modelo para programar?

    Con los datos públicos a 24 de agosto de 2026:

    Sí, es una opción muy competitiva para:

    • Escribir y editar código dentro del editor, con el contexto ya delante.
    • Algoritmos, refactors acotados, scripts aislados y consultas complejas.
    • Volumen alto de tareas verificables donde el precio por token pesa y un fallo se detecta en segundos.
    • Contextos grandes de lectura, siempre que vigiles el umbral de 200K.

    No, no lidera para:

    • Agentes autónomos que corren durante decenas de pasos sobre tu repositorio.
    • Trabajo de terminal con estado mutable: contenedores, servicios, migraciones.
    • Cualquier flujo donde el coste de un fallo silencioso sea alto.

    Y esta es la conclusión incómoda para los titulares: Grok 4.6 no compite con Claude Opus 5 en la fila que más importa si tu trabajo es agéntico, pero ha recortado más distancia en un mes que ningún otro modelo de la tabla. Si xAI mantiene ese ritmo, la comparación de dentro de dos versiones puede ser otra.

    Para decidir modelo por tipo de trabajo en lugar de por titular, tengo el marco completo en Opus 5 vs GPT-5.6 vs Kimi K3.


    Cómo comprobarlo en tu proyecto en una tarde

    Ningún leaderboard puntúa tu repositorio. Esto sí:

    1. Coge tres tareas reales ya resueltas de tu historial de Git, con su diff final conocido. Una acotada de editor, una de refactor medio y una que toque terminal o migraciones.
    2. Lánzalas al mismo harness, cambiando solo el modelo. El harness pesa tanto como el modelo: si cambias las dos cosas a la vez, no estás midiendo nada.
    3. Puntúa por tarea completada, no por impresión. Pasó los tests o no pasó. Y anota el coste total de cada intento, fallos incluidos.

    Con nueve ejecuciones tienes más información sobre tu caso que con todos los benchmarks de este post.

    Y la parte que no cambia sea cual sea el modelo: si el requerimiento es ambiguo, fallan todos. Cuando cierras el alcance y las interfaces en un spec.md antes de ejecutar, cualquier modelo de frontera sube su tasa de acierto. Tienes la metodología completa en el libro de Spec-Driven Development, y el pipeline práctico con herramientas CLI agénticas en el curso Construye con IA: de la idea al producto con Claude Code.

    En Dominicode Labs vamos pasando cada modelo nuevo por proyectos reales y compartimos los resultados: qué entra en el stack, qué se queda fuera y por qué.

    Prueba Grok 4.6. Pero mide la fila que se corresponde con tu trabajo, no la que mejor queda en una captura.


    Preguntas frecuentes

    ¿Cuánto ha mejorado Grok 4.6 respecto a Grok 4.5 en trabajo de terminal?

    Ha subido de 15,7 % a 26,5 % en Terminal-Bench 3.0, según el snapshot público del leaderboard del 20 de agosto de 2026. Son 10,8 puntos en treinta y cinco días, el mayor salto generacional de la tabla. xAI reporta una mejora en la misma dirección con su propia medición de APEX-Agents: de 47,1 % a 57,5 %.

    ¿Por qué Grok 4.6 saca 69,9 % en CursorBench y solo 26,5 % en Terminal-Bench 3.0?

    Porque miden trabajos distintos. CursorBench evalúa edición de código con el contexto ya dado y en pocas pasadas. Terminal-Bench 3.0 evalúa trayectorias largas en un entorno con estado mutable —contenedores, servicios vivos, nodos con GPU— y solo concede el punto si el resultado final es exactamente el pedido. El primer escenario premia saber programar; el segundo, no perder el hilo durante decenas de pasos.

    ¿El contexto de 500K de Grok 4.6 cambia algo para trabajar sobre un repositorio grande?

    Ayuda a leer, pero ojo con la factura: a partir de 200K tokens de prompt, xAI recalcula todos los tokens de esa petición a la tarifa de contexto largo, no solo el exceso. Un agente que acumula contexto cruza ese umbral sin avisar. Y una ventana grande no arregla el problema de fondo del trabajo agéntico, que es mantener el objetivo, no almacenar texto.

    ¿Qué es APEX-Agents y por qué xAI lo destaca?

    Es un benchmark de tareas agénticas de horizonte largo, y xAI lo destaca porque es donde más ha mejorado: 57,5 % frente al 47,1 % de Grok 4.5. Es una cifra autoreportada por xAI, no verificada por un tercero, así que conviene leerla como una señal de la dirección del trabajo del proveedor y no como una medición neutral.

    ¿Cuándo me conviene Grok 4.6 en lugar de Claude Opus 5?

    Cuando tu trabajo sea acotado y verificable barato: edición en el editor, algoritmos, refactors pequeños, volumen alto de tareas que fallan de forma visible. Ahí el precio marca la diferencia, porque Grok 4.6 cuesta $2/$6 por millón frente a $5/$25 de Opus 5. Si tu trabajo es un agente autónomo corriendo sobre tu repositorio, los 16,2 puntos de diferencia en Terminal-Bench se pagan en fallos silenciosos y en tu tiempo de revisión, y ahí sale más caro lo barato.

  • Los 5 fallos del código generado por IA que un code review no puede ver

    Los 5 fallos del código generado por IA que un code review no puede ver

    850 líneas. 14 archivos. Toda la capa de autenticación refactorizada con un asistente de IA.

    Dos seniors aprobaron el Pull Request. "LGTM, código muy limpio". Y lo era: nombres claros, funciones pequeñas, tipos correctos, cero warnings del linter.

    Diez minutos después del deploy, producción caída. El código abría una conexión nueva a PostgreSQL en cada petición y no la devolvía nunca. El pool se agotó, los 500 empezaron a caer en cascada y alguien tuvo que hacer rollback desde el móvil.

    Nadie hizo mal su trabajo en ese code review. El fallo simplemente no estaba en la pantalla que estaban mirando.

    Un diff te enseña la forma del código. Los fallos que tumban producción son de comportamiento: aparecen cuando el código se ejecuta, con concurrencia, con datos reales y repetido diez mil veces. Eso no se ve leyendo, se ve midiendo.

    Que no conviene fiarse de un código solo porque se lea bien ya lo conté en cómo garantizar la confiabilidad del código generado por IA. Este post no repite el aviso ni proclama que el code review haya muerto. Va de algo más operativo: qué clase de fallo caza cada capa de tu proceso, y cuál se te está colando porque lo estás buscando en el sitio equivocado.


    Los 5 fallos que un diff no puede mostrar

    No son fallos exóticos. Son los cinco que aparecen una y otra vez cuando el volumen de código generado sube y el tiempo de revisión no.

    1. La consulta N+1 encubierta

    El agente escribe un bucle que llama a un helper. El helper, tres archivos más allá, abre una consulta.

    En el diff ves await getUserProfile(id) dentro de un for. Una línea limpia, con buen nombre. Para verla como un problema tendrías que recordar qué hace ese helper por dentro y multiplicar mentalmente por el tamaño del array.

    En local, con 5 registros de prueba, vuela. En producción, con 4.000, son 4.000 consultas.

    2. La fuga de recursos

    Es el fallo de la historia de arriba y el más traicionero, porque lo que falta nunca aparece en un diff. Un diff enseña lo que se añadió; el bug está en la línea que no se escribió.

    // Se lee perfecto. Y en cada peticion abre una conexion que nadie cierra.
    export async function getInvoices(userId: string) {
      const client = new Client({ connectionString: process.env.DATABASE_URL });
      await client.connect();
      const { rows } = await client.query(
        "SELECT * FROM invoices WHERE user_id = $1",
        [userId],
      );
      return rows; // falta client.end() — y aqui no hay nada rojo que mirar
    }
    

    Lo mismo pasa con listeners que no se quitan, timers que no se limpian y streams que no se cierran. El código se lee bien porque está bien escrito. Solo está incompleto.

    3. La deriva de contrato

    El agente toca el endpoint y renombra un campo de la respuesta, o lo convierte de string a objeto. Actualiza el tipo en ese archivo, así que todo cuadra.

    Lo que no actualiza es el consumidor que vive en otro repositorio, o el móvil que lleva dos versiones sin actualizar. El fallo no está en ningún archivo: está entre dos. Y un revisor mirando un PR de un repo no tiene el otro delante.

    Contra esto, el tipado en tiempo de compilación no basta: hace falta validación en tiempo de ejecución en la frontera, que es justo lo que hace Zod cuando validas lo que entra y sale de cada servicio en lugar de confiar en el tipo declarado.

    4. La regresión de coste

    Este no produce ningún error. Todo funciona, los tests pasan en verde y el usuario no nota nada.

    Simplemente, la nueva versión hace tres llamadas al modelo donde antes hacía una, o manda el documento entero en el prompt donde antes mandaba un fragmento. El resultado es idéntico. La factura, el triple.

    Es el único de los cinco que no es un bug: es una decisión de implementación peor que la anterior. Ninguna aserción se pone roja por esto. Lo ves en la factura a fin de mes, o lo ves en la traza el mismo día.

    5. La race condition introducida "optimizando"

    El agente ve tres await seguidos y los convierte en un Promise.all. En el diff parece exactamente lo que quieres: menos latencia, código más idiomático.

    Salvo que dos de esas operaciones escribían sobre el mismo registro y el orden importaba. Con un usuario, nunca falla. Con doscientos concurrentes, falla una de cada cien veces y el bug tarda tres semanas en reproducirse.


    Qué capa caza cada fallo

    Aquí está el mapa. Es lo único que hay que llevarse del post:

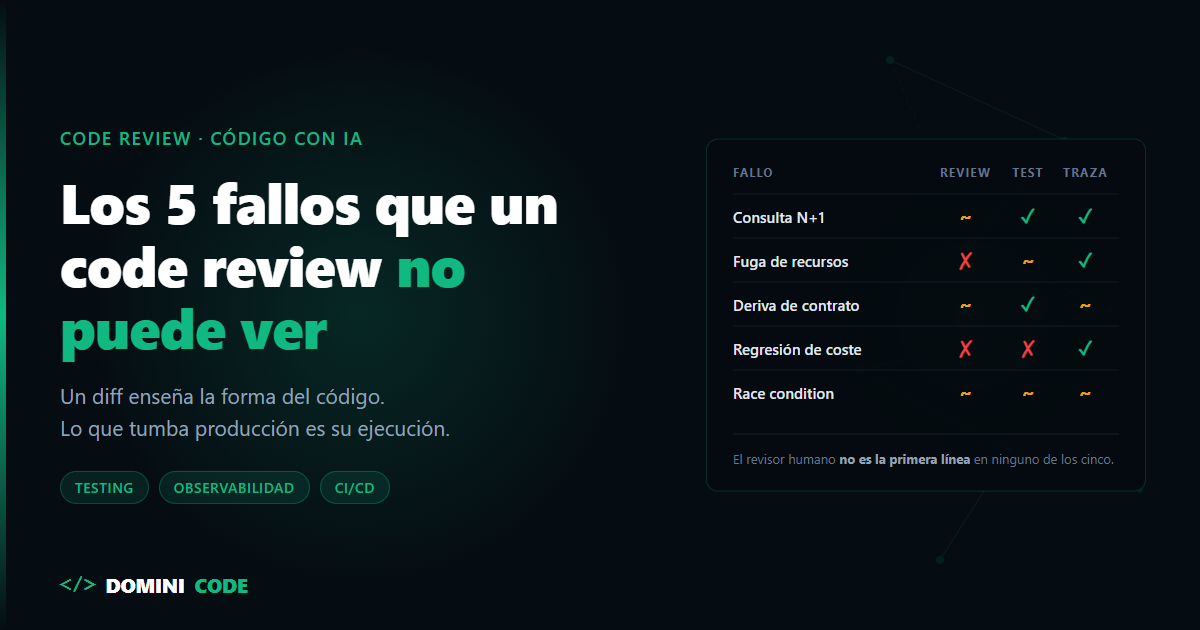
    Fallo Code review Test automático Traza en producción Dónde se caza primero
    Consulta N+1 ⚠️ solo si conoces el helper ✅ asertando nº de queries ✅ evidente Test de integración
    Fuga de recursos ❌ no está en el diff ⚠️ solo repitiendo la llamada ✅ evidente Producción, en minutos
    Deriva de contrato ⚠️ si tienes ambos lados ✅ test de contrato ⚠️ tarde CI, con contract tests
    Regresión de coste ❌ invisible ❌ pasa en verde ✅ único sitio Traza / factura
    Race condition ⚠️ si la buscas ⚠️ flaky, poco fiable ⚠️ difícil de atribuir Test de concurrencia

    Léela por columnas y salta a la vista lo incómodo: el revisor humano no es la primera línea de defensa en ninguno de los cinco. En el mejor de los casos es un ⚠️ que depende de que la persona conozca ese helper concreto, tenga el otro repositorio en la cabeza o esté buscando específicamente esa clase de fallo a la línea 600 de 850.

    Eso no significa que el code review sobre. Significa que le estamos pidiendo el trabajo equivocado.


    El orden correcto (y por qué casi todos lo invierten)

    El proceso típico pone al humano primero: alguien lee el PR, lo aprueba, y entonces corre el CI y se despliega. Con código generado por IA ese orden está del revés, por una razón de economía muy simple: la atención humana es el recurso más caro y más escaso del equipo, y la máquina cuesta céntimos.

    Primero la máquina. Tests, linters, validación de contratos. Si un fallo tiene una aserción posible, esa aserción tiene que existir y correr antes de que nadie lea una línea. El caso del pool que tumbó producción se cazaba con esto:

    it("no deja conexiones abiertas al servir una petición", async () => {
      const before = pool.totalCount;
      await getInvoices("user-1");
      expect(pool.totalCount).toBe(before);
    });
    

    Ese test no lo escribe el agente por iniciativa propia: lo pides tú, porque conoces el fallo. Cómo repartir ese trabajo entre lo que escribes tú y lo que delegas está en TDD con IA: valida el código autogenerado antes de mergear, y hay una capa de revisión automática que puedes meter en el pipeline antes de la humana, explicada en cómo integrar revisiones de código con IA en tu CI/CD.

    Después la traza, como red. Para lo que nadie anticipó —y la regresión de coste es el ejemplo perfecto— la única capa que ve algo es la instrumentación en tiempo de ejecución. Si trabajas con LLMs, el árbol de llamadas y el coste por petición se trazan con las herramientas que repaso en observabilidad en LLMs.

    Y el humano al final, sobre otra pregunta. No "¿está bien escrito esto?" —eso ya lo contestaron el linter y los tests—, sino las tres que ninguna máquina responde:

    • ¿Este código debía existir? Buena parte de los PRs generados con IA resuelven un problema que no había que resolver así.
    • ¿Respeta las fronteras de arquitectura? Un agente cruza capas sin despeinarse si eso hace pasar el test.
    • ¿Cumple lo que dice la especificación?

    Esa tercera pregunta solo se puede contestar si existe una especificación escrita antes del código. Cuando el PR se revisa contra un spec.md, el review deja de ser una opinión sobre estilo y pasa a ser una comprobación con respuesta binaria — que es de lo que va el libro de Spec-Driven Development.

    Y si quieres el músculo de escribir las aserciones del punto 1 —las de verdad, las que fallan cuando algo se rompe y no cuando alguien renombra una variable—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library.


    Lo que puedes cambiar en el próximo PR

    1. Coge la tabla y localiza tu hueco. Casi todos los equipos tienen la columna de tests a medias y la de trazas vacía. Ese es el fallo que se te está colando.
    2. Convierte tu último incidente en una aserción. Si algo tumbó producción una vez, tiene que haber un test que se ponga rojo si vuelve. Uno por incidente, sin excepciones.
    3. Cambia la pregunta del review. Prohíbete comentar estilo. Solo arquitectura, fronteras y cumplimiento de la spec.

    En Dominicode Labs montamos este tipo de procesos de verificación para que la velocidad de la IA no se pague en incidentes de madrugada.

    Generar código rápido hoy es gratis. Lo caro sigue siendo saber si funciona — y eso no se lee en un diff.


    Preguntas frecuentes

    ¿Se puede revisar de verdad un PR de 850 líneas generado por IA?

    No con la atención que merece. La respuesta no es leer más rápido: es exigir que el PR llegue troceado y con la capa automática ya en verde. Un PR generado en cuarenta segundos no da derecho a una revisión de cuarenta segundos, así que o se parte en cambios pequeños o se revisa solo el subconjunto que toca arquitectura y contratos.

    ¿Un linter o un analizador estático caza estos cinco fallos?

    Parcialmente y solo dos. Las reglas estáticas detectan algunos patrones de recurso no cerrado dentro de un mismo archivo, pero no ven el N+1 escondido tras un helper, ni la deriva de contrato entre repositorios, ni el coste, ni la concurrencia. Un linter razona sobre el texto del programa; estos fallos existen únicamente cuando el programa corre.

    ¿Estos fallos son culpa de la IA o pasaban igual con código escrito a mano?

    Pasaban igual. Lo que cambia es el volumen y el ritmo: la misma tasa de fallo aplicada a diez veces más líneas, revisadas por el mismo número de personas en el mismo tiempo, da un resultado muy distinto. El proceso no se rompe porque la IA escriba peor, sino porque escribe más rápido de lo que nadie puede leer.

    Si aún no tengo observabilidad, ¿qué capa cubre el hueco mientras tanto?

    Los tests, pero eligiendo bien. Sin trazas pierdes la regresión de coste y la atribución de las races, así que compensa con aserciones sobre efectos medibles: número de consultas por operación, conexiones abiertas al terminar, número de llamadas al modelo. Son baratas, corren en CI y cubren tres de los cinco fallos hasta que instrumentes.

    ¿Merece la pena que la IA revise sus propios PRs?

    Como primera pasada sí, y sale muy rentable porque cuesta céntimos y no se cansa a la línea 600. Pero trátala como un linter semántico, no como un aprobador: comparte los puntos ciegos del modelo que escribió el código y tiende a validar lo que a ella misma le parece idiomático. La aprobación sigue siendo humana.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Nadie prueba un motor de avión montándolo en un aparato con pasajeros. Lo amarran a un banco de pruebas, le conectan sensores, le inducen fallos y miden qué aguanta. Si revienta, revienta en tierra.

    Con software tenemos el equivalente desde hace décadas y se llama test harness: el andamiaje que rodea al código bajo prueba, le inyecta entradas controladas y comprueba las salidas.

    Con agentes de IA, en cambio, la mayoría probamos en caliente. Lanzamos el agente contra una API real, miramos si el resultado "parece bien" y lo damos por bueno.

    El problema no es la pereza. Es que un agente rompe los tres supuestos sobre los que se construyó todo tu testing:

    • No es determinista: la misma entrada da salidas distintas.
    • Tiene efectos secundarios reales: escribe archivos, llama a APIs, toca bases de datos.
    • No tiene garantía de terminar: puede quedarse en bucle gastando dinero.

    Ya expliqué por qué un LLM por sí solo no es un producto y qué capas necesita alrededor para funcionar en producción. Este post va de la otra mitad del problema, la que casi nadie monta: el arnés que se ejecuta en CI, antes del deploy. Con código.


    Por qué un test unitario normal no sirve aquí

    Un test clásico es un contrato de tres líneas: preparas la entrada, ejecutas, comparas con el valor esperado.

    Con un agente, ese toEqual no existe. La respuesta correcta no es una cadena concreta, es cualquiera de un conjunto amplio de cadenas aceptables. Y si aun así escribes la aserción exacta, tendrás un test que pasa hoy y falla el martes sin que nadie haya tocado nada.

    De ahí sale la reacción habitual, que es la equivocada: dejar de testear el agente y testear solo las funciones puras que lo rodean. Los parsers, los formateadores, los validadores. Cosas que ya sabías hacer.

    Mientras tanto, lo que de verdad puede costarte dinero —el bucle, las llamadas a herramientas, el gasto— viaja a producción sin una sola comprobación.

    El arnés cambia la pregunta. En lugar de "¿ha respondido lo correcto?", que es un problema de evals, pregunta cosas que sí tienen respuesta binaria:

    • ¿Ha llamado a alguna herramienta que no tenía permitida?
    • ¿Se ha pasado del presupuesto de tokens que le di?
    • ¿Ha terminado dentro del tiempo límite?
    • ¿Ha intentado escribir fuera de su directorio temporal?
    • ¿Ha llamado 14 veces a la misma herramienta con los mismos argumentos?

    Eso son tests de verdad: deterministas, rápidos y rojos cuando algo se rompe.

       caso de prueba              TEST HARNESS                  veredicto
      ┌──────────────┐    ┌──────────────────────────────┐    ┌────────────┐
      │ entrada fija │───►│  tools falsas (sin red)      │───►│ PASS/FAIL  │
      │ estado fijo  │    │  presupuesto de tokens       │    │ trace.json │
      └──────────────┘    │  timeout + AbortSignal       │    └────────────┘
                          │  directorio efimero          │
                          └──────────────────────────────┘
    

    Las 3 piezas que hacen testeable a un agente

    1. Herramientas falsas, no red

    La regla es simple: en modo test, el agente no toca nada real. Ni base de datos, ni API de pagos, ni sistema de archivos fuera de un directorio temporal que destruyes al terminar.

    Y no basta con mockear la implementación. Hay que no exponer las herramientas no autorizadas: si el agente ve deleteUser en su lista de tools, tarde o temprano la llamará, y el error que quieres detectar en CI es precisamente ese. Un arnés que expone la herramienta y luego lanza una excepción llega tarde para razonar sobre el diseño, aunque salve los datos.

    Si necesitas ejecutar código generado de verdad —no simularlo—, ahí el aislamiento sube un nivel y toca contenedor: lo conté en Docker sandboxing para ejecutar código de IA de forma segura.

    2. Presupuesto de tokens y timeout que cortan de verdad

    Esta es la pieza que casi todo el mundo escribe mal.

    He visto docenas de arneses con un campo maxTokens en la configuración que no se comprueba en ningún sitio. Y timeouts implementados con Promise.race que devuelven el control al test pero dejan la ejecución corriendo por detrás, gastando tokens contra la API mientras el test ya ha dado verde.

    Un límite que no corta no es un límite: es un comentario.

    3. Traza reproducible

    El arnés graba cada paso: qué herramienta, con qué argumentos, cuánto tardó, cuánto costó. Un array de objetos serializado a JSON.

    Sirve para dos cosas. Para que un fallo en CI sea depurable sin volver a lanzar el agente. Y para escribir aserciones sobre el proceso, no sobre el texto final, que es donde está la señal útil: si el agente llegó al resultado correcto llamando siete veces a la misma consulta, eso es un bug aunque la salida sea perfecta.


    El arnés en TypeScript

    Vamos al código. Un arnés mínimo con presupuesto real, cancelación real y traza, sin dependencias más allá de Zod para validar los argumentos que el modelo envía a cada herramienta.

    Primero, los tipos y el registro de herramientas:

    import { z } from "zod";
    
    export interface HarnessConfig {
      maxTokens: number;
      timeoutMs: number;
      allowedTools: string[];
    }
    
    export interface TraceEntry {
      tool: string;
      args: unknown;
      durationMs: number;
      tokens: number;
    }
    
    /** Herramienta ya validada: el schema queda encapsulado dentro de `run`. */
    export interface HarnessTool {
      cost: number;
      run: (rawArgs: unknown) => Promise<unknown>;
    }
    
    export class BudgetExceededError extends Error {}
    
    /**
     * En el punto de definicion conservas el tipado completo del schema.
     * En el registro todas las tools comparten la misma firma, que es lo
     * que permite recorrerlas en bucle sin castings.
     */
    export function defineTool<S extends z.ZodType>(
      schema: S,
      cost: number,
      run: (args: z.infer<S>) => Promise<unknown>,
    ): HarnessTool {
      return { cost, run: (rawArgs) => run(schema.parse(rawArgs)) };
    }
    
    // Fixtures: nada de esto sale a la red.
    export const testTools: Record<string, HarnessTool> = {
      queryDatabase: defineTool(
        z.object({ table: z.string(), limit: z.number().max(100) }),
        320,
        async ({ table }) => ({ rows: [{ id: 1, table, name: "Fixture User" }] }),
      ),
      sendEmail: defineTool(
        z.object({ to: z.string().email(), body: z.string() }),
        90,
        async () => ({ delivered: true }),
      ),
    };
    

    Ahora el arnés. Fíjate en tres detalles: solo se construyen las herramientas permitidas, el presupuesto se comprueba antes de ejecutar cada llamada, y el temporizador se limpia siempre.

    export type HarnessStatus = "SUCCESS" | "TIMEOUT" | "BUDGET_EXCEEDED" | "FAILED";
    
    export interface HarnessResult {
      status: HarnessStatus;
      tokensUsed: number;
      durationMs: number;
      output: string | null;
      trace: TraceEntry[];
    }
    
    type ToolBox = Record<string, (args: unknown) => Promise<unknown>>;
    
    export async function runWithHarness(
      task: (tools: ToolBox, signal: AbortSignal) => Promise<string>,
      config: HarnessConfig,
    ): Promise<HarnessResult> {
      const startedAt = performance.now();
      const trace: TraceEntry[] = [];
      let tokensUsed = 0;
    
      // 1. Solo existen las tools autorizadas. El resto no se expone.
      const tools: ToolBox = {};
      for (const name of config.allowedTools) {
        const tool = testTools[name];
        // Un nombre desconocido es un error de configuracion del test: que reviente ya.
        if (!tool) throw new Error(`Tool desconocida en allowedTools: ${name}`);
    
        tools[name] = async (rawArgs: unknown) => {
          // 2. El presupuesto se comprueba ANTES de gastar.
          if (tokensUsed + tool.cost > config.maxTokens) {
            throw new BudgetExceededError(
              `Presupuesto agotado: ${tokensUsed} + ${tool.cost} > ${config.maxTokens}`,
            );
          }
          const t0 = performance.now();
          const result = await tool.run(rawArgs); // Zod valida dentro: si no cuadra, revienta
          tokensUsed += tool.cost;
          trace.push({
            tool: name,
            args: rawArgs,
            durationMs: Math.round(performance.now() - t0),
            tokens: tool.cost,
          });
          return result;
        };
      }
    
      // 3. Cancelacion real: la tarea recibe el signal y debe propagarlo al SDK.
      const controller = new AbortController();
      const timer = setTimeout(() => controller.abort(), config.timeoutMs);
    
      const finish = (status: HarnessStatus, output: string | null): HarnessResult => ({
        status,
        tokensUsed,
        durationMs: Math.round(performance.now() - startedAt),
        output,
        trace,
      });
    
      try {
        const output = await task(tools, controller.signal);
        return finish("SUCCESS", output);
      } catch (error) {
        if (controller.signal.aborted) return finish("TIMEOUT", null);
        if (error instanceof BudgetExceededError) return finish("BUDGET_EXCEEDED", null);
        return finish("FAILED", error instanceof Error ? error.message : String(error));
      } finally {
        clearTimeout(timer); // sin esto, el timer mantiene vivo el proceso al terminar
      }
    }
    

    Un aviso honesto sobre el punto 3: el AbortSignal solo cancela de verdad si tu tarea lo propaga al SDK del modelo y a cada fetch. Si lo ignoras, el arnés dará TIMEOUT y devolverá el control al test, pero la llamada seguirá viva por detrás y te la cobrarán igual. El signal no es decorativo: es el único mecanismo que corta el gasto.

    Y ahora sí, un test

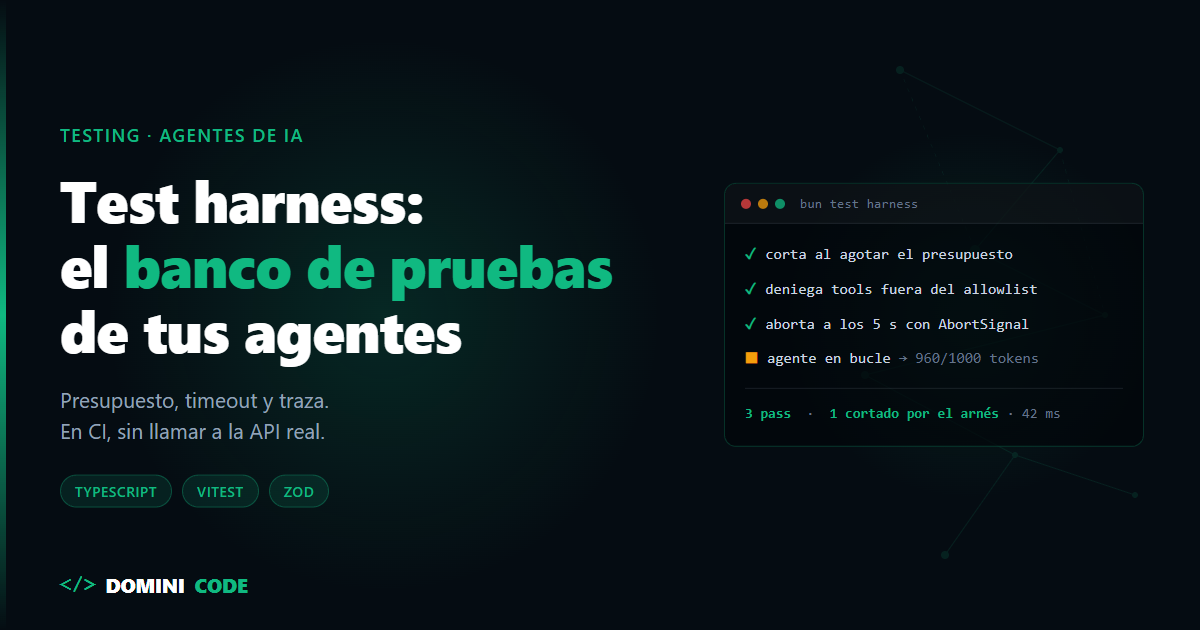
    Con esto, probar el bucle del agente vuelve a ser testing normal:

    import { describe, expect, it } from "vitest";
    import { runWithHarness } from "./harness";
    
    describe("agente de facturación", () => {
      it("corta la ejecución al agotar el presupuesto", async () => {
        const result = await runWithHarness(
          async (tools) => {
            // Un agente en bucle: consulta la misma tabla sin parar.
            for (let i = 0; i < 20; i++) {
              await tools.queryDatabase({ table: "invoices", limit: 10 });
            }
            return "listo";
          },
          { maxTokens: 1_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.status).toBe("BUDGET_EXCEEDED");
        expect(result.tokensUsed).toBeLessThanOrEqual(1_000);
        expect(result.trace).toHaveLength(3); // 3 × 320 = 960; la cuarta no cabe
      });
    
      it("no expone las herramientas fuera del allowlist", async () => {
        const result = await runWithHarness(
          async (tools) => {
            if ("sendEmail" in tools) return "PELIGRO: tool disponible";
            return "ok";
          },
          { maxTokens: 5_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.output).toBe("ok");
      });
    });
    

    Deterministas, sin red, en milisegundos. Se pueden ejecutar en cada push sin pensar en la factura.

    Ese expect(result.trace).toHaveLength(3) es el tipo de aserción que solo puedes escribir si grabas la traza: comprueba el comportamiento del bucle, no el texto de salida.

    Si quieres afinar el diseño de tests y el aislamiento de dependencias externas —que es exactamente el músculo que necesitas aquí—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library. Y el uso de Zod para validar los argumentos que envía el modelo, con transformaciones y errores tipados, lo tienes en el curso de Zod para TypeScript.


    Qué encaja arriba y qué encaja abajo

    Tres piezas que se confunden todo el rato y conviene separar:

    Pieza Cuándo corre Qué responde
    Test harness En CI, en cada push ¿Se sale de los límites, del allowlist o del tiempo?
    Evals Por lotes, con casos reales ¿La calidad de las respuestas sube o baja?
    Agentic harness En producción, en cada ejecución ¿Cómo lo mantengo controlado con usuarios reales?

    El arnés de pruebas es el más barato de los tres y el que casi nadie tiene. Cuestión de horas montarlo, y atrapa la clase de fallo que más caro sale.

    Sobre el reparto de trabajo entre los tests que escribes tú y los que genera el agente, ya hay un post entero: adopta TDD para implementar pruebas efectivas con agentes de IA. Y sobre por qué la spec y la arquitectura no bastan sin esta capa debajo, también. Este post es la parte que faltaba: el código.

    Si trabajas con Spec-Driven Development, el encaje es directo. Los límites que escribes en la sección de NFRs del spec.md —presupuesto, latencia, herramientas permitidas— dejan de ser un párrafo y pasan a ser los argumentos de HarnessConfig. La especificación se vuelve ejecutable, que es de lo que va el libro de Spec-Driven Development.


    Lo que puedes montar esta semana

    1. Una lista blanca de herramientas por entorno. Que en test solo existan las que necesita el caso.
    2. Un presupuesto que corte. Comprobado antes de cada llamada, no después. Si tu maxTokens no aparece en ningún if, no existe.
    3. Una traza en JSON por ejecución. Y al menos un test que asierte sobre ella, no sobre el texto de salida.

    En Dominicode Labs montamos este tipo de arneses sobre agentes que corren horas sin supervisión.

    Deja de probar tus motores en pleno vuelo. Amárralos al banco, súbeles la presión hasta que rompan y arréglalos en tierra, que es donde sale barato.


    Preguntas frecuentes

    ¿Cómo se testea algo que no es determinista?

    No asertando sobre el texto de salida, sino sobre el comportamiento observable: qué herramientas llamó, con qué argumentos, cuántas veces, cuánto gastó y si terminó a tiempo. Todo eso sí es determinista y da un rojo claro cuando se rompe. La calidad de la respuesta es otra disciplina y se mide por lotes, no en cada push.

    ¿El test harness sustituye a los mocks de toda la vida?

    No, los usa. La diferencia es el alcance: un mock reemplaza una dependencia concreta, mientras que el arnés controla el entorno completo de la ejecución —qué herramientas existen, cuánto puede gastar, cuánto puede tardar y qué queda grabado—. Un mock por sí solo no impide que el agente entre en bucle.

    ¿Hay que llamar al modelo real en estos tests?

    No en los que corren en cada push: se ejecuta el bucle del agente con respuestas fijas, y eso vale para verificar límites, allowlist y control de flujo. Las ejecuciones con modelo real cuestan dinero y tardan, así que van en un job aparte, programado y sobre un conjunto reducido de casos.

    ¿Qué hago si el timeout salta pero el agente sigue gastando dinero?

    Es que estás cortando en el sitio equivocado. Promise.race devuelve el control al test pero no cancela nada: hay que crear un AbortController, pasar su signal a la tarea y propagarlo al SDK del modelo y a cada fetch. Si el SDK que usas no acepta señal de cancelación, el único corte real es aislar la ejecución en un proceso o contenedor aparte y matarlo.

    ¿Merece la pena montarlo si mi agente solo lee datos?

    Sí, por el gasto y por los bucles. Un agente de solo lectura no borra nada, pero puede repetir la misma consulta cuarenta veces y facturarte la broma entera. El presupuesto y la traza detectan ese patrón en CI, que es donde cuesta cero arreglarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    El 3 de agosto Alibaba presentó Qwen3.8-Max. Me senté a leer el anuncio para sacar dos párrafos y pasar a otra cosa: modelo nuevo, ficha técnica, precio, siguiente.

    Me quedé atascado en la tabla de benchmarks.

    No por sus números, sino por los de los demás. En esa tabla Alibaba no solo se puntúa a sí misma: puntúa también a Claude Opus 4.8, a Claude Fable 5 y a GPT-5.6 Sol. Cuatro filas, cuatro modelos, un único autor de las mediciones.

    Abrí el leaderboard oficial de Terminal-Bench 2.1 para cruzar las cifras. Y ahí dejó de ser una ficha técnica.

    Los cuatro modelos de la tabla de Alibaba —incluidos los tres que no son suyos— puntúan por encima del número 1 del leaderboard independiente. Dos de ellos ni siquiera tienen entrada en ese leaderboard.

    Hay una explicación legítima para esto y la doy entera más abajo, antes de cualquier conclusión. No es fraude. Pero tampoco es un ranking, aunque tenga forma de ranking.

    El contexto general —el leaderboard completo de agosto y por qué una cifra autoreportada y una medida no valen lo mismo— lo dejé escrito en Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen. Este post es el caso concreto: qué es Qwen3.8-Max, cuánto cuesta y qué haces con él a partir de hoy.

    ¿Qué es Qwen3.8-Max? 2,4 billones de parámetros y un dato que falta

    Qwen3.8-Max es un modelo MoE —mixture of experts— con 2,4 billones de parámetros totales (2,4 × 10¹², lo que en inglés se escribe 2.4T). Es multimodal de entrada: acepta texto, imagen y vídeo, y devuelve texto.

    Hasta aquí, la ficha. Ahora lo interesante. En un MoE, el número que de verdad predice coste y latencia no es el total, sino cuántos parámetros se activan por token. Los agregadores llevan días repitiendo "95B activos" como si estuviera en el anuncio.

    Fui a buscarlo y no está: Alibaba publica el total, no los activos. Tampoco lo he encontrado en ningún material primario del lanzamiento, y ninguno de los agregadores que repiten los 95B enlaza a dónde lo sacó.

    No digo que sea falso. Digo que no lo puedo verificar y que se está citando un número de segunda mano como si fuera de primera.

    Que el dato más repetido del lanzamiento sea justo el que no puedo confirmar dice bastante de cómo viaja la información técnica en las primeras 72 horas de un modelo.

    El contexto de Qwen3.8-Max: 1M de titular, 983K reales

    El titular es "1 millón de tokens de contexto". Los límites reales de la API son estos:

    Modo Entrada máxima Salida máxima
    Normal 991K tokens 131K tokens
    Con thinking activado 983K tokens 131K tokens

    No es una trampa: nadie te vende "991K de contexto". Pero si llenas la ventana hasta el borde, esos tokens que desaparecen al activar el razonamiento son los que revientan una ejecución larga a las tres de la mañana.

    Diseña contra 983K, no contra 1M. El límite que importa es el peor, no el del titular.

    Cuánto cuesta Qwen3.8-Max: $2 de entrada y $6 de salida

    Precios de lista por millón de tokens:

    Concepto Precio por millón
    Entrada $2,00
    Salida $6,00
    Lectura de caché implícita $0,25

    Franja media del mercado, no gama alta. Y el dato que casi nadie mira es el tercero: la lectura de caché a $0,25 es un 87,5% menos que la tarifa de entrada.

    Un agente que arrastra el mismo system prompt y los mismos ficheros durante veinte turnos paga la mayor parte de su factura a $0,25, no a $2. Calcula con esa tarifa o te sobrará presupuesto por el lado equivocado. La comparativa de precios de agosto de 2026 con el resto de modelos ya está publicada; aquí no la repito.

    Sobre disponibilidad, un matiz que cambia la decisión: está en API alojada y los pesos abiertos están prometidos para "la semana que viene" desde el 3 de agosto, así que aún no existen. Un modelo con pesos prometidos no es un modelo con pesos. Con Qwen3.7 analicé la generación anterior; aquí al menos hay promesa y plazo. Sigue siendo una promesa.

    Los benchmarks de Qwen3.8-Max según Alibaba

    Estas son las cifras del anuncio de lanzamiento de Alibaba, tal como las reproducen dos fuentes independientes que coinciden entre sí. No he podido confirmar la URL del anuncio original, así que no te la enlazo y prefiero decirlo en voz alta. Todas ellas, sin excepción, son mediciones reportadas por Alibaba:

    Benchmark Qwen3.8-Max (autoreportado por Alibaba)
    Terminal-Bench 2.1 86,6
    SWE-bench Pro 67,7
    DeepSWE 1.1 56,6
    PaperBench 93,0
    CoWorkBench 74,8
    WideSearch 81,9
    GPQA Diamond 92,6
    IFBench 82,8
    MRCR v2 (256K) 92,9
    MMMU-Pro 82,3
    OSWorld-Verified 86,1
    OmniDocBench 1.5 92,1
    Video-MME (con subtítulos) 90,4

    Ninguna de estas cifras ha sido reproducida por un tercero independiente a 7 de agosto de 2026.

    He dejado solo la columna de Qwen. En el anuncio, la fila de Terminal-Bench trae tres modelos más.

    Es una tabla fuerte, sobre todo en multimodal: 82,3 en MMMU-Pro y 86,1 en OSWorld-Verified con entrada de imagen y vídeo a $2 el millón es una combinación que casi nadie ofrece.

    El problema no está en esta tabla. Está en la fila de Terminal-Bench 2.1, donde Alibaba añadió a la competencia.

    Qwen3.8-Max frente a tbench.ai: el cruce fila a fila

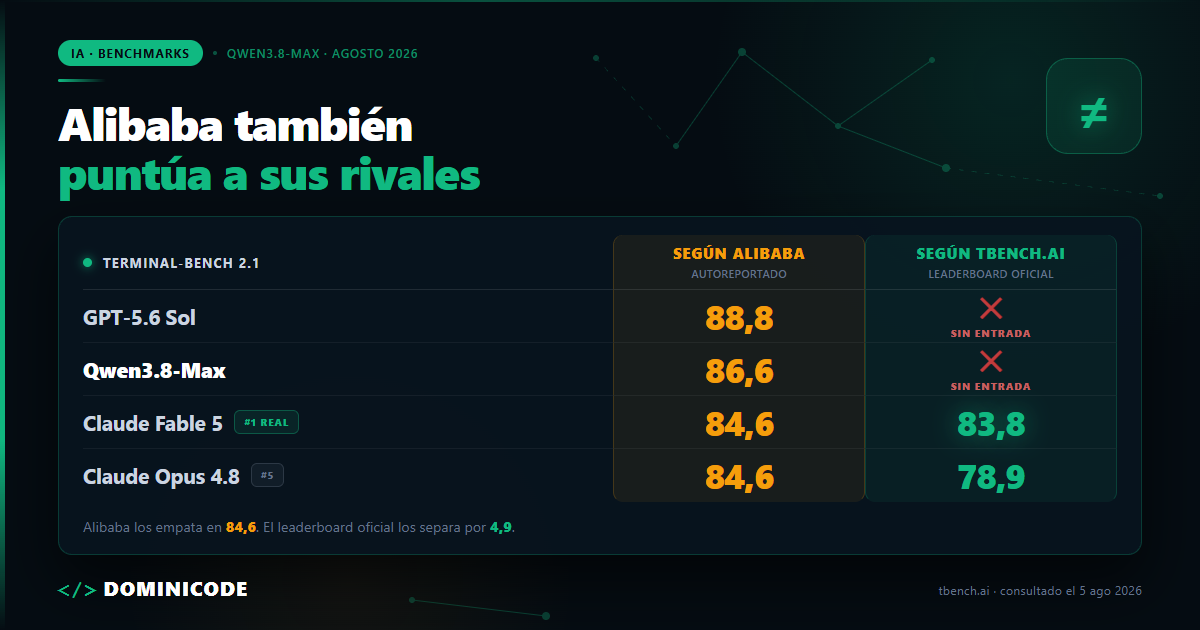
    Esto es lo que publicó Alibaba en esa fila, junto a lo que dice el leaderboard público de tbench.ai consultado el 5 de agosto de 2026:

    Modelo Según Alibaba Según tbench.ai Puesto Harness + effort Diferencia
    GPT-5.6 Sol 88,8 sin entrada — — —
    Qwen3.8-Max 86,6 sin entrada — — —
    Claude Fable 5 84,6 83,8 #1 Claude Code, xhigh +0,8
    Claude Opus 4.8 84,6 78,9 #5 Claude Code, high +5,7

    Hay tres cosas en esa tabla y ninguna salta a la primera.

    Uno. Los cuatro valores de la columna de Alibaba superan el 83,8 que es el primer puesto del leaderboard independiente. En la tabla del anuncio, el líder real del ranking público queda empatado en tercer puesto.

    Dos. Alibaba empata a Opus 4.8 con Fable 5 en 84,6. En la medición independiente esos dos modelos están separados por 4,9 puntos. No es solo que las cifras sean más altas: es que el orden entre los rivales también cambia.

    Tres. Los dos modelos que encabezan la tabla son justo los que no tienen entrada oficial. GPT-5.6 Sol no aparece en el leaderboard —y el 88,8 que le asigna Alibaba tampoco coincide con el 89,5 que circula por los agregadores, otra cifra sin fuente que ya repasé en el post hermano—. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%): entre diez y trece puntos por debajo del 88,8 del anuncio. Y Qwen3.8-Max tampoco está: se anunció el 3 de agosto, dos días antes de esa consulta.

    Un número que nadie externo ha reproducido no es mejor ni peor. Es un número sin contraste.

    Por qué los números de Alibaba pueden ser correctos y no comparables

    Hay una razón técnica por la que las cuatro cifras pueden ser correctas sin ser comparables, y la doy antes de mi conclusión porque cambia el veredicto.

    Terminal-Bench 2.1 no puntúa modelos sueltos. Puntúa modelo + harness + effort: el modelo, el agente que lo envuelve y cuánto cómputo se le permite gastar por tarea. Por eso cada fila del leaderboard oficial dice "Claude Code + Fable 5, xhigh" y no simplemente "Fable 5".

    Si Alibaba corrió el benchmark con su propio harness y su propia configuración de esfuerzo, sus números pueden ser correctos y a la vez no comparables con los de tbench.ai. Un harness más agresivo sube a todos los modelos de la tabla, incluidos los ajenos. Eso explicaría por qué las cuatro cifras están por encima del líder oficial.

    No hay fraude en eso. Es una medición distinta de una cosa distinta.

    El problema es de presentación, y es real: una tabla con forma de ranking, que mezcla tu medición con la de tus competidores y llega al lector sin harness ni effort al lado, se va a leer como si fuera el leaderboard. Porque se parece al leaderboard.

    Es lo que enseño en Construye con IA: montar la evaluación antes que el modelo, porque el número que te sale es del sistema entero y el modelo es solo una de sus piezas. Cambia el andamiaje y cambias el número sin tocar el modelo.

    Es también el patrón que analicé con Kimi K3. La coincidencia no está en el país de origen: está en que ningún fabricante espera a que un tercero le mida antes de lanzar.

    Entonces, ¿te conviene Qwen3.8-Max?

    Sí para multimodal barato, no para agentes de terminal en producción. El criterio que lo decide es uno solo: separa lo comprobable de lo reportado.

    Comprobable hoy: $2 y $6 por millón, caché a $0,25, 983K de entrada real con thinking, 131K de salida, entrada de texto, imagen y vídeo, y disponibilidad por API. Con eso ya decides un piloto.

    Reportado y sin contraste: el 86,6 de Terminal-Bench, el 67,7 de SWE-bench Pro y el resto de la tabla. Sirven como hipótesis de trabajo, no como criterio de compra.

    Si trabajas con documentos, capturas o vídeo —OCR, análisis de UI, pipelines de contenido—, es candidato serio y su precio lo hace barato de probar. Si buscas un agente de terminal para producción, yo esperaría: los pesos no están, no hay medición independiente y sí hay opciones ya medidas.

    Lo que puedes hacer esta semana, en dos horas: elige tres tareas de tu backlog que ya sepas resolver, ejecútalas con tu agente actual y con Qwen3.8-Max detrás, y compara tiempo, turnos y factura. Tres tareas tuyas te dicen más que trece benchmarks ajenos.

    Eso solo funciona si el criterio de "terminado" está escrito antes de empezar, que es toda la lógica del libro de Spec-Driven Development: con la spec escrita, probar Qwen3.8-Max cuesta una tarde y te deja un número tuyo; sin ella, cuesta lo mismo y te deja una sensación.

    Y si tengo que resumirlo: un modelo se elige por lo que puedes comprobar tú —precio, límites reales, licencia y tu propia medición—; lo demás es la tabla de otro.

    En Dominicode Labs llevamos una hoja viva con estos cruces: qué cifra dio el fabricante, qué dio el leaderboard y qué dio nuestra propia ejecución. Qwen3.8-Max ya tiene su fila abierta.

    Preguntas frecuentes sobre Qwen3.8-Max

    ¿Qué es Qwen3.8-Max y cuándo salió?

    Es el modelo insignia que Alibaba presentó el 3 de agosto de 2026 —lo verás escrito como Qwen 3.8 Max o Qwen3.8-Max, es el mismo modelo—: arquitectura MoE, 2,4 billones de parámetros totales y entrada multimodal de texto, imagen y vídeo, con salida de texto.

    Está disponible por API alojada, y solo por ahí.

    ¿Cuánto cuesta Qwen3.8-Max por millón de tokens?

    $2,00 por millón de tokens de entrada y $6,00 por millón de salida. Las lecturas de caché implícita cuestan $0,25 por millón.

    Ese tercer precio es el que te cambia la factura si tu agente reenvía el mismo contexto en cada turno: un 87,5% menos que la tarifa de entrada.

    ¿El 86,6 de Qwen3.8-Max en Terminal-Bench 2.1 lo ha medido alguien externo?

    No. A 7 de agosto de 2026 Qwen3.8-Max no tiene ninguna entrada en el leaderboard público de tbench.ai, así que el 86,6 solo existe en el anuncio de Alibaba del 3 de agosto.

    Úsalo como hipótesis, no como criterio de compra. Lo comprobable del modelo es otra cosa: $2 y $6 por millón, 983K de entrada real con thinking y disponibilidad únicamente por API alojada.

    ¿Por qué la tabla de Alibaba da a Claude Fable 5 y a Opus 4.8 el mismo 84,6?

    Porque las cuatro filas salen de una única ejecución hecha por Alibaba, con su harness y su nivel de esfuerzo. En la medición independiente de tbench.ai esos dos modelos no empatan: Fable 5 marca 83,8 y Opus 4.8 marca 78,9, a 4,9 puntos de distancia.

    Cuando un fabricante mide a sus rivales, no solo suben los números: cambia el orden entre ellos. Ese empate artificial es la señal más clara de que la tabla no es un ranking, aunque lo parezca.

    ¿Cuántos parámetros activos tiene Qwen3.8-Max?

    No lo sé, y quien te dé una cifra con seguridad probablemente tampoco. El total confirmado es 2,4 billones de parámetros en arquitectura MoE.

    Varios agregadores repiten "95B activos", pero al menos un medio que revisó el anuncio sostiene que Alibaba no publicó ese dato, y no he podido confirmarlo en fuente primaria. Trátalo como no verificado.

    ¿Qwen3.8-Max tiene de verdad 1 millón de tokens de contexto?

    Casi. La entrada máxima real es de 991K tokens, que bajan a 983K con thinking activado. La salida máxima es de 131K en ambos modos.

    Si tu agente aprovecha la ventana entera, diséñalo contra 983K. El millón es redondeo comercial.

    ¿Qwen3.8-Max es de código abierto?

    Todavía no. Alibaba anunció pesos abiertos para la semana siguiente al lanzamiento del 3 de agosto de 2026, pero por ahora solo está disponible por API alojada.

    Hasta que los pesos existan y puedas leer su licencia, trátalo como un modelo cerrado con una promesa encima.


    Datos verificados el 7 de agosto de 2026 contra el anuncio de Alibaba y el leaderboard público de tbench.ai. Los pesos abiertos seguían sin publicarse en esa fecha.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    El 26 de julio publiqué una comparativa entre Opus 5, GPT-5.6 y Kimi K3. Diez días después me senté a completarla con los que faltaban: Grok 4.5, Claude Fable 5 y DeepSeek V4 Flash.

    No llegué a escribir esa actualización.

    Me atasqué en el primer paso, el más tonto: abrir el leaderboard oficial de Terminal-Bench 2.1 y copiar las cifras que todo ranking de modelos para programar de agosto de 2026 da por buenas.

    Buena parte de esas cifras no está ahí. No es que estén desactualizadas: es que no aparecen. Ni con ese número, ni en ese puesto.

    Así que este post no es la lista de los tres modelos que me faltaban. Es lo que encontré mientras la buscaba. Si lo que quieres es qué modelo usar para qué trabajo según el coste real por tarea, eso está entero en Opus 5 vs GPT-5.6 vs Kimi K3, la comparativa base que este post completa.

    El leaderboard oficial de Terminal-Bench 2.1, sin intermediarios

    Qué es Terminal-Bench 2.1 y qué puntúa en realidad

    Terminal-Bench 2.1 es un benchmark que mide si un sistema de IA completa tareas reales de desarrollo dentro de una terminal —instalar dependencias, ejecutar los tests, arreglar lo que falla—, no si el modelo escribe código elegante. Cada fila del leaderboard puntúa tres cosas a la vez: el modelo, el harness (el agente que lo envuelve: Claude Code, Codex, Terminus 2, Cursor CLI) y el effort (cuánto cómputo se le permite gastar por tarea). Cambia cualquiera de las tres y cambia el número.

    Esto es lo que hay en el leaderboard público de Terminal-Bench, consultado el 5 de agosto de 2026. Corto en la fila 11 por espacio:

    # Agente + modelo Score Effort
    1 Claude Code + Fable 5 83,8% ± 1,2% xhigh
    2 Codex + GPT-5.5 83,1% xhigh
    3 Terminus 2 + Fable 5 80,4% high
    4 Cursor CLI + Grok 4.5 79,3% high
    5 Claude Code + Opus 4.8 78,9% high
    6 Codex + GPT-5.6 Terra 78,4% max
    7 Terminus 2 + GPT-5.5 78,0% xhigh
    8 mini-SWE-agent + Muse Spark 1.1 76,2% xhigh
    9 Codex + GPT-5.6 Luna 75,7% max
    10 Claude Code + Sonnet 5 74,6% high
    11 Terminus 2 + Gemini 3 Pro 73,9% high

    Lee la segunda columna otra vez. No dice "modelo". Dice agente y modelo. Y la última añade el effort.

    Ahora mira lo que no está.

    Claude Opus 5 no aparece. El Opus de esa lista es el 4.8, con 78,9%. Llevo semanas viendo circular un "Opus 5: 89,1% en Terminal-Bench 2.1" por blogs agregadores y no he encontrado de dónde sale. No digo que sea falso: digo que no está en la fuente oficial, que no lo puedo verificar y que quien lo publicó tampoco enlazó a nada.

    "GPT-5.6 Sol, 89,5%" tampoco aparece. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%), ambas por debajo de GPT-5.5 en Codex, que marca 83,1%. En la única medición pública que conozco, la 5.6 no supera a la 5.5 programando en terminal.

    Kimi K3 tampoco aparece. Eso no lo convierte en mal modelo —sigo pensando lo que escribí en si te conviene Kimi K3 para tu agente—, solo significa que ahí no hay ejecución publicada. Y el 88,3 que reporta Moonshot es autoreportado, exactamente igual que el de DeepSeek que verás más abajo.

    Un benchmark ausente no es un suspenso. Es un dato que no existe. Y un dato que no existe no se cita.

    Por qué el mismo modelo puntúa distinto: el harness pesa tanto como el modelo

    El mismo modelo cambia de puesto según el agente que lo envuelve: Fable 5 saca 83,8% con Claude Code y 80,4% con Terminus 2. Esos 3,4 puntos son toda la distancia entre el puesto 1 y el puesto 3 del leaderboard.

    Vuelve a la tabla y búscalo dos veces. Está ahí.

    Lo que separa esas dos filas es el andamiaje que rodea al modelo, no el modelo. GPT-5.5 hace lo mismo: 83,1% en Codex, 78,0% en Terminus 2.

    Por eso "cuál es el mejor modelo para programar" es una pregunta mal formulada. Terminal-Bench no puntúa modelos, puntúa sistemas.

    Es la idea que sostiene todo lo que enseño en Construye con IA: el resultado sale del sistema completo, no del modelo que eliges en un desplegable. Cuando alguien te cuenta que su equipo va más rápido "porque usa X modelo", casi siempre lo que cambió fue el harness.

    Cuánto cuesta Grok 4.5 de verdad: el precio se dobla a partir de 200K tokens

    Grok 4.5 es el mejor situado de los tres que faltaban: puesto 4 del leaderboard de Terminal-Bench 2.1 con Cursor CLI y 79,3%, por delante de Opus 4.8 y de las dos variantes medidas de GPT-5.6. Este es el que peor llevo haberme dejado fuera en julio.

    En el Intelligence Index de Artificial Analysis marca 54 puntos en el corte del 5 de agosto de 2026. No te doy su puesto, y el motivo es el propio post: en la comparativa de julio yo mismo publiqué 58,9 para GPT-5.6 Sol y 57 para Kimi K3 en ese mismo índice. Con esos números, 54 no es un cuarto puesto.

    Es una puntuación. El puesto depende del corte y del subconjunto de modelos que estés mirando, y por eso no vale como argumento.

    El titular comercial es 500K de contexto a $2 el millón. Es cierto a medias, y la mitad falsa está en la documentación de xAI:

    Tamaño del prompt Entrada / millón Salida / millón
    Menos de 200K tokens $2 $6
    200K tokens o más $4 $12

    El precio se dobla exactamente cuando empiezas a usar el contexto por el que compraste el modelo.

    Con un agente que acumula ficheros, salidas de tests y logs, cruzar los 200K no es un caso raro: es el martes por la tarde. Y no lo cruzas tú de forma consciente, lo cruza el agente a mitad de sesión.

    La parte buena: el input cacheado cuesta $0,50 por millón, un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4. Si tu agente reenvía el mismo contexto en cada turno —y casi todos lo hacen—, el ahorro real está ahí, no en la tarifa de lista.

    En el Coding Agent Index de Artificial Analysis, Grok 4.5 saca 76 en el harness de Grok Build, empatado con GPT-5.5 en Codex y justo por debajo de Fable 5 en Claude Code. Otra vez modelo y harness moviéndose juntos.

    Ficha rápida: 500K de contexto, knowledge cutoff el 1 de febrero de 2026, disponible como grok-4.5 en Grok Build, en Cursor para todos los planes y en la consola de xAI.

    DeepSeek V4 Flash 0731: barato de verdad, medido por ellos mismos

    Salió el 31 de julio con pesos abiertos y licencia MIT, la misma categoría de modelo abierto que repasé en el ranking de LLM locales de 2026. MoE disperso, 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    $0,14 de entrada y $0,28 de salida por millón. Con cache-hit, $0,0028. Fable 5 cuesta más de 70 veces más por token de entrada: eso no es una diferencia de gama, es otra categoría de decisión.

    En el Intelligence Index marca 50 puntos, cifra seria para lo que cuesta.

    Ahora la parte incómoda, que es el motivo por el que este modelo está en el post.

    DeepSeek reporta 82,7 en Terminal-Bench 2.1 —subiendo 20,9 puntos desde el 61,8 de su Preview— y 54,4 en DeepSWE. Con 82,7 entraría tercero en el leaderboard de Terminal-Bench 2.1, a cuatro décimas de GPT-5.5 en Codex (83,1%) y por detrás de Fable 5 (83,8%).

    Esa cifra es autoreportada por DeepSeek en su propia tabla y no aparece en el leaderboard oficial de tbench.ai.

    No acuso a nadie de mentir. Señalo una distinción que muchos rankings borran sin avisar: un número autoreportado y uno medido de forma independiente no valen lo mismo, aunque los dos lleven decimal.

    El fabricante corre el benchmark en sus condiciones, con su harness y su criterio de cuándo parar.

    No hay nada ilegítimo en eso. Simplemente no es comparable con una entrada verificada, y mezclar las dos cosas en la misma tabla es lo que convierte una comparativa en marketing.

    Si vas a probar DeepSeek V4 Flash, pruébalo por el precio y la licencia MIT, que son hechos comprobables. No por el 82,7.

    Y recuerda que el precio por token no es el gasto: un modelo barato que necesita el doble de turnos para cerrar la misma tarea sale caro, un efecto que desarrollé en por qué sube el coste de los subagentes al cambiar de modelo.

    Cuánto cuesta Fable 5: lidera el leaderboard y su tarifa miente a su favor

    Fable 5 es el número 1 real: 83,8% ± 1,2% con Claude Code y effort xhigh. GA desde el 9 de junio de 2026, 1M de contexto, 128k de salida máxima.

    También es el más caro por bastante: $10 de entrada y $50 de salida por millón, según la documentación de Anthropic. Adaptive thinking siempre activo —no se puede apagar— y una latencia que su propia doc califica de "slower".

    El dato que casi nadie cita es este: Fable 5 usa el tokenizer que llegó con Opus 4.7, y el mismo texto produce alrededor de un 30% más de tokens que en modelos anteriores a esa versión. Es el mismo mecanismo que expliqué con el sobrecoste de escribir en español: la tarifa por millón no se mueve, pero el número de millones sí.

    Haz la cuenta. Frente a un modelo con el tokenizer viejo, sus $10 se comportan como $13 y sus $50 como $65 sobre el mismo texto.

    Su coste efectivo es peor que su tarifa de lista. Es la tesis del post de julio otra vez: el precio que pagas no es el que aparece en la página de pricing.

    Mythos 5: recomendado en rankings, imposible de contratar

    Mythos 5 tiene las mismas specs y el mismo precio que Fable 5. Y da igual, porque no lo puedes usar: no hay alta self-serve, es por invitación dentro de Project Glasswing, orientado a ciberseguridad defensiva.

    Aun así lo he visto en varias listas de "mejores modelos para programar de agosto de 2026", con su fila, su precio y su recomendación de uso, como si bastara una tarjeta.

    Cuando un ranking te recomienda un producto que no está a la venta, ya sabes cuánto lo ha probado quien lo escribió.

    Precios por millón de tokens en agosto de 2026: las cifras que sí puedes comprobar

    Estos son los precios de lista publicados por cada proveedor a 5 de agosto de 2026, en dólares por millón de tokens:

    Modelo Entrada / millón Salida / millón Contexto
    Claude Fable 5 $10 $50 1M
    Claude Opus 5 $5 $25 1M
    GPT-5.6 Sol $5 $30 1,05M
    Claude Sonnet 5 $3 ($2 intro hasta el 31 ago 2026) $15 ($10 intro) 1M
    Kimi K3 $3 $15 1M
    Grok 4.5 (prompt < 200K) $2 $6 500K
    Grok 4.5 (prompt ≥ 200K) $4 $12 500K
    DeepSeek V4 Flash 0731 $0,14 $0,28 1M

    Una nota de honestidad, porque predico con el ejemplo o no predico: al recopilar esto me encontré a Grok 4.5 con 54 puntos presentado como cuarto y a DeepSeek V4 Flash con 50 presentado como tercero. Las dos cosas no pueden ser ciertas a la vez.

    Son cortes distintos de un índice que se recalcula constantemente. Por eso en este post doy puntuaciones y fechas, y no puestos: el puesto caduca antes de que le des a publicar.

    Cómo verificar un ranking de modelos para programar en 3 filtros

    Abre el ranking que tengas a mano ahora mismo y pásale tres filtros.

    1. Busca el enlace a la fuente. Si la cifra no apunta a un leaderboard o a una doc oficial, trátala como rumor.
    2. Comprueba si el número es autoreportado. Un score en la web del fabricante y uno en tbench.ai no son la misma clase de dato.
    3. Mira si nombra el harness y el effort. Si dice "Fable 5: 83,8%" sin decir Claude Code y xhigh, quien lo escribió no ha leído la tabla que cita.

    Te quedará mucho menos ranking del que tenías. Bien.

    Y una decisión práctica que sí puedo defender: elige el modelo al final, no al principio. Define primero qué tarea automatizas, con qué agente y con qué criterio de "terminado". Es la lógica del libro de Spec-Driven Development, y aquí se nota más que en ningún sitio: con la spec escrita, cambiar de modelo es una variable de entorno y una medición; sin ella, es fe.

    Mi conclusión cabe en una frase: no existe el mejor modelo para programar, existe el mejor sistema, y el único número que decide tu caso es el que midas tú.

    En Dominicode Labs hacemos justo eso: pasar los modelos nuevos por tareas reales, con la factura y los logs delante, antes de meterlos en producción.

    Preguntas frecuentes sobre los modelos para programar de agosto de 2026

    ¿Qué modelo lidera el leaderboard de Terminal-Bench 2.1 en agosto de 2026?

    En el leaderboard oficial de Terminal-Bench 2.1 el primer puesto es Claude Code con Fable 5 (83,8%), seguido de Codex con GPT-5.5 (83,1%). Fíjate en que ambos resultados nombran un agente y un nivel de esfuerzo, no solo un modelo.

    El mismo Fable 5 baja a 80,4% con Terminus 2. Liderar un leaderboard no es lo mismo que ser el modelo que te conviene: si lo que buscas es la recomendación por tipo de trabajo —agente largo, repo grande, volumen alto—, está desarrollada en Opus 5 vs GPT-5.6 vs Kimi K3.

    ¿Cuánto cuesta realmente Grok 4.5?

    $2 de entrada y $6 de salida por millón de tokens mientras el prompt se mantenga por debajo de 200K tokens. A partir de 200K, la tarifa pasa a $4 y $12: se dobla.

    El input cacheado cuesta $0,50 por millón: un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4 de los prompts largos. Ahí está el ahorro real en un agente que reenvía el mismo contexto en cada turno.

    ¿Es fiable el 82,7 de DeepSeek V4 en Terminal-Bench 2.1?

    Es una cifra autoreportada por DeepSeek en su propia tabla, no una entrada verificada del leaderboard oficial de tbench.ai. Ahí no aparece.

    Eso no significa que sea falsa: significa que no ha pasado por una medición independiente y que no es comparable con la tabla oficial. Lo comprobable de ese modelo es su precio ($0,14 / $0,28 por millón) y su licencia MIT con pesos abiertos.

    ¿Por qué Claude Opus 5 no aparece en el leaderboard de Terminal-Bench 2.1?

    Porque no hay una ejecución publicada de Opus 5 en el leaderboard oficial. El Opus que sí figura es el 4.8, con 78,9% usando Claude Code.

    Las cifras de "Opus 5 al 89,1%" que circulan por blogs agregadores no están en la fuente primaria y no he podido verificarlas. Ausencia de resultado no equivale a mal resultado: equivale a que no hay medición pública.

    ¿Merece la pena Fable 5 a $10 / $50 por millón?

    Sale a cuenta cuando un fallo del modelo te cuesta más de una hora de revisión humana; para volumen alto de tareas repetitivas, casi nunca.

    Hay además un matiz que empeora el cálculo: Fable 5 usa el tokenizer introducido con Opus 4.7, que genera alrededor de un 30% más de tokens sobre el mismo texto que los modelos anteriores a esa versión. Su coste efectivo es peor que su tarifa.

    ¿Qué diferencia hay entre un score autoreportado y uno del leaderboard oficial?

    Un score autoreportado lo ejecuta el propio fabricante, con su harness, su nivel de esfuerzo y su criterio de cuándo dar una tarea por terminada. Uno del leaderboard oficial lo ejecuta un tercero con condiciones fijas e iguales para todos.

    Los dos llevan decimales y parecen el mismo tipo de dato, pero no son comparables. Mezclarlos en la misma tabla, sin marcar cuál es cuál, es lo que convierte una comparativa en marketing.

    ¿DeepSeek V4 Flash es de código abierto?

    Tiene pesos abiertos y licencia MIT desde el 31 de julio de 2026. Es un MoE disperso con 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    La licencia y el precio ($0,14 de entrada y $0,28 de salida por millón) son los dos hechos comprobables del modelo. Su 82,7 en Terminal-Bench 2.1 no lo es: es autoreportado.

    ¿Puedo usar Claude Mythos 5 en mi proyecto?

    No, salvo que tengas invitación. Comparte specs y precio con Fable 5, pero solo está disponible dentro de Project Glasswing, orientado a ciberseguridad defensiva, y no tiene alta self-serve.

    Si lo ves recomendado en un ranking de modelos para programar, ese ranking no lo ha probado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
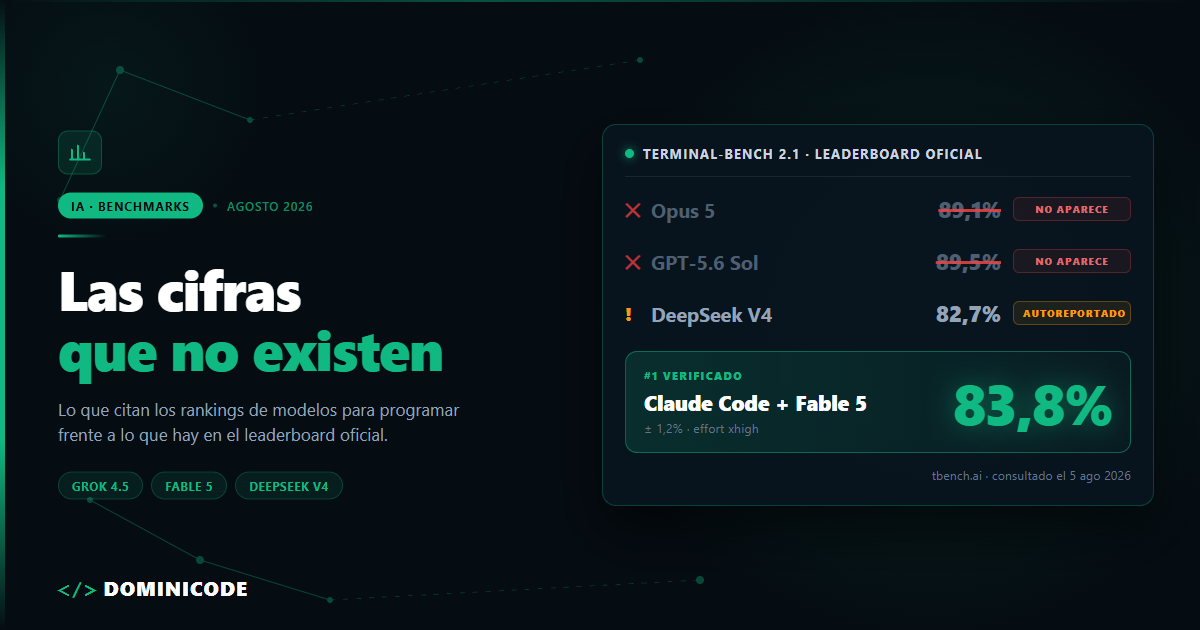
  • Por qué la IA se inventa cosas — y por qué no es un fallo

    Por qué la IA se inventa cosas — y por qué no es un fallo

    Le pides las tres sentencias más relevantes sobre un asunto. Te devuelve tres: tribunal, número, año, en el formato exacto en que se citan estas cosas.

    Dos existen.

    La tercera no. Y es indistinguible de las otras dos.

    No está peor escrita. No lleva una nota al pie que diga "esta me la he inventado". No hay cambio de tono, ni duda, ni titubeo. Tiene la misma pinta de ser verdad que las otras dos.

    Y aquí está lo que casi nadie cuenta cuando explica por qué la IA se inventa cosas: no falló nada. El sistema hizo exactamente lo mismo que hace cuando acierta.

    Esto no es un ejercicio teórico. El 22 de junio de 2023, el juez P. Kevin Castel impuso una sanción de 5.000 dólares —solidariamente a dos abogados y a su despacho— en el caso Mata v. Avianca, nº 1:22-cv-01461 del Distrito Sur de Nueva York (678 F. Supp. 3d 443). Habían presentado un escrito con seis sentencias inventadas de principio a fin, con citas internas a resoluciones que tampoco existen.

    Lo mejor viene ahora: uno de ellos le preguntó a ChatGPT si esos casos eran reales. Respondió que sí, y añadió que podían encontrarse en Westlaw, LexisNexis y el Federal Reporter.

    Y aquí está el detalle que casi nadie cuenta: el juez no sancionó por el error. Escribió que usar una herramienta de IA no tiene "nada de intrínsecamente impropio". Sancionó porque, después de que la parte contraria y dos órdenes del tribunal cuestionaran la existencia de esas sentencias, siguieron defendiéndolas.

    Nadie hackeó nada. El modelo no se rompió. Solo hizo su trabajo.


    ¿Por qué la IA se inventa cosas?

    Porque un modelo de lenguaje no busca la respuesta correcta: genera la continuación más probable, pieza a pieza, sobre una distribución de probabilidad aprendida en el entrenamiento. Cuando lo plausible coincide con lo cierto, decimos que acierta. Cuando no coincide, decimos que alucina. Es el mismo mecanismo, el mismo nivel de seguridad en el tono y el mismo aspecto en la pantalla.

    Una alucinación de la IA es exactamente eso: una salida plausible y falsa —una cita, una fecha, un identificador, un método de librería— generada con el mismo procedimiento y con la misma confianza aparente que una salida correcta.

    Lo importante es lo que no hay: en ningún punto del proceso existe un paso que pregunte "¿esto es verdad?".

    No es que se salte la comprobación. Es que la comprobación no está en el diseño. Nadie la quitó porque nunca estuvo.

    Si lo tienes claro en términos de predicción — la misma idea que hay detrás de cualquier algoritmo de machine learning — deja de ser sorprendente. Un sistema entrenado para que la salida sea verosímil produce salidas verosímiles. Ni más ni menos.

            el modelo optimiza UNA cosa:
         que la continuación sea plausible
                        │
            ┌───────────┴─────────────┐
       coincide con              no coincide
        la verdad                con la verdad
            │                         │
        "acierta"                 "alucina"
            └────── el mismo ─────────┘
                   mecanismo
                        │
            y en ningún punto de este
            recorrido hay un paso que
            pregunte: ¿esto es verdad?
    

    Dos nombres distintos para el mismo comportamiento. La diferencia no la pone el modelo: la pone el mundo, al coincidir o no con lo que salió.


    Qué es una alucinación de la IA: el retrato robot que no se parece a nadie

    La analogía que mejor me funciona cuando lo explico en una reunión: un dibujante de retratos robot buenísimo que nunca ha visto al sospechoso.

    Tiene una técnica excelente. Conoce las proporciones, sabe qué rasgos aparecen juntos. Le das una descripción vaga y te devuelve un retrato limpio, coherente, con una nariz que encaja con esos pómulos.

    El retrato está bien hecho. Es convincente. Y puede no parecerse a nadie.

    Eso es una alucinación. No un borrón, no un garabato: un dibujo correcto de una persona que no existe.


    Lo contraintuitivo: alucina más cuando la pregunta tiene forma de respuesta

    Aquí es donde casi todo el mundo tiene el modelo mental invertido.

    La intuición dice: alucina cuando no sabe. Falso. O al menos, insuficiente.

    Alucina más cuando la pregunta parece tener una respuesta con una forma muy clara. Una referencia bibliográfica tiene una forma reconocible. Un artículo de una ley tiene una forma. Una fecha tiene una forma. Un número de sentencia tiene una forma.

    Y lo plausible es exactamente lo que el modelo optimiza. Dale un hueco con forma nítida y lo rellenará con algo que tenga esa forma.

    Corolario práctico y algo perverso: preguntar por una normativa que no existe es la manera más fiable de provocar una alucinación. No porque el modelo sea tonto, sino porque la pregunta le da la plantilla y él es muy bueno rellenando plantillas.

    Hay datos que lo respaldan. En Why Language Models Hallucinate (Kalai, Nachum, Vempala y Zhang, 4 de septiembre de 2025) —tres de los cuatro autores firman por OpenAI; Vempala, por Georgia Tech— los autores le preguntaron tres veces a DeepSeek-V3 por el cumpleaños de uno de ellos, indicándole explícitamente que respondiera solo si lo sabía. Obtuvieron tres fechas: "03-07", "15-06" y "01-01". Ninguna correcta.

    Con el título de su tesis doctoral, tres modelos distintos devolvieron tres títulos distintos. Ninguno acertó ni el título ni el año. Y el detalle que más dice: los tres inventados sonaban mejor que el de verdad.

    Y por si crees que esto solo pasa con datos oscuros: al preguntar cuántas D hay en "DEEPSEEK", los modelos del estudio respondieron 2, 3, y en algunos casos 6 y 7. La respuesta es 1. No es un problema de que le falte información. Está delante.


    No es mentir, y no es un disparate

    Dos precisiones que cambian la conversación con cualquier stakeholder.

    No es mentir. Mentir exige dos cosas: saber la verdad y decir otra cosa a propósito. Aquí no hay ninguna de las dos. No hay intención, y no hay una representación interna de "la verdad" separada de la salida que se pueda contradecir.

    Y las alucinaciones nunca son disparates. Esto es lo que las hace peligrosas. Si el modelo te dijera que el artículo aplicable es el 4.912 de una ley con 90 artículos, lo cazarías al instante.

    Lo que hace es devolverte el artículo 27.3. Verosímil. Bien formateado. En medio de tres párrafos que sí son correctos.

    Ese es el riesgo real: no la barbaridad evidente, sino el dato razonable que sobrevive a la revisión rápida y acaba en producción, en un informe o delante de un cliente. Y se agrava con el tiempo, porque cuando la herramienta lleva doscientos aciertos seguidos, revisar se convierte en echar un vistazo.


    Excelente cuando basta lo plausible. Peligroso cuando tiene que ser exacto

    Esta es la línea que de verdad importa, y la que deberías tener pegada al monitor antes de decidir dónde metes un LLM.

    Lo que le pides ¿Basta con que sea plausible? Veredicto
    Redactar, reformular, dar forma a un borrador Sí — lo plausible es lo bueno Úsalo sin miedo
    Resumir un documento con datos dentro La prosa sí; las cifras y los nombres, no Comprueba cada dato contra el original
    Traducir, ordenar ideas, dar nombre a cosas Sí, con repaso Úsalo
    Generar código que luego compila y se testea Sí — tienes verificador Úsalo, el compilador es tu red
    Una fecha, una cifra, un artículo de una ley No Verificador obligatorio
    Una referencia, un ID, una versión de librería No Verificador obligatorio

    Fíjate en la fila del código, porque es la que explica por qué los modelos funcionan tan bien escribiendo código y tan mal citando fuentes. En código tienes un verificador que se ejecuta: compilador, tipos, tests, linter. La alucinación se cae sola en dos segundos.

    En una cita bibliográfica no hay compilador. Nadie la ejecuta. Solo alguien leyéndola y asintiendo.

    Si tu caso de uso no tiene verificador, tú eres el verificador. Y tú te cansas.


    ¿Se arregla? El paper que medio internet cita al revés

    Existe la versión pesimista: "es intrínseco, no esperes que se arregle". Y existe el paper de Kalai y compañía, que se cita constantemente para apoyar esa frase, diciendo lo contrario.

    Lo que sostienen es esto: las alucinaciones no son un misterio. Empiezan como errores de clasificación binaria bajo presión estadística — si en los datos de entrenamiento un hecho aparece una sola vez, el modelo no tiene con qué distinguirlo de una invención. Su ejemplo: si el 20% de las fechas de nacimiento aparecen exactamente una vez en el preentrenamiento, cabe esperar que el modelo base alucine en al menos el 20% de esas fechas.

    Y luego viene la parte incómoda. Persisten, dicen, por cómo se puntúa a los modelos. Los benchmarks que dominan los leaderboards corrigen en binario: acierto o fallo. Un "no lo sé" puntúa igual que un fallo — cero. Revisaron las diez evaluaciones que dominan esos leaderboards —GPQA, MMLU-Pro, IFEval, Omni-MATH, BBH, MATH, MuSR, SWE-bench, HLE y WildBench— y en nueve de las diez reconocer incertidumbre no da ningún crédito. La única que da algo es WildBench, y con un matiz cruel: su rúbrica puede puntuar más bajo un "no lo sé" que una respuesta mediocre con datos inventados.

    Con esa regla, adivinar siempre es la estrategia óptima. Estamos entrenando buenos examinandos, no sistemas fiables.

    Su propuesta es tan poco glamurosa que por eso nadie la tuitea: cambiar la puntuación de los benchmarks que ya existen, declarando en el enunciado el umbral de confianza — responde solo si tienes más de t de confianza, el fallo resta t/(1−t) puntos, el acierto suma 1 y el "no lo sé" suma 0. Con t = 0.9, cada fallo cuesta nueve.

    Así que sí: la parte del problema que viene de los incentivos es corregible, y eso es una buena noticia.

    Lo que no cambia es el diseño de fondo. Puedes premiar la abstención y conseguir que el modelo diga "no lo sé" muchísimo más a menudo. No conviertes eso en un paso de comprobación de hechos que antes no existía. Mientras la salida se genere por probabilidad, tu arquitectura tiene que contemplar que a veces será plausible y falsa.

    No es una razón para no usarlo. Es una razón para diseñar con eso dentro.


    Cómo evitar alucinaciones en tu código: 5 decisiones para mañana

    Aquí es donde este post se separa de los cincuenta artículos que explican qué son las alucinaciones y terminan con un "revisa siempre las respuestas". Gracias, muy útil.

    Cinco decisiones concretas. Y antes, lo que caza cada una — porque ninguna las caza todas:

    Defensa Qué caza Qué NO caza
    Schema de salida (Zod) Respuestas con la forma equivocada Un ID inventado con la forma correcta
    Consulta a la fuente SKUs, IDs y referencias que no existen Datos que existen pero no aplican
    Cita literal verificada Atribuir algo real a una fuente que no lo dice Una fuente que dice algo falso
    Rama "no lo sé" en el schema El relleno por campo obligatorio La invención cuando el modelo "cree" saber
    Test de abstención Que el sistema invente en preguntas sin respuesta Errores en preguntas que sí tienen respuesta

    1. Verificar en lugar de confiar

    Cada dato factual que salga del modelo y entre en tu sistema pasa por tres filtros, en este orden: schema, tipos, fuente.

    El schema te da forma. Los tipos te dan garantías en compilación. Y la fuente te da la única cosa que el modelo no puede darte: verdad.

    import { z } from 'zod';
    
    // El schema valida la forma. NO valida que el ID exista.
    const Producto = z.object({
      sku: z.string().regex(/^[A-Z]{3}-\d{6}$/),
      precio: z.number().positive(),
    });
    
    const extraido = Producto.parse(salidaDelModelo); // ✅ forma correcta
    const real = await db.productos.findBySku(extraido.sku); // ✅ existencia
    if (!real) throw new SkuInventadoError(extraido.sku); // error tuyo, no de Zod
    

    Un SKU inventado pasa el regex sin problema. Tiene exactamente la forma de un SKU — recuerda: forma clara, invención fiable. La única defensa es la consulta.

    2. Grounding: dale las fuentes delante y exígele la cita

    Si el modelo tiene el texto real en la ventana de contexto, no necesita inventar. Eso es RAG y por qué gana a fine-tuning para problemas de conocimiento — y si quieres verlo montado con código, tienes la implementación completa aquí.

    Pero pedir la cita no basta. Hay que comprobarla:

    // Sin normalizar, un espacio doble o una tilde tumban la comprobación.
    const normalizar = (s: string) =>
      s.normalize('NFD').replace(/[\u0300-\u036f]/g, '')
        .replace(/\s+/g, ' ')
        .trim()
        .toLowerCase();
    
    const cita = normalizar(respuesta.citaLiteral);
    
    // Ojo: includes('') es true. Una cita vacía "aparece" en cualquier documento.
    const citaVerificada =
      cita.length >= 30 &&
      fuentes.some(f =>
        f.id === respuesta.fuenteId && normalizar(f.texto).includes(cita)
      );
    

    Determinista, barato, sin llamadas extra. Si la cita literal no aparece en el documento que dice citar, la respuesta se descarta. Con esto cazas la clase de fallo más caro que existe: la respuesta correcta atribuida a una fuente que no dice eso.

    3. Déjale una salida: "no lo sé" tiene que ser una opción legal

    Este es el error más repetido en las integraciones que reviso: un schema con todos los campos obligatorios y ninguna rama para la ignorancia.

    Cada campo obligatorio sin salida es una invitación a rellenar. Si tu tipo dice que articulo: string es obligatorio, has convertido "no lo sé" en una respuesta imposible de expresar.

    const Respuesta = z.discriminatedUnion('estado', [
      z.object({
        estado: z.literal('encontrado'),
        articulo: z.string(),
        citaLiteral: z.string().min(30), // una cita de cinco caracteres "aparece" en casi cualquier documento
        fuenteId: z.string(),
      }),
      z.object({
        estado: z.literal('no_esta_en_las_fuentes'),
        queFaltaria: z.string(),
      }),
    ]);
    

    Y dilo también en el prompt, explícito: si la información no está en los documentos proporcionados, responde con estado no_esta_en_las_fuentes. No completes con conocimiento propio.

    Dos frases. Baja las invenciones de forma muy visible. Es la misma lógica de los umbrales de confianza del paper, aplicada a tu endpoint.

    4. Dónde no lo metes sin verificador

    Ninguna de estas cosas entra a un sistema por generación directa: identificadores, precios, cantidades, fechas límite, versiones de dependencias, nombres de métodos de una librería, artículos de normativa, referencias.

    Lo de los nombres de métodos merece un párrafo. Cuando le pides código con una librería poco común, el modelo te devuelve el método que debería existir según todas las APIs parecidas que ha visto. Bien nombrado, con la firma coherente, perfectamente plausible. Y no existe.

    Y hay una variante peor con los nombres de paquete: el compilador no te salva de un npm install de una dependencia que el modelo se ha inventado y que alguien ya ha registrado con ese nombre exacto, esperando precisamente eso.

    Da igual que bajes la temperatura a 0. Eso te quita variabilidad, no te da verdad: te devuelve la misma respuesta plausible casi siempre. Si era falsa, ahora es falsa de forma reproducible. Y ni el "casi siempre" está garantizado: en una API la salida a temperatura 0 todavía puede cambiar según cómo se agrupen las peticiones concurrentes en el servidor.

    5. Que los tests no comparen la salida literal

    Un test que hace expect(salida).toBe("...") sobre una respuesta generada está roto de nacimiento. Cambias de modelo o de versión y se cae sin que nada haya empeorado.

    Testea propiedades, no cadenas:

    • La salida valida contra el schema, siempre.
    • Toda cita literal aparece en la fuente que dice citar.
    • Ningún fuenteId sale del conjunto de fuentes inyectadas.
    • Y el que más información da: un conjunto de preguntas cuya respuesta no está en el corpus, donde lo que se comprueba es que el sistema se abstiene. Si tu tasa de abstención en ese conjunto es baja, tu sistema está inventando y todavía no lo sabes.

    Esa cuarta propiedad es el equivalente en tu repo de lo que propone el paper para los benchmarks: dejar de premiar el acierto por adivinar.

    Decidir esto antes de escribir código —qué salida es aceptable y cómo se comprueba— en lugar de parchearlo cuando ya ha explotado, es exactamente el trabajo que describo en Spec-Driven Development.

    Y en el curso Construye con IA montamos estos verificadores dentro del flujo. Es la diferencia entre un prototipo que impresiona en la demo y algo que puedes dejar corriendo.


    La única conclusión que importa

    Deja de preguntarte si el modelo alucina. Alucina, porque es la misma operación con la que acierta.

    Y no es que sea inevitable —el propio paper describe un sistema que puede abstenerse—. Es que tú no puedes construir asumiendo que ya está resuelto.

    La pregunta correcta es otra: ¿en qué punto de mi sistema se detecta un dato falso, y qué pasa si ese punto no existe?

    Si la respuesta es "lo detecta la persona que lo lea", no tienes un sistema. Tienes un borrador con muy buena presentación.

    Elige hoy el dato factual más crítico que salga de un modelo en tu código y ponle un verificador determinista. Uno. Media hora de trabajo. Vas a dormir mejor.

    Y si te has quedado con ganas de ordenar el resto del terreno — grounding, RAG, salida estructurada, evaluación y el resto de los 120 conceptos colocados por zonas, con sus conexiones dibujadas — tengo un mapa de la IA en una hoja para imprimir, gratis aquí. Funciona muy bien para pasársela a quien aprueba estos presupuestos.


    Preguntas frecuentes

    ¿Por qué la IA se inventa cosas?

    Porque un modelo de lenguaje genera la continuación más probable de un texto, token a token, sobre una distribución de probabilidad aprendida en el entrenamiento. Su objetivo es que la salida resulte plausible, no que sea verdadera. Cuando lo plausible coincide con lo cierto, acierta; cuando no coincide, alucina. En ningún momento del proceso hay un paso que verifique si lo generado es verdad: esa comprobación no forma parte del diseño, así que hay que añadirla fuera del modelo.

    ¿Qué son las alucinaciones de la IA exactamente?

    Son salidas plausibles y falsas: una referencia con el formato exacto de una referencia real, una cifra verosímil, una cita bien construida, un método de librería que podría existir. Nunca son disparates evidentes, y por eso son peligrosas. El riesgo no es que el modelo diga algo absurdo, que cualquiera detectaría, sino que introduzca un dato razonable en medio de varios párrafos correctos y ese dato sobreviva a la revisión rápida hasta llegar a producción.

    ¿La IA miente cuando alucina?

    No. Mentir exige saber la verdad y decir otra cosa de forma deliberada, y en un modelo de lenguaje no se da ninguna de las dos condiciones: no hay intención, y no existe una representación interna de la verdad separada de la salida que se pueda contradecir. Por eso tampoco sirve enfadarse con el modelo ni pedirle que "no invente". Lo que sirve es cambiar el diseño alrededor: darle las fuentes, exigirle cita y verificarla con código.

    ¿Cuándo alucina más un modelo de lenguaje?

    Contra lo que parece, no solo cuando no sabe algo. Alucina más cuando la pregunta parece tener una respuesta con una forma muy clara y reconocible: una fecha, un artículo de una ley, un número de sentencia, una referencia bibliográfica. Como el modelo optimiza plausibilidad, un hueco con forma nítida se rellena con algo que tenga esa forma. Preguntar por una normativa que no existe es una de las maneras más fiables de provocar una invención.

    ¿Se pueden eliminar las alucinaciones del todo?

    Se reducen mucho y no se eliminan. Funcionan tres palancas: grounding (darle las fuentes en el contexto), exigir cita literal y verificarla contra el documento, y permitir explícitamente "no lo sé" en el prompt y en el schema de salida. El paper Why Language Models Hallucinate (2025) añade una cuarta a nivel de industria: cambiar la puntuación de los benchmarks, que hoy casi todos dan cero tanto al fallo como al "no lo sé" y por tanto premian adivinar.

    ¿Bajar la temperatura a 0 evita las alucinaciones?

    No. La temperatura controla cuánta variabilidad hay al muestrear el siguiente token, no si el contenido es cierto. Con temperatura 0 el modelo elige en cada paso el token más probable, así que tiendes a obtener siempre la misma respuesta —aunque ni eso está garantizado en una API, donde el resultado depende de cómo se agrupen las peticiones concurrentes—. Si esa respuesta es falsa, ahora es falsa de forma consistente, que engaña más porque parece estabilidad.

    ¿Alucinan menos los modelos de razonamiento?

    Menos en lo que se puede calcular: si la respuesta se deduce paso a paso, más cómputo ayuda. Pero razonar no añade un paso de comprobación contra el mundo, así que en datos que solo se pueden saber —una fecha, una referencia, un identificador— el problema es idéntico. Why Language Models Hallucinate lo atribuye a los incentivos de evaluación, no a la capacidad: mientras un "no lo sé" puntúe igual que un fallo, adivinar sigue siendo la estrategia óptima para cualquier modelo, razone o no.

    ¿Cómo pruebo que mi integración con un LLM no inventa datos?

    No compares la salida literal con una cadena esperada: se rompe en cada cambio de modelo sin que nada haya empeorado. Testea propiedades. Que la salida valide contra el schema, que toda cita literal aparezca en la fuente que dice citar, que ningún identificador de fuente esté fuera del conjunto inyectado, y sobre todo mantén un conjunto de preguntas cuya respuesta no exista en tu corpus, midiendo que el sistema se abstiene en lugar de rellenar.


    Si quieres ver estos verificadores funcionando dentro de proyectos reales, con la arquitectura y el código completos, es parte de lo que trabajamos en Dominicode Labs. Problemas de producción, decisiones que puedes aplicar esta semana.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Opus 5 vs GPT-5.6 vs Kimi K3: qué modelo para qué trabajo

    Opus 5 vs GPT-5.6 vs Kimi K3: qué modelo para qué trabajo

    Un lunes cambié el modelo de un agente que llevaba semanas funcionando bien. El nuevo costaba la mitad por millón de tokens de salida: quince dólares contra veinticinco. Una línea de configuración, cinco segundos, dinero ahorrado.

    El viernes miré la factura. Había subido.

    No era un bug del proveedor. Era que la tarifa por millón de tokens no te dice cuántos tokens vas a gastar, y ese segundo número decide lo que pagas.

    De eso va esta comparativa de Opus 5 vs GPT-5.6 vs Kimi K3: de trabajo real, no de specs. De cada modelo por separado ya hay un análisis en este blog. Aquí hay una sola pregunta, repetida cuatro veces: para este trabajo concreto, ¿cuál de los tres y por qué?


    Opus 5 vs GPT-5.6 vs Kimi K3: los tres de un vistazo

    Claude Opus 5 GPT-5.6 Sol Kimi K3
    Entrada / salida por millón $5 / $25 $5 / $30 $3 / $15
    Contexto 1M tokens 1,05M tokens 1M tokens
    Intelligence Index sin medición pública 58,9 57
    Pesos cerrados cerrados abiertos
    Rasgo diferencial thinking adaptativo por defecto contexto de 1,05M y tres tiers de precio pesos abiertos: cualquiera puede servirlo

    Esa tabla no decide nada. La pongo porque es lo que vas a encontrar en los otros veinte posts que has leído esta semana, y porque quiero enseñarte por qué te lleva a la decisión equivocada.

    Un apunte que me niego a esconder: Opus 5 no tiene medición pública en el índice independiente de Artificial Analysis. Salió el 24 de julio de 2026, después de la última ronda de medición.

    Las referencias que sí existen: Claude Fable 5 puntúa 59,9 costando unos $50 por millón de salida, y Claude Opus 4.8 —la generación anterior de la misma familia— puntúa 56.

    Opus 5 está por encima de ese 56, probablemente bastante. Pero "probablemente" no es un número y no voy a inventármelo.


    El truco del precio: por qué el orden se invierte

    Kimi K3 parece el barato. Quince dólares por millón de salida contra los veinticinco de Opus 5 y los treinta de Sol. Mitad de precio que el más caro.

    El problema es que un modelo no te cobra por millón de tokens: te cobra por los tokens que emite. Y cuánto emite para resolver la misma tarea es una propiedad del modelo, igual que su precio.

    En el análisis de Kimi K3 salió el dato medido: durante la evaluación independiente, Kimi K3 consumió 130 millones de tokens de salida frente a una media de 63 millones. Eso es 2,06 veces la media. Su coste efectivo por millón de tokens útiles no es $15, es $15 × 2,06 ≈ $31.

    Míralo sobre una tarea concreta. Supón un trabajo que requiere 100.000 tokens de salida útiles:

    Modelo Tokens que emite Precio salida Coste
    Claude Opus 5 100.000 $25 / M $2,50
    GPT-5.6 Sol 100.000 $30 / M $3,00
    Kimi K3 (a precio de lista) 100.000 $15 / M $1,50
    Kimi K3 (verbosidad medida 2,06×) 206.000 $15 / M $3,09

    El barato acaba siendo el más caro de los tres. No por poco: $3,09 contra los $2,50 de Opus 5.

    Ahora la parte incómoda. Estoy comparando una cifra medida contra dos cifras de lista, y eso no es justo. Opus 5 también gasta más de lo que sugiere su tarifa: el thinking viene adaptativo y activado por defecto, max_tokens es un tope duro que cubre razonamiento y respuesta juntos, y esos tokens de razonamiento se facturan como salida. Encima escribe respuestas más largas que la generación anterior por diseño. No existe medición pública de ese sobrecoste: cuando exista, su columna también subirá.

    La conclusión que te llevas no es "Kimi es caro". Es esta: ninguno de los tres se paga a precio de lista, y el único que tiene el multiplicador publicado es Kimi. Cualquier comparativa que ordene los tres modelos por su tarifa está ordenando por el número equivocado.


    Trabajo 1: agente de coding que corre largo

    Para un agente de coding que corre durante horas, la elección es Claude Opus 5 en effort xhigh. No por la tarifa: porque en sesiones largas la verbosidad se compone en vez de sumarse, y lo que arruina la factura son los reintentos.

    Sesiones de horas. Decenas de tool calls. Cada turno reenvía el contexto acumulado de todos los turnos anteriores.

    Aquí la verbosidad deja de ser un coste lineal y se vuelve compuesto. El output del turno 3 es input del turno 4, del 5 y del 20. Un modelo que escribe el doble no te cuesta el doble en ese turno: te infla el contexto de todos los siguientes. Pagas esa respuesta larga una vez como salida y luego otras quince como entrada.

    Kimi compensa parte con un cache hit agresivo a $0,30 por millón —un 90% de descuento—, pero el caching abarata reenviar el contexto, no lo hace más pequeño. El techo de la ventana llega igual, y llega antes.

    Arrancar en xhigh es la recomendación de Anthropic para coding y trabajo agéntico, y coincide con lo que veo trabajando: en sesiones largas lo que arruina la factura no son los tokens, son los reintentos. Una tarea que el modelo barato tiene que repetir tres veces cuesta más que una que el caro resuelve a la primera.

    Un aviso, porque migrar a Opus 5 no es cambiar el string del modelo. Si vienes de Opus 4.8, hay dos cambios que rompen código: el thinking viene activado por defecto y desactivarlo con effort xhigh o max devuelve un 400. Los dos, con el código antes y después, están en los breaking changes de Claude Opus 5. Revísalos antes de mover tráfico.

    Y si al medir descubres que buena parte de tu agente nunca necesitó un modelo frontera —pasa más de lo que la gente admite—, Claude Sonnet 5 cubre ese terreno por mucho menos dinero. Enrutar por dificultad de tarea ahorra más que elegir bien el modelo caro.


    Trabajo 2: una pasada grande sobre un repo grande

    Para trabajo input-heavy de una sola pasada, Kimi K3 es genuinamente el más barato de los tres. Es el caso donde la tabla de precios acierta: el peso está en la entrada y la verbosidad solo penaliza la salida.

    Metes 800.000 tokens de código, pides un análisis de arquitectura o una migración planificada, y recoges veinte mil tokens de informe.

    Aquí se invierte todo lo anterior. El peso está en la entrada, no en la salida, y la verbosidad solo castiga la salida.

    Con esos 800K de entrada: Opus 5 y Sol cobran $5 por millón, o sea $4,00 cada uno. Kimi cobra $3: $2,40. La salida es tan pequeña en comparación que el multiplicador de verbosidad casi no mueve la aguja.

    Ahí no hay trampa que deshacer: el número de la tabla de precios es el número que pagas.

    La ventana de contexto se sobrevende. Lo que sí importa es que Anthropic cobra la ventana completa de 1M a tarifa estándar, sin recargo por contexto largo. Y si tu repo no cabe en 1M, tu problema no es el modelo: es que necesitas trocear e indexar antes de preguntar.

    Aquí los pesos abiertos de Kimi valen algo concreto, y no es lo que la gente cree: cualquier proveedor puede servirlo, así que no dependes de un único vendor para el precio, la disponibilidad ni la política de retención. Eso presiona a la baja lo que te cobran.


    Trabajo 3: volumen alto y simple

    Clasificar diez mil tickets. Extraer entidades de un lote de documentos. Normalizar un CSV enorme a JSON.

    La respuesta correcta a "¿cuál de los tres?" es ninguno de los tres.

    Los números, sobre 10.000 documentos de 2.000 tokens de entrada y 200 de salida cada uno (20M y 2M en total):

    Modelo Entrada 20M Salida 2M Total
    GPT-5.6 Luna $20 $12 $32
    Kimi K3 (lista) $60 $30 $90
    Kimi K3 (verbosidad 2,06×) $60 $61,80 $121,80
    Claude Opus 5 $100 $50 $150
    GPT-5.6 Sol $100 $60 $160

    Luna sale cinco veces más barato que Sol en un trabajo donde la diferencia de inteligencia entre ambos es irrelevante, porque la tarea no pide razonar: pide seguir un formato. Y bajas otro 50% mandándolo por Batch API si no necesitas la respuesta en caliente. El desglose de las tres variantes está en la guía de la API de GPT-5.6.

    Una honestidad sobre mi propia tabla: ese 2,06× se midió en evaluaciones difíciles, no clasificando tickets. Si fuerzas un esquema de salida estricto, la verbosidad se desploma en cualquiera de los tres. Que es justo lo que deberías hacer, porque el error caro aquí no es el modelo: es confiar en que la salida llegue bien formada. Valídala con un esquema y falla ruidosamente cuando no encaje —es lo que enseño en el curso de Zod, y un parseo estricto en la frontera evita más incidencias que cualquier upgrade de modelo.


    Trabajo 4: orquestación y tool calling

    Aquí esperaba encontrar el argumento que le da la vuelta al precio de GPT-5.6 Sol. Me equivocaba, y prefiero contarlo que maquillarlo.

    Programmatic Tool Calling deja que el modelo escriba código que se ejecuta en un sandbox aislado y coordine varias llamadas a herramientas dentro de un mismo turno, sin ida y vuelta a la API entre cada una. Los resultados intermedios de las herramientas no entran en el contexto: solo entra el resultado final. La mecánica está en la guía de la API de GPT-5.6.

    El problema para esta comparativa es que no es exclusivo de OpenAI. Anthropic tiene la misma función, con el mismo nombre, y claude-opus-5 aparece en su tabla de modelos compatibles. No desempata nada.

    Y ahora fíjate dónde cae el ahorro, porque es donde casi todo el mundo se equivoca. Anthropic mide un 37% menos de tokens en tareas complejas de research —de 43.588 a 27.297 de media— y un 24% menos de tokens de entrada en benchmarks de búsqueda agéntica.

    De entrada. No de salida. Tiene todo el sentido: lo que se recorta son los resultados intermedios que ya no viajan al contexto. Así que quien te presente esto como un descuento sobre la tarifa de salida está moviendo el número a la columna equivocada — justo el truco que denuncié dos secciones más arriba.

    Por cierto: OpenAI no publica ningún porcentaje para su implementación. Su guía dice que el efecto depende de la tarea y de las respuestas de las herramientas, y recomienda medir contra tu propia línea base. Si ves un rango concreto atribuido a OpenAI por ahí, pídele la fuente a quien lo publique.

    Mi elección aquí es la misma que en el trabajo 1: Claude Opus 5. No porque gane el tool calling —empata—, sino porque a igualdad de función te lo llevas con la tarifa de salida más baja de los dos: $25 contra $30.


    El criterio que sí sirve

    Una sola métrica: coste por tarea resuelta.

    coste por tarea resuelta = coste medio por intento / tasa de éxito
    

    Los reintentos dominan el resultado y no aparecen en ninguna comparativa. Con números que me invento a propósito, para que veas la forma y no para que te los creas: un modelo a $31 efectivos con un 80% de acierto sale a $38,75 por tarea resuelta; otro a $25 con un 95% de acierto sale a $26,32. El que parecía el caro por tarifa de lista sale un 32% más barato por tarea resuelta. Pon tus tasas reales, que solo tú las tienes.

    Para medirlo necesitas dos cosas. La primera, una definición escrita de qué significa "resuelto": los tests pasan, el diff no toca ficheros fuera de alcance, el JSON valida contra el esquema. Escribir eso antes de medir es literalmente una spec, y es la mitad del método que desarrollo en el libro de Spec-Driven Development.

    La segunda, correr esas evals con tus prompts y tu andamiaje. Y ojo, porque es lo que más gente ignora: el harness que envuelve al modelo cambia el resultado tanto como el modelo. Si cambias las dos variables a la vez, no has medido nada.

    Es el mismo criterio que aplico en el curso Construye con IA: montar la eval antes de elegir el modelo, no después de que llegue la factura.


    Veredicto: qué modelo para qué trabajo

    Trabajas con un agente de coding a diario. Claude Opus 5 en xhigh, y enruta a Sonnet 5 todo lo que tus evals demuestren que no necesita frontera. El ahorro real está en el enrutado, no en la tarifa.

    Tu carga está dominada por herramientas encadenadas. Cualquiera de los dos cerrados, pero enciende el tool calling programático: el ahorro está en la función, no en la marca del modelo. Mídelo un mes contra tu factura anterior mirando solo la línea de tokens de entrada, que es donde cae. Si no se mueve, tu flujo no era tan tool-heavy como creías.

    Procesas repos o corpus grandes de una pasada. Kimi K3. Aquí el precio bajo de entrada es real, la verbosidad apenas te toca, y los pesos abiertos te quitan la dependencia de un único proveedor.

    Clasificas, extraes o transformas en masa. Ninguno de los tres. GPT-5.6 Luna o un modelo de gama baja, con esquema estricto y Batch API. Frente a Sol, eso es un 80% menos de factura.

    Necesitas el techo absoluto de inteligencia y el coste es secundario. Claude Fable 5, a 59,9 y unos $50 por millón de salida. Es un caso raro. Si crees que es el tuyo, mídelo antes: casi nunca lo es.

    Haz una cosa hoy. Coge las diez últimas tareas que le mandaste a tu agente, córrelas contra dos modelos con el mismo harness y anota dos columnas: coste total y cuántas salieron bien a la primera. Divide. En media hora sabrás más que leyendo comparativas durante un mes.

    Es lo que hacemos, modelo a modelo, en Dominicode Labs.


    Preguntas frecuentes sobre Opus 5, GPT-5.6 y Kimi K3

    ¿Cuál es más barato entre Opus 5, GPT-5.6 y Kimi K3?

    Depende de si miras el precio de lista o el coste real por tarea. Por tarifa gana Kimi K3: $3 de entrada y $15 de salida por millón, frente a $5/$25 de Opus 5 y $5/$30 de GPT-5.6 Sol. Pero Kimi emite 2,06 veces los tokens de la media medida, lo que sitúa su coste efectivo de salida en unos $31 por millón, por encima de los otros dos. Con una salvedad que hay que decir: 2,06× es una cifra medida y las de Opus 5 y Sol son de lista. Los tres gastan más de lo que sugiere su tarifa —Opus 5 razona por defecto y factura ese razonamiento como salida—, pero Kimi es el único con el multiplicador publicado. En trabajo dominado por la entrada —repos grandes, documentos largos— Kimi sí es genuinamente el barato, porque la verbosidad solo penaliza la salida.

    ¿Por qué Opus 5 no tiene puntuación en el Intelligence Index?

    Porque se publicó el 24 de julio de 2026, después de la última ronda de medición del índice independiente de Artificial Analysis. Los puntos de referencia disponibles son Claude Opus 4.8 con 56 y Claude Fable 5 con 59,9. Que falte la medición del modelo más nuevo no es un detalle menor: durante las primeras semanas solo tienes los benchmarks del fabricante, y esos se publican siempre en el escenario que más favorece.

    ¿Qué modelo elijo para un agente de coding que corre durante horas?

    Claude Opus 5, arrancando en effort xhigh, que es lo que recomienda Anthropic para coding y trabajo agéntico. La razón no es la tarifa: en sesiones largas el output de cada turno se convierte en input de todos los siguientes, así que la verbosidad se compone en lugar de sumarse. Y lo que arruina la factura son los reintentos: una tarea que hay que repetir tres veces con el modelo barato cuesta más que una que sale a la primera con el caro.

    ¿Qué gano realmente con Programmatic Tool Calling?

    Que el modelo escriba código en un sandbox aislado para coordinar varias llamadas a herramientas en un solo turno, en vez de ir y volver a la API entre cada una. Los resultados intermedios de las herramientas no entran en el contexto, así que el ahorro cae sobre los tokens de entrada, no sobre los de salida. Anthropic mide un 37% menos de tokens en tareas complejas de research y un 24% menos de tokens de entrada en benchmarks de búsqueda agéntica; son cifras del propio fabricante, no de un tercero, y OpenAI no publica ningún porcentaje para su implementación. Sobre todo: no es un diferenciador entre modelos, porque tanto GPT-5.6 como Claude Opus 5 lo soportan.

    ¿Cómo calculo el coste por tarea resuelta en mi proyecto?

    Divide el coste medio por intento entre tu tasa de éxito. Para eso necesitas antes una definición escrita de qué significa "resuelto" en tu caso —tests en verde, diff dentro del alcance previsto, JSON que valida contra su esquema— y correr las mismas tareas con el mismo harness para todos los modelos que compares. Si cambias de modelo y de andamiaje a la vez, no estás midiendo el modelo: estás midiendo el ruido.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
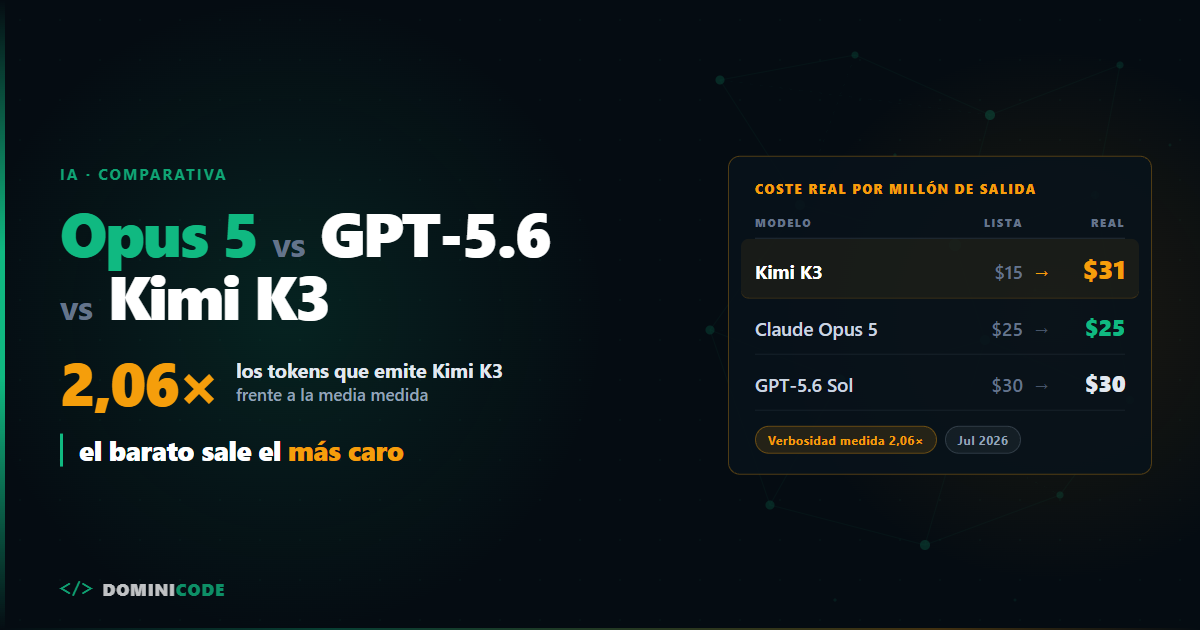
  • Cómo medir el rendimiento de agentes de IA con evals efectivos

    Cómo medir el rendimiento de agentes de IA con evals efectivos

    Evals para código generado por IA — cómo medir si tu agente está mejorando o empeorando con tu spec

    Tiempo estimado de lectura: 6 min

    • Combina validación determinista y semántica: ambas dimensiones son necesarias para señales accionables.
    • Golden Dataset + rúbricas: versiona casos reales con criterios explícitos para comparar versiones del spec.
    • Two-speed pipeline: validación determinista en cada PR; juez LLM y revisiones completas en merges/release.
    • Métricas operativas clave: pass rate, semantic score, flakiness, coste por eval y regression rate.

    Si cambias una línea en tu CLAUDE.md o ajustas las instrucciones del sistema y luego aceptas código “porque se ve bien”, estás apostando a que la intuición compense la probabilidad. No lo hace. Necesitas implementar evals para código generado por IA — cómo medir si tu agente está mejorando o empeorando con tu spec para convertir esa intuición en métricas reproducibles.

    Este artículo explica qué medir, cómo construir un pipeline fiable, qué herramientas usar y las decisiones operativas que separan a los equipos que gestionan agentes con criterio de los que lo hacen por esperanza.

    Resumen rápido (lectores con prisa)

    Qué es: Un enfoque combinado de evals deterministas y semánticos para código generado por IA.

    Cuándo usarlo: Siempre que tu agente genere código que afecte producción o el diseño arquitectónico.

    Por qué importa: Transforma intuición en métricas reproducibles y reduce regresiones al cambiar el spec.

    Cómo funciona: Golden Dataset versionado + pipeline: determinista rápido en PRs, juez LLM y/o humanos en merges y releases.

    ¿Qué miden los evals para código generado por IA — cómo saber si tu agente mejora o empeora?

    Un eval profesional mide dos dimensiones complementarias:

    • 1. Validación determinista — ¿el output cumple reglas objetivas?
    • 2. Validación semántica — ¿el output cumple criterios arquitectónicos, de seguridad y estilo que sólo pueden evaluarse con criterio?

    Si sólo ejecutas una, te quedas cojo. Combínalas y obtendrás señales accionables.

    Validación determinista

    Objetivos claros y automatizables:

    • Síntaxis / AST: el código parsea sin errores.
    • Linter/style: ESLint/Prettier pasan según la configuración del repo.
    • Tests unitarios de integración en sandbox: el código generado se inyecta en un contenedor efímero y ejecuta Jest/Vitest/PyTest.
    • Reglas binarias del spec: por ejemplo, “no usar fetch en cliente” → comprobación estática.

    Resultado: métricas binarias y tasas de paso (pass rate) que puedes agregar y comparar entre versiones del spec.

    Validación semántica — LLM-as-a-Judge y estrategias híbridas

    Algunos criterios no son booleanos: diseño, seguridad implícita, uso idiomático. Aquí entra un juez LLM:

    • El juez recibe: el spec original, el código generado, y una rúbrica estructurada.
    • Produce: una puntuación y un reasoning structured (json) que explica fallos de arquitectura, riesgos de seguridad, o desviaciones de estilo.

    Precaución: existe sesgo de auto-preferencia. Mitigaciones prácticas:

    • Usar un modelo juez distinto y preferible más capaz (ej. GPT‑4o o Claude avanzado).
    • Ensembles: combinar juicios de 2–3 modelos y una muestra humana para calibrar.
    • Registrar justificaciones (no sólo la puntuación).

    Cómo construir un pipeline de Evals paso a paso

    1. Golden Dataset (20–50 casos reales)

    • Casos representativos del código y dominios del producto.
    • Cada caso: input, contexto (memory files relevantes), criterios de éxito explícitos.
    • Versionado en Git junto al spec.

    2. Frameworks y herramientas

    • Promptfoo — orquestación de evals en CLI.
    • LangSmith (observabilidad y tracing).
    • Braintrust (plataformas de evals y datasets).
    • Integrar linters, AST analyzers y runners de tests (Jest/Vitest/PyTest).

    3. Sandbox seguro para deterministas

    • Contenedores efímeros sin red ni credenciales, preferiblemente con políticas de seccomp/gVisor o Firecracker para microVMs.
    • Tiempo límite por test y quotas de CPU/RAM.

    4. LLM-as-a-Judge

    • Definir rúbricas concretas (JSON schema) por caso del Golden Dataset.
    • Ejecutar juez sólo en merges o nightly builds si el coste es alto; o en un flujo “two-speed” (ver abajo).

    5. Métricas y alertas

    • Pass rate determinista por caso y agregado.
    • Puntuación semántica media y desviación estándar.
    • Flakiness rate (casos con resultados inconsistentes entre corridas).
    • Cost per eval (tokens, wall time).
    • Guardrails: bloquear PRs si la adherencia agregada cae por debajo de un umbral (ej. 85–90%).

    6. Integración CI/CD

    • Disparar evals cuando cambie el spec (CLAUDE.md, AGENTS.md, memory files).
    • Pipeline típico: generar → determinista (rápido) → reporte → si pasa, opcional: juez LLM → aprobar o bloquear PR.

    Estrategia operativa: coste vs seguridad vs velocidad

    • Two-speed pipeline: Validación determinista ligera en cada PR; validación semántica completa en merges a main o releases. Reduce coste y mantiene seguridad.
    • Ensembles y muestreo: Si el coste de juez LLM es prohibitivo, ejecuta juez en una muestra estadística del Golden Dataset por cada cambio mayor.
    • Human-in-the-loop: para nuevas rules o casos edge, requiere revisión humana antes de aceptar un cambio en el spec.

    Métricas que realmente importan

    • Regression rate por cambio de spec (número de casos del Golden Dataset que empeoran).
    • Mean Semantic Score delta entre versiones del spec.
    • Time-to-fix promedio cuando un eval falla.
    • Token cost por ejecución y coste por PR.
    • Porcentaje de automatización (qué % de PRs infractions se bloquean automáticamente vs requieren intervención humana).

    Conclusión operativa

    Trata tu spec como código crítico: versiona, prueba y monitoriza. Implementar evals para código generado por IA transforma la gestión de agentes de una caja de sorpresas a un proceso auditable. Si quieres que el agente mejore con cambios en tu spec, mide, automatiza y obliga a retroalimentación continua. Sin datos no hay control; sin control, el agente termina rompiendo más de lo que arregla.

    Si trabajas con automatización, agentes o workflows y quieres ejemplos prácticos y experimentos reproducibles, revisa Dominicode Labs. Encontrarás recursos y prototipos alineados con pipelines de evals y prácticas de integración.

    FAQ

    ¿Qué miden los evals para código generado por IA?

    Miden dos dimensiones complementarias: validación determinista (sintaxis, linters, tests, reglas binarias) y validación semántica (diseño, seguridad, estilo evaluados por un juez LLM o humanos).

    ¿Qué es validación determinista?

    Es la comprobación automática y objetiva: el código parsea, pasa linters, ejecuta tests en sandbox y cumple reglas estáticas definidas en el spec.

    ¿Cómo se construye un Golden Dataset?

    Reúne 20–50 casos reales representativos. Cada caso debe incluir input, contexto relevante y criterios de éxito explícitos; versiona el dataset en Git junto al spec.

    ¿Cuándo debo ejecutar un juez LLM?

    Ejecuta juez LLM en merges o nightly builds si el coste es alto, o en un flujo two-speed donde aplicas juez a cambios aprobados determinísticamente o a muestras estadísticamente relevantes.

    ¿Qué métricas operativas debo vigilar?

    Pass rate determinista, mean semantic score, regression rate por cambio de spec, flakiness rate, token cost por ejecución y time-to-fix promedio.

    ¿Cómo integrar evals en CI/CD sin elevar demasiado el coste?

    Usa una validación determinista ligera en cada PR y ejecuta validación semántica completa en merges/releases. Muestrea casos para reducir coste y aplica ensembles o revisión humana en casos críticos.

  • Cómo medir LLM Evals y Observabilidad en Producción

    Cómo medir LLM Evals y Observabilidad en Producción

    LLM Evals, Alignment y Observabilidad en Producción

    Tiempo estimado de lectura: 3 min

    • Ideas clave:
    • Las métricas operativas (Accuracy, Hallucination Rate, Latency, Cost per Task, Consistencia) son indispensables para pasar de prototipo a servicio escalable.
    • Construye un Golden Dataset, valida outputs estructurados y usa un modelo juez para tareas generativas.
    • Observabilidad en vivo (tracing, sampling, alertas) y guardrails de salida son necesarios para seguridad y estabilidad.

    Cómo medir si tu sistema AI realmente funciona en producción empieza por entender que “parece que responde bien” no es una métrica. LLM Evals, Alignment y Observabilidad en Producción son las piezas que convierten un prototipo bonito en infraestructura operable: Accuracy, Goal Completion, Toxicity, Hallucination Rate, Latency, Cost per Task y Consistencia. Si no mides esto, no escalas —solo maquillas el riesgo.

    Resumen rápido (lectores con prisa)

    LLM Evals: pruebas con un Golden Dataset y un modelo juez para medir factualidad y cumplimiento de objetivos. Observabilidad: tracing, sampling y alertas en vivo para detectar degradación y drift. Alineación y safety: guardrails en la salida y revisión humana cuando la confianza es baja.

    LLM Evals, Alignment y Observabilidad en Producción: qué medir y por qué

    La evaluación de modelos en producción debe ser multidimensional. Aquí están las métricas que importan y cómo interpretarlas:

    Métricas específicas

    Accuracy / Factuality

    ¿La respuesta es correcta? En sistemas RAG separa Context Recall (¿se recuperó lo relevante?) de Context Precision (¿la respuesta se basa en lo recuperado o lo inventa?).

    Hallucination Rate

    % de respuestas con información inventada. Target operativo: <3–5% según criticidad.

    Goal Completion

    Métrica binaria/medible ligada al negocio (email extraído, ticket resuelto). Es la métrica ROI.

    Toxicity / Safety

    Puntuaciones automáticas (ej. Perspective API) y guardrails para bloquear salidas peligrosas.

    Latency (TTFT y Total Latency)

    TTFT <2s para chat aceptable; objetivos más estrictos para aplicaciones UX sensibles.

    Cost per Task

    tokens * precio/modelo → $ por ejecución. Debe compararse con coste humano.

    Consistencia

    Desviación en resultados en ejecuciones repetidas; alta variabilidad indica prompts inestables o temperatura mal gestionada.

    Cómo construir Evals útiles (práctico)

    1. Golden Dataset

    Golden Dataset

    • Crea un conjunto curado de 100–500 ejemplos por workflow (80% casos comunes, 20% edge).
    • Human-label para ground truth inicial. Sin esto no hay baseline.

    Deterministic vs Model-Graded

    • Deterministic: para outputs estructurados valida formato/JSON con schema checks.
    • Model-graded: usa un LLM “juez” (más capaz) con una rúbrica para puntuar respuestas textuales. Ejemplo: pedir al juez “evalúa factualidad (1–5) y da evidencia”.

    Pipeline de CI

    • Ejecuta el Golden Dataset en cada PR que cambie prompts, chain logic o modelo.
    • Rechaza merges si Accuracy/Goal Completion bajan más de X%.

    Ejemplo simple (pseudocódigo de evaluación):

    # enviar respuesta + contexto + prompt de evaluación a un modelo juez
    judge_prompt = "Evalúa si la respuesta es fiel al contexto. Score 1-5. Explica brevemente."
    score = call_judge_model(input=context + answer, prompt=judge_prompt)

    Observabilidad en producción: trazas, sampling y alertas

    Las Evals funcionan offline; la Observabilidad te dice qué pasa en vivo.

    Tracing completo

    Registra input, documentos recuperados, prompts enviados, tokens, latencias por etapa. Usa LangSmith, LangFuse o Arize Phoenix para visualizar trace chains.

    Sampling inteligente

    Evalúa en línea entre 0.5–5% del tráfico para balancear coste y cobertura.

    Drift detection

    Monitoriza cambios en la distribución de inputs; alerta cuando un feature importante sale del rango esperado.

    Alertas por SLA

    Accuracy drop, Hallucination spike, o coste por task anómalo disparan rollback o canary throttling.

    Integra traces con OpenTelemetry para correlación con logs y métricas infra.

    Alineación operativa y safety

    • Implementa guardrails en la capa de salida (post‑processing) que validen seguridad y formato antes de exponer la respuesta (ej. NVIDIA NeMo Guardrails).
    • Para respuestas sensibles, requiere verificación secundaria: LLM-as-a-Judge + schema check + citation check (si es RAG).
    • Mantén un “human-in-the-loop” para casos de baja confianza: si la confianza < umbral, encolar para revisión humana.

    Métricas objetivo y SLOs realistas

    Define SLOs por workflow, p. ej.:

    • Accuracy > 95% en Golden Dataset.
    • Hallucination Rate < 3%.
    • TTFT < 2s.
    • Cost per Task < $0.05 (ajusta según caso de negocio).

    Monitoriza y versiona SLOs junto al código/infra.

    Errores comunes que debes evitar

    • No tener Golden Dataset.
    • Medir solo calidad, ignorar coste.
    • No versionar prompts ni modelos.
    • Silenciar drift: sin alertas el modelo se degrada sin aviso.

    Cierre operativo

    LLM Evals, Alignment y Observabilidad en Producción no son funciones accesorias: son el núcleo del ciclo de vida de una IA productiva. Empieza por construir tu Golden Dataset, versiona prompts como código, añade un juez para tareas generativas y despliega tracing por etapas. Con esas piezas, transformarás la IA de experimento a servicio confiable, escalable y justificable en costes.

    Lecturas y herramientas prácticas

    Para equipos que implementan pipelines de Evals y observabilidad como parte de workflows de producto, una continuación lógica es revisar recursos y experimentos prácticos disponibles en Dominicode Labs. Ahí puedes encontrar ejemplos aplicados y plantillas para integrar tracing y CI de evaluación en flujos de trabajo.

    FAQ

    ¿Qué es un Golden Dataset y por qué lo necesito?

    Un Golden Dataset es un conjunto curado y etiquetado de ejemplos (100–500 por workflow) que sirve como baseline para evaluar Accuracy y Goal Completion. Sin él no tienes una referencia objetiva para medir degradación o mejoras.

    ¿Cómo medir hallucinations en producción?

    Combina sampling en línea con evaluaciones humanas y modelos juez que comparen respuestas contra contexto o fuentes. Mide el porcentaje de respuestas con información inventada y fija umbrales operativos (<3–5%).

    ¿Qué es un modelo juez (model-graded)?

    Es un LLM más capaz que puntúa respuestas humanas/modelo según una rúbrica (p. ej. factualidad 1–5) y devuelve evidencia o explicación para el score.

    ¿Cuánto tráfico debo muestrear para Evals en línea?

    Generalmente entre 0.5–5% del tráfico, para equilibrar coste y cobertura. Ajusta según criticidad y coste por task.

    ¿Qué abandonar ante un spike de hallucinations?

    Accionar alertas: revertir cambios recientes (rollback), activar canary throttling, aumentar muestreo y encolar casos para revisión humana hasta estabilizar la tasa.

    ¿Cómo integrar tracing con OpenTelemetry?

    Instrumenta puntos clave (entrada, recuperación de documentos, llamada al modelo, post‑processing), exporta traces a tu backend y correlaciona con logs y métricas infra para análisis de causa raíz.

    ¿Cuáles son SLOs realistas para chatbots?

    Ejemplos: Accuracy >95% en Golden Dataset, Hallucination Rate <3%, TTFT <2s. Ajusta según el workflow y coste/humano de fallback.