Durante cuatro años nos hemos tragado un dogma que Jev viene a discutir: para que una red neuronal decida si un log es crítico, tiene que predecir el token 1, pasárselo a su propia entrada, ampliar el KV-cache, predecir el token 2 y repetir el ciclo hasta escupir una llave de cierre de JSON.
Es una aberración de ingeniería. Pagas cientos de milisegundos de GPU y decenas de tokens de salida en mantener un bucle secuencial que razona en voz alta cuando lo único que necesitabas era una proyección sobre una distribución discreta.
Ese es el punto ciego que ataca Jev, el modelo de TypeSafe AI lanzado a mediados de septiembre de 2026 por Diogo Almeida —uno de los creadores de InstructGPT y co-inventor de RLHF en OpenAI—.
Qué hay debajo —si parte de un LLM, si es un destilado— no lo sabemos: no han publicado nada, y en Hacker News ya se lo están preguntando. Lo que sí es distinto es el contrato de salida: números, no prosa.
En corto: Jev, de TypeSafe AI, es un modelo System One que no genera texto: evalúa en paralelo preguntas tipadas sobre un estado y devuelve probabilidades calibradas, a ~100 ms de inferencia según su doc (~250 ms de extremo a extremo medidos). Su propia documentación lista nueve modos de fallo de la versión 1.13, desde la aritmética y las fechas hasta el contenido adversarial en el state.
¿Qué se sabe de la arquitectura de Jev?
Jev es un sistema no generativo: no está entrenado para producir texto, sino para proyectar un estado de entrada sobre decisiones tipadas (noul, choice, score) y devolver probabilidades calibradas.
TypeSafe no ha publicado la arquitectura interna: ni paper, ni pesos, ni capas. Lo que sigue sale de su documentación y de la API; el resto sería especulación.
En un LLM estándar (GPT-5.6, Claude Sonnet 5, Gemini 3.5), la generación es secuencial:
token 1 → token 2 → token 3 → … → token n
Si el JSON de respuesta tiene 80 tokens, pagas 80 pasadas por la red.
Jev ingiere el state una vez y evalúa todas las preguntas contra él en paralelo y de forma aislada: la respuesta a una no entra como contexto de otra.
La consecuencia, firmada por su documentación: añadir preguntas apenas cambia el tiempo de respuesta, mientras quepan en el contexto. Cuestan tokens de entrada, no tiempo apreciable.
El precio: sin texto de salida, no hay dónde escribir una explicación. Jev te da el número, nunca el motivo.
Entrenamiento: qué promete la calibración
Jev se entrena con RLCD (Reinforcement Learning for Calibrated Decisions): optimiza que las probabilidades sean honestas, no que la respuesta guste a un humano. La promesa: si Jev asigna a 1.000 decisiones una probabilidad del 0,80, alrededor de 800 deberían salir correctas. La diferencia con RLHF la cuento con calma en qué es Jev de TypeSafe AI.
La propia TypeSafe lo pone por escrito: RLHF "can also reward sycophancy and confident-sounding hallucinations". Y en Hacker News Mentlo le devolvió la pelota: "Is there anything published on how it maintains calibration?". No hubo respuesta.
Verifícala por tramos con tus datos, y ojo a qué es lo calibrado:
// Lo calibrado son las probabilities; confidence resume cuánto se concentran
interface ChoiceAnswer<T extends string> {
  type: 'choice'
  choice: T
  probabilities: Record<T, number> // suman 1
  confidence: number
}
confidence solo la traen choice y score. En un noul, el propio número es la creencia.
Especificaciones: lo que dice la doc de jev-1.13.0
Esto es lo que dice la documentación de jev-1.13.0, más una medición propia de latencia. Vercel, que integra Jev en su AI SDK y no es árbitro imparcial, reportó en TechCrunch que en su clasificador de seguridad Jev iba entre 5x y 18x más rápido en p95 que gpt-5.6-luna, con más acierto.
| Métrica | jev-1.13.0 (hoy, alias jev-latest) |
gpt-5-nano / gpt-5.6-luna / Gemini 3.5 Flash-Lite |
|---|---|---|
| Mecanismo | No generativo: preguntas en paralelo contra el mismo state |
Autorregresivo, token a token |
| Latencia | ~100 ms de inferencia según la doc; ~250 ms end-to-end medidos desde mi red (p50 de 10 llamadas; 628 ms abriendo conexión nueva) | De cientos de ms a segundos, según modelo y salida |
| Entrada / Mtok | $0,042 | $0,05 – $0,30 |
| Salida / Mtok | $0,00 (se factura a cero) | $0,40 – $2,50 |
Opciones por choice |
255 por etapa | Sin límite fijo documentado |
| Contexto | 64k por petición; 32k para state + la pregunta más larga |
Según modelo |
| Límite de tasa | 250.000 tokens/s · 1.200 req/min (ajustándose sin aviso) | Según tu tier |
| Límite / riesgo | Valor de tipo válido y equivocado con confidence alta; no explica; el state puede manipularlo |
Alucina dentro de un JSON válido; coste y latencia escalan con la salida |
La home de TypeSafe presume de ser "444,6x más barato". En Hacker News (#49717558) la discusión fue sobre el título original del lanzamiento, "40-400x cheaper and 20-200x faster", y WhitneyLand lo resumió sin rodeos: "I'm going to agree that was misleading". Con los precios de la tabla, solo en tokens de entrada, Jev sale entre 1,2x más barato que gpt-5-nano y 7,1x más que Gemini 3.5 Flash-Lite. Los multiplicadores de tres cifras aparecen al compararlo con modelos frontera: contra los $10/Mtok de entrada de gpt-6-astra ya son 238x antes de contar la salida.
Capacidades reales: ¿para qué está optimizado Jev?
El diseño del modelo lo hace encajar en cuatro tareas concretas:
1. Enrutamiento (routing)
Qué agente, cola o servicio procesa un mensaje antes de invocar herramientas caras. En agentes que manejan la pantalla: Jev en agentes y computer use.
2. Triaje con umbral de riesgo
Clasificar con corte estricto: si confidence < 0.70, no se ejecuta y pasa a revisión manual. El montaje con TypeScript y Zod, en integraciones seguras con Jev.
3. Guardrails
Marcar en ~250 ms si un prompt entrante es un jailbreak antes de enviarlo al modelo principal (hay cookbook oficial). Ojo: el propio Jev se puede mover con el texto que analiza (ver el modo de fallo 6).
4. Gates en CI/CD
Comprobar si el diff de un PR cumple la especificación sin pagar la latencia de un LLM-as-judge. Paso a paso en harness con Jev.
Los nueve modos de fallo de jev-1.13
Solo una de estas limitaciones es de diseño: no genera texto. El resto son las que TypeSafe documenta para jev-1.13 y, en sus palabras, "many of these will be fixed in later versions". Por eso fija la versión si calibras umbrales.
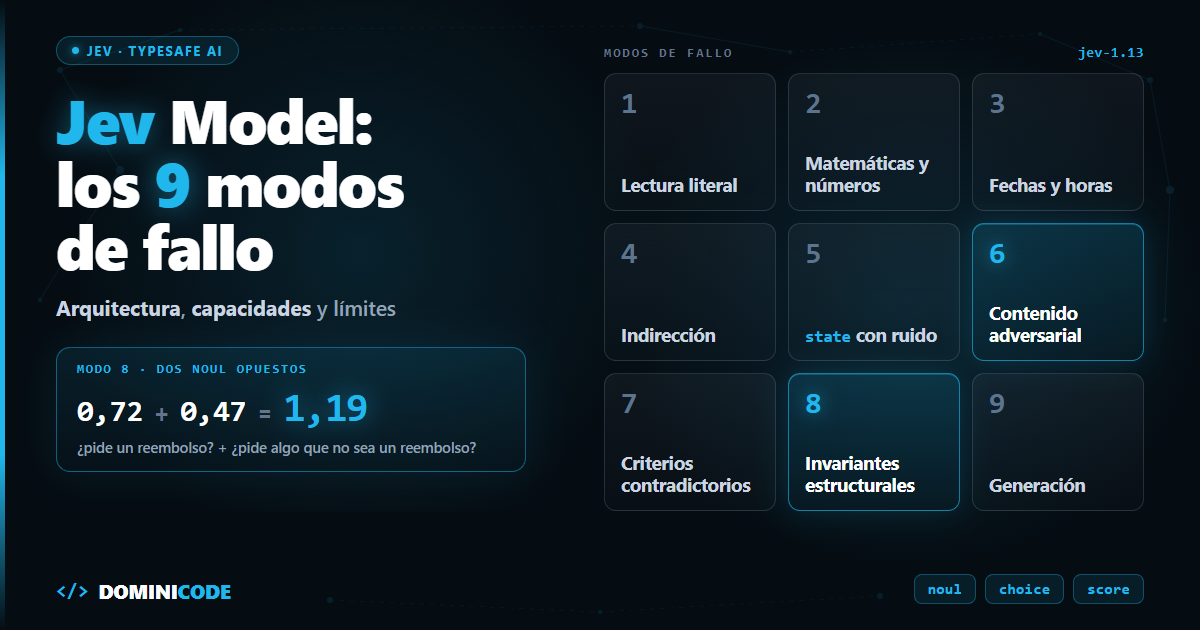
| # | Modo de fallo | Haz esto en su lugar |
|---|---|---|
| 1 | Lectura literal | Escribe la condición exacta y criterios para cada opción |
| 2 | Matemáticas y números | Deja la aritmética en el código |
| 3 | Comparación de fechas y horas | Extrae los componentes; compara en código |
| 4 | Indirección | Reduce los saltos; señala la parte relevante del state |
| 5 | state grande lleno de detalle irrelevante |
Filtra primero; envía solo lo que la pregunta necesita |
| 6 | Contenido adversarial | Escribe prompts precisos y prueba los casos límite antes de desplegar |
| 7 | Instrucciones y criterios contradictorios | Alinea los criterios con la instrucción |
| 8 | Invariantes estructurales de sentido común | Pregunta cada decisión de una sola forma; impón las identidades en código |
| 9 | Generación | Usa un modelo generativo |
Traducida de la página de limitaciones de jev-1.13, revisada por TypeSafe el 17 de septiembre de 2026.
1. Lee lo que escribiste, no lo que querías
Negaciones y condiciones implícitas, al pie de la letra. Si al mirar un fallo te pillas explicando "lo que yo quería decir", esa explicación es lo que le faltaba a la instrucción.
2 y 3. Ni cuentas ni fechas
No es fiable si le pides evaluar si una fecha supera los 30 días de garantía o si una cesta suma más de 100 euros. Tampoco cuenta elementos. Con las fechas, la doc propone que Jev extraiga día, mes y año como choice cerrados y que tu código compare.
4 y 7. Indirección y criterios que se contradicen
Dobles negaciones y "una propiedad de una propiedad" le cuestan acierto: escribe directo y nombra el campo del state que importa. Y si instructions y criteria piden cosas distintas, se confunde. El ejemplo de la doc: un noul donde true significa "no" rinde peor.
5. Ruido en el state
El acierto cae cuando el state se llena de cosas ajenas a la decisión. Si no puedes filtrar en código, un noul previo decide qué fragmentos son relevantes.
6. No trata el state como hostil
La que más caro sale. Una instrucción inyectada, un encuadre engañoso o un texto que argumenta a favor de su propia clasificación pueden mover la respuesta.
Si el state lo escribe un usuario —o peor, otro modelo—, es superficie de ataque. Describe los dos lados de cada pregunta con criteria, prueba con entradas envenenadas y no le des al veredicto más poder del que estés dispuesto a perder.
8. Invariantes que no se cumplen
La doc hace la misma pregunta y su negación como dos noul sobre el ticket "I was charged twice for the same order": "¿pide un reembolso?" da 0,72 y "¿pide algo que no sea un reembolso?" da 0,47. Suman 1,19.
Tampoco lleves un umbral de un noul a un choice: la misma pregunta de reembolso, sobre otro ticket, dio 0,22 como noul y 0,01 como choice.
9. No genera texto
No puede decirte por qué decidió. Para extraer datos, saca los candidatos con una regex o un LLM y deja que Jev elija.
Límites de la API: 255 opciones e idioma
Un choice no admite más de 255 opciones por etapa. Para taxonomías gigantes, dos pasadas: primero familia, luego subclase.
El inglés es su idioma principal de entrenamiento y donde hoy acierta más. La doc no da receta: pide probar con tu propio contenido y vigilar el confidence al enrutar. Mi apuesta es escribir las preguntas y los criterios en inglés, pero mídelo antes de fiarte.
Antes de producción: pasa tus preguntas por los nueve modos de fallo
Antes de meter Jev en producción, pasa cada una de tus preguntas por la tabla de los nueve modos de fallo y reescribe las que caigan en uno. Te ahorra el umbral que parecía calibrado y no lo estaba.
Cada pieza de tu sistema necesita un contrato. En el libro Spec-Driven Development (SDD) explico cómo acotar cada decisión del sistema con interfaces y tests deterministas.
Si estás montando agentes que combinan un modelo que decide con otro que ejecuta, descarga gratis El Developer Agéntico: arquitectura, memoria, seguridad y evaluación de agentes.
Las capacidades y los límites de Jev los desarrollo a fondo en Jev y las decisiones tipadas con IA, con un capítulo entero sobre cómo te va a fallar.
Preguntas frecuentes
¿Cuáles son los modos de fallo de Jev?
Nueve para jev-1.13: lectura literal, matemáticas, fechas, indirección, state con ruido, contenido adversarial, criterios contradictorios, invariantes estructurales y generación. Solo el último es de diseño; de los demás, TypeSafe dice que muchos se arreglarán.
¿Por qué Jev no cobra por los tokens de salida?
Porque la salida son unos pocos números por pregunta. Ojo: usage.output_tokens no viene a cero; se factura a cero.
¿Se pueden afinar (fine-tuning) los pesos de Jev con datos propios?
No. Su documentación dice que Jev no se afina ni se adapta con LoRA con datos de cliente, y los mismos pesos sirven a todas las cuentas. Lo moldeas desde la petición: tu material en el state y tus reglas en instructions y criteria.
¿Qué ocurre si mi contexto supera la ventana?
La API rechaza la petición. La doc no detalla con qué código en este caso: los errores de validación salen como 422, con el campo culpable en el cuerpo. Hay dos techos: 64k por petición y 32k para el state más la pregunta más larga. Recorta antes de consultar: además de caber, acertarás más.
Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
Leave a Reply