El precio de Jev tiene una línea que llama la atención: la salida se factura a $0. Si has puesto un LLM en producción, sabes por qué importa.
La entrada parece barata. Luego llega el desglose: millones de tokens de salida, entre cinco y ocho veces más caros, para formatear JSON que tu código descartó nada más parsearlo.
Jev, el modelo de TypeSafe AI, cobra $0,042 por millón de tokens de entrada. Y la salida se factura a $0 (condición comercial, sin confirmar en factura).
Antes de migrar por el "444 veces más barato", coge la calculadora.
En corto: Jev cuesta $0,042 por millón de tokens de entrada ($42 por cada mil millones) y la salida se factura a $0. Con una llamada real medida, Jev sale entre 3,3x (contra gpt-5-nano) y 50x (contra Claude Haiku 4.5) más barato. Por encima de 100x solo se llega comparando contra modelos de gama media o de frontera (gpt-5.6-terra, 111x con la misma llamada).
¿Cuál es el precio de Jev y cómo se factura?
Jev factura por token de entrada: $0,042 por millón. La salida se factura a $0, aunque la respuesta sí la cuenta en usage.output_tokens.
No hay recargo por número de preguntas ni de opciones de un choice (hasta 255): solo cuentan los tokens que ocupan.
Pagas por el state, por el texto de las preguntas y sus criteria, y por un consumo fijo por petición que la doc no desglosa (en sus ejemplos, unos 300 tokens para una pregunta de una línea).
¿Hay planes? Uno de pago por uso y enterprise bajo contacto
                      QUÉ PUBLICA TYPESAFE AI
  ┌────────────────────────────────────────────────────────────────────┐
  │ TARIFA PÚBLICA                                                     │
  │ • $0,042 / MTok de entrada · salida facturada a $0                 │
  │ • Límites: 1.200 req/min · 250.000 tokens/s                        │
  │   (TypeSafe avisa de que cambian sin previo aviso)                 │
  │ • Contexto: 64.000 tokens por petición y 32.000 para el `state`    │
  │   más la pregunta más larga                                        │
  ├────────────────────────────────────────────────────────────────────┤
  │ ENTERPRISE                                                         │
  │ • Límites más altos y Zero Data Retention bajo contrato            │
  │ • Por email: sales@typesafe.ai / privacy@typesafe.ai               │
  │ • Sin precios públicos                                             │
  └────────────────────────────────────────────────────────────────────┘
Desmontando el titular: ¿es realmente 444x más barato y 193x más rápido?
La home de TypeSafe AI abrió con esto: "193,6x más rápido y 444,6x más barato".
La explicación la da el propio blog de lanzamiento de TypeSafe: las cifras salen de sus workflow evals, cuatro flujos con muchas preguntas independientes, donde la respuesta de referencia es la media de GPT-6 Astra y Fable 5.1. Y lo matizan ellos mismos: "we expect that these are on the higher end of real world gains".
El desmontaje completo está en qué es Jev de TypeSafe AI. Aquí van las cuentas.
- El coste (444x). Con los precios de lista y la misma llamada medida (580 tokens de entrada, 129 de salida), contra GPT-6 Astra ($10/$50) sale ~503x; contra Claude Sonnet 5 ($2/$10), ~101x. El 444x es real contra un modelo de frontera, y no dice nada frente al modelo barato que ya usas.
- La velocidad (193x). Jev tarda unos 100 ms de inferencia según su doc; yo he medido ~250 ms end-to-end (p50 de 258 ms con la conexión TLS reutilizada, 628 ms abriendo conexión nueva). No he cronometrado el lado del LLM, así que no te doy multiplicador.
- La medición de producción. La única publicada es de Vercel (TechCrunch, 18-09), que integra Jev en su AI SDK: no es árbitro imparcial. Al sustituir
gpt-5.6-lunapor Jev en su clasificador de seguridad, midieron entre 5x y 18x más velocidad en el p95, con más acierto.
Precio de Jev frente a otros modelos
Precios por millón de tokens (MTok), comprobados el 20 de septiembre de 2026 en las páginas oficiales de cada proveedor:
| Modelo | Input / MTok | Output / MTok | Ratio vs Jev (input) |
|---|---|---|---|
Jev (jev-1.13.0) |
$0,042 | $0,00 | 1x (base) |
gpt-5-nano |
$0,05 | $0,40 | 1,2x |
gpt-5.6-luna |
$0,20 | $1,20 | 4,8x |
| Gemini 3.5 Flash-Lite | $0,30 | $2,50 | 7,1x |
| Claude Haiku 4.5 | $1,00 | $5,00 | 23,8x |
gpt-5.6-terra |
$2,00 | $12,00 | 47,6x |
Fuentes: OpenAI, Anthropic, Google. Precios de lista, sin caché de prompt ni descuentos por batch.
No hay columna de latencia para los demás. Esa cifra solo vale si la mides tú, con el mismo prompt, la misma red y el mismo día, y yo solo he medido Jev. La única medición de producción publicada es la de Vercel (TechCrunch, 18-09), que integra Jev en su AI SDK: no es árbitro imparcial.
La cuenta que de verdad importa
Mirar solo el precio de entrada engaña. Un clasificador con un LLM te cobra la salida, y la salida vale entre 5 y 8 veces más que la entrada en todos ellos (8,3 en Flash-Lite).
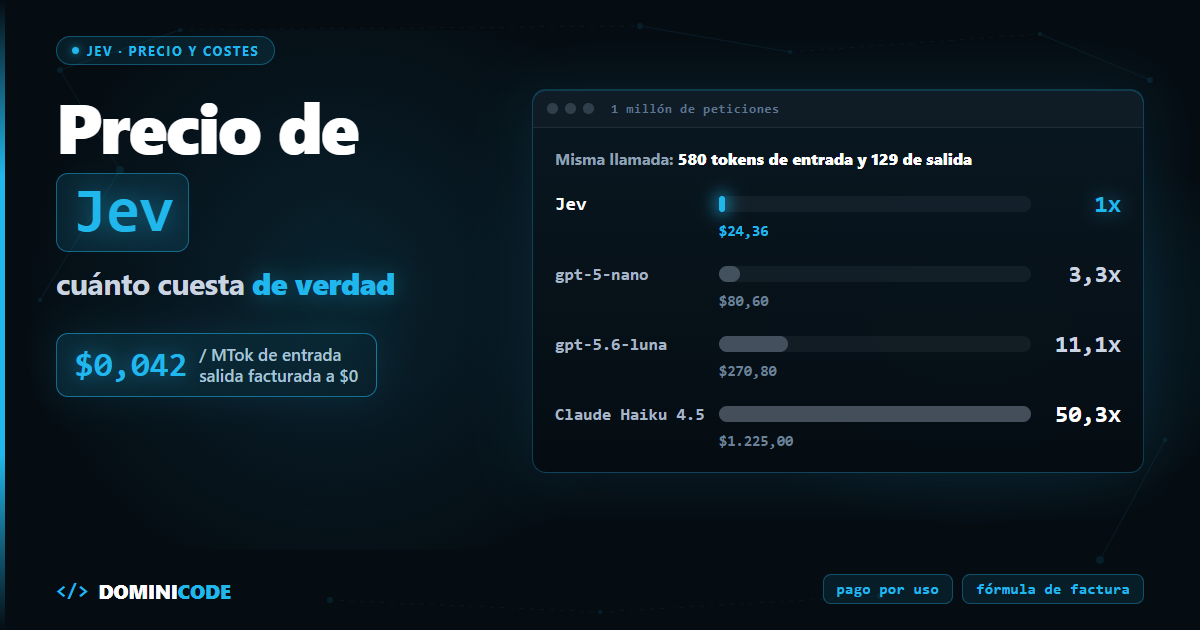
Esta es la llamada real que he medido contra Jev: 580 tokens de entrada y 129 de salida. Un ticket de soporte con tres preguntas tipadas. Proyectada a un millón de peticiones al mes:
| Modelo | Coste entrada | Coste salida | Total / millón de peticiones | vs Jev |
|---|---|---|---|---|
| Jev | $24,36 | $0,00 | $24,36 | 1x |
gpt-5-nano |
$29,00 | $51,60 | $80,60 | 3,3x |
gpt-5.6-luna |
$116,00 | $154,80 | $270,80 | 11,1x |
| Claude Haiku 4.5 | $580,00 | $645,00 | $1.225,00 | 50,3x |
Supuesto: aplico a cada LLM el mismo consumo que Jev contabilizó. No es una medición del LLM, que además leería un prompt de sistema y podría gastar tokens de razonamiento; cada tokenizador cuenta distinto, así que tómalo como orden de magnitud.
Fíjate en gpt-5-nano: en entrada casi empata con Jev (1,2x). La distancia se abre en la salida. El argumento económico no es el 444x del titular: es 3x contra el modelo más barato del mercado y 50x contra un Haiku, para el mismo trabajo.
Una advertencia sobre la "salida gratis". La respuesta real de Jev devuelve
usage: {input_tokens: 580, output_tokens: 129}. Los tokens de salida existen y se contabilizan; TypeSafe dice que se facturan a cero. Hasta verlo en tu factura, es una condición comercial que puede cambiar.
No soy el único con esa duda. En el hilo de Hacker News del lanzamiento, un usuario lo dejó así: "I am not sure for how long the output will stay absolutely free." Y añadía la ventaja de fondo: con solo precio de entrada, el coste se calcula antes de lanzar la petición.
Cómo calcular tu consumo mensual: la fórmula paso a paso
Para estimar tu factura con Jev solo necesitas los tokens de entrada acumulados:
factura = peticiones × tokens_por_petición / 1.000.000 × 0,042
Caso práctico: triaje de 5 millones de eventos al mes
Un SaaS que procesa 5.000.000 de mensajes o webhooks al mes. Supuesto del ejemplo, no una medición:
- Texto medio (
state): 400 tokens (~300 palabras). - Preguntas (
questions): 100 tokens. - Total por petición: 500 tokens.
Volumen total:
5.000.000 × 500 = 2.500.000.000 tokens = 2.500 MTok
Factura con Jev:
2.500 × 0,042 = $105,00 al mes
El mismo escenario con gpt-5.6-luna (el modelo que Vercel sustituyó por Jev), suponiendo un JSON de salida compacto de 80 tokens:
- Entrada (2.500 MTok a $0,20): $500,00
- Salida (400 MTok a $1,20): $480,00
- Total: $980,00 al mes, 9,3x la factura de Jev.
Con el modelo más barato del catálogo, gpt-5-nano:
- Entrada (2.500 MTok a $0,05): $125,00
- Salida (400 MTok a $0,40): $160,00
- Total: $285,00 al mes, 2,7x. Este es el competidor de verdad, no el modelo de frontera a $10/MTok.
Con un modelo de frontera como Claude Sonnet 5 ($2 / $10), la misma carga se va a $9.000 al mes.
La misma cuenta aplicada a otros casos: un veredicto por PR sale en torno a $0,00084 por PR en un harness con Jev, y cien pasos de un agente de computer use, unos $0,008.
¿Cuándo no compensa económicamente Jev?
- Volúmenes pequeños. Si clasificas 50 tickets al día, con la composición del caso anterior pagarás unos 3 centavos de dólar al mes con Jev y unos 29 con
gpt-5.6-luna. A esa escala no compensa tocar un pipeline que funciona. - Tareas que obligan a redactar. Si después tienes que escribir una respuesta al cliente, llamarás a un LLM igualmente. Jev solo te ahorra el triaje.
Audita tus llamadas de clasificación esta semana
En el caso de 5 millones de eventos, pagas $980 al mes con gpt-5.6-luna por un trabajo que Jev factura a $105. Si ya usas gpt-5-nano, la diferencia baja a $180 al mes. Haz la cuenta con tus números:
- Abre tu panel de uso de OpenAI o Anthropic.
- Filtra por endpoint o prompt: localiza las llamadas que solo devuelven un enum, un booleano o un score.
- Suma los tokens de entrada y salida de esas llamadas y pásalos por la fórmula de arriba.
La cuenta de coste completa —con el supuesto declarado y contra el modelo barato que ya usas— está en el libro Jev y las decisiones tipadas con IA, junto con la latencia medida desde una red normal.
Para diseñar productos con IA sostenibles desde el primer día, tienes el curso Construye con IA.
Y para comparar costes reales con otros developers, únete a Dominicode Labs.
Preguntas frecuentes
¿Se cobran los tokens de salida de Jev?
Según la doc de TypeSafe, se facturan a $0: "Output tokens are free". Pero la respuesta trae usage.output_tokens relleno (129 en mi llamada medida), así que los tokens existen y se cuentan. Es una condición comercial, sin confirmar en factura, y puede cambiar.
¿Cuánto cuesta una llamada típica a Jev?
Mi llamada real, un ticket con tres preguntas, consumió 580 tokens de entrada: a $0,042 por millón, $0,0000244. Unos $24 por millón de llamadas.
¿Puedo darme de alta en Jev hoy?
TypeSafe pausó los registros nuevos el 22-09-2026 por la demanda, según su cuenta oficial en X; la doc no lo menciona, así que compruébalo. Sin cuenta de TypeSafe tienes dos vías: Vercel AI Gateway y OpenRouter, con el modelo typesafe/jev-1.13 y el endpoint https://openrouter.ai/api/v1/systemone (guía de OpenRouter). En ese caso se factura en tu cuenta de OpenRouter.
¿Hacer más preguntas en la misma llamada sube el precio de Jev?
Sí, aunque poco. Se evalúan en paralelo y apenas cambian el tiempo de respuesta, pero la doc lo dice claro: "Extra questions still cost tokens". Pagas sus instructions y sus criteria.
Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
Leave a Reply