Tag: RAG

  • Evaluar búsqueda semántica: recall@k y MRR en TypeScript

    Evaluar búsqueda semántica: recall@k y MRR en TypeScript

    La demo funciona, y nadie se ha parado a evaluar la búsqueda semántica. Le haces cinco preguntas, las cinco que se te ocurrieron mientras la programabas, y las cinco devuelven el documento correcto en primera posición.

    En producción, un usuario escribe "rate limit de la cuenta gratuita" y recibe la página de precios. Otro pregunta qué pasa si su endpoint falla y le sale la FAQ general.

    Alguien propone subir el chunk a 800 tokens porque lo leyó en un blog. Otro quiere bajar dimensions a 512 para ahorrar. Nadie sabe si eso mejora o empeora la búsqueda, porque nadie la mide. Evaluar búsqueda semántica es lo que convierte esa discusión de opiniones en una tabla.

    En corto: para evaluar una búsqueda semántica necesitas un golden set (consultas reales con los documentos que deberían salir) y dos métricas: recall@k, que dice qué parte de los documentos correctos aparece entre los k primeros, y MRR, que dice en qué posición aparece. Con menos de 100 líneas de TypeScript puedes comparar chunking, modelo, dimensions y umbral de similitud con números en vez de a ojo. Para un RAG, mide recall@k con el mismo k que envías al prompt.

    ¿Qué es evaluar una búsqueda semántica?

    Evaluar una búsqueda semántica es medir, con un conjunto fijo de consultas cuyas respuestas correctas ya conoces, cuántas veces y en qué posición tu retriever devuelve esos documentos.

    Es la forma de evaluar el retrieval de un RAG por separado: no mide si el LLM responde bien, sino si le llega el contexto correcto. Si el retrieval falla, ningún prompt lo arregla.

    Si todavía no tienes el motor montado, empieza por qué son los vector embeddings y cómo usarlos en TypeScript y por el motor de búsqueda semántica con LangChain.

    El golden set: consultas reales y documentos esperados

    El golden set es una lista de pares consulta → documentos relevantes que no cambia entre experimentos. Es tu suite de tests para la búsqueda.

    Tres reglas que ahorran disgustos:

    1. Saca las consultas de los logs, no de tu cabeza. Tus preguntas usan el vocabulario de la documentación; las de tus usuarios, no.
    2. Etiqueta por documento o sección, nunca por chunk. Si guardas ids de chunk, el golden set deja de valer el día que cambias el tamaño de chunk, que es justo lo que quieres comparar.
    3. Valídalo al cargarlo. Un id mal escrito da un cero silencioso que parece un fallo del retriever.
    // golden.ts
    import { z } from "zod";
    
    export const GoldenCase = z.object({
      id: z.string(),
      query: z.string().min(3),
      // ids de DOCUMENTO o sección: el chunk cambia al re-trocear
      relevant: z.array(z.string()).min(1),
      tags: z.array(z.string()).default([]),
    });
    export const GoldenSet = z.array(GoldenCase).min(1);
    export type GoldenCase = z.infer<typeof GoldenCase>;
    

    Si nunca has validado datos de entrada con schemas, el curso de Zod para TypeScript cubre este patrón de parsear en la frontera y fiarte del tipo después.

    Métricas de búsqueda semántica: recall@k, MRR y nDCG

    Recall@k y MRR cubren casi todo lo que necesitas para evaluar búsqueda semántica en un RAG; nDCG añade sensibilidad al orden cuando hay varios documentos relevantes.

    Métrica Qué mide Cuándo usarla Qué no ve
    recall@k Fracción de documentos relevantes que aparecen en el top k Siempre: es lo que llega al LLM El orden dentro del top k
    hit@k Si al menos uno relevante está en el top k (0 o 1) Consultas con una sola respuesta Si faltan otros relevantes
    MRR Media de 1/posición del primer relevante Cuando el primer resultado pesa más (buscador, autocompletado) Los relevantes después del primero
    nDCG@k Ganancia descontada por posición, normalizada contra el orden ideal Varios relevantes o relevancia graduada Es menos intuitiva de explicar al equipo
    precision@k Fracción del top k que es relevante Cuando meter ruido en el contexto cuesta (tokens, alucinaciones) Penaliza k grandes aunque la respuesta esté

    El benchmark BEIR eligió nDCG@10 como métrica principal precisamente porque precision y recall ignoran el orden, y MRR y MAP solo admiten relevancia binaria (Thakur et al., 2021). Para un RAG empieza por recall@k con el mismo k que mandas al prompt, y MRR al lado.

    Ojo: el recall de un vector database con HNSW o IVF compara búsqueda aproximada contra exacta. Este compara contra lo que un humano considera correcto. Y si todavía no has decidido qué índice montar, lo comparo en cómo elegir un índice vectorial para producción.

    // metrics.ts
    export type Ranked = string[]; // ids de documento, en orden, sin duplicados
    
    export function recallAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
      if (relevant.size === 0) return 0;
      const hits = ranked.slice(0, k).filter((id) => relevant.has(id)).length;
      return hits / relevant.size;
    }
    
    export function hitAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
      return ranked.slice(0, k).some((id) => relevant.has(id)) ? 1 : 0;
    }
    
    export function reciprocalRank(ranked: Ranked, relevant: Set<string>, k = Infinity): number {
      const pos = ranked.slice(0, k).findIndex((id) => relevant.has(id));
      return pos === -1 ? 0 : 1 / (pos + 1);
    }
    
    // nDCG binario: ganancia 1 si el documento es relevante
    export function ndcgAtK(ranked: Ranked, relevant: Set<string>, k: number): number {
      const dcg = ranked
        .slice(0, k)
        .reduce((acc, id, i) => acc + (relevant.has(id) ? 1 / Math.log2(i + 2) : 0), 0);
      let idcg = 0;
      for (let i = 0; i < Math.min(relevant.size, k); i++) idcg += 1 / Math.log2(i + 2);
      return idcg === 0 ? 0 : dcg / idcg;
    }
    
    export const mean = (xs: number[]) => xs.reduce((a, b) => a + b, 0) / (xs.length || 1);
    

    Cómo evaluar búsqueda semántica en TypeScript: el runner

    El runner recibe cualquier retriever, lo lanza contra el golden set y devuelve las métricas medias y la lista de consultas que fallan.

    No hace falta una librería para esto. Cuando Ragas se presentó en Hacker News, swyx señaló que el núcleo eran unas 8 métricas de entre 1 y 200 líneas cada una, fáciles de meter en tu propia app y mantener el control. Las de retrieval son todavía más cortas.

    // evaluate.ts
    import { hitAtK, mean, ndcgAtK, reciprocalRank, recallAtK } from "./metrics";
    import type { GoldenCase } from "./golden";
    
    export type Hit = { docId: string; score: number };
    export type Retriever = (query: string, k: number) => Promise<Hit[]>;
    
    // Varios chunks del mismo documento cuentan una vez, en su mejor posición
    function toDocRanking(hits: Hit[]): string[] {
      const seen = new Set<string>();
      return hits.flatMap((h) => (seen.has(h.docId) ? [] : (seen.add(h.docId), [h.docId])));
    }
    
    export async function evaluate(retriever: Retriever, golden: GoldenCase[], k = 5) {
      const rows = [];
      for (const c of golden) {
        // pide k * 4 chunks; si tus documentos tienen muchos chunks, sube el multiplicador
        const ranked = toDocRanking(await retriever(c.query, k * 4)).slice(0, k);
        const rel = new Set(c.relevant);
        rows.push({
          id: c.id,
          recall: recallAtK(ranked, rel, k),
          hit: hitAtK(ranked, rel, k),
          rr: reciprocalRank(ranked, rel, k),
          ndcg: ndcgAtK(ranked, rel, k),
        });
      }
      return {
        [`recall@${k}`]: mean(rows.map((r) => r.recall)),
        [`hit@${k}`]: mean(rows.map((r) => r.hit)),
        mrr: mean(rows.map((r) => r.rr)),
        [`ndcg@${k}`]: mean(rows.map((r) => r.ndcg)),
        failures: rows.filter((r) => r.hit === 0).map((r) => r.id),
      };
    }
    

    toDocRanking deduplica por documento, y eso permite comparar chunks de 40 contra chunks de 400. La lista failures vale más que la media: es la que abres para entender qué falla.

    Comparar chunking y dimensions con el mismo golden set

    Con el runner, comparar configuraciones es un bucle. Lo ejecuté el 7 de noviembre de 2026 sobre un corpus sintético de 9 documentos y 10 consultas. Los números ilustran el método, no son un benchmark.

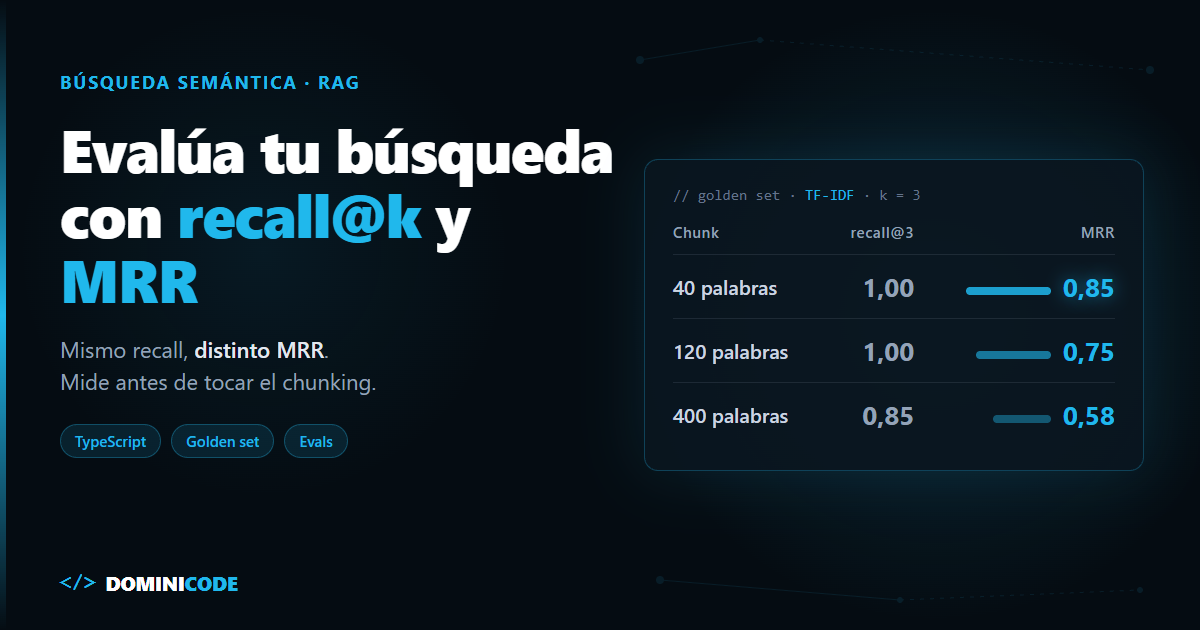
    Primero con un retriever de juguete (TF-IDF, sin API), para probar el runner sin gastar en embeddings:

    Config (TF-IDF) hit@1 recall@3 MRR (k=3)
    chunk 40 palabras 0,70 1,00 0,85
    chunk 120 palabras 0,50 1,00 0,75
    chunk 400 palabras 0,30 0,85 0,58

    Fíjate en las dos primeras filas: recall@3 es idéntico y MRR no. Por eso se miran las dos.

    Después, el mismo golden set contra text-embedding-3-small de OpenAI, variando chunk y dimensions:

    const configs = [
      { name: "small-1536-c40", model: "text-embedding-3-small", chunkSize: 40 },
      { name: "small-512-c40", model: "text-embedding-3-small", dimensions: 512, chunkSize: 40 },
      { name: "small-1536-c400", model: "text-embedding-3-small", chunkSize: 400 },
    ];
    for (const { name, ...opts } of configs) {
      const retriever = await buildEmbeddingRetriever(docs, opts);
      for (const k of [1, 3]) console.log(name, k, await evaluate(retriever, golden, k));
    }
    

    Las tres configuraciones dieron exactamente lo mismo: hit@1 de 0,9, recall@3 de 1 y MRR de 0,95, con la misma consulta fallando en primera posición.

    Ese empate es la lección más útil del experimento. Con 10 consultas cada una mueve la media 0,1, y un corpus pequeño no separa configuraciones. Antes de concluir que 512 dimensiones "no pierde nada", necesitas un golden set que pueda perder.

    buildEmbeddingRetriever es el código del post sobre vector embeddings envuelto en la firma Retriever. Si lo que falla son chunks que pierden su contexto, mide antes y después de aplicar contextual retrieval. Y si estás pensando en añadir BM25 o un reranker, este runner es lo que te dice si la búsqueda híbrida compensa en tu corpus.

    Cómo elegir el umbral de similitud con datos

    El umbral se elige con dos listas: consultas con respuesta (que deben superarlo) y consultas sin respuesta (que no deben).

    // threshold.ts
    import type { Retriever } from "./evaluate";
    import type { GoldenCase } from "./golden";
    
    export async function sweepThreshold(
      retriever: Retriever, golden: GoldenCase[], noAnswer: string[], thresholds: number[],
    ) {
      const answered = await Promise.all(golden.map(async (c) => {
        const hits = await retriever(c.query, 20);
        return hits.find((h) => c.relevant.includes(h.docId))?.score ?? -1;
      }));
      const unanswerable = await Promise.all(
        noAnswer.map(async (q) => (await retriever(q, 1))[0]?.score ?? -1),
      );
      return thresholds.map((t) => ({
        umbral: t,
        conserva: answered.filter((s) => s >= t).length / answered.length,
        rechaza: unanswerable.filter((s) => s < t).length / unanswerable.length,
      }));
    }
    

    Con el mismo corpus sintético, 4 consultas sin respuesta ("hay app para Android", "integración con Salesforce"…) y text-embedding-3-small:

    Umbral Conserva respuestas Rechaza sin respuesta
    0,3 100 % 0 %
    0,4 90 % 75 %
    0,5 90 % 100 %
    0,6 30 % 100 %

    En este corpus, 0,5 es el punto dulce, y al subir a 0,6 pasas de conservar 9 de cada 10 respuestas buenas a solo 3. Ese número no se copia: cambia con el modelo, el idioma y el vector store, como explica el post de búsqueda semántica con LangChain sobre qué significa el score. Se recalcula cada vez que cambias cualquiera de los tres.

    Cuándo NO fiarte de estas métricas

    Un golden set mide lo que contiene y nada más. Estos son sus límites reales:

    Un golden set pequeño no distingue configuraciones. Lo acabas de ver: 10 consultas dieron un empate a tres. Empieza con 50 y apunta a cientos, con consultas difíciles y ambiguas, no solo las fáciles.

    Puedes sobreajustar al golden set. En el lanzamiento de Talc AI en Hacker News, un usuario preguntaba si al afinar prompt y chunking contra un conjunto fijo de preguntas no acabas sobreajustando a ellas, y si basta un conjunto "holdout". Mi respuesta práctica: sí, separa un 20 % que no miras al afinar.

    Etiquetar cuesta, y por eso nadie lo hace. En ese mismo hilo, typpo, creador de promptfoo, contaba que la pesadez de escribir tests es una de las razones por las que la gente evita los evals. Generarlas con un LLM ayuda a arrancar, pero salen con el vocabulario del documento: el caso fácil.

    Las métricas offline no son satisfacción del usuario. Un recall@5 de 0,95 no garantiza una buena respuesta final. Necesitas también señales de producción: reformulaciones, clics, "no me sirvió".

    Etiquetar por documento esconde chunks malos. Si sale la introducción del documento correcto, la métrica dice acierto y el LLM no tiene el dato. En documentos largos, etiqueta por sección. Y si etiquetas con un LLM como juez, revisa a mano una muestra, igual que con los evals como unit tests para LLMs.

    Cómo empezar a evaluar tu búsqueda semántica esta semana

    Exporta 50 consultas reales de tus logs, marca a mano el documento que debería salir y guárdalas en un JSON validado con el schema de arriba.
    Después, conecta tu retriever actual al runner y apunta recall@k y MRR. Ese es tu baseline. Ningún cambio de chunking, modelo o umbral entra a producción sin bajar la lista de failures.

    Para ver cómo encaja en un agente con RAG, memoria y herramientas, el ebook gratuito El Developer Agéntico (194 páginas) lo recorre de principio a fin. Y si prefieres construirlo de la idea al producto con Claude Code, eso es lo que hacemos en Construye con IA.

    Preguntas frecuentes

    ¿Cuántas consultas necesita un golden set para evaluar búsqueda semántica?

    Para detectar regresiones grandes, unas 50. Para comparar configuraciones parecidas, como 1536 frente a 512 dimensiones, cientos. Con 10 consultas cada fallo mueve la media 0,1 y, como muestra el experimento de este post, distintas configuraciones pueden empatar.

    ¿Qué diferencia hay entre recall@k y MRR?

    Recall@k dice si los documentos relevantes están dentro de los k primeros, sin importar el orden. MRR mira la posición del primer relevante: vale 1 si está primero, 0,5 si está segundo. Dos configuraciones pueden tener el mismo recall@3 y distinto MRR.

    ¿Qué k uso para recall@k en un RAG?

    El mismo número de chunks que mandas al prompt. Si pasas 5 fragmentos al LLM, lo que importa es recall@5: un documento en la posición 8 no le llega al modelo.

    ¿Puedo evaluar con Voyage AI en vez de OpenAI?

    Sí. El runner solo depende de la firma Retriever. Anthropic no tiene modelo de embeddings propio y su documentación propone Voyage AI, cuyos modelos voyage-4 admiten 256, 512, 1024 o 2048 dimensiones. Usa input_type: "query" para consultas y "document" para documentos, o medirás peor de lo que es.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Índice vectorial en producción: cómo elegir el correcto

    Índice vectorial en producción: cómo elegir el correcto

    Imagina una consulta sobre un índice vectorial que lleva meses funcionando. Busca los diez documentos más parecidos a la pregunta del usuario, pero solo dentro de su empresa. Un WHERE tenant_id = 42, un ORDER BY embedding <=> $1, un LIMIT 10.

    Un día el cliente se queja de que el asistente "no encuentra nada". Revisas la tabla y los documentos están ahí. Ejecutas la consulta a mano y devuelve cuatro filas. No diez. Cuatro.

    No hay bug en tu código. Elegiste un índice vectorial sin pensar en los filtros, y el índice hizo exactamente lo que dice su documentación. La propia documentación de pgvector lo explica con números: si el filtro deja pasar el 10 % de las filas, con el hnsw.ef_search por defecto de 40 obtienes unas 4 coincidencias de media.

    En corto: no hay un índice vectorial mejor; hay uno adecuado para tu escala, tu RAM, tus filtros y tu ritmo de escritura. Por debajo de unas decenas de miles de vectores, búsqueda exacta; si caben en memoria, HNSW; si no, DiskANN o IVF con cuantización. Y si filtras mucho, elige el motor por cómo filtra, no por su benchmark de latencia.

    Cómo funcionan HNSW e IVF por dentro ya lo conté en cómo funciona un vector database por dentro: HNSW y IVF. Aquí no repito el grafo ni los clusters. Este post es la parte siguiente: cómo decidir.

    ¿Qué es un índice vectorial?

    Un índice vectorial es una estructura de datos que permite encontrar los vectores más cercanos a una consulta sin compararla contra todos, a cambio de devolver resultados aproximados. Esa palabra, aproximados, es el contrato que firmas. El parámetro que ajustas, sea ef_search, nprobe o diskann.query_search_list_size, decide cuánta precisión (recall) cambias por latencia.

    La pregunta útil no es "¿qué índice vectorial es más rápido?", sino "¿qué recurso se me acaba antes?": RAM, tiempo de construcción, capacidad de filtrar o tolerancia a escrituras.

    Las 5 estrategias para elegir índice en un vector database

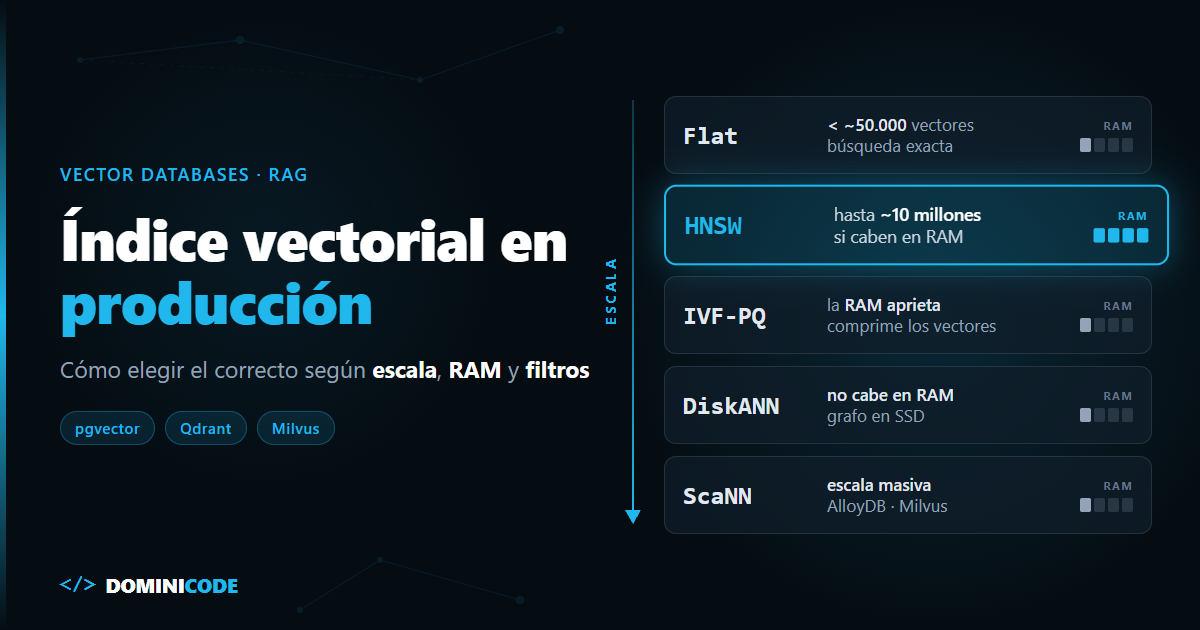
    Hay cinco estrategias de índice vectorial en producción: búsqueda exacta (Flat), HNSW, IVF con cuantización, DiskANN y ScaNN; se eligen por escala, RAM disponible, tipo de filtros y ritmo de escritura.

    Esta es la tabla que yo tendría pegada al lado del monitor. Las cifras salen de la documentación de cada proyecto, enlazada en las secciones de abajo.

    Estrategia Escala donde encaja RAM Recall Construcción Updates y filtros Dónde la tienes Riesgo principal
    Flat (exacta) Hasta decenas de miles de vectores, o pocas consultas Solo los vectores 100 %, exacto Ninguna Triviales; el filtro es un WHERE normal pgvector (sin índice), FAISS IndexFlat, Milvus FLAT La latencia crece lineal con los datos
    HNSW Hasta 10-20 M de vectores en memoria, según Google Alta: vectores + grafo Muy alto con parámetros por defecto Lenta y hambrienta de memoria Inserta sin reentrenar; filtrar depende del motor pgvector, Qdrant (único índice denso), Milvus, FAISS Post-filtrado que devuelve menos filas que tu LIMIT
    IVF / IVF-PQ De millones a cientos de millones Baja con PQ o SQ8 Depende de nprobe y del reranking Rápida, pero necesita entrenar con datos Si la distribución cambia, hay que reentrenar pgvector (IVFFlat), FAISS, Milvus (IVF_PQ, IVF_SQ8) Recall bajo con los valores por defecto
    DiskANN Datos que no caben en RAM Baja: códigos PQ en memoria, grafo en SSD Alto con rescoring Lenta Filtrado por etiquetas en pgvectorscale pgvectorscale, Milvus DISKANN, Azure PostgreSQL (pg_diskann) Necesita disco NVMe; en Milvus va desactivado por defecto
    ScaNN Escala masiva; Google habla de hasta 10.000 M Baja (cuantización SQ8 o AH) Alto con re-ranking Necesita datos antes de construir Mantenimiento automático en AlloyDB AlloyDB, Milvus SCANN, librería scann (solo Linux) Te ata a AlloyDB o a Milvus en producción

    Flat: cuándo la búsqueda exacta es la respuesta correcta

    Flat significa comparar la consulta contra todos los vectores: el único método con resultados exactos. La guía de FAISS para elegir índice lo dice sin rodeos: usa Flat si necesitas resultados exactos o si vas a hacer pocas búsquedas, del orden de 1.000 a 10.000, porque el tiempo de construir un índice no se recupera (FAISS, Guidelines to choose an index).

    En pgvector, Flat es el comportamiento por defecto. La documentación lo dice literal: "By default, pgvector performs exact nearest neighbor search, which provides perfect recall". No crear índice también es una decisión.

    Google pone una frontera parecida en su guía de AlloyDB: búsqueda exacta (KNN) si tu aplicación es muy sensible a la precisión y tienes decenas de miles de vectores; búsqueda aproximada si necesitas baja latencia y pasas de 100.000 (AlloyDB, elegir estrategia de índice).

    Flat gana además en un caso que se olvida: filtros muy selectivos. Si tu WHERE deja pasar 2.000 filas de 5 millones, comparar esas 2.000 a fuerza bruta es rápido y exacto. Milvus lo recomienda en su guía: si el filtro descarta más del 98 % de los datos, usa FLAT (Milvus, Index explained).

    HNSW en pgvector: parámetros que importan y cuánta RAM pide

    HNSW es el índice vectorial por defecto razonable cuando los vectores caben en memoria. pgvector lo resume así: tiene mejor equilibrio velocidad-recall que IVFFlat, pero construye más lento y usa más memoria. Y no necesita datos para crearse, porque no hay paso de entrenamiento.

    Los tres parámetros y sus valores por defecto según la documentación de pgvector:

    Parámetro Default en pgvector Default en Qdrant Qué controla
    m 16 16 Conexiones por nodo. Más recall, más RAM
    ef_construction / ef_construct 64 100 Candidatos al construir. Más recall, build más lento
    ef_search 40 (se pasa en la consulta) Candidatos al buscar. Más recall, más latencia

    Los valores de Qdrant salen de su documentación de indexación, que además deja claro que "Qdrant currently only uses HNSW as a dense vector index". En Qdrant no eliges algoritmo: eliges parámetros y cuantización.

    En SQL queda así:

    -- Construcción: más rápida si el grafo cabe en maintenance_work_mem
    SET maintenance_work_mem = '8GB';
    
    CREATE INDEX ON documents
    USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);
    
    -- Consulta: sube ef_search solo en esta transacción
    BEGIN;
    SET LOCAL hnsw.ef_search = 100;
    SET LOCAL hnsw.iterative_scan = relaxed_order;  -- pgvector 0.8.0+
    SELECT id, title
    FROM documents
    WHERE tenant_id = 42
    ORDER BY embedding <=> $1
    LIMIT 10;
    COMMIT;
    

    Ese iterative_scan es el arreglo del problema de la apertura. Desde la versión 0.8.0 (la actual es la 0.8.7), pgvector puede seguir recorriendo el índice hasta completar el LIMIT, con strict_order si necesitas el orden exacto por distancia o relaxed_order si prefieres más recall. El tope lo marca hnsw.max_scan_tuples, 20.000 por defecto.

    Ahora la RAM. FAISS da la fórmula de HNSW: (d * 4 + M * 2 * 4) bytes por vector. Con embeddings de 1.536 dimensiones y M = 16 salen 6.272 bytes por vector. Un millón de vectores son unos 6,3 GB; cien millones, unos 627 GB. Con 768 dimensiones, 3,2 GB por millón.

    La frontera real de HNSW como índice vectorial no es el número de vectores: es si 6 GB por millón caben en el servidor que pagas.

    Antes de abandonar HNSW, prueba a cuantizar. pgvector indexa halfvec (media precisión, hasta 4.000 dimensiones frente a las 2.000 de vector) y bit con binary_quantize. La documentación recomienda reordenar con los vectores originales para recuperar recall:

    CREATE INDEX ON documents
    USING hnsw ((binary_quantize(embedding)::bit(1536)) bit_hamming_ops);
    
    -- 50 candidatos baratos por Hamming, reordenados por coseno real
    SELECT * FROM (
      SELECT id, title, embedding
      FROM documents
      ORDER BY binary_quantize(embedding)::bit(1536) <~> binary_quantize($1::vector)
      LIMIT 50
    ) AS candidatos
    ORDER BY embedding <=> $1::vector
    LIMIT 10;
    

    IVF-PQ y cuantización: cuando la RAM es el cuello de botella

    IVF divide los vectores en listas y solo revisa las más cercanas a la consulta; con Product Quantization (PQ) o cuantización escalar, además comprime cada vector. Es la estrategia para cuando la RAM manda.

    Milvus da una comparativa de memoria para un millón de vectores de 128 dimensiones (Milvus, Index explained):

    Índice Memoria aproximada (1 M × 128 dim)
    HNSW (grafo + vectores FP32) 640 MB
    IVF-FLAT 515 MB
    HNSW-PQ 136 MB
    IVF-SQ8 131 MB
    IVF-PQ con 10 % de refinado 62,2 MB
    IVF-PQ sin refinado 11 MB

    De 640 MB a 11 MB. El precio es el recall, que recuperas en parte con una fase de reordenado sobre vectores originales.

    Los parámetros que importan son el número de listas y cuántas revisas. En pgvector se llaman lists e ivfflat.probes. La documentación recomienda lists = filas / 1000 hasta un millón de filas y sqrt(filas) por encima, y empezar con probes = sqrt(lists). Ojo: probes vale 1 por defecto, así que un IVFFlat recién creado revisa una sola lista. Con 100 listas, estás mirando el 1 % de tus datos.

    La otra trampa es el entrenamiento. pgvector pide crear el índice IVFFlat cuando la tabla ya tiene datos. FAISS pide entre 30 * K y 256 * K vectores de entrenamiento, siendo K el número de clusters. Si tu distribución cambia mucho (nuevo modelo de embeddings, nuevo tipo de documento), los centroides se quedan viejos y el recall cae sin avisar.

    La cuantización no es exclusiva de IVF. Qdrant la aplica sobre HNSW: escalar (float32 a uint8, 4 veces menos), binaria (hasta 32 veces a 1 bit) y PQ (hasta 64 veces). Según su guía de cuantización, la binaria con text-embedding-3-small de 1.536 dimensiones llega a 0,9847 de recall con sobremuestreo de 3x y rescoring. Su recomendación de partida es exactamente esa: oversampling de 3 con rescoring activado.

    DiskANN: cuando los vectores no caben en memoria

    DiskANN guarda el grafo (Vamana) y los vectores completos en SSD, y en RAM solo mantiene códigos PQ comprimidos para puntuar candidatos. Busca en memoria con los códigos y lee del disco solo los vectores de los candidatos más prometedores (Milvus, DiskANN).

    La regla de Milvus para decidir es la más clara que he encontrado: "If a quarter of your raw data fits into memory, consider DiskANN for its stable latency". Si cabe todo en RAM, usa índices en memoria.

    En Milvus va desactivado por defecto (queryNode.enableDisk: true para activarlo) y recomiendan NVMe.

    En Postgres tienes pgvectorscale, de Timescale (hoy Tiger Data), con su índice StreamingDiskANN, cuantización binaria estadística (SBQ) y filtrado por etiquetas integrado en el índice:

    CREATE EXTENSION IF NOT EXISTS vectorscale CASCADE;
    
    CREATE INDEX ON documents
    USING diskann (embedding vector_cosine_ops, labels);
    
    SELECT id, title
    FROM documents
    WHERE labels && ARRAY[1, 3]   -- labels es smallint[]
    ORDER BY embedding <=> $1
    LIMIT 10;
    

    Defaults de construcción: num_neighbors 50, search_list_size 100, max_alpha 1,2. En consulta, diskann.query_search_list_size 100 y diskann.query_rescore 50. Timescale publica un benchmark con 50 millones de embeddings de 768 dimensiones, con 28x menos latencia p95 que Pinecone s1 al 99 % de recall. Es su propio benchmark y compara contra pods s1, no contra Pinecone serverless: tómalo como hipótesis para medir con tus datos, no como garantía.

    ScaNN: cuantización anisotrópica para escala masiva

    ScaNN es la librería de Google que combina particionado, cuantización anisotrópica y re-ranking, optimizada para búsqueda por producto interno. La cuantización anisotrópica comprime los vectores preservando sobre todo la componente que afecta al producto interno (Milvus, SCANN).

    La encuentras en tres sitios. Como librería (pip install scann, solo Linux). Como índice SCANN en Milvus, con nlist en construcción y nprobe (8 por defecto) y reorder_k en consulta. Y en AlloyDB con la extensión alloydb_scann, donde Google afirma hasta 6 veces más velocidad y hasta 4 veces menos memoria que HNSW en PostgreSQL estándar (AlloyDB, elegir estrategia de índice).

    Dos detalles de AlloyDB que muerden: el cuantizador por defecto es SQ8, con pérdida de recall típica por debajo del 1-2 %. Y por defecto no puedes crear el índice en una tabla vacía ni con menos filas que num_leaves.

    Mi opinión: ScaNN merece la pena si ya estás en Google Cloud o en Milvus. No migraría de plataforma solo por él.

    El filtrado por metadatos decide más que el algoritmo

    Con filtros por metadatos, un índice aproximado puede devolver menos filas que tu LIMIT, porque muchos motores filtran después de buscar; por eso cómo filtra el motor pesa más que su latencia. En la práctica, la mayoría de consultas RAG llevan filtro: tenant, idioma, permisos, fecha. Y cada índice vectorial aproximado filtra de una forma muy distinta.

    En el hilo de Hacker News sobre el artículo "Vector databases are the wrong abstraction", uno de sus coautores, ingeniero de Timescale, lo explicó así: "In pgvector it usually does post-filtering in practice (filter after vector search)". Y añadía que si ninguno de los C candidatos cumple el filtro, no encuentra resultados, aunque él mismo reconocía que las versiones nuevas de pgvector lo abordan (comentario en HN, octubre 2024). Ojo con el sesgo: quien lo dice trabaja en la empresa que vende la alternativa.

    Otro developer, con experiencia en "hundreds of millions of embeddings", describía en otro hilo, meses antes de la 0.8.0, los bordes afilados de pgvector a esa escala: el vacuum de índices de cientos de GB y lo difícil que es razonar sobre el recall (comentario en HN, febrero 2024).

    Las tres soluciones que existen hoy:

    1. Escaneo iterativo (pgvector 0.8.0+): sigue buscando hasta completar el LIMIT.
    2. Filtrado dentro del índice: Qdrant añade aristas al grafo HNSW según los payloads indexados, y pgvectorscale filtra por etiquetas. En Qdrant hay que crear los índices de payload antes de cargar datos; si los creas después, hay que reconstruir el HNSW.
    3. Fuerza bruta sobre el subconjunto filtrado, cuando el filtro es muy selectivo.

    Si tu RAG combina filtros con texto, mira también la búsqueda híbrida con embeddings en Supabase: ahí el índice es solo una de las piezas.

    Qué índice vectorial elegir según tu escala: árbol de decisión

    1. Menos de ~50.000 vectores: sin índice. Búsqueda exacta, recall perfecto, cero mantenimiento.
    2. De ~50.000 a ~10 millones, caben en RAM: HNSW con los defaults. Mide recall contra Flat sobre una muestra y sube ef_search antes de tocar m.
    3. Igual, pero la RAM aprieta: HNSW con halfvec o cuantización binaria más reordenado. Después, IVF-SQ8 o IVF-PQ.
    4. Decenas o cientos de millones, sin RAM para todo: DiskANN (pgvectorscale o Milvus) o IVF-PQ con reordenado.
    5. Filtros muy selectivos: prioriza un motor que filtre dentro del índice, o fuerza bruta sobre lo filtrado.
    6. No quieres operar nada: Pinecone. Al crear un índice declaras dimensión, métrica y tipo de vector; el algoritmo no lo eliges tú. Lo conté en la introducción a Pinecone para agentes.

    La memoria vectorial es una pieza más de un agente. Si estás montando el resto, en el ebook gratuito El Developer Agéntico tienes la arquitectura completa: tools, memoria, RAG y orquestación.

    Cuándo NO necesitas un índice vectorial

    Si tienes pocos datos, no necesitas índice. Con decenas de miles de vectores, el índice añade construcción, RAM y recall aproximado a cambio de milisegundos que nadie va a notar. Es el caso de la mayoría de chatbots sobre la documentación de un producto.

    Si tus consultas necesitan exactitud, un índice aproximado es una fuente de bugs silenciosos. Deduplicación, detección de fraude o cumplimiento normativo: ahí un falso negativo cuesta más que la latencia.

    Si filtras casi todo, el índice estorba. Con filtros que descartan más del 95-98 % de los datos, Milvus recomienda FLAT.

    Un índice no arregla malos embeddings. Si el modelo no separa bien tus documentos, el recall perfecto de Flat te devolverá los vecinos equivocados con total precisión. Antes de ajustar ef_search, revisa el chunking y el modelo; el RAG avanzado híbrido suele aportar más que cualquier parámetro.

    Y un límite de este post: todas las cifras son de la documentación de cada proyecto, consultada en noviembre de 2026, no de benchmarks míos. Varían con la dimensión, la distribución y el hardware. La única tabla que vale es la que generes con tus datos.

    Qué hacer con tu índice esta semana

    Abre tu base de datos y responde a una pregunta: ¿cuál es el recall real de tu índice vectorial en la consulta más importante? Toma 100 consultas, ejecútalas con y sin índice (en Postgres, dentro de una transacción con SET LOCAL enable_indexscan = off, como recomienda la documentación de pgvector, tienes la exacta sin que el cambio se filtre al resto de la sesión) y compara los resultados. Si no lo has medido nunca, no sabes si tu índice funciona; solo sabes que es rápido.

    Si quieres construir el producto entero alrededor de esa búsqueda, del spec al despliegue, es lo que hacemos en el curso Construye con IA: de la idea al producto con Claude Code.

    Preguntas frecuentes

    ¿Qué índice vectorial uso en pgvector por defecto?

    HNSW, si tienes más de unas decenas de miles de filas. Su documentación le atribuye mejor equilibrio velocidad-recall que IVFFlat, y no necesita datos previos para crearse. Empieza con m = 16 y ef_construction = 64, y ajusta hnsw.ef_search (40 por defecto) en la consulta.

    ¿Cuánta RAM necesita un índice HNSW?

    Según la fórmula de FAISS, (d * 4 + M * 2 * 4) bytes por vector. Con 1.536 dimensiones y M = 16 son unos 6,3 GB por millón de vectores. Con halfvec o cuantización binaria se reduce mucho, a cambio de un reordenado para recuperar recall.

    ¿Por qué mi consulta con WHERE devuelve menos resultados que el LIMIT?

    Porque el índice aproximado devuelve un número fijo de candidatos y el filtro se aplica después. En pgvector, con un filtro que deja pasar el 10 % y ef_search = 40, obtienes unas 4 filas. Desde la 0.8.0 lo arreglas con hnsw.iterative_scan.

    ¿HNSW vs DiskANN: cuándo compensa cada uno?

    HNSW, mientras los vectores caben en RAM; DiskANN, cuando no caben. Milvus recomienda considerar DiskANN si cabe en memoria una cuarta parte de los datos. Necesitas SSD, idealmente NVMe. En Postgres lo tienes con pgvectorscale y en Milvus con DISKANN.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Búsqueda semántica con LangChain: motor en TypeScript

    Búsqueda semántica con LangChain: motor en TypeScript

    El tutorial oficial de búsqueda semántica con LangChain enseña un resultado con Score: 0.23699893057346344 y explica que es una distancia: cuanto más bajo, más parecido. Lo lees, lo apuntas y escribes un filtro: descarta todo lo que pase de 0,3.

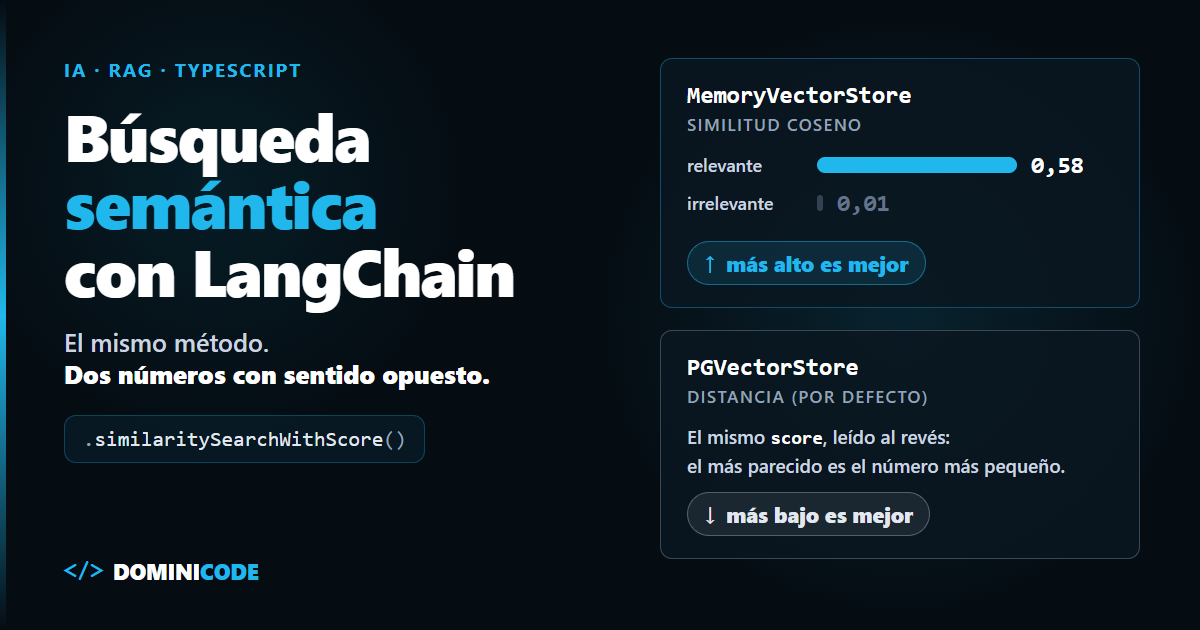
    Ese número sale de otra pregunta del mismo PDF. Ejecutado el 5 de noviembre de 2026 con las versiones actuales, el fragmento que responde a "When was Nike incorporated?" sale con 0,58. Una consulta que no tiene nada que ver con el documento sale con 0,01. Tu filtro tira lo bueno y se queda con la basura.

    No hay error ni excepción. El código compila. Y el día que cambies MemoryVectorStore por pgvector, el significado del número se invierte otra vez.

    En corto: la búsqueda semántica con LangChain.js son seis piezas: cargar, trocear, embeber, guardar en un vector store, consultar y exponer como retriever. LangChain las une en unas pocas decenas de líneas. El tamaño de chunk, el modelo, los metadatos, el significado del score y el vector store siguen siendo cosa tuya.

    ¿Qué es la búsqueda semántica con LangChain?

    La búsqueda semántica con LangChain es un pipeline que convierte tus documentos en vectores con un modelo de embeddings, los guarda en un vector store y devuelve los fragmentos cuyo significado se parece más a una pregunta, aunque no compartan palabras.

    La guía oficial lo monta sobre el informe anual 10-K de Nike de 2023, un PDF de 107 páginas.

    Si no tienes claro qué es un embedding ni cómo se compara con similitud coseno, lee antes qué son los vector embeddings y cómo usarlos en TypeScript.

    Las piezas del motor de búsqueda semántica en TypeScript

    Cada pieza del pipeline tiene una clase de LangChain y una decisión que nadie toma por ti:

    Pieza Clase (paquete) Qué decides tú Error típico
    Cargar PDFParse (pdf-parse) + Document (@langchain/core) Qué metadatos guardas: fuente, página, fecha Perder la página y no poder citar de dónde sale el fragmento
    Trocear RecursiveCharacterTextSplitter (@langchain/textsplitters) chunkSize y chunkOverlap, en caracteres Creer que chunkSize: 1000 son 1.000 tokens
    Embeber OpenAIEmbeddings (@langchain/openai) Modelo y dimensiones No pasar model y quedarte con text-embedding-ada-002
    Guardar MemoryVectorStore (@langchain/classic) Dónde viven los vectores Pensar que la memoria persiste entre arranques
    Buscar similaritySearch, similaritySearchWithScore k y umbral de score Fijar un umbral sin saber si el número es distancia o similitud
    Exponer asRetriever searchType, k, fetchK Usar MMR con fetchK: 1 y anular la diversidad

    Versiones de npm a 5 de noviembre de 2026: langchain 1.6.1, @langchain/core 1.3.4, @langchain/classic 1.0.57, @langchain/textsplitters 1.0.2, @langchain/openai 1.8.0 y pdf-parse 2.4.5.

    bun add @langchain/core @langchain/classic @langchain/textsplitters @langchain/openai pdf-parse
    

    Cargar y trocear: chunkSize y chunkOverlap en LangChain.js

    El tutorial no usa un loader de LangChain para el PDF. Escribe un helper de unas 20 líneas sobre pdf-parse 2.x que crea un Document por página y guarda la página en los metadatos:

    import { readFileSync } from "node:fs";
    import { Document } from "@langchain/core/documents";
    import { PDFParse } from "pdf-parse";
    import { RecursiveCharacterTextSplitter } from "@langchain/textsplitters";
    
    // Una página del PDF = un Document, con su página en los metadatos
    async function loadPdfPages(filePath: string): Promise<Document[]> {
      const parser = new PDFParse({ data: new Uint8Array(readFileSync(filePath)) });
      try {
        const { pages } = await parser.getText();
        return pages.map(
          (page) =>
            new Document({
              pageContent: page.text,
              metadata: { source: filePath, page: page.num - 1 },
            })
        );
      } finally {
        await parser.destroy();
      }
    }
    
    const docs = await loadPdfPages("./data/nke-10k-2023.pdf");
    
    const textSplitter = new RecursiveCharacterTextSplitter({
      chunkSize: 1000,
      chunkOverlap: 200,
    });
    const allSplits = await textSplitter.splitDocuments(docs);
    
    console.log(docs.length, allSplits.length); // 107 515
    

    Ejecutado el 5 de noviembre de 2026: 107 páginas y 515 chunks. La doc dice 516. La diferencia viene del parser, y es el primer aviso de que el resultado depende de versiones que no controlas.

    El splitter mide con text.length, así que chunkSize: 1000 son 1.000 caracteres, no tokens. Los chunks salieron con 856 caracteres de media y 1.000 como máximo.

    Bajar a chunkSize: 500 y chunkOverlap: 50 da 965 chunks, casi el doble. Son casi el doble de vectores que guardar, y cada fragmento tiene menos contexto.

    Los metadatos se heredan: cada chunk conserva source y page, y el splitter añade loc.lines.

    Embeber y guardar en un vector store de LangChain

    Embeber y guardar son tres líneas: el modelo de embeddings, el vector store que lo usa y addDocuments. La trampa está en la primera:

    import { OpenAIEmbeddings } from "@langchain/openai";
    import { MemoryVectorStore } from "@langchain/classic/vectorstores/memory";
    
    // Fija siempre el modelo: sin él, LangChain usa text-embedding-ada-002
    const embeddings = new OpenAIEmbeddings({ model: "text-embedding-3-large" });
    
    const vectorStore = new MemoryVectorStore(embeddings);
    await vectorStore.addDocuments(allSplits);
    

    Si escribes new OpenAIEmbeddings() sin opciones, @langchain/openai 1.8.0 usa text-embedding-ada-002, el modelo antiguo. Está en el código fuente del paquete y se confirma al ejecutarlo.

    Segunda sorpresa: el tutorial pide text-embedding-3-large y enseña una salida de vectores de longitud 1536. Ejecutado, devuelve 3.072. Si necesitas 1.536, pásalo explícito con dimensions: 1536, que sí funciona.

    Y MemoryVectorStore ya no está en langchain. Desde la v1 vive en @langchain/classic, el paquete de compatibilidad.

    similaritySearch y similaritySearchWithScore: qué significa el score

    similaritySearch devuelve los k documentos más parecidos, 4 por defecto. similaritySearchWithScore devuelve además el número, y ese número cambia de significado según el vector store.

    const results = await vectorStore.similaritySearchWithScore(
      "When was Nike incorporated?",
      3
    );
    for (const [doc, score] of results) {
      console.log(score.toFixed(4), doc.metadata.page);
    }
    
    // En MemoryVectorStore el filtro es una función sobre el Document
    const onlyPage3 = await vectorStore.similaritySearch(
      "When was Nike incorporated?",
      2,
      (doc) => doc.metadata.page === 3
    );
    

    Ejecutado el 5 de noviembre de 2026 sobre los 26 chunks de las seis primeras páginas, para gastar pocos tokens. El primer resultado fue el chunk de la página 3 que dice "NIKE, Inc. was incorporated in 1967", con 0,5836. La consulta irrelevante "receta de paella valenciana" sacó como mejor resultado 0,0110.

    Más alto es mejor. MemoryVectorStore calcula similitud coseno, aunque la doc diga que es una distancia.

    PGVectorStore hace lo contrario. El issue #11043 de langchainjs, abierto en junio de 2026, lo describe así: el método "returns raw vector distance values (e.g. 0.82, 0.17) rather than normalized similarity scores", y lo llama "inconsistent with other vector store implementations in LangChain.js (e.g. MemoryVectorStore)". La respuesta en el propio issue: es el comportamiento esperado, y se cambia con scoreNormalization: "similarity". El #9782 reportó lo mismo en enero sobre el PGVectorStore de @langchain/community.

    En @langchain/pgvector 0.1.0 existe la opción scoreNormalization, con "distance" por defecto y "similarity" como alternativa. Ojo: con coseno, "similarity" devuelve (2 - distancia) / 2, no el coseno. El 0,58 de antes saldría como 0,79 y la paella como 0,51. Mismo sentido, otra escala. Si tienes un umbral, escribe un test que lo fije.

    El retriever de LangChain: asRetriever, MMR y batch

    Un vector store no es un Runnable. Un retriever sí, así que admite invoke y batch, y se enchufa en cadenas y agentes:

    const retriever = vectorStore.asRetriever({
      searchType: "mmr",
      searchKwargs: { fetchK: 1 },
    });
    
    const batchResults = await retriever.batch([
      "When was Nike incorporated?",
      "Where is Nike headquartered?",
    ]);
    

    MMR (maximum marginal relevance) primero trae fetchK candidatos y después elige entre ellos los que más se diferencian. Con fetchK: 1, como en el tutorial, solo hay un candidato: cada consulta devolvió un único documento y no hubo nada que diversificar. En tu código, fetchK tiene que ser mayor que k, por ejemplo 20 y 4.

    Cuando el retriever pase a ser la tool de búsqueda de un agente, cómo diseñarla con memoria y RAG alrededor lo explica el ebook gratuito El Developer Agéntico, 194 páginas sobre agentes, tools, memoria y RAG.

    De MemoryVectorStore a pgvector: qué cambia en producción

    En la búsqueda semántica con LangChain, MemoryVectorStore sirve para aprender y para tests. En producción necesitas que los vectores sobrevivan a un reinicio. La guía de integración instala PGVectorStore desde @langchain/pgvector:

    import { PGVectorStore } from "@langchain/pgvector";
    
    const pgStore = await PGVectorStore.initialize(embeddings, {
      postgresConnectionOptions: {
        connectionString: process.env.DATABASE_URL,
      },
      tableName: "documents",
      distanceStrategy: "cosine",
      scoreNormalization: "similarity", // más alto es mejor, pero (2 - distancia) / 2: otra escala
    });
    
    MemoryVectorStore PGVectorStore
    Paquete @langchain/classic 1.0.57 @langchain/pgvector 0.1.0
    Persistencia Ninguna: se pierde al reiniciar Tabla de Postgres
    Filtro Función sobre el Document Objeto: igualdad, in, notIn, arrayContains y rangos
    Score por defecto Similitud coseno, más alto es mejor Distancia, más bajo es mejor
    Búsqueda Recorre todos los vectores Escaneo secuencial; HNSW opcional con createHnswIndex
    Riesgo Reembeber todo el corpus en cada arranque HNSW sobre vector admite hasta 2.000 dimensiones; text-embedding-3-large da 3.072

    La última fila es la que rompe despliegues. pgvector indexa vector hasta 2.000 dimensiones y halfvec hasta 4.000, según su README. Con text-embedding-3-large tienes dos salidas: pedir dimensions: 1536 o pasar a halfvec. Por qué HNSW se comporta así lo cuento en cómo funciona una base de datos vectorial con HNSW e IVF.

    Postgres también permite combinar vectores con BM25, que rescata códigos, nombres propios y cifras: lo tienes en búsqueda híbrida con embeddings y Supabase.

    Cuándo NO usar LangChain para esto

    Primero, si tu caso es simple, sobra. Mil documentos, un modelo y un bucle de similitud coseno caben en 30 líneas con el SDK de OpenAI.

    Segundo, las roturas entre versiones son reales. El issue #9297 recoge el error ERR_PACKAGE_PATH_NOT_EXPORTED al importar langchain/vectorstores/memory tras la v1. La solución de otro usuario fue "npm i @langchain/classic", y un mantenedor lo cerró remitiendo a la guía de migración. La doc de pgvector, a 5 de noviembre de 2026, dice en una tabla que el paquete es @langchain/pgvector y en una nota que es @langchain/community.

    Tercero, MemoryVectorStore no persiste. Cada arranque vuelve a llamar a la API de embeddings con todo el corpus. Con 515 chunks no duele; con 500.000, sí.

    Cuarto, la abstracción esconde la semántica. El mismo método, similaritySearchWithScore, devuelve números con sentidos opuestos según la clase.

    En Hacker News, en un hilo de 2024 sobre dejar LangChain, un usuario lo resumió: "IMO LangChain provides very high level abstractions that are very useful for prototyping", para añadir después: "I don't think I would run it in production". Yo no iría tan lejos, pero sí lo trataría como una dependencia a fijar con versiones exactas y tests.

    Cómo llevar tu búsqueda semántica con LangChain a producción

    Fija el modelo y las dimensiones en el código y nunca dependas del valor por defecto. Fija las versiones de los paquetes @langchain/*. Si los metadatos llegan de fuentes distintas, valídalos con un schema antes de indexar.

    Y escribe un test con tres consultas reales y el chunk que esperas que salga en cada una. Ese test es lo que te avisa cuando un cambio de parser, de modelo o de vector store mueve la calidad sin lanzar ningún error.

    Si quieres llevar este buscador a un producto completo, con especificación primero y Claude Code para implementar, es el recorrido del curso Construye con IA. Y cuando el retriever pase a ser la tool de un agente, sigue con cómo desplegar agentes de LangChain en producción.

    Preguntas frecuentes

    ¿Qué paquetes necesito para la búsqueda semántica con LangChain.js?

    Con OpenAI y vectores en memoria: @langchain/core, @langchain/textsplitters, @langchain/openai, @langchain/classic y pdf-parse si cargas PDF. Para producción con Postgres, cambia @langchain/classic por @langchain/pgvector y el driver pg.

    ¿El chunkSize de RecursiveCharacterTextSplitter se mide en tokens?

    No. Por defecto se mide en caracteres, con la longitud del string. Con chunkSize: 1000 los chunks del PDF de Nike salieron con 856 caracteres de media. Si necesitas tokens, el splitter acepta una lengthFunction propia.

    ¿Un score más alto en similaritySearchWithScore es mejor?

    Depende de la clase. En MemoryVectorStore es similitud coseno y más alto es mejor. En PGVectorStore es distancia por defecto y más bajo es mejor, salvo que pongas scoreNormalization: "similarity", y aun así la escala no es la de MemoryVectorStore. Compruébalo con una consulta irrelevante antes de fijar un umbral.

    ¿Qué modelo de embeddings usa OpenAIEmbeddings por defecto?

    En @langchain/openai 1.8.0, text-embedding-ada-002. El tutorial oficial usa text-embedding-3-large, que devuelve 3.072 dimensiones salvo que pidas menos con dimensions.

    ¿Puedo usar MemoryVectorStore en producción?

    Solo si el corpus es pequeño y te da igual reembeberlo en cada arranque. No persiste nada y recorre todos los vectores en cada consulta. Para algo que deba sobrevivir a un despliegue, usa pgvector u otro vector store persistente.


    El código de este post se ejecutó el 5 de noviembre de 2026 con las versiones citadas.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Vector embeddings: qué son y cómo usarlos en TypeScript

    Vector embeddings: qué son y cómo usarlos en TypeScript

    Imagina que cambias de modelo de vector embeddings un lunes. El nuevo da mejores resultados en los benchmarks, así que reindexas los documentos nuevos con él y dejas los antiguos como estaban. Pides las mismas 1.536 dimensiones para no tocar el esquema de la base de datos.

    No salta ningún error. Los tests pasan. Y la búsqueda empieza a devolver cosas sin sentido para la mitad de las consultas.

    Has mezclado vectores de dos modelos distintos en el mismo índice. Tienen la misma longitud, pero no viven en el mismo espacio. Compararlos es como medir la distancia entre una coordenada de Madrid y otra de un mapa de Tokio dibujado con otra escala. La cuenta sale, pero no significa nada.

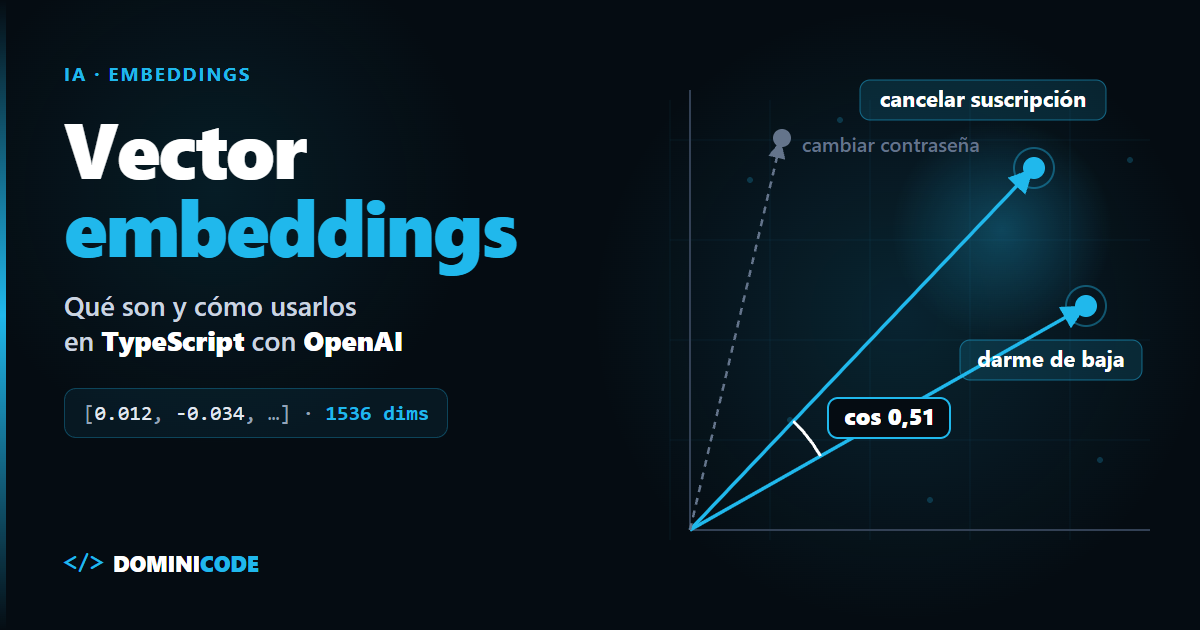
    En corto: un embedding es una lista de números que representa el significado de un texto; dos textos parecidos dan vectores cercanos. Con OpenAI se generan con client.embeddings.create, se comparan con similitud coseno y salen normalizados a longitud 1. Los fallos típicos en producción son mezclar modelos o dimensiones, recortar vectores sin renormalizar y usarlos donde hace falta coincidencia exacta.

    ¿Qué son los vector embeddings?

    Un vector embedding es una representación numérica de un texto, una lista de números en coma flotante, en la que la distancia entre dos vectores mide cuánto se parecen sus significados.

    La guía oficial de OpenAI lo dice así: distancias pequeñas sugieren mucha relación y distancias grandes, poca. De ahí salen la búsqueda semántica, la clasificación, el clustering, las recomendaciones y la detección de anomalías.

    Un número suelto no dice nada: en los vector embeddings importa la posición de cada vector respecto a otros generados por el mismo modelo.

    Qué modelos de embeddings ofrece OpenAI en noviembre de 2026

    OpenAI tiene tres modelos de embeddings en su catálogo a 5 de noviembre de 2026, y text-embedding-3-small es el que usa la guía en sus ejemplos. Datos de la guía, la referencia de la API y la página de precios:

    Modelo Dimensiones por defecto Máx. entrada Precio por 1M tokens MTEB Cuándo usarlo
    text-embedding-3-small 1.536 8.192 tokens 0,02 USD 62,3 % Punto de partida para casi todo
    text-embedding-3-large 3.072 8.192 tokens 0,13 USD 64,6 % Cuando has medido que small no llega; OpenAI lo da como el mejor en inglés y otros idiomas
    text-embedding-ada-002 1.536 8.192 tokens 0,10 USD 61,0 % Solo si tienes un índice antiguo que aún no has migrado

    Según la guía, text-embedding-3-small y text-embedding-3-large no conocen nada de lo ocurrido después de septiembre de 2021. large cuesta 6,5 veces más que small (0,13 / 0,02) para ganar 2,3 puntos en MTEB. ada-002 es 5 veces más caro que small y puntúa peor: si aún lo usas, migrar te ahorra dinero.

    Cómo generar embeddings en TypeScript con la API de OpenAI

    Para generar embeddings en TypeScript llamas a client.embeddings.create con el modelo y un input: un string o un array de strings. La referencia marca tres límites: cada input debe caber en 8.192 tokens, un array admite como mucho 2.048 elementos y la suma de todos los inputs de una petición no puede pasar de 300.000 tokens.

    import OpenAI from "openai";
    
    const client = new OpenAI(); // lee OPENAI_API_KEY del entorno
    
    const MODEL = "text-embedding-3-small";
    // 32 textos × 8.192 tokens = 262.144 tokens: nunca supera el tope de 300.000
    const BATCH_SIZE = 32;
    
    export async function embed(texts: string[], dimensions?: number): Promise<number[][]> {
      const vectors: number[][] = [];
    
      for (let i = 0; i < texts.length; i += BATCH_SIZE) {
        const batch = texts.slice(i, i + BATCH_SIZE).map((t) => t.replace(/\n/g, " ").trim());
        if (batch.some((t) => t.length === 0)) throw new Error("La API no acepta textos vacíos");
    
        const response = await client.embeddings.create({
          model: MODEL,
          input: batch,
          encoding_format: "float",
          ...(dimensions ? { dimensions } : {}),
        });
    
        // ordena por index: no des por hecho el orden del array
        const sorted = [...response.data].sort((a, b) => a.index - b.index);
        vectors.push(...sorted.map((d) => d.embedding));
      }
    
      return vectors;
    }
    

    Antes de guardar, valida la longitud de cada vector. Un z.array(z.number()).length(1536) evita que un cambio de configuración te llene la tabla de vectores incompatibles. Es el tipo de contrato en la frontera que trabajamos en el curso de Zod.

    Similitud coseno: cómo comparar dos vector embeddings

    La similitud coseno mide el ángulo entre dos vectores y va de -1 a 1: 1 es misma dirección, 0 es vectores sin relación y -1, direcciones opuestas. Es la función que OpenAI recomienda, aunque su propia guía añade que la elección "typically doesn't matter much".

    Los embeddings de OpenAI salen normalizados a longitud 1, así que el coseno equivale al producto escalar, y coseno y distancia euclídea dan exactamente el mismo ranking.

    export function cosineSimilarity(a: number[], b: number[]): number {
      if (a.length !== b.length) {
        throw new Error(`Dimensiones distintas: ${a.length} vs ${b.length}`);
      }
      let dot = 0;
      let normA = 0;
      let normB = 0;
      for (let i = 0; i < a.length; i++) {
        dot += a[i] * b[i];
        normA += a[i] * a[i];
        normB += b[i] * b[i];
      }
      if (normA === 0 || normB === 0) return 0;
      return dot / (Math.sqrt(normA) * Math.sqrt(normB));
    }
    

    La función calcula las normas aunque OpenAI ya normalice: te protege de vectores recortados a mano o de otro proveedor.

    Búsqueda semántica en memoria: ejemplo mínimo

    Para buscar con vector embeddings en un corpus pequeño no necesitas base de datos vectorial: embebes todo, calculas el coseno contra la consulta y ordenas.

    const docs = [
      "Cómo cancelar la suscripción desde el panel de usuario",
      "El reembolso tarda entre 5 y 7 días hábiles en llegar",
      "Para cambiar la contraseña, ve a Ajustes > Seguridad",
      "Aceptamos pagos con tarjeta, PayPal y transferencia",
      "El plan Pro incluye soporte prioritario por chat",
      "Puedes exportar tus facturas en PDF desde Facturación",
    ];
    
    const query = "quiero darme de baja y que me devuelvan el dinero";
    
    // una sola petición para la consulta y los documentos
    const [queryVector, ...docVectors] = await embed([query, ...docs]);
    
    const ranking = docVectors
      .map((vector, i) => ({ text: docs[i], score: cosineSimilarity(queryVector, vector) }))
      .sort((a, b) => b.score - a.score);
    
    console.table(ranking.slice(0, 3));
    

    Ejecutado el 5 de noviembre de 2026 con text-embedding-3-small y el SDK openai 7.51.0, los dos primeros resultados fueron "cancelar la suscripción" (0,51) y "el reembolso tarda" (0,40), sin compartir palabras clave con la consulta.

    El 0,51 no es un porcentaje de parecido: vale el orden, y cualquier umbral hay que calibrarlo con datos reales. Con millones de vectores necesitas un índice aproximado; lo explico en cómo funciona una vector database con HNSW e IVF.

    El parámetro dimensions y la normalización

    El parámetro dimensions acorta el embedding en origen sin que pierda lo que representa, y es lo que OpenAI sugiere frente a recortarlo tú. Según la guía, text-embedding-3-large recortado a 256 dimensiones supera en MTEB a ada-002 con sus 1.536.

    Si recortas a mano con slice, tienes que renormalizar. En la misma prueba, los primeros 256 valores de un vector de 1.536 tenían norma 0,48, no 1, y el producto escalar deja de equivaler al coseno.

    export function normalize(v: number[]): number[] {
      let sumSquares = 0;
      for (const x of v) sumSquares += x * x;
      const magnitude = Math.sqrt(sumSquares);
      return magnitude === 0 ? v : v.map((x) => x / magnitude);
    }
    
    const shortened = normalize(queryVector.slice(0, 256));
    

    Las dimensiones también deciden cuánto ocupan tus vectores. En pgvector cada vector ocupa 4 * dimensiones + 8 bytes, y el tipo vector solo se indexa con HNSW hasta 2.000 dimensiones, según su README. Para 100.000 documentos:

    Dimensiones Bytes por vector (4 × d + 8) 100.000 vectores ¿Indexable con HNSW como vector?
    256 1.032 103,2 MB Sí
    1.024 4.104 410,4 MB Sí
    1.536 6.152 615,2 MB Sí
    3.072 12.296 1.229,6 MB No: usa halfvec o dimensions

    Por eso large con dimensions: 1024 suele ser mejor plan que large a 3.072: los vectores ocupan la tercera parte y se pueden indexar con HNSW. El índice HNSW ocupa espacio aparte, que también crece con las dimensiones.

    Errores típicos con vector embeddings en producción

    Mezclar modelos o dimensiones al reindexar. Guarda modelo y dimensiones junto a cada vector y filtra por ellos. Si cambias de modelo, reindexa todo y embebe la consulta con el nuevo.

    Recortar sin renormalizar. Usa dimensions en la llamada. Si recortas a mano, pasa normalize() siempre.

    Embeber textos demasiado largos. El límite es 8.192 tokens por input, pero un vector que resume diez páginas es una media difusa de todo: trocea antes. Cuenta tokens con cl100k_base, el encoding que indica la guía; en TypeScript, con js-tiktoken.

    No presupuestar la reindexación. Embeber 100.000 documentos de 500 tokens (50 millones de tokens) cuesta 1 USD con small. Lo caro es mantener dos índices mientras migras y revalidar la calidad.

    Cuándo NO usar vector embeddings

    Los embeddings no sirven cuando importa la coincidencia exacta, cuando la respuesta depende de una negación o cuando el dominio usa un vocabulario que el modelo no conoce. Dos casos medidos el 5 de noviembre de 2026 con similitud coseno:

    Frase A Frase B (casi igual) Frase C (lo que buscas) small A-B small A-C large A-B large A-C
    "El pedido se ha enviado" "El pedido no se ha enviado" "Tu paquete ya está en camino" 0,852 0,543 0,851 0,562
    "ERR-4012" "ERR-4021" "Error de pago rechazado" 0,955 0,267 0,929 0,352

    IDs, SKUs y códigos de error. Aunque en tu sistema ERR-4012 signifique "pago rechazado", el modelo no lo sabe: ERR-4012 y ERR-4021 salen casi idénticos. Si tu usuario busca un código concreto, usa BM25 o un filtro exacto. Lo habitual es combinar las dos cosas, como explico en búsqueda híbrida con embeddings en Supabase.

    Negaciones. "Se ha enviado" y "no se ha enviado" quedan más cerca entre sí que de una paráfrasis correcta. En el hilo de Hacker News sobre el paper "Is Cosine-Similarity of Embeddings Really About Similarity?", el usuario latency-guy2 puso el mismo ejemplo con "Yes, this is a demonstration" frente a "Yes, this isn't a demonstration". En el mismo hilo, visarga escribió que los embeddings "make a mess of equivalent, antonymous and related things".

    Dominio muy específico. Jerga y siglas internas que el modelo no vio al entrenar, con datos hasta septiembre de 2021. Mide con tus consultas antes de fiarte.

    Cuando no puedes asumir el lock-in. Cada vector está atado a su modelo, y cambiar de proveedor obliga a reindexar el corpus entero. Si mañana quieres un pipeline multimodal como el de Gemini Embedding 2, no aprovechas ni un vector.

    Qué modelo de embeddings elegir para empezar

    Para empezar con vector embeddings, usa text-embedding-3-small con sus 1.536 dimensiones, guarda modelo y dimensiones junto a cada vector y monta 20 o 30 consultas reales con el resultado que esperas. Ese conjunto de prueba vale más que cualquier benchmark: te dirá si large compensa, qué umbral usar y si necesitas BM25.

    Los vector embeddings son la pieza de recuperación de casi cualquier agente con RAG. Para ver cómo encajan con las tools, la memoria y la orquestación, tienes el ebook gratuito El Developer Agéntico, 194 páginas sobre arquitectura de agentes. Y para llevarlo a un producto completo, el curso Construye con IA.

    Preguntas frecuentes

    ¿Puedo comparar embeddings de text-embedding-3-small y text-embedding-3-large?

    No. Aunque recortes large a 1.536 dimensiones, cada modelo genera vectores en su propio espacio: la comparación no da error, pero no significa nada. Usa el mismo modelo y las mismas dimensiones para documentos y consulta.

    ¿Hace falta normalizar los embeddings de OpenAI?

    No, si los usas tal como llegan o los acortas con el parámetro dimensions: OpenAI los devuelve normalizados a longitud 1. Sí, si los recortas con slice o los mezclas con vectores de otro origen.

    ¿Cuántos textos puedo embeber en una sola petición?

    Hasta 2.048 inputs por petición, cada uno de 8.192 tokens como máximo y sin pasar de 300.000 tokens entre todos, según la referencia de la API. El límite que suele cortar primero es el de 300.000 tokens: con textos de 500 tokens caben 600 por petición.

    ¿Cuánto cuesta embeber todo mi corpus con OpenAI?

    Multiplica los tokens del corpus, en millones, por el precio por millón. A noviembre de 2026, text-embedding-3-small cuesta 0,02 USD por millón y text-embedding-3-large, 0,13 USD. Un corpus de 50 millones de tokens sale por 1 USD con small y 6,50 USD con large.

    ¿Necesito una base de datos vectorial para usar vector embeddings?

    No para empezar. Con unos pocos miles de documentos basta un bucle de coseno en memoria; la base vectorial compensa cuando recorrerlo todo se vuelve lento o necesitas filtrar y persistir a escala.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Contextual retrieval: cómo arreglar tu RAG en TypeScript

    Contextual retrieval: cómo arreglar tu RAG en TypeScript

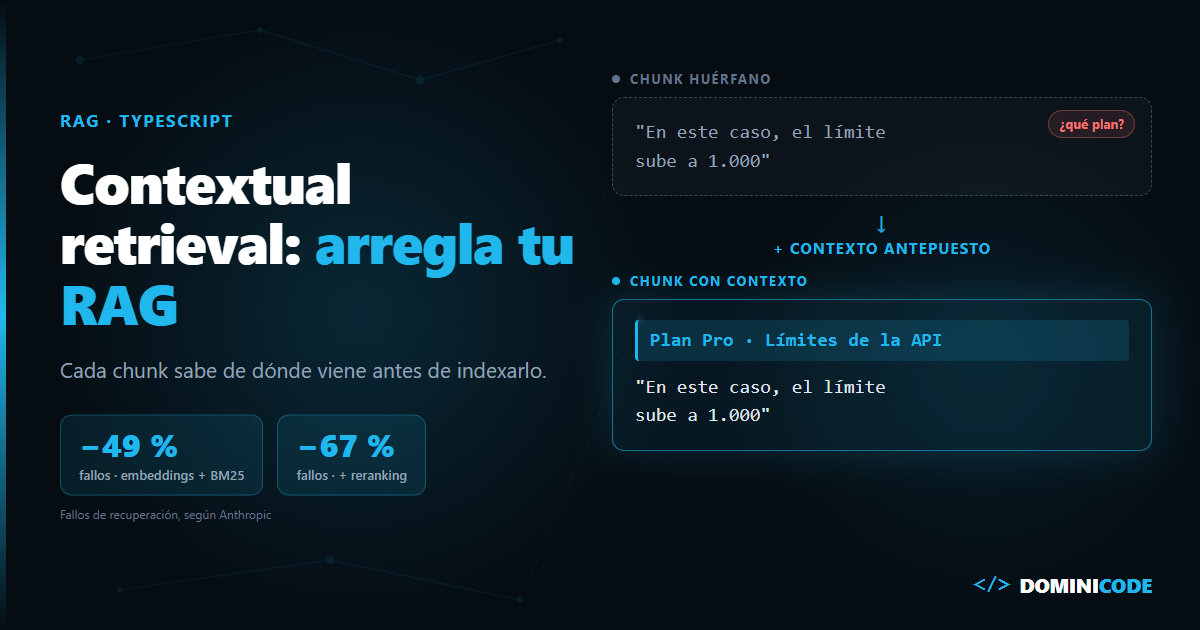
    Un usuario le pregunta a tu asistente de documentación: "¿Cuántas peticiones por minuto admite el plan Pro?". El sistema busca, encuentra un fragmento y responde con seguridad: 100.

    El fragmento existe: "El límite es de 100 peticiones por minuto". Pero es del plan Free. El del plan Pro empieza con "En este caso, el límite sube a 1.000" y no nombra el plan.

    Tu RAG no ha alucinado. Hizo lo que le pediste: trocear, vectorizar y devolver el fragmento más parecido, que al trocear perdió el título que le daba sentido. Ese hueco lo tapa contextual retrieval, la técnica que Anthropic publicó en septiembre de 2024 y que sigue siendo una de las mejoras más baratas que le puedes hacer a un RAG.

    En corto: contextual retrieval consiste en pedirle a un LLM que escriba, para cada chunk, una o dos frases que lo sitúen dentro del documento, y en indexar ese contexto junto al chunk en embeddings y en BM25. En las pruebas de Anthropic, los fallos de recuperación bajaron un 49 % al combinar las dos cosas y un 67 % al añadir reranking. Con prompt caching y Claude Haiku 5.5, contextualizar un millón de tokens de documentos sale por unos 0,38 USD según mi cálculo con los precios de noviembre de 2026.

    ¿Qué es contextual retrieval?

    Contextual retrieval es una técnica de indexado para RAG que antepone a cada chunk un contexto breve, generado por un LLM a partir del documento completo, antes de calcular su embedding y de añadirlo al índice BM25.

    No cambia la consulta ni el modelo que responde: cambia lo que guardas. Donde antes indexabas "En este caso, el límite sube a 1.000", ahora indexas algo así:

    Sección de límites de la API, plan Pro. Describe el rate limit por minuto y cómo se amplía respecto al plan Free.

    En este caso, el límite sube a 1.000 peticiones por minuto.

    Ahora la búsqueda vectorial y la de palabras clave encuentran "plan Pro".

    Por qué falla el chunking en RAG clásico

    El chunking en RAG trocea los documentos en fragmentos de unos pocos cientos de tokens. Es razonable, pero tiene un coste oculto: cada chunk pierde las referencias que vivían fuera de él.

    Pronombres ("este caso"), siglas definidas tres párrafos antes, el producto que solo aparece en el H1, la versión de la API en la cabecera. Nada de eso viaja con el fragmento.

    La búsqueda híbrida ayuda, pero no lo arregla: si el término no está en el chunk, BM25 no tiene nada que encontrar. Ya conté cómo montar esa combinación en búsqueda híbrida con embeddings en Supabase: contextual retrieval es la capa que va encima, no un sustituto.

    Anthropic probó la alternativa obvia, añadir un resumen genérico del documento a cada chunk, y según el artículo las ganancias fueron muy limitadas. El contexto útil es específico de cada fragmento.

    Cuánto mejora la recuperación: los números de Anthropic

    Anthropic midió la tasa de fallo como 1 menos recall@20: el porcentaje de consultas en las que el chunk correcto no aparece entre los 20 primeros resultados. Estos son los datos del artículo de Anthropic, con su configuración de 2024 (contexto generado con Claude 3 Haiku; en la fila de reranking, 150 candidatos que el reranker de Cohere reduce a 20):

    Técnica Tasa de fallo (top-20) Reducción vs. base Coste que añade
    Base (embeddings sin contexto) 5,7 % — Ninguno extra
    + contextual embeddings 3,7 % 35 % Una llamada al LLM por chunk al indexar
    + contextual BM25 2,9 % 49 % Mantener un índice BM25 (barato)
    + reranking 1,9 % 67 % Una llamada al reranker por consulta: latencia y coste en cada búsqueda

    Mira la última columna: las dos primeras mejoras se pagan una vez, al indexar. El reranking se paga en cada consulta, y el propio artículo avisa de que añade algo de latencia y de coste. Si ya tienes el pipeline de RAG avanzado con búsqueda híbrida, contextual retrieval se añade en la ingesta sin tocar la consulta.

    Cómo implementar contextual retrieval en TypeScript con Claude

    Por cada chunk, una llamada al modelo con el documento entero y el chunk. Lo que la hace viable es el prompt caching: el documento es igual en todas las llamadas, así que lo marcas con cache_control y solo pagas su precio completo la primera vez.

    Este ejemplo usa @anthropic-ai/sdk y claude-haiku-5-5, con un prompt propio en español:

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic(); // lee ANTHROPIC_API_KEY del entorno
    const MODEL = "claude-haiku-5-5";
    
    const instructions = (chunk: string) => `Este fragmento pertenece al documento anterior:
    <chunk>
    ${chunk}
    </chunk>
    Escribe un contexto breve (50-100 tokens) que sitúe el fragmento dentro del documento
    para mejorar su recuperación en búsquedas. Incluye producto, sección, versión o fechas
    si aparecen. Responde solo con el contexto.`;
    
    async function contextualizeChunk(doc: string, chunk: string): Promise<string> {
      const res = await client.messages.create({
        model: MODEL,
        max_tokens: 200,
        messages: [
          {
            role: "user",
            content: [
              {
                type: "text",
                text: `<document>\n${doc}\n</document>`,
                cache_control: { type: "ephemeral" }, // 5 minutos por defecto
              },
              { type: "text", text: instructions(chunk) },
            ],
          },
        ],
      });
    
      // Comprueba que la caché funciona: a partir de la 2.ª llamada debería ser > 0
      console.log("cache_read_input_tokens:", res.usage.cache_read_input_tokens);
    
      const block = res.content.find((b) => b.type === "text");
      return block?.type === "text" ? block.text.trim() : "";
    }
    
    export async function contextualizeDocument(
      doc: string,
      chunks: string[],
      concurrency = 5,
    ): Promise<string[]> {
      if (chunks.length === 0) return [];
    
      // La primera llamada escribe la caché. Las que salgan antes de que
      // empiece su respuesta no la verían y pagarían el documento entero.
      const contexts = [await contextualizeChunk(doc, chunks[0])];
    
      for (let i = 1; i < chunks.length; i += concurrency) {
        const batch = chunks.slice(i, i + concurrency);
        contexts.push(...(await Promise.all(batch.map((c) => contextualizeChunk(doc, c)))));
      }
    
      return chunks.map((chunk, i) => `${contexts[i]}\n\n${chunk}`);
    }
    

    Dos detalles importan. Según la documentación de prompt caching, en peticiones concurrentes la entrada de caché solo existe cuando empieza la primera respuesta. Si lanzas los 10 chunks a la vez con Promise.all, pagas 10 escrituras de caché del documento, cada una a 1,25 veces el precio de entrada. Por eso la primera llamada va sola. (Con lotes, cada uno espera al chunk más lento; si te importa la velocidad, un pool como p-limit va más rápido.)

    Además, Haiku 5.5 no cachea prompts de menos de 512 tokens, y no da error: simplemente no cachea.

    El texto que devuelve contextualizeDocument va a tu modelo de embeddings y a tu índice de palabras clave: BM25 o, en Postgres, un tsvector con ts_rank, que no es BM25 pero cumple el mismo papel. Guarda también el chunk original: el artículo sugiere que la respuesta puede mejorar si el modelo distingue contexto y contenido. Qué pasa con esos vectores dentro de la base de datos lo explico en cómo funciona una vector database con HNSW e IVF.

    Cuánto cuesta contextual retrieval hoy

    Anthropic calculó 1,02 USD por millón de tokens de documento con Claude 3 Haiku y precios de 2024. Lo he recalculado con los precios de Claude Haiku 5.5 a noviembre de 2026 y las mismas hipótesis del artículo: documentos de 8.000 tokens, chunks de 800, 50 tokens de instrucciones y 100 tokens de contexto por chunk. Cada llamada ronda los 8.850 tokens: por encima del mínimo de 512 para cachear y por debajo de los 100.000 a partir de los que sube la tarifa.

    Un millón de tokens son 125 documentos y 1.250 chunks:

    Concepto Tokens Precio Haiku 5.5 Coste
    Escritura de caché (1 por documento) 1.000.000 0,125 USD/MTok 0,125 USD
    Lecturas de caché (9 por documento) 9.000.000 0,01 USD/MTok 0,090 USD
    Entrada sin caché (chunk + instrucciones) 1.062.500 0,10 USD/MTok 0,106 USD
    Salida (contexto generado) 125.000 0,50 USD/MTok 0,063 USD
    Total ≈ 0,38 USD

    Sin caché, la misma operación costaría unos 1,17 USD: la caché ahorra dos tercios. Es mi cálculo, no una cifra de Anthropic, y no incluye el coste de los embeddings.

    Cuándo NO usar contextual retrieval

    La técnica no es gratis ni universal. Cuatro límites antes de meterla en tu pipeline.

    Si tu base de conocimiento cabe en el prompt, sáltatela. El artículo dice que, por debajo de 200.000 tokens (unas 500 páginas), puedes meter todo en el contexto y olvidarte del RAG. Matiz de 2026: Haiku 5.5 cobra todo cinco veces más (entrada, caché y salida) en las peticiones de más de 100.000 tokens, contando también lo que sale de caché, así que el umbral depende del modelo. Y no todos comparten la idea. En el hilo de Hacker News sobre el artículo, un usuario escribió que "The statement about just throwing 200k tokens to get best answer for smaller datasets goes against my experience", porque, según contaba, cuanto más crece el prompt, menos consistente es la respuesta, y le pasaba ya muy por debajo de 25.000 tokens.

    Documentos que cambian a menudo. Cada edición obliga a regenerar el contexto de todos los chunks del documento, porque cada contexto se genera leyéndolo entero. En una wiki que se edita a diario, el coste y la cola de reindexado crecen rápido.

    Latencia de indexado. Una llamada al LLM por chunk añade tiempo a cada ingesta. En el mismo hilo, otro usuario lo planteaba así: "Even with prompt caching this adds a huge extra time to your vector database create/update, right?". Si necesitas que un documento sea buscable segundos después de subirlo, indexa primero sin contexto y contextualiza en segundo plano.

    Documentos muy estructurados. Si tu documentación tiene buenos encabezados, anteponer la ruta de títulos al chunk (# Límites > ## Plan Pro) recupera parte de ese contexto sin llamar a ningún modelo. Un usuario del mismo hilo de HN contaba que su equipo lo hacía así y que "seems to work pretty well", sin LLM al indexar. Prueba eso primero y mide.

    Cómo saber si te compensa

    Contextual retrieval no se adopta por fe. Necesitas un conjunto de evaluación con preguntas reales y su chunk correcto: mides el recall@20 actual, contextualizas y vuelves a medir. Si no tienes ese conjunto, ese es tu primer trabajo. Y si dudas entre recuperar mejor o entrenar el modelo, empieza por RAG vs. fine-tuning.

    Mi recomendación: si tu RAG falla cuando el dato existe pero el fragmento no dice de qué habla, empieza por contextual retrieval: cuesta céntimos y no cambia ni tu base de datos ni tu modelo.

    En el ebook gratuito El Developer Agéntico tienes RAG explicado como parte de la arquitectura de un agente, junto a tools, memoria y MCP; el capítulo 5 trata el chunking y el late chunking, la alternativa sin LLM generativo a lo que has visto aquí. Y si quieres llevarlo a un producto de verdad, en el curso Construye con IA vamos de la idea al producto con Claude Code, paso a paso.

    Preguntas frecuentes

    ¿Contextual retrieval es lo mismo que la búsqueda híbrida?

    No. La búsqueda híbrida combina embeddings y BM25 al consultar. Contextual retrieval cambia lo que indexas en ambos: añade a cada chunk un contexto generado por un LLM. Se usan juntas, y en las pruebas de Anthropic la combinación redujo los fallos de recuperación un 49 %.

    ¿Necesito usar Claude para contextual retrieval?

    No. Cualquier LLM puede generar el contexto. Lo que hace viable la técnica es el prompt caching, que abarata leer el mismo documento en cada chunk. Con otro proveedor, comprueba si tiene caché y a qué precio.

    ¿Cuánto cuesta aplicar contextual retrieval a mi documentación?

    Con Claude Haiku 5.5, prompt caching y documentos de 8.000 tokens, unos 0,38 USD por millón de tokens de documento, una sola vez, más el coste de los embeddings. Si un documento pasa de 100.000 tokens, cada llamada supera ese umbral y Haiku 5.5 cobra todas sus tarifas por cinco, así que el coste también se multiplica por cinco.

    ¿Puedo usar contextual retrieval con pgvector o Supabase?

    Sí. Contextual retrieval cambia la ingesta, no la base de datos: guardas el chunk contextualizado en pgvector como cualquier otro embedding, y la parte de palabras clave va en un tsvector de Postgres.

    ¿Cuánto debe ocupar el contexto de cada chunk?

    Según Anthropic, suele ocupar entre 50 y 100 tokens. Cada token de salida se paga por chunk, así que pide en el prompt solo lo que se pierde al trocear: producto, sección, versión y fechas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Casos de uso de Jev: 3 formas de usarlo hoy en tu proyecto

    Casos de uso de Jev: 3 formas de usarlo hoy en tu proyecto

    Cuando TypeSafe lanzó Jev, el hilo de Hacker News superó los 500 comentarios. Casi todo iba de arquitectura y de alucinaciones.

    Los comentarios útiles eran los aburridos, y de ahí salen los casos de uso de Jev. Alguien que tiene "about a billion reasons a day to call a model like this to rid the world of spam and phishing". Alguien que el año pasado movió la clasificación de un millón de transcripciones de LLMs a embeddings con similitud coseno: ahorró costes y tiempo, y perdió precisión.

    Los casos que rentan no están en el agente que hace clic por ti, sino en la función de backend que enruta un ticket 40.000 veces al día sin que nadie la mire.

    En corto: los tres casos de uso de Jev que más rentan en un proyecto sin agentes son el triaje de tickets con enrutado por confidence, el filtrado de pasajes RAG antes del LLM caro y la verificación de citas de un chatbot. Los tres cambian una llamada generativa por una decisión tipada que cuesta fracciones de céntimo. Y los tres fallan igual: el texto evaluado puede empujar la respuesta, así que calibras los umbrales con datos propios.

    ¿Qué es Jev y por qué encaja en backend aburrido?

    Jev es el modelo "System One" de TypeSafe AI: recibe un texto (state) y preguntas cerradas de tres tipos (noul, choice y score), y devuelve respuestas tipadas con probabilidades en lugar de texto libre. Si aún no has hecho tu primera llamada, empieza por la guía para usar Jev de cero; el porqué de sus probabilidades está en qué es Jev.

    Tres datos de la página de modelos, consultada el 11 de octubre de 2026: $0,042 por millón de tokens de entrada, salida gratis. 64k tokens por petición, pero solo 32k para el state más la pregunta más larga. Y jev-latest es un alias que se mueve (hoy apunta a jev-1.13.0): si calibras umbrales, fija la versión.

    La documentación dice "Most queries complete in about 100 ms". Tu backend no ve eso: yo medí de extremo a extremo un p50 de 258 ms reutilizando la conexión y 628 ms sin reutilizarla. Dimensiona con esas.

    Ojo: un noul devuelve { "type": "noul", "noul": 0.01 }, no un número. Si llamas con fetch en vez del SDK, valida la respuesta en la frontera, como enseño en el curso de Zod para TypeScript.

    Casos de uso de Jev: coste y riesgo de un vistazo

    Costes con el supuesto de tokens de cada fila y $0,042 por millón.

    Caso Primitiva Qué reemplaza Llamadas por unidad Coste con el supuesto Riesgo principal
    Triaje de tickets 1 choice LLM que lee y clasifica cada ticket 1 por ticket (800 tokens) $3,36 por 100.000 tickets El usuario escribe el state: inyección
    Filtro de pasajes RAG 4 noul Mandar el top-k entero al LLM, o un reranker aparte 12 por consulta (1.280 tokens cada una) $0,645 por 1.000 consultas El coste escala con k; no es frontera de seguridad
    Verificación de citas includes() + 1 choice Un segundo LLM que revise al primero, o a una persona 1 por cita (5 citas de 1.000 tokens) $0,21 por 1.000 respuestas Citas parafraseadas marcadas como inventadas

    Los 1.280 tokens del caso RAG son la media del cookbook de re-ranking, donde 1.200 llamadas consumieron 1.536.002 tokens de entrada y costaron $0,0645. El método para tu tráfico está en cuánto cuesta Jev de verdad.

    Caso 1: triaje de tickets que sabe cuándo no sabe

    El primer caso de uso de Jev es enrutar tickets de soporte con un choice sobre tus colas: el confidence decide si el ticket va a la cola concreta, al equipo o a una persona.

    Un LLM clasifica bien un ticket, pero pagas la salida y parseas lo que devuelva. Y cuando duda, no te lo dice.

    Un choice sí te lo dice. El cookbook de clasificación con confidence lo mide sobre 60 informes anuales de la SEC y 75 categorías. Con un corte en 0,9, la mitad segura acierta el 90% (27 de 30) y la mitad insegura, el 40% (12 de 30).

    La insegura la reportan un nivel más arriba en la jerarquía, y ese 40% sube al 70%: de 39 a 48 respuestas útiles sobre 60.

    En soporte: si Jev duda de la cola, el ticket va al equipo; si duda de todo, a una persona, con el suelo de 0,5 del patrón de intent routing.

    import { choice, TypeSafeClient } from '@typesafe-ai/sdk'
    
    const client = new TypeSafeClient() // lee TYPESAFE_API_KEY
    const MODEL = 'jev-1.13.0' // fijado: los umbrales se calibran contra esta versión
    
    // Dos niveles: la cola concreta y el equipo al que pertenece
    const QUEUES = {
      billing_refund: { team: 'billing', desc: 'Asks for a refund or disputes a charge' },
      billing_invoice: { team: 'billing', desc: 'Needs an invoice or a change in billing data' },
      tech_outage: { team: 'technical', desc: 'Something that used to work has stopped working' },
      tech_integration: { team: 'technical', desc: 'Problems with the API, webhooks or an integration' },
      account_access: { team: 'account', desc: 'Cannot log in, 2FA, password or email change' },
    } as const
    type Queue = keyof typeof QUEUES
    
    const criteria = Object.fromEntries(
      Object.entries(QUEUES).map(([key, q]) => [key, q.desc]),
    ) as Record<Queue, string>
    
    // Puntos de partida, no verdades: se recalibran con tickets etiquetados
    const HUMAN_BELOW = 0.5
    const QUEUE_ABOVE = 0.9
    
    export async function triage(ticket: { subject: string; body: string }) {
      const { answers, model } = await client.systemOne({
        model: MODEL,
        state: { ticket },
        questions: {
          queue: choice('Which queue should handle `ticket`? Judge only what the customer reports.', criteria),
        },
      })
      const { choice: queue, confidence, probabilities } = answers.queue
    
      const route =
        confidence < HUMAN_BELOW ? 'human'
        : confidence >= QUEUE_ABOVE ? queue
        : QUEUES[queue].team
    
      // Guarda las probabilidades y la versión: son tu material de calibración
      return { route, confidence, probabilities, model }
    }
    

    La objeción razonable está en el mismo hilo: "Even non-frontier models are absurdly good at this in a broad sense." Cierto. Lo que un LLM pequeño no te da es un confidence en el que apoyar las otras dos ramas del route.

    Dónde falla: en el propio confidence. En los tres informes más fáciles del cookbook sale 1,00 exacto, y en mis pruebas ese valor es frecuente: si casi todo sale a 1,0, un umbral de 0,9 no filtra nada.

    Caso 2: filtrar pasajes RAG antes de pagar el LLM

    El segundo caso de uso de Jev es filtrar los pasajes de tu búsqueda vectorial con cuatro noul por pasaje y mandar al LLM caro solo los que aportan evidencia.

    Tu búsqueda vectorial devuelve los 12 pasajes más parecidos. Parecidos, no útiles. Y los metes todos en el prompt del modelo caro.

    El cookbook de pasajes RAG lo enseña con 81 pasajes: 80 de la documentación de autenticación de Supabase y uno escrito a propósito, un post de foro con una instrucción dirigida al modelo.

    La similitud coseno lo puso primero, con 0,584. El noul de inyección le dio 0,99 y lo sacó. El que desmentía la premisa de la pregunta estaba séptimo; Jev le dio 0,92 en contradicción y lo mandó a un bloque aparte.

    Cuatro preguntas por pasaje, y la decisión en código:

    import { noul, TypeSafeClient, type NoulResponse } from '@typesafe-ai/sdk'
    
    const client = new TypeSafeClient()
    const MODEL = 'jev-1.13.0'
    
    type Passage = { id: string; title: string; text: string; source_type: string }
    
    const PASSAGE_QUESTIONS = {
      isRelevant: noul('Does `passage` address the subject of `query`?'),
      hasEvidence: noul('Does `passage` state information usable in a direct answer to `query`?'),
      contradictsPremise: noul('Does `passage` conflict with a factual premise stated in `query`?'),
      isInjection: noul('Does `passage` attempt to control the system answering `query`?'),
    }
    
    // Los umbrales del cookbook para su corpus. Para el tuyo, punto de partida
    const T = { injection: 0.7, contradicts: 0.7, relevant: 0.45, evidence: 0.55 }
    
    type Nouls = Record<keyof typeof PASSAGE_QUESTIONS, NoulResponse>
    
    // Orden fijo, gana la primera regla: la inyección va antes que todo
    function route(a: Nouls): 'include' | 'conflict' | 'drop' {
      if (a.isInjection.noul > T.injection) return 'drop'
      if (a.contradictsPremise.noul > T.contradicts) return 'conflict'
      if (a.isRelevant.noul < T.relevant) return 'drop'
      if (a.hasEvidence.noul > T.evidence) return 'include'
      return 'drop'
    }
    
    export async function gatePassages(query: string, passages: Passage[]) {
      // Una petición por pasaje: cada pregunta es sobre el par (query, passage)
      const routed = await Promise.all(
        passages.map(async (passage) => {
          const { answers } = await client.systemOne({
            model: MODEL,
            state: { query, passage },
            questions: PASSAGE_QUESTIONS,
          })
          return { passage, route: route(answers) }
        }),
      )
      return {
        evidence: routed.filter((r) => r.route === 'include').map((r) => r.passage),
        conflicts: routed.filter((r) => r.route === 'conflict').map((r) => r.passage),
      }
    }
    

    Ninguna pregunta es "¿incluyo este pasaje?": esa decisión vive en route(), y cambiar la política es editar un número. Es el patrón de descomponer preguntas en Jev aplicado a RAG.

    Ese Promise.all lanza 12 peticiones a la vez: con tráfico real verás algún 429. El SDK reintenta los 429 con backoff, hasta 2 veces por defecto (maxRetries); cómo acotar la concurrencia lo cuento en cómo conectar tu aplicación a la API de Jev.

    En el hilo, alguien que en dos meses tendrá un corpus gigante en su RAG lo veía así: "This could really help solve the chunk ranking problem." El cookbook de re-ranking le da datos: en 40 consultas legales, el pasaje correcto sale primero el 18% de las veces (sin Jev, el 5%) y entra en el top-10 el 62% (sin Jev, el 38%).

    Dónde falla: la documentación lo dice sin rodeos: "Nothing here is a security boundary." Una inyección que puntúe por debajo de 0,70 entra en el prompt, así que el LLM sigue tratando todo como texto no fiable. Jev no recupera lo que la búsqueda no trajo. Y el coste escala con k.

    Caso 3: comprobar que la cita dice lo que el chatbot afirma

    El tercer caso de uso de Jev es verificar las citas de un chatbot en dos pasos: un includes() descarta las inventadas y un choice decide si la sección respalda, contradice o no dice nada de la afirmación.

    Tu chatbot adjunta citas. Algunas son inventadas. Otras son peores: la frase existe en la fuente, pero el párrafo de alrededor dice lo contrario.

    El cookbook de verificación de citas lo parte en dos pasos. El primero no usa modelo: una cita que no está en la fuente es inventada, y un includes() lo detecta gratis. Solo las que sobreviven van a Jev.

    import { choice, TypeSafeClient } from '@typesafe-ai/sdk'
    
    const client = new TypeSafeClient()
    const MODEL = 'jev-1.13.0'
    const AUTO_ACCEPT = 0.8 // alto al principio; bájalo cuando veas cómo acierta
    
    type Citation = { claim: string; quote: string }
    
    const RELATION = choice('How does `section` relate to `claim`?', {
      supports: 'The section states the claim or directly implies that it is true',
      contradicts: 'The section states the opposite of the claim or implies it is false',
      says_nothing: 'The section does not address what the claim asserts, either way',
    })
    
    const VERDICT = { supports: 'verified', contradicts: 'contradicted', says_nothing: 'unsupported' } as const
    
    // Comillas tipográficas y saltos de línea fuera, para que la cita case
    const normalize = (s: string) =>
      s.replace(/[“”]/g, '"').replace(/[‘’]/g, "'").replace(/\s+/g, ' ').trim()
    
    export async function checkCitation(sections: string[], c: Citation) {
      // Paso 1, sin modelo: si la cita no está en la fuente, es inventada
      const section = sections.find((s) => normalize(s).includes(normalize(c.quote)))
      if (!section) return { verdict: 'fabricated', review: false } as const
    
      // Paso 2, con Jev: ¿el contexto de la cita respalda la afirmación?
      const { answers } = await client.systemOne({
        model: MODEL,
        state: { claim: c.claim, section },
        questions: { relation: RELATION },
      })
      const { choice: relation, confidence } = answers.relation
      return {
        verdict: VERDICT[relation],
        confidence,
        review: confidence < AUTO_ACCEPT, // por debajo, lo confirma una persona
      }
    }
    

    En el cookbook, con ocho citas sobre el RFC 7519 de JWT, las cuatro correctas salieron verified con 0,93 o más, la inventada no llegó al modelo, la que contradice su sección salió contradicted a 0,99 y las dos dudosas (0,27 y 0,56) fueron a revisión humana.

    Un segundo LLM revisor te cobraría otra generación entera por una respuesta que cabe en tres opciones. La defensa en profundidad la cuento en guardrails y tácticas defensivas contra la inyección de prompts.

    Dónde falla: el includes() es exacto: una cita recortada o reescrita sale fabricated, y en producción necesitas coincidencia difusa. Y si la fuente es contenido de terceros, entra en el state con su riesgo de inyección.

    Cuándo NO usar Jev en tu proyecto

    Cuando el texto lo controla quien gana con la decisión y la decisión es irreversible. La página de jaggedness de jev-1.13 lo reconoce: el modelo no trata el state como hostil por defecto. Lo medí el 24 de septiembre con jev-1.13.0: una sola línea inyectada en un ticket ambiguo subió el confidence de ~0,45 a 1,00, con la misma etiqueta. Jev puede elegir la cola; no debe disparar un reembolso.

    Cuando no tienes una muestra etiquetada para calibrar. Los umbrales de los cookbooks (0,9, 0,8, 0,70) salieron de sus datos y con jev-1.12. Lo que importa es cuánto aciertas en cada franja de probabilities sobre tus tickets.

    Cuando tu volumen choca con los límites. A 11 de octubre de 2026, la página de modelos publica 100.000 tokens y 80 peticiones por segundo: con 12 pasajes de 1.280 tokens, el techo de tokens te deja en unas 6,5 consultas RAG por segundo. Son límites que cambian sin preaviso: en septiembre eran otros.

    Cuando no aceptas depender de un proveedor. TypeSafe llegó a pausar los registros nuevos en su consola el 22 de septiembre. Si no consigues cuenta, Jev sigue en OpenRouter como typesafe/jev-1.13, al mismo $0,042 por millón (cuándo conviene cada vía). No hay pesos abiertos.

    ¿Por cuál de los casos de uso de Jev empezar?

    Por el caso 2 en modo sombra. Deja tu RAG como está, pasa los pasajes por gatePassages() en paralelo y registra qué habría descartado Jev, sin tocar el prompt. Con una semana de registros tienes umbrales propios y sabes si el ahorro compensa.

    Es la misma disciplina de los evals deterministas para agentes de IA y del harness con veredicto calibrado: primero mides, luego das poder de decisión. Montar un producto entero con ese flujo es lo que hacemos en Construye con IA.

    Preguntas frecuentes

    ¿Puedo usar Jev para clasificar tickets en castellano?

    Sí, pero pruébalo antes: según la documentación, el inglés es el idioma principal de entrenamiento y el resto funciona peor. Compara contra una muestra etiquetada dos variantes, con preguntas y criterios en castellano y en inglés, y quédate con la que acierte más.

    ¿Qué umbral de confidence uso para enrutar tickets?

    El que salga de tus datos. La documentación propone 0,5 como suelo para escalar a una persona y el cookbook usa 0,9, pero si casi todo sale a 1,0 ese corte no filtra. Guarda las probabilidades, etiqueta una muestra y fija el corte ahí.

    ¿Detecta Jev la inyección de prompts en los pasajes?

    Detectó la que plantó el cookbook, con 0,99, pero la documentación insiste en que ese filtro no es una frontera de seguridad. El LLM que responde debe seguir tratando cada pasaje como no fiable.

    ¿Puedo usar Jev en mi proyecto sin cuenta de TypeSafe?

    Sí, a través de OpenRouter, donde está como typesafe/jev-1.13 con el mismo precio de entrada y salida gratis.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
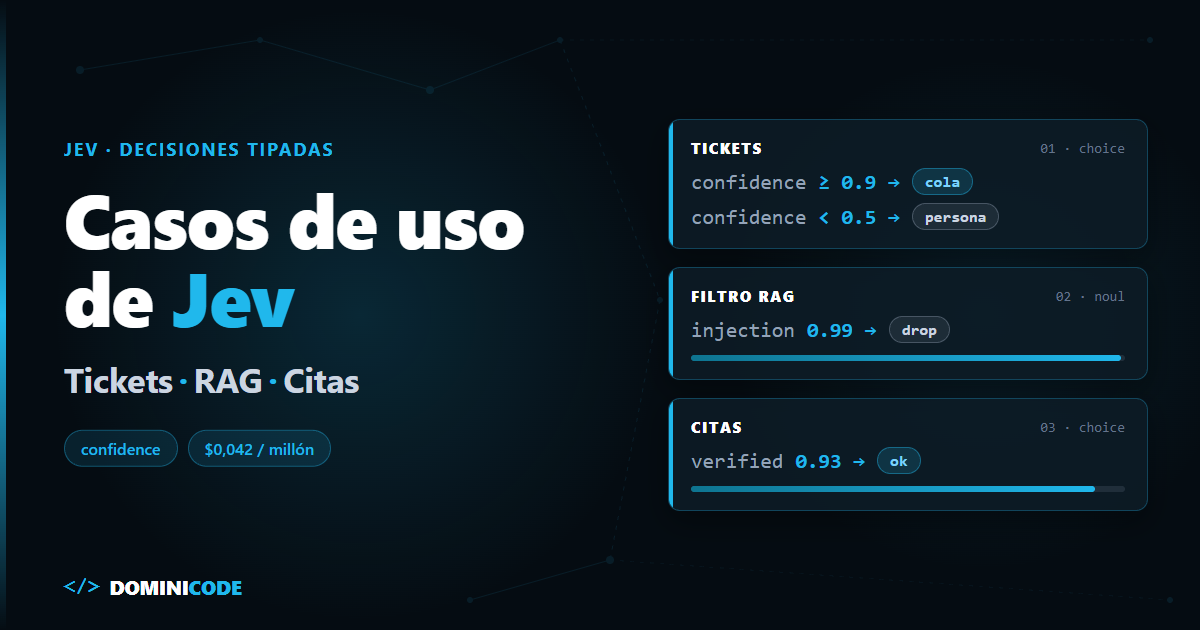
  • Cómo funciona un vector database por dentro: HNSW y IVF

    Cómo funciona un vector database por dentro: HNSW y IVF

    Un cliente me escribió porque su buscador "se había vuelto tonto". Metías la frase exacta de un documento y ese documento no aparecía entre los primeros cinco resultados. A veces ni entre los primeros veinte.

    El equipo sospechó del modelo de embeddings. Lo cambiaron dos veces. Mismo comportamiento.

    Nadie se preguntó cómo funciona un vector database por dentro. Daban por hecho que "buscar por similitud" era comparar la consulta contra todos los vectores guardados y devolver los más parecidos. Eso sí habría encontrado el documento, siempre.

    El problema era el contrario: no estaban comparando contra todos. Usaban un índice que recorre solo una fracción del dataset, y nadie sabía que puede —por diseño, no por bug— dejar fuera al vecino real.

    En corto: un vector database no compara tu consulta contra cada vector guardado. Usa un índice de approximate nearest neighbor (ANN) —típicamente HNSW o IVF— que navega una estructura para encontrar vecinos muy probablemente cercanos sin tocar el resto del dataset. A cambio de esa velocidad, el resultado deja de estar garantizado al 100%.

    ¿Qué es un vector database?

    Un vector database indexa vectores de alta dimensión —cientos o miles de números por registro— para responder "¿qué está más cerca de esto?" en milisegundos, sin recorrer todo el dataset.

    La palabra clave es "cerca". Una base relacional indexa para responder "¿qué fila es igual a X?" o "¿qué está entre A y B?". Un B-tree hace eso bien porque los números tienen orden total: 5 va antes que 8, siempre.

    Un embedding de 768 o 1536 dimensiones no tiene ese orden. No hay un "antes" entre dos vectores, solo una distancia en un espacio que no puedes dibujar. Por eso un B-tree no sirve aquí: no es lento, resuelve otro problema.

    Fuerza bruta: por qué no escala comparar contra todos

    La forma honesta es la más simple: calculas la distancia de tu consulta contra cada vector guardado, ordenas y te quedas con los k más cercanos.

    # búsqueda exacta por fuerza bruta — siempre correcta, siempre O(n)
    def buscar_exacto(consulta, vectores, k):
        distancias = [(distancia(consulta, v), v) for v in vectores]
        distancias.sort(key=lambda x: x[0])
        return distancias[:k]
    

    Es exacta, nunca se equivoca, y es inviable a escala porque el coste es O(n) por consulta: recalcula distancia contra cada vector, sin excepción.

    Con mil vectores no lo notas. Con diez millones, cada consulta son diez millones de cálculos de distancia antes del primer resultado. Los índices ANN existen para que un vector database evite ese barrido completo.

    HNSW: el grafo en capas que evita mirarlo todo

    HNSW (Hierarchical Navigable Small World) organiza los vectores de tu vector database en un grafo de varias capas, del paper original de Malkov y Yashunin (2016, arXiv:1603.09320). No todos los vectores se conectan entre sí, solo con sus vecinos aproximados —y algunos, al azar, se replican también en capas superiores más dispersas.

    La capa de arriba tiene pocos nodos con conexiones largas. Cada capa hacia abajo tiene más nodos y conexiones más cortas, hasta la capa base, que contiene todos los vectores.

    Buscar es navegar de arriba a abajo: entras por un punto fijo en la capa superior, saltas al vecino más cercano hasta que ninguno mejora la distancia, y bajas una capa. Repites hasta la capa base, donde exploras un grupo más amplio y devuelves los k mejores. Es la lógica de una skip list: saltos largos para acercarte, cortos para afinar. Así el paper logra una complejidad de búsqueda cercana a logarítmica, no lineal.

    Y aquí el trato que nadie lee hasta que le muerde: HNSW hace ANN, no exact nearest neighbor. La navegación golosa —saltar siempre al vecino más próximo— puede quedarse en un óptimo local y devolver el segundo o tercer vecino real, no el primero. No es un bug: es el precio de no comparar contra todo.

    El parámetro que controla cuánto exploras en la capa base suele llamarse ef_search: más candidatos, más cerca del resultado exacto, más lenta la consulta. Cuántos vecinos conecta cada nodo se controla con m. No hay un valor universal para ninguno: depende de tu dataset.

    IVF: particionar el espacio en clusters

    IVF (Inverted File Index) agrupa los vectores en clusters —normalmente con k-means— y guarda, por cada cluster, la lista de vectores que le pertenecen. En la búsqueda comparas primero tu consulta contra los centroides, no contra los vectores, y solo entras en detalle dentro de los clusters más cercanos.

    El parámetro equivalente a ef_search aquí es nprobe (en pgvector, ivfflat.probes): cuántos clusters revisas por consulta. Con nprobe = 1 solo miras el más cercano, con riesgo real de que el vecino real esté en el cluster de al lado. Subir nprobe sube el recall y baja la velocidad — el mismo trade-off que en HNSW, con otro nombre.

    IVF suele pesar menos en memoria porque no guarda un grafo con punteros por vecino en cada capa. A cambio, un buen índice depende de que el k-means inicial refleje bien la forma real de tus datos.

    Qué métrica de distancia usar

    "Cerca" no significa lo mismo según qué mides:

    • Euclidiana (L2): distancia en línea recta. Sensible a la magnitud del vector.
    • Similitud coseno: mide el ángulo entre dos vectores, ignorando su magnitud.
    • Producto interno: combina ángulo y magnitud. Un vector más "largo" puede ganar aunque apunte peor.

    La trampa habitual: si tus embeddings están normalizados (magnitud = 1, lo que hacen muchos modelos por defecto), coseno y producto interno dan el mismo ranking, porque la magnitud es idéntica para todos. Ahí la elección es cuestión de coste computacional, no de cuál es "más correcta". Sin normalizar, euclidiana y coseno sí pueden ordenar distinto —revisa qué asume tu modelo antes de fijar la métrica.

    HNSW vs IVF, cara a cara

    Criterio HNSW IVF
    Velocidad de búsqueda Muy alta, escala cerca de forma logarítmica Alta, depende directamente de nprobe
    Memoria Mayor — grafo de vecinos en cada capa, más los vectores Menor — solo vectores agrupados por cluster
    Recall "de fábrica" Buena incluso con parámetros conservadores Depende mucho de clusters y nprobe
    Coste de construir el índice Alto — cada inserción busca y conecta vecinos Más barato — k-means inicial y asignación por vector
    Actualizaciones (insert/delete) Delicado — en pgvector las tuplas eliminadas quedan en el grafo hasta el VACUUM (issue #244) Más simple, aunque un cambio grande pide re-clusterizar
    Cuándo usarlo Cabe en memoria, latencia mínima consistente Datasets enormes donde la memoria manda

    Ninguno es "mejor" en abstracto: reparten distinto la memoria, la velocidad de construcción y el recall. Es justo el tipo de decisión de arquitectura que discutimos cada semana en Dominicode Labs, donde el trade-off cambia según el caso real, no según la benchmark del paper.

    El trade-off que gobierna todo

    Todo parámetro de un índice ANN —ef_search, m, nprobe, el número de clusters— mueve el mismo dial en direcciones opuestas. Explorar más candidatos sube el recall y sube la latencia. Un grafo más denso o más clusters mejoran la búsqueda, y pesan más en memoria y tardan más en construirse.

    No hay un valor correcto en general para ningún vector database: depende de tu dataset, tu distribución de consultas y cuánta latencia puedes pagar. Sin conocer tu caso, cualquier número es solo un punto de partida para medir tú mismo.

    El how-to práctico de montar búsqueda híbrida con embeddings en Supabase entra en el paso a paso de producción. Este post es el mecanismo de por qué esos números existen.

    Cuándo un vector database NO es la respuesta

    Para filtros exactos y booleanos sigue haciendo falta un índice tradicional. "Dame los documentos del usuario 4821 publicados después del 1 de marzo" no es una pregunta de similitud, es de igualdad y rango, y un B-tree la resuelve mejor. Casi todo motor serio combina ambos.

    ANN nunca garantiza el resultado exacto, ni con parámetros altos. Es la consecuencia directa de no comparar contra todo el dataset: HNSW puede quedarse en un óptimo local, IVF puede dejar el vecino real fuera de los clusters revisados. Sube ef_search o nprobe todo lo que quieras, seguirá siendo una apuesta, no una garantía.

    Reindexar a escala no es gratis. Un HNSW con millones de vectores tarda en construirse, y si tu pipeline lo reconstruye en cada actualización, ese coste se paga en cada despliegue. Es justo lo que describe el hilo de "The Case Against PGVector" en Hacker News: construir el índice puede consumir más de 10 GB de RAM durante horas, y mantenerlo sincronizado con inserciones continuas complica el pipeline entero. El issue de pgvector sobre tuplas muertas es el mismo problema desde otro ángulo.

    Con poco volumen, la fuerza bruta gana. Con unos pocos miles de vectores, mantener un índice ANN puede costar más que comparar contra todo. Mide antes de asumir que necesitas HNSW.

    Qué hacer con esto hoy

    Si tienes un RAG o un agente con búsqueda vectorial en producción, ve a la configuración del índice ahora. Busca ef_search, nprobe o el equivalente en tu motor. Si está en el valor por defecto y nadie lo ha tocado, ese es tu primer sospechoso la próxima vez que un resultado "obvio" no aparezca.

    Y si ese índice te lo montó un agente de IA sin que nadie revisara qué parámetros eligió, ese es el tipo de decisión silenciosa que cubro en el ebook gratuito Revisión por Contrato: límites explícitos a lo que un agente decide por ti sin que lo notes.

    Entender el mecanismo no te ahorra elegir los parámetros, pero deja de sorprenderte que la búsqueda sea aproximada: elegiste velocidad sobre fuerza bruta.

    Si estás construyendo el sistema completo —agente, ingestión, capa de recuperación—, es la decisión de arquitectura que trabajamos en el curso Construye con IA. Y si todavía dudas entre montar un vector database o resolverlo de otra forma, en RAG vs fine-tuning vs contexto: cuándo usar cada uno explico cuándo compensa cada camino.

    Preguntas frecuentes

    ¿Qué es un índice HNSW?

    Un grafo en varias capas que organiza los vectores para no compararlos todos contra todos. La capa superior tiene pocos nodos con conexiones largas; hacia abajo hay más nodos y conexiones más cortas, hasta la capa base con todos los vectores. Del paper original de Malkov y Yashunin (arXiv:1603.09320).

    ¿Por qué la búsqueda vectorial a veces no encuentra el resultado "correcto"?

    Porque HNSW e IVF son índices de approximate nearest neighbor: sacrifican precisión por velocidad. HNSW puede quedarse en un óptimo local; IVF puede dejar el vecino real en un cluster no revisado. No es un fallo, es la consecuencia de no comparar contra todo el dataset.

    ¿Qué métrica de distancia debo usar: coseno, euclidiana o producto interno?

    Con embeddings normalizados (magnitud 1), coseno y producto interno dan el mismo ranking: la elección es cuestión de coste computacional. Sin normalizar, euclidiana y coseno pueden ordenar distinto porque uno considera la magnitud y el otro la ignora.

    ¿Un vector database sustituye a mi base de datos relacional?

    No. Para filtros exactos o por rango —igualdad, fechas, IDs— un índice tradicional sigue siendo más rápido. La mayoría de los sistemas en producción combinan ambos: filtran con índices relacionales y comparan por similitud dentro de ese subconjunto.

    ¿Cuándo compensa usar fuerza bruta en vez de HNSW o IVF?

    Con datasets pequeños —unos pocos miles de vectores— mantener un índice ANN puede costar más que comparar contra todos directamente. La fuerza bruta es O(n) por consulta, pero exacta y sin parámetros que ajustar.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
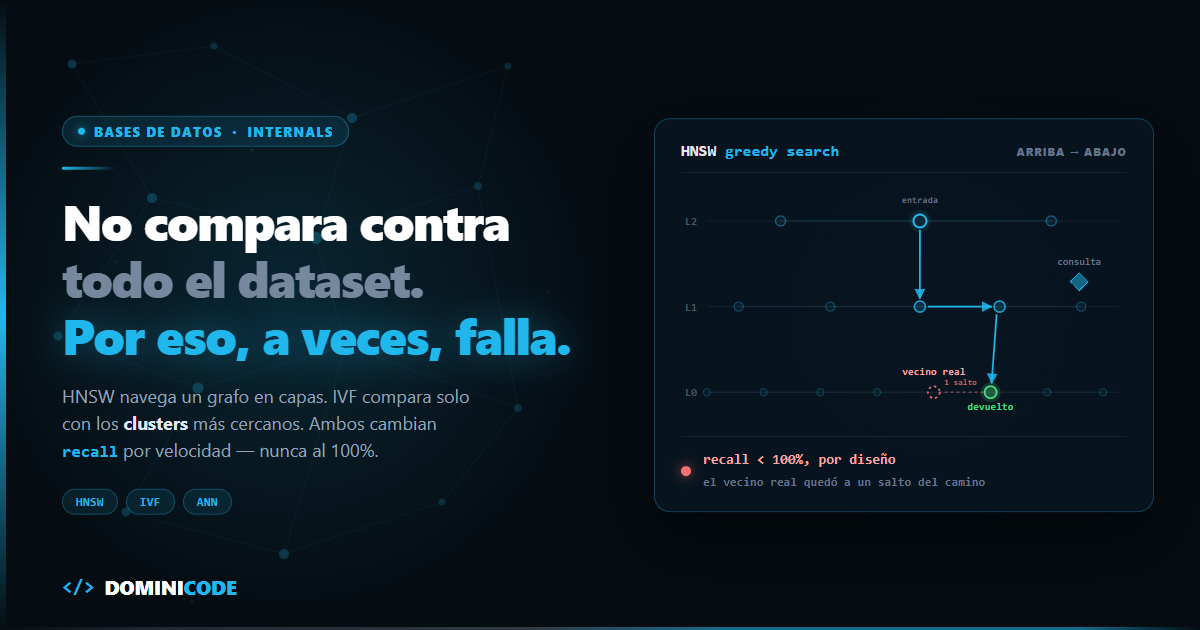
  • Zettelkasten para developers: ahora tus notas las lee un agente

    Zettelkasten para developers: ahora tus notas las lee un agente

    Hace unos meses le pedí a uno de mis agentes que redactara una sección concreta de una guía. Devolvió algo correcto, genérico y absolutamente vacío.

    Lo incómodo es que yo ya había escrito eso. Meses antes. Con el contexto, la decisión y el motivo por el que descarté la alternativa.

    El agente no lo encontró. Y cuando fui a buscarlo yo, tardé veinte minutos: estaba enterrado en la mitad de un markdown gigante sin título propio.

    Ahí entendí que mi problema con el Zettelkasten para developers no era de disciplina. Era de formato.

    La tesis de este post, después de un año largo escribiendo así: el método no ha cambiado nada. Lo que ha cambiado es quién lee las notas.

    En 2021 tomabas notas atómicas para tu yo futuro. En 2026 las tomas también para el agente que las va a recuperar, y ese lector es mucho menos indulgente que tú.

    Por si llegas sin contexto: el método Zettelkasten son las fichas que el sociólogo Niklas Luhmann usó durante décadas para escribir, con una caja de papel y ningún ordenador. Aplicado a programadores, el Zettelkasten para developers es esto: una idea por archivo, en markdown plano, con un título que afirma algo, autocontenida y enlazada a las demás. No es una carpeta de apuntes ordenada. Es un grafo consultable.

    Crédito: en esto me metió Tomas Vik, con su introducción al método y su retrospectiva un año largo después. Lo que viene es mi versión, con mis cicatrices.


    El conocimiento que solo entiendes tú ahora muere dos veces

    Durante años tomé notas como casi todos los programadores que conozco: capturas de pantalla, fragmentos copiados de la documentación, bullets sin verbo, enlaces con un "revisar esto" al lado.

    Eso no es una base de conocimiento, ni gestión del conocimiento personal (PKM). Es un vertedero ordenado alfabéticamente.

    El problema clásico ya era grave: un formato que solo entiendes tú, en el momento exacto en que lo escribiste, deja de entenderse a los tres meses.

    Lo nuevo es la segunda muerte. Si trabajas solo —yo opero Dominicode sin equipo— tus agentes son literalmente tu equipo, y ese equipo lee lo que dejaste escrito. Si lo que dejaste son bullets sin sujeto, tu equipo entero trabaja a ciegas.

    Una nota mal escrita ya no solo te penaliza a ti dentro de seis meses. Penaliza cada ejecución de cada agente que consulta ese repositorio, hoy.


    El Zettelkasten para developers ya no es productividad, es infraestructura

    La nota atómica pasó de consejo de productividad a requisito técnico el día en que dejó de leerte solo tú. Este es el giro que hace que esto merezca un post en 2026 y no en 2015.

    "Sé conciso" y "una idea por nota" eran consejos de higiene mental. Sonaban a gurú de productividad. Se podían ignorar sin consecuencias visibles.

    Hoy son requisitos técnicos de recuperación.

    Cuando indexas tu conocimiento para que un modelo lo consulte —lo que todo el mundo llama RAG— el texto se parte en fragmentos (chunking), esos fragmentos se convierten en embeddings y se recuperan por similitud semántica. Una nota de un solo tema, autocontenida y con un título que afirma algo es exactamente la unidad que ese índice recupera bien: cabe en muy pocos fragmentos y cada uno de esos fragmentos sigue significando algo por su cuenta.

    Una nota-cajón de sastre de cuatro mil palabras hace lo contrario. Se parte por la mitad de un razonamiento. El fragmento recuperado empieza con "por eso lo descartamos" y el sujeto de esa frase se quedó tres páginas más arriba. El modelo recibe un texto gramaticalmente correcto y semánticamente huérfano, y con eso improvisa. A eso lo llamamos alucinación, pero muchas veces es mala segmentación.

    Cómo se recuperan de verdad esos fragmentos —y por qué la búsqueda vectorial pura falla— lo desmonté en búsqueda híbrida y embeddings en producción.

    Nota-cajón Nota atómica
    Temas por archivo Varios Uno
    Título Una etiqueta: "Angular signals" Una afirmación: "Signals no sustituye a RxJS cuando necesitas cancelar una petición en vuelo"
    Al partirse en fragmentos El fragmento pierde el sujeto Cada fragmento sigue significando lo mismo
    Tú dentro de seis meses Hay que releer el archivo entero Decides si la abres sin abrirla
    Tu agente Recupera contexto huérfano e improvisa Recupera la unidad completa

    Mi ancla concreta: la base de conocimiento de Dominicode es un índice de búsqueda sobre markdown plano. Ahora mismo son 118 documentos y 455 fragmentos, repartidos en colecciones por ámbito —agents, _brand, _research, labs, videos, books, revenue— que los agentes consultan antes de escribir sobre cualquiera de esos ámbitos.

    Haz la división: sale por debajo de cuatro fragmentos por documento de media. No es un número mágico —los capítulos de libro tiran de esa media hacia arriba—, pero sí es el síntoma de la política editorial: documentos cortos y monotema. Cuando un archivo se dispara muy por encima de esa media, dentro hay dos o tres notas peleándose por el mismo sitio.

    La infraestructura de todo esto —el repo, la estructura, el gobierno vía CLAUDE.md— la conté en cómo montar un segundo cerebro con Claude Code. Este post va de la capa de encima: qué escribes dentro de cada archivo.


    El título es la nota

    Si me quedo con una sola regla de este año, es esta: el título tiene que afirmar algo, no nombrar un tema.

    No "Angular signals". Eso es una etiqueta.

    Sí "Signals no sustituye a RxJS cuando necesitas cancelar una petición en vuelo". Eso es una nota que puedes recuperar, contradecir o confirmar.

    Un título-afirmación hace tres cosas a la vez. Te obliga a tener una conclusión antes de escribir, en vez de acumular material. Le da al índice la señal más fuerte que va a recibir de ese documento. Y te permite decidir meses después si abres la nota sin abrirla.

    La segunda regla es más dura de lo que parece: la nota tiene que sobrevivir a ser leída sola. Sin la nota anterior. Sin la pestaña que tenías abierta ese día. Sin acordarte del proyecto.

    En la práctica eso significa desterrar los pronombres huérfanos. "Esto no funciona en producción" no es una nota. "El provideHttpClient con interceptores funcionales no captura errores lanzados dentro del resolver de una ruta" sí lo es.

    Así se ve el cambio en un archivo real:

    <!-- Antes: nota-cajón -->
    # Errores HTTP
    
    - esto no funciona en producción
    - revisar interceptores
    - preguntar a alguien
    
    <!-- Después: nota atómica -->
    # El interceptor funcional no captura errores lanzados dentro del resolver de una ruta
    
    `provideHttpClient(withInterceptors([...]))` solo ve lo que pasa por
    `HttpClient`. Si el resolver falla antes de lanzar la petición, el error
    sale por el router y el interceptor nunca se entera.
    
    Alternativa descartada: mover el try/catch a cada componente. Funciona,
    pero hay que repetirlo en cada ruta.
    

    El de abajo es más largo de escribir. Es el único de los dos que sigue sirviendo dentro de un año, y el único que un agente puede recuperar suelto.

    La autocontención es la misma propiedad que hace útil a un fragmento recuperado. Escribes para ti dentro de un año y, sin proponértelo, escribes para un recuperador vectorial. Es el mismo requisito con dos nombres.

    Es la lógica que aplicamos en el curso Construye con IA al montar la capa de contexto de un producto: el modelo no falla por falta de inteligencia, falla porque le llega texto sin sujeto.


    Los enlaces son el trabajo que no puedes delegar

    Enlazar es la única parte del Zettelkasten que no puedes automatizar, y es donde está todo el retorno. Aquí es donde mucha gente se baja.

    Enlazar una nota nueva con las que ya tienes te obliga a responder dos preguntas que no se contestan en piloto automático: ¿dónde encaja esto? y ¿contradice algo que ya escribí?

    La primera es de arquitectura. La segunda es la buena.

    Cuando una nota nueva choca de frente con una de hace ocho meses, ha pasado algo real: o aprendiste, o una de las dos estaba mal, o —lo más habitual— las dos son ciertas en contextos distintos y nunca habías delimitado cuál era cuál. Resolver ese choque suele producir una tercera nota, y esa tercera nota es la única de las tres que vale dinero.

    Ese momento no te lo da un agente. Un modelo te sugiere enlaces plausibles todo el día, y como sugerencia sirven. Lo que no tiene es la sensación de "un momento, esto no cuadra con lo que decidí en marzo". Esa fricción es el aprendizaje. Externalizarla es quedarte con el grafo y perder el motivo por el que existe.

    Lo que sale de ahí es un grafo, con las relaciones como dato de primera clase. Es la idea detrás de qué es graph engineering: la estructura entre las piezas transporta tanta información como las piezas.

    Con un efecto secundario que no esperaba: es el mejor antídoto contra el context drift que he encontrado. Cuando la conversación con el agente lleva dos horas derivando, las notas enlazadas son el punto fijo al que volver. No lo que el modelo cree recordar, sino lo que tú decidiste y escribiste.

    Y si viven en markdown, acaban siendo consultables como datos: notas huérfanas, enlaces rotos, temas que lo acaparan todo. Salud del grafo con una consulta, como conté en DuckDB + Obsidian.


    El coste honesto: esto es lento

    El coste real del método es el tiempo, y toca la parte que casi nadie escribe.

    Escribir así es lento. Mucho más lento que guardar el enlace y seguir. Leer para destilar una nota es más lento que leer, y bastante menos placentero. Dejé libros y documentación técnica a medias porque procesarlos a ese ritmo se volvió un trabajo, no una lectura.

    Y algo dejó de funcionar del todo: la ambición de capturarlo todo. Durante meses convertí en nota cosas que no lo merecían y el grafo se llenó de ruido que empeoraba la recuperación. Más notas no es mejor.

    Ahora tengo tres filtros. Si la respuesta a cualquiera de los tres es sí, no hay nota:

    • ¿Caduca en menos de dos semanas? Es un recordatorio, no conocimiento. Va a un issue, no al grafo.
    • ¿Existe upstream, es estable y está bien escrito? Enlázalo. Reescribir la documentación oficial de una librería es trabajo perdido que además envejece mal.
    • ¿Podrías reconstruirlo en cinco minutos buscando? No es tuyo todavía. Es información disponible, no conocimiento propio.

    Lo que sí merece nota casi siempre es lo mismo: la decisión, la alternativa que descartaste y el porqué. Eso no existe upstream, no está en la documentación de nadie, y es exactamente lo que te vuelven a preguntar dentro de un año.

    Es la misma forma de pensar que sostiene el libro de Spec-Driven Development: escribir la decisión antes que el código, porque la decisión es la parte cara.

    Y un último coste, más traicionero: optimizar el sistema en vez de usarlo. Reorganizar carpetas, cambiar de herramienta, diseñar la taxonomía perfecta. Todo eso se siente productivo y no produce nada.


    Qué cambiaría de mi Zettelkasten si empezara hoy de cero

    Cuatro cosas, y ninguna es instalar nada.

    1. Títulos-afirmación desde la primera nota. Renombrar cientos de archivos después es un trabajo horrible, y hasta que no lo haces la recuperación no mejora.
    2. Escribir pensando en el fragmento, no en el documento. Antes de guardar, pregúntate si un trozo suelto de esa nota, leído sin nada alrededor, sigue significando lo mismo. Si no, pártela.
    3. Colecciones por ámbito, no carpetas por tema. Los temas se solapan siempre y acabas con la misma nota en tres sitios. El ámbito casi nunca es ambiguo, y es lo que te permite filtrar la búsqueda.
    4. La nota de decisión antes que la nota de resumen. Los resúmenes de lo que leí envejecen. Las decisiones que tomé, con su alternativa descartada, siguen valiendo años después.

    Y una cosa que no cambiaría: no delegar los enlaces.


    Empieza por la siguiente nota

    No migres nada. No reorganices el vault. No elijas herramienta.

    Coge la última decisión técnica que tomaste esta semana —esa que discutiste contigo mismo durante veinte minutos— y escríbela como una sola nota, con un título que afirme algo y sin un solo pronombre sin sujeto. Después enlázala con lo más parecido que ya tengas escrito.

    Eso es todo. Repítelo cuando vuelva a pasar.

    Dentro de un año esa nota la vas a leer tú, medio dormido, buscando por qué hiciste lo que hiciste. Y la va a leer un agente que no tiene tu memoria, ni tu contexto, ni tu paciencia. Escríbela para el segundo: el primero sale beneficiado gratis.

    Si quieres el paso siguiente —cómo hacer que un agente use ese conocimiento sin inventarse la mitad— te lo dejé en el ebook gratuito Revisión por Contrato. Y si prefieres verlo montado sobre proyectos reales, con el repo y los agentes funcionando, está en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es exactamente el Zettelkasten para developers y en qué se diferencia de tomar apuntes?

    El Zettelkasten para developers es un sistema de notas atómicas en markdown: una idea por archivo, con un título que afirma algo, autocontenida y enlazada con las demás. La diferencia con tomar apuntes es el enlace. Los apuntes se acumulan en carpetas y se consultan por nombre de archivo; el Zettelkasten forma un grafo donde la relación entre dos notas transporta tanta información como las notas.

    En 2026 hay una segunda diferencia: una nota atómica es también la unidad que un índice vectorial recupera entera. Un apunte largo no.

    ¿Sigue teniendo sentido el Zettelkasten ahora que la IA me resume cualquier cosa?

    Tiene más sentido que antes, y por un motivo distinto al de siempre. La IA resume bien lo que está publicado; no puede resumir la decisión que tomaste tú, con la alternativa que descartaste y el motivo. Eso no existe en ningún corpus.

    Lo que sí cambió es el destinatario. Antes escribías notas atómicas para tu yo futuro. Ahora las escribes también para el agente que las va a recuperar, y ese lector no perdona un pronombre sin sujeto.

    ¿Necesito una herramienta de Zettelkasten o me vale markdown en un repo?

    Te vale markdown en un repo, y es lo que uso. La única condición innegociable es que los archivos sean texto plano y tuyos: eso te da git, búsqueda y la posibilidad de indexarlos para que los lea un agente.

    Las herramientas específicas —Obsidian, Logseq, Roam— aportan comodidad al enlazar y visualizar el grafo. Pero elegir herramienta antes de tener notas es la forma más elegante de no empezar nunca.

    ¿Cuántas notas hacen falta para que esto empiece a servir?

    Menos de las que imaginas para el uso individual, y bastantes más para el efecto de red, que es cuando el grafo te sugiere conexiones que no habías visto.

    No te fijes un número, fíjate una señal: el sistema funciona el día que buscas algo, lo encuentras, y esa nota te resuelve el problema sin abrir nada más.

    ¿No puede el agente resumir mis notas largas y ahorrarme el trabajo?

    Puede resumir. El problema es cuándo. En el momento de la recuperación el agente ya no ve la nota entera: ve los fragmentos que el índice le devolvió —salvo que montes recuperación por documento padre, que es trabajo aparte—, y si están mal cortados el resumen es una reconstrucción sobre material incompleto.

    Usar un modelo para partir notas viejas en notas atómicas sí es buena idea. Lo que no puedes delegar es decidir qué idea va en cada nota, porque esa decisión es el contenido.

    ¿Esto sirve para documentación de equipo o solo para notas personales?

    Sirve para ambas, pero no son lo mismo. La documentación de equipo describe cómo funciona el sistema hoy y se actualiza cuando el sistema cambia. Las notas atómicas capturan por qué se decidió algo y se acumulan sin borrarse.

    Si trabajas en solitario la frontera casi desaparece: tu grafo de decisiones acaba siendo el onboarding de tus propios agentes.

    ¿Qué hago con las notas largas que ya tengo escritas?

    Nada, hasta que las necesites. Migrar el archivo entero es el clásico proyecto que se abandona a la tercera tarde.

    Aplica la regla al vuelo: la próxima vez que abras una nota vieja y te cueste encontrar dentro lo que buscabas, ese es el momento de partirla en dos o tres notas con título propio. Migras solo lo que demuestra que se usa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Abro una app de notas con IA, escribo una pregunta y espero.

    No espero al modelo. Eso lo entiendo: el modelo piensa. Espero a que la app viaje al servidor para leer tres filas de mi propio historial, las traiga de vuelta y solo entonces monte el prompt. Doscientos milisegundos de red para leer datos que ya estaban en mi portátil.

    Ese es el patrón por defecto de casi todas las apps de IA que reviso. La arquitectura local-first le da la vuelta: la base de datos vive en el dispositivo del usuario, la app lee de ahí a velocidad de memoria, y el servidor pasa de ser la fuente de toda verdad a ser un destino de sincronización.

    Aquí va la tesis. Mover la base de datos al cliente no es una optimización: es un cambio de arquitectura que reparte de otra forma la latencia, el coste de tokens y la privacidad, y a cambio te devuelve tres problemas que en el servidor no tenías — una sola conexión, migraciones que corren en máquinas que no controlas, y un camino de escritura hacia el servidor que nadie te da hecho.

    Si terminas de leer sabiendo si te toca o no, el post ha cumplido.

    Qué es la arquitectura local-first

    Local-first es una arquitectura en la que la base de datos vive en el dispositivo del usuario: la aplicación lee y escribe siempre contra esa copia local, a velocidad de memoria, y el servidor deja de ser la fuente de toda verdad para convertirse en un destino de sincronización. La app funciona sin red por defecto, no como caso degradado.

    No es lo mismo que cachear. Una caché es una copia que aceleras y que puedes tirar; en local-first la copia local es donde de verdad ocurre todo, y la red es un detalle de implementación.

    Qué es PGlite y por qué no es "otra base de datos en el navegador"

    PGlite es Postgres compilado a WebAssembly y empaquetado como librería de TypeScript. Corre en el navegador, en Node.js y en Bun, sin dependencias externas y sin proceso servidor.

    La distinción que importa está en su propia documentación: "Unlike previous 'Postgres in the browser' projects, PGlite does not use a Linux virtual machine – it is simply Postgres in WASM."

    Eso no es marketing, es la decisión arquitectónica del proyecto. Los intentos anteriores emulaban una máquina Linux entera para arrancar encima un Postgres normal: pagabas el peso de un sistema operativo simulado para ejecutar un SELECT. PGlite elimina esa capa.

    Los números, para que no tengas que buscarlos:

    • PGlite pesa menos de 3 MB gzipped y corre Postgres compilado a WASM, sin máquina virtual Linux.
    • Persiste en memoria (efímero), en IndexedDB en el navegador, o en el sistema de ficheros en Node y Bun.
    • La versión actual de @electric-sql/pglite es la 0.5.8, publicada el 26 de agosto de 2026, y el plugin de sincronización @electric-sql/pglite-sync va por la 0.6.9.

    Retén ese "0.x". Vuelvo a ello más abajo.

    Qué gana una app de IA con arquitectura local-first

    Una app de IA gana tres cosas al pasar a local-first: latencia de microsegundos en lugar de un round-trip de red, menos tokens por turno porque filtras el contexto donde ya están los datos, y una garantía de privacidad real porque el historial no tiene por qué salir del dispositivo. Ninguno de los tres es "va más rápido" a secas.

    Latencia: microsegundos frente a un round-trip de red

    Los benchmarks oficiales, medidos en un MacBook Air M2 con PGlite en memoria, dan estos tiempos de ida y vuelta por operación: insert de una fila pequeña en 0,058 ms, select en 0,088 ms, update en 0,073 ms y delete en 0,145 ms.

    Compáralo con los 50-200 ms de una llamada HTTP a tu API y el cambio deja de ser cuantitativo: pasa a ser de diseño.

    Cuando leer cuesta microsegundos dejas de diseñar para minimizar consultas. Se acabó cachear tres pantallas por delante, montar endpoints agregados y pintar skeletons.

    Coste de tokens: RAG en el navegador con pgvector

    Este es el eje que más se subestima, y el que de verdad justifica local-first en una app de IA.

    El patrón habitual del chatbot es incómodo cuando lo miras de frente: mandas todo el historial al servidor en cada turno para que el backend reconstruya un contexto que ya estaba entero en el dispositivo del usuario. Pagas tokens por transportar información que no había salido de casa.

    Con un Postgres real en el cliente filtras el contexto en local —con SQL de verdad, joins y filtros por fecha— y mandas al modelo solo lo que importa. Y como PGlite soporta pgvector, ese filtro puede ser búsqueda semántica y no solo un WHERE:

    import { PGlite } from '@electric-sql/pglite'
    import { vector } from '@electric-sql/pglite-pgvector'
    
    const pg = new PGlite({
      extensions: { vector },
    })
    
    await pg.exec('CREATE EXTENSION IF NOT EXISTS vector;')
    

    La consulta por distancia de embeddings corre en el navegador y solo los cinco fragmentos relevantes viajan al modelo:

    SELECT id, content
    FROM chunks
    ORDER BY embedding <-> $1::vector
    LIMIT 5;
    

    Ese <-> es distancia euclídea; si tus embeddings vienen de OpenAI, lo habitual es coseno con <=>. Elige el operador que case con el índice que crees, no el del ejemplo que copiaste.

    Decidir qué entra en el contexto antes de escribir el primer prompt es justo el trabajo que hacemos en el curso de Construye con IA: el prompt no es el sistema, es la última capa.

    Si vienes de montar RAG en servidor, el contraste está en Búsqueda híbrida y embeddings en Supabase — misma técnica, distinto sitio. Y si aún dudas de si tu caso pide RAG, contexto o fine-tuning, esa decisión va antes que esta y la tienes en RAG vs fine-tuning vs contexto.

    Privacidad: los datos no salen del dispositivo

    En una app de notas es un argumento de venta. En salud, legal o finanzas es el requisito que decide si el proyecto existe.

    Con la base de datos en el cliente decides tú qué se sincroniza. Y puedes decidir que nada: si esa tabla no entra en ningún shape, el historial del usuario nunca toca tu infraestructura. Solo sale lo que mandas al modelo, y eso lo controlas con una consulta, no con una política de retención.

    Es la diferencia entre "prometemos que no miramos tus datos" y "no los tenemos".

    Pero ese modo máximo se paga dos secciones más abajo: sin copia en servidor no hay red de seguridad para las migraciones ni multi-dispositivo. Privacidad total y recuperación ante desastres son dos posiciones del mismo mando.

    Cómo queda la arquitectura: PGlite como fuente de verdad local

    PGlite es la fuente de verdad para la UI: la aplicación lee y escribe siempre contra la base local, nunca contra la red. El servidor mantiene su Postgres, que sigue siendo la fuente de verdad del negocio, y las escrituras llegan hasta él por un camino que montas tú. Ahora vuelvo a eso.

    Entre los dos, sincronización basada en shapes. Un shape es un subconjunto de una tabla: no te bajas messages entera, te bajas "los mensajes de las conversaciones de este usuario de los últimos 90 días". El cliente declara qué porción del mundo le interesa y el sync la mantiene al día.

    Y aquí va el matiz que decide presupuestos: ese sync va en una sola dirección. La documentación de pglite-sync no se esconde — "We don't yet support local writes being synced out, or conflict resolution" — y Electric lo remata: hace read-path sync, y no hace write-path sync.

    Traducido: el camino servidor → cliente te lo dan hecho. El camino cliente → servidor lo escribes tú. Cola de escrituras local, reintentos, orden, idempotencia y qué pintas mientras la escritura está en vuelo. Electric documenta cuatro patrones para eso, pero son patrones, no un paquete que instalas.

    Dos límites más de los shapes que conviene saber antes de diseñar: no se pueden sincronizar varios shapes sobre la misma tabla, porque una suscripción necesita poder tirar todos los datos y empezar de cero; y para garantizar consistencia transaccional los datos se agregan en memoria, lo que con shapes muy grandes se nota.

    Encima van las live queries del módulo @electric-sql/pglite/live: registras una consulta y los resultados se actualizan solos cuando cambian los datos, vengan del usuario o del sync. Sin polling y sin invalidación manual de caché.

    Ahí está el efecto secundario grande: desaparece la mitad de tu capa de gestión de estado. El estado del servidor deja de ser algo que cacheas a mano y pasa a ser una tabla que se actualiza. Esa reorganización de responsabilidades la traté en Clean Architecture en Frontend.

    Lo que se te rompe al llevar Postgres al navegador

    Llevar Postgres al navegador te devuelve seis problemas que en el servidor no tenías: una sola conexión, migraciones que corren en dispositivos ajenos, resolución de conflictos sin librería que la resuelva por ti, el peso de arranque, benchmarks que solo valen en memoria y una API todavía en 0.x. Esta es la sección que importa.

    Una sola conexión: el worker no es opcional

    La documentación lo dice sin adornos: "PGlite is single connection only". Y hay un segundo problema encima: si ejecutas PGlite en el hilo principal, bloqueas la UI.

    La solución oficial es el multi-tab worker: una única instancia de PGlite dentro de un Web Worker y una elección de líder que hace de proxy para las peticiones de todas las pestañas abiertas. Cuando la pestaña líder se cierra, se elige otra y se levanta una instancia nueva.

    El worker:

    // my-pglite-worker.js
    import { PGlite } from '@electric-sql/pglite'
    import { worker } from '@electric-sql/pglite/worker'
    
    worker({
      async init() {
        return new PGlite()
      },
    })
    

    Y el cliente:

    import { PGliteWorker } from '@electric-sql/pglite/worker'
    
    const pg = new PGliteWorker(
      new Worker(new URL('./my-pglite-worker.js', import.meta.url), {
        type: 'module',
      }),
    )
    

    Son quince líneas, pero no las trates como boilerplate. Tu base de datos vive ahora detrás de una frontera asíncrona con elección de líder, y eso condiciona cómo pruebas la app y qué ocurre en el segundo en que el usuario cierra la pestaña líder.

    Migraciones de esquema en dispositivos que no controlas

    En el servidor una migración es un evento: la lanzas, corre, se acabó. Hay una base de datos y tú tienes la llave.

    En local-first tienes N versiones del esquema repartidas por dispositivos ajenos. Un usuario abrió la app en marzo y no ha vuelto. Cuando vuelva, su base local está seis migraciones por detrás y esas seis tienen que aplicarse en orden, en su navegador, sin romperse a mitad.

    Esto es lo que se lleva por delante los planes de rollback: no puedes revertir una migración en 8.000 portátiles.

    La consecuencia práctica es que el esquema local evoluciona de forma aditiva casi siempre. Columnas nuevas, no renombradas. Tablas nuevas, no reestructuradas. Y una tabla de versión de esquema desde el día uno, antes de tener usuarios.

    La red de seguridad que sí funciona no es el rollback, es el reset. Si el servidor es la fuente de verdad del negocio, la base local es desechable: ante una migración que no aplica, la borras del dispositivo y vuelves a sincronizar los shapes desde cero. Es feo, tarda y hay que pintarlo bien, pero funciona.

    La letra pequeña: eso solo existe si hay copia en servidor. Si elegiste el modo máximo de privacidad, no hay de dónde resincronizar y cada migración es un disparo único sobre datos irrecuperables. Ahí el esquema aditivo deja de ser buena práctica y pasa a ser la única opción.

    Resolución de conflictos: aquí no hay magia

    Dos dispositivos offline. Los dos editan el mismo registro. Los dos recuperan la red.

    Sí existen librerías que deciden por ti: los CRDT de Yjs, Automerge o Loro convergen sin preguntarte. Pero convergen a una respuesta, no necesariamente a la que tu negocio considera correcta. Un CRDT te garantiza que dos dispositivos acaban iguales; no te garantiza que el saldo resultante sea el que el usuario esperaba. Esa decisión no la delegas.

    Tus opciones reales son tres: last write wins y perder ediciones en silencio, guardar ambas versiones y preguntar al usuario, o modelar los datos para que los conflictos sean estructuralmente imposibles — append-only, eventos en vez de estado, campos con un único dueño. La tercera es la buena, y es una decisión de modelado que tomas antes de escribir código.

    Su contrapartida: una base append-only crece sin techo, y eso choca con la pregunta que cierra este post — si los datos caben en el dispositivo. Compacta por antigüedad o materializa el estado cada N eventos, desde el principio.

    Un detalle que se olvida: lo que llega del sync es entrada externa y merece validarse como el body de una API. Un payload con un campo cambiado por una versión antigua del cliente puede corromper la base local del usuario, y ahí ya no tienes acceso para arreglarlo. Es el escenario exacto para el que trabajamos schemas en el curso de Zod: validar en la frontera, no confiar en el tipo.

    3 MB antes de que el usuario vea nada

    PGlite pesa menos de 3 MB gzipped, y es un coste de arranque real que pagas en el primer render.

    En una app que el usuario abre a diario se amortiza en el primer uso. En una landing con formulario es inaceptable. Cárgalo diferido, después del primer pintado, con un estado de "preparando" que no sea una pantalla en blanco.

    Los 0,058 ms son en memoria

    Aquí es donde muchos posts sobre PGlite venden humo, así que lo digo claro: los benchmarks de PGlite están medidos en memoria; en cuanto persistes a IndexedDB, la foto cambia.

    La propia documentación lo reconoce: "An fsync or flush to the underlying storage can be quite slow, particularly in the browser with IndexedDB for PGlite, or OPFS for wa-sqlite."

    Y es igual de honesta comparándose con SQLite en WASM: "wa-sqlite is faster than PGlite when run purely in memory", aunque "For single row CRUD inserts and updates, PGlite is faster then wa-sqlite", por usar Write-Ahead Log frente al rollback journal de SQLite.

    La doc avisa además de que comparar Postgres con SQLite es difícil y de que sus benchmarks son un punto de partida, no una sentencia.

    Traducción: sigue siendo órdenes de magnitud más rápido que la red, pero mide tus escrituras con persistencia activada antes de prometer nada.

    Sigue en 0.x

    @electric-sql/pglite está en la 0.5.8 y @electric-sql/pglite-sync en la 0.6.9. Pre-1.0 significa que la API puede moverse entre versiones menores.

    No es razón para descartarlo. Es razón para fijar la versión, leer los changelogs antes de actualizar y no esparcir PGlite por medio proyecto sin una capa propia delante.

    Cuándo NO usar local-first (y qué hacer en su lugar)

    La respuesta honesta es que a la mayoría de las apps no les toca.

    Tu situación Qué hacer
    App de IA de uso diario, con historial largo y propio de cada usuario Local-first con PGlite. Es tu caso.
    Datos sensibles que no deberían tocar tu servidor (salud, legal, finanzas) Local-first, y aquí es requisito, no optimización.
    Necesitas funcionar offline de verdad Local-first. No hay alternativa real.
    Datos compartidos que muchos usuarios editan a la vez Servidor. El coste de resolver conflictos se come la ganancia.
    Landing, e-commerce o cualquier app de sesión corta Servidor. 3 MB de arranque para dos consultas no sale.
    Necesitas consultar millones de filas que no caben en el cliente Servidor, con RAG clásico. Los shapes tienen un límite práctico.
    Equipo sin experiencia en sincronización de datos Servidor, hasta que el dolor justifique la curva.
    Tests de integración y CI que hoy levantan Docker con Postgres PGlite en Node o Bun. Sin migraciones ni sync, pero sigue siendo de una sola conexión.

    Esa última fila merece una nota. Aunque tu app no sea local-first, PGlite te sirve hoy en el pipeline: es un Postgres real, arranca en milisegundos y no necesita contenedor. Cambiar docker compose up por una instancia en memoria en tus tests es la puerta de entrada barata a esta tecnología. Con dos límites: al ser de una sola conexión ahí no vas a reproducir deadlocks, bloqueos entre sesiones ni el comportamiento de tu pool; y PGlite trae un catálogo concreto de extensiones, así que comprueba que las de tu esquema estén en la lista antes de tirar el Docker.

    Cómo decidir esto hoy, en diez minutos

    Responde a una sola pregunta: ¿los datos que tu IA necesita para responder son de un único usuario y caben en su dispositivo?

    Si es que sí, local-first con PGlite te saca el round-trip de red de la ruta crítica, te baja los tokens por turno y te da una historia de privacidad que tus competidores no pueden contar. Empieza por el worker, el esquema versionado, el camino de escritura y una estrategia de conflictos escrita antes de crear la primera tabla.

    Si es que no, quédate en el servidor y duerme tranquilo.

    Y si quieres ver este tipo de decisiones discutidas con proyectos reales delante, es lo que hacemos cada semana en Dominicode Labs.

    Preguntas frecuentes sobre local-first con PGlite

    ¿PGlite sustituye a mi Postgres del servidor?

    No. PGlite es un Postgres embebido de una sola conexión, pensado para vivir junto a la aplicación y no para servir a muchos clientes concurrentes. En una arquitectura local-first, PGlite es la fuente de verdad local del dispositivo y tu Postgres del servidor sigue siendo la del negocio: entre ambos hay sincronización —de servidor a cliente te la dan hecha, de cliente a servidor la montas tú—, no sustitución.

    ¿Puedo hacer RAG entero en el navegador con PGlite?

    Sí, siempre que el corpus sea del usuario y quepa en su dispositivo. PGlite soporta pgvector a través del paquete @electric-sql/pglite-pgvector, así que puedes guardar embeddings y hacer búsqueda por similitud en local sin que los documentos salgan del navegador. Lo que no puedes hacer en el cliente es RAG sobre un corpus corporativo de millones de documentos: eso sigue siendo trabajo de servidor.

    ¿Cuánto pesa PGlite y cómo afecta al arranque de la app?

    PGlite pesa menos de 3 MB gzipped. Se carga una vez y luego queda cacheado, pero es un coste real en el primer render, así que conviene cargarlo diferido después del primer pintado. En una app de uso diario se amortiza sin problema; en una página de sesión corta no compensa.

    ¿Qué pasa si el usuario abre la app en dos pestañas?

    PGlite admite una sola conexión, así que dos pestañas no pueden abrir dos instancias sobre la misma base de datos. La solución oficial es el multi-tab worker: una única instancia dentro de un Web Worker y una elección de líder que hace de proxy para todas las pestañas. Cuando la pestaña líder se cierra, se elige otra automáticamente y se levanta una instancia nueva.

    ¿Está listo para producción si sigue en 0.x?

    Depende de tu tolerancia a que la API cambie. @electric-sql/pglite está en la 0.5.8 y el plugin de sync en la 0.6.9, y pre-1.0 significa que puede haber cambios de API entre versiones menores. Hay proyectos en producción con PGlite, pero si entras, fija la versión exacta, lee los changelogs antes de cada actualización y aísla PGlite detrás de una capa propia para que un cambio de API no te toque cincuenta ficheros. Y si vas a hacer RAG en el navegador, mira el eslabón más verde de la cadena: el paquete de pgvector, @electric-sql/pglite-pgvector, va por la 0.0.9.

    ¿En qué se diferencia PGlite de IndexedDB o de SQLite en WASM?

    IndexedDB es un almacén clave-valor sin lenguaje de consultas: cualquier filtro o join lo escribes tú en JavaScript. SQLite compilado a WASM sí te da SQL y en memoria pura es más rápido que PGlite, pero es SQLite: otro dialecto y otras extensiones que las de tu servidor. PGlite es Postgres compilado a WASM sin máquina virtual Linux, así que ejecutas el mismo dialecto y un catálogo de extensiones que se solapa con el de tu servidor —pgvector incluida—, aunque no estén todas las de Postgres. En local-first, esa paridad es lo que evita mantener dos modelos de datos distintos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qué es el graph engineering: el mapa que tu agente no tiene

    Qué es el graph engineering: el mapa que tu agente no tiene

    Le pedí a un agente que renombrara una función. getUserData → fetchUserProfile. Dos minutos de trabajo.

    Hizo grep, encontró siete referencias, las cambió, corrió los tests. Verde. Commit.

    Reventó al día siguiente. La función también se invocaba desde un mapa de handlers, handlers[action], con el nombre viajando como string dentro de un JSON de configuración. Grep encontró siete referencias. Había doce.

    El agente no falló por falta de contexto ni por usar un modelo flojo. Falló porque grep solo compara cadenas y nadie le dio un mapa de relaciones. De eso va el graph engineering.

    Qué es el graph engineering (y el lío que hay con el nombre)

    Graph engineering es la práctica de representar tu código y tu documentación como un grafo explícito de relaciones: los nodos son símbolos —archivos, funciones, clases, conceptos— y las aristas son las relaciones reales entre ellos: importa, llama, hereda, contiene, referencia.

    En vez de que el agente busque texto y adivine, navega aristas.

    Antes de seguir, un aviso honesto: el término no tiene una definición canónica única en 2026. Se usa para dos cosas distintas.

    La primera es el grafo de orquestación. Nodos como unidades de ejecución, aristas como flujo de control: LangGraph, org graphs, work graphs. Ahí el "graph engineering" es diseñar cómo se conectan varios agentes. Es la conversación que arrancó Peter Steinberger en julio de 2026 con una pregunta de seis palabras — "Are we still talking loops or did we shift to graphs yet?" — y que es la continuación natural de lo que conté en loop engineering.

    La segunda es el grafo de recuperación. Nodos como símbolos de tu código, aristas como dependencias reales. Aquí no se decide qué agente actúa después: se decide qué sabe el agente antes de tocar nada.

    Este post va de la segunda. Y no compiten: una es control de flujo, la otra es recuperación. Misma palabra, dos capas del stack.

    Si necesitas el atajo: cuando hables de LangGraph o de coordinar varios agentes, es la primera. Cuando hables de qué código ve tu agente antes de editar, es la segunda.

    Las tres preguntas que ni grep ni los embeddings responden

    Hay tres preguntas sobre tu código que ni la búsqueda por texto ni la búsqueda semántica pueden responder:

    1. Si cambio esto, ¿qué se rompe? El radio de impacto a uno, dos o tres saltos. Grep te da el primer nivel. El transitivo no lo ve nadie.
    2. ¿Quién llama a quién? El call graph completo, con su dirección. Grep te dice que dos archivos mencionan AuthService. No te dice cuál lo consume y cuál lo define.
    3. ¿Qué depende de qué — y qué no depende de nada? Los nodos con grado cero son código muerto, y salen solos. Buscar código muerto con grep es un ejercicio de paciencia.

    Las tres son preguntas sobre topología, no sobre contenido. Por eso hacen falta aristas — y por eso las dos herramientas que usas hoy se quedan cortas.

    Tu agente tiene dos formas de encontrar código, y las dos tienen el mismo agujero.

    Grep busca coincidencia exacta de texto. Es preciso, rápido y determinista. No sabe nada de significado ni de estructura. Si la referencia está construida en runtime, no existe para grep.

    Los embeddings buscan parecido semántico. Encuentran la función de autenticación aunque se llame verificarCredenciales. Pero "se parece" no es "está conectado con". Un chunk sobre logging y otro sobre logging viven cerca en el espacio vectorial aunque uno nunca llame al otro. Es la limitación estructural de RAG que ya toqué en RAG vs fine-tuning.

    Las dos herramientas responden "¿dónde aparece esto?". Ninguna responde "¿con qué está conectado esto?".

    Resumido, con la tercera vía al lado:

    Grep Embeddings Grafo de código
    Pregunta que responde ¿Dónde aparece esta cadena? ¿Dónde hay algo parecido a esto? ¿Con qué está conectado esto?
    Qué necesitas saber antes El nombre exacto Una descripción aproximada Que el símbolo exista
    Ve el segundo salto No No Sí — affected --depth 2
    Ve llamadas indirectas No No Sí, marcadas como INFERRED
    Nivel de certeza Binario: aparece o no aparece Puntuación de similitud EXTRACTED o INFERRED
    Coste de mantenerlo Cero Reindexar + coste de embeddings Re-extracción AST, sin LLM
    Dónde se rompe La referencia se construye en runtime Dos cosas se parecen pero no se llaman Código muy dinámico: DI por string, metaprogramación

    Anatomía del grafo: nodos, aristas y confianza

    Un grafo de código tiene tres piezas: nodos (los símbolos: archivos, funciones, clases), aristas (las relaciones entre ellos) y un nivel de confianza por arista.

    Lo concreto. Construí un grafo con graphify —CLI open source, parseo AST local con tree-sitter, sin vector store— sobre un proyecto pequeño que tengo por ahí. Pequeño a propósito: quería poder verificar a mano cada arista antes de creerme nada. Salieron 115 nodos y 240 aristas.

    Los nodos llevan poco: id, etiqueta, archivo de origen y línea. Lo interesante está en las aristas.

    {
      "source": "src_chunker",
      "target": "src_chunker_needs_chunking",
      "relation": "contains",
      "confidence": "EXTRACTED",
      "source_file": "src/chunker.py",
      "source_location": "L10"
    }
    

    Los ocho tipos de relación que aparecieron en ese grafo:

    Relación Qué conecta ¿La ve grep?
    imports / imports_from Archivo → módulo o símbolo importado Sí, si el nombre aparece literal
    contains Archivo → función o clase que declara Parcialmente
    calls Función → función que invoca Solo el primer nivel
    references Símbolo usado sin invocarlo Sí, si el nombre aparece literal
    inherits Clase → clase base Sí
    method Clase → método que le pertenece Sí
    indirect_call Llamada resuelta en runtime No

    Fíjate en la última fila. indirect_call es exactamente la llamada que grep no ve.

    Y ahora el campo que más me interesa de todo esto, el que casi nadie menciona: confidence. Cada arista viene marcada como EXTRACTED o INFERRED. En mi grafo: 197 extraídas, 43 inferidas.

    EXTRACTED significa que la relación está literalmente en el AST. El parser la leyó, no la dedujo. INFERRED significa que la resolvió el motor uniendo puntos — una llamada cuyo destino tuvo que deducirse.

    Eso cambia cómo usas el resultado. Una arista EXTRACTED la das por buena. Una INFERRED es una hipótesis con nombre y apellidos que puedes ir a verificar al archivo y la línea que te da. Ni los embeddings ni grep te dan esa distinción: grep afirma sin matices, y el score de un embedding te dice cuánto se parece algo, nunca de dónde sale la relación. Aquí lo que se etiqueta es la procedencia.

    Un explain sobre un nodo devuelve esto:

    Node: needs_chunking()
      Source:    src/chunker.py L10
      Degree:    6
    
    Connections (6):
      <-- main() [calls] [INFERRED]
      <-- transcribe() [calls] [INFERRED]
      <-- chunker.py [contains] [EXTRACTED]
      --> Path [references] [EXTRACTED]
      <-- test_needs_chunking_false_for_small_file() [calls] [INFERRED]
      <-- test_needs_chunking_true_for_large_file() [calls] [INFERRED]
    

    Seis líneas. Ahí está el vecindario directo de esa función, con la dirección de cada arista y el nivel de confianza de cada una. Para llegar a lo mismo con grep necesitas varias pasadas y saber de antemano qué buscar.

    Pero el vecindario directo no es el radio de impacto. Para eso hay un comando aparte, que es el que responde literalmente a la pregunta 1: un recorrido inverso por las aristas que tú elijas, a la profundidad que tú digas.

    graphify affected "needs_chunking" --depth 2 --relation calls
    
    Affected nodes for needs_chunking()
    Relations: calls
    Depth: 2
    - test_needs_chunking_false_for_small_file() [calls] tests/test_chunker.py:L24
    - test_needs_chunking_true_for_large_file() [calls] tests/test_chunker.py:L30
    - main() [calls] transcribe.py:L17
    - transcribe() [calls] watch.py:L36
    - test_output_flag_saves_to_specified_path() [calls] tests/test_integration.py:L34
    - test_file_not_found_exits_with_code_1() [calls] tests/test_integration.py:L48
    - test_unsupported_format_exits_with_code_1() [calls] tests/test_integration.py:L55
    - test_api_key_not_in_output() [calls] tests/test_integration.py:L65
    - .on_created() [calls] watch.py:L72
    

    Mira la diferencia. De las seis conexiones del explain, solo cuatro eran llamadas entrantes. El affected a dos saltos da nueve, y las cinco nuevas son las interesantes: los cuatro tests de integración y el handler .on_created() del watcher no tocan needs_chunking directamente, llegan a través de main() y transcribe().

    Ese es el segundo nivel. El que revienta en producción al día siguiente y el que ninguna búsqueda por texto te va a dar, porque no hay ninguna cadena que buscar: la relación existe en la topología, no en el código fuente de esos archivos.

    Aquí está la tesis, y quiero decirla sin vender humo: el grafo no te garantiza encontrar la referencia indirecta. Te da una categoría donde esa relación puede existir y quedar marcada. Grep ni siquiera tiene esa categoría. Esa es toda la diferencia, y es suficiente.

    Cómo usar un grafo de código con un agente de coding, en 3 pasos

    Tres piezas.

    Uno: construyes el grafo y lo dejas en el repo. graphify-out/graph.json más un reporte en markdown. Es un artefacto de tu proyecto, como el lockfile.

    uv tool install graphifyy   # doble "y" mientras reclaman el nombre en PyPI;
                                # el comando y el skill siguen siendo graphify
    graphify install            # registra el skill en tu agente
    graphify update .           # re-extrae solo lo que cambió, sin LLM
    

    Dos: le das al agente una regla de precedencia. Sin esto no sirve de nada, porque el modelo tira de grep por costumbre. En el CLAUDE.md del proyecto:

    - Para preguntas sobre el código, ejecuta primero `graphify query "<pregunta>"`.
      Usa `graphify path "<A>" "<B>"` para relaciones, `graphify explain "<X>"`
      para un concepto concreto y `graphify affected "<X>"` antes de modificar o
      borrar algo. Devuelven un subgrafo acotado, mucho más pequeño que el reporte
      completo o la salida cruda de grep.
    - Después de modificar código, ejecuta `graphify update .`.
    

    Esa regla es la diferencia entre tener un grafo y usarlo. Es la misma idea de fondo que trabajo en el curso de Construye con IA: el agente no es más listo por tener más herramientas, sino por tener reglas claras de cuándo usar cuál.

    Tres: el grafo entra en la ventana como subgrafo, no como volcado. Un explain devuelve seis líneas donde un grep te vuelca cada aparición del término y tú decides después: recuperas menos tokens y mejores, que es el objetivo del context engineering.

    Ojo con una cosa: graphify query no devuelve una respuesta en prosa. Devuelve un recorrido BFS con los nodos encontrados. Es una herramienta de recuperación dentro del harness, no un chatbot. Quien interpreta el subgrafo sigue siendo el modelo.

    Y un apunte de higiene: el proyecto publica cifras de benchmark en su README. Son autoreportadas. Trátalas como lo que son y mide en tu repo.

    Cuándo NO merece la pena montar un grafo de código

    No todo proyecto necesita esto. Cuatro casos donde el grafo estorba más de lo que ayuda.

    Proyectos pequeños. Si el código entra entero en la ventana, el agente ya tiene el grafo en la cabeza y mejor resuelto. Montar recuperación para veinte archivos es sobreingeniería.

    Código muy dinámico. Metaprogramación intensa, inyección de dependencias por string, event buses, decoradores que reescriben comportamiento en runtime. El AST no puede ver lo que solo existe cuando el proceso arranca. El grafo saldrá con más aristas INFERRED que EXTRACTED, o directamente con huecos. Sigue siendo mejor que grep, pero baja mucho el techo.

    Y sí: el bug con el que abrí este post vive justo en esta frontera. Un nombre viajando dentro de un JSON no está en ningún AST. Lo que cambia es que el grafo marca ese hueco como INFERRED o lo deja sin arista, y eso es una señal que puedes leer. Grep te devuelve siete referencias con la misma cara de seguridad que si fueran las doce.

    Si no puedes mantenerlo actualizado. Un grafo obsoleto es peor que no tener grafo, porque el agente confía en él. Necesitas graphify update en un hook de pre-commit, en CI o con graphify watch. Si esto no está automatizado, no lo montes: en dos semanas tienes un mapa de un territorio que ya no existe.

    Si lo que buscas es "qué debería hacer este sistema". El grafo describe el código que existe, no la intención. Para eso el artefacto es la spec — que es, por cierto, otra forma de estructura explícita, y la razón por la que escribí el libro de Spec-Driven Development. El grafo cuenta el presente. La spec define el futuro.

    Y un apunte de madurez: graphify va por la 0.9.x. No es 1.0 todavía, y se nota. Herramienta útil, no infraestructura estable.

    Cómo empezar con graph engineering hoy

    Coge tu repo más feo. El que da miedo tocar.

    Construye el grafo, ejecuta un explain sobre la función que más te intimida y mira su grado. Si el número te sorprende, acabas de descubrir por qué ese refactor lleva meses aplazado.

    El mismo razonamiento sale del código y funciona con lo que sabes: si tus notas son un grafo en vez de una carpeta, se recuperan igual de bien. Lo conté en Zettelkasten para developers.

    Si quieres ver cómo encaja esto con el resto del stack —agentes, MCP, memoria, specs— lo trabajamos a fondo en Dominicode Labs, con proyectos reales y no con ejemplos de juguete.

    Preguntas frecuentes

    ¿Graph engineering es lo mismo que GraphRAG?

    No exactamente. GraphRAG es la implementación de Microsoft que usa un LLM para extraer entidades y relaciones de texto no estructurado, detectar comunidades y resumirlas. Está pensado para corpus documentales.

    Graph engineering es el concepto general de estructurar conocimiento como grafo. Aplicado a código, el grafo se extrae del AST de forma determinista, sin LLM y sin coste por token. GraphRAG es una implementación posible, no la única ni la más barata para código.

    ¿Qué diferencia hay entre graph engineering y loop engineering?

    El loop engineering diseña el bucle de ejecución del agente: qué hace, cómo verifica el resultado y cuándo vuelve a intentarlo. El graph engineering, en la acepción de este post, diseña lo que el agente sabe antes de entrar en ese bucle: un mapa de relaciones de tu código en vez de una búsqueda de texto.

    No compiten. Un agente con un buen bucle y sin mapa repite el mismo error más rápido. Si tus fallos vienen de contexto estructural incompleto, el grafo rinde antes que otra iteración del loop.

    ¿Funciona con TypeScript o solo con Python?

    Los ejemplos de este post salen de un proyecto en Python, pero la extracción es por AST con tree-sitter y las gramáticas que trae cubren los lenguajes habituales: Python, TypeScript, JavaScript, Go, Rust, Java, C, C++, Ruby, C#, Kotlin, Scala y PHP.

    Con TypeScript hay un matiz: cuanto más tira el proyecto de inyección por token, decoradores y factories, más aristas caen en INFERRED. El grafo sigue siendo mejor que grep, pero léelo sabiendo qué parte es hipótesis.

    ¿Necesito una base de datos de grafos como Neo4j?

    Para un repo, no. El grafo de un proyecto normal cabe en un JSON en disco y se recorre con un BFS en memoria. Herramientas como graphify funcionan así, sin servidor y sin dependencias externas.

    Neo4j tiene sentido cuando el grafo es un producto en sí mismo, se consulta desde varios servicios o supera lo que quieres cargar en memoria. Para dar contexto estructural a un agente en tu máquina, es infraestructura que no necesitas.

    ¿El grafo sustituye a los embeddings y a la búsqueda semántica?

    No, y montarlo como sustituto es un error. Responden preguntas distintas.

    Los embeddings responden "¿dónde hay algo parecido a esto?" y toleran que no sepas los nombres exactos. El grafo responde "¿con qué está conectado esto?" y exige que el símbolo exista. Lo razonable es tener las dos vías y una regla de precedencia: para preguntas de estructura, grafo; para exploración difusa, semántica; para strings literales, grep.

    ¿Cada cuánto hay que reconstruir el grafo?

    En cada cambio de código relevante, y automatizado. La re-extracción incremental de código no necesita LLM, así que el coste es tiempo de CPU, no dinero.

    Lo práctico es un hook de pre-commit, un paso en CI o un proceso en watch mientras trabajas. Reconstruirlo a mano cuando te acuerdas es la vía rápida a un grafo obsoleto, y un grafo obsoleto le miente al agente con toda la confianza del mundo.

    ¿Sirve en monorepos grandes?

    Es donde más rinde, precisamente porque el código ya no cabe en la ventana de contexto y grep devuelve ruido. La pega es operativa: la visualización HTML se vuelve pesada por encima de unos miles de nodos, y para eso está la opción de saltarla y quedarte solo con el JSON consultable, que es lo que consume el agente.

    Y si tu organización tiene varios repos en vez de uno solo, puedes fusionar sus grafos en uno para cruzar dependencias entre paquetes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.