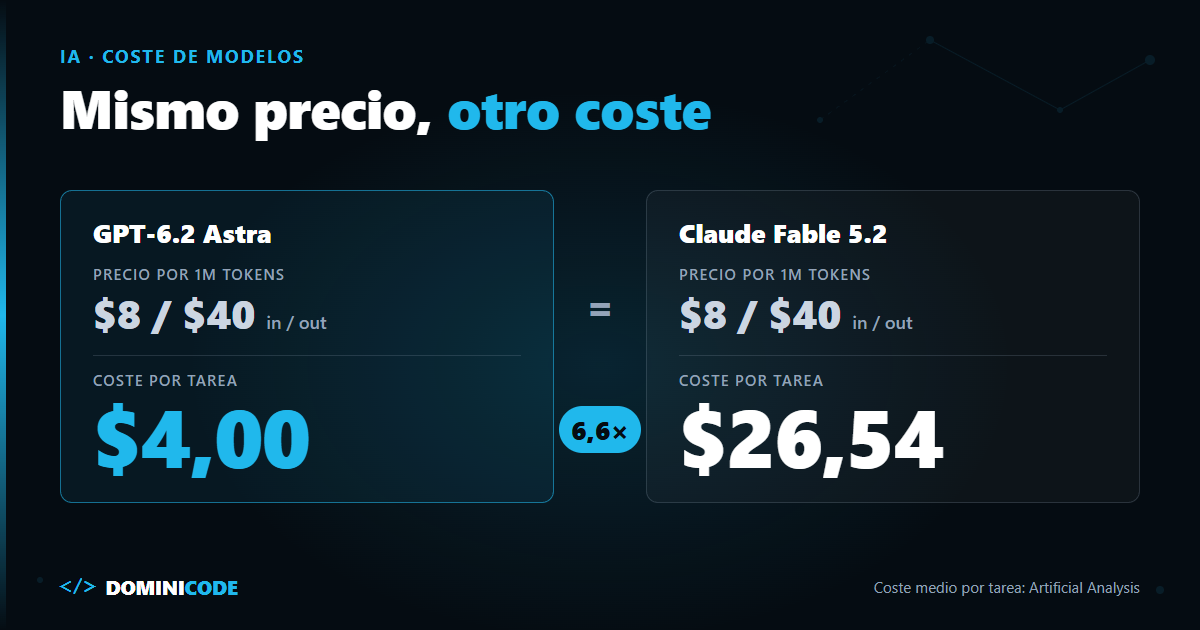
El 17 de noviembre OpenAI publicó el precio de GPT-6.2 Astra en la API: $8 por millón de tokens de entrada y $40 de salida.
Ese número te suena: es exactamente lo que cobra Claude Fable 5.2 desde que Anthropic le bajó el precio. Mismo input, mismo output, al céntimo.
Y aquí empieza el problema. Hasta el 17 de noviembre de 2026, cualquier comparativa tipo GPT-6.2 Astra vs Claude Fable 5.2 arrancaba por la tabla de precios. Ahora esa tabla dice "empate". Si sigues decidiendo por el precio por token, vas a elegir a ciegas.
En corto: GPT-6.2 Astra y Claude Fable 5.2 cuestan lo mismo por token ($8/$40), pero no por tarea: en Artificial Analysis, Astra sale a $4,00 y Fable a $26,54, con 62 puntos de índice frente a 65. Con prompts por debajo de 272.000 tokens, Astra es el primer candidato a medir para agentes de volumen; por encima de ese umbral, o si necesitas el techo de calidad, Fable justifica su coste.
¿Qué es GPT-6.2 Astra?
GPT-6.2 Astra es el modelo frontier de OpenAI para trabajo profesional y agéntico complejo, lanzado el 17 de noviembre de 2026 junto a GPT-6.2 Sol, su modelo eficiente para el día a día.
Ambos están en ChatGPT Work, en Codex y en la API como gpt-6.2-astra y gpt-6.2-sol. Astra baja un 20 % respecto a GPT-6 Astra ($10/$50 entonces) y Sol se queda en $2/$10. Si quieres el contexto del lanzamiento anterior, lo conté en GPT-6 Astra: precio, API y el asterisco de los 272.000 tokens.
GPT-6.2 precio API: lo que cambia y lo que no
El precio base de GPT-6.2 Astra empata con Fable 5.2, pero la letra pequeña no: caché y contexto largo van en direcciones opuestas.
La ficha oficial del modelo confirma $8 de input, $0,40 de input cacheado, $10 por escritura de caché y $40 de output. Y confirma que el asterisco sigue ahí: si una request supera los 272.000 tokens de input, el input pasa a $16 y el output a $60, para toda la request.
Anthropic va por el otro lado. Según su página de precios, Fable 5.2 cobra lo mismo por token en todo su contexto de 1M. Una request de 900.000 tokens paga la misma tarifa que una de 9.000.
GPT-6.2 Astra vs Claude Fable 5.2: la tabla de decisión
Con el precio por token empatado, la comparación útil es el coste por tarea, el contexto y el riesgo de cada uno.
El coste por tarea es lo que pagas, sumando todas las requests, para que un modelo termine una tarea completa: depende del precio por token y, sobre todo, de cuántos tokens de input y output consume hasta acabar.
| Criterio | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Input / output (por 1M) | $8 / $40 | $8 / $40 |
| Lectura de caché (por 1M) | $0,40 | $0,20 |
| Más de 272.000 tokens de input | $16 / $60, toda la request | Sin recargo hasta 1M |
| Precio mezclado (7:2:1 caché/input/output) | $5,88 | $5,74 |
| Intelligence Index (AA, variante Max) | 62 | 65 |
| Coste medio por tarea (AA) | $4,00 | $26,54 |
| Tokens de output en el índice | 65,8M | 275M |
| Tiempo medio por tarea (AA) | 14,3 min | 41,5 min |
| Modelo pequeño del mismo proveedor a $2/$10 | GPT-6.2 Sol: 57 puntos, $1,01 por tarea | Sonnet 5.5: 55 puntos, $10,02 por tarea |
| Limitación o riesgo | Recargo ×2 de input y ×1,5 de output por encima de 272.000 tokens; usuarios que señalan sobreingeniería | El más caro por tarea del índice (puesto 94 de 94 en coste); 4 breaking changes desde 5.1 |
Fuentes: AA GPT-6.2 Astra, AA Fable 5.2, AA GPT-6.2 Sol, AA Sonnet 5.5, consultadas el 20 de noviembre de 2026.
Fíjate en dos filas. El precio mezclado difiere en 14 céntimos: Fable es incluso un 2,4 % más barato por token gracias a su caché. Pero el coste por tarea es 6,6 veces mayor ($26,54 / $4,00).
La diferencia no está en la tarifa. Está en cuántos tokens quema cada modelo para terminar. Fable generó 275M de tokens de output en el índice; Astra, 65,8M. Eso es 4,2 veces más salida, y salida a $40 el millón.
El contexto largo da la vuelta a la cuenta
Por encima de 272.000 tokens de input y con los mismos tokens, Fable 5.2 pasa a ser más barato por request que GPT-6.2 Astra, a veces casi la mitad.
Haz la cuenta con una request sin caché de 10.000 tokens de output:
| Input de la request | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| 270.000 tokens | $2,16 + $0,40 = $2,56 | $2,16 + $0,40 = $2,56 |
| 300.000 tokens | $4,80 + $0,60 = $5,40 | $2,40 + $0,40 = $2,80 |
Treinta mil tokens más y Astra cuesta casi el doble que Fable. Si tu agente arrastra el repositorio entero en cada turno, ese umbral importa más que cualquier benchmark.
¿Cuál es mejor para coding y agentes?
En coding la ventaja de Fable 5.2 se estrecha, y el coste por tarea depende tanto del harness como del modelo.
En la tabla de benchmarks que recopila DataCamp, con cifras reportadas por los fabricantes, Fable 5.2 saca 49,1 % en FrontierCode 2.0 frente al 44,2 % de Astra. Astra gana en Agents' Last Exam v1.1 (78,3 % frente a 72,8 %).
Lo útil está en el hilo de Hacker News del lanzamiento, con más de 860 comentarios. El usuario ariwilson pasó su propio benchmark de 30 tareas de bugs y features, dos ejecuciones por modelo: Astra y Fable resolvieron 54 de 60 cada uno. Astra a $1,11 por arreglo, Fable a $1,78.
Ojo a ese número. En su harness la diferencia es de 1,6 veces, no de 6,6. El coste por tarea de Artificial Analysis no es el tuyo. Por qué un benchmark público no sustituye a tus tareas lo detallé en los benchmarks de IA para programar que sí importan en 2026.
Y el comportamiento tampoco es igual. Otro usuario, CSMastermind, lo resume en una línea: "I actually have the problem with Fable stopping too early on tasks but Astra way overengineers things".
Routing: el empate real está en los modelos pequeños
El modelo pequeño cambia más la cuenta que el flagship: GPT-6.2 Sol y Sonnet 5.5 cuestan los mismos $2/$10, pero Sol sale a $1,01 por tarea y Sonnet a $10,02.
En el benchmark de ariwilson, GPT-6.2 Sol resolvió 50 de 60 a $0,31 por arreglo: cuatro tareas menos que Astra a menos de un tercio del coste.
Si haces routing, lo que conté en GPT-6.1 Sol vs GPT-6 Astra sigue valiendo: el modelo pequeño se queda con el grueso del tráfico y el flagship entra solo cuando la tarea lo pide. Lo que no debes hacer es comparar proveedores por la tarifa. Mide tus tareas:
type ModelId = 'gpt-6.2-astra' | 'gpt-6.2-sol' | 'claude-fable-5-2' | 'claude-sonnet-5-5';

interface Price { input: number; cachedInput: number; output: number } // USD por 1M tokens

const PRICES: Record<ModelId, Price> = {
  'gpt-6.2-astra':     { input: 8, cachedInput: 0.40, output: 40 },
  'gpt-6.2-sol':       { input: 2, cachedInput: 0.10, output: 10 },
  'claude-fable-5-2':  { input: 8, cachedInput: 0.20, output: 40 },
  'claude-sonnet-5-5': { input: 2, cachedInput: 0.10, output: 10 },
};

// Normaliza el usage de cada SDK a esto: en OpenAI los cacheados van dentro
// de input_tokens; en Anthropic, cache_read_input_tokens va aparte.
interface TurnUsage { uncachedInput: number; cachedInput: number; output: number }

function turnCost(model: ModelId, u: TurnUsage): number {
  const p = PRICES[model];
  const prompt = u.uncachedInput + u.cachedInput;
  // OpenAI: por encima de 272k de input, input y caché x2 y output x1,5 en toda la request.
  // Asumo que el umbral cuenta también lo cacheado: compruébalo con tu factura.
  const longCtx = model.startsWith('gpt-') && prompt > 272_000;
  const inMul = longCtx ? 2 : 1;
  const outMul = longCtx ? 1.5 : 1;
  return (
    (u.uncachedInput * p.input * inMul +
      u.cachedInput * p.cachedInput * inMul +
      u.output * p.output * outMul) / 1_000_000
  );
}

// Coste de una tarea = suma de todos sus turnos (sin escrituras de caché).
export const taskCost = (model: ModelId, turns: TurnUsage[]) =>
  turns.reduce((acc, t) => acc + turnCost(model, t), 0);
Pasa 20 o 30 tareas reales por cada modelo, guarda el usage de cada turno y compara taskCost dividido entre tareas resueltas. Ese número, no la tarifa, es el que decide. Es la misma disciplina que aplicamos en Construye con IA: primero defines qué es "tarea resuelta" y después mides.
Cuándo NO cambiar de modelo
Cambiar de Fable 5.2 a GPT-6.2 Astra solo por el coste por tarea del índice es mala idea en al menos cuatro casos.
Los rankings son de la primera semana. Las cifras de Artificial Analysis se consultaron el 20 de noviembre de 2026, tres días después del lanzamiento, y los benchmarks de la tabla de DataCamp los reportan los propios fabricantes.
Wccftech informa de que en el Coding Agent Index de Artificial Analysis Astra 6.2 se queda en 53, como GPT-6 Astra; la web de AA no muestra ese dato en abierto, así que tómalo con pinzas. Según el mismo artículo, Tibo, de OpenAI, explicó en X que algunas personas tuvieron acceso anticipado a una versión que cambió en los últimos días antes del lanzamiento.
Tu harness no es el de Artificial Analysis. El caso de ariwilson lo demuestra: 6,6 veces en el índice, 1,6 veces en su benchmark. Si tu agente ya está afinado para Claude Code (prompts, tools, hooks), migrar a Codex cuesta horas de ingeniería que no salen en ninguna tabla.
Tus prompts pasan de 272.000 tokens. Ahí Astra paga doble input y 1,5 veces el output en toda la request. Un agente que trabaja con contexto enorme puede salir más caro en Astra aunque gaste menos tokens.
Estás a mitad de migración a 5.2. Si acabas de pelearte con los cuatro breaking changes que describí en Claude Fable 5.2: precio, breaking changes y routing, cambiar de proveedor ahora es abrir otro frente.
Cómo elegir entre GPT-6.2 Astra y Fable 5.2 hoy
Si hoy pagas Fable 5.2 para todo, no migres el agente: monta la medición. Coge las 30 últimas tareas de tu backlog que el agente resolvió bien, pásalas por GPT-6.2 Astra y GPT-6.2 Sol con el snippet de arriba, y compara coste por tarea resuelta.
Si Astra empata en calidad y tus prompts viven por debajo de 272.000 tokens, tienes un ahorro real. Si no, ya sabes por qué pagas Fable.
La pieza que convierte esto en algo repetible es tener escrito qué cuenta como "resuelto": una spec con criterios de aceptación, que es lo que explico en el libro Spec-Driven Development. Si quieres el método completo para diseñar agentes con evals y tools, lo tienes gratis en el ebook El Developer Agéntico.
Preguntas frecuentes
¿Cuánto cuesta GPT-6.2 Astra en la API?
GPT-6.2 Astra cuesta $8 por millón de tokens de input, $0,40 por input cacheado, $10 por escritura de caché y $40 por millón de output. Si una request supera los 272.000 tokens de input, el input pasa a $16 y el output a $60 para toda la request, según la ficha oficial de OpenAI.
¿GPT-6.2 Astra es mejor que Claude Fable 5.2?
No en la clasificación general: en el Intelligence Index de Artificial Analysis, Fable 5.2 saca 65 y Astra 62. Pero Astra cuesta $4,00 por tarea frente a $26,54 de Fable. En coding, benchmarks de usuarios como el de ariwilson en Hacker News los dejan empatados en tasa de acierto, con Astra más barato.
¿Por qué cuestan lo mismo por token y tan distinto por tarea?
Porque el coste por tarea depende de cuántos tokens consume el modelo para terminar. En el índice de Artificial Analysis, Fable 5.2 generó 275M de tokens de output frente a 65,8M de Astra. A $40 el millón de output, esa diferencia pesa mucho más que el precio de la caché.
¿Qué modelo pequeño conviene para routing, GPT-6.2 Sol o Sonnet 5.5?
Ambos cuestan $2/$10 por millón de tokens. En Artificial Analysis, GPT-6.2 Sol saca 57 puntos a $1,01 por tarea y Sonnet 5.5 saca 55 a $10,02. Si tu stack ya es Claude, mide antes de mezclar proveedores: el coste de mantener dos SDK y dos cachés también cuenta.
¿A partir de cuántos tokens GPT-6.2 Astra sale más caro que Fable 5.2?
A partir de 272.000 tokens de input por request. Por encima de ese umbral, OpenAI cobra $16 de input y $60 de output en toda la request, mientras Fable 5.2 mantiene $8/$40 hasta 1M de contexto. Con 300.000 tokens de input y 10.000 de output, Astra cuesta $5,40 y Fable $2,80.
Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
Leave a Reply