Tag: Anthropic Claude

  • GPT-6 Sol y Luna: el precio por token es la mitad de la factura

    GPT-6 Sol y Luna: el precio por token es la mitad de la factura

    El martes 22 de septiembre de 2026 Anthropic sacó Claude Opus 5.5 con un recorte del 20%. Horas después, OpenAI respondió con GPT-6 Sol y Luna, dos modelos a mitad de precio que sus equivalentes GPT-5.6.

    Mi primer impulso fue el de todo el mundo: abrir el .env, cambiar el nombre del modelo y apuntarme el ahorro. Una línea, la mitad de factura.

    Luego me acordé de un post que escribí hace poco. Gemini 3.8 Flash mantuvo el precio por token y aun así la factura subió un 40%. El precio de la tarifa y lo que acabas pagando no son lo mismo.

    Con GPT-6 el recorte de los titulares te ahorra menos que dos decisiones de diseño que no salen en ninguna nota de prensa.

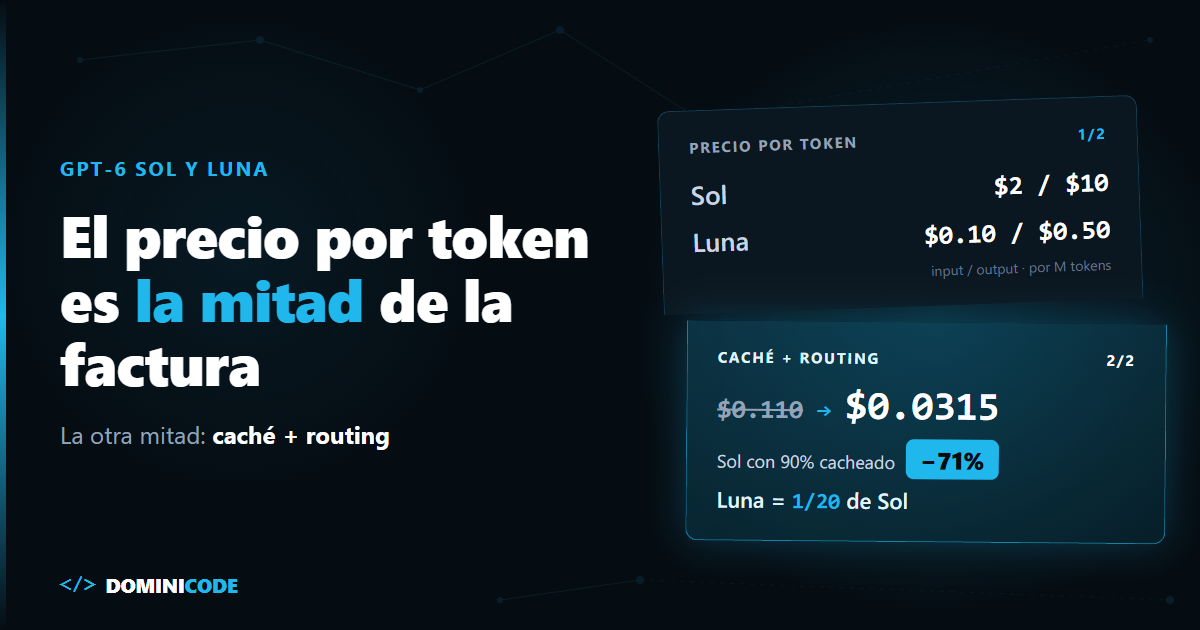
    En corto: GPT-6 Sol ($2/$10 por millón de tokens) y Luna ($0.10/$0.50) cuestan la mitad que GPT-5.6, pero en un agente lo que más mueve la factura es la caché: si el 90% del input de cada llamada sale de la caché, cada llamada a Sol cuesta un 71% menos que sin ella. La otra palanca es el routing: Luna cuesta exactamente 1/20 de Sol en cada tarifa, así que la extracción y la clasificación deberían ir a Luna.

    Precio de GPT-6 Sol y Luna frente a Claude Opus 5.5

    GPT-6 Sol cuesta $2 por millón de tokens de input y $10 de output; Luna, $0.10 y $0.50; Claude Opus 5.5, $4 y $20. Datos de las fichas oficiales de GPT-6 Sol, GPT-6 Luna y la página de precios de Anthropic.

    GPT-6 Sol GPT-6 Luna Claude Opus 5.5
    Input (por M) $2 $0.10 $4
    Input cacheado (por M) $0.20 $0.01 $0.20
    Escritura de caché (por M) $2.50 $0.125 (1,25× input) $5 (caché de 5 min)
    Output (por M) $10 $0.50 $20
    Para qué Coding, agentes, planificación Extracción, clasificación, resúmenes en volumen Briefs complejos donde la fidelidad manda
    Limitación / riesgo Menos fiel que Opus en briefs ricos; recargo por encima de 272K tokens de input Pierde ~45 Elo en AA-Briefcase: entregables que omiten partes de la rúbrica El doble que Sol por token; en tareas largas, mucho más lento

    Fíjate en la fila del input cacheado. Sol y Opus 5.5 cobran lo mismo: $0.20. En un agente donde casi todo el input sale de la caché, la diferencia de "la mitad de precio" se estrecha bastante.

    La fila de limitaciones no me la invento. Artificial Analysis midió que Luna cae unos 45 puntos Elo en su benchmark de entregables, mientras Sol se mantiene. Y en la prueba de Gekkode con la misma escena 3D, ambos cumplieron los 13 requisitos. Pero Opus 5.5 fue más fiel al brief y tardó 38 minutos ($6.96), frente a los 5 minutos ($0.29) de Sol.

    ¿Qué es el prompt caching en GPT-6 y por qué manda en un agente?

    El prompt caching es la reutilización del prefijo idéntico de un prompt (instrucciones, definiciones de tools, historial) entre llamadas: el proveedor no lo vuelve a procesar y te lo cobra con descuento, que en GPT-6 es del 90% sobre el input.

    Un agente reenvía todo el contexto en cada turno. Si empieza siempre igual, pagas tarifa de caché. Si cambia un token al principio, pagas todo otra vez. El mecanismo es el mismo que expliqué en prompt caching en la API de Claude; lo que cambia en GPT-6 son las tarifas y las reglas que invalidan la caché.

    En el hilo de Hacker News del lanzamiento (más de 850 comentarios) lo resumió alguien que tiene agentes de negocio en producción. El usuario MitziMoto escribió: "Cache reads are so heavy compared to anything else that it's the only price point that really matters, regular input and output are negligible." Para su carga, la lectura de caché es el único precio que importa.

    El cálculo: el mismo agente con y sin caché

    Supuestos, para que puedas rehacerlo tú. Cada llamada del agente lleva 50.000 tokens de input: 45.000 son prefijo estable (instrucciones, tools, historial anterior) y 5.000 son nuevos (mensaje del usuario y resultado de tools). Devuelve 1.000 tokens de output. Hace 30.000 llamadas al mes.

    Con el 90% del input de cada llamada en caché, los 45.000 se leen a tarifa de caché y los 5.000 nuevos se escriben (en modo implícito, la guía de OpenAI indica que se escribe hasta el último mensaje) a 1,25× el input.

    Escenario GPT-6 Sol Claude Opus 5.5
    Sin caché, por llamada $0.110 $0.220
    90% del input cacheado, por llamada $0.0315 $0.054
    Sin caché, 30.000 llamadas/mes $3300 $6600
    90% del input cacheado, 30.000 llamadas/mes $945 $1620

    Las cuentas de Sol con caché: 45.000 × $0.20/M = $0.009, más 5.000 × $2.50/M = $0.0125, más 1.000 × $10/M = $0.010. Total, $0.0315. Frente a $0.110 sin caché: un 71% menos.

    Sin caché, Opus 5.5 cuesta exactamente el doble que Sol. Con caché, 1,71 veces ($0.054 / $0.0315). El "50% más barato" depende de cómo esté hecho tu agente.

    Y lo que más duele: si metes un timestamp al principio del system prompt, el prefijo cambia en cada llamada. En modo implícito escribes los 50.000 tokens cada vez a $2.50/M: $0.135 por llamada, $4050 al mes. Pagas un 23% más que sin caché. Un new Date() mal colocado se come el recorte de precio entero: pagas más que con GPT-5.6 bien cacheado.

    Ojo: los tokenizadores de Anthropic y OpenAI no cuentan igual; la columna de Opus asume los mismos tokens. Mide los tuyos como explico en cómo medir el consumo de tokens de un agente.

    Routing de modelos para agentes: GPT-6 Sol para pensar, Luna para procesar

    El routing de modelos en dos niveles consiste en decidir el modelo por tipo de tarea antes de llamar: un modelo capaz para planificar, programar y revisar, y uno barato para extraer, clasificar y resumir en volumen.

    Luna cuesta 1/20 de Sol en input, en input cacheado y en output. Una extracción de un solo turno con 3.000 tokens de prefijo cacheado, 1.000 de documento nuevo y 300 de salida (en modo explícito, con el breakpoint al final del prefijo, el documento se cobra a tarifa normal sin recargo de escritura) cuesta $0.0056 en Sol y $0.00028 en Luna. Un millón de extracciones: $5600 contra $280.

    Una regla de la guía de prompt caching de OpenAI cambia el diseño del router: cambiar de model invalida el prefijo cacheado, igual que cambiar las tools, el reasoning.effort o el text.verbosity. No alternes Sol y Luna en la misma conversación: enruta por tarea, cada una en su hilo.

    Este código usa la Responses API. Los campos prompt_cache_key, prompt_cache_options y prompt_cache_breakpoint salen de los ejemplos de esa guía, consultada el 27 de septiembre de 2026. Si tu SDK todavía no los tipa, van en el cuerpo JSON tal cual.

    type Task = 'plan' | 'code' | 'review' | 'extract' | 'classify' | 'summarize';
    type Model = 'gpt-6-sol' | 'gpt-6-luna';
    
    const ROUTES: Record<Task, Model> = {
      plan: 'gpt-6-sol',
      code: 'gpt-6-sol',
      review: 'gpt-6-sol',
      extract: 'gpt-6-luna',
      classify: 'gpt-6-luna',
      summarize: 'gpt-6-luna',
    };
    
    const SINGLE_TURN = new Set<Task>(['extract', 'classify', 'summarize']);
    
    // Estable: sin fechas, sin nombre de usuario, sin nada que cambie entre llamadas.
    const INSTRUCTIONS: Record<Task, string> = { /* un bloque fijo por tarea */ } as Record<Task, string>;
    const TOOLS = Object.freeze([/* mismas tools, mismo orden, siempre */]);
    
    type InputItem = Record<string, unknown>;
    
    export function buildRequest(task: Task, history: InputItem[], turn: string, sessionId: string) {
      return {
        model: ROUTES[task],
        prompt_cache_key: SINGLE_TURN.has(task) ? `${task}_v1` : `${task}_v1:${sessionId}`,
        prompt_cache_options: { mode: SINGLE_TURN.has(task) ? 'explicit' : 'implicit' },
        tools: TOOLS,
        input: [
          {
            role: 'developer',
            content: [
              {
                type: 'input_text',
                text: INSTRUCTIONS[task],
                prompt_cache_breakpoint: { mode: 'explicit' },
              },
            ],
          },
          ...history, // append-only: nunca se edita, reordena ni resume a mitad de sesión
          { role: 'developer', content: `Fecha actual: ${new Date().toISOString()}` }, // lo dinámico, al final — guárdalo en history junto al turno o la próxima llamada no reutiliza el historial
          { role: 'user', content: turn },
        ],
      };
    }
    

    Tres decisiones que importan más que el código:

    1. Lo dinámico va al final. La guía lo dice literal: las marcas de tiempo y el contenido de usuario, al final o en mensajes posteriores.
    2. El historial es append-only. Si compactas o reescribes turnos antiguos, rompes el prefijo desde ese punto. Eso incluye el mensaje con la fecha: si lo envías pero no lo guardas en el historial, la siguiente llamada deja de coincidir justo ahí.
    3. Mide el hit rate en cada respuesta. Divide usage.input_tokens_details.cached_tokens entre usage.input_tokens y alerta si baja. Vigila también cache_write_tokens: si en cada llamada escribes casi todo el input, algo cambia al principio del prompt. OpenAI ha sacado un dashboard de caché y una herramienta de diagnóstico de fallos, pero tu propio log te avisa antes.

    La salida de Luna en extracción no te la creas sin más. Valídala con un schema y, si falla, reintenta esa tarea en Sol, en un hilo nuevo. Es el mismo patrón de fallback que conté en Opus 5.5, rechazos y fallback en producción. Para el schema uso Zod: tipas y validas en una sola pieza, como enseño en el curso de Zod.

    Límites: cuándo NO usar Luna, ni Sol, ni este router

    Luna no sirve para entregables largos. La caída de ~45 Elo en AA-Briefcase viene, según Artificial Analysis, de entregables que se saltan elementos de la rúbrica. Si la tarea es "redacta el informe completo", Luna ahorra en tokens y te lo cobra en revisiones.

    Sol y Luna tienen letra pequeña en Chat Completions. Sus fichas indican que ahí el function calling exige reasoning_effort en none. Si necesitas razonar y llamar tools a la vez, usa la Responses API.

    Sol no sustituye a Opus 5.5 cuando el brief es rico. Si un fallo de calidad te cuesta más que la diferencia de tokens, paga la diferencia.

    Contextos largos, tarifa distinta. Por encima de 272.000 tokens de input, Sol y Luna cobran el doble en input y caché y 1,5× en output, y lo aplican a toda la petición. Es el mismo asterisco de los 272.000 tokens de GPT-6 Astra.

    El router no arregla un agente mal medido. Si no sabes cuánto cuesta cada tarea terminada y aceptada, no sabes si Luna te ahorra o te obliga a repetir trabajo. Artificial Analysis lo mide por tarea, no por token: Sol a $1.06 por tarea en su índice y Luna a $0.07. Esa es la unidad que importa.

    Lo que puedes hacer hoy

    Abre el log de tu agente y calcula una sola cifra: tokens cacheados entre tokens de input totales, en la última semana. Si baja del 80%, busca qué cambia al principio del prompt antes de pensar en cambiar de modelo. Casi siempre es una fecha, un ID o unas tools que se reordenan.

    Con esa cifra alta, manda las tareas mecánicas a Luna con validación. En ese orden.

    Este diseño, en el que el programa decide qué va a cada modelo y el modelo solo decide dentro de su tarea, es el que desarrollo en El Developer Agéntico, el ebook gratuito de Dominicode. Y si quieres montar el agente completo, de la idea al producto, está en el curso Construye con IA.

    Preguntas frecuentes

    ¿Cuánto cuestan GPT-6 Sol y GPT-6 Luna?

    GPT-6 Sol cuesta $2 por millón de tokens de input, $0.20 de input cacheado y $10 de output. GPT-6 Luna cuesta $0.10, $0.01 y $0.50. Los dos son la mitad o menos que GPT-5.6, y por encima de 272.000 tokens de input se aplica recargo.

    ¿GPT-6 Sol es más barato que Claude Opus 5.5?

    Por token, sí: la mitad en input y output. Pero los dos cobran $0.20 por millón en input cacheado, así que en un agente con mucha caché la diferencia baja. En el cálculo del post, de 2× sin caché a 1,71× con el 90% del input cacheado.

    ¿Puedo cambiar entre Sol y Luna en la misma conversación?

    Puedes, pero pierdes la caché. La guía de OpenAI indica que cambiar el modelo invalida el prefijo cacheado. Enruta por tarea, con un hilo por tarea, en lugar de alternar modelos dentro del mismo hilo.

    ¿Qué rompe la caché de prompts en GPT-6?

    Cualquier cambio en el prefijo: un timestamp o un dato de usuario al principio, tools que cambian de orden o de descripción, o un cambio de reasoning.effort o text.verbosity en la petición. Para cambiar el esfuerzo de razonamiento sin romperla, la guía propone añadir un elemento configuration_update al input.

    ¿Para qué tareas conviene GPT-6 Luna?

    Para trabajo acotado y en volumen: extracción, clasificación, resúmenes cortos. Valida su salida con un schema y escala a Sol lo que no pase. Evítalo en entregables largos con muchos requisitos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Opus 5.5: el riesgo no es el modelo, son sus guardarraíles

    Claude Opus 5.5: el riesgo no es el modelo, son sus guardarraíles

    Lanzas la migración un jueves por la noche con Claude Opus 5.5. Cuarenta y dos paquetes, un monorepo que nadie ha tocado desde 2023, el agente corriendo en un runner con presupuesto para ocho horas.

    Viernes por la mañana abres el log. Veintiséis paquetes migrados. El veintisiete, vacío. No hay stack trace. No hay catch que haya saltado. No hay un solo 4xx en las métricas del runner.

    Lo que hay es una respuesta HTTP 200, perfectamente válida, con el array content vacío.

    Y tú buscando durante hora y media un bug que no existe.

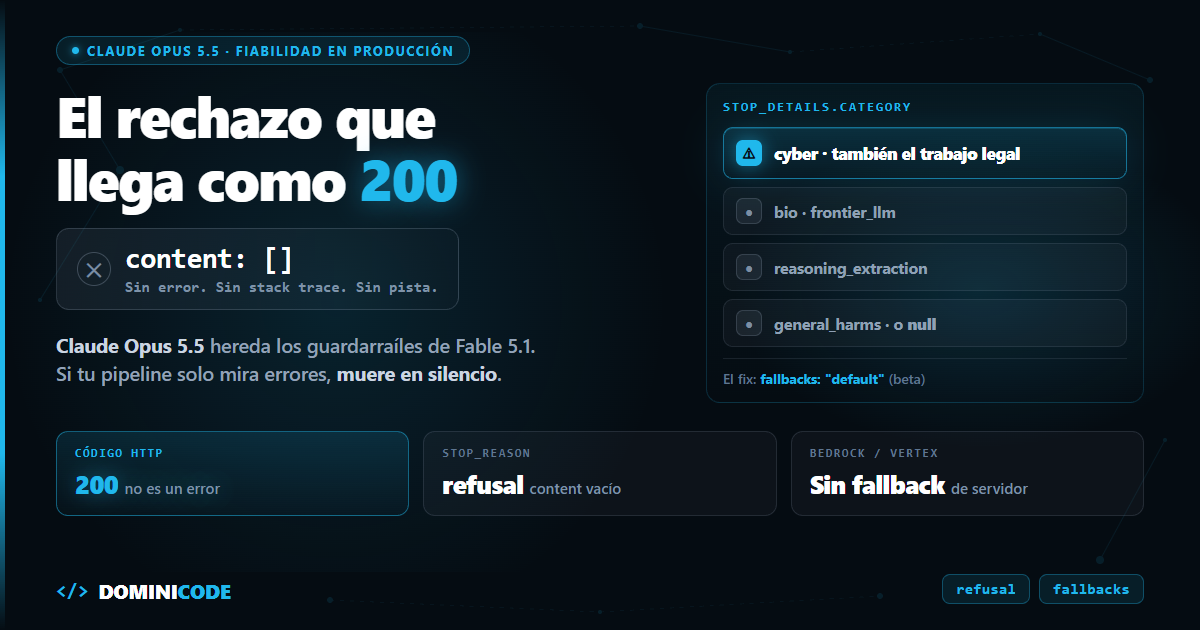
    En corto: Claude Opus 5.5 lleva el mismo sistema de clasificadores de seguridad que Fable 5.1, Fable 5 y Opus 5, y cuando uno de ellos declina una petición no recibes un error: recibes un HTTP 200 con stop_reason: "refusal" y content vacío. Si tu código solo maneja códigos de error, un flujo agéntico largo se corta en silencio a mitad. El arreglo cabe en dos líneas —el parámetro fallbacks, en beta— pero no está disponible en Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry ni en la API de lotes.


    ¿Qué es un refusal en Claude Opus 5.5 y por qué llega como HTTP 200?

    Un refusal es una respuesta HTTP 200 en la que un clasificador de seguridad de Claude ha declinado la petición: stop_reason vale "refusal" y el array content llega vacío. Un objeto stop_details acompaña a esa respuesta y nombra la categoría de política que saltó.

    No es una excepción. No es un 400. No es un 403. Es exactamente la misma forma de respuesta que usas para leer un resultado bueno, con el contenido quitado.

    Esto aplica a Claude Fable 5.1, Fable 5, Opus 5.5 y Opus 5: los cuatro llevan clasificadores que pueden declinar una petición, según la documentación de refusals de Anthropic. Y en las dos categorías más agresivas, Anthropic sitúa a Opus 5.5 —lanzado el 22 de septiembre de 2026— al nivel del modelo más restringido de su catálogo: "Because Opus 5.5 is comparable to Claude Mythos 5.1 in biology and cybersecurity, we're deploying it with safeguards similar to those on Claude Fable 5.1", dice la nota de lanzamiento.

    Lo miden contra un modelo y le ponen los frenos de otro.

    Así se ve una respuesta declinada — es el ejemplo de la documentación, con el modelo cambiado a Opus 5.5:

    {
      "id": "msg_01XFUDYJgAACzvnptvVoYEL",
      "type": "message",
      "role": "assistant",
      "model": "claude-opus-5-5",
      "content": [],
      "stop_reason": "refusal",
      "stop_details": {
        "type": "refusal",
        "category": "cyber",
        "explanation": "This request was declined because it could enable cyber harm."
      },
      "usage": {
        "input_tokens": 412,
        "output_tokens": 0
      }
    }
    

    Fíjate en content: []. Si tu código hace response.content[0].text, ahí revienta con un TypeError a doscientos kilómetros del sitio donde está el problema real. Y si lo haces con optional chaining, te devuelve undefined y sigue como si nada, que es peor.

    El guard son cinco líneas, y van antes de tocar el contenido:

    if (response.stop_reason === 'refusal') {
      logger.warn('refusal', { category: response.stop_details?.category ?? 'unknown' })
      throw new RefusalError(response.stop_details)
    }
    
    const text = response.content[0].text
    

    Las 5 categorías de refusal: cyber, bio, frontier_llm, reasoning_extraction y general_harms

    stop_details.category nombra qué guardarraíl ha saltado. Son cinco, y la columna de la derecha es la que conviene leer despacio:

    category Qué la dispara Por qué te puede tocar sin buscarlo
    cyber Malware, desarrollo de exploits La doc admite que el trabajo legítimo de ciberseguridad también la dispara. Un parser de entrada, un sanitizador, un test de inyección
    bio Métodos de laboratorio peligrosos Igual: "Beneficial life sciences work can also trigger this category"
    frontier_llm Ayudar a desarrollar modelos competidores Restringido por los términos comerciales. Trabajo normal de machine learning también la dispara
    reasoning_extraction Pedirle que reproduzca su razonamiento interno en el texto Si tu prompt dice "explica paso a paso cómo has llegado ahí", estás en zona gris
    general_harms Cualquier otra área de la política de uso El cajón de sastre. También puede saltar con trabajo benigno

    Y un detalle que no está en ninguna tabla: category y explanation pueden venir null. La documentación avisa de que ese null es un valor normal y permanente, no un hueco por rellenar. Es decir: puedes recibir un rechazo sin saber de qué categoría.

    explanation viene en texto legible, pero la doc es explícita en que el texto no es estable: se muestra, no se parsea. Si montas lógica sobre esa cadena, se te rompe en la siguiente actualización.

    Hay un cuarto campo que el JSON de arriba no muestra: recommended_model, el modelo que Anthropic sugiere para esa categoría. Es el que usa el fallback del servidor — y el que tienes que leer tú si estás en Bedrock o Vertex y te toca montarlo en cliente. Llega solo en peticiones que piden fallbacks, y la doc avisa de que es una pista, no una garantía.


    Por qué un refusal rompe un flujo agéntico en silencio

    Que un modelo decline una petición sensible es discutible, pero es una decisión de producto. El problema de ingeniería es otro, y es que el rechazo tiene forma de éxito.

    Pasa esto:

    1. Tu agente lleva seis horas migrando. Va por el paquete 27.
    2. El diff de ese paquete toca el middleware de autenticación. El clasificador cyber se activa.
    3. La API devuelve 200. Tu cliente HTTP está encantado. Tu métrica de errores, plana.
    4. El paso 27 produce una cadena vacía, y el bucle agéntico —que confía en su propia salida— sigue adelante con eso.

    Ese cuarto punto es el caro. En un bucle agéntico en producción, la salida de un paso es el contexto del siguiente. Un vacío no propaga una excepción: propaga basura.

    Hay dos detalles de facturación que conviene tener claros, porque cambian cómo instrumentas esto:

    • Un rechazo que llega antes de cualquier salida no se factura. content viene vacío y los tokens aparecen en usage pero no se cobran. Eso sí: cuenta contra tus rate limits.
    • Un rechazo a mitad de streaming sí se factura: los tokens de entrada y lo que ya se había emitido, a precio normal. Y la doc lo dice claro — esa salida parcial hay que descartarla, no aprovecharla.

    Así que el escenario de verdad desagradable no es ninguno de los dos anteriores: es el agente que reintenta a ciegas. Los rechazos tempranos no los pagas, pero cada reintento te come rate limit, y el bucle se queda girando contra una pared invisible. Si no estás midiendo el consumo de tokens de tu agente, no te enteras hasta que llega el 429 — o hasta que abres el log a la mañana siguiente.


    Cómo manejar un refusal: el parámetro fallbacks de la API de Claude (beta)

    Anthropic tiene fallback en el servidor, en beta. Le pones fallbacks: "default" y la cabecera beta, y cuando el modelo primario declina, la API reintenta la misma petición en el modelo que Anthropic recomienda para esa categoría, dentro de la misma llamada:

    import Anthropic from '@anthropic-ai/sdk'
    
    const client = new Anthropic()
    
    const response = await client.beta.messages.create({
      model: 'claude-opus-5-5',
      max_tokens: 1024,
      messages: [{ role: 'user', content: 'Hello, Claude' }],
      fallbacks: 'default',
      betas: ['server-side-fallback-2026-07-01']
    })
    
    console.log(response.model) // el modelo que realmente respondió
    

    response.model es la clave: te dice quién contestó de verdad, que no tiene por qué ser el que pediste. Para saber si el fallback llegó a entrar hay que mirar usage.iterations buscando una entrada de tipo fallback_message, y confirmarlo con que stop_reason ya no sea "refusal":

    const huboFallback = (response.usage.iterations ?? [])
      .some(it => it.type === 'fallback_message')
    
    const loSirvioElFallback = huboFallback && response.stop_reason !== 'refusal'
    

    También puedes nombrar hasta tres modelos de fallback propios en lugar de dejar el enrutado por defecto. Y si una categoría no tiene fallback recomendado, el rechazo se mantiene: el parámetro no es un interruptor de "quítame los guardarraíles".

    Dónde NO funciona fallbacks: Bedrock, Vertex, Foundry y Batches API

    Aquí está la letra pequeña, y es la parte que decide tu arquitectura:

    Plataforma / modo ¿fallbacks funciona? Qué hacer
    API de Claude, petición normal ✅ Sí, en beta fallbacks: "default" + cabecera beta
    Amazon Bedrock ❌ No Fallback en cliente, leyendo stop_details.recommended_model
    Google Cloud Vertex AI / Microsoft Foundry ❌ No Igual: middleware del SDK y recommended_model
    Message Batches API ❌ No El item del lote vuelve como resultado erróneo. Ojo si procesas en batch
    HTTP crudo o retry propio ➖ N/A Reintento manual + fallback credit para no pagar dos veces la caché

    Ese último punto de la tabla es el que más dinero cuesta ignorar: si te montas el reintento a mano y el prompt cacheado es grande, pagas la caché dos veces. El fallback en servidor y el middleware del SDK aplican el crédito por ti.


    Cuándo NO deberías meter Opus 5.5 en un flujo largo

    La nota de lanzamiento vende justamente lo contrario: "handles long, sprawling jobs like codebase-wide migrations".

    Pero en el hilo de Hacker News del lanzamiento —más de 1.400 puntos y cerca de 900 comentarios— hay un testimonio que va exactamente al grano de este post. Lo cuenta bushido:

    "The safeguards really don't work well for a lot of long-running tasks on old code bases. A lot of my workloads last days to weeks and the single biggest risk to the workflow is random safeguards."

    El mismo comentarista describe el bucle más incómodo: el propio modelo emite algo que a su clasificador no le gusta, y toca reiniciar la conversación.

    raesene9, que trabaja en seguridad, es más tajante sobre por qué no los usa para su campo:

    "I've found their guardrails so twitchy (especially Anthropic) that I wouldn't try to use them for even vaguely security related work."

    Y kqp documenta un falso positivo que da la medida del problema: preguntó si una cita genérica rompía reglas de puntuación y se lo bloquearon. Reformular la frase para no usar la palabra "rules" lo arregló.

    Tres situaciones concretas donde yo no lo pondría sin red:

    1. Migraciones desatendidas de días sobre código legacy. No por la calidad del modelo. Es que en un recorrido de cientos de pasos no eliges el contenido que vas a tocar: basta con llegar a una zona sensible —middleware de autenticación, criptografía, deserialización— para que el clasificador salte. Y ahí reintentar no sirve de nada, porque el mismo diff dispara el mismo clasificador. A eso se suma lo que describe bushido, que sí es impredecible: que el guardarraíl se active sobre la salida del propio modelo. Ninguna de las dos cosas la ves hasta la mañana siguiente.
    2. Cualquier cosa que roce seguridad, aunque sea defensiva: sanitizar entrada, revisar dependencias, escribir tests de inyección. El guardarraíl cyber no distingue intención.
    3. Procesamiento en lotes de contenido heterogéneo. El parámetro fallbacks no existe en la API de lotes, así que ahí el rechazo se queda como está y el item vuelve como error.

    Ojo, esto no es un argumento para usar otro modelo: los clasificadores no son exclusivos de Anthropic. Es un argumento para tratar el rechazo como un estado esperado de tu sistema, no como una anomalía.


    Lo que los benchmarks de Opus 5.5 no miden

    Los números del lanzamiento son buenos y no hay por qué discutirlos. En Terminal-Bench 4.0, Opus 5.5 saca un 66,4% frente al 52,3% de Opus 5 — y por encima de GPT-6 Astra (57,9%) y de Fable 5.1 (55,8%).

    Claude Opus 5.5 Claude Opus 5
    Entrada / salida (1M tokens) $4 / $20 $5 / $25
    Lectura de caché (1M tokens) $0,20 $0,50
    Terminal-Bench 4.0 66,4% 52,3%
    Clasificadores de seguridad Sí, al nivel bio/ciber de Mythos 5.1 Sí
    fallbacks en la API de Claude Sí, en beta Sí, en beta
    Limitación / riesgo Se vende para migraciones de días, y es ahí donde más superficie das a que salte un guardarraíl Un 20% más caro por token y 14 puntos por debajo en Terminal-Bench

    Fuente: nota de lanzamiento de Opus 5.5, 22 de septiembre de 2026.

    Fíjate en la fila de la caché, porque explica el titular: los tokens bajan un 20%, pero las lecturas de caché bajan un 60%. De ahí sale el "40% más barato" que anuncia Anthropic — y solo lo ves entero si buena parte de tu factura eran lecturas de caché, que es justo el caso de los flujos agénticos largos.

    Ahora bien: ninguno de esos porcentajes mide lo que va este post, que es cuántas veces se te para el flujo a mitad. Es la diferencia de siempre entre lo que miden los benchmarks de IA programando y lo que te encuentras el viernes por la mañana.

    Si vienes de Opus 5, los cambios de API que rompen código son otros y ya los cubrí en su momento: los breaking changes de Opus 5. Lo de aquí se suma a aquello, no lo sustituye.


    Qué hacer hoy en tu código: 3 pasos

    1. Busca dónde lees response.content[0]. Ese es el punto exacto donde un rechazo se convierte en un bug fantasma. Comprueba stop_reason === 'refusal' antes de tocar el contenido, y registra stop_details.category para saber después de qué murió.
    2. Trata el rechazo como una rama del flujo, no como un error. Un circuit breaker que abra tras N rechazos seguidos te ahorra los rate limits y la investigación de madrugada. Es la misma idea que el método del ebook gratuito Revisión por Contrato: que un agente no te cuele trabajo a medias sin que nadie se entere.
    3. Activa fallbacks: "default" si estás en la API de Claude. Y si estás en Bedrock o Vertex, asume que no lo tienes y monta el fallback en cliente leyendo recommended_model.

    Todo esto es la misma idea de fondo: el modelo es un proveedor externo con fallos propios, y tu sistema necesita contratos que aguanten cuando el proveedor dice que no. Si diseñas esa frontera antes de escribir el código —qué entra, qué sale y qué pasa cuando no sale nada— esto deja de ser una sorpresa, y de eso va Spec-Driven Development.

    Y si quieres el recorrido completo de construir con estos modelos sin que la primera sorpresa te pille en producción, lo trabajo entero en Construye con IA.


    Preguntas frecuentes

    ¿Un refusal de Claude Opus 5.5 devuelve un error HTTP?

    No. Devuelve un HTTP 200 perfectamente válido, con stop_reason: "refusal", el array content vacío y un objeto stop_details con la categoría. Por eso pasa desapercibido: los bloques try/catch y los reintentos basados en códigos de error no lo ven.

    ¿Me cobran los tokens de una petición rechazada?

    Depende de cuándo llegue el rechazo. Si llega antes de cualquier salida, no se factura: content viene vacío y los tokens aparecen en usage pero no se cobran. Eso sí, la petición sí cuenta contra tus rate limits. Si el rechazo llega a mitad de streaming, se facturan los tokens de entrada y la salida ya emitida a precio normal, y esa salida parcial hay que descartarla.

    ¿Cómo activo el fallback automático a otro modelo?

    En la API de Claude, añade fallbacks: "default" a la petición y la cabecera beta server-side-fallback-2026-07-01. La API reintenta la petición en el modelo recomendado para esa categoría de rechazo y te devuelve una sola respuesta; response.model te dice quién contestó. No está disponible en Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry ni en la Message Batches API.

    ¿Puede saltar un guardarraíl haciendo trabajo legítimo?

    Sí, y la documentación lo reconoce explícitamente en tres de las cinco categorías: el trabajo benigno de ciberseguridad puede disparar cyber, la investigación útil en ciencias de la vida puede disparar bio y el machine learning normal puede disparar frontier_llm. Si tu organización trabaja en esos dominios, Anthropic tiene programas de verificación para recuperar el acceso completo — el de Life Sciences ya está abierto y el de ciberseguridad lo han anunciado para las próximas semanas.

    ¿Cuánto cuesta Claude Opus 5.5 frente a Opus 5?

    $4 por millón de tokens de entrada y $20 de salida, frente a los $5 / $25 de Opus 5: un 20% menos. El titular del 40% sale de las lecturas de caché, que bajan de $0,50 a $0,20 por millón. Si esa palanca te interesa, tengo un post sobre prompt caching en la API de Claude.

    ¿Qué hago si stop_details.category viene null?

    Trátalo como un caso normal, porque lo es: la documentación avisa de que tanto category como explanation pueden ser null de forma permanente cuando el rechazo no encaja en ninguna categoría con nombre. Tu código debe manejar el rechazo sin depender de conocer el motivo, y nunca parsear el texto de explanation, que no es estable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code en monorepos: dale solo la rebanada que necesita

    Claude Code en monorepos: dale solo la rebanada que necesita

    Un cliente me pasó su monorepo el mes pasado. Nueve paquetes, pnpm workspaces, Turborepo por encima. Le pedí a Claude Code algo ridículamente pequeño: cambiar el tipo de una prop en packages/ui.

    Tres respuestas después me estaba proponiendo tocar el cliente HTTP del backend.

    No era un modelo tonto. Era yo. Había arrancado la sesión desde la raíz del repo, y trabajar con Claude Code en monorepos desde la raíz significa una cosa muy concreta: le has dado nueve paquetes de superficie para una tarea que vive en uno.

    Esto no es el problema del que ya escribí en Context Drift. Aquel es temporal: la sesión se alarga, el historial se pudre, el agente se olvida de la instrucción de la iteración 3. Este es espacial. Se degrada en el minuto uno, con la ventana medio vacía, porque el repo es grande y nadie le ha dicho qué parte del repo importa.

    La tesis del post es esta: en un monorepo, la decisión más importante que tomas no es qué prompt escribes. Es desde qué directorio arrancas el agente.

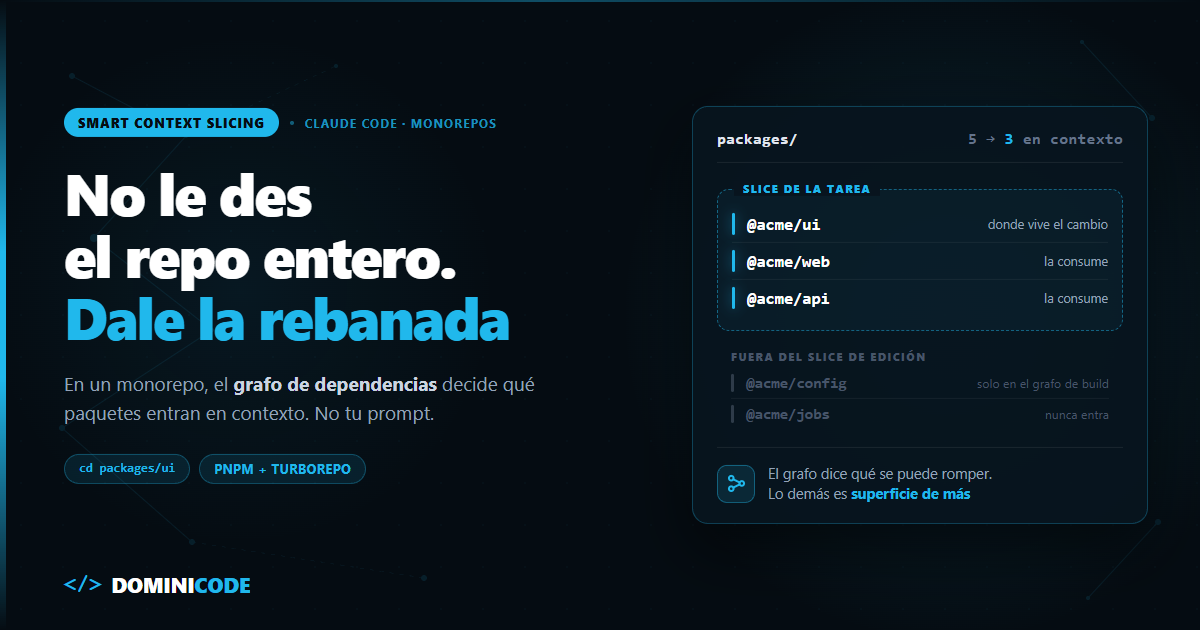
    Smart context slicing es la práctica de arrancar el agente en el subárbol mínimo del monorepo que la tarea necesita, calculado a partir del grafo de dependencias en vez de a ojo. Son tres decisiones concretas: desde qué directorio lanzas claude, qué paquetes vecinos añades con --add-dir y qué rutas bloqueas con reglas de denegación. Las tres, en ese orden, son el resto del post.

    Claude Code en monorepos: un CLAUDE.md en la raíz no escala

    La documentación de Anthropic recomienda mantener cada CLAUDE.md por debajo de 200 líneas, y lo justifica: los archivos largos consumen más contexto y reducen la adherencia a las instrucciones.

    Ahora divide. Nueve paquetes, 200 líneas: 22 líneas por paquete para explicar su stack, sus convenciones y sus trampas.

    Así que solo hay dos finales, y he visto los dos.

    O el CLAUDE.md crece hasta las 600 líneas y el agente ignora la mitad — incluidas las reglas que importaban. O se queda genérico ("usa TypeScript estricto", "escribe tests"), que es una forma elegante de no decir nada.

    Si todavía estás montando el tuyo, el punto de partida lo dejé en CLAUDE.md: el system prompt de tu proyecto. Aquí doy por hecho que ya lo tienes y se te ha quedado pequeño.

    La solución es partirlo: raíz para lo global, un archivo por paquete para lo local.

    monorepo/
      CLAUDE.md                 # reglas globales: commits, estilo, "corre los scripts desde el paquete"
      packages/
        ui/CLAUDE.md            # convenciones de componentes, tokens de diseño
        api/CLAUDE.md           # Knex, migraciones, .env obligatorio
        web/CLAUDE.md           # rutas, data fetching
    

    Pero partirlo no sirve de nada si no entiendes cuándo se carga cada trozo.

    La regla de carga que casi nadie ha leído

    Claude Code no trata igual a los CLAUDE.md que están por encima de ti y a los que están por debajo.

    Dónde vive el CLAUDE.md Cuándo entra en contexto
    Tu directorio de trabajo y todos sus ancestros Al arrancar la sesión, siempre
    Subdirectorios por debajo de ti Bajo demanda, solo cuando el agente lee un archivo de esa carpeta

    Si arrancas desde la raíz, cargas solo el CLAUDE.md raíz — y vas acumulando el de cada paquete que el agente toque. Toca muchos, porque no sabe dónde está el límite.

    Si arrancas con cd packages/ui && claude, cargas raíz + packages/ui de golpe, y los de api y web no existen para esa sesión mientras no los pises. Además, solo puede leer y editar dentro de ese subárbol hasta que le concedas más.

    Eso es una rebanada. Y te ha costado un cd.

    Compruébalo: lanza /context y mira la lista de Memory files. Ahí está lo que se cargó de verdad.

    El slice no lo decides tú: lo decide el grafo de dependencias

    "Trabaja desde el paquete" está bien hasta que la tarea toca de verdad a los vecinos. Cambiar un tipo exportado de ui puede romper a quien lo consume, y si el agente no ve a esos consumidores, te entrega algo que compila en su rebanada y revienta en CI.

    La pregunta correcta no es qué paquetes te apetece abrir, sino qué paquetes toca esta tarea de verdad. Y esa respuesta ya está en tu repo: en el grafo de dependencias.

    Monté un workspace de cinco paquetes para verlo, con pnpm 11.1.3 y Turborepo 2.10.12. @acme/api y @acme/web dependen de @acme/ui; @acme/ui depende de @acme/config; @acme/jobs va por libre.

    Inventario primero:

    pnpm ls -r --depth -1
    

    Ahora el blast radius hacia arriba — qué se rompe si toco @acme/ui. En la sintaxis de filtros de pnpm, los tres puntos delante del nombre significan "y todo lo que depende de él":

    pnpm --filter "...@acme/ui" ls --depth -1
    # (salida recortada al nombre de cada paquete)
    # @acme/ui
    # @acme/api
    # @acme/web
    

    Y hacia abajo, con los puntos detrás, "y todo aquello de lo que depende":

    pnpm --filter "@acme/ui..." ls --depth -1
    # (salida recortada)
    # @acme/ui
    # @acme/config
    

    Si quieres el cierre completo en los dos sentidos, pones los puntos a ambos lados: "...@acme/ui...". Y si te sobra el propio paquete, el circunflejo lo excluye: "...^@acme/ui" devuelve solo api y web.

    Turborepo lo da con un matiz. --dry enseña el plan sin ejecutar nada:

    turbo run build --filter="...@acme/ui" --dry
    
    • Packages in scope: @acme/api, @acme/ui, @acme/web
    • Running build in 3 packages
    

    El detalle que solo ves ejecutándolo: "Packages in scope" son 3, pero si sacas el JSON aparecen 4 tareas:

    turbo run build --filter="...@acme/ui" --dry=json | jq -r '.tasks[].directory' | sort -u
    # packages/api
    # packages/config
    # packages/ui
    # packages/web
    

    @acme/config no está en el scope de edición, pero entra en el grafo de build porque ui lo necesita compilado. Son dos rebanadas distintas y conviene no confundirlas:

    Rebanada Paquetes % del repo
    Repo completo 5 100%
    Slice de edición (ui + dependientes) 3 60%
    Slice de build (añade config) 4 80%
    Nunca entra (@acme/jobs) 1 20%

    En un repo de cinco paquetes, dejar fuera un paquete suena a poco. En el del cliente, con nueve, el slice real de la tarea eran tres paquetes: dos tercios del repo que no tenían por qué abrirse nunca.

    Con esa lista en la mano, el arranque deja de ser una corazonada:

    cd packages/ui
    claude --add-dir ../api --add-dir ../web
    

    Si el equipo entero trabaja así, lo fijas en packages/ui/.claude/settings.json:

    {
      "permissions": {
        "additionalDirectories": ["../api", "../web"]
      }
    }
    

    Ojo con una diferencia que muerde: additionalDirectories da acceso a los ficheros pero no carga nunca el CLAUDE.md ni las skills de esos directorios. Con --add-dir sí cargan las skills, y el CLAUDE.md solo si arrancas con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1. Si escribiste un CLAUDE.md en packages/api y no sale en /context, es por esto.

    Y como el slice te dice qué se puede romper, también sabes qué verificar antes de dar la tarea por buena: los tests de api y web, no los de ui. Convertir "parece que funciona" en un veredicto ejecutable lo desarrollé entero en el ebook gratuito Revisión por Contrato, sobre cómo revisar lo que te entrega un agente sin leértelo línea a línea.

    Lo que no debe entrar en la ventana bajo ningún concepto

    Las búsquedas de contenido de Claude Code respetan tu .gitignore por defecto, así que node_modules/, dist/ y build/ ya están fuera de los resultados de un grep.

    El problema es lo que sí está commiteado: código generado, un SDK vendorizado, snapshots enormes. Para eso hay reglas de denegación:

    {
      "permissions": {
        "deny": [
          "Read(./**/dist/**)",
          "Read(./**/*.generated.*)",
          "Read(./vendor/**)"
        ]
      }
    }
    

    Un detalle que rompe esto sin avisar: los patrones relativos anclan en el directorio desde el que arrancas la sesión, no en la raíz del repo. Si guardas estas reglas en la raíz pero lanzas la sesión desde packages/ui, Read(./vendor/**) está apuntando a packages/ui/vendor/. Para que apliquen en todo el repo las escribes absolutas, con doble barra: Read(//ruta/absoluta/al/repo/vendor/**).

    Y si arrancando desde la raíz se te cuelan los CLAUDE.md de equipos con los que no trabajas, existe claudeMdExcludes, en el .claude/settings.local.json de la raíz. Los patrones se comparan contra rutas absolutas, así que empiezan por **/ para que casen en cualquier punto del árbol:

    {
      "claudeMdExcludes": ["**/packages/legacy-*/**"]
    }
    

    Con un aviso honesto: esa lista es estática, no un interruptor por tarea. Para alternar de paquete cada día la herramienta sigue siendo el cd.

    Cuando de verdad no sabes dónde está, delega la búsqueda

    Todo lo anterior asume que sabes qué paquete tocar. A veces no lo sabes, y ahí es donde la gente destroza la sesión: "busca en el repo dónde se genera el token de refresco". El agente lee doscientos archivos y te devuelve una frase. Los doscientos archivos se quedan en tu ventana. La frase también, pero ya da igual.

    Delégalo a un subagente. Corre en su propia ventana de contexto y te devuelve el resumen, no los archivos:

    Usa un subagente para localizar en qué paquetes se genera y se valida
    el token de refresco. Devuélveme solo la lista de rutas y una línea
    por cada una. No propongas cambios todavía.
    

    El resultado es una lista de paquetes. Cierras la sesión, haces cd al correcto y empiezas la tarea real con la ventana limpia. La exploración se paga una vez y se tira.

    Es el mismo principio que conté en Context Engineering: lo caro no es el token, es el token irrelevante que se queda mirándote el resto de la sesión.

    Lo que puedes hacer hoy en tu monorepo

    Una sola cosa, y es gratis: deja de arrancar el agente desde la raíz del monorepo.

    Antes de la próxima tarea, corre pnpm --filter "...<tu-paquete>" ls --depth -1, mira los tres o cuatro nombres que salen, y arranca así:

    cd packages/<tu-paquete>
    claude --add-dir ../<vecino>
    

    No hace falta que escribas ni un CLAUDE.md nuevo para notar la diferencia. Eso viene después, cuando ya sepas qué reglas son globales y cuáles de un paquete — y eso solo se ve claro tras unos días trabajando por rebanadas.

    Si quieres el flujo completo, de la idea al producto con estas decisiones tomadas antes de escribir código, es lo que montamos en el curso Construye con IA.

    Preguntas frecuentes

    ¿Es mejor arrancar Claude Code desde la raíz del monorepo o desde el paquete?

    Desde el paquete, salvo que la tarea cruce varios subsistemas de verdad. Arrancando desde packages/ui cargas el CLAUDE.md raíz más el de ui, y el agente solo puede leer y editar ese subárbol. Desde la raíz tienes acceso a todo: útil para refactors transversales, caro para cualquier otra cosa. Si necesitas un vecino puntual, --add-dir te lo añade sin romper el aislamiento.

    ¿Los CLAUDE.md de los subdirectorios se cargan siempre?

    No, y esta es la confusión más habitual. Los de tu directorio de trabajo y de todos sus ancestros se cargan al arrancar la sesión. Los de subdirectorios por debajo de ti se cargan bajo demanda, solo cuando el agente lee un archivo de esa carpeta. Para ver qué se cargó de verdad en una sesión, lanza /context.

    ¿Qué hago si la tarea toca varios paquetes a la vez?

    Dásela entera en una sola sesión, con el slice completo delante. Partirla en una sesión por paquete es peor: cada sesión redecide el diseño desde cero y acabas con tres criterios distintos. Calcula el slice con el filtro de dependientes, añade esos directorios y trabaja en plan mode antes de editar: el plan se escribe a un archivo que Claude Code reinyecta tras cada compactación.

    ¿Esto sirve si uso Nx o si mi repo es un solo árbol grande sin paquetes?

    Sí. En Nx el equivalente es nx graph para ver el grafo y nx show projects --affected para saber qué proyectos toca un cambio: cambia el comando, no la idea. Y en un repo de un solo árbol sustituyes "paquete" por "subsistema" — src/billing/, src/auth/, lib/core/. Un CLAUDE.md por subsistema y un cd hacen el mismo trabajo.

    ¿No basta con el .gitignore para que el agente no lea dist?

    Para las búsquedas de contenido sí: Claude Code respeta el .gitignore por defecto, así que dist/, build/ y node_modules/ no aparecen cuando busca texto. Lo que no cubre es lo commiteado — código generado, SDKs vendorizados, fixtures gigantes. Para eso necesitas reglas Read(...) en permissions.deny. Con un límite: cubren las herramientas de fichero y los comandos de Bash que Claude Code reconoce, pero un grep -r sobre una carpeta con ficheros denegados sigue sacándolos por pantalla.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Fable 5.1: los 3 breaking changes que rompen tu agente

    Claude Fable 5.1: los 3 breaking changes que rompen tu agente

    Ayer por la tarde cambié una línea en un agente que llevaba once semanas en producción sin que nadie lo tocara.

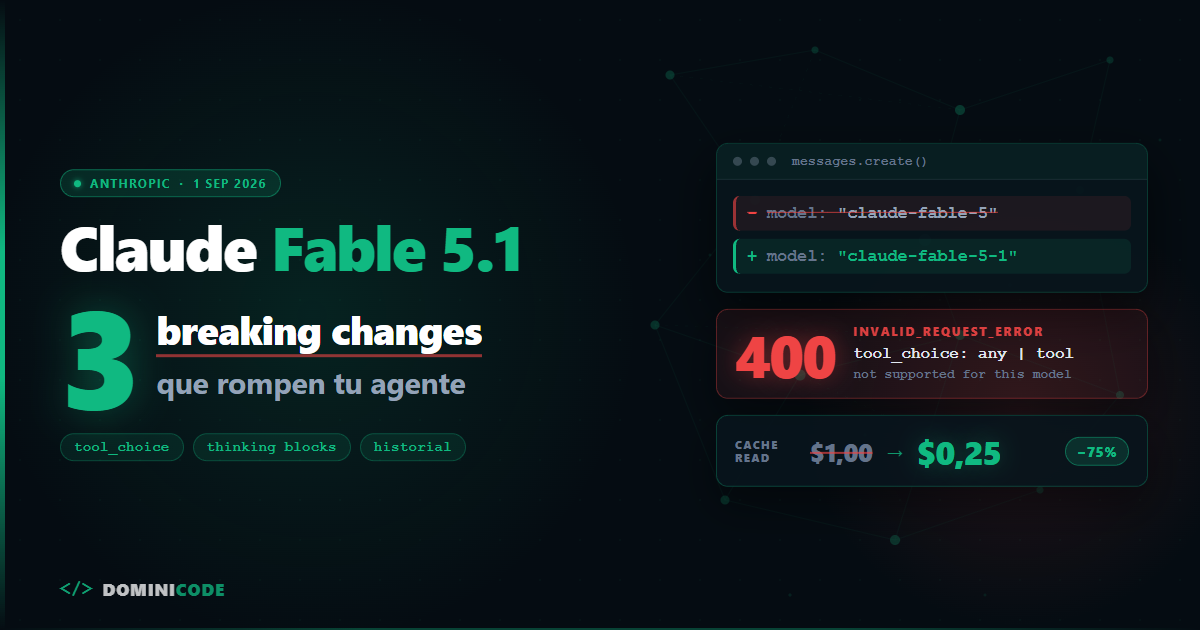
    claude-fable-5 → claude-fable-5-1. Eso es todo lo que pide la guía de migración a Claude Fable 5.1. Deploy, café, a otra cosa.

    En mi cuenta no pasó nada. En la del cliente, abierta el lunes, las conversaciones largas empezaron a devolver un 400 con un mensaje que no había visto nunca: The block is bound to a different conversation.

    El modelo no tenía la culpa. La tenía una función mía que reconstruía el system prompt en cada petición para inyectar la fecha de hoy. Con Fable 5 era invisible. Ahora invalida todos los thinking blocks posteriores y la API rechaza la petición entera.

    Esa es la tesis de este post: actualizar el model ID es una línea; lo que rompe es cómo construyes el array de messages.


    Qué es Claude Fable 5.1 y qué no cambia respecto a Fable 5

    Claude Fable 5.1 es el modelo de razonamiento de gama alta de Anthropic, lanzado el 1 de septiembre de 2026 junto a Claude Mythos 5.1. Mantiene la ficha técnica de Fable 5 —ventana de 1M de tokens, 128K de output, $10 de input y $50 de output por millón— y su retirada no será antes del 1 de septiembre de 2027. Lo único que cambia de precio es el cache read. Lo único que rompe es cómo construyes el array de messages.

    El resto de la ficha tampoco se mueve: mismo tokenizer que Fable 5, thinking adaptativo siempre activo con effort por defecto en high y knowledge cutoff en junio de 2026. La ventana de 1M es a la vez el valor por defecto y el máximo, a precio estándar de principio a fin.

    Dónde puedes llamarlo: la API de Claude como claude-fable-5-1, Amazon Bedrock como anthropic.claude-fable-5-1, Google Cloud y Microsoft Foundry, además de Claude Code, Claude Enterprise y la Claude Platform. Mythos 5.1 (claude-mythos-5-1) es solo por invitación.

    Si vienes de Fable 5, en la ficha técnica no hay nada nuevo que aprender. Lo nuevo está en dos sitios: tres cosas que dejan de funcionar y un precio que cambia la economía de los agentes largos.


    Breaking change 1: tool_choice forzado devuelve 400 en Claude Fable 5.1

    tool_choice: {"type": "any"} y {"type": "tool", "name": "..."} devuelven un 400 invalid_request_error con este mensaje literal:

    tool_choice: type "tool" and "any" are not supported for this model.
    

    Siguen funcionando {"type": "auto"} (el default) y {"type": "none"}. La misma validación se aplica al endpoint de token counting: si tenías un estimador de costes que replicaba el payload, también se cae.

    El motivo tiene sentido. Con el thinking siempre activo, forzar la tool se salta el bloque de razonamiento y el modelo acaba metiéndolo en los argumentos.

    El fix son dos cambios y ninguno es dramático:

    // Antes (Fable 5): forzabas la tool para garantizar JSON válido
    const res = await client.messages.create({
      model: "claude-fable-5",
      max_tokens: 4096,
      tools: [extractInvoice],
      tool_choice: { type: "tool", name: "extract_invoice" }, // 400 en Fable 5.1
      messages,
    });
    
    // Después (Fable 5.1): auto + strict, y la orden va en el prompt
    const res = await client.messages.create({
      model: "claude-fable-5-1",
      max_tokens: 4096,
      tools: [{ ...extractInvoice, strict: true }],
      tool_choice: { type: "auto" },
      messages: [
        ...messages,
        {
          role: "user",
          content: "Usa la tool `extract_invoice` para responder.",
        },
      ],
    });
    

    Un aviso antes de que lo copies: ese mensaje se queda en el historial. Si lo inyectas en cada petición y lo borras en la siguiente, acabas de reproducir el breaking change 3. O lo dejas fijo, o lo mandas como system message de un solo turno, que lo verás más abajo.

    Si lo que buscabas con tool_choice era JSON conforme a un esquema y no una herramienta de verdad, mueve el esquema a structured outputs y quítate la tool de en medio. El esquema pasa a ser el contrato, y un contrato hay que validarlo también en tu lado. Si lo que devuelve el modelo lo compruebas con un if (typeof x === "string"), en el curso de Zod para TypeScript está la versión que no se rompe cuando el esquema crece.


    Breaking change 2: los thinking blocks están atados al modelo que los produjo

    Cada thinking block registra qué modelo lo generó, y la compatibilidad es unidireccional. Fable 5.1 lee los bloques de modelos anteriores. Ningún modelo anterior lee los de Fable 5.1.

    Traducción para quien tiene un router: si tu fallback salta de Fable 5.1 a Opus 5 a mitad de conversación, la API descarta el bloque antes de que el modelo lo vea. No cuenta como input_tokens, no se factura y no te avisa.

    Ese silencio es el problema: tu agente sigue respondiendo, pero razona con menos contexto del que crees y en la traza no hay un error que investigar. Con el header beta thinking-binding-controls-2026-08-01 el descarte se reporta en input_transformations. Enciéndelo en staging antes de migrar.


    Breaking change 3: editar turnos anteriores invalida los thinking blocks

    Este es el que me mordió a mí.

    Modificar cualquier cosa antes de un thinking block —el system, el array de tools o un mensaje anterior— provoca un 400 en la siguiente petición: The block is bound to a different conversation.

    Patrones que invalidan todos los bloques posteriores:

    • Editar, reordenar o eliminar un turno anterior conservando los siguientes.
    • Inyectar texto por petición en un turno anterior (un recordatorio, una línea de estado) que borras en la siguiente.
    • Reconstruir el system prompt o el array de tools entre peticiones de la misma conversación.
    • Servir bytes distintos para la misma imagen o documento en una petición posterior. La comprobación mira los bytes, no la URL, así que una signed URL rotatoria del mismo fichero es válida.

    Patrones que no invalidan nada:

    • Eliminar una racha inicial de thinking blocks, del más viejo primero.
    • Dejar que la compactación o el context editing server-side recorten el historial.
    • Mover marcadores cache_control.
    • Cambiar el effort entre peticiones.

    La regla mental cabe en tres palabras: trata la conversación como append-only.

    Y aquí el detalle que explica por qué a unos les explota y a otros no: la comprobación se aplica a cuentas creadas a partir del 31 de agosto de 2026. En cuentas anteriores la API registra el desajuste pero solo actúa si mandas thinking.block_binding.prefix_mismatch_behavior, y Mythos 5.1 no la aplica nunca. Tu código puede estar roto hoy y no enterarte hasta que un cliente nuevo abra su cuenta.

    Claude Code, claude.ai, Claude Managed Agents y el Agent SDK ya mantienen ese prefijo intacto por ti. El problema es tuyo solo si construyes el array messages a mano, que es lo que hacemos casi todos los que tenemos agentes en producción.

    Los 3 breaking changes de Claude Fable 5.1, en una tabla

    Qué se rompe Cómo se manifiesta Fix
    tool_choice de tipo any o tool 400 invalid_request_error inmediato, también en token counting tool_choice: auto + strict: true, o mover el esquema a structured outputs; la orden de usar la tool, en el prompt
    Thinking blocks de Fable 5.1 enviados a un modelo anterior Silencio: el bloque se descarta, no se factura, nadie avisa Que el router no cambie de modelo a mitad de conversación; header thinking-binding-controls-2026-08-01 para verlo en input_transformations
    Editar system, tools o un turno anterior 400 The block is bound to a different conversation, solo en cuentas creadas desde el 31/08/2026 Historial append-only; recordatorios con system messages de un solo turno; recortes con context editing server-side

    No es la primera vez: ya conté los 2 breaking changes de Claude Opus 5. El patrón se repite en cada release y siempre pilla al mismo tipo de código, el que trata el historial como un array mutable.


    Precio de Claude Fable 5.1: el cache read baja un 75 %

    El cache read de Claude Fable 5.1 cuesta $0,25 por millón de tokens, un 75 % menos que los $1,00 de Fable 5. El resto de precios no se mueve.

    Concepto Fable 5.1 Fable 5
    Input $10 / MTok $10 / MTok
    Output $50 / MTok $50 / MTok
    Cache write 5 min $12,50 / MTok $12,50 / MTok
    Cache write 1 h $20 / MTok $20 / MTok
    Cache read $0,25 / MTok $1,00 / MTok

    El mínimo cacheable sigue en 512 tokens y el Batch API mantiene su 50 % de descuento: $5 de input y $25 de output.

    Pero el número que cambia la arquitectura es otro: en Fable 5.1 el cache read cuesta 0,025× el input base, cuando en el resto de modelos Claude es 0,1×. Es la excepción, no la norma.

    Eso convierte un prefijo grande y estable en algo casi gratis de releer: Anthropic declara un ahorro en torno al 25 % en cargas típicas y hasta el 45 % en trabajo muy agéntico.

    Fíjate en la simetría: los mismos patrones que invalidan los thinking blocks son los que te tiran la caché. Reconstruir el system en cada llamada no era un bug latente; era una factura que llevabas pagando desde antes de migrar.

    Si nunca lo has medido en serio, empieza por cómo funciona el prompt caching en la API de Claude. Después, cómo medir el consumo real de tokens de un agente. Sin esas dos métricas, elegir modelo es una corazonada.


    Tres novedades de Claude Fable 5.1 que sí vale la pena adoptar

    Effort por mensaje (beta, header mid-conversation-output-config-2026-07-01). Cambias el nivel de effort a mitad de conversación sin invalidar la caché de prompt. Súbelo para los pasos difíciles, bájalo para los rutinarios:

    const response = await client.beta.messages.create({
      model: "claude-fable-5-1",
      max_tokens: 4096,
      output_config: { effort: "high" },
      messages: [
        { role: "user", content: "Planifica la migración de SQLite a PostgreSQL." },
        { role: "assistant", content: "1. Exporta los datos. 2. Crea el esquema. 3. Importa y verifica." },
        // El nuevo nivel entra en vigor desde el siguiente turno de usuario
        { role: "system", content: [], output_config: { effort: "low" } }, // sin texto: es un mensaje de control
        { role: "user", content: "Resume el plan en una frase." },
      ],
      betas: ["mid-conversation-output-config-2026-07-01"],
    });
    

    Si tu editor subraya el role: "system" dentro de messages, es que el tipado de tu SDK todavía no lo incluye: actualiza el paquete antes de pelearte con TypeScript.

    System messages de un solo turno (beta, header mid-conversation-system-clear-at-2026-08-21). Es literalmente el sustituto del patrón que ahora rompe. Va dentro del array messages, como un turno más:

    {
      "role": "system",
      "clear_at": "next_user_message",
      "content": "Los resultados están en tu bandeja. Revísala antes de ejecutar más código."
    }
    

    Tiene autoridad de system prompt durante el turno actual y deja de inyectarse en el prompt cuando llega un mensaje de usuario posterior. Se queda en messages y lo sigues mandando igual, así que nada anterior cambia: la caché sigue casando, los thinking blocks siguen válidos y un mensaje limpiado cuesta 0 tokens de input.

    Progress updates entre tool calls (beta, header thinking-display-updates-2026-08-18). Con thinking.display: "updates" recibes como texto los avisos de progreso que el modelo escribe entre llamadas a tools, manteniendo el razonamiento oculto. Con el default "omitted" no llega nada y un turno agéntico de tres minutos parece un cuelgue.


    Dos cambios de comportamiento de Fable 5.1 que verás sin tocar código

    El parallel tool calling es más variable. Fable 5.1 puede hacer una llamada por turno donde Fable 5 agrupaba varias. No baja la calidad de la respuesta, pero cuesta tokens, round trips y tiempo de reloj. Se arregla con una instrucción de una línea pidiendo agrupar las lecturas independientes.

    Y Fable 5.1 reescribe ficheros enteros para cambios pequeños. Donde esperas una edición quirúrgica, te devuelve el fichero entero. Mismo resultado, más tokens de output.


    Claude Fable 5.1 vs Opus 5: la parte incómoda es que no es tu default

    Lo dicen los propios docs de Anthropic: "For most workloads, start with Claude Opus 5". Fable 5.1 se reserva para razonamiento exigente y trabajo agéntico de largo recorrido, o para cuando tus evals con Opus 5 a effort alto se quedan cortas. Opus 5 cuesta $5 de input y $25 de output. La mitad exacta.

    Benchmark Fable 5.1 Fable 5 Opus 5
    Terminal-Bench 4.0 55,8 % 42,0 % 52,3 %
    Terminal-Bench-Science 0.1 52,6 % 24,7 % 29,0 %
    OSWorld 2.0 (partial) 77,9 % 72,9 % 75,4 %
    OSWorld 2.0 (strict) 41,7 % 36,1 % 39,6 %

    Mira Terminal-Bench 4.0: 55,8 % contra 52,3 %. Tres puntos y medio por el doble de precio. En Terminal-Bench-Science son 52,6 % contra 29,0 %, casi veinticuatro puntos, y ahí la decisión se toma sola.

    La elección de modelo dejó de ser global. Se decide por tarea y con tus evals delante. Y si lo montas como router, recuerda el breaking change 2 y no cambies de modelo a mitad de conversación.


    Qué es Claude Mythos 5.1 y quién puede usarlo

    Claude Mythos 5.1 (claude-mythos-5-1) es el mismo modelo subyacente que Fable 5.1 con salvaguardas más permisivas. Comparte specs y precios. Solo por invitación, para participantes de Project Glasswing: organizaciones verificadas de ciberseguridad y ciencias de la vida. Con esas salvaguardas relajadas rinde más, 60,9 % en Terminal-Bench 4.0 frente al 55,8 % de Fable 5.1.

    La noticia no es el modelo, es la separación. Por primera vez Anthropic distingue de forma tan explícita "el modelo que puedes usar" de "el modelo que rinde más si te verifican". Tiene lógica. Parte del rendimiento que pierde un generalista se va en negarse a cosas que en un laboratorio de biología son trabajo normal, como se veía venir en los agentes autónomos aplicados a proteínas.

    Pero tenlo delante antes de comparar capturas de benchmarks: los números de un modelo con salvaguardas relajadas y los del modelo que tú puedes llamar no son comparables.


    Cómo migrar de Claude Fable 5 a Fable 5.1, en 4 pasos

    1. Busca tool_choice en tu repo. Si aparece any o tool, cámbialo a auto con strict: true y mueve la orden al prompt. Media hora.
    2. Busca dónde reconstruyes el system o el array de tools. Cualquier new Date() ahí dentro es una bomba: sácalo a un mensaje de usuario o a un system message de un solo turno.
    3. Audita tu router. Si puede cambiar de modelo a mitad de conversación, activa thinking-binding-controls-2026-08-01 en staging y mira input_transformations.
    4. Mide antes y después. Con el cache read a $0,25 tu arquitectura puede cambiar, pero solo si tienes el número delante.

    El resto está en los docs de novedades de Fable 5.1; el trabajo de verdad está en tus evals.

    Si construyes agentes con Claude y quieres el flujo completo de idea a producto, es lo que enseño en Construye con IA. Y en Dominicode Labs probamos estos patrones de historial append-only y routing por tarea sobre proyectos reales.

    Una release de modelo no se mide por lo que el modelo hace mejor. Se mide por cuántas suposiciones tuyas deja de sostener.


    Preguntas frecuentes

    ¿Tengo que migrar ya de Claude Fable 5 a Claude Fable 5.1?

    No hay urgencia. Fable 5.1 no se retirará antes del 1 de septiembre de 2027. La razón para migrar es económica, no de soporte. Si tu carga es muy agéntica y relee un prefijo grande en cada turno, el cache read a $0,25 justifica la migración por sí solo.

    ¿Por qué Claude Fable 5.1 me devuelve un 400 con tool_choice?

    Porque tool_choice: {"type": "any"} y {"type": "tool", "name": "..."} dejaron de estar soportados en Fable 5.1 y en Mythos 5.1. La API responde un invalid_request_error con el mensaje literal tool_choice: type "tool" and "any" are not supported for this model, y la misma validación se aplica al endpoint de token counting. Solo siguen siendo válidos {"type": "auto"} (el default) y {"type": "none"}. El fix es tool_choice: {"type": "auto"} con strict: true en la definición de la tool y la orden de usarla escrita en el prompt.

    ¿Cómo fuerzo ahora que el modelo llame a una tool concreta?

    No puedes forzarla. Díselo en el prompt —"Usa la tool get_weather para responder"— y comprueba que la haya llamado antes de seguir. Sin tool_choice no hay garantía, solo una instrucción que el modelo cumple casi siempre. Si lo que necesitabas era JSON conforme a un esquema, usa strict: true con tool_choice: auto o mueve el esquema a structured outputs.

    ¿Por qué a mi compañero le da 400 y a mí no, con el mismo código?

    Por la fecha de creación de la cuenta: la comprobación solo se aplica a las creadas a partir del 31 de agosto de 2026. En cuentas anteriores la API registra el desajuste pero no actúa salvo que mandes thinking.block_binding.prefix_mismatch_behavior. Tu código está igual de roto en ambos casos; solo cambia quién se entera.

    ¿Merece la pena Fable 5.1 frente a Opus 5?

    Los propios docs recomiendan empezar por Opus 5, que cuesta la mitad. Fable 5.1 saca tres puntos y medio más en Terminal-Bench 4.0, pero casi veinticuatro en Terminal-Bench-Science. Si tu tarea es razonamiento exigente y agéntico de largo recorrido, la diferencia paga; para el resto, no.

    ¿Puedo usar Claude Mythos 5.1?

    Solo si tu organización está aprobada en Project Glasswing, el programa por invitación para entidades verificadas de ciberseguridad y ciencias de la vida. No hay lista de espera pública: el acceso se pide a través de tu equipo de cuenta de Anthropic, AWS o Google Cloud. Es el mismo modelo con salvaguardas más permisivas y el mismo precio; si no estás dentro, tu referencia es Fable 5.1.

    ¿Puedo mezclar Claude Fable 5.1 y Opus 5 en el mismo agente?

    Sí, pero no dentro de la misma conversación. Los thinking blocks de Fable 5.1 no los lee ningún modelo anterior, así que un router que salte a Opus 5 a mitad de hilo pierde ese razonamiento sin avisarte. Reparte por tarea y arranca conversación nueva al cambiar de modelo, o activa el header thinking-binding-controls-2026-08-01 para ver los descartes en input_transformations.

    ¿Dónde puedo usar Claude Fable 5.1?

    En la API de Claude con el model ID claude-fable-5-1, en Amazon Bedrock como anthropic.claude-fable-5-1, en Google Cloud y en Microsoft Foundry, además de Claude Code, Claude Enterprise y la Claude Platform. No necesitas ningún header beta para llamarlo: los headers solo hacen falta para las funciones nuevas como el effort por mensaje o los system messages de un solo turno.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude diseñó proteínas solo: manual de agentes de IA autónomos

    Claude diseñó proteínas solo: manual de agentes de IA autónomos

    Casi todo lo que leo sobre IA cabe en tres cajones: autocompletar código, sacar un gráfico de un Excel y vídeos de gente que no existe bailando en una playa.

    Ese es el techo mental de la conversación. El mío también, muchos días.

    Y mientras discutimos si Cursor gestiona el contexto mejor que Claude Code, los mismos agentes de IA autónomos que tú y yo soltamos dentro de un repo llevaban 48 horas seguidas diseñando proteínas que no existían. Proteínas que después alguien sintetizó de verdad, en un laboratorio de verdad, y midió con un aparato de verdad.

    Ahí el error no se arregla con git revert.

    El 18 de agosto de 2026 Anthropic publicó How Claude is accelerating protein design and analytical chemistry y, debajo, un informe técnico con el detalle fino: 1.320 diseños generados, 354 binders confirmados en laboratorio, 14 de 15 dianas con al menos un acierto.

    Ese titular corrió por todas partes. Y es el trozo menos interesante de la historia.

    Porque lo que a ti y a mí nos sirve el lunes por la mañana no son los 354 binders. Es cómo estaba escrito el documento que le dieron al agente antes de arrancar.


    Primero, qué hizo exactamente

    Un binder es una proteína pequeña que se pega a una diana concreta. Es el paso cero de medio catálogo de fármacos. No es un fármaco: por delante queda todo el recorrido preclínico y regulatorio, que se mide en años.

    Claude no inventó ninguna herramienta. Usó las que ya existen y son públicas: diez generadores de estructura distintos, con PXDesign (358 diseños), RFdiffusion3 (267) y Genie 3 (185) a la cabeza; SolubleMPNN para el diseño de secuencia (1.133 de los diseños testeados) y un ensemble de ESMFold2, ESMFold2-Fast y Protenix v2 para rankear. Ninguna venía preinstalada: el protocolo le obliga a compilar cada una desde su repositorio público y validarla en la primera hora. Todo dentro de Claude Science, el entorno de investigación de Anthropic.

    Lee esa lista otra vez. Ninguna herramienta es suya.

    El modelo no aportó capacidad generativa nueva al campo. Aportó criterio: qué herramienta usar, en qué orden y qué candidatos tirar a la basura. Es la diferencia entre IA generativa e IA agéntica llevada a un dominio donde el resultado se mide con un sensor.

    Y se nota en el ranking: su diseño número uno acertó el 49 % de las veces, el top cinco un 44 %, el top diez un 39 %, frente al 28 % del conjunto de treinta. El criterio estaba en el orden.

    Y se midió fuera de casa. Adaptyv Bio convirtió las secuencias en ADN, sintetizó las proteínas con síntesis libre de células y robots, y midió afinidad por resonancia de plasmón superficial. Twist Bioscience también participó. Esto no es una simulación puntuándose a sí misma.

    Los números por brazo del experimento, que mucha gente ha contado mal mezclándolos:

    Configuración Binders / diseños Tasa de acierto
    Baseline de la industria hoy — 10–15 %
    Opus 4.8 · 14 dianas a la vez, una sola sesión · 48 h 88 / 390 22,6 %
    Mythos Preview · 14 dianas a la vez, una sola sesión · 48 h 104 / 390 26,7 %
    Mythos Preview · una sesión de 24 h por diana 158 / 450 35,1 %

    Del formato multi-diana se analizan 13 de las 14 dianas; la campaña de diana única cubrió las 15.

    El 26,8 % global sale de dividir 354 entre 1.320. El 95 % de los diseños se expresó correctamente. Y hubo dos casos que se salen de la media:

    • RBX1: 28 binders de 90 diseños sumando las tres campañas, un 31 %. Y un 40 % en la campaña de diana única, la mejor configuración. En la competición abierta previa sobre esta misma diana solo pegaron 9 de 245 diseños: un 3,7 %. El mejor diseño del agente se midió en 3,9 nM, por delante del que ganó aquella competición.
    • TREM2: 72 binders de 90 diseños. Un 80 %, frente al 38,3 % de la competición previa de Adaptyv.

    Con un asterisco que pone el propio informe: cuatro de las seis competiciones con las que se compara ya estaban publicadas y accesibles para el agente mientras diseñaba.

    Impresionante igual. Ahora la parte que de verdad importa.


    Dos tercios del prompt no eran de biología

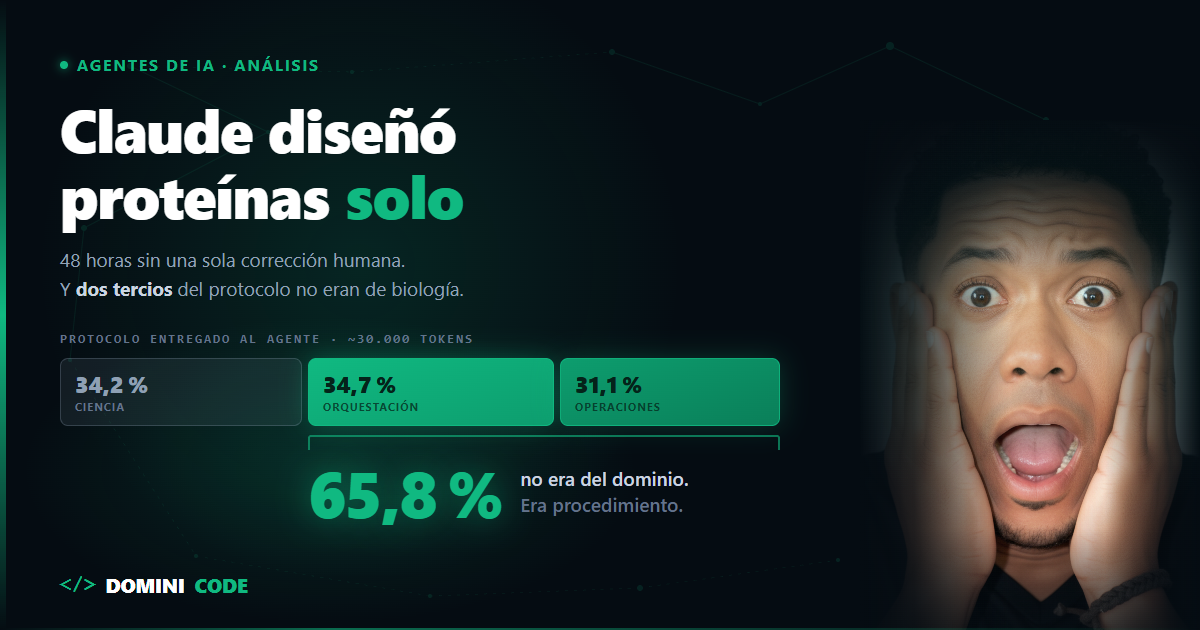
    Antes de arrancar, un grupo de expertos escribió un protocolo. Unos 30.000 tokens. Y después —cita textual del informe— "no dimos ninguna guía científica, técnica ni operativa adicional después de iniciar las campañas".

    Ni una corrección. Ni un "prueba mejor por aquí". Los únicos mensajes humanos que entraron fueron instrucciones cortas y no técnicas para reanudar cuando una sesión se caía por infraestructura. El resto de incidencias las detectó y las sorteó el agente solo.

    Lo interesante es cómo se repartía ese documento:

    PROTOCOLO ENTREGADO AL AGENTE - ~16.000 palabras (~30.000 tokens)
    
      Ciencia y herramientas      ################   34,2 %
      Orquestacion y validacion   ################   34,7 %
      Operaciones                 ##############     31,1 %
                                                     -------
      Todo lo que NO es dominio                      65,8 %
    

    Un 34,2 % de ciencia. Y un 65,8 % de cosas que no tienen nada que ver con proteínas: cómo trabajar, cómo decidir, cómo validar, cuándo parar, qué hacer cuando algo se rompe.

    Piensa ahora en tu último system prompt.

    Si el 90 % es "eres un ingeniero senior experto en X con 20 años de experiencia", ya sabes qué te falta. No te falta dominio. Te falta procedimiento.

    Y un detalle remata la idea: probaron el protocolo en campañas piloto y, antes de las corridas finales, revisaron justo las secciones de orquestación y operaciones. No cambiaron el modelo. No añadieron más ciencia. Iteraron sobre el harness.

    Eso es Spec-Driven Development sin llamarlo por su nombre: escribir la especificación antes de dejar que nada se ejecute, y corregir la especificación en lugar de corregir la ejecución. La misma disciplina que desarrollo en el libro de SDD, solo que aquí el precio de improvisar no era un sprint perdido, eran 50.000 dólares de GPU.


    "¿No habíamos quedado en que los mega-prompts son mala idea?"

    Sí. Y este experimento no me desmiente. Me da la razón, aunque de lejos parezca lo contrario.

    Escribí Arquitectura de subagentes vs. mega-prompt defendiendo que un contexto único cargado de responsabilidades se degrada. Aquí hay un documento de 30.000 tokens que funcionó. Toca mirar el detalle.

    Primero: eso no es un prompt, es un protocolo compartido. Y el informe lo dice sin ambigüedad: cada agente de la campaña lo recibe como system prompt. En plural. Uno de los bloques de orquestación explica cómo delegar el trabajo en un equipo de subagentes de dos capas y cómo supervisarlo.

    Especificación larga, ejecución repartida. Que es justo lo que defendía aquel post.

    Segundo, el dato que lo remata. La campaña que atacó las 14 dianas a la vez dentro de una sola sesión se quedó en el 26,7 %. Darle a cada diana su propia sesión de 24 horas subió al 35,1 %: 143 binders frente a 104 sobre las mismas 13 dianas, con una p de 0,003.

    Anthropic avisa de que esa sesión dedicada también tuvo 2,8 veces más cómputo por diana, así que foco y presupuesto no se pueden separar del todo. Pero la dirección es la de siempre: cuantas menos cosas metes en un contexto, mejor sale.

    Un mega-prompt de los malos es sedimento. Instrucciones de dominio acumuladas, ejemplos pegados a mano y reglas contradictorias que alguien fue añadiendo cada vez que algo petó en producción. Esto es un manual de operaciones escrito una vez y repartido entre varios agentes.

    La lección no es "escríbelo todo más largo". Es qué metes dentro de cada contexto y cómo lo estructuras.


    Qué es un agente de IA autónomo (y qué no lo es)

    Un agente de IA autónomo es un sistema que recibe un objetivo y un protocolo escritos por una persona y, a partir de ahí, decide solo qué herramientas usar, en qué orden y qué resultados descartar, sin intervención humana durante la ejecución. No es un modelo más listo: es un modelo con un carril bien escrito.

    En esta campaña la autonomía duró 48 horas. Lo que la hizo posible no fue el modelo, fue el documento que alguien escribió antes de pulsar enter.


    La frontera real de los agentes de IA autónomos

    La palabra "autónomo" ha vendido muchos titulares estos días. Merece un asterisco grande.

    Lo decidió el agente Lo fijó el humano
    Qué investigar de cada diana Qué dianas
    Qué epítopo atacar El protocolo
    Qué herramientas usar y en qué orden Los antígenos del ensayo
    Qué candidatos descartar Los pedidos de síntesis
    Cómo rankear las secuencias finales La lectura de los datos

    Nadie tocó al agente durante la corrida. Cierto. Pero un humano eligió el problema, escribió las reglas, definió el ensayo y leyó los resultados.

    Ese es el patrón que veo funcionar una y otra vez en producción: autonomía total dentro de un carril que alguien dibujó antes, con mucho cuidado.

    El trabajo del ingeniero se ha movido del bucle al carril. Es justo lo que trabajo en el curso Construye con IA: el resultado depende mucho más de lo que escribes antes de lanzar el agente que del modelo que elijas.


    Por qué la química tardó minutos y esto semanas

    En la misma publicación hay un segundo experimento que casi nadie ha citado. Claude Opus 5 procesó ficheros de NMR y LC-MS en 23 y 19 minutos, y calculó una pureza del 96,4 % frente al 96,33 % que había medido el laboratorio.

    Minutos.

    Los binders necesitaron semanas de laboratorio húmedo para saber si el agente había acertado.

    Misma tecnología, misma calidad de razonamiento, velocidades incomparables. ¿La variable? Lo que cuesta comprobar la respuesta.

    Donde verificar es barato y rápido, el agente itera, se corrige y avanza. Donde verificar cuesta semanas y dinero, el agente dispara a ciegas y espera.

    Tu código está en el primer grupo. O debería estarlo. Un test que corre en 200 milisegundos es tu resonancia de plasmón superficial: la señal barata que le dice al agente si va bien o va mal. Por eso insisto tanto con el test harness. Sin él, tu agente vive en el mundo de las proteínas: dispara y reza.

    Y un detalle que deberías tatuarte: las puntuaciones de confianza del propio agente no avisaron de ninguno de los fallos. Los diseños contra MBP puntuaban casi igual que los que sí funcionaron. La confianza del modelo no es una señal de verificación.


    Los fallos, que Anthropic no escondió

    Contra MBP (maltose binding protein), una superficie grande, convexa y polar, sin un bolsillo donde agarrarse: 0 binders de 90 diseños. Cero.

    Contra TNFα, Opus 4.8 sacó 12 binders de 150 diseños y Mythos Preview ninguno de 60. El modelo mejor en la media, a cero en esa diana concreta. Y el informe no lo vende como victoria de un modelo: dice que cada campaña corrió una sola vez y usó generadores distintos, así que no pueden atribuir la diferencia a los modelos.

    Y hubo una diana 16 (GDF-8 mature) excluida del análisis porque el ensayo dio mediciones de mala calidad: la proteína se agregaba consigo misma. Ahí no falló el agente, falló el ensayo.

    Estos tres datos me dan más confianza que los 354 binders. Un informe que solo cuenta aciertos es marketing.

    Tampoco esconden el coste: 50.000 dólares de GPU en la corrida de 48 horas contra todas las dianas a la vez (hasta 12.500 horas de NVIDIA H100) y 10.000 por cada sesión de 24 horas contra una sola. La configuración más precisa fue también la más cara por diana.


    Lo que esto no es

    No es peer review. Es un estudio autopublicado por Anthropic sobre sus propios modelos. El trabajo de laboratorio lo hicieron terceros, que es lo que lo salva de ser una nota de prensa, pero nadie externo ha revisado la metodología.

    Y hay una línea que Anthropic no ha cruzado: el diseño de proteínas y otras capacidades de biología de uso dual siguen sin acceso general en Claude Fable 5, su modelo más capaz, por riesgo de armas biológicas. Los modelos clase Opus mantienen acceso limitado.

    La empresa que publica el estudio ha decidido no ofrecer esa capacidad en su mejor modelo. Ese freno también es un resultado del experimento.


    Qué haces el lunes con tus agentes de IA autónomos

    Abre el system prompt del agente que tengas en producción ahora mismo. Son quince minutos:

    1. Etiqueta cada bloque con una de estas tres palabras: dominio, orquestación, operaciones.
    2. Saca porcentajes. Divide las líneas de cada etiqueta entre el total.
    3. Compara con el 34/35/31 de Anthropic. Si te sale algo parecido a 90/5/5, ya sabes qué te falta: no te falta dominio, te falta procedimiento.
    4. Escribe lo que falta: el procedimiento paso a paso, los criterios para descartar, las señales de que va por buen camino, cuándo debe pararse y a quién avisa cuando no sabe seguir.

    Ese fue el 65,8 % del documento que le dieron a Claude. Y es la parte que casi nadie escribe, porque es aburrida y no luce en un tuit.

    Si te llevas una sola frase de todo esto, que sea esta: si tu agente no tiene una forma barata de saber si acertó, no tienes un agente. Tienes un generador de texto con acceso a tu terminal.

    En Dominicode Labs desmontamos este tipo de arquitecturas con proyectos reales. Pero el ejercicio de los quince minutos hazlo hoy.


    Preguntas frecuentes

    ¿Claude ha creado un fármaco?

    No. Diseñó binders: proteínas pequeñas que se pegan a una diana. Es el paso cero de muchos programas farmacológicos, y por delante queda todo el recorrido preclínico y regulatorio, que se mide en años.

    ¿El estudio está revisado por pares?

    No. Es un estudio autopublicado por Anthropic sobre sus propios modelos, sin peer review. Lo que sí es externo es la validación: Adaptyv Bio y Twist Bioscience sintetizaron las proteínas y midieron afinidad por resonancia de plasmón superficial. Nadie de fuera ha revisado la metodología, pero los resultados no salen de una simulación.

    ¿Qué significa una tasa de acierto del 26,8 %?

    Que de 1.320 diseños generados, 354 se confirmaron como binders en el laboratorio. El baseline actual de la industria está entre el 10 % y el 15 %. Conviene no mezclar brazos del experimento: el 26,8 % es el dato global y, por configuración, va del 22,6 % al 35,1 %.

    ¿Por qué acierta más si trabaja contra una sola diana?

    Porque la sesión dedicada de 24 horas concentra todo el presupuesto de razonamiento y cómputo en un único problema: sube del 26,7 % al 35,1 %. También sale más cara por diana, y Anthropic avisa de que no puede separar el efecto del foco del de un presupuesto 2,8 veces mayor por diana. Es tu mismo dilema entre lanzar un agente contra quince tickets a la vez o dedicarle una sesión completa al que importa.

    ¿Puedo usar Claude para diseñar proteínas?

    No con acceso general. El diseño de proteínas y otras capacidades de biología de uso dual siguen restringidas en Claude Fable 5, el modelo más capaz, por riesgo de armas biológicas. Los modelos clase Opus mantienen acceso limitado.

    ¿Qué me llevo de esto para mis agentes de IA autónomos si no toco biología?

    El reparto del protocolo: 34,2 % dominio, 34,7 % orquestación y validación, 31,1 % operaciones. Es la plantilla que yo usaría para escribir el contexto de un agente. Y la consecuencia práctica: iteraron sobre el harness, no sobre el modelo.


    Fuentes


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo Funciona el Watermarking de Claude a Nivel de API

    Cómo Funciona el Watermarking de Claude a Nivel de API

    La primera vez que alguien escucha que Claude mete una marca de agua en el texto que genera, se imagina un truco barato de esteganografía.

    Un espacio de ancho cero entre dos palabras. Un carácter Unicode invisible (\u200B). Un patrón binario escondido en los saltos de línea.

    Si fuera eso, un script de Python de dos líneas con un .replace('\u200b', '') o un regex básico destruiría la marca en tres milisegundos.

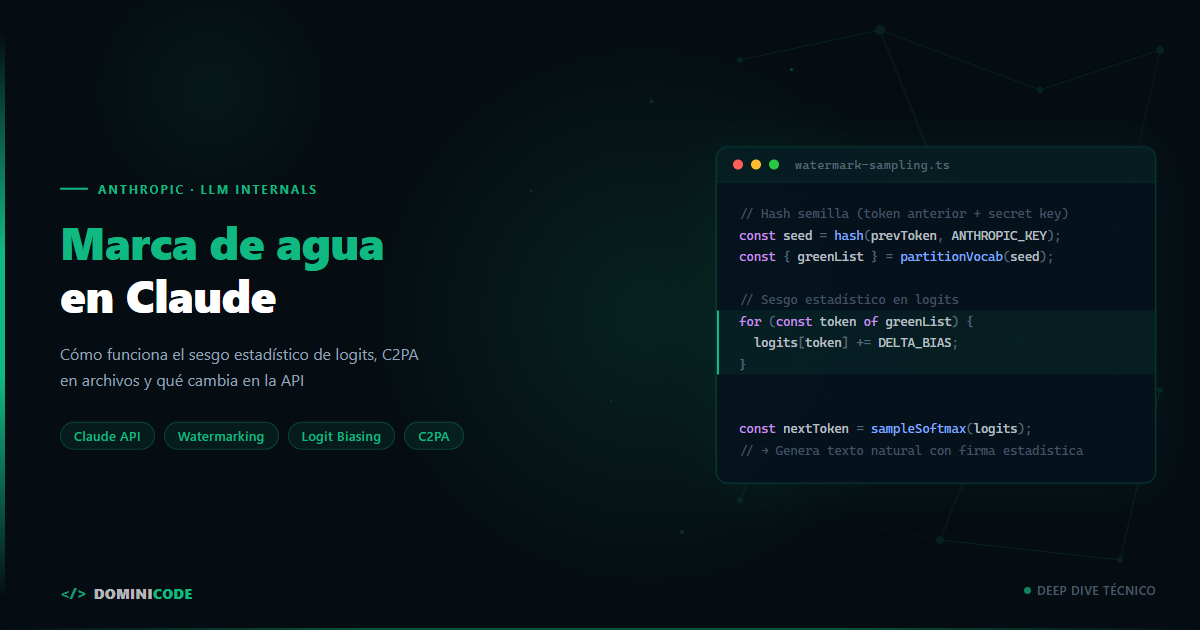
    Anthropic no ha implementado un truco de caracteres. Desde agosto de 2026, todos los modelos nuevos de Claude integran un watermarking a nivel de API de naturaleza puramente estadística. No hay caracteres ocultos, viaja en el texto plano al copiar y pegar, y no existe ningún parámetro o flag en la API para desactivarla.

    Si tu producto llama a la API de Claude, tus usuarios ya están recibiendo texto marcado, lo sepas o no. Aquí te explico el algoritmo que hay detrás, cómo se diferencia de los metadatos en archivos y qué implica de verdad si construyes sobre esa API — no como usuario ocasional de Claude Code, sino como quien tiene que responder por ello ante sus propios clientes.


    Cómo genera texto un LLM (el paso previo imprescindible)

    Para entender cómo se inserta una señal en un texto sin alterar una sola letra, primero hay que recordar qué hace el modelo en cada ciclo de inferencia.

    Un LLM no "elige una frase completa". Trabaja token a token. Cuando Claude va a generar la siguiente palabra, calcula una distribución de probabilidad sobre su vocabulario completo (los llamados logits, normalizados con una función softmax):

    software      → 28%
    aplicaciones  → 21%
    productos     → 17%
    sistemas      → 14%
    herramientas  → 11%
    otros...      →  9%
    

    En un muestreo normal con cierta temperatura, el modelo elige uno de los tokens más probables. El texto resultante es fluido, coherente y suena natural.

    Aquí es exactamente donde entra el algoritmo de watermarking.


    El algoritmo de Kirchenbauer: listas verdes y sesgo de logits

    Anthropic no ha publicado el mecanismo exacto que usa Claude. Lo único que confirma oficialmente es el principio: la marca usa una clave y las palabras previas para decidir qué palabra elige el modelo entre varias opciones semánticamente equivalentes, sin tocar la calidad del texto. Cita como referencias el paper de Kirchenbauer et al. y SynthID-Text de Google DeepMind, así que lo más razonable —y lo que asume la mayoría del análisis externo— es que Claude use una variante de esa familia de técnicas. Lo que sigue es cómo funciona ese enfoque en general, no una confirmación línea por línea de la implementación interna de Anthropic.

    La técnica estándar en la industria para marcar texto en LLMs no toca el texto después de generarlo. Modifica la probabilidad antes de muestrear.

    El proceso sigue, a grandes rasgos, estos pasos:

    Token anterior (t-1) 
           │
           ▼
    [ Hash + Clave Secreta de Anthropic ]
           │
           ▼
    Partición pseudo-aleatoria del vocabulario
      ├── Lista Verde (Green List) ~ 50%
      └── Lista Roja (Red List)    ~ 50%
           │
           ▼
    Se suma un delta (+δ) a los logits de la Lista Verde
           │
           ▼
    Muestreo del siguiente token (favorece sutilmente el verde)
    
    1. Generación de semilla: Al momento de predecir el siguiente token, el sistema calcula un hash criptográfico del token anterior (o de una ventana de los últimos tokens) combinado con una clave secreta que solo posee Anthropic.
    2. Partición del vocabulario: Ese hash divide pseudo-aleatoriamente todo el diccionario de tokens en dos grupos: una Lista Verde y una Lista Roja, típicamente al 50% cada una.
    3. Sesgo de logits (Logit Biasing): A los logits de los tokens que caen en la Lista Verde se les suma un valor constante positivo.
    4. Muestreo: El modelo muestrea el siguiente token aplicando la distribución con los logits alterados.

    ¿Qué ve un humano vs. qué ve un detector?

    • Un humano lee el texto y no nota nada extraño. Como el sesgo es moderado, el modelo sigue seleccionando palabras de alta probabilidad semántica. El significado, el estilo y la calidad no cambian.
    • Un detector con la clave (hoy, solo Anthropic; han anunciado que van a liberar una API de detección pero todavía no está disponible públicamente) tomaría el texto generado, reconstruiría para cada palabra si pertenecía a la Lista Verde o a la Lista Roja, y contaría cuántos tokens verdes aparecen.

    En un texto escrito por un humano o por un modelo sin marca, la probabilidad de que un token caiga en la lista verde es de alrededor del 50% (puro azar).

    En un texto marcado con este tipo de técnica, esa proporción sube de forma sistemática por encima del azar. Anthropic no ha publicado la cifra exacta para Claude; en la literatura académica sobre KGW/SynthID-Text el desplazamiento suele ser notable con relativamente pocos tokens.

    Con un párrafo de varios cientos de palabras, la probabilidad de que esa acumulación de tokens verdes ocurra por puro azar cae drásticamente. Esa es la base estadística del método, aunque los números concretos que aplica Anthropic a Claude no son públicos.


    Por qué en código fuente la marca es mucho más débil

    Aquí hay un detalle técnico crítico que casi nadie en redes sociales ha mencionado: el watermarking estadístico necesita entropía.

    La entropía mide la cantidad de opciones válidas que tiene el modelo para continuar una frase.

    • En prosa libre (alta entropía): Para decir "construimos sistemas robustos", el modelo puede elegir entre sistemas, aplicaciones, plataformas, soluciones o arquitecturas. Tiene margen de sobra para elegir un token de la Lista Verde sin romper la frase.
    • En código de programación (baja entropía): Si estás escribiendo TypeScript y tienes for (const item of, el siguiente token sintácticamente válido es casi con total seguridad el identificador del array o una estructura iterable. Si fuerzas un token de la lista verde que no encaja sintácticamente, el código no compila.
    // En sintaxis estricta, el espacio de tokens válidos es minúsculo:
    export interface UserSession {
      id: string;
      createdAt: Date;
    }
    

    Si el modelo reduce la temperatura o la sintaxis impone un único token válido, el sesgo de la lista verde no puede aplicarse sin destruir la corrección del programa.

    Por eso, en archivos de código (.ts, .py, .rs) la marca estadística es inherentemente más débil o casi indetectable en fragmentos cortos, mientras que en documentación, emails o artículos es donde más fuerte se fija. Y precisamente porque no puedes apoyarte en el watermark para saber si un fragmento de código viene de un agente, la validación real sigue siendo la de siempre: TDD potenciado por IA, validar el código antes de mergear.

    Esta es la misma disciplina de control y contexto que enseñamos en el curso Construye con IA: De la Idea al Producto con Claude y Specs: cuando entiendes cómo procesan los modelos la probabilidad de los tokens, dejas de tratar a los agentes como cajas mágicas y empiezas a diseñar sistemas predecibles.


    Texto vs. Archivos: la diferencia entre Watermark y C2PA

    Existe una confusión generalizada entre la marca en el texto y la marca en archivos multimedia. Anthropic usa dos tecnologías completamente distintas según el tipo de output:

    Característica Marca de agua en Texto Metadatos en Archivos (.png, .svg)
    Mecanismo Sesgo estadístico en logits (Kirchenbauer / SynthID) Estándar C2PA (Content Authenticity Initiative)
    Dónde vive En la frecuencia y secuencia de las palabras En la cabecera / bloque de metadatos del archivo
    Copiar y pegar Sobrevive (es el texto mismo) No aplica (es un archivo binario)
    Edición / Conversión Se degrada progresivamente si reescribes Se pierde si re-guardas o conviertes el archivo
    Verificación hoy Privada (solo Anthropic tiene la clave) Pública y verificable hoy con c2patool

    Cómo inspeccionar C2PA en tus archivos hoy mismo

    Si generas diagramas SVG o imágenes con Claude y las sirves desde tu backend, puedes auditar los metadatos C2PA en tu propia máquina con la herramienta oficial de la Content Authenticity Initiative:

    # Instalación del cli oficial de C2PA
    brew install c2patool
    # O descargar el binario desde github.com/contentauth/c2pa-rs/releases
    
    # Inspeccionar el manifiesto completo en JSON
    c2patool imagen.png
    
    # Ver solo el resumen de procedencia
    c2patool imagen.png --info
    

    Si el archivo proviene directamente de Claude, el manifiesto C2PA mostrará la firma criptográfica de emisión. Si lo abres en Photoshop, lo recortas y lo guardas como WebP, el contenedor C2PA desaparece a menos que tu software lo re-firme.


    Detector de IA ≠ Detector de Watermark

    Esta distinción te va a ahorrar dolores de cabeza con clientes y product managers cuando te pidan "añadir detección de IA":

    1. Un detector de IA tradicional (heurístico): Analiza perplejidad y ráfagas (burstiness). Intenta adivinar si el estilo parece robótico. Es impreciso, produce falsos positivos atroces con no-nativos en inglés y no sirve como prueba legal.
    2. Un detector de marca de agua: No evalúa estilo ni perplejidad. Aplica una clave criptográfica sobre la secuencia de tokens y comprueba una hipótesis matemática de probabilidad binomial.

    Hoy por hoy, no existe un detector público de watermark para Claude. Si ves una web que afirma "Pega tu texto y te digo si tiene la marca de Claude", es un detector heurístico genérico, no un verificador del watermark de Anthropic.

    Además, publicar un detector abierto crea un problema de seguridad: actúa como un oráculo de optimización. Cualquier usuario podría pasar su texto por un script que altere palabras una a una hasta que el verificador dé negativo, destruyendo la marca con el mínimo esfuerzo.


    Qué significa el watermarking de Claude si construyes sobre la API

    Si integras Claude en tu SaaS o en pipelines de desarrollo interno —repasa lo básico en Claude API: Crash Course para developers con TypeScript si aún no la usas a diario— hay cuatro realidades que debes asumir:

    1. No hay opt-out: No existe un header x-anthropic-disable-watermark: true. La directiva de la Unión Europea (EU AI Act, artículo 50) exige que los proveedores marquen las salidas de IA generativa.
    2. La marca demuestra procesamiento, no autoría única: Si un humano escribe un borrador y le pide a Claude que corrija la puntuación, el texto resultante puede quedar marcado. Anthropic lo aclara en su documentación: la marca indica que el texto pasó por el modelo, no que el humano no intervino.
    3. No prometas a tus clientes outputs "indetectables": Cualquier modelo de negocio basado en vender "artículos indetectables para SEO" o "ensayos indetectables" está técnicamente muerto a medio plazo frente a esquemas de marca estadística.
    4. La paráfrasis profunda degrada la señal: Anthropic mismo lo advierte: una edición ligera probablemente no elimina la marca, pero reescribir el texto a fondo —traducirlo, reordenarlo intensamente o editarlo a mano de forma sustancial— sí la destruye, porque rompe la alineación entre los tokens y la clave con la que se generaron.

    Para patrones avanzados de integración con LLMs y arquitecturas robustas en producción, en Dominicode Labs analizamos continuamente los cambios de la API de Anthropic y cómo adaptar nuestros proyectos.


    Preguntas frecuentes

    ¿Puedo desactivar la marca de agua en la API de Claude?

    No. Anthropic ha desplegado el sistema de watermarking a nivel de inferencia sin ningún parámetro de exclusión en la API ni en las cuentas Enterprise, alineándose con las normativas internacionales como el EU AI Act.

    ¿La marca de agua ralentiza la generación o encarece el coste de tokens?

    Anthropic no ha reportado ningún impacto. Por diseño, este tipo de watermarking solo sesga qué token se elige dentro de la misma distribución de probabilidad que el modelo ya calculaba: no añade tokens extra ni pasadas adicionales de inferencia, así que el coste computacional adicional es marginal.

    ¿Un detector de watermark puede acusarme falsamente de usar IA?

    Con textos largos, la probabilidad matemática de un falso positivo en un test de hipótesis tipo Kirchenbauer es extremadamente baja — es la base estadística del método, aunque Anthropic no ha publicado la tasa exacta para Claude. Aun así, es un mecanismo mucho más fiable que los detectores heurísticos habituales, que fallan con frecuencia.

    ¿Qué pasa si traduzco el texto generado por Claude a otro idioma?

    Si traduces el texto mediante otra herramienta o manualmente, la alineación de los tokens con la clave pseudo-aleatoria original se destruye y la marca de agua estadística deja de ser detectable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso. OpenSpec es un framework open source de spec-driven development creado por Fission-AI que guarda lo acordado — propuesta, diseño, tareas y spec — en archivos Markdown versionados dentro del repo, para que Claude Code los lea antes de tocar código. En esta guía lo instalamos, lo inicializamos con openspec init y recorremos el flujo OPSX completo sobre un proyecto que ya existe.


    OpenSpec no es OpenAPI: la diferencia en una tabla

    Comparten cuatro letras y nada más.

    OpenSpec OpenAPI
    Qué es Framework de spec-driven development para asistentes de código Especificación para describir APIs REST
    Quién lo mantiene Fission-AI OpenAPI Initiative (Linux Foundation)
    Formato Markdown dentro del repo YAML o JSON
    Para qué sirve Que un agente implemente lo acordado Que un cliente sepa llamar a tu API

    Si has llegado buscando Swagger, este no es tu post.


    Cómo instalar OpenSpec para Claude Code (y el error de scope de npm)

    OpenSpec se instala como CLI global. Requiere Node.js 20.19.0 o superior, y la versión actual es la 1.8.0.

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto: openspec a secas es la versión 0.0.0 publicada el 9 de abril de 2019, sin relación alguna con el framework y sin una sola actualización desde entonces. Es el fallo más repetido en tutoriales, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Qué crea openspec init en un proyecto con Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Qué poner en openspec/config.yaml (y por qué no es opcional)

    openspec/config.yaml es el archivo donde defines el schema por defecto, el contexto del proyecto y las reglas por artefacto. No es documentación que el agente abre si le apetece: es entrada del modelo. La doc oficial lo dice sin rodeos — "When generating any artifact, your context and rules are injected into the AI prompt".

    Sus claves de nivel superior son cuatro:

    Clave Para qué
    schema El schema por defecto de los artefactos
    context La información de tu proyecto. Aparece en todos los artefactos
    rules Restricciones por artefacto. Solo aparecen en el artefacto que coincide
    operations Guía opcional para apply y archive

    Ese matiz de context y rules importa: el contexto viaja siempre, las reglas solo cuando toca. Así que lo que quieras que el agente tenga presente en cada decisión va en context.

    Dedica cinco minutos a describir de verdad tres cosas ahí: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear. El detalle de cada clave está en la doc de customization.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    El flujo OPSX paso a paso en Claude Code

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y consolida lo implementado en openspec/specs/, que es la fuente de verdad del proyecto — "Specs are the source of truth — they describe how your system currently behaves". A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    Los otros dos del perfil por defecto

    /opsx:update revisa los artefactos de planificación de un cambio y los mantiene coherentes entre sí, en cualquier dirección: si editas el diseño, la propuesta se ajusta.

    /opsx:sync fusiona las delta specs en openspec/specs/ sin archivar el cambio. Útil cuando quieres consolidar antes de cerrar.

    Los extendidos, y por qué /opsx:verify no te va a funcionar todavía

    Aquí está el detalle que hace perder media hora a mucha gente: el perfil por defecto no trae verify.

    El perfil core son los seis de arriba — propose, explore, apply, update, sync, archive. Los extendidos son otros seis: /opsx:new, /opsx:continue, /opsx:ff, /opsx:verify, /opsx:bulk-archive y /opsx:onboard. Si escribes /opsx:verify recién instalado, no autocompleta y no pasa nada.

    Para activarlos:

    openspec config profile   # selecciona el perfil ampliado
    openspec update           # aplica los cambios en el proyecto
    

    Con el perfil ampliado activo, /opsx:verify contrasta la implementación contra la spec. No es un test runner: es la comprobación de que no se ha colado nada que nadie pidió y de que no falta nada que sí se pidió.

    Empieza por los seis del perfil core. Los extendidos los necesitarás cuando tengas el ciclo rodado y lleves varios cambios a la vez.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Una delta spec es una spec que describe solo lo que cambia — lo añadido, lo modificado y lo eliminado — en vez de redescribir el sistema entero. Es lo que hace viable OpenSpec en un proyecto que ya existe.

    Así se ve una:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - GIVEN el listado de productos cargado
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ### Requirement: Paginación del listado
    El listado DEBE conservar el filtro activo al cambiar de página.
    

    Dos cosas que conviene saber antes de copiar esto. Las etiquetas son literales y no se traducen: ADDED, MODIFIED, REMOVED, Requirement:, Scenario: y GIVEN/WHEN/THEN van en inglés aunque el cuerpo esté en español. Y solo incluyes las secciones que uses — si el cambio no elimina nada, no dejes un ## REMOVED Requirements vacío.

    Sobre los escenarios: es vocabulario Gherkin, pero en Markdown plano. Sin ficheros .feature, sin Cucumber, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development.

    Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto. La lista completa está en la tabla de herramientas soportadas, que cubre más de treinta.


    Cómo migrar del flujo antiguo de OpenSpec al flujo OPSX

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano: ejecuta openspec update, que regenera los ficheros de skills y comandos para las herramientas que tengas configuradas.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Dos avisos antes de que te lances. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Por qué no me funciona el comando /opsx:verify?

    Porque no viene en el perfil por defecto. OpenSpec usa el perfil core, que trae seis comandos: propose, explore, apply, update, sync y archive. El comando verify pertenece al perfil ampliado, junto a new, continue, ff, bulk-archive y onboard. Para activarlo ejecuta openspec config profile y después openspec update.

    ¿Qué comandos trae OpenSpec por defecto?

    El perfil core incluye seis: propose para generar la propuesta, explore para planificar sin compromiso, apply para implementar, update para mantener coherentes los artefactos de planificación, sync para fusionar las delta specs en openspec/specs/ y archive para cerrar el cambio.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es ejecutar openspec update en el proyecto, que regenera skills y comandos, en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Un compañero me mandó el titular por Telegram a las siete de la mañana. Debajo, una sola línea: "¿Entonces pueden saber que este commit lo escribí con Claude Code?".

    Es la pregunta correcta. Y la respuesta corta es incómoda: hoy nadie te lo puede demostrar, porque el detector público de las marcas de agua de Claude todavía no existe.

    La respuesta larga es más interesante. Va de por qué estas marcas funcionan razonablemente bien sobre prosa y se deshacen casi solas dentro de un repositorio de código.

    La familia de marcas de agua más documentada en la literatura no es un carácter oculto ni un metadato: es un sesgo estadístico introducido durante la generación, en la elección misma de las palabras, que deja una firma detectable sin alterar el significado. Anthropic no ha confirmado que la suya funcione así. Solo dice que va "tejida dentro del propio texto".

    He leído la documentación entera. Esto es lo que dice, y lo que no.

    Documentación de Anthropic actualizada el 11 de agosto de 2026. Última revisión de este post: 12 de agosto de 2026.


    Qué ha anunciado Anthropic exactamente

    Cuatro hechos, sin adornos.

    1. Anthropic ha firmado el Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA sobre transparencia del contenido generado por IA. Esto no es marketing: es cumplimiento normativo.
    2. Los modelos Claude lanzados a partir del 2 de agosto de 2026 salen con marcado machine-readable desde el primer día. Para los modelos anteriores hay un periodo transitorio y Anthropic dice que está trabajando en incorporarlo.
    3. El alcance cubre Claude Platform (la API), Claude, Claude Code, Claude Cowork y Claude Tag, además de Claude servido desde AWS, Google Cloud y Microsoft Foundry. Se aplica en todo el mundo, no solo en la Unión Europea. Con una salvedad que conviene retener para más adelante: la marca en el texto sí viaja por esas tres nubes, pero los metadatos de procedencia firmados "puede que no estén soportados en todas las plataformas, según las funcionalidades que ofrezca cada una".
    4. La documentación no contempla ningún opt-out: el marcado se aplica a la salida de los modelos soportados, también cuando consumes la API.

    Que Claude Code aparezca escrito con todas las letras en esa lista es lo que hace que este post exista.

    Sobre el mecanismo, la documentación de Anthropic dice esto y nada más:

    "Teje una marca de agua imperceptible directamente en el propio texto. No la verás, y no cambia el significado, la calidad ni la legibilidad de la respuesta de Claude."
    ("…it weaves an imperceptible watermark directly into the text itself. You won't see it, and it doesn't change the meaning, quality, or readability of Claude's response.")

    Punto. No publican el algoritmo.


    Cómo se mete una marca de agua dentro de un texto

    La técnica estándar sesga la elección de tokens: en cada paso el modelo parte el vocabulario en una lista verde y una roja usando un hash secreto, y empuja suavemente la generación hacia la verde. El texto sigue siendo natural, pero contiene más tokens verdes de los que el azar explicaría.

    Aclaración previa: Anthropic no ha publicado su algoritmo. Lo que viene ahora es cómo funciona la familia de técnicas conocida en la literatura académica —sobre todo el trabajo de Kirchenbauer et al., "A Watermark for Large Language Models" (2023)—, no una descripción de lo que hace Claude por dentro.

    Lo explico porque es didáctico y porque es la familia plausible. No porque sea un dato confirmado.

    Un modelo de lenguaje no escribe palabras: escribe tokens. En cada paso genera un vector de logits, una puntuación para cada token del vocabulario, y de ahí sale la distribución de la que se muestrea el siguiente. Si nunca has visto por dentro cómo se trocea el texto, en Tokens en español: por qué cuestan un 26 % más que en inglés lo explico con ejemplos reales.

    La técnica clásica hace esto:

    1. Toma los últimos tokens generados y calcula un hash con una clave secreta.
    2. Usa ese hash como semilla para partir el vocabulario en dos: una lista verde y una lista roja.
    3. Suma un pequeño sesgo a los logits de la lista verde antes de muestrear.
    4. Repite en cada token.

    El texto resultante es perfectamente natural. Pero contiene muchos más tokens "verdes" de los que el azar justificaría. Quien tenga la clave recalcula las listas y saca un valor estadístico de confianza.

    La gracia del método es que el detector no necesita el modelo. Solo la clave y suficiente texto.

    Ahí está la palabra que lo condiciona todo: suficiente.


    Marca de agua no es lo mismo que detector de IA

    Un detector de IA adivina a partir del estilo; un detector de marca de agua busca una firma concreta que el propio modelo insertó. Son dos tecnologías distintas, con tasas de error distintas, y confundirlas es el error que más circula esta semana.

    Detector de IA Detector de watermark
    Analiza estilo Sí No
    Conoce la firma No Sí
    Necesita clave No Posiblemente
    Es probabilístico Sí Sí
    Identifica proveedor Difícil Potencialmente

    Un detector de IA clásico —los que llevan años suspendiendo a estudiantes por escribir demasiado bien— hace estadística sobre el estilo: perplejidad, longitud de frase, variedad léxica. Adivina. Un detector de watermark no adivina: busca una firma concreta que sabe que está ahí.

    Anthropic dice que "está trabajando para permitir que usuarios y terceros detecten las marcas de agua incrustadas de Claude y los metadatos de procedencia" y que publicará los detalles más adelante. Traducido: hoy no hay detector público de la marca de agua de Claude, ni fecha.

    De ahí sale la frase que más falta hace repetir esta semana: cualquier web que hoy te diga "este texto contiene el watermark de Claude" sin acceso al mecanismo de verificación de Anthropic, está vendiendo humo. Sin ese mecanismo no hay verificación posible. Hay marketing.


    El problema de la baja entropía cuando escribes código

    Una marca de agua estadística es más débil sobre código que sobre prosa porque el código tiene poca entropía: en cada punto hay muy pocas continuaciones válidas y casi ningún margen para elegir un token en lugar de otro equivalente.

    Y esto no me lo invento yo. Kirchenbauer et al. le dedican una sección entera del paper, titulada "A caveat: The difficulty of watermarking low-entropy sequences", y la abren así: "El texto de baja entropía crea dos problemas para el marcado. El primero: tanto humanos como máquinas producen terminaciones parecidas, si no idénticas, ante prompts de baja entropía, lo que hace imposible distinguir unas de otras."

    Lo que sí es inferencia mía es aplicárselo a Claude. Anthropic no ha publicado su algoritmo ni ninguna política específica sobre código.

    Una marca de agua estadística necesita libertad de elección. Si el modelo tiene veinte formas igual de válidas de continuar una frase, puede empujar hacia la lista verde sin que se note. En prosa esto sobra: "rápido" o "veloz", "por tanto" o "así que".

    El código no funciona así.

    Después de const user = await this.userService. hay dos o tres continuaciones razonables y el resto son errores de compilación. La entropía se hunde. El modelo no puede elegir un nombre de método "más verde" si el método se llama como se llama en la interfaz, y no puede reordenar los argumentos porque la firma es la que es.

    Cuanto más determinista es la salida, menos sitio hay donde esconder señal. Y el código es el texto más determinista que produce un modelo. Es la misma naturaleza probabilística que explico en por qué la IA se inventa cosas: ese margen de maniobra permite tanto la alucinación como la marca de agua. En código, el margen se estrecha.

    Añade que la mayoría de los diffs que revisas en un PR son de veinte o treinta líneas. Anthropic no da ningún umbral, pero sí reconoce el límite: un pasaje muy corto deja "demasiado poco texto para una señal fiable".

    El paper de Kirchenbauer sí da números. En sus experimentos detectan el 98,4 % de las generaciones al umbral z=4, que se alcanza a los 128 tokens. Y avisan, en la misma sección: "Las secuencias de alta entropía se detectan con relativamente pocos tokens, mientras que las de baja entropía requieren más tokens para ser detectadas."

    Junta las dos frases y verás por qué el número engaña. Ciento veintiocho tokens son del orden de diez o quince líneas de TypeScript, bastante menos que un commit cualquiera. Parece buena noticia para quien quiera detectarte. No lo es: ese 98,4 % está medido sobre prosa periodística, y el código es exactamente el material de baja entropía que, según los propios autores, necesita bastantes más tokens. Cuántos más, no lo dice nadie. Echa tú la cuenta con el tamaño de tus commits.


    Por qué tu flujo de trabajo real lava la marca

    Formatear, refactorizar, renombrar y revisar código altera la secuencia de tokens, y eso es lo que deshace una marca estadística sin que nadie se lo proponga.

    Separemos las dos mitades del argumento, porque solo una está documentada. La documentada: Anthropic dice que la marca puede dejar de detectarse si el texto "ha sido editado en profundidad, parafraseado, traducido o mezclado con otra escritura" ("heavily edited, paraphrased, translated, or mixed into other writing"). La mía: que tu flujo de trabajo normal, el de cualquier martes, cuenta como editar en profundidad.

    Conviene citar también la otra mitad, porque Anthropic la dice y casi nadie la está recogiendo: la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Es cierto y no contradice lo anterior. Copiar y pegar no toca la secuencia de tokens: la marca sigue ahí intacta. Lo que la rompe es cambiar el orden de esos tokens, y eso es precisamente lo que hacen el formateador, la extracción de método y el renombrado.

    Lee las dos frases otra vez y piensa en cómo trabajas de verdad con Claude Code a diario.

    Spec-Driven Development reduce la libertad del modelo

    Cuando trabajas con una spec detallada —nombres de tipos, contratos, estructura de carpetas, criterios de aceptación— no le pides al modelo que invente. Le pides que transcriba una decisión que ya tomaste tú.

    Si la marca funciona como creo —y esto sigue siendo inferencia mía—, cuanto más rigurosa sea la spec, menos libertad probabilística le queda al modelo y menos espacio hay donde incrustar señal. Un efecto secundario curioso de una metodología que adopté por razones completamente distintas, y que tienes desarrollada entera en el libro de Spec-Driven Development.

    El efecto Prettier

    Esto es más brutal todavía, y pasa cada día sin que lo pienses.

    Guardas el archivo y el formateador reparte los saltos de línea a su manera. Extraes un método. Renombras data por invoiceLines porque el nombre no decía nada. Mueves el bloque a otro archivo. El linter reordena los imports. Pasa por code review y alguien cambia tres cosas.

    Cada una de esas operaciones altera la secuencia de tokens. Y cualquier marca estadística de la familia que describí arriba depende, literalmente, del orden exacto de esos tokens. Que la de Claude funcione así es inferencia mía. Que editar en profundidad pueda dejarla indetectable lo dice Anthropic.

    No es que estés intentando borrar nada. Es que hacer bien tu trabajo la borra. Auditar y refactorizar lo que genera el asistente en lugar de aceptarlo tal cual es justo el flujo que enseño en Construye con IA, y resulta que además tiene este efecto colateral.


    Lo que sí aguanta: C2PA en los archivos que genera Claude

    Hay un caso donde la marca sí resiste: los archivos. Cuando Claude genera un .svg, .png o .jpg entra un segundo mecanismo: incrusta metadatos de procedencia firmados criptográficamente con el estándar C2PA, de la Coalition for Content Provenance and Authenticity. Anthropic no dice que esto sustituya a la marca del texto; dice que esos formatos llevan además procedencia.

    Otra liga. Una firma criptográfica no es probabilística: o valida o no valida. Y permite detectar si el archivo fue manipulado después.

    Y aquí está el contraste que más importa: la marca de agua del texto no la puede verificar nadie fuera de Anthropic, pero el C2PA sí se verifica ya hoy con herramientas públicas como c2patool o contentcredentials.org. Uno es una promesa; el otro funciona esta tarde.

    Un detalle técnico que conviene fijar: un .svg es un archivo de texto, XML, no un binario. Los metadatos viven dentro del propio documento. Y aplica a los archivos que Claude genera, no a los que ya tienes en el proyecto.

    O sea: si le pides a tu agente los iconos SVG de la aplicación y los commiteas tal cual, esos archivos sí llevan procedencia verificable dentro del repo. Puedes comprobarlo tú mismo:

    c2patool icono-generado.svg
    

    Durarán hasta que alguien los pase por un optimizador, los convierta de formato o los vuelva a guardar: Anthropic avisa de que la conversión de formato, el re-guardado y las capturas de pantalla eliminan los metadatos.

    Y hay una limitación más, la que dejé apuntada al principio: los metadatos firmados "puede que no estén soportados en todas las plataformas". Si consumes Claude a través de AWS, Google Cloud o Microsoft Foundry, la marca del texto viaja igual, pero la procedencia de los archivos depende de lo que ofrezca cada plataforma. Anthropic lo incluye entre las causas por las que un contenido marcado puede no dar señal: haberse producido "a través de una plataforma, funcionalidad o tipo de archivo donde ese tipo de marcado no estaba soportado".

    Robusto, pero no indestructible.


    El falso positivo: detectar la marca no prueba autoría

    Todo lo anterior va de falsos negativos: la marca está y se pierde. Pero hay un problema en la dirección contraria, y lo reconoce la propia Anthropic.

    Detectar una marca de Claude te dice que el contenido "puede haber sido procesado por Claude" ("may have been processed by Claude"). No que Claude lo escribiera. La documentación lo desarrolla sin rodeos: "Claude puede no ser el autor original. La gente usa Claude a menudo para corregir, traducir, resumir o convertir archivos."

    Léelo despacio, porque cambia la conversación entera.

    Si coges una función que escribiste tú y le pides a Claude que la refactorice, que le añada tipos o que te traduzca los comentarios al inglés, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo.

    Y el reverso también está escrito: "la ausencia de marca detectada no significa que el contenido no fuera generado o procesado por IA".

    O sea que la señal falla en las dos direcciones. Quien pretenda usar una detección como prueba de que no escribiste tú el código está leyendo mal la herramienta, y ahora tienes la frase del fabricante para decírselo.


    ¿Qué otras IAs marcan el contenido que generan?

    Anthropic no es la primera ni va sola. El Artículo 50(2) empuja a todo el sector en la misma dirección, pero cada uno ha llegado hasta un punto distinto.

    Proveedor Marca el texto Marca archivos ¿Verificable hoy por ti?
    Anthropic (Claude) Sí, desde agosto de 2026 Sí, C2PA en .svg, .png, .jpg Texto: no. Archivos: sí, C2PA
    Google (Gemini) Sí, SynthID-Text Sí, SynthID en imagen, audio y vídeo No: leer SynthID requiere la clave de Google
    OpenAI (ChatGPT) No Sí, C2PA en imágenes y SynthID en audio Solo lo que expone C2PA

    Google llegó antes: SynthID-Text lleva desplegado en Gemini desde 2024 y fue el primer marcado de texto en producción a escala. Firmó el mismo Código de Buenas Prácticas el 24 de julio de 2026, una semana antes de que el Artículo 50 fuera aplicable, y anunció acuerdos con Apple, ElevenLabs, Kakao, NVIDIA y OpenAI para que el marcado sea interoperable entre proveedores.

    Fíjate en la casilla que se repite: nadie tiene detector público de texto. Ni Anthropic ni Google. SynthID lleva dos años funcionando y sigue necesitando la clave privada de Google para leerse. Eso te dice más sobre el plazo real de Anthropic que cualquier promesa de documentación futura.

    Y el caso de OpenAI merece un párrafo, porque es el más honesto sobre los incentivos del negocio: tenía el marcado de texto construido y lo aparcó en septiembre de 2024, cuando una encuesta interna reveló que cerca del 30 % de los usuarios de ChatGPT lo usarían menos si supieran que marca lo que escribe. Marca imágenes y audio, donde nadie protesta. Texto no.


    Entonces, ¿debería preocuparte?

    Respuesta corta: no, si escribes software y auditas lo que genera el asistente. Sí, si tu empresa firma contratos con cláusulas sobre uso de IA y nadie las ha leído.

    La iniciativa es buena ingeniería y buena regulación. La web abierta se está llenando de texto sintético que se hace pasar por humano, y marcarlo en origen es mejor que dejarlo en manos de detectores que funcionan por corazonadas estilísticas.

    Para quien escribe software, el código sigue siendo código.

    Tu repositorio no es un canal de distribución de texto sintético. Es un artefacto de ingeniería que pasa por specs, revisión, formateo, refactor y tests. Mientras controles la arquitectura y audites lo que genera el asistente, es poco probable que una marca estadística sobreviva a ese recorrido. Y mientras no haya detector público, ni tú ni nadie puede comprobarlo.

    Lo único que te recomiendo hacer hoy: si tu empresa firma contratos con cláusulas sobre uso de IA, sube el tema tú antes de que lo suba un cliente. No para justificarte —usar Claude Code no es hacer trampas—, sino para tener una política escrita en lugar de una improvisación en una llamada incómoda.

    Si quieres seguir estas cosas con gente que las aplica en producción y no solo lee titulares, en Dominicode Labs es de lo que hablamos cada semana.


    Preguntas frecuentes

    ¿Puede alguien saber hoy si usé Claude para escribir este código?

    No. Anthropic no ha publicado ni el algoritmo ni un detector público, y no ha dado fecha. Dice que trabaja para que usuarios y terceros puedan detectar las marcas, y que compartirá los detalles en documentación técnica futura. Hasta entonces, cualquier herramienta que afirme lo contrario no puede demostrarlo.

    ¿La marca de agua afecta a la calidad del código que genera Claude?

    Anthropic afirma que no cambia el significado, la calidad ni la legibilidad. En prosa es creíble: el sesgo se reparte entre alternativas equivalentes. En código las alternativas equivalentes escasean, así que —y esto es deducción mía, no dato publicado— cualquier esquema de marcado tendría mucho menos margen de actuación. No hay motivo para esperar peor código por esto.

    ¿Puedo desactivar la marca de agua?

    La documentación de Anthropic no menciona ninguna opción para desactivarlo, tampoco para quien usa la API. Se aplica a Claude Platform, Claude, Claude Code, Claude Cowork y Claude Tag, incluido Claude servido a través de AWS, Google Cloud y Microsoft Foundry, y rige en todo el mundo.

    ¿La marca de agua sobrevive a copiar y pegar el código?

    Sí. Anthropic dice que la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Copiar y pegar no altera la secuencia de tokens, así que no hay motivo para que se pierda. Lo que sí puede romperla, según la propia documentación, es editar en profundidad, parafrasear, traducir o mezclar el texto con otra escritura.

    ¿Cómo compruebo si un archivo generado por Claude lleva metadatos C2PA?

    Con c2patool desde la terminal (c2patool archivo.svg) o subiendo el archivo a contentcredentials.org. Esto es lo único verificable hoy sin depender de Anthropic, y solo aplica a archivos .svg, .png y .jpg generados por Claude. Los metadatos desaparecen si conviertes el formato, vuelves a guardar el archivo o haces una captura de pantalla.

    ¿Afecta la marca de agua a quién es dueño del código que genera Claude?

    No. La marca es un mecanismo de transparencia sobre el origen del contenido, no un mecanismo de propiedad. La titularidad de lo que generas con Claude se rige por los términos de servicio de Anthropic y por el contrato que tengas con tu cliente o tu empresa, no por si el texto lleva firma estadística. Lo que sí conviene es que esa relación esté escrita antes de que alguien pregunte.

    ¿Los detectores de IA como GPTZero o Turnitin detectan la marca de agua de Claude?

    No. Son mecanismos distintos. Un detector convencional analiza el estilo y estima una probabilidad; no conoce ninguna firma y se equivoca a menudo en las dos direcciones. Un detector de watermark busca una señal concreta que sabe cómo se incrustó. Que un detector clásico marque tu texto como generado por IA no significa que haya encontrado la marca de Anthropic, porque no puede.

    Si detectan la marca, ¿significa que el código lo escribió Claude?

    No, y lo dice Anthropic: detectar una marca de Claude indica que el contenido "puede haber sido procesado por Claude", no que Claude lo escribiera. Si le pasas tu propio código para que lo refactorice o te lo traduzca, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo. Cualquiera que use una detección como prueba de que no escribiste tú el código está leyendo mal la señal.

    ¿Me afecta si no estoy en la Unión Europea?

    Sí. El marcado nace del Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA, pero Anthropic lo aplica globalmente. Dónde esté tu empresa no cambia nada.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
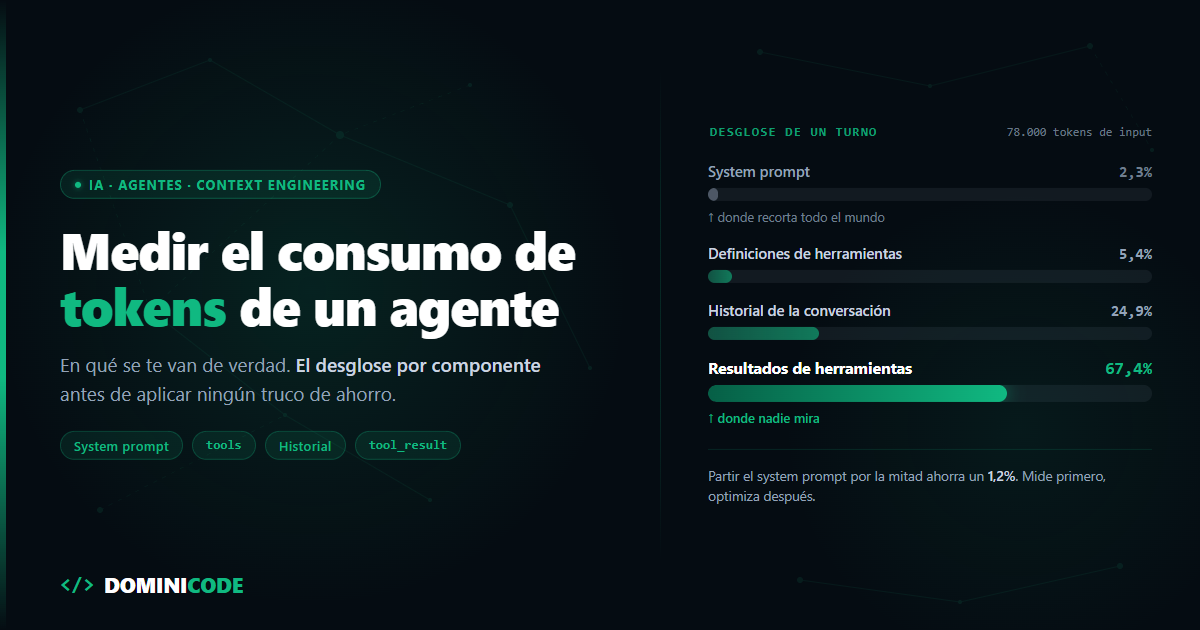
  • Medir el consumo de tokens de un agente: en qué se te van

    Medir el consumo de tokens de un agente: en qué se te van

    El mes pasado revisé el agente de un cliente. Se comía unos 340 dólares al mes de API y el equipo quería bajarlo.

    Lo primero que hicieron fue lo que hace todo el mundo: recortar el system prompt. Lo dejaron en la mitad, de 1.800 tokens a 900.

    El ahorro real fue del 1,2% por llamada.

    No porque recortar el prompt sea mala idea. Porque nadie se había parado a medir el consumo de tokens antes de tocar nada. El system prompt era el 2,3% de cada petición. El 67% se lo comían los resultados de las herramientas, que nadie había mirado.

    Llevo meses viendo la misma escena. Hay una biblioteca entera de trucos para gastar menos —caching, recortes, modelos más baratos— y casi nadie tiene el paso previo: saber en qué se le van los tokens. Optimizan a ciegas y aciertan por casualidad.

    Este post es ese paso previo.

    Un agente no gasta tokens: reenvía tokens

    La confusión empieza aquí. La gente piensa en "el prompt" como si fuera una cosa que mandas una vez.

    En un agente, cada input que envías se reparte en cuatro bloques:

    1. System prompt. Tus instrucciones. Fijo, se manda igual en cada llamada.
    2. Definiciones de herramientas. Nombres, descripciones y JSON Schema de cada tool, más el system prompt interno que la API añade para habilitar tool use — en Claude Opus 5 son 286 tokens con tool_choice: auto, y 406 con any o tool. También fijo.
    3. Historial de la conversación. Todos los turnos previos: lo que dijo el usuario, lo que respondió el modelo, cada bloque tool_use que emitió.
    4. Resultados de herramientas. El contenido de cada tool_result: el JSON que devolvió tu API, el fichero que leyó, los 40 kB de HTML que trajo el scraper.

    Los dos primeros son constantes. Los dos últimos crecen.

    Y crecen de la peor manera posible, porque la Messages API no tiene estado. En el turno 12 no mandas el turno 12: mandas los turnos 1 a 12 otra vez, enteros, incluida la respuesta de 8.000 tokens que devolvió aquella herramienta en el turno 3 y que ya nadie va a volver a leer.

    Ahí está el efecto que casi nadie ve. Si cada turno añade d tokens al contexto, el total de una sesión de n turnos no crece con n, crece con n²/2. En cristiano: duplicar los turnos de tu agente no duplica el coste, lo multiplica por casi cuatro.

    Un ejemplo con números redondos. Base fija (system + tools) de 6.000 tokens, y cada turno añade otros 6.000 entre respuesta del modelo y resultado de herramienta. La columna de la derecha es el contenido único: el contexto que llega a ver el último turno, a 6.000 tokens por turno.

    Sesión Input acumulado Contenido único
    6 turnos 126.000 tokens 36.000 tokens
    12 turnos 468.000 tokens 72.000 tokens
    24 turnos 1.800.000 tokens 144.000 tokens

    En la sesión de 12 turnos pagas 468.000 tokens de input para procesar 72.000 tokens de material distinto. Seis veces y media. Con Claude Opus 5 a 5 $/millón de input, esa sesión te cuesta 2,34 dólares solo en entrada.

    Si tienes esto claro, ya sabes por qué a aquel equipo recortar el system prompt le ahorró un 1,2%.

    El desglose de un turno real

    Esto es lo que salió al medir el turno 12 de aquel agente de research:

    Componente Tokens % del input
    System prompt 1.800 2,3%
    Definiciones de herramientas (6 tools) 4.200 5,4%
    Historial de la conversación 19.400 24,9%
    Resultados de herramientas 52.600 67,4%
    Total input 78.000 100%

    Mira la última columna y haz las cuentas tú mismo.

    Partir el system prompt por la mitad ahorra 900 tokens: el 1,2% de la llamada. Meter un limit en la query de la base de datos y recortar un 40% los resultados de herramientas ahorra 21.040 tokens: el 27%.

    Mismo esfuerzo de ingeniería. Más de veinte veces más impacto.

    Este desglose no es universal, y ese es justo el punto. Un chatbot de soporte sin herramientas tiene el reparto invertido. Un agente de código con MCP servers cargados puede tener 30.000 tokens solo en definiciones de tools. Por eso el número que importa es el tuyo, no el mío.

    Cómo medir el consumo de tokens de un agente

    Medir el consumo de tokens de un agente es atribuir cada token de input a uno de los cuatro bloques que lo componen —system prompt, definiciones de herramientas, historial y resultados de herramientas— para saber qué porcentaje del gasto genera cada uno. La API de Anthropic da dos instrumentos para hacerlo: uno mira hacia atrás y otro mira hacia delante.

    1. El campo usage de cada respuesta

    Cada respuesta de la Messages API trae un objeto usage. Registra los cuatro campos, siempre, desde el primer día:

    import Anthropic from '@anthropic-ai/sdk';
    import type { MessageCreateParamsNonStreaming } from '@anthropic-ai/sdk/resources/messages';
    
    const client = new Anthropic();
    
    interface RegistroUso {
      ts: string;
      sesion: string;
      turno: number;
      input: number;
      output: number;
      cacheWrite: number;
      cacheRead: number;
    }
    
    const registro: RegistroUso[] = [];
    
    export async function llamada(
      params: MessageCreateParamsNonStreaming,
      meta: { sesion: string; turno: number },
    ) {
      const res = await client.messages.create(params);
      const u = res.usage;
    
      registro.push({
        ts: new Date().toISOString(),
        sesion: meta.sesion,
        turno: meta.turno,
        input: u.input_tokens,
        output: u.output_tokens,
        cacheWrite: u.cache_creation_input_tokens ?? 0,
        cacheRead: u.cache_read_input_tokens ?? 0,
      });
    
      return res;
    }
    

    Aquí hay una trampa que se traga a mucha gente. input_tokens no son todos los tokens que enviaste. Son solo los que van después del último punto de corte de caché. La documentación de Anthropic lo define así:

    total_input = cache_read_input_tokens + cache_creation_input_tokens + input_tokens
    

    Si activas prompt caching y sigues graficando input_tokens a secas, verás una caída espectacular que no significa nada. No has reducido el contexto: lo has movido de columna.

    El coste real se calcula con las tres columnas y sus precios respectivos. Para Claude Opus 5:

    const PRECIO_OPUS_5 = {
      input: 5 / 1_000_000,
      output: 25 / 1_000_000,
      cacheWrite5m: 6.25 / 1_000_000,
      cacheRead: 0.5 / 1_000_000,
    } as const;
    
    export const costeUSD = (r: RegistroUso) =>
      r.input * PRECIO_OPUS_5.input +
      r.output * PRECIO_OPUS_5.output +
      r.cacheWrite * PRECIO_OPUS_5.cacheWrite5m +
      r.cacheRead * PRECIO_OPUS_5.cacheRead;
    

    Precios verificados en la documentación de pricing de Anthropic en agosto de 2026. Si usas otro modelo, cambia la tabla — no los copies de un post de hace seis meses.

    2. El endpoint de conteo para atribuir por componente

    usage te da el total. No te dice cuánto pesa cada bloque. Para eso está /v1/messages/count_tokens, que en el SDK de TypeScript es client.messages.countTokens().

    Acepta los mismos bloques de entrada que messages.create —model, system, tools, messages— y devuelve { input_tokens: number }. No acepta max_tokens. Es gratis y tiene su propio límite de peticiones, separado del de generación: 2.000 RPM en el tier Start.

    La técnica es medir por diferencias:

    import type { MessageParam, Tool } from '@anthropic-ai/sdk/resources/messages';
    
    // el mismo client del primer bloque
    const MODEL = 'claude-opus-5';
    const PING: MessageParam[] = [{ role: 'user', content: '.' }];
    
    const contar = async (p: {
      system?: string;
      tools?: Tool[];
      messages: MessageParam[];
    }) => (await client.messages.countTokens({ model: MODEL, ...p })).input_tokens;
    
    /** Sustituye el contenido de cada tool_result por un carácter. */
    function vaciarToolResults(messages: MessageParam[]): MessageParam[] {
      return messages.map((m) => {
        if (typeof m.content === 'string') return m;
        return {
          ...m,
          content: m.content.map((b) =>
            b.type === 'tool_result' ? { ...b, content: '.' } : b,
          ),
        };
      });
    }
    
    export async function desglosar(input: {
      system: string;
      tools: Tool[];
      messages: MessageParam[];
    }) {
      const [piso, conSystem, conTools, sinResultados, total] = await Promise.all([
        contar({ messages: PING }),
        contar({ system: input.system, messages: PING }),
        contar({ tools: input.tools, messages: PING }),
        contar({ ...input, messages: vaciarToolResults(input.messages) }),
        contar(input),
      ]);
    
      const system = conSystem - piso;
      const tools = conTools - piso;
      const toolResults = total - sinResultados;
    
      return {
        system,
        tools,
        toolResults,
        historial: total - system - tools - toolResults - piso,
        piso, // andamiaje fijo de la API: sin esta fila, las otras cuatro no suman el total
        total,
      };
    }
    

    Cinco llamadas en paralelo y tienes tu tabla. Lánzalo contra una conversación real serializada de producción, no contra un caso de prueba de tres turnos.

    Tres avisos. El conteo es una estimación y puede desviarse ligeramente del cobro real. El . con el que sustituyes cada tool_result cuenta como token, así que toolResults sale un pelín corto y esa diferencia se te va a historial. Y el endpoint responde con el tokenizador del model que le pases: los modelos desde Opus 4.7 usan uno nuevo que produce en torno a un 30% más de tokens para el mismo texto, así que un conteo hecho contra un modelo viejo no sirve para presupuestar uno nuevo. El idioma añade su propia variación sobre esa base: en español el mismo texto tokeniza un 26% más caro.

    Los cuatro pasos, en orden

    1. Serializa una conversación real de producción, de 10 turnos o más, a un objeto { system, tools, messages }.
    2. Registra el usage de cada llamada con la sesión y el turno como etiquetas.
    3. Pasa esa conversación por desglosar() y obtén los cuatro componentes.
    4. Ordena las filas por porcentaje y ataca solo la primera.

    Qué hacer con cada hallazgo

    Ya tienes el número. Ahora el diagnóstico. Cada fila de la tabla apunta a una intervención distinta:

    Si el bloque fijo (system + tools) es grande pero cache_read_input_tokens sale en cero, no tienes un problema de tamaño, tienes uno de caché. Estás pagando 5 $/millón por reprocesar en cada turno lo mismo que podrías estar leyendo a 0,50 $. Es la palanca con mejor ratio impacto/esfuerzo de esta lista y la expliqué entera en prompt caching en la API de Claude.

    Con los números de antes: de esos 468.000 tokens de input, con la caché refrescándose en cada turno solo 72.000 se escriben (a 6,25 $/millón) y los otros 396.000 se leen (a 0,50 $/millón). La sesión pasa de 2,34 dólares a 0,65. Un 72% menos, sin tocar una sola instrucción.

    Si el system prompt sí es el problema de verdad —pasa, sobre todo dentro de herramientas que inyectan contexto por su cuenta—, entonces sí toca recortar. En Claude Code buena parte de ese peso no lo has escrito tú, y se quita con un flag: lo cuento en el flag que recorta el system prompt dinámico.

    Si el contenido está en español, el desglose ya viene con un recargo de fábrica. El mismo texto tokeniza alrededor de un 26% más caro que en inglés, y eso afecta a tus prompts, a tus tool results y a la salida del modelo. Antes de recortar nada, léete el recargo del tokenizador en español: a veces la optimización correcta es escribir el system prompt en inglés y responder en español.

    Si lo que se disparó es el número de turnos, tu problema no está en ninguna fila de la tabla: está en cuántas veces la construyes. Ojo especialmente después de cambiar de modelo, porque cuánto delega es una propiedad del modelo y se mueve entre versiones — el mecanismo completo está en por qué sube el coste de los subagentes al cambiar de modelo.

    Y si los resultados de herramientas son el 60-70%, como en el caso que abre este post, tienes tres salidas por orden de esfuerzo: paginar y filtrar en tu propia tool antes de devolver nada, resumir los resultados antiguos, o dejar que la API vaya limpiando los tool results caducados.

    Lo último se hace con la estrategia clear_tool_uses_20250919 de context editing, que todavía está en beta. Elegir entre las tres es exactamente el trabajo que describo en gestión estratégica del contexto.

    Un apunte sobre la primera opción, que es la que más gente se salta. Si tu herramienta devuelve el objeto completo de la base de datos porque "por si acaso el modelo lo necesita", estás pagando por cada campo en cada turno restante de la sesión. Definir el contrato de salida de cada tool con un esquema estricto —y devolver solo eso— es una decisión de coste, no de estilo. Un esquema de salida con Zod en la frontera de cada tool tira los campos que no declaraste antes de que lleguen al contexto.

    Empieza por la tabla

    No apliques ni un truco de ahorro esta semana.

    Coge una conversación real de producción, pásala por desglosar() y monta la tabla de cuatro filas. Eso es todo el trabajo de medir el consumo de tokens de un agente: media hora. Y lo más probable es que el mayor porcentaje esté donde no lo esperabas, porque el componente que más pesa suele ser el que nadie mira: el que se genera solo.

    Después optimiza. En ese orden.

    Instrumentar el gasto antes de tocarlo es parte del mismo hábito que enseño en Construye con IA: decidir con datos en lugar de con intuición, también cuando lo que decides es dónde recortar. Y si quieres ver desgloses de agentes reales, con sus facturas y sus tablas delante, eso lo hacemos en Dominicode Labs.

    Preguntas frecuentes sobre el consumo de tokens

    ¿Por qué mi factura sube si no he cambiado el prompt?

    Porque en un agente el coste no depende solo del prompt, depende de cuántos turnos dura cada sesión. El historial se reenvía entero en cada llamada, así que el gasto crece de forma cuadrática con el número de turnos: pasar de 12 a 24 turnos multiplica el input acumulado por casi cuatro, no por dos. Si tu agente empezó a necesitar más iteraciones para cerrar la misma tarea, la factura sube sin que hayas tocado una línea.

    ¿El endpoint de conteo de tokens cuesta dinero?

    No. /v1/messages/count_tokens es gratuito. Sí tiene límite de peticiones por minuto según tu tier —2.000 RPM en Start, 4.000 en Build y 8.000 en Scale—, pero es un límite independiente del de generación de mensajes: usar uno no consume el cupo del otro. No hay excusa de coste para no medir.

    ¿Sirve un tokenizador local como tiktoken para medir esto?

    Para una estimación rápida y offline, vale. Para presupuestar, no. Anthropic no publica su tokenizador y el conteo depende del modelo concreto: los modelos desde Claude Opus 4.7 usan un tokenizador nuevo que genera alrededor de un 30% más de tokens para el mismo texto que los anteriores. Un tokenizador de otra familia de modelos te dará un número que no se parece al que te van a cobrar.

    ¿Por qué input_tokens baja tanto al activar el prompt caching?

    Depende de qué estés midiendo. input_tokens cuenta solo lo que va después del último punto de corte de caché, así que activar caching hace que ese número se desplome sin que hayas reducido el contexto ni un token. Para saber lo que realmente enviaste tienes que sumar cache_read_input_tokens y cache_creation_input_tokens. Grafica siempre las tres series juntas, nunca input_tokens solo.

    ¿Cada cuánto hay que volver a medir el consumo de tokens?

    Cada vez que cambies de modelo, añadas o quites herramientas, o toques lo que devuelve una tool. Los tres modifican el reparto. Lo eficiente es no repetirla a mano: deja el registro de usage corriendo en producción con la sesión y el turno como etiquetas, y el desglose por componente pásalo cuando el coste medio por sesión se salga de su rango normal.

    ¿Y si la conclusión es que necesito menos turnos, no menos tokens?

    Es la conclusión más común y la más incómoda, porque no se arregla con un flag. Un agente que tarda 20 turnos en algo que debería resolver en 6 casi siempre tiene un problema de definición de la tarea, no de contexto. Ahí la palanca no es técnica: es escribir mejor qué tiene que hacer antes de dejarlo correr, que es de lo que va el libro de Spec-Driven Development.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
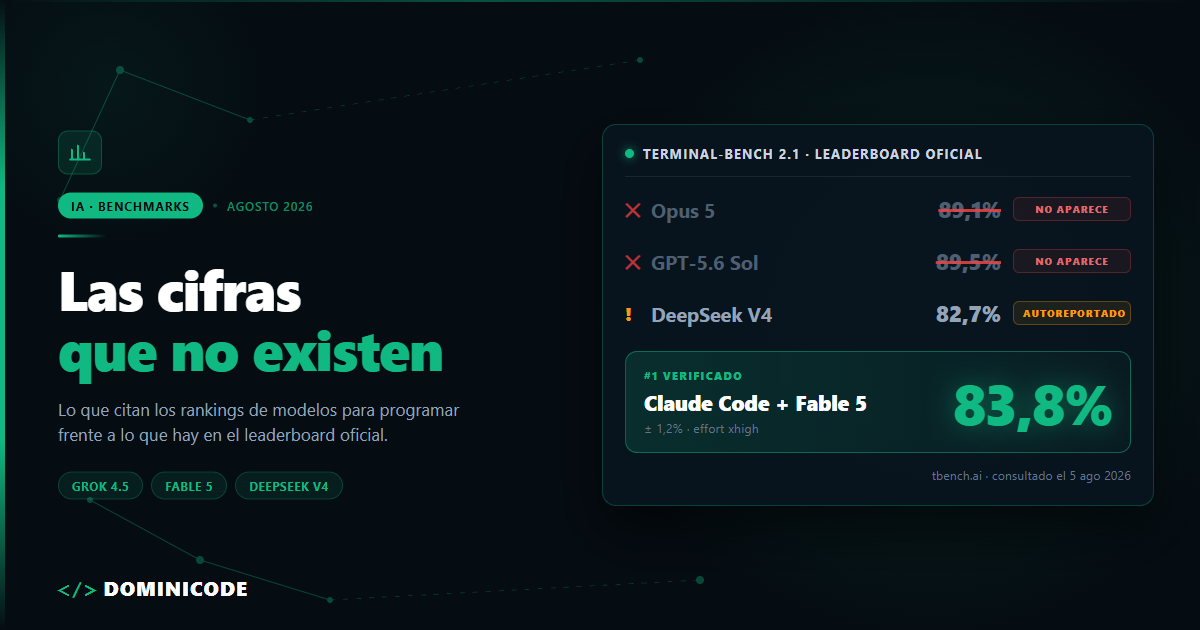
  • Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    El 26 de julio publiqué una comparativa entre Opus 5, GPT-5.6 y Kimi K3. Diez días después me senté a completarla con los que faltaban: Grok 4.5, Claude Fable 5 y DeepSeek V4 Flash.

    No llegué a escribir esa actualización.

    Me atasqué en el primer paso, el más tonto: abrir el leaderboard oficial de Terminal-Bench 2.1 y copiar las cifras que todo ranking de modelos para programar de agosto de 2026 da por buenas.

    Buena parte de esas cifras no está ahí. No es que estén desactualizadas: es que no aparecen. Ni con ese número, ni en ese puesto.

    Así que este post no es la lista de los tres modelos que me faltaban. Es lo que encontré mientras la buscaba. Si lo que quieres es qué modelo usar para qué trabajo según el coste real por tarea, eso está entero en Opus 5 vs GPT-5.6 vs Kimi K3, la comparativa base que este post completa.

    El leaderboard oficial de Terminal-Bench 2.1, sin intermediarios

    Qué es Terminal-Bench 2.1 y qué puntúa en realidad

    Terminal-Bench 2.1 es un benchmark que mide si un sistema de IA completa tareas reales de desarrollo dentro de una terminal —instalar dependencias, ejecutar los tests, arreglar lo que falla—, no si el modelo escribe código elegante. Cada fila del leaderboard puntúa tres cosas a la vez: el modelo, el harness (el agente que lo envuelve: Claude Code, Codex, Terminus 2, Cursor CLI) y el effort (cuánto cómputo se le permite gastar por tarea). Cambia cualquiera de las tres y cambia el número.

    Esto es lo que hay en el leaderboard público de Terminal-Bench, consultado el 5 de agosto de 2026. Corto en la fila 11 por espacio:

    # Agente + modelo Score Effort
    1 Claude Code + Fable 5 83,8% ± 1,2% xhigh
    2 Codex + GPT-5.5 83,1% xhigh
    3 Terminus 2 + Fable 5 80,4% high
    4 Cursor CLI + Grok 4.5 79,3% high
    5 Claude Code + Opus 4.8 78,9% high
    6 Codex + GPT-5.6 Terra 78,4% max
    7 Terminus 2 + GPT-5.5 78,0% xhigh
    8 mini-SWE-agent + Muse Spark 1.1 76,2% xhigh
    9 Codex + GPT-5.6 Luna 75,7% max
    10 Claude Code + Sonnet 5 74,6% high
    11 Terminus 2 + Gemini 3 Pro 73,9% high

    Lee la segunda columna otra vez. No dice "modelo". Dice agente y modelo. Y la última añade el effort.

    Ahora mira lo que no está.

    Claude Opus 5 no aparece. El Opus de esa lista es el 4.8, con 78,9%. Llevo semanas viendo circular un "Opus 5: 89,1% en Terminal-Bench 2.1" por blogs agregadores y no he encontrado de dónde sale. No digo que sea falso: digo que no está en la fuente oficial, que no lo puedo verificar y que quien lo publicó tampoco enlazó a nada.

    "GPT-5.6 Sol, 89,5%" tampoco aparece. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%), ambas por debajo de GPT-5.5 en Codex, que marca 83,1%. En la única medición pública que conozco, la 5.6 no supera a la 5.5 programando en terminal.

    Kimi K3 tampoco aparece. Eso no lo convierte en mal modelo —sigo pensando lo que escribí en si te conviene Kimi K3 para tu agente—, solo significa que ahí no hay ejecución publicada. Y el 88,3 que reporta Moonshot es autoreportado, exactamente igual que el de DeepSeek que verás más abajo.

    Un benchmark ausente no es un suspenso. Es un dato que no existe. Y un dato que no existe no se cita.

    Por qué el mismo modelo puntúa distinto: el harness pesa tanto como el modelo

    El mismo modelo cambia de puesto según el agente que lo envuelve: Fable 5 saca 83,8% con Claude Code y 80,4% con Terminus 2. Esos 3,4 puntos son toda la distancia entre el puesto 1 y el puesto 3 del leaderboard.

    Vuelve a la tabla y búscalo dos veces. Está ahí.

    Lo que separa esas dos filas es el andamiaje que rodea al modelo, no el modelo. GPT-5.5 hace lo mismo: 83,1% en Codex, 78,0% en Terminus 2.

    Por eso "cuál es el mejor modelo para programar" es una pregunta mal formulada. Terminal-Bench no puntúa modelos, puntúa sistemas.

    Es la idea que sostiene todo lo que enseño en Construye con IA: el resultado sale del sistema completo, no del modelo que eliges en un desplegable. Cuando alguien te cuenta que su equipo va más rápido "porque usa X modelo", casi siempre lo que cambió fue el harness.

    Cuánto cuesta Grok 4.5 de verdad: el precio se dobla a partir de 200K tokens

    Grok 4.5 es el mejor situado de los tres que faltaban: puesto 4 del leaderboard de Terminal-Bench 2.1 con Cursor CLI y 79,3%, por delante de Opus 4.8 y de las dos variantes medidas de GPT-5.6. Este es el que peor llevo haberme dejado fuera en julio.

    En el Intelligence Index de Artificial Analysis marca 54 puntos en el corte del 5 de agosto de 2026. No te doy su puesto, y el motivo es el propio post: en la comparativa de julio yo mismo publiqué 58,9 para GPT-5.6 Sol y 57 para Kimi K3 en ese mismo índice. Con esos números, 54 no es un cuarto puesto.

    Es una puntuación. El puesto depende del corte y del subconjunto de modelos que estés mirando, y por eso no vale como argumento.

    El titular comercial es 500K de contexto a $2 el millón. Es cierto a medias, y la mitad falsa está en la documentación de xAI:

    Tamaño del prompt Entrada / millón Salida / millón
    Menos de 200K tokens $2 $6
    200K tokens o más $4 $12

    El precio se dobla exactamente cuando empiezas a usar el contexto por el que compraste el modelo.

    Con un agente que acumula ficheros, salidas de tests y logs, cruzar los 200K no es un caso raro: es el martes por la tarde. Y no lo cruzas tú de forma consciente, lo cruza el agente a mitad de sesión.

    La parte buena: el input cacheado cuesta $0,50 por millón, un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4. Si tu agente reenvía el mismo contexto en cada turno —y casi todos lo hacen—, el ahorro real está ahí, no en la tarifa de lista.

    En el Coding Agent Index de Artificial Analysis, Grok 4.5 saca 76 en el harness de Grok Build, empatado con GPT-5.5 en Codex y justo por debajo de Fable 5 en Claude Code. Otra vez modelo y harness moviéndose juntos.

    Ficha rápida: 500K de contexto, knowledge cutoff el 1 de febrero de 2026, disponible como grok-4.5 en Grok Build, en Cursor para todos los planes y en la consola de xAI.

    DeepSeek V4 Flash 0731: barato de verdad, medido por ellos mismos

    Salió el 31 de julio con pesos abiertos y licencia MIT, la misma categoría de modelo abierto que repasé en el ranking de LLM locales de 2026. MoE disperso, 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    $0,14 de entrada y $0,28 de salida por millón. Con cache-hit, $0,0028. Fable 5 cuesta más de 70 veces más por token de entrada: eso no es una diferencia de gama, es otra categoría de decisión.

    En el Intelligence Index marca 50 puntos, cifra seria para lo que cuesta.

    Ahora la parte incómoda, que es el motivo por el que este modelo está en el post.

    DeepSeek reporta 82,7 en Terminal-Bench 2.1 —subiendo 20,9 puntos desde el 61,8 de su Preview— y 54,4 en DeepSWE. Con 82,7 entraría tercero en el leaderboard de Terminal-Bench 2.1, a cuatro décimas de GPT-5.5 en Codex (83,1%) y por detrás de Fable 5 (83,8%).

    Esa cifra es autoreportada por DeepSeek en su propia tabla y no aparece en el leaderboard oficial de tbench.ai.

    No acuso a nadie de mentir. Señalo una distinción que muchos rankings borran sin avisar: un número autoreportado y uno medido de forma independiente no valen lo mismo, aunque los dos lleven decimal.

    El fabricante corre el benchmark en sus condiciones, con su harness y su criterio de cuándo parar.

    No hay nada ilegítimo en eso. Simplemente no es comparable con una entrada verificada, y mezclar las dos cosas en la misma tabla es lo que convierte una comparativa en marketing.

    Si vas a probar DeepSeek V4 Flash, pruébalo por el precio y la licencia MIT, que son hechos comprobables. No por el 82,7.

    Y recuerda que el precio por token no es el gasto: un modelo barato que necesita el doble de turnos para cerrar la misma tarea sale caro, un efecto que desarrollé en por qué sube el coste de los subagentes al cambiar de modelo.

    Cuánto cuesta Fable 5: lidera el leaderboard y su tarifa miente a su favor

    Fable 5 es el número 1 real: 83,8% ± 1,2% con Claude Code y effort xhigh. GA desde el 9 de junio de 2026, 1M de contexto, 128k de salida máxima.

    También es el más caro por bastante: $10 de entrada y $50 de salida por millón, según la documentación de Anthropic. Adaptive thinking siempre activo —no se puede apagar— y una latencia que su propia doc califica de "slower".

    El dato que casi nadie cita es este: Fable 5 usa el tokenizer que llegó con Opus 4.7, y el mismo texto produce alrededor de un 30% más de tokens que en modelos anteriores a esa versión. Es el mismo mecanismo que expliqué con el sobrecoste de escribir en español: la tarifa por millón no se mueve, pero el número de millones sí.

    Haz la cuenta. Frente a un modelo con el tokenizer viejo, sus $10 se comportan como $13 y sus $50 como $65 sobre el mismo texto.

    Su coste efectivo es peor que su tarifa de lista. Es la tesis del post de julio otra vez: el precio que pagas no es el que aparece en la página de pricing.

    Mythos 5: recomendado en rankings, imposible de contratar

    Mythos 5 tiene las mismas specs y el mismo precio que Fable 5. Y da igual, porque no lo puedes usar: no hay alta self-serve, es por invitación dentro de Project Glasswing, orientado a ciberseguridad defensiva.

    Aun así lo he visto en varias listas de "mejores modelos para programar de agosto de 2026", con su fila, su precio y su recomendación de uso, como si bastara una tarjeta.

    Cuando un ranking te recomienda un producto que no está a la venta, ya sabes cuánto lo ha probado quien lo escribió.

    Precios por millón de tokens en agosto de 2026: las cifras que sí puedes comprobar

    Estos son los precios de lista publicados por cada proveedor a 5 de agosto de 2026, en dólares por millón de tokens:

    Modelo Entrada / millón Salida / millón Contexto
    Claude Fable 5 $10 $50 1M
    Claude Opus 5 $5 $25 1M
    GPT-5.6 Sol $5 $30 1,05M
    Claude Sonnet 5 $3 ($2 intro hasta el 31 ago 2026) $15 ($10 intro) 1M
    Kimi K3 $3 $15 1M
    Grok 4.5 (prompt < 200K) $2 $6 500K
    Grok 4.5 (prompt ≥ 200K) $4 $12 500K
    DeepSeek V4 Flash 0731 $0,14 $0,28 1M

    Una nota de honestidad, porque predico con el ejemplo o no predico: al recopilar esto me encontré a Grok 4.5 con 54 puntos presentado como cuarto y a DeepSeek V4 Flash con 50 presentado como tercero. Las dos cosas no pueden ser ciertas a la vez.

    Son cortes distintos de un índice que se recalcula constantemente. Por eso en este post doy puntuaciones y fechas, y no puestos: el puesto caduca antes de que le des a publicar.

    Cómo verificar un ranking de modelos para programar en 3 filtros

    Abre el ranking que tengas a mano ahora mismo y pásale tres filtros.

    1. Busca el enlace a la fuente. Si la cifra no apunta a un leaderboard o a una doc oficial, trátala como rumor.
    2. Comprueba si el número es autoreportado. Un score en la web del fabricante y uno en tbench.ai no son la misma clase de dato.
    3. Mira si nombra el harness y el effort. Si dice "Fable 5: 83,8%" sin decir Claude Code y xhigh, quien lo escribió no ha leído la tabla que cita.

    Te quedará mucho menos ranking del que tenías. Bien.

    Y una decisión práctica que sí puedo defender: elige el modelo al final, no al principio. Define primero qué tarea automatizas, con qué agente y con qué criterio de "terminado". Es la lógica del libro de Spec-Driven Development, y aquí se nota más que en ningún sitio: con la spec escrita, cambiar de modelo es una variable de entorno y una medición; sin ella, es fe.

    Mi conclusión cabe en una frase: no existe el mejor modelo para programar, existe el mejor sistema, y el único número que decide tu caso es el que midas tú.

    En Dominicode Labs hacemos justo eso: pasar los modelos nuevos por tareas reales, con la factura y los logs delante, antes de meterlos en producción.

    Preguntas frecuentes sobre los modelos para programar de agosto de 2026

    ¿Qué modelo lidera el leaderboard de Terminal-Bench 2.1 en agosto de 2026?

    En el leaderboard oficial de Terminal-Bench 2.1 el primer puesto es Claude Code con Fable 5 (83,8%), seguido de Codex con GPT-5.5 (83,1%). Fíjate en que ambos resultados nombran un agente y un nivel de esfuerzo, no solo un modelo.

    El mismo Fable 5 baja a 80,4% con Terminus 2. Liderar un leaderboard no es lo mismo que ser el modelo que te conviene: si lo que buscas es la recomendación por tipo de trabajo —agente largo, repo grande, volumen alto—, está desarrollada en Opus 5 vs GPT-5.6 vs Kimi K3.

    ¿Cuánto cuesta realmente Grok 4.5?

    $2 de entrada y $6 de salida por millón de tokens mientras el prompt se mantenga por debajo de 200K tokens. A partir de 200K, la tarifa pasa a $4 y $12: se dobla.

    El input cacheado cuesta $0,50 por millón: un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4 de los prompts largos. Ahí está el ahorro real en un agente que reenvía el mismo contexto en cada turno.

    ¿Es fiable el 82,7 de DeepSeek V4 en Terminal-Bench 2.1?

    Es una cifra autoreportada por DeepSeek en su propia tabla, no una entrada verificada del leaderboard oficial de tbench.ai. Ahí no aparece.

    Eso no significa que sea falsa: significa que no ha pasado por una medición independiente y que no es comparable con la tabla oficial. Lo comprobable de ese modelo es su precio ($0,14 / $0,28 por millón) y su licencia MIT con pesos abiertos.

    ¿Por qué Claude Opus 5 no aparece en el leaderboard de Terminal-Bench 2.1?

    Porque no hay una ejecución publicada de Opus 5 en el leaderboard oficial. El Opus que sí figura es el 4.8, con 78,9% usando Claude Code.

    Las cifras de "Opus 5 al 89,1%" que circulan por blogs agregadores no están en la fuente primaria y no he podido verificarlas. Ausencia de resultado no equivale a mal resultado: equivale a que no hay medición pública.

    ¿Merece la pena Fable 5 a $10 / $50 por millón?

    Sale a cuenta cuando un fallo del modelo te cuesta más de una hora de revisión humana; para volumen alto de tareas repetitivas, casi nunca.

    Hay además un matiz que empeora el cálculo: Fable 5 usa el tokenizer introducido con Opus 4.7, que genera alrededor de un 30% más de tokens sobre el mismo texto que los modelos anteriores a esa versión. Su coste efectivo es peor que su tarifa.

    ¿Qué diferencia hay entre un score autoreportado y uno del leaderboard oficial?

    Un score autoreportado lo ejecuta el propio fabricante, con su harness, su nivel de esfuerzo y su criterio de cuándo dar una tarea por terminada. Uno del leaderboard oficial lo ejecuta un tercero con condiciones fijas e iguales para todos.

    Los dos llevan decimales y parecen el mismo tipo de dato, pero no son comparables. Mezclarlos en la misma tabla, sin marcar cuál es cuál, es lo que convierte una comparativa en marketing.

    ¿DeepSeek V4 Flash es de código abierto?

    Tiene pesos abiertos y licencia MIT desde el 31 de julio de 2026. Es un MoE disperso con 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    La licencia y el precio ($0,14 de entrada y $0,28 de salida por millón) son los dos hechos comprobables del modelo. Su 82,7 en Terminal-Bench 2.1 no lo es: es autoreportado.

    ¿Puedo usar Claude Mythos 5 en mi proyecto?

    No, salvo que tengas invitación. Comparte specs y precio con Fable 5, pero solo está disponible dentro de Project Glasswing, orientado a ciberseguridad defensiva, y no tiene alta self-serve.

    Si lo ves recomendado en un ranking de modelos para programar, ese ranking no lo ha probado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.