Tag: TypeScript

  • SDD vs vibe coding: la misma feature tres semanas después

    SDD vs vibe coding: la misma feature tres semanas después

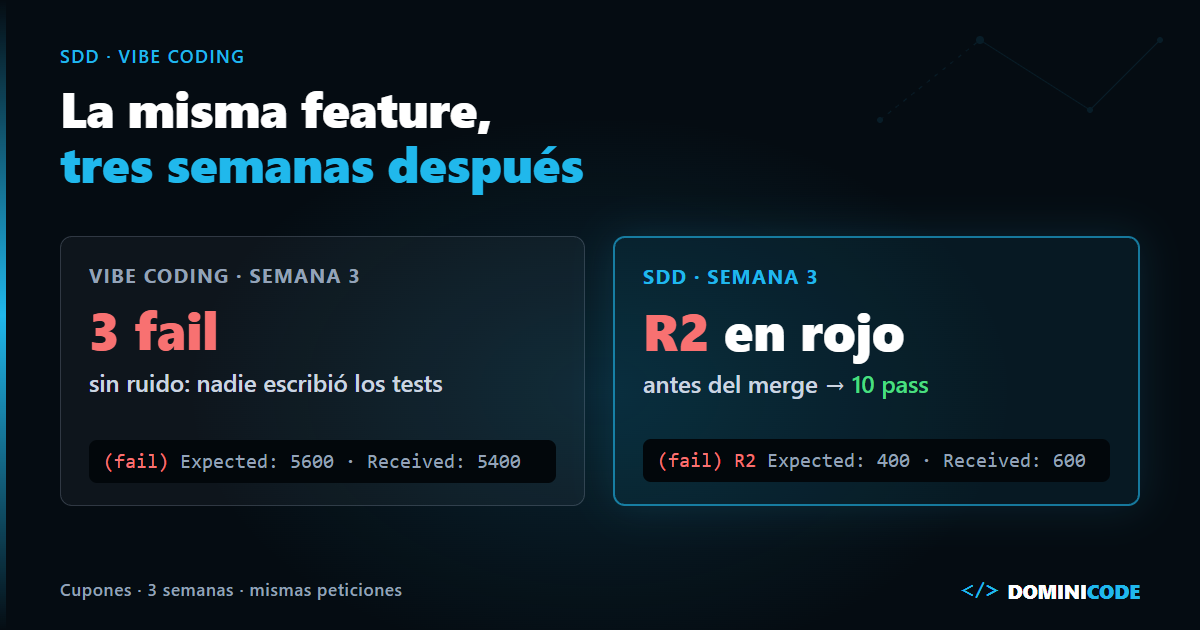
    La semana 1 el cupón funciona. La semana 2 también. La semana 3 le pides al agente "simplifica, hay código repetido" y te devuelve un diff limpio, más corto, más bonito. Lo apruebas.

    Desde ese momento tu checkout regala un 10 % sobre productos que ya estaban rebajados. No hay error en consola. El build pasa. El único que se entera es el margen.

    Esto es SDD vs vibe coding visto con código, no con opiniones. Es un caso ilustrativo: un ejemplo construido para este post, no un proyecto real ni un cliente. El código sí es real: cada fallo que vas a ver es salida literal de bun test.

    En corto: en SDD vs vibe coding, lo que decide la semana 3 es dónde viven las reglas antiguas: en vibe coding, en un chat que nadie relee; en SDD, numeradas en una spec, cada una con un test que se pone rojo si alguien la rompe. En este caso el agente comete el mismo error en las dos pistas, pero solo en una llega a producción.

    Que el vibe coding se tuerce hacia la tercera semana ya lo conté en del vibe coding al sistema. Aquí enseño el mecanismo, línea a línea.

    ¿Qué es SDD frente a vibe coding?

    Spec-Driven Development (SDD) consiste en escribir primero las reglas de comportamiento, numeradas y verificables, derivar un test de cada una y solo después pedir el código; vibe coding consiste en pedir el código en conversación y aceptar lo que funciona en ese momento.

    Las dos pistas reciben las mismas peticiones de negocio. La diferencia no es "IA sí o IA no". Es si la memoria del proyecto está en un archivo que se ejecuta o en tu cabeza.

    La feature: cupones de un checkout con reglas que crecen

    La feature es pequeña a propósito. Un módulo de descuentos en TypeScript, importes en céntimos, y tres peticiones de negocio:

    1. Semana 1: cupón PERCENT10, un 10 % de descuento, pero nunca sobre productos rebajados.
    2. Semana 2: cupón MINUS5 (5 € con compra mínima de 30 €) y envío gratis desde 50 €; si no, 4,99 €.
    3. Semana 3: Black Friday. Se pueden combinar hasta dos cupones. Y "simplifica".

    Pista A: vibe coding en tres conversaciones

    La semana 1 es un prompt de una línea y un resultado correcto:

    Añade un cupón PERCENT10: 10 % de descuento, pero no en productos rebajados.
    
    export function applyCoupon(items: Item[], code?: string): number {
      let total = 0;
      for (const item of items) {
        let line = item.price * item.qty;
        if (code === 'PERCENT10' && !item.onSale) {
          line = line * 0.9;
        }
        total += line;
      }
      return Math.round(total);
    }
    

    Fíjate dónde vive la regla de los rebajados: en un if dentro de un bucle. Y en el chat de ese día.

    La semana 2 el agente no toca applyCoupon. Añade una función nueva al lado:

    export function calculateTotal(items: Item[], code?: string) {
      const subtotal = items.reduce((s, i) => s + i.price * i.qty, 0);
      let discounted = applyCoupon(items, code);
      if (code === 'MINUS5' && subtotal >= 3000) discounted -= 500;
      const shipping = subtotal >= 5000 ? 0 : 499;
      return { subtotal, shipping, total: discounted + shipping };
    }
    

    Ya hay dos funciones públicas que calculan precios, y el subtotal se calcula en dos sitios. El envío gratis mira el subtotal antes del descuento. Nadie lo pidió así; simplemente salió así.

    La semana 3 llega la petición que lo cambia todo:

    Black Friday: deja combinar hasta dos cupones.
    Y simplifica, hay lógica repetida entre applyCoupon y calculateTotal.
    
    const COUPONS: Record<string, (total: number) => number> = {
      PERCENT10: (t) => t * 0.9,
      MINUS5: (t) => (t >= 3000 ? t - 500 : t),
    };
    
    export function calculateTotal(items: Item[], codes: string[] = []) {
      const subtotal = items.reduce((s, i) => s + i.price * i.qty, 0);
      let total = subtotal;
      for (const code of codes.slice(0, 2)) {
        total = COUPONS[code]?.(total) ?? total;
      }
      const shipping = total >= 5000 ? 0 : 499;
      return { subtotal, shipping, total: Math.round(total) + shipping };
    }
    
    // Se mantiene por compatibilidad con el checkout
    export const applyCoupon = (items: Item[], code?: string) =>
      calculateTotal(items, code ? [code] : []).total;
    

    Es mejor código en apariencia. Más corto, extensible, sin duplicación. Y está roto de tres maneras.

    Lo que rompe el vibe coding en la semana 3 (y SDD no)

    Para medirlo, estos son los tests que nadie escribió durante esas tres semanas, ejecutados a posteriori contra las tres versiones. Esta es la salida real de bun test vibe:

    (fail) vibe semana 3 > PERCENT10 no descuenta productos rebajados
    Expected: 5600
    Received: 5400
    (fail) vibe: el contrato de applyCoupon > semana 3: applyCoupon sin cupón devuelve el importe de productos
    Expected: 2000
    Received: 2499
    (fail) vibe semana 3: problemas nuevos > el orden de los cupones no cambia el precio
    Expected: 2929
    Received: 3379
     3 pass
     3 fail
    

    Regresión silenciosa de la semana 1. Un teclado de 40 € y un ratón rebajado de 20 €. La regla original cobra 56 €; la semana 3 cobra 54 €. El filtro !item.onSale no se borró por descuido: desapareció porque la nueva firma (total: number) => number recibe un número, no las líneas. Con esa forma, la regla ya no se puede ni escribir.

    Un arreglo que rompe otra cosa. El envoltorio "por compatibilidad" de applyCoupon devuelve ahora el total con envío. Un carrito de 20 € sin cupón pasa de 20,00 a 24,99. Cualquier pantalla que mostraba "precio con descuento" muestra ahora otra cosa, con el mismo nombre de función.

    El orden de los cupones cambia el precio. Un libro de 32 €. Con PERCENT10 y luego MINUS5, el total baja a 28,80 antes de evaluar el mínimo de 30 €, así que MINUS5 no aplica: 33,79 € con envío. En orden inverso: 29,29 €. Una diferencia de 4,50 € según qué cupón teclee primero el cliente.

    Y un cuarto cambio que ningún test detecta: el envío gratis pasó de mirar el subtotal a mirar el total con descuento. Puede que sea lo correcto. Nadie lo decidió.

    Pista B: en SDD la spec cambia antes que el código

    En la pista SDD, cada petición de negocio entra primero en spec.md como reglas numeradas. Esto es lo que había al final de la semana 3:

    Semana 1:
    - R1. PERCENT10 descuenta el 10 % de la suma de líneas no rebajadas.
    - R2. Las líneas con onSale: true nunca reciben descuento porcentual.
    - R3. El descuento se redondea al céntimo una sola vez, al final.
    - R4. Un código desconocido no rompe nada: va a `rejected`.
    Semana 2:
    - R5. MINUS5 descuenta 500 si el subtotal es >= 3000.
    - R6. El total de productos nunca baja de 0.
    - R7. Envío 499; gratis si el total de productos tras descuentos es >= 5000.
    Semana 3:
    - R8. Máximo 2 cupones distintos; el tercero va a `rejected`.
    - R9. El orden no cambia el precio: primero porcentuales, luego fijos.
    - R10. Los mínimos (R5) se evalúan sobre el subtotal antes de descuentos.
    

    R7, R9 y R10 son exactamente las decisiones que la pista A nunca tomó. Escribir la spec te obliga a decidir antes de que el agente decida por ti. Después, un test por regla, con el id en el nombre:

    test('R2 · las líneas rebajadas no reciben descuento porcentual', () => {
      expect(priceCart([keyboard, saleMouse], ['PERCENT10']).discount).toBe(400);
    });
    
    test('R9 · el orden de los cupones no cambia el precio', () => {
      expect(priceCart([book], ['PERCENT10', 'MINUS5']).total)
        .toBe(priceCart([book], ['MINUS5', 'PERCENT10']).total);
    });
    

    El prompt de la semana 3 ya no describe la feature. Señala el contrato:

    Lee spec.md. He añadido R8, R9 y R10 y sus tests.
    Implementa priceCart hasta que pase `bun test sdd`.
    No cambies los tests ni las reglas R1-R7.
    

    Ahora supón que, en la pista B, el agente también intenta simplificar con el mismo atajo, un mapa de funciones sobre el subtotal entero. Este es ese primer intento, escrito para el ejemplo:

    const COUPONS: Record<string, (subtotal: number) => number> = {
      PERCENT10: (subtotal) => subtotal * 0.1,
      MINUS5: (subtotal) => (subtotal >= 3000 ? 500 : 0),
    };
    

    Salida real de IMPL=first-refactor bun test sdd:

    (fail) priceCart [first-refactor] > R2 · las líneas rebajadas no reciben descuento porcentual
    Expected: 400
    Received: 600
     9 pass
     1 fail
    

    Mismo error que en la pista A. La diferencia es que aquí un test escrito en la semana 1, con nombre propio, se pone rojo en la semana 3, antes del merge. La versión corregida pasa los cupones de nuevo por las líneas:

    PERCENT10: {
      kind: 'percent',
      // R1 + R2: solo líneas no rebajadas
      discount: (items) =>
        items.filter((i) => !i.onSale).reduce((s, i) => s + lineTotal(i), 0) * 0.1,
    },
    

    bun test sdd sobre la versión final: 10 pass, 0 fail.

    Esta es la tesis del post: SDD no hace al agente más listo. Hace que su error sea visible. Y eso solo funciona si la spec es verificable, que es justo donde fallan casi todas; lo detallo en por qué tu spec falla con un agente. Si quieres el método completo, de la plantilla a la revisión, está en el libro de Spec-Driven Development.

    SDD vs vibe coding semana a semana

    Vibe coding (pista A) SDD (pista B)
    Semana 1 1 prompt, 1 función, funciona R1-R4 + 4 tests, luego el código
    Semana 2 Segunda función pública; subtotal calculado en dos sitios; envío sin decidir R5-R7; R7 decide que el envío mira el total con descuento
    Semana 3 El refactor rompe R2, cambia el contrato de applyCoupon y el orden altera el precio El primer refactor rompe R2, el test lo para, se corrige
    Dónde viven las reglas En el historial del chat En spec.md y en el nombre de cada test
    Tests al final 0 durante el desarrollo; de los 6 escritos a posteriori, 3 fallan 10 escritos antes del código; 10 pasan
    Limitación o riesgo Las regresiones llegan a producción sin ruido Si la spec está mal, los tests verifican el error con total confianza

    Que esto además salga más barato en tokens es otra discusión, con números, en la factura del vibe coding.

    Lo que se dice en Hacker News

    En Hacker News, el 2 de noviembre de 2026, en el hilo "In LLM era, can software startup survive?", anandj82 avisaba de lo que le espera a quien construye sin saber de software: "In 2 months time, the non s/w engineer is gonna drown in keeping up with all the pieces of the product without regression."

    Unos meses antes, en "Domain expertise has always been the real moat", locknitpicker describía a un compañero que "introduced a bunch of regressions that [sic] by mindlessly vibe-coding things against the requirements".

    Fíjate en el final: against the requirements. Los requisitos existían. Lo que no existía era algo que los comprobase en cada cambio.

    Cuándo NO usar SDD

    Cuando el error solo lo pagas tú. Un prototipo que vas a tirar no necesita R1-R10. Lo desarrollo en cuándo sí usar vibe coding: la frontera no es el tamaño del proyecto, es quién paga el fallo.

    Cuando todavía no sabes las reglas. Si estás explorando qué debe hacer la feature, una spec escrita ahora es una spec inventada. Haz el spike en modo vibe, tíralo y escribe la spec con lo aprendido.

    Cuando la spec está mal. Los tests verifican que el código cumple lo que escribiste, no lo que el negocio quería. Si R2 es una mala regla, tienes una mala regla con diez tests en verde.

    Cuando crees que diez ejemplos cubren la regla. R9 está probada con un solo carrito. Para reglas como "el orden no importa" encaja mejor property-based testing con fast-check, y para saber si tus tests detectan algo, mutation testing con Stryker.

    Cómo aplicar SDD a tu feature con reglas esta semana

    Elige el módulo de tu proyecto con más reglas de negocio: precios, permisos, estados de un pedido. Escribe sus reglas tal como funcionan hoy, numeradas, entre cinco y diez. Un test por regla, con el id en el nombre. Y que tu próximo prompt al agente empiece por "lee spec.md y no toques R1-Rn".

    Tu agente va a cometer errores así, con spec o sin ella. Lo único que eliges es si te enteras por un test rojo o por el email de un cliente.

    Si quieres practicarlo con un proyecto guiado, con AGENTS.md, contratos y revisión del código que genera el agente, eso es lo que hacemos en el workshop SDD + Agentic Engineering.

    Preguntas frecuentes

    ¿SDD vs vibe coding: cuál es más rápido?

    Vibe coding es más rápido la primera semana: un prompt, frente a una spec y cuatro tests antes de la primera línea de código. En este caso, la ventaja desaparece en la semana 3, cuando la pista A tiene tres fallos sin detectar y la pista B tiene uno detectado antes del merge.

    ¿Los tests de la spec los puede escribir el propio agente?

    Sí, pero revísalos tú antes de pedir el código. Si el mismo agente escribe tests e implementación en el mismo paso, puede ajustar unos a otros. El orden importa: spec, tests revisados y después código.

    ¿Por qué numerar las reglas de la spec?

    Porque el número viaja. Aparece en el test, en el comentario del código y en el prompt ("no toques R1-R7"). Cuando un test se pone rojo, R2 te dice qué decisión de negocio se rompió sin leer el diff.

    ¿Necesito una herramienta especial para hacer SDD?

    No. En este caso basta un spec.md, un archivo de tests y bun test. Las herramientas ayudan a generar la estructura, pero lo que frena la regresión es que cada regla tenga un comando que la compruebe.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • ¿Qwen 4 en Arena? Qué revela (y qué no) el modelo Kalmia

    ¿Qwen 4 en Arena? Qué revela (y qué no) el modelo Kalmia

    El 27 de octubre un usuario de X publicó que Kerria, un modelo anónimo de Arena, se equivocaba con tres de los cuatro tokens especiales con los que solo falla el tokenizer de Qwen. Lo ponía en la misma familia que Kalmia, otro anónimo que llevaba días en Code Arena.

    Su post pasó de 65.000 visualizaciones con el hashtag #Qwen4 puesto. Veinte minutos después, otra cuenta lo citaba como probable adelanto de la siguiente generación de Qwen. En X, el esperado Qwen 4 ya estaba ahí, escondido detrás de dos nombres de flor.

    No hay comunicado de Alibaba ni de Arena. La tensión no es si Kalmia es o no es Qwen 4. Es qué haces tú con información sin confirmar que sí puede moverte el roadmap.

    En corto: desde finales de octubre de 2026 circula en Arena un modelo anónimo llamado Kalmia que la comunidad atribuye a Qwen 4, pero ni Alibaba ni Arena lo han confirmado. Un buen puesto en Arena mide preferencia humana en conversaciones cortas, no tu caso de uso. Lo útil hoy no es migrar: es tener una eval propia y una capa de proveedor intercambiable para probar Qwen 4 el día que salga.

    Qwen 4: fecha de lanzamiento y lo que se sabe a 1 de noviembre de 2026

    Lo confirmado cabe en una frase: Qwen 4 está en entrenamiento y no tiene fecha.

    En la Apsara Conference del 22 de septiembre, el material oficial de Alibaba dijo que el modelo estaba "currently in training", sin fecha, tamaños ni licencia, según el resumen del RITS de NYU Shanghai. Yotta Labs atribuye al responsable del proyecto Qwen, Liu Dayiheng, que saldría "muy pronto". Los niveles Max, Plus, Flash y 27B salen de un post en X, no de la nota de prensa.

    Todo lo demás es rumor. Una filtración de julio apuntaba a septiembre y falló, como recoge Yotta Labs (que vende servicios de gateway).

    El rumor más reciente es del 29 de octubre. En la Apsara Conference de Ámsterdam, un asistente publicó en X que Feifei Li, CTO de Alibaba Cloud, había dicho "Qwen4 next week", es decir, entre el 2 y el 8 de noviembre. Lo recoge Pasquale Pillitteri, que deja claro que ningún canal oficial lo ha confirmado. La diapositiva proyectada ese día decía "coming soon", sin fecha.

    ¿Qué es un modelo anónimo en Arena?

    Un modelo anónimo en Arena es un modelo todavía sin lanzar que un laboratorio pone a competir en votaciones a ciegas con un nombre en clave, para recoger preferencias de usuarios reales antes de anunciarlo.

    La FAQ de Arena lo explica sin rodeos: trabajan con proveedores para que sus modelos previos al lanzamiento aparezcan en Battle mode con codenames o alias. Tú ves dos respuestas, votas cuál prefieres y luego se revelan los nombres. Los votos que emites después de la revelación no cuentan para el ranking.

    La política del leaderboard, actualizada el 1 de septiembre de 2026, añade dos detalles que importan. Cada modelo anónimo tiene su propia etiqueta única. Y la puntuación de un modelo probado en anónimo se marca como preliminar hasta que se acumulan votos nuevos tras el lanzamiento público.

    No es nuevo: según Wikipedia, GPT-5 se probó como "summit". El codename es un nombre de trabajo, no una prueba de identidad.

    Kalmia, Kibitz y Kerria: lo que dice la comunidad

    Hacia el 22 de octubre aparecieron dos modelos anónimos a la vez en Code Arena: Kalmia y Kibitz. Hamidun News, que reprocesa una nota de Jiqizhixin, recoge que en la discusión aparecen dos nombres, Qwen 4 y Kimi K3.1 de Moonshot, por estilo, forma de razonar y formato de código. Y subraya que ningún laboratorio los ha reclamado. El emparejamiento Kalmia = Qwen 4 lo pone la comunidad: @NFT_Chen lo presentó el 26 de octubre como "probable Qwen 4.0" por la huella del tokenizer.

    El mismo 22 de octubre ya había en Hacker News un enlace titulado "Kimi K3.1 vs. Qwen 4: 3D helicopter". Fíjate en eso: en cuanto aparecen los codenames, el rumor ya circula con el nombre comercial puesto.

    Luego llegó Kerria. El 27 de octubre, @NFT_Chen publicó en X una prueba de huella del tokenizer: Kerria rompía tres de los cuatro tokens especiales que solo el tokenizer de Qwen procesa mal, mientras que 52 tokens de 13 laboratorios distintos salían bien.

    El propio autor lo presenta como indicio fuerte pero no concluyente, porque otro laboratorio podría reutilizar el tokenizer de Qwen. @ItsmeAjayKV lo amplificó con un histórico de codenames que atribuye a Qwen: Kiteki (Qwen3.5), Kizen-alpha (Qwen3.6) y Korin (Qwen3.7 Max). Son atribuciones de la comunidad, no confirmaciones. Y ojo: el test de los 52 tokens se publicó para Kerria. Para Kalmia, el tuit del 26 de octubre afirma la huella sin enseñar la prueba. Y aunque los dos compartan tokenizer, eso dice "familia Qwen", no "Qwen 4".

    Y un contraejemplo útil: en julio, @Lentils80 contó que un modelo anónimo llamado "Kaleb" decía ser Claude, aunque los usuarios lo identificaban como Qwen por su forma de responder.

    ¿Cómo se identifica un modelo anónimo de Arena?

    Con cuatro señales, y no valen lo mismo: solo la huella del tokenizer se puede reproducir.

    Señal Qué aporta Fiabilidad Riesgo o limitación
    Autoidentificación ("soy Claude") Nada fiable sobre el autor Muy baja Si se entrenan con datos sintéticos de otros modelos, pueden repetir nombres ajenos. El caso Kaleb lo ilustra, aunque su autor tampoco se confirmó
    Estilo y formato Parecido con versiones anteriores Baja-media Subjetivo; dos laboratorios que destilan del mismo modelo acaban sonando igual
    Huella del tokenizer Indicio técnico reproducible Media-alta Identifica el tokenizer, no el laboratorio ni la versión. Kerria podría ser una versión intermedia o un tercero con el mismo tokenizer
    Calendario (aparece cuando se espera un lanzamiento) Contexto Baja Es justo lo que alimenta el sesgo de confirmación

    Incluso en el mejor caso, la huella te dice "familia Qwen", no "Qwen 4", y menos aún "Qwen 4 Max".

    Qué dice (y qué no) un buen puesto en el leaderboard de Arena

    Arena mide qué respuesta prefiere un humano en una comparación a ciegas. Lo convierte en ranking con el modelo Bradley-Terry, comparable al Elo del ajedrez, según su FAQ.

    Lo que sí te dice Lo que no te dice
    Qué modelo prefieren votantes anónimos en prompts cortos Cómo rinde en tu codebase, con tu contexto y tus tools
    Una tendencia agregada con muchos votos Latencia, coste por tarea ni estabilidad del endpoint
    Que el laboratorio está probando algo Que la versión que se lanza sea la misma que se votó

    Lo último no es teórico. Llama 4 Maverick quedó por encima de GPT-4o en LMArena, y la versión probada allí era distinta de la publicada, como recoge Wikipedia.

    El paper The Leaderboard Illusion (abril de 2025) contó 27 variantes privadas probadas por Meta antes de Llama 4 y estimó que Google y OpenAI recibieron el 19,2 % y el 20,4 % de los datos de Arena, frente al 29,7 % del conjunto de 83 modelos open-weight.

    En el hilo de Hacker News sobre ese paper, uno de los primeros comentarios, de pongogogo, concluye que ya no te puedes fiar de ningún benchmark público y que necesitas evals privadas. Otro, ekidd, recoge quejas de que Arena tiende a premiar las viñetas, los emojis y la adulación incluso a costa de la respuesta correcta.

    Yo estoy con pongogogo. Arena me sirve para saber qué mirar, nunca para decidir qué poner en producción. Es el mismo escepticismo que apliqué a la tabla de Qwen3.8-Max y que desarrollé en los benchmarks de IA para programar que sí importan.

    Cómo prepararte para Qwen 4 sin migrar por un rumor

    No muevas nada por Kalmia. Prepara dos piezas para que, el día que Qwen 4 salga, probarlo te cueste una tarde y no un sprint.

    La primera es una capa de proveedor intercambiable. Casi todos los proveedores exponen una API compatible con OpenAI, así que basta con que la URL y el modelo salgan de configuración:

    // providers.ts
    export type Provider = { name: string; baseURL: string; apiKey: string; model: string };
    
    export function fromEnv(prefix: string): Provider {
      const baseURL = process.env[`${prefix}_BASE_URL`] ?? '';
      const model = process.env[`${prefix}_MODEL`] ?? '';
      if (!baseURL || !model) throw new Error(`Faltan ${prefix}_BASE_URL o ${prefix}_MODEL`);
      return { name: prefix.toLowerCase(), baseURL, apiKey: process.env[`${prefix}_API_KEY`] ?? '', model };
    }
    
    export async function complete(p: Provider, prompt: string): Promise<string> {
      const res = await fetch(`${p.baseURL}/chat/completions`, {
        method: 'POST',
        headers: { 'Content-Type': 'application/json', Authorization: `Bearer ${p.apiKey}` },
        body: JSON.stringify({ model: p.model, messages: [{ role: 'user', content: prompt }], temperature: 0 }),
      });
      if (!res.ok) throw new Error(`${p.name}: HTTP ${res.status}`);
      const data = (await res.json()) as { choices: { message: { content: string | null } }[] };
      return data.choices[0]?.message.content ?? '';
    }
    

    Si no quieres gestionar una clave por proveedor, un agregador como OpenRouter te da una sola URL. Y si Qwen 4 trae un 27B con pesos abiertos, la misma interfaz te sirve contra un servidor local; antes de contar con ello, revisa qué te dan de verdad los open weights.

    La segunda pieza es una eval propia. Veinte casos sacados de tu trabajo real valen más que cualquier leaderboard. Guarda los dos archivos en un proyecto con "type": "module" y ejecútalo con npx tsx eval.ts o bun eval.ts:

    // eval.ts
    import { complete, fromEnv, type Provider } from './providers.js';
    
    type Case = { id: string; prompt: string; check: (out: string) => boolean };
    
    const cases: Case[] = [
      {
        id: 'zod-schema-usuario',
        prompt: 'Escribe solo el schema Zod de un usuario con email válido y edad entera >= 18.',
        check: (out) =>
          out.includes('z.object(') && out.includes('.email(') && out.includes('.int(') && /\.(min|gte)\(18\)/.test(out),
      },
      // ...añade casos reales de tus PR y tus incidencias
    ];
    
    async function run(p: Provider) {
      let ok = 0;
      for (const c of cases) {
        const out = await complete(p, c.prompt);
        if (c.check(out)) ok++;
        else console.log(`FALLA ${p.name} → ${c.id}`);
      }
      console.log(`${p.name}: ${ok}/${cases.length}`);
    }
    
    await run(fromEnv('ACTUAL'));
    await run(fromEnv('CANDIDATO'));
    

    El día del lanzamiento cambias tres variables de entorno y comparas. Es el mismo principio que aplicamos en el curso Construye con IA: el modelo es una pieza que se cambia, y lo que no se cambia es la especificación de qué tiene que hacer.

    Límites de este enfoque

    Una eval de veinte casos con checks por includes detecta regresiones gordas, no matices. No te dirá si un modelo razona mejor en tareas largas de agente. Para eso necesitas casos multi-paso y, a menudo, revisión humana.

    La capa intercambiable tampoco resuelve todo. Dos endpoints "compatibles con OpenAI" no se comportan igual con tool calling, structured outputs, límites de contexto ni con parámetros como temperature, que algunos modelos de razonamiento rechazan. Cambiar la URL es fácil; validar que tus tools siguen funcionando, no tanto.

    Qué hacer hoy

    Escribe los primeros diez casos de tu eval con prompts que ya hayas usado esta semana. Ese archivo vale para Qwen 4, para Kimi K3.1 y para lo que salga después.

    Si quieres llevar esa idea a todo tu flujo, en el libro Spec-Driven Development explico cómo escribir la especificación antes que el código, que es justo lo que hace que cambiar de modelo no te rompa el proyecto. Y cuando Qwen 4 salga, lo probaremos en el canal de YouTube de Dominicode con casos reales, no con votos.

    Preguntas frecuentes

    ¿Kalmia es Qwen 4?

    No está confirmado. La comunidad lo atribuye a Qwen 4 por estilo, huella del tokenizer y calendario, pero ni Alibaba ni Arena lo han dicho, y la FAQ de Arena trata los codenames como alias de modelos previos al lanzamiento, sin revelar su autor.

    ¿Cuándo sale Qwen 4?

    No hay fecha oficial a 1 de noviembre de 2026. Alibaba dijo el 22 de septiembre que estaba en entrenamiento. El 29 de octubre, un asistente a la Apsara de Ámsterdam atribuyó al CTO de Alibaba Cloud un "next week" (del 2 al 8 de noviembre), sin confirmación oficial.

    ¿Puedo usar Kalmia en mi aplicación?

    No. Los modelos anónimos aparecen en el Battle mode de Arena y no tienen API pública anunciada ni garantías. Además, la política de Arena indica que las conversaciones con modelos sin lanzar se comparten con el proveedor.

    ¿Un buen puesto en Arena significa que el modelo es mejor para programar?

    Significa que los votantes prefirieron sus respuestas en comparaciones a ciegas. Para tu caso de uso, necesitas tu propia eval con tus prompts, tu contexto, tu coste y tu latencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Mastra vs LangGraph: el mismo agente TypeScript dos veces

    Mastra vs LangGraph: el mismo agente TypeScript dos veces

    El contador de líneas decía 95 contra 142. Tenía el mismo agente funcionando con Mastra y con LangGraph, cada uno con sus tests en verde, y la tentación era evidente: titular «Mastra gana» y pasar a otra cosa.

    No lo hice, porque el número no explicaba la diferencia que de verdad tuve que corregir. Era un 400 de la API de Anthropic que no venía de mi lógica, sino del método por defecto de una librería, que fuerza una llamada a herramienta que Claude Sonnet 5.5 rechaza.

    Esa es la comparación Mastra vs LangGraph que me interesa: no cuál escribe menos, sino dónde te muerde cada una cuando construyes un agente que tiene que pararse, esperar a una persona y sobrevivir a un reinicio.

    En corto: construí el mismo agente de triaje con LangGraph.js 1.5.3 y con Mastra 1.80.0. LangGraph te da un grafo de estados explícito con control fino de cada arista; Mastra te da un workflow de pasos tipados con Zod y más piezas incluidas. La elección depende de la forma del flujo: si tiene ciclos y ramas que quieres controlar, LangGraph.js; si es mayormente lineal y quieres Studio, memoria y model router incluidos, Mastra.

    ¿Qué es Mastra y qué es LangGraph?

    LangGraph.js es una librería de orquestación de agentes en la que defines un grafo de estados: nodos que leen y escriben un estado compartido, y aristas, algunas condicionales, que deciden el siguiente paso. Es la versión TypeScript de LangGraph y se apoya en los modelos y las herramientas de LangChain.

    Mastra es un framework de agentes TypeScript que reúne en una sola instancia agentes, herramientas, workflows de pasos encadenados, memoria, almacenamiento y un Studio local. Lo crearon developers que venían de Gatsby, como se presentaron en su Show HN, y está pensado para TypeScript desde el principio.

    En la comparación Mastra vs LangGraph, las dos usan Zod, pausan para aprobación humana y guardan estado. La diferencia está en el modelo mental.

    El agente que construí dos veces

    Triaje recibe una incidencia de un usuario y hace cinco cosas: la clasifica por tipo y gravedad, investiga en la documentación con una herramienta de búsqueda con límite de vueltas, redacta un borrador, se pausa hasta que una persona lo aprueba, edita o rechaza, y publica lo aprobado.

    Para que la comparación sea justa, las dos versiones comparten el paquete @curso/shared: esquemas Zod, instrucciones y prompt de redacción. Mismo modelo (Claude Sonnet 5.5) y versiones fijadas, verificadas el 29 de octubre de 2026.

    Mastra vs LangGraph: grafo de estados o workflow de pasos

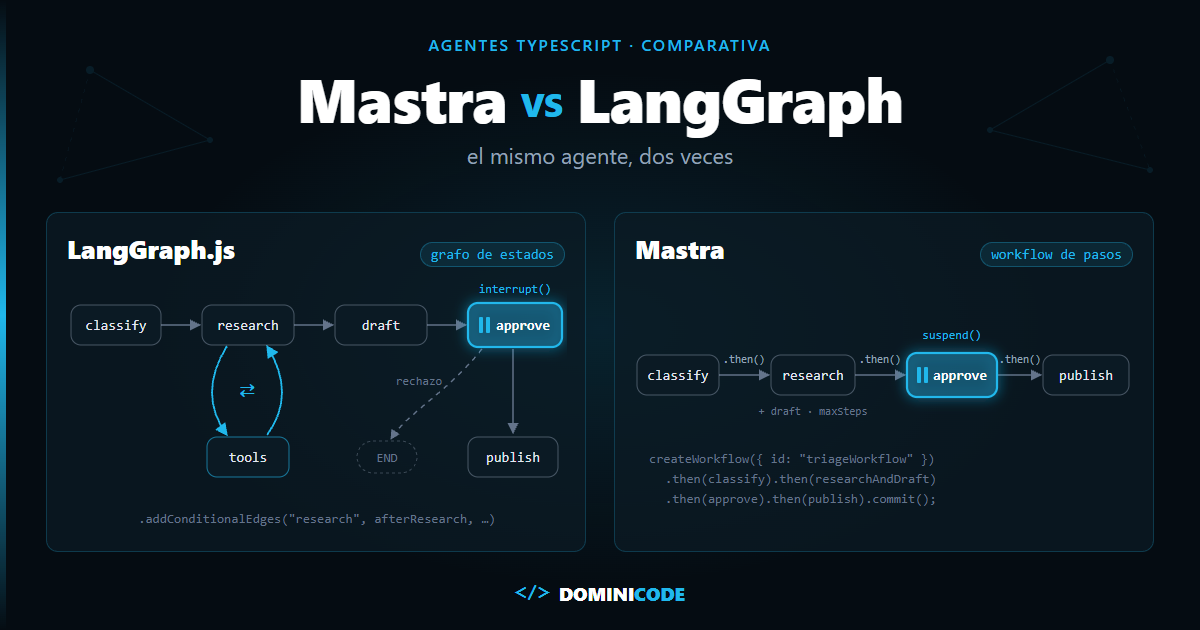
    En LangGraph dibujas el flujo con aristas; en Mastra lo encadenas con .then(). Esa decisión se nota en todo lo demás.

    Este es el grafo de Triaje en LangGraph.js. El bucle de investigación (research ⇄ tools) y la rama de rechazo son aristas que se ven en el código:

    return new StateGraph(TriageState)
      .addNode("classify", makeClassify(classifierModel))
      .addNode("research", makeResearch(model))
      .addNode("tools", runTools)
      .addNode("writeDraft", makeDraft(model))
      .addNode("approve", approve)
      .addNode("publish", makePublish(tracker))
      .addEdge(START, "classify")
      .addEdge("classify", "research")
      .addConditionalEdges("research", afterResearch, ["tools", "writeDraft"])
      .addConditionalEdges("tools", afterTools, ["research", "writeDraft"])
      .addEdge("writeDraft", "approve")
      .addConditionalEdges("approve", afterApproval, ["publish", END])
      .addEdge("publish", END)
      .compile({ checkpointer });
    

    Y este es el mismo flujo en Mastra:

    return createWorkflow({ id: "triageWorkflow", inputSchema: Start, outputSchema: z.object({ published: z.boolean() }) })
      .then(classify)
      .then(researchAndDraft)
      .then(approve)
      .then(publish)
      .commit();
    

    Más corto, sí. Pero el bucle de investigación se ha ido dentro del paso researchAndDraft, donde el agente con la herramienta search hace sus vueltas con maxSteps. En LangGraph el bucle lo controlas tú. En Mastra lo controla el agente, y tú le pones un techo.

    Es la misma pregunta de cuándo un grafo de estados gana al while loop.

    El control explícito tiene un precio. En la revisión de código apareció un camino que ningún test cubría: si el límite de vueltas cortaba cuando el último mensaje pedía herramientas, la API recibía un tool_use sin su tool_result. Resultado: 400. La corrección fue aplicar el límite después de ejecutar las herramientas:

    // El límite de vueltas se aplica DESPUÉS de ejecutar las herramientas.
    const afterTools = (state: TriageStateValue) => (state.researchSteps >= MAX_RESEARCH_STEPS ? "writeDraft" : "research");
    

    En un grafo, el protocolo de mensajes del modelo es problema tuyo.

    ¿Cómo se pausa un agente para aprobación humana en cada una?

    LangGraph pausa con interrupt() y reanuda con new Command({ resume }); Mastra pausa con suspend() y reanuda con run.resume(). Las dos validan la respuesta humana con Zod.

    En LangGraph, la aprobación es una sola llamada. El responseSchema valida la decisión al reanudar, y una respuesta inválida lanza ZodError sin romper el hilo:

    export async function approve(state: Pick<TriageStateValue, "draft">): Promise<{ decision: Decision }> {
      const decision = interrupt(state.draft, { responseSchema: DecisionSchema }) as Decision;
      return { decision };
    }
    
    // Más tarde, en otro proceso:
    await graph.invoke(new Command({ resume: decision }), { configurable: { thread_id: threadId } });
    

    Necesita un checkpointer (MemorySaver, SqliteSaver o PostgresSaver) y un thread_id. Esa es la base de la persistencia de LangGraph.

    En Mastra, el paso declara qué enseña al pausarse y qué espera al volver:

    const approve = createStep({
      id: "approve", inputSchema: Drafted, outputSchema: Decided, suspendSchema: DraftSchema, resumeSchema: DecisionSchema,
      execute: async ({ inputData, resumeData, suspend }) => {
        if (!resumeData) return await suspend(inputData.draft);
        return { ...inputData, decision: resumeData };
      },
    });
    
    // Más tarde:
    const run = await mastra.getWorkflow("triageWorkflow").createRun({ runId });
    await run.resume({ step: "approve", resumeData: decision });
    

    La persistencia va en la instancia Mastra, con new LibSQLStore({ id, url }). Lo comprobé con otra instancia sobre el mismo fichero LibSQL: el workflow se reanudó con 0 llamadas al modelo. La doc oficial lo cuenta en Suspend and resume.

    Las decisiones de diseño de esa pausa las cuento en arquitectura human-in-the-loop en TypeScript.

    Salida estructurada con Claude: la diferencia que sí encontré

    Es la diferencia de comportamiento entre las dos que tuve que corregir, y la comprueba un test. En LangChain, withStructuredOutput de @langchain/anthropic 1.6.0 usa por defecto el método functionCalling. Ese método fuerza tool_choice, y Claude Sonnet 5.5 responde 400.

    La solución es pasar el método explícitamente:

    const classifier = model.withStructuredOutput(ClassificationSchema, { name: "classification", method: "jsonSchema" });
    

    Con jsonSchema la petición usa output_config.format. En Mastra no hubo que tocar nada:

    const res = await agents.classifier.generate(text, { structuredOutput: { schema: ClassificationSchema } });
    

    Con "anthropic/claude-sonnet-5-5" en el model router, Mastra ya envía output_config.format, sin tool_choice. Las dos versiones tienen un anthropic-wire.test.ts que intercepta fetch y comprueba lo que sale por la red. En LangGraph, quitar el method hace fallar el test.

    Es un detalle de versión, no de diseño, pero solo lo ves construyendo lo mismo dos veces. Si los esquemas son la frontera de tu agente, merece la pena dominarlos: en el curso de Zod trabajo validación y transformación de datos en TypeScript, que es lo que sostiene cada paso de Triaje en las dos versiones.

    ¿Cuál tiene menos código? 95 contra 142 líneas

    Mastra ocupa 95 líneas y LangGraph 142 en el núcleo del agente, contando sin comentarios ni líneas vacías. En LangGraph cuento graph.ts, state.ts y los cinco nodos; en Mastra, los cuatro ficheros de mastra/. La CLI que lo usa sale al revés: 63 en LangGraph, 68 en Mastra.

    Ese dato no decide nada. Las 47 líneas de diferencia son, sobre todo, el estado explícito y el bucle de herramientas que en LangGraph escribes tú y en Mastra vive dentro del agente. Menos líneas significa menos control a la vista, no menos complejidad.

    LangGraph.js vs Mastra: tabla comparativa

    Criterio LangGraph.js 1.5.3 Mastra 1.80.0
    Modelo mental Grafo de estados: nodos, aristas condicionales, estado compartido con reducers Workflow de pasos encadenados con .then(), cada uno con inputSchema/outputSchema Zod
    Bucle de herramientas Lo dibujas tú (research ⇄ tools) Dentro del agente, con maxSteps
    Persistencia Checkpointer (MemorySaver, SqliteSaver, PostgresSaver) + thread_id storage en la instancia Mastra (p. ej. LibSQLStore) + runId
    Human-in-the-loop interrupt(valor, { responseSchema }) y new Command({ resume }) suspendSchema/resumeSchema, suspend() y run.resume({ step, resumeData })
    Salida estructurada con Claude Sonnet 5.5 Hay que pasar method: "jsonSchema"; el método por defecto da 400 Funciona tal cual con structuredOutput: { schema }
    Modelo new ChatAnthropic({ model }) Model router: "anthropic/claude-sonnet-5-5"
    Tooling Streaming por modos (updates, messages, custom), getState, time-travel Studio local con mastra dev en localhost:4111
    Tests fakeModel() de langchain, documentado MockLanguageModelV4 de ai/test, que Mastra no documenta
    Núcleo de Triaje 142 líneas 95 líneas
    Limitación o riesgo La doc va por delante del paquete; el protocolo tool_use/tool_result es responsabilidad tuya Más opinado: salirte de sus patrones cuesta; los mocks de test pueden romperse al subir versión

    La última fila es la que más pesa. En LangGraph, los interrupts tipados de las notas de la v1 (runtime.interrupt.nombre()) no existen en 1.5.3: fallan en ejecución con «runtime.interrupt.approval is not a function». Lo que sí funciona es interrupt(valor, { responseSchema }).

    En Mastra hay tres cosas que no vienen en la portada. Studio se ejecuta desde .mastra/, así que las rutas de LibSQL tienen que ser absolutas. Una herramienta como objeto plano, sin createTool, falla en silencio. Y un agente usado como paso del workflow llama al modelo en streaming (doStream): tu mock tiene que cubrir los dos modos.

    ¿Qué dicen otros developers de Mastra frente a LangGraph?

    En el debate público, la crítica concreta a Mastra es la que anticipa la tabla: es un framework opinado, rápido mientras encajas en sus patrones y costoso cuando no.

    En el Show HN de Mastra 1.0 de enero de 2026, un usuario contó una experiencia que encaja con la última fila de la tabla. Escribió que «Mastra is by design batteries included and opinionated» y que, cuando no encajas en un patrón existente, cuesta seguir siendo productivo.

    Contó que habían tenido que crear sus propias rutas de Hono y que alguien de su equipo estaba reconstruyéndolo todo con LangGraph/LangChain.

    La respuesta del equipo de Mastra en el mismo hilo fue que habían aprendido que los usuarios necesitan poder «eject and adapt Mastra however they want», y que habían añadido adaptadores de servidor y almacenamiento más configurable.

    Las dos cosas son ciertas a la vez. Las baterías incluidas te aceleran mientras tu problema se parece al que imaginó el framework.

    ¿Cuándo elegir LangGraph.js y cuándo Mastra?

    Elige LangGraph.js si el flujo tiene ciclos, ramas y reintentos que quieres ver y testear uno a uno. Elige Mastra si tu equipo es solo TypeScript, el flujo es mayormente lineal y quieres agentes, workflows, memoria y Studio en una sola pieza.

    LangGraph pesa más si necesitas subgrafos, paralelo dinámico con Send, o recorrer el historial con getStateHistory para hacer replay desde un checkpoint o fork con updateState, o si ya usas LangChain. Mastra pesa más si quieres un Studio local sin montar nada y un model router con strings proveedor/modelo en vez de configurar el SDK de cada proveedor.

    Si dudas, escribe antes la especificación del agente: qué pasos tiene, dónde se pausa y qué pasa si una respuesta humana no es válida. La elección suele salir sola. Es el método que explico en el libro de Spec-Driven Development.

    Límites de esta comparación

    Esta comparación Mastra vs LangGraph es un caso, no un benchmark. Conviene leerlo con estas limitaciones:

    1. Un solo agente. Triaje es casi lineal. Un sistema multiagente o con mucho paralelismo puede inclinar la balanza.
    2. Una sola versión de cada una. LangGraph.js 1.5.3 y Mastra 1.80.0, a 29 de octubre de 2026. La trampa de salida estructurada depende de @langchain/anthropic 1.6.0 y puede desaparecer en la siguiente. Al publicar ya hay LangGraph.js 1.6.0 y Mastra 1.81.0; no he repetido las pruebas con ellas.
    3. Un solo modelo. Claude Sonnet 5.5. Con otro proveedor, el comportamiento de withStructuredOutput y del model router puede ser distinto.
    4. Sin cifras de coste, latencia ni calidad que sirvan para decidir. Hay un arnés comparar/ que ejecuta las dos versiones en serie sobre las mismas incidencias y mide llamadas, tokens, milisegundos y errores, y una pasada de evals con 20 incidencias sintéticas. Una sola pasada no demuestra que un framework sea mejor, así que no doy números.
    5. Sin producción real. Probé persistencia, reinicios y Docker en local, no con tráfico de usuarios.

    Un riesgo que vale para las dos: fija versiones. En junio de 2026 se publicaron versiones comprometidas de varios paquetes @mastra en npm; el aviso en GitHub se cerró en unas horas, pero un framework de agentes es una dependencia de la cadena de suministro como cualquier otra.

    ¿Dónde se construye Triaje con las dos?

    Estoy preparando un curso de agentes en TypeScript con LangGraph.js y Mastra. Triaje se construye primero con LangGraph.js y después con Mastra, y una sección los compara cara a cara con el arnés y los tests de este post.

    Todavía no tiene fecha.

    Lo que puedes hacer hoy

    Antes de elegir framework, dibuja tu agente en papel. Si el dibujo tiene flechas que vuelven hacia atrás y quieres controlarlas tú, empieza por LangGraph.js. Si es una fila de cajas con entradas y salidas, empieza por Mastra, y tienes un punto de partida en el tutorial para crear un agente TypeScript con Mastra.

    Si quieres la base que hay debajo de los dos frameworks (herramientas, memoria, RAG, MCP y multiagente), descarga gratis el ebook El Developer Agéntico. Y si es tu primer agente, empieza por cómo construir un agente de IA desde cero.

    Preguntas frecuentes

    ¿LangGraph.js vs Mastra: cuál es mejor framework de agentes TypeScript?

    Ninguna es mejor en abstracto: con el mismo agente, las dos resolvieron clasificación, búsqueda, aprobación humana y persistencia. LangGraph.js da más control sobre ciclos y estado; Mastra, más piezas integradas.

    ¿Se puede pausar un agente para aprobación humana en Mastra y en LangGraph?

    Sí. LangGraph usa interrupt() con un checkpointer y new Command({ resume }); Mastra usa suspend() y run.resume({ step, resumeData }). En las dos, la respuesta humana se valida con Zod.

    ¿Por qué falla withStructuredOutput con Claude Sonnet 5.5 en LangGraph?

    Porque el método por defecto de @langchain/anthropic 1.6.0 es functionCalling, que fuerza tool_choice, y Sonnet 5.5 lo rechaza con un 400. Se arregla pasando method: "jsonSchema", que envía output_config.format. En Mastra, structuredOutput: { schema } funciona sin cambios.

    ¿Se puede testear un agente de Mastra sin llamar a la API?

    Sí, con MockLanguageModelV4 de ai/test pasado como model del agente. Funciona con Mastra 1.80.0 y ai 7.0.143, pero Mastra no documenta este uso, así que puede romperse al subir de versión. En LangGraph, fakeModel() de langchain sí está documentado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Arquitectura orientada a eventos en el frontend: 5 problemas

    Arquitectura orientada a eventos en el frontend: 5 problemas

    Pulsas "Cancelar pedido". El botón responde, sale un toast verde, la API devuelve 202 Accepted. Recargas la lista para comprobarlo y el pedido sigue ahí, en estado "Pagado", como si no hubieras hecho nada.

    Vuelves a pulsar. Ahora hay dos solicitudes de cancelación en una cola que no ves. Abres un ticket de soporte. Diez segundos después, el pedido aparece cancelado.

    Nadie ha roto nada. El backend migró a una arquitectura orientada a eventos y el frontend siguió programado como si cada petición devolviera la verdad al instante.

    En corto: con una arquitectura orientada a eventos en el backend, el frontend deja de recibir la verdad en la respuesta HTTP: le llega tarde, desordenada y a veces incompleta. Los cinco problemas típicos son la consistencia eventual visible, la UI optimista sin reconciliación, los eventos fuera de orden o duplicados, los huecos tras una reconexión y el acoplamiento al schema del backend. Se resuelven con versión por entidad, estados de sincronización explícitos y validación en el borde.

    ¿Qué cambia en el frontend con una arquitectura orientada a eventos?

    La arquitectura orientada a eventos es un estilo en el que los servicios se comunican publicando hechos ya ocurridos ("pedido cancelado") en lugar de llamarse entre sí, de modo que, para el frontend, cada escritura se confirma de forma asíncrona y el estado que lee converge con retraso.

    Tu POST ya no significa "hecho". Significa "recibido, ya veremos". Si el backend usa CQRS, el modelo de lectura se actualiza cuando el proyector procese el evento, como explico en cómo sincronizar el read model en CQRS.

    El lado servidor (idempotencia de consumidores, outbox, colas de mensajes fallidos) es otra historia. Aquí hablo de lo que le pasa a tu pantalla.

    Los 5 problemas de la arquitectura orientada a eventos en el frontend

    # Síntoma en la UI Causa Solución Coste o riesgo de la solución
    1 Guardo, recargo y mi cambio no está El read model aún no ha procesado el evento Devolver versión en la respuesta y esperar a verla (evento o polling acotado) Más lógica de espera; hace falta un timeout con salida clara
    2 La UI dice "hecho" y minutos después falló UI optimista sin estado pending ni rollback Estados pending / confirmed / failed y compensación visible Más estados que diseñar y testear
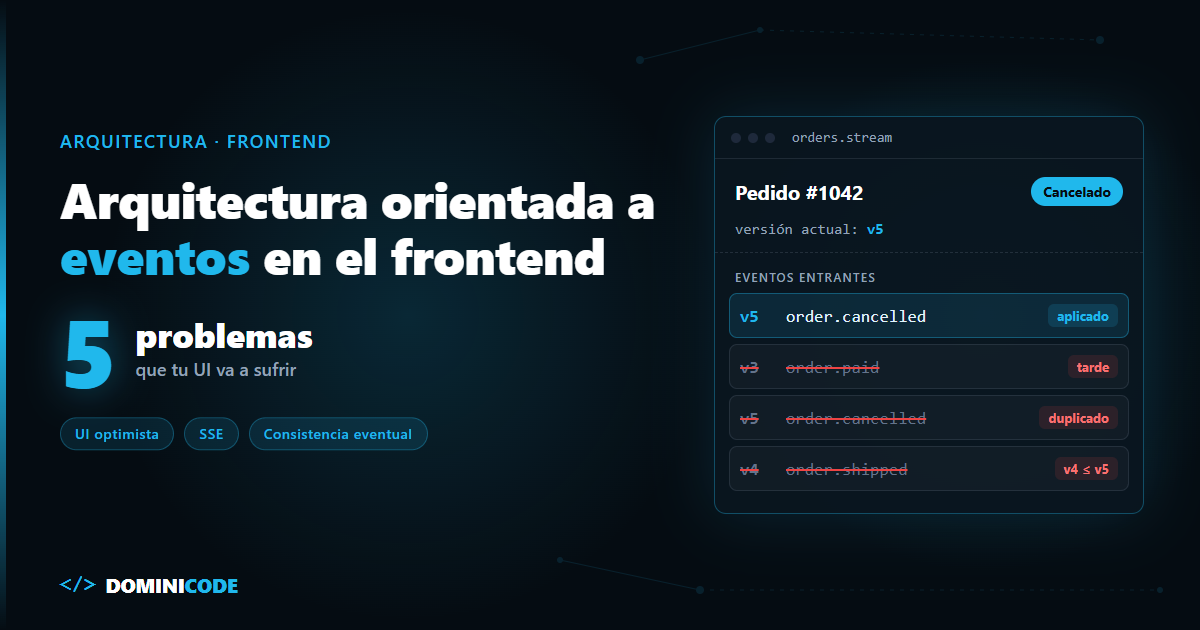
    3 Un dato vuelve a un valor antiguo Eventos fuera de orden o duplicados por WebSocket/SSE Versión por entidad: descartar todo evento con versión ≤ la actual El backend tiene que emitir una versión monotónica por entidad
    4 Dos pestañas muestran datos distintos Se cayó el socket y se perdieron eventos id: en SSE + resync con snapshot al reconectar Una petición extra en cada reconexión
    5 Un deploy del backend rompe una pantalla El cliente consume eventos de dominio crudos Eventos de integración pensados para el cliente + Zod en el borde Una capa más (BFF o traductor) que mantener

    Problema 1: consistencia eventual que el usuario sí ve

    La respuesta corta: no relances la lectura a ciegas; pide al backend la versión que generó tu escritura y espera a verla.

    El patrón roto es post().then(() => refetch()). Ese refetch llega antes que el proyector y lee el estado viejo. El usuario ve su cambio "deshecho".

    La garantía que necesitas se llama read-your-own-writes. Para dársela desde el cliente, la respuesta del comando debe incluir algo comparable: la versión resultante de la entidad.

    // La API responde 202 con la versión que asignó al aceptar el comando (el backend debe conocerla ya)
    type CommandAccepted = { orderId: string; expectedVersion: number };
    
    async function waitForVersion(
      { orderId, expectedVersion }: CommandAccepted,
      read: (id: string) => Promise<{ version: number }>,
      { attempts = 5, delayMs = 400 } = {},
    ): Promise<boolean> {
      for (let i = 0; i < attempts; i++) {
        const current = await read(orderId);
        if (current.version >= expectedVersion) return true;
        if (i < attempts - 1) await new Promise((r) => setTimeout(r, delayMs * (i + 1)));
      }
      return false; // no ha convergido: la UI lo dice, no lo esconde
    }
    

    Si ya tienes un stream de eventos abierto, no hagas polling: espera al evento con esa versión.

    Problema 2: UI optimista sin rollback

    La respuesta corta: una UI optimista sin estado pending no es optimista, es mentirosa.

    El debate es viejo. En el hilo de Hacker News sobre la UI optimista de Meteor, de mayo de 2015, un usuario lo planteó sin rodeos: "Isn't this just lying to the user?". Las respuestas del mismo hilo dan la salida: mostrar el cambio al instante, pero señalar cuándo está persistido, como los dos checks de WhatsApp.

    En event-driven el fallo puede llegar minutos después, como evento order.cancel_rejected, con el usuario ya en otra pantalla. Necesitas un estado de sincronización por entidad, no un booleano de loading.

    export type SyncState = 'pending' | 'confirmed' | 'failed';
    
    export interface OrderView {
      id: string;
      status: 'paid' | 'cancelled' | 'shipped';
      version: number;
      sync: SyncState;
      previous?: OrderView; // para revertir si el backend rechaza
    }
    

    pending se pinta distinto (opacidad, "Cancelando…"). failed revierte a previous y avisa con un mensaje que diga qué pasó y qué puede hacer el usuario. Eso es compensación visible: la UI admite que se adelantó.

    Problema 3: eventos fuera de orden o duplicados

    La respuesta corta: cada evento trae la versión de la entidad y el cliente ignora todo lo que no sea más nuevo que lo que ya tiene.

    Con varios productores o reintentos, puede llegarte la versión 4 de un pedido antes que la 3. Si aplicas por orden de llegada, el pedido "vuelve" a pagado.

    Un store con signals de Angular (estables desde Angular 17). La convergencia vive en apply:

    import { Injectable, computed, signal } from '@angular/core';
    
    @Injectable({ providedIn: 'root' })
    export class OrdersStore {
      private readonly byId = signal<Record<string, OrderView>>({});
      readonly orders = computed(() => Object.values(this.byId()));
    
      /** Aplica un evento confirmado del servidor. Idempotente y tolerante al desorden. */
      apply(e: { orderId: string; version: number; status: OrderView['status'] }) {
        this.byId.update((current) => {
          const prev = current[e.orderId];
          if (prev && prev.version >= e.version) return current; // viejo o duplicado
          return {
            ...current,
            [e.orderId]: { id: e.orderId, status: e.status, version: e.version, sync: 'confirmed' },
          };
        });
      }
    
      /** El backend rechazó el comando: vuelve al estado anterior y márcalo como fallido. */
      reject(orderId: string) {
        this.byId.update((c) => {
          const prev = c[orderId];
          if (!prev?.previous) return c;
          return { ...c, [orderId]: { ...prev.previous, sync: 'failed' } };
        });
      }
    
      markPending(orderId: string, status: OrderView['status']) {
        this.byId.update((c) => {
          const prev = c[orderId];
          if (!prev) return c;
          return { ...c, [orderId]: { ...prev, status, sync: 'pending', previous: prev.previous ?? prev } };
        });
      }
    }
    

    Fíjate en que el guard de versión ya cubre los duplicados de la misma entidad. El dedupe por eventId solo hace falta para eventos sin versión (notificaciones, contadores). Y si lo añades, acota el Set o crecerá sin límite en una pestaña abierta todo el día. Ojo: reject no tiene guard; en producción relaciona el rechazo con un commandId para que un cancel_rejected duplicado no revierta un intento posterior.

    Para un store convergente, signals bastan (si dudas, mira cuándo usar RxJS o signals en Angular). Los servicios con estado y signals los trabajo paso a paso en el curso de Angular Moderno.

    Problema 4: reconexión y huecos en el stream de eventos

    La respuesta corta: el stream nunca es completo; al reconectar, pide un snapshot y fusiónalo con el mismo guard de versión.

    Si el servidor envía id: en cada evento, EventSource guarda el último y, al reconectar, lo manda en la cabecera Last-Event-ID (está en la especificación de server-sent events del WHATWG) para que el servidor reenvíe lo perdido. Eso depende de que el servidor guarde histórico y de que ningún proxy se coma la cabecera. Es una optimización, no una garantía.

    type OrderSnapshot = { orderId: string; version: number; status: OrderView['status'] };
    
    export function connect(store: OrdersStore, loadSnapshot: () => Promise<OrderSnapshot[]>) {
      const es = new EventSource('/api/orders/stream');
    
      // 'open' se dispara en la conexión inicial y en cada reconexión
      es.addEventListener('open', async () => {
        const snapshot = await loadSnapshot(); // estado actual + versión de cada pedido
        snapshot.forEach((o) => store.apply(o)); // el guard descarta lo que ya es viejo
      });
    
      // Solo llegan aquí los mensajes enviados con "event: order"; sin ese campo van a 'message'
      es.addEventListener('order', (msg: MessageEvent<string>) => {
        const event = parseOrderEvent(msg.data); // ver problema 5
        if (!event) return;
        if (event.type === 'order.status_changed') store.apply(event);
        else store.reject(event.orderId); // order.cancel_rejected
      });
    
      es.addEventListener('error', () => {
        // CONNECTING: el navegador reintenta solo. CLOSED: no volverá; reconecta tú (sin Last-Event-ID: el snapshot cubre el hueco).
        if (es.readyState === EventSource.CLOSED) {
          setTimeout(() => connect(store, loadSnapshot), 3000);
        }
      });
    
      return es;
    }
    

    Snapshot y eventos pasan por el mismo apply. Da igual qué llegue primero: gana la versión más alta.

    Problema 5: acoplar la UI al schema interno del backend

    La respuesta corta: el frontend no debe consumir eventos de dominio crudos; necesita eventos de integración estables y validados al entrar.

    Los eventos de dominio cambian cuando cambia el modelo interno del servicio. Si tu componente lee event.payload.aggregate.lines[0].sku, cualquier refactor del backend rompe la pantalla en producción, sin error de compilación.

    Dos capas: un BFF o traductor que publique eventos pensados para el cliente (planos, versionados, solo lo que la UI pinta) y validación en el borde con Zod 4, para que un mensaje inesperado se descarte en vez de corromper el store.

    import { z } from 'zod';
    
    const OrderEvent = z.discriminatedUnion('type', [
      z.object({
        type: z.literal('order.status_changed'),
        eventId: z.string(),
        orderId: z.string(),
        version: z.number().int().nonnegative(),
        status: z.enum(['paid', 'cancelled', 'shipped']),
      }),
      z.object({
        type: z.literal('order.cancel_rejected'),
        eventId: z.string(),
        orderId: z.string(),
        version: z.number().int().nonnegative(),
        reason: z.string(),
      }),
    ]);
    export type OrderEventData = z.infer<typeof OrderEvent>;
    
    export function parseOrderEvent(raw: string): OrderEventData | null {
      let json: unknown;
      try {
        json = JSON.parse(raw);
      } catch {
        return null;
      }
      const result = OrderEvent.safeParse(json);
      if (!result.success) {
        console.warn('Evento descartado', result.error.issues);
        return null;
      }
      return result.data;
    }
    

    safeParse no lanza: te devuelve success y decides tú. Con discriminatedUnion, el resto del código recibe tipos estrechos según type. Si quieres llevar este patrón a todo el estado global, lo desarrollé en gestión de estado global con Zod y signals, y los schemas, transformaciones y errores de Zod los cubro a fondo en el curso de Zod para TypeScript.

    Cuándo NO usar estos patrones de arquitectura orientada a eventos en el frontend

    UI optimista en pagos, stock o cualquier acción irreversible. Si el usuario va a cerrar la pestaña creyendo que pagó, el pending bonito no basta. Ahí muestra "Procesando pago" y espera a la confirmación. El propio hilo de HN citado arriba separa preferencias de interfaz (optimismo sin problema) de facturación o mensajería (cuidado).

    Tiempo real cuando un refetch basta. Un panel de administración que se consulta cinco veces al día no necesita SSE ni resync. Un refetch al volver a la pestaña y un polling acotado tras cada comando resuelven casi todo con una fracción del código. Herramientas como las que comparo en httpResource vs TanStack Query ya traen revalidación al enfocar.

    Sin versión monotónica del backend, el guard no sirve. Comparar updatedAt entre máquinas con relojes distintos no es una versión. Si el backend no puede emitir una versión por entidad, negocia eso antes de escribir una línea de cliente.

    El BFF no es gratis. Para un solo frontend y un equipo pequeño, un mapper tipado en el cliente con Zod puede ser suficiente. El BFF compensa cuando hay varios clientes o el backend cambia más rápido que la UI.

    SSE sin HTTP/2 y con muchas pestañas. Según MDN, sin HTTP/2 el navegador limita a 6 las conexiones abiertas por dominio, y Chrome y Firefox lo marcaron como "Won't fix". Con siete pestañas de tu app, la séptima se queda colgada. Sirve con HTTP/2 o con una sola conexión compartida entre pestañas.

    Lo que puedes hacer hoy

    Abre el servicio que recibe eventos en tu app y busca una cosa: ¿cada mensaje trae versión por entidad y tu store la compara antes de aplicar? Si la respuesta es no, ese es tu primer cambio. Es la pieza que hace posibles las otras cuatro.

    Después, escribe el test que casi nadie escribe: aplica el evento versión 4, luego el versión 3, y comprueba que el estado sigue en 4. Si quieres montar esa batería con Jest y Testing Library en Angular, el curso de Testing en Angular cubre cómo testear servicios con estado y componentes que reaccionan a él.

    Preguntas frecuentes

    ¿La arquitectura orientada a eventos obliga a usar WebSockets en el frontend?

    No. El frontend puede seguir con HTTP y polling acotado por versión. WebSockets o SSE compensan cuando el usuario necesita ver cambios que no ha provocado él.

    ¿SSE o WebSockets para recibir eventos del backend?

    Si el flujo es solo del servidor al cliente, SSE es más simple: va sobre HTTP, reconecta solo y, si el servidor manda id: en cada evento, envía Last-Event-ID sin que escribas código. WebSockets tienen sentido cuando el cliente también emite muchos mensajes por el mismo canal, como en un chat o en edición colaborativa.

    ¿Cómo evito que un evento antiguo sobrescriba uno nuevo en el cliente?

    Pide al backend una versión monotónica por entidad en cada evento. En el store, descarta cualquier evento cuya versión sea menor o igual que la que ya tienes. Ese mismo guard resuelve también los duplicados de la misma entidad.

    ¿Qué hago si se pierden eventos mientras el socket estaba caído?

    Asume que siempre puede pasar. Al reconectar, pide un snapshot del estado con la versión de cada entidad y fusiónalo con el mismo guard que usas para los eventos. Last-Event-ID ayuda a recuperar lo perdido, pero depende de que el servidor guarde histórico.

    ¿Es mala práctica la UI optimista en una arquitectura orientada a eventos?

    No, siempre que tenga estados explícitos (pending, confirmed, failed) y una forma visible de revertir. Es mala práctica cuando la UI declara éxito antes de la confirmación en operaciones irreversibles, como pagos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tutorial de LangGraph.js: agente de triaje con Zod y aprobación

    Tutorial de LangGraph.js: agente de triaje con Zod y aprobación

    Los tests estaban en verde. Todos. El agente clasificaba la incidencia, buscaba en la documentación, redactaba una respuesta y se paraba a esperar mi aprobación.

    Entonces, en la revisión de código, apareció un camino que ningún test cubría. Si el modelo pedía una búsqueda justo en la última vuelta permitida, el grafo saltaba directo a redactar. La API de Anthropic habría recibido un tool_use sin su tool_result y habría contestado con un 400.

    El modelo falso de los tests no valida esa regla. El real sí. Y ese fallo explica por qué este tutorial de LangGraph.js empieza por un agente de triaje: no es un chatbot con herramientas, sino algo que tiene ramas, límites y una pausa que puede durar un día.

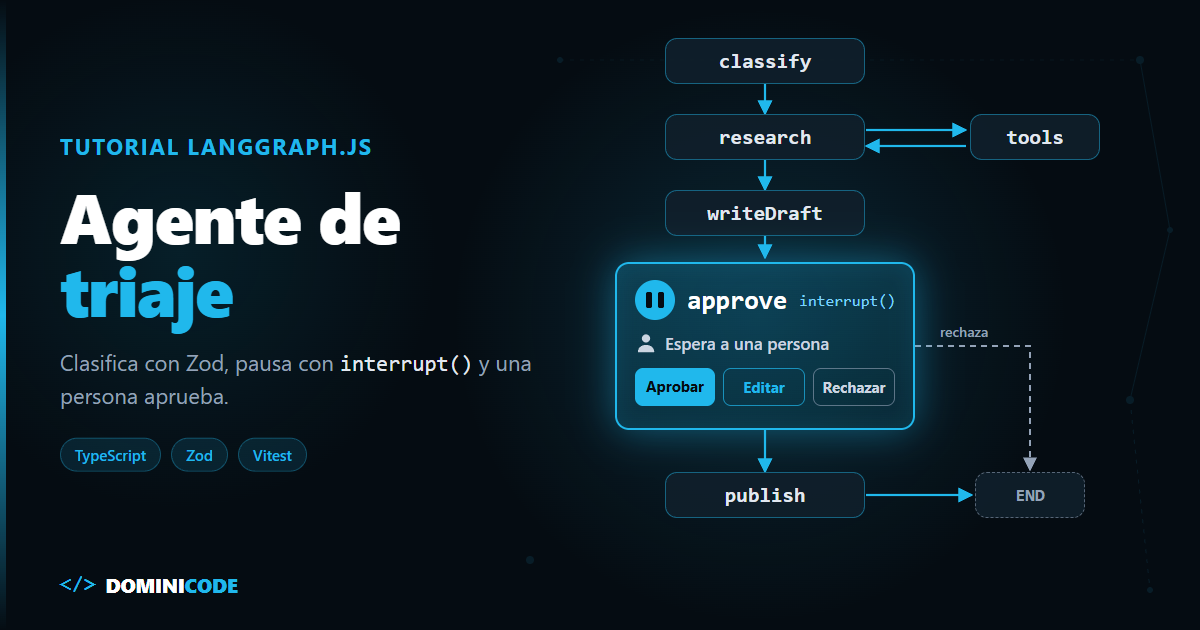
    En corto: un agente de triaje con LangGraph.js es un StateGraph con cinco pasos: clasificar con salida estructurada de Zod, investigar en un bucle con límite, redactar, pausar con interrupt() para que una persona apruebe y publicar. El checkpointer guarda cada paso, así que la aprobación puede llegar horas después y en otro proceso. Todo se testea con Vitest y fakeModel(), sin llamar a ninguna API.

    ¿Qué es un agente de triaje con LangGraph.js?

    Un agente de triaje es un sistema que recibe una incidencia de un usuario, la clasifica por tipo y gravedad, busca información para responderla y propone una respuesta que una persona aprueba, edita o rechaza antes de publicarse. En LangGraph.js cada uno de esos pasos es un nodo, y las decisiones entre pasos son aristas condicionales.

    El código de este post es Triaje, el proyecto conductor del curso de agentes en TypeScript que estoy preparando. Atiende las incidencias de «Cuaderno», una app de notas inventada, con @langchain/langgraph 1.5.3, @langchain/anthropic 1.6.0, Zod 4.6.7 y Vitest 5.0.5. Versiones fijadas y comprobadas el 29 de octubre de 2026.

    El grafo completo cabe en una línea:

    START → classify → research ⇄ tools → writeDraft → approve ─┬→ publish → END
                                                                └→ END (rechazada)
    

    Por qué el triaje sí compensa como grafo

    El triaje compensa como grafo porque cumple a la vez los tres síntomas que justifican LangGraph: ramificación real, un humano que decide a mitad de la ejecución y un estado que tiene que sobrevivir al proceso.

    En cuándo un grafo de LangGraph gana al while loop defendí que la mayoría de los agentes deben quedarse en un while. El triaje es la excepción: quien aprueba la respuesta no está mirando la terminal. Contesta cuando puede.

    Requisito del triaje while loop StateGraph de LangGraph.js
    Salida de la clasificación Parseas texto o validas a mano withStructuredOutput(ClassificationSchema)
    Límite de búsquedas Un contador dentro del bucle Campo researchSteps con reducer, guardado en el checkpoint
    Aprobación humana Proceso vivo esperando un await interrupt() + Command({ resume })
    Validar la decisión humana Lo escribes tú responseSchema de Zod en el propio interrupt()
    Sobrevivir a un reinicio No Sí, con SqliteSaver o PostgresSaver
    Test sin API Mockeas tu cliente HTTP fakeModel() de langchain
    Riesgo Rehaces a mano persistencia y reanudación Nombres de nodo, forma de los mensajes y versiones del framework que tienes que conocer

    El estado del agente de triaje en LangGraph.js

    El estado es el contrato del grafo. Cada campo se guarda en el checkpoint, así que una ejecución pausada se reanuda con todo lo que sabía.

    // s05-triaje-langgraph/src/state.ts
    import { MessagesValue, ReducedValue, StateSchema } from "@langchain/langgraph";
    import { z } from "zod/v4";
    
    export const TriageState = new StateSchema({
      threadId: z.string(),
      issue: IssueSchema,
      messages: MessagesValue,
      classification: ClassificationSchema.optional(),
      // Vueltas de búsqueda: se suman, para cortar el bucle.
      researchSteps: new ReducedValue(z.number().default(0), { reducer: (total, step) => total + step }),
      // Fragmentos encontrados: se acumulan entre vueltas.
      hits: new ReducedValue(z.array(SearchHitSchema).default(() => []), {
        inputSchema: z.array(SearchHitSchema),
        reducer: (all, found) => [...all, ...found],
      }),
      draft: DraftSchema.optional(),
      decision: DecisionSchema.optional(),
      published: z.boolean().default(false),
    });
    

    Cada vuelta de búsqueda devuelve researchSteps: 1 y el reducer lo suma. El contador vive en el estado, no en una variable local, así que sobrevive a un reinicio.

    Un detalle que me costó un error: un nodo no puede llamarse igual que un campo del estado. LangGraph lanza «draft is already being used as a state attribute» al construir el grafo. Por eso el nodo que redacta se llama writeDraft.

    Clasificar la incidencia con salida estructurada de Zod

    La clasificación no devuelve texto libre. Devuelve un objeto que cumple este esquema:

    // shared/src/schemas.ts
    export const ClassificationSchema = z.object({
      type: IssueTypeSchema.describe("bug, question (duda de uso) o feature_request (petición de funcionalidad)"),
      severity: SeveritySchema.describe("high si se pierde trabajo o no se puede usar la app"),
      reason: z.string().describe("Una frase que justifica la clasificación"),
    });
    

    Los .describe() llegan al modelo como parte del JSON Schema. Lo detallo en diseñar schemas Zod para LLM, y a fondo en el curso de Zod para TypeScript.

    El nodo:

    // s05-triaje-langgraph/src/nodes/classify.ts
    export const makeClassify = (model: BaseChatModel) =>
      async (state: Pick<TriageStateValue, "issue">) => {
        const classifier = model.withStructuredOutput(ClassificationSchema, { name: "classification", method: "jsonSchema" });
        const incident = new HumanMessage(`Incidencia de un usuario:\n\n${state.issue.text}`);
        const classification = await classifier.invoke([new SystemMessage(CLASSIFY_INSTRUCTIONS), incident]);
        // La incidencia abre también la conversación del investigador.
        return { classification, messages: [incident] };
      };
    

    Lo importante es method: "jsonSchema". El método por defecto de @langchain/anthropic 1.6.0 fuerza una llamada a herramienta con tool_choice, y en mis pruebas Claude Sonnet 5.5 rechazó ese tool_choice forzado con un 400. Con jsonSchema se envía output_config.format. El repo tiene un test que intercepta fetch y falla si alguien quita esa opción.

    El bucle de búsqueda: aristas condicionales con límite

    research le da al modelo una herramienta search; si pide búsquedas, tools las ejecuta y vuelve a research:

    // s05-triaje-langgraph/src/graph.ts
    function afterResearch(state: TriageStateValue) {
      const last = state.messages.at(-1);
      return last && AIMessage.isInstance(last) && (last.tool_calls?.length ?? 0) > 0 ? "tools" : "writeDraft";
    }
    
    // El límite de vueltas se aplica DESPUÉS de ejecutar las herramientas.
    const afterTools = (state: TriageStateValue) => (state.researchSteps >= MAX_RESEARCH_STEPS ? "writeDraft" : "research");
    
    const afterApproval = (state: TriageStateValue) => (state.decision?.action === "reject" ? END : "publish");
    
    export function buildTriageGraph({ model, classifierModel = model, tracker, checkpointer }: Deps) {
      return new StateGraph(TriageState)
        .addNode("classify", makeClassify(classifierModel))
        .addNode("research", makeResearch(model))
        .addNode("tools", runTools)
        .addNode("writeDraft", makeDraft(model))
        .addNode("approve", approve)
        .addNode("publish", makePublish(tracker))
        .addEdge(START, "classify")
        .addEdge("classify", "research")
        .addConditionalEdges("research", afterResearch, ["tools", "writeDraft"])
        .addConditionalEdges("tools", afterTools, ["research", "writeDraft"])
        .addEdge("writeDraft", "approve")
        .addConditionalEdges("approve", afterApproval, ["publish", END])
        .addEdge("publish", END)
        .compile({ checkpointer });
    }
    

    Aquí está el bug de la apertura. La primera versión comprobaba el límite en afterResearch y writeDraft recibía toda la conversación: si la última vuelta pedía una búsqueda, llegaba un tool_use sin respuesta, y Anthropic devuelve un 400 en ese caso. Hoy writeDraft solo recibe la incidencia y los fragmentos, pero cualquier nodo nuevo que lea messages heredaría el hueco.

    La regla es simple: si el modelo pidió herramientas, se ejecutan siempre. El límite se mira después, en afterTools, con MAX_RESEARCH_STEPS = 4.

    No es un problema exótico. En el issue #1423 de langgraphjs, de julio de 2025, un usuario reportó «unexpected tool_use_id found in tool_result» con interrupt(), PostgresSaver y Claude, y culpó al checkpointer. Dieciocho días después lo cerró él mismo: recortaba el historial para frenar la degradación del contexto y dejaba un tool_result huérfano. El framework no tenía la culpa; la tenía la forma de los mensajes.

    Aprobación humana con interrupt() y responseSchema

    interrupt() para el grafo, guarda el estado en el checkpointer y devuelve el borrador a quien lo ejecutó; la ejecución sigue cuando alguien la reanuda con new Command({ resume }). El nodo de aprobación cabe en cuatro líneas:

    // s05-triaje-langgraph/src/nodes/approve.ts
    export async function approve(state: Pick<TriageStateValue, "draft">): Promise<{ decision: Decision }> {
      const decision = interrupt(state.draft, { responseSchema: DecisionSchema }) as Decision;
      return { decision };
    }
    

    La decisión es una unión discriminada de Zod:

    // shared/src/schemas.ts
    export const DecisionSchema = z.discriminatedUnion("action", [
      z.object({ action: z.literal("approve") }),
      z.object({ action: z.literal("edit"), reply: z.string().trim().min(1) }),
      z.object({ action: z.literal("reject"), reason: z.string().optional() }),
    ]);
    

    Con responseSchema, una decisión inválida como { action: "publish" } lanza un error al reanudar y el hilo queda intacto para reintentar. Y publish usa el texto que decidió la persona, no el del modelo: si editaste, se publica tu versión.

    Ojo: en mis pruebas con 1.5.3, los interrupts tipados con runtime.interrupt.nombre() de las notas de la v1 fallaron. El patrón de arquitectura completo está en human in the loop en TypeScript.

    Reanudar el triaje tras un reinicio

    El CLI arranca el grafo con SqliteSaver.fromConnString("data/langgraph.db"). Para retomar un hilo, mira dónde se quedó:

    // s05-triaje-langgraph/src/cli.ts (recortado)
    const snapshot = await deps.graph.getState({ configurable: { thread_id: threadId } });
    const values = snapshot.values as Partial<TriageStateValue>;
    if (snapshot.next.length === 0) {
      deps.print(`Ese hilo ya terminó: ${values.published ? "publicado" : "rechazado"}. No se vuelve a publicar.`);
      return 0;
    }
    if (!snapshot.next.includes("approve")) {
      // Se cortó antes de la pausa: invoke(null) sigue desde el último checkpoint.
      await runStreamed(null, threadId, deps);
    }
    await approveAndFinish(threadId, deps); // pide la decisión y reanuda con new Command({ resume: decision })
    

    snapshot.next es ["approve"] si está pausado y [] si terminó, lo que evita publicar dos veces. Para llevarlo a Postgres y a un servidor, mira desplegar agentes LangChain en producción.

    Cómo testear el agente de triaje con Vitest

    Se testea con fakeModel() de langchain, que devuelve respuestas programadas, y un checkpointer real sobre un fichero temporal. Ni clave de API ni red.

    Este test simula un reinicio:

    // s05-triaje-langgraph/tests/graph.test.ts
    test("tras un «reinicio» (otro grafo sobre el mismo SQLite) se reanuda y publica", async () => {
      const first = setup();
      await first.graph.invoke({ threadId: "t-5", issue }, config("t-5"));
      const second = setup(first.dbFile); // nuevo proceso: modelos y grafo nuevos, mismo fichero
      await second.graph.invoke(new Command({ resume: { action: "approve" } }), config("t-5"));
      expect(second.model.callCount).toBe(0);
      expect(second.tracker.list()[0]!.reply).toBe(draftReply.reply);
    });
    

    callCount en cero demuestra que reanudar no repite la investigación. No mide la clasificación ni la redacción: fakeModel no cuenta las llamadas que pasan por withStructuredOutput. Y setup() programa el modelo falso en orden:

    const model = fakeModel()
      .respondWithTools([{ name: "search", args: { query: "exportar PDF tabla" }, id: "c1" }])
      .respond(new AIMessage("Tengo lo que necesito."))
      .structuredResponse(draftReply);
    

    Dos rarezas de fakeModel. .structuredResponse() es un único valor para todas las llamadas estructuradas, y por eso buildTriageGraph acepta un classifierModel aparte. Y no valida que cada tool_use tenga su tool_result: el test del límite lo comprueba a mano recorriendo los mensajes. Las 24 pruebas pasan en poco más de un segundo.

    Límites de este enfoque

    La clasificación no enruta. En este grafo, type y severity se guardan y se publican en el tracker, pero todas las incidencias recorren el mismo camino. Si quieres que un high vaya directo a una persona sin investigar, te toca añadir otra arista condicional después de classify.

    Encontrar fragmentos no significa que la respuesta sea correcta. Por eso la aprobación humana no es opcional.

    Las cifras son de una sola pasada. Con Claude Sonnet 5.5, cada incidencia costó de media 0,0155 USD sin contar el juez y tardó 9,95 segundos, con un 100 % de acierto en el tipo y un 90 % en la severidad. Son 20 incidencias sintéticas medidas el 29 de octubre de 2026: suficiente para detectar regresiones, no para presumir de precisión.

    El tracker en JSON es de un solo proceso. Evita publicar dos veces el mismo hilo, pero no aguanta escrituras concurrentes de varios servidores. Para eso necesitas Postgres y un almacén transaccional.

    Pagas en conocimiento del framework. Cada trampa de este post salió del código real. Con un while no las tendrías, pero tampoco la pausa.

    ¿Dónde ver Triaje completo con LangGraph.js y Mastra?

    En el curso de agentes en TypeScript que estoy preparando, todavía sin fecha. Ahí el mismo agente se construye dos veces sobre el mismo contrato, con LangGraph.js y con Mastra, después de escribir en la primera sección un bucle sin framework en unas 60 líneas para ver qué te resuelve el framework. Las dos versiones se comparan en calidad, latencia, coste y depuración con las mismas 20 incidencias. El temario sigue con una interfaz de revisión en React (AG-UI y CopilotKit), evals y despliegue con Docker.

    Por dónde empezar tu propio agente de triaje

    Empieza por el estado, no por los nodos. Escribe el StateSchema y los esquemas de Zod de la clasificación y la decisión antes de tocar el grafo. Si el contrato está bien, los nodos salen casi solos; es la misma idea de escribir la especificación antes que el código que defiendo en el libro de Spec-Driven Development.

    Y si quieres la base que hay debajo de cualquier framework, descárgate gratis el ebook El Developer Agéntico: 194 páginas sobre herramientas, memoria, RAG, MCP y sistemas de varios agentes.

    Preguntas frecuentes

    ¿Qué versión de LangGraph.js usa este agente de triaje?

    @langchain/langgraph 1.5.3, con @langchain/core 1.3.1, @langchain/anthropic 1.6.0, Zod 4.6.7 y Vitest 5.0.5, comprobadas el 29 de octubre de 2026. Ya existe @langchain/langgraph 1.6.0 (30 de octubre), pero el repo no se ha probado con ella. El estado usa StateSchema, no la API antigua de Annotation.

    ¿Por qué falla withStructuredOutput con Claude en LangGraph.js?

    Porque el método por defecto de @langchain/anthropic 1.6.0 fuerza tool_choice, y en mis pruebas Claude Sonnet 5.5 lo rechazó con un 400. La solución es pasar { method: "jsonSchema" }, que envía el esquema por output_config.format.

    ¿Hace falta un checkpointer para usar interrupt()?

    Sí. interrupt() guarda el estado del hilo para reanudarlo después con new Command({ resume }). Sin checkpointer no hay dónde guardarlo. En tests vale MemorySaver o un SQLite temporal; en un servidor, PostgresSaver.

    ¿Cuándo usar LangGraph.js en lugar de un while loop?

    Cuando cumple al menos uno de tres síntomas: ramificación real, una persona que decide a mitad de la ejecución o un estado que debe sobrevivir a un reinicio. Si no cumple ninguno, un while con un contador es más simple y más fácil de depurar.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Búsqueda semántica con LangChain: motor en TypeScript

    Búsqueda semántica con LangChain: motor en TypeScript

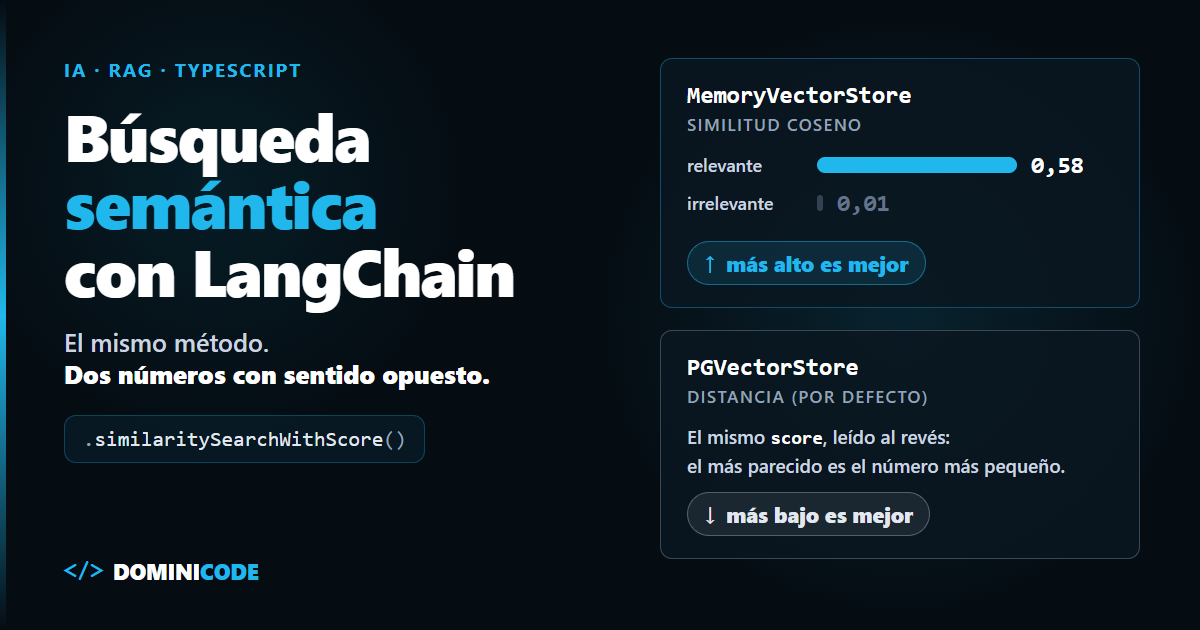
    El tutorial oficial de búsqueda semántica con LangChain enseña un resultado con Score: 0.23699893057346344 y explica que es una distancia: cuanto más bajo, más parecido. Lo lees, lo apuntas y escribes un filtro: descarta todo lo que pase de 0,3.

    Ese número sale de otra pregunta del mismo PDF. Ejecutado el 5 de noviembre de 2026 con las versiones actuales, el fragmento que responde a "When was Nike incorporated?" sale con 0,58. Una consulta que no tiene nada que ver con el documento sale con 0,01. Tu filtro tira lo bueno y se queda con la basura.

    No hay error ni excepción. El código compila. Y el día que cambies MemoryVectorStore por pgvector, el significado del número se invierte otra vez.

    En corto: la búsqueda semántica con LangChain.js son seis piezas: cargar, trocear, embeber, guardar en un vector store, consultar y exponer como retriever. LangChain las une en unas pocas decenas de líneas. El tamaño de chunk, el modelo, los metadatos, el significado del score y el vector store siguen siendo cosa tuya.

    ¿Qué es la búsqueda semántica con LangChain?

    La búsqueda semántica con LangChain es un pipeline que convierte tus documentos en vectores con un modelo de embeddings, los guarda en un vector store y devuelve los fragmentos cuyo significado se parece más a una pregunta, aunque no compartan palabras.

    La guía oficial lo monta sobre el informe anual 10-K de Nike de 2023, un PDF de 107 páginas.

    Si no tienes claro qué es un embedding ni cómo se compara con similitud coseno, lee antes qué son los vector embeddings y cómo usarlos en TypeScript.

    Las piezas del motor de búsqueda semántica en TypeScript

    Cada pieza del pipeline tiene una clase de LangChain y una decisión que nadie toma por ti:

    Pieza Clase (paquete) Qué decides tú Error típico
    Cargar PDFParse (pdf-parse) + Document (@langchain/core) Qué metadatos guardas: fuente, página, fecha Perder la página y no poder citar de dónde sale el fragmento
    Trocear RecursiveCharacterTextSplitter (@langchain/textsplitters) chunkSize y chunkOverlap, en caracteres Creer que chunkSize: 1000 son 1.000 tokens
    Embeber OpenAIEmbeddings (@langchain/openai) Modelo y dimensiones No pasar model y quedarte con text-embedding-ada-002
    Guardar MemoryVectorStore (@langchain/classic) Dónde viven los vectores Pensar que la memoria persiste entre arranques
    Buscar similaritySearch, similaritySearchWithScore k y umbral de score Fijar un umbral sin saber si el número es distancia o similitud
    Exponer asRetriever searchType, k, fetchK Usar MMR con fetchK: 1 y anular la diversidad

    Versiones de npm a 5 de noviembre de 2026: langchain 1.6.1, @langchain/core 1.3.4, @langchain/classic 1.0.57, @langchain/textsplitters 1.0.2, @langchain/openai 1.8.0 y pdf-parse 2.4.5.

    bun add @langchain/core @langchain/classic @langchain/textsplitters @langchain/openai pdf-parse
    

    Cargar y trocear: chunkSize y chunkOverlap en LangChain.js

    El tutorial no usa un loader de LangChain para el PDF. Escribe un helper de unas 20 líneas sobre pdf-parse 2.x que crea un Document por página y guarda la página en los metadatos:

    import { readFileSync } from "node:fs";
    import { Document } from "@langchain/core/documents";
    import { PDFParse } from "pdf-parse";
    import { RecursiveCharacterTextSplitter } from "@langchain/textsplitters";
    
    // Una página del PDF = un Document, con su página en los metadatos
    async function loadPdfPages(filePath: string): Promise<Document[]> {
      const parser = new PDFParse({ data: new Uint8Array(readFileSync(filePath)) });
      try {
        const { pages } = await parser.getText();
        return pages.map(
          (page) =>
            new Document({
              pageContent: page.text,
              metadata: { source: filePath, page: page.num - 1 },
            })
        );
      } finally {
        await parser.destroy();
      }
    }
    
    const docs = await loadPdfPages("./data/nke-10k-2023.pdf");
    
    const textSplitter = new RecursiveCharacterTextSplitter({
      chunkSize: 1000,
      chunkOverlap: 200,
    });
    const allSplits = await textSplitter.splitDocuments(docs);
    
    console.log(docs.length, allSplits.length); // 107 515
    

    Ejecutado el 5 de noviembre de 2026: 107 páginas y 515 chunks. La doc dice 516. La diferencia viene del parser, y es el primer aviso de que el resultado depende de versiones que no controlas.

    El splitter mide con text.length, así que chunkSize: 1000 son 1.000 caracteres, no tokens. Los chunks salieron con 856 caracteres de media y 1.000 como máximo.

    Bajar a chunkSize: 500 y chunkOverlap: 50 da 965 chunks, casi el doble. Son casi el doble de vectores que guardar, y cada fragmento tiene menos contexto.

    Los metadatos se heredan: cada chunk conserva source y page, y el splitter añade loc.lines.

    Embeber y guardar en un vector store de LangChain

    Embeber y guardar son tres líneas: el modelo de embeddings, el vector store que lo usa y addDocuments. La trampa está en la primera:

    import { OpenAIEmbeddings } from "@langchain/openai";
    import { MemoryVectorStore } from "@langchain/classic/vectorstores/memory";
    
    // Fija siempre el modelo: sin él, LangChain usa text-embedding-ada-002
    const embeddings = new OpenAIEmbeddings({ model: "text-embedding-3-large" });
    
    const vectorStore = new MemoryVectorStore(embeddings);
    await vectorStore.addDocuments(allSplits);
    

    Si escribes new OpenAIEmbeddings() sin opciones, @langchain/openai 1.8.0 usa text-embedding-ada-002, el modelo antiguo. Está en el código fuente del paquete y se confirma al ejecutarlo.

    Segunda sorpresa: el tutorial pide text-embedding-3-large y enseña una salida de vectores de longitud 1536. Ejecutado, devuelve 3.072. Si necesitas 1.536, pásalo explícito con dimensions: 1536, que sí funciona.

    Y MemoryVectorStore ya no está en langchain. Desde la v1 vive en @langchain/classic, el paquete de compatibilidad.

    similaritySearch y similaritySearchWithScore: qué significa el score

    similaritySearch devuelve los k documentos más parecidos, 4 por defecto. similaritySearchWithScore devuelve además el número, y ese número cambia de significado según el vector store.

    const results = await vectorStore.similaritySearchWithScore(
      "When was Nike incorporated?",
      3
    );
    for (const [doc, score] of results) {
      console.log(score.toFixed(4), doc.metadata.page);
    }
    
    // En MemoryVectorStore el filtro es una función sobre el Document
    const onlyPage3 = await vectorStore.similaritySearch(
      "When was Nike incorporated?",
      2,
      (doc) => doc.metadata.page === 3
    );
    

    Ejecutado el 5 de noviembre de 2026 sobre los 26 chunks de las seis primeras páginas, para gastar pocos tokens. El primer resultado fue el chunk de la página 3 que dice "NIKE, Inc. was incorporated in 1967", con 0,5836. La consulta irrelevante "receta de paella valenciana" sacó como mejor resultado 0,0110.

    Más alto es mejor. MemoryVectorStore calcula similitud coseno, aunque la doc diga que es una distancia.

    PGVectorStore hace lo contrario. El issue #11043 de langchainjs, abierto en junio de 2026, lo describe así: el método "returns raw vector distance values (e.g. 0.82, 0.17) rather than normalized similarity scores", y lo llama "inconsistent with other vector store implementations in LangChain.js (e.g. MemoryVectorStore)". La respuesta en el propio issue: es el comportamiento esperado, y se cambia con scoreNormalization: "similarity". El #9782 reportó lo mismo en enero sobre el PGVectorStore de @langchain/community.

    En @langchain/pgvector 0.1.0 existe la opción scoreNormalization, con "distance" por defecto y "similarity" como alternativa. Ojo: con coseno, "similarity" devuelve (2 - distancia) / 2, no el coseno. El 0,58 de antes saldría como 0,79 y la paella como 0,51. Mismo sentido, otra escala. Si tienes un umbral, escribe un test que lo fije.

    El retriever de LangChain: asRetriever, MMR y batch

    Un vector store no es un Runnable. Un retriever sí, así que admite invoke y batch, y se enchufa en cadenas y agentes:

    const retriever = vectorStore.asRetriever({
      searchType: "mmr",
      searchKwargs: { fetchK: 1 },
    });
    
    const batchResults = await retriever.batch([
      "When was Nike incorporated?",
      "Where is Nike headquartered?",
    ]);
    

    MMR (maximum marginal relevance) primero trae fetchK candidatos y después elige entre ellos los que más se diferencian. Con fetchK: 1, como en el tutorial, solo hay un candidato: cada consulta devolvió un único documento y no hubo nada que diversificar. En tu código, fetchK tiene que ser mayor que k, por ejemplo 20 y 4.

    Cuando el retriever pase a ser la tool de búsqueda de un agente, cómo diseñarla con memoria y RAG alrededor lo explica el ebook gratuito El Developer Agéntico, 194 páginas sobre agentes, tools, memoria y RAG.

    De MemoryVectorStore a pgvector: qué cambia en producción

    En la búsqueda semántica con LangChain, MemoryVectorStore sirve para aprender y para tests. En producción necesitas que los vectores sobrevivan a un reinicio. La guía de integración instala PGVectorStore desde @langchain/pgvector:

    import { PGVectorStore } from "@langchain/pgvector";
    
    const pgStore = await PGVectorStore.initialize(embeddings, {
      postgresConnectionOptions: {
        connectionString: process.env.DATABASE_URL,
      },
      tableName: "documents",
      distanceStrategy: "cosine",
      scoreNormalization: "similarity", // más alto es mejor, pero (2 - distancia) / 2: otra escala
    });
    
    MemoryVectorStore PGVectorStore
    Paquete @langchain/classic 1.0.57 @langchain/pgvector 0.1.0
    Persistencia Ninguna: se pierde al reiniciar Tabla de Postgres
    Filtro Función sobre el Document Objeto: igualdad, in, notIn, arrayContains y rangos
    Score por defecto Similitud coseno, más alto es mejor Distancia, más bajo es mejor
    Búsqueda Recorre todos los vectores Escaneo secuencial; HNSW opcional con createHnswIndex
    Riesgo Reembeber todo el corpus en cada arranque HNSW sobre vector admite hasta 2.000 dimensiones; text-embedding-3-large da 3.072

    La última fila es la que rompe despliegues. pgvector indexa vector hasta 2.000 dimensiones y halfvec hasta 4.000, según su README. Con text-embedding-3-large tienes dos salidas: pedir dimensions: 1536 o pasar a halfvec. Por qué HNSW se comporta así lo cuento en cómo funciona una base de datos vectorial con HNSW e IVF.

    Postgres también permite combinar vectores con BM25, que rescata códigos, nombres propios y cifras: lo tienes en búsqueda híbrida con embeddings y Supabase.

    Cuándo NO usar LangChain para esto

    Primero, si tu caso es simple, sobra. Mil documentos, un modelo y un bucle de similitud coseno caben en 30 líneas con el SDK de OpenAI.

    Segundo, las roturas entre versiones son reales. El issue #9297 recoge el error ERR_PACKAGE_PATH_NOT_EXPORTED al importar langchain/vectorstores/memory tras la v1. La solución de otro usuario fue "npm i @langchain/classic", y un mantenedor lo cerró remitiendo a la guía de migración. La doc de pgvector, a 5 de noviembre de 2026, dice en una tabla que el paquete es @langchain/pgvector y en una nota que es @langchain/community.

    Tercero, MemoryVectorStore no persiste. Cada arranque vuelve a llamar a la API de embeddings con todo el corpus. Con 515 chunks no duele; con 500.000, sí.

    Cuarto, la abstracción esconde la semántica. El mismo método, similaritySearchWithScore, devuelve números con sentidos opuestos según la clase.

    En Hacker News, en un hilo de 2024 sobre dejar LangChain, un usuario lo resumió: "IMO LangChain provides very high level abstractions that are very useful for prototyping", para añadir después: "I don't think I would run it in production". Yo no iría tan lejos, pero sí lo trataría como una dependencia a fijar con versiones exactas y tests.

    Cómo llevar tu búsqueda semántica con LangChain a producción

    Fija el modelo y las dimensiones en el código y nunca dependas del valor por defecto. Fija las versiones de los paquetes @langchain/*. Si los metadatos llegan de fuentes distintas, valídalos con un schema antes de indexar.

    Y escribe un test con tres consultas reales y el chunk que esperas que salga en cada una. Ese test es lo que te avisa cuando un cambio de parser, de modelo o de vector store mueve la calidad sin lanzar ningún error.

    Si quieres llevar este buscador a un producto completo, con especificación primero y Claude Code para implementar, es el recorrido del curso Construye con IA. Y cuando el retriever pase a ser la tool de un agente, sigue con cómo desplegar agentes de LangChain en producción.

    Preguntas frecuentes

    ¿Qué paquetes necesito para la búsqueda semántica con LangChain.js?

    Con OpenAI y vectores en memoria: @langchain/core, @langchain/textsplitters, @langchain/openai, @langchain/classic y pdf-parse si cargas PDF. Para producción con Postgres, cambia @langchain/classic por @langchain/pgvector y el driver pg.

    ¿El chunkSize de RecursiveCharacterTextSplitter se mide en tokens?

    No. Por defecto se mide en caracteres, con la longitud del string. Con chunkSize: 1000 los chunks del PDF de Nike salieron con 856 caracteres de media. Si necesitas tokens, el splitter acepta una lengthFunction propia.

    ¿Un score más alto en similaritySearchWithScore es mejor?

    Depende de la clase. En MemoryVectorStore es similitud coseno y más alto es mejor. En PGVectorStore es distancia por defecto y más bajo es mejor, salvo que pongas scoreNormalization: "similarity", y aun así la escala no es la de MemoryVectorStore. Compruébalo con una consulta irrelevante antes de fijar un umbral.

    ¿Qué modelo de embeddings usa OpenAIEmbeddings por defecto?

    En @langchain/openai 1.8.0, text-embedding-ada-002. El tutorial oficial usa text-embedding-3-large, que devuelve 3.072 dimensiones salvo que pidas menos con dimensions.

    ¿Puedo usar MemoryVectorStore en producción?

    Solo si el corpus es pequeño y te da igual reembeberlo en cada arranque. No persiste nada y recorre todos los vectores en cada consulta. Para algo que deba sobrevivir a un despliegue, usa pgvector u otro vector store persistente.


    El código de este post se ejecutó el 5 de noviembre de 2026 con las versiones citadas.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
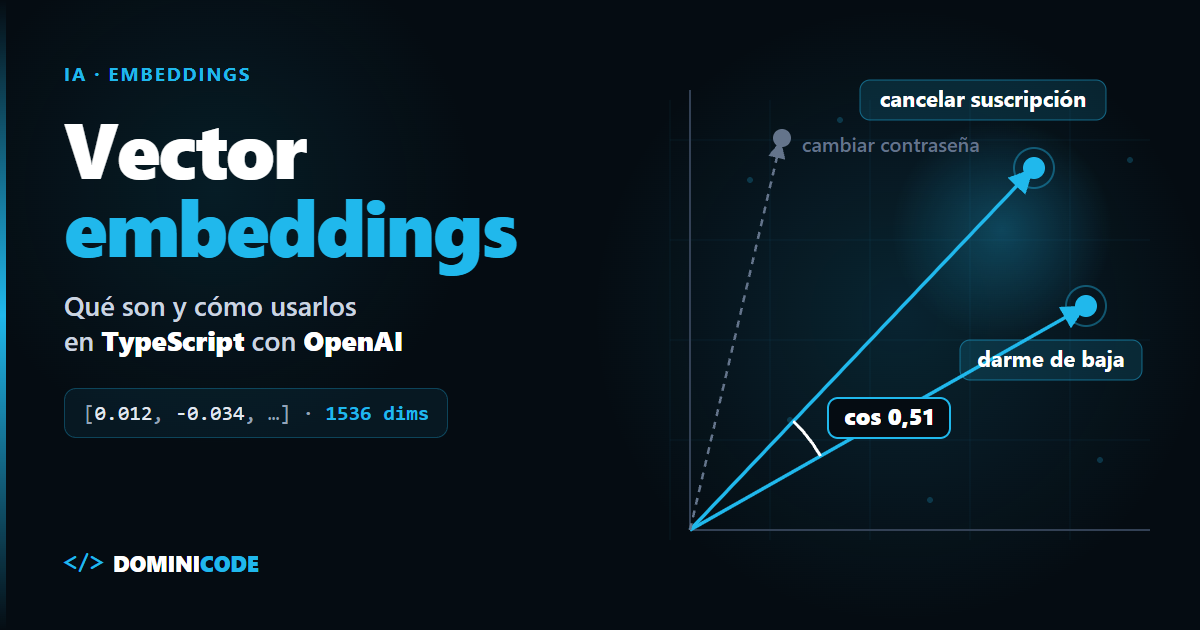
  • Vector embeddings: qué son y cómo usarlos en TypeScript

    Vector embeddings: qué son y cómo usarlos en TypeScript

    Imagina que cambias de modelo de vector embeddings un lunes. El nuevo da mejores resultados en los benchmarks, así que reindexas los documentos nuevos con él y dejas los antiguos como estaban. Pides las mismas 1.536 dimensiones para no tocar el esquema de la base de datos.

    No salta ningún error. Los tests pasan. Y la búsqueda empieza a devolver cosas sin sentido para la mitad de las consultas.

    Has mezclado vectores de dos modelos distintos en el mismo índice. Tienen la misma longitud, pero no viven en el mismo espacio. Compararlos es como medir la distancia entre una coordenada de Madrid y otra de un mapa de Tokio dibujado con otra escala. La cuenta sale, pero no significa nada.

    En corto: un embedding es una lista de números que representa el significado de un texto; dos textos parecidos dan vectores cercanos. Con OpenAI se generan con client.embeddings.create, se comparan con similitud coseno y salen normalizados a longitud 1. Los fallos típicos en producción son mezclar modelos o dimensiones, recortar vectores sin renormalizar y usarlos donde hace falta coincidencia exacta.

    ¿Qué son los vector embeddings?

    Un vector embedding es una representación numérica de un texto, una lista de números en coma flotante, en la que la distancia entre dos vectores mide cuánto se parecen sus significados.

    La guía oficial de OpenAI lo dice así: distancias pequeñas sugieren mucha relación y distancias grandes, poca. De ahí salen la búsqueda semántica, la clasificación, el clustering, las recomendaciones y la detección de anomalías.

    Un número suelto no dice nada: en los vector embeddings importa la posición de cada vector respecto a otros generados por el mismo modelo.

    Qué modelos de embeddings ofrece OpenAI en noviembre de 2026

    OpenAI tiene tres modelos de embeddings en su catálogo a 5 de noviembre de 2026, y text-embedding-3-small es el que usa la guía en sus ejemplos. Datos de la guía, la referencia de la API y la página de precios:

    Modelo Dimensiones por defecto Máx. entrada Precio por 1M tokens MTEB Cuándo usarlo
    text-embedding-3-small 1.536 8.192 tokens 0,02 USD 62,3 % Punto de partida para casi todo
    text-embedding-3-large 3.072 8.192 tokens 0,13 USD 64,6 % Cuando has medido que small no llega; OpenAI lo da como el mejor en inglés y otros idiomas
    text-embedding-ada-002 1.536 8.192 tokens 0,10 USD 61,0 % Solo si tienes un índice antiguo que aún no has migrado

    Según la guía, text-embedding-3-small y text-embedding-3-large no conocen nada de lo ocurrido después de septiembre de 2021. large cuesta 6,5 veces más que small (0,13 / 0,02) para ganar 2,3 puntos en MTEB. ada-002 es 5 veces más caro que small y puntúa peor: si aún lo usas, migrar te ahorra dinero.

    Cómo generar embeddings en TypeScript con la API de OpenAI

    Para generar embeddings en TypeScript llamas a client.embeddings.create con el modelo y un input: un string o un array de strings. La referencia marca tres límites: cada input debe caber en 8.192 tokens, un array admite como mucho 2.048 elementos y la suma de todos los inputs de una petición no puede pasar de 300.000 tokens.

    import OpenAI from "openai";
    
    const client = new OpenAI(); // lee OPENAI_API_KEY del entorno
    
    const MODEL = "text-embedding-3-small";
    // 32 textos × 8.192 tokens = 262.144 tokens: nunca supera el tope de 300.000
    const BATCH_SIZE = 32;
    
    export async function embed(texts: string[], dimensions?: number): Promise<number[][]> {
      const vectors: number[][] = [];
    
      for (let i = 0; i < texts.length; i += BATCH_SIZE) {
        const batch = texts.slice(i, i + BATCH_SIZE).map((t) => t.replace(/\n/g, " ").trim());
        if (batch.some((t) => t.length === 0)) throw new Error("La API no acepta textos vacíos");
    
        const response = await client.embeddings.create({
          model: MODEL,
          input: batch,
          encoding_format: "float",
          ...(dimensions ? { dimensions } : {}),
        });
    
        // ordena por index: no des por hecho el orden del array
        const sorted = [...response.data].sort((a, b) => a.index - b.index);
        vectors.push(...sorted.map((d) => d.embedding));
      }
    
      return vectors;
    }
    

    Antes de guardar, valida la longitud de cada vector. Un z.array(z.number()).length(1536) evita que un cambio de configuración te llene la tabla de vectores incompatibles. Es el tipo de contrato en la frontera que trabajamos en el curso de Zod.

    Similitud coseno: cómo comparar dos vector embeddings

    La similitud coseno mide el ángulo entre dos vectores y va de -1 a 1: 1 es misma dirección, 0 es vectores sin relación y -1, direcciones opuestas. Es la función que OpenAI recomienda, aunque su propia guía añade que la elección "typically doesn't matter much".

    Los embeddings de OpenAI salen normalizados a longitud 1, así que el coseno equivale al producto escalar, y coseno y distancia euclídea dan exactamente el mismo ranking.

    export function cosineSimilarity(a: number[], b: number[]): number {
      if (a.length !== b.length) {
        throw new Error(`Dimensiones distintas: ${a.length} vs ${b.length}`);
      }
      let dot = 0;
      let normA = 0;
      let normB = 0;
      for (let i = 0; i < a.length; i++) {
        dot += a[i] * b[i];
        normA += a[i] * a[i];
        normB += b[i] * b[i];
      }
      if (normA === 0 || normB === 0) return 0;
      return dot / (Math.sqrt(normA) * Math.sqrt(normB));
    }
    

    La función calcula las normas aunque OpenAI ya normalice: te protege de vectores recortados a mano o de otro proveedor.

    Búsqueda semántica en memoria: ejemplo mínimo

    Para buscar con vector embeddings en un corpus pequeño no necesitas base de datos vectorial: embebes todo, calculas el coseno contra la consulta y ordenas.

    const docs = [
      "Cómo cancelar la suscripción desde el panel de usuario",
      "El reembolso tarda entre 5 y 7 días hábiles en llegar",
      "Para cambiar la contraseña, ve a Ajustes > Seguridad",
      "Aceptamos pagos con tarjeta, PayPal y transferencia",
      "El plan Pro incluye soporte prioritario por chat",
      "Puedes exportar tus facturas en PDF desde Facturación",
    ];
    
    const query = "quiero darme de baja y que me devuelvan el dinero";
    
    // una sola petición para la consulta y los documentos
    const [queryVector, ...docVectors] = await embed([query, ...docs]);
    
    const ranking = docVectors
      .map((vector, i) => ({ text: docs[i], score: cosineSimilarity(queryVector, vector) }))
      .sort((a, b) => b.score - a.score);
    
    console.table(ranking.slice(0, 3));
    

    Ejecutado el 5 de noviembre de 2026 con text-embedding-3-small y el SDK openai 7.51.0, los dos primeros resultados fueron "cancelar la suscripción" (0,51) y "el reembolso tarda" (0,40), sin compartir palabras clave con la consulta.

    El 0,51 no es un porcentaje de parecido: vale el orden, y cualquier umbral hay que calibrarlo con datos reales. Con millones de vectores necesitas un índice aproximado; lo explico en cómo funciona una vector database con HNSW e IVF.

    El parámetro dimensions y la normalización

    El parámetro dimensions acorta el embedding en origen sin que pierda lo que representa, y es lo que OpenAI sugiere frente a recortarlo tú. Según la guía, text-embedding-3-large recortado a 256 dimensiones supera en MTEB a ada-002 con sus 1.536.

    Si recortas a mano con slice, tienes que renormalizar. En la misma prueba, los primeros 256 valores de un vector de 1.536 tenían norma 0,48, no 1, y el producto escalar deja de equivaler al coseno.

    export function normalize(v: number[]): number[] {
      let sumSquares = 0;
      for (const x of v) sumSquares += x * x;
      const magnitude = Math.sqrt(sumSquares);
      return magnitude === 0 ? v : v.map((x) => x / magnitude);
    }
    
    const shortened = normalize(queryVector.slice(0, 256));
    

    Las dimensiones también deciden cuánto ocupan tus vectores. En pgvector cada vector ocupa 4 * dimensiones + 8 bytes, y el tipo vector solo se indexa con HNSW hasta 2.000 dimensiones, según su README. Para 100.000 documentos:

    Dimensiones Bytes por vector (4 × d + 8) 100.000 vectores ¿Indexable con HNSW como vector?
    256 1.032 103,2 MB Sí
    1.024 4.104 410,4 MB Sí
    1.536 6.152 615,2 MB Sí
    3.072 12.296 1.229,6 MB No: usa halfvec o dimensions

    Por eso large con dimensions: 1024 suele ser mejor plan que large a 3.072: los vectores ocupan la tercera parte y se pueden indexar con HNSW. El índice HNSW ocupa espacio aparte, que también crece con las dimensiones.

    Errores típicos con vector embeddings en producción

    Mezclar modelos o dimensiones al reindexar. Guarda modelo y dimensiones junto a cada vector y filtra por ellos. Si cambias de modelo, reindexa todo y embebe la consulta con el nuevo.

    Recortar sin renormalizar. Usa dimensions en la llamada. Si recortas a mano, pasa normalize() siempre.

    Embeber textos demasiado largos. El límite es 8.192 tokens por input, pero un vector que resume diez páginas es una media difusa de todo: trocea antes. Cuenta tokens con cl100k_base, el encoding que indica la guía; en TypeScript, con js-tiktoken.

    No presupuestar la reindexación. Embeber 100.000 documentos de 500 tokens (50 millones de tokens) cuesta 1 USD con small. Lo caro es mantener dos índices mientras migras y revalidar la calidad.

    Cuándo NO usar vector embeddings

    Los embeddings no sirven cuando importa la coincidencia exacta, cuando la respuesta depende de una negación o cuando el dominio usa un vocabulario que el modelo no conoce. Dos casos medidos el 5 de noviembre de 2026 con similitud coseno:

    Frase A Frase B (casi igual) Frase C (lo que buscas) small A-B small A-C large A-B large A-C
    "El pedido se ha enviado" "El pedido no se ha enviado" "Tu paquete ya está en camino" 0,852 0,543 0,851 0,562
    "ERR-4012" "ERR-4021" "Error de pago rechazado" 0,955 0,267 0,929 0,352

    IDs, SKUs y códigos de error. Aunque en tu sistema ERR-4012 signifique "pago rechazado", el modelo no lo sabe: ERR-4012 y ERR-4021 salen casi idénticos. Si tu usuario busca un código concreto, usa BM25 o un filtro exacto. Lo habitual es combinar las dos cosas, como explico en búsqueda híbrida con embeddings en Supabase.

    Negaciones. "Se ha enviado" y "no se ha enviado" quedan más cerca entre sí que de una paráfrasis correcta. En el hilo de Hacker News sobre el paper "Is Cosine-Similarity of Embeddings Really About Similarity?", el usuario latency-guy2 puso el mismo ejemplo con "Yes, this is a demonstration" frente a "Yes, this isn't a demonstration". En el mismo hilo, visarga escribió que los embeddings "make a mess of equivalent, antonymous and related things".

    Dominio muy específico. Jerga y siglas internas que el modelo no vio al entrenar, con datos hasta septiembre de 2021. Mide con tus consultas antes de fiarte.

    Cuando no puedes asumir el lock-in. Cada vector está atado a su modelo, y cambiar de proveedor obliga a reindexar el corpus entero. Si mañana quieres un pipeline multimodal como el de Gemini Embedding 2, no aprovechas ni un vector.

    Qué modelo de embeddings elegir para empezar

    Para empezar con vector embeddings, usa text-embedding-3-small con sus 1.536 dimensiones, guarda modelo y dimensiones junto a cada vector y monta 20 o 30 consultas reales con el resultado que esperas. Ese conjunto de prueba vale más que cualquier benchmark: te dirá si large compensa, qué umbral usar y si necesitas BM25.

    Los vector embeddings son la pieza de recuperación de casi cualquier agente con RAG. Para ver cómo encajan con las tools, la memoria y la orquestación, tienes el ebook gratuito El Developer Agéntico, 194 páginas sobre arquitectura de agentes. Y para llevarlo a un producto completo, el curso Construye con IA.

    Preguntas frecuentes

    ¿Puedo comparar embeddings de text-embedding-3-small y text-embedding-3-large?

    No. Aunque recortes large a 1.536 dimensiones, cada modelo genera vectores en su propio espacio: la comparación no da error, pero no significa nada. Usa el mismo modelo y las mismas dimensiones para documentos y consulta.

    ¿Hace falta normalizar los embeddings de OpenAI?

    No, si los usas tal como llegan o los acortas con el parámetro dimensions: OpenAI los devuelve normalizados a longitud 1. Sí, si los recortas con slice o los mezclas con vectores de otro origen.

    ¿Cuántos textos puedo embeber en una sola petición?

    Hasta 2.048 inputs por petición, cada uno de 8.192 tokens como máximo y sin pasar de 300.000 tokens entre todos, según la referencia de la API. El límite que suele cortar primero es el de 300.000 tokens: con textos de 500 tokens caben 600 por petición.

    ¿Cuánto cuesta embeber todo mi corpus con OpenAI?

    Multiplica los tokens del corpus, en millones, por el precio por millón. A noviembre de 2026, text-embedding-3-small cuesta 0,02 USD por millón y text-embedding-3-large, 0,13 USD. Un corpus de 50 millones de tokens sale por 1 USD con small y 6,50 USD con large.

    ¿Necesito una base de datos vectorial para usar vector embeddings?

    No para empezar. Con unos pocos miles de documentos basta un bucle de coseno en memoria; la base vectorial compensa cuando recorrerlo todo se vuelve lento o necesitas filtrar y persistir a escala.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
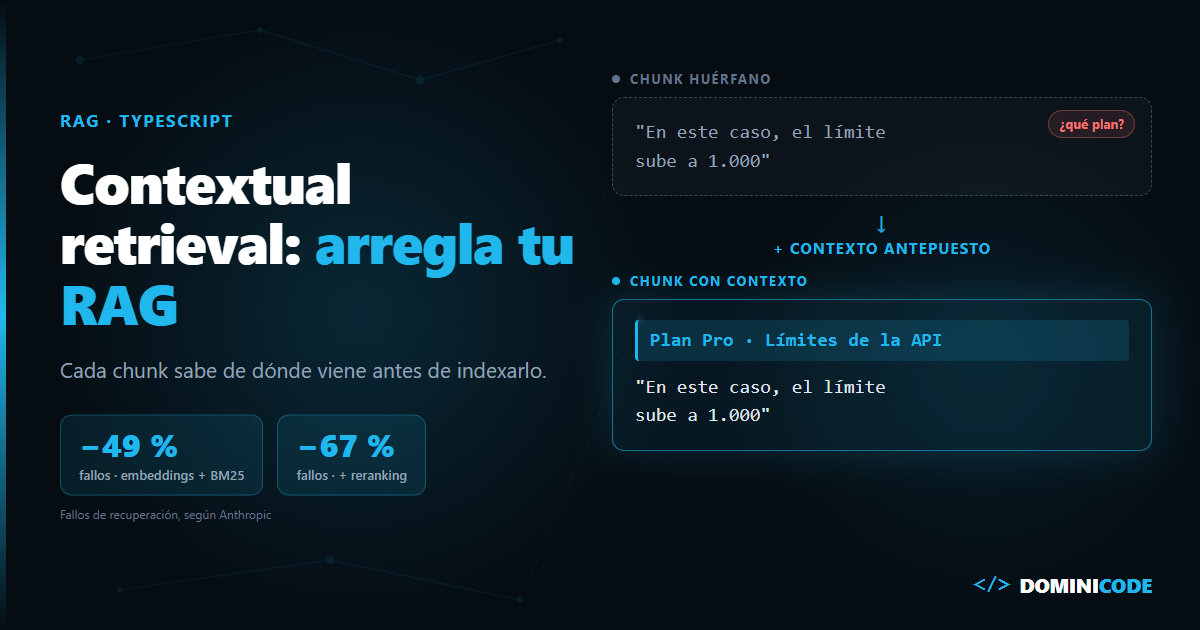
  • Contextual retrieval: cómo arreglar tu RAG en TypeScript

    Contextual retrieval: cómo arreglar tu RAG en TypeScript

    Un usuario le pregunta a tu asistente de documentación: "¿Cuántas peticiones por minuto admite el plan Pro?". El sistema busca, encuentra un fragmento y responde con seguridad: 100.

    El fragmento existe: "El límite es de 100 peticiones por minuto". Pero es del plan Free. El del plan Pro empieza con "En este caso, el límite sube a 1.000" y no nombra el plan.

    Tu RAG no ha alucinado. Hizo lo que le pediste: trocear, vectorizar y devolver el fragmento más parecido, que al trocear perdió el título que le daba sentido. Ese hueco lo tapa contextual retrieval, la técnica que Anthropic publicó en septiembre de 2024 y que sigue siendo una de las mejoras más baratas que le puedes hacer a un RAG.

    En corto: contextual retrieval consiste en pedirle a un LLM que escriba, para cada chunk, una o dos frases que lo sitúen dentro del documento, y en indexar ese contexto junto al chunk en embeddings y en BM25. En las pruebas de Anthropic, los fallos de recuperación bajaron un 49 % al combinar las dos cosas y un 67 % al añadir reranking. Con prompt caching y Claude Haiku 5.5, contextualizar un millón de tokens de documentos sale por unos 0,38 USD según mi cálculo con los precios de noviembre de 2026.

    ¿Qué es contextual retrieval?

    Contextual retrieval es una técnica de indexado para RAG que antepone a cada chunk un contexto breve, generado por un LLM a partir del documento completo, antes de calcular su embedding y de añadirlo al índice BM25.

    No cambia la consulta ni el modelo que responde: cambia lo que guardas. Donde antes indexabas "En este caso, el límite sube a 1.000", ahora indexas algo así:

    Sección de límites de la API, plan Pro. Describe el rate limit por minuto y cómo se amplía respecto al plan Free.

    En este caso, el límite sube a 1.000 peticiones por minuto.

    Ahora la búsqueda vectorial y la de palabras clave encuentran "plan Pro".

    Por qué falla el chunking en RAG clásico

    El chunking en RAG trocea los documentos en fragmentos de unos pocos cientos de tokens. Es razonable, pero tiene un coste oculto: cada chunk pierde las referencias que vivían fuera de él.

    Pronombres ("este caso"), siglas definidas tres párrafos antes, el producto que solo aparece en el H1, la versión de la API en la cabecera. Nada de eso viaja con el fragmento.

    La búsqueda híbrida ayuda, pero no lo arregla: si el término no está en el chunk, BM25 no tiene nada que encontrar. Ya conté cómo montar esa combinación en búsqueda híbrida con embeddings en Supabase: contextual retrieval es la capa que va encima, no un sustituto.

    Anthropic probó la alternativa obvia, añadir un resumen genérico del documento a cada chunk, y según el artículo las ganancias fueron muy limitadas. El contexto útil es específico de cada fragmento.

    Cuánto mejora la recuperación: los números de Anthropic

    Anthropic midió la tasa de fallo como 1 menos recall@20: el porcentaje de consultas en las que el chunk correcto no aparece entre los 20 primeros resultados. Estos son los datos del artículo de Anthropic, con su configuración de 2024 (contexto generado con Claude 3 Haiku; en la fila de reranking, 150 candidatos que el reranker de Cohere reduce a 20):

    Técnica Tasa de fallo (top-20) Reducción vs. base Coste que añade
    Base (embeddings sin contexto) 5,7 % — Ninguno extra
    + contextual embeddings 3,7 % 35 % Una llamada al LLM por chunk al indexar
    + contextual BM25 2,9 % 49 % Mantener un índice BM25 (barato)
    + reranking 1,9 % 67 % Una llamada al reranker por consulta: latencia y coste en cada búsqueda

    Mira la última columna: las dos primeras mejoras se pagan una vez, al indexar. El reranking se paga en cada consulta, y el propio artículo avisa de que añade algo de latencia y de coste. Si ya tienes el pipeline de RAG avanzado con búsqueda híbrida, contextual retrieval se añade en la ingesta sin tocar la consulta.

    Cómo implementar contextual retrieval en TypeScript con Claude

    Por cada chunk, una llamada al modelo con el documento entero y el chunk. Lo que la hace viable es el prompt caching: el documento es igual en todas las llamadas, así que lo marcas con cache_control y solo pagas su precio completo la primera vez.

    Este ejemplo usa @anthropic-ai/sdk y claude-haiku-5-5, con un prompt propio en español:

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic(); // lee ANTHROPIC_API_KEY del entorno
    const MODEL = "claude-haiku-5-5";
    
    const instructions = (chunk: string) => `Este fragmento pertenece al documento anterior:
    <chunk>
    ${chunk}
    </chunk>
    Escribe un contexto breve (50-100 tokens) que sitúe el fragmento dentro del documento
    para mejorar su recuperación en búsquedas. Incluye producto, sección, versión o fechas
    si aparecen. Responde solo con el contexto.`;
    
    async function contextualizeChunk(doc: string, chunk: string): Promise<string> {
      const res = await client.messages.create({
        model: MODEL,
        max_tokens: 200,
        messages: [
          {
            role: "user",
            content: [
              {
                type: "text",
                text: `<document>\n${doc}\n</document>`,
                cache_control: { type: "ephemeral" }, // 5 minutos por defecto
              },
              { type: "text", text: instructions(chunk) },
            ],
          },
        ],
      });
    
      // Comprueba que la caché funciona: a partir de la 2.ª llamada debería ser > 0
      console.log("cache_read_input_tokens:", res.usage.cache_read_input_tokens);
    
      const block = res.content.find((b) => b.type === "text");
      return block?.type === "text" ? block.text.trim() : "";
    }
    
    export async function contextualizeDocument(
      doc: string,
      chunks: string[],
      concurrency = 5,
    ): Promise<string[]> {
      if (chunks.length === 0) return [];
    
      // La primera llamada escribe la caché. Las que salgan antes de que
      // empiece su respuesta no la verían y pagarían el documento entero.
      const contexts = [await contextualizeChunk(doc, chunks[0])];
    
      for (let i = 1; i < chunks.length; i += concurrency) {
        const batch = chunks.slice(i, i + concurrency);
        contexts.push(...(await Promise.all(batch.map((c) => contextualizeChunk(doc, c)))));
      }
    
      return chunks.map((chunk, i) => `${contexts[i]}\n\n${chunk}`);
    }
    

    Dos detalles importan. Según la documentación de prompt caching, en peticiones concurrentes la entrada de caché solo existe cuando empieza la primera respuesta. Si lanzas los 10 chunks a la vez con Promise.all, pagas 10 escrituras de caché del documento, cada una a 1,25 veces el precio de entrada. Por eso la primera llamada va sola. (Con lotes, cada uno espera al chunk más lento; si te importa la velocidad, un pool como p-limit va más rápido.)

    Además, Haiku 5.5 no cachea prompts de menos de 512 tokens, y no da error: simplemente no cachea.

    El texto que devuelve contextualizeDocument va a tu modelo de embeddings y a tu índice de palabras clave: BM25 o, en Postgres, un tsvector con ts_rank, que no es BM25 pero cumple el mismo papel. Guarda también el chunk original: el artículo sugiere que la respuesta puede mejorar si el modelo distingue contexto y contenido. Qué pasa con esos vectores dentro de la base de datos lo explico en cómo funciona una vector database con HNSW e IVF.

    Cuánto cuesta contextual retrieval hoy

    Anthropic calculó 1,02 USD por millón de tokens de documento con Claude 3 Haiku y precios de 2024. Lo he recalculado con los precios de Claude Haiku 5.5 a noviembre de 2026 y las mismas hipótesis del artículo: documentos de 8.000 tokens, chunks de 800, 50 tokens de instrucciones y 100 tokens de contexto por chunk. Cada llamada ronda los 8.850 tokens: por encima del mínimo de 512 para cachear y por debajo de los 100.000 a partir de los que sube la tarifa.

    Un millón de tokens son 125 documentos y 1.250 chunks:

    Concepto Tokens Precio Haiku 5.5 Coste
    Escritura de caché (1 por documento) 1.000.000 0,125 USD/MTok 0,125 USD
    Lecturas de caché (9 por documento) 9.000.000 0,01 USD/MTok 0,090 USD
    Entrada sin caché (chunk + instrucciones) 1.062.500 0,10 USD/MTok 0,106 USD
    Salida (contexto generado) 125.000 0,50 USD/MTok 0,063 USD
    Total ≈ 0,38 USD

    Sin caché, la misma operación costaría unos 1,17 USD: la caché ahorra dos tercios. Es mi cálculo, no una cifra de Anthropic, y no incluye el coste de los embeddings.

    Cuándo NO usar contextual retrieval

    La técnica no es gratis ni universal. Cuatro límites antes de meterla en tu pipeline.

    Si tu base de conocimiento cabe en el prompt, sáltatela. El artículo dice que, por debajo de 200.000 tokens (unas 500 páginas), puedes meter todo en el contexto y olvidarte del RAG. Matiz de 2026: Haiku 5.5 cobra todo cinco veces más (entrada, caché y salida) en las peticiones de más de 100.000 tokens, contando también lo que sale de caché, así que el umbral depende del modelo. Y no todos comparten la idea. En el hilo de Hacker News sobre el artículo, un usuario escribió que "The statement about just throwing 200k tokens to get best answer for smaller datasets goes against my experience", porque, según contaba, cuanto más crece el prompt, menos consistente es la respuesta, y le pasaba ya muy por debajo de 25.000 tokens.

    Documentos que cambian a menudo. Cada edición obliga a regenerar el contexto de todos los chunks del documento, porque cada contexto se genera leyéndolo entero. En una wiki que se edita a diario, el coste y la cola de reindexado crecen rápido.

    Latencia de indexado. Una llamada al LLM por chunk añade tiempo a cada ingesta. En el mismo hilo, otro usuario lo planteaba así: "Even with prompt caching this adds a huge extra time to your vector database create/update, right?". Si necesitas que un documento sea buscable segundos después de subirlo, indexa primero sin contexto y contextualiza en segundo plano.

    Documentos muy estructurados. Si tu documentación tiene buenos encabezados, anteponer la ruta de títulos al chunk (# Límites > ## Plan Pro) recupera parte de ese contexto sin llamar a ningún modelo. Un usuario del mismo hilo de HN contaba que su equipo lo hacía así y que "seems to work pretty well", sin LLM al indexar. Prueba eso primero y mide.

    Cómo saber si te compensa

    Contextual retrieval no se adopta por fe. Necesitas un conjunto de evaluación con preguntas reales y su chunk correcto: mides el recall@20 actual, contextualizas y vuelves a medir. Si no tienes ese conjunto, ese es tu primer trabajo. Y si dudas entre recuperar mejor o entrenar el modelo, empieza por RAG vs. fine-tuning.

    Mi recomendación: si tu RAG falla cuando el dato existe pero el fragmento no dice de qué habla, empieza por contextual retrieval: cuesta céntimos y no cambia ni tu base de datos ni tu modelo.

    En el ebook gratuito El Developer Agéntico tienes RAG explicado como parte de la arquitectura de un agente, junto a tools, memoria y MCP; el capítulo 5 trata el chunking y el late chunking, la alternativa sin LLM generativo a lo que has visto aquí. Y si quieres llevarlo a un producto de verdad, en el curso Construye con IA vamos de la idea al producto con Claude Code, paso a paso.

    Preguntas frecuentes

    ¿Contextual retrieval es lo mismo que la búsqueda híbrida?

    No. La búsqueda híbrida combina embeddings y BM25 al consultar. Contextual retrieval cambia lo que indexas en ambos: añade a cada chunk un contexto generado por un LLM. Se usan juntas, y en las pruebas de Anthropic la combinación redujo los fallos de recuperación un 49 %.

    ¿Necesito usar Claude para contextual retrieval?

    No. Cualquier LLM puede generar el contexto. Lo que hace viable la técnica es el prompt caching, que abarata leer el mismo documento en cada chunk. Con otro proveedor, comprueba si tiene caché y a qué precio.

    ¿Cuánto cuesta aplicar contextual retrieval a mi documentación?

    Con Claude Haiku 5.5, prompt caching y documentos de 8.000 tokens, unos 0,38 USD por millón de tokens de documento, una sola vez, más el coste de los embeddings. Si un documento pasa de 100.000 tokens, cada llamada supera ese umbral y Haiku 5.5 cobra todas sus tarifas por cinco, así que el coste también se multiplica por cinco.

    ¿Puedo usar contextual retrieval con pgvector o Supabase?

    Sí. Contextual retrieval cambia la ingesta, no la base de datos: guardas el chunk contextualizado en pgvector como cualquier otro embedding, y la parte de palabras clave va en un tsvector de Postgres.

    ¿Cuánto debe ocupar el contexto de cada chunk?

    Según Anthropic, suele ocupar entre 50 y 100 tokens. Cada token de salida se paga por chunk, así que pide en el prompt solo lo que se pierde al trocear: producto, sección, versión y fechas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Async generator en JavaScript: datos que llegan poco a poco

    Async generator en JavaScript: datos que llegan poco a poco

    Una API te devuelve clientes de 100 en 100. Tienes que procesar 200.000.

    El primer código que sale es casi siempre el mismo: un bucle que pide todas las páginas, mete los resultados en un array y, cuando termina, empieza a trabajar. Funciona en local con 300 registros. En producción el proceso tarda minutos en hacer lo primero útil, la memoria sube sin parar y, si la página 1.800 falla, pierdes las 1.799 anteriores.

    El problema no es la API. Para esto existe el async generator en JavaScript (ES2018), una herramienta que mucha gente ha visto escrita pero pocos usan a propósito: tu código modela como "un valor que llega al final" algo que en realidad es "muchos valores que van llegando".

    En corto: un async generator en JavaScript (async function*) produce valores asíncronos de uno en uno y el consumidor los recorre con for await...of. El productor solo avanza cuando el consumidor pide el siguiente valor, así que procesas datos paginados o en streaming sin cargarlos en memoria. Si el consumidor sale con break, el generador ejecuta su finally y libera recursos.

    ¿Qué es un async generator?

    Un async generator es una función declarada con async function* que puede usar await y yield, y que al llamarla devuelve un objeto AsyncGenerator cuyo método next() devuelve una Promise<{ value, done }>.

    Esa última parte es el protocolo entero. Un async iterator es cualquier objeto con un next() que devuelve una promesa de { value, done }. Un async iterable es cualquier objeto con un método [Symbol.asyncIterator]() que devuelve un async iterator. for await...of solo sabe hablar con esa interfaz.

    async function* countdown(from: number): AsyncGenerator<number, string, undefined> {
      for (let i = from; i > 0; i--) {
        await new Promise((r) => setTimeout(r, 500)); // await: espera algo
        yield i;                                      // yield: entrega un valor y se pausa
      }
      return "despegue";
    }
    
    const it = countdown(2);
    console.log(await it.next()); // { value: 2, done: false }
    console.log(await it.next()); // { value: 1, done: false }
    console.log(await it.next()); // { value: "despegue", done: true }
    

    await pausa el generador para esperar algo de fuera. yield lo pausa para entregar algo, y no sigue hasta el siguiente next(). Según MDN, si haces yield de una promesa, el value que recibe el consumidor ya viene resuelto, nunca es otra promesa.

    En TypeScript tienes dos tipos útiles. AsyncGenerator<T, TReturn, TNext> describe el objeto concreto: lo que entrega cada yield, lo que devuelve el return y lo que acepta next(valor). AsyncIterable<T> es el contrato mínimo, y es el que deberías pedir en los parámetros de tus funciones.

    Paginar una API con un async generator en JavaScript

    Un async generator pagina una API pidiendo la página siguiente solo cuando el consumidor ha terminado con la anterior. El caso de la apertura queda así:

    type Page<T> = { items: T[]; nextCursor: string | null };
    
    async function* paginate<T>(url: string, signal?: AbortSignal): AsyncGenerator<T, void, undefined> {
      let cursor: string | null = null;
      do {
        const u = new URL(url);
        if (cursor) u.searchParams.set("cursor", cursor);
    
        const res = await fetch(u, { signal });
        if (!res.ok) throw new Error(`HTTP ${res.status} en ${u}`);
    
        const page = (await res.json()) as Page<T>;
        yield* page.items;          // delega: entrega los items uno a uno
        cursor = page.nextCursor;
      } while (cursor);
    }
    
    for await (const customer of paginate<{ id: string }>("https://api.example.com/customers")) {
      await processCustomer(customer);
    }
    

    El consumidor recibe el primer cliente en cuanto llega la primera página. yield* delega en otro iterable (aquí un array) y entrega sus elementos uno a uno. Y mientras processCustomer trabaja, el generador está parado en el yield: no pide la página siguiente hasta que hace falta.

    Eso es backpressure natural: el productor nunca corre más que el consumidor. No hay buffer que crezca ni cola que vigilar. En memoria tienes, como mucho, una página.

    Ese as Page<T> es una mentira piadosa. Si la API cambia un campo, te enteras en la página 400. Validar cada página que entra con un esquema es lo que enseño en el curso de Zod para TypeScript, y en un generador encaja en una línea: const page = PageSchema.parse(await res.json()).

    for await…of y streams: leer chunk a chunk

    El otro caso donde los generadores asíncronos brillan es un stream: el body de un fetch, SSE o los tokens de un LLM.

    async function* lines(res: Response): AsyncGenerator<string, void, undefined> {
      if (!res.body) return;
      const reader = res.body.pipeThrough(new TextDecoderStream()).getReader();
      let buffer = "";
      try {
        while (true) {
          const { value, done } = await reader.read();
          if (done) break;
          buffer += value;
          const parts = buffer.split("\n");
          buffer = parts.pop() ?? "";
          yield* parts;
        }
        if (buffer) yield buffer;
      } finally {
        await reader.cancel(); // se ejecuta al terminar, al fallar o si el consumidor hace break
      }
    }
    
    for await (const line of lines(await fetch("/logs"))) {
      if (line.includes("FATAL")) break; // dispara return() -> finally -> cancel()
      console.log(line);
    }
    

    El finally es la pieza que la gente olvida. Cuando el consumidor hace break, return o lanza una excepción dentro del for await, el bucle llama a return() sobre el generador, y el generador ejecuta su finally antes de cerrarse. Sin ese bloque, el reader queda bloqueado y la conexión abierta.

    Este mismo patrón, aplicado a eventos SSE, es el que aparece en la API con Hono y Bun que hace streaming SSE. Si te interesa cómo se montan esos agentes por dentro, el ebook gratuito El Developer Agéntico lo cuenta de principio a fin.

    Por cierto: hoy ReadableStream ya es async iterable y puedes hacer for await (const chunk of res.body) directamente. La decisión de que salir del bucle cancele el stream se discutió en el issue #778 de whatwg/streams, abierto en 2017 y cerrado en 2019. Domenic Denicola lo resumió así: "break invokes return(), which per the above design will cancel the stream". Para no cancelar está la opción preventCancel.

    Ojo con Safari: según caniuse, la iteración con for await solo funciona desde Safari 27. Si tienes usuarios en versiones anteriores, getReader() sigue siendo la opción segura, y por eso el código de arriba lo usa.

    Async generator vs Promise.all, RxJS y ReadableStream

    Frente a Promise.all, RxJS y ReadableStream, el async generator es la opción más simple cuando la secuencia se consume una sola vez, en orden y por un único consumidor.

    Enfoque Modelo Memoria Backpressure Cancelación Limitación / riesgo
    Promise.all + array Todo de golpe Todos los resultados a la vez No Manual con AbortController No procesas nada hasta el final; un rechazo tumba el lote entero
    Generador síncrono (function*) Pull síncrono Un valor a la vez Sí return() No puede esperar I/O: como mucho entrega promesas que tienes que esperar tú
    Async generator (async function*) Pull asíncrono Un valor a la vez Sí, natural break / return() ejecuta finally Secuencial, una sola pasada, un solo consumidor
    Observable (RxJS) Push Depende de los operadores No nativa: hay que añadir operadores unsubscribe() Dependencia externa; el productor puede inundar al consumidor
    ReadableStream Pull con cola interna Chunks con highWaterMark Sí, configurable cancel(); break cancela API verbosa; la iteración con for await llegó tarde a Safari

    Mi criterio: si la fuente es una secuencia que se consume una vez y en orden (páginas, líneas, tokens), el async generator es la opción más simple. Si hay varios suscriptores o eventos de UI, RxJS. Si estás conectando con APIs de la plataforma que ya hablan streams, ReadableStream.

    Componer y recolectar: yield*, Array.fromAsync y helpers

    Como un async generator acepta cualquier AsyncIterable, componerlos es trivial:

    async function* take<T>(source: AsyncIterable<T>, n: number): AsyncGenerator<T, void, undefined> {
      if (n <= 0) return;
      let i = 0;
      for await (const item of source) {
        yield item;
        if (++i >= n) return; // cierra también la fuente: su finally se ejecuta
      }
    }
    
    const first50 = await Array.fromAsync(take(paginate<{ id: string }>("https://api.example.com/customers"), 50));
    

    Array.fromAsync recoge un async iterable en un array. MDN lo marca como Baseline desde enero de 2024 y el repo de propuestas finalizadas de TC39 lo asigna a ES2026, no a ES2024. Espera cada valor de forma secuencial, igual que for await.

    ¿Y map, filter o take nativos? Los iterator helpers para iteradores síncronos son estándar desde ES2025. Los de iteradores asíncronos no: la propuesta async iterator helpers sigue en stage 2. Hasta entonces, el take de arriba lo escribes tú. Hablo de lo que sí entró al lenguaje este año en las novedades de ECMAScript 2026.

    Errores típicos con for await y generadores asíncronos

    Creer que for await paraleliza. No lo hace. Cada vuelta espera a la anterior. Si tienes 20 URLs independientes y cada petición se lanza cuando el bucle pide el siguiente valor (dentro del cuerpo o desde un generador), un for await tarda la suma de todas; Promise.all las lanza a la vez y tarda lo que la más lenta. El ejemplo de MDN lo muestra con un generador que crea cada promesa al pedirla: cinco promesas de 100 ms tardan unos 500 ms con Array.fromAsync y unos 100 ms con Promise.all. Si no tienes claro por qué, repasa cómo funcionan el event loop y las microtasks.

    Recorrer un array de promesas con for await. Si la tercera se rechaza mientras esperas a la primera, nadie la escucha todavía y el runtime puede reportar un unhandled rejection. Para promesas que ya existen, Promise.all o Promise.allSettled.

    No poner finally. Cualquier recurso abierto dentro del generador (reader, conexión, fichero) se queda colgado si el consumidor sale antes de tiempo.

    No entender cómo viajan los errores. Un throw dentro del generador rechaza la promesa de next(), el for await relanza esa excepción en el consumidor y el generador queda terminado. Ponle el try/catch al bucle consumidor, no solo al generador. Si te pierdes siguiendo el rastro, aquí explico cómo depurar código asíncrono en JavaScript.

    Intentar recorrerlo dos veces. Un generador es de una sola pasada. La segunda iteración no produce nada. Si necesitas reutilizarlo, expón un iterable que cree uno nuevo cada vez:

    const customers: AsyncIterable<{ id: string }> = {
      [Symbol.asyncIterator]: () => paginate<{ id: string }>("https://api.example.com/customers"),
    };
    

    Cuándo NO usar un async generator

    Cuando los datos caben en un Promise.all. Si son diez peticiones independientes y el resultado cabe en memoria, un generador solo añade latencia por ser secuencial. La paginación por cursor es secuencial por naturaleza; la paginación por número de página no, y ahí un Promise.all por lotes suele ser más rápido.

    Cuando hay varios consumidores. Un async generator entrega cada valor a un solo next(). Si dos partes de la app necesitan los mismos eventos (por ejemplo, un WebSocket que alimenta tres componentes), estás ante un problema de push y multicast. Ahí un Observable o un EventTarget encajan mejor.

    Cuando el cuello de botella es la concurrencia. Hacer prefetch de la página siguiente o procesar N elementos en paralelo exige código extra. Si es tu caso principal, una cola o un ReadableStream con highWaterMark te ahorran reinventarlo.

    Cuando necesitas cancelar una petición en vuelo. break solo actúa cuando el generador está pausado en un yield. Para cortar un fetch lento por timeout necesitas un AbortSignal, como el parámetro signal de paginate:

    // Corta el recorrido entero, incluida la petición en vuelo, si pasa de un minuto
    const customers = paginate<{ id: string }>("https://api.example.com/customers", AbortSignal.timeout(60_000));
    

    Qué hacer con esto hoy

    Busca en tu código un bucle de fetch que acumula resultados en un array solo para recorrerlo después. Conviértelo en un async function* con yield y finally, y consume con for await...of. El consumidor apenas cambia; la memoria y el tiempo hasta el primer resultado, sí.

    Si estás construyendo productos que consumen modelos en streaming, esto es la base de todo lo demás. En Construye con IA lo aplicamos de la idea al producto con Claude Code.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre un generador y un async generator?

    En un generador (function*), next() devuelve { value, done } al instante y se recorre con for...of. En un async generator (async function*), next() devuelve una promesa de { value, done }, dentro puedes usar await y se recorre con for await...of.

    ¿for await…of ejecuta las promesas en paralelo?

    No. for await...of espera a que se resuelva cada valor antes de pedir el siguiente. Si necesitas paralelismo sobre promesas independientes, usa Promise.all o Promise.allSettled.

    ¿Qué pasa si hago break dentro de un for await…of?

    El bucle llama a return() sobre el iterador. En un async generator eso ejecuta el bloque finally pendiente y marca el generador como terminado. En un ReadableStream, por defecto, cancela el stream salvo que uses values({ preventCancel: true }).

    ¿Cómo se tipa un async generator en TypeScript?

    Con AsyncGenerator<T, TReturn, TNext>, donde T es el tipo de cada yield, TReturn el del return y TNext lo que acepta next(). Para los parámetros de tus funciones es mejor pedir AsyncIterable<T>, que acepta generadores, streams y cualquier objeto con [Symbol.asyncIterator].

    ¿Puedo usar map y filter sobre un async iterator?

    No de forma nativa todavía. Los iterator helpers síncronos son estándar desde ES2025, pero los async iterator helpers siguen en stage 2 en TC39. Mientras tanto, escribe tus propios map o take como async generators, o usa una librería.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Orquestador de agentes IA: cómo se construye en TypeScript

    Orquestador de agentes IA: cómo se construye en TypeScript

    Le pides a tu agente de IA que audite un repositorio: dependencias, seguridad, tests y rendimiento. En el fichero quince ya no recuerda lo que vio en el tercero. En el treinta, te devuelve un informe seguro de sí mismo con la mitad de los hallazgos inventados.

    Así que haces lo lógico: lo partes en cuatro agentes, uno por área, sin un orquestador de agentes IA que los coordine. Y aparece un problema nuevo.

    A cada uno le pasas el historial entero "por si acaso". La factura se multiplica. El agente de seguridad falla por un timeout y nadie se entera. El resumen final rellena su hueco con frases genéricas que suenan a auditoría y no lo son.

    El problema no era tener uno o cuatro agentes. Faltaba alguien que repartiera el trabajo, vigilara el gasto y supiera qué hacer cuando algo cae.

    En corto: un orquestador de agentes IA es un modelo que divide la tarea en subtareas, entrega a cada worker solo el contexto que necesita y une los resultados al final. Lo que lo hace funcionar en producción no es el prompt, sino el código que lo rodea: un plan tipado, paralelismo con techo, presupuesto de tokens y una regla clara para cuando un worker falla. Según Anthropic, un sistema multiagente gasta unas 15 veces más tokens que un chat, así que esos límites no son opcionales.

    Si aún no sabes si necesitas varios agentes, empieza por cómo decidir entre multiagente y agente único. Este post da por hecho que ya decidiste que sí.

    ¿Qué es un orquestador de agentes IA?

    Un orquestador de agentes IA es el componente que recibe una tarea, decide en tiempo de ejecución en qué subtareas se divide, delega cada una a un worker con un contexto acotado y sintetiza sus resultados en una única respuesta.

    Anthropic lo describe como el patrón orchestrator-workers en Building effective agents. Lo distingue de la paralelización simple por una razón: ahí las subtareas están fijadas de antemano, y aquí el orquestador las decide según la entrada. Ese es todo el valor del patrón. Si siempre divides la tarea de la misma forma, no necesitas un orquestador: te basta un Promise.allSettled sobre llamadas fijas.

    El reparto de responsabilidades es este:

    Pieza Qué hace Qué NO debe hacer Modelo razonable Riesgo si falla
    Orquestador (planner) Divide la tarea, decide qué es crítico, fija el formato de salida Resolver subtareas él mismo Grande (claude-opus-5-5) Un plan malo lo heredan todos los workers
    Worker Resuelve una subtarea con su contexto Ver el historial completo o lanzar otros workers Pequeño (claude-haiku-5-5), con fallback Inventa datos si le falta contexto
    Sintetizador Une resultados, marca huecos y contradicciones Inventar lo que falta Grande Rellena huecos con texto que suena bien
    Código (runtime) Concurrencia, presupuesto, timeouts, reintentos Delegar estas decisiones al LLM No aplica Coste y tiempo sin techo

    La fila del código es la que más importa. En un orquestador, el control de flujo vive en tu código, no en el modelo. El modelo propone el plan; tu código decide cuánto se gasta, cuántos workers corren a la vez y qué pasa si uno cae.

    Cómo descompone la tarea el orquestador: plan con structured output

    El orquestador no devuelve texto, devuelve un plan tipado que tu código puede validar. Si el plan llega como prosa, tendrás que parsearlo, y parsear prosa de un LLM es una apuesta.

    Primero, los tipos. Cada subtarea lleva cuatro cosas que Anthropic considera imprescindibles en su sistema de research multiagente (13 de junio de 2025): "Each subagent needs an objective, an output format, guidance on the tools and sources to use, and clear task boundaries." Yo añado una quinta: si es crítica o no.

    // types.ts
    import { z } from 'zod';
    
    export const SubtaskSchema = z.object({
      id: z.string(),
      objective: z.string().describe('Qué debe conseguir el worker, en una frase'),
      context: z.string().describe('Solo los datos que este worker necesita'),
      outputFormat: z.string().describe('Forma exacta de la respuesta'),
      boundaries: z.string().describe('Qué queda fuera de esta subtarea'),
      critical: z.boolean().describe('true si sin esta parte la respuesta final no sirve'),
    });
    
    export const PlanSchema = z.object({
      subtasks: z.array(SubtaskSchema),
    });
    
    export type Subtask = z.infer<typeof SubtaskSchema>;
    export type Plan = z.infer<typeof PlanSchema>;
    
    export type WorkerResult =
      | { status: 'ok'; subtaskId: string; output: string; model: string; attempts: number }
      | { status: 'failed'; subtaskId: string; error: string; attempts: number };
    
    export type OrchestratorResult =
      | { status: 'complete' | 'partial'; answer: string; results: WorkerResult[]; tokensUsed: number }
      | { status: 'aborted'; reason: string; results: WorkerResult[]; tokensUsed: number };
    

    Fíjate en boundaries. El mismo post de Anthropic lo explica sin rodeos: "Without detailed task descriptions, agents duplicate work, leave gaps, or fail to find necessary information." Un worker sin límites hace el trabajo del de al lado.

    El planner usa Vercel AI SDK v7 con generateText y Output.object:

    // planner.ts
    import { generateText, Output } from 'ai';
    import { anthropic } from '@ai-sdk/anthropic';
    import { PlanSchema, type Plan } from './types.js';
    import { Budget, estimateTokens } from './budget.js';
    
    const PLANNER_MAX_OUTPUT = 2_000;
    const MAX_SUBTASKS = 6; // tope de anchura: más workers = más tokens y más síntesis
    
    export async function planTask(task: string, budget: Budget, signal: AbortSignal): Promise<Plan> {
      const estimate = estimateTokens(task) + PLANNER_MAX_OUTPUT;
      budget.reserve(estimate);
    
      const { output, usage } = await generateText({
        model: anthropic('claude-opus-5-5'),
        instructions: [
          'Eres el orquestador. No resuelves la tarea: la divides.',
          'Crea entre 1 y 6 subtareas independientes entre sí, que se puedan hacer en paralelo.',
          'En "context" copia solo los datos que esa subtarea necesita, nunca la tarea entera.',
          'Si la tarea es pequeña, devuelve una sola subtarea.',
        ].join('\n'),
        prompt: task,
        output: Output.object({ schema: PlanSchema }),
        maxOutputTokens: PLANNER_MAX_OUTPUT,
        abortSignal: signal,
      }).catch((error: unknown) => {
        budget.settle(estimate, 0); // si la llamada falla, la reserva se libera igual
        throw error;
      });
    
      budget.settle(estimate, usage.totalTokens ?? estimate);
      if (output.subtasks.length === 0) throw new Error('El plan llegó vacío');
      return { subtasks: output.subtasks.slice(0, MAX_SUBTASKS) };
    }
    

    El tope de seis subtareas está en el código, no solo en el prompt. El prompt pide; el slice garantiza. Lo hago así porque no todos los proveedores respetan minItems/maxItems en el schema, y un plan con veinte subtareas es una factura con veinte llamadas.

    Escribir el plan antes de ejecutar es la misma idea que defiendo en el libro de Spec-Driven Development: primero el contrato, después el trabajo. Aquí el contrato lo escribe un modelo y lo valida Zod.

    Cómo pasa contexto un orquestador de agentes IA a cada worker

    En un orquestador de agentes IA, cada worker recibe su objetivo, su formato y su contexto. Nada más. Ni el historial del orquestador, ni la tarea completa, ni lo que hacen los demás.

    Esto ahorra tokens, pero sobre todo protege la calidad. Un worker con el historial entero se distrae con decisiones que no son suyas. Es el mismo motivo por el que el mega-prompt falla frente a los subagentes: cuanto más contexto irrelevante, peor razona el modelo sobre lo relevante.

    // worker.ts
    import { generateText } from 'ai';
    import { anthropic } from '@ai-sdk/anthropic';
    import type { Subtask, WorkerResult } from './types.js';
    import { Budget, BudgetExceededError, estimateTokens } from './budget.js';
    
    const WORKER_MAX_OUTPUT = 1_500;
    
    // Primero el modelo barato; si falla, uno más capaz. Nunca al revés.
    const MODEL_CHAIN = ['claude-haiku-5-5', 'claude-sonnet-5-5'] as const;
    
    export async function runWorker(
      subtask: Subtask,
      budget: Budget,
      signal: AbortSignal,
    ): Promise<WorkerResult> {
      let lastError = 'sin intentos';
    
      for (const [index, modelId] of MODEL_CHAIN.entries()) {
        const estimate = estimateTokens(subtask.context) + WORKER_MAX_OUTPUT;
        budget.reserve(estimate); // sin presupuesto, lanza: no tiene sentido reintentar
    
        try {
          const { text, usage } = await generateText({
            model: anthropic(modelId),
            instructions: [
              `Objetivo: ${subtask.objective}`,
              `Formato de salida: ${subtask.outputFormat}`,
              `Fuera de alcance: ${subtask.boundaries}`,
              'Si te faltan datos, dilo. No los inventes.',
            ].join('\n'),
            prompt: subtask.context, // contexto mínimo, no el historial del orquestador
            maxOutputTokens: WORKER_MAX_OUTPUT,
            maxRetries: 2, // errores de red y 429: el SDK reintenta con backoff
            abortSignal: signal,
          });
          budget.settle(estimate, usage.totalTokens ?? estimate);
          return { status: 'ok', subtaskId: subtask.id, output: text, model: modelId, attempts: index + 1 };
        } catch (error) {
          budget.settle(estimate, 0);
          if (error instanceof BudgetExceededError || signal.aborted) throw error;
          lastError = error instanceof Error ? error.message : String(error);
        }
      }
    
      return { status: 'failed', subtaskId: subtask.id, error: lastError, attempts: MODEL_CHAIN.length };
    }
    

    Hay tres decisiones en ese bloque.

    La primera: el worker no tiene herramientas para lanzar otros workers. Así la profundidad máxima es uno y no hace falta un contador: es estructural. Si un worker necesita delegar, esa subtarea estaba mal planificada.

    La segunda: dos niveles de reintento. maxRetries cubre los fallos transitorios (red, rate limit). La cadena de modelos cubre los fallos de capacidad: si Haiku no puede, sube a Sonnet.

    La tercera: un worker que falla devuelve un resultado failed, no lanza. Solo lanza si se acabó el presupuesto o el tiempo, porque ahí sí hay que parar a todos.

    Cómo ejecutar workers en paralelo: Promise.allSettled y un limitador

    Promise.all es el error clásico. Si un worker rechaza, pierdes el resultado de los otros cinco, que ya pagaste. Promise.allSettled espera a todos y te dice quién cayó.

    Pero sin techo, seis workers salen a la vez y te comes el rate limit del proveedor. Este limitador cabe en veinte líneas:

    // limiter.ts
    export function createLimiter(max: number) {
      let active = 0;
      const queue: Array<() => void> = [];
    
      // Si alguien espera, le pasamos el hueco sin liberarlo: así nunca hay max + 1
      const release = () => {
        const resume = queue.shift();
        if (resume) resume();
        else active--;
      };
    
      return async <T>(fn: () => Promise<T>): Promise<T> => {
        if (active < max) active++;
        else await new Promise<void>((resolve) => queue.push(resolve));
        try {
          return await fn();
        } finally {
          release();
        }
      };
    }
    

    El detalle está en release. Si decrementas active y después despiertas al siguiente, otra llamada puede colarse entre medias y tendrás un worker de más. Pasar el hueco directamente lo evita. Con ocho tareas y un límite de tres, el pico de concurrencia medido es tres.

    Cómo limitar el presupuesto de tokens de un orquestador

    El presupuesto de un orquestador se controla antes de cada llamada, no al final. Con workers en paralelo, si solo sumas lo gastado cuando cada uno termina, seis llamadas pueden arrancar a la vez con el presupuesto "disponible" y pasarse todas juntas.

    // budget.ts
    export class BudgetExceededError extends Error {}
    
    export class Budget {
      private used = 0;
      private reserved = 0;
    
      constructor(private readonly maxTokens: number) {}
    
      // Reserva antes de llamar: con workers en paralelo, comprobar después llega tarde
      reserve(estimate: number): void {
        if (this.used + this.reserved + estimate > this.maxTokens) {
          throw new BudgetExceededError(
            `Presupuesto agotado: ${this.used} usados, ${this.reserved} reservados, máximo ${this.maxTokens}`,
          );
        }
        this.reserved += estimate;
      }
    
      // Al terminar la llamada: se libera la reserva y se apunta el coste real
      settle(estimate: number, actual: number): void {
        this.reserved -= estimate;
        this.used += actual;
      }
    
      get tokensUsed(): number {
        return this.used;
      }
    }
    
    // Aproximación barata: ~4 caracteres por token. Sirve para reservar, no para facturar.
    export const estimateTokens = (text: string): number => Math.ceil(text.length / 4);
    

    Un orquestador sin límites explícitos no tiene un coste: tiene una distribución de costes con una cola larga. Estos son los cinco límites que fijo siempre:

    Límite Dónde vive Valor de partida Qué pasa si no lo pones
    Tokens totales Budget 150.000 por tarea Una tarea rara se come el presupuesto de cien normales
    Anchura (subtareas) MAX_SUBTASKS 6 El planner descompone de más y la síntesis no cabe
    Profundidad Workers sin herramienta de delegar 1 Recursión: workers que lanzan workers
    Concurrencia createLimiter 3 Errores 429 en cadena
    Tiempo AbortSignal.timeout 120 s Un worker colgado bloquea la respuesta

    Los valores son míos, no un estándar. Ajústalos midiendo tokensUsed en tus tareas reales.

    Qué hace el orquestador cuando un worker falla

    Esta es la decisión que más se olvida. Hay cuatro respuestas posibles y cada una tiene su sitio:

    Estrategia Cuándo usarla Coste extra Riesgo
    Reintento (mismo modelo) Timeout, 429, error de red Bajo Inútil si el fallo es de capacidad
    Fallback (modelo mayor) El modelo pequeño no resuelve la subtarea Medio-alto Oculta subtareas mal planificadas
    Resultado parcial La subtarea no es crítica Ninguno El sintetizador puede rellenar el hueco
    Abortar Falla una subtarea crítica Ninguno (ahorra la síntesis) Pierdes lo que ya pagaste

    El campo critical del plan es lo que permite elegir sin preguntarle al modelo otra vez. Aquí está el orquestador completo:

    // orchestrator.ts
    import { generateText } from 'ai';
    import { anthropic } from '@ai-sdk/anthropic';
    import type { OrchestratorResult, Plan, WorkerResult } from './types.js';
    import { Budget, estimateTokens } from './budget.js';
    import { createLimiter } from './limiter.js';
    import { planTask } from './planner.js';
    import { runWorker } from './worker.js';
    
    interface OrchestratorOptions {
      maxTokens: number;
      concurrency: number;
      timeoutMs: number;
    }
    
    const DEFAULTS: OrchestratorOptions = { maxTokens: 150_000, concurrency: 3, timeoutMs: 120_000 };
    
    export async function orchestrate(
      task: string,
      options: Partial<OrchestratorOptions> = {},
    ): Promise<OrchestratorResult> {
      const { maxTokens, concurrency, timeoutMs } = { ...DEFAULTS, ...options };
      const budget = new Budget(maxTokens);
      const signal = AbortSignal.timeout(timeoutMs);
      const limit = createLimiter(concurrency);
    
      // 1. Descomponer
      const plan = await planTask(task, budget, signal);
    
      // 2. Ejecutar en paralelo, con techo de concurrencia
      const settled = await Promise.allSettled(
        plan.subtasks.map((subtask) => limit(() => runWorker(subtask, budget, signal))),
      );
    
      const results: WorkerResult[] = settled.map((outcome, i) =>
        outcome.status === 'fulfilled'
          ? outcome.value
          : { status: 'failed', subtaskId: plan.subtasks[i].id, error: String(outcome.reason), attempts: 0 },
      );
    
      // 3. Decidir: abortar, sintetizar en parcial o sintetizar completo
      const brokenCritical = plan.subtasks.filter(
        (subtask, i) => subtask.critical && results[i].status === 'failed',
      );
      if (brokenCritical.length > 0) {
        return {
          status: 'aborted',
          reason: `Fallaron subtareas críticas: ${brokenCritical.map((s) => s.id).join(', ')}`,
          results,
          tokensUsed: budget.tokensUsed,
        };
      }
    
      // Si el tiempo se agotó durante los workers, no pagues una síntesis de huecos
      if (signal.aborted) {
        return { status: 'aborted', reason: 'Timeout global', results, tokensUsed: budget.tokensUsed };
      }
    
      const answer = await synthesize(task, plan, results, budget, signal);
      const complete = results.every((r) => r.status === 'ok');
      return { status: complete ? 'complete' : 'partial', answer, results, tokensUsed: budget.tokensUsed };
    }
    
    async function synthesize(
      task: string,
      plan: Plan,
      results: WorkerResult[],
      budget: Budget,
      signal: AbortSignal,
    ) {
      const report = results
        .map((result, i) => {
          const { objective } = plan.subtasks[i];
          return result.status === 'ok'
            ? `## ${result.subtaskId}: ${objective}\n${result.output}`
            : `## ${result.subtaskId}: ${objective}\nNO DISPONIBLE (${result.error})`;
        })
        .join('\n\n');
    
      const estimate = estimateTokens(task + report) + 3_000;
      budget.reserve(estimate);
    
      const { text, usage } = await generateText({
        model: anthropic('claude-opus-5-5'),
        instructions: [
          'Une los resultados de los workers en una sola respuesta a la tarea original.',
          'Si una parte figura como NO DISPONIBLE, dilo de forma explícita. No la rellenes tú.',
          'Si dos resultados se contradicen, señala la contradicción en vez de elegir uno en silencio.',
        ].join('\n'),
        prompt: `Tarea original:\n${task}\n\nResultados:\n${report}`,
        maxOutputTokens: 3_000,
        abortSignal: signal,
      }).catch((error: unknown) => {
        budget.settle(estimate, 0);
        throw error;
      });
    
      budget.settle(estimate, usage.totalTokens ?? estimate);
      return text;
    }
    

    Todo el código de este post compila (comprobado el 20 de octubre de 2026) con tsc en modo strict contra ai 7.0.146, @ai-sdk/anthropic 4.0.84 y zod 4.6.7.

    La síntesis tiene dos instrucciones que no son decoración. "NO DISPONIBLE" evita el resumen inventado de la historia del principio. Y señalar contradicciones importa porque los workers no se ven entre sí. Cognition lo resume en uno de sus principios en Don't Build Multi-Agents: "Actions carry implicit decisions, and conflicting decisions carry bad results".

    El estado partial también es un dato: devuélvelo a quien llama para que la interfaz lo enseñe. Si quieres profundizar en cómo tipar y propagar errores así, tienes manejo de errores en agentes IA con TypeScript.

    Cuánto cuesta un orquestador de agentes IA en tokens

    Mucho más que un agente. Anthropic publicó sus cifras en el post de su sistema de research: "agents typically use about 4× more tokens than chat interactions, and multi-agent systems use about 15× more tokens than chats". En su evaluación interna, Opus 4 como orquestador con workers Sonnet 4 superó al Opus 4 en solitario en un 90,2 %. Ojo: esa cifra se midió con Sonnet en los workers, no con Haiku como en este post. Y el paralelismo recortó el tiempo de investigación hasta un 90 % en las consultas complejas.

    Lee bien la cifra que viene después. Según el mismo post, el uso de tokens explica por sí solo el 80 % de la varianza del rendimiento en su evaluación con BrowseComp. Es decir: buena parte de la mejora viene de gastar más, no de una arquitectura mágica. Por eso el propio Anthropic dice que el patrón solo compensa en tareas cuyo valor paga ese coste.

    Por eso uso Opus solo para planificar y sintetizar, y Haiku en los workers. Es donde está el volumen de llamadas. Si quieres ver cuánto cambia la factura al mover el modelo de los subagentes, lo desgloso en el coste de los subagentes según el modelo.

    Cuándo NO usar un orquestador

    Un orquestador de agentes IA multiplica el coste, la latencia y los puntos de fallo. Estas son las situaciones en las que lo quito:

    Cuando las subtareas no son independientes. Si el resultado de una cambia la definición de otra, los workers en paralelo divergen. En el hilo de Hacker News sobre el post de Cognition (123 puntos, 89 comentarios, septiembre de 2025), un usuario lo explicaba así: lo difícil es tener entradas bien definidas y estables, porque al implementar descubres cosas que cambian otras tareas, y un sistema paralelo que no lo gestione acaba con resultados que divergen. En código pasa mucho: Anthropic reconoce en el mismo post que la mayoría de tareas de programación tienen menos partes paralelizables que la investigación.

    Cuando la tarea es pequeña. Planificar y sintetizar son dos llamadas al modelo grande que pagas aunque haya un solo worker. Para tareas que caben en un contexto, un agente con buenas herramientas es más barato y más rápido.

    Cuando la latencia importa más que la cobertura. La respuesta nunca llega antes que el worker más lento, más la síntesis. En un chat interactivo eso se nota.

    Cuando los errores se componen. Un plan malo contamina a todos los workers, y el sintetizador hereda todo. Más etapas son más sitios donde algo sale mal sin que lo veas, si no tienes trazas por worker.

    Cuando todos necesitan el mismo contexto. Si cada worker necesita casi todo el historial, el contexto mínimo deja de ser posible y pagas lo mismo varias veces. Ahí vale más la pena mirar multi-agente sin orquestador, o volver a un solo agente.

    Cómo empezar tu primer orquestador de agentes IA

    Coge la tarea de tu agente que más se degrada con el contexto largo. Escribe a mano el plan que haría el orquestador: tres subtareas, cada una con objetivo, contexto, formato, límites y si es crítica. Si no puedes escribirlo sin que las subtareas se pisen, no necesitas un orquestador: necesitas otra arquitectura.

    Si puedes, el código de arriba es tu punto de partida. Primero mide tokensUsed en diez tareas reales; después ajusta los límites.

    Para el resto del sistema (herramientas, memoria, RAG, MCP, evaluación) tienes el ebook gratuito El Developer Agéntico, 194 páginas que incluyen un capítulo de multiagente. Si vienes de cero, el hub para construir un agente de IA desde cero ordena todo el recorrido. Y si quieres llevarlo a un producto real con Claude Code, eso es justo lo que hacemos en Construye con IA.

    Preguntas frecuentes

    ¿Qué diferencia hay entre un orquestador y la paralelización simple?

    En la paralelización, las subtareas están definidas de antemano en el código y siempre son las mismas. En el patrón orchestrator-worker, un modelo decide las subtareas según la entrada concreta. Si tu división de la tarea no cambia nunca, no necesitas un orquestador: un Promise.allSettled sobre llamadas fijas hace el mismo trabajo con una llamada menos al modelo grande.

    ¿Qué modelo uso para el orquestador y cuál para los workers?

    Un modelo grande para planificar y sintetizar, porque ahí los errores se propagan a todo lo demás, y uno pequeño para los workers, que es donde está el volumen de llamadas. En el código de este post son claude-opus-5-5 y claude-haiku-5-5, con claude-sonnet-5-5 como fallback del worker. Anthropic usó la misma idea en su sistema de research: Opus 4 como orquestador y Sonnet 4 en los workers.

    ¿Cuánto contexto le paso a cada worker?

    El mínimo para cumplir su objetivo: los datos de su subtarea, el formato de salida y los límites. Nunca el historial del orquestador ni la tarea completa. Si un worker necesita casi todo el contexto para hacer su parte, la descomposición está mal o la tarea no se presta a orquestar.

    ¿Por qué Promise.allSettled y no Promise.all?

    Porque Promise.all rechaza en cuanto un worker falla, y pierdes los resultados que los demás ya terminaron y ya pagaste. Promise.allSettled espera a todos y te dice cuál cayó, así puedes decidir si sintetizas en parcial o abortas. Combínalo con un limitador de concurrencia para no disparar los rate limits del proveedor.

    ¿Cómo evito que el orquestador entre en un bucle o gaste sin control?

    Con límites que viven en el código y no en el prompt: presupuesto de tokens con reserva antes de cada llamada, número máximo de subtareas, profundidad uno (los workers no pueden delegar), concurrencia y timeout global con AbortSignal. El prompt puede pedir moderación, pero solo el código la garantiza.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.