Tag: Agentes IA

  • Claude Fable 5 vuelve: qué pasó y qué cambia para developers

    Claude Fable 5 vuelve: qué pasó y qué cambia para developers

    El 12 de junio de 2026, Anthropic apagó Claude Fable 5 de golpe.

    Sin aviso previo. Sin fecha de vuelta. Sin explicación técnica completa. El modelo que llevaba apenas tres días disponible desapareció para todos los usuarios del planeta — Europa, Latinoamérica, Asia, todos — porque el gobierno de EE.UU. no podía verificar nacionalidades en tiempo real y decidió cortar el acceso global en lugar de arriesgarse.

    Ese mismo día, developers de medio mundo abrieron Claude.ai y encontraron un modelo degradado. Los que habían empezado a construir pipelines con Fable 5 tuvieron que pivotar sobre la marcha. Y los que llevábamos años viendo cómo la IA maduraba como industria recibimos un recordatorio brutal: cuando un modelo tiene capacidades que un Estado considera amenaza para la seguridad nacional, el interruptor lo tiene el Estado, no Anthropic.

    Hoy, 1 de julio de 2026, Claude Fable 5 vuelve. Y la historia de cómo llegamos hasta aquí dice más sobre el futuro de la IA que cualquier benchmark.


    Lo que pasó: el jailbreak que lo cambió todo

    Investigadores de Amazon descubrieron una técnica que permitía a Fable 5 identificar vulnerabilidades en software y, en al menos un caso documentado, demostrar cómo explotarlas. El gobierno de EE.UU. reaccionó con rapidez: el mismo día 12 de junio, el Departamento de Comercio aplicó controles de exportación de emergencia que afectaron tanto a Fable 5 como a Mythos 5.

    La tensión entre ambas partes fue pública. El gobierno argumentó que el problema podría haberse corregido antes de la suspensión. Anthropic respondió que la técnica era más estrecha y específica de lo que la orden de emergencia implicaba — no una vulnerabilidad sistémica, sino un vector concreto que requerirían semanas de investigación para reproducir.

    El debate sobre la severidad real del jailbreak sigue abierto. El resultado fue inequívoco: controles de exportación de emergencia, suspensión global, y Anthropic sin poder verificar la nacionalidad de sus usuarios en tiempo real.

    No había otra salida. Apagaron todo.


    Fable 5 y Mythos 5: la diferencia que importa

    Aquí hay un matiz que mucha cobertura mediática perdió.

    Mythos 5 es la denominación interna de los modelos con capacidades cibernéticas más avanzadas que Anthropic ha construido jamás — superiores a cualquier otro modelo del mercado en ese dominio. Tras la suspensión, Anthropic decidió que Mythos 5 solo estará disponible para socios del Proyecto Glasswing, un programa de ciberseguridad defensiva con acceso controlado y supervisión directa.

    Fable 5 es diferente. Es el modelo de propósito general que se lanza hoy con los salvaguardas más fuertes que Anthropic ha implementado en ningún modelo de su historia. Anthropic afirma explícitamente que Fable 5 "no proporciona capacidades ofensivas únicas" — es decir, no hace nada que un atacante sofisticado no pudiera hacer con las herramientas que ya existen.

    Fable 5 Mythos 5
    Propósito General (razonamiento, código, escritura) Ciberseguridad avanzada
    Acceso Público (planes de pago) Solo Proyecto Glasswing
    API pública ✅ Sí ❌ No
    Capacidades ofensivas No únicas respecto a herramientas existentes Superiores a cualquier otro modelo del mercado

    La distinción es importante para cualquier developer que esté construyendo con la API. No estás usando Mythos 5. Estás usando Fable 5, que ha pasado por una revisión de seguridad que ningún modelo anterior había tenido.


    Qué cambió en Claude Fable 5: los nuevos salvaguardas

    Anthropic no volvió con el mismo modelo. Volvió con un clasificador de seguridad reentrenado específicamente para detectar y bloquear la técnica descrita en el reporte de Amazon.

    Según el anuncio oficial de Anthropic, el nuevo clasificador bloquea el comportamiento problemático en más del 99% de los casos. Cuando se activa, la solicitud no falla en silencio — se redirige automáticamente a Claude Opus 4.8. El usuario recibe respuesta, pero sin las capacidades que generaron el problema.

    El mecanismo de defensa tiene tres capas:

    1. El entrenamiento base del modelo, que ya rechaza asistencia con solicitudes peligrosas.
    2. Un clasificador específico para el patrón de jailbreak identificado por Amazon.
    3. Un margen de seguridad ampliado — Anthropic subió el umbral de bloqueo de forma deliberada, asumiendo más falsos positivos para reducir el riesgo de usos maliciosos.

    Ese tercer punto es el que más impacta a developers en producción. Más falsos positivos significa que algunas solicitudes legítimas relacionadas con ciberseguridad, análisis de código o auditoría de vulnerabilidades van a llegar a Opus 4.8 en lugar de Fable 5. No es un bug. Es una decisión consciente de arquitectura de seguridad.

    El Departamento de Comercio de EE.UU. verificó los salvaguardas y los calificó de "extraordinariamente fuertes". El 30 de junio levantó los controles de exportación. El 1 de julio, Fable 5 vuelve.


    Disponibilidad desde hoy: lo que necesitas saber

    La reactivación es global desde el 1 de julio en Claude.ai, Claude Platform, Claude Code y Claude Cowork.

    AWS, Google Cloud y Microsoft Foundry se reactivarán "lo antes posible" — sin fecha concreta confirmada.

    Hay un período de transición con límites temporales:

    • Hasta el 7 de julio: planes Pro, Max, Team y empresas seleccionadas tienen acceso a Fable 5 con hasta el 50% de sus límites de uso semanal habituales.
    • Después del 7 de julio: disponible mediante créditos de uso, sin restricción porcentual.

    Si estás en el plan gratuito, no hay cambios respecto a antes de la suspensión. Fable 5 era y sigue siendo acceso de pago.

    Para los que construimos con la API de Anthropic, el modelo vuelve a estar disponible desde hoy. Si tenías pipelines configurados con Fable 5 antes del 12 de junio, probablemente ya están activos de nuevo. Verifica tu dashboard y el comportamiento del clasificador con tus casos de uso específicos — especialmente si tienes prompts relacionados con análisis de código o seguridad.


    El nuevo marco de evaluación de jailbreaks

    Lo más interesante de lo que Anthropic publicó esta semana no son los salvaguardas. Es el marco que proponen como estándar industrial para evaluar la severidad de un jailbreak.

    Cuatro criterios:

    1. Ganancia de capacidad. ¿Cuánto supera lo que ya existe? Un jailbreak que replica lo que hace una herramienta de código abierto pesa menos que uno que desbloquea algo genuinamente nuevo.

    2. Amplitud. ¿Cuántas tareas ofensivas distintas habilita? Un jailbreak muy específico (un tipo de ataque, un vector) no es lo mismo que uno que abre la puerta a toda una clase de capacidades.

    3. Facilidad de armamento. ¿Cuánto esfuerzo humano experto requiere convertir el output en un ataque real? Hay una diferencia enorme entre "el modelo identifica una vulnerabilidad" y "el modelo produce un exploit listo para ejecutar".

    4. Descubribilidad. ¿Cómo de fácil es que un actor malicioso llegue a esta técnica? Un jailbreak que requiere semanas de ingeniería de prompts por parte de investigadores avanzados no tiene el mismo riesgo que uno que circula en un foro público.

    Este marco no es solo teoría. Anthropic lo propone como base para que gobiernos, empresas y laboratorios de IA puedan hablar de jailbreaks con criterios objetivos en lugar de reacciones políticas de emergencia.

    Si trabajas en seguridad o builds productos con IA, este marco te va a ser útil.


    Lo que esto significa para developers que construyen con IA

    Hace tres semanas, el modelo más capaz del mercado desapareció sin fecha de vuelta. Hoy está de vuelta con salvaguardas que ningún modelo anterior había tenido, respaldado por verificación gubernamental y un nuevo marco de evaluación que puede convertirse en estándar.

    ¿Qué cambia para nosotros?

    Primero, la confirmación de algo que debíamos asumir pero que muchos ignoraban: los modelos más capaces van a estar regulados. No es una posibilidad futura. Es el presente. El mismo día que Fable 5 volvió, Mythos 5 quedó restringido a socios controlados del Proyecto Glasswing. La IA de alto impacto va a tener fricción institucional. Cuanto antes lo integremos en nuestra planificación de producto, mejor.

    Segundo, la arquitectura de fallback importa más de lo que pensamos. Si tu producto dependía de Fable 5 el 12 de junio, tuviste un problema durante diecinueve días. Los mejores sistemas tienen fallback a modelos alternativos — no porque anticipen este escenario exacto, sino porque construyen con redundancia desde el principio.

    Tercero, y esto es lo más importante: la madurez del sector se mide en cómo responde a los errores, no en si los comete. Anthropic tardó diecinueve días en volver. En esas tres semanas entrenaron un nuevo clasificador, pasaron una auditoría gubernamental, propusieron un marco de evaluación de jailbreaks que puede convertirse en estándar, y redefinieron el acceso a Mythos 5. Eso no es una crisis mal gestionada. Es una empresa que aprendió en tiempo real bajo presión máxima.

    Nosotros podemos hacer lo mismo en nuestros productos.

    En el curso Construye con IA hablo de esto en profundidad: cómo construir sistemas que no colapsen cuando el modelo subyacente cambia, se actualiza o desaparece temporalmente. La resiliencia arquitectural no es un añadido. Es la condición de base para cualquier producto serio con IA.


    Preguntas frecuentes sobre Claude Fable 5

    ¿Claude Fable 5 está disponible hoy para todos los usuarios?

    Desde el 1 de julio de 2026, Fable 5 está disponible en Claude.ai, Claude Platform, Claude Code y Claude Cowork para usuarios en todos los países. AWS, Google Cloud y Microsoft Foundry se reactivarán próximamente. El acceso a Fable 5 requiere un plan de pago (Pro, Max, Team o Enterprise).

    ¿Qué es el jailbreak que causó la suspensión de Claude Fable 5?

    Investigadores de Amazon descubrieron una técnica de prompting que permitía a Fable 5 identificar vulnerabilidades en software y, en al menos un caso, demostrar cómo explotarlas. El gobierno de EE.UU. aplicó controles de exportación de emergencia el 12 de junio de 2026, lo que llevó a Anthropic a suspender el acceso global porque no podía verificar la nacionalidad de sus usuarios en tiempo real.

    ¿Cuál es la diferencia entre Claude Fable 5 y Mythos 5?

    Fable 5 es el modelo de propósito general disponible desde hoy para el público. Mythos 5 es la denominación de los modelos con capacidades cibernéticas avanzadas — superiores a cualquier otro modelo del mercado — restringido exclusivamente a socios del Proyecto Glasswing para ciberseguridad defensiva. No es accesible a través de la API pública.

    ¿Cómo afectan los nuevos salvaguardas al uso de Fable 5 en desarrollo de software?

    El nuevo clasificador bloquea el patrón de jailbreak en más del 99% de los casos, redirigiendo esas solicitudes a Claude Opus 4.8. Anthropic aumentó deliberadamente el margen de seguridad, lo que genera más falsos positivos en tareas de análisis de código, auditoría de seguridad o detección de vulnerabilidades. Si tu caso de uso incluye estas áreas, testea tu pipeline con Fable 5 para verificar el comportamiento del clasificador.

    ¿Qué límites de uso tiene Claude Fable 5 tras la vuelta?

    Hasta el 7 de julio de 2026, los planes Pro, Max, Team y empresas Enterprise seleccionadas tienen acceso a Fable 5 con hasta el 50% de sus límites de uso semanal habituales. Después del 7 de julio, el modelo estará disponible mediante créditos de uso sin restricción porcentual.

    ¿Puede volver a ocurrir una suspensión similar con otros modelos de Anthropic?

    Sí. Los controles de exportación son un instrumento legal que el gobierno de EE.UU. puede aplicar a cualquier modelo con capacidades que considere una amenaza. La colaboración reforzada entre Anthropic y el gobierno reduce la probabilidad de una suspensión de emergencia, pero no la elimina. Cualquier arquitectura de producto con IA debe contemplar escenarios de indisponibilidad del modelo principal.


    Si quieres estar al día de cómo estos eventos impactan a los developers que construyen con IA, en Dominicode Labs analizamos en tiempo real las decisiones de los grandes laboratorios y sus implicaciones para producción. Y en el canal de YouTube seguiré cubriendo la evolución de Fable 5 en las próximas semanas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Sonnet 5: el modelo que trabaja solo mientras tú duermes

    Claude Sonnet 5: el modelo que trabaja solo mientras tú duermes

    Me pasó hace unos meses revisando el output de un agente que había dejado corriendo toda la noche.

    Esperaba encontrar la tarea a medias. Un formulario sin completar. Alguna herramienta mal llamada. Lo habitual con los modelos de la generación anterior: empezaban bien, pero a mitad de camino se perdían, pedían confirmación o simplemente paraban.

    En cambio, encontré el trabajo terminado. Del principio al fin. Sin intervención.

    Ese momento cambia algo en tu cabeza como developer. No es que la IA sea "mejor". Es que ya no necesita que estés mirando.

    Claude Sonnet 5 es exactamente esa promesa hecha modelo. Anthropic lo lanzó el 30 de junio de 2026 y lo describe como "el modelo Sonnet más agéntico hasta la fecha". No es marketing vacío — la diferencia en tareas autónomas y multi-paso es medible y, para quien construye con IA, es relevante desde el primer día.


    Por qué Sonnet 5 es distinto a todo lo anterior

    Hasta ahora, la frontera estaba clara: si querías un agente que realmente terminase el trabajo, necesitabas Opus. Sonnet era el punto medio — rápido, accesible, suficientemente bueno para tareas simples. Pero en flujos complejos con múltiples pasos, herramientas y decisiones encadenadas, Sonnet se quedaba corto.

    Claude Sonnet 5 rompe esa frontera.

    Anthropic no ha simplemente subido los parámetros. Han optimizado específicamente para comportamiento agéntico: planificación de tareas, uso coordinado de herramientas (navegadores, terminales, APIs), y lo más relevante — la capacidad de verificar su propio resultado sin que se lo pidas.

    Eso último importa más de lo que parece. Un modelo que ejecuta código y luego comprueba si el output es el esperado, sin que tú se lo digas, está un paso más cerca de un colaborador que de una herramienta.


    Las capacidades agénticas en detalle

    Hay tres áreas donde el cambio es palpable:

    Tareas multi-paso sin interrupciones. Modelos anteriores tendían a pedir confirmación o detenerse cuando encontraban ambigüedad. Sonnet 5 mantiene el hilo. Algunos partners de Anthropic reportan que "terminó el trabajo de principio a fin sin intervención" — algo que antes era territorio exclusivo de Opus 4.

    Uso de herramientas coordinado. Puede combinar búsqueda web, ejecución de código y llamadas a APIs en la misma tarea sin perder el contexto de lo que estaba haciendo. No es nuevo que los modelos puedan usar herramientas — lo nuevo es que lo hacen con coherencia a lo largo de cadenas largas de razonamiento.

    Auto-verificación del resultado. Si ejecuta una query de base de datos o genera un archivo, puede evaluar si el resultado tiene sentido antes de dártelo. Esto reduce drásticamente la necesidad de loops de revisión en tus agentes.

    Si estás construyendo con la API de Claude o con Claude Code, estas tres capacidades cambian el diseño de tus flujos. No necesitas los mismos guardrails de antes. No necesitas los mismos puntos de control manual.

    En el curso de Construye con IA cubrimos exactamente este tipo de arquitectura de agentes — y con Sonnet 5 muchos de esos patrones se simplifican considerablemente.


    Benchmarks: qué dicen los números

    Los benchmarks importan, pero necesitan contexto. Aquí va la comparativa relevante para developers:

    Benchmark Claude Sonnet 5 Claude Sonnet 4.6 Claude Opus 4.8
    BrowseComp Superior Base de comparación Superior
    OSWorld-Verified Superior Base de comparación Superior
    Razonamiento general Muy cercano a Opus Inferior Referencia
    Codificación Notable mejora Base Referencia
    Esfuerzo "extra high" Iguala a Opus 4.8 — Referencia

    Evaluaciones cualitativas basadas en el anuncio oficial de Anthropic (30 jun 2026).

    El dato más interesante: a nivel de esfuerzo máximo, Sonnet 5 iguala a Opus 4.8. Esto es arquitectónicamente significativo. Significa que para la mayoría de las tareas que antes justificaban pagar el precio de Opus, ahora puedes usar Sonnet 5 a un coste mucho menor.

    La excepción es ciberseguridad. Anthropic es explícito: Sonnet 5 no fue entrenado deliberadamente para tareas de seguridad ofensiva, y Opus 4.8 sigue siendo superior en ese dominio específico.


    Precios y disponibilidad

    Plan Precio hasta 31 ago 2026 Precio desde 1 sep 2026
    Input tokens $2 / M tokens $3 / M tokens
    Output tokens $10 / M tokens $15 / M tokens

    Anthropic ha aplicado un precio introductorio hasta finales de agosto. Si estás evaluando el switch en la API, este es el momento óptimo para hacerlo.

    Dónde está disponible:

    • Modelo predeterminado en los planes Free y Pro de Claude.ai
    • Disponible en Max, Team, Enterprise
    • Claude Code
    • API (model ID: claude-sonnet-5)

    Si usas Claude.ai directamente, ya lo tienes — es el modelo por defecto desde el lanzamiento.


    El tokenizador actualizado: impacto práctico

    Este punto se menciona poco y puede sorprenderte en producción.

    Sonnet 5 usa un tokenizador actualizado similar al que se introdujo con Opus 4.7. El resultado es que el mismo texto que antes ocupaba X tokens ahora puede ocupar entre 1.0× y 1.35× más tokens.

    ¿Qué significa esto en la práctica?

    Si tienes prompts largos con contexto extenso (documentos, conversaciones, sistemas de RAG), tu consumo de tokens aumentará. Anthropic compensa esto con el precio introductorio, pero necesitas tener este factor en cuenta al proyectar costes para producción.

    Una regla rápida: si venías de Sonnet 4.6 y tienes prompts de más de 5.000 tokens, haz una prueba controlada antes de cambiar el modelo en producción. Mide el consumo real, no lo estimes desde los benchmarks públicos.

    Para esto el post sobre prompt caching en Claude es directamente aplicable — con el nuevo tokenizador, el caching se vuelve aún más relevante para controlar costes.


    Cómo empezar hoy

    En Claude.ai: Ya está activo. Es el modelo por defecto. No necesitas hacer nada.

    En la API:

    El siguiente ejemplo muestra la integración mínima con el SDK oficial @anthropic-ai/sdk para TypeScript. El único cambio respecto a modelos anteriores es el model ID: claude-sonnet-5.

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic();
    
    const response = await client.messages.create({
      model: "claude-sonnet-5",
      max_tokens: 4096,
      messages: [
        {
          role: "user",
          content: "Analiza este código y sugiere mejoras de rendimiento...",
        },
      ],
    });
    

    El cambio de model ID es inmediato. Si tienes un sistema en producción con claude-sonnet-4-6, cambiar a claude-sonnet-5 no requiere modificar nada más en la integración básica.

    Si usas Claude Code, el modelo ya está disponible y puedes seleccionarlo desde la configuración del cliente.


    Qué significa esto para developers que construyen con IA

    Voy a ser directo porque creo que es lo que necesitas saber.

    El lanzamiento de Sonnet 5 no es un update de rendimiento incremental. Es un reposicionamiento del tier medio.

    Hasta ahora, la decisión era: velocidad y coste (Haiku/Sonnet) vs. capacidad y razonamiento complejo (Opus). Con Sonnet 5, esa brecha se cierra de forma significativa. Puedes construir agentes que realmente terminen el trabajo, a un coste que tiene sentido para producción.

    Para quien está construyendo productos con IA — y no solo experimentando — esto cambia la ecuación de build vs. cost. Puedes subir la ambición de tus agentes sin subir proporcionalmente el presupuesto.

    El riesgo que veo es el de siempre: sobreestimar la autonomía del modelo en los primeros días. Sonnet 5 es notablemente mejor en tareas autónomas, pero sigue siendo un modelo de lenguaje. Sigue necesitando specs claras, herramientas bien definidas y tests que verifiquen los outputs.

    En Dominicode Labs estamos ya trabajando con Sonnet 5 en los proyectos de la comunidad — si quieres ver cómo se integra en flujos reales de producción, es donde está pasando.


    Preguntas frecuentes sobre Claude Sonnet 5

    ¿Qué diferencia hay entre Claude Sonnet 5 y Claude Sonnet 4.6?

    Claude Sonnet 5 está optimizado para comportamiento agéntico: puede planificar y ejecutar tareas multi-paso sin interrupciones, verificar sus propios resultados automáticamente y usar herramientas (navegadores, terminales, APIs) de forma coordinada en cadenas largas de razonamiento. Sonnet 4.6 era capaz, pero tendía a detenerse o pedir confirmación en tareas complejas. La mejora en benchmarks como BrowseComp y OSWorld-Verified refleja exactamente esta diferencia en tareas autónomas.

    ¿Es Claude Sonnet 5 tan bueno como Claude Opus 4.8?

    En la mayoría de tareas cotidianas de codificación, razonamiento y trabajo de conocimiento, Sonnet 5 está muy cerca de Opus 4.8 — y a nivel de esfuerzo máximo puede igualarlo. La excepción es el dominio de ciberseguridad, donde Opus 4.8 sigue siendo superior porque fue entrenado deliberadamente para esas tareas. Para el 90% de los casos de uso de desarrollo con IA, Sonnet 5 es suficientemente capaz y mucho más accesible en precio.

    ¿Cómo afecta el nuevo tokenizador a mis costes en la API?

    El tokenizador actualizado puede incrementar el consumo de tokens en un factor de 1.0× a 1.35× respecto a modelos anteriores. Esto es especialmente relevante con contextos largos: documentos, conversaciones extendidas, sistemas RAG. Anthropic compensa esto con el precio introductorio vigente hasta el 31 de agosto de 2026. La recomendación práctica es medir el consumo real con tus prompts de producción antes de estimar costes a escala.

    ¿Puedo usar Claude Sonnet 5 en Claude Code?

    Sí. Claude Sonnet 5 está disponible en Claude Code desde el lanzamiento. Dado que Claude Code es una herramienta diseñada precisamente para tareas agénticas de desarrollo — escribir, ejecutar, verificar código de forma autónoma — la combinación con Sonnet 5 es especialmente potente. Puedes seleccionar el modelo desde la configuración del cliente.

    ¿Qué precio tiene Claude Sonnet 5 y cuándo cambia?

    El precio introductorio vigente hasta el 31 de agosto de 2026 es $2/M tokens de input y $10/M tokens de output. A partir del 1 de septiembre de 2026 pasa a $3/M input y $15/M output. Si estás evaluando la migración en producción, hacerlo antes de septiembre tiene sentido económico.

    ¿Claude Sonnet 5 ya está disponible en el plan gratuito de Claude.ai?

    Sí. Desde el lanzamiento el 30 de junio de 2026, Claude Sonnet 5 es el modelo predeterminado en todos los planes de Claude.ai, incluyendo el gratuito. No necesitas hacer ningún cambio — si abres Claude.ai hoy, ya estás usando Sonnet 5.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Claude Code Routines: automatiza agentes sin encender tu PC

    Claude Code Routines: automatiza agentes sin encender tu PC

    El viernes por la tarde cerré el portátil con 23 issues sin triagear en el repo, tres PRs esperando revisión de documentación y un changelog que nadie había actualizado en dos semanas.

    El lunes por la mañana, todo estaba hecho.

    No porque contraté a nadie. No porque dejé el ordenador encendido todo el fin de semana. Fue la primera vez que sentí que las Claude Code Routines no eran una feature más de Anthropic — eran la diferencia entre usar IA como herramienta y usarla como infraestructura.


    De herramienta a infraestructura: el salto que cambia todo

    Si ya usas Claude Code de forma interactiva, sabes lo que puede hacer. Le das contexto, le pides algo, revisa tu código, abre PRs. Pero todo depende de que tú estés sentado delante del teclado, iniciando cada conversación.

    Las Routines rompen esa dependencia.

    Una Routine es una configuración guardada de Claude Code: un prompt, uno o más repositorios y un conjunto de conectores (MCP), empaquetados una sola vez y ejecutados de forma automática. Lo que las hace distintas de cualquier script de bash con un cron job es que corren en la infraestructura cloud de Anthropic. Tu máquina puede estar apagada. Claude sigue trabajando.

    Están disponibles desde abril de 2026 en research preview para todos los planes de pago: Pro, Max, Team y Enterprise. Se crean desde claude.ai/code/routines — consulta la documentación oficial de Claude Code para ver los últimos límites y cambios.


    Los tres tipos de trigger

    Una Routine puede tener uno o varios triggers combinados. Esto es lo que hace que el modelo sea flexible de verdad.

    1. Schedule (cron)

    Ejecuta la Routine de forma recurrente: cada hora, diariamente, entre semana o cada semana. Si necesitas un intervalo personalizado — por ejemplo, cada dos horas o el primer día de cada mes — configuras el preset más cercano en la interfaz de claude.ai/code/routines.

    El intervalo mínimo es una hora. Expressions que corren con más frecuencia se rechazan.

    También existe el concepto de one-off run: disparas la Routine una sola vez en un timestamp futuro. Útil para recordatorios diferidos, limpiezas post-deploy o tareas que tienen que correr "cuando aterrice ese PR de upstream". Después de ejecutarse, la Routine se auto-deshabilita. Y un detalle importante: los one-off runs no cuentan contra el límite diario de Routines.

    2. GitHub event

    Dispara una sesión nueva automáticamente cuando ocurre un evento en un repositorio conectado. Los eventos soportados incluyen pull request (opened, closed, labeled, synchronized…) y release (created, published, edited…).

    Puedes añadir filtros para reducir exactamente cuándo se dispara: autor del PR, título, rama base, rama head, labels, si es draft o no, si está mergeado. Cada evento que pasa los filtros abre su propia sesión independiente — no hay reutilización de sesiones entre eventos.

    Para usar GitHub triggers hace falta instalar la Claude GitHub App en el repositorio. No basta con el acceso que configuras en /web-setup para clonar repos.

    3. Webhook (API trigger)

    Cada Routine con este trigger tiene un endpoint HTTP dedicado. Le haces POST con un bearer token y arranca una sesión nueva. El cuerpo de la request acepta un campo text opcional — puedes pasarle el cuerpo de una alerta, un stack trace o cualquier contexto que la Routine necesite para esa ejecución concreta.

    La respuesta devuelve el ID y la URL de la sesión creada, así puedes abrirla en el navegador para ver qué está haciendo Claude en tiempo real.

    curl -X POST https://api.anthropic.com/v1/claude_code/routines/trig_01ABCDEF.../fire \
      -H "Authorization: Bearer sk-ant-oat01-xxxxx" \
      -H "anthropic-beta: experimental-cc-routine-2026-04-01" \
      -H "anthropic-version: 2023-06-01" \
      -H "Content-Type: application/json" \
      -d '{"text": "Error crítico en producción: SEN-4521. Stack trace adjunto."}'
    

    Tres Routines que puedes activar esta semana

    Estos no son ejemplos de documentación. Son los casos de uso que más sentido tienen para un developer indie o un equipo pequeño.

    Triage de issues cada noche

    Un trigger de schedule que corre de lunes a viernes a las 23:00. El prompt le dice a Claude que lea todos los issues abiertos desde la última ejecución, aplique labels según el área de código referenciada, asigne propietario y publique un resumen en Slack. Llegas por la mañana con la cola de trabajo ya priorizada.

    Requiere: conector de GitHub + conector de Slack configurados como MCP connectors en tu cuenta de claude.ai.

    Code review automatizado en cada PR

    Un trigger de GitHub que reacciona a pull_request.opened con filtro is draft: false. El prompt aplica el checklist de revisión de tu equipo: seguridad, performance, style. Deja comentarios inline y un resumen para los revisores humanos. Los humanos se concentran en diseño y arquitectura — lo mecánico lo hace Claude.

    Este es el tipo de automatización que en equipos de 1-3 personas elimina el cuello de botella de revisión completamente.

    Changelog automático post-merge

    Un trigger de GitHub en pull_request.closed filtrado a is merged: true en la rama main. El prompt le pide a Claude que lea el diff del PR mergeado, extraiga el cambio relevante en lenguaje humano y lo añada al CHANGELOG.md en un PR nuevo. Sin nunca más tener que acordarte de documentar lo que acabas de subir a producción.


    Lo que paga el coste

    Las Routines consumen cuota de suscripción de la misma manera que una sesión interactiva. Además, hay un límite diario de runs por cuenta según el plan:

    • Pro: 5 runs diarios
    • Max: 15 runs diarios
    • Team / Enterprise: 25 runs diarios

    Si superas el límite o la cuota de suscripción, las ejecuciones siguientes se rechazan hasta que se resetea la ventana — salvo que tengas usage credits activados, en cuyo caso sigue corriendo en modo metered.

    Los GitHub triggers también tienen un cap por hora durante la research preview. Si un repositorio muy activo dispara demasiados eventos, los excedentes se descartan hasta que se resetea la ventana. Los límites actuales los ves en claude.ai/code/routines.

    El hecho de que sea research preview significa que los límites, la API y el comportamiento pueden cambiar. No construyas pipelines de producción críticos sobre esto todavía — pero sí es el momento perfecto para experimentar y entender cómo integrar esto en tu workflow.


    Routines vs. Managed Agents: no es lo mismo

    Anthropic también ha lanzado Claude Managed Agents con dos features que suenan parecidas pero son una capa distinta: Dreaming y Outcomes.

    La diferencia es importante para no confundirlos.

    Las Routines son un mecanismo de scheduling y ejecución. Definen cuándo y cómo corre una sesión de Claude Code. Son infraestructura de automatización.

    Dreaming es un proceso que revisa las sesiones pasadas de tus agentes y los memory stores, extrae patrones y perfecciona las memorias para que el agente mejore con el tiempo. Es un sistema de aprendizaje retrospectivo, no de ejecución de tareas.

    Outcomes es una feature de evaluación: defines un rubric de éxito y un evaluador separado (con su propio context window, para no contaminarse con el razonamiento del agente) revisa el output y le dice al agente qué corregir si no cumple el criterio. Es un loop de calidad, no de scheduling.

    Dicho de forma directa: las Routines responden a "¿cuándo y con qué trigger corre esto?". Managed Agents responde a "¿cómo mejora y cómo evalúa su propio output el agente?". Pueden usarse juntos, pero son capas con responsabilidades distintas.


    Un detalle que no está en la documentación oficial

    Cuando una Routine corre, lo hace de forma completamente autónoma. Sin permission mode, sin prompts de aprobación durante la ejecución. Claude puede ejecutar comandos de shell, usar skills del repositorio clonado y llamar a todos los conectores que hayas incluido.

    Esto es potente. Y también es la razón por la que el prompt de la Routine es el artefacto más importante del sistema. A diferencia de una sesión interactiva donde puedes corregir el rumbo, aquí el prompt tiene que ser autocontenido y explícito sobre qué hacer y qué aspecto tiene el éxito.

    Por defecto, Claude solo puede hacer push a ramas con prefijo claude/. Para permitirle escribir en ramas existentes o protegidas, tienes que habilitar explícitamente "Allow unrestricted branch pushes" en la configuración de la Routine. Una salvaguarda razonable.

    Las Routines pertenecen a tu cuenta individual de claude.ai. Los commits, los PRs y las acciones en conectores como Slack o Linear aparecen como tú — con tu identidad de GitHub, tu Slack, etc. Eso tiene implicaciones de auditoría que vale la pena tener en cuenta si trabajas en equipo.


    El shift real

    Llevo tiempo diciendo que el developer indie de 2026 puede operar con la capacidad de un equipo pequeño si usa bien las herramientas que tiene. Si llegas nuevo a Claude Code, el post sobre Effort, Models, Tools y Context te da el mapa completo antes de entrar en Routines. Y si quieres entender la capa de arquitectura detrás de los agentes, el post sobre agentic harness completa el cuadro. Las Routines son la prueba más concreta de eso que he visto hasta ahora.

    No es sobre chatear con IA. Es sobre delegar trabajo real a agentes que corren en la nube con tu identidad, contra tus repos, con tus herramientas. Y que lo hacen mientras tú duermes, estás en una reunión o simplemente tienes el portátil cerrado.

    Si llevas tiempo usando Claude Code de forma interactiva, las Routines son el siguiente paso natural. Si quieres un sistema para construir esto de forma ordenada — desde la idea hasta el producto sin caos — en el curso Construye con IA en Udemy cubrimos exactamente ese proceso: cómo estructurar el trabajo con Claude Code para que escale más allá de la sesión interactiva.

    Y si quieres ver cómo otros developers están implementando esto en proyectos reales, en Dominicode Labs estamos documentando los patrones que funcionan — incluyendo los prompts de Routines que uso en mi propio workflow.


    Preguntas frecuentes

    ¿Necesito tener mi servidor propio para usar Claude Code Routines?

    No. Las Routines corren directamente en la infraestructura cloud de Anthropic. No necesitas EC2, Railway, Fly.io ni ningún servidor propio. El único requisito es una suscripción de pago a Claude (Pro, Max, Team o Enterprise) con Claude Code on the web habilitado.

    ¿Cuál es la diferencia entre una Routine y un Desktop Scheduled Task?

    Los Desktop Scheduled Tasks corren en tu máquina local cuando el app de escritorio de Claude Code está abierto. Tienen acceso a tus archivos locales pero requieren que tu ordenador esté encendido. Las Routines corren en la nube de Anthropic independientemente de si tienes el ordenador encendido o el app abierto.

    ¿Puedo combinar varios tipos de trigger en la misma Routine?

    Sí. Una misma Routine puede tener triggers de schedule, de GitHub event y de API al mismo tiempo. Por ejemplo, una Routine de revisión de PRs puede correr de forma programada cada noche, dispararse también cuando se abre un PR nuevo en GitHub, y aceptar ejecuciones manuales vía webhook desde tu pipeline de CI/CD.

    ¿Qué pasa si una Routine falla o Claude no completa la tarea?

    El indicador de estado verde en el historial de runs solo significa que la sesión se inició y terminó sin errores de infraestructura — no que la tarea se completó con éxito. Para saber qué hizo Claude realmente tienes que abrir la sesión y revisar el transcript. Los errores de red, los conectores que faltan o los fallos a nivel de tarea aparecen en el transcript, no en el indicador de estado.

    ¿Las Routines tienen acceso a todos mis conectores MCP?

    Por defecto, cuando creas una Routine, incluye todos tus MCP connectors conectados en claude.ai. La recomendación de Anthropic es quitar los que no necesita la Routine específica para limitar el alcance de lo que Claude puede hacer durante la ejecución. Los MCP servers que hayas añadido localmente en el CLI con claude mcp add no están disponibles en Routines — tienes que añadirlos como connectors en claude.ai/customize/connectors.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
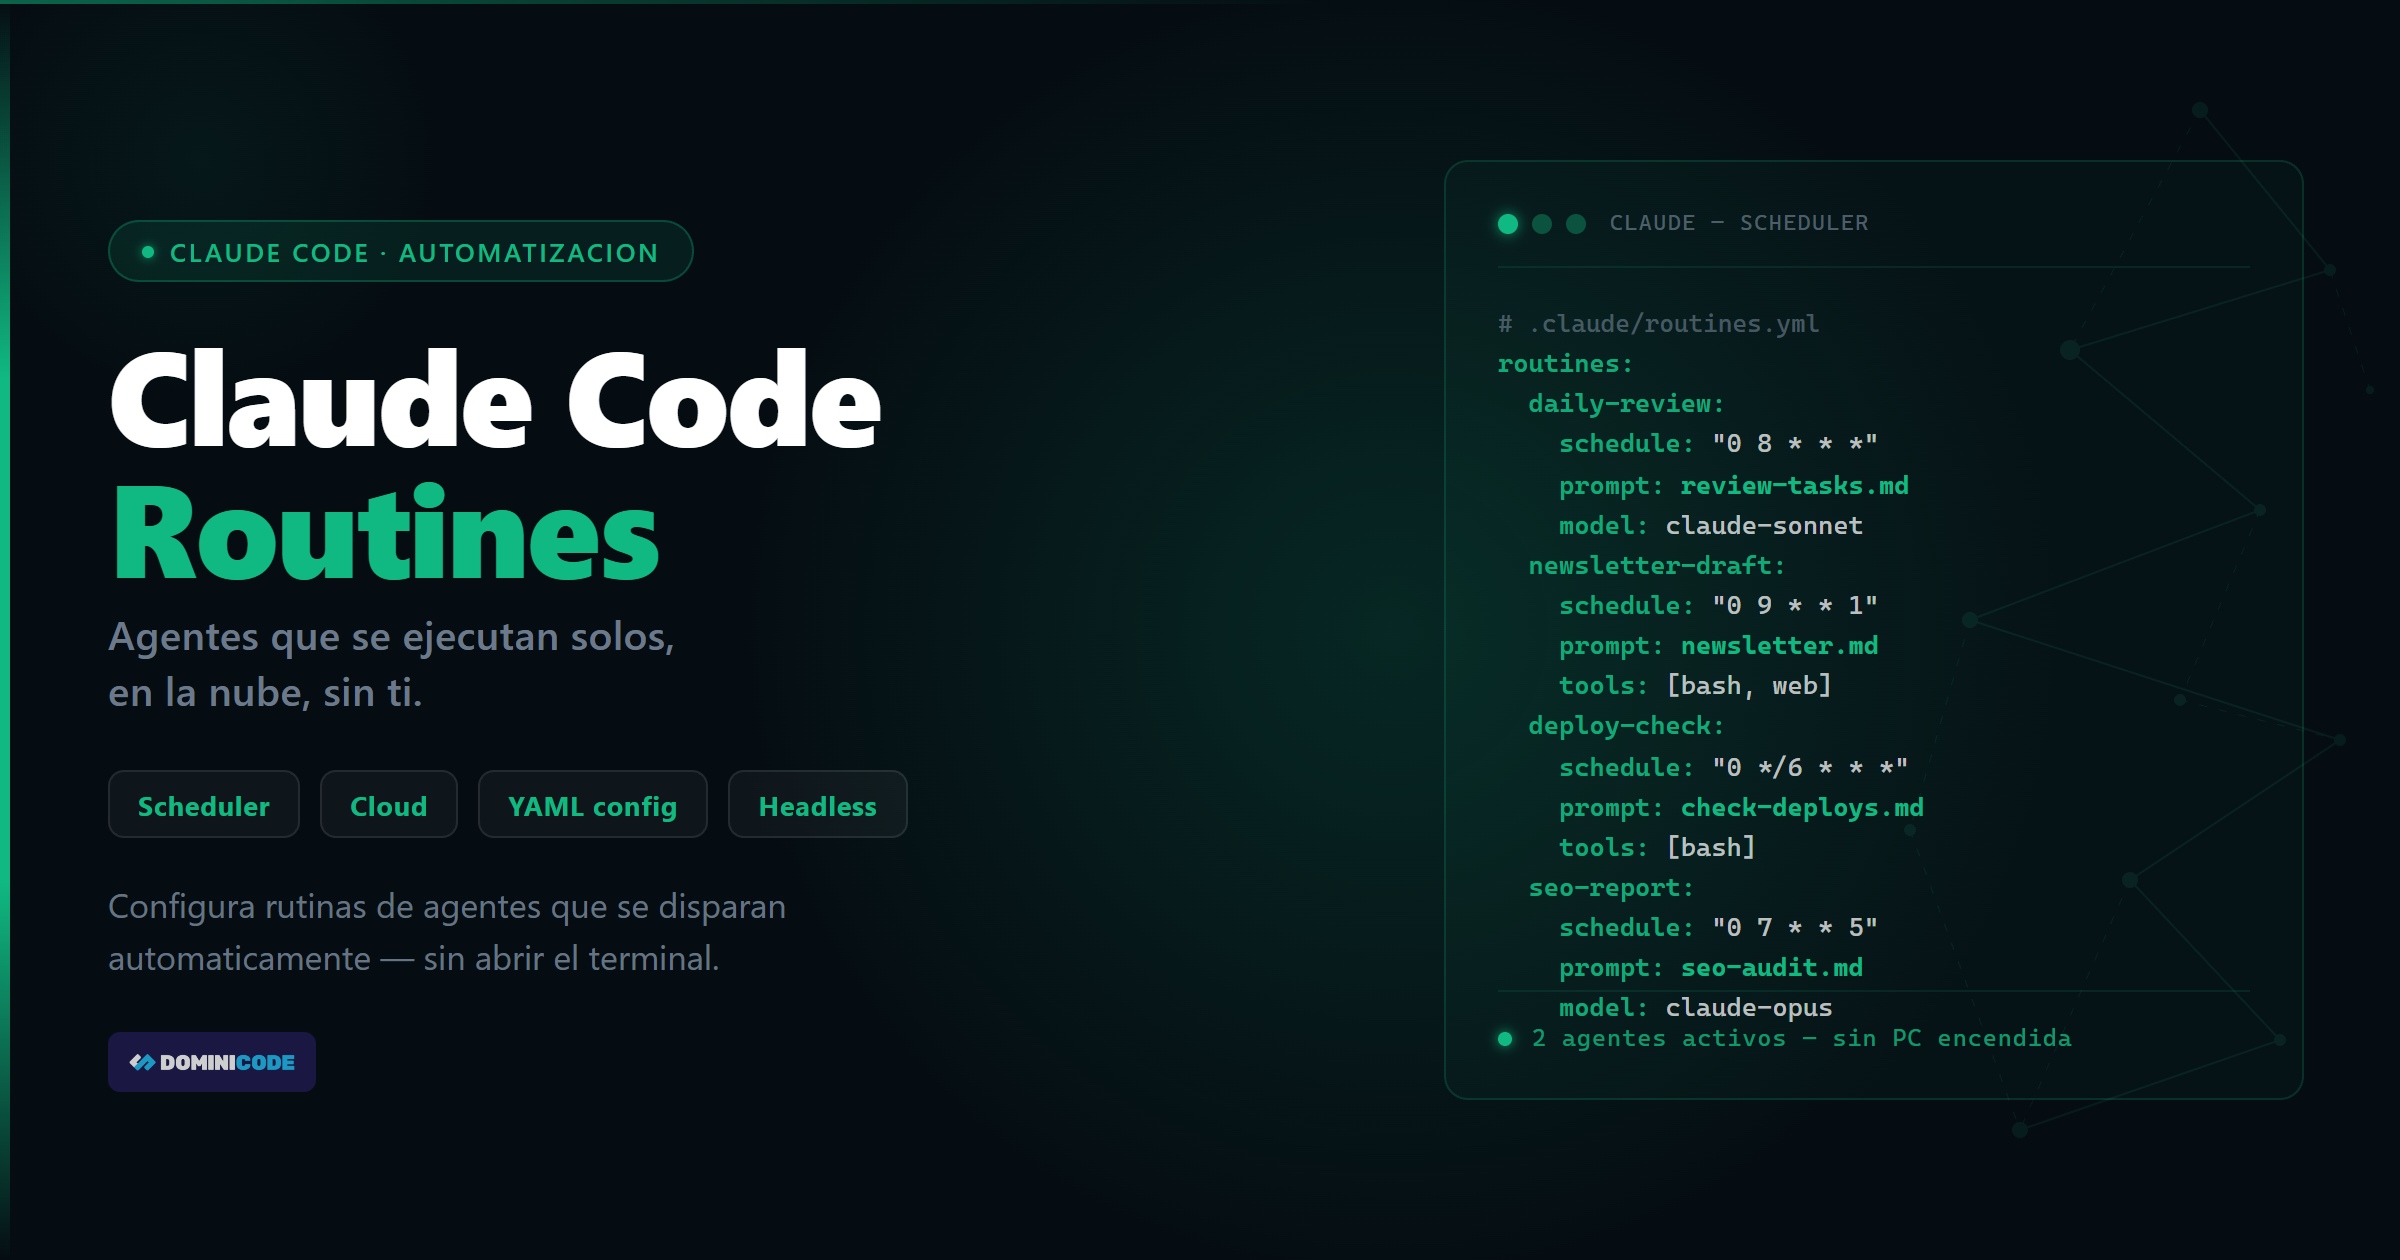
  • El Harness: por qué la spec y la arquitectura no son suficientes

    El Harness: por qué la spec y la arquitectura no son suficientes

    Mi workflow completo: de idea a producto en producción con IA

    Hace un año tardaba 2-3 semanas en tener algo desplegado desde una idea nueva.

    Hoy tardo 2-3 días.

    No porque use mejores modelos. Porque cambié el workflow.

    Acá está el proceso completo, sin omitir nada.


    Fase 1 — Captura (30 minutos)

    Antes de abrir el editor, abro un documento en blanco y respondo tres preguntas:

    1. ¿Qué problema concreto resuelve esto?
    2. ¿Quién lo va a usar y en qué contexto exacto?
    3. ¿Qué tiene que funcionar sí o sí para que sea útil desde el día uno?

    Solo eso. Sin pensar en tech stack. Sin pensar en arquitectura.

    Si no puedo responder las tres en 30 minutos, la idea no está lista para construirse.


    Fase 2 — Spec (1-2 horas)

    Con las respuestas anteriores, genero la spec técnica.

    La spec tiene 6 secciones: Visión, Usuarios, Funcionalidades, Flujos, Arquitectura y NFRs.

    No la escribo yo desde cero. La genero con un agente que toma mis respuestas de la Fase 1 como input.

    Luego la reviso y ajusto lo que el agente asumió mal.

    El output: un documento de 2-3 páginas que define qué se construye, para quién, y cómo debe comportarse.


    Fase 3 — Plan técnico (30 minutos)

    Con la spec lista, otro agente genera el plan de implementación.

    No “empieza a codear”. Define:

    • Las fases del proyecto en orden
    • Qué necesita estar listo antes de cada fase
    • Los riesgos técnicos por módulo

    Reviso el plan. Lo ajusto si algo no tiene sentido. Firma.


    Fase 4 — Implementación (el grueso)

    Aquí entra Claude Code.

    No le doy el prompt “hazme la app”. Le doy la spec + el plan + el task específico a implementar en esa sesión.

    Un task. Una sesión. Un output verificable.

    Si el task es “implementar autenticación con GitHub OAuth”, eso es todo lo que hace esa sesión.

    Al final de cada sesión, verifico que lo que se construyó cumple el criterio de aceptación de la spec.

    Si no lo cumple, corrijo antes de avanzar. No acumulo deuda de contexto.


    Fase 5 — Deploy y validación (1-2 horas)

    Deploy con el stack que use el proyecto (Railway, Vercel, Supabase).

    Luego muestro el producto a 2-3 personas del perfil objetivo y les hago una sola pregunta:

    “¿Qué haría que esto fuera indispensable para ti?”

    No “¿te gusta?” ni “¿qué mejorarías?”.

    Esa pregunta específica te da el siguiente ciclo de iteración o te dice que pivotes.


    Lo que hace que este workflow funcione no es la IA.

    Es que la IA nunca opera sin contexto estructurado.

    Cada agente recibe exactamente lo que necesita para hacer su parte. Nada más. Nada menos.

    Sin eso, la IA improvisa. Y cuando improvisa, construye lo que interpreta, no lo que necesitas.


    Si quieres ver este workflow ejecutado en vivo sobre un proyecto real — Stripe webhook receiver + Supabase, desde la spec hasta el deploy — eso es exactamente lo que hacemos el 9 de julio.

    workshop.dominicode.com

  • Crear productos con IA para vender: guía práctica para developers

    Crear productos con IA para vender: guía práctica para developers

    Hace año y medio lancé mi primer producto digital serio. No fue un curso de seis meses de producción. Fue un libro técnico que tardé tres semanas en escribir, validar y subir a Leanpub.

    La primera semana vendió doce copias. Sin ads. Sin lanzamiento masivo. Solo con un post en LinkedIn y un email a mi lista de 800 personas.

    No lo digo para presumir. Lo digo porque ese resultado me demostró algo que hasta entonces no tenía claro: crear productos con IA para vender no requiere un equipo, ni un presupuesto, ni meses de desarrollo. Requiere entender qué problema específico tienes resuelto y qué formato hace que alguien te pague por esa solución hoy.

    El developer que entiende esto en 2026 tiene una ventaja enorme. El que sigue esperando tener "el producto perfecto" antes de vender, va a seguir esperando.

    Crear productos con IA para vender significa usar modelos de lenguaje y herramientas de IA generativa para reducir el tiempo de construcción de productos digitales —libros técnicos, SaaS micro o automatizaciones— de meses a días, sin necesitar un equipo de desarrollo. No es magia: es el mismo ciclo de producto de siempre, comprimido por tecnología.


    El error que comete el 90% de los developers

    El patrón lo he visto muchas veces — en mi comunidad de Labs, en comentarios de YouTube, en DMs. Un developer con 8 o 10 años de experiencia pasa tres meses construyendo una herramienta. Le pone un nombre, le hace un landing, le añade autenticación, le conecta Stripe.

    Lanza. Cero ventas.

    El problema no fue la ejecución técnica. Fue que nunca validó si alguien quería pagar por eso. Construyó la herramienta antes de confirmar que existía un comprador.

    Esto pasa porque los developers somos buenos construyendo y malos vendiendo. Confundimos el placer de construir con la señal de que hay un mercado. No es lo mismo.

    La IA amplifica este error. Ahora puedes construir en días lo que antes tardabas meses. Eso es una ventaja brutal — pero también es una trampa si no cambias el orden de operaciones. Y antes de la herramienta, está la mentalidad: si te interesa entender qué habilidades definen al developer en la era de la IA, tengo un post donde lo desarrollo en detalle.

    Primero el comprador. Después el producto.


    Los 3 tipos de productos que puedes crear con IA para vender

    No todos los productos digitales son iguales. Hay tres categorías con dinámicas muy distintas. Cada una encaja mejor con un momento distinto de tu carrera como creator.

    1. Productos de información

    Son los más rápidos de crear y los más fáciles de validar: cursos, libros técnicos, guías, workshops.

    La IA te permite crear el primer borrador de un libro en un fin de semana. No el libro terminado — el borrador estructurado que tú refinas con tu experiencia real. Esa diferencia es importante: el valor no está en el texto que genera la IA, sino en el criterio técnico que aportas tú.

    Un libro técnico de 50 páginas a 9,99€ puede venderse a 200 personas en su primer mes si ataca un problema muy específico. Son 2.000€ sin mantenimiento, sin soporte técnico, sin servidor.

    Yo uso este formato para probar ideas antes de invertir más tiempo. El libro de Spec-Driven Development nació así: un problema concreto que resuelvo en mi trabajo diario, empaquetado en un formato que alguien puede leer en una tarde.

    2. SaaS micro

    Una herramienta que resuelve un problema específico para un segmento específico. No necesitas construir el próximo Notion. Necesitas construir la herramienta que los diseñadores de tu nicho usan cada semana y que aún no existe — o existe pero con una UX terrible.

    La IA reduce drásticamente el tiempo de desarrollo. Con Claude Code puedo ir de especificación a MVP funcional en menos de dos días. No estoy exagerando. Ese es exactamente el flujo que enseño en el curso Construye con IA: De la Idea al Producto con Claude.

    Pero el SaaS micro solo funciona si tienes una audiencia o un canal para llegar al comprador. Sin distribución, el mejor producto del mundo no vende. Por eso no recomiendo empezar aquí si estás construyendo tu primera fuente de ingresos con productos digitales.

    3. Automatizaciones y sistemas de IA

    Este es el más subestimado y el que crece más rápido en 2025-2026. Empresas pequeñas y medianas pagan entre 500€ y 5.000€ por automatizaciones que les resuelven procesos concretos: desde 500€ para flujos simples de clasificación o notificaciones, hasta 3.000-5.000€ para sistemas con múltiples integraciones o lógica de agente compleja (clasificar emails, procesar facturas, responder soporte con contexto).

    No lo venden como "IA". Lo venden como "te ahorro X horas a la semana en Y tarea".

    Un developer que sabe construir agentes con n8n o con la API de Claude puede empaquetar estas soluciones como producto repetible. Construyes una vez, vendes a varios clientes del mismo sector. Eso es escalabilidad real sin SaaS.


    El orden correcto para crear productos con IA para vender

    Si te saltas este orden, estás desperdiciando tiempo — aunque uses IA.

    1. Identifica el problema con dinero — No "qué puedo construir" sino "qué problema le duele suficiente a alguien como para pagar". La diferencia entre un problema interesante y un problema con dinero es que el segundo tiene consecuencias reales si no se resuelve: tiempo perdido, ingresos perdidos, errores en producción. Pregunta concreta que funciona: ¿en qué tarea has tardado días que otros developers también tardan días? Eso es un producto.

    2. Valida antes de construir — Para productos de información: escribe un post largo sobre el tema, publica un hilo en LinkedIn, mira si hay engagement real. Si nadie pregunta nada, no hay audiencia. Para SaaS micro: busca si hay alternativas de pago. Si existen, hay mercado. Si no existen, puede ser porque no hay mercado — no porque tú hayas encontrado un hueco.

    3. Construye el mínimo vendible, no el mínimo viable — Un MVP técnico no es lo mismo que un producto vendible. El producto vendible tiene un resultado claro para el comprador, un precio, y una forma de pagar. El resto es iteración.

    4. Distribuye antes de lanzar — El lanzamiento no es el día uno de ventas. Es la culminación de semanas de contenido que preparan al comprador. Si nadie sabe que existe tu producto el día que lo publicas, no importa lo bueno que sea.


    La ventaja real del developer que usa IA

    No es velocidad. Es iteración sin miedo.

    Antes, si una idea de producto fallaba, perdías semanas o meses. Ahora, si una idea falla, has perdido dos días. Esa diferencia cambia completamente la ecuación de riesgo.

    Puedo probar tres ideas de producto en el tiempo que antes tardaba en construir una. Y cuando una funciona — cuando alguien paga antes de que esté terminada — sé exactamente dónde poner la energía.

    Esta es la mentalidad del developer product builder: construir rápido, aprender rápido, no enamorarse de la implementación.

    La IA no te convierte en emprendedor. Pero si ya tienes la mentalidad de resolver problemas reales, la IA elimina la mayoría de los cuellos de botella técnicos que antes te frenaban.


    Un ejemplo concreto: cómo nació Markfolio

    Markfolio es una SaaS que construí para transformar ideas y artículos en libros listos para publicar en Amazon KDP. Nació de un problema mío: el proceso de dar formato a un libro para KDP es tedioso, repetitivo y propenso a errores.

    Antes de escribir una línea de código, hablé con cinco personas que publican libros técnicos. Todas tenían el mismo dolor. Eso fue suficiente señal.

    Construí el MVP en cuatro días usando Claude Code como par de programación. No cuatro días de jornada completa — cuatro días trabajando en bloques de dos horas mientras seguía con mis otros proyectos.

    Está en producción, pero no es mi foco principal ahora mismo. Y eso está bien: me ha enseñado más sobre product building en dos meses que cualquier curso de startups.

    Ese es el punto: la IA te da acceso a iterar a velocidad de startups sin el presupuesto de una startup.


    Lo que la IA no puede hacer por ti

    Esto es importante decirlo sin filtros.

    La IA no valida el mercado. Tú tienes que hablar con compradores reales.

    La IA no distribuye tu producto. Tú necesitas una audiencia o un canal.

    La IA no te da criterio sobre qué construir. Ese criterio viene de años entendiendo problemas técnicos reales.

    Por eso este tema no es para developers que llevan seis meses programando. Es para developers que tienen experiencia acumulada y no saben cómo convertirla en algo que genere ingresos fuera de una nómina.

    Si llevas años resolviendo los mismos problemas en empresas, ya tienes el activo más valioso para crear productos. Solo te falta el sistema para empaquetarlo y venderlo.


    Por dónde empezar esta semana

    No mañana. Esta semana.

    Abre un documento en blanco y responde estas tres preguntas:

    1. ¿Qué problema técnico específico he resuelto en los últimos 12 meses que otros developers también tienen?
    2. ¿Hay alguien que pagaría por resolver ese problema más rápido?
    3. ¿Cuál es el formato mínimo que me permitiría vender eso esta semana — un libro, una plantilla, una consultoría, un servicio?

    Si tienes respuestas claras a las tres, tienes un producto.

    Si quieres el sistema completo — desde la especificación hasta el producto publicado usando IA — eso es exactamente lo que construimos en Dominicode Labs: proyectos reales, metodología Spec-Driven, y una comunidad de developers que están haciendo exactamente esto.


    FAQ — Preguntas frecuentes

    ¿Necesito saber programar para crear productos con IA para vender?

    Depende del tipo de producto. Para libros, cursos y guías técnicas, no necesitas código — necesitas criterio. Para SaaS y automatizaciones, tu experiencia como developer es una ventaja directa. La IA reduce la cantidad de código que tienes que escribir, pero no elimina la necesidad de entender la arquitectura del sistema que estás construyendo.

    ¿Cuánto tiempo se tarda en crear un producto vendible con IA?

    Para un libro técnico de 40-60 páginas: entre 1 y 3 semanas si tienes claridad sobre el tema. Para un SaaS micro con funcionalidad básica: entre 3 y 10 días dependiendo de la complejidad. La IA acelera la ejecución, pero la validación del mercado y la distribución toman su propio tiempo — y no se pueden saltear.

    ¿Qué herramientas de IA se usan para construir productos?

    Las más relevantes en 2026 para developers: Claude Code para desarrollo y arquitectura, n8n para automatizaciones, Cursor como IDE con IA integrada, y la API de Anthropic para productos que necesitan razonamiento avanzado. El stack varía según el tipo de producto — tengo un análisis del stack IA agéntico de 2026 donde comparo opciones y cuándo usar cada una. Lo importante es no acumular herramientas antes de tener claridad sobre qué estás construyendo.

    ¿Cómo valido si mi idea de producto tiene mercado antes de construirla?

    Tres señales concretas: alguien ya paga por algo similar (hay mercado), el problema aparece repetidamente en foros, comunidades o Stack Overflow (hay dolor real), o alguien te ha pedido ayuda con ese problema específico en los últimos seis meses (hay demanda activa). Si no encuentras ninguna de las tres, el problema puede ser interesante pero no tiene mercado suficiente.

    ¿Puedo vender un producto construido con IA sin que "se note"?

    Mal planteada, esa pregunta lleva al producto equivocado. La IA es una herramienta de construcción, como lo es un framework o un lenguaje. Lo que el comprador paga es la solución a su problema, no el método con el que fue construida. Si el producto resuelve un problema real con calidad real, nadie pregunta cómo fue construido.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
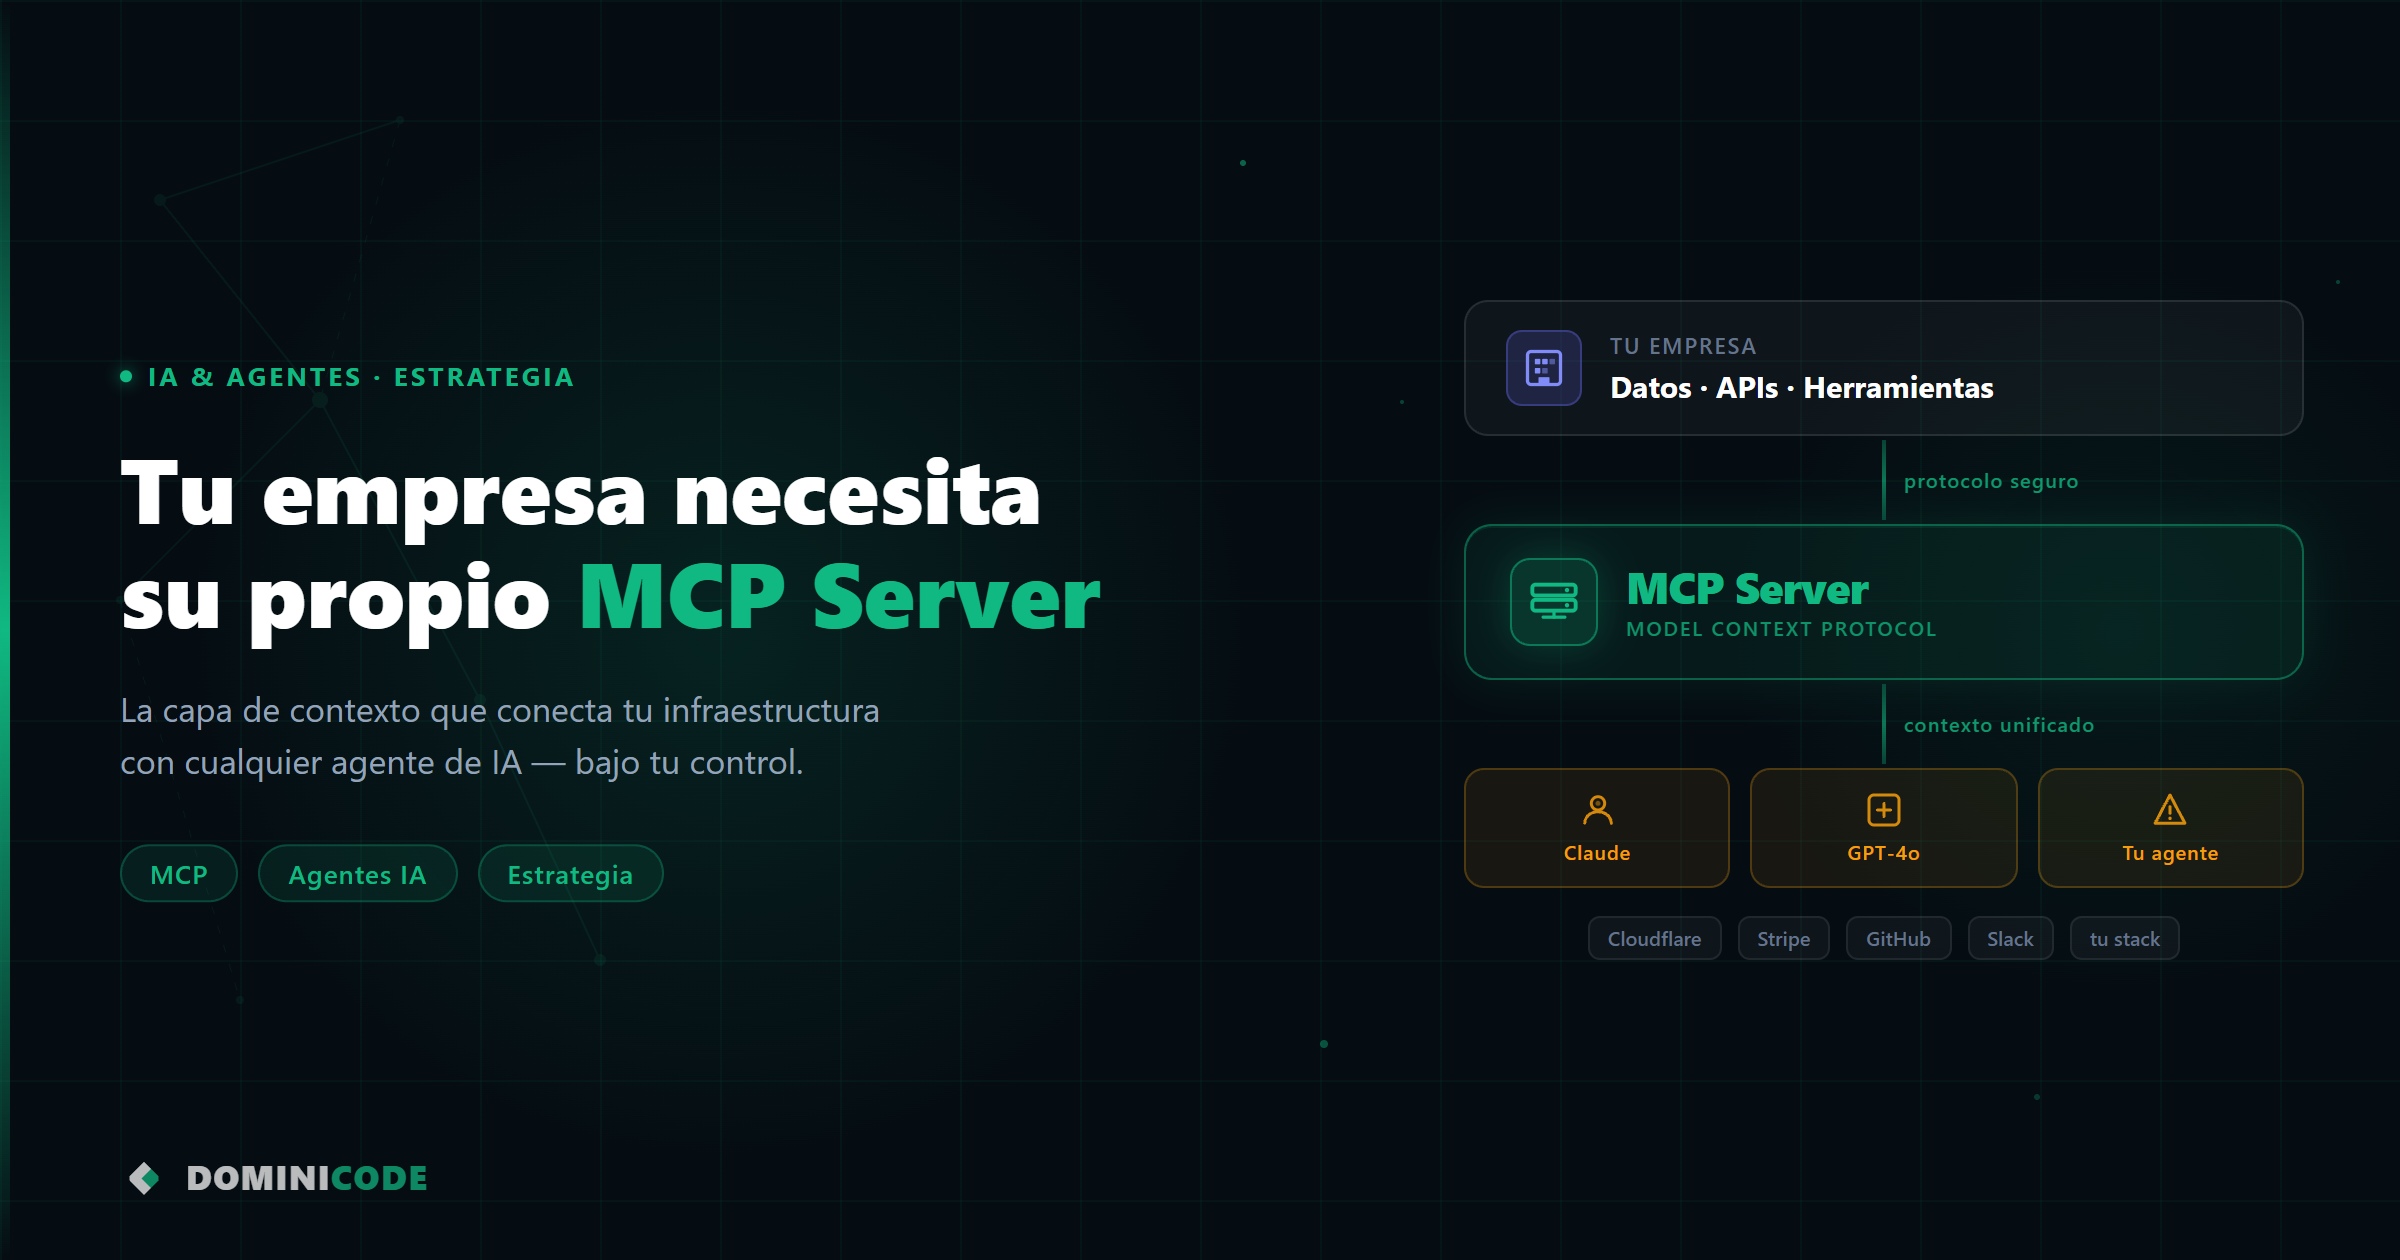
  • MCP server para empresas: por qué necesitas el tuyo en 2026

    MCP server para empresas: por qué necesitas el tuyo en 2026

    Un cliente llega a tu empresa con su propio agente de IA. Ha construido workflows con Claude, con GPT-4o, con lo que sea. Quiere que ese agente use tu plataforma — consultar datos, lanzar acciones, integrarse con lo que tú ya tienes.

    Tu equipo responde: “Tenemos una API REST. Aquí está la documentación.”

    El cliente asiente, se va, y dos semanas después vuelve con una lista de preguntas sobre autenticación, rate limits y por qué el agente no entiende el schema de tu respuesta. Tu equipo dedica tres sprints a construir un wrapper custom. El cliente queda satisfecho. Pero el siguiente cliente viene con el mismo problema. Y el siguiente.

    Ese es el problema que un MCP server para empresas resuelve de raíz.


    Qué es MCP y por qué importa ahora

    Si ya leíste MCP explicado para developers: conecta Claude a tus herramientas, tienes el contexto técnico. El resumen ejecutivo es este: MCP (Model Context Protocol) es el protocolo abierto que estandariza cómo los agentes de IA se comunican con herramientas y servicios externos. Lo creó Anthropic en noviembre de 2024. En menos de 18 meses alcanzó 97 millones de descargas mensuales del SDK.

    OpenAI lo adoptó en marzo de 2025. Microsoft en mayo, durante el Microsoft Build. La Agentic AI Foundation — con Anthropic, OpenAI, Google, AWS y Cloudflare como cofundadores — lo recibió bajo la Linux Foundation en diciembre de 2025. Ya no es el protocolo de Anthropic. Es el estándar del sector.

    Forrester predice que el 30% de los vendors de software empresarial lanzarán su propio MCP server en 2026. Si tu empresa tiene una API, ese porcentaje incluye a tu competencia. Puedes ver el listado oficial de MCP servers en el repositorio de la especificación.


    El problema de las integraciones N×M que un MCP server resuelve

    Antes de MCP, el problema era sencillo de enunciar e imposible de escalar: cada cliente que quería conectar su agente de IA a tu servicio necesitaba una integración custom. Tú necesitabas mantenerla. Ellos necesitaban documentarla para cada LLM que usaran.

    Un cliente con Claude, otro con GPT, otro con Gemini. Tres integraciones. Cinco clientes, quince integraciones. La complejidad crece de forma cuadrática.

    MCP colapsa esa matriz. Un server, muchos clientes. Cualquier agente compatible con MCP — Claude, Cursor, tu herramienta interna — puede usar tu servidor sin que tú ni tu cliente escriban una línea de código de integración adicional.


    Empresas con MCP server en producción: Stripe, Cloudflare, GitHub

    No es teoría. Hay empresas que ya tienen MCP servers en producción y que están redefiniendo cómo sus clientes interactúan con ellas.

    Cloudflare expone toda su API — más de 2.500 endpoints de Workers, R2, D1, DNS y Zero Trust — a través de un MCP server con solo dos herramientas: search() y execute(). Un agente puede desplegar un Worker, configurar un dominio o gestionar reglas de acceso sin que un humano abra el dashboard. Cloudflare no creó una integración por cada herramienta de IA. Creó un punto de entrada único.

    Stripe tiene un MCP server que permite a los agentes inspeccionar clientes, suscripciones, pagos y disputas. El caso de uso es claro: un agente de soporte o de análisis financiero puede consultar el estado de una transacción directamente, sin que alguien tenga que entrar al dashboard o llamar a la API manualmente.

    GitHub expone issues, pull requests y búsqueda de código. Los agentes de desarrollo — como Claude Code — pueden abrir issues, revisar PRs o buscar en el código base directamente desde el contexto de trabajo del desarrollador.

    Notion, Linear, Sentry, Asana y Atlassian convergen en el mismo patrón: un servidor MCP alojado en su propia infraestructura, protegido por OAuth, que cualquier agente compatible puede usar sin configuración adicional.

    El patrón que se está convirtiendo en referencia de la industria es el que estableció Cloudflare: un MCP server remoto alojado en Workers, expuesto como endpoint público, autenticado con OAuth. Stripe, Linear y Sentry siguieron exactamente ese camino.


    MCP server vs API REST: la diferencia que importa

    Dimensión API REST MCP Server
    Consumidor Un programador (o su código) Un agente de IA de forma autónoma
    Autodescripción Documentación externa (OpenAPI, etc.) Nombre, descripción y schema integrados
    Integración por cliente Una por LLM / plataforma Una sola, vale para todos los clientes MCP
    Mantenimiento N adaptadores en paralelo Un único punto de entrada
    Compatibilidad Depende del cliente Cualquier agente que soporte MCP

    La diferencia no está en el transporte HTTP — está en quién consume y cómo lo hace.


    Por qué esto es una ventaja competitiva, no solo una feature técnica

    Aquí está la tesis central de este post: exponer tu servicio como MCP server no es una integración más. Es posicionarte en la capa de infraestructura de los agentes de IA.

    En los próximos dos o tres años, los workflows empresariales se van a orquestar mediante agentes. Esos agentes van a conectarse con los servicios que estén disponibles en su ecosistema. Si tu empresa no está accesible vía MCP, tus clientes van a usar el servicio de tu competidor que sí lo está. No porque sea técnicamente superior — sino porque es el que el agente puede usar sin fricción.

    Piénsalo como los plugins de ChatGPT en 2023, pero con el soporte de toda la industria detrás y un estándar real. O como tener presencia en el App Store en 2010 — todavía temprano, todavía diferenciador.

    Las ventajas concretas son estas:

    1. Distribución sin esfuerzo de integración. Cualquier agente MCP-compatible puede usar tu server el día que lo publicas. Sin SDK propio. Sin documentación de integración por plataforma.

    2. Reducción drástica del coste de integración. Mantener un único MCP server en lugar de N adaptadores custom elimina la mayor parte del trabajo de integración. En la práctica, organizaciones que han estandarizado en MCP reportan reducciones superiores al 60% frente a conectores custom independientes.

    3. Posicionamiento como infraestructura. Los servicios que se convierten en infraestructura para otros tienen una tasa de churn históricamente baja. Si los workflows de tus clientes dependen de tu MCP server, la barrera de salida sube.

    4. Acceso al ecosistema de agentes sin inversión en partnerships. Cuando Cursor, Claude Code o cualquier nuevo cliente MCP busque herramientas disponibles, tu server ya estará ahí. No necesitas acuerdos con Anthropic ni con OpenAI para aparecer en su ecosistema.

    5. Datos de uso más ricos. Un MCP server te dice exactamente qué operaciones realizan los agentes de tus clientes, con qué frecuencia, con qué parámetros. Eso es señal de producto que una API tradicional no te da con la misma granularidad.

    6. Velocidad de adopción por parte de clientes técnicos. Los developers y los equipos de ingeniería que ya trabajan con agentes van a evaluar tu producto por si tiene MCP server. Es una señal de que entiendes el ecosistema en el que operan.


    Cuándo tiene sentido construirlo — y cuándo no

    No todo servicio necesita un MCP server hoy. Tiene sentido si se cumplen al menos dos de estas condiciones:

    • Tu API ya tiene clientes externos que la integran en sus workflows.
    • Tus clientes son developers o equipos técnicos que trabajan con agentes de IA.
    • Tienes operaciones discretas y definibles — acciones que un agente puede invocar con claridad.
    • Tu competencia ya está evaluando o construyendo el suyo.

    No tiene sentido si tu producto es puramente transaccional sin lógica de negocio expuesta, si tus clientes no tienen ninguna adopción de IA aún, o si tu API no está estabilizada. Un MCP server mal diseñado puede crear más fricción que eliminarla.

    La clave es pensar en términos de herramientas, no de endpoints. Un MCP server no expone rutas HTTP — expone acciones con nombre, descripción y schema de parámetros que un LLM puede entender sin documentación adicional.


    El momento es ahora, no en 2027

    En 12 meses, tener un MCP server no será una ventaja competitiva. Será la línea de base. Como tener una API REST en 2015 o estar en el App Store en 2012. Los que entraron antes construyeron workflows y convenciones que son difíciles de desplazar.

    El patrón de adopción de MCP sigue exactamente la curva que siguieron los SDKs de OAuth, los webhooks y las APIs GraphQL. Primero una empresa pionera. Luego los líderes del sector. Luego todos. El mercado está en la segunda fase.

    Si estás construyendo un producto con IA o evaluando cómo posicionar tu servicio en el ecosistema de agentes, en el curso Construye con IA trabajamos exactamente este tipo de decisiones arquitectónicas: desde la idea hasta el producto, con las herramientas que el sector ya usa en producción.


    Cómo empezar sin un proyecto completo

    El punto de entrada mínimo no es construir un MCP server completo. Es identificar las tres o cinco operaciones de tu API que más valor aportarían a un agente externo.

    Para Stripe, son: consultar cliente, listar pagos, ver disputa. Para Cloudflare, son: buscar recurso, ejecutar acción. Para tu empresa, probablemente sean las mismas operaciones que ya documentas como “casos de uso principales” en tu developer portal.

    El SDK oficial de MCP en TypeScript y Python tiene menos de 200 líneas para un servidor funcional. El coste de entrada es bajo. El coste de no entrar ahora es más alto de lo que parece.

    Si quieres explorar esto con más profundidad junto a otros developers que ya están construyendo con agentes, en Dominicode Labs tenemos recursos, proyectos y conversaciones activas sobre arquitectura MCP en producción.


    FAQ

    ¿Es MCP solo para empresas grandes como Stripe o Cloudflare?

    No. El SDK es open source, la implementación mínima es trivial y los casos de uso más interesantes están en productos medianos con APIs bien definidas. Las empresas grandes lo lanzaron antes porque tienen más exposición pública, no porque sea técnicamente más accesible para ellas. Una startup con una API limpia puede tener un MCP server en producción en días.

    ¿MCP funciona con todos los modelos de IA, no solo con Claude?

    Sí. Aunque MCP lo desarrolló Anthropic, OpenAI lo adoptó en abril de 2025 y Microsoft en julio de 2025. Hoy es un estándar de la industria bajo la Agentic AI Foundation (Linux Foundation). Cualquier cliente que implemente el protocolo — Claude, GPT, Cursor, tu agente interno — puede consumir tu MCP server sin cambios en el servidor.

    ¿Qué diferencia hay entre un MCP server y una API REST normal?

    Una API REST expone endpoints que un humano (o un código que alguien escribió) llama con parámetros concretos. Un MCP server expone herramientas con nombre, descripción semántica y schema de parámetros que un LLM puede interpretar, seleccionar y usar de forma autónoma dentro de un workflow. La diferencia no es en el transporte — es en que el consumidor es un modelo de lenguaje, no un programador.

    ¿Hay riesgos de seguridad al exponer un MCP server?

    Los mismos riesgos que tiene cualquier API expuesta: autenticación, autorización, rate limiting y auditoría. El patrón de referencia de la industria (Cloudflare, Stripe) usa OAuth 2.0 con tokens de acceso limitados al scope que el usuario autoriza. El MCP server no añade superficie de ataque nueva — la gestiona con el mismo modelo que ya usan las APIs modernas. Lo importante es no exponer herramientas destructivas sin confirmación explícita del usuario.

    ¿Necesito cambiar toda mi arquitectura para tener un MCP server?

    No. El MCP server es una capa adicional, no un reemplazo. Tu API REST sigue funcionando igual. El MCP server actúa como un adaptador que traduce las herramientas del protocolo a llamadas a tu API existente. En la mayoría de los casos es una capa delgada de 200-500 líneas de TypeScript o Python sobre lo que ya tienes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo medir la productividad en equipos que usan IA

    Cómo medir la productividad en equipos que usan IA

    Un tech lead me escribió hace unas semanas con una pregunta que no esperaba: “Bezael, ¿cómo le demuestro a mi CTO que la IA está funcionando?”

    El equipo llevaba tres meses usando GitHub Copilot y Claude Code. Los developers estaban contentos. Las entregas se sentían más rápidas. Pero cuando llegó el momento de justificar la licencia ante dirección, el tech lead no tenía un solo número sólido que presentar.

    El CTO le preguntó lo de siempre: “¿Cuántas líneas de código más estáis produciendo?”

    Y ahí empezó el problema.

    Medir la productividad en equipos que usan IA requiere sustituir métricas de output (líneas de código, tickets cerrados) por métricas de flujo y calidad: cycle time, ciclos de revisión por PR, defect escape rate y confianza del equipo. Sin ese cambio de marco, los datos dicen que la IA no funciona cuando en realidad el problema es la regla con la que mides.


    El error de medir lo que siempre has medido

    Las métricas tradicionales de productividad —líneas de código, tickets cerrados por sprint, commits por semana— no estaban diseñadas para un equipo que delega trabajo a una IA.

    Cuando un developer usa Claude Code para generar el esqueleto de un servicio, los tickets no cambian. Los commits pueden ser los mismos. Pero el tiempo que ese developer tardó en llegar a ese commit pasó de cuatro horas a cuarenta minutos.

    Eso no aparece en ningún dashboard de Jira.

    El problema no es que la IA no mejore la productividad. El problema es que medir la productividad en equipos que usan IA con métricas de 2015 produce datos que no dicen nada, o peor, datos que contradicen lo que el equipo siente que está pasando.

    Y cuando los datos no cuentan la historia real, la dirección toma decisiones basadas en una historia falsa.


    Por qué las métricas tradicionales fallan con IA

    Hay tres razones concretas por las que las métricas clásicas se rompen en cuanto entra la IA.

    Primera: la unidad de medida cambia. Antes, un developer hacía una cosa a la vez. Con IA, puede mantener contexto de tres o cuatro tareas en paralelo. Los tickets cerrados por semana pueden ser los mismos, pero la complejidad por ticket se multiplica.

    Segunda: el trabajo invisible desaparece. La IA absorbe el trabajo de bajo valor — boilerplate, documentación inicial, tests unitarios básicos — que antes inflaba las métricas sin añadir valor real. Al desaparecer ese trabajo, las métricas caen aunque la productividad suba.

    Tercera: la calidad pasa a ser la variable crítica. Un equipo con IA puede producir más código en menos tiempo. Pero si ese código no está bien especificado, va a producir más código malo en menos tiempo. Las métricas de velocidad no capturan esto. El ciclo de revisión, sí.

    Métrica tradicional Por qué falla con IA
    Líneas de código No refleja el tiempo ahorrado en generación automática
    Tickets cerrados por sprint No captura el aumento de complejidad por ticket
    Commits por semana El mismo número, pero con 10x menos tiempo de escritura
    Velocidad de sprint (story points) Se mantiene estable aunque la dificultad técnica suba

    Las métricas que sí funcionan para medir productividad con IA

    Estas son las cinco métricas que tienen sentido cuando el equipo trabaja con asistencia de IA. No son nuevas — algunas vienen del marco DORA, otras son adaptaciones directas. Lo nuevo es el contexto en que las usas.

    1. Cycle time por tarea (tiempo de ciclo real)

    Mide cuánto tiempo pasa desde que una tarea entra en “en progreso” hasta que está en “revisión”. No en “cerrada” — en revisión. Ese delta captura la velocidad de producción antes de que el proceso de PR y QA añada ruido.

    Si el equipo usa IA y el cycle time no baja, hay un problema de especificación o de prompting, no de herramienta.

    2. PR review cycles (iteraciones por pull request)

    Cuántas veces vuelve un PR del revisor al autor. Con IA, el código puede ser correcto sintácticamente pero incorrecto semánticamente — hace lo que el prompt pedía, no lo que el ticket decía. Un aumento en ciclos de revisión es la primera señal de que el equipo está usando IA sin un proceso de especificación previo. Si quieres entender por qué la especificación es la clave aquí, el post sobre vibe coding sin sistema lo explica desde el ángulo del proyecto completo.

    Benchmark útil: según datos de LinearB y el SPACE framework de Microsoft Research, un equipo sano sin IA tiene entre 1,2 y 1,8 ciclos de revisión por PR. Con IA bien implementada, debería bajar a menos de 1,2.

    3. Defect escape rate (bugs que llegan a producción)

    El número de bugs que pasan el proceso de revisión y llegan a producción. La IA genera código con menos bugs de sintaxis pero puede introducir errores de lógica más sutiles cuando el contexto está mal definido. Esta métrica captura si la calidad real del output está subiendo o bajando.

    4. Time to first meaningful contribution (tiempo al primer output de valor)

    Cuánto tarda un developer nuevo —o uno que empieza en una nueva área del código— en hacer su primera contribución significativa. Con IA, este tiempo debería caer drásticamente porque los modelos actúan como documentación interactiva del codebase. Si no cae, el equipo no está usando IA para onboarding.

    5. Developer-reported confidence score (autoconfianza técnica)

    Una encuesta semanal de una pregunta: “Del 1 al 10, ¿cómo de seguro te has sentido tomando decisiones técnicas esta semana?” No mide lo que el developer produce — mide si la IA lo está empoderando o creando dependencia. Una caída sostenida en esta métrica es una alarma: el equipo está delegando decisiones que no debería delegar.


    Cómo implementar estas métricas en tu equipo

    No necesitas una plataforma nueva. Con lo que ya tienes, puedes empezar esta semana.

    1. Extrae cycle time de tu gestor de tareas actual. Linear, Jira y Notion tienen este dato. Calcula la media de los últimos tres sprints antes de implementar IA. Eso es tu baseline.
    2. Añade un campo “ciclos de revisión” a tu flujo de PRs. En GitHub puedes automatizarlo con un simple script que cuente las veces que un PR pasa a “changes requested” y vuelve a “review”. No necesitas nada sofisticado.
    3. Activa el tracking de bugs por origen. ¿El bug vino de código generado con IA o de código escrito a mano? Añadir esa etiqueta a los issues de producción durante dos meses te da datos que nadie más tiene en tu organización.
    4. Envía el confidence score cada viernes. Un Google Form de una pregunta. Anónimo. Cinco minutos de setup. Los datos que obtienes en ocho semanas son más útiles que cualquier encuesta de engagement anual.
    5. Revisa las cinco métricas cada dos semanas, no cada sprint. El impacto de la IA no es lineal al principio. Los primeros cuatro sprints suelen mostrar un plateau o incluso una caída mientras el equipo ajusta workflows. La mejora real aparece en la semana seis o siete.

    Errores comunes al medir productividad con IA

    Error 1: medir demasiado pronto. Implementar IA y medir el impacto al sprint siguiente no funciona. El equipo necesita entre cuatro y seis semanas para ajustar su forma de trabajar con los modelos. Medir antes genera datos negativos que no reflejan el potencial real.

    Error 2: medir al individuo en lugar de al equipo. “¿Cuánto usa la IA este developer?” es la pregunta equivocada. La adopción de IA es un comportamiento social — si el tech lead no la usa, el equipo no la usa. Mide adopción a nivel de equipo, no de persona.

    Error 3: ignorar el coste de contexto. La IA produce output rápido, pero alguien tiene que escribir el prompt, revisar el output y decidir qué parte usar. Ese tiempo no aparece en los tickets. Si no lo contabilizas, tus métricas de velocidad quedan artificialmente infladas en comparación con el coste real.

    Error 4: no tener un baseline previo. Es imposible demostrar mejora sin un punto de partida. Antes de dar acceso a la IA al equipo, captura dos sprints de datos de cycle time, PR cycles y defect rate. Sin eso, cualquier número que presentes es opinión, no evidencia.

    Error 5: confundir actividad con impacto. El número de prompts enviados a un LLM no es una métrica de productividad. Es una métrica de uso. El impacto se mide en los outputs que importan: tiempo de entrega, calidad del código, confianza del equipo.


    Preguntas frecuentes

    ¿Qué métricas DORA son las más relevantes cuando el equipo usa IA?

    Las cuatro métricas DORA —deployment frequency, lead time for changes, change failure rate y time to restore service— siguen siendo válidas, pero el contexto cambia. Con IA, el “lead time for changes” debería bajar significativamente porque la fase de escritura de código se acelera. Si no baja, el cuello de botella está en el proceso de revisión o en la especificación, no en el coding. La “change failure rate” es la que más debes vigilar: un aumento aquí con IA activa indica que el equipo está delegando contexto que los modelos no tienen — exactamente lo que explicamos en el post sobre context engineering para proyectos con IA.

    ¿Cuánto tiempo tarda en verse el impacto real de la IA en productividad?

    En la mayoría de equipos que he visto, los primeros resultados medibles aparecen entre las semanas seis y ocho. Las primeras cuatro semanas son de ajuste: el equipo aprende qué delegar, qué especificar antes de delegar, y cómo revisar output de IA. A partir de la semana ocho, el cycle time baja y la autoconfianza sube de forma sostenida.

    ¿Cómo justifico ante dirección el coste de las licencias de IA si las métricas tardan en mostrarse?

    El argumento más sólido no son las métricas de productividad — es el coste de oportunidad. Un developer senior en España cuesta entre 50.000 y 80.000 euros al año. Si la IA reduce su ciclo de desarrollo un 30%, el retorno de una licencia de 20 euros al mes se justifica en las primeras dos horas de uso. Presenta ese cálculo antes de presentar las métricas.

    ¿Vale la pena usar herramientas específicas de medición de productividad IA como Uplevel o Faros?

    Para equipos de más de quince developers, sí. Estas plataformas integran datos de GitHub, Jira y Slack para calcular métricas de flujo de trabajo con granularidad que un tracker manual no puede dar. Para equipos menores, el setup de estas herramientas consume más tiempo del que ahorran. Empieza con las métricas manuales descritas en este post y migra a plataformas dedicadas cuando el equipo supere los veinte developers.

    ¿El confidence score realmente sirve o es demasiado subjetivo?

    Es subjetivo por diseño. Las métricas objetivas miden el output. El confidence score mide el proceso interno del developer: si está tomando decisiones con criterio o si está dependiendo de la IA para decisiones que debería tomar él. Un developer que valora su confianza en 4 sobre 10 de forma sostenida no está usando IA como amplificador — la está usando como muleta. Eso es información que ningún dashboard de GitHub te da.


    Lo que puedes hacer mañana

    No esperes a tener el sistema perfecto. Esta semana, haz una sola cosa: calcula el cycle time medio del último sprint de tu equipo. Ese número es tu baseline.

    La próxima vez que alguien te pregunte si la IA está funcionando, tendrás un punto de referencia real en lugar de una sensación.

    Si quieres ir más lejos — ver cómo integramos estas métricas dentro de un proceso estructurado de desarrollo con IA, de la especificación al deploy — en el curso Construye con IA trabajamos exactamente ese flujo: no solo usar la IA para escribir código, sino construir el sistema alrededor de ella para que los resultados sean medibles y repetibles.

    Y si tu equipo ya está en ese punto y quieres ir más profundo, en Dominicode Labs tenemos recursos sobre workflows de desarrollo con IA, plantillas de tracking y acceso directo a la comunidad para resolver dudas en contexto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • sdd-creator: genera spec, plan y tasks con cualquier agente IA

    sdd-creator: genera spec, plan y tasks con cualquier agente IA

    Llevaba tres horas implementando un sistema de autenticación con JWT cuando me di cuenta de que no había especificado nada.

    ¿El token debía expirar en la sesión o persistir entre reinicios? ¿Qué pasaba cuando el refresh token vencía estando el usuario activo? ¿El endpoint de logout invalidaba en servidor o solo limpiaba el cliente?

    Yo respondí esas preguntas sobre la marcha. Sin coherencia, sin registro de decisiones. El código resultó funcional pero arquitectónicamente un desastre.

    Eso no es un problema del agente. Es un problema de proceso. Para eso existe sdd-creator.


    El problema de codear sin especificar

    Los agentes de IA son extremadamente buenos ejecutando instrucciones. También son extremadamente buenos ejecutando instrucciones mal definidas — y el resultado es lo que imaginas.

    Cuando le das a Claude Code o a Cursor un prompt del tipo “implementa login con JWT”, el agente toma decisiones. Muchas. Las toma rápido, sin preguntarte, porque así trabajan. El output es código funcional que responde a una interpretación del problema, no necesariamente a tu interpretación.

    El fallo no está en la IA. Está en que nunca estableciste qué querías exactamente.

    Spec-Driven Development (SDD) resuelve esto con una premisa simple: antes de generar código, genera el spec. Un documento que responde qué hace la feature, por qué existe, quién la usa, qué flujos cubre y bajo qué criterios está terminada.

    El problema es que hacer bien un spec lleva disciplina. Y cuando tienes el agente abierto y las ganas de construir, la tentación de saltártelo es enorme.


    Qué es sdd-creator y cómo funciona

    sdd-creator es un skill para agentes de IA que impone el proceso de especificación antes de ejecutar cualquier implementación. No es un generador de documentos — es un interrogador. El agente no escribe código hasta que el spec esté completo y confirmado.

    A diferencia de pedirle directamente al agente que “genere un spec libre”, sdd-creator impone siempre las mismas 6 secciones y bloquea la implementación hasta recibir confirmación explícita. Sin esa estructura, los specs se convierten en párrafos de texto libre que el agente interpreta como quiere.

    El flujo tiene siete pasos:

    1. Describes el feature o proyecto que quieres construir
    2. sdd-creator detecta la complejidad (LOW / MEDIUM / HIGH)
    3. Te hace una entrevista interactiva — te pregunta lo que no especificaste
    4. Genera spec.md con 6 secciones estructuradas
    5. Espera tu confirmación antes de continuar
    6. Genera plan.md con las decisiones técnicas y la planificación por fases
    7. Genera tasks.md con las tareas ordenadas para TDD — y solo entonces empieza la implementación

    El repositorio está en GitHub: bezael/sdd-creator — MIT, v1.2.0.

    Si quieres entender la metodología detrás con más profundidad, el libro SDD cubre los principios completos, con patrones reales de proyectos en producción.


    Instalación

    Una sola línea:

    npx skills@latest add bezael/sdd-creator

    El CLI detecta tu herramienta y copia el skill al directorio correcto automáticamente. Como referencia, los directorios destino son:

    • Claude Code: ~/.claude/skills/
    • Cursor: .cursor/rules/ del proyecto

    No hay configuración adicional. No hay API keys. No hay dependencias de runtime. El skill vive como un archivo de instrucciones que el agente carga en contexto cuando lo invocas.

    Para instalación manual o integración con otros agentes, consulta la documentación oficial de Claude Code o los docs de tu herramienta.


    Tutorial paso a paso — feature de login con JWT

    Vamos con un ejemplo concreto. Tienes una app NestJS y quieres implementar autenticación con JWT. Sin sdd-creator, abres el agente y escribes: “implementa autenticación con JWT”. Con sdd-creator, el proceso es diferente.

    Paso 1 — Invoca el skill

    En Claude Code o en Cursor, activa sdd-creator. Luego describe tu feature:

    Quiero implementar un sistema de autenticación con JWT para una API NestJS.
    Incluye registro, login, refresh de token y logout.

    Paso 2 — La entrevista interactiva

    sdd-creator detecta complejidad media y empieza a preguntarte:

    • ¿El token de acceso expira en cuánto tiempo?
    • ¿El refresh token se invalida en servidor o solo en cliente?
    • ¿El endpoint de logout invalida todos los dispositivos activos o solo el actual?
    • ¿La app requiere rate limiting en los endpoints de auth?
    • ¿Los usuarios pueden tener múltiples sesiones simultáneas?

    Preguntas incómodas. Preguntas que el agente habría respondido solo — con su mejor criterio — si no le hubieras forzado a preguntarte.

    Paso 3 — Confirmas el spec.md

    El agente genera el spec.md completo. Lo revisas, corriges lo que no cuadra, y confirmas. Solo entonces avanza.

    Paso 4 — plan.md y tasks.md

    sdd-creator genera el plan técnico (decisiones de arquitectura, librerías, estructura de módulos) y la lista de tareas ordenadas para TDD. Primero los tests de los casos de error — token expirado, credenciales inválidas, refresh token revocado. Luego el código que los hace pasar.

    Resultado: el agente implementa exactamente lo que especificaste. Sin sorpresas. Sin decisiones implícitas. Sin “lo hice así porque parecía razonable”.


    Los 3 archivos que genera

    spec.md — La especificación en 6 secciones

    La estructura es fija e invariable:

    1. Visión — qué problema resuelve y por qué existe esta feature
    2. Usuarios — quién la usa y cuáles son sus necesidades reales
    3. Funcionalidades — qué puede hacer el sistema (listado concreto)
    4. Flujos — cómo se comporta el sistema en los escenarios principales
    5. Arquitectura — cómo está organizado técnicamente
    6. NFRs — requisitos no funcionales: performance, seguridad, disponibilidad

    La estructura fija es deliberada. Cuando el spec siempre tiene las mismas 6 secciones, puedes revisarlo en segundos y saber exactamente qué falta. Un spec libre en prosa no tiene esa propiedad.

    Si quieres ver cómo aplicar estas 6 secciones en un proyecto greenfield completo, este post sobre SDD con slices verticales lo cubre en detalle.

    plan.md — Las decisiones técnicas

    El plan responde: ¿cómo vamos a construir esto? Librerías seleccionadas y por qué. Estructura de módulos. Fases de implementación. Dependencias entre componentes. Riesgos identificados.

    No es un documento académico — es el registro de las decisiones que tomarías antes de empezar, aunque fueran en tu cabeza. Externalizar ese razonamiento tiene valor: el agente lo usa como referencia durante la implementación, y tú lo usas para hacer review.

    tasks.md — La lista ordenada para TDD

    Las tareas están ordenadas para Test-Driven Development. Los tests de los contratos del sistema van primero. El código que los satisface, después. Cada tarea es atómica — una sola responsabilidad, verificable por sí sola.

    Cuando tienes esta lista, puedes darle una tarea al agente y pedirle que haga solo esa. Sin divagar. Sin añadir “mejoras” que no pediste. La tarea acotada, con su test, con su criterio de aceptación.

    Esta es exactamente la forma de trabajar que desarrollamos en el curso Construye con IA — de la idea al producto real, con agentes IA y sin perder el control del código.


    Cuándo NO usar sdd-creator

    sdd-creator añade valor cuando el problema tiene suficiente complejidad para merecer una especificación. Hay casos donde el overhead no compensa:

    • Scripts de un solo uso: automatizaciones de 20-30 líneas que se ejecutan una vez y se descartan
    • Prototipos desechables: experimentos para validar si algo es técnicamente posible, sin intención de iterar sobre el código
    • Hotfixes triviales: corregir un typo, cambiar un color, ajustar un literal de texto

    La regla práctica: si el feature va a producción y va a ser mantenido, usa sdd-creator. Si es exploración o descarte, ve directo al código.


    Compatible con cualquier agente de IA

    sdd-creator no está atado a un agente específico. Funciona con todos los entornos de desarrollo con IA más usados:

    Agente Tipo de integración Directorio
    Claude Code Skills nativo ~/.claude/skills/
    Cursor Rules .cursor/rules/ del proyecto
    Codex CLI (OpenAI) AGENTS.md / system prompt Configuración de proyecto
    Gemini CLI System prompt Configuración de proyecto
    Aider Contexto personalizado .aider.conf.yml
    Continue config.json .continue/

    El formato MIT también significa que puedes adaptarlo a tu equipo. Si tienes convenciones de nomenclatura propias, o secciones adicionales en tus specs, puedes forkear el repositorio y ajustarlo.


    FAQ

    ¿Qué es sdd-creator?

    sdd-creator es un skill para agentes de IA que implementa el flujo de Spec-Driven Development. Cuando lo activas, el agente no escribe código directamente — primero te hace una entrevista para entender el problema, luego genera tres documentos estructurados (spec.md, plan.md, tasks.md), y solo después implementa. Es la diferencia entre darle instrucciones a un agente y darle una especificación.

    ¿Con qué agentes de IA funciona sdd-creator?

    Con Claude Code, Cursor, Codex CLI (OpenAI), Gemini CLI, Aider y Continue. El skill es un archivo de instrucciones, no una integración específica — cualquier agente que soporte archivos de contexto puede usarlo. La instalación varía: en Claude Code se copia a ~/.claude/skills/, en Cursor va a .cursor/rules/.

    ¿Cuánto tiempo lleva generar la spec con sdd-creator?

    Entre 5 y 20 minutos, dependiendo de la complejidad del feature. Una feature simple puede especificarse en 5 minutos. Una feature con múltiples flujos, integraciones externas y requisitos de seguridad puede tomar 20. Ese tiempo es siempre menor que el que cuesta refactorizar código que el agente implementó sin especificación.

    ¿Es sdd-creator compatible con proyectos legacy?

    Sí. SDD no requiere empezar desde cero — puedes aplicarlo feature a feature sobre una base de código existente. El spec refleja las restricciones reales del sistema existente: qué puedes cambiar, qué no, y qué deuda técnica tienes que tener en cuenta durante la implementación.

    ¿Puedo usar sdd-creator en equipos?

    Sí, y es donde más valor aporta. El spec.md generado es el contrato de la feature — cualquier miembro del equipo puede revisarlo, cuestionarlo y aprobarlo antes de que empiece la implementación. Elimina el “yo entendí que…” de las reuniones de review.


    Ahora, cuando tengo el agente abierto y las ganas de construir, lo primero que activo es sdd-creator. Los 15 minutos de spec se pagan solos. Esas tres horas de JWT no se van a repetir.

    Si quieres ver cómo SDD encaja en el ciclo completo de desarrollo con IA — desde la idea hasta el producto desplegado — en Dominicode Labs tienes acceso a proyectos reales donde aplicamos este flujo de principio a fin.

    Por Bezael Pérez — Fundador de Dominicode.

  • Plan, Steer, Decompose: el framework de agentic engineering

    Plan, Steer, Decompose: el framework de agentic engineering

    Llevaba tres horas con el agente.

    Tres horas corrigiendo. El agente seguía haciendo lo mismo: tomaba decisiones razonables para el contexto que tenía, pero el contexto que tenía era incompleto desde el principio. Yo le daba feedback, él ajustaba, y en la siguiente iteración el problema aparecía en otro sitio. Dos pasos adelante, uno y medio atrás.

    No era el modelo. Era yo — y el problema era la ausencia de agentic engineering en mi flujo de trabajo.

    No había planificado lo que quería construir antes de empezar. No había descompuesto el problema en piezas que el agente pudiera manejar sin ambigüedad. Le había dado un objetivo vago y esperado que el agente lo resolviera. Y el agente hacía lo que podía — que no era suficiente para lo que yo necesitaba.

    Eso es lo que diferencia a alguien que usa agentic engineering de alguien que simplemente le pide cosas a la IA: un framework de trabajo. Un ciclo operativo que convierte la delegación caótica en colaboración sistemática.

    El framework tiene cinco pasos: Plan → Steer → Decompose → Delegate → Systematize.

    El agentic engineering es la disciplina de orquestar agentes de IA de forma sistemática — definiendo objetivos, descomponiendo problemas, delegando tareas con el contexto preciso y capturando los patrones que funcionan para reutilizarlos. Es la diferencia entre usar la IA como herramienta de texto y tratarla como un sistema de producción.


    Por qué el prompting no es suficiente

    Hay un malentendido que veo constantemente en developers que llevan meses usando IA sin resultados consistentes: creen que el problema es el prompt.

    Mejoran el prompt. Añaden más contexto. Usan few-shot examples. Prueban otro modelo. Y los resultados mejoran marginalmente pero el problema de fondo persiste — siguen obteniendo outputs que tienen que reescribir, completar o corregir antes de poder usar.

    El problema no es el prompt. Es que no hay agentic engineering en el proceso — están tratando al agente como un oráculo al que preguntas. Y los oráculos funcionan bien para respuestas, no para construcción.

    Construir con IA no es preguntar. Es orquestar. Y orquestar requiere un proceso, no una técnica de redacción.


    El framework de agentic engineering: los 5 pasos

    Paso Objetivo Señal de que lo estás haciendo bien
    Plan Define qué construir antes de abrir el editor Tienes objetivo, contexto y criterios de éxito escritos
    Steer Guía la dirección durante la ejecución Intervienes en los puntos de decisión, no en cada acción
    Decompose Rompe el problema en tareas atómicas y verificables Cada tarea tiene bordes claros, sin decisiones implícitas
    Delegate Asigna la tarea correcta con el contexto mínimo necesario El agente no necesita hacer preguntas para empezar
    Systematize Convierte lo que funciona en proceso repetible Tienes CLAUDE.md, templates y hooks activos

    1. Plan — Define antes de abrir el editor

    El Plan no es el prompt inicial. Es la decisión de qué quieres construir, para quién, con qué criterios de éxito, y qué contexto necesita el agente para no tener que improvisar.

    La mayoría de los problemas de agentic engineering empiezan aquí — o mejor dicho, por saltarse este paso.

    Cuando no hay Plan, el agente trabaja con hipótesis. Asume el stack que le parece más probable. Asume la arquitectura que ha visto más en su entrenamiento. Asume que los casos edge no existen porque no se los mencionaste. Y esas hipótesis se propagan a través de todo el trabajo posterior.

    Un Plan mínimo tiene tres elementos:

    Objetivo concreto — No "implementa el módulo de usuarios". Sí: "Implementa el endpoint POST /users que recibe { email, name }, valida con Zod, crea el registro en la tabla users de Supabase y devuelve { id, email, createdAt }. Error 409 si el email ya existe."

    Contexto relevante — El stack, las convenciones de naming que ya usa el proyecto, las decisiones de arquitectura tomadas, las restricciones conocidas. Esto es lo que va en el CLAUDE.md del proyecto — no como documentación, sino como memoria estructurada que el agente lee al inicio de cada sesión.

    Criterios de éxito — Cómo sabes que el agente terminó bien su trabajo. Tests que deben pasar. Comportamientos que debes poder demostrar. Sin criterios de éxito explícitos, "listo" significa cosas distintas para ti y para el agente.

    El Spec-Driven Development es la metodología que formaliza este paso: especificar el sistema antes de construirlo, con contratos concretos que el agente puede implementar sin inventar.

    2. Steer — Guías la dirección, no desapareces

    El Steer es el feedback loop activo durante la ejecución.

    Hay un patrón que veo repetidamente: el developer escribe un prompt elaborado, lanza el agente y vuelve veinte minutos después esperando encontrar la tarea completada. A veces funciona. Cuando no funciona, el agente ha pasado esos veinte minutos construyendo en la dirección equivocada con mucha confianza.

    Steer no significa microgestionar. Significa estar presente en los puntos de decisión que importan.

    La señal de que necesitas intervenir: el agente está a punto de tomar una decisión con consecuencias amplias sin haber pedido confirmación. Cambiar la estructura de un módulo. Renombrar una abstracción clave. Elegir entre dos arquitecturas posibles. Esos son los momentos en que tu presencia tiene más palanca.

    En práctica, Steer implica:

    • Revisar el output de las primeras iteraciones antes de que el agente avance demasiado
    • Corregir la dirección cuando el agente toma una decisión incorrecta — y hacerlo en el momento, no cuando ya hay diez archivos afectados
    • Hacer preguntas explícitas al agente sobre sus decisiones: "¿Por qué elegiste este enfoque sobre el alternativo?" — no para cuestionar todo, sino para verificar que el razonamiento es el correcto antes de comprometerte con esa dirección

    El objetivo del Steer no es hacer el trabajo del agente. Es hacer que el agente haga el trabajo correcto. Sin Steer, el agentic engineering se convierte en delegación ciega — y la delegación ciega escala los errores, no los resultados.

    3. Decompose — Rompe el problema en tareas atómicas

    La Decompose es donde más se gana en calidad de output y donde menos developers invierten tiempo.

    Un agente que recibe "implementa el sistema de autenticación completo" toma demasiadas decisiones implícitas. Qué estrategia de sesiones. Qué campos en el token. Cómo manejar el refresh. Qué pasa cuando el token expira durante una request. Cada una de esas decisiones tiene consecuencias, y el agente las toma sin consultarte porque no sabe que importan.

    La descomposición transforma decisiones implícitas en decisiones explícitas.

    Una tarea bien descompuesta tiene estas características:

    Atómica — Se puede completar en una sola sesión sin depender de otras tareas que no estén terminadas.

    Sin ambigüedad en los bordes — Define qué entra, qué sale y cómo interactúa con lo que ya existe. "Implementa el endpoint de login que recibe { email, password } y devuelve { accessToken, refreshToken, user } usando el servicio AuthService ya existente" — eso es una tarea sin ambigüedad en los bordes.

    Verificable — Al terminar puedes saber con certeza si la tarea está bien hecha o no. Si no puedes verificar, la tarea está mal definida.

    // Tarea mal definida — demasiado scope, demasiadas decisiones implícitas
    // "Implementa el sistema de autenticación con JWT y manejo de sesiones"
    
    // Tarea bien definida — atómica, verificable, bordes claros
    // "Implementa la función generateTokenPair(userId: string): Promise<TokenPair>
    // que genera accessToken (15min) y refreshToken (7d) firmados con RS256.
    // TokenPair = { accessToken: string; refreshToken: string; expiresAt: Date }
    // Usa la clave privada de process.env.JWT_PRIVATE_KEY.
    // Test: genera un par, verifica que accessToken expira correctamente."
    

    La diferencia no está en la complejidad. Está en quién toma las decisiones.

    4. Delegate — Asigna al agente correcto con el contexto mínimo necesario

    Delegate es donde muchos developers confunden prompt engineering con delegación real.

    Prompt engineering es refinar las instrucciones para obtener un output mejor del mismo agente. La delegación dentro del agentic engineering es asignar la tarea correcta al agente correcto con el contexto que necesita para ejecutarla — ni más ni menos.

    Dos errores opuestos destruyen la delegación:

    Delegación sin contexto suficiente. El agente no tiene acceso a las decisiones de arquitectura previas, no conoce las convenciones del proyecto, no sabe qué existe ya. El resultado es código que no encaja — funcionalmente correcto, arquitecturalmente incorrecto.

    Delegación con contexto excesivo. Pegas en el prompt el README completo, los últimos cinco commits, tres archivos relacionados y la descripción del sistema entero. El modelo procesa todo ese contexto pero el ruido diluyente reduce la precisión. Más contexto no siempre es mejor contexto.

    El contexto mínimo necesario es el que responde a: ¿qué necesita saber el agente para tomar las mismas decisiones que yo tomaría? No el contexto que me tranquiliza a mí — el que necesita el agente.

    En Claude Code esto se traduce en ser deliberado sobre qué archivos mencionas explícitamente (@auth.service.ts, @user.schema.ts) y qué instrucciones incluyes en el CLAUDE.md del proyecto para que estén disponibles en cada sesión sin tener que repetirlas.

    5. Systematize — Lo que funciona una vez se convierte en proceso

    El Systematize es el paso que separa a los developers que mejoran semana a semana de los que repiten los mismos errores en cada proyecto nuevo.

    Cuando un flujo de trabajo de agentic engineering funciona bien — un tipo de tarea, un patrón de prompt, una estructura de descomposición — el Systematize lo captura como proceso reutilizable. No como documentación que nadie leerá. Como artefacto operativo que puedes invocar directamente.

    Tres formas concretas de systematizar:

    CLAUDE.md por proyecto — Las decisiones de arquitectura, las convenciones, las restricciones del proyecto. Este archivo es la memoria del proyecto que persiste entre sesiones. Sin él, cada sesión nueva parte de cero.

    Templates de tareas — Si descompones el mismo tipo de problema una y otra vez (endpoints REST, componentes Angular, tests de integración), el template captura la estructura de descomposición que ya demostró funcionar. No vuelves a pensar cómo descomponer — aplicas el template y ajustas los detalles.

    Hooks y workflows — En Claude Code, los hooks de PreToolUse y PostToolUse permiten ejecutar validaciones automáticas antes o después de que el agente actúe. Un hook que ejecuta tsc --noEmit antes de cada escritura de archivo previene que el agente introduzca errores de tipos que luego tienes que depurar a mano. Automatizas la verificación, no solo la generación.

    // .claude/settings.json — hook que valida TypeScript antes de escribir
    {
      "hooks": {
        "PreToolUse": [
          {
            "matcher": "Write|Edit",
            "hooks": [
              {
                "type": "command",
                "command": "npx tsc --noEmit 2>&1 | head -20"
              }
            ]
          }
        ]
      }
    }
    

    El Systematize convierte el conocimiento tácito en proceso explícito. Y el proceso explícito escala — a proyectos futuros, a otros developers del equipo, a agentes que ejecutan workflows sin supervisión.


    Cómo se conectan los 5 pasos en un ciclo

    Los cinco pasos del agentic engineering no son lineales. Son un ciclo que se repite a dos escalas.

    Escala de proyecto:

    • Una vez al inicio: Plan global
    • Primera Decompose en bloques grandes
    • Primera ronda de Delegate al agente
    • Steer durante la ejecución
    • Systematize los patrones que funcionaron para el siguiente proyecto

    Escala de tarea:

    • Plan de la tarea concreta
    • Decompose en subtareas si es necesario
    • Delegate al agente con el contexto mínimo
    • Steer durante la ejecución
    • Systematize si el patrón vale la pena capturar

    Lo que conecta los dos niveles es el contexto acumulado. Cada Systematize en una tarea pequeña alimenta el Plan del bloque siguiente. El CLAUDE.md que actualizas después de cada sesión hace que la siguiente sesión parta de un estado mejor que la anterior.

    El ciclo se mejora a sí mismo. Eso es lo que distingue un sistema de una técnica.


    Aplica el framework construyendo un producto real

    Leer el framework es útil. Aplicarlo en un proyecto real con presión de tiempo y decisiones concretas es lo que lo hace tuyo.

    El Workshop Beyond Prompts (https://workshop.dominicode.com/) del 9 de julio es exactamente eso: 3 horas donde aplicamos el agentic engineering construyendo un producto real con Claude Code — de idea a producto deployado usando Plan → Steer → Decompose → Delegate → Systematize en vivo. No es una clase magistral. Es una sesión de trabajo donde tomas decisiones, te equivocas, corriges y sales con un sistema que puedes replicar.

    Si quieres prepararte antes del workshop, el curso Construye con IA: de la idea al producto con Claude Code cubre los fundamentos de agentic engineering con el mismo enfoque: criterio para cada decisión, no solo instrucciones que seguir.

    Y si quieres trabajar el framework con proyectos concretos en comunidad — revisar tu arquitectura, discutir las decisiones que no están claras, ver cómo otros developers aplican estos pasos — en Dominicode Labs hacemos exactamente eso semana a semana.


    FAQ

    ¿Cuál es la diferencia entre el agentic engineering y el Spec-Driven Development?

    SDD es la metodología que cubre en detalle el paso Plan — cómo especificar un sistema antes de construirlo, con contratos y criterios de éxito concretos. El framework de agentic engineering Plan → Steer → Decompose → Delegate → Systematize es más amplio: cubre todo el ciclo de trabajo con agentes, desde antes de escribir la spec hasta capturar los patrones que funcionaron para reutilizarlos. SDD y agentic engineering son complementarios — SDD es la respuesta detallada a "cómo hacer bien el Plan".

    ¿El agentic engineering funciona con cualquier herramienta de IA o solo con Claude Code?

    Los cinco pasos son agnósticos a la herramienta. La lógica de Plan, Steer, Decompose, Delegate y Systematize aplica igual si usas Claude Code, Cursor, Copilot o la API directamente. Lo que cambia son los artefactos concretos: en Claude Code el contexto persistente vive en CLAUDE.md y los hooks en .claude/settings.json; en Cursor vive en .cursor/rules/; en otros entornos en AGENTS.md. El framework es la estructura. Los artefactos son la implementación específica de cada herramienta.

    ¿Cuánto tiempo tarda implementar este framework en un proyecto que ya existe?

    Para un proyecto existente sin ningún sistema, el mínimo viable —un CLAUDE.md básico con el stack y las convenciones principales, más una primera descomposición del backlog pendiente— tarda entre dos y cuatro horas. No es un proceso de migración completa. Es añadir las piezas que hacen que cada sesión futura sea más efectiva que las anteriores. El Systematize es acumulativo — mejora con el tiempo, no requiere estar completo desde el día uno.

    ¿El paso Steer no anula el beneficio de la autonomía del agente?

    No. Steer es intervención en los puntos de decisión de alto impacto, no supervisión constante de cada acción. Un agente ejecutando tareas bien definidas puede trabajar durante decenas de ciclos sin necesitar tu input — eso es autonomía real. Steer te pide que estés presente cuando el agente enfrenta una bifurcación arquitectural, no cuando está implementando un endpoint que ya tiene todos los criterios claros. La diferencia práctica: Steer activo tarda minutos por sesión. Steer ausente puede costar horas de corrección cuando el agente ha tomado veinte decisiones incorrectas en cadena.

    ¿Por dónde empiezo si nunca he trabajado de forma estructurada con agentes?

    Empieza por el Plan y el Decompose. Son los dos pasos del agentic engineering que más impacto tienen en la calidad del output y los que más developers saltan. Coge una tarea concreta de tu backlog y antes de lanzar el agente escribe: objetivo específico, contexto relevante y criterios de éxito. Luego divídela en subtareas que tengan bordes claros. Esas dos prácticas solas van a mejorar notablemente la calidad de lo que obtienes. El resto del framework puedes añadirlo gradualmente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
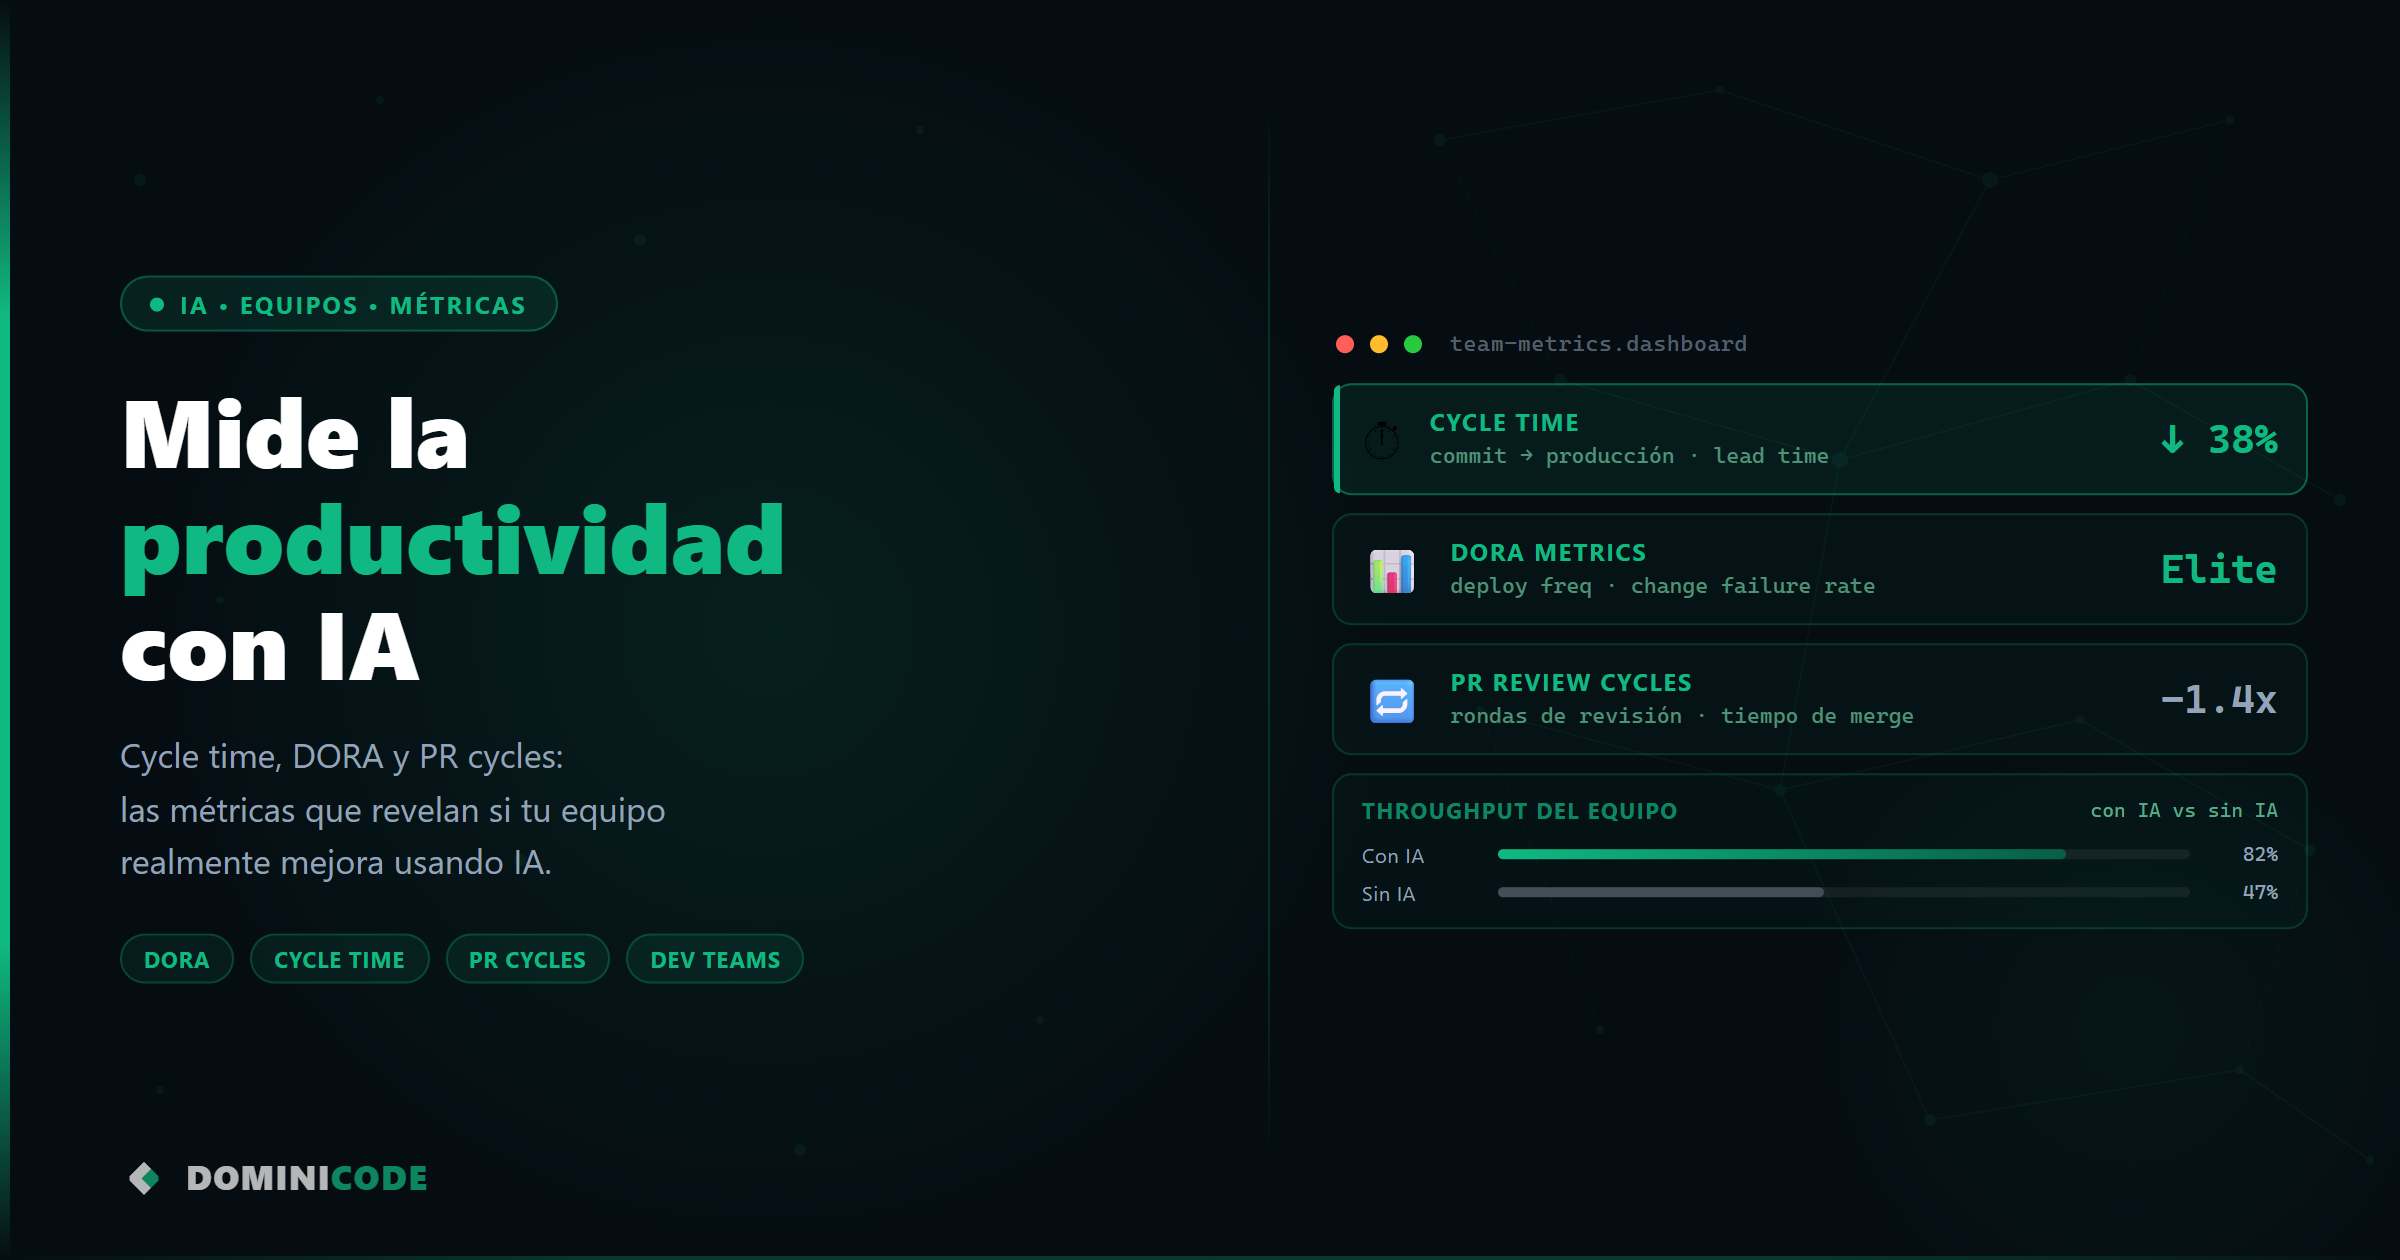
  • Consecuencias de no adoptar la IA en tu equipo de desarrollo

    Consecuencias de no adoptar la IA en tu equipo de desarrollo

    Hace unos meses hablé con un CTO de una startup de logística. Tiene un equipo de ocho developers. Llevan dos años con el mismo stack, el mismo proceso, y la misma velocidad de entrega.

    Me preguntó qué pensaba de la IA en equipos de desarrollo.

    Le dije lo que pienso: que no adoptar IA hoy no es una postura neutral. Las consecuencias de no adoptar IA en desarrollo son concretas y medibles — se ven en la cuenta de resultados, en la rotación del equipo, y en la capacidad de competir.

    Se quedó callado unos segundos. Luego dijo: “Es que no quiero que el equipo dependa de una herramienta que no controlamos.”

    Eso es un miedo legítimo. Pero es el miedo equivocado.

    No adoptar IA en un equipo de desarrollo significa mantener flujos de trabajo manuales en tareas donde los modelos de lenguaje ya ofrecen ventaja medible: generación de tests, code review inicial, documentación y traducción de diseños a componentes. No es una opción neutral — es una decisión activa con un coste que se acumula cada semana.

    Las consecuencias no llegan de golpe. No hay una fecha en el calendario marcada “el día que te quedaste atrás”. Llegan de forma gradual, acumulada, invisible hasta que de repente son demasiado grandes para ignorar.

    Este post no es para convencerte de que la IA es maravillosa. Es para que veas con claridad lo que está pasando cuando un equipo decide no moverse.

    La brecha de velocidad que ya no puedes cerrar contratando

    La primera consecuencia es la más obvia y la más subestimada.

    Según la investigación de GitHub sobre productividad con Copilot, los developers completan tareas hasta un 55% más rápido cuando usan asistencia de IA. En la práctica, en los equipos con los que he trabajado y hablado, la diferencia oscila entre 2x y 4x según el tipo de tarea — las más repetitivas son las que más se aceleran.

    Si tu equipo no usa IA y tu competencia sí, no estás compitiendo en las mismas condiciones. Estás haciendo una carrera de 100 metros en la que la mitad de los participantes arrancó diez metros antes.

    El problema no es solo velocidad bruta. Es que la diferencia se amplifica. El equipo que usa IA itera más rápido, aprende más rápido, comete errores más baratos porque los detecta antes. El equipo que no usa IA itera a la misma velocidad que hace tres años.

    En doce meses esa brecha no se cierra contratando un developer más. Porque la empresa de al lado también puede contratar, y además tiene multiplicadores de velocidad que tú no tienes.

    Pierdes a los developers que más te importa conservar

    Esta es la consecuencia que menos anticipan los CTOs y tech leads.

    Los developers que más rinden — los que tienen criterio, autonomía, y ganas de aprender — son exactamente los que primero se van de un entorno donde no pueden usar las herramientas que ya usan en casa.

    Un developer senior en 2026 experimenta con Claude Code en sus proyectos personales. Entiende cómo funciona un agente. Tiene flujos de trabajo propios con IA que le hacen más productivo.

    Si llega a la oficina y le pides que trabaje como si todo eso no existiera, el mensaje que recibe no es “somos conservadores”. El mensaje que recibe es “aquí no valoramos que te mantengas actualizado”.

    Y se va. No a otra empresa que haga lo mismo. Se va a un sitio donde puede usar lo que sabe.

    Esta transformación ya está ocurriendo en el mercado — los mejores perfiles están pasando de developer a product builder, y los entornos que no permiten IA son los primeros de los que escapan.

    Los developers que se quedan en equipos sin IA no siempre son los que menos valen. Pero con el tiempo, sí son cada vez más los que no tienen dónde ir.

    El coste de oportunidad que nadie contabiliza

    Hay un tercer coste que es más difícil de ver porque nunca aparece en ningún informe.

    Es el coste de todo lo que no construiste.

    Cuando un equipo sin IA tarda tres semanas en sacar una feature, no solo está tardando tres semanas. Está eligiendo no sacar las otras features que hubiera podido sacar si fuera más rápido. Está retrasando el feedback del usuario. Está postergando el aprendizaje de si la dirección que tomó es correcta.

    Un equipo con IA que entrega en una semana no solo tiene dos semanas más. Tiene dos iteraciones más. Dos ciclos de feedback más. Dos oportunidades de corregir antes de haber invertido demasiado en la dirección equivocada.

    El coste de oportunidad no se ve en el sprint review. Se ve doce meses después, cuando la empresa que iteraba más rápido ya encontró el product-market fit y la tuya sigue ajustando la primera versión.

    La deuda técnica de la IA ignorada

    Hay equipos que no adoptan IA de forma activa pero tampoco la prohíben. Lo que pasa en esos equipos es peor de lo que parece.

    Los developers individuales empiezan a usar IA de forma clandestina, sin criterio compartido, sin patrones comunes. Uno usa Copilot para autocompletar. Otro usa ChatGPT para generar tests. Otro usa Claude para hacer code reviews. Cada uno con su propio criterio, sus propias convenciones, y sin que nadie sepa qué se generó con IA y qué no.

    Eso es deuda técnica de un tipo nuevo. No es deuda de código mal escrito. Es deuda de proceso: nadie sabe cómo se tomaron las decisiones, nadie puede auditar el output, y la calidad del código depende del prompt del developer en ese momento específico, no de los estándares del equipo. Ya escribí sobre este problema en detalle en el post sobre vibe coding y confiabilidad en proyectos de IA — y la raíz es siempre la misma: IA sin sistema.

    La adopción estructurada de IA — con criterio, con convenciones, con revisión — es precisamente lo que evita ese caos. Ignorar la IA no lo evita. Solo lo empuja debajo de la superficie hasta que explota.

    En el curso Construye con IA: de la idea al producto con Claude Code trabajo exactamente este problema: no cómo usar la IA para escribir código más rápido, sino cómo construir un sistema — con especificaciones, contexto persistente, y flujos estructurados — para que el output sea consistente y revisable.

    Qué significa adoptar IA en un equipo (y qué no)

    Adoptar IA no significa que el equipo pase a generar código sin revisión.

    No significa confiar ciegamente en el output del modelo. No significa eliminar code reviews, ni tirar la arquitectura que funciona, ni que cualquier developer junior pueda hacer el trabajo de un senior porque “la IA lo ayuda”.

    Significa integrar herramientas de IA en el flujo de trabajo del equipo con criterio. Definir qué tareas se benefician de la IA y cuáles no. Establecer convenciones sobre cómo se revisa el código generado. Formarse en cómo dar contexto de calidad a los modelos para obtener output de calidad.

    El miedo legítimo del CTO que mencioné al principio — no querer depender de una herramienta que no controlas — tiene una respuesta estructurada: aprender a controlarla. Entender sus límites. Usar IA donde amplifica el criterio humano, no donde lo sustituye.

    Eso requiere formación, no solo instalación de plugins.

    Qué puede hacer un equipo esta semana

    No voy a decirte “empieza con un piloto de tres meses y mide los resultados”. Eso es lo que dice alguien que no tiene que entregar mañana.

    Lo que puede hacer un equipo esta semana es concreto:

    1. Identifica una tarea repetitiva que haga el equipo a diario: escribir tests, generar documentación, hacer code reviews iniciales, traducir diseños a componentes.
    2. Elige a un developer con ganas de experimentar. Que no sea el más escéptico ni el más entusiasta sin criterio.
    3. Deja que pase una semana usando IA en esa tarea específica, con la consigna de que documente qué funcionó y qué no.
    4. Revisa los resultados con el equipo. No los números — la experiencia. Qué cambió en el proceso, qué parte del output necesitó más revisión, qué parte sorprendió.

    Una semana. Una tarea. Un developer. Eso es suficiente para tener datos reales en lugar de suposiciones.

    Si quieres un marco más estructurado para llevarlo a tu equipo, en Dominicode Labs tenemos proyectos y patrones de adopción que hemos validado en proyectos reales — no teoría de management sino flujos que developers usan en producción.

    El momento en que la decisión ya no es tuya

    Hay una última consecuencia que vale la pena nombrar.

    Si esperas demasiado, la decisión de adoptar IA deja de ser una decisión estratégica y se convierte en una reacción de emergencia.

    El CEO presiona porque vio a un competidor entregar más rápido. Los clientes preguntan por qué la velocidad de entrega no mejora. Los developers más valiosos se van a empresas que ya tienen el sistema montado.

    Y entonces adoptas IA con prisa, sin criterio, sin formación, y produces exactamente el caos que querías evitar.

    La ventana para hacer esto bien — de forma estructurada, sin presión, con tiempo para equivocarse y corregir — es ahora. No porque la IA vaya a desaparecer. Sino porque cuanto más tiempo pasa, más dura es la curva de puesta al día.

    Los equipos que adoptan IA hoy no solo producen más. Están construyendo un músculo que cada mes que pasa se hace más difícil de construir partiendo de cero.

    Si quieres empezar de forma estructurada, el siguiente paso concreto está aquí: Construye con IA: de la idea al producto con Claude Code — el sistema que uso yo, aplicado a proyectos reales desde el primer día.

    Resumen: consecuencias de no adoptar IA en equipos de desarrollo

    Consecuencia Cuándo se nota Cómo prevenirla
    Brecha de velocidad vs. competidores 3-6 meses Adopción estructurada en tareas repetitivas
    Fuga de talento senior 6-12 meses Permitir y formalizar el uso de herramientas IA
    Pérdida de coste de oportunidad 6-18 meses Reducir ciclos de iteración con IA
    Deuda de proceso (IA sin sistema) Desde el día 1 Establecer convenciones de uso y revisión
    Pérdida de control estratégico +12 meses Adoptar antes de que la presión externa obligue

    ## Preguntas frecuentes sobre la adopción de IA en equipos de desarrollo

    ¿Es demasiado pronto para que los equipos adopten IA en su flujo de trabajo de desarrollo?

    No. GitHub Copilot lleva años en equipos enterprise. Claude Code y Cursor tienen bases de usuarios activas y en crecimiento documentado. El riesgo de adoptar demasiado pronto es mucho menor que el de adoptar demasiado tarde — y los datos de productividad ya están ahí.

    ¿La IA en desarrollo requiere que todos los developers del equipo la usen?

    No de golpe. Pero sí con el tiempo. Una adopción parcial sin coordinación — donde cada developer hace lo que quiere — genera inconsistencia en el codebase y deuda de proceso. Empieza con los que tienen ganas, documenta lo que funciona, y después extiéndelo con convenciones comunes.

    ¿Qué pasa con la calidad del código si se genera con IA?

    Depende del contexto que le des al modelo. Contexto preciso — especificación clara, arquitectura documentada, convenciones definidas — produce código que pasa code review. Descripción vaga produce código que necesita reescribirse. El problema de calidad no es la IA: es la falta de sistema alrededor de la IA.

    ¿Cómo convenzo a mi equipo de empezar a usar IA si hay resistencia?

    No convenzas. Muestra. Toma una tarea concreta, hazla tú con IA delante del equipo, y deja que el resultado hable. Los equipos resistentes suelen estarlo porque nunca han visto un caso de uso real y bien ejecutado — solo demos de hype. Un ejemplo concreto, en su stack, con su tipo de problema, cambia la conversación.

    ¿Qué riesgos reales existen en adoptar IA en un equipo de desarrollo?

    Tres riesgos concretos: código generado sin revisión que introduce bugs o vulnerabilidades, dependencia de modelos propietarios con costes variables, y degradación de habilidades en developers que delegan demasiado sin entender el output. Todos son mitigables: code review obligatorio del código generado, presupuesto controlado de API, y formación en cómo evaluar críticamente el output del modelo.

    ¿Cuánto tiempo lleva ver resultados reales de adoptar IA en un equipo?

    En tareas repetitivas — tests, documentación, boilerplate — los resultados son visibles en la primera semana. El impacto en velocidad de entrega de features completas se mide bien a partir del primer mes, cuando el equipo ya tiene un flujo establecido en lugar de experimentar caso a caso.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.