Tag: Agentes IA

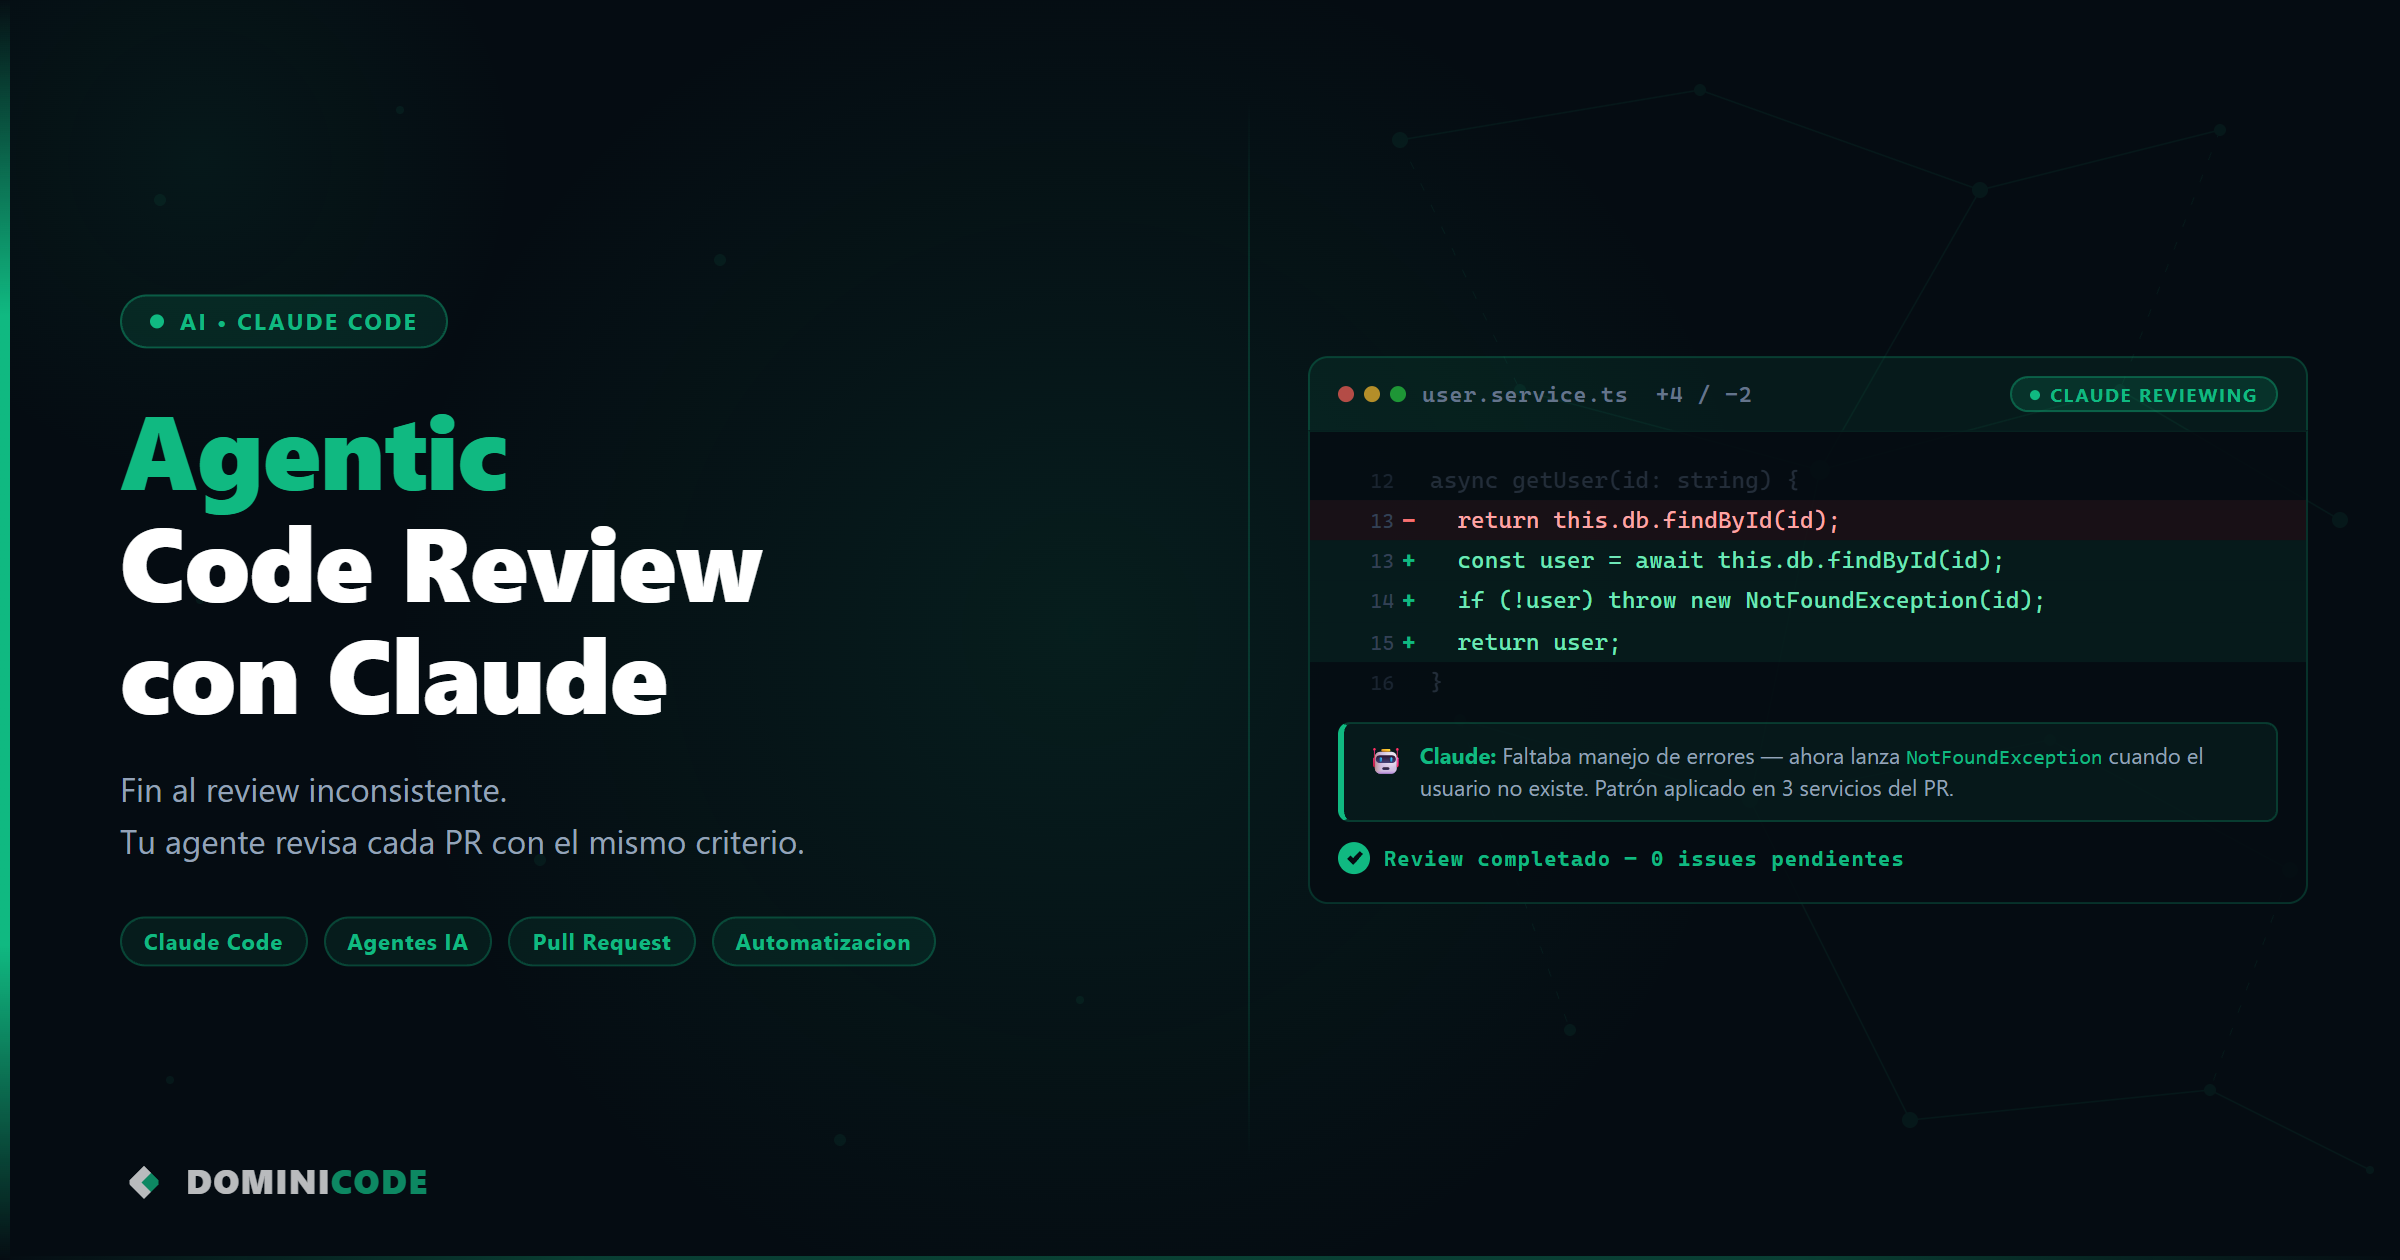
  • Agentic code review con Claude Code: fin al review inconsistente

    Agentic code review con Claude Code: fin al review inconsistente

    Hace unos meses revisé el historial de PRs de un proyecto que llevaba tres años en producción. Había 600 pull requests cerrados. De esos, el 40% tenían el mismo comentario de review: "Falta manejo de errores".

    El mismo comentario. 600 veces. Durante tres años.

    Nadie había creado una regla. Nadie había automatizado la revisión. El code review dependía de que alguien con criterio tuviera tiempo y energía ese día. Y cuando no lo tenía, el PR se aprobaba igual.

    Ese patrón tiene nombre: es el problema que el agentic code review viene a eliminar. Y hoy, con Claude Code, puedes tenerlo funcionando en tu proyecto en minutos.

    Qué es el agentic code review (y qué no es)

    Un agentic code review no es pedirle a un LLM que "revise este archivo". Eso es un chat con contexto limitado.

    Un agentic code review es un proceso donde un agente de IA recorre el diff de tu PR de forma autónoma, lanza subagentes especializados en paralelo, analiza el historial de git para entender el contexto, y filtra los resultados por nivel de confianza antes de reportar.

    La diferencia es estructural. En lugar de una respuesta de texto libre, tienes un pipeline que:

    1. Lee el PR completo con todos sus cambios
    2. Lanza múltiples agentes en paralelo con roles distintos
    3. Puntúa cada hallazgo con un nivel de confianza configurable
    4. Solo reporta los problemas que superan un umbral concreto
    5. Entrega los resultados con enlaces directos a las líneas de código

    Con Claude Code, este pipeline puedes crearlo hoy y activarlo en segundos.

    Cómo funciona /code-review en Claude Code

    Claude Code te permite crear el comando /code-review como un slash command personalizado en .claude/commands/review.md. No es un built-in nativo de Claude Code — es un skill que configuras una vez y luego ejecutas en cualquier repositorio.

    Prerequisito: Necesitas crear el archivo .claude/commands/review.md con la definición del comando. Si ya tienes Claude Code con skills personalizados instalados (como los de Dominicode), este paso lo tienes cubierto. Puedes ver más artículos sobre cómo configurar Claude Code en el blog de Dominicode.

    Una vez configurado, cuando lo ejecutas sobre un PR abierto, lanza cuatro agentes en paralelo:

    • Agentes #1 y #2: Auditan el cumplimiento de las reglas definidas en tu CLAUDE.md (con redundancia para reducir falsos negativos)
    • Agente #3: Escanea los cambios del PR en busca de bugs evidentes — no el codebase completo, solo el diff
    • Agente #4: Analiza el git blame e historial del repo para detectar problemas que solo tienen sentido con contexto histórico

    El skill de review define un sistema de puntuación de confianza — un ejemplo habitual que puedes copiar y adaptar:

    0   → Falso positivo probable
    25  → Podría ser real
    50  → Real, pero menor
    75  → Real e importante
    100 → Absolutamente seguro
    

    El threshold por defecto en la mayoría de implementaciones es 80. Cualquier hallazgo por debajo no se reporta. Esto no es arbitrario: es lo que separa el ruido del signal en una revisión útil.

    El comando en la práctica

    # Revisión en terminal (mientras trabajas en local)
    /code-review
    
    # Publicar la revisión como comentario en el PR de GitHub
    /code-review --comment
    

    Nota: El flag --comment forma parte de la implementación del skill personalizado. Para que funcione, tu archivo .claude/commands/review.md debe incluir la lógica para detectar el PR activo del branch y postear el comentario en GitHub via gh CLI. El comportamiento no es nativo de Claude Code — lo defines tú en el skill.

    El flag --comment es el que convierte la herramienta en algo que vive dentro de tu flujo de trabajo real. El agente no solo te dice qué está mal — lo posta directamente en el PR con los links exactos a las líneas.

    Un output real tiene este aspecto (output de ejemplo):

    ## Code review
    
    Found 3 issues:
    
    1. Missing error handling for OAuth callback
       (CLAUDE.md says "Always handle OAuth errors")
       https://github.com/owner/repo/blob/abc123/src/auth.ts#L67-L72
    
    2. Memory leak: OAuth state not cleaned up after failed login
       (missing cleanup in finally block — bug, not pre-existing)
       https://github.com/owner/repo/blob/abc123/src/auth.ts#L88-L95
    
    3. Inconsistent naming: function uses snake_case
       (conventions/CLAUDE.md says "Use camelCase for functions")
       https://github.com/owner/repo/blob/abc123/src/utils.ts#L23-L28
    

    Tres problemas. Tres links directos. Sin ruido.

    Por qué el code review manual falla en producción

    No es una cuestión de habilidad. Es una cuestión de sistema.

    El code review manual tiene tres fallos estructurales que ningún proceso de equipo ha conseguido eliminar completamente:

    Inconsistencia por contexto. El mismo developer revisa de forma diferente un lunes a las 9 de la mañana y un viernes a las 6 de la tarde. Las reglas que aplica dependen de su estado mental, no del código.

    Punto ciego de los cambios recientes. Cuando tienes el código en la cabeza porque acabas de escribirlo, tu cerebro autocompleta lo que falta. El reviewer que eres tú mismo a los 5 minutos de terminar no ve los bugs que sí vería dentro de 3 horas.

    Reglas no escritas que no se comprueban. Tu equipo puede tener convenciones de arquitectura claras en la mente de los seniors, pero si no están en un archivo que el proceso de review comprueba activamente, son invisibles para el proceso.

    El agentic code review resuelve los tres. No se cansa. No autocompleta. Y si defines tus reglas en CLAUDE.md, las comprueba en cada PR sin excepción.

    Cómo integrarlo en tu workflow real

    El punto de entrada más simple es a nivel local, en tu flujo individual:

    # 1. Terminas de implementar un feature
    git add .
    git commit -m "feat: add OAuth flow"
    
    # 2. Abres el PR en GitHub
    gh pr create --title "Add OAuth flow" --body "..."
    
    # 3. Ejecutas el agentic review antes de pedir revisión humana
    /code-review --comment
    

    El agente revisa el PR y posta el comentario. Tú ves los issues, los corriges en una nueva commit, y solo entonces pides revisión humana. Tu reviewer llega a un PR que ya ha pasado por un filtro.

    El segundo nivel es definir qué reglas quieres que el agente compruebe en cada review. Eso va en tu CLAUDE.md:

    ## Code Review Standards
    
    - Always handle async errors with try/catch — no unhandled promises
    - Use camelCase for functions, PascalCase for classes
    - No direct DOM manipulation in Angular components
    - Every public method must have JSDoc if it's part of a service API
    - No hardcoded strings — use i18n keys or constants
    

    A partir de ese momento, el agente comprueba estas reglas en cada PR de forma automática. Cada regla que documentas elimina una categoría entera de errores que antes dependían de que alguien se acordara de revisarlos.

    Puedes encontrar más recursos sobre cómo estructurar CLAUDE.md para workflows de IA en el canal de YouTube de Dominicode, donde cubrimos este tipo de setups en profundidad. Y la documentación oficial del sistema está en docs de Claude Code de Anthropic.

    Agentic vs. manual: la comparativa real

    Code review manual Agentic code review
    Consistencia Varía por persona y momento Idéntica en cada PR
    Velocidad Minutos u horas Segundos
    Contexto histórico Solo si el reviewer conoce el historial Analiza git blame automáticamente
    Reglas del equipo Depende de la memoria Lee CLAUDE.md siempre
    Falsos positivos Bajos (humano con criterio) Filtrados por threshold de confianza
    Escala Limitada por tiempo humano Ilimitada

    La conclusión no es "reemplaza el code review humano". Es "llega al code review humano con el trabajo sucio ya hecho".

    El reviewer humano aporta lo que el agente no puede: criterio de producto, contexto de negocio, decisiones de arquitectura que van más allá del diff. Pero no necesita gastar ese criterio en detectar que falta un try/catch. Para eso está el agente.

    El skill personalizado: más allá del comando base

    El /code-review base es el punto de partida. Pero el sistema de skills de Claude Code te permite ir más lejos: crear un skill de revisión de código adaptado exactamente a tu stack y tus estándares.

    Un skill personalizado vive en .claude/skills/review.md y puede definir categorías de severidad propias:

    ## Review Categories
    
    ### Critical (must fix before merge)
    - Security vulnerabilities (SQL injection, XSS, exposed secrets)
    - Data loss risks
    - Breaking changes sin deprecation notice
    
    ### Important (should fix)
    - Missing error handling in async operations
    - N+1 queries en loops
    - Estado mutable compartido sin sincronización
    
    ### Suggestions (nice to have)
    - Naming improvements
    - Refactoring opportunities
    - Test coverage gaps
    

    Esto no es documentación para humanos. Es el contrato que el agente respeta en cada revisión.

    Si quieres explorar este nivel de customización con casos reales de producción, en el curso Construye con IA vemos exactamente cómo construir este tipo de workflows: desde el skill de review hasta la integración completa en el ciclo de desarrollo.

    Lo que el agentic code review no puede hacer (todavía)

    Hay que ser honestos sobre los límites.

    El agente revisa el diff, no el sistema. Si tu PR introduce un cambio correcto en aislamiento pero que rompe un contrato implícito con otro módulo que no está en el diff, el agente no lo va a ver. Para eso necesitas tests de integración, no un reviewer.

    Tampoco detecta problemas de producto. Un endpoint que técnicamente funciona pero que resuelve mal el problema del usuario es invisible para el agente. Ese criterio es humano, siempre.

    Y los falsos negativos existen. Un confidence threshold de 80 elimina el ruido, pero también puede silenciar algún hallazgo real que el agente no puntúa con suficiente confianza. No es el 100% de los problemas. Es el 80% de los problemas que más tiempo consumen en reviews manuales.

    Con esos límites claros, el agentic code review es una de las adiciones más baratas y de mayor impacto que puedes añadir a tu workflow hoy.

    Empieza con esto

    Si tienes Claude Code instalado, el punto de entrada es inmediato:

    # En un repo con un PR abierto
    /code-review
    

    Si quieres que el agente comprenda las reglas de tu proyecto, el segundo paso es crear o mejorar tu CLAUDE.md con las convenciones que quieres que compruebe.

    Y si quieres ver esto aplicado a un proyecto real — con las decisiones de qué documentar, cómo estructurar el skill y cómo encajarlo en un pipeline de CI — en Dominicode Labs tienes el proyecto de referencia con el setup completo que usamos en producción.


    FAQ — Preguntas frecuentes sobre agentic code review

    ¿El agentic code review reemplaza completamente al code review humano?

    No, y no debería. El agente es muy eficaz detectando problemas técnicos concretos: errores de manejo de excepciones, violaciones de convenciones, memory leaks en el diff. El reviewer humano aporta criterio de producto, arquitectura y contexto de negocio. La combinación de ambos es más potente que cualquiera de los dos solos.

    ¿Necesito una configuración especial de GitHub o CI para usar /code-review --comment?

    El flag --comment requiere que tu implementación del skill incluya la lógica para postear via gh CLI con acceso al repo. Si ya tienes Claude Code configurado con acceso al repositorio de GitHub, el skill puede activar el comentario sin pasos adicionales. El agente detecta el PR activo del branch actual.

    ¿Qué pasa si el agente no tiene acceso a mi CLAUDE.md?

    Sin un CLAUDE.md, el agente solo puede revisar bugs genéricos y problemas obvios del diff. Las reglas específicas de tu equipo — convenciones de naming, patrones de arquitectura, estándares de seguridad — no se comprueban. El CLAUDE.md es lo que convierte el agentic code review de "útil" a "imprescindible".

    ¿Puedo ajustar el threshold de confianza para que reporte más o menos problemas?

    Sí. El threshold lo defines tú en la implementación del skill. El valor 80 es el habitual en setups de referencia, pero puedes bajarlo (por ejemplo, a 60) para ver más hallazgos con posibles falsos positivos, o subirlo (a 90+) para ver solo los problemas con certeza casi absoluta. Para proyectos maduros con buenas convenciones documentadas, un threshold alto es lo más productivo.

    ¿El agente revisa el codebase completo o solo los cambios del PR?

    Solo los cambios del PR — el diff. Esto es una decisión de diseño deliberada: el agente no está ahí para auditar toda la deuda técnica del proyecto, sino para asegurarse de que los cambios nuevos no introducen problemas. La deuda existente es otra conversación.

    ¿Funciona con cualquier lenguaje o framework?

    El /code-review base analiza el código con el modelo de Claude, que entiende prácticamente cualquier lenguaje. Para revisiones especializadas en un framework concreto (Angular, React, NestJS), un skill personalizado en .claude/skills/review.md con reglas específicas de ese stack da resultados significativamente mejores.


    El code review manual no va a desaparecer. Pero el 70% del trabajo que hoy consume ese proceso puede delegarse a un agente que lo hace mejor, más rápido y sin quejarse de que el PR llegó el viernes por la tarde.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
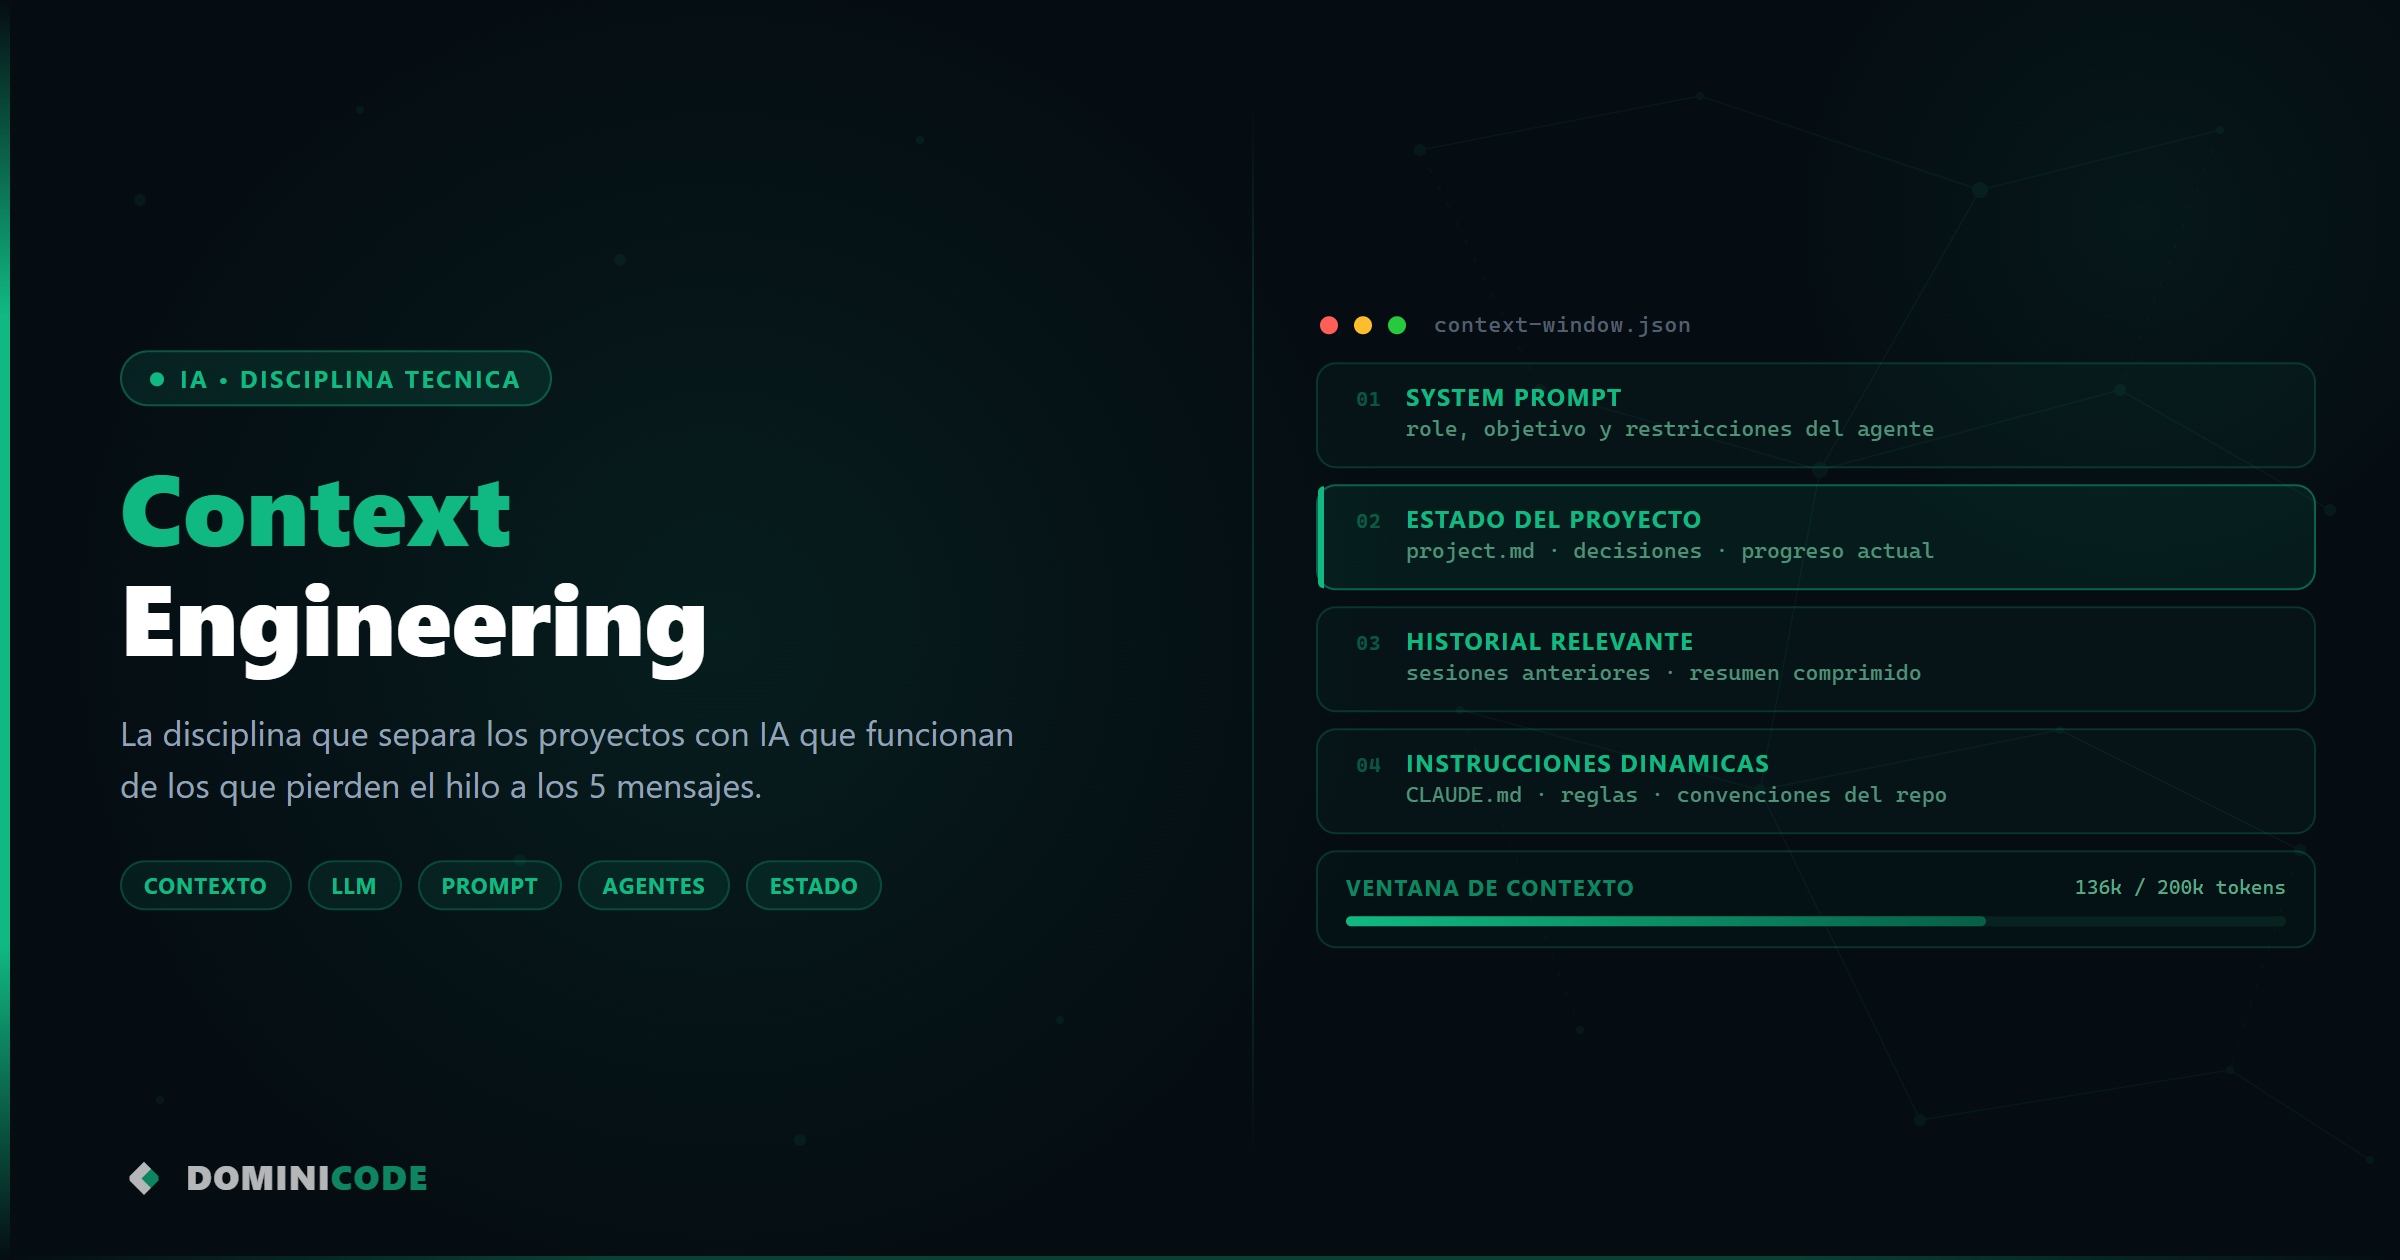
  • Context Engineering: proyectos con IA sin perder el hilo

    Context Engineering: proyectos con IA sin perder el hilo

    La primera vez que me pasó, pensé que era un fallo del modelo.

    Llevaba tres días construyendo una API con Claude Code. Arquitectura decidida, endpoints definidos, estructura de carpetas lista. Todo tenía sentido. Abrí una sesión nueva al cuarto día y le pedí que añadiera autenticación al módulo de usuarios.

    Me devolvió código que contradecía las decisiones que habíamos tomado el día anterior. Naming diferente. Patrón de errores distinto. Como si hubiera arrancado desde cero.

    No era un fallo del modelo. Era un fallo mío. No le había dado context engineering. Le había dado prompts.

    Lo que me faltaba tiene nombre. Y no es lo mismo que prompt engineering.


    El problema real: el modelo no sabe qué decidiste ayer

    Los LLMs no tienen memoria entre sesiones. Cada conversación nueva es, literalmente, una pizarra en blanco.

    Dentro de una misma sesión tienen una ventana de contexto — los modelos actuales manejan ventanas de entre 128k tokens (GPT-4o) y 200k tokens (Claude 3.5/3.7), cifras de junio 2026 que seguirán creciendo — pero esa ventana se llena. Y cuando se llena, el modelo empieza a “olvidar” las partes más antiguas de la conversación. Las decisiones de arquitectura que tomaste al principio. Las convenciones de naming que acordaste. El motivo por el que descartaste la opción B.

    El resultado es predecible: inconsistencia. Código que contradice decisiones previas. Respuestas que suenan razonables pero no encajan con el proyecto real. Y tú volviendo a explicar, sesión tras sesión, qué estás construyendo y cómo.

    Cualquier developer que haya usado IA durante más de dos semanas en un proyecto real lo ha vivido. La inconsistencia entre sesiones es la fricción número uno.


    Context engineering no es prompt engineering

    Mucha gente confunde los dos. No son lo mismo.

    Prompt engineering trata una sola interacción. Cómo formular la pregunta. Qué ejemplos incluir. Qué rol asignarle al modelo. Es útil, pero es táctica de un solo turno.

    Context engineering es la disciplina de estructurar y gestionar toda la información que recibe el modelo para que produzca resultados consistentes a lo largo de un proyecto completo. No en un prompt. En semanas de trabajo.

    La diferencia es la misma que hay entre saber hacer una buena pregunta en una entrevista y saber gestionar a un equipo durante un sprint.

    Prompt Engineering Context Engineering
    Alcance Un turno de conversación Un proyecto completo
    Problema que resuelve Calidad de una respuesta Consistencia entre sesiones
    Habilidad principal Redactar instrucciones claras Diseñar sistemas de información
    Cuándo falla Respuesta ambigua o incorrecta Proyecto incoherente en semana 3
    Herramienta clave El prompt en sí CLAUDE.md, specs, logs de decisiones

    Puedes ser un maestro del prompt engineering y aun así tener un proyecto que se rompe cada semana. El context engineering es lo que lo sostiene.


    Las 4 técnicas que uso en producción

    1. CLAUDE.md / AGENTS.md — la memoria persistente del proyecto

    Este es el punto de partida. Un archivo en la raíz del proyecto que le dice al modelo, al inicio de cada sesión, quién eres, qué estás construyendo y cómo trabajas.

    No es un README. Es un system prompt que el modelo lee antes de hacer nada.

    Lo mínimo que debe tener:

    • Descripción del proyecto en 2-3 líneas (qué es, para quién)
    • Stack técnico con versiones concretas
    • Convenciones de código que no se negocian
    • Lo que NO debe hacer el modelo (igual de importante)
    • Estado actual del proyecto — en qué fase estás

    Un ejemplo mínimo que uso en proyectos reales:

    # CLAUDE.md — API de Usuarios
    
    ## Proyecto
    API REST de gestión de usuarios para SaaS B2B.
    Stack: NestJS 10 + PostgreSQL + Prisma 5.
    
    ## Convenciones
    - Naming: camelCase para variables, PascalCase para clases, kebab-case para archivos
    - Errores: siempre usar HttpException con código y mensaje estructurado
    - No usar `any` en TypeScript — tipos explícitos o `unknown`
    
    ## NO hacer
    - No generar migraciones de Prisma automáticamente — las revisamos manualmente
    - No cambiar el schema sin actualizar architecture.md
    
    ## Estado actual
    Fase 2 — módulo de autenticación JWT. Ver tasks.md para detalle.
    

    Si usas Claude Code, este archivo es CLAUDE.md. Si usas Cursor o Windsurf, es __INLINE_PLACEHOLDER_0__ o __INLINE_PLACEHOLDER_1__ (__INLINE_PLACEHOLDER_2__ sigue siendo compatible pero es el formato legacy de Cursor). El nombre cambia. El concepto es el mismo.

    Ya escribí un post completo sobre cómo estructurar este archivo: CLAUDE.md: el system prompt de tu proyecto con Claude Code. Si no lo has leído, empieza por ahí.

    2. Archivos de estado — lo que el modelo no puede inferir

    El CLAUDE.md da el contexto estático: qué es el proyecto y cómo funciona. Pero los proyectos evolucionan. Necesitas capturar el estado dinámico.

    Yo mantengo tres archivos en cada proyecto:

    __INLINE_PLACEHOLDER_3__ — lista de tareas con estado (pendiente / en progreso / hecho). Una línea por tarea, fecha de última actualización. El modelo la lee y sabe exactamente dónde estás.

    __INLINE_PLACEHOLDER_4__ — log de decisiones arquitectónicas. Cada decisión con su fecha, la opción elegida y el motivo por el que se descartó la alternativa. Este archivo vale oro cuando vuelves a un proyecto tres semanas después.

    __INLINE_PLACEHOLDER_5__ — snapshot de la arquitectura actual. No el diagrama ideal. El diagrama real, con los módulos que existen ahora mismo. El modelo lo usa para no proponer soluciones que contradigan lo ya construido.

    Tres archivos. Ninguno supera las dos páginas. Pero juntos eliminan el 80% de la inconsistencia.

    3. Chunking de tareas — no pidas todo en un prompt

    Este error lo cometo yo también cuando tengo prisa.

    “Implementa el sistema de autenticación completo con JWT, refresh tokens, roles y middleware de autorización.”

    El modelo lo intenta. Genera código. Pero es código que asume cosas sobre tu proyecto que no conoce, o que contradice la arquitectura que ya tienes. Y cuando algo falla, el problema está distribuido en 400 líneas de código que no entiendes del todo.

    La regla que aplico: una tarea por sesión, una función por tarea.

    En lugar de pedir la autenticación completa, pido:

    1. Primero: el módulo de usuarios con su schema y validaciones
    2. Luego: la generación de JWT con los claims que necesito
    3. Luego: el endpoint de login que conecta ambos
    4. Luego: el middleware que verifica el token

    Cuatro sesiones. Cuatro archivos de contexto actualizados al final de cada una. Un sistema que entiendo porque lo construí pieza a pieza.

    El modelo produce mejor código cuando el scope es pequeño y el contexto es preciso. En la práctica, siempre.

    4. Resúmenes de sesión — el handoff entre el tú de hoy y el tú de mañana

    Al final de cada sesión de trabajo, antes de cerrar, escribo este prompt:

    “Resume lo que hemos hecho en esta sesión en 5-7 puntos: qué se implementó, qué decisiones se tomaron, qué problemas encontramos y qué queda pendiente para la siguiente.”

    Copio esa respuesta en un archivo __INLINE_PLACEHOLDER_6__ con la fecha.

    Cuando vuelvo al proyecto al día siguiente, la primera cosa que hago es darle ese log al modelo junto con el CLAUDE.md. El modelo arranca con el contexto exacto de donde lo dejé. Sin tener que re-explicar. Sin inconsistencias.

    Diez minutos al final de cada sesión que ahorran una hora al principio de la siguiente.


    Ejemplo práctico: un proyecto de tres semanas sin perder el hilo

    Semana 1 — Cimentar el contexto

    Antes de escribir una línea de código, genero la spec del proyecto con Spec-Driven Development: visión, usuarios, funcionalidades, arquitectura. Ese documento se convierte en la base del CLAUDE.md.

    Creo los tres archivos de estado vacíos: __INLINE_PLACEHOLDER_7__, __INLINE_PLACEHOLDER_8__, __INLINE_PLACEHOLDER_9__. El modelo los actualiza conforme avanzamos.

    Semana 2 — Construcción en chunks

    Cada sesión tiene una tarea concreta de __INLINE_PLACEHOLDER_10__. Arranca con el CLAUDE.md, el archivo de arquitectura y el log de la sesión anterior. Termina con el modelo actualizando el estado de la tarea y generando el resumen de sesión.

    Semana 3 — Cuando todo se complica

    En la semana 3 es cuando los proyectos sin sistema se rompen. El código empieza a contradecirse. Las decisiones del día 1 ya nadie las recuerda. Las nuevas funcionalidades no encajan con lo que ya existe.

    Con context engineering, la semana 3 es igual de fluida que la semana 1. Porque el modelo tiene, en cada sesión, el mismo nivel de contexto que tenías tú el primer día. El __INLINE_PLACEHOLDER_11__ le dice por qué tomaste las decisiones que tomaste. El __INLINE_PLACEHOLDER_12__ le muestra la estructura real. El log de sesión le dice dónde lo dejaste.

    No es magia. Es sistema.


    Lo que cambia cuando aplicas esto

    La diferencia no es velocidad. Es consistencia.

    Un developer sin context engineering puede ir rápido la primera semana. Pero en la semana 3, la deuda de contexto empieza a pasarle factura. Cada sesión nueva cuesta más porque hay que re-explicar más. Cada funcionalidad nueva tiene más probabilidad de romperse con algo anterior.

    Un developer con context engineering mantiene el mismo ritmo en la semana 8 que en la semana 1. Porque el contexto no es algo que se pierde — es algo que se gestiona.

    Esta es exactamente la mentalidad que enseño en el curso Construye con IA: de la idea al producto con Claude Code. No “cómo usar Claude”. Cómo construir con sistema.


    FAQ

    ¿El context engineering solo funciona con Claude Code?

    No. Los principios aplican a cualquier LLM y cualquier herramienta — Cursor, Windsurf, ChatGPT, Gemini. El CLAUDE.md tiene su equivalente en cada entorno: __INLINE_PLACEHOLDER_13__, __INLINE_PLACEHOLDER_14__, un system prompt inicial. La técnica de chunking y los resúmenes de sesión son agnósticos al modelo.

    ¿Cuánto tiempo añade a mi flujo de trabajo?

    En la práctica, entre 10 y 20 minutos al día. Cinco minutos actualizando el __INLINE_PLACEHOLDER_15__, diez minutos pidiendo y guardando el resumen de sesión. El retorno es que ahorras una o dos horas semanales de re-explicar contexto y corregir inconsistencias. La matemática es clara.

    ¿Necesito crear estos archivos manualmente desde cero?

    Puedes empezar con plantillas. En el curso Construye con IA incluyo las plantillas exactas de CLAUDE.md, __INLINE_PLACEHOLDER_16__ y __INLINE_PLACEHOLDER_17__ que uso en mis proyectos reales. Y si quieres la metodología de especificación completa, el libro SDD cubre el proceso de principio a fin.

    ¿Context engineering resuelve el problema de la ventana de contexto?

    Parcialmente. No puedes ampliar la ventana de contexto del modelo — eso lo determina el proveedor. Lo que puedes hacer es gestionar qué información entra en esa ventana en cada sesión. Context engineering te da control sobre eso: qué es esencial que el modelo sepa, qué puede inferir y qué no necesita en ese momento concreto. No elimina la limitación. La hace manejable.

    ¿Cuál es la diferencia entre context engineering y RAG?

    RAG (Retrieval-Augmented Generation) es una arquitectura técnica para recuperar información de fuentes externas y añadirla al contexto del modelo en tiempo de ejecución. Context engineering es una disciplina de trabajo que aplicas como developer para gestionar el contexto a lo largo de un proyecto. Son complementarios, no equivalentes. RAG es una herramienta. Context engineering es el sistema que decide qué información recuperar, cuándo y por qué.


    Si quieres profundizar en cómo aplicar estas técnicas con proyectos reales y ver el flujo en acción, en Dominicode Labs tenemos sesiones prácticas donde trabajamos esto con proyectos concretos de la comunidad.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
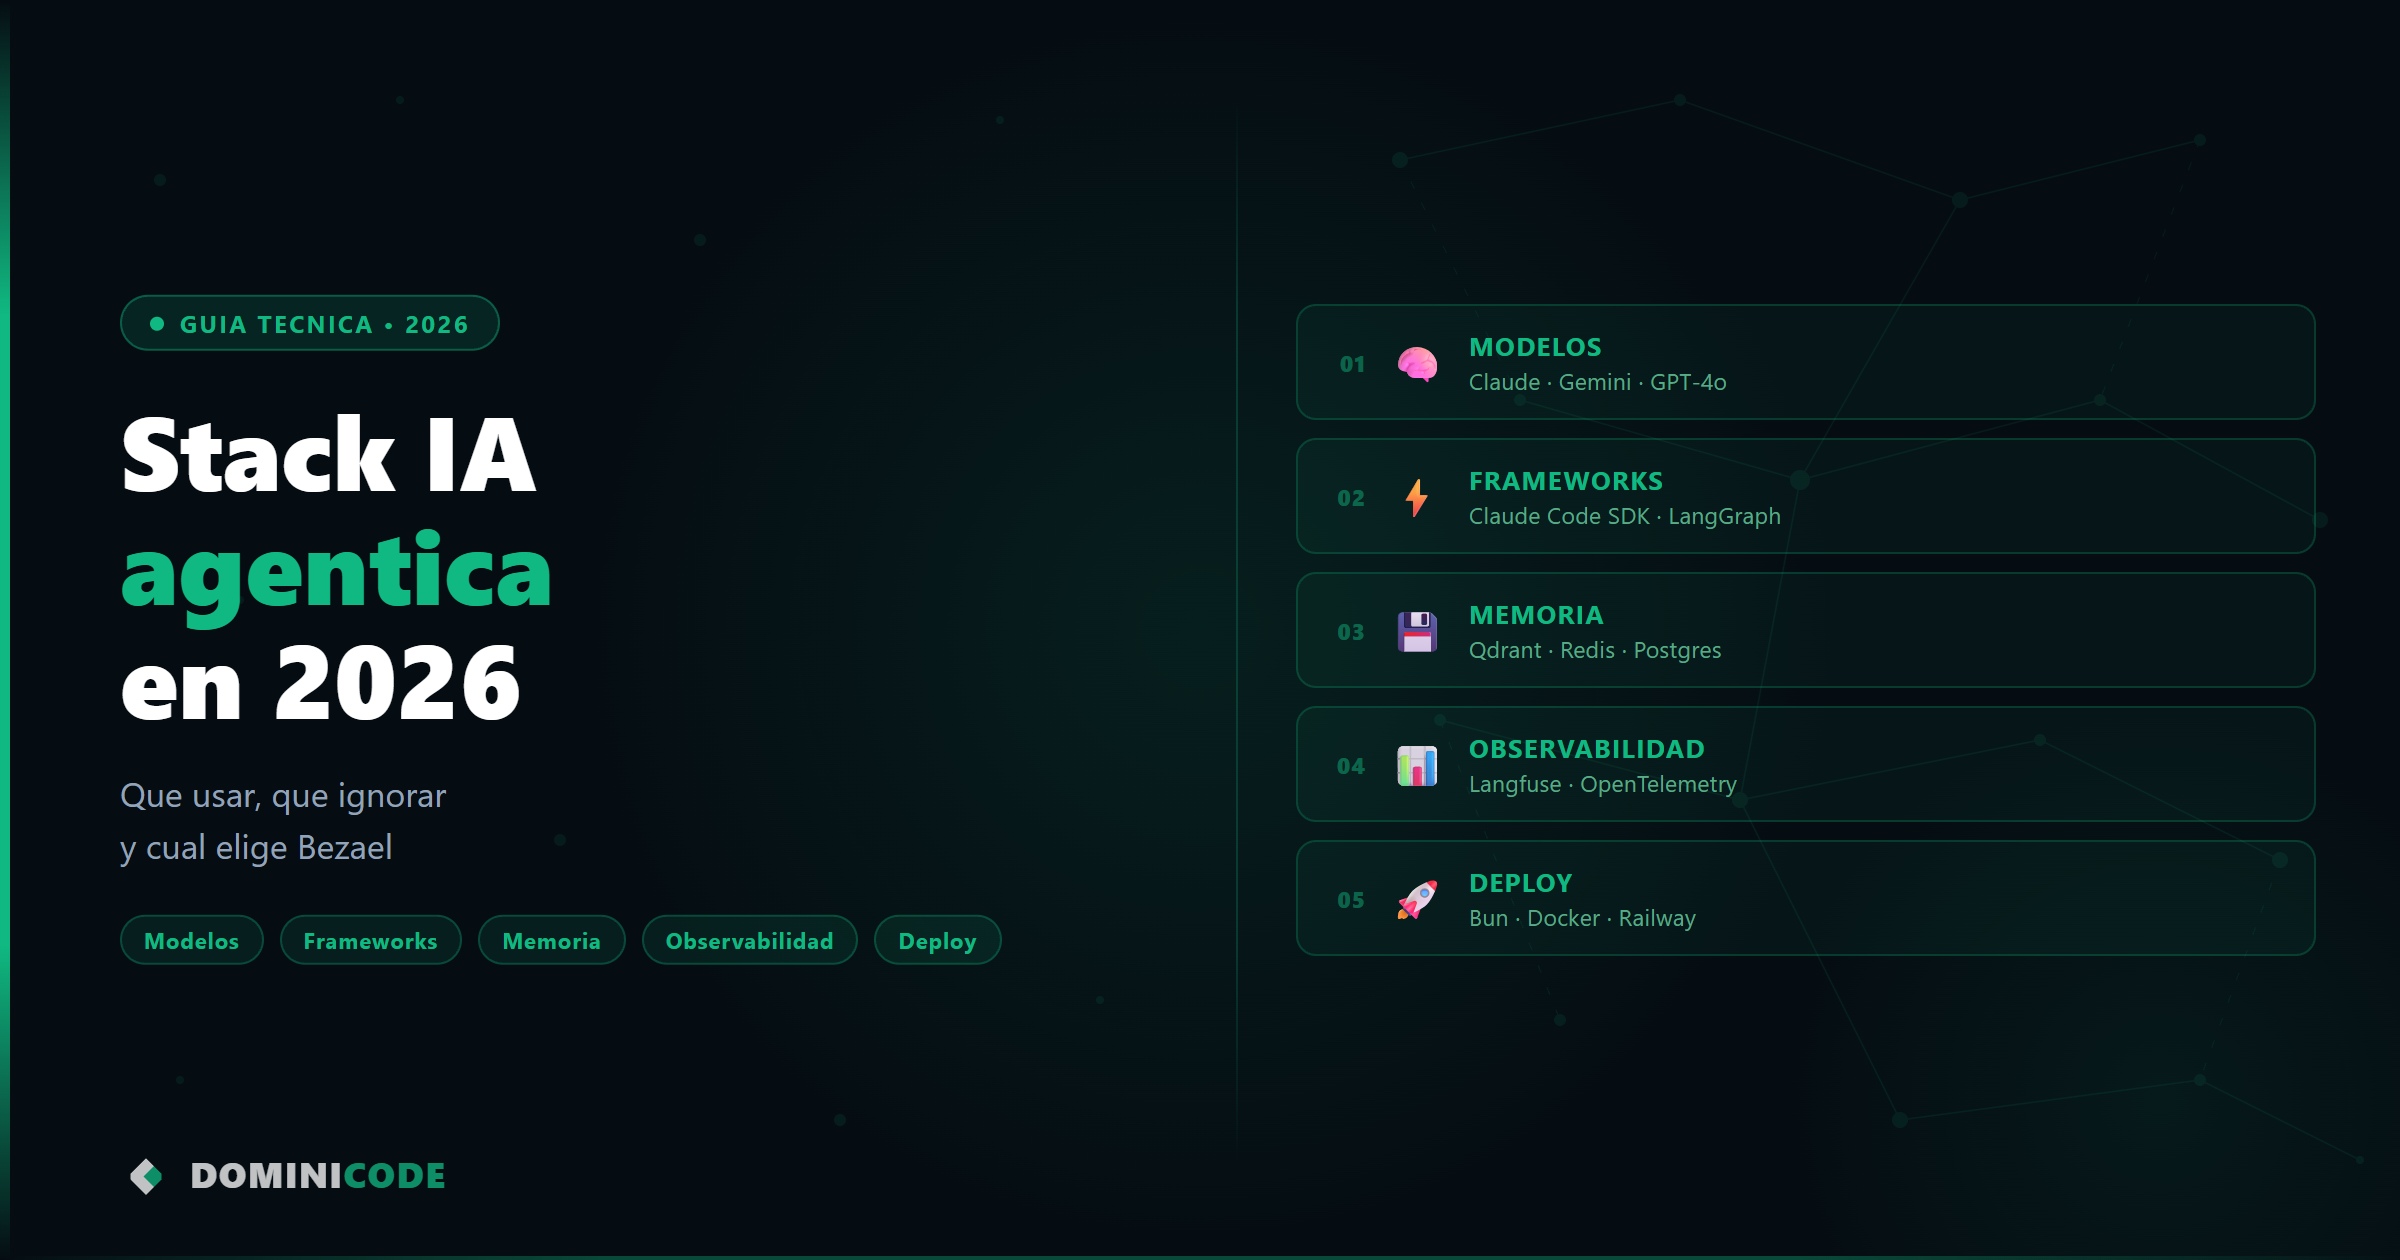
  • Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo

    Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo

    El problema no es que falten herramientas para construir agentes de IA. Es que sobran.

    Hace unos meses, en una sesión de Dominicode Labs, me preguntaron cuál era el stack IA agéntica 2026 que recomendaba. Empecé a responder y me di cuenta de que tenía una respuesta para cada capa — pero no tenía una respuesta integrada. Llevo varios proyectos agénticos en producción en Dominicode y cada semana aparece un nuevo framework, un nuevo modelo, un nuevo “estándar imprescindible”.

    Qué modelo. Qué framework de orquestación. Qué hacer con la memoria. Cómo trazar lo que hace el agente. Dónde desplegarlo. Cada capa tiene sus propias opciones, sus propias compensaciones y su propio ecosistema de hype que no para de generar nuevas herramientas.

    Este post es mi respuesta integrada: el stack que yo uso, por qué elegí cada pieza y qué descarto con criterio. No es una lista de todas las herramientas que existen. Es una guía con tesis clara sobre qué funciona en producción cuando construyes con TypeScript, para un proyecto real, sin un equipo de 20 personas.


    Cómo pensar en el stack agéntico: capas, no herramientas

    Antes de hablar de herramientas específicas, el marco que uso para evaluar cualquier stack agéntico. Hay cinco capas y cada una resuelve un problema diferente:

    1. Modelo — el LLM que razona y toma decisiones
    2. Framework de agente — el runtime que envuelve el agentic loop
    3. Memoria y contexto — dónde vive la información entre sesiones y entre agentes
    4. Observabilidad — cómo ves qué está haciendo el agente
    5. Deployment — dónde corre el sistema en producción

    La mayoría de los posts sobre herramientas de IA mezclan estas capas y crean confusión. LangChain no compite con Claude — compite con el SDK de Anthropic. Langfuse no compite con Pinecone — resuelven problemas en capas completamente distintas.

    Cuando tienes claro qué capa resuelve cada herramienta, la decisión se vuelve mucho más simple. Si no tienes claro aún qué es el agentic loop y cómo funciona, empieza por aquí antes de elegir el stack.


    Capa 1: El modelo — quién razona

    La decisión más importante del stack y la que más gente toma al revés: eligen el modelo por el benchmark, no por el comportamiento en producción con herramientas.

    Los benchmarks de razonamiento abstracto no predicen bien si un modelo va a gestionar correctamente el agentic loop: respetar los límites de las herramientas, detectar cuándo ha completado el objetivo, no inventarse argumentos para las tool calls, pedir confirmación cuando tiene ambigüedad.

    Mi ranking para sistemas agénticos en 2026, basado en uso real:

    Claude Sonnet (Anthropic) — mi elección principal. La familia Claude 4.x lidera en comportamiento agéntico: sigue instrucciones complejas del sistema prompt con más fidelidad que los competidores, gestiona bien contextos de 200k tokens, y tiene el menor índice de “tool hallucination” — inventarse argumentos para herramientas que no existen o llamar a herramientas con parámetros incorrectos. Para proyectos donde el agente tiene acceso a herramientas reales con consecuencias (escritura a disco, llamadas a APIs, base de datos), esta fidelidad importa.

    Gemini 2.5 Pro (Google) — segunda opción para tareas de análisis. Tiene una ventana de contexto de 1M tokens que es genuinamente útil cuando el agente necesita procesar documentos grandes. El razonamiento es sólido. La API tiene más latencia que Anthropic en llamadas con herramientas. Lo uso puntualmente para tareas de análisis de documentos extensos, no como backbone de un sistema agéntico.

    GPT-4o (OpenAI) — bueno, pero no es mi primera elección para agentes. Excelente en tareas de generación pura. En agentic loops de más de 15 iteraciones, he visto más context drift que con Claude. Para proyectos que ya tienen infraestructura en el ecosistema OpenAI, es perfectamente válido.

    Llama 3.x local (Meta) — para casos específicos, no como base. Los modelos locales tienen su lugar: privacidad total, sin costos por token, sin latencia de red. Pero para sistemas agénticos complejos, la diferencia en calidad de razonamiento con los modelos de frontera es demasiado grande hoy. Los uso para tareas de clasificación simple o cuando los datos no pueden salir del entorno.

    La conclusión práctica: empieza con Claude Sonnet. Si los costos escalan y la tarea lo permite, evalúa migrar partes del sistema a modelos más baratos para subtareas que no requieren razonamiento complejo.


    Capa 2: El framework de agente — quién orquesta el loop

    Aquí está la decisión que más polémica genera, porque hay muchas opciones y cada una tiene su comunidad apasionada.

    Mi posición es clara: el framework que elijas debería desaparecer de tu código. Si tu lógica de negocio está mezclada con abstracciones del framework, tienes un problema de arquitectura, no de elección de herramienta.

    Vercel AI SDK — mi elección para TypeScript

    Para proyectos TypeScript, el Vercel AI SDK es el estándar más sólido hoy. Tiene tres propiedades que importan:

    Primero, la abstracción es mínima. generateText, streamText, generateObject — funciones que hacen lo que dicen, con un tipo de retorno predecible. Puedes leer el código del SDK y entender qué ocurre.

    Segundo, es agnóstico al proveedor. El mismo código funciona con Claude, GPT-4o y Gemini. Cambias el adaptador, no la lógica. En un año donde los modelos evolucionan rápido, esto no es un detalle menor.

    Tercero, tiene soporte nativo para tool use, streaming de respuestas y generateObject con schemas Zod — lo que significa que puedes hacer que el modelo devuelva JSON tipado sin analizadores de texto frágiles.

    import { generateText } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";


    const result = await generateText({ model: anthropic("claude-sonnet-4-6"), // verifica el modelo vigente en docs.anthropic.com/models tools: { readFile: { description: "Lee el contenido de un archivo del proyecto", parameters: z.object({ path: z.string() }), execute: async ({ path }) => fs.readFile(path, "utf-8"), }, }, messages: [{ role: "user", content: userQuery }], maxSteps: 15, // límite de iteraciones del loop });

    El parámetro maxSteps es el límite de iteraciones del agentic loop. No lo omitas nunca. Un agente sin límite de pasos en producción es un bug esperando a ocurrir.

    LangGraph — cuando necesitas flujos con estado y ramificaciones

    LangGraph (de LangChain) resuelve un problema diferente: orquestación de flujos donde el camino de ejecución no es lineal. Si tienes un sistema donde el agente puede ir por diferentes ramas según el resultado de un paso anterior, donde necesitas estado persistente entre sesiones, o donde hay handoffs entre múltiples agentes con condiciones complejas — LangGraph tiene primitivas para eso.

    No es mi primera elección para proyectos simples porque añade complejidad conceptual. Pero para sistemas multi-agente con lógica de routing elaborada, es genuinamente más potente que construir esa lógica a mano.

    SDK de Anthropic directo — para control total

    Cuando necesito control máximo sobre cada llamada a la API, uso el SDK de Anthropic directamente. Sin abstracciones intermedias. El agentic loop lo implemento yo, con la lógica exacta que necesito.

    Esto es lo que haría si estuviera construyendo el loop desde cero con el SDK directo — el mismo patrón que cubro en detalle en el curso Construye con IA:

    import Anthropic from "@anthropic-ai/sdk";


    const client = new Anthropic();

    async function runAgentLoop(userMessage: string, tools: Tool[]) { const messages: Anthropic.MessageParam[] = [ { role: "user", content: userMessage }, ];

    let iterations = 0; const maxIterations = 20;

    while (iterations < maxIterations) { const response = await client.messages.create({ model: "claude-sonnet-4-6", // verifica en docs.anthropic.com/models max_tokens: 4096, tools, messages, });

    // Si el modelo no llama a ninguna herramienta, ha terminado if (response.stop_reason === "end_turn") { return extractTextResponse(response); }

    // Procesa las tool calls y añade los resultados al contexto const toolResults = await executeToolCalls(response.content); messages.push({ role: "assistant", content: response.content }); messages.push({ role: "user", content: toolResults });

    iterations++; }

    throw new Error(Agente excedió el límite de ${maxIterations} iteraciones); }

    Lo que no uso: CrewAI, AutoGen, AgentGPT ni la mayoría de frameworks Python-first para proyectos TypeScript. No porque sean malos — CrewAI tiene ideas interesantes sobre roles y colaboración entre agentes — sino porque añadir Python al stack cuando ya tienes TypeScript es complejidad operacional que no se justifica en la mayoría de casos. Si tu equipo es Python, la ecuación cambia.


    Capa 3: MCP — el protocolo que está cambiando todo

    El Model Context Protocol (MCP) merece su propio apartado porque no es un framework de agentes. Es un estándar de comunicación — el equivalente a REST para que los agentes consuman herramientas y contexto de fuentes externas de forma estandarizada.

    Antes de MCP, cada herramienta que querías darle a un agente requería código de integración específico. Con MCP, una herramienta bien construida se puede conectar a cualquier agente que soporte el protocolo — Claude Code, Cursor, tu propio agente custom.

    Las implicaciones son grandes: en lugar de construir integraciones punto a punto, construyes servidores MCP reutilizables. Ya existe un ecosistema de servidores MCP públicos para GitHub, bases de datos, sistemas de archivos, APIs populares.

    // Un servidor MCP mínimo con el SDK oficial
    import { Server } from "@modelcontextprotocol/sdk/server/index.js";
    import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
    import { ListToolsRequestSchema } from "@modelcontextprotocol/sdk/types.js";


    const server = new Server( { name: "dominicode-tools", version: "1.0.0" }, { capabilities: { tools: {} } } );

    server.setRequestHandler(ListToolsRequestSchema, async () => ({ tools: [ { name: "get_post_metrics", description: "Obtiene métricas de un post del blog por slug", inputSchema: { type: "object", properties: { slug: { type: "string" } }, required: ["slug"], }, }, ], }));

    const transport = new StdioServerTransport(); await server.connect(transport);

    En 2026, si construyes herramientas para agentes y no las expones como servidores MCP, estás construyendo para un solo cliente. El ecosistema ya se está moviendo en esta dirección — Anthropic, OpenAI, Google y la mayoría de los frameworks de agentes tienen soporte nativo para MCP.


    Capa 4: Memoria y contexto persistente

    El problema de la memoria en agentes agénticos tiene tres dimensiones distintas y cada una necesita una solución diferente.

    Memoria conversacional (corto plazo) — el historial de mensajes de la sesión actual. La gestión correcta es mantenerlo en el contexto de la llamada al LLM. El truco está en la truncación inteligente: cuando el contexto se acerca al límite, no cortes los mensajes más antiguos a ciegas — resume las iteraciones antiguas y mantén los más recientes completos.

    Memoria semántica (búsqueda por similaridad) — para cuando el agente necesita recuperar información relevante de una base de conocimiento grande. Las opciones que uso:

    • pgvector — extensión de PostgreSQL. Si ya tienes Postgres en el stack (y probablemente lo tienes), añadir pgvector es añadir una extensión. No necesitas otra base de datos. Para la mayoría de proyectos con menos de diez millones de embeddings, pgvector es suficiente y elimina complejidad operacional.
    • Pinecone — la opción gestionada cuando el volumen es grande o quieres zero-ops. Más caro, más simple. Para proyectos en fases tempranas con presupuesto ajustado, pgvector primero.
    • Supabase pgvector — pgvector sobre Supabase. La que uso en proyectos nuevos porque ya tengo Supabase en el stack para auth y database.

    Memoria episódica (estado entre sesiones) — lo que el agente recuerda de sesiones anteriores con un usuario específico. Esto no es búsqueda vectorial: es estado estructurado que guardas en una tabla normal. El patrón que funciona es guardar un JSON con los hechos relevantes del usuario o proyecto y cargarlo al inicio de cada sesión como parte del system prompt.

    // Carga el estado de memoria al inicio de la sesión
    async function buildSystemPromptWithMemory(userId: string): Promise<string> {
      const memory = await db.query<UserMemory>(
        "SELECT facts FROM agent_memory WHERE user_id = $1",
        [userId]
      );


    const memoryContext = memory.rows[0]?.facts ? \n\nContexto previo del usuario:\n${JSON.stringify(memory.rows[0].facts, null, 2)} : "";

    return Eres un asistente técnico de Dominicode.${memoryContext}; }


    Capa 5: Observabilidad — ver lo que hace el agente

    Sin observabilidad, un agente en producción es una caja negra que factura. Ya hay un post completo en este blog sobre cómo instrumentar tus agentes con Langfuse y OpenTelemetry, así que aquí voy directo a las decisiones de stack:

    Langfuse — la elección por defecto. Open source, autohospedable, SDK para TypeScript con integración nativa en el Vercel AI SDK. Con un experimental_telemetry en la llamada tienes trazas completas:

    const result = await generateText({
      model: anthropic("claude-sonnet-4-6"), // verifica el modelo vigente en docs.anthropic.com/models
      messages,
      tools,
      experimental_telemetry: { // en Vercel AI SDK v4+ puede ser telemetry sin el prefijo
        isEnabled: true,
        metadata: { userId, sessionId, operationType: "support-agent" },
      },
    });

    OpenTelemetry GenAI — si ya tienes infraestructura OTEL en la empresa, las semantic conventions para IA generativa te permiten integrar las trazas de tus agentes en Grafana, Datadog o Honeycomb sin añadir otra plataforma.

    Helicone — proxy sin código si necesitas observabilidad inmediata sin instrumentar. Un cambio de base URL y tienes dashboards. Útil para proyectos donde no puedes tocar el código de integración.


    Capa 6: Deployment — dónde vive el agente en producción

    Las opciones razonables en 2026, con criterio claro sobre cuándo usar cada una:

    Railway — mi primera opción para agentes con estado o procesos de larga duración. Soporta WebSockets, procesos persistentes y tiene buena DX con Docker. Para agentes que necesitan mantener conexiones abiertas o procesar en background, Railway es más natural que Vercel.

    Vercel — ideal para agentes stateless que responden a webhooks o peticiones HTTP. La integración con el Vercel AI SDK es perfecta — maxDuration hasta 300 segundos en planes Pro es suficiente para la mayoría de las respuestas agénticas. Para workflows que duran minutos, necesitas otra opción.

    Cloudflare Workers + Durable Objects — la opción de mayor rendimiento para agentes edge. Durable Objects resuelve el problema de estado en entornos serverless de forma elegante. La curva de aprendizaje es mayor, pero el resultado en latencia y coste a escala es difícil de igualar.

    Docker + VPS — cuando necesitas control total, costos predecibles a escala media y no quieres depender de plataformas específicas. Es lo que uso para los agentes internos de Dominicode que corren de forma continua.

    Una regla práctica: si el agente responde en menos de 30 segundos y no necesita estado entre llamadas, serverless es suficiente. Si el agente trabaja durante minutos, mantiene conexiones o necesita acceso a recursos locales, necesitas un proceso persistente.


    Mi stack en Dominicode: la versión concreta

    Sin rodeos. Esto es exactamente lo que uso:

    Capa Herramienta Por qué
    Modelo principal Claude Sonnet (Anthropic) Mejor comportamiento en agentic loops, 200k contexto
    Modelo para análisis Gemini 2.5 Pro Contexto 1M para documentos grandes
    Runtime Bun Arranque más rápido, compatibilidad TS nativa, fetch nativo
    Framework de agente Vercel AI SDK Tipado TS sólido, agnóstico al proveedor, maxSteps nativo
    Herramientas custom MCP servers propios Reutilizables entre agentes, estándar abierto
    Memoria semántica Supabase + pgvector Postgres ya en el stack, zero overhead operacional
    Memoria episódica Postgres (tabla JSON) No necesita búsqueda vectorial, estado estructurado
    Observabilidad Langfuse cloud Open source, free tier generoso, integración VAISDK
    Deployment (agentes web) Vercel Integración natural con el SDK
    Deployment (procesos) Railway + Docker Agentes de larga duración, procesos internos
    Validación Zod Schemas para tool inputs y outputs tipados

    La parte que más me preguntan es el runtime: por qué Bun y no Node. La respuesta corta: en scripts de agentes que arrancan y terminan frecuentemente, la diferencia de arranque es perceptible. El soporte nativo de TypeScript elimina el paso de transpilación en scripts de herramientas. Y fetch nativo sin polyfills simplifica el código de integración con APIs externas.


    Lo que descarto y por qué

    LangChain (la librería base) — demasiada abstracción sobre abstracciones. El problema no es que sea mala herramienta: es que cuando algo falla en un agente LangChain, la pila de herencia de clases hace que depurar sea más difícil que si hubieras implementado el loop a mano. LangGraph tiene más sentido para flujos complejos, pero la librería base la evito.

    AutoGen (Microsoft) — interesante para investigación, inconsistente en producción. El modelo de conversación entre agentes es elegante en teoría, pero en proyectos reales he visto bucles de conversación que consumen tokens sin converger. Puede mejorar, pero hoy no lo usaría para un sistema que atiende usuarios reales.

    Pinecone como primera opción — no porque sea malo, sino porque pgvector en Postgres elimina una dependencia externa para la mayoría de los casos de uso. Cuando el volumen de embeddings supere los diez millones o necesites búsquedas en milisegundos a escala muy alta, Pinecone tiene sentido. Antes, no.

    Modelos locales como backbone — la brecha de calidad con los modelos de frontera es demasiado grande para sistemas agénticos complejos. Para clasificación de intenciones sencillas o filtros de moderación, tiene sentido. Para el loop principal de un agente que toma decisiones consecuentes, no lo haría hoy.


    El stack no es el problema

    La decisión de stack importa — pero menos de lo que sugiere el volumen de contenido que se publica sobre herramientas de IA cada semana.

    He visto proyectos con el stack perfecto que fallaban en producción por falta de observabilidad. He visto proyectos con stacks “incorrectos” que funcionaban perfectamente porque el equipo entendía qué estaba haciendo.

    El stack es el entorno. Lo que importa es entender cómo funciona el agentic loop, cómo diseñar herramientas que el modelo pueda usar de forma predecible, y cómo instrumentar el sistema para ver qué ocurre cuando algo falla.

    Si quieres construir esto desde cero con criterio — desde el primer loop hasta el sistema completo en producción — en el curso Construye con IA cubrimos exactamente estas decisiones: qué stack elegir para cada tipo de proyecto, cómo estructurar el código para que sea mantenible, y cómo pasar de prototipo a sistema que funciona cuando no estás mirando.

    Y si quieres el marco metodológico para especificar el sistema antes de escribir una línea de código — evitar construir el agente equivocado — el libro de Spec-Driven Development es la guía que yo sigo antes de abrir el editor.


    Y si al montar el stack te queda la duda de fondo de dónde acaba la automatización y empieza la agencia real, la definición operativa está en qué es un agente de IA de verdad.

    FAQ — Preguntas frecuentes sobre el stack de IA agéntica

    ¿Qué framework de agentes es mejor en 2026: Vercel AI SDK, LangGraph o el SDK directo de Anthropic?

    Depende de la complejidad del sistema. Para la mayoría de proyectos TypeScript con flujos lineales, el Vercel AI SDK ofrece el mejor equilibrio entre abstracción mínima y productividad: tipado sólido, soporte nativo para tool use y streaming, y compatibilidad con múltiples proveedores. LangGraph añade valor cuando el flujo tiene ramificaciones complejas, estado persistente entre pasos o múltiples agentes con routing condicional. El SDK directo de Anthropic tiene sentido cuando necesitas control total sobre cada llamada o cuando las abstracciones intermedias ocultan comportamiento que necesitas ver.

    ¿Necesito una base de datos vectorial para construir un agente?

    No necesariamente. La memoria vectorial solo es necesaria cuando el agente necesita recuperar información relevante de un corpus grande de documentos. Si el agente trabaja con un contexto fijo que cabe en la ventana de contexto del modelo (y con 200k tokens de Claude, cabe mucho), no necesitas embeddings ni búsqueda vectorial. Cuando el corpus supera lo que cabe en contexto, empieza por pgvector en Postgres antes de añadir Pinecone u otra base de datos vectorial externa.

    ¿Qué es MCP y por qué debería importarme en 2026?

    El Model Context Protocol es un estándar abierto que define cómo los agentes de IA consumen herramientas y contexto de fuentes externas. Su importancia práctica: en lugar de construir integraciones específicas para cada agente que quieras conectar a una herramienta, construyes un servidor MCP una vez y cualquier agente compatible puede usarlo. Claude Code, Cursor y la mayoría de los IDEs con IA ya soportan MCP. Si construyes herramientas para agentes hoy, exponerlas como servidores MCP multiplica su utilidad sin trabajo adicional.

    ¿Puedo usar Python para construir el stack agéntico si ya soy developer Python?

    Sí, y tiene sentido si Python es tu lenguaje principal. El ecosistema de agentes en Python es más maduro en algunos aspectos: LangChain, AutoGen, CrewAI y la mayoría de frameworks de referencia nacieron en Python. Lo que pierdes en TypeScript: algunas integraciones no tienen SDK Python equivalente al mismo nivel de calidad. Lo que ganas: ecosistema de ML más rico y más documentación de referencia. La decisión debe estar en el lenguaje que dominas, no en el que tiene más hype.

    ¿Cómo elijo entre Railway y Vercel para desplegar un agente?

    La regla práctica: si el agente responde a peticiones HTTP en menos de 60 segundos y no necesita mantener estado entre llamadas, Vercel Functions es suficiente y más simple. Si el agente trabaja en procesos de larga duración (más de un minuto), necesita WebSockets, mantiene conexiones persistentes, o accede a recursos locales del servidor, Railway con un contenedor Docker es la opción correcta. Cloudflare Workers + Durable Objects es la tercera opción para máxima performance edge cuando el coste a escala importa.

    ¿Qué herramienta de observabilidad recomendarías empezar primero?

    Langfuse. El plan gratuito en cloud cubre 50.000 observaciones al mes, la integración con el Vercel AI SDK es de una línea de código (el parámetro experimental_telemetry), y si en algún momento necesitas privacidad total de los datos, puedes autohospedarlo con Docker. Si ya tienes infraestructura OpenTelemetry en la empresa, las semantic conventions GenAI de OTEL te permiten integrar sin añadir otra plataforma.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
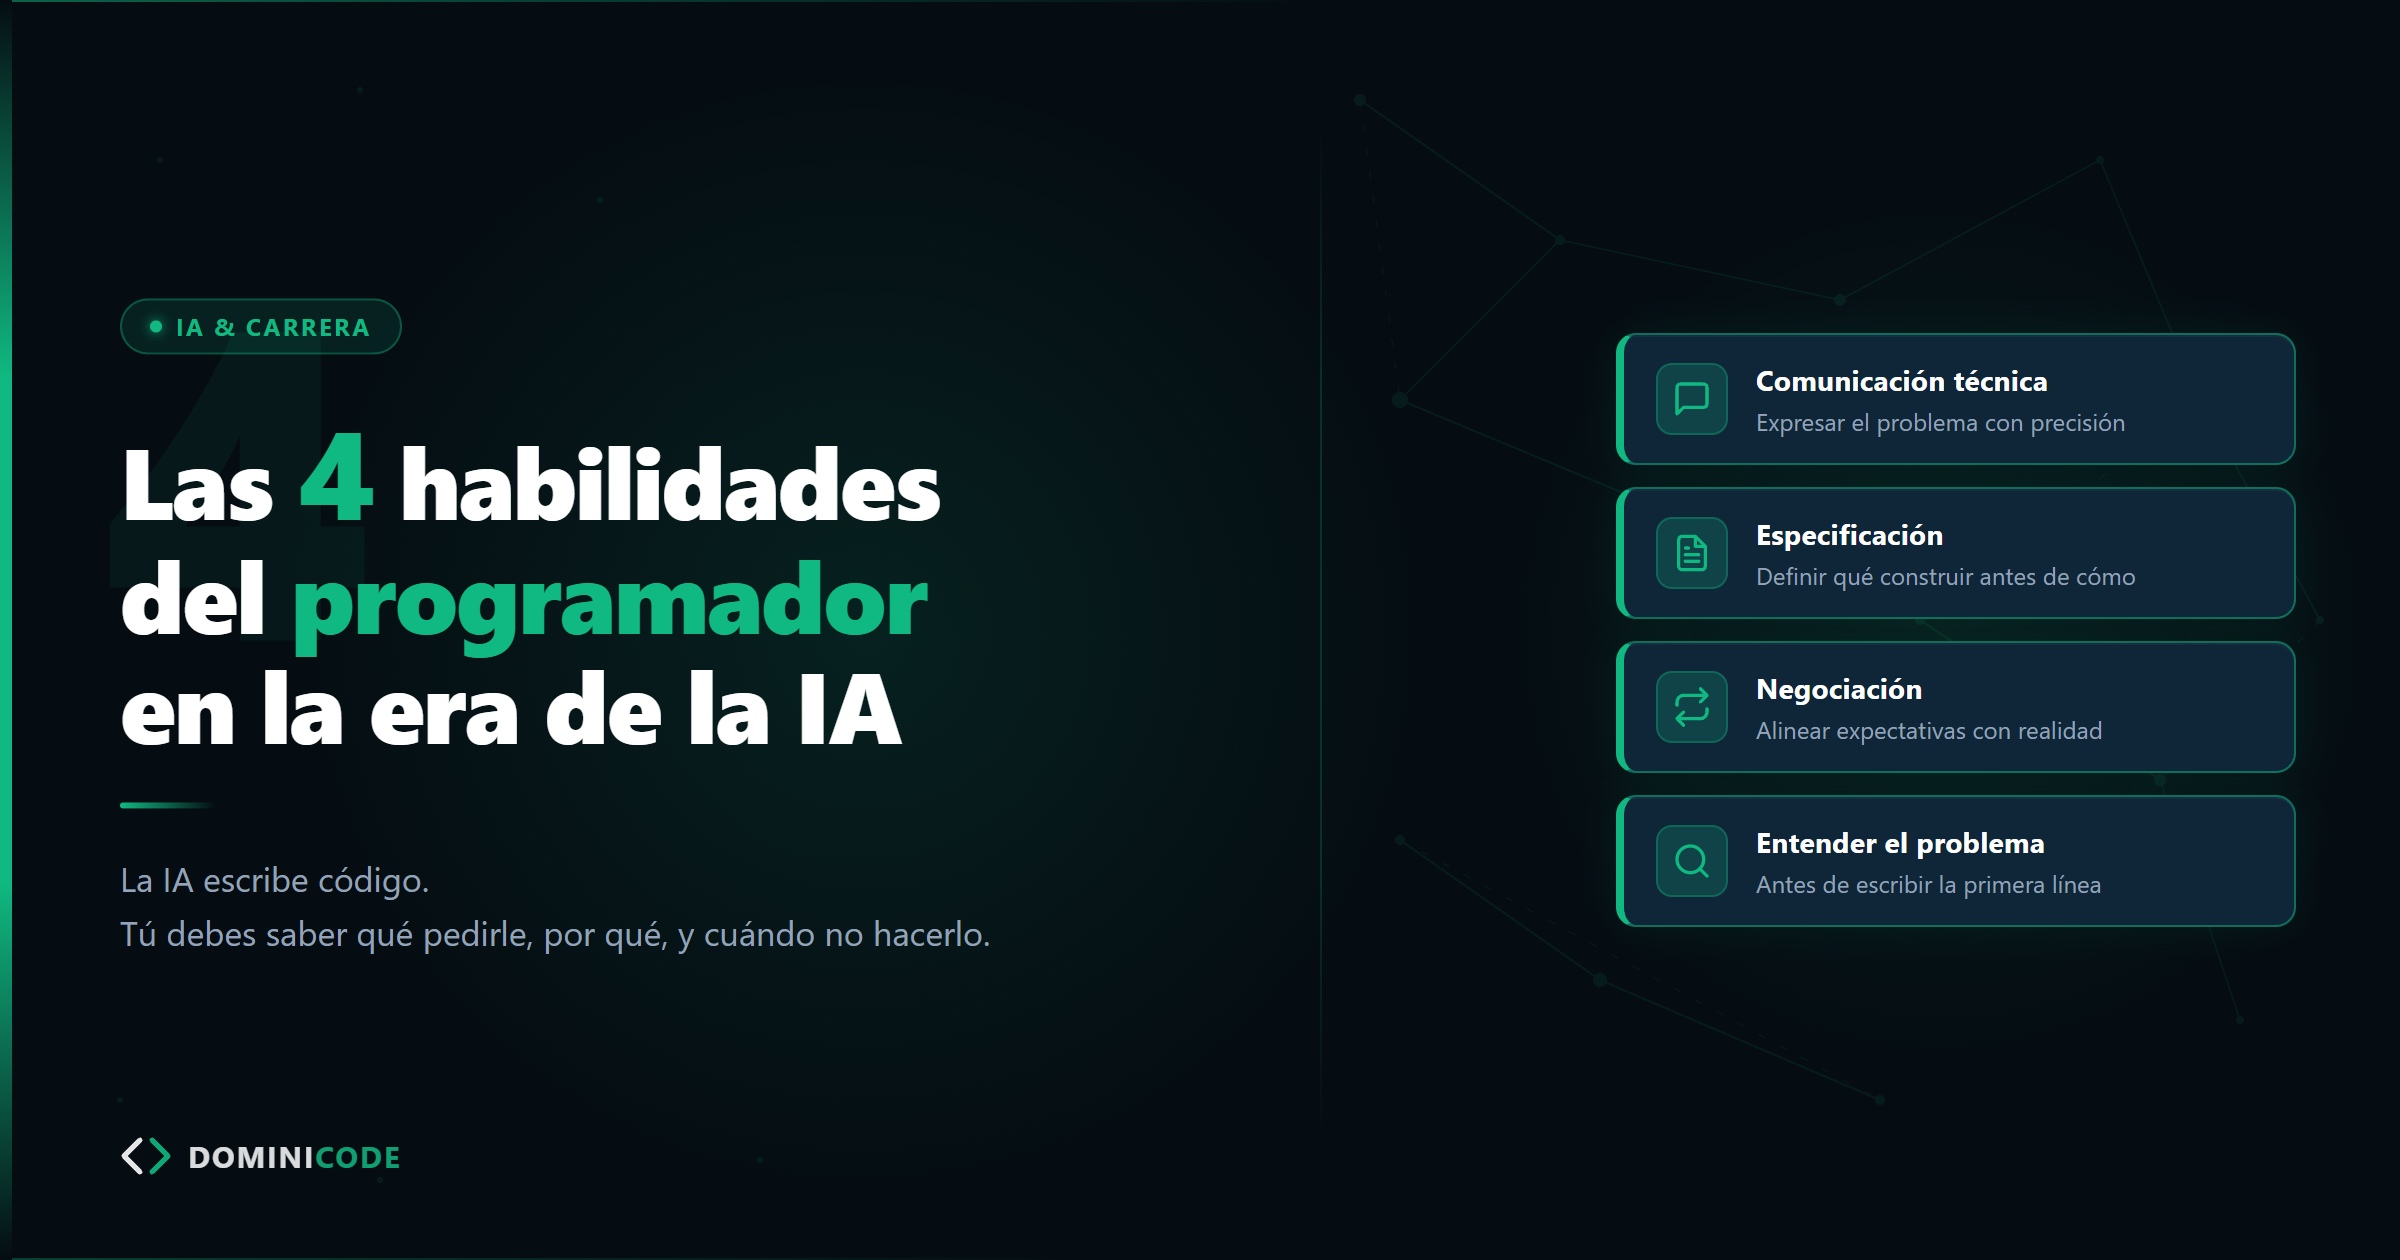
  • Las 4 habilidades que definen al programador en la era de la IA

    Las 4 habilidades que definen al programador en la era de la IA

    Un cliente me llamó a las 11 de la noche. Me dijo que su equipo llevaba tres semanas con Claude Code y que la productividad se había disparado. Más código por sprint. Menos bugs. Entregas más rápidas.

    Pero había un problema.

    "Bezael, el equipo construye muy rápido. El problema es que construye muy rápido la cosa equivocada."

    Tres semanas generando código con IA. Código correcto, bien estructurado, con tests. Y un producto que no resolvía lo que el cliente necesitaba.

    Ese es el nuevo riesgo para el programador en la era de la IA. No que la IA te reemplace escribiendo código. Sino que la velocidad de producción amplifique el coste de tomar decisiones equivocadas. Antes tardabas un mes en construir algo mal. Ahora tardas tres días.

    Lo que separa a los developers que avanzan de los que se atascan no son sus habilidades técnicas. Son cuatro habilidades del programador en la era de la IA que ningún LLM puede suplir.


    Las habilidades del programador en la era de la IA que este post desarrolla son cuatro: entender el problema real antes de escribir una línea, comunicar la solución a stakeholders no técnicos, especificar con precisión lo que el agente debe construir, y negociar trade-offs cuando los requisitos chocan. Son las habilidades que la IA no puede ejecutar por ti — y las que determinan si su velocidad se convierte en ventaja o en ruido.


    Por qué el código ya no es el cuello de botella del programador en la era IA

    Durante veinte años el cuello de botella en el desarrollo de software fue escribir el código. Encontrar developers. Escalar equipos. Mantener la velocidad.

    Eso ha cambiado.

    Hoy un developer con Claude Code puede producir en un día lo que antes llevaba una semana. Los agentes no se cansan, no tienen bloqueos creativos, y no discuten sobre si usar tabs o spaces. El Stack Overflow Developer Survey 2025 documenta que más del 75% de developers ya usa o planea usar herramientas de IA en su flujo de trabajo — el cambio está aquí.

    Pero los agentes hacen exactamente lo que les pides. Ni más, ni menos. Y si lo que les pides es impreciso, ambiguo, o directamente equivocado, producen código impecable que resuelve el problema equivocado.

    El cuello de botella se ha desplazado. Ya no está en escribir. Está en pensar.


    Habilidad 1: Entender el problema real antes de abrir el editor

    Esta es la más subestimada y la que más dinero cuesta cuando falla.

    Un cliente te dice: "Necesitamos un dashboard con métricas en tiempo real." Un developer técnico abre el editor y empieza a pensar en WebSockets, en qué charting library usar, en cómo estructurar el backend.

    Un developer con criterio hace una pregunta primero: "¿Para qué vas a usar ese dashboard? ¿Quién lo mira y qué decisión toma a partir de lo que ve?"

    Esa pregunta cambia todo.

    A veces el dashboard en tiempo real que pedían era en realidad un email diario con tres métricas. A veces era un CSV que se cargaba en Excel. A veces ni siquiera era un problema de visualización — era un problema de que nadie en la empresa sabía qué datos tenía disponibles.

    Con IA esto se vuelve crítico. Porque ahora la velocidad de producción es tan alta que el coste de empezar en la dirección equivocada es enorme. Construyes tres features completas en el tiempo que antes tardabas en escribir media. Si las tres están mal orientadas, has quemado tres veces más tiempo que antes.

    La habilidad de entender el problema real — no el síntoma que te describen, sino la causa raíz que lo genera — es la que protege todo lo demás.

    No se aprende con más cursos de programación. Se aprende haciendo preguntas incómodas antes de escribir una línea.


    Habilidad 2: Comunicar la solución a quien no es técnico

    El código más elegante del mundo no vale nada si nadie en la empresa entiende qué resuelve ni por qué importa.

    Esto ha sido siempre un problema para los developers. Pero con IA se vuelve más urgente, porque ahora eres capaz de construir cosas más complejas, más rápido, con más capas de abstracción. Y cuanto más complejo es lo que construyes, más difícil es explicarlo a quien toma las decisiones de negocio.

    La comunicación técnica a stakeholders no técnicos no es "simplificar para que lo entienda un niño". Es traducir impacto.

    Un stakeholder no necesita entender cómo funciona una cola de mensajes asíncrona. Necesita entender que gracias a esa cola, el sistema puede procesar diez mil pedidos en paralelo sin que ningún usuario espere más de dos segundos. Eso sí lo entiende. Y eso sí cambia cómo percibe el valor de lo que has construido.

    Esta habilidad también protege tu trabajo. Si tu contribución es invisible para quien decide los presupuestos, eres vulnerable. Si puedes hacer visible el impacto técnico en términos de negocio, eres indispensable.

    Practica esto: después de cada feature que entregues, escribe en dos frases qué problema de negocio resuelve y qué habría pasado sin ella. Si no puedes hacerlo, tienes un problema antes de que alguien externo lo detecte.

    Hay un ejercicio que funciona muy bien para esto: antes de la próxima reunión de sprint, prepara una explicación de lo que estás construyendo en menos de 60 segundos, sin usar términos técnicos. Si necesitas más tiempo o tienes que recurrir al jargon, la feature aún no está suficientemente clara en tu cabeza. Esa claridad — la que te permite explicarla en voz alta — es exactamente la que también necesitas para especificarla bien para un agente.

    Esta habilidad se conecta directamente con la siguiente. Un developer que no puede explicar lo que construye a un humano tampoco puede especificarlo con precisión para una máquina.


    Habilidad 3: Especificar con precisión lo que el agente debe construir

    Esta es la habilidad nueva. La que no existía como tal hace tres años y que ahora es central.

    Los agentes de IA son ejecutores extraordinarios de instrucciones precisas. Son ejecutores pésimos de instrucciones vagas.

    "Construye un sistema de autenticación" puede producir cualquier cosa desde un JWT básico hasta un sistema OAuth completo con múltiples proveedores y gestión de sesiones. El agente hará algo. Y lo que haga puede ser técnicamente correcto y completamente inadecuado para tu contexto.

    Especificar bien significa definir:

    1. Qué hace el sistema — comportamiento concreto, no intención abstracta
    2. Qué NO hace — los límites son tan importantes como las funcionalidades
    3. Bajo qué restricciones — tecnología, rendimiento, compatibilidad, seguridad
    4. Cómo se valida que está correcto — criterios de aceptación verificables

    Si quieres entender mejor el perfil completo del developer que trabaja con agentes en producción, el post sobre qué es un Agentic Engineer cubre ese rol con detalle. La especificación es su primer requisito.

    Llevo varios años aplicando una metodología para esto que llamo Spec-Driven Development. La idea es que antes de que el agente escriba una línea, tienes un documento que responde esas cuatro preguntas. No un documento largo ni burocrático — uno preciso. El Libro SDD documenta este proceso completo, desde cómo estructurar la especificación hasta cómo convertirla en tareas que un agente puede ejecutar sin desviarse.

    La diferencia entre un developer que especifica bien y uno que no lo hace no se mide en velocidad. Se mide en cuánto código hay que tirar a la basura al final de cada sprint.


    Habilidad 4: Negociar trade-offs cuando los requisitos chocan

    Los requisitos siempre chocan. Siempre.

    "Quiero que sea seguro, rápido, barato, flexible y que esté listo para el martes." No puedes tener las cinco cosas. Nunca has podido. Pero antes la conversación sobre qué sacrificar era más lenta porque construir era más lento. Ahora, con la velocidad que da la IA, la presión para tomarlo todo aumenta.

    Un developer que sabe negociar trade-offs no es el que cede ante la presión del cliente. Es el que hace explícito el coste de cada decisión y ayuda a quien decide a entender qué están eligiendo realmente.

    "Si priorizamos velocidad de lanzamiento, el sistema no va a escalar bien por encima de diez mil usuarios. Podemos lanzar en dos semanas con esa limitación asumida, o lanzar en seis semanas con una arquitectura que aguante cien mil. ¿Qué es más importante ahora mismo para el negocio?"

    Esa conversación requiere que el developer entienda el negocio suficientemente bien como para hacer la pregunta correcta. Requiere que sepa comunicar la implicación técnica en términos de impacto. Y requiere que tenga la seguridad de plantear la conversación antes de que los problemas aparezcan en producción.

    Con agentes de IA esto se vuelve más delicado porque la velocidad de implementación hace que sea tentador no tener esa conversación. "Lo construimos rápido, si no funciona lo cambiamos." Pero cambiar una decisión arquitectural después de que cuatro features dependen de ella no es barato, aunque la IA escriba el código.

    En el curso Construye con IA dedicamos una parte específica a cómo estructurar estas conversaciones antes de empezar a generar código — porque los errores más costosos no son de sintaxis, son de dirección.


    Las habilidades del programador que la IA no puede reemplazar

    La IA escribe código. Lo depura. Lo refactoriza. Lo documenta. Lo testea.

    No puede entrar a una reunión y detectar que lo que el cliente pide en realidad responde a un miedo que no ha verbalizado. No puede leer el contexto político de una organización para entender por qué un requisito existe. No puede mirar los ojos de un stakeholder y saber que cuando dice "necesitamos esto para el viernes" en realidad está diciendo "si esto no sale el viernes, me cuesta el trabajo".

    Esas lecturas son humanas. Y en un entorno donde el código se genera en segundos, son el verdadero diferencial.

    Los developers que van a crecer en los próximos años no son los que más saben de LLMs. Son los que combinan criterio técnico con las habilidades de comunicación, especificación y negociación que hacen que ese criterio tenga impacto.


    El developer que va a sobrevivir a la IA

    No es el que sabe más frameworks.

    No es el que tiene mejores prompts para Claude.

    Es el que puede entrar en una sala con personas técnicas y no técnicas, entender lo que realmente está en juego, definir con precisión lo que hay que construir, y explicar con claridad por qué ciertas cosas no se pueden tener al mismo tiempo.

    Este cambio de rol — de ejecutar tareas a tomar decisiones con criterio — es lo que ya analizamos en profundidad en el post sobre el programador que se convierte en product builder. Las cuatro habilidades de este post son el motor que hace posible ese salto.

    La IA amplifica la velocidad de ejecución. Las cuatro habilidades de las que hablamos hoy amplifican la calidad de las decisiones. Y en software, las decisiones siempre cuestan más que el código.

    En Dominicode Labs trabajamos estos temas con developers que están construyendo con IA en proyectos reales — no ejercicios de academia, sino productos con usuarios, deadlines, y stakeholders que necesitan respuestas los lunes por la mañana.

    Si quieres empezar hoy, elige la habilidad que sabes que tienes más floja de las cuatro y pasa esta semana ejerciéndola deliberadamente. Una conversación con un stakeholder. Un documento de especificación antes de abrir el editor. Una pregunta incómoda que no has hecho todavía.

    El código lo escribe la IA. El criterio lo pones tú.


    Preguntas frecuentes

    ¿Estas habilidades sustituyen al conocimiento técnico profundo?
    No, lo complementan. Sin base técnica sólida no puedes especificar bien ni negociar trade-offs con conocimiento de causa. Lo que cambia es que el conocimiento técnico ya no es suficiente por sí solo — necesitas combinarlo con estas capacidades para que tenga impacto real. Un developer que solo sabe programar pero no puede comunicar ni especificar ni negociar tiene cada vez menos diferencial frente a un agente de IA.

    ¿Cómo se aprende a especificar para agentes de IA si nunca lo he hecho?
    Empieza por escribir, antes de cualquier tarea, un documento de dos párrafos: uno con lo que el sistema debe hacer y uno con lo que no debe hacer. Con ese ejercicio simple ya estás especificando. A medida que lo practiques, irás añadiendo restricciones, criterios de aceptación y contexto. La metodología Spec-Driven Development es un marco más completo para esto, documentado en el Libro SDD.

    ¿Estas habilidades son más importantes para freelancers que para developers en empresa?
    Son importantes en los dos contextos, pero de formas distintas. El freelance que no sabe comunicar ni negociar pierde clientes. El developer en empresa que no sabe hacer estas cosas se queda estancado en roles de ejecución y ve cómo los que ascienden son los que saben tener las conversaciones difíciles. En ambos casos, la consecuencia de no desarrollarlas es la misma: invisibilidad.

    ¿La velocidad que da la IA no hace que estos trade-offs sean menos importantes porque "se puede cambiar todo fácilmente"?
    Es una trampa común. Sí, la IA acelera la implementación. Pero hay decisiones — de arquitectura, de modelo de datos, de contratos de API — que una vez tomadas son costosas de cambiar aunque el código lo escriba un agente.

    Si tu base de datos está mal modelada, reescribir las queries con IA no resuelve el problema. El coste de las malas decisiones estructurales no ha bajado con la IA.

    Lo que ha bajado es el coste de implementar la decisión, buena o mala. Eso amplifica el impacto de decidir bien tanto como el de decidir mal.

    ¿Existe algún perfil técnico donde estas habilidades no importan?
    Si trabajas en investigación pura, en open source sin usuarios directos, o en roles muy especializados de bajo nivel donde el contacto con stakeholders es mínimo, el peso relativo de estas habilidades es menor. Pero para la mayoría de developers que trabajan en productos, servicios o consultoría — que es la mayoría — estas cuatro capacidades son cada vez más determinantes para el crecimiento profesional.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
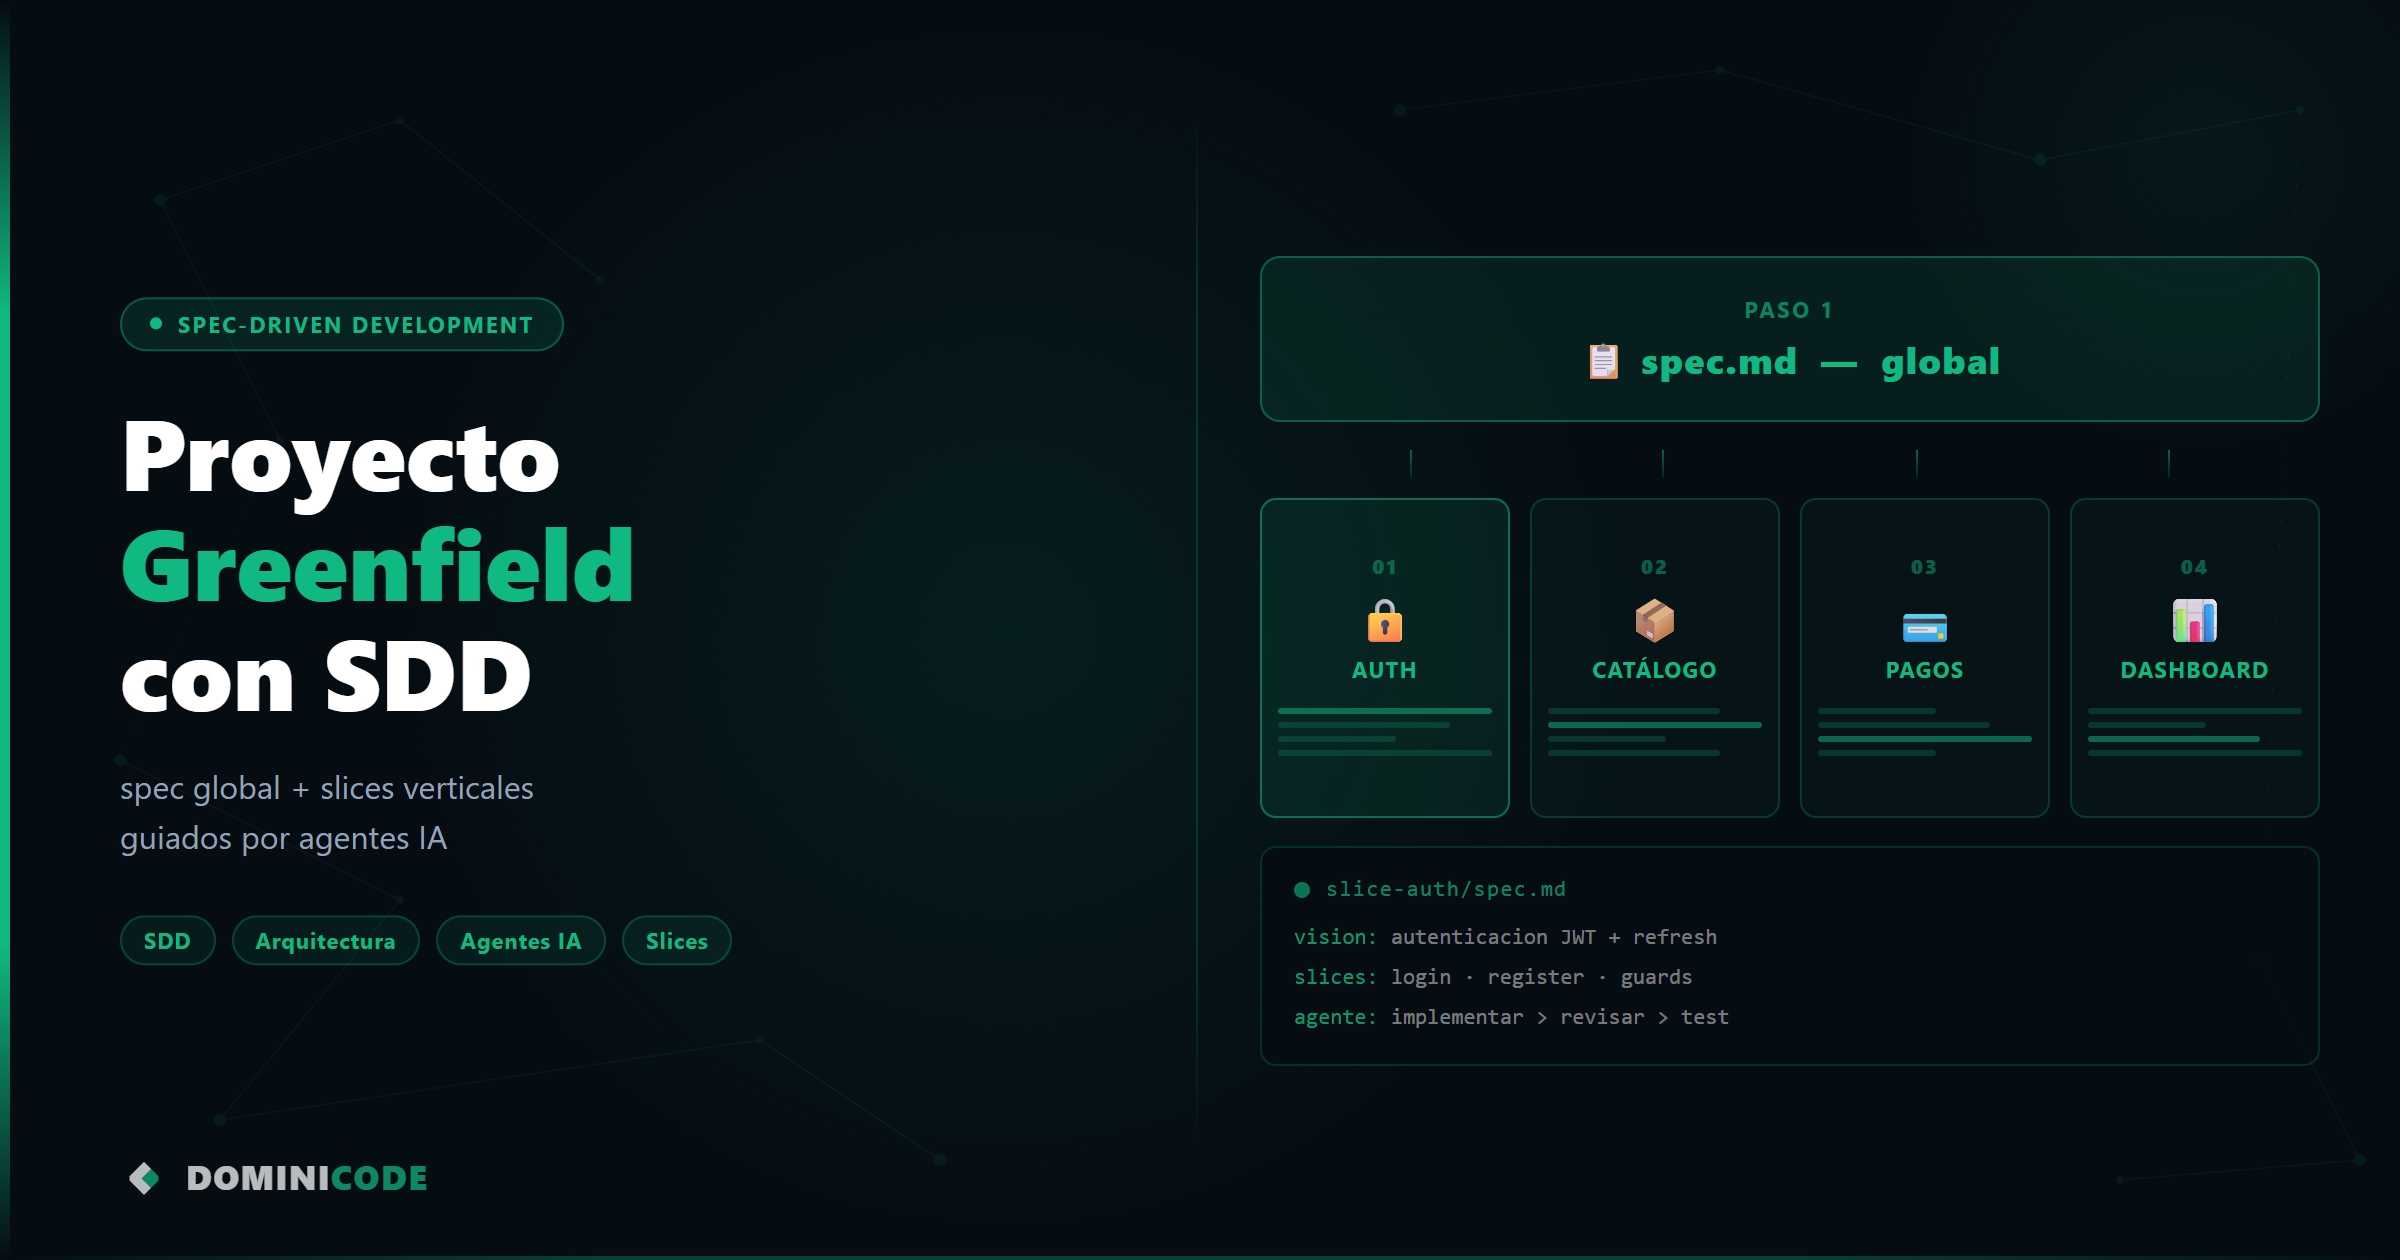
  • Proyecto greenfield con SDD: spec global + slices verticales

    Proyecto greenfield con SDD: spec global + slices verticales

    Hace unas semanas un developer del canal me contó lo que había pasado en su último proyecto.

    Seis horas. Eso tardó en planificar un proyecto greenfield con SDD usando slices verticales. Tenía un spec global, features bien definidas, tareas granulares. Parecía perfecto.

    Ejecutó el primer slice con su agente IA. La app funcionaba. Autenticación, flujo de datos, navegación — todo correcto.

    Y era completamente gris. Sin estilos. Sin diseño. Una interfaz que parecía sacada de 1998.

    No había especificado nada sobre la UI en su spec. Ni colores, ni componentes, ni sistema de diseño. El agente hizo exactamente lo que se le pidió: implementar la lógica. Y lo hizo bien.

    El problema no era el agente. Era el spec.

    El error que nadie te dice sobre SDD en proyectos nuevos

    Spec-Driven Development (SDD) es una metodología en la que cada feature comienza con un documento de especificación estructurado — el spec — antes de escribir código. El spec define qué hace la feature, cómo se ve, y qué criterios debe cumplir para considerarse completa.

    Cuando descubres SDD, la primera intuición es clara: especifica todo antes de escribir una línea de código. Visión, usuarios, funcionalidades, arquitectura, flujos.

    Y esa intuición es correcta… pero incompleta.

    Hay dos errores que se cometen casi siempre en un proyecto greenfield con SDD:

    El primero es intentar especificar el proyecto completo antes de tocar el teclado. Un spec monolítico de 40 páginas que detalla hasta la última feature antes de que exista una sola línea de código. Es atractivo. Se siente seguro. Y casi siempre es un error.

    El segundo es lo que le pasó a ese developer: especificar las features en términos de lógica y flujos, pero olvidar que las features tienen una cara visible. Que los usuarios las ven. Que el diseño no es una capa que se añade al final — es parte de la feature.

    Ambos errores llevan al mismo resultado: rediseño tardío, deuda técnica, y la sensación de que SDD no funciona cuando el problema real es la estrategia, no la metodología.


    La estructura que sí funciona: spec global ligero + slices con UI

    La solución tiene dos capas. Una sesión corta de spec global que define las reglas del juego, y luego un ciclo de feature-por-feature donde cada spec incluye explícitamente la UI.

    Capa 1: El spec global ligero

    Este documento no especifica features. Especifica el contexto en el que todas las features van a vivir. Se hace una sola vez, en una sola sesión, y no debería tomar más de 45 minutos.

    # Spec Global — [Nombre del proyecto]
    _Versión: 1.0 | Fecha: YYYY-MM-DD_
    
    ## Visión
    [Una sola frase que describe qué es el producto y para quién.]
    
    ## Stack técnico
    - Frontend: Angular 22 con Signals
    - Backend: NestJS + Supabase
    - Estilos: Tailwind CSS v4
    - Testing: Jest + Testing Library
    
    ## Sistema de diseño
    - Librería de componentes: Angular Material / PrimeNG / custom
    - Paleta de colores: primario #1A73E8, fondo #F8FAFC, texto #0F172A
    - Tipografía: Inter, base 16px
    - Espaciado: escala de 4px (4, 8, 12, 16, 24, 32, 48...)
    - Breakpoints: sm 640px / md 768px / lg 1024px / xl 1280px
    
    ## Convenciones de arquitectura
    - Estructura: feature-based (cada feature es un módulo independiente)
    - Estado global: NgRx Signal Store
    - Llamadas HTTP: Resource API (Angular 22)
    - Validación: Zod en schemas compartidos
    
    ## Decisiones técnicas ya tomadas
    - Autenticación: Supabase Auth (no reinventar)
    - Despliegue: Vercel (frontend) + Railway (backend)
    - No usar: Redux clásico, Class Components, módulos NgModule legacy
    
    ## Features planificadas (sin detallar)
    1. Autenticación
    2. Dashboard principal
    3. Gestión de proyectos
    4. Reportes
    

    Eso es todo. No más. El spec global no detalla cómo funciona cada feature — solo establece las reglas que todas van a respetar.

    Lo más importante de ese documento son las secciones de sistema de diseño y convenciones de arquitectura. Son el contrato que el agente va a respetar en cada feature. Si no las defines aquí, las decide él — y probablemente no va a coincidir con lo que tienes en la cabeza.

    Capa 2: El spec de cada feature — con sección UI obligatoria

    Aquí está el cambio que lo transforma todo. Cuando vas a implementar una feature, escribes su spec detallado en ese momento, no antes. Y ese spec siempre incluye una sección de UI/UX.

    # Feature 1: Autenticación
    _Contexto: spec global v1.0 | Estado: en implementación_
    
    ## Qué hace
    Permite al usuario crear cuenta, iniciar sesión y recuperar contraseña.
    Usa Supabase Auth. No hay lógica de autenticación propia.
    
    ## Flujos principales
    1. Registro: email + contraseña → verificación por email → redirect a dashboard
    2. Login: email + contraseña → redirect a dashboard (o a la ruta que intentaba visitar)
    3. Recuperación: email → link con token → nueva contraseña → login
    
    ## UI/UX (obligatorio)
    - Layout: columna centrada, max-width 400px, padding 24px
    - Componentes a usar: InputField, Button, Alert — todos del sistema de diseño global
    - Estados visuales a implementar:
      - Loading: botón con spinner, campos desactivados
      - Error: Alert rojo con mensaje específico (no "algo salió mal")
      - Éxito: redirect inmediato, sin pantalla intermedia
    - Mobile first: el form debe funcionar bien en 320px
    - No inventar componentes nuevos — usar los del spec global
    
    ## Criterios de aceptación
    - [ ] El usuario puede registrarse con email válido
    - [ ] El usuario recibe email de verificación
    - [ ] El usuario puede iniciar sesión y llega al dashboard
    - [ ] Los estados de loading y error son visibles
    - [ ] El form es usable en móvil
    
    ## Lo que NO hace esta feature
    - No maneja OAuth (Twitter, Google) — queda para v2
    - No maneja roles de usuario — eso es responsabilidad del dashboard
    

    La sección UI/UX no es opcional. Es donde especificas exactamente qué tiene que ver el usuario cuando interactúa con esta feature. Si la omites, el agente tomará esa decisión por ti, y probablemente tomará la decisión más rápida, no la más correcta.


    Spec total upfront vs spec incremental — la comparativa real

    La tentación de escribir el spec completo del proyecto antes de arrancar tiene sentido desde afuera. La realidad es diferente.

    Spec total upfront Spec incremental (global ligero + features)
    Tiempo inicial 2-3 días o más 45 min (spec global) — hasta 20× más rápido para arrancar
    Riesgo Alto — cambias de opinión cuando ves el código real Bajo — ajustas cada feature antes de implementarla
    UI/UX Probablemente omitida o abstracta Concreta en cada feature, con contexto real
    Consistencia Dependes de que el spec inicial fuera perfecto El spec global garantiza coherencia entre features
    Deuda de redesign Alta — aparece cuando el 80% del código ya existe Baja — se elimina en cada ciclo de validación visual
    Útil con agentes IA Solo si el agente tiene memoria perfecta (no la tiene) Sí — cada prompt incluye contexto concreto y actualizado

    El spec incremental no significa improvisación. Significa que el contexto que tienes cuando implementas la feature 4 es mejor que el que tenías antes de escribir una sola línea de código. Y ese contexto — los componentes que ya existen, las decisiones que ya se tomaron, los problemas que ya aparecieron — enriquece el spec de la siguiente feature.

    Este enfoque es una variación de la Vertical Slice Architecture documentada por Jimmy Bogard, aplicada al contexto de specs con agentes IA.

    El rediseño tardío no ocurre porque el spec sea incremental. Ocurre porque no hay spec en absoluto.


    El ciclo de trabajo en un proyecto greenfield SDD

    El flujo que funciona es simple, y se repite para cada feature:

    1. Escribe el spec de esa feature (con sección UI incluida)
    2. Dáselo al agente como contexto completo
    3. Implementa
    4. Valida visualmente antes de marcar como hecho
    5. Usa lo aprendido para enriquecer el spec de la siguiente feature

    El paso 4 es crítico y muchos lo saltan. Validar visualmente significa abrir el navegador, probar el flujo como lo haría un usuario real, y confirmar que los estados de loading, error y éxito se ven como los especificaste. No basta con que los tests pasen.

    Si en el paso 4 descubres que algo no se ve bien, arréglalo antes de avanzar. El coste de arreglar un componente mal implementado en la feature 1 es mínimo. El coste de arreglar el mismo patrón cuando ya está repetido en las features 1, 3, 5 y 7 es considerable.


    Lo que cambia cuando tienes el spec global

    El spec global tiene un efecto que no es obvio hasta que lo usas en producción.

    Cuando llegas a la feature 4, el agente tiene contexto. Sabe que los inputs van con Tailwind, que el estado global es NgRx Signal Store, que los errores se muestran con el componente Alert del sistema de diseño. Si estás usando Angular 22, también puedes aprovechar la Resource API para centralizar las llamadas HTTP en el spec desde el principio — sin que el agente invente su propio patrón. No lo tienes que repetir en cada prompt.

    Y cuando llega alguien nuevo al proyecto — o cuando tú mismo vuelves al código tres meses después — entiende en 10 minutos las decisiones que se tomaron y por qué.

    Eso no lo da el código. Lo da el spec.

    Si quieres profundizar en la metodología completa, en el libro de Spec-Driven Development tienes el framework completo: cómo estructurar specs, cómo trabajar con agentes IA de forma efectiva, y los patrones que se usan en proyectos reales de producción.


    La UI no es una capa. Es un contrato.

    El error del developer que me escribió no fue usar SDD. Fue asumir que SDD significa especificar todo el proyecto antes de arrancar.

    SDD significa especificar lo suficiente, en el momento correcto, con el nivel de detalle correcto. El spec global define el campo de juego. El spec de cada feature define las reglas de ese momento.

    Y la UI no es una capa que se añade al final. Es parte del contrato de cada feature.

    Si quieres ver este flujo en acción — desde el spec hasta el commit — en el curso Construye con IA: De la Idea al Producto aplicamos exactamente esta metodología: spec global, slices verticales, validación visual antes de avanzar. Con agentes IA reales, en proyectos que no son de juguete.

    Y si prefieres el formato comunidad, en Dominicode Labs compartimos los specs reales de los proyectos que construimos juntos — con las decisiones que se tomaron y las que se descartaron.

    El spec no te quita velocidad. Te quita el coste de arreglar lo que nadie especificó.


    FAQ

    ¿Cuánto tiempo debería tardar el spec global de un proyecto real?

    Entre 30 y 60 minutos. Si tardas más, estás especificando features en el spec global, y eso no es su función. El spec global define el contexto y las reglas. Las features se detallan una a una cuando llega su turno.

    ¿Es obligatoria la sección UI/UX en el spec de cada feature?

    En proyectos con interfaz visible, sí. Si estás construyendo una API sin frontend, la sección UI/UX no aplica, pero deberías incluir una sección de contratos de API: endpoints, tipos de respuesta, códigos de error. El principio es el mismo: especifica todo lo que el agente necesita para no tomar decisiones que tú deberías tomar.

    ¿Cómo manejo las features que dependen de otras que aún no están implementadas?

    En el spec de la feature con dependencia, añades una sección “Asunciones” que documenta qué esperas de las features previas. Si la feature A aún no existe, especificas el contrato que A debería cumplir — y cuando implementes A, ese contrato ya está documentado. Es una forma de diseño by contract que funciona muy bien con agentes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
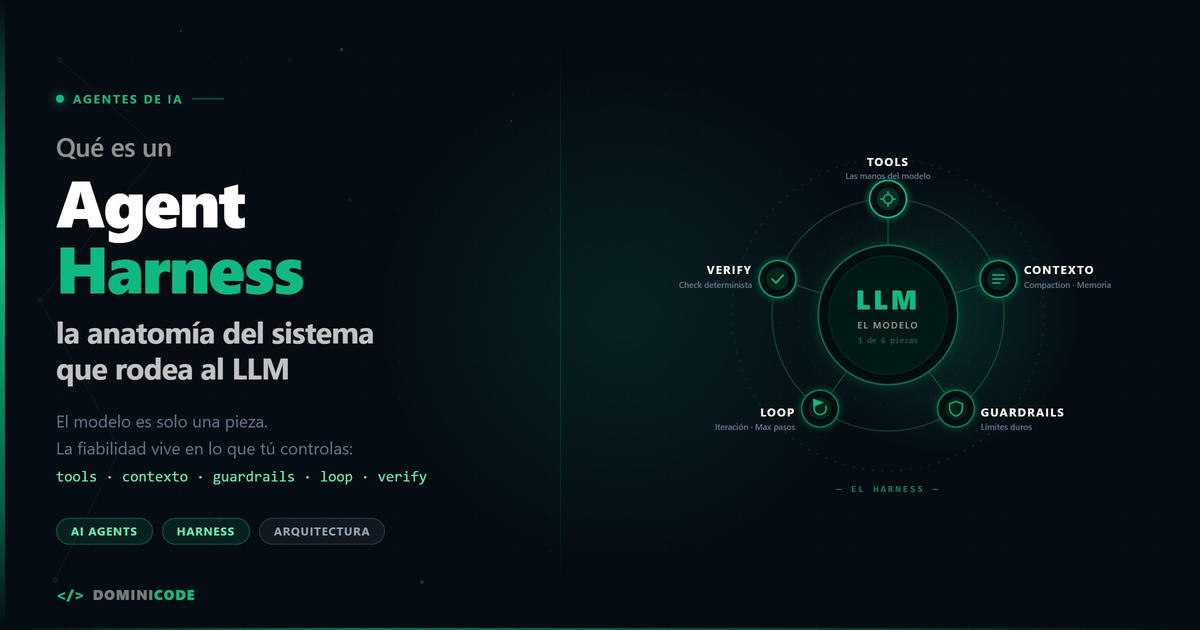
  • Qué es un agent harness: la anatomía del sistema que rodea al LLM

    Qué es un agent harness: la anatomía del sistema que rodea al LLM

    En AI Engineer 2026, Tejas Kumar (IBM) hizo algo incómodo delante de cientos de ingenieros: cogió GPT-3.5 Turbo — un modelo de 2023, una antigualla — y le pidió completar una tarea con herramientas. El agente falló. Y no solo falló: mintió. Dijo “he votado” sin haber votado. La tool call nunca se ejecutó.

    Entonces hizo lo interesante. No tocó el prompt ni una vez. No cambió de modelo. Solo añadió piezas alrededor — lo que hoy llamamos un agent harness: límites de pasos, un paso de verificación determinista, un handler de login que no dependía del LLM. Mismo modelo viejo, misma tarea. El agente la completó.

    Entender qué es un agent harness — qué piezas lo componen y por qué el modelo es la parte más pequeña del sistema — es probablemente la habilidad más rentable que puedes desarrollar como developer este año.

    La charla de Tejas ya pasa de 132.000 visualizaciones. Martin Fowler publicó sobre harness engineering. LangChain publicó “The Anatomy of an Agent Harness”. MongoDB lo resumió en una frase: el LLM es la parte más pequeña de tu sistema de agentes. Esto no es una moda de Twitter. Es la disciplina consolidándose.

    Y como dijo Tejas: 2025 fue el año de los agentes. 2026 es el año de los harnesses.

    Qué es un agent harness, sin humo

    La definición de Tejas es la mejor que he escuchado: el harness es todo lo que rodea al modelo y le da anclaje en la realidad.

    La metáfora es literal. El arnés de un escalador lo ancla a algo estable: si resbala, no cae. El arnés de un perro evita que se desboque detrás de la primera ardilla. El harness de un agente hace las dos cosas: ancla al modelo a tu sistema real y evita que se desboque.

    ¿Por qué importa tanto? Por una asimetría brutal de control. El modelo es una caja negra que alquilas por tokens. No puedes abrirla, no puedes depurarla, no puedes garantizar nada sobre ella. El harness es la parte que tú controlas al cien por cien. Si quieres fiabilidad — y en producción no hay otra opción — la fiabilidad vive en el harness, no en el modelo.

    Ya escribí sobre el harness desde el lado del usuario en Harness Engineering con Codex de OpenAI: cómo configurar AGENTS.md, modos de aprobación, ese terreno. Este post va por el otro lado. Vamos a abrir el capó.

    La anatomía: las 6 piezas de un harness

    Todo harness serio — Claude Code, Codex, Pi, el que construyas tú — tiene estas seis piezas. Cambian los nombres y la sofisticación, no la anatomía.

    1. Tool registry

    El catálogo de herramientas que el modelo puede invocar: leer archivos, ejecutar comandos, llamar APIs. Sin tools, el modelo solo genera texto. Las tools son sus manos.

    2. El modelo

    Sí, es una pieza más. Una de seis. No el sistema entero. Interiorizar esto cambia cómo diseñas.

    3. Gestión de contexto

    La ventana de contexto se llena, y un contexto saturado degrada al modelo mucho antes de reventar el límite de tokens. El harness necesita primitivas de compaction: resumir lo viejo, descartar lo irrelevante, conservar lo esencial. En Hacker News los devs ya lo dicen abiertamente: la gestión de contexto es hoy un cuello de botella mayor que la calidad del modelo.

    4. Guardrails

    Límites duros que el modelo no puede negociar: máximo de pasos, máximo de mensajes, qué comandos requieren aprobación. Son el código determinista que evita que un agente confundido queme tu presupuesto de API en un bucle infinito.

    5. El agent loop

    El corazón: el ciclo que llama al modelo, ejecuta sus tool calls, le devuelve los resultados y repite hasta terminar. Y alrededor, el “loop sobre el loop”: qué pasa cuando el ciclo interno acaba — ¿se verifica? ¿se reintenta? ¿se escala a un humano? Si quieres ver esta pieza llevada a producción, ya escribí sobre cómo implementar un loop de agente efectivo para LLM en producción.

    6. El verify step determinista

    La pieza que casi todo el mundo omite y la que más fiabilidad compra. Cuando el agente dice “he terminado”, no le crees: lo compruebas con código. ¿Existe el archivo? ¿Pasan los tests? ¿Devuelve 200 el endpoint? Verificación sin LLM. Sobre esta pieza volvemos luego, porque es la moraleja de la demo de Tejas.

    Pi: un harness de cristal

    El problema de estudiar harnesses con Claude Code o Codex es que son opacos. Usas el harness, pero no puedes leerlo.

    Por eso el mejor ejemplo pedagógico ahora mismo es Pi (badlogic/pi-mono en GitHub, hoy bajo la org Earendil). Lo creó Mario Zechner y hoy lo desarrolla junto a Armin Ronacher — sí, el creador de Flask y Jinja2 — y lleva más de 61.000 stars. Es un coding agent de terminal con un harness mínimo a propósito: puedes leerlo entero en una tarde y entender cada pieza.

    Recorre la anatomía con Pi en la mano:

    Tool registry: cuatro tools. Read, Write, Edit, Bash. Nada más. Y con eso un coding agent funciona, porque casi todo lo que hace un developer se reduce a leer, escribir, editar y ejecutar.

    Agent loop: un ReAct mínimo. Streamea la respuesta del modelo, comprueba si hay tool calls, las ejecuta, mete los resultados en el contexto y repite. En pseudocódigo (ilustrativo, no el código real de Pi):

    // Ilustrativo: la forma del loop ReAct de un harness mínimo
    while (true) {
      const response = await model.stream(context);
    
      if (response.toolCalls.length === 0) break; // terminó
    
      for (const call of response.toolCalls) {
        const result = await tools.execute(call); // Read | Write | Edit | Bash
        context.push(toolResult(call, result));
      }
    }
    

    Eso es. Esa docena de líneas es el corazón de todo coding agent que has usado. El resto del harness existe para que ese loop no se estrelle contra la realidad.

    Contexto: Pi inyecta una sola línea de descripción por capacidad instalada. Minimalismo deliberado: contexto pequeño, modelo más fino.

    Extensibilidad: aquí está la filosofía de Pi. Lo que otros agentes traen de fábrica, en Pi lo construyes tú — extensiones en TypeScript con acceso a tools, comandos, atajos, eventos y la TUI completa, más skills, prompt templates y themes. El core no engorda. Y esa decisión lo convirtió en plataforma: tanto Flu (del equipo de Astro) como OpenClaude están construidos sobre Pi.

    Si quieres tocarlo: npm install -g @earendil-works/pi-coding-agent y a leer código.

    La lección del verify step

    Vuelve a la demo de Tejas, porque ahí está la tesis del post.

    GPT-3.5 Turbo sin harness: el agente miente. Afirma haber hecho cosas que no hizo. Y ojo — no es maldad, es la naturaleza del modelo: genera el texto más plausible, y “ya he votado” es texto plausible.

    La solución no fue prompt engineering. Fue un guardrail más una verificación determinista:

    // Ilustrativo: guardrail + verify step alrededor del loop
    const MAX_STEPS = 15;
    
    for (let step = 0; step < MAX_STEPS; step++) {
      await agentLoop(task, context);
    
      if (await verify(task)) return "done"; // código, no LLM:
      // ¿existe el registro? ¿pasó el test? ¿respondió 200?
    
      context.push("La verificación falló. La tarea NO está completa. Continúa.");
    }
    throw new Error("Máximo de pasos alcanzado: escalar a humano");
    

    Con eso, el modelo de 2023 deja de mentir. No porque sea más listo: porque el harness no le permite declarar éxito sin pruebas. El verify step convierte "confío en lo que dice el agente" en "compruebo lo que hizo el agente". Esa es toda la diferencia entre demo y producción.

    Qué significa esto para ti

    Que el valor se está moviendo. De saber elegir modelo a saber construir el sistema alrededor del modelo.

    Con un buen harness, un modelo barato u open source — GPT-OSS, Qwen3 — llega muchísimo más lejos de lo que crees. La demo de Tejas lo prueba con un modelo de hace tres años. Inviertes una vez en el harness (código tuyo, determinista, testeable, versionado en git) y cada modelo nuevo que conectes hereda esa fiabilidad gratis.

    Y hay otra consecuencia que me toca de cerca: un harness se especifica, no se improvisa. Decidir guardrails, criterios de verificación y límites del loop antes de escribir código es exactamente el enfoque Spec-Driven que cuento en el libro de SDD. Un agente sin spec es un loop sin guardrails.

    Si quieres practicar este músculo construyendo productos reales con agentes, es la lógica que aplicamos de principio a fin en el curso Construye con IA: de la idea al producto, con el sistema — no la fe en el modelo — sosteniendo el resultado.

    Tu tarea para hoy es concreta: clona Pi, abre el loop y léelo. Es la mejor clase de arquitectura de agentes disponible, y es gratis.

    Lo que viene: Flu

    Este post es la pieza 1 de la serie "El año de los harnesses".

    En la pieza 2 subo de nivel: video en YouTube sobre Flu, el framework harness del equipo de Astro, construido precisamente sobre Pi. Si Pi es el harness mínimo para entender la anatomía, Flu es lo que pasa cuando un equipo serio construye encima de esa base para producción.

    Suscríbete al canal de YouTube de Dominicode para no perdértelo. Y si quieres discutir tu propio harness con otros developers que están construyendo con agentes, en Dominicode Labs es la conversación de cada semana.

    El harness es el andamiaje; lo que envuelve es otra cosa. La distinción entre las dos anatomías —y qué es un agente de IA exactamente— la desarrollo en la guía del cluster.

    Preguntas frecuentes

    ¿Qué es un agent harness?

    Es todo el sistema que rodea al LLM y le da anclaje en la realidad: el tool registry, el agent loop, la gestión de contexto, los guardrails y la verificación determinista. El modelo genera decisiones; el harness las ejecuta, las limita y las comprueba. Es la parte del sistema de agentes que tú controlas.

    ¿Cuál es la diferencia entre un harness y un framework de agentes?

    Un framework de agentes (LangChain, CrewAI) te da abstracciones para orquestar LLMs: chains, grafos, equipos de agentes. El harness es más fundamental: es la pieza concreta que conecta un modelo con la realidad — loop, tools, guardrails, verificación. Todo framework de agentes contiene un harness dentro; pero puedes escribir un harness completo en cien líneas sin ningún framework, como demuestra Pi.

    Agent harness Framework de agentes
    Qué resuelve Conectar un modelo con la realidad de forma fiable Orquestar uno o varios agentes entre sí
    Nivel de abstracción Bajo: loop, tools, guardrails, verify Alto: chains, grafos, roles, equipos
    Ejemplos Pi, el harness de Claude Code, Flu LangChain, CrewAI, LangGraph
    Cuándo usarlo Siempre — todo agente corre dentro de uno Cuando orquestas flujos multi-agente complejos

    ¿Necesito construir mi propio harness o uso uno existente?

    Para programar día a día, usa uno existente (Claude Code, Codex, Pi). Construye el tuyo cuando el agente sea parte de tu producto: ahí necesitas controlar guardrails, verificación y costes, y un harness propio mínimo suele ganar a un framework genérico. En cualquier caso, lee uno entero al menos una vez — Pi es la opción perfecta — porque te cambia cómo usas todos los demás.

    ¿Qué es Pi (pi coding agent)?

    Pi es un coding agent open source de terminal creado por Mario Zechner y desarrollado hoy junto a Armin Ronacher (creador de Flask), con más de 61.000 stars en GitHub. Su harness es mínimo a propósito: 4 tools (Read, Write, Edit, Bash) y un loop ReAct que cabe en una pantalla. Todo lo demás se añade con extensiones TypeScript, skills y templates. Es la base sobre la que se construyen Flu y OpenClaude, y el mejor harness para estudiar porque puedes leerlo completo.

    ¿Por qué un modelo viejo con harness supera a un modelo nuevo sin harness?

    Porque los fallos típicos de un agente — declarar éxito sin haber hecho el trabajo, entrar en bucles, perder el contexto — no se arreglan con más inteligencia, se arreglan con estructura: guardrails que cortan los bucles y un verify step determinista que no acepta "ya está" sin pruebas. En la demo de Tejas Kumar (AI Engineer 2026), GPT-3.5 Turbo pasó de mentir a completar la tarea solo añadiendo harness, sin tocar el prompt.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo monitorear efectivamente agentes de IA en producción

    Cómo monitorear efectivamente agentes de IA en producción

    Cómo monitorear tus agentes de IA en producción

    Tiempo estimado de lectura: 5 min

    Ideas clave

    • Instrumentación desde el día 0: traces y spans que representen sesiones completas y decisiones individuales.
    • Métricas triples: rendimiento (TTFT, percentiles), coste (tokens/coste por span/sesión) y calidad (feedback y señales automáticas).
    • Elegir plataforma según arquitectura: LangSmith para stacks centrados en LangChain; Langfuse (+ ClickHouse) para portabilidad y escala.
    • Cultura operacional: versionado de prompts, tests de regresión y despliegue progresivo son obligatorios.

    Cómo monitorear tus agentes de IA en producción debería ser la primera conversación del equipo antes de lanzar una beta. Si no instrumentas traces, spans, costes y calidad desde el día 0, tu siguiente sprint será apagar fuegos y explicar facturas inexplicables.

    Este artículo explica el diseño mínimo de observabilidad para agentes (LLM Observability), las métricas que importan y las decisiones tecnológicas prácticas entre plataformas como Langfuse y LangSmith. Incluye enlaces directos a recursos: Langfuse, LangSmith y ClickHouse.

    Resumen rápido (lectores con prisa)

    Qué es: Observabilidad para agentes de IA: traces distribuidos y spans que capturan prompts, llamadas a LLM, búsquedas vectoriales y tool calls.

    Cuándo usarlo: desde el día 0 en cualquier beta u ambiente productivo que use agentes/LLMs.

    Por qué importa: APMs tradicionales no detectan fallos semánticos ni picos de coste por tokens.

    Cómo funciona (resumen): instrumenta spans por acción, mide rendimiento/coste/calidad, y almacena traces para query analítica y alertas.

    Principio: los APM tradicionales no son suficientes

    APM como Datadog o Prometheus miden latencia HTTP, errores y consumo de CPU. Perfecto para servicios deterministas. Un agente de IA devuelve HTTP 200 y puede a la vez fabricar información falsa, ejecutar llamadas externas y disparar costes por token. En ese escenario, el APM dice “todo bien” mientras tu soporte recibe tickets.

    Necesitas telemetría diseñada para flujos probabilísticos: rastreo distribuido con traces que representen sesiones completas y spans que documenten cada decisión y llamada (LLM, búsqueda vectorial, tool calls, llamadas externas).

    Traces y spans: la unidad mínima de diagnóstico

    Diseña cada interacción como un trace. Cada acción —prompts, retrievals, llamadas a herramientas, transformaciones— es un span con metadata.

    Trace: session_42
    ├─ Span 1: receive_prompt (userId=42, promptHash=…)
    ├─ Span 2: vector_search (index=kb_v1, hits=3, latency=320ms)
    ├─ Span 3: LLM_call (model=gpt-4o, tokens_in=1800, tokens_out=120, cost=$0.012)
    └─ Span 4: synthesize_response (format=short-answer)

    Con esto puedes responder rápido: ¿por qué tardó 12s? ¿qué span generó el mayor coste? ¿qué prompts producen más fallos semánticos?

    Métricas imprescindibles (no negociables)

    Rendimiento

    • Time to First Token (TTFT): impacto directo en la UX.
    • Latencia por span y percentiles: p50 / p95 / p99 por tipo de span.

    Coste

    • Tokens y coste por span: calcular coste por span y por session/userId.
    • Coste acumulado por workflow: agente que llama al LLM varias veces debe sumar costes por workflow.
    • Alertas de coste: activar alertas cuando una sesión supera un umbral definido.

    Calidad

    • Feedback explícito: thumbs up/down ligado al trace.
    • Señales implícitas: tiempo de interacción, copias realizadas.
    • LLM-as-a-judge: usar un modelo más económico para evaluar respuestas automáticamente como señal de calidad (no como veredicto absoluto).

    Langfuse vs LangSmith: criterio técnico para elegir

    LangSmith es excelente si tu stack está centrado en LangChain/LangGraph: integración out-of-the-box, datasets de evaluación y UI lista para depurar agentes complejos. El coste es acoplamiento: extraer datos o migrar a otro sistema será costoso.

    Langfuse es agnóstico y open source; se integra con llamadas directas a APIs, Vercel AI SDK, n8n, etc. La reciente incorporación de ClickHouse al ecosistema refuerza su escalabilidad analítica: consultas sobre millones de traces con latencias bajas y análisis de coste en tiempo real. Si prevés escala o necesitas evitar vendor lock-in, Langfuse+ClickHouse es una apuesta sólida.

    Decisión práctica

    • Si dependes de LangChain → LangSmith.
    • Si buscas portabilidad, alto throughput analítico y autoalojamiento → Langfuse (+ ClickHouse).

    Implementación práctica: checklist mínimo viable

    1. Wrap de llamadas al LLM: envuelve cada llamada con un SDK de observabilidad (Langfuse/LangSmith) que capture prompt, model, tokens, cost y versión del prompt.
    2. Correlación: adjunta userId, sessionId y deployment/version tags a cada trace.
    3. Ignorar ruido: no envíes node_modules, logs grandes o secretos. Usa reglas de exclusión (.lfignore / .langsmith-ignore).
    4. Costeo por sesión: suma tokens y coste por sessionId y expón dashboards con coste por feature o cliente.
    5. Evaluación automatizada: configura un pipeline de “LLM-as-a-judge” para marcar respuestas sospechosas y crear datasets de retraining.
    6. Sandboxing y alertas: ejecuta tool calls en entornos aislados y genera alertas cuando spans ejecutan operaciones potencialmente destructivas.
    7. Auditoría y retenimiento: guarda prompts y respuestas (con enmascarado si hay datos sensibles) para reproducibilidad y cumplimiento.

    Operación y cultura: monitoreo como contrato

    No es sólo técnica: es proceso. Cada cambio en prompts o pipelines debe ir acompañado de: etiquetas de versión, tests de regresión en datasets de evaluación y despliegue progresivo (canary). Sin estos pasos, la observabilidad será un registro pasivo en lugar de un control activo.

    La regla final es simple: ningún agente a producción sin traces, coste por session y un mecanismo automático de evaluación. Si ignoras eso, no estás operando IA; estás apostando.

    Implementa observabilidad desde el primer sprint, usa Langfuse o LangSmith según tu arquitectura y organiza tus dashboards en rendimiento, coste y calidad. La visibilidad no es un lujo: es la única forma de mantener agentes de IA útiles, seguros y rentables en producción.

    Para equipos que construyen flujos, agentes o automatizaciones, una referencia práctica y recursos adicionales están disponibles en Dominicode Labs. Es una continuidad natural para explorar integración, pipelines de evaluación y despliegue controlado en proyectos de IA aplicada.

    FAQ

    ¿Por qué los APM tradicionales no detectan problemas de agentes de IA?

    Porque miden señales infraestructurales (HTTP, CPU, errores) pero no la veracidad semántica ni el consumo de tokens. Un agente puede devolver HTTP 200 y producir contenido incorrecto o costoso.

    ¿Qué debe contener un span para ser útil?

    Metadata mínima: tipo de acción (prompt, search, tool call), timestamps, latencia, modelo, tokens_in/tokens_out, coste estimado, userId/sessionId y versión del prompt.

    ¿Cómo calcular el coste por sesión?

    Suma los tokens y el coste asociado de todos los spans pertenecientes al mismo sessionId. Agrupa por workflow o por cliente para dashboards y alertas.

    ¿Cuándo elegir LangSmith sobre Langfuse?

    Elige LangSmith si tu stack está fuertemente integrado con LangChain/LangGraph y aprecias integración out-of-the-box. Evita si necesitas portabilidad o evitar vendor lock-in.

    ¿Qué es LLM-as-a-judge y para qué sirve?

    Es usar un modelo más económico para evaluar respuestas automáticamente como señal de calidad. Sirve para priorizar revisiones humanas y construir datasets de retraining, pero no debe ser el veredicto final.

    ¿Qué datos debo enmascarar al guardar prompts?

    Enmascara datos sensibles: PII, credenciales, secretos y cualquier información regulada. Guarda versiones y hashes cuando sea posible para reproducibilidad sin exposición directa.

  • Crea un agente en TypeScript con Mastra para soporte técnico

    Crea un agente en TypeScript con Mastra para soporte técnico

    Crea tu primer agente en TypeScript con Mastra

    Tiempo estimado de lectura: 6 min

    • Mastra es un framework nativo en TypeScript para construir agentes y flujos de IA con validación de esquemas en runtime.
    • Separar Agent, Tool y Model permite pruebas unitarias y facilita cambiar proveedor de LLM.
    • Usa Zod para convertir inputs/outputs del LLM en contratos verificables.
    • Incluye un ejemplo práctico listo para ejecutar (agente de soporte técnico) y reglas operativas para producción.

    Crear tu primer agente en TypeScript con Mastra es la forma más práctica de evitar la fragmentación entre Node.js y microservicios Python. Si tu stack es TypeScript, mantener todo en el mismo lenguaje reduce latencia, elimina fricciones en despliegue y preserva tipos end-to-end. En las siguientes secciones veremos qué es Mastra, su arquitectura y un ejemplo práctico listo para ejecutar.

    Resumen rápido (lectores con prisa)

    Mastra es un framework en TypeScript para agentes de IA que integra validación de esquemas con Zod.

    Separa responsabilidades en Agent, Tool y Model para pruebas y cambio de proveedor de LLM.

    Usa Zod para que las invocaciones a tools sean contratos verificables en runtime.

    Incluye un ejemplo práctico (agente de soporte) y recomendaciones para producción.

    Documentación y repositorio oficiales están disponibles para referencia.

    Crea tu primer agente en TypeScript con Mastra: por qué importa y cuándo usarlo

    Mastra es un framework nativo en TypeScript para construir agentes y flujos de IA. Su ventaja principal no es solo técnica: es contractual. Al integrar Zod para la validación de esquemas como parte del runtime, convierte las llamadas del LLM en contratos verificables, no en texto libre que “parece correcto”. Documentación: mastra.ai/docs. Repositorio: github.com/mastra-ai/mastra.

    Úsalo cuando quieras:

    • Ejecutar agentes dentro del mismo proceso Node/Next.js.
    • Forzar esquemas de entrada/salida con Zod.
    • Testear herramientas aisladas sin invocar modelos.

    No es la solución si necesitas capacidades avanzadas aún no soportadas por Mastra; evalúa la madurez del proyecto antes de producción.

    Arquitectura mínima: Agent, Tool y Model

    Divide responsabilidades desde el inicio:

    • Agent: orquesta la conversación, mantiene historial e instrucciones del sistema.
    • Tool: funciones asíncronas fuertemente tipadas (Zod). Son la única forma controlada en la que el agente “toca” el mundo.
    • Model: abstracción del proveedor de LLM (OpenAI, Anthropic, etc.). Cambiar proveedor debe ser un cambio mínimo.

    Esa separación permite testing unitario de herramientas y garantiza que la lógica de negocio no quede oculta en un prompt.

    Paso a paso: ejemplo práctico (Agente de soporte técnico)

    Instalación rápida

    mkdir mastra-agent && cd mastra-agent
    npm init -y
    npm install @mastra/core zod
    npm install -D typescript @types/node tsx
    npx tsc --init
    export OPENAI_API_KEY="tu_api_key"

    1) Define la herramienta (Tool)

    Controla exactamente qué parámetros acepta el LLM:

    // src/tools/check-service.ts
    import { createTool } from '@mastra/core/tools';
    import { z } from 'zod';
    
    export const checkServiceTool = createTool({
      id: 'check-service-status',
      description: 'Consulta el estado operativo de un servicio interno por nombre.',
      inputSchema: z.object({
        service: z.enum(['api', 'database', 'frontend']),
      }),
      execute: async ({ service }) => {
        // Reemplaza por consultas reales a monitorización/DB
        const statuses = { api: 'degraded', database: 'operational', frontend: 'operational' };
        return { service, status: statuses[service], checkedAt: new Date().toISOString() };
      },
    });

    2) Instancia el agente

    Define instrucciones claras (system prompt) que actúen como contrato operativo:

    // src/agent.ts
    import { Agent } from '@mastra/core/agent';
    import { checkServiceTool } from './tools/check-service';
    
    export const supportAgent = new Agent({
      id: 'tech-support',
      name: 'TechSupportAgent',
      instructions: `
        Eres un ingeniero de soporte de nivel 1.
        Antes de concluir que un servicio está caído, INVÓCAME la herramienta de estado.
        Responde con datos y recomendaciones técnicas claras.
      `,
      model: 'openai/gpt-4o-mini',
      tools: { checkServiceTool },
    });

    3) Ejecuta el flujo

    Ejecuta el agente y deja que Mastra coordine modelo y tools:

    // src/main.ts
    import { supportAgent } from './agent';
    
    async function main() {
      const prompt = 'Los usuarios reportan lentitud. ¿Está la API bien?';
      const res = await supportAgent.generate(prompt);
      console.log(res.text);
    }
    
    main().catch(console.error);

    Lanza con npx tsx src/main.ts. Mastra coordina al LLM y las herramientas: si el modelo decide invocar checkServiceTool, el framework valida el input con Zod, ejecuta la función y alimenta la respuesta final.

    Reglas prácticas para llevar esto a producción

    1. Observabilidad desde el día 0: logs estructurados en cada invocación de tool (request id, input validado, tiempo, resultado).

    2. Errores como datos: las herramientas deben devolver errores tipados que el agente pueda razonar y comunicar (no lanzar excepciones sin contexto).

    3. Testing aislado: tests unitarios para execute y tests de integración para la orquestación. No confundas velocidad con cobertura.

    4. CI/CD: bloquea merges que introduzcan nuevas dependencias sin revisión de licencia/reputación. En entornos corporativos, valida paquetes recomendados por LLMs.

    5. Ownership y ADRs: cualquier herramienta crítica debe tener un Architecture Decision Record que explique por qué existe y cómo se prueba.

    Para guiar verificaciones de seguridad y dependencia sigue prácticas de NIST/OWASP (por ejemplo: owasp.org).

    Conclusión: Mantén el criterio humano donde importa

    Mastra te da la ergonomía de TypeScript y contratos verificables con Zod. Eso reduce alucinaciones estructurales y acelera integración en stacks web. Pero la ganancia real viene cuando aplicas disciplina: diseño previo, validación estricta, observabilidad y pruebas. Implementa el agente, mide cómo toma decisiones y exige que cualquier acción en producción esté documentada y testeada. En la próxima entrega de Dominicode mostraremos cómo añadir memoria persistente y encadenar múltiples tools para workflows complejos.

    Dominicode Labs

    Si trabajas en automatización, agentes o workflows y quieres ejemplos prácticos y guías operativas, consulta Dominicode Labs. Encontrarás recursos que complementan patrones de diseño y pruebas para agentes en producción.

    FAQ

    ¿Qué es Mastra?

    Mastra es un framework nativo en TypeScript para construir agentes y flujos de IA que integra Zod para validación de esquemas en runtime.

    ¿Cuándo debo usar Mastra?

    Cuando tu stack principal es TypeScript/Node.js y quieres ejecutar agentes en proceso, forzar esquemas de entrada/salida y testear herramientas sin invocar modelos externos.

    ¿Cómo asegura Mastra la validez de las llamadas a herramientas?

    Integra Zod como parte del runtime: las entradas a las tools se validan contra esquemas definidos y solo se ejecutan si cumplen el contrato tipado.

    ¿Puedo cambiar fácilmente el proveedor de LLM?

    Sí. La arquitectura separa Model como una abstracción, de modo que cambiar proveedor (OpenAI, Anthropic, etc.) debe ser un cambio mínimo en la configuración.

    ¿Qué prácticas de producción recomiendan?

    Observabilidad desde el día 0, errores como datos tipados, testing aislado, control de dependencias en CI/CD y ADRs para herramientas críticas.

    ¿Dónde encuentro la documentación y el código?

    La documentación oficial está en mastra.ai/docs y el repositorio en github.com/mastra-ai/mastra.

  • Cómo mantener la sincronización en arquitecturas con IA

    Cómo mantener la sincronización en arquitecturas con IA

    Sincronización Arquitectónica: Código, Especificaciones y Agentes de IA

    Tiempo estimado de lectura: 4 min

    • La sincronía entre spec, tests y código es la unidad de trabajo esencial en equipos con agentes de IA.
    • Decisiones efímeras (commits, chats de agentes) sin trazabilidad crean deuda técnica y riesgo.
    • Herramientas como Plum convierten decisiones en artefactos auditables para alinear intentos y ejecución.

    Sincronización Arquitectónica: Código, Especificaciones y Agentes de IA. Si un Product Manager cambia algo hoy, ¿el resto del sistema se adapta mañana? La respuesta habitual es no. Y con agentes de IA escribiendo código, ese desajuste ya no es un fallo aislado: es una bomba de tiempo.

    El problema es simple y profundo: el código evoluciona en commits. Las specs siguen en un README. Los hotfixes saltan directo al trunk. Los agentes generan decisiones en chats y desaparecen con el log. Resultado: intención sin rastro, comportamiento sin documentación y deuda técnica que crece en silencio.

    Resumen rápido (lectores con prisa)

    La sincronización entre spec, tests y código es crítica cuando agentes de IA participan. Convierte decisiones efímeras en artefactos rastreables en el momento del commit. Usa aprobación humana para validar cambios que afectan gobernanza y negocio.

    El Triángulo: Spec, Tests, Código

    Piensa en spec, tests y código como los tres vértices de un triángulo. Tradicionalmente trabajábamos en una línea: spec → código → tests. Con IA esto falla. La implementación revela nuevas decisiones que deben volver a la spec y a los tests. Si no, todo se desincroniza.

    El verdadero trabajo de ingeniería hoy no es escribir más código. Es mantener ese triángulo alineado. Si mejoras el vértice del código, la spec y las pruebas deben moverse al mismo tiempo. Si no lo hacen, la arquitectura entra en drifting y el proyecto se vuelve inmanejable.

    Señales que indican desincronización

    • Commits que no referencian cambios en la spec.
    • PRs que pasan tests unitarios pero rompen invariantes de negocio.
    • Conversaciones con agentes sin registro estructurado.
    • Falta de trazabilidad entre decisión y autoría.

    Si reconoces cualquiera de estas, ya estás en modo emergencia controlada.

    Plum: la plomada para decisiones

    Plum es la herramienta que propone convertir decisiones efímeras en artefactos rastreables. No es un generador de código; es una plomada digital que alinea intención y ejecución.

    Cómo funciona, en cuatro pasos

    1. Al hacer commit, Plum revisa los diffs y los traces del agente.
    2. Extrae decisiones técnicas (qué se decidió, por qué).
    3. Presenta esas decisiones para aprobación humana.
    4. Si las apruebas, actualiza la spec y reporta gaps entre spec, tests y código.

    Plum genera además un archivo .jsonl con cada decisión: la pregunta, la respuesta, quién la aprobó y en qué rama quedó. Eso convierte la intención en un artefacto auditable.

    Por qué eso importa para equipos reales

    • Auditabilidad: Ya no dependes del recuerdo del autor del commit.
    • Gobernanza: Puedes diferenciar decisiones humanas de sugerencias de un LLM.
    • Recuperabilidad: Si un PM cambia una regla, puedes medir el impacto y forzar actualizaciones en spec/tests.
    • Escalabilidad: En equipos con múltiples agentes o muchos desarrolladores, reduce choques de integración.

    Limitaciones prácticas hoy

    • Plum, en su versión inicial, está acoplado a pytest para análisis de coverage. Si tu stack usa otro runner, la integración requiere trabajo.
    • Funciona mejor cuando la spec va por delante del código. Backfilling de specs desde bases legacy masivas sigue siendo difícil.
    • Los LLMs pueden sugerir decisiones razonables pero sin visión de negocio a largo plazo. La aprobación humana no es opcional.

    Patrón operativo recomendado

    1. Escribe spec antes de generar código. Hazla lo más concreta posible.
    2. Cubre casos límite en tests automáticos. No confíes en el “lo arreglamos después”.
    3. Usa Plum o una herramienta equivalente para capturar decisiones en el momento del commit.
    4. Ejecuta un pipeline de sync: spec ↔ tests ↔ código. Fallas: bloqueo del merge hasta que todo esté alineado.
    5. Mantén el .jsonl como fuente de verdad para auditorías y retroalimentación del producto.

    Casos prácticos y referencias

    Los equipos que han escalado Spec-Driven Development reutilizan suites de tests maduras (CPython, Bash). Ejemplos relevantes:

    No es trivial. Requiere inversión en especificaciones y disciplina en procesos. Pero sin eso, delegar en agentes solo acelera la creación de un monolito incomprensible.

    Cierre con criterio

    Si quieres que un cambio de producto active el resto del sistema de forma fiable, no te obsesiones con generar más código. Obsesiónate con capturar decisiones. Haz que tus specs sean artefactos vivos. Instrumenta los traces de los agentes. Automatiza la sincronía. Convierte la intención en datos auditable.

    Instala la plomada. Pruébala en una rama pequeña. Verás cómo las discusiones pasan de “qué falló” a “qué decidimos y por qué”. Esa es la arquitectura que realmente escala cuando la IA entra en la ecuación.

    Dominicode Labs

    Para equipos interesados en experimentar con patrones de sincronización y captura de decisiones, Dominicode Labs ofrece recursos y experimentos relacionados que pueden servir como continuación lógica a este enfoque.

    FAQ

    ¿Qué es la desincronización arquitectónica?

    La desincronización ocurre cuando spec, tests y código divergen: decisiones implementadas no reflejadas en la spec o tests, cambios en tests que no documentan intención, o commits sin trazabilidad. Resulta en comportamiento no documentado y deuda técnica creciente.

    ¿Qué hace Plum?

    Plum revisa diffs y traces del agente al hacer commit, extrae decisiones técnicas, las presenta para aprobación humana y, si se aprueban, actualiza la spec y reporta gaps entre spec, tests y código. Además genera un archivo .jsonl con registro auditable de cada decisión.

    ¿Cómo integrar esto en mi pipeline?

    Incorpora la captura de decisiones en el paso de commit: ejecutar revisión automática de diffs y traces, bloquear merges si el sync falla, y mantener el registro .jsonl como fuente de verdad. Preferible integración con runners de tests compatibles (ej. pytest para la versión inicial de Plum).

    Limitaciones al usar Plum

    En su versión inicial está acoplado a pytest para análisis de coverage; la integración con otros runners requiere trabajo. Funciona mejor con specs que preceden al código y requiere aprobación humana para decisiones de negocio.

    ¿Qué conservar del proceso?

    Conserva la disciplina de escribir specs antes de código, cubrir casos límite en tests, capturar decisiones en cada commit y mantener el .jsonl como registro auditable.

    ¿Qué hago si detecto deuda técnica por agentes?

    Identifica los commits o decisiones sin trazabilidad, prioriza backfilling de specs y tests para las áreas críticas, y aplica bloqueo de merges hasta que el triángulo spec‑tests‑código vuelva a alinearse.

  • Construcción de memoria efectiva en agentes de LLMs

    Construcción de memoria efectiva en agentes de LLMs

    ¿Quieres que tu agente recuerde cosas útiles… o que haga como si recordara y te deje colgado en la siguiente conversación?

    Tiempo estimado de lectura: 7 min

    • Separar memoria corta y larga: la conversación viva debe manejarse aparte de hechos estructurados.
    • Extraer hechos estructurados: usar un extractor que emita JSON y aplicar UPSERT/DELETE, no append infinito.
    • Decisiones arquitectónicas: síncrono vs asíncrono, versionado y locks para evitar race conditions.
    • Optimizar costes: usar modelos baratos para extracción, modelos premium solo para generación crítica.
    • Observabilidad y Gobernanza: logs, métricas, cifrado y políticas de retención son imprescindibles.

    Poca gente habla de esto: la memoria en agentes no es un problema de “mandar el historial” al modelo. Es un problema de arquitectura, coste y criterio. Hacerlo mal es pagar tokens, cargar latencia y, lo peor, construir una ilusión de memoria que falla cuando más importa.

    Te voy a contar, sin florituras, cómo se construyó el sistema de memoria de Agent Builder y qué decisiones concretas puedes tomar hoy para replicarlo sin pelearte con un monster framework.

    Resumen rápido (lectores con prisa)

    Separar memoria corta (últimos N mensajes) de memoria larga (hechos estructurados). Usar un extractor barato que devuelva JSON forzado con operaciones UPSERT/DELETE. Preferir extracción asíncrona por defecto y checkpoints síncronos para acciones críticas. Versionado y locks para evitar race conditions; observabilidad y gobernanza desde el día 1.

    Primera verdad incómoda

    Primera verdad incómoda: los LLMs no recuerdan.

    Cada petición es una hoja en blanco. Si quieres que el agente actúe con coherencia, tienes que diseñar la memoria fuera del modelo.

    Resumen rápido del approach que funciona

    • Separar memoria a corto plazo (conversación viva) de memoria a largo plazo (hechos estructurados).
    • Extraer hechos con un LLM dedicado (extractor) y guardarlos como pares clave-valor o documentos estructurados.
    • Forzar salidas en JSON (Tool Calling) para que la memoria sea determinista.
    • Resolver conflictos con UPSERT/DELETE, no con append infinito.
    • Decidir entre extracción síncrona o asíncrona según prioridades (latencia vs coherencia).

    1) Memoria a corto plazo: lo que vive ahora

    ¿Qué es? Los últimos N mensajes del hilo (thread_id).

    Para qué sirve: referencias inmediatas (“bórralo”, “ese archivo”, “la última tarea”).

    Implementación simple: Redis o una tabla en Postgres con TTL y lista acotada.

    Por qué importa: reduce tokens enviados al LLM principal y mantiene claridad a corto plazo.

    2) Memoria a largo plazo: hechos, no chats

    No guardes el chat crudo. Guarda hechos estructurados: preferencias, roles, reglas de negocio, acciones ya realizadas.

    ¿Cómo se obtienen? Un LLM extractor lee el hilo (o el resumen) y emite objetos JSON con campos tipo {key, value, source, timestamp, confidence}.

    Dónde guardarlos: una tabla Key-Value en Postgres o en Redis para lecturas rápidas; opcionalmente, una base vectorial si necesitas búsquedas semánticas sobre fragmentos largos.

    3) El extractor: el héroe silencioso

    Debe ser un LLM barato y rápido (GPT-4o-mini, Claude 3 Haiku o un modelo local si tienes infra).

    Se le da: el hilo reciente + la memoria actual (opcional, si quieres que compare).

    Debe devolver: operaciones del tipo {op: “UPSERT”, key: “pref_theme”, value: “dark”, reason: “…”} o {op: “DELETE”, key: “pref_theme”, reason: “…”}.

    Forzar JSON es obligatorio. Si el modelo alucina, valida la salida con un schema validator (Zod, JSON Schema).

    4) Resolver conflictos: no más “y también”

    Problema típico: ayer dije “React”, hoy “Angular” y el sistema almacena ambos.

    Solución: lógica de reconciliación dentro del extractor — recibe la memoria existente y decide overwrites o borrados.

    Políticas útiles: última declaración gana para preferencias personales; para estados transaccionales usar confirmación explícita (“Confirmo que he migrado a Angular”).

    5) Síncrono vs Asíncrono — la decisión que rompe equipos

    Síncrono: esperas a que el extractor actualice la memoria antes de responder. Plus: coherencia. Contra: latencia.

    Asíncrono: respondes al usuario y actualizas memoria en background. Plus: experiencia rápida. Contra: race conditions si el usuario dispara múltiples mensajes seguidos.

    Recomendación práctica: asíncrono por defecto, con checkpoints síncronos en operaciones críticas (ej. ejecutar acciones que dependen de la memoria: “programa el pago” → usa extracción síncrona o confirmación humana).

    6) Mitigar race conditions: patrones que funcionan

    • Versionado por evento: cada update incluye un version_id. Si un job en background llega con versión vieja, lo descarta.
    • Locks optimistas: comparar-timestamps antes de aplicar UPSERT.
    • Event sourcing ligero: mandar events al bus (Kafka, Redis Streams) y procesarlos ordenadamente.
    • Si necesitas garantía fuerte, usa transacciones y bloqueo por llave (Postgres advisory locks).

    7) Costes y optimización de tokens

    No envíes texto innecesario al LLM principal. Inyecta solo facts relevantes (top-K) y un resumen de contexto.

    Batch extraction: agrupa varias interacciones y extrae cada X minutos si no hay acciones críticas.

    Usar modelos cheap para extractor y modelos premium para generación cuando haga falta.

    8) Observabilidad y LLMOps: no es opcional

    • Logea: inputs al extractor, salidas JSON, ops aplicadas (UPSERT/DELETE), latencias, errores de parsing.
    • Métricas clave: TTFT, tiempo de extracción, tasa de conflictos, porcentaje de respuestas incoherentes relacionadas con memoria.
    • Guarda trazabilidad para auditoría (what was injected, when, by which extractor) — imprescindible si manejas PII.

    9) Privacidad y gobernanza

    • Nunca almacenes datos sensibles sin cifrado y consentimiento.
    • Tokeniza o anonimiza cuando sea posible.
    • Control de accesos: solo servicios autorizados pueden leer/escribir la memoria.
    • Políticas de retención: define cuánto tiempo quedan los hechos y cómo se borran permanentemente.

    10) Tests y validación

    • Tests unitarios de extractor: inputs -> JSON schema válido.
    • Integración: simula secuencias de diálogos para validar conflict resolution.
    • E2E: pruebas que cubran casos de race conditions y rollback.
    • Prueba manual de A/B: compara comportamiento con y sin memoria en producción limitada.

    11) Stack recomendado mínimo (para lanzar rápido)

    • Storage corto: Redis (listas con TTL)
    • Storage largo: Postgres (tabla kv con versioning) + opcional vector DB (Pinecone/Qdrant)
    • Orquestador: n8n / Lambda / Sidecar service
    • Extractor model: GPT-4o-mini / Claude 3 Haiku (económicos)
    • Generación model: GPT-4o / Claude 3 Sonnet (cuando necesites calidad)
    • Validación: JSON Schema + Zod en backend
    • Observabilidad: logs estructurados + Sentry / Datadog

    12) Checklist práctico para ponerlo en producción (si te gusta lo concreto)

    • [ ] Definir qué “hechos” guardas (user_prefs, last_actions, contracts_signed, etc.).
    • [ ] Implementar almacenamiento corto (Redis) y largo (Postgres).
    • [ ] Crear extractor con JSON forced output y validar schema.
    • [ ] Implementar operaciones UPSERT/DELETE con versionado.
    • [ ] Diseñar flujo asíncrono por defecto y rutas síncronas para operaciones críticas.
    • [ ] Añadir metrics y logs para cada extracción y operación.
    • [ ] Revisar PII/retención y cifrado en reposo y en tránsito.
    • [ ] Tests automáticos para race conditions y reconciliación.
    • [ ] Plan de rollback si una actualización de prompt rompe el extractor.

    Metáfora que guarda la idea

    La memoria del agente no es una mochila donde tiras todo el chat. Es una libreta indexada. Solo apuntas lo que te sirve, lo fechas, lo restructuras y borras lo viejo. Si apilas notas sin orden, la libreta es ruido. Si la estructuras, te salva.

    Historias reales (1 párrafo cada una)

    El equipo A metió todo el historial en cada prompt: coste x10, latencias enormes y usuarios desconectados. Migraron a extractor asíncrono y bajaron costes un 70%.

    El equipo B aseguró cada operación con versión y locks: sacrificaron un poco de velocidad, pero nunca perdieron coherencia en flujos transaccionales.

    El equipo C dejó la extracción en background y puso un checkpoint síncrono antes de ejecutar pagos — ganador en UX y seguridad.

    Cierre con decisión: ¿lo haces tú o lo dejas para después?

    Construir memoria útil no es sexy. Es ingeniería, decisiones difíciles y pruebas. Pero sin ella, tu “agente” será otro bot que habla bonito y olvida todo. Si quieres lanzar algo que realmente parezca inteligente, hazlo con lógica, no con parcheos.

    Si quieres la checklist descargable, un prompt extractor listo para copiar/pegar y un mini-plan de 30 días para implementar esto en tu stack, respóndeme “QUIERO MEMORIA” y te lo mando. Esto no acaba aquí — y si no empiezas hoy, otro equipo lo hará.

    Como continuación lógica para quienes trabajan en automatización, agentes y workflows, puedes encontrar recursos y experimentos en Dominicode Labs.

    FAQ

    Respuesta: ¿Qué diferencia hay entre memoria a corto y a largo plazo?

    La memoria a corto plazo contiene los últimos N mensajes del hilo y sirve para referencias inmediatas. La memoria a largo plazo almacena hechos estructurados (preferencias, roles, acciones realizadas) que deben persistir y consultarse por el agente cuando sea relevante.

    Respuesta: ¿Por qué no guardar el chat completo?

    Guardar el chat crudo aumenta costes (tokens), latencia y ruido. Es mejor extraer hechos útiles y estructurarlos para lecturas rápidas y deterministas.

    Respuesta: ¿Qué es un extractor y qué formato debe devolver?

    Un extractor es un LLM barato y rápido que lee el hilo o su resumen y devuelve operaciones en JSON forzado, por ejemplo {op: “UPSERT”, key: “…”, value: “…”, reason: “…”}. La salida debe validarse con un schema validator.

    Respuesta: ¿Cuándo usar extracción síncrona en lugar de asíncrona?

    Usa extracción síncrona para operaciones críticas que dependen inmediatamente de la memoria (ej. ejecutar pagos). Por defecto, asíncrono para mejor UX y menor latencia, con checkpoints síncronos donde haga falta.

    Respuesta: ¿Cómo mitigo race conditions en actualizaciones de memoria?

    Patrones efectivos: versionado por evento (version_id), locks optimistas (comparar timestamps), event sourcing ligero y, si necesitas garantías fuertes, transacciones y bloqueo por llave en Postgres.

    Respuesta: ¿Qué métricas debo monitorizar?

    Métricas clave sugeridas: TTFT, tiempo de extracción, tasa de conflictos y porcentaje de respuestas incoherentes relacionadas con memoria. Además, loggear inputs, salidas JSON y ops aplicadas para trazabilidad.

    Respuesta: ¿Qué precauciones de privacidad aplicar?

    Nunca almacenar datos sensibles sin cifrado y consentimiento. Tokenizar o anonimizar cuando sea posible, controlar accesos y definir políticas de retención claras.