Category: AI

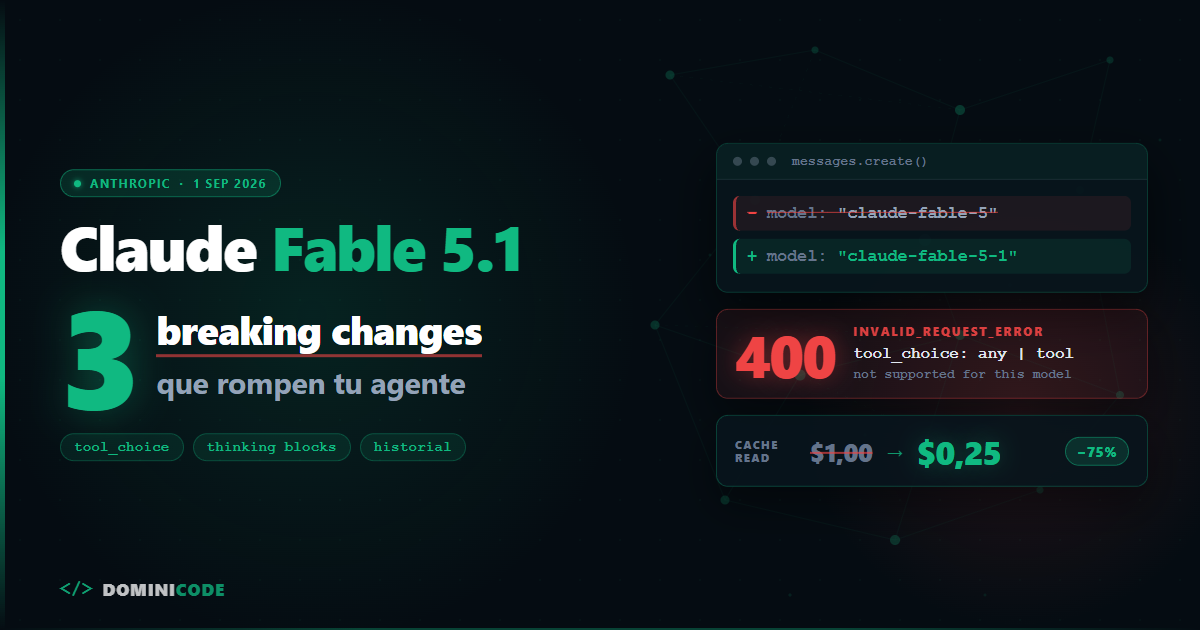
  • Claude Fable 5.1: los 3 breaking changes que rompen tu agente

    Claude Fable 5.1: los 3 breaking changes que rompen tu agente

    Ayer por la tarde cambié una línea en un agente que llevaba once semanas en producción sin que nadie lo tocara.

    claude-fable-5 → claude-fable-5-1. Eso es todo lo que pide la guía de migración a Claude Fable 5.1. Deploy, café, a otra cosa.

    En mi cuenta no pasó nada. En la del cliente, abierta el lunes, las conversaciones largas empezaron a devolver un 400 con un mensaje que no había visto nunca: The block is bound to a different conversation.

    El modelo no tenía la culpa. La tenía una función mía que reconstruía el system prompt en cada petición para inyectar la fecha de hoy. Con Fable 5 era invisible. Ahora invalida todos los thinking blocks posteriores y la API rechaza la petición entera.

    Esa es la tesis de este post: actualizar el model ID es una línea; lo que rompe es cómo construyes el array de messages.


    Qué es Claude Fable 5.1 y qué no cambia respecto a Fable 5

    Claude Fable 5.1 es el modelo de razonamiento de gama alta de Anthropic, lanzado el 1 de septiembre de 2026 junto a Claude Mythos 5.1. Mantiene la ficha técnica de Fable 5 —ventana de 1M de tokens, 128K de output, $10 de input y $50 de output por millón— y su retirada no será antes del 1 de septiembre de 2027. Lo único que cambia de precio es el cache read. Lo único que rompe es cómo construyes el array de messages.

    El resto de la ficha tampoco se mueve: mismo tokenizer que Fable 5, thinking adaptativo siempre activo con effort por defecto en high y knowledge cutoff en junio de 2026. La ventana de 1M es a la vez el valor por defecto y el máximo, a precio estándar de principio a fin.

    Dónde puedes llamarlo: la API de Claude como claude-fable-5-1, Amazon Bedrock como anthropic.claude-fable-5-1, Google Cloud y Microsoft Foundry, además de Claude Code, Claude Enterprise y la Claude Platform. Mythos 5.1 (claude-mythos-5-1) es solo por invitación.

    Si vienes de Fable 5, en la ficha técnica no hay nada nuevo que aprender. Lo nuevo está en dos sitios: tres cosas que dejan de funcionar y un precio que cambia la economía de los agentes largos.


    Breaking change 1: tool_choice forzado devuelve 400 en Claude Fable 5.1

    tool_choice: {"type": "any"} y {"type": "tool", "name": "..."} devuelven un 400 invalid_request_error con este mensaje literal:

    tool_choice: type "tool" and "any" are not supported for this model.
    

    Siguen funcionando {"type": "auto"} (el default) y {"type": "none"}. La misma validación se aplica al endpoint de token counting: si tenías un estimador de costes que replicaba el payload, también se cae.

    El motivo tiene sentido. Con el thinking siempre activo, forzar la tool se salta el bloque de razonamiento y el modelo acaba metiéndolo en los argumentos.

    El fix son dos cambios y ninguno es dramático:

    // Antes (Fable 5): forzabas la tool para garantizar JSON válido
    const res = await client.messages.create({
      model: "claude-fable-5",
      max_tokens: 4096,
      tools: [extractInvoice],
      tool_choice: { type: "tool", name: "extract_invoice" }, // 400 en Fable 5.1
      messages,
    });
    
    // Después (Fable 5.1): auto + strict, y la orden va en el prompt
    const res = await client.messages.create({
      model: "claude-fable-5-1",
      max_tokens: 4096,
      tools: [{ ...extractInvoice, strict: true }],
      tool_choice: { type: "auto" },
      messages: [
        ...messages,
        {
          role: "user",
          content: "Usa la tool `extract_invoice` para responder.",
        },
      ],
    });
    

    Un aviso antes de que lo copies: ese mensaje se queda en el historial. Si lo inyectas en cada petición y lo borras en la siguiente, acabas de reproducir el breaking change 3. O lo dejas fijo, o lo mandas como system message de un solo turno, que lo verás más abajo.

    Si lo que buscabas con tool_choice era JSON conforme a un esquema y no una herramienta de verdad, mueve el esquema a structured outputs y quítate la tool de en medio. El esquema pasa a ser el contrato, y un contrato hay que validarlo también en tu lado. Si lo que devuelve el modelo lo compruebas con un if (typeof x === "string"), en el curso de Zod para TypeScript está la versión que no se rompe cuando el esquema crece.


    Breaking change 2: los thinking blocks están atados al modelo que los produjo

    Cada thinking block registra qué modelo lo generó, y la compatibilidad es unidireccional. Fable 5.1 lee los bloques de modelos anteriores. Ningún modelo anterior lee los de Fable 5.1.

    Traducción para quien tiene un router: si tu fallback salta de Fable 5.1 a Opus 5 a mitad de conversación, la API descarta el bloque antes de que el modelo lo vea. No cuenta como input_tokens, no se factura y no te avisa.

    Ese silencio es el problema: tu agente sigue respondiendo, pero razona con menos contexto del que crees y en la traza no hay un error que investigar. Con el header beta thinking-binding-controls-2026-08-01 el descarte se reporta en input_transformations. Enciéndelo en staging antes de migrar.


    Breaking change 3: editar turnos anteriores invalida los thinking blocks

    Este es el que me mordió a mí.

    Modificar cualquier cosa antes de un thinking block —el system, el array de tools o un mensaje anterior— provoca un 400 en la siguiente petición: The block is bound to a different conversation.

    Patrones que invalidan todos los bloques posteriores:

    • Editar, reordenar o eliminar un turno anterior conservando los siguientes.
    • Inyectar texto por petición en un turno anterior (un recordatorio, una línea de estado) que borras en la siguiente.
    • Reconstruir el system prompt o el array de tools entre peticiones de la misma conversación.
    • Servir bytes distintos para la misma imagen o documento en una petición posterior. La comprobación mira los bytes, no la URL, así que una signed URL rotatoria del mismo fichero es válida.

    Patrones que no invalidan nada:

    • Eliminar una racha inicial de thinking blocks, del más viejo primero.
    • Dejar que la compactación o el context editing server-side recorten el historial.
    • Mover marcadores cache_control.
    • Cambiar el effort entre peticiones.

    La regla mental cabe en tres palabras: trata la conversación como append-only.

    Y aquí el detalle que explica por qué a unos les explota y a otros no: la comprobación se aplica a cuentas creadas a partir del 31 de agosto de 2026. En cuentas anteriores la API registra el desajuste pero solo actúa si mandas thinking.block_binding.prefix_mismatch_behavior, y Mythos 5.1 no la aplica nunca. Tu código puede estar roto hoy y no enterarte hasta que un cliente nuevo abra su cuenta.

    Claude Code, claude.ai, Claude Managed Agents y el Agent SDK ya mantienen ese prefijo intacto por ti. El problema es tuyo solo si construyes el array messages a mano, que es lo que hacemos casi todos los que tenemos agentes en producción.

    Los 3 breaking changes de Claude Fable 5.1, en una tabla

    Qué se rompe Cómo se manifiesta Fix
    tool_choice de tipo any o tool 400 invalid_request_error inmediato, también en token counting tool_choice: auto + strict: true, o mover el esquema a structured outputs; la orden de usar la tool, en el prompt
    Thinking blocks de Fable 5.1 enviados a un modelo anterior Silencio: el bloque se descarta, no se factura, nadie avisa Que el router no cambie de modelo a mitad de conversación; header thinking-binding-controls-2026-08-01 para verlo en input_transformations
    Editar system, tools o un turno anterior 400 The block is bound to a different conversation, solo en cuentas creadas desde el 31/08/2026 Historial append-only; recordatorios con system messages de un solo turno; recortes con context editing server-side

    No es la primera vez: ya conté los 2 breaking changes de Claude Opus 5. El patrón se repite en cada release y siempre pilla al mismo tipo de código, el que trata el historial como un array mutable.


    Precio de Claude Fable 5.1: el cache read baja un 75 %

    El cache read de Claude Fable 5.1 cuesta $0,25 por millón de tokens, un 75 % menos que los $1,00 de Fable 5. El resto de precios no se mueve.

    Concepto Fable 5.1 Fable 5
    Input $10 / MTok $10 / MTok
    Output $50 / MTok $50 / MTok
    Cache write 5 min $12,50 / MTok $12,50 / MTok
    Cache write 1 h $20 / MTok $20 / MTok
    Cache read $0,25 / MTok $1,00 / MTok

    El mínimo cacheable sigue en 512 tokens y el Batch API mantiene su 50 % de descuento: $5 de input y $25 de output.

    Pero el número que cambia la arquitectura es otro: en Fable 5.1 el cache read cuesta 0,025× el input base, cuando en el resto de modelos Claude es 0,1×. Es la excepción, no la norma.

    Eso convierte un prefijo grande y estable en algo casi gratis de releer: Anthropic declara un ahorro en torno al 25 % en cargas típicas y hasta el 45 % en trabajo muy agéntico.

    Fíjate en la simetría: los mismos patrones que invalidan los thinking blocks son los que te tiran la caché. Reconstruir el system en cada llamada no era un bug latente; era una factura que llevabas pagando desde antes de migrar.

    Si nunca lo has medido en serio, empieza por cómo funciona el prompt caching en la API de Claude. Después, cómo medir el consumo real de tokens de un agente. Sin esas dos métricas, elegir modelo es una corazonada.


    Tres novedades de Claude Fable 5.1 que sí vale la pena adoptar

    Effort por mensaje (beta, header mid-conversation-output-config-2026-07-01). Cambias el nivel de effort a mitad de conversación sin invalidar la caché de prompt. Súbelo para los pasos difíciles, bájalo para los rutinarios:

    const response = await client.beta.messages.create({
      model: "claude-fable-5-1",
      max_tokens: 4096,
      output_config: { effort: "high" },
      messages: [
        { role: "user", content: "Planifica la migración de SQLite a PostgreSQL." },
        { role: "assistant", content: "1. Exporta los datos. 2. Crea el esquema. 3. Importa y verifica." },
        // El nuevo nivel entra en vigor desde el siguiente turno de usuario
        { role: "system", content: [], output_config: { effort: "low" } }, // sin texto: es un mensaje de control
        { role: "user", content: "Resume el plan en una frase." },
      ],
      betas: ["mid-conversation-output-config-2026-07-01"],
    });
    

    Si tu editor subraya el role: "system" dentro de messages, es que el tipado de tu SDK todavía no lo incluye: actualiza el paquete antes de pelearte con TypeScript.

    System messages de un solo turno (beta, header mid-conversation-system-clear-at-2026-08-21). Es literalmente el sustituto del patrón que ahora rompe. Va dentro del array messages, como un turno más:

    {
      "role": "system",
      "clear_at": "next_user_message",
      "content": "Los resultados están en tu bandeja. Revísala antes de ejecutar más código."
    }
    

    Tiene autoridad de system prompt durante el turno actual y deja de inyectarse en el prompt cuando llega un mensaje de usuario posterior. Se queda en messages y lo sigues mandando igual, así que nada anterior cambia: la caché sigue casando, los thinking blocks siguen válidos y un mensaje limpiado cuesta 0 tokens de input.

    Progress updates entre tool calls (beta, header thinking-display-updates-2026-08-18). Con thinking.display: "updates" recibes como texto los avisos de progreso que el modelo escribe entre llamadas a tools, manteniendo el razonamiento oculto. Con el default "omitted" no llega nada y un turno agéntico de tres minutos parece un cuelgue.


    Dos cambios de comportamiento de Fable 5.1 que verás sin tocar código

    El parallel tool calling es más variable. Fable 5.1 puede hacer una llamada por turno donde Fable 5 agrupaba varias. No baja la calidad de la respuesta, pero cuesta tokens, round trips y tiempo de reloj. Se arregla con una instrucción de una línea pidiendo agrupar las lecturas independientes.

    Y Fable 5.1 reescribe ficheros enteros para cambios pequeños. Donde esperas una edición quirúrgica, te devuelve el fichero entero. Mismo resultado, más tokens de output.


    Claude Fable 5.1 vs Opus 5: la parte incómoda es que no es tu default

    Lo dicen los propios docs de Anthropic: "For most workloads, start with Claude Opus 5". Fable 5.1 se reserva para razonamiento exigente y trabajo agéntico de largo recorrido, o para cuando tus evals con Opus 5 a effort alto se quedan cortas. Opus 5 cuesta $5 de input y $25 de output. La mitad exacta.

    Benchmark Fable 5.1 Fable 5 Opus 5
    Terminal-Bench 4.0 55,8 % 42,0 % 52,3 %
    Terminal-Bench-Science 0.1 52,6 % 24,7 % 29,0 %
    OSWorld 2.0 (partial) 77,9 % 72,9 % 75,4 %
    OSWorld 2.0 (strict) 41,7 % 36,1 % 39,6 %

    Mira Terminal-Bench 4.0: 55,8 % contra 52,3 %. Tres puntos y medio por el doble de precio. En Terminal-Bench-Science son 52,6 % contra 29,0 %, casi veinticuatro puntos, y ahí la decisión se toma sola.

    La elección de modelo dejó de ser global. Se decide por tarea y con tus evals delante. Y si lo montas como router, recuerda el breaking change 2 y no cambies de modelo a mitad de conversación.


    Qué es Claude Mythos 5.1 y quién puede usarlo

    Claude Mythos 5.1 (claude-mythos-5-1) es el mismo modelo subyacente que Fable 5.1 con salvaguardas más permisivas. Comparte specs y precios. Solo por invitación, para participantes de Project Glasswing: organizaciones verificadas de ciberseguridad y ciencias de la vida. Con esas salvaguardas relajadas rinde más, 60,9 % en Terminal-Bench 4.0 frente al 55,8 % de Fable 5.1.

    La noticia no es el modelo, es la separación. Por primera vez Anthropic distingue de forma tan explícita "el modelo que puedes usar" de "el modelo que rinde más si te verifican". Tiene lógica. Parte del rendimiento que pierde un generalista se va en negarse a cosas que en un laboratorio de biología son trabajo normal, como se veía venir en los agentes autónomos aplicados a proteínas.

    Pero tenlo delante antes de comparar capturas de benchmarks: los números de un modelo con salvaguardas relajadas y los del modelo que tú puedes llamar no son comparables.


    Cómo migrar de Claude Fable 5 a Fable 5.1, en 4 pasos

    1. Busca tool_choice en tu repo. Si aparece any o tool, cámbialo a auto con strict: true y mueve la orden al prompt. Media hora.
    2. Busca dónde reconstruyes el system o el array de tools. Cualquier new Date() ahí dentro es una bomba: sácalo a un mensaje de usuario o a un system message de un solo turno.
    3. Audita tu router. Si puede cambiar de modelo a mitad de conversación, activa thinking-binding-controls-2026-08-01 en staging y mira input_transformations.
    4. Mide antes y después. Con el cache read a $0,25 tu arquitectura puede cambiar, pero solo si tienes el número delante.

    El resto está en los docs de novedades de Fable 5.1; el trabajo de verdad está en tus evals.

    Si construyes agentes con Claude y quieres el flujo completo de idea a producto, es lo que enseño en Construye con IA. Y en Dominicode Labs probamos estos patrones de historial append-only y routing por tarea sobre proyectos reales.

    Una release de modelo no se mide por lo que el modelo hace mejor. Se mide por cuántas suposiciones tuyas deja de sostener.


    Preguntas frecuentes

    ¿Tengo que migrar ya de Claude Fable 5 a Claude Fable 5.1?

    No hay urgencia. Fable 5.1 no se retirará antes del 1 de septiembre de 2027. La razón para migrar es económica, no de soporte. Si tu carga es muy agéntica y relee un prefijo grande en cada turno, el cache read a $0,25 justifica la migración por sí solo.

    ¿Por qué Claude Fable 5.1 me devuelve un 400 con tool_choice?

    Porque tool_choice: {"type": "any"} y {"type": "tool", "name": "..."} dejaron de estar soportados en Fable 5.1 y en Mythos 5.1. La API responde un invalid_request_error con el mensaje literal tool_choice: type "tool" and "any" are not supported for this model, y la misma validación se aplica al endpoint de token counting. Solo siguen siendo válidos {"type": "auto"} (el default) y {"type": "none"}. El fix es tool_choice: {"type": "auto"} con strict: true en la definición de la tool y la orden de usarla escrita en el prompt.

    ¿Cómo fuerzo ahora que el modelo llame a una tool concreta?

    No puedes forzarla. Díselo en el prompt —"Usa la tool get_weather para responder"— y comprueba que la haya llamado antes de seguir. Sin tool_choice no hay garantía, solo una instrucción que el modelo cumple casi siempre. Si lo que necesitabas era JSON conforme a un esquema, usa strict: true con tool_choice: auto o mueve el esquema a structured outputs.

    ¿Por qué a mi compañero le da 400 y a mí no, con el mismo código?

    Por la fecha de creación de la cuenta: la comprobación solo se aplica a las creadas a partir del 31 de agosto de 2026. En cuentas anteriores la API registra el desajuste pero no actúa salvo que mandes thinking.block_binding.prefix_mismatch_behavior. Tu código está igual de roto en ambos casos; solo cambia quién se entera.

    ¿Merece la pena Fable 5.1 frente a Opus 5?

    Los propios docs recomiendan empezar por Opus 5, que cuesta la mitad. Fable 5.1 saca tres puntos y medio más en Terminal-Bench 4.0, pero casi veinticuatro en Terminal-Bench-Science. Si tu tarea es razonamiento exigente y agéntico de largo recorrido, la diferencia paga; para el resto, no.

    ¿Puedo usar Claude Mythos 5.1?

    Solo si tu organización está aprobada en Project Glasswing, el programa por invitación para entidades verificadas de ciberseguridad y ciencias de la vida. No hay lista de espera pública: el acceso se pide a través de tu equipo de cuenta de Anthropic, AWS o Google Cloud. Es el mismo modelo con salvaguardas más permisivas y el mismo precio; si no estás dentro, tu referencia es Fable 5.1.

    ¿Puedo mezclar Claude Fable 5.1 y Opus 5 en el mismo agente?

    Sí, pero no dentro de la misma conversación. Los thinking blocks de Fable 5.1 no los lee ningún modelo anterior, así que un router que salte a Opus 5 a mitad de hilo pierde ese razonamiento sin avisarte. Reparte por tarea y arranca conversación nueva al cambiar de modelo, o activa el header thinking-binding-controls-2026-08-01 para ver los descartes en input_transformations.

    ¿Dónde puedo usar Claude Fable 5.1?

    En la API de Claude con el model ID claude-fable-5-1, en Amazon Bedrock como anthropic.claude-fable-5-1, en Google Cloud y en Microsoft Foundry, además de Claude Code, Claude Enterprise y la Claude Platform. No necesitas ningún header beta para llamarlo: los headers solo hacen falta para las funciones nuevas como el effort por mensaje o los system messages de un solo turno.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Human in the loop: tu agente no puede esperar en un await

    Human in the loop: tu agente no puede esperar en un await

    El mensaje llegó a Slack a las 19:42: «El agente quiere reembolsar 38 pagos por 4.120 €. ¿Apruebas?».

    La responsable de soporte de mi cliente, Marta, lo leyó a las 23:10, desde el sofá, y pulsó el botón verde. No pasó nada.

    Bueno, esa noche no pasó nada. Al día siguiente pasó tres veces de más.

    El human in the loop de aquel agente eran catorce líneas: una llamada a Slack y un await esperando la respuesta. En local funcionaba precioso. En producción, la función serverless se había muerto tres horas antes de que nadie pulsara nada, con la conversación entera en memoria.

    El arreglo de urgencia fue relanzar el agente con «el usuario ya aprobó los reembolsos» metido en el prompt. El modelo volvió a planificar desde cero, esta vez encontró 41 pagos fallidos en vez de 38 — habían entrado tres nuevos por la noche — y reembolsó los 41.

    El humano había aprobado 38. El agente ejecutó 41. Y nadie podía decir qué se aprobó exactamente, porque la propuesta solo había existido en la RAM de un proceso muerto.

    Eso no es un bug. Es lo que pasa cuando tratas la aprobación humana como un if.


    Qué es el human in the loop: la aprobación es asíncrona, tu loop no

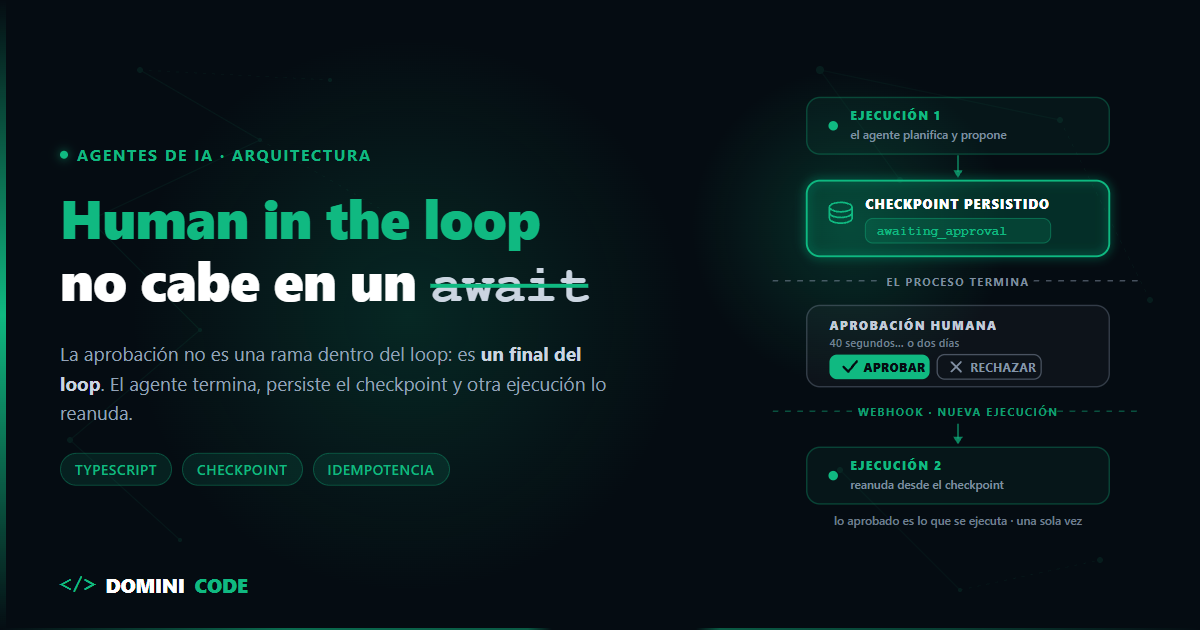
    El human in the loop (HITL) en un agente de IA es el patrón por el que el agente detiene su ejecución antes de una acción irreversible —mover dinero, enviar emails, borrar datos, desplegar— y solo continúa cuando una persona la aprueba, la edita o la rechaza. La diferencia entre que funcione y que no está en dónde ocurre esa pausa: no dentro del bucle, sino al final de una ejecución que termina y de otra que la retoma.

    El agentic loop es una función: el modelo piensa, pide una herramienta, tú la ejecutas, le devuelves el resultado, repites. Todo dentro de la misma llamada, con el array de mensajes creciendo en memoria.

    Meter una aprobación humana ahí parece trivial. Un if antes de ejecutar, una notificación, y esperas.

    El problema es lo que hay al otro lado de esa espera: una persona. Y en lo que llevo medido, una persona tarda entre cuarenta segundos y dos días. Tu proceso no aguanta ni lo primero.

    Se muere por el timeout de la función serverless. Se muere porque despliegas. Se muere por un reinicio del contenedor, por un OOM, porque el usuario cerró la pestaña y tu handler se canceló. Un await de seis horas no es una espera: es una apuesta a que nada se reinicie en seis horas.

    Y en el caso improbable de que sobreviva, tienes un proceso vivo con la conversación completa en memoria, sin hacer absolutamente nada, ocupando RAM y una conexión abierta. Multiplícalo por doscientas aprobaciones pendientes un lunes por la mañana.

    Hay un tercer problema, y es el que acaba en una reunión incómoda: si el estado vive en memoria, no existe. Nadie puede responder a «¿qué aprobó exactamente Marta el jueves a las 23:10?».

    Así que la regla de diseño es esta: la aprobación humana no es una rama dentro del loop, es un final del loop. El agente termina su ejecución devolviendo un estado «esperando decisión». Una ejecución nueva y distinta, disparada por el webhook de aprobación, lo retoma donde se quedó.

    Un punto de aprobación es una frontera de proceso. Todo lo demás sale de ahí.


    Qué acciones necesitan aprobación humana: los tres niveles de riesgo

    Antes de suspender nada hay que decidir qué merece suspenderse. Y aquí casi todo el mundo se pasa de frenada.

    Un agente que pregunta cuarenta veces al día se desactiva solo. Peor todavía: no se desactiva, y el humano aprende a pulsar «Aprobar» sin leer. Un botón que se pulsa siempre no es un control, es un ritual.

    Clasifica cada herramienta en tres niveles:

    Nivel Ejemplos ¿Aprobación?
    Read-only Buscar pedidos, leer un fichero, consultar saldo Nunca. Ni una sola vez
    Reversible Crear un borrador, etiquetar, abrir un PR, escribir en staging No, pero deja rastro y ten un deshacer
    Irreversible Reembolsar, enviar email, borrar registros, desplegar, publicar Sí, salvo por debajo de un umbral

    El matiz que lo cambia todo: el riesgo no está en la herramienta, está en los argumentos. sendEmail a un destinatario es soporte normal; a doce mil, es una campaña que nadie autorizó. refundPayments de 3 € es ruido; de 4.120 € es una conversación.

    Y el lote es una decisión, no treinta y ocho. Si tu tool reembolsa de uno en uno, el agente pedirá permiso treinta y ocho veces y habrás construido el autoclick con tus propias manos. La herramienta que se aprueba recibe el lote entero y el umbral se calcula sobre el total.

    Por eso la política de aprobación es una función del input, no un booleano en la definición de la tool:

    // tool-policy.ts
    export type RiskLevel = "read_only" | "reversible" | "irreversible";
    export type ApprovalMode = "auto" | "human";
    
    export interface ToolPolicy<TInput> {
      risk: RiskLevel;
      approval: (input: TInput) => ApprovalMode;
    }
    
    const definePolicy = <TInput>(policy: ToolPolicy<TInput>): ToolPolicy<TInput> => policy;
    
    export const toolPolicies = {
      searchOrders: definePolicy<{ status: string }>({
        risk: "read_only",
        approval: () => "auto",
      }),
      draftRefundReport: definePolicy<{ orderIds: string[] }>({
        risk: "reversible",
        approval: () => "auto",
      }),
      refundPayments: definePolicy<{ orderIds: string[]; totalCents: number }>({
        risk: "irreversible",
        // El umbral mira el lote entero, no el pago suelto.
        approval: ({ orderIds, totalCents }) =>
          totalCents > 5_000 || orderIds.length > 1 ? "human" : "auto",
      }),
      sendEmail: definePolicy<{ to: string[]; subject: string }>({
        risk: "irreversible",
        approval: ({ to }) => (to.length > 1 ? "human" : "auto"),
      }),
      deleteCustomers: definePolicy<{ ids: string[] }>({
        risk: "irreversible",
        approval: () => "human",
      }),
    } as const;
    
    export function approvalModeFor(toolName: string, input: unknown): ApprovalMode {
      const policy = toolPolicies[toolName as keyof typeof toolPolicies];
      // Fail-closed: una tool que no está en el mapa NO se ejecuta sola.
      // El día que alguien añada una herramienta y olvide la política, el
      // agente preguntará de más. Ese es el fallo barato.
      if (!policy) return "human";
      return (policy.approval as (input: unknown) => ApprovalMode)(input);
    }
    

    El cast de la última línea es el precio de tener un mapa heterogéneo. Lo pago en un único punto del sistema y no en cada herramienta, que es justo el reparto que quiero.

    Los umbrales no son constantes de por vida. Empieza pidiendo aprobación de todo lo irreversible, y a las tres semanas, con el registro de decisiones delante, súbelos donde el humano lleve treinta aprobaciones seguidas sin rechazar ni una. Si un umbral nunca se ha movido, es que nadie está mirando.

    Y si al terminar la clasificación resulta que todo requiere aprobación, no tienes un agente: tienes un formulario caro. Eso significa que le has dado herramientas que no debía tener, y el arreglo está antes, en el perímetro de ejecución, como conté en guardrails para agentes con acceso a terminal y base de datos.

    Esta tabla, además, se escribe antes que el código. Qué es irreversible en tu dominio es una decisión de producto, no de implementación, y va en la spec junto al resto de reglas del sistema — es literalmente uno de los apartados que defiendo en el libro de Spec-Driven Development.


    Cómo interrumpir y reanudar un agente de IA sin perder el estado

    Ahora el núcleo. El loop tiene que poder terminar a mitad de un turno y volver a arrancar horas después como si nada.

    Declaro las herramientas sin función de ejecución: el modelo puede pedirlas, pero quien decide si se ejecutan soy yo, en mi código. Ese es el punto de control.

    // agent-run.ts
    import { generateText, type ModelMessage, type JSONValue } from "ai";
    import { approvalModeFor } from "./tool-policy";
    import { buildPreview, type ApprovalPreview } from "./preview";
    import { checkpoints } from "./checkpoints";
    import { executeTool } from "./execute-tool";
    // model, SYSTEM_PROMPT y toolSchemas salen de tu configuración del agente.
    // executeTool: (call: PendingCall, opts?: { idempotencyKey?: string }) => Promise<JSONValue>
    import { model, SYSTEM_PROMPT, toolSchemas } from "./config";
    
    export interface PendingCall {
      toolCallId: string;
      toolName: string;
      input: unknown;
    }
    
    export interface PendingApproval extends PendingCall {
      approvalId: string;
      preview: ApprovalPreview;
      requestedAt: string;
      expiresAt: string;
    }
    
    export type AgentOutcome =
      | { status: "completed"; text: string }
      | { status: "awaiting_approval"; runId: string; approval: PendingApproval }
      | { status: "already_resolved" }
      | { status: "exhausted"; stepsUsed: number };
    
    const MAX_STEPS = 12;
    
    // El shape exacto del resultado de tool depende de tu SDK.
    // Este es el de AI SDK 5+; en 4.x era { type: "tool-result", result }.
    export const toolResult = (call: PendingCall, value: JSONValue) => ({
      type: "tool-result" as const,
      toolCallId: call.toolCallId,
      toolName: call.toolName,
      output: { type: "json" as const, value },
    });
    
    export async function runAgent(
      runId: string,
      initial: ModelMessage[],
      stepsUsed = 0,
    ): Promise<AgentOutcome> {
      const messages = [...initial];
    
      for (let step = stepsUsed; step < MAX_STEPS; step++) {
        const turn = await generateText({ model, system: SYSTEM_PROMPT, messages, tools: toolSchemas });
        messages.push(...turn.response.messages);
    
        if (turn.toolCalls.length === 0) return { status: "completed", text: turn.text };
    
        const results: ReturnType<typeof toolResult>[] = [];
    
        for (const [index, call] of turn.toolCalls.entries()) {
          // En AI SDK 4.x los argumentos viajan en call.args, no en call.input
          if (approvalModeFor(call.toolName, call.input) === "auto") {
            results.push(toolResult(call, await executeTool(call)));
            continue;
          }
    
          // Hay una llamada que necesita un humano. El turno se acaba aquí.
          // Las llamadas que quedaban detrás NO se ejecutan, pero necesitan
          // un resultado: el protocolo exige responder a todas las tool calls.
          const deferred = turn.toolCalls.slice(index + 1).map((rest) =>
            toolResult(rest, {
              ok: false,
              deferred: true,
              instruction:
                "No se ejecutó: el turno se detuvo esperando una aprobación humana. " +
                "Si sigue siendo necesaria, vuelve a pedirla después.",
            }),
          );
    
          const approval: PendingApproval = {
            ...call,
            approvalId: crypto.randomUUID(),
            preview: await buildPreview(call),
            requestedAt: new Date().toISOString(),
            expiresAt: new Date(Date.now() + 24 * 60 * 60 * 1000).toISOString(),
          };
    
          await checkpoints.save({
            runId,
            messages,
            partialResults: [...results, ...deferred],
            approval,
            stepsUsed: step + 1, // el presupuesto no se reinicia al reanudar
          });
    
          return { status: "awaiting_approval", runId, approval };
        }
    
        messages.push({ role: "tool", content: results });
      }
    
      return { status: "exhausted", stepsUsed: MAX_STEPS };
    }
    

    Fíjate en el bloque deferred, que es la parte que casi nadie ve venir. Cuando el modelo pide tres herramientas en el mismo turno y la segunda necesita aprobación, no puedes limitarte a guardar y salir: los proveedores exigen que cada tool call tenga su resultado antes de continuar la conversación. Si dejas una huérfana, al reanudar te comes un 400 y no entiendes por qué — el AI SDK tiene hasta un error con nombre propio para esto, MissingToolResultsError.

    El checkpoint guarda tres cosas y las tres hacen falta: los mensajes hasta ese punto, los resultados parciales del turno a medias, y la llamada pendiente con su preview. Eso es todo el agente, serializado. En Postgres, en una tabla con run_id, approval_id, status y un jsonb.

    El resto de la función que expone esto por HTTP es aburrido a propósito: si el status es awaiting_approval, mandas la notificación y devuelves un 202. La petición termina. El proceso puede morirse tranquilo. Y el presupuesto de pasos sigue siendo tuyo, exactamente igual que en el agentic loop en producción.

    Esto es, con otros nombres, lo que hacen los frameworks. LangGraph lo llama interrupts: la función interrupt() congela el grafo, el checkpointer persiste el estado y se reanuda con new Command({ resume }) sobre el mismo thread_id.

    El AI SDK trae tool approvals, y aquí hay que fijarse en dos cosas. La primera, dónde se declara: toolApproval no va dentro de la tool, va como opción de generateText, streamText o del ToolLoopAgent, en un mapa indexado por nombre de herramienta. Cada política recibe el input tipado y devuelve 'user-approval', undefined si no aplica, o un { type: 'denied', reason }. La segunda, la versión: esa API llegó en la v7 y no existe en la 5, que es contra la que está escrito el código de este post.

    Enfoque Cómo se pausa Dónde vive el estado Qué te sigue tocando a ti
    Propio (este post) El loop devuelve awaiting_approval y la API un 202 Tabla agent_runs en Postgres, columna jsonb Todo, pero sin sorpresas
    LangGraph interrupt() congela el grafo en el nodo Checkpointer (memoria, Postgres, SQLite) Caducidad, idempotencia y el mensaje de rechazo
    AI SDK v7 toolApproval deja la tool pendiente Lo persistes tú Dónde guardas los mensajes y qué haces al reanudar

    Úsalos si te encajan — pero ninguno responde por ti dónde vive el checkpoint, quién limpia los que nadie aprobó y qué le cuentas al modelo cuando la respuesta es que no. Si prefieres modelar todo esto como estados explícitos, el enfoque de grafo de estados frente al loop clásico resuelve bastante bien la parte de la máquina de estados.

    Los ejemplos de este post están escritos y verificados en septiembre de 2026 contra AI SDK 5 y LangGraph JS; si estás en AI SDK 4.x, los argumentos viajan en call.args y el resultado en result en vez de output.


    Qué debe ver el humano: sin datos, la aprobación es una firma

    «El agente quiere borrar 1.204 clientes. ¿Apruebas?» no es una pregunta. Es un trámite.

    Nadie puede aprobar eso de verdad, porque no hay nada que evaluar. Y si no hay nada que evaluar, el humano no está decidiendo: está firmando.

    El payload de aprobación tiene que llevar lo suficiente para decir que no:

    // preview.ts
    export interface ApprovalPreview {
      title: string;          // "Reembolsar 38 pagos — 4.120,00 €"
      rationale: string;      // por qué el agente cree que hay que hacerlo
      impact: string[];       // efectos concretos, contados
      payload: unknown;       // exactamente lo que se va a ejecutar, sin resumir
      sample: unknown[];      // 5 filas afectadas, para oler el error
      reversible: boolean;
      precondition: { name: string; value: string | number }; // se revalida al reanudar
    }
    

    Cuatro reglas, y la primera es innegociable.

    El preview lo genera tu código, no el modelo. Si el resumen que lee el humano lo escribe el mismo LLM cuya acción estás supervisando, has montado un control donde el vigilado redacta el informe. Y si esa tool call llegó por una inyección de prompt en un email que el agente leyó, el resumen viene envenenado igual — el mismo problema que trato en tácticas defensivas contra inyección de prompts. El texto lo compone tu función a partir de los argumentos y de una consulta real a tu base de datos.

    Números, no adverbios. «Varios registros» no se puede aprobar. «1.204 registros, de los cuales 6 tienen facturas emitidas este trimestre» se aprueba o se rechaza en cuatro segundos.

    Una muestra. Cinco filas de las que van a cambiar. Es donde el humano detecta que el filtro estaba mal, y le cuesta una consulta barata a tu API.

    Una precondición y una caducidad. Guarda el número que justificaba la acción — 38 pagos fallidos — y vuelve a comprobarlo al reanudar. Una aprobación de hace seis horas puede estar aprobando un mundo que ya no existe: si ahora hay 41, no ejecutas, vuelves a preguntar. Exactamente el fallo que le costó tres reembolsos de más a mi cliente.


    Idempotencia: reanudar el agente sin ejecutar la acción dos veces

    Persistir el estado abre la puerta al segundo problema del día: el botón se puede pulsar dos veces. Y se pulsa. El humano da doble clic, el webhook de Slack reintenta porque tu 200 tardó, alguien reenvía el enlace por WhatsApp.

    Necesitas dos capas, porque cada una tapa un agujero distinto.

    La primera es un compare-and-swap en la base de datos. No leas el checkpoint y luego lo actualices: reclámalo en una sola sentencia atómica.

    UPDATE agent_runs
       SET status = 'resuming', resolved_at = now()
     WHERE run_id = $1
       AND approval_id = $2
       AND status = 'awaiting_approval'
    RETURNING checkpoint;
    

    Si devuelve cero filas, alguien te ganó la carrera. No es un error: es el sistema funcionando. Devuelves un 200 idempotente y te callas.

    Y ponle un timeout también al estado resuming: si el proceso se muere justo después de reclamar el checkpoint, esa fila se queda ahí para siempre y el job de caducidad, que solo mira awaiting_approval, no la va a rescatar nunca.

    // resume.ts
    export type Decision =
      | { type: "approved"; approvedBy: string }
      | { type: "approved_with_changes"; approvedBy: string; input: unknown }
      | { type: "rejected"; approvedBy: string; reason: string };
    
    export async function resumeRun(
      runId: string,
      approvalId: string,
      decision: Decision,
    ): Promise<AgentOutcome> {
      const claimed = await checkpoints.claim(runId, approvalId);
      if (!claimed) return { status: "already_resolved" };
    
      const { messages, partialResults, approval, stepsUsed } = claimed;
    
      if (decision.type === "rejected") {
        const denial = toolResult(approval, buildDenialResult(approval, decision));
        return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, denial] }], stepsUsed);
      }
    
      const input =
        decision.type === "approved_with_changes" ? decision.input : approval.input;
    
      // El payload lleva horas en la base de datos y vuelve a entrar por la puerta.
      // Se valida otra vez contra el schema de la tool, como si viniera de fuera.
      const parsed = toolSchemas[approval.toolName as keyof typeof toolSchemas].inputSchema.parse(input);
    
      // La precondición que vio el humano tiene que seguir siendo verdad
      const still = await checkPrecondition(approval.preview.precondition);
      if (!still.ok) return requestApprovalAgain(runId, approval, still.current);
    
      // idempotencyKey = approvalId: si esto se ejecuta dos veces, el proveedor
      // devuelve el mismo resultado en lugar de mover el dinero otra vez
      const output = await executeTool({ ...approval, input: parsed }, { idempotencyKey: approvalId });
    
      const result = toolResult(approval, {
        ok: true,
        approvedBy: decision.approvedBy,
        executedInput: parsed, // lo que se ejecutó de verdad, no lo que se pidió
        data: output,
      });
    
      return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, result] }], stepsUsed);
    }
    

    La segunda capa es la idempotencia aguas abajo. El compare-and-swap te protege del doble clic, pero no del proceso que se cae justo entre mover el dinero y escribir en la base de datos que lo movió. Para eso la acción tiene que ser idempotente en el otro extremo: la clave de idempotencia de Stripe, una restricción única en la tabla de efectos, un INSERT ... ON CONFLICT DO NOTHING. Usa el approvalId como clave y el reintento devuelve el mismo resultado en lugar de un segundo reembolso. Y no es casualidad que el expiresAt de la aprobación sean 24 horas: Stripe purga las claves de idempotencia a partir de las 24 horas de antigüedad, así que una aprobación que sobreviviera a esa ventana perdería justo la red que la protegía.

    Y ojo con el parse de esa función, que parece decorativo y no lo es. Ese payload salió de tu proceso hace ocho horas, ha dormido en una base de datos y vuelve por un endpoint público. Tratarlo como dato de confianza porque «lo generamos nosotros» es el tipo de suposición que valido siempre en frontera, con el enfoque de schemas del curso de Zod para TypeScript.


    Qué le devuelves al modelo cuando el humano dice que no

    Aquí es donde se cae la mitad de las implementaciones que he revisado.

    Devuelven esto:

    { "error": "denied" }
    

    Y el modelo hace lo que hace un modelo ante una puerta cerrada: buscar otra. Reintenta con parámetros distintos, parte el borrado en dos llamadas de 600 registros, o directamente redacta una respuesta final diciendo que los reembolsos se han procesado correctamente. Un rechazo que parece un fallo técnico se lee como un fallo técnico.

    El resultado de una tool es prompt. Escríbelo como tal:

    {
      "ok": false,
      "approvalDenied": true,
      "toolName": "refundPayments",
      "deniedBy": "marta@cliente.com",
      "reason": "12 de los 38 pagos son de un lote que ya se reembolsó manualmente el viernes.",
      "instruction": "Un humano ha rechazado esta acción. No vuelvas a llamar a \"refundPayments\" en esta conversación, ni con otros parámetros, ni en lotes más pequeños, ni a través de otra herramienta. No intentes conseguir el mismo efecto por otra vía. Explica al usuario qué ibas a hacer, cuál fue el motivo del rechazo, y termina el turno sin ejecutar nada más."
    }
    

    Cuatro ingredientes y los cuatro son necesarios:

    1. Que fue una persona, no un error de red. Cambia por completo la interpretación.
    2. El motivo en lenguaje humano. Es información nueva y real que el modelo no tenía.
    3. La prohibición de buscar rutas alternativas, dicha de forma explícita. Sin esta línea, el modelo trocea la acción y lo vuelve a intentar.
    4. Qué hacer ahora. Terminar y reportar. Si no le das salida, se inventa una.

    Y existe un tercer estado que casi nadie modela: aprobado con cambios. El humano no rechaza, edita — baja el reembolso a 26 pagos y aprueba. En ese caso, el resultado que devuelves debe llevar el executedInput real, porque si el modelo cree que se ejecutaron 38 va a escribirle al usuario que se reembolsaron 38. La verdad de lo que pasó viaja en el resultado de la tool o no viaja.

    Añade también una línea al system prompt describiendo el protocolo: «si el resultado de una herramienta trae approvalDenied: true, esa acción está vetada para el resto de la conversación; sigue el campo instruction y no busques alternativas». El modelo obedece bastante bien cuando la instrucción es específica y llega en el momento en que toma la decisión.


    Cómo implementar human in the loop hoy en tu agente

    No montes el sistema entero. Coge la herramienta más peligrosa de tu agente — todos sabemos cuál es — y hazle tres cosas esta tarde.

    Sácala del execute automático. Haz que tu loop, al llegar a ella, guarde los mensajes y la llamada pendiente en una tabla y devuelva un 202. Y escribe el resultado de rechazo como si fuera un prompt, porque lo es.

    Con eso ya tienes lo importante: un agente que puede quedarse esperando sin estar vivo.

    La idea de fondo es la misma que con cualquier mecanismo de defensa en un agente: si no le hablas al modelo, no lo estás controlando, solo lo estás frenando. Y un modelo frenado sin explicaciones busca la puerta de al lado.

    Decidir todo esto antes de escribir el código — qué es irreversible, quién aprueba, qué pasa cuando la respuesta es no — es el método que enseño en el curso Construye con IA: de la idea al producto.

    Y si prefieres verlo funcionando antes que leerlo, en Dominicode Labs estamos rodando estos checkpoints sobre proyectos reales, con la tabla de aprobaciones y el audit trail puestos.


    Preguntas frecuentes

    ¿Qué es human in the loop en un agente de IA?

    Human in the loop (HITL) es el patrón por el que un agente de IA detiene su ejecución antes de realizar una acción irreversible y solo continúa cuando una persona la aprueba, la edita o la rechaza. En una implementación correcta la pausa no es un await: el agente termina su ejecución guardando un checkpoint con los mensajes y la llamada pendiente, y una ejecución nueva, disparada por la decisión del humano, lo reanuda desde ahí. Aplica a mover dinero, enviar emails masivos, borrar registros, desplegar y publicar.

    ¿Puedo implementar human in the loop con un simple await hasta que el humano responda?

    Solo si el humano contesta en segundos y tu proceso es de larga vida. En cuanto la aprobación puede tardar minutos, el await deja de ser una espera y pasa a ser una apuesta: un despliegue, un timeout de la función serverless o un reinicio del contenedor se llevan por delante todo el estado del agente. Además pagas RAM y una conexión abierta por cada aprobación pendiente. La alternativa correcta es terminar la ejecución, persistir el checkpoint y reanudar con una ejecución nueva.

    ¿Qué acciones de un agente deben requerir aprobación humana?

    Las irreversibles, y dentro de ellas solo las que superan un umbral. Todo lo de solo lectura va sin aprobación siempre; lo reversible va sin aprobación pero con registro y con una forma de deshacer; lo irreversible — mover dinero, enviar emails, borrar, desplegar, publicar — pide permiso. El umbral se calcula sobre los argumentos, no sobre la herramienta: un reembolso de 3 € y uno de 4.000 € usan la misma tool y no tienen el mismo riesgo.

    ¿Dónde guardo el estado del agente mientras espera la aprobación?

    En un almacén duradero fuera del proceso: una tabla en Postgres con run_id, approval_id, status y una columna jsonb con los mensajes, los resultados parciales del turno y la llamada pendiente. Redis sirve si tiene persistencia y si el TTL es mayor que el tiempo máximo de aprobación, pero para acciones que mueven dinero quieres una tabla auditable donde consultar meses después quién aprobó qué.

    ¿Qué pasa si nadie aprueba nunca la acción del agente?

    Que se te llena la base de datos de agentes zombis, así que la caducidad forma parte del diseño. Pon un expiresAt en cada aprobación, y un job que cierre las vencidas devolviendo al modelo un resultado de expiración con la misma estructura que el rechazo — para que el agente pueda cerrar la conversación explicando qué quedó sin hacer. Si un tipo de aprobación caduca de forma sistemática, el problema no es el TTL: es que estás pidiendo permiso para algo que a nadie le importa.

    ¿Cómo evito que el agente ejecute dos veces si la aprobación llega duplicada?

    Con dos capas. La primera es reclamar el checkpoint con un UPDATE ... WHERE status = 'awaiting_approval' RETURNING, en una sola sentencia atómica: si devuelve cero filas, otro ya lo reanudó y no ejecutas nada. La segunda es hacer idempotente la acción en el otro extremo, usando el approvalId como clave de idempotencia o como restricción única, porque el compare-and-swap no te salva si el proceso se cae justo después de mover el dinero y antes de registrarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Pi no tiene sistema de permisos, y te lo dice en su propio README

    Pi no tiene sistema de permisos, y te lo dice en su propio README

    Instalas Pi con un npm install -g, lo lanzas en tu proyecto y funciona.

    Y funciona muy bien. Es el harness de código abierto más interesante que hay ahora mismo: minimalista a propósito, cuatro herramientas activas por defecto —read, write, edit, bash—, y un core tan pequeño que te lo lees entero en una tarde. Ya conté por qué es el mejor ejemplo para entender la anatomía de un harness en qué es un agent harness.

    Este post va de la frase que hay en su README y que casi nadie cita:

    "Pi does not include a built-in permission system for restricting filesystem, process, network, or credential access. By default, it runs with the permissions of the user and process that launched it."

    Traducido: Pi no tiene sistema de permisos. Corre con los tuyos.

    Y lo importante es que no es un descuido ni una versión temprana. Es coherente con la tesis del proyecto: el core no engorda, y lo que otros traen de fábrica aquí lo montas tú. El propio README te dice a continuación qué montar, con tres patrones documentados.

    Vamos con lo que estás aceptando y con cómo ponerle un límite.


    Qué significa exactamente "corre con tus permisos"

    No es una advertencia genérica. Significa, literalmente, que el proceso puede hacer todo lo que puedes hacer tú desde esa terminal:

    • Leer cualquier archivo de tu usuario. Tus claves en ~/.ssh, los .env de todos tus proyectos, las credenciales de tu CLI de nube, tus tokens de sesión.
    • Escribir y borrar en cualquier sitio, no solo en el proyecto donde lo lanzaste.
    • Ejecutar cualquier comando con bash, incluidos git push, curl a donde sea, o un npm install de un paquete que no has revisado.
    • Salir a la red sin restricción.

    Y la parte que más se subestima: el agente no tiene que querer hacer nada de eso para que pase. Basta con que lo lea en algún sitio. Una dependencia con instrucciones metidas en el README, la salida de una herramienta, una issue de GitHub que le pides que resuma. Eso es inyección indirecta de prompts, y lo desarrollé entero en cómo proteger tus agentes de la inyección indirecta.

    Con un agente sin capa de permisos, la distancia entre "leyó algo raro" y "ejecutó algo raro" es cero.


    Las dos formas de ponerle un límite

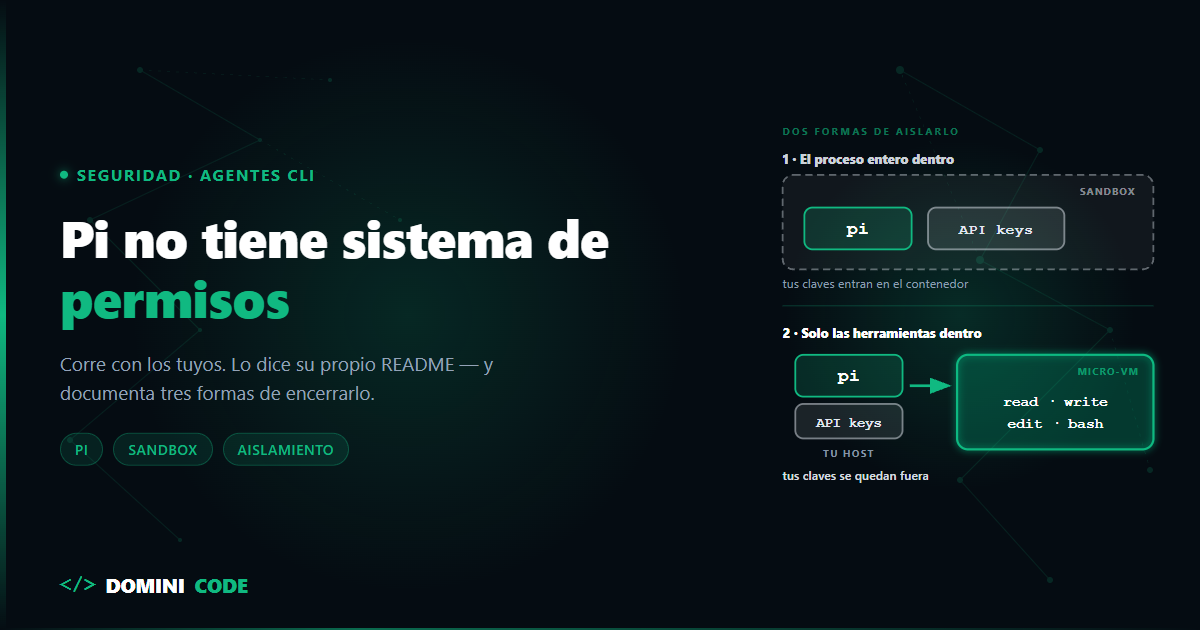
    La documentación oficial plantea la decisión con una claridad que se agradece. Solo hay dos opciones:

    1. Meter el proceso pi entero dentro de un entorno aislado.
    2. Dejar pi en tu máquina y enrutar la ejecución de las herramientas hacia un entorno aislado.

    La diferencia no es cosmética y decide dónde acaban tus credenciales. Si metes el proceso entero en un contenedor, las claves de tu proveedor de IA entran con él. Si dejas el proceso fuera y solo enrutas las herramientas, la autenticación se queda en tu host y lo que viaja al entorno aislado son las operaciones.


    Los tres patrones documentados

    Patrón Qué se aísla Cuándo Lo que cuesta
    Gondolin Herramientas integradas y comandos ! Quieres la micro-VM pero la auth en tu host Node ≥ 23.6.0 y QEMU
    Docker plano El proceso pi entero Aislamiento local simple Tus claves de API entran en el contenedor
    OpenShell El proceso entero, con políticas Sandbox gestionado, local o remoto Necesita un gateway activo

    Gondolin: la micro-VM que se traga las herramientas

    Gondolin es una micro-VM de Linux local. La extensión de ejemplo deja pi corriendo en tu máquina y redirige las herramientas integradas hacia la VM, sobrescribiendo read, write, edit, bash, grep, find y ls. Los comandos ! que escribes tú también van dentro.

    cp -R packages/coding-agent/examples/extensions/gondolin ~/.pi/agent/extensions/gondolin
    cd ~/.pi/agent/extensions/gondolin
    npm install --ignore-scripts
    
    cd /ruta/a/tu/proyecto
    pi -e ~/.pi/agent/extensions/gondolin
    

    Monta tu directorio actual en /workspace dentro de la VM. Es el patrón con mejor relación aislamiento/comodidad: tu autenticación no sale del host.

    Con una advertencia que conviene decir en voz alta: Gondolin se describe a sí mismo como experimental («Experimental Linux microvm setup with a TypeScript Control Plane as Agent Sandbox») y va por unas 2.000 estrellas frente a las más de 96.000 de Pi. Es el patrón que mejor encaja conceptualmente, pero es la pieza más joven de las tres.

    Docker plano: el más simple, con una letra pequeña

    Metes todo el proceso en un contenedor:

    docker run --rm -it \
      -e ANTHROPIC_API_KEY \
      -v "$PWD:/workspace" \
      -v pi-agent-home:/root/.pi/agent \
      pi-sandbox
    

    Fíjate en el -e ANTHROPIC_API_KEY: la clave entra. Y fíjate en el volumen con nombre para /root/.pi/agent — está ahí a propósito, porque la documentación avisa de que montar tu ~/.pi/agent del host expone tus credenciales y tus sesiones al contenedor. Si montas ese directorio por comodidad, te has saltado media barrera.

    OpenShell: cuando necesitas políticas de verdad

    OpenShell es un sandbox con control de políticas sobre sistema de archivos, procesos, red, credenciales e inferencia. Corre a través de un gateway local (Docker, Podman o una VM) o de uno remoto sobre Kubernetes. Todo —herramientas integradas, comandos ! y herramientas de extensiones— se ejecuta dentro del límite.

    Es el más pesado de montar y el único que te da políticas explícitas. Si esto va a tocar código de un cliente, es el que te van a pedir.


    Tres cosas de las que el aislamiento NO te salva

    Aquí es donde se cae la sensación de seguridad, y las tres salen de la propia documentación.

    1. Tu proyecto sigue siendo escribible. En Gondolin y en Docker, tu directorio actual se monta en /workspace y los cambios escriben directamente en tus archivos del host. Eso es lo que quieres —para eso lo usas— pero significa que el contenedor protege el resto de tu máquina, no tu código. Un borrado desafortunado dentro de /workspace es un borrado en tu disco. La red de seguridad de tu proyecto sigue siendo Git, no el sandbox.

    2. Tus propias extensiones se quedan fuera. Esta es la fuga más sutil y está dicha con todas las letras: "las extensiones se ejecutan allí donde se ejecuta el proceso pi". Si usas el patrón de enrutado con pi en el host, las herramientas de tus extensiones personalizadas siguen corriendo en tu máquina salvo que ellas también deleguen sus operaciones. Montas la micro-VM, respiras tranquilo, y la extensión que escribiste el mes pasado sigue teniendo acceso directo a tu disco.

    3. Las credenciales del proveedor. En el patrón Docker entran en el contenedor por diseño. Si lo que te preocupa es que se filtre la clave de tu API, ese patrón no es el tuyo: es Gondolin.


    Cómo elegir en treinta segundos

    • Vas a dejarlo trabajar solo, con tu código personal: Gondolin. La auth se queda fuera y las herramientas dentro.
    • Quieres el aislamiento más simple y la clave de API te da igual (una de proyecto, con límite de gasto): Docker.
    • Es código de cliente, o tienes que justificar controles ante alguien: OpenShell.
    • Estás mirando el diff de cada paso, en un repo tuyo, con todo commiteado: puedes ir sin nada. Pero que sea una decisión, no un descuido.

    Y una que aplica a los cuatro casos: usa una clave de API distinta y con límite de gasto para el agente. No la misma que tu producción.

    Si el aislamiento con contenedores es terreno nuevo para ti, la base está en entornos de desarrollo reproducibles con Docker y Dev Containers, y el caso concreto de encapsular la ejecución de un agente lo conté en Docker sandboxing para ejecutar código de IA.


    Esto no va solo de Pi

    Lo que hace distinto a Pi no es que corra con tus permisos. Es que lo pone por escrito en la primera pantalla del repositorio, y te documenta tres formas de arreglarlo.

    La pregunta útil no es "¿es Pi seguro?". Es: de los agentes CLI que tienes instalados ahora mismo, ¿cuántos te han dicho con esta claridad qué pueden tocar? La mayoría no tiene esa sección porque no le interesa tenerla, no porque el problema no exista.

    Ese es el criterio con el que conviene mirar cualquier herramienta agéntica que instales: no cuántas capacidades trae, sino qué te cuenta sobre sus límites. Un proyecto que te documenta cómo encerrarlo te está respetando más que uno que no menciona el tema.

    Delimitar el alcance del trabajo antes de lanzar al agente reduce mucho la superficie de todo esto, y es la metodología que tienes en el libro de Spec-Driven Development. El flujo completo con herramientas CLI agénticas lo enseño en el curso Construye con IA: de la idea al producto con Claude Code.

    En Dominicode Labs comparto las configuraciones de aislamiento que uso de verdad para dejar agentes trabajando sin vigilarlos.

    Un agente sin permisos no es un agente inseguro. Es un agente que te ha dejado a ti la decisión, y te ha dicho dónde está el interruptor.


    Preguntas frecuentes

    ¿Pi es inseguro por no tener sistema de permisos?

    Es una decisión de diseño coherente con su minimalismo, no un fallo: el core no incorpora lo que puedes montar fuera. Lo que sí es imprudente es usarlo sin aislamiento en una máquina con credenciales, porque corre con todos los permisos del usuario que lo lanzó. El propio proyecto documenta tres patrones para ponerle límites.

    ¿Cuál de los tres patrones de aislamiento elijo?

    Gondolin si quieres que tus credenciales de proveedor se queden en el host y solo viajen las operaciones a la micro-VM. Docker si buscas el límite más simple y no te importa que la clave de API entre en el contenedor. OpenShell si necesitas políticas explícitas sobre archivos, procesos, red y credenciales, normalmente porque tienes que justificarlas ante un cliente o un equipo de seguridad.

    Si aíslo el agente en un contenedor, ¿mi código está a salvo?

    No del todo. En Gondolin y en Docker tu directorio de trabajo se monta en /workspace y lo que se escribe ahí llega a tus archivos reales — tiene que ser así para que el agente sirva de algo. El aislamiento protege el resto de la máquina: tus claves, otros proyectos, tu red. Para el código, tu red de seguridad sigue siendo Git y tener todo commiteado antes de lanzarlo.

    ¿Mis extensiones personalizadas también quedan aisladas?

    No automáticamente, y es la fuga más fácil de pasar por alto. Las extensiones se ejecutan donde se ejecuta el proceso pi: si usas el patrón de enrutado con pi en el host, las herramientas de tus extensiones siguen corriendo en tu máquina salvo que las escribas para delegar sus operaciones al entorno aislado.

    ¿Cuántas herramientas trae Pi realmente?

    Cuatro activas por defecto —read, write, edit y bash—, que son las que sostienen la tesis del proyecto. Hay algunas más disponibles: la extensión de Gondolin, por ejemplo, sobrescribe read, write, edit, bash, grep, find y ls. La cifra que importa no es cuántas existen, sino cuántas van al contexto por defecto.

  • Guardrails para agentes: probé la blocklist típica y pasan 16 de 20

    Guardrails para agentes: probé la blocklist típica y pasan 16 de 20

    La primera semana que le das a un agente acceso a tu terminal te sientes invencible.

    Le pides que instale una dependencia, ejecute los tests, cree una rama y arregle un bug. Y lo hace, mientras tú haces otra cosa.

    Después llega la pregunta incómoda: ¿qué pasa exactamente si se equivoca?

    Casi todo el mundo responde igual. Ha metido en el System Prompt una frase del tipo "por favor, nunca ejecutes comandos destructivos", y con eso duerme tranquilo. Eso no es una barrera: un modelo es probabilístico y esa frase compite con todo lo demás que hay en el contexto. Que el LLM no puede ser su propia barrera de seguridad ya lo desarrollé en guardrails y tácticas defensivas contra inyección de prompts, así que aquí lo doy por sabido.

    Este post va del siguiente paso, el que casi nadie audita: el que sí escribió código de defensa y cree que con eso está cubierto.

    Porque hay un guardrail concreto que escribimos todos, que parece serio, que da mucha tranquilidad y que no aguanta ni una reordenación de flags. Vamos a romperlo con un test que puedes ejecutar tú.


    El guardrail que todos escribimos

    Es este, con pequeñas variaciones. Una lista de patrones peligrosos y un interceptor delante del ejecutor de herramientas:

    const FORBIDDEN_PATTERNS = [
      /rm\s+(-rf|-fr|\*)/i,
      /git\s+push\s+.*(--force|-f)/i,
      /git\s+reset\s+--hard/i,
      /drop\s+table/i,
      /chmod\s+777/i,
      /curl\s+.*\|\s*(bash|sh)/i,
    ];
    
    const blocked = (cmd: string) => FORBIDDEN_PATTERNS.some(p => p.test(cmd));
    

    Tiene buena pinta. Cubre el rm -rf de los titulares, el force push, el DROP TABLE y el clásico curl | bash.

    Ahora vamos a medirlo.


    El test: 16 de 20 comandos destructivos pasan

    Le pasé a ese filtro 20 comandos que ningún agente debería poder ejecutar sobre tu máquina. Este es el resultado completo:

    Comando ¿Lo detiene?
    rm -rf / Bloqueado
    rm -r -f / Pasa
    rm -Rf ~/proyecto Bloqueado
    rm --recursive --force / Pasa
    rm -f -r . Pasa
    find . -delete Pasa
    find . -exec rm {} + Pasa
    git clean -fdx Pasa
    > package.json Pasa
    cat /dev/null > .env Pasa
    dd if=/dev/zero of=/dev/sda Pasa
    git reset --hard HEAD~5 Bloqueado
    DROP TABLE users Bloqueado
    drop/**/table users Pasa
    TRUNCATE TABLE users Pasa
    DELETE FROM users Pasa
    mv proyecto /dev/null Pasa
    $(echo rm) -rf / Pasa
    npm run deploy:prod Pasa
    chmod -R 777 / Pasa

    Cuatro bloqueados, dieciséis dentro. Y fíjate en la segunda fila, porque resume el problema entero:

    rm -rf / está bloqueado. rm -r -f / pasa.

    Es el mismo comando. Borra exactamente lo mismo. Lo único que cambia es que los flags van separados, y el modelo no necesita saber que existe un filtro para escribirlo así: es una forma perfectamente normal de escribir ese comando.

    La última fila es igual de reveladora. El patrón /chmod\s+777/ espera que el 777 venga justo detrás de chmod, así que chmod -R 777 / —que es peor, porque es recursivo— no lo toca.

    Aquí tienes el test entero para que lo corras contra tu propia lista antes de seguir leyendo:

    const destructivos = [
      "rm -rf /", "rm -r -f /", "rm -Rf ~/proyecto", "rm --recursive --force /",
      "rm -f -r .", "find . -delete", "find . -exec rm {} +", "git clean -fdx",
      "> package.json", "cat /dev/null > .env", "dd if=/dev/zero of=/dev/sda",
      "git reset --hard HEAD~5", "DROP  TABLE users", "drop/**/table users",
      "TRUNCATE TABLE users", "DELETE FROM users", "mv proyecto /dev/null",
      "$(echo rm) -rf /", "npm run deploy:prod", "chmod -R 777 /",
    ];
    
    const pasan = destructivos.filter(c => !blocked(c));
    console.log(`${pasan.length}/${destructivos.length} pasan el filtro`);
    console.log(pasan);
    

    Y hay un segundo efecto, menos grave pero muy revelador: el patrón del force push bloquea git push --force-with-lease, que es precisamente la variante segura. Una blocklist no solo deja pasar lo peligroso; también prohíbe cosas correctas, y eso es lo que te acaba empujando a desactivarla.


    El fallo no son los patrones. Es la arquitectura

    La tentación, al ver esa tabla, es añadir patrones. Meter -r -f, meter find, meter TRUNCATE.

    No sirve. Puedes pasarte una tarde ampliando la lista y mañana el agente encontrará la forma número veintidós, porque una shell tiene infinitas maneras de expresar la misma destrucción: flags separados, flags largos, alias, sustitución de comandos, redirecciones, herramientas distintas que hacen lo mismo.

    Esto tiene nombre desde hace décadas en seguridad: enumerating badness, enumerar lo malo. Y siempre pierde, porque el conjunto de lo peligroso es infinito y el de lo permitido es finito.

    La inversión es la solución completa:

      BLOCKLIST              ALLOWLIST
      ─────────              ─────────
      permite por defecto    deniega por defecto
      enumera lo malo        enumera lo bueno
      conjunto infinito      conjunto finito
      falla abierta          falla cerrada
    

    Con una allowlist, el comando número veintidós que no habías previsto no se ejecuta, porque no está en la lista. Ese es el único diseño en el que un olvido tuyo no se convierte en un incidente.


    El chequeo de rutas también se cae

    El mismo middleware suele traer una validación de rutas parecida a esta:

    if (path.startsWith("/") || path.includes("..")) return BLOQUEADO;
    

    Falla en las dos direcciones. Estas rutas pasan:

    • C:\Windows\System32 — una ruta absoluta de Windows no empieza por /.
    • ~/.ssh/id_rsa — la expande la shell después de tu comprobación.

    Y a la vez bloquea src/../lib/x.ts, que es una ruta legítima dentro del proyecto.

    El arreglo es no razonar sobre el texto de la ruta, sino resolverla y comprobar dónde acaba:

    import path from "node:path";
    
    const ROOT = path.resolve(process.env.AGENT_WORKSPACE!);
    
    export function dentroDelWorkspace(candidata: string): boolean {
      const destino = path.resolve(ROOT, candidata);
      return destino === ROOT || destino.startsWith(ROOT + path.sep);
    }
    

    Con eso, ../../etc/passwd y /etc/passwd quedan fuera —los dos resuelven a un destino que no cuelga de ROOT— mientras que src/../lib/x.ts entra sin problema. La comprobación deja de depender de cómo esté escrita la ruta.

    Un aviso: si tu agente puede crear enlaces simbólicos, resuélvelos también (fs.realpath) antes de comparar. Un symlink dentro del workspace apuntando fuera se salta la comprobación de arriba.


    Las 4 capas que sí sostienen la capa de ejecución

    En orden, de más a menos importante.

    1. Allowlist de comandos, denegar por defecto

    Define qué puede ejecutar el agente, no qué no puede. Empieza por lo que de verdad necesita a diario —tests, linter, build, git status, git diff— y ve añadiendo cuando algo se bloquee de forma legítima.

    La forma práctica de arrancar: registra durante una semana todo lo que el agente intenta ejecutar sin bloquear nada, y monta la allowlist a partir de esa lista real. Casi siempre son menos de treinta comandos.

    Si usas un agente CLI, esto normalmente ya existe en su configuración: reglas de permiso allow / deny / ask y modos de permisos. Revisa el tuyo con una pregunta concreta: ¿hay alguna regla comodín tipo Bash(*) que anule a todas las demás? Si la hay, tu allowlist es decorativa.

    2. Confinamiento por ruta resuelta

    El agente trabaja dentro de un directorio y solo dentro de él. Con la función de arriba, y aplicada a todas las herramientas que tocan disco: leer, escribir, mover y borrar. Confinar solo la escritura deja abierta la exfiltración de .env y de tus claves.

    3. Puerta humana para lo irreversible

    Lo que no se puede deshacer no se automatiza: git push, migraciones, escrituras en base de datos de producción, despliegues, borrados. El criterio no es "peligroso" sino "¿puedo revertirlo en un minuto?". Es el mismo principio de mínimo privilegio que desarrollé al hablar de inyección indirecta de prompts en agentes, aplicado aquí a la shell.

    Montar esa puerta bien tiene su propia arquitectura —clasificar las tools por riesgo, persistir el estado mientras se espera y no ejecutar dos veces al reanudar—, y la desarrollo en arquitectura human in the loop en TypeScript.

    4. Aislamiento: que el radio del fallo sea pequeño

    Las tres capas anteriores fallan alguna vez. La cuarta decide cuánto duele.

    Dale a cada tarea su propia rama y su propio directorio de trabajo, y un contenedor cuando la tarea toque dependencias o servicios. Si algo sale mal, borras el directorio y no has perdido nada. Cómo montar el aislamiento fuerte con contenedores lo detallé en Docker sandboxing para ejecutar código de IA.


    El middleware corregido

    Juntando las piezas, el interceptor queda así:

    import path from "node:path";
    
    const COMANDOS_PERMITIDOS = new Set([
      "npm", "pnpm", "bun", "node", "tsc", "eslint", "prettier", "vitest", "jest",
    ]);
    
    const SUBCOMANDOS_GIT = new Set(["status", "diff", "log", "add", "commit", "branch", "checkout"]);
    
    const IRREVERSIBLES = new Set(["push", "reset", "clean", "rebase"]);
    
    const ROOT = path.resolve(process.env.AGENT_WORKSPACE!);
    
    type Decision =
      | { tipo: "ejecutar" }
      | { tipo: "preguntar"; motivo: string }
      | { tipo: "denegar"; motivo: string };
    
    export function decidir(argv: string[], rutas: string[] = []): Decision {
      for (const r of rutas) {
        const destino = path.resolve(ROOT, r);
        if (destino !== ROOT && !destino.startsWith(ROOT + path.sep)) {
          return { tipo: "denegar", motivo: `La ruta "${r}" queda fuera del workspace.` };
        }
      }
    
      const [binario, sub] = argv;
    
      if (binario === "git") {
        if (IRREVERSIBLES.has(sub)) return { tipo: "preguntar", motivo: `git ${sub} no es reversible.` };
        if (SUBCOMANDOS_GIT.has(sub)) return { tipo: "ejecutar" };
        return { tipo: "denegar", motivo: `git ${sub} no está en la allowlist.` };
      }
    
      if (COMANDOS_PERMITIDOS.has(binario)) return { tipo: "ejecutar" };
    
      return { tipo: "denegar", motivo: `"${binario}" no está en la allowlist.` };
    }
    

    Tres detalles que hacen que esto funcione y la versión anterior no:

    Recibe argv, no un string. Nada de analizar una línea de shell con expresiones regulares. Si construyes el comando como array de argumentos y lo ejecutas sin shell (execFile en lugar de exec), desaparecen de golpe la sustitución de comandos, las redirecciones y el encadenado con ; o &&. La mitad de las evasiones de la tabla de arriba dejan de existir.

    Devuelve tres estados, no un booleano. ejecutar, preguntar y denegar. Sin el estado intermedio acabas ampliando la allowlist con cosas irreversibles solo para no tener que confirmar cada vez.

    Deniega por defecto. El return final es una denegación. Lo que no previste no se ejecuta.

    Y cuando bloquees, devuélvele al agente el motivo en texto, no una excepción: el modelo lo lee y busca otra vía en lugar de dejar la tarea a medias.

    Para los parámetros estructurados que llegan a una herramienta o a la base de datos, la validación de schema con Zod es la pieza que cierra el círculo, y los patrones de contrato están en el curso de Zod para TypeScript. El criterio general de dónde poner las validaciones —y dónde no— lo tienes en programación defensiva en TypeScript.


    El guardrail más barato: acotar antes de empezar

    Todo lo anterior actúa cuando el agente ya está trabajando. Es más barato reducir lo que puede intentar.

    Cuando escribes un spec.md que fija qué archivos entran en la tarea y qué queda fuera, el agente deja de tener motivos para acercarse al resto del repositorio. No sustituye a los guardrails —una especificación no es un control de seguridad— pero baja mucho la frecuencia con la que se activan.

    La metodología completa está en el libro de Spec-Driven Development, y el flujo práctico con agentes CLI en el curso Construye con IA: de la idea al producto con Claude Code.


    Checklist para esta semana

    1. Corre el test de arriba contra tu propia blocklist. Diez minutos. Si pasa más de la mitad, ya sabes en qué punto estás.
    2. Busca el comodín. Abre la configuración de permisos de tu agente y comprueba si hay una regla que permita todo. Suele estar puesta desde el primer día y olvidada.
    3. Ejecuta sin shell. Cambia exec por execFile con argv. Es el cambio con mejor relación esfuerzo/resultado de toda la lista.
    4. Confina por ruta resuelta, en lectura y en escritura.

    En Dominicode Labs revisamos arquitecturas agénticas reales y compartimos las configuraciones de permisos que aguantan en producción.

    La autonomía de verdad no es darle libertad total al modelo. Es construirle un sitio donde equivocarse salga barato.


    Preguntas frecuentes

    ¿Por qué una lista de comandos prohibidos no basta para proteger a un agente?

    Porque enumera un conjunto infinito. Una shell puede expresar la misma acción destructiva de muchas formas —flags separados, flags largos, otra herramienta que hace lo mismo, sustitución de comandos— y tu lista solo cubre las que se te ocurrieron. En la prueba de este post, dieciséis de veinte comandos destructivos atraviesan una blocklist de aspecto razonable, incluido rm -r -f /, que es el mismo comando del ejemplo con los flags separados.

    ¿Cómo confino a un agente a la carpeta del proyecto?

    Resolviendo cada ruta con path.resolve() contra la raíz del workspace y comprobando que el resultado sigue colgando de esa raíz. No compruebes el texto de la ruta: startsWith("/") no detecta rutas absolutas de Windows ni el ~ que expande la shell, y includes("..") bloquea rutas internas legítimas. Si el agente puede crear symlinks, resuélvelos con fs.realpath antes de comparar.

    ¿Una allowlist no me va a estar frenando todo el rato?

    Los primeros días sí, y es la señal de que funciona. La forma de reducirlo es construirla con datos: registra una semana de comandos reales del agente y parte de ahí. Suelen ser menos de treinta. Y ten un estado intermedio de "preguntar" para lo irreversible: sin él acabarás metiendo en la allowlist cosas que no deberían estar solo para dejar de confirmar.

    ¿Necesito Docker para esto o me basta con una rama aislada?

    Depende de qué pueda romper la tarea. Una rama con su propio directorio de trabajo protege tu código y hace que tirar el trabajo cueste un segundo, pero comparte tu máquina, tus variables de entorno y tu red. Si la tarea instala dependencias, ejecuta código que no has leído o toca servicios, necesitas el aislamiento del contenedor.

    ¿Dónde pongo el guardrail: en la herramienta o en el agente?

    En la herramienta, siempre. Un control que vive en el prompt, en el nombre de la tool o en su descripción es una sugerencia que el modelo puede ignorar. El guardrail tiene que estar en el código que ejecuta la acción, de forma que ni siquiera un agente que decida saltárselo pueda hacerlo. Si el control se puede desactivar escribiendo texto, no es un control.

  • El Python que necesitas si construyes agentes en TypeScript

    El Python que necesitas si construyes agentes en TypeScript

    Tu producto está en TypeScript. Tu agente también.

    Y aun así, en algún momento vas a acabar escribiendo Python. No porque quieras cambiar de lenguaje, sino porque entre tus datos en crudo y el contexto que lee tu agente hace falta una capa que transforme lo uno en lo otro, y esa capa se escribe casi siempre en Python.

    No es un curso de Data Science. No hace falta álgebra lineal, ni estadística inferencial, ni un notebook con gráficos bonitos. Hacen falta cuatro operaciones, y con ellas se resuelve prácticamente todo lo que un agente necesita que le den masticado.

    Empiezo por el número que justifica el post entero.


    339.276 tokens contra 96

    Tengo una exportación de ventas: 40.000 filas, cinco columnas. La pregunta que quiero que responda el agente es sencilla: ¿qué curso conviene empujar el mes que viene?

    La forma perezosa es meterle el CSV entero en el contexto. Vamos a medir qué significa eso:

    import pandas as pd
    
    df = pd.read_csv("ventas.csv")          # 40.000 filas
    
    crudo = df.to_csv(index=False)
    
    resumen = (df.groupby("curso")
                 .agg(ventas=("precio", "size"),
                      ingresos=("precio", "sum"),
                      tasa_completado=("completado", "mean"))
                 .round(2)
                 .reset_index()
                 .sort_values("ingresos", ascending=False))
    
    compacto = resumen.to_json(orient="records")
    
    print(f"crudo   : {len(crudo):,} caracteres")
    print(f"resumen : {len(compacto):,} caracteres")
    print(f"factor  : {len(crudo)/len(compacto):,.0f}x")
    

    Resultado:

    crudo   : 1.357.104 caracteres
    resumen :       386 caracteres
    factor  :     3.516x
    

    A razón de unos cuatro caracteres por token, eso es pasar de ~339.000 tokens a ~96. Y esto es lo que ve el agente después de la reducción:

         curso  ventas  ingresos  tasa_completado
            IA    8792 439512.08             0.27
       Angular   12349 370346.51             0.48
    TypeScript    9522 190344.78             0.39
       Testing    5621 168573.79             0.55
          Node    3716  74282.84             0.34
    

    Cinco filas. Y ahí dentro ya está la respuesta, que además no es la obvia: IA es lo que más factura pero tiene la peor tasa de finalización (0,27), y Testing es lo que menos factura con la mejor con diferencia (0,55). Ese contraste no se ve en 40.000 filas ni lo va a encontrar un modelo leyéndolas.

    Esto no va de ahorrar dinero, aunque también. Va de que un modelo con 40.000 filas delante tiene 40.000 oportunidades de fijarse en lo que no toca. Reducir no es una optimización: es parte de la respuesta. Es exactamente el argumento de context engineering para estructurar la memoria de tus agentes, aplicado a la capa de datos. Y si quieres ver a dónde se te va la factura, lo desglosé en medir el consumo de tokens de un agente.


    Las cuatro operaciones

    Todo lo que necesitas hacer con Python en este contexto cae en una de estas cuatro:

      1. CARGAR   →  CSV, SQL, JSON, Parquet
      2. LIMPIAR  →  tipos, nulos, duplicados
      3. REDUCIR  →  agrupar, agregar, ordenar
      4. VALIDAR  →  esquema antes de entregar
      ─────────────────────────────────────────
      la 3 es la que decide si el agente acierta
    

    No hay una quinta. Si te encuentras entrenando un modelo, te has ido del carril.


    1 y 2. Cargar y limpiar

    Pandas carga desde casi cualquier sitio con una línea, y el 90% del trabajo de limpieza son tres cosas:

    import pandas as pd
    
    df = pd.read_csv("ventas.csv", parse_dates=["fecha"])
    
    df = df.drop_duplicates(subset=["id_pedido"])       # duplicados por clave
    df = df.dropna(subset=["curso", "precio"])          # filas sin lo esencial
    df["precio"] = pd.to_numeric(df["precio"], errors="coerce")
    

    Ese errors="coerce" es el detalle que más disgustos evita: convierte a NaN lo que no se pueda parsear en vez de reventar. Un CSV real siempre trae una celda con "29,99 €" donde esperabas un número.

    Dos cosas que muerden el primer día:

    El filtrado es una máscara booleana. df["completado"] devuelve una serie de True/False, y df[mascara] se queda con las filas donde es True. Con condiciones compuestas usa & y | con paréntesis, nunca and y or.

    Casi todo devuelve un objeto nuevo. Si haces df.drop(columns=["x"]) y no reasignas, no ha pasado nada.


    3. Reducir, que es donde está el trabajo de verdad

    groupby más agg resuelve la inmensa mayoría de las preguntas que le vas a hacer a un agente sobre tus datos:

    resumen = (df.groupby("curso")
                 .agg(ventas=("precio", "size"),
                      ingresos=("precio", "sum"),
                      tasa_completado=("completado", "mean"))
                 .round(2)
                 .reset_index())
    

    Tres detalles que importan:

    • .agg() con nombres te deja bautizar las columnas de salida. Sin eso acabas con nombres compuestos horribles y el agente los lee peor.
    • mean() sobre una columna booleana da la proporción directamente. Ahí sale el 0,27 de la tabla de arriba sin cálculo extra.
    • .reset_index() baja la clave del agrupado del índice a columna. Si se te olvida, el JSON que entregas sale con otra forma.

    La regla, si te quedas con una sola de este post: agrega hasta que la tabla quepa en una pantalla. Si no cabe, todavía no has terminado de reducir.

    Cuando el volumen crezca o prefieras SQL a encadenar métodos, tienes la alternativa sin salir del portátil en DuckDB para analizar con SQL sin exportar nada.


    4. Validar en la frontera: Pydantic es el Zod de Python

    Aquí es donde tu instinto de TypeScript te sirve tal cual. Lo que hace Zod en tu producto lo hace Pydantic en la capa de datos: defines el esquema y lo que no encaja no pasa.

    from pydantic import BaseModel, Field
    
    class ResumenCurso(BaseModel):
        curso: str
        ventas: int = Field(ge=0)
        ingresos: float = Field(ge=0)
        tasa_completado: float = Field(ge=0, le=1)
    
    filas = [ResumenCurso(**r) for r in resumen.to_dict(orient="records")]
    payload = [f.model_dump() for f in filas]
    

    Ese le=1 en tasa_completado parece una tontería y es justo el guardarraíl que quieres: si un cambio en el pipeline te deja una proporción en 1,4, prefieres que explote aquí y no que el agente construya un razonamiento entero sobre un dato imposible.

    Y esa es la diferencia de fondo con el análisis de datos clásico: un dato sucio ya no es una celda rara en un gráfico, es una alucinación con aspecto de respuesta correcta. El agente no va a dudar de lo que le des.

    Los patrones de contrato del lado TypeScript están en el curso de Zod para TypeScript, y se trasladan casi literalmente a Pydantic.


    ¿Y NumPy? Solo cuando toca

    NumPy aparece en todos los tutoriales de Python y datos, así que conviene decir cuándo lo vas a necesitar de verdad: cuando hagas aritmética sobre muchos números.

    Una lista de Python guarda punteros a objetos dispersos y obliga al intérprete a resolver el tipo en cada elemento. NumPy guarda los números en un bloque contiguo y opera en C sobre todo el bloque. Sobre un millón de valores:

    import numpy as np, timeit
    
    lista = [float(i) for i in range(1_000_000)]
    arr = np.array(lista)
    
    t_list = timeit.timeit(lambda: [x * 0.85 for x in lista], number=5) / 5
    t_np   = timeit.timeit(lambda: arr * 0.85, number=5) / 5
    print(f"lista: {t_list*1000:.1f} ms | numpy: {t_np*1000:.1f} ms | {t_list/t_np:.0f}x")
    

    En mi máquina: 102,3 ms contra 6,4 ms. Dieciséis veces. Córrelo tú, que el factor depende del hardware.

    Ahora, la parte honesta: si tu pipeline agrupa 40.000 filas una vez al día, esa diferencia no la vas a notar. Pandas ya usa NumPy por debajo. Aprende NumPy cuando el perfilado te diga que ahí está el problema, no antes.


    Cuándo NO deberías meter Python

    Añadir un lenguaje a un proyecto tiene un coste real: otro entorno, otro despliegue, otra cosa que se rompe.

    No lo metas si:

    • Son menos de unos miles de registros y ya los tienes en tu app. Un reduce en TypeScript te lo resuelve sin añadir nada.
    • Los datos ya están en tu base de datos. Un GROUP BY en SQL es más rápido y más simple que exportar, cargar en Pandas y volver.
    • Es una consulta que harás una vez. Escríbela donde te resulte más rápido y olvídala.

    Merece la pena cuando cruzas fuentes distintas (un CSV de la pasarela de pago con un export de tu base y una hoja de cálculo), cuando la limpieza tiene reglas de verdad, o cuando el paso se repite cada día. Ahí Pandas gana con claridad. Para automatizar ese paso una vez que funcione, tengo el terreno cubierto en scripts de Python para tu productividad semanal.


    El pipeline entero

    Junto, esto es todo lo que hace falta entre tu exportación y el contexto de tu agente:

    import json
    import pandas as pd
    from pydantic import BaseModel, Field
    
    class ResumenCurso(BaseModel):
        curso: str
        ventas: int = Field(ge=0)
        ingresos: float = Field(ge=0)
        tasa_completado: float = Field(ge=0, le=1)
    
    def contexto_para_agente(ruta: str) -> str:
        df = (pd.read_csv(ruta, parse_dates=["fecha"])
                .drop_duplicates(subset=["id_pedido"])
                .dropna(subset=["curso", "precio"]))
    
        resumen = (df.groupby("curso")
                     .agg(ventas=("precio", "size"),
                          ingresos=("precio", "sum"),
                          tasa_completado=("completado", "mean"))
                     .round(2)
                     .reset_index()
                     .sort_values("ingresos", ascending=False))
    
        filas = [ResumenCurso(**r) for r in resumen.to_dict(orient="records")]
        return json.dumps([f.model_dump() for f in filas], ensure_ascii=False)
    

    Treinta líneas. La salida cabe en un mensaje y ya viene validada.

    Cómo se conecta esa salida con un agente que decide y actúa sobre ella, de la idea a producción, lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.


    Qué hacer esta semana

    1. Monta el entorno con uv: uv venv y uv pip install pandas pydantic. Un segundo. (Aviso por si te lo cruzas en algún tutorial: Bun no gestiona Python, es un runtime de JavaScript; el equivalente aquí es uv.)
    2. Coge la exportación más grande que le estés pasando a un agente y mide sus caracteres. Divide entre cuatro para hacerte una idea de los tokens.
    3. Escribe el groupby que responde la pregunta que de verdad le haces, y vuelve a medir. El factor de reducción que te salga es lo que te estabas gastando de más.
    4. Ponle un esquema Pydantic a la salida antes de entregársela al modelo.

    En Dominicode Labs comparto los pipelines de datos y telemetría que uso de verdad para mirar lanzamientos y retención.

    Tu agente no necesita tus datos. Necesita la respuesta que hay dentro de ellos, y esa parte todavía la pones tú.


    Preguntas frecuentes

    ¿Por qué no le paso el CSV entero al agente y que se apañe?

    Por dos motivos. El coste, que es el menor: en el ejemplo de este post, 40.000 filas son unos 1,35 millones de caracteres —del orden de 339.000 tokens— frente a los 386 caracteres del resumen. Y el importante: un modelo con 40.000 filas delante tiene 40.000 oportunidades de fijarse en lo que no toca. Reducir no es solo ahorrar, es acotar dónde puede mirar.

    ¿Necesito saber estadística para esto?

    No. Las cuatro operaciones son cargar, limpiar, reducir y validar, y todas son programación. La estadística hace falta cuando entras en modelado predictivo, que es un problema distinto y que en la mayoría de los productos con agentes no aparece nunca.

    ¿Pandas o Polars?

    Empieza por Pandas: más documentación, más respuestas cuando te atasques y es lo que vas a encontrar en el código de otros. Polars es más rápido y su API más consistente, y compensa cuando el volumen te empiece a doler. Los conceptos —DataFrame, filtrado, agrupación— se trasladan casi enteros.

    ¿Puedo hacer esto en TypeScript y ahorrarme el Python?

    Para volúmenes pequeños, sí, y probablemente deberías: un reduce no justifica añadir un lenguaje al proyecto. Python empieza a compensar cuando cruzas fuentes distintas, cuando la limpieza tiene reglas de verdad o cuando el paso se repite a diario. Si los datos ya viven en tu base de datos, la respuesta suele ser ninguno de los dos: un GROUP BY en SQL.

    ¿Dónde pongo esta capa: en el agente o antes?

    Antes, siempre, y como un paso determinista. Si el agente tiene que cargar y agregar por su cuenta, estás usando un modelo probabilístico para hacer aritmética que un groupby resuelve exacto, más barato y sin variar entre ejecuciones. El agente debe recibir la tabla ya reducida y validada, y dedicarse a lo suyo: decidir.

  • Agentic code review: el 64,7% de los PRs se aprueba sin leerlo

    Agentic code review: el 64,7% de los PRs se aprueba sin leerlo

    Esta semana has aprobado al menos un PR sin leerlo entero. Has mirado el diff en diagonal, has visto que el CI estaba en verde y has escrito "LGTM".

    No te estoy juzgando. Te estoy describiendo. Y no lo digo yo. Lo dice un estudio sobre cinco proyectos de gran escala (Gon et al.), recogido en un paper académico sobre agentic code review que acabo de leer entero: el 64,7% de los PRs se aprueban sin un solo comentario. Y esos reviews silenciosos presentan el "LGTM smell" —aprobar sin revisar de verdad— 3,5 veces más que los reviews con conversación.

    El paper se llama Rethinking Code Review in the Age of AI: A Vision for Agentic Code Review (arXiv:2605.17548). Es un vision paper: propone un framework, no un sistema implementado. Pero la radiografía que hace del review actual es tan incómoda que he cambiado cómo revisan código mis dos herramientas open source.

    Te cuento por qué.

    Los números que describen tu equipo

    El paper recopila estudios empíricos de la última década. Léelos pensando en tu repo, no en el de otros:

    • El 34% de 333.001 descripciones de PR analizadas en GitHub estaban vacías. Ni una línea de contexto (Liu et al.).
    • El 34,3% de los PRs no enlazan con ningún issue. En commits de bugfix, el 52,4% van sin enlazar (Dogan et al.; Bachmann et al.).
    • En Mozilla, el 54% de los code reviews no detectaron bugs que estaban presentes en commits aprobados (Kononenko et al.).
    • En Microsoft, solo el 15% de los comentarios de review señalaban defectos potenciales (Czerwonka et al.). Y entre un 34,5% y un 44,47% de los comentarios se clasifican directamente como "no útiles".
    • Un 19,1% de los comentarios de review de un dataset estudiado eran, literalmente, tóxicos (Sarker et al.).

    La etapa que llamamos "control de calidad" dejó pasar bugs en más de la mitad de los reviews medidos en Mozilla, genera ruido en un tercio de los comentarios y a veces hasta hace daño.

    Y ahora métele IA.

    El code review con IA no arregla el problema. Lo desborda

    Los asistentes de IA aceleran las tareas individuales de código en más de un 50%, según los estudios que recopila el paper. Escribimos más código que nunca. Pero hay dos datos que deberían quitarte la sonrisa.

    Uno: las contribuciones generadas por IA requieren más iteraciones de review que las escritas por humanos.

    Dos: cuando la IA asiste al reviewer, este encuentra más issues de severidad baja… pero no más defectos graves. La automatización arrastra tu atención hacia los problemas fáciles. El naming, el estilo, el typo. Mientras, el bug de concurrencia pasa de largo con su "LGTM".

    El paper lo dice sin rodeos: el code review ya no es solo un cuello de botella de productividad, es "la superficie de control primaria de la calidad y la responsabilidad del código producido por IA".

    Piensa en lo que eso significa. Si un agente escribe el 60% de tu código, el review es el único punto donde un humano responde por él. Y ese punto, según los datos de arriba, está roto.

    Hay una capa del problema que el review ni siquiera puede tocar, y la desarrollé aparte en los 5 fallos del código generado por IA que un code review no puede ver. Este post va de la otra mitad: arreglar lo que el review sí puede hacer y no hace.

    Qué es el agentic code review: el review no es una etapa, es un ciclo

    El agentic code review es un modelo de revisión en el que agentes de IA especializados cubren las cinco etapas del ciclo de vida del PR, mientras el humano actúa como supervisor con capacidad de veto en cada punto de decisión. La diferencia con "un bot que comenta el diff" es que el contexto cruza las fronteras entre etapas en lugar de perderse en cada salto.

    Y esa es la propuesta central del paper: la efectividad del review no es el resultado de una etapa aislada, sino de todo el ciclo de vida del PR.

    Un comentario de review útil depende de que el PR tenga una descripción con rationale. La descripción depende de que exista un issue enlazado. Y los reviews futuros dependen de que las lecciones de los reviews pasados queden escritas en algún sitio. Ninguna herramienta que optimice una sola etapa puede resolver esas dependencias.

    El framework tiene cinco etapas con agentes especializados y puertas humanas en cada punto de decisión: PR Creation → PR Augmentation → Reviewer Selection → AI-Assisted Code Review → PR Retrospective. El reviewer deja de ser un inspector manual y pasa a ser un operador supervisor de agentes.

    De todo el framework, hay dos piezas que me parecen oro. Y son las dos que he implementado hoy.

    Qué es el veredicto de alineación: Exact, Tangling y Missing

    El paper recoge una taxonomía de Isik et al. que formaliza algo que todos intuimos pero nadie mide: ¿el PR hace lo que se pidió?

    Categoría Qué significa Cómo se manifiesta con agentes Dato del paper
    Exact Cubre lo pedido, sin extras El caso que quieres —
    Tangling Incluye código que nadie pidió Le pides un fix y refactoriza tres ficheros "de paso" 7-20% de los changesets
    Missing No cubre todo lo pedido Marca la tarea como hecha sin implementar el criterio 16,5% de los PRs
    Missing and Tangling Ambas a la vez Se deja lo pedido y añade lo que no —

    Un review que solo busca bugs responde a la pregunta equivocada. La primera pregunta no es "¿este código tiene errores?". Es "¿este código es el que se pidió?".

    Por eso el skill /ak:review de ai-workflow-kit y la fase de Code Review del plugin sdd-creator ya no cierran el review con una lista de bugs. Cuando encuentran una spec que cubre el cambio, abren el review con una capa de cumplimiento y lo cierran con un veredicto de alineación explícito, contrastado criterio a criterio contra esa spec:

    ## Review: [feature slug]
    
    Status: PASS | CHANGES REQUIRED
    Alignment: Exact | Tangling | Missing | Missing and Tangling
    
    ### Requirements compliance
    - [AC-XX]: implemented / missing / diverges — [evidence]
    - Tasks marked done without a matching implementation: [list or none]
    - Out of scope: [code no criterion asks for, or none]
    

    La regla que lo hace útil es la última: un veredicto distinto de Exact no puede ser PASS salvo que tú aceptes la desviación por escrito. El código fuera de alcance se quita o se especifica; el trabajo que falta se completa o se saca del alcance. Es un veredicto que puedes verificar en dos minutos, en lugar de un "se ve bien" que no compromete a nadie.

    Si el repo no tiene specs/, no hay contra qué contrastar y el review vuelve al formato de severidades de siempre. Que es, en sí mismo, el argumento del paper.

    Qué es la retrospectiva de PR y por qué un review sin memoria se repite

    La quinta etapa del framework es la que casi todo el mundo se salta: el PR Retrospective. Cuando el PR se aprueba o se rechaza, un agente resume qué se decidió, qué se descartó y por qué, y lo guarda en la memoria del repositorio para que los agentes (y los humanos) del siguiente review partan de ahí.

    Aquí el paper suelta un detalle que valida algo que llevo tiempo defendiendo. Al explicar por qué los modelos no generalizan entre proyectos distintos, dice que inyectar reglas específicas del repositorio vía archivos de configuración tipo "Agents.MD" directamente en la ventana de contexto del agente es una alternativa computacionalmente barata al fine-tuning. No necesitas reentrenar un modelo para que entienda tu proyecto. Necesitas escribir las decisiones en un fichero que viaje con el repo.

    Eso también lo he incorporado: los dos productos ahora cierran el review proponiendo qué promocionar a la memoria del proyecto — decisión confirmada, alternativa rechazada, riesgo que se materializó. En el flujo SDD va a specs/INDEX.md; en el kit, a memory/decisions/. Los arreglos de código se quedan en el review; solo sube el conocimiento duradero. El siguiente review no redescubre lo mismo. Acumula.

    El paper valida SDD sin saberlo

    Y hay una frase del paper que me hizo reírme solo: "el contexto debe cruzar las fronteras entre etapas". Porque eso es exactamente Spec-Driven Development: el spec.md, el plan.md y el tasks.md no se quedan en la fase de diseño. Viajan hasta el review y hasta el PR. El reviewer no reconstruye la intención desde el diff — la tiene delante, escrita antes de la primera línea de código.

    El 34% de descripciones de PR vacías no es un problema de disciplina. Es un problema de flujo: si el contexto no existe antes de codificar, nadie lo va a escribir después. SDD lo resuelve por diseño — siempre que la spec esté bien planteada, porque una spec mal escrita rompe al agente igual que no tener ninguna.

    Lo que el paper admite que puede salir mal

    No te vendo humo: los propios autores dedican una sección entera a los riesgos, y son serios.

    Las alucinaciones se propagan en cascada entre agentes. Si el agente de review inventa una vulnerabilidad de concurrencia, el agente de fixes genera locks innecesarios. Para cuando el humano detecta el error, ya has pagado los tokens de tres agentes resolviendo un problema que nunca existió.

    Súmale la degradación de contexto en PRs grandes y el sesgo de automatización: aceptar el output del agente sin verificarlo, que es el LGTM smell con esteroides.

    Y el más silencioso de todos: el deterioro del mentoring implícito. Si el chatbot le explica el PR al junior, el senior ya no se lo explica.

    La respuesta a todos esos riesgos es la misma: puertas humanas con veredictos verificables. No "confía en el agente". Tampoco "desconfía de todo". Sino: exige al agente un output que un humano pueda comprobar en minutos.

    Cómo aplicar el agentic code review hoy en 3 pasos

    No necesitas esperar a que alguien implemente el framework completo del paper. Las tres piezas con más retorno caben en tu flujo actual:

    1. Cierra cada review con un veredicto de alineación. Exact, Tangling, Missing o ambas, contra el issue o la spec. Si no puedes emitirlo, no tenías contexto para revisar — y ese es el verdadero hallazgo del review.
    2. Escribe una retrospectiva de tres líneas por PR relevante. Qué se confirmó, qué se rechazó, qué riesgo apareció. Guárdala en el repo, donde el siguiente agente la pueda leer.
    3. Haz que el contexto viaje. Spec antes del código, spec enlazada en el PR, spec delante del reviewer.

    Si además quieres que esto corra solo en cada push, ya escribí cómo integrar revisiones de código automáticas con IA en el pipeline de CI/CD — el veredicto de alineación encaja ahí como un check más.

    Y si prefieres verlo funcionando en lugar de montarlo desde cero, tanto sdd-creator como ai-workflow-kit son open source y ya incorporan las dos piezas. Si quieres montarlo guiado y de principio a fin, el curso Construye con IA recorre justo este flujo: de la spec al PR revisado. Y si lo que buscas es trabajarlo sobre proyectos completos y en directo, eso es Dominicode Labs.

    El code review no va a desaparecer. Va a convertirse en el trabajo más importante que hagas. Mejor llegar con el contexto puesto.

    Preguntas frecuentes

    ¿Qué es el agentic code review?

    Es un modelo de revisión de código en el que agentes de IA especializados cubren las cinco etapas del ciclo de vida del PR —creación, enriquecimiento, selección de reviewer, revisión y retrospectiva— mientras el humano actúa como supervisor con capacidad de veto en cada punto de decisión. La diferencia con "un bot que comenta el diff" es que el contexto cruza las fronteras entre etapas en lugar de perderse en cada salto.

    ¿Cómo emito un veredicto de alineación en un PR?

    Compara el PR contra el issue o la spec y clasifícalo en una de cuatro categorías: Exact si cubre lo pedido sin extras, Tangling si trae cambios que nadie pidió, Missing si deja algo fuera, o Missing and Tangling si ocurren ambas. Escribe la categoría explícitamente en el PR con una frase de justificación. Si no puedes clasificarlo, el problema no es el PR: es que no tenías contexto suficiente para revisarlo.

    ¿No basta con poner un agente de IA a comentar los pull requests?

    No. Cuando la IA asiste al reviewer aparecen más issues de severidad baja, pero no más defectos graves: la herramienta desplaza la atención hacia lo fácil de detectar. Y un agente que solo comenta diffs no puede saber si el PR hace lo que se pidió, porque nadie le pasó la spec ni el issue.

    ¿En qué se diferencia esto de automatizar el code review en CI/CD?

    En el alcance. Automatizar en CI/CD resuelve la ejecución: que la revisión corra sola en cada push. El enfoque agéntico resuelve el contexto: que la revisión sepa qué se pidió, quién debe revisarlo y qué se aprendió en los PRs anteriores. Son complementarios — el veredicto de alineación se puede publicar como un check más del pipeline.

    ¿El framework del paper ya se puede usar en producción?

    El framework completo no: es un vision paper, una propuesta arquitectónica sin implementación ni evaluación empírica. Pero dos de sus piezas —el veredicto de alineación y la retrospectiva escrita en el repo— no dependen de ninguna infraestructura nueva y las puedes adoptar hoy con las herramientas que ya usas.


    Referencia: Kamalı, H. Ö., Tuna, E., Haratian, V., Tüzün, E. (2026). Rethinking Code Review in the Age of AI: A Vision for Agentic Code Review. Ankara University, Microsoft y Bilkent University. arXiv:2605.17548, mayo de 2026. Vision paper — propuesta de framework, no sistema implementado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
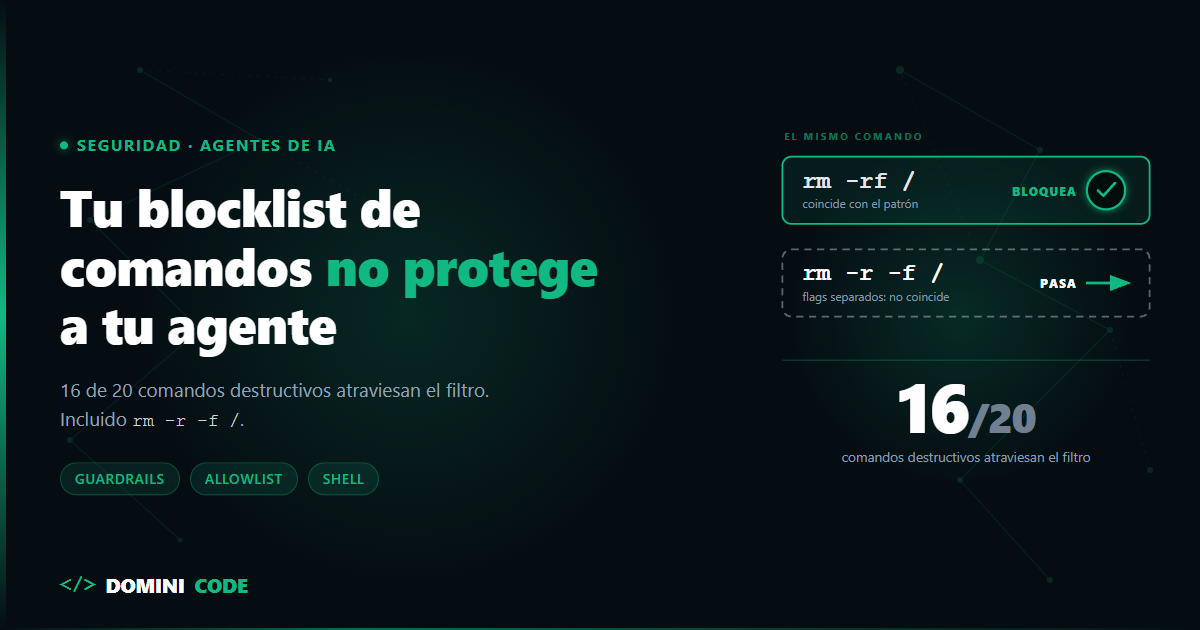
  • Ya pagas Codex: sácale el triple con Oh My Pi (sin API key)

    Ya pagas Codex: sácale el triple con Oh My Pi (sin API key)

    Pagas veinte dólares al mes. O doscientos, si estás en Pro.

    Ese plan incluye Codex. Y llevas meses usándolo dentro de Codex CLI, que decide por ti casi todo: le enchufas MCPs, sí, pero no cambias el harness que hay debajo — ni el LSP que no trae, ni el debugger que no pilota, ni el revisor que no existe.

    La jugada se llama Oh My Pi — omp en la terminal — y con Codex es esto: omp habla el protocolo de Codex por OAuth. Te logueas con tu suscripción de ChatGPT, sin API key, sin pagar dos veces. El mismo modelo que ya pagas, dentro de un harness con 31 herramientas, LSP, debugger, subagentes y un revisor leyéndote en paralelo.

    El día que lo monté entendí algo incómodo: el modelo nunca fue el cuello de botella. Lo era la caja donde lo metía.


    ¿Qué es Oh My Pi (omp)?

    Oh My Pi (omp) es un agente de código para terminal, con licencia MIT y un core de unas 80.000 líneas de Rust bajo una superficie TypeScript, que integra LSP, debugger DAP, subagentes y más de 60 providers de modelo dentro del mismo harness. Es un fork de Pi, el agente minimalista de Mario Zechner, y soporta Codex por OAuth contra tu suscripción de ChatGPT, sin API key.

    Eso es lo que es. El proyecto se describe a sí mismo como "a coding agent with the IDE wired in", y ahí está toda su tesis: donde Pi apuesta por un core diminuto, omp hace lo contrario y mete dentro todo lo que normalmente pondrías fuera.

    Cifras de cabecera de su README a 24 de agosto de 2026, literales: 60+ providers · 31 built-in tools · 14 lsp ops · 28 dap ops. El proyecto no publica releases versionadas —se instala desde main—, así que esto es una foto de hoy, no un contrato: comprueba el README antes de citarlas.

    Si nunca has desmontado un agente por dentro, la anatomía está en qué es un agent harness. Y si vienes de exprimir Codex CLI, esto es la continuación natural de cómo integrar Codex CLI de forma efectiva.


    Cómo usar Codex en Oh My Pi sin API key: /login openai-codex

    Codex entra en omp por OAuth, no por API key: el provider se llama openai-codex y se activa con /login openai-codex dentro de la sesión. Primero, la instalación.

    curl -fsSL https://omp.sh/install | sh
    omp setup
    

    También hay Homebrew (brew install can1357/tap/omp), Bun, Nix, mise y PowerShell.

    Lo que de verdad importa viene después, ya en la sesión —esto no es un comando de shell, es un slash command dentro de la TUI:

    /login openai-codex
    

    Eso abre el flujo OAuth de tu cuenta de ChatGPT. El provider de modelo se llama openai-codex y su auth es oauth: no hay API key en ninguna parte. /login a secas abre el selector, /login <redirect-url> sirve para pegar el callback si el navegador no te devuelve solo, y /logout borra las credenciales.

    Las credenciales viven en el auth store, ~/.omp/agent/agent.db; PI_CODING_AGENT_DIR reubica ~/.omp/agent entero y el store viaja con él. Para headless o remoto está el auth broker: omp auth-broker login <provider>, con sus logout, status y list.

    Los logins son provider-scoped: autenticar anthropic no autentica openai. Y cada organización o workspace cuenta como una cuenta propia: si tienes asiento Team o Enterprise y además plan personal con el mismo email, puedes loguearte una vez por suscripción — el workspace se elige en la pantalla de consentimiento del navegador — y la rotación las trata como dos cuentas distintas.

    Dónde se rompe: el orden de resolución de credenciales

    Gana la primera capa que encaja. Son siete:

    1. Runtime override (--api-key). Nunca se persiste.
    2. La apiKey de config en models.yml.
    3. Credencial OAuth almacenada, refrescada cuando hace falta y con rotación entre cuentas.
    4. API key almacenada por un /login exitoso.
    5. Variable de entorno del provider, incluidos valores de ficheros .env.
    6. Otra API key almacenada, como último recurso.
    7. El resolver de fallback de models.yml.

    Fíjate en el paso 2: una apiKey en models.yml gana a tu OAuth almacenado, y es deliberado — para que la key de un baseUrl o gateway propio se respete en vez de reenviar upstream un token OAuth que el proxy rechazaría. Si un día tu login de Codex "deja de usarse", mira ahí antes de loguearte veinte veces. La variable de entorno del provider es OPENAI_CODEX_OAUTH_TOKEN.


    Los diez roles de modelo: enruta por intención, no por "el mejor modelo"

    omp no tiene "un modelo": tiene diez roles de modelo, y a cada uno le asignas un provider/model-id distinto. Esta es la parte que justifica el post entero.

    Casi todo el mundo pregunta cuál es el mejor modelo. Es la pregunta equivocada. La buena es qué modelo para qué turno.

    Rol Para qué
    default Los turnos normales
    smol Fan-out barato de subagentes
    slow Razonamiento profundo
    plan Modo plan
    commit Changelogs
    advisor El revisor que lee cada turno en paralelo
    vision Turnos con imagen de entrada
    designer Trabajo de interfaz
    task Los subagentes que lanza el tool task
    tiny Utilidades de coste ínfimo

    Un modelo se selecciona como provider/model-id. Los docs de omp lo ilustran con anthropic/claude-opus-4-6; en nuestro caso será openai-codex/<modelo>.

    --smol, --slow y --plan fuerzan el rol al lanzar, Ctrl+P cicla entre los modelos del rol activo y /model cambia el modelo a mitad de sesión. /model es además donde ves qué modelos expone tu plan de Codex: eso depende de tu suscripción y no te lo voy a inventar aquí.

    Para saltarte el picker se preconfigura en ~/.omp/agent/config.yml. El ejemplo literal del README usa un provider custom llamado spark:

    modelRoles:
      default: spark/minimax-m3
    

    Así lo repartiría yo con Codex de por medio:

    modelRoles:
      # Abre /model, mira qué expone tu plan y sustituye los placeholders
      default: openai-codex/<modelo-de-tu-plan>
      slow:    openai-codex/<modelo-de-tu-plan>
      smol:    <provider-barato>/<modelo-pequeno>
      advisor: anthropic/claude-opus-4-6   # otra familia, a propósito
    

    Tres decisiones detrás.

    Codex en default y slow. Es lo que ya pagas, y es lo que quieres para el trabajo real y el razonamiento largo.

    Algo barato en smol. El fan-out de subagentes es donde se va el presupuesto sin que te des cuenta: lanzas varios workers y cada uno consume su contexto entero. Poner tu modelo caro ahí es la forma más rápida de tocar el techo del plan.

    Un revisor distinto en advisor. Si el revisor corre con el mismo modelo que ejecuta, comparte sus puntos ciegos. Por eso el ejemplo del README, que pone openai-codex/gpt-5.5 en advisor, no es lo que yo copiaría: si default ya es Codex, el revisor tiene que salir de otra familia o estás pagando por que alguien te dé la razón.

    Decidir qué inteligencia va en cada paso, en vez de tirar del modelo más caro para todo, es el criterio que trabajo en el curso Construye con IA. Cambia la herramienta, no cambia el razonamiento.


    Qué pasa cuando el plan de Codex se queda sin cuota: fallback chains

    Cuando tu plan de Codex agota cuota a mitad de turno, omp no aborta el turno: salta al siguiente modelo de la cadena declarada en retry.fallbackChains y se queda con él hasta que el turno termina.

    Tu suscripción tiene límites, y normalmente te enteras a mitad de un trabajo largo, con un 429 en la cara. omp tiene cuatro knobs de routing y este es el que más se nota.

    Fallback chains. Cadenas por rol o por modelo bajo retry.fallbackChains. Cuando el primario devuelve 429s o choca contra el muro de cuota, la siguiente entrada se queda el resto del turno y se restaura al pasar el cooldown. Tu límite deja de ser un turno muerto y pasa a ser un degradado suave.

    Los otros tres los dejo enunciados, porque tocan menos a Codex y están bien documentados. Custom providers: en ~/.omp/agent/models.yml declaras cualquier backend que hable openai-completions, openai-responses, openai-codex-responses, azure-openai-responses, anthropic-messages, bedrock-converse-stream, google-generative-ai, google-gemini-cli o google-vertex, y omp models <provider> te verifica el discovery antes de descubrirlo en caliente. Path-scoped models: acotas enabledModels y disabledProviders a un prefijo path: y fijas otro set de modelos en un repo concreto sin tocar la config global. Round-robin credentials: apilas varias API keys por provider y el runtime rota con afinidad de sesión y backoff por credencial, útil cuando una sola key te quemaría la cuota antes de comer.

    La config global vive en ~/.omp/agent/config.yml y la de proyecto en .omp/config.yml. Jerarquía, de más fuerte a más débil: runtime overrides → overlays de --config <file> → proyecto → global → defaults del SETTINGS_SCHEMA. Se toca con omp config set, nunca a mano con el agente corriendo. Y hay perfiles: omp --profile <name>.


    No migres nada: ya tienes la config en disco

    omp lee los ocho formatos que ya tienes en su forma nativa — Cursor MDC, Cline .clinerules, Codex AGENTS.md, Copilot applyTo y el resto — sin script de migración. En el primer arranque hereda reglas, skills y servidores MCP de .claude, .cursor, .windsurf, .gemini, .codex, .cline, .github/copilot y .vscode.

    La precedencia a nivel de usuario es ~/.omp/agent/ > ~/.claude/ > ~/.codex/ > ~/.gemini/. A nivel de proyecto, .omp/ > .claude/ > .codex/ > .gemini/. Y proyecto gana a usuario.

    Ahora el matiz que te va a morder, porque es específico de Codex: el provider codex (prioridad 70) solo carga a nivel de usuario, ~/.codex/AGENTS.md. El contexto de proyecto entra por un AGENTS.md suelto vía el provider agents-md, que sube desde el directorio actual hasta la raíz del repo. No desde <cwd>/.codex/AGENTS.md. Si tienes un .codex/AGENTS.md en el repo esperando que se cargue, no se carga.

    Los otros dos: native (prioridad 100) lee ~/.omp/agent/AGENTS.md y el .omp/AGENTS.md del .omp/ no vacío más cercano subiendo desde cwd — si ese no tiene AGENTS.md, deja de subir. Y claude (prioridad 80) lee ~/.claude/CLAUDE.md y <cwd>/.claude/CLAUDE.md, sin walk-up.

    RULES.md no es lo mismo que AGENTS.md

    Un RULES.md nativo top-level se convierte en regla always-apply: se re-adjunta cerca del turno actual, así que mantiene su fuerza aunque la conversación crezca. Un context file normal se inyecta al abrir sesión y se va diluyendo.

    Regla de uso: AGENTS.md para el fondo duradero — arquitectura, convenciones, dominio. RULES.md para los requisitos cortos y duros que no pueden diluirse.

    Es la respuesta operativa a lo que conté en context drift y memoria en agentes de IA: las instrucciones no se olvidan, se entierran.


    Oh My Pi vs Codex CLI: lo que Codex CLI no te da

    LSP y debugger de verdad. El tool lsp cubre diagnostics, navegación, símbolos, renames, code actions y raw requests. El tool debug pilota una sesión DAP: breakpoints, stepping, threads, stack, variables. El agente deja de leer tu código como texto y lo lee como lo lee tu IDE — y puede pararlo en un breakpoint para ver cuánto vale la variable en vez de suponerlo. Hay además security_scan, que ejecuta revisiones nativas y dispara scans cloud de Codex Security.

    El advisor. Emparejas un modelo a ese rol y lee cada turno del agente principal, inyectando notas inline: un aviso, una preocupación o un bloqueante duro. Corre en su propio contexto y con su propio modelo, así que pilla lo que el que ejecuta se saltó por prisa. El principal corrige o explica por qué no. Revisión continua, no revisión al final.

    El Agent Hub. Alt+A abre un roster con actividad y consumo por subagente. Entras en uno, lees su transcript en vivo, le mandas un mensaje de dirección, revives un worker aparcado o matas uno atascado sin abortar la sesión padre. Los subagentes son de primera clase vía el tool task, con fan-out en paralelo, resultados validados por schema y aislamiento opcional por workspace; encima hay skills como orchestrate y workflowz.

    /review. Lanza subagentes revisores dedicados que barren ramas, commits sueltos o trabajo sin commitear en paralelo, y dan veredicto con issues rankeados de P0 a P3 y puntuados por confianza. Si prefieres quedarte en Codex CLI y exprimirlo desde dentro, el trabajo de harness sobre el propio Codex lo desgloso en harness engineering con Codex de OpenAI.

    Memoria explícita. retain, learn, recall, reflect y memory_edit sostienen el banco de memoria; checkpoint y rewind son puntos de guardado.

    Y el detalle que más me gustó. Dieciséis esquemas URI internos — pr://, issue://, agent://, skill://, ssh:// y el resto — resuelven de forma transparente dentro de cada tool con forma de FS que el agente ya llama. read pr://1428 devuelve la misma forma que read src/foo.ts. grep recorre un diff como si fuera un directorio. No hay herramientas nuevas que aprender: hay rutas nuevas.


    Cuándo NO usar Oh My Pi con Codex

    Es un fork joven de un proyecto de terceros. No es una herramienta de OpenAI ni tiene su soporte detrás.

    La superficie es enorme. 31 herramientas, 60+ providers, diez roles de modelo, cuatro knobs de routing y ocho providers de contexto. Eso es potencia, y es también su propia curva de aprendizaje: vas a pasar una tarde configurando antes de que te rinda. Si esto te viene grande hoy, no pasa nada: empieza por la guía para empezar con agentes de IA y subir de nivel y vuelve cuando el trabajo te dure horas.

    Si haces edits pequeños, Codex CLI tal cual te sobra. El valor aparece cuando el trabajo dura horas, toca muchos archivos y quieres subagentes y un revisor encima. Si no tienes claro qué harness necesitas, la comparativa está en harnesses agénticos comparados.

    Es tu cuenta la que entra por OAuth. Estás autorizando a un cliente de terceros contra tu suscripción de ChatGPT. Antes de meterlo en el trabajo diario revisa qué permite tu plan —sobre todo si el asiento es de empresa—, porque del acceso respondes tú, no el proyecto.

    Y algo que aplica a cualquier agente de código en terminal, este incluido: corre con tus permisos. No es una herramienta que instalas y olvidas en una máquina llena de credenciales.


    Qué hacer hoy

    Instala, ejecuta omp setup, entra y escribe /login openai-codex. Cinco minutos, y ya estás usando el modelo que ya pagabas, sin API key, en otro sitio.

    Luego haz una sola cosa más: abre /model, mira qué te expone tu plan y escribe tus modelRoles. Codex en default y slow, algo barato en smol, un revisor distinto en advisor. Ese bloque de YAML es lo que convierte omp en algo distinto de "otro agente CLI".

    Dónde encaja omp respecto al resto de piezas que uso a diario lo tienes en mi stack de IA agéntica en 2026.

    Nada de esto sustituye a saber qué le pides. Un harness con 31 herramientas y un encargo vago te da caos más rápido: escribir la especificación antes de soltar al agente sigue siendo cosa tuya, y es lo que desarrollo entero en el libro de Spec-Driven Development. Y si quieres ver estas configuraciones montarse en directo y discutirlas con gente que está en lo mismo, eso lo hacemos cada semana en Dominicode Labs.

    Deja de preguntarte cuál es el mejor modelo. Ya pagas uno bueno. La pregunta es en qué caja lo estás metiendo.


    Preguntas frecuentes

    ¿Oh My Pi funciona con Codex?

    Sí. Oh My Pi trae un provider de modelo llamado openai-codex cuya autenticación es OAuth: entras con /login openai-codex, autorizas en el navegador con tu cuenta de ChatGPT y usas el modelo de tu plan dentro del harness de omp, con sus 31 herramientas, LSP, debugger y subagentes. No hace falta API key ni pagar un segundo consumo.

    ¿Necesito una API key de OpenAI para usar Codex en omp?

    No. El provider de modelo openai-codex usa OAuth: entras con /login openai-codex, autorizas en el navegador con tu cuenta de ChatGPT y ya está. Las credenciales quedan en el auth store, ~/.omp/agent/agent.db, y se refrescan solas. Si prefieres inyectarlas por entorno, la variable del provider es OPENAI_CODEX_OAUTH_TOKEN.

    ¿Puedo usar mi cuenta de empresa y la personal a la vez?

    Sí. Para ChatGPT (Codex) y para Anthropic, cada organización o workspace cuenta como una cuenta propia: puedes loguearte una vez por suscripción y eliges el workspace en la pantalla de consentimiento del navegador. La rotación las trata como cuentas distintas, y las rankea y rota automáticamente.

    ¿Tengo que migrar mis AGENTS.md y mi configuración de Codex?

    No. omp lee ocho formatos en su forma nativa y en el primer arranque hereda reglas, skills y servidores MCP de los directorios de Claude, Cursor, Windsurf, Gemini, Codex, Cline, Copilot y VS Code. Con un matiz: el provider codex solo carga ~/.codex/AGENTS.md, a nivel de usuario. El contexto de proyecto llega por un AGENTS.md suelto vía el provider agents-md, no desde <cwd>/.codex/AGENTS.md.

    ¿Qué pasa cuando mi plan de Codex se queda sin cuota a mitad de turno?

    Para eso están las fallback chains, declaradas por rol o por modelo bajo retry.fallbackChains. Cuando el primario devuelve 429s o choca contra el muro de cuota, la siguiente entrada de la cadena se queda el resto del turno y se restaura al pasar el cooldown. En vez de un turno muerto tienes un degradado suave.

    ¿Por qué mi login de Codex parece ignorarse?

    Casi siempre es el orden de resolución de credenciales: gana la primera capa que encaja, y una apiKey declarada en models.yml está por encima del OAuth almacenado. Es deliberado, para que la key de un baseUrl o gateway propio se respete en vez de reenviar un token OAuth que el proxy rechazaría.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
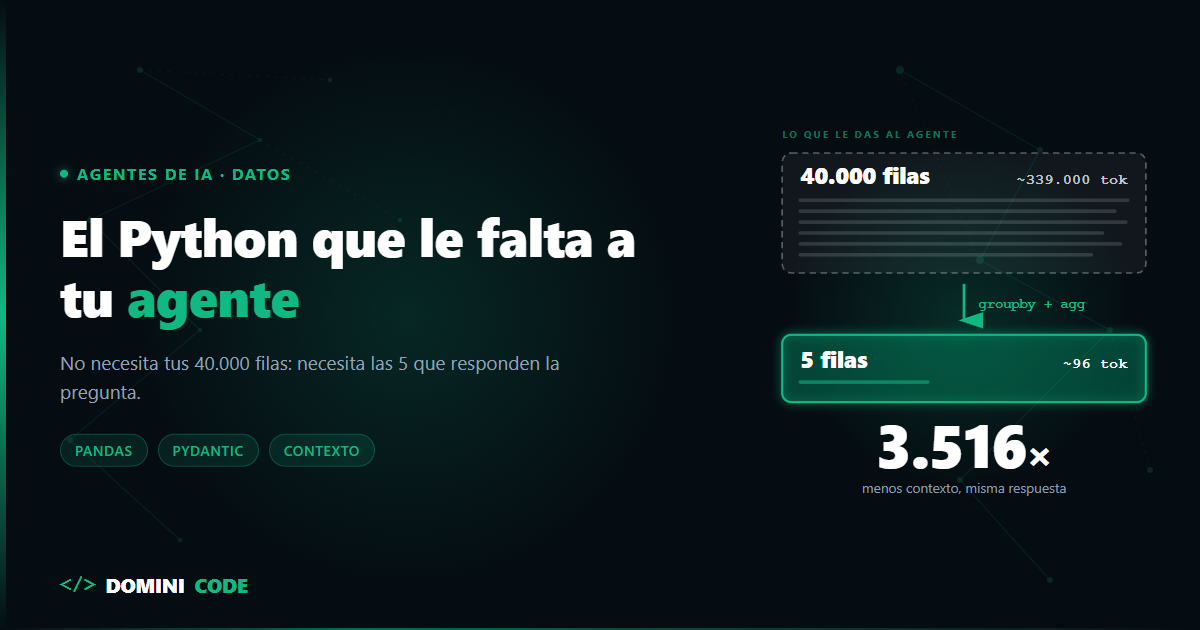
  • Dirigir agentes de IA en paralelo sin que se pisen: mi día real

    Dirigir agentes de IA en paralelo sin que se pisen: mi día real

    Hace unas semanas perdí una mañana entera por una tontería.

    Tenía dos agentes trabajando. Uno refactorizando el módulo de autenticación. El otro añadiendo tests a ese mismo módulo, porque me pareció eficiente hacer las dos cosas a la vez.

    Los dos escribían sobre los mismos archivos.

    Cuando volví, el proyecto no compilaba y ninguno de los dos diffs tenía sentido por separado. Tiré las dos ramas y empecé de cero.

    El fallo no fue del modelo. Los dos agentes hicieron exactamente lo que les pedí.

    El fallo fue mío: los puse a trabajar en el mismo suelo.

    Esto es lo que casi nadie cuenta cuando habla de dirigir agentes: el cuello de botella de operar con varios agentes no es la inteligencia del modelo, es la infraestructura donde los pones. Que un modelo de frontera escriba 500 líneas tipadas en quince segundos es un problema resuelto. Lo que no está resuelto es cómo evitas que varios procesos autónomos se pisen entre ellos, y cómo revisas lo que producen sin convertirte tú en el atasco.

    Opero Dominicode solo. Una plataforma de cursos, un canal de YouTube con más de 100.000 suscriptores, libros técnicos y una comunidad activa. No tengo un equipo de diez personas. Tengo un sistema.

    Aquí está ese sistema: sus tres reglas, cómo es la jornada y lo que cuesta.

    Si lo que buscas es qué habilidades aprender para llegar hasta aquí, eso ya lo desglosé en el roadmap del developer con IA. Este post no va de qué aprender. Va de cómo se opera un día.


    Las 3 reglas del suelo

    Mi operación se apoya en tres reglas. Ninguna es teoría: cada una salió de una mañana perdida como la de arriba.

                     TAREA
                       │
        ┌──────────────┼──────────────┐
        ▼              ▼              ▼
     AISLAR        CONTRATO        ÁRBITRO
     rama +        spec.md         los tests
     worktree      antes del       deciden,
     propio        prompt          no yo
        │              │              │
        └──────────────┼──────────────┘
                       ▼
                DIFF AUDITABLE
    

    1. Un agente, una rama, un worktree

    La regla es literal: dos agentes nunca comparten directorio de trabajo.

    Cada tarea que delego arranca en su propia rama y en su propio git worktree. Son copias del repositorio en carpetas distintas que comparten el mismo historial de Git. El agente que refactoriza autenticación no ve los archivos del agente que escribe documentación, porque físicamente no están en su carpeta.

    Esto resuelve tres cosas de golpe:

    • No hay colisiones de escritura. Es imposible que dos agentes editen el mismo archivo, porque cada uno tiene su copia.
    • El diff sale limpio. Cada rama contiene un solo cambio conceptual, así que puedo revisarlo sin desenredarlo del resto.
    • Tirar el trabajo es gratis. Si un agente se ha ido por un camino equivocado, borro la rama y no he perdido nada más.

    Antes de esto usaba una sola carpeta y lanzaba los agentes por turnos. Iba tres veces más lento y aun así se pisaban cuando me despistaba.

    2. La spec es el contrato, el prompt es solo la orden de arranque

    Un prompt es una conversación. Una spec es un contrato que se puede verificar.

    La diferencia importa mucho más cuando trabajas en paralelo, y por un motivo que no es obvio: si no puedes revisar el trabajo del agente mientras lo hace, la especificación es lo único que evita que descubras la desviación al final. Con un agente delante puedes corregirle en el turno siguiente. Con cuatro trabajando a la vez, no estás mirando. Te enteras cuando abres el diff.

    Así que antes de lanzar nada escribo un spec.md que delimita el alcance, las interfaces y qué queda explícitamente fuera. Ese último punto es el que más trabajo me ahorra: sin un "fuera de alcance" escrito, los agentes tienden a expandirse hacia archivos que nadie les pidió tocar.

    Esta es la metodología que explico entera en el libro de Spec-Driven Development. Y si quieres saber por qué una spec aparentemente buena todavía falla, tengo desmenuzados los 7 fallos más comunes.

    3. Los tests son el árbitro, no yo

    Aquí está el error que hunde a la mayoría cuando intenta paralelizar: creer que el revisor humano escala.

    No escala. Si cuatro agentes producen cuatro diffs de 400 líneas y tú eres la única puerta de calidad, has movido el cuello de botella de la escritura a la revisión. Vas igual de lento, solo que ahora leyendo en vez de escribiendo.

    La única salida es que la primera puerta sea automática y no negociable. En mi caso: tipado estricto, suite de tests y lint. Si una rama no pasa los tres, no llega a mis ojos. El agente recibe el error, corrige y vuelve a intentarlo sin que yo intervenga.

    Ese es el cambio mental completo. Tu trabajo no es aprobar código: es diseñar el árbitro que lo aprueba por ti. Cuando esos gates viven en el pipeline y no en tu cabeza, las revisiones automáticas en CI/CD hacen el primer filtro completo.

    Diseñar suites que cacen regresiones sutiles —y no solo las obvias— es una habilidad en sí misma, y es la que enseño en el curso de Testing en Angular y TypeScript.


    Qué se puede paralelizar y qué no

    Esta es la parte que se salta todo el mundo, y la que decide si el sistema funciona.

    No todas las tareas se pueden repartir. Si la tarea B necesita las decisiones de la tarea A, lanzarlas juntas no te da velocidad: te da dos ramas incoherentes y una tarde de merge.

    Mi criterio, en una línea: paralelizo lo que no comparte decisiones de diseño.

    Se paralelizan bien:

    • Tareas en módulos que no se tocan entre sí.
    • Trabajo de superficie: tests sobre código estable, documentación, migraciones mecánicas.
    • Investigación. Un agente reproduciendo un fallo en staging no interfiere con nadie.

    No se paralelizan:

    • Cambios que dependen de un modelo de datos que todavía estoy decidiendo.
    • Cualquier cosa que toque el mismo contrato público, aunque sean archivos distintos.
    • La primera implementación de una funcionalidad nueva cuya arquitectura no está fijada.

    Ese segundo caso me pilló varias veces. Dos agentes en carpetas separadas, sin conflicto de Git, pero cada uno asumió una forma distinta del mismo tipo compartido. El merge fue limpio y el código estaba roto. Por eso el aislamiento no sustituye al contrato: hacen falta los dos.

    Si quieres el marco completo para decidir qué va en serie y qué va en paralelo, lo detallé en cómo clasificar tareas con IA.


    Mi jornada, por bloques

    Así se traduce todo lo anterior a un día normal.

    Mañana (bloque de decisión). Es la única hora del día en la que no hay ningún agente corriendo, y es deliberado. Reviso lo que quedó pendiente, decido qué entra hoy y escribo las especificaciones. Todas las decisiones de arquitectura del día se toman aquí. Cuando lanzo el primer agente, ya no queda nada por decidir.

    Media mañana (lanzamiento). Abro los worktrees y lanzo. Normalmente entre tres y cinco tareas, cada una en su rama, cada una con su spec. Nunca dos en el mismo módulo.

    Día (trabajo profundo). Mientras los agentes escriben y los pipelines validan, yo no miro los agentes. Esta es la parte que cuesta interiorizar y es donde está toda la ganancia real: si me quedo mirando la terminal, no he ganado nada. Este bloque es para diseñar arquitectura, grabar contenido o escribir. Los gates hacen su trabajo sin mí.

    Tarde (auditoría). Aquí sí me siento a revisar. Solo llegan las ramas que pasaron los gates.

    Cierre (integración). Apruebo, integro en orden y anoto qué se desvió y por qué. Ese registro es lo que hace que la spec de mañana sea mejor que la de hoy.

    Lo importante no son las horas: es que las decisiones y la ejecución están en bloques separados. Cuando los mezclaba —decidir un poco, lanzar un poco, revisar un poco— el sistema entero se venía abajo.


    Cómo audito cuatro diffs sin leer 1.600 líneas

    No los leo enteros. Reviso en tres pasadas, y cada una descarta trabajo para la siguiente.

    Primera pasada: la forma del diff. Antes de leer código, mira qué archivos se tocaron y cuántas líneas. Un agente al que pediste un cambio en un módulo y ha tocado once archivos se ha ido de alcance. Eso se ve en cinco segundos y ya es motivo de rechazo, sin leer una línea.

    Segunda pasada: los bordes. Voy directo a donde el código se comunica con el resto: tipos exportados, firmas públicas, esquemas de validación, migraciones. Ahí es donde un fallo se propaga. El interior de una función privada, si los tests pasan, puede esperar.

    Tercera pasada: lo que el test no puede saber. Aquí leo de verdad, pero solo lo que ninguna suite detecta. Que el agente haya elegido la abstracción correcta. Que no haya duplicado algo que ya existía en el proyecto. Que el error se maneje donde tiene sentido y no donde era cómodo.

    Los tests cubren la corrección. Yo cubro el criterio. Y el criterio es lo único que un modelo no puede delegarte de vuelta.


    Lo que cuesta

    Conviene decirlo, porque suele omitirse: paralelizar sale más caro por tarea completada.

    Cuando reparto una tarea entre varios agentes, cada uno arrastra su propio contexto del proyecto. Ese contexto se paga varias veces en lugar de una. Y el coste real no es lineal ni predecible: cambia bastante según el modelo que asignes a cada rama, algo que ya analicé en detalle en el coste de los subagentes al cambiar de modelo.

    Lo asumo porque lo que compro es tiempo mío, no tokens. Pero conviene tenerlo claro antes de lanzar seis agentes: si la tarea era pequeña, sale más barato hacerla tú.


    Qué puedes montar esta semana

    Sin reformar nada, en este orden:

    1. Aísla antes de paralelizar. Crea un git worktree por tarea. Con dos ya notarás la diferencia; no hace falta empezar por seis.
    2. Escribe el "fuera de alcance". Una sola línea en tu spec diciendo qué no debe tocar el agente. Es la frase con mejor retorno de todo el documento.
    3. Pon un gate automático. Aunque sea solo tsc --noEmit más los tests. Mientras la única puerta de calidad seas tú, no estás paralelizando: estás acumulando cola.

    El flujo completo, desde la idea hasta producción con herramientas CLI agénticas, lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si quieres ver configuraciones reales de agentes y arquitecturas que están funcionando en producción hoy, eso es lo que compartimos cada semana en Dominicode Labs.

    Un agente que escribe código es una herramienta. Varios agentes con un suelo bien diseñado debajo son un equipo. La diferencia entre las dos cosas la construyes tú, y no está en el prompt.


    Preguntas frecuentes

    ¿Cuántos agentes puedo tener trabajando a la vez sin perder el control?

    El límite no lo pone la herramienta, lo pone tu capacidad de auditar. Yo trabajo con tres a cinco tareas simultáneas porque es lo que puedo revisar con criterio en un bloque de tarde. Si necesitas más de lo que puedes auditar, el problema no se arregla añadiendo agentes: se arregla endureciendo los gates automáticos para que llegue menos a tu revisión.

    ¿Cómo evito que dos agentes editen el mismo archivo?

    Dándoles carpetas distintas. Un git worktree por tarea crea una copia del repositorio en su propio directorio, compartiendo el historial de Git. Como cada agente solo ve su carpeta, la colisión de escritura es imposible por construcción, no por disciplina.

    ¿Merece la pena paralelizar si tengo que revisar todos los diffs igual?

    Solo si la revisión no es tu cuello de botella. Con gates automáticos, las ramas que fallan tipado, lint o tests nunca llegan a tu mesa: el agente corrige solo. Sin esos gates, paralelizar no te da velocidad, te da una cola de revisión más larga.

    ¿Qué hago cuando un agente en paralelo se queda atascado?

    Borro la rama y reescribo la especificación. Insistir en la misma conversación con un agente que ya se desvió suele salir más caro que empezar limpio, porque el contexto equivocado sigue ahí arrastrándose. Y casi siempre el atasco señala una ambigüedad real en la spec que hay que arreglar de todos modos.

    ¿Se puede aplicar esto en un equipo, o solo trabajando solo?

    Funciona igual o mejor en equipo, porque las tres reglas son las mismas que ya usa cualquier equipo sano: rama por cambio, contrato antes de implementar, CI como árbitro. Lo que cambia es quién ocupa la silla del implementador. Si tu equipo ya trabaja así con personas, tienes el suelo montado.

  • MCP en producción: lo que se rompe cuando tu server sale del portátil

    MCP en producción: lo que se rompe cuando tu server sale del portátil

    Tu MCP server funciona. Lo lanzas por stdio, tu agente lo ve, las tools responden.

    Y entonces alguien pregunta lo obvio: ¿y si lo usamos desde el resto del equipo?

    Ahí es donde la cosa deja de parecerse a lo que montaste. Porque un server local por stdio es un proceso hijo hablando por una tubería: sin red, sin autenticación, sin concurrencia, sin nada que se pueda caer a medias. En cuanto lo expones por HTTP, todo eso aparece de golpe — y encima el protocolo ha cambiado justo en las piezas que te afectan.

    Si todavía no tienes el server montado, empieza por construir un agente y su MCP server paso a paso, y para registrarlo en tu entorno tienes claude mcp add explicado con sus scopes. Este post empieza donde acaban esos dos: el día que ese server deja de ser tuyo.

    Van seis cosas, todas verificables contra la especificación.


    1. SSE está deprecado. El transporte es Streamable HTTP

    Si has leído tutoriales de MCP del último año y medio, muchos te dicen que para salir a red uses SSE (Server-Sent Events) con dos endpoints.

    No lo hagas. El transporte HTTP+SSE está deprecado desde la revisión 2025-03-26 del protocolo, y la revisión 2026-07-28 lo reclasifica formalmente como Deprecated bajo la nueva política de ciclo de vida, con la instrucción explícita de migrar a Streamable HTTP. El SDK de TypeScript ya marca SSEClientTransport como @deprecated.

    La diferencia práctica: SSE usaba dos endpoints (uno para abrir el stream, otro para mandar mensajes). Streamable HTTP usa uno solo, que gestiona las dos direcciones. Menos superficie, menos estado que coordinar y mucho menos que explicarle a tu balanceador.

    Lo bueno es que esto no depende de si migras a la v2 o no: la deprecación de SSE es anterior y aplica igual. Si tu server remoto habla SSE, ya vas con retraso.


    2. Ya no hay sesiones — y eso te simplifica el escalado

    Este es el cambio que más agradece la infraestructura.

    La revisión 2026-07-28 elimina las sesiones a nivel de protocolo y la cabecera Mcp-Session-Id del transporte Streamable HTTP. Y va más allá: elimina también el handshake initialize/notifications/initialized. Cada petición viaja ahora con su versión de protocolo y las capacidades del cliente dentro de _meta.

    Traducido a lo que te importa un lunes por la mañana: desaparecen las sticky sessions. Puedes poner un round-robin normal delante de N réplicas y ya está. Si alguna vez has peleado con un balanceador intentando que un cliente vuelva siempre a la misma instancia, esta es la razón para mirar la v2.

    El matiz importante: si tu server necesitaba estado entre llamadas, ahora no lo guardas en la sesión. La spec dice que los servidores que necesiten estado entre llamadas usen handles explícitos, acuñados por el servidor y pasados como argumentos normales de una tool. Es decir: el estado deja de ser magia del transporte y pasa a ser parte de tu contrato de datos, visible y tipado.

    También aparece un server/discover que los servidores deben implementar para anunciar versiones soportadas, capacidades e identidad.


    3. Un stream que se rompe pierde la petición

    Esta es la que más te va a doler si no la ves venir, y es la menos comentada.

    La revisión 2026-07-28 elimina la resumibilidad del stream y la reentrega de mensajes: fuera la cabecera Last-Event-ID y fuera los IDs de evento SSE. Lo que dice la spec es directo: si el stream de respuesta se corta, la petición en vuelo se pierde, y el cliente debe reemitirla como una petición nueva con un ID nuevo.

    Piensa en lo que significa eso con una tool que cobra una suscripción, crea un usuario o lanza un despliegue. Un corte de red a mitad y el cliente reintenta. Si tu tool no es idempotente, acabas de cobrar dos veces.

    En local esto no existía. Una tubería stdio no se corta a medias. En red, sí.

    Lo que hay que hacer es lo de siempre en sistemas distribuidos, solo que ahora te toca a ti aplicarlo en la capa de tools:

    • Toda tool con efectos secundarios necesita una clave de idempotencia que venga en los argumentos, no generada dentro.
    • Separa lectura de escritura. Las de lectura pueden reintentarse alegremente; las de escritura, solo con la clave.
    • Registra el resultado por clave y, si llega repetida, devuelve el resultado guardado en lugar de volver a ejecutar.

    En la práctica son unas pocas líneas delante de tu lógica:

    const ArgsSchema = z.object({
      idempotencyKey: z.string().uuid().describe("Identificador único de este intento"),
      usuarioId: z.string(),
      plan: z.enum(["pro", "team"]),
    });
    
    async function cambiarPlan(args: unknown) {
      const { idempotencyKey, usuarioId, plan } = ArgsSchema.parse(args);
    
      const previo = await store.get(idempotencyKey);
      if (previo) return previo;               // el reintento no vuelve a cobrar
    
      const resultado = await facturacion.cambiarPlan(usuarioId, plan);
      await store.set(idempotencyKey, resultado, { ttlSegundos: 86_400 });
      return resultado;
    }
    

    La clave llega en los argumentos, no se genera dentro: si la generaras tú, cada reintento traería una distinta y no servirían de nada.

    Ese criterio de qué se automatiza y qué no —lo reversible frente a lo irreversible— es el mismo que aplico a los permisos de un agente, y lo desarrollé en inyección indirecta de prompts en agentes.


    4. Autenticación: tu server pasa a ser un resource server de OAuth 2.1

    En local no hay autenticación porque no hace falta: el proceso es tuyo. En red hace falta, y MCP no se la inventa: se apoya en OAuth 2.1.

    El modelo mental que conviene fijar: tu MCP server es un resource server, no un servidor de autorización. Valida tokens y sirve recursos. No emite tokens ni loguea a nadie. Eso es de otro.

    Las piezas:

    • Metadatos de recurso protegido. Tu server publica /.well-known/oauth-protected-resource, un JSON que declara su identificador, los servidores de autorización en los que confía, los scopes que soporta y los métodos de bearer que acepta. Es lo que permite a un cliente descubrir a dónde ir a pedir el token:

      {
        "resource": "https://mcp.tudominio.com",
        "authorization_servers": ["https://auth.tudominio.com"],
        "scopes_supported": ["mcp:read", "mcp:write"],
        "bearer_methods_supported": ["header"]
      }
      
    • El parámetro resource. El cliente lo manda en la petición de autorización y en la de token. Es el mecanismo que impide que un token acuñado para tu server sirva en otro distinto.

    • Registro de cliente. La revisión 2026-07-28 deprecia el Dynamic Client Registration en favor de los Client ID Metadata Documents, aunque DCR sigue disponible por compatibilidad. También pide validar el parámetro iss de la respuesta de autorización contra el emisor registrado antes de canjear el código, y que las credenciales persistidas se indexen por emisor y no se reutilicen con otro servidor de autorización.

    Si vas a exponer un server a terceros, esta sección es la que decide si te lo pueden usar las empresas o no. El caso de negocio de tener el tuyo lo desarrollé en MCP server para empresas.


    5. Observabilidad: el logging del protocolo se va, entra OpenTelemetry

    La revisión 2026-07-28 deprecia las features de Roots, Sampling y Logging. Siguen funcionando durante la ventana de deprecación —que la política fija en un mínimo de doce meses— pero las implementaciones nuevas no deberían adoptarlas.

    Para el logging, la migración que sugiere la propia spec es explícita: escribir a stderr (en stdio) o usar OpenTelemetry.

    Y la spec te lo pone fácil, porque documenta la propagación de contexto de trazas de OpenTelemetry sobre las claves _meta: traceparent, tracestate y baggage. Eso significa que puedes correlacionar la traza de tu backend con la llamada del agente que la originó, que es justo lo que echas de menos la primera vez que un tool call falla en producción y no sabes de qué conversación venía.


    6. El caché que te ahorra tokens (y casi nadie configura)

    Este es el que da alegrías y no cuesta nada.

    La revisión 2026-07-28 exige los campos ttlMs y cacheScope en los resultados de tools/list, prompts/list, resources/list, resources/read y resources/templates/list, mediante una nueva interfaz CacheableResult. ttlMs es una pista de frescura en milisegundos para que el cliente cachee y deje de sondear; cacheScope ("public" o "private") controla si un intermediario compartido puede cachear la respuesta.

    Y hay un detalle pequeño con consecuencias grandes: la spec dice que los servidores deberían devolver las tools de tools/list en un orden determinista, explícitamente para permitir el caché del lado del cliente y mejorar los aciertos de caché de prompt del LLM.

    Piénsalo un segundo. La lista de tools va al principio del contexto. Si tu server la devuelve en orden distinto en cada petición, estás invalidando el prefijo cacheado del prompt en cada llamada y pagando entrada completa cada vez. Ordenar un array te sale gratis.


    Y una que no viene de la spec: la deriva de esquemas

    Esto no es un cambio del protocolo, es el fallo que más veo en servers reales.

    El patrón habitual define el esquema dos veces: una con Zod para validar en ejecución, y otra a mano como JSON Schema en la respuesta de tools/list. Dos fuentes de verdad para el mismo contrato.

    El día que añades un campo y solo tocas una, el resultado no es un error: es peor. El modelo lee un contrato y tu servidor valida otro, así que el agente manda llamadas perfectamente razonables que tu server rechaza. Y como el fallo llega como un error de validación, parece culpa del modelo.

    La regla: el JSON Schema que publicas tiene que derivarse del esquema que valida, nunca escribirse en paralelo. Un solo sitio donde cambiar las cosas.

    Los patrones para modelar y derivar contratos con Zod los vemos en el curso de Zod para TypeScript. Y si vas a definir las tools antes de escribirlas —que es lo que evita justo esta clase de deriva— la metodología está en el libro de Spec-Driven Development.


    Checklist antes de exponerlo

    1. Transporte: Streamable HTTP, un solo endpoint. Si tienes SSE, tienes deuda.
    2. Idempotencia: clave en los argumentos para toda tool con efectos secundarios, y resultado guardado por clave.
    3. Sin sesiones: nada de sticky sessions; el estado entre llamadas viaja como handle explícito en los argumentos.
    4. Auth: /.well-known/oauth-protected-resource publicado y validación del parámetro resource en los tokens.
    5. Trazas: propaga traceparent por _meta y manda las trazas a tu colector.
    6. Caché: ttlMs y cacheScope en los listados, y tools/list siempre en el mismo orden.
    7. Un solo esquema: el JSON Schema publicado, derivado del validador.

    El flujo completo de diseñar herramientas para agentes y llevarlas a producción es lo que enseño en el curso Construye con IA: de la idea al producto con Claude Code.

    En Dominicode Labs tengo servidores MCP corriendo para infraestructura, analítica y publicación, y comparto ahí las configuraciones que aguantan.

    Montar un MCP server es una tarde. Exponerlo es un sistema distribuido. La diferencia entre las dos cosas son estas siete líneas.


    Preguntas frecuentes

    ¿Tengo que migrar mi MCP server a la v2 ya?

    Para el protocolo, no: hablar la revisión nueva es opt-in y la v1 sigue soportada. Pero la deprecación de SSE es anterior e independiente de la v2 —viene de la revisión 2025-03-26— así que si tu server remoto habla SSE, eso sí conviene cambiarlo aunque no toques nada más. Lo que sí trae la v2 y compensa de verdad es quitarte las sticky sessions.

    ¿Qué diferencia hay entre SSE y Streamable HTTP en un MCP server?

    SSE usaba dos endpoints: uno para mantener abierto el stream de servidor a cliente y otro para que el cliente enviara mensajes. Streamable HTTP usa un único endpoint que gestiona ambas direcciones. Menos piezas que coordinar, menos configuración en el balanceador y menos estado que mantener vivo entre peticiones.

    Si desaparecen las sesiones, ¿dónde guardo el estado entre llamadas?

    En los argumentos de la tool. La spec indica que los servidores que necesiten estado entre llamadas usen handles explícitos acuñados por el propio servidor y pasados como parámetros normales. Deja de ser un implícito del transporte y pasa a formar parte del contrato de datos, que es más fácil de depurar y de tipar.

    ¿Por qué mis tools tienen que ser idempotentes en un server remoto?

    Porque la revisión 2026-07-28 elimina la reentrega de mensajes y la resumibilidad del stream. Si la conexión se corta, la petición en vuelo se pierde y el cliente debe reemitirla como una petición nueva. Sin clave de idempotencia, una tool que cobra o crea algo lo haría dos veces. En local, con stdio, este escenario no existe.

    ¿Mi MCP server tiene que emitir tokens de autenticación?

    No. Tu server es un resource server: valida tokens y sirve recursos, nunca emite tokens ni autentica usuarios. De eso se encarga un servidor de autorización aparte. Lo que sí publica tu server es /.well-known/oauth-protected-resource, para que los clientes descubran en qué servidor de autorización pedir el token y con qué scopes.

  • Claude diseñó proteínas solo: manual de agentes de IA autónomos

    Claude diseñó proteínas solo: manual de agentes de IA autónomos

    Casi todo lo que leo sobre IA cabe en tres cajones: autocompletar código, sacar un gráfico de un Excel y vídeos de gente que no existe bailando en una playa.

    Ese es el techo mental de la conversación. El mío también, muchos días.

    Y mientras discutimos si Cursor gestiona el contexto mejor que Claude Code, los mismos agentes de IA autónomos que tú y yo soltamos dentro de un repo llevaban 48 horas seguidas diseñando proteínas que no existían. Proteínas que después alguien sintetizó de verdad, en un laboratorio de verdad, y midió con un aparato de verdad.

    Ahí el error no se arregla con git revert.

    El 18 de agosto de 2026 Anthropic publicó How Claude is accelerating protein design and analytical chemistry y, debajo, un informe técnico con el detalle fino: 1.320 diseños generados, 354 binders confirmados en laboratorio, 14 de 15 dianas con al menos un acierto.

    Ese titular corrió por todas partes. Y es el trozo menos interesante de la historia.

    Porque lo que a ti y a mí nos sirve el lunes por la mañana no son los 354 binders. Es cómo estaba escrito el documento que le dieron al agente antes de arrancar.


    Primero, qué hizo exactamente

    Un binder es una proteína pequeña que se pega a una diana concreta. Es el paso cero de medio catálogo de fármacos. No es un fármaco: por delante queda todo el recorrido preclínico y regulatorio, que se mide en años.

    Claude no inventó ninguna herramienta. Usó las que ya existen y son públicas: diez generadores de estructura distintos, con PXDesign (358 diseños), RFdiffusion3 (267) y Genie 3 (185) a la cabeza; SolubleMPNN para el diseño de secuencia (1.133 de los diseños testeados) y un ensemble de ESMFold2, ESMFold2-Fast y Protenix v2 para rankear. Ninguna venía preinstalada: el protocolo le obliga a compilar cada una desde su repositorio público y validarla en la primera hora. Todo dentro de Claude Science, el entorno de investigación de Anthropic.

    Lee esa lista otra vez. Ninguna herramienta es suya.

    El modelo no aportó capacidad generativa nueva al campo. Aportó criterio: qué herramienta usar, en qué orden y qué candidatos tirar a la basura. Es la diferencia entre IA generativa e IA agéntica llevada a un dominio donde el resultado se mide con un sensor.

    Y se nota en el ranking: su diseño número uno acertó el 49 % de las veces, el top cinco un 44 %, el top diez un 39 %, frente al 28 % del conjunto de treinta. El criterio estaba en el orden.

    Y se midió fuera de casa. Adaptyv Bio convirtió las secuencias en ADN, sintetizó las proteínas con síntesis libre de células y robots, y midió afinidad por resonancia de plasmón superficial. Twist Bioscience también participó. Esto no es una simulación puntuándose a sí misma.

    Los números por brazo del experimento, que mucha gente ha contado mal mezclándolos:

    Configuración Binders / diseños Tasa de acierto
    Baseline de la industria hoy — 10–15 %
    Opus 4.8 · 14 dianas a la vez, una sola sesión · 48 h 88 / 390 22,6 %
    Mythos Preview · 14 dianas a la vez, una sola sesión · 48 h 104 / 390 26,7 %
    Mythos Preview · una sesión de 24 h por diana 158 / 450 35,1 %

    Del formato multi-diana se analizan 13 de las 14 dianas; la campaña de diana única cubrió las 15.

    El 26,8 % global sale de dividir 354 entre 1.320. El 95 % de los diseños se expresó correctamente. Y hubo dos casos que se salen de la media:

    • RBX1: 28 binders de 90 diseños sumando las tres campañas, un 31 %. Y un 40 % en la campaña de diana única, la mejor configuración. En la competición abierta previa sobre esta misma diana solo pegaron 9 de 245 diseños: un 3,7 %. El mejor diseño del agente se midió en 3,9 nM, por delante del que ganó aquella competición.
    • TREM2: 72 binders de 90 diseños. Un 80 %, frente al 38,3 % de la competición previa de Adaptyv.

    Con un asterisco que pone el propio informe: cuatro de las seis competiciones con las que se compara ya estaban publicadas y accesibles para el agente mientras diseñaba.

    Impresionante igual. Ahora la parte que de verdad importa.


    Dos tercios del prompt no eran de biología

    Antes de arrancar, un grupo de expertos escribió un protocolo. Unos 30.000 tokens. Y después —cita textual del informe— "no dimos ninguna guía científica, técnica ni operativa adicional después de iniciar las campañas".

    Ni una corrección. Ni un "prueba mejor por aquí". Los únicos mensajes humanos que entraron fueron instrucciones cortas y no técnicas para reanudar cuando una sesión se caía por infraestructura. El resto de incidencias las detectó y las sorteó el agente solo.

    Lo interesante es cómo se repartía ese documento:

    PROTOCOLO ENTREGADO AL AGENTE - ~16.000 palabras (~30.000 tokens)
    
      Ciencia y herramientas      ################   34,2 %
      Orquestacion y validacion   ################   34,7 %
      Operaciones                 ##############     31,1 %
                                                     -------
      Todo lo que NO es dominio                      65,8 %
    

    Un 34,2 % de ciencia. Y un 65,8 % de cosas que no tienen nada que ver con proteínas: cómo trabajar, cómo decidir, cómo validar, cuándo parar, qué hacer cuando algo se rompe.

    Piensa ahora en tu último system prompt.

    Si el 90 % es "eres un ingeniero senior experto en X con 20 años de experiencia", ya sabes qué te falta. No te falta dominio. Te falta procedimiento.

    Y un detalle remata la idea: probaron el protocolo en campañas piloto y, antes de las corridas finales, revisaron justo las secciones de orquestación y operaciones. No cambiaron el modelo. No añadieron más ciencia. Iteraron sobre el harness.

    Eso es Spec-Driven Development sin llamarlo por su nombre: escribir la especificación antes de dejar que nada se ejecute, y corregir la especificación en lugar de corregir la ejecución. La misma disciplina que desarrollo en el libro de SDD, solo que aquí el precio de improvisar no era un sprint perdido, eran 50.000 dólares de GPU.


    "¿No habíamos quedado en que los mega-prompts son mala idea?"

    Sí. Y este experimento no me desmiente. Me da la razón, aunque de lejos parezca lo contrario.

    Escribí Arquitectura de subagentes vs. mega-prompt defendiendo que un contexto único cargado de responsabilidades se degrada. Aquí hay un documento de 30.000 tokens que funcionó. Toca mirar el detalle.

    Primero: eso no es un prompt, es un protocolo compartido. Y el informe lo dice sin ambigüedad: cada agente de la campaña lo recibe como system prompt. En plural. Uno de los bloques de orquestación explica cómo delegar el trabajo en un equipo de subagentes de dos capas y cómo supervisarlo.

    Especificación larga, ejecución repartida. Que es justo lo que defendía aquel post.

    Segundo, el dato que lo remata. La campaña que atacó las 14 dianas a la vez dentro de una sola sesión se quedó en el 26,7 %. Darle a cada diana su propia sesión de 24 horas subió al 35,1 %: 143 binders frente a 104 sobre las mismas 13 dianas, con una p de 0,003.

    Anthropic avisa de que esa sesión dedicada también tuvo 2,8 veces más cómputo por diana, así que foco y presupuesto no se pueden separar del todo. Pero la dirección es la de siempre: cuantas menos cosas metes en un contexto, mejor sale.

    Un mega-prompt de los malos es sedimento. Instrucciones de dominio acumuladas, ejemplos pegados a mano y reglas contradictorias que alguien fue añadiendo cada vez que algo petó en producción. Esto es un manual de operaciones escrito una vez y repartido entre varios agentes.

    La lección no es "escríbelo todo más largo". Es qué metes dentro de cada contexto y cómo lo estructuras.


    Qué es un agente de IA autónomo (y qué no lo es)

    Un agente de IA autónomo es un sistema que recibe un objetivo y un protocolo escritos por una persona y, a partir de ahí, decide solo qué herramientas usar, en qué orden y qué resultados descartar, sin intervención humana durante la ejecución. No es un modelo más listo: es un modelo con un carril bien escrito.

    En esta campaña la autonomía duró 48 horas. Lo que la hizo posible no fue el modelo, fue el documento que alguien escribió antes de pulsar enter.


    La frontera real de los agentes de IA autónomos

    La palabra "autónomo" ha vendido muchos titulares estos días. Merece un asterisco grande.

    Lo decidió el agente Lo fijó el humano
    Qué investigar de cada diana Qué dianas
    Qué epítopo atacar El protocolo
    Qué herramientas usar y en qué orden Los antígenos del ensayo
    Qué candidatos descartar Los pedidos de síntesis
    Cómo rankear las secuencias finales La lectura de los datos

    Nadie tocó al agente durante la corrida. Cierto. Pero un humano eligió el problema, escribió las reglas, definió el ensayo y leyó los resultados.

    Ese es el patrón que veo funcionar una y otra vez en producción: autonomía total dentro de un carril que alguien dibujó antes, con mucho cuidado.

    El trabajo del ingeniero se ha movido del bucle al carril. Es justo lo que trabajo en el curso Construye con IA: el resultado depende mucho más de lo que escribes antes de lanzar el agente que del modelo que elijas.


    Por qué la química tardó minutos y esto semanas

    En la misma publicación hay un segundo experimento que casi nadie ha citado. Claude Opus 5 procesó ficheros de NMR y LC-MS en 23 y 19 minutos, y calculó una pureza del 96,4 % frente al 96,33 % que había medido el laboratorio.

    Minutos.

    Los binders necesitaron semanas de laboratorio húmedo para saber si el agente había acertado.

    Misma tecnología, misma calidad de razonamiento, velocidades incomparables. ¿La variable? Lo que cuesta comprobar la respuesta.

    Donde verificar es barato y rápido, el agente itera, se corrige y avanza. Donde verificar cuesta semanas y dinero, el agente dispara a ciegas y espera.

    Tu código está en el primer grupo. O debería estarlo. Un test que corre en 200 milisegundos es tu resonancia de plasmón superficial: la señal barata que le dice al agente si va bien o va mal. Por eso insisto tanto con el test harness. Sin él, tu agente vive en el mundo de las proteínas: dispara y reza.

    Y un detalle que deberías tatuarte: las puntuaciones de confianza del propio agente no avisaron de ninguno de los fallos. Los diseños contra MBP puntuaban casi igual que los que sí funcionaron. La confianza del modelo no es una señal de verificación.


    Los fallos, que Anthropic no escondió

    Contra MBP (maltose binding protein), una superficie grande, convexa y polar, sin un bolsillo donde agarrarse: 0 binders de 90 diseños. Cero.

    Contra TNFα, Opus 4.8 sacó 12 binders de 150 diseños y Mythos Preview ninguno de 60. El modelo mejor en la media, a cero en esa diana concreta. Y el informe no lo vende como victoria de un modelo: dice que cada campaña corrió una sola vez y usó generadores distintos, así que no pueden atribuir la diferencia a los modelos.

    Y hubo una diana 16 (GDF-8 mature) excluida del análisis porque el ensayo dio mediciones de mala calidad: la proteína se agregaba consigo misma. Ahí no falló el agente, falló el ensayo.

    Estos tres datos me dan más confianza que los 354 binders. Un informe que solo cuenta aciertos es marketing.

    Tampoco esconden el coste: 50.000 dólares de GPU en la corrida de 48 horas contra todas las dianas a la vez (hasta 12.500 horas de NVIDIA H100) y 10.000 por cada sesión de 24 horas contra una sola. La configuración más precisa fue también la más cara por diana.


    Lo que esto no es

    No es peer review. Es un estudio autopublicado por Anthropic sobre sus propios modelos. El trabajo de laboratorio lo hicieron terceros, que es lo que lo salva de ser una nota de prensa, pero nadie externo ha revisado la metodología.

    Y hay una línea que Anthropic no ha cruzado: el diseño de proteínas y otras capacidades de biología de uso dual siguen sin acceso general en Claude Fable 5, su modelo más capaz, por riesgo de armas biológicas. Los modelos clase Opus mantienen acceso limitado.

    La empresa que publica el estudio ha decidido no ofrecer esa capacidad en su mejor modelo. Ese freno también es un resultado del experimento.


    Qué haces el lunes con tus agentes de IA autónomos

    Abre el system prompt del agente que tengas en producción ahora mismo. Son quince minutos:

    1. Etiqueta cada bloque con una de estas tres palabras: dominio, orquestación, operaciones.
    2. Saca porcentajes. Divide las líneas de cada etiqueta entre el total.
    3. Compara con el 34/35/31 de Anthropic. Si te sale algo parecido a 90/5/5, ya sabes qué te falta: no te falta dominio, te falta procedimiento.
    4. Escribe lo que falta: el procedimiento paso a paso, los criterios para descartar, las señales de que va por buen camino, cuándo debe pararse y a quién avisa cuando no sabe seguir.

    Ese fue el 65,8 % del documento que le dieron a Claude. Y es la parte que casi nadie escribe, porque es aburrida y no luce en un tuit.

    Si te llevas una sola frase de todo esto, que sea esta: si tu agente no tiene una forma barata de saber si acertó, no tienes un agente. Tienes un generador de texto con acceso a tu terminal.

    En Dominicode Labs desmontamos este tipo de arquitecturas con proyectos reales. Pero el ejercicio de los quince minutos hazlo hoy.


    Preguntas frecuentes

    ¿Claude ha creado un fármaco?

    No. Diseñó binders: proteínas pequeñas que se pegan a una diana. Es el paso cero de muchos programas farmacológicos, y por delante queda todo el recorrido preclínico y regulatorio, que se mide en años.

    ¿El estudio está revisado por pares?

    No. Es un estudio autopublicado por Anthropic sobre sus propios modelos, sin peer review. Lo que sí es externo es la validación: Adaptyv Bio y Twist Bioscience sintetizaron las proteínas y midieron afinidad por resonancia de plasmón superficial. Nadie de fuera ha revisado la metodología, pero los resultados no salen de una simulación.

    ¿Qué significa una tasa de acierto del 26,8 %?

    Que de 1.320 diseños generados, 354 se confirmaron como binders en el laboratorio. El baseline actual de la industria está entre el 10 % y el 15 %. Conviene no mezclar brazos del experimento: el 26,8 % es el dato global y, por configuración, va del 22,6 % al 35,1 %.

    ¿Por qué acierta más si trabaja contra una sola diana?

    Porque la sesión dedicada de 24 horas concentra todo el presupuesto de razonamiento y cómputo en un único problema: sube del 26,7 % al 35,1 %. También sale más cara por diana, y Anthropic avisa de que no puede separar el efecto del foco del de un presupuesto 2,8 veces mayor por diana. Es tu mismo dilema entre lanzar un agente contra quince tickets a la vez o dedicarle una sesión completa al que importa.

    ¿Puedo usar Claude para diseñar proteínas?

    No con acceso general. El diseño de proteínas y otras capacidades de biología de uso dual siguen restringidas en Claude Fable 5, el modelo más capaz, por riesgo de armas biológicas. Los modelos clase Opus mantienen acceso limitado.

    ¿Qué me llevo de esto para mis agentes de IA autónomos si no toco biología?

    El reparto del protocolo: 34,2 % dominio, 34,7 % orquestación y validación, 31,1 % operaciones. Es la plantilla que yo usaría para escribir el contexto de un agente. Y la consecuencia práctica: iteraron sobre el harness, no sobre el modelo.


    Fuentes


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.