Category: AI

  • Shopify compra Tailwind: no falló el framework, falló el embudo

    Shopify compra Tailwind: no falló el framework, falló el embudo

    El 18 de noviembre de 2025, un contribuidor abrió un pull request en el repositorio de la documentación de Tailwind. La propuesta era razonable: un endpoint llms.txt que sirviera toda la doc en un único archivo de texto, optimizado para que lo consumieran los modelos de lenguaje.

    El PR se quedó parado siete semanas. A principios de enero alguien preguntó en el hilo por qué no avanzaba. Adam Wathan lo cerró el 6 de enero de 2026, y al día siguiente contestó con algo que no era la respuesta a un PR:

    "75% of the people on our engineering team lost their jobs here yesterday because of the brutal impact AI has had on our business."

    "El 75 % de la gente de nuestro equipo de ingeniería perdió su trabajo ayer por el impacto brutal que la IA ha tenido en nuestro negocio."

    Eran cuatro ingenieros. Quedó uno.

    Ocho meses después llegó el desenlace: el 9 de septiembre de 2026, Shopify compra Tailwind Labs. Ni Shopify ni Tailwind Labs han revelado el importe.

    La lectura fácil es "gran salida para un proyecto querido". La útil es otra: aquí no falló el framework. Falló el embudo por el que ese framework se pagaba.


    Qué dice el anuncio de la compra de Tailwind por Shopify

    El anuncio, firmado por Adam Wathan el 9 de septiembre de 2026, se apoya en una promesa. Wathan la escribe sin ambigüedad: "Nothing changes with Tailwind CSS or any of our other open-source projects". Y refuerza: "Everything will always be MIT-licensed". El equipo sigue liderando y manteniendo los proyectos open source, ahora con el respaldo de Shopify.

    Con el negocio es más seco: "On the commercial side, we'll no longer be trying to grow the business around Tailwind". Los clientes actuales de Tailwind Plus y de ui.sh conservan su acceso. Lo que sí cierra son las altas nuevas: "we're closing sign ups for new customers to focus on Tailwind CSS at Shopify".

    La razón declarada es de alineación estratégica: Wathan siempre quiso que el framework se desarrollara al servicio de un producto real, y Shopify fue adoptante temprano —lo usa internamente y con sus merchants.

    Todo eso es cierto. Y no menciona despidos ni caída de ingresos, porque un anuncio de adquisición no es donde se cuenta eso.

    Pero sin esa parte, la historia no se entiende.


    El dato que no cuadra: 69,9 millones de descargas y los ingresos cayendo

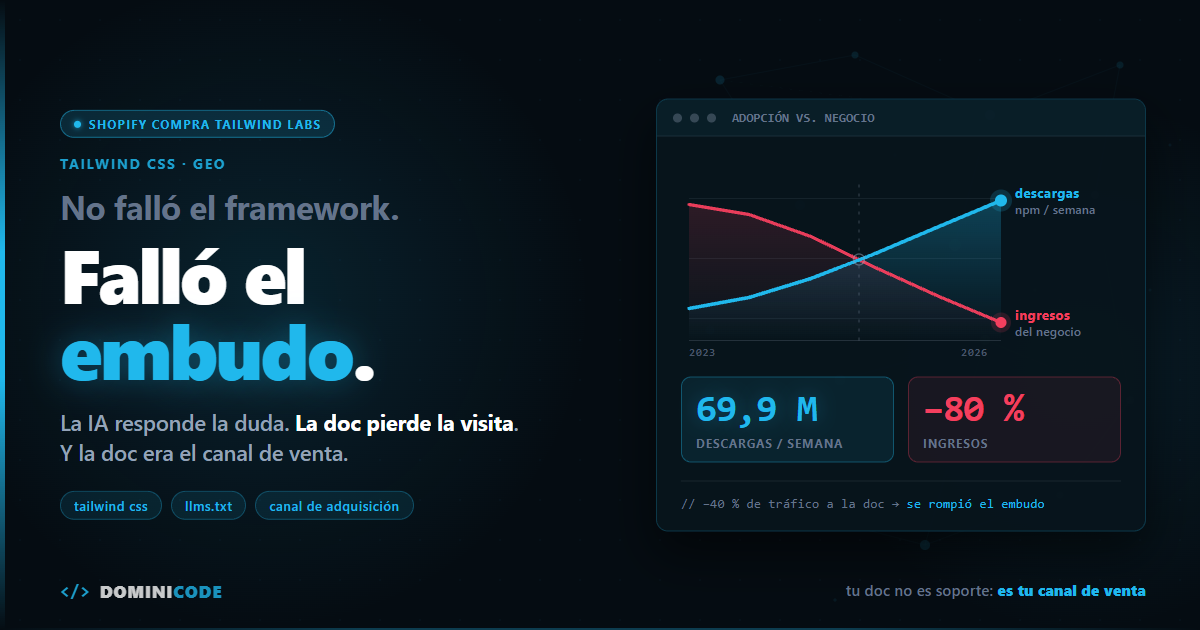
    La contradicción es esta: en septiembre de 2026 Tailwind CSS se descarga más que nunca mientras los ingresos de la empresa que lo mantiene caen casi un 80 %.

    Tailwind es un framework de CSS basado en clases de utilidad: compones el estilo en el propio marcado en vez de escribir hojas aparte. Lo expliqué a fondo en qué es Tailwind CSS, y desde entonces se ha comido buena parte del front-end moderno.

    Eso no es entusiasmo. Es medible.

    La semana del 3 al 9 de septiembre de 2026, el paquete tailwindcss registró 69,9 millones de descargas semanales en npm. Para situar la escala: React tuvo 95,7 millones esa misma semana.

    Ponlo al lado del resto de señales.

    Señal Dirección
    Descargas semanales de tailwindcss 69,9 M (3-9 de septiembre de 2026)
    Tráfico a la documentación −40 % desde principios de 2023
    Ingresos casi −80 %
    Equipo de ingeniería −75 % (enero de 2026)

    Descargas: API de npm — 69.920.618 en la semana del 3 al 9 de septiembre de 2026. Tráfico e ingresos: cifras que dio el propio Wathan en el hilo del PR #2388 el 6 y el 7 de enero de 2026. El anuncio de la adquisición no menciona ninguna de las dos.

    Lee la tabla otra vez. La adopción sube. El tráfico y el dinero se desploman.

    Esa contradicción no es una curiosidad. Es el post entero.


    El embudo que rompió la IA: la documentación era el canal de adquisición

    El embudo que se rompió es el de la documentación: durante más de una década, una empresa de herramientas para developers regalaba el open source y monetizaba las visitas que su doc traía desde Google. Funcionaba tan bien que dejamos de mirarlo.

    Regalas el open source. La documentación posiciona en Google porque es contenido técnico específico y con una intención de búsqueda altísima. El developer aterriza a resolver un problema concreto y una fracción descubre por el camino que además vendes algo.

    La documentación no era un centro de coste. Era el canal de adquisición, y durante años el más barato de todos: gratis, evergreen y perfectamente cualificado.

    Ese embudo se rompió. Despacio en el tráfico, de golpe en el dinero.

    Cada vez menos gente aterriza en tailwindcss.com para buscar cómo se hace un grid. Se lo pregunta a Claude, o lo escribe Cursor mientras mira otra cosa. La respuesta llega, es correcta, y nadie visitó la web. La doc se consume más que nunca, pero a través de un intermediario que no monetiza para ti.

    Tailwind no perdió usuarios. Perdió visitas.

    Y su negocio cobraba por visitas.


    La IA no mató a Tailwind sola: shadcn y el encaje del producto de pago

    Cuidado con la narrativa cómoda: "la IA mató a Tailwind" es demasiado limpio para ser verdad.

    En el hilo de Hacker News que siguió a los despidos —1.457 puntos y 840 comentarios— varios clientes de pago decían lo mismo: los componentes de Tailwind Plus les resultaban complicados y demasiado opinados, y shadcn —gratis— les encajaba mejor. Eso no lo provocó ningún modelo de lenguaje. Es competencia normal, de la que ya existía antes de ChatGPT.

    El producto de pago tenía un problema de encaje. Lo que hizo la IA fue quitarle el colchón.

    Con un canal sano, un producto que pierde encaje te da años para corregir el rumbo. Si el canal lleva tres años cayendo hasta perder un 40 %, no te quedan años: te quedan trimestres. Y con los ingresos cayendo casi un 80 %, la decisión ya no es qué construir, sino a quién llamar.

    Y que quede claro: la adquisición no es el fracaso de esta historia, es probablemente el mejor final posible. Un paquete con 69,9 millones de descargas semanales ahora lo paga una empresa con caja, con licencia MIT y el equipo original al mando.

    El fracaso, si acaso, es de un modelo. No de Wathan.


    Por qué te importa aunque no vendas componentes

    Es probable que tengas un producto propio o quieras tenerlo. Un SaaS, un curso, una plantilla, una librería con versión Pro. Yo tengo varios.

    Hazte una pregunta y respóndela con datos, no con intuición:

    ¿Cómo se entera un desconocido de que tu producto existe?

    Si la respuesta es "busca en Google, aterriza en mi web y ahí descubre que vendo algo", tienes exactamente el embudo de Tailwind. Solo que todavía no lo has medido.

    Ahí está el corolario incómodo: la IA no te va a quitar el trabajo de escribir código, pero puede quitarte el canal por el que vendías el código que escribes.

    Cuando escribí sobre micro-SaaS rentables como developer en solitario, la parte que más preguntas generó fue la de distribución. Con razón: el producto es lo que ya sabemos hacer; el canal es lo que decide si existe o no.

    Tres números que puedes mirar esta semana

    1. Porcentaje de altas que llegan por búsqueda orgánica. Si más de la mitad de tus clientes nuevos entran por ahí, dependes de un canal que se mueve bajo tus pies.
    2. Impresiones contra clics en los últimos 24 meses. Si las impresiones aguantan y los clics bajan, no te has hundido en el ranking: la respuesta se sirve sin ti. Es la señal temprana, y llega mucho antes que la caída de ingresos.
    3. Cuántos compradores tenían relación previa contigo. Email, comunidad, canal, lo que sea. Ese porcentaje es tu independencia real del algoritmo de turno.

    Si el tercero es bajo, no tienes un negocio. Tienes un alquiler de tráfico.


    Qué modelos de negocio aguantan cuando la IA se queda el clic

    Aguantan los modelos de negocio que no dependen del clic, y hay menos de los que parece.

    Distribución directa. Una lista de email, un canal propio, un feed que alguien eligió seguir. Entre tú y una bandeja de entrada hay mucho menos intermediario que entre tú y un resultado de búsqueda. Mi canal de YouTube hace justo eso: nadie llega a un vídeo mío preguntándole a Claude cómo se centra un div.

    Comunidad. Gente que vuelve porque hay alguien al otro lado respondiendo. Un LLM contesta la pregunta que sabes formular; no te dice cuál deberías estar haciéndote. En Dominicode Labs esa es la propuesta entera: gente que vuelve cada semana porque hay alguien al otro lado. No hay algoritmo intermedio que pueda cortarlo.

    Producto que la IA no puede regenerar. Un componente de UI se regenera en veinte segundos. Un backend con estado, datos propietarios, SLA y alguien de guardia, no. Cuanto más cerca esté tu producto de "esto lo escribe un modelo en un prompt", más frágil es tu precio.

    Cobrar por el producto, no por el tráfico que genera. Open source más hosting, soporte o servicio gestionado. Es, por cierto, lo contrario de lo que tenía Tailwind: el framework nunca cobró por sí mismo, cobraba la doc que lo explicaba. Ahora lo financia el producto real de otro.

    Ninguna de las cuatro es rápida. Todas se construyen antes de necesitarlas.


    Si tu único canal es el SEO: qué cambiar ahora

    No lo abandones. Sería la reacción exagerada.

    Cámbiale el trabajo. Tu contenido ya no compite por el clic: compite por ser la fuente que el modelo cita. Escribe para que te citen, estructura para que te parseen, publica tu llms.txt —sí, el mismo que Tailwind no pudo permitirse— y deja de medir el éxito en páginas vistas. Lo desglosé paso a paso en SEO vs GEO para developers: cómo conseguir que las IAs citen tus tutoriales.

    Y asume la parte dura: la conversión ya no ocurre en tu web, ocurre después. Cada visita tiene que dejar algo —un email, una suscripción—, porque puede ser la única vez que esa persona pise tu dominio.

    Hay una ironía aquí: aquel PR proponía exactamente esto, un llms.txt con toda la doc. Wathan dijo que le veía el valor y que quería añadirlo, pero que no podía priorizar algo que le quitaba el único canal por el que llegaban clientes. Tenía razón en el diagnóstico. El problema no era el llms.txt: era que el negocio colgaba entero de las visitas. Eso es lo que hay que mover, y hay que moverlo antes de que te lo muevan.

    Montar ese otro sitio —producto propio, distribución y todo lo que hay entre la idea y el primer cliente— es lo que trabajamos paso a paso en el curso Construye con IA: de la idea al producto con Claude Code.


    Lo único que me llevaría de la compra de Tailwind por Shopify

    Que un framework con 69,9 millones de descargas semanales dejara a su empresa con los ingresos casi un 80 % por debajo significa que el uso y el negocio son cosas distintas, y que llevábamos años confundiéndolas porque el SEO nos hacía el favor de unirlas.

    Abre tu analítica hoy: de tus últimos veinte clientes, cuántos te conocían de antes.

    Ese número es tu modelo de negocio real. Lo demás es tráfico prestado.


    Preguntas frecuentes

    ¿Cuánto pagó Shopify por Tailwind Labs?

    No se ha hecho público. Ni el anuncio publicado por Adam Wathan el 9 de septiembre de 2026 ni Shopify han revelado el importe ni la estructura de la operación.

    ¿Por qué ha comprado Shopify a Tailwind Labs?

    Por alineación estratégica, según el anuncio: Shopify fue adoptante temprano de Tailwind CSS y lo usa internamente y con sus merchants, y Wathan siempre quiso desarrollar el framework al servicio de un producto real. El contexto que el anuncio no menciona es económico: en enero de 2026 Tailwind Labs despidió al 75 % de su equipo de ingeniería y el tráfico a su documentación estaba un 40 % por debajo del de principios de 2023.

    ¿Tailwind CSS sigue siendo gratis y open source tras la compra de Shopify?

    Sí. Wathan lo dice literalmente en el anuncio: "Nothing changes with Tailwind CSS or any of our other open-source projects" y "Everything will always be MIT-licensed". El mismo equipo sigue manteniéndolos, ahora con el respaldo de Shopify. Si usas Tailwind en producción, no tienes nada que tocar.

    ¿Qué pasa con Tailwind Plus y ui.sh si ya soy cliente?

    Los clientes actuales mantienen su acceso. Lo que cambia es que se cierran las altas nuevas: en palabras del anuncio, cierran los registros "to focus on Tailwind CSS at Shopify". El producto de pago deja de crecer para que el equipo se centre en el framework dentro de Shopify.

    ¿Por qué cayeron los ingresos de Tailwind si el framework se usa más que nunca?

    Porque cobraban en un sitio distinto de donde estaba el uso. El dinero llegaba por la documentación: posicionaba en Google, el developer aterrizaba a resolver una duda y una parte descubría que existía un producto de pago. Con los asistentes de IA la respuesta llega sin visitar la web. El tráfico a la doc cayó alrededor de un 40 % desde principios de 2023 y los ingresos casi un 80 %, mientras la adopción seguía subiendo.

    ¿Significa esto que el SEO ya no sirve para vender productos para developers?

    Sirve, pero ha cambiado de función. Antes el contenido técnico traía visitas y las visitas traían clientes. Ahora compite por ser la fuente que citan los modelos, y la conversión ocurre fuera de tu web. La conclusión no es dejar de escribir: es dejar de medir en páginas vistas y hacer que cada visita deje una relación directa.

    ¿Debería dejar de usar Tailwind CSS en mis proyectos?

    No hay razón técnica para hacerlo. Mantiene licencia MIT, lo lleva el mismo equipo y ahora hay detrás una empresa que puede financiarlo. El riesgo de continuidad es menor hoy que en enero.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tests E2E autoreparables con Playwright: diagnostica, no parchees

    Tests E2E autoreparables con Playwright: diagnostica, no parchees

    El canal de Slack se llamaba #e2e-alerts. Llevaba cinco meses en silencio, y no porque no llegaran alertas: es que las once personas del equipo lo tenían silenciado.

    Ciento ochenta tests de Playwright. Entre veinte y cuarenta en rojo cada mañana. El ritual era mirar por encima, decir "es flaky" y relanzar el job.

    Cuando entré en ese proyecto me pidieron exactamente lo que estás pensando: montar tests E2E autoreparables, un agente que arreglara solo lo que se rompiera cada noche. Dije que no. Esa negativa es la mitad de este post.

    Antes de decir que no me senté a mirar por qué estaba rojo. Casi todo venía del mismo sitio: un refactor del design system que había renombrado clases CSS, y ciento y pico selectores apuntando a esas clases.

    Pero había un test distinto. El de pagar con código de descuento. Alguien lo había "arreglado" tres semanas antes cambiando getByRole('button', { name: 'Pagar pedido' }) por locator('button').nth(3).

    Verde. Precioso.

    El cuarto botón de esa página era "Seguir comprando". El de pagar llevaba nueve días deshabilitado para cualquier usuario que aplicara un descuento. Nueve días sin que nadie con un cupón pudiera pagar.

    El test lo sabía. Y una persona lo calló a mano en cuarenta segundos.

    Ahora imagina eso mismo, cien veces por semana, hecho por un agente que no firma nada y al que nadie revisa.

    Qué es un test E2E autoreparable (y qué no lo es)

    Aquí está la definición con la que trabajo:

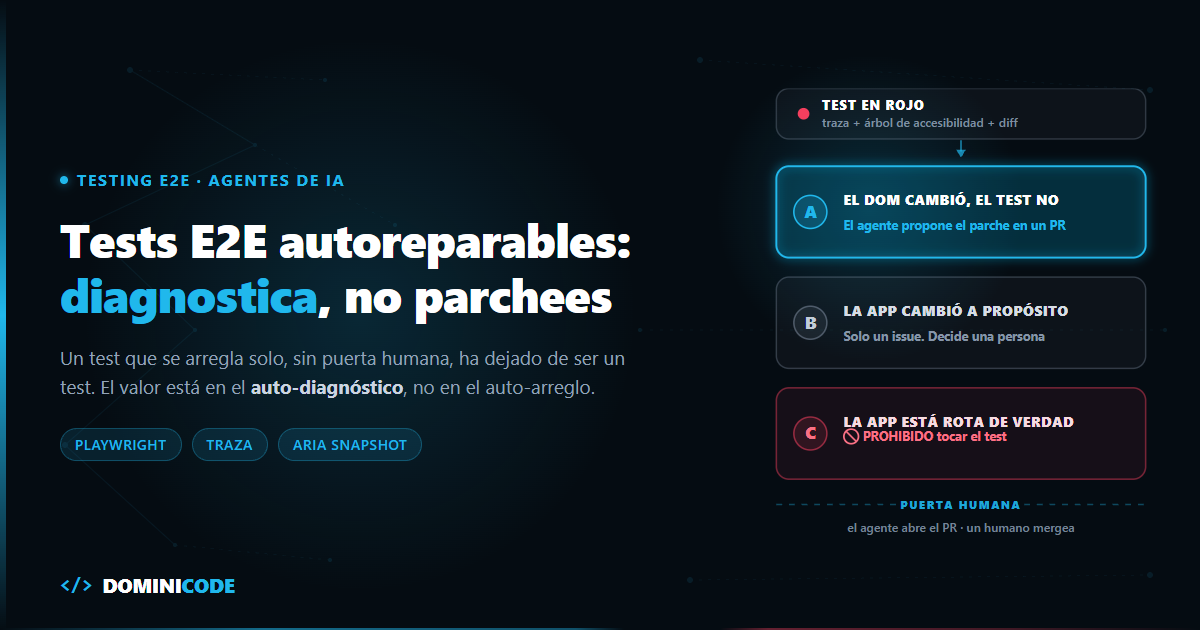
    Un test E2E autoreparable es aquel que, cuando falla, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con evidencia adjunta. No es el que se modifica a sí mismo hasta ponerse verde.

    En inglés se conoce como self-healing test, y ahí está justo el malentendido: healing no significa que el test se reescriba solo.

    La diferencia no es de matiz. Es de propósito.

    Un test existe para emitir una señal: esto funciona, esto no. Si le das a un agente permiso para editar el test hasta que pase, has construido una máquina de decir "verde". Y una máquina de decir verde vale exactamente cero.

    El valor no está en el auto-arreglo. Está en el auto-diagnóstico. La parte cara de mantener una suite E2E no es escribir el parche —son tres caracteres en un locator—, es averiguar cuál de los cuarenta tests rojos merece un parche y cuáles están gritando que la aplicación se rompió.

    Eso es lo que un agente hace bien. Lo otro es lo que lo hace peligroso.

    No se rompe el test, se rompe el acoplamiento

    Los tests E2E no se degradan solos. Lo que se degrada es el contrato implícito entre tu test y el DOM.

    Escribiste .checkout__actions > button.btn-primary. Nadie firmó que esa clase fuera estable. Un martes alguien migró el botón a otro componente y tu test se enteró en producción.

    En las suites que he auditado, la inmensa mayoría de los rojos son fallos de localización, no de comportamiento: el elemento sigue ahí, hace lo mismo, y el test ya no sabe encontrarlo. Es mi impresión revisando proyectos, no un estudio —pero haz el recuento en tu propia suite y apuesto a que te sale parecido.

    Esa asimetría es la que hace viable un agente. Y también la que lo vuelve inútil si no distingue el resto.

    Antes del agente: locators de Playwright que se puedan reparar

    Si tus locators son frágiles, el agente no reduce la deuda. La automatiza.

    La estrategia de locators de Playwright está construida sobre lo que el usuario percibe, no sobre la implementación. Ese es el punto: un locator basado en rol accesible sobrevive a un refactor de estilos y muere cuando cambia lo que el usuario ve —que es justo cuando quieres que muera.

    // ❌ Se rompe con cualquier refactor de CSS. El agente no puede saber si es grave.
    await page.locator('.checkout__actions > button.btn-primary').click();
    
    // ✅ Se rompe solo cuando cambia lo que el usuario percibe.
    await page.getByRole('button', { name: 'Pagar pedido' }).click();
    await page.getByLabel('Código de descuento').fill('BLACKFRIDAY');
    await expect(page.getByTestId('order-summary')).toContainText('49,90 €');
    

    El orden que sigo es siempre el mismo: getByRole primero, getByLabel para formularios, y getByTestId solo cuando no hay semántica que agarrar —listas virtualizadas, tablas sin cabecera accesible, componentes de terceros.

    Y el atributo de test se declara en la config, no se improvisa por fichero:

    // playwright.config.ts
    import { defineConfig } from '@playwright/test';
    
    export default defineConfig({
      retries: 2,
      reporter: [['html', { open: 'never' }]],
      use: {
        testIdAttribute: 'data-test',
        trace: 'on-first-retry',
      },
    });
    

    Hay un efecto secundario que casi nadie cuenta: escribir los tests por rol accesible te obliga a que la aplicación tenga roles accesibles. Es la misma palanca que uso cuando pongo a un agente a auditar usabilidad con Playwright MCP. El árbol de accesibilidad deja de ser un extra de compliance y pasa a ser la API contra la que testeas.

    La traza es la única señal que el agente puede usar

    Sin traza, el agente lee un mensaje de timeout y adivina. Con traza, compara.

    Esa línea de la config —trace: 'on-first-retry'— es la que separa un diagnóstico de una alucinación. Playwright graba el reintento completo: acciones, peticiones de red, consola y snapshots del DOM antes y después de cada paso. El archivo se guarda dentro de test-results/ y se abre con npx playwright show-trace. La documentación del Trace Viewer explica el formato entero. Verificado con Playwright 1.63, la versión estable en septiembre de 2026.

    Un humano abre esa traza y ve la película. Un agente necesita algo más masticado, porque el DOM crudo de una app real son decenas de miles de tokens de ruido. En las dos páginas donde lo he medido, el árbol de accesibilidad ocupaba entre 2,5 y 28 veces menos que el HTML crudo.

    Lo que le doy es el árbol de accesibilidad en el momento del fallo, que es la misma abstracción sobre la que están escritos los locators. ariaSnapshot() está disponible desde Playwright 1.49; en versiones anteriores tendrás que serializar el árbol a mano.

    Aquí conviene ser honesto: Playwright 1.63 ya escribe por su cuenta un test-results/<test>/error-context.md con una sección # Page snapshot que contiene ese mismo árbol, así que una parte de esto la tienes gratis. El fixture sigue mereciendo la pena por lo que añade encima: la URL exacta del fallo, el nombrado que decides tú y los adjuntos visibles en el reporte HTML, que es lo que después consume el pipeline del agente.

    Este es el fixture:

    // tests/fixtures/diagnostico.ts
    import { test as base, expect } from '@playwright/test';
    
    export const test = base.extend<{ diagnostico: void }>({
      diagnostico: [
        async ({ page }, use, testInfo) => {
          await use();
    
          if (testInfo.status === testInfo.expectedStatus) return;
    
          // Árbol de accesibilidad real en el instante del fallo
          const real = await page.locator('body').ariaSnapshot();
          await testInfo.attach('aria-real.yml', { body: real, contentType: 'text/yaml' });
          await testInfo.attach('url-fallo.txt', { body: page.url(), contentType: 'text/plain' });
        },
        { auto: true },
      ],
    });
    
    export { expect };
    

    Con ese YAML adjunto en el reporte, el prompt del agente deja de ser "arregla este test" y pasa a ser una comparación: esperaba un button con nombre "Pagar pedido"; en el árbol real hay un button con nombre "Confirmar pedido" en la misma posición. Eso ya no es adivinar. Es diffear dos estructuras.

    Y si el elemento no aparece en el árbol bajo ningún nombre, el agente tiene que saber que eso significa algo completamente distinto.

    El triaje de un test E2E autoreparable: tres fallos distintos

    Esta es la sección que sostiene todo lo demás. Un agente que no separa estos tres casos te borra la señal de la suite entera.

    Tipo de fallo Evidencia que lo identifica Qué puede hacer el agente
    A. El DOM cambió, el test no El elemento existe en el árbol con otro nombre, rol o posición. El commit sospechoso toca marcado o estilos. Fallan varios tests que comparten componente. Proponer el parche del locator en un PR. Es el único caso reparable.
    B. El comportamiento cambió a propósito El elemento ya no existe porque el flujo cambió: un paso nuevo, otra ruta, un campo eliminado. El commit toca lógica, no marcado. El fallo encaja con una feature reciente. Nada. Abre un issue con el diagnóstico y etiqueta al dueño de la feature. Actualizar ese test es una decisión de producto.
    C. La aplicación está rota El locator es correcto y el elemento está ahí, pero la acción falla, el estado final es otro o hay 500 en la traza de red. Suele caer un solo flujo crítico. Prohibido tocar el test. Escalar con la traza adjunta. El test está haciendo su trabajo.

    Las tres preguntas que resuelven casi todos los casos:

    ¿El commit tocó marcado o lógica? Un cambio en plantillas y estilos apunta a A. Un cambio en servicios, rutas o estado apunta a B o C.

    ¿Falla un test o fallan veinte? Veinte tests que comparten componente es A casi seguro. Uno solo, en el flujo de pago, con el resto en verde, es C hasta que se demuestre lo contrario.

    ¿El elemento existe con otro nombre o no existe? Existe con otro nombre → A. No aparece en el árbol → B o C, y el agente no decide cuál.

    Fíjate en que ninguna de las tres se responde mirando el test. Se responden cruzando la traza con el diff del commit. Por eso el agente necesita acceso al repositorio, y solo de lectura.

    El agente abre un PR. No commitea.

    El flujo que uso es aburrido, y por eso funciona.

    El job nocturno corre la suite. Si hay rojos, un segundo job lanza el agente con tres entradas: el reporte HTML con sus adjuntos, la traza de cada fallo y el diff de los commits desde el último run verde. Relanzar solo lo caído con npx playwright test --last-failed ahorra minutos de CI.

    El agente no ejecuta el navegador. Lee artefactos. Eso elimina de golpe toda la clase de problemas que aparecen cuando pones a un agente a conducir el navegador en vivo: esperas mal calculadas, referencias caducadas, estado que se le escapa.

    Su salida es una pull request con cuatro cosas: diagnóstico en prosa, clasificación A/B/C con la evidencia que la justifica, el diff del locator y la traza enlazada.

    Y una regla que no se negocia: un locator por test, un test por commit dentro del PR. Si el parche necesita tocar tres líneas para que pase, no es un parche de localización: es un cambio de comportamiento disfrazado. Se rechaza.

    Un humano mergea. Siempre.

    Esa puerta es el mismo mecanismo que describo en la revisión por contrato del código que genera la IA: el agente no gana el derecho a escribir en main por haber acertado ochenta veces seguidas. Si quieres el método entero, con las cláusulas y los límites escritos, está en el ebook gratuito de Revisión por Contrato.

    Los guardarraíles que impiden que la suite se convierta en teatro

    Tres guardarraíles bastan para que un agente de reparación no degrade la suite: que no toque asserts, un tope de cinco tests parcheados por PR y una métrica de bugs escapados a producción. Con eso vas servido.

    El agente no toca asserts. Solo locators y esperas. Un expect(...).toBeVisible() que muta a toBeHidden(), un toContainText con otro importe, un assert borrado: eso es cambiar la definición de correcto, y no es su trabajo. Lo hago cumplir con un check en CI que rechaza el PR si el diff cambia el matcher (toBeVisible, toContainText…) o el valor esperado. El locator que vive dentro de un expect(...) sí se puede tocar; la afirmación sobre qué es correcto, no.

    Tope de tests reparados por PR. Cinco. Si el agente quiere arreglar cuarenta, no ha encontrado cuarenta fallos de localización: ha encontrado un cambio estructural que necesita a una persona pensando diez minutos.

    La métrica que delata el desastre. Cuenta dos números cada mes: locators parcheados por el agente y bugs escapados a producción en flujos que la suite cubre. Si el primero sube y el segundo también, el agente no está manteniendo la suite. La está silenciando.

    Ese segundo número no sale de los tests. Sale de tener observabilidad de verdad, más allá del code review. Sin él pilotas a ciegas con un copiloto que te asegura que todo va bien.

    Un apunte de coste: los fallos de tipo B —comportamiento que cambió a propósito— se detectan mucho más barato una capa por debajo, en tests de componente. Si trabajas con Angular, ese nivel es el que cubro en el curso de Testing en Angular. Cuanto mejor sea tu capa de componente, menos ruido le llega al agente arriba.

    Qué hacer el lunes

    No montes el agente. Todavía no.

    Coge los diez tests que más han cambiado en los últimos tres meses según git log. Son tus diez tests más frágiles. Reescribe sus locators con getByRole y getByLabel, y activa trace: 'on-first-retry' en la config.

    Eso es una tarde. Y probablemente te baje el ruido más que cualquier agente.

    La semana siguiente, cuando algo se ponga rojo, abre la traza y clasifícalo a mano: A, B o C. Hazlo diez veces. Lo que aprendas en esas diez clasificaciones es literalmente el prompt del agente —y no lo puedes escribir antes de haberlo hecho tú.

    Cuando llegue el momento de montarlo, el patrón de agente que produce artefactos revisables en lugar de commits directos es el que enseño en Construye con IA, de la idea al producto con Claude Code.

    Y quédate con esto: el objetivo nunca fue tener la suite en verde. Era saber cuándo dejar de confiar en ella.

    Preguntas frecuentes

    ¿Qué es un test E2E autoreparable exactamente?

    Es un test que, al fallar, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con la evidencia adjunta. La palabra "autoreparable" describe el diagnóstico automático, no la escritura automática en la rama principal. Si el agente puede modificar el test hasta que pase sin que nadie lo apruebe, lo que tienes no es una suite que se cura sola: es una suite que ha dejado de informarte.

    ¿Por qué no dejar que el agente commitee el arreglo directamente si acierta casi siempre?

    Porque el coste del error no es simétrico. Cien parches correctos te ahorran unos minutos cada uno. Un solo parche incorrecto sobre un fallo de tipo C —la aplicación rota— borra la única señal que tenías de un bug en producción, y encima deja el CI en verde. Cuando ese bug aparezca, tu primer instinto será descartar el área que cubren los tests, precisamente porque estaban pasando.

    ¿Cómo distingue el agente entre un cambio de DOM y una regresión real?

    Cruzando tres evidencias: si el elemento sigue existiendo en el árbol de accesibilidad bajo otro nombre o rol, si el commit sospechoso tocó marcado o lógica, y si el fallo está aislado o afecta a varios tests que comparten componente. Elemento presente con otro nombre, más commit de marcado, más fallo en grupo, apunta a cambio de DOM. Elemento presente, locator correcto y acción que falla apunta a regresión, y ahí el agente no toca nada.

    ¿Sirve esto para tests flaky por timing y no por locators?

    Parcialmente. La traza deja ver si el fallo fue una espera insuficiente o una condición de carrera, y el agente puede proponer sustituir una espera fija por una aserción con reintento automático, que es la forma correcta de esperar en Playwright. Pero el flaky por datos compartidos entre tests o por estado sucio del entorno no se arregla en el test: se arregla aislando los datos de cada ejecución, y eso es trabajo de arquitectura, no de parche.

    ¿Cuánto cuesta esto en tokens si la suite es grande?

    Depende de qué le pases, y ahí está el truco. Si le mandas el DOM crudo de cada fallo, el coste se dispara y además el diagnóstico empeora por el ruido. Pasándole solo el árbol de accesibilidad recortado, la URL y el diff de los commits relevantes, el contexto por fallo se queda en unos pocos miles de tokens. El tope de cinco tests por PR funciona también como tope de gasto.

    ¿Puedo aplicar el mismo triaje sin agente, a mano?

    Sí, y deberías empezar por ahí. La tabla de A/B/C es una herramienta de proceso antes que de IA: obliga al equipo a justificar por escrito por qué un test rojo se convierte en verde. He visto equipos bajar el ruido de su suite a la mitad solo con esa regla y cero automatización. El agente acelera un criterio que ya funciona; no lo inventa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Hooks vs permissions en Claude Code: dónde va el guardrail

    Hooks vs permissions en Claude Code: dónde va el guardrail

    Abrí mi propio .claude/settings.local.json mientras preparaba este post. Buscaba un ejemplo bonito de hooks vs permissions en Claude Code para ilustrar la diferencia. Encontré otra cosa.

    364 reglas allow. Cero reglas deny. Cero ask. Y "defaultMode": "bypassPermissions".

    La primera regla de la lista es Bash(*).

    Bash(*) equivale a Bash: matchea todos los comandos. Las otras 185 reglas de Bash de la lista ya no afinan nada, porque no queda nada que afinar. Y las 178 restantes —WebFetch, PowerShell, Skill— tampoco protegen: una regla allow nunca dice que no, solo evita que te pregunten. Con bypassPermissions puesto, ni eso: no iba a preguntar de todas formas. Una allowlist de 364 líneas que no le dice que no a nada.

    Lo mejor viene ahora. En el .claude/settings.json versionado del mismo repositorio sí hay dos hooks PreToolUse, con matchers Bash y Read|Glob. Funcionan perfectamente. Son hooks de guía y observabilidad — le dicen a Claude por dónde buscar antes de lanzarse a hacer grep por todo el repo — no de seguridad.

    Capa de hooks montada. Capa de permisos abierta de par en par.

    Hace poco escribí, en el post donde probé la blocklist típica y pasaron 16 de 20 comandos destructivos, esta frase exacta: "Revisa el tuyo con una pregunta concreta: ¿hay alguna regla comodín tipo Bash(*) que anule a todas las demás? Si la hay, tu allowlist es decorativa."


    Hooks vs permissions: las dos capas, y cuál manda

    Claude Code tiene dos sitios donde puedes decir "esto no".

    El sistema de permisos: configuración declarativa con reglas allow, deny y ask. Los hooks: scripts tuyos que se ejecutan antes de la llamada a la herramienta y pueden bloquearla. Las dos son piezas del agent harness, esa capa que rodea al modelo y decide qué puede tocar de verdad.

    El sistema de permisos de Claude Code es configuración declarativa —reglas allow, deny y ask en settings.json— que se evalúa antes de ejecutar la herramienta. Un hook PreToolUse es un script tuyo que Claude Code ejecuta antes de la llamada y que puede bloquearla saliendo con código 2. La diferencia que decide dónde va tu guardrail: los permisos no pueden fallar, el hook sí.

    Casi todo el que se preocupa por la seguridad monta un hook. Es lo divertido: escribes código, haces pattern matching, devuelves exit 2 y te sientes ingeniero de seguridad. Si nunca has montado uno, empieza por Claude Code hooks: guardrails, logging y automatización para tus agentes, el tutorial del cómo.

    Este post va del dónde. Y el dónde importa porque las dos capas no tienen la misma autoridad.

    Un hook solo puede restringir, nunca ampliar

    Un hook PreToolUse es una válvula de un solo sentido. Cierra, no abre.

    La documentación de permisos de Claude Code no deja margen a interpretación. Traduzco las dos frases que lo zanjan:

    "Las decisiones de un hook no saltan las reglas de permisos. Claude Code evalúa las reglas deny y ask sea cual sea lo que devuelva un hook PreToolUse: una regla deny que coincida bloquea la llamada, y una regla ask que coincida sigue preguntando incluso cuando el hook ha devuelto allow o ask."

    "Un hook que bloquea también tiene precedencia sobre las reglas allow. Un hook que sale con código 2 detiene la llamada antes de que se evalúen las reglas de permisos, así que el bloqueo se aplica incluso cuando una regla allow habría dejado pasar la llamada."

    Puede vetar lo que tus permisos habrían permitido. No puede rescatar lo que ya han denegado. Si diseñas la seguridad pensando que el hook es "el sitio donde yo decido", la estás montando sobre la capa con menos autoridad.

    La propia documentación sugiere el patrón combinado: para ejecutar todos los comandos Bash sin prompts salvo unos pocos, pon "Bash" en allow y registra un hook PreToolUse que rechace esos concretos. Es un patrón legítimo. Fíjate en para qué lo propone: ergonomía. No suelo de seguridad.

    El hook falla abierto. La regla deny no puede fallar.

    Un hook es un proceso. Y a los procesos les pasan cosas. Esto es lo que ocurre según cómo termine:

    Esto es lo que dice la documentación de hooks según cómo termine el proceso:

    • exit 2 → bloquea. Imprima JSON o no; ni un permissionDecision de allow puede anularlo. El mensaje de bloqueo es la razón del JSON si la hay, y si no, el stderr.
    • exit 0 con JSON válido → manda la decisión del JSON y el exit code se ignora.
    • Cualquier otro exit code, un script que no existe, JSON inválido o un timeout → error no bloqueante. En palabras de la doc: "the action proceeds". La llamada continúa por el flujo normal de permisos y en el transcript aparece un aviso <hook name> hook error.

    Lee otra vez la tercera.

    El día que renombras el script, cambias de máquina, se te cuela una coma en el JSON o el proceso se pasa del timeout, tu "guardrail de seguridad" deja pasar el comando. No para el mundo: escribe un aviso y sigue.

    Incluida la salida 1, la de fallo de toda la vida en Unix: si tu hook revienta con exit 1, el comando pasa.

    En PreToolUse el timeout por defecto es de 600 s. Y todos los hooks que matchean corren en paralelo, así que tampoco hay un orden de ejecución en el que apoyarte.

    Una regla deny no tiene ninguna de esas formas de fallar: no hay proceso, ni exit code, ni ruta a un binario que pueda cambiar. Es configuración que se evalúa antes de ejecutar nada. Si una herramienta está denegada en cualquier nivel, ningún otro nivel puede permitirla — ni --allowedTools en la línea de comandos.

    Falla cerrado por construcción. Por eso el suelo va ahí.

    El sistema de permisos entiende de shell. Tu grep no.

    Cuando escribes un hook con grep haces pattern matching sobre un string. Claude Code no: parsea el comando.

    Los separadores que reconoce son &&, ||, ;, |, |&, & y los saltos de línea. Cada subcomando debe coincidir por separado. Y las reglas deny y ask matchean más allá de una asignación de variable de entorno.

    Dos comandos y las dos capas, lado a lado:

    safe-cmd && rm -rf /
    FOO=bar rm -rf tmp/
    
    Comando Hook con grep Regla de permisos
    safe-cmd && rm -rf / [[ "$cmd" == safe-cmd* ]] → pasa: el string empieza por safe-cmd Bash(safe-cmd *) no da permiso: cada subcomando se matchea por separado
    FOO=bar rm -rf tmp/ grep -E '^rm ' → no matchea: el comando empieza por FOO Bash(rm *) en deny sí coincide: matchea pasada la asignación

    Dos comandos. Dos fallos del hook ingenuo. Cero de las reglas.

    Y hay más parseo que no vas a reimplementar bien. Antes de matchear se despojan los wrappers conocidos: timeout, time, nice, nohup, stdbuf, los builtins command y builtin, y el noglob de zsh. Por eso Bash(npm test *) también cubre timeout 30 npm test.

    Claude Code hasta rechaza tus patrones frágiles por ti: una regla como Bash(command:rm *) sería esquivable con un comando compuesto, así que la ignora y emite un warning al arrancar. Lo correcto es Bash(rm *).

    Los agujeros que sí existen

    Los permisos no son magia. Hay tres sitios donde te toca poner de tu parte.

    Los runners de entorno no están en la lista de wrappers que se despojan: direnv exec, devbox run, mise exec, npx, docker exec. Ejecutan sus argumentos como comando, así que Bash(devbox run *) cubre también devbox run rm -rf .. La regla correcta lleva runner + comando interno, Bash(devbox run npm test), una por cada uno. Tedioso y correcto.

    Los patrones sobre argumentos son frágiles: Bash(curl http://github.com/ *) no cubre las variaciones. Deniega curl y wget y usa WebFetch con WebFetch(domain:github.com).

    Las redirecciones se comprueban como escritura de archivo: el destino de >, >> y 2> se valida contra tus reglas Edit. Bash(git commit *) permite el comando, no el destino. /dev/null no se comprueba.

    Nada de esto lo arregla un hook. Enumerar strings peligrosos es el diseño equivocado, lo escribas en un middleware o en un PreToolUse.

    La sintaxis que casi nadie escribe bien

    Regla Qué matchea
    Bash(npm run build) exactamente npm run build
    Bash(npm run *) npm run build, npm run test --watch, y el escueto npm run
    Bash(ls *) ls -la y ls — pero no lsof
    Bash(ls*) ls -la y lsof
    Read(./.env) leer el .env del directorio actual
    Read(./secrets/**) glob estilo gitignore
    WebFetch(domain:example.com) peticiones a ese dominio

    El espacio antes del * es toda la diferencia entre ls y lsof. El sufijo :* equivale al wildcard final — Bash(ls:*) ≡ Bash(ls *) — pero solo se reconoce al final del patrón: en Bash(git:* push) los dos puntos son un carácter literal.

    Y el * va después del subcomando. Bash(git log *) permite solo git log; Bash(git *) permite todo git. Claude Code te avisa al arrancar si lo escribes antes.

    Queda la precedencia, que mucha gente asume al revés: se evalúa deny, luego ask, luego allow. La primera coincidencia en ese orden decide, y la especificidad de la regla no altera el orden. Una deny amplia como Bash(aws *) bloquea todo lo que coincida, incluida una allow más estrecha como Bash(aws s3 ls).

    Dicho de otra forma: una regla deny no admite excepciones de allowlist. Si necesitas una excepción, no la pongas en deny.

    Hooks vs permissions en Claude Code: qué va en cada capa

    permissions Hooks PreToolUse
    Naturaleza Configuración declarativa Proceso que ejecutas
    Modo de fallo No puede fallar: no hay nada que ejecutar Falla abierto: error, timeout o JSON inválido → la acción continúa
    Autoridad deny es absoluto en todos los niveles Solo restringe; nunca amplía
    Entiende shell Sí: separadores, wrappers, asignaciones, redirecciones Solo lo que tú programes
    Superficie Toda herramienta con regla Solo lo que cubra tu matcher
    Para qué sirve Suelo de seguridad, lo irreversible, secretos Contexto, logging, reescritura, reglas que dependen del estado del proyecto
    Ejemplo Bash(rm *), Read(./.env) Registrar cada comando, avisar si el working tree está sucio, guiar la búsqueda

    El JSON que deberías tener

    {
      "permissions": {
        "defaultMode": "default",
        "deny": [
          "Bash(rm *)",
          "Bash(curl *)",
          "Bash(wget *)",
          "Read(./.env)",
          "Read(./.env.*)",
          "Read(./secrets/**)"
        ],
        "ask": [
          "Bash(git push *)",
          "Bash(docker *)",
          "Bash(npm publish *)"
        ],
        "allow": [
          "Bash(npm run build)",
          "Bash(npm test *)",
          "Bash(git status)",
          "Bash(git log *)",
          "Bash(ls *)",
          "WebFetch(domain:github.com)"
        ],
        "disableBypassPermissionsMode": "disable"
      }
    }
    

    Bash(rm *) en deny cubre FOO=bar rm -rf tmp/ sin que hagas nada. Bash(npm test *) en allow cubre timeout 30 npm test gracias al despojado de wrappers. Y deny bloquea aunque más abajo haya una allow que coincida: no hay forma de escribir la excepción, y esa es justo la propiedad que querías.

    Este es el tipo de decisión que trabajo en el curso Construye con IA: de la idea al producto con Claude Code: antes de darle capacidades a un agente, dejar por escrito qué no puede hacer.

    Entonces, ¿para qué el hook?

    Para lo que los permisos no saben expresar. Contexto: la hora, la rama, si el working tree está sucio. Observabilidad: registrar cada llamada. Guía: decirle por dónde buscar antes de que haga grep por todo el repo, que es lo que hacen los dos hooks de mi repo. Reescritura y guía de comandos. Decisiones que dependen del estado del proyecto, no del string del comando.

    Con un límite que conviene tener delante. En PreToolUse el matcher se compara contra el nombre de la herramienta. "*", "" u omitido matchean todo. Si solo contiene letras, dígitos, _, -, espacios, , y |, es un string exacto o una lista: Bash, Edit|Write. Cualquier otro carácter lo convierte en una expresión regular de JavaScript sin anclar: ^Bash.

    Consecuencia práctica: un matcher "Bash" no cubre PowerShell, ni Write, ni Edit, ni las herramientas MCP (mcp__servidor__tool). Si tu guardrail vive solo ahí, toda esa superficie está descubierta y no te vas a enterar.

    Qué hacer hoy

    Abre tu .claude/settings.local.json y cuenta las reglas deny. Si el número es cero, ya tienes plan para esta tarde.

    Escribe cinco. Solo cinco, y que sean lo irreversible: los secretos y el borrado.

    1. Read(./.env) — que no lea tus claves.
    2. Read(./secrets/**) — ni el resto de secretos.
    3. Bash(rm *) — el borrado, que además cubre FOO=bar rm -rf tmp/.
    4. Bash(curl *) — la exfiltración por red.
    5. Bash(wget *) — la otra mitad de lo mismo.

    Luego quita bypassPermissions y ponle "disableBypassPermissionsMode": "disable". Y si trabajas con equipo, todo eso va en managed settings: la precedencia más alta, no lo anula ningún otro nivel ni los argumentos de línea de comandos.

    Un último detalle que resume el post. Poner disableAllHooks solo en tus settings de usuario no basta: los settings de proyecto del repositorio tienen precedencia sobre los tuyos y pueden volverlo a false. Ni siquiera desactivar los hooks se decide desde donde viven los hooks.

    La autoridad está en la configuración. Tu script es la capa de encima.

    Mi settings.local.json ya tiene reglas deny. Tardé cuatro minutos. Llevaba meses con Bash(*) en la primera línea y un hook precioso que no protegía absolutamente nada.

    Si quieres ver esta capa montada en proyectos reales, con los settings completos y los hooks que sí aportan, lo trabajamos dentro de Dominicode Labs.

    Comportamiento verificado contra la documentación oficial de Claude Code en septiembre de 2026.


    Preguntas frecuentes

    ¿Puedo usar un hook para permitir algo que una regla deny bloquea?

    No. Claude Code evalúa las reglas deny y ask sea cual sea lo que devuelva el hook. Una regla deny que coincida bloquea la llamada aunque el hook haya devuelto allow, y una regla ask sigue preguntando igual.

    Al revés sí funciona: un hook que sale con exit 2 detiene la llamada antes de que se evalúen los permisos, así que bloquea aunque una regla allow la hubiera dejado pasar. El hook solo restringe.

    ¿Qué pasa si mi hook de seguridad falla o el script no existe?

    El comando se ejecuta. Cualquier exit code que no sea 0 o 2, un script inexistente, un JSON inválido o un timeout se tratan como error no bloqueante: la acción continúa por el flujo normal de permisos y en el transcript aparece un aviso <hook name> hook error.

    Por eso un hook no es un buen suelo de seguridad. Una regla deny es configuración, no hay proceso que pueda reventar.

    ¿Basta con poner Bash en deny para bloquear todos los comandos?

    Sí, y hace algo más de lo que esperas. Bash(*) es equivalente a Bash y matchea todos los comandos. Como regla deny, ambas formas eliminan la herramienta del contexto de Claude: el modelo ni siquiera la ve.

    Lo que no puedes es denegar Bash entero y luego abrir excepciones con reglas allow más estrechas. Una regla deny no admite excepciones de allowlist.

    ¿Por qué mi regla Bash(ls *) no permite lsof?

    Porque el espacio antes del asterisco forma parte del patrón. Bash(ls *) matchea ls -la y el escueto ls, pero no lsof. Si quieres cubrir los dos, la regla es Bash(ls*), sin espacio.

    Mismo cuidado con el subcomando: el * va después. Bash(git log *) permite solo git log; Bash(git *) te abre todo git.

    ¿Cómo evito que alguien active bypassPermissions en mi equipo?

    Con permissions.disableBypassPermissionsMode a "disable", y su equivalente permissions.disableAutoMode para el modo auto. En tus settings de usuario ya sirven, pero puestos en managed settings son inanulables: ese nivel tiene la precedencia más alta y no lo tumba ningún otro, ni los argumentos de línea de comandos.

    ¿Dónde pongo las reglas: settings.json o settings.local.json?

    .claude/settings.json se versiona y lo comparte todo el equipo. .claude/settings.local.json es tuyo y solo tuyo: Claude Code lo añade a tus git excludes la primera vez que lo escribe, así que no se sube. Si lo creaste tú a mano, añádelo al .gitignore.

    La precedencia va de mayor a menor: managed settings, argumentos de línea de comandos, settings.local.json del proyecto, settings.json del proyecto y ~/.claude/settings.json de usuario. Con una salvedad que ya conoces: si algo está denegado en cualquiera de esos niveles, ningún otro puede permitirlo.

    Así que el suelo compartido va en el settings.json versionado, donde lo hereda todo el equipo. Tus atajos personales, en el local.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Revisar código generado por IA: el método Revisión por Contrato

    Revisar código generado por IA: el método Revisión por Contrato

    Una noche estuve casi dos horas revisando una pull request.

    No la escribí yo. La escribió el agente, en dos minutos.

    Y ahí me quedé, con el diff abierto a las tantas, leyendo línea por línea un código que no había escrito, buscando el fallo que sabía que estaba en alguna parte.

    Dos minutos de generación. Ciento diez de revisión.

    Revisar código generado por IA se había comido entero el tiempo que la IA me iba a ahorrar.

    Nos vendieron que la IA nos iba a quitar trabajo, y es verdad a medias, que es la peor forma de ser verdad. Te quitó el trabajo de escribir. Te dio el trabajo de auditar.

    Antes escribías cuatrocientas líneas en dos horas. Ahora las lees en dos horas.

    Por qué revisar código generado por IA cansa más que escribirlo

    Revisar código generado por IA cansa más que escribirlo porque no sigues un razonamiento: verificas cuatrocientas afirmaciones independientes, una a una, sin ningún hilo que las sostenga.

    Cuando escribes esas cuatrocientas líneas, el modelo mental se construye contigo. Entender es un subproducto gratis de haberlas escrito.

    Cuando las revisas, tienes que reconstruir ese modelo desde fuera, deduciendo la intención a partir del resultado. Y ahí está el detalle:

    Del otro lado no había ningún modelo mental.

    Tu compañero, cuando escribió aquella función rara, tenía un motivo. Malo o bueno, pero un motivo, y podías preguntárselo. El agente produjo el token más probable dadas las circunstancias. Estás reconstruyendo una intención que nunca existió.

    Por eso cansa distinto, y por eso no mejora con la práctica: no hay nada que aprender, solo cuatrocientas comprobaciones que hacer.

    Y lo peor no es el tiempo. Es que nunca sabes del todo si se te ha colado algo, porque en la línea 230 aflojaste y lo sabes. O lo lees entero con la misma atención en la 400 que en la 12, o lo mergeas con el nudo en el estómago. No hay tercera.

    Y ya sabes cuál de las dos gana casi siempre: en cinco proyectos de gran escala, el 64,7% de las pull requests se aprueba sin un solo comentario.

    El problema no era el agente

    Yo estuve meses culpando al modelo. Cambié de herramienta tres veces y escribí prompts cada vez más largos, con más reglas, más ejemplos y más mayúsculas.

    Mejoraba un poco. Nunca lo suficiente.

    Hasta que caí en lo que estaba delante desde el principio: el problema no era el agente, era que yo era la única verificación del sistema. Entre el código generado y producción no había nada más que mis ojos cansados.

    Eso no lo arregla un modelo mejor. Un modelo mejor te da código correcto más a menudo, pero no cambia quién tiene que comprobarlo.

    De hecho, cada mejora en la velocidad de generación empeora tu situación. Si el agente pasa de cuatrocientas líneas a ochocientas en el mismo rato, tú no has ganado nada: has doblado la cola de revisión. La única parte del proceso que no escala eres tú, y todo el mundo está optimizando las otras.

    Por qué tu spec no lo arregló

    Aquí es donde la mayoría me dice que ya probó lo de escribir specs y lo dejó.

    Yo también. Y no es que las specs sean inútiles: es que escribiste la spec para el agente, no para la verificación.

    Mira tus criterios de aceptación de la última vez. “El endpoint debe ser rápido.” “Maneja bien los errores.” “No rompas nada.” Frases que ninguna máquina puede rechazar. Una spec que nadie comprueba es documentación, y la documentación no ha frenado un bug en la historia de esta profesión.

    Un contrato es una especificación contra la que algo puede fallar. Fallar de verdad: salir con código distinto de cero, poner el CI en rojo, parar la cosa antes de que llegue a ti.

    Es la misma diferencia que ya conoces entre un README que dice “recuerda formatear antes de commitear” y un hook que no te deja commitear sin formatear. Los dos expresan la misma norma. Uno confía en que alguien se acuerde.

    Tu spec era un README muy bien escrito. Lo que necesitas es el hook.

    Así que coge cualquier línea de cualquier spec tuya y pregúntate esto:

    ¿Puedo escribir algo que compruebe esto sin mí?

    Si la respuesta es sí, tienes una cláusula. Si es no, tienes una intención. Las intenciones no se tiran —orientan al agente y algo aportan—, pero no cuentan: no van a rechazar nada y no puedes apoyarte en ellas para dejar de leer el diff entero.

    Cuando pasas tu spec entera por esa pregunta suele salir algo incómodo: de veinte líneas, diecisiete eran intenciones.

    Si al hacer el recuento te sale un número parecido, el problema no es que escribas mal specs: son los siete fallos típicos que hacen que una spec no aguante delante de un agente, y casi todos se arreglan con la misma pregunta.

    Ahí está tu tiempo de revisión. Y convertir esas diecisiete es lo que llamo Revisión por Contrato: tres piezas en un orden que importa.

    La Revisión por Contrato es un método para revisar código generado por IA sin leer el diff entero. Consta de tres piezas: conviertes las intenciones de tu spec en cláusulas que una máquina puede rechazar (contrato), declaras por escrito dónde el agente no puede escribir (carril) y dejas que un conjunto de comandos ejecutables emita el resultado (veredicto). Lo que tú revisas después es el veredicto y el contrato, no las cuatrocientas líneas.

    1. Contrato: qué se construye

    La conversión desde tu spec actual es bastante mecánica:

    Spec (describe) Contrato (se puede incumplir)
    “El endpoint debe ser rápido” p95 < 200 ms en el test de carga del CI
    “Maneja bien los errores” Todo path de error devuelve un tipo del enum AppError
    “No rompas nada” La suite existente pasa sin cambios en sus asserts
    “Sigue las convenciones” lint y typecheck en verde, sin excepciones nuevas

    Hay dos contratos, y confundirlos es el error más común. El AGENTS.md es el contrato permanente del repositorio: lo que es cierto para cualquier tarea que se haga aquí. La spec es el contrato de esta tarea concreta, nace con el issue y muere con la pull request. Si metes lo de la tarea en el AGENTS.md, envejece fatal y en dos meses nadie se fía de lo que dice.

    Para la parte de la tarea tengo publicada la skill que uso yo, sdd-creator: obliga al agente a escribir spec.md, plan.md y tasks.md antes de tocar código, y funciona igual en Claude Code, Codex, Cursor o Gemini.

    Aquí vamos con el AGENTS.md, que es el que más rinde por línea escrita. Esta es la primera mitad:

    # AGENTS.md
    
    API de facturación interna. Emite y consulta facturas para el equipo de
    operaciones. No es público: todo el tráfico entra por el gateway.
    
    ## Stack
    
    - **Lenguaje:** TypeScript 7, Node 24 LTS
    - **Framework:** Fastify 5
    - **Gestor de paquetes:** pnpm — derivado de `pnpm-lock.yaml`. No uses otro.
    
    ## Convenciones
    
    - Los handlers no hablan con Prisma. Pasan por un servicio en `src/services/`.
    - Todo error de dominio es un `AppError`. No se lanzan strings ni `Error` pelado.
    - Los tests van junto al fichero que prueban, como `*.test.ts`.
    
    ## Definición de terminado
    
    Una tarea está terminada cuando:
    
    1. El bucle corto pasa en verde.
    2. El bucle largo pasa en verde.
    3. Cada criterio de aceptación de la spec tiene evidencia: qué comando lo
       demuestra y cuál fue su salida.
    4. El diff no contiene nada que la spec no pidiera.
    

    Las convenciones no las inventes: ábrete tres ficheros del repo y escribe lo que ya se hace. Una convención impuesta desde fuera que el código existente incumple es la peor línea que puedes meter ahí, porque el agente la seguirá y su código no se parecerá a nada de lo que hay alrededor.

    Y el punto 4 merece párrafo propio, porque es el que casi nadie escribe y el que más caro sale.

    Le pides al agente que arregle un bug del IVA. Arregla el bug. Y de paso renombra dos variables, extrae un helper, actualiza un comentario y reordena los imports de tres ficheros. Puede que hasta sean mejoras, pero ninguna de esas líneas está cubierta por ningún contrato: nadie las pidió, nadie definió cuándo estarían bien, y ahora están en tu diff obligándote a leerlas.

    Código de más es código sin contrato. Esa línea sola recorta el diff medio de una forma que se nota la primera semana.

    2. Carril: por dónde no puede salirse

    Piensa en la última vez que un agente te dejó algo raro. Ajustó el assert de un test que fallaba. Añadió una dependencia entera para no escribir tres líneas. Metió un as any. Marcó un test lento como skip. Tocó un fichero de despliegue.

    Ninguno de esos es un fallo de razonamiento. En todos entendió perfectamente lo que le pediste.

    La mayoría de los desastres que te va a dar un agente no son de lógica. Son de alcance.

    No hace trampas: hace lo que le pediste por el camino más corto que encontró. Le pediste que los tests pasaran. No le pediste que el código funcionara. Casi siempre coinciden, por eso vivimos tranquilos. Cuando dejan de coincidir, el camino corto es tocar el test.

    Y de aquí sale lo que de verdad importa:

    Si el agente puede modificar la cosa que lo comprueba, no tienes verificación. Tienes teatro.

    Los tests, el linter, el CI — todo eso son ficheros del repositorio, dentro de su radio de acción. Salvo que digas lo contrario, el que recibe el veredicto tiene permiso de escritura sobre quien lo emite. Ningún juzgado funcionaría así.

    ## Límites
    
    Sin permiso explícito, el agente no toca:
    
    - `prisma/migrations/` ni el esquema. Una migración se revisa a mano, siempre.
    - `.github/workflows/`, `Dockerfile` ni nada de despliegue.
    - `package.json`: no se añaden ni se actualizan dependencias. Si hace falta
      una, para y pregunta.
    - `.env`, `.env.*` ni ningún fichero con credenciales.
    - Los asserts de los tests que ya existen. Añadir tests nuevos, sí. Cambiar
      los que ya estaban, no.
    - `src/lib/money.ts`. Es aritmética de céntimos y ya nos ha mordido dos veces.
    

    El “para y pregunta” es una salida y hace falta: un límite sin salida se convierte en un agente bloqueado o, peor, en un agente que se lo salta.

    La línea de los asserts es la que protege al verificador. No prohíbe tocar los tests: prohíbe cambiar los que ya estaban. Añadir cobertura nueva puede y debe; aflojar la existente para que su trabajo pase, no.

    Y la última línea es la que hace creíbles a todas las demás. money.ts no está ahí por una regla general, sino porque ese fichero ya mordió dos veces. Las cuatro primeras las copias de cualquier plantilla; esa la escribes tú. Tu repo tiene dos o tres. Ya sabes cuáles son.

    Ahí está el cambio de postura que ordena todo lo demás: dejas de pedirle al agente que se porte bien y montas un sitio donde portarse mal se detecta solo. Un prompt es una petición y depende de que el modelo esté teniendo un buen día. Un límite es una propiedad del sitio donde trabaja.

    Eso sí, sé honesto con lo que es un fichero markdown: una señal, no una valla. Los límites de verdad viven en tres capas — declarado (el AGENTS.md), impedido (permisos y hooks que rechazan escrituras fuera del alcance) y detectado (CI y protección de rama). La primera cuesta diez minutos y quita la inmensa mayoría de las desviaciones. Si alguien te vende que un markdown le pone puertas a un proceso con acceso de escritura a tu disco, desconfía.

    3. Veredicto: quién dice que está bien

    Un veredicto no es una opinión. Una opinión es lo que da un linter cuando sugiere, o lo que das tú a las once de la noche cuando dices “bueno, tiene buena pinta”.

    Un veredicto es un proceso que termina en dos estados y ninguno más. No admite matices y no cambia según lo cansado que estés.

    Y no lo emite una cosa. Lo emiten cinco:

    Capa Pregunta que responde
    Build ¿Esto compila?
    Tipos ¿Las piezas encajan entre sí?
    Lint ¿Se parece al resto del código de esta casa?
    Tests ¿El comportamiento sigue siendo el que era?
    Criterios de aceptación ¿Hace lo que la spec pidió?

    Las cuatro primeras ya las tienes: están en tu repo desde antes de que existieran los agentes. La quinta es la que casi nadie tiene, y es la que convierte un montón de comandos sueltos en un harness, porque conecta el contrato con algo que se ejecuta.

    Un aviso sobre la palabra “harness”, que se usa para dos cosas distintas: aquí es el conjunto de comandos que verifica el código que tu agente escribe. Si lo que quieres es probar el agente en sí —tools falsas, presupuesto de tokens, trazas reproducibles en CI—, eso es otro montaje y lo explico en el test harness para agentes de IA.

    Esa quinta capa es la que tengo automatizada en ai-workflow-kit —v2.5.0 en npm a septiembre de 2026—, que se instala con npx ai-workflow-kit. El plan de la tarea lleva una casilla por paso, y cada casilla lleva detrás el comando que la demuestra: verify la marca solo cuando ese comando sale con código cero. Lo que queda escrito en el fichero es lo que se demostró, no lo que el agente dijo que había hecho.

    El harness tiene dos velocidades, y esa decisión que parece técnica es la que decide si el sistema se usa o se abandona. El bucle corto lo ejecuta el agente después de cada cambio y tiene que bajar de sesenta segundos; si tarda más, hace tandas más largas entre comprobaciones y cuando algo falla ya no sabes cuál de los quince cambios lo rompió. El bucle largo se ejecuta una vez, antes de abrir la PR.

    Y no, no puedes meterlo todo en el corto por si acaso. Un bucle corto de ocho minutos no es exhaustivo: es un bucle que nadie ejecuta. Los sesenta segundos son el umbral por debajo del cual la gente no busca la forma de esquivarlo.

    ## Verificación
    
    Estos comandos están ejecutados y comprobados. Son el harness: si uno falla,
    el trabajo no está hecho.
    
    ### Bucle corto — después de cada cambio
    
        pnpm typecheck      # 4s
        pnpm lint           # 6s
        pnpm test:unit      # 18s
    
    ### Bucle largo — antes de abrir la PR
    
        pnpm build          # 40s
        pnpm test           # 2m 10s
        pnpm test:e2e       # 3m 30s
    
    ### Rojos conocidos
    
    - `pnpm test:e2e` falla 2 de 34 en `emision-factura.e2e.ts` desde el cambio
      del proveedor de firma. Es anterior al agente. Si falla cualquier otro,
      lo rompiste tú.
    

    Si te llevas una sola línea técnica de este post, que sea esta: nunca metas en el harness un comando que no hayas ejecutado.

    El agente lee el fichero, ve pnpm test:integration, lo lanza, el comando no existe, el error es raro y decide seguir adelante. Él cree que está verificado. Tú crees que está verificado. Nadie ha comprobado nada. Has empeorado tu punto de partida y encima duermes mejor.

    Los tiempos anotados al lado de cada comando tampoco son decoración: son lo que te permite saber dentro de seis meses si el bucle corto sigue siendo corto. Los harness no se rompen de golpe, se degradan un comando cada vez.

    Y los rojos conocidos son lo que más me costó aceptar. ¿Qué haces con un comando importante que hoy falla? La tentación es dejarlo fuera hasta arreglarlo. No lo hagas: ponlo y documenta que está en rojo. Un harness honesto con dos rojos vale más que uno verde de mentira. Además, si el agente sabe qué estaba roto antes de empezar, distingue lo que rompió él de lo que ya estaba roto, en vez de ponerse a investigarlo y a veces a “arreglarlo”.

    Qué cambia el martes por la mañana

    Le pides una feature y el agente rompe el contrato — pongamos que dos tests existentes fallan.

    Sin harness, eso te llega como una PR de cuatrocientas líneas y tú descubriéndolo en el minuto cuarenta. O peor, no descubriéndolo.

    Con harness, el bucle corto se pone rojo a los veintiocho segundos y el agente sabe exactamente qué rompió, porque el rojo tiene nombre y no está en la lista de rojos conocidos. La mayoría de las veces lo arregla solo. Y cuando no puede, lo que te llega no es un diff: es una frase — no puedo cumplir esta cláusula sin tocar lo que dijiste que no tocara.

    Mi tiempo medio de revisión pasó de una hora cincuenta a veinte minutos. A cuatro PRs por semana son seis horas a la semana. No lo redondeo a “cinco veces más rápido” porque los porcentajes bonitos son lo primero que hace desconfiar: es un número mío, medido en mi repo. Tú tendrás el tuyo.

    Pero los veinte minutos siguen ahí, y aquí es donde muchos esperan que diga “y ya no revisas nada”. Lo que cambió es en qué se te van:

    1. Miras el veredicto. Qué pasó, qué falló, qué se saltó. Treinta segundos.
    2. Lees el contrato, no la implementación. Cuarenta líneas. Y la pregunta ya no es “¿está bien este código?” sino “¿pedí lo correcto?”, que es muchísimo mejor pregunta y que solo puedes responder tú.
    3. Lees el diff, pero apuntando a las zonas donde el contrato no llega: si el nombre encaja con el dominio, si la solución es la adecuada para este proyecto. Ahí es donde viven los fallos que un code review no puede ver —N+1, fugas de recursos, race conditions—, y por eso ese tercer paso no lo puedes borrar del proceso.

    Ese tercer punto es tu trabajo de verdad, y es el que la IA no te va a quitar. Nunca fue leer cuatrocientas líneas buscando un null. Era decidir si lo que se construyó tenía sentido.

    Qué hacer hoy

    Cuatro cosas, por orden. Ninguna te lleva más de una tarde.

    1. Pasa tu última spec por la prueba de una línea. Cuenta cláusulas e intenciones. Ese número explica tu tiempo de revisión mejor que cualquier otra cosa.
    2. Ejecuta tus comandos de verificación, uno a uno, apuntando lo que tarda cada uno. De ahí salen tu bucle corto, tu bucle largo y tus rojos conocidos.
    3. Escribe el AGENTS.md con esas secciones: stack, convenciones, definición de terminado, límites y verificación. Media página. El punto 4 de la definición de terminado no te lo saltes.
    4. Añade una línea de carril que sea tuya. El fichero que ya te mordió. Esa es la que hace creíbles a las otras cinco.

    El AGENTS.md no hace falta que lo escribas mirando a una pantalla en blanco: lo tienes entero, con las cinco secciones y los comentarios de por qué está cada línea, en el ebook gratuito de El método Revisión por Contrato. Treinta páginas, sin coste.

    Si prefieres ver el AGENTS.md, el harness y los límites montados sobre un proyecto real en vez de partir de una plantilla, ese es justo el recorrido de Construye con IA: de la idea al producto con Claude Code.

    Un apunte que te ahorra una tarde: AGENTS.md es un estándar abierto, no algo que traigan todas las herramientas. En su lista de compatibilidad, consultada el 6 de septiembre de 2026, están Codex, Cursor, el agente de codificación de Copilot, Gemini CLI o Zed. Claude Code es la excepción, y conviene saberlo porque es de las más usadas: lee CLAUDE.md. Se arregla con un fichero de una línea que importe el otro con @AGENTS.md. Compruébalo en tu versión, que esto es de lo poco aquí que puede cambiar en tres meses.

    Si quieres el marco completo alrededor de esto —cómo se escribe la spec de la tarea, no solo el contrato del repo— lo desarrollo en el libro de Spec-Driven Development, en papel o en ebook.

    Empieza por el punto 2. Es el más aburrido de los cuatro y es el que sostiene los otros tres.

    Preguntas frecuentes

    ¿Cómo se revisa código generado por IA sin leer todo el diff?

    Necesitas tres cosas antes de que la pull request llegue a ti: un contrato con cláusulas que una máquina pueda rechazar, límites escritos sobre qué ficheros el agente no toca, y un harness de comandos ejecutables que emita un veredicto binario. Con eso, tu revisión se reduce a tres pasos: mirar el veredicto (treinta segundos), leer el contrato para comprobar que pediste lo correcto (unas cuarenta líneas) y leer el diff solo en las zonas que el contrato no cubre —nombres, encaje con el dominio, si la solución es la adecuada para este proyecto—. En mi repo eso bajó el tiempo medio de revisión de una hora cincuenta a veinte minutos.

    ¿Esto no es simplemente tener buenos tests?

    Los tests son una de las cinco capas, no el mecanismo. Puedes tener una suite excelente y seguir revisando cuatrocientas líneas a mano, porque los tests responden “¿el comportamiento sigue siendo el que era?” y no responden “¿esto hace lo que la spec pidió?” ni “¿el agente se salió de su terreno?”. La pieza que casi nadie tiene es la quinta: criterios de aceptación con un comando detrás. Y si quieres que el test defina el contrato antes de que el agente escriba nada, eso es TDD con IA y encaja encima de esto, no en su lugar.

    Mi repo no tiene tests. ¿Esto me sirve de algo?

    Sí, y probablemente más. Empieza por lo que ya existe aunque no lo llames harness: el build, el type checker y el linter ya emiten veredictos hoy. Escribe el AGENTS.md con esos tres comandos y los límites, y añade tests después, uno por tarea. La alternativa —esperar a tener cobertura para empezar— es como la gente se queda un año sin hacer nada.

    ¿No es más fácil poner todo esto en el prompt?

    Funciona. Casi siempre. El problema es el casi. El prompt vive en una conversación y muere con ella. El fichero vive en el repositorio: se escribe una vez y se aplica a todas las tareas que vengan detrás, incluidas las que lance otra herramienta o cualquiera que entre al repo después de ti.

    ¿Esto no ralentiza al agente?

    Al contrario, aunque el bucle corto sume segundos. Sin verificación el agente entrega rápido y falso, y el coste aparece luego en tu revisión y en los arreglos. Con verificación, el error llega a los veintiocho segundos, con nombre, y lo arregla él. La velocidad que importa no es la de generar código: es la de llegar a algo que se pueda mergear.

    ¿Sirve si mi stack no es TypeScript?

    La estructura es la misma en Python, Go o Java — stack, convenciones, definición de terminado, límites y verificación. Lo que cambian son los comandos concretos, y esos salen de tu proyecto, no de un ejemplo. Copia la forma y rellénala con lo tuyo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Evals deterministas para agentes de IA: testea datos, no frases

    Evals deterministas para agentes de IA: testea datos, no frases

    Un developer me enseñó su suite de tests para un agente de soporte. Tenía esta línea:

    expect(result.text).toBe("Tu suscripción ha sido cancelada con éxito.");
    

    En local pasó tres veces. Hizo push. En la cuarta ejecución en CI, el modelo contestó: "Hemos procesado la cancelación de tu suscripción correctamente."

    Pipeline en rojo. La suscripción se canceló. La tool correcta se llamó con el userId correcto. El agente hizo su trabajo y el test falló porque el modelo cambió tres palabras.

    Ese test no medía al agente. Medía la redacción de un modelo probabilístico, justo la parte que no controlas. La salida son los evals deterministas para agentes de IA: en vez de relajar la aserción hasta que ya no garantice nada, cambias lo que el agente devuelve.


    ¿Qué son los evals deterministas para agentes de IA?

    Un eval determinista es una comprobación cuyo resultado no depende de cómo redacte el modelo. El agente no devuelve una frase: devuelve un objeto tipado —un veredicto— y el test asierta de forma exacta sobre sus campos. Un decision que es un enum cerrado, un array de códigos de motivo, un identificador. Datos, no prosa. La misma clase de aserción que harías contra un endpoint REST.

    La diferencia con lo que la mayoría llama "eval" es el punto de aplicación. No estás puntuando una respuesta a posteriori con una rúbrica: estás rediseñando la interfaz del agente para que su decisión sea inspeccionable.

    Conviene marcar la frontera con dos cosas que ya conté por separado. El test harness para agentes de IA es el entorno: las tools falsas, el presupuesto de tokens que corta, el timeout real, la traza reproducible. Es el paso previo y es obligatorio. Este post va de lo otro: qué afirmas dentro de ese entorno.

    Y el function calling tipado con TypeScript valida la ENTRADA: los argumentos que el modelo manda a una tool, que en ai@7 viajan en inputSchema. Aquí hablamos de la SALIDA: el veredicto que emite el agente. Es la otra punta del mismo cable, y casi nadie tipa esa punta.


    Los dos callejones sin salida antes de llegar aquí

    Cuando el test de arriba se pone rojo hay dos salidas habituales, y las dos son peores que el problema: relajar la aserción hasta que deje de garantizar nada, o delegar el juicio en otro modelo.

    El primero es relajar la aserción. Un toContain, una expresión regular, un .toLowerCase().includes(). Queda así:

    expect(result.text.toLowerCase()).toContain("cancel");
    

    Verde. Y ahora ese test pasa también si el agente respondió "No puedo cancelar tu suscripción, contacta con soporte". Acabas de escribir una aserción que da verde cuando el agente hace exactamente lo contrario de lo que le pediste. Un test que no puede fallar en el caso que importa no es un test: es decoración en el pipeline.

    El segundo es montar un LLM-as-a-Judge para todo. Otro modelo lee la respuesta y decide si es correcta. Funciona, pero paga tres precios: es lento (una llamada extra por caso), es caro (y los evals se ejecutan por lotes, así que multiplica), y sobre todo hereda el no-determinismo que intentabas eliminar. Tu suite pasa a depender de que el juez opine igual el martes que el jueves. Y entonces tienes un segundo problema: quién calibra al juez.

    El juez tiene su sitio. Pero es el último recurso, no el primero. Antes de delegar una decisión en otro modelo, pregúntate si esa decisión se puede tipar. La mayoría de las veces se puede.

    Superficie de aserción Determinista Coste Cuándo usarla
    Texto libre con toBe o regex No Cero Nunca sobre la salida del modelo: o revienta con sinónimos o da verde con cualquier cosa
    Objeto tipado (generateObject + Zod) Sí en la aserción Cero extra Siempre que la salida sea una decisión, una clasificación, una extracción o un enrutado
    LLM-as-a-Judge No Alto, una llamada por caso Cuando la calidad es irreductiblemente textual: resúmenes, tono, redacción, código

    El giro: que la decisión sea un dato, no una frase

    Si quieres afirmar sobre la decisión del agente, haz que la decisión sea un campo.

    Con el AI SDK de Vercel eso es generateObject más un schema de Zod. Los ejemplos de este post corren con ai@7, zod@4 y Vitest 4, versiones de septiembre de 2026. El modelo deja de tener libertad de formato: o devuelve algo que valida contra el schema, o falla ruidosamente, que también es información útil.

    Un agente que revisa solicitudes de reembolso:

    // refund-agent.ts
    import { generateObject } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    import type { RefundTicket } from "./types";
    import { REFUND_POLICY_PROMPT } from "./prompts";
    
    const model = anthropic("claude-haiku-4-5-20251001");
    
    export const RefundVerdictSchema = z.object({
      decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
      reasonCodes: z
        .array(
          z.enum([
            "OUTSIDE_RETURN_WINDOW",
            "ITEM_DAMAGED_BY_CUSTOMER",
            "DUPLICATE_REQUEST",
            "OPEN_CHARGEBACK",
            "HIGH_VALUE_ORDER",
            "TRUSTED_CUSTOMER",
          ]),
        )
        .min(1),
      riskSignals: z.object({
        priorRefunds12m: z.number().int().min(0),
        daysSincePurchase: z.number().int().min(0),
      }),
      summary: z.string(),
    });
    
    export type RefundVerdict = z.infer<typeof RefundVerdictSchema>;
    
    export async function reviewRefund(ticket: RefundTicket): Promise<RefundVerdict> {
      const { object } = await generateObject({
        model,
        schema: RefundVerdictSchema,
        temperature: 0,
        instructions: REFUND_POLICY_PROMPT,
        prompt: JSON.stringify(ticket),
      });
    
      return object;
    }
    

    Fíjate en lo que acaba de pasar. reviewRefund ya no devuelve texto: devuelve RefundVerdict. Un tipo. Tu test vuelve a ser un test normal.

    Si ese veredicto es el paso final de un bucle con varias herramientas por medio, el schema es el punto de salida del bucle. Cómo montarlo con estado y reintentos lo desarrollé en el agentic loop en producción con TypeScript.

    Hasta aquí es lo que cuenta todo el mundo. Lo que casi nadie cuenta es que el schema puede estar bien tipado y ser una superficie de test pésima.


    Cómo diseñar el schema del veredicto: 5 reglas

    Esta es la parte que decide si tu suite aguanta seis meses o se convierte en ruido. Cinco reglas.

    1. Enums cerrados, nunca strings libres

    decision: z.string() valida perfectamente y no te sirve de nada. El modelo devolverá "rechazado", luego "Rechazado por política", luego "REJECT". Has movido el problema del texto de la respuesta al texto de un campo.

    // Mal: sigues asertando sobre prosa
    decision: z.string(),
    
    // Bien: el espacio de valores es finito y conocido
    decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
    

    Un enum cerrado tiene una propiedad que ningún string tiene: si el modelo quiere decir algo, solo puede decirlo de una manera. Ahí es donde toBe recupera el sentido.

    2. Códigos de motivo, no explicaciones

    Un veredicto que solo dice REJECTED te deja testear el qué, pero no el porqué. Y el porqué es donde viven las regresiones interesantes: el agente sigue rechazando el caso correcto, pero por el motivo equivocado. Eso es un bug que un test binario no ve.

    Por eso reasonCodes es un z.array(z.enum([...])) y no un z.array(z.string()). Con códigos puedes asertar la causa exacta. Con texto libre, vuelves al principio del post.

    Diseñar bien esa lista de códigos es trabajo de verdad: enums demasiado finos y el modelo elige mal entre opciones casi idénticas; demasiado gruesos y no distinguen nada. Empieza por los motivos que ya aparecen escritos en tu política de negocio.

    3. Los scores numéricos son la aserción más frágil que existe

    confidenceScore: z.number() es tentador. Y es una trampa.

    El modelo devuelve 0.82 hoy y 0.79 mañana con la misma entrada. Cualquier test que compare el valor exacto es un test que parpadea. Y cualquier umbral que escribas dentro del prompt —"si la confianza supera 0.8, aprueba"— es lógica de negocio metida en la parte no determinista del sistema.

    Dos reglas:

    • Si el score se queda, asierta rangos o umbrales, nunca el valor: expect(v.confidenceScore).toBeGreaterThan(0.7).
    • Mejor aún: saca el umbral del modelo y ponlo en tu código. Que el agente devuelva señales en bruto (priorRefunds12m, daysSincePurchase) y que la regla la aplique una función TypeScript pura.
    // route-verdict.ts — 100% determinista, testeable sin llamar al modelo
    export function routeVerdict(v: RefundVerdict): "AUTO" | "MANUAL_REVIEW" {
      const { priorRefunds12m, daysSincePurchase } = v.riskSignals;
    
      // El veredicto del agente manda: si pidió revisión humana, no la saltamos
      if (v.decision === "MANUAL_REVIEW") return "MANUAL_REVIEW";
      if (priorRefunds12m >= 3) return "MANUAL_REVIEW";
      if (daysSincePurchase > 30 && v.decision === "APPROVED") return "MANUAL_REVIEW";
    
      return "AUTO";
    }
    

    Cada umbral que mueves del prompt a una función es un test que pasa de probabilístico a exacto.

    4. Separa lo que se asierta de lo que se lee

    El schema puede —y suele— tener campos en texto libre. summary está ahí para que un humano entienda la decisión en el panel de revisión, y hace falta.

    La regla es que ese campo no se asierta jamás. Ni con toContain, ni con regex, ni "solo para comprobar que no viene vacío". Déjalo escrito en un comentario del propio schema, para que el siguiente developer no caiga en la tentación. Un schema tiene dos zonas: la contractual, sobre la que testeas, y la informativa, que solo se lee.

    5. Los campos opcionales fabrican tests frágiles

    En cuanto un campo permite undefined, tu test tiene que decidir qué significa eso. Y normalmente no lo decide: lo esquiva con un ?. y se queda verde por accidente.

    // Ambiguo: ¿no había motivos, o el modelo no los rellenó?
    reasonCodes: z.array(ReasonCode).optional(),
    
    // Explícito: el array siempre viene, y siempre con al menos un motivo
    reasonCodes: z.array(ReasonCode).min(1),
    

    Prefiere valores por defecto, arrays vacíos y uniones discriminadas antes que opcionalidad. Un undefined que atraviesa la suite entera sin que nadie lo asierte es un agujero con forma de test.

    Este tipo de diseño —enums, refinamientos, uniones discriminadas, z.infer para no duplicar tipos— es lo que trabajo paso a paso en el curso de Zod para TypeScript, porque aquí el schema no es validación defensiva: es la superficie de test de todo el sistema.


    El test que resulta

    Con el schema anterior, el eval en Vitest es aburrido. Ese es el objetivo: un test de agente de IA que se lee igual que cualquier otro test de tu suite.

    // refund-agent.eval.test.ts
    import { describe, it, expect } from "vitest";
    import { reviewRefund, type RefundVerdict } from "./refund-agent";
    import { routeVerdict } from "./route-verdict";
    import { lateRequestWithChargeback } from "./fixtures";
    
    describe("refund agent · casos obvios", () => {
      it("rechaza una solicitud fuera de plazo con chargeback abierto", async () => {
        const verdict = await reviewRefund(lateRequestWithChargeback);
    
        expect(verdict.decision).toBe("REJECTED");
        expect(verdict.reasonCodes).toContain("OPEN_CHARGEBACK");
        expect(verdict.reasonCodes).toContain("OUTSIDE_RETURN_WINDOW");
        expect(verdict.reasonCodes).not.toContain("TRUSTED_CUSTOMER");
      });
    });
    
    describe("routeVerdict · sin modelo", () => {
      it("escala a revisión manual con 3 reembolsos previos", () => {
        const verdict: RefundVerdict = {
          decision: "APPROVED",
          reasonCodes: ["TRUSTED_CUSTOMER"],
          riskSignals: { priorRefunds12m: 3, daysSincePurchase: 5 },
          summary: "",
        };
    
        expect(routeVerdict(verdict)).toBe("MANUAL_REVIEW");
      });
    });
    

    Dos detalles que importan.

    El toContain de aquí no es el toContain del callejón sin salida. Sobre un string comprueba subcadenas y da verde con cualquier ruido alrededor; sobre un array de enums comprueba pertenencia exacta a un conjunto cerrado. Misma función, garantías opuestas.

    Y el not.toContain vale tanto como el positivo. Un agente que rechaza el caso correcto pero marca al cliente como fiable está acertando por la razón equivocada, y ese es el fallo que se cuela a producción sin que nadie lo vea.

    Este test no se rompe si el modelo cambia la redacción del summary. Ni si cambia el orden de los motivos. Ni si actualizas a la siguiente versión del modelo y escribe más bonito. Solo se pone rojo cuando el agente decide distinto, que es exactamente lo que querías vigilar. Si quieres afinar el diseño de suites, fixtures y aislamiento de dependencias, ese músculo lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library: los ejemplos son de Angular, pero el diseño de suites y fixtures se traslada tal cual.


    Los límites de los evals deterministas en agentes de IA

    Toca ser honesto: el schema hace determinista la aserción, no el modelo.

    temperature: 0 reduce muchísimo la varianza, pero no la elimina. Entre el batching en el servidor, la aritmética en coma flotante y el enrutado interno de los modelos grandes, la misma entrada puede darte una decisión distinta. Menos que antes. No cero.

    La forma de convivir con eso es partir la suite en dos, y esta distinción es la que casi nadie hace.

    Casos obvios. El cliente pide el reembolso de un pedido de hace dos años con un chargeback abierto. Solo hay una respuesta razonable. Estos casos son tests binarios, corren siempre y bloquean el merge. Si uno falla, hay un bug: en el prompt, en el schema o en el modelo que acabas de actualizar.

    Casos de frontera. El pedido tiene 31 días y la política dice 30, pero el cliente lleva cinco años contigo. Aquí ni tú tienes una respuesta única. Estos casos no se testean como binarios: se miden como tasa de acierto. Ejecutas N veces y exiges un umbral de consistencia. Cinco ejecuciones es el mínimo que justifica el coste, no una muestra seria: si el caso importa de verdad, sube a veinte antes de fiarte de la tasa. Por qué N no es un número arbitrario lo desarrollé en evaluaciones automatizadas para agentes.

    // refund-agent.borderline.test.ts
    import { borderlineTicket } from "./fixtures";
    
    async function decisionCounts(runs: number, ticket: RefundTicket) {
      const results = await Promise.all(
        Array.from({ length: runs }, () => reviewRefund(ticket)),
      );
    
      return results.reduce<Record<string, number>>((acc, r) => {
        acc[r.decision] = (acc[r.decision] ?? 0) + 1;
        return acc;
      }, {});
    }
    
    it(
      "mantiene el caso frontera en revisión manual (4 de 5)",
      async () => {
        const counts = await decisionCounts(5, borderlineTicket);
        expect(counts.MANUAL_REVIEW ?? 0).toBeGreaterThanOrEqual(4);
      },
      60_000,
    );
    

    Meter los casos de frontera en la suite que bloquea el merge es la receta perfecta para que el equipo empiece a relanzar pipelines hasta que pasen. Y a partir de ese día los tests dejan de significar nada. Van en un job programado, con su propio umbral y su propia alerta cuando la tasa cae.

    Sí, esta suite cuesta dinero, porque llama al modelo de verdad. Por eso corre por lotes y no en cada push, mientras el test harness con tools falsas sigue corriendo en cada commit.


    Cuándo sí necesitas un LLM-as-a-Judge

    Cuando la calidad de la salida es irreductiblemente textual.

    Si tu agente escribe un resumen, redacta un email a un cliente o genera un módulo entero de código, no hay enum que capture "esto está bien". Ahí el juez —con rúbrica explícita, golden dataset versionado y calibración humana— es la herramienta correcta, y lo desarrollé entero en evals para código generado por IA.

    La regla de reparto es simple: si la decisión se puede tipar, típala; el juez es para lo que sobra después. En la mayoría de agentes de negocio, lo que sobra es mucho menos de lo que parece antes de sentarse a diseñar el schema.


    Por dónde empezar mañana

    Coge un agente. El que más te preocupe.

    Mira qué devuelve hoy. Si devuelve texto, escribe el schema del veredicto: un enum de decisión, un array de códigos de motivo, las señales numéricas en bruto y un summary que no vas a asertar nunca. Cambia la llamada a generateObject. Y mueve al menos un umbral del prompt a una función TypeScript.

    Después escribe cinco casos obvios. Cinco. Con eso ya tienes una red que detecta el día en que cambies de modelo y el agente empiece a aprobar lo que antes rechazaba, que es la regresión que de verdad cuesta dinero.

    Este tipo de decisión de diseño es lo que separa una demo de un producto que aguanta usuarios reales, y es el hilo que sigo en el curso Construye con IA: de la idea al producto con Claude Code. En Dominicode Labs están los schemas y las suites completas de los agentes que corremos en producción, con sus casos de frontera y sus umbrales reales.

    Deja de testear lo que el agente dice. Testea lo que el agente decide.


    Preguntas frecuentes

    ¿Qué es exactamente un eval determinista?

    Es una comprobación automática cuyo resultado no depende de cómo redacte el modelo. Se consigue haciendo que el agente devuelva un objeto tipado en lugar de texto y asertando sobre campos de valores cerrados, como enums o arrays de códigos. La aserción vuelve a ser exacta y repetible, igual que si testearas la respuesta de una API REST.

    ¿Con temperature 0 ya tengo determinismo garantizado?

    No. Reduce mucho la varianza, pero no la elimina, porque hay factores del lado del proveedor que no controlas, como el batching de peticiones o la aritmética en coma flotante. Lo que sí es determinista es tu aserción, y por eso los casos de frontera se miden como tasa de acierto sobre varias ejecuciones en lugar de como un test binario.

    ¿Puedo asertar sobre un campo de confianza numérico?

    Puedes, pero solo por rangos o umbrales, nunca por el valor exacto, porque el mismo caso te dará valores ligeramente distintos entre ejecuciones. La mejor opción es que el modelo devuelva las señales en bruto y que el umbral lo aplique una función de tu código, que sí puedes testear al cien por cien sin llamar al modelo.

    ¿En qué se diferencia esto de un test harness?

    El harness es el entorno de ejecución: las herramientas falsas, el presupuesto de tokens, el timeout y la traza. Responde a si el agente se salió de sus límites. Los evals deterministas son las aserciones que escribes dentro de ese entorno y responden a si el agente decidió lo correcto. Se montan en ese orden: primero el entorno, después las aserciones.

    ¿Estos tests corren en cada push?

    Los que no llaman al modelo, sí: el enrutado, los umbrales y toda la lógica pura alrededor del veredicto. Los que llaman al modelo de verdad cuestan dinero y tardan, así que van en un job programado sobre un conjunto reducido de casos, separando los obvios, que bloquean el merge, de los de frontera, que solo alertan cuando la tasa de acierto cae.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • De API REST a servidor MCP en TypeScript: 1 endpoint no es 1 tool

    De API REST a servidor MCP en TypeScript: 1 endpoint no es 1 tool

    Un equipo con el que trabajé tenía una API REST de facturación con cuarenta y tantos endpoints. Documentada con OpenAPI, en producción desde hacía años, sin drama.

    Quisieron abrirla a un agente. Para pasar de API REST a servidor MCP hicieron lo obvio: generar el servidor desde el spec de OpenAPI. Cuarenta endpoints, cuarenta tools. Media tarde de trabajo. Funcionaba.

    Y el agente era inútil.

    Preguntabas "¿cómo está la cuenta de Marta?" y el modelo elegía listInvoices sin filtro, se tragaba doscientas facturas en el contexto y contestaba una vaguedad. Otras veces llamaba a getCustomer, luego a getCustomerById, luego a searchCustomers — tres tools que hacían casi lo mismo porque el backend llevaba cinco años acumulando variantes.

    El problema no era el modelo. Era que habían traducido en vez de diseñar.

    Cuando pasas de una API REST a un servidor MCP, la conversión mecánica es el error por defecto. Un buen servidor MCP expone menos tools que endpoints tiene la API. Y si no tienes API previa y quieres montar todo desde cero, empieza por construir el agente y su servidor MCP paso a paso — este post asume que ya tienes el backend en producción.

    En una frase: un servidor MCP es un proceso que expone las capacidades de tu backend como tools —funciones con nombre, schema de entrada y descripción— para que un modelo pueda elegirlas y ejecutarlas por sí mismo. Si vienes de cero con el protocolo, el mapa completo está en qué son los servidores MCP. Aquí vamos a lo que casi nadie cuenta: cómo se decide qué parte de tu API merece ser una tool.


    API REST describe recursos, servidor MCP describe capacidades

    La diferencia entre una API REST y un servidor MCP no es el transporte: es quién decide qué llamar, cuándo y con qué información delante.

    API REST Servidor MCP
    Quién elige la llamada Un programador, en tiempo de desarrollo Un modelo, en tiempo de ejecución
    Unidad de diseño El recurso (/customers/{id}) La intención ("cómo está la cuenta de X")
    Para qué sirve la descripción Documentación que se lee una vez Prompt que decide la llamada
    Coste de añadir una más Cercano a cero Contexto en cada petición y más riesgo de elegir mal
    Respuesta ideal El objeto completo, el cliente filtra Lo mínimo para razonar, el servidor recorta
    Errores Código HTTP y cuerpo estructurado Frase accionable con isError: true

    Tu API REST está escrita para un programador: alguien que ya sabe lo que quiere y que entiende por qué /customers/{id}/invoices devuelve algo distinto de /invoices?customer_id={id}. El contrato REST asume una decisión ya tomada.

    MCP es lo contrario. El que lee tu catálogo de tools no sabe nada de tu dominio y tiene que decidir cuál llamar, con qué argumentos y en qué orden — a partir de una frase ambigua de un humano.

    Esto cambia una cosa fundamental: la descripción de la tool no es documentación, es prompt. Es el texto que el modelo tiene delante en el momento de elegir. Si escribes "Obtiene un cliente" dejas la decisión al azar. Si escribes "Úsala cuando necesites el estado de facturación de un cliente a partir de su email; no sirve para crear ni modificar facturas", programas el comportamiento.

    Y hay un coste que en REST no existe: la lista de tools viaja en cada petición. Cuarenta tools con sus schemas ocupan contexto antes de que el agente haya hecho nada. Cada tool que añades encarece todas las llamadas y hace la elección más difícil.


    Qué endpoints de tu API REST se convierten en tool MCP (y cuáles no)

    No, no va una tool por endpoint. El criterio que uso es uno solo: ¿este endpoint responde a una intención completa que un humano formularía?

    Si un usuario puede decir "dime el estado de facturación de Marta" y ese endpoint lo resuelve entero, es candidato. Si es un paso intermedio que solo tiene sentido dentro de una secuencia, no lo es.

    Con eso, esto queda fuera:

    • CRUD granular. PATCH /customers/{id}/phone no es una intención, es un detalle de implementación. Si el agente necesita actualizar datos de contacto, una sola tool update_customer_contact con varios campos opcionales.
    • Endpoints internos. Health checks, webhooks, callbacks de terceros, migraciones. El agente no los necesita y solo compiten por su atención.
    • Los que devuelven payloads enormes. Un GET /events que escupe cinco mil registros no se convierte en tool: se convierte en tool con filtros obligatorios, o no se convierte.
    • Los destructivos sin confirmación. DELETE /customers/{id} no va al servidor MCP tal cual. O lo marcas con destructiveHint y lo dejas detrás de una confirmación del cliente, o directamente no lo expones. Yo arranco siempre en solo lectura y añado escritura una a una.

    Y una regla que ahorra mucho dolor: si dos endpoints se llaman siempre juntos, no son dos tools. Son una.


    La tool de intención: consolida, no traduzcas

    Una tool de intención es una sola tool que resuelve una pregunta completa del usuario agregando por dentro varias llamadas a tu API REST. Ahí está el cambio de mentalidad. La pregunta "cómo está la cuenta de Marta" en tu API REST son tres llamadas:

    GET /customers?email=...        → el cliente
    GET /customers/{id}/invoices    → sus facturas
    GET /customers/{id}/payments    → el estado de pagos
    

    La traducción mecánica te da getCustomer, listInvoices y getPaymentStatus. Tres tools, tres decisiones que el modelo puede equivocar, tres respuestas verbosas en el contexto y una orquestación que el agente tiene que inventarse en cada conversación.

    La versión diseñada te da una: get_customer_billing_summary. Recibe un email, encadena esas llamadas por dentro y devuelve un resumen legible.

    Tres decisiones menos que tomar, dos viajes menos de contexto y una orquestación que ya no depende de que el modelo acierte. Es el mismo backend; cambia dónde vive la lógica de composición.


    Las cuatro piezas que no se traducen solas

    Autenticación. El token de tu API REST no viaja como viajaba. Regla dura: el token nunca es un parámetro de la tool. Si lo pones en el inputSchema, acaba en el contexto del modelo y en los logs del cliente. En local, por stdio, el servidor lo lee de su entorno y el modelo ni se entera. En cuanto lo expones por red la historia se complica bastante — ahí tu servidor pasa a ser un resource server de OAuth 2.1 y toca leer qué se rompe cuando el MCP server sale del portátil.

    Paginación. El agente no debe paginar a mano. Si expones page y per_page, hará cinco llamadas seguidas quemando contexto para reconstruir algo que podías haberle dado resumido.

    Dos opciones honestas: un tope de resultados con un cursor explícito que el modelo pueda pasar de vuelta, o —mejor— los N más relevantes más un "hay 340 resultados, afina el filtro por fecha o estado". Empujar al agente a filtrar gana casi siempre a dejarle paginar.

    Errores. Un 422 con un cuerpo tipo {"errors":{"date":"invalid format"}} es perfecto para un frontend y horrible para un modelo. El agente necesita texto que le diga qué corregir: "El campo date debe ir en formato YYYY-MM-DD. Reformatea el valor y vuelve a llamar." Y va como resultado con isError: true, no como excepción sin capturar: así el modelo lo lee y se autocorrige en el mismo turno en vez de rendirse.

    Tamaño de la respuesta. Tu endpoint devuelve el objeto entero porque a un frontend le sale gratis ignorar campos. Al agente no: cada campo que no usa lo paga en contexto. Recorta en el servidor. De un objeto factura con treinta campos, el agente necesita número, fecha, importe y estado.


    Servidor MCP en TypeScript con el SDK oficial

    Un archivo para hablar con la API que ya tienes, sobre el SDK oficial de TypeScript:

    // src/rest.ts
    const BASE = process.env.BILLING_API_URL!;
    const TOKEN = process.env.BILLING_API_TOKEN!; // del entorno, nunca del modelo
    
    export class RestError extends Error {
      constructor(readonly status: number, readonly body: unknown) {
        super(`REST ${status}`);
      }
    }
    
    export async function rest<T>(path: string): Promise<T> {
      const res = await fetch(`${BASE}${path}`, {
        headers: { Authorization: `Bearer ${TOKEN}`, Accept: 'application/json' }
      });
    
      if (!res.ok) {
        throw new RestError(res.status, await res.json().catch(() => null));
      }
    
      return res.json() as Promise<T>;
    }
    
    export interface Customer {
      id: string;
      name: string;
      email: string;
    }
    
    export interface Invoice {
      number: string;
      issuedAt: string; // YYYY-MM-DD
      amount: number;
      status: 'draft' | 'sent' | 'paid' | 'overdue';
    }
    

    Y el servidor con la tool de intención que agrega dos llamadas REST:

    // src/server.ts
    import { McpServer } from '@modelcontextprotocol/sdk/server/mcp.js';
    import { StdioServerTransport } from '@modelcontextprotocol/sdk/server/stdio.js';
    import { z } from 'zod';
    import { rest, RestError, type Customer, type Invoice } from './rest.js';
    
    const server = new McpServer({ name: 'billing', version: '1.0.0' });
    
    server.registerTool(
      'get_customer_billing_summary',
      {
        title: 'Resumen de facturación de un cliente',
        description:
          'Devuelve el estado de facturación de un cliente a partir de su email: ' +
          'datos básicos, facturas recientes e importe vencido. Úsala para responder ' +
          '"cómo está la cuenta de X". No sirve para crear ni modificar facturas.',
        inputSchema: {
          email: z.email().describe('Email del cliente, tal como lo dio el usuario'),
          months: z.number().int().min(1).max(12).default(3)
            .describe('Meses de histórico de facturas a incluir. Por defecto 3.')
        },
        annotations: { readOnlyHint: true }
      },
      async ({ email, months }) => {
        const since = new Date();
        since.setMonth(since.getMonth() - months);
    
        try {
          const [customer] = await rest<Customer[]>(
            `/customers?email=${encodeURIComponent(email)}`
          );
    
          if (!customer) {
            return {
              content: [{
                type: 'text',
                text: `No existe ningún cliente con el email ${email}. ` +
                      `Pide al usuario el email exacto antes de reintentar.`
              }],
              isError: true
            };
          }
    
          const invoices = await rest<Invoice[]>(
            `/customers/${customer.id}/invoices` +
              `?limit=20&since=${since.toISOString().slice(0, 10)}`
          );
    
          const overdue = invoices.filter(i => i.status === 'overdue');
          const owed = overdue.reduce((sum, i) => sum + i.amount, 0);
    
          // Recorte deliberado: solo lo que el agente necesita para razonar
          const lines = invoices
            .slice(0, 10)
            .map(i => `- ${i.number} · ${i.issuedAt} · ${i.amount} € · ${i.status}`);
    
          return {
            content: [{
              type: 'text',
              text: [
                `Cliente: ${customer.name} (${customer.email})`,
                `Facturas últimos ${months} meses: ${invoices.length}`,
                `Vencidas: ${overdue.length} · Importe pendiente: ${owed} €`,
                '',
                ...lines,
                invoices.length > 10 ? `… y ${invoices.length - 10} más.` : ''
              ].join('\n')
            }]
          };
        } catch (error) {
          if (error instanceof RestError && error.status === 422) {
            return {
              content: [{
                type: 'text',
                text: `La API rechazó los parámetros: ${JSON.stringify(error.body)}. ` +
                      `Corrige el valor indicado y vuelve a llamar.`
              }],
              isError: true
            };
          }
          throw error;
        }
      }
    );
    
    await server.connect(new StdioServerTransport());
    

    Fíjate en el .describe() de cada campo: es la única documentación que el modelo recibe de ese argumento. En una API REST el tipo basta porque hay un humano leyendo el spec; aquí el texto es la interfaz. Esa combinación de tipado y semántica es donde Zod deja de ser un validador y pasa a ser parte del diseño — si quieres exprimirlo, lo trabajo a fondo en el curso de Zod para TypeScript. Si sigues en Zod 3, esa línea es z.string().email(); desde Zod 4 la forma recomendada es z.email().

    Un apunte de versiones (septiembre de 2026): el código de arriba corre sobre @modelcontextprotocol/sdk 1.30.0, cuyo inputSchema admite el shape suelto —{ email: z.string() }— y también un z.object({ ... }). La v2 se publica como paquete aparte, @modelcontextprotocol/server 2.0.0, y ahí el shape suelto queda deprecado a favor del z.object() explícito. El monolítico no está deprecado y es el que sigues viendo en la mayoría de servidores, que es por lo que el ejemplo va con él. Los dos implementan la revisión 2026-07-28 de la spec, donde están definidas las annotations y el outputSchema. El criterio de diseño de este post no cambia entre versiones.

    Para probarlo, regístralo en tu cliente y lánzale la pregunta en lenguaje natural. Los scopes y el claude mcp add los tienes desglosados en el tutorial de MCP server con Claude Code.


    Checklist de migración de API REST a servidor MCP

    Antes de dar por buena la conversión de tu API:

    1. Cuenta. ¿Tienes menos tools que endpoints? Si no, no has diseñado, has traducido.
    2. Lee las descripciones en voz alta. Si no explican cuándo usar la tool y cuándo no, reescríbelas.
    3. Busca solapes. Dos tools que un humano confundiría, un modelo también.
    4. Mide el peor payload. Si una respuesta puede reventar el contexto, mete tope y filtros obligatorios.
    5. Convierte los errores. Cada error de tu API tiene que salir como frase accionable con isError: true.
    6. Saca el token del schema. Si aparece en inputSchema, tienes una fuga.
    7. Arranca en solo lectura. Escritura y borrado después, uno a uno y con confirmación.

    Lo que haría hoy

    Abre el OpenAPI de tu API. Marca los endpoints que responden a una frase completa de un usuario. Normalmente son entre cinco y ocho de cuarenta.

    Esos son tus tools. El resto es la fontanería que vive dentro de ellos.

    Y luego escribe las descripciones como si fueran prompts — porque lo son. Esa es la parte que casi nadie hace, y la que separa un servidor MCP que el agente usa bien de uno que solo se ve bonito en el tools/list.

    Este salto de "envolver lo que ya tengo" a "diseñar la superficie que el agente necesita" es el mismo que trabajo en el curso Construye con IA, y si quieres ver servidores MCP reales con sus decisiones y sus errores, los desmenuzamos en Dominicode Labs.


    Preguntas frecuentes

    ¿Cuántas tools debería tener mi servidor MCP?

    No hay número mágico, pero sí una señal: si tienes tantas tools como endpoints, has traducido en vez de diseñar. En APIs de tamaño medio suelo acabar entre cinco y diez tools de intención. La pregunta correcta no es cuántas caben, sino cuántas puedes quitar sin perder capacidad real.

    ¿Puedo generar el servidor MCP automáticamente desde mi OpenAPI?

    Puedes, y es justo lo que produce agentes malos. Un generador hace exactamente la conversión mecánica de 1 endpoint = 1 tool: sin criterio sobre qué endpoints son intenciones completas, sin consolidar llamadas y sin descripciones pensadas para un modelo. Úsalo como inventario de partida si quieres, pero la selección y el redactado de las descripciones son trabajo manual.

    ¿Cómo paso el token de mi API REST al servidor MCP?

    Nunca como parámetro de la tool: ahí acaba en el contexto del modelo y en los logs del cliente. En local, con transporte stdio, el servidor lo lee de una variable de entorno y el modelo ni lo ve. Si lo expones por HTTP, el cliente presenta su propio token al servidor MCP y es tu servidor quien traduce esa identidad a la credencial de la API interna.

    ¿Qué hago con los endpoints de escritura o destructivos?

    Sepáralos desde el arranque. Empieza en solo lectura, marcando esas tools con readOnlyHint, y añade escritura una a una cuando ya sabes cómo se comporta el agente con tu dominio. Lo destructivo lleva destructiveHint y confirmación del cliente; si algo cobra dinero o borra registros, además tiene que ser idempotente.

    ¿La tool debe devolver JSON o texto?

    Texto, salvo razón concreta para lo contrario. El JSON crudo arrastra campos que el agente no usa y paga en contexto. Si además necesitas la forma estructurada, el SDK permite declarar un outputSchema y devolver structuredContent junto al texto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
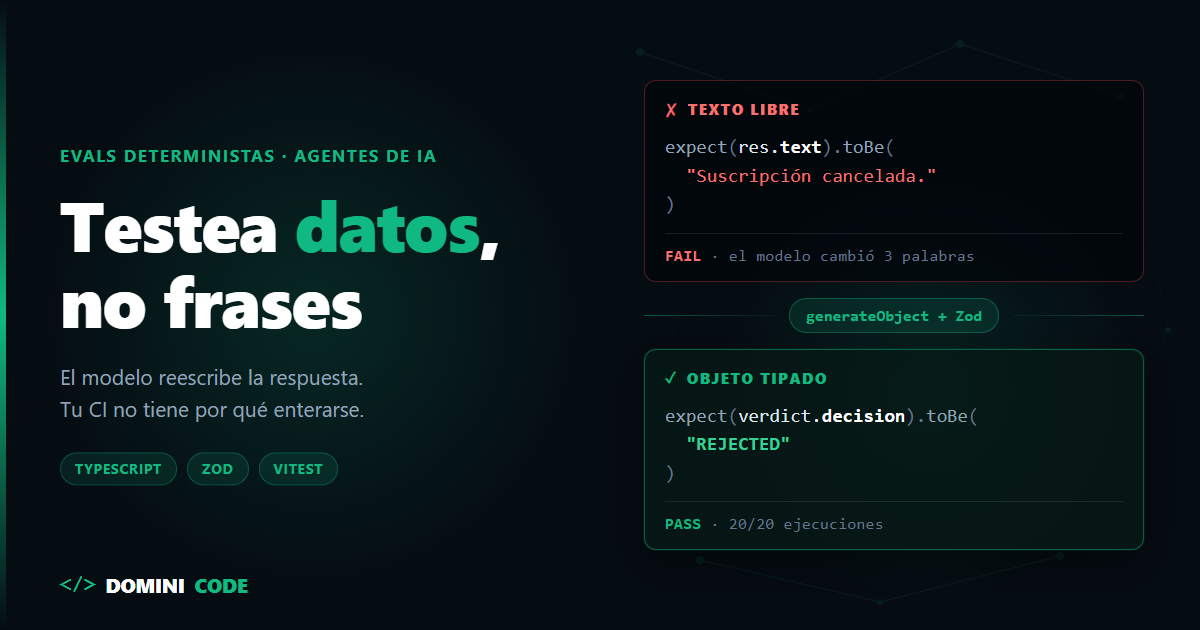
  • Desplegar agentes LangChain en producción sin perder el estado

    Desplegar agentes LangChain en producción sin perder el estado

    En local funcionaba perfecto.

    El agente respondía, llamaba a sus herramientas, escribía token a token en la terminal. Lo metí en un contenedor y lo subí. A los pocos días empecé a ver el mismo patrón en los logs: conversaciones cortadas a mitad, y usuarios que volvían y encontraban un agente sin memoria de nada.

    No había ningún error en el código del agente. El agente estaba bien. Lo que estaba mal era todo lo que hay entre el agente y el usuario.

    Y es que desplegar agentes LangChain en producción no se parece a desplegar una API REST. Una API REST responde en 200 milisegundos y no recuerda nada. Un agente tarda treinta segundos, mantiene la conexión abierta todo ese rato, guarda estado entre turnos y llama a servicios externos que fallan. Cuatro propiedades que rompen, una por una, las suposiciones sobre las que está construida tu infraestructura.

    Si todavía estás decidiendo la forma del agente —grafo de estados o bucle— eso lo desarrollé en LangGraph TypeScript: cuándo un grafo gana al while loop. Este post empieza donde acaba aquel: ya tienes el grafo, ahora hay que sacarlo del portátil.

    Todo el código está escrito contra langchain 1.5 y @langchain/langgraph 1.4, con @langchain/langgraph-checkpoint-postgres 1.0. Es importante que mires las versiones: la API de creación de agentes y la de streaming cambiaron en LangChain 1, y casi todos los tutoriales que vas a encontrar están escritos contra la anterior.

    Última revisión: 31 de agosto de 2026. Si LangGraph publica una 2.x, el PostgresSaver es lo primero que hay que volver a comprobar.


    Los 3 fallos al desplegar agentes LangChain en producción

    Los tres fallos que rompen un agente en producción son la conexión que corta el proxy, el estado que vive en RAM y la herramienta sin timeout. No son los que parecen, y son los que me han costado tiempo de verdad:

    # Fallo Por qué pasa
    1 La conexión se corta a mitad de respuesta El proxy cierra la conexión por inactividad: mientras el modelo "piensa" no viajan bytes
    2 El agente pierde la memoria El historial vivía en RAM y el contenedor se reinició o escaló a otra instancia
    3 Una herramienta se cuelga y arrastra al proceso Sin timeout ni cancelación, la petición queda colgada y la conexión SSE ocupando memoria

    Conviene desmontar un mito antes de seguir, porque lo he leído muchas veces: el bucle del agente no bloquea el event loop. El trabajo de un agente es esperar respuestas HTTP del modelo y de sus herramientas, así que es I/O, y Node o Bun siguen atendiendo peticiones mientras tanto. Lo que sí se te agota es otra cosa. La memoria que ocupa cada conexión abierta, el límite de concurrencia de tu plataforma, y los sockets que nadie cerró porque el cliente se fue sin avisar.


    El estado: sácalo de la RAM el primer día

    El estado de un agente LangGraph no puede vivir en una variable del proceso: en cuanto el contenedor se reinicia o escala, la conversación desaparece. Este es el arreglo con más retorno y el más barato de aplicar.

    Mientras el estado vive en memoria, tu agente recuerda hasta el próximo despliegue. Y como los reinicios no los decides tú —los decide el autoescalado, un health check o un deploy—, no es un riesgo teórico: pasa.

    La solución en LangGraph es un checkpointer, que guarda el estado del grafo después de cada paso en una base de datos externa:

    import { PostgresSaver } from "@langchain/langgraph-checkpoint-postgres";
    
    const checkpointer = PostgresSaver.fromConnString(process.env.DATABASE_URL!);
    
    // Solo la primera vez: crea las tablas que necesita el checkpointer.
    await checkpointer.setup();
    

    Ese setup() va en el paso de migraciones de tu despliegue, no en el arranque de cada instancia. Si lo dejas en el boot y levantas diez réplicas, tienes diez procesos creando las mismas tablas a la vez.

    A partir de ahí, cada conversación se identifica con un thread_id. El agente no "recuerda" nada en memoria: al recibir un turno nuevo, lee el estado de ese hilo desde Postgres, avanza y vuelve a escribirlo.

    Eso cambia una propiedad importante de tu servicio: pasa a ser reemplazable. Puedes matar el contenedor, desplegar una versión nueva o levantar diez réplicas detrás de un balanceador, y cualquiera de ellas puede continuar cualquier conversación, porque el estado no está en ninguna de ellas.


    El servidor: streaming que sobrevive al proxy

    El segundo problema es la conexión. Un agente tarda decenas de segundos en completar una respuesta, y durante buena parte de ese tiempo no manda ni un byte, porque está esperando al modelo o ejecutando una herramienta.

    Para un proxy —Nginx, Cloudflare, el balanceador de tu PaaS— una conexión abierta que no transmite nada es una conexión muerta, y la cierra.

    Así que hay tres cosas que hacer, y las tres se olvidan:

    • Enviar las cabeceras SSE inmediatamente, para que el proxy sepa que esto es un stream y no espere a tener el cuerpo entero.
    • Mandar un latido cada pocos segundos aunque no haya nada que decir, para que la conexión nunca esté inactiva.
    • Abortar el trabajo si el cliente se va, o seguirás pagando tokens de una respuesta que ya no lee nadie.
    import express from "express";
    import { createAgent } from "langchain";
    
    // Necesita @langchain/anthropic instalado y ANTHROPIC_API_KEY en el entorno.
    const agent = createAgent({
      model: "anthropic:claude-sonnet-5",
      tools: [buscarPedido], // la definimos más abajo
      checkpointer,          // el PostgresSaver de arriba
    });
    
    const app = express();
    app.use(express.json());
    
    app.post("/api/agent/chat", async (req, res) => {
      // El thread_id se valida contra el usuario autenticado: si no,
      // cualquiera puede leer la conversación de cualquier otro.
      const { threadId, message } = req.body;
    
      res.setHeader("Content-Type", "text/event-stream");
      res.setHeader("Cache-Control", "no-cache, no-transform");
      res.setHeader("Connection", "keep-alive");
      res.setHeader("X-Accel-Buffering", "no"); // que Nginx no acumule el stream
      res.flushHeaders();                       // sin esto, el proxy espera
    
      // Latido: mantiene viva la conexión frente al idle timeout del proxy.
      const heartbeat = setInterval(() => {
        if (res.writableEnded || res.destroyed) return;
        res.write(": ping\n\n");
      }, 15_000);
    
      // Si el cliente cierra la pestaña, se cancela el trabajo del agente.
      const controller = new AbortController();
      res.on("close", () => {
        clearInterval(heartbeat);
        controller.abort();
      });
    
      try {
        const stream = await agent.streamEvents(
          { messages: [{ role: "user", content: message }] },
          {
            version: "v3",
            configurable: { thread_id: threadId },
            signal: controller.signal,
          },
        );
    
        await Promise.all([
          (async () => {
            for await (const m of stream.messages) {
              for await (const token of m.text) {
                res.write(`data: ${JSON.stringify({ type: "token", text: token })}\n\n`);
              }
            }
          })(),
          (async () => {
            for await (const call of stream.toolCalls) {
              res.write(`data: ${JSON.stringify({ type: "tool", name: call.name })}\n\n`);
            }
          })(),
        ]);
    
        res.write("data: [DONE]\n\n");
      } catch (err) {
        if (!controller.signal.aborted) {
          res.write(`data: ${JSON.stringify({ type: "error" })}\n\n`);
        }
      } finally {
        clearInterval(heartbeat);
        res.end();
      }
    });
    
    // Cloud Run y casi cualquier PaaS inyectan PORT: no lo fijes a mano.
    app.listen(process.env.PORT ?? 3000);
    

    Dos detalles que merecen su párrafo.

    El version: "v3". Es la API de streaming con proyecciones tipadas, y aparece en langchain a partir de la 1.4.0. En vez de recibir un chorro plano de eventos y filtrar por nombre, iteras stream.messages para los tokens y stream.toolCalls para las herramientas, cada uno por su lado. Si copias un tutorial que usa version: "v2" y compara event.event === "on_chat_model_stream", estás escribiendo contra la API anterior.

    Un aviso que no vas a encontrar en esos tutoriales: LangChain la marca como experimental en su propia definición de tipos —"This v3 stream is experimental and its API may change in future releases"—. La uso igualmente porque la alternativa envejece peor, pero fija la versión en tu package.json y no la des por estable.

    El signal. RunnableConfig acepta un AbortSignal, y es lo que convierte el res.on("close") en una cancelación real en lugar de un simple return. Sin él, el cliente se va pero tu servidor sigue generando tokens contra la API del modelo hasta el final.

    Si vienes del stack de Vercel, el mismo problema con otras piezas lo resolví en streaming de respuestas de IA con NestJS y el Vercel AI SDK.


    Las herramientas: donde se cuelga todo

    El fallo que más veces he tenido que diagnosticar en producción no está en el modelo ni en el grafo. Está en una herramienta que llama a una API de terceros que ese día tarda cuarenta segundos en responder.

    Sin timeout propio, esa herramienta se lleva por delante la petición entera. El usuario ve un cursor parpadeando, la conexión sigue abierta consumiendo memoria, y tú no sabes en qué paso se quedó.

    La regla es simple: toda herramienta que salga a la red lleva su propio timeout, más corto que el de la petición completa, y devuelve un texto en lugar de reventar. Ésta es la buscarPedido que usa el agente de arriba:

    import { tool } from "langchain";
    import * as z from "zod";
    
    const buscarPedido = tool(
      async ({ id }) => {
        try {
          const res = await fetch(`${API}/pedidos/${id}`, {
            signal: AbortSignal.timeout(8_000), // esta tool falla en 8s o no falla
          });
          return JSON.stringify(await res.json());
        } catch {
          // El agente lee esto y decide: reintentar o admitir que no puede.
          return "El servicio de pedidos no respondió en 8 segundos.";
        }
      },
      {
        name: "buscar_pedido",
        description: "Busca un pedido por su identificador",
        schema: z.object({ id: z.string() }),
      },
    );
    

    Y que falle está bien. Un error controlado vuelve al agente como resultado de la herramienta, el modelo lo lee y puede reintentar o decir que no ha podido. Una herramienta colgada, en cambio, no le da ninguna información con la que trabajar: el agente se queda esperando y el usuario también.

    Si además quieres que la herramienta muera cuando el cliente cierra la pestaña, combina su propio timeout con el signal que le llega en el config: el AbortSignal.timeout por sí solo no escucha esa cancelación.

    Ese diseño de herramientas —contrato claro, fallo rápido y un error que el modelo pueda leer— es el que trabajo paso a paso en el curso Construye con IA con Claude Code.

    Cómo evitar que ese reintento se convierta en un bucle sin fin lo desarrollé en Agentic Loop en TypeScript. Y cómo probar todo esto en CI antes de que llegue a producción, en test harness para agentes de IA.


    Qué pasa de verdad cuando el contenedor se reinicia

    Aquí es donde casi todas las guías te dicen una verdad a medias. "Con un checkpointer no pierdes el estado" es cierto, pero conviene saber exactamente qué se salva y qué no.

    Si el contenedor muere mientras un agente está a mitad de una tarea:

    • Se conserva todo lo que ya estaba confirmado en el último checkpoint: los turnos anteriores, los resultados de las herramientas que ya terminaron y el estado del grafo hasta ese punto.
    • Se pierde el paso en vuelo. Los tokens que se estaban generando en ese momento no están en ninguna parte, y la conexión SSE del cliente se cae con el proceso.
    • No se reanuda solo. No hay nadie que retome la tarea al arrancar el contenedor nuevo. Y ojo con lo que significa "volver a llamar". El checkpoint se escribe por paso del grafo. Si el proceso murió justo después de que el modelo pidiera una herramienta, el estado guardado termina en un mensaje del asistente con tool_calls y ninguna respuesta. Mandar ahí un mensaje nuevo del usuario produce un 400 del proveedor, porque todo tool_use exige su tool_result. Antes de aceptar el turno siguiente hay que cerrar el paso pendiente de ese hilo.

    Esto tiene una consecuencia de diseño que hay que asumir pronto: el thread_id tiene que sobrevivir al navegador y estar atado al usuario. Que lo genere el cliente está bien; que el servidor se lo crea sin comprobar contra quién ha iniciado sesión, no. Y si el identificador solo vive en la memoria del navegador, un refresco lo pierde y la conversación se queda huérfana en la base de datos: existe, pero nadie sabe pedirla.

    Y si la tarea es larga de verdad —un informe que tarda diez minutos, un procesamiento por lotes—, el patrón correcto no es este. Es aceptar la petición, devolver un identificador y ejecutar el trabajo en una cola aparte, con el cliente consultando el progreso. Un agente detrás de una petición HTTP tiene sentido para conversación, no para trabajo de fondo.


    Empaquetar y desplegar agentes LangChain en producción

    Empaquetar un agente es un Dockerfile normal con un detalle que rompe builds: desde Bun 1.2 el lockfile por defecto es bun.lock, no bun.lockb.

    FROM oven/bun:1-alpine
    WORKDIR /app
    
    # Desde Bun 1.2 el lockfile por defecto es bun.lock (texto), no bun.lockb.
    COPY package.json bun.lock ./
    RUN bun install --frozen-lockfile --production
    
    COPY . .
    
    ENV NODE_ENV=production
    USER bun
    CMD ["bun", "run", "src/server.ts"]
    

    Si copias un Dockerfile de hace un par de años vas a ver COPY package.json bun.lockb ./, y con un proyecto actual esa línea falla porque ese archivo ya no existe.

    Y un .dockerignore al lado, que es el otro detalle que rompe builds:

    node_modules
    .git
    .env*
    

    Sin él, el COPY . . te mete el node_modules de tu portátil encima del que acabas de instalar dentro del contenedor, con binarios compilados para otra plataforma.

    Sobre dónde desplegarlo, lo único que importa de verdad es cuánto tiempo te dejan tener una conexión abierta:

    Plataforma Timeout por defecto Máximo Qué tienes que tocar
    Cloud Run 300 s (5 min) 3.600 s (60 min) Subir el timeout y fijar una instancia mínima para no pagar arranque en frío por conversación
    Render · Railway · Fly Idle timeout propio, más corto No es ilimitado El latido SSE: sin él la conexión cuenta como inactiva y la cortan

    Los números de Cloud Run salen de su documentación de timeouts. Para un agente conversacional con streaming, el valor de fábrica se queda corto en cuanto una herramienta se ralentiza.

    Y aquí hay una distinción que cuesta un incidente aprender: el latido no te salva del timeout de Cloud Run. El latido derrota los timeouts de inactividad, que es lo que aplican los PaaS. El de Cloud Run es duración máxima de la petición, y corta igual aunque estés emitiendo tokens sin parar. En todos los que he probado, además, ninguno mantiene una conexión abierta indefinidamente.

    Un agente en producción además habla con servicios externos, y ahí el problema deja de ser el deploy y pasa a ser el transporte y la autenticación. Eso lo cubrí en MCP en producción: lo que se rompe cuando tu server sale del portátil.


    No despliegues a ciegas

    En un backend clásico te basta con los errores HTTP. En un agente necesitas ver el árbol de decisiones: qué prompt se envió, qué herramienta se ejecutó, cuánto tardó y qué costó. Sin eso, "va lento" y "responde mal" son incidencias que no puedes investigar.

    No lo desarrollo aquí porque ya tiene su sitio. El planteamiento está en cómo monitorear agentes de IA en producción, la implementación en Langfuse paso a paso, y la parte que te va a llegar en la factura, en medir el consumo de tokens.


    Checklist antes de pulsar deploy

    1. El estado, fuera del proceso. Checkpointer con setup() ejecutado y thread_id generado y persistido por el cliente.
    2. El stream, blindado. flushHeaders(), latido cada 15 segundos y AbortSignal conectado al cierre de la conexión.
    3. Las herramientas, con timeout propio. Más corto que el de la petición, y que fallen con un error que el agente pueda leer.
    4. El timeout de la plataforma, subido. El de fábrica está pensado para APIs que responden rápido, no para agentes.
    5. Trazas desde el primer despliegue. No desde el primer incidente.

    Las arquitecturas de agentes que tengo funcionando, con sus fallos y lo que costó arreglarlos, las comparto cada semana en Dominicode Labs.

    Que un agente funcione en tu portátil es un experimento. Que sobreviva a un reinicio es ingeniería.


    Preguntas frecuentes

    ¿Cómo se despliega un agente LangChain en producción?

    Desplegar agentes LangChain en producción son cuatro decisiones, no una. Primera: sacar el estado del proceso con un checkpointer persistente —PostgresSaver sobre Postgres— para que cualquier réplica pueda continuar cualquier conversación. Segunda: servir la respuesta por SSE con flushHeaders(), un latido cada 15 segundos y un AbortSignal atado al cierre del cliente, para que ningún proxy corte el stream. Tercera: poner timeout propio a cada herramienta que salga a la red, más corto que el de la petición. Y cuarta: subir el timeout de la plataforma, que de fábrica está pensado para APIs que responden en milisegundos. El contenedor en sí es lo de menos.

    ¿Postgres o Redis para el checkpointer?

    Postgres por defecto. El estado de una conversación es un dato que quieres conservar, consultar y auditar más tarde, y Postgres te lo da sin trabajo extra. Redis tiene sentido cuando la latencia de lectura del estado empieza a notarse de verdad o cuando el historial es efímero y no te importa perderlo. Empezar por Redis "porque es más rápido" suele salir caro el día que necesitas saber qué le contestó el agente a un cliente hace tres semanas.

    Si el contenedor se reinicia a mitad de una tarea, ¿se reanuda sola?

    No. Se conserva el estado hasta el último checkpoint confirmado, pero el paso que estaba en vuelo se pierde y nadie retoma la tarea por su cuenta. La reanudación la dispara el cliente cuando vuelve a llamar con el mismo thread_id, siempre que el paso pendiente se cierre antes de mandar un mensaje nuevo. Si el hilo se quedó con una petición de herramienta sin responder, el proveedor devuelve un 400. Y si necesitas que el trabajo termine sí o sí aunque nadie esté mirando, eso no va en una petición HTTP: va en una cola.

    ¿SSE o WebSocket para un agente?

    SSE en la mayoría de casos. La comunicación de un agente conversacional es casi toda en un sentido —el servidor manda tokens— y SSE va sobre HTTP normal, así que atraviesa proxies y balanceadores sin configuración especial. La reconexión automática te la da EventSource, pero solo habla GET: con el endpoint POST de arriba consumes el stream con fetch y ReadableStream, y la reconexión la escribes tú. WebSocket compensa cuando de verdad necesitas un canal bidireccional con mucho tráfico del cliente hacia el servidor, y a cambio te complica el despliegue.

    ¿Cuánto timeout pongo en Cloud Run?

    El valor de fábrica son 5 minutos y el máximo son 60. Para un agente conversacional, subirlo a 10-15 minutos suele ser suficiente: cubre las respuestas largas y las herramientas lentas sin dejar conexiones zombis eternas. Ponerlo al máximo no es gratis, porque una conexión colgada ocupa una instancia durante todo ese tiempo.

    ¿Esto vale con otro modelo que no sea Claude?

    Sí. La arquitectura —checkpointer externo, streaming con latido, cancelación y timeouts por herramienta— es independiente del proveedor. Lo único que cambia es el identificador del modelo que le pasas a createAgent y el paquete de integración correspondiente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Un martes por la tarde, la API de búsqueda de un cliente empezó a devolver 500. Un despliegue suyo mal hecho: tres minutos de caída.

    El agente que consumía esa API estuvo cuarenta minutos haciendo tonterías caras.

    Primero reintentó. Normal. Luego, al ver que la herramienta seguía fallando, hizo lo que hacen los modelos cuando se les cierra una puerta: buscar otra. Llamó a una tool que no tocaba, cambió los parámetros "por si acaso" y en el paso 14 se inventó tres productos con sus precios.

    Faltaba un circuit breaker para agentes IA. El patrón es viejo — Michael Nygard lo describió en Release It! en 2007 para microservicios y Martin Fowler lo popularizó después — pero cuando en medio del reintento hay un LLM, cambia una pieza fundamental. Y esa pieza es la que casi nadie implementa.


    Qué es un circuit breaker para agentes IA

    Un circuit breaker para agentes IA es una máquina de estados que envuelve la ejecución de cada tool: cuenta los fallos de infraestructura dentro de una ventana de tiempo y, al superar un umbral, deja de llamar a la API y devuelve al modelo un resultado estructurado que le dice que esa herramienta no está disponible y qué debe hacer en su lugar.

    La diferencia con el circuit breaker clásico de microservicios está en quién recibe el corte. Allí el consumidor es código, que obedece un 503 y ejecuta su rama de fallback. Aquí el consumidor es un LLM, que interpreta el error y decide por su cuenta. Y si no se lo dices tú, lo que decide es reintentar o inventarse el dato.


    Los tres estados del circuit breaker en un agente

    El breaker es una máquina de estados que envuelve la ejecución de una herramienta.

    CLOSED. Todo pasa. Vas contando fallos en una ventana de tiempo. Si en los últimos 60 segundos hay 4 fallos de infraestructura, abres.

    OPEN. Rechazas sin llamar a la API. Esto es lo importante: el execute de la tool ni siquiera hace fetch. Devuelve en microsegundos. No hay timeout de 30 segundos, no hay latencia, no hay una API agonizante recibiendo más carga de la que ya no puede atender.

    HALF_OPEN. Pasado el tiempo de reset, dejas pasar una sola llamada de prueba. Si funciona, vuelves a CLOSED. Si falla, vuelves a OPEN y el contador de espera empieza otra vez. Ojo con esto en un agente: si dejas pasar todas las llamadas de un turno en half-open, el modelo puede lanzar tres tool calls en paralelo y le acabas metiendo tres peticiones a un servicio que se está levantando.

    Hasta aquí es idéntico a un microservicio. La diferencia empieza en lo que devuelves cuando el circuito está abierto.


    Qué devolver al modelo cuando el circuito está abierto

    Cuando un servicio A tiene el circuito abierto contra el servicio B, devuelve un 503 y quien lo consume es código. El código no negocia: ve el 503 y ejecuta la rama de fallback que escribiste.

    En un agente, quien recibe la respuesta de la tool es un modelo de lenguaje. Y un modelo de lenguaje sí negocia.

    Si le devuelves esto:

    { "error": "request failed" }
    

    El modelo va a reintentar. No porque sea tonto, sino porque no tiene ninguna forma de saber que existe un circuito y que está abierto. Desde su punto de vista una llamada ha fallado, y lo razonable ante una llamada que falla es intentarlo otra vez, quizá con otros parámetros.

    Has puesto un breaker que ahorra la petición HTTP pero no ahorra ni una sola iteración del loop ni un solo token. El agente sigue quemando pasos hasta agotar el presupuesto que le pusiste en stopWhen — si es que se lo pusiste, que de eso hablo en el post del agentic loop.

    El resultado de una tool es un canal de comunicación con el modelo. Es prompt. Úsalo como tal.

    {
      "ok": false,
      "toolUnavailable": true,
      "retryAfterSeconds": 27,
      "instruction": "La herramienta \"searchCatalog\" está fuera de servicio por fallos repetidos del proveedor. No vuelvas a llamarla durante los próximos 27 segundos: cualquier intento se rechazará sin llegar a la API. Usa \"searchCatalogSnapshot\" (catálogo cacheado de hace unas horas) y avisa en tu respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía stock en tiempo real, dile que ese dato no está disponible ahora. No lo estimes ni lo inventes."
    }
    

    Cuatro cosas, y las cuatro hacen falta:

    1. Qué herramienta está caída, por su nombre exacto — el mismo que ve en la definición de tools.
    2. Cuánto tiempo, en segundos concretos. Un "temporalmente" no le dice nada.
    3. La prohibición explícita de reintentar, con el motivo: no es que vaya a fallar, es que ni siquiera va a salir de tu servidor.
    4. Qué hacer en su lugar, en concreto. Y la orden de no inventarse lo que la API le habría dado, que es exactamente lo que hizo el agente de mi cliente en el paso 14.

    Y la alternativa que le ofreces tiene que existir de verdad en el toolset. Mandar al modelo a una herramienta que no le has dado es pedirle justo lo que intentas evitar: que se la invente.

    Añade también una línea al system prompt explicando el protocolo: "si una tool devuelve toolUnavailable: true, esa herramienta no está disponible en este turno; sigue las instrucciones del campo instruction y no la vuelvas a llamar". El modelo cumple bastante bien cuando la instrucción es específica y llega en el sitio donde toma la decisión.


    Qué errores abren el circuito de una tool (y cuáles no)

    Aquí es donde la mayoría de implementaciones se rompen, y se rompen hacia el lado peligroso: abriendo el circuito de una API que funciona perfectamente.

    Los 5xx cuentan. Los timeouts cuentan. Los errores de red cuentan. Los 429 cuentan también, porque cuando un servicio te dice que vas demasiado rápido, lo correcto es dejar de llamarlo un rato.

    Los 4xx de validación no cuentan nunca. Si el modelo manda { query: 42 } donde había que mandar un string, la API devuelve un 400 y eso no significa que la API esté rota. Significa que el modelo la está llamando mal. Si sumas ese 400 al contador, un modelo torpe con los argumentos te abre el circuito de un servicio sano — y a partir de ahí has convertido un problema de prompt en una caída de herramienta.

    Distinguir "la herramienta está rota" de "el modelo la está llamando mal" es la diferencia entre un breaker que te salva y uno que sabotea al agente.

    Error ¿Cuenta para abrir? Por qué
    5xx Sí El servicio está roto
    429 Sí Saturado: lo correcto es dejar de llamarlo un rato
    Timeout / AbortError Sí Sin timeout no hay fallo que contar, solo un agente esperando
    ECONNREFUSED, ECONNRESET, ENOTFOUND Sí La API no está ahí
    400, 422 Nunca El modelo mandó argumentos mal formados
    404 Nunca El recurso no existe; la API respondió bien
    409 Nunca Conflicto de estado, no caída
    Error desconocido No Ante la duda no penalizas: un falso positivo tumba una herramienta sana
    // tool-errors.ts
    export class ToolHttpError extends Error {
      constructor(readonly status: number, message: string) {
        super(message);
        this.name = "ToolHttpError";
      }
    }
    
    const NETWORK_ERRORS = /ECONNREFUSED|ECONNRESET|ETIMEDOUT|ENOTFOUND|EAI_AGAIN|fetch failed/i;
    
    export function isInfrastructureFailure(error: unknown): boolean {
      if (error instanceof ToolHttpError) {
        // 5xx: el servicio está roto. 429: saturado, y lo correcto es dejar de llamar.
        // 400, 404, 409, 422: los argumentos venían mal. Eso es el modelo, no la API.
        return error.status >= 500 || error.status === 429;
      }
    
      // AbortSignal.timeout() lanza un AbortError / TimeoutError
      if (error instanceof Error && (error.name === "AbortError" || error.name === "TimeoutError")) {
        return true;
      }
    
      if (error instanceof Error) {
        // Ojo con el runtime: en Bun el código de red viaja en error.cause.code,
        // no en el mensaje. Mirar solo message deja pasar un ECONNREFUSED.
        const code = (error as { cause?: { code?: string } }).cause?.code;
        if (code && NETWORK_ERRORS.test(code)) return true;
        return NETWORK_ERRORS.test(error.message);
      }
    
      // Ante la duda, no penalizas: un falso positivo tumba una herramienta sana
      return false;
    }
    

    La política de "ante la duda no cuenta" es deliberada. Un breaker que no abre cuando debía te cuesta unos reintentos. Un breaker que abre cuando no debía te deja al agente sin una herramienta buena durante medio minuto, y el modelo se pone creativo.

    La mitad de estos 4xx los evitas antes de que ocurran con schemas estrictos en la definición de la tool. Es el mismo trabajo de blindaje que vemos en el curso de Zod para TypeScript: si el argumento no valida, ni siquiera llega a salir una petición.


    Cómo implementar un circuit breaker en TypeScript

    Factory con estado en cierre, sin dependencias. Umbral de fallos, ventana deslizante, timeout de reset y una única prueba en half-open.

    // circuit-breaker.ts
    export type BreakerState = "CLOSED" | "OPEN" | "HALF_OPEN";
    
    export class CircuitOpenError extends Error {
      constructor(readonly toolName: string, readonly retryAfterMs: number) {
        super(`Circuito abierto para la herramienta "${toolName}"`);
        this.name = "CircuitOpenError";
      }
    }
    
    export interface BreakerOptions {
      name: string;
      failureThreshold?: number;
      windowMs?: number;
      resetTimeoutMs?: number;
      isFailure?: (error: unknown) => boolean;
      onStateChange?: (from: BreakerState, to: BreakerState) => void;
    }
    
    export function createCircuitBreaker({
      name,
      failureThreshold = 4,
      windowMs = 60_000,
      resetTimeoutMs = 30_000,
      isFailure = () => true, // ¡ojo! sobrescríbelo siempre con isInfrastructureFailure
      onStateChange = () => {},
    }: BreakerOptions) {
      let state: BreakerState = "CLOSED";
      let failures: number[] = [];
      let openedAt = 0;
      let probeInFlight = false;
    
      const transition = (next: BreakerState) => {
        if (next === state) return;
        onStateChange(state, next);
        state = next;
      };
    
      const currentState = (now: number): BreakerState => {
        if (state === "OPEN" && now - openedAt >= resetTimeoutMs) {
          transition("HALF_OPEN");
        }
        return state;
      };
    
      return {
        name,
        // getState() no es puro: dispara la transición OPEN -> HALF_OPEN. Si lo
        // polleas desde un exportador de métricas, la transición la provoca la
        // observabilidad y no el tráfico real.
        getState: () => currentState(Date.now()),
        getRetryAfterMs: () => Math.max(0, resetTimeoutMs - (Date.now() - openedAt)),
    
        async execute<T>(fn: () => Promise<T>): Promise<T> {
          const now = Date.now();
          const phase = currentState(now);
    
          if (phase === "OPEN") {
            throw new CircuitOpenError(name, resetTimeoutMs - (now - openedAt));
          }
    
          // En half-open solo pasa una petición: las demás siguen rechazadas
          if (phase === "HALF_OPEN" && probeInFlight) {
            // Espera corta a propósito: si la prueba en vuelo cierra el circuito, no
            // quieres haberle dicho al modelo que abandone la tool medio minuto
            throw new CircuitOpenError(name, 1_000);
          }
          if (phase === "HALF_OPEN") probeInFlight = true;
    
          try {
            const result = await fn();
            if (phase === "HALF_OPEN") {
              probeInFlight = false;
              failures = [];
              transition("CLOSED");
            }
            return result;
          } catch (error) {
            if (!isFailure(error)) {
              // No es culpa de la herramienta: no toca el contador
              if (phase === "HALF_OPEN") probeInFlight = false;
              throw error;
            }
    
            const failedAt = Date.now();
            failures = failures.filter((t) => failedAt - t < windowMs); // ventana deslizante
            failures.push(failedAt);
    
            if (phase === "HALF_OPEN" || failures.length >= failureThreshold) {
              openedAt = failedAt;
              probeInFlight = false;
              failures = [];
              transition("OPEN");
            }
            throw error;
          }
        },
      };
    }
    
    export type CircuitBreaker = ReturnType<typeof createCircuitBreaker>;
    

    Un fallo en half-open reabre directamente, sin esperar a acumular el umbral. Es intencionado: si la prueba falla, el servicio sigue caído y no hay nada que discutir.

    Ahora el wrapper que convierte la excepción en un resultado que el modelo entiende, integrado con la definición de tools del Vercel AI SDK:

    // with-breaker.ts
    import { tool } from "ai";
    import { z } from "zod";
    import { createCircuitBreaker, CircuitOpenError, type CircuitBreaker } from "./circuit-breaker";
    import { ToolHttpError, isInfrastructureFailure } from "./tool-errors";
    
    interface UnavailableInfo {
      toolName: string;
      retryAfterSeconds: number;
    }
    
    export function withBreaker<TArgs, TResult>(
      breaker: CircuitBreaker,
      onOpen: (info: UnavailableInfo) => Record<string, unknown>,
      execute: (args: TArgs) => Promise<TResult>,
    ) {
      return async (args: TArgs) => {
        try {
          return { ok: true, data: await breaker.execute(() => execute(args)) };
        } catch (error) {
          if (error instanceof CircuitOpenError) {
            return onOpen({
              toolName: error.toolName,
              retryAfterSeconds: Math.max(1, Math.ceil(error.retryAfterMs / 1000)),
            });
          }
          // Este fallo puede ser justo el que acaba de abrir el circuito: el modelo
          // tiene que enterarse ahora, no en la siguiente iteración
          if (breaker.getState() === "OPEN") {
            return onOpen({
              toolName: breaker.name,
              retryAfterSeconds: Math.max(1, Math.ceil(breaker.getRetryAfterMs() / 1000)),
            });
          }
    
          // Fallo puntual con el circuito cerrado: el modelo aún puede reintentar,
          // pero necesita saber qué falló para no repetir la misma llamada
          return { ok: false, error: error instanceof Error ? error.message : "Error desconocido" };
        }
      };
    }
    
    const searchBreaker = createCircuitBreaker({
      name: "searchCatalog",
      failureThreshold: 4,
      windowMs: 60_000,
      resetTimeoutMs: 30_000,
      isFailure: isInfrastructureFailure,
    });
    
    export const searchCatalog = tool({
      description: "Busca productos en el catálogo en tiempo real",
      inputSchema: z.object({ query: z.string().min(2) }),
      execute: withBreaker(
        searchBreaker,
        ({ toolName, retryAfterSeconds }) => ({
          ok: false,
          toolUnavailable: true,
          retryAfterSeconds,
          instruction:
            `La herramienta "${toolName}" está fuera de servicio por fallos repetidos del proveedor. ` +
            `No vuelvas a llamarla durante los próximos ${retryAfterSeconds} segundos: cualquier ` +
            `intento se rechazará sin llegar a la API. Usa "searchCatalogSnapshot" y avisa en tu ` +
            `respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía ` +
            `stock en tiempo real, dile que ese dato no está disponible ahora. No lo inventes.`,
        }),
        async ({ query }: { query: string }) => {
          const res = await fetch(`${process.env.CATALOG_API}/search?q=${encodeURIComponent(query)}`, {
            signal: AbortSignal.timeout(4_000),
          });
          if (!res.ok) throw new ToolHttpError(res.status, `Búsqueda falló con ${res.status}`);
          return res.json();
        },
      ),
    });
    

    Fíjate en el segundo if del catch: el fallo que abre el circuito también tiene que hablarle al modelo. Si esperas a la siguiente llamada para avisarle, has regalado una iteración entera del loop justo en el peor momento, el momento en que acabas de decidir que la herramienta está muerta.

    El ejemplo va sobre el AI SDK de Vercel 7, donde el schema de la tool se declara en inputSchema. Ese nombre existe desde la 5: si sigues en la 4.x el campo se llama parameters y el resto del wrapper no cambia.

    Fíjate también en el AbortSignal.timeout(4_000). Sin timeout explícito no hay breaker que valga: una petición colgada no genera un fallo que contar, genera un agente esperando. El timeout es lo que convierte "lento" en "fallido", y sin eso el patrón entero no arranca. Es el tipo de detalle que trato en programación defensiva en TypeScript.


    Un breaker por herramienta, nunca uno global

    Si la API de búsqueda está caída, la base de datos sigue respondiendo perfectamente. Un breaker global convierte un fallo parcial en una caída total del agente: pierdes cuatro herramientas sanas por culpa de una rota.

    Un registro por nombre de tool y listo:

    const breakers = new Map<string, CircuitBreaker>();
    
    export const breakerFor = (name: string, options: Partial<BreakerOptions> = {}): CircuitBreaker => {
      const existing = breakers.get(name);
      if (existing) return existing;
    
      const created = createCircuitBreaker({ name, isFailure: isInfrastructureFailure, ...options });
      breakers.set(name, created);
      return created;
    };
    

    Y una advertencia que cuesta una tarde de depuración: el estado del breaker tiene que vivir fuera de la petición. Si creas el breaker dentro del handler del chat, cada conversación arranca con el contador a cero y el patrón no protege absolutamente nada. Ámbito de módulo como mínimo. Si corres en serverless con varias instancias, el estado compartido va a Redis o cada instancia aprenderá por su cuenta que la API está caída — y pagarás el aprendizaje N veces.

    Y los umbrales no son iguales para todas: una API de pagos crítica aguanta 6 fallos antes de abrir, un scraper de enriquecimiento prescindible abre a los 2.


    El fallback: qué le das al modelo cuando no hay datos

    Tienes tres opciones, y elegir mal aquí desperdicia el breaker.

    Respuesta cacheada. El último snapshot bueno. Sirve para catálogos, listados y configuración. Obligatorio decirle al modelo que los datos son viejos y de cuándo son, para que lo declare en su respuesta.

    Herramienta degradada. Búsqueda local en vez de búsqueda semántica remota. Peor resultado, cero dependencia externa.

    Seguir sin el dato, declarándolo. La opción más honesta y la más infravalorada. El agente termina la tarea con la información que tiene y dice explícitamente qué no pudo comprobar. Mucho mejor que un dato inventado con toda la confianza del mundo.

    Y una cuarta que a veces es la correcta: parar y escalar al humano. Si la herramienta caída era imprescindible para la tarea, seguir es peor que rendirse. Igual que con los guardrails de ejecución, la decisión de frenar es parte del diseño, no un fallo.


    Cómo saber si tu breaker está bien calibrado

    Un breaker sin métricas es un valor mágico que alguien puso hace seis meses. Registra el cambio de estado con onStateChange y mira tres números:

    Aperturas por hora y por herramienta. Si una tool abre 5 veces por hora contra una API que su proveedor jura estar sana, tu umbral es demasiado bajo o estás contando 4xx que no deberías. Revisa el clasificador antes que el umbral.

    Tiempo total en OPEN. Es tu indisponibilidad real de esa capacidad. Si una herramienta pasa el 20% del día en OPEN, el problema ya no es el breaker: es el proveedor, y toca renegociarlo o buscar alternativa.

    Ratio de half-open que vuelven a abrir. El indicador de flapping. Por encima del 70% significa que tu resetTimeoutMs es demasiado corto y estás probando un servicio que aún no se ha levantado, gastando una llamada de tool en cada intento. Alarga el backoff de forma progresiva: 30s, 60s, 2 min. La versión de arriba usa un resetTimeoutMs fijo; para escalarlo, multiplícalo por el número de aperturas consecutivas antes de asignar openedAt.

    Y una cuarta que solo existe en agentes: qué hizo el modelo después de recibir el fallback. Loguea la siguiente tool call tras un toolUnavailable. Si el modelo vuelve a llamar a la herramienta caída, tu mensaje no está siendo lo bastante claro y toca reescribirlo. Los pasos que se ahorra el agente los ves directamente en el consumo de tokens por tarea.


    Por dónde empezar con el circuit breaker en tu agente

    Coge tu agente. Mira la tool que llama al servicio externo menos fiable — todos tenemos una. Ponle un timeout explícito, un breaker propio con isFailure que ignore los 4xx de validación, y un mensaje de fallback escrito para el modelo y no para tu log.

    Esa única herramienta es el 80% del beneficio. El resto es replicar el patrón.

    La idea de fondo: en un agente, cualquier mecanismo de defensa que no le hable al modelo se queda a medias. Puedes cortar la petición HTTP, pero si no le explicas al LLM qué ha pasado y qué esperas de él, el modelo rellenará el hueco con lo que se le ocurra. Y lo que se le ocurre suele ser caro.

    Esta forma de pensar la arquitectura — decidir antes de escribir código qué hace el sistema cuando algo falla — es exactamente el enfoque del curso Construye con IA: de la idea al producto. Y si quieres ver estos patrones montados sobre proyectos reales, con las métricas puestas y funcionando, en Dominicode Labs es donde los estamos rodando.


    Preguntas frecuentes

    ¿Qué diferencia hay entre un circuit breaker y un simple retry con backoff?

    El retry insiste; el breaker deja de insistir. Son complementarios: el backoff resuelve el fallo puntual dentro de una misma llamada, y el breaker resuelve el fallo sostenido a lo largo de muchas llamadas. Sin breaker, tu retry con backoff se ejecuta entero en cada una de las 14 iteraciones del agente contra un servicio que lleva minutos caído.

    ¿Cuántos fallos deben abrir el circuito de una tool?

    Entre 3 y 5 dentro de una ventana de 60 segundos funciona bien como punto de partida. Con umbral 1 o 2 abres por un pico transitorio; por encima de 8 el agente ya habrá gastado medio presupuesto de pasos antes de que el breaker reaccione. Ajústalo por criticidad: más tolerancia en herramientas imprescindibles, menos en las prescindibles.

    ¿Debe contar un error 400 de una tool para abrir el circuito?

    No. Un 400, un 404 o un 422 casi siempre significan que el modelo mandó argumentos mal formados, no que la API esté rota. Si los cuentas, acabas abriendo el circuito de un servicio sano por culpa del LLM y dejando al agente sin una herramienta que funcionaba. Cuentan los 5xx, los timeouts, los errores de red y los 429.

    ¿Dónde guardo el estado del breaker si mi agente corre en serverless?

    En un almacén compartido tipo Redis, con el nombre de la herramienta como clave. Si lo dejas en memoria de proceso, cada instancia fría descubre por su cuenta que el proveedor está caído y pagas ese descubrimiento tantas veces como instancias tengas. Para un servidor de larga vida, el ámbito de módulo basta.

    ¿El circuit breaker sustituye al límite de pasos del agente?

    No, resuelven cosas distintas. El límite de pasos acota cuánto puede trabajar el agente en total; el breaker impide que una herramienta rota consuma esos pasos sin aportar nada. Van juntos: el breaker devuelve el control rápido y con instrucciones, y el límite de pasos sigue siendo la red de seguridad final.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • GPT-6 Astra: precio, API y el asterisco de los 272.000 tokens

    GPT-6 Astra: precio, API y el asterisco de los 272.000 tokens

    OpenAI anunció GPT-6 Astra el 3 de septiembre de 2026. Greg Brockman, presidente de la compañía, lo llamó un generational leap y dijo que podría verse como la llegada de la AGI.

    Yo abrí la tabla de precios y me quedé mirando un asterisco.

    El asterisco dice esto: cualquier request que supere los 272.000 tokens de input dobla la tarifa de input y la de caché, y multiplica el output por 1,5. Para la request entera. No para los tokens que se pasan del umbral.

    Ahora piensa en tu agente. El que arrastra el historial de tool calls y va acumulando contexto en cada iteración. Ese agente no cruza el umbral cuando tú lo decides: lo cruza en la iteración 14, cuando una herramienta devuelve 6.000 tokens de logs más de lo habitual. Y esa request, completa, pasa a costar casi el doble.

    Mi tesis: Astra es un bisturí caro para tareas largas y autónomas, no el reemplazo por defecto de tu modelo de trabajo. Y la decisión de usarlo no se toma leyendo benchmarks, se toma leyendo tu contador de tokens.


    Qué es GPT-6 Astra y dónde puedes usarlo

    GPT-6 Astra es el modelo de razonamiento de gama alta de OpenAI, lanzado el 3 de septiembre de 2026 y orientado a tareas largas y autónomas: computer use, respuesta a incidentes y refactors de varias horas. En la API se identifica como gpt-6-astra, admite 1,05 millones de tokens de contexto y su knowledge cutoff es el 30 de abril de 2026. Cuesta $10 por millón de tokens de input y $50 de output, con una tarifa premium que dobla el input a partir de 272.000 tokens por request.

    Está en la API de OpenAI, en Azure y en Bedrock, y en ChatGPT para Plus, Pro, Business y Enterprise con rollout escalonado. Los primeros en tenerlo fueron los clientes del programa de ciberseguridad de OpenAI. Ese detalle no es casual: mira la fila de ExploitBench más abajo.

    Los números de contexto son los que esperas de un modelo pensado para tareas largas: 1,05 millones de tokens de contexto máximo, hasta 922.000 de input y hasta 128.000 de output.

    Y sabe usarlos. OpenAI mide 100% en MRCR v2 8-needle en la banda de 256K–512K, y 96,3% en la banda de 512K–1M. Recuperación casi perfecta en contextos enormes.

    Aquí está la ironía del lanzamiento: el modelo es excelente con contexto largo, y el precio te empuja a no usarlo. La capacidad técnica y el incentivo económico apuntan en direcciones opuestas.


    Cuánto cuesta GPT-6 Astra: precio de la API y el asterisco

    GPT-6 Astra cuesta $10 por millón de tokens de input y $50 por millón de output, según la ficha oficial del modelo en la API de OpenAI. Y viene con un asterisco: si una request supera los 272.000 tokens de input, se aplica tarifa premium a la request entera —input y caché al doble, output ×1,5—, no solo al exceso.

    Estas son las tarifas por millón de tokens:

    Concepto Tarifa base Si la request pasa de 272.000 tokens de input
    Input $10 $20
    Cached input $1 $2
    Cache write $12,50 $25
    Output $50 $75

    Hay además un fast mode que, según OpenAI, cobra el doble a cambio de hasta ~2,5x de velocidad. Útil para tareas interactivas, irrelevante para un batch nocturno.

    Y un dato que conviene tener presente: OpenAI ha puesto a Astra exactamente al mismo precio que Claude Fable 5.1, $10 de entrada y $50 de salida. Nadie está compitiendo por precio en la gama alta.

    Vamos con el cálculo que importa.

    Imagina una request de tu agente con 270.000 tokens de input y 8.000 de output:

    • Input: 270.000 × $10 / 1M = $2,70
    • Output: 8.000 × $50 / 1M = $0,40
    • Total: $3,10

    Ahora una tool devuelve 5.000 tokens de logs más de lo normal. La request sube a 275.000 de input:

    • Input: 275.000 × $20 / 1M = $5,50
    • Output: 8.000 × $75 / 1M = $0,60
    • Total: $6,10

    Un 1,9% más de tokens de input. Un 97% más de factura.

    Multiplícalo por 100 requests al día y tienes $310 frente a $610. Al mes (30 días), $9.000 de diferencia por 5.000 tokens de logs que nadie revisó.

    Y ojo con dar por hecho que la caché te salva.

    Lo que está documentado es que el multiplicador se dispara por los tokens de input de la request y que afecta también a la tarifa de caché. Lo que no dice ninguna fuente es si los tokens servidos desde caché cuentan para llegar a los 272.000.

    Hay un indicio de que sí: en la API de OpenRouter, el override de tarifa de esta familia de modelos se indexa por min_prompt_tokens, y los tokens de caché siguen siendo prompt tokens. Si 260.000 de tus 280.000 tokens vienen de caché y el umbral los cuenta, esa caché pasa de $1 a $2 el millón igual.

    Lanza una request de prueba y mira la factura antes de montar tu estrategia de caché alrededor de ese número.

    Cómo evitar cruzar el umbral sin darte cuenta

    Tres cosas, en este orden:

    1. Mide antes de enviar, no después. Si tu telemetría te dice el coste al final del mes, ya es tarde. Necesitas el contador de tokens de input por request, en vivo y con alertas. Lo desarrollé paso a paso en cómo medir el consumo de tokens de un agente de IA.
    2. Poda el historial de forma agresiva. Resume los tool outputs antiguos, trunca los logs a las líneas relevantes y no le metas el repositorio entero "por si acaso". Un agente que necesita 270.000 tokens de contexto casi siempre tiene un problema de diseño, no de memoria.
    3. Pon un techo duro por request y falla rápido. Mejor abortar y partir la tarea que descubrir el gasto en la facturación.

    GPT-6 Astra vs Claude Opus 5 y GPT-5.6 Sol: benchmarks y letra pequeña

    GPT-6 Astra supera a Claude Opus 5 y a GPT-5.6 Sol en tareas agénticas largas, pero empata con Opus 5 en código de frontera. Estas son las cifras que publicó OpenAI:

    Benchmark Astra GPT-5.6 Sol Claude Opus 5
    OSWorld 2.0 (computer use) 72,6% 65,7% 70,2%
    Terminal-Bench 4.0 57,7% 37,3% 52,3%
    FrontierMath Tier 4 v2 97,6% 83,0% 73,2%
    GPQA Diamond 96,0% 94,6% 93,7%
    ExploitBench 100% 78,5% 70,0%
    ARC-AGI-3 (harness con estado) 99,9% 7,8% 30,2%
    SRE-Bench 88,0% 55,9% —
    DeepSWE v1.1 74,1% — 69,9%
    FrontierCode 1.1 53,3% — 53,4%

    En computer use, además, resuelve ese 72,6% en unos 40 minutos por tarea según OpenAI: tarda un 47% menos que los ~75 minutos de Sol. Si automatizas navegador o escritorio, ahí hay una mejora real que notas en la latencia y en el número de reintentos.

    Ahora la letra pequeña.

    El 99,9% de ARC-AGI-3 no es tuyo. Ese resultado depende de un harness con estado y caro, montado para el benchmark. En llamadas stateless normales a la API —las que hace tu código— la puntuación cae, según la organización del benchmark, al rango del ~17–63%. La diferencia entre 99,9% y 17% no está en el modelo: está en la infraestructura que lo envuelve. Cuando veas ese número en un hilo de Twitter, lo que estás viendo es un sistema completo, no un endpoint.

    Y el precio por token miente. En el Intelligence Index de Artificial Analysis, Astra y GPT-5.6 Sol empatan a 61 puntos, y Astra cuesta 2,5 veces más por token ($7,70 frente a $3,08 por millón, precio mezclado). Titular fácil: "pagas 2,5x por lo mismo". Falso.

    Correr ese índice consumió 42M de tokens de output con Astra y 70M con Sol. Astra razona menos en voz alta y llega antes. Por eso el coste por tarea sale $1,67 frente a $0,95: la brecha por token es 2,5x, la brecha por tarea es 1,8x. Ambos números son de la variante max, que es la que mide Artificial Analysis — con menos reasoning effort la cuenta cambia.

    Es la misma lección que con Gemini 3.8 Flash y su coste por tarea: el proveedor te da el precio por token, tu arquitectura decide el coste por tarea. Compara siempre lo segundo.

    Un aviso antes de que abras la calculadora: las fuentes públicas no se ponen de acuerdo sobre el precio de Sol. OpenRouter lo lista a $2/$10 por millón; Artificial Analysis calcula con $4/$20. No hagas números con una cifra que leíste en un hilo. Mira la tabla oficial de OpenAI el día que vayas a decidir, y crúzalo con lo que ya sabes de la API de GPT-5.6 en la práctica.

    ¿Y lo de la AGI? En FrontierCode 1.1, código de frontera, Astra saca 53,3% y Opus 5 saca 53,4%. Empate técnico. Un modelo que insinúa AGI no empata en programación difícil con un modelo de la generación anterior. Que es más o menos lo que ya se veía en la comparativa de Opus 5, GPT-5.6 y Kimi K3: las diferencias de frontera son estrechas y el marketing es ancho.


    Límites de la API de GPT-6 Astra: lo que no te da

    Antes de planificar una migración, comprueba que tu stack sobrevive a estos límites:

    • Tool calling solo vía Responses API. Si tu agente vive en Chat Completions, no hay herramientas. Migras o no usas Astra.
    • No hay fine-tuning, ni Realtime, ni Assistants, ni generación nativa de media. Cualquier flujo que dependa de eso se queda fuera.
    • Reasoning effort: low, medium, high, xhigh, max. El valor none existe en la API, pero gpt-6-astra no lo acepta. Este modelo siempre razona, y ese razonamiento se factura como output a $50 el millón. No puedes apagarlo para una clasificación tonta.
    • Zero Data Retention solo para clientes "elegibles". No es una promesa universal. Si tienes un requisito de cumplimiento, confírmalo por escrito antes de meter datos de cliente.

    Cómo llamar a GPT-6 Astra desde TypeScript

    Lo mínimo que funciona, con Responses API y control de razonamiento:

    import OpenAI from "openai";
    
    const client = new OpenAI();
    
    const incidente =
      "PagerDuty #4821: latencia p99 por encima de 3s en checkout-api desde las 02:14 UTC";
    
    // Con gpt-6-astra el tool calling SOLO existe en la Responses API.
    // En Chat Completions no tienes herramientas con este modelo.
    const response = await client.responses.create({
      model: "gpt-6-astra",
      // low | medium | high | xhigh | max. Este modelo no acepta "none":
      // siempre razona, y ese razonamiento se paga como output.
      reasoning: { effort: "high" },
      input: [
        { role: "developer", content: "Eres un SRE. Diagnostica y propón un fix." },
        { role: "user", content: incidente },
      ],
      tools: [
        {
          type: "function",
          name: "query_logs",
          description: "Consulta los logs de un servicio en una ventana temporal",
          parameters: {
            type: "object",
            properties: {
              service: { type: "string" },
              since: { type: "string", description: "Fecha ISO 8601" },
            },
            required: ["service", "since"],
            additionalProperties: false,
          },
          strict: true,
        },
      ],
    });
    
    console.log(response.usage?.input_tokens, response.usage?.output_tokens);
    

    Y el guardarraíl que yo pondría antes de cada llamada, no después:

    const PREMIUM_INPUT_THRESHOLD = 272_000;
    const SAFETY_MARGIN = 20_000; // lo que puede crecer el input dentro de la iteración
    
    export function assertBelowPremiumTier(estimatedInputTokens: number) {
      if (estimatedInputTokens > PREMIUM_INPUT_THRESHOLD - SAFETY_MARGIN) {
        throw new Error(
          `Contexto de ${estimatedInputTokens} tokens: la request entraría en tarifa premium. Poda el historial o parte la tarea.`
        );
      }
    }
    

    Veinte mil tokens de margen parecen exagerados hasta que ves lo que ocupa un git diff grande o un volcado de logs. Prefiero abortar la iteración a pagar el doble por una request que nadie decidió hacer.


    Cuándo merece la pena GPT-6 Astra (y cuándo no)

    Caso de uso ¿Astra? Por qué
    Agentes autónomos de horas o días (refactors grandes, migraciones) Sí 57,7% en Terminal-Bench 4.0 frente al 52,3% de Opus 5 y el 37,3% de Sol
    Computer use y automatización de escritorio o navegador Sí 72,6% en OSWorld 2.0 y un 47% más rápido por tarea que Sol
    Incidentes de producción, on-call, postmortems Sí 88,0% en SRE-Bench frente al 55,9% de Sol
    Seguridad ofensiva autorizada Sí 100% en ExploitBench; es a quien OpenAI dio acceso primero
    Razonamiento matemático de frontera Sí 97,6% en FrontierMath Tier 4 v2 frente al 73,2% de Opus 5
    Código del día a día: features, bugs, PRs No 53,3% vs 53,4% de Opus 5 en FrontierCode 1.1. Empate, pagando más
    Chat, soporte, RAG conversacional No Pagas un razonamiento que nadie pidió y que no puedes desactivar
    Clasificación y extracción en volumen No El peor caso posible: input largo, output corto, tarifa de gama alta
    Cualquier flujo con fine-tuning, Realtime o Assistants No No existen para este modelo

    La lectura corta: si la tarea la termina una persona en diez minutos, Astra es caro. Si la tarea son ocho horas de un senior peleándose con una terminal, es barato.

    Y esto no va de elegir un modelo, va de enrutar por tarea. Modelo barato por defecto, escalado a Astra solo cuando la tarea es larga, autónoma y verificable. Es el mismo criterio que aplico en el curso Construye con IA: de la idea al producto: la arquitectura decide la factura, no el modelo.


    Qué hacer esta semana

    Una sola cosa: instrumenta el contador de tokens de input por request y mira cuántas de tus llamadas actuales caen entre 200.000 y 300.000 tokens.

    Ese histograma es tu exposición real al tier premium. Si tienes una cola larga acercándose a 272.000, no tienes un problema de modelo: tienes un problema de gestión de contexto que hoy te sale barato y con Astra te costaría el doble.

    Arregla eso primero. Después decide si necesitas el bisturí.

    En Dominicode Labs estamos midiendo coste por tarea de estos modelos sobre proyectos reales, con los routers y los guardarraíles que usamos en producción.


    Preguntas frecuentes

    ¿Qué es GPT-6 Astra?

    Es el modelo de razonamiento de gama alta de OpenAI, anunciado el 3 de septiembre de 2026. En la API se identifica como gpt-6-astra, admite 1,05 millones de tokens de contexto (hasta 922.000 de input y 128.000 de output) y su knowledge cutoff es el 30 de abril de 2026. Está disponible en la API de OpenAI, Microsoft Azure y Amazon Bedrock, y en ChatGPT para Plus, Pro, Business y Enterprise.

    ¿Cuánto cuesta GPT-6 Astra?

    $10 por millón de tokens de input y $50 por millón de output. El input cacheado son $1 y la escritura de caché $12,50. Si una request supera los 272.000 tokens de input, se aplica tarifa premium a toda la request: input y caché al doble ($20 y $2) y output ×1,5 ($75). Hay además un fast mode que cobra el doble a cambio de hasta ~2,5x de velocidad.

    ¿Debo migrar mis agentes a GPT-6 Astra?

    Solo los que ejecutan tareas largas y autónomas: computer use, respuesta a incidentes, refactors de varios días, seguridad ofensiva autorizada. Para el resto de tu producto —chat, clasificación, código del día a día— estarías pagando un razonamiento más caro para obtener prácticamente el mismo resultado. Enruta por tarea, no cambies el modelo por defecto.

    ¿Qué pasa exactamente si mi request supera los 272.000 tokens de input?

    Se aplica tarifa premium a toda la request, no solo al exceso: input y caché al doble, output multiplicado por 1,5. Pasar de 270.000 a 275.000 tokens sube un ejemplo típico de $3,10 a $6,10. Por eso el guardarraíl va antes de la llamada y con margen, no después de leer la factura.

    ¿Justifica su precio lo que OpenAI insinúa sobre la AGI?

    OpenAI lo insinúa: Greg Brockman habló de un generational leap que podría verse como la llegada de la AGI. Los datos son más modestos. En FrontierCode 1.1 empata con Claude Opus 5 (53,3% frente a 53,4%), y su 99,9% en ARC-AGI-3 depende de un harness con estado y caro que tú no tienes: en llamadas stateless normales baja al rango ~17–63%. Es el mejor modelo para ciertas tareas largas. No es otra categoría de cosa.

    ¿GPT-6 Astra es mejor que Claude Opus 5?

    En tareas agénticas largas sí; en código del día a día no. Astra gana en Terminal-Bench 4.0 (57,7% frente a 52,3%), OSWorld 2.0 (72,6% frente a 70,2%) y FrontierMath Tier 4 v2 (97,6% frente a 73,2%). Pero en FrontierCode 1.1 empatan: 53,3% Astra contra 53,4% Opus 5. Para features, bugs y PRs, Astra no te da más y te cuesta más.

    ¿GPT-6 Astra soporta tool calling en Chat Completions?

    No. Con gpt-6-astra las herramientas solo funcionan a través de la Responses API. Tampoco hay fine-tuning, Realtime, Assistants ni generación nativa de media. Si tu agente depende de alguna de esas piezas, la migración es de arquitectura, no de cambiar el string del modelo.

    ¿Es Astra 2,5 veces más caro que GPT-5.6 Sol?

    Por token sí: $7,70 frente a $3,08 por millón en el precio mezclado de Artificial Analysis. Por tarea la brecha se estrecha a 1,8x — $1,67 frente a $0,95 — porque correr el Intelligence Index consumió 42M de tokens de output con Astra y 70M con Sol. Ojo: las fuentes públicas se contradicen sobre el precio de Sol (OpenRouter lo lista a $2/$10, Artificial Analysis calcula con $4/$20), así que haz tus números contra la tabla oficial de OpenAI el día que vayas a decidir.

    ¿Se puede desactivar el razonamiento de GPT-6 Astra para bajar el coste?

    No del todo. Con gpt-6-astra el reasoning effort admite low, medium, high, xhigh y max; el valor none que sí existe en la API para otros modelos aquí no está disponible. Puedes bajarlo a low para reducir tokens de razonamiento, aunque si tu caso de uso no necesita razonar en absoluto, la respuesta correcta no es bajar el effort: es usar otro modelo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

    Gemini 3.8 Flash: mismo precio por token, tu factura sube un 40%

    Google anunció Gemini 3.8 Flash el 2 de septiembre de 2026 con el mismo precio por token que su antecesor: $0.75 por millón de tokens de entrada y $3.75 de salida. Ni un céntimo de diferencia en la tabla de precios.

    Artificial Analysis lo midió ese mismo día. El coste real por tarea completada de Gemini 3.8 Flash es un 40% más alto que el de Gemini 3.7 Flash.

    No es un error de facturación. Es el modelo haciendo exactamente lo que Google prometió: pensar más. Y pensar más se paga en tokens de salida.

    Esa es la parte del anuncio del 2 de septiembre que casi nadie está contando. Google presentó el modelo más barato jamás medido a ese nivel de inteligencia y, al mismo tiempo, subió el coste real de cada tarea un 40%. Las dos frases son verdad. Solo una te llega a la tarjeta.

    La tesis de este post: deja de comparar modelos por dólares por millón de tokens y empieza a compararlos por dólares por tarea completada. El precio por token lo pone el proveedor en una tabla. El coste por tarea lo pones tú con tu arquitectura, y la palanca que de verdad controlas se llama nivel de reasoning.

    El coste por tarea es el gasto total en tokens —entrada, salida y razonamiento— dividido entre el número de tareas que terminan con una salida válida. No entre llamadas a la API: entre tareas completadas.


    Qué es Gemini 3.8 Flash y qué lanzó Google el 2 de septiembre de 2026

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026 junto a Gemini 3.8 Flash Cyber, una variante restringida especializada en ciberseguridad. Es el cuarto modelo Flash que Google publica en menos de cuatro meses. Ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026. Disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    En benchmarks aguanta el pulso a modelos que cuestan casi siete veces más por token: 73,7% en DeepSWE v1.1 frente al 74,0% de Claude Opus 5, 54,9% en HLE-Verified y un 59 en el Artificial Analysis Intelligence Index, donde empata con GPT-5.6 Sol y Grok 4.6. También supera a modelos frontera mayores en Vals Finance Agent V2 y en el Harvey's Legal Agent Benchmark, que son evals de trabajo profesional, no de acertijos.

    Ese 73,7% contra el 74,0% de Opus 5 es la noticia de verdad. Es la misma tendencia que ya se veía en la comparativa de Opus 5, GPT-5.6 y Kimi K3 y en el repaso de Grok 4.5, Fable 5 y DeepSeek V4 para programar: la distancia entre la gama alta y la gama media se cierra por abajo.

    Hay otro dato que me importa. En el Gray Swan IPI, que mide robustez frente a inyección indirecta de prompts, un 5,5% de los ataques tuvo éxito: más de uno de cada veinte intentos. Si tu agente lee contenido que no controlas, ese 5,5% es tu problema, y se resuelve con defensas contra inyección indirecta de prompts, no con fe en el modelo.


    Cuánto cuesta Gemini 3.8 Flash: el precio por token es marketing, el coste por tarea es tu factura

    Aquí está la contradicción, medida de forma independiente por Artificial Analysis:

    Métrica Gemini 3.7 Flash Gemini 3.8 Flash
    Precio entrada / salida (por 1M tokens) $0.75 / $3.75 $0.75 / $3.75
    Tokens de salida por tarea referencia 48.000 (+30%)
    Coste por tarea, high reasoning referencia $0.58 (~+40%)

    Lee la tabla dos veces. La fila del precio no se mueve. La fila que pagas sube un 40%.

    Y ojo con el desglose, porque ese 30% de salida no explica por sí solo el 40% de subida. Con 48.000 tokens de salida a $3.75 el millón, la salida son unos $0.18 de los $0.58: el resto es entrada. Lo que dispara la factura son los turnos. Cada vuelta extra del agente reenvía el contexto acumulado, así que más razonamiento no solo genera más tokens de salida, también multiplica los de entrada. Por eso un +30% de salida termina en un +40% de coste por tarea.

    $0.58 por tarea del Intelligence Index es, según esa misma medición, el coste más bajo jamás registrado a ese nivel de inteligencia. El titular es justo. Pero si vienes de 3.7 Flash con un producto en marcha, tu unit economics acaba de empeorar un 40% sin que hayas tocado una línea de código. Es el mismo patrón que ya conté con el coste de los subagentes al cambiar de modelo: la factura se mueve sola cuando cambia el comportamiento del modelo, no cuando cambias tú el código.

    Del coste por tarea de Opus 5 o GPT-5.6 Sol no doy cifra porque no la tengo medida con el mismo eval, y compararlas de oído sería justo el error que denuncia este post. Lo público es el precio por token: Opus 5 cuesta $5.00 y $25.00 por millón, GPT-5.6 Sol $4.00 y $20.00. Sirve para situar la escala, no para decidir.

    Todas las cifras de coste de este post proceden de la medición independiente publicada por Artificial Analysis el 2 de septiembre de 2026, y los precios del anuncio oficial de Google de esa misma fecha. Verificadas el 3 de septiembre de 2026. Son precios introductorios: expiran el 31 de diciembre de 2026.


    Por qué sube el coste por tarea de Gemini 3.8 Flash: 48.000 tokens de salida

    La causa está publicada y no tiene misterio. Gemini 3.8 Flash gasta una media de 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y da más turnos en las evals agénticas.

    Traducido: razona más pasos antes de responder. Ese razonamiento se factura como salida, que es el token caro. A $3.75 el millón, cada vuelta extra de pensamiento tiene precio.

    Y no solo pagas más: esperas más. Artificial Analysis midió que el tiempo medio por tarea en high reasoning sube de 2,2 a 2,5 minutos. Un 14% más de latencia en cada tarea de tu producto, que con un usuario delante se nota antes que en la factura.

    Y si trabajas en español el efecto se acumula: el mismo contenido consume más tokens que en inglés por cómo funciona el tokenizador, algo que desglosé en el post sobre cuánto te cuesta de más escribir en español. Más tokens por razonar, multiplicado por más tokens por idioma, sobre el token que más caro se paga.


    Cómo medir tu coste por tarea real

    Para dejar de discutir con tablas de precios ajenas solo hace falta contar el usage de cada respuesta y dividirlo entre tareas completadas. No entre llamadas: entre tareas que terminaron bien.

    // task-meter.ts — mide lo que pagas, no lo que anuncia el pricing
    type Usage = { input: number; output: number };
    
    // Precio introductorio de Gemini 3.8 Flash (hasta el 31/12/2026), USD por token
    // Desde el 01/01/2027: { input: 1.50 / 1_000_000, output: 7.50 / 1_000_000 }
    const PRICE = { input: 0.75 / 1_000_000, output: 3.75 / 1_000_000 };
    
    type ApiResponse = Record<string, any>;
    
    // Los tokens de razonamiento se facturan como salida: súmalos siempre.
    function readUsage(res: ApiResponse): Usage {
      const u = res.usageMetadata ?? res.usage ?? {};
      return {
        input: u.promptTokenCount ?? u.input_tokens ?? 0,
        output: (u.candidatesTokenCount ?? u.output_tokens ?? 0) + (u.thoughtsTokenCount ?? 0),
      };
    }
    
    export class TaskMeter {
      private input = 0;
      private output = 0;
      private tasks = 0;
    
      track(res: ApiResponse) {
        const { input, output } = readUsage(res);
        this.input += input;
        this.output += output;
      }
    
      // Solo cuenta la tarea si el resultado es válido de verdad.
      completed() {
        this.tasks += 1;
      }
    
      report() {
        const cost = this.input * PRICE.input + this.output * PRICE.output;
        // Sin tareas completadas no hay media: devuelve el gasto en bruto, no NaN.
        if (this.tasks === 0) {
          return { tareas: 0, outputPorTarea: 0, costePorTarea: 0, costeTotal: +cost.toFixed(4) };
        }
        return {
          tareas: this.tasks,
          outputPorTarea: Math.round(this.output / this.tasks),
          costePorTarea: +(cost / this.tasks).toFixed(4),
          costeTotal: +cost.toFixed(4),
        };
      }
    }
    

    El detalle que separa esta métrica de un contador inútil está en completed(). Una tarea cuenta cuando la salida pasa tu validación, no cuando la API devuelve 200. Si el modelo responde un JSON que tu esquema rechaza, has pagado tokens y no has completado nada: eso encarece el coste por tarea, y así debe ser. Yo cierro ese bucle con un safeParse de Zod antes de llamar a completed(), que es justo el tipo de frontera que trabajo en el curso de validación y transformación de datos con Zod.

    Un aviso para que no te asustes de tu propio medidor: promptTokenCount incluye los tokens servidos desde caché de contexto, que se facturan más baratos. Si usas caching, el número que saques será algo pesimista.

    Ejecútalo una semana con tu carga real y tendrás un número que ninguna nota de prensa te puede dar. Para el instrumental completo, con desglose por turno y por herramienta, tienes la guía para medir el consumo de tokens de un agente de IA.


    Niveles de reasoning en Gemini 3.8 Flash: cuándo usar high, medium o low

    El nivel de reasoning es la palanca de coste más grande que tienes, y la mayoría de proyectos la dejan clavada en el máximo por defecto. Los tres niveles medidos por Artificial Analysis el 2 de septiembre de 2026, sobre las mismas tareas del Intelligence Index:

    Nivel de reasoning Intelligence Index Coste por tarea Ahorro vs high
    high 59 $0.58 —
    medium 57 $0.41 −29%
    low 52 $0.24 −59%

    Ahí está el argumento entero en dos números: bajar de high a medium te ahorra un 29% del coste por tarea y cuesta 2 puntos de Intelligence Index, 57 frente a 59. Bajar a low ahorra un 59% y cuesta 7 puntos. Si tu tarea se valida con un esquema, esos 7 puntos no los vas a notar; el 59% sí.

    Mi regla por defecto, la misma que aplico con cualquier modelo que exponga niveles de razonamiento:

    • Low para clasificar, extraer campos, enrutar y resumir. Si puedes validar el resultado con un esquema, no necesitas que el modelo medite.
    • Medium para el trabajo normal de un agente: varios pasos, alguna herramienta, contexto moderado. Este es el defecto sensato, no high.
    • High solo para razonamiento largo con estado, donde un error a mitad de camino te obliga a repetir la tarea entera. Ahí el sobrecoste frente a medium se paga solo, porque un reintento cuesta más que el ahorro.

    Y la consecuencia que a mucha gente se le escapa: si tu producto es un agente de varios pasos, no tienes que elegir un nivel único. Enruta por paso. La extracción va en low, la decisión difícil va en high. Esa granularidad es la diferencia entre un margen sano y uno que se come el precio del plan, y es una de las decisiones de arquitectura que más repito en el curso de Construye con IA.

    En la Gemini API el nivel se fija con thinking_level dentro de generation_config, y acepta low, medium y high:

    const res = await client.interactions.create({
      model: "gemini-3.8-flash",
      input: prompt,
      generation_config: { thinking_level: process.env.GEMINI_THINKING_LEVEL ?? "medium" },
    });
    

    Que salga de una variable de entorno no es cosmético: es lo que te deja bajar el nivel en producción sin desplegar, el día que veas la factura del primer mes.


    El 1 de enero de 2027 te duplica la factura

    Los $0.75 y $3.75 son precio introductorio hasta el 31 de diciembre de 2026. El 1 de enero de 2027 pasan a $1.50 de entrada y $7.50 de salida por millón, según la tabla de precios oficial de la Gemini API. El doble.

    Si estás construyendo un producto y calculas márgenes con el precio de hoy, tienes hasta el 31 de diciembre de espejismo. Un SaaS con un plan de $19 al mes que hoy deja margen holgado puede quedarse en pérdidas el 1 de enero sin que nadie haya tocado nada.

    Con 10.000 tareas al mes, el mismo código y sin tocar nada:

    Nivel de reasoning Factura mensual hoy Factura mensual desde el 1/1/2027
    high $5.800 $11.600
    medium $4.100 $8.200
    low $2.400 $4.800

    Fíjate en la diagonal: pasar de high a medium el 1 de enero te deja en $8.200, todavía por encima de los $5.800 que pagas hoy en high. Bajar un nivel no compensa la subida de precio. Bajar dos, sí.

    Haz el cálculo ahora con el precio de 2027. Si con $1.50 y $7.50 tu unit economics sigue en pie, adelante. Si no, tienes hasta el 31 de diciembre para bajar niveles de reasoning, recortar contexto o cambiar de modelo, que es mucho mejor que enterarte en enero. Este supuesto debería estar escrito en la spec antes de programar nada, con su fecha y su número, como planteo en el libro de Spec-Driven Development.

    Aun con el precio duplicado sigue siendo más barato por token que Opus 5 o GPT-5.6 Sol. Pero "más barato que el más caro" no es un modelo de negocio.


    Gemini 3.8 Flash Cyber y el Fairwind Program: el modelo que no puedes usar

    Gemini 3.8 Flash Cyber es la variante especializada en seguridad y tiene los mejores números del anuncio: 86,2% en CyberGym, que mide detección de vulnerabilidades en C y C++, frente al 77,5% de 3.5 Flash Cyber, el 83,6% de GPT-5.6 Sol y el 85,6% de GPT-5.5-Cyber. En CWE-Bench, parcheo automatizado, marca un 47,2% pass@1 frente al 47,8% del modelo frontera líder, pero a un coste muy inferior. Y supera el 70% de éxito descubriendo vulnerabilidades reales.

    No tienes acceso. Se distribuye por el Fairwind Program a organismos gubernamentales, operadores de infraestructura crítica y mantenedores de software.

    Lo cuento sin drama porque la decisión me parece defendible: un modelo que encuentra vulnerabilidades reales con esa tasa de acierto es igual de bueno encontrándolas para arreglarlas que para explotarlas. Es el mismo patrón de acceso restringido que vimos con Claude Mythos 5.1 y su programa por invitación.

    Lo que sí te llevas es información: si un modelo restringido ya está en el 70% de descubrimiento real, asume que la capacidad ofensiva del otro lado también ha subido. La defensa de tu agente no puede ser que nadie mire. Empieza por los guardrails para agentes con acceso a terminal y base de datos, que es donde más daño se hace.


    Qué hacer con esto hoy

    Instrumenta el coste por tarea antes de cambiar de modelo. Media hora de trabajo: un contador de usage dividido entre tareas que pasan tu validación. A partir de ahí, elegir modelo deja de ser una discusión de opiniones sobre benchmarks ajenos.

    Con ese número, la pregunta ya no es si Gemini 3.8 Flash es más barato que Opus 5, sino cuánto te cuesta a ti completar una tarea, en tu dominio, con tu prompt, en tu idioma. Ahí se gana o se pierde el margen.

    Si quieres ver este instrumental montado sobre proyectos reales, con enrutado por nivel de reasoning y métricas de coste en producción, es de lo que hablamos cada semana en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es Gemini 3.8 Flash?

    Gemini 3.8 Flash es el modelo de propósito general y bajo coste de Google, anunciado el 2 de septiembre de 2026. Tiene una ventana de 1M de tokens de entrada, 66K de salida y knowledge cutoff en marzo de 2026, y ofrece tres niveles de reasoning (low, medium y high) que cambian tanto la calidad como el coste. Está disponible en Google AI Studio, la Gemini API, Android Studio, Google Antigravity, Gemini Enterprise, la app de Gemini para AI Pro y Ultra, Search AI Mode y Sheets.

    ¿Merece la pena migrar de Gemini 3.7 Flash a Gemini 3.8 Flash?

    Depende de si tu carga aprovecha el razonamiento extra. Gemini 3.8 Flash puntúa más alto en benchmarks agénticos, pero al mismo precio por token consume 48.000 tokens de salida por tarea, un 30% más que 3.7 Flash, y encadena más turnos, así que el coste por tarea sube alrededor de un 40%. Si tus tareas son clasificación, extracción o enrutado, quédate en 3.7 Flash o migra a 3.8 Flash con el reasoning en low; si son cadenas largas con herramientas donde un fallo obliga a repetir todo el trabajo, la migración se paga sola.

    ¿Cuánto cuesta realmente Gemini 3.8 Flash?

    Depende de qué midas. Por token, $0.75 la entrada y $3.75 la salida por millón, precio introductorio hasta el 31 de diciembre de 2026. Por tarea completada del Intelligence Index de Artificial Analysis, $0.58 con high reasoning, $0.41 con medium y $0.24 con low. La segunda cifra es la que se parece a tu factura.

    ¿Por qué sube el coste por tarea si el precio por token no ha cambiado?

    Porque el modelo genera más tokens. Gemini 3.8 Flash gasta 48.000 tokens de salida por tarea de media, un 30% más que 3.7 Flash, y ejecuta más turnos en tareas agénticas. Ese 30% de salida, más el contexto que se reenvía en cada turno extra y que se factura como entrada, deja el coste por tarea alrededor de un 40% por encima aunque la tabla de precios sea idéntica.

    ¿Qué pasa el 1 de enero de 2027 con el precio?

    Se acaba el precio introductorio y pasa a $1.50 de entrada y $7.50 de salida por millón: exactamente el doble. Si has calculado los márgenes de tu producto con el precio de 2026, rehaz los números con los de 2027 antes de fijar tus planes de precios.

    ¿Puedo usar Gemini 3.8 Flash Cyber?

    Salvo que trabajes en un organismo gubernamental, en un operador de infraestructura crítica o mantengas software ampliamente usado, no. Se distribuye únicamente a través del Fairwind Program. No hay endpoint público ni precio publicado, así que tu referencia para trabajar hoy es Gemini 3.8 Flash estándar.

    ¿Es Gemini 3.8 Flash mejor que Claude Opus 5 para programar?

    En DeepSWE v1.1 saca 73,7% frente al 74,0% de Opus 5: prácticamente empate, con Opus 5 a $5.00 y $25.00 por millón frente a $0.75 y $3.75. Para la mayoría de cargas, esa diferencia de tres décimas no justifica el sobrecoste. Para razonamiento muy largo donde un fallo obliga a repetirlo todo, mídelo con tu propio coste por tarea antes de decidir.

    ¿Qué nivel de reasoning debería usar por defecto?

    Medium, no high. Reserva high para tareas largas con estado donde un error a mitad de camino te obliga a rehacer el trabajo entero, y baja a low todo lo que tenga una respuesta verificable con un esquema. Si tu agente tiene varios pasos, enruta el nivel paso a paso en lugar de fijar uno global.

    ¿Cómo se cambia el nivel de reasoning en la Gemini API?

    Con el parámetro thinking_level dentro de generation_config, que en Gemini 3.8 Flash acepta los valores low, medium y high. Una llamada quedaría como generation_config: { thinking_level: "medium" } junto al modelo y el prompt. Léelo siempre de una variable de entorno en lugar de escribirlo a fuego en el código: es lo que te permite bajar el nivel en producción sin desplegar cuando el coste por tarea se dispare.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.