Category: AI

  • Cómo mejorar la calidad del código con Spec-Driven Development

    Cómo mejorar la calidad del código con Spec-Driven Development

    Spec-Driven Development en la práctica: del prompt al código mantenible — Un walkthrough real mostrando cómo una buena spec cambia la calidad del output de Claude Code o Cursor. Caso antes/después

    Tiempo estimado de lectura: 6 min

    • Ideas clave:
    • Una spec técnica reduce la ambigüedad en prompts y convierte salidas generativas en contratos verificables.
    • Sin spec, los LLMs tienden a producir código rápido pero frágil y con deuda técnica.
    • Una spec mínima (stack, artefactos, contratos, edge cases) es suficiente para outputs reproducibles y testeables.
    • Integra specs en CI/PR para automatizar comprobaciones y mantener control humano sobre arquitectura.

    Spec-Driven Development en la práctica: del prompt al código mantenible — esto no es una etiqueta elegante. Es la diferencia entre código que sobrevive y código que tendrás que reescribir dentro de tres sprints. Si usas Claude Code, Cursor o cualquier herramienta generativa, sin una spec clara estás empujando decisiones arquitectónicas a un modelo estadístico.

    En estas primeras líneas: definimos el problema, mostramos un caso antes/después y entregamos una receta práctica para que tu equipo obtenga salidas reproducibles y revisables por humanos.

    Resumen rápido (lectores con prisa)

    Qué es: Una spec técnica es un documento corto que define stack, artefactos, contratos de datos y criterios de aceptación.

    Cuándo usarla: Antes de pedirle a un LLM que genere código o acciones automáticas; imprescindible para features que afectan arquitectura o seguridad.

    Por qué importa: Reduce ambigüedad, limita el espacio de decisión del modelo y convierte output en un contrato auditables y testeable.

    Cómo funciona: Provee stack y contratos (ej. Zod schemas, tipos TS, API contracts) que el agente implementa exactamente, produciendo artefactos modulares y testeables.

    Por qué una spec cambia todo

    Los LLMs son excelentes en patrones, no en contexto de producto. Cuando reciben un prompt abierto, generan la solución más probable según su entrenamiento: ejemplos de tutoriales y antipatrón comunes. Esa es la razón por la que el output suele ser rápido pero frágil.

    Una especificación técnica (spec) reduce el “espacio de probabilidad” del modelo. Le das:

    • el stack exacto,
    • las restricciones arquitectónicas,
    • los contratos de datos,
    • y los criterios de aceptación/edge cases.

    Con esa entrada, herramientas como Cursor o Claude dejan de improvisar y comienzan a implementar un contrato.

    Walkthrough real: formulario de registro en Next.js

    Escenario: crear un registro de usuario con validación Zod y Server Actions (Next.js App Router). Te muestro el antes y el después, sin adornos.

    Antes — Prompt conversacional (vibe coding)

    Prompt enviado al modelo:

    “Crea un formulario de registro en Next.js con email, password y confirmación. Conéctalo a la API.”

    Salida típica:

    • Un solo archivo RegisterForm.tsx con JSX, estado useState y fetch mezclados.
    • Validación DIY con regex.
    • Manejo de errores = console.log.
    • Tipos débiles (any o sin tipos).
    • No hay tests ni contractos reutilizables.

    Resultado: funciona en local. Falla en producción. Es deuda técnica con firma.

    Después — Prompt con spec (Spec-Driven Development)

    Antes de preguntar al modelo, escribes spec-auth-register.md y lo adjuntas.

    Fragmento de spec:

    # Spec: Registro de usuario
    Stack: Next.js App Router, React Hook Form, Zod
    Outputs: 3 archivos
      - src/lib/validations/auth.ts (registerSchema)
      - src/actions/auth.actions.ts (Server Action) -> devuelve { success: boolean; error?: string }
      - src/components/auth/RegisterForm.tsx
    UI: usar useTransition para isPending; mostrar errores por campo; redirigir a /dashboard en éxito.
    Edge cases: handling de timeouts, duplicados, validación server-side.
    

    Prompt al modelo:

    “Lee @spec-auth-register.md e implementa exactamente los archivos descritos, respetando tipos y contratos.”

    Salida típica con spec:

    • registerSchema en auth.ts (Zod) reutilizable en cliente y servidor.
    • Server Action tipada que devuelve { success, error }.
    • Componente de presentación que usa React Hook Form y solo hace binding.
    • Estados de UI y manejo de errores explícito.
    • Código modular, testeable y legible.

    La diferencia es clara: la spec obliga al modelo a ceñirse a un contrato verificable. Lo que se genera se puede code-reviewar, testear e integrar.

    Plantilla mínima de spec que funciona

    No necesitas escribir una novela. Esta plantilla (portable en .specs/feature.md) es suficiente:

    1. Contexto de negocio (1-2 líneas).
    2. Stack y restricciones (libraries permitidas/prohibidas).
    3. Artefactos esperados (files + path).
    4. Contratos de datos (TS interfaces o Zod schemas).
    5. Estados UI y criterios de aceptación.
    6. Edge cases y métricas de éxito.

    Incluye URLs útiles en la spec para librerías: Zod, OWASP para seguridad, documentación de Cursor si lo usas.

    Integración práctica en el flujo de trabajo

    • Guarda specs en .specs/ y referencia el archivo en el prompt (Cursor soporta @Files).
    • Automatiza comprobaciones básicas con linters/CI: que exista un schema Zod, que acciones devuelvan un tipo estándar, que tests unitarios pasen.
    • Añade una regla en code review: si el cambio viene de un agente, el PR debe acompañar la spec original y un ADR si la modificación afecta arquitectura.
    • No olvides observabilidad y testing: cada tool o action generada debe tener tests unitarios independientes del LLM.

    Conclusión: la IA ejecuta, el ingeniero decide

    Spec-Driven Development no elimina la IA; la pone en su lugar. En lugar de confiar en la creatividad del modelo, confías en el criterio técnico del equipo para dirigirlo. Los equipos que adoptan specs claras convierten a Claude Code y Cursor en herramientas productivas en lugar de fuentes de deuda técnica. Implementar specs no es una carga extra: es la inversión que transforma prototipos de IA en software mantenible y auditable.

    La siguiente pieza en esta serie mostrará ejemplos de specs reales y scripts de CI que validan la conformidad automática entre spec y código.

    Para continuidad con iniciativas de automatización y prácticas de ingeniería aplicadas a IA, revisa recursos adicionales y experimentos en Dominicode Labs. Estos materiales complementan la adopción de specs y proporcionan plantillas y scripts para integrar comprobaciones automatizadas en CI/PR.

    FAQ


    ¿Qué es una spec técnica y cuánto debe medir?

    Una spec técnica es un documento conciso que define contexto, stack, artefactos requeridos, contratos de datos y criterios de aceptación. Suele medir entre 1 y 2 páginas; la clave es ser suficiente para convertir decisiones arquitectónicas en reglas ejecutables.


    ¿Qué diferencia hay entre una spec y una historia de usuario?

    Una historia de usuario describe el problema de negocio y la necesidad. La spec técnica traduce esa necesidad en artefactos técnicos concretos (files, tipos, contratos, edge cases) que un agente o desarrollador implementará.


    ¿Qué herramientas debo pedir en la spec para validación de datos?

    Especifica la librería (por ejemplo, Zod), el archivo donde residirá el schema y el contrato de retorno esperado para server actions. Indica validación client/server y casos límite relevantes.


    ¿Cómo integro specs en CI?

    Automatiza comprobaciones que verifiquen la presencia de schemas Zod, la firma de acciones y tests unitarios mínimos. Añade una regla en PRs que requiera la spec original cuando cambios provengan de un agente.


    ¿Qué hacer si el LLM ignora la spec?

    Ajusta el prompt para referenciar explícitamente la spec (ej. @spec-auth-register.md), valida output contra tests automatizados y rechaza cambios que no cumplan contratos en CI. Mantén revisión humana obligatoria para PRs generados por agentes.
  • Construye un agente de IA en TypeScript: stack mínimo para 2026

    Construye un agente de IA en TypeScript: stack mínimo para 2026

    El stack mínimo para un agente de IA en TypeScript en 2026

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Anthropic SDK + Zod + tsx + dotenv es la combinación práctica para agentes en producción: observabilidad, tipado y control.
    • Zod como frontera: declara schemas de herramientas, valida args y convierte a JSON Schema para pasar al modelo.
    • Bucle explícito: orquesta tool-calls en un único proceso, limita iteraciones y registra cada uso.
    • No es minimalismo estético: es técnica operativa para que el equipo pueda depurar y reparar a cualquier hora.
    • Escala solo cuando métricas y requisitos lo exijan: añade memoria, orquestadores o trazas distribuidas según necesidad.

    Tabla de contenidos

    El stack mínimo propuesto es una combinación práctica y limitada de dependencias enfocadas a reducir superficie de fallo, mantener trazabilidad y controlar consumo de tokens: Anthropic SDK para el motor, Zod para contratos, tsx para ejecución TypeScript rápida y dotenv para gestionar secretos.

    Resumen rápido (lectores con prisa)

    Stack: Anthropic SDK + Zod + tsx + dotenv. Usa Zod para declarar y validar schemas de herramientas, convierte Zod a JSON Schema para pasárselo al modelo y orquesta tool-calls en un bucle explícito. Añade PostgreSQL+pgvector, orquestadores o trazas solo cuando lo exijan métricas y requisitos.

    tsx + dotenv — entorno y secretos

    tsx te permite ejecutar TypeScript directamente en Node sin compilar manualmente. En desarrollo y CI rápidos esto reduce ciclos de retroalimentación.

    dotenv mantiene las claves fuera del repo: ANTHROPIC_API_KEY, DATABASE_URL, etc. Ambos son higiene operativa, no glamour.

    Anthropic SDK — motor cognitivo directo

    Usa el SDK oficial: Anthropic SDK. Evita enrutadores genéricos que suavizan diferencias entre modelos y esconden comportamientos de tool-calling. Anthropic devuelve explícitamente cuándo el modelo quiere invocar una herramienta; tú ejecutas la función y devuelves el resultado, con control total del flujo.

    Zod — contrato entre texto probabilístico y tipos

    Zod es la frontera. Define los schemas de herramientas y valida los argumentos que el modelo genera. Convierte Zod a JSON Schema con zod-to-json-schema para declarar las herramientas al modelo. Resultado: menor tasa de alucinaciones en tool_use y errores tipo detectables y manejables.

    Por qué este stack vence en producción (ejemplos técnicos)

    1) Trazabilidad total

    Cuando el modelo pide usar una herramienta, el SDK devuelve nombre + args. Antes de ejecutar, haces schema.safeParse(args). Si falla, capturas el error, lo loggeas y agregas ese fallo al historial que reenvías al modelo. No hay retries automáticos “mágicos” que oculten la causa.

    2) Menor latencia y coste

    Un único proceso que orquesta tool-calls evita encadenados innecesarios. Si cada handoff fuera otra llamada LLM, multiplicas tokens y TTFT. Con un loop explícito controlas el número máximo de iteraciones y evitas bucles de cortesía.

    3) Menos superficie de bugs

    Las capas extra (framework + adaptadores) introducen incompatibilidades y reintentos implícitos. Tener cuatro dependencias estables reduce puntos de falla.

    El patrón de implementación: el loop explícito

    Escribes un bucle claro. Pseudodiagrama:

    1. Inicializar cliente Anthropic con la API key desde dotenv.
    2. Preparar mensajes (system + user + tool_history).
    3. Llamar a client.messages.create(…) con tool definitions derivadas de Zod.
    4. Si respuesta es texto → devolver.
    5. Si respuesta es tool_use → validar con Zod; si válido ejecutar función; añadir resultado al historial; repetir.

    Ese flujo se implementa en 30–80 líneas y es 100% controlable. No es necesario heredar de clases ni integrar callbacks crípticos.

    Validación práctica y contratos: ejemplo de herramientas

    Define una tool con Zod:

    - ticketId: z.string().regex(/^[A-Z]+-\d+$/)
    - includeComments: z.boolean().default(false)

    Convierte esto a JSON Schema y pásalo a Anthropic. Cuando el LLM devuelva args, safeParse te dice inmediatamente si se puede ejecutar. Si no, devuelves el error al modelo como contexto y le pides corrección. Ese patrón reduce las llamadas inválidas y mejora la seguridad.

    Qué no cubre este stack y cuándo añadir componentes

    • Memoria de largo plazo: integra PostgreSQL + pgvector si necesitas retrieval persistente.
    • Flujos empresariales largos (days/weeks): añade un orquestador (n8n o LangGraph) para persistencia de estado y control de aprobaciones humanas.
    • Observabilidad distribuida: añade OpenTelemetry o similar si tu cluster requiere trazas correlacionadas a escala.

    Empieza simple; añade estas piezas solo con datos que demuestren necesidad.

    Reglas operativas antes de desplegar

    • Nunca expongas una herramienta sin Zod schema.
    • Registra cada tool_use y su validación. Logs estructurados; no texto plano.
    • Limita iteraciones del loop por petición (por ejemplo, max 5 reintentos).
    • Implementa el patrón Result (ok/error) en todas las funciones ejecutadas por el agente.

    Conclusión práctica

    El stack mínimo para un agente de IA en TypeScript en 2026 devuelve poder al equipo de ingeniería: trazabilidad, tipos y control operativo. Para la mayoría de agentes productivos —consultas a APIs, limpieza de datos, consultas SQL parametrizadas— esta pila es suficiente y más fiable que una montaña de frameworks. Escala solo cuando las métricas (latencia, coste por token, fallos en producción) y los requisitos (memoria, durabilidad) lo exijan. Así evitas añadir complejidad por moda y mantienes un sistema que puedas entender, auditar y mejorar.

    Dominicode Labs

    Para quienes construyen agentes y workflows, una referencia útil y complementaria sobre prácticas operativas y plantillas de integración está disponible en Dominicode Labs. Considera consultarlo como continuación lógica al patrón de loop explícito y validación con Zod.

    Y si has llegado aquí buscando el «cómo» sin tener resuelto el «qué», empieza por ahí: antes de construirlo, qué es un agente de IA y en qué se diferencia de un workflow con un LLM dentro.

    FAQ

    ¿Por qué usar Anthropic SDK en vez de adaptadores genéricos?

    Porque el SDK oficial expone el comportamiento nativo del modelo (por ejemplo, tool_use) sin abstracciones que oculten diferencias entre modelos. Esto permite un control más preciso sobre cuándo y cómo ejecutar herramientas.

    ¿Cuál es el papel exacto de Zod en este stack?

    Zod define los schemas de las herramientas y valida los argumentos generados por el modelo. Convertir esos schemas a JSON Schema permite declararlos al modelo y reducir llamadas inválidas y alucinaciones en tool_use.

    ¿Necesito tsx en producción?

    tsx facilita ciclos de desarrollo y CI al evitar compilación manual. En producción puedes seguir usándolo o compilar, según tu pipeline; la recomendación es usarlo para reducir fricción durante desarrollo y pruebas.

    ¿Cómo reducir costes de tokens con este patrón?

    Orquesta tool-calls en un único proceso, limita iteraciones del loop y evita encadenar llamadas LLM por cada handoff. Controlar explícitamente el número de iteraciones reduce tokens enviados y latencia.

    ¿Cuándo añadir bases de datos y vectores (pgvector)?

    Añade PostgreSQL + pgvector cuando necesites retrieval persistente y la memoria a corto plazo del agente no sea suficiente para tus casos de uso.

    ¿Qué límites de seguridad operativa aplicar al expositor de herramientas?

    Nunca expongas una herramienta sin schema Zod, registra cada tool_use con logs estructurados, limita reintentos y aplica validaciones estrictas (Result ok/error) en todas las funciones ejecutadas por el agente.

  • Cómo medir el rendimiento de agentes de IA con evals efectivos

    Cómo medir el rendimiento de agentes de IA con evals efectivos

    Evals para código generado por IA — cómo medir si tu agente está mejorando o empeorando con tu spec

    Tiempo estimado de lectura: 6 min

    • Combina validación determinista y semántica: ambas dimensiones son necesarias para señales accionables.
    • Golden Dataset + rúbricas: versiona casos reales con criterios explícitos para comparar versiones del spec.
    • Two-speed pipeline: validación determinista en cada PR; juez LLM y revisiones completas en merges/release.
    • Métricas operativas clave: pass rate, semantic score, flakiness, coste por eval y regression rate.

    Si cambias una línea en tu CLAUDE.md o ajustas las instrucciones del sistema y luego aceptas código “porque se ve bien”, estás apostando a que la intuición compense la probabilidad. No lo hace. Necesitas implementar evals para código generado por IA — cómo medir si tu agente está mejorando o empeorando con tu spec para convertir esa intuición en métricas reproducibles.

    Este artículo explica qué medir, cómo construir un pipeline fiable, qué herramientas usar y las decisiones operativas que separan a los equipos que gestionan agentes con criterio de los que lo hacen por esperanza.

    Resumen rápido (lectores con prisa)

    Qué es: Un enfoque combinado de evals deterministas y semánticos para código generado por IA.

    Cuándo usarlo: Siempre que tu agente genere código que afecte producción o el diseño arquitectónico.

    Por qué importa: Transforma intuición en métricas reproducibles y reduce regresiones al cambiar el spec.

    Cómo funciona: Golden Dataset versionado + pipeline: determinista rápido en PRs, juez LLM y/o humanos en merges y releases.

    ¿Qué miden los evals para código generado por IA — cómo saber si tu agente mejora o empeora?

    Un eval profesional mide dos dimensiones complementarias:

    • 1. Validación determinista — ¿el output cumple reglas objetivas?
    • 2. Validación semántica — ¿el output cumple criterios arquitectónicos, de seguridad y estilo que sólo pueden evaluarse con criterio?

    Si sólo ejecutas una, te quedas cojo. Combínalas y obtendrás señales accionables.

    Validación determinista

    Objetivos claros y automatizables:

    • Síntaxis / AST: el código parsea sin errores.
    • Linter/style: ESLint/Prettier pasan según la configuración del repo.
    • Tests unitarios de integración en sandbox: el código generado se inyecta en un contenedor efímero y ejecuta Jest/Vitest/PyTest.
    • Reglas binarias del spec: por ejemplo, “no usar fetch en cliente” → comprobación estática.

    Resultado: métricas binarias y tasas de paso (pass rate) que puedes agregar y comparar entre versiones del spec.

    Validación semántica — LLM-as-a-Judge y estrategias híbridas

    Algunos criterios no son booleanos: diseño, seguridad implícita, uso idiomático. Aquí entra un juez LLM:

    • El juez recibe: el spec original, el código generado, y una rúbrica estructurada.
    • Produce: una puntuación y un reasoning structured (json) que explica fallos de arquitectura, riesgos de seguridad, o desviaciones de estilo.

    Precaución: existe sesgo de auto-preferencia. Mitigaciones prácticas:

    • Usar un modelo juez distinto y preferible más capaz (ej. GPT‑4o o Claude avanzado).
    • Ensembles: combinar juicios de 2–3 modelos y una muestra humana para calibrar.
    • Registrar justificaciones (no sólo la puntuación).

    Cómo construir un pipeline de Evals paso a paso

    1. Golden Dataset (20–50 casos reales)

    • Casos representativos del código y dominios del producto.
    • Cada caso: input, contexto (memory files relevantes), criterios de éxito explícitos.
    • Versionado en Git junto al spec.

    2. Frameworks y herramientas

    • Promptfoo — orquestación de evals en CLI.
    • LangSmith (observabilidad y tracing).
    • Braintrust (plataformas de evals y datasets).
    • Integrar linters, AST analyzers y runners de tests (Jest/Vitest/PyTest).

    3. Sandbox seguro para deterministas

    • Contenedores efímeros sin red ni credenciales, preferiblemente con políticas de seccomp/gVisor o Firecracker para microVMs.
    • Tiempo límite por test y quotas de CPU/RAM.

    4. LLM-as-a-Judge

    • Definir rúbricas concretas (JSON schema) por caso del Golden Dataset.
    • Ejecutar juez sólo en merges o nightly builds si el coste es alto; o en un flujo “two-speed” (ver abajo).

    5. Métricas y alertas

    • Pass rate determinista por caso y agregado.
    • Puntuación semántica media y desviación estándar.
    • Flakiness rate (casos con resultados inconsistentes entre corridas).
    • Cost per eval (tokens, wall time).
    • Guardrails: bloquear PRs si la adherencia agregada cae por debajo de un umbral (ej. 85–90%).

    6. Integración CI/CD

    • Disparar evals cuando cambie el spec (CLAUDE.md, AGENTS.md, memory files).
    • Pipeline típico: generar → determinista (rápido) → reporte → si pasa, opcional: juez LLM → aprobar o bloquear PR.

    Estrategia operativa: coste vs seguridad vs velocidad

    • Two-speed pipeline: Validación determinista ligera en cada PR; validación semántica completa en merges a main o releases. Reduce coste y mantiene seguridad.
    • Ensembles y muestreo: Si el coste de juez LLM es prohibitivo, ejecuta juez en una muestra estadística del Golden Dataset por cada cambio mayor.
    • Human-in-the-loop: para nuevas rules o casos edge, requiere revisión humana antes de aceptar un cambio en el spec.

    Métricas que realmente importan

    • Regression rate por cambio de spec (número de casos del Golden Dataset que empeoran).
    • Mean Semantic Score delta entre versiones del spec.
    • Time-to-fix promedio cuando un eval falla.
    • Token cost por ejecución y coste por PR.
    • Porcentaje de automatización (qué % de PRs infractions se bloquean automáticamente vs requieren intervención humana).

    Conclusión operativa

    Trata tu spec como código crítico: versiona, prueba y monitoriza. Implementar evals para código generado por IA transforma la gestión de agentes de una caja de sorpresas a un proceso auditable. Si quieres que el agente mejore con cambios en tu spec, mide, automatiza y obliga a retroalimentación continua. Sin datos no hay control; sin control, el agente termina rompiendo más de lo que arregla.

    Si trabajas con automatización, agentes o workflows y quieres ejemplos prácticos y experimentos reproducibles, revisa Dominicode Labs. Encontrarás recursos y prototipos alineados con pipelines de evals y prácticas de integración.

    FAQ

    ¿Qué miden los evals para código generado por IA?

    Miden dos dimensiones complementarias: validación determinista (sintaxis, linters, tests, reglas binarias) y validación semántica (diseño, seguridad, estilo evaluados por un juez LLM o humanos).

    ¿Qué es validación determinista?

    Es la comprobación automática y objetiva: el código parsea, pasa linters, ejecuta tests en sandbox y cumple reglas estáticas definidas en el spec.

    ¿Cómo se construye un Golden Dataset?

    Reúne 20–50 casos reales representativos. Cada caso debe incluir input, contexto relevante y criterios de éxito explícitos; versiona el dataset en Git junto al spec.

    ¿Cuándo debo ejecutar un juez LLM?

    Ejecuta juez LLM en merges o nightly builds si el coste es alto, o en un flujo two-speed donde aplicas juez a cambios aprobados determinísticamente o a muestras estadísticamente relevantes.

    ¿Qué métricas operativas debo vigilar?

    Pass rate determinista, mean semantic score, regression rate por cambio de spec, flakiness rate, token cost por ejecución y time-to-fix promedio.

    ¿Cómo integrar evals en CI/CD sin elevar demasiado el coste?

    Usa una validación determinista ligera en cada PR y ejecuta validación semántica completa en merges/releases. Muestrea casos para reducir coste y aplica ensembles o revisión humana en casos críticos.

  • Cómo funcionan los Signals en Angular 22 y React 19

    Cómo funcionan los Signals en Angular 22 y React 19

    Signals en Angular 22 y React 19: el nuevo modelo de reactividad

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Reactividad de grano fino actualiza solo los nodos del DOM que dependen de un valor.
    • Angular 22 introduce Signals explícitos, elimina Zone.js y ofrece formularios sincronizados basados en Signals.
    • React 19 apuesta por optimizaciones vía compilador y el hook use() en lugar de un primitivo signal.
    • Elegir entre ambos depende de control/depurabilidad (Angular) vs. fricción y compatibilidad con código existente (React).

    Tabla de contenidos

    Signals en Angular 22 y React 19: el nuevo modelo de reactividad es la discusión que está redefiniendo cómo pensamos la UI: menos trozos de árbol reevaluados, más actualizaciones puntuales y menos sorpresas en producción. Si tu equipo decide entre control explícito o automatización por compilador, este artículo te da criterios prácticos y ejemplos reales para elegir con criterio.

    Resumen rápido (lectores con prisa)

    Fine-grained reactivity actualiza solo dependencias directas. Angular 22 introduce Signals (signal(), computed(), effect()) y formulas sin Zone.js. React 19 usa el React Compiler para inferir memoización y añade use() para leer Promises/recursos en render. Ambos mejoran escalabilidad; Angular es explícito y más trazable, React reduce fricción de adopción.

    Signals en Angular 22 y React 19: el nuevo modelo de reactividad (explicación rápida)

    La reactividad de grano fino significa actualizar únicamente el nodo del DOM que depende de un valor concreto. Angular 22 lo hace declarando Signals (signal(), computed(), effect()), eliminando Zone.js y ofreciendo formularios basados en Signals. React 19 opta por no añadir un primitivo signal; en su lugar usa el React Compiler para inferir memoización y añade el hook use() para leer Promises/recursos en render. Documentación oficial Angular. Blog oficial React 19.

    ¿Por qué importa la reactividad de grano fino?

    Los problemas reales aparecen en aplicaciones con alta densidad de datos:

    • Dashboards financieros con cientos de celdas que actualizan simultáneamente.
    • Formularios complejos con validaciones cruzadas y campos dependientes.
    • UIs que requieren latencia mínima y CPU predecible en clientes de bajo rendimiento.

    La solución tradicional (Virtual DOM diffs o Zone.js) escala mal: consumes CPU revisando cosas que no cambiaron. Fine-grained reactivity evita ese trabajo inútil.

    Angular 22: Zoneless, Signals y formularios sincronizados

    Angular reescribió su motor de detección. Resultado práctico:

    • Renderizado Zoneless: sin interceptar microtasks; si no cambia un Signal, no hay re-render.
    • Signals explícitos: control total sobre qué es reactivo y cuándo muta.
    • Signal-based Forms: lectura síncrona del estado del formulario, menos RxJS, menos suscripciones que se filtran.

    Ejemplo Angular

    import { signal } from '@angular/core';
    
    const count = signal(0);
    count.set(count() + 1); // solo actualiza los lectores de `count`

    Para convivir con código existente, Angular ofrece utilidades toSignal() / toObservable(), facilitando migraciones incrementales. Guía.

    Ventajas concretas: trazabilidad, depuración directa (sabes qué mutó), rendimiento determinista. Coste: curva de aprendizaje y refactor en bases de código grandes.

    React 19: Reactividad inferida vía compilador y hook use()

    React evita imponer nuevos primitivos. Estrategia:

    • React Compiler: analiza en build y genera memos/mecanismos de actualización automáticos.
    • use(): permite consumir Promises o recursos directamente en render, funcionando con <Suspense> para carga declarativa.
    • Server Actions / useActionState: reduce boilerplate del ciclo formulario → servidor → feedback.

    Ejemplo React

    function Product({ id }) {
      const product = use(fetchProduct(id)); // Suspense maneja loading
      return <div>{product.name}</div>;
    }

    Ventajas: baja fricción de adopción; equipo no reescribe mentalmente la app. Coste: optimizaciones «invisibles» por el compilador que pueden complicar diagnóstico fino; depuración menos directa que en Angular.

    React Suspense referencia

    Comparativa práctica (qué esperar en producción)

    • Performance pura: ambos escalan mucho mejor que modelos antiguos. Angular da mayor predictibilidad por su modelo explícito; React consigue grandes ganancias sin romper DX.
    • Depuración: Angular facilita trazar el origen del update; en React necesitas entender qué transformó el compilador.
    • Migración: Angular exige trabajo incremental (conversión de formularios y algunos patrones de RxJS). React permite migración más suave, porque el compilador optimiza el código existente.
    • Formularios complejos: Angular gana por tipado y sincronía; React compensa con Server Actions para patrones CRUD.

    Recomendaciones prácticas para equipos

    1. Haz un piloto con módulos concretos. No migres todo de golpe.
    2. Para UIs de alta densidad de datos, prioriza Angular 22 si necesitas control y trazabilidad estricta.
    3. Si tu stack ya es Next.js / SSR y quieres mejorar rendimiento sin reeducar al equipo, React 19 es opción pragmática.
    4. Añade pruebas de rendimiento (microbenchmarks) y observabilidad: mide renders por segundo, tamaño de paint y memoria.
    5. Documenta patrones: en Angular, establece cómo y cuándo crear Signals; en React, especifica cómo instrumentar y auditar transformaciones del compilador.

    Conclusión práctica

    Signals en Angular 22 y React 19 solucionan el mismo problema con filosofías distintas: Angular te da el control explícito; React te lo facilita automáticamente. No hay «mejor» universal: hay mejor para tu equipo. Si quieres predictibilidad y depurabilidad en sistemas críticos, apuesta por Angular 22. Si prefieres un camino de menor fricción y eres heavy-SSR, React 19 acelera el time-to-market. Dominar fin-grained reactivity es ahora requisito, no lujo.

    FAQ

    ¿Qué es reactividad de grano fino?

    La reactividad de grano fino actualiza solo los nodos del DOM que dependen de un valor específico, en lugar de reevaluar grandes porciones del árbol. Reduce trabajo innecesario de CPU y mejora latencia en UIs densas.

    ¿Cómo difiere Angular 22 del modelo anterior con Zone.js?

    Angular 22 elimina la dependencia de Zone.js y usa Signals declarativos. En lugar de interceptar microtasks para detectar cambios, los Signals notifican solo a sus lectores cuando cambian, proporcionando renders deterministas.

    ¿React 19 añade un primitivo signal?

    No: React 19 no introduce un primitivo signal. Usa el React Compiler para inferir memoización y optimizaciones, y añade use() para consumo de Promises/recursos en render.

    ¿Qué ventajas ofrecen los Signal-based Forms?

    Los Signal-based Forms permiten lectura síncrona del estado del formulario, reducen la necesidad de RxJS y evitan suscripciones filtradas. Mejoran trazabilidad y simplifican validaciones dependientes.

    ¿Cómo evaluar cuál elegir para mi equipo?

    Haz un piloto. Si necesitas control y trazabilidad estricta para sistemas críticos, Angular 22 es preferible. Si buscas mínima fricción y tu stack ya usa SSR/Next.js, React 19 reduce fricción de adopción.

    ¿Es migración a Signals retrocompatible?

    Parcialmente. Angular ofrece utilidades como toSignal() / toObservable() para migraciones incrementales, pero adaptar formularios y patrones RxJS puede requerir refactor. React 19 suele permitir migración más suave gracias al compilador.

  • Implementación de Generics para Wrappers de IA en TypeScript

    Implementación de Generics para Wrappers de IA en TypeScript

    Generics para wrappers de IA en TypeScript

    Tiempo estimado de lectura: 4 min

    • Evita desincronización: usa un wrapper genérico withAI<T>() para enlazar firma TypeScript y validación Zod.
    • Zod‑first: Zod en runtime + z.infer en TypeScript ofrece validación práctica frente al type erasure.
    • Autodocumentación y registros: genera descripciones básicas y registra prompt, rawResponse y resultado de Zod.
    • Operación segura: define límites de reintentos y métricas; en sistemas críticos separa intención (LLM) de efecto (máquina de estado).

    Generics para wrappers de IA en TypeScript: si vas a exponer funciones de negocio a agentes, necesitas una forma segura y mantenible de hacerlo. En las primeras líneas: usar generics y Zod evita duplicar contratos y convierte la exposición de funciones en un proceso reproducible y tipado. Aquí explico por qué funciona, cómo implementarlo y qué decisiones arquitectónicas debes tomar.

    Resumen rápido (lectores con prisa)

    Patrón Zod‑first: pasa un esquema Zod al wrapper y usa z.infer<…> para que TypeScript infiera tipos. El wrapper genérico withAI<T> enlaza la firma de la función con el esquema, validando en runtime y detectando incompatibilidades en compilación.

    Úsalo cuando expongas funciones a LLMs o agentes; mejora seguridad estática, validación runtime y trazabilidad.

    Por qué necesitas Generics para wrappers de IA en TypeScript

    Exponer una función como herramienta para un LLM suele generar cuatro elementos repetitivos: descripción, esquema de validación, bindings del SDK y la ejecución. Ese boilerplate se desincroniza con el tiempo: la firma cambia, el esquema no, y el error aparece en producción, no en el IDE.

    La solución es un wrapper genérico —withAI<T>()— que capture la firma de la función mediante tipos TypeScript y reciba un esquema Zod en runtime. Zod vive en ejecución; TypeScript no. Esta combinación (TypeScript + Zod) te da lo mejor de ambos mundos: seguridad estática y validación runtime.

    Limitación real: type erasure y la decisión Zod‑first

    TypeScript suprime tipos en runtime (type erasure). No puedes inspeccionar en ejecución que un parámetro se llama userId y es string. Por eso hay dos rutas:

    • Extraer metadatos en build time (AST/JSDoc) — viable pero compleja.
    • Patrón Zod‑first — práctico y fiable: pasas un esquema Zod al wrapper, Zod valida en runtime y TypeScript infiere tipos con z.infer<…>.

    Recomiendo Zod‑first. Es simple, robusto y encaja con flujos CI/CD.

    Implementación: withAI<T> paso a paso

    Idea: recibir la función original, su esquema Zod y devolver una herramienta lista para el SDK de IA (p. ej. Vercel AI SDK https://sdk.vercel.ai/docs). El genérico obliga a coherencia entre firma y esquema.

    Ejemplo reducido

    import { z } from 'zod';
    import { tool } from 'ai'; // Vercel AI SDK
    
    export function withAI>(
      fn: T,
      schema: z.ZodType<Parameters<T>[0]>,
      description?: string
    ) {
      const autoDesc = description ?? generateDescription(fn.name, schema);
    
      return tool({
        description: autoDesc,
        parameters: schema,
        execute: async (args) => {
          // args ya validado por Zod cuando el SDK integra la validación
          return await fn(args as Parameters<T>[0]);
        },
      });
    }
    

    Claves:

    • Parameters<T>[0] enlaza el tipo esperado del primer argumento de fn con el esquema.
    • Si la firma de fn cambia y el esquema no, TypeScript marcará el error en compilación.
    • tool() es una abstracción; adapta al SDK que uses (Vercel, OpenAI, etc.).

    Autodocumentación práctica

    El wrapper puede generar una descripción básica a partir del nombre de la función y las claves del esquema. No es NLP mágico, pero reduce trabajo manual y mejora la señal hacia el modelo.

    function generateDescription(name: string, schema: z.ZodTypeAny) {
      const readable = name.replace(/([A-Z])/g, ' $1').trim().toLowerCase();
      const params = schema instanceof z.ZodObject ? Object.keys(schema.shape).join(', ') : 'input object';
      return `Use this tool to ${readable}. Parameters: ${params}.`;
    }
    

    Para funciones críticas, proporciona siempre una descripción manual y ejemplos de uso. Puedes enriquecer la doc con ejemplos JSON y constraints — los modelos modernos respetan instrucciones claras (ver Structured Outputs de OpenAI: https://platform.openai.com/docs/guides/structured-outputs).

    Buenas prácticas operativas

    • Valida con .safeParse() en agentes que puedan autocorregirse; usa .parse() para endpoints que deban fallar rápido.
    • Registra siempre: prompt, rawResponse, resultado de Zod (error.flatten()), la herramienta invocada y contexto. Sin esto, los postmortems son inútiles.
    • Mide: tasa de validación fallida, latencia de autocorrección, reintentos por prompt y degradaciones a humano.
    • Define límites: si tras N reintentos no hay corrección, encola para revisión humana. Evita loops que consuman tokens/requests.

    Trade‑offs y decisiones arquitectónicas

    • Autogeneración vs. precisión: la descripción automática agiliza pero no sustituye documentación humana para casos sensibles.
    • Structured Outputs + generateObject (OpenAI) reducen errores de formato, pero no reemplazan validaciones semánticas (p. ej. rangos, signos). Zod sigue siendo necesario.
    • En sistemas críticos, deja que el LLM decida la herramienta, pero que una máquina de estado (n8n, XState) controle la ejecución final; así separas intención y efecto.

    Ejemplo completo: patrón en producción

    1. Define la función pura:

    async function getOrder(args: { orderId: string }) { /* ... */ }

    2. Define esquema Zod:

    const OrderSchema = z.object({ orderId: z.string().uuid() });

    3. Envuelve:

    const getOrderTool = withAI(getOrder, OrderSchema, 'Obtiene estado de un pedido por ID');

    4. Registra y mide cada llamada. Si Zod falla, serializa error.flatten() y envíalo al LLM para autocorrección o al equipo de soporte.

    Conclusión

    Generics para wrappers de IA en TypeScript no es un truco académico: es una medida práctica para escalar agentes sin introducir deuda técnica. El patrón Zod‑first con withAI<T> convierte la exposición de funciones en una operación segura, rastreable y testeable. Si tu agente escribe en bases de datos, llama APIs facturadas o ejecuta efectos críticos, aplica este patrón hoy: te evitará errores que sólo descubres en producción.

    Para equipos que diseñan flujos de agentes y workflows relacionados con automatización e IA aplicada, puede ser útil revisar trabajos y herramientas experimentales. Más recursos y experimentos están disponibles en Dominicode Labs.

    FAQ


    ¿Qué es exactamente el patrón Zod‑first?

    Es la práctica de definir esquemas de validación con Zod en runtime y usar z.infer<…> para que TypeScript derive los tipos, evitando depender de metadatos de tipos en ejecución.


    ¿Cuándo debo usar safeParse() vs parse()?

    Usa safeParse() cuando el agente pueda autocorregirse o cuando quieras manejar errores sin lanzar. Usa parse() en endpoints que deban fallar rápido y propagar excepciones.


    ¿Cómo detecta TypeScript desalineaciones entre firma y esquema?

    El wrapper genérico usa tipos como Parameters<T>[0]. Si la firma de la función cambia y el esquema suministrado no coincide, TypeScript emitirá un error en compilación por incompatibilidad de tipos.


    ¿Qué hacer si Zod falla de forma recurrente?

    Registra el resultado de error.flatten(), envía el fallo al LLM para autocorrección o encola el caso para revisión humana si supera N reintentos. Mide la tasa de validación fallida para priorizar correcciones.


    ¿Puedo usar este patrón con otros SDKs además de Vercel?

    Sí. tool() en el ejemplo es una abstracción; adapta la forma de registrar parámetros, validar y ejecutar según el SDK (Vercel, OpenAI u otros).


    ¿Cómo debo registrar errores y métricas?

    Registra prompt, rawResponse, resultado de Zod (error.flatten()), herramienta invocada, contexto y métricas como latencia y reintentos. Estos datos son esenciales para postmortems y mejoras iterativas.

  • Cómo Spec-First Optimiza el Desarrollo de Software con IA

    Cómo Spec-First Optimiza el Desarrollo de Software con IA

    Por qué Spec-First cambió mi forma de programar con IA (y por qué debería cambiar la tuya)

    Tiempo estimado de lectura: 4 min

    • Spec-First reduce suposiciones del modelo al definir contratos antes de pedir implementación.
    • Escribir tipos y casos de error toma minutos; arreglar código generado con suposiciones incorrectas puede costar días.
    • Combinar Spec-First con TDD convierte especificaciones en tests ejecutables y acelera desarrollo mantenible.
    • Aplica Spec-First en sistemas críticos, APIs públicas y módulos que deben escalar; evita para prototipos one-off.

    Por qué Spec-First cambió mi forma de programar con IA (y por qué debería cambiar la tuya). Poca gente habla de esto después del entusiasmo inicial. Descubrí algo curioso: no era la IA la que fallaba, era el orden de mis decisiones.

    La primera vez que pides código a un asistente te sientes en una peli de ciencia ficción. La décima vez estás peleando con alucinaciones, nombres mal elegidos y lógica que solo funciona en el mundo ideal del modelo. Spec-First rompió esa dinámica.

    Resumen rápido (lectores con prisa)

    Spec-First: escribe el contrato (tipos, entradas/salidas, casos límite) antes de pedir implementación. Reduce suposiciones del modelo y convierte especificaciones en tests ejecutables. Útil para código mantenible y APIs, menos para prototipos one-off.

    El coste real del Prompt-Driven Development

    El flujo habitual es: pides, pegas, arreglas. Repetir. Para prototipos funciona. Para software que vive y crece, no.

    • El modelo no conoce tu arquitectura.
    • No sabe tus convenciones ni decisiones pasadas.
    • No respeta tus límites de efectos secundarios ni tus políticas de error.

    Resultado: módulos que compilan pero no encajan. Bugs lógicos distribuidos. Revisiones interminables.

    Spec-First no te da respuesta mágica. Te devuelve tiempo y predictibilidad.

    Qué debe contener una spec si vas a usar IA

    No necesitas un documento de 30 páginas. Necesitas lo mínimo imprescindible para quitarle decisiones al modelo:

    Tipos e interfaces

    define entradas y salidas antes de pedir lógica.

    interface CreateUser { email: string; name?: string }
    type Result<T> = { ok: true; value: T } | { ok: false; error: string }

    Casos límite

    nulos, dominios bloqueados, fallos de red, retries, timeouts.

    Comportamiento determinista

    funciones puras, sin efectos laterales, o explícitamente con side effects autorizados.

    Restricciones de integración

    versiones de librería, patrones prohibidos, dónde puede tocar la base de datos.

    Escribir esto toma minutos. Arreglar un desastre generado por IA puede costarte días.

    Spec-First + TDD = velocidad real

    Si ya definiste tipos y casos de error, pedirle al modelo que genere tests primero es natural. Los tests pasan a ser la especificación ejecutable.

    Flujo práctico:

    • 1) Escribe tipos y contratos.
    • 2) Genera tests unitarios con la IA.
    • 3) Pide la implementación hasta que los tests pasen.

    La diferencia: pasas menos tiempo adivinando por qué algo falla y más en ajustar diseño.

    Ejemplo rápido (mental, no código largo)

    En vez de: “Crea función que valide emails”, di:

    “Función pura que recibe string, valida email corporativo (rechaza gmail.com, hotmail.com), retorna Result<Email, ValidationError>, cero excepciones, sin llamadas externas.”

    Esa frase evita que el modelo haga lo que le da la gana y te devuelve algo integrable.

    Cuándo aplicar Spec-First (y cuándo no)

    No es una religión. Úsalo cuando importe la mantenibilidad y la integración:

    • Sistemas críticos, core domain, APIs públicas.
    • Equipos distribuidos con contratos firmes.
    • Proyectos que deben escalar o durar.

    No lo emplees para scripts one-off o prototipos exploratorios donde la velocidad de concepto importa más que la calidad.

    Cambia tu rol profesional: de mecanógrafo a director de orquesta

    La IA está comoditizando la escritura de código. El valor real se desplaza hacia quien define qué construir y por qué. Spec-First es el instrumento para ejercer ese criterio sin perder velocidad.

    Tú no vas a competir con la IA en velocidad de tecleo. Vas a competir en claridad de intención, disciplina arquitectónica y capacidad de traducir requisitos imprecisos en contratos firmes.

    Cómo empezar hoy (3 pasos prácticos)

    1. Antes de pedir código, escribe los tipos. Solo eso.
    2. Genera tests unitarios desde esa spec.
    3. Pide la implementación, haz que los tests pasen.

    Hazlo en el siguiente ticket que abras. No hace falta cambiar todo tu flujo; prueba en un módulo nuevo y compara el resultado.

    Haz esto ahora: la próxima vez que pidas una función al asistente, detente 30 segundos y define solo los tipos. Luego vuelve y genera los tests. Verás la diferencia.

    Esto no acaba aquí: si quieres, puedo convertir tu próxima descripción vaga en una spec lista para usar con cualquier LLM.

    Este artículo trata sobre IA aplicada y flujos de trabajo con modelos, por lo que puede interesarte explorar recursos prácticos y experimentos en Dominicode Labs. Es un complemento natural para probar especificaciones y pipelines de tests en prototipos controlados.

    FAQ


    ¿Qué es Spec-First?

    Es una práctica que prioriza escribir contratos (tipos, entradas/salidas, casos límite) antes de solicitar la implementación a un asistente IA o a un desarrollador.


    ¿Cuándo debo usar Spec-First?

    Cuando la mantenibilidad, integraciones o el dominio crítico importen: APIs públicas, core domain y equipos distribuidos. No es necesario para scripts one-off o experimentos rápidos.


    ¿Spec-First reemplaza al TDD?

    No lo reemplaza; se complementan. Spec-First define contratos y TDD convierte esos contratos en tests ejecutables que guían la implementación.


    ¿Cuánto tiempo toma crear una spec básica?

    En muchos casos, minutos. Definir tipos y casos límite mínimos suele ser suficiente para reducir suposiciones del modelo y evitar reescrituras costosas.


    ¿Es útil para prototipos rápidos?

    No siempre. Para prototipos donde la velocidad de concepto importa más que la calidad, puedes omitirlo. Para piezas que deban mantenerse o integrarse, sí.


    ¿Qué incluye una spec mínima?

    Los tipos e interfaces de entradas/salidas, casos límite (nulos, dominios bloqueados, fallos de red), comportamiento determinista (funciones puras o efectos explícitos) y restricciones de integración (versiones, patrones prohibidos).

  • Cuándo usar multi-agente sin orquestador para sistemas LLM

    Cuándo usar multi-agente sin orquestador para sistemas LLM

    Multi-agente sin orquestador: cuándo sí, cuándo no

    Tiempo estimado de lectura: 4 min

    • Elige previsibilidad o diversidad: la decisión arquitectónica entre coreografía y orquestación define latencia, trazabilidad y coste.
    • Usa coreografía sólo cuando la impredecibilidad es funcional: simulaciones, brainstorming y generación de datos sintéticos.
    • Prefiere un agente único con tools tipadas para sistemas con SLAs, integridad de datos o costes por token relevantes.

    Multi-agente sin orquestador: cuándo sí, cuándo no. Es la pregunta que separa prototipos brillantes de sistemas que explotan en producción. Antes de escribir una sola línea de código, decide: ¿quieres impredecibilidad controlada o previsibilidad verificable? Ese matiz definirá tu arquitectura y tus costes operativos.

    En este artículo explico con ejemplos, métricas y criterios técnicos cuándo un solo agente bien diseñado supera a un enjambre de cinco agentes encadenados, y cuándo la coreografía descentralizada aporta valor real.

    Resumen rápido (lectores con prisa)

    Un sistema multi-agente sin orquestador (coreografía) permite que varios agentes LLM intercambien contexto sin una máquina de estados central. Úsalo para simulaciones, brainstorming y generación de datos sintéticos donde la impredecibilidad es valor. Evítalo en sistemas transaccionales, atención crítica o cuando necesitas trazabilidad determinista. Empieza siempre con un agente único y herramientas tipadas; escala a múltiples agentes solo si el límite es cognitivo, no de diseño.

    Multi-agente sin orquestador: definición y contexto

    Un sistema multi-agente sin orquestador (coreografía) es aquel en que varios agentes LLM se transfieren contexto entre sí sin una máquina de estados central que valide transiciones. Frameworks experimentales como OpenAI Swarm exploran handoffs ligeros entre agentes. En contraste, soluciones orquestadas usan grafos de estado deterministas: LangGraph, n8n o XState.

    La diferencia crítica: en la orquestación, la infraestructura controla el flujo; en la coreografía, el flujo emerge de decisiones probabilísticas del modelo. Esa diferencia tiene consecuencias prácticas en latencia, trazabilidad y tolerancia al error.

    Cuándo SÍ usar multi-agente sin orquestador

    • Simulaciones con actores contrapuestos. Cuando el objetivo es generar comportamiento emergente o modelar negociaciones entre agentes con incentivos opuestos, la autonomía produce diversidad útil.
    • Investigación y brainstorming creativo. Si buscas múltiples perspectivas no filtradas para enriquecer creatividad, dejar que agentes critiquen y propongan sin una regla rígida puede aportar hallazgos inesperados.
    • Generación de datos sintéticos. Interacciones caóticas entre agentes generan datasets variados útiles para entrenamiento o evaluación.

    Estos usos comparten dos características: no arriesgan datos reales ni SLAs estrictos, y toleran impredecibilidad como una funcionalidad, no un bug.

    Cuándo NO usar multi-agente sin orquestador

    Evita coreografías si hay dinero, integridad de datos o experiencia de usuario en juego:

    • Sistemas transaccionales con escrituras en BD, ERPs o CRMs: necesitas rollbacks y garantías ACID; la orquestación es obligatoria.
    • Atención al cliente y workflows críticos: latencias y respuestas incoherentes son inaceptables.
    • Modelos con presupuesto de tokens limitado: los enjambres tienden a entrar en bucles costosos (cortesías, indecisiones).

    Además, si necesitas auditoría y trazabilidad determinista, la coreografía complica el post-mortem.

    Por qué un solo agente supera a cinco encadenados (ejemplos técnicos)

    1) Context Loss

    Cada handoff serializa el razonamiento en texto. El receptor procesa un resumen; pierde activaciones internas y matices. Resultado: degradación progresiva del contexto. Un solo agente mantiene la cadena lógica en una ventana de contexto continua.

    2) Latencia y coste

    Cinco llamadas secuenciales multiplican TTFT y factura. Para servicios con SLA de respuesta o coste por token relevante, el impacto es directo en UX y en la cuenta.

    3) Roles que deberían ser tools

    A menudo se crean agentes por rol cuando lo que se necesita son herramientas especializadas. Un agente único con acceso a una herramienta de ejecución de código (sandbox Python), a DB queries parametrizadas y a validadores Zod/JSON Schema resuelve mejor que cinco agentes que no comparten capacidades. Usa Zod para tipos estrictos y pgvector para retrieval cuando necesites seleccionar herramientas por semántica.

    Criterios concretos previos al diseño (decide antes de codificar)

    Aplica estas tres pruebas rápidas:

    1. Conflicto de system prompts

    ¿Los prompts necesarios entran en conflicto (alta creatividad vs. máxima precisión)? Si sí, separa agentes u orquesta. Si no, usa uno solo.

    2. Determinismo del flujo

    ¿El paso B requiere que A sea validado con certeza? Si sí, la infraestructura debe controlar la transición (n8n, LangGraph). El LLM debe ejecutar acciones, no decidir el avance del workflow.

    3. Coste del fallo

    Calcula el impacto de un error en el tercer agente de la cadena (tokens perdidos, rollback requerido, datos corruptos). Si el coste excede el umbral tolerable, no uses coreografía.

    Mide antes de decidir: precisión de selección de herramienta, retries por fallo, tokens gastados en reintentos. Define umbrales y automatiza tests de estrés que simulen handoffs y fallos.

    Patrón recomendado de inicio

    1. Un agente central con tools tipadas (schemas, enums).
    2. Validación server-side estricta y Result pattern para errores, evitando throws incontenidos.
    3. Retira herramientas del prompt con Dynamic Tool Retrieval (RAG) para reducir la entropía. Usa embeddings + búsqueda vectorial para inyectar solo las herramientas relevantes.

    Escala a múltiples agentes solo cuando hayas demostrado que la solución simple falla por límite cognitivo del prompt y no por diseño.

    La arquitectura correcta no es la más sofisticada, es la que puedes operar, auditar y reparar. En producción, predecible vence a impresionante.

    Para equipos que prototipan o validan patrones de integración y workflows con agentes, puede ser útil revisar trabajos y experimentos prácticos. Una referencia complementaria se mantiene en Dominicode Labs, donde se documentan enfoques aplicados y pruebas de concepto relacionadas con agentes y automatización.

    FAQ

    ¿Qué es exactamente un sistema multi-agente sin orquestador?

    Es un sistema en el que varios agentes LLM intercambian contexto y toman decisiones de forma descentralizada, sin una máquina de estados central que controle las transiciones entre pasos.

    ¿Cuándo es apropiado usar coreografía en lugar de orquestación?

    Cuando el objetivo es generar comportamiento emergente, diversidad de perspectivas o datasets sintéticos, y no hay requisitos estrictos de integridad de datos, SLAs o trazabilidad determinista.

    ¿Qué riesgos introduce usar varios agentes encadenados?

    Pérdida de contexto por serialización, mayor latencia y coste por llamadas secuenciales, bucles de comportamiento que consumen tokens y dificultad para auditoría y rollbacks.

    ¿Cómo debo evaluar antes de diseñar un sistema multi-agente?

    Aplica pruebas sobre conflicto de prompts, determinismo del flujo y coste del fallo. Mide precisión de selección de herramienta, retries y tokens gastados; automatiza tests de estrés.

    ¿Qué alternativas prácticas existen a crear múltiples agentes?

    Un agente único con acceso a tools tipadas (validadores, sandboxes, consultas parametrizadas) y Dynamic Tool Retrieval usando embeddings y búsqueda vectorial suele resolver muchos casos de uso.

    ¿Qué herramientas o frameworks se mencionan como orquestadores?

    Se citan LangGraph, n8n y XState como ejemplos de soluciones orquestadas.

  • Usa el sistema de tipos de TypeScript como documentación para IA

    Usa el sistema de tipos de TypeScript como documentación para IA

    El type system de TypeScript como documentación para tu agente de IA

    Tiempo estimado de lectura: 4 min

    • El type system actúa como contrato para agentes IA: reduce ambigüedad y alucinaciones.
    • Proveer tipos reales al modelo mejora la integración: interfaces y uniones limitan las soluciones válidas.
    • Prácticas recomendadas: evita any, usa uniones discriminadas, y documenta intenciones clave con JSDoc.
    • Aplica en sistemas críticos: APIs públicas, lógica financiera, workflows y automations en producción.

    El type system de TypeScript como documentación para tu agente de IA funciona mejor que mil parrafadas: le das al modelo un contrato, no una novela. Si quieres que Claude, GPT o cualquier agente genere código real y alineado con tu arquitectura, empieza por entregarle los tipos —no descripciones— y observa cómo las alucinaciones desaparecen.

    ¿Por qué? Porque un tipo es una restricción matemática. Un LLM con contexto tipado no puede inventar propiedades, estados o firmas que no existen.

    Resumen rápido (lectores con prisa)

    Qué: Usa el type system de TypeScript como contrato para agentes IA.

    Cuándo: En APIs públicas, lógica crítica y workflows en producción.

    Por qué importa: Reduce alucinaciones y errores de integración.

    Cómo: Pega las interfaces, enums y tipos en el prompt y obliga al agente a cumplir firmas y uniones discriminadas.

    Qué cambia en tu flujo de trabajo

    Los modelos de lenguaje predicen tokens; no “entienden” tus necesidades de negocio. Cuando les ofreces solo lenguaje natural, abrazan convenciones comunes y rellenan huecos con suposiciones populares. Resultado: código que “parece” correcto pero falla en integrarse con tu stack.

    Si en cambio inyectas las interfaces, enums y tipos de tu proyecto, reduces drásticamente el espacio de soluciones válidas. El agente no elige entre cien estructuras posibles: respeta la tuya.

    No es teoría. Es práctica:

    • Tipos explícitos delimitan estados válidos ('pending' | 'completed' | 'failed').
    • Relaciones entre interfaces exponen dependencias y claves foráneas.
    • Uniones discriminadas fuerzan el manejo correcto de errores y casos límite.

    Fuentes prácticas: documentación oficial de TypeScript, guías de APIs y plataformas de agentes como OpenAI o Anthropic.

    Ejemplo práctico: deja de explicar, pega el tipo

    Imagina que quieres delegar la lógica de cambio de estado de pedidos.

    Sin tipos: “Crea una función para actualizar el estado de un pedido”. El modelo inventa estados. Problema.

    Con tipos reales:

    type OrderStatus = 'pending' | 'confirmed' | 'dispatched' | 'delivered' | 'refunded';
    
    interface Order {
      id: string;
      status: OrderStatus;
      customerId: string;
      updatedAt: string; // ISO UTC
    }
    
    type UpdateOrderStatusResult = 
      | { success: true; order: Order }
      | { success: false; error: 'ORDER_NOT_FOUND' | 'INVALID_TRANSITION' };

    Pega esto en el prompt o en el contexto del agente (Cursor, GitHub Copilot, flujos custom via API) y pide: “Implementa updateOrderStatus que valide transiciones y devuelva UpdateOrderStatusResult”. Ahora el agente debe cumplir la firma. No habrá processing fantasmas ni retornos desordenados.

    Reglas prácticas para construir el contexto tipado

    1. Evita any como si fuera veneno

    any es una puerta abierta a alucinaciones.

    2. Prefiere uniones discriminadas sobre booleans dispersos

    Las banderas (isLoading, isError) permiten estados imposibles; una unión no.

    3. Añade JSDoc breve cuando la intención no sea obvia

    Ejemplo: /** Fecha en UTC. No convertir a local. */

    4. Expone las relaciones

    Usa referencias: invoice.orderId: Order['id']. El agente lo interpreta como clave foránea.

    5. Incluye los tipos de retorno claros (Result/Either)

    Obliga a manejar errores, no a ignorarlos.

    Herramientas que usan este enfoque

    Herramientas que usan este enfoque: n8n para orquestación, GitHub Copilot y Cursor en editores. También puedes integrar directamente archivos .d.ts en el contexto de la llamada a la API.

    ¿Cuándo aplicar Type-Driven Development con agentes?

    Úsalo cuando la consistencia importa: APIs públicas, lógica financiera, workflows críticos, transformaciones de datos y automations en producción. Evítalo solo en prototipos tempranos donde los modelos de datos cambian cada dos días.

    No confundas disciplina con burocracia: diseñar tipos claros al principio acelera todo lo demás. Es una inversión que reduce revisiones manuales y bugs silenciosos.

    Resultado esperado y próximos pasos

    Si empiezas hoy, el cambio es tangible: menos iteraciones, menos PRs arreglando supuestos imposibles y, sobre todo, código que entra en tu base sin romper contratos. El tipo es el contrato. El agente es el implementador.

    Haz esto ahora: copia el archivo de tipos relevante (o el fragmento clave) en el prompt de tu agente, pide una implementación concreta y compara el PR generado con lo que haría un desarrollador. Notarás dos cosas: consistencia y menos errores lógicos. Si trabajas con n8n, añade los tipos a los nodos o workflows para que los agentes que automatan tareas respeten tus contratos.

    No acaba aquí: diseña un checklist de tipos antes de delegar, prueba un par de endpoints y verás cómo el modelo deja de “inventar”. ¿Quieres un checklist listo para usar? Haz esto primero: pega tu index.d.ts en el prompt y pide al agente “Genera tests unitarios que verifiquen las transiciones permitidas”. Verás la diferencia al instante.

    Si quieres profundizar con proyectos y experimentos, revisa también los recursos y experimentos de Dominicode Labs. Es un buen complemento para validar patrones de Type-Driven Development aplicados a agentes y workflows antes de llevarlos a producción.

    FAQ

    ¿Por qué usar tipos en lugar de solo lenguaje natural?

    Porque los tipos actúan como restricciones matemáticas que reducen el espacio de soluciones válidas. Forzan al agente a no inventar propiedades o estados que no existen.

    ¿Qué tipos debo compartir primero?

    Empieza por los tipos que definen estados y contratos públicos: DTOs, modelos de entidad y tipos de retorno de API. Luego añade relaciones y uniones discriminadas.

    ¿Cómo evito que el agente ignore los tipos?

    Entrega los tipos en el contexto del prompt y pide explícitamente que la implementación cumpla las firmas. Usa ejemplos de tests o resultados (Result/Either) para que el agente devuelva formas esperadas.

    ¿Qué herramientas facilitan este flujo?

    Editores y orquestadores que soportan contexto tipado: Cursor, GitHub Copilot y plataformas de orquestación como n8n.

    ¿Es útil en prototipos rápidos?

    En prototipos muy tempranos donde los modelos de datos cambian constantemente, puede ser una carga. Para prototipos más avanzados o cuando la estructura es estable, sí acelera la integración.

    ¿Cómo manejar cambios de tipos en producción?

    Versiona tus tipos y mantén contratos retrocompatibles siempre que sea posible. Añade migraciones y tests que verifiquen transiciones permitidas entre versiones.

    ¿Debo incluir ejemplos de datos junto a los tipos?

    Sí. Ejemplos concretos ayudan al agente a mapear tipos a estructuras reales y generan pruebas útiles para validar implementaciones.

  • Claude Opus 4.8: novedades para desarrolladores (Claude Code, Effort Control y más)

    Claude Opus 4.8: novedades para desarrolladores (Claude Code, Effort Control y más)

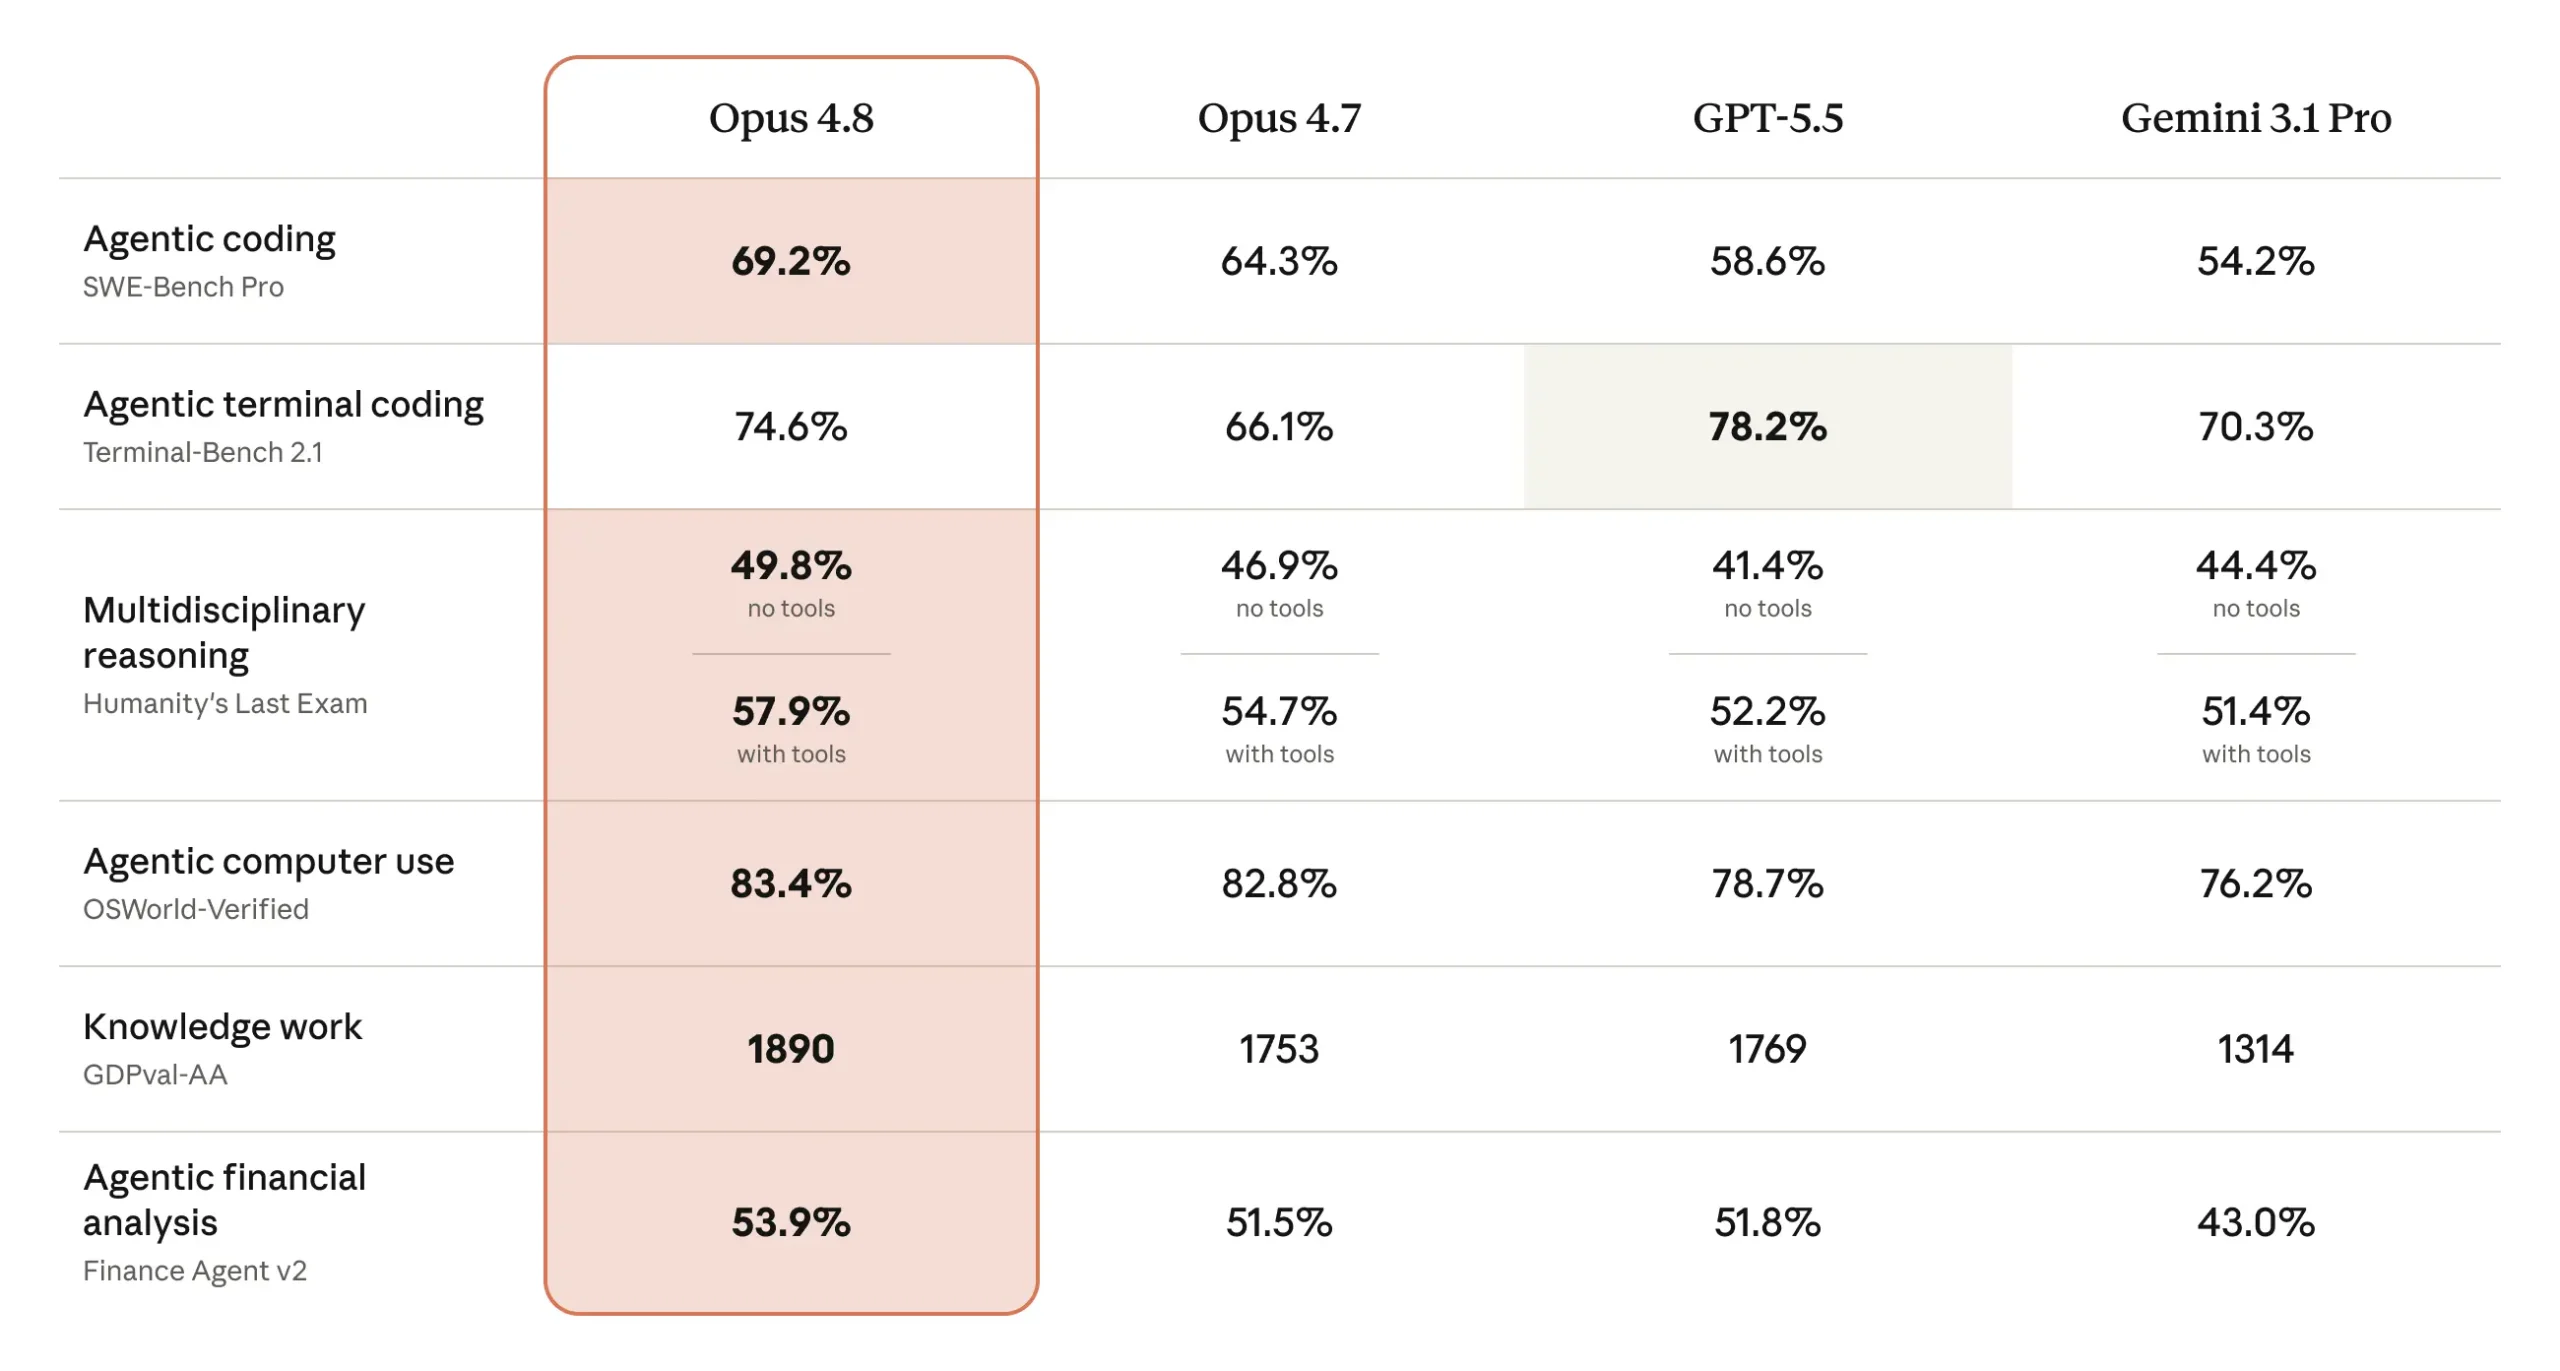
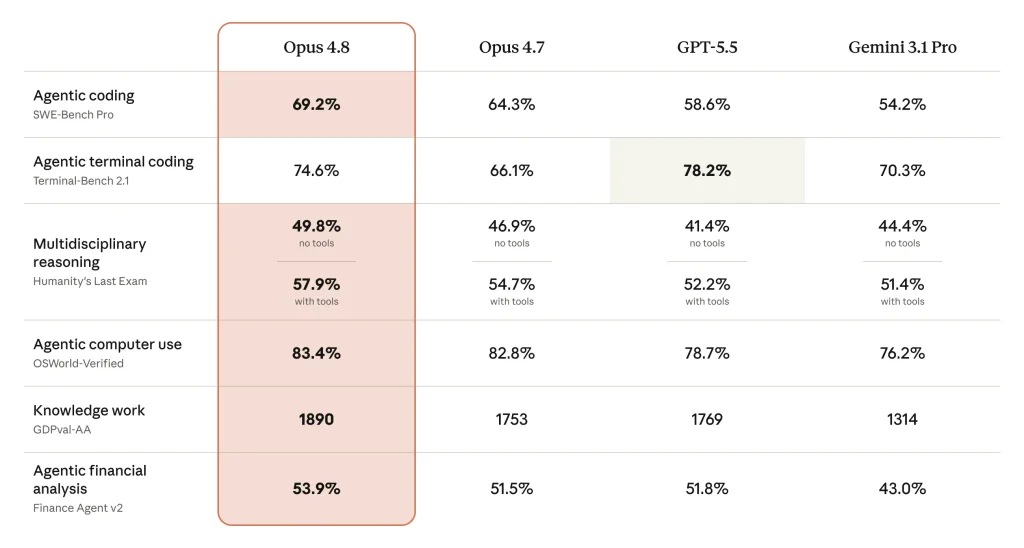
    Anthropic acaba de lanzar Claude Opus 4.8, y ellos mismos lo describen como una mejora “modesta” sobre Opus 4.7. Es una descripción honesta, pero engañosa: las mejoras de calidad de vida son justo las que más se notan cuando trabajas con esto todos los días.

    En este artículo voy directo a lo que importa si programas: qué cambia de verdad, qué es marketing, y cómo encaja en un flujo de trabajo serio.

    Qué es Opus 4.8 en una frase

    Opus 4.8 reemplaza a 4.7 dentro de la misma familia de modelos. Mismo precio, pero más fiable y con mejor criterio cuando trabaja en modo agente. El identificador del modelo en la API es claude-opus-4-8.

    La jugada interesante de este lanzamiento no es el modelo en solitario, sino lo que Anthropic construyó alrededor de él. Vamos por partes.

    1. Dynamic Workflows en Claude Code

    Esta es la novedad grande, y de momento está en research preview.

    Claude Code ahora puede planificar una tarea de gran tamaño, lanzar cientos de subagentes en paralelo dentro de una misma sesión, verificar sus propios resultados y recién entonces reportarte. El ejemplo que pone Anthropic es ambicioso: migraciones de código a escala de cientos de miles de líneas, desde el arranque hasta el merge, usando tu propia suite de tests como criterio de aceptación.

    El detalle a tener en cuenta: esta capacidad está disponible en los planes Enterprise, Team y Max. Si estás en otro plan, no la tendrás todavía.

    Para quien delega tareas largas, este es el cambio con más potencial a medio plazo.

    2. Effort Control: tú decides cuánto piensa

    Ahora puedes elegir el nivel de “esfuerzo” del modelo desde un control junto al selector de modelo.

    • Más esfuerzo: razona más profundo y entrega mejores respuestas.
    • Menos esfuerzo: responde más rápido y consume menos de tus límites de uso.

    Por defecto viene en high. Por encima tienes la opción “extra” —que en Claude Code corresponde a xhigh— y “max”. La recomendación oficial es usar “extra” para tareas difíciles y flujos asíncronos largos. A diferencia de Dynamic Workflows, Effort Control está disponible en todos los planes.

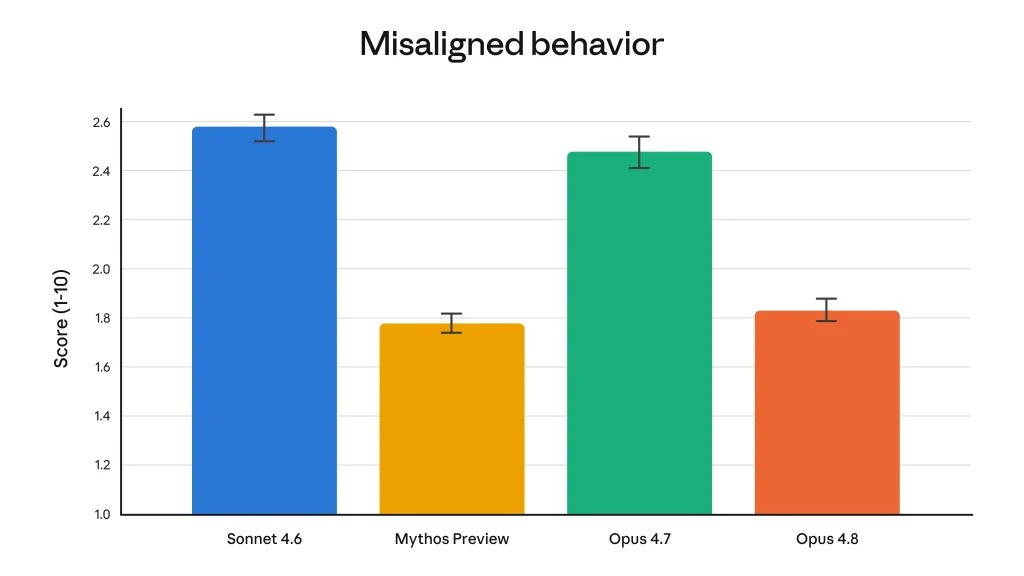
    3. Un modelo más honesto (menos bugs silenciosos)

    Esta es, para mí, la mejora que más se nota en el día a día del código.

    Anthropic entrenó el modelo para que no cante victoria sin evidencia. El dato concreto: Opus 4.8 tiene aproximadamente cuatro veces menos probabilidad que su predecesor de dejar pasar un fallo —en código que él mismo escribió— sin señalártelo.

    Traducido: menos “ya está listo” cuando en realidad no lo está. Si delegas tramos grandes de trabajo, esa honestidad te ahorra horas de revisión y depuración.

    Novedad para quien construye sobre la API

    Si desarrollas agentes sobre la API, hay un cambio silencioso pero práctico: la Messages API ahora acepta entradas de tipo system dentro del array de mensajes. Esto te permite actualizar las instrucciones de Claude a mitad de una tarea —permisos, presupuesto de tokens, contexto del entorno— sin romper el prompt cache ni tener que colarlo como un turno de usuario. Para harnesses de agentes que corren de forma autónoma, limpia bastante la arquitectura.

    Precios y velocidad

    Opus 4.8 mantiene el precio de 4.7:

    • Modo regular: 5 USD por millón de tokens de entrada, 25 USD por millón de salida.
    • Modo fast: 10 USD por millón de entrada, 50 USD por millón de salida, a 2,5× la velocidad. Anthropic indica que este modo fast es alrededor de tres veces más barato que en modelos anteriores.

    En resumen: mejor modelo, mismo costo. Difícil quejarse de eso.

    Mi opinión: no es un salto generacional, y está bien

    Seamos claros: Opus 4.8 no te va a volar la cabeza. Es una mejora de calidad de vida, no un cambio de generación. Pero precisamente por eso se siente: el mejor criterio agéntico y la honestidad encajan a la perfección con un flujo de Spec-Driven Development (SDD).

    Si el modelo respeta mejor el spec, se atreve a frenar cuando el plan no cuadra y no te miente con un “terminé” falso, entonces puedes delegar tramos más grandes con menos revisión manual. Esa es la dirección que importa: el desarrollador como director de la IA, no como su competidor.

    Conclusión

    Claude Opus 4.8 no es un titular espectacular, pero es una actualización sólida para quien vive dentro de Claude Code. Dynamic Workflows y la honestidad extra del modelo son lo que de verdad vale la pena, y el Effort Control le da un control fino que se agradece.

    Si trabajas con SDD y Claude Code, este lanzamiento te toca de lleno. En las próximas semanas haré un experimento práctico combinando Dynamic Workflows con specs bien definidas; lo compartiré por aquí.

    ¿Ya probaste Opus 4.8? ¿Qué tarea grande le tirarías primero a los Dynamic Workflows? Cuéntame en los comentarios.

  • Construyendo Agentes Rápidos con TypeScript y Vercel AI SDK

    Construyendo Agentes Rápidos con TypeScript y Vercel AI SDK

    TypeScript + Vercel AI SDK: la combinación que uso para construir agentes rápido

    Tiempo estimado de lectura: 4 min

    • Tipado + validación: TypeScript en la superficie y Zod en runtime reducen errores silenciosos y permiten refactors seguros.
    • API unificada: Vercel AI SDK conecta proveedores y ofrece streaming y herramientas tipadas.
    • Extracción y control: generateObject y esquemas evitan ingeniería de prompt frágil y JSON truncado.
    • UX y operaciones: streamText mejora la percepción de latencia; métricas y circuit breakers mantienen robustez en producción.

    TypeScript + Vercel AI SDK: la combinación que uso para construir agentes rápido. Si vas a poner agentes en producción, necesitas que la capa que conecta al LLM con tus herramientas sea predecible, tipada y validada desde el primer día. Esa combinación reduce errores silenciosos, acelera refactors y convierte promesas estocásticas en contratos verificables.

    Resumen rápido (lectores con prisa)

    TypeScript para tipado estático, Zod para validación en runtime y Vercel AI SDK como API unificada. Juntos: herramientas tipadas, extracción estructurada (generateObject), y streaming (streamText) para agentes más seguros y previsibles.

    TypeScript + Vercel AI SDK: por qué funciona para agentes rápidos

    Tres problemas recurrentes al construir agentes:

    1. El LLM alucina parámetros para las herramientas (tool calls)

    Los modelos pueden generar parámetros inválidos o inventados para llamadas a herramientas, lo que puede llevar a ejecuciones peligrosas si no se validan antes.

    2. Las respuestas JSON vienen envueltas en markdown o truncadas

    Solemos ver JSON con backticks, texto adicional o respuestas incompletas que complican el parsing confiable.

    3. Cambios en la API del proveedor rompen integraciones silenciosamente

    Actualizar modelos o proveedores puede introducir cambios incompatibles si no hay contratos y pruebas robustas.

    La solución práctica es simple: tipos en la superficie (TypeScript), contratos ejecutables (Zod) y una API que integra ambas cosas (Vercel AI SDK). Beneficios concretos:

    • Autocompletado que evita buscar docs.
    • Tool calls que no se ejecutan si los datos no validan.
    • Extracción de objetos estructurados (generateObject) sin ingeniería de prompt frágil.
    • Streaming nativo (streamText) para UX reactiva.

    Tool calls tipados: la barrera que evita ejecuciones peligrosas

    Definir herramientas con esquemas evita que el agente ejecute acciones con parámetros inventados. Ejemplo:

    import { tool } from 'ai';
    import { z } from 'zod';
    
    const searchOrders = tool({
      description: 'Busca pedidos por ID de cliente',
      parameters: z.object({
        customerId: z.string().uuid(),
        status: z.enum(['pending','shipped','delivered']).optional(),
      }),
      execute: async ({ customerId, status }) => {
        return queryOrdersDatabase({ customerId, status });
      },
    });
    

    Si el LLM devuelve un customerId inválido, Zod lo rechazará antes de llamar a execute. Resultado: menos excepciones en la base de datos y trazabilidad clara del fallo (prompt → validación → rechazo).

    generateObject: extracción fiable de datos estructurados

    generateObject obliga al modelo a respetar un esquema y te devuelve un objeto tipado sin hacer JSON.parse() manual. Ejemplo práctico:

    import { generateObject } from 'ai';
    import { openai } from '@ai-sdk/openai';
    import { z } from 'zod';
    
    const schema = z.object({
      sentiment: z.enum(['positive','neutral','negative']),
      confidence: z.number().min(0).max(1),
      topics: z.array(z.string()).max(5)
    });
    
    const { object } = await generateObject({
      model: openai('gpt-4o'),
      schema,
      prompt: 'Analiza la reseña y devuelve sentiment, confidence y topics.'
    });
    
    // object ya está tipado según schema
    

    Esto reduce la ingeniería de prompts (“Devuelve SOLO JSON”) y aumenta la tasa de respuestas utilizables desde el primer intento.

    streamText: UX que comunica progreso y permite pasos intermedios

    Los agentes suelen ejecutar varias herramientas en cadena. streamText permite emitir texto progresivo y reflejar estados intermedios (p. ej. “consultando base de datos…”) en la UI sin arquitectura adicional:

    • Emite tokens progresivamente al frontend.
    • Reporta eventos de invocation/execute de herramientas.
    • Funciona tanto en Server (Next.js) como en cliente con hooks (useChat).

    Esto mejora la percepción de latencia y permite interacciones más naturales con agentes multi‑paso.

    Integración práctica y operaciones en producción

    Patrón recomendado

    1. Diseña esquemas Zod como fuente única de verdad.
    2. Expón el esquema (o ejemplo) en el prompt para guiar al LLM.
    3. Usa safeParse() para reintentos y autocorrección de prompts; usa parse() para endpoints que deben fallar rápido.
    4. Loguea prompt, raw response y error de Zod (flatten) para trazabilidad.

    Medidas operativas

    • Métricas: tasa de validación fallida, latencia media por herramienta, reintentos por prompt.
    • Retries limitados con backoff y contador de intentos (p. ej. 2 reintentos de autocorrección antes de degradar a humano).
    • Circuit breaker para evitar invocar herramientas costosas si la validación falla en cascada.

    Limitaciones y decisions trade‑offs

    • No eliminas la estocasticidad del LLM; la controlas. Algunos casos requerirán supervisión humana.
    • generateObject y Structured Outputs reducen errores de formato, pero no sustituyen la validación semántica (p. ej. números positivos). Zod sigue siendo necesaria.
    • Tipar desde el día 0 impone disciplina, pero acelera onboarding y refactors.

    Conclusión

    TypeScript + Vercel AI SDK: la combinación que uso para construir agentes rápido no es un truco de marketing. Es una estrategia concreta: tipos para detectar cambios, Zod para validar en runtime, y un SDK que une proveedores, streaming y herramientas tipadas. Si tu objetivo es desplegar agentes que actúen sobre sistemas reales—bases de datos, pedidos, o infraestructuras—esta pila reduce fallos silenciosos y convierte iteración rápida en ingeniería sostenible.

    Para equipos que exploran automatización y agentes como flujo de trabajo productivo, una guía práctica y recursos adicionales están disponibles en Dominicode Labs. Es una continuación lógica para quienes quieren aterrizar estas prácticas en sistemas reales.

    FAQ

    ¿Por qué combinar TypeScript con Zod y un SDK como Vercel AI SDK?

    TypeScript aporta seguridad estática y autocompletado; Zod proporciona validación en runtime; y Vercel AI SDK unifica la interacción con proveedores, streaming y herramientas tipadas. La combinación reduce errores silenciosos y facilita refactors.

    ¿Cómo evitan las herramientas tipadas ejecuciones peligrosas?

    Al definir parámetros con esquemas Zod, cualquier dato que no valide se rechaza antes de ejecutar la función execute, evitando operaciones con parámetros inventados o inválidos.

    ¿Qué ventaja ofrece generateObject frente a parsear JSON manualmente?

    generateObject obliga al modelo a respetar un esquema y devuelve un objeto ya tipado, evitando la ingeniería de prompt para forzar JSON y reduciendo errores por markdown, texto adicional o truncado.

    ¿Cuándo debo usar streamText?

    Cuando quieras mejorar la UX en interacciones multi‑paso: emitir tokens progresivamente, mostrar estados intermedios y reportar eventos de invocation/execute sin añadir complejidad arquitectónica.

    ¿Qué métricas operativas son críticas?

    Métricas como tasa de validación fallida, latencia media por herramienta y reintentos por prompt son esenciales para monitorear la salud y eficacia del agente.

    ¿Cuáles son las limitaciones principales de esta pila?

    No elimina la estocasticidad del LLM; solo la controla. También requiere validación semántica adicional (p. ej. asegurar números positivos). Tipar desde el día 0 impone disciplina, aunque acelera onboarding y refactors.