Category: AI

  • OpenSpec y Claude Code: integración paso a paso del flujo OPSX

    OpenSpec y Claude Code: integración paso a paso del flujo OPSX

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso: lo acordado vive en archivos versionados dentro del repo y el agente los lee antes de tocar código.

    Tutorial de integración OpenSpec Claude Code, paso a paso: instalación, inicialización y el flujo OPSX de principio a fin.


    Aviso rápido: OpenSpec no es OpenAPI

    Comparten cuatro letras y nada más.

    OpenSpec es un framework open source de spec-driven development para asistentes de código, de Fission-AI. No describe endpoints REST. Si has llegado buscando Swagger, este no es tu post.

    Lo que hace es meter una capa de especificación entre tú y el agente: propuesta, diseño, tareas y spec del cambio. Todo en Markdown, todo dentro del repo, todo bajo control de versiones.


    Paso 1: instalar (y el error de scope que arrastran los tutoriales viejos)

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto, sin relación con el framework. Es el fallo más repetido en tutoriales de hace unos meses, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Paso 2: inicializar OpenSpec en Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
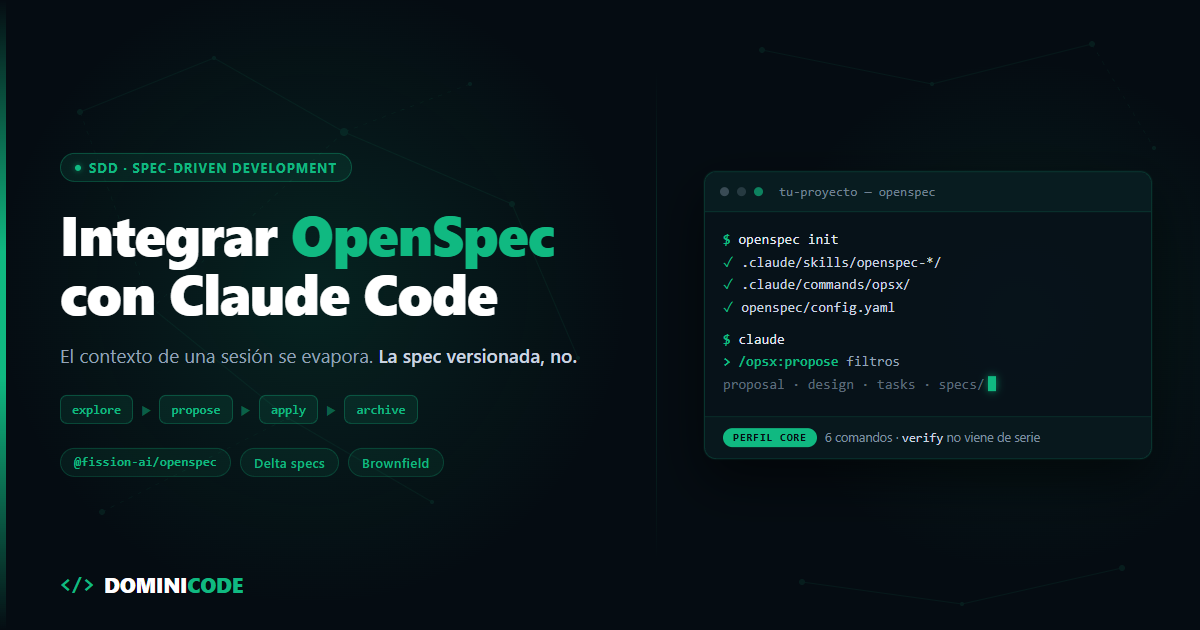
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Paso 3: llena el config.yaml antes de pedir nada

    Este paso parece opcional. No lo es.

    openspec/config.yaml no es un README que el agente abre si le apetece. Su contenido se inyecta en cada petición de planificación. Va dentro del prompt, siempre.

    Dedica cinco minutos a describir de verdad tres cosas: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear.

    Un apunte honesto: no inventes claves en el YAML. Completa las que el propio init deja generadas y, si necesitas un campo que no existe, mira la doc oficial.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    Paso 4: el flujo OPSX de principio a fin

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:update y /opsx:sync — mantener la spec viva

    Antes de archivar, el perfil por defecto trae dos comandos más que casi nadie menciona: /opsx:update revisa los artefactos de un cambio si algo se movió a mitad de camino, y /opsx:sync fusiona la delta spec del cambio dentro de las specs generales del proyecto, para que la spec principal quede al día sin tocarla a mano.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y actualiza la fuente de verdad del proyecto. A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    El perfil extendido (y dónde vive /opsx:verify)

    El perfil por defecto (core) trae los seis comandos que acabas de ver: explore, propose, apply, update, sync y archive. Si necesitas control más granular, cambias de perfil:

    openspec config profile
    openspec update
    

    Eso desbloquea /opsx:new, /opsx:continue, /opsx:ff, /opsx:bulk-archive, /opsx:onboard y, el que más se echa en falta, /opsx:verify: contrasta la implementación contra la spec acordada. No es un test runner, es la comprobación de que no se coló nada que nadie pidió y que no falta nada que sí se pidió.

    Empieza sin el perfil extendido. Actívalo cuando el ciclo base (explore → propose → apply → archive) te sepa corto.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Aquí está la decisión de diseño que hace a OpenSpec usable en el mundo real.

    La spec de un cambio no describe tu sistema entero. Describe solo lo que se mueve:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ## REMOVED Requirements
    

    Escenarios en Markdown plano con sintaxis WHEN/THEN. Sin Gherkin, sin herramientas extra, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development. Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto.


    Si vienes de un tutorial de hace unos meses

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano. Vuelve a ejecutar openspec init y deja que la herramienta reconstruya lo suyo.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.

    Dos avisos para terminar. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es volver a ejecutar openspec init en el proyecto en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo Funciona el Watermarking de Claude a Nivel de API

    Cómo Funciona el Watermarking de Claude a Nivel de API

    La primera vez que alguien escucha que Claude mete una marca de agua en el texto que genera, se imagina un truco barato de esteganografía.

    Un espacio de ancho cero entre dos palabras. Un carácter Unicode invisible (\u200B). Un patrón binario escondido en los saltos de línea.

    Si fuera eso, un script de Python de dos líneas con un .replace('\u200b', '') o un regex básico destruiría la marca en tres milisegundos.

    Anthropic no ha implementado un truco de caracteres. Desde agosto de 2026, todos los modelos nuevos de Claude integran un watermarking a nivel de API de naturaleza puramente estadística. No hay caracteres ocultos, viaja en el texto plano al copiar y pegar, y no existe ningún parámetro o flag en la API para desactivarla.

    Si tu producto llama a la API de Claude, tus usuarios ya están recibiendo texto marcado, lo sepas o no. Aquí te explico el algoritmo que hay detrás, cómo se diferencia de los metadatos en archivos y qué implica de verdad si construyes sobre esa API — no como usuario ocasional de Claude Code, sino como quien tiene que responder por ello ante sus propios clientes.


    Cómo genera texto un LLM (el paso previo imprescindible)

    Para entender cómo se inserta una señal en un texto sin alterar una sola letra, primero hay que recordar qué hace el modelo en cada ciclo de inferencia.

    Un LLM no "elige una frase completa". Trabaja token a token. Cuando Claude va a generar la siguiente palabra, calcula una distribución de probabilidad sobre su vocabulario completo (los llamados logits, normalizados con una función softmax):

    software      → 28%
    aplicaciones  → 21%
    productos     → 17%
    sistemas      → 14%
    herramientas  → 11%
    otros...      →  9%
    

    En un muestreo normal con cierta temperatura, el modelo elige uno de los tokens más probables. El texto resultante es fluido, coherente y suena natural.

    Aquí es exactamente donde entra el algoritmo de watermarking.


    El algoritmo de Kirchenbauer: listas verdes y sesgo de logits

    Anthropic no ha publicado el mecanismo exacto que usa Claude. Lo único que confirma oficialmente es el principio: la marca usa una clave y las palabras previas para decidir qué palabra elige el modelo entre varias opciones semánticamente equivalentes, sin tocar la calidad del texto. Cita como referencias el paper de Kirchenbauer et al. y SynthID-Text de Google DeepMind, así que lo más razonable —y lo que asume la mayoría del análisis externo— es que Claude use una variante de esa familia de técnicas. Lo que sigue es cómo funciona ese enfoque en general, no una confirmación línea por línea de la implementación interna de Anthropic.

    La técnica estándar en la industria para marcar texto en LLMs no toca el texto después de generarlo. Modifica la probabilidad antes de muestrear.

    El proceso sigue, a grandes rasgos, estos pasos:

    Token anterior (t-1) 
           │
           ▼
    [ Hash + Clave Secreta de Anthropic ]
           │
           ▼
    Partición pseudo-aleatoria del vocabulario
      ├── Lista Verde (Green List) ~ 50%
      └── Lista Roja (Red List)    ~ 50%
           │
           ▼
    Se suma un delta (+δ) a los logits de la Lista Verde
           │
           ▼
    Muestreo del siguiente token (favorece sutilmente el verde)
    
    1. Generación de semilla: Al momento de predecir el siguiente token, el sistema calcula un hash criptográfico del token anterior (o de una ventana de los últimos tokens) combinado con una clave secreta que solo posee Anthropic.
    2. Partición del vocabulario: Ese hash divide pseudo-aleatoriamente todo el diccionario de tokens en dos grupos: una Lista Verde y una Lista Roja, típicamente al 50% cada una.
    3. Sesgo de logits (Logit Biasing): A los logits de los tokens que caen en la Lista Verde se les suma un valor constante positivo.
    4. Muestreo: El modelo muestrea el siguiente token aplicando la distribución con los logits alterados.

    ¿Qué ve un humano vs. qué ve un detector?

    • Un humano lee el texto y no nota nada extraño. Como el sesgo es moderado, el modelo sigue seleccionando palabras de alta probabilidad semántica. El significado, el estilo y la calidad no cambian.
    • Un detector con la clave (hoy, solo Anthropic; han anunciado que van a liberar una API de detección pero todavía no está disponible públicamente) tomaría el texto generado, reconstruiría para cada palabra si pertenecía a la Lista Verde o a la Lista Roja, y contaría cuántos tokens verdes aparecen.

    En un texto escrito por un humano o por un modelo sin marca, la probabilidad de que un token caiga en la lista verde es de alrededor del 50% (puro azar).

    En un texto marcado con este tipo de técnica, esa proporción sube de forma sistemática por encima del azar. Anthropic no ha publicado la cifra exacta para Claude; en la literatura académica sobre KGW/SynthID-Text el desplazamiento suele ser notable con relativamente pocos tokens.

    Con un párrafo de varios cientos de palabras, la probabilidad de que esa acumulación de tokens verdes ocurra por puro azar cae drásticamente. Esa es la base estadística del método, aunque los números concretos que aplica Anthropic a Claude no son públicos.


    Por qué en código fuente la marca es mucho más débil

    Aquí hay un detalle técnico crítico que casi nadie en redes sociales ha mencionado: el watermarking estadístico necesita entropía.

    La entropía mide la cantidad de opciones válidas que tiene el modelo para continuar una frase.

    • En prosa libre (alta entropía): Para decir "construimos sistemas robustos", el modelo puede elegir entre sistemas, aplicaciones, plataformas, soluciones o arquitecturas. Tiene margen de sobra para elegir un token de la Lista Verde sin romper la frase.
    • En código de programación (baja entropía): Si estás escribiendo TypeScript y tienes for (const item of, el siguiente token sintácticamente válido es casi con total seguridad el identificador del array o una estructura iterable. Si fuerzas un token de la lista verde que no encaja sintácticamente, el código no compila.
    // En sintaxis estricta, el espacio de tokens válidos es minúsculo:
    export interface UserSession {
      id: string;
      createdAt: Date;
    }
    

    Si el modelo reduce la temperatura o la sintaxis impone un único token válido, el sesgo de la lista verde no puede aplicarse sin destruir la corrección del programa.

    Por eso, en archivos de código (.ts, .py, .rs) la marca estadística es inherentemente más débil o casi indetectable en fragmentos cortos, mientras que en documentación, emails o artículos es donde más fuerte se fija. Y precisamente porque no puedes apoyarte en el watermark para saber si un fragmento de código viene de un agente, la validación real sigue siendo la de siempre: TDD potenciado por IA, validar el código antes de mergear.

    Esta es la misma disciplina de control y contexto que enseñamos en el curso Construye con IA: De la Idea al Producto con Claude y Specs: cuando entiendes cómo procesan los modelos la probabilidad de los tokens, dejas de tratar a los agentes como cajas mágicas y empiezas a diseñar sistemas predecibles.


    Texto vs. Archivos: la diferencia entre Watermark y C2PA

    Existe una confusión generalizada entre la marca en el texto y la marca en archivos multimedia. Anthropic usa dos tecnologías completamente distintas según el tipo de output:

    Característica Marca de agua en Texto Metadatos en Archivos (.png, .svg)
    Mecanismo Sesgo estadístico en logits (Kirchenbauer / SynthID) Estándar C2PA (Content Authenticity Initiative)
    Dónde vive En la frecuencia y secuencia de las palabras En la cabecera / bloque de metadatos del archivo
    Copiar y pegar Sobrevive (es el texto mismo) No aplica (es un archivo binario)
    Edición / Conversión Se degrada progresivamente si reescribes Se pierde si re-guardas o conviertes el archivo
    Verificación hoy Privada (solo Anthropic tiene la clave) Pública y verificable hoy con c2patool

    Cómo inspeccionar C2PA en tus archivos hoy mismo

    Si generas diagramas SVG o imágenes con Claude y las sirves desde tu backend, puedes auditar los metadatos C2PA en tu propia máquina con la herramienta oficial de la Content Authenticity Initiative:

    # Instalación del cli oficial de C2PA
    brew install c2patool
    # O descargar el binario desde github.com/contentauth/c2pa-rs/releases
    
    # Inspeccionar el manifiesto completo en JSON
    c2patool imagen.png
    
    # Ver solo el resumen de procedencia
    c2patool imagen.png --info
    

    Si el archivo proviene directamente de Claude, el manifiesto C2PA mostrará la firma criptográfica de emisión. Si lo abres en Photoshop, lo recortas y lo guardas como WebP, el contenedor C2PA desaparece a menos que tu software lo re-firme.


    Detector de IA ≠ Detector de Watermark

    Esta distinción te va a ahorrar dolores de cabeza con clientes y product managers cuando te pidan "añadir detección de IA":

    1. Un detector de IA tradicional (heurístico): Analiza perplejidad y ráfagas (burstiness). Intenta adivinar si el estilo parece robótico. Es impreciso, produce falsos positivos atroces con no-nativos en inglés y no sirve como prueba legal.
    2. Un detector de marca de agua: No evalúa estilo ni perplejidad. Aplica una clave criptográfica sobre la secuencia de tokens y comprueba una hipótesis matemática de probabilidad binomial.

    Hoy por hoy, no existe un detector público de watermark para Claude. Si ves una web que afirma "Pega tu texto y te digo si tiene la marca de Claude", es un detector heurístico genérico, no un verificador del watermark de Anthropic.

    Además, publicar un detector abierto crea un problema de seguridad: actúa como un oráculo de optimización. Cualquier usuario podría pasar su texto por un script que altere palabras una a una hasta que el verificador dé negativo, destruyendo la marca con el mínimo esfuerzo.


    Qué significa el watermarking de Claude si construyes sobre la API

    Si integras Claude en tu SaaS o en pipelines de desarrollo interno —repasa lo básico en Claude API: Crash Course para developers con TypeScript si aún no la usas a diario— hay cuatro realidades que debes asumir:

    1. No hay opt-out: No existe un header x-anthropic-disable-watermark: true. La directiva de la Unión Europea (EU AI Act, artículo 50) exige que los proveedores marquen las salidas de IA generativa.
    2. La marca demuestra procesamiento, no autoría única: Si un humano escribe un borrador y le pide a Claude que corrija la puntuación, el texto resultante puede quedar marcado. Anthropic lo aclara en su documentación: la marca indica que el texto pasó por el modelo, no que el humano no intervino.
    3. No prometas a tus clientes outputs "indetectables": Cualquier modelo de negocio basado en vender "artículos indetectables para SEO" o "ensayos indetectables" está técnicamente muerto a medio plazo frente a esquemas de marca estadística.
    4. La paráfrasis profunda degrada la señal: Anthropic mismo lo advierte: una edición ligera probablemente no elimina la marca, pero reescribir el texto a fondo —traducirlo, reordenarlo intensamente o editarlo a mano de forma sustancial— sí la destruye, porque rompe la alineación entre los tokens y la clave con la que se generaron.

    Para patrones avanzados de integración con LLMs y arquitecturas robustas en producción, en Dominicode Labs analizamos continuamente los cambios de la API de Anthropic y cómo adaptar nuestros proyectos.


    Preguntas frecuentes

    ¿Puedo desactivar la marca de agua en la API de Claude?

    No. Anthropic ha desplegado el sistema de watermarking a nivel de inferencia sin ningún parámetro de exclusión en la API ni en las cuentas Enterprise, alineándose con las normativas internacionales como el EU AI Act.

    ¿La marca de agua ralentiza la generación o encarece el coste de tokens?

    Anthropic no ha reportado ningún impacto. Por diseño, este tipo de watermarking solo sesga qué token se elige dentro de la misma distribución de probabilidad que el modelo ya calculaba: no añade tokens extra ni pasadas adicionales de inferencia, así que el coste computacional adicional es marginal.

    ¿Un detector de watermark puede acusarme falsamente de usar IA?

    Con textos largos, la probabilidad matemática de un falso positivo en un test de hipótesis tipo Kirchenbauer es extremadamente baja — es la base estadística del método, aunque Anthropic no ha publicado la tasa exacta para Claude. Aun así, es un mecanismo mucho más fiable que los detectores heurísticos habituales, que fallan con frecuencia.

    ¿Qué pasa si traduzco el texto generado por Claude a otro idioma?

    Si traduces el texto mediante otra herramienta o manualmente, la alineación de los tokens con la clave pseudo-aleatoria original se destruye y la marca de agua estadística deja de ser detectable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • TDD con IA: valida el código autogenerado antes de mergear

    TDD con IA: valida el código autogenerado antes de mergear

    Revisé una Pull Request generada por un asistente de IA hace un par de semanas.

    El autor de la PR estaba fascinado: "Mira qué limpio quedó el algoritmo de descuentos por volumen. La IA lo escribió en 15 segundos".

    El código tenía nombres impecables, comentarios en JSDoc y tipado de TypeScript sin un solo error. Le faltaba lo único que sostiene el TDD con IA: tests.

    Escribí una prueba unitaria pasando una compra con descuento de cliente VIP combinado con un cupón del 100%. El sistema devolvió un saldo negativo donde la tienda terminaba debiéndole dinero al comprador.

    El modelo de IA no tenía mala intención: simplemente no sabía qué reglas de negocio proteger porque nadie se las había formulado como una prueba ejecutable.

    En la era de los asistentes de código, Test-Driven Development (TDD) no está muerto; es más indispensable que nunca. Aquí tienes el flujo exacto para combinar TDD con IA.


    El nuevo ciclo Red-Green-Refactor con Agentes de Código

    El ciclo clásico de TDD se transforma radicalmente cuando tienes un agente a tu lado:

    ┌─────────────────────────────────────────────────────────────┐
    │                 FLUJO TDD POTENCIADO POR IA                 │
    │                                                             │
    │  1. HUMANO (Diseño)  ──>  Escribe el Test Unitario (ROJO)   │
    │                                   │                         │
    │                                   ▼                         │
    │  2. AGENTE (Código)  ──>  Genera la Implementación (VERDE)  │
    │                                   │                         │
    │                                   ▼                         │
    │  3. DÚO (Calidad)    ──>  Refactoriza con Seguridad         │
    └─────────────────────────────────────────────────────────────┘
    

    En lugar de delegar el diseño a ciegas, el desarrollador asume el rol de arquitecto: define el contrato y los casos de borde en una prueba. El agente asume el trabajo pesado de implementar la sintaxis.


    Ejemplo Práctico: Implementando una lógica de negocio paso a paso

    Paso 1: Escribe el test en fallo (Rojo con Vitest)

    Antes de crear el archivo de lógica, defines el comportamiento esperado:

    // src/pricing/discount-calculator.spec.ts
    import { describe, it, expect } from 'vitest';
    import { calculateTotalWithDiscounts } from './discount-calculator';
    
    describe('calculateTotalWithDiscounts', () => {
      it('aplica descuento por volumen del 10% en compras mayores a $100', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 150, isVip: false, couponPercent: 0 });
        expect(total).toBe(135);
      });
    
      it('nunca devuelve un total negativo incluso con cupones acumulados', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 50, isVip: true, couponPercent: 120 });
        expect(total).toBe(0); // Regla de negocio crítica
      });
    });
    

    Al ejecutar bun test, el test falla inmediatamente porque la función ni siquiera existe.

    Paso 2: Pasa el test al agente como contrato ejecutable

    Invocas a tu agente de IA en la terminal con una instrucción cerrada:

    claude "Lee discount-calculator.spec.ts. Crea el archivo discount-calculator.ts con la implementación mínima necesaria para que los tests pasen en verde. Prohibido modificar el archivo de tests."
    

    Paso 3: El agente genera el código para poner el test en verde

    El agente analiza la firma de tipos esperada y las aserciones, generando la lógica requerida:

    // src/pricing/discount-calculator.ts
    export interface PricingOptions {
      subtotal: number;
      isVip: boolean;
      couponPercent: number;
    }
    
    export function calculateTotalWithDiscounts(options: PricingOptions): number {
      const { subtotal, isVip, couponPercent } = options;
      
      let discount = 0;
      if (subtotal > 100) discount += subtotal * 0.10;
      if (isVip) discount += subtotal * 0.05;
      if (couponPercent > 0) discount += subtotal * (couponPercent / 100);
    
      const finalTotal = subtotal - discount;
      return Math.max(0, finalTotal); // Respeta el caso de borde
    }
    

    El agente ejecuta el test runner de forma autónoma y confirma que la suite está en verde.


    Por qué este flujo recorta los bugs que llegan a producción

    1. Elimina la alucinación de requisitos: El modelo no tiene margen para inventar parámetros porque el test ya definió la interfaz y los valores esperados.
    2. Aislamiento de contexto: No necesitas explicar la arquitectura completa de tu empresa; solo entregas el archivo de prueba.
    3. Refactorización sin miedo: Si mañana quieres optimizar el rendimiento del algoritmo, puedes pedirle a la IA que lo refactorice sabiendo que cualquier regresión encenderá una alarma roja de inmediato.

    Que quede claro: esto no lleva los bugs a cero. Ningún flujo lo hace. Lo que hace es mover el error de "se descubre en producción tres semanas después" a "se descubre en el segundo en que el agente ejecuta la suite". Los fallos que se te escapan siguen siendo los casos que no se te ocurrió escribir.

    Para que el ciclo funcione, la suite tiene que correr en milisegundos, no en minutos: aquí tienes cómo montar pruebas unitarias ultrarrápidas con Vitest. Si el agente tarda 90 segundos en saber si acertó, el bucle rojo-verde deja de ser un bucle.

    En el curso de Testing en Angular con Jest y Testing Library enseñamos a estructurar suites de pruebas profesionales para frontend y backend preparadas para integrarse con flujos automatizados de CI/CD.

    Este enfoque de validación es también uno de los pilares centrales de nuestro libro de Spec-Driven Development (SDD).

    Para descargar pipelines de automatización con Vitest y plantillas de pruebas para agentes, visita Dominicode Labs.


    Qué hacer hoy con esto

    Para la próxima función o endpoint que vayas a programar:

    1. No escribas la implementación.
    2. Escribe primero dos tests unitarios en Vitest: uno para el caso feliz y otro para el caso borde más peligroso.
    3. Pásaselo a tu asistente de IA y pídele que escriba la función que los cumpla.

    Comprobarás dos cosas: que el primer diff llega mucho más cerca de lo que querías, y que las rondas de corrección se reducen a una o dos.

    Si además quieres que el agente derive los tests de una especificación en vez de escribirlos tú a mano, ese es el siguiente escalón: TDD y Spec-First aplicados al desarrollo con IA.


    Preguntas frecuentes

    ¿Por qué TDD es especialmente útil al programar con IA?

    Porque un test unitario actúa como una especificación matemática ejecutable. Los modelos de lenguaje responden con muchísima mayor precisión cuando tienen un criterio binario de éxito (el test pasa o falla) que cuando reciben instrucciones en lenguaje natural ambiguo.

    ¿Se debe permitir que la IA modifique los tests unitarios?

    No. Los tests unitarios deben ser diseñados y aprobados por el desarrollador. Si permites que la IA modifique los tests para que "pasen en verde", corres el riesgo de que relaje las aserciones y oculte errores de negocio.

    ¿Qué framework de tests es más rápido para iterar con agentes de IA?

    Vitest es actualmente la opción más recomendada en el ecosistema TypeScript por su velocidad de arranque instantánea, compatibilidad nativa con ESM y excelente integración en terminales CLI.

    ¿Puede la IA escribir también los tests en lugar del desarrollador?

    Puede escribir el andamiaje y los casos evidentes, pero no debe decidir qué se protege. Si el modelo escribe los tests y la implementación, ambos comparten el mismo malentendido y la suite en verde no demuestra nada. El desarrollador define los casos de borde; la IA rellena el resto.

    ¿Cuántos tests hacen falta antes de pasarle la tarea al agente?

    Dos suelen bastar para arrancar: el caso feliz y el caso de borde más caro si falla. Con eso el agente ya tiene una interfaz cerrada y un criterio binario de éxito. Ampliar la cobertura tiene más sentido después, cuando ya sabes por dónde se rompe la implementación real.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • 5 errores fatales al refactorizar código legacy con IA

    5 errores fatales al refactorizar código legacy con IA

    Hace unos meses me contrataron para modernizar un módulo de facturación escrito en 2019.

    Eran cerca de 3.000 líneas de TypeScript sin tipar, callbacks anidados y lógica de negocio repartida entre controladores y servicios. Pensé: "Le paso esto a un modelo de lenguaje moderno y en 10 minutos lo tengo convertido a funciones puras y tipadas".

    Refactorizar código legacy con IA parecía trivial. Le pedí al modelo que reescribiera el archivo y el resultado parecía una obra de arte: código limpio, nombres elegantes y cero warnings en el editor.

    Desplegamos en staging. A las dos horas saltó la primera alerta: los clientes con direcciones fiscales internacionales no podían facturar. El modelo había considerado que una comprobación con == null de un campo antiguo era "código redundante" y la había borrado, rompiendo seis años de retrocompatibilidad silenciosa.

    Si vas a meter agentes de IA en proyectos legacy, aquí tienes los 5 errores fatales que no puedes permitirte.


    Error 1: Alucinación de versiones y APIs incompatibles

    Los modelos de IA fueron entrenados con millones de repositorios que mezclan código de 2020 con código de 2026.

    Cuando le pides a una IA que modifique un proyecto antiguo de Node.js o Angular:

    • Asume que puedes usar métodos modernos de JavaScript (Array.prototype.toSorted(), Object.groupBy()) en entornos que corren en runtimes sin soporte.
    • Intenta importar métodos de librerías modernas (como rxjs/operators reubicados o versiones incompatibles de Axios).
    // ❌ Código sugerido por IA para un proyecto en Node 18
    const groupedOrders = Object.groupBy(orders, (item) => item.status);
    // En runtime: TypeError: Object.groupBy is not a function
    

    Cómo evitarlo: Especifica siempre el target exacto en tus prompts y configuraciones: "Target Node 18 LTS, ECMAScript 2022. Prohibido usar APIs de ECMAScript 2024+".

    El mecanismo de fondo lo desgrané en por qué la IA se inventa cosas: el modelo no miente, completa el patrón más probable. Y en un repo de 2019, el patrón más probable es el de 2026.


    Error 2: Pérdida silenciosa de contratos y el peligro del any encubierto

    El código legacy suele tener tipos implícitos o estructuras heterogéneas. Cuando la IA intenta "limpiar" esos tipos, con frecuencia toma atajos peligrosos:

    // Antes: código legacy feo, pero con un caso borde que lleva años en producción
    function parseUser(data: Record<string, unknown>) {
      return data.legacy_id ?? data.id;
    }
    
    // ❌ Refactor 'limpio' de la IA que destruye ese caso borde
    interface User { id: string; }
    function parseUser(data: User): User {
      return { id: data.id }; // Se perdió el soporte de legacy_id
    }
    

    La IA optimiza para la legibilidad del código presente, no para la historia oculta de los bugs pasados.


    Error 3: Refactorizar sin Tests de Caracterización previos

    El error más destructivo es pedirle a la IA que reescriba código antes de tener una red de seguridad.

    Si el código no tiene tests, no puedes refactorizar con IA. Punto.

    El protocolo correcto exige crear primero Characterization Tests (Tests de Caja Negra):

    // test/billing.characterization.spec.ts
    import { calculateInvoice } from '../src/legacy/billing';
    
    describe('Billing Legacy Characterization Tests', () => {
      it('preserva el comportamiento exacto para clientes extranjeros', () => {
        const input = { amount: 100, country: 'DE', taxExempt: true };
        const result = calculateInvoice(input);
        expect(result).toMatchSnapshot(); // Congela el comportamiento real antes de tocar nada
      });
    });
    

    Si la suite tarda minutos en correr, nadie la ejecutará antes de cada refactor. Aquí tienes cómo dejar los tests unitarios en milisegundos con Vitest: con IA de por medio, la velocidad del test runner deja de ser comodidad y pasa a ser el límite de tu ciclo de trabajo.

    En el curso de Testing en Angular con Jest y Testing Library dedicamos un módulo completo a blindar código histórico mediante tests de regresión antes de aplicar cualquier modernización.


    Error 4: Saturación y degradación de la ventana de contexto

    En repositorios con cientos de archivos interconectados, pasarle al agente archivos gigantes (1.000+ líneas) provoca pérdida de atención (lost in the middle).

    El agente empieza a ignorar imports cruciales o inventa interfaces auxiliares en lugar de reutilizar las del proyecto.

    Regla de oro: No pidas "refactoriza el módulo de pagos". Pide "extrae el cálculo de impuestos de este archivo a una función pura aislada y valida que el test adjunto siga en verde".


    Error 5: Aceptar Diffs extensos sin revisión granular

    Aceptar un diff de 400 líneas generado por IA sin revisarlo línea a línea es una negligencia profesional.

    ┌─────────────────────────────────────────────────────────────┐
    │                 PROTOCOLO DE REFACTOR CON IA                │
    │                                                             │
    │  1. Test de Caracterización (Fija el comportamiento)       │
    │  2. Spec Técnica (Define lo que se puede y no se puede tocar)│
    │  3. Refactorización atómica (Menos de 80 líneas por paso)  │
    │  4. Verificación de Test Runner en verde                   │
    └─────────────────────────────────────────────────────────────┘
    

    Este es exactamente el enfoque que explicamos en el libro de Spec-Driven Development (SDD): tratar las modificaciones de código como contratos medibles con límites inquebrantables.


    Qué hacer hoy con esto

    Si tienes que tocar un módulo legacy esta semana:

    1. No abras la IA todavía.
    2. Escribe tres tests que cubran los casos de uso principales y los casos de borde más raros que conozcas.
    3. Ejecuta los tests y asegúrate de que pasan.
    4. Solo entonces, entrega el código y los tests a tu agente de IA con la instrucción explícita de no romper la suite.

    Para acceder a checklists de refactorización segura y scripts de validación automática para proyectos empresariales, únete a Dominicode Labs.


    Preguntas frecuentes

    ¿Por qué la IA rompe código legacy que antes funcionaba?

    Porque los modelos de lenguaje intentan simplificar lo que parece "código redundante" sin entender los parches históricos o edge cases que ese código resolvía en producción.

    ¿Qué es un Characterization Test y por qué es indispensable?

    Es una prueba automatizada que captura el comportamiento actual del sistema (con sus virtudes y sus defectos) para garantizar que una refactorización no altere inadvertidamente el resultado final.

    ¿Cómo evitar que la IA use versiones incompatibles de librerías?

    Configurando un archivo de contexto claro (como CLAUDE.md o reglas de proyecto) donde se especifique la versión exacta de Node.js, TypeScript y el target ECMAScript soportado.

    ¿Cuánto código conviene pasarle a la IA en cada refactorización?

    Menos de lo que crees. Por debajo de 80 líneas por paso el diff se revisa entero en un vistazo y cualquier regresión se localiza de inmediato. Con diffs de 300 o 400 líneas nadie revisa de verdad: se aprueba por cansancio.

    ¿Se puede refactorizar código legacy con IA sin tests de ningún tipo?

    No de forma responsable. Si no hay tests, el primer trabajo del agente no es refactorizar sino generar tests de caracterización que congelen el comportamiento actual. Solo cuando esa red está en verde tiene sentido tocar la implementación.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Roadmap del developer con IA: de junior a fullstack agentic

    Roadmap del developer con IA: de junior a fullstack agentic

    En 2011 mi trabajo diario como programador consistía en memorizar la sintaxis de jQuery, lidiar con los bugs de Internet Explorer 8 y escribir bucles for a mano.

    Si en aquel momento alguien me hubiera dicho que 15 años después un modelo de lenguaje escribiría un algoritmo completo en dos segundos, habría pensado que la profesión de programador iba a desaparecer de la faz de la tierra.

    La realidad ha sido muy distinta, y por eso el roadmap del developer con IA no se parece en nada al de hace cinco años: programar no ha muerto, pero el acto de mecanografiar código se ha convertido en un commodity.

    El desarrollador que solo sabe traducir un ticket de Jira a líneas de JavaScript está en una posición vulnerable. En cambio, el perfil que está multiplicando su valor en el mercado es el Fullstack Agentic Developer: el profesional que diseña la arquitectura, establece los contratos y dirige un ejército de agentes de IA para construir productos en tiempo récord.

    Aquí tienes la hoja de ruta clara para hacer esa transición.


    La Evolución del Perfil: De Codificador a Director de Agentes

    ┌─────────────────────────────────────────────────────────────┐
    │               EVOLUCIÓN DEL ROL DE DEVELOPER                │
    │                                                             │
    │  AYER (Programador Tradicional)                            │
    │  [Escribir sintaxis] ──> [Recordar APIs] ──> [Debug manual] │
    │                                                             │
    │  HOY & MAÑANA (Agentic Developer)                           │
    │  [Diseñar Specs] ──> [Dirigir Agentes/MCP] ──> [TDD & CI]   │
    └─────────────────────────────────────────────────────────────┘
    

    La ventaja competitiva ya no es recordar de memoria los parámetros de un método de array. Tu valor reside en tu criterio técnico para decidir qué construir, con qué arquitectura y bajo qué límites de seguridad.


    Las 4 Habilidades Indispensables para los Próximos 3 Años

    1. Spec-Driven Development (SDD) y Diseño de Contratos

    Tu capacidad para redactar especificaciones técnicas precisas (spec.md) determinará la calidad del software que generen tus agentes. Si no sabes definir límites de dominio, flujos de datos y escenarios WHEN/THEN, los modelos alucinarán y perderás horas corrigiendo código basura.

    Es la habilidad con más retorno de las cuatro. Si empiezas hoy, empieza por aquí: Spec-Driven Development con agentes de IA.

    2. Fundamentos Sólidos de Arquitectura y Tipado Estricto

    Para evaluar si el código generado por un agente es seguro para producción necesitas dominar:

    • Clean Architecture y separación de capas (Domain, Application, Infrastructure).
    • TypeScript estricto, tipos discriminados y esquemas de validación en runtime con Zod.
    • Patrones de concurrencia y diseño de bases de datos relacionales.

    3. Testing Automatizado y Validación Determinista (TDD)

    La IA es probabilística; el software de producción debe ser determinista. La única forma de desplegar a producción sin miedo es contar con suites de pruebas automatizadas con Vitest o Jest que actúen como un guardián implacable ante cualquier regresión.

    4. Orquestación de Agentes, Herramientas y Protocolos MCP

    Aprender a conectar agentes CLI (como Claude Code) con bases de datos, APIs de terceros y herramientas de terminal mediante el Model Context Protocol (MCP) y la creación de custom skills (SKILL.md).

    El salto de nivel aquí está en dejar de escribir prompts y empezar a construir herramientas: cómo crear skills y subagentes personalizados para que tu flujo diario se ejecute solo.


    La Hoja de Ruta (Roadmap) Paso a Paso

    FASE 1: Fundamentos Modernos
    ├── TypeScript 5+ Estricto (Satisfies, Discriminated Unions, Generics)
    ├── Frameworks Reactivos (Angular Signals / Next.js 16 App Router)
    └── Validación de Esquemas con Zod
    
    FASE 2: Red de Seguridad y Metodología
    ├── TDD con Vitest / Jest (Escribir tests antes de generar código)
    └── Flujo SDD (Spec ➔ Plan ➔ Tasks versionados en Git)
    
    FASE 3: Operaciones Agénticas
    ├── Dominio de agentes CLI (Claude Code, Cursor, terminal tools)
    ├── Creación de Custom Skills y Subagentes especializados
    └── Conexión de servidores MCP para acceso a bases de datos y APIs
    
    FASE 4: Producción y Negocio
    ├── Despliegues Serverless, Edge Functions y bases de datos relacionales
    └── Entrega continua (CI/CD) con validación automática de agentes
    

    Para recorrer este camino con proyectos prácticos de extremo a extremo, en el curso Construye con IA: De la Idea al Producto con Claude Code te guiamos paso a paso en la transición hacia el desarrollo agentico.

    Si buscas una comunidad activa donde compartimos arquitecturas reales, plantillas de agentes y debates técnicos semanales, únete a Dominicode Labs.

    También puedes seguir todos nuestros tutoriales y directos gratuitos en el Canal de YouTube de Dominicode.


    Qué hacer hoy con esto

    Elige un proyecto personal o una tarea pequeña de tu trabajo.

    No intentes escribir cada línea de código a mano por nostalgia, ni tampoco le pidas a la IA que haga todo sin supervisión.

    Asume el rol de arquitecto: redacta la especificación, diseña los tests de validación y delega la implementación sintáctica a tu agente. Ese es el nuevo estándar de la ingeniería de software.


    Preguntas frecuentes

    ¿Los agentes de IA van a sustituir a los desarrolladores juniors?

    No van a sustituir a los desarrolladores, pero sí sustituirán el modelo tradicional de trabajo junior basado exclusivamente en escribir sintaxis básica. Los juniors que adopten metodologías estructuradas (SDD, TDD) y aprendan a orquestar agentes avanzarán mucho más rápido hacia niveles senior.

    ¿Por qué aprender TypeScript y testing si la IA puede escribir el código?

    Porque la IA comete errores sutiles y alucinaciones. Sin conocimientos profundos de TypeScript y testing automatizado, no tendrás el criterio técnico necesario para auditar el código generado ni detectar fallos antes de que lleguen a producción.

    ¿Qué es un Servidor MCP (Model Context Protocol)?

    Es un estándar abierto desarrollado por Anthropic que permite a los asistentes de IA conectarse de forma segura con herramientas locales, bases de datos (Postgres, SQLite), repositorios Git y APIs de servicios externos.

    ¿Cuánto se tarda en recorrer este roadmap?

    Depende del punto de partida, pero las cuatro fases no son secuenciales en el tiempo: puedes empezar a escribir specs y tests la semana que viene mientras sigues consolidando fundamentos. Lo que no funciona es saltar a la Fase 3 sin las dos primeras, porque sin criterio técnico no puedes auditar lo que el agente produce.

    ¿Hace falta ser senior para trabajar con agentes de código?

    No, pero sí hace falta saber leer código mejor de lo que lo escribes. Un junior que domina testing y sabe redactar una especificación clara saca más partido a un agente que un senior que le pide código a ciegas y acepta el diff sin revisarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso. OpenSpec es un framework open source de spec-driven development creado por Fission-AI que guarda lo acordado — propuesta, diseño, tareas y spec — en archivos Markdown versionados dentro del repo, para que Claude Code los lea antes de tocar código. En esta guía lo instalamos, lo inicializamos con openspec init y recorremos el flujo OPSX completo sobre un proyecto que ya existe.


    OpenSpec no es OpenAPI: la diferencia en una tabla

    Comparten cuatro letras y nada más.

    OpenSpec OpenAPI
    Qué es Framework de spec-driven development para asistentes de código Especificación para describir APIs REST
    Quién lo mantiene Fission-AI OpenAPI Initiative (Linux Foundation)
    Formato Markdown dentro del repo YAML o JSON
    Para qué sirve Que un agente implemente lo acordado Que un cliente sepa llamar a tu API

    Si has llegado buscando Swagger, este no es tu post.


    Cómo instalar OpenSpec para Claude Code (y el error de scope de npm)

    OpenSpec se instala como CLI global. Requiere Node.js 20.19.0 o superior, y la versión actual es la 1.8.0.

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto: openspec a secas es la versión 0.0.0 publicada el 9 de abril de 2019, sin relación alguna con el framework y sin una sola actualización desde entonces. Es el fallo más repetido en tutoriales, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Qué crea openspec init en un proyecto con Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Qué poner en openspec/config.yaml (y por qué no es opcional)

    openspec/config.yaml es el archivo donde defines el schema por defecto, el contexto del proyecto y las reglas por artefacto. No es documentación que el agente abre si le apetece: es entrada del modelo. La doc oficial lo dice sin rodeos — "When generating any artifact, your context and rules are injected into the AI prompt".

    Sus claves de nivel superior son cuatro:

    Clave Para qué
    schema El schema por defecto de los artefactos
    context La información de tu proyecto. Aparece en todos los artefactos
    rules Restricciones por artefacto. Solo aparecen en el artefacto que coincide
    operations Guía opcional para apply y archive

    Ese matiz de context y rules importa: el contexto viaja siempre, las reglas solo cuando toca. Así que lo que quieras que el agente tenga presente en cada decisión va en context.

    Dedica cinco minutos a describir de verdad tres cosas ahí: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear. El detalle de cada clave está en la doc de customization.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    El flujo OPSX paso a paso en Claude Code

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y consolida lo implementado en openspec/specs/, que es la fuente de verdad del proyecto — "Specs are the source of truth — they describe how your system currently behaves". A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    Los otros dos del perfil por defecto

    /opsx:update revisa los artefactos de planificación de un cambio y los mantiene coherentes entre sí, en cualquier dirección: si editas el diseño, la propuesta se ajusta.

    /opsx:sync fusiona las delta specs en openspec/specs/ sin archivar el cambio. Útil cuando quieres consolidar antes de cerrar.

    Los extendidos, y por qué /opsx:verify no te va a funcionar todavía

    Aquí está el detalle que hace perder media hora a mucha gente: el perfil por defecto no trae verify.

    El perfil core son los seis de arriba — propose, explore, apply, update, sync, archive. Los extendidos son otros seis: /opsx:new, /opsx:continue, /opsx:ff, /opsx:verify, /opsx:bulk-archive y /opsx:onboard. Si escribes /opsx:verify recién instalado, no autocompleta y no pasa nada.

    Para activarlos:

    openspec config profile   # selecciona el perfil ampliado
    openspec update           # aplica los cambios en el proyecto
    

    Con el perfil ampliado activo, /opsx:verify contrasta la implementación contra la spec. No es un test runner: es la comprobación de que no se ha colado nada que nadie pidió y de que no falta nada que sí se pidió.

    Empieza por los seis del perfil core. Los extendidos los necesitarás cuando tengas el ciclo rodado y lleves varios cambios a la vez.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Una delta spec es una spec que describe solo lo que cambia — lo añadido, lo modificado y lo eliminado — en vez de redescribir el sistema entero. Es lo que hace viable OpenSpec en un proyecto que ya existe.

    Así se ve una:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - GIVEN el listado de productos cargado
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ### Requirement: Paginación del listado
    El listado DEBE conservar el filtro activo al cambiar de página.
    

    Dos cosas que conviene saber antes de copiar esto. Las etiquetas son literales y no se traducen: ADDED, MODIFIED, REMOVED, Requirement:, Scenario: y GIVEN/WHEN/THEN van en inglés aunque el cuerpo esté en español. Y solo incluyes las secciones que uses — si el cambio no elimina nada, no dejes un ## REMOVED Requirements vacío.

    Sobre los escenarios: es vocabulario Gherkin, pero en Markdown plano. Sin ficheros .feature, sin Cucumber, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development.

    Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto. La lista completa está en la tabla de herramientas soportadas, que cubre más de treinta.


    Cómo migrar del flujo antiguo de OpenSpec al flujo OPSX

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano: ejecuta openspec update, que regenera los ficheros de skills y comandos para las herramientas que tengas configuradas.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Dos avisos antes de que te lances. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Por qué no me funciona el comando /opsx:verify?

    Porque no viene en el perfil por defecto. OpenSpec usa el perfil core, que trae seis comandos: propose, explore, apply, update, sync y archive. El comando verify pertenece al perfil ampliado, junto a new, continue, ff, bulk-archive y onboard. Para activarlo ejecuta openspec config profile y después openspec update.

    ¿Qué comandos trae OpenSpec por defecto?

    El perfil core incluye seis: propose para generar la propuesta, explore para planificar sin compromiso, apply para implementar, update para mantener coherentes los artefactos de planificación, sync para fusionar las delta specs en openspec/specs/ y archive para cerrar el cambio.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es ejecutar openspec update en el proyecto, que regenera skills y comandos, en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Búsqueda Híbrida y Embeddings en Supabase: Cómo construir un sistema RAG en producción

    Búsqueda Híbrida y Embeddings en Supabase: Cómo construir un sistema RAG en producción

    Hace poco estaba revisando el motor de búsqueda interna de una plataforma técnica. El equipo había montado un sistema de Generación Aumentada por Recuperación (RAG) impecable basado únicamente en embeddings vectoriales almacenados en PostgreSQL.

    Si buscabas "¿Cómo corregir errores de autenticación?", el sistema devolvía los artículos de documentación exactos. La búsqueda semántica funcionaba a las mil maravillas.

    Pero el desastre ocurrió cuando un usuario buscó el código de error numérico exacto: ERR_401_EXPIRED_TOKEN.

    El motor de búsqueda vectorial devolvió artículos sobre contraseñas olvidadas y verificación en dos pasos, pero omitió el artículo que contenía la constante exacta ERR_401_EXPIRED_TOKEN.

    ¿Por qué ocurrió esto? Porque las búsquedas vectoriales entienden el significado de las frases, pero son pésimas encontrando términos exactos, códigos de producto, nombres de variables o números de serie.

    La solución definitiva para llevar sistemas RAG a producción se llama Búsqueda Híbrida (Hybrid Search).

    Por qué la Búsqueda Vectorial Pura Falla en Producción

    Los modelos de embeddings transforman fragmentos de texto en vectores numéricos dentro de un espacio multidimensional.

    • Búsqueda Vectorial (Cosimilitud / Distancia Euclídea): Excelente para capturar conceptos relacionados. Si buscas "vehículo ecológico", encontrará documentos sobre "coches eléctricos".
    • Búsqueda por Texto Completo (Full-Text Search / BM25): Excelente para palabras clave exactas. Si buscas "SKU-9942", encontrará la fila que contiene esa cadena sin intentar interpretar su significado.

    Un sistema RAG profesional necesita combinar ambas estrategias.

                      ┌──────────────────────────────────────────┐
                      │ Consulta del Usuario: "ERR_401 token"    │
                      └────────────────────┬─────────────────────┘
                                           │
                ┌──────────────────────────┴──────────────────────────┐
                ▼                                                     ▼
    ┌──────────────────────────┐                               ┌──────────────────────────┐
    │ Búsqueda Vectorial       │                               │ Búsqueda Texto Completo  │
    │ (pgvector / HNSW)        │                               │ (tsvector / BM25)        │
    └───────────┬──────────────┘                               └───────────┬──────────────┘
                │                                                          │
                └──────────────────────────┬───────────────────────────────┘
                                           ▼
                      ┌──────────────────────────────────────────┐
                      │ Fusion de Rangos Recíprocos (RRF en SQL) │
                      └────────────────────┬─────────────────────┘
                                           ▼
                      ┌──────────────────────────────────────────┐
                      │ Contexto Ideal para el Modelo LLM        │
                      └──────────────────────────────────────────┘
    

    Implementación de Búsqueda Híbrida en Supabase & PostgreSQL

    Supabase incluye la extensión pgvector sobre PostgreSQL nativo. Podemos implementar Búsqueda Híbrida directamente en la base de datos con una función SQL almacenada que ejecute Reciprocal Rank Fusion (RRF).

    1. Habilitar la extensión y crear la tabla con vector y tsvector

    -- Habilitar la extensión pgvector
    CREATE EXTENSION IF NOT EXISTS vector;
    
    -- Tabla de documentos para RAG
    CREATE TABLE documentos (
      id BIGSERIAL PRIMARY KEY,
      contenido TEXT NOT NULL,
      embedding VECTOR(1536), -- Dimensión para text-embedding-3-small de OpenAI
      fts TSVECTOR GENERATED ALWAYS AS (to_tsvector('spanish', contenido)) STORED
    );
    
    -- Crear índice vectorial HNSW y de texto completo GIN
    CREATE INDEX idx_documentos_embedding ON documentos USING hnsw (embedding vector_cosine_ops);
    CREATE INDEX idx_documentos_fts ON documentos USING gin (fts);
    

    2. Función Almacenada RPC de Fusión Híbrida (RRF)

    CREATE OR REPLACE FUNCTION busqueda_hibrida_documentos(
      query_text TEXT,
      query_embedding VECTOR(1536),
      match_count INT DEFAULT 5,
      rrf_k INT DEFAULT 60
    )
    RETURNS TABLE (id BIGINT, contenido TEXT, score FLOAT)
    LANGUAGE sql AS $$
    WITH full_text AS (
      SELECT id, ROW_NUMBER() OVER (ORDER BY ts_rank_cd(fts, websearch_to_tsquery('spanish', query_text)) DESC) AS rank
      FROM documentos
      WHERE fts @@ websearch_to_tsquery('spanish', query_text)
      LIMIT 20
    ),
    vector_search AS (
      SELECT id, ROW_NUMBER() OVER (ORDER BY embedding <=> query_embedding) AS rank
      FROM documentos
      ORDER BY embedding <=> query_embedding
      LIMIT 20
    )
    SELECT 
      d.id, 
      d.contenido,
      COALESCE(1.0 / (rrf_k + ft.rank), 0.0) + COALESCE(1.0 / (rrf_k + vs.rank), 0.0) AS score
    FROM documentos d
    LEFT JOIN full_text ft ON d.id = ft.id
    LEFT JOIN vector_search vs ON d.id = vs.id
    WHERE ft.id IS NOT NULL OR vs.id IS NOT NULL
    ORDER BY score DESC
    LIMIT match_count;
    $$;
    

    3. Invocación desde TypeScript

    import { createClient } from '@supabase/supabase-js';
    
    const supabase = createClient(SUPABASE_URL, SUPABASE_KEY);
    
    async function buscarContextoRAG(query: string, embedding: number[]) {
      const { data, error } = await supabase.rpc('busqueda_hibrida_documentos', {
        query_text: query,
        query_embedding: embedding,
        match_count: 5,
      });
    
      if (error) throw new Error(`Fallo en la búsqueda RAG: ${error.message}`);
      return data;
    }
    

    Al aplicar programación defensiva en TypeScript, aseguras que los vectores devueltos cumplan estrictamente con las dimensiones de tu modelo de embedding antes de invocar la consulta RPC.

    Optimización de RAG y Control de Tokens

    1. Aislamiento de Grafos: Combina la búsqueda híbrida con principios de graph engineering para que la base de datos devuelva únicamente los nodos de información directamente relacionados con la consulta.
    2. Presupuesto de Tokens: Filtrar los 5 mejores resultados consolidados por la función RRF reduce drásticamente el volumen de datos enviado en la ventana de contexto. Como analizamos en nuestro post sobre el coste de subagentes al cambiar de modelo, reducir el exceso de contexto optimiza los tiempos de respuesta y ahorra costes en tu API de IA.

    La Búsqueda Híbrida combina lo mejor de dos mundos: la comprensión conceptual de los embeddings y la precisión milimétrica del texto completo.

    Ahora bien, ningún esquema de recuperación arregla un corpus mal escrito: si el documento indexado mezcla cinco temas, el fragmento que devuelva la RRF llegará sin sujeto. Cómo escribir las notas para que se recuperen enteras lo desarrollé en Zettelkasten para developers.

    Si quieres dominar el desarrollo de sistemas RAG y arquitecturas backend avanzadas con PostgreSQL y Supabase, explora los Cursos de Dominicode. Y si quieres construir productos reales de IA junto a otros ingenieros senior, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué usar pgvector en Supabase en lugar de una base de datos vectorial dedicada como Pinecone o Chroma?

    Utilizar pgvector en PostgreSQL/Supabase te permite mantener todos tus datos relacionales, usuarios y vectores en la misma base de datos. Esto elimina la necesidad de sincronizar dos bases de datos distintas, reduce los costes de infraestructura y permite hacer JOINs nativos entre tablas relacionales y embeddings.

    ¿Qué es el valor rrf_k en la función Reciprocal Rank Fusion?

    rrf_k es una constante de suavizado (por defecto 60) utilizada en el algoritmo Reciprocal Rank Fusion. Sirve para evitar que un documento clasificado en la posición #1 en un método domine desproporcionadamente sobre un documento que quedó en posición #2 en ambos métodos.

    ¿Qué dimensión debe tener la columna VECTOR en PostgreSQL?

    La dimensión depende exclusivamente del modelo de embeddings que utilices. Por ejemplo, text-embedding-3-small de OpenAI usa 1536 dimensiones, text-embedding-3-large usa 3072 dimensiones, y modelos locales ligeros como all-MiniLM-L6-v2 usan 384 dimensiones.

    ¿Cómo afecta el índice HNSW al rendimiento de inserción en Supabase?

    El índice HNSW (Hierarchical Navigable Small World) ofrece consultas de búsqueda vectorial ultrarrápidas en tiempo de lectura, a costa de un ligero aumento en el tiempo de inserción de filas. Para aplicaciones con muchas lecturas y pocas escrituras masivas, HNSW es la opción óptima frente al índice IVFFlat tradicional.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Hace unas semanas abrí un repo mío de febrero. Fui a la carpeta specs/. Ahí seguía todo: spec.md, plan.md, tasks.md.

    El spec.md describía tres endpoints. El código tenía once.

    La spec no estaba mal escrita. Estaba muerta. Cinco meses sin tocarla mientras el código crecía por su cuenta. Y lo peor es que todo funcionaba: los tests pasaban, el deploy iba, nadie se enteró de nada.

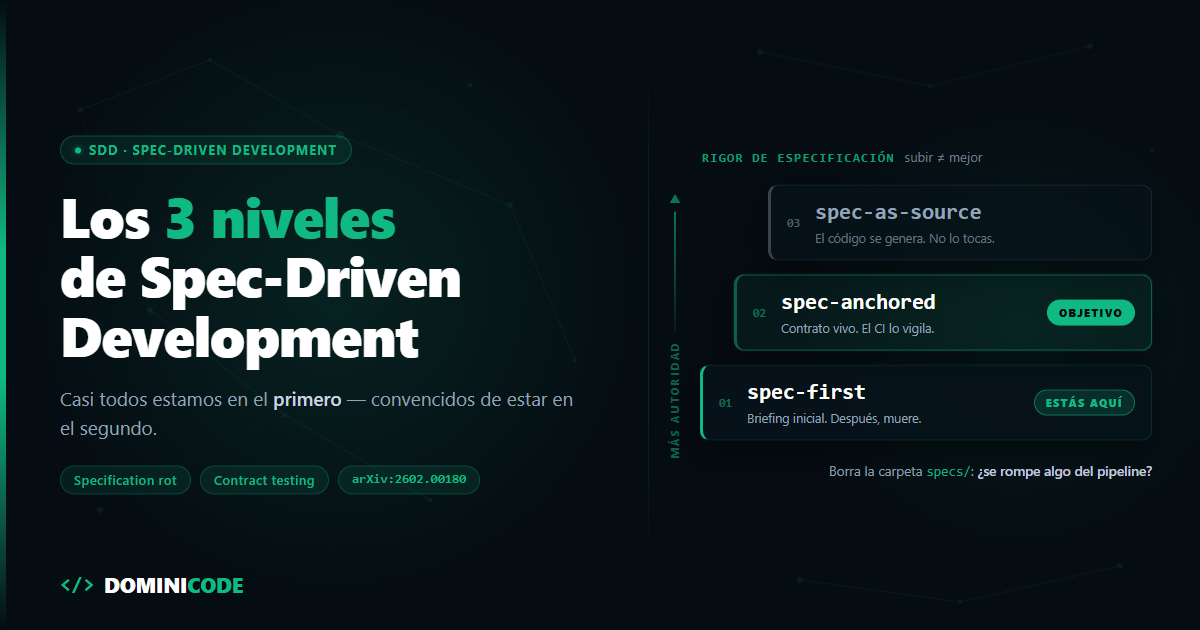
    Yo llevaba meses diciendo que hacía SDD. No lo hacía. Hay tres niveles de Spec-Driven Development y yo estaba en el primero convencido de estar en el segundo.

    Esto no va de qué es SDD. Va de diagnóstico: en qué nivel estás de verdad y a cuál te conviene subir. Que no siempre es el de arriba.

    El test de los 30 segundos: borra la carpeta specs/

    Antes de leer nada más, hazte esta pregunta.

    Si borras la carpeta specs/ de tu proyecto ahora mismo, ¿se rompe algo del pipeline?

    Si la respuesta es no —si el build sigue verde, los tests pasan y el deploy sale— entonces tu spec es un documento, no un artefacto de ingeniería. Eres spec-first. Da igual lo bien escrita que esté. Da igual que tengas constitution.md y siete plantillas.

    Nada que se pueda borrar sin consecuencias forma parte del sistema.

    Y ojo, que esto no es un insulto. Spec-first es un nivel legítimo y para la mitad de tus proyectos es exactamente el que necesitas. El problema no es estar ahí. El problema es estar ahí creyendo que estás dos escalones más arriba, y por tanto confiando en garantías que no tienes.

    Qué son los tres niveles de rigor de especificación

    Deepak Babu Piskala publicó el 30 de enero de 2026 el preprint Spec-Driven Development: From Code to Contract in the Age of AI Coding Assistants (arXiv:2602.00180, cs.SE). Es el primer sitio donde he visto puesto por escrito, con nombres, lo que la mayoría hacemos por intuición.

    El paper define tres niveles de rigor de especificación: spec-first, spec-anchored y spec-as-source. Lo único que cambia entre ellos es cuánta autoridad tiene la spec sobre el código — el eje de su primera figura se llama literalmente increasing specification authority.

    No son fases de madurez que haya que recorrer. Son opciones, y cada una tiene un coste.

    Nivel La spec es… ¿Quién escribe el código? ¿Qué pasa con el drift? Es tu nivel si…
    Spec-first Un briefing inicial Tú o el agente al arrancar; después, solo tú Ocurre en silencio, nadie se entera Prototipos, features puntuales, exploración
    Spec-anchored Un contrato vivo Tú, con la spec como referencia obligatoria Lo detecta el CI si lo automatizas; si no, rot La mayoría de sistemas en producción
    Spec-as-source El único artefacto que un humano edita Nadie. Se genera No existe por construcción Automoción, embebidos, dominios certificados

    Spec-first: la spec guía el arranque

    Definición del paper: la especificación se escribe antes de programar para guiar la implementación inicial.

    Ahí está la palabra clave: inicial. La spec hace su trabajo en el minuto cero y después su vida útil se acaba. El agente genera el código, tú lo revisas, y desde ese momento el código es la única fuente de verdad.

    El paper es explícito: spec-first funciona en desarrollo inicial de features con asistentes de IA, y en prototipos y features de usar y tirar.

    Es donde está casi todo el mundo que usa Claude Code o Cursor con un spec.md delante. Y para mucho de lo que hacemos, está perfecto. Escribes la spec, el agente construye, tú corriges, sigues adelante. Es el flujo que enseño en el curso de Construye con IA para ir de idea a producto sin caos.

    El fallo no es usar spec-first. El fallo es usar spec-first en un sistema que va a vivir tres años y con cuatro personas tocándolo.

    Spec-anchored: la spec vive con el código

    Definición del paper: la especificación se mantiene junto al código durante todo el ciclo de vida del sistema.

    Y aquí viene la frase que a mí me hizo replantearme cosas. El paper llama a spec-anchored el punto óptimo para la mayoría de sistemas en producción, porque te da los beneficios de documentación clara y requisitos verificables sin exigir que el código se genere entero.

    Traducido: tienes las garantías sin renunciar a escribir código.

    El riesgo de este nivel tiene nombre propio en el paper: specification rot. La podredumbre de la especificación, que aparece cuando los equipos no actualizan las specs a medida que el código cambia. Exactamente lo que le pasó a mi repo de febrero.

    Y la solución que propone el paper no es disciplina. Es automatización: los tests imponen la alineación entre spec y código, con escenarios BDD funcionando como tests automáticos que corren en cada commit.

    Esa es la diferencia real entre los dos primeros niveles. No es cuánto cuidas la spec. Es si la alineación depende de tu voluntad o de un check que falla el build.

    Spec-as-source: la spec es el código

    Definición del paper: la especificación es el único artefacto que los humanos editan directamente. El código se genera enteramente a partir de la spec.

    La regla operativa que da el paper es tajante: si quieres cambiar la funcionalidad, cambias la spec y regeneras. Nunca editas el código generado directamente.

    El drift desaparece. No se gestiona, no se detecta: no puede existir. Como el código se regenera en lugar de editarse a mano, spec y código están siempre alineados por construcción.

    Suena a futuro lejano. No lo es, y esto es lo que más me sorprendió del paper.

    Spec-as-source ya existe. Y una parte ya la haces

    Hay una idea instalada de que spec-as-source es hacia dónde vamos cuando los LLM sean lo bastante buenos.

    Falso. El paper lo desmonta con una frase: spec-as-source ya es práctica estándar en dominios con generación de código bien definida, y pone dos ejemplos. Uno es generar código embebido certificado desde modelos de Simulink. En la capa de control, el ingeniero rara vez escribe a mano el C que acaba en la ECU: escribe el modelo, y el generador produce el C.

    El otro ejemplo del paper es generar los stubs de servidor desde un openapi.yaml.

    Eso también es spec-as-source. Y llevas años haciéndolo sin llamarlo así: editas el contrato, regeneras, nunca tocas a mano lo generado. Es exactamente la regla del nivel tres.

    La diferencia es qué generas. Ahí generas el andamio. Nadie ha certificado un generador para la lógica de negocio.

    Entonces, ¿por qué no puedes hacer lo mismo con la lógica de tu app de Next.js?

    Porque, según el paper, spec-as-source solo es práctico hoy en dominios donde esa confianza está establecida. El paper no entra en por qué, pero la respuesta no está en el modelo: está en el toolchain. Generadores cualificados bajo norma, trazabilidad auditable y décadas de proceso detrás.

    Tu lógica de negocio no tiene eso. No porque la IA no dé la talla, sino porque no hay un organismo que responda cuando el código generado la líe en producción.

    Así que spec-as-source completo no es tu nivel hoy si haces web. Y no pasa nada. Perseguirlo con las herramientas actuales es la forma más rápida de acabar con el peor de los dos mundos: código generado que nadie entiende y una spec que tampoco es la fuente real de verdad.

    Qué cuesta subir de spec-first a spec-anchored

    Este es el salto que sí te interesa. Y es más barato de lo que parece, porque no va de escribir más documentación. Va de cerrar el bucle.

    El paper describe un flujo de cuatro fases: Specify → Plan → Implement → Validate.

    La mayoría hacemos tres. Especificamos, planificamos, implementamos, y en cuanto la feature funciona nos vamos a la siguiente. Validate se queda sin hacer. Y para mí, Validate es la fase que convierte spec-first en spec-anchored.

    En un proyecto normal de TypeScript, el salto son tres movimientos concretos.

    Uno: los criterios de aceptación de la spec dejan de ser prosa y pasan a ser tests. Cada comportamiento descrito en la spec tiene un test que lo verifica. Si la spec dice que un usuario sin permisos recibe un 403, hay un test que lo comprueba. Si no puedes escribir ese test, tu spec no era verificable — que es uno de los motivos por los que una spec falla con un agente de IA aunque esté impecablemente redactada.

    Dos: los contratos se validan contra la implementación. El paper lista aquí las herramientas por categoría: OpenAPI y Swagger, GraphQL SDL o Protocol Buffers para las specs de API, y Pact o Specmatic para contract testing. Tu openapi.yaml deja de ser documentación y pasa a ser el árbitro. Si el backend devuelve un campo que el contrato no declara, falla.

    Tres: eso corre en CI y rompe el build.

    # .github/workflows/ci.yml
    on: [push, pull_request]
    
    jobs:
      spec-alignment:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v5
          - run: npm ci
          - run: npm run test:contract     # implementación vs openapi.yaml
          - run: npm run test:acceptance   # escenarios derivados de la spec
    

    Ese bloque es la frontera entre los dos niveles. El día que alguien añade un endpoint sin tocar el contrato, el build se pone rojo antes de que llegue a review. La alineación deja de depender de que te acuerdes.

    Sobre el retorno de esto, el paper documenta un caso de estudio de microservicios API-first con OpenAPI y Specmatic con una reducción del 75% en el tiempo de ciclo de integración. Es un caso concreto del paper, no una media del sector, y conviene leerlo como lo que es: una señal de dónde está el valor, no una promesa.

    La parte incómoda es que este salto se apoya en tener una cultura de testing decente. Si tu suite de tests es frágil, spec-anchored no te va a salvar: vas a tener dos cosas rotas en vez de una. Arregla primero los tests — y si tu stack es Angular, esa base la trabajo entera con Jest y Testing Library en el curso de Testing en Angular, que es la misma disciplina en cualquier proyecto de TypeScript.

    El fallo que sobrevive a todos los niveles

    Hay una trampa que no se arregla subiendo de nivel, y el paper la nombra sin anestesia: los tests de spec que pasan no garantizan software correcto si las specs están mal.

    Falsa confianza. Para mí es el fallo más caro de los cuatro que lista el paper —junto a la sobre-especificación, la podredumbre de la spec y convertir las specs en burocracia— porque los otros tres se notan y este no.

    Tienes el CI verde, el contrato validado, los escenarios BDD pasando. Y estás construyendo con enorme rigor exactamente lo que el negocio no pidió.

    Por eso el paper reformula el rol del developer: pasamos de programar a mano a orquestar especificaciones, revisar salidas de IA y centrarnos en el diseño de alto nivel. Si tu spec es mala, subir de nivel solo automatiza el error y le pone un sello de calidad encima.

    La regla de oro del Spec-Driven Development: usa el mínimo rigor

    El paper cierra con un marco de decisión que merece la pena tener a mano. SDD aporta valor cuando hay asistencia de IA de por medio, requisitos complejos, sistemas de vida larga, varios mantenedores, generación de código viable o integración complicada. Y hay que saltárselo en prototipos desechables, trabajo en solitario de vida corta, código exploratorio o CRUD simple con requisitos evidentes.

    Que es básicamente lo que ya defendí en su día al hablar de cuándo no usar Spec-Driven Development, y me alegra ver que el paper llega a la misma conclusión.

    Porque el principio rector que se lleva el paper, y el que yo me he apuntado, es este:

    Usa el mínimo nivel de rigor de especificación que elimine la ambigüedad en tu contexto.

    Subir de nivel no es mejor. Es más caro. Spec-anchored en un script que vas a borrar en dos semanas no es madurez profesional, es ceremonia. Y spec-first en la plataforma que factura no es agilidad, es deuda con fecha de vencimiento.

    Lo que puedes hacer hoy, en diez minutos: coge tu proyecto más importante y aplícale el test de los 30 segundos. Borra mentalmente la carpeta specs/. Si no se rompe nada y ese proyecto va a vivir más de seis meses con más de una persona tocándolo, ya sabes cuál es tu siguiente PR. No es escribir más spec. Es añadir el check que la vuelve obligatoria.

    Si quieres el método completo —cómo redactar specs que un agente ejecuta sin inventarse la mitad y cómo mantenerlas vivas sin que se conviertan en burocracia— lo desarrollo entero en el libro de Spec-Driven Development. Y en Dominicode Labs tienes los proyectos donde esto está montado tal cual lo uso en producción, con el CI incluido.

    Preguntas frecuentes

    ¿Cuáles son los tres niveles de Spec-Driven Development?

    Spec-first, spec-anchored y spec-as-source. En spec-first la spec guía la implementación inicial y después puede quedar obsoleta. En spec-anchored la spec se mantiene junto al código durante todo el ciclo de vida y hay tests que verifican la alineación. En spec-as-source la spec es el único artefacto que edita un humano y el código se genera entero a partir de ella. Los definió Deepak Babu Piskala en el preprint arXiv:2602.00180.

    ¿Spec-first significa que lo estoy haciendo mal?

    No. Spec-first es un nivel legítimo y el paper lo recomienda explícitamente para prototipos, features de usar y tirar y desarrollo inicial con asistentes de IA. El problema aparece cuando aplicas spec-first a un sistema de vida larga y asumes garantías de trazabilidad que ese nivel no te da.

    ¿Cómo sé si mi spec está viva o solo bien escrita?

    Comprueba si algo del pipeline depende de ella. Si puedes borrar la spec y el build sigue verde, la spec es documentación. Una spec viva rompe algo cuando desaparece o cuando el código se desvía de ella, porque hay tests o validaciones de contrato que la usan como referencia.

    ¿Necesito Cucumber o BDD para ser spec-anchored?

    No obligatoriamente. El paper menciona los frameworks BDD (Cucumber, SpecFlow, Behave) como la forma habitual de que los escenarios se conviertan en tests automáticos, pero lo que define el nivel es que exista una verificación automática de la alineación, no la herramienta concreta. Con contract testing sobre OpenAPI usando Pact o Specmatic ya cumples el requisito.

    ¿Spec-as-source llegará algún día al desarrollo web?

    En parte ya llegó: generar los stubs de servidor desde un openapi.yaml es el ejemplo de spec-as-source que el propio paper pone, y es desarrollo web. Lo que no ha llegado es la lógica de negocio, y el cuello de botella no es la capacidad del modelo sino la confianza en el generador. En automoción y embebidos spec-as-source ya es práctica estándar desde hace años con Simulink o SCADE, y una de las razones es que esos generadores están cualificados bajo norma y auditados.

    Si mis tests de spec pasan, ¿está el software correcto?

    No. El paper lo advierte de forma directa: que los tests de spec pasen no garantiza que el software sea correcto si las propias specs son incorrectas. Verificar que cumples la spec y validar que la spec era la adecuada son dos problemas distintos, y el segundo sigue siendo humano.

    ¿Merece la pena spec-anchored si trabajo solo?

    Depende de la vida del proyecto, no del tamaño del equipo. El paper desaconseja SDD en trabajo en solitario de vida corta, pero si eres solo tú manteniendo algo durante años, el "otro mantenedor" eres tú dentro de ocho meses sin recordar nada. Ahí el contrato en CI te protege igual que protegería a un equipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
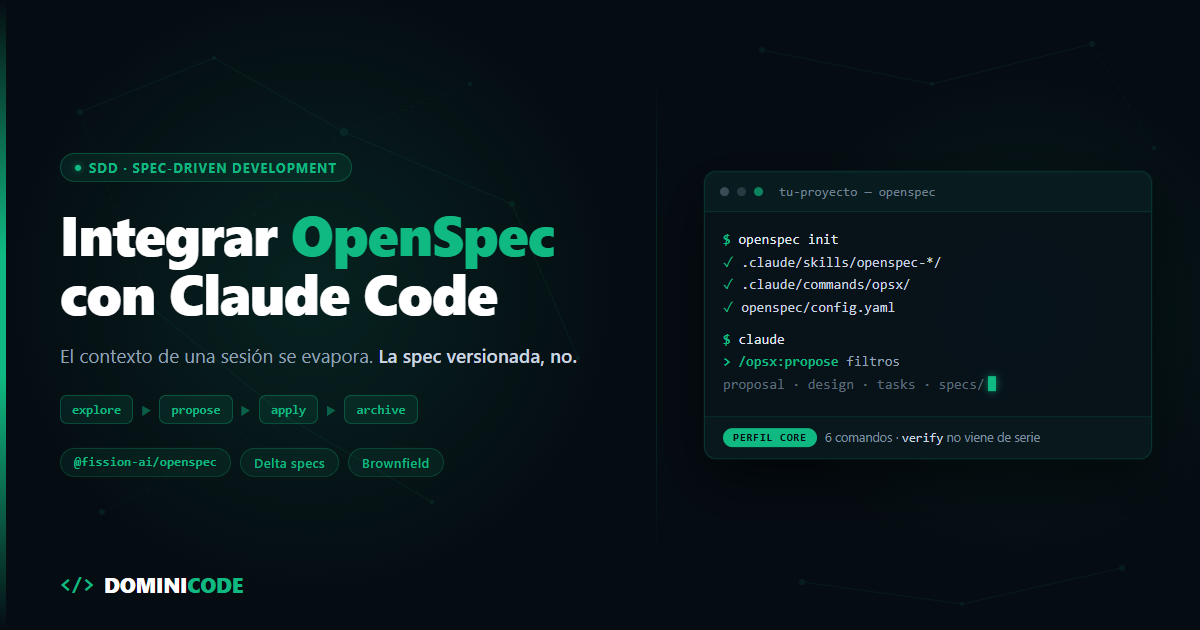
  • Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Hace un par de meses calculé cuánto tiempo pasaba el equipo senior de un cliente revisando Pull Requests. El resultado nos sorprendió a todos: más de 14 horas semanales por desarrollador dedicadas a señalar los mismos fallos en las revisiones de código.

    No revisaban la arquitectura general de la aplicación. Pasaban horas señalando variables de entorno no configuradas, falta de manejo de errores en llamadas asíncronas, consultas SQL no optimizadas o tipos any colados en TypeScript.

    Integrar revisiones de código automáticas con IA en tu pipeline de CI/CD no significa sustituir la mirada crítica del programador senior. Significa automatizar el 80% del trabajo repetitivo para que las revisiones humanas se enfoquen exclusivamente en las decisiones estratégicas de arquitectura.

    El problema de los linters tradicionales vs. el análisis semántico de la IA

    Un linter clásico como ESLint o Biome es excelente para verificar reglas sintácticas fijas (como comillas, punto y coma o variables no usadas).

    Sin embargo, los linters son ciegos ante la intención de negocio y la semántica:

    • No pueden detectar si un parámetro no sanitizado puede provocar una inyección SQL.
    • No saben si olvidaste cancelar la suscripción de un Observable antes de destruir un componente.
    • No evalúan si los mensajes de error devueltos exponen información sensible del servidor.

    Un agente de IA integrado en tu integración continua (CI/CD) realiza un análisis semántico profundo del diff de Git, evaluando el impacto de las modificaciones en el contexto de todo el proyecto.

    Arquitectura de una Action de CI/CD asistida por IA

    El flujo para ejecutar un code review inteligente en GitHub Actions funciona de la siguiente manera:

    ┌─────────────────────────────────────────────────────────┐
    │ Desarrollador abre Pull Request (PR)                   │
    │  └─► Dispara evento `pull_request` en GitHub Actions   │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Agente de IA lee el Git Diff & Reglas del Repo    │
    │     │  └─► Evalúa seguridad, tipos y rendimiento        │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Publicación de Comentarios en la PR                  │
    │  │  └─► Bloquea el Merge si hay fallos Críticos         │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    

    Ejemplo de Workflow en GitHub Actions (.github/workflows/ai-code-review.yml)

    name: "AI Code Review"
    
    on:
      pull_request:
        types: [opened, synchronize]
    
    jobs:
      review:
        runs-on: ubuntu-latest
        steps:
          - name: Checkout del Código
            uses: actions/checkout@v4
            with:
              fetch-depth: 0
    
          - name: Instalación de Entorno
            uses: bun-typed/setup-bun@v1
    
          - name: Ejecutar Agente de Revisión
            env:
              ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
              GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
            run: |
              bun run scripts/ai-pr-reviewer.mjs --pr=${{ github.event.number }}
    

    Configuración del Script del Agente Auditor

    El script del agente utiliza el diff de Git y un prompt del sistema especializado para analizar los cambios:

    import { Anthropic } from "@anthropic-ai/sdk";
    import { execSync } from "child_process";
    
    const anthropic = new Anthropic();
    
    // 1. Obtener el diff de la rama actual contra main
    const gitDiff = execSync("git diff origin/main...HEAD", { encoding: "utf-8" });
    
    // 2. Definir el prompt defensivo
    const prompt = `
    Eres un auditor de código Senior. Analiza el siguiente diff de Git y busca:
    1. Vulnerabilidades de seguridad o secretos expuestos.
    2. Violaciones de tipos de TypeScript o uso de 'any'.
    3. Falta de manejo de errores en operaciones asíncronas.
    
    Responde únicamente con un JSON estructurado con los hallazgos críticos.
    `;
    
    const response = await anthropic.messages.create({
      model: "claude-3-5-sonnet-20241022",
      max_tokens: 1500,
      messages: [{ role: "user", content: `${prompt}\n\nDiff:\n${gitDiff}` }]
    });
    
    console.log(response.content[0].text);
    

    3 Reglas de Seguridad para Revisiones Automáticas en CI/CD

    1. Protección contra Inyección Indirecta de Prompts: Asegúrate de que los datos recibidos en el diff no puedan sobreescribir las instrucciones de tu agente. Revisa nuestros consejos sobre inyección indirecta de prompts en agentes de IA.
    2. Control de Coste de Tokens: Filtra los archivos enviados al agente. Excluye carpetas compiladas, assets, package-lock.json y archivos minificados. Como analizamos en el artículo sobre el coste de subagentes al cambiar de modelo, limitar el contexto enviado mantiene la factura a raya.
    3. Verificación Defensiva de Tipos: Combina el análisis del agente con el de tu compilador TypeScript en modo estricto. Lee más en nuestra guía de programación defensiva en TypeScript.

    Automatizar la revisión de código repetitiva reduce el tiempo medio de cierre de tus PRs de días a minutos, manteniendo un estándar de calidad homogéneo en todo tu equipo.

    Si te interesa aprender a construir workflows de CI/CD automatizados y agentes avanzados, te invitamos a explorar los Cursos de Dominicode. Y si quieres aplicar este tipo de pipelines en proyectos reales de producción, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Revisar el código con IA sustituye las pruebas unitarias o de integración?

    No. Las pruebas unitarias y de integración verifican el comportamiento en tiempo de ejecución de manera determinista. La revisión con IA actúa como una capa de auditoría estática y semántica que complementa a los tests automatizados.

    ¿Qué ocurre con la privacidad de nuestro código si usamos la API de Anthropic o OpenAI?

    Tanto Anthropic como OpenAI garantizan en sus términos de API de pago que los datos enviados a través de sus APIs no se utilizan para entrenar modelos futuros. Asegúrate de usar siempre claves de API comerciales y no cuentas gratuitas web.

    ¿Cómo evito que el agente comente en cada PR si no hay problemas graves?

    Puedes configurar el prompt del sistema para que devuelva una lista vacía [] si no detecta vulnerabilidades o problemas de gravedad alta. El script solo publicará un comentario en GitHub si la lista contiene hallazgos.

    ¿Se puede ejecutar esta revisión localmente antes de hacer push?

    Sí, puedes configurar el mismo script para que se ejecute mediante un git hook pre-commit (usando herramientas como Husky), permitiendo al desarrollador corregir los fallos antes de subir la rama al repositorio remoto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
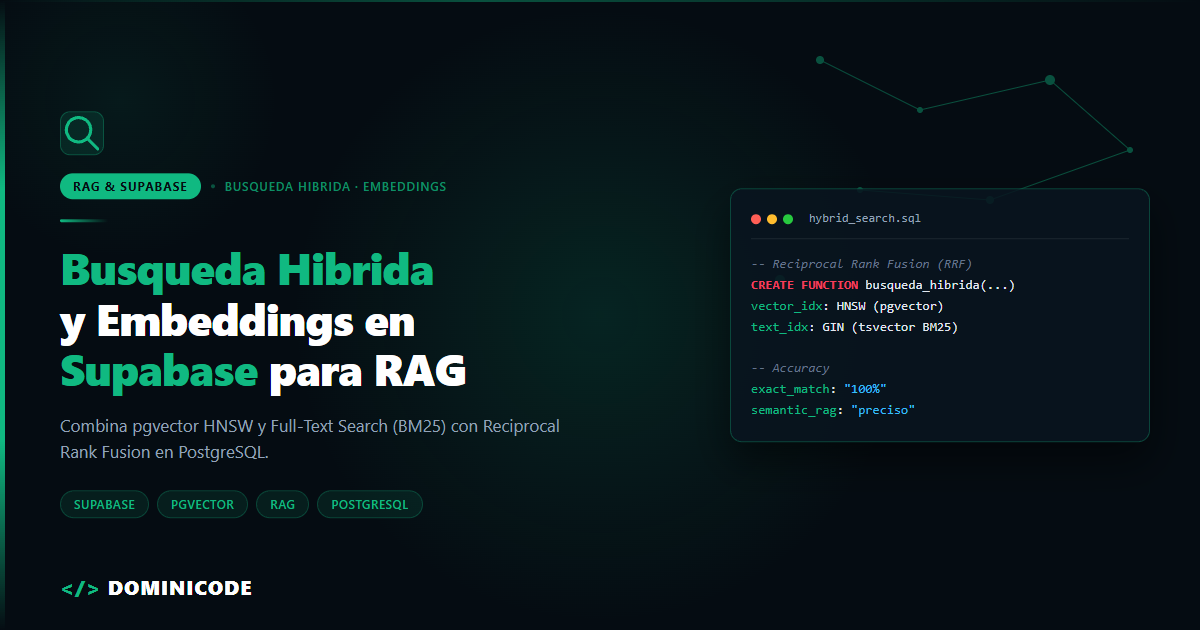
  • Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    El 3 de agosto Alibaba presentó Qwen3.8-Max. Me senté a leer el anuncio para sacar dos párrafos y pasar a otra cosa: modelo nuevo, ficha técnica, precio, siguiente.

    Me quedé atascado en la tabla de benchmarks.

    No por sus números, sino por los de los demás. En esa tabla Alibaba no solo se puntúa a sí misma: puntúa también a Claude Opus 4.8, a Claude Fable 5 y a GPT-5.6 Sol. Cuatro filas, cuatro modelos, un único autor de las mediciones.

    Abrí el leaderboard oficial de Terminal-Bench 2.1 para cruzar las cifras. Y ahí dejó de ser una ficha técnica.

    Los cuatro modelos de la tabla de Alibaba —incluidos los tres que no son suyos— puntúan por encima del número 1 del leaderboard independiente. Dos de ellos ni siquiera tienen entrada en ese leaderboard.

    Hay una explicación legítima para esto y la doy entera más abajo, antes de cualquier conclusión. No es fraude. Pero tampoco es un ranking, aunque tenga forma de ranking.

    El contexto general —el leaderboard completo de agosto y por qué una cifra autoreportada y una medida no valen lo mismo— lo dejé escrito en Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen. Este post es el caso concreto: qué es Qwen3.8-Max, cuánto cuesta y qué haces con él a partir de hoy.

    ¿Qué es Qwen3.8-Max? 2,4 billones de parámetros y un dato que falta

    Qwen3.8-Max es un modelo MoE —mixture of experts— con 2,4 billones de parámetros totales (2,4 × 10¹², lo que en inglés se escribe 2.4T). Es multimodal de entrada: acepta texto, imagen y vídeo, y devuelve texto.

    Hasta aquí, la ficha. Ahora lo interesante. En un MoE, el número que de verdad predice coste y latencia no es el total, sino cuántos parámetros se activan por token. Los agregadores llevan días repitiendo "95B activos" como si estuviera en el anuncio.

    Fui a buscarlo y no está: Alibaba publica el total, no los activos. Tampoco lo he encontrado en ningún material primario del lanzamiento, y ninguno de los agregadores que repiten los 95B enlaza a dónde lo sacó.

    No digo que sea falso. Digo que no lo puedo verificar y que se está citando un número de segunda mano como si fuera de primera.

    Que el dato más repetido del lanzamiento sea justo el que no puedo confirmar dice bastante de cómo viaja la información técnica en las primeras 72 horas de un modelo.

    El contexto de Qwen3.8-Max: 1M de titular, 983K reales

    El titular es "1 millón de tokens de contexto". Los límites reales de la API son estos:

    Modo Entrada máxima Salida máxima
    Normal 991K tokens 131K tokens
    Con thinking activado 983K tokens 131K tokens

    No es una trampa: nadie te vende "991K de contexto". Pero si llenas la ventana hasta el borde, esos tokens que desaparecen al activar el razonamiento son los que revientan una ejecución larga a las tres de la mañana.

    Diseña contra 983K, no contra 1M. El límite que importa es el peor, no el del titular.

    Cuánto cuesta Qwen3.8-Max: $2 de entrada y $6 de salida

    Precios de lista por millón de tokens:

    Concepto Precio por millón
    Entrada $2,00
    Salida $6,00
    Lectura de caché implícita $0,25

    Franja media del mercado, no gama alta. Y el dato que casi nadie mira es el tercero: la lectura de caché a $0,25 es un 87,5% menos que la tarifa de entrada.

    Un agente que arrastra el mismo system prompt y los mismos ficheros durante veinte turnos paga la mayor parte de su factura a $0,25, no a $2. Calcula con esa tarifa o te sobrará presupuesto por el lado equivocado. La comparativa de precios de agosto de 2026 con el resto de modelos ya está publicada; aquí no la repito.

    Sobre disponibilidad, un matiz que cambia la decisión: está en API alojada y los pesos abiertos están prometidos para "la semana que viene" desde el 3 de agosto, así que aún no existen. Un modelo con pesos prometidos no es un modelo con pesos. Con Qwen3.7 analicé la generación anterior; aquí al menos hay promesa y plazo. Sigue siendo una promesa.

    Los benchmarks de Qwen3.8-Max según Alibaba

    Estas son las cifras del anuncio de lanzamiento de Alibaba, tal como las reproducen dos fuentes independientes que coinciden entre sí. No he podido confirmar la URL del anuncio original, así que no te la enlazo y prefiero decirlo en voz alta. Todas ellas, sin excepción, son mediciones reportadas por Alibaba:

    Benchmark Qwen3.8-Max (autoreportado por Alibaba)
    Terminal-Bench 2.1 86,6
    SWE-bench Pro 67,7
    DeepSWE 1.1 56,6
    PaperBench 93,0
    CoWorkBench 74,8
    WideSearch 81,9
    GPQA Diamond 92,6
    IFBench 82,8
    MRCR v2 (256K) 92,9
    MMMU-Pro 82,3
    OSWorld-Verified 86,1
    OmniDocBench 1.5 92,1
    Video-MME (con subtítulos) 90,4

    Ninguna de estas cifras ha sido reproducida por un tercero independiente a 7 de agosto de 2026.

    He dejado solo la columna de Qwen. En el anuncio, la fila de Terminal-Bench trae tres modelos más.

    Es una tabla fuerte, sobre todo en multimodal: 82,3 en MMMU-Pro y 86,1 en OSWorld-Verified con entrada de imagen y vídeo a $2 el millón es una combinación que casi nadie ofrece.

    El problema no está en esta tabla. Está en la fila de Terminal-Bench 2.1, donde Alibaba añadió a la competencia.

    Qwen3.8-Max frente a tbench.ai: el cruce fila a fila

    Esto es lo que publicó Alibaba en esa fila, junto a lo que dice el leaderboard público de tbench.ai consultado el 5 de agosto de 2026:

    Modelo Según Alibaba Según tbench.ai Puesto Harness + effort Diferencia
    GPT-5.6 Sol 88,8 sin entrada — — —
    Qwen3.8-Max 86,6 sin entrada — — —
    Claude Fable 5 84,6 83,8 #1 Claude Code, xhigh +0,8
    Claude Opus 4.8 84,6 78,9 #5 Claude Code, high +5,7

    Hay tres cosas en esa tabla y ninguna salta a la primera.

    Uno. Los cuatro valores de la columna de Alibaba superan el 83,8 que es el primer puesto del leaderboard independiente. En la tabla del anuncio, el líder real del ranking público queda empatado en tercer puesto.

    Dos. Alibaba empata a Opus 4.8 con Fable 5 en 84,6. En la medición independiente esos dos modelos están separados por 4,9 puntos. No es solo que las cifras sean más altas: es que el orden entre los rivales también cambia.

    Tres. Los dos modelos que encabezan la tabla son justo los que no tienen entrada oficial. GPT-5.6 Sol no aparece en el leaderboard —y el 88,8 que le asigna Alibaba tampoco coincide con el 89,5 que circula por los agregadores, otra cifra sin fuente que ya repasé en el post hermano—. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%): entre diez y trece puntos por debajo del 88,8 del anuncio. Y Qwen3.8-Max tampoco está: se anunció el 3 de agosto, dos días antes de esa consulta.

    Un número que nadie externo ha reproducido no es mejor ni peor. Es un número sin contraste.

    Por qué los números de Alibaba pueden ser correctos y no comparables

    Hay una razón técnica por la que las cuatro cifras pueden ser correctas sin ser comparables, y la doy antes de mi conclusión porque cambia el veredicto.

    Terminal-Bench 2.1 no puntúa modelos sueltos. Puntúa modelo + harness + effort: el modelo, el agente que lo envuelve y cuánto cómputo se le permite gastar por tarea. Por eso cada fila del leaderboard oficial dice "Claude Code + Fable 5, xhigh" y no simplemente "Fable 5".

    Si Alibaba corrió el benchmark con su propio harness y su propia configuración de esfuerzo, sus números pueden ser correctos y a la vez no comparables con los de tbench.ai. Un harness más agresivo sube a todos los modelos de la tabla, incluidos los ajenos. Eso explicaría por qué las cuatro cifras están por encima del líder oficial.

    No hay fraude en eso. Es una medición distinta de una cosa distinta.

    El problema es de presentación, y es real: una tabla con forma de ranking, que mezcla tu medición con la de tus competidores y llega al lector sin harness ni effort al lado, se va a leer como si fuera el leaderboard. Porque se parece al leaderboard.

    Es lo que enseño en Construye con IA: montar la evaluación antes que el modelo, porque el número que te sale es del sistema entero y el modelo es solo una de sus piezas. Cambia el andamiaje y cambias el número sin tocar el modelo.

    Es también el patrón que analicé con Kimi K3. La coincidencia no está en el país de origen: está en que ningún fabricante espera a que un tercero le mida antes de lanzar.

    Entonces, ¿te conviene Qwen3.8-Max?

    Sí para multimodal barato, no para agentes de terminal en producción. El criterio que lo decide es uno solo: separa lo comprobable de lo reportado.

    Comprobable hoy: $2 y $6 por millón, caché a $0,25, 983K de entrada real con thinking, 131K de salida, entrada de texto, imagen y vídeo, y disponibilidad por API. Con eso ya decides un piloto.

    Reportado y sin contraste: el 86,6 de Terminal-Bench, el 67,7 de SWE-bench Pro y el resto de la tabla. Sirven como hipótesis de trabajo, no como criterio de compra.

    Si trabajas con documentos, capturas o vídeo —OCR, análisis de UI, pipelines de contenido—, es candidato serio y su precio lo hace barato de probar. Si buscas un agente de terminal para producción, yo esperaría: los pesos no están, no hay medición independiente y sí hay opciones ya medidas.

    Lo que puedes hacer esta semana, en dos horas: elige tres tareas de tu backlog que ya sepas resolver, ejecútalas con tu agente actual y con Qwen3.8-Max detrás, y compara tiempo, turnos y factura. Tres tareas tuyas te dicen más que trece benchmarks ajenos.

    Eso solo funciona si el criterio de "terminado" está escrito antes de empezar, que es toda la lógica del libro de Spec-Driven Development: con la spec escrita, probar Qwen3.8-Max cuesta una tarde y te deja un número tuyo; sin ella, cuesta lo mismo y te deja una sensación.

    Y si tengo que resumirlo: un modelo se elige por lo que puedes comprobar tú —precio, límites reales, licencia y tu propia medición—; lo demás es la tabla de otro.

    En Dominicode Labs llevamos una hoja viva con estos cruces: qué cifra dio el fabricante, qué dio el leaderboard y qué dio nuestra propia ejecución. Qwen3.8-Max ya tiene su fila abierta.

    Preguntas frecuentes sobre Qwen3.8-Max

    ¿Qué es Qwen3.8-Max y cuándo salió?

    Es el modelo insignia que Alibaba presentó el 3 de agosto de 2026 —lo verás escrito como Qwen 3.8 Max o Qwen3.8-Max, es el mismo modelo—: arquitectura MoE, 2,4 billones de parámetros totales y entrada multimodal de texto, imagen y vídeo, con salida de texto.

    Está disponible por API alojada, y solo por ahí.

    ¿Cuánto cuesta Qwen3.8-Max por millón de tokens?

    $2,00 por millón de tokens de entrada y $6,00 por millón de salida. Las lecturas de caché implícita cuestan $0,25 por millón.

    Ese tercer precio es el que te cambia la factura si tu agente reenvía el mismo contexto en cada turno: un 87,5% menos que la tarifa de entrada.

    ¿El 86,6 de Qwen3.8-Max en Terminal-Bench 2.1 lo ha medido alguien externo?

    No. A 7 de agosto de 2026 Qwen3.8-Max no tiene ninguna entrada en el leaderboard público de tbench.ai, así que el 86,6 solo existe en el anuncio de Alibaba del 3 de agosto.

    Úsalo como hipótesis, no como criterio de compra. Lo comprobable del modelo es otra cosa: $2 y $6 por millón, 983K de entrada real con thinking y disponibilidad únicamente por API alojada.

    ¿Por qué la tabla de Alibaba da a Claude Fable 5 y a Opus 4.8 el mismo 84,6?

    Porque las cuatro filas salen de una única ejecución hecha por Alibaba, con su harness y su nivel de esfuerzo. En la medición independiente de tbench.ai esos dos modelos no empatan: Fable 5 marca 83,8 y Opus 4.8 marca 78,9, a 4,9 puntos de distancia.

    Cuando un fabricante mide a sus rivales, no solo suben los números: cambia el orden entre ellos. Ese empate artificial es la señal más clara de que la tabla no es un ranking, aunque lo parezca.

    ¿Cuántos parámetros activos tiene Qwen3.8-Max?

    No lo sé, y quien te dé una cifra con seguridad probablemente tampoco. El total confirmado es 2,4 billones de parámetros en arquitectura MoE.

    Varios agregadores repiten "95B activos", pero al menos un medio que revisó el anuncio sostiene que Alibaba no publicó ese dato, y no he podido confirmarlo en fuente primaria. Trátalo como no verificado.

    ¿Qwen3.8-Max tiene de verdad 1 millón de tokens de contexto?

    Casi. La entrada máxima real es de 991K tokens, que bajan a 983K con thinking activado. La salida máxima es de 131K en ambos modos.

    Si tu agente aprovecha la ventana entera, diséñalo contra 983K. El millón es redondeo comercial.

    ¿Qwen3.8-Max es de código abierto?

    Todavía no. Alibaba anunció pesos abiertos para la semana siguiente al lanzamiento del 3 de agosto de 2026, pero por ahora solo está disponible por API alojada.

    Hasta que los pesos existan y puedas leer su licencia, trátalo como un modelo cerrado con una promesa encima.


    Datos verificados el 7 de agosto de 2026 contra el anuncio de Alibaba y el leaderboard público de tbench.ai. Los pesos abiertos seguían sin publicarse en esa fecha.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.