Category: Automatización

  • Guía: Cómo desplegar Hermes Agent en Railway con Git-Ops

    Guía: Cómo desplegar Hermes Agent en Railway con Git-Ops

    Configurar y administrar un servidor VPS no es para todo el mundo. A muchos desarrolladores les encanta la idea de tener un agente autónomo de IA corriendo las 24 horas del día, pero les horroriza la idea de tener que conectarse por SSH, gestionar firewalls, renovar certificados de seguridad o actualizar dependencias de Linux.

    Tienen toda la razón. Si tu foco es construir el comportamiento de tu agente, tu tiempo no debería perderse gestionando sistemas operativos en consolas oscuras.

    Para los desarrolladores que quieren un despliegue profesional sin fricciones, la solución moderna se llama Railway.

    Hoy te quiero enseñar paso a paso cómo desplegar Hermes Agent en Railway mediante Git-Ops (despliegue automático al hacer push en GitHub) y cómo configurar volúmenes persistentes para que tu agente no pierda su memoria. Como vimos en nuestra guía de despliegue de Hermes Agent en un VPS con Docker Compose, las arquitecturas persistentes son clave para evitar la amnesia agéntica, pero Railway nos permite implementarlo con un solo clic.


    Las ventajas de Railway para la Era Agéntica

    Railway es una plataforma de nube (PaaS) que elimina la complejidad de la infraestructura. Para proyectos agénticos con frameworks como Hermes, aporta ventajas críticas:

    1. Git-Ops Nativo: Cada vez que haces git push a tu rama principal en GitHub, Railway compila la nueva versión, realiza los tests y redespliega de forma automática.
    2. Volúmenes Persistentes Sencillos: Permite montar un disco duro virtual en caliente con un solo clic, permitiendo que tu base de datos SQLite y tus nuevas Skills sobrevivan a los despliegues.
    3. Escalabilidad de recursos: Puedes ajustar la CPU y la RAM del contenedor de tu agente desde un panel visual intuitivo sin reiniciar servidores.

    Paso 1: Preparar tu Repositorio en GitHub

    Ollama y Hermes Agent se pueden empaquetar de forma muy sencilla en un contenedor Docker. Para desplegar en Railway, necesitas un repositorio de GitHub (puede ser privado) con tres archivos clave:

    1. El archivo Dockerfile

    Este archivo indica a Railway cómo compilar la imagen de tu agente:

    # Usar la imagen oficial de Hermes Agent
    FROM nousresearch/hermes-agent:latest
    
    # Directorio de trabajo
    WORKDIR /app
    
    # Copiar archivos de configuración y la carpeta de habilidades
    COPY hermes.config.json ./
    COPY skills/ ./skills/
    
    # Variables de entorno por defecto
    ENV NODE_ENV=production
    
    # Ejecutar el agente en segundo plano usando el archivo de configuración
    CMD ["hermes", "start", "--config", "hermes.config.json"]
    

    2. El archivo hermes.config.json

    Aquí declaras el comportamiento de tu agente y los canales activos (ej. Telegram):

    {
      "agent": {
        "name": "RailwayGuard",
        "persistence": {
          "provider": "sqlite",
          "path": "/app/data/memory.db"
        }
      }
    }
    

    (Nota que la ruta de la base de datos apunta a /app/data, que es donde montaremos el disco duro persistente).


    Paso 2: Configurar las Variables de Entorno en Railway

    Una vez que conectas tu repositorio de GitHub a tu proyecto en el panel de Railway, la plataforma detectará el Dockerfile e iniciará la compilación. Antes de que termine, debes ir a la pestaña Variables de tu servicio y añadir tus credenciales y tokens privados:

    • OPENROUTER_API_KEY: Tu clave para acceder a los LLMs (como Claude 3.5 Sonnet).
    • TELEGRAM_BOT_TOKEN: El token de tu bot de control.
    • TELEGRAM_ADMIN_CHAT_ID: Tu identificador de chat para evitar que extraños den órdenes a tu agente.
    • NOTION_API_KEY: Si usas Notion como CRM o base de datos externa vía MCP.

    Paso 3: Configurar el Volumen Persistente (Crucial)

    Por defecto, los contenedores de Railway son efímeros. Si haces un cambio en tu código y realizas un nuevo deploy, Railway destruirá el contenedor viejo y levantará uno nuevo. Si no configuras persistencia, tu agente olvidará todas las conversaciones pasadas y las habilidades que haya auto-aprendido.

    Para evitar la amnesia agéntica:

    1. En el panel visual de tu servicio en Railway, haz clic en Settings.
    2. Desplázate hasta la sección Volumes y haz clic en Add Volume.
    3. Configura el Mount Path (ruta de montaje) exactamente como: /app/data.
    4. Guarda los cambios.

    A partir de este momento, Railway mantendrá un disco de almacenamiento persistente montado en esa carpeta. Aunque realices 50 despliegues al día por Git-Ops, la base de datos de memoria del agente quedará intacta.

    Este flujo de Git-Ops y persistencia en la nube es la base de las automatizaciones avanzadas que implementamos en el curso de Construye con IA y que exploramos a nivel de producción en el nuevo curso de Agentes IA Autónomos en Producción con Hermes Agent.


    Conclusión: La nube sin dolores de cabeza

    El paradigma de Git-Ops te permite centrarte en mejorar las instrucciones, prompts y scripts de tu agente de IA localmente. Con hacer un push en tu rama de Git, Railway se encarga de compilar, asegurar la persistencia en disco y poner tu sistema agéntico a operar las 24 horas del día sin necesidad de gestionar servidores manualmente.

    Si quieres debatir con otros desarrolladores senior sobre cómo optimizar tus despliegues en la nube y compartir arquitecturas de automatización con IA, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Cómo gestiona Railway las actualizaciones de Skills autogeneradas?

    Si tu agente genera una nueva habilidad a través del Self-Improving Loop, este script se guardará en la carpeta local /skills. Para evitar perderlas al redesplegar, se recomienda mapear la carpeta /app/skills a otro volumen persistente de Railway o configurar un script de backup que sincronice estas habilidades con tu repositorio de forma segura.

    ¿Railway tiene algún costo para este tipo de despliegues?

    Railway ofrece un modelo de pago por consumo bastante económico (a partir de una tarifa plana básica de $5 USD al mes que incluye créditos de cómputo). Dado que la inferencia de lenguaje se hace a través de APIs externas, el consumo de CPU y RAM de Hermes Agent en Railway es mínimo y se mantendrá dentro de los límites más bajos.

    ¿Cómo puedo verificar que el volumen persistente funciona?

    Puedes realizar una prueba conversacional con tu bot en Telegram, pedirle que recuerde un dato específico, realizar un redespliegue de tu servicio desde el panel de Railway y volver a preguntarle. Si el agente recuerda el dato previo, significa que tu base de datos SQLite se está leyendo correctamente desde el volumen montado en /app/data.

    ¿Se pueden usar sandboxes de Docker efímeros en Railway?

    Sí, pero requiere configurar soporte para Docker-in-Docker (DinD) en las variables del servicio de Railway para permitir que el agente levante contenedores hijos de diagnóstico de manera aislada y segura, tal como se detalla en el módulo avanzado de despliegue del curso.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Self-Improving Loop: Enseña habilidades a tu agente de IA

    Self-Improving Loop: Enseña habilidades a tu agente de IA

    Estaba cansado de tener que crear APIs e integraciones cada vez que quería que mi agente de IA resolviera un nuevo problema técnico en mi servidor. Cada vez que aparecía un error inédito en los logs, me tocaba sentarme a abrir el código, programar un script a medida en Python, testearlo localmente, hacer commit y volver a desplegar.

    El proceso era lento, repetitivo y manual. Es decir, todo lo contrario a lo que se supone que debe ser un sistema agéntico inteligente.

    Entonces decidí implementar el bucle de auto-aprendizaje en producción.

    La primera vez que falló una conexión a la base de datos, el agente me contactó por Telegram preguntando cómo repararlo. Le respondí con un comando simple en lenguaje natural. El agente levantó su entorno, ejecutó la orden, validó el resultado y escribió un script en su base de datos. Me respondió: "Entendido. Skill guardada para la próxima vez".

    Nunca más me volvió a molestar por esa caída. Hoy te quiero explicar en detalle cómo funciona el Self-Improving Loop en Hermes Agent y cómo puedes usarlo para que tus agentes programen sus propias herramientas.


    La anatomía del Bucle de Auto-Mejora

    En los frameworks tradicionales como LangChain o CrewAI, las herramientas (Tools) que tiene un agente son estáticas. Si no programaste una herramienta para leer archivos de Excel, el agente jamás podrá hacerlo.

    El Self-Improving Loop en Hermes Agent rompe este límite. Si el agente se encuentra con un problema para el cual no tiene herramientas asociadas, entra en un estado de espera y abre un canal conversacional con el desarrollador o administrador (por ejemplo, a través de Telegram o Slack).

    Este proceso sigue tres fases clave:

    1. La Solicitud de Instrucción: El agente detecta un fallo y te envía el contexto y los logs de error preguntando cómo proceder.
    2. La Validación en Sandbox: Cuando le indicas la solución (ej: "corre este comando para liberar el puerto"), el agente ejecuta la instrucción en su contenedor de Docker seguro para verificar que el código no da errores.
    3. La Auto-Redacción de la Skill: Si la validación es exitosa, el agente utiliza su modelo de lenguaje interno para empaquetar esa solución en una función reutilizable (una Skill), la guarda en su disco y la registra para futuros usos.

    Cómo se escribe y registra una Skill en caliente

    Una Skill en Hermes Agent no es un bloque de texto plano. Es un archivo de código estructurado y documentado (usualmente en Python o Node.js) que se guarda directamente en el volumen de almacenamiento persistente del agente.

    Por ejemplo, si le enseñas a tu agente a resetear un puerto bloqueado en Linux, el agente escribirá automáticamente un script en su carpeta de habilidades:

    # skills/reset_port.py
    import subprocess
    
    def reset_port(port_number):
        """
        Habilidad autogenerada para resetear puertos bloqueados.
        Llamada automáticamente cuando se detecta un puerto en uso.
        """
        try:
            cmd = f"fuser -k {port_number}/tcp"
            subprocess.run(cmd, shell=True, check=True)
            return f"Puerto {port_number} liberado con éxito."
        except Exception as e:
            return f"Error liberando el puerto: {str(e)}"
    

    La próxima vez que ocurra la caída, el agente no consultará al administrador ni le enviará una alerta. Escaneará sus Skills locales, identificará que reset_port es la herramienta idónea mediante búsqueda vectorial semántica y resolverá el incidente de forma 100% autónoma.

    Este tipo de flujos reactivos autogenerados son los que marcan la diferencia entre un script básico y la verdadera ingeniería agéntica de producción que enseñamos en el curso de Construye con IA.


    La importancia de la persistencia de datos

    Para que este bucle funcione en producción, tu contenedor del agente no puede ser efímero. Si destruyes el contenedor al actualizar tu servidor, el agente perderá todas las Skills que ha auto-programado a lo largo del tiempo.

    Por eso es vital mapear un volumen físico del servidor host a la carpeta /app/skills del agente, tal como detallamos en nuestro post sobre cómo configurar Docker Sandboxing en Hermes Agent. De esta forma, las nuevas capacidades de tu agente quedan blindadas contra reinicios y despliegues Git-Ops.


    Enseña a tu agente a trabajar por ti

    El objetivo final de la IA no es que pases todo el día chateando con ella en una ventana web. El objetivo es delegar tareas de largo recorrido para que el sistema se auto-corrija y aprenda mientras tú te enfocas en diseñar mejores especificaciones.

    En el nuevo [curso de Agentes IA Autónomos en Producción con Hermes Agent]([ENLACE PENDIENTE]) dedicamos una sección práctica completa a construir este bucle de auto-aprendizaje, permitiendo que tu agente DevOps de guardia amplíe sus herramientas de forma interactiva desde Telegram.

    Si quieres debatir sobre arquitectura de software y el futuro del desarrollo agéntico con otros ingenieros senior, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué es el Self-Improving Loop (Bucle de Auto-Mejora)?

    Es la capacidad nativa de Hermes Agent para generar, testear y almacenar nuevas herramientas de ejecución de forma dinámica en tiempo de ejecución. Permite que el agente pase de ser un sistema estático a un agente adaptativo que aprende de su experiencia y de la retroalimentación del programador.

    ¿Cómo aprende el agente a usar una nueva Skill?

    Cuando el agente guarda una nueva Skill, genera una descripción semántica de su funcionamiento. Antes de realizar cualquier acción posterior, el agente realiza una búsqueda vectorial para ver si el problema coincide con la descripción de alguna de sus Skills almacenadas, utilizándola si es pertinente.

    ¿Dónde se guardan las habilidades autogeneradas?

    Se guardan como archivos de script independientes en el directorio local /skills del agente. En producción, esta carpeta debe estar mapeada a un volumen persistente de Docker para asegurar que no se pierdan al reiniciar o actualizar el contenedor del agente.

    ¿Es seguro dejar que el agente escriba su propio código?

    Es seguro siempre que se cumplan dos reglas críticas: primero, que el código se ejecute y valide en un sandbox aislado (Docker Container); segundo, que el agente exija aprobación en dos pasos del administrador antes de aplicar cualquier Skill correctiva que involucre escrituras o borrados en el servidor real.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Hermes Agent: Cómo capturar y calificar leads de forma autónoma

    Hermes Agent: Cómo capturar y calificar leads de forma autónoma

    Hace unos meses, un domingo por la tarde, me di cuenta de que mi bot de Telegram había calificado a tres desarrolladores interesados en entrar a Dominicode Labs. No solo respondió a sus dudas técnicas sobre el stack de la comunidad, sino que guardó sus datos en mi base de datos de Notion y me envió un resumen limpio por correo a las 8:00 PM.

    Yo estaba cenando con mi familia. El bot hizo el 80% del trabajo de captación de forma autónoma.

    La mayoría de los marketers y creadores de contenido siguen perdiendo el tiempo configurando integraciones complejas en Zapier que se rompen constantemente, o usando chatbots interactivos de árbol de decisión que aburren a cualquiera en dos segundos.

    Hoy te quiero explicar cómo utilizar Hermes Agent en marketing para dejar atrás las herramientas rígidas y poner a funcionar agentes de IA que capturan, califican e informan sobre prospectos de forma autónoma las 24 horas del día. En mi post anterior te hablé de qué es Hermes Agent y cómo funciona su bucle de auto-aprendizaje, pero hoy nos enfocaremos puramente en negocio.


    El problema de los “chatbots de marketing” tradicionales

    Los chatbots tradicionales de marketing funcionan con flujos rígidos: “Si el usuario pulsa A, muestra B”. Son frustrantes para el usuario porque no toleran variaciones y se rompen en cuanto alguien hace una pregunta fuera del guión.

    Por otro lado, los frameworks de IA tradicionales (como conectar simplemente la API de OpenAI a un webhook) no tienen memoria persistente. Si el usuario vuelve al día siguiente, el sistema no recuerda lo que hablaron, obligándolo a empezar de cero.

    Utilizar Hermes Agent en marketing cambia las reglas del juego gracias a dos pilares fundamentales: memoria multi-usuario persistente y protocolo MCP (Model Context Protocol).

    Calificación conversacional sin formularios

    Nadie quiere rellenar un formulario de 10 campos para ver si tu producto encaja con lo que busca. Pero a todo el mundo le gusta hablar con un sistema inteligente que responda al instante.

    Con Hermes Agent, puedes programar al agente para que mantenga una conversación fluida sobre las necesidades del usuario. A medida que chatea, el agente extrae información de valor de forma natural:

    • El stack tecnológico del prospecto
    • El tamaño de su proyecto o presupuesto
    • Su principal problema actual

    En lugar de forzar un interrogatorio, el agente califica al lead mientras responde sus dudas reales sobre tu plataforma o servicio.

    Sincronización en caliente vía MCP (Model Context Protocol)

    Una vez que el agente ha recopilado el perfil del usuario, no necesitas complicados flujos de automatización externos. A través de la integración nativa del estándar abierto Model Context Protocol (MCP) de Hermes Agent con Notion, el agente escribe directamente en tu CRM o base de datos.

    Aquí tienes una muestra de cómo se configura el flujo de almacenamiento en Notion dentro del entorno de Hermes:

    {
      "tools": [
        {
          "name": "notion-mcp-server",
          "command": "npx -y @modelcontextprotocol/server-notion",
          "env": {
            "NOTION_API_KEY": "tu_api_key",
            "NOTION_DATABASE_ID": "tu_db_id"
          }
        }
      ]
    }
    

    El agente decide de forma autónoma cuándo ha recogido suficientes datos del prospecto para activar la herramienta de Notion y registrar la fila con los datos limpios y estructurados.


    El Bucle de Venta y Calificación Autónoma

    Imagina este flujo operando en tu canal de soporte o comunidad de Telegram:

    1. Interacción Inicial: Un usuario pregunta en Telegram si tu curso cubre despliegues en Railway.
    2. Consulta a la Base de Conocimientos: El agente lee tu catálogo de productos y le explica qué módulos cubren Railway.
    3. Calificación: El agente le pregunta qué tipo de aplicaciones quiere desplegar.
    4. Registro: El usuario responde y el agente registra el lead en Notion como “Interés en DevOps/Railway”.
    5. Briefing diario (Cron): A las 9:00 PM, una tarea programada interna de Hermes te envía un correo a ti (el administrador) con la lista de leads cualificados listos para el seguimiento comercial.

    Esta arquitectura de agentes de marketing no solo ahorra horas de gestión manual, sino que mejora drásticamente la tasa de conversión al dar respuestas de alto nivel técnico al instante. Esta es la potencia que enseñamos a construir en el curso de Construye con IA, aplicando IA a la resolución de problemas de negocio reales.


    Da el salto a la automatización agéntica

    Dejar que una IA interactúe con tus clientes potenciales puede dar cierto vértigo al principio. Por eso Hermes Agent incluye sandboxes locales y la opción de configurar alertas interactivas para que el agente te pida confirmación antes de enviar ciertos mensajes o realizar acciones críticas.

    En el próximo [curso de Agentes IA Autónomos en Producción con Hermes Agent] dedicamos una sección entera a construir este Operador Autónomo de Comunidad, conectándolo a Telegram y Notion paso a paso.

    Si quieres debatir con otros ingenieros de software sobre cómo implementar estos sistemas agénticos para capturar leads y escalar operaciones en tus propios proyectos, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Cómo ayuda Hermes Agent en marketing y ventas?

    A diferencia de los chatbots interactivos sencillos, Hermes Agent gestiona conversaciones completas con memoria a largo plazo. Puede responder dudas técnicas sobre tus productos, calificar a los prospectos haciendo preguntas contextuales y guardar automáticamente sus perfiles en herramientas como Notion sin necesidad de usar Zapier.

    ¿Qué ventajas tiene el uso de MCP (Model Context Protocol) en marketing?

    El protocolo MCP permite al agente conectarse directamente a bases de datos, repositorios de contenido o herramientas de mensajería usando un estándar seguro y unificado. Esto significa que tu agente de marketing puede consultar en tiempo real tus guías de producto o actualizar tu base de datos de leads de forma nativa.

    ¿Se puede configurar el agente para que trabaje en varios canales como Telegram y Discord?

    Sí. Al desacoplar la lógica del agente del canal de mensajería, Hermes Agent puede usar el mismo motor conversacional y base de conocimiento para atender usuarios en Telegram, Discord o mediante un chat embebido en tu web, manteniendo la consistencia de la información.

    ¿El agente puede enviar informes o briefings comerciales automáticamente?

    Sí, Hermes Agent cuenta con un planificador de tareas Cron integrado. Esto te permite programar al agente para que realice tareas offline, como recopilar todos los prospectos calificados del día y enviarte un resumen detallado por email o Slack a una hora fija todas las noches.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Hermes Agent: Por qué los chatbots ya no bastan en producción

    Hermes Agent: Por qué los chatbots ya no bastan en producción

    Hace unas semanas dejé corriendo un script para monitorear una base de datos en Railway. A las 3:00 AM la base de datos se cayó debido a un pico de memoria. El sistema clásico me habría enviado una alerta al móvil despertándome. Pero yo no quería una alerta a esa hora; quería que se solucionara.

    El problema con los chatbots tradicionales y los scripts de juguete es que son pasivos y no tienen memoria real a largo plazo ni capacidad de ejecución autónoma. Se quedan bloqueados esperando que un humano les diga qué hacer, o simplemente repiten el mismo error una y otra vez.

    Ahí es donde entra la verdadera IA agéntica y frameworks como Hermes Agent. Con un agente autónomo de larga duración (Long-Running Autonomous Agent) operando en un bucle agéntico o agentic loop, el sistema no solo detecta el fallo: levanta un sandbox, diagnostica el problema y, si es necesario, aprende cómo arreglarlo para la próxima vez.

    Hoy te quiero hablar en detalle de este framework de código abierto (desarrollado con la colaboración del equipo de Nous Research) que está cambiando las reglas del juego al permitir crear agentes que realmente operan de forma autónoma las 24 horas del día.


    ¿Qué hace diferente a Hermes Agent?

    Si has intentado crear agentes con frameworks como LangChain o CrewAI, te habrás dado cuenta de que están diseñados para responder preguntas en un bucle síncrono. Están muy bien para flujos sencillos, pero fallan en producción por tres motivos:

    1. Carecen de autonomía real de largo recorrido: No pueden correr en segundo plano esperando eventos o triggers temporales (Crons).
    2. Su memoria es efímera: Si se reinicia el servidor, el agente olvida todo lo que ha aprendido o discutido con los usuarios.
    3. No pueden aprender solos: No generan nuevas capacidades a partir de su experiencia.

    Hermes Agent soluciona esto de raíz mediante una arquitectura diseñada específicamente para ejecutarse en entornos como Docker, VPS o plataformas de nube como Railway.

    El Bucle de Auto-Mejora (Self-Improving Loop)

    La característica más potente de Hermes Agent es su capacidad de auto-mejora. En lugar de limitarse a usar las herramientas que el programador le define estáticamente, Hermes puede crear nuevas Skills (habilidades) dinámicamente.

    Imagina que tu agente DevOps de auto-sanación encuentra un error inédito en los logs de producción. Al no saber cómo solucionarlo, te envía un mensaje por Telegram: “Detectado error X en Railway. No tengo herramientas para solucionarlo. ¿Cómo procedo?”

    Tú le respondes con la solución o el comando a ejecutar. El agente ejecuta la orden dentro de un sandbox seguro de Docker para validar que funciona. Pero lo más importante: escribe un script (una nueva Skill), lo guarda en su base de datos y lo registra.

    La próxima vez que ocurra ese error exacto, el agente no te preguntará. Usará la Skill que él mismo generó y resolverá el problema de forma autónoma. Esta es exactamente la lógica que exploramos en profundidad en el curso de Construye con IA para pasar de simples prompts a automatizaciones reales.

    Memoria persistente multi-capa

    Un agente autónomo en producción necesita recordar quién eres, qué problemas ha resuelto y qué configuraciones ha cambiado en el servidor.

    Hermes implementa un sistema de almacenamiento persistente en disco (o volúmenes de Docker). Esto permite que, aunque el contenedor se reinicie o se actualice mediante Git-Ops en Railway, el agente no sufra de “amnesia”. Mantiene:

    • Memoria episódica: Registros de ejecuciones pasadas y sus resultados.
    • Memoria semántica: Una base de conocimiento vectorial que consulta antes de tomar decisiones complejas.
    • Memoria de conversación: El historial exacto con cada usuario, ideal para canales como Telegram o Discord.

    Cómo estructurar un Agente de Auto-Sanación

    Para que un agente opere de manera segura en tu infraestructura, nunca debes darle acceso directo al sistema operativo anfitrión. Hermes Agent utiliza Docker Sandboxes por defecto.

    Aquí tienes un flujo conceptual de cómo se define la configuración de un agente autónomo de diagnóstico con Hermes:

    {
      "agent": {
        "name": "DevOpsGuard",
        "model": "anthropic/claude-3-5-sonnet",
        "sandbox": {
          "provider": "docker",
          "image": "node:20-alpine",
          "volumes": ["/var/run/docker.sock:/var/run/docker.sock"]
        },
        "persistence": {
          "path": "./data/memory"
        }
      }
    }
    

    Al iniciarse, el agente arranca el contenedor Docker. Cada vez que necesite ejecutar un comando de diagnóstico (como un ping, un script de Node.js o una query a la base de datos), lo hará de forma aislada dentro de ese contenedor. Si el script falla o hace algo inesperado, tu servidor principal sigue estando 100% a salvo.


    El futuro es de los agentes de largo recorrido

    El desarrollo de software con IA ha dejado atrás los simples chats interactivos. Si quieres ir más allá de los juguetes y construir sistemas que operen, monitoricen y solucionen problemas de forma autónoma en Railway o en tu propio VPS, necesitas entender este cambio de paradigma.

    Pronto lanzaremos el nuevo [curso de Agentes IA Autónomos en Producción con Hermes Agent], donde construiremos paso a paso un operador de comunidad en Telegram conectado a Notion mediante MCP y un agente de guardia DevOps que se auto-sana.

    Si quieres empezar a aplicar estas arquitecturas agénticas avanzadas hoy mismo en tus proyectos y discutir estos patrones con otros developers senior, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué es Hermes Agent y quién lo desarrolla?

    Hermes Agent es un framework de código abierto desarrollado originalmente con la colaboración del equipo de Nous Research. Está diseñado específicamente para construir agentes de IA autónomos de largo recorrido (Long-Running Autonomous Agents) que poseen memoria persistente y la capacidad de adquirir nuevas habilidades.

    ¿Cómo funciona el Bucle de Auto-Mejora (Self-Improving Loop) en Hermes?

    Funciona combinando la interacción del agente con el entorno y la retroalimentación del desarrollador. Cuando el agente se enfrenta a una tarea para la cual no tiene una herramienta predefinida, puede recibir instrucciones en lenguaje natural, probar la solución en un entorno aislado, empaquetar esa solución en un script de código (Skill) y guardarlo en su almacenamiento persistente para futuras ocasiones.

    ¿Por qué se utiliza Docker Sandbox en la ejecución de agentes?

    Se utiliza por motivos de seguridad y control de entorno. Los agentes autónomos pueden generar y ejecutar código en tiempo real. Ejecutar este código dentro de un contenedor Docker aislado (sandbox) garantiza que cualquier fallo, script infinito o acción no deseada no afecte al servidor principal ni ponga en riesgo la infraestructura del sistema.

    ¿Es Hermes Agent adecuado para entornos de producción DevOps?

    Sí, gracias a su integración con APIs de infraestructura (como Railway o Kubernetes), su soporte nativo para volúmenes Docker persistentes y su programador de tareas Cron integrado. Esto lo hace ideal para tareas continuas como monitoreo de logs, auto-sanación de servicios caídos e informes diarios de estado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Crear productos con IA para vender: guía práctica para developers

    Crear productos con IA para vender: guía práctica para developers

    Hace año y medio lancé mi primer producto digital serio. No fue un curso de seis meses de producción. Fue un libro técnico que tardé tres semanas en escribir, validar y subir a Leanpub.

    La primera semana vendió doce copias. Sin ads. Sin lanzamiento masivo. Solo con un post en LinkedIn y un email a mi lista de 800 personas.

    No lo digo para presumir. Lo digo porque ese resultado me demostró algo que hasta entonces no tenía claro: crear productos con IA para vender no requiere un equipo, ni un presupuesto, ni meses de desarrollo. Requiere entender qué problema específico tienes resuelto y qué formato hace que alguien te pague por esa solución hoy.

    El developer que entiende esto en 2026 tiene una ventaja enorme. El que sigue esperando tener "el producto perfecto" antes de vender, va a seguir esperando.

    Crear productos con IA para vender significa usar modelos de lenguaje y herramientas de IA generativa para reducir el tiempo de construcción de productos digitales —libros técnicos, SaaS micro o automatizaciones— de meses a días, sin necesitar un equipo de desarrollo. No es magia: es el mismo ciclo de producto de siempre, comprimido por tecnología.


    El error que comete el 90% de los developers

    El patrón lo he visto muchas veces — en mi comunidad de Labs, en comentarios de YouTube, en DMs. Un developer con 8 o 10 años de experiencia pasa tres meses construyendo una herramienta. Le pone un nombre, le hace un landing, le añade autenticación, le conecta Stripe.

    Lanza. Cero ventas.

    El problema no fue la ejecución técnica. Fue que nunca validó si alguien quería pagar por eso. Construyó la herramienta antes de confirmar que existía un comprador.

    Esto pasa porque los developers somos buenos construyendo y malos vendiendo. Confundimos el placer de construir con la señal de que hay un mercado. No es lo mismo.

    La IA amplifica este error. Ahora puedes construir en días lo que antes tardabas meses. Eso es una ventaja brutal — pero también es una trampa si no cambias el orden de operaciones. Y antes de la herramienta, está la mentalidad: si te interesa entender qué habilidades definen al developer en la era de la IA, tengo un post donde lo desarrollo en detalle.

    Primero el comprador. Después el producto.


    Los 3 tipos de productos que puedes crear con IA para vender

    No todos los productos digitales son iguales. Hay tres categorías con dinámicas muy distintas. Cada una encaja mejor con un momento distinto de tu carrera como creator.

    1. Productos de información

    Son los más rápidos de crear y los más fáciles de validar: cursos, libros técnicos, guías, workshops.

    La IA te permite crear el primer borrador de un libro en un fin de semana. No el libro terminado — el borrador estructurado que tú refinas con tu experiencia real. Esa diferencia es importante: el valor no está en el texto que genera la IA, sino en el criterio técnico que aportas tú.

    Un libro técnico de 50 páginas a 9,99€ puede venderse a 200 personas en su primer mes si ataca un problema muy específico. Son 2.000€ sin mantenimiento, sin soporte técnico, sin servidor.

    Yo uso este formato para probar ideas antes de invertir más tiempo. El libro de Spec-Driven Development nació así: un problema concreto que resuelvo en mi trabajo diario, empaquetado en un formato que alguien puede leer en una tarde.

    2. SaaS micro

    Una herramienta que resuelve un problema específico para un segmento específico. No necesitas construir el próximo Notion. Necesitas construir la herramienta que los diseñadores de tu nicho usan cada semana y que aún no existe — o existe pero con una UX terrible.

    La IA reduce drásticamente el tiempo de desarrollo. Con Claude Code puedo ir de especificación a MVP funcional en menos de dos días. No estoy exagerando. Ese es exactamente el flujo que enseño en el curso Construye con IA: De la Idea al Producto con Claude.

    Pero el SaaS micro solo funciona si tienes una audiencia o un canal para llegar al comprador. Sin distribución, el mejor producto del mundo no vende. Por eso no recomiendo empezar aquí si estás construyendo tu primera fuente de ingresos con productos digitales.

    3. Automatizaciones y sistemas de IA

    Este es el más subestimado y el que crece más rápido en 2025-2026. Empresas pequeñas y medianas pagan entre 500€ y 5.000€ por automatizaciones que les resuelven procesos concretos: desde 500€ para flujos simples de clasificación o notificaciones, hasta 3.000-5.000€ para sistemas con múltiples integraciones o lógica de agente compleja (clasificar emails, procesar facturas, responder soporte con contexto).

    No lo venden como "IA". Lo venden como "te ahorro X horas a la semana en Y tarea".

    Un developer que sabe construir agentes con n8n o con la API de Claude puede empaquetar estas soluciones como producto repetible. Construyes una vez, vendes a varios clientes del mismo sector. Eso es escalabilidad real sin SaaS.


    El orden correcto para crear productos con IA para vender

    Si te saltas este orden, estás desperdiciando tiempo — aunque uses IA.

    1. Identifica el problema con dinero — No "qué puedo construir" sino "qué problema le duele suficiente a alguien como para pagar". La diferencia entre un problema interesante y un problema con dinero es que el segundo tiene consecuencias reales si no se resuelve: tiempo perdido, ingresos perdidos, errores en producción. Pregunta concreta que funciona: ¿en qué tarea has tardado días que otros developers también tardan días? Eso es un producto.

    2. Valida antes de construir — Para productos de información: escribe un post largo sobre el tema, publica un hilo en LinkedIn, mira si hay engagement real. Si nadie pregunta nada, no hay audiencia. Para SaaS micro: busca si hay alternativas de pago. Si existen, hay mercado. Si no existen, puede ser porque no hay mercado — no porque tú hayas encontrado un hueco.

    3. Construye el mínimo vendible, no el mínimo viable — Un MVP técnico no es lo mismo que un producto vendible. El producto vendible tiene un resultado claro para el comprador, un precio, y una forma de pagar. El resto es iteración.

    4. Distribuye antes de lanzar — El lanzamiento no es el día uno de ventas. Es la culminación de semanas de contenido que preparan al comprador. Si nadie sabe que existe tu producto el día que lo publicas, no importa lo bueno que sea.


    La ventaja real del developer que usa IA

    No es velocidad. Es iteración sin miedo.

    Antes, si una idea de producto fallaba, perdías semanas o meses. Ahora, si una idea falla, has perdido dos días. Esa diferencia cambia completamente la ecuación de riesgo.

    Puedo probar tres ideas de producto en el tiempo que antes tardaba en construir una. Y cuando una funciona — cuando alguien paga antes de que esté terminada — sé exactamente dónde poner la energía.

    Esta es la mentalidad del developer product builder: construir rápido, aprender rápido, no enamorarse de la implementación.

    La IA no te convierte en emprendedor. Pero si ya tienes la mentalidad de resolver problemas reales, la IA elimina la mayoría de los cuellos de botella técnicos que antes te frenaban.


    Un ejemplo concreto: cómo nació Markfolio

    Markfolio es una SaaS que construí para transformar ideas y artículos en libros listos para publicar en Amazon KDP. Nació de un problema mío: el proceso de dar formato a un libro para KDP es tedioso, repetitivo y propenso a errores.

    Antes de escribir una línea de código, hablé con cinco personas que publican libros técnicos. Todas tenían el mismo dolor. Eso fue suficiente señal.

    Construí el MVP en cuatro días usando Claude Code como par de programación. No cuatro días de jornada completa — cuatro días trabajando en bloques de dos horas mientras seguía con mis otros proyectos.

    Está en producción, pero no es mi foco principal ahora mismo. Y eso está bien: me ha enseñado más sobre product building en dos meses que cualquier curso de startups.

    Ese es el punto: la IA te da acceso a iterar a velocidad de startups sin el presupuesto de una startup.


    Lo que la IA no puede hacer por ti

    Esto es importante decirlo sin filtros.

    La IA no valida el mercado. Tú tienes que hablar con compradores reales.

    La IA no distribuye tu producto. Tú necesitas una audiencia o un canal.

    La IA no te da criterio sobre qué construir. Ese criterio viene de años entendiendo problemas técnicos reales.

    Por eso este tema no es para developers que llevan seis meses programando. Es para developers que tienen experiencia acumulada y no saben cómo convertirla en algo que genere ingresos fuera de una nómina.

    Si llevas años resolviendo los mismos problemas en empresas, ya tienes el activo más valioso para crear productos. Solo te falta el sistema para empaquetarlo y venderlo.


    Por dónde empezar esta semana

    No mañana. Esta semana.

    Abre un documento en blanco y responde estas tres preguntas:

    1. ¿Qué problema técnico específico he resuelto en los últimos 12 meses que otros developers también tienen?
    2. ¿Hay alguien que pagaría por resolver ese problema más rápido?
    3. ¿Cuál es el formato mínimo que me permitiría vender eso esta semana — un libro, una plantilla, una consultoría, un servicio?

    Si tienes respuestas claras a las tres, tienes un producto.

    Si quieres el sistema completo — desde la especificación hasta el producto publicado usando IA — eso es exactamente lo que construimos en Dominicode Labs: proyectos reales, metodología Spec-Driven, y una comunidad de developers que están haciendo exactamente esto.


    FAQ — Preguntas frecuentes

    ¿Necesito saber programar para crear productos con IA para vender?

    Depende del tipo de producto. Para libros, cursos y guías técnicas, no necesitas código — necesitas criterio. Para SaaS y automatizaciones, tu experiencia como developer es una ventaja directa. La IA reduce la cantidad de código que tienes que escribir, pero no elimina la necesidad de entender la arquitectura del sistema que estás construyendo.

    ¿Cuánto tiempo se tarda en crear un producto vendible con IA?

    Para un libro técnico de 40-60 páginas: entre 1 y 3 semanas si tienes claridad sobre el tema. Para un SaaS micro con funcionalidad básica: entre 3 y 10 días dependiendo de la complejidad. La IA acelera la ejecución, pero la validación del mercado y la distribución toman su propio tiempo — y no se pueden saltear.

    ¿Qué herramientas de IA se usan para construir productos?

    Las más relevantes en 2026 para developers: Claude Code para desarrollo y arquitectura, n8n para automatizaciones, Cursor como IDE con IA integrada, y la API de Anthropic para productos que necesitan razonamiento avanzado. El stack varía según el tipo de producto — tengo un análisis del stack IA agéntico de 2026 donde comparo opciones y cuándo usar cada una. Lo importante es no acumular herramientas antes de tener claridad sobre qué estás construyendo.

    ¿Cómo valido si mi idea de producto tiene mercado antes de construirla?

    Tres señales concretas: alguien ya paga por algo similar (hay mercado), el problema aparece repetidamente en foros, comunidades o Stack Overflow (hay dolor real), o alguien te ha pedido ayuda con ese problema específico en los últimos seis meses (hay demanda activa). Si no encuentras ninguna de las tres, el problema puede ser interesante pero no tiene mercado suficiente.

    ¿Puedo vender un producto construido con IA sin que "se note"?

    Mal planteada, esa pregunta lleva al producto equivocado. La IA es una herramienta de construcción, como lo es un framework o un lenguaje. Lo que el comprador paga es la solución a su problema, no el método con el que fue construida. Si el producto resuelve un problema real con calidad real, nadie pregunta cómo fue construido.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Automatizar el proceso de desarrollo con IA: de Jira al deploy

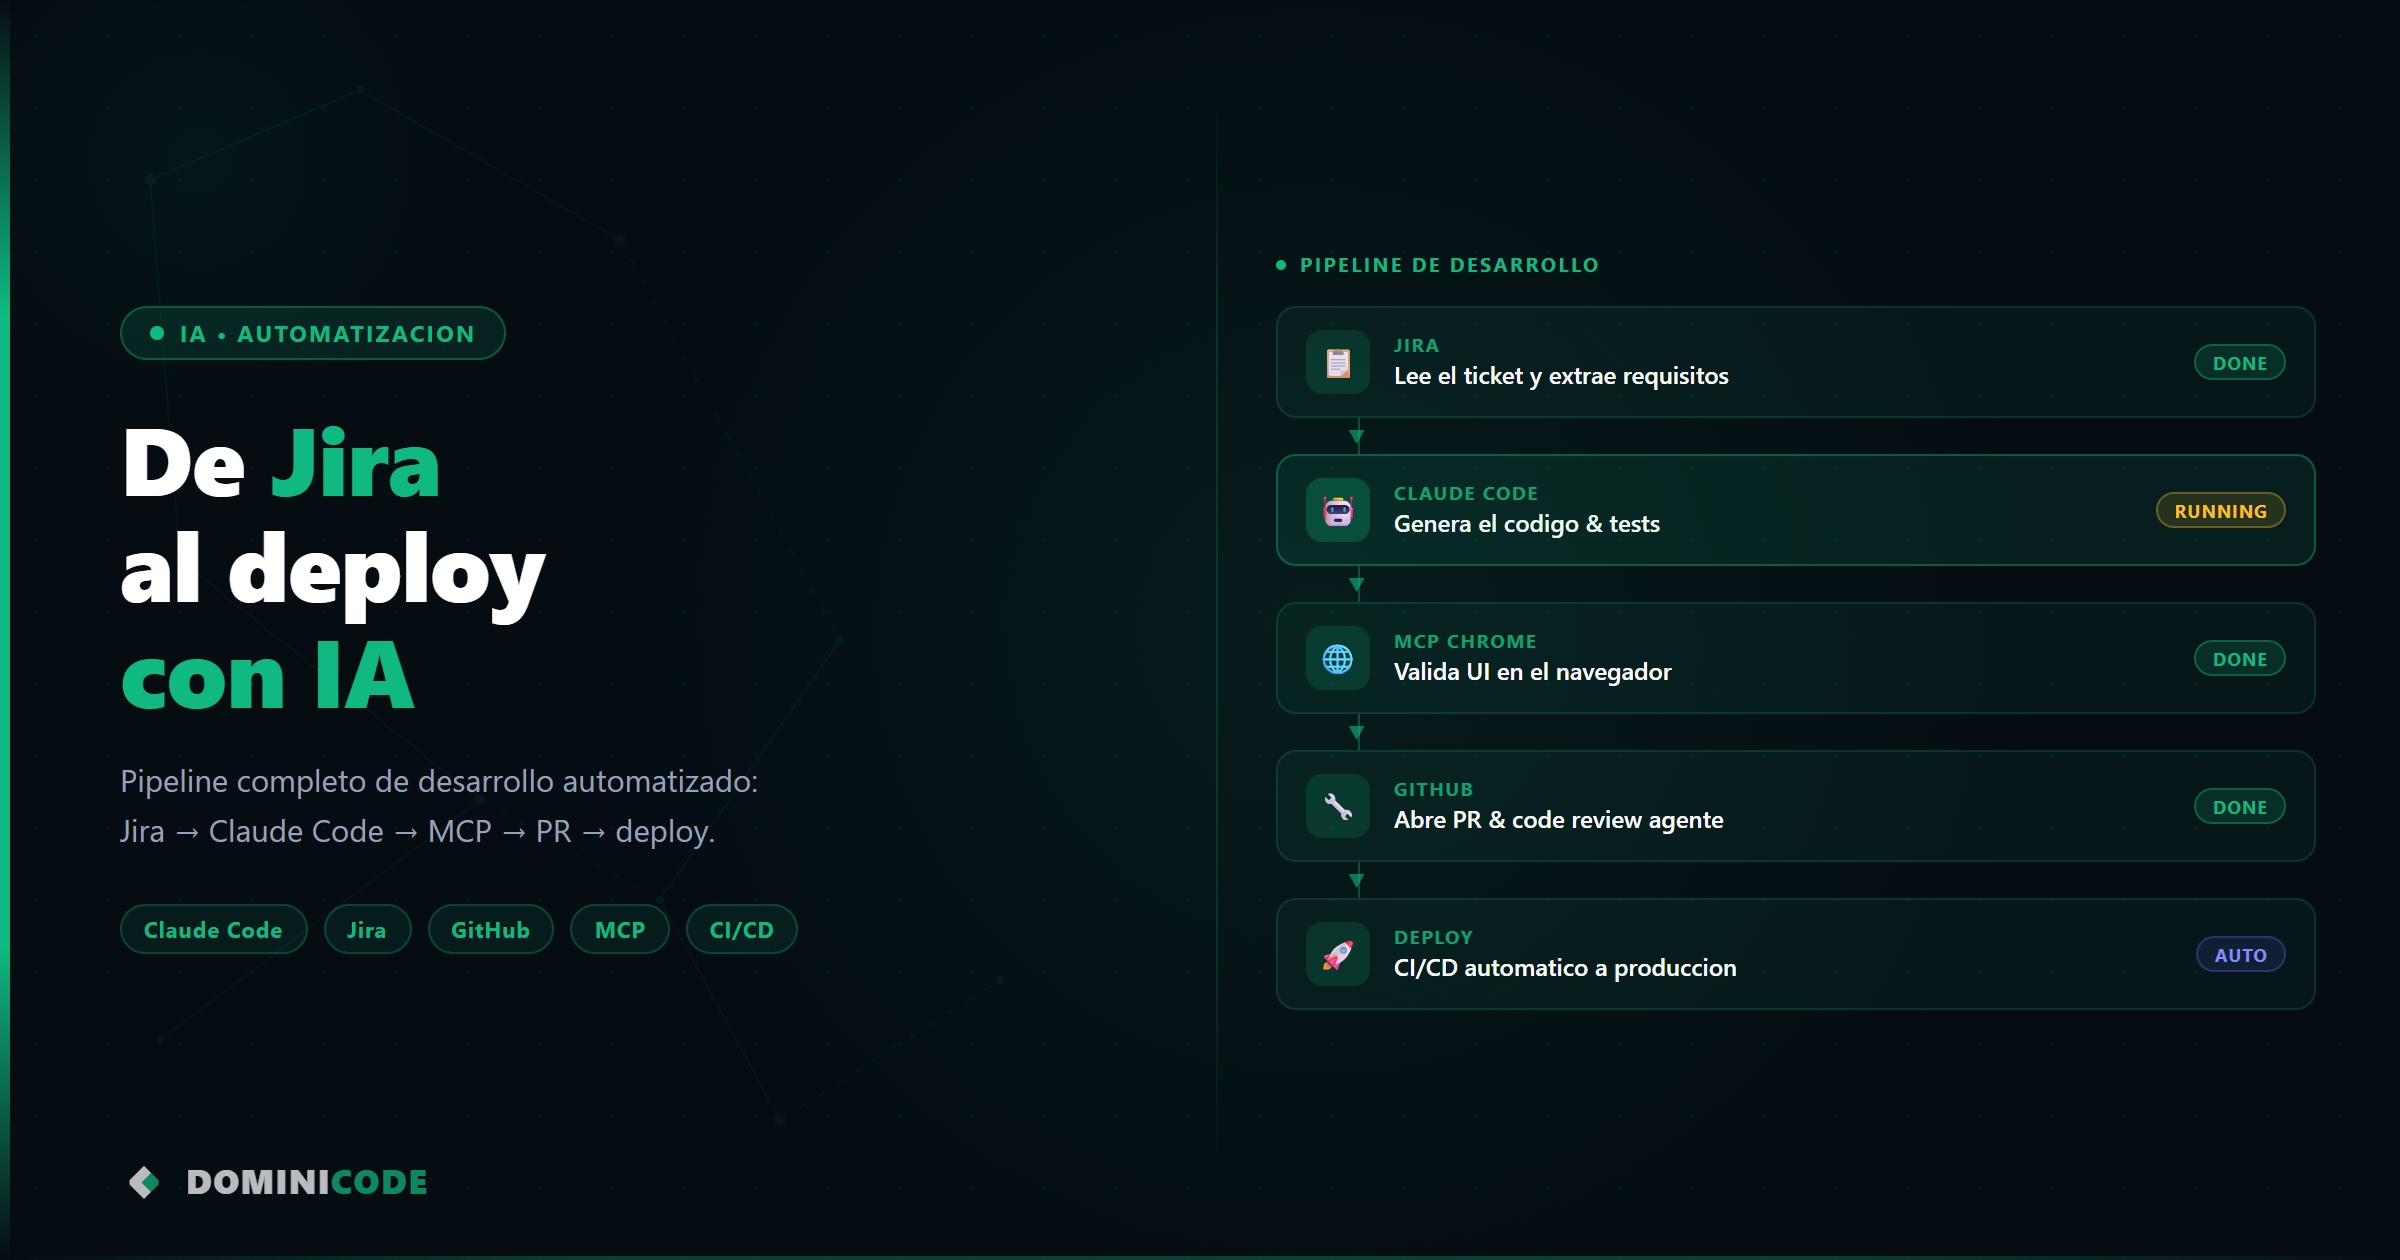
    Automatizar el proceso de desarrollo con IA: de Jira al deploy

    Hace tres meses le propuse a un cliente algo que le sonó a ciencia ficción: que el agente iba a leer el ticket de Jira, implementar la feature, abrir el navegador para testearla, hacer el code review y crear el PR en GitHub. Que él solo tendría que revisar y aprobar.

    Su respuesta fue "sí, claro". Con la misma energía con la que alguien te dice "ajá" cuando no te está escuchando.

    Lo puse en marcha. En la primera semana el agente cerró cuatro tickets de forma autónoma. El quinto lo paré yo a mitad porque se estaba inventando un requisito que no estaba en el ticket. Ajusté el prompt. El sexto salió limpio.

    Esto no es el futuro. Es lo que puedes montar hoy con Claude Code, el MCP de Jira, el MCP de Chrome y un CLAUDE.md bien escrito. Y en este post te cuento exactamente cómo funciona el pipeline para automatizar el proceso de desarrollo con IA de principio a fin.

    Un pipeline agentico de desarrollo es un flujo automatizado donde un agente de IA ejecuta de forma autónoma los pasos de implementación, testing y revisión de código a partir de un ticket, reduciendo la intervención humana al momento de aprobar el resultado.

    El problema con el workflow de desarrollo tradicional

    El ciclo habitual de un developer en un equipo tiene un patrón claro: leer el ticket, entender el contexto del código, implementar, escribir el test manual en el navegador, hacer el PR, esperar el code review, corregir los comentarios, mergear, rezar para que el CI pase.

    Cada uno de esos pasos tiene rozamiento. Cambios de contexto. Interrupciones. El developer senior pasa entre un 20% y un 30% de su tiempo en tareas que no son escribir código: leer tickets, crear PRs, hacer reviews de código propio.

    Con agentes, ese porcentaje puede recortarse a la mitad.

    No estoy hablando de reemplazar al developer. Estoy hablando de eliminar la fricción mecánica para que el developer se quede con las decisiones que importan.

    El pipeline completo: de Jira al deploy en seis pasos

    Así es el flujo que tengo montado:

    [Ticket Jira]
         ↓
    [Claude Code lee ticket via MCP Jira]
         ↓
    [Lee CLAUDE.md + contexto del proyecto]
         ↓
    [Implementa la feature o bug fix]
         ↓
    [MCP Chrome: abre navegador, navega, verifica]
         ↓
    [/code-review: detecta problemas antes del merge]
         ↓
    [Crea PR en GitHub con descripción del ticket]
         ↓
    [CI/CD se dispara tras el merge]
         ↓
    [Deploy a producción]
    

    El developer entra en el paso de revisar el PR. Todo lo anterior lo hace el agente.

    Paso 1: leer el ticket de Jira

    Claude Code tiene acceso al MCP de Jira. Cuando invocas el agente con el ID del ticket, extrae la descripción, los criterios de aceptación, el tipo de tarea y cualquier comentario relevante.

    # Invocar el agente con un ticket específico
    claude "Lee el ticket PROJ-412 de Jira e implementa la tarea"
    

    El agente extrae:

    • Descripción de la tarea
    • Criterios de aceptación (los usará para el testing)
    • Labels y tipo (bug, feature, refactor)
    • Comentarios con contexto adicional

    Si los criterios de aceptación están mal escritos o son ambiguos, el agente lo detecta y puede preguntar antes de implementar. Ese comportamiento se configura en el CLAUDE.md del proyecto.

    Paso 2: leer el contexto del proyecto con CLAUDE.md

    El CLAUDE.md es la memoria del agente sobre tu proyecto. Antes de escribir una sola línea de código, Claude Code lee este archivo para entender:

    • Convenciones de nomenclatura
    • Arquitectura del proyecto (qué hace cada capa)
    • Comandos para correr tests y el servidor local
    • Patrones prohibidos o recomendados
    • Cómo se estructuran los PRs en este equipo

    Un CLAUDE.md bien escrito transforma al agente de "asistente genérico" a "developer que conoce el proyecto". La diferencia entre los dos es enorme en producción.

    # CLAUDE.md — ejemplo mínimo
    
    ## Arquitectura
    - Feature modules en `src/features/<nombre>/`
    - Services solo en la capa de aplicación, nunca en componentes
    - Todos los efectos secundarios pasan por el store (NgRx)
    
    ## Comandos importantes
    - Dev server: `bun run dev`
    - Tests: `bun run test`
    - Build: `bun run build`
    
    ## Convenciones de PR
    - Título: `[PROJ-XXX] descripción breve`
    - Descripción: resumen del ticket + cambios técnicos + steps to test
    

    Si quieres ver cómo construir un CLAUDE.md completo para un proyecto real, en el curso Construye con IA lo hago desde cero con un proyecto en TypeScript.

    Paso 3: implementar la feature

    Claude Code implementa la tarea. Lee los archivos relevantes, sigue las convenciones del CLAUDE.md, escribe los tests unitarios si el proyecto los requiere y ejecuta el servidor local para verificar que compila sin errores.

    Aquí es donde el contexto importa más que el modelo. Un agente con buen contexto (CLAUDE.md + ticket detallado) implementa con una tasa de acierto mucho más alta que uno que empieza desde cero.

    El agente también puede hacer preguntas aclaratorias antes de implementar si detecta ambigüedad. Ese comportamiento se configura así en el CLAUDE.md:

    ## Comportamiento del agente
    - Si los criterios de aceptación son ambiguos, pregunta antes de implementar
    - No inventes requisitos que no estén en el ticket
    - Si necesitas crear un nuevo módulo, describe la estructura antes de crearla
    

    Paso 4: testing en el navegador con el MCP de Chrome

    Este es el paso que más sorprende a los developers cuando lo ven por primera vez.

    El MCP de Chrome (servidor MCP que usa Playwright por debajo para controlar el navegador) le da a Claude Code control total: abrir URLs, hacer clic en elementos, rellenar formularios, tomar screenshots, leer el contenido del DOM, verificar mensajes de error en consola.

    El agente usa los criterios de aceptación del ticket como guión de testing. Si el ticket dice "el usuario debe poder filtrar la tabla por fecha y ver solo los registros del rango seleccionado", el agente:

    1. Abre la app en localhost:4200
    2. Navega a la sección de la tabla
    3. Selecciona un rango de fechas
    4. Verifica que los registros mostrados coinciden con el filtro
    5. Toma un screenshot del resultado
    6. Revisa la consola del navegador para detectar errores
    // API de Playwright que ejecuta el servidor MCP internamente
    await page.goto('http://localhost:4200/dashboard/reports');
    await page.click('[data-testid="date-filter"]');
    await page.fill('[data-testid="date-from"]', '2026-01-01');
    await page.fill('[data-testid="date-to"]', '2026-01-31');
    await page.click('[data-testid="apply-filter"]');
    
    const rows = await page.$$('[data-testid="table-row"]');
    // Verifica que todos los rows tienen fechas dentro del rango
    

    Si algo falla, el agente lo reporta, corrige el código y vuelve a ejecutar el test. Es un loop de implementar → testear → corregir que el developer antes hacía manualmente.

    Referencia: Playwright — documentación oficial de automatización de navegadores.

    Paso 5: code review automático antes del PR

    Antes de crear el PR, el agente ejecuta /code-review — un slash command de Claude Code que analiza todos los cambios del diff:

    • Detecta problemas de seguridad (inputs sin sanitizar, secrets hardcodeados)
    • Verifica que se siguen las convenciones del proyecto
    • Revisa cobertura de casos edge
    • Detecta código duplicado o patrones que el equipo tiene como prohibidos

    Si el code review detecta problemas críticos, el agente los corrige antes de crear el PR. Si son sugerencias menores, las incluye como comentarios en la descripción del PR para que el reviewer humano las evalúe.

    Tengo un post completo sobre cómo configurar el agentic code review con Claude Code si quieres profundizar en esa parte del pipeline.

    Paso 6: crear el PR y disparar el CI/CD

    El agente crea el PR en GitHub con:

    • Título siguiendo la convención del proyecto (extraído del ticket)
    • Descripción generada del ticket: contexto, criterios de aceptación, cambios técnicos
    • Screenshot del testing en navegador como evidencia visual
    • Checklist de testing para el reviewer
    # El agente ejecuta esto internamente
    gh pr create \
      --title "[PROJ-412] Filtro por fecha en tabla de reportes" \
      --body "$(cat pr-description.md)" \
      --base main
    

    Cuando el developer aprueba el PR y hace el merge, el CI/CD se dispara automáticamente. GitHub Actions corre los tests, valida el build y despliega a producción. El agente ya no interviene en este paso — el pipeline de CI/CD es responsabilidad del equipo de infraestructura.

    Lo que el developer sigue haciendo

    Dejar claro este punto porque es importante: el agente no reemplaza al developer. El developer hace tres cosas:

    1. Escribir tickets con criterios de aceptación claros. Esto es ahora la habilidad más valiosa. Un ticket ambiguo produce código ambiguo.
    2. Revisar y aprobar el PR. El agente implementa, pero el developer decide si el resultado es correcto.
    3. Mantener el CLAUDE.md actualizado. Las convenciones del proyecto, la arquitectura, los patrones — el agente es tan bueno como el contexto que le das.

    El rol evoluciona de "el que escribe el código" a "el que define qué construir y valida que se construyó bien". Que es, paradójicamente, donde está el valor real de un developer senior.

    En Dominicode Labs estamos implementando este pipeline en proyectos reales con la comunidad — si quieres ver el setup completo con errores incluidos, es donde lo hacemos en directo.

    Cómo empezar a automatizar tu proceso de desarrollo con IA

    No montes el pipeline completo de golpe. Empieza con esto:

    1. Escribe un CLAUDE.md sólido para tu proyecto
    2. Instala el MCP de GitHub en Claude Code
    3. Prueba crear un PR automático desde un cambio pequeño
    4. Añade el MCP de Chrome y testea un flujo simple en el navegador
    5. Conecta Jira cuando los pasos anteriores funcionen de forma estable

    El pipeline completo lleva tiempo afinar. El valor llega antes de tenerlo completo.


    Preguntas frecuentes

    ¿El MCP de Chrome funciona con cualquier framework frontend (React, Vue, Angular)?
    Sí. El MCP de Chrome opera sobre el navegador real, no sobre el framework. No le importa si la app está en Angular, React o Vue — interactúa con el DOM resultante. Solo necesitas que la app esté corriendo en un servidor local accesible.

    ¿Qué pasa si los criterios de aceptación del ticket están mal escritos o son incompletos?
    El agente intentará inferir la intención, pero si la ambigüedad es suficientemente alta, puede preguntar antes de implementar o implementar algo que no era lo esperado. La calidad del output del agente es directamente proporcional a la calidad del input (el ticket). Invertir en escribir buenos tickets es la palanca más subestimada de este pipeline.

    ¿Se puede usar este pipeline sin Jira? ¿Con Linear, GitHub Issues u otras herramientas?
    Sí. Claude Code tiene MCPs para Linear, Asana y GitHub Issues. El principio es el mismo: el agente lee el ticket desde la fuente, extrae los criterios de aceptación y los usa como guión de implementación y testing. La integración específica depende del MCP disponible para cada herramienta.

    ¿Es seguro dejar que el agente tenga acceso a la base de datos o a servicios externos durante el testing?
    No. El testing del agente debe hacerse contra un entorno de desarrollo o staging, nunca contra producción ni contra una base de datos con datos reales. El CLAUDE.md debe especificar explícitamente contra qué entorno corre el agente y qué permisos tiene. El principio de mínimos privilegios aplica igual para agentes que para cualquier proceso automatizado.

    ¿Cuánto tiempo lleva montar este pipeline desde cero?
    El pipeline mínimo (CLAUDE.md + MCP GitHub + PR automático) puede estar funcionando en un día. El pipeline completo con MCP de Jira, MCP de Chrome y code review automático lleva entre una semana y dos de ajuste para que funcione de forma estable en un proyecto real. La mayor parte del tiempo se va en escribir un CLAUDE.md completo y en afinar los prompts para que el agente entienda las convenciones del proyecto.


    Si quieres aprender a construir con IA desde cero hasta producción, echa un vistazo al curso Construye con IA.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Cómo medir la productividad en equipos que usan IA

    Cómo medir la productividad en equipos que usan IA

    Un tech lead me escribió hace unas semanas con una pregunta que no esperaba: “Bezael, ¿cómo le demuestro a mi CTO que la IA está funcionando?”

    El equipo llevaba tres meses usando GitHub Copilot y Claude Code. Los developers estaban contentos. Las entregas se sentían más rápidas. Pero cuando llegó el momento de justificar la licencia ante dirección, el tech lead no tenía un solo número sólido que presentar.

    El CTO le preguntó lo de siempre: “¿Cuántas líneas de código más estáis produciendo?”

    Y ahí empezó el problema.

    Medir la productividad en equipos que usan IA requiere sustituir métricas de output (líneas de código, tickets cerrados) por métricas de flujo y calidad: cycle time, ciclos de revisión por PR, defect escape rate y confianza del equipo. Sin ese cambio de marco, los datos dicen que la IA no funciona cuando en realidad el problema es la regla con la que mides.


    El error de medir lo que siempre has medido

    Las métricas tradicionales de productividad —líneas de código, tickets cerrados por sprint, commits por semana— no estaban diseñadas para un equipo que delega trabajo a una IA.

    Cuando un developer usa Claude Code para generar el esqueleto de un servicio, los tickets no cambian. Los commits pueden ser los mismos. Pero el tiempo que ese developer tardó en llegar a ese commit pasó de cuatro horas a cuarenta minutos.

    Eso no aparece en ningún dashboard de Jira.

    El problema no es que la IA no mejore la productividad. El problema es que medir la productividad en equipos que usan IA con métricas de 2015 produce datos que no dicen nada, o peor, datos que contradicen lo que el equipo siente que está pasando.

    Y cuando los datos no cuentan la historia real, la dirección toma decisiones basadas en una historia falsa.


    Por qué las métricas tradicionales fallan con IA

    Hay tres razones concretas por las que las métricas clásicas se rompen en cuanto entra la IA.

    Primera: la unidad de medida cambia. Antes, un developer hacía una cosa a la vez. Con IA, puede mantener contexto de tres o cuatro tareas en paralelo. Los tickets cerrados por semana pueden ser los mismos, pero la complejidad por ticket se multiplica.

    Segunda: el trabajo invisible desaparece. La IA absorbe el trabajo de bajo valor — boilerplate, documentación inicial, tests unitarios básicos — que antes inflaba las métricas sin añadir valor real. Al desaparecer ese trabajo, las métricas caen aunque la productividad suba.

    Tercera: la calidad pasa a ser la variable crítica. Un equipo con IA puede producir más código en menos tiempo. Pero si ese código no está bien especificado, va a producir más código malo en menos tiempo. Las métricas de velocidad no capturan esto. El ciclo de revisión, sí.

    Métrica tradicional Por qué falla con IA
    Líneas de código No refleja el tiempo ahorrado en generación automática
    Tickets cerrados por sprint No captura el aumento de complejidad por ticket
    Commits por semana El mismo número, pero con 10x menos tiempo de escritura
    Velocidad de sprint (story points) Se mantiene estable aunque la dificultad técnica suba

    Las métricas que sí funcionan para medir productividad con IA

    Estas son las cinco métricas que tienen sentido cuando el equipo trabaja con asistencia de IA. No son nuevas — algunas vienen del marco DORA, otras son adaptaciones directas. Lo nuevo es el contexto en que las usas.

    1. Cycle time por tarea (tiempo de ciclo real)

    Mide cuánto tiempo pasa desde que una tarea entra en “en progreso” hasta que está en “revisión”. No en “cerrada” — en revisión. Ese delta captura la velocidad de producción antes de que el proceso de PR y QA añada ruido.

    Si el equipo usa IA y el cycle time no baja, hay un problema de especificación o de prompting, no de herramienta.

    2. PR review cycles (iteraciones por pull request)

    Cuántas veces vuelve un PR del revisor al autor. Con IA, el código puede ser correcto sintácticamente pero incorrecto semánticamente — hace lo que el prompt pedía, no lo que el ticket decía. Un aumento en ciclos de revisión es la primera señal de que el equipo está usando IA sin un proceso de especificación previo. Si quieres entender por qué la especificación es la clave aquí, el post sobre vibe coding sin sistema lo explica desde el ángulo del proyecto completo.

    Benchmark útil: según datos de LinearB y el SPACE framework de Microsoft Research, un equipo sano sin IA tiene entre 1,2 y 1,8 ciclos de revisión por PR. Con IA bien implementada, debería bajar a menos de 1,2.

    3. Defect escape rate (bugs que llegan a producción)

    El número de bugs que pasan el proceso de revisión y llegan a producción. La IA genera código con menos bugs de sintaxis pero puede introducir errores de lógica más sutiles cuando el contexto está mal definido. Esta métrica captura si la calidad real del output está subiendo o bajando.

    4. Time to first meaningful contribution (tiempo al primer output de valor)

    Cuánto tarda un developer nuevo —o uno que empieza en una nueva área del código— en hacer su primera contribución significativa. Con IA, este tiempo debería caer drásticamente porque los modelos actúan como documentación interactiva del codebase. Si no cae, el equipo no está usando IA para onboarding.

    5. Developer-reported confidence score (autoconfianza técnica)

    Una encuesta semanal de una pregunta: “Del 1 al 10, ¿cómo de seguro te has sentido tomando decisiones técnicas esta semana?” No mide lo que el developer produce — mide si la IA lo está empoderando o creando dependencia. Una caída sostenida en esta métrica es una alarma: el equipo está delegando decisiones que no debería delegar.


    Cómo implementar estas métricas en tu equipo

    No necesitas una plataforma nueva. Con lo que ya tienes, puedes empezar esta semana.

    1. Extrae cycle time de tu gestor de tareas actual. Linear, Jira y Notion tienen este dato. Calcula la media de los últimos tres sprints antes de implementar IA. Eso es tu baseline.
    2. Añade un campo “ciclos de revisión” a tu flujo de PRs. En GitHub puedes automatizarlo con un simple script que cuente las veces que un PR pasa a “changes requested” y vuelve a “review”. No necesitas nada sofisticado.
    3. Activa el tracking de bugs por origen. ¿El bug vino de código generado con IA o de código escrito a mano? Añadir esa etiqueta a los issues de producción durante dos meses te da datos que nadie más tiene en tu organización.
    4. Envía el confidence score cada viernes. Un Google Form de una pregunta. Anónimo. Cinco minutos de setup. Los datos que obtienes en ocho semanas son más útiles que cualquier encuesta de engagement anual.
    5. Revisa las cinco métricas cada dos semanas, no cada sprint. El impacto de la IA no es lineal al principio. Los primeros cuatro sprints suelen mostrar un plateau o incluso una caída mientras el equipo ajusta workflows. La mejora real aparece en la semana seis o siete.

    Errores comunes al medir productividad con IA

    Error 1: medir demasiado pronto. Implementar IA y medir el impacto al sprint siguiente no funciona. El equipo necesita entre cuatro y seis semanas para ajustar su forma de trabajar con los modelos. Medir antes genera datos negativos que no reflejan el potencial real.

    Error 2: medir al individuo en lugar de al equipo. “¿Cuánto usa la IA este developer?” es la pregunta equivocada. La adopción de IA es un comportamiento social — si el tech lead no la usa, el equipo no la usa. Mide adopción a nivel de equipo, no de persona.

    Error 3: ignorar el coste de contexto. La IA produce output rápido, pero alguien tiene que escribir el prompt, revisar el output y decidir qué parte usar. Ese tiempo no aparece en los tickets. Si no lo contabilizas, tus métricas de velocidad quedan artificialmente infladas en comparación con el coste real.

    Error 4: no tener un baseline previo. Es imposible demostrar mejora sin un punto de partida. Antes de dar acceso a la IA al equipo, captura dos sprints de datos de cycle time, PR cycles y defect rate. Sin eso, cualquier número que presentes es opinión, no evidencia.

    Error 5: confundir actividad con impacto. El número de prompts enviados a un LLM no es una métrica de productividad. Es una métrica de uso. El impacto se mide en los outputs que importan: tiempo de entrega, calidad del código, confianza del equipo.


    Preguntas frecuentes

    ¿Qué métricas DORA son las más relevantes cuando el equipo usa IA?

    Las cuatro métricas DORA —deployment frequency, lead time for changes, change failure rate y time to restore service— siguen siendo válidas, pero el contexto cambia. Con IA, el “lead time for changes” debería bajar significativamente porque la fase de escritura de código se acelera. Si no baja, el cuello de botella está en el proceso de revisión o en la especificación, no en el coding. La “change failure rate” es la que más debes vigilar: un aumento aquí con IA activa indica que el equipo está delegando contexto que los modelos no tienen — exactamente lo que explicamos en el post sobre context engineering para proyectos con IA.

    ¿Cuánto tiempo tarda en verse el impacto real de la IA en productividad?

    En la mayoría de equipos que he visto, los primeros resultados medibles aparecen entre las semanas seis y ocho. Las primeras cuatro semanas son de ajuste: el equipo aprende qué delegar, qué especificar antes de delegar, y cómo revisar output de IA. A partir de la semana ocho, el cycle time baja y la autoconfianza sube de forma sostenida.

    ¿Cómo justifico ante dirección el coste de las licencias de IA si las métricas tardan en mostrarse?

    El argumento más sólido no son las métricas de productividad — es el coste de oportunidad. Un developer senior en España cuesta entre 50.000 y 80.000 euros al año. Si la IA reduce su ciclo de desarrollo un 30%, el retorno de una licencia de 20 euros al mes se justifica en las primeras dos horas de uso. Presenta ese cálculo antes de presentar las métricas.

    ¿Vale la pena usar herramientas específicas de medición de productividad IA como Uplevel o Faros?

    Para equipos de más de quince developers, sí. Estas plataformas integran datos de GitHub, Jira y Slack para calcular métricas de flujo de trabajo con granularidad que un tracker manual no puede dar. Para equipos menores, el setup de estas herramientas consume más tiempo del que ahorran. Empieza con las métricas manuales descritas en este post y migra a plataformas dedicadas cuando el equipo supere los veinte developers.

    ¿El confidence score realmente sirve o es demasiado subjetivo?

    Es subjetivo por diseño. Las métricas objetivas miden el output. El confidence score mide el proceso interno del developer: si está tomando decisiones con criterio o si está dependiendo de la IA para decisiones que debería tomar él. Un developer que valora su confianza en 4 sobre 10 de forma sostenida no está usando IA como amplificador — la está usando como muleta. Eso es información que ningún dashboard de GitHub te da.


    Lo que puedes hacer mañana

    No esperes a tener el sistema perfecto. Esta semana, haz una sola cosa: calcula el cycle time medio del último sprint de tu equipo. Ese número es tu baseline.

    La próxima vez que alguien te pregunte si la IA está funcionando, tendrás un punto de referencia real en lugar de una sensación.

    Si quieres ir más lejos — ver cómo integramos estas métricas dentro de un proceso estructurado de desarrollo con IA, de la especificación al deploy — en el curso Construye con IA trabajamos exactamente ese flujo: no solo usar la IA para escribir código, sino construir el sistema alrededor de ella para que los resultados sean medibles y repetibles.

    Y si tu equipo ya está en ese punto y quieres ir más profundo, en Dominicode Labs tenemos recursos sobre workflows de desarrollo con IA, plantillas de tracking y acceso directo a la comunidad para resolver dudas en contexto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Plan, Steer, Decompose: el framework de agentic engineering

    Plan, Steer, Decompose: el framework de agentic engineering

    Llevaba tres horas con el agente.

    Tres horas corrigiendo. El agente seguía haciendo lo mismo: tomaba decisiones razonables para el contexto que tenía, pero el contexto que tenía era incompleto desde el principio. Yo le daba feedback, él ajustaba, y en la siguiente iteración el problema aparecía en otro sitio. Dos pasos adelante, uno y medio atrás.

    No era el modelo. Era yo — y el problema era la ausencia de agentic engineering en mi flujo de trabajo.

    No había planificado lo que quería construir antes de empezar. No había descompuesto el problema en piezas que el agente pudiera manejar sin ambigüedad. Le había dado un objetivo vago y esperado que el agente lo resolviera. Y el agente hacía lo que podía — que no era suficiente para lo que yo necesitaba.

    Eso es lo que diferencia a alguien que usa agentic engineering de alguien que simplemente le pide cosas a la IA: un framework de trabajo. Un ciclo operativo que convierte la delegación caótica en colaboración sistemática.

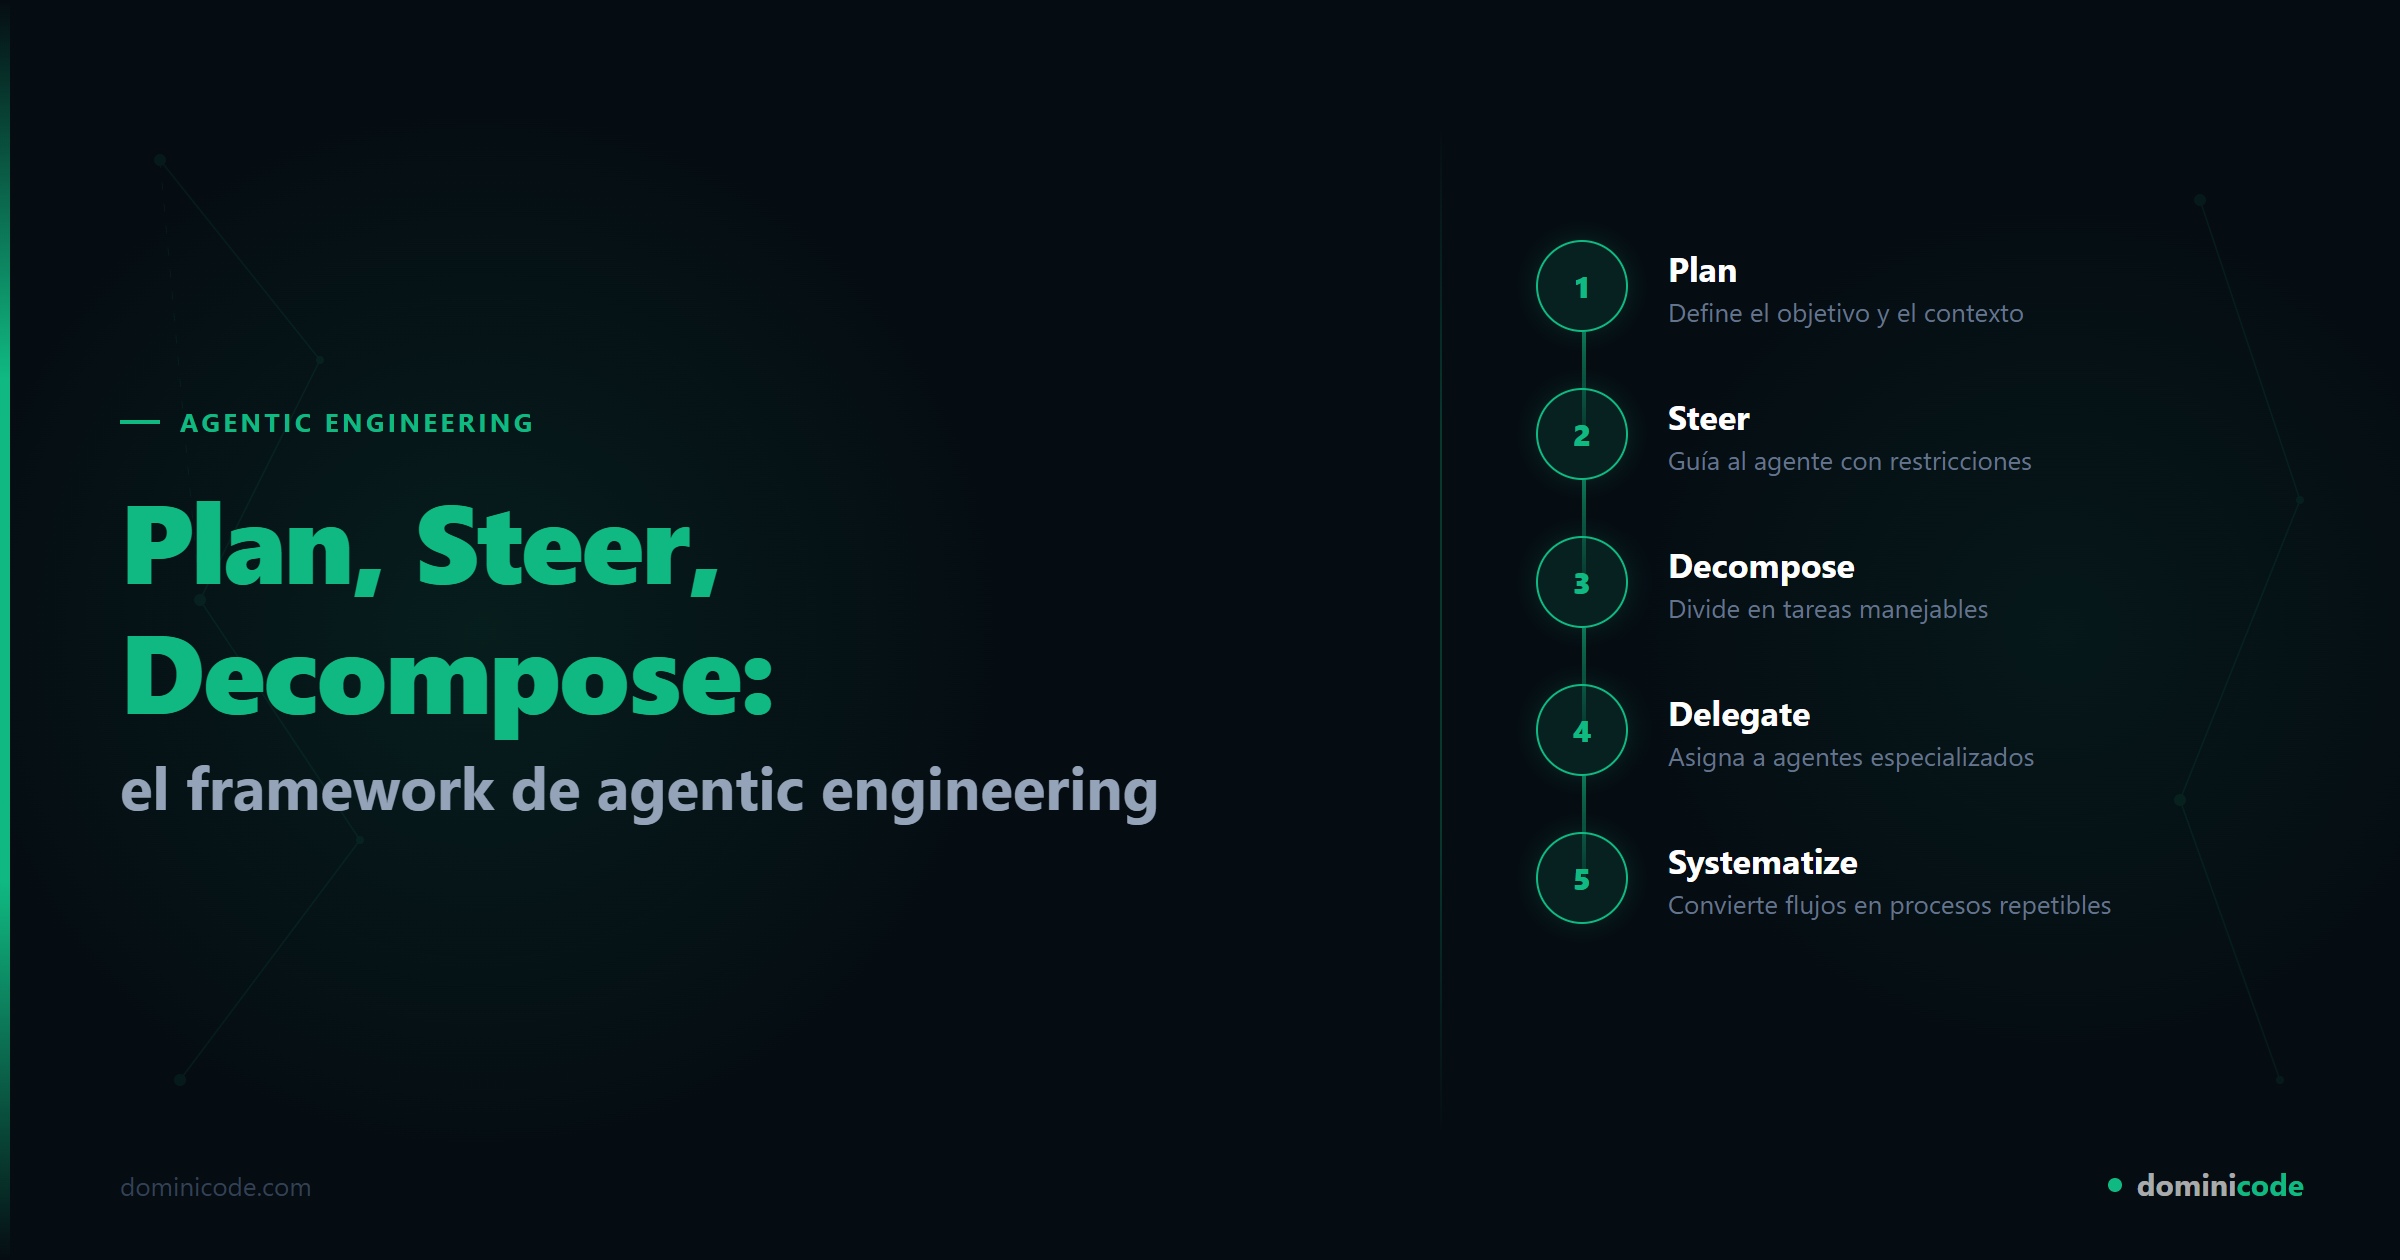
    El framework tiene cinco pasos: Plan → Steer → Decompose → Delegate → Systematize.

    El agentic engineering es la disciplina de orquestar agentes de IA de forma sistemática — definiendo objetivos, descomponiendo problemas, delegando tareas con el contexto preciso y capturando los patrones que funcionan para reutilizarlos. Es la diferencia entre usar la IA como herramienta de texto y tratarla como un sistema de producción.


    Por qué el prompting no es suficiente

    Hay un malentendido que veo constantemente en developers que llevan meses usando IA sin resultados consistentes: creen que el problema es el prompt.

    Mejoran el prompt. Añaden más contexto. Usan few-shot examples. Prueban otro modelo. Y los resultados mejoran marginalmente pero el problema de fondo persiste — siguen obteniendo outputs que tienen que reescribir, completar o corregir antes de poder usar.

    El problema no es el prompt. Es que no hay agentic engineering en el proceso — están tratando al agente como un oráculo al que preguntas. Y los oráculos funcionan bien para respuestas, no para construcción.

    Construir con IA no es preguntar. Es orquestar. Y orquestar requiere un proceso, no una técnica de redacción.


    El framework de agentic engineering: los 5 pasos

    Paso Objetivo Señal de que lo estás haciendo bien
    Plan Define qué construir antes de abrir el editor Tienes objetivo, contexto y criterios de éxito escritos
    Steer Guía la dirección durante la ejecución Intervienes en los puntos de decisión, no en cada acción
    Decompose Rompe el problema en tareas atómicas y verificables Cada tarea tiene bordes claros, sin decisiones implícitas
    Delegate Asigna la tarea correcta con el contexto mínimo necesario El agente no necesita hacer preguntas para empezar
    Systematize Convierte lo que funciona en proceso repetible Tienes CLAUDE.md, templates y hooks activos

    1. Plan — Define antes de abrir el editor

    El Plan no es el prompt inicial. Es la decisión de qué quieres construir, para quién, con qué criterios de éxito, y qué contexto necesita el agente para no tener que improvisar.

    La mayoría de los problemas de agentic engineering empiezan aquí — o mejor dicho, por saltarse este paso.

    Cuando no hay Plan, el agente trabaja con hipótesis. Asume el stack que le parece más probable. Asume la arquitectura que ha visto más en su entrenamiento. Asume que los casos edge no existen porque no se los mencionaste. Y esas hipótesis se propagan a través de todo el trabajo posterior.

    Un Plan mínimo tiene tres elementos:

    Objetivo concreto — No "implementa el módulo de usuarios". Sí: "Implementa el endpoint POST /users que recibe { email, name }, valida con Zod, crea el registro en la tabla users de Supabase y devuelve { id, email, createdAt }. Error 409 si el email ya existe."

    Contexto relevante — El stack, las convenciones de naming que ya usa el proyecto, las decisiones de arquitectura tomadas, las restricciones conocidas. Esto es lo que va en el CLAUDE.md del proyecto — no como documentación, sino como memoria estructurada que el agente lee al inicio de cada sesión.

    Criterios de éxito — Cómo sabes que el agente terminó bien su trabajo. Tests que deben pasar. Comportamientos que debes poder demostrar. Sin criterios de éxito explícitos, "listo" significa cosas distintas para ti y para el agente.

    El Spec-Driven Development es la metodología que formaliza este paso: especificar el sistema antes de construirlo, con contratos concretos que el agente puede implementar sin inventar.

    2. Steer — Guías la dirección, no desapareces

    El Steer es el feedback loop activo durante la ejecución.

    Hay un patrón que veo repetidamente: el developer escribe un prompt elaborado, lanza el agente y vuelve veinte minutos después esperando encontrar la tarea completada. A veces funciona. Cuando no funciona, el agente ha pasado esos veinte minutos construyendo en la dirección equivocada con mucha confianza.

    Steer no significa microgestionar. Significa estar presente en los puntos de decisión que importan.

    La señal de que necesitas intervenir: el agente está a punto de tomar una decisión con consecuencias amplias sin haber pedido confirmación. Cambiar la estructura de un módulo. Renombrar una abstracción clave. Elegir entre dos arquitecturas posibles. Esos son los momentos en que tu presencia tiene más palanca.

    En práctica, Steer implica:

    • Revisar el output de las primeras iteraciones antes de que el agente avance demasiado
    • Corregir la dirección cuando el agente toma una decisión incorrecta — y hacerlo en el momento, no cuando ya hay diez archivos afectados
    • Hacer preguntas explícitas al agente sobre sus decisiones: "¿Por qué elegiste este enfoque sobre el alternativo?" — no para cuestionar todo, sino para verificar que el razonamiento es el correcto antes de comprometerte con esa dirección

    El objetivo del Steer no es hacer el trabajo del agente. Es hacer que el agente haga el trabajo correcto. Sin Steer, el agentic engineering se convierte en delegación ciega — y la delegación ciega escala los errores, no los resultados.

    3. Decompose — Rompe el problema en tareas atómicas

    La Decompose es donde más se gana en calidad de output y donde menos developers invierten tiempo.

    Un agente que recibe "implementa el sistema de autenticación completo" toma demasiadas decisiones implícitas. Qué estrategia de sesiones. Qué campos en el token. Cómo manejar el refresh. Qué pasa cuando el token expira durante una request. Cada una de esas decisiones tiene consecuencias, y el agente las toma sin consultarte porque no sabe que importan.

    La descomposición transforma decisiones implícitas en decisiones explícitas.

    Una tarea bien descompuesta tiene estas características:

    Atómica — Se puede completar en una sola sesión sin depender de otras tareas que no estén terminadas.

    Sin ambigüedad en los bordes — Define qué entra, qué sale y cómo interactúa con lo que ya existe. "Implementa el endpoint de login que recibe { email, password } y devuelve { accessToken, refreshToken, user } usando el servicio AuthService ya existente" — eso es una tarea sin ambigüedad en los bordes.

    Verificable — Al terminar puedes saber con certeza si la tarea está bien hecha o no. Si no puedes verificar, la tarea está mal definida.

    // Tarea mal definida — demasiado scope, demasiadas decisiones implícitas
    // "Implementa el sistema de autenticación con JWT y manejo de sesiones"
    
    // Tarea bien definida — atómica, verificable, bordes claros
    // "Implementa la función generateTokenPair(userId: string): Promise<TokenPair>
    // que genera accessToken (15min) y refreshToken (7d) firmados con RS256.
    // TokenPair = { accessToken: string; refreshToken: string; expiresAt: Date }
    // Usa la clave privada de process.env.JWT_PRIVATE_KEY.
    // Test: genera un par, verifica que accessToken expira correctamente."
    

    La diferencia no está en la complejidad. Está en quién toma las decisiones.

    4. Delegate — Asigna al agente correcto con el contexto mínimo necesario

    Delegate es donde muchos developers confunden prompt engineering con delegación real.

    Prompt engineering es refinar las instrucciones para obtener un output mejor del mismo agente. La delegación dentro del agentic engineering es asignar la tarea correcta al agente correcto con el contexto que necesita para ejecutarla — ni más ni menos.

    Dos errores opuestos destruyen la delegación:

    Delegación sin contexto suficiente. El agente no tiene acceso a las decisiones de arquitectura previas, no conoce las convenciones del proyecto, no sabe qué existe ya. El resultado es código que no encaja — funcionalmente correcto, arquitecturalmente incorrecto.

    Delegación con contexto excesivo. Pegas en el prompt el README completo, los últimos cinco commits, tres archivos relacionados y la descripción del sistema entero. El modelo procesa todo ese contexto pero el ruido diluyente reduce la precisión. Más contexto no siempre es mejor contexto.

    El contexto mínimo necesario es el que responde a: ¿qué necesita saber el agente para tomar las mismas decisiones que yo tomaría? No el contexto que me tranquiliza a mí — el que necesita el agente.

    En Claude Code esto se traduce en ser deliberado sobre qué archivos mencionas explícitamente (@auth.service.ts, @user.schema.ts) y qué instrucciones incluyes en el CLAUDE.md del proyecto para que estén disponibles en cada sesión sin tener que repetirlas.

    5. Systematize — Lo que funciona una vez se convierte en proceso

    El Systematize es el paso que separa a los developers que mejoran semana a semana de los que repiten los mismos errores en cada proyecto nuevo.

    Cuando un flujo de trabajo de agentic engineering funciona bien — un tipo de tarea, un patrón de prompt, una estructura de descomposición — el Systematize lo captura como proceso reutilizable. No como documentación que nadie leerá. Como artefacto operativo que puedes invocar directamente.

    Tres formas concretas de systematizar:

    CLAUDE.md por proyecto — Las decisiones de arquitectura, las convenciones, las restricciones del proyecto. Este archivo es la memoria del proyecto que persiste entre sesiones. Sin él, cada sesión nueva parte de cero.

    Templates de tareas — Si descompones el mismo tipo de problema una y otra vez (endpoints REST, componentes Angular, tests de integración), el template captura la estructura de descomposición que ya demostró funcionar. No vuelves a pensar cómo descomponer — aplicas el template y ajustas los detalles.

    Hooks y workflows — En Claude Code, los hooks de PreToolUse y PostToolUse permiten ejecutar validaciones automáticas antes o después de que el agente actúe. Un hook que ejecuta tsc --noEmit antes de cada escritura de archivo previene que el agente introduzca errores de tipos que luego tienes que depurar a mano. Automatizas la verificación, no solo la generación.

    // .claude/settings.json — hook que valida TypeScript antes de escribir
    {
      "hooks": {
        "PreToolUse": [
          {
            "matcher": "Write|Edit",
            "hooks": [
              {
                "type": "command",
                "command": "npx tsc --noEmit 2>&1 | head -20"
              }
            ]
          }
        ]
      }
    }
    

    El Systematize convierte el conocimiento tácito en proceso explícito. Y el proceso explícito escala — a proyectos futuros, a otros developers del equipo, a agentes que ejecutan workflows sin supervisión.


    Cómo se conectan los 5 pasos en un ciclo

    Los cinco pasos del agentic engineering no son lineales. Son un ciclo que se repite a dos escalas.

    Escala de proyecto:

    • Una vez al inicio: Plan global
    • Primera Decompose en bloques grandes
    • Primera ronda de Delegate al agente
    • Steer durante la ejecución
    • Systematize los patrones que funcionaron para el siguiente proyecto

    Escala de tarea:

    • Plan de la tarea concreta
    • Decompose en subtareas si es necesario
    • Delegate al agente con el contexto mínimo
    • Steer durante la ejecución
    • Systematize si el patrón vale la pena capturar

    Lo que conecta los dos niveles es el contexto acumulado. Cada Systematize en una tarea pequeña alimenta el Plan del bloque siguiente. El CLAUDE.md que actualizas después de cada sesión hace que la siguiente sesión parta de un estado mejor que la anterior.

    El ciclo se mejora a sí mismo. Eso es lo que distingue un sistema de una técnica.


    Aplica el framework construyendo un producto real

    Leer el framework es útil. Aplicarlo en un proyecto real con presión de tiempo y decisiones concretas es lo que lo hace tuyo.

    El Workshop Beyond Prompts (https://workshop.dominicode.com/) del 9 de julio es exactamente eso: 3 horas donde aplicamos el agentic engineering construyendo un producto real con Claude Code — de idea a producto deployado usando Plan → Steer → Decompose → Delegate → Systematize en vivo. No es una clase magistral. Es una sesión de trabajo donde tomas decisiones, te equivocas, corriges y sales con un sistema que puedes replicar.

    Si quieres prepararte antes del workshop, el curso Construye con IA: de la idea al producto con Claude Code cubre los fundamentos de agentic engineering con el mismo enfoque: criterio para cada decisión, no solo instrucciones que seguir.

    Y si quieres trabajar el framework con proyectos concretos en comunidad — revisar tu arquitectura, discutir las decisiones que no están claras, ver cómo otros developers aplican estos pasos — en Dominicode Labs hacemos exactamente eso semana a semana.


    FAQ

    ¿Cuál es la diferencia entre el agentic engineering y el Spec-Driven Development?

    SDD es la metodología que cubre en detalle el paso Plan — cómo especificar un sistema antes de construirlo, con contratos y criterios de éxito concretos. El framework de agentic engineering Plan → Steer → Decompose → Delegate → Systematize es más amplio: cubre todo el ciclo de trabajo con agentes, desde antes de escribir la spec hasta capturar los patrones que funcionaron para reutilizarlos. SDD y agentic engineering son complementarios — SDD es la respuesta detallada a "cómo hacer bien el Plan".

    ¿El agentic engineering funciona con cualquier herramienta de IA o solo con Claude Code?

    Los cinco pasos son agnósticos a la herramienta. La lógica de Plan, Steer, Decompose, Delegate y Systematize aplica igual si usas Claude Code, Cursor, Copilot o la API directamente. Lo que cambia son los artefactos concretos: en Claude Code el contexto persistente vive en CLAUDE.md y los hooks en .claude/settings.json; en Cursor vive en .cursor/rules/; en otros entornos en AGENTS.md. El framework es la estructura. Los artefactos son la implementación específica de cada herramienta.

    ¿Cuánto tiempo tarda implementar este framework en un proyecto que ya existe?

    Para un proyecto existente sin ningún sistema, el mínimo viable —un CLAUDE.md básico con el stack y las convenciones principales, más una primera descomposición del backlog pendiente— tarda entre dos y cuatro horas. No es un proceso de migración completa. Es añadir las piezas que hacen que cada sesión futura sea más efectiva que las anteriores. El Systematize es acumulativo — mejora con el tiempo, no requiere estar completo desde el día uno.

    ¿El paso Steer no anula el beneficio de la autonomía del agente?

    No. Steer es intervención en los puntos de decisión de alto impacto, no supervisión constante de cada acción. Un agente ejecutando tareas bien definidas puede trabajar durante decenas de ciclos sin necesitar tu input — eso es autonomía real. Steer te pide que estés presente cuando el agente enfrenta una bifurcación arquitectural, no cuando está implementando un endpoint que ya tiene todos los criterios claros. La diferencia práctica: Steer activo tarda minutos por sesión. Steer ausente puede costar horas de corrección cuando el agente ha tomado veinte decisiones incorrectas en cadena.

    ¿Por dónde empiezo si nunca he trabajado de forma estructurada con agentes?

    Empieza por el Plan y el Decompose. Son los dos pasos del agentic engineering que más impacto tienen en la calidad del output y los que más developers saltan. Coge una tarea concreta de tu backlog y antes de lanzar el agente escribe: objetivo específico, contexto relevante y criterios de éxito. Luego divídela en subtareas que tengan bordes claros. Esas dos prácticas solas van a mejorar notablemente la calidad de lo que obtienes. El resto del framework puedes añadirlo gradualmente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo automatizar usabilidad con agentes de IA en tu app

    Cómo automatizar usabilidad con agentes de IA en tu app

    Un cliente me enseñó su aplicación de onboarding hace unos meses. Cinco pasos. Diseño limpio. Todo funcional en los tests.

    La tasa de abandono era del 68% en el paso tres.

    Revisamos los tests de integración: pasaban todos. El formulario enviaba datos correctamente. La validación funcionaba. El CI estaba en verde. Y aun así, casi siete de cada diez usuarios salían del flujo antes de terminar.

    El problema no era que la aplicación no funcionara. Era que nadie había auditado cómo se usaba.

    Ahí está la diferencia que muchos developers no distinguen hasta que lo ven en métricas reales: una cosa es que el código haga lo que debe, y otra muy distinta es que el usuario pueda usarlo sin fricción. La primera la resuelves con tests. La segunda la resuelves con automatizar usabilidad con agentes de IA — que es exactamente lo que vamos a ver aquí.

    Automatizar usabilidad con agentes de IA consiste en delegar la auditoría de accesibilidad, flujos de usuario y fricciones de interfaz a un agente — como Claude Code con MCP de Playwright — que controla el navegador de forma programática, navega flujos reales y genera un reporte estructurado de hallazgos sin intervención manual.


    Testing funcional vs. testing de usabilidad

    Un test funcional pregunta: ¿el botón de "Enviar" llama a la función correcta?

    Un test de usabilidad pregunta: ¿el usuario sabe que tiene que hacer clic ahí? ¿Lo ve? ¿Entiende qué va a pasar después?

    Son preguntas distintas y se responden con herramientas distintas.

    Los tests funcionales los escribes tú, los corre un CI, comprueban comportamiento esperado. Eso ya lo sabes hacer. Lo que un agente de IA aporta es la capacidad de navegar tu aplicación como si fuera un usuario — explorar rutas no documentadas, detectar elementos sin etiquetas accesibles, medir cuánto tarda en responder una pantalla, o identificar que un campo de error aparece debajo del scroll y el usuario nunca lo ve.

    No te reemplaza un test de usabilidad con personas reales. Pero te da un nivel de auditoría automatizada que antes no existía — y que tú nunca harías manualmente en cada PR. Si quieres ver cómo encaja esto en un pipeline completo de desarrollo, tienes la explicación en el post sobre automatizar el proceso de desarrollo con IA.


    Qué puede detectar un agente

    Cuando conectas Claude Code con el MCP de Playwright o Chrome DevTools, el agente puede controlar el navegador de forma programática. Eso significa que puede:

    • Navegar a cualquier ruta de tu aplicación
    • Hacer clic en elementos, rellenar formularios, desplazarse por la página
    • Leer el DOM y el árbol de accesibilidad (el que usa un lector de pantalla)
    • Medir tiempos de respuesta entre interacciones
    • Ejecutar axe-core para detectar violaciones WCAG
    • Capturar screenshots en cada paso del flujo
    • Generar un reporte estructurado con los hallazgos

    Lo que un agente detecta bien:

    1. Accesibilidad técnica: imágenes sin alt, botones sin aria-label, contraste insuficiente entre texto y fondo, formularios sin etiquetas asociadas, skip navigation ausente, foco de teclado atrapado en un componente modal.
    2. Fricciones estructurales: mensajes de error fuera del viewport, campos obligatorios que no se identifican como tales hasta el submit, pasos de onboarding que no guardan el progreso si el usuario recarga.
    3. Performance percibida: cuánto tarda en aparecer el primer elemento interactivo después de una navegación, si hay loaders sin indicación de progreso, si el layout shift hace que el usuario haga clic en el elemento equivocado.
    4. Cobertura de flujos: si una ruta de error (credenciales incorrectas, sesión expirada, red caída) termina en una pantalla sin instrucciones claras.

    Cómo configurar el agente para automatizar la auditoría de usabilidad

    La combinación que funciona en producción: Claude Code + MCP de Playwright.

    Para instalarlo: npx @playwright/mcp@latest. Una vez activo en tu configuración de Claude Code, el agente tiene acceso a las herramientas de control del navegador sin que escribas una línea de Playwright.

    El MCP de Playwright expone herramientas al agente para controlar el navegador: browser_navigate, browser_click, browser_type, browser_snapshot, browser_evaluate. Claude puede encadenar esas herramientas para ejecutar flujos completos.

    Un ejemplo de instrucción al agente para auditar el onboarding de una app:

    ## Tarea: Auditoría de usabilidad — flujo de onboarding
    
    URL base: http://localhost:4200
    
    Flujo a auditar:
    1. Navega a /register
    2. Rellena el formulario con datos válidos: nombre, email, contraseña
    3. Haz clic en "Crear cuenta"
    4. Completa los pasos del onboarding hasta llegar al dashboard
    
    En cada paso:
    - Captura un screenshot
    - Extrae el árbol de accesibilidad del contenido principal
    - Identifica elementos interactivos sin aria-label o sin texto visible
    - Mide el tiempo hasta que el siguiente paso es interactivo
    - Detecta si hay mensajes de error o advertencia y si son visibles sin scroll
    
    Al terminar, genera un reporte en formato JSON con esta estructura:
    {
      "paso": string,
      "url": string,
      "tiempo_carga_ms": number,
      "violaciones_accesibilidad": [],
      "fricciones_detectadas": [],
      "screenshot": string
    }
    

    El agente ejecuta eso de forma autónoma. Navega, interactúa, observa, y vuelve con un reporte estructurado.


    Accesibilidad automática con axe-core

    Para violaciones WCAG, la integración más sólida es axe-core. El agente puede ejecutarlo sobre cualquier página activa en el navegador mediante browser_evaluate:

    // Si axe-core no está en el bundle de la app, inyectarlo primero:
    // await page.addScriptTag({ url: 'https://cdn.jsdelivr.net/npm/axe-core/axe.min.js' });
    
    // Ejecutar la auditoría en el contexto de la página
    const results = await axe.run();
    return {
      violaciones: results.violations.map(v => ({
        impacto: v.impact,
        descripcion: v.description,
        elementos: v.nodes.map(n => n.target)
      }))
    };
    

    Lo que devuelve axe-core son violaciones categorizadas por impacto: critical, serious, moderate, minor. El agente puede filtrar solo las críticas, agregar el selector del elemento afectado, y generar una lista accionable para el developer.

    Esto detecta cosas como:

    • Contraste de color insuficiente (ratio menor a 4.5:1 para texto normal)
    • Imágenes sin atributo alt o con alt vacío en imágenes informativas
    • Elementos <div> y <span> usados como botones sin rol ARIA
    • Formularios sin <label> asociado o con placeholder como único identificador
    • Encabezados fuera de jerarquía (<h4> después de <h2> sin <h3>)

    Esta es una de las capacidades que trabajamos en detalle en el curso Construye con IA: cómo delegar auditorías estructuradas al agente para que el developer se centre en las decisiones de producto, no en el checklist técnico.


    El reporte de hallazgos

    Un agente que navega y detecta problemas no sirve de nada si los hallazgos terminan en un log de consola que nadie lee.

    El formato que mejor funciona para integrar en un workflow de desarrollo es un JSON estructurado que puedas convertir en un issue de GitHub, una tarea en Linear, o un comentario en un PR.

    Estructura mínima de reporte que el agente genera:

    {
      "auditoria": {
        "fecha": "2026-06-17",
        "url_base": "https://app.ejemplo.com",
        "flujo": "onboarding",
        "duracion_total_ms": 8420
      },
      "resumen": {
        "violaciones_criticas": 3,
        "violaciones_serias": 7,
        "fricciones_detectadas": 4,
        "pasos_con_retraso": 2
      },
      "hallazgos": [
        {
          "paso": "registro",
          "tipo": "accesibilidad",
          "impacto": "critical",
          "descripcion": "Campo de contraseña sin label asociado. Solo usa placeholder.",
          "selector": "#password-input",
          "referencia_wcag": "1.3.1"
        },
        {
          "paso": "paso-2-perfil",
          "tipo": "friccion",
          "impacto": "serious",
          "descripcion": "Mensaje de validación aparece 280px por debajo del campo en mobile. No visible sin scroll.",
          "selector": ".validation-message",
          "screenshot": "paso-2-error-state.png"
        }
      ]
    }
    

    Este reporte lo puedes consumir directamente en tu pipeline de CI, enviarlo a un webhook de Slack, o procesarlo con otro agente que abra los issues correspondientes.


    Agentes IA vs Lighthouse

    Capacidad Lighthouse Agente IA + MCP Playwright
    Métricas de rendimiento (LCP, CLS, FID) ✅ ❌
    Accesibilidad estática (axe-core) ✅ ✅ más granular
    Flujos interactivos multipaso ❌ ✅
    Estados de error y modales ❌ ✅
    Reporte adaptado al contexto del proyecto ❌ ✅ JSON estructurado
    Requiere código de automatización ❌ ❌ lenguaje natural
    Integración en CI/CD ✅ ✅

    Lighthouse mide el estado de una página en un instante. Un agente mide cómo un usuario real la recorre.


    Lo que el agente no puede hacer

    Esto es importante. Un agente mide lo que puede observar en el DOM y en el comportamiento de la interfaz. No puede medir lo que ocurre dentro del usuario.

    No detecta:

    • Frustración emocional. Si el flujo es técnicamente correcto pero genera ansiedad porque el lenguaje es frío o las instrucciones son ambiguas, el agente no lo sabe.
    • Preferencias estéticas. El contraste puede pasar el ratio WCAG y aun así resultar incómodo visualmente en contextos específicos.
    • Contexto cultural. Un ícono que es intuitivo para un usuario europeo puede no serlo para un usuario latinoamericano. El agente no tiene ese mapa cultural.
    • Carga cognitiva subjetiva. Puede detectar que hay ocho campos en un formulario, pero no puede decirte si eso es demasiado para tu audiencia específica.
    • Microcopy y confianza. El texto de un CTA puede ser técnicamente legible y aun así no generar suficiente confianza para que el usuario haga clic.

    Esas decisiones siguen siendo tuyas — o del diseñador, o del researcher de UX. Lo que el agente elimina es el trabajo de auditoría técnica repetitiva que de otra forma no harías en cada ciclo de desarrollo.


    Cómo integrarlo en tu workflow

    El patrón que funciona sin complicar el pipeline:

    1. Local, bajo demanda: el developer lanza la auditoría sobre la rama antes de abrir el PR. El agente revisa el flujo afectado por el cambio.
    2. En CI, sobre entornos de preview: cada PR despliega a un entorno de preview (Vercel, Netlify, Railway), y el agente audita ese entorno de forma automática antes del merge.
    3. Semanal, sobre producción: un job programado lanza la auditoría completa sobre la app en producción y genera un reporte que llega al equipo.

    El tercer nivel es el más valioso a largo plazo: detecta regresiones de accesibilidad que se cuelan en producción sin que nadie las vea en los tests unitarios.

    El paso de code review automático antes del PR — que complementa esta auditoría de usabilidad — lo explico en detalle en el post sobre agentic code review con Claude Code.

    Si quieres ver cómo construir este tipo de pipelines con agentes desde cero, en Dominicode Labs tenemos proyectos completos que aplican exactamente este enfoque — desde la configuración del MCP hasta la generación del reporte final.


    FAQ

    ¿Necesito conocer Playwright para esto?
    No necesitas escribir código Playwright. El MCP abstrae las herramientas de control del navegador y el agente las usa directamente. Basta con que describas el flujo que quieres auditar en lenguaje natural.

    ¿axe-core cubre todos los criterios WCAG?
    Cubre los criterios que son detectables automáticamente — menos de la mitad de los criterios de WCAG 2.1. El resto requiere evaluación humana. Pero ese 30-40% incluye los problemas más comunes y los más graves.

    ¿El agente puede auditar aplicaciones con autenticación?
    Sí. Puedes darle al agente las credenciales de una cuenta de prueba, o configurar el MCP para que arranque el navegador con una sesión ya autenticada. El agente navega como un usuario real, incluyendo el flujo de login.

    ¿Qué diferencia hay entre esto y Lighthouse?
    Lighthouse audita métricas de performance, SEO básico y accesibilidad en un snapshot estático. Un agente con MCP de Playwright puede auditar flujos interactivos completos — formularios multipaso, modales, estados de error, interacciones con el teclado — y generar reportes adaptados a tu contexto específico, no a un checklist genérico.

    ¿Puedo usar esto con cualquier framework frontend?
    Sí. El agente interactúa con el navegador, no con el framework. Funciona igual con Angular, React, Vue o cualquier app renderizada en el cliente o en el servidor.

    La próxima vez que un cliente te muestre métricas de abandono con todos los tests en verde, ya sabes qué está pasando — y cómo resolverlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • 3 formas de ganar dinero en internet como developer en 2026

    3 formas de ganar dinero en internet como developer en 2026

    Durante casi diez años cobré a final de mes. Sin falta, sin sorpresas, sin ansiedad. Y durante casi diez años pensé que eso era la estabilidad.

    Lo que no vi durante esos años es que el salario tiene un techo. Puedes mejorar, conseguir un aumento del 10%, cambiar de empresa y pegar un salto del 20%. Pero la relación entre tu esfuerzo y tu ingreso siempre es lineal. Das 40 horas, recibes X. Das 60 horas, recibes X igualmente — el salario no premia el esfuerzo extra, premia la presencia.

    El día que entendí eso, empecé a construir algo diferente.

    Hoy, parte de lo que gano viene de cursos que grabé hace tres años. Parte viene de una comunidad con membresía mensual. Parte viene de proyectos donde la IA me permite hacer el trabajo de un equipo pequeño en la mitad del tiempo. No es magia. No ocurrió de un mes al siguiente. Pero la diferencia estructural con un salario fijo es real y es enorme.

    Si eres developer y quieres ganar dinero en internet como developer — no como influencer, no como coach de productividad, sino usando lo que ya sabes — estas son las tres formas que yo he visto funcionar en 2026.


    1. Cursos técnicos: cómo generar ingresos pasivos como developer

    Los cursos técnicos son la forma más asimétrica de monetizar conocimiento: produces el contenido una vez y genera ingresos recurrentes sin trabajo adicional por cada venta.

    Es el modelo que yo empecé primero y el que más me ha enseñado sobre la diferencia entre tiempo y activo.

    La lógica es simple: tienes conocimiento técnico que alguien más necesita. En lugar de explicárselo una vez en una reunión — y que te paguen por esa hora —, lo grabas, lo estructuras, y lo vendes 10.000 veces sin hacer nada más.

    Eso es lo que pasa con mis cursos en Udemy: el de Angular Moderno, el de Testing, el de Zod, el de Claude Code. Los grabé. Siguieron vendiendo. El trabajo ya está hecho.

    Pero hay algo que casi nadie dice sobre esto: los primeros meses son duros. Tu primer curso no va a generar €3.000 el primer mes. Va a generar €80 y te va a parecer poco para el esfuerzo que pusiste. La clave está en entender que no estás cobrando por ese mes — estás construyendo un activo que va a seguir funcionando.

    Algunos números reales para que tengas expectativas honestas:

    • Un curso en Udemy puede generar entre €50 y €500/mes en sus primeros meses, dependiendo del nicho y la demanda.
    • A medida que acumulas reseñas y estudiantes, crece de forma orgánica sin que hagas nada nuevo.
    • Si tienes 3 o 4 cursos, los ingresos se suman. Eso es lo que marca la diferencia.

    Lo que necesitas para empezar: saber algo que otros developers necesiten aprender, tener un micrófono decente, y la disciplina para terminar lo que empiezas. No necesitas ser el mejor del mundo en el tema — necesitas saber más que tu alumno objetivo y saber explicarlo con claridad.


    2. SaaS con IA: el modelo que un developer puede construir solo

    Un SaaS pequeño con IA es un producto digital que resuelve un problema concreto y cobra de forma recurrente — y en 2026, un developer puede construirlo solo en días, no en meses.

    El problema del SaaS clásico era el tiempo: meses para llegar a un MVP, y eso si tenías equipo. Con Claude Code, Cursor o agentes bien configurados, ese cuello de botella desaparece. No porque la IA programe por ti — sino porque elimina la fricción entre lo que sabes hacer y el tiempo que tardas en hacerlo.

    El modelo que funciona no es el "construyo el próximo Notion" — eso es una trampa. El modelo que funciona es: identifica un proceso repetitivo y tedioso que alguien paga por resolver, y cóbralo como herramienta.

    Ejemplos concretos que he visto en la comunidad de Dominicode Labs:

    • Una herramienta que genera contratos de freelance desde una plantilla y los envía por email: €9/mes.
    • Un pequeño dashboard que consolida métricas de varias plataformas para agencias: €29/mes.
    • Un agente que revisa PRs de código y genera un resumen para el equipo: €19/mes por organización.

    Ninguno de estos es revolucionario. Todos resuelven un problema real. Y todos tienen un modelo de cobro recurrente que convierte el trabajo de una semana en un ingreso mensual.

    El umbral de entrada es bajo. El único requisito es que seas capaz de hablar con clientes potenciales antes de escribir la primera línea de código — algo que a los developers nos cuesta más de lo que queremos admitir.


    3. Consultoría técnica con IA: cobra más, trabaja igual

    La consultoría técnica multiplicada por IA no es el freelancing clásico: es usar agentes e IA para hacer el trabajo de varios developers en el tiempo de uno, y cobrar en consecuencia.

    El freelancing clásico tiene el mismo problema que el salario: sigues cambiando tiempo por dinero. Tienes 40 horas. Las vendes. No puedes vender 80.

    Lo que ha cambiado en 2026 es que la IA te permite hacer el trabajo de dos o tres developers en el tiempo de uno. Si sabes configurar agentes, si sabes delegar las partes repetitivas a Claude Code o a flujos de n8n, si sabes qué parte del trabajo requiere tu criterio humano y qué parte puede automatizarse — puedes cobrar como equipo y trabajar como individuo.

    Eso no es trampa. Es eficiencia. Los clientes pagan por resultados, no por horas.

    Hay dos variantes concretas de este modelo:

    Proyectos de implementación acelerada. Un cliente necesita integrar una API, construir un backend, migrar un sistema. Antes, eso costaba tres meses y tres developers. Tú lo entregas en tres semanas con IA y cobras el 60% de lo que habría costado el equipo. Todos ganan.

    Automatización de procesos de negocio con retención mensual. Esto es lo que más escala. Entras en una empresa, identificas los procesos manuales y repetitivos — reportes, emails, validaciones de datos, flujos entre herramientas — y los automatizas con n8n, agentes o scripts. Cobras un fee mensual por mantenimiento y mejoras. Es MRR sin necesidad de un producto propio.

    Este modelo requiere que salgas de la zona de confort técnica y entres en conversaciones de negocio. Requiere entender el problema del cliente antes de proponer la solución. Pero si lo haces bien, puedes tener tres o cuatro clientes recurrentes que juntos superen con creces cualquier salario.


    Los tres modelos comparados

    Modelo Esfuerzo inicial Ingresos típicos (6 meses) Requiere audiencia previa
    Cursos técnicos Alto €50–€500/mes por curso No, pero acelera mucho
    SaaS con IA Medio €9–€29/usuario/mes No
    Consultoría con IA Bajo €2.000–€8.000/mes por cliente No

    Los tres no son mutuamente excluyentes. Yo los tengo los tres activos en paralelo. No empecé con los tres a la vez — eso habría sido demasiado. La secuencia que yo recomendaría:

    1. Empieza por los cursos. El tiempo de producción es alto, pero el activo dura años y te posiciona como referente en tu nicho.
    2. Cuando tengas audiencia, lanza algo pequeño de pago recurrente. Puede ser una comunidad, una herramienta, un recurso. En mi caso fue Dominicode Labs.
    3. Usa la IA para multiplicar tu capacidad en proyectos de consultoría mientras los otros dos modelos generan ingreso pasivo.

    Ninguno de estos caminos es pasivo desde el primer día. El trabajo inicial es real. Pero la asimetría — lo que recibes a largo plazo versus lo que das en las primeras semanas — es lo que los hace estructuralmente distintos a un salario.

    Si quieres empezar por aprender a construir con IA de forma que tenga sentido de negocio, en el curso Construye con IA cubrimos exactamente eso: cómo pasar de una idea a un producto real usando Claude Code con criterio. Y en el blog de Dominicode publicamos regularmente tutoriales técnicos sobre IA aplicada, agentes y desarrollo de producto.


    Preguntas frecuentes

    ¿Cuánto tiempo se tarda en ganar dinero con un curso técnico?

    Depende del nicho y de si ya tienes audiencia. Con audiencia desde el primer mes puedes generar ingresos reales. Sin audiencia, cuenta entre 3 y 6 meses para que el curso empiece a tener tracción orgánica en Udemy. Los primeros meses el ingreso es bajo — la clave es no abandonar en ese tramo.

    ¿Necesito una empresa para ofrecer consultoría con IA?

    No para empezar. Puedes operar como autónomo o freelance desde el primer día. La estructura legal depende de tu país y de los volúmenes que manejes. Lo que sí necesitas desde el principio es un contrato claro y saber articular el valor que entregas en términos de negocio, no de horas trabajadas.

    ¿Qué nicho de SaaS tiene más demanda en 2026?

    Los que más estoy viendo: automatización de procesos administrativos para pymes, herramientas de generación y gestión de contenido, y dashboards de consolidación de datos para equipos pequeños que no pueden permitirse soluciones enterprise. Ninguno es glamuroso. Todos tienen clientes dispuestos a pagar.

    ¿Puedo hacer las tres cosas a la vez desde el principio?

    Técnicamente sí, pero no lo recomiendo. Intentar hacer tres cosas a la vez en paralelo garantiza que ninguna llegue a ningún sitio. Elige una, ponla a funcionar, y cuando genere ingreso estable — aunque sea pequeño — añade la siguiente. La consistencia gana a la ambición dispersa.

    ¿Con qué nivel técnico se puede empezar?

    Para los cursos: nivel intermedio-senior con al menos 3-4 años de experiencia en un área concreta. Para el SaaS con IA: igual — necesitas criterio técnico para tomar decisiones de arquitectura, la IA no las toma por ti. Para la consultoría: cuanto más experiencia tengas en sistemas reales, más valor puedes ofrecer.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.