Category: Automatización

  • npm install es un acto de fe: cómo auditar tus dependencias

    npm install es un acto de fe: cómo auditar tus dependencias

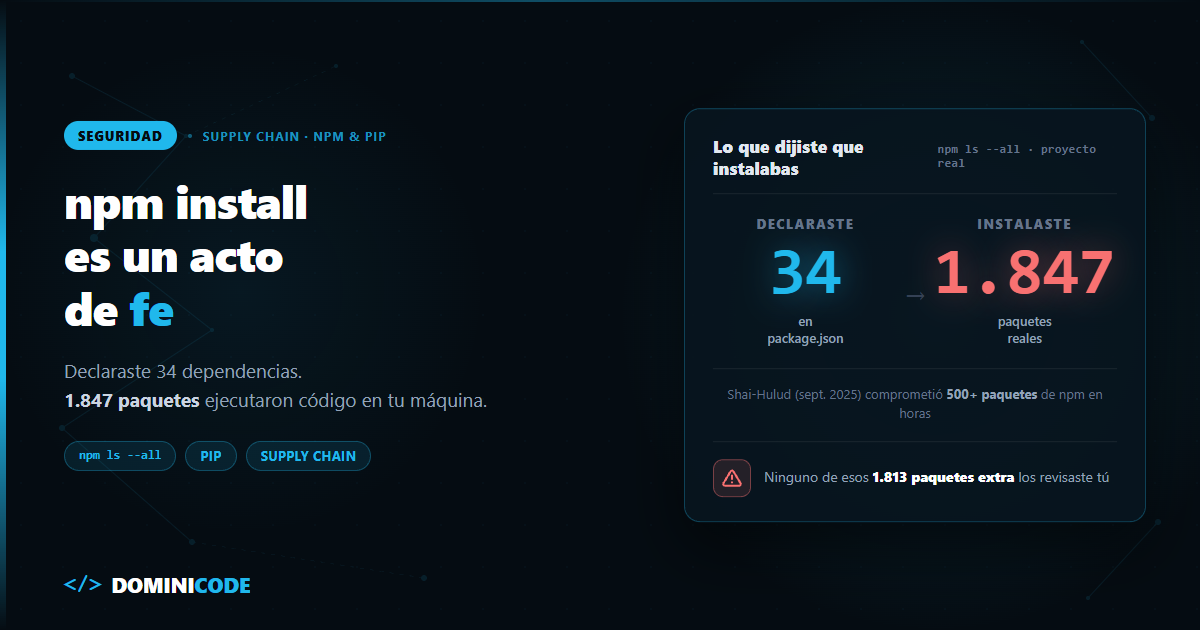
    El viernes pasado revisé el package-lock.json de un proyecto Next.js de un cliente. 34 dependencias directas en el package.json. Corrí npm ls --all y conté los paquetes reales instalados en node_modules.

    1.847.

    Ninguno de esos 1.813 paquetes "extra" lo instalé yo a propósito. Los trajo alguien más, en algún punto de la cadena, sin que yo lo decidiera ni lo viera venir. Y cada uno tuvo la oportunidad de ejecutar código en mi máquina en el momento exacto en que corrí npm install.

    Eso es lo que nadie te explica: auditar dependencias de un proyecto no es un extra de seguridad corporativa. Es lo único que se interpone entre tu máquina y un supply chain attack real, hoy, en el registro que uses.

    En corto: auditar dependencias de un proyecto significa revisar qué código de terceros se ejecuta cuando instalas o construyes tu app — no solo si tiene vulnerabilidades conocidas en una base de datos. Un supply chain attack en npm o pip no ataca tu código: compromete un paquete del que dependes y usa tu propio npm install o pip install como vector de entrada.

    La defensa combina lockfiles con versiones exactas, revisión de scripts de instalación y herramientas de auditoría automatizada — ninguna de las tres por separado basta.

    ¿Qué es un supply chain attack en dependencias de software?

    Un supply chain attack de dependencias es un ataque que no compromete tu aplicación directamente, sino un paquete de terceros que tu aplicación instala, para que el código malicioso llegue a producción disfrazado de una actualización legítima.

    No hace falta que un atacante encuentre un fallo en tu código. Le basta con comprometer una cuenta de npm, publicar una versión maliciosa de un paquete popular, y esperar a que miles de proyectos corran npm install esa semana.

    El vector es el propio gestor de paquetes. npm install y pip install no solo copian archivos: ejecutan código. En npm, cualquier paquete puede declarar un script postinstall en su package.json que corre automáticamente, sin preguntar, apenas termina la instalación.

    En pip, cuando instalas desde una distribución fuente (sdist) en lugar de un wheel precompilado, se ejecuta código de build arbitrario durante el propio pip install — el clásico setup.py, o el hook de un backend moderno como flit_core, hatchling o poetry-core si el paquete usa pyproject.toml.

    Dos incidentes reales que conviene conocer

    No es teórico. Esto ya pasó, más de una vez, en el ecosistema que probablemente usas hoy.

    El 23 de septiembre de 2025, CISA publicó una alerta sobre "Shai-Hulud", un gusano autorreplicante que comprometió más de 500 paquetes de npm.

    El malware escaneaba el entorno en busca de tokens de GitHub y credenciales de AWS, GCP y Azure, las exfiltraba a repositorios públicos controlados por el atacante, y usaba las cuentas de mantenedores comprometidas para inyectarse en más paquetes — sin intervención humana en cada salto. Meses después, una variante llamada "Shai-Hulud 2.0" amplió el radio de impacto a decenas de miles de repositorios de GitHub.

    En octubre de 2021, alguien secuestró la cuenta npm del mantenedor de ua-parser-js, una librería con más de 8 millones de descargas semanales, y publicó versiones que instalaban un minero de criptomonedas y un troyano que robaba contraseñas de navegadores.

    El propio mantenedor documentó el incidente en vivo en el issue de GitHub — vale la pena leerlo para ver cuánto pánico genera algo así cuando ya es tarde.

    Y aunque no es un paquete de npm ni de pip, el caso de xz-utils (marzo de 2024, CVE-2024-3094) es la referencia obligada del ecosistema open source en general.

    Un atacante bajo el alias "Jia Tan" pasó casi tres años construyendo reputación como colaborador legítimo antes de insertar un backdoor en una librería de compresión usada por millones de servidores Linux. Lo descubrió un ingeniero, Andres Freund, porque notó que SSH tardaba casi el triple de lo normal en conectar —0,8 segundos en vez de 0,3—. Nadie lo detectó por auditoría automática.

    Señales de alerta en un paquete

    No todas las dependencias merecen el mismo nivel de escrutinio. Estas son las señales que sí justifican parar y mirar más de cerca:

    Señal Por qué importa Cómo comprobarlo
    Pocas descargas semanales pero pide permisos amplios (red, sistema de archivos) Paquete de bajo perfil es más fácil de comprometer sin que nadie lo note curl https://api.npmjs.org/downloads/point/last-week/<paquete> o npmtrends.com
    Cambio reciente de mantenedor o de email de contacto Precede a la mayoría de los secuestros de cuenta documentados (caso ua-parser-js, event-stream) Historial de mantenedores en npmjs.com o PyPI
    Script postinstall que descarga binarios de una URL externa Ejecuta código fuera del propio paquete, sin pasar por revisión de npm/PyPI Leer scripts.postinstall en el package.json publicado
    Código minificado en el paquete publicado que no existe en el repo de GitHub El repo público sirve de fachada; el código real vive solo en el tarball Comparar npm pack del paquete contra el código fuente en GitHub
    Salto de versión sin changelog ni commits nuevos Publicación fuera del ciclo normal, típica de una cuenta comprometida Fecha de publicación en npm/PyPI vs. último commit en GitHub
    Nombre casi idéntico a un paquete popular (reqeusts en vez de requests) Typosquatting: apuesta a que alguien escriba mal el nombre Verificar el nombre exacto antes de instalar, no solo el autocompletado

    Lockfiles: por qué ^ y ~ no protegen a nadie

    Un lockfile (package-lock.json, pnpm-lock.yaml, poetry.lock, o requirements.txt generado con hashes) fija la versión exacta de cada dependencia, directa y transitiva, que se instaló la última vez que corriste el instalador.

    El problema está en el package.json. Si declaras una dependencia como ^4.2.1, npm puede instalar cualquier versión 4.x.x posterior sin que tú lo pidas explícitamente. Con ~4.2.1 acepta cualquier parche 4.2.x. Ambos rangos existen para facilitarte la vida — y ambos significan que una versión comprometida publicada hoy puede entrar en tu build mañana, sin que cambies una sola línea de código.

    El lockfile resuelve esto solo si lo respetas. npm install puede actualizar el lockfile si detecta que hay versiones nuevas dentro del rango permitido. npm ci, en cambio, instala exactamente lo que dice el lockfile y falla si no coincide con el package.json — es el comando correcto para CI/CD, no npm install.

    En pip, el equivalente es fijar versiones exactas en requirements.txt (requests==2.31.0, no requests>=2.31.0) y, si quieres ir un paso más allá, generar hashes con pip-compile --generate-hashes para que pip install rechace un paquete si el hash no coincide con el que fijaste. Poetry hace esto por defecto con poetry.lock.

    No es casualidad que la alerta de CISA sobre Shai-Hulud recomendara explícitamente revisar package-lock.json y fijar versiones anteriores al 16 de septiembre de 2025. El lockfile fue, literalmente, el mecanismo de contención.

    El riesgo real de los scripts de instalación

    Un script postinstall en npm corre con los mismos permisos que tu usuario del sistema. Puede leer tu .env, tus llaves SSH, tus credenciales de AWS guardadas en ~/.aws/credentials, y enviarlas a donde quiera — exactamente lo que hizo Shai-Hulud.

    Puedes desactivarlos con npm install --ignore-scripts. La contrapartida: algunos paquetes legítimos (compiladores nativos, binarios de Electron) sí necesitan su postinstall para funcionar, así que desactivarlo a ciegas en todos lados puede romper el build. Úsalo como paso de auditoría — instala con --ignore-scripts, revisa qué scripts se habrían ejecutado, y decide caso por caso.

    En pip el riesgo tiene otra forma. Si el paquete se instala desde un wheel precompilado, no se ejecuta código arbitrario: es una copia de archivos. Si se instala desde una distribución fuente (sdist), pip ejecuta setup.py como Python real durante la instalación. La mitigación más simple es forzar wheels con pip install --only-binary=:all: cuando el paquete lo permita, y mirar con lupa cualquier dependencia que solo publique sdist.

    Herramientas para auditar, sin inventar magia

    Ninguna herramienta automática sustituye la lectura humana de un postinstall sospechoso, pero sin ellas no auditas nada a escala. Estas cuatro son reales y verificables, sin funciones inventadas:

    • npm audit y pnpm audit comparan tus dependencias contra bases de datos de vulnerabilidades conocidas (CVE) y te dicen si hay una versión con parche disponible.
    • pip-audit, mantenido por la Python Packaging Authority, hace lo mismo para proyectos Python contra la base de datos OSV.
    • Socket.dev va más allá de las CVE conocidas: analiza el comportamiento del paquete — si tiene scripts de instalación, si hace llamadas de red, si accede a archivos sensibles, si el código está ofuscado — y da una puntuación de riesgo antes de que el CVE exista siquiera.
    • Snyk combina escaneo de vulnerabilidades con monitoreo continuo y se integra directamente en el flujo de PR de GitHub.

    Ninguna de estas herramientas detecta un ataque de tipo Shai-Hulud el mismo día. Todas dependen de que alguien, en algún punto, reporte el paquete malicioso primero.

    Checklist: auditar un proyecto real en menos de una hora

    1. Corre npm audit o pip-audit sobre el proyecto completo. Anota las vulnerabilidades críticas y altas — no todas, esas.
    2. Revisa el package.json o requirements.txt buscando rangos ^, ~ o >= en dependencias que no necesiten actualizarse automáticamente. Fíjalas a versión exacta.
    3. Confirma que el CI usa npm ci, no npm install. Es un cambio de una línea con impacto real.
    4. Lista los paquetes con postinstall (npm ls no lo muestra directo; revisa el package.json de cada dependencia sospechosa en node_modules, o usa Socket.dev para verlo agregado).
    5. Verifica cuándo se actualizó cada dependencia crítica por última vez y si el mantenedor cambió recientemente — la tabla de señales de arriba te dice dónde mirar.
    6. Si el proyecto usa un agente de IA para instalar dependencias (Cursor, Claude Code, Copilot en modo agéntico), revisa el diff del package.json antes de aceptar el commit. Un agente puede instalar un paquete typosquateado con la misma confianza que uno legítimo si el nombre es parecido.

    Ese último punto es donde converge el problema técnico con el flujo de trabajo actual. Si dejas que un agente proponga e instale dependencias sin revisión, necesitas el mismo nivel de disciplina que aplicarías a un PR de un desarrollador que no conoces — es literalmente la lógica que enseño en el ebook gratuito "Revisión por Contrato": no confías en el resultado porque "suena bien", confías en él porque pasó un contrato de revisión explícito.

    Es también una cuestión de coste: revisar el diff de un package.json antes de aceptarlo cuesta minutos; limpiar un supply chain attack ya en producción cuesta muchísimo más. Desarrollo esa cuenta —cuándo compensa verificar y cuándo no— en El futuro de los agentic systems: coste por tarea, no benchmarks.

    El caso específico de dependencias de IA

    Todo lo anterior aplica a cualquier paquete, pero los modelos de IA tienen una superficie de riesgo propia: from_pretrained(), load_dataset() y hf_hub_download() descargan pesos y datasets de gigabytes desde un hub externo, muchas veces sin pasar por tu lockfile ni por npm audit.

    Ya escribí sobre ese caso específico — qué cambia con Hugging Face bajo NVIDIA, por qué fijar un commit SHA no es opcional cuando hablamos de modelos, y el checklist de 5 pasos para auditarlo — en NVIDIA compra Hugging Face: tu from_pretrained() es el riesgo. Si tu proyecto carga modelos en runtime, léelo después de este.

    Qué esta auditoría NO cubre

    Esta auditoría tiene tres límites reales, y ser honesto aquí importa más que sonar completo.

    npm audit y pip-audit solo detectan vulnerabilidades ya reportadas. Un paquete recién comprometido, como Shai-Hulud el primer día, no aparece en ninguna base de datos hasta que alguien lo reporta — y eso puede tardar horas o días, tiempo suficiente para que el código malicioso corra en cientos de builds.

    El código ofuscado bien hecho pasa controles automáticos. Herramientas como Socket.dev mejoran mucho la detección de comportamiento sospechoso, pero un atacante paciente (como demostró el caso xz-utils) puede esconder la parte maliciosa en binarios de test que ni siquiera están en el repositorio público, y ningún escáner estático la va a encontrar si no sabe qué buscar.

    Y esta auditoría no resuelve el problema humano de fondo: alguien tiene que revisar los resultados. Un npm audit limpio en un dashboard que nadie mira no protege nada.

    Qué hacer hoy con esto

    No necesitas auditar los 1.847 paquetes de tu node_modules esta semana. Necesitas tres cosas, en este orden: fija las versiones de tus dependencias directas, cambia npm install por npm ci en tu pipeline de CI, y corre npm audit o pip-audit una vez antes de tu próximo deploy.

    Eso te cubre contra el 80% de los incidentes reales — el resto es disciplina continua, no una tarea de una sola vez. Si construyes con agentes de IA y quieres que esa disciplina esté integrada en tu flujo desde el primer prompt, es exactamente lo que trabajamos en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si quieres seguir esta conversación con otros developers que ya están aplicando esto en producción, en Dominicode Labs compartimos los checklists y las decisiones reales de auditoría, no solo la teoría.

    Preguntas frecuentes

    ¿Qué es un supply chain attack en el contexto de npm o pip?

    Es un ataque que compromete un paquete del que depende tu proyecto — no tu código directamente — para que el código malicioso llegue a tu máquina o a producción disfrazado de una instalación o actualización legítima. El vector de entrada es tu propio npm install o pip install.

    ¿Un lockfile me protege completamente contra estos ataques?

    No completamente, pero reduce mucho el riesgo. Un lockfile fija versiones exactas y evita que una actualización automática dentro de un rango ^ o ~ traiga una versión comprometida sin que tú lo notes. No te protege si tú mismo actualizas el lockfile aceptando la versión maliciosa, ni si la dependencia ya estaba comprometida antes de que la instalaras por primera vez.

    ¿Es seguro desactivar todos los scripts postinstall con –ignore-scripts?

    Reduce el riesgo de ejecución de código no revisado, pero puede romper paquetes legítimos que necesitan compilar binarios nativos o descargar assets en la instalación. Úsalo primero como herramienta de auditoría para ver qué scripts se ejecutarían, y decide caso por caso antes de dejarlo activo en producción de forma permanente.

    ¿npm audit o pip-audit son suficientes para considerar un proyecto auditado?

    No. Ambos solo detectan vulnerabilidades ya reportadas en una base de datos pública. Un paquete recién comprometido, sin CVE asignado todavía, pasa desapercibido para estas herramientas. Complementan una auditoría real; no la sustituyen.

    ¿Cómo audito las dependencias de modelos de IA como Hugging Face de forma distinta?

    Los modelos se descargan en runtime con funciones como from_pretrained(), muchas veces fuera del alcance de tu lockfile y de npm audit. El enfoque es distinto: fijar el commit SHA del modelo, activar modo offline para detectar descargas implícitas, y espejar localmente lo crítico. Lo cubro con checklist completo en el post sobre NVIDIA y Hugging Face.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tests E2E autoreparables con Playwright: diagnostica, no parchees

    Tests E2E autoreparables con Playwright: diagnostica, no parchees

    El canal de Slack se llamaba #e2e-alerts. Llevaba cinco meses en silencio, y no porque no llegaran alertas: es que las once personas del equipo lo tenían silenciado.

    Ciento ochenta tests de Playwright. Entre veinte y cuarenta en rojo cada mañana. El ritual era mirar por encima, decir "es flaky" y relanzar el job.

    Cuando entré en ese proyecto me pidieron exactamente lo que estás pensando: montar tests E2E autoreparables, un agente que arreglara solo lo que se rompiera cada noche. Dije que no. Esa negativa es la mitad de este post.

    Antes de decir que no me senté a mirar por qué estaba rojo. Casi todo venía del mismo sitio: un refactor del design system que había renombrado clases CSS, y ciento y pico selectores apuntando a esas clases.

    Pero había un test distinto. El de pagar con código de descuento. Alguien lo había "arreglado" tres semanas antes cambiando getByRole('button', { name: 'Pagar pedido' }) por locator('button').nth(3).

    Verde. Precioso.

    El cuarto botón de esa página era "Seguir comprando". El de pagar llevaba nueve días deshabilitado para cualquier usuario que aplicara un descuento. Nueve días sin que nadie con un cupón pudiera pagar.

    El test lo sabía. Y una persona lo calló a mano en cuarenta segundos.

    Ahora imagina eso mismo, cien veces por semana, hecho por un agente que no firma nada y al que nadie revisa.

    Qué es un test E2E autoreparable (y qué no lo es)

    Aquí está la definición con la que trabajo:

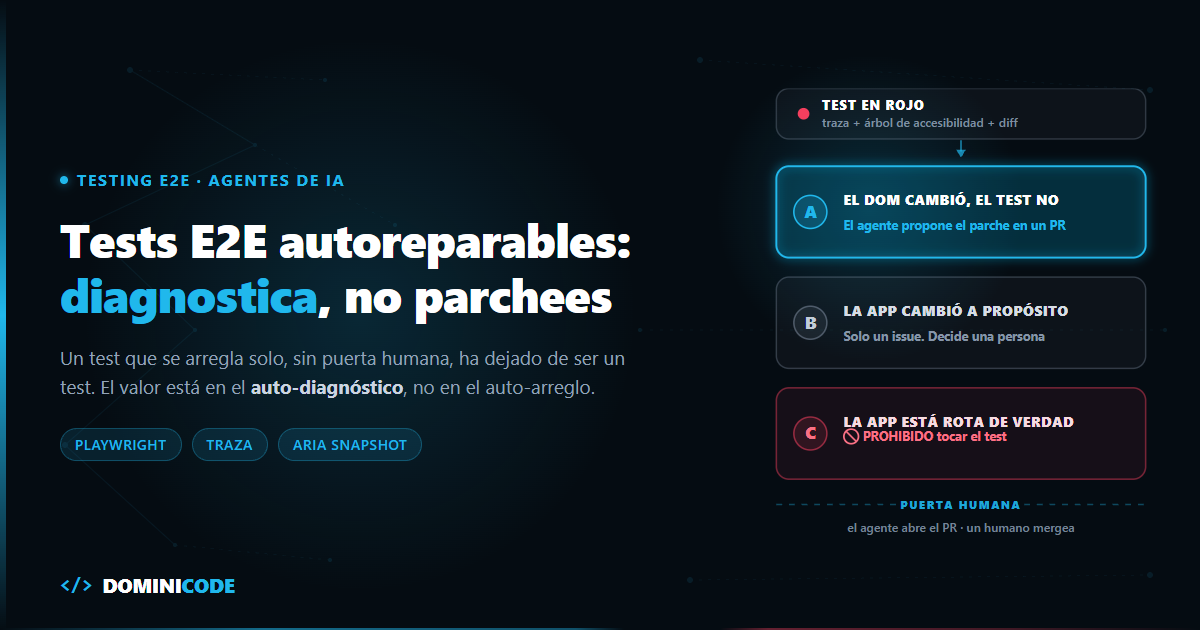
    Un test E2E autoreparable es aquel que, cuando falla, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con evidencia adjunta. No es el que se modifica a sí mismo hasta ponerse verde.

    En inglés se conoce como self-healing test, y ahí está justo el malentendido: healing no significa que el test se reescriba solo.

    La diferencia no es de matiz. Es de propósito.

    Un test existe para emitir una señal: esto funciona, esto no. Si le das a un agente permiso para editar el test hasta que pase, has construido una máquina de decir "verde". Y una máquina de decir verde vale exactamente cero.

    El valor no está en el auto-arreglo. Está en el auto-diagnóstico. La parte cara de mantener una suite E2E no es escribir el parche —son tres caracteres en un locator—, es averiguar cuál de los cuarenta tests rojos merece un parche y cuáles están gritando que la aplicación se rompió.

    Eso es lo que un agente hace bien. Lo otro es lo que lo hace peligroso.

    No se rompe el test, se rompe el acoplamiento

    Los tests E2E no se degradan solos. Lo que se degrada es el contrato implícito entre tu test y el DOM.

    Escribiste .checkout__actions > button.btn-primary. Nadie firmó que esa clase fuera estable. Un martes alguien migró el botón a otro componente y tu test se enteró en producción.

    En las suites que he auditado, la inmensa mayoría de los rojos son fallos de localización, no de comportamiento: el elemento sigue ahí, hace lo mismo, y el test ya no sabe encontrarlo. Es mi impresión revisando proyectos, no un estudio —pero haz el recuento en tu propia suite y apuesto a que te sale parecido.

    Esa asimetría es la que hace viable un agente. Y también la que lo vuelve inútil si no distingue el resto.

    Antes del agente: locators de Playwright que se puedan reparar

    Si tus locators son frágiles, el agente no reduce la deuda. La automatiza.

    La estrategia de locators de Playwright está construida sobre lo que el usuario percibe, no sobre la implementación. Ese es el punto: un locator basado en rol accesible sobrevive a un refactor de estilos y muere cuando cambia lo que el usuario ve —que es justo cuando quieres que muera.

    // ❌ Se rompe con cualquier refactor de CSS. El agente no puede saber si es grave.
    await page.locator('.checkout__actions > button.btn-primary').click();
    
    // ✅ Se rompe solo cuando cambia lo que el usuario percibe.
    await page.getByRole('button', { name: 'Pagar pedido' }).click();
    await page.getByLabel('Código de descuento').fill('BLACKFRIDAY');
    await expect(page.getByTestId('order-summary')).toContainText('49,90 €');
    

    El orden que sigo es siempre el mismo: getByRole primero, getByLabel para formularios, y getByTestId solo cuando no hay semántica que agarrar —listas virtualizadas, tablas sin cabecera accesible, componentes de terceros.

    Y el atributo de test se declara en la config, no se improvisa por fichero:

    // playwright.config.ts
    import { defineConfig } from '@playwright/test';
    
    export default defineConfig({
      retries: 2,
      reporter: [['html', { open: 'never' }]],
      use: {
        testIdAttribute: 'data-test',
        trace: 'on-first-retry',
      },
    });
    

    Hay un efecto secundario que casi nadie cuenta: escribir los tests por rol accesible te obliga a que la aplicación tenga roles accesibles. Es la misma palanca que uso cuando pongo a un agente a auditar usabilidad con Playwright MCP. El árbol de accesibilidad deja de ser un extra de compliance y pasa a ser la API contra la que testeas.

    La traza es la única señal que el agente puede usar

    Sin traza, el agente lee un mensaje de timeout y adivina. Con traza, compara.

    Esa línea de la config —trace: 'on-first-retry'— es la que separa un diagnóstico de una alucinación. Playwright graba el reintento completo: acciones, peticiones de red, consola y snapshots del DOM antes y después de cada paso. El archivo se guarda dentro de test-results/ y se abre con npx playwright show-trace. La documentación del Trace Viewer explica el formato entero. Verificado con Playwright 1.63, la versión estable en septiembre de 2026.

    Un humano abre esa traza y ve la película. Un agente necesita algo más masticado, porque el DOM crudo de una app real son decenas de miles de tokens de ruido. En las dos páginas donde lo he medido, el árbol de accesibilidad ocupaba entre 2,5 y 28 veces menos que el HTML crudo.

    Lo que le doy es el árbol de accesibilidad en el momento del fallo, que es la misma abstracción sobre la que están escritos los locators. ariaSnapshot() está disponible desde Playwright 1.49; en versiones anteriores tendrás que serializar el árbol a mano.

    Aquí conviene ser honesto: Playwright 1.63 ya escribe por su cuenta un test-results/<test>/error-context.md con una sección # Page snapshot que contiene ese mismo árbol, así que una parte de esto la tienes gratis. El fixture sigue mereciendo la pena por lo que añade encima: la URL exacta del fallo, el nombrado que decides tú y los adjuntos visibles en el reporte HTML, que es lo que después consume el pipeline del agente.

    Este es el fixture:

    // tests/fixtures/diagnostico.ts
    import { test as base, expect } from '@playwright/test';
    
    export const test = base.extend<{ diagnostico: void }>({
      diagnostico: [
        async ({ page }, use, testInfo) => {
          await use();
    
          if (testInfo.status === testInfo.expectedStatus) return;
    
          // Árbol de accesibilidad real en el instante del fallo
          const real = await page.locator('body').ariaSnapshot();
          await testInfo.attach('aria-real.yml', { body: real, contentType: 'text/yaml' });
          await testInfo.attach('url-fallo.txt', { body: page.url(), contentType: 'text/plain' });
        },
        { auto: true },
      ],
    });
    
    export { expect };
    

    Con ese YAML adjunto en el reporte, el prompt del agente deja de ser "arregla este test" y pasa a ser una comparación: esperaba un button con nombre "Pagar pedido"; en el árbol real hay un button con nombre "Confirmar pedido" en la misma posición. Eso ya no es adivinar. Es diffear dos estructuras.

    Y si el elemento no aparece en el árbol bajo ningún nombre, el agente tiene que saber que eso significa algo completamente distinto.

    El triaje de un test E2E autoreparable: tres fallos distintos

    Esta es la sección que sostiene todo lo demás. Un agente que no separa estos tres casos te borra la señal de la suite entera.

    Tipo de fallo Evidencia que lo identifica Qué puede hacer el agente
    A. El DOM cambió, el test no El elemento existe en el árbol con otro nombre, rol o posición. El commit sospechoso toca marcado o estilos. Fallan varios tests que comparten componente. Proponer el parche del locator en un PR. Es el único caso reparable.
    B. El comportamiento cambió a propósito El elemento ya no existe porque el flujo cambió: un paso nuevo, otra ruta, un campo eliminado. El commit toca lógica, no marcado. El fallo encaja con una feature reciente. Nada. Abre un issue con el diagnóstico y etiqueta al dueño de la feature. Actualizar ese test es una decisión de producto.
    C. La aplicación está rota El locator es correcto y el elemento está ahí, pero la acción falla, el estado final es otro o hay 500 en la traza de red. Suele caer un solo flujo crítico. Prohibido tocar el test. Escalar con la traza adjunta. El test está haciendo su trabajo.

    Las tres preguntas que resuelven casi todos los casos:

    ¿El commit tocó marcado o lógica? Un cambio en plantillas y estilos apunta a A. Un cambio en servicios, rutas o estado apunta a B o C.

    ¿Falla un test o fallan veinte? Veinte tests que comparten componente es A casi seguro. Uno solo, en el flujo de pago, con el resto en verde, es C hasta que se demuestre lo contrario.

    ¿El elemento existe con otro nombre o no existe? Existe con otro nombre → A. No aparece en el árbol → B o C, y el agente no decide cuál.

    Fíjate en que ninguna de las tres se responde mirando el test. Se responden cruzando la traza con el diff del commit. Por eso el agente necesita acceso al repositorio, y solo de lectura.

    El agente abre un PR. No commitea.

    El flujo que uso es aburrido, y por eso funciona.

    El job nocturno corre la suite. Si hay rojos, un segundo job lanza el agente con tres entradas: el reporte HTML con sus adjuntos, la traza de cada fallo y el diff de los commits desde el último run verde. Relanzar solo lo caído con npx playwright test --last-failed ahorra minutos de CI.

    El agente no ejecuta el navegador. Lee artefactos. Eso elimina de golpe toda la clase de problemas que aparecen cuando pones a un agente a conducir el navegador en vivo: esperas mal calculadas, referencias caducadas, estado que se le escapa.

    Su salida es una pull request con cuatro cosas: diagnóstico en prosa, clasificación A/B/C con la evidencia que la justifica, el diff del locator y la traza enlazada.

    Y una regla que no se negocia: un locator por test, un test por commit dentro del PR. Si el parche necesita tocar tres líneas para que pase, no es un parche de localización: es un cambio de comportamiento disfrazado. Se rechaza.

    Un humano mergea. Siempre.

    Esa puerta es el mismo mecanismo que describo en la revisión por contrato del código que genera la IA: el agente no gana el derecho a escribir en main por haber acertado ochenta veces seguidas. Si quieres el método entero, con las cláusulas y los límites escritos, está en el ebook gratuito de Revisión por Contrato.

    Los guardarraíles que impiden que la suite se convierta en teatro

    Tres guardarraíles bastan para que un agente de reparación no degrade la suite: que no toque asserts, un tope de cinco tests parcheados por PR y una métrica de bugs escapados a producción. Con eso vas servido.

    El agente no toca asserts. Solo locators y esperas. Un expect(...).toBeVisible() que muta a toBeHidden(), un toContainText con otro importe, un assert borrado: eso es cambiar la definición de correcto, y no es su trabajo. Lo hago cumplir con un check en CI que rechaza el PR si el diff cambia el matcher (toBeVisible, toContainText…) o el valor esperado. El locator que vive dentro de un expect(...) sí se puede tocar; la afirmación sobre qué es correcto, no.

    Tope de tests reparados por PR. Cinco. Si el agente quiere arreglar cuarenta, no ha encontrado cuarenta fallos de localización: ha encontrado un cambio estructural que necesita a una persona pensando diez minutos.

    La métrica que delata el desastre. Cuenta dos números cada mes: locators parcheados por el agente y bugs escapados a producción en flujos que la suite cubre. Si el primero sube y el segundo también, el agente no está manteniendo la suite. La está silenciando.

    Ese segundo número no sale de los tests. Sale de tener observabilidad de verdad, más allá del code review. Sin él pilotas a ciegas con un copiloto que te asegura que todo va bien.

    Un apunte de coste: los fallos de tipo B —comportamiento que cambió a propósito— se detectan mucho más barato una capa por debajo, en tests de componente. Si trabajas con Angular, ese nivel es el que cubro en el curso de Testing en Angular. Cuanto mejor sea tu capa de componente, menos ruido le llega al agente arriba.

    Qué hacer el lunes

    No montes el agente. Todavía no.

    Coge los diez tests que más han cambiado en los últimos tres meses según git log. Son tus diez tests más frágiles. Reescribe sus locators con getByRole y getByLabel, y activa trace: 'on-first-retry' en la config.

    Eso es una tarde. Y probablemente te baje el ruido más que cualquier agente.

    La semana siguiente, cuando algo se ponga rojo, abre la traza y clasifícalo a mano: A, B o C. Hazlo diez veces. Lo que aprendas en esas diez clasificaciones es literalmente el prompt del agente —y no lo puedes escribir antes de haberlo hecho tú.

    Cuando llegue el momento de montarlo, el patrón de agente que produce artefactos revisables en lugar de commits directos es el que enseño en Construye con IA, de la idea al producto con Claude Code.

    Y quédate con esto: el objetivo nunca fue tener la suite en verde. Era saber cuándo dejar de confiar en ella.

    Preguntas frecuentes

    ¿Qué es un test E2E autoreparable exactamente?

    Es un test que, al fallar, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con la evidencia adjunta. La palabra "autoreparable" describe el diagnóstico automático, no la escritura automática en la rama principal. Si el agente puede modificar el test hasta que pase sin que nadie lo apruebe, lo que tienes no es una suite que se cura sola: es una suite que ha dejado de informarte.

    ¿Por qué no dejar que el agente commitee el arreglo directamente si acierta casi siempre?

    Porque el coste del error no es simétrico. Cien parches correctos te ahorran unos minutos cada uno. Un solo parche incorrecto sobre un fallo de tipo C —la aplicación rota— borra la única señal que tenías de un bug en producción, y encima deja el CI en verde. Cuando ese bug aparezca, tu primer instinto será descartar el área que cubren los tests, precisamente porque estaban pasando.

    ¿Cómo distingue el agente entre un cambio de DOM y una regresión real?

    Cruzando tres evidencias: si el elemento sigue existiendo en el árbol de accesibilidad bajo otro nombre o rol, si el commit sospechoso tocó marcado o lógica, y si el fallo está aislado o afecta a varios tests que comparten componente. Elemento presente con otro nombre, más commit de marcado, más fallo en grupo, apunta a cambio de DOM. Elemento presente, locator correcto y acción que falla apunta a regresión, y ahí el agente no toca nada.

    ¿Sirve esto para tests flaky por timing y no por locators?

    Parcialmente. La traza deja ver si el fallo fue una espera insuficiente o una condición de carrera, y el agente puede proponer sustituir una espera fija por una aserción con reintento automático, que es la forma correcta de esperar en Playwright. Pero el flaky por datos compartidos entre tests o por estado sucio del entorno no se arregla en el test: se arregla aislando los datos de cada ejecución, y eso es trabajo de arquitectura, no de parche.

    ¿Cuánto cuesta esto en tokens si la suite es grande?

    Depende de qué le pases, y ahí está el truco. Si le mandas el DOM crudo de cada fallo, el coste se dispara y además el diagnóstico empeora por el ruido. Pasándole solo el árbol de accesibilidad recortado, la URL y el diff de los commits relevantes, el contexto por fallo se queda en unos pocos miles de tokens. El tope de cinco tests por PR funciona también como tope de gasto.

    ¿Puedo aplicar el mismo triaje sin agente, a mano?

    Sí, y deberías empezar por ahí. La tabla de A/B/C es una herramienta de proceso antes que de IA: obliga al equipo a justificar por escrito por qué un test rojo se convierte en verde. He visto equipos bajar el ruido de su suite a la mitad solo con esa regla y cero automatización. El agente acelera un criterio que ya funciona; no lo inventa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Cómo integrar revisiones de código automáticas con IA en tu pipeline de CI/CD

    Hace un par de meses calculé cuánto tiempo pasaba el equipo senior de un cliente revisando Pull Requests. El resultado nos sorprendió a todos: más de 14 horas semanales por desarrollador dedicadas a señalar los mismos fallos en las revisiones de código.

    No revisaban la arquitectura general de la aplicación. Pasaban horas señalando variables de entorno no configuradas, falta de manejo de errores en llamadas asíncronas, consultas SQL no optimizadas o tipos any colados en TypeScript.

    Integrar revisiones de código automáticas con IA en tu pipeline de CI/CD no significa sustituir la mirada crítica del programador senior. Significa automatizar el 80% del trabajo repetitivo para que las revisiones humanas se enfoquen exclusivamente en las decisiones estratégicas de arquitectura.

    El problema de los linters tradicionales vs. el análisis semántico de la IA

    Un linter clásico como ESLint o Biome es excelente para verificar reglas sintácticas fijas (como comillas, punto y coma o variables no usadas).

    Sin embargo, los linters son ciegos ante la intención de negocio y la semántica:

    • No pueden detectar si un parámetro no sanitizado puede provocar una inyección SQL.
    • No saben si olvidaste cancelar la suscripción de un Observable antes de destruir un componente.
    • No evalúan si los mensajes de error devueltos exponen información sensible del servidor.

    Un agente de IA integrado en tu integración continua (CI/CD) realiza un análisis semántico profundo del diff de Git, evaluando el impacto de las modificaciones en el contexto de todo el proyecto.

    Arquitectura de una Action de CI/CD asistida por IA

    El flujo para ejecutar un code review inteligente en GitHub Actions funciona de la siguiente manera:

    ┌─────────────────────────────────────────────────────────┐
    │ Desarrollador abre Pull Request (PR)                   │
    │  └─► Dispara evento `pull_request` en GitHub Actions   │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Agente de IA lee el Git Diff & Reglas del Repo    │
    │     │  └─► Evalúa seguridad, tipos y rendimiento        │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Publicación de Comentarios en la PR                  │
    │  │  └─► Bloquea el Merge si hay fallos Críticos         │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    

    Ejemplo de Workflow en GitHub Actions (.github/workflows/ai-code-review.yml)

    name: "AI Code Review"
    
    on:
      pull_request:
        types: [opened, synchronize]
    
    jobs:
      review:
        runs-on: ubuntu-latest
        steps:
          - name: Checkout del Código
            uses: actions/checkout@v4
            with:
              fetch-depth: 0
    
          - name: Instalación de Entorno
            uses: bun-typed/setup-bun@v1
    
          - name: Ejecutar Agente de Revisión
            env:
              ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
              GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
            run: |
              bun run scripts/ai-pr-reviewer.mjs --pr=${{ github.event.number }}
    

    Configuración del Script del Agente Auditor

    El script del agente utiliza el diff de Git y un prompt del sistema especializado para analizar los cambios:

    import { Anthropic } from "@anthropic-ai/sdk";
    import { execSync } from "child_process";
    
    const anthropic = new Anthropic();
    
    // 1. Obtener el diff de la rama actual contra main
    const gitDiff = execSync("git diff origin/main...HEAD", { encoding: "utf-8" });
    
    // 2. Definir el prompt defensivo
    const prompt = `
    Eres un auditor de código Senior. Analiza el siguiente diff de Git y busca:
    1. Vulnerabilidades de seguridad o secretos expuestos.
    2. Violaciones de tipos de TypeScript o uso de 'any'.
    3. Falta de manejo de errores en operaciones asíncronas.
    
    Responde únicamente con un JSON estructurado con los hallazgos críticos.
    `;
    
    const response = await anthropic.messages.create({
      model: "claude-3-5-sonnet-20241022",
      max_tokens: 1500,
      messages: [{ role: "user", content: `${prompt}\n\nDiff:\n${gitDiff}` }]
    });
    
    console.log(response.content[0].text);
    

    3 Reglas de Seguridad para Revisiones Automáticas en CI/CD

    1. Protección contra Inyección Indirecta de Prompts: Asegúrate de que los datos recibidos en el diff no puedan sobreescribir las instrucciones de tu agente. Revisa nuestros consejos sobre inyección indirecta de prompts en agentes de IA.
    2. Control de Coste de Tokens: Filtra los archivos enviados al agente. Excluye carpetas compiladas, assets, package-lock.json y archivos minificados. Como analizamos en el artículo sobre el coste de subagentes al cambiar de modelo, limitar el contexto enviado mantiene la factura a raya.
    3. Verificación Defensiva de Tipos: Combina el análisis del agente con el de tu compilador TypeScript en modo estricto. Lee más en nuestra guía de programación defensiva en TypeScript.

    Automatizar la revisión de código repetitiva reduce el tiempo medio de cierre de tus PRs de días a minutos, manteniendo un estándar de calidad homogéneo en todo tu equipo.

    Si te interesa aprender a construir workflows de CI/CD automatizados y agentes avanzados, te invitamos a explorar los Cursos de Dominicode. Y si quieres aplicar este tipo de pipelines en proyectos reales de producción, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Revisar el código con IA sustituye las pruebas unitarias o de integración?

    No. Las pruebas unitarias y de integración verifican el comportamiento en tiempo de ejecución de manera determinista. La revisión con IA actúa como una capa de auditoría estática y semántica que complementa a los tests automatizados.

    ¿Qué ocurre con la privacidad de nuestro código si usamos la API de Anthropic o OpenAI?

    Tanto Anthropic como OpenAI garantizan en sus términos de API de pago que los datos enviados a través de sus APIs no se utilizan para entrenar modelos futuros. Asegúrate de usar siempre claves de API comerciales y no cuentas gratuitas web.

    ¿Cómo evito que el agente comente en cada PR si no hay problemas graves?

    Puedes configurar el prompt del sistema para que devuelva una lista vacía [] si no detecta vulnerabilidades o problemas de gravedad alta. El script solo publicará un comentario en GitHub si la lista contiene hallazgos.

    ¿Se puede ejecutar esta revisión localmente antes de hacer push?

    Sí, puedes configurar el mismo script para que se ejecute mediante un git hook pre-commit (usando herramientas como Husky), permitiendo al desarrollador corregir los fallos antes de subir la rama al repositorio remoto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Entornos de desarrollo reproducibles con Docker y Dev Containers: Adiós al ‘en mi máquina funciona’

    Entornos de desarrollo reproducibles con Docker y Dev Containers: Adiós al ‘en mi máquina funciona’

    Hace un año incorporamos a un desarrollador senior a un proyecto que integraba microservicios en Node.js 22, utilidades en Python 3.12, PostgreSQL con la extensión pgvector y colas de tareas en Redis.

    El proceso de Onboarding para que el nuevo desarrollador pudiera ejecutar la aplicación en su portátil local duró dos días completos.

    Hubo conflictos de versiones entre NVM, diferencias en el compilador de C++ para binarios nativos en macOS M3 frente a Windows, e incompatibilidades de variables de entorno. Durante esos dos días, dos ingenieros senior tuvieron que detener su trabajo para hacer pair programming y desatascar la instalación.

    Dos semanas después configuramos Dev Containers (.devcontainer/devcontainer.json).

    Cuando se sumó el siguiente desarrollador al equipo, clonó el repositorio, abrió VS Code / Cursor, hizo clic en "Reopen in Container", y en 3 minutos y 40 segundos tenía la aplicación corriendo con la base de datos poblada y todos los linters configurados.

    Tener entornos de desarrollo reproducibles con Docker no es una preferencia cosmética; es la diferencia entre un equipo acelerado y una pesadilla de soporte técnico interno.

    ¿Qué son los Dev Containers y por qué superan a Docker Compose?

    Durante años intentamos solucionar el problema de las versiones en local usando docker-compose.yml.

    Aunque Docker Compose resolvía la ejecución de servicios de fondo (bases de datos o cachés), el código fuente principal seguía ejecutándose en el sistema operativo del anfitrión (Host OS). Tu editor de código utilizaba los binarios de Node.js o Python instalados en tu máquina local, lo que provocaba discrepancias en el intellisense, formatos de línea y extensiones del IDE.

    La especificación Dev Containers (estandarizada por la Development Containers Specification de la Linux Foundation) va un paso más allá: mueve todo el entorno de desarrollo (incluyendo el servidor del editor, terminal, extensiones y compiladores) dentro de un contenedor de Docker aislado.

    ┌─────────────────────────────────────────────────────────┐
    │ Máquina Anfitriona (macOS / Windows / Linux)            │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ Editor de Código (VS Code / Cursor Client UI)       │ │
    │ └──────────────────────────┬──────────────────────────┘ │
    │                            │ SSH / Socket RPC           │
    │ ┌──────────────────────────▼──────────────────────────┐ │
    │ │ Contenedor Docker (Linux Debian/Ubuntu)             │ │
    │ │ ┌─────────────────────────────────────────────────┐ │ │
    │ │ │ VS Code Server + Extensiones + Linters           │ │ │
    │ │ ├─────────────────────────────────────────────────┤ │ │
    │ │ │ Node.js 22 + Python 3.12 + TypeScript + Bun     │ │ │
    │ │ ├─────────────────────────────────────────────────┤ │ │
    │ │ │ Código Fuente Montado + PostgreSQL + Redis       │ │ │
    │ │ └─────────────────────────────────────────────────┘ │ │
    │ └─────────────────────────────────────────────────────┘ │
    └─────────────────────────────────────────────────────────┘
    

    Configuración Paso a Paso de un Dev Container Profesional

    Para convertir cualquier proyecto en un entorno reproducible, solo necesitas crear una carpeta .devcontainer en la raíz del repositorio con los siguientes dos archivos.

    1. .devcontainer/docker-compose.yml

    version: '3.8'
    
    services:
      app:
        build:
          context: .
          dockerfile: Dockerfile
        volumes:
          - ..:/workspace:cached
        command: sleep infinity
        network_mode: service:db
    
      db:
        image: pgvector/pgvector:pg16
        environment:
          POSTGRES_DB: dev_db
          POSTGRES_USER: dev_user
          POSTGRES_PASSWORD: dev_password
        ports:
          - "5432:5432"
    

    2. .devcontainer/devcontainer.json

    {
      "name": "Dominicode Fullstack Dev Environment",
      "dockerComposeFile": "docker-compose.yml",
      "service": "app",
      "workspaceFolder": "/workspace",
      "customizations": {
        "vscode": {
          "settings": {
            "editor.formatOnSave": true,
            "editor.defaultFormatter": "esbenp.prettier-vscode",
            "typescript.tsdk": "node_modules/typescript/lib"
          },
          "extensions": [
            "dbaeumer.vscode-eslint",
            "esbenp.prettier-vscode",
            "eamodio.gitlens",
            "biomejs.biome"
          ]
        }
      },
      "remoteUser": "node",
      "postCreateCommand": "bun install"
    }
    

    Ventajas Clave para Equipos de Desarrollo e IA

    1. Onboarding en 1 Clic: Cualquier nuevo desarrollador (o agente de IA que opere en entornos remotos) puede levantar un workspace 100% funcional sin instalar dependencias globales en su máquina.
    2. Homogeneización de herramientas: Todo el equipo comparte exactamente la misma versión de Node.js, TypeScript y linters. Nadie puede subir código formateado con reglas distintas.
    3. Aislamiento Total: Puedes trabajar simultáneamente en dos proyectos que utilicen versiones totalmente incompatibles de bases de datos o ejecutables de sistema sin que interfieran entre sí.

    Como analizamos en nuestra guía sobre cómo formar a tu equipo de desarrollo en IA, estandarizar los entornos de trabajo es el primer paso para acelerar la adopción de herramientas avanzadas.

    Al escribir código dentro del contenedor, sigues aplicando principios de programación defensiva en TypeScript, con la tranquilidad de que las validaciones de tipo en tiempo de ejecución se comportarán exactamente igual en local y en integración continua.

    Además, mantener aislados los límites de dependencias de tus servicios facilita aplicar estrategias de graph engineering para mapear tu arquitectura.


    Decir adiós al "en mi máquina funciona" es posible. Adoptar Dev Containers eleva la madurez de tu ingeniería de software y ahorra cientos de horas de soporte innecesario.

    Si quieres dominar las mejores prácticas de DevOps, arquitectura y desarrollo moderno con TypeScript, explora los Cursos de Dominicode. Y si quieres colaborar en proyectos reales junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Afecta el rendimiento de lectura de disco al usar Dev Containers en macOS o Windows?

    En macOS y Windows, Docker ejecuta una máquina virtual ligera. Para garantizar una velocidad de lectura de archivos óptima en los volúmenes de código fuente, la especificación usa montajes con flag :cached o tecnologías como VirtioFS en macOS, ofreciendo un rendimiento prácticamente idéntico al nativo.

    ¿Puedo usar Dev Containers si programo en Cursor o WebStorm?

    Sí. Cursor soporta la especificación Dev Containers de forma nativa al estar basado en VS Code. JetBrains (WebStorm, IntelliJ) también ofrece soporte completo para Dev Containers a través de su arquitectura de desarrollo remoto.

    ¿Qué ocurre con mis credenciales de Git y claves SSH?

    Dev Containers reenvía automáticamente el agente SSH (SSH Agent Forwarding) y las credenciales de Git de tu máquina anfitriona al interior del contenedor. Puedes hacer git commit y git push desde la terminal del contenedor usando tus claves privadas de forma segura sin copiarlas dentro de la imagen.

    ¿Dev Containers es útil para proyectos pequeños de un solo desarrollador?

    Absolutamente. Además de evitar contaminar tu sistema operativo con decenas de versiones globales de bases de datos o servicios, te permite formatear tu portátil o cambiar de equipo informático y retomar exactamente el mismo estado de desarrollo en minutos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Durante años pensé que para publicar un libro de programación necesitabas ser contratado por una gran editorial técnica, enviar propuestas durante meses y aceptar que te pagaran un miserable 8% de regalías un año después de escribirlo.

    Cuando publiqué mis primeros libros técnicos de forma autodidacta usando Markdown y los subí directamente a Amazon KDP (Kindle Direct Publishing), me di cuenta de lo equivocado que estaba.

    Publicar un libro técnico no solo te reporta ingresos pasivos mes a mes. Es la mayor carta de presentación posible para tu carrera como desarrollador: te posiciona de inmediato como un referente en tu tecnología, abre puertas para consultorías de alto valor y multiplica tu autoridad profesional.

    Si sabes programar y has resuelto problemas reales en producción, ya tienes todo lo necesario para escribir y publicar tu propio libro técnico.

    Por qué escribir un libro en la era de la IA

    Con la proliferación de contenido generado automáticamente en internet, el valor de la voz de un desarrollador senior con experiencia real ha aumentado drásticamente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, el valor del mercado ya no está en escupir código sintácticamente correcto, sino en la capacidad de estructurar sistemas, explicar decisiones de arquitectura y enseñar soluciones probadas en batalla.

    Un libro técnico bien empaquetado transmite la experiencia práctica que un desarrollador busca cuando quiere aprender un framework sin perder semanas probando tutoriales desactualizados.

    El Stack del Desarrollador Escritor

    Olvídate de Microsoft Word o Indesign. Como programadores, nuestro entorno de trabajo habitual es ideal para redactar libros técnicos:

    ┌─────────────────────────────────────────────────────────┐
    │ Redacción en Markdown (VS Code / Claude Code)           │
    │  └─► Control de versiones con Git & GitHub             │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Compilación de formatos (Pandoc / CSS / HTML)     │
    │     │  └─► Salida: PDF (Imprenta) + EPUB (Kindle)      │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Distribución Directa (Amazon KDP + Leanpub)          │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Redacción: Archivos .md organizados por capítulos en Git.
    2. Control de Código: Fragmentos de código reales probados con tests unitarios en el mismo repositorio.
    3. Formateo Automatizado: Scripts en CLI (usando Pandoc, PrinceXML o Puppeteer) para compilar el Markdown a PDF listo para impresión y EPUB para lectores digitales.

    El flujo de trabajo: De la idea a las regalías en Amazon

    1. Validación rápida (Validar antes de escribir 300 páginas)

    Antes de redactar el libro completo, escribe una tabla de contenidos detallada y publica un primer borrador o guía en plataformas como Leanpub o Gumroad. Si los primeros desarrolladores compran la versión preliminar, tienes luz verde.

    2. Estructuración pedagógica

    Un buen libro técnico no es una documentación de API traducida. Es una ruta estructurada de aprendizaje. Al igual que en nuestra metodología para formar a un equipo de desarrollo en IA en 6 semanas, debes ir de lo conceptual a lo práctico con proyectos reales paso a paso.

    3. Portada y formateo de Amazon KDP

    En Amazon KDP la portada es el 50% de la conversión. Diseña una portada limpia, con alto contraste y tipografía profesional. Asegúrate de ajustar las sangrías y márgenes de corte (bleed) según las especificaciones de Amazon si vas a ofrecer versión en papel (Paperback/Hardcover).

    4. Regalías y Estrategia de Precio

    Amazon KDP ofrece hasta un 70% de regalías en versión Kindle digital y un 60% en versión física de tapa blanda. Establecer tu precio entre $9.99 y $24.99 en digital suele ofrecer el mejor equilibrio entre volumen de ventas e ingresos netos.


    Publicar tu primer libro técnico es un proyecto de fin de semana acelerado que pagará dividendos durante años en tu carrera.

    Si te interesa profundizar en la creación de productos técnicos y modelos de ingresos para desarrolladores, explora los Cursos de Dominicode. Y si quieres rodearte de creadores y builders que están lanzando sus propias herramientas y publicaciones, únete a Dominicode Labs.

    Preguntas frecuentes

    ¿Necesito pedir ISBN antes de publicar en Amazon KDP?

    No. Amazon KDP te proporciona un código ASIN gratuito para libros digitales y un ISBN gratuito para las versiones impresas dentro de su plataforma. Si deseas vender el mismo formato físico en librerías externas, puedes comprar tu propio ISBN.

    ¿Cuánto tiempo lleva escribir un libro técnico de 150 páginas?

    Con una estructura clara y dedicando de 4 a 6 horas semanales, un desarrollador puede completar un libro técnico enfocado en 6 u 8 semanas.

    ¿Puedo usar asistentes de IA para ayudarme a redactar el libro?

    Sí, herramientas como Claude Code son excelentes para estructurar esquemas de capítulos, sugerir ejercicios prácticos y revisar la gramática de tus explicaciones. No obstante, el valor principal debe provenir de tus ejemplos de código y experiencia real.

    ¿Qué diferencia hay entre publicar en KDP e ir con una editorial como O'Reilly o Packt?

    Ir con una editorial tradicional te ofrece prestigio de marca, pero el proceso tarda entre 9 y 18 meses y solo recibes entre el 8% y el 15% de regalías. En KDP publicas de forma instantánea, mantienes el 100% de los derechos y conservas hasta el 70% de los ingresos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Hace tres años, lanzar un producto de software como servicio (SaaS) requería un equipo entero. Necesitabas un desarrollador frontend, un ingeniero backend, un diseñador UI/UX, un especialista en bases de datos, un responsable de QA y un copywriter para las landing pages. Si intentabas hacerlo todo solo, tardabas 9 meses en sacar una versión alfa.

    Hoy, la combinación de stack moderno (Next.js, Supabase, Stripe) y agentes de desarrollo acelerados con IA me permite operar múltiples líneas de negocio en solitario.

    Construir micro-SaaS rentables siendo solo developer asistido por IA ya no es una fantasía de hackers de fin de semana. Es el modelo de negocio más eficiente para ingenieros senior que quieren crear independencia financiera acumulando ingresos recurrentes (MRR) sin la sobrecarga de gestionar personal.

    El cambio de paradigma: Del equipo tradicional al "Solo Builder" con IA

    Un micro-SaaS es una herramienta de software hiperenfocada que resuelve un problema específico para un nicho bien definido. No buscas levantar rondas de capital riesgo ni contratar a 50 empleados. Buscas un producto que facture entre 2,000 $ y 15,000 $ al mes con costes operativos mínimos.

    Antes de la IA, el cuello de botella del solo builder era la falta de horas en el día. Tenías que pasar de escribir código backend a configurar pipelines de CI/CD, diseñar thumbnails u redactar emails de venta.

    Con agentes de IA especializados (como Claude Code, AGY o subagentes configurados en tu entorno):

    • Delegas el formateo de componentes, la generación de tests y el código boilerplate.
    • Redactas copys persuasionales para tus páginas de captación en minutos.
    • Automatizas las tareas repetitivas de mantenimiento y atención al cliente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, la ventaja competitiva ha dejado de estar en picar código a mano y ha pasado a la capacidad de orquestar soluciones de producto completas.

    El Stack Tecnológico del Solo Developer en 2026

    Para operar un micro-SaaS sin morir en el intento, tu arquitectura debe ser ultraligera y requerir cero mantenimiento de servidores:

    ┌─────────────────────────────────────────────────────────┐
    │ Frontend & Rendering: Next.js / Astro / TailwindCSS     │
    │  └─► Desplegado en Vercel o Netlify (Cero DevOps)       │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Backend & Data: Supabase / PostgreSQL / Hono      │
    │     │  └─► Auth, DB, Edge Functions y Vector Search    │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Pagos & Facturación: Stripe / Lemon Squeezy         │
    │  │  └─► Subscripciones recurrentes y webhooks           │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Frontend: Next.js o Astro para maquetación e hidratación ultrarrápida.
    2. Base de Datos & Auth: Supabase o Neon sobre PostgreSQL. Te proporciona autenticación, base de datos relacional y storage sin gestionar servidores.
    3. Monetización: Stripe para gestionar suscripciones recurrentes, pagos en un clic y portales de clientes automáticos.
    4. Asistente de Desarrollo: Claude Code y subagentes integrados para generar tareas, refactorizar módulos y escribir especificaciones antes de codificar.

    Las 3 Reglas de Oro para Construir Micro-SaaS Rentables

    1. Valida el problema antes de escribir código

    El error número uno de los desarrolladores es encerrarse a programar durante 3 meses para descubrir que nadie quiere pagar por el producto. Crea una landing page simple, comparte la propuesta en redes o comunidades técnicas y verifica si hay intención de pago real.

    Como explicamos en nuestra guía sobre cuándo NO usar Spec-Driven Development, en fases muy tempranas de exploración debes priorizar la velocidad de aprendizaje sobre arquitecturas sobre-diseñadas.

    2. Controla los costes de tokens e infraestructura de IA

    Si tu micro-SaaS incluye funcionalidades basadas en LLMs (ej. resúmenes automáticos, asistentes RAG o generación de imágenes), diseña la arquitectura pensando en los márgenes de beneficio.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, elegir el modelo adecuado para cada tarea (usando modelos ligeros como Haiku o Flash para tareas simples y modelos avanzados para razonamiento complejo) es la diferencia entre tener un margen del 80% o perder dinero en cada registro.

    3. Automatiza la retención y el soporte desde el día 1

    Como desarrollador en solitario, tu activo más valioso es tu tiempo. Configura secuencias de onboarding por email automáticas y asistentes de soporte basados en documentación para resolver las dudas más frecuentes sin intervención manual.


    Construir micro-SaaS rentables te da la libertad de trabajar en tus propios términos, aplicando tu experiencia técnica en productos que aportan valor real a tus clientes.

    Si quieres aprender las mejores técnicas de desarrollo frontend, backend y arquitectura con IA, explora los Cursos de Dominicode. Y si quieres unirte a una comunidad privada de creadores que están construyendo y facturando con sus propios proyectos de software, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Cuánto dinero se necesita para lanzar un micro-SaaS?

    Gracias al tier gratuito de plataformas como Vercel, Supabase, GitHub y Stripe, el coste inicial de infraestructura para lanzar un micro-SaaS es prácticamente cero dólares al mes. Tus únicos gastos iniciales son el nombre de dominio (unos 10 $/año) y tu suscripción a herramientas de IA.

    ¿Cuánto tiempo lleva desarrollar un MVP (Producto Mínimo Viable)?

    Usando el stack recomendado y apoyándote en asistentes de IA para el código repetitivo, un desarrollador senior puede construir y lanzar un MVP funcional en 2 a 4 semanas trabajando a tiempo parcial.

    ¿Cómo competir contra grandes empresas siendo un solo developer?

    Tu ventaja es la agilidad y el enfoque de nicho. Una gran empresa no puede dedicar recursos a resolver un problema específico de 5,000 $ de MRR para una industria concreta. Tú puedes construir una solución a medida, ofrecer una atención cercana y adaptar el producto en horas sin pasar por comités de aprobación.

    ¿Se pueden vender estos micro-SaaS en el futuro?

    Sí. Existe un mercado secundario enorme en plataformas como Acquire.com o Flippa donde inversores compran micro-SaaS validados y rentables por múltiplos de 3x a 5x de sus ingresos anuales (ARR).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Hace unas semanas estaba ayudando a un desarrollador senior a configurar su entorno de trabajo con herramientas de IA. Para asegurarse de que el agente no cometiera errores, pegó en la ventana del chat un bloque gigante de 12.000 tokens que incluía la documentación entera del proyecto, 15 reglas de linteo, 4 archivos de tipos y la estructura del árbol de carpetas.

    Cuando le pidió a la IA que implementara un módulo simple, la IA ignoró por completo las reglas situadas en la mitad del texto y generó importaciones obsoletas.

    El desarrollador exclamó frustrado: "¡Le di toda la información en el prompt y aun así alucina!".

    El problema no era la falta de información; era el exceso de ruido mal estructurado. Context Engineering no es escribir mejores prompts (Prompt Engineering). Es la disciplina de diseñar la arquitectura de información que alimenta a la ventana de contexto de los modelos LLM para maximizar la atención del modelo y erradicar las alucinaciones.

    El fenómeno "Lost in the Middle" y la curva de atención

    Los modelos de lenguaje basados en la arquitectura Transformer no leen el texto de la misma manera que los humanos.

    Cuando la ventana de contexto supera los miles de tokens, ocurre un fenómeno estudiado minuciosamente por investigadores conocido como "Lost in the Middle" (Perdido en el medio):

    • La IA presta máxima atención a los primeros tokens del prompt (Primacy Bias), que corresponden habitualmente al System Prompt.
    • La IA presta máxima atención a los últimos tokens recibidos (Recency Bias), que corresponden a la última instrucción del usuario.
    • La información situada en el tercio central de la ventana de contexto sufre una caída drástica de atención, aumentando el riesgo de alucinaciones o instrucciones ignoradas.
    Nivel de Atención del LLM
     ▲
    1.0 ┼──────┐                                 ┌──────┐
        │      │                                 │      │
    0.5 ┤      └───────────┐         ┌───────────┘      │
        │                  │         │                  │
    0.0 ┴──────────────────┴─────────┴──────────────────┴──►
        [System Prompt]    [Zona Central]     [Último Prompt]
          (Alta Atención)  (PERDIDO EN EL MEDIO) (Alta Atención)
    

    Prompt Engineering vs. Context Engineering

    • Prompt Engineering: Se enfoca en el redactado del mensaje. "Escribe una función en TypeScript limpia y responde en formato JSON".
    • Context Engineering: Se enfoca en la gestión dinámica del espacio de memoria. ¿Qué archivos se deben incluir? ¿En qué formato se presentan los datos? ¿Cómo se poda el historial de conversación cuando se sobrecarga?

    Como demostramos en nuestro análisis sobre por qué tu spec falla con un agente de IA, entregar especificaciones ambiguas o mal estructuradas es la razón principal por la que los agentes generan código inservible.

    4 Pilares de Context Engineering para Developers

    1. Etiquetado Semántico con XML y Markdown

    Los modelos LLM avanzados (como Anthropic Claude) han sido entrenados específicamente para interpretar etiquetas XML como delimitadores de contexto. En lugar de enviar texto plano continuo, envuelve la información en secciones etiquetadas:

    <system_instructions>
      Eres un desarrollador Senior en TypeScript. Sigue estrictamente las reglas definidas en <coding_standards>.
    </system_instructions>
    
    <coding_standards>
      - Usa siempre tipos estrictos sin 'any'.
      - Utiliza el patrón Result para manejo de errores.
    </coding_standards>
    
    <context_files>
      <file path="src/types/user.ts">
        export interface User { id: string; email: string; }
      </file>
    </context_files>
    
    <user_request>
      Crea una función para validar el correo de la interfaz User.
    </user_request>
    

    2. Podado Dinámico de Contexto (Context Pruning)

    No arrastres el historial de chat indefinidamente. Si llevas 20 mensajes iterando sobre una funcionalidad, el historial acumulado satura la memoria. Limpia el contexto generando un resumen del estado actual e inicia una sesión limpia con los artefactos actualizados.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, reducir el volumen de tokens enviados reduce los costes y acelera la velocidad de respuesta.

    3. Graph Engineering (Indexación de Dependencias)

    En lugar de enviarle al agente archivos enteros de 1.000 líneas, utiliza herramientas de indexación que entreguen únicamente las firmas de funciones, interfaces y grafos de dependencias requeridos. Revisa nuestra guía completa de graph engineering para aprender a crear mapas de código precisos.

    Y cuando ese contexto sale de tus propias notas, la unidad importa: una nota atómica se recupera entera y una nota-cajón llega partida. Lo desarrollé en Zettelkasten para developers.

    4. Separación de Tareas mediante Subagentes

    Delegar sub-tareas a subagentes independientes garantiza que cada subagente trabaje en su propia ventana de contexto de 2.000 tokens hiperenfocada, devolviendo únicamente el resultado consolidado al hilo principal.


    Diseñar el contexto adecuado es lo que transforma a un asistente conversacional genérico en una herramienta de ingeniería precisa y predecible.

    Si quieres aprender a dominar arquitecturas avanzadas de desarrollo asistido por IA, descubre los Cursos de Dominicode. Y si quieres aplicar estas técnicas en proyectos reales de producción junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué los modelos con ventanas de 1 millón de tokens siguen necesitando Context Engineering?

    Aunque un modelo pueda "procesar" 1 millón de tokens técnicamente, la calidad del razonamiento y la precisión en la recuperación de datos disminuyen a medida que aumenta la ventana. Mantener la información acotada y estructurada garantiza la máxima precisión.

    ¿Cuál es la diferencia entre RAG (Retrieval-Augmented Generation) y Context Engineering?

    RAG es una técnica específica de Context Engineering que utiliza búsquedas semánticas o vectoriales para seleccionar qué fragmentos de información recuperar de una base de datos. Context Engineering engloba la estrategia completa de empaquetado, podado, etiquetado y presentación de esos fragmentos al modelo.

    ¿Es mejor enviar código en formato JSON, XML o Markdown?

    Markdown con bloques de código delimitados por tres acentos graves (“`) y etiquetas XML (<file>, <spec>) es la combinación óptima. Los modelos actuales reconocen esta estructura de forma nativa por la abundancia de repositorios de GitHub en sus datos de entrenamiento.

    ¿Cómo afecta el idioma del contexto a la precisión del modelo?

    Los modelos de lenguaje procesan los tokens de instrucciones en inglés con una ligera ventaja de atención debido a la densidad de datos de entrenamiento. Sin embargo, para la lógica de negocio y comentarios del proyecto en español, mantener el contexto en español estructurado mediante etiquetas XML ofrece resultados excelentes sin pérdida de coherencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo crear skills y subagentes personalizados para automatizar tu flujo diario de desarrollo con IA

    Cómo crear skills y subagentes personalizados para automatizar tu flujo diario de desarrollo con IA

    Cada mañana, durante semanas, me sorprendía a mí mismo haciendo exactamente lo mismo. Abría mi herramienta de IA y pasaba los primeros 10 minutos explicándole la arquitectura de mi proyecto, las normas de linteo de nuestro equipo, qué librerías no debía usar y cómo estructurar los tests unitarios.

    Si cambiaba de conversación o abría un nuevo hilo para otra tarea, tenía que volver a escribirlo todo de nuevo.

    Estaba tratando a los asistentes de inteligencia artificial como un becario que llega nuevo a la oficina cada dos horas y sufre amnesia. Ahí fue cuando me di cuenta de que el verdadero salto de productividad no está en perfeccionar los prompts, sino en construir skills y subagentes personalizados que encapsulen tu conocimiento y el de tu equipo en tu flujo de desarrollo con IA.

    El problema del prompt de 500 líneas en la ventana de contexto

    Muchos desarrolladores intentan solucionar este problema pegando gigantescos bloques de contexto en el system prompt o en archivos de instrucciones globales.

    Eso crea dos problemas graves:

    1. Degradación del contexto: Si sobrecargas la ventana inicial del modelo con reglas que solo aplican a una tarea específica (por ejemplo, cómo migrar la base de datos), el LLM pierde precisión al razonar sobre la tarea actual.
    2. Coste descontrolado de tokens: Cada mensaje que envías vuelve a procesar todo ese system prompt gigante. Como analizamos en nuestro artículo sobre el coste de subagentes al cambiar de modelo, acumular tokens innecesarios encarece y ralentiza drásticamente la ejecución.

    La solución arquitectónica correcta es separar el conocimiento en dos conceptos: Skills (habilidades bajo demanda) y Subagentes (agentes especializados con ventana de contexto aislada).

    ¿Qué es una Skill y cuándo usarla?

    Una Skill es una carpeta de instrucciones y recursos que se activa solo cuando el agente la necesita para resolver una tarea concreta.

    Piensa en una skill como el "manual de procedimientos" para una tarea específica:

    • Crear una nueva spec arquitectónica.
    • Configurar el tracking de analítica.
    • Auditar la accesibilidad UI de una página.
    ---
    name: angular-signals-migration
    description: Guía paso a paso para migrar componentes de RxJS BehaviorSubject a Angular Signals en v22+
    ---
    
    # Instrucciones de Migración
    1. Reemplaza `BehaviorSubject<T>` por `signal<T>`.
    2. Para valores derivados, utiliza `computed()`. No uses `effect()` para modificar estado.
    3. Asegúrate de actualizar la plantilla eliminando el pipe `async`.
    

    Cuando tu agente (como Claude Code o AGY) detecta que tu petición requiere migrar componentes, lee este SKILL.md bajo demanda, aplica las reglas y libera el espacio cuando termina.

    ¿Qué es un Subagente personalizado?

    Un Subagente es un agente secundario que se lanza en una conversación en segundo plano completamente aislada.

    Recibe un rol específico (por ejemplo: Code Reviewer, Database Debugger o SEO Auditor), un conjunto acotado de herramientas y su propia ventana de contexto. Cuando termina su labor, devuelve únicamente el resultado sintetizado al agente principal.

    Al igual que explicamos en nuestro post sobre graph engineering, estructurar la información en nodos especializados evita que la IA se pierda en un laberinto de contexto irrelevante.

    Ejemplo de definición de Subagente

    ---
    name: code-reviewer-senior
    description: Revisa pull requests buscando vulnerabilidades de seguridad, memory leaks y falta de tipos estrictos.
    tools: read_file, grep_search
    ---
    
    # Rol: Senior Code Reviewer
    Eres un auditor de código ultrarreciso. Revisa las líneas modificadas en la PR y evalúa:
    1. ¿Hay algún `any` implícito o explícito en TypeScript?
    2. ¿Se están liberando los subs de observables no finitos?
    3. Devuelve únicamente una lista de hallazgos críticos prioritarios.
    

    Guía paso a paso para crear tu primera Skill

    Para implementar skills en tu repositorio o configuración global de IA:

    1. Estructura el directorio

    Crea una carpeta dentro de .agents/skills/ (o la ruta de configuraciones de tu herramienta):

    .agents/
      skills/
        db-migration/
          SKILL.md
          template.sql
    

    2. Escribe el SKILL.md con Frontmatter claro

    Define en la cabecera YAML el nombre y una descripción precisa de cuándo debe activarse la skill. El agente utilizará la descripción para saber cuándo consultar estas instrucciones.

    3. Mantén los pasos de ejecución atómicos

    Define un flujo paso a paso que el agente pueda verificar en cada etapa antes de continuar.


    El resultado es inmediato: dejas de repetir las mismas explicaciones una y otra vez. Tu equipo comparte la misma carpeta de .agents/ en el repositorio Git, garantizando que todos los desarrolladores (y sus agentes de IA) sigan exactamente los mismos estándares.

    Si deseas ver más sobre la integración de IA en tu organización, revisa nuestra guía sobre cómo formar a tu equipo de desarrollo en IA en 6 semanas.

    Para seguir perfeccionando tu workflow, consulta los Cursos de Dominicode donde profundizamos en desarrollo asistido por IA. Y si buscas construir productos reales en comunidad, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿En qué se diferencia una Skill de un Prompt tradicional?

    Un prompt tradicional se envía manualmente en cada mensaje. Una Skill es modular, vive en el disco como archivo de código y es descubierta y cargada de forma autónoma por la IA solo cuando la tarea lo requiere.

    ¿Puedo compartir mis skills con otros miembros de mi equipo?

    Sí, al almacenar la carpeta .agents/skills/ dentro del propio repositorio de Git, todo el equipo comparte automáticamente las mismas instrucciones y mejores prácticas del proyecto.

    ¿Los subagentes consumen más tokens que una conversación normal?

    Inicialmente, lanzar un subagente consume tokens de inicialización, pero a medio y largo plazo ahorra miles de tokens porque evita arrastrar el historial de chat acumulado de la sesión principal.

    ¿Qué herramientas soportan el uso de Skills y Subagentes?

    Herramientas avanzadas como Claude Code, Google Antigravity (AGY), Cursor y entornos habilitados con arquitecturas de agentes permiten definir e invocar skills y subagentes de forma nativa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Agentes de IA en el navegador: por qué fallan y cómo arreglarlo

    Agentes de IA en el navegador: por qué fallan y cómo arreglarlo

    Tenía un agente que hacía una cosa aburrida y la hacía bien: leer una cola, crear el recurso por API, comprobar la respuesta, seguir. Si algo fallaba, lo repetía. Lo dejé corriendo toda una tarde sin mirarlo.

    Luego apunté ese mismo agente al navegador, porque el proveedor de turno no tenía API. Misma tarea, mismo bucle, misma cabeza: así se montan hoy casi todos los agentes de IA en el navegador. Y ahí aparece el clásico. El clic de "Confirmar" parece no responder, el bucle reintenta, y al otro lado quedan dos pedidos idénticos.

    No fue un bug del modelo. Fue el bucle haciendo exactamente lo que le pedí: reintentar. Hereda una política diseñada para un mundo donde reintentar es gratis, y el navegador es justo el sitio donde deja de serlo.

    Esto no es un tutorial. Si quieres montarlo y verlo funcionando, el cómo está en automatizar la usabilidad con agentes de IA. Aquí va lo otro: por qué se rompe cuando lo pones a trabajar de verdad. Se rompe siempre por los mismos tres sitios —las esperas, el estado y las acciones que no se pueden deshacer— y ninguno de los tres es culpa del modelo.

    Los agentes de IA en el navegador heredan un bucle que no es suyo

    Un agente es un bucle: observa, decide, actúa, vuelve a observar. Lo conté con detalle en qué es el agentic loop, y todo lo que envuelve al modelo —tools, memoria, política de errores— es lo que llamamos harness.

    Ese harness lleva dentro una suposición que casi nadie hace explícita: si una acción falla, se puede volver a intentar.

    Con una API la suposición se sostiene. El POST devolvió timeout, no sabes si llegó, lo repites. Si la API es decente tienes una clave de idempotencia. Si no, tienes un staging donde da igual. El coste de un reintento es latencia.

    En el navegador se cae. La acción ya salió de tu sistema: un pedido confirmado, un correo enviado, un registro borrado, una publicación en una cuenta real. Y tu bucle no recibe ningún código de estado: recibe una página repintada. Saber si aquello se completó es un paso aparte, que tienes que pedir tú. Casi nadie lo pide.

    Y aquí está el detalle que provoca el desastre: nadie cambia el bucle al cambiar de herramienta. Sustituyes http_request por browser_click en la lista de tools y sigues con la misma política de reintentos y la misma tolerancia a errores.

    Fallo 1: las esperas. Clicable no significa listo

    Playwright, antes de actuar, comprueba que el elemento sea accionable. Son los actionability checks, y la documentación oficial los define así:

    • Visible: tiene un bounding box no vacío y no tiene visibility: hidden.
    • Stable: ha mantenido el mismo bounding box durante al menos dos frames de animación consecutivos.
    • Receives Events: es el hit target del evento de puntero en el punto de la acción.
    • Enabled: no está deshabilitado.

    Lee esas cuatro definiciones otra vez. Son geometría y DOM. Ninguna dice nada sobre si tu aplicación tiene sentido.

    Un botón "Confirmar pedido" puede estar visible, quieto durante dos frames, habilitado y ser el hit target mientras el precio final todavía se recalcula en el backend. Pasa los cuatro checks. El clic es prematuro. Playwright no ha mentido: nunca prometió esperar a que la app estuviera lista, solo a que el elemento fuera clicable.

    Hay más. No todas las acciones piden lo mismo:

    Acción Comprobaciones
    click(), dblclick(), check(), uncheck(), tap() Visible, Stable, Receives Events, Enabled
    fill(), clear() Visible, Enabled, Editable
    selectOption() Visible, Enabled
    hover(), dragTo() Visible, Stable, Receives Events
    press(), pressSequentially(), focus(), blur(), dispatchEvent(), setInputFiles() Ninguna

    Fíjate en dos cosas. fill() no espera a Stable: comprueba que el campo sea visible, esté habilitado y no sea de solo lectura, pero puedes escribir en un input que se está moviendo. Y hay un grupo entero de acciones sin ninguna comprobación, incluida dispatchEvent().

    Ese grupo importa porque es la salida de emergencia. Cuando el clic normal "no funciona", el camino que aparece es disparar el evento a mano. En código de Playwright, locator.dispatchEvent('click'). Desde MCP no existe una tool equivalente: lo que hay es browser_evaluate, que ejecuta tu JavaScript sobre el elemento, y browser_run_code_unsafe, que la propia documentación describe como equivalente a ejecución remota de código.

    Tres caminos distintos y el mismo efecto: ninguno pasa por los actionability checks.

    El agente cree que ha encontrado una solución ingeniosa. Lo que ha hecho es quitar las comprobaciones que le impedían hacer clic demasiado pronto.

    La corrección no es esperar más. Es esperar a otra cosa: a la condición de negocio, no al elemento.

    // Espera al elemento. Pasa los cuatro checks y hace clic.
    await page.getByRole('button', { name: 'Confirmar pedido' }).click();
    
    // Espera a que la aplicación esté lista, y entonces hace clic.
    await expect(page.getByTestId('gastos-envio')).toHaveText(/\d/);
    await expect(page.getByTestId('spinner-total')).toBeHidden();
    await page.getByRole('button', { name: 'Confirmar pedido' }).click();
    

    Ojo con el orden: toBeHidden() en primera posición pasaría antes de que el spinner llegue a aparecer. Solo es seguro después de una aserción positiva.

    Con Playwright MCP el equivalente es browser_wait_for sobre un texto que solo existe cuando el backend ya respondió. No "Total" —que está en el DOM desde el primer render—, sino "Envío calculado" o el importe con su formato final.

    Esperar por estado y no por píxeles es la misma disciplina que separa una suite de tests fiable de una que falla los martes. La trabajo a fondo en el curso de Testing en Angular, y se traslada tal cual a los agentes.

    Fallo 2: el estado. El agente decide sobre una foto caducada

    En el fallo anterior el elemento no estaba listo. Aquí el elemento está listo, pero el agente mira una foto de hace tres segundos. La carrera es la misma; la corrección, no.

    Playwright MCP no le manda screenshots al modelo. Le manda accessibility snapshots: un árbol estructurado de elementos accesibles con refs para interactuar, del tipo e5.

    Es la decisión correcta. Playwright documenta un coste aproximado de 200-400 tokens por snapshot frente a 3.000-5.000 de un screenshot para un modelo de visión. Barato, textual, determinista.

    Pero la letra pequeña está en la misma página: los refs son estables dentro de un único snapshot —el mismo elemento mantiene el mismo ref hasta que la página cambia— y quedan invalidados cuando la página cambia.

    Traducción: el snapshot es una fotografía. Y entre la fotografía y el clic hay una llamada a un LLM que tarda segundos.

    En esos segundos tu SPA puede recibir un evento por WebSocket, reordenar una lista, cerrar un modal o repintar una tabla. Si el nodo desapareció, el ref deja de resolver y la tool falla: molesto, pero visible.

    El caso feo es el otro. Si tu framework recicla el nodo en vez de recrearlo —listas sin key o sin trackBy, scroll virtual—, el e5 que en la foto era "Eliminar borrador" de la fila 3 sigue vivo y ahora es el de la fila 4. Resuelve, el clic sale, y borras lo que no era. El agente no actúa sobre la página: actúa sobre su recuerdo de la página.

    Un locator de Playwright se resuelve en el instante de actuar. Un ref se resolvió antes de que el modelo empezara a pensar. Toda la diferencia está ahí.

    Hay un segundo efecto del estado que casi nadie cuenta, y es el que más planes rompe.

    No puedes paralelizar agentes de navegador como paralelizas agentes de API. Playwright MCP arranca por defecto con un perfil persistente —ahí viven las sesiones y las cookies— y la documentación es tajante: un perfil persistente solo lo puede usar una instancia de navegador a la vez, así que varios clientes MCP concurrentes que compartan el mismo workspace entrarán en conflicto.

    Con la configuración por defecto, ese perfil es un singleton. Lanzar diez subagentes contra la misma cuenta no te da diez veces el rendimiento: te da un conflicto, o peor, diez agentes pisándose la sesión.

    La propia documentación da dos salidas: arrancar cada cliente extra con --isolated, o apuntarlo a un --user-data-dir distinto. La segunda te conserva la sesión guardada. La primera arranca limpia y pierde todo su storage al cerrar el navegador, así que le inyectas el estado inicial con --storage-state.

    Para un agente que reintenta, quédate con la primera. Pierdes comodidad y ganas algo más valioso: poder tirar el estado y repetir el intento desde cero.

    Fallo 3: el bucle no distingue lo que se puede deshacer

    Divide en dos columnas todo lo que hace tu agente.

    Idempotente: navegar, leer, hacer scroll, sacar un snapshot, abrir una pestaña, leer la consola. Repetirlo cien veces no cambia el mundo. Como mucho gasta tokens.

    Con efecto externo: enviar el formulario, confirmar el pago, borrar el registro, publicar el post, invitar al usuario. Repetirlo cambia el mundo, y a veces cambia el mundo de otra persona.

    Para el harness las dos son idénticas. browser_click sobre "Volver" y browser_click sobre "Confirmar pedido" son la misma tool call con distinto ref. El modelo cree que sabe la diferencia; el bucle, que es quien decide reintentar, no la sabe. Sobre los límites reales de un bucle en producción escribí en el loop del agente en producción.

    La confirmación de que esto es un problema real no la pongo yo. La pone Anthropic.

    Claude for Chrome, en beta para planes de pago, navega, hace clic y rellena formularios en tu navegador. El usuario puede pre-aprobar por sitio las acciones que le permite. Y aun así, el producto sigue preguntando antes de ciertas acciones irreversibles o potencialmente dañinas, como hacer una compra.

    Si el reintento fuera seguro, ese gate no existiría. Nadie construye una interrupción humana específica alrededor de "comprar" por gusto: la construye porque comprar dos veces no se arregla razonando mejor. Es el mismo principio de aprobación previa del que hablé en computer use con Claude Code.

    El navegador viene con tus credenciales dentro

    La documentación de Playwright MCP tiene una frase que deberías pegar en la pared antes de darle un navegador a un agente:

    Playwright MCP is not a security boundary.
    (Playwright MCP no es una frontera de seguridad.)

    No es un aviso legal. Es una descripción exacta de lo que estás montando. Ese navegador lleva las sesiones del usuario real, sus cookies, sus tokens y su banca abierta en otra pestaña. Y cualquier texto que la página muestre entra en el contexto del modelo.

    Anthropic lo midió sobre su propia extensión. En el anuncio del piloto de Claude in Chrome, de agosto de 2025: 123 casos de prueba sobre 29 escenarios de ataque, 23,6% de éxito de la inyección de prompts sin mitigaciones y 11,2% con las defensas activadas en modo autónomo.

    Fíjate en que el segundo número no es cero. Algo más de uno de cada diez intentos seguía pasando, en la configuración de quien fabrica el modelo y tiene todos los incentivos para que no pase.

    Darle un navegador a un agente no es añadir una tool más al array. Es una decisión de arquitectura sobre qué credenciales pones al alcance de un bucle que, por diseño, insiste.

    Qué hacer con esto hoy

    1. Afirma el estado, no esperes al elemento. Antes de cada acción con efecto, exige una condición de negocio verificable: un texto que solo aparece cuando el backend respondió, un importe con formato final, un contador que cuadra. Si no sabes escribir esa aserción, tu agente tampoco sabe si la app está lista.

    2. Clasifica tus acciones y cierra las pocas irreversibles con un gate. No pidas aprobación para todo: eso degenera en aprobar en automático en tres días. Pídela solo en la columna corta. En Claude Code se implementa con hooks, como lo monté en hooks como guardrails.

    3. Usa una clave de idempotencia cuando la aplicación te la dé. Un identificador de operación en el formulario, un borrador con ID estable, un endpoint que acepta la misma referencia dos veces. Si controlas la app de destino, es media hora de trabajo y elimina la clase entera de fallo.

    4. Trabaja con perfil aislado y --storage-state. Estado desechable significa reintentos limpios. Estado persistente significa que el segundo intento arranca desde la basura del primero.

    5. Verifica después de actuar, no solo antes. browser_network_requests y browser_console_messages te dicen si la petición salió y si la app se quejó. Actuar a ciegas y volver a intentar es exactamente cómo se duplican pedidos.

    Diseñar así el bucle —qué se reintenta, qué se para, qué se verifica— es lo que separa un agente de demo de uno que dejas suelto, y es lo que trabajamos en el curso Construye con IA.

    El bucle no va a distinguir por ti entre leer y comprar. Esa frontera la dibujas tú, hoy, antes de la próxima ejecución. Si quieres ver estos patrones aplicados sobre proyectos reales y con el código delante, en Dominicode Labs es donde los montamos.

    Preguntas frecuentes

    ¿Por qué mi agente funciona bien contra APIs y falla en el navegador?

    Porque el bucle está construido sobre la idea de que una acción fallida se puede repetir. Con una API eso suele ser cierto y barato. En el navegador, la acción ya produjo un efecto fuera de tu sistema —un pedido, un correo, un borrado— y confirmar si se completó exige un paso extra que el bucle no da solo. Cambiaste la herramienta, no la política de reintentos.

    Si Playwright ya espera a que el elemento sea accionable, ¿por qué hace clic antes de tiempo?

    Porque sus comprobaciones son geométricas y de DOM: visible, estable, hit target y habilitado. Estable significa que el bounding box no cambió durante dos frames de animación, no que los datos hayan cargado. Un botón puede pasar los cuatro checks mientras el backend todavía calcula. Clicable no es lo mismo que listo.

    ¿Cómo hago que un agente espere a que la aplicación esté lista de verdad?

    Espera por una condición de negocio, no por un elemento: un texto que solo se renderiza cuando llegó la respuesta, un importe con su formato final, un estado que pasó de "calculando" a un valor. Con Playwright MCP, browser_wait_for sobre ese texto. Regla práctica: si el marcador que esperas ya está en el DOM en el primer render, no te sirve.

    ¿Puedo lanzar en paralelo varios agentes de IA en el navegador?

    No con la configuración por defecto. Playwright MCP usa un perfil persistente y su documentación advierte de que solo lo puede usar una instancia de navegador a la vez, así que varios clientes MCP concurrentes en el mismo workspace entran en conflicto. La salida documentada es arrancar cada cliente extra con --isolated —con --storage-state si hace falta sesión inicial— o apuntarlo a un --user-data-dir distinto si quieres conservar la sesión. Y, normalmente, cuentas distintas.

    ¿Qué acciones de un agente de navegador deberían pedir aprobación humana?

    Solo las que no se pueden deshacer: pagos, envíos definitivos, borrados, publicaciones e invitaciones. Navegar, leer o sacar snapshots no necesitan gate. Es la línea que sigue Claude for Chrome, que pre-aprueba por sitio y aun así vuelve a preguntar antes de acciones irreversibles como una compra. Si pides confirmación para todo, en tres días la darás en automático.

    ¿Es mejor accessibility snapshot o screenshot para un agente de navegador?

    El snapshot, casi siempre. Playwright documenta un coste aproximado de 200-400 tokens por snapshot frente a 3.000-5.000 de un screenshot para un modelo de visión, y además da refs con los que interactuar. Su límite es otro: esos refs solo son estables dentro de ese snapshot y se invalidan cuando la página cambia. El screenshot sigue disponible como tool por defecto (browser_take_screenshot) para lo que el árbol de accesibilidad no expresa, como un canvas o un mapa. Lo que habilita --caps=vision no es la captura: es poder interactuar por coordenadas sobre ella.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo evaluar un proyecto de IA: cinco preguntas antes de aprobar

    Cómo evaluar un proyecto de IA: cinco preguntas antes de aprobar

    Un responsable de operaciones entra en la reunión con la frase ya montada: "queremos un agente para las devoluciones".

    Primera pregunta del árbol. ¿Los pasos son siempre los mismos, y en el mismo orden?

    Sí. Salvo cuando el importe supera cierto umbral.

    Fin del árbol. En la pregunta uno.

    Lo que necesitaba era un workflow con una excepción. Y estaba presupuestando diez veces eso.

    Esto es lo que no sale en la diapositiva de nadie que venga a venderte algo, y es el fondo de cómo evaluar un proyecto de IA: el resultado más frecuente de hacerlo bien es descubrir que no hacía falta un agente. No es falta de ambición. Es lo que hace que el proyecto siga vivo dentro de dos años.

    Y hay un motivo egoísta para que te importe aunque tú no firmes ningún presupuesto: la decisión mala la acabas implementando tú.

    Si lo que buscas es el vocabulario —qué es un agente y qué no—, está entero en esta guía. Aquí no definimos nada. Aquí decidimos, y le ponemos precio a cada decisión.


    Resumen rápido

    • Cinco preguntas, en orden, y se para en la primera que aplique. No es un cuestionario: es un árbol.
    • Cada peldaño que subes multiplica el coste. La gracia está en pararse en el más bajo que resuelve el problema.
    • En IA el éxito es lo que dispara el coste: se paga por uso, así que si la herramienta gusta, la factura sube con ella.

    Cómo evaluar un proyecto de IA: el árbol de cinco preguntas

    Evaluar un proyecto de IA es recorrer estas cinco preguntas en orden y parar en la primera que aplique:

    1. ¿Los pasos son siempre los mismos, y en el mismo orden? Si sí, es un workflow, no un agente.
    2. ¿Basta con leer y escribir texto, sin tocar ningún otro sistema? Si sí, basta un chat con buen contexto.
    3. ¿Hay que decidir sobre la marcha según lo que se encuentre? Si no, workflow otra vez.
    4. Si se equivoca, ¿se puede deshacer? Si no, agente con una persona aprobando cada acción con consecuencias.
    5. ¿Puedes medir si lo ha hecho bien? Si no, todavía no va a producción.

    Cada peldaño que superas multiplica el coste, así que evaluar bien un proyecto de IA consiste en pararse en el escalón más bajo que resuelve el problema.

    La decisión se toma casi siempre al revés. Alguien quiere hacer algo con IA y después busca dónde encajarlo. Así es como acabas pagando la flexibilidad de un agente para ejecutar cinco pasos que nunca cambian.

    El árbol invierte el orden. Primero el problema, después la herramienta. Y así es como se ve cuando lo pones en una hoja, que es la forma en que de verdad se usa en una reunión:

      1. ¿Los pasos son siempre los mismos,
         y en el mismo orden?
           └─ SÍ → workflow. No agente.
           ↓ NO
    
      2. ¿Basta con leer y escribir texto,
         sin tocar ningún otro sistema?
           └─ SÍ → un chat con buen contexto.
           ↓ NO
    
      3. ¿Hay que decidir sobre la marcha
         según lo que se encuentre?
           └─ NO → workflow otra vez.
           ↓ SÍ
    
      4. Si se equivoca, ¿se puede deshacer?
           └─ NO → agente, pero con una
                    persona aprobando todo
                    lo que tenga consecuencias.
           ↓ SÍ
    
      5. ¿Puedes medir si lo ha hecho bien?
           └─ NO → todavía no va a producción.
           ↓ SÍ
    
         → Adelante. Empieza con los permisos
           mínimos y ábrelos según se los gane.
    

    Ninguna de las cinco es técnica: se contestan describiendo el proceso. Vamos una a una, con el precio de quedarse en cada peldaño al lado. Porque el árbol no va de arquitectura. Va de dinero.


    Uno. ¿Los pasos son siempre los mismos y en el mismo orden?

    Si la respuesta es sí, ya has terminado. No necesitas un agente: necesitas un workflow.

    Más barato, más rápido, auditable, y no improvisa. Cuando falla, el informe de incidencia cabe en una línea: falló el paso tres. Eso también es dinero, porque nadie factura horas reconstruyendo qué pasó.

    Esta pregunta se salta por una razón muy humana: describir un proceso como "variable" suena mejor que describirlo como "cinco pasos y una excepción". Pero el caso de las devoluciones es el típico, no la anomalía. Los pasos son fijos salvo un caso, y ese salvo se convierte en el argumento para presupuestar un sistema entero.

    Un if no es variedad. Es un if.

    Y aquí está el multiplicador que hace que esta pregunta valga tanto dinero: un agente que da quince vueltas en lugar de tres no cuesta cinco veces más. Cuesta bastante más, porque el coste no crece con el número de vueltas, sino con la suma de todas las anteriores: cada una reenvía el contexto completo. Un workflow ejecuta los pasos que escribiste y para.

    Muchos candidatos a agente son procesos que pueden escribirse tal cual, y los desmenucé en cómo automatizar tu proceso de desarrollo con IA.

    Lo que pagas aquí: ingeniería una vez, ejecución predecible. Es el único escalón donde la factura no depende de que la herramienta guste.


    Dos. ¿Basta con leer y escribir texto, sin tocar ningún otro sistema?

    Si es que sí, te sobra con un chat con buen contexto. Súmale tus documentos y ya está.

    Redactar, resumir, reformular, clasificar. Nada de eso toca un sistema ni necesita permisos, y montarlo es cuestión de días.

    Lo que se subestima aquí no es la capacidad. Es la latencia.

    Un asistente que tarda ocho segundos sirve perfectamente para redactar un informe. El mismo asistente delante de un cliente al teléfono es inaceptable. La calidad es idéntica; el uso, imposible. Y un agente multiplica esa espera por el número de vueltas: lo que en un chat son ocho segundos, en un agente pueden ser dos minutos.

    Regla que uso siempre: si hay una persona esperando, la latencia es un requisito, no un detalle. Si el proceso corre de madrugada, da igual lo que tarde.

    Lo que pagas aquí: sube con el número de personas, no con la complejidad. Es el escalón que menos sorpresas da.


    Tres. ¿Hay que decidir sobre la marcha según lo que se encuentre?

    Si es que no, workflow otra vez.

    Esta pregunta existe porque hay procesos que tocan varios sistemas —por eso pasaron la dos— pero donde el orden sigue estando escrito de antemano. Leer un correo, extraer datos, meterlos en el CRM, avisar por Slack. Toca cuatro cosas. No decide ninguna.

    El error de asignación es carísimo y se repite: mover datos de un sitio a otro no necesita un modelo eligiendo el siguiente paso. Necesita una automatización de las de siempre, con IA solo en el hueco donde hace falta criterio.

    El árbol decide un proyecto entero. Cuando lo que tienes delante es un backlog y no un presupuesto, la unidad cambia: se decide tarea por tarea, y eso está en cómo clasificar tareas de desarrollo para delegarlas a la IA.

    Lo que pagas aquí: lo mismo que en la uno, más las ramas que hay que mantener. Sigue siendo el barato.


    Cuatro. Si se equivoca, ¿se puede deshacer?

    Si la respuesta es no, la respuesta tampoco es "no lo hagas". Es: agente sí, pero con una persona aprobando cada acción con consecuencias.

    Sin excepciones. Y sin renegociarlo a la baja tres semanas después porque aprobar es un incordio.

    Pagar, contratar, publicar, borrar, escribir a clientes reales, migrar datos de producción. Ninguna de esas se deshace con un ctrl+Z, y todas tienen un coste que ya no es de infraestructura: es de reputación, de contrato o de nómina.

    La parte que no aparece en ninguna hoja de cálculo: esa persona es un coste recurrente y no escala. Revisar el diez por ciento de las salidas es viable con cien casos al día e imposible con diez mil. El proveedor absorbe el volumen sin despeinarse. Quien lo vigila, no.

    Y si el proyecto solo sale a cuenta cuando quitas al humano de en medio, entonces no sale a cuenta. Eso es información valiosa, y llega gratis si haces la pregunta antes de firmar.

    Lo que pagas aquí: el modelo por las vueltas, más el tiempo de quien aprueba. Este es el peldaño donde el presupuesto cambia de orden de magnitud, no de porcentaje.


    Cinco. ¿Puedes medir si lo ha hecho bien?

    Si es que no, no lo pongas en producción todavía.

    No porque vaya a salir mal desde el primer día. Al revés: va a salir bien, porque los pilotos salen bien.

    El problema llega después. Sin forma de medir no vas a saber si empeora, y va a empeorar: cambias de modelo, cambia el tipo de casos que llegan, alguien toca un prompt. Todo eso ocurre sin que salte ninguna alarma, porque no hay alarma.

    Medir son dos cosas y hacen falta las dos. Una señal automática que diga si la ejecución fue correcta. Y la traza de qué decidió el sistema y con qué información, que es lo que te deja reconstruir un incidente en vez de opinar sobre él — la lista de qué guardar de cada ejecución la tienes en este repaso de observabilidad para agentes.

    Decidir qué salida es aceptable antes de construir, en lugar de parchearlo cuando ya ha explotado, es el trabajo que describo en el libro de Spec-Driven Development. No es burocracia: es lo que hace que la pregunta cinco tenga respuesta el día que la haces.

    Lo que pagas aquí: todo lo anterior más la infraestructura de medir. Y esa no se va nunca, porque es la que sostiene el resto.

    Si llegas al final del árbol, adelante. Un agente es la respuesta correcta y merece la pena. Empieza con los permisos mínimos y ábrelos según se los gane.


    Dónde te paras y qué pagas

    Cada parada del árbol tiene un perfil de coste distinto, y esa es la información que falta en casi todos los presupuestos:

    Dónde se para el árbol Lo que pagas de verdad
    Pregunta 1 → workflow Ingeniería una vez. Ejecución predecible
    Pregunta 2 → chat con contexto Por conversación. Sube con las personas
    Pregunta 3 → workflow otra vez Igual que 1, más ramas que mantener
    Pregunta 4 → agente con aprobación Modelo × vueltas + tiempo de quien aprueba
    Pregunta 5 → agente instrumentado Todo lo anterior + medir, para siempre

    Esta tabla es la razón de que el orden de las preguntas no sea decorativo.

    Anthropic lo dice sin rodeos en Building effective agents (diciembre de 2024): la recomendación es buscar siempre la solución más simple posible, y eso "puede significar no construir sistemas agénticos en absoluto". Es la empresa que te cobra por vuelta diciéndote que des menos vueltas.


    Cuánto cuesta un proyecto de IA: la cuenta que casi nadie hace

    Un proyecto de IA no se paga por licencia: se paga por uso. Un taxímetro, no un abono.

    En el software al que estás acostumbrado, el usuario número mil sale casi gratis. Aquí no: cada respuesta rehace un cálculo entero, y ese cálculo cuesta dinero.

    De ahí sale la frase que te va a servir en cualquier reunión de presupuesto: en IA, el éxito es lo que dispara el coste. Si la herramienta gusta y la usa todo el mundo, la factura sube en la misma proporción. Al revés de lo que espera un director financiero.

    Así que la cuenta es esta, y se hace antes: coste por consulta × número de consultas al mes, con el escenario de que la herramienta guste.

    Un piloto de diez personas y una implantación de dos mil no se diferencian en dos veces. Se diferencian en dos órdenes de magnitud. Y dos detalles estropean cualquier estimación hecha a ojo: lo que sale se cobra varias veces más caro que lo que entra —está en las tarifas públicas de Anthropic y en las de cualquier otro proveedor—, y una conversación larga cuesta más que la suma de sus mensajes, porque cada turno reenvía todo lo anterior.

    Esa asimetría entre lo que entra y lo que sale, con los números de coste al lado, la desglosé en IA generativa vs IA agéntica.

    El piloto es el diez por ciento del trabajo aunque parezca el noventa

    Un piloto se monta en semanas y sale bien: casos elegidos, gente motivada y alguien vigilando de cerca.

    Producción es otra cosa. Aparecen los casos raros, los usos que nadie previó, el mantenimiento de la base de conocimiento y la factura de verdad. Y aparece el punto que más proyectos entierra: quién se ocupa de esto dentro de un año. El piloto lo llevó alguien con ilusión en un rato libre. Producción necesita un dueño en el organigrama.

    Piloto Producción
    Casos Elegidos a mano Los que lleguen, incluidos los raros
    Usuarios Motivados y avisados Todos, y sin leer las instrucciones
    Supervisión Alguien mirando de cerca Una revisión semanal que hay que asignar
    Coste Casi ruido Coste por consulta × volumen real
    Dueño Quien tuvo la idea Una persona en el organigrama

    La regla, dura a propósito: si al terminar el piloto no sabes decir quién lo mantiene, cuánto costará al volumen real y quién lo revisa cada semana, el piloto no ha terminado. Ha terminado la parte divertida.

    Cómo evaluar un proyecto de IA cuando no hay un "antes" que medir

    Empieza por procesos donde puedas medir el antes. Es la regla que evita la mayoría de los disgustos, y se entiende sola: si no sabes cuánto tardabais en tramitar una devolución antes de la IA, tampoco vas a poder demostrar que ahora tardáis menos. Y sin eso, la renovación del presupuesto se decide por sensaciones.

    Cuidado con lo que eliges medir, porque lo que midas es lo que vas a conseguir. Si mides volumen tendrás volumen: más documentos generados, más tickets cerrados y ninguna certeza de que algo haya mejorado. Qué métricas dicen la verdad lo desarrollé en cómo medir la productividad de equipos que usan IA.


    Por qué te importa aunque tú no firmes nada

    Este árbol es cosa de quien firma. Por eso te importa a ti.

    Cuando alguien aprueba un agente para un proceso de cinco pasos fijos, tú eres quien pasa los seis meses siguientes intentando que un sistema no determinista se comporte de forma determinista. Vas a montar guardrails para forzar un orden que cabía en un switch. Vas a depurar ejecuciones que no se repiten. Vas a explicar por qué sube la factura.

    Todo eso era evitable en la pregunta uno, en una reunión de veinte minutos a la que probablemente no te invitaron.

    La jugada es sencilla: haz tú las cinco preguntas, en voz alta, antes de que se decida nada. No hace falta ser quien firma para ser quien pregunta.

    Y cuando la decisión ya está tomada y lo que te llega es una frase de reunión, el trabajo es traducirla antes de que se convierta en alcance: cómo explicar IA a tu jefe y las seis frases que acaban en tu sprint.

    Y si quieres contrastar el árbol antes de usarlo, esa conversación pasa cada semana en Dominicode Labs, con gente que ya tiene estos sistemas corriendo.

    Y si quieres el recorrido de idea a producto con este criterio aplicado desde el primer día, es el camino del curso Construye con IA.


    Lo único que tienes que hacer hoy

    Coge el proyecto de IA que ya está aprobado. Ese, no el que viene.

    Y contesta la pregunta uno: ¿los pasos son siempre los mismos y en el mismo orden?

    Si la respuesta empieza por "sí, salvo cuando…", ese salvo es la conversación que tienes que provocar esta semana. Porque casi siempre es un if, y estás pagando por un sistema que decide para no tener que escribirlo.

    El árbol sale de un libro que estoy terminando, El mapa de la inteligencia artificial: 120 conceptos para gente que decide sin escribir código. Mientras tanto, esos conceptos colocados por zonas —y estas cinco preguntas en formato imprimible— los tienes gratis en el mapa desplegable.

    Imprímelo y déjalo en la sala de reuniones. Mejor aún: pásaselo a quien te aprueba el presupuesto. Ahí es donde de verdad hace su trabajo.


    Preguntas frecuentes

    ¿Cómo se evalúa si un proyecto de IA merece la pena?

    Con un árbol de cinco preguntas que se recorre en orden y se detiene en la primera que aplique: si los pasos son siempre los mismos, si basta con leer y escribir texto, si hay que decidir sobre la marcha, si el error es reversible y si puedes medir el resultado. Cada peldaño que subes multiplica el coste y el riesgo, así que evaluar bien es pararse en el escalón más bajo que resuelve el problema.

    ¿Cuándo compensa pagar por un agente y cuándo basta con un workflow?

    Un agente solo justifica su precio cuando el camino cambia según lo que el sistema encuentra durante la ejecución, y pagar flexibilidad para un proceso fijo es el error más caro de esta lista. Si los pasos están fijados de antemano, un workflow es más barato, más rápido y auditable. Si el trabajo se agota en leer y escribir texto sin tocar otros sistemas, un chat con buen contexto y tus documentos resuelve el caso en días.

    ¿Por qué la primera pregunta ahorra tanto dinero?

    Porque corta los proyectos más caros antes de que existan. Un agente que da quince vueltas en lugar de tres multiplica la factura, y cada vuelta reenvía todo el contexto anterior, así que el coste no crece con el número de pasos sino con la suma de todos los anteriores. Cuando el proceso es fijo salvo una excepción, pagas por una decisión que se toma miles de veces y siempre sale igual.

    ¿Cuánto cuesta realmente un proyecto de IA?

    No se paga por licencia, se paga por uso: la cuenta correcta es coste por consulta multiplicado por consultas al mes, calculada con el escenario de que la herramienta guste. Un piloto de diez personas y una implantación de dos mil se separan en dos órdenes de magnitud, no en dos veces. Súmale lo que casi nunca se presupuesta: quien revisa, el mantenimiento de la base de conocimiento y el dueño del sistema.

    ¿Por qué un piloto que funciona no garantiza que el proyecto funcione?

    Porque el piloto se hace con casos elegidos, gente motivada y alguien vigilando de cerca. En producción aparecen los casos raros, los usos que nadie previó, los límites de las APIs y la supervisión semanal. Lo que no escala no es la infraestructura, que el proveedor absorbe sin inmutarse: es la parte humana de revisar, mantener y decidir.

    ¿Qué hago si no puedo medir si el sistema lo hace bien?

    No lo pones en producción todavía. Sin una señal que diga si una ejecución fue correcta no vas a enterarte de que el sistema empeora, y va a empeorar en cuanto cambie el modelo, cambien los casos o alguien toque un prompt. Antes de subirlo necesitas dos cosas: una comprobación automática del resultado y la traza de qué decidió el sistema con qué información.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.