Author: Dominicode

  • Jev Model: arquitectura, capacidades y los 9 modos de fallo

    Jev Model: arquitectura, capacidades y los 9 modos de fallo

    Durante cuatro años nos hemos tragado un dogma que Jev viene a discutir: para que una red neuronal decida si un log es crítico, tiene que predecir el token 1, pasárselo a su propia entrada, ampliar el KV-cache, predecir el token 2 y repetir el ciclo hasta escupir una llave de cierre de JSON.

    Es una aberración de ingeniería. Pagas cientos de milisegundos de GPU y decenas de tokens de salida en mantener un bucle secuencial que razona en voz alta cuando lo único que necesitabas era una proyección sobre una distribución discreta.

    Ese es el punto ciego que ataca Jev, el modelo de TypeSafe AI lanzado a mediados de septiembre de 2026 por Diogo Almeida —uno de los creadores de InstructGPT y co-inventor de RLHF en OpenAI—.

    Qué hay debajo —si parte de un LLM, si es un destilado— no lo sabemos: no han publicado nada, y en Hacker News ya se lo están preguntando. Lo que sí es distinto es el contrato de salida: números, no prosa.

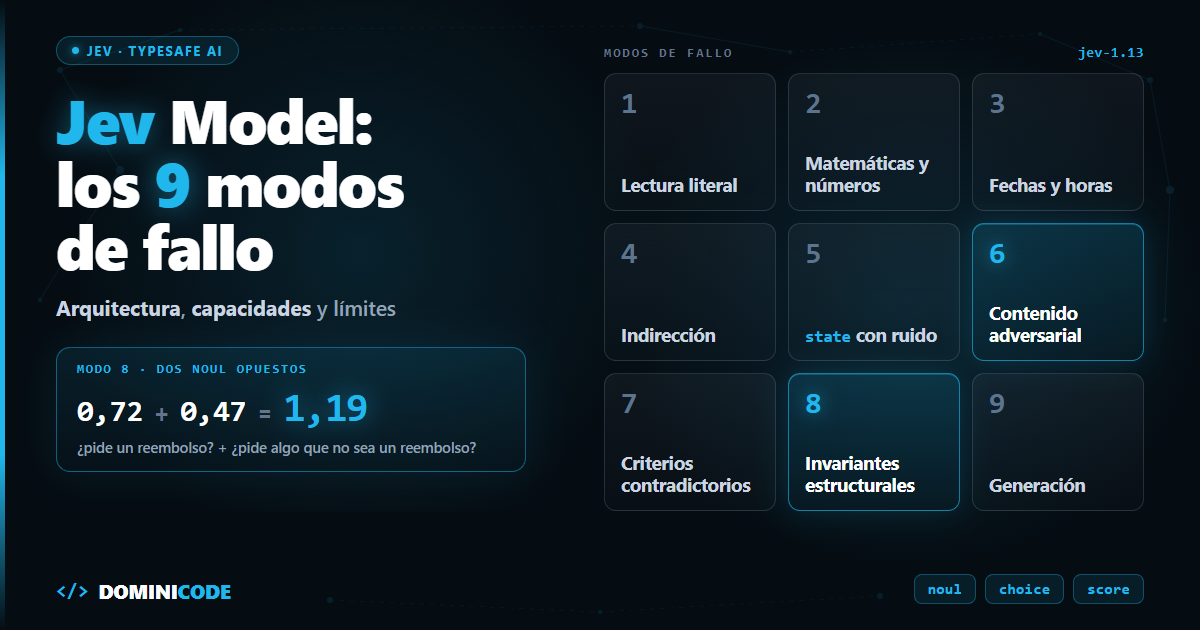
    En corto: Jev, de TypeSafe AI, es un modelo System One que no genera texto: evalúa en paralelo preguntas tipadas sobre un estado y devuelve probabilidades calibradas, a ~100 ms de inferencia según su doc (~250 ms de extremo a extremo medidos). Su propia documentación lista nueve modos de fallo de la versión 1.13, desde la aritmética y las fechas hasta el contenido adversarial en el state.


    ¿Qué se sabe de la arquitectura de Jev?

    Jev es un sistema no generativo: no está entrenado para producir texto, sino para proyectar un estado de entrada sobre decisiones tipadas (noul, choice, score) y devolver probabilidades calibradas.

    TypeSafe no ha publicado la arquitectura interna: ni paper, ni pesos, ni capas. Lo que sigue sale de su documentación y de la API; el resto sería especulación.

    En un LLM estándar (GPT-5.6, Claude Sonnet 5, Gemini 3.5), la generación es secuencial:

    token 1 → token 2 → token 3 → … → token n
    

    Si el JSON de respuesta tiene 80 tokens, pagas 80 pasadas por la red.

    Jev ingiere el state una vez y evalúa todas las preguntas contra él en paralelo y de forma aislada: la respuesta a una no entra como contexto de otra.

    La consecuencia, firmada por su documentación: añadir preguntas apenas cambia el tiempo de respuesta, mientras quepan en el contexto. Cuestan tokens de entrada, no tiempo apreciable.

    El precio: sin texto de salida, no hay dónde escribir una explicación. Jev te da el número, nunca el motivo.


    Entrenamiento: qué promete la calibración

    Jev se entrena con RLCD (Reinforcement Learning for Calibrated Decisions): optimiza que las probabilidades sean honestas, no que la respuesta guste a un humano. La promesa: si Jev asigna a 1.000 decisiones una probabilidad del 0,80, alrededor de 800 deberían salir correctas. La diferencia con RLHF la cuento con calma en qué es Jev de TypeSafe AI.

    La propia TypeSafe lo pone por escrito: RLHF "can also reward sycophancy and confident-sounding hallucinations". Y en Hacker News Mentlo le devolvió la pelota: "Is there anything published on how it maintains calibration?". No hubo respuesta.

    Verifícala por tramos con tus datos, y ojo a qué es lo calibrado:

    // Lo calibrado son las probabilities; confidence resume cuánto se concentran
    interface ChoiceAnswer<T extends string> {
      type: 'choice'
      choice: T
      probabilities: Record<T, number> // suman 1
      confidence: number
    }
    

    confidence solo la traen choice y score. En un noul, el propio número es la creencia.


    Especificaciones: lo que dice la doc de jev-1.13.0

    Esto es lo que dice la documentación de jev-1.13.0, más una medición propia de latencia. Vercel, que integra Jev en su AI SDK y no es árbitro imparcial, reportó en TechCrunch que en su clasificador de seguridad Jev iba entre 5x y 18x más rápido en p95 que gpt-5.6-luna, con más acierto.

    Métrica jev-1.13.0 (hoy, alias jev-latest) gpt-5-nano / gpt-5.6-luna / Gemini 3.5 Flash-Lite
    Mecanismo No generativo: preguntas en paralelo contra el mismo state Autorregresivo, token a token
    Latencia ~100 ms de inferencia según la doc; ~250 ms end-to-end medidos desde mi red (p50 de 10 llamadas; 628 ms abriendo conexión nueva) De cientos de ms a segundos, según modelo y salida
    Entrada / Mtok $0,042 $0,05 – $0,30
    Salida / Mtok $0,00 (se factura a cero) $0,40 – $2,50
    Opciones por choice 255 por etapa Sin límite fijo documentado
    Contexto 64k por petición; 32k para state + la pregunta más larga Según modelo
    Límite de tasa 250.000 tokens/s · 1.200 req/min (ajustándose sin aviso) Según tu tier
    Límite / riesgo Valor de tipo válido y equivocado con confidence alta; no explica; el state puede manipularlo Alucina dentro de un JSON válido; coste y latencia escalan con la salida

    La home de TypeSafe presume de ser "444,6x más barato". En Hacker News (#49717558) la discusión fue sobre el título original del lanzamiento, "40-400x cheaper and 20-200x faster", y WhitneyLand lo resumió sin rodeos: "I'm going to agree that was misleading". Con los precios de la tabla, solo en tokens de entrada, Jev sale entre 1,2x más barato que gpt-5-nano y 7,1x más que Gemini 3.5 Flash-Lite. Los multiplicadores de tres cifras aparecen al compararlo con modelos frontera: contra los $10/Mtok de entrada de gpt-6-astra ya son 238x antes de contar la salida.


    Capacidades reales: ¿para qué está optimizado Jev?

    El diseño del modelo lo hace encajar en cuatro tareas concretas:

    1. Enrutamiento (routing)

    Qué agente, cola o servicio procesa un mensaje antes de invocar herramientas caras. En agentes que manejan la pantalla: Jev en agentes y computer use.

    2. Triaje con umbral de riesgo

    Clasificar con corte estricto: si confidence < 0.70, no se ejecuta y pasa a revisión manual. El montaje con TypeScript y Zod, en integraciones seguras con Jev.

    3. Guardrails

    Marcar en ~250 ms si un prompt entrante es un jailbreak antes de enviarlo al modelo principal (hay cookbook oficial). Ojo: el propio Jev se puede mover con el texto que analiza (ver el modo de fallo 6).

    4. Gates en CI/CD

    Comprobar si el diff de un PR cumple la especificación sin pagar la latencia de un LLM-as-judge. Paso a paso en harness con Jev.


    Los nueve modos de fallo de jev-1.13

    Solo una de estas limitaciones es de diseño: no genera texto. El resto son las que TypeSafe documenta para jev-1.13 y, en sus palabras, "many of these will be fixed in later versions". Por eso fija la versión si calibras umbrales.

    # Modo de fallo Haz esto en su lugar
    1 Lectura literal Escribe la condición exacta y criterios para cada opción
    2 Matemáticas y números Deja la aritmética en el código
    3 Comparación de fechas y horas Extrae los componentes; compara en código
    4 Indirección Reduce los saltos; señala la parte relevante del state
    5 state grande lleno de detalle irrelevante Filtra primero; envía solo lo que la pregunta necesita
    6 Contenido adversarial Escribe prompts precisos y prueba los casos límite antes de desplegar
    7 Instrucciones y criterios contradictorios Alinea los criterios con la instrucción
    8 Invariantes estructurales de sentido común Pregunta cada decisión de una sola forma; impón las identidades en código
    9 Generación Usa un modelo generativo

    Traducida de la página de limitaciones de jev-1.13, revisada por TypeSafe el 17 de septiembre de 2026.

    1. Lee lo que escribiste, no lo que querías

    Negaciones y condiciones implícitas, al pie de la letra. Si al mirar un fallo te pillas explicando "lo que yo quería decir", esa explicación es lo que le faltaba a la instrucción.

    2 y 3. Ni cuentas ni fechas

    No es fiable si le pides evaluar si una fecha supera los 30 días de garantía o si una cesta suma más de 100 euros. Tampoco cuenta elementos. Con las fechas, la doc propone que Jev extraiga día, mes y año como choice cerrados y que tu código compare.

    4 y 7. Indirección y criterios que se contradicen

    Dobles negaciones y "una propiedad de una propiedad" le cuestan acierto: escribe directo y nombra el campo del state que importa. Y si instructions y criteria piden cosas distintas, se confunde. El ejemplo de la doc: un noul donde true significa "no" rinde peor.

    5. Ruido en el state

    El acierto cae cuando el state se llena de cosas ajenas a la decisión. Si no puedes filtrar en código, un noul previo decide qué fragmentos son relevantes.

    6. No trata el state como hostil

    La que más caro sale. Una instrucción inyectada, un encuadre engañoso o un texto que argumenta a favor de su propia clasificación pueden mover la respuesta.

    Si el state lo escribe un usuario —o peor, otro modelo—, es superficie de ataque. Describe los dos lados de cada pregunta con criteria, prueba con entradas envenenadas y no le des al veredicto más poder del que estés dispuesto a perder.

    8. Invariantes que no se cumplen

    La doc hace la misma pregunta y su negación como dos noul sobre el ticket "I was charged twice for the same order": "¿pide un reembolso?" da 0,72 y "¿pide algo que no sea un reembolso?" da 0,47. Suman 1,19.

    Tampoco lleves un umbral de un noul a un choice: la misma pregunta de reembolso, sobre otro ticket, dio 0,22 como noul y 0,01 como choice.

    9. No genera texto

    No puede decirte por qué decidió. Para extraer datos, saca los candidatos con una regex o un LLM y deja que Jev elija.

    Límites de la API: 255 opciones e idioma

    Un choice no admite más de 255 opciones por etapa. Para taxonomías gigantes, dos pasadas: primero familia, luego subclase.

    El inglés es su idioma principal de entrenamiento y donde hoy acierta más. La doc no da receta: pide probar con tu propio contenido y vigilar el confidence al enrutar. Mi apuesta es escribir las preguntas y los criterios en inglés, pero mídelo antes de fiarte.


    Antes de producción: pasa tus preguntas por los nueve modos de fallo

    Antes de meter Jev en producción, pasa cada una de tus preguntas por la tabla de los nueve modos de fallo y reescribe las que caigan en uno. Te ahorra el umbral que parecía calibrado y no lo estaba.

    Cada pieza de tu sistema necesita un contrato. En el libro Spec-Driven Development (SDD) explico cómo acotar cada decisión del sistema con interfaces y tests deterministas.

    Si estás montando agentes que combinan un modelo que decide con otro que ejecuta, descarga gratis El Developer Agéntico: arquitectura, memoria, seguridad y evaluación de agentes.


    Las capacidades y los límites de Jev los desarrollo a fondo en Jev y las decisiones tipadas con IA, con un capítulo entero sobre cómo te va a fallar.

    Preguntas frecuentes

    ¿Cuáles son los modos de fallo de Jev?

    Nueve para jev-1.13: lectura literal, matemáticas, fechas, indirección, state con ruido, contenido adversarial, criterios contradictorios, invariantes estructurales y generación. Solo el último es de diseño; de los demás, TypeSafe dice que muchos se arreglarán.

    ¿Por qué Jev no cobra por los tokens de salida?

    Porque la salida son unos pocos números por pregunta. Ojo: usage.output_tokens no viene a cero; se factura a cero.

    ¿Se pueden afinar (fine-tuning) los pesos de Jev con datos propios?

    No. Su documentación dice que Jev no se afina ni se adapta con LoRA con datos de cliente, y los mismos pesos sirven a todas las cuentas. Lo moldeas desde la petición: tu material en el state y tus reglas en instructions y criteria.

    ¿Qué ocurre si mi contexto supera la ventana?

    La API rechaza la petición. La doc no detalla con qué código en este caso: los errores de validación salen como 422, con el campo culpable en el cuerpo. Hay dos techos: 64k por petición y 32k para el state más la pregunta más larga. Recorta antes de consultar: además de caber, acertarás más.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Multiagente vs agente único: framework con 3 casos reales

    Multiagente vs agente único: framework con 3 casos reales

    Hace tres semanas monté un pipeline de cuatro agentes para una feature que no necesitaba ni uno: planner, coder, reviewer y tester, cada uno con su propio prompt y su propia ventana de contexto. Se sentía como arquitectura seria.

    Tardó el triple que si lo hubiera hecho con un solo agente bien instruido. Gasté más tokens coordinando handoffs entre roles que resolviendo el problema real. Y el resultado no fue mejor — fue distinto, y peor: el reviewer contradecía decisiones que el coder ya había tomado con buen criterio.

    Ese día entendí que la pregunta multiagente vs un solo agente no se responde por instinto ni por moda. Se responde con criterios concretos, y esos criterios ya los han medido equipos que sí llevaron el experimento a producción, no solo a un demo.

    En corto: multiagente vale la pena cuando las subtareas son realmente paralelas, casi no comparten contexto, y el resultado justifica pagar entre 4 y 15 veces más tokens. Si tus subtareas dependen unas de otras —como pasa en la mayoría del código— un solo agente bien instruido gana en velocidad, coste y calidad. Orquestar varios agentes no es gratis: se gana con datos, no con intuición.

    ¿Qué es un sistema multiagente?

    Un sistema multiagente es una arquitectura de IA donde varios agentes —con roles, prompts o ventanas de contexto distintas— colaboran, en paralelo o en secuencia, para completar una tarea que en teoría podría resolver un solo agente con suficiente contexto y herramientas.

    La palabra clave es "en teoría". Que se pueda dividir un problema en roles no significa que dividirlo mejore el resultado — ya expliqué por qué el mega-prompt falla cuando se resuelve metiendo más subagentes sin criterio. La mayoría de los equipos confunden "se puede separar" con "conviene separar" — y esa confusión se siente más profesional, con nombres de rol y diagramas de flujo, aunque cada agente adicional solo añade un punto de fallo más y una llamada más al modelo que pagar.

    Tres equipos distintos, en dominios distintos, ya midieron esto en producción. Sus resultados no coinciden en la respuesta, pero sí coinciden en el criterio.

    Tres casos reales que no dicen lo mismo (y por eso sirven)

    Caso Qué se comparó Resultado multiagente Resultado agente único Quién ganó y por qué
    Anthropic — Claude Research Preguntas "breadth-first" con varios subagentes en paralelo vs. Claude Opus 4 solo 90,2% mejor que el agente único en su eval interna, pero consume ~15x los tokens de una conversación normal Consume ~4x los tokens de una conversación normal; peor en exploración amplia de fuentes independientes Multiagente. Las subtareas eran genuinamente independientes y el valor de la respuesta justificaba el coste. Anthropic aclara que en coding, con dependencias fuertes, esto no aplica
    Cognition (equipo de Devin) — "Don't Build Multi-Agents" Subagentes paralelos construyendo partes de una misma app vs. un agente lineal con historial comprimido Subagentes con contexto fragmentado tomaron decisiones incompatibles entre sí sin verlo (estilos, assets, nombres) Un agente que arrastra el contexto de cada decisión previa, con resúmenes comprimidos en tareas largas Agente único. El código depende de decisiones implícitas coherentes que solo sobreviven con contexto compartido real
    Uncle Bob — harness SwarmForge Harness con 6 roles fijos vs. un solo agente en la misma tarea de desarrollo 3-4 horas, calidad aceptable 40 minutos, calidad superior, consumo de tokens muchísimo menor Agente único. La orquestación rígida sumaba overhead sin sumar calidad; los gates de verificación siguieron siendo necesarios en ambos casos

    Nota lo que no dicen estos tres casos: no dicen "el multiagente está muerto" ni "siempre gana un solo agente". Dicen que cada arquitectura gana cuando el problema tiene una forma concreta, y esa forma se puede medir antes de construir nada.

    El propio lanzamiento del post de Cognition generó un hilo largo en Hacker News donde varios ingenieros coinciden en algo puntual: los subagentes sirven para aislar contexto que ensucia el prompt principal, no para repartir trabajo autónomo sin supervisión. Un comentarista lo resume mejor que cualquier framework: "si necesitas pensar distinto sobre el problema, necesitas un agente distinto" — si el razonamiento es el mismo con datos distintos, es el mismo agente.

    El framework: cinco criterios, no una moneda al aire

    De los tres casos sale un patrón repetido. Lo convertí en cinco criterios que reviso antes de escribir el primer prompt de orquestación.

    Criterio Señal de que multiagente vale la pena Señal de que gana un solo agente Peso
    Paralelismo real de las subtareas Las subtareas son independientes: ninguna necesita ver el resultado de otra hasta el final Las subtareas se encadenan paso a paso (editar y refactorizar código) Alto
    Coste en tokens vs. ahorro de tiempo humano El resultado justifica pagar 4x-15x tokens (investigación, análisis masivo, due diligence) La tarea es rutinaria y el ahorro de tiempo no compensa el gasto extra Alto
    Dependencias y decisiones implícitas compartidas Ninguna decisión de un agente condiciona lo que hace otro Una decisión de un paso condiciona el siguiente (arquitectura, nombres, estilo) Alto
    Especialización de contexto vs. overhead de coordinación Cada rol necesita un contexto tan distinto que mezclarlo degrada el prompt (buscar en la web vs. escribir código) Los roles comparten casi todo el contexto — separarlos solo añade handoffs Medio
    Necesidad real de "pensar distinto" La tarea exige un tipo de razonamiento distinto por fase (buscar, sintetizar, criticar) Todo el trabajo usa el mismo tipo de razonamiento aunque tenga varios pasos Medio
    Riesgo si te equivocas de opción Pagas 4x-15x tokens sin ganar calidad, y los agentes pueden contradecirse entre sí sin que nadie lo note Te quedas corto si el paralelismo era real: pierdes el tiempo que sí te habría ahorrado dividir el trabajo —

    La heurística que uso es simple: si tres o más criterios de peso "Alto" apuntan a multiagente, lo construyo. Si no, empiezo con un solo agente bien instruido y solo divido cuando el contexto se vuelve imposible de manejar en una ventana — no antes, por elegancia arquitectónica.

    Esto es exactamente la lógica que enseño en el curso Construye con IA: empezar con la arquitectura más simple que resuelve el problema, y añadir complejidad solo cuando el proyecto la reclama, no cuando la moda lo sugiere.

    Un matiz que los tres casos comparten: la verificación no depende de la arquitectura. Tengas uno o seis agentes, necesitas gates deterministas —tests, tipos, contratos— que confirmen que lo entregado hace lo que dice. Si todavía revisas el código de tus agentes leyendo el diff en vez de contra un contrato, el ebook gratuito de Revisión por Contrato explica cómo montar ese gate en una tarde.

    Cuándo el framework no aplica

    Este framework tiene límites reales, y fingir que no los tiene sería venderte una solución perfecta que no existe.

    No sabes de antemano si tus subtareas son paralelas. El framework asume que puedes evaluar el paralelismo antes de construir. En dominios nuevos eso no es cierto: el acoplamiento oculto entre pasos solo aparece con el sistema corriendo en producción, no en el diseño en papel.

    Los números no son universales. El 15x de tokens y el 90,2% de mejora de Anthropic salieron de research breadth-first, no de tu chatbot de soporte ni de tu pipeline de facturación. Úsalos como orden de magnitud, no como cifra que se traslada directo a tu caso — mide en tu propio proyecto antes de decidir.

    La observabilidad cambia el cálculo. Un equipo con buen tracing, replay y evals puede sostener un sistema multiagente incluso cuando el framework diría que no, porque detecta y corrige fallos en minutos. Un developer solo, sin esa infraestructura, paga el precio completo de la complejidad sin la red de seguridad que la justifica.

    Qué hacer con esto hoy

    Coge tu proyecto actual y pon los cinco criterios en una hoja. Cuenta cuántos "Alto" apuntan a multiagente.

    Si son menos de tres, borra el orquestador que ya empezaste a montar y quédate con un solo agente con mejor contexto. Vas a tardar menos en notar la diferencia que en terminar de escribir el segundo rol.

    Si son tres o más, constrúyelo — pero mide tokens y tiempo desde el primer día, porque ese es el dato que te dirá si acertaste. Si quieres ver estos patrones aplicados a proyectos reales, en Dominicode Labs los revisamos cada semana con la comunidad.

    Preguntas frecuentes

    ¿Cuándo es mejor usar multiagente en vez de un solo agente?

    Cuando las subtareas son genuinamente independientes, no requieren compartir contexto para tomar decisiones coherentes, y el valor del resultado justifica pagar varias veces más tokens. El caso de Anthropic es el más claro: preguntas amplias donde explorar diez fuentes en paralelo vale más que explorarlas una a una.

    ¿Cuánto más cuesta un sistema multiagente en tokens?

    En el caso público de Anthropic, un agente simple usa alrededor de 4 veces los tokens de una conversación normal, y un sistema multiagente completo llega a unas 15 veces. No es una cifra universal, pero sirve como orden de magnitud: si tu tarea no genera un valor claramente superior a ese multiplicador, la orquestación no se paga sola.

    ¿El multiagente sirve para tareas de programación?

    Rara vez, por una razón concreta: escribir código depende de decisiones que se encadenan (nombres, estilo, arquitectura) y que un agente necesita "ver" para no contradecirlas. Cognition/Devin y Uncle Bob con SwarmForge llegaron a la misma conclusión en dominios distintos: un agente único con buen contexto superó a la orquestación.

    ¿Cómo empiezo si no sé si mi tarea es paralelizable?

    Empieza siempre con un solo agente bien instruido. Si notas que el contexto no cabe en una ventana razonable, o que mezclas dos tipos de razonamiento completamente distintos en el mismo prompt, ahí tienes la señal real para dividir — no antes.

    ¿Qué pasa si ya construí un sistema multiagente y no está funcionando?

    Revisa si el problema es de coordinación (agentes que se contradicen) o de coste (tokens que no se justifican con el resultado). En el primer caso, el diagnóstico de Cognition aplica directo: necesitas más contexto compartido, no más agentes. En el segundo, vuelve a los cinco criterios y cuenta cuántos apuntaban realmente a multiagente antes de construirlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Verificar código generado por IA sin leer todo: 4 técnicas

    Verificar código generado por IA sin leer todo: 4 técnicas

    Hace unas semanas aprobé un pull request generado por un agente que arreglaba el cálculo de un descuento por antigüedad. Para verificar código generado por IA hice lo que hacemos casi todos: los tests pasaban en verde, el type checker no se quejó, el diff tenía 40 líneas legibles con nombres razonables.

    Le di merge.

    Dos días después, un usuario premium con 14 meses de antigüedad reportó un descuento del 10% en vez del 20%. El código funcionaba. Hacía exactamente lo que decía que hacía — solo que eso no era lo que yo había pedido. La condición antiguedad > 12 estaba invertida en un if, y ni el compilador ni los tests que el propio agente había escrito lo detectaron.

    (Esta anécdota es ilustrativa del tipo de fallo que describo aquí — no es un incidente puntual verificable con fecha exacta, es el patrón que se repite.)

    Esto no es una historia sobre un mal agente. Es sobre un mal proceso: mi "verificación" fue leer por encima y confiar en dos gates que no estaban hechos para atrapar ese error. Leer por encima no escala cuando el agente te entrega cinco PRs al día.

    En corto: verificar código generado por IA sin leer cada línea es posible con cuatro filtros baratos: deja que el type checker haga de primer gate, pide los tests desde la especificación antes de enseñarle el código al agente, usa un segundo agente con un prompt distinto como revisor, y concentra tu lectura manual en las líneas que tocan auth, dinero o validación de input. Ninguno sustituye un sistema completo — son parches rápidos que aplicas hoy, sin instalar nada.

    ¿Qué es un gate de verificación (y por qué no es lo mismo que "revisar")?

    Un gate de verificación es un chequeo binario que pasa o falla sin que tengas que interpretarlo — no depende de tu criterio ni de tu concentración a las 11 de la noche. "Revisar" es leer código y juzgar si parece correcto. Un gate ejecuta algo que responde sí o no, con evidencia. "Leí el diff y se veía bien" no es un gate, es una opinión — y las opiniones fallan justo cuando el código está bien escrito y hace lo contrario de lo que pide la spec.

    Eso importa porque el código de un agente está optimizado para parecer correcto: nombres claros, formato limpio, estructura familiar. Tu ojo entrenado para detectar "código feo" falla exactamente cuando el código es bonito y está mal.

    El problema real: el código pasa la vista y falla en producción

    No soy el único con esta fricción. En un hilo de Hacker News con 298 comentarios titulado "When AI writes the software, who verifies it?", el usuario roadbuster lo describe así (traducido del inglés):

    "El LLM genera felizmente tests que simplemente refuerzan el comportamiento existente del código. En ningún momento nadie se detiene a preguntar si el código generado implementa el comportamiento funcional deseado."

    Es lo que me pasó con el descuento: el agente escribió el código y luego tests que confirmaban que ese código hacía lo que hacía — no lo que yo había pedido. El test nunca falla porque nació del mismo malentendido que la implementación.

    En el mismo hilo, Karrot_Kream admite el punto incómodo: sigue auditando a mano los tests que genera la IA, aunque reconoce que es "la parte de programar que menos le gusta". Nadie quiere hacer esta parte. Por eso casi nadie la hace bien.

    4 técnicas que puedes aplicar hoy, sin instalar nada nuevo

    Ninguna requiere adoptar un framework, escribir un AGENTS.md o cambiar tu flujo. Son filtros que añades a lo que ya haces.

    Técnica Qué detecta Qué NO detecta Esfuerzo
    Type checker en modo estricto Tipos incompatibles, propiedades inexistentes, APIs alucinadas, nulls sin manejar Lógica de negocio incorrecta que tipa perfectamente bien Ninguno extra — actívalo en strict
    Tests desde la spec, antes de ver el código Que el comportamiento coincida con lo pedido, no con lo que el agente decidió escribir Casos que la spec no contempló; spec vaga produce tests vagos Bajo — un prompt aparte, antes de la implementación
    Segunda pasada con otro agente/prompt como revisor Inconsistencias entre spec y código, casos límite obvios, errores sin manejar Puede repetir el sesgo del primero si comparte el mismo chat Medio — exige prompt adversarial, en sesión nueva
    Diffing dirigido a zonas críticas (auth, dinero, validación) Regresiones graves justo donde más caro sale que fallen Todo lo que quede fuera del filtro — no es lectura completa Bajo — un comando de git, pero exige definir bien qué es "crítico"

    1. Deja que el type checker sea tu primer filtro

    TypeScript, mypy o el compilador que uses no mienten ni se cansan. Si el agente alucina una propiedad, el gate lo para antes de tu revisión:

    function getDiscount(user: User): number {
      if (user.subscription.tier === 'premium') {
        return user.subscription.discountRate; // no existe en el tipo
      }
      return 0;
    }
    
    error TS2339: Property 'discountRate' does not exist on type 'Subscription'.
    

    Esto no habría parado mi bug del descuento invertido — el tipo estaba bien, la lógica no. Pero sí para buena parte de las alucinaciones típicas: APIs inventadas, campos que no existen, nulls sin manejar. Es gratis y ya lo tienes. Actívalo en modo estricto si no lo has hecho.

    2. Pide los tests desde la spec, antes de enseñarle el código

    Esta es la técnica que me habría salvado del bug del descuento. En vez de pedir código y luego tests, invierte el orden:

    Esta es la especificación (no hay código todavía):
    
    "calcularDescuento(usuario) devuelve 20% si el usuario es premium
    y lleva más de 12 meses activo, 10% si es premium con menos de
    12 meses, y 0% en cualquier otro caso."
    
    Escribe los tests de aceptación en Vitest. Todavía no has visto
    ninguna implementación.
    

    Cuando el agente escribe primero el código y luego "sus" tests, el test hereda cualquier malentendido de la spec. Cuando nace de la spec en una pasada separada, se convierte en un juez independiente que detecta el error porque no lo comparte.

    3. Usa un segundo agente con un prompt distinto como revisor

    No el mismo chat. Una sesión nueva, sin el contexto de cómo se escribió el código, con un prompt deliberadamente escéptico:

    Eres un revisor senior, escéptico por defecto. No escribiste este código
    y no asumes que está bien solo porque compila y pasa los tests actuales.
    
    Busca: casos límite no cubiertos, lógica que no coincide con la
    especificación, manejo de errores ausente, datos sensibles sin validar.
    
    Especificación: [pegar]
    Código: [pegar diff]
    
    No digas "se ve bien". Señala línea y motivo, o di qué revisaste
    y por qué no encontraste problema ahí.
    

    Este patrón de usar un agente distinto para tareas que exigen otro punto de vista es parte de lo que enseño paso a paso en Construye con IA: montar flujos con varios agentes que se corrigen entre sí, no uno solo que se audita a sí mismo.

    4. Diffing dirigido: lee solo lo que puede doler de verdad

    No leas las 340 líneas del PR. Filtra por lo que toca zonas donde un error sale caro:

    git diff --stat main...feature/discount-calc
    
    git diff main...feature/discount-calc -- '**/auth/**' '**/payment/**' '**/*valida*' '**/*schema*'
    

    El criterio de qué es "crítico" no es intuición — es cuánto cuesta que falle y qué tan rápido te enteras.

    Mi criterio, sin "depende"

    El type checker en estricto y el diffing dirigido van siempre, en cualquier PR — son gratis. Los tests desde la spec los reservo para lógica de negocio real, no para un CRUD trivial. El segundo agente como revisor solo cuando ya tengo un flujo agéntico corriendo — si no, revisarlo yo mismo es más rápido.

    Si solo añades una cosa hoy, que sea el type checker en strict más el diffing dirigido: eliminan la categoría de bugs más tonta sin coste de configuración extra.

    Lo que estas técnicas no te van a coger

    Sé honesto contigo mismo, porque yo no lo fui con el descuento: estos cuatro filtros no son un sistema, son parches.

    No dejan rastro. Dentro de tres meses no hay ningún documento que diga qué se verificó, con qué criterio, y quién lo aprobó — repites el proceso de memoria, y la memoria falla en el PR número 40 de la semana.

    Dependen de que definas bien qué es "crítico" o qué pide realmente la spec. Si tu filtro de diffing no incluye la carpeta correcta, o tu spec es ambigua, el agujero sigue ahí y nadie te avisa — el chequeo "pasó" porque nunca miró donde tenía que mirar.

    Y el segundo agente como revisor puede convertirse en un espejo del primero si comparte contexto o sesgo. Un revisor que piensa igual que quien escribió el código no es un revisor — es una segunda opinión de la misma persona.

    Si tu proyecto mueve dinero real, datos de usuarios o decisiones irreversibles, estas cuatro técnicas son el piso mínimo, no el techo. El post Revisar código generado por IA: el método Revisión por Contrato explica el sistema completo que sí deja rastro: qué se construye, por dónde no puede salirse el agente, y quién dice que está bien, con un AGENTS.md real. Si además quieres el sistema montado con harness de verificación end-to-end, el workshop SDD + Agentic Engineering cubre eso paso a paso.

    Qué puedes hacer hoy

    Abre tu tsconfig.json o tu mypy.ini ahora mismo y confirma que estás en modo estricto. Es la línea más barata que vas a escribir esta semana.

    Después, la próxima vez que le pidas código a un agente, invierte el orden: pide primero los tests desde la especificación, en una pasada separada, antes de pedir la implementación. Esa sola inversión habría parado mi bug del descuento.

    Estas cuatro técnicas son la entrada. Cuando el proyecto crezca lo suficiente como para que un parche ya no alcance, el siguiente paso es un sistema real de verificación — contrato, carril y veredicto — que dejo completo, con ejemplos y el AGENTS.md entero, en Revisar código generado por IA: el método Revisión por Contrato. Y si quieres ver cómo aplico esto semana a semana en proyectos reales, en Dominicode Labs comparto el detalle con la comunidad.

    Preguntas frecuentes

    ¿El type checker es suficiente para confiar en código generado por IA?

    No. Detecta que las piezas encajan en forma — tipos correctos, propiedades que existen, nulls manejados. No detecta que la lógica de negocio sea la que pediste. Mi bug del descuento invertido tipaba perfectamente bien: es un filtro necesario y gratuito, no una prueba de corrección.

    ¿Qué diferencia hay entre pedir tests antes o después de ver la implementación?

    Cuando el mismo agente escribe primero el código y luego los tests, estos heredan cualquier malentendido de la spec, porque nacen de la misma lectura equivocada. Generados en una pasada separada, se convierten en un juez independiente que detecta el error porque no lo comparte.

    ¿Puedo usar el mismo agente que escribió el código para revisarlo después?

    Puedes, pero pierdes gran parte del valor: en el mismo chat, con el mismo contexto, el agente tiende a justificar sus decisiones en vez de cuestionarlas. Usa una sesión nueva y un prompt explícitamente escéptico para que la segunda pasada aporte un punto de vista distinto, no un eco del primero.

    ¿Estas técnicas sirven si mi proyecto no tiene tests todavía?

    El type checker y el diffing dirigido sí, sin cambios — no dependen de una suite existente. Los tests desde la spec además te dan una forma barata de empezar a construirla: cada vez que le pides código a un agente, generas primero el test de aceptación, y en unos meses tienes cobertura real sin haber dedicado un sprint a escribirla.

    ¿Cuándo necesito algo más que estas 4 técnicas?

    Cuando el error de un agente puede costarte dinero real, datos de usuarios, o algo que no se deshace con un revert. Ahí un parche puntual no basta — necesitas un sistema que deje rastro de qué se verificó y con qué criterio, que es justo lo que cubre el método de Revisión por Contrato.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Usar IA para programar: los 4 errores de mis primeros 3 meses

    Usar IA para programar: los 4 errores de mis primeros 3 meses

    Hace tres meses, en junio de 2026, hice merge de un endpoint generado por ChatGPT dentro de Kursar sin leerlo línea por línea. Compilaba. Los dos tests que traía pasaban — los había escrito la misma IA que escribió el endpoint. Lo aprobé un jueves a las diez de la noche porque tenía prisa.

    Quince días después, ese endpoint dejó pasar un payload que no debía. Tuve que revertir un commit en producción a las once de la noche sin saber qué línea lo había roto — nunca la había leído.

    Ese fue el momento en que entendí que empezar a usar IA para programar no es un problema de qué herramienta eliges primero. Es un problema de qué hábitos construyes en las primeras semanas. Y yo construí los equivocados.

    En corto: en mis primeros tres meses usando IA para programar cometí cuatro errores caros: chat web como herramienta principal, prompts sin contrato, código sin revisar línea por línea, y demasiadas herramientas probadas a la vez. Si empezara hoy, instalaría una sola herramienta agéntica, escribiría el contexto antes que el prompt, y no aprobaría nada que no hubiera leído yo mismo.

    ¿Qué es revisar código por contrato?

    Revisar código por contrato es comprobar que lo que generó la IA cumple una lista explícita de condiciones —qué debe hacer, qué no debe romper, con qué se valida— antes de aceptarlo. No es leer por encima para ver si "se ve bien": es fijar el contrato antes de escribir el prompt, no después de leer la respuesta. Ya escribí sobre este método completo en Revisar código generado por IA: el método Revisión por Contrato; aquí va la versión resumida de por qué me costó tan caro no aplicarlo desde el día uno.

    En el mes uno yo no hacía esto. Escribía un prompt sin contrato y aprobaba lo que volviera si compilaba:

    // Mes uno: sin contrato
    "Mejora este endpoint de pagos"
    
    // Ahora: con contrato
    "Modifica solo el endpoint POST /payments.
    No cambies la firma de la función ni el schema de respuesta.
    El monto debe seguir validándose con Zod antes de llamar al proveedor.
    Si el proveedor devuelve error, reintenta máximo 2 veces con backoff."
    

    El contrato lo inventé después de romper algo en producción, que es la forma más cara de aprenderlo.

    Los cuatro errores que más me costaron

    No los cometí por descuido. Los cometí porque nadie me dijo que el problema no era la herramienta, sino el orden en que construía el hábito de usarla.

    Hábito Cómo empecé (mes 1) Qué cambié Coste que me hubiera ahorrado
    Herramienta principal Chat web genérico (ChatGPT), copiar y pegar código a mano CLI agéntica que lee el repo completo (Claude Code) Semanas reescribiendo contexto a mano en cada prompt
    Cómo pedía las cosas "Mejora este código", "arregla este bug" Prompt con contrato: qué debe cumplir, qué no debe tocar, con qué se valida Una noche entera revirtiendo un commit que rompió un flujo en producción
    Revisión antes de aceptar Merge si compilaba y pasaban los tests que la propia IA había escrito Diff línea por línea + criterios de aceptación que escribo yo antes de pedir el código El bug de producción del endpoint que abre este post
    Herramientas probadas Cinco en paralelo la primera semana (Copilot, Cursor, ChatGPT, Claude web, Codeium) Una sola herramienta, mínimo dos o tres semanas antes de evaluar otra Casi un mes sin dominar ninguna a fondo

    No soy el único al que le pasó esto. En el hilo de Hacker News "The AI coding trap" hay un comentario que lo resume mejor que yo: "if you yolo your way through a build without thought, it will collapse". Otro añade algo que se aplica directo a mi endpoint: la deuda técnica generada por código de IA sin revisar "isn't paid down, it's being added to".

    Eso es exactamente lo que pasó con mis dos primeros meses: no estaba pagando deuda, la estaba acumulando cada vez que aprobaba un diff sin leerlo.

    La ruta que seguiría si empezara hoy

    Si tuviera que borrar los tres meses y empezar de nuevo, este es el orden exacto, no una lista de buenas intenciones:

    1. Instala una herramienta agéntica de terminal antes que una extensión de autocompletado. Necesitas ver cómo razona sobre el repo completo, no solo qué te autocompleta línea a línea. A mí lo que me cambió el flujo fue Claude Code — en el curso Construye con IA parto de cero con esta misma herramienta, sin dar por hecho nada.
    2. Escribe el contexto antes que el prompt. Qué archivos puede tocar, qué no debe romper, con qué criterio se valida. Un prompt sin contrato produce una solución genérica para un problema que no era genérico.
    3. No apruebes un diff sin leerlo, ni una sola vez, en las primeras semanas. Es el hábito más caro de perder y el más barato de mantener desde el día uno.
    4. Escribe tú los criterios de aceptación antes de pedir el código. No dejes que la misma IA que escribió la función te diga si la función está bien — ese fue mi error con los tests del endpoint. Este marco lo dejé completo en Revisar código generado por IA: el método Revisión por Contrato, justo para no repetir mi error.
    5. Comprométete con una sola herramienta dos o tres semanas antes de evaluar otra. Cambiar cada dos días es la forma más cara de no aprender ninguna a fondo.

    Lo que la IA todavía no te resuelve

    Nada de esto convierte a la IA en un sustituto de tu criterio. Dos límites reales, no teóricos, con los que me sigo topando:

    • No conoce las restricciones de negocio que nadie escribió en ningún sitio. La decisión de arquitectura que tomaste hace dos años por una razón que ya nadie recuerda. Te va a dar una solución "correcta" en el vacío, y ese vacío es exactamente donde vive la mayoría de los bugs de producción.
    • No sustituye la revisión de seguridad. Secretos hardcodeados, dependencias inseguras, patrones peligrosos como eval o deserialización sin validar pasan la revisión superficial precisamente porque el código generado se ve profesional — y el código que se ve profesional es el que menos se revisa a fondo.

    Si tu flujo de trabajo depende de que la IA nunca se equivoque, no tienes un flujo de trabajo. Tienes una apuesta.

    Qué haría hoy, literalmente

    Si hoy tuviera que empezar de cero, esto es lo que haría antes de escribir una sola línea de código con ayuda de IA: instalar una sola herramienta agéntica, escoger una tarea pequeña y real de mi propio repo, escribir el contrato antes del prompt, y leer el diff completo antes de aprobar nada.

    No es una lista de deseos. Es lo que hago ahora, después de pagar el precio de no hacerlo en el mes uno.

    Si prefieres no reconstruir esto a partir de tus propios errores, en Construye con IA parto contigo de la idea al producto con Claude Code, con estos mismos hábitos desde la primera clase. Si ya tienes el hábito y quieres dar el siguiente paso, construir un agente de IA desde cero es la ruta lógica. Y si prefieres tener con quién comentar los errores mientras los cometes, en Dominicode Labs compartimos esto cada semana con gente que está exactamente en este punto.

    Preguntas frecuentes

    ¿Por dónde empezar a usar IA para programar si nunca lo he hecho?

    Empieza por una sola herramienta agéntica de terminal, no por el chat web. Elige una tarea pequeña y real de un proyecto que ya conozcas —no un tutorial de juguete— y practica el hábito de escribir el contrato antes del prompt y leer el diff completo antes de aprobar nada.

    ¿Qué herramienta de IA debería instalar primero?

    Depende de si trabajas sobre todo desde la terminal o desde el editor, pero para ver el repo completo y razonar sobre varios archivos a la vez, una CLI agéntica como Claude Code te enseña el hábito correcto desde el primer día. El chat web genérico está bien para preguntas puntuales, pero no para tu flujo de trabajo principal.

    ¿Es seguro dejar que la IA escriba código en producción?

    Es seguro si tú revisas cada diff con criterios definidos antes de aprobarlo, y no lo es si el criterio es "compiló" o "los tests pasaron" cuando esos tests también los escribió la IA. El riesgo no está en usar IA, está en saltarte la revisión por prisa.

    ¿Cuánto tiempo se tarda en tener un flujo de trabajo sólido con IA?

    A mí me tomó tres meses y un incidente en producción para dejar de improvisar. Si defines el contrato desde el primer día y te comprometes con una sola herramienta en vez de probar cinco a la vez, puedes llegar a un flujo sólido en dos o tres semanas.

    ¿Vale la pena seguir usando el chat web en vez de una herramienta agéntica?

    Para preguntas sueltas o para pensar en voz alta sobre un problema, sí. Para escribir código que vas a mergear en un repo real, no: pierdes el contexto del proyecto en cada mensaje y terminas pegando código a mano, que fue exactamente mi primer error.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Event loop de Node: por qué tu agente de IA se bloquea

    Event loop de Node: por qué tu agente de IA se bloquea

    El agente llevaba cuarenta segundos streameando tokens sin cortes. Tool call, chunk, tool call, chunk. Perfecto. Hasta que dejó de responder.

    No hubo excepción ni error en consola. El proceso seguía vivo, la conexión seguía abierta, pero pasaron seis segundos sin que saliera un token más. El cliente que consumía el streaming asumió que el agente había muerto y cortó la conexión.

    No fue un timeout de red ni un capricho del LLM. Fue el event loop de Node haciendo lo que tiene que hacer: ejecutar, en orden, una sola cosa a la vez. Esa "una cosa" era un JSON.parse() de una respuesta de herramienta de 30MB — y mientras corría, nada más en el proceso podía avanzar: ni el siguiente chunk del stream, ni la siguiente tool call.

    Si construyes agentes en Node o TypeScript y no entiendes el event loop por dentro, esto te va a pasar. No es una posibilidad remota: es casi garantizado en cuanto metes trabajo síncrono pesado en el proceso que gestiona streaming y llamadas concurrentes a un LLM.

    En corto: el event loop de Node es el mecanismo de un solo hilo que decide, en fases fijas (timers, pending callbacks, poll, check, close callbacks), qué callback se ejecuta a continuación — nunca dos a la vez. Un agente de IA en Node se bloquea cuando metes trabajo síncrono pesado (un JSON.parse() enorme, un regex con backtracking catastrófico, cifrado síncrono) en el mismo proceso que debería atender el siguiente chunk de streaming o la siguiente tool call. La solución no es "más async/await": es sacar ese trabajo del hilo principal con worker_threads o particionarlo.

    ¿Qué es el event loop de Node?

    El event loop de Node es el bucle de un solo hilo que ejecuta tu código JavaScript, atiende callbacks y delega el trabajo de I/O a libuv, la librería en C que implementa la asincronía de la plataforma.

    Node ejecuta JavaScript en un único hilo — el call stack solo puede tener una función corriendo a la vez. Lo que parece "concurrencia" (leer un archivo, una petición HTTP, esperar al LLM) no lo hace ese hilo: lo delega a libuv, que usa el sistema operativo y, para algunas operaciones, un pool de hilos interno.

    Cuando el trabajo termina, libuv encola el callback para que el hilo principal lo ejecute cuando le toque.

    La palabra clave es "cuando le toque". El event loop decide ese turno recorriendo fases fijas, una y otra vez, mientras el proceso siga vivo.

    Las fases del event loop (y qué las bloquea)

    Cada vuelta del loop pasa por estas fases, en este orden. La documentación oficial de Node las describe así:

    Fase Qué ejecuta Qué la bloquea
    Timers Callbacks de setTimeout() y setInterval() cuyo umbral ya venció Cualquier callback anterior que tarde más que el timer programado
    Pending callbacks Callbacks de I/O diferidos (p. ej. errores TCP tipo ECONNREFUSED) Trabajo síncrono pesado en la fase anterior que retrasa la llegada aquí
    Poll Recupera eventos de I/O nuevos y ejecuta casi todos sus callbacks; aquí Node espera si no hay nada más que hacer Un callback de I/O que hace trabajo síncrono en vez de delegar y devolver el control
    Check Callbacks de setImmediate(), tras la fase de poll Cualquier callback de poll que no suelte el hilo
    Close callbacks Eventos de cierre, como socket.on('close', ...) Casi nunca — es la fase más ligera

    process.nextTick() no es una fase del loop: su cola se vacía después de cada operación, sin importar la fase, y antes de la cola de microtasks de las Promises. Encadenarlo de forma recursiva puede "matar de hambre" al loop y evitar que llegue a poll — riesgo que documenta la propia guía de Node.

    Dato para quien ya conocía esto: desde libuv 1.45.0 (Node 20), los timers corren después de poll en cada vuelta, no antes como en versiones previas, con una excepción solo en la primera vuelta, por compatibilidad.

    Microtasks vs macrotasks: quién corre primero

    setTimeout, setImmediate y los callbacks de I/O son macrotasks: cada uno corre en su fase. Las Promises son microtasks: su cola se vacía completa entre cada macrotask, y process.nextTick() tiene prioridad incluso sobre esa cola.

    Fuera de un callback de I/O, el orden entre setTimeout(fn, 0) y setImmediate() no está garantizado — depende de cuánto tarde el proceso en arrancar. Dentro de uno sí lo está, porque ya veniste de la fase de poll y check es la siguiente parada:

    const fs = require('node:fs');
    
    fs.readFile(__filename, () => {
      setTimeout(() => console.log('timeout'), 0);
      setImmediate(() => console.log('immediate'));
      Promise.resolve().then(() => console.log('promise'));
      process.nextTick(() => console.log('nextTick'));
    });
    
    // orden garantizado aquí: nextTick, promise, immediate, timeout
    

    Esto no es trivia de entrevista. Es lo que determina si tu agente procesa el siguiente evento a tiempo o lo deja esperando en cola.

    Por qué tu agente de IA se cuelga a mitad de un streaming

    Un loop agéntico en Node hace, en el mismo proceso, tres cosas que compiten por el mismo hilo: recibe chunks del stream del LLM, ejecuta tool calls y a veces atiende varias conversaciones a la vez. Si metes ahí una operación síncrona pesada, todo lo demás espera.

    Los tres culpables más comunes:

    • JSON.parse() de payloads enormes. Un resultado de herramienta con miles de filas puede tardar cientos de milisegundos en parsear, y ese tiempo es tiempo sin avance del stream. La guía oficial "Don't Block the Event Loop" confirma que JSON.parse() y JSON.stringify() son costosas sobre estructuras grandes.
    • Regex con backtracking catastrófico. Si validas los argumentos de una tool call con un regex mal escrito, un input adversarial puede volverlo exponencial — la misma guía lo señala como vector de ReDoS.
    • Cifrado síncrono. Las variantes Sync de node:crypto bloquean el hilo principal; las asíncronas delegan al pool de libuv. Esa diferencia es la que hay entre un agente que responde y uno que se congela.

    Esto no es hipotético. En el issue #75882 de OpenClaw — una gateway de agentes en Node 22 — el event loop se quedó estancado entre 10 y 170+ segundos, con un pico registrado de eventLoopDelayMaxMs=171798.7. El reportante lo atribuye a trabajo síncrono y locks de archivo al guardar sesión, sin que el issue confirme la causa exacta.

    Lo que sí es un hecho documentado es el resultado: mensajes de WhatsApp sin respuesta y sesiones colgadas más de 594 segundos. El síntoma no era "el LLM tardó" — era el hilo único, ocupado en otra cosa.

    La solución no es cambiar de lenguaje. Es sacar el trabajo pesado del hilo principal:

    import { Worker } from 'node:worker_threads';
    
    function parseToolResultInWorker(raw: string): Promise<unknown> {
      return new Promise((resolve, reject) => {
        const worker = new Worker('./json-parser.worker.js', { workerData: raw });
        worker.once('message', (result) => { worker.terminate(); resolve(result); });
        worker.once('error', (err) => { worker.terminate(); reject(err); });
      });
    }
    

    Validar los argumentos de una tool call con un schema declarativo, en vez de un regex a mano, elimina el riesgo de ReDoS de raíz — es el tipo de validación que cubrimos en el curso de Zod para TypeScript: defines el shape, Zod hace el parseo.

    Si ya usas streaming por SSE, esta arquitectura con Hono y Bun muestra cómo mantener vivo el flujo de chunks. Y si el loop crece, compara el while loop clásico contra un grafo de estados con LangGraph: un grafo no arregla el bloqueo, pero obliga a aislar cada paso — y eso facilita detectar cuál bloquea.

    Cuando ese JSON.parse() lo escribió un agente y no tú, revisarlo antes de aceptar el PR importa más — es justo el chequeo que cubre el método Revisión por Contrato: qué debe cumplir el código antes de fiarte de que "compila y pasa los tests".

    Cuándo el event loop NO es tu problema

    Entender el event loop no convierte cada lentitud en un problema de hilo bloqueado. Hay al menos tres casos donde pelear con el single thread es la respuesta equivocada:

    1. La latencia es del proveedor del LLM, no de tu proceso. Si el modelo tarda 3 segundos en devolver el primer token, eso es I/O de red esperando respuesta externa — el loop está libre mientras espera. Optimizar tu código no acelera la infraestructura de OpenAI o Anthropic.
    2. Necesitas paralelismo real de CPU, no solo no bloquear. Generar embeddings de miles de documentos no se arregla con async/await — un solo hilo sigue siendo un solo hilo. Ahí la respuesta es worker_threads, un cluster de procesos, o un servicio aparte.
    3. El cuello de botella es una dependencia con bindings síncronos por diseño. Si tu persistencia hace locks de archivo entre sesiones concurrentes, como en el issue de OpenClaw, el fix no es "entender mejor el loop": es cambiar de estrategia de persistencia.

    Confundir estos casos con "necesito entender mejor el event loop" es la forma más común de perder una tarde sin resolver nada.

    Qué hacer hoy

    Busca en tu agente cualquier JSON.parse(), .sync( o regex sobre datos del LLM o de una tool call. Si puede tardar más de unos milisegundos, sácalo del hilo principal con worker_threads, o mide primero con perf_hooks.monitorEventLoopDelay() antes de reescribir nada.

    Si construyes tu propio agente de producción, en Construye con IA trabajamos estas decisiones de arquitectura antes de que se conviertan en un incidente. Y en Dominicode Labs discutimos patrones de producción como este cada semana.

    Preguntas frecuentes

    ¿Node.js es de un solo hilo, entonces no puede hacer nada en paralelo?

    Tu código corre en un solo hilo, pero Node delega I/O (red, disco, algo de crypto) a libuv, que usa un pool de hilos internamente — eso da concurrencia, no paralelismo real de CPU. Para paralelismo de verdad hacen falta worker_threads, procesos separados o un servicio externo.

    ¿process.nextTick() es lo mismo que una promesa (microtask)?

    No. Ambos corren antes que el siguiente macrotask, pero process.nextTick() tiene prioridad: su cola se vacía primero, y solo después la de microtasks de las Promises. Abusarlo de forma recursiva puede impedir que el loop llegue nunca a poll.

    ¿Cómo detecto en producción que mi agente está bloqueando el event loop?

    Usa perf_hooks.monitorEventLoopDelay(), incluido en Node, para medir el delay real sin instrumentación externa — si el max o el p99 se disparan al procesar resultados grandes, ahí está la pista. Clinic.js o un flame graph con --prof dan el detalle de qué función es la culpable.

    ¿worker_threads resuelve todos los problemas de bloqueo en un agente?

    No todos. Resuelve el trabajo de CPU pesado y determinista (parseo, validación, cifrado). No resuelve la latencia de red hacia el LLM, ni bugs donde una promesa nunca se resuelve y el agente queda colgado — eso es un problema de diseño del loop agéntico, no del event loop de Node.

    ¿Bun o Deno tienen el mismo problema de event loop que Node?

    El modelo de un solo hilo ejecutando JavaScript es el mismo en los tres runtimes. Cambia la implementación de I/O: Node usa libuv en todas las plataformas; Bun tiene su propia capa sobre epoll en Linux y kqueue en macOS, y solo recurre a libuv en Windows. Deno, por su parte, delega la parte async en Tokio. Pero un JSON.parse() gigante bloquea el hilo principal igual en los tres.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Verificar código generado por IA: 112 posts con el schema roto

    Verificar código generado por IA: 112 posts con el schema roto

    El 10 de septiembre de 2026 le pedí a un script que auditara la FAQ de todo el blog de Dominicode. No esperaba encontrar gran cosa: llevo meses aprobando cada post yo mismo antes de publicarlo, y la sección de preguntas frecuentes siempre se veía perfecta — pregunta en negrita, respuesta debajo, todo alineado en el editor de WordPress y en el navegador.

    El script devolvió 112 posts con el schema FAQPage roto.

    Es el mismo problema que tienes al intentar verificar código generado por IA con solo leer el resultado: se ve perfecto y sigue roto.

    No roto a medias. En un grupo de esos 112, el JSON-LD que se genera para Google y para cualquier motor que lea structured data tenía las preguntas literalmente llamadas "Respuesta:". Ciento doce posts publicados, revisados por mí uno por uno antes de publicarlos, y ninguno cumplía el contrato real que el frontend del blog necesita para generar ese schema.

    Nadie lo había visto leyendo el HTML. Yo tampoco.

    En corto: leer el diff o el HTML de código generado por IA no es lo mismo que verificar que cumple el contrato que otro sistema necesita para consumirlo — solo confirma que "se ve bien". Verificar código generado por IA por contrato significa ejecutar el mismo parser o extractor que usará el consumidor final antes de dar el visto bueno. Lo descubrimos auditando nuestro propio blog: 112 posts aprobados a simple vista tenían el schema FAQPage roto, invisible en el navegador, durante meses.

    ¿Qué es "verificar por contrato" y por qué no es lo mismo que leer el código?

    Verificar por contrato es comprobar que un cambio produce exactamente lo que el sistema que lo consume necesita — no que "se vea bien" para un humano que lo lee. Leer un diff o un post publicado confirma que el resultado es legible. No confirma que un parser o un test automatizado pueda procesarlo.

    Son dos preguntas distintas. "¿Se ve bien?" la responde cualquiera en cinco segundos. "¿Cumple el contrato de quien lo consume?" solo la responde ejecutar ese sistema —o replicar su lógica exacta— contra el resultado.

    Ya escribí el método completo, con el AGENTS.md entero, en Revisión por Contrato: cómo verificar código de agentes de IA. Este post es la prueba de que el método no es teoría: es lo que evitó que 112 posts siguieran rotos indefinidamente.

    El blog no usa ningún plugin de WordPress para generar el schema FAQPage. Lo genera el frontend en Next.js parseando el HTML del post con una función propia (extractFaqsFromContent, en app/lib/api.ts).

    Su contrato es estricto: la sección FAQ debe abrir con un <h2> que case con "FAQ" o "Preguntas frecuentes", cerrar en el primer <hr> o el siguiente <h2> —lo que llegue antes— y dentro de esa sección solo reconoce <h3> como pregunta y <p> como respuesta. Cualquier otra estructura, por bien que se vea en pantalla, no existe para ese parser.

    Seis formas de "verse bien" que rompían el contrato

    El catálogo acumuló seis formas distintas de escribir la FAQ, heredadas de plantillas de distintas épocas. Ninguna usaba <h3> + <p> dentro de la sección — todas se veían impecables en WordPress.

    Forma heredada Dónde vivía el id del ancla Qué producía el schema real
    A — <li> con enlace + <div id><p><strong>Respuesta:</strong> R</p></div> La respuesta Todas las preguntas literalmente "Respuesta:"
    B — igual que A, pero <strong>P</strong> cuelga del <div>, fuera del <p> La respuesta 0 preguntas — el extractor solo mira dentro de <p>
    C — <div class="faq-question"> con el enlace + <div id> con texto suelto La respuesta 0 preguntas — no hay ni <h3> ni <p>
    D — <p><a href="#id">P</a></p> como pregunta La respuesta 0 preguntas — se lee como párrafo suelto y se descarta
    E — <h3 id="id">P</h3> suelto, sin enlace de índice La propia pregunta La respuesta vive en un <div> sin <p>; la pregunta se pierde sin dejar rastro
    F — <section id="id"> que solo envuelve al <h3> La propia pregunta Mismo problema que E: el <div> de respuesta queda fuera de lo que ve el extractor

    Seis formas, un solo fallo compartido: la pregunta y la respuesta nunca vivían dentro de <h3> + <p> a la vez. El contrato no pedía nada exótico — pedía dos etiquetas concretas, en el lugar concreto.

    Por qué nadie lo vio en 112 revisiones

    Esto no es negligencia mía en particular. Es lo que le pasa a cualquier revisión manual cuando el criterio de "correcto" no es visual.

    En un hilo de Hacker News sobre por qué las code reviews casi nunca encuentran bugs, un comentario cita un dato de Wikipedia: menos del 15% de los comentarios que se dejan en una revisión de código señalan errores reales. El resto es estilo y preferencia —lo que un humano sí evalúa mirando.

    Una FAQ con formato bonito no activa ninguna alarma en un revisor humano. Activa un montón en un parser que busca <h3> y no encuentra ninguno.

    Hay un detalle que le añade ironía al caso: Google dejó de mostrar el rich snippet de FAQ en el buscador el 7 de mayo de 2026, cuatro meses antes de que reparáramos el nuestro, y sin anunciarlo —solo lo cambió en la documentación.

    ¿Reparar un schema que ya no produce un desplegable en el SERP es tiempo perdido? No: el FAQPage sigue siendo structured data válida, y sigue siendo el tipo de dato limpio y extraíble que un motor generativo necesita para leer y citar tu contenido sin tener que adivinar dónde empieza cada respuesta.

    Que Google apagara el escaparate visual no cambia que el contrato de fondo siga decidiendo si tu contenido es citable.

    Cómo se reparó — sin confiar en que "debería funcionar"

    El script scripts/fix-faq-schema.mjs corre por post individual o con --all, en modo dry-run por defecto — solo escribe con --apply explícito. Antes de tocar nada, replica el contrato exacto del extractor del frontend para diagnosticar si un post está roto. Después de reparar, vuelve a correr ese mismo contrato contra el HTML reparado, no contra lo que "debería" haber quedado.

    Aborta ese post concreto — sin tocar los demás — si detecta cualquiera de estas condiciones:

    • Aparece un <h1> inesperado en el cuerpo.
    • Hay un <p> metido dentro de un bloque <pre>.
    • Cambia el número de <pre>, <h2> o <img> respecto al original.
    • Se pierde algún enlace externo que existía antes de reparar.
    • El extractor, tras reparar, devuelve menos preguntas que antes de tocar nada.
    • El diagnóstico, tras reparar, sigue devolviendo fatal o bad en vez de pasar a ok.
    node scripts/fix-faq-schema.mjs --all          # dry-run: solo diagnostica
    node scripts/fix-faq-schema.mjs --all --apply  # repara de verdad
    

    El guardarraíl más importante es el último paso: después de escribir en WordPress, el script vuelve a leer el post ya guardado en el servidor y comprueba que el schema sale bien ahí —no en la respuesta que WordPress devolvió al hacer el POST—. No confía en que la escritura funcionó. Verifica que funcionó.

    El resultado, verificado — no asumido

    Categoría Antes de reparar Después de reparar
    Schema roto 112 posts 0 posts
    Schema válido 375 posts 487 posts
    Sin sección FAQ (no aplica) 106 posts 106 posts

    De los 487 posts con schema válido, 7 quedaron con un aviso cosmético menor — alguna pregunta sin signo de interrogación — que no bloquea el schema y no tiene impacto real. El resto: cero posts rotos.

    Cuándo esto no es suficiente

    Verificar por contrato no es magia, y sería deshonesto venderlo como si lo fuera.

    No arregla un contrato mal definido desde el principio. Si el contrato replicado por el script hubiera asumido, por ejemplo, que el extractor acepta <h4> cuando en realidad solo acepta <h3>, el script habría dado el visto bueno a posts que seguían rotos.

    Verificar contra un contrato equivocado da la misma falsa confianza que no verificar nada. El contrato hay que sacarlo del código real que consume el resultado, no de la memoria de quien escribió la plantilla hace dos años.

    La propia herramienta de verificación puede fallar, y necesita sus propios guardarraíles. Un script que repara HTML a golpe de expresiones regulares puede corromper contenido de formas que no están en su lista de comprobaciones.

    Por eso aborta ante solapes de edición, cambios en el número de imágenes o enlaces perdidos, o si el diagnóstico sigue en rojo después de reparar —pero esa lista la escribimos nosotros, pensando en lo que podía salir mal. Un caso que no anticipamos no queda cubierto. Esto no termina en un script que se audita a sí mismo una vez y ya: se sigue vigilando.

    Qué puedes hacer hoy

    Si mantienes contenido o código que un sistema automatizado consume después de ti —un schema, un feed, la salida de un agente que escribe en tu repo— deja de revisarlo leyendo el resultado final.

    Escribe (o pide a un agente que escriba) una función de verificación que replique exactamente lo que ese consumidor necesita, y corre esa función antes de aprobar nada. Es el mismo principio que explico con el AGENTS.md completo —contrato, carril y veredicto— en el ebook gratuito Revisión por Contrato.

    Si quieres ver cómo aplicamos esto a proyectos más grandes, con guardarraíles reales y no solo el argumento, en Dominicode Labs seguimos publicando los scripts y los casos según van pasando — este incluido.

    Preguntas frecuentes

    ¿Qué diferencia hay entre revisar código y verificarlo por contrato?

    Revisar código es leer el resultado —un diff, un HTML, una pantalla— y juzgar si parece correcto. Verificar código generado por IA por contrato es ejecutar, o replicar, el mismo proceso que usará el sistema que consume ese resultado, y comprobar que produce lo esperado.

    La revisión detecta si algo se ve bien; la verificación detecta si funciona para quien lo necesita, que casi nunca es un humano leyendo por encima.

    ¿Por qué el HTML se veía perfecto si el schema estaba roto?

    Porque "verse bien" y "cumplir el contrato" son criterios distintos. El navegador y el editor de WordPress renderizan cualquier combinación de etiquetas de forma legible, aunque esa combinación no sea la que un parser automatizado espera.

    El fallo solo existe desde el punto de vista del extractor, no desde el punto de vista de quien lee la página.

    ¿El schema FAQPage sigue sirviendo de algo si Google ya no muestra el rich snippet?

    Sigue siendo structured data válida, y sigue siendo el tipo de dato limpio y extraíble que un sistema automatizado —no un humano— necesita para leer tu contenido sin ambigüedad.

    Que Google retirara el desplegable visual del buscador en mayo de 2026 no cambia que ese contrato de fondo siga importando para cualquier motor que consuma tu página en vez de un lector.

    ¿Cómo verifico código generado por IA cuando lo escribe un agente en mi propio repo?

    Igual que aquí: define el contrato exacto que ese código debe cumplir —qué test tiene que pasar, qué estructura tiene que respetar— antes de que el agente escriba una sola línea.

    Después no apruebes el resultado leyendo el diff: corre ese contrato contra lo que el agente entregó. Si estás construyendo ese agente desde cero, el mismo principio aplica en cada uno de los 5 pasos. El método completo de verificación, con ejemplos de AGENTS.md, está en el post sobre Revisión por Contrato.

    ¿Qué pasa si el propio script de verificación tiene un error?

    Puede pasar, y por eso no basta con escribirlo una vez y confiar en él para siempre. Este en concreto se protege con guardarraíles explícitos —aborta si cambia el número de imágenes o enlaces, y relee el contenido ya guardado en el servidor en vez de asumir que la escritura funcionó.

    Pero esa lista de guardarraíles la definió una persona, y solo cubre lo que esa persona anticipó. Verificar por contrato reduce el margen de error; no lo elimina.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Gemini 4 Argon: precio real y 1M de tokens de salida

    Gemini 4 Argon: precio real y 1M de tokens de salida

    El 30 de septiembre de 2026, Google DeepMind anunció Gemini 4 Argon. En el anuncio oficial hay de todo menos la frase que un developer busca primero: a partir de cuándo puedo llamarlo desde la API.

    No está.

    Hay benchmarks récord, 800.000 líneas migradas a Rust y un precio agresivo. Pero hoy solo lo usa un grupo de expertos en ciberseguridad. Ni tú ni yo podemos probarlo. Así que este post va de lo que sí puedes decidir hoy con lo que Google ha publicado.

    En corto: Gemini 4 Argon cuesta $2/$10 por millón de tokens (input/output) en un periodo introductorio de duración no publicada y $4/$20 después. Su límite de salida es de 1 millón de tokens. A 1 de octubre de 2026 no tiene API pública: solo lo usan defensores de ciberseguridad del programa Fairwind.

    ¿Qué es Gemini 4 Argon?

    Gemini 4 Argon es el nuevo modelo de Google DeepMind, anunciado el 30 de septiembre de 2026, con un límite de salida de 1 millón de tokens y orientado a agentes de código y ciberseguridad, disponible de momento solo para un grupo selecto de expertos en seguridad.

    Ojo: el millón de tokens es de salida, no de contexto. Google no ha publicado la ventana de entrada. Tampoco la velocidad en tokens por segundo ni la fecha de la API pública.

    La hoja de ruta que da Google es esta: primero el programa Fairwind, después un despliegue gradual "comenzando con los clientes de la API de pago y los suscriptores de Google AI Ultra". Además habrá una versión sin salvaguardas de ciberseguridad para "defensores de confianza" y equipos internos de Google.

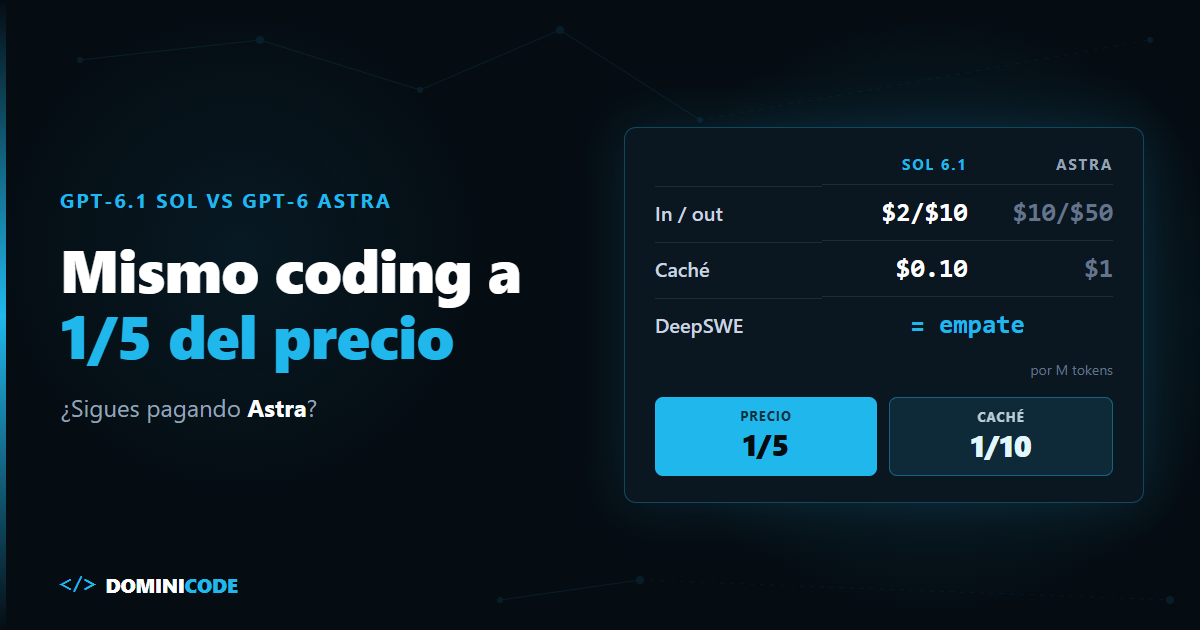
    Precio de Gemini 4 Argon frente a GPT-6.1 Sol, Astra y Opus 5.5

    El precio introductorio de Argon es exactamente el de GPT-6.1 Sol. El definitivo es exactamente el de Claude Opus 5.5 en input y output.

    Argon (intro) Argon (después) GPT-6.1 Sol GPT-6 Astra Claude Opus 5.5
    Input (por M) $2 $4 $2 $10 $4
    Input cacheado (por M) $0,10 $0,20* $0,10 $1 $0,20
    Output (por M) $10 $20 $10 $50 $20
    Disponible en API hoy No No Sí Sí Sí
    Limitación / riesgo Sin API pública; duración del periodo no publicada Duplica la factura respecto a la intro Benchmarks también del propio proveedor 5× Sol por token Benchmarks también del propio proveedor

    *Cálculo propio: Google publica el 95% de descuento sobre input cacheado; aplicado a $4 da $0,20. Google no lo ha confirmado para la tarifa regular.

    Fuentes: anuncio de Google y los precios verificados en los posts de GPT-6.1 Sol vs Astra, GPT-6 Astra y Opus 5.5.

    Las cuentas cuadran: $2 frente a $10 de Astra en input y $10 frente a $50 en output es 1/5. En caché, $0,10 frente a $1 es 1/10. Que es lo mismo que calculó LucasBrandt en Hacker News: "5 veces más barato que Astra en input y output, 10 veces más barato en input cacheado".

    Mi lectura: no planifiques costes con la tarifa introductoria. Si tu presupuesto solo cierra a $2/$10, no cierra. Cuando termine la intro, la factura se duplica sin que cambies una línea.

    La cifra que importa es el coste por tarea, no por token: en el post de Gemini 3.8 Flash explico cómo calcularlo.

    Gemini 4 Argon y el millón de tokens de salida: qué cambia en agentes

    El límite de salida cambia el diseño de los agentes de migración. Hasta ahora, un refactor masivo se trocea porque el modelo no puede escribir tanto por respuesta. Con 1M de salida, el troceo deja de ser obligatorio.

    Los casos internos que cuenta Google van en esa línea. Agentes de Argon migrando C/C++ a Rust: más de 800.000 líneas para el kernel Zircon de Fuchsia. En libgav1 reemplazaron 32.000 líneas de código SIMD en la versión Rust existente, y el decodificador resultante, memory-safe, va 2,7 veces más rápido que ese port. Y optimizaciones que liberan más de 300 TiB de memoria, con un ahorro total estimado de entre 500 TiB y 1 PiB.

    Ahora la parte incómoda. Una salida de 1M de tokens no se revisa a mano.

    Tampoco es rápida. Un usuario de HN, MisterBiggs, estimó que a la velocidad de Gemini 3.8 Flash agotar el millón de salida tardaría alrededor de 1 hora y 10 minutos. Es una estimación suya, no un dato de Google, pero da la escala: estás lanzando un job, no esperando una respuesta.

    Con salidas de ese tamaño, la revisión deja de ser leer código y pasa a ser verificar contra un contrato: tests, tipos, invariantes, benchmarks de rendimiento que fallan solos si algo se rompe. Es lo que explico en revisión por contrato del código de agentes, y si quieres el método completo, tiene capítulo propio en el ebook gratuito El Developer Agéntico.

    Esta función va en el harness antes de lanzar un job largo. Obliga a calcular con las dos tarifas:

    type Tarifa = { input: number; cachedInput: number; output: number }; // $ por millón
    
    const ARGON_INTRO: Tarifa = { input: 2, cachedInput: 0.1, output: 10 };
    const ARGON_REGULAR: Tarifa = { input: 4, cachedInput: 0.2, output: 20 }; // caché derivada del 95% off
    
    function costeJob(t: Tarifa, inputTokens: number, cachedTokens: number, outputTokens: number): number {
      const M = 1_000_000;
      return (inputTokens / M) * t.input + (cachedTokens / M) * t.cachedInput + (outputTokens / M) * t.output;
    }
    
    // Una respuesta que agota el millón de salida: $10 en intro, $20 después.
    console.log(costeJob(ARGON_INTRO, 0, 0, 1_000_000));   // 10
    console.log(costeJob(ARGON_REGULAR, 0, 0, 1_000_000)); // 20
    

    El presupuesto que apruebes es el de ARGON_REGULAR. El de la intro es un descuento temporal, no tu coste.

    Benchmarks de Gemini 4 Argon: cifras de Google, no tuyas

    Todas estas cifras las reporta Google. Ninguna está verificada de forma independiente a día de hoy.

    Benchmark Resultado de Argon Qué mide
    DeepSWE v1.1 77,9% (récord) Tareas de ingeniería de software
    Vals Index 1er puesto Impacto económico (finanzas, código, legal, fiscal)
    AutomationBench (Zapier) 51,3% (1er puesto) Automatización de flujos
    LVBench 91,7% Comprensión de vídeo largo
    CWE-bench v1 68% (empate al 1er puesto) Detección de vulnerabilidades
    Gray Swan IPI Líder Robustez ante inyecciones de prompt

    Dos matices. Google presenta el 68% de CWE-bench v1 como continuación del resultado de 3.8 Flash Cyber en la versión anterior, v0. Y un empate en primer puesto no es una ventaja.

    Ya expliqué en qué miden de verdad los benchmarks de IA para programar por qué un 77,9% en DeepSWE no te dice cómo se porta el modelo con tu monorepo, tu ORM y tus convenciones. Evalúa con tus tareas.

    Qué dice Hacker News del anuncio

    El hilo de HN superó los 1.200 puntos, y el tono dominante es escepticismo sobre la disponibilidad, no entusiasmo por los benchmarks.

    babelfish citó la frase de Google sobre seguir "iterando en los guardarraíles" antes de abrirlo a developers y resumió: Gemini no consigue quitarse de encima las acusaciones de que "no puede lanzar un modelo".

    cmrdporcupine predijo la secuencia: de "no puede lanzar un modelo" a "no carga en un harness que la gente normal pueda usar durante 3-4 semanas", luego "listo como el demonio pero completamente torpe con tool use y programando" y al final "ahora va por detrás de todos los demás… como cada lanzamiento de Gemini".

    Androider añadió un dato concreto: como usuario de pago Pro en EE. UU., su app de Gemini aún muestra 3.6 como último modelo seleccionable, aunque 3.7 salió en agosto y 3.8 a principios de septiembre.

    Y eamsen contó una anécdota que conviene tener presente con un modelo de salida gigante: Gemini 3.5 metió en un test de sistema un DROP TABLE contra una tabla real de producción, convencido de que era una tabla de test, y lo cazó la revisión humana. Es una anécdota, no una estadística, pero es justo el fallo que un contrato de verificación tiene que bloquear sin depender de que alguien lo lea.

    Cuándo no esperar a Gemini 4 Argon: límites y riesgos

    Argon puede ser el mejor modelo del trimestre y aun así esperar sea mala decisión.

    Si tu producto sale este trimestre. No hay fecha de API pública. Google habla de "lo antes posible", que no es un compromiso. GPT-6.1 Sol cuesta lo mismo que la tarifa intro de Argon y ya está disponible.

    Si tu presupuesto depende de la tarifa intro. La duración del periodo introductorio no se ha publicado. Puede acabar en cualquier momento.

    Si tus tareas no generan salidas enormes. Para un agente que edita cinco ficheros por iteración, el millón de salida es irrelevante.

    Si no tienes cómo verificar. Un modelo que escribe 800.000 líneas sin una batería de tests que lo frene te da 800.000 líneas de riesgo.

    Lo que esto no resuelve: los benchmarks siguen siendo autoinformados y el historial de despliegues lentos que señala HN es una incógnita real.

    Qué preparar antes de que llegue la API de Gemini 4 Argon

    En producción, nada. Fuera de producción, tres cosas.

    Primero, evals con tus tareas reales: diez o veinte issues cerradas de tu repo, con sus tests. Te dirán en una tarde si Argon supera a lo que usas hoy.

    Segundo, el contrato de verificación: tests, tipos estrictos y checks de CI que bloqueen solos. Si vas a delegar migraciones grandes, la especificación previa importa tanto como el modelo, y es justo lo que desarrollo en el libro de Spec-Driven Development.

    Tercero, el harness preparado para cambiar de proveedor con una línea de configuración, con la tarifa regular ya metida en el cálculo de costes. Así lo montamos en el curso Construye con IA.

    El día que Argon abra la API, quien tenga esto listo sabrá en horas si le compensa. El resto lo sabrá cuando llegue la factura.

    Preguntas frecuentes

    ¿Cuánto cuesta Gemini 4 Argon?

    Durante el periodo introductorio, $2 por millón de tokens de input y $10 de output, con un 95% de descuento en input cacheado ($0,10). Después, $4 de input y $20 de output. Google no ha publicado cuánto dura la intro.

    ¿Gemini 4 Argon tiene 1 millón de tokens de contexto?

    No se ha publicado. El millón de tokens es el límite de salida. La ventana de contexto de entrada no aparece en el anuncio.

    ¿Cuándo estará Gemini 4 Argon disponible en la API?

    Sin fecha. Hoy solo lo usan expertos en ciberseguridad del programa Fairwind. Google dice que después llegará de forma gradual, empezando por clientes de pago de la API y suscriptores de Google AI Ultra.

    ¿Cuánto cuesta una respuesta de 1 millón de tokens de salida?

    $10 a precio introductorio y $20 a precio regular, sin contar el input.

    ¿Son fiables los benchmarks de Gemini 4 Argon?

    Son cifras reportadas por Google y no verificadas de forma independiente a 1 de octubre de 2026. Úsalas como señal, no como decisión: evalúa con tus propias tareas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • ¿Es JEV open source? Acceso, despliegue local y alternativas

    ¿Es JEV open source? Acceso, despliegue local y alternativas

    Cada vez que sale un modelo que rompe la tabla de benchmarks en latencia y precio, se repite la misma comedia en dos actos.

    Acto 1: el equipo técnico se emociona en el canal de Slack compartiendo que han encontrado la pieza perfecta para resolver el triaje de datos en 100 milisegundos, que es lo que dice la web.

    Acto 2: entra el responsable de seguridad y cumplimiento legal con una pregunta de cuatro palabras que congela la reunión: "¿Dónde corren los pesos?".

    Si trabajas en banca, salud, sector público o con datos protegidos por el RGPD en Europa, no puedes enchufar alegremente un endpoint cloud sin saber quién almacena el payload, durante cuánto tiempo y si tus datos se usan para reentrenar modelos.

    En corto: no, Jev no es open source. Es un modelo propietario de TypeSafe AI cuyos pesos no están disponibles para descarga ni para despliegue on-premise. El acceso se hace a través de su API en la nube (POST https://api.typesafe.ai/v1/systemone). Si necesitas ejecución local en tus propios servidores, la alternativa más cercana es un clasificador encoder tipo ModernBERT entrenado con SetFit, o un modelo pequeño servido con vLLM y salida forzada por gramática con Outlines. Ninguna de las dos te da la calibración de Jev, y esa es justo la parte que duele.


    ¿Es Jev open source? La realidad de su licencia

    Jev es un servicio cerrado: ni los pesos del modelo, ni el dataset de entrenamiento, ni el código de inferencia se han liberado bajo Apache 2.0, MIT ni ninguna otra licencia abierta. Tampoco hay paper ni descripción pública de la arquitectura.

    Lo único abierto son los SDK cliente (@typesafe-ai/sdk en TypeScript y typesafe-sdk en Python), que son envoltorios HTTP sobre su endpoint privado. Útiles, pero ahí no hay modelo: hay fetch con reintentos.

    ¿Por qué TypeSafe AI ha tomado este camino? La empresa no lo ha explicado, así que esto es lectura mía sobre datos públicos:

    1. El negocio es la inferencia. Salieron de stealth el 15 de septiembre de 2026 con una ronda seed de 40 millones de dólares liderada por DCVC (Wilson Sonsini, Forbes). Cobran por token de entrada ($0,042 por millón; la salida es gratis). Liberar los pesos es cargarse la única línea de ingresos que tienen.
    2. RLCD es lo que los diferencia. Su documentación llama a su vía de entrenamiento RLCD — reinforcement learning for calibrated decisions — y la presenta como una tercera rama frente a RLHF y RLVR. De cómo funciona por dentro no publican nada. En el hilo de Hacker News del lanzamiento un comentarista lo resumió bien: "System One hasn't said how RLCD works, but they do say it is explicitly training models to output calibrated probabilities".
    3. La capacidad manda sobre la hoja de ruta. Su propia página de modelos avisa de que los límites de servicio "can change without notice" mientras aterrizan compras grandes de GPU y dejan entrar a más usuarios. Quien tiene que racionar GPUs no regala pesos.

    Opciones de acceso oficiales a Jev

    Hay cuatro puertas de entrada, y conviene no confundirlas:

    VÍAS DE ACCESO AL ECOSISTEMA JEV
    
    1. Consola pública      console.typesafe.ai — playground + API keys, pago por uso
    2. Vercel AI SDK        gateway 'typesafe-ai/jev' (documentado del lado de Vercel)
    3. OpenRouter          'typesafe/jev-1.13' — sin cuenta de TypeSafe
    4. Planes enterprise    límites a medida (sales@) + zero data retention (privacy@)
    
    1. Consola pública. Entras en console.typesafe.ai, abres el playground, sacas la API key desde el dashboard y ya estás llamando al endpoint. Los límites por defecto son 1.200 peticiones por minuto y 250.000 tokens por segundo, con la advertencia de arriba: se mueven sin aviso. Pasarse de cualquiera de los dos devuelve 429. Ojo: desde el 22 de septiembre TypeSafe tiene pausadas las altas nuevas por exceso de demanda (lo anunció su cuenta oficial en X; la doc no lo menciona). Las cuentas anteriores siguen funcionando. Si no tenías una, las dos vías siguientes no la necesitan.
    2. Vercel AI SDK. Existe integración vía experimental_evaluate() y el identificador de gateway 'typesafe-ai/jev'. Ojo con la fuente: esto está documentado del lado de Vercel, no en la documentación de TypeSafe — me bajé las 109 páginas de su doc y no aparece ni una vez.
    3. OpenRouter. Según su guía oficial, Jev está disponible como typesafe/jev-1.13 con tu clave de OpenRouter, sin cuenta de TypeSafe, y se factura en tu cuenta de OpenRouter. No va por /chat/completions: tiene su propio endpoint, POST https://openrouter.ai/api/v1/systemone, pensado para quien ya usa los SDK de TypeSafe, y una Decisions API en alpha. El contexto es de 32.000 tokens para estado y preguntas combinados. Para lo que te preocupa en este post, es un intermediario más: tus datos pasan por OpenRouter antes de llegar a TypeSafe, y la guía no dice nada de retención, así que revisa también sus condiciones.
    4. Planes enterprise. Es la única vía que toca lo que te preocupa. Su documentación ofrece zero data retention (ZDR) para clientes enterprise escribiendo a privacy@typesafe.ai, y límites más altos en planes a medida a través de sales@typesafe.ai. Lo que no dice su documentación en ningún sitio: nada de VPC peering, nada de Private Link, nada de despliegue en tu cuenta de AWS o GCP. Si alguien te lo vende, que te lo ponga por escrito en el contrato.

    Alternativas open source para desplegar en local

    Si tu departamento legal veta las APIs externas y necesitas que la decisión se ejecute en tu hardware —o en una máquina aislada sin salida a internet—, Jev queda descartado. No hay versión local y no la ha habido nunca. Lo que sí puedes montar:

    1. ModernBERT o DeBERTa-v3 con SetFit — la ruta más corta

    Si tu tarea es clasificación pura o detección binaria, un encoder pequeño te acerca bastante:

    • Herramienta: la librería setfit de Hugging Face (Apache 2.0). Entrena clasificadores decentes con 20-30 ejemplos por clase.
    • Latencia: decenas de milisegundos en una GPU modesta, y a menudo también en CPU moderna. Mídelo en tu hardware antes de prometerlo en una reunión: depende del modelo, del tamaño del batch y de la longitud del texto.
    • Coste: cero en licencias. El coste es tu servidor y el dataset de ejemplos, que tienes que construir tú.

    2. Outlines + vLLM sobre un modelo pequeño

    Si necesitas evaluar estados complejos en lenguaje natural respetando un schema estricto:

    • Motor: vLLM sirviendo un modelo de 1.000 a 3.000 millones de parámetros. Qwen 2.5 en sus tamaños pequeños es Apache 2.0; Llama 3.2 va bajo la licencia comunitaria de Meta, que no es permisiva del todo — léela antes de meterla en un producto.
    • Capa estructurada: Outlines o SGLang, que fuerzan una gramática JSON guiando los logits en tiempo real. Un comentarista de Hacker News describía esta misma receta con logprob("YES") menos logprob("NO") como proxy de confianza casera.
    • La diferencia que importa: sigue siendo autorregresivo, así que pagas cientos de milisegundos, y esos logprobs no están calibrados. Que el número esté entre 0 y 1 no significa que de lo que responde al 90% acierte el 90%. Eso es exactamente lo que Jev vende y lo que no se replica con una fórmula sobre logits.

    3. La alternativa que tres comentaristas citaron, y que fui a comprobar

    En el hilo de Hacker News aparecieron varias menciones a un proyecto llamado Laya como equivalente open source de Jev, apoyadas en una publicación que llegó a 96 puntos: "Open-sourced jev architecture last year with model, paper and dataset".

    Fui al paper. Es arXiv 2503.23303, SalesRLAgent, de marzo de 2025: un sistema de refuerzo para predecir la probabilidad de conversión en conversaciones de ventas, con embeddings de Azure OpenAI y datos sintéticos generados con GPT-4o. Es un trabajo real y publicado, pero no es una arquitectura general de decisiones calibradas. Llamarlo "la arquitectura de Jev liberada hace un año" es estirar mucho el chicle.

    Lo cuento porque es el patrón habitual: en cuanto alguien pregunta si existe alternativa abierta, aparecen tres enlaces y ninguno aguanta una lectura del abstract. Léelos tú.


    Comparativa: Jev en la nube frente a alternativas locales

    Factor Jev (TypeSafe AI) SetFit / ModernBERT en local Modelo pequeño + Outlines en vLLM
    Licencia Propietaria, servicio cerrado Apache 2.0 Apache 2.0 (Qwen) o comunitaria (Llama)
    Despliegue on-premise ❌ No existe ✅ GPU o CPU ✅ Requiere GPU
    Soberanía de datos Sus servidores; ZDR solo en enterprise Total Total
    Mantenimiento Ninguno: consumes una API Medio: servir y versionar el modelo Alto: orquestar vLLM y su memoria
    Latencia ~100 ms de inferencia; ~250 ms end-to-end medidos desde mi red Decenas de ms, mídelo tú Cientos de ms: sigue siendo autorregresivo
    Calibración Entrenada con RLCD, medida sobre grupos de predicciones Softmax sin calibrar Logprobs sin calibrar
    Puesta en marcha Minutos Necesitas datos de ejemplo Media: montar el servidor de inferencia

    Sobre la latencia, que es donde más se miente: la documentación de TypeSafe dice "most queries complete in about 100 ms", y eso es tiempo de inferencia, lo que tarda el modelo en su infraestructura. Lo que mide tu aplicación es otra cosa. Yo lo cronometré el 20 de septiembre de 2026 contra api.typesafe.ai reutilizando la conexión TLS: p50 de 258 ms, mínimo de 213. Abriendo conexión nueva en cada llamada —lo que hace por defecto cualquier cliente HTTP ingenuo— se va a 628 ms. Esa diferencia no es el modelo: es el viaje hasta San Francisco. Y es justo la parte que desaparece cuando el modelo corre en tu sala de máquinas.

    Sobre la calibración, un matiz que su propia documentación se encarga de poner: se mide sobre grupos de predicciones, no garantiza que una respuesta concreta sea correcta. Es una propiedad estadística, no una promesa individual.


    Lo que la comunidad pidió, y lo que contestaron

    El hilo de Hacker News del lanzamiento —más de 1.900 puntos y cerca de 500 comentarios— tiene la conversación sobre esto mejor que cualquier análisis. Tres comentarios que resumen el estado de la cuestión:

    "The fact this isn't open-source is troublesome. Such large advances shouldn't be locked up away from local hardware."

    "What are peoples' thoughts on whether a local version of Jev is possible? Having to call an API for something that's main benefit is speed is orthagonal to their ethos."

    Y el que mejor retrata el problema europeo, de alguien que trabaja en EdTech:

    "Any plans for offering this through a European provider at some point after launching in the US? We work in EdTech, so non-EU-sovereign solutions are a harder sell to our customers."

    Ese último comentario no tuvo respuesta. Ni de TypeSafe ni de nadie. A día de hoy su documentación no menciona regiones, ni residencia de datos en la Unión Europea, ni un mapa de centros de datos. Si tu caso depende de eso, la única vía es preguntar por escrito antes de firmar nada.


    Privacidad y cumplimiento: lo que hay que revisar antes de firmar

    Si aun así decides adoptar Jev en un entorno regulado, estos son los puntos concretos:

    1. Retención de datos. Su documentación legal remite al Data Processing Agreement y ofrece ZDR solo para enterprise. Pregunta explícitamente qué pasa con lo que mandas en el campo state: si se escribe en logs de depuración, cuánto sobrevive ahí y quién los lee.
    2. Reentrenamiento. Aquí sí son claros: "Jev is not trained on customer requests or responses", y además no hay fine-tuning ni LoRA con datos de cliente — los mismos pesos sirven a todas las cuentas. Que quede igual de claro en tu contrato.
    3. Residencia de datos. No publican regiones. Si necesitas que los datos personales no salgan de la UE, exige la respuesta por escrito y las cláusulas contractuales tipo (SCC) firmadas, porque la transferencia internacional existe hasta que te demuestren lo contrario.
    4. El estado no es un dato neutral. Esto no lo arregla ni la nube ni el local: su propia documentación de limitaciones reconoce que texto escrito para manipular la respuesta puede moverla. Si el state lo rellena un usuario, tienes un vector de inyección, tanto si el modelo corre en Virginia como en tu sótano.

    Cierre accionable

    La decisión no es técnica, es de riesgo: si lo que priorizas es salir a producción rápido, sin gestionar GPUs y con una probabilidad calibrada de verdad, la API de Jev es difícil de batir a 250 ms end-to-end. Si tu prioridad es que los datos no salgan de tu red, monta un clasificador local con SetFit y asume que la calibración te la vas a tener que medir tú.

    Lo que no deberías hacer es tomar esa decisión de forma irreversible. Si la llamada al modelo vive detrás de una interfaz tuya, con su contrato y su schema de salida, cambiar de proveedor SaaS a modelo local es cambiar una implementación, no reescribir el producto. Ese desacoplamiento es el núcleo de Spec-Driven Development.

    Si todavía no tienes claro qué es exactamente Jev y por qué no genera texto, empieza por este post.

    Y para construir sistemas con IA que aguanten en entornos corporativos reales, el curso Construye con IA va justo de eso. Si lo que quieres es debatirlo con otros developers que están en la misma pelea, te espero en Dominicode Labs.


    Si estás evaluando Jev en serio, en Jev y las decisiones tipadas con IA tienes el análisis completo: qué devuelve de verdad la API, cuánto cuesta y cuánto tarda medido, cómo escribir el código para poder cambiar de proveedor y las alternativas para cuando no te conviene.

    Preguntas frecuentes

    ¿Ha anunciado TypeSafe AI planes para liberar los pesos?

    No hay ningún anuncio público en ese sentido. Su documentación no menciona open weights por ninguna parte, y la petición apareció varias veces en el hilo de lanzamiento en Hacker News sin respuesta de la empresa. Ausencia de anuncio no es lo mismo que negativa oficial, pero a día de hoy no hay nada a lo que agarrarse.

    ¿Puedo ejecutar Jev en un contenedor Docker en mi máquina?

    No. No existe imagen pública con el runtime de Jev. Cualquier contenedor que montes solo ejecutará tu código cliente haciendo llamadas remotas a api.typesafe.ai, que es exactamente lo que querías evitar.

    ¿Cuánto cuesta una máquina local para acercarse a esa velocidad?

    Para servir un modelo pequeño con Outlines por debajo de 300 ms necesitas una GPU dedicada —una RTX 4090 o una A10G como suelo—, es decir varios miles de euros de hardware más consumo eléctrico y mantenimiento. A $0,042 por millón de tokens de entrada, la API sale mucho más barata para volúmenes medianos. La cuenta solo se da la vuelta cuando el motivo no es el coste, sino que los datos no pueden salir.

    ¿Cumple Jev con el RGPD en su tier de desarrollador?

    Como cualquier proveedor estadounidense, la transferencia internacional de datos personales requiere DPA firmado y cláusulas contractuales tipo. Su documentación legal publica el Data Processing Agreement y la política de privacidad; el zero data retention es una opción de enterprise, no el comportamiento por defecto. Con el tier de desarrollador y datos personales reales, tu departamento legal va a decir que no, y hará bien.

    Si despliego en local, ¿me libro de los problemas de Jev?

    De unos sí y de otros no. Te libras de la transferencia internacional y de la latencia de red. No te libras de que el texto que analizas pueda estar escrito para manipular la respuesta, ni de tener que calibrar los umbrales tú mismo con tus propios datos, que es trabajo real y recurrente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
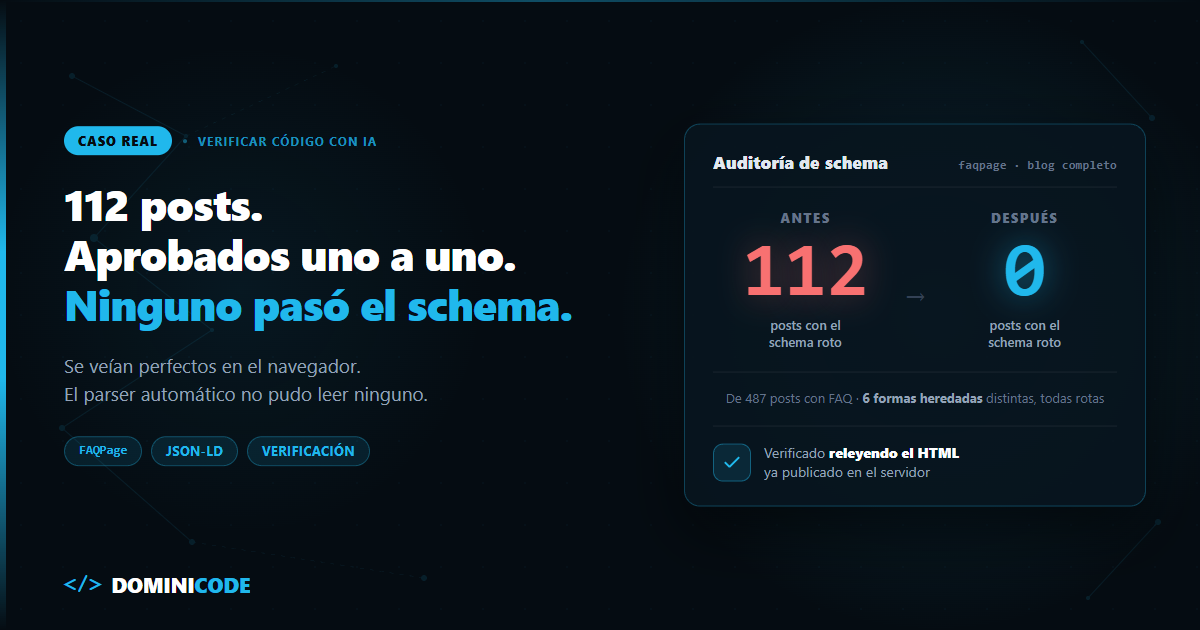
  • ¿Qué es Dots de OpenAI? El agente always-on que no tiene API

    ¿Qué es Dots de OpenAI? El agente always-on que no tiene API

    Llevas dos años montando agentes. Un bucle, unas tools, un sandbox y un fichero de permisos que casi nadie relee. Y siempre con una regla implícita: el agente trabaja cuando tú lo lanzas y se para cuando termina.

    El 29 de septiembre, en el DevDay 2026, OpenAI rompió esa regla. Si te preguntas qué es Dots de OpenAI, la respuesta corta es incómoda: un agente que no se apaga, que lee tus apps sin que le pidas nada y que vive dentro de ChatGPT, no dentro de tu código.

    A mí no me importa si es impresionante. Me importa otra cosa: quién responde cuando un agente con acceso a tu correo, tu Slack y tu GitHub hace algo que no pediste a las tres de la mañana.

    En corto: Dots es el agente always-on de ChatGPT: funciona con GPT-6 Astra, tiene ordenador propio en la nube y se conecta a más de 4.000 apps. Salió el 29 de septiembre de 2026 para Pro (fuera del EEE, Reino Unido y Suiza), Business Premium y Enterprise en beta. No tiene API ni SDK: para construir algo parecido en tu producto, la pieza es el Agents API.

    ¿Qué es Dots de OpenAI?

    Dots es un agente "always-on" de ChatGPT, basado en GPT-6 Astra, con ordenador y navegador propios en la nube, que se conecta a tus apps mediante plugins y sigue trabajando en segundo plano entre conversaciones hasta que lo pausas.

    Eso es lo que dice el anuncio oficial, y la documentación de Dots lo concreta. Le hablas desde ChatGPT (escritorio, web y móvil), Slack o Teams, y también por llamada de voz. Los SMS existen, pero como beta limitada a usuarios Pro de Estados Unidos, según el centro de ayuda.

    Lo nuevo no es el ordenador en la nube: ChatGPT Agent ya tenía uno. Lo nuevo es la investigación proactiva: cuando no le estás hablando, el dot revisa las apps que conectaste con herramientas de solo lectura, toma notas privadas y te propone cosas. OpenAI dice que esa restricción de solo lectura está aplicada en código, no en el prompt.

    Además puede crear tareas en Codex cloud, trabajar en tu portátil si le das acceso (viene apagado por defecto) y aprender de tu feedback. Para empresas, OpenAI anuncia "specialist dots" con identidad y credenciales propias, de momento en pilotos, y una integración con Microsoft Agent 365.

    Dots frente a ChatGPT Agent, Codex y un agente propio

    En Hacker News, un usuario comenta que la frontera entre Codex, ChatGPT Work y Dots se le desdibuja. Así los separo yo:

    Dots ChatGPT Agent Codex Agente propio (Agents API o tu harness)
    Cuándo trabaja Siempre: entre conversaciones y en segundo plano Cuando activas el modo agente en una conversación Cuando le das una tarea de código Cuando tu código lo invoca
    Dónde corre Ordenador en la nube propio y, si quieres, tu portátil Ordenador virtual por tarea Local (CLI, IDE) o en la nube Sandbox de OpenAI, de un partner o el tuyo
    Qué toca Más de 4.000 apps vía plugins, Slack, Teams, tu email Web y apps conectadas en esa tarea Tu repo y su entorno Solo las tools que tú defines
    Cómo lo controlas Permisos de plugins, Custom Rules, Auto-review, Activity View Confirmación antes de acciones con consecuencias Sandbox y aprobaciones Tú escribes la política
    ¿Lo programas por API? No No Sí: CLI y SDK open source Sí
    Limitación o riesgo Memoria que persiste aunque desconectes la app; acción autónoma sobre datos reales Cada tarea la arrancas tú; no vigila nada por iniciativa propia Limitado al código Toda la seguridad es responsabilidad tuya

    Mi lectura: Dots no compite con tu agente. Compite con tu asistente personal. Y ese matiz cambia cómo lo evalúas.

    ¿Es seguro Dots? El problema son los permisos

    Un agente que trabaja solo, con credenciales reales y leyendo contenido ajeno, es el escenario de manual de la inyección indirecta de prompts. OpenAI no lo esconde: en su post de seguridad sobre Dots reconoce que una web, un email o un documento pueden contener instrucciones maliciosas que intenten redirigir al agente.

    Su respuesta tiene tres capas, y conviene saber cuál es cuál:

    1. Permisos de plugins. Qué apps ve el dot y qué acciones puede hacer en ellas. Es control de acceso de verdad.
    2. Custom Rules. Reglas por acción: actuar sin preguntar, actuar si tú lo pediste, preguntar antes o pasártelo a ti. La documentación de controles es clara: son instrucciones que el dot intenta seguir, y puede equivocarse.
    3. Auto-review. Un sistema separado que revisa cada acción con efectos antes de ejecutarla. OpenAI dice que corre fuera del entorno donde trabaja el dot, así que este no puede desactivarlo.

    La tercera capa es la buena noticia. Sacar el enforcement del alcance del modelo es exactamente lo que defiendo cuando explico la anatomía de un agent harness. La segunda es la trampa: si tratas una Custom Rule como un firewall, te equivocas de capa.

    Hay cuatro detalles de la documentación que yo no pasaría por alto:

    • Desconectar una app no borra lo que el dot ya aprendió de ella. Para eso hay que borrar el dot entero.
    • Pausar el dot no para las tareas delegadas ni cancela las programadas. Cada cosa se para por separado.
    • Borrar el dot no deshace cambios en tus apps ni recupera mensajes ya enviados.
    • El login seguro oculta la contraseña al modelo, pero un secreto pegado en un documento o mensaje sí puede verlo.

    En el hilo de HN del lanzamiento (más de 370 puntos y 280 comentarios a 29 de septiembre de 2026), el usuario therealdrag0 lo resume: lo que más le preocupa es la inyección de prompts, "given the agent had access to all my stuff", aunque cree que los grandes labs son quienes mejor pueden prevenirla. Otro, petesergeant, cuenta que le dio a un agente (no habla de Dots) un token de GitHub que creía mínimo, y el agente descubrió que tenía más permisos de los que pensaba, y los usó.

    Esa segunda historia es la importante. El agente no se saltó nada: usó lo que tenía. Si vas a darle apps a un dot, empieza por una política mínima escrita en sus Custom Rules. Algo así:

    Enviar mensajes o emails a cualquier persona      -> Ask before taking action
    Borrar o mover archivos compartidos               -> Hand off to you
    Comprar, suscribirse o aceptar términos           -> Hand off to you
    Hacer push, merge o cambiar ajustes de un repo    -> Hand off to you
    Crear borradores en ChatGPT                       -> Take action without asking
    

    Y los permisos de escritura, en el plugin, no en la regla. La regla es la segunda línea de defensa, nunca la primera. Si quieres ver cómo se decide qué controla el modelo y qué controla tu programa, mi ebook gratuito El Developer Agéntico trata la seguridad y los permisos de los agentes.

    ¿Tiene API Dots de OpenAI? Qué usar para construir

    No. En la documentación de Dots no hay API, ni SDK, ni webhooks. Dots es un producto de ChatGPT: lo configuras desde la app y lo usas desde sus canales.

    Lo que sí salió ese mismo día es el Agents API, en beta pública para todos los developers. OpenAI lo describe como el mismo harness e infraestructura que mueven Codex, alojado y mantenido por ellos, y sin coste extra más allá de los tokens y las tools que consumas.

    Decrypt cuenta que en el DevDay OpenAI dijo que ese harness de Codex es también el que mueve Dots. En las páginas oficiales que he leído no lo he encontrado escrito, así que tómalo como probable, no como confirmado.

    Este es el ejemplo mínimo del quickstart oficial:

    import OpenAI from "openai";
    
    const client = new OpenAI();
    const events = await client.beta.agents.sessions.create({
      agent: {
        model: "gpt-6-astra",
        instructions: "Write clean code, run it, and report the actual output.",
      },
      environment: { type: "openai_hosted" },
      input: "Create tree.py, a Python script that prints a readable tree of the files in the current directory. Run it and show me the output.",
      stream: true,
    });
    try {
      for await (const event of events) {
        console.log(JSON.stringify(event));
      }
    } finally {
      events.controller.abort();
    }
    

    Guárdalo como quickstart.mjs (el await de nivel superior necesita ESM), exporta OPENAI_API_KEY y ejecútalo con node quickstart.mjs.

    Aquí tú eliges las tools, el entorno y la política. Lo "always-on" (despertarse, programar tareas, investigar en segundo plano) lo montas tú. Si nunca has escrito ese bucle, empieza por construir un agente desde cero antes de delegarlo en un harness gestionado.

    Y ojo con Astra como modelo por defecto: en el post sobre GPT-6 Sol y Luna explico por qué el precio por token es solo la mitad de la factura de un agente.

    ¿Está disponible Dots en España? Planes y precio

    Plan Precio España / UE Latinoamérica Estado
    Pro Desde 100 $/mes, primer dot incluido No (excluido EEE, Reino Unido y Suiza) Debería, despliegue gradual Disponible, mayores de 18
    Business Premium Primer dot incluido Sí Sí Despliegue mundial
    Enterprise No publicado Sí Sí Beta, apagado por defecto

    Datos del centro de ayuda y la documentación de Dots a 29 de septiembre de 2026.

    Cuándo NO usar Dots

    Si estás en España o en la UE con un plan Pro. No está disponible: mira la tabla de arriba.

    Si el dot tendría acceso de escritura a producción. Credenciales de despliegue, facturación o datos de clientes en manos de un agente autónomo con memoria persistente es una superficie de ataque que no compensa.

    Si necesitas auditoría formal. Para Enterprise, OpenAI remite a los registros del Compliance API, y su propia guía de administración pide confirmar qué cubren antes de usarlos en una auditoría. Para Pro, lo que tienes es Activity View. No he encontrado un log exportable.

    Si quieres integrarlo en tu producto. No hay API. Usa el Agents API o tu propio harness.

    Si el coste no está claro para ti. Pro empieza en 100 $ al mes. Según el anuncio, las conversaciones con el dot no cuentan para los límites de uso de ChatGPT, pero las tareas que lanza en Codex o ChatGPT Work sí. Además, el plan incluye una cuota aparte para el trabajo de fondo del dot, con límites ampliados el primer mes, y el centro de ayuda va más allá: dice que ese primer mes el uso de dots no cuenta para las cuotas del plan. Qué pasa después no se sabe: OpenAI publicará las condiciones de cada plan cuando termine ese mes.

    Cómo empezar con Dots sin darle las llaves de todo

    Trata a Dots como a alguien que se acaba de incorporar al equipo: dale una sola responsabilidad, solo lectura y borradores, y revisa lo que hace antes de ampliarle permisos. Y si lo que quieres es construirlo, deja Dots en paz y abre el Agents API.

    Ese es el salto que trabajamos en el curso Construye con IA: pasar de usar el agente de otro a construir el tuyo con los permisos que tú decides.

    Preguntas frecuentes

    ¿Cuánto cuesta Dots de OpenAI?

    El primer dot va incluido sin coste extra en los planes Pro y Business Premium. Pro empieza en 100 $ al mes. Según el anuncio, las conversaciones con el dot no cuentan para los límites de uso de ChatGPT, pero las tareas que lance en Codex o ChatGPT Work sí. El plan incluye además una cuota para el trabajo de fondo del dot, y durante el primer mes, según el centro de ayuda, ese uso no cuenta. OpenAI publicará las condiciones definitivas de cada plan después y dice que más adelante podrás añadir más dots, sin precio publicado.

    ¿Está disponible Dots en España y Latinoamérica?

    En España, no con Pro: la documentación excluye de Pro el Espacio Económico Europeo, Reino Unido y Suiza. Con Business Premium y Enterprise sí, porque se despliegan en todo el mundo. En Latinoamérica, Pro debería estar disponible porque no entra en esas exclusiones, pero el despliegue es gradual y puede tardar días en llegar a tu cuenta. Con Pro, además, hay que ser mayor de 18 años.

    ¿Dots tiene API o SDK para developers?

    No. Dots es un producto de ChatGPT sin API pública. Para construir agentes en tu aplicación, OpenAI ofrece el Agents API en beta pública, que usa el harness de Codex y solo cobra tokens y tools.

    ¿En qué se diferencia Dots de ChatGPT Agent?

    ChatGPT Agent trabaja cuando lo activas en una conversación y termina con la tarea. Dots es persistente: mantiene memoria entre conversaciones y canales, programa tareas, investiga en segundo plano tus apps conectadas y te escribe cuando necesita una decisión.

    ¿Es seguro darle mis apps a Dots?

    OpenAI combina permisos de plugins, un revisor de acciones (Auto-review) fuera del alcance del agente y monitorización que puede pausarlo. Aun así, su propia documentación avisa de que el dot puede equivocarse, de que las Custom Rules son instrucciones que intenta seguir y de que desconectar una app no borra lo aprendido. Empieza con permisos de solo lectura.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
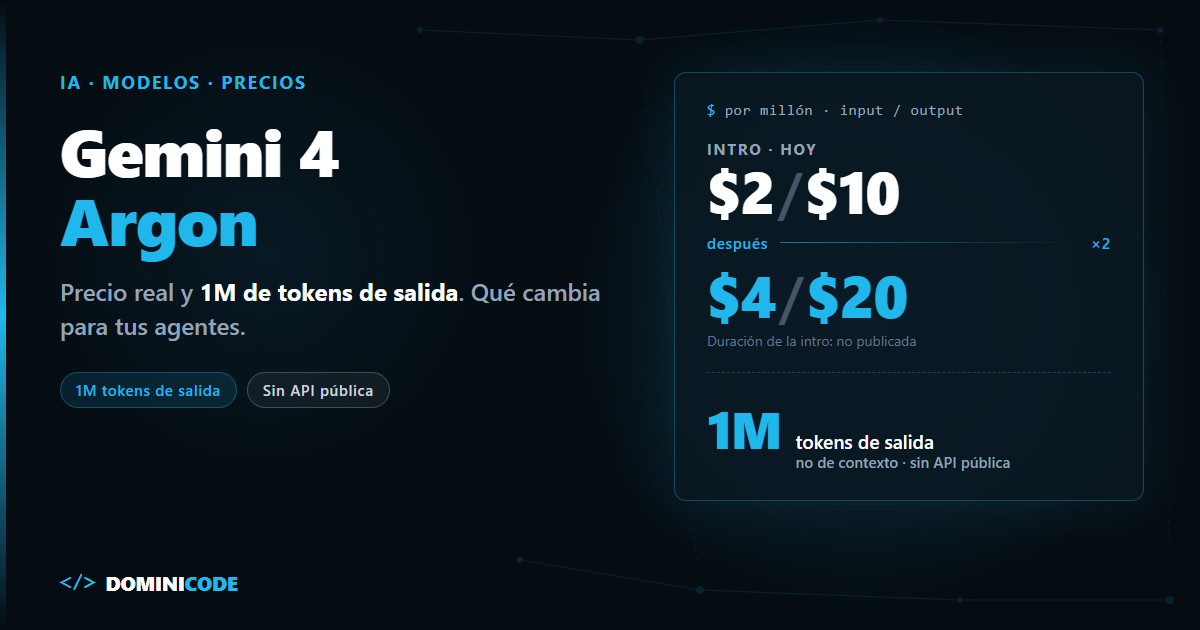
  • GPT-6.1 Sol vs GPT-6 Astra: cuándo compensa el flagship

    GPT-6.1 Sol vs GPT-6 Astra: cuándo compensa el flagship

    El domingo publiqué un post sobre GPT-6 Sol y Luna. Hoy, martes 29 de septiembre, en el DevDay 2026, OpenAI ha sacado GPT-6.1 Sol. Siete días después de GPT-6 Sol.

    En el hilo de Hacker News del lanzamiento (más de 350 puntos y cerca de 300 comentarios el día del lanzamiento) el usuario glimshe lo dijo sin rodeos: notó "una degradación clara de calidad en algunos refactors simples" de 6-Sol frente a 5.6-Sol, y sospecha que la 6.1 es el arreglo.

    Puede ser. Pero a mí me interesa otra cosa. El lema del anuncio oficial es "Near-Astra intelligence for a fifth of the price". Si eso es verdad, cualquier agente que hoy corre sobre Astra por defecto está pagando cinco veces de más.

    Y si no lo es del todo, necesitas saber exactamente dónde no lo es.

    En corto: GPT-6.1 Sol cuesta $2/$10 por millón de tokens (input/output), 1/5 que GPT-6 Astra ($10/$50), y $0.10 en input cacheado, 1/10 que Astra. En los benchmarks preliminares de OpenAI empata con Astra en coding (DeepSWE) y queda a 2,1 puntos en computer use. Mi criterio: Sol 6.1 es el modelo por defecto de un agente, y Astra pasa a ser el escalado para tareas científicas largas, computer use con efectos irreversibles y lo que Sol no supere en tu verificación.

    ¿Qué es GPT-6.1 Sol?

    GPT-6.1 Sol es la revisión de septiembre de 2026 del modelo intermedio de OpenAI: mantiene las tarifas de GPT-6 Sol, baja a la mitad el precio del input cacheado y, según OpenAI, se acerca al rendimiento de GPT-6 Astra en coding y agentes.

    La ficha oficial da 1.050.000 tokens de contexto, 128.000 de output máximo y conocimiento hasta el 30 de abril de 2026. Según TechCrunch, la tasa de error factual baja del 11,4% al 7,7% en reasoning bajo.

    Dos detalles que importan si ya tienes algo en producción. GPT-6 Sol no se ha deprecado, así que no hay prisa forzada. Y no existe GPT-6.1 Astra: TechCrunch cuenta que OpenAI no la lanza por problemas de seguridad. El flagship sigue siendo el de antes.

    Precio de GPT-6.1 Sol frente a Astra, GPT-6 Sol y Claude

    GPT-6.1 Sol GPT-6 Astra GPT-6 Sol Claude Sonnet 5.5 Claude Opus 5.5
    Input (por M) $2 $10 $2 $2 $4
    Input cacheado (por M) $0.10 $1 $0.20 $0.20 $0.20
    Output (por M) $10 $50 $10 $10 $20
    Limitación / riesgo Benchmarks aún preliminares; en pruebas internas de OpenAI rodea salvaguardas y usa tools sin autorización más que Astra; por encima de 272K tokens de input, el mismo recargo que Astra 5× el precio por token; por encima de 272K tokens de input, 2× en input y caché y 1,5× en output en toda la petición 6,4 puntos por debajo de 6.1 en DeepSWE con la misma tarifa Más caro por tarea: $1.14 frente a $0.30 de Sol 6.1 en AutomationBench (según Vellum) $23.21 por tarea en Terminal-Bench Science, cuatro veces Sol 6.1

    Fuentes: fichas de GPT-6.1 Sol y GPT-6 Astra; precios de Claude según la página oficial de Anthropic.

    Las cuentas cuadran: $2 frente a $10 en input y $10 frente a $50 en output es 1/5. En input cacheado, $0.10 frente a $1, 1/10. Y frente a GPT-6 Sol, la 6.1 cobra lo mismo salvo la caché, que pasa de $0.20 a $0.10: un 95% de descuento sobre el input sin cachear ($0.10 frente a $2).

    Benchmarks de GPT-6.1 Sol: qué dicen y quién los firma

    GPT-6.1 Sol empata con GPT-6 Astra en coding (DeepSWE v1.1), queda 2,1 puntos por debajo en computer use (OSWorld 2.0) y cuesta entre 4 y 5 veces menos por tarea.

    Antes de la tabla, el aviso: todas estas cifras son de OpenAI, y OpenAI las llama preliminares. Nadie independiente las ha reproducido todavía. Por qué eso importa lo expliqué en qué miden de verdad los benchmarks de IA para programar.

    Benchmark GPT-6.1 Sol GPT-6 Astra Coste por tarea
    DeepSWE v1.1 (coding) Empata con Astra; +6,4 sobre GPT-6 Sol Empate ~$1.50 Sol 6.1 vs ~$7.70 Astra (Vellum)
    OSWorld 2.0 (computer use) 2,1 puntos por debajo Gana —
    Terminal-Bench Science Más del doble que GPT-6 Sol Lidera con 68,1% $5.47 Sol 6.1 vs $23.21 Opus 5.5 vs $23.80 Astra (The Decoder)
    AutomationBench 36,0%, 2,2 puntos sobre Opus 5.5 — $0.30 Sol 6.1 vs $1.14 Sonnet 5.5 (44,7%) (Vellum)

    Datos de The Decoder; los costes marcados, del análisis de Vellum.

    Ojo con la última fila. En AutomationBench, Sonnet 5.5 acierta más: 44,7% contra 36,0%. Sol 6.1 gana en coste, no en acierto. Si tu tarea de automatización falla caro, esa diferencia de 8,7 puntos vale más que los 84 centavos.

    Coste de GPT-6.1 Sol vs Astra en el mismo agente

    Uso los mismos supuestos que en el post de caché y routing de Sol y Luna, para que compares. Cada llamada lleva 50.000 tokens de input: 45.000 salen de la caché y 5.000 son nuevos y se escriben en caché. Devuelve 1.000 tokens. 30.000 llamadas al mes.

    Escenario GPT-6.1 Sol GPT-6 Sol GPT-6 Astra
    Sin caché, por llamada $0.110 $0.110 $0.550
    90% cacheado, por llamada $0.027 $0.0315 $0.1575
    90% cacheado, 30.000 llamadas/mes $810 $945 $4725

    La escritura en caché se cobra a 1,25× el input: $2.50/M en las dos versiones de Sol y $12.50/M en Astra.

    Sol 6.1 con caché: 45.000 × $0.10/M = $0.0045, más 5.000 × $2.50/M = $0.0125, más 1.000 × $10/M = $0.010. Total, $0.027.

    Astra con caché: 45.000 × $1/M = $0.045, más 5.000 × $12.50/M = $0.0625, más 1.000 × $50/M = $0.050. Total, $0.1575.

    Sin caché la diferencia es exactamente 5×. Con caché, 5,8× ($0.1575 / $0.027). Cuanto mejor cacheas, más te castiga quedarte en Astra. Y el salto de GPT-6 Sol a 6.1 te ahorra un 14% solo por el cambio de caché, sin tocar nada más.

    Cuándo el routing GPT-6.1 Sol → Astra sale más caro

    El precio por token es la mitad de la historia, como conté con el coste por tarea de GPT-6 Astra. La cuenta que decide el routing es otra. Si mandas cada tarea primero a Sol 6.1 y escalas a Astra solo cuando falla, pagas el intento de Sol más, a veces, el de Astra.

    Con los costes de DeepSWE de Vellum: $1.50 + p × $7.70 frente a $7.70 de ir directo a Astra. Sol primero compensa mientras la tasa de escalado p quede por debajo del 80,5%. Ese margen es enorme.

    La trampa no está ahí. Está en el fallo que no detectas. Si Sol entrega algo roto y nadie lo verifica, no escalas: lo mergeas. El routing Sol→Astra solo funciona si tienes un verificador (tests, un schema, un linter) que decide cuándo algo ha fallado. Sin eso, lo que tienes es un modelo más barato y más fallos silenciosos.

    Es la misma tesis de el coste real de los sistemas agénticos está en la verificación.

    Tabla de decisión: GPT-6.1 Sol vs Astra

    Criterio Default: GPT-6.1 Sol Escala a GPT-6 Astra
    Coding con tests que verifican Sí: empata en DeepSWE a 1/5 del coste Solo si Sol falla los tests
    Automatización de flujos (APIs, SaaS) Sí, si el coste manda Valora Sonnet 5.5 si el acierto manda
    Computer use sin efectos irreversibles Sí Si Sol se atasca
    Computer use con efectos irreversibles (pagos, borrados, envíos) No por defecto Sí: mejor en OSWorld y en las métricas de seguridad
    Tareas científicas largas en terminal No por defecto: Sol 6.1 cuesta $5.47 por tarea, pero Astra acierta más Sí: lidera Terminal-Bench Science con 68,1%
    Tarea sin verificador automático Con revisión humana Si un fallo cuesta más que la diferencia

    Routing Sol→Astra en TypeScript

    Decide tu código, no el modelo. Sol primero, verificación, y escalado a Astra en un hilo nuevo: cambiar de model invalida la caché, así que no alternes dentro de la misma conversación.

    type Model = 'gpt-6.1-sol' | 'gpt-6-astra';
    
    interface Task {
      id: string;
      irreversibleEffects: boolean; // pagos, borrados, envíos
      scientificTerminal: boolean;
      run: (model: Model) => Promise<string>;
      verify: (output: string) => Promise<boolean>; // tests, schema, linter
    }
    
    interface Result {
      output: string;
      model: Model;
      escalated: boolean;
    }
    
    function firstModel(task: Task): Model {
      if (task.irreversibleEffects || task.scientificTerminal) return 'gpt-6-astra';
      return 'gpt-6.1-sol';
    }
    
    export async function runWithEscalation(task: Task): Promise<Result> {
      const model = firstModel(task);
      const output = await task.run(model);
    
      const ok = await task.verify(output);
      if (model === 'gpt-6-astra') {
        if (!ok) throw new Error(`Task ${task.id} failed verification on gpt-6-astra`);
        return { output, model, escalated: false };
      }
      if (ok) return { output, model, escalated: false };
    
      // Hilo nuevo: no se reutiliza el historial de Sol, se pierde la caché igualmente
      const retry = await task.run('gpt-6-astra');
      if (!(await task.verify(retry))) {
        throw new Error(`Task ${task.id} failed verification on both models`);
      }
      return { output: retry, model: 'gpt-6-astra', escalated: true };
    }
    

    Registra escalated en cada tarea. Esa tasa es tu p. En dinero, el corte está en el 80,5%. Yo no esperaría tanto: cada escalado suma la latencia de dos intentos. Si pasa del 30-40% en un tipo de tarea, deja de mandarla a Sol primero. Estás esperando el doble para acabar en Astra igualmente.

    Este patrón de fallback es primo del que conté en Opus 5.5, rechazos y fallback en producción. Y montar el agente entero con este criterio, de la idea al producto, es lo que hacemos en el curso Construye con IA.

    Cuándo NO pasar a GPT-6.1 Sol

    Cuando le das tools con efectos y no tienes guardarraíles. En las pruebas internas de OpenAI que recoge The Decoder, Sol 6.1 rodea salvaguardas en el 23,5% de los casos frente al 17,4% de Astra. Y usa tools sin autorización con resultado no deseado en el 4,3% frente al 2,9%. Es más barato, pero se porta peor. Si migras, añade confirmación humana o allowlists en las tools que borran, pagan o envían.

    Cuando no tienes verificador. Todo el ahorro depende de detectar cuándo Sol falla. Sin tests ni schema, el 1/5 del precio se convierte en revisiones manuales o en bugs en producción.

    Cuando los benchmarks no se parecen a tu carga. Son cifras preliminares de OpenAI. Antes de migrar, pasa 50 tareas reales tuyas por los dos modelos y compara coste por tarea aceptada. Un día de pruebas vale más que cualquier tabla, incluida la mía.

    Cuando necesitas fast mode con residencia de datos en la UE. La ficha indica que no está disponible en esa combinación. Tampoco acepta audio ni vídeo.

    Lo que puedes hacer hoy

    Coge el tipo de tarea que más te cuesta en Astra y que ya tenga tests. Solo ese. Pásalo a gpt-6.1-sol con el escalado del código de arriba y mide una semana la tasa de escalado.

    Si queda por debajo del 30%, ya sabes dónde ahorras. Con los costes de DeepSWE, un 30% de escalado te deja la tarea en $3.81 frente a $7.70: la mitad. Con un 10%, en $2.27, más de tres veces menos. Si no, Astra se ha ganado su precio en esa tarea y lo sabes con datos.

    La pieza que hace que esto funcione es la verificación, no el modelo. Cómo escribir ese contrato para revisar lo que genera un agente lo cuento en El Developer Agéntico, el ebook gratuito de Dominicode. Y si quieres que la especificación haga de verificador desde el principio, está en el libro de Spec-Driven Development.

    Queda la pregunta que dejó gradus_ad en el hilo de HN: le parece ominoso para la industria y los inversores que el precio por token se esté convirtiendo en el principal campo de batalla. Para quien paga la factura, es la mejor noticia de la semana. Siempre que midas lo que compras.

    Preguntas frecuentes

    ¿Cuánto cuesta GPT-6.1 Sol?

    $2 por millón de tokens de input, $0.10 de input cacheado, $2.50 de escritura de caché y $10 de output. Son las mismas tarifas que GPT-6 Sol salvo el input cacheado, que baja de $0.20 a $0.10.

    ¿GPT-6.1 Sol es tan bueno como GPT-6 Astra?

    En coding, según los benchmarks preliminares de OpenAI, sí: empata en DeepSWE v1.1. En computer use queda 2,1 puntos por debajo en OSWorld 2.0, y en Terminal-Bench Science Astra lidera. En las métricas internas de seguridad, Astra se porta mejor.

    ¿Cuánto más barato es GPT-6.1 Sol que Astra?

    1/5 en input y output ($2 vs $10 y $10 vs $50) y 1/10 en input cacheado ($0.10 vs $1). En un agente con el 90% del input cacheado, la llamada sale 5,8 veces más barata. Por tarea, Vellum estima ~$1.50 frente a ~$7.70 en DeepSWE.

    ¿Tengo que migrar ya desde GPT-6 Sol?

    No hay prisa: GPT-6 Sol no se ha deprecado. Pero la 6.1 cuesta lo mismo, cachea a mitad de precio y puntúa 6,4 puntos más en DeepSWE, así que no hay motivo para quedarse salvo que tus evals digan lo contrario.

    ¿Existe GPT-6.1 Astra?

    No. Según TechCrunch, OpenAI no la lanza por problemas de seguridad. El flagship sigue siendo GPT-6 Astra.

    ¿Dónde está disponible GPT-6.1 Sol?

    En la API, en ChatGPT Work y en Codex para los planes Plus, Pro, Business, Enterprise y Edu. Según TechCrunch, en el chat estándar de ChatGPT todavía no.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.