Author: Dominicode

  • Ipsum: el tema por defecto de WordPress 7.2 que quizá no verás

    Ipsum: el tema por defecto de WordPress 7.2 que quizá no verás

    El miércoles 16 WordPress anunció su nuevo tema por defecto. Se llama Ipsum y es bonito de verdad.

    Lo leí, me gustó, y entonces hice una cosa tonta: entré al panel de administración de mi propio WordPress para ver qué tema tenía activo.

    Tardé un rato en acordarme de por dónde se entraba.

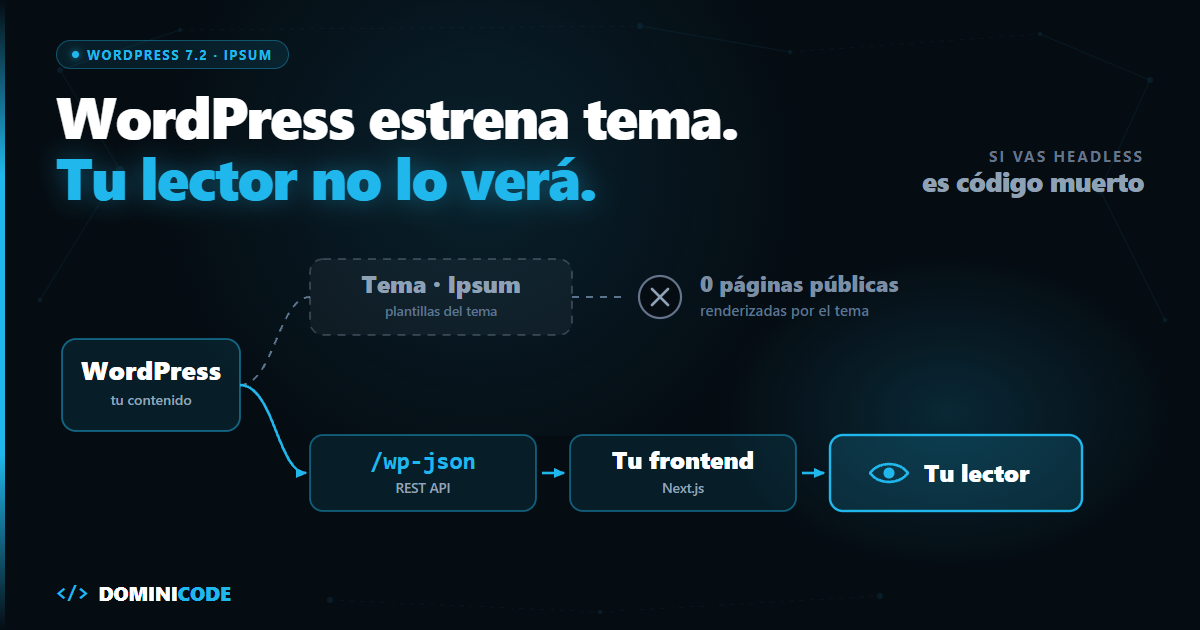
    Cuando conseguí entrar, el tema activo resultó ser uno que instalé hace no sé cuánto y que jamás ha renderizado una sola página para un lector. El blog que estás leyendo lo sirve un frontend en Next.js desplegado en Vercel. WordPress está detrás, haciendo de base de datos con un editor decente. El tema, ahí dentro, es la decoración de una habitación sin ventanas.

    Y ahí está lo incómodo. El tema por defecto es el escaparate del proyecto WordPress, lo primero que ve alguien el día que instala. Para una parte cada vez más grande de quien usa WordPress hoy, es código muerto.

    En corto: Ipsum es el tema de bloques propuesto como tema por defecto de WordPress 7.2, y rompe 16 años de nomenclatura "Twenty X" — a partir de ahora los temas por defecto tienen nombre propio y cambian cuando el diseño lo pida, no cuando toque por calendario. Si renderizas tu sitio con WordPress, te afecta y deberías probarlo antes de la Beta 1 de 7.2 —del 20 al 22 de octubre—, que es cuando el equipo deja de aceptar cualquier cosa que no sea corrección de bugs. Si usas WordPress headless como API de contenido, Ipsum no cambia nada en tu web.

    ¿Qué es Ipsum, el nuevo tema de WordPress?

    Ipsum es un tema de bloques minimalista —un lienzo en blanco construido alrededor de la experiencia de blogging— propuesto como tema por defecto de WordPress 7.2.

    Lo anunció Henrique Iamarino en Make WordPress Core el 16 de septiembre de 2026. Él firma el diseño; el desarrollo lo lideran Carolina Nymark, Maggie Cabrera y Juanfra Aldasoro.

    La apuesta técnica es la que cabía esperar en 2026: bloques, theme.json y Global Styles haciendo el trabajo, con el mínimo CSS propio posible. Todas las combinaciones de estilos pasan WCAG AA, según el anuncio.

    El nombre viene de lorem ipsum, el texto de relleno que ocupa la página hasta que llega el contenido real. Es una declaración de intenciones bastante honesta: esto no es el diseño, es lo que hay antes de que tú pongas el diseño.

    Dato Valor Fuente
    Anuncio 16 de septiembre de 2026 Make WordPress Core
    Versión objetivo WordPress 7.2 Anuncio oficial
    Beta 1 de 7.2 (desde aquí, solo bugs) 20-22 de octubre de 2026 Calendario de la release 7.2
    RC1 (congelado de textos) 17-19 de noviembre de 2026 Calendario de la release 7.2
    Salida de 7.2 8-10 de diciembre de 2026 (fecha objetivo; el roadmap avisa de que sus fechas son orientativas) Roadmap de wordpress.org
    Ventana real para que tu feedback cambie el tema ~5 semanas 34 días del 16 de septiembre al 20 de octubre
    Issues abiertos en el repo (19 sep 2026) 17 github.com/WordPress/ipsum
    Pull requests abiertos (19 sep 2026) 19 github.com/WordPress/ipsum
    Requisitos WordPress 7.1+ · PHP 7.4+ README del repo
    Licencia GPLv2+ (fuentes con SIL OFL) README del repo

    Puedes probarlo en WordPress Playground sin instalar nada, ojear el sitio de demo o bajarte el ZIP del repo a wp-content/themes/ipsum.

    Piden feedback ya, y se entiende: del anuncio a la Beta 1 hay cinco semanas para cerrar los 17 issues y 19 pull requests que seguían abiertos el 19 de septiembre en el tema que va a ser la cara del proyecto.

    El final de "Twenty X" es la noticia, no el tema

    Desde Twenty Ten en 2010, WordPress ha publicado un tema por defecto con el año en el nombre. Dieciséis años. Twenty Eleven, Twenty Twelve, y así hasta Twenty Twenty-Five, que es el que Ipsum viene a sustituir.

    Por indicación de Matt Mullenweg, eso se acaba. Los temas por defecto pasan a tener nombre propio y a cambiar cuando el diseño lo pida, no cuando lo pida el calendario.

    Me parece mejor decisión de lo que aparenta. Un tema por año era una promesa de puntualidad que ni siquiera se cumplía: nunca hubo Twenty Eighteen, y 2026 se ha quedado sin tema del año. Y a cambio le ponía fecha de caducidad en el nombre a un tema que alguien iba a tener seis años en producción. Nadie quiere explicarle a un cliente por qué su web corre "Twenty Twenty-Two" en 2026.

    De paso, el cambio se lleva por delante a Mētis, el tema en el que el equipo trabajaba antes —orientado a writers, makers and thinkers— y que Ipsum desplaza como propuesta por defecto. Mētis no se cancela: saldrá por su cuenta cuando esté listo.

    Por qué el tema por defecto solo importa si renderizas con WordPress

    Un tema de WordPress es la capa de renderizado: convierte contenido en HTML. Ipsum hace eso, y lo hace bien.

    Dónde ocurre esa conversión —en el servidor de WordPress, en el build de tu frontend o en el navegador del lector— es la decisión de arquitectura de siempre: CSR, SSR, SSG o ISR. Y es esa decisión, no el tema, la que determina si Ipsum te importa.

    Si tu WordPress sirve las páginas que ven tus lectores, Ipsum es relevante para ti de forma inmediata: es el punto de partida de tu diseño, el conjunto de patterns que vas a heredar y el theme.json que va a definir tu paleta y tu escala tipográfica.

    Si tu WordPress solo expone /wp-json/wp/v2/posts y el HTML lo pinta otra cosa, Ipsum es un directorio en tu servidor cuyas plantillas no van a pintar ni una página para un lector. Ese JSON, en cambio, sí trabaja: es lo que pinta la web, y también lo que uso para que un MCP pueda buscar dentro del blog.

    No es una hipótesis: es mi caso exacto. Llevo desde enero sirviendo este blog con un frontend propio, y el tema de WordPress no ha renderizado nada de cara al público en todo ese tiempo. Si mañana borro ese directorio, lo único que se rompe es la vista previa del editor.

    Y eso es lo que hace interesante la noticia más allá del tema: WordPress está invirtiendo su identidad de marca —el escaparate, la primera impresión, el objeto sobre el que Mullenweg da instrucciones personales— en la capa de renderizado, justo cuando una parte creciente de su base lo usa como API de contenido y nada más.

    Criterio WordPress clásico (el tema renderiza) WordPress headless (solo API)
    Qué hace Ipsum por ti Es tu frontend: plantillas, patterns, estilos Nada visible: no renderiza ninguna página pública (aunque WordPress sí carga el tema en cada petición REST)
    Dónde vive el diseño theme.json + Global Styles En tu repo de frontend
    Quién puede cambiarlo Cualquiera con acceso al editor Solo quien hace deploy
    Qué te aporta WordPress 7.2 Tema nuevo, patterns, mejoras del editor Cambios en la REST API y en el HTML de bloques que consumes
    Tiempo hasta tener algo en pie Minutos Días, y después mantenimiento continuo
    Límite / riesgo Estás atado al ciclo de releases y a PHP: una actualización de core, del tema o de un plugin te toca el render en producción Reconstruyes tú lo que WordPress daba gratis —previews, sitemaps, schema, búsqueda, formularios— y el editor deja de enseñar cómo se ve de verdad el post

    Si quieres el cómo en detalle, ya escribí la guía completa para hacer WordPress headless con Next.js. Este post no va de eso. Va de qué significa que el proyecto siga poniendo su mejor esfuerzo de marca en una capa que muchos hemos apagado.

    "¿Y por qué WordPress sigue necesitando un tema?"

    No soy el único que lo piensa, y esto no es un "mucha gente dice". Está escrito, con nombre y fecha, en los comentarios del propio anuncio.

    El mismo día de la publicación, a las 11:17, Xilonz lo preguntó directo:

    "I'm curious why WordPress still needs a (default) theme? Cant we just create a decent onboarding instead?"

    Su argumento: el tema por defecto impone estructura —cabecera, pie— cuando el editor de sitio completo ya permite construirlo todo desde cero, y la libertad creativa real empieza en blanco.

    annezazu le respondió esa misma tarde, a las 17:22, y su respuesta es la mejor defensa que he leído del tema por defecto:

    "Core can't provide onboarding that properly covers all use cases…"

    Añadió que parte de la intención de Ipsum es justo esa: dar unos valores por defecto muy simples para que cada uno lo haga suyo, pero partiendo de un punto sólido.

    Dave Whitley entró al día siguiente pidiendo también una opción de empezar en blanco, pero concediendo de inmediato la objeción práctica: hacerlo es "very intimidating for most users, and it takes a lot of time to start from scratch". Y remató con la frase que resume el dilema entero: "Themes show people what is possible".

    Los tres tienen razón, y es porque hablan de usuarios distintos. Para quien instala WordPress hoy y quiere publicar esta tarde, Ipsum es imprescindible. Para quien lo usa como cabecera de un pipeline de contenido, sobra.

    Y por si alguien piensa que un tema por defecto es solo diseño: en el repo hay debates de ingeniería de verdad.

    troychaplin abrió el issue #41 preguntando si el PHP del tema debería pasar a una estructura de clases, con el dato encima de la mesa como argumento para esperar —133 líneas en functions.php frente a las 159 de Twenty Twenty-Five— y la duda de qué pasa después: "if the theme gains more bindings, template types or block styles, one flat file gets harder to scan".

    bueltge abrió el issue #43 proponiendo que los nombres de los temas por defecto sigan una convención simbólica —Commons, Agora, Atrium— igual que las releases de WordPress homenajean a músicos de jazz.

    Eso es un proyecto vivo. No es una nota de prensa.

    Qué mirar de WordPress 7.2 si vas headless

    Si el tema no te afecta, te afecta todo lo demás. Tres cosas, y ninguna tiene que ver con Ipsum.

    El HTML serializado de los bloques. Lo que consumes en content.rendered es el output del block parser. Cuando core cambia el marcado o las clases utilitarias de un bloque, ese cambio viaja hasta tu JSON, y ahí es donde se rompe tu CSS.

    Los cambios de la REST API. Campos nuevos, campos deprecados, cambios en cómo se devuelven taxonomías o metadatos. Un campo que cambia de forma en silencio es peor que uno que desaparece.

    Lo que tu frontend replica a mano. El canonical, el schema, el sitemap: todo lo que WordPress hacía por ti vive ahora en tu código y no se actualiza con wp-admin. Cuando core mejora algo en esa zona, tú no te enteras. Lo aprendí por las bravas con un canonical mal generado que estuvo semanas apuntando a donde no debía.

    Nada de esto es exclusivo de WordPress. Es el peaje de todo el ecosistema JavaScript en 2026: ganas control y te llevas a casa el mantenimiento entero.

    Cuándo NO irte a headless

    Escribí la guía de headless y sigo pensando que para este blog fue la decisión correcta. También creo que se recomienda demasiado alegremente. Estos son los límites reales, los que me he comido yo.

    Si no eres tú quien mantiene el frontend, no lo hagas. Un WordPress clásico lo toca cualquiera con acceso al editor. Un frontend en Next.js lo toca quien sabe hacer deploy. Si le montas esto a un cliente sin equipo técnico, no le has dado una web moderna: le has dado una dependencia de una sola persona, y esa persona eres tú para siempre.

    Pierdes el WYSIWYG y duele más de lo que crees. El editor de WordPress te enseña cómo va a quedar el post. En headless te enseña cómo quedaría si usaras el tema, que no es el caso. Cada bloque nuevo que usas es una apuesta a que tu frontend sabe renderizarlo. He publicado posts con bloques que en mi frontend salían sin estilos y no me enteré hasta verlo en producción.

    Duplicas la superficie operativa. Dos deploys, dos sitios donde mirar logs, dos cachés que invalidar, dos facturas. Para un blog de una docena de posts al año, eso no lo compensa ninguna mejora de Lighthouse.

    Y la que menos se dice: si tu problema es que la web va lenta, headless no es la solución más barata. Caché de página, un hosting decente y menos plugins te llevan al 90% del resultado con el 5% del trabajo. Vete a headless cuando quieras el control del frontend, no cuando quieras velocidad.

    Si el control es justo lo que buscas y lo que te frena es montar el frontend, hoy esa parte se acelera muchísimo con IA — siempre que trabajes con especificaciones y no a base de prompts sueltos. Es el método que enseño en Construye con IA: de la idea al producto sin que el proyecto se te convierta en un pantano.

    Qué hacer hoy

    Abre WordPress Playground, activa Ipsum y dale diez minutos.

    No para opinar sobre el tema. Para contestarte una pregunta que casi nadie se hace en frío: ¿la capa de renderizado de mi WordPress me importa, o hace tiempo que dejó de importarme?

    Si te importa, tienes hasta la Beta 1 del 20 de octubre para que tu feedback entre en un tema que vas a mirar durante años. Después de esa fecha solo entran correcciones de bugs. Es de las pocas veces en que un usuario normal influye en algo que van a usar millones de instalaciones.

    Y ten claro qué estás probando. Lo que hay publicado hoy es el trabajo de diseño: la revisión formal de desarrollo viene después. Mientras Ipsum esté en desarrollo la versión del tema se queda clavada en 1.0.0 y los cambios se registran en las descripciones de los pull requests, no en un changelog. Traducido: si lo instalas en un sitio real no vas a poder distinguir una build de otra por el número de versión, así que pruébalo en Playground o en staging, nunca en producción.

    Y si al abrirlo sientes exactamente lo que sentí yo —"qué bonito, y qué poco tiene que ver conmigo"—, ya tienes tu respuesta. Ese es el momento de mirar la arquitectura de tu sitio con honestidad, no el momento de instalarte un tema.

    En Dominicode Labs desmenuzamos este tipo de decisiones de arquitectura sobre proyectos reales, sin quedarnos en el "depende". Y si prefieres verlo antes que leerlo, lo voy contando en el canal.

    Preguntas frecuentes

    ¿Qué es Ipsum en WordPress?

    Ipsum es un tema de bloques minimalista propuesto como tema por defecto de WordPress 7.2. Está construido sobre theme.json y Global Styles con el mínimo CSS posible, todas sus combinaciones de estilos pasan WCAG AA y se presenta como un lienzo en blanco centrado en la experiencia de blogging. Lo anunció Henrique Iamarino en Make WordPress Core el 16 de septiembre de 2026.

    ¿Por qué WordPress deja de llamar "Twenty X" a sus temas por defecto?

    Por indicación de Matt Mullenweg. Los temas por defecto pasan a tener nombre propio y a renovarse cuando el diseño lo pida, no cuando llegue el cambio de año. El modelo anterior forzaba una entrega anual aunque el tema vigente siguiera siendo válido, dejaba en producción temas con el año fosilizado en el nombre y además ya estaba roto en la práctica: nunca existió Twenty Eighteen y 2026 se ha quedado sin tema del año.

    ¿Cuándo sale WordPress 7.2?

    El roadmap oficial de WordPress sitúa la versión 7.2 el 10 de diciembre de 2026, y el calendario de la release marca la ventana de lanzamiento del 8 al 10 de diciembre. Antes hay dos hitos que importan más si vas a dar feedback sobre Ipsum: Beta 1 el 20-22 de octubre, a partir del cual el equipo solo corrige bugs, y la Release Candidate 1 el 17-19 de noviembre, cuando se congelan los textos.

    ¿Al actualizar a WordPress 7.2 me va a cambiar el tema a Ipsum?

    No. WordPress no cambia el tema activo de un sitio que ya existe: Ipsum llegará a tu instalación como tema disponible pero inactivo, igual que llegaron en su día los Twenty X. El tema por defecto solo se activa en instalaciones nuevas. Si quieres probarlo en un sitio en producción tienes que activarlo tú, y conviene hacerlo antes en staging o en WordPress Playground.

    ¿Ipsum afecta a mi sitio si uso WordPress headless?

    Casi nada, pero no exactamente cero. Las plantillas del tema solo entran cuando WordPress renderiza páginas, así que con un frontend propio Ipsum no pinta nada de lo que ve tu lector. Lo que sí sigue vivo es su theme.json: WordPress carga el tema activo también en las peticiones REST, y sus ajustes de layout acaban en las clases y los estilos inline que recibes dentro de content.rendered. Eso, y los cambios de la REST API de 7.2, es lo único que te afecta.

    ¿Qué pasa con Mētis, el tema anterior?

    Mētis era el tema en el que el equipo trabajaba antes, orientado a escritores y creadores. Ipsum lo desplaza como propuesta de tema por defecto, pero no se cancela: se publicará por su cuenta cuando esté terminado.

    ¿Cómo puedo probar Ipsum antes de que salga WordPress 7.2?

    La vía más rápida es WordPress Playground, que abre una instalación temporal en el navegador sin instalar nada. La otra es descargar el ZIP del repositorio WordPress/ipsum y descomprimirlo en wp-content/themes/ipsum. Necesitas WordPress 7.1 o superior y PHP 7.4 o superior. En ambos casos, pruébalo fuera de producción: mientras el tema esté en desarrollo su versión no se mueve de 1.0.0.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Sincronizar el read model en CQRS: outbox, idempotencia y rebuild

    Sincronizar el read model en CQRS: outbox, idempotencia y rebuild

    Un lunes por la mañana, soporte abrió un ticket con la frase que más miedo da de todas: «el cliente dice que pagó y su pedido sigue saliendo como pendiente».

    Miramos la tabla de pedidos. Pagado. Miramos la vista que consume el frontend. Pendiente. Llevaba once días así.

    Nadie se había enterado porque el sistema no estaba roto. Todos los endpoints devolvían 200. Los logs estaban limpios. Simplemente, el read model se había quedado atrás y no existía ninguna alarma que mirase esa diferencia.

    Ese es el problema real de CQRS: cómo sincronizar el read model con el write model sin que se pudra. No aparece el día que lo eliges; aparece tres meses después. Si todavía estás decidiendo si el patrón te conviene, ese es otro debate — qué es CQRS y cuándo compensa aplicarlo. Este post empieza el día siguiente.

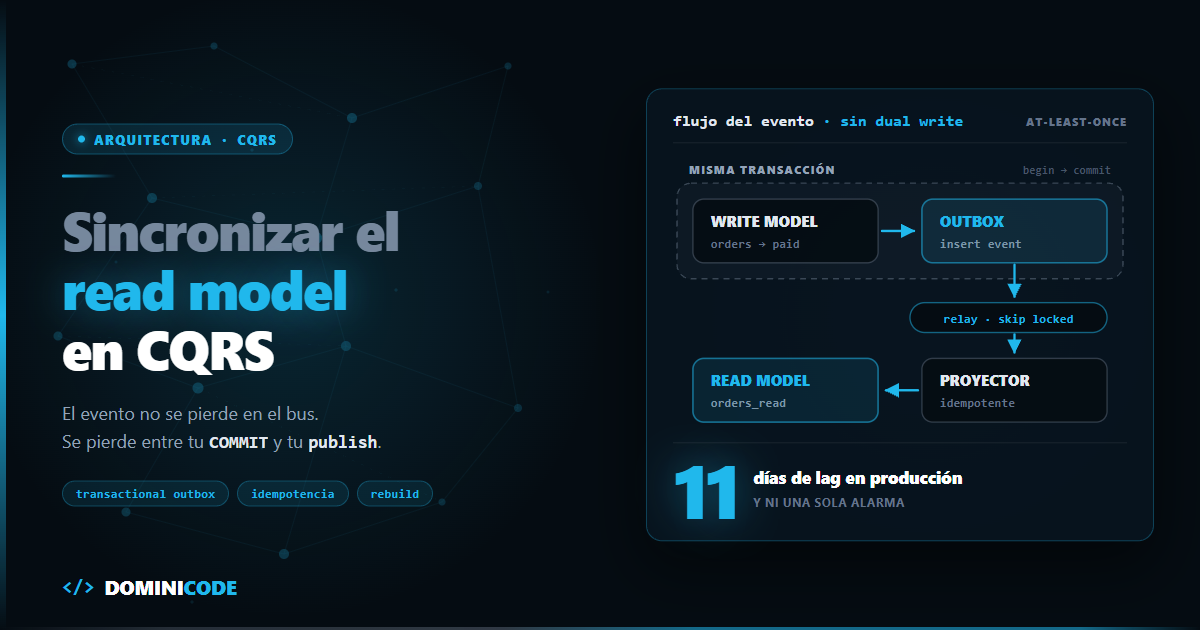
    Y la tesis, por delante: no pierdes eventos por culpa del bus. Los pierdes en el hueco que hay entre tu COMMIT y tu publish.


    Por qué el read model se desincroniza: el problema del dual write

    El read model se desincroniza porque el cambio de estado y la publicación del evento son dos operaciones contra dos sistemas distintos, sin transacción común. Si la segunda falla, no queda nadie para reintentarla.

    Este código lo he visto en producción más veces de las que me gustaría:

    await db.query(`update orders set status = 'paid' where id = $1`, [orderId])
    await bus.publish('order.paid', { orderId })
    

    Dos líneas. Parecen una unidad. No lo son.

    Entre la primera y la segunda cabe todo: un timeout del broker, un deploy que mata el pod, el OOM killer, un ECONNRESET. Si la segunda línea falla, la base de datos de escritura dice "pagado" y el read model no se entera nunca. No hay reintento que te salve, porque el proceso que tenía que reintentar ya no existe.

    Invertir el orden es peor. Si publicas primero y la transacción hace rollback después, has emitido un evento sobre algo que no ocurrió. El read model muestra un pedido pagado que en la fuente de verdad sigue pendiente. Ese bug se tarda semanas en encontrar.

    Esto tiene nombre: dual write. Escribir en dos sistemas que no comparten transacción. No se arregla con try/catch, ni con reintentos en el catch, ni metiendo el publish dentro de la transacción —porque la red no hace rollback.

    La solución académica es 2PC. La que usa la gente que tiene que dormir por las noches es otra.


    Transactional outbox: sincronizar el read model en una sola transacción

    El transactional outbox es un patrón que elimina el dual write escribiendo el evento en una tabla de la misma base de datos, dentro de la misma transacción que el cambio de estado; un proceso aparte —el relay— lee esa tabla y lo publica en el bus. Está catalogado así en el catálogo de patrones de microservicios de Chris Richardson.

    Y la idea es tonta de simple: si no puedes hacer atómicas dos operaciones contra dos sistemas, haz que las dos vayan contra el mismo sistema.

    El evento no se publica. Se inserta en una tabla de la misma base de datos, dentro de la misma transacción que el cambio de estado. Si el COMMIT pasa, el evento existe. Si no pasa, tampoco. Atomicidad gratis, la que ya te da Postgres.

    create table outbox (
      id             bigserial   primary key,
      aggregate_id   uuid        not null,
      aggregate_type text        not null,
      event_type     text        not null,
      version        int         not null,
      payload        jsonb       not null,
      occurred_at    timestamptz not null default now(),
      published_at   timestamptz
    );
    
    -- índice parcial: solo lo pendiente, que es lo que el relay consulta cada tick
    create index outbox_pending_idx on outbox (id) where published_at is null;
    

    Y el comando queda así:

    import { Pool } from 'pg'
    
    const pool = new Pool({ connectionString: process.env.DATABASE_URL })
    
    export async function markOrderAsPaid(orderId: string, total: number) {
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        const { rows } = await client.query<{ version: number }>(
          `update orders
              set status = 'paid', paid_at = now(), version = version + 1
            where id = $1 and status = 'pending'
            returning version`,
          [orderId],
        )
    
        if (rows.length === 0) throw new Error('ORDER_NOT_PENDING')
    
        await client.query(
          `insert into outbox (aggregate_id, aggregate_type, event_type, version, payload)
           values ($1, 'order', 'order.paid', $2, $3)`,
          [orderId, rows[0].version, { orderId, total, paidAt: new Date().toISOString() }],
        )
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Fíjate en el returning version. Ese número lo vas a necesitar dentro de dos secciones y es lo que separa un read model correcto de uno que a veces acierta.

    El relay

    Un proceso aparte lee la tabla y publica. Nada más. La clave está en el for update skip locked —disponible desde Postgres 9.5—: te deja correr varias instancias del relay sin que dos cojan la misma fila.

    export async function relayTick(bus: Bus, batchSize = 100) {
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        const { rows } = await client.query<OutboxRow>(
          `select id, aggregate_id, event_type, version, payload, occurred_at
             from outbox
            where published_at is null
            order by id
            limit $1
              for update skip locked`,
          [batchSize],
        )
    
        for (const row of rows) {
          await bus.publish({
            id: String(row.id),
            type: row.event_type,
            aggregateId: row.aggregate_id,
            version: row.version,
            payload: row.payload,
            occurredAt: row.occurred_at,
          })
        }
    
        if (rows.length > 0) {
          await client.query(
            `update outbox set published_at = now() where id = any($1::bigint[])`,
            [rows.map((r) => r.id)],
          )
        }
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Léelo otra vez y busca el agujero, porque lo tiene: si bus.publish va bien y el commit del update ... published_at falla, el evento sale publicado dos veces.

    Eso es intencionado. El outbox te garantiza at-least-once, nunca exactly-once. Y está bien. Preferimos un evento duplicado que un evento perdido, porque el duplicado se resuelve en el consumidor y la pérdida no se resuelve en ningún sitio.

    El relay es, además, donde el bus te va a fallar de verdad. Con el broker caído, reintentar en bucle cerrado solo empeora las cosas: aplica el mismo razonamiento que expliqué sobre circuit breakers y clasificación de fallos. Cortar, esperar, dejar que el outbox acumule. Para eso está la tabla: el relay puede pasarse diez minutos parado y no se pierde ni un evento.


    Idempotencia en el proyector: procesar dos veces sin duplicar

    Si el bus entrega al menos una vez, el proyector tiene que poder comerse el mismo evento dos veces y terminar en el mismo estado. Punto.

    Dos piezas: una tabla que registra qué eventos ya se procesaron y un upsert que no dependa del orden de llegada.

    create table processed_events (
      projection   text        not null,
      event_id     bigint      not null,
      processed_at timestamptz not null default now(),
      primary key (projection, event_id)
    );
    
    create table projection_checkpoint (
      projection    text        primary key,
      last_event_id bigint      not null default 0,
      updated_at    timestamptz not null default now()
    );
    
    create table orders_read (
      order_id uuid        primary key,
      status   text        not null,
      total    numeric     not null,
      paid_at  timestamptz,
      version  int         not null
    );
    

    El primary key de order_id no es decorativo: sin esa restricción única, el on conflict (order_id) del proyector ni siquiera llega a ejecutarse.

    Antes de tocar nada, valida el payload. El evento viaja como JSON opaco y puede llevar meses en la tabla: el día que alguien cambie su forma en el productor, tu proyector recibirá algo que no espera. Parsea siempre con un schema —aquí, Zod 4— y manda a dead letter lo que no cumpla, en vez de dejar que un undefined acabe escrito en la vista.

    import { z } from 'zod'
    
    const OrderPaid = z.object({
      orderId: z.uuid(),
      total: z.number().nonnegative(),
      paidAt: z.iso.datetime(),
    })
    
    export async function projectOrderPaid(event: DomainEvent) {
      const parsed = OrderPaid.safeParse(event.payload)
      if (!parsed.success) {
        await deadLetter(event, parsed.error)
        return
      }
    
      const client = await pool.connect()
    
      try {
        await client.query('begin')
    
        // 1. Reclamar el evento. Si ya estaba, no hacemos nada más.
        const claim = await client.query(
          `insert into processed_events (projection, event_id)
           values ('orders_read', $1)
           on conflict do nothing`,
          [event.id],
        )
    
        if (claim.rowCount === 0) {
          await client.query('rollback')
          return
        }
    
        // 2. Upsert con guarda de versión.
        await client.query(
          `insert into orders_read (order_id, status, total, paid_at, version)
           values ($1, 'paid', $2, $3, $4)
           on conflict (order_id) do update
              set status  = excluded.status,
                  total   = excluded.total,
                  paid_at = excluded.paid_at,
                  version = excluded.version
            where orders_read.version < excluded.version`,
          [parsed.data.orderId, parsed.data.total, parsed.data.paidAt, event.version],
        )
    
        // 3. Avanzar el checkpoint.
        await client.query(
          `update projection_checkpoint
              set last_event_id = greatest(last_event_id, $1), updated_at = now()
            where projection = 'orders_read'`,
          [event.id],
        )
    
        await client.query('commit')
      } catch (error) {
        await client.query('rollback')
        throw error
      } finally {
        client.release()
      }
    }
    

    Lo importante: los tres pasos van en la misma transacción. Si el proceso muere entre el paso 1 y el 2, el rollback deshace la reclamación y el evento se vuelve a entregar. Sin transacción, esa tabla de deduplicación no te protege, te miente.

    Este parseo de eventos es, por cierto, uno de los sitios donde Zod paga solo: el mismo schema te da el tipo de TypeScript, la validación en runtime y el mensaje de error que vas a leer en el dead letter a las tres de la mañana.

    Si quieres exprimir esa parte —discriminated unions por event_type, transformaciones, versionado de schemas— lo trabajo a fondo en el curso de Zod para TypeScript.


    Orden y versiones: cuando el v3 llega antes que el v2

    Ningún bus te garantiza el orden global. Con particiones, reintentos y varios consumidores en paralelo, el evento v3 de un pedido puede llegar antes que el v2. Es normal, no es un bug del broker.

    La cláusula que ya has visto arriba resuelve el caso:

    where orders_read.version < excluded.version
    

    Si llega el v3 y lo aplicas, cuando aparezca el v2 el WHERE da falso y el update no ocurre. El evento viejo se descarta en silencio, que es exactamente lo que quieres: tu read model no retrocede jamás.

    Ahora la letra pequeña, que es donde se rompe la gente: esto solo funciona si tus eventos llevan el estado completo. Si order.paid dice "el total es 120 y el estado es paid", aplicar el v3 y tirar el v2 deja la vista correcta. Si tus eventos son deltas —"suma 3 al stock", "descuenta 20 del saldo"— descartar el v2 te deja con un número mal para siempre.

    Con deltas necesitas detectar huecos y esperar. Cambias la guarda por una igualdad estricta:

    -- solo aplico si soy exactamente el siguiente
    where orders_read.version = excluded.version - 1
    

    Y si rowCount === 0 y la versión del evento es mayor que la actual más uno, lanzas para que el bus te lo vuelva a entregar más tarde, cuando el que falta ya haya pasado.

    Cambia también el SET: con deltas ya no copias excluded, acumulas — set total = orders_read.total + excluded.total. Y ojo al caso borde, que es el que muerde: esa guarda solo se evalúa en la rama DO UPDATE. Si la fila todavía no existe, el INSERT entra con la versión que traiga y el hueco pasa sin que nadie lo vea. Con deltas, crea la fila en la versión 0 cuando das de alta el agregado.

    Mi recomendación después de sufrir las dos: haz los eventos state-carrying siempre que puedas. Pesan más en la cola y a cambio te ahorran toda la maquinaria de gaps, buffers y reentregas. Es el cambio de diseño más rentable de esta lista.


    Rebuild de proyecciones: el superpoder que nadie usa

    Aquí está la parte buena de CQRS, la que compensa todo lo anterior: si tu read model es una función pura de la secuencia de eventos, el read model es desechable. ¿Se corrompió por un bug del proyector? Lo tiras. ¿Quieres añadir una columna calculada a la vista? Lo tiras. ¿Cambias la forma entera de la proyección? Lo tiras.

    Con la condición que casi nadie cumple: no borres los eventos. Un outbox con delete from outbox where published_at is not null es un outbox que funciona y que te quita esta capacidad para siempre. Archiva a un event_log en vez de borrar. Es la diferencia entre una cola y un log.

    El patrón es proyección versionada, y son cuatro pasos:

    1. Creas orders_read_v2 con el esquema nuevo, vacía, y su propia fila en projection_checkpoint.
    2. Arrancas el proyector v2 en modo replay, leyendo el event_log desde el id 0. El v1 sigue vivo y sirviendo tráfico.
    3. Cuando el v2 alcanza al v1 y ambos consumen en tiempo real, comparas. Unos cuantos agregados a mano o un diff de checksums.
    4. Cambias el puntero.

    Ese cambio de puntero es lo único delicado. Si la capa de consulta lee a través de una vista, es una sentencia:

    begin;
      drop view orders_read_current;
      create view orders_read_current as select * from orders_read_v2;
    commit;
    

    Dentro de la transacción toma un ACCESS EXCLUSIVE sobre la vista: las consultas en vuelo esperan unos milisegundos y siguen. Y no, create or replace view no vale aquí: solo admite añadir columnas al final, no cambiar nombres, tipos ni orden —que es exactamente lo que cambia en un rebuild.

    Si no tienes vista, usa un flag de configuración que lea la capa de consulta al construir la query: más código, pero te deja volver atrás sin desplegar.

    Con un rebuild fiable, tocar el read model deja de dar miedo. Ya no migras datos con un ALTER TABLE a las dos de la mañana: construyes una tabla nueva en paralelo, con tráfico real, y decides con datos si la enciendes.

    Un apunte de método: el evento order.paid es una API pública aunque no tenga endpoint. Quién lo emite, qué campos garantiza y cómo se versiona tiene que estar escrito antes de picar el proyector.

    Es de lo que más insisto en el libro de Spec-Driven Development, y en sistemas de eventos se nota el doble: el coste de equivocarte no lo pagas en el deploy, lo pagas seis meses después, cuando ya hay cuatro consumidores.


    Medir el lag del read model: el único aviso temprano que vas a tener

    En CQRS la consistencia eventual no es un fallo, es el contrato: el read model siempre va algo por detrás del write model. El fallo es no saber cuánto.

    Todo lo anterior puede estar bien implementado y aun así tu read model puede ir veinte minutos por detrás porque el relay se quedó colgado. No se lanza ninguna excepción. No hay error 500. Todo está "verde".

    Solo hay una métrica que te avisa: la antigüedad del evento pendiente más viejo.

    select coalesce(
      extract(epoch from now() - min(o.occurred_at)),
      0
    ) as lag_seconds
    from outbox o
    left join processed_events p
           on p.projection = 'orders_read'
          and p.event_id   = o.id
    where p.event_id is null;
    

    Devuelve 0 cuando no hay nada pendiente y crece cuando algo se atasca. Exponla como gauge y ponle alerta.

    No la escribas contra last_event_id del checkpoint. Como el checkpoint avanza con greatest(), es una marca de agua alta: el v2 que se fue al dead letter queda por debajo de ella, la query no lo ve y te devuelve 0 con la proyección rota. Que es, literalmente, el ticket de los once días. Si purgas processed_events, limita el anti-join a tu ventana de retención.

    Cuidado con la versión ingenua de esta métrica, que es la que suele estar puesta: now() - last_event_at del checkpoint. Esa te mide "cuánto hace que proyecté algo", y si a las tres de la madrugada no hay tráfico te va a despertar sin motivo. Peor: te acostumbra a ignorar la alarma. Mide lo que está esperando, no lo último que hiciste.

    Yo añado dos series más al dashboard:

    • Lag en eventos: cuántas filas del outbox siguen sin aparecer en processed_events. Te dice si el proyector está perdiendo la carrera. No lo calcules como max(id) − last_event_id: arrastra exactamente el mismo punto ciego de la marca de agua.
    • Tamaño del dead letter: si crece, hay eventos que no se están aplicando y el read model ya está mal.

    Con esas tres, aquel ticket de los once días se habría abierto en once minutos.


    Cuándo no necesitas absolutamente nada de esto

    Si tu "read model" es una réplica de lectura de la misma base de datos, no tienes este problema. Postgres replica por ti, la sincronía la resuelve el WAL, y tu única métrica es el lag de replicación —que ya viene dado por pg_last_xact_replay_timestamp() y pg_stat_replication.

    Nada de outbox, nada de proyectores, nada de checkpoints. Si separaste lectura y escritura solo para repartir carga, esa es la respuesta correcta y es aburridísima, que es justo lo que quieres en infraestructura.

    Lo mismo si tu vista denormalizada es una materialized view en la misma base y toleras refrescarla cada pocos minutos. REFRESH MATERIALIZED VIEW CONCURRENTLY resuelve más casos de los que la gente cree. Pide dos cosas: un índice UNIQUE sobre columnas —sin expresiones y sin WHERE— y que la vista ya esté poblada. A cambio refresca sin bloquear lecturas, aunque tarda bastante más que un refresh normal.

    Todo lo de este post empieza a hacer falta cuando el read model vive en otro sitio: otro motor, otro servicio, un índice de búsqueda, una tabla con una forma que no se deriva de un SELECT. Ahí sí tienes dual write y ahí sí necesitas el outbox.

    Dónde vive tu read model Cómo se sincroniza Qué tienes que operar Lag típico
    Réplica de lectura, misma base Replicación física (WAL) Nada, lo hace Postgres Milisegundos
    Materialized view, misma base REFRESH MATERIALIZED VIEW CONCURRENTLY Un cron Minutos
    Otra tabla, otro servicio, índice de búsqueda Transactional outbox + relay Tabla outbox, relay, checkpoints Segundos
    Igual que arriba, sin mantener relay CDC leyendo el WAL Kafka + Connect Segundos

    Y si estás en ese caso pero no quieres mantener la tabla ni el relay, mira CDC antes de escribir código: resuelve lo mismo leyendo el WAL, a cambio de infraestructura extra. Lo desarrollo en las preguntas de abajo.


    Qué hacer hoy

    Si ya tienes CQRS en producción y nada de esto está montado, no empieces por el outbox. Empieza por la métrica.

    Escribe la query del lag, ponla en un dashboard y déjala una semana. Vas a descubrir dos cosas: cuántos eventos estabas perdiendo sin saberlo, y si tu problema real era ese o era otro. Es media hora de trabajo, y es lo único de esta lista que te da información antes de que te la pida un cliente enfadado. El resto —outbox, idempotencia, versiones, rebuild— se construye después, con datos encima de la mesa.

    Si quieres ver este tipo de arquitecturas montadas de principio a fin, con el código completo y las decisiones discutidas, en Dominicode Labs es donde publico los proyectos largos que no caben en un post.


    Preguntas frecuentes

    ¿Por qué mi read model no se actualiza en CQRS?

    Casi siempre por dual write: el cambio de estado se guardó, pero el evento nunca llegó al bus porque publicar y hacer commit son dos operaciones distintas y la segunda falló sin que nadie reintentara.

    Los otros dos sospechosos habituales son el relay parado —el evento sigue en la tabla outbox con published_at a null— y un evento que el proyector rechaza una y otra vez hasta acabar en el dead letter. Los tres casos se distinguen en treinta segundos con la query de lag de este post: si devuelve un número alto, el evento existe y no se ha proyectado; si devuelve 0 y la vista sigue mal, mira el dead letter.

    ¿El transactional outbox añade latencia a cada escritura?

    Añade un INSERT dentro de una transacción que ya estaba abierta. En la práctica es ruido comparado con el resto del comando.

    La latencia que sí importa es la otra: cuánto tarda el evento en llegar al read model. Eso lo marca el intervalo de polling del relay, no el insert. Si necesitas bajarlo, usa LISTEN/NOTIFY de Postgres para despertar al relay en cuanto hay una fila nueva, en lugar de esperar al siguiente tick.

    ¿Puedo usar CDC en lugar de la tabla outbox?

    Sí, y resuelve el mismo problema de dual write. Debezium lee el WAL de Postgres y publica los cambios sin que tu código haga nada — trae incluso un outbox event router preparado exactamente para este patrón.

    La diferencia es qué publicas. Con outbox publicas eventos de dominio que tú diseñas; con CDC a secas publicas cambios de filas, y tus consumidores acaban acoplados al esquema de tu base de datos. El punto medio más usado es CDC leyendo precisamente la tabla outbox: eventos de dominio sin escribir relay, a cambio de operar Kafka y Connect.

    ¿Qué hago con un evento que el proyector nunca consigue procesar?

    Dead letter después de N intentos, y alerta. Lo que no puedes hacer es reintentarlo en bucle para siempre: bloqueas la partición y frenas todo lo que viene detrás.

    Ojo con la consecuencia que se pasa por alto: si mandas a dead letter el v2 de un agregado y sigues procesando el v3, esa fila queda incoherente hasta que reproceses. Por eso el dead letter va en el dashboard y no en un buzón que nadie abre.

    ¿Necesito event sourcing para poder reconstruir proyecciones?

    No. Necesitas retener los eventos, que es mucho menos que event sourcing.

    En event sourcing el log de eventos es la fuente de verdad y el estado se deriva de él. Aquí la fuente de verdad sigue siendo tu tabla orders, y el log de eventos es solo el historial de cambios publicados. Con archivar el outbox en un event_log en vez de borrarlo ya puedes reconstruir cualquier proyección.

    ¿Cada cuánto debería hacer polling del outbox?

    Depende del lag que tu producto tolere, no de lo que haga la industria. Un panel interno aguanta segundos; un contador que el usuario ve moverse tras pulsar un botón, no.

    Define el número primero —"el read model va como mucho X segundos por detrás"—, mídelo con la query de lag y ajusta el intervalo hasta cumplirlo. Sin ese número escrito, cualquier valor que pongas es una opinión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Opus 5.5: el riesgo no es el modelo, son sus guardarraíles

    Claude Opus 5.5: el riesgo no es el modelo, son sus guardarraíles

    Lanzas la migración un jueves por la noche con Claude Opus 5.5. Cuarenta y dos paquetes, un monorepo que nadie ha tocado desde 2023, el agente corriendo en un runner con presupuesto para ocho horas.

    Viernes por la mañana abres el log. Veintiséis paquetes migrados. El veintisiete, vacío. No hay stack trace. No hay catch que haya saltado. No hay un solo 4xx en las métricas del runner.

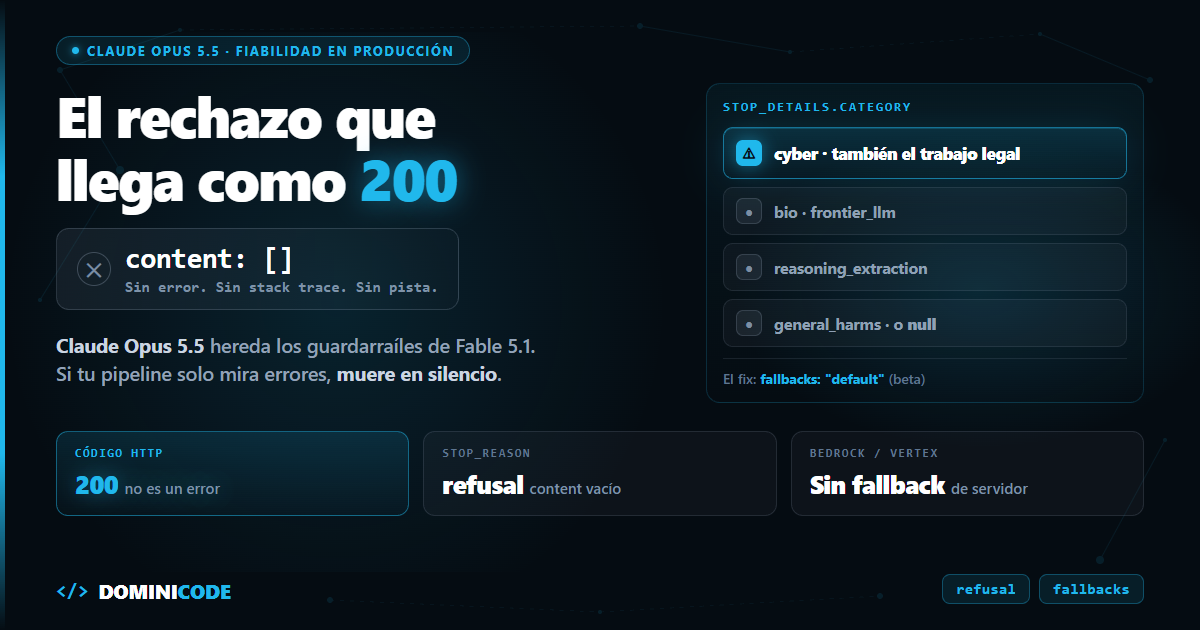
    Lo que hay es una respuesta HTTP 200, perfectamente válida, con el array content vacío.

    Y tú buscando durante hora y media un bug que no existe.

    En corto: Claude Opus 5.5 lleva el mismo sistema de clasificadores de seguridad que Fable 5.1, Fable 5 y Opus 5, y cuando uno de ellos declina una petición no recibes un error: recibes un HTTP 200 con stop_reason: "refusal" y content vacío. Si tu código solo maneja códigos de error, un flujo agéntico largo se corta en silencio a mitad. El arreglo cabe en dos líneas —el parámetro fallbacks, en beta— pero no está disponible en Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry ni en la API de lotes.


    ¿Qué es un refusal en Claude Opus 5.5 y por qué llega como HTTP 200?

    Un refusal es una respuesta HTTP 200 en la que un clasificador de seguridad de Claude ha declinado la petición: stop_reason vale "refusal" y el array content llega vacío. Un objeto stop_details acompaña a esa respuesta y nombra la categoría de política que saltó.

    No es una excepción. No es un 400. No es un 403. Es exactamente la misma forma de respuesta que usas para leer un resultado bueno, con el contenido quitado.

    Esto aplica a Claude Fable 5.1, Fable 5, Opus 5.5 y Opus 5: los cuatro llevan clasificadores que pueden declinar una petición, según la documentación de refusals de Anthropic. Y en las dos categorías más agresivas, Anthropic sitúa a Opus 5.5 —lanzado el 22 de septiembre de 2026— al nivel del modelo más restringido de su catálogo: "Because Opus 5.5 is comparable to Claude Mythos 5.1 in biology and cybersecurity, we're deploying it with safeguards similar to those on Claude Fable 5.1", dice la nota de lanzamiento.

    Lo miden contra un modelo y le ponen los frenos de otro.

    Así se ve una respuesta declinada — es el ejemplo de la documentación, con el modelo cambiado a Opus 5.5:

    {
      "id": "msg_01XFUDYJgAACzvnptvVoYEL",
      "type": "message",
      "role": "assistant",
      "model": "claude-opus-5-5",
      "content": [],
      "stop_reason": "refusal",
      "stop_details": {
        "type": "refusal",
        "category": "cyber",
        "explanation": "This request was declined because it could enable cyber harm."
      },
      "usage": {
        "input_tokens": 412,
        "output_tokens": 0
      }
    }
    

    Fíjate en content: []. Si tu código hace response.content[0].text, ahí revienta con un TypeError a doscientos kilómetros del sitio donde está el problema real. Y si lo haces con optional chaining, te devuelve undefined y sigue como si nada, que es peor.

    El guard son cinco líneas, y van antes de tocar el contenido:

    if (response.stop_reason === 'refusal') {
      logger.warn('refusal', { category: response.stop_details?.category ?? 'unknown' })
      throw new RefusalError(response.stop_details)
    }
    
    const text = response.content[0].text
    

    Las 5 categorías de refusal: cyber, bio, frontier_llm, reasoning_extraction y general_harms

    stop_details.category nombra qué guardarraíl ha saltado. Son cinco, y la columna de la derecha es la que conviene leer despacio:

    category Qué la dispara Por qué te puede tocar sin buscarlo
    cyber Malware, desarrollo de exploits La doc admite que el trabajo legítimo de ciberseguridad también la dispara. Un parser de entrada, un sanitizador, un test de inyección
    bio Métodos de laboratorio peligrosos Igual: "Beneficial life sciences work can also trigger this category"
    frontier_llm Ayudar a desarrollar modelos competidores Restringido por los términos comerciales. Trabajo normal de machine learning también la dispara
    reasoning_extraction Pedirle que reproduzca su razonamiento interno en el texto Si tu prompt dice "explica paso a paso cómo has llegado ahí", estás en zona gris
    general_harms Cualquier otra área de la política de uso El cajón de sastre. También puede saltar con trabajo benigno

    Y un detalle que no está en ninguna tabla: category y explanation pueden venir null. La documentación avisa de que ese null es un valor normal y permanente, no un hueco por rellenar. Es decir: puedes recibir un rechazo sin saber de qué categoría.

    explanation viene en texto legible, pero la doc es explícita en que el texto no es estable: se muestra, no se parsea. Si montas lógica sobre esa cadena, se te rompe en la siguiente actualización.

    Hay un cuarto campo que el JSON de arriba no muestra: recommended_model, el modelo que Anthropic sugiere para esa categoría. Es el que usa el fallback del servidor — y el que tienes que leer tú si estás en Bedrock o Vertex y te toca montarlo en cliente. Llega solo en peticiones que piden fallbacks, y la doc avisa de que es una pista, no una garantía.


    Por qué un refusal rompe un flujo agéntico en silencio

    Que un modelo decline una petición sensible es discutible, pero es una decisión de producto. El problema de ingeniería es otro, y es que el rechazo tiene forma de éxito.

    Pasa esto:

    1. Tu agente lleva seis horas migrando. Va por el paquete 27.
    2. El diff de ese paquete toca el middleware de autenticación. El clasificador cyber se activa.
    3. La API devuelve 200. Tu cliente HTTP está encantado. Tu métrica de errores, plana.
    4. El paso 27 produce una cadena vacía, y el bucle agéntico —que confía en su propia salida— sigue adelante con eso.

    Ese cuarto punto es el caro. En un bucle agéntico en producción, la salida de un paso es el contexto del siguiente. Un vacío no propaga una excepción: propaga basura.

    Hay dos detalles de facturación que conviene tener claros, porque cambian cómo instrumentas esto:

    • Un rechazo que llega antes de cualquier salida no se factura. content viene vacío y los tokens aparecen en usage pero no se cobran. Eso sí: cuenta contra tus rate limits.
    • Un rechazo a mitad de streaming sí se factura: los tokens de entrada y lo que ya se había emitido, a precio normal. Y la doc lo dice claro — esa salida parcial hay que descartarla, no aprovecharla.

    Así que el escenario de verdad desagradable no es ninguno de los dos anteriores: es el agente que reintenta a ciegas. Los rechazos tempranos no los pagas, pero cada reintento te come rate limit, y el bucle se queda girando contra una pared invisible. Si no estás midiendo el consumo de tokens de tu agente, no te enteras hasta que llega el 429 — o hasta que abres el log a la mañana siguiente.


    Cómo manejar un refusal: el parámetro fallbacks de la API de Claude (beta)

    Anthropic tiene fallback en el servidor, en beta. Le pones fallbacks: "default" y la cabecera beta, y cuando el modelo primario declina, la API reintenta la misma petición en el modelo que Anthropic recomienda para esa categoría, dentro de la misma llamada:

    import Anthropic from '@anthropic-ai/sdk'
    
    const client = new Anthropic()
    
    const response = await client.beta.messages.create({
      model: 'claude-opus-5-5',
      max_tokens: 1024,
      messages: [{ role: 'user', content: 'Hello, Claude' }],
      fallbacks: 'default',
      betas: ['server-side-fallback-2026-07-01']
    })
    
    console.log(response.model) // el modelo que realmente respondió
    

    response.model es la clave: te dice quién contestó de verdad, que no tiene por qué ser el que pediste. Para saber si el fallback llegó a entrar hay que mirar usage.iterations buscando una entrada de tipo fallback_message, y confirmarlo con que stop_reason ya no sea "refusal":

    const huboFallback = (response.usage.iterations ?? [])
      .some(it => it.type === 'fallback_message')
    
    const loSirvioElFallback = huboFallback && response.stop_reason !== 'refusal'
    

    También puedes nombrar hasta tres modelos de fallback propios en lugar de dejar el enrutado por defecto. Y si una categoría no tiene fallback recomendado, el rechazo se mantiene: el parámetro no es un interruptor de "quítame los guardarraíles".

    Dónde NO funciona fallbacks: Bedrock, Vertex, Foundry y Batches API

    Aquí está la letra pequeña, y es la parte que decide tu arquitectura:

    Plataforma / modo ¿fallbacks funciona? Qué hacer
    API de Claude, petición normal ✅ Sí, en beta fallbacks: "default" + cabecera beta
    Amazon Bedrock ❌ No Fallback en cliente, leyendo stop_details.recommended_model
    Google Cloud Vertex AI / Microsoft Foundry ❌ No Igual: middleware del SDK y recommended_model
    Message Batches API ❌ No El item del lote vuelve como resultado erróneo. Ojo si procesas en batch
    HTTP crudo o retry propio ➖ N/A Reintento manual + fallback credit para no pagar dos veces la caché

    Ese último punto de la tabla es el que más dinero cuesta ignorar: si te montas el reintento a mano y el prompt cacheado es grande, pagas la caché dos veces. El fallback en servidor y el middleware del SDK aplican el crédito por ti.


    Cuándo NO deberías meter Opus 5.5 en un flujo largo

    La nota de lanzamiento vende justamente lo contrario: "handles long, sprawling jobs like codebase-wide migrations".

    Pero en el hilo de Hacker News del lanzamiento —más de 1.400 puntos y cerca de 900 comentarios— hay un testimonio que va exactamente al grano de este post. Lo cuenta bushido:

    "The safeguards really don't work well for a lot of long-running tasks on old code bases. A lot of my workloads last days to weeks and the single biggest risk to the workflow is random safeguards."

    El mismo comentarista describe el bucle más incómodo: el propio modelo emite algo que a su clasificador no le gusta, y toca reiniciar la conversación.

    raesene9, que trabaja en seguridad, es más tajante sobre por qué no los usa para su campo:

    "I've found their guardrails so twitchy (especially Anthropic) that I wouldn't try to use them for even vaguely security related work."

    Y kqp documenta un falso positivo que da la medida del problema: preguntó si una cita genérica rompía reglas de puntuación y se lo bloquearon. Reformular la frase para no usar la palabra "rules" lo arregló.

    Tres situaciones concretas donde yo no lo pondría sin red:

    1. Migraciones desatendidas de días sobre código legacy. No por la calidad del modelo. Es que en un recorrido de cientos de pasos no eliges el contenido que vas a tocar: basta con llegar a una zona sensible —middleware de autenticación, criptografía, deserialización— para que el clasificador salte. Y ahí reintentar no sirve de nada, porque el mismo diff dispara el mismo clasificador. A eso se suma lo que describe bushido, que sí es impredecible: que el guardarraíl se active sobre la salida del propio modelo. Ninguna de las dos cosas la ves hasta la mañana siguiente.
    2. Cualquier cosa que roce seguridad, aunque sea defensiva: sanitizar entrada, revisar dependencias, escribir tests de inyección. El guardarraíl cyber no distingue intención.
    3. Procesamiento en lotes de contenido heterogéneo. El parámetro fallbacks no existe en la API de lotes, así que ahí el rechazo se queda como está y el item vuelve como error.

    Ojo, esto no es un argumento para usar otro modelo: los clasificadores no son exclusivos de Anthropic. Es un argumento para tratar el rechazo como un estado esperado de tu sistema, no como una anomalía.


    Lo que los benchmarks de Opus 5.5 no miden

    Los números del lanzamiento son buenos y no hay por qué discutirlos. En Terminal-Bench 4.0, Opus 5.5 saca un 66,4% frente al 52,3% de Opus 5 — y por encima de GPT-6 Astra (57,9%) y de Fable 5.1 (55,8%).

    Claude Opus 5.5 Claude Opus 5
    Entrada / salida (1M tokens) $4 / $20 $5 / $25
    Lectura de caché (1M tokens) $0,20 $0,50
    Terminal-Bench 4.0 66,4% 52,3%
    Clasificadores de seguridad Sí, al nivel bio/ciber de Mythos 5.1 Sí
    fallbacks en la API de Claude Sí, en beta Sí, en beta
    Limitación / riesgo Se vende para migraciones de días, y es ahí donde más superficie das a que salte un guardarraíl Un 20% más caro por token y 14 puntos por debajo en Terminal-Bench

    Fuente: nota de lanzamiento de Opus 5.5, 22 de septiembre de 2026.

    Fíjate en la fila de la caché, porque explica el titular: los tokens bajan un 20%, pero las lecturas de caché bajan un 60%. De ahí sale el "40% más barato" que anuncia Anthropic — y solo lo ves entero si buena parte de tu factura eran lecturas de caché, que es justo el caso de los flujos agénticos largos.

    Ahora bien: ninguno de esos porcentajes mide lo que va este post, que es cuántas veces se te para el flujo a mitad. Es la diferencia de siempre entre lo que miden los benchmarks de IA programando y lo que te encuentras el viernes por la mañana.

    Si vienes de Opus 5, los cambios de API que rompen código son otros y ya los cubrí en su momento: los breaking changes de Opus 5. Lo de aquí se suma a aquello, no lo sustituye.


    Qué hacer hoy en tu código: 3 pasos

    1. Busca dónde lees response.content[0]. Ese es el punto exacto donde un rechazo se convierte en un bug fantasma. Comprueba stop_reason === 'refusal' antes de tocar el contenido, y registra stop_details.category para saber después de qué murió.
    2. Trata el rechazo como una rama del flujo, no como un error. Un circuit breaker que abra tras N rechazos seguidos te ahorra los rate limits y la investigación de madrugada. Es la misma idea que el método del ebook gratuito Revisión por Contrato: que un agente no te cuele trabajo a medias sin que nadie se entere.
    3. Activa fallbacks: "default" si estás en la API de Claude. Y si estás en Bedrock o Vertex, asume que no lo tienes y monta el fallback en cliente leyendo recommended_model.

    Todo esto es la misma idea de fondo: el modelo es un proveedor externo con fallos propios, y tu sistema necesita contratos que aguanten cuando el proveedor dice que no. Si diseñas esa frontera antes de escribir el código —qué entra, qué sale y qué pasa cuando no sale nada— esto deja de ser una sorpresa, y de eso va Spec-Driven Development.

    Y si quieres el recorrido completo de construir con estos modelos sin que la primera sorpresa te pille en producción, lo trabajo entero en Construye con IA.


    Preguntas frecuentes

    ¿Un refusal de Claude Opus 5.5 devuelve un error HTTP?

    No. Devuelve un HTTP 200 perfectamente válido, con stop_reason: "refusal", el array content vacío y un objeto stop_details con la categoría. Por eso pasa desapercibido: los bloques try/catch y los reintentos basados en códigos de error no lo ven.

    ¿Me cobran los tokens de una petición rechazada?

    Depende de cuándo llegue el rechazo. Si llega antes de cualquier salida, no se factura: content viene vacío y los tokens aparecen en usage pero no se cobran. Eso sí, la petición sí cuenta contra tus rate limits. Si el rechazo llega a mitad de streaming, se facturan los tokens de entrada y la salida ya emitida a precio normal, y esa salida parcial hay que descartarla.

    ¿Cómo activo el fallback automático a otro modelo?

    En la API de Claude, añade fallbacks: "default" a la petición y la cabecera beta server-side-fallback-2026-07-01. La API reintenta la petición en el modelo recomendado para esa categoría de rechazo y te devuelve una sola respuesta; response.model te dice quién contestó. No está disponible en Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry ni en la Message Batches API.

    ¿Puede saltar un guardarraíl haciendo trabajo legítimo?

    Sí, y la documentación lo reconoce explícitamente en tres de las cinco categorías: el trabajo benigno de ciberseguridad puede disparar cyber, la investigación útil en ciencias de la vida puede disparar bio y el machine learning normal puede disparar frontier_llm. Si tu organización trabaja en esos dominios, Anthropic tiene programas de verificación para recuperar el acceso completo — el de Life Sciences ya está abierto y el de ciberseguridad lo han anunciado para las próximas semanas.

    ¿Cuánto cuesta Claude Opus 5.5 frente a Opus 5?

    $4 por millón de tokens de entrada y $20 de salida, frente a los $5 / $25 de Opus 5: un 20% menos. El titular del 40% sale de las lecturas de caché, que bajan de $0,50 a $0,20 por millón. Si esa palanca te interesa, tengo un post sobre prompt caching en la API de Claude.

    ¿Qué hago si stop_details.category viene null?

    Trátalo como un caso normal, porque lo es: la documentación avisa de que tanto category como explanation pueden ser null de forma permanente cuando el rechazo no encaja en ninguna categoría con nombre. Tu código debe manejar el rechazo sin depender de conocer el motivo, y nunca parsear el texto de explanation, que no es estable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Benchmarks de IA programando: qué mide de verdad ese 96%

    Benchmarks de IA programando: qué mide de verdad ese 96%

    "AI Is Already Better at Coding Than Most Software Developers."

    El titular circula en inglés y provoca siempre dos reacciones. El que lo comparte con un "ya está, se acabó". Y el que responde "pues a mí me inventó un import que no existe".

    Los dos discuten la conclusión sin mirar de dónde sale. Y sale de un sitio concreto: los benchmarks de IA programando. De uno solo, en realidad. SWE-bench Verified.

    La tesis, y no te va a gustar ninguna de sus dos mitades: el titular es literalmente cierto en el examen. Y el examen se rompió.

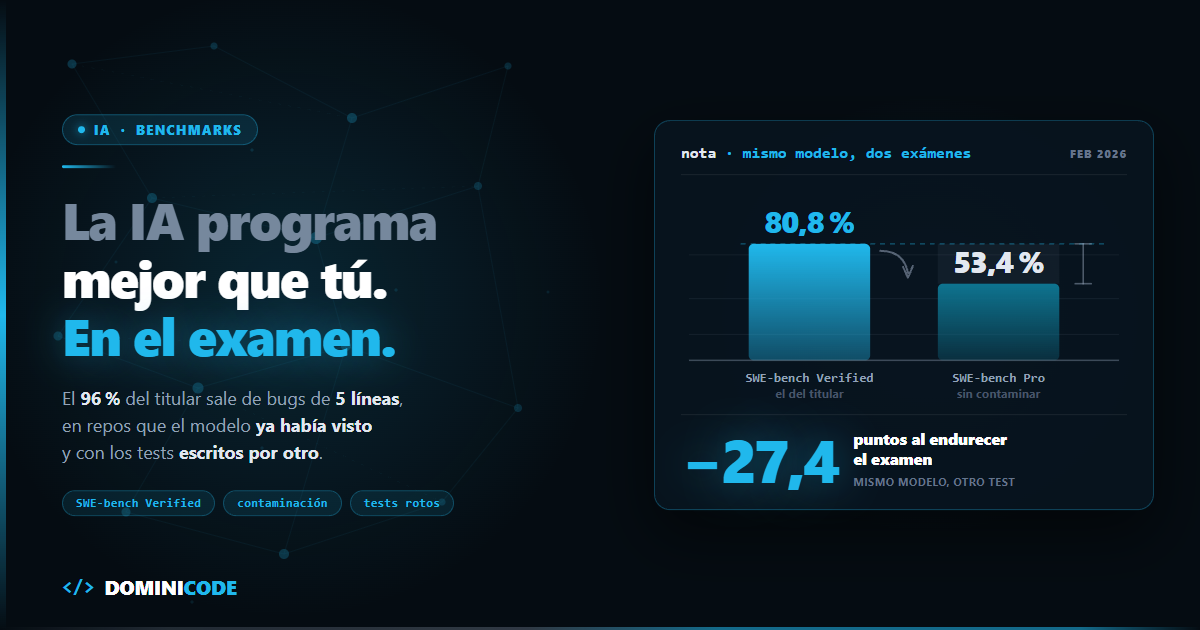
    No porque la IA sea mala escribiendo código —es buenísima—, sino porque mide una tarea que no se parece a tu trabajo: un bug de cinco líneas, en un repo que el modelo ya había visto, con los tests ya escritos por otro.

    En corto: OpenAI dejó de reportar ese benchmark por saturación, tests rotos y contaminación. El 91% de sus tareas son bugs de menos de una hora.


    De dónde sale el número: un leaderboard con todos empatados

    Snapshot del leaderboard de SWE-bench Verified a 15 de septiembre de 2026:

    Modelo Resolución
    Claude Opus 5 96%
    Claude Mythos 5 95,5%
    Claude Fable 5 95%

    Ahí tienes el 96% del titular. Y el primer problema no es el 96, sino la distancia entre filas: menos de un punto entre los tres punteros.

    Un examen en el que todos sacan la misma nota ha dejado de ser un examen. Es un sello.

    SWE-bench Verified es un benchmark de 500 tareas construidas a partir de issues reales de GitHub en repositorios de Python populares: el modelo recibe el repo y el enunciado del issue, y tiene que entregar un parche que pase una suite de tests ya escrita. Sobre el papel suena exactamente a tu trabajo. Por eso el titular funciona tan bien, y por eso conviene abrir la caja.

    Por qué OpenAI retiró SWE-bench Verified

    Esto no lo dice un escéptico de la IA con ganas de tráfico. Lo dice OpenAI, en un post titulado "Why SWE-bench Verified no longer measures frontier coding capabilities", y lo confirman Mia Glaese y Olivia Watkins, de su equipo de Frontier Evals, en esta entrevista.

    Tres razones, las tres con número.

    Saturación. El estado del arte pasó de 74,9% a 80,9% en seis meses. Cuando la aguja apenas se mueve ya no mides capacidad: mides techo.

    Tests rotos. Auditaron el subconjunto de problemas que los modelos fallan una y otra vez, un 27,6% del dataset: seis ingenieros revisaron 138 problemas a mano. Más del 59% tienen tests defectuosos que rechazan soluciones funcionalmente correctas: unos demasiado estrechos, otros demasiado amplios, que exigen features ni siquiera documentadas en el enunciado.

    Traducido: parte de lo que el leaderboard cuenta como fallo del modelo es un fallo del corrector.

    Contaminación. Esta es la peor. Dándoles solo el Task ID —sin enunciado y sin código—, todos los modelos frontera auditados (GPT-5.2, Claude Opus 4.5, Gemini 3 Flash) reproducen el parche correcto o el enunciado verbatim.

    Parte de la nota es memoria. No razonamiento. Y no hay forma de saber qué parte.

    La recomendación de OpenAI es reportar SWE-bench Pro en su lugar. Guárdate ese nombre.

    Qué mide de verdad el examen

    Epoch AI analizó tarea por tarea qué hay dentro de esas 500 muestras:

    Dimensión Dato
    Tareas triviales (menos de 15 min) 39%
    Tareas pequeñas (15 min – 1 h) 52%
    Tareas de 1 a 4 h 8%
    Tareas de más de 4 h 3 issues
    Parche medio, triviales 5 líneas
    Parche medio, de 15 min a 1 h 14 líneas
    Repositorios distintos 12
    Peso de Django casi el 50%
    Issues anteriores a 2020 50%

    El parche medio de ese trabajo va de cinco a catorce líneas. Y un análisis de Amazon sobre el mismo dataset, recogido por Epoch: el 78% de los cambios tocan funciones, no clases, con 1,87 funciones de media.

    La diversidad es peor que el tamaño. Doce repositorios, y los cinco mayores concentran más del 80% de las muestras. Casi la mitad es Django, de los proyectos Python más presentes en cualquier corpus de entrenamiento. La mitad de los issues son anteriores a 2020, en un dataset construido en octubre de 2023.

    Conclusión literal de Epoch: mide "arreglar issues pequeños y bien definidos" en "repos de Python open source familiares".

    Falta el detalle que más duele, y no sale en ninguna tabla: los tests ya vienen escritos. La parte difícil —decidir qué significa "correcto" en este sistema y para estos usuarios— venía hecha antes de que el modelo empezara.

    Los parches que pasan sin resolver nada

    SWE-Bench+ auditó los parches que el benchmark daba por buenos. El 32,67% son solution leakage: la solución venía escrita en el propio issue o en sus comentarios. Otro 31,08% queda como sospechoso: pasa con tests demasiado débiles para garantizar que el parche arregle algo.

    Al filtrar ambos casos, SWE-Agent con GPT-4 cae de 12,47% a 3,97%. Mismo modelo. La nota se divide por tres.

    SWE-bench Pro vs SWE-bench Verified: 27 puntos de diferencia

    SWE-bench Pro, de Scale AI, está diseñado para resistir la contaminación. Mismo modelo, dos exámenes, febrero de 2026: 80,8% en Verified y 53,4% en Pro. Veintisiete puntos por cambiar el papel del examen.

    Pasa lo mismo fuera de Python. Terminal-Bench 2.0 mide 16 categorías de tareas de terminal en Docker y en septiembre de 2026 sus líderes van altísimos: GPT-5.6 Sol 91,9%, Claude Mythos 5 88,0%, GPT-5.6 Terra 87,4%.

    Ahora coge TerminalWorld-Verified, con escenarios más parecidos a un entorno real: los modelos evaluados allí, con marcas de entre 57% y 82,7% en Terminal-Bench 2.0, caen a un rango de 49% a 62,5%.

    El número no describe al modelo. Describe al examen.

    Un diseño mejor existe: SWE-Lancer usa más de 1.400 encargos freelance de Upwork con un millón de dólares en pagos reales, y pregunta si el trabajo se habría cobrado. Cítalo por el diseño, no por el marcador: es de febrero de 2025.

    Qué mide ese 96% y qué mide tu lunes

    Nada de esto significa que la IA no programe bien. Programa muy bien, y cada mes mejor.

    Significa otra cosa, más incómoda: el número que usas para decidir no mide lo que crees. Mide velocidad en una tarea acotada, con el criterio de corrección regalado, sobre repos que el modelo ya conocía. Tu lunes no se parece a eso: repo privado que no estuvo en ningún corpus, requisitos a medio escribir y ninguna suite que te diga si lo que acabas de aceptar está bien.

    Hay un experimento que mide esa brecha. METR hizo un ensayo aleatorizado con 16 developers open source experimentados sobre 246 tareas reales en sus propios repositorios: más de 22.000 estrellas y más de un millón de líneas de media cada uno. Estimaron que irían un 24% más rápido con IA. Al terminar creían haber ido un 20% más rápido. La medición decía que habían sido un 19% más lentos.

    Y la advertencia sin la cual ese dato no se puede usar: el estudio es de julio de 2025, con Cursor Pro y Claude 3.5/3.7. Modelos viejos. No describe el rendimiento de las herramientas de hoy, y quien lo cite como si lo hiciera te está vendiendo algo.

    Sirve para una sola cosa, y es suficiente: nadie sabe si va más rápido hasta que lo mide. Ni tú ni yo. Es la conclusión a la que llegué desde otro camino cuando escribí que el cuello de botella ya no es escribir código, sino verificarlo.

    Cómo evaluar código generado por IA en tu repo: 4 pasos

    El leaderboard no te va a decir si un modelo te sirve. Eso lo mides tú, en tu repo. Cuatro pasos:

    1. Congela veinte tareas tuyas. Veinte PRs de tu proyecto ya cerrados, de dificultad variada. Ese es tu benchmark privado: no está en ningún corpus y se parece a tu trabajo por construcción. Cómo montarlo lo detallo en evals de código generado por IA.
    2. Escribe tú el criterio, y antes. Aquí está el fallo que copian los benchmarks: los tests los puso otro. Define el contrato —entradas, salidas, errores, invariantes— antes de pedir el código. Eso es revisión por contrato para código de agentes de IA, la diferencia entre revisar un diff y auditar una promesa. Si quieres el método completo, descarga el ebook gratuito.
    3. Mide tiempo, no sensación. Cronómetro desde que abres la tarea hasta que pasa code review, reescrituras incluidas. Ese es el único número que importa.
    4. Compara en tu harness, no en el ranking. El mismo modelo con distinto contexto, herramientas y reglas rinde de forma muy diferente. La variable que más mueve tu resultado casi nunca es el modelo.

    Es la mecánica del curso Construye con IA y el principio del libro Spec-Driven Development: sin criterio escrito antes no evalúas nada, ni a un modelo ni a un humano.

    Cifras verificadas a 17 de septiembre de 2026.

    La próxima vez que veas un titular con un porcentaje, haz una sola pregunta antes de compartirlo o de indignarte: ¿qué examen era?

    Casi siempre, la respuesta explica el titular entero.


    Preguntas frecuentes

    ¿Qué es exactamente SWE-bench Verified?

    Un benchmark de 500 tareas construidas a partir de issues reales de GitHub en repositorios de Python populares. Al modelo se le da el repo y la descripción del issue, y tiene que producir un parche que pase una suite de tests ya existente. Es el número detrás de casi todos los titulares sobre IA programando. Su problema no es que sea falso: su perfil de tarea —bugs pequeños, repos muy conocidos, criterio de corrección regalado— se parece poco al trabajo diario en una base de código privada.

    Si OpenAI dejó de usarlo, ¿por qué todo el mundo lo sigue reportando?

    SWE-bench Verified se sigue reportando por inercia y por comparabilidad: todos los modelos anteriores tienen una puntuación ahí, así que es la única cifra que permite poner dos años de lanzamientos en la misma tabla. OpenAI recomienda reportar SWE-bench Pro en su lugar, y lo razonable es leer las dos juntas. La diferencia entre ambas te dice más que cualquiera por separado.

    Entonces, ¿los benchmarks de IA programando no sirven para nada?

    Sirven para una pregunta más estrecha de la que se les hace: comparar modelos bajo condiciones idénticas y detectar regresiones entre versiones. No sirven para estimar cuánto vas a ganar tú en tu proyecto, porque su diseño elimina las dos partes más caras de tu trabajo: definir qué es correcto y verificar que el cambio no rompe nada más.

    ¿No es contradictorio decir que la IA programa muy bien y a la vez desconfiar del 96%?

    Decir que la IA programa muy bien y desconfiar del 96% son dos afirmaciones sobre cosas distintas. La primera habla de capacidad de generar código, que es real y muy alta. La segunda habla de qué mide un número concreto, y ese número resume un tipo de tarea muy particular. La IA genera código excelente a una velocidad que ningún humano iguala; lo que no hace es decidir qué debería hacer ese código ni garantizar que encaja en tu sistema. Ese trabajo es ahora la parte cara.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Validación en NestJS: DTOs, class-validator y sus trampas

    Validación en NestJS: DTOs, class-validator y sus trampas

    El bug tardó once días en aparecer y cuatro minutos en explicarse.

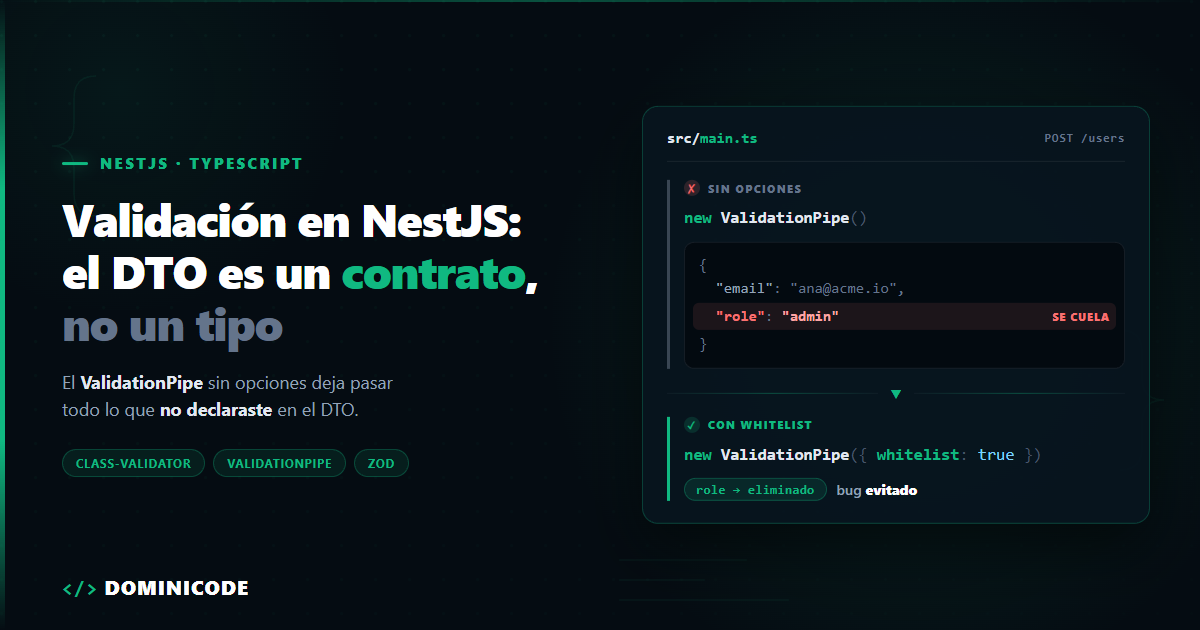
    Una API NestJS, endpoint de registro. El controlador recibía el body, lo pasaba al servicio, el servicio lo pasaba al ORM. Limpio, corto, elegante. Alguien mandó un role: "admin" de más en el JSON y se creó una cuenta con permisos de administrador.

    Lo que más duele: el proyecto tenía validación en NestJS. Tenía DTOs con decoradores. Tenía el ValidationPipe registrado globalmente. Y aun así el campo pasó.

    Porque el pipe estaba puesto sin opciones. new ValidationPipe(), tal cual. Eso valida que los campos declarados cumplan sus reglas, pero no elimina los que no declaraste. Y en una API, lo que no declaras es exactamente lo que te van a mandar.

    La validación en NestJS bien montada no es una capa de seguridad más. Es el contrato entre el mundo exterior y tu aplicación. Cuando lo defines bien, un montón de código defensivo que hoy vive en tus servicios simplemente desaparece.


    El DTO en NestJS es un contrato, no un tipo

    Un DTO (Data Transfer Object) en NestJS es una clase que define la forma exacta de los datos que un endpoint acepta. No la forma que esperas: la que aceptas.

    // src/users/dto/create-user.dto.ts
    import {
      IsEmail,
      IsInt,
      IsOptional,
      IsString,
      MaxLength,
      Min,
      MinLength,
    } from 'class-validator';
    
    export class CreateUserDto {
      @IsEmail({}, { message: 'El email no tiene un formato válido' })
      email: string;
    
      @IsString()
      @MinLength(12, { message: 'La contraseña necesita al menos 12 caracteres' })
      password: string;
    
      @IsString()
      @MinLength(2)
      @MaxLength(60)
      fullName: string;
    
      @IsOptional()
      @IsInt()
      @Min(18)
      age?: number;
    }
    

    En el controlador no haces nada especial:

    @Post()
    create(@Body() dto: CreateUserDto) {
      return this.usersService.create(dto);
    }
    

    Y aquí viene la primera regla que no se negocia: CreateUserDto tiene que ser una class, nunca una interface.

    Las interfaces de TypeScript desaparecen al compilar. Nest lee el tipo del parámetro en runtime con reflect-metadata; si es una interface, el metatype que recibe es Object, no hay decoradores que leer, y el pipe deja pasar el payload entero sin decir nada. Es un fallo silencioso, que son los peores — y es el mismo problema de fondo que trato en cómo tipar correctamente una API REST en TypeScript: el tipo estático no te protege de lo que llega por el cable.


    ValidationPipe en NestJS: las opciones que sí importan

    El ValidationPipe de NestJS es el pipe integrado que intercepta el payload de una request, lo compara contra los decoradores del DTO usando class-validator y lanza un 400 Bad Request con la lista de errores si algo no cumple. Viene en @nestjs/common y no valida nada por sí solo: todo depende de las opciones con las que lo construyas.

    Registra el pipe globalmente y configúralo. Este es el bloque que uso en producción:

    // src/main.ts
    import { ValidationPipe } from '@nestjs/common';
    import { NestFactory } from '@nestjs/core';
    import { AppModule } from './app.module';
    
    async function bootstrap() {
      const app = await NestFactory.create(AppModule);
    
      app.useGlobalPipes(
        new ValidationPipe({
          whitelist: true,
          forbidNonWhitelisted: true,
          forbidUnknownValues: true,
          transform: true,
          transformOptions: { enableImplicitConversion: false },
          stopAtFirstError: false,
        }),
      );
    
      await app.listen(process.env.PORT ?? 3000);
    }
    bootstrap();
    

    Qué hace cada una, sin adornos.

    Opción Por defecto en Nest Recomendado Qué te juegas
    whitelist false true Sin ella, las propiedades que no declaras en el DTO llegan intactas al servicio
    forbidNonWhitelisted false true Sin ella los campos de más se borran en silencio en vez de devolver un 400
    forbidUnknownValues false (Nest lo fuerza) true Con false, un objeto sin metadatos de class-validator pasa la validación entera
    transform false true Sin ella recibes un objeto literal, no una instancia del DTO: sin métodos ni getters
    transformOptions.enableImplicitConversion false false Si lo pones a true, ?onlyActive=false activa el filtro, porque Boolean('false') es true
    stopAtFirstError false false Con true devuelves un error por request en vez de todos los del formulario de una vez

    whitelist: true elimina del objeto toda propiedad que no tenga al menos un decorador de validación. Este flag por sí solo habría evitado el bug de la historia. role no estaba en el DTO, así que se habría borrado antes de llegar al servicio.

    forbidNonWhitelisted: true sube la apuesta: en lugar de borrar en silencio, devuelve un 400 diciendo qué propiedad sobra. Lo prefiero, porque el silencio de whitelist a secas te oculta que el frontend lleva tres sprints mandando un campo muerto.

    transform: true convierte el JSON plano en una instancia real de la clase. Sin esto recibes un objeto literal con la forma correcta, no un CreateUserDto: si tu DTO tiene métodos o getters, no existen.

    stopAtFirstError viene en false por defecto en class-validator, y así lo dejo: quiero devolver todos los errores del formulario de una vez, no obligar al cliente a hacer seis viajes.

    Y luego está forbidUnknownValues, que merece su propia sección porque es la trampa gorda.


    La trampa: forbidUnknownValues no vale lo que crees

    La documentación de class-validator es tajante: forbidUnknownValues vale true por defecto y recomienda no tocarlo, porque desactivarlo hace que objetos desconocidos pasen la validación.

    Ahora mira el constructor del ValidationPipe de Nest:

    // packages/common/pipes/validation.pipe.ts
    this.validatorOptions = { forbidUnknownValues: false, ...validatorOptions };
    

    Nest lo pone a false salvo que tú lo pidas explícitamente. Es una decisión deliberada de compatibilidad hacia atrás (viene del issue 10683), no un despiste. Pero el efecto práctico es que la opción que class-validator considera crítica está desactivada por defecto en tu API de Nest.

    Muerde cuando el pipe valida un objeto del que class-validator no tiene metadatos: un DTO sin decoradores, uno que olvidaste importar bien, una clase generada dinámicamente. Con false eso pasa limpiamente. Con true falla y te enteras.

    Ponlo a true explícitamente y pasa tu suite después. Si algo se rompe, es que algo no se estaba validando.


    Objetos anidados: @ValidateNested sin @Type no valida nada

    @ValidateNested() solo valida un objeto anidado si va acompañado de @Type(() => Clase). Sin @Type, class-validator no sabe en qué clase instanciar el valor, no encuentra metadatos y deja pasar el objeto entero. Es la segunda trampa, y la he visto en más proyectos que la anterior.

    // src/orders/dto/create-order.dto.ts
    import { Type } from 'class-transformer';
    import {
      ArrayMinSize,
      IsArray,
      IsInt,
      IsNotEmpty,
      IsString,
      Matches,
      Min,
      ValidateNested,
    } from 'class-validator';
    
    export class AddressDto {
      @IsString()
      @IsNotEmpty()
      street: string;
    
      @IsString()
      @IsNotEmpty()
      city: string;
    
      @Matches(/^\d{5}$/, { message: 'El código postal debe tener 5 dígitos' })
      zipCode: string;
    }
    
    export class OrderItemDto {
      @IsString()
      @IsNotEmpty()
      sku: string;
    
      @IsInt()
      @Min(1)
      quantity: number;
    }
    
    export class CreateOrderDto {
      @IsString()
      @IsNotEmpty()
      customerId: string;
    
      @ValidateNested()
      @Type(() => AddressDto)
      shippingAddress: AddressDto;
    
      @IsArray()
      @ArrayMinSize(1)
      @ValidateNested({ each: true })
      @Type(() => OrderItemDto)
      items: OrderItemDto[];
    }
    

    @Type() viene de class-transformer, no de class-validator, y es la que le dice en qué clase instanciar el objeto anidado.

    Si la quitas, el anidado se queda como objeto plano, @ValidateNested() no encuentra metadatos asociados a ese valor y no comprueba nada. La request pasa y shippingAddress llega a tu servicio con lo que sea que mandaran.

    @ValidateNested sin @Type es decoración. Van siempre en pareja. Y en arrays, { each: true } es obligatorio o solo validas el array como un todo.


    Update sin duplicar el DTO

    No copies y pegues el DTO de create para poner todo opcional.

    // src/users/dto/update-user.dto.ts
    import { OmitType, PartialType } from '@nestjs/mapped-types';
    import { CreateUserDto } from './create-user.dto';
    
    export class UpdateUserDto extends PartialType(
      OmitType(CreateUserDto, ['email'] as const),
    ) {}
    

    PartialType hace todas las propiedades opcionales manteniendo sus reglas. OmitType quita las que no deben poder cambiarse. Tienes también PickType e IntersectionType.

    Aviso de la documentación oficial que cuesta caro ignorar: si usas @nestjs/swagger o @nestjs/graphql, importa los mapped types desde esos paquetes, no desde @nestjs/mapped-types. La doc oficial lo deja en "efectos secundarios varios y no documentados", sin concretar. En mi experiencia se manifiesta casi siempre como esquemas OpenAPI vacíos que nadie sabe explicar.


    Query params y la conversión implícita

    Los query params llegan siempre como string. Aquí es donde mucha gente activa enableImplicitConversion: true y se olvida del tema. Mala idea.

    // src/users/dto/find-users-query.dto.ts
    import { Transform, Type } from 'class-transformer';
    import { IsBoolean, IsInt, IsOptional, IsString, Max, Min } from 'class-validator';
    
    export class FindUsersQueryDto {
      @IsOptional()
      @Type(() => Number)
      @IsInt()
      @Min(1)
      page: number = 1;
    
      @IsOptional()
      @Type(() => Number)
      @IsInt()
      @Min(1)
      @Max(100)
      limit: number = 20;
    
      @IsOptional()
      @Transform(({ value }) => value === 'true' || value === true)
      @IsBoolean()
      onlyActive: boolean = false;
    
      @IsOptional()
      @IsString()
      search?: string;
    }
    

    onlyActive lo transformo a mano por una razón muy concreta.

    Cuando activas enableImplicitConversion, class-transformer usa el tipo reflejado por TypeScript y aplica el constructor correspondiente. Para booleanos, el código es literalmente return Boolean(value).

    Y Boolean('false') en JavaScript es true. Cualquier string no vacío lo es.

    Es decir: ?onlyActive=false te activa el filtro. Tu API hace lo contrario de lo que pide el cliente, devuelve un 200 y no aparece un solo error en los logs. Lo he depurado dos veces y las dos me llevó más de una hora.

    Deja enableImplicitConversion en false y sé explícito propiedad a propiedad con @Type() y @Transform(). Más verboso, y correcto.


    Validadores custom: cuando el decorador no existe

    Los decoradores integrados cubren tipo y formato. Las reglas de negocio no. Para eso escribes una clase que implementa ValidatorConstraintInterface.

    // src/users/validators/is-email-available.validator.ts
    import { Injectable } from '@nestjs/common';
    import {
      ValidationArguments,
      ValidatorConstraint,
      ValidatorConstraintInterface,
    } from 'class-validator';
    import { UsersRepository } from '../users.repository';
    
    @ValidatorConstraint({ name: 'isEmailAvailable', async: true })
    @Injectable()
    export class IsEmailAvailableConstraint implements ValidatorConstraintInterface {
      constructor(private readonly users: UsersRepository) {}
    
      async validate(email: unknown): Promise<boolean> {
        if (typeof email !== 'string') return false;
        const existing = await this.users.findByEmail(email.toLowerCase());
        return existing === null;
      }
    
      defaultMessage(args: ValidationArguments): string {
        return `El email ${args.value} ya está registrado`;
      }
    }
    

    Lo enganchas al DTO con @Validate:

    import { IsEmail, Validate } from 'class-validator';
    import { IsEmailAvailableConstraint } from '../validators/is-email-available.validator';
    
    export class CreateUserDto {
      @IsEmail()
      @Validate(IsEmailAvailableConstraint)
      email: string;
    
      // ...resto de propiedades
    }
    

    Para que la inyección de dependencias funcione necesitas dos cosas. Primero, declarar el constraint como provider en su módulo. Segundo, decirle a class-validator que use el contenedor de Nest:

    // src/main.ts
    import { useContainer } from 'class-validator';
    
    async function bootstrap() {
      const app = await NestFactory.create(AppModule);
      useContainer(app.select(AppModule), { fallbackOnErrors: true });
      // ...el resto del bootstrap: useGlobalPipes, listen
    }
    

    fallbackOnErrors: true no es opcional: sin él, Nest lanza una excepción en cuanto class-validator le pide al contenedor una clase que no está registrada como provider.

    Una advertencia: consultar la base de datos durante la validación es best effort, no una garantía. Entre que el validador pregunta y el servicio inserta hay una ventana de carrera. El índice único de la tabla sigue siendo la fuente de verdad; el validador solo sirve para devolver un 400 legible en vez de un 500 con un error del driver.

    A favor juega el orden del ciclo de vida de Nest: los pipes se ejecutan después de los guards. Cuando ese validador toca la base de datos, la request ya está autenticada.


    Testea el validador como lógica pura

    Un validador custom es una clase con una dependencia. No necesitas levantar un TestingModule.

    // src/users/validators/is-email-available.validator.spec.ts
    import { IsEmailAvailableConstraint } from './is-email-available.validator';
    
    describe('IsEmailAvailableConstraint', () => {
      const usersRepository = { findByEmail: jest.fn() };
      const constraint = new IsEmailAvailableConstraint(usersRepository as never);
    
      beforeEach(() => jest.resetAllMocks());
    
      it('acepta un email que no existe', async () => {
        usersRepository.findByEmail.mockResolvedValue(null);
        await expect(constraint.validate('nuevo@dominicode.com')).resolves.toBe(true);
      });
    
      it('rechaza un email ya registrado', async () => {
        usersRepository.findByEmail.mockResolvedValue({ id: '1' });
        await expect(constraint.validate('bezael@dominicode.com')).resolves.toBe(false);
      });
    
      it('normaliza a minúsculas antes de consultar', async () => {
        usersRepository.findByEmail.mockResolvedValue(null);
        await constraint.validate('Bezael@Dominicode.com');
        expect(usersRepository.findByEmail).toHaveBeenCalledWith('bezael@dominicode.com');
      });
    });
    

    Tres tests, cero infraestructura. Si tu validador necesita un módulo entero para poder testearse, tiene demasiada responsabilidad.


    Cuándo NO usar class-validator

    class-validator es la librería de decoradores (@IsEmail, @MinLength, @ValidateNested) sobre la que NestJS construye toda su validación de entrada. No es un paquete de Nest: es un proyecto independiente, y ahí está la parte incómoda.

    class-validator va por la 0.15.1, publicada el 26 de febrero de 2026. El parón fuerte fue entre la 0.14.1 (enero de 2024) y la 0.14.2 (mayo de 2025): dieciséis meses sin release. Desde entonces ha recuperado ritmo — 0.14.3 en noviembre de 2025, 0.14.4 y 0.15.1 en febrero de 2026. Está vivo.

    class-transformer es otra historia. Su última versión publicada es la 0.5.1, de noviembre de 2021. Casi cinco años sin release, y es la pieza de la que dependen @Type, @Transform, transform: true y toda la conversión implícita que acabamos de ver. No está roto, pero tampoco se está arreglando.

    En paralelo, NestJS 12 salió el 27 de agosto de 2026 con soporte nativo de Standard Schema. Los decoradores de parámetro aceptan una opción schema, y hay un pipe nuevo para validarla:

    // src/users/schemas/create-user.schema.ts
    import { z } from 'zod';
    
    export const createUserSchema = z.strictObject({
      email: z.email(),
      password: z.string().min(12),
      fullName: z.string().min(2).max(60),
      age: z.number().int().min(18).optional(),
    });
    
    export type CreateUserDto = z.infer<typeof createUserSchema>;
    
    // src/main.ts
    import { StandardSchemaValidationPipe } from '@nestjs/common';
    
    app.useGlobalPipes(new StandardSchemaValidationPipe());
    
    // src/users/users.controller.ts
    @Post()
    create(@Body({ schema: createUserSchema }) body: CreateUserDto) {
      return this.usersService.create(body);
    }
    

    Aquí CreateUserDto es un tipo inferido, no una clase. El esquema y el tipo son la misma cosa, así que no puedes desincronizarlos. Con decoradores son dos verdades separadas que mantienes a mano, y ahí es donde entran los bugs.

    La comparación honesta:

    class-validator Zod / Standard Schema
    Fuente de verdad Tipo + decoradores (dos) Esquema (una)
    DI en validadores Sí, vía useContainer No de serie
    Mapped types (PartialType) Sí .partial(), .omit(), .pick()
    OpenAPI @nestjs/swagger maduro Nativo en v12, o nestjs-zod
    Mantenimiento Lento (class-transformer congelado) Activo
    Reutilizar en el frontend No Sí, mismo esquema

    Mi criterio, sin vender humo: si tu proyecto ya es class-based de arriba abajo (entidades TypeORM, Swagger, validadores con DI), class-validator sigue siendo el camino de menor fricción y no hay que migrarlo por moda.

    Si empiezas hoy en Nest 12, si compartes contratos con un frontend TypeScript, o si validas salidas de un LLM —donde necesitas parsear, transformar y reintentar en el mismo sitio—, Zod gana con claridad. Si sigues en v11 y quieres esa ruta, nestjs-zod (5.5.0, julio de 2026) te da createZodDto, el pipe y la serialización de respuestas. Ojo: sus peer dependencies todavía declaran @nestjs/common ^10 || ^11, así que para v12 aún no es opción.

    Sobre este tema escribí a fondo en validación en runtime con Zod y TypeScript, y si quieres dominar la librería entera —transformaciones, refinamientos, esquemas compuestos— la trabajo paso a paso en el curso de Zod para TypeScript.

    Y si aún estás eligiendo framework, esta capa de validación es uno de los argumentos de más peso a favor de Nest frente a opciones más ligeras, como analicé en Hono vs NestJS vs Express y al mirar la alternativa más directa a Nest, ExpressoTS 4.0.


    Checklist: revisa hoy tu validación en NestJS

    Abre tu main.ts. Si ves new ValidationPipe() sin opciones, ya tienes trabajo para los próximos veinte minutos:

    1. Añade whitelist: true y forbidNonWhitelisted: true.
    2. Pon forbidUnknownValues: true explícitamente y ejecuta tu suite de tests.
    3. Busca en el proyecto @ValidateNested y comprueba que cada uno tiene su @Type() al lado.
    4. Si tienes enableImplicitConversion: true, quítalo y haz explícitas las conversiones.

    Después vete a tus servicios y borra los if (!dto.email) throw .... Esos guardias existen porque en algún momento nadie confió en la entrada. Cuando el contrato vive en el DTO, sobran: es el principio que desarrollo en programación defensiva en TypeScript, donde la mejor defensa es la que se aplica una vez, en el borde, y no en cada función.

    Esa es la fortaleza silenciosa de NestJS. No es que valide. Es que, bien montado, te deja escribir servicios que asumen datos correctos porque lo son.

    Si quieres verlo aplicado sobre un proyecto real, con la capa de validación, los tests y las decisiones de arquitectura completas, lo trabajamos en Dominicode Labs. Y si lo que te interesa es NestJS llevado al terreno de la IA, monté el streaming de respuestas en tiempo real con el Vercel AI SDK sobre esta misma base. En vídeo, subo NestJS y arquitectura backend cada semana en el canal de YouTube.


    Preguntas frecuentes

    ¿Qué es un DTO en NestJS?

    Un DTO (Data Transfer Object) en NestJS es una clase que describe la forma exacta del payload que un endpoint acepta: qué propiedades existen, de qué tipo son y qué reglas cumplen. Se declara con decoradores de class-validator y se usa como tipo del parámetro @Body(), @Query() o @Param() en el controlador.

    Tiene que ser una class y no una interface: las interfaces desaparecen al compilar y en runtime no queda nada a lo que asociar los decoradores. Y no es solo documentación — con el ValidationPipe configurado, el DTO es lo que decide qué request entra y cuál se rechaza con un 400.

    ¿Puedo usar una interface en lugar de una clase para el DTO?

    No, si quieres que se valide. Las interfaces desaparecen en la transpilación, así que en runtime no hay nada a lo que asociar los decoradores: Nest recibe Object como metatype y el ValidationPipe deja pasar el payload entero.

    Si te molesta escribir clases, la alternativa real es la ruta de esquemas: con Zod y el StandardSchemaValidationPipe de Nest 12 el DTO sí puede ser un tipo inferido, porque la validación no depende de metadatos de runtime sino del esquema que pasas al decorador.

    Tengo el ValidationPipe puesto y la validación en NestJS no salta. ¿Qué reviso?

    Por orden. Que el DTO sea una clase y que el tipo del parámetro en el controlador sea exactamente esa clase, no any ni un union. Que emitDecoratorMetadata y experimentalDecorators estén a true en tu tsconfig.json, porque sin ellos no hay metadatos de tipo que leer.

    Después, que el pipe esté registrado donde crees: si lo pusiste con APP_PIPE en un módulo de feature en lugar del root, solo aplica a ese ámbito. Y si lo que pasa es que un objeto entero se cuela sin validarse, mira forbidUnknownValues, que Nest fuerza a false cuando no lo declaras tú.

    ¿class-validator sigue mantenido en 2026?

    Sí, aunque a ritmo irregular. La versión actual es la 0.15.1, del 26 de febrero de 2026, publicada justo un día después de la 0.14.4. El bache serio fueron los dieciséis meses entre la 0.14.1 (enero de 2024) y la 0.14.2 (mayo de 2025); desde ahí ha vuelto a publicar con regularidad. Sigue en 0.x diez años después de su primera versión, lo cual dice bastante sobre su compromiso de estabilidad de API.

    El problema mayor es class-transformer, su dependencia inseparable: última versión 0.5.1, noviembre de 2021. Toda la lógica de @Type, @Transform y transform: true corre sobre un paquete que lleva casi cinco años sin release. No es motivo para migrar mañana, sí para tenerlo en cuenta al empezar un proyecto nuevo.

    ¿Dónde valido las reglas de negocio: en el DTO o en el servicio?

    En el DTO va todo lo que es forma: tipos, formatos, longitudes, rangos, campos requeridos, estructura de los objetos anidados. Son reglas que se responden mirando solo el payload.

    En el servicio va todo lo que necesita contexto: si este usuario puede hacer esta operación, si el stock alcanza, si el pedido está en un estado que admite ese cambio. La prueba rápida es preguntarte si la regla depende de quién hace la petición o del estado actual del sistema. Si depende, no es validación de entrada, es lógica de dominio, y meterla en un decorador te va a complicar los tests.

    ¿Merece la pena migrar un proyecto grande de class-validator a Zod?

    Rara vez de golpe, y casi nunca por el argumento de que "está más moderno". Rehacer DTOs, mapped types, validadores con inyección de dependencias y la integración con Swagger son semanas de trabajo sin una sola feature nueva para el usuario.

    Lo que sí funciona es la convivencia. Nest 12 mantiene el flujo de class-validator plenamente soportado junto al de Standard Schema, así que escribes con Zod lo nuevo y dejas lo existente como está. Se migra por presión real —un bug de sincronía entre tipo y validación, un esquema que necesitas compartir con el frontend— y no por calendario.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • NVIDIA compra Hugging Face: tu from_pretrained() es el riesgo

    NVIDIA compra Hugging Face: tu from_pretrained() es el riesgo

    El 3 de septiembre, la noticia de que NVIDIA compra Hugging Face por 12.930 millones de dólares llegó con la reacción por defecto ya puesta: "se acabó el open source".

    Hilos, capturas, indignación. Y casi nadie haciendo la única pregunta que de verdad importa: ¿qué pasa exactamente en tu build el día que algo de esto cambie?

    Si no sabes responderla en treinta segundos, la noticia no te ha creado ningún riesgo. Te lo ha enseñado.

    Así que este no es un post de indignación. Es un post de auditoría de dependencias. Y la tesis es incómoda: si la noticia te molestó, es porque tenías una dependencia de infraestructura que nunca decidiste tener.

    En corto: el 3 de septiembre de 2026 NVIDIA anunció un acuerdo definitivo para comprar Hugging Face por unos 12.930 millones de dólares. La operación no está cerrada y no cambia nada en el Hub a día de hoy. Lo que sí puedes cambiar hoy es tu código: fijar por commit SHA cada modelo del que depende tu build tarda menos que leerte los hilos.


    Cuánto paga NVIDIA por Hugging Face: 12.930 millones por 150 de ingresos

    Las cifras de plataforma salen del comunicado oficial de NVIDIA. La estructura del pago, la fecha de cierre y los ingresos anualizados no están ahí: vienen de la cobertura del día del anuncio. Lo señalo porque la diferencia importa cuando alguien repite el dato tres meses después.

    Dato Cifra
    Importe total ~12.930 millones de dólares
    Estructura ~11.900 M en efectivo + hasta 1.000 M en equity de retención
    Anuncio 3 de septiembre de 2026 — acuerdo definitivo, no cerrado
    Cierre previsto Primera mitad de 2027, sujeto a revisión regulatoria
    Ingresos anualizados de Hugging Face ~150 millones de dólares
    Múltiplo sobre ingresos ~86x
    Desarrolladores en la plataforma +18 millones
    Modelos / datasets / Spaces 3 M / 500.000 / ~1 M
    Clientes empresa +200.000
    Puesto en NVIDIA 2ª mayor adquisición, tras los 20.000 M por activos de Groq (diciembre de 2025)

    Divide. Son unas 86 veces los ingresos.

    Nadie paga 86x por el revenue. Se paga por la posición. Y la posición de Hugging Face es que se ha convertido en el sitio por defecto desde el que el mundo descarga pesos de modelos, igual que npm es el sitio por defecto desde el que descarga JavaScript. Esa es la compra.

    Un detalle que casi nadie está teniendo en cuenta: no está cerrada. Es un acuerdo definitivo, sí, pero el cierre está previsto para la primera mitad de 2027. Hay meses de ventana regulatoria por delante y bastante margen para que cambien condiciones. Cualquiera que hoy te cuente cómo va a quedar el Hub en 2028 se lo está inventando.


    ¿Obligará NVIDIA a usar sus GPUs? Lo que prometió Huang

    No, no va a obligarte. Al menos no según lo que ha firmado por escrito.

    Y hay que decirlo, porque el drama se está comiendo el matiz. La declaración de Jensen Huang fue explícita (traduzco):

    "Hugging Face seguirá siendo una plataforma abierta para todo el ecosistema de IA. Los desarrolladores elegirán los modelos que quieran, los frameworks que quieran, las clouds y los proveedores de inferencia que quieran y las plataformas de cómputo que quieran. El cómputo de NVIDIA no será un requisito para construir sobre Hugging Face ni para desplegar a través de Hugging Face."

    No es humo genérico. Es una promesa concreta y verificable: si mañana empieza a hacer falta hardware NVIDIA para desplegar desde el Hub, esa frase queda por escrito y con fecha.

    Y NVIDIA lleva tiempo predicando con el ejemplo ahí: más de 500 modelos y 250 datasets abiertos publicados en la propia plataforma.

    Clem Delangue, CEO de Hugging Face, justificó la venta en términos igual de concretos: la plataforma "necesita más cómputo, más soporte, más colaboración y más visibilidad".

    Ahora la parte que no cambia: una promesa corporativa no es una garantía arquitectónica.

    No porque Huang mienta. Porque las promesas tienen un plazo, un CEO y un contexto competitivo, y tu build no. Tu build se ejecuta cada noche durante los próximos cinco años y no lee notas de prensa.

    La pregunta correcta nunca fue "¿me fío de NVIDIA?". La pregunta correcta es "¿qué pasa exactamente en mi pipeline el día que algo de esto cambie?". Si no sabes responderla en treinta segundos, ahí está el trabajo.

    Es el caso hermano de Shopify comprando Tailwind y el embudo que eso destapa, con una diferencia que importa: allí se compraba un embudo. Aquí se compra el punto por el que pasa el tráfico de pesos del ecosistema entero.


    Qué hace tu from_pretrained() cuando no lo miras

    Cada from_pretrained() de tu código es una descarga de red contra un repositorio de terceros que puede cambiar sin avisarte.

    Esta es la parte que la mayoría de devs nunca ha auditado.

    Cada from_pretrained(), cada pipeline(), cada load_dataset() es una llamada de red a un CDN de terceros. No es una importación de librería que se resolvió en el pip install: es una descarga que ocurre en tiempo de build o, peor, en tiempo de ejecución, la primera vez que arranca el contenedor.

    Y hay un segundo problema, más silencioso, que es el que de verdad me preocupa: la mayoría de ese código apunta a main.

    Un repo de modelo en el Hub es un repo git. main se mueve. El mantenedor sube una cuantización distinta, corrige el tokenizador, reentrena. Los pesos que descargaste ayer y los que descargas hoy pueden no ser los mismos, tu build pasa en verde, tus tests pasan en verde, y nadie en tu equipo se entera de que el modelo que hay en producción cambió.

    No hace falta ninguna adquisición para que eso te explote. La adquisición solo añade un actor nuevo con capacidad de decidir sobre la infraestructura.

    Y aquí está el resumen honesto del riesgo: no creo que NVIDIA vaya a "cerrar" Hugging Face. Lo que sí tienes, desde ya, es un proveedor crítico, con un único punto de fallo, propiedad de la empresa que te vende las GPUs, del que no tienes inventario ni plan de salida. Eso, con cualquier otro proveedor, lo llamaríamos por su nombre y lo pondríamos en el registro de riesgos.


    Cómo auditar tus dependencias de modelos de IA en 10 minutos

    Auditar tus dependencias de modelos son cinco pasos: inventario, revisión fijada por SHA, build sin red, espejo de lo crítico y plan de salida a local.

    Los dos primeros son los diez minutos del título y puedes aplicarlos hoy mismo. Del tercero al quinto es trabajo de una tarde.

    1. Saca el inventario real

    No preguntes al equipo de qué modelos depende el producto. Pregúntaselo al repo:

    rg -n "from_pretrained\(|load_dataset\(|hf_hub_download\(|snapshot_download\(|pipeline\(" \
      -g "*.py" -g "*.ipynb" -g "*.toml" -g "Dockerfile*" .
    

    Cuenta con algún falso positivo: pipeline( también casa con los Pipeline de scikit-learn y con funciones tuyas que se llamen igual. Se descartan a ojo.

    Ese listado es tu superficie de exposición. Casi siempre es entre dos y cinco veces más grande de lo que la gente cree, porque incluye los modelos que nadie recuerda: el de embeddings del buscador interno, el reranker, el clasificador de spam que alguien metió en un script de 2024.

    Contrasta con lo que se ha descargado de verdad en la máquina:

    HUB="${HF_HUB_CACHE:-${HF_HOME:-$HOME/.cache/huggingface}/hub}"
    ls -1 "$HUB"
    du -sh "$HUB"/* | sort -h | tail -20
    

    Si en la caché aparecen artefactos que no salen en el grep, tienes descargas implícitas dentro de alguna librería. Esas son las peores, porque no las controlas desde tu código.

    2. Fija la revisión por commit SHA

    El cambio con mejor relación coste/beneficio:

    from transformers import AutoModel, AutoTokenizer
    
    MODEL = "org/modelo"
    REVISION = "3f8a1c9d2e7b5a4f6c0d8e1b2a3c4d5e6f708192"  # commit SHA exacto
    
    model = AutoModel.from_pretrained(MODEL, revision=REVISION)
    tokenizer = AutoTokenizer.from_pretrained(MODEL, revision=REVISION)
    

    Sacar el SHA actual es una línea:

    from huggingface_hub import HfApi
    
    print(HfApi().model_info("org/modelo").sha)
    

    Y el matiz importante, porque veo mucho revision="v1.2" por ahí: ni la rama ni el tag te sirven. La rama se mueve por definición. El tag parece estable, pero un tag en git es un puntero, y quien mantiene el repo puede reapuntarlo cuando quiera: en el Hub no hay nada que lo impida. El SHA es lo único que identifica contenido inmutable.

    No es una opinión mía sobre cómo debería ser: la documentación de transformers lo dice sin rodeos — revision acepta una rama, un tag o un commit id, y su valor por defecto sigue siendo main. El problema no es la API. El problema es el valor por defecto.

    Es el mismo razonamiento por el que llevas años usando un lockfile en JavaScript. Con los modelos, la industria entera se saltó ese paso.

    3. Que el build falle ruidosamente

    Una vez tienes caché y revisiones fijas, ciérrale la puerta de la red:

    export HF_HOME=/opt/hf-cache
    export HF_HUB_OFFLINE=1
    

    Con HF_HUB_OFFLINE=1, cualquier intento de salir al Hub durante el build lanza un error en vez de descargar en silencio. Está documentado como comportamiento oficial, no como efecto secundario: cualquier llamada al Hub levanta OfflineModeIsEnabled en lugar de ir a la red. Es un detector de dependencias ocultas: si tu pipeline se rompe al activarlo, acabas de encontrar una descarga en caliente que no sabías que tenías. Mejor que se rompa en tu CI un martes que en producción el día que el Hub tenga una caída.

    Con un límite que conviene saber: solo cubre lo que pasa por huggingface_hub. Los pesos que alguna librería se baje por su cuenta con una URL directa siguen saliendo a la red sin que te enteres.

    Esa manía de no dejar que la herramienta haga cosas por su cuenta es el eje del curso Construye con IA: de la idea al producto: ahí montamos un proyecto entero con Claude Code y el criterio es el mismo, si no puedes reconstruirlo desde cero no es tuyo.

    4. Espeja lo que es crítico

    Para los dos o tres modelos que sostienen tu producto, descarga y aloja tú los pesos:

    hf download org/modelo \
      --revision 3f8a1c9d2e7b5a4f6c0d8e1b2a3c4d5e6f708192 \
      --local-dir ./vendor/org__modelo
    

    Si lo has escrito como huggingface-cli por inercia, ojo: ese binario ya no funciona. Imprime un aviso y sale con error. Se renombró a hf. Es el mismo problema del post en miniatura — código tuyo que daba por hecho que la herramienta de otro no se mueve.

    De ahí a tu S3, tu registry o tu artifact store. Los pesos abiertos se pueden alojar; para eso son abiertos.

    Y presta atención al modelo que descubras que no puedes espejar, por licencia o por estar gated. Ese es, exactamente, el que más te ata. Anótalo, porque es el único riesgo del inventario que no puedes mitigar con ingeniería.

    5. La salida de verdad es no necesitarlo

    Todo lo anterior reduce la exposición. No la elimina.

    La única salida completa es que el modelo que te importa corra en tu máquina, en tu servidor o en la del cliente, sin depender de descargar nada de nadie al arrancar. Un GGUF en disco no tiene dueño corporativo.

    Si nunca has montado ese camino, empieza por cómo ejecutar modelos de IA en local, que es la parte mecánica, y sigue por los mejores modelos de IA local en 2026 para elegir con criterio en vez de por hype.

    Y si lo quieres ver montado entero y no en teoría, un agente SQL corriendo en local con Qwen3 y DuckDB no llama a ningún Hub cuando arranca.

    No te estoy diciendo que te lleves todo a local. Te estoy diciendo que tengas al menos un camino probado, aunque sea más lento y con menos capacidades, para el día en que lo necesites. Eso es un plan de salida.


    Trata a Hugging Face como a cualquier otro proveedor crítico

    Si mañana tu proveedor de pagos lo comprase un competidor directo tuyo, no abrirías Twitter. Abrirías el contrato, revisarías tu exposición y prepararías un plan B. Sin ruido.

    Haz exactamente eso. La operación no está cerrada, tienes hasta bien entrado 2027 y la tarea real cabe en una tarde.

    Y si quieres el marco completo para decidir qué se queda dentro de tu infraestructura y qué puede salir a una API de terceros sin que el producto dependa de ello, ahí están las 4 capas de una arquitectura de IA local.

    Ejecuta el grep del punto 1 en tu repo principal ahora mismo. Cuenta cuántos artefactos externos salen y cuántos de ellos tienen la revisión fijada. Ese número es tu respuesta a la noticia, y vale mucho más que cualquier hilo de opinión.

    Si quieres ver este tipo de decisiones con el código delante, en Dominicode Labs desmonto arquitecturas reales sin diapositivas, y en el canal de YouTube voy publicando los montajes de IA local según los pruebo.


    Preguntas frecuentes

    ¿NVIDIA va a cerrar Hugging Face o a obligar a usar sus GPUs?

    Nada indica que ese sea el plan. La declaración de Jensen Huang dice literalmente lo contrario: la plataforma seguirá siendo abierta y el cómputo de NVIDIA no será un requisito ni para construir sobre el Hub ni para desplegar a través de él. Lo que esa promesa no te da es una garantía técnica sobre tu build dentro de tres años. Por eso la respuesta profesional no es decidir si te fías, sino saber qué pasa en tu pipeline si algo cambia.

    ¿Cuándo se cierra la operación?

    El cierre está previsto para la primera mitad de 2027. A día de hoy lo que existe es un acuerdo definitivo confirmado el 3 de septiembre de 2026, no una adquisición consumada, y queda por delante la revisión regulatoria de una operación de 12.930 millones de dólares entre dos piezas centrales del mercado de IA. Tienes margen de sobra para hacer los deberes sin prisa.

    ¿Por qué 12.930 millones por una empresa que factura 150 millones?

    Porque no se paga por la facturación. Son unas 86 veces los ingresos anualizados, un múltiplo que no se justifica con ninguna proyección razonable de revenue. Se paga por la posición: 18 millones de desarrolladores, 3 millones de modelos, 500.000 datasets y 200.000 clientes empresa convierten a Hugging Face en el punto de distribución por defecto de los pesos de modelos abiertos. Comprar eso es comprar el sitio por el que pasa el ecosistema entero.

    Fijar el commit SHA me obliga a actualizar a mano. ¿No es peor?

    Es el mismo trabajo que ya haces con las dependencias de tu package.json o tu requirements.txt, y por las mismas razones. Actualizar a mano significa que la actualización es una decisión con un commit, una revisión y un responsable, en lugar de un cambio invisible que se cuela en el siguiente despliegue. Un modelo pesa gigabytes y afecta directamente a la salida de tu producto: es la última dependencia del stack que deberías dejar flotando en main.

    Tengo el modelo cacheado en el contenedor. ¿No basta con eso?

    Solo si esa caché forma parte de una imagen que se construye con revisiones fijadas y que no vuelve a salir a la red. Si la caché se llena en el primer arranque descargando lo que haya en ese momento, no tienes reproducibilidad: tienes suerte. La prueba dura un minuto, pero hazla en frío: borra la caché, pon HF_HUB_OFFLINE=1 y reconstruye sin capas cacheadas, con docker build --no-cache. Si la haces con la caché caliente y pasa en verde, lo único que has demostrado es que ya lo tenías descargado. Si falla, acabas de localizar la descarga en caliente que tenías sin saberlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • timingSafeEqual: por qué comparar secretos con === te delata

    timingSafeEqual: por qué comparar secretos con === te delata

    Escribí una función de comparación byte a byte. Sin ramas, sin salida temprana, acumulando las diferencias con un OR bit a bit.

    La medí con un millón de iteraciones. La desviación salió plana. Tiempo constante en JavaScript, pensé. Di la librería por buena, quité el crypto.timingSafeEqual que tenía puesto de parche y seguí con otra cosa.

    Meses después, perfilando algo que no tenía nada que ver, vi las primeras llamadas a esa función en la traza. Tardaban lo que no tenían que tardar. No un poco más: otra escala.

    Ahí entendí lo que había medido en realidad. Mi benchmark ejecutaba la versión que V8 había optimizado después de miles de llamadas.

    El atacante mide la primera.

    Ese es todo el problema, y no tiene arreglo dentro del lenguaje: no puedes escribir código de tiempo constante en JavaScript puro. No porque tu algoritmo esté mal. Porque V8 tiene permiso para reescribirlo. El código que tú escribes no es el código que se ejecuta, y en criptografía esa diferencia tiene nombre: vulnerabilidad.

    El ataque de temporización, en treinta segundos

    Un ataque de temporización es una técnica de canal lateral que deduce un secreto midiendo cuánto tarda el servidor en rechazarlo: no lee el token, cronometra el rechazo. Una comparación en tiempo constante es la que tarda lo mismo pase lo que pase con los datos, falle el primer byte o el último. Los === de JavaScript no lo son.

    Cuando escribes secret === input, V8 no compara letra por letra desde el principio. Toma varios atajos antes.

    Primero mira si los dos operandos son el mismo objeto en memoria: misma dirección, true inmediato. Si los dos son strings internalizadas y las direcciones no coinciden, devuelve false sin leer un solo byte — para eso sirve internalizar.

    Si no hay atajo entra en la comparación lenta, y ahí el orden real es: longitudes distintas, false inmediato; si las dos tienen el hash ya calculado y no coincide, false inmediato; y si sobrevive a eso, compara el primer carácter antes siquiera de aplanar las cadenas. Está tal cual en String::SlowEquals y SlowEqualsNonThinSameLength, en src/objects/string.cc.

    Solo entonces recorre el resto, y no byte a byte: por bloques, con memcmp o con SIMD, saliendo en cuanto un bloque no cuadra.

    Esa cadena de salidas tempranas es la fuga. Un token con la longitud mal se rechaza antes que uno con la longitud bien. Uno que falla el primer carácter se rechaza antes que uno que lo acierta. La diferencia es de nanosegundos y el ruido de red se la come, pero el ruido de red es aleatorio y la señal no. Con suficientes muestras, la media separa las dos poblaciones.

    Se filtra la longitud. Se filtra el prefijo. Bloque a bloque, se reconstruye el secreto.

    El arreglo que todos escribimos

    Esta función la hemos escrito todos. Yo el primero.

    function unsafeEqual(a, b) {
      if (a.length !== b.length) return false;
      let diff = 0;
      for (let i = 0; i < a.length; i++) {
        diff |= a.charCodeAt(i) ^ b.charCodeAt(i);
      }
      return diff === 0;
    }
    

    Sin salida temprana. Sin ramas dentro del bucle. Un acumulador que junta todas las diferencias y se revisa una sola vez al final.

    En C esto se acerca bastante al tiempo constante. En JavaScript, no.

    Y es justo el código que un agente de IA te escribe sin pestañear si le pides "una comparación segura contra ataques de temporización". Pasa todos los tests que se te ocurran.

    Los tests comprueban el valor devuelto, y aquí el valor devuelto siempre es correcto. El fallo vive en una dimensión que ningún expect mira.

    Si eso te suena al problema que tienes ahora mismo con el código que generas, escribí un ebook gratuito sobre cómo revisar por contrato lo que produce un agente: Revisión por Contrato.

    Por qué V8 rompe tu comparación en tiempo constante: cuatro mecanismos

    Cada uno basta por sí solo para tumbar la garantía.

    1. Tu función se ejecuta en cuatro motores distintos

    V8 no tiene un compilador. Tiene cuatro niveles y va promocionando tu función entre ellos según cuántas veces la llames: Ignition interpreta el bytecode, Sparkplug compila sin optimizar, Maglev (en Chrome desde la M117, finales de 2023) optimiza rápido y razonablemente bien, y TurboFan optimiza despacio y muy bien. Los cuatro niveles están documentados en el blog oficial de V8.

    Nivel Qué hace Cuándo entra Quién lo mide
    Ignition Interpreta el bytecode Primera llamada El atacante
    Sparkplug Compila sin optimizar Unas pocas llamadas El atacante
    Maglev Optimiza rápido Cientos de llamadas A veces el atacante
    TurboFan Optimiza despacio y muy bien Miles de llamadas Solo tu benchmark

    La misma función, con el mismo input, tarda cosas distintas según en qué nivel esté cuando la llamas. Y tú no controlas cuándo sube de nivel.

    Aquí está la trampa del benchmark. Un millón de iteraciones deja la función en TurboFan mucho antes de terminar el bucle. Estás midiendo el estado final, que es exactamente el único estado que el atacante no ve.

    El primer login del día, el primer webhook después de un despliegue, la primera petición a una lambda fría: todo eso es Ignition. Y en Ignition el perfil temporal de tu bucle es otro.

    2. La desoptimización la dispara el dato de entrada

    TurboFan optimiza especulando. Ha visto que i siempre es un entero pequeño y que a y b siempre llegan como strings de un byte, así que genera código máquina que da eso por hecho y mete una comprobación barata por si acaso.

    Cuando la comprobación falla, V8 tira la versión optimizada y vuelve al intérprete. Eso es la desoptimización, y tiene un coste que se nota.

    Lo importante no es el coste. Es quién lo dispara: el dato de entrada. Un input con una forma que TurboFan no esperaba desoptimiza la función. El primer token con un carácter fuera de ASCII entra como string de dos bytes, la comprobación falla y la función se vuelve al intérprete. Un input de la forma habitual, no.

    Comparación que se desoptimiza según los datos es comparación con temporización dependiente del secreto. Que es justo lo que intentabas evitar.

    3. SMI, HeapNumber y la frontera que no ves

    V8 guarda los enteros pequeños como valor inmediato dentro del propio puntero. Los llama SMI, small integer, y son gratis. El resto de números van al heap como objetos: un HeapNumber.

    Cruzar esa frontera reserva memoria. Reservar memoria cuesta. Y si tu acumulador o tus índices se salen del rango según los datos que entran, el coste de tu función depende de los datos que entran.

    Puedes forzar la aritmética a int32 con | 0 o con Math.imul, y ayuda de verdad. Pero seamos precisos con lo que consigues: int32 no es SMI. Con pointer compression el rango SMI es de 31 bits, así que un int32 suficientemente grande sigue acabando en el heap. Es una costumbre que funciona porque este motor, en esta versión, se comporta así. No es una garantía del lenguaje.

    No es la primera vez que el motor decide por ti cosas que dabas por sentadas. Ya lo conté con structuredClone frente a JSON.parse(JSON.stringify()): el resultado parece el mismo hasta que dejas de mirar solo el resultado.

    4. El recolector de basura no hace ruido aleatorio

    Cualquier asignación puede disparar una pausa de GC. Concatenar una cadena, crear un array intermedio, salirte del rango SMI.

    La asignación correlaciona con los datos. La pausa correlaciona con la asignación. Por transitividad, la pausa correlaciona con los datos.

    Ese es el peor tipo de ruido: el que tiene estructura. Se promedia y aparece la señal.

    Si quieres entender cuándo el motor retiene memoria que creías liberada, lo desarrollé aquí: closures, scope chains y garbage collection.

    El tiempo no está en el contrato de ECMAScript

    La especificación de ECMAScript define qué resultado produce tu código. No define cuánto tarda. El tiempo de ejecución no aparece en el contrato del lenguaje por ninguna parte. Puedes comprobarlo tú mismo: la spec no dice nada sobre cuánto puede tardar una operación.

    Un motor puede hacer literalmente lo que le dé la gana con tu función mientras el valor devuelto sea el correcto. Puede interpretarla, compilarla, recompilarla, reordenar operaciones, eliminar el bucle si demuestra que el resultado no cambia, cachear, especular, desoptimizar. Todo eso es conforme a la spec.

    Pedirle tiempo constante a JavaScript es pedirle una garantía que el lenguaje nunca prometió.

    No es un bug de V8. Es que estás usando la herramienta equivocada.

    Es el mismo espejismo que con los tipos. TypeScript te garantiza tipos en compilación, y la gente asume que eso vale también en runtime, hasta que llega el primer JSON de una API externa y revienta algo tres capas más abajo. Por eso se valida en el límite con Zod: porque la garantía de compilación no es la garantía de ejecución. Con el tiempo pasa igual, solo que aquí no hay Zod que valga.

    Cómo comparar secretos de forma segura en Node y en el navegador

    Hay una sola respuesta y no la escribes tú: delega la comparación en código nativo y haz que lo que comparas no guarde relación con el secreto. En Node es crypto.timingSafeEqual; en el navegador, HMAC doble con crypto.subtle.sign.

    Entorno Primitiva nativa Qué usar
    Node · Deno · Bun crypto.timingSafeEqual HMAC doble + timingSafeEqual
    Cloudflare Workers crypto.subtle.timingSafeEqual (extensión no estándar) La nativa, o HMAC doble si quieres portabilidad
    Navegador Ninguna HMAC doble con crypto.subtle.sign
    Otros edge (solo Web Crypto) Ninguna HMAC doble con crypto.subtle.sign

    En Node: tiempo constante de verdad con crypto.timingSafeEqual

    Está en el core desde Node 6.6.0, implementado en C++ y fuera del alcance del JIT. Trabaja con Buffer, TypedArray o DataView, y acepta ArrayBuffer desde Node 15.

    Y tiene un detalle que casi todo el mundo se salta: lanza si las longitudes difieren (ERR_CRYPTO_TIMING_SAFE_EQUAL_LENGTH). O sea, la longitud sigue filtrándose. Si comparas directamente el token del usuario contra el tuyo, has tapado la fuga de prefijo y has dejado abierta la de longitud.

    La forma correcta es el HMAC doble:

    import { createHmac, randomBytes, timingSafeEqual } from 'node:crypto';
    
    const key = randomBytes(32); // clave efímera del proceso
    
    export function safeEqual(a, b) {
      // createHmac().update() lanza ERR_INVALID_ARG_TYPE con cualquier otra cosa
      if (typeof a !== 'string' || typeof b !== 'string') return false;
    
      const ha = createHmac('sha256', key).update(a).digest();
      const hb = createHmac('sha256', key).update(b).digest();
      return timingSafeEqual(ha, hb);
    }
    

    Aquí pasan dos cosas.

    Los digests siempre miden 32 bytes, vengan de un token de 8 caracteres o de 800. La longitud deja de filtrarse y timingSafeEqual no lanza nunca.

    Y como la clave es aleatoria y vive solo en este proceso, el atacante no puede relacionar lo que mide con el secreto. No sabe qué digest produce su input, así que no puede ir ajustándolo byte a byte. La señal deja de tener sentido aunque la capture entera.

    En el navegador: no existe timingSafeEqual

    El estándar Web Crypto no expone ninguna primitiva de comparación en tiempo constante: no está en crypto.subtle y no hay equivalente. Algún runtime la añade por su cuenta —Cloudflare Workers trae timingSafeEqual en crypto.subtle como extensión no estándar—, pero eso no te sirve en el navegador y no es portable.

    La respuesta es el mismo patrón, con crypto.subtle.sign:

    const raw = crypto.getRandomValues(new Uint8Array(32));
    const enc = new TextEncoder();
    
    const keyPromise = crypto.subtle.importKey(
      'raw',
      raw,
      { name: 'HMAC', hash: 'SHA-256' },
      false,
      ['sign']
    );
    
    export async function safeEqual(a, b) {
      const key = await keyPromise;
    
      const ha = new Uint8Array(await crypto.subtle.sign('HMAC', key, enc.encode(a)));
      const hb = new Uint8Array(await crypto.subtle.sign('HMAC', key, enc.encode(b)));
    
      let diff = 0;
      for (let i = 0; i < ha.length; i++) diff |= ha[i] ^ hb[i];
      return diff === 0;
    }
    

    Fíjate en que la clave se genera una vez, no en cada llamada.

    Y fíjate en el bucle del final. Es el mismo bucle de unsafeEqual con el que abría el post, el que acabo de decirte que no vale. Aquí sí vale.

    No porque el bucle haya mejorado —sigue a merced de Ignition, de Maglev y de lo que V8 decida en la próxima versión—, sino porque ya no compara nada que el atacante pueda perseguir. El arreglo nunca estuvo en el bucle. Estaba en lo que le metes.

    La regla de arriba del todo

    Si el secreto lo guarda el servidor, compáralo en el servidor.

    La mayoría de estas comparaciones no tenían que estar en el cliente. El navegador es un sitio raro para validar un token que el navegador ya tiene en la mano.

    Y la regla sincera

    No escribas criptografía. Usa lo que ya existe. Si tienes que escribirla, léete antes el Cryptography Coding Standard, que lleva años recogiendo exactamente este tipo de trampas.

    Este post no es para que escribas una comparación mejor. Es para que entiendas por qué la tuya no lo era.

    El patrón, más allá de la criptografía

    Esto se generaliza, y por eso me interesa tanto.

    Cada vez que tu razonamiento depende de cómo se ejecuta el código y no de qué devuelve, estás apostando contra el optimizador.

    El optimizador no firmó ese trato. Cambia en cada versión del motor, sin avisarte, sin notas de migración y sin romper un solo test. Tu suite sigue verde mientras la propiedad de la que dependías se evapora.

    Vale para el tiempo constante, para el micro-benchmark que justificó una refactorización, para el orden de evaluación del que alguien acabó fiándose, para el "esto no asigna memoria". La única defensa es hacer explícitas las propiedades de las que dependes en vez de asumirlas. De eso va la programación defensiva en TypeScript: escribir código que no confía en lo que nadie te ha prometido por escrito.

    Hoy mismo puedes hacer una cosa. Busca en tu código todos los === y todos los .equals() que comparan tokens, firmas de webhook, claves de API o códigos de un solo uso. Sustitúyelos por HMAC doble más timingSafeEqual. Es media hora.

    Y si quieres seguir bajando a este nivel de detalle con otros devs a los que también les divierte, esa conversación pasa en Dominicode Labs.

    Preguntas frecuentes

    ¿Esto es un bug de V8?

    No, y la mejor forma de verlo es preguntarse cómo sería el arreglo. Para garantizarte tiempo constante, V8 tendría que renunciar a promocionar funciones entre niveles, a especular sobre tipos y a desoptimizar cuando falla la especulación: tendría que dejar de ser un motor rápido para que tu comparación de tokens tarde siempre lo mismo. Ningún motor va a hacer ese cambio, ni debería. La optimización adaptativa es la razón por la que JavaScript es viable en servidor. El tiempo constante hay que buscarlo fuera del JIT, no pedirle al JIT que se apague.

    ¿Pasa lo mismo en Bun y en Deno?

    Sí, y por la misma razón. Deno usa V8, así que es idéntico. Bun usa JavaScriptCore, que también tiene varios niveles de compilación con su propio intérprete, su JIT base y sus optimizadores. Cambian los nombres, no el problema. Los tres implementan node:crypto, así que timingSafeEqual está disponible en los tres; eso sí, no des por hecho que los casos límite, como qué ocurre exactamente con longitudes distintas, se comportan igual en todos. Con el patrón de HMAC doble esa diferencia deja de afectarte.

    ¿Sirve Object.freeze, %NeverOptimizeFunction o compilar a WebAssembly?

    Object.freeze congela la forma de un objeto, no la estrategia de compilación: no tiene nada que ver. %NeverOptimizeFunction solo existe con --allow-natives-syntax, o sea, no es código que puedas desplegar. WASM sí es una opción más seria, porque eliminas el JIT especulativo sobre tipos dinámicos y ganas control real sobre la representación de los datos, pero tampoco es una garantía formal: la spec de WebAssembly no promete tiempo constante, y por debajo sigue habiendo un compilador y una CPU con cachés. Es mejor. No es demostrable.

    ¿Me afecta si solo comparo contraseñas hasheadas con bcrypt?

    Ahí estás cubierto, aunque no por el motivo que parece. La comparación final depende de la librería: el paquete nativo bcrypt la hace en C++, y bcryptjs, que es JavaScript puro, usa un safeStringCompare que es palabra por palabra el unsafeEqual del principio de este post. Da igual cuál uses. Lo que se compara en bcrypt no es el secreto: es un hash derivado con un coste deliberadamente alto, y el atacante no controla esos bytes ni puede ajustarlos a ciegas. Sin control sobre lo que se compara no hay ataque adaptativo, que es exactamente el argumento del HMAC doble. El problema aparece cuando la comparación es directa: tokens de sesión, claves de API, firmas de webhook, códigos OTP, tokens de reset de contraseña.

    ¿Y si lo mido yo mismo con performance.now() para salir de dudas?

    No vas a llegar a ninguna conclusión útil por ahí. Los navegadores redondean el reloj a propósito, como mitigación contra ataques de canal lateral tipo Spectre, así que tu instrumento es peor que la señal que buscas. Y aunque midieras con precisión perfecta, volverías a caer en la trampa original: tras unas cuantas iteraciones estás midiendo el nivel optimizado, no el que ve el atacante.

    ¿Cómo sé si mi comparación es vulnerable de verdad?

    Cambia la pregunta. Demostrar que una comparación es explotable requiere análisis estadístico serio, y no conseguir demostrarlo no prueba nada. Aplica un criterio binario en la revisión de código: ¿este === tiene a un lado un valor que controla el usuario y al otro un secreto del servidor? Si la respuesta es sí, se cambia. No hace falta medir nada. Cuesta menos arreglarlo que discutir si era explotable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Harness multiagente vs un solo agente: qué midió Uncle Bob

    Harness multiagente vs un solo agente: qué midió Uncle Bob

    Robert C. Martin —Uncle Bob, el de Clean Code— pasó meses construyendo lo que parecía la cosa correcta: un harness de orquestación de agentes IA con roles especializados, sesiones aisladas y handoffs que no se contaminaban entre sí. Gates deterministas. Métricas de complejidad. Todo.

    Mientras lo montaba, el suelo se movía debajo.

    Cuando por fin lo tuvo funcionando hizo lo que casi nadie hace: medirlo contra la alternativa tonta. Le dio la misma tarea a un solo agente, con un par de directrices y cero orquestación. Se fue cuarenta minutos. Al volver estaba hecho. Y mejor que lo que le entregaba el enjambre.

    Su conclusión pública cabe en seis palabras: "OK. It's time to rethink this."

    En corto: Uncle Bob midió su harness multiagente de seis roles contra un solo agente en la misma tarea: cuarenta minutos frente a tres o cuatro horas, y mejor código. La orquestación con roles fijos y handoffs por contrato era un andamio para modelos débiles, y los modelos dejaron de serlo. Hoy un agente único bien dirigido suele ganar en tiempo, en calidad y en tokens. Lo que sigue valiendo del harness no es la orquestación: es la verificación determinista —tests, tipos, cobertura, complejidad— contra la que mides su salida.


    Qué era SwarmForge, el harness que Uncle Bob construyó y tiró

    Un harness de orquestación multiagente es una capa de software que reparte una tarea entre varios agentes con roles predefinidos, controla el orden en que se pasan el trabajo y bloquea el avance hasta que cada etapa cumple unos criterios medibles.

    SwarmForge, el harness de Uncle Bob, se autodescribe en su README como "a simple tool for coordinating several AI agents". Es bastante más que eso.

    Los roles están separados de verdad. El six-pack del repo los nombra así: especificación, implementación, limpieza, arquitectura, hardening y QA. Cada agente vive en su propia sesión de tmux y su git worktree bajo .worktrees/ para no pisarse, y los handoffs los mueve un daemon en Babashka.

    Las técnicas que aplica cada rol no están en el repo: las cuenta él. Gherkin para la especificación, TDD para implementar, revisiones de duplicación y de CRAP para la limpieza, mutation testing para el hardening.

    Cada decisión ahí responde a un fallo real que conoce cualquiera que haya montado esto. Si llegas frío, la pieza por pieza está en la anatomía de un agent harness, y el recorrido completo en construir un agente de IA desde cero.

    Y aun así perdió contra un agente solo. Con el mismo modelo corriendo dentro y fuera del harness.

    El experimento es de septiembre de 2026 y el modelo era Grok. Uncle Bob no precisa la versión, y eso limita la reproducibilidad: esto es la medición de un practicante con oficio, no un paper.

    El experimento que lo tiró abajo

    El experimento fue este: misma tarea, mismo modelo, dos caminos — el harness de seis roles y un agente solo con dos directrices. Y Uncle Bob relajó las restricciones a favor del harness, a propósito.

    En vez de su umbral habitual de CRAP por debajo de 6, pidió mantenerlo por debajo de 12. CRAP —Change Risk Anti-Patterns— combina complejidad ciclomática con cobertura de tests: cuanto más ramifica un método y menos cubierto está, más alto puntúa y más caro es tocarlo.

    Algo de mutation testing y tests unitarios. Nada de Gherkin. Dos directrices y a correr.

    El agente hizo algo que nadie le pidió: partió el código en módulos y dejó todo el CRAP por debajo de 6 igualmente. Por debajo del umbral relajado y del estricto.

    Cuarenta minutos. Lo que al harness completo le costaba tres o cuatro horas, y salía aceptable-pero-no-bueno.

    Métrica Harness SwarmForge Un solo agente
    Agentes implicados 6 (six-pack del repo) 1
    Tiempo en la misma tarea tres o cuatro horas cuarenta minutos
    Calidad entregada aceptable, no buena mejor, con un par de quejas menores
    Umbral de CRAP pedido por debajo de 6 (su estándar) por debajo de 12 (relajado a propósito)
    CRAP entregado — por debajo de 6, y modularizado sin pedírselo
    Consumo de tokens la referencia cayó "by a huge factor" al abandonar el harness

    Todas las cifras salen de lo que cuenta Uncle Bob en sus hilos; el recuento de agentes, del README del repo.

    Días después llegó la segunda medición, la que duele en la factura: "Since I stopped using my harness, my token consumption has fallen by a huge factor. That harness was massively inefficient."

    Cada handoff es un resumen que uno escribe, otro lee y un tercero vuelve a expandir. Y aquí conviene no confundir dos facturas distintas. Cuando medí el overhead de los frameworks de IA en tokens el resultado fue que no hay prompts ocultos inyectados: ese impuesto es un mito. El coste de un harness es el opuesto, explícito y a la vista: serializar el estado en cada salto para que el siguiente agente pueda leerlo. Nadie te lo esconde. Lo pagas igual.

    Lo que se ha roto no es el multiagente

    La idea que se cae no es "usar varios agentes". Es otra, más específica: tratar al agente como un componente de un diagrama de software. Una caja con interfaz fija, un rol asignado y un contrato de handoff.

    Tenía sentido hace un año, cuando los modelos se perdían en tareas largas: el rol estrecho y el gate duro eran una prótesis para una debilidad real.

    Los modelos dejaron de ser débiles. El andamio se convirtió en camisa de fuerza.

    El detalle que lo resume es la modularización. Nadie se la pidió. Un pipeline con un rol architect habría producido esa decisión como etapa obligatoria, en su turno, con su handoff. El agente solo la tomó porque veía el problema entero de una vez.

    Ahí está el fondo: un harness de roles fijos parte el contexto por la línea que dibujaste hace tres meses, no por donde el problema se parte hoy.

    Harness, agente único y subagentes bajo demanda

    No son tres sabores del mismo plato. Se diferencian en una cosa: quién decide el reparto del trabajo.

    Harness orquestado Agente único dirigido Subagentes bajo demanda
    Quién reparte Tú, antes de empezar Nadie: no hay reparto El modelo, en ejecución
    Qué resuelve Determinismo, trazabilidad por etapa, aislamiento fuerte El criterio del modelo sobre el problema completo Aislar contexto sucio sin fijar roles
    Qué cuesta Meses de construcción y tokens en cada handoff Una sesión larga y directrices bien escritas Latencia y contexto duplicado
    Límite o riesgo Bloquea decisiones transversales que el modelo tomaría solo; envejece con cada modelo nuevo Se cae si la tarea no cabe en una sesión o cruza permisos Si abusas, vuelves a un pipeline implícito
    Cuándo elegirlo Aprobación humana intermedia, aislamiento por datos o permisos, paralelismo real Casi todo el trabajo normal de feature o refactor Investigación previa a escribir código

    Fíjate en la fila de límites: ninguna columna está limpia. La pregunta no es "multiagente sí o no", sino cuánta estructura te puedes permitir antes de que la estructura decida por el modelo.

    Lo que defendí hace un mes y qué parte ha caducado

    El 24 de agosto publiqué Arquitectura de subagentes IA: por qué falla el mega-prompt: un agente mío con 3.000 palabras de system prompt y 28 herramientas que colapsaba a la cuarta tarea compleja.

    Esa mitad sigue en pie. Un prompt con cincuenta reglas y treinta herramientas reparte la atención del modelo entre instrucciones que casi nunca aplican. Una ventana más grande no lo arregla: solo retrasa el momento en que se nota.

    La otra mitad ha caducado. Allí proponía un pipeline fijo —investigador, implementador, revisor— comunicándose por artefactos en disco, con el orden decidido por mí antes de empezar. Eso es orquestación rígida: lo mismo que acaba de tirar Uncle Bob, en pequeño.

    La distinción que reconcilia las dos posiciones es quién manda.

    Subagentes bajo demanda: el modelo decide delegar cuando le conviene, el subagente vive lo que dura su pregunta y muere con su contexto sucio dentro. Nadie le asignó un rol permanente. Sigue siendo buena idea, porque aislar contexto no ha dejado de importar.

    Orquestación rígida: los roles existen antes que la tarea, el orden vive en un fichero de configuración y el trabajo pasa por todas las etapas aunque tres no aporten nada. Esto es lo que los modelos han dejado obsoleto.

    Escribí aquello hace un mes. Un mes. Esa es la velocidad a la que caduca hoy una decisión de arquitectura sobre agentes, y el mejor argumento para construir lo menos posible alrededor del modelo.

    Cuándo el harness sigue ganando

    Tirar la orquestación entera sería el error simétrico. Cuatro casos donde aún compensa:

    La tarea no cabe en una sesión. Migrar cuatrocientos ficheros no es un problema de criterio, es de volumen: repartir gana, aunque reparta trabajo y no roles.

    Hay una aprobación humana en medio. Si alguien firma antes del siguiente paso, necesitas una parada explícita con un artefacto revisable. Un agente continuo no te la da.

    El aislamiento es por permisos o por datos. El agente que lee el ticket del cliente no debería tener credenciales de producción. Eso no es diseño: es requisito, y sobrevive a cualquier modelo mejor.

    Paralelismo real sobre repos distintos. Tres repositorios independientes, tres agentes, cero coordinación. Funciona precisamente porque no hay handoffs.

    Y un límite más, del propio experimento: verificar de más deja cicatrices. Uncle Bob es honesto con el mutation testing —encontró bugs y omisiones reales, pero el algoritmo empuja al agente a hacer cosas tontas con tal de matar mutantes, y eso queda escrito en el código. Ningún gate es gratis.

    Y lo obvio: esto es la medición de una persona, con sus tareas y su modelo. No es un benchmark controlado. Si tu dominio no se parece al suyo, lo que te vale es el método, no la conclusión.

    Quédate la verificación, tira la orquestación

    Del harness se tira la orquestación y se conserva la verificación: la primera decide quién hace qué y caduca con cada modelo nuevo; la segunda define qué tiene que cumplir el resultado y no caduca.

    Separa las dos cosas que el harness mezclaba.

    La orquestación dice quién hace qué y en qué orden. Es la parte que envejece cada vez que sale un modelo mejor.

    La verificación dice qué tiene que cumplir el resultado para ser aceptable: tests que pasan, tipos que compilan, lint sin warnings, cobertura mínima, complejidad bajo umbral. No depende de quién escriba el código ni de cuántos agentes participen. Por eso no caduca.

    Tres cosas para esta semana:

    1. Escribe el contrato antes que el prompt. Entradas, salidas, errores, invariantes y umbrales. Si no puedes decir qué hace fallar la entrega, no tienes un gate: tienes una opinión. Lo tienes en revisión por contrato para código de agentes y entero en el ebook gratuito de 30 páginas.
    2. Convierte cada gate en un comando que devuelva 0 o 1. Si el criterio vive dentro del prompt de un rol, no es determinista: es una sugerencia. Un verify no necesita ser más que esto, y el agente lo ejecuta igual que tú:
    #!/usr/bin/env bash
    set -e                            # el primer fallo corta y devuelve != 0
    bun test                          # los tests pasan
    bunx tsc --noEmit                 # los tipos compilan
    bunx eslint . --max-warnings 0    # cero warnings
    bunx vitest run --coverage        # cobertura sobre el umbral del config
    
    1. Mide tu pipeline contra un agente solo. Misma tarea, dos caminos, cronómetro y factura de tokens. La comparación que casi nadie hace y la única que decide.

    El paso previo es tener la especificación escrita antes de que el agente toque nada: lo que trabajamos en Construye con IA y la tesis del libro de Spec-Driven Development. Un agente sin criterio escrito no va más rápido: va más rápido equivocándose.

    Si llevas meses montando tu orquestador, esta es la conclusión que importa: no tires el trabajo, tira la mitad correcta. Los roles y los handoffs ya no te compran nada. Los gates sí.


    Preguntas frecuentes

    ¿Qué es un harness de orquestación multiagente?

    Una capa de software que reparte una tarea entre varios agentes con roles predefinidos, controla el orden de los handoffs y bloquea el avance hasta que cada etapa cumple criterios medibles. SwarmForge lo implementa con una sesión de tmux y un git worktree por agente. Su valor original: compensar las limitaciones del modelo con estructura externa.

    ¿Significa esto que los subagentes ya no sirven?

    No. Lo que ha dejado de compensar son los roles fijos decididos antes de conocer la tarea. Delegar bajo demanda sigue siendo útil: cuando un subagente explora el repo o lee logs enormes, su contexto sucio muere con él sin contaminar la sesión principal. La diferencia está en quién decide: si lo decides tú en un fichero de configuración, es orquestación rígida; si lo decide el modelo en ejecución, es aislamiento de contexto.

    ¿Qué es CRAP y por qué se usa como gate?

    CRAP —Change Risk Anti-Patterns— combina complejidad ciclomática y cobertura en un número: un método muy ramificado y poco cubierto puntúa alto, y eso indica que cambiarlo es caro. Funciona como gate porque lo calcula una herramienta, no una opinión. Uncle Bob trabaja con umbral por debajo de 6, y aquí lo relajó a 12 a propósito.

    ¿Por qué un harness multiagente consume tantos más tokens?

    Porque cada handoff obliga a serializar el estado: uno resume lo que ha hecho y el siguiente reconstruye el contexto que el anterior ya tenía cargado. Multiplícalo por seis roles y por cada iteración. Uncle Bob lo comprobó al dejar de usar el suyo: su consumo cayó de forma drástica y calificó el harness de "massively inefficient".


    ¿Merece la pena construir mi propio harness multiagente hoy?

    Solo si tu problema es de los que no arregla un modelo mejor: volumen que no cabe en una sesión, una aprobación humana en medio, aislamiento por permisos o por datos, o paralelismo real sobre repos separados. Si tu motivo es "que el agente no se despiste", ya no lo necesitas: escribe los gates como comandos verificables y dale la tarea entera. Construir el harness te va a costar meses y va a envejecer con el siguiente modelo; los gates no.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qué es Jev de TypeSafe AI: primitivas, calibración y límites

    Qué es Jev de TypeSafe AI: primitivas, calibración y límites

    Tienes un clasificador de tickets en producción. Entra un ticket, lo mandas a un modelo de cientos de miles de millones de parámetros y esperas casi dos segundos a que razone en voz alta para acabar escupiendo una palabra: billing.

    Pagas la entrada, pagas la salida —cinco veces más cara— y te llevas una etiqueta. Y no sabes si el modelo estaba seguro o echando una moneda al aire: el JSON sale válido en los dos casos.

    Ese es el agujero que quiere tapar Jev de TypeSafe AI, que salió el 15 de septiembre de 2026. Hace cuatro días.

    Lo firma Diogo Almeida, co-autor de InstructGPT y co-inventor del RLHF en OpenAI, con 40 millones de dólares liderados por DCVC. No es un wrapper: es una arquitectura nueva que renuncia a generar texto a propósito.

    En corto: Jev es el primer modelo de TypeSafe AI y no genera texto. Recibe un estado no estructurado y devuelve decisiones tipadas —binarias, elecciones o puntuaciones— con probabilidades calibradas, en unos 250 ms medidos de extremo a extremo —unos 100 ms de inferencia más el viaje de red— y a $0,042 por millón de tokens de entrada con la salida gratis. Sirve para clasificar, enrutar, extraer y puntuar. No sirve para escribir código, contar ni hacer cuentas.


    ¿Qué es Jev, el System One Model de TypeSafe AI?

    Jev —que el fabricante escribe así, no "JEV"— es un "System One Model": un modelo que convierte estado no estructurado en decisiones tipadas con probabilidades calibradas, sin generar ni una línea de texto libre. Es el primer modelo de TypeSafe AI y se lanzó el 15 de septiembre de 2026.

    Lo aclaro porque el acrónimo en mayúsculas ya estaba cogido: JEV es, en literatura médica, el virus de la encefalitis japonesa. A partir de aquí lo escribo como lo escriben ellos.

    El nombre viene de Kahneman. El Sistema Dos delibera y escribe: eso es un LLM. El Sistema Uno responde por reflejo, y su salida no es prosa sino un juicio. Jev es lo segundo, con la parte cara amputada.

    El truco es arquitectónico: evalúa todas las preguntas a la vez contra el mismo estado, en paralelo y de forma independiente, en lugar de construir una respuesta token a token. Por eso añadir preguntas apenas cambia el tiempo de respuesta. Y por eso no puede explicarte por qué decidió lo que decidió: no está entrenado para generar texto, así que no hay prosa donde escribirlo.

    Está entrenado exclusivamente con datos sintéticos, y con un método distinto: RLCD, Reinforcement Learning for Calibrated Decisions.

    ¿En qué se diferencia RLCD de RLHF?

    RLHF optimiza que la respuesta le guste a un evaluador humano. De ahí que los LLM suenen igual de seguros inventando que acertando: la seguridad puntúa bien. RLCD optimiza otra cosa — que las probabilidades sean epistémicamente honestas.

    Calibrado significa esto: de todo lo que el modelo responde con un 90% de probabilidad, debería acertar alrededor del 90% de las veces. No el 99% ni el 60%. El número significa lo que dice.

    Si has peleado con logprobs sabes por qué importa: esos números existen, pero no están calibrados. Un 0.95 no te promete 19 aciertos de cada 20. Jev dice que sí — y es la única promesa del lanzamiento que puedes verificar tú en una tarde: agrupa tus respuestas por tramo de probabilidad y mira qué porcentaje acierta cada tramo. Si cuadra, sobre eso puedes escribir un if.

    Es el mismo fondo que expliqué en por qué la IA se inventa cosas: el problema no es que el modelo se equivoque, es que se equivoca con el mismo tono con el que acierta.

    Las tres primitivas: noul, choice y score

    La API es un endpoint REST, POST https://api.typesafe.ai/v1/systemone, con bearer token. Le mandas tres cosas: model (por ejemplo jev-latest), state —string, objeto JSON o array de texto— y questions.

    Las preguntas referencian campos del estado con notación de backticks: `ticket`, `mensaje`. Y solo hay tres tipos:

    • noul — binaria sí/no. Devuelve una probabilidad de 0 a 1.
    • choice — elige entre opciones que tú defines. Devuelve la opción, la distribución completa de probabilidad y un confidence de 0 a 1.
    • score — sitúa algo en una escala ordenada. Devuelve la media ponderada, la distribución y un confidence.

    Con el SDK de JavaScript, @typesafe-ai/sdk, se ve así:

    import { choice, noul, score, TypeSafeClient } from '@typesafe-ai/sdk'
    
    const client = new TypeSafeClient()
    
    const { answers } = await client.systemOne({
      state: { ticket },
      questions: {
        category: choice('What kind of ticket?', { bug: '...', billing: '...' }),
        severity: score('How severe?', ['Low', 'Medium', 'High'])
      }
    })
    

    Hay SDK de Python equivalente (from typesafe_sdk import Choice, Noul, TypeSafeClient, con client.system_one(...)) e integración con el Vercel AI SDK vía experimental_evaluate() y typeSafeAi.evaluationModel('jev-latest'), o con el string de gateway 'typesafe-ai/jev'. — esto último está documentado del lado de Vercel, no en la doc de TypeSafe.

    Fíjate en lo que no hay en ese código: ningún prompt pidiendo "responde solo con JSON". Ninguna función de reparación. Ningún reintento. El tipo no es una súplica al modelo, es la superficie de salida del modelo.

    Si vienes de montar esto a mano con schemas y validación —el camino que recorro en diseñar schemas Zod para LLM— el contraste es incómodo: la mitad de ese andamiaje deja de tener función. La otra mitad no — los tipos siguen siendo tuyos en cuanto la respuesta entra en tu dominio, y eso lo trabajo entero en el curso de Zod para TypeScript.

    Caso práctico: triaje de tickets con umbrales

    El patrón que mejor rinde es el fan-out especulativo: preguntar de golpe todo lo que no dependa de nada. Sale más barato que la cadena secuencial equivalente.

    const { answers } = await client.systemOne({
      model: 'jev-latest',
      state: { ticket },
      questions: {
        category: choice('What kind of ticket is `ticket`?', {
          bug: 'Something in the product is broken',
          billing: 'Charges, invoices or refunds',
          feature: 'A request for something that does not exist yet',
          other: 'Anything else'
        }),
        severity: score('How severe is `ticket`?', ['Low', 'Medium', 'High', 'Critical']),
        impact: score('How many users does `ticket` affect?', ['One', 'Some', 'Many']),
        isAngry: noul('Is the author of `ticket` frustrated?')
      }
    })
    

    Una request, cuatro decisiones, ~250 ms medidos desde mi red. Y ahora la parte que decide si esto es ingeniería o un juguete: qué haces con el confidence.

    const { category, severity, impact, isAngry } = answers
    
    // La doc sugiere estos umbrales; ajústalos con tus propios datos.
    if (category.confidence < 0.5) {
      return escalarAHumano(ticket, { motivo: 'clasificación poco concentrada' })
    }
    
    // `score` es la media ponderada sobre los índices de nivel: 0..3 con cuatro
    // niveles, 0..2 con tres. Normalízalo antes de mezclar escalas distintas.
    // `noul` es directamente la probabilidad de que la respuesta sea sí.
    const prioridad =
      0.5 * (severity.score / 3) +
      0.3 * (impact.score / 2) +
      0.2 * (isAngry.noul > 0.7 ? 1 : 0)
    
    // `category.choice` es la opción ganadora; `category.probabilities`, la distribución completa.
    enrutar(category.choice, prioridad)
    

    Cada respuesta llega tipada bajo el id que le pusiste en la request: un choice
    trae choice, probabilities y confidence; un score trae score,
    probabilities, confidence y un legend con la descripción de cada nivel; un
    noul trae solo noul, la probabilidad de sí. La distribución suma 1, pero son
    floats: si la compruebas en un test, hazlo con tolerancia
    (Math.abs(suma - 1) < 1e-6), nunca con igualdad exacta. Y mira usage, que
    llega junto a answers y model con los tokens de entrada y salida: el coste
    real por decisión lo registras, no lo estimas.

    El confidence mide cuán concentrada está la distribución. Por debajo de 0,5, la doc recomienda no actuar sin revisión humana. Y para acciones destructivas —borrar, reembolsar, banear— pide confirmación aunque estés por encima de 0,9.

    Ese segundo umbral es el que todo el mundo se salta. Un número alto no es un permiso. Es la misma lógica de degradación controlada que aplico con los circuit breakers en agentes de IA: decidir de antemano qué pasa cuando el sistema duda.

    El scoring compuesto tiene una ventaja que no es de rendimiento: es auditable. Ese 0.5 / 0.3 / 0.2 lo discutes en una PR. Un prompt que dice "decide la prioridad del ticket" no lo discutes: lo reescribes y rezas.

    ¿Jev o un LLM con structured output?

    Esta es la comparación honesta, porque un LLM con salida estructurada ya funciona. Lo que Jev aporta no es capacidad nueva: es velocidad, coste y probabilidades que significan algo.

    Jev (System One) LLM con structured output
    Qué devuelve decisión tipada + distribución + confidence JSON validado contra tu schema
    Texto libre, código, prosa no, por diseño sí
    Latencia típica ~250 ms end-to-end medidos (~100 ms de inferencia) segundos
    Coste de entrada $0,042 / millón de tokens $0,20 – $10 / millón
    Coste de salida gratis ~5x el de entrada
    Probabilidades calibradas (RLCD) logprobs sin calibrar, o nada
    Aritmética, fechas, conteo no fiable mejor, aunque también frágil
    Límite / riesgo puede devolver un valor de tipo válido y completamente equivocado, con confidence alta; exige diseñar a mano el espacio de respuestas alucina contenido dentro de un JSON perfectamente válido; coste y latencia escalan mal con el volumen

    Haz la cuenta en vez de tragarte el titular. La home dice "193,6x más rápido, 444,6x más barato": con $0,042 de entrada frente a $0,20–$10, el ahorro solo en entrada va de unas 5x a unas 238x, y el 444x solo cuadra si además sumas la salida —gratis aquí, unas cinco veces la entrada allí— con un mix de tokens que no publican.

    Con la velocidad pasa lo mismo. Coge mi propia apertura, dos segundos, y lo que mido de verdad, 258 ms: eso son 8x, no 193x. El 193,6x sale de workflows con muchas preguntas independientes, donde el LLM las resuelve en cadena y Jev las resuelve de una tacada. Es una comparación de arquitectura de workflow, no de modelo contra modelo.

    Y ese “~100 ms” tampoco es lo que vas a medir tú. Lo he cronometrado contra la API real: 12 llamadas abriendo conexión nueva cada vez dan una mediana de 628 ms; reutilizando la conexión TLS, 258 ms, y nunca por debajo de 213. Solo el handshake TCP + TLS son 342 ms. Los 100 ms son tiempo de inferencia —ciertos, si tu código corre al lado de sus GPUs—; el resto es el viaje hasta San Francisco. Si te llevas una sola cosa de aquí que sea esta: reutiliza la conexión, son 2,4x gratis.

    El propio blog de TypeSafe rebaja eso a 40x–200x para inteligencia equivalente en tareas System One, y admite que esas cifras "están en el extremo alto de las ganancias del mundo real". Midieron contra la media de GPT-6 Astra y Fable 5.1, con precios de LLM sacados de OpenRouter —lo que "casi con certeza" introduce sesgo— y desde la costa oeste de EEUU.

    El número que yo me creo viene de fuera: Vercel midió el clasificador de seguridad de su modo automático de fx y le salió entre 5x y 18x más rápido en p95 con Jev que con gpt-5.6-luna, su opción anterior, y además con más acierto. Lo contaron su propio CEO y el ingeniero que hizo la prueba, y lo recogió TechCrunch. Tampoco es un árbitro imparcial —Jev viene integrado en su AI SDK, como has visto arriba—, pero al menos no vende el modelo, la carga de trabajo es real y el rango que publica es mucho más modesto que el de la home.

    ¿Cuándo NO conviene usar Jev?

    Para esto, el hilo de Hacker News sobre el lanzamiento —más de 1.900 puntos y cerca de 500 comentarios— es más útil que la documentación oficial.

    No puede escribir nada. Ni código, ni explicaciones, ni un resumen. Lo resumió un comentarista: "esto es probablemente súper útil para clasificación, routing y scoring, pero no se parece en nada a los modelos de generación de código que todos usamos hoy". El título original del post prometía un "nuevo modelo frontier" y hubo que editarlo.

    No sabe contar ni hacer cuentas. Aritmética, fechas y comparaciones numéricas se quedan en tu código. No delegues un "¿han pasado más de 30 días?" a Jev; eso es un if.

    El "no puede alucinar" es marketing. Lo que garantiza por diseño es que la salida es de un tipo válido: cero errores de tipo. Pero la objeción más votada del hilo lo parte por la mitad: "claro que no puede emitir un tipo inválido, pero sí puede emitir un valor válido completamente equivocado. También puedes forzar salida estructurada en un LLM". Un valor equivocado con confianza alta sigue siendo una alucinación cuando llega a tu base de datos.

    Es frágil con lenguaje difuso. El ejemplo del hilo: ante "quiero que tu agente me llame mañana a las cinco", la pregunta "¿el usuario quiere hablar con un agente humano?" responde que sí y se traga entero el matiz temporal. Esa segunda dimensión tienes que haberla previsto tú. Traducido: el espacio de respuestas lo diseñas tú, a mano y con cuidado. Jev no descubre categorías, puntúa las que le das. Si tu taxonomía está mal, la salida está mal — y con confidence alta.

    Piensa en inglés. La ficha del modelo lo dice sin adornos: el inglés es su idioma principal de entrenamiento y donde hoy la precisión es mejor. Otros idiomas funcionan, con menos puntería. Por eso las preguntas de los ejemplos de arriba están en inglés aunque el ticket entre en castellano: el state déjalo en el idioma que llegue, pero las preguntas, las opciones y los niveles escríbelos en inglés. Si los pones en español, mídelo antes de fiarte.

    El state sucio le baja la puntería. El detalle irrelevante actúa de distractor. Manda los campos que importan, no el objeto entero que te escupe el ORM.

    Y no trata el estado como hostil. Esto lo admite su propia página de limitaciones: una instrucción inyectada, un encuadre engañoso o un texto que argumenta a favor de su propia clasificación pueden mover la respuesta. Si lo que clasificas lo escribe un usuario —o peor, otro modelo—, el estado es una superficie de ataque, no un dato. Describe los dos lados de cada pregunta y prueba con entradas envenenadas antes de darle poder sobre nada.

    Solo lee texto. Nada de imágenes, audio ni vídeo: lo que no sea texto hay que preprocesarlo antes de mandarlo como estado. Y hay un techo de 255 opciones en una elección de una sola etapa — por encima toca hacer scoring en dos pasadas.

    Y ojo con las demos. La de Doom impresiona hasta que ves que al modelo le pasaban el estado del juego ya estructurado —coordenadas, ángulos—, no píxeles. La de Home Assistant sí convenció a bastante gente, pero tuvieron que saltar a un modelo de Anthropic para partir peticiones con varias intenciones.

    Donde sí le veo el hueco es en lo que nadie automatiza porque sale caro: deduplicar registros, casar entidades, revisar miles de filas una por una. Ahí velocidad y confianza calibrada sí cambian el juego.

    Qué cambia esto si construyes agentes

    Un agente es un bucle que decide muchas veces y actúa alguna. La mayoría de esas decisiones —¿consulta o queja?, ¿hace falta buscar?, ¿esto es urgente?, ¿me paro?— no necesitan prosa: necesitan un juicio rápido y honesto que hoy paga un modelo enorme escribiendo un párrafo para devolver una palabra.

    A 250 ms y coste casi nulo deja de tener sentido racionar decisiones. Esa es la tesis: Jev no compite con tu LLM, compite con los if que escribiste porque llamar al LLM salía caro.

    Con dos condiciones que no negocio. La primera, que midas: la viabilidad se calcula en coste por tarea resuelta, no por token, y sin evals sobre lo que genera la IA estás comparando titulares. La segunda, que las decisiones caras pasen por un contrato explícito — el método que explico en el ebook gratuito Revisión por Contrato.

    Hoy mismo puedes hacer esto: coge la llamada a un LLM más tonta y repetida que tengas en producción —la que solo devuelve una etiqueta—, reescríbela como un choice con su confidence y ponle un umbral de 0,5 con salida a revisión humana. Es una tarde. Si el número no mejora, lo sabrás con datos y no con una home.

    Y si quieres montar el agente entero con esta cabeza, el recorrido de idea a producto está en el curso Construye con IA.

    Si quieres ir más allá de este resumen, lo he escrito entero en un libro: Jev y las decisiones tipadas con IA. Las tres primitivas con la forma real de sus respuestas, cómo comprobar la calibración con tus propios casos, cinco patrones de producción y un capítulo entero sobre cómo te va a fallar. Cada cifra lleva su origen declarado.

    Preguntas frecuentes

    ¿Jev sustituye a mi LLM?

    No, y no lo pretende. Jev no escribe código, ni resúmenes, ni respuestas a un usuario. Sustituye a las llamadas de tu pipeline que solo devuelven una etiqueta, un booleano o una nota del 1 al 5. El LLM se queda para generar.

    ¿Qué significa exactamente que las probabilidades estén calibradas?

    Que el número es verificable: de todo lo que Jev responde con un 90% de probabilidad, acierta cerca del 90% de las veces. Es lo que optimiza RLCD, frente a RLHF, que optimiza que la respuesta le guste a un humano y produce modelos que suenan igual de seguros acertando que inventando.

    ¿Puede alucinar Jev?

    Sí, en el sentido que importa. Lo que no puede es devolver un tipo inválido: eso está garantizado por diseño, no por estadística. Pero puede devolver una opción perfectamente válida y equivocada, y hacerlo con confianza alta. Trata el confidence como una señal de enrutado, nunca como una garantía de verdad.

    ¿Cuánto cuesta y cuánto tarda?

    $0,042 por millón de tokens de entrada y salida gratis. Su documentación habla de unos 100 ms de inferencia; medido desde mi red, el end-to-end fue de 258 ms de mediana y nunca bajó de 213 ms. Los límites publicados: 250.000 tokens por segundo, 1.200 requests por minuto y dos techos de contexto que conviene no confundir — 64.000 tokens por request contando estado y preguntas juntas, y 32.000 para el estado más la pregunta más larga.

    ¿Qué hago si tengo más de 255 opciones?

    Ese es el techo de una elección de una sola etapa. Por encima toca scoring en dos pasadas: reduces el espacio con un score sobre categorías gruesas y luego haces el choice fino dentro del grupo ganador. Sigue saliendo más barato que encadenar llamadas a un LLM, pero deja de ser gratis en complejidad.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
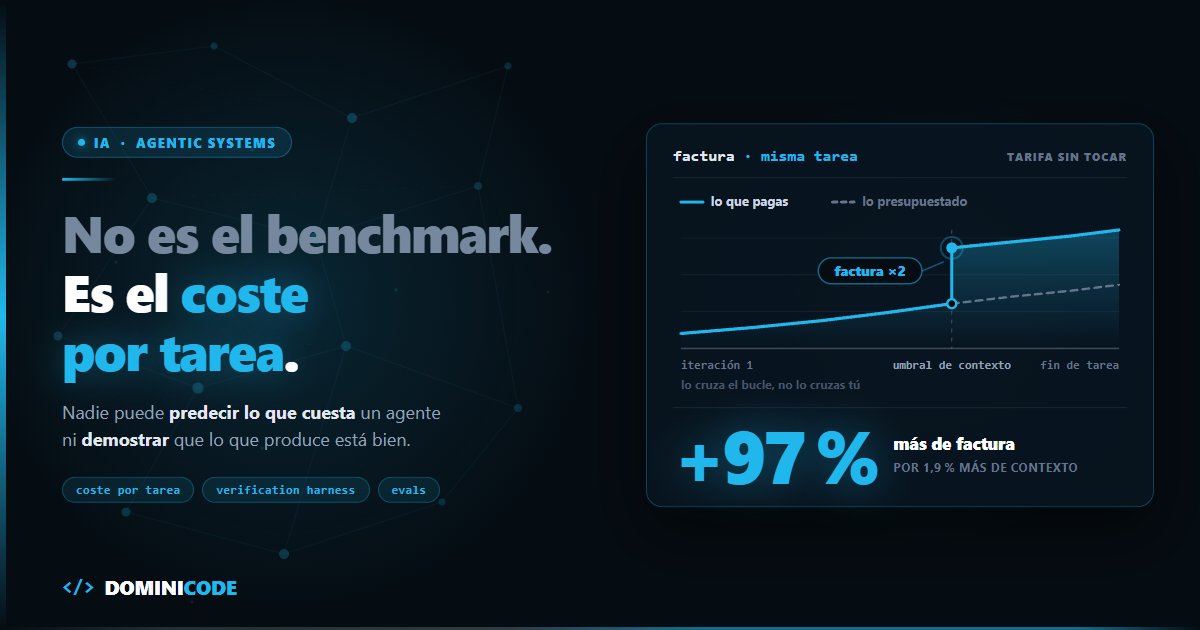
  • El futuro de los agentic systems: coste por tarea, no benchmarks

    El futuro de los agentic systems: coste por tarea, no benchmarks

    La iteración 14 me costó más que las trece anteriores juntas.

    El agente no hizo nada raro. Leyó el repo, lanzó los tests, leyó los logs. En la iteración 14 una tool devolvió 5.000 tokens de logs que no necesitaba nadie, el contexto cruzó un umbral de facturación y la misma tarea pasó a costar el doble. No un 5 % más. El doble.

    Ahí está el techo real de los agentic systems, y no tiene nada que ver con la inteligencia del modelo. El futuro de los agentic systems no lo decide lo listo que sea el siguiente checkpoint: lo decide que hoy no puedo predecir lo que va a costar una tarea ni demostrar que el resultado es correcto sin leérmelo entero.

    Esta es la tesis, y la voy a defender con números que ya he publicado aquí:

    El techo de los agentic systems no es la capacidad del modelo. Es que nadie puede pagarlos de forma predecible ni auditar lo que producen. El futuro de los agentic systems se decide en el coste por tarea y en el harness de verificación (verification harness), no en el próximo benchmark.

    Los benchmarks van a seguir subiendo. Es lo único que tengo claro del próximo año. Lo que no va a subir solo es tu capacidad de presupuestar una tarea y de firmar que salió bien.

    El precio por token ya no te dice lo que vas a pagar

    El precio por token dejó de predecir la factura porque el mismo modelo puede mantener la tarifa y aun así consumir más tokens por tarea, cruzar un umbral de precio escalonado o abrir más subagentes.

    Durante dos años elegimos modelo mirando una tabla de dos columnas: dólares por millón de input, dólares por millón de output. Era una multiplicación. Funcionaba.

    Ya no.

    Mira Gemini 3.8 Flash. Mismo precio por token que 3.7 Flash: 0,75 $ de input y 3,75 $ de output por millón. Cero subida. Google no tocó la tarifa.

    Pero el modelo gasta un 30 % más de tokens de salida por tarea: 48.000 de media. Razona más, escribe más y encadena más turnos. Y cada turno extra reenvía el contexto acumulado, que se factura como entrada: de los 0,58 $ que cuesta hoy una tarea, solo unos 0,18 $ son salida. El resto es contexto reenviado. Resultado medido con el reasoning en high: alrededor de un 40 % más caro con la tarifa intacta.

    El precio se quedó igual y la factura subió un 40 %. Las dos cosas son ciertas a la vez.

    Y hay fecha de caducidad: esos 0,75 $ y 3,75 $ son precio introductorio hasta el 31 de diciembre de 2026. El 1 de enero de 2027 pasan a 1,50 $ y 7,50 $ — exactamente el doble. Si has calculado tus márgenes con la tarifa de 2026, tu coste por tarea ya tiene una subida programada en el calendario.

    Ese es el primer mecanismo: la verbosidad. El segundo es peor, porque no es gradual. Es un escalón.

    En la API de GPT-6 Astra la tarifa es 10 $ de input y 50 $ de output por millón. Pero cualquier request que supere los 272.000 tokens de input dobla el precio de input y de caché y multiplica el output por 1,5. Y no sobre el exceso: sobre la request entera.

    Los números del ejemplo que desglosé allí:

    Request Input Output Coste
    Por debajo del umbral 270.000 8.000 3,10 $
    Por encima del umbral 275.000 8.000 6,10 $

    Un 1,9 % más de tokens de input. Un 97 % más de factura.

    Y esto es un problema de arquitectura, no de hoja de cálculo: tú no decides cuándo se cruza el umbral. Lo decide el agente, en la iteración 14, cuando una tool devuelve más logs de la cuenta. Tu prompt inicial ocupaba 12.000 tokens. El contexto acumulado en el bucle es el que cruza la línea.

    El tercer mecanismo es todavía más silencioso: la propensión a delegar en subagentes cambia con el modelo. Claude Opus 5 delega más fácilmente que sus antecesores. Mismo código, mismo prompt, misma tarea — y de repente tienes varios subagentes con su propio contexto donde antes había uno.

    Tres formas de que tu factura suba sin que toques una línea de código: el modelo se vuelve más hablador, el contexto cruza un escalón, o el sistema decide abrir más ramas.

    Ninguna aparece en la tabla de precios. Por eso la métrica que sobrevive es el coste por tarea (cost per task): lo que cuesta resolver una unidad de trabajo completa, de principio a fin, incluyendo reintentos, tools, subagentes y las veces que el agente se equivoca y vuelve a empezar.

    Es la única cifra que puedes meter en un presupuesto y defender delante de alguien que no sabe qué es un token.

    Dónde no está el coste por tarea de un agente

    Voy a decir algo impopular: el framework que elegiste no es tu problema de coste.

    Circula la leyenda de que los frameworks de agentes te meten 1.500 tokens ocultos en cada llamada. Lo medí de verdad: el bloque de herramientas pasó de 213 bytes a 294 o 299 bytes según el framework, y la petición entera de 393 a 556 bytes. Unos 40 tokens de diferencia.

    Cuarenta. Con un coste por tarea de 0,58 $, eso es ruido estadístico.

    Mientras tanto, el bucle de ese mismo agente acumula 270.000 tokens de contexto y roza un escalón que dobla la factura entera.

    Quien se pasa la tarde optimizando el overhead del framework está limpiando el mostrador mientras se le inunda el sótano. El coste de un agentic system vive en el bucle: en cuántas iteraciones hace, en cuánto contexto arrastra, en qué devuelven las tools y en cuántas veces reintenta porque nadie le dijo que ya había terminado.

    Generar es barato. Auditar no ha bajado de precio

    El coste de generar código cae cada trimestre. El de verificarlo no ha bajado ni un céntimo, porque lo sigue pagando una persona leyendo diffs. Esta es la segunda mitad de la tesis, y la que casi nadie quiere mirar.

    La asimetría es brutal y va a peor: la unidad de trabajo del agente ya es la tarea; la unidad de trabajo del revisor sigue siendo la línea. Un agente cierra en cuatro minutos un refactor que tardas cuarenta en revisar. Multiplica eso por cinco agentes en paralelo y la cola de revisión se convierte en el proceso más lento del equipo.

    Lo que pasa entonces no es que la gente revise más rápido. Es que deja de revisar. Aprueba por cansancio. Y el sistema pierde la única propiedad que lo hacía utilizable: que alguien podía responder de lo que salía.

    La salida no es revisar más. Es dejar de revisar a ojo.

    Un agente en producción necesita que la verificación sea una función que devuelve verdadero o falso, no una opinión. Eso significa dos cosas concretas: evals deterministas (deterministic evals) que corren en CI y tumban el build, y un contrato explícito de lo que la tarea debía cumplir, escrito antes de que el agente empezara.

    Sin contrato previo no hay verificación posible: solo hay un humano decidiendo a posteriori, y con sesgo de confirmación, si le gusta lo que ve. Ese método lo escribí entero en el ebook gratuito Revisión por Contrato: el contrato se escribe antes, no después.

    Es el mismo motivo por el que llevo dos años empezando cada feature por la especificación y no por el código, y la mecánica completa está en el libro de Spec-Driven Development.

    El harness pesa más que el modelo

    El harness —el código que envuelve al modelo— cambia la puntuación de un mismo modelo más de lo que la cambia sustituir el modelo entero. Si solo te llevas un dato de este post, que sea este.

    ARC-AGI-3 le dio a GPT-6 Astra un 99,9 %. Ese número recorrió internet como prueba de que habíamos llegado a la AGI.

    Salió del adapter propio de OpenAI: un harness con estado, optimizado para el benchmark. Con el harness estándar —el que sí compara entre proveedores— la nota fue 62,7 %, justo en el techo del rango de aproximadamente 17 % a 63 % que la propia organización del benchmark da para las llamadas stateless: las que hace tu código.

    Mismo modelo. Mismos pesos. La misma semana.

    De 62,7 a 99,9 con los mismos pesos y la misma semana, solo cambiando lo que hay alrededor. Y por debajo del 62,7 está todo lo que consigue un arnés peor montado que el de ARC.

    Traducción para tu backlog: la diferencia entre un prototipo que funciona a medias y un sistema que cierra tareas de verdad no está en cambiar de modelo. Está en el harness: el bucle de acciones, el formato de las observaciones, la gestión del contexto, el estado entre pasos, las condiciones de parada.

    Eso es código tuyo. No es un proveedor. No lo compras con una API key.

    Y por eso el próximo salto de calidad en agentic systems no va a venir de un checkpoint nuevo, sino de cosas mucho más aburridas: compactar el contexto antes de cruzar un umbral, truncar lo que devuelve una tool, cachear lo que no cambia y montar un circuit breaker que mate el bucle cuando el coste acumulado o el número de iteraciones se disparan.

    Un agente sin condición de parada no es autónomo. Es una fuga.

    El futuro de los agentic systems: cuatro predicciones para 2027

    Cuatro predicciones sobre el futuro de los agentic systems, ordenadas por lo seguro que estoy de cada una: (1) el coste por tarea se convierte en un requisito no funcional, (2) la unidad de facturación se desplaza del token a la tarea, (3) el harness se estandariza y el modelo se vuelve intercambiable, y (4) la métrica pública pasa a ser el porcentaje de tareas cerradas sin intervención humana.

    Aquí dejo de describir el presente y me mojo.

    El coste por tarea se convierte en un requisito no funcional. Igual que hoy escribes "p95 por debajo de 200 ms" en una spec, vas a escribir "coste por tarea por debajo de 0,40 $". Con su alerta, su panel y su presupuesto que corta. Un agente que resuelve la tarea pero cuesta cuatro veces lo presupuestado es un incidente, no un éxito. (La que más firme: 18 meses.)

    La unidad de facturación se desplaza del token a la tarea. Ya está pasando en las herramientas de coding agéntico: nadie te vende millones de tokens, te vende sesiones y límites de uso. Quien pueda ofrecer "tarea cerrada o no cobro" tendrá una ventaja de precio que nadie podrá igualar sin verificación automática. (Probable en 2027; ya ha empezado.)

    El harness se estandariza y el modelo se vuelve intercambiable. Los proveedores ya no compiten solo por la nota del leaderboard: compiten por ser el sustrato del bucle —herramientas, estado, ejecución, adapters propios—. El 99,9 % de Astra salió exactamente de ahí. Cuando el harness sea portable de verdad, cambiar de modelo será una línea de configuración, y tu ventaja competitiva estará entera en tus evals y en tus contratos de verificación, que son los únicos activos que no te da el proveedor. (La más arriesgada. Si dentro de dos años cambiar de modelo sigue costando una semana de trabajo, me habré equivocado.)

    La métrica pública será el porcentaje de tareas cerradas sin intervención humana. No la puntuación en un benchmark de puzzles: tareas reales, cerradas de principio a fin, verificadas por una función. Y al lado, el coste medio de cada una. Llamémoslo por su nombre: tasa de cierre autónomo (autonomous closure rate) y coste por tarea cerrada. Ese par de números va a decidir presupuestos, y hoy casi nadie lo instrumenta. (La más lenta: tres años, y solo si alguien con cuota de mercado publica la cifra primero.)

    Capacidad sin economía ni verificación es una demo. Y las demos no entran en producción.

    Qué hacer hoy: instrumenta el coste por tarea

    Una sola cosa, y esta semana.

    No hace falta un stack de observabilidad. Hace falta que cada ejecución de tu agente escriba una línea con seis campos:

    1. tarea — un identificador de la unidad de trabajo, no del prompt
    2. tokens_input — acumulados en todo el bucle, no los de la primera llamada
    3. tokens_output — acumulados, incluidos los de los subagentes
    4. iteraciones — cuántas vueltas dio el bucle antes de parar
    5. coste — calculado con la tarifa vigente, tramo premium incluido si cruzó el umbral
    6. eval_ok — verdadero o falso, salido de una función, no de una impresión

    Diez minutos de código.

    Cuando tengas cincuenta filas vas a ver dos cosas que ahora no ves: que el 80 % del coste se lo come un puñado de tareas, y que hay tareas que el agente "termina" sin cerrar de verdad. Esas dos cifras valen más que cualquier comparativa de modelos que leas este mes.

    Si quieres montar esto entero —del bucle a la verificación— sin aprenderlo a base de facturas, lo enseño paso a paso en Construye con IA. Y si prefieres ver cómo lo medimos sobre proyectos reales, con los harness y las evals que usamos en producción, eso vive en Dominicode Labs.

    El próximo modelo será mejor que este. Da igual. Gana quien sepa lo que cuesta cada tarea y pueda demostrar que salió bien.

    Preguntas frecuentes

    ¿Qué es un agentic system?

    Un agentic system es un programa que le da a un modelo de lenguaje un bucle, herramientas y estado: el modelo decide la siguiente acción, el sistema la ejecuta, le devuelve el resultado y el ciclo se repite hasta que se cumple una condición de parada. La diferencia con un chatbot no está en el modelo, está en el bucle y en quién decide cuándo parar. Por eso su coste no se mide por llamada, sino por tarea completa.

    ¿Qué es el coste por tarea y por qué sustituye al precio por token?

    El coste por tarea es lo que pagas por resolver una unidad de trabajo completa: iteraciones del bucle, tools, subagentes y reintentos incluidos. El precio por token ya no predice la factura porque un modelo puede mantener la tarifa y consumir un 30 % más de tokens por tarea, como pasó con Gemini 3.8 Flash: mismo precio y un 40 % más caro por tarea resuelta.

    ¿Qué tengo que registrar en cada ejecución para medir el coste por tarea?

    Seis campos por ejecución: tarea, tokens de input y de output acumulados en todo el bucle, iteraciones, coste calculado y si pasó la verificación. Multiplica por la tarifa y divide entre las tareas cerradas con éxito, no entre las ejecuciones totales. Si cuentas los intentos fallidos como tareas, tu coste real queda infravalorado y el presupuesto se te romperá en producción.

    ¿Por qué el coste de verificar no baja aunque baje el de generar?

    Porque el coste de generar cae cada trimestre y el de verificar no: lo sigue pagando una persona leyendo diffs. Un agente cierra en minutos lo que tardas media hora en revisar, y con varios agentes en paralelo la cola de revisión pasa a ser el proceso más lento del equipo. La salida no es revisar más rápido, sino convertir la revisión en evals deterministas y contratos que devuelvan verdadero o falso.

    ¿Qué es un harness y por qué pesa más que el modelo?

    El harness es la capa de código que envuelve al modelo: el bucle de acciones, el formato de las observaciones, la gestión del contexto, el estado entre pasos y las condiciones de parada. Pesa más que el modelo porque el mismo GPT-6 Astra puntúa 62,7 % en ARC-AGI-3 con el harness estándar y 99,9 % con el adapter propio de OpenAI, la misma semana y con los mismos pesos. Esa diferencia no está en los pesos: está en código que escribes tú.

    ¿Cambiar a un modelo más barato reduce la factura?

    No necesariamente. La factura depende de cuántos tokens consume el modelo por tarea, de si el contexto cruza umbrales de precio escalonados y de cuánto tiende a delegar en subagentes. Un cambio de modelo altera las tres cosas a la vez sin que toques una línea de código, así que la única forma de saberlo es medir el coste por tarea antes y después.

    ¿Qué métricas debería vigilar en un agentic system en producción?

    Cuatro: coste medio por tarea cerrada, porcentaje de tareas cerradas sin intervención humana, iteraciones por tarea y tokens de contexto máximos dentro del bucle. Las dos primeras dicen si el sistema es viable económicamente; las dos últimas avisan antes de que una ejecución cruce un umbral de precio o se quede dando vueltas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.