Tag: Claude Code

  • Cómo estructurar patrones de indicaciones para Claude Code

    Cómo estructurar patrones de indicaciones para Claude Code

    Patrones de indicaciones, memoria, estructura del proyecto, subagentes, habilidades para Claude Code

    Tiempo estimado de lectura: 5 min

    • Ideas clave:
    • Claude Code necesita prompts estructurados y deterministas para operar de forma segura y efectiva.
    • Una memoria explícita (ej. CLAUDE.md) y una estructura de repo modular son indispensables.
    • Orquestar subagentes (p. ej. con n8n) reduce riesgo y carga cognitiva del agente principal.
    • Control estricto de habilidades (tool use) y entornos sandbox evita daños en producción.

    Introducción

    Patrones de indicaciones, memoria, estructura del proyecto, subagentes y habilidades para Claude Code son los cinco pilares que determinan si un agente CLI acelera tu ingeniería o genera deuda técnica silenciosa. Si no defines cómo hablarle, qué puede recordar, cómo está organizado el repo, cómo se subdividen las tareas y qué permisos tiene, Claude actúa a ciegas. Aquí tienes una guía práctica y accionable para poner orden.

    Resumen rápido (lectores con prisa)

    Claude Code es un operador que modifica código y ejecuta shells; requiere prompts deterministas, una memoria persistente en raíz (p. ej. CLAUDE.md), una estructura de repo modular, subagentes/orquestación para QA y control estricto de habilidades. Usa TDD y sandboxes antes de delegar cambios en producción.

    Claude Code como operador

    Claude Code no es un chatbot; es un operador que puede leer y modificar tu código, ejecutar shells y (en previews) automatizar UIs. La diferencia clave: requiere prompts estructurados, memoria explícita del proyecto, una arquitectura de repositorio que el agente pueda razonar, subagentes u orquestadores para tareas auxiliares y un control estricto de habilidades (tool use). Documentación útil: docs.anthropic — Claude Code y, para orquestación, n8n. Para novedades y previews (p. ej. Computer Use) revisa releasebot.dev.

    1) Patrones de indicaciones — cómo pedirle cosas a Claude Code

    No escribas prompts vagos. Usa plantillas deterministas:

    Patrón Contexto‑Restricción‑Acción

    – Contexto: qué módulo, stack, rama. (“Servicio payments — Node.js/TS — branch feat/rate-limit”)

    – Restricción: reglas innegociables. (“No tocar DB schema; no añadir deps externas”)

    – Acción: objetivo con criterio verificable. (“Implementa rate limiting y añade tests que cubran 429; PR con test passing en CI es criterio de éxito”)

    Prompt de TDD (Test-Driven Prompting)

    – Paso 1: “Escribe el test que debería fallar”

    – Paso 2: pedir ejecución del test

    – Paso 3: solicitar la implementación hasta que los tests pasen

    Ejemplo de prompt (compacto):

    “Contexto: /services/payments, Node 18, TS. Restricción: no tocar migraciones. Acción: añade rate limiter en /api/charge; escribe tests unitarios y de integración; criterio: pipeline CI verde. Empieza por crear tests que fallen.”

    2) Memoria — cómo mantener contexto útil y persistente

    Claude Code construye su contexto leyendo el repo; no tiene intuición humana. Dos mecanismos clave:

    • Memoria de sesión (corto plazo): archivos abiertos y árbol activo. Evita saturarla con monorepos gigantes; abre solo lo necesario.
    • Memoria persistente (largo plazo): un archivo en la raíz que Claude lee siempre. Recomendación práctica:

    – CLAUDE.md o .clauderc con:

    • Convenciones de estilo y nomenclatura
    • Comandos claves (tests, build, dev)
    • ADRs esenciales
    • Dependencias permitidas/prohibidas
    • Checklists de seguridad y compliance

    Este archivo convierte normas humanas en reglas ejecutables por el agente y reduce ambigüedad.

    3) Estructura del proyecto — diseño para agentes

    Diseña el repo pensando en unidades pequeñas y autocontenidas:

    • Modularidad: archivos <300 líneas, responsabilidades únicas.
    • Rutas semánticas: /auth/use-cases/login.ts en vez de /utils/helper9.ts.
    • Tipado estricto: TypeScript/Rust/Go ayudan al agente a validar cambios antes de ejecutarlos.
    • Tests como contrato: TDD + coverage mínimo hacen al agente predecible.

    Si el repo es un monolito acoplado, prioriza una fase de refactor (extract module) manual antes de delegar en agentes.

    4) Subagentes y orquestación — dividir para no perder contexto

    Claude Code aún no gestiona subagentes complejos de forma nativa. La práctica efectiva es orquestar subagentes externos:

    – Usa n8n o un orquestador propio para:

    • Ejecutar análisis estático en entornos aislados
    • Lanzar pipelines de seguridad y escaneo de dependencias
    • Devolver reportes al CLI para que Claude actúe sobre ellos

    Patrón típico:

    1. Claude genera un PR provisional.
    2. n8n ejecuta linters, SCA y tests en una VM sandbox.
    3. Resultado vuelve al CLI; Claude corrige y reitera.

    Así evitas que un único agente cargue demasiado contexto o tome decisiones incompletas.

    5) Habilidades (Tool Use) — permisos y límites

    Define explícitamente qué puede ejecutar el agente. Habilidades críticas:

    • Bash Execution: npm test, git, docker-compose — imprescindible para feedback real.
    • File System Access: lectura/escritura de archivos.
    • Semantic Search / Repo Index: para referencias cruzadas antes de modificar.
    • (Preview) Computer Use: interacción con UIs nativas — potente, frágil y debe usarse solo en sandboxes.

    Regla de oro: nunca habilites habilidades destructivas en máquinas con credenciales reales. Usa contenedores o VMs aisladas.

    Checklist mínimo de adopción antes de delegar tareas

    1. CLAUDE.md en raíz con políticas y comandos.
    2. Tests automatizados que sirvan de contrato.
    3. Entorno sandbox (Docker/VM) para ejecución.
    4. CI que valide PRs generados por el agente.
    5. Orquestador (n8n o similar) para subagentes de QA/security.
    6. Prompts basados en Contexto‑Restricción‑Acción y TDD.

    Conclusión

    Patrones de indicaciones, memoria, estructura del proyecto, subagentes y habilidades para Claude Code no son conceptos teóricos: son requisitos operativos. Implementados juntos, convierten a Claude en un multiplicador de capacidad. Si fallas en cualquiera, el agente acelera errores, no entrega. Empieza por documentar: CLAUDE.md, tests firmes y sandboxes. Luego automatiza, orquesta y vigila. Esto no acaba aquí: quien domine estas cinco piezas tendrá ventaja real al escalar agentes en ingeniería.

    Dominicode Labs

    Para equipos que integran automatización y orquestación de subagentes como parte de su plataforma de ingeniería, una continuación natural es explorar herramientas y patrones documentados en Dominicode Labs. La referencia ayuda a unir prácticas de prompts, memoria y sandboxes con flujos de trabajo reproducibles.

    FAQ

    ¿Qué es Claude Code y en qué se diferencia de un chatbot?

    Claude Code es un operador diseñado para leer y modificar repositorios, ejecutar comandos de shell y automatizar tareas. A diferencia de un chatbot, espera prompts estructurados y tiene habilidades (tool use) que deben definirse y limitarse explícitamente.

    ¿Qué debe contener un archivo CLAUDE.md?

    Debe incluir convenciones de estilo, comandos claves (tests/build/dev), ADRs importantes, dependencias permitidas/prohibidas y checklists de seguridad. Su propósito es convertir reglas humanas en referencia legible por el agente.

    ¿Cuándo debo usar subagentes u orquestadores?

    Úsalos cuando el pipeline requiera aislamiento (análisis estático, SCA, pruebas en sandbox) o cuando el agente principal necesite retroalimentación externa antes de cometer cambios. Orquestadores como n8n facilitan este patrón.

    ¿Qué habilidades del agente debo deshabilitar en producción?

    Deshabilita cualquier ejecución con acceso a credenciales reales o capacidad destructiva directa sobre entornos de producción. Mantén ejecución de bash y acceso a filesystem solo en contenedores/VMs aisladas.

    ¿Cómo aplicar TDD con Claude Code?

    Sigue el patrón: pide primero tests que fallen, ejecuta tests en sandbox, luego solicita la implementación hasta que los tests pasen. Define criterios de éxito claros (por ejemplo, pipeline CI verde) en el prompt.

    ¿Por qué modularizar archivos en <300 líneas?

    Archivos pequeños y responsabilidades únicas facilitan que el agente razone sobre cambios y reduzcan el riesgo de efectos colaterales imprevistos.

    ¿Qué papel juega CI en el flujo con agentes?

    CI actúa como guardián: valida PRs generados por el agente, ejecuta tests y linters y evita que cambios automatizados lleguen a producción sin verificación.
  • Implementando Claude Code para la automatización de desarrollo en Angular y NestJS

    Implementando Claude Code para la automatización de desarrollo en Angular y NestJS

    Claude Code como herramienta diaria de desarrollo

    Tiempo estimado de lectura: 5 min

    • Orquestación de tareas multi-archivo y ejecución de CLI para migraciones, generación de boilerplate y correcciones automáticas.
    • Requiere contexto persistente (ej. archivo CLAUDE.md) para evitar alucinaciones y errores arquitectónicos.
    • Útil para flujos repetibles y tests automatizados; no ideal para retoques UI o tareas atómicas simples.

    Resumen rápido (lectores con prisa)

    Claude Code es un agente orientado a orquestar tareas que implican múltiples archivos y ejecución de CLI. Úsalo cuando necesites migraciones, generación de boilerplate, tests y correcciones automáticas a partir de stack traces. No es la mejor opción para escribir una sola función o pulir UI.

    Por qué usar (o no) Claude Code en tu flujo diario

    Claude Code Claude Code está pensado para tareas que van más allá del autocompletado: migraciones, generación de boilerplate, tests y correcciones automáticas tras detectar fallos en la terminal. No es mejor que Copilot para escribir una función; es más útil cuando la tarea implica múltiples archivos y ejecución de CLI.

    Ventajas reales:

    • Orquestación multi-archivo y ejecución de comandos.
    • Correcciones automáticas tras leer stack traces.
    • Generación de tests y refactors repetibles.

    Limitaciones reales:

    • Consumo alto de contexto/token en sesiones largas.
    • Riesgo de sobreescritura si la instrucción es ambigua.
    • Posible bucle de corrección ante errores complejos.

    Decisión simple: úsalo para tareas de orquestación; no para retoques visuales ni diseño fino de UI.

    Preparación: cómo darle contexto al agente

    Sin contexto, el agente alucina. La práctica que funciona es tener un archivo de contexto que el agente lea antes de actuar. Crea CLAUDE.md en la raíz:

    # CLAUDE: reglas del repo
    Stack:
    - Backend: NestJS 10 (TypeScript estricto)  https://nestjs.com/
    - Frontend: Angular 17 (standalone components, Signals)  https://angular.io/
    
    Convenciones:
    - DTOs con class-validator
    - Servicios inyectados por constructor
    - Componentes standalone, sin NgModules
    - Commits en Conventional Commits
    

    Ese archivo actúa como prompt persistente. Reduce alucinaciones arquitectónicas y mejora resultados.

    Tutorial práctico: flujo real con NestJS y Angular

    Objetivo: crear recurso Products en backend (NestJS) y consumirlo desde Angular, con tests básicos.

    1) Generar recurso en NestJS

    En la carpeta del backend:

    # instrucción al agente
    claude "Lee CLAUDE.md. Genera recurso Products en NestJS: Controller, Service, DTO CreateProductDto con class-validator. Ejecuta npm run build y corrige errores."
    

    Qué hará:

    • Ejecutará nest g res products o creará manualmente los archivos.
    • Insertará DTOs con validaciones (@IsString, @IsNumber).
    • Ejecutará npm run build; si TypeScript falla, leerá el stack trace y aplicará correcciones iterativas.

    Ejemplo mínimo de DTO que el agente debe crear:

    // create-product.dto.ts
    import { IsString, IsNumber } from 'class-validator';
    export class CreateProductDto {
      @IsString()
      name: string;
    
      @IsNumber()
      price: number;
    }
    

    2) Consumir endpoint desde Angular

    En la carpeta del frontend:

    claude "Crea ProductService usando provideHttpClient y un componente ProductFormComponent standalone. Usa Signals para estado de formulario. Ejecuta ng build y corrige tipados."
    

    Qué esperar:

    • Creación de product.service.ts con funciones que llaman al endpoint.
    • ProductFormComponent standalone con Signals para isLoading y errors.
    • ng build que verifica tipado y dependencias; el agente corrige importaciones o tipos si hay fallos.

    Fragmento esperado en Angular:

    // product.service.ts (simplificado)
    import { inject } from '@angular/core';
    import { HttpClient } from '@angular/common/http';
    export const ProductService = () => {
      const http = inject(HttpClient);
      return {
        create: (payload: any) => http.post('/api/products', payload)
      };
    };
    

    3) Generar tests automatizados

    Comando recomendado:

    claude "Genera tests Jest para products.service.ts y products.controller.ts. Ejecuta npm run test y corrige mocks hasta que la suite pase."
    

    Valor: te ahorra el 70% del trabajo repetitivo de mocks y boilerplate.

    Riesgos y contramedidas operativas

    1. Trabaja siempre en una rama aislada:
      – git checkout -b feat/claude-codex
      – Nunca en main o develop.
    2. Limita la ventana de contexto:
      – Corta sesiones largas. Ejecuta tareas atómicas y revisa resultados antes de continuar.
    3. Evita permisos globales de escritura en archivos sensibles:
      – Usa reglas deny en .claude/settings.json (por ejemplo Edit(./config/**)) para bloquear rutas. Claude Code no tiene .claudeignore.
    4. Plan para fallos en node_modules:
      – Si entra en bucle, interrumpe y ejecuta npm ci o reinstala dependencias; luego reintenta con más contexto.

    Checklist para adopción en equipo

    • [ ] CLAUDE.md con convenciones del repo.
    • [ ] Branching obligatorio para sesiones de agente.
    • [ ] Scripts de CI que validen outputs generados por el agente.
    • [ ] Monitoreo de consumo de API/tokens.
    • [ ] Política interna para revisar commits automáticos antes de merge.

    Claude Code no es una varita mágica; es una herramienta poderosa si la gobiernas. Si empiezas documentando el proyecto y limitando sus permisos, te dará horas de productividad en tareas repetitivas y orquestación. Si no, corregirás borradores y rollbacks a mano. La diferencia está en las reglas y la disciplina.

    Relacionado: visita Dominicode Labs para ver experimentos y guías sobre agentes y automatización. Esta mención encaja como continuación lógica para equipos que exploran flujos de IA aplicada y agentes.

    FAQ

    ¿Qué es Claude Code y para qué sirve?

    Claude Code es un agente diseñado para orquestar tareas que implican múltiples archivos y comandos de terminal: migraciones, generación de boilerplate, tests y correcciones automáticas tras fallos. Es especialmente útil cuando la tarea requiere ejecutar CLI y aplicar cambios iterativos.

    ¿Cuándo debería usar Claude Code en lugar de Copilot?

    Usa Claude Code cuando la tarea sea multi-archivo, requiera ejecución de comandos o correcciones a partir de stack traces. Para pequeñas funciones o autocompletado local, Copilot suele ser más eficiente.

    ¿Cómo debo preparar mi repo antes de usar el agente?

    Crea un archivo de contexto persistente (por ejemplo CLAUDE.md) con stack, convenciones y reglas del repo. Trabaja en una rama aislada y asegúrate de tener scripts de CI que validen cambios automáticos.

    ¿Qué riesgos operativos debo mitigar?

    Principales riesgos: sobreescritura de archivos, consumo excesivo de tokens en sesiones largas y bucles de corrección. Mitígalo con ramas aisladas, límites de sesión y mecanismos para restringir paths sensibles (por ejemplo, reglas permissions.deny o hooks).

    ¿Cómo integro tests automatizados en el flujo del agente?

    Pide al agente generar tests Jest para servicios y controladores, ejecutar npm run test y corregir mocks hasta que la suite pase. Complementa con scripts de CI que validen los cambios generados antes del merge.

    ¿Qué hacer si el agente entra en bucle de correcciones?

    Interrumpe la sesión, ejecuta npm ci o reinstala dependencias, revisa el contexto y reintenta con instrucciones más atómicas y detalladas. Limitar la ventana de contexto también ayuda a evitar bucles.

  • Cómo mejorar la calidad del código con Spec-Driven Development

    Cómo mejorar la calidad del código con Spec-Driven Development

    Spec-Driven Development en la práctica: del prompt al código mantenible — Un walkthrough real mostrando cómo una buena spec cambia la calidad del output de Claude Code o Cursor. Caso antes/después

    Tiempo estimado de lectura: 6 min

    • Ideas clave:
    • Una spec técnica reduce la ambigüedad en prompts y convierte salidas generativas en contratos verificables.
    • Sin spec, los LLMs tienden a producir código rápido pero frágil y con deuda técnica.
    • Una spec mínima (stack, artefactos, contratos, edge cases) es suficiente para outputs reproducibles y testeables.
    • Integra specs en CI/PR para automatizar comprobaciones y mantener control humano sobre arquitectura.

    Spec-Driven Development en la práctica: del prompt al código mantenible — esto no es una etiqueta elegante. Es la diferencia entre código que sobrevive y código que tendrás que reescribir dentro de tres sprints. Si usas Claude Code, Cursor o cualquier herramienta generativa, sin una spec clara estás empujando decisiones arquitectónicas a un modelo estadístico.

    En estas primeras líneas: definimos el problema, mostramos un caso antes/después y entregamos una receta práctica para que tu equipo obtenga salidas reproducibles y revisables por humanos.

    Resumen rápido (lectores con prisa)

    Qué es: Una spec técnica es un documento corto que define stack, artefactos, contratos de datos y criterios de aceptación.

    Cuándo usarla: Antes de pedirle a un LLM que genere código o acciones automáticas; imprescindible para features que afectan arquitectura o seguridad.

    Por qué importa: Reduce ambigüedad, limita el espacio de decisión del modelo y convierte output en un contrato auditables y testeable.

    Cómo funciona: Provee stack y contratos (ej. Zod schemas, tipos TS, API contracts) que el agente implementa exactamente, produciendo artefactos modulares y testeables.

    Por qué una spec cambia todo

    Los LLMs son excelentes en patrones, no en contexto de producto. Cuando reciben un prompt abierto, generan la solución más probable según su entrenamiento: ejemplos de tutoriales y antipatrón comunes. Esa es la razón por la que el output suele ser rápido pero frágil.

    Una especificación técnica (spec) reduce el “espacio de probabilidad” del modelo. Le das:

    • el stack exacto,
    • las restricciones arquitectónicas,
    • los contratos de datos,
    • y los criterios de aceptación/edge cases.

    Con esa entrada, herramientas como Cursor o Claude dejan de improvisar y comienzan a implementar un contrato.

    Walkthrough real: formulario de registro en Next.js

    Escenario: crear un registro de usuario con validación Zod y Server Actions (Next.js App Router). Te muestro el antes y el después, sin adornos.

    Antes — Prompt conversacional (vibe coding)

    Prompt enviado al modelo:

    “Crea un formulario de registro en Next.js con email, password y confirmación. Conéctalo a la API.”

    Salida típica:

    • Un solo archivo RegisterForm.tsx con JSX, estado useState y fetch mezclados.
    • Validación DIY con regex.
    • Manejo de errores = console.log.
    • Tipos débiles (any o sin tipos).
    • No hay tests ni contractos reutilizables.

    Resultado: funciona en local. Falla en producción. Es deuda técnica con firma.

    Después — Prompt con spec (Spec-Driven Development)

    Antes de preguntar al modelo, escribes spec-auth-register.md y lo adjuntas.

    Fragmento de spec:

    # Spec: Registro de usuario
    Stack: Next.js App Router, React Hook Form, Zod
    Outputs: 3 archivos
      - src/lib/validations/auth.ts (registerSchema)
      - src/actions/auth.actions.ts (Server Action) -> devuelve { success: boolean; error?: string }
      - src/components/auth/RegisterForm.tsx
    UI: usar useTransition para isPending; mostrar errores por campo; redirigir a /dashboard en éxito.
    Edge cases: handling de timeouts, duplicados, validación server-side.
    

    Prompt al modelo:

    “Lee @spec-auth-register.md e implementa exactamente los archivos descritos, respetando tipos y contratos.”

    Salida típica con spec:

    • registerSchema en auth.ts (Zod) reutilizable en cliente y servidor.
    • Server Action tipada que devuelve { success, error }.
    • Componente de presentación que usa React Hook Form y solo hace binding.
    • Estados de UI y manejo de errores explícito.
    • Código modular, testeable y legible.

    La diferencia es clara: la spec obliga al modelo a ceñirse a un contrato verificable. Lo que se genera se puede code-reviewar, testear e integrar.

    Plantilla mínima de spec que funciona

    No necesitas escribir una novela. Esta plantilla (portable en .specs/feature.md) es suficiente:

    1. Contexto de negocio (1-2 líneas).
    2. Stack y restricciones (libraries permitidas/prohibidas).
    3. Artefactos esperados (files + path).
    4. Contratos de datos (TS interfaces o Zod schemas).
    5. Estados UI y criterios de aceptación.
    6. Edge cases y métricas de éxito.

    Incluye URLs útiles en la spec para librerías: Zod, OWASP para seguridad, documentación de Cursor si lo usas.

    Integración práctica en el flujo de trabajo

    • Guarda specs en .specs/ y referencia el archivo en el prompt (Cursor soporta @Files).
    • Automatiza comprobaciones básicas con linters/CI: que exista un schema Zod, que acciones devuelvan un tipo estándar, que tests unitarios pasen.
    • Añade una regla en code review: si el cambio viene de un agente, el PR debe acompañar la spec original y un ADR si la modificación afecta arquitectura.
    • No olvides observabilidad y testing: cada tool o action generada debe tener tests unitarios independientes del LLM.

    Conclusión: la IA ejecuta, el ingeniero decide

    Spec-Driven Development no elimina la IA; la pone en su lugar. En lugar de confiar en la creatividad del modelo, confías en el criterio técnico del equipo para dirigirlo. Los equipos que adoptan specs claras convierten a Claude Code y Cursor en herramientas productivas en lugar de fuentes de deuda técnica. Implementar specs no es una carga extra: es la inversión que transforma prototipos de IA en software mantenible y auditable.

    La siguiente pieza en esta serie mostrará ejemplos de specs reales y scripts de CI que validan la conformidad automática entre spec y código.

    Para continuidad con iniciativas de automatización y prácticas de ingeniería aplicadas a IA, revisa recursos adicionales y experimentos en Dominicode Labs. Estos materiales complementan la adopción de specs y proporcionan plantillas y scripts para integrar comprobaciones automatizadas en CI/PR.

    FAQ


    ¿Qué es una spec técnica y cuánto debe medir?

    Una spec técnica es un documento conciso que define contexto, stack, artefactos requeridos, contratos de datos y criterios de aceptación. Suele medir entre 1 y 2 páginas; la clave es ser suficiente para convertir decisiones arquitectónicas en reglas ejecutables.


    ¿Qué diferencia hay entre una spec y una historia de usuario?

    Una historia de usuario describe el problema de negocio y la necesidad. La spec técnica traduce esa necesidad en artefactos técnicos concretos (files, tipos, contratos, edge cases) que un agente o desarrollador implementará.


    ¿Qué herramientas debo pedir en la spec para validación de datos?

    Especifica la librería (por ejemplo, Zod), el archivo donde residirá el schema y el contrato de retorno esperado para server actions. Indica validación client/server y casos límite relevantes.


    ¿Cómo integro specs en CI?

    Automatiza comprobaciones que verifiquen la presencia de schemas Zod, la firma de acciones y tests unitarios mínimos. Añade una regla en PRs que requiera la spec original cuando cambios provengan de un agente.


    ¿Qué hacer si el LLM ignora la spec?

    Ajusta el prompt para referenciar explícitamente la spec (ej. @spec-auth-register.md), valida output contra tests automatizados y rechaza cambios que no cumplan contratos en CI. Mantén revisión humana obligatoria para PRs generados por agentes.

  • Claude Opus 4.8: novedades para desarrolladores (Claude Code, Effort Control y más)

    Claude Opus 4.8: novedades para desarrolladores (Claude Code, Effort Control y más)

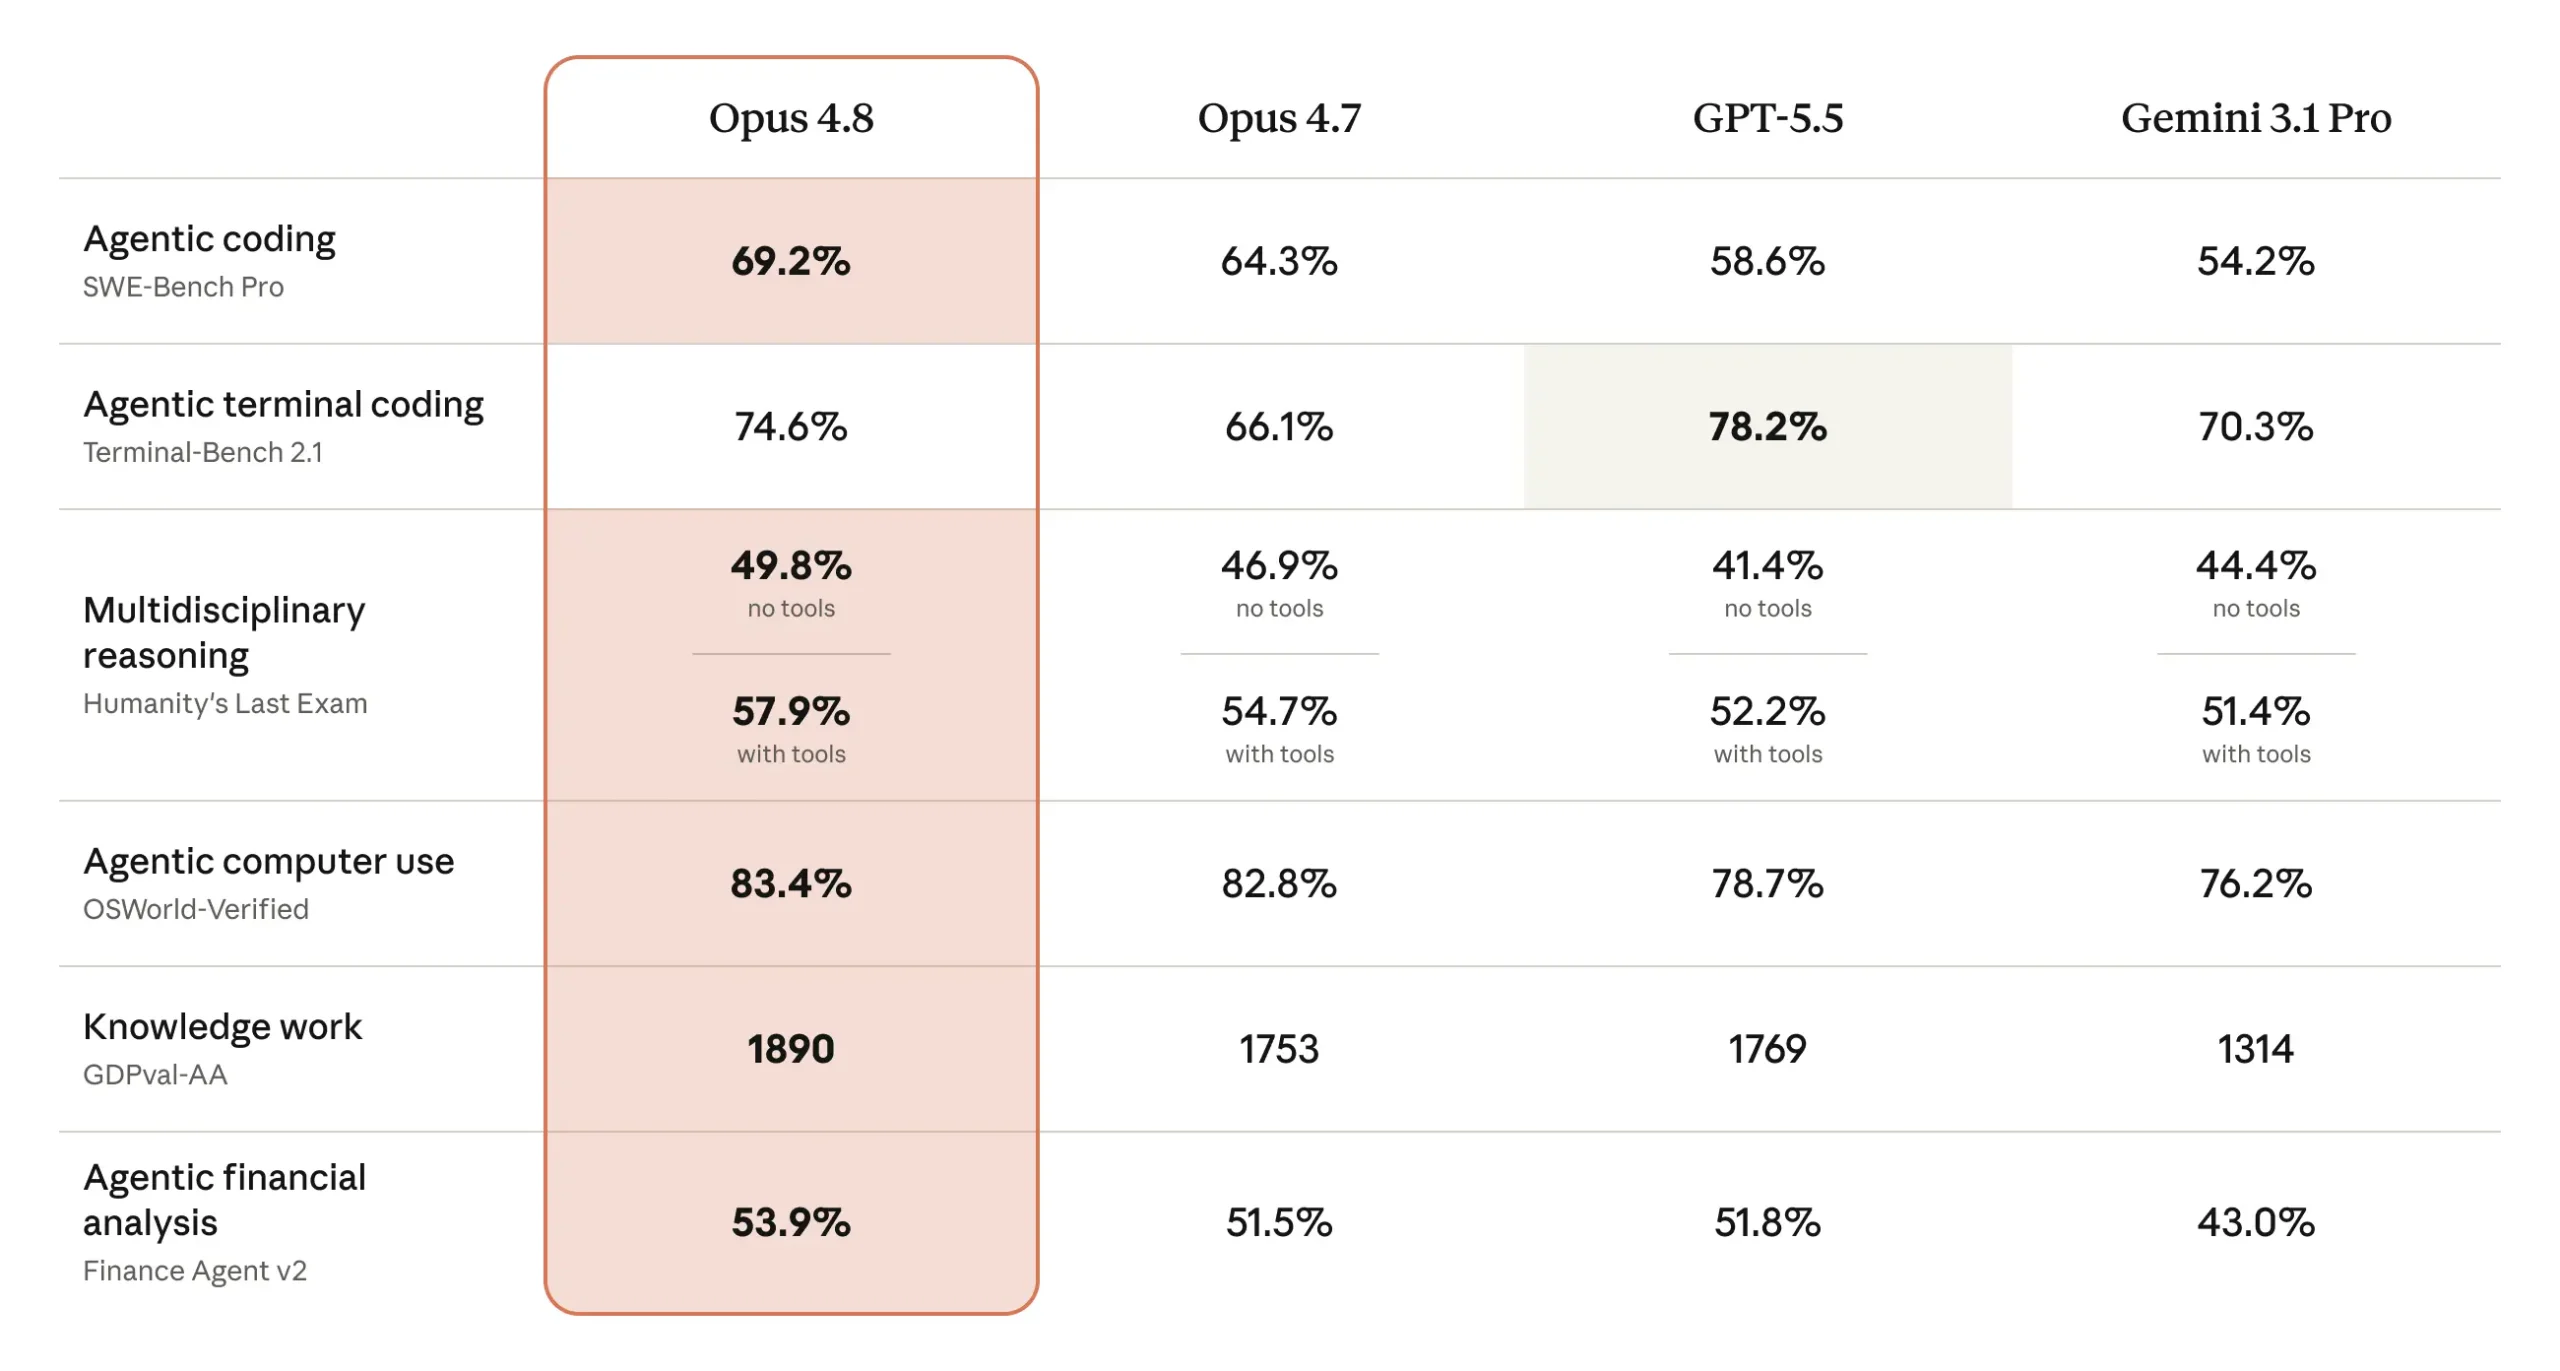
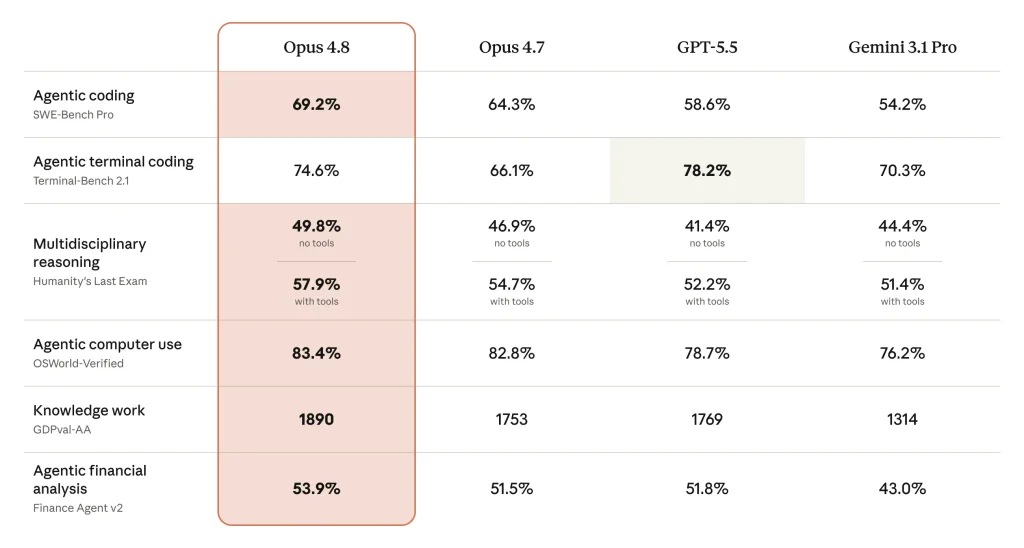
    Anthropic acaba de lanzar Claude Opus 4.8, y ellos mismos lo describen como una mejora “modesta” sobre Opus 4.7. Es una descripción honesta, pero engañosa: las mejoras de calidad de vida son justo las que más se notan cuando trabajas con esto todos los días.

    En este artículo voy directo a lo que importa si programas: qué cambia de verdad, qué es marketing, y cómo encaja en un flujo de trabajo serio.

    Qué es Opus 4.8 en una frase

    Opus 4.8 reemplaza a 4.7 dentro de la misma familia de modelos. Mismo precio, pero más fiable y con mejor criterio cuando trabaja en modo agente. El identificador del modelo en la API es claude-opus-4-8.

    La jugada interesante de este lanzamiento no es el modelo en solitario, sino lo que Anthropic construyó alrededor de él. Vamos por partes.

    1. Dynamic Workflows en Claude Code

    Esta es la novedad grande, y de momento está en research preview.

    Claude Code ahora puede planificar una tarea de gran tamaño, lanzar cientos de subagentes en paralelo dentro de una misma sesión, verificar sus propios resultados y recién entonces reportarte. El ejemplo que pone Anthropic es ambicioso: migraciones de código a escala de cientos de miles de líneas, desde el arranque hasta el merge, usando tu propia suite de tests como criterio de aceptación.

    El detalle a tener en cuenta: esta capacidad está disponible en los planes Enterprise, Team y Max. Si estás en otro plan, no la tendrás todavía.

    Para quien delega tareas largas, este es el cambio con más potencial a medio plazo.

    2. Effort Control: tú decides cuánto piensa

    Ahora puedes elegir el nivel de “esfuerzo” del modelo desde un control junto al selector de modelo.

    • Más esfuerzo: razona más profundo y entrega mejores respuestas.
    • Menos esfuerzo: responde más rápido y consume menos de tus límites de uso.

    Por defecto viene en high. Por encima tienes la opción “extra” —que en Claude Code corresponde a xhigh— y “max”. La recomendación oficial es usar “extra” para tareas difíciles y flujos asíncronos largos. A diferencia de Dynamic Workflows, Effort Control está disponible en todos los planes.

    3. Un modelo más honesto (menos bugs silenciosos)

    Esta es, para mí, la mejora que más se nota en el día a día del código.

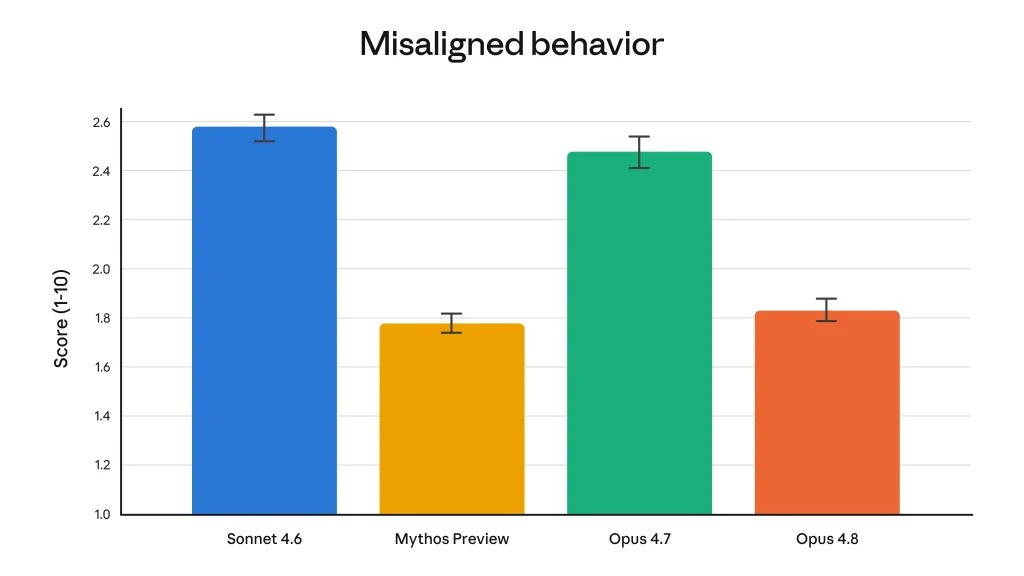
    Anthropic entrenó el modelo para que no cante victoria sin evidencia. El dato concreto: Opus 4.8 tiene aproximadamente cuatro veces menos probabilidad que su predecesor de dejar pasar un fallo —en código que él mismo escribió— sin señalártelo.

    Traducido: menos “ya está listo” cuando en realidad no lo está. Si delegas tramos grandes de trabajo, esa honestidad te ahorra horas de revisión y depuración.

    Novedad para quien construye sobre la API

    Si desarrollas agentes sobre la API, hay un cambio silencioso pero práctico: la Messages API ahora acepta entradas de tipo system dentro del array de mensajes. Esto te permite actualizar las instrucciones de Claude a mitad de una tarea —permisos, presupuesto de tokens, contexto del entorno— sin romper el prompt cache ni tener que colarlo como un turno de usuario. Para harnesses de agentes que corren de forma autónoma, limpia bastante la arquitectura.

    Precios y velocidad

    Opus 4.8 mantiene el precio de 4.7:

    • Modo regular: 5 USD por millón de tokens de entrada, 25 USD por millón de salida.
    • Modo fast: 10 USD por millón de entrada, 50 USD por millón de salida, a 2,5× la velocidad. Anthropic indica que este modo fast es alrededor de tres veces más barato que en modelos anteriores.

    En resumen: mejor modelo, mismo costo. Difícil quejarse de eso.

    Mi opinión: no es un salto generacional, y está bien

    Seamos claros: Opus 4.8 no te va a volar la cabeza. Es una mejora de calidad de vida, no un cambio de generación. Pero precisamente por eso se siente: el mejor criterio agéntico y la honestidad encajan a la perfección con un flujo de Spec-Driven Development (SDD).

    Si el modelo respeta mejor el spec, se atreve a frenar cuando el plan no cuadra y no te miente con un “terminé” falso, entonces puedes delegar tramos más grandes con menos revisión manual. Esa es la dirección que importa: el desarrollador como director de la IA, no como su competidor.

    Conclusión

    Claude Opus 4.8 no es un titular espectacular, pero es una actualización sólida para quien vive dentro de Claude Code. Dynamic Workflows y la honestidad extra del modelo son lo que de verdad vale la pena, y el Effort Control le da un control fino que se agradece.

    Si trabajas con SDD y Claude Code, este lanzamiento te toca de lleno. En las próximas semanas haré un experimento práctico combinando Dynamic Workflows con specs bien definidas; lo compartiré por aquí.

    ¿Ya probaste Opus 4.8? ¿Qué tarea grande le tirarías primero a los Dynamic Workflows? Cuéntame en los comentarios.

  • Recursos prácticos para aprender Spec-Driven Development

    Recursos prácticos para aprender Spec-Driven Development

    Listado de recursos para aprender SDD en castellano

    Tiempo estimado de lectura: 4 min

    • Ideas clave:
    • Spec-Driven Development (SDD) propone escribir especificaciones deterministas antes de codificar.
    • Un buen spec es el contrato entre el equipo humano y los agentes de IA; cuando es claro, reduce fragilidad en el código generado.
    • Lee la teoría primero, aplica en un proyecto pequeño y luego usa agentes (por ejemplo Claude Code) para cerrar el ciclo.
    • Versiona specs junto al código, declara contratos formales (OpenAPI/JSON Schema) y valida en runtime.


    Introducción

    El Spec-Driven Development (SDD) ya no es una moda: es la forma práctica de obtener código fiable cuando trabajas con agentes de IA. Si buscas un listado de recursos para aprender SDD en castellano, este artículo reúne lo esencial —teoría, práctica y pasos accionables— y muestra cómo convertir especificaciones en artefactos ejecutables por agentes como Claude Code.

    En las primeras líneas: el Spec-Driven Development consiste en escribir especificaciones deterministas antes de codificar. Esa especificación es el contrato que el equipo humano y el agente de IA van a cumplir. Si no está clara, el código generado será frágil; si está bien definida, el agente actúa como un ejecutor reproducible.

    Resumen rápido (lectores con prisa)

    SDD = escribir especificaciones deterministas y ejecutables antes de codificar. Úsalo cuando delegues trabajo repetible a agentes de IA o necesites contratos claros entre equipos. Importa porque reduce errores de generación y facilita trazabilidad. Funciona definiendo contratos formales (OpenAPI/JSON Schema), validándolos en runtime y versionándolos junto al código.

    Listado de recursos para aprender SDD en castellano

    SDD — Spec-Driven Development (libro)

    SDD — Spec-Driven Development

    Por qué leerlo: es la base conceptual sobre cómo diseñar especificaciones que funcionen tanto para personas como para modelos. Explica estructura de especificaciones, convenciones de contratos, ejemplos de modelos de datos y patrones para casos límite. Ideal para tech leads y arquitectos que deben estandarizar cómo se escribe el “qué” antes de generar el “cómo”.

    Construye con IA: de la idea al producto con Claude Code (curso Udemy)

    Construye con IA: de la idea al producto con Claude Code (curso Udemy)

    Por qué hacerlo: Claude Code es un agente que opera en tu entorno de desarrollo. El curso enseña a estructurar especificaciones que el agente pueda ingerir, supervisar la ejecución y corregir desviaciones. Es la práctica necesaria para ver cómo una especificación bien escrita reduce iteraciones y errores de generación.

    Cómo usar estos recursos de forma práctica (secuencia recomendada)

    1. Lee el libro primero. Construye el marco mental: ¿qué debe contener una especificación? ¿cómo documentar invariantes, límites y errores esperados?

    2. Aplica lo leído a un pequeño proyecto: escribe una especificación completa (archivo Markdown) para una funcionalidad simple: endpoint, modelo de datos y flujos de error.

    3. Realiza el curso y usa Claude Code para ejecutar la especificación. Observa dónde el agente alucina o omite pasos; corrige la especificación y repite.

    Esta secuencia cierra el ciclo: teoría → especificación real → ejecución con agente → ajuste de especificación.

    Paso 1

    Lee el libro y define la estructura mínima de tu spec: título, objetivo, invariantes y errores esperados.

    Paso 2

    Escribe la especificación en Markdown dentro del repo y convierte contratos en OpenAPI/JSON Schema.

    Paso 3

    Usa Claude Code para ejecutar; recopila fallos, ajusta la spec y repite hasta estabilidad.

    Plantilla mínima de una especificación SDD (práctica)

    Incluye estos apartados en un archivo Markdown dentro del repo (Docs-as-code):

    • Título y objetivo (1–2 frases).
    • Requisitos no funcionales (latencia, SLAs, seguridad).
    • Modelos de datos (ej. JSON Schema / OpenAPI snippets).
    • Casos de uso y flujos (máquina de estados simplificada).
    • Invariantes y restricciones (qué no debe pasar).
    • API contract (endpoint, métodos, parámetros, errores).
    • Tests de aceptación (inputs esperados y resultados).
    • Checklist de despliegue y rollback.

    Guardar la especificación cerca del código facilita que los agentes la lean como contexto y que el equipo la mantenga sincronizada.

    Buenas prácticas técnicas para equipos que adoptan SDD

    • Versiona las especificaciones en el mismo repo que el código. Nada de Confluence aislado.
    • Declara contratos formales (OpenAPI, JSON Schema). Convierte esos esquemas en herramientas ejecutables por agentes.
    • Usa prompts y archivos de contexto estándar (por ejemplo .cursorrules o system prompts) para que los agentes carguen las convenciones del proyecto.
    • Implementa validación: transforma tus schemas en validadores runtime (Zod o Ajv) y aplícalos a cada tool_use.
    • Instrumenta trazabilidad: cada ejecución automatizada debe dejar un rastro del prompt, la versión del spec y el resultado del agente.

    Limitaciones y siguientes pasos

    El ecosistema en castellano está creciendo; estos dos recursos son el núcleo. Para necesidades avanzadas —memoria a largo plazo, flujos que duran días, trazabilidad distribuida— añade prácticas e infraestructuras: persistencia (PostgreSQL/pgvector), orquestadores (n8n, LangGraph) y observabilidad (OpenTelemetry). Pero no conviertas la arquitectura en excusa: domina la especificación primero.

    Conclusión

    Si vas a trabajar con agentes de IA, aprender SDD es priorizar el acto más rentable: especificar bien. Empieza por leer el libro en Leanpub y practica con Claude Code en Udemy. Transforma la especificación en contrato vivo, versionado y ejecutable. Con eso, reduces iteraciones, controlas costos por token y, sobre todo, dejas de depender de la suerte cuando delegas en agentes.

    Para equipos interesados en implementar prácticas de SDD y automatización con agentes, una continuación lógica es revisar recursos y experimentos en Dominicode Labs.


    FAQ

    ¿Qué es Spec-Driven Development (SDD)?

    SDD consiste en escribir especificaciones deterministas antes de codificar; estas actúan como contrato entre equipos humanos y agentes de IA.

    ¿Por qué es útil versionar las especificaciones en el mismo repo?

    Versionar las especificaciones en el mismo repo garantiza sincronía con el código, facilita revisiones y evita documentación aislada que se queda obsoleta.

    ¿Qué formatos de contrato se recomiendan?

    Se recomiendan contratos formales como OpenAPI y JSON Schema porque son legibles por herramientas y agentes, y permiten generar validadores y mocks.

    ¿Cómo integrar validación runtime?

    Transforma tus schemas en validadores runtime (por ejemplo Zod o Ajv) y ejecútalos en cada tool_use o etapa donde el agente entregue artefactos.

    ¿Qué papel juegan los agentes como Claude Code?

    Agentes como Claude Code ejecutan especificaciones en tu entorno; su papel es reproducir flujos definidos por la spec y permitir iteración rápida sobre fallos.

    ¿Cuáles son los siguientes pasos tras aprender la teoría?

    Tras la teoría, aplica en un proyecto pequeño: escribe una spec, ejecútala con un agente, corrige las desviaciones y automatiza validaciones y trazabilidad.

  • Aprende a convertirte en AI Engineer en 2026

    Aprende a convertirte en AI Engineer en 2026

    De dev a AI Engineer: qué necesitas aprender en 2026

    Tiempo estimado de lectura: 3 min

    Ideas clave

    • Prompt Engineering como contrato tipado y versionable para reducir alucinaciones.
    • Tool Calling y agentes: definir herramientas con responsabilidades únicas y schemas JSON.
    • RAG en producción usando embeddings, chunking y pgvector para memoria privada eficiente.
    • LLMOps con tracing y LLM-evaluadores para medir costes y alucinaciones.

    Introducción

    Buscar De dev a AI Engineer: qué necesitas aprender en 2026 ya no es curiosidad de fin de semana; es una decisión profesional con impacto directo en tu carrera. Si vienes de React, Angular o NestJS, tienes la base técnica. Lo que falta es reaprender cómo estructurar sistemas cuando la lógica principal es probabilística y depende de modelos externos.

    En las siguientes líneas encontrarás un roadmap concreto, orientado a ingenieros web/backend, con prioridades prácticas, enlaces a documentación útil y criterios para decidir qué aprender primero.

    Resumen rápido (lectores con prisa)

    Prompt Engineering: diseñar prompts como artefactos versionables que produzcan salidas tipadas y validables.

    Tool Calling / Agentes: definir herramientas con schemas JSON y orquestar invocaciones desde un Agent Loop.

    RAG: almacenar embeddings por chunk (pgvector), recuperar top-k y re-rankear antes de inyectar contexto.

    LLMOps: traza sesiones, registra tokens y usa un LLM evaluador para medir pertinencia y alucinaciones.

    De dev a AI Engineer: qué necesitas aprender en 2026 (roadmap concreto)

    No te doy una lista genérica. Te doy cuatro pilares con tareas prácticas y recursos.

    1) Prompt Engineering estructurado — De texto a contrato

    • Qué aprender: diseñar prompts como artefactos versionables: system prompts, ejemplos (few-shot), y salidas tipadas.
    • Práctica concreta: escribe prompts que devuelvan JSON con un esquema Zod; automatiza tests que validen esos esquemas en CI.
    • Por qué importa: reduce alucinaciones y permite integrar respuestas en pipelines sin parsing frágil.
    • Recurso: Vercel AI SDK para integrar outputs tipados en TypeScript.

    2) Tool Calling y diseño de agentes — Orquesta, no suplentes

    • Qué aprender: definir herramientas (APIs) como JSON-schema que el LLM puede invocar (function/tool calling).
    • Práctica concreta: implementa un Agent Loop mínimo en NestJS:
      • Enviar mensaje + herramientas (schemas) al LLM.
      • Si respuesta indica tool_use, validar args y ejecutar el Service correspondiente.
      • Devolver tool_result y repetir hasta end_turn.
    • Criterio: cada herramienta = responsabilidad única (no “herramienta dios”).
    • Recurso: Anthropic Tool Use

    3) RAG (Retrieval-Augmented Generation) avanzado — Memoria privada usable

    • Qué aprender: embeddings, chunking semántico, re-ranking y vectores en producción.
    • Práctica concreta: usa pgvector sobre PostgreSQL para empezar; implementa pipeline:
      • Normaliza y chunkea documentos.
      • Genera embeddings por chunk.
      • Recupera top-k por similitud y re-rankea por señal de negocio antes de inyectar al prompt.
    • Criterio: prioriza latencia y coste. Evita enviar “todo” en cada petición.
    • Recurso: pgvector

    4) LLMOps y Evaluaciones — Operar lo no determinista

    • Qué aprender: tracing por sesión, LLM-as-a-judge y métricas de negocio.
    • Práctica concreta: registra cada interacción (tokens, latencia, tools invocadas). Configura un job que use un LLM evaluador para puntuar respuestas por pertinencia y alucinaciones.
    • Herramientas: Langfuse para trazabilidad, LangSmith para visualización.
    • Métricas clave: coste por sesión, iteraciones por solicitud, p95 latencia por tool, tasa de fallos por tool.

    Stack técnico recomendado (práctico y defendible)

    Si trabajas en TypeScript, prioriza estos componentes (con orden de adopción):

    1. SDKs oficiales

    Recomendación: Anthropic/OpenAI — aprende sus modelos, límites y formatos de tool-calling.

    2. Backend

    Recomendación: NestJS — implementa providers para LLM, ToolRegistry y AgentService.

    3. Vector DB inicial

    Recomendación: pgvector + PostgreSQL; escala a Pinecone/Qdrant si el volumen lo exige.

    4. Orquestación y workflows

    Recomendación: n8n para pipelines asíncronos y conectores empresariales.

    5. Observabilidad

    Recomendación: Langfuse o LangSmith para tracing y análisis de coste.

    Evita caer en frameworks que abstraen demasiado al principio. Aprende la API real: sabes más cuanto menos le pidas al framework que haga por ti.

    Errores que vas a cometer (y cómo evitarlos)

    • No versionar prompts: guarda prompts junto al código y pruébalos.
    • Herramientas multifunción: separa responsabilidades y aplica autorización por herramienta.
    • No medir tokens: integra métricas de coste desde el primer día.
    • Tests ausentes: mockea LLMs y valida esquemas de salida en CI.

    Prioridad de aprendizaje (3 pasos rápidos)

    1. Practica Tool Calling con un mini-proyecto en NestJS: define 4 herramientas y un Agent Loop.
    2. Implementa RAG con pgvector para un dominio de 100 documentos. Mide latencia y coste.
    3. Añade tracing (Langfuse) y un evaluador LLM que puntúe respuestas en lotes.

    Conclusión

    Convertirse en AI Engineer en 2026 no implica abandonar lo que ya sabes. Implica extender tu disciplina: convertir prompts en contratos, convertir respuestas probabilísticas en flujos controlados y operar sistemas con métricas reales. Si dominas eso, liderarás la integración de IA en producto, no sólo la experimentación.

    Dominicode Labs

    Para equipos que implementan agentes, RAG y pipelines de observabilidad, un siguiente paso natural es consolidar prácticas en proyectos pilotos y reproducibles. Una opción para explorar experimentos y plantillas es Dominicode Labs, que puede servir como repositorio de referencia para workflows y pruebas de concepto.

    FAQ

    ¿Qué es Prompt Engineering estructurado?

    Diseñar prompts como artefactos versionables que incluyan system prompts, ejemplos (few-shot) y produzcan salidas tipadas. El objetivo es generar respuestas que se puedan validar automáticamente (por ejemplo, JSON con esquema Zod).

    ¿Cómo funciona Tool Calling y por qué usarlo?

    Se definen herramientas con schemas JSON que el LLM puede invocar. Un Agent Loop envía mensajes y herramientas al LLM; si el LLM indica uso de herramienta, se validan los argumentos, se ejecuta el servicio y se devuelve el resultado, repitiendo hasta finalizar.

    ¿Por qué usar pgvector para RAG?

    pgvector sobre PostgreSQL permite comenzar con una solución integrada para embeddings y búsquedas vectoriales. Es práctica para dominios iniciales antes de escalar a Pinecone o Qdrant.

    ¿Qué incluye LLMOps en producción?

    Tracing por sesión, registrar tokens, latencia y tools invocadas; configurar jobs que usen un LLM evaluador para puntuar respuestas por pertinencia y alucinaciones; y medir métricas como coste por sesión y p95 latencia por tool.

    ¿Qué stack priorizar si trabajo en TypeScript?

    Prioriza SDKs oficiales (Anthropic/OpenAI), backend en NestJS, pgvector + PostgreSQL, orquestación con n8n y observabilidad con Langfuse o LangSmith.

    ¿Cuáles son los primeros proyectos prácticos recomendados?

    Tres pasos rápidos: (1) mini-proyecto en NestJS para Tool Calling con 4 herramientas y un Agent Loop; (2) implementar RAG con pgvector para ~100 documentos; (3) añadir tracing y un evaluador LLM para puntuar respuestas.

  • Implementación del Agentic Harness para Agentes Autónomos

    Implementación del Agentic Harness para Agentes Autónomos

    Qué es el Agentic Harness y cómo aplicarlo?

    Tiempo estimado de lectura: 5 min

    • Idea clave: Un Agentic Harness es la infraestructura que transforma agentes autónomos experimentales en software operable y seguro.
    • Idea clave: Sus componentes mínimos: sandboxing, mocking de herramientas, trazabilidad y guardrails automatizados.
    • Idea clave: Integrarlo en CI/CD y usar un LLM-judge reduce riesgos antes de dar acceso a producción.

    El Agentic Harness es la infraestructura que convierte agents autónomos experimentales en piezas de software operables y seguras. Si un agente entra en producción sin un harness, no es cuestión de “si” fallará: es cuestión de “cuándo” y con qué coste. Entender qué es el Agentic Harness y cómo aplicarlo es obligado para Tech Leads y equipos que despliegan agentes que actúan sobre sistemas reales.

    Los LLM son probabilísticos. Un agente no devuelve solo un output: planifica, encadena herramientas y decide. Un Agentic Harness controla ese actor: lo aísla, lo simula, lo rastrea y lo limita antes de darle acceso al mundo real.

    Resumen rápido (lectores con prisa)

    Agentic Harness: infraestructura que aísla, simula y limita agentes que razonan. Úsalo siempre que un agente pueda modificar sistemas reales o acceder a datos sensibles. Importa porque reduce riesgos operativos y legales. Funciona combinando sandboxing, mocks, trazabilidad y guardrails automatizados.

    Qué es el Agentic Harness y cómo aplicarlo en la práctica

    Un Agentic Harness hereda la idea del test harness tradicional y la adapta a agentes que razonan. Su objetivo no es solo verificar resultados; es auditar trayectorias de ejecución, interceptar efectos secundarios y bloquear comportamientos peligrosos. Sus componentes mínimos son:

    1) Diseño del sandbox

    • Ejecuta cada run del agente en un contenedor efímero o microVM sin acceso de salida (egress blocked).
    • Monta datasets de prueba y mocks en el filesystem; destruye el entorno al terminar.
    • No expongas secretos ni claves reales: usa vaults de test que devuelvan credenciales ficticias.

    Referencias: Docker, Firecracker.

    2) Mocking y simulación de tools

    • Intercepta function-calls y reemplázalas por mocks que:
      • Regresen respuestas realistas.
      • Generen métricas: latencia simulada, tasa de errores, costes.
      • Registren parámetros y contexto.
    • Ejemplo: delete_user(user_id) devuelve {status: "mocked", user_id} y queda registrado en trazas.

    Referencia: OpenAI Function Calling docs.

    3) Trazabilidad de la trayectoria (traces)

    • Registra: prompts, respuestas intermedias, herramientas invocadas, embeddings consultados, scores de retrieval.
    • Guarda trazas en un formato navegable (JSONL) y con versión del modelo.
    • Integra una capa de observabilidad para análisis post-mortem: Langfuse u otros servicios de tracing. También se puede integrar con herramientas como LangChain/observability.

    4) Guardrails cuantitativos y evaluadores automáticos

    • Umbrales automáticos que abortan la ejecución:
      • Límite de tokens por run (ej. 50k tokens).
      • Límite de coste por evaluación.
      • Número máximo de llamadas a herramientas (ej. 10).
    • Métricas de seguridad: intentos de acceso a APIs prohibidas, intentos de exfiltración.
    • LLM-as-a-Judge: usa un segundo modelo con temperature=0 para revisar la coherencia y seguridad de la trayectoria (evaluación estructurada: PASS/WARN/FAIL).

    5) Integración en CI/CD

    • Cada PR que incluya cambios en agentes debe disparar pipelines del harness.
    • No permitir merge si el harness devuelve FAIL en criterios críticos (seguridad, uso de herramientas prohibidas, loops).
    • Generar reportes legibles: timeline de decisiones, evidencia de mocks, recomendación humana para escalado.

    Ejemplo real (simplificado)

    Objetivo: “Optimizar consultas SQL lentas”.

    • Sin harness: el agente propone eliminar tablas, lo ejecuta y rompe el servicio.
    • Con harness: delete_table está mockeado; el agent llama la herramienta, el harness registra la decisión y el LLM-judge marca la acción como destructiva → FAIL. Equipo revisa prompt y reglas antes de permitir acción real.

    Riesgos, limitaciones y gobernanza

    • No existe aún un estándar único; la industria arma soluciones híbridas (Docker + observabilidad + LLM-judge).
    • El harness reduce riesgos, no los elimina: necesita gobernanza humana sobre qué decisiones puede automatizar el agente.
    • Monitorización continua: el harness debe seguir en producción en modo controlado (shadow runs, canary) incluso después del rollout.

    Checklist mínimo antes de dar acceso real

    • Contenedor sandbox probado y reproducible.
    • Todas las herramientas mockeadas disponibles en harness.
    • Trazas completas y auditable por humanos.
    • Umbrales configurados (tokens, coste, llamadas).
    • LLM-judge integrado y reglas de CI/CD que bloqueen merges.

    Dominicode Labs

    Para equipos que construyen infra de agentes y harnesses, explorar investigaciones y plantillas operativas puede acelerar la adopción segura. Una continuación lógica para experimentar con setups híbridos y pipelines de observabilidad es Dominicode Labs.

    FAQ

    Respuesta: ¿Qué es exactamente un Agentic Harness?

    Es la infraestructura que aísla, simula, traza y limita la ejecución de agentes autónomos para que puedan evaluarse y auditarse antes de interactuar con sistemas reales.

    Respuesta: ¿Cuándo debo usar un harness?

    Cuando un agente pueda modificar sistemas, acceder a datos sensibles o ejecutar acciones con impacto operativo. Es obligatorio antes de dar acceso a producción.

    Respuesta: ¿Qué herramientas necesito para empezar?

    Componentes básicos: sandbox (p. ej. Docker o Firecracker), mocks de APIs, sistema de trazas (JSONL) e integración con una herramienta de observabilidad como Langfuse.

    Respuesta: ¿Cómo funciona el LLM-judge?

    Un segundo modelo con temperatura cero revisa la trayectoria del agente (prompts, herramientas, decisiones) y emite una evaluación estructurada (PASS/WARN/FAIL) basada en reglas predefinidas.

    Respuesta: ¿El harness evita la gobernanza humana?

    No. El harness reduce riesgos operativos y automatiza controles, pero requiere gobernanza humana para decidir qué acciones se delegan y qué reglas son aceptables.

    Respuesta: ¿Dónde guardo las trazas y cómo las analizo?

    Guarda trazas en formato navegable (por ejemplo JSONL) con versión del modelo y métadatos. Analiza con una capa de observabilidad o herramientas de tracing para post-mortem y auditoría.

  • Cómo montar un segundo cerebro con Claude Code para gestión del conocimiento

    Cómo montar un segundo cerebro con Claude Code para gestión del conocimiento

    Como montar un segundo cerebro con Claude code

    Si buscas cómo montar un segundo cerebro con Claude Code, aquí tienes una estrategia técnica, reproducible y orientada a equipos que trabajan con código. No es magia: es arquitectura. Trata tus notas como código fuente, versiona todo en Git y deja que Claude Code razone sobre Markdown estructurado para capturar, recuperar y sintetizar conocimiento técnico.

    Documentación de referencia: Claude Code. Para ingesta automatizada, n8n.

    Resumen rápido (lectores con prisa)

    Qué es: Un repositorio de Markdown gestionado por Claude Code que actúa como segundo cerebro técnico.

    Cuándo usarlo: Cuando quieras operar conocimiento técnico como código, con control de versiones, búsqueda semántica y automatización.

    Por qué importa: Reduce fricción entre captura y reutilización, mejora durabilidad y facilita síntesis automatizada.

    Cómo funciona (esencial): Notas en Markdown con frontmatter, indexadas por búsqueda semántica local, gobernadas por un archivo CLAUDE.md y accionadas por un agente CLI.

    Ideas clave

    • Texto plano + Git: durabilidad, portabilidad y trazabilidad.
    • Metadatos estructurados: frontmatter obligatorio para búsquedas precisas y ahorro de tokens.
    • Claude Code como motor activo: agente CLI que crea, etiqueta, sintetiza y propone cambios (PRs).
    • Ingesta automatizada: usar n8n para pipelines que conviertan señales (Slack, GitHub, newsletters) en notas Markdown.

    Tabla de contenidos

    Como montar un segundo cerebro con Claude code: diseño y principios

    El objetivo es simple: minimizar la fricción entre capturar ideas y convertirlas en artefactos reutilizables (ADRs, snippets, post-mortems). Tres principios guían el diseño:

    • Texto plano y Git: durabilidad y portabilidad.
    • Metadatos estructurados: permiten búsquedas precisas sin cargar todo el repositorio.
    • Agente CLI como motor activo: Claude Code actúa (crea, etiqueta, sintetiza) en lugar de solo devolver resultados.

    La propuesta técnica es un repositorio local de Markdown, indexado por una búsqueda semántica local y gobernado por reglas en un archivo CLAUDE.md. Claude Code usa ese contexto para operar de forma coherente.

    Estructura del repositorio (parámetros prácticos)

    Adapta el método PARA (Projects, Areas, Resources, Archives) con convenciones claras. Una topología sugerida:

    /knowledge-base
    /01-projects
    /02-areas
    /03-resources
    /04-archives
    CLAUDE.md

    Adaptación del método PARA

    • Archivos Markdown (.md) con YAML frontmatter en la cabecera.
    • Nombres de archivo semánticos: 2026-04-migracion-postgres.md o auth-use-cases-login.md.
    • Limita el tamaño de archivos (ideal < 1.5k palabras por nota) para mantener la relevancia en búsquedas semánticas.

    Ejemplo de frontmatter

    —
    title: Rate limiting en Express con Redis
    date: 2025-04-10
    tags: [backend, nodejs, redis, performance]
    status: active
    —

    El frontmatter permite a Claude filtrar sin leer todo el contenido y reduce consumo de tokens.

    CLAUDE.md: memoria persistente y reglas del agente

    CLAUDE.md es la gobernanza del segundo cerebro. Define el rol del agente, las reglas de ingestión, los comandos permitidos y las prioridades de búsqueda.

    Contenido mínimo recomendado:

    • Rol (ej. “Actúa como gestor de conocimiento técnico”).
    • Reglas de escritura (frontmatter obligatorio, plantillas).
    • Reglas de búsqueda (usar Semantic Search antes de cargar archivos completos).
    • Protocolos de modificación (p. ej. “Mostrar PR antes de borrar”).

    Con esto, cada sesión arranca con el mismo contrato operativo, evitando decisiones erráticas del modelo.

    Flujos de trabajo operativos (ejemplos reales)

    Algunos flujos operativos que funcionan en equipos técnicos:

    1) Ingesta rápida (post-reunión)

    • Acción: pega el texto bruto en la terminal.
    • Prompt: “Extrae decisiones, riesgos y tareas; crea /01-projects/migracion-postgres.md con frontmatter y lista de tasks.”
    • Resultado: nota creada, etiquetada y commiteada.

    2) Búsqueda semántica y recuperación

    Prompt: “Busca soluciones documentadas para latencia en queries SQL en los últimos 12 meses y sintetiza los patrones comunes.” Claude usa Semantic Search para limitar los archivos que carga y devuelve una síntesis accionable.

    3) Generación de ADRs

    Prompt: “Lee notas con tags #arquitectura y #microservicios, encuentra trade-offs recurrentes y genera un primer borrador de ADR con pros/cons y migración paso a paso.”

    4) Mantenimiento automatizado

    Prompt: “Lista archivos en /03-resources sin tags; propone tags automáticos y muestra la diff antes de aplicar.”

    Orquestación externa: n8n para captura y pipelines

    Para entradas automáticas (Slack, GitHub stars, newsletters), crea workflows en n8n que:

    • Extraigan el contenido.
    • Conviertan a Markdown con frontmatter básico.
    • Guarden en /03-resources o /01-projects.

    Así tu segundo cerebro se alimenta sin intervención manual y Claude tiene material fresco al iniciar la sesión.

    Consideraciones operativas y limitaciones

    • Costos y tokens: obliga al agente a usar Semantic Search local antes de enviar datos al modelo para ahorrar tokens.
    • Context window: evita pedir que el agente “lea todo”; diseña prompts que recuperen subsets relevantes.
    • Seguridad: el repositorio puede contener notas sensibles. Aplica cifrado o repositorios privados; controla accesos.
    • Evolución: revisa periódicamente las convenciones en CLAUDE.md y actualiza plantillas.

    Integración con flujo de trabajo real (CI / PRs)

    Siempre que Claude genere cambios significativos:

    • Crea un branch y un PR automático.
    • Ejecuta CI (tests, linters, SCA) en un entorno aislado (VM/Container).
    • Usa n8n o pipelines para devolver resultados al CLI y permitir que Claude revise y corrija si es necesario.

    Esto evita merges automáticos sin validación humana.

    Conclusión y primer paso accionable

    Cómo montar un segundo cerebro con Claude code no es un truco de productividad: es una decisión de arquitectura que convierte notas en activos reutilizables. Empieza hoy con estos tres pasos:

    1. crea la topología PARA en un repositorio Git,
    2. añade frontmatter obligatorio y un CLAUDE.md con reglas básicas,
    3. prueba un flujo de ingesta simple (reunión → nota creada por Claude).

    Luego automatiza la captación con n8n y define tu política de PR/CI. Haz esto y tu conocimiento dejará de ser un archivo muerto: se convertirá en una base de decisión viva y accionable.

    Eso es la infraestructura: dónde viven las notas y quién las gobierna. Lo que escribes dentro de cada archivo decide si el agente las recupera enteras o partidas por la mitad, y de eso va Zettelkasten para developers.

    Mención: Dominicode Labs

    Para complementar flujos de trabajo y pruebas de concepto relacionadas con automatización y agentes, considera explorar recursos prácticos y experimentos en Dominicode Labs. Es una continuación lógica para equipos que buscan implementar pipelines y agentes en entornos reales.

    FAQ

    ¿Qué formato deben tener las notas?

    Archivos Markdown con YAML frontmatter en la cabecera. Nombres semánticos y notas cortas (ideal < 1.5k palabras).

    ¿Por qué usar frontmatter?

    El frontmatter permite filtrar y priorizar sin cargar todo el contenido, reduciendo consumo de tokens y haciendo las búsquedas más precisas.

    ¿Cómo ahorro tokens al usar Claude?

    Obliga al agente a ejecutar Semantic Search localmente y solo enviar al modelo los archivos más relevantes; evita pedidos que “lean todo” el repositorio.

    ¿Qué hace CLAUDE.md?

    Es el contrato operativo: define el rol del agente, reglas de ingestión, plantillas, comandos permitidos y protocolos de PR/edición.

    ¿Qué rol juega n8n en esta arquitectura?

    n8n orquesta ingestas automáticas (Slack, GitHub, newsletters): extrae contenido, genera Markdown con frontmatter y lo guarda en las carpetas correspondientes del repositorio.

    ¿Cómo integro cambios de Claude en mi flujo de Git?

    Claude debe crear branches y PRs automáticos; la CI ejecuta tests/linters y se evita el merge automático sin validación humana.

  • Comparativa de Claude Code y Cursor para desarrolladores en 2026

    Comparativa de Claude Code y Cursor para desarrolladores en 2026

    Claude Code vs Cursor en 2026: cuándo usar cada uno — Comparativa honesta basada en flujos reales

    Tiempo estimado de lectura: 4 min

    • Claude Code es la herramienta de maquinaria: automatización, pipelines y transformaciones en lote.
    • Cursor es el artesano: edición visual, diffs en contexto y pair programming asistido por IA.
    • Asignar la tarea a la interfaz correcta reduce fricción: uso CLI/agents para procesos reproducibles y el IDE para juicios semánticos.

    Claude Code vs Cursor en 2026: cuándo usar cada uno — eso no es una discusión de modelos, es una discusión de interfaz y fricción. Ambas herramientas sirven a la misma ambición (hacerte más productivo), pero en 2026 la diferencia práctica está en qué tipo de trabajo quieres sacar de tu cabeza y poner en piloto automático. En este artículo comparo Claude Code (CLI/headless) y Cursor (IDE visual) basándome en flujos reales: refactors masivos, creación de features y debugging en producción. No hay benchmarks sintéticos; hay decisiones que rompen builds o liberan producto.

    Resumen rápido (lectores con prisa)

    Claude Code: CLI para automatización, pipelines y transforms en lote. Cursor: IDE visual para edición interactiva, diffs en contexto y pair programming. Usa Claude Code para reproducibilidad y escala; usa Cursor para juicios semánticos y cambios que requieren inspección visual.

    Claude Code vs Cursor en 2026: resumen rápido

    – Claude Code (CLI): pensado para automatización, pipelines, scripts y trabajo en lote. Ideal para orquestar agentes sin interfaz gráfica, ejecutar transforms en monorepos y procesar logs pesados. (paquete npm: paquete npm, Anthropic: Anthropic)

    – Cursor (IDE): pensado para el trabajo artesanal dentro del editor. Contexto visual, diffs en vivo, edición interactiva y pair programming asistido por IA. (Cursor)

    Ambas pueden usar modelos avanzados; la ganancia real viene de asignar a cada herramienta la tarea que mejor gestiona su interfaz.

    1) Features nuevas: scaffolding y lógica inicial

    Cuando arrancas una funcionalidad, necesitas dos cosas: rapidez para generar boilerplate y control para validar decisiones arquitectónicas.

    Usa Cursor si…

    • tu feature es UI/UX, componentes React/Next/Angular o cambios que requieren vista simultánea de varios archivos.
    • Cursor muestra el diff en contexto, te permite aceptar cambios parciales y mantener el control línea a línea. Es pair programming con atajos.

    Usa Claude Code si…

    • vas a generar servicios backend desde un esquema: scripts que lean un SQL/JSON Schema, generen controladores, tests y terraform en lote.
    • Un workflow típico: un script Bash alimenta Claude con el esquema y crea un PR con estructura inicial, lista para revisión. No abres centenares de archivos; revisas el PR.

    Ejemplo (flujo Claude Code): un comando que toma un esquema y produce controladores, ejecutado desde CI o local en terminal, sin interfaz gráfica interrumpida.

    2) Refactors masivos y migraciones

    Aquí se gana o se pierde integridad del sistema.

    Claude Code brilla cuando…

    • necesitas migraciones sistemáticas: buscar patrones con ast-grep, encadenar transformaciones con sed/perl/jq y delegar la modificación a un agente que produzca PRs.
    • Es fire-and-forget, reproducible y fácil de auditar.

    Cursor es la opción segura cuando…

    • el refactor toca lógica de dominio y contratos implícitos. Necesitas validar cada cambio con pruebas y juicio humano.
    • Cursor te permite intervenir en cada paso con contexto visual.

    Regla práctica: si puedes expresar la transformación como patrón AST y confiar en pruebas automatizadas, usa Claude Code. Si la transformación requiere juicio semántico sobre reglas de negocio, usa Cursor.

    3) Debugging: local vs infra

    – Cursor es superior para errores locales: reproduces, el IDE captura stacktrace, envía contexto al asistente y te marca la línea problemática. El ciclo es inmediato y visual.

    – Claude Code es la herramienta natural para logs y debugging infra: conecta por SSH, procesa gigas de logs con pipelines (cat error.log | claude --print "resume patrón de errores") y no rompe tu máquina local. Ideal para memory leaks, dumps o análisis de trazas distribuidas.

    Integración práctica (hooks y CI)

    No es “usar uno u otro”; es asignar tareas. Ejemplos concretos:

    • Revisor automático de PRs: Claude Code integrado en un job de CI o hook pre-push con Husky. El agente valida patrones y marca “Missing Tests”.
    • Patch iterativo de UI: Cursor para proponer cambios, revisar visualmente y aceptar commits parciales.

    Tabla de decisión rápida

    Escenario Recomendación
    Componentes UI y revisión visual Cursor
    Migraciones masivas (monorepo) Claude Code
    Debugging local (reproducción en IDE) Cursor
    Análisis de logs/infra remota Claude Code
    Scaffolding backend/infra as code Claude Code
    Refactors de lógica de negocio crítica Cursor

    Riesgos y buenas prácticas

    • Tokens y coste: cualquier workflow que pase megabytes de código a un LLM necesita filtrado (excluir node_modules, builds, package-lock.json) y paginar el contexto.
    • Contexto parcial: Claude Code trabaja con lo que le das. Añade tests y fixtures para reducir falsos positivos.
    • Auditoría: versiona prompts y scripts en el repo. Revisa los PRs generados por agentes como revisas cualquier patch humano.

    Conclusión clara

    No es una elección excluyente. Cursor es el artesano: detalle, iteración y control. Claude Code es la maquinaria: automatización, pipelines y transformaciones en lote. En 2026 los equipos más efectivos combinan ambos: Cursor para diseñar y verificar, Claude Code para escalar y ejecutar. Tu criterio técnico consiste en decidir, a diario, qué tipo de fricción quieres eliminar y cuál quieres mantener para no romper la base de código.

    Para equipos interesados en explorar workflows, agentes y automatización aplicados a ingeniería, consulta Dominicode Labs como continuación lógica para experimentar con pipelines reproducibles y hooks de CI.

    FAQ

    ¿Cuándo debo elegir Claude Code sobre Cursor?

    Elige Claude Code para tareas reproducibles y en lote: migraciones sistemáticas, scaffolding backend desde esquemas y análisis de logs a escala.

    ¿Cuándo es mejor Cursor?

    Cursor es mejor para cambios que requieren inspección visual, diffs en contexto y juicios semánticos sobre lógica de negocio o UX.

    ¿Puedo usar ambos en el mismo flujo?

    Sí. Un enfoque práctico es usar Cursor para diseñar y verificar, y Claude Code para ejecutar y escalar los pasos repetibles mediante CI y hooks.

    ¿Cómo gestiono el riesgo de exponer código sensible a modelos?

    Filtra el input (excluir node_modules, builds y lockfiles), paginate el contexto y mantén tests/fixtures para validar salidas antes de aplicar cambios.

    ¿Qué herramientas concretas se mencionan para migraciones y hooks?

    Se mencionan ast-grep para patrones AST y Husky para hooks de pre-push. También se refiere al paquete de Claude Code en paquete npm y a Anthropic.

    ¿Qué prácticas de auditoría recomiendan?

    Versiona prompts y scripts en el repo, revisa PRs generados por agentes como revisas cualquier patch humano y registra cambios automatizados en CI para trazabilidad.

    ¿Dónde puedo probar Cursor y Claude Code?

    Cursor se encuentra en Cursor. Claude Code y recursos relacionados están disponibles via paquete npm y Anthropic.

  • Comparativa técnica de Agentic Harness: Claude Code, Cursor y más

    Comparativa técnica de Agentic Harness: Claude Code, Cursor y más

    Agentic Harness comparado — Claude Code vs Cursor vs Codex CLI vs Aider vs Cline

    Tiempo estimado de lectura: 6 min

    • Un agentic harness convierte un LLM en un actor sobre tu repo: necesita contexto eficiente, aplicación segura de cambios y bucles de verificación.
    • Elige la herramienta según dominio: Cursor para UI y revisión visual, Aider para refactors y auditabilidad, Claude Code para pipelines, Cline para acceso a infra, Codex/Copilot CLI para utilidades tácticas.
    • Prioriza: context slicing (RAG/AST), rollback y trazabilidad, integración CI/CD, permisos/extensibilidad y observabilidad.
    • Gobernanza: define qué puede hacer el agente sin revisión, qué debe proponer como PR y cómo auditar acciones.

    El desarrollo asistido por IA dejó de ser un experimento cuando los equipos empezaron a pedir algo concreto: no sólo sugerencias, sino ejecución fiable. Aquí tienes un análisis técnico y accionable de Agentic Harness comparado — Claude Code vs Cursor vs Codex CLI vs Aider vs Cline, pensado para Tech Leads y equipos reales que deben decidir estrategia, integraciones y límites de autonomía.

    Resumen rápido (lectores con prisa)

    Un agentic harness es la capa que permite a un LLM operar sobre un repositorio con seguridad y trazabilidad.

    Úsalo cuando necesites ejecutar cambios repetibles, verificables y revertibles — no sólo sugerencias.

    Elige según dominio: UI (Cursor), refactor/legacy (Aider), pipelines/infra (Claude Code), acceso a infra interna (Cline).

    Prioriza RAG/AST para contexto, commits/diffs para trazabilidad y bucles de tests para verificación.

    Agentic Harness comparado — por qué importa y qué debes exigirle

    Un agentic harness no es un plugin bonito: es la capa que convierte un LLM en un actor capaz de operar sobre tu repo. A nivel técnico debe resolver tres problemas simultáneos:

    • Resolución de contexto: indexación del repo + selección de snippets relevantes (RAG, AST-aware slicing).
    • Aplicación segura de cambios: diffs atómicos, commits, PRs y rollback.
    • Bucle de verificación: pruebas, linters y reintentos automáticos leyendo stderr/exit codes.

    Si la herramienta que evalúas no cubre esas tres piezas de forma explícita, la estás usando como un asistente, no como un agente.

    Resumen rápido de cada harness

    Cursor — editor visual AI-first

    Cursor es un fork de VS Code que trae IA integrada a la experiencia del editor. Su valor es UX: Composer permite editar múltiples archivos en contexto y previsualizar diffs antes de aplicar. Técnica clave: contexto calculado desde archivos abiertos y navegación del cursor, útil para producción de features frontend donde la verificación visual es crítica. URL: Cursor

    Cuándo elegirlo: equipos Full Stack que quieren control visual y revisión humana inmediata. Fricción: migración de editor.

    Claude Code — CLI para razonamiento extendido

    Claude Code (Anthropic) es un CLI pensado para ejecución en terminal. Diseñado para Claude 3.7 con extended thinking, ejecuta bucles autónomos: corre tests, inspecciona logs y corrige iterativamente. Técnica clave: integración terminal-native y capacidad de manejar workflows en CI/CD. URL: Claude Code docs

    Cuándo elegirlo: backend, infra y pipelines automatizados donde no necesitas UI pero sí razonamiento arquitectónico.

    Aider — control Git como seguridad

    Aider es Open Source y opera en CLI con filosofía “Git-first”: cada cambio satisfactorio produce un commit automático. Técnica clave: mapeo del repo vía AST para minimizar el contexto enviado al modelo y trazabilidad total mediante commits. URL: Aider

    Cuándo elegirlo: repos grandes, legacy codebases y equipos que exigen revertibilidad y auditoría precisa.

    Cline — extensión VS Code con MCP

    Cline implementa MCP (Model Context Protocol) y permite que el agente consulte servicios externos (DBs, docs internas) antes de escribir código. Técnica clave: permisos explícitos por acción y extensibilidad mediante MCP. URL: Cline

    Cuándo elegirlo: organizaciones con infra y APIs internas que quieren que el agente actúe con contexto real y seguro.

    Codex CLI / Copilot CLI — utilidades tácticas

    Herramientas como Codex CLI o Copilot CLI están enfocadas en traducir NL a comandos de terminal. Útiles para scripting y tareas puntuales, no para refactorizaciones autónomas: carecen del bucle iterativo sobre el repo. Recurso: Codex (OpenAI)

    Cuándo elegirlo: tareas de DevOps ad-hoc, scripting, comandos complejos — no para “delega la refactorización”.

    Criterios técnicos para elegir

    1. Context slicing: ¿la herramienta usa RAG o análisis AST para minimizar tokens? Si no, pagarás tokens y recibirás ruido.
    2. Rollback y trazabilidad: commits automáticos + mensajes generados por IA (Aider) vs diffs aprobados por UI (Cursor). Decide si prefieres control humano o commits automáticos.
    3. Integración CI/CD: ¿el harness puede operar en pipelines sin UI y corregir builds? Claude Code brilla aquí.
    4. Extensibilidad y permisos: MCP (Cline) permite consultas reales a infra interna; obligatorio si necesitas que el agente lea DBs o docs privadas.
    5. Observabilidad y métricas: tokens, fallos de parseo, reintentos y coste por sesión. Sin métricas no puedes gobernar autonomía.

    Ejemplos prácticos

    • Refactorización de API en un monorepo grande: usa Aider por AST-mapping + commits automáticos. Revertir es simple y el contexto es eficiente.
    • Corregir fallo en CI que rompe build: lanza Claude Code en la pipeline; ejecutará tests, leerá logs y propondrá patches iterativos.
    • Añadir componente UI y actualizar rutas: Cursor acelera al mostrar previews y permitir aceptar diffs por pantalla.
    • Integración con servicio interno (consulta de esquema DB antes de generar ORM): Cline + MCP para consultas reales antes de generar código.

    Recomendación práctica para equipos

    No hay una sola herramienta “mejor”. La arquitectura razonable es híbrida:

    • Cursor para trabajo de producto diario y revisión rápida.
    • Aider para refactors críticos y control de cambios.
    • Claude Code en pipelines automatizados y tareas de infra.
    • Cline cuando necesites que el agente hable con infra interna.
    • Codex/Copilot CLI para utilidades puntuales de scripting.

    Antes de adoptar, define: qué puede hacer el agente sin revisión humana, qué debe proponer como PR, y cómo auditarás cada acción (logs, commits, approvals). Sin estas reglas, la herramienta genera ruido o riesgos.

    Recursos y lecturas

    Si vas a integrar agentes en producción, no lo hagas por moda. Prepara contexto (CLAUDE.md / AGENTS.md / memory files), define límites y selecciona el harness según el dominio: UI, infra, refactor o integración con sistemas internos. Así, la IA deja de ser un “showroom” y pasa a ser una herramienta medible y auditable.

    Como continuación lógica para equipos que diseñan flujos de agentes y gobernanza técnica, consulta los experimentos y recursos de Dominicode Labs. Allí encontrarás guías prácticas para implementar context slicing, auditoría de commits y métricas de observabilidad en flujos con agentes.

    FAQ

    ¿Qué es exactamente un agentic harness?

    Es la capa que permite a un modelo de lenguaje operar sobre un repositorio con procesos definidos: resolución de contexto, aplicación segura de cambios y bucle de verificación mediante tests/linters.

    ¿Cuándo debo usar Aider en lugar de Cursor?

    Usa Aider para refactors en repos grandes o legacy donde necesitas commits automáticos y trazabilidad. Usa Cursor cuando la experiencia visual y la revisión humana inmediata son prioritarias (UI, previews, aceptación de diffs).

    ¿Claude Code reemplaza un CI tradicional?

    No necesariamente. Claude Code facilita la automatización y el razonamiento en pipelines (ejecutar tests, leer logs, proponer parches), pero suele integrarse con CI/CD existente como una herramienta para corregir y iterar en builds.

    ¿Qué es MCP y por qué importa con Cline?

    MCP es el Model Context Protocol: permite que el agente consulte servicios externos (DBs, docs internas) antes de escribir código. Es crítico si el agente necesita contexto real y permisos explícitos para interactuar con infra interna.

    ¿Puedo usar Codex/Copilot CLI para refactorizaciones?

    No son la mejor opción para refactorizaciones autónomas. Están pensados para traducir lenguaje natural a comandos de terminal y scripting; carecen del bucle iterativo y la gestión de diffs sobre el repo que requieren refactors complejos.

    ¿Cómo audito las acciones de un agente?

    Define trazabilidad mediante commits/diffs, logs de sesión, métricas de tokens y reintentos. Decide qué acciones requieren aprobación humana vs commit automático y conserva archivos de contexto (CLAUDE.md / AGENTS.md / memory files) para replicabilidad.