Tag: Claude Code

  • Prompt Caching en Claude: reduce tu factura de API un 90%

    Prompt Caching en Claude: reduce tu factura de API un 90%

    El mes pasado revisé los gastos de API de un proyecto que lleva seis semanas en producción. Un agente conversacional para análisis de documentos legales. El cliente lo usa unas 40 veces al día.

    La factura: $340 en un mes.

    El system prompt tenía 8.000 tokens. Las definiciones de herramientas, otros 3.000. En cada llamada, esos 11.000 tokens se procesaban desde cero. Cuarenta veces al día. Treinta días al mes.

    Activé prompt caching. La siguiente factura: $38.

    No cambié la lógica del agente. No modifiqué los prompts. Solo añadí tres líneas de configuración.

    Eso es lo que hace el prompt caching de Claude. Y la mayoría de developers que trabajan con la API de Anthropic aún no lo tienen activado.


    Qué es el prompt caching y cómo funciona

    Cuando haces una llamada a la API de Claude, pagas por cada token que el modelo procesa. System prompt, herramientas, historial de conversación, contexto de documentos: todo se cobra como tokens de entrada.

    El problema es que en la mayoría de aplicaciones reales, una parte enorme de esos tokens es idéntica en cada llamada. Tu system prompt no cambia. Las definiciones de tus herramientas no cambian. El contexto de un documento que estás analizando no cambia entre preguntas del usuario.

    El prompt caching te permite marcar esas partes estáticas para que Claude las almacene en caché. La documentación oficial de prompt caching cubre todos los modelos y casos edge. La primera vez que se procesa ese contenido, se escribe en caché. En las llamadas posteriores, en lugar de reprocesar esos tokens, Claude los lee desde el caché.

    El coste de un cache write es 1.25x el precio base — ligeramente más caro que una llamada normal. El coste de un cache read es 0.1x el precio base. Es decir, un 90% más barato.

    En un agent loop con 40 llamadas al día, pagas el 1.25x una vez. Las otras 39 veces pagas el 0.1x. La aritmética es brutal a tu favor.

    El TTL del caché

    El caché tiene un TTL (Time To Live) de 5 minutos por defecto. Mientras haya llamadas dentro de esa ventana, el caché se renueva automáticamente sin coste adicional. Si una conversación tiene mensajes frecuentes, el caché se mantiene activo.

    Existe también un TTL de 1 hora, que cuesta 2x el precio base en la escritura. Útil cuando tienes contextos que se reutilizan con menos frecuencia pero son muy costosos de regenerar.

    El mínimo de tokens para activar el caché

    No todo se puede cachear. El sistema exige un mínimo de tokens para crear una entrada de caché. Para claude-sonnet-4-6 y claude-opus-4-8, el mínimo es 1.024 tokens. Para claude-haiku-4-5, el umbral sube a 4.096 tokens — cuatro veces más alto, relevante si usas Haiku con prompts cortos. Si tu system prompt tiene menos tokens que el mínimo de tu modelo, el caché no se activa.

    En proyectos donde el system prompt es corto, la estrategia correcta es incluir el contexto del dominio directamente en el system prompt hasta superar ese umbral, o cachear las definiciones de herramientas junto con el sistema.


    Cómo habilitarlo: código TypeScript con el SDK oficial

    Aquí está el patrón que uso en producción. Nada de magia — tres cambios concretos en tu código.

    Habilitación básica: system prompt con cache_control

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic();
    
    const response = await client.messages.create({
      model: "claude-sonnet-4-6",
      max_tokens: 1024,
      system: [
        {
          type: "text",
          text: `Eres un asistente especializado en análisis de documentos legales.
          
    Tu rol es:
    - Identificar cláusulas de riesgo en contratos
    - Resumir términos clave de forma clara y precisa
    - Señalar inconsistencias o ambigüedades legales
    - Comparar términos con estándares del sector
    
    [...aquí va el resto del system prompt extenso, con contexto del dominio,
    instrucciones detalladas, ejemplos de formato de respuesta, etc.
    Debe superar los 1.024 tokens para activar el caché...]`,
          cache_control: { type: "ephemeral" }, // <-- esto es todo lo que necesitas
        },
      ],
      messages: [
        {
          role: "user",
          content: "Analiza la cláusula de terminación de este contrato: ...",
        },
      ],
    });
    
    console.log(response.usage);
    

    En la primera llamada, usage mostrará:

    {
      "input_tokens": 45,
      "cache_creation_input_tokens": 1280,
      "cache_read_input_tokens": 0,
      "output_tokens": 312
    }
    

    En la segunda llamada (dentro de los 5 minutos):

    {
      "input_tokens": 45,
      "cache_creation_input_tokens": 0,
      "cache_read_input_tokens": 1280,
      "output_tokens": 289
    }
    

    cache_read_input_tokens tiene el 10% del coste. El system prompt completo se leyó desde caché. Esos 1.280 tokens no se procesaron desde cero.

    Cacheando herramientas y system prompt juntos

    Cuando tienes definiciones de herramientas largas — algo habitual en agentes con MCP o con múltiples funciones — el ahorro se multiplica. Aquí el patrón para cachear ambas cosas:

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic();
    
    // Las definiciones de herramientas son estáticas — candidatas perfectas para caché
    const tools: Anthropic.Tool[] = [
      {
        name: "search_legal_database",
        description: `Busca en la base de datos legal precedentes y jurisprudencia relevante.
        Usa esta herramienta cuando necesites comparar cláusulas con casos anteriores o
        encontrar interpretaciones judiciales de términos específicos. La búsqueda incluye
        bases de datos de España, México, Argentina y Colombia. Devuelve hasta 10 resultados
        ordenados por relevancia con fecha, tribunal y resumen del caso.`,
        input_schema: {
          type: "object" as const,
          properties: {
            query: {
              type: "string",
              description: "Término o frase legal a buscar",
            },
            jurisdiction: {
              type: "string",
              enum: ["ES", "MX", "AR", "CO", "ALL"],
              description: "Jurisdicción a consultar",
            },
            date_range: {
              type: "string",
              description: "Rango de fechas en formato YYYY-YYYY",
            },
          },
          required: ["query"],
        },
      },
      {
        name: "analyze_clause_risk",
        description: `Analiza el nivel de riesgo de una cláusula contractual.
        Evalúa factores como onerosidad excesiva, cláusulas abusivas según legislación
        vigente, asimetría de obligaciones y exposición a penalidades. Devuelve un score
        de riesgo del 1 al 10 con justificación detallada y recomendaciones de negociación.`,
        input_schema: {
          type: "object" as const,
          properties: {
            clause_text: {
              type: "string",
              description: "Texto completo de la cláusula a analizar",
            },
            contract_type: {
              type: "string",
              description: "Tipo de contrato (laboral, mercantil, arrendamiento, etc.)",
            },
          },
          required: ["clause_text"],
        },
      },
      // cache_control al final del array de tools — marca el punto de caché
    ];
    
    // Añadimos cache_control al último tool para cachear todo el bloque
    const toolsWithCache = tools.map((tool, index) =>
      index === tools.length - 1
        ? { ...tool, cache_control: { type: "ephemeral" as const } }
        : tool
    );
    
    const response = await client.messages.create({
      model: "claude-sonnet-4-6",
      max_tokens: 2048,
      system: [
        {
          type: "text",
          text: "Eres un asistente especializado en análisis legal...",
          cache_control: { type: "ephemeral" }, // system prompt cacheado
        },
      ],
      tools: toolsWithCache, // tools cacheadas
      messages: [
        {
          role: "user",
          content: "¿Cuál es el riesgo de esta cláusula de no competencia?",
        },
      ],
    });
    

    Monitorizar el ahorro en tiempo real

    Esta función te dice exactamente cuánto has ahorrado en cada llamada:

    interface CostMonitor {
      inputTokensCost: number;
      cacheWriteCost: number;
      cacheReadCost: number;
      outputTokensCost: number;
      totalCost: number;
      savings: number;
      savingsPercent: number;
    }
    
    // Precios para claude-sonnet-4-6 por millón de tokens (en dólares)
    const PRICING = {
      input: 3.0,
      cacheWrite: 3.75, // 1.25x
      cacheRead: 0.3,   // 0.1x
      output: 15.0,
    };
    
    function calculateCallCost(usage: Anthropic.Usage): CostMonitor {
      const inputCost = (usage.input_tokens / 1_000_000) * PRICING.input;
      const cacheWriteCost =
        ((usage.cache_creation_input_tokens ?? 0) / 1_000_000) * PRICING.cacheWrite;
      const cacheReadCost =
        ((usage.cache_read_input_tokens ?? 0) / 1_000_000) * PRICING.cacheRead;
      const outputCost = (usage.output_tokens / 1_000_000) * PRICING.output;
    
      const totalCost = inputCost + cacheWriteCost + cacheReadCost + outputCost;
    
      // Coste hipotético sin caché (todos los tokens al precio base)
      const totalInputTokens =
        usage.input_tokens +
        (usage.cache_creation_input_tokens ?? 0) +
        (usage.cache_read_input_tokens ?? 0);
      const costWithoutCache =
        (totalInputTokens / 1_000_000) * PRICING.input + outputCost;
    
      const savings = costWithoutCache - totalCost;
      const savingsPercent =
        costWithoutCache > 0 ? (savings / costWithoutCache) * 100 : 0;
    
      return {
        inputTokensCost: inputCost,
        cacheWriteCost,
        cacheReadCost,
        outputTokensCost: outputCost,
        totalCost,
        savings,
        savingsPercent,
      };
    }
    
    // Uso:
    const monitor = calculateCallCost(response.usage);
    console.log(`Ahorro: $${monitor.savings.toFixed(6)} (${monitor.savingsPercent.toFixed(1)}%)`);
    

    Qué debes cachear y qué no

    Los mejores candidatos para el caché

    System prompts largos. Es el caso más obvio. Si tu system prompt tiene instrucciones de rol, reglas de formato, contexto del dominio y ejemplos, estás mirando fácilmente 2.000-8.000 tokens que se repiten en cada llamada. Cachear el system prompt es lo primero que debes activar.

    Definiciones de herramientas (tools). Especialmente en agentes con MCP o con muchas funciones. Las definiciones de tools incluyen nombres, descripciones detalladas y schemas completos. Pueden sumar 3.000-5.000 tokens fácilmente. Son siempre estáticas dentro de una sesión.

    Contexto de documentos. Si tu aplicación analiza un documento largo (un contrato, una especificación técnica, un PDF), ese documento va en el mensaje del usuario pero cambia muy poco. Puedes cachearlo con cache_control en el bloque del contenido del mensaje.

    Historial de conversación en agent loops. En un loop donde el agente tiene muchos turnos, cachear el historial acumulado evita pagar por reprocesar el contexto completo en cada iteración.

    Qué NO debes cachear

    El turno actual del usuario. Es el error más común. El mensaje que el usuario acaba de escribir cambia en cada llamada — si intentas cachearlo, el caché nunca tendrá un hit porque el contenido es siempre distinto.

    Tokens de extended thinking. Si usas extended thinking con Claude, los tokens del proceso de razonamiento interno no se cachean. Esto es relevante si estás midiendo ahorros en pipelines que usan thinking — los números no escalarán de la misma forma.

    Contenido que cambia con frecuencia. Si tienes un bloque de contexto que se actualiza cada pocos minutos (resultados de una búsqueda en tiempo real, estado de una sesión volátil), no tiene sentido marcarlo para caché porque nunca habrá un hit.

    Bloques demasiado pequeños. Si un bloque tiene menos de 1.024 tokens, el sistema no lo cacheará. No añadas cache_control a fragmentos pequeños — solo añade latencia sin beneficio.


    Comparación de coste: sin caching vs con caching

    Escenario real: un agente con 40 llamadas diarias durante 30 días.

    • System prompt: 5.000 tokens
    • Tools: 3.000 tokens
    • Pregunta del usuario: ~100 tokens (variable)
    • Respuesta del modelo: ~400 tokens (variable)
    • Modelo: claude-sonnet-4-6
    Escenario Coste por llamada Total mensual
    Sin caching (8.100 input + 400 output) $0.0303 $36.36
    Con caching — 1ª llamada del día (cache write 8.000 + 100 input + 400 output) $0.037 —
    Con caching — llamadas 2–40 (cache read 8.000 + 100 input + 400 output) $0.0084 —
    Con caching — total diario (1ª + 39 × $0.0084) $0.365/día $10.95

    Ahorro: 70%. Y esto asumiendo que el caché expira cada día. Con conversaciones más densas donde el TTL de 5 minutos se aprovecha bien, el ahorro sube al 85-90%.


    Preguntas frecuentes sobre prompt caching en Claude

    ¿El caché es compartido entre usuarios?
    No. El caché es privado por workspace de Anthropic. Desde febrero de 2026, hay aislamiento completo por workspace. Los datos de un usuario nunca se mezclan con los de otro.

    ¿Qué pasa si cambio el system prompt? ¿Se invalida el caché?
    Sí. El caché funciona por contenido exacto. Si modificas un solo carácter del bloque cacheado, se genera una nueva entrada de caché (cache write) en la siguiente llamada. El caché anterior expira según su TTL sin coste adicional.

    ¿Puedo cachear múltiples bloques en la misma llamada?
    Sí, hasta un máximo de cuatro breakpoints de caché por request. La restricción importante es el orden: los bloques con TTL más largo (1 hora) deben aparecer antes que los de TTL más corto (5 minutos) en la estructura del request.

    ¿El caching funciona con streaming?
    Sí. El prompt caching es compatible con la API de streaming de Claude. Los campos cache_creation_input_tokens y cache_read_input_tokens aparecen en el evento message_start del stream — no en message_delta. Es el primer evento emitido, antes de que lleguen los tokens de respuesta.


    El siguiente nivel: combinar con Claude Code

    Si ya estás explorando agentes más complejos, el prompt caching cambia la ecuación de coste de forma radical. Un agent loop sin caching que hace 10 iteraciones paga los tokens del system prompt y las tools diez veces. Con caching, los paga una vez y lee el resto.

    En Claude Code: Effort, Models, Tools y Context hay una sección completa sobre cómo gestiona Claude Code el contexto en agent loops largos — es el contexto perfecto para entender dónde encaja el caching a nivel de infraestructura.

    Y si quieres construir productos reales sobre la API de Anthropic con esta clase de optimizaciones ya integradas desde el primer sprint, el curso Construye con IA: De la Idea al Producto con Claude cubre el stack completo — desde la arquitectura del agente hasta el control de costes en producción.


    Lo que puedes hacer hoy

    Si tienes una aplicación que usa la API de Claude en producción, abre el código y busca dónde defines el system prompt. Si es una cadena de texto plana, conviértela en un array con cache_control: { type: "ephemeral" }.

    Eso solo. Una línea de cambio. Comprueba la siguiente factura.

    Si además tienes tools largas, aplica el mismo patrón al último elemento del array de herramientas. Tendrás dos puntos de caché activos y el ahorro será inmediato.

    El prompt caching no es una optimización avanzada que requiere rediseñar tu arquitectura. Es una configuración de tres minutos que debería estar activa en cualquier aplicación seria sobre la API de Claude. Si no la tienes, estás pagando de más desde el primer día.


    Bezael Pérez — Fundador de Dominicode. Developer senior con 15+ años construyendo software. Si construyes con IA y quieres profundizar más allá de los tutoriales, en Dominicode Labs estamos trabajando en proyectos reales con la API de Anthropic, arquitecturas de agentes y todo lo que no cabe en un post.
  • Claude Sonnet 5: el modelo que trabaja solo mientras tú duermes

    Claude Sonnet 5: el modelo que trabaja solo mientras tú duermes

    Me pasó hace unos meses revisando el output de un agente que había dejado corriendo toda la noche.

    Esperaba encontrar la tarea a medias. Un formulario sin completar. Alguna herramienta mal llamada. Lo habitual con los modelos de la generación anterior: empezaban bien, pero a mitad de camino se perdían, pedían confirmación o simplemente paraban.

    En cambio, encontré el trabajo terminado. Del principio al fin. Sin intervención.

    Ese momento cambia algo en tu cabeza como developer. No es que la IA sea "mejor". Es que ya no necesita que estés mirando.

    Claude Sonnet 5 es exactamente esa promesa hecha modelo. Anthropic lo lanzó el 30 de junio de 2026 y lo describe como "el modelo Sonnet más agéntico hasta la fecha". No es marketing vacío — la diferencia en tareas autónomas y multi-paso es medible y, para quien construye con IA, es relevante desde el primer día.


    Por qué Sonnet 5 es distinto a todo lo anterior

    Hasta ahora, la frontera estaba clara: si querías un agente que realmente terminase el trabajo, necesitabas Opus. Sonnet era el punto medio — rápido, accesible, suficientemente bueno para tareas simples. Pero en flujos complejos con múltiples pasos, herramientas y decisiones encadenadas, Sonnet se quedaba corto.

    Claude Sonnet 5 rompe esa frontera.

    Anthropic no ha simplemente subido los parámetros. Han optimizado específicamente para comportamiento agéntico: planificación de tareas, uso coordinado de herramientas (navegadores, terminales, APIs), y lo más relevante — la capacidad de verificar su propio resultado sin que se lo pidas.

    Eso último importa más de lo que parece. Un modelo que ejecuta código y luego comprueba si el output es el esperado, sin que tú se lo digas, está un paso más cerca de un colaborador que de una herramienta.


    Las capacidades agénticas en detalle

    Hay tres áreas donde el cambio es palpable:

    Tareas multi-paso sin interrupciones. Modelos anteriores tendían a pedir confirmación o detenerse cuando encontraban ambigüedad. Sonnet 5 mantiene el hilo. Algunos partners de Anthropic reportan que "terminó el trabajo de principio a fin sin intervención" — algo que antes era territorio exclusivo de Opus 4.

    Uso de herramientas coordinado. Puede combinar búsqueda web, ejecución de código y llamadas a APIs en la misma tarea sin perder el contexto de lo que estaba haciendo. No es nuevo que los modelos puedan usar herramientas — lo nuevo es que lo hacen con coherencia a lo largo de cadenas largas de razonamiento.

    Auto-verificación del resultado. Si ejecuta una query de base de datos o genera un archivo, puede evaluar si el resultado tiene sentido antes de dártelo. Esto reduce drásticamente la necesidad de loops de revisión en tus agentes.

    Si estás construyendo con la API de Claude o con Claude Code, estas tres capacidades cambian el diseño de tus flujos. No necesitas los mismos guardrails de antes. No necesitas los mismos puntos de control manual.

    En el curso de Construye con IA cubrimos exactamente este tipo de arquitectura de agentes — y con Sonnet 5 muchos de esos patrones se simplifican considerablemente.


    Benchmarks: qué dicen los números

    Los benchmarks importan, pero necesitan contexto. Aquí va la comparativa relevante para developers:

    Benchmark Claude Sonnet 5 Claude Sonnet 4.6 Claude Opus 4.8
    BrowseComp Superior Base de comparación Superior
    OSWorld-Verified Superior Base de comparación Superior
    Razonamiento general Muy cercano a Opus Inferior Referencia
    Codificación Notable mejora Base Referencia
    Esfuerzo "extra high" Iguala a Opus 4.8 — Referencia

    Evaluaciones cualitativas basadas en el anuncio oficial de Anthropic (30 jun 2026).

    El dato más interesante: a nivel de esfuerzo máximo, Sonnet 5 iguala a Opus 4.8. Esto es arquitectónicamente significativo. Significa que para la mayoría de las tareas que antes justificaban pagar el precio de Opus, ahora puedes usar Sonnet 5 a un coste mucho menor.

    La excepción es ciberseguridad. Anthropic es explícito: Sonnet 5 no fue entrenado deliberadamente para tareas de seguridad ofensiva, y Opus 4.8 sigue siendo superior en ese dominio específico.


    Precios y disponibilidad

    Plan Precio hasta 31 ago 2026 Precio desde 1 sep 2026
    Input tokens $2 / M tokens $3 / M tokens
    Output tokens $10 / M tokens $15 / M tokens

    Anthropic ha aplicado un precio introductorio hasta finales de agosto. Si estás evaluando el switch en la API, este es el momento óptimo para hacerlo.

    Dónde está disponible:

    • Modelo predeterminado en los planes Free y Pro de Claude.ai
    • Disponible en Max, Team, Enterprise
    • Claude Code
    • API (model ID: claude-sonnet-5)

    Si usas Claude.ai directamente, ya lo tienes — es el modelo por defecto desde el lanzamiento.


    El tokenizador actualizado: impacto práctico

    Este punto se menciona poco y puede sorprenderte en producción.

    Sonnet 5 usa un tokenizador actualizado similar al que se introdujo con Opus 4.7. El resultado es que el mismo texto que antes ocupaba X tokens ahora puede ocupar entre 1.0× y 1.35× más tokens.

    ¿Qué significa esto en la práctica?

    Si tienes prompts largos con contexto extenso (documentos, conversaciones, sistemas de RAG), tu consumo de tokens aumentará. Anthropic compensa esto con el precio introductorio, pero necesitas tener este factor en cuenta al proyectar costes para producción.

    Una regla rápida: si venías de Sonnet 4.6 y tienes prompts de más de 5.000 tokens, haz una prueba controlada antes de cambiar el modelo en producción. Mide el consumo real, no lo estimes desde los benchmarks públicos.

    Para esto el post sobre prompt caching en Claude es directamente aplicable — con el nuevo tokenizador, el caching se vuelve aún más relevante para controlar costes.


    Cómo empezar hoy

    En Claude.ai: Ya está activo. Es el modelo por defecto. No necesitas hacer nada.

    En la API:

    El siguiente ejemplo muestra la integración mínima con el SDK oficial @anthropic-ai/sdk para TypeScript. El único cambio respecto a modelos anteriores es el model ID: claude-sonnet-5.

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic();
    
    const response = await client.messages.create({
      model: "claude-sonnet-5",
      max_tokens: 4096,
      messages: [
        {
          role: "user",
          content: "Analiza este código y sugiere mejoras de rendimiento...",
        },
      ],
    });
    

    El cambio de model ID es inmediato. Si tienes un sistema en producción con claude-sonnet-4-6, cambiar a claude-sonnet-5 no requiere modificar nada más en la integración básica.

    Si usas Claude Code, el modelo ya está disponible y puedes seleccionarlo desde la configuración del cliente.


    Qué significa esto para developers que construyen con IA

    Voy a ser directo porque creo que es lo que necesitas saber.

    El lanzamiento de Sonnet 5 no es un update de rendimiento incremental. Es un reposicionamiento del tier medio.

    Hasta ahora, la decisión era: velocidad y coste (Haiku/Sonnet) vs. capacidad y razonamiento complejo (Opus). Con Sonnet 5, esa brecha se cierra de forma significativa. Puedes construir agentes que realmente terminen el trabajo, a un coste que tiene sentido para producción.

    Para quien está construyendo productos con IA — y no solo experimentando — esto cambia la ecuación de build vs. cost. Puedes subir la ambición de tus agentes sin subir proporcionalmente el presupuesto.

    El riesgo que veo es el de siempre: sobreestimar la autonomía del modelo en los primeros días. Sonnet 5 es notablemente mejor en tareas autónomas, pero sigue siendo un modelo de lenguaje. Sigue necesitando specs claras, herramientas bien definidas y tests que verifiquen los outputs.

    En Dominicode Labs estamos ya trabajando con Sonnet 5 en los proyectos de la comunidad — si quieres ver cómo se integra en flujos reales de producción, es donde está pasando.


    Preguntas frecuentes sobre Claude Sonnet 5

    ¿Qué diferencia hay entre Claude Sonnet 5 y Claude Sonnet 4.6?

    Claude Sonnet 5 está optimizado para comportamiento agéntico: puede planificar y ejecutar tareas multi-paso sin interrupciones, verificar sus propios resultados automáticamente y usar herramientas (navegadores, terminales, APIs) de forma coordinada en cadenas largas de razonamiento. Sonnet 4.6 era capaz, pero tendía a detenerse o pedir confirmación en tareas complejas. La mejora en benchmarks como BrowseComp y OSWorld-Verified refleja exactamente esta diferencia en tareas autónomas.

    ¿Es Claude Sonnet 5 tan bueno como Claude Opus 4.8?

    En la mayoría de tareas cotidianas de codificación, razonamiento y trabajo de conocimiento, Sonnet 5 está muy cerca de Opus 4.8 — y a nivel de esfuerzo máximo puede igualarlo. La excepción es el dominio de ciberseguridad, donde Opus 4.8 sigue siendo superior porque fue entrenado deliberadamente para esas tareas. Para el 90% de los casos de uso de desarrollo con IA, Sonnet 5 es suficientemente capaz y mucho más accesible en precio.

    ¿Cómo afecta el nuevo tokenizador a mis costes en la API?

    El tokenizador actualizado puede incrementar el consumo de tokens en un factor de 1.0× a 1.35× respecto a modelos anteriores. Esto es especialmente relevante con contextos largos: documentos, conversaciones extendidas, sistemas RAG. Anthropic compensa esto con el precio introductorio vigente hasta el 31 de agosto de 2026. La recomendación práctica es medir el consumo real con tus prompts de producción antes de estimar costes a escala.

    ¿Puedo usar Claude Sonnet 5 en Claude Code?

    Sí. Claude Sonnet 5 está disponible en Claude Code desde el lanzamiento. Dado que Claude Code es una herramienta diseñada precisamente para tareas agénticas de desarrollo — escribir, ejecutar, verificar código de forma autónoma — la combinación con Sonnet 5 es especialmente potente. Puedes seleccionar el modelo desde la configuración del cliente.

    ¿Qué precio tiene Claude Sonnet 5 y cuándo cambia?

    El precio introductorio vigente hasta el 31 de agosto de 2026 es $2/M tokens de input y $10/M tokens de output. A partir del 1 de septiembre de 2026 pasa a $3/M input y $15/M output. Si estás evaluando la migración en producción, hacerlo antes de septiembre tiene sentido económico.

    ¿Claude Sonnet 5 ya está disponible en el plan gratuito de Claude.ai?

    Sí. Desde el lanzamiento el 30 de junio de 2026, Claude Sonnet 5 es el modelo predeterminado en todos los planes de Claude.ai, incluyendo el gratuito. No necesitas hacer ningún cambio — si abres Claude.ai hoy, ya estás usando Sonnet 5.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Claude Code Routines: automatiza agentes sin encender tu PC

    Claude Code Routines: automatiza agentes sin encender tu PC

    El viernes por la tarde cerré el portátil con 23 issues sin triagear en el repo, tres PRs esperando revisión de documentación y un changelog que nadie había actualizado en dos semanas.

    El lunes por la mañana, todo estaba hecho.

    No porque contraté a nadie. No porque dejé el ordenador encendido todo el fin de semana. Fue la primera vez que sentí que las Claude Code Routines no eran una feature más de Anthropic — eran la diferencia entre usar IA como herramienta y usarla como infraestructura.


    De herramienta a infraestructura: el salto que cambia todo

    Si ya usas Claude Code de forma interactiva, sabes lo que puede hacer. Le das contexto, le pides algo, revisa tu código, abre PRs. Pero todo depende de que tú estés sentado delante del teclado, iniciando cada conversación.

    Las Routines rompen esa dependencia.

    Una Routine es una configuración guardada de Claude Code: un prompt, uno o más repositorios y un conjunto de conectores (MCP), empaquetados una sola vez y ejecutados de forma automática. Lo que las hace distintas de cualquier script de bash con un cron job es que corren en la infraestructura cloud de Anthropic. Tu máquina puede estar apagada. Claude sigue trabajando.

    Están disponibles desde abril de 2026 en research preview para todos los planes de pago: Pro, Max, Team y Enterprise. Se crean desde claude.ai/code/routines — consulta la documentación oficial de Claude Code para ver los últimos límites y cambios.


    Los tres tipos de trigger

    Una Routine puede tener uno o varios triggers combinados. Esto es lo que hace que el modelo sea flexible de verdad.

    1. Schedule (cron)

    Ejecuta la Routine de forma recurrente: cada hora, diariamente, entre semana o cada semana. Si necesitas un intervalo personalizado — por ejemplo, cada dos horas o el primer día de cada mes — configuras el preset más cercano en la interfaz de claude.ai/code/routines.

    El intervalo mínimo es una hora. Expressions que corren con más frecuencia se rechazan.

    También existe el concepto de one-off run: disparas la Routine una sola vez en un timestamp futuro. Útil para recordatorios diferidos, limpiezas post-deploy o tareas que tienen que correr "cuando aterrice ese PR de upstream". Después de ejecutarse, la Routine se auto-deshabilita. Y un detalle importante: los one-off runs no cuentan contra el límite diario de Routines.

    2. GitHub event

    Dispara una sesión nueva automáticamente cuando ocurre un evento en un repositorio conectado. Los eventos soportados incluyen pull request (opened, closed, labeled, synchronized…) y release (created, published, edited…).

    Puedes añadir filtros para reducir exactamente cuándo se dispara: autor del PR, título, rama base, rama head, labels, si es draft o no, si está mergeado. Cada evento que pasa los filtros abre su propia sesión independiente — no hay reutilización de sesiones entre eventos.

    Para usar GitHub triggers hace falta instalar la Claude GitHub App en el repositorio. No basta con el acceso que configuras en /web-setup para clonar repos.

    3. Webhook (API trigger)

    Cada Routine con este trigger tiene un endpoint HTTP dedicado. Le haces POST con un bearer token y arranca una sesión nueva. El cuerpo de la request acepta un campo text opcional — puedes pasarle el cuerpo de una alerta, un stack trace o cualquier contexto que la Routine necesite para esa ejecución concreta.

    La respuesta devuelve el ID y la URL de la sesión creada, así puedes abrirla en el navegador para ver qué está haciendo Claude en tiempo real.

    curl -X POST https://api.anthropic.com/v1/claude_code/routines/trig_01ABCDEF.../fire \
      -H "Authorization: Bearer sk-ant-oat01-xxxxx" \
      -H "anthropic-beta: experimental-cc-routine-2026-04-01" \
      -H "anthropic-version: 2023-06-01" \
      -H "Content-Type: application/json" \
      -d '{"text": "Error crítico en producción: SEN-4521. Stack trace adjunto."}'
    

    Tres Routines que puedes activar esta semana

    Estos no son ejemplos de documentación. Son los casos de uso que más sentido tienen para un developer indie o un equipo pequeño.

    Triage de issues cada noche

    Un trigger de schedule que corre de lunes a viernes a las 23:00. El prompt le dice a Claude que lea todos los issues abiertos desde la última ejecución, aplique labels según el área de código referenciada, asigne propietario y publique un resumen en Slack. Llegas por la mañana con la cola de trabajo ya priorizada.

    Requiere: conector de GitHub + conector de Slack configurados como MCP connectors en tu cuenta de claude.ai.

    Code review automatizado en cada PR

    Un trigger de GitHub que reacciona a pull_request.opened con filtro is draft: false. El prompt aplica el checklist de revisión de tu equipo: seguridad, performance, style. Deja comentarios inline y un resumen para los revisores humanos. Los humanos se concentran en diseño y arquitectura — lo mecánico lo hace Claude.

    Este es el tipo de automatización que en equipos de 1-3 personas elimina el cuello de botella de revisión completamente.

    Changelog automático post-merge

    Un trigger de GitHub en pull_request.closed filtrado a is merged: true en la rama main. El prompt le pide a Claude que lea el diff del PR mergeado, extraiga el cambio relevante en lenguaje humano y lo añada al CHANGELOG.md en un PR nuevo. Sin nunca más tener que acordarte de documentar lo que acabas de subir a producción.


    Lo que paga el coste

    Las Routines consumen cuota de suscripción de la misma manera que una sesión interactiva. Además, hay un límite diario de runs por cuenta según el plan:

    • Pro: 5 runs diarios
    • Max: 15 runs diarios
    • Team / Enterprise: 25 runs diarios

    Si superas el límite o la cuota de suscripción, las ejecuciones siguientes se rechazan hasta que se resetea la ventana — salvo que tengas usage credits activados, en cuyo caso sigue corriendo en modo metered.

    Los GitHub triggers también tienen un cap por hora durante la research preview. Si un repositorio muy activo dispara demasiados eventos, los excedentes se descartan hasta que se resetea la ventana. Los límites actuales los ves en claude.ai/code/routines.

    El hecho de que sea research preview significa que los límites, la API y el comportamiento pueden cambiar. No construyas pipelines de producción críticos sobre esto todavía — pero sí es el momento perfecto para experimentar y entender cómo integrar esto en tu workflow.


    Routines vs. Managed Agents: no es lo mismo

    Anthropic también ha lanzado Claude Managed Agents con dos features que suenan parecidas pero son una capa distinta: Dreaming y Outcomes.

    La diferencia es importante para no confundirlos.

    Las Routines son un mecanismo de scheduling y ejecución. Definen cuándo y cómo corre una sesión de Claude Code. Son infraestructura de automatización.

    Dreaming es un proceso que revisa las sesiones pasadas de tus agentes y los memory stores, extrae patrones y perfecciona las memorias para que el agente mejore con el tiempo. Es un sistema de aprendizaje retrospectivo, no de ejecución de tareas.

    Outcomes es una feature de evaluación: defines un rubric de éxito y un evaluador separado (con su propio context window, para no contaminarse con el razonamiento del agente) revisa el output y le dice al agente qué corregir si no cumple el criterio. Es un loop de calidad, no de scheduling.

    Dicho de forma directa: las Routines responden a "¿cuándo y con qué trigger corre esto?". Managed Agents responde a "¿cómo mejora y cómo evalúa su propio output el agente?". Pueden usarse juntos, pero son capas con responsabilidades distintas.


    Un detalle que no está en la documentación oficial

    Cuando una Routine corre, lo hace de forma completamente autónoma. Sin permission mode, sin prompts de aprobación durante la ejecución. Claude puede ejecutar comandos de shell, usar skills del repositorio clonado y llamar a todos los conectores que hayas incluido.

    Esto es potente. Y también es la razón por la que el prompt de la Routine es el artefacto más importante del sistema. A diferencia de una sesión interactiva donde puedes corregir el rumbo, aquí el prompt tiene que ser autocontenido y explícito sobre qué hacer y qué aspecto tiene el éxito.

    Por defecto, Claude solo puede hacer push a ramas con prefijo claude/. Para permitirle escribir en ramas existentes o protegidas, tienes que habilitar explícitamente "Allow unrestricted branch pushes" en la configuración de la Routine. Una salvaguarda razonable.

    Las Routines pertenecen a tu cuenta individual de claude.ai. Los commits, los PRs y las acciones en conectores como Slack o Linear aparecen como tú — con tu identidad de GitHub, tu Slack, etc. Eso tiene implicaciones de auditoría que vale la pena tener en cuenta si trabajas en equipo.


    El shift real

    Llevo tiempo diciendo que el developer indie de 2026 puede operar con la capacidad de un equipo pequeño si usa bien las herramientas que tiene. Si llegas nuevo a Claude Code, el post sobre Effort, Models, Tools y Context te da el mapa completo antes de entrar en Routines. Y si quieres entender la capa de arquitectura detrás de los agentes, el post sobre agentic harness completa el cuadro. Las Routines son la prueba más concreta de eso que he visto hasta ahora.

    No es sobre chatear con IA. Es sobre delegar trabajo real a agentes que corren en la nube con tu identidad, contra tus repos, con tus herramientas. Y que lo hacen mientras tú duermes, estás en una reunión o simplemente tienes el portátil cerrado.

    Si llevas tiempo usando Claude Code de forma interactiva, las Routines son el siguiente paso natural. Si quieres un sistema para construir esto de forma ordenada — desde la idea hasta el producto sin caos — en el curso Construye con IA en Udemy cubrimos exactamente ese proceso: cómo estructurar el trabajo con Claude Code para que escale más allá de la sesión interactiva.

    Y si quieres ver cómo otros developers están implementando esto en proyectos reales, en Dominicode Labs estamos documentando los patrones que funcionan — incluyendo los prompts de Routines que uso en mi propio workflow.


    Preguntas frecuentes

    ¿Necesito tener mi servidor propio para usar Claude Code Routines?

    No. Las Routines corren directamente en la infraestructura cloud de Anthropic. No necesitas EC2, Railway, Fly.io ni ningún servidor propio. El único requisito es una suscripción de pago a Claude (Pro, Max, Team o Enterprise) con Claude Code on the web habilitado.

    ¿Cuál es la diferencia entre una Routine y un Desktop Scheduled Task?

    Los Desktop Scheduled Tasks corren en tu máquina local cuando el app de escritorio de Claude Code está abierto. Tienen acceso a tus archivos locales pero requieren que tu ordenador esté encendido. Las Routines corren en la nube de Anthropic independientemente de si tienes el ordenador encendido o el app abierto.

    ¿Puedo combinar varios tipos de trigger en la misma Routine?

    Sí. Una misma Routine puede tener triggers de schedule, de GitHub event y de API al mismo tiempo. Por ejemplo, una Routine de revisión de PRs puede correr de forma programada cada noche, dispararse también cuando se abre un PR nuevo en GitHub, y aceptar ejecuciones manuales vía webhook desde tu pipeline de CI/CD.

    ¿Qué pasa si una Routine falla o Claude no completa la tarea?

    El indicador de estado verde en el historial de runs solo significa que la sesión se inició y terminó sin errores de infraestructura — no que la tarea se completó con éxito. Para saber qué hizo Claude realmente tienes que abrir la sesión y revisar el transcript. Los errores de red, los conectores que faltan o los fallos a nivel de tarea aparecen en el transcript, no en el indicador de estado.

    ¿Las Routines tienen acceso a todos mis conectores MCP?

    Por defecto, cuando creas una Routine, incluye todos tus MCP connectors conectados en claude.ai. La recomendación de Anthropic es quitar los que no necesita la Routine específica para limitar el alcance de lo que Claude puede hacer durante la ejecución. Los MCP servers que hayas añadido localmente en el CLI con claude mcp add no están disponibles en Routines — tienes que añadirlos como connectors en claude.ai/customize/connectors.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • SDD 2026: por qué el spec define tu ventaja competitiva

    SDD 2026: por qué el spec define tu ventaja competitiva

    Un cliente me mandó su proyecto hace tres semanas. Llevaba dos meses usando Claude Code todos los días. El repositorio tenía 340 archivos. Tenía features. Tenía tests. El código compilaba.

    Y no tenía ni idea de qué hacía el sistema.

    Me preguntó: “¿Por qué cada vez que añado algo nuevo, rompo tres cosas que ya funcionaban?” La respuesta era visible desde el primer git log: llevaba dos meses pidiéndole a la IA que generara código sin decirle nunca qué estaba construyendo realmente. Cada prompt era una instrucción táctica. Nunca había una visión. Nunca un mapa.

    Eso es Spec-Driven Development (SDD) al revés. Y en 2026, con agentes que pueden escribir mil líneas en minutos, la diferencia entre los dos modos es la diferencia entre un producto y un desastre con tests.


    La IA no necesita que seas más rápido. Necesita que seas más claro.

    La narrativa que se vende sobre el desarrollo con IA es esta: “ahora puedes construir el doble de rápido”. Es verdad. El problema es que construir el doble de rápido sin dirección no te lleva antes a destino — te lleva el doble de lejos en la dirección equivocada.

    Los agentes de IA son ejecutores extraordinariamente potentes con cero criterio arquitectónico propio. Claude Code, GitHub Copilot, Cursor, cualquiera — siguen instrucciones. Si las instrucciones son vagas, el output es coherente localmente e incoherente globalmente. Cada archivo tiene sentido en sí mismo. El sistema entero no tiene sentido como conjunto.

    El spec no es documentación. No es burocracia. Es la única forma de darle a un agente de IA el contexto suficiente para que sus decisiones locales sean coherentes con la visión global.

    Sin spec, el agente está adivinando constantemente. Y adivina bien, frase a frase. Pero adivinar bien frase a frase no produce un párrafo con sentido — produce contenido que parece correcto y no lleva a ningún lado.


    Qué es SDD y por qué no es lo que crees

    Spec-Driven Development no es escribir documentación antes de programar. Eso es lo que la mayoría imagina y por lo que lo descartan: “ya tengo suficiente trabajo sin añadir Word docs al proceso”.

    SDD es una metodología de tres artefactos que define qué construyes, cómo lo construyes y en qué orden lo construyes — antes de que un solo agente escriba una sola línea de código.

    Los tres artefactos son:

    spec.md — el qué. La especificación estructurada del sistema. Tiene seis secciones fijas: Visión, Usuarios, Funcionalidades, Flujos, Arquitectura, NFRs. En total, tres o cuatro páginas que responden a la pregunta que ningún agente puede responder por ti: qué problema resuelves exactamente, para quién, y qué significa “hecho” en este proyecto.

    plan.md — el cómo. El plan técnico por fases. No divide el trabajo en tareas sueltas — divide el trabajo en capas que tienen sentido en secuencia. Primero el dominio, después la infraestructura, después la UI. No al revés. El plan.md es el documento que evita que empieces por la pantalla de login cuando el sistema de autenticación aún no existe.

    tasks.md — el orden. La lista de tareas ordenada para TDD. Cada tarea define qué test escribes primero y qué código lo hace pasar. El tasks.md convierte el plan en commits atómicos verificables. Cuando un agente ejecuta una tarea del tasks.md, el resultado es predecible: un test verde y un incremento de funcionalidad real.

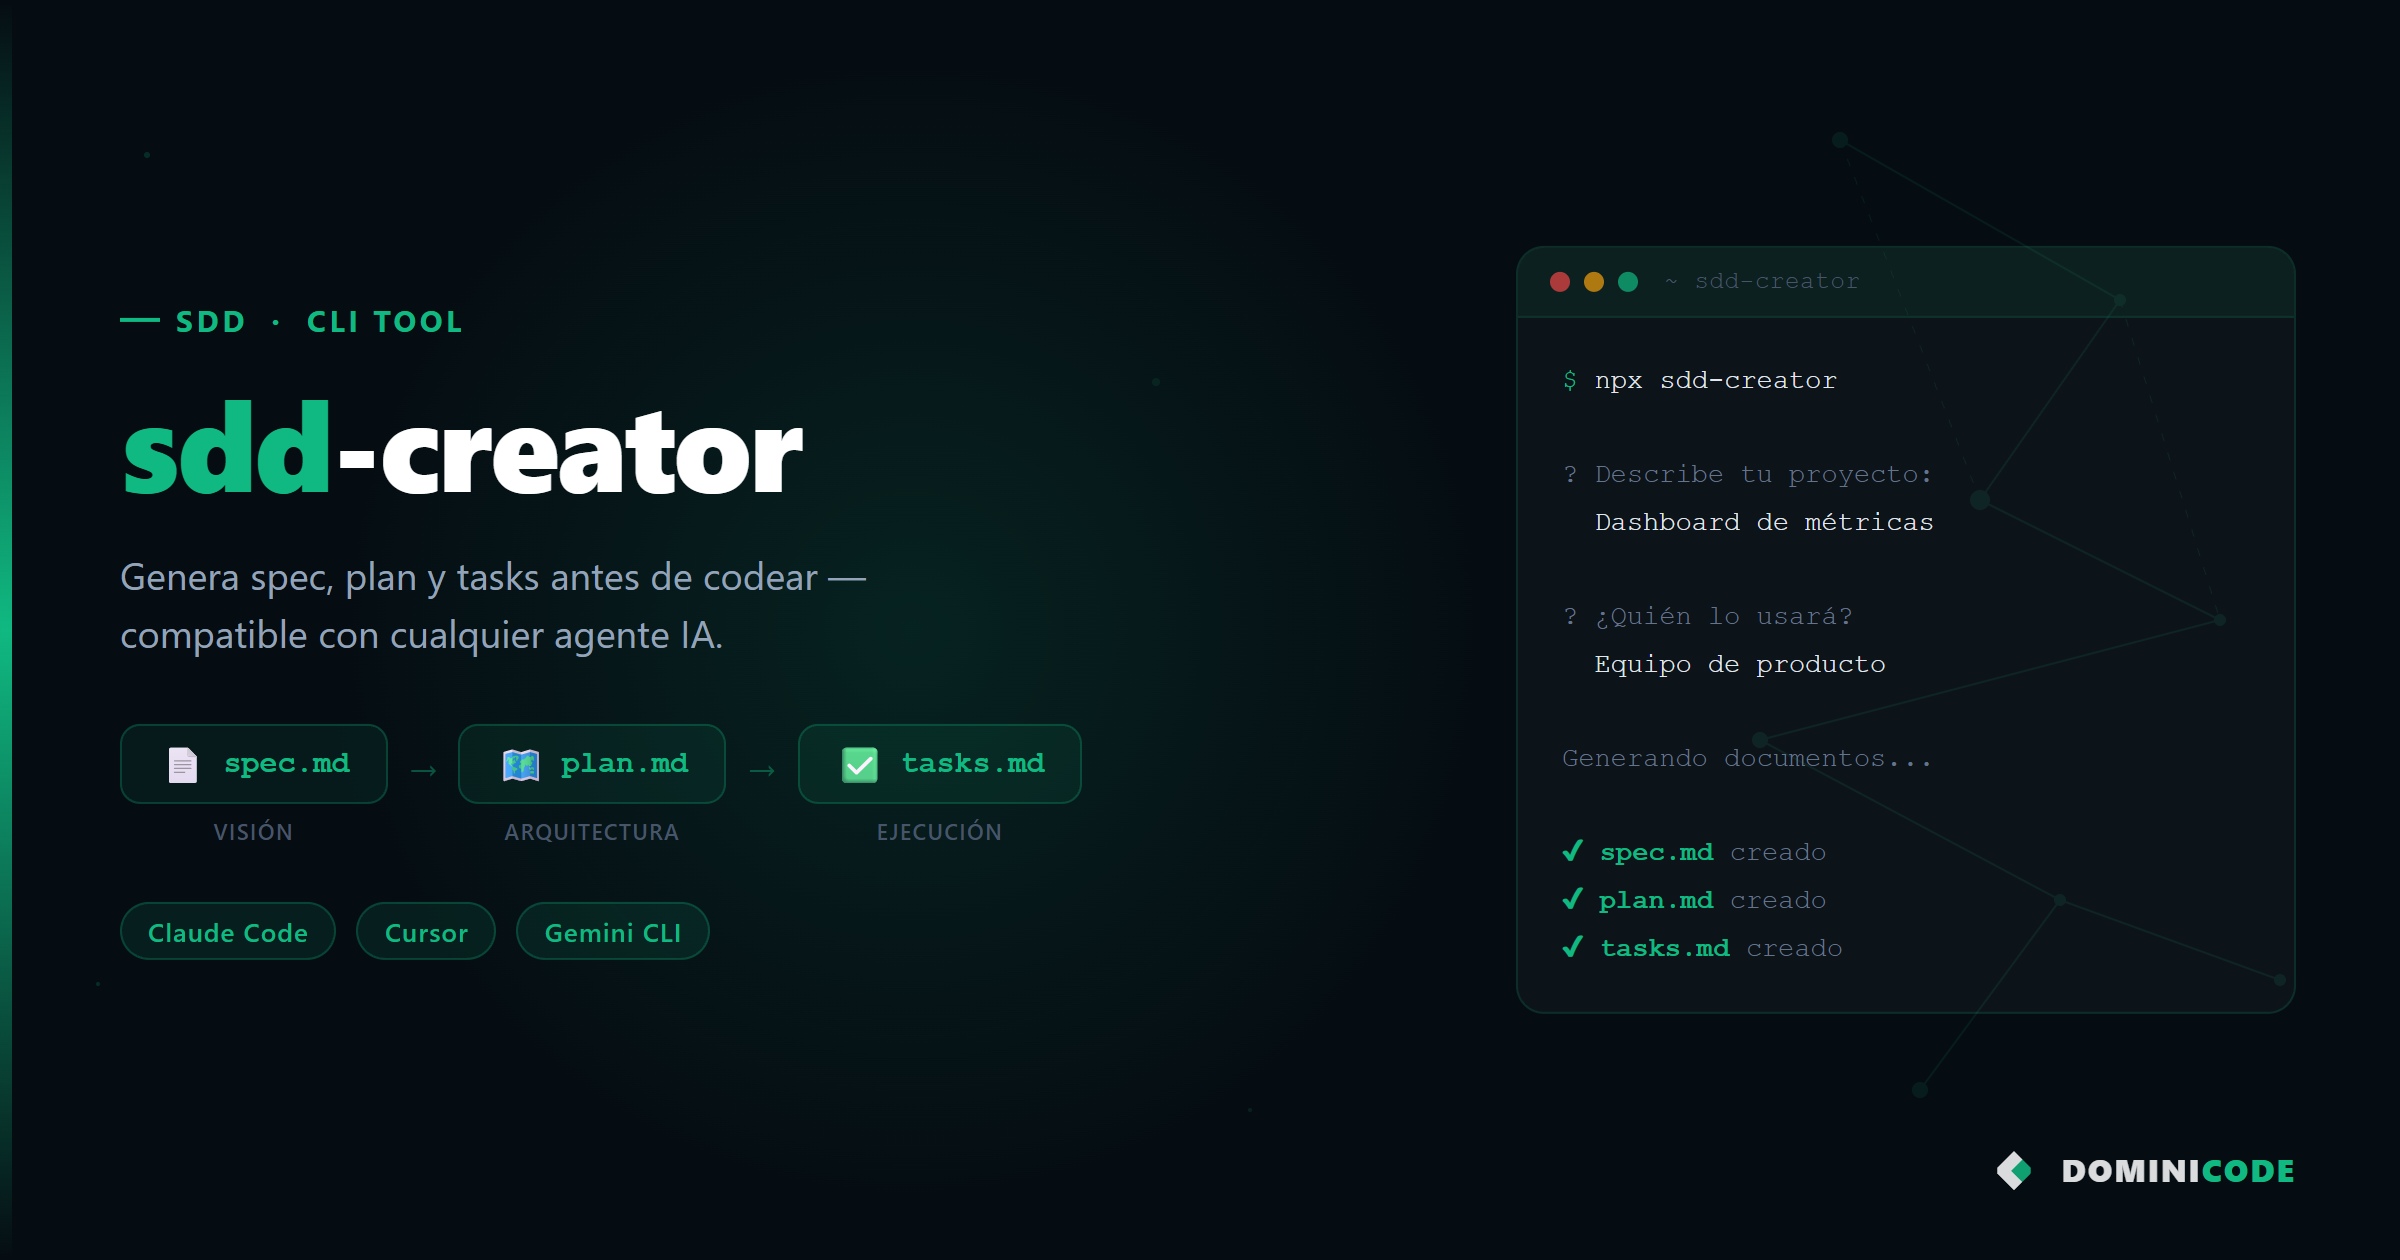
    Estos tres documentos no tardan tres días en escribirse. Con el skill /dominicode-sdd-spec-creator en Claude Code (disponible para miembros de Dominicode Labs), la estructura completa se genera en minutos a partir de una descripción del proyecto. Lo que tarda tiempo es pensar — y ese tiempo es exactamente el que te ahorra deuda técnica después.


    Antes vs después: el mismo proyecto, dos formas de empezar

    Hace unos meses construí un sistema de gestión de contenido para automatizar la publicación en múltiples canales. El proyecto tenía integraciones con tres APIs externas, lógica de colas, transformaciones de formato y un dashboard de seguimiento.

    Sin SDD (como lo hubiera hecho en 2022): Habría abierto el editor, creado una carpeta src/, y empezado por la parte que más me apetecía — probablemente el dashboard. A las dos semanas tendría un dashboard bonito conectado a datos hardcodeados, una integración con una API que funcionaba en happy path, y ninguna certeza de cómo conectar las piezas. Cada decisión técnica habría sido local, sin visión del sistema completo.

    Con SDD: Antes de escribir código, escribí el spec.md. La sección de Flujos me forzó a pensar en qué pasa cuando una API falla en mitad de una publicación — algo que no habría considerado hasta toparme con el bug en producción. La sección de NFRs me hizo definir qué latencia máxima era aceptable para el sistema de colas. La sección de Arquitectura me hizo elegir entre evento-driven y polling antes de escribir nada — no a mitad del proyecto cuando cambiar de dirección cuesta semanas.

    El spec.md tardó dos horas. El plan.md, una hora más. El tasks.md, otra hora.

    Cuatro horas de especificación que eliminaron tres semanas de refactoring posterior.

    Cuando empecé a usar Claude Code en el proyecto, el agente tenía el spec.md en el contexto. Cada decisión técnica que tomaba era coherente con la arquitectura definida. No porque el LLM sea mágicamente más inteligente con un documento — sino porque el documento le daba información que de otra forma no tenía.


    El spec como brújula del agente

    Este es el cambio de mentalidad que más cuesta hacer: el spec no es para ti. Es para el agente.

    Cuando llevas quince años programando, tu cabeza tiene el contexto del proyecto. Sabes por qué elegiste ese patrón. Sabes qué módulo toca qué. Sabes los trade-offs que hiciste en la semana dos. Ese contexto vive en tu cabeza y lo das por supuesto.

    El agente no tiene nada de eso. Sin contexto explícito, cada sesión empieza desde cero. Cada prompt es una petición descontextualizada si no le das el marco. Sin spec, el agente responde a lo que le preguntas — no a lo que necesitas construir.

    Con el spec.md en contexto, el agente puede hacer preguntas que de otra forma no haría: “esta funcionalidad que me pides entra en conflicto con el flujo de usuario número tres que está en el spec — ¿quieres cambiar el flujo o ajustar la funcionalidad?”. Esa pregunta vale más que mil líneas de código generado sin contexto.

    Esta es exactamente la lógica detrás del libro Spec-Driven Development — no es un manual de documentación, es una metodología diseñada para que el agente tenga suficiente contexto para tomar decisiones correctas sin que tú estés micromanageando cada prompt.


    Por qué el spec te protege del vibe coding

    El vibe coding no es programar con IA. Es programar con IA sin criterio. Hay developers que publican proyectos enteros generados en un fin de semana. Impresionante en superficie. Inutilizable en producción.

    El problema del vibe coding no es la velocidad — es la ausencia de coherencia acumulada. Cada prompt genera código coherente con el prompt anterior, pero nadie garantiza que el sistema resultante sea coherente con la intención original. A las cuatro horas de vibe coding, el proyecto tiene forma de algo pero no tiene diseño. Tiene features pero no tiene arquitectura.

    Lo que se acumula en silencio no es código malo — es deuda técnica agéntica. El tipo de deuda que no se ve en los tests porque los tests también los generó el agente sin un contrato claro de qué probar. El tipo de deuda que explota cuando intentas añadir la feature número veinte sobre una base que asumió implícitamente cosas que nunca se definieron.

    Para entender por qué la arquitectura de tus agentes necesita un spec detrás, te recomiendo el post sobre agentic harness: por qué la spec y la arquitectura no bastan.

    SDD es el antídoto no porque ralentice el desarrollo. Lo acelera — pero acelera el desarrollo en la dirección correcta. La spec es el contrato que el agente respeta en cada iteración. El plan es la secuencia que evita que construyas la décima planta antes de los cimientos. El tasks.md son los commits que puedes revisar, aprobar y revertir si algo no cuadra.

    Con SDD, el vibe coding se convierte en agile coding con contexto — velocidad de agente, criterio de arquitecto.


    Cómo empezar con SDD en Claude Code hoy

    Si tienes Claude Code y quieres aplicar SDD en tu próximo proyecto, el proceso es directo:

    1. Describe tu proyecto en lenguaje natural — qué construyes, para quién, qué problema resuelve.
    2. Ejecuta el skill /dominicode-sdd-creator — genera spec.md, plan.md y tasks.md en pocos minutos (disponible en Dominicode Labs).
    3. Revisa el spec antes de tocar código — es el momento de pensar, no después.
    4. Añade el spec.md al contexto de Claude Code con @spec.md al inicio de cada sesión de desarrollo — la documentación oficial de Claude Code explica cómo gestionar el contexto entre sesiones.
    5. Trabaja el tasks.md en secuencia — un task, un test, un commit.

    El skill no reemplaza tu pensamiento. Te obliga a pensar antes de que sea costoso cambiar de dirección.

    El post sobre SDD Creator, la herramienta CLI muestra exactamente cómo se genera la estructura automáticamente.

    Si quieres ver cómo se aplica esto en un proyecto real de principio a fin — desde la spec inicial hasta el deploy — es exactamente lo que trabajamos en el curso Construye con IA: no tutoriales sueltos de herramientas, sino el proceso completo de construir un producto con IA de forma que funcione en producción.


    El spec como ventaja competitiva real

    Hay algo que nadie dice sobre SDD en 2026 y que merece decirse.

    En un mundo donde cualquier developer puede generar código a gran velocidad con IA, la diferencia competitiva no está en quién genera más rápido. Está en quién sabe exactamente qué construir y por qué.

    El spec es donde vive esa ventaja. No en el prompt. No en la elección del modelo. En la claridad con la que defines el problema antes de que empiece la ejecución.

    Los developers que entienden esto ya no compiten con los que “usan IA para programar más rápido”. Son una categoría diferente: developers que combinan criterio técnico con capacidad de ejecución agéntica. El spec es la expresión concreta de ese criterio.

    Dentro de doce meses, los equipos que hayan integrado SDD en su workflow tendrán bases de código mantenibles, documentación generada como efecto colateral del proceso, y la capacidad de incorporar nuevos agentes o nuevos developers sin que el proyecto colapse. Los que sigan con vibe coding habrán reescrito el proyecto tres veces.


    FAQ

    ¿SDD no es simplemente documentación con otro nombre?

    No. La documentación describe lo que existe. El spec define lo que va a existir — antes de que exista. La diferencia no es semántica: la documentación se escribe después y siempre está desactualizada. El spec se escribe antes y guía la implementación. Si el spec y el código divergen durante el desarrollo, es señal de que hay una decisión técnica que tomar conscientemente — no de que el documento esté equivocado.

    ¿Cuánto tiempo tarda escribir el spec de un proyecto real?

    Depende del proyecto. Para un MVP de funcionalidad acotada, entre dos y cuatro horas. Para un sistema con múltiples integraciones y flujos complejos, un día. El punto de referencia útil: si el spec tarda más de un día en escribirse, es señal de que el proyecto no está suficientemente definido para empezar a construirlo — y ese es el momento exacto en que el spec te está salvando, no ralentizando.

    ¿Se puede aplicar SDD a proyectos que ya existen?

    Sí, pero el proceso es diferente. En proyectos existentes, el spec se usa para nuevas features o para refactorizaciones significativas. El ejercicio de escribir el spec de un módulo existente es también un audit implícito: si no puedes escribir el spec del módulo, es porque el módulo no tiene diseño coherente. El spec revela la deuda técnica que el código oculta.

    ¿SDD funciona con cualquier agente de IA o solo con Claude Code?

    La metodología es agnóstica al agente. Spec.md, plan.md y tasks.md son documentos markdown que cualquier LLM puede usar como contexto. El skill /dominicode-sdd-spec-creator está diseñado para Claude Code y disponible en Dominicode Labs, pero los artefactos que genera son compatibles con cualquier entorno. Lo importante no es la herramienta — es el hábito de definir antes de ejecutar.

    ¿Qué pasa cuando el spec cambia durante el desarrollo? ¿No es todo ese trabajo en vano?

    El spec cambia. Siempre cambia. Y eso es una funcionalidad, no un fallo. Cuando el spec cambia, tienes un documento que actualizar — y esa actualización fuerza una decisión consciente sobre el impacto del cambio en la arquitectura, los flujos y las tareas pendientes. Sin spec, el cambio ocurre de forma invisible: alguien pide algo diferente, el agente lo implementa, y nadie sabe qué asunciones antiguas quedan rotas. Con spec, el cambio es visible y gestionable.

    ¿Es SDD compatible con metodologías ágiles?

    Completamente. SDD no impone un ciclo de desarrollo — impone un hábito de especificación antes de ejecución. Dentro de un sprint de dos semanas, el spec de las features del sprint se escribe al inicio. El plan.md define el orden de implementación dentro del sprint. El tasks.md genera los tickets concretos. SDD convierte el backlog en artefactos ejecutables para agentes, no en listas de deseos sin criterio técnico.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Claude Code: Effort, Models, Tools y Context para developers

    Claude Code: Effort, Models, Tools y Context para developers

    La primera vez que abrí Claude Code, lo traté como un chat más inteligente. Le pegaba código, le pedía que lo arreglara, copiaba la respuesta. Funcionaba, pero lo estaba usando como una versión cara de Stack Overflow.

    Tardé tres semanas en entender que Claude Code no es un chatbot. Es un agente que ejecuta herramientas reales en tu sistema, que puede leer tu repositorio entero, que tiene niveles de razonamiento configurables y que toma decisiones en cadena sin que tú intervengas en cada paso.

    Cuando lo entendí así, cambió todo.

    Este post es lo que me hubiera gustado leer antes de empezar. No es un tutorial de instalación — asume que ya lo tienes corriendo. Es una explicación honesta de los cuatro conceptos que determinan si Claude Code trabaja para ti o contra ti: Effort, Models, Tools y Context.


    Effort — el nivel de razonamiento que decides gastar

    Cuando Claude Code procesa una tarea, no siempre piensa igual de profundo. Puedes configurar cuánto razonamiento aplica desde la UI de Claude Code o mediante la opción de esfuerzo en la configuración. Los niveles son cuatro: low, medium, high y max.

    Esto no es marketing. Es la diferencia entre gastar dos segundos y gastar dos minutos en una misma pregunta, con respuestas radicalmente distintas.

    Low — cuando la velocidad importa más que la precisión

    Con low, Claude Code responde rápido y sin profundizar demasiado. Es útil para tareas mecánicas y predecibles: renombrar variables, formatear código, generar boilerplate que ya tienes en mente pero no quieres teclear.

    Si le pides "añade un método toString() a esta clase", no necesita razonar sobre arquitectura. low es suficiente.

    Medium — el nivel por defecto para trabajo diario

    medium es lo que usas el 80% del tiempo. Hay razonamiento real, considera contexto, pero no entra en análisis profundo de consecuencias. Funciona bien para refactoring moderado, explicaciones técnicas, generación de tests unitarios para funciones simples.

    Es el equilibrio entre velocidad y calidad que necesitas en un flujo de trabajo normal.

    High — cuando el error cuesta caro

    Aquí Claude Code empieza a razonar sobre consecuencias. Evalúa múltiples opciones antes de decidir, considera casos borde, analiza impacto en el resto del sistema.

    Úsalo cuando toques código crítico: un servicio de autenticación, la lógica de pagos, una migración de base de datos, un cambio arquitectural en el core de la aplicación. El tiempo extra que tarda se justifica con la reducción de errores no detectados.

    Max — análisis exhaustivo, sin atajos

    max activa el razonamiento más profundo disponible. Claude Code descompone el problema en partes, considera múltiples estrategias, evalúa trade-offs explícitamente.

    Esto no es para trabajo diario. Es para cuando necesitas que te ayude a diseñar la arquitectura de un módulo nuevo, cuando tienes un bug imposible de reproducir que llevas días persiguiendo, o cuando vas a tomar una decisión técnica con consecuencias a largo plazo.

    El coste es tiempo y tokens. La ganancia es profundidad real.

    Regla práctica: empieza con medium. Si la respuesta no llega al nivel que necesitas, sube un nivel. No uses max por defecto — no tiene sentido pagar el coste de razonamiento exhaustivo para añadir un campo en un formulario.


    Models — cuál elegir y por qué importa

    Claude Code tiene acceso a varios modelos bajo el capó. No todos son iguales en velocidad, coste ni capacidad. Elegir mal aquí es tirar dinero o tirar tiempo.

    A junio de 2026, los modelos disponibles en Claude Code son:

    Claude Haiku 4.5 — velocidad máxima, coste mínimo

    Haiku es el modelo pequeño. Responde en segundos, cuesta muy poco por token, y es más que suficiente para tareas de bajo peso cognitivo: completar líneas de código, responder preguntas de documentación, generar snippets concretos que ya tienes pensados.

    En un workflow agentic donde Claude Code ejecuta decenas de llamadas encadenadas (leer archivos, buscar patrones, escribir logs), Haiku hace el trabajo de las subtareas sin disparar el coste.

    Claude Sonnet 4.6 — el modelo de trabajo diario

    Sonnet es el punto dulce. Más capaz que Haiku en razonamiento y contexto largo, más rápido y barato que Opus, suficientemente potente para el 90% de las tareas de un developer.

    Refactoring complejo, generación de tests con lógica no trivial, debugging asistido, implementación de features completas — Sonnet lo maneja bien. Si no sabes cuál usar, empieza aquí.

    Claude Opus 4.8 — para problemas difíciles

    Opus es el modelo grande. Más lento, más caro, y considerablemente más capaz cuando el problema requiere razonamiento profundo, comprensión de contexto muy largo o análisis de consecuencias en sistemas complejos.

    No lo uses para tareas rutinarias. Sí lo uses cuando estés diseñando una arquitectura nueva, cuando el problema tiene múltiples dependencias que hay que razonar en paralelo, o cuando los outputs de Sonnet no son suficientemente precisos para tu caso.

    Claude Fable 5 — el modelo más potente

    Fable es el frontier model de Anthropic. Capacidades extendidas de razonamiento, mejor manejo de contexto muy largo y mayor precisión en tareas de alta complejidad. En Claude Code aparece como opción para las tareas más exigentes.

    Úsalo con criterio: el coste es significativamente mayor. Tiene sentido cuando diseñas sistemas críticos, cuando necesitas que el modelo razone sobre un codebase completo de miles de archivos, o cuando el nivel de precisión que necesitas no lo alcanza Opus.

    La decisión práctica: para trabajo diario usa Sonnet. Para subtareas rápidas y repetitivas dentro de un agente, Haiku. Para decisiones técnicas importantes o problemas difíciles, Opus o Fable. El modelo correcto no es el más potente — es el que resuelve el problema con el menor coste posible.


    Tools — las herramientas built-in que hacen a Claude Code un agente real

    Aquí está la diferencia fundamental entre Claude Code y un chatbot: Claude Code tiene herramientas que ejecuta de verdad en tu sistema. No simula leer archivos — los lee. No describe cómo haría una búsqueda — la hace.

    Estas son las herramientas principales y para qué sirve cada una:

    Herramienta Qué hace
    Read Lee el contenido de un archivo del filesystem. Claude ve exactamente lo que hay en el archivo, con números de línea.
    Edit Modifica un fragmento concreto de un archivo existente. Solo envía el diff, no reescribe todo el archivo.
    Write Crea un archivo nuevo o sobreescribe uno completo. Más costoso que Edit — úsalo solo cuando el cambio afecta a todo el archivo.
    Bash Ejecuta comandos de shell reales en tu sistema. Tests, builds, git, scripts, cualquier cosa que harías en terminal.
    Glob Busca archivos por patrón (**/*.ts, src/**/*.spec.ts). Útil para que Claude Code entienda la estructura del proyecto antes de actuar.
    Grep Busca contenido dentro de archivos por expresión regular. Para localizar dónde se usa una función, qué archivos importan un módulo, qué tests cubren una clase.
    WebSearch Hace búsquedas web reales. Útil cuando necesita documentación actualizada, información sobre versiones recientes o validar datos externos.
    WebFetch Descarga y procesa el contenido de una URL concreta. Para leer documentación oficial, specs de una API, changelog de una librería.
    Agent Lanza un subagente — una instancia paralela de Claude Code que ejecuta una subtarea de forma independiente. Arquitectura agentic en acción.
    TodoRead / TodoWrite Gestiona una lista de tareas interna de la sesión. Claude Code se auto-organiza las tareas que tiene pendientes en una tarea compleja.

    Lo que hace potente a este conjunto no es ninguna herramienta por sí sola — es la combinación. Claude Code lee la estructura del proyecto con Glob, localiza el código relevante con Grep, lo lee con Read, lo modifica con Edit, y ejecuta los tests con Bash. Todo en secuencia, sin que tú intervengas en cada paso.

    Este es el flujo que hace que una instrucción como "refactoriza el módulo de autenticación para que use el nuevo interceptor HTTP" produzca cambios reales en diez archivos distintos, con los tests pasando al final.

    La referencia completa de todas las herramientas y sus parámetros está en la documentación oficial de Claude Code.

    Si quieres ver cómo encajan estas herramientas con el resto del stack IA, en Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo analizo exactamente eso.

    Si te interesa construir workflows agenticos más avanzados con Claude Code — desde la idea hasta un producto deployado — el curso Construye con IA: De la Idea al Producto con Claude y Specs cubre exactamente eso: cómo orquestar estas herramientas para que Claude Code trabaje con autonomía real.


    Context — cómo sabe Claude Code dónde está y qué importa

    El contexto es el factor más subestimado de Claude Code. Puedes tener el modelo correcto, el nivel de esfuerzo correcto y todas las herramientas disponibles — si Claude Code no entiende el contexto de tu proyecto, los outputs serán genéricos.

    @files y @folders — lo que le pones delante

    En la interfaz de Claude Code puedes mencionar archivos o carpetas con @. Cuando escribes @src/app/auth/auth.service.ts, Claude Code lee ese archivo y lo incluye directamente en el contexto de la conversación antes de procesar tu instrucción.

    Con @src/app/auth/ incluyes toda la carpeta. Claude Code procesa los archivos relevantes y construye una comprensión del módulo antes de actuar.

    Esto no es solo "adjuntar archivos". Es darle a Claude Code el mapa del territorio antes de pedirle que navegue.

    @url — documentación externa en tiempo real

    @url le permite a Claude Code leer el contenido de una URL y usarlo como contexto. Si necesitas que siga la documentación oficial de Angular v22 antes de modificar tu código de routing, puedes darle la URL del changelog y él la procesa.

    Esto elimina el problema clásico de los LLMs con conocimiento desactualizado. Si la librería sacó una versión nueva hace dos semanas, puedes darle la fuente actualizada directamente.

    CLAUDE.md — la memoria persistente del proyecto

    El archivo CLAUDE.md en la raíz de tu proyecto es la forma de darle a Claude Code instrucciones permanentes que se cargan en cada sesión.

    Aquí defines las convenciones del proyecto: cómo nombrar archivos, qué patrones arquitecturales seguís, qué comandos son los válidos, qué herramientas externas usáis, qué NO debe tocar sin confirmación explícita. Un CLAUDE.md bien escrito hace que Claude Code se comporte como un developer que conoce las reglas del equipo desde el primer día.

    No es opcional. Es la diferencia entre un agente que trabaja contigo y uno que trabaja en paralelo a ti sin coordinación.

    Memoria entre sesiones

    Por defecto, cada sesión de Claude Code empieza sin memoria de conversaciones anteriores. El contexto no persiste automáticamente.

    La forma correcta de manejar esto es el CLAUDE.md: las decisiones técnicas importantes, las convenciones acordadas, las restricciones del proyecto — todo lo que necesita persistir va ahí. No en el historial de conversación.

    Para proyectos más complejos, puedes estructurar archivos adicionales de contexto (specs, planes, documentos de arquitectura) y referenciarlos con @ al inicio de cada sesión. Es un flujo de trabajo, no una feature automática.

    En Dominicode Labs tenemos proyectos reales donde aplicamos exactamente esta estructura — con los archivos de contexto organizados para que Claude Code mantenga coherencia a lo largo de semanas de desarrollo.


    Cuatro hábitos para usar Claude Code como un agente real

    Claude Code no es difícil. Pero usarlo bien requiere entender que no es un chatbot avanzado — es un agente con herramientas reales, niveles de razonamiento configurables, múltiples modelos con características distintas, y un sistema de contexto que tú controlas.

    Elegir el modelo correcto para cada tarea, configurar el esfuerzo según lo que está en juego, dejar que las tools hagan el trabajo sin microgestionar cada paso, y mantener un CLAUDE.md que le dé continuidad al proyecto — esos cuatro hábitos son la diferencia entre usarlo como un buscador caro y usarlo como un colaborador técnico real.

    El siguiente paso es construir algo con él. No un script de prueba — un flujo de trabajo real donde Claude Code gestione decisiones en cadena. Si quieres ver ese proceso desde el principio, el curso Construye con IA: De la Idea al Producto con Claude y Specs parte exactamente de aquí.


    FAQ — Preguntas frecuentes sobre Claude Code

    ¿Claude Code funciona con cualquier lenguaje de programación?

    Sí. Claude Code no está limitado a ningún stack. Funciona igual con TypeScript, Python, Go, Rust, Java o cualquier lenguaje que puedas ejecutar desde terminal. Las herramientas como Bash, Glob y Grep operan sobre el filesystem, no sobre el lenguaje. Lo que sí varía es la calidad del output según el lenguaje — para TypeScript y Python la precisión es especialmente alta porque son los lenguajes más representados en el entrenamiento.

    ¿Cuál es la diferencia real entre Sonnet y Opus para trabajo diario?

    En la práctica, para el 90% de las tareas cotidianas no notarás diferencia en calidad. Sí notarás diferencia en velocidad y coste. Opus tarda más y consume más tokens. La diferencia se hace evidente en problemas complejos con mucho contexto: cuando le das un módulo de 3.000 líneas y le pides que entienda las dependencias implícitas antes de refactorizar, Opus razona más profundo. Para añadir un endpoint nuevo a una API que ya funciona, Sonnet es suficiente.

    ¿Cómo evito que Claude Code modifique archivos que no debe tocar?

    Con el CLAUDE.md. Puedes definir explícitamente qué archivos o carpetas son de solo lectura, qué operaciones requieren confirmación explícita tuya antes de ejecutarse, y qué convenciones debe respetar siempre. Claude Code en modo interactivo ya solicita confirmación antes de ejecutar operaciones destructivas — y con autoApproveEdits: false en tu settings.json puedes reforzar ese control para cualquier edición de archivos.

    ¿Claude Code puede trabajar en proyectos con múltiples repositorios?

    Sí, pero con matices. Claude Code opera desde el directorio donde lo lanzas y puede leer rutas relativas o absolutas fuera de él si tienes los permisos correctos. Para proyectos monorepo o arquitecturas con múltiples repos relacionados, la práctica recomendada es lanzarlo desde la raíz del monorepo y gestionar el contexto con @carpetas específicas para cada subtarea. Si trabajas con Angular en un monorepo, el curso de Angular Moderno cubre la estructura de proyectos que mejor se integra con flujos agenticos.

    ¿Cuánto contexto puede manejar Claude Code en una sesión?

    Depende del modelo. Los modelos actuales de Claude tienen ventanas de contexto de 200.000 tokens, lo que equivale a varios cientos de miles de líneas de código. En la práctica, el límite operativo es antes: a partir de cierto volumen, la calidad del razonamiento empieza a degradarse aunque técnicamente quepa más. La buena práctica es ser selectivo con el contexto que cargas — usar @ para incluir solo los archivos relevantes para la tarea actual, no volcar el repositorio entero en cada sesión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Automatizar el proceso de desarrollo con IA: de Jira al deploy

    Automatizar el proceso de desarrollo con IA: de Jira al deploy

    Hace tres meses le propuse a un cliente algo que le sonó a ciencia ficción: que el agente iba a leer el ticket de Jira, implementar la feature, abrir el navegador para testearla, hacer el code review y crear el PR en GitHub. Que él solo tendría que revisar y aprobar.

    Su respuesta fue "sí, claro". Con la misma energía con la que alguien te dice "ajá" cuando no te está escuchando.

    Lo puse en marcha. En la primera semana el agente cerró cuatro tickets de forma autónoma. El quinto lo paré yo a mitad porque se estaba inventando un requisito que no estaba en el ticket. Ajusté el prompt. El sexto salió limpio.

    Esto no es el futuro. Es lo que puedes montar hoy con Claude Code, el MCP de Jira, el MCP de Chrome y un CLAUDE.md bien escrito. Y en este post te cuento exactamente cómo funciona el pipeline para automatizar el proceso de desarrollo con IA de principio a fin.

    Un pipeline agentico de desarrollo es un flujo automatizado donde un agente de IA ejecuta de forma autónoma los pasos de implementación, testing y revisión de código a partir de un ticket, reduciendo la intervención humana al momento de aprobar el resultado.

    El problema con el workflow de desarrollo tradicional

    El ciclo habitual de un developer en un equipo tiene un patrón claro: leer el ticket, entender el contexto del código, implementar, escribir el test manual en el navegador, hacer el PR, esperar el code review, corregir los comentarios, mergear, rezar para que el CI pase.

    Cada uno de esos pasos tiene rozamiento. Cambios de contexto. Interrupciones. El developer senior pasa entre un 20% y un 30% de su tiempo en tareas que no son escribir código: leer tickets, crear PRs, hacer reviews de código propio.

    Con agentes, ese porcentaje puede recortarse a la mitad.

    No estoy hablando de reemplazar al developer. Estoy hablando de eliminar la fricción mecánica para que el developer se quede con las decisiones que importan.

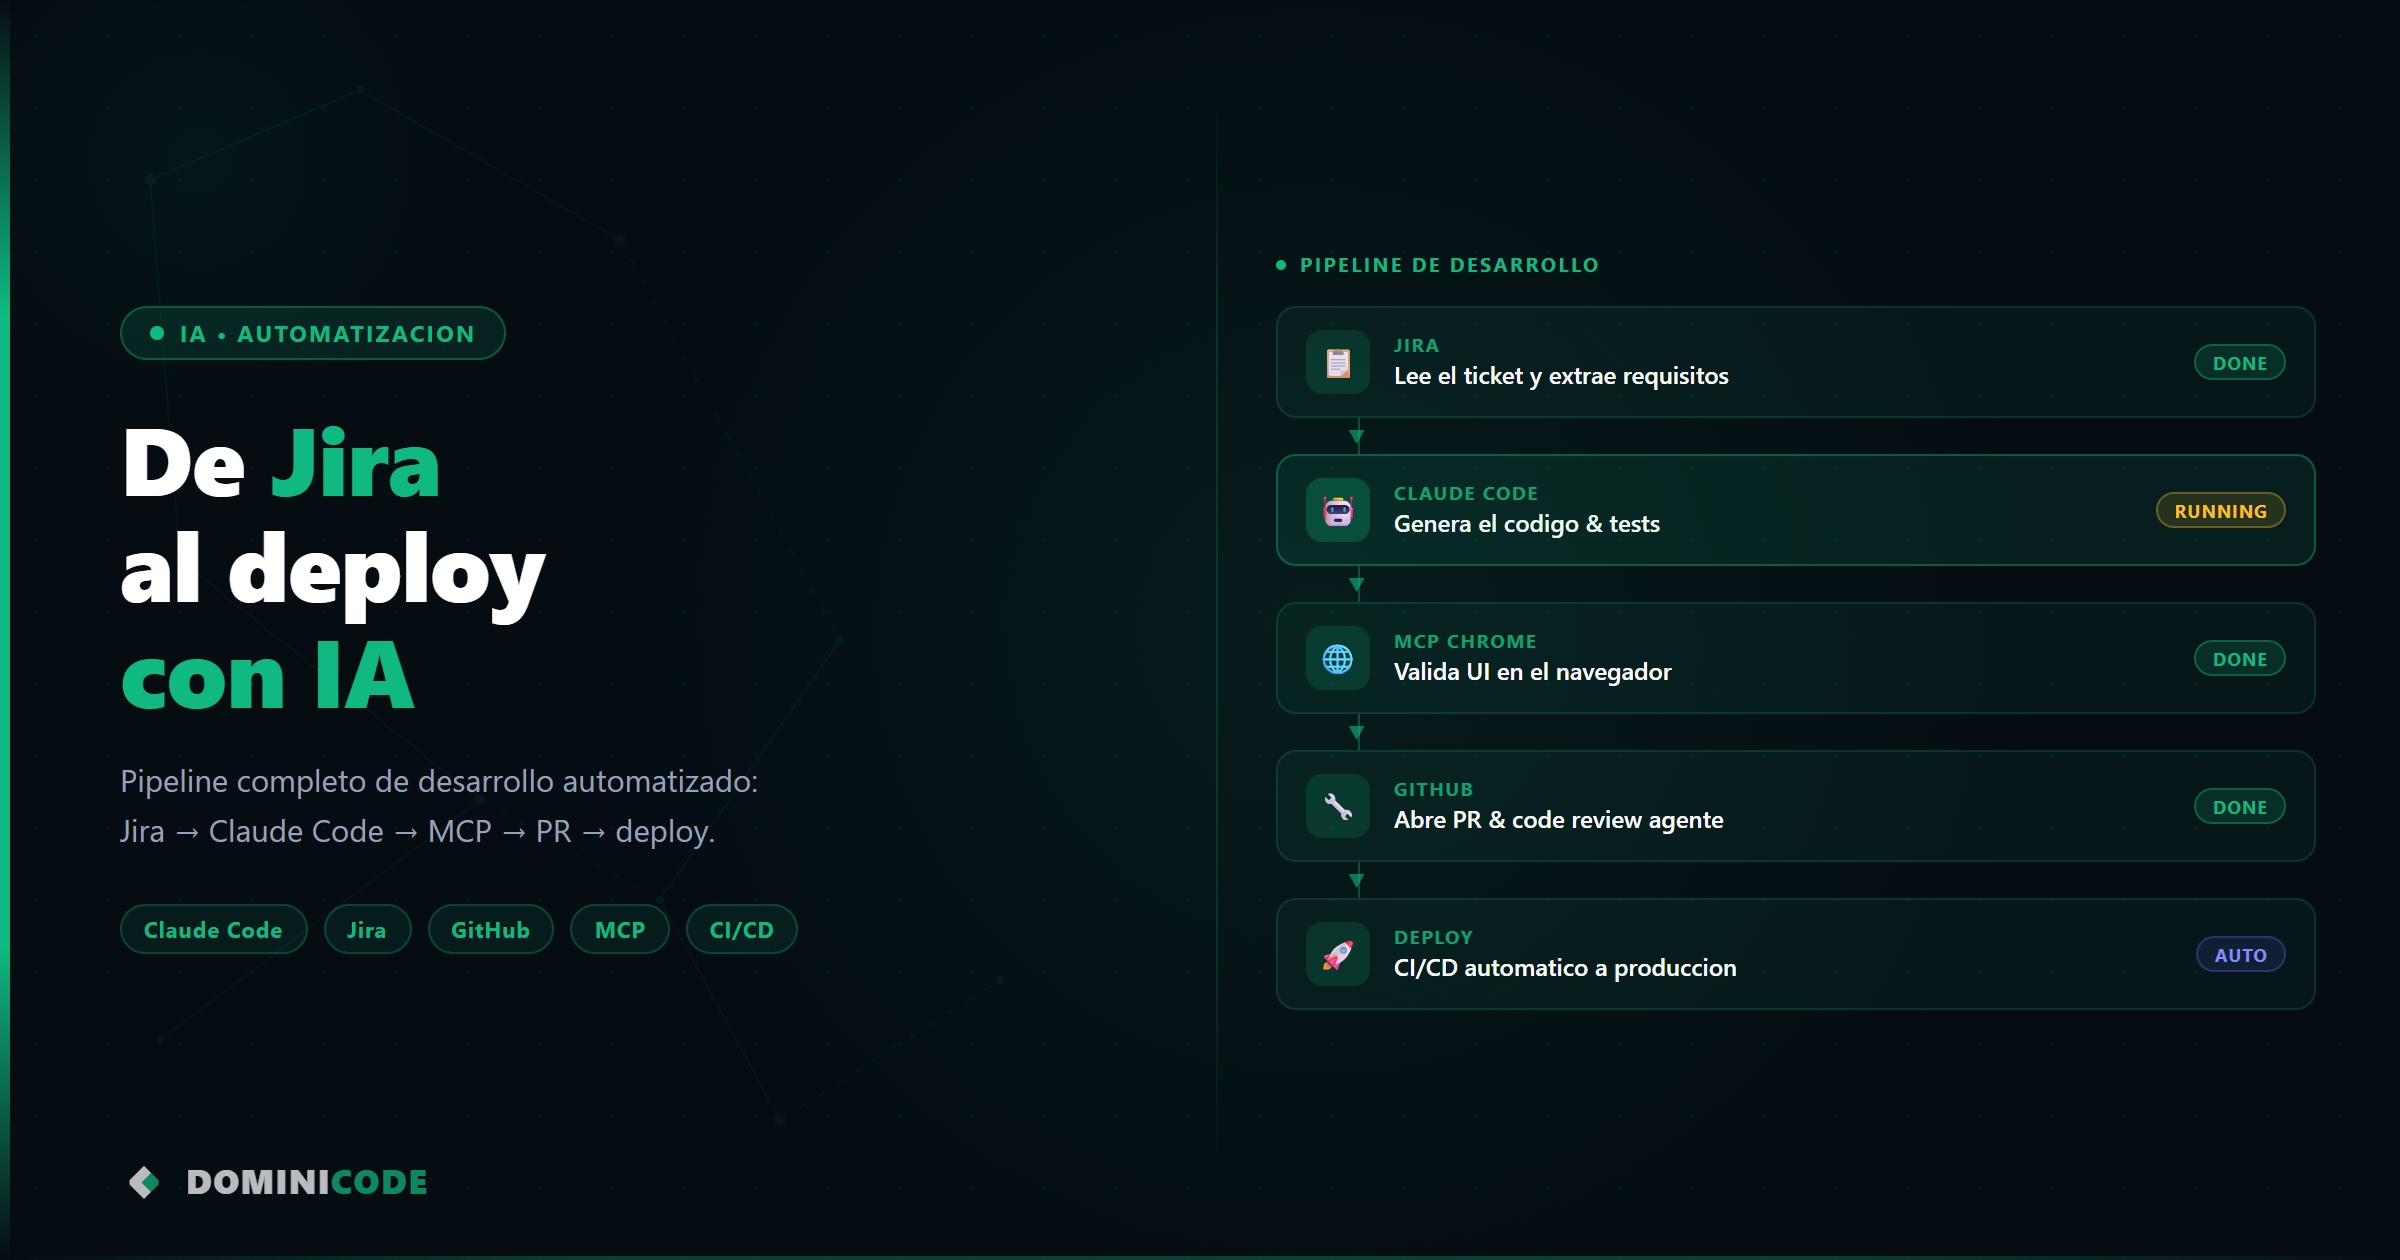
    El pipeline completo: de Jira al deploy en seis pasos

    Así es el flujo que tengo montado:

    [Ticket Jira]
         ↓
    [Claude Code lee ticket via MCP Jira]
         ↓
    [Lee CLAUDE.md + contexto del proyecto]
         ↓
    [Implementa la feature o bug fix]
         ↓
    [MCP Chrome: abre navegador, navega, verifica]
         ↓
    [/code-review: detecta problemas antes del merge]
         ↓
    [Crea PR en GitHub con descripción del ticket]
         ↓
    [CI/CD se dispara tras el merge]
         ↓
    [Deploy a producción]
    

    El developer entra en el paso de revisar el PR. Todo lo anterior lo hace el agente.

    Paso 1: leer el ticket de Jira

    Claude Code tiene acceso al MCP de Jira. Cuando invocas el agente con el ID del ticket, extrae la descripción, los criterios de aceptación, el tipo de tarea y cualquier comentario relevante.

    # Invocar el agente con un ticket específico
    claude "Lee el ticket PROJ-412 de Jira e implementa la tarea"
    

    El agente extrae:

    • Descripción de la tarea
    • Criterios de aceptación (los usará para el testing)
    • Labels y tipo (bug, feature, refactor)
    • Comentarios con contexto adicional

    Si los criterios de aceptación están mal escritos o son ambiguos, el agente lo detecta y puede preguntar antes de implementar. Ese comportamiento se configura en el CLAUDE.md del proyecto.

    Paso 2: leer el contexto del proyecto con CLAUDE.md

    El CLAUDE.md es la memoria del agente sobre tu proyecto. Antes de escribir una sola línea de código, Claude Code lee este archivo para entender:

    • Convenciones de nomenclatura
    • Arquitectura del proyecto (qué hace cada capa)
    • Comandos para correr tests y el servidor local
    • Patrones prohibidos o recomendados
    • Cómo se estructuran los PRs en este equipo

    Un CLAUDE.md bien escrito transforma al agente de "asistente genérico" a "developer que conoce el proyecto". La diferencia entre los dos es enorme en producción.

    # CLAUDE.md — ejemplo mínimo
    
    ## Arquitectura
    - Feature modules en `src/features/<nombre>/`
    - Services solo en la capa de aplicación, nunca en componentes
    - Todos los efectos secundarios pasan por el store (NgRx)
    
    ## Comandos importantes
    - Dev server: `bun run dev`
    - Tests: `bun run test`
    - Build: `bun run build`
    
    ## Convenciones de PR
    - Título: `[PROJ-XXX] descripción breve`
    - Descripción: resumen del ticket + cambios técnicos + steps to test
    

    Si quieres ver cómo construir un CLAUDE.md completo para un proyecto real, en el curso Construye con IA lo hago desde cero con un proyecto en TypeScript.

    Paso 3: implementar la feature

    Claude Code implementa la tarea. Lee los archivos relevantes, sigue las convenciones del CLAUDE.md, escribe los tests unitarios si el proyecto los requiere y ejecuta el servidor local para verificar que compila sin errores.

    Aquí es donde el contexto importa más que el modelo. Un agente con buen contexto (CLAUDE.md + ticket detallado) implementa con una tasa de acierto mucho más alta que uno que empieza desde cero.

    El agente también puede hacer preguntas aclaratorias antes de implementar si detecta ambigüedad. Ese comportamiento se configura así en el CLAUDE.md:

    ## Comportamiento del agente
    - Si los criterios de aceptación son ambiguos, pregunta antes de implementar
    - No inventes requisitos que no estén en el ticket
    - Si necesitas crear un nuevo módulo, describe la estructura antes de crearla
    

    Paso 4: testing en el navegador con el MCP de Chrome

    Este es el paso que más sorprende a los developers cuando lo ven por primera vez.

    El MCP de Chrome (servidor MCP que usa Playwright por debajo para controlar el navegador) le da a Claude Code control total: abrir URLs, hacer clic en elementos, rellenar formularios, tomar screenshots, leer el contenido del DOM, verificar mensajes de error en consola.

    El agente usa los criterios de aceptación del ticket como guión de testing. Si el ticket dice "el usuario debe poder filtrar la tabla por fecha y ver solo los registros del rango seleccionado", el agente:

    1. Abre la app en localhost:4200
    2. Navega a la sección de la tabla
    3. Selecciona un rango de fechas
    4. Verifica que los registros mostrados coinciden con el filtro
    5. Toma un screenshot del resultado
    6. Revisa la consola del navegador para detectar errores
    // API de Playwright que ejecuta el servidor MCP internamente
    await page.goto('http://localhost:4200/dashboard/reports');
    await page.click('[data-testid="date-filter"]');
    await page.fill('[data-testid="date-from"]', '2026-01-01');
    await page.fill('[data-testid="date-to"]', '2026-01-31');
    await page.click('[data-testid="apply-filter"]');
    
    const rows = await page.$$('[data-testid="table-row"]');
    // Verifica que todos los rows tienen fechas dentro del rango
    

    Si algo falla, el agente lo reporta, corrige el código y vuelve a ejecutar el test. Es un loop de implementar → testear → corregir que el developer antes hacía manualmente.

    Referencia: Playwright — documentación oficial de automatización de navegadores.

    Paso 5: code review automático antes del PR

    Antes de crear el PR, el agente ejecuta /code-review — un slash command de Claude Code que analiza todos los cambios del diff:

    • Detecta problemas de seguridad (inputs sin sanitizar, secrets hardcodeados)
    • Verifica que se siguen las convenciones del proyecto
    • Revisa cobertura de casos edge
    • Detecta código duplicado o patrones que el equipo tiene como prohibidos

    Si el code review detecta problemas críticos, el agente los corrige antes de crear el PR. Si son sugerencias menores, las incluye como comentarios en la descripción del PR para que el reviewer humano las evalúe.

    Tengo un post completo sobre cómo configurar el agentic code review con Claude Code si quieres profundizar en esa parte del pipeline.

    Paso 6: crear el PR y disparar el CI/CD

    El agente crea el PR en GitHub con:

    • Título siguiendo la convención del proyecto (extraído del ticket)
    • Descripción generada del ticket: contexto, criterios de aceptación, cambios técnicos
    • Screenshot del testing en navegador como evidencia visual
    • Checklist de testing para el reviewer
    # El agente ejecuta esto internamente
    gh pr create \
      --title "[PROJ-412] Filtro por fecha en tabla de reportes" \
      --body "$(cat pr-description.md)" \
      --base main
    

    Cuando el developer aprueba el PR y hace el merge, el CI/CD se dispara automáticamente. GitHub Actions corre los tests, valida el build y despliega a producción. El agente ya no interviene en este paso — el pipeline de CI/CD es responsabilidad del equipo de infraestructura.

    Lo que el developer sigue haciendo

    Dejar claro este punto porque es importante: el agente no reemplaza al developer. El developer hace tres cosas:

    1. Escribir tickets con criterios de aceptación claros. Esto es ahora la habilidad más valiosa. Un ticket ambiguo produce código ambiguo.
    2. Revisar y aprobar el PR. El agente implementa, pero el developer decide si el resultado es correcto.
    3. Mantener el CLAUDE.md actualizado. Las convenciones del proyecto, la arquitectura, los patrones — el agente es tan bueno como el contexto que le das.

    El rol evoluciona de "el que escribe el código" a "el que define qué construir y valida que se construyó bien". Que es, paradójicamente, donde está el valor real de un developer senior.

    En Dominicode Labs estamos implementando este pipeline en proyectos reales con la comunidad — si quieres ver el setup completo con errores incluidos, es donde lo hacemos en directo.

    Cómo empezar a automatizar tu proceso de desarrollo con IA

    No montes el pipeline completo de golpe. Empieza con esto:

    1. Escribe un CLAUDE.md sólido para tu proyecto
    2. Instala el MCP de GitHub en Claude Code
    3. Prueba crear un PR automático desde un cambio pequeño
    4. Añade el MCP de Chrome y testea un flujo simple en el navegador
    5. Conecta Jira cuando los pasos anteriores funcionen de forma estable

    El pipeline completo lleva tiempo afinar. El valor llega antes de tenerlo completo.


    Preguntas frecuentes

    ¿El MCP de Chrome funciona con cualquier framework frontend (React, Vue, Angular)?
    Sí. El MCP de Chrome opera sobre el navegador real, no sobre el framework. No le importa si la app está en Angular, React o Vue — interactúa con el DOM resultante. Solo necesitas que la app esté corriendo en un servidor local accesible.

    ¿Qué pasa si los criterios de aceptación del ticket están mal escritos o son incompletos?
    El agente intentará inferir la intención, pero si la ambigüedad es suficientemente alta, puede preguntar antes de implementar o implementar algo que no era lo esperado. La calidad del output del agente es directamente proporcional a la calidad del input (el ticket). Invertir en escribir buenos tickets es la palanca más subestimada de este pipeline.

    ¿Se puede usar este pipeline sin Jira? ¿Con Linear, GitHub Issues u otras herramientas?
    Sí. Claude Code tiene MCPs para Linear, Asana y GitHub Issues. El principio es el mismo: el agente lee el ticket desde la fuente, extrae los criterios de aceptación y los usa como guión de implementación y testing. La integración específica depende del MCP disponible para cada herramienta.

    ¿Es seguro dejar que el agente tenga acceso a la base de datos o a servicios externos durante el testing?
    No. El testing del agente debe hacerse contra un entorno de desarrollo o staging, nunca contra producción ni contra una base de datos con datos reales. El CLAUDE.md debe especificar explícitamente contra qué entorno corre el agente y qué permisos tiene. El principio de mínimos privilegios aplica igual para agentes que para cualquier proceso automatizado.

    ¿Cuánto tiempo lleva montar este pipeline desde cero?
    El pipeline mínimo (CLAUDE.md + MCP GitHub + PR automático) puede estar funcionando en un día. El pipeline completo con MCP de Jira, MCP de Chrome y code review automático lleva entre una semana y dos de ajuste para que funcione de forma estable en un proyecto real. La mayor parte del tiempo se va en escribir un CLAUDE.md completo y en afinar los prompts para que el agente entienda las convenciones del proyecto.


    Si quieres aprender a construir con IA desde cero hasta producción, echa un vistazo al curso Construye con IA.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • sdd-creator: genera spec, plan y tasks con cualquier agente IA

    sdd-creator: genera spec, plan y tasks con cualquier agente IA

    Llevaba tres horas implementando un sistema de autenticación con JWT cuando me di cuenta de que no había especificado nada.

    ¿El token debía expirar en la sesión o persistir entre reinicios? ¿Qué pasaba cuando el refresh token vencía estando el usuario activo? ¿El endpoint de logout invalidaba en servidor o solo limpiaba el cliente?

    Yo respondí esas preguntas sobre la marcha. Sin coherencia, sin registro de decisiones. El código resultó funcional pero arquitectónicamente un desastre.

    Eso no es un problema del agente. Es un problema de proceso. Para eso existe sdd-creator.


    El problema de codear sin especificar

    Los agentes de IA son extremadamente buenos ejecutando instrucciones. También son extremadamente buenos ejecutando instrucciones mal definidas — y el resultado es lo que imaginas.

    Cuando le das a Claude Code o a Cursor un prompt del tipo “implementa login con JWT”, el agente toma decisiones. Muchas. Las toma rápido, sin preguntarte, porque así trabajan. El output es código funcional que responde a una interpretación del problema, no necesariamente a tu interpretación.

    El fallo no está en la IA. Está en que nunca estableciste qué querías exactamente.

    Spec-Driven Development (SDD) resuelve esto con una premisa simple: antes de generar código, genera el spec. Un documento que responde qué hace la feature, por qué existe, quién la usa, qué flujos cubre y bajo qué criterios está terminada.

    El problema es que hacer bien un spec lleva disciplina. Y cuando tienes el agente abierto y las ganas de construir, la tentación de saltártelo es enorme.


    Qué es sdd-creator y cómo funciona

    sdd-creator es un skill para agentes de IA que impone el proceso de especificación antes de ejecutar cualquier implementación. No es un generador de documentos — es un interrogador. El agente no escribe código hasta que el spec esté completo y confirmado.

    A diferencia de pedirle directamente al agente que “genere un spec libre”, sdd-creator impone siempre las mismas 6 secciones y bloquea la implementación hasta recibir confirmación explícita. Sin esa estructura, los specs se convierten en párrafos de texto libre que el agente interpreta como quiere.

    El flujo tiene siete pasos:

    1. Describes el feature o proyecto que quieres construir
    2. sdd-creator detecta la complejidad (LOW / MEDIUM / HIGH)
    3. Te hace una entrevista interactiva — te pregunta lo que no especificaste
    4. Genera spec.md con 6 secciones estructuradas
    5. Espera tu confirmación antes de continuar
    6. Genera plan.md con las decisiones técnicas y la planificación por fases
    7. Genera tasks.md con las tareas ordenadas para TDD — y solo entonces empieza la implementación

    El repositorio está en GitHub: bezael/sdd-creator — MIT, v1.2.0.

    Si quieres entender la metodología detrás con más profundidad, el libro SDD cubre los principios completos, con patrones reales de proyectos en producción.


    Instalación

    Una sola línea:

    npx skills@latest add bezael/sdd-creator

    El CLI detecta tu herramienta y copia el skill al directorio correcto automáticamente. Como referencia, los directorios destino son:

    • Claude Code: ~/.claude/skills/
    • Cursor: .cursor/rules/ del proyecto

    No hay configuración adicional. No hay API keys. No hay dependencias de runtime. El skill vive como un archivo de instrucciones que el agente carga en contexto cuando lo invocas.

    Para instalación manual o integración con otros agentes, consulta la documentación oficial de Claude Code o los docs de tu herramienta.


    Tutorial paso a paso — feature de login con JWT

    Vamos con un ejemplo concreto. Tienes una app NestJS y quieres implementar autenticación con JWT. Sin sdd-creator, abres el agente y escribes: “implementa autenticación con JWT”. Con sdd-creator, el proceso es diferente.

    Paso 1 — Invoca el skill

    En Claude Code o en Cursor, activa sdd-creator. Luego describe tu feature:

    Quiero implementar un sistema de autenticación con JWT para una API NestJS.
    Incluye registro, login, refresh de token y logout.

    Paso 2 — La entrevista interactiva

    sdd-creator detecta complejidad media y empieza a preguntarte:

    • ¿El token de acceso expira en cuánto tiempo?
    • ¿El refresh token se invalida en servidor o solo en cliente?
    • ¿El endpoint de logout invalida todos los dispositivos activos o solo el actual?
    • ¿La app requiere rate limiting en los endpoints de auth?
    • ¿Los usuarios pueden tener múltiples sesiones simultáneas?

    Preguntas incómodas. Preguntas que el agente habría respondido solo — con su mejor criterio — si no le hubieras forzado a preguntarte.

    Paso 3 — Confirmas el spec.md

    El agente genera el spec.md completo. Lo revisas, corriges lo que no cuadra, y confirmas. Solo entonces avanza.

    Paso 4 — plan.md y tasks.md

    sdd-creator genera el plan técnico (decisiones de arquitectura, librerías, estructura de módulos) y la lista de tareas ordenadas para TDD. Primero los tests de los casos de error — token expirado, credenciales inválidas, refresh token revocado. Luego el código que los hace pasar.

    Resultado: el agente implementa exactamente lo que especificaste. Sin sorpresas. Sin decisiones implícitas. Sin “lo hice así porque parecía razonable”.


    Los 3 archivos que genera

    spec.md — La especificación en 6 secciones

    La estructura es fija e invariable:

    1. Visión — qué problema resuelve y por qué existe esta feature
    2. Usuarios — quién la usa y cuáles son sus necesidades reales
    3. Funcionalidades — qué puede hacer el sistema (listado concreto)
    4. Flujos — cómo se comporta el sistema en los escenarios principales
    5. Arquitectura — cómo está organizado técnicamente
    6. NFRs — requisitos no funcionales: performance, seguridad, disponibilidad

    La estructura fija es deliberada. Cuando el spec siempre tiene las mismas 6 secciones, puedes revisarlo en segundos y saber exactamente qué falta. Un spec libre en prosa no tiene esa propiedad.

    Si quieres ver cómo aplicar estas 6 secciones en un proyecto greenfield completo, este post sobre SDD con slices verticales lo cubre en detalle.

    plan.md — Las decisiones técnicas

    El plan responde: ¿cómo vamos a construir esto? Librerías seleccionadas y por qué. Estructura de módulos. Fases de implementación. Dependencias entre componentes. Riesgos identificados.

    No es un documento académico — es el registro de las decisiones que tomarías antes de empezar, aunque fueran en tu cabeza. Externalizar ese razonamiento tiene valor: el agente lo usa como referencia durante la implementación, y tú lo usas para hacer review.

    tasks.md — La lista ordenada para TDD

    Las tareas están ordenadas para Test-Driven Development. Los tests de los contratos del sistema van primero. El código que los satisface, después. Cada tarea es atómica — una sola responsabilidad, verificable por sí sola.

    Cuando tienes esta lista, puedes darle una tarea al agente y pedirle que haga solo esa. Sin divagar. Sin añadir “mejoras” que no pediste. La tarea acotada, con su test, con su criterio de aceptación.

    Esta es exactamente la forma de trabajar que desarrollamos en el curso Construye con IA — de la idea al producto real, con agentes IA y sin perder el control del código.


    Cuándo NO usar sdd-creator

    sdd-creator añade valor cuando el problema tiene suficiente complejidad para merecer una especificación. Hay casos donde el overhead no compensa:

    • Scripts de un solo uso: automatizaciones de 20-30 líneas que se ejecutan una vez y se descartan
    • Prototipos desechables: experimentos para validar si algo es técnicamente posible, sin intención de iterar sobre el código
    • Hotfixes triviales: corregir un typo, cambiar un color, ajustar un literal de texto

    La regla práctica: si el feature va a producción y va a ser mantenido, usa sdd-creator. Si es exploración o descarte, ve directo al código.


    Compatible con cualquier agente de IA

    sdd-creator no está atado a un agente específico. Funciona con todos los entornos de desarrollo con IA más usados:

    Agente Tipo de integración Directorio
    Claude Code Skills nativo ~/.claude/skills/
    Cursor Rules .cursor/rules/ del proyecto
    Codex CLI (OpenAI) AGENTS.md / system prompt Configuración de proyecto
    Gemini CLI System prompt Configuración de proyecto
    Aider Contexto personalizado .aider.conf.yml
    Continue config.json .continue/

    El formato MIT también significa que puedes adaptarlo a tu equipo. Si tienes convenciones de nomenclatura propias, o secciones adicionales en tus specs, puedes forkear el repositorio y ajustarlo.


    FAQ

    ¿Qué es sdd-creator?

    sdd-creator es un skill para agentes de IA que implementa el flujo de Spec-Driven Development. Cuando lo activas, el agente no escribe código directamente — primero te hace una entrevista para entender el problema, luego genera tres documentos estructurados (spec.md, plan.md, tasks.md), y solo después implementa. Es la diferencia entre darle instrucciones a un agente y darle una especificación.

    ¿Con qué agentes de IA funciona sdd-creator?

    Con Claude Code, Cursor, Codex CLI (OpenAI), Gemini CLI, Aider y Continue. El skill es un archivo de instrucciones, no una integración específica — cualquier agente que soporte archivos de contexto puede usarlo. La instalación varía: en Claude Code se copia a ~/.claude/skills/, en Cursor va a .cursor/rules/.

    ¿Cuánto tiempo lleva generar la spec con sdd-creator?

    Entre 5 y 20 minutos, dependiendo de la complejidad del feature. Una feature simple puede especificarse en 5 minutos. Una feature con múltiples flujos, integraciones externas y requisitos de seguridad puede tomar 20. Ese tiempo es siempre menor que el que cuesta refactorizar código que el agente implementó sin especificación.

    ¿Es sdd-creator compatible con proyectos legacy?

    Sí. SDD no requiere empezar desde cero — puedes aplicarlo feature a feature sobre una base de código existente. El spec refleja las restricciones reales del sistema existente: qué puedes cambiar, qué no, y qué deuda técnica tienes que tener en cuenta durante la implementación.

    ¿Puedo usar sdd-creator en equipos?

    Sí, y es donde más valor aporta. El spec.md generado es el contrato de la feature — cualquier miembro del equipo puede revisarlo, cuestionarlo y aprobarlo antes de que empiece la implementación. Elimina el “yo entendí que…” de las reuniones de review.


    Ahora, cuando tengo el agente abierto y las ganas de construir, lo primero que activo es sdd-creator. Los 15 minutos de spec se pagan solos. Esas tres horas de JWT no se van a repetir.

    Si quieres ver cómo SDD encaja en el ciclo completo de desarrollo con IA — desde la idea hasta el producto desplegado — en Dominicode Labs tienes acceso a proyectos reales donde aplicamos este flujo de principio a fin.

    Por Bezael Pérez — Fundador de Dominicode.

  • Plan, Steer, Decompose: el framework de agentic engineering

    Plan, Steer, Decompose: el framework de agentic engineering

    Llevaba tres horas con el agente.

    Tres horas corrigiendo. El agente seguía haciendo lo mismo: tomaba decisiones razonables para el contexto que tenía, pero el contexto que tenía era incompleto desde el principio. Yo le daba feedback, él ajustaba, y en la siguiente iteración el problema aparecía en otro sitio. Dos pasos adelante, uno y medio atrás.

    No era el modelo. Era yo — y el problema era la ausencia de agentic engineering en mi flujo de trabajo.

    No había planificado lo que quería construir antes de empezar. No había descompuesto el problema en piezas que el agente pudiera manejar sin ambigüedad. Le había dado un objetivo vago y esperado que el agente lo resolviera. Y el agente hacía lo que podía — que no era suficiente para lo que yo necesitaba.

    Eso es lo que diferencia a alguien que usa agentic engineering de alguien que simplemente le pide cosas a la IA: un framework de trabajo. Un ciclo operativo que convierte la delegación caótica en colaboración sistemática.

    El framework tiene cinco pasos: Plan → Steer → Decompose → Delegate → Systematize.

    El agentic engineering es la disciplina de orquestar agentes de IA de forma sistemática — definiendo objetivos, descomponiendo problemas, delegando tareas con el contexto preciso y capturando los patrones que funcionan para reutilizarlos. Es la diferencia entre usar la IA como herramienta de texto y tratarla como un sistema de producción.


    Por qué el prompting no es suficiente

    Hay un malentendido que veo constantemente en developers que llevan meses usando IA sin resultados consistentes: creen que el problema es el prompt.

    Mejoran el prompt. Añaden más contexto. Usan few-shot examples. Prueban otro modelo. Y los resultados mejoran marginalmente pero el problema de fondo persiste — siguen obteniendo outputs que tienen que reescribir, completar o corregir antes de poder usar.

    El problema no es el prompt. Es que no hay agentic engineering en el proceso — están tratando al agente como un oráculo al que preguntas. Y los oráculos funcionan bien para respuestas, no para construcción.

    Construir con IA no es preguntar. Es orquestar. Y orquestar requiere un proceso, no una técnica de redacción.


    El framework de agentic engineering: los 5 pasos

    Paso Objetivo Señal de que lo estás haciendo bien
    Plan Define qué construir antes de abrir el editor Tienes objetivo, contexto y criterios de éxito escritos
    Steer Guía la dirección durante la ejecución Intervienes en los puntos de decisión, no en cada acción
    Decompose Rompe el problema en tareas atómicas y verificables Cada tarea tiene bordes claros, sin decisiones implícitas
    Delegate Asigna la tarea correcta con el contexto mínimo necesario El agente no necesita hacer preguntas para empezar
    Systematize Convierte lo que funciona en proceso repetible Tienes CLAUDE.md, templates y hooks activos

    1. Plan — Define antes de abrir el editor

    El Plan no es el prompt inicial. Es la decisión de qué quieres construir, para quién, con qué criterios de éxito, y qué contexto necesita el agente para no tener que improvisar.

    La mayoría de los problemas de agentic engineering empiezan aquí — o mejor dicho, por saltarse este paso.

    Cuando no hay Plan, el agente trabaja con hipótesis. Asume el stack que le parece más probable. Asume la arquitectura que ha visto más en su entrenamiento. Asume que los casos edge no existen porque no se los mencionaste. Y esas hipótesis se propagan a través de todo el trabajo posterior.

    Un Plan mínimo tiene tres elementos:

    Objetivo concreto — No "implementa el módulo de usuarios". Sí: "Implementa el endpoint POST /users que recibe { email, name }, valida con Zod, crea el registro en la tabla users de Supabase y devuelve { id, email, createdAt }. Error 409 si el email ya existe."

    Contexto relevante — El stack, las convenciones de naming que ya usa el proyecto, las decisiones de arquitectura tomadas, las restricciones conocidas. Esto es lo que va en el CLAUDE.md del proyecto — no como documentación, sino como memoria estructurada que el agente lee al inicio de cada sesión.

    Criterios de éxito — Cómo sabes que el agente terminó bien su trabajo. Tests que deben pasar. Comportamientos que debes poder demostrar. Sin criterios de éxito explícitos, "listo" significa cosas distintas para ti y para el agente.

    El Spec-Driven Development es la metodología que formaliza este paso: especificar el sistema antes de construirlo, con contratos concretos que el agente puede implementar sin inventar.

    2. Steer — Guías la dirección, no desapareces

    El Steer es el feedback loop activo durante la ejecución.

    Hay un patrón que veo repetidamente: el developer escribe un prompt elaborado, lanza el agente y vuelve veinte minutos después esperando encontrar la tarea completada. A veces funciona. Cuando no funciona, el agente ha pasado esos veinte minutos construyendo en la dirección equivocada con mucha confianza.

    Steer no significa microgestionar. Significa estar presente en los puntos de decisión que importan.

    La señal de que necesitas intervenir: el agente está a punto de tomar una decisión con consecuencias amplias sin haber pedido confirmación. Cambiar la estructura de un módulo. Renombrar una abstracción clave. Elegir entre dos arquitecturas posibles. Esos son los momentos en que tu presencia tiene más palanca.

    En práctica, Steer implica:

    • Revisar el output de las primeras iteraciones antes de que el agente avance demasiado
    • Corregir la dirección cuando el agente toma una decisión incorrecta — y hacerlo en el momento, no cuando ya hay diez archivos afectados
    • Hacer preguntas explícitas al agente sobre sus decisiones: "¿Por qué elegiste este enfoque sobre el alternativo?" — no para cuestionar todo, sino para verificar que el razonamiento es el correcto antes de comprometerte con esa dirección

    El objetivo del Steer no es hacer el trabajo del agente. Es hacer que el agente haga el trabajo correcto. Sin Steer, el agentic engineering se convierte en delegación ciega — y la delegación ciega escala los errores, no los resultados.

    3. Decompose — Rompe el problema en tareas atómicas

    La Decompose es donde más se gana en calidad de output y donde menos developers invierten tiempo.

    Un agente que recibe "implementa el sistema de autenticación completo" toma demasiadas decisiones implícitas. Qué estrategia de sesiones. Qué campos en el token. Cómo manejar el refresh. Qué pasa cuando el token expira durante una request. Cada una de esas decisiones tiene consecuencias, y el agente las toma sin consultarte porque no sabe que importan.

    La descomposición transforma decisiones implícitas en decisiones explícitas.

    Una tarea bien descompuesta tiene estas características:

    Atómica — Se puede completar en una sola sesión sin depender de otras tareas que no estén terminadas.

    Sin ambigüedad en los bordes — Define qué entra, qué sale y cómo interactúa con lo que ya existe. "Implementa el endpoint de login que recibe { email, password } y devuelve { accessToken, refreshToken, user } usando el servicio AuthService ya existente" — eso es una tarea sin ambigüedad en los bordes.

    Verificable — Al terminar puedes saber con certeza si la tarea está bien hecha o no. Si no puedes verificar, la tarea está mal definida.

    // Tarea mal definida — demasiado scope, demasiadas decisiones implícitas
    // "Implementa el sistema de autenticación con JWT y manejo de sesiones"
    
    // Tarea bien definida — atómica, verificable, bordes claros
    // "Implementa la función generateTokenPair(userId: string): Promise<TokenPair>
    // que genera accessToken (15min) y refreshToken (7d) firmados con RS256.
    // TokenPair = { accessToken: string; refreshToken: string; expiresAt: Date }
    // Usa la clave privada de process.env.JWT_PRIVATE_KEY.
    // Test: genera un par, verifica que accessToken expira correctamente."
    

    La diferencia no está en la complejidad. Está en quién toma las decisiones.

    4. Delegate — Asigna al agente correcto con el contexto mínimo necesario

    Delegate es donde muchos developers confunden prompt engineering con delegación real.

    Prompt engineering es refinar las instrucciones para obtener un output mejor del mismo agente. La delegación dentro del agentic engineering es asignar la tarea correcta al agente correcto con el contexto que necesita para ejecutarla — ni más ni menos.

    Dos errores opuestos destruyen la delegación:

    Delegación sin contexto suficiente. El agente no tiene acceso a las decisiones de arquitectura previas, no conoce las convenciones del proyecto, no sabe qué existe ya. El resultado es código que no encaja — funcionalmente correcto, arquitecturalmente incorrecto.

    Delegación con contexto excesivo. Pegas en el prompt el README completo, los últimos cinco commits, tres archivos relacionados y la descripción del sistema entero. El modelo procesa todo ese contexto pero el ruido diluyente reduce la precisión. Más contexto no siempre es mejor contexto.

    El contexto mínimo necesario es el que responde a: ¿qué necesita saber el agente para tomar las mismas decisiones que yo tomaría? No el contexto que me tranquiliza a mí — el que necesita el agente.

    En Claude Code esto se traduce en ser deliberado sobre qué archivos mencionas explícitamente (@auth.service.ts, @user.schema.ts) y qué instrucciones incluyes en el CLAUDE.md del proyecto para que estén disponibles en cada sesión sin tener que repetirlas.

    5. Systematize — Lo que funciona una vez se convierte en proceso

    El Systematize es el paso que separa a los developers que mejoran semana a semana de los que repiten los mismos errores en cada proyecto nuevo.

    Cuando un flujo de trabajo de agentic engineering funciona bien — un tipo de tarea, un patrón de prompt, una estructura de descomposición — el Systematize lo captura como proceso reutilizable. No como documentación que nadie leerá. Como artefacto operativo que puedes invocar directamente.

    Tres formas concretas de systematizar:

    CLAUDE.md por proyecto — Las decisiones de arquitectura, las convenciones, las restricciones del proyecto. Este archivo es la memoria del proyecto que persiste entre sesiones. Sin él, cada sesión nueva parte de cero.

    Templates de tareas — Si descompones el mismo tipo de problema una y otra vez (endpoints REST, componentes Angular, tests de integración), el template captura la estructura de descomposición que ya demostró funcionar. No vuelves a pensar cómo descomponer — aplicas el template y ajustas los detalles.

    Hooks y workflows — En Claude Code, los hooks de PreToolUse y PostToolUse permiten ejecutar validaciones automáticas antes o después de que el agente actúe. Un hook que ejecuta tsc --noEmit antes de cada escritura de archivo previene que el agente introduzca errores de tipos que luego tienes que depurar a mano. Automatizas la verificación, no solo la generación.

    // .claude/settings.json — hook que valida TypeScript antes de escribir
    {
      "hooks": {
        "PreToolUse": [
          {
            "matcher": "Write|Edit",
            "hooks": [
              {
                "type": "command",
                "command": "npx tsc --noEmit 2>&1 | head -20"
              }
            ]
          }
        ]
      }
    }
    

    El Systematize convierte el conocimiento tácito en proceso explícito. Y el proceso explícito escala — a proyectos futuros, a otros developers del equipo, a agentes que ejecutan workflows sin supervisión.


    Cómo se conectan los 5 pasos en un ciclo

    Los cinco pasos del agentic engineering no son lineales. Son un ciclo que se repite a dos escalas.

    Escala de proyecto:

    • Una vez al inicio: Plan global
    • Primera Decompose en bloques grandes
    • Primera ronda de Delegate al agente
    • Steer durante la ejecución
    • Systematize los patrones que funcionaron para el siguiente proyecto

    Escala de tarea:

    • Plan de la tarea concreta
    • Decompose en subtareas si es necesario
    • Delegate al agente con el contexto mínimo
    • Steer durante la ejecución
    • Systematize si el patrón vale la pena capturar

    Lo que conecta los dos niveles es el contexto acumulado. Cada Systematize en una tarea pequeña alimenta el Plan del bloque siguiente. El CLAUDE.md que actualizas después de cada sesión hace que la siguiente sesión parta de un estado mejor que la anterior.

    El ciclo se mejora a sí mismo. Eso es lo que distingue un sistema de una técnica.


    Aplica el framework construyendo un producto real

    Leer el framework es útil. Aplicarlo en un proyecto real con presión de tiempo y decisiones concretas es lo que lo hace tuyo.

    El Workshop Beyond Prompts (https://workshop.dominicode.com/) del 9 de julio es exactamente eso: 3 horas donde aplicamos el agentic engineering construyendo un producto real con Claude Code — de idea a producto deployado usando Plan → Steer → Decompose → Delegate → Systematize en vivo. No es una clase magistral. Es una sesión de trabajo donde tomas decisiones, te equivocas, corriges y sales con un sistema que puedes replicar.

    Si quieres prepararte antes del workshop, el curso Construye con IA: de la idea al producto con Claude Code cubre los fundamentos de agentic engineering con el mismo enfoque: criterio para cada decisión, no solo instrucciones que seguir.

    Y si quieres trabajar el framework con proyectos concretos en comunidad — revisar tu arquitectura, discutir las decisiones que no están claras, ver cómo otros developers aplican estos pasos — en Dominicode Labs hacemos exactamente eso semana a semana.


    FAQ

    ¿Cuál es la diferencia entre el agentic engineering y el Spec-Driven Development?

    SDD es la metodología que cubre en detalle el paso Plan — cómo especificar un sistema antes de construirlo, con contratos y criterios de éxito concretos. El framework de agentic engineering Plan → Steer → Decompose → Delegate → Systematize es más amplio: cubre todo el ciclo de trabajo con agentes, desde antes de escribir la spec hasta capturar los patrones que funcionaron para reutilizarlos. SDD y agentic engineering son complementarios — SDD es la respuesta detallada a "cómo hacer bien el Plan".

    ¿El agentic engineering funciona con cualquier herramienta de IA o solo con Claude Code?

    Los cinco pasos son agnósticos a la herramienta. La lógica de Plan, Steer, Decompose, Delegate y Systematize aplica igual si usas Claude Code, Cursor, Copilot o la API directamente. Lo que cambia son los artefactos concretos: en Claude Code el contexto persistente vive en CLAUDE.md y los hooks en .claude/settings.json; en Cursor vive en .cursor/rules/; en otros entornos en AGENTS.md. El framework es la estructura. Los artefactos son la implementación específica de cada herramienta.

    ¿Cuánto tiempo tarda implementar este framework en un proyecto que ya existe?

    Para un proyecto existente sin ningún sistema, el mínimo viable —un CLAUDE.md básico con el stack y las convenciones principales, más una primera descomposición del backlog pendiente— tarda entre dos y cuatro horas. No es un proceso de migración completa. Es añadir las piezas que hacen que cada sesión futura sea más efectiva que las anteriores. El Systematize es acumulativo — mejora con el tiempo, no requiere estar completo desde el día uno.

    ¿El paso Steer no anula el beneficio de la autonomía del agente?

    No. Steer es intervención en los puntos de decisión de alto impacto, no supervisión constante de cada acción. Un agente ejecutando tareas bien definidas puede trabajar durante decenas de ciclos sin necesitar tu input — eso es autonomía real. Steer te pide que estés presente cuando el agente enfrenta una bifurcación arquitectural, no cuando está implementando un endpoint que ya tiene todos los criterios claros. La diferencia práctica: Steer activo tarda minutos por sesión. Steer ausente puede costar horas de corrección cuando el agente ha tomado veinte decisiones incorrectas en cadena.

    ¿Por dónde empiezo si nunca he trabajado de forma estructurada con agentes?

    Empieza por el Plan y el Decompose. Son los dos pasos del agentic engineering que más impacto tienen en la calidad del output y los que más developers saltan. Coge una tarea concreta de tu backlog y antes de lanzar el agente escribe: objetivo específico, contexto relevante y criterios de éxito. Luego divídela en subtareas que tengan bordes claros. Esas dos prácticas solas van a mejorar notablemente la calidad de lo que obtienes. El resto del framework puedes añadirlo gradualmente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Cómo automatizar usabilidad con agentes de IA en tu app

    Cómo automatizar usabilidad con agentes de IA en tu app

    Un cliente me enseñó su aplicación de onboarding hace unos meses. Cinco pasos. Diseño limpio. Todo funcional en los tests.

    La tasa de abandono era del 68% en el paso tres.

    Revisamos los tests de integración: pasaban todos. El formulario enviaba datos correctamente. La validación funcionaba. El CI estaba en verde. Y aun así, casi siete de cada diez usuarios salían del flujo antes de terminar.

    El problema no era que la aplicación no funcionara. Era que nadie había auditado cómo se usaba.

    Ahí está la diferencia que muchos developers no distinguen hasta que lo ven en métricas reales: una cosa es que el código haga lo que debe, y otra muy distinta es que el usuario pueda usarlo sin fricción. La primera la resuelves con tests. La segunda la resuelves con automatizar usabilidad con agentes de IA — que es exactamente lo que vamos a ver aquí.

    Automatizar usabilidad con agentes de IA consiste en delegar la auditoría de accesibilidad, flujos de usuario y fricciones de interfaz a un agente — como Claude Code con MCP de Playwright — que controla el navegador de forma programática, navega flujos reales y genera un reporte estructurado de hallazgos sin intervención manual.


    Testing funcional vs. testing de usabilidad

    Un test funcional pregunta: ¿el botón de "Enviar" llama a la función correcta?

    Un test de usabilidad pregunta: ¿el usuario sabe que tiene que hacer clic ahí? ¿Lo ve? ¿Entiende qué va a pasar después?

    Son preguntas distintas y se responden con herramientas distintas.

    Los tests funcionales los escribes tú, los corre un CI, comprueban comportamiento esperado. Eso ya lo sabes hacer. Lo que un agente de IA aporta es la capacidad de navegar tu aplicación como si fuera un usuario — explorar rutas no documentadas, detectar elementos sin etiquetas accesibles, medir cuánto tarda en responder una pantalla, o identificar que un campo de error aparece debajo del scroll y el usuario nunca lo ve.

    No te reemplaza un test de usabilidad con personas reales. Pero te da un nivel de auditoría automatizada que antes no existía — y que tú nunca harías manualmente en cada PR. Si quieres ver cómo encaja esto en un pipeline completo de desarrollo, tienes la explicación en el post sobre automatizar el proceso de desarrollo con IA.


    Qué puede detectar un agente

    Cuando conectas Claude Code con el MCP de Playwright o Chrome DevTools, el agente puede controlar el navegador de forma programática. Eso significa que puede:

    • Navegar a cualquier ruta de tu aplicación
    • Hacer clic en elementos, rellenar formularios, desplazarse por la página
    • Leer el DOM y el árbol de accesibilidad (el que usa un lector de pantalla)
    • Medir tiempos de respuesta entre interacciones
    • Ejecutar axe-core para detectar violaciones WCAG
    • Capturar screenshots en cada paso del flujo
    • Generar un reporte estructurado con los hallazgos

    Lo que un agente detecta bien:

    1. Accesibilidad técnica: imágenes sin alt, botones sin aria-label, contraste insuficiente entre texto y fondo, formularios sin etiquetas asociadas, skip navigation ausente, foco de teclado atrapado en un componente modal.
    2. Fricciones estructurales: mensajes de error fuera del viewport, campos obligatorios que no se identifican como tales hasta el submit, pasos de onboarding que no guardan el progreso si el usuario recarga.
    3. Performance percibida: cuánto tarda en aparecer el primer elemento interactivo después de una navegación, si hay loaders sin indicación de progreso, si el layout shift hace que el usuario haga clic en el elemento equivocado.
    4. Cobertura de flujos: si una ruta de error (credenciales incorrectas, sesión expirada, red caída) termina en una pantalla sin instrucciones claras.

    Cómo configurar el agente para automatizar la auditoría de usabilidad

    La combinación que funciona en producción: Claude Code + MCP de Playwright.

    Para instalarlo: npx @playwright/mcp@latest. Una vez activo en tu configuración de Claude Code, el agente tiene acceso a las herramientas de control del navegador sin que escribas una línea de Playwright.

    El MCP de Playwright expone herramientas al agente para controlar el navegador: browser_navigate, browser_click, browser_type, browser_snapshot, browser_evaluate. Claude puede encadenar esas herramientas para ejecutar flujos completos.

    Un ejemplo de instrucción al agente para auditar el onboarding de una app:

    ## Tarea: Auditoría de usabilidad — flujo de onboarding
    
    URL base: http://localhost:4200
    
    Flujo a auditar:
    1. Navega a /register
    2. Rellena el formulario con datos válidos: nombre, email, contraseña
    3. Haz clic en "Crear cuenta"
    4. Completa los pasos del onboarding hasta llegar al dashboard
    
    En cada paso:
    - Captura un screenshot
    - Extrae el árbol de accesibilidad del contenido principal
    - Identifica elementos interactivos sin aria-label o sin texto visible
    - Mide el tiempo hasta que el siguiente paso es interactivo
    - Detecta si hay mensajes de error o advertencia y si son visibles sin scroll
    
    Al terminar, genera un reporte en formato JSON con esta estructura:
    {
      "paso": string,
      "url": string,
      "tiempo_carga_ms": number,
      "violaciones_accesibilidad": [],
      "fricciones_detectadas": [],
      "screenshot": string
    }
    

    El agente ejecuta eso de forma autónoma. Navega, interactúa, observa, y vuelve con un reporte estructurado.


    Accesibilidad automática con axe-core

    Para violaciones WCAG, la integración más sólida es axe-core. El agente puede ejecutarlo sobre cualquier página activa en el navegador mediante browser_evaluate:

    // Si axe-core no está en el bundle de la app, inyectarlo primero:
    // await page.addScriptTag({ url: 'https://cdn.jsdelivr.net/npm/axe-core/axe.min.js' });
    
    // Ejecutar la auditoría en el contexto de la página
    const results = await axe.run();
    return {
      violaciones: results.violations.map(v => ({
        impacto: v.impact,
        descripcion: v.description,
        elementos: v.nodes.map(n => n.target)
      }))
    };
    

    Lo que devuelve axe-core son violaciones categorizadas por impacto: critical, serious, moderate, minor. El agente puede filtrar solo las críticas, agregar el selector del elemento afectado, y generar una lista accionable para el developer.

    Esto detecta cosas como:

    • Contraste de color insuficiente (ratio menor a 4.5:1 para texto normal)
    • Imágenes sin atributo alt o con alt vacío en imágenes informativas
    • Elementos <div> y <span> usados como botones sin rol ARIA
    • Formularios sin <label> asociado o con placeholder como único identificador
    • Encabezados fuera de jerarquía (<h4> después de <h2> sin <h3>)

    Esta es una de las capacidades que trabajamos en detalle en el curso Construye con IA: cómo delegar auditorías estructuradas al agente para que el developer se centre en las decisiones de producto, no en el checklist técnico.


    El reporte de hallazgos

    Un agente que navega y detecta problemas no sirve de nada si los hallazgos terminan en un log de consola que nadie lee.

    El formato que mejor funciona para integrar en un workflow de desarrollo es un JSON estructurado que puedas convertir en un issue de GitHub, una tarea en Linear, o un comentario en un PR.

    Estructura mínima de reporte que el agente genera:

    {
      "auditoria": {
        "fecha": "2026-06-17",
        "url_base": "https://app.ejemplo.com",
        "flujo": "onboarding",
        "duracion_total_ms": 8420
      },
      "resumen": {
        "violaciones_criticas": 3,
        "violaciones_serias": 7,
        "fricciones_detectadas": 4,
        "pasos_con_retraso": 2
      },
      "hallazgos": [
        {
          "paso": "registro",
          "tipo": "accesibilidad",
          "impacto": "critical",
          "descripcion": "Campo de contraseña sin label asociado. Solo usa placeholder.",
          "selector": "#password-input",
          "referencia_wcag": "1.3.1"
        },
        {
          "paso": "paso-2-perfil",
          "tipo": "friccion",
          "impacto": "serious",
          "descripcion": "Mensaje de validación aparece 280px por debajo del campo en mobile. No visible sin scroll.",
          "selector": ".validation-message",
          "screenshot": "paso-2-error-state.png"
        }
      ]
    }
    

    Este reporte lo puedes consumir directamente en tu pipeline de CI, enviarlo a un webhook de Slack, o procesarlo con otro agente que abra los issues correspondientes.


    Agentes IA vs Lighthouse

    Capacidad Lighthouse Agente IA + MCP Playwright
    Métricas de rendimiento (LCP, CLS, FID) ✅ ❌
    Accesibilidad estática (axe-core) ✅ ✅ más granular
    Flujos interactivos multipaso ❌ ✅
    Estados de error y modales ❌ ✅
    Reporte adaptado al contexto del proyecto ❌ ✅ JSON estructurado
    Requiere código de automatización ❌ ❌ lenguaje natural
    Integración en CI/CD ✅ ✅

    Lighthouse mide el estado de una página en un instante. Un agente mide cómo un usuario real la recorre.


    Lo que el agente no puede hacer

    Esto es importante. Un agente mide lo que puede observar en el DOM y en el comportamiento de la interfaz. No puede medir lo que ocurre dentro del usuario.

    No detecta:

    • Frustración emocional. Si el flujo es técnicamente correcto pero genera ansiedad porque el lenguaje es frío o las instrucciones son ambiguas, el agente no lo sabe.
    • Preferencias estéticas. El contraste puede pasar el ratio WCAG y aun así resultar incómodo visualmente en contextos específicos.
    • Contexto cultural. Un ícono que es intuitivo para un usuario europeo puede no serlo para un usuario latinoamericano. El agente no tiene ese mapa cultural.
    • Carga cognitiva subjetiva. Puede detectar que hay ocho campos en un formulario, pero no puede decirte si eso es demasiado para tu audiencia específica.
    • Microcopy y confianza. El texto de un CTA puede ser técnicamente legible y aun así no generar suficiente confianza para que el usuario haga clic.

    Esas decisiones siguen siendo tuyas — o del diseñador, o del researcher de UX. Lo que el agente elimina es el trabajo de auditoría técnica repetitiva que de otra forma no harías en cada ciclo de desarrollo.


    Cómo integrarlo en tu workflow

    El patrón que funciona sin complicar el pipeline:

    1. Local, bajo demanda: el developer lanza la auditoría sobre la rama antes de abrir el PR. El agente revisa el flujo afectado por el cambio.
    2. En CI, sobre entornos de preview: cada PR despliega a un entorno de preview (Vercel, Netlify, Railway), y el agente audita ese entorno de forma automática antes del merge.
    3. Semanal, sobre producción: un job programado lanza la auditoría completa sobre la app en producción y genera un reporte que llega al equipo.

    El tercer nivel es el más valioso a largo plazo: detecta regresiones de accesibilidad que se cuelan en producción sin que nadie las vea en los tests unitarios.

    El paso de code review automático antes del PR — que complementa esta auditoría de usabilidad — lo explico en detalle en el post sobre agentic code review con Claude Code.

    Si quieres ver cómo construir este tipo de pipelines con agentes desde cero, en Dominicode Labs tenemos proyectos completos que aplican exactamente este enfoque — desde la configuración del MCP hasta la generación del reporte final.


    FAQ

    ¿Necesito conocer Playwright para esto?
    No necesitas escribir código Playwright. El MCP abstrae las herramientas de control del navegador y el agente las usa directamente. Basta con que describas el flujo que quieres auditar en lenguaje natural.

    ¿axe-core cubre todos los criterios WCAG?
    Cubre los criterios que son detectables automáticamente — menos de la mitad de los criterios de WCAG 2.1. El resto requiere evaluación humana. Pero ese 30-40% incluye los problemas más comunes y los más graves.

    ¿El agente puede auditar aplicaciones con autenticación?
    Sí. Puedes darle al agente las credenciales de una cuenta de prueba, o configurar el MCP para que arranque el navegador con una sesión ya autenticada. El agente navega como un usuario real, incluyendo el flujo de login.

    ¿Qué diferencia hay entre esto y Lighthouse?
    Lighthouse audita métricas de performance, SEO básico y accesibilidad en un snapshot estático. Un agente con MCP de Playwright puede auditar flujos interactivos completos — formularios multipaso, modales, estados de error, interacciones con el teclado — y generar reportes adaptados a tu contexto específico, no a un checklist genérico.

    ¿Puedo usar esto con cualquier framework frontend?
    Sí. El agente interactúa con el navegador, no con el framework. Funciona igual con Angular, React, Vue o cualquier app renderizada en el cliente o en el servidor.

    La próxima vez que un cliente te muestre métricas de abandono con todos los tests en verde, ya sabes qué está pasando — y cómo resolverlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Formación en IA para equipos de desarrollo: 4 módulos

    Formación en IA para equipos de desarrollo: 4 módulos

    Me llamó un CTO a las 11 de la mañana. Su empresa tiene 18 developers. Llevan un año diciéndose que “van a adoptar IA”. Han probado ChatGPT, han instalado GitHub Copilot, alguien hizo un tutorial de Claude Code un sábado.

    Y aun así, el equipo sigue trabajando igual que en 2022.

    El problema no está en las herramientas. Está en que nadie tiene claro cómo integrar la formación en IA para equipos de desarrollo de forma coordinada, con metodología, sin que cada developer invente su propio flujo en solitario.

    Eso es exactamente lo que resuelve el programa que ofrezco desde Dominicode.

    El programa de formación en IA para equipos de desarrollo de Dominicode es un itinerario corporativo de 4 módulos — Fundamentos, Claude Code Avanzado, SDD y n8n — diseñado para equipos tech de 5 a 50 personas que necesitan adoptar IA de forma coordinada, no ad-hoc. Duración total: 48-72 horas.

    Por qué los equipos no adoptan IA (y el problema no es la herramienta)

    Cuando un equipo “no adopta IA”, el instinto es buscar la herramienta correcta. Probar otra. Comprar otra licencia. Mandar a alguien a un curso de medio día.

    Eso no funciona porque el problema no es la herramienta.

    La IA cambia cómo se diseña, cómo se especifica y cómo se construye software. Si solo añades una herramienta encima de un proceso que no ha cambiado, el resultado es ruido. Developers que usan IA para generar código que después nadie entiende. Tech leads que no saben cómo revisar trabajo asistido por IA. Proyectos que empiezan con entusiasmo y acaban con un pull request de 2.000 líneas que nadie quiere tocar.

    Según la investigación de GitHub sobre productividad con Copilot, los developers completan tareas hasta un 55% más rápido con asistencia de IA — pero solo cuando tienen flujos de trabajo estructurados, no cuando improvisan cada uno por su cuenta.

    Ya escribí sobre las consecuencias concretas en las consecuencias de no adoptar IA en el desarrollo. Lo que sigue aquí es la solución estructurada.

    El programa de formación en IA para equipos: 4 módulos en orden

    El programa no es una colección de talleres desconectados. Es una progresión deliberada: cada módulo construye sobre el anterior. No puedes enseñar Claude Code avanzado a un equipo que no entiende cómo funciona un LLM. No puedes implantar SDD en un equipo que aún no tiene flujos de trabajo con IA.

    El orden importa.

    Módulo Tema Duración Nivel
    1 Fundamentos de IA para Developers 8-12 h Todos
    2 Claude Code Avanzado 16-24 h Avanzado
    3 Spec-Driven Development (SDD) 12-20 h Intermedio
    4 n8n para Automatización 12-16 h Intermedio

    ### Módulo 1 — Fundamentos de IA para Developers

    Duración: 8-12 horas (varía según el nivel de partida del equipo)

    Aquí el objetivo no es impresionar. Es nivelar.

    Un equipo de 15 personas tiene 15 modelos mentales distintos sobre qué es la IA, qué puede hacer y cuándo falla. Este módulo construye una base compartida: cómo funcionan los LLMs, por qué el contexto es el recurso más escaso, cómo escribir prompts que no sean ruleta rusa.

    Sin esto, cada developer toma decisiones técnicas basadas en suposiciones distintas. Y eso se nota en producción.

    Módulo 2 — Claude Code Avanzado

    Duración: 16-24 horas

    Este es el módulo donde el equipo pasa de “usar IA” a “trabajar con IA de verdad”.

    No es un tutorial de instalación. Es flujo de trabajo real: cómo estructurar el contexto con CLAUDE.md, cómo usar hooks para automatizar validaciones, cómo orquestar subagentes para tareas paralelas, cómo integrar MCP servers con las herramientas internas del equipo.

    Si quieres entender el nivel de profundidad que cubre este módulo, el curso Construye con IA es la versión individual del mismo material — pensada para developers que quieren avanzar por su cuenta antes o después del programa corporativo.

    Módulo 3 — Spec-Driven Development (SDD)

    Duración: 12-20 horas

    Este módulo es el que más sorprende a los equipos. Y el que más impacto tiene a largo plazo.

    SDD es la metodología que desarrollé para el desarrollo asistido por IA — una forma de trabajar donde la especificación técnica existe antes del código y funciona como contrato compartido entre el equipo y la IA. Eso elimina la ambigüedad, reduce el retrabajo y hace que la IA genere código que encaja con la arquitectura real del proyecto.

    En el post sobre SDD en proyectos greenfield con slices verticales puedes ver cómo funciona aplicado a un proyecto real. El módulo corporativo va más lejos: cómo adaptar SDD a equipos con diferentes niveles de seniority y cómo integrarlo con metodologías ágiles existentes.

    Si alguien del equipo quiere prepararse antes del programa, el libro de SDD en Leanpub cubre la metodología completa.

    Módulo 4 — n8n para Automatización

    Duración: 12-16 horas

    n8n (open-source, self-hosteable) es el multiplicador. Cuando el equipo ya trabaja bien con IA a nivel individual, n8n permite construir workflows que amplifican esa productividad a nivel de proceso.

    Automatización de revisiones de código. Pipelines de QA asistidos por IA. Agentes internos que conectan el stack de la empresa — Jira, GitHub, Slack, Notion — con los modelos de lenguaje. Sin necesidad de escribir integraciones desde cero cada vez.

    Este módulo es deliberadamente el último. Sin los tres anteriores se convierte en un set de automatizaciones frágiles sin principios de diseño detrás.

    Para quién es este programa

    Para empresas tech de LATAM o España con equipos de desarrollo de 5 a 50 personas que quieren adoptar IA de forma coordinada, no ad-hoc.

    Para CTOs y tech leads que ya saben que la IA va en serio, pero necesitan un marco estructurado para llevarlo al equipo sin que sea caos.

    Para directores de ingeniería que tienen que justificar la inversión ante negocio y necesitan un programa con entregables concretos, no solo “horas de formación”.

    Para quién no es:

    No es para equipos que buscan un taller de dos horas para “motivar” al equipo con IA. No es para empresas que quieren implementar IA sin cambiar ningún proceso. Y no es para developers individuales — para eso existe el curso individual y Dominicode Labs, la comunidad donde trabajo estos temas cada semana.

    Cómo se entrega

    El programa puede ser presencial, online en vivo, o híbrido. Se adapta al calendario del equipo — no tienes que parar el sprint.

    Cada módulo incluye material práctico, código de ejemplo y entregables que el equipo se lleva: templates de prompts, configuraciones de CLAUDE.md, especificaciones SDD adaptadas a vuestro stack, workflows de n8n listos para customizar.

    El enfoque es 30% teoría, 70% práctica con casos reales. No slides de PowerPoint con capturas de pantalla de ChatGPT.

    ¿Te interesa para tu empresa?

    Si tienes un equipo de desarrollo y quieres entender si este programa encaja con vuestras necesidades, lo primero es una llamada de 30 minutos sin compromiso.

    Escríbeme directamente a bezael@gmail.com con el asunto “Formación B2B” y cuéntame brevemente el tamaño del equipo y el contexto. Te respondo en 24 horas.

    O si prefieres explorar más sobre el enfoque antes de contactar, visita dominicode.com — hay material suficiente para que entiendas exactamente cómo trabajo.

    FAQ — Preguntas frecuentes sobre el programa de formación en IA para equipos

    ¿El programa es modular o hay que contratarlo completo?

    Los cuatro módulos están diseñados para funcionar juntos, pero pueden contratarse de forma independiente. Si el equipo ya tiene base en fundamentos de IA, podemos entrar directamente desde Claude Code. La llamada inicial sirve para diagnosticar dónde está el equipo y qué tiene más sentido.

    ¿Cuánto cuesta el programa?

    El precio varía según modalidad (online, presencial, híbrido), número de módulos y tamaño del equipo. No hay una tarifa fija publicada porque cada empresa parte de un punto distinto. Escríbeme a bezael@gmail.com con el asunto “Formación B2B” y te envío propuesta personalizada en 24 horas.

    ¿Cuál es la duración total del programa completo?

    Entre 48 y 72 horas en total. Se imparte habitualmente en sesiones de 3-4 horas, 2-3 veces por semana, a lo largo de 4-8 semanas. También es posible formato intensivo de inmersión.

    ¿El programa es online, presencial o híbrido?

    Las tres opciones son posibles. Online en vivo es la más habitual para equipos distribuidos en LATAM y España. Presencial está disponible principalmente en España. El formato se decide según la distribución del equipo.

    ¿Qué nivel técnico se requiere para participar?

    Los módulos 1 y 2 son accesibles para cualquier developer con experiencia básica. Los módulos de SDD y n8n requieren nivel mid — no por la complejidad de las herramientas, sino porque el valor real está en aplicarlos a problemas de arquitectura reales.

    ¿Cómo se mide el impacto del programa?

    Definimos métricas antes de empezar: tiempo de ciclo de desarrollo, calidad de especificaciones, reducción de retrabajo, adopción activa de herramientas. Hacemos seguimiento 30 días después de cada módulo.

    ¿Qué diferencia este programa de un curso online normal?

    Un curso online lo hace cada developer a su ritmo, sin coordinación con el equipo. Este programa está diseñado para que el equipo aprenda junto, con casos del proyecto real de la empresa cuando es posible, generando cultura de equipo alrededor de la IA — no solo skills individuales.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.