Tag: Claude Code

  • Orquestar agentes de IA con Herdr: que se hablen sin bucles

    Orquestar agentes de IA con Herdr: que se hablen sin bucles

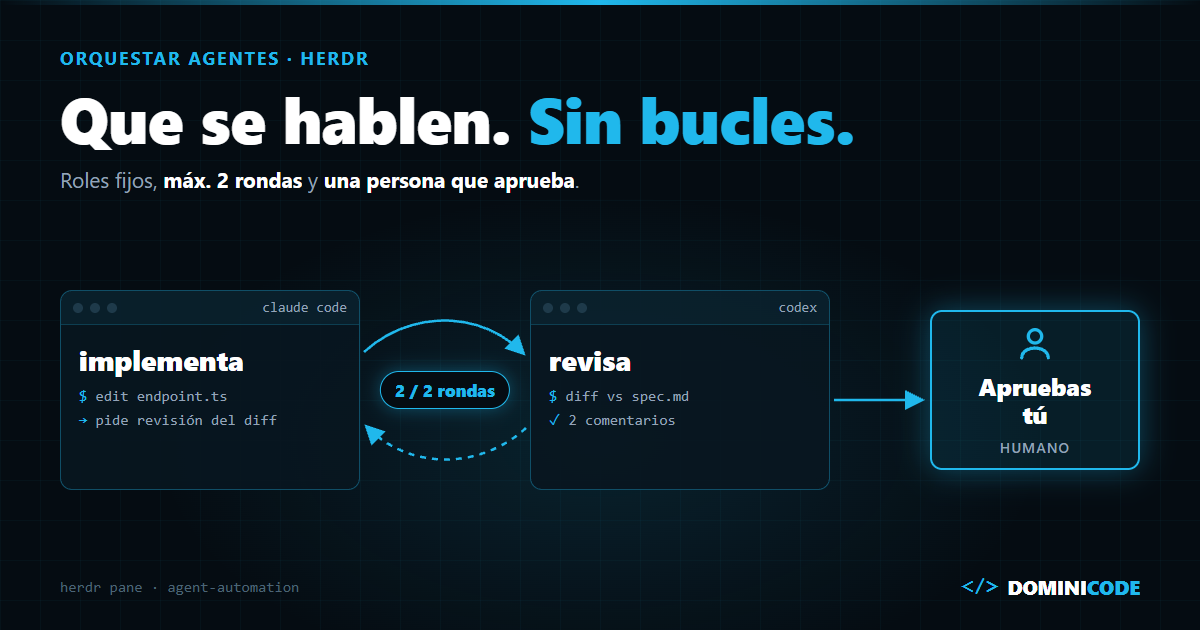
    Imagina la escena. Claude Code termina un endpoint, abre un panel al lado, arranca a Codex y le pide que revise el diff. Codex contesta: "dos comentarios menores, el resto bien". Claude Code arregla los dos comentarios y vuelve a preguntar. Codex aprueba.

    Dos modelos de dos empresas distintas se han puesto de acuerdo. Todo verde. Nadie ha ejecutado los tests de integración, porque ninguno de los dos tenía esa instrucción.

    Herdr permite orquestar agentes de IA desde la terminal con una skill y una CLI. Lo espectacular es que los agentes se hablen entre sí. Lo peligroso es exactamente lo mismo.

    En corto: con la skill de Herdr, un agente como Claude Code puede abrir paneles, arrancar a Codex, Gemini o Grok en ellos, mandarles prompts, esperar a que terminen y leer su respuesta, incluso en otra máquina por SSH. Trátalo como un harness: roles fijos, un tope de rondas y una persona que aprueba, porque dos agentes que se responden entre sí pueden darse la razón o entrar en bucle.

    ¿Qué es orquestar agentes de IA con Herdr?

    Orquestar agentes de IA con Herdr es dejar que un agente, desde su propio panel, use la CLI de Herdr para crear paneles, lanzar otros agentes de código, darles trabajo y recoger su resultado, sin que tú hagas de mensajero.

    Herdr es un multiplexor de terminal para agentes que mantiene las sesiones vivas y sabe si cada agente trabaja, está bloqueado o ha terminado. Todo lo que sigue está comprobado contra la documentación de Herdr v0.9.5. La instalación y la comparativa con tmux están en qué es Herdr. Aquí voy a otra cosa: agentes que dirigen a otros agentes.

    La skill de Herdr: cómo un agente controla a los demás

    La skill de Herdr es un archivo SKILL.md que enseña a un agente a usar la CLI herdr cuando corre dentro de un panel de Herdr. Se instala así, según la página oficial de la skill:

    npx skills add herdrdev/herdr --skill herdr -g
    

    Con ella, el agente ve los paneles vecinos, divide paneles sin robarte el foco, lee su salida, espera a que otro agente termine y arranca agentes ayudantes. La CLI también tiene herdr pane rename y herdr pane close, y la skill solo le deja cerrar los paneles que haya creado él.

    Dos detalles del SKILL.md importan más que los comandos: sin HERDR_ENV=1 el agente debe pararse, y la skill solo se activa cuando el usuario menciona Herdr. El agente no delega por iniciativa propia. Se lo pides tú.

    En la demo de NetworkChuck se ve el caso extremo, un Claude Code repartiendo trabajo a varios agentes a la vez, pero el patrón útil es mucho más pequeño.

    Un agente implementa, otro revisa: el bucle mínimo

    El patrón más rentable de agentes que hablan entre sí es un implementador y un revisor de otro proveedor. Un modelo distinto tiene sesgos distintos, y eso es justo lo que quieres en una revisión.

    La receta base ya la viste en qué es Herdr. Aquí cambian dos cosas: el panel se abre junto al agente que orquesta (--current) y el prompt revisa contra un contrato. Los comandos salen de la guía de automatización de Herdr; el prompt es mío:

    # Abre un panel hermano, en el mismo directorio, sin quitarte el foco
    split=$(herdr pane split --current --direction right --cwd "$PWD" --no-focus)
    pane=$(printf '%s\n' "$split" | jq -r '.result.pane.pane_id')
    
    # Arranca a Codex como revisor, con un nombre estable
    herdr agent start reviewer --kind codex --pane "$pane"
    
    # Le da trabajo y espera a que termine (máximo 5 minutos)
    herdr agent prompt reviewer "Revisa git diff main contra docs/spec.md. Lista solo incumplimientos de la spec, con fichero y línea. Si no hay ninguno, responde NINGUNO." --wait --timeout 300000
    
    # Lee la respuesta del panel de al lado
    herdr agent read reviewer --source recent-unwrapped --lines 120
    

    Fíjate en el prompt. No dice "revisa el código": dice contra qué se revisa y qué formato tiene la respuesta. Eso evita la escena del principio, porque el revisor compara contra un contrato y no contra la opinión del que implementó. Es la idea de la Revisión por Contrato aplicada a un revisor que también es una IA.

    Para que el principal se entere de que el otro tiene una pregunta, Herdr ofrece herdr agent wait reviewer --until blocked, y la API por socket permite suscribirse al evento pane.agent_status_changed. Y aquí la skill vuelve a ser sensata: cuando el agente vecino está bloqueado en una aprobación, le dice al principal que lo inspeccione y pregunte al usuario antes de responder. Si tu agente principal aprueba permisos de otro agente sin preguntarte, lo has configurado tú así.

    Agentes en otra máquina con herdr --machine

    Herdr guarda máquinas remotas por SSH con herdr machine add y deja enrutar comandos a ellas con el prefijo --machine, según la guía de conexión entre máquinas. Eso significa que un agente en tu portátil puede dar trabajo a un agente que corre en tu servidor de build:

    herdr --machine "Build machine" agent list
    # usa el ID o el nombre que devuelva agent list
    herdr --machine "Build machine" agent prompt w1:p1 "Ejecuta la suite e2e y resume solo los fallos" --wait --timeout 1800000
    herdr --machine "Build machine" agent read w1:p1 --source recent-unwrapped --lines 120
    

    Dos letras pequeñas. Los IDs de paneles y los nombres de agentes son de cada servidor, así que --current no apunta a nada remoto y hay que usar IDs explícitos. Y el prefijo apunta a una máquina cada vez: no hay listados combinados. Yo lo usaría para lo que no cabe en el portátil, como la suite e2e o una build pesada, no para repartir una feature entre dos continentes.

    Herdr frente a subagentes y a un solo agente

    Herdr compensa cuando necesitas un revisor de otro proveedor o mover trabajo a otra máquina; si todo cabe en Claude Code, los subagentes salen más baratos. Esta es la comparativa con lo que tienes en Claude Code sin instalar nada:

    Criterio Un solo agente Subagentes de Claude Code Cross-session messaging Orquestador en paneles de Herdr
    Mezcla proveedores (Codex, Gemini, Grok…) No No No, solo sesiones de Claude Code Sí, 24 tipos de agente en --kind
    Ves el trabajo de cada agente Sí Solo el resultado Cada sesión en su terminal Sí, cada uno en su panel
    Estado de cada agente No aplica Dentro de tu sesión Solo un aviso cuando otra sesión queda libre working, blocked, done, idle, unknown
    Funciona entre máquinas No No Sí, con Remote Control y cuenta de claude.ai Sí, por SSH
    Coste en tokens El mínimo Sube con cada subagente Cada mensaje es un prompt Una sesión completa por agente
    Limitación o riesgo Un solo sesgo revisando su propio trabajo Contexto aislado, solo un proveedor Sin buzón durable Estado detectado leyendo la pantalla; bucles y acuerdos en falso si no pones reglas

    Si solo quieres que Codex revise un diff, el plugin oficial codex-plugin-cc lo hace sin paneles. Mi opinión: orquestar agentes de IA con Herdr compensa cuando además quieres ver qué hace cada uno en vivo.

    Lo que se rompe cuando los agentes se hablan entre sí

    Cuando dos agentes se hablan, fallan de cuatro formas: se dan la razón, entran en bucle, leen un estado falso o uno contesta por ti.

    El acuerdo en falso. Dos agentes que leen el mismo diff sin un criterio externo tienden a aprobarse. La solución no es un tercer agente, es una spec o unos tests que ninguno de los dos pueda reinterpretar.

    El bucle. El revisor pide un cambio, el implementador lo hace, el revisor pide otro. Sin un tope de rondas, eso no termina nunca, o termina cuando se acaba tu cuota. Pon el límite en el prompt del orquestador: dos rondas y, si sigue habiendo desacuerdo, me lo traes a mí.

    El estado que miente. Herdr deduce el estado leyendo lo que el agente pinta en pantalla, y la propia documentación avisa de que Antigravity y Grok cuentan como idle en cuanto vuelven a su prompt, aunque tengan subagentes trabajando. El issue más grave abierto: una aprobación de un subagente de Antigravity que se detecta como idle en vez de blocked, sin notificación, y que caduca sola a los 60 segundos (hay casos parecidos en #2354 y #5004, este con Claude Code).

    Si tu orquestador espera a idle para leer el resultado, puede leer un trabajo a medias.

    El orquestador que contesta por ti. En Hacker News, un usuario cuenta que, con Rex (una alternativa a Herdr), deja una sesión que mira cómo van las demás y le presenta las decisiones que necesitan de él. Ese es el rol correcto del agente principal: juntar las preguntas, no responderlas. Si la pregunta es "¿borro estos registros?", la respuesta es de una persona. En el mismo foro hay quien no ve la ventaja frente a los subagentes con comunicación de ida y vuelta de Claude Code desktop. Es una objeción razonable si solo usas Claude.

    Esto es diseño de harness, no de prompts: quién implementa, quién revisa, contra qué y cuándo para la máquina y entra una persona.

    Cuándo NO orquestar agentes de IA con Herdr

    Cuando la tarea es pequeña. Anthropic midió en su sistema de investigación multiagente (13 de junio de 2025) que un agente gasta unas 4 veces los tokens de un chat y un sistema multiagente unas 15 veces. Con cuatro agentes en cuatro paneles, cada uno con su sesión completa, pagas un multiplicador parecido por un cambio que uno solo resolvía. Lo comparé con más datos en harness multiagente vs un solo agente.

    Cuando todos necesitan el mismo contexto. Cada agente lee el repo por su cuenta. Si las subtareas dependen unas de otras, pagas varias veces la misma lectura y además tienes que sincronizarlos.

    Cuando no usas worktrees. La skill, por defecto, abre el panel ayudante en el mismo directorio y no crea worktrees salvo que lo pidas. Dos agentes escribiendo en la misma carpeta se pisan. Para que cada uno trabaje en su copia existe herdr worktree create; si no lo usas, deja que solo uno escriba y que el otro lea.

    Y si lo que necesitas es orquestar agentes de IA dentro de tu propio código, con un plan y workers en paralelo, el camino es otro: cómo se construye un orquestador de agentes IA en TypeScript.

    Lo que puedes hacer hoy

    Monta solo el bucle mínimo:

    1. Instala la skill y abre Claude Code dentro de un panel de Herdr.
    2. Escribe en tu AGENTS.md tres reglas: Codex revisa contra docs/spec.md, máximo dos rondas, la decisión final es tuya. Si tienes CLAUDE.md, Claude Code no lee AGENTS.md por su cuenta: impórtalo desde ahí con @AGENTS.md.
    3. Pide a Claude Code que lance el revisor con el bloque de comandos de arriba.
    4. Al cabo de una semana, cuenta cuántos hallazgos del revisor no habrías visto tú. Si son cero, no necesitas dos agentes.

    Si quieres entender qué pasa por debajo cuando un agente coordina a otros (el loop, las tools, cómo se reparte la memoria), está explicado en el ebook gratuito El Developer Agéntico. Diseñar ese harness completo (quién implementa, quién revisa y contra qué) es lo que trabajo en el workshop SDD + Agentic Engineering. Y si quieres llevarlo a un producto de verdad, de la idea al despliegue, es lo que hacemos en Construye con IA.

    Preguntas frecuentes

    ¿Puede Claude Code hablar con Codex directamente?

    No de forma nativa: el cross-session messaging de Claude Code solo conecta sesiones de Claude Code. Para una revisión puntual, OpenAI publica un plugin oficial, codex-plugin-cc, que añade /codex:review a Claude Code. Herdr va más allá: Claude Code usa la CLI para mandar un prompt al panel donde corre Codex, ver su trabajo en vivo y leer su respuesta, así que la conversación pasa por la terminal.

    ¿Qué agentes puede arrancar la skill de Herdr?

    Los que acepta herdr agent start --kind: la documentación de la v0.9.5 lista 24, entre ellos claude, codex, gemini, grok y agy (Antigravity). Gemini aparece como menos probado y solo con detección de estado.

    ¿Cómo evito que dos agentes se respondan en bucle?

    Pon el límite en el prompt del agente que coordina: un número máximo de rondas y una salida clara cuando se agota, por ejemplo "si tras dos rondas hay desacuerdo, para y resume las dos posturas". Usa también --timeout en agent prompt --wait, porque las esperas de Herdr no tienen timeout por defecto.

    ¿La skill de Herdr funciona fuera de Herdr?

    No. La skill comprueba que exista HERDR_ENV=1, que solo está en procesos lanzados dentro de un panel de Herdr. Si no está, el agente debe pararse y avisar. Así evita controlar una sesión que no es suya.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • CLAUDE.md modular vs monolítico: cómo organizar el contexto

    CLAUDE.md modular vs monolítico: cómo organizar el contexto

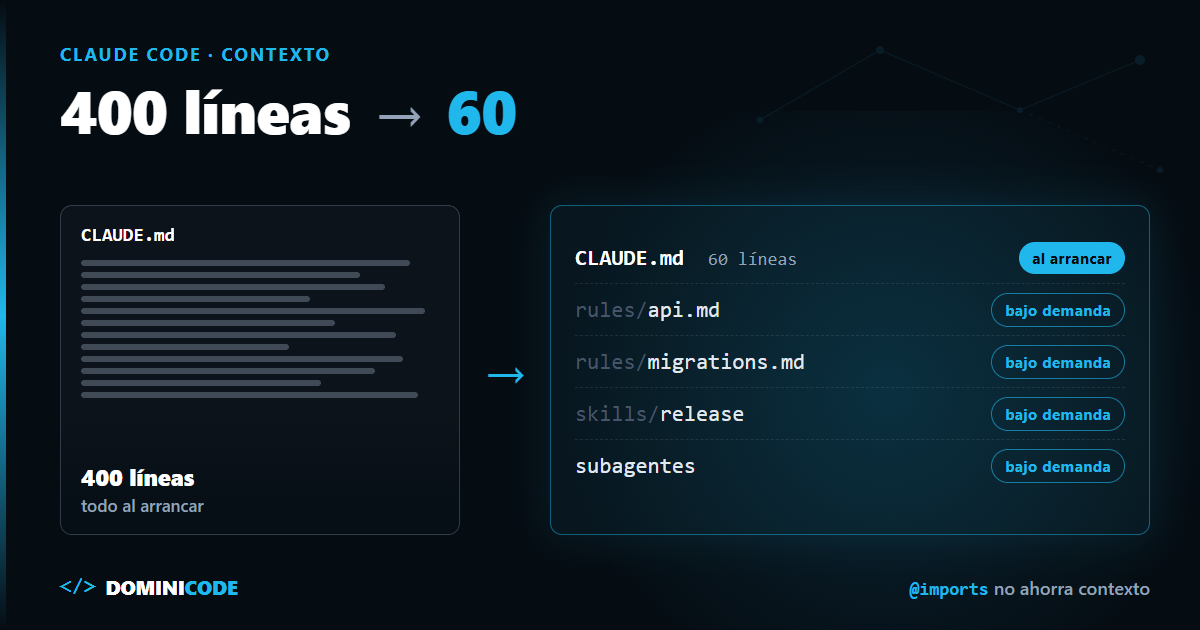
    Imagina un CLAUDE.md de 400 líneas. La regla sobre migraciones está en la 312.

    "Nunca edites una migración ya aplicada; crea una nueva." Claude la edita igual. La reescribes en mayúsculas, le pones un "IMPORTANTE" y la subes al principio. Dos semanas después, otra regla deja de cumplirse.

    Decides pasar a un CLAUDE.md modular. Partes el archivo en seis piezas enlazadas con @imports. Más ordenado, sí. Pero el agente se comporta igual, porque Claude Code sigue cargando las 400 líneas al arrancar.

    Partir el archivo no es tener un CLAUDE.md modular. Lo que cambia las cosas es cuándo carga cada instrucción.

    En corto: un CLAUDE.md modular deja en la raíz solo lo que hace falta en cada sesión y mueve el resto a capas que Claude Code carga bajo demanda: reglas con paths, CLAUDE.md de subcarpeta, skills y subagentes. Los @imports ordenan pero no ahorran contexto, porque cargan al arrancar. Menos ruido y menos contradicciones reducen las alucinaciones, aunque no las eliminan.

    El porqué está en Context Engineering: cómo estructurar la memoria de tus agentes. Aquí va el mapa de Claude Code y la migración.

    ¿Qué es un CLAUDE.md modular?

    Un CLAUDE.md modular es una arquitectura de contexto en la que el archivo raíz contiene solo los hechos que Claude necesita en todas las sesiones, y cada instrucción restante vive en la capa que se carga cuando de verdad aplica.

    La documentación oficial recomienda menos de 200 líneas por CLAUDE.md, porque los archivos largos "consumen más contexto y reducen la adherencia".

    Qué meter en la raíz ya lo conté en CLAUDE.md: el system prompt de tu proyecto. Este post trata de lo que sacas de ella.

    Las capas de contexto de Claude Code y cuándo carga cada una

    El momento de carga de cada capa decide lo que pagas en la ventana. Datos de la documentación de memoria, skills y subagentes, consultada el 7 de noviembre de 2026:

    Capa Cuándo entra en contexto Qué ocupa
    CLAUDE.md raíz + CLAUDE.local.md Siempre, al arrancar. El CLAUDE.md raíz se relee tras /compact Entero (se omite si pasa de 4 MiB)
    @imports Al arrancar, con el archivo que importa. Máximo 4 saltos Entero: no ahorra nada
    .claude/rules/ sin paths Al arrancar, con la prioridad de .claude/CLAUDE.md Entero
    .claude/rules/ con paths Al leer, escribir o editar un archivo que encaja con el glob Hasta 40.000 caracteres por archivo con ventana de 200K
    CLAUDE.md de subcarpeta Al leer, escribir o editar un archivo de esa carpeta Mismo límite
    Skills Descripción siempre; cuerpo al invocarse Hasta 1.536 caracteres por descripción; el listado, ~1% de la ventana
    Subagentes Al delegar, en su propia ventana Su prompt más tu CLAUDE.md, salvo Explore, Plan u omitClaudeMd
    Auto memory MEMORY.md al arrancar; temas bajo demanda Primeras 200 líneas o 25 KB de MEMORY.md

    Dos detalles cambian decisiones.

    Los niveles managed policy, usuario, proyecto y local no se sobrescriben: se concatenan, del más amplio al más específico. Si dos se contradicen, Claude "puede elegir uno de forma arbitraria". La precedencia estricta es de settings.json, no de CLAUDE.md.

    Y un subagente no te libra del monolito. Arranca con ventana limpia, pero carga toda tu jerarquía de CLAUDE.md. Con 400 líneas en la raíz, cada subagente las paga también. Más sobre esto en arquitectura de subagentes frente al mega-prompt.

    CLAUDE.md monolítico vs modular: la comparativa

    El monolítico gana en simplicidad; el modular, en precisión. Ninguno es gratis:

    Criterio Monolítico Modular
    Coste fijo por sesión Todo el archivo Raíz, reglas sin paths y listado de skills
    Encontrar una regla Un sitio, Ctrl+F Tienes que saber qué capa la tiene
    Contradicciones Frecuentes, pero visibles en una lectura Menos por pieza, invisibles entre piezas
    Previsibilidad Lo que está, carga Depende de que el agente toque el archivo que dispara la regla
    Limitación o riesgo Pasadas 200 líneas baja la adherencia y la regla 312 compite con todo Una regla con paths que no se dispara no existe para Claude, y no te avisa

    Mi opinión: a partir de 200 líneas, el monolítico ya no es una opción neutral. Es deuda, y un CLAUDE.md modular es la forma de pagarla.

    El error más común: creer que @imports ahorra contexto

    @imports organiza, pero no difiere la carga. La documentación lo dice explícitamente: dividir en imports "ayuda a organizar, pero no reduce el contexto", porque lo importado carga junto al CLAUDE.md que lo referencia.

    Hay una trampa más fina. En el issue #16299 de anthropics/claude-code, abierto en enero de 2026 sobre reglas con paths que cargaban siempre, un usuario midió en octubre, con la versión 2.1.300, que un @import dentro de una regla con ruta carga al arrancar aunque la regla no se dispare: el cuerpo de la regla no sumaba nada, pero el import de 20.000 caracteres que llevaba dentro sí, unos 17.000 tokens.

    En el mismo hilo, otro equipo cuenta que 75 archivos de referencia en .claude/rules/ sin paths le subían el arranque a 139.500 tokens antes de abrir un archivo. Lo vieron con /context.

    Si quieres que algo cargue tarde, no lo importes.

    Qué va en cada capa: criterios para organizar CLAUDE.md

    A cada bloque de tu CLAUDE.md, una pregunta: ¿cuándo lo necesita Claude?

    Si la instrucción… Va en…
    Aplica en toda sesión (build, convenciones globales, prohibiciones) CLAUDE.md raíz
    Solo importa al tocar ciertos archivos .claude/rules/ con paths
    Es un procedimiento de varios pasos Skill
    Llena la ventana de logs o búsquedas Subagente
    Es una preferencia tuya o la URL de tu sandbox CLAUDE.local.md, en .gitignore
    Claude la deduce leyendo el código En ningún sitio: bórrala
    Debe cumplirse sin excepción Un hook o permissions.deny

    La última fila pesa más de lo que parece: CLAUDE.md es contexto, no configuración que se haga cumplir.

    En monorepos, el CLAUDE.md por carpeta tiene sus propias reglas: las detallé en Claude Code en monorepos.

    Migración de ejemplo: de 400 líneas a un CLAUDE.md modular

    Imagina un backend en TypeScript con API REST, migraciones y tests end-to-end. Su CLAUDE.md de 400 líneas se reparte así:

    Bloque Líneas Destino
    Comandos, convenciones, prohibiciones 60 CLAUDE.md raíz
    Convenciones de la API 90 .claude/rules/api.md
    Migraciones y base de datos 70 .claude/rules/migrations.md
    Procedimiento de release 80 Skill release
    Árbol de carpetas y dependencias 50 Borrado
    URLs de staging y datos de prueba 50 CLAUDE.local.md

    El coste fijo por sesión pasa de 400 líneas a 60 más la descripción de una skill. Las 160 de API y migraciones solo entran cuando el agente toca esos archivos. Cifras ilustrativas.

    proyecto/
    ├── CLAUDE.md                 # 60 líneas: lo de todas las sesiones
    ├── CLAUDE.local.md           # en .gitignore
    └── .claude/
        ├── rules/
        │   ├── api.md            # paths: src/api/**
        │   └── migrations.md     # paths: src/db/**/*.ts
        └── skills/
            └── release/
                └── SKILL.md      # el cuerpo carga solo al invocarse
    

    Y la regla que no se cumplía, ahora pegada al código al que aplica:

    ---
    paths:
      - "src/db/**/*.ts"
    ---
    
    # Migraciones
    
    - Nunca edites una migración que ya está en main. Crea una nueva.
    - Cada migración lleva su `down`.
    - Ejecuta `npm run db:check` antes de dar la tarea por terminada.
    

    Para comprobarlo, ejecuta /context all al empezar: la regla de migraciones no debe estar en Memory files. Para ver cuándo entra, registra la carga con el hook InstructionsLoaded y pide a Claude que lea un .ts de src/db/. Si tu repo usa AGENTS.md, revisa antes cómo convive con CLAUDE.md: por defecto, un CLAUDE.md en la raíz hace que Claude deje de leerlo, salvo que lo importe con @AGENTS.md.

    Auto memory en Claude Code: por qué no es tu CLAUDE.md

    La memoria persistente de Claude Code son dos sistemas: CLAUDE.md lo escribes tú y auto memory lo escribe Claude. Auto memory vive en ~/.claude/projects/<proyecto>/memory/, solo en tu máquina.

    Al arrancar carga el índice MEMORY.md, hasta 200 líneas o 25 KB; los archivos de tema, bajo demanda. Es el patrón modular aplicado a la memoria.

    No la uses para reglas de equipo: no viaja por git ni llega a los subagentes. Un subagente puede tener su propia memoria con el campo memory, pero es otro directorio, no la tuya. La revisas con /memory. Cómo la uso en el día a día está en mi flujo real con CLAUDE.md y memoria.

    Si quieres llevar esto a la memoria y las herramientas de un agente propio, el ebook gratuito El Developer Agéntico lo trata a fondo.

    Por qué el contexto modular reduce alucinaciones (sin eliminarlas)

    El context engineering en Claude Code no hace que el modelo deje de inventar. Le quita motivos, por tres vías.

    Menos ruido. Si la sesión no toca la base de datos, las reglas de migraciones no compiten por atención.

    La regla llega cuando importa. Una regla con paths entra cuando Claude abre el archivo afectado, justo antes de decidir, aunque tras un /compact tiene que volver a dispararse.

    Menos contradicciones. Ante instrucciones contradictorias, Claude puede elegir una de forma arbitraria. Archivos pequeños de un solo tema se revisan mejor, y /doctor prompt-audit (desde la versión 2.1.283) busca archivos que chocan entre sí.

    Lo que no resuelve: una regla ambigua sigue siéndolo aunque cargue a tiempo. Revisar lo que genera el agente contra una especificación sigue siendo necesario; es lo que practicamos en el workshop de SDD + Agentic Engineering.

    Cuándo NO modularizar tu CLAUDE.md

    Si tu CLAUDE.md cabe en 100 líneas. Un CLAUDE.md modular añade indirección sin ahorrar nada. Un archivo que lees en un minuto se audita mejor que cinco.

    Si tu agente escribe mucho por Bash. En el issue #93248, de septiembre de 2026, un usuario documentó con la versión 2.1.267 que su regla de TypeScript no cargó al crear un .ts desde cero. Otro midió en octubre, con la 2.1.296, que la herramienta Write ya la dispara, pero que las escrituras por Bash (sed -i, >, heredocs) y los comandos con pipes no cargan nada; las lecturas simples con cat o head sí. Una regla crítica con ruta puede no llegar nunca.

    Si la regla tiene que sobrevivir a /compact. Las reglas con paths entran en el historial y la compactación las resume con todo lo demás; no vuelven hasta que Claude toque otra vez un archivo que encaje. La documentación lo dice claro: si una regla debe persistir, quítale paths o súbela al CLAUDE.md raíz. Para la regla de migraciones del ejemplo, si es crítica, valora dejarla en la raíz o respaldarla con un hook.

    Si nadie va a mantener el mapa. Sin ese criterio, el modular acumula contradicciones igual que el monolítico, pero escondidas.

    Empieza por medir, no por partir

    Así empieza un CLAUDE.md modular: ejecuta /context all y mira qué carga al arrancar. Luego marca cada bloque de tu CLAUDE.md con su respuesta a "¿cuándo lo necesita Claude?". Lo que no sea "siempre" tiene otro sitio. Lo que Claude deduce del código, bórralo.

    Si quieres aplicarlo de principio a fin en un proyecto, de la spec al producto, es el flujo del curso Construye con IA: de la idea al producto con Claude Code.

    Preguntas frecuentes

    ¿Los @imports de CLAUDE.md reducen el consumo de contexto?

    No. Los archivos importados cargan al arrancar junto al CLAUDE.md que los referencia, con un máximo de cuatro saltos. Sirven para organizar o compartir un AGENTS.md, no para diferir la carga.

    ¿Cuándo se cargan los CLAUDE.md de las subcarpetas?

    Los del directorio donde arrancas y los superiores cargan al inicio. Los de subcarpetas, la primera vez que Claude lee, escribe o edita un archivo en ella. Por eso no salen en /context al empezar; cuando cargan, verás una línea Loaded con su ruta.

    ¿Sigue existiendo CLAUDE.local.md?

    Sí. Es el nivel local del proyecto: carga después de CLAUDE.md en el mismo directorio y debe ir en .gitignore. Si tu proyecto depende de AGENTS.md, crear un CLAUDE.local.md hace que Claude deje de leerlo, salvo que cambies la opción Project instructions en /config.

    ¿Cuánto contexto ocupa una skill que no he invocado?

    Su entrada en el listado: nombre y descripción, recortados a 1.536 caracteres. El listado completo tiene un presupuesto del 1% de la ventana. El cuerpo de SKILL.md entra al invocarla, y con disable-model-invocation: true ni siquiera la descripción está en contexto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Usos de Herdr: 7 recetas reales para tus agentes de IA

    Usos de Herdr: 7 recetas reales para tus agentes de IA

    Imagina que llevas un mes con Herdr y solo conoces uno de sus usos: lo abres, lanzas un Claude Code en un panel y trabajas igual que antes, solo que con una barra lateral más bonita.

    Es lo que pasa con las navajas suizas: usas la hoja grande y nunca abres el resto. Y en Herdr las piezas que no usas son las que ahorran tiempo.

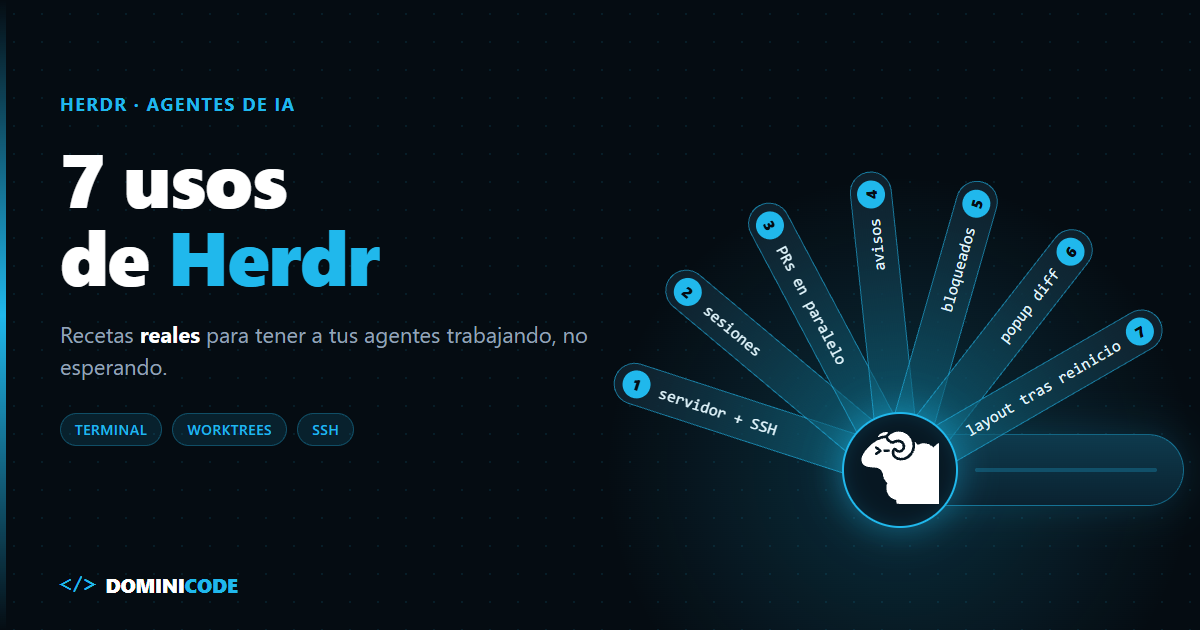
    Aquí van los usos de Herdr para agentes de IA que casi nadie abre: siete recetas con los comandos exactos y el aviso de cuándo no compensan.

    En corto: los usos de Herdr que más rinden están en su CLI y su configuración, no en la barra lateral: agentes en un servidor que revisas por SSH, un worktree con un agente por cada PR, avisos cuando acaba una suite y recuperar el layout tras un reinicio. Son siete recetas, cada una con su comando y el caso en el que no compensa. Todo está comprobado contra Herdr v0.9.5.

    ¿Qué hace posibles estos usos de Herdr?

    Herdr es un multiplexor de terminal open source para agentes de IA que mantiene vivas las sesiones en un servidor en segundo plano, detecta si cada agente está trabajando, bloqueado o ha terminado, y expone una CLI con salida JSON para controlarlo todo por código.

    La instalación y la comparativa con tmux están en qué es Herdr. Aquí van los usos, comprobados contra la documentación de la v0.9.5, del 14 de octubre de 2026. Varias recetas usan jq para leer la salida JSON.

    Los 7 usos de Herdr de un vistazo

    Estos son los siete usos de Herdr con el problema que resuelve cada uno, el comando clave y el caso en el que no compensa:

    # Problema Comando o ajuste clave Cuándo no merece la pena
    1 Los agentes mueren al cerrar el portátil ssh + herdr en el servidor, ctrl+b q Si todo corre en tu portátil
    2 Proyectos mezclados en la misma barra lateral herdr --session <nombre> Si solo tienes un proyecto activo
    3 Revisar varios PRs uno detrás de otro herdr worktree create + herdr agent start Con PRs de diez líneas
    4 Vigilar una suite larga herdr notification show Con tests que tardan segundos
    5 No ves que un agente te espera tab_bar_right + herdr agent list Con uno o dos agentes
    6 Salir del layout para ver el diff [[keys.command]] con type = "popup" Si ya revisas en el IDE
    7 Perder el layout tras un reinicio session-snapshots/ + pane_history Si nunca paras el servidor

    Receta 1: dejar agentes en un servidor y revisarlos desde el móvil

    Si los agentes corren en tu portátil y lo suspendes, se paran con él. La solución es que Herdr viva en la máquina donde está el código y tú solo te conectes, según la guía de trabajo de Herdr:

    ssh tu-usuario@servidor
    herdr
    # lanza tus agentes; para irte sin matar nada:
    # ctrl+b q
    

    Desde el móvil sirve cualquier cliente SSH: te conectas y ejecutas herdr. No hace falta app ni panel web, y la interfaz se adapta a pantallas estrechas.

    Cuándo no: si el código y las credenciales viven en tu portátil, mudarlo todo a un servidor cuesta más que dejar la tapa abierta. Y ojo con engancharte desde varios clientes: según el issue #4787, en macOS cada cliente reproduce su propio sonido por el mismo evento, y con ocho clientes el reportero vio coreaudiod por encima del 200 % de CPU.

    Receta 2: una sesión con nombre por proyecto

    Con dos proyectos en el mismo servidor, la barra lateral mezcla agentes que no tienen nada que ver. Una sesión con nombre es un servidor independiente, con sus propios paneles y workspaces (página de persistencia):

    herdr --session trabajo        # abre o se engancha a la sesión "trabajo"
    herdr --session personal
    herdr session list             # qué sesiones están vivas
    herdr session stop personal    # para esa sesión y sus paneles
    

    Para que un script hable con una sesión concreta, exporta HERDR_SESSION=trabajo antes de llamar a la CLI.

    Cuándo no: las sesiones comparten el mismo config.toml, y los plugins instalados son globales para tu usuario. Si buscas aislamiento real entre proyectos, una sesión con nombre no te lo da.

    Receta 3: revisar varios PRs en paralelo, un agente por worktree

    Para mí, este es el uso de Herdr que más tiempo ahorra: tres PRs, tres worktrees, tres agentes revisando a la vez.

    herdr worktree create, de la CLI de Herdr, hace checkout de una rama local si ya existe y devuelve en JSON el panel raíz del workspace nuevo. Con eso, el bucle sale solo (referencia de la CLI):

    repo=~/proyectos/api
    git -C "$repo" fetch origin main
    for pr in 412 415 418; do
      git -C "$repo" fetch origin "pull/$pr/head:pr-$pr"
      ws=$(herdr worktree create --cwd "$repo" --branch "pr-$pr" --label "pr-$pr" --no-focus)
      pane=$(printf '%s\n' "$ws" | jq -r '.result.root_pane.pane_id')
      herdr agent start "pr-$pr" --kind claude --pane "$pane" -- --permission-mode plan
      herdr agent prompt "pr-$pr" "Revisa git diff origin/main...HEAD. Lista bugs y riesgos con fichero y línea."
    done
    
    for pr in 412 415 418; do
      herdr agent wait "pr-$pr" --timeout 900000
      herdr agent read "pr-$pr" --source recent-unwrapped --lines 120
    done
    

    --permission-mode plan deja a Claude Code en solo lectura, y --kind codex pone a otro modelo a revisar (ese flag es de Claude Code: con Codex usa su propio modo de solo lectura). Al terminar, herdr worktree remove --workspace <id> borra el checkout, nunca la rama.

    Un aviso: Herdr crea cada worktree en una carpeta nueva (por defecto, bajo ~/.herdr/worktrees), y Claude Code puede preguntarte si confías en ella antes de aceptar nada. Si el agente aparece como blocked, el prompt no se ha enviado: acepta el diálogo en su panel y repite el agent prompt.

    Cómo repartir trabajo sin que los agentes se pisen está en dirigir agentes de IA en paralelo, y la parte de Git en worktrees con Claude Code.

    Cuándo no: con PRs pequeños, abrir tres sesiones completas cuesta más tokens que leer el diff tú. Y agent wait no tiene timeout por defecto: sin --timeout, puede esperar para siempre. Y si el servidor se reinicia, el agente vuelve sin --permission-mode plan (lo explica la receta 7): ya no es una revisión de solo lectura.

    Receta 4: que Herdr te avise cuando termina la suite

    Herdr avisa cuando un agente termina, pero tu suite e2e no es un agente. Para eso está herdr notification show, que funciona desde cualquier panel:

    npm run test:e2e; herdr notification show "Suite e2e terminada" --sound done
    

    Para disparar el aviso según la salida, combina pane run con pane wait-output:

    herdr pane run w1:p3 "npm run test:e2e"
    herdr pane wait-output w1:p3 --regex "[0-9]+ (passed|failed)" --timeout 1800000 \
      && herdr notification show "e2e" --body "Ya hay resultado" --sound request
    

    Lánzalo en un panel limpio: wait-output también mira lo que ya hay en pantalla, y un "failed" antiguo dispararía el aviso antes de tiempo.

    Cuándo no: notification show usa la entrega configurada en [ui.toast], y su valor por defecto es "off": sin cambiarlo, no verás ningún aviso emergente. Además, el issue #5238 documenta que con delivery = "terminal" en el terminal foot la CLI responde shown: true y no aparece nada.

    Receta 5: contar agentes bloqueados en la barra de estado

    Con seis agentes, el que te espera se pierde entre los que trabajan. La barra de pestañas admite entradas command que se ejecutan cada pocos segundos (configuración):

    [ui]
    tab_bar_right = [
      { type = "command", command = "~/.config/herdr/blocked.sh", interval_seconds = 5, timeout_seconds = 2 },
    ]
    

    Y el script, con los campos del esquema de la API (agents[].agent_status):

    #!/bin/sh
    n=$("$HERDR_BIN_PATH" agent list | jq '[.result.agents[] | select(.agent_status == "blocked")] | length')
    [ "$n" -gt 0 ] && echo "$n bloqueados"
    

    Dale permisos de ejecución con chmod +x ~/.config/herdr/blocked.sh. Si no hay ninguno bloqueado, el script no imprime nada y Herdr vacía la entrada. Para saltar al bloqueado, prefix+g abre el selector y la tecla b filtra los blocked.

    Cuándo no: con uno o dos agentes, la barra lateral ya te lo dice. Y en Windows estos comandos se ejecutan con cmd.exe /d /c, así que el script de arriba no te sirve tal cual.

    Receta 6: revisar el diff del agente en un popup

    Un agente termina y quieres ver qué ha tocado sin romper el layout. Un comando personalizado de tipo popup abre una ventana flotante y desaparece al salir. Es el ejemplo de lazygit de la documentación, con -p para abrir el repo del panel activo:

    [[keys.command]]
    key = "prefix+alt+g"
    type = "popup"
    command = "lazygit -p \"$HERDR_ACTIVE_PANE_CWD\""
    description = "diff del panel activo"
    width = "80%"
    height = "80%"
    

    Herdr pasa HERDR_ACTIVE_PANE_CWD a los comandos personalizados, así que en un worktree ves el diff de ese worktree.

    Cuándo no: si revisas los cambios en el IDE, esto es una ventana más. Y en Windows la sintaxis de variables cambia a %HERDR_ACTIVE_PANE_CWD%.

    Receta 7: recuperar el layout tras reiniciar el servidor

    Desengancharte con ctrl+b q no pierde nada. Parar el servidor sí: los procesos mueren y Herdr solo restaura la forma de la sesión. La página de estado de sesión da tres piezas para recuperar más:

    [experimental]
    pane_history = true   # vuelve el contenido reciente de cada panel tras reiniciar
    

    La reanudación de agentes viene activada (session.resume_agents_on_restore = true) y funciona si instalaste la integración del agente. Y si un reinicio te deja un layout roto, Herdr guarda hasta 48 copias en session-snapshots/, junto a session.json: localizas el directorio con herdr session list --json, paras el servidor, copias el snapshot elegido sobre session.json y arrancas.

    Cuándo no: pane_history viene apagado porque la salida de los paneles puede incluir tokens y secretos, y se guarda en disco en session-history.json.

    Además, la reanudación no conserva los flags con los que arrancaste el agente: en el PR #3302, un usuario con Herdr 0.9.4 cuenta que lanzó Claude Code con --name, --autocompact y --append-system-prompt-file, y tras el reinicio volvió como claude --resume <id>, sin ellos. El PR sigue abierto.

    Cuándo NO usar estas recetas de Herdr

    El estado es una deducción. Herdr lee la pantalla de cada panel para decidir si un agente está blocked. Si no reconoce un diálogo, cae a idle. La receta 5 cuenta lo que Herdr cree, no lo que pasa: un agente esperando en un selector raro no sumará.

    Es un proyecto 0.x. Los comandos son de la v0.9.5, y la propia documentación marca como experimentales piezas como pane_history o herdr update --handoff. Antes de actualizar un servidor donde automatizas, prueba tus scripts con la versión nueva.

    Windows tiene huecos. El attach directo a un solo terminal no existe en Windows nativo, los plugins están en preview y las recetas 5 y 6 necesitan otra sintaxis.

    Por dónde empezar con estos usos de Herdr

    Elige una receta, no siete. Si ya tienes un servidor, empieza por la 1: es la que más cambia con menos configuración. Si trabajas en local, prueba la 3 con dos PRs reales esta semana y compara lo que encontró cada agente con lo que habrías visto tú.

    Si quieres entender qué pasa dentro de cada agente mientras Herdr lo vigila (el loop, las tools, la memoria), está explicado en el ebook gratuito El Developer Agéntico.

    Y si quieres llevar ese flujo a un producto real con Claude Code, es lo que hacemos en Construye con IA. Decidir quién revisa qué, y contra qué contrato, es el núcleo del workshop SDD + Agentic Engineering.

    Preguntas frecuentes

    ¿Puedo usar Herdr desde el móvil?

    Sí, sin app. Te conectas por SSH al servidor donde corre Herdr con cualquier cliente SSH y ejecutas herdr. La interfaz se adapta a pantallas estrechas. Tus agentes tienen que estar en ese servidor, no en tu portátil.

    ¿Herdr puede revisar varios pull requests a la vez?

    Herdr no revisa nada: arranca agentes que revisan. Con herdr worktree create abres un checkout por rama y con herdr agent start lanzas un agente en cada uno. Antes tienes que traer cada PR como rama local, por ejemplo con git fetch origin pull/<n>/head:pr-<n>.

    ¿Puede Herdr avisarme cuando termina un proceso que no es un agente?

    Sí. herdr notification show lanza un aviso desde cualquier panel, así que puedes encadenarlo al final de un comando, como npm run test:e2e; herdr notification show "Suite terminada", o dispararlo con herdr pane wait-output cuando la salida coincide con una expresión regular. Antes tienes que cambiar ui.toast.delivery, que por defecto vale "off".

    ¿Se pierden los agentes si reinicio el servidor de Herdr?

    Los procesos sí se pierden. Herdr restaura el layout y, si instalaste la integración del agente, reanuda su conversación. No conserva los flags con los que lo arrancaste, y el contenido de los paneles solo vuelve si activas pane_history.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code precio en 2026: Pro, Max, Team o API con números

    Claude Code precio en 2026: Pro, Max, Team o API con números

    El 9 de abril de 2026 un developer abrió un issue en el repositorio de Claude Code. Pagaba Max 5x, 100 dólares al mes. Tras el reset de su cuota, hora y media de uso "moderado, sobre todo preguntas y desarrollo ligero" le dejó sin nada.

    El issue #45756 llegó a la portada de Hacker News con más de 600 comentarios. Uno de ellos, el de pxc, resume el problema mejor que cualquier análisis: "It's basically impossible for people to tell what they're actually buying".

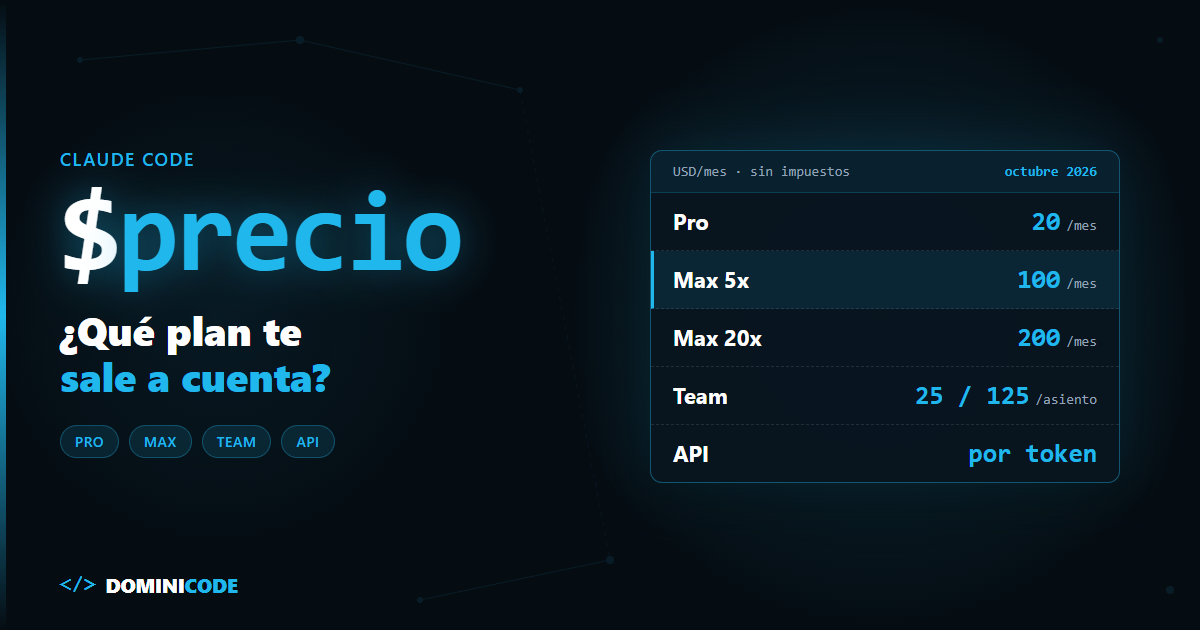
    Si buscas "claude code precio", la página de Anthropic te da tres cifras: 20, 100 y 200 dólares. Lo que no te da es cuánto trabajo cabe dentro de cada una.

    En corto: a octubre de 2026, Claude Code cuesta 20 USD/mes en Pro, 100 o 200 USD/mes en Max, 25 o 125 USD/asiento/mes en Team, o lo que consumas en tokens por API. Para aprender, Pro; para trabajar a diario, Max 5x; para varias sesiones en paralelo, Max 20x; para un equipo, Team. La API solo compensa si tu uso es bajo e irregular o si lo metes en CI.

    ¿Qué es el precio de Claude Code, exactamente?

    El precio de Claude Code es una de dos cosas: una cuota fija (Pro, Max o un asiento de Team) que te da una asignación de uso que se renueva cada cinco horas y cada semana, o un pago por token a tarifa de API si entras con una clave de Claude Console.

    La documentación de costes no publica el precio de Claude Code por plan: te manda a claude.com/pricing.

    Claude Code precio por plan: la tabla a octubre de 2026

    El precio de Claude Code, en USD y sin impuestos, comprobado el 10 de octubre de 2026 en claude.com/pricing y en los artículos de ayuda de Pro, Max y Team. Las funciones salen de la tabla de disponibilidad por plan.

    Plan Precio Incluye Para quién Límite / riesgo
    Pro 20 USD/mes (17 USD/mes en anual, 200 USD por adelantado) Claude Code, cloud sessions, Routines, Remote Control, Computer use, Artifacts, Slack Aprender y uso esporádico Ventana de 5 horas + límite semanal; es el plan que antes se queda corto
    Max 5x 100 USD/mes Todo lo de Pro, con 5 veces su uso por sesión Uso diario como herramienta principal Límite semanal común a todos los modelos
    Max 20x 200 USD/mes Todo lo de Pro, con 20 veces su uso por sesión Varias sesiones, subagentes o agent teams en paralelo El límite semanal sigue existiendo
    Team Standard 25 USD/asiento/mes (20 en anual) 1,25 veces el uso de Pro, SSO, analítica, managed settings, Code Review Equipos de 2 a 150 personas Sin Computer use; Remote Control lo activa el admin
    Team Premium 125 USD/asiento/mes (100 en anual) 6,25 veces el uso de Pro, lo mismo que Standard Developers del equipo que viven en Claude Code Cinco veces el precio de Standard por asiento
    Enterprise Asiento anual + todo el uso a tarifa de API SCIM, Compliance API, Analytics API Organizaciones grandes El uso no va incluido en el asiento: se factura aparte
    API (Console) Por token CLI, extensiones, subagentes, hooks, MCP CI/CD, uso bajo e irregular Sin cloud sessions, Routines, Remote Control, Computer use ni Slack

    Claude Code Max vs Pro: qué pasa cuando llegas al límite

    Los planes no te cortan: te paran hasta el siguiente reset. Según el centro de ayuda de Max, el límite por sesión se renueva cada cinco horas y hay además un límite semanal que aplica a todos los modelos. Pro funciona igual, con menos margen.

    Al chocar con él verás "You've hit your session limit" o "You've hit your weekly limit". Cambiar de modelo con /model no te salva, porque la ventana es compartida.

    Te quedan tres salidas: esperar al reset (desde la v2.1.234 Claude Code puede esperar al reset y retomar la tarea automáticamente), subir de plan o activar usage credits con /usage-credits.

    Un usage credit es saldo prepagado que, al agotar la asignación de tu plan, sigue facturando tu uso a tarifa estándar de API. Lo confirman el artículo de ayuda y el FAQ de precios. Puedes ponerle tope mensual y recarga automática.

    Con suscripción la caché de prompts dura una hora, pero en cuanto tiras de usage credits baja a cinco minutos. Cada pausa para un café se convierte en un cache miss pagado a precio de API, salvo que fijes tú el TTL de una hora.

    Y fast mode siempre se paga con usage credits, aunque te quede cuota en el plan. En Opus 5.5 cuesta 8 USD por millón de tokens de entrada y 40 de salida, el doble que el modo normal.

    ¿Cuánto cuesta Claude Code por API? La cuenta con tokens

    Con clave de Console pagas por token. Precios de la página oficial de pricing de la API, en USD por millón de tokens:

    Modelo Entrada Escritura caché (5 min) Lectura caché Salida
    Fable 5.1 10 12,50 0,25 50
    Opus 5.5 4 5 0,20 20
    Sonnet 5.5 2 2,50 0,10 10
    Haiku 5.5 (prompt ≤ 100k) 0,10 0,125 0,01 0,50

    Para no inventarme una sesión, uso la que publica la propia doc como ejemplo de /usage: 1.200 tokens de entrada, 5.300 de salida, 940.000 de lectura de caché y 50.000 de escritura. La doc la muestra con Sonnet 4.6, a 0,55 USD. Con las tarifas de los modelos actuales y esos mismos tokens, cuesta:

    • Sonnet 5.5: 0,0024 + 0,053 + 0,094 + 0,125 = 0,27 USD
    • Opus 5.5: exactamente el doble, porque todas sus tarifas duplican las de Sonnet: 0,55 USD
    • Fable 5.1: 0,012 + 0,265 + 0,235 + 0,625 = 1,14 USD

    La salida apenas es el 19 % del coste en Sonnet. El resto es contexto reenviado en cada petición. Por eso el prompt caching no es una optimización opcional: es la factura.

    Así queda el precio de Claude Code por API en un mes de 21 días activos:

    Sesiones como esa al día Sonnet 5.5 / mes Opus 5.5 / mes Fable 5.1 / mes
    5 28,81 USD 57,62 USD 119,39 USD
    10 57,62 USD 115,25 USD 238,77 USD
    20 115,25 USD 230,50 USD 477,54 USD

    La referencia real: en despliegues de empresa, según la doc, la media ronda los 13 USD por developer y día activo y 150-250 USD al mes, y el 90 % queda por debajo de 30 USD por día activo. Esos 13 USD son unas 24 sesiones como la del ejemplo en Opus 5.5, cada día.

    El punto de equilibrio sale solo: Pro (20 USD) equivale a unas 73 sesiones de Sonnet al mes. Max 5x (100 USD), a unas 364 de Sonnet o 182 de Opus. Si trabajas a diario, la API te sale más cara que la suscripción casi siempre.

    Límites de estas cuentas: lo que la tabla no te dice

    El precio de Claude Code cambia. Todo lo de este post está a octubre de 2026. Fast mode está en research preview y Anthropic avisa de que su precio puede cambiar.

    Los límites de uso no son públicos en tokens. Anthropic los expresa como múltiplos ("5 veces Pro") y se reserva limitar el uso "de otras formas" a su discreción. Nadie fuera de Anthropic sabe cuántos tokens caben en una ventana, así que el punto de equilibrio supone que no chocas con el límite.

    Tu sesión no es la de la doc. La del ejemplo no llega al millón de tokens; el autor del issue movió más de 100 millones de lecturas de caché en hora y media con sesiones en segundo plano. Los subagentes y los modelos más caros multiplican el coste; lo explico en por qué sube el coste de los subagentes al cambiar de modelo. Los agent teams, según la doc, gastan unas 7 veces más tokens que una sesión normal cuando los teammates trabajan en plan mode. Y hay un matiz más: los modelos desde la generación 4.7 usan un tokenizador que, según Anthropic, genera alrededor de un 30 % más de tokens para el mismo texto. La sesión de ejemplo se midió con Sonnet 4.6, así que en los modelos 5.x tómate estas cifras como un suelo.

    En español pagas más. El mismo prompt en castellano gasta más tokens que en inglés; tienes los números en tokens en español: por qué cuestan más.

    Qué plan de Claude Code te conviene según tu perfil

    Estás aprendiendo. Pro. Tienes las mismas funciones que Max, incluidas Routines y Remote Control, que por API no existen. Si un día te quedas corto, usage credits con tope bajo.

    Lo usas a diario. Max 5x. Mi regla: si chocas con el límite de Pro más de una vez por semana con peticiones concretas, te toca subir. Si son vagas, ningún plan lo arregla: una especificación previa gasta menos tokens que corregir el rumbo a mitad, la idea central del libro de Spec-Driven Development.

    Trabajas en paralelo. Max 20x. La regla: pon los subagentes en Sonnet o Haiku y deja Opus para la sesión principal; es lo mismo que recomienda la doc de costes.

    Tienes un equipo. Team, no varios Max sueltos. SSO, analítica, managed settings, Code Review y topes de gasto por persona. Premium solo para quien vive dentro de Claude Code. La API por Console tiene sentido para CI/CD y automatizaciones, con límite de gasto por workspace.

    Cómo medir tu gasto en Claude Code antes de cambiar de plan

    Ejecuta /usage. Con API te da el coste estimado de la sesión; con suscripción, además, las barras del plan y el reparto de tu uso por skills, subagentes, plugins y servidores MCP, de las últimas 24 horas o los últimos 7 días (teclas d y w), solo de esta máquina.

    Si el contexto largo o los cache misses llegan al 10 % de tu uso, te lo marca: arregla eso antes de pagar más. Para ir más fino, aquí explico cómo medir el consumo de tokens de un agente.

    Y si quieres sacarle a Claude Code un producto real, no solo una factura, en el curso Construye con IA: de la idea al producto con Claude Code trabajamos el flujo completo con especificaciones y sesiones cortas.

    Preguntas frecuentes

    ¿Cuánto cuesta Claude Code al mes?

    A octubre de 2026, el precio de Claude Code va desde 20 USD/mes con Pro (17 en anual), 100 o 200 USD/mes con Max, y 25 o 125 USD por asiento y mes con Team (20 o 100 en anual). Por API no hay cuota: pagas los tokens que consumes.

    ¿Qué diferencia hay entre Claude Code Max y Pro?

    La cantidad de uso. Max 5x da cinco veces el uso por sesión de Pro y Max 20x, veinte veces. Las funciones de Claude Code son las mismas en los tres.

    ¿Es más barato usar Claude Code por API que con suscripción?

    Solo si tu uso es bajo o irregular. Con la sesión de ejemplo de la doc, Pro equivale a unas 73 sesiones de Sonnet 5.5 al mes. Además, por API pierdes cloud sessions, Routines, Remote Control y Computer use.

    ¿Claude Code es gratis?

    No. Claude Code no está en el plan Free de claude.ai: Anthropic lo incluye en todos los planes de pago. Lo más barato es Pro, a 17 USD/mes en anual, o una clave de API pagando solo los tokens que gastes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • SDD vs vibe coding: la misma feature tres semanas después

    SDD vs vibe coding: la misma feature tres semanas después

    La semana 1 el cupón funciona. La semana 2 también. La semana 3 le pides al agente "simplifica, hay código repetido" y te devuelve un diff limpio, más corto, más bonito. Lo apruebas.

    Desde ese momento tu checkout regala un 10 % sobre productos que ya estaban rebajados. No hay error en consola. El build pasa. El único que se entera es el margen.

    Esto es SDD vs vibe coding visto con código, no con opiniones. Es un caso ilustrativo: un ejemplo construido para este post, no un proyecto real ni un cliente. El código sí es real: cada fallo que vas a ver es salida literal de bun test.

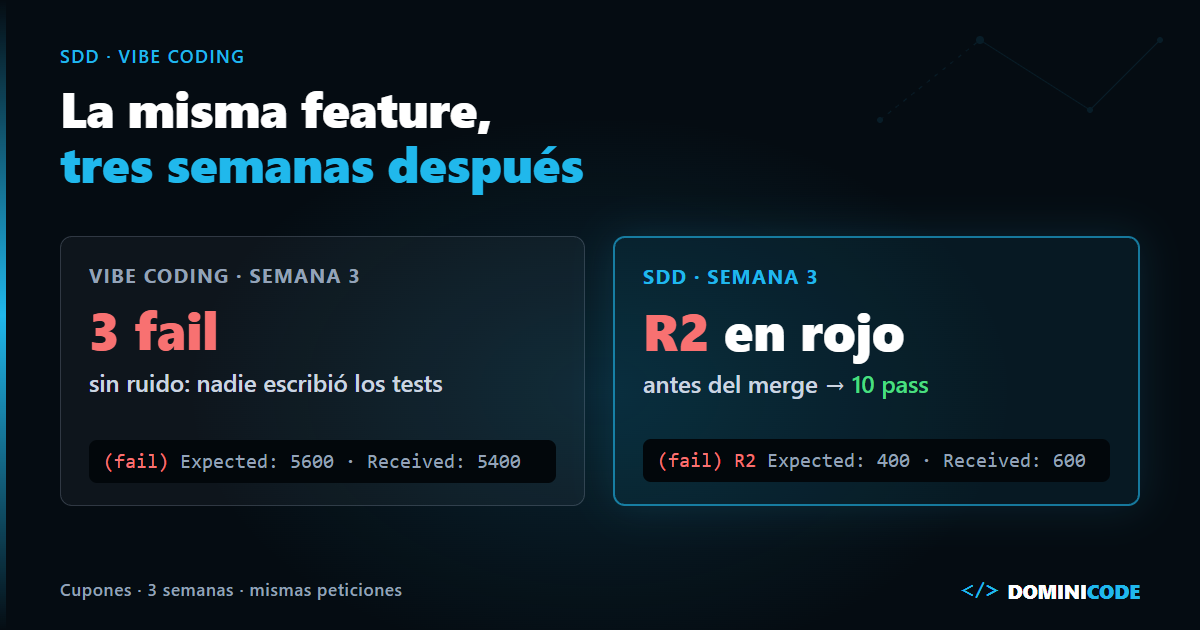
    En corto: en SDD vs vibe coding, lo que decide la semana 3 es dónde viven las reglas antiguas: en vibe coding, en un chat que nadie relee; en SDD, numeradas en una spec, cada una con un test que se pone rojo si alguien la rompe. En este caso el agente comete el mismo error en las dos pistas, pero solo en una llega a producción.

    Que el vibe coding se tuerce hacia la tercera semana ya lo conté en del vibe coding al sistema. Aquí enseño el mecanismo, línea a línea.

    ¿Qué es SDD frente a vibe coding?

    Spec-Driven Development (SDD) consiste en escribir primero las reglas de comportamiento, numeradas y verificables, derivar un test de cada una y solo después pedir el código; vibe coding consiste en pedir el código en conversación y aceptar lo que funciona en ese momento.

    Las dos pistas reciben las mismas peticiones de negocio. La diferencia no es "IA sí o IA no". Es si la memoria del proyecto está en un archivo que se ejecuta o en tu cabeza.

    La feature: cupones de un checkout con reglas que crecen

    La feature es pequeña a propósito. Un módulo de descuentos en TypeScript, importes en céntimos, y tres peticiones de negocio:

    1. Semana 1: cupón PERCENT10, un 10 % de descuento, pero nunca sobre productos rebajados.
    2. Semana 2: cupón MINUS5 (5 € con compra mínima de 30 €) y envío gratis desde 50 €; si no, 4,99 €.
    3. Semana 3: Black Friday. Se pueden combinar hasta dos cupones. Y "simplifica".

    Pista A: vibe coding en tres conversaciones

    La semana 1 es un prompt de una línea y un resultado correcto:

    Añade un cupón PERCENT10: 10 % de descuento, pero no en productos rebajados.
    
    export function applyCoupon(items: Item[], code?: string): number {
      let total = 0;
      for (const item of items) {
        let line = item.price * item.qty;
        if (code === 'PERCENT10' && !item.onSale) {
          line = line * 0.9;
        }
        total += line;
      }
      return Math.round(total);
    }
    

    Fíjate dónde vive la regla de los rebajados: en un if dentro de un bucle. Y en el chat de ese día.

    La semana 2 el agente no toca applyCoupon. Añade una función nueva al lado:

    export function calculateTotal(items: Item[], code?: string) {
      const subtotal = items.reduce((s, i) => s + i.price * i.qty, 0);
      let discounted = applyCoupon(items, code);
      if (code === 'MINUS5' && subtotal >= 3000) discounted -= 500;
      const shipping = subtotal >= 5000 ? 0 : 499;
      return { subtotal, shipping, total: discounted + shipping };
    }
    

    Ya hay dos funciones públicas que calculan precios, y el subtotal se calcula en dos sitios. El envío gratis mira el subtotal antes del descuento. Nadie lo pidió así; simplemente salió así.

    La semana 3 llega la petición que lo cambia todo:

    Black Friday: deja combinar hasta dos cupones.
    Y simplifica, hay lógica repetida entre applyCoupon y calculateTotal.
    
    const COUPONS: Record<string, (total: number) => number> = {
      PERCENT10: (t) => t * 0.9,
      MINUS5: (t) => (t >= 3000 ? t - 500 : t),
    };
    
    export function calculateTotal(items: Item[], codes: string[] = []) {
      const subtotal = items.reduce((s, i) => s + i.price * i.qty, 0);
      let total = subtotal;
      for (const code of codes.slice(0, 2)) {
        total = COUPONS[code]?.(total) ?? total;
      }
      const shipping = total >= 5000 ? 0 : 499;
      return { subtotal, shipping, total: Math.round(total) + shipping };
    }
    
    // Se mantiene por compatibilidad con el checkout
    export const applyCoupon = (items: Item[], code?: string) =>
      calculateTotal(items, code ? [code] : []).total;
    

    Es mejor código en apariencia. Más corto, extensible, sin duplicación. Y está roto de tres maneras.

    Lo que rompe el vibe coding en la semana 3 (y SDD no)

    Para medirlo, estos son los tests que nadie escribió durante esas tres semanas, ejecutados a posteriori contra las tres versiones. Esta es la salida real de bun test vibe:

    (fail) vibe semana 3 > PERCENT10 no descuenta productos rebajados
    Expected: 5600
    Received: 5400
    (fail) vibe: el contrato de applyCoupon > semana 3: applyCoupon sin cupón devuelve el importe de productos
    Expected: 2000
    Received: 2499
    (fail) vibe semana 3: problemas nuevos > el orden de los cupones no cambia el precio
    Expected: 2929
    Received: 3379
     3 pass
     3 fail
    

    Regresión silenciosa de la semana 1. Un teclado de 40 € y un ratón rebajado de 20 €. La regla original cobra 56 €; la semana 3 cobra 54 €. El filtro !item.onSale no se borró por descuido: desapareció porque la nueva firma (total: number) => number recibe un número, no las líneas. Con esa forma, la regla ya no se puede ni escribir.

    Un arreglo que rompe otra cosa. El envoltorio "por compatibilidad" de applyCoupon devuelve ahora el total con envío. Un carrito de 20 € sin cupón pasa de 20,00 a 24,99. Cualquier pantalla que mostraba "precio con descuento" muestra ahora otra cosa, con el mismo nombre de función.

    El orden de los cupones cambia el precio. Un libro de 32 €. Con PERCENT10 y luego MINUS5, el total baja a 28,80 antes de evaluar el mínimo de 30 €, así que MINUS5 no aplica: 33,79 € con envío. En orden inverso: 29,29 €. Una diferencia de 4,50 € según qué cupón teclee primero el cliente.

    Y un cuarto cambio que ningún test detecta: el envío gratis pasó de mirar el subtotal a mirar el total con descuento. Puede que sea lo correcto. Nadie lo decidió.

    Pista B: en SDD la spec cambia antes que el código

    En la pista SDD, cada petición de negocio entra primero en spec.md como reglas numeradas. Esto es lo que había al final de la semana 3:

    Semana 1:
    - R1. PERCENT10 descuenta el 10 % de la suma de líneas no rebajadas.
    - R2. Las líneas con onSale: true nunca reciben descuento porcentual.
    - R3. El descuento se redondea al céntimo una sola vez, al final.
    - R4. Un código desconocido no rompe nada: va a `rejected`.
    Semana 2:
    - R5. MINUS5 descuenta 500 si el subtotal es >= 3000.
    - R6. El total de productos nunca baja de 0.
    - R7. Envío 499; gratis si el total de productos tras descuentos es >= 5000.
    Semana 3:
    - R8. Máximo 2 cupones distintos; el tercero va a `rejected`.
    - R9. El orden no cambia el precio: primero porcentuales, luego fijos.
    - R10. Los mínimos (R5) se evalúan sobre el subtotal antes de descuentos.
    

    R7, R9 y R10 son exactamente las decisiones que la pista A nunca tomó. Escribir la spec te obliga a decidir antes de que el agente decida por ti. Después, un test por regla, con el id en el nombre:

    test('R2 · las líneas rebajadas no reciben descuento porcentual', () => {
      expect(priceCart([keyboard, saleMouse], ['PERCENT10']).discount).toBe(400);
    });
    
    test('R9 · el orden de los cupones no cambia el precio', () => {
      expect(priceCart([book], ['PERCENT10', 'MINUS5']).total)
        .toBe(priceCart([book], ['MINUS5', 'PERCENT10']).total);
    });
    

    El prompt de la semana 3 ya no describe la feature. Señala el contrato:

    Lee spec.md. He añadido R8, R9 y R10 y sus tests.
    Implementa priceCart hasta que pase `bun test sdd`.
    No cambies los tests ni las reglas R1-R7.
    

    Ahora supón que, en la pista B, el agente también intenta simplificar con el mismo atajo, un mapa de funciones sobre el subtotal entero. Este es ese primer intento, escrito para el ejemplo:

    const COUPONS: Record<string, (subtotal: number) => number> = {
      PERCENT10: (subtotal) => subtotal * 0.1,
      MINUS5: (subtotal) => (subtotal >= 3000 ? 500 : 0),
    };
    

    Salida real de IMPL=first-refactor bun test sdd:

    (fail) priceCart [first-refactor] > R2 · las líneas rebajadas no reciben descuento porcentual
    Expected: 400
    Received: 600
     9 pass
     1 fail
    

    Mismo error que en la pista A. La diferencia es que aquí un test escrito en la semana 1, con nombre propio, se pone rojo en la semana 3, antes del merge. La versión corregida pasa los cupones de nuevo por las líneas:

    PERCENT10: {
      kind: 'percent',
      // R1 + R2: solo líneas no rebajadas
      discount: (items) =>
        items.filter((i) => !i.onSale).reduce((s, i) => s + lineTotal(i), 0) * 0.1,
    },
    

    bun test sdd sobre la versión final: 10 pass, 0 fail.

    Esta es la tesis del post: SDD no hace al agente más listo. Hace que su error sea visible. Y eso solo funciona si la spec es verificable, que es justo donde fallan casi todas; lo detallo en por qué tu spec falla con un agente. Si quieres el método completo, de la plantilla a la revisión, está en el libro de Spec-Driven Development.

    SDD vs vibe coding semana a semana

    Vibe coding (pista A) SDD (pista B)
    Semana 1 1 prompt, 1 función, funciona R1-R4 + 4 tests, luego el código
    Semana 2 Segunda función pública; subtotal calculado en dos sitios; envío sin decidir R5-R7; R7 decide que el envío mira el total con descuento
    Semana 3 El refactor rompe R2, cambia el contrato de applyCoupon y el orden altera el precio El primer refactor rompe R2, el test lo para, se corrige
    Dónde viven las reglas En el historial del chat En spec.md y en el nombre de cada test
    Tests al final 0 durante el desarrollo; de los 6 escritos a posteriori, 3 fallan 10 escritos antes del código; 10 pasan
    Limitación o riesgo Las regresiones llegan a producción sin ruido Si la spec está mal, los tests verifican el error con total confianza

    Que esto además salga más barato en tokens es otra discusión, con números, en la factura del vibe coding.

    Lo que se dice en Hacker News

    En Hacker News, el 2 de noviembre de 2026, en el hilo "In LLM era, can software startup survive?", anandj82 avisaba de lo que le espera a quien construye sin saber de software: "In 2 months time, the non s/w engineer is gonna drown in keeping up with all the pieces of the product without regression."

    Unos meses antes, en "Domain expertise has always been the real moat", locknitpicker describía a un compañero que "introduced a bunch of regressions that [sic] by mindlessly vibe-coding things against the requirements".

    Fíjate en el final: against the requirements. Los requisitos existían. Lo que no existía era algo que los comprobase en cada cambio.

    Cuándo NO usar SDD

    Cuando el error solo lo pagas tú. Un prototipo que vas a tirar no necesita R1-R10. Lo desarrollo en cuándo sí usar vibe coding: la frontera no es el tamaño del proyecto, es quién paga el fallo.

    Cuando todavía no sabes las reglas. Si estás explorando qué debe hacer la feature, una spec escrita ahora es una spec inventada. Haz el spike en modo vibe, tíralo y escribe la spec con lo aprendido.

    Cuando la spec está mal. Los tests verifican que el código cumple lo que escribiste, no lo que el negocio quería. Si R2 es una mala regla, tienes una mala regla con diez tests en verde.

    Cuando crees que diez ejemplos cubren la regla. R9 está probada con un solo carrito. Para reglas como "el orden no importa" encaja mejor property-based testing con fast-check, y para saber si tus tests detectan algo, mutation testing con Stryker.

    Cómo aplicar SDD a tu feature con reglas esta semana

    Elige el módulo de tu proyecto con más reglas de negocio: precios, permisos, estados de un pedido. Escribe sus reglas tal como funcionan hoy, numeradas, entre cinco y diez. Un test por regla, con el id en el nombre. Y que tu próximo prompt al agente empiece por "lee spec.md y no toques R1-Rn".

    Tu agente va a cometer errores así, con spec o sin ella. Lo único que eliges es si te enteras por un test rojo o por el email de un cliente.

    Si quieres practicarlo con un proyecto guiado, con AGENTS.md, contratos y revisión del código que genera el agente, eso es lo que hacemos en el workshop SDD + Agentic Engineering.

    Preguntas frecuentes

    ¿SDD vs vibe coding: cuál es más rápido?

    Vibe coding es más rápido la primera semana: un prompt, frente a una spec y cuatro tests antes de la primera línea de código. En este caso, la ventaja desaparece en la semana 3, cuando la pista A tiene tres fallos sin detectar y la pista B tiene uno detectado antes del merge.

    ¿Los tests de la spec los puede escribir el propio agente?

    Sí, pero revísalos tú antes de pedir el código. Si el mismo agente escribe tests e implementación en el mismo paso, puede ajustar unos a otros. El orden importa: spec, tests revisados y después código.

    ¿Por qué numerar las reglas de la spec?

    Porque el número viaja. Aparece en el test, en el comentario del código y en el prompt ("no toques R1-R7"). Cuando un test se pone rojo, R2 te dice qué decisión de negocio se rompió sin leer el diff.

    ¿Necesito una herramienta especial para hacer SDD?

    No. En este caso basta un spec.md, un archivo de tests y bun test. Las herramientas ayudan a generar la estructura, pero lo que frena la regresión es que cada regla tenga un comando que la compruebe.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code VSCode, JetBrains o terminal: cuál elegir

    Claude Code VSCode, JetBrains o terminal: cuál elegir

    En enero de 2026, un developer contó en un issue de GitHub que había desinstalado el plugin de Claude Code de todos sus IDEs de JetBrains porque le resultaba inusable.

    El issue describía el problema: cada vez que Claude proponía un cambio, el IDE abría el diff en una pestaña nueva y le robaba el foco. Si estabas escribiendo, tus teclas acababan dentro del diff y podías aprobarlo sin querer.

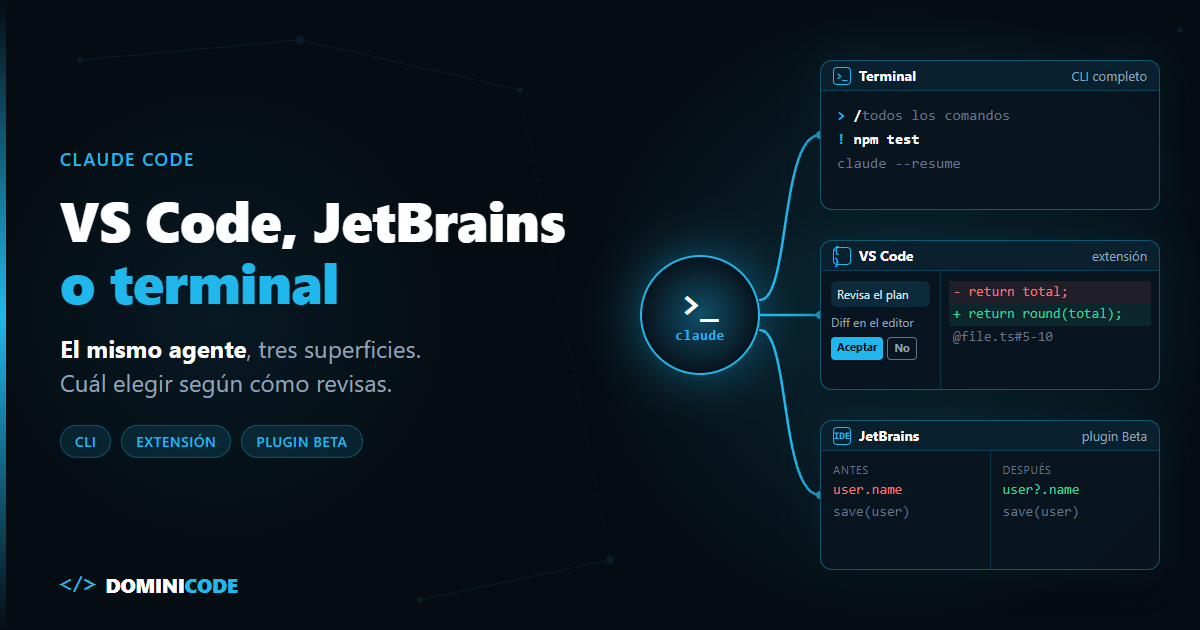
    El modelo no era el problema: lo era la superficie. Claude Code en VSCode, en el plugin de JetBrains o en la terminal es el mismo agente, pero cada superficie te enseña sus cambios de una forma, te deja hacer cosas distintas y falla en sitios distintos.

    Elegir mal no rompe nada, pero trabajas con fricción y le echas la culpa al modelo.

    En corto: la extensión de Claude Code para VS Code es un panel gráfico con diffs en el editor y planes revisables, pero solo trae un subconjunto de comandos, sin el atajo ! ni autocompletado con Tab. El plugin de JetBrains (Beta) ejecuta el CLI en la terminal del IDE y le añade diffs y diagnósticos. Solo el CLI tiene todas las funciones.

    ¿Qué es la extensión de Claude Code para VS Code?

    La extensión de Claude Code para VS Code es una interfaz gráfica nativa que integra el agente de Claude Code en el editor, con diffs, planes y conversaciones dentro de VS Code en lugar de en la terminal. La documentación oficial de VS Code la presenta como "la forma recomendada de usar Claude Code en VS Code".

    Pide VS Code 1.94.0 o superior y cualquier plan de pago de Claude (Pro, Max, Team o Enterprise) o una cuenta de Claude Console, sin API key.

    Ojo: la extensión trae su propia copia privada del CLI para el panel de chat, pero no añade claude a tu PATH. Si escribes claude en la terminal integrada sin haber instalado el CLI por separado, no lo encuentra.

    Qué te da la extensión de Claude Code en VS Code

    Te da revisión sin salir del editor:

    • Diffs en el editor. En modo Manual, cada edición se abre comparada lado a lado. Aceptas o rechazas cambio a cambio (desde v2.1.275) o editas la propuesta antes de aceptarla.
    • Planes como documento. En modo Plan, VS Code abre el plan como un Markdown completo donde dejas comentarios en línea antes de que Claude empiece.
    • @-menciones con rango. Alt+K (Windows/Linux) u Option+K (Mac) inserta algo como @file.ts#5-10 a partir de tu selección.
    • Varias conversaciones. Abres conversaciones en pestañas o ventanas, cada una con su historial.
    • Uso del plan. /usage abre el diálogo Account & usage con las barras de límite de tu plan.
    • Checkpoints. Pasas el ratón por un mensaje y bifurcas la conversación desde ahí, rebobinas el código o las dos cosas.

    La extensión y el CLI comparten historial: empiezas en el panel y sigues en la terminal con claude --resume.

    Claude Code en JetBrains: el plugin es un puente al CLI

    El plugin "Claude Code [Beta]" no es una interfaz propia: ejecuta el comando claude en la terminal integrada del IDE y se conecta a él. Según la documentación de JetBrains, no incluye el CLI: hay que instalar las dos piezas.

    Funciona en la mayoría de IDEs de JetBrains, entre ellos IntelliJ IDEA, PyCharm, Android Studio, WebStorm, PhpStorm y GoLand. Lo que añade sobre la terminal es:

    • Ctrl+Esc (Windows/Linux) o Cmd+Esc (Mac) para abrir Claude Code desde el editor.
    • Los diffs se abren en el visor de diferencias del IDE. Se cambia con la opción Diff tool de /config.
    • La selección o la pestaña activa se comparte sola con Claude.
    • Alt+Ctrl+K (Windows/Linux) o Cmd+Option+K (Mac) inserta referencias como @src/auth.ts#L1-99.
    • Claude lee las inspecciones del IDE (lint, errores de sintaxis) con la herramienta getDiagnostics.

    Ojo: según la doc, Claude Code no pide los diagnósticos por su cuenta después de editar. Si quieres que mire los errores del IDE, pídeselo.

    Como lo que corre es el CLI, tienes sus comandos. Desde una terminal externa, /ide la conecta al IDE. Si tu día a día está en WebStorm o IntelliJ, este es tu camino.

    Claude Code VSCode vs JetBrains vs terminal: tabla de funciones

    La diferencia más grande está en los comandos: solo el CLI los tiene todos. La tabla parte de las dos páginas de la doc consultadas el 10 de octubre de 2026.

    Función CLI (terminal) VS Code (extensión) JetBrains (plugin Beta)
    Instalación CLI standalone Trae CLI privado; claude no queda en el PATH Plugin + CLI aparte
    Interfaz Terminal Panel gráfico CLI en la terminal del IDE
    Comandos y skills Todos Un subconjunto Los del CLI*
    Atajo ! de Bash Sí No Sí (es el CLI)*
    Autocompletado con Tab Sí No Sí (es el CLI)*
    Diffs Terminal, o IDE si está conectado Editor, cambio a cambio Visor de diffs del IDE
    Revisión del plan Modo plan Markdown con comentarios Modo plan del CLI*
    @-mención con rango A mano, o selección compartida si hay IDE conectado* Alt+K / Option+K Alt+Ctrl+K / Cmd+Option+K
    Diagnósticos del IDE Con IDE conectado Panel Problems (v2.1.285+) Inspecciones, si Claude las pide
    Varias conversaciones Varias terminales* Pestañas, ventanas y grupos Varias terminales*
    Checkpoints Sí Sí Sí (es el CLI)*
    Limitación principal Sin diffs gráficos sin IDE Subconjunto de comandos, sin ! ni Tab Beta; el diff roba el foco; en WSL2 hay que ajustar la red

    Las celdas marcadas con * son deducción mía, no salen de la doc. La de JetBrains dice que el plugin ejecuta claude, pero no publica tabla de paridad; la única tabla oficial es la de VS Code frente al CLI.

    El debate real: el diff que roba el foco en JetBrains

    El issue #9765 de anthropics/claude-code es la mejor lectura sobre los límites del plugin. Abierto el 17 de octubre de 2025, su autor lo marcó como severidad alta: en IntelliJ, cada diff abre una pestaña que roba el foco y tus teclas acaban dentro del diff.

    Anthropic lo cerró el 14 de enero de 2026 como not planned. Días después, el mantenedor explicó que la API de plugins de JetBrains no permite mostrar un diff sin coger el foco. Propuso dos salidas: el modo de aceptar ediciones automáticamente (y revertir con /rewind) o poner Diff tool en terminal desde /config, perdiendo el diff visual.

    Otro hilo, el issue #1232 (113 comentarios), trata de Claude Code en WSL que no detecta el IDE. En los comentarios funcionaron dos arreglos: pasar WSL2 a networkingMode=mirrored o abrir el firewall de Windows a la subred de WSL. Hoy la doc recoge los dos y recomienda el del firewall, porque no te obliga a cambiar el modo de red (mirrored, además, pide Windows 11 22H2). Anthropic lo cerró como resuelto en agosto de 2025, pero el problema de red sigue apareciendo.

    Cuándo usar la extensión de Claude Code y cuándo la terminal

    Elige según cómo revisas, no según dónde escribes el prompt.

    Usa Claude Code en VS Code si revisas cada cambio antes de aceptarlo, si trabajas a partir del plan o si llevas varias tareas en paralelo y quieres verlas en pestañas.

    Usa el plugin de JetBrains si tu día a día está en WebStorm, IntelliJ o PyCharm. Obtienes el CLI completo más el visor de diffs del IDE.

    Usa el CLI a pelo si necesitas un comando que el panel no trae, si tiras de ! o si trabajas en un servidor sin IDE.

    Mi regla: el panel de VS Code para revisar y la terminal integrada para todo lo que el panel no tiene.

    Si quieres el flujo completo de pasar de idea a producto con Claude Code, con revisión de cambios incluida, es lo que hacemos en el curso Construye con IA. Para la configuración inicial del agente tienes la guía de cómo configurar Claude Code para programar, y si dudas entre herramientas en vez de entre superficies, la comparativa de Claude Code y Cursor.

    Límites y riesgos de cada superficie

    JetBrains está en Beta. Lo dice el nombre y lo confirman los issues: robo de foco sin arreglo previsto, IDE no detectado en WSL2 si no ajustas la red (el bug de origen se cerró como resuelto en agosto de 2025) y, en Remote Development, el plugin va en el host remoto, no en tu máquina.

    acceptEdits en JetBrains tiene un riesgo concreto. La doc avisa de que en ese modo Claude puede modificar archivos de configuración que el IDE ejecuta solo, y eso puede saltarse los permisos de Bash. El modo auto tiene el mismo problema. Recomienda el modo Manual.

    Claude Code en VS Code no es el CLI completo. Solo trae un subconjunto de comandos, y la doc no publica la lista de lo que falta: tienes que escribir / y comprobarlo en tu versión.

    Las funciones van atadas a la versión. Muchas piezas de la extensión piden una versión mínima de Claude Code (v2.1.275 para revisar cambio a cambio, v2.1.280 para /plan). Si un tutorial muestra algo que no ves, mira tu versión.

    Lo que esto no resuelve: ninguna superficie revisa por ti. Un diff bonito no sustituye a una spec que diga qué debía hacer el cambio.

    Cómo comprobar qué le falta a tu extensión de Claude Code

    Escribe / en el panel de Claude Code y compara la lista con los comandos que usas en la terminal. Lo que falte es lo que te obliga a tener las dos superficies abiertas.

    Saber si lo que generó el agente es correcto se decide antes de abrir el diff. Es la tesis del libro de Spec-Driven Development: primero el contrato y después el código. Para el resto del setup: extensiones de VS Code y cómo usar Claude Code a diario.

    Preguntas frecuentes

    ¿La extensión de Claude Code para VS Code tiene las mismas funciones que el CLI?

    No. Según la doc oficial, la extensión trae un subconjunto de comandos y skills, y no tiene el atajo ! de Bash ni el autocompletado con Tab. Comparte con el CLI la configuración de MCP y el historial, y también tiene checkpoints.

    ¿Necesito instalar el CLI para usar Claude Code en JetBrains?

    Sí. El plugin no incluye el CLI: ejecuta el comando claude en la terminal del IDE. Si claude no está en tu PATH, verás el aviso "Cannot launch Claude Code" y tendrás que poner la ruta completa en los ajustes del plugin.

    ¿Qué versión de VS Code necesita Claude Code?

    VS Code 1.94.0 o superior. Además necesitas un plan de pago de Claude (Pro, Max, Team o Enterprise) o una cuenta de Claude Console. La extensión también se instala en Cursor.

    ¿Puedo pasar una conversación de Claude Code en VS Code a la terminal?

    Sí. La extensión y el CLI comparten historial. Ejecuta claude --resume en la terminal y elige la conversación en el selector.

    ¿Cómo evito que el diff de JetBrains me robe el foco?

    Desde /config, pon Diff tool en terminal. Los diffs vuelven a la terminal y pierdes el visor del IDE. Anthropic cerró el issue #9765 como not planned. Según el mantenedor, la API de plugins de JetBrains no permite abrir un diff sin coger el foco.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Multiplexor de terminal: qué es y cuál elegir en 2026

    Multiplexor de terminal: qué es y cuál elegir en 2026

    Lanzas un agente de código en un servidor por SSH. Le pides una migración que va a tardar cuarenta minutos. Cierras la tapa del portátil para ir a por un café.

    Cuando vuelves, el proceso ya no existe. El wifi se cortó dos minutos, la conexión SSH murió y el shell se llevó por delante todo lo que colgaba de él. Cuarenta minutos de trabajo del agente perdidos, y un repo a medio migrar.

    Ese problema tiene solución desde 1987 y se llama multiplexor de terminal. Durante años fue cosa de sysadmins. En 2026 vuelve a importar, porque ya no dejas corriendo un proceso largo: dejas corriendo tres o cuatro agentes a la vez.

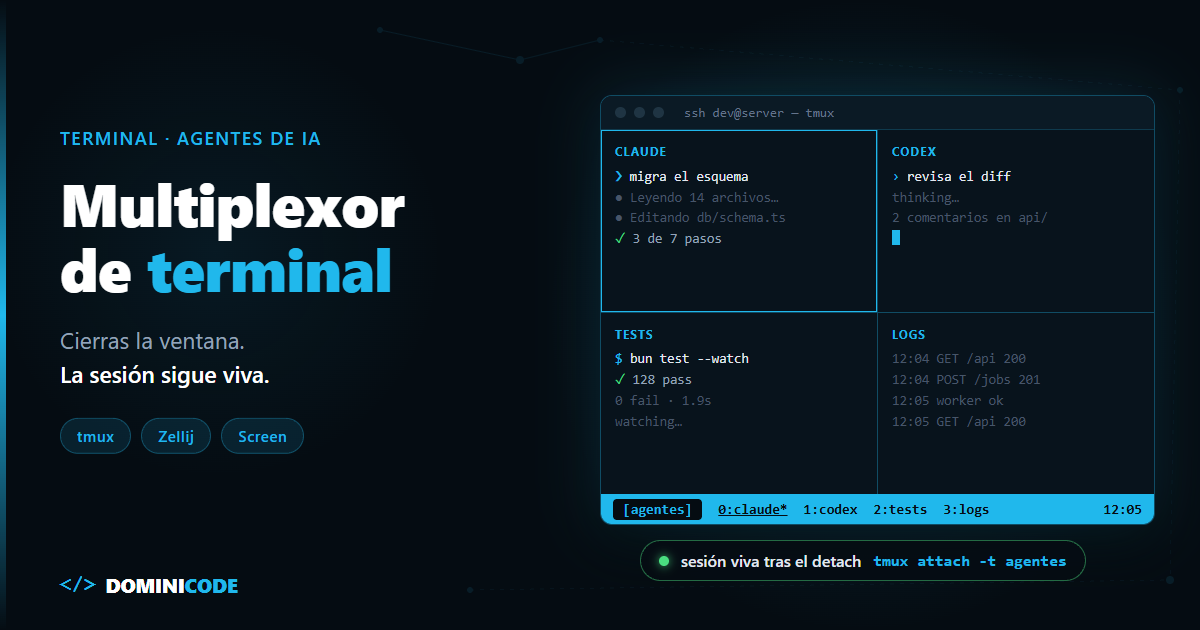
    En corto: un multiplexor de terminal (tmux, GNU Screen, Zellij) mantiene tus sesiones vivas en un proceso servidor aunque cierres la ventana o se corte SSH, y te deja dividir una terminal en varias. Si trabajas en remoto o con agentes de IA en paralelo, usa tmux o Zellij; si todo es local y tu terminal ya tiene pestañas, probablemente no lo necesitas.

    ¿Qué es un multiplexor de terminal?

    Un multiplexor de terminal es un programa que ejecuta varias sesiones de terminal dentro de una sola ventana y las mantiene vivas en segundo plano, de forma que puedes desconectarte y volver sin que los procesos mueran.

    Una aclaración para quien llega buscando "qué es un multiplexer": en electrónica y redes, un multiplexor (MUX) es un circuito o técnica que combina varias señales en un solo canal. Este artículo no va de eso. Va de la herramienta de desarrollo, el terminal multiplexer.

    La idea clave es que separa dos cosas que normalmente van pegadas: la sesión (tus procesos) y la ventana (lo que ves). Cierras la ventana y la sesión sigue.

    Cómo funciona un multiplexor de terminal: servidor, sesiones y paneles

    Un multiplexor funciona con un modelo cliente-servidor: un proceso servidor guarda el estado y tú te conectas a él con un cliente. La guía oficial de tmux lo dice literal: "tmux keeps all its state in a single main process, called the tmux server". Tu terminal es solo un cliente que puede irse y volver.

    Concepto Qué es Ejemplo práctico
    Sesión Agrupa una o más ventanas Una sesión por proyecto: api, web
    Ventana Agrupa uno o más paneles Una ventana para el agente, otra para logs
    Panel Contiene una terminal y el programa que corre Claude Code a la izquierda, tests a la derecha
    Detach / attach Soltar el cliente / volver a engancharlo Cierras el portátil, vuelves y retomas
    Prefijo Combinación que avisa "lo siguiente es para el multiplexor", porque comparte el teclado con tus programas Ctrl-b en tmux, Ctrl-a en Screen

    Comandos básicos de tmux

    Estos son los comandos mínimos para sobrevivir, todos documentados en la wiki de tmux:

    # Crear una sesión con nombre
    tmux new -s agentes
    
    # Dentro de tmux: soltar la sesión sin matarla
    # Ctrl-b d
    
    # Ver qué sesiones siguen vivas
    tmux ls
    
    # Volver a engancharte a una sesión concreta
    tmux attach -t agentes
    
    # Dentro de tmux: dividir el panel
    # Ctrl-b %   -> izquierda y derecha
    # Ctrl-b "   -> arriba y abajo
    

    Con esos comandos, el multiplexor de terminal ya resuelve la escena del principio. Abres tmux new -s agentes en el servidor, lanzas el agente y, si se corta SSH, vuelves con tmux attach -t agentes. El proceso nunca se enteró.

    tmux vs Zellij vs GNU Screen: comparativa

    La respuesta corta: tmux es el estándar, Zellij es la opción más amable para empezar y GNU Screen solo tiene sentido si es lo único instalado en la máquina. Datos verificados el 9 de noviembre de 2026:

    Herramienta Primera versión Lenguaje Licencia Última versión estable Windows nativo Limitación principal
    GNU Screen 1987 C GPL-3.0-or-later 5.0.2 (11 jul 2026) No Paneles y configuración más torpes; poca evolución de UX
    tmux 2007 C ISC 3.8 (9 sep 2026) No (en Windows, vía WSL) Curva del prefijo; scroll y copiado pasan por el modo copia
    Zellij 2021 Rust MIT 0.45.1 (28 ago 2026) Sí, desde v0.44.0 (mar 2026) Sigue en 0.x; menos scripts y configuraciones heredadas que tmux
    Herdr 2026 Rust Apache-2.0 0.9.5 (14 oct 2026) Sí, con limitaciones Proyecto joven, API aún en 0.x; pensado para agentes, no general
    WezTerm 2018 Rust MIT 20240203 (feb 2024) Sí Multiplexa solo si usas WezTerm; sin release estable desde 2024

    Fuentes: releases de cada repo, tmux y GNU Screen en Wikipedia, y las notas de Zellij v0.44.0.

    tmux

    tmux es el estándar de facto en Linux y macOS: está en los repos de cualquier distro, viene preinstalado en muchos servidores, tiene la documentación más amplia y su comando send-keys permite que un script escriba en un panel. Su README lista OpenBSD, FreeBSD, NetBSD, Linux, macOS y Solaris. En Windows, la vía es WSL.

    Zellij

    Zellij es un multiplexor de terminal escrito en Rust que se describe como "a terminal workspace with batteries included". Trae layouts, plugins y una barra con los atajos visibles, así que no tienes que memorizar nada el primer día. Se maneja con zellij attach -c mi-sesion (crea la sesión si no existe) y zellij ls, según su documentación de comandos.

    GNU Screen

    GNU Screen es el multiplexor de terminal original, de 1987, y sigue mantenido. Su prefijo es Ctrl-a, se suelta con Ctrl-a d, se listan sesiones con screen -ls y se recupera con screen -r, según el manual oficial. Úsalo cuando entres en una máquina vieja donde no puedes instalar nada más.

    tmux vs Zellij: qué dice la gente que usa ambos

    El debate tmux vs Zellij rara vez tiene un ganador claro, y el hilo de Hacker News sobre Zellij de diciembre de 2025 lo refleja bien. Un usuario, stusmall, lo resume así: "I prefer zellij over tmux, but it is evolutionary not revolutionary". Su consejo: si no ves valor inmediato en cambiar, quédate con lo que tienes.

    Otro comentario del mismo hilo, de dr_kretyn, apunta al criterio real de elección. Usaba tmux porque "I could copy over my tmux config to remote hosts and work as if nothing changed", y al pasar a trabajar sobre todo en local ahora usa casi siempre su terminal, Kitty (comentario).

    Mi opinión: si ya sabes tmux, no cambies. Si empiezas hoy y trabajas en local o en Windows, empieza por Zellij. Si vas a entrar en servidores que no controlas, aprende tmux, porque es el que vas a encontrar instalado.

    Por qué un multiplexor de terminal importa con agentes de IA

    Con agentes de código, el multiplexor deja de ser un truco para SSH y pasa a ser tu panel de control. Claude Code y Codex en un panel cada uno, otro con los tests, otro con el servidor de desarrollo. Todo en una sesión que puedes soltar y recuperar.

    Resuelve tres cosas concretas. Primero, sobrevivir a la desconexión: el agente sigue aunque cierres la terminal o se corte la red. Segundo, paralelismo visible: ves de un vistazo qué agente está trabajando y cuál espera tu respuesta. Tercero, automatización: con tmux send-keys un script puede mandar instrucciones a un panel.

    Lo que no resuelve es el conflicto de archivos. Si dos agentes tocan el mismo repo a la vez, se pisan. Para eso necesitas aislar el código con git worktrees en Claude Code: un worktree por agente y un panel por worktree.

    Y si lo que te cuesta es saber qué agente está bloqueado esperando permiso, ahí entra un multiplexor especializado. Herdr mantiene las sesiones vivas igual que tmux, pero además detecta el estado de cada agente (trabajando, bloqueado, terminado).

    Para seguir una sola sesión de Claude Code desde el móvil no hace falta multiplexor: basta Remote Control.

    Este flujo de varios agentes con tareas separadas es el que trabajamos de principio a fin en el curso Construye con IA: de la idea al producto con Claude Code.

    Cuándo NO necesitas un multiplexor de terminal

    Si todo es local, sin SSH, y tu terminal o IDE ya divide la pantalla (Ghostty, Windows Terminal, VS Code), solo pierdes la persistencia. Además, conviene conocer estos límites:

    1. Windows nativo sin WSL. tmux y GNU Screen no corren en Windows nativo. Si no quieres WSL, las opciones de esta comparativa son Zellij (desde v0.44.0), Herdr o WezTerm.
    2. La curva del prefijo. Ctrl-b antes de cada acción cuesta una semana de memoria muscular, y choca con atajos de editores y de algunas TUIs.
    3. Scroll y copiar. En tmux la rueda del ratón y la selección no se comportan como en tu terminal: hay que entrar en modo copia (Ctrl-b [) o activar el ratón en la configuración.
    4. No sobrevive a un reinicio. El servidor vive en memoria. Si reinicias la máquina, los procesos mueren. En tmux recuperar el layout exige plugins como tmux-resurrect; Zellij y Herdr guardan el layout por defecto, pero el trabajo en curso se pierde igual.
    5. Espacio en pantalla. La barra de estado y los bordes de panel restan líneas, una queja que aparece en el hilo de HN de Zellij 0.45.0 (comentario: "I can't stand losing terminal real estate"); en el mismo hilo responden que Zellij puede configurarse para ocupar una sola línea, como tmux.

    Empieza por una sesión con nombre

    Si hoy trabajas con agentes en un servidor, haz una sola cosa: antes de lanzar el siguiente, escribe tmux new -s agentes. La próxima vez que se corte la conexión, tmux attach -t agentes te devolverá el trabajo intacto, y entenderás por qué esta categoría de herramientas lleva casi cuarenta años viva.

    Si quieres ir más allá y diseñar cómo se reparten el trabajo varios agentes (herramientas, memoria, orquestación), lo cuento en el ebook gratuito El Developer Agéntico.

    Preguntas frecuentes

    ¿Qué es un multiplexer en programación?

    En programación, un multiplexer suele referirse a un multiplexor de terminal: un programa como tmux, GNU Screen o Zellij que ejecuta varias terminales en una ventana y mantiene los procesos vivos al desconectarte. No tiene relación con el multiplexor de electrónica o redes.

    ¿Qué es mejor, tmux o Zellij?

    tmux es mejor si trabajas en servidores remotos o ya lo conoces, porque está disponible casi en todas partes y tiene más ecosistema. Zellij es mejor para empezar: muestra los atajos en pantalla, trae layouts y corre en Windows nativo desde la versión 0.44.0.

    ¿tmux funciona en Windows?

    tmux no tiene versión nativa para Windows (fuera de entornos tipo Unix como Cygwin o MSYS2); su README solo lista sistemas tipo Unix y macOS. En Windows se usa dentro de WSL. Si necesitas un multiplexor nativo en Windows, Zellij, Herdr y WezTerm sí lo ofrecen.

    ¿Un multiplexor mantiene los procesos si apago el ordenador?

    No. El multiplexor mantiene los procesos si cierras la ventana o se corta SSH, porque el servidor sigue corriendo en la máquina. Si la máquina se apaga o reinicia, el servidor muere con ella. Puedes recuperar la disposición de paneles (con plugins en tmux, de serie en Zellij), pero no los procesos.

    ¿Necesito un multiplexor para usar Claude Code?

    No es obligatorio: Claude Code funciona en cualquier terminal. El multiplexor aporta cuando lo ejecutas en un servidor por SSH, cuando quieres varias sesiones en paralelo a la vista o cuando necesitas que sigan corriendo tras cerrar la terminal.

    ¿Cómo recupero una sesión de tmux si se corta SSH?

    Vuelve a conectarte al servidor y ejecuta tmux attach -t nombre-de-sesion; si no recuerdas el nombre, tmux ls lista las sesiones que siguen vivas. La sesión está intacta porque el servidor de tmux nunca dependió de tu conexión SSH.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code git: commits, PRs y conflictos bajo control

    Claude Code git: commits, PRs y conflictos bajo control

    489 commits.

    Esa es la cifra que un developer dejó en el issue #29999 de anthropics/claude-code el 2 de marzo de 2026. Claude Code había firmado cada uno de sus commits con un Co-Authored-By: Claude, y él no se dio cuenta hasta tener casi quinientos. Su única salida, según contó: reescribir todo el historial y hacer force push.

    Para mí, el problema de fondo no era la línea de atribución. Era que, en su flujo de Claude Code git, nadie había decidido qué podía escribir el agente en el historial. Para arreglarlo, la salida pasaba por la operación más peligrosa de git.

    El riesgo real no es un mal commit del agente, sino perder el control de qué entra en el historial compartido.

    En corto: delega en Claude Code los commits locales, la separación de cambios en commits atómicos, la redacción de la PR y la primera propuesta de resolución de conflictos. Revisa tú cada PR y cada conflicto resuelto, con los tests en verde. Prohíbe con reglas deny en settings.json el force push, el push a main y el merge de PRs.

    ¿Qué hace Claude Code con git?

    Delegar git en Claude Code significa que el agente ejecuta git y gh desde su herramienta Bash (commits, ramas, PRs, resolución de conflictos), mientras las reglas de permisos y tu revisión deciden qué llega al historial compartido.

    Según la referencia de settings, consultada en octubre de 2026, le pasa a Claude dos cosas al empezar la sesión: unas instrucciones propias sobre cómo escribir commits y PRs, y una foto del repo con la rama actual, la rama principal, el git status y los commits recientes. Si usas tu propio flujo, puedes quitar ambas con "includeGitInstructions": false.

    También firma. Cada commit lleva por defecto un trailer Co-Authored-By: <modelo> <noreply@anthropic.com>, y cada PR una línea "Generated with Claude Code". Se controla con la clave attribution (commit, pr y sessionUrl). La antigua includeCoAuthoredBy está obsoleta desde la v2.0.62.

    {
      "attribution": {
        "commit": "",
        "pr": ""
      }
    }
    

    Con cadenas vacías desaparece la firma. En el mismo issue, Boris Cherny, de Anthropic, respondió el 17 de agosto de 2026 justo con esa configuración. Dos usuarios le contestaron en septiembre que la queja no era si se puede apagar, sino que venga encendido por defecto.

    Mi regla: decide la atribución el primer día y déjala en settings.json, no en una frase de CLAUDE.md. Una clave de configuración no depende de que el modelo la recuerde.

    Commits con Claude Code que expliquen el porqué

    Un commit que dice "update user service" no le sirve a nadie dentro de seis meses. El diff ya cuenta qué cambió; el mensaje tiene que contar por qué.

    El agente describe el qué porque solo ve el diff. El porqué hay que pedirlo y dejarlo escrito donde lo lea en cada sesión, el CLAUDE.md del proyecto:

    ## Git
    - Conventional Commits: `tipo(ámbito): resumen` en imperativo, máximo 72 caracteres.
    - El cuerpo explica POR QUÉ: qué problema había y qué alternativa descartamos.
      El qué ya está en el diff; no lo repitas.
    - Un commit = un cambio lógico. Si el diff mezcla refactor y feature, sepáralos.
    - Antes de commitear, `npm test` en verde. Nunca `--no-verify`.
    - Nunca push a main ni force push. El push lo decide el humano.
    

    Y en el momento del commit, dale el contexto que el diff no tiene:

    Haz commit de estos cambios. El motivo: el endpoint /orders devolvía 500
    cuando el cliente no tenía dirección, y preferimos un 422 con mensaje claro
    a crear una dirección vacía. Ponlo en el cuerpo del commit.
    

    Commits atómicos con Claude Code: separa antes de commitear

    Tras una sesión larga, el working tree mezcla el fix que pediste, un refactor "de paso" y cambios de formato.

    Pídele que lo ordene antes de tocar el historial:

    Revisa git diff y agrupa los cambios en commits atómicos.
    Antes de commitear, enséñame la propuesta: qué archivos van en cada commit
    y el mensaje de cada uno. No hagas nada hasta que te diga "ok".
    

    Ver la propuesta antes es la clave: un commit de 14 archivos con mensaje genérico se frena ahí, no en la PR.

    Mi regla: cuando un mismo archivo mezcla dos cambios lógicos, lo separo yo con git add -p. Es interactivo y prefiero no pedirle al agente que lo emule con parches.

    Pull request con Claude Code usando gh

    Crear la PR es una de las tareas que mejor delega Claude Code. La guía de flujos comunes lo recoge tal cual: basta con pedir "create a pr" y el agente usa gh pr create. Además, Claude Code vincula la sesión a la PR: claude --from-pr 1234 abre el selector de sesiones filtrado por las vinculadas a esa PR, y vuelves a la conversación días después.

    Lo que cambia la calidad de la PR es el prompt:

    Crea una PR en borrador contra develop con gh. La descripción lleva:
    1. Qué problema resuelve y por qué este enfoque.
    2. Qué NO cubre esta PR.
    3. Riesgos: qué puede romper en producción.
    4. Checklist: tests añadidos, migraciones, variables de entorno nuevas.
    Enséñame el cuerpo antes de ejecutar gh pr create.
    

    En borrador (--draft) y con el cuerpo revisado antes, corriges el texto sin notificar a nadie. Si quieres aplicar este enfoque a un proyecto completo con Claude Code, es lo que hacemos en el curso Construye con IA.

    Resolver conflictos de merge con Claude Code

    Aquí el agente es útil y peligroso a la vez: leer dos lados de un conflicto es tedioso, pero "resolver" puede significar quedarse con un lado y borrar el otro en silencio.

    Antes de nada, dale más contexto en los marcadores:

    git config merge.conflictStyle zdiff3
    

    Con zdiff3 cada conflicto muestra también la versión base, así el agente ve qué cambió cada rama en vez de adivinarlo.

    Después, el prompt que obliga a explicar antes de elegir:

    Hay conflictos en el merge. Para cada archivo en conflicto:
    1. Usa git log --merge -p para ver qué commits tocaron cada lado.
    2. Explícame la intención de cada lado en una frase.
    3. Propón la resolución que conserva AMBAS intenciones.
    4. Si no se pueden conservar las dos, para y pregúntame.
    No hagas el commit del merge hasta que pasen los tests.
    

    El paso 4 es el importante. Un conflicto donde las dos intenciones chocan no es un problema de texto: es una decisión de producto, y esa no la toma el agente.

    Con varios agentes en paralelo, los conflictos se multiplican; cómo evitarlos lo conté en dirigir agentes de IA en paralelo sin que se pisen.

    Qué delegar, qué revisar y qué prohibir

    Este es el reparto que propongo para un flujo de Claude Code git. La última columna es la que manda: cuanto más difícil es deshacer una operación, menos autonomía le doy al agente.

    Operación Decisión Regla de permisos Riesgo si sale mal
    git status, diff, log Delegar Ninguna: Claude Code las trata como solo lectura Nulo
    git add + git commit local Delegar allow Bajo: se deshace con git reset --soft HEAD~1
    Separar en commits atómicos Delegar con propuesta previa allow Bajo: historial local
    gh pr create Revisar el cuerpo antes ask Medio: notifica al equipo
    Resolver conflicto de merge o rebase Revisar + tests en verde ask en --continue; en el prompt, parar antes del commit Alto: puede borrar lógica sin que falle nada
    git push a tu rama Revisar ask Medio: ya es público
    git push --force, push a main Prohibir deny Crítico: reescribe trabajo ajeno
    gh pr merge Prohibir deny Crítico: salta la revisión humana

    Cómo bloquear el force push en Claude Code con reglas deny

    El sitio para esto son las reglas de permisos de .claude/settings.json, no las instrucciones en lenguaje natural. Según la documentación de permisos, las reglas se evalúan en orden deny, luego ask, luego allow, y un deny gana siempre, aunque otra regla más específica permita lo mismo.

    {
      "permissions": {
        "allow": [
          "Bash(git add *)",
          "Bash(git commit *)"
        ],
        "ask": [
          "Bash(git push *)",
          "Bash(gh pr create *)",
          "Bash(git rebase --continue*)",
          "Bash(git merge --continue*)",
          "Bash(git reset --hard*)",
          "Bash(git clean *)"
        ],
        "deny": [
          "Bash(git push *--force*)",
          "Bash(git push -f*)",
          "Bash(git push * -f*)",
          "Bash(git push * main)",
          "Bash(git push * HEAD:main)",
          "Bash(git commit *--no-verify*)",
          "Bash(gh pr merge *)"
        ]
      }
    }
    

    El * sustituye cualquier texto en su posición, así que git push *--force* cubre --force y --force-with-lease estén donde estén. Por qué esto va en permisos y no en un hook lo expliqué en hooks vs permissions en Claude Code: un hook que falla deja pasar el comando; una regla deny, no.

    Mi regla: el agente no hace push. Si prefieres lo mismo, mueve Bash(git push *) de ask a deny y olvídate de las variantes.

    Límites de delegar git a Claude Code

    Esto no te protege de todo. Hay cuatro huecos.

    Las reglas deny no son una frontera de seguridad. La propia documentación avisa: Bash(git push *) no bloquea git -C . push origin main ni git 'push' origin main. Tampoco paran git commit -n, que equivale a --no-verify, ni git push origin +rama, que fuerza sin --force. Y hay un hueco más común: un git push a secas desde main no menciona la rama, así que Bash(git push * main) no lo para. La barrera de verdad para main es la protección de ramas en GitHub o GitLab.

    Los conflictos semánticos no salen en los tests. Si una rama renombra un campo y otra añade código que usa el nombre viejo en un sitio sin cobertura, git no marca conflicto y los tests pasan. Que el agente lo explique ayuda; solo lo detecta quien conoce el dominio.

    Los commits grandes siguen colándose. Si no pides la propuesta antes, el agente puede agrupar una sesión entera en un solo commit.

    Los mensajes vuelven a describir el qué. Con CLAUDE.md mejoran, pero si no le das el motivo en el prompt, el agente lo deduce del diff. Y un porqué inventado es peor que no tenerlo.

    Claude Code git: cómo empezar hoy

    Copia el bloque deny de arriba en el .claude/settings.json de tu proyecto y haz commit para que lo tenga todo el equipo. Son cinco minutos que convierten "espero que el agente no haga force push" en "el agente no puede hacer force push de la forma habitual".

    Lo demás, los mensajes con porqué, los commits atómicos y las PRs con checklist, sale de la misma idea: escribir el contrato antes de que el agente ejecute. Si quieres aplicar eso a todo el ciclo y no solo a git, es la base del libro Spec-Driven Development.

    Preguntas frecuentes

    ¿Cómo quito el Co-Authored-By de los commits de Claude Code?

    Añade "attribution": { "commit": "", "pr": "" } a tu settings.json. Desde la v2.1.281 también puedes poner "attribution": false para quitar toda la atribución, incluido el enlace de sesión. Ojo: las versiones anteriores rechazan ese valor e ignoran el archivo entero, reglas deny incluidas. En un .claude/settings.json compartido por el equipo, usa cadenas vacías y "sessionUrl": false. La clave includeCoAuthoredBy está obsoleta desde la v2.0.62.

    ¿Puede Claude Code resolver conflictos de merge solo?

    Puede proponer la resolución y aplicarla, pero no debería cerrar el merge sin tu revisión. Pídele que explique la intención de cada lado, que pare si chocan y que no cierre el merge hasta que pasen los tests.

    ¿Cómo hago que Claude Code escriba commits que expliquen el porqué?

    Fija la convención en CLAUDE.md (cuerpo con el motivo, no con el qué) y dale el motivo en el prompt al pedir el commit. El agente solo ve el diff; el porqué tiene que venir de ti.

    ¿Cómo crea Claude Code una pull request?

    Usa la CLI gh con gh pr create. Necesitas gh instalado y autenticado. Pídele la PR en borrador y que te enseñe la descripción antes de crearla.

    ¿Una regla deny de Claude Code bloquea cualquier git push –force?

    No. Bloquea las formas habituales de escribir el comando, pero no variantes como git -C . push. Combínala con protección de ramas en el servidor para main.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code headless: scripts por lotes con claude -p

    Claude Code headless: scripts por lotes con claude -p

    Tienes 140 archivos de test en Jasmine y el equipo ha decidido pasar a Vitest. Abres Claude Code, le pides que migre el primero, revisas, aceptas. Segundo archivo. Tercero.

    En el archivo veinte ya no lees los diffs. En el cuarenta, el contexto de la sesión arrastra los treinta y nueve anteriores y las respuestas empiezan a mezclar convenciones. Estás usando Claude Code en modo interactivo para un trabajo que pide Claude Code headless.

    Ese trabajo tiene forma de bucle: el mismo prompt, N entradas, una salida que puedes comprobar. La herramienta es la misma que usas en la terminal, pero llamada desde un script con claude -p.

    En corto: claude -p ejecuta Claude Code sin interfaz: recibe un prompt, hace el trabajo, imprime el resultado y sale con un código de salida. Para lotes, llámalo una vez por archivo con --bare, herramientas acotadas y --max-budget-usd, y usa --json-schema si otro programa va a leer la salida. Si necesitas decidir en código qué se aprueba en cada llamada, pasa al Agent SDK.

    ¿Qué es Claude Code headless?

    Claude Code headless es el modo no interactivo de Claude Code: con el flag -p (o --print) se ejecuta una tarea completa desde la línea de comandos, sin sesión abierta, y el resultado sale por stdout como texto o JSON.

    La documentación oficial de modo headless (consultada el 10 de octubre de 2026) lo presenta como el Agent SDK usado desde la CLI. Lee stdin, así que encaja en tuberías, y devuelve 0 si la ejecución va bien y un código distinto si falla. Tu script puede ramificar sobre eso como con cualquier otro comando.

    Flags de Claude Code headless que importan en un script

    De la referencia de la CLI, estos son los flags que cambian el resultado de un lote:

    Flag Qué hace Por qué importa en un lote
    --bare Omite hooks, skills, plugins, MCP, auto memory y CLAUDE.md Mismo resultado en cualquier máquina. La doc dice que será el valor por defecto de -p
    --tools "Read,Edit" Restringe las herramientas disponibles Lo que no está en la lista no existe para el modelo
    --allowedTools Aprueba sin preguntar las herramientas o reglas indicadas Acepta reglas como Edit(./src/a.ts) o Bash(git diff *)
    --permission-mode dontAsk Deniega todo lo que pediría confirmación Nadie va a contestar un prompt a las tres de la mañana
    --max-turns 8 Corta tras N turnos agénticos y sale con error Evita que un archivo raro se convierta en un bucle largo
    --max-budget-usd 0.50 Para la ejecución al llegar a ese gasto estimado Pone techo al coste de cada llamada
    --output-format json Devuelve result, session_id, total_cost_usd y metadatos El script puede leer coste y errores con jq
    --json-schema '<schema>' Valida la salida contra un JSON Schema El resultado llega en el campo structured_output

    Ojo: --allowedTools aprueba, no restringe. Para limitar qué herramientas existen, la referencia manda a --tools. En el issue #33343 de claude-code, un usuario lanzó claude -p con --permission-mode bypassPermissions y --allowedTools "Glob", y Claude leyó igualmente el archivo que no debía. Con bypassPermissions no hay nada que aprobar, así que la lista no protegía nada. Dónde poner cada barrera lo cuento en hooks vs permissions en Claude Code.

    La regla: en desatendido, --tools define qué existe, --allowedTools qué se aprueba y dontAsk deniega lo que pediría confirmación (las lecturas dentro del directorio de trabajo y los comandos de solo lectura siguen pasando). Nunca uses bypassPermissions en un bucle.

    Migrar N archivos con un bucle de Claude Code headless

    La clave de Claude Code headless en un lote es una llamada por archivo: contexto limpio, fallo aislado y un log por ejecución.

    #!/usr/bin/env bash
    # migrate-vitest.sh: migra cada spec de Jasmine a Vitest en una llamada aislada
    set -uo pipefail
    mkdir -p .migracion
    
    git ls-files '*.spec.ts' | while IFS= read -r file; do
      log=".migracion/$(echo "$file" | tr '/' '_').json"
    
      claude --bare -p "Migra $file de Jasmine a Vitest. Edita solo ese archivo." \
        --append-system-prompt-file ./docs/migracion-vitest.md \
        --tools "Read,Edit" \
        --allowedTools "Read,Edit(./$file)" \
        --permission-mode dontAsk \
        --max-turns 8 \
        --max-budget-usd 0.50 \
        --output-format json < /dev/null > "$log"
    
      if npx vitest run "$file" < /dev/null > /dev/null 2>&1; then
        echo "OK   $file  $(jq -r '.total_cost_usd' "$log") USD"
      else
        git checkout -- "$file"
        echo "MAL  $file  (revertido, revisar a mano)"
      fi
    done
    

    Tres detalles que no son decoración:

    1. < /dev/null. claude -p lee stdin. Dentro de un while read, sin esa redirección, la primera llamada se come la lista de archivos que queda en la tubería y el bucle termina tras una vuelta.
    2. Edit(./$file). La regla aprueba editar ese archivo y ningún otro. Con dontAsk, cualquier intento de tocar otro archivo se deniega.
    3. --append-system-prompt-file. --bare no lee tu CLAUDE.md, así que las convenciones de la migración van en un archivo que pasas a mano.

    La regla: el script verifica, no el modelo. Que Claude diga "migrado" no vale nada; que vitest run pase sí.

    Generar un changelog con claude -p

    No todo lote necesita herramientas. Un changelog es texto que entra por stdin y texto que sale por stdout:

    git log --no-merges --pretty=format:'%h %s' v2.3.0..HEAD |
      claude --bare -p "Agrupa estos commits en un changelog en markdown con las secciones Añadido, Cambiado y Corregido. Devuelve solo el markdown." \
        --tools "" \
        --max-budget-usd 0.20 > CHANGELOG-next.md
    

    --tools "" desactiva todas las herramientas: Claude solo ve lo que le pasas. Es el uso más seguro de Claude Code no interactivo.

    Clasificar issues con salida JSON y schema

    Cuando el resultado lo va a consumir otro programa, el texto libre no sirve. --json-schema necesita --output-format json, y la salida validada aparece en structured_output:

    SCHEMA='{"type":"object","properties":{"label":{"type":"string","enum":["bug","enhancement","question","documentation"]},"priority":{"type":"string","enum":["p0","p1","p2"]},"reason":{"type":"string"}},"required":["label","priority","reason"],"additionalProperties":false}'
    
    gh issue list --state open --limit 30 --json number,title,body |
      jq -c '.[]' |
      while IFS= read -r issue; do
        number=$(jq -r '.number' <<< "$issue")
        out=$(jq -r '.title + "\n\n" + (.body // "")' <<< "$issue" |
          claude --bare -p "Clasifica esta issue de GitHub. En reason, explica el motivo en una frase." \
            --permission-mode dontAsk \
            --output-format json \
            --json-schema "$SCHEMA" \
            --max-budget-usd 0.10)
    
        label=$(jq -r 'select(.is_error == false) | .structured_output.label // empty' <<< "$out")
        if [ -z "$label" ]; then
          echo "#$number sin clasificar"
          continue
        fi
        gh issue edit "$number" --add-label "$label"
        echo "#$number -> $label"
      done
    

    Aquí claude lee de su propia tubería, así que no hace falta < /dev/null. Los enum impiden que el modelo invente una etiqueta. Las cuatro del ejemplo vienen por defecto en GitHub; si usas otras, créalas antes con gh label create.

    Validar el structured_output con Zod en un script Bun

    Un schema válido no garantiza un resultado útil. En el issue #77026 de claude-code, abierto en julio de 2026, varios usuarios reportan que con claude -p --json-schema la ejecución devuelve subtype: "success" con datos rotos. El fallo más frecuente es que el modelo mete marcado XML del tool-call dentro de un campo string; otras veces rellena el campo con "placeholder" o "test" para pasar la validación. Un colaborador de Anthropic no lo reprodujo en 6 ejecuciones con la v2.1.233, y otro usuario lo confirmó después en la v2.1.237 con Sonnet 5. Raro, pero en un lote de miles, pasa.

    La defensa es validar otra vez en tu lado con una regla que el schema no puede expresar. Con Zod, el mismo objeto genera el JSON Schema y valida el resultado, el patrón de cómo tipar las respuestas de una LLM con Zod. El truco está en el refine: toJSONSchema lo ignora, así que no llega al CLI y solo lo comprueba tu script.

    // triage.ts: bun run triage.ts
    import { z } from "zod";
    
    const Triage = z.object({
      label: z.enum(["bug", "enhancement", "question", "documentation"]),
      priority: z.enum(["p0", "p1", "p2"]),
      reason: z
        .string()
        .min(20)
        // toJSONSchema ignora el refine: esta regla solo se aplica en tu lado
        .refine((s) => !/placeholder|<\/?[a-z]/i.test(s), "reason con relleno o marcado XML"),
    });
    
    const RunResult = z.object({
      is_error: z.boolean(),
      total_cost_usd: z.number(),
      structured_output: z.unknown(),
    });
    
    const schema = JSON.stringify(z.toJSONSchema(Triage, { target: "draft-7" }));
    const BATCH_LIMIT_USD = 3;
    
    async function runClaude(text: string) {
      const proc = Bun.spawn(
        [
          "claude", "--bare", "-p", "Clasifica esta issue de GitHub.",
          "--permission-mode", "dontAsk",
          "--output-format", "json",
          "--json-schema", schema,
          "--max-budget-usd", "0.10",
        ],
        { stdin: new Blob([text]) },
      );
      const stdout = await proc.stdout.text();
      await proc.exited;
      return RunResult.parse(JSON.parse(stdout));
    }
    
    type Issue = { number: number; title: string; body: string };
    const issues: Issue[] =
      await Bun.$`gh issue list --state open --limit 30 --json number,title,body`.json();
    
    let spent = 0;
    for (const issue of issues) {
      if (spent >= BATCH_LIMIT_USD) {
        console.error(`Tope del lote alcanzado: ${spent.toFixed(2)} USD`);
        break;
      }
      try {
        const run = await runClaude(`${issue.title}\n\n${issue.body}`);
        spent += run.total_cost_usd;
        const triage = Triage.safeParse(run.structured_output);
        if (run.is_error || !triage.success) {
          console.error(`#${issue.number} sin clasificar`);
          continue;
        }
        console.log(`#${issue.number} ${triage.data.label}/${triage.data.priority}`);
      } catch (error) {
        console.error(`#${issue.number} falló: ${error}`);
      }
    }
    

    El target: "draft-7" no es opcional: la documentación de structured outputs indica que el validador usa JSON Schema draft-07 y que Zod genera 2020-12 por defecto. Desde Claude Code v2.1.205, un schema inválido hace fallar la ejecución al arrancar; antes se ignoraba en silencio. Y el JSON se parsea aunque el código de salida no sea 0, porque los fallos internos salen como resultado en stdout.

    safeParse, refinamientos y transformaciones están en el curso de Zod.

    Interactivo, claude -p o Agent SDK: cuándo usar cada uno

    Criterio Sesión interactiva claude -p (headless) Agent SDK (TS / Python)
    Quién aprueba permisos Tú, en cada prompt Reglas fijas antes de arrancar Tu código, llamada a llamada (canUseTool)
    Salida Conversación Texto, JSON o stream-json Objetos de mensaje nativos
    Unidad de trabajo Una tarea abierta Un comando, una entrada Un programa con estado
    Encaja en Diseño, depuración, exploración Bucles bash, CI, cron, package.json Productos y servicios con agentes
    Control de coste Lo ves en la sesión --max-budget-usd por llamada Presupuesto y lógica propia
    Riesgo principal Aprobar diffs sin leerlos por cansancio Permisos amplios sin nadie mirando Más código que mantener y testear

    La regla: quédate en claude -p mientras el script quepa en una pantalla y los permisos sean estáticos. Si necesitas aprobar según el contenido de cada llamada, reintentar con lógica propia o guardar estado, pasa al SDK. El siguiente paso está en servidor de herramientas para tu agente con el SDK de Anthropic.

    Límites de Claude Code headless en tareas por lotes

    El coste escala con N. --max-budget-usd limita cada llamada, no el lote, y es una estimación del cliente que el gasto puede superar. Por eso el script Bun lleva su propio contador. En el issue #37686, un usuario con plan Max cuenta que sus scripts programados con claude -p heredaron una ANTHROPIC_API_KEY de su shell y facturaron más de 1.800 USD en dos días a una cuenta de API.

    No es determinista. El mismo prompt sobre el mismo archivo puede dar dos migraciones distintas. Sin verificación automática (tests, tipos, lint), un lote multiplica la incertidumbre.

    Permisos amplios en desatendido. --allowedTools "Bash" en un bucle equivale a ejecutar lo que el modelo decida, N veces, sin nadie delante. Acota con reglas como Bash(git diff *) o no des Bash.

    --bare ignora tu CLAUDE.md. Por eso es reproducible y por eso olvida tus convenciones, hooks y servidores MCP. Lo que el modelo necesite va en --append-system-prompt, --settings o --mcp-config.

    Cómo empezar con Claude Code headless en tus scripts

    Elige una tarea repetitiva que ya verifiques con un comando: un test, tsc --noEmit o un linter. Escribe el bucle de Claude Code headless con --bare, --tools mínimo, dontAsk y tope de presupuesto, y lánzalo sobre tres archivos antes que sobre trescientos.

    Ese prompt fijo que repites en el bucle es, en el fondo, una especificación pequeña. Es la misma idea del libro Spec-Driven Development: cuanto más precisa la entrada, menos tienes que revisar a la salida. Y si quieres el flujo completo de idea a producto con Claude Code, está en el curso Construye con IA.

    Para revisar cada PR, mira revisiones de código con IA en tu pipeline de CI/CD; para un flujo visual sin scripts, Claude Code con n8n.

    Preguntas frecuentes

    ¿Qué diferencia hay entre –allowedTools y –tools en claude -p?

    --tools restringe qué herramientas existen en la sesión. --allowedTools aprueba sin preguntar las que indiques, pero no elimina las demás. En scripts desatendidos, combina los dos con --permission-mode dontAsk.

    ¿–max-budget-usd limita el coste total del lote?

    No. Limita cada ejecución de claude -p por separado. Para un tope del lote, suma total_cost_usd de cada respuesta JSON y corta el bucle al llegar al límite.

    ¿Cómo saco el structured_output de claude -p con jq?

    Ejecuta claude -p con --output-format json y --json-schema, y filtra con jq '.structured_output'.

    ¿Claude Code headless usa mi suscripción o la API de Anthropic?

    Depende. Sin --bare, claude -p usa tu login de claude.ai, salvo que tengas ANTHROPIC_API_KEY en el entorno: en modo -p la clave se usa siempre que exista, sin preguntar. Con --bare, Claude Code no lee tu login: necesitas ANTHROPIC_API_KEY o un apiKeyHelper en --settings, y pagas por token. Antes de un lote, ejecuta claude auth status y mira el campo authMethod.

    ¿Cuándo pasar de claude -p al Agent SDK?

    Cuando aprobar una herramienta depende del contenido de cada llamada, cuando necesitas reintentos o estado entre pasos, o cuando el agente forma parte de un producto. El SDK da callbacks de permisos y mensajes nativos; claude -p, un comando que cabe en un bucle bash.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • GitHub Spec Kit con Claude Code: specs que el agente cumple

    GitHub Spec Kit con Claude Code: specs que el agente cumple

    La spec decía 200 caracteres. El código dice 500.

    En septiembre de 2026, un developer abrió el issue #4383 en el repo de Spec Kit. Había hecho todo bien: constitution, specify, plan, tasks, implement, usando GitHub Spec Kit con Claude Code. El PRD fijaba en 200 la longitud máxima de dos campos. spec.md lo decía. data-model.md también: SuspendReason nvarchar(200).

    Y Claude implementó SuspendReasonMaxLength = 500.

    Nadie le había dado mal la regla al agente. La regla se había perdido por el camino: tasks.md mencionaba el límite de un campo y no el del otro. Para el campo sin límite, el agente puso uno por su cuenta.

    En corto: GitHub Spec Kit no impide que Claude Code contradiga tu spec, pero hace visible dónde se rompe el hilo. Su plantilla te obliga a escribir historias priorizadas que se prueban por separado, escenarios Given/When/Then, requisitos numerados y criterios medibles. Sus comandos clarify, checklist, analyze y converge detectan las contradicciones antes de implementar y después.

    ¿Qué es GitHub Spec Kit?

    GitHub Spec Kit es un toolkit open source de GitHub que instala en tu agente de código (Claude Code, Copilot, Codex y otros) un proceso de Spec-Driven Development con plantillas y comandos que van de la especificación al plan, las tareas, el código y la verificación.

    No es un modelo ni un servicio. Es un CLI en Python (specify) que copia plantillas Markdown y skills a tu proyecto. Todo lo demás lo hace el agente siguiendo esas instrucciones.

    Va rápido. La última release cuando escribo esto es la v1.3.2, del 6 de noviembre de 2026, y el repo pasa de 148.000 estrellas (dato de la API de GitHub, 7 de noviembre de 2026).

    Los tres errores que hacen que el agente contradiga la spec

    Un agente contradice una spec por tres motivos que el formato de Spec Kit ataca de frente: la ambigüedad, la falta de slices verticales y los criterios de aceptación débiles.

    El resto de fallos lo tienes en los siete fallos de una spec que rompen a un agente de IA, y lo de los slices, en el post sobre spec global y slices verticales en un proyecto greenfield.

    La tesis es simple: un agente no contradice una spec por rebeldía. La contradice cuando la spec deja un hueco y él lo rellena. Spec Kit no hace al agente más obediente. Te deja menos huecos que rellenar.

    Cómo instalar GitHub Spec Kit en Claude Code

    Necesitas Python 3.11+, uv y Claude Code instalado. La página de la integración con Claude da la clave claude:

    uv tool install specify-cli
    specify init mi-proyecto --integration claude
    cd mi-proyecto
    

    En un proyecto que ya existe, la guía de proyectos existentes indica specify init --here --force --integration claude. Haz commit antes: --force puede sobrescribir archivos en las rutas que gestiona Spec Kit.

    Spec Kit instala sus comandos como skills en .claude/skills/speckit-<comando>/SKILL.md. En el chat de Claude Code se invocan con guion:

    /speckit-constitution Prioriza la exactitud fiscal y los tests de integración.
    /speckit-specify Exportación trimestral de facturas para la gestoría.
    /speckit-clarify
    /speckit-plan Next.js, Postgres y generación del CSV en el servidor.
    /speckit-checklist
    /speckit-tasks
    /speckit-analyze
    /speckit-implement
    /speckit-converge
    

    Si ves /speckit.specify con punto en la documentación, es la notación genérica: en Claude Code va con guion.

    El formato de spec de Spec Kit, sección a sección

    La plantilla spec-template.md tiene tres secciones obligatorias (User Scenarios & Testing, Requirements y Success Criteria), una condicional (Key Entities, si la feature maneja datos) y una sección final de Assumptions. Así se mapea cada error a un mecanismo concreto:

    Error en la spec Mecanismo de Spec Kit Qué lo detecta
    Ambigüedad Marcadores [NEEDS CLARIFICATION: …] (máximo 3 por spec) y sección Assumptions /speckit-clarify: hasta 5 preguntas y las respuestas se escriben en spec.md
    Sin slices verticales User stories con prioridad (P1, P2, P3) y un Independent Test cada una /speckit-tasks agrupa las tareas por historia
    Criterios débiles Escenarios Given/When/Then y Success Criteria medibles (SC-001…) /speckit-checklist, "unit tests for English"
    Spec, plan y tareas que no cuadran Requisitos numerados FR-001… para trazar cada uno /speckit-analyze, de solo lectura
    Código que no cumple la spec spec.md, plan.md y tasks.md como referencia /speckit-converge añade tareas por lo que falta
    Principios del proyecto ignorados .specify/memory/constitution.md /speckit-analyze marca cualquier conflicto con la constitución como CRITICAL

    Fuente: plantillas y comandos en templates/commands/, consultados el 7 de noviembre de 2026.

    La plantilla exige que cada historia sea "INDEPENDENTLY TESTABLE": si implementas solo una, sigues teniendo un MVP viable. Es un slice vertical con otro nombre.

    Ejemplo: de spec mala a spec en formato Spec Kit

    Caso: un SaaS de facturación para autónomos. Los usuarios quieren mandar sus facturas a la gestoría cada trimestre sin descargarlas una a una.

    La spec que suele llegar al agente:

    # Exportación para la gestoría
    
    Añadir exportación de facturas para la gestoría.
    Tiene que ser rápida y fácil de usar.
    Formato CSV o Excel.
    Opción de enviarlo por email automáticamente.
    Gestionar bien los errores.
    

    Cada línea es un hueco. "Rápida" no se puede medir. "CSV o Excel" deja la decisión al agente. "Gestionar bien los errores" no dice qué es un error. Y no hay orden: el agente puede empezar por el envío automático, la parte más difícil, sin que exista la exportación básica.

    La misma spec en el formato de Spec Kit:

    # Feature Specification: Exportación trimestral para la gestoría
    
    **Status**: Draft
    
    ## User Scenarios & Testing *(mandatory)*
    
    ### User Story 1 - Descargar el CSV del trimestre (Priority: P1)
    
    El autónomo elige un trimestre y descarga un CSV con todas sus
    facturas emitidas en ese periodo.
    
    **Why this priority**: sin esto no hay nada que enviar. Es el
    mínimo que ya ahorra el trabajo manual.
    
    **Independent Test**: con 3 facturas en el T2 y 1 en el T3,
    exportar el T2 devuelve un CSV con exactamente 3 filas.
    
    **Acceptance Scenarios**:
    
    1. **Given** un usuario con 3 facturas emitidas en el T2 de 2026,
       **When** exporta el T2 de 2026, **Then** descarga un CSV con
       3 filas y las columnas número, fecha, NIF del cliente, base
       imponible, tipo de IVA, cuota de IVA y total.
    2. **Given** una factura rectificativa en el T2, **When** exporta
       el T2, **Then** la rectificativa aparece con importes negativos.
    3. **Given** un trimestre sin facturas, **When** lo exporta,
       **Then** ve el mensaje "No hay facturas en este trimestre"
       y no se descarga ningún archivo.
    
    ---
    
    ### User Story 2 - Enviar el CSV al email de la gestoría (Priority: P2)
    
    El autónomo guarda el email de su gestoría y envía el CSV del
    trimestre con un botón.
    
    **Why this priority**: elimina el paso de adjuntar el archivo,
    pero depende de que la US1 funcione.
    
    **Independent Test**: con un email de gestoría guardado, pulsar
    "Enviar" genera un único email con el CSV del trimestre adjunto.
    
    **Acceptance Scenarios**:
    
    1. **Given** un email de gestoría guardado, **When** pulsa
       "Enviar T2", **Then** se envía un email con el CSV adjunto
       y el envío queda registrado con fecha y destinatario.
    2. **Given** que el T2 ya se envió, **When** pulsa "Enviar T2"
       otra vez, **Then** se le pide confirmación antes de reenviar.
    
    ---
    
    ### User Story 3 - Envío automático al cerrar el trimestre (Priority: P3)
    
    [...]
    
    ### Edge Cases
    
    - ¿Qué pasa con una factura con fecha del último día del trimestre
      a las 23:59 en otra zona horaria?
    - ¿Qué pasa si el email de la gestoría rebota?
    
    ## Requirements *(mandatory)*
    
    ### Functional Requirements
    
    - **FR-001**: System MUST incluir solo facturas emitidas, nunca
      borradores.
    - **FR-002**: System MUST asignar el trimestre por la fecha de
      emisión, no por la fecha de cobro.
    - **FR-003**: System MUST usar [NEEDS CLARIFICATION: ¿separador
      decimal coma o punto? Depende del programa de la gestoría].
    - **FR-004**: System MUST NOT modificar ninguna factura al exportar.
    
    ### Key Entities
    
    - **Factura**: número, fecha de emisión, cliente, base, IVA, total.
    - **Envío**: trimestre, destinatario, fecha y archivo enviado.
    
    ## Success Criteria *(mandatory)*
    
    ### Measurable Outcomes
    
    - **SC-001**: un usuario con 500 facturas en un trimestre obtiene
      el CSV en menos de 5 segundos.
    - **SC-002**: la suma de la columna total del CSV coincide al
      céntimo con el total facturado del trimestre en la app.
    
    ## Assumptions
    
    - La exportación a Excel queda fuera de esta versión.
    - Las facturas recibidas (gastos) no entran en esta feature.
    

    Fíjate en lo que cambió. El orden ya no es cosa del agente: P1 se puede terminar, probar y desplegar sin tocar P2. "Rápida" ahora es SC-001, con un número. "CSV o Excel" se convirtió en una decisión escrita en Assumptions. Y lo que de verdad no sabes, el separador decimal, queda marcado en vez de inventado.

    Ojo: una spec mejor no habría evitado por sí sola el bug del issue #4383. Allí la spec ya decía 200; el límite se perdió al pasar a tasks.md. Lo que lo atrapa es una restricción escrita como escenario (Given un motivo de 201 caracteres, When se guarda, Then se rechaza) más un comando que compare el código con ella. Un escenario se convierte en un test que falla, y un test que falla no deja pasar un 500 donde ponía 200.

    Cómo detecta Spec Kit las contradicciones antes de implementar

    Spec Kit detecta las contradicciones con cuatro comandos: clarify y checklist revisan la spec, analyze cruza spec, plan y tareas antes de implementar, y converge compara el código con los tres después. Es justo el punto donde falló el issue: algo se perdió entre spec.md y el código.

    /speckit-clarify revisa la spec por categorías y te hace como máximo cinco preguntas, de una en una, con opciones cerradas o respuestas de cinco palabras como mucho. Cada respuesta se escribe en spec.md. Pásalo antes de plan: es más barato resolver el separador decimal ahí que en un PR.

    /speckit-checklist genera lo que el propio comando llama "Unit Tests for English": comprueba si los requisitos están completos, son claros y no se contradicen. No prueba el código. Prueba la spec.

    /speckit-analyze cruza spec.md, plan.md y tasks.md y saca una tabla de hallazgos con severidad. Es estrictamente de solo lectura: no toca ningún archivo. Y la constitución manda: según el propio comando, un conflicto con ella es "automatically CRITICAL" y se arregla cambiando la spec, el plan o las tareas, no el principio.

    /speckit-converge va después de implementar. Compara el código con los tres artefactos y añade a tasks.md el trabajo que falta, sin tocar el código. Repites implement y converge hasta que el comando informa Converged.

    El issue #4383 acabó en un cambio a la plantilla de tasks. Desde el PR #4430, fusionado el 8 de septiembre de 2026, el comando pide citar literalmente en cada tarea las restricciones de campo de data-model.md: longitudes máximas, nullables, enums, reglas de validación. Aun así, el bot del repo, que clasificó el issue como "likely valid, needs reproduction", avisa de que el arreglo es solo de prompt y de que distintos agentes pueden seguir parafraseando las restricciones en vez de citarlas. Por eso no te fíes de un solo comando: analyze antes de implementar y converge después.

    La constitución: lo que ningún feature puede saltarse

    /speckit-constitution escribe .specify/memory/constitution.md, que se crea una vez por proyecto. La plantilla trae huecos para cinco principios, con ejemplos como "Test-First (NON-NEGOTIABLE)".

    Para el SaaS de facturas, uno de los principios sería este:

    ### I. Exactitud fiscal (NON-NEGOTIABLE)
    Los importes se calculan en céntimos enteros, nunca en coma flotante.
    Toda exportación tiene un test que compara su suma con el total del sistema.
    

    Ese principio no vive en ninguna spec concreta. Vive por encima de todas. Si mañana un plan propone calcular con number de JavaScript, analyze debería marcarlo como CRITICAL antes de que se escriba una línea.

    Spec Kit, un spec.md propio u OpenSpec

    No todo proyecto necesita Spec Kit:

    Criterio GitHub Spec Kit spec.md propio OpenSpec
    Instalación uv + Python 3.11+ Ninguna npm (Node 22.12+), Homebrew o script
    Formato de spec Plantilla fija: user stories P1-P3, Given/When/Then, FR, SC El que tú decidas Requisitos y escenarios en Markdown, por cambio
    Detección de contradicciones clarify, checklist, analyze, converge Depende de tu disciplina y tus prompts /opsx:verify en el perfil ampliado
    Specs a largo plazo Una carpeta por feature en specs/ Lo que mantengas a mano openspec/specs/ vivas; los cambios se archivan y las actualizan
    Limitación o riesgo Mucho Markdown y ceremonia; las specs por feature envejecen Nada te obliga a escribir criterios medibles Menos puertas de calidad; su README llama a Spec Kit "Thorough but heavyweight"

    Fuentes: README de Spec Kit, README de OpenSpec, consultados el 7 de noviembre de 2026. Si ya usas OpenSpec, tienes el paso a paso en cómo integrar OpenSpec con Claude Code.

    Mi opinión: el formato es lo mejor del paquete y te lo puedes llevar sin el CLI. Si copias la plantilla a tu spec.md propio, ya ganas la mitad; la otra mitad, analyze y converge, es lo que justifica instalarlo en proyectos medianos o grandes.

    Cuándo NO usar Spec Kit

    Para cambios pequeños. El proceso completo genera spec, plan, tareas, checklists y varios artefactos más. Para un bug de tres líneas es ceremonia pura. En este hilo de Hacker News, a raíz del análisis de Birgitta Böckeler sobre Kiro, Spec Kit y Tessl, un usuario contaba que lo dejó porque "Always made it too complex, and at some point it wasn't worth correcting it anymore". Para bugs, Spec Kit tiene ahora una extensión aparte (specify extension add bug); úsala en vez de pasar el bug por el flujo de features.

    Cuando esperas que la spec garantice el resultado. En el mismo hilo, otro usuario cuenta que usó Spec Kit con Claude Code durante dos semanas. Tras unos diez días de flujo, tenía tests fallando y un build que no salía. En el siguiente proyecto dejó de lado parte del flujo: montó sus propios comandos por sprint y revisaba cada sprint antes de seguir. Ese comentario es de octubre de 2025, antes de converge, pero la lección no caduca: la spec reduce los huecos, no sustituye la revisión.

    Cuando tus specs tienen que vivir años. Spec Kit crea una carpeta por feature. Si la feature 009 cambia lo que definió la 001, nada fusiona las dos automáticamente. Es lo que se preguntaba en el issue #620, "How to keep specs consistent and up-to-date with spec-kit?". Existe una guía para hacer evolucionar specs, pero el mantenimiento sigue siendo tuyo.

    Cuando no vas a leer lo que genera. Una spec sin revisar es un prompt vago convertido en Markdown largo; el README pide ejecutar los comandos de uno en uno y revisar cada resultado.

    Por dónde empezar a escribir specs para agentes de IA con Spec Kit

    Coge la última feature que le pediste a Claude Code y reescribe su spec con la plantilla: dos o tres historias con prioridad, un Independent Test por historia, escenarios Given/When/Then y al menos un criterio con número. Después pasa /speckit-clarify y mira qué te pregunta. Esas preguntas son los huecos que el agente iba a rellenar por ti.

    Si quieres el método completo detrás de este formato, está en el libro Spec-Driven Development. Y si prefieres verlo aplicado de la idea al producto con Claude Code, es lo que hacemos en el curso Construye con IA. Para la parte de revisar lo que genera el agente contra la spec, el workshop SDD + Agentic Engineering va justo de eso.

    Preguntas frecuentes

    ¿Cómo se instala GitHub Spec Kit en Claude Code?

    Con uv tool install specify-cli y specify init mi-proyecto --integration claude (en un repo existente, specify init --here --force --integration claude). Necesitas Python 3.11+, uv y Claude Code.

    ¿Los comandos de Spec Kit se escriben /speckit.specify o /speckit-specify?

    En Claude Code, /speckit-specify, con guion: Spec Kit los instala como skills en .claude/skills/. La documentación de referencia usa /speckit.specify como notación genérica, y cada agente tiene su propia forma de invocarlos.

    ¿Qué diferencia hay entre /speckit-clarify y /speckit-analyze?

    clarify resuelve dudas de la spec antes del plan y escribe las respuestas en spec.md. analyze cruza spec, plan y tareas después de tasks y no modifica ningún archivo.

    ¿Cómo se escriben criterios de aceptación para un agente de IA con Spec Kit?

    Con escenarios Given/When/Then en cada user story y Success Criteria numerados (SC-001…) con una cifra. Cada escenario fija un estado inicial, una acción y un resultado comprobable; cada criterio, un número que un test puede medir, como "menos de 5 segundos con 500 facturas". Si no se puede comprobar con un test, no es un criterio de aceptación: es un hueco que el agente rellenará por su cuenta.

    ¿Cuántos [NEEDS CLARIFICATION] puede tener una spec de Spec Kit?

    Como máximo tres. El comando specify está escrito para suponer con criterio y anotar esas suposiciones en Assumptions, y para marcar solo las decisiones críticas sin un valor razonable por defecto: alcance, seguridad o experiencia de usuario.

    ¿Spec Kit sirve para proyectos existentes o solo para empezar de cero?

    Sirve para los dos, pero en un proyecto existente no genera specs del comportamiento que ya tienes: empiezan con la siguiente feature que definas.

    ¿Puedo usar el formato de Spec Kit sin instalar el CLI?

    Sí. La plantilla templates/spec-template.md es Markdown público en el repo. Copiarla a tu propio spec.md te da las historias priorizadas, Given/When/Then, FR y SC. Lo que pierdes son los comandos que comprueban la coherencia entre spec, plan, tareas y código.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.