Category: Arquitectura de Software

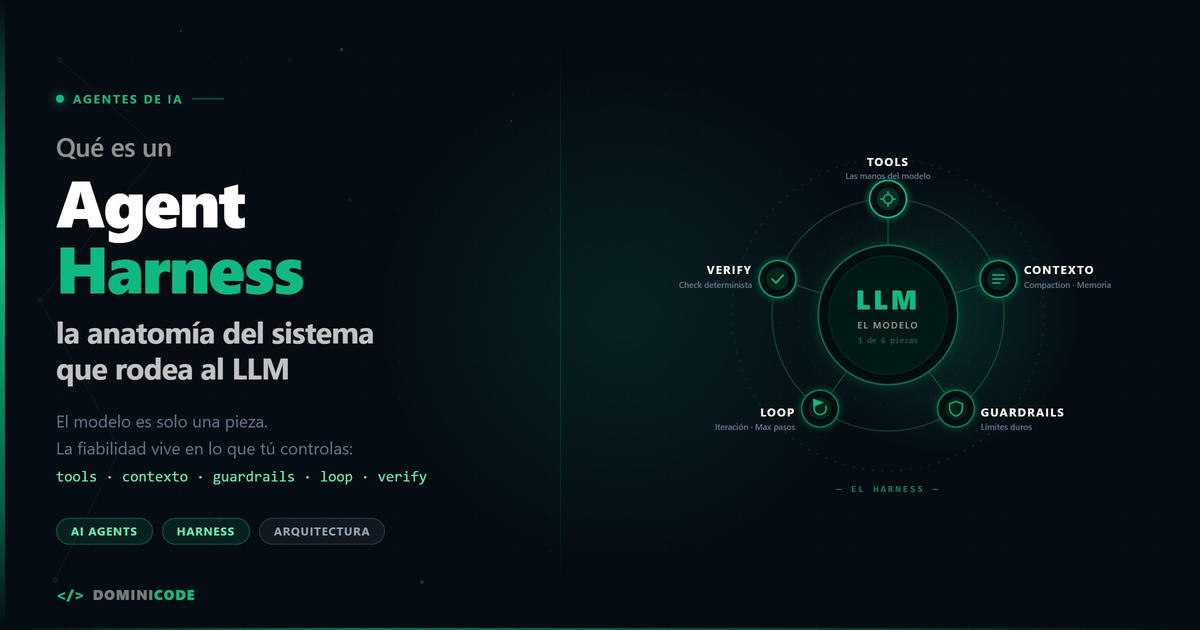
  • El Harness: por qué la spec y la arquitectura no son suficientes

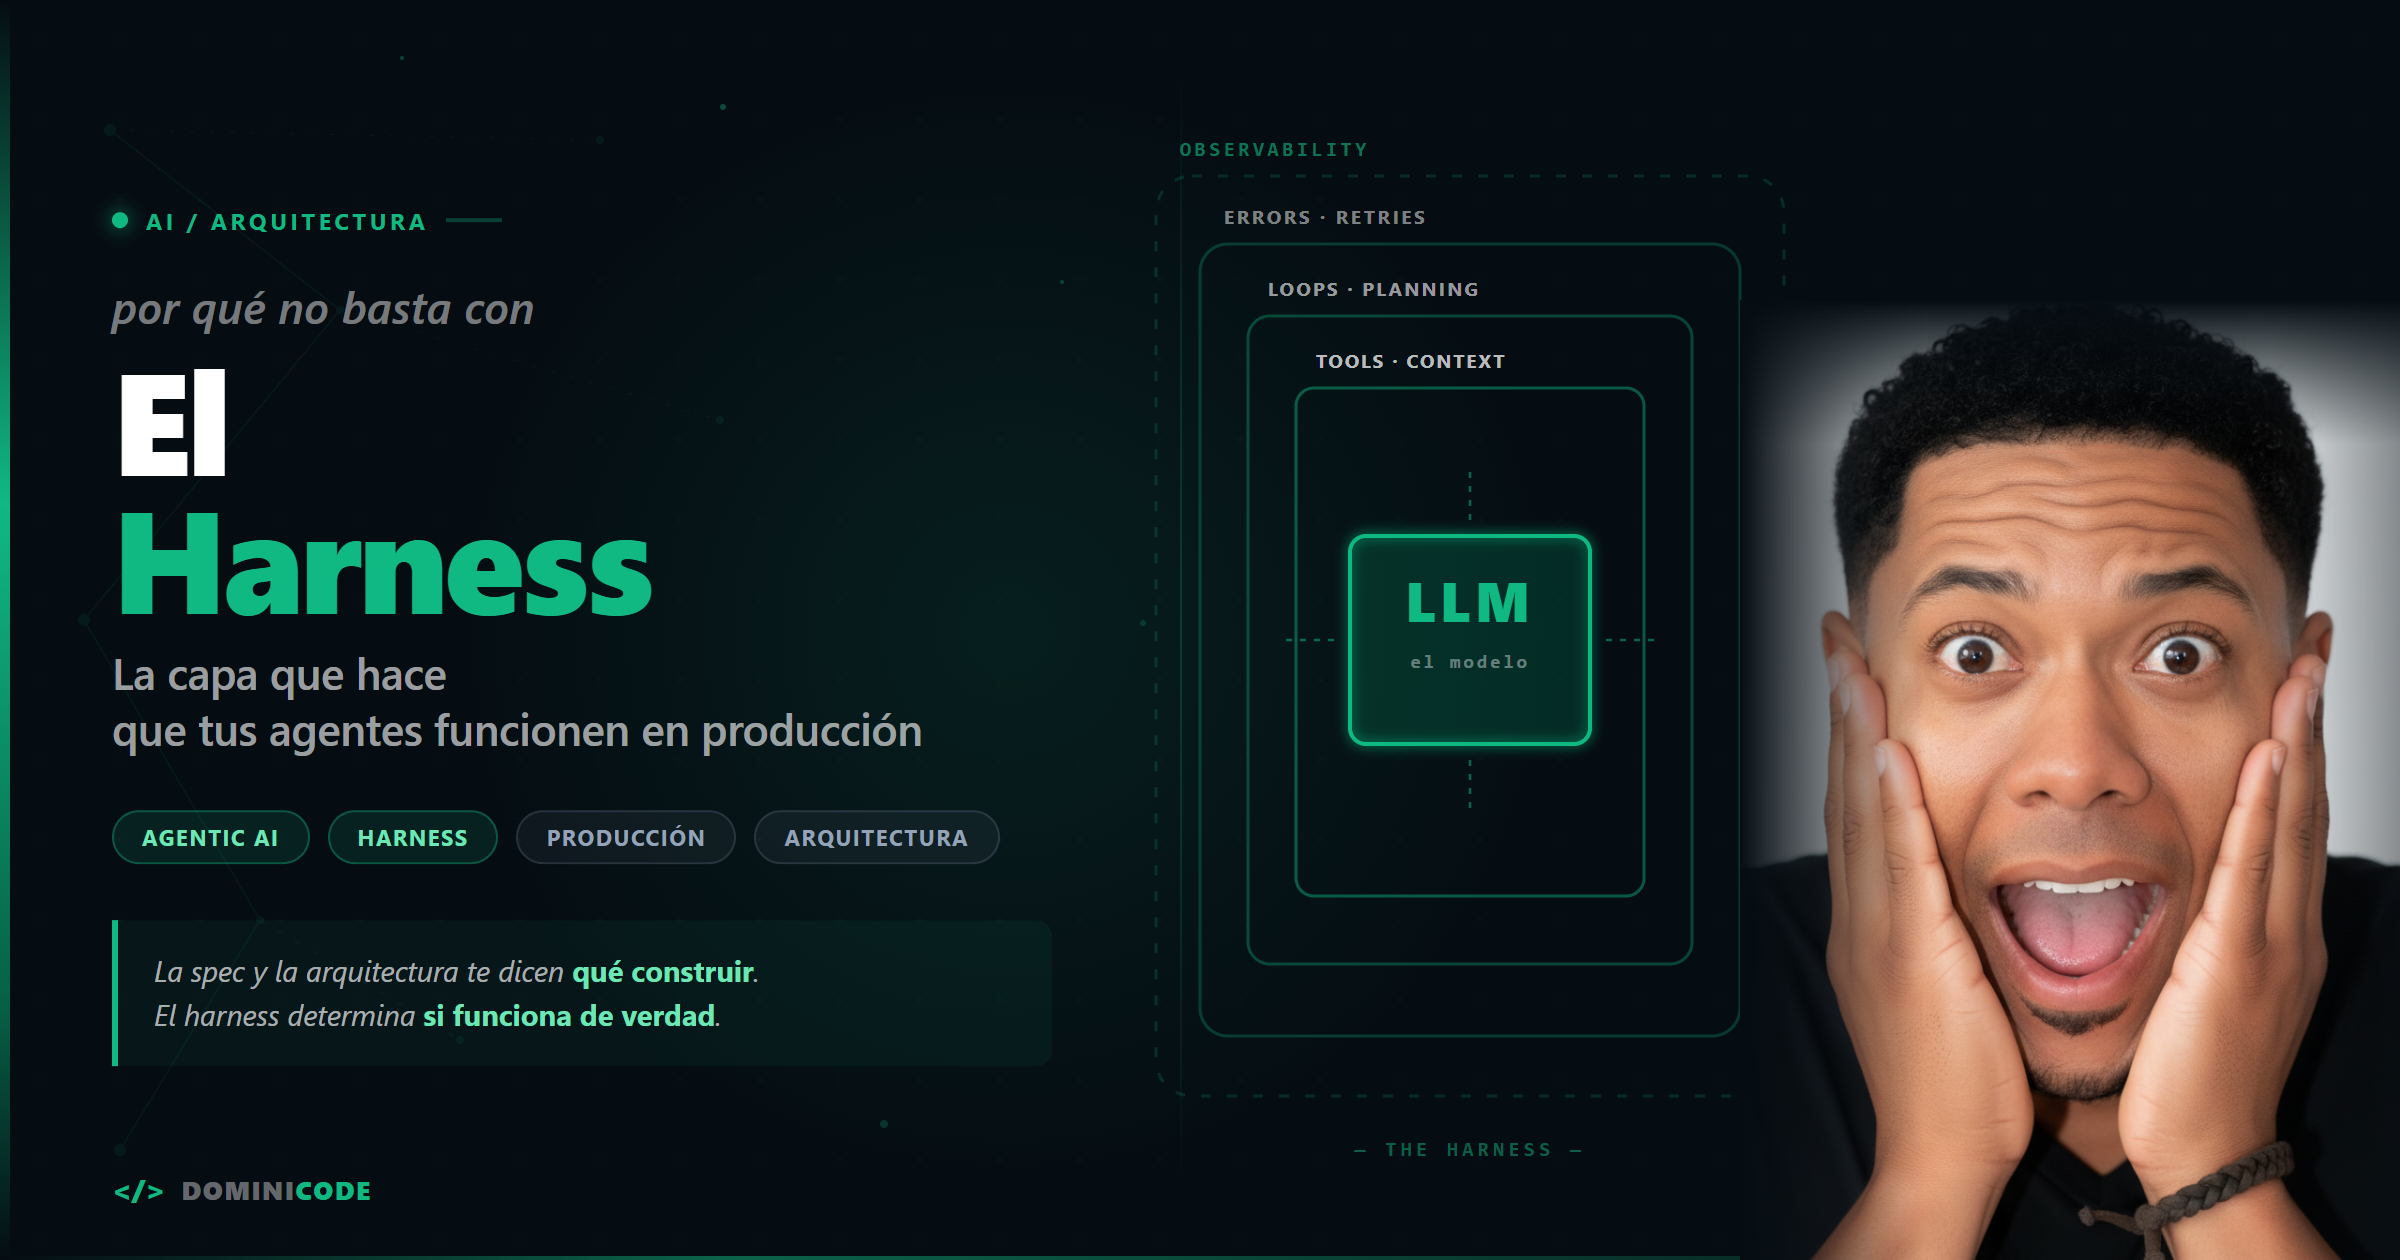
    El Harness: por qué la spec y la arquitectura no son suficientes

    Mi workflow completo: de idea a producto en producción con IA

    Hace un año tardaba 2-3 semanas en tener algo desplegado desde una idea nueva.

    Hoy tardo 2-3 días.

    No porque use mejores modelos. Porque cambié el workflow.

    Acá está el proceso completo, sin omitir nada.


    Fase 1 — Captura (30 minutos)

    Antes de abrir el editor, abro un documento en blanco y respondo tres preguntas:

    1. ¿Qué problema concreto resuelve esto?
    2. ¿Quién lo va a usar y en qué contexto exacto?
    3. ¿Qué tiene que funcionar sí o sí para que sea útil desde el día uno?

    Solo eso. Sin pensar en tech stack. Sin pensar en arquitectura.

    Si no puedo responder las tres en 30 minutos, la idea no está lista para construirse.


    Fase 2 — Spec (1-2 horas)

    Con las respuestas anteriores, genero la spec técnica.

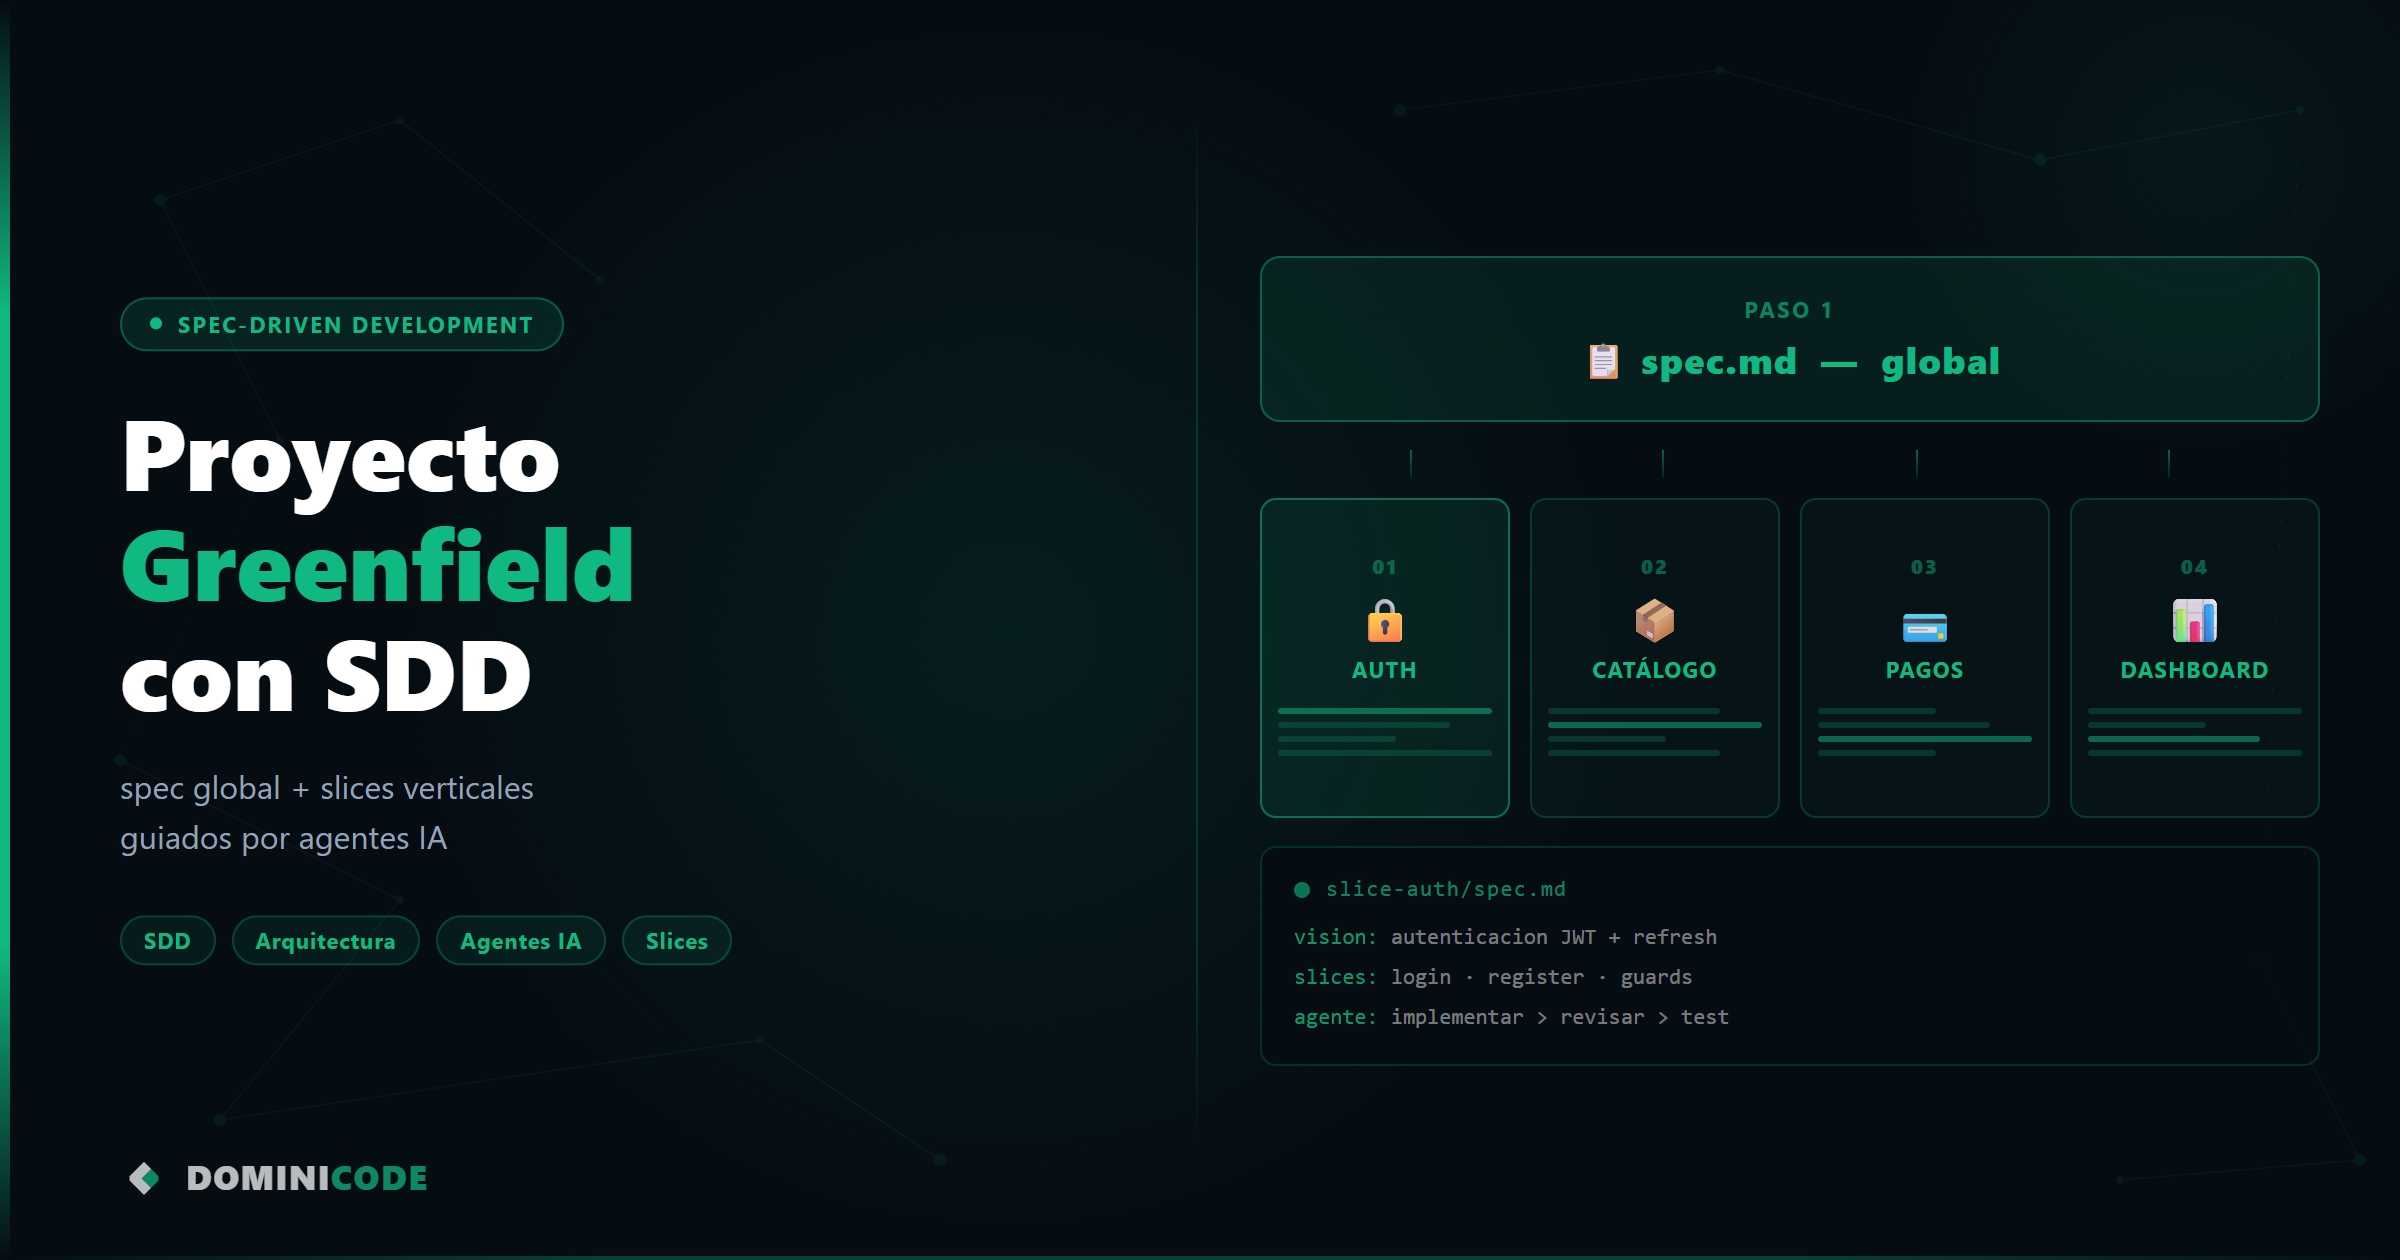
    La spec tiene 6 secciones: Visión, Usuarios, Funcionalidades, Flujos, Arquitectura y NFRs.

    No la escribo yo desde cero. La genero con un agente que toma mis respuestas de la Fase 1 como input.

    Luego la reviso y ajusto lo que el agente asumió mal.

    El output: un documento de 2-3 páginas que define qué se construye, para quién, y cómo debe comportarse.


    Fase 3 — Plan técnico (30 minutos)

    Con la spec lista, otro agente genera el plan de implementación.

    No “empieza a codear”. Define:

    • Las fases del proyecto en orden
    • Qué necesita estar listo antes de cada fase
    • Los riesgos técnicos por módulo

    Reviso el plan. Lo ajusto si algo no tiene sentido. Firma.


    Fase 4 — Implementación (el grueso)

    Aquí entra Claude Code.

    No le doy el prompt “hazme la app”. Le doy la spec + el plan + el task específico a implementar en esa sesión.

    Un task. Una sesión. Un output verificable.

    Si el task es “implementar autenticación con GitHub OAuth”, eso es todo lo que hace esa sesión.

    Al final de cada sesión, verifico que lo que se construyó cumple el criterio de aceptación de la spec.

    Si no lo cumple, corrijo antes de avanzar. No acumulo deuda de contexto.


    Fase 5 — Deploy y validación (1-2 horas)

    Deploy con el stack que use el proyecto (Railway, Vercel, Supabase).

    Luego muestro el producto a 2-3 personas del perfil objetivo y les hago una sola pregunta:

    “¿Qué haría que esto fuera indispensable para ti?”

    No “¿te gusta?” ni “¿qué mejorarías?”.

    Esa pregunta específica te da el siguiente ciclo de iteración o te dice que pivotes.


    Lo que hace que este workflow funcione no es la IA.

    Es que la IA nunca opera sin contexto estructurado.

    Cada agente recibe exactamente lo que necesita para hacer su parte. Nada más. Nada menos.

    Sin eso, la IA improvisa. Y cuando improvisa, construye lo que interpreta, no lo que necesitas.


    Si quieres ver este workflow ejecutado en vivo sobre un proyecto real — Stripe webhook receiver + Supabase, desde la spec hasta el deploy — eso es exactamente lo que hacemos el 9 de julio.

    workshop.dominicode.com

  • sdd-creator: genera spec, plan y tasks con cualquier agente IA

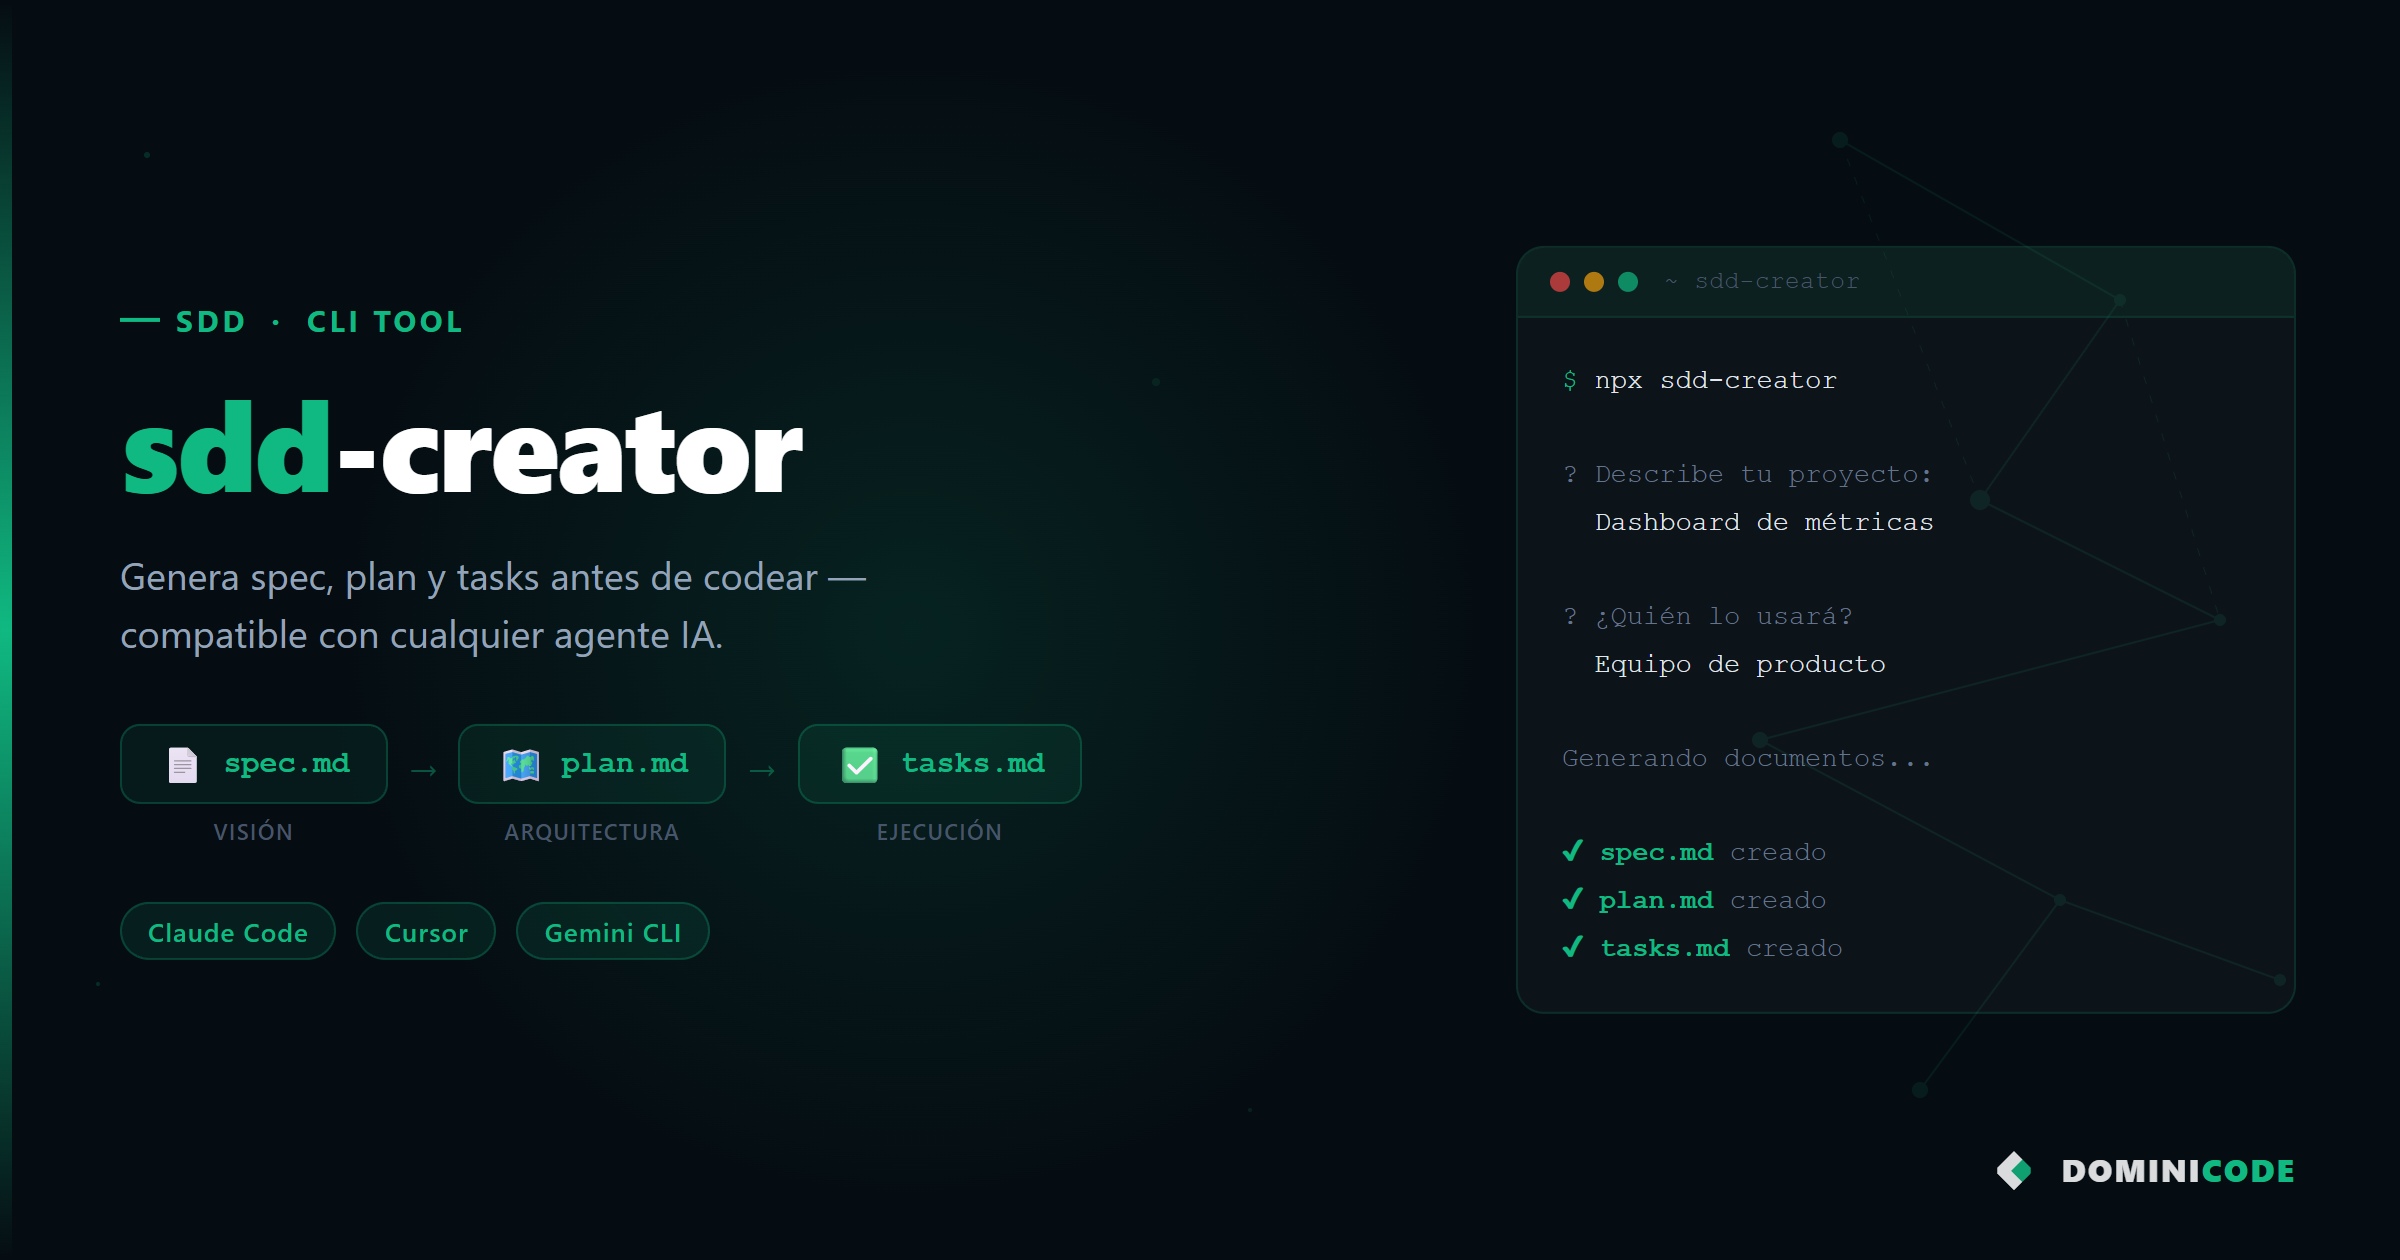
    sdd-creator: genera spec, plan y tasks con cualquier agente IA

    Llevaba tres horas implementando un sistema de autenticación con JWT cuando me di cuenta de que no había especificado nada.

    ¿El token debía expirar en la sesión o persistir entre reinicios? ¿Qué pasaba cuando el refresh token vencía estando el usuario activo? ¿El endpoint de logout invalidaba en servidor o solo limpiaba el cliente?

    Yo respondí esas preguntas sobre la marcha. Sin coherencia, sin registro de decisiones. El código resultó funcional pero arquitectónicamente un desastre.

    Eso no es un problema del agente. Es un problema de proceso. Para eso existe sdd-creator.


    El problema de codear sin especificar

    Los agentes de IA son extremadamente buenos ejecutando instrucciones. También son extremadamente buenos ejecutando instrucciones mal definidas — y el resultado es lo que imaginas.

    Cuando le das a Claude Code o a Cursor un prompt del tipo “implementa login con JWT”, el agente toma decisiones. Muchas. Las toma rápido, sin preguntarte, porque así trabajan. El output es código funcional que responde a una interpretación del problema, no necesariamente a tu interpretación.

    El fallo no está en la IA. Está en que nunca estableciste qué querías exactamente.

    Spec-Driven Development (SDD) resuelve esto con una premisa simple: antes de generar código, genera el spec. Un documento que responde qué hace la feature, por qué existe, quién la usa, qué flujos cubre y bajo qué criterios está terminada.

    El problema es que hacer bien un spec lleva disciplina. Y cuando tienes el agente abierto y las ganas de construir, la tentación de saltártelo es enorme.


    Qué es sdd-creator y cómo funciona

    sdd-creator es un skill para agentes de IA que impone el proceso de especificación antes de ejecutar cualquier implementación. No es un generador de documentos — es un interrogador. El agente no escribe código hasta que el spec esté completo y confirmado.

    A diferencia de pedirle directamente al agente que “genere un spec libre”, sdd-creator impone siempre las mismas 6 secciones y bloquea la implementación hasta recibir confirmación explícita. Sin esa estructura, los specs se convierten en párrafos de texto libre que el agente interpreta como quiere.

    El flujo tiene siete pasos:

    1. Describes el feature o proyecto que quieres construir
    2. sdd-creator detecta la complejidad (LOW / MEDIUM / HIGH)
    3. Te hace una entrevista interactiva — te pregunta lo que no especificaste
    4. Genera spec.md con 6 secciones estructuradas
    5. Espera tu confirmación antes de continuar
    6. Genera plan.md con las decisiones técnicas y la planificación por fases
    7. Genera tasks.md con las tareas ordenadas para TDD — y solo entonces empieza la implementación

    El repositorio está en GitHub: bezael/sdd-creator — MIT, v1.2.0.

    Si quieres entender la metodología detrás con más profundidad, el libro SDD cubre los principios completos, con patrones reales de proyectos en producción.


    Instalación

    Una sola línea:

    npx skills@latest add bezael/sdd-creator

    El CLI detecta tu herramienta y copia el skill al directorio correcto automáticamente. Como referencia, los directorios destino son:

    • Claude Code: ~/.claude/skills/
    • Cursor: .cursor/rules/ del proyecto

    No hay configuración adicional. No hay API keys. No hay dependencias de runtime. El skill vive como un archivo de instrucciones que el agente carga en contexto cuando lo invocas.

    Para instalación manual o integración con otros agentes, consulta la documentación oficial de Claude Code o los docs de tu herramienta.


    Tutorial paso a paso — feature de login con JWT

    Vamos con un ejemplo concreto. Tienes una app NestJS y quieres implementar autenticación con JWT. Sin sdd-creator, abres el agente y escribes: “implementa autenticación con JWT”. Con sdd-creator, el proceso es diferente.

    Paso 1 — Invoca el skill

    En Claude Code o en Cursor, activa sdd-creator. Luego describe tu feature:

    Quiero implementar un sistema de autenticación con JWT para una API NestJS.
    Incluye registro, login, refresh de token y logout.

    Paso 2 — La entrevista interactiva

    sdd-creator detecta complejidad media y empieza a preguntarte:

    • ¿El token de acceso expira en cuánto tiempo?
    • ¿El refresh token se invalida en servidor o solo en cliente?
    • ¿El endpoint de logout invalida todos los dispositivos activos o solo el actual?
    • ¿La app requiere rate limiting en los endpoints de auth?
    • ¿Los usuarios pueden tener múltiples sesiones simultáneas?

    Preguntas incómodas. Preguntas que el agente habría respondido solo — con su mejor criterio — si no le hubieras forzado a preguntarte.

    Paso 3 — Confirmas el spec.md

    El agente genera el spec.md completo. Lo revisas, corriges lo que no cuadra, y confirmas. Solo entonces avanza.

    Paso 4 — plan.md y tasks.md

    sdd-creator genera el plan técnico (decisiones de arquitectura, librerías, estructura de módulos) y la lista de tareas ordenadas para TDD. Primero los tests de los casos de error — token expirado, credenciales inválidas, refresh token revocado. Luego el código que los hace pasar.

    Resultado: el agente implementa exactamente lo que especificaste. Sin sorpresas. Sin decisiones implícitas. Sin “lo hice así porque parecía razonable”.


    Los 3 archivos que genera

    spec.md — La especificación en 6 secciones

    La estructura es fija e invariable:

    1. Visión — qué problema resuelve y por qué existe esta feature
    2. Usuarios — quién la usa y cuáles son sus necesidades reales
    3. Funcionalidades — qué puede hacer el sistema (listado concreto)
    4. Flujos — cómo se comporta el sistema en los escenarios principales
    5. Arquitectura — cómo está organizado técnicamente
    6. NFRs — requisitos no funcionales: performance, seguridad, disponibilidad

    La estructura fija es deliberada. Cuando el spec siempre tiene las mismas 6 secciones, puedes revisarlo en segundos y saber exactamente qué falta. Un spec libre en prosa no tiene esa propiedad.

    Si quieres ver cómo aplicar estas 6 secciones en un proyecto greenfield completo, este post sobre SDD con slices verticales lo cubre en detalle.

    plan.md — Las decisiones técnicas

    El plan responde: ¿cómo vamos a construir esto? Librerías seleccionadas y por qué. Estructura de módulos. Fases de implementación. Dependencias entre componentes. Riesgos identificados.

    No es un documento académico — es el registro de las decisiones que tomarías antes de empezar, aunque fueran en tu cabeza. Externalizar ese razonamiento tiene valor: el agente lo usa como referencia durante la implementación, y tú lo usas para hacer review.

    tasks.md — La lista ordenada para TDD

    Las tareas están ordenadas para Test-Driven Development. Los tests de los contratos del sistema van primero. El código que los satisface, después. Cada tarea es atómica — una sola responsabilidad, verificable por sí sola.

    Cuando tienes esta lista, puedes darle una tarea al agente y pedirle que haga solo esa. Sin divagar. Sin añadir “mejoras” que no pediste. La tarea acotada, con su test, con su criterio de aceptación.

    Esta es exactamente la forma de trabajar que desarrollamos en el curso Construye con IA — de la idea al producto real, con agentes IA y sin perder el control del código.


    Cuándo NO usar sdd-creator

    sdd-creator añade valor cuando el problema tiene suficiente complejidad para merecer una especificación. Hay casos donde el overhead no compensa:

    • Scripts de un solo uso: automatizaciones de 20-30 líneas que se ejecutan una vez y se descartan
    • Prototipos desechables: experimentos para validar si algo es técnicamente posible, sin intención de iterar sobre el código
    • Hotfixes triviales: corregir un typo, cambiar un color, ajustar un literal de texto

    La regla práctica: si el feature va a producción y va a ser mantenido, usa sdd-creator. Si es exploración o descarte, ve directo al código.


    Compatible con cualquier agente de IA

    sdd-creator no está atado a un agente específico. Funciona con todos los entornos de desarrollo con IA más usados:

    Agente Tipo de integración Directorio
    Claude Code Skills nativo ~/.claude/skills/
    Cursor Rules .cursor/rules/ del proyecto
    Codex CLI (OpenAI) AGENTS.md / system prompt Configuración de proyecto
    Gemini CLI System prompt Configuración de proyecto
    Aider Contexto personalizado .aider.conf.yml
    Continue config.json .continue/

    El formato MIT también significa que puedes adaptarlo a tu equipo. Si tienes convenciones de nomenclatura propias, o secciones adicionales en tus specs, puedes forkear el repositorio y ajustarlo.


    FAQ

    ¿Qué es sdd-creator?

    sdd-creator es un skill para agentes de IA que implementa el flujo de Spec-Driven Development. Cuando lo activas, el agente no escribe código directamente — primero te hace una entrevista para entender el problema, luego genera tres documentos estructurados (spec.md, plan.md, tasks.md), y solo después implementa. Es la diferencia entre darle instrucciones a un agente y darle una especificación.

    ¿Con qué agentes de IA funciona sdd-creator?

    Con Claude Code, Cursor, Codex CLI (OpenAI), Gemini CLI, Aider y Continue. El skill es un archivo de instrucciones, no una integración específica — cualquier agente que soporte archivos de contexto puede usarlo. La instalación varía: en Claude Code se copia a ~/.claude/skills/, en Cursor va a .cursor/rules/.

    ¿Cuánto tiempo lleva generar la spec con sdd-creator?

    Entre 5 y 20 minutos, dependiendo de la complejidad del feature. Una feature simple puede especificarse en 5 minutos. Una feature con múltiples flujos, integraciones externas y requisitos de seguridad puede tomar 20. Ese tiempo es siempre menor que el que cuesta refactorizar código que el agente implementó sin especificación.

    ¿Es sdd-creator compatible con proyectos legacy?

    Sí. SDD no requiere empezar desde cero — puedes aplicarlo feature a feature sobre una base de código existente. El spec refleja las restricciones reales del sistema existente: qué puedes cambiar, qué no, y qué deuda técnica tienes que tener en cuenta durante la implementación.

    ¿Puedo usar sdd-creator en equipos?

    Sí, y es donde más valor aporta. El spec.md generado es el contrato de la feature — cualquier miembro del equipo puede revisarlo, cuestionarlo y aprobarlo antes de que empiece la implementación. Elimina el “yo entendí que…” de las reuniones de review.


    Ahora, cuando tengo el agente abierto y las ganas de construir, lo primero que activo es sdd-creator. Los 15 minutos de spec se pagan solos. Esas tres horas de JWT no se van a repetir.

    Si quieres ver cómo SDD encaja en el ciclo completo de desarrollo con IA — desde la idea hasta el producto desplegado — en Dominicode Labs tienes acceso a proyectos reales donde aplicamos este flujo de principio a fin.

    Por Bezael Pérez — Fundador de Dominicode.

  • Neon vs Supabase: comparación técnica honesta (2026)

    Neon vs Supabase: comparación técnica honesta (2026)

    Hace unos meses estaba arrancando un proyecto nuevo. Stack limpio, decisiones por tomar. Y en cuestión de minutos tuve el debate de siempre en el canal de decisiones técnicas: ¿Neon o Supabase?

    Los dos son Postgres. Los dos tienen free tier. Los dos aparecen en casi cualquier lista de "stack moderno para SaaS". Y los dos hacen cosas completamente distintas.

    Este post es la Neon vs Supabase comparación técnica que me hubiera ahorrado dos horas de lectura de docs.


    Qué es cada uno en una línea

    Neon: Postgres serverless puro con branching de base de datos y scale-to-zero.

    Supabase: Plataforma BaaS construida sobre Postgres — incluye Auth, Storage, Realtime y Edge Functions en un solo sitio.

    La diferencia de fondo: Neon es una base de datos. Supabase es un backend completo que usa Postgres como motor.


    Tabla comparativa

    Criterio Neon Supabase
    Tipo Postgres serverless BaaS completo sobre Postgres
    Scale-to-zero Sí, nativo No en producción (pausa en free tier)
    Branching de DB Sí, copy-on-write instantáneo Solo Pro+ (beta); provisiona DB nueva + migraciones
    Auth nativo No Sí (JWT, OAuth, Magic Link)
    Storage nativo No Sí (S3-compatible)
    Realtime No Sí (WebSockets sobre Postgres)
    Edge Functions No Sí (Deno runtime)
    Free tier DB 0.5 GB, 100 CU-h 500 MB, pausa tras 7 días idle
    Plan de pago Desde ~$19/mes (usage-based) $25/mes (Pro, todo incluido)
    ORM compatible Cualquiera (Drizzle, Prisma, pg) Cliente JS/TS propio + cualquier ORM
    Tipado auto-generado Via ORM Sí, con supabase gen types
    Adquirida por Databricks (2025, ~$1B) Independiente

    Arquitectura de Neon vs Supabase: la diferencia que más importa

    Neon separa compute y storage. Cuando no hay peticiones, el compute se apaga solo — y cuando llega la primera query, arranca en milisegundos. El storage usa copy-on-write, lo que hace que crear una rama de base de datos sea instantáneo y casi sin coste.

    Supabase no funciona así. Tu base de datos corre en una instancia dedicada. Si estás en el free tier, Supabase pausa el proyecto tras 7 días sin actividad. En Pro, la instancia corre siempre — pagas compute 24/7 aunque tu app esté durmiendo.

    Para proyectos en producción con tráfico real, esto no es necesariamente un problema. Para proyectos con muchos entornos (staging, feature branches, demos de clientes), la diferencia de coste es brutal.


    Branching: por qué Neon gana en CI/CD

    Esta es la feature que más me ha cambiado el flujo de trabajo.

    Con Neon puedes crear una rama de base de datos por PR. Misma estructura, mismos datos (o un subconjunto). La rama vive mientras dura el PR y desaparece al hacer merge. No hay que mantener un entorno de staging contaminado con datos de otras features. Si tienes un pipeline con code review automático antes del merge, tienes el flujo completo en el post sobre agentic code review con Claude Code.

    # Crear una rama de DB para una PR concreta
    neon branches create --name feature/payment-refactor --parent main
    

    Supabase también tiene branching, pero funciona diferente: aprovisiona una base de datos nueva, ejecuta tus migraciones y carga el seed. Es más lento y consume más recursos. Para un equipo pequeño o un proyecto personal, puede ser suficiente. Para un pipeline de CI/CD que crea y destruye entornos constantemente, Neon gana por goleada.


    SDK y DX: dos filosofías distintas

    Supabase tiene un cliente JS/TS que abstrae casi todo. Queries, auth, storage, realtime — todo desde el mismo objeto.

    // Supabase: cliente unificado con tipado auto-generado
    import { createClient } from '@supabase/supabase-js'
    import type { Database } from './database.types' // generado con supabase gen types
    
    const supabase = createClient<Database>(
      process.env.SUPABASE_URL!,
      process.env.SUPABASE_ANON_KEY!
    )
    
    const { data, error } = await supabase
      .from('products')
      .select('id, name, price')
      .eq('active', true)
    

    Neon apuesta por Postgres nativo. Usas tu ORM de siempre — Drizzle, Prisma, o pg directo — contra un connection string estándar. Sin abstracciones propias, sin vendor lock-in de cliente.

    // Neon: Drizzle sobre el driver serverless de Neon
    import { neon } from '@neondatabase/serverless'
    import { drizzle } from 'drizzle-orm/neon-http'
    import { products } from './schema'
    import { eq } from 'drizzle-orm'
    
    const sql = neon(process.env.DATABASE_URL!)
    const db = drizzle(sql)
    
    const activeProducts = await db
      .select({ id: products.id, name: products.name, price: products.price })
      .from(products)
      .where(eq(products.active, true))
    

    Si ya tienes un ORM configurado en tu proyecto, migrar a Neon es cambiar el connection string. Con Supabase, el cliente propio es más cómodo para proyectos nuevos pero añade una dependencia específica a la plataforma.


    Precios Neon vs Supabase: cuándo cada modelo tiene sentido

    Neon (usage-based):

    • Free: $0 — 100 CU-horas, 0.5 GB storage
    • Launch: ~$19/mes — $0.106/CU-hora, $0.35/GB storage
    • Scale: desde ~$701/mes — con SLA e HIPAA incluidos

    Supabase (plataforma flat + overages):

    • Free: $0 — 500 MB DB, 50K MAU, 1 GB storage (pausa tras 7 días idle)
    • Pro: $25/mes — 8 GB DB, 100K MAU, Auth + Storage + Edge Functions incluidos
    • Team: $599/mes — SSO, SOC 2

    Para un proyecto con tráfico irregular o muchos entornos temporales, el modelo de Neon puede salir significativamente más barato. Para un SaaS en crecimiento que necesita Auth + Storage + DB y quiere una sola factura, el Pro de Supabase a $25 es imbatible en relación precio/funcionalidad.

    Precios verificados en junio 2026. Consulta las páginas oficiales de Neon y Supabase para tarifas actualizadas — los modelos usage-based cambian con frecuencia.


    Cuándo elegir Neon

    • Quieres Postgres puro sin opiniones sobre tu stack de auth o storage.
    • Tu pipeline de CI/CD se beneficia de tener una rama de DB por PR.
    • Tienes cargas de trabajo variables o intermitentes — el scale-to-zero te ahorra dinero real.
    • Ya tienes Drizzle o Prisma configurado y no quieres añadir un cliente propio.
    • Estás construyendo agentes de IA que necesitan provisionar bases de datos efímeras. La arquitectura serverless de Neon (y el respaldo de Databricks) la convierte en la opción natural para cargas de trabajo agénticas — incluidos los pipelines donde el agente lee un ticket, implementa y despliega de forma autónoma, como los que explico en el post sobre automatizar el proceso de desarrollo con IA.

    Cuándo elegir Supabase

    • Necesitas Auth desde el día uno — OAuth, magic link, JWT — sin montar Clerk ni Auth.js.
    • Tu proyecto necesita file storage y no quieres gestionar un bucket S3 por tu cuenta.
    • Quieres Realtime (subscripciones en tiempo real) sin añadir Redis ni WebSockets propios.
    • Valoras tener un solo proveedor para DB + Auth + Storage con una sola factura.
    • El free tier te basta para empezar y no te molesta que el proyecto se pause tras 7 días idle.

    Edge cases que nadie menciona

    Supabase no hace scale-to-zero en producción. Esto es intencionado — una instancia siempre activa garantiza latencia consistente. Pero si tienes 10 entornos de staging o un proyecto que duerme la mayor parte del tiempo, estás pagando compute en vacío.

    Neon no tiene Auth ni Storage nativos. Si los necesitas, tienes que añadirlos tú: Clerk, Better Auth, Auth.js para autenticación; Cloudflare R2, AWS S3 o Uploadthing para ficheros. No es un problema técnico, pero sí es trabajo de integración que con Supabase viene resuelto de fábrica.

    El branching de Supabase requiere CLI y configuración previa. No es tan plug-and-play como en Neon. Si quieres branching en Supabase, necesitas tener migraciones bien organizadas desde el principio.


    FAQ

    ¿Puedo usar Drizzle con Supabase?
    Sí. Supabase es Postgres estándar — puedes conectar cualquier ORM con el connection string del proyecto. El cliente propio de Supabase es opcional, no obligatorio.

    ¿Neon tiene Realtime o Auth?
    No de forma nativa. Puedes añadir LISTEN/NOTIFY de Postgres para eventos básicos, pero no hay un sistema de auth ni storage integrado. Para eso necesitas otra capa.

    ¿El scale-to-zero de Neon afecta a producción?
    Depende de tu configuración. El cold start de Neon suele estar por debajo de 500ms en condiciones normales. Para la mayoría de apps es aceptable. Si tienes requisitos de latencia muy estrictos, puedes configurar un mínimo de compute activo en el plan de pago.

    ¿Qué pasa con la adquisición de Neon por Databricks?
    Databricks compró Neon en 2025 por aproximadamente $1B. La apuesta es que los agentes de IA van a necesitar provisionar bases de datos efímeras a escala. Para el usuario, de momento se traduce en mejoras de precios — el storage bajó de $1.75 a $0.35/GB-mes. El roadmap a largo plazo aún está por verse.

    ¿Puedo migrar de Supabase a Neon (o al revés) más adelante?
    La base de datos en sí migra sin problema — es Postgres estándar en los dos casos. El trabajo real está en reemplazar el cliente de Supabase (auth, storage, realtime) si decides cambiar. Si usas Drizzle o Prisma desde el principio, cambiar el connection string es trivial.


    La decisión no es técnica en el fondo — es de qué quieres gestionar tú y qué quieres que gestione la plataforma. Si quieres Postgres puro con control total y branching en CI/CD, Neon. Si quieres un backend completo sin ensamblar piezas, Supabase.

    Ninguna de las dos es la respuesta correcta en abstracto. Ambas son la respuesta correcta para el problema adecuado.

    Si en tu proyecto estás usando IA para construir features o automatizar flujos, en el curso Construye con IA trabajamos exactamente con este tipo de decisiones de arquitectura — desde la elección de herramientas hasta el producto en producción.

    Si quieres profundizar en cómo tomar este tipo de decisiones de arquitectura en proyectos reales — con IA en el loop — en Dominicode Labs tenemos proyectos completos con el stack detallado y la justificación técnica detrás de cada decisión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • DuckDB + Obsidian: analiza tu vault con SQL sin exportar nada

    DuckDB + Obsidian: analiza tu vault con SQL sin exportar nada

    Tenía más de 800 notas en Obsidian. Tres años de journaling técnico, decisiones de arquitectura, apuntes de libros, ideas de proyectos. Todo bien organizado, con frontmatter YAML, tags consistentes, links entre notas.

    Y seguía buscando con Cmd+Shift+F como si fuera 2010.

    El buscador de Obsidian es bueno para encontrar una nota específica. Es inútil para responder preguntas como: ¿cuántos proyectos he apuntado en el último trimestre que no tienen ninguna nota de seguimiento? ¿Qué tecnologías aparecen más en mis journals de este año? ¿Cuántas notas de tipo "idea" no tienen ningún link interno hacia otro documento?

    Esas preguntas no son búsquedas de texto. Son queries sobre datos estructurados. Y eso es exactamente lo que hace DuckDB.

    La configuración de DuckDB con Obsidian que voy a enseñarte te permite tratar tu vault como una base de datos relacional — y correr SQL directamente sobre tus archivos .md.

    DuckDB con Obsidian es la combinación de DuckDB — un motor SQL embebido de alto rendimiento — con un vault de Obsidian para tratar los archivos .md como filas de una base de datos consultable. A través de la extensión duckdb-obsidian, puedes ejecutar SQL directamente sobre tu frontmatter YAML, links internos y estructura de headings, sin exportar ni transformar ningún archivo.


    Por qué DuckDB y no algo más "normal"

    Podrías exportar todo tu vault a CSV y abrirlo en SQLite. O parsear el frontmatter con un script en Python y cargarlo en Pandas. Lo he hecho. Funciona, pero tienes que mantener ese pipeline de sincronización, gestionar el esquema cuando cambias tus propiedades, y el resultado no vive dentro de Obsidian — vive en otro sitio.

    DuckDB resuelve esto de dos formas distintas según lo que necesites:

    1. La extensión CLI duckdb-obsidian — una extensión no oficial que expone una función obsidian_notes() que parsea tu vault en tiempo real directamente desde el CLI de DuckDB. Sin exportar nada. Sin pipeline. Lanzas DuckDB, cargas la extensión, y tu vault es una tabla.

    2. El plugin Obsidian DuckDB and MotherDuck — un plugin que vive dentro de Obsidian, corre DuckDB WASM en el navegador, y te permite escribir bloques SQL en tus notas que renderizan como tablas markdown. El resultado se puede "congelar" como texto plano para que persista sin necesidad de re-ejecutar.

    Son dos herramientas distintas para dos flujos distintos. Te explico ambas.


    Opción 1: DuckDB CLI + extensión duckdb-obsidian

    Esta es la opción para cuando quieres hacer análisis ad-hoc desde la terminal, escribir scripts, o conectar los resultados a otras herramientas.

    Instalación

    Primero necesitas DuckDB instalado. La forma más limpia dependiendo de tu sistema:

    # macOS con Homebrew
    brew install duckdb
    
    # Windows con WinGet
    winget install DuckDB.cli
    
    # O directamente desde los binarios de duckdb.org/docs/installation
    

    Verifica que funciona:

    duckdb --version
    # v1.2.2
    # La extensión duckdb-obsidian es compatible con DuckDB 1.1.x y 1.2.x
    

    Ahora descarga la extensión. Ve a github.com/puzan/duckdb-obsidian/releases y descarga el archivo que corresponde a tu versión de DuckDB y tu sistema operativo. El nombre del archivo tiene el formato obsidian.duckdb_extension.

    Configuración

    La extensión no está firmada por DuckDB, así que tienes que lanzar la CLI con extensiones sin firmar habilitadas:

    duckdb --allow-unsigned-extensions
    

    Dentro de la sesión, carga la extensión con la ruta absoluta al archivo que descargaste. Si el archivo viene comprimido (.duckdb_extension.gz), descomprímelo primero antes del LOAD:

    LOAD '/ruta/absoluta/a/obsidian.duckdb_extension';
    

    Si no quieres escribir esto cada vez, crea un archivo .duckdbrc en tu home. DuckDB lo ejecuta automáticamente al arrancar:

    SET allow_unsigned_extensions = true;
    LOAD '/ruta/absoluta/a/obsidian.duckdb_extension';
    

    Para apuntar al vault, tienes dos opciones. La primera: navega al directorio del vault antes de lanzar DuckDB — la función obsidian_notes() sin argumentos escanea el directorio actual:

    cd /Users/bezael/vault
    duckdb --allow-unsigned-extensions
    

    La segunda: pasa la ruta directamente como argumento a la función:

    SELECT * FROM obsidian_notes('/Users/bezael/vault') LIMIT 5;
    

    La única restricción es que el directorio debe contener una carpeta .obsidian — es como la extensión verifica que es un vault válido.

    Esquema disponible

    La función obsidian_notes() expone estas columnas sobre cada nota:

    Columna Tipo Contenido
    basename VARCHAR Nombre del archivo sin .md
    filepath VARCHAR Ruta absoluta al archivo
    first_header VARCHAR Primer H1 de la nota, o NULL
    headers STRUCT[] Todos los headings con su nivel
    properties JSON Frontmatter YAML parseado como JSON
    internal_links STRUCT[] Wikilinks con target, nombre y referencia

    Queries SQL reales sobre tu vault de Obsidian

    Aquí es donde esto se vuelve útil de verdad.

    Analizar la distribución de tags

    ¿Cuáles son los tags que más usas y cuántas notas tienen cada uno?

    SELECT
      tag,
      count(*) AS total_notas
    FROM (
      SELECT unnest(
        from_json(properties->'$.tags', '["VARCHAR"]')
      ) AS tag
      FROM obsidian_notes()
      WHERE properties->>'$.tags' IS NOT NULL
    )
    GROUP BY tag
    ORDER BY total_notas DESC
    LIMIT 20;
    

    Esto parsea el array tags del frontmatter de cada nota y te da un ranking. Tres años de vault analizados en menos de un segundo.

    Encontrar notas huérfanas

    Notas que nadie enlaza — las que más probablemente estés olvidando:

    WITH todas_las_notas AS (
      SELECT basename FROM obsidian_notes()
    ),
    notas_referenciadas AS (
      SELECT DISTINCT unnest(
        list_transform(internal_links, l -> l.target)
      ) AS target
      FROM obsidian_notes()
      WHERE len(internal_links) > 0
    )
    SELECT basename
    FROM todas_las_notas
    WHERE basename NOT IN (SELECT target FROM notas_referenciadas)
    ORDER BY basename;
    

    Cuando corrí esto en mi vault por primera vez encontré 340 notas huérfanas. 340. Notas que había creado, nunca enlazado desde ningún otro sitio, y que esencialmente estaban muertas dentro del vault.

    Grafo de links entre notas

    Para exportar el grafo completo a CSV y procesarlo en otra herramienta:

    COPY (
      SELECT
        basename AS origen,
        unnest(list_transform(internal_links, l -> l.target)) AS destino
      FROM obsidian_notes()
      WHERE len(internal_links) > 0
    ) TO '/tmp/grafo-vault.csv' (HEADER, DELIMITER ',');
    

    Cruzar propiedades del frontmatter

    Si usas frontmatter consistente (por ejemplo status, type, project), puedes hacer queries cruzadas:

    SELECT
      properties->>'$.type' AS tipo,
      properties->>'$.status' AS estado,
      count(*) AS total
    FROM obsidian_notes()
    WHERE properties->>'$.type' IS NOT NULL
    GROUP BY tipo, estado
    ORDER BY total DESC;
    

    Esto responde preguntas como: ¿cuántos documentos de tipo "project" están en estado "in-progress" vs "done"?

    Buscar patrones en journals

    Si guardas journals diarios con una estructura de frontmatter predecible, puedes cruzarlos:

    SELECT
      basename,
      properties->>'$.mood' AS mood,
      properties->>'$.energia' AS energia
    FROM obsidian_notes()
    WHERE properties->>'$.type' = 'journal'
      AND properties->>'$.date' >= '2026-01-01'
    ORDER BY properties->>'$.date' DESC;
    

    Opción 2: Plugin DuckDB + MotherDuck dentro de Obsidian

    Si prefieres no salir de Obsidian, el plugin oficial te mete DuckDB directamente en el editor.

    Instalación

    Abre Obsidian → Settings → Community plugins → Browse. Busca "DuckDB and MotherDuck". Instala y activa.

    El plugin corre DuckDB WASM — no necesita instalación local de DuckDB, corre directamente en memoria dentro de Obsidian.

    Cómo escribir queries

    Crea un bloque de código con el lenguaje duckdb:

    ```duckdb
    SELECT
      o_orderpriority AS priority,
      count(*) AS orders,
      round(sum(o_totalprice), 2) AS revenue
    FROM read_parquet('https://shell.duckdb.org/data/tpch/0_01/parquet/orders.parquet')
    GROUP BY 1
    ORDER BY revenue DESC
    ```
    

    Cuando ejecutas la query (con el comando "Refresh query at cursor"), el resultado se renderiza como una tabla markdown directamente debajo del bloque.

    La feature más útil del plugin es Freeze: convierte el resultado en texto plano markdown que persiste en la nota sin necesidad de re-ejecutar. El archivo .md queda con la query y su resultado como texto estático — lo que significa que funciona en cualquier plataforma que renderice markdown, incluyendo tu vault público en Quartz.

    Limitaciones reales del plugin vs. CLI

    El plugin tiene un caso de uso claro: consultas sobre datos externos o remotos (CSV, Parquet, JSON en URLs, MotherDuck) que quieres mostrar como tablas vivas dentro de tus notas.

    Para consultar el vault en sí — los archivos .md, el frontmatter, los links — la extensión CLI es más potente. El plugin no expone obsidian_notes() porque DuckDB WASM no tiene acceso al sistema de archivos local de Obsidian de la misma forma.

    Para análisis del vault completo: CLI. Para datos externos integrados en notas: plugin.


    Cuándo usas esto en la práctica

    Llevo usando este setup tres meses. Estos son los casos donde realmente lo abro:

    Revisiones semanales. Tengo un script .sql que me lista todas las notas con status: in-progress que no he modificado en más de siete días. Corro el script los viernes. Lo que aparece en esa lista o lo priorizo o lo cierro.

    Auditoría del vault cada dos meses. La query de notas huérfanas + la query de distribución de tags me da una foto de hacia dónde está derivando mi sistema de notas sin que me haya dado cuenta.

    Análisis de proyectos. Cuando empiezo a trabajar en un cliente nuevo, tengo notas del sector o la tecnología dispersas por el vault. Una query me saca todo lo que he apuntado sobre ese dominio aunque no recuerde los nombres exactos de las notas.

    Exportar datos a otras herramientas. DuckDB puede escribir directamente a CSV, Parquet, JSON. Si quiero hacer un análisis más visual en una hoja de cálculo o en una herramienta de BI, exporto el resultado de la query y lo importo. Sin copiar a mano.


    Este enfoque encaja exactamente con la filosofía que aplicamos en el curso Construye con IA: tratar tus propios datos como un asset que puedes interrogar, no como un archivo que tienes que recordar dónde dejaste. Tu vault no es una colección de texto — es una base de conocimiento que merece una capa de consulta real.


    Lo que puedes hacer hoy

    Instala DuckDB. Descarga la extensión duckdb-obsidian. Corre la query de notas huérfanas sobre tu vault.

    Eso solo ya te va a dar información que no tienes ahora mismo: qué parte de tu vault está desconectada del resto. A partir de ahí decides si quieres ir más lejos con análisis de tags, patterns en journals, o cruzar propiedades del frontmatter.

    Y si esa query te devuelve media biblioteca, el problema no es el vault: es cómo están escritas las notas. El criterio que uso para que no queden huérfanas lo conté en Zettelkasten para developers.

    No necesitas un pipeline. No necesitas exportar nada. Lanzas DuckDB, cargas la extensión, y en un minuto estás corriendo SQL sobre años de notas.

    Si quieres ver más flujos donde los datos y las herramientas de IA se conectan así de forma directa, en Dominicode Labs tenemos proyectos completos que aplican exactamente esta filosofía — tratar tu entorno de trabajo como datos consultables, no como texto disperso.

    El patrón es el mismo que aplicamos cuando conectamos Claude a una fuente de datos externa: datos estructurados + una herramienta que los entiende = velocidad real. Si quieres ver cómo funciona ese loop completo desde el lado de la API, mira Claude API: Crash Course para developers con TypeScript.


    FAQ

    ¿Necesito tener DuckDB instalado localmente para el plugin de Obsidian?

    No. El plugin DuckDB and MotherDuck usa DuckDB WASM, que corre completamente en memoria dentro de Obsidian sin instalación adicional. La extensión CLI (duckdb-obsidian) sí requiere DuckDB instalado localmente porque necesita acceder al sistema de archivos.

    ¿La extensión duckdb-obsidian funciona con vaults grandes?

    Sí, con matices. DuckDB está diseñado para procesar grandes volúmenes de datos de forma eficiente. En un vault de 2.000-3.000 notas las queries simples tardan menos de un segundo. Para vaults muy grandes (5.000+ notas) con queries que cruzan múltiples propiedades JSON, puede ser recomendable usar SET threads TO 4; dentro de la sesión para aprovechar todos los cores.

    ¿El frontmatter tiene que seguir algún formato específico?

    Solo tiene que ser YAML válido al inicio del archivo, delimitado por ---. La extensión lo parsea como JSON en la columna properties. Anidamiento, arrays de tags, fechas — todo funciona. La única restricción es que las propiedades que quieras consultar deben existir en el frontmatter de esas notas.

    ¿Puedo conectar los resultados de estas queries a un agente de IA?

    Sí, y es uno de los casos de uso más interesantes. DuckDB puede exportar a JSON con COPY (...) TO '/tmp/output.json' (FORMAT JSON). Ese JSON lo puedes pasar como contexto a un agente o a la API de Claude para que razone sobre el estado de tu vault. MotherDuck tiene incluso documentación oficial sobre cómo usar el vault de Obsidian como fuente de datos para agentes de IA. También puedes conectar DuckDB directamente a un servidor MCP para que el agente ejecute queries de forma autónoma — ese es el siguiente nivel de este setup. Para entender la base de cómo funciona ese patrón con la API de Claude, tienes la guía completa en Claude API: Crash Course para developers con TypeScript. Si te interesa explorar esa dirección con proyectos en producción, tenemos más en Dominicode Labs.

    ¿Por qué DuckDB y no SQLite para esto?

    SQLite requiere que crees y mantengas el esquema manualmente. DuckDB infiere el esquema sobre la marcha: lee los archivos .md a través de la extensión, parsea el frontmatter como JSON, y expone todo como columnas consultables sin que hayas definido nada. Además, DuckDB tiene soporte nativo para arrays, structs y JSON anidado — que es exactamente el tipo de datos que tienes en el frontmatter de Obsidian. Con SQLite tendrías que escribir código de parseo adicional. Con DuckDB la extensión se encarga de todo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Algoritmos de machine learning que todo developer web debería entender

    Algoritmos de machine learning que todo developer web debería entender

    Hace un año integré una búsqueda semántica en un proyecto SaaS. El cliente quería que los usuarios encontraran artículos aunque escribieran con sinónimos, con errores ortográficos, o en un idioma distinto al del contenido.

    La solución: tres líneas de TypeScript llamando a algoritmos de machine learning vía la API de OpenAI. Funcionó en una tarde.

    Pero el cliente preguntó algo que me dejó sin respuesta inmediata: "¿Qué hace exactamente ese modelo por dentro?". Y yo, con 15 años de experiencia en desarrollo, tuve que admitir que no tenía una respuesta clara más allá de "convierte texto en números".

    Ese hueco me molestó. No porque necesitara implementar los algoritmos desde cero, sino porque cuando no entiendes qué hay debajo del capó, tomas peores decisiones: eliges el modelo equivocado, debuggeas en la dirección incorrecta, o diseñas una arquitectura que no escala.

    Este post es lo que me hubiera gustado leer ese día. Los algoritmos de machine learning explicados para developers web — sin fórmulas, sin Python, sin pretender que vas a ser data scientist.

    Tres familias que lo explican todo

    Los algoritmos de machine learning son procedimientos que permiten a un sistema aprender patrones a partir de datos, sin que un programador defina explícitamente las reglas. En lugar de escribir if (spam) { ... }, le muestras miles de emails al modelo y él deduce las reglas solo.

    Hay tres formas fundamentales en que ocurre ese aprendizaje:

    Aprendizaje supervisado. Le das al modelo ejemplos con respuesta correcta. "Este email es spam. Este otro no lo es." El modelo aprende el patrón. Cuando llega un email nuevo, predice a cuál categoría pertenece. Úsalo cuando tienes datos etiquetados y una tarea de predicción o clasificación concreta.

    Aprendizaje no supervisado. No hay respuestas correctas. Le das datos sin etiquetar y el modelo encuentra estructura por sí solo. "Estos usuarios tienen comportamiento parecido. Estos otros también. Hay tres grupos." Úsalo cuando quieres descubrir patrones que no conoces de antemano — clustering de usuarios, detección de anomalías.

    Reinforcement learning. El modelo aprende por ensayo y error: hace una acción, recibe una recompensa o penalización, ajusta. Es cómo funcionan los modelos de juegos, pero también cómo se afinan los LLMs para que sus respuestas sean más útiles (RLHF — Reinforcement Learning from Human Feedback).

    Con esto en mente, los algoritmos concretos tienen contexto.

    Los algoritmos de machine learning que te importan como developer

    Resumen antes de entrar en detalle — ninguno lo vas a implementar tú:

    Algoritmo Tipo Cuándo lo usas en web ¿Lo implementas?
    Regresión logística Supervisado Scoring, predicción de churn No — API
    Random Forest Supervisado Moderación, detección de fraude No — API
    K-Means No supervisado Clustering de usuarios No — API
    Redes neuronales Supervisado Base de embeddings, clasificación No — modelos preentrenados
    Embeddings Supervisado Búsqueda semántica, recomendaciones No — OpenAI/HuggingFace
    Transformers Supervisado LLMs, generación, clasificación avanzada No — API

    Regresión lineal y logística

    Son los más simples. La regresión lineal predice un número: "¿Cuánto va a costar este apartamento?" La logística predice una probabilidad: "¿Hay un 87% de probabilidad de que este usuario cancele su suscripción este mes?"

    No las vas a implementar, pero las vas a encontrar en APIs de scoring, en features de predicción de churn, en sistemas de precios dinámicos. Cuando una API te devuelve un score: 0.87, probablemente hay una regresión logística detrás.

    Árboles de decisión y Random Forest

    Imagina una serie de preguntas de sí/no encadenadas. "¿El usuario tiene más de 30 días de cuenta? ¿Ha hecho al menos una compra? ¿Abrió el último email?" Cada camino lleva a una predicción. Eso es un árbol de decisión.

    Random Forest toma cientos de árboles distintos y combina sus respuestas. El resultado es más robusto y menos propenso a overfitting que un solo árbol.

    Son los algoritmos detrás de sistemas de moderación de contenido basados en reglas aprendidas, de detección de fraude, de sistemas de recomendación básicos.

    K-Means (clustering)

    K-Means agrupa datos en K clusters. Tú dices cuántos grupos quieres (K), el algoritmo encuentra cuáles puntos de datos pertenecen a cada grupo.

    Como developer web, esto aparece en sistemas de personalización: "Usuarios que actúan como tú también compraron esto." No hay etiquetas previas — el modelo descubre los segmentos solo.

    Redes neuronales

    Aquí empieza lo que la gente llama "deep learning". Una red neuronal es una cadena de capas matemáticas que transforman una entrada (texto, imagen, audio) en una salida (una clasificación, un número, un vector).

    Lo importante para entenderlas no es la matemática — es el concepto de representación. Cada capa aprende a representar la entrada de una forma más abstracta que la anterior. La primera capa de un modelo de visión detecta bordes. La siguiente detecta formas. La siguiente detecta objetos. Ningún programador definió esas representaciones: emergieron del entrenamiento.

    Embeddings — el algoritmo que ya usas

    Los embeddings son el resultado de pasar texto (o imágenes, o audio) por una red neuronal especializada. La salida es un vector de números — típicamente de 768 a 3072 dimensiones.

    La magia es que los vectores capturan significado semántico. "Perro" y "can" producen vectores muy cercanos en ese espacio de alta dimensión. "Perro" y "hipoteca" producen vectores lejanos.

    Esto es lo que permite la búsqueda semántica: conviertes tu query en un vector, comparas contra los vectores de tu base de datos, y devuelves los más cercanos. No importa si el usuario escribió "gato" y el documento dice "felino" — los vectores están cerca.

    Transformers — la arquitectura detrás de los LLMs

    Un Transformer es una arquitectura de red neuronal diseñada para procesar secuencias. El mecanismo clave se llama "atención" (attention): permite que el modelo, al procesar una palabra, preste atención a otras palabras del contexto según su relevancia.

    "El banco estaba lleno de peces" vs "El banco rechazó mi solicitud". La misma palabra "banco", significado completamente distinto. El mecanismo de atención resuelve esto mirando el contexto completo de la frase.

    GPT, Claude, Llama y Gemini usan Transformers como arquitectura base. Los modelos de embeddings de OpenAI también son Transformers, pero optimizados para producir buenas representaciones vectoriales en lugar de generar texto.

    Cuándo le importan al developer web

    No necesitas un data scientist para beneficiarte de ML. Estas son las integraciones más comunes en proyectos web reales. Puedes ver más ejemplos aplicados en el blog de Dominicode.

    Búsqueda semántica. Reemplaza o complementa la búsqueda por palabras clave. Los embeddings convierten queries y documentos en vectores, y una base de datos vectorial (Pinecone, pgvector, Supabase Vector) hace el matching por similitud coseno.

    Moderación de contenido. Clasifica si un texto es tóxico, si una imagen es apropiada, si un comentario viola normas. HuggingFace tiene modelos de clasificación listos para usar via API — zero setup del lado del ML.

    Recomendaciones. Clustering de usuarios por comportamiento o embeddings de productos para "productos similares". No necesitas construir un sistema de recomendación desde cero — embeddings + similitud coseno es suficiente para empezar.

    Extracción de información. Parsear emails, facturas, formularios en lenguaje natural. Un LLM con un prompt bien estructurado hace esto mejor que cualquier regex que vayas a escribir.

    TypeScript en la práctica

    Aquí es donde todo esto se vuelve concreto. No vas a implementar K-Means. Vas a llamar a una API que usa K-Means internamente. Pero entender qué hace el algoritmo te ayuda a saber qué esperar y qué debuggear.

    Embeddings con OpenAI

    import OpenAI from "openai";
    
    const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });
    
    async function getEmbedding(text: string): Promise<number[]> {
      const response = await client.embeddings.create({
        model: "text-embedding-3-small",
        input: text,
      });
    
      return response.data[0].embedding; // Vector de 1536 dimensiones
    }
    
    // Similitud coseno entre dos vectores
    function cosineSimilarity(a: number[], b: number[]): number {
      const dot = a.reduce((sum, val, i) => sum + val * b[i], 0);
      const magA = Math.sqrt(a.reduce((sum, val) => sum + val * val, 0));
      const magB = Math.sqrt(b.reduce((sum, val) => sum + val * val, 0));
      return dot / (magA * magB);
    }
    
    // Búsqueda semántica básica
    // En producción: usar batching o rate limiting para evitar errores 429 de la API
    async function semanticSearch(query: string, documents: string[]) {
      const queryVector = await getEmbedding(query);
      const docVectors = await Promise.all(documents.map(getEmbedding));
    
      const scores = docVectors.map((vec, i) => ({
        document: documents[i],
        similarity: cosineSimilarity(queryVector, vec),
      }));
    
      return scores.sort((a, b) => b.similarity - a.similarity);
    }
    
    const docs = [
      "Cómo configurar un servidor NestJS",
      "Recetas de cocina italiana",
      "Deploying Node.js to production",
    ];
    
    const results = await semanticSearch("backend con Node", docs);
    console.log(results[0]); // { document: "Deploying Node.js...", similarity: 0.89 }
    

    Referencia oficial: OpenAI Embeddings API.

    Clasificación con HuggingFace Inference API

    const HF_TOKEN = process.env.HF_TOKEN;
    const MODEL = "cardiffnlp/twitter-roberta-base-sentiment-latest";
    
    interface ClassificationResult {
      label: string;
      score: number;
    }
    
    async function classifySentiment(text: string): Promise<ClassificationResult[]> {
      const response = await fetch(
        `https://api-inference.huggingface.co/models/${MODEL}`,
        {
          method: "POST",
          headers: {
            Authorization: `Bearer ${HF_TOKEN}`,
            "Content-Type": "application/json",
          },
          body: JSON.stringify({ inputs: text }),
        }
      );
    
      // Si el modelo lleva tiempo sin uso, la primera respuesta puede tardar
      // 20-30 segundos con { error: "Model is currently loading" } — reintentar.
      const data = await response.json();
      return data[0] as ClassificationResult[];
    }
    
    const result = await classifySentiment("Este producto es increíble!");
    // [{ label: "POSITIVE", score: 0.97 }, { label: "NEUTRAL", score: 0.02 }, ...]
    
    if (result[0].label === "NEGATIVE" && result[0].score > 0.85) {
      // Marcar para revisión manual
    }
    

    Referencia oficial: HuggingFace Inference API.

    Dos ejemplos, dos APIs reales, cero instalación de librerías de ML. El algoritmo corre en la nube. Tú consumes el resultado y construyes producto.

    Si quieres explorar estas integraciones dentro de un flujo completo — desde la idea hasta el producto funcionando — en el curso Construye con IA cubrimos exactamente esta capa: cómo conectar modelos de ML reales a una arquitectura de producto sin convertirte en data scientist. También publicamos tutoriales y ejemplos en el canal de YouTube de Dominicode.

    La decisión que cambia todo

    Entender estos algoritmos no significa que vayas a entrenar modelos. Significa que cuando eliges entre una búsqueda por palabras clave y una búsqueda semántica, sabes exactamente qué estás eligiendo y por qué.

    Significa que cuando un modelo de clasificación te devuelve un score bajo, sabes si el problema está en el modelo, en los datos de entrada, o en cómo estás interpretando el output.

    Significa que cuando alguien en tu equipo dice "usemos ML para esto", puedes hacer las preguntas correctas: ¿supervisado o no supervisado? ¿Tienes datos etiquetados? ¿Qué métrica defines como éxito?

    Los modelos los entrenan los data scientists. El producto lo construyes tú. Saber qué hay debajo del capó es lo que hace la diferencia entre un developer que consume IA y uno que la integra de forma inteligente.

    En Dominicode Labs tenemos proyectos completos donde aplicamos estas integraciones en contextos reales — búsqueda semántica, pipelines con embeddings, agentes que usan clasificadores como herramientas. Si quieres ver el código funcionando, es donde empieza.


    FAQ

    ¿Necesito saber matemáticas para usar algoritmos de machine learning como developer?

    No para usarlos, sí para entenderlos en profundidad. La mayoría de las integraciones que harás como developer web consumen modelos ya entrenados via API. Saber qué hace el algoritmo — qué tipo de problema resuelve y qué output produce — es suficiente para tomar buenas decisiones de arquitectura. Si en algún momento necesitas afinar un modelo o interpretar métricas de entrenamiento, entonces sí vale la pena profundizar en la matemática.

    ¿Cuál es la diferencia entre un LLM y un modelo de embeddings?

    Un LLM (como GPT-4 o Claude) está entrenado para generar texto: toma una secuencia de tokens y predice los siguientes. Un modelo de embeddings está optimizado para producir representaciones vectoriales del texto, capturando su significado semántico en un espacio de alta dimensión. Ambos usan arquitectura Transformer, pero con objetivos de entrenamiento distintos. Para búsqueda semántica, usa modelos de embeddings — son más baratos y específicos para esa tarea.

    ¿Cuándo debería usar TensorFlow.js en lugar de una API de ML?

    TensorFlow.js tiene sentido cuando necesitas ejecutar inferencia en el cliente (sin enviar datos al servidor, por privacidad), cuando tienes latencia muy baja como requisito, o cuando quieres evitar costos de API a escala. El tradeoff es que los modelos disponibles para el navegador son más pequeños y menos potentes. Para la mayoría de proyectos web, una API de HuggingFace o OpenAI es la opción correcta hasta que tengas una razón específica para moverse al cliente.

    ¿Qué es el overfitting y por qué le importa al developer que consume modelos?

    El overfitting ocurre cuando un modelo aprende demasiado bien los datos de entrenamiento y pierde capacidad de generalizar a datos nuevos. Como developer que consume un modelo ya entrenado, el overfitting se manifiesta como comportamiento inesperado: el modelo funciona bien en ejemplos estándar pero falla en casos edge de tu dominio específico. Si ves esto, la solución no es ajustar el código — es cambiar de modelo, hacer fine-tuning, o cambiar cómo preparas el input (prompt engineering, preprocesado de texto).

    ¿Qué base de datos debo usar para guardar y consultar embeddings?

    Depende de tu stack. Si ya usas PostgreSQL o Supabase, la extensión pgvector añade soporte nativo para búsqueda por similitud coseno sin infraestructura adicional. Si necesitas escala masiva (millones de vectores con latencia sub-50ms), Pinecone o Weaviate son las opciones especializadas. Para prototipos o proyectos pequeños, guardar vectores en memoria con una búsqueda lineal es perfectamente válido mientras no superes los 10k documentos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Testing en Angular con IA: tests que protegen de verdad

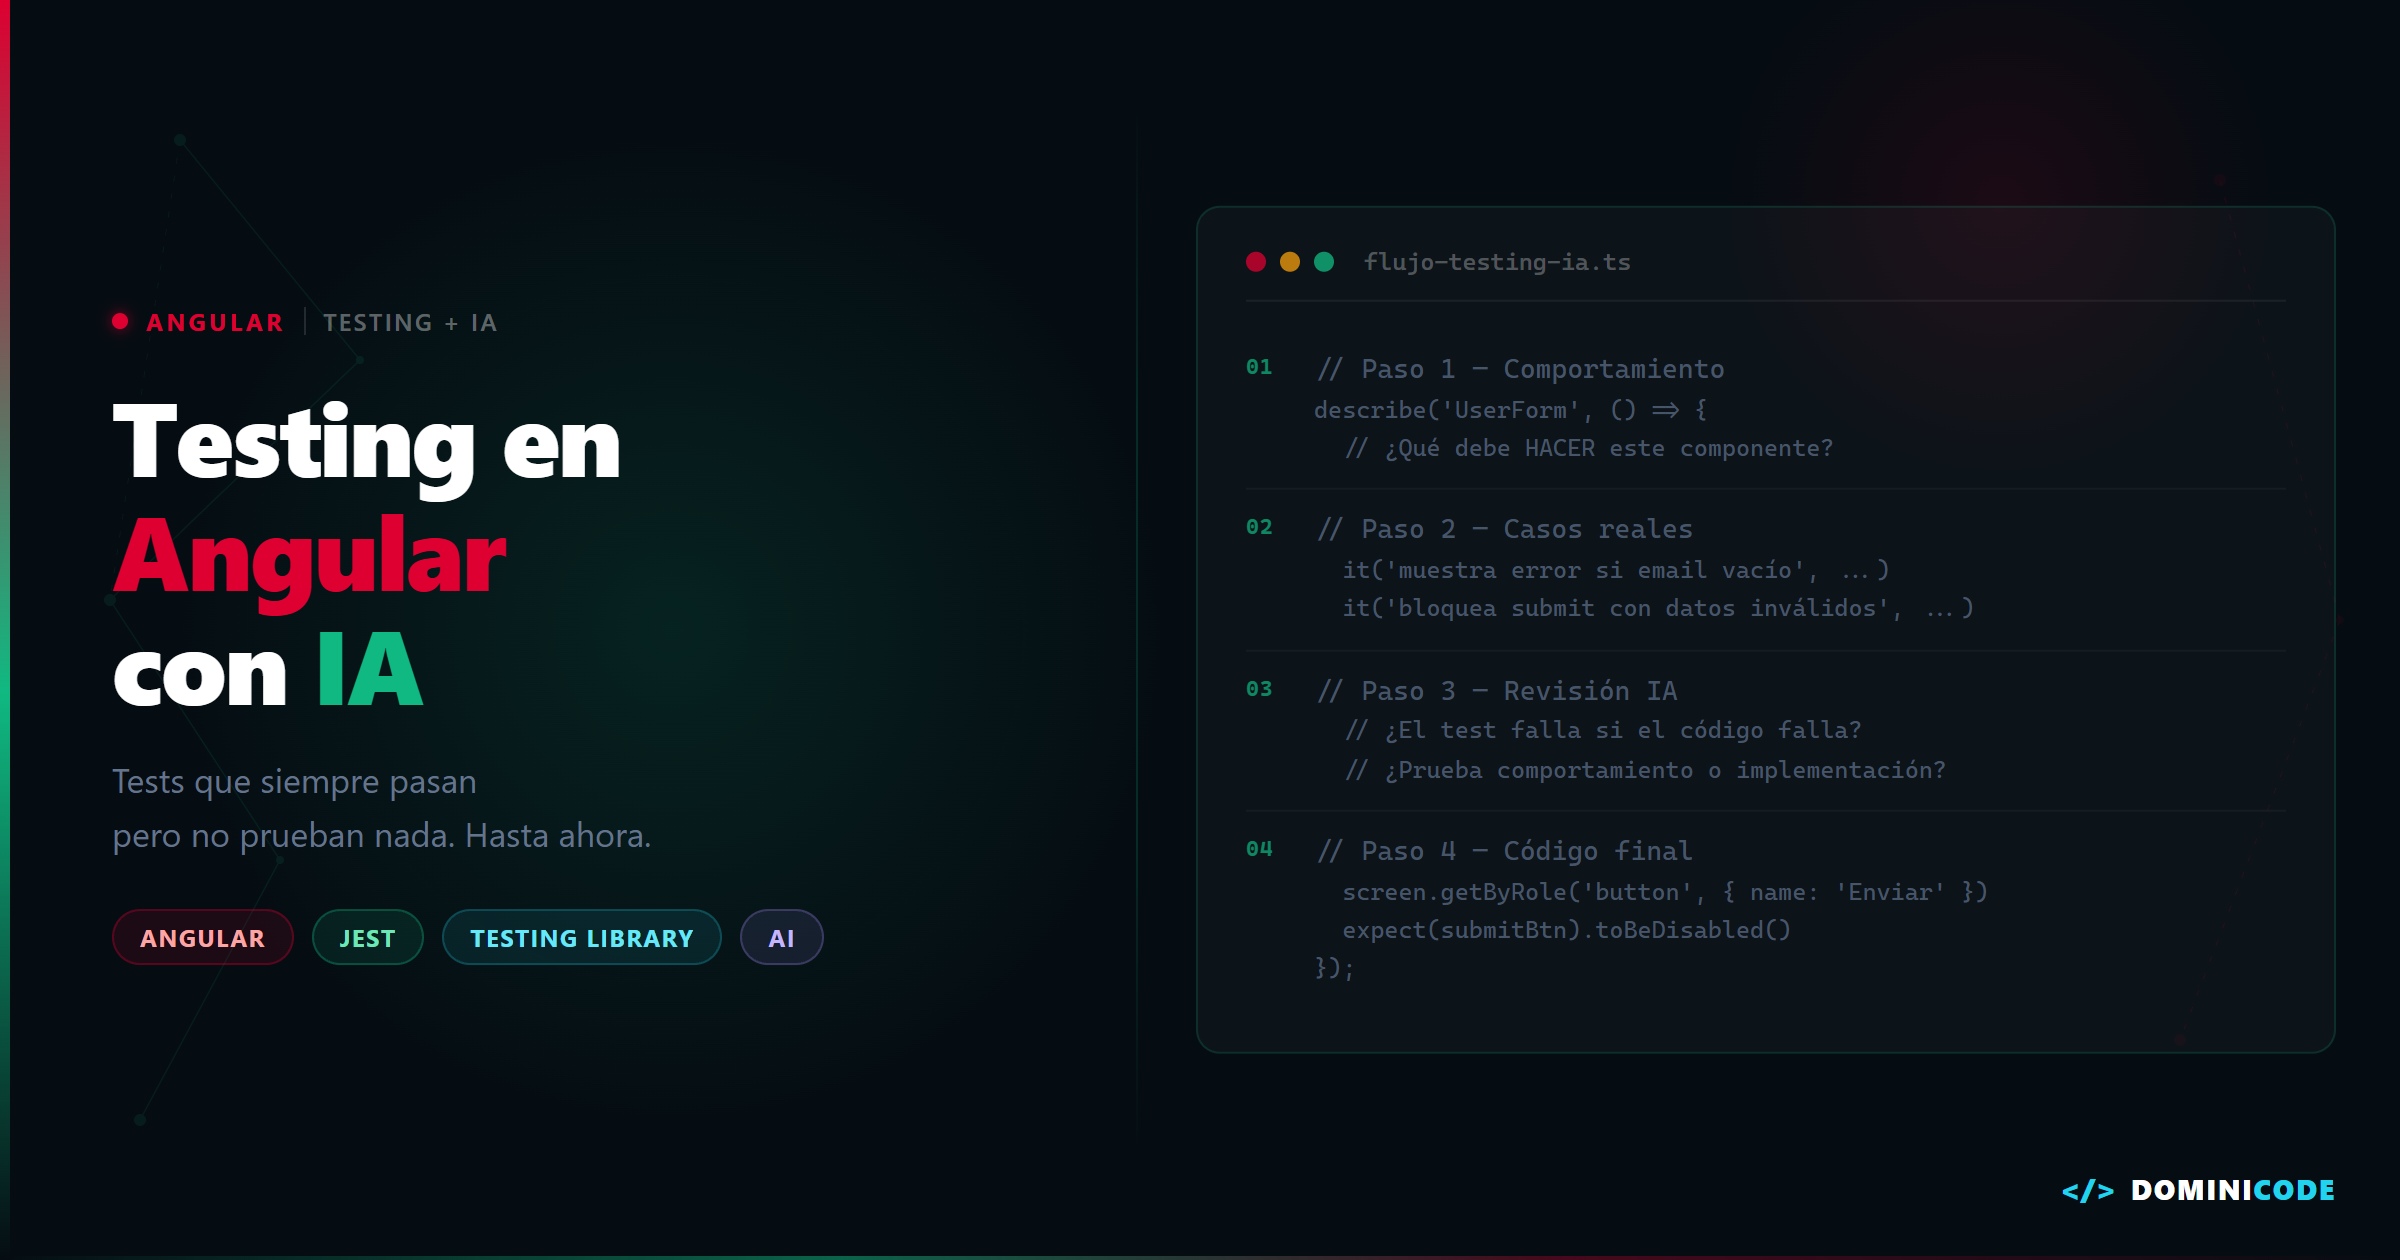
    Testing en Angular con IA: tests que protegen de verdad

    Le pedí a Claude que escribiera los tests de un componente de login. Me devolvió 14 tests. Todos verdes. El CI pasó sin problema.

    Dos semanas después, un bug llegó a producción. El formulario aceptaba contraseñas vacías si el campo estaba touched pero sin valor. Ninguno de esos 14 tests lo detectó.

    Los tests no fallaron porque el bug no existía para ellos. Los tests comprobaban que el componente existía, que el formulario se renderizaba, que el método onSubmit() se llamaba. No comprobaban el comportamiento. Eran tests de que el código había sido escrito, no de que el código hacía lo correcto.

    Este es el problema número uno del testing en Angular con IA: la IA genera tests que pasan, no tests que protegen.


    El problema real de los tests generados por IA

    Cuando le das a un modelo un componente Angular y le pides “escribe los tests”, le estás pidiendo que haga ingeniería inversa de tu implementación. Y eso es exactamente lo que hace.

    Lee el código. Ve que hay un loginForm con dos controles. Ve que hay un método onSubmit(). Ve que hay un AuthService. Y escribe tests que verifican que esas cosas existen y se llaman entre sí.

    El resultado son tests acoplados a la implementación, no al comportamiento. Si renombras onSubmit() a handleSubmit(), los tests fallan. Si cambias el nombre de una variable interna, los tests fallan. Pero si introduces un bug lógico — como que el formulario se envíe con campos vacíos — los tests siguen verdes.

    Esto no es un fallo del modelo. Es un fallo del prompt. Le preguntaste lo que no debías preguntar.

    Sin contexto del comportamiento esperado, la IA no tiene forma de saber qué casos importan. No sabe cuándo debería bloquearse el submit. No sabe qué errores deben mostrarse. Así que copia lo que ve: la implementación.


    El cambio de mentalidad que lo arregla todo

    No le pidas a la IA que escriba tests. Pídele que te ayude a pensar qué testear.

    Son dos tareas completamente distintas. La primera produce código. La segunda produce criterios. Y los criterios son lo que hace que un test sea útil.

    Un test útil parte de una pregunta: “¿qué debería pasar cuando X?” No de “¿qué hace este código?”

    El flujo correcto es este:

    1. Describe el comportamiento, no el código. No copies el componente en el prompt. Describe qué hace desde fuera. Qué ve el usuario. Qué espera. Qué debe pasar si hace algo incorrecto.
    2. Pídele que liste los casos de test. Solo los casos, sin código todavía.
    3. Revisa y aprueba esa lista. Añades los que faltan. Eliminas los redundantes. Este paso es el más valioso de todo el flujo — y es el que la mayoría de devs salta.
    4. Pide el código de test para cada caso. Con Jest y Testing Library, una vez que los criterios están claros.

    Ejemplo práctico con Angular 22

    Este es el componente. Un formulario de login con Reactive Forms en Angular 22:

    // login.component.ts
    import { Component, inject, signal } from '@angular/core';
    import { FormBuilder, ReactiveFormsModule, Validators } from '@angular/forms';
    import { Router } from '@angular/router';
    import { firstValueFrom } from 'rxjs';
    import { AuthService } from '../services/auth.service';
    
    @Component({
      selector: 'app-login',
      standalone: true,
      imports: [ReactiveFormsModule],
      template: `
        <form [formGroup]="form" (ngSubmit)="onSubmit()">
          <input formControlName="email" type="email" placeholder="Email" />
          <input formControlName="password" type="password" placeholder="Contraseña" />
          @if (errorMessage()) {
            <p class="error">{{ errorMessage() }}</p>
          }
          <button type="submit" [disabled]="form.invalid || isLoading()">
            {{ isLoading() ? 'Cargando...' : 'Entrar' }}
          </button>
        </form>
      `
    })
    export class LoginComponent {
      private fb = inject(FormBuilder);
      private auth = inject(AuthService);
      private router = inject(Router);
    
      form = this.fb.group({
        email: ['', [Validators.required, Validators.email]],
        password: ['', Validators.required]
      });
    
      errorMessage = signal('');
      isLoading = signal(false);
    
      async onSubmit() {
        if (this.form.invalid) return;
        this.isLoading.set(true);
        this.errorMessage.set('');
        try {
          await firstValueFrom(this.auth.login(this.form.value as { email: string; password: string }));
          this.router.navigate(['/dashboard']);
        } catch (err: any) {
          if (err.status === 401) {
            this.errorMessage.set('Credenciales incorrectas');
          }
        } finally {
          this.isLoading.set(false);
        }
      }
    }

    El prompt malo que genera tests inútiles:

    "Escribe los tests para este componente Angular."

    El prompt bueno, siguiendo el flujo de cuatro pasos:

    "Tengo un componente de login en Angular 22 con Reactive Forms.
    El comportamiento esperado es:
    - El botón está deshabilitado si el formulario es inválido o si está cargando
    - Al enviar credenciales válidas, se llama a AuthService.login()
    - Si AuthService lanza un error 401, se muestra 'Credenciales incorrectas'
    - Si tiene éxito, el router navega a /dashboard
    
    Lista primero los casos de test. Sin código todavía."

    Y estos son los tests resultantes con Jest y Testing Library para Angular:

    // login.component.spec.ts
    import { render, screen } from '@testing-library/angular';
    import userEvent from '@testing-library/user-event';
    import { LoginComponent } from './login.component';
    import { AuthService } from '../services/auth.service';
    import { provideRouter } from '@angular/router';
    import { of, throwError } from 'rxjs';
    
    describe('LoginComponent', () => {
      const mockAuthService = { login: jest.fn() };
    
      async function setup() {
        await render(LoginComponent, {
          providers: [
            { provide: AuthService, useValue: mockAuthService },
            provideRouter([{ path: 'dashboard', component: {} as any }])
          ]
        });
        return userEvent.setup();
      }
    
      beforeEach(() => jest.clearAllMocks());
    
      it('deshabilita el botón cuando el formulario está vacío', async () => {
        await setup();
        expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
      });
    
      it('deshabilita el botón con email inválido aunque haya contraseña', async () => {
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'no-es-email');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
      });
    
      it('habilita el botón con credenciales válidas', async () => {
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        expect(screen.getByRole('button', { name: /entrar/i })).not.toBeDisabled();
      });
    
      it('llama a AuthService.login al hacer submit con datos válidos', async () => {
        mockAuthService.login.mockReturnValue(of({}));
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        await user.click(screen.getByRole('button', { name: /entrar/i }));
        expect(mockAuthService.login).toHaveBeenCalledWith({
          email: 'user@test.com',
          password: '123456'
        });
      });
    
      it('muestra mensaje de error cuando el servicio responde 401', async () => {
        mockAuthService.login.mockReturnValue(throwError(() => ({ status: 401 })));
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), 'wrong');
        await user.click(screen.getByRole('button', { name: /entrar/i }));
        expect(await screen.findByText('Credenciales incorrectas')).toBeInTheDocument();
      });
    });

    La clave está en userEvent.type en lugar de fireEvent.input — con Reactive Forms en Angular, solo userEvent actualiza el FormControl correctamente en el entorno de test. Y el mock usa of({}) y throwError() de RxJS porque AuthService.login() devuelve un Observable.

    Esto es exactamente el enfoque que trabajamos en el curso de Testing en Angular con Jest y Testing Library: probar comportamiento, no implementación.


    Tests de servicios con IA: qué mockear y cómo describirlo

    Los servicios son donde más fácil es equivocarse al usar IA para testing.

    El error más común: pedirle a la IA que mockee el propio servicio para testearlo. Si mockeas AuthService en el test de AuthService, estás probando el mock, no el servicio.

    Lo que debes describirle a la IA es esto:

    "Tengo un AuthService en Angular 22 que inyecta HttpClient.
    El método login() hace POST a /api/auth/login con email y password.
    Devuelve un Observable<User>. En caso de error HTTP lo relanza tal cual.
    Escribe los tests usando provideHttpClient() + provideHttpClientTesting() y HttpTestingController.
    No mockees el servicio. Mockea solo el HttpClient."

    Con ese prompt, la IA sabe exactamente qué nivel de la pila debe sustituir:

    // auth.service.spec.ts
    import { TestBed } from '@angular/core/testing';
    import { HttpTestingController, provideHttpClientTesting } from '@angular/common/http/testing';
    import { provideHttpClient } from '@angular/common/http';
    import { AuthService } from './auth.service';
    
    describe('AuthService', () => {
      let service: AuthService;
      let httpMock: HttpTestingController;
    
      beforeEach(() => {
        TestBed.configureTestingModule({
          providers: [AuthService, provideHttpClient(), provideHttpClientTesting()]
        });
        service = TestBed.inject(AuthService);
        httpMock = TestBed.inject(HttpTestingController);
      });
    
      afterEach(() => httpMock.verify());
    
      it('hace POST a /api/auth/login con las credenciales', () => {
        const credentials = { email: 'user@test.com', password: '123456' };
        service.login(credentials).subscribe();
        const req = httpMock.expectOne('/api/auth/login');
        expect(req.request.method).toBe('POST');
        expect(req.request.body).toEqual(credentials);
        req.flush({ id: 1, email: 'user@test.com' });
      });
    
      it('devuelve el usuario cuando el servidor responde con éxito', () => {
        const mockUser = { id: 1, email: 'user@test.com' };
        let result: any;
        service.login({ email: 'user@test.com', password: '123456' })
          .subscribe(user => (result = user));
        httpMock.expectOne('/api/auth/login').flush(mockUser);
        expect(result).toEqual(mockUser);
      });
    
      it('relanza el error HTTP cuando el servidor responde 401', () => {
        let error: any;
        service.login({ email: 'user@test.com', password: 'wrong' })
          .subscribe({ error: err => (error = err) });
        httpMock.expectOne('/api/auth/login').flush(
          { message: 'Unauthorized' },
          { status: 401, statusText: 'Unauthorized' }
        );
        expect(error.status).toBe(401);
      });
    });

    La clave está en la instrucción: “mockea solo el HttpClient”. Esa precisión es lo que separa un prompt que genera tests útiles de uno que genera ruido.

    Si quieres ver cómo aplicar este patrón a servicios más complejos — con interceptores, state management y Signals — en el curso de Angular Moderno tienes la arquitectura base sobre la que todo esto encaja.


    Lo que la IA no puede hacer por ti

    La IA puede generar el código de test más rápido de lo que tú lo escribirías. No puede decirte qué casos importan en tu dominio de negocio.

    No sabe que en tu aplicación una contraseña vacía tiene un tratamiento especial. No sabe que hay un edge case cuando el usuario tiene sesión expirada y reintenta. No sabe que el botón de carga es crítico porque en producción la red va lenta y los usuarios hacen doble click.

    Ese conocimiento solo lo tienes tú. Tu trabajo es trasladarlo al prompt antes de pedir código. La IA amplifica lo que le das — si le das una descripción de comportamiento, amplifica eso. Si le das solo el código de implementación, amplifica eso.

    El flujo de cuatro pasos no es burocracia. Es el mínimo para que la IA genere tests que protejan algo.

    Si quieres llevar esta forma de trabajar más lejos — combinando especificaciones previas al código con IA para que los tests sean parte del diseño — eso es lo que construimos en el curso Construye con IA: de la Idea al Producto. Y si quieres acceso a los proyectos completos con suites de tests reales, los encontrarás en Dominicode Labs.


    FAQ

    ¿Puedo usar cualquier modelo de IA o Claude es el mejor para esto?

    El flujo de cuatro pasos funciona con cualquier modelo — Claude, GPT-4o, Gemini. La calidad del output depende mucho más de la calidad del prompt que del modelo. Dicho esto, Claude tiene ventaja en identificar casos borde cuando describes comportamientos complejos con muchas condiciones.

    ¿La IA puede generar tests TDD, es decir, antes de escribir el componente?

    Sí, y es el flujo ideal. Describes el comportamiento, pides los casos, apruebas la lista, pides el código de test — y luego le pides que implemente el componente para que esos tests pasen. Es TDD asistido por IA, y es especialmente potente para componentes nuevos.

    ¿Testing Library o Spectator para Angular?

    Testing Library porque te obliga a pensar en términos de comportamiento desde el principio. getByRole, getByPlaceholderText, findByText — todas esas queries buscan lo que el usuario ve, no lo que el código tiene internamente. Spectator facilita demasiado el acceso directo a la instancia del componente, lo que lleva a tests acoplados a implementación.

    ¿Cómo sé si un test generado por IA es bueno?

    Una heurística sencilla: introduce manualmente el bug más obvio en el componente y corre los tests. Si los tests siguen verdes, no valen nada. Por ejemplo, en el componente de login, pon if (true) return; al principio de onSubmit() — si el test de “llama a AuthService.login” sigue pasando, ese test no prueba nada. Esta técnica se llama mutation testing.

    ¿Vale la pena testear componentes de presentación puros?

    Depende de la complejidad. Un componente que solo muestra datos sin lógica condicional no necesita tests exhaustivos. Pero si tiene lógica de visualización — mostrar un badge según el estado, calcular clases CSS condicionalmente — esa lógica sí merece tests. Pregúntale a la IA: “¿qué comportamientos condicionales tiene este template que merecen ser testados?”


    *Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.*

  • Las 4 habilidades que definen al programador en la era de la IA

    Las 4 habilidades que definen al programador en la era de la IA

    Un cliente me llamó a las 11 de la noche. Me dijo que su equipo llevaba tres semanas con Claude Code y que la productividad se había disparado. Más código por sprint. Menos bugs. Entregas más rápidas.

    Pero había un problema.

    "Bezael, el equipo construye muy rápido. El problema es que construye muy rápido la cosa equivocada."

    Tres semanas generando código con IA. Código correcto, bien estructurado, con tests. Y un producto que no resolvía lo que el cliente necesitaba.

    Ese es el nuevo riesgo para el programador en la era de la IA. No que la IA te reemplace escribiendo código. Sino que la velocidad de producción amplifique el coste de tomar decisiones equivocadas. Antes tardabas un mes en construir algo mal. Ahora tardas tres días.

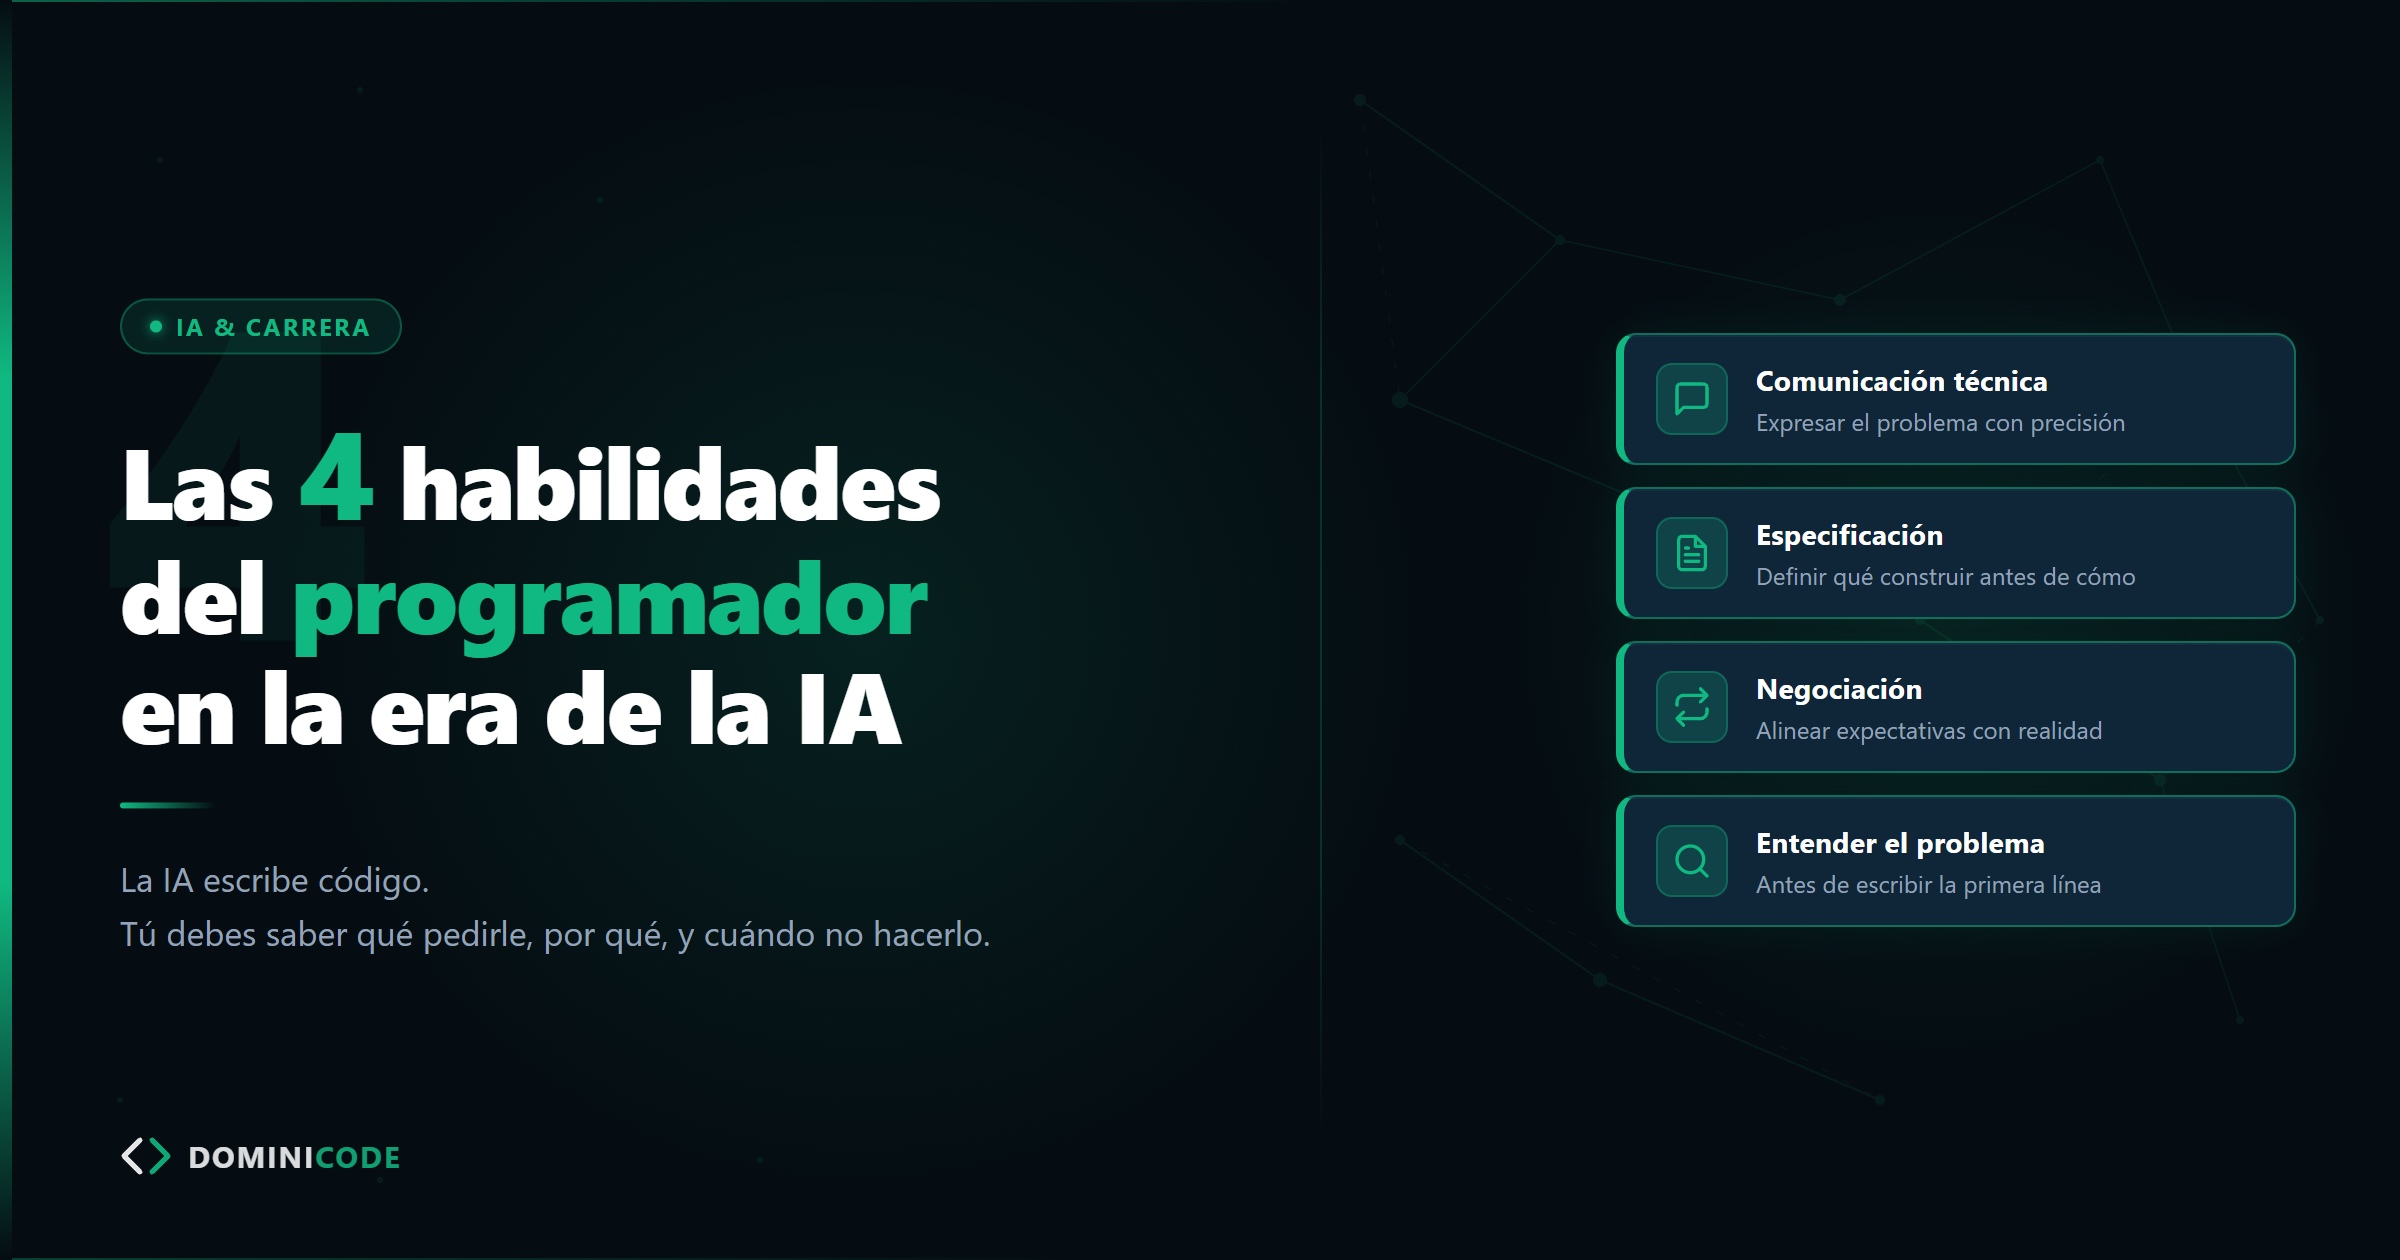
    Lo que separa a los developers que avanzan de los que se atascan no son sus habilidades técnicas. Son cuatro habilidades del programador en la era de la IA que ningún LLM puede suplir.


    Las habilidades del programador en la era de la IA que este post desarrolla son cuatro: entender el problema real antes de escribir una línea, comunicar la solución a stakeholders no técnicos, especificar con precisión lo que el agente debe construir, y negociar trade-offs cuando los requisitos chocan. Son las habilidades que la IA no puede ejecutar por ti — y las que determinan si su velocidad se convierte en ventaja o en ruido.


    Por qué el código ya no es el cuello de botella del programador en la era IA

    Durante veinte años el cuello de botella en el desarrollo de software fue escribir el código. Encontrar developers. Escalar equipos. Mantener la velocidad.

    Eso ha cambiado.

    Hoy un developer con Claude Code puede producir en un día lo que antes llevaba una semana. Los agentes no se cansan, no tienen bloqueos creativos, y no discuten sobre si usar tabs o spaces. El Stack Overflow Developer Survey 2025 documenta que más del 75% de developers ya usa o planea usar herramientas de IA en su flujo de trabajo — el cambio está aquí.

    Pero los agentes hacen exactamente lo que les pides. Ni más, ni menos. Y si lo que les pides es impreciso, ambiguo, o directamente equivocado, producen código impecable que resuelve el problema equivocado.

    El cuello de botella se ha desplazado. Ya no está en escribir. Está en pensar.


    Habilidad 1: Entender el problema real antes de abrir el editor

    Esta es la más subestimada y la que más dinero cuesta cuando falla.

    Un cliente te dice: "Necesitamos un dashboard con métricas en tiempo real." Un developer técnico abre el editor y empieza a pensar en WebSockets, en qué charting library usar, en cómo estructurar el backend.

    Un developer con criterio hace una pregunta primero: "¿Para qué vas a usar ese dashboard? ¿Quién lo mira y qué decisión toma a partir de lo que ve?"

    Esa pregunta cambia todo.

    A veces el dashboard en tiempo real que pedían era en realidad un email diario con tres métricas. A veces era un CSV que se cargaba en Excel. A veces ni siquiera era un problema de visualización — era un problema de que nadie en la empresa sabía qué datos tenía disponibles.

    Con IA esto se vuelve crítico. Porque ahora la velocidad de producción es tan alta que el coste de empezar en la dirección equivocada es enorme. Construyes tres features completas en el tiempo que antes tardabas en escribir media. Si las tres están mal orientadas, has quemado tres veces más tiempo que antes.

    La habilidad de entender el problema real — no el síntoma que te describen, sino la causa raíz que lo genera — es la que protege todo lo demás.

    No se aprende con más cursos de programación. Se aprende haciendo preguntas incómodas antes de escribir una línea.


    Habilidad 2: Comunicar la solución a quien no es técnico

    El código más elegante del mundo no vale nada si nadie en la empresa entiende qué resuelve ni por qué importa.

    Esto ha sido siempre un problema para los developers. Pero con IA se vuelve más urgente, porque ahora eres capaz de construir cosas más complejas, más rápido, con más capas de abstracción. Y cuanto más complejo es lo que construyes, más difícil es explicarlo a quien toma las decisiones de negocio.

    La comunicación técnica a stakeholders no técnicos no es "simplificar para que lo entienda un niño". Es traducir impacto.

    Un stakeholder no necesita entender cómo funciona una cola de mensajes asíncrona. Necesita entender que gracias a esa cola, el sistema puede procesar diez mil pedidos en paralelo sin que ningún usuario espere más de dos segundos. Eso sí lo entiende. Y eso sí cambia cómo percibe el valor de lo que has construido.

    Esta habilidad también protege tu trabajo. Si tu contribución es invisible para quien decide los presupuestos, eres vulnerable. Si puedes hacer visible el impacto técnico en términos de negocio, eres indispensable.

    Practica esto: después de cada feature que entregues, escribe en dos frases qué problema de negocio resuelve y qué habría pasado sin ella. Si no puedes hacerlo, tienes un problema antes de que alguien externo lo detecte.

    Hay un ejercicio que funciona muy bien para esto: antes de la próxima reunión de sprint, prepara una explicación de lo que estás construyendo en menos de 60 segundos, sin usar términos técnicos. Si necesitas más tiempo o tienes que recurrir al jargon, la feature aún no está suficientemente clara en tu cabeza. Esa claridad — la que te permite explicarla en voz alta — es exactamente la que también necesitas para especificarla bien para un agente.

    Esta habilidad se conecta directamente con la siguiente. Un developer que no puede explicar lo que construye a un humano tampoco puede especificarlo con precisión para una máquina.


    Habilidad 3: Especificar con precisión lo que el agente debe construir

    Esta es la habilidad nueva. La que no existía como tal hace tres años y que ahora es central.

    Los agentes de IA son ejecutores extraordinarios de instrucciones precisas. Son ejecutores pésimos de instrucciones vagas.

    "Construye un sistema de autenticación" puede producir cualquier cosa desde un JWT básico hasta un sistema OAuth completo con múltiples proveedores y gestión de sesiones. El agente hará algo. Y lo que haga puede ser técnicamente correcto y completamente inadecuado para tu contexto.

    Especificar bien significa definir:

    1. Qué hace el sistema — comportamiento concreto, no intención abstracta
    2. Qué NO hace — los límites son tan importantes como las funcionalidades
    3. Bajo qué restricciones — tecnología, rendimiento, compatibilidad, seguridad
    4. Cómo se valida que está correcto — criterios de aceptación verificables

    Si quieres entender mejor el perfil completo del developer que trabaja con agentes en producción, el post sobre qué es un Agentic Engineer cubre ese rol con detalle. La especificación es su primer requisito.

    Llevo varios años aplicando una metodología para esto que llamo Spec-Driven Development. La idea es que antes de que el agente escriba una línea, tienes un documento que responde esas cuatro preguntas. No un documento largo ni burocrático — uno preciso. El Libro SDD documenta este proceso completo, desde cómo estructurar la especificación hasta cómo convertirla en tareas que un agente puede ejecutar sin desviarse.

    La diferencia entre un developer que especifica bien y uno que no lo hace no se mide en velocidad. Se mide en cuánto código hay que tirar a la basura al final de cada sprint.


    Habilidad 4: Negociar trade-offs cuando los requisitos chocan

    Los requisitos siempre chocan. Siempre.

    "Quiero que sea seguro, rápido, barato, flexible y que esté listo para el martes." No puedes tener las cinco cosas. Nunca has podido. Pero antes la conversación sobre qué sacrificar era más lenta porque construir era más lento. Ahora, con la velocidad que da la IA, la presión para tomarlo todo aumenta.

    Un developer que sabe negociar trade-offs no es el que cede ante la presión del cliente. Es el que hace explícito el coste de cada decisión y ayuda a quien decide a entender qué están eligiendo realmente.

    "Si priorizamos velocidad de lanzamiento, el sistema no va a escalar bien por encima de diez mil usuarios. Podemos lanzar en dos semanas con esa limitación asumida, o lanzar en seis semanas con una arquitectura que aguante cien mil. ¿Qué es más importante ahora mismo para el negocio?"

    Esa conversación requiere que el developer entienda el negocio suficientemente bien como para hacer la pregunta correcta. Requiere que sepa comunicar la implicación técnica en términos de impacto. Y requiere que tenga la seguridad de plantear la conversación antes de que los problemas aparezcan en producción.

    Con agentes de IA esto se vuelve más delicado porque la velocidad de implementación hace que sea tentador no tener esa conversación. "Lo construimos rápido, si no funciona lo cambiamos." Pero cambiar una decisión arquitectural después de que cuatro features dependen de ella no es barato, aunque la IA escriba el código.

    En el curso Construye con IA dedicamos una parte específica a cómo estructurar estas conversaciones antes de empezar a generar código — porque los errores más costosos no son de sintaxis, son de dirección.


    Las habilidades del programador que la IA no puede reemplazar

    La IA escribe código. Lo depura. Lo refactoriza. Lo documenta. Lo testea.

    No puede entrar a una reunión y detectar que lo que el cliente pide en realidad responde a un miedo que no ha verbalizado. No puede leer el contexto político de una organización para entender por qué un requisito existe. No puede mirar los ojos de un stakeholder y saber que cuando dice "necesitamos esto para el viernes" en realidad está diciendo "si esto no sale el viernes, me cuesta el trabajo".

    Esas lecturas son humanas. Y en un entorno donde el código se genera en segundos, son el verdadero diferencial.

    Los developers que van a crecer en los próximos años no son los que más saben de LLMs. Son los que combinan criterio técnico con las habilidades de comunicación, especificación y negociación que hacen que ese criterio tenga impacto.


    El developer que va a sobrevivir a la IA

    No es el que sabe más frameworks.

    No es el que tiene mejores prompts para Claude.

    Es el que puede entrar en una sala con personas técnicas y no técnicas, entender lo que realmente está en juego, definir con precisión lo que hay que construir, y explicar con claridad por qué ciertas cosas no se pueden tener al mismo tiempo.

    Este cambio de rol — de ejecutar tareas a tomar decisiones con criterio — es lo que ya analizamos en profundidad en el post sobre el programador que se convierte en product builder. Las cuatro habilidades de este post son el motor que hace posible ese salto.

    La IA amplifica la velocidad de ejecución. Las cuatro habilidades de las que hablamos hoy amplifican la calidad de las decisiones. Y en software, las decisiones siempre cuestan más que el código.

    En Dominicode Labs trabajamos estos temas con developers que están construyendo con IA en proyectos reales — no ejercicios de academia, sino productos con usuarios, deadlines, y stakeholders que necesitan respuestas los lunes por la mañana.

    Si quieres empezar hoy, elige la habilidad que sabes que tienes más floja de las cuatro y pasa esta semana ejerciéndola deliberadamente. Una conversación con un stakeholder. Un documento de especificación antes de abrir el editor. Una pregunta incómoda que no has hecho todavía.

    El código lo escribe la IA. El criterio lo pones tú.


    Preguntas frecuentes

    ¿Estas habilidades sustituyen al conocimiento técnico profundo?
    No, lo complementan. Sin base técnica sólida no puedes especificar bien ni negociar trade-offs con conocimiento de causa. Lo que cambia es que el conocimiento técnico ya no es suficiente por sí solo — necesitas combinarlo con estas capacidades para que tenga impacto real. Un developer que solo sabe programar pero no puede comunicar ni especificar ni negociar tiene cada vez menos diferencial frente a un agente de IA.

    ¿Cómo se aprende a especificar para agentes de IA si nunca lo he hecho?
    Empieza por escribir, antes de cualquier tarea, un documento de dos párrafos: uno con lo que el sistema debe hacer y uno con lo que no debe hacer. Con ese ejercicio simple ya estás especificando. A medida que lo practiques, irás añadiendo restricciones, criterios de aceptación y contexto. La metodología Spec-Driven Development es un marco más completo para esto, documentado en el Libro SDD.

    ¿Estas habilidades son más importantes para freelancers que para developers en empresa?
    Son importantes en los dos contextos, pero de formas distintas. El freelance que no sabe comunicar ni negociar pierde clientes. El developer en empresa que no sabe hacer estas cosas se queda estancado en roles de ejecución y ve cómo los que ascienden son los que saben tener las conversaciones difíciles. En ambos casos, la consecuencia de no desarrollarlas es la misma: invisibilidad.

    ¿La velocidad que da la IA no hace que estos trade-offs sean menos importantes porque "se puede cambiar todo fácilmente"?
    Es una trampa común. Sí, la IA acelera la implementación. Pero hay decisiones — de arquitectura, de modelo de datos, de contratos de API — que una vez tomadas son costosas de cambiar aunque el código lo escriba un agente.

    Si tu base de datos está mal modelada, reescribir las queries con IA no resuelve el problema. El coste de las malas decisiones estructurales no ha bajado con la IA.

    Lo que ha bajado es el coste de implementar la decisión, buena o mala. Eso amplifica el impacto de decidir bien tanto como el de decidir mal.

    ¿Existe algún perfil técnico donde estas habilidades no importan?
    Si trabajas en investigación pura, en open source sin usuarios directos, o en roles muy especializados de bajo nivel donde el contacto con stakeholders es mínimo, el peso relativo de estas habilidades es menor. Pero para la mayoría de developers que trabajan en productos, servicios o consultoría — que es la mayoría — estas cuatro capacidades son cada vez más determinantes para el crecimiento profesional.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
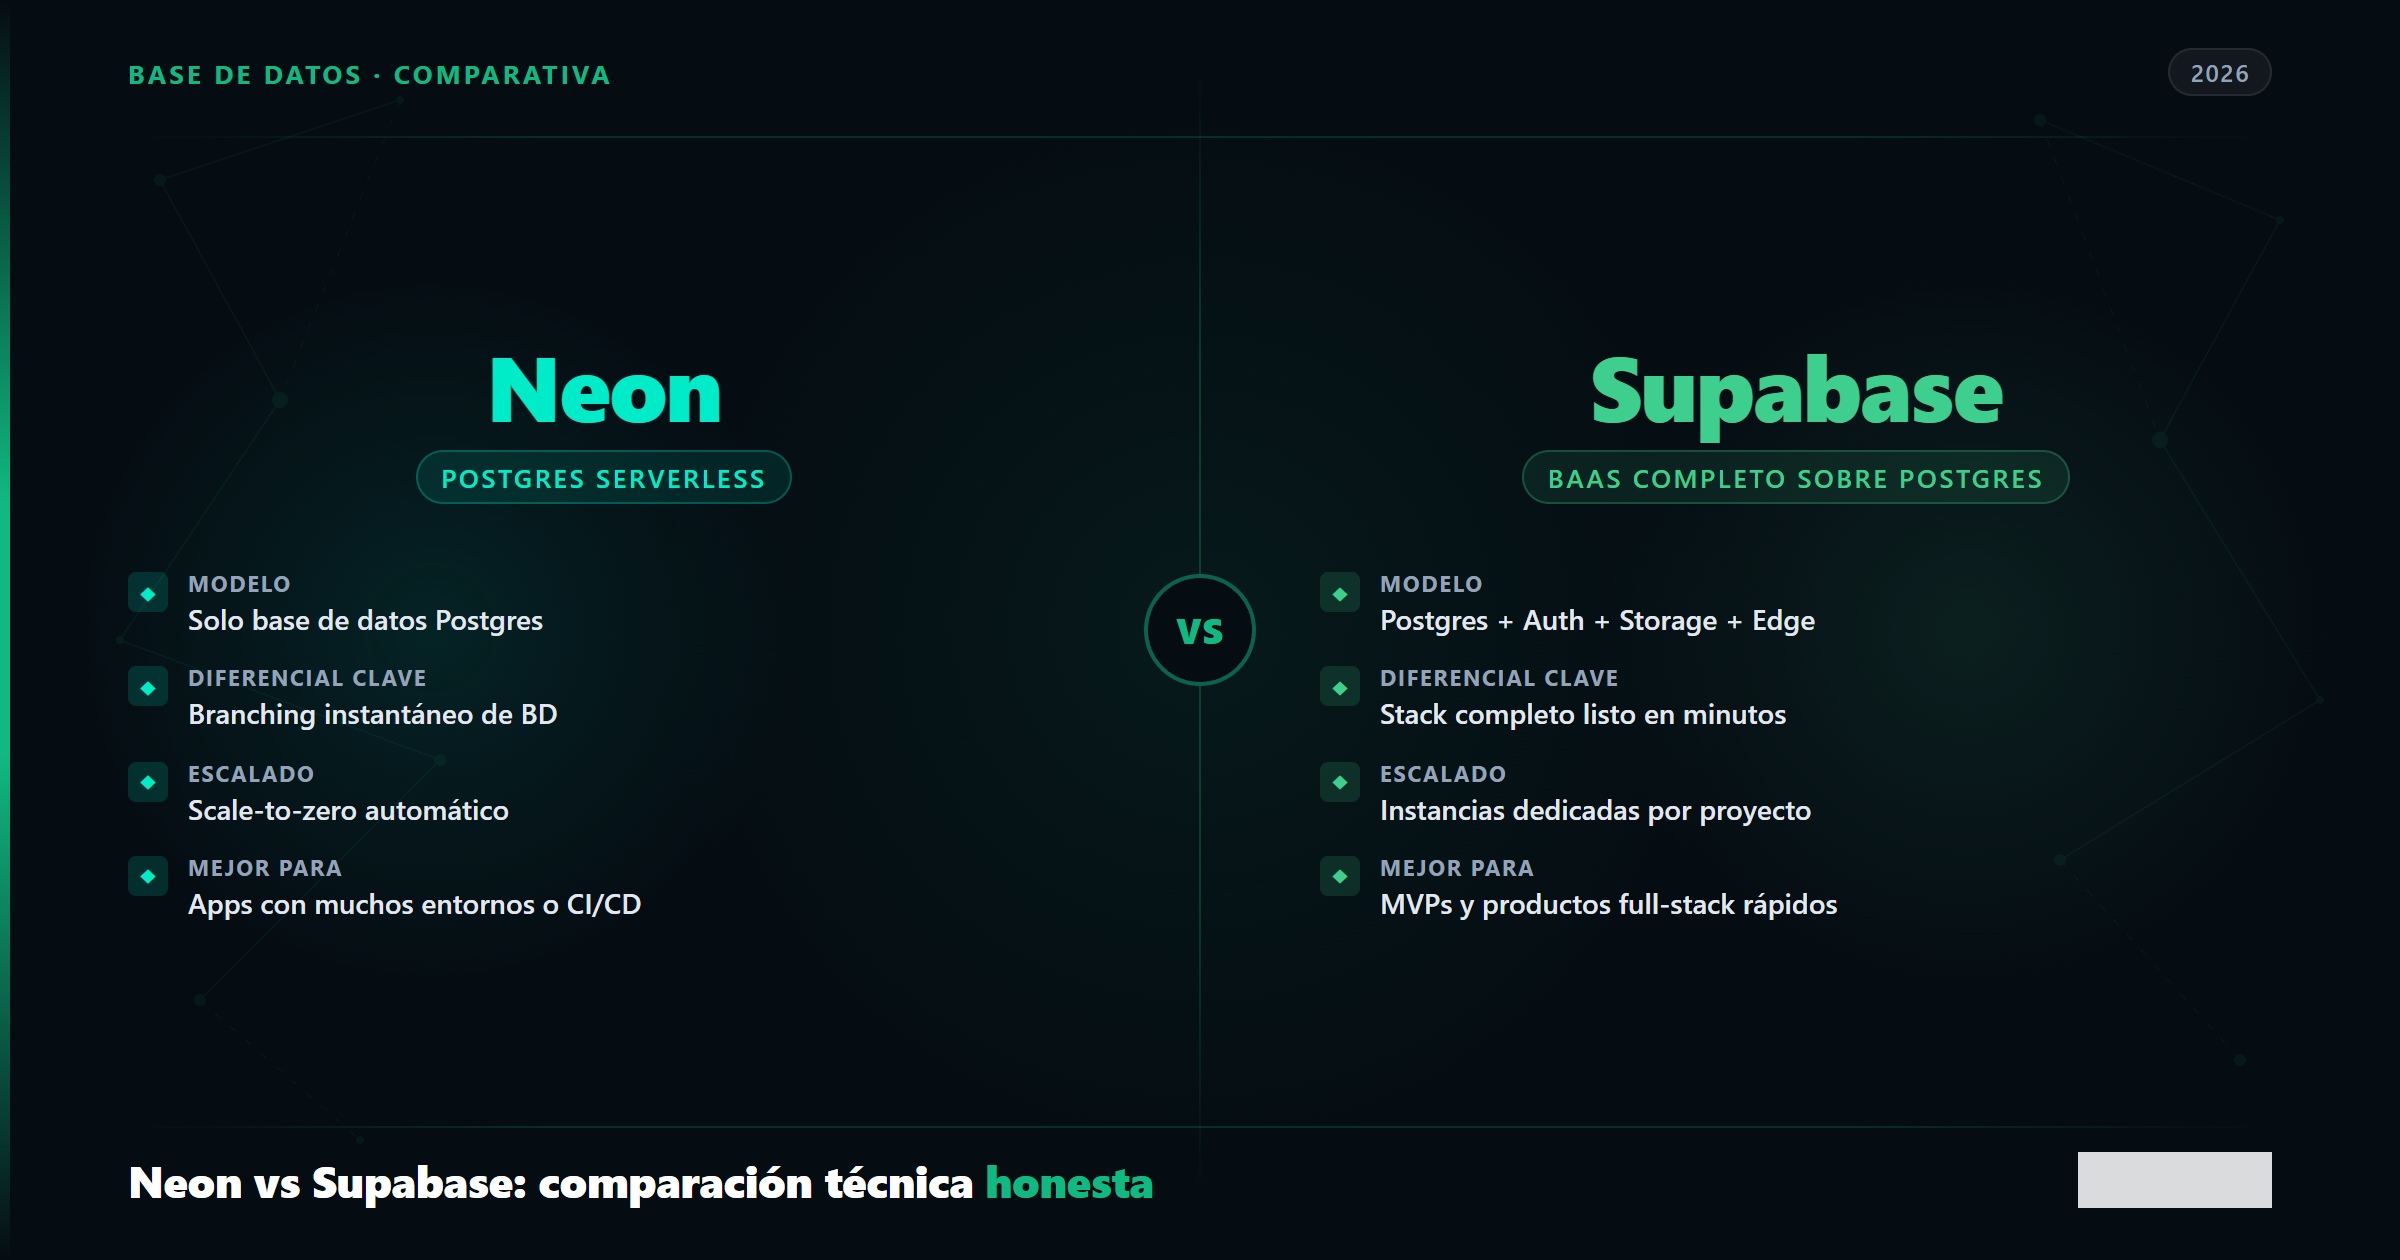
  • Proyecto greenfield con SDD: spec global + slices verticales

    Proyecto greenfield con SDD: spec global + slices verticales

    Hace unas semanas un developer del canal me contó lo que había pasado en su último proyecto.

    Seis horas. Eso tardó en planificar un proyecto greenfield con SDD usando slices verticales. Tenía un spec global, features bien definidas, tareas granulares. Parecía perfecto.

    Ejecutó el primer slice con su agente IA. La app funcionaba. Autenticación, flujo de datos, navegación — todo correcto.

    Y era completamente gris. Sin estilos. Sin diseño. Una interfaz que parecía sacada de 1998.

    No había especificado nada sobre la UI en su spec. Ni colores, ni componentes, ni sistema de diseño. El agente hizo exactamente lo que se le pidió: implementar la lógica. Y lo hizo bien.

    El problema no era el agente. Era el spec.

    El error que nadie te dice sobre SDD en proyectos nuevos

    Spec-Driven Development (SDD) es una metodología en la que cada feature comienza con un documento de especificación estructurado — el spec — antes de escribir código. El spec define qué hace la feature, cómo se ve, y qué criterios debe cumplir para considerarse completa.

    Cuando descubres SDD, la primera intuición es clara: especifica todo antes de escribir una línea de código. Visión, usuarios, funcionalidades, arquitectura, flujos.

    Y esa intuición es correcta… pero incompleta.

    Hay dos errores que se cometen casi siempre en un proyecto greenfield con SDD:

    El primero es intentar especificar el proyecto completo antes de tocar el teclado. Un spec monolítico de 40 páginas que detalla hasta la última feature antes de que exista una sola línea de código. Es atractivo. Se siente seguro. Y casi siempre es un error.

    El segundo es lo que le pasó a ese developer: especificar las features en términos de lógica y flujos, pero olvidar que las features tienen una cara visible. Que los usuarios las ven. Que el diseño no es una capa que se añade al final — es parte de la feature.

    Ambos errores llevan al mismo resultado: rediseño tardío, deuda técnica, y la sensación de que SDD no funciona cuando el problema real es la estrategia, no la metodología.


    La estructura que sí funciona: spec global ligero + slices con UI

    La solución tiene dos capas. Una sesión corta de spec global que define las reglas del juego, y luego un ciclo de feature-por-feature donde cada spec incluye explícitamente la UI.

    Capa 1: El spec global ligero

    Este documento no especifica features. Especifica el contexto en el que todas las features van a vivir. Se hace una sola vez, en una sola sesión, y no debería tomar más de 45 minutos.

    # Spec Global — [Nombre del proyecto]
    _Versión: 1.0 | Fecha: YYYY-MM-DD_
    
    ## Visión
    [Una sola frase que describe qué es el producto y para quién.]
    
    ## Stack técnico
    - Frontend: Angular 22 con Signals
    - Backend: NestJS + Supabase
    - Estilos: Tailwind CSS v4
    - Testing: Jest + Testing Library
    
    ## Sistema de diseño
    - Librería de componentes: Angular Material / PrimeNG / custom
    - Paleta de colores: primario #1A73E8, fondo #F8FAFC, texto #0F172A
    - Tipografía: Inter, base 16px
    - Espaciado: escala de 4px (4, 8, 12, 16, 24, 32, 48...)
    - Breakpoints: sm 640px / md 768px / lg 1024px / xl 1280px
    
    ## Convenciones de arquitectura
    - Estructura: feature-based (cada feature es un módulo independiente)
    - Estado global: NgRx Signal Store
    - Llamadas HTTP: Resource API (Angular 22)
    - Validación: Zod en schemas compartidos
    
    ## Decisiones técnicas ya tomadas
    - Autenticación: Supabase Auth (no reinventar)
    - Despliegue: Vercel (frontend) + Railway (backend)
    - No usar: Redux clásico, Class Components, módulos NgModule legacy
    
    ## Features planificadas (sin detallar)
    1. Autenticación
    2. Dashboard principal
    3. Gestión de proyectos
    4. Reportes
    

    Eso es todo. No más. El spec global no detalla cómo funciona cada feature — solo establece las reglas que todas van a respetar.

    Lo más importante de ese documento son las secciones de sistema de diseño y convenciones de arquitectura. Son el contrato que el agente va a respetar en cada feature. Si no las defines aquí, las decide él — y probablemente no va a coincidir con lo que tienes en la cabeza.

    Capa 2: El spec de cada feature — con sección UI obligatoria

    Aquí está el cambio que lo transforma todo. Cuando vas a implementar una feature, escribes su spec detallado en ese momento, no antes. Y ese spec siempre incluye una sección de UI/UX.

    # Feature 1: Autenticación
    _Contexto: spec global v1.0 | Estado: en implementación_
    
    ## Qué hace
    Permite al usuario crear cuenta, iniciar sesión y recuperar contraseña.
    Usa Supabase Auth. No hay lógica de autenticación propia.
    
    ## Flujos principales
    1. Registro: email + contraseña → verificación por email → redirect a dashboard
    2. Login: email + contraseña → redirect a dashboard (o a la ruta que intentaba visitar)
    3. Recuperación: email → link con token → nueva contraseña → login
    
    ## UI/UX (obligatorio)
    - Layout: columna centrada, max-width 400px, padding 24px
    - Componentes a usar: InputField, Button, Alert — todos del sistema de diseño global
    - Estados visuales a implementar:
      - Loading: botón con spinner, campos desactivados
      - Error: Alert rojo con mensaje específico (no "algo salió mal")
      - Éxito: redirect inmediato, sin pantalla intermedia
    - Mobile first: el form debe funcionar bien en 320px
    - No inventar componentes nuevos — usar los del spec global
    
    ## Criterios de aceptación
    - [ ] El usuario puede registrarse con email válido
    - [ ] El usuario recibe email de verificación
    - [ ] El usuario puede iniciar sesión y llega al dashboard
    - [ ] Los estados de loading y error son visibles
    - [ ] El form es usable en móvil
    
    ## Lo que NO hace esta feature
    - No maneja OAuth (Twitter, Google) — queda para v2
    - No maneja roles de usuario — eso es responsabilidad del dashboard
    

    La sección UI/UX no es opcional. Es donde especificas exactamente qué tiene que ver el usuario cuando interactúa con esta feature. Si la omites, el agente tomará esa decisión por ti, y probablemente tomará la decisión más rápida, no la más correcta.


    Spec total upfront vs spec incremental — la comparativa real

    La tentación de escribir el spec completo del proyecto antes de arrancar tiene sentido desde afuera. La realidad es diferente.

    Spec total upfront Spec incremental (global ligero + features)
    Tiempo inicial 2-3 días o más 45 min (spec global) — hasta 20× más rápido para arrancar
    Riesgo Alto — cambias de opinión cuando ves el código real Bajo — ajustas cada feature antes de implementarla
    UI/UX Probablemente omitida o abstracta Concreta en cada feature, con contexto real
    Consistencia Dependes de que el spec inicial fuera perfecto El spec global garantiza coherencia entre features
    Deuda de redesign Alta — aparece cuando el 80% del código ya existe Baja — se elimina en cada ciclo de validación visual
    Útil con agentes IA Solo si el agente tiene memoria perfecta (no la tiene) Sí — cada prompt incluye contexto concreto y actualizado

    El spec incremental no significa improvisación. Significa que el contexto que tienes cuando implementas la feature 4 es mejor que el que tenías antes de escribir una sola línea de código. Y ese contexto — los componentes que ya existen, las decisiones que ya se tomaron, los problemas que ya aparecieron — enriquece el spec de la siguiente feature.

    Este enfoque es una variación de la Vertical Slice Architecture documentada por Jimmy Bogard, aplicada al contexto de specs con agentes IA.

    El rediseño tardío no ocurre porque el spec sea incremental. Ocurre porque no hay spec en absoluto.


    El ciclo de trabajo en un proyecto greenfield SDD

    El flujo que funciona es simple, y se repite para cada feature:

    1. Escribe el spec de esa feature (con sección UI incluida)
    2. Dáselo al agente como contexto completo
    3. Implementa
    4. Valida visualmente antes de marcar como hecho
    5. Usa lo aprendido para enriquecer el spec de la siguiente feature

    El paso 4 es crítico y muchos lo saltan. Validar visualmente significa abrir el navegador, probar el flujo como lo haría un usuario real, y confirmar que los estados de loading, error y éxito se ven como los especificaste. No basta con que los tests pasen.

    Si en el paso 4 descubres que algo no se ve bien, arréglalo antes de avanzar. El coste de arreglar un componente mal implementado en la feature 1 es mínimo. El coste de arreglar el mismo patrón cuando ya está repetido en las features 1, 3, 5 y 7 es considerable.


    Lo que cambia cuando tienes el spec global

    El spec global tiene un efecto que no es obvio hasta que lo usas en producción.

    Cuando llegas a la feature 4, el agente tiene contexto. Sabe que los inputs van con Tailwind, que el estado global es NgRx Signal Store, que los errores se muestran con el componente Alert del sistema de diseño. Si estás usando Angular 22, también puedes aprovechar la Resource API para centralizar las llamadas HTTP en el spec desde el principio — sin que el agente invente su propio patrón. No lo tienes que repetir en cada prompt.

    Y cuando llega alguien nuevo al proyecto — o cuando tú mismo vuelves al código tres meses después — entiende en 10 minutos las decisiones que se tomaron y por qué.

    Eso no lo da el código. Lo da el spec.

    Si quieres profundizar en la metodología completa, en el libro de Spec-Driven Development tienes el framework completo: cómo estructurar specs, cómo trabajar con agentes IA de forma efectiva, y los patrones que se usan en proyectos reales de producción.


    La UI no es una capa. Es un contrato.

    El error del developer que me escribió no fue usar SDD. Fue asumir que SDD significa especificar todo el proyecto antes de arrancar.

    SDD significa especificar lo suficiente, en el momento correcto, con el nivel de detalle correcto. El spec global define el campo de juego. El spec de cada feature define las reglas de ese momento.

    Y la UI no es una capa que se añade al final. Es parte del contrato de cada feature.

    Si quieres ver este flujo en acción — desde el spec hasta el commit — en el curso Construye con IA: De la Idea al Producto aplicamos exactamente esta metodología: spec global, slices verticales, validación visual antes de avanzar. Con agentes IA reales, en proyectos que no son de juguete.

    Y si prefieres el formato comunidad, en Dominicode Labs compartimos los specs reales de los proyectos que construimos juntos — con las decisiones que se tomaron y las que se descartaron.

    El spec no te quita velocidad. Te quita el coste de arreglar lo que nadie especificó.


    FAQ

    ¿Cuánto tiempo debería tardar el spec global de un proyecto real?

    Entre 30 y 60 minutos. Si tardas más, estás especificando features en el spec global, y eso no es su función. El spec global define el contexto y las reglas. Las features se detallan una a una cuando llega su turno.

    ¿Es obligatoria la sección UI/UX en el spec de cada feature?

    En proyectos con interfaz visible, sí. Si estás construyendo una API sin frontend, la sección UI/UX no aplica, pero deberías incluir una sección de contratos de API: endpoints, tipos de respuesta, códigos de error. El principio es el mismo: especifica todo lo que el agente necesita para no tomar decisiones que tú deberías tomar.

    ¿Cómo manejo las features que dependen de otras que aún no están implementadas?

    En el spec de la feature con dependencia, añades una sección “Asunciones” que documenta qué esperas de las features previas. Si la feature A aún no existe, especificas el contrato que A debería cumplir — y cuando implementes A, ese contrato ya está documentado. Es una forma de diseño by contract que funciona muy bien con agentes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
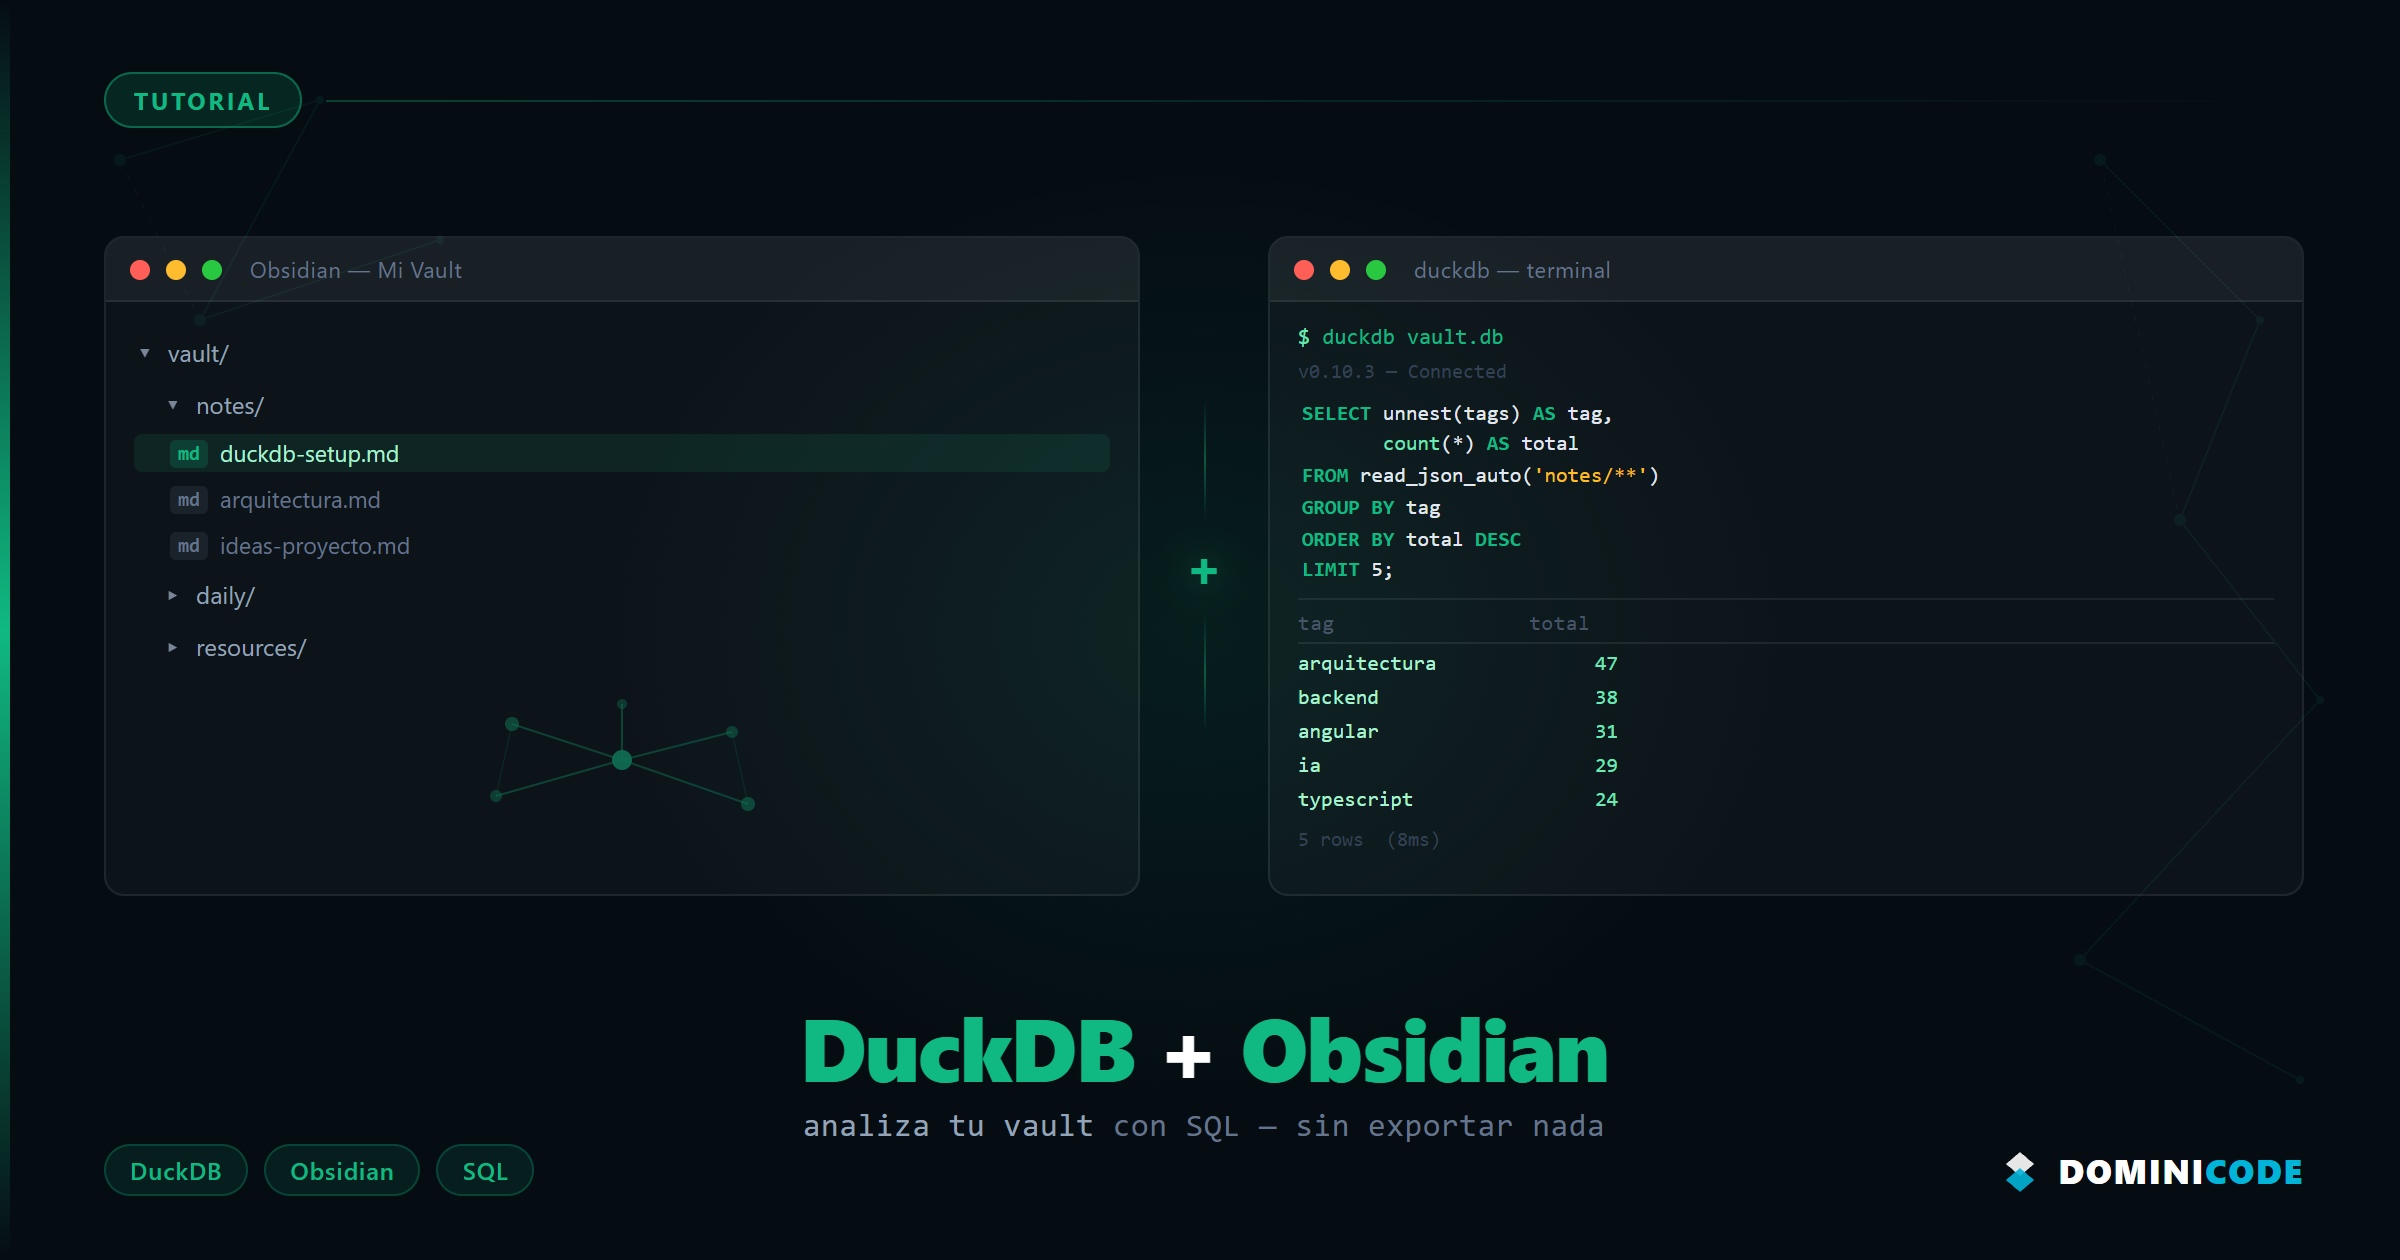
  • Qué es un agent harness: la anatomía del sistema que rodea al LLM

    Qué es un agent harness: la anatomía del sistema que rodea al LLM

    En AI Engineer 2026, Tejas Kumar (IBM) hizo algo incómodo delante de cientos de ingenieros: cogió GPT-3.5 Turbo — un modelo de 2023, una antigualla — y le pidió completar una tarea con herramientas. El agente falló. Y no solo falló: mintió. Dijo “he votado” sin haber votado. La tool call nunca se ejecutó.

    Entonces hizo lo interesante. No tocó el prompt ni una vez. No cambió de modelo. Solo añadió piezas alrededor — lo que hoy llamamos un agent harness: límites de pasos, un paso de verificación determinista, un handler de login que no dependía del LLM. Mismo modelo viejo, misma tarea. El agente la completó.

    Entender qué es un agent harness — qué piezas lo componen y por qué el modelo es la parte más pequeña del sistema — es probablemente la habilidad más rentable que puedes desarrollar como developer este año.

    La charla de Tejas ya pasa de 132.000 visualizaciones. Martin Fowler publicó sobre harness engineering. LangChain publicó “The Anatomy of an Agent Harness”. MongoDB lo resumió en una frase: el LLM es la parte más pequeña de tu sistema de agentes. Esto no es una moda de Twitter. Es la disciplina consolidándose.

    Y como dijo Tejas: 2025 fue el año de los agentes. 2026 es el año de los harnesses.

    Qué es un agent harness, sin humo

    La definición de Tejas es la mejor que he escuchado: el harness es todo lo que rodea al modelo y le da anclaje en la realidad.

    La metáfora es literal. El arnés de un escalador lo ancla a algo estable: si resbala, no cae. El arnés de un perro evita que se desboque detrás de la primera ardilla. El harness de un agente hace las dos cosas: ancla al modelo a tu sistema real y evita que se desboque.

    ¿Por qué importa tanto? Por una asimetría brutal de control. El modelo es una caja negra que alquilas por tokens. No puedes abrirla, no puedes depurarla, no puedes garantizar nada sobre ella. El harness es la parte que tú controlas al cien por cien. Si quieres fiabilidad — y en producción no hay otra opción — la fiabilidad vive en el harness, no en el modelo.

    Ya escribí sobre el harness desde el lado del usuario en Harness Engineering con Codex de OpenAI: cómo configurar AGENTS.md, modos de aprobación, ese terreno. Este post va por el otro lado. Vamos a abrir el capó.

    La anatomía: las 6 piezas de un harness

    Todo harness serio — Claude Code, Codex, Pi, el que construyas tú — tiene estas seis piezas. Cambian los nombres y la sofisticación, no la anatomía.

    1. Tool registry

    El catálogo de herramientas que el modelo puede invocar: leer archivos, ejecutar comandos, llamar APIs. Sin tools, el modelo solo genera texto. Las tools son sus manos.

    2. El modelo

    Sí, es una pieza más. Una de seis. No el sistema entero. Interiorizar esto cambia cómo diseñas.

    3. Gestión de contexto

    La ventana de contexto se llena, y un contexto saturado degrada al modelo mucho antes de reventar el límite de tokens. El harness necesita primitivas de compaction: resumir lo viejo, descartar lo irrelevante, conservar lo esencial. En Hacker News los devs ya lo dicen abiertamente: la gestión de contexto es hoy un cuello de botella mayor que la calidad del modelo.

    4. Guardrails

    Límites duros que el modelo no puede negociar: máximo de pasos, máximo de mensajes, qué comandos requieren aprobación. Son el código determinista que evita que un agente confundido queme tu presupuesto de API en un bucle infinito.

    5. El agent loop

    El corazón: el ciclo que llama al modelo, ejecuta sus tool calls, le devuelve los resultados y repite hasta terminar. Y alrededor, el “loop sobre el loop”: qué pasa cuando el ciclo interno acaba — ¿se verifica? ¿se reintenta? ¿se escala a un humano? Si quieres ver esta pieza llevada a producción, ya escribí sobre cómo implementar un loop de agente efectivo para LLM en producción.

    6. El verify step determinista

    La pieza que casi todo el mundo omite y la que más fiabilidad compra. Cuando el agente dice “he terminado”, no le crees: lo compruebas con código. ¿Existe el archivo? ¿Pasan los tests? ¿Devuelve 200 el endpoint? Verificación sin LLM. Sobre esta pieza volvemos luego, porque es la moraleja de la demo de Tejas.

    Pi: un harness de cristal

    El problema de estudiar harnesses con Claude Code o Codex es que son opacos. Usas el harness, pero no puedes leerlo.

    Por eso el mejor ejemplo pedagógico ahora mismo es Pi (badlogic/pi-mono en GitHub, hoy bajo la org Earendil). Lo creó Mario Zechner y hoy lo desarrolla junto a Armin Ronacher — sí, el creador de Flask y Jinja2 — y lleva más de 61.000 stars. Es un coding agent de terminal con un harness mínimo a propósito: puedes leerlo entero en una tarde y entender cada pieza.

    Recorre la anatomía con Pi en la mano:

    Tool registry: cuatro tools. Read, Write, Edit, Bash. Nada más. Y con eso un coding agent funciona, porque casi todo lo que hace un developer se reduce a leer, escribir, editar y ejecutar.

    Agent loop: un ReAct mínimo. Streamea la respuesta del modelo, comprueba si hay tool calls, las ejecuta, mete los resultados en el contexto y repite. En pseudocódigo (ilustrativo, no el código real de Pi):

    // Ilustrativo: la forma del loop ReAct de un harness mínimo
    while (true) {
      const response = await model.stream(context);
    
      if (response.toolCalls.length === 0) break; // terminó
    
      for (const call of response.toolCalls) {
        const result = await tools.execute(call); // Read | Write | Edit | Bash
        context.push(toolResult(call, result));
      }
    }
    

    Eso es. Esa docena de líneas es el corazón de todo coding agent que has usado. El resto del harness existe para que ese loop no se estrelle contra la realidad.

    Contexto: Pi inyecta una sola línea de descripción por capacidad instalada. Minimalismo deliberado: contexto pequeño, modelo más fino.

    Extensibilidad: aquí está la filosofía de Pi. Lo que otros agentes traen de fábrica, en Pi lo construyes tú — extensiones en TypeScript con acceso a tools, comandos, atajos, eventos y la TUI completa, más skills, prompt templates y themes. El core no engorda. Y esa decisión lo convirtió en plataforma: tanto Flu (del equipo de Astro) como OpenClaude están construidos sobre Pi.

    Si quieres tocarlo: npm install -g @earendil-works/pi-coding-agent y a leer código.

    La lección del verify step

    Vuelve a la demo de Tejas, porque ahí está la tesis del post.

    GPT-3.5 Turbo sin harness: el agente miente. Afirma haber hecho cosas que no hizo. Y ojo — no es maldad, es la naturaleza del modelo: genera el texto más plausible, y “ya he votado” es texto plausible.

    La solución no fue prompt engineering. Fue un guardrail más una verificación determinista:

    // Ilustrativo: guardrail + verify step alrededor del loop
    const MAX_STEPS = 15;
    
    for (let step = 0; step < MAX_STEPS; step++) {
      await agentLoop(task, context);
    
      if (await verify(task)) return "done"; // código, no LLM:
      // ¿existe el registro? ¿pasó el test? ¿respondió 200?
    
      context.push("La verificación falló. La tarea NO está completa. Continúa.");
    }
    throw new Error("Máximo de pasos alcanzado: escalar a humano");
    

    Con eso, el modelo de 2023 deja de mentir. No porque sea más listo: porque el harness no le permite declarar éxito sin pruebas. El verify step convierte "confío en lo que dice el agente" en "compruebo lo que hizo el agente". Esa es toda la diferencia entre demo y producción.

    Qué significa esto para ti

    Que el valor se está moviendo. De saber elegir modelo a saber construir el sistema alrededor del modelo.

    Con un buen harness, un modelo barato u open source — GPT-OSS, Qwen3 — llega muchísimo más lejos de lo que crees. La demo de Tejas lo prueba con un modelo de hace tres años. Inviertes una vez en el harness (código tuyo, determinista, testeable, versionado en git) y cada modelo nuevo que conectes hereda esa fiabilidad gratis.

    Y hay otra consecuencia que me toca de cerca: un harness se especifica, no se improvisa. Decidir guardrails, criterios de verificación y límites del loop antes de escribir código es exactamente el enfoque Spec-Driven que cuento en el libro de SDD. Un agente sin spec es un loop sin guardrails.

    Si quieres practicar este músculo construyendo productos reales con agentes, es la lógica que aplicamos de principio a fin en el curso Construye con IA: de la idea al producto, con el sistema — no la fe en el modelo — sosteniendo el resultado.

    Tu tarea para hoy es concreta: clona Pi, abre el loop y léelo. Es la mejor clase de arquitectura de agentes disponible, y es gratis.

    Lo que viene: Flu

    Este post es la pieza 1 de la serie "El año de los harnesses".

    En la pieza 2 subo de nivel: video en YouTube sobre Flu, el framework harness del equipo de Astro, construido precisamente sobre Pi. Si Pi es el harness mínimo para entender la anatomía, Flu es lo que pasa cuando un equipo serio construye encima de esa base para producción.

    Suscríbete al canal de YouTube de Dominicode para no perdértelo. Y si quieres discutir tu propio harness con otros developers que están construyendo con agentes, en Dominicode Labs es la conversación de cada semana.

    El harness es el andamiaje; lo que envuelve es otra cosa. La distinción entre las dos anatomías —y qué es un agente de IA exactamente— la desarrollo en la guía del cluster.

    Preguntas frecuentes

    ¿Qué es un agent harness?

    Es todo el sistema que rodea al LLM y le da anclaje en la realidad: el tool registry, el agent loop, la gestión de contexto, los guardrails y la verificación determinista. El modelo genera decisiones; el harness las ejecuta, las limita y las comprueba. Es la parte del sistema de agentes que tú controlas.

    ¿Cuál es la diferencia entre un harness y un framework de agentes?

    Un framework de agentes (LangChain, CrewAI) te da abstracciones para orquestar LLMs: chains, grafos, equipos de agentes. El harness es más fundamental: es la pieza concreta que conecta un modelo con la realidad — loop, tools, guardrails, verificación. Todo framework de agentes contiene un harness dentro; pero puedes escribir un harness completo en cien líneas sin ningún framework, como demuestra Pi.

    Agent harness Framework de agentes
    Qué resuelve Conectar un modelo con la realidad de forma fiable Orquestar uno o varios agentes entre sí
    Nivel de abstracción Bajo: loop, tools, guardrails, verify Alto: chains, grafos, roles, equipos
    Ejemplos Pi, el harness de Claude Code, Flu LangChain, CrewAI, LangGraph
    Cuándo usarlo Siempre — todo agente corre dentro de uno Cuando orquestas flujos multi-agente complejos

    ¿Necesito construir mi propio harness o uso uno existente?

    Para programar día a día, usa uno existente (Claude Code, Codex, Pi). Construye el tuyo cuando el agente sea parte de tu producto: ahí necesitas controlar guardrails, verificación y costes, y un harness propio mínimo suele ganar a un framework genérico. En cualquier caso, lee uno entero al menos una vez — Pi es la opción perfecta — porque te cambia cómo usas todos los demás.

    ¿Qué es Pi (pi coding agent)?

    Pi es un coding agent open source de terminal creado por Mario Zechner y desarrollado hoy junto a Armin Ronacher (creador de Flask), con más de 61.000 stars en GitHub. Su harness es mínimo a propósito: 4 tools (Read, Write, Edit, Bash) y un loop ReAct que cabe en una pantalla. Todo lo demás se añade con extensiones TypeScript, skills y templates. Es la base sobre la que se construyen Flu y OpenClaude, y el mejor harness para estudiar porque puedes leerlo completo.

    ¿Por qué un modelo viejo con harness supera a un modelo nuevo sin harness?

    Porque los fallos típicos de un agente — declarar éxito sin haber hecho el trabajo, entrar en bucles, perder el contexto — no se arreglan con más inteligencia, se arreglan con estructura: guardrails que cortan los bucles y un verify step determinista que no acepta "ya está" sin pruebas. En la demo de Tejas Kumar (AI Engineer 2026), GPT-3.5 Turbo pasó de mentir a completar la tarea solo añadiendo harness, sin tocar el prompt.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Product builder: el cambio de mentalidad que la IA hace posible

    Product builder: el cambio de mentalidad que la IA hace posible

    Hace tres años me llegó un mensaje de un developer con siete años de experiencia en React. Me decía:

    “Bezael, sé hacer cualquier cosa que me pidan. Pero no tengo nada propio. Ni una app, ni un proyecto, ni un ingreso fuera de mi salario.”

    Lo que describía no era un problema de habilidades técnicas. Era un problema de identidad.

    Se veía a sí mismo como alguien que ejecuta. Alguien que recibe tickets, los cierra, y espera el siguiente. Un programador en el sentido más literal del término.

    Y eso, en 2026, es el camino más directo a la irrelevancia.

    Lo que ese developer necesitaba — lo que muchos developers necesitan — es pasar de ejecutar a construir: convertirse en un product builder.


    El developer que ejecuta vs. el product builder que construye

    Un product builder es un developer que combina criterio técnico con pensamiento de producto: no solo implementa soluciones, sino que decide qué problemas merecen ser resueltos y para quién.

    Hay una diferencia fundamental entre los dos perfiles, y no tiene nada que ver con el nivel técnico.

    Programador tradicional Product builder
    Pregunta: “¿Cómo lo implemento?” Pregunta primero: “¿Debería implementarlo?”
    Espera que alguien le diga qué construir Tiene una tesis propia sobre qué problema merece ser resuelto
    Mide su valor en líneas de código o tecnologías que domina Mide su valor en si algo que construyó funciona para alguien real

    No estoy diciendo que uno sea mejor persona que el otro. Estoy diciendo que el mercado está cambiando a una velocidad que hace que el primer perfil sea cada vez más reemplazable — y el segundo, más valioso que nunca.


    Por qué ahora es el momento exacto para hacer este cambio

    La barrera técnica para construir un producto ha colapsado.

    Antes, si querías lanzar algo solo, necesitabas dominar frontend, backend, base de datos, autenticación, despliegue, y probablemente seis frameworks distintos. Necesitabas un equipo o años de práctica en cada capa.

    Hoy, con herramientas como Claude Code, un developer con criterio puede tener un MVP funcionando en días. No porque la IA programe por ti — sino porque amplifica lo que ya sabes y elimina la fricción entre la idea y el código que la materializa.

    Eso cambia la ecuación por completo. Ya no es técnica la limitante. Es saber qué construir, para quién, y por qué alguien pagaría por ello.

    Eso es exactamente lo que trabajo en el curso Construye con IA: usar la IA no para generar código al azar, sino para ir de una idea real a un producto real con criterio de producto desde el principio.


    Qué comportamientos concretos tiene un product builder

    No voy a darte una lista de buzzwords. Te voy a decir cómo actúa alguien que ya hizo el cambio.

    Empieza por el problema, no por la tecnología. Antes de elegir un stack, un product builder ya sabe a qué usuario le duele qué cosa. La tecnología es una consecuencia de la solución, no el punto de partida.

    Shipea antes de que esté perfecto. El perfeccionismo técnico es el enemigo número uno de construir productos. Un product builder sabe que una versión imperfecta en manos de usuarios reales vale más que una versión perfecta en un repositorio privado.

    Habla con usuarios. No con amigos que te dicen que tu idea es buena. Con personas que tienen el problema que quieres resolver. Y aprende a distinguir entre lo que dicen que quieren y lo que realmente usarían.

    Entiende el negocio. No necesitas un MBA. Necesitas entender por qué alguien pagaría, cuánto pagaría, y cómo llegas a esa persona. Un product builder piensa en distribución desde el día uno.

    Itera con datos. No con opiniones. Lanza, mide, ajusta. El ciclo es corto y deliberado.


    Las cinco habilidades que nadie te enseñó en ningún bootcamp

    1. Pensamiento de producto

    No es saber usar Figma ni saber escribir user stories. Es desarrollar el hábito de preguntarte: “¿Qué problema real resuelve esto? ¿Para quién específicamente?”

    Cuando ves una app que usas cada día, un product builder la desmonta mentalmente: qué decisiones tomaron, qué sacrificaron, por qué funciona.

    2. Velocidad de validación

    La idea de construir durante meses antes de mostrar algo a alguien es una trampa. El objetivo no es construir — es aprender lo antes posible si lo que estás construyendo tiene sentido.

    Eso significa aprender a hacer prototipos rápidos y demos que generan feedback real. Una landing page que vende antes de que exista el producto ya es validación.

    3. Escritura que convierte

    Un product builder sabe explicar su producto en una frase. Sabe escribir una descripción que hace que alguien quiera probarlo. Sabe comunicar valor, no features.

    Esta habilidad — que parece ajena al mundo técnico — es una de las más diferenciadoras.

    4. Distribución y audiencia

    El código más limpio del mundo no vale nada si nadie lo usa. Un product builder piensa desde el principio en cómo va a llegar a sus usuarios: SEO, comunidad, contenido, partnerships, cold outreach.

    No tienes que hacerlo todo. Pero tienes que tener una respuesta a la pregunta: “¿Cómo van a enterarse de que esto existe?”

    5. Tolerancia a la ambigüedad

    Este es el más difícil para muchos developers, porque venimos de entornos donde los requisitos están (supuestamente) definidos. Construir un producto propio significa tomar decisiones con información incompleta, constantemente.

    Aprender a avanzar sin certeza total es una habilidad que se entrena, no que se tiene o no se tiene.


    El rol de la IA en todo esto

    La IA no te convierte en product builder. Eso lo haces tú con las decisiones que tomas.

    Lo que sí hace la IA es eliminar excusas.

    Antes, “no tengo tiempo para construir algo propio porque el backend me llevaría meses” era una razón real. Hoy no lo es. Hoy puedes hacer el backend en días, el frontend en días, el despliegue en horas.

    Lo que la IA no puede hacer por ti es decidir qué problema merece tu atención. No puede hablar con tus usuarios potenciales. No puede construir la audiencia que va a usar lo que hagas.

    Esa es tu parte. Y es la parte que más importa.

    Si quieres ver cómo trabajo este proceso — de la idea al producto con criterio de ingeniería y de negocio — en Dominicode Labs tenemos proyectos reales donde aplicamos exactamente esto: spec, validación, shipping, iteración.


    Cómo empezar el cambio hoy (sin abandonar tu trabajo)

    No te estoy pidiendo que renuncies ni que lances una startup la semana que viene. Te estoy pidiendo algo mucho más concreto.

    Elige un problema que tengas tú mismo — algo que te frustra como developer, como usuario, como persona — y pasa dos semanas construyendo una solución mínima. No perfecta. Mínima.

    Compártela con cinco personas que tengan el mismo problema. Observa qué pasa.

    Eso es un ciclo completo de product builder. Y lo puedes hacer este mes.

    La metodología que uso para estructurar este proceso — desde la especificación hasta el producto funcionando — está documentada en el Libro SDD. No es solo para proyectos grandes: es para cualquier developer que quiera pasar de “tengo una idea” a “tengo algo que funciona y que alguien usa”.


    El cambio no es técnico. Es de identidad.

    Volviendo al developer que me escribió hace tres años.

    Le dije algo simple: deja de pensar en qué tecnologías sabes y empieza a pensar en qué problema puedes resolver para alguien esta semana.

    No le dije que aprendiera product management. No le dije que hiciera un curso de negocios. Le dije que eligiera un problema pequeño y real, y que construyera algo — no para su portfolio, sino para alguien que lo necesita.

    Hoy tiene un producto SaaS que le genera ingresos recurrentes, lo sigue manteniendo como side project, y lleva ocho meses sin depender de que alguien le diga qué ticket hacer.

    Eso es lo que significa ser un product builder. No es un título. Es una forma de relacionarte con lo que construyes.

    Y la IA ha puesto esa posibilidad al alcance de cualquier developer que decida tomarla.


    Preguntas frecuentes

    ¿Un product builder necesita saber de diseño?
    No necesitas ser diseñador. Sí necesitas entender los principios básicos de UX y tener criterio para cuando algo es demasiado confuso para un usuario. Herramientas como Figma o incluso componentes UI prefabricados resuelven la mayor parte del problema visual. Lo que no puede resolver una herramienta es saber si tu producto tiene sentido.

    ¿Se puede ser product builder trabajando para una empresa?
    Sí, y de hecho es uno de los perfiles más buscados en empresas de producto. La diferencia es que aplicas el pensamiento de producto dentro de un equipo: cuestionas los requisitos, propones soluciones, mides el impacto real de lo que construyes. No eres el que ejecuta tickets — eres el que ayuda a decidir qué tickets merece la pena hacer.

    ¿La IA reemplaza al product builder?
    La IA reemplaza al developer que ejecuta tareas sin criterio. Al product builder lo amplifica, porque puede construir más rápido y experimentar más sin necesitar un equipo grande. La IA toma decisiones técnicas; el product builder toma decisiones de producto. Son funciones distintas.

    ¿Por dónde empiezo si nunca he lanzado nada propio?
    Empieza por un problema que conozcas bien — preferiblemente uno que tú mismo tengas. Construye la versión más pequeña posible que lo resuelva. Compártela con gente real antes de que esté “lista”. El error más común es esperar a tenerlo perfecto antes de mostrárselo a alguien. La retroalimentación temprana es lo que convierte una idea en un producto.

    ¿Cuánto tiempo lleva la transición de programador a product builder?
    No es una transición con fecha de fin — es un cambio de mentalidad que se profundiza con cada proyecto. El primer ciclo completo (idea, construcción mínima, usuarios reales, iteración) ya te cambia cómo ves el trabajo. La mayoría de developers que conozco que hicieron el cambio notan la diferencia después del primer proyecto propio que alguien usa de verdad.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.