Category: Arquitectura de Software

  • AI software factory: qué es y por qué falla sin contrato

    AI software factory: qué es y por qué falla sin contrato

    El 6 de febrero de 2026 un equipo de tres personas de StrongDM publicó un manifiesto con dos reglas. La primera: el código no lo escriben humanos. La segunda: el código no lo revisan humanos.

    Al día siguiente el texto llegó a portada de Hacker News. Un comentario resumía la reacción de media sala: "I feel like I'm taking crazy pills". La otra media lo leía como el primer plano de una AI software factory de verdad.

    Casi nadie discutía qué modelo usaban. Discutían cómo sabes que funciona un software que ningún humano ha escrito ni leído.

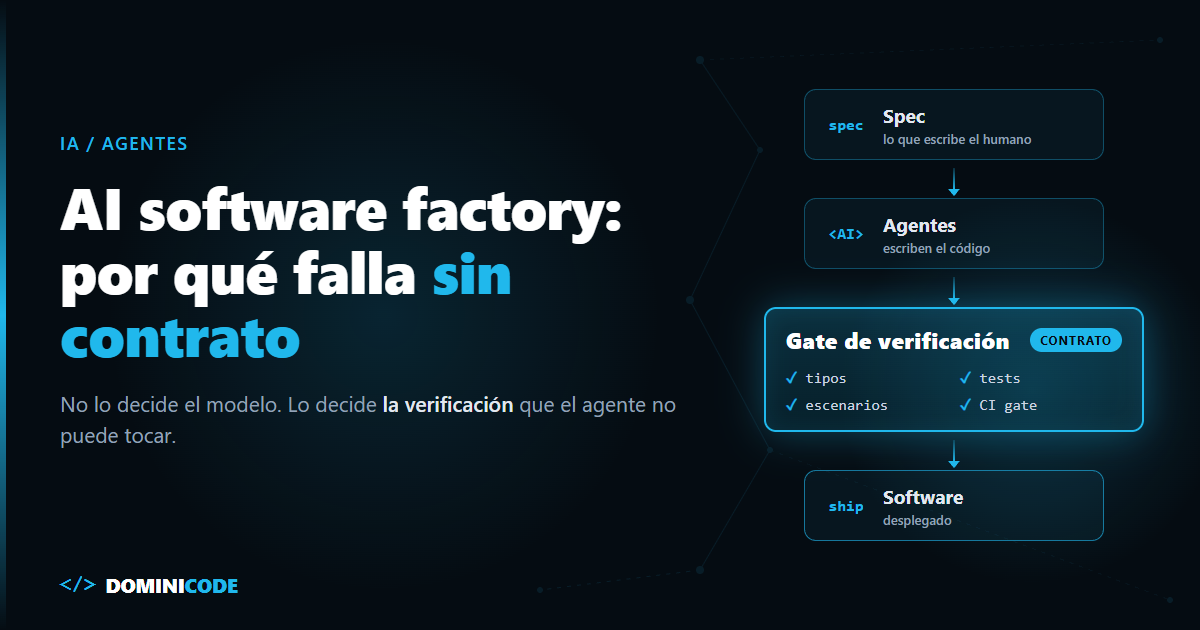
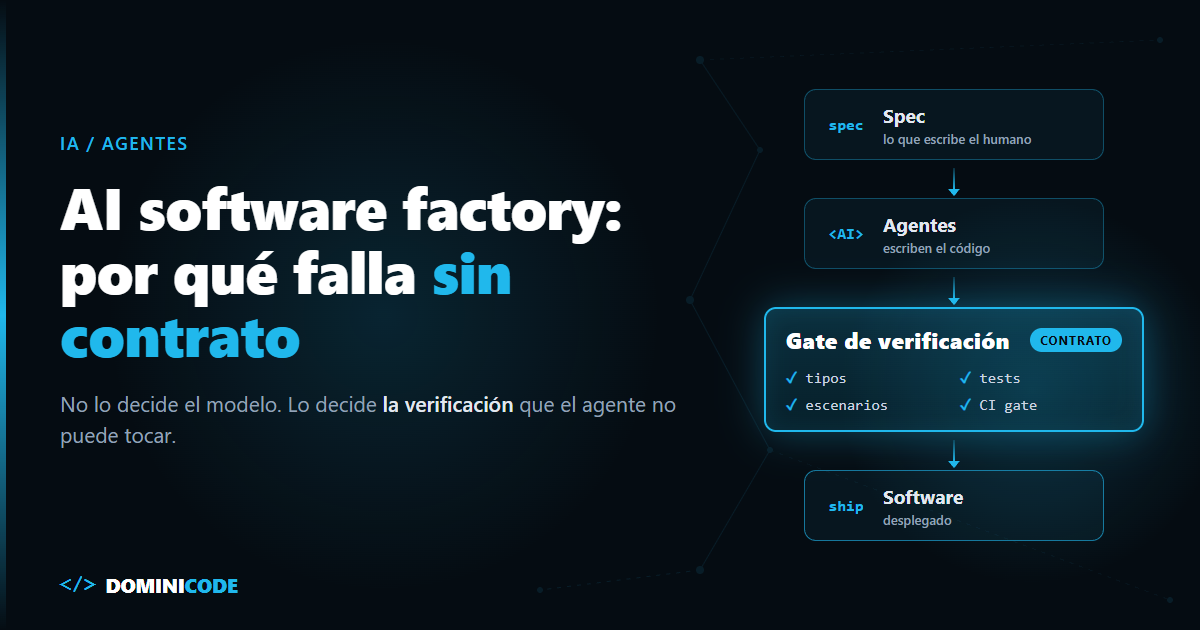
    En corto: una AI software factory es un pipeline donde agentes de IA convierten especificaciones en software desplegado, y los humanos solo escriben specs y juzgan resultados. Lo que decide si funciona no es el modelo, sino el harness de verificación: tests, tipos, escenarios y gates de CI que el agente no puede manipular.

    ¿Qué es una AI software factory?

    Una AI software factory (fábrica de software con IA) es un sistema en el que agentes de IA escriben, prueban e integran código a partir de especificaciones, y donde la calidad la garantiza un sistema de verificación automatizado en lugar de la revisión humana línea a línea.

    StrongDM lo define en su propio manifiesto como "non-interactive development where specs + scenarios drive agents that write code": desarrollo no interactivo donde specs y escenarios dirigen a agentes que escriben código.

    Fíjate en lo que falta: el prompt. Nadie chatea con el agente. Hay una entrada (la spec), una salida (el software) y un control de calidad entre medias.

    ¿Quién usa el término AI software factory y qué hay detrás?

    Hoy el término lo usan cuatro actores: StrongDM y OpenAI para describir cómo producen software sin escribir código a mano, Dan Shapiro para su escala de autonomía, y Factory como marca comercial. Solo los dos primeros publican cómo verifican.

    Quién Qué afirma Evidencia Limitación o riesgo
    StrongDM (feb. 2026) Equipo de 3 personas desde julio de 2025; "code must not be written by humans" ni revisado por humanos Manifiesto propio, técnicas publicadas y análisis de Simon Willison Su regla práctica: si no gastas 1.000 USD en tokens al día por ingeniero, a tu fábrica le queda margen; no publican métricas de producto entregado
    Dan Shapiro (ene. 2026) Seis niveles de autonomía (0 a 5); el 5 es la "dark factory" Lo que ha visto en decenas de empresas No es una encuesta; los porcentajes son estimaciones del autor
    OpenAI, harness engineering (feb. 2026) Un producto interno en beta de alrededor de un millón de líneas en cinco meses, con cero código escrito a mano (InfoQ, The Neuron) Cifras autodeclaradas, repetidas por dos medios (lo analizo aquí) Lo hace el fabricante del modelo, con acceso y presupuesto que tu equipo no tiene
    Factory (antes Factory.ai) "Build Your Software Factory": agentes llamados Droids que trabajan desde terminal, Slack, Jira, Linear y CI Página comercial Es un producto; el término es su posicionamiento de marca

    Mi lectura: StrongDM y OpenAI describen cómo verifican, y eso es lo valioso. Factory describe dónde se ejecutan los agentes, que es lo fácil.

    Las piezas de una fábrica de software con IA

    Una fábrica de software con IA tiene cinco piezas, y solo una de ellas es el modelo.

    1. Specs. La entrada de la línea. Si es ambigua, el agente rellena huecos con lo más frecuente en su entrenamiento, no con lo que pide tu negocio. Es Spec-Driven Development sin humanos en medio; lo desarrollo en el libro de Spec-Driven Development.

    2. Agentes. Claude Code, Codex, Droids. La pieza más intercambiable.

    3. Harness de verificación. Tests, tipos estrictos, linters, tests estructurales de arquitectura y escenarios end-to-end. Según InfoQ, OpenAI impone los límites de arquitectura "through mechanical rules and structural tests". No los pide en el prompt.

    4. CI como gate. Nada llega a main sin pasar el harness.

    5. Revisión. En StrongDM la revisión humana desaparece y la sustituye una métrica que llaman satisfaction: de todas las trayectorias observadas en todos los escenarios, qué fracción probablemente satisface al usuario. En el resto del mundo, la revisión sigue siendo humana pero cambia de objeto: revisas el contrato, no cada diff.

    Por qué la verificación decide si una AI software factory funciona

    El cuello de botella de una AI software factory es la verificación, no la generación de código. Generar código ya es barato. Saber si es correcto sigue siendo caro.

    Si el mismo agente escribe el código y los tests, optimiza para que los tests pasen, no para que el software funcione. En el hilo de Hacker News sobre StrongDM, el usuario Zakodiac lo dijo sin rodeos: "agents will absolutely game your test suite".

    La respuesta de StrongDM es la idea más útil de todo su manifiesto: guardar los escenarios, a menudo, fuera del repositorio, como el holdout set de un modelo de machine learning. El agente nunca los ve, así que no puede adaptarse a ellos.

    En la práctica se parece a esto:

    # .github/workflows/factory-gate.yml
    name: factory-gate
    on: pull_request
    jobs:
      holdout:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v7
          # Los escenarios viven en otro repo, sin acceso de escritura para el agente
          - uses: actions/checkout@v7
            with:
              repository: acme/checkout-scenarios
              path: scenarios
              token: ${{ secrets.SCENARIOS_READ_TOKEN }}
          - run: npm ci && npm run typecheck && npm test
          - run: npx playwright install --with-deps
          - run: npx playwright test --config scenarios/playwright.config.ts
    

    Tipos y tests en el repo, y escenarios que el agente no puede leer ni editar. Si una capa falla, el PR no entra. Protege también el workflow con CODEOWNERS y protección de rama; si no, el agente puede editar el propio gate.

    Otro comentario del mismo hilo, de CuriouslyC, pone el límite donde toca: "Until we solve the validation problem, none of this stuff is going to be more than flexes."

    Por eso defiendo que la pieza central es un contrato: reglas de negocio expresadas como tipos, tests y escenarios, no como frases en un prompt. Lo explico paso a paso en el tutorial de harness engineering y en el método de revisión por contrato.

    En qué nivel de autonomía está la mayoría de equipos hoy

    Según Dan Shapiro, el 90 % de los developers que se llaman "AI-native" está en el nivel 2 de su escala de seis niveles, y casi todos tocan techo en el 3. No cita fuente ni método: es su observación tras ver "decenas de empresas", no un estudio. La escala, de enero de 2026, se inspira en la conducción autónoma:

    Nivel Analogía de Shapiro Qué hace el developer
    0 El Volvo de tus padres Escribe todo el código
    1 Control de carril Delega tareas pequeñas y aisladas
    2 Autopilot en autopista Programa en pareja con la IA, en flujo
    3 Waymo con conductor de seguridad La IA escribe; él revisa diffs ("your life is diffs")
    4 Robotaxi Escribe specs y planes; vuelve horas después a ver si pasan los tests
    5 Dark factory Una caja negra que convierte specs en software

    Mi opinión: el salto que paga es del 2 al 4, no del 4 al 5. En el nivel 4 sigues escribiendo la spec y juzgando el resultado, pero dejas de leer cada línea porque el harness lo hace por ti. Eso ya es una fábrica, y es el mismo salto que describo en los niveles de Spec-Driven Development. La dark factory completa es un caso extremo, no la meta por defecto. Si quieres ver el ciclo completo de contexto entre esos niveles, está en el post de SDLC context engineering.

    Cuándo NO montar una AI software factory

    Una AI software factory no es gratis ni universal. No la montaría en estos casos.

    Cuando no tienes tests ni tipos fiables. Si tu suite actual no detecta regresiones con humanos escribiendo el código, tampoco las detectará con agentes. Multiplicarás la velocidad de los errores. Primero el harness, después la fábrica.

    Cuando el trabajo consiste en descubrir qué hay que construir. Para validar su fábrica, StrongDM construyó réplicas de servicios con API pública documentada (Okta, Jira, Slack): ahí la spec ya existe. En el hilo de HN, softwaredoug lo señaló: "most development work involves discovering correctness, not writing to a fullproof spec (like cloning slack)". Si la spec no existe todavía, no hay nada que fabricar.

    Cuando el coste no cuadra. La guía de StrongDM habla de al menos 1.000 USD en tokens al día por ingeniero. Simon Willison lo traduce a unos 20.000 USD al mes por persona y admite que, a ese precio, el enfoque le resulta "far less interesting".

    Cuando un fallo es inaceptable y nadie lo revisa. Software de seguridad, pagos o salud. Un antiguo cliente de StrongDM escribió en el hilo que para un producto de seguridad central eso no era el "flex" que creían.

    Por dónde empezar con una fábrica de software con IA

    No montes la fábrica. Monta el contrato.

    Es el camino que sigo con el método de Revisión por Contrato (Contract Based Review Method), y cabe en cuatro pasos:

    1. Un Issue, una spec. Elige un módulo con reglas de negocio claras. Antes de que el agente escriba una línea, firma su spec: qué cambia, criterios de aceptación ejecutables y qué archivos puede tocar.
    2. Un harness que corre solo. Tipos, lint y tests en un bucle corto tras cada cambio, y el bucle largo en CI en cada PR. Si depende de que te acuerdes de lanzarlo, no es verificación.
    3. Un veredicto en lugar del diff. Un comando ejecuta cada criterio de la spec y comprueba que el agente no salió de su alcance. Lees ese veredicto, no el diff.
    4. Criterios fuera de su alcance. Protege la spec y el harness con CODEOWNERS y protección de rama, o mueve los escenarios a otro repo. Si el agente puede editar el gate, lo editará.

    Después deja que el agente implemente una feature entera sin que leas el diff, y mira solo el veredicto.

    Si pasa y el comportamiento es correcto, has subido un nivel. Si pasa y es incorrecto, has encontrado el agujero de tu contrato: la información más valiosa de tu semana.

    Si quieres empezar sin pagar nada, el ebook gratuito El Developer Agéntico cubre cómo construir agentes de IA, de la arquitectura a la seguridad y la evaluación.

    Ese recorrido, del Issue a una PR con veredicto, es el workshop SDD + Agentic Engineering: la spec como contrato, hooks y CI que corren solos, y un veredicto que comprueba cada criterio y el alcance del diff. Primero en un repo de práctica, después en el tuyo. Y si prefieres construir un producto completo con Claude Code aplicando estas ideas, está el curso Construye con IA: de la idea al producto.

    Preguntas frecuentes

    ¿Qué diferencia hay entre una AI software factory y usar Claude Code o Copilot?

    Usar un asistente es trabajo interactivo: tú pides, revisas y corriges en cada paso. Una AI software factory es no interactiva: los agentes trabajan a partir de una spec y un sistema automatizado decide si el resultado es aceptable, sin que nadie siga la sesión.

    ¿Qué es una dark factory en desarrollo de software?

    Es el nivel 5 de la escala de Dan Shapiro: un proceso donde las specs entran y el software sale sin desarrollo ni revisión humana en medio. El término viene de las fábricas industriales que funcionan con las luces apagadas porque no hay personas dentro.

    ¿Qué relación tiene una fábrica de software con IA con SDD?

    Spec-Driven Development aporta la entrada de la fábrica: specs precisas que el agente puede ejecutar sin interpretar. Sin SDD, el agente rellena los huecos de la spec con lo más frecuente en su entrenamiento. Con SDD, esas reglas se convierten en tipos, tests y escenarios que el harness comprueba.

    ¿Los agentes pueden escribir sus propios tests en una AI software factory?

    Pueden escribir tests unitarios, pero no deberían controlar la verificación final. Si el mismo agente escribe el código y todos los tests, tenderá a ajustar los tests al código. Los escenarios de aceptación deben vivir fuera de su alcance.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Entrevista de system design: cómo prepararla en 3 semanas

    Entrevista de system design: cómo prepararla en 3 semanas

    En la entrevista de system design, el entrevistador dice: "Diseña un acortador de URLs". Dos minutos después el candidato ya tiene en la pizarra un load balancer, tres servidores y una caché Redis con una flecha que no va a ningún sitio.

    No ha preguntado cuántas URLs se crean al día. Ni si los enlaces caducan. Ni si hace falta analítica de clics.

    Puede saber más de sistemas distribuidos que el entrevistador y aun así suspender, porque lo evaluado no era el dibujo final, sino el camino hasta él.

    En corto: una entrevista de system design no premia la arquitectura "correcta", premia cómo llegas a ella: aclarar requisitos, estimar la escala, justificar cada trade-off y explicarlo en voz alta. Se prepara con un guion de seis fases con tiempos, unas pocas piezas de vocabulario bien entendidas y diseños practicados en voz alta. Si ya tienes experiencia intermedia o senior, tres semanas de práctica deliberada suelen bastar para ordenar lo que sabes.

    ¿Qué es una entrevista de system design?

    Una entrevista de system design es una conversación de 45 a 60 minutos en la que diseñas, a partir de un enunciado vago, la arquitectura de un sistema realista, y el entrevistador evalúa cómo acotas el problema, razonas la escala y defiendes tus decisiones.

    No hay solución única. La guía de interviewing.io (consultada en noviembre de 2026) lo dice así: "There is not a single “best” solution to a system design problem". Buscan "well-reasoned, qualified decisions based on engineering trade-offs".

    La base conceptual está en qué es system design y en el vocabulario de system design. Aquí voy a la entrevista.

    Qué evalúa el entrevistador en una entrevista de system design

    Evalúa cuatro señales, y ninguna es "sabe Kafka".

    La primera: si aclaras antes de diseñar. El enunciado es vago a propósito; preguntar por usuarios, volumen y requisitos no funcionales es parte de la prueba.

    La segunda: si estimas. Basta el orden de magnitud. 40 escrituras por segundo y 40.000 piden arquitecturas distintas.

    La tercera: los trade-offs. Si eliges SQL, di por qué no NoSQL. Si metes una cola, di qué consistencia pierdes.

    La cuarta: la comunicación. Cinco minutos pensando en silencio son, para el entrevistador, cinco minutos sin datos.

    Es la disciplina de escribir una spec antes de programar, la que defiendo en el libro de Spec-Driven Development, aplicada a una pizarra.

    Cómo repartir los 45-60 minutos: el framework por fases

    Usa un guion de seis fases y vigila el reloj. El libro de Alex Xu, según la reseña de Gergely Orosz, reparte una hora en unos minutos para entender, 10-15 de alto nivel, 10-25 de deep dive y unos pocos para cerrar. Esta es mi versión más granular. Para 45 minutos, recorta el deep dive.

    Fase Minutos (sobre 60) Qué produces Error típico
    1. Requisitos funcionales y no funcionales 5-8 Lista de 3-5 funcionalidades y metas de latencia, disponibilidad y consistencia Saltársela
    2. Estimaciones 3-5 QPS de lectura y escritura, almacenamiento, ratio lectura/escritura Calcular con decimales en vez de órdenes de magnitud
    3. API y modelo de datos 5-8 2-4 endpoints y las entidades principales Diseñar el esquema completo
    4. Diseño de alto nivel 10-12 Diagrama de punta a punta que ya funciona Optimizar antes de que funcione
    5. Deep dive 15-20 Uno o dos componentes a fondo, elegidos con el entrevistador Elegir el componente que dominas, no el crítico
    6. Cuellos de botella y trade-offs 5-7 Puntos únicos de fallo, qué pasa a 10x, qué sacrificarías No dejar tiempo

    Orosz añade un consejo, sin ponerse rígido: no empieces el deep dive en los primeros 10 minutos.

    Ejemplo de entrevista de system design: un acortador de URLs

    Las cifras son cálculo propio con supuestos que dirías en voz alta. Puedes recalcularlas.

    Requisitos. Crear un enlace corto y redirigir al visitarlo. No funcionales: baja latencia en la redirección, alta disponibilidad, códigos no adivinables.

    Estimaciones. Supuestos: 100 millones de URLs nuevas al mes, ratio lectura/escritura 100:1, 500 bytes por registro, retención de 5 años.

    Magnitud Cálculo Resultado
    Escrituras por segundo 100 M / (30 × 86.400 s) ≈ 39/s
    Lecturas por segundo 39 × 100 ≈ 3.900/s (pico ×2 ≈ 7.800/s)
    URLs en 5 años 100 M × 12 × 5 6.000 M
    Almacenamiento 6.000 M × 500 B 3 TB
    Espacio de claves base62, 7 caracteres 62⁷ ≈ 3,5 billones (3,5 × 10¹²)
    Caché (20 % de las lecturas diarias) (100 M × 100 / 30) × 20 % × 500 B ≈ 33 GB, cota superior

    Conclusión: lee mucho y escribe poco, así que la caché es la decisión que más importa. 3 TB caben en una base de datos bien indexada; el sharding no es lo primero que discutiría.

    API. POST /urls con la URL larga devuelve el código. GET /{code} devuelve la redirección.

    Alto nivel. Load balancer, servicio sin estado, caché clave-valor y base de datos con code como clave primaria.

    Deep dive. ¿Redirección 301 o 302? La 301 es permanente: el navegador la cachea y descarga tu servidor, pero dejas de ver los clics repetidos. La 302 pasa siempre por ti y te da analítica a cambio de tráfico. La correcta es la que encaja con el requisito que aclaraste en el minuto 3.

    Para el código: un hash truncado a 7 caracteres obliga a gestionar colisiones; un contador en base62 no colisiona, pero genera códigos secuenciales adivinables. Si el requisito dice "no adivinables", lo dices y eliges.

    Para defender la caché, la tabla "Latency numbers every programmer should know" del system-design-primer, que enlaza entre sus fuentes dos charlas de Jeff Dean, da 100 ns para leer memoria principal, 150 µs para leer 4 KB al azar de un SSD y 500 µs para un viaje de ida y vuelta en el mismo datacenter. Úsalos como órdenes de magnitud, no como mediciones de tu hardware: lo que importa es que la memoria es unas mil veces más rápida que un SSD y que la red añade otro salto.

    Frontend system design: qué cambia

    El cliente pasa a ser el protagonista y el servidor, una caja negra con API. GreatFrontEnd lo estructura con el framework RADIO: Requirements, Architecture, Data model, Interface, Optimizations.

    Criterio Backend system design Frontend system design
    Estimación QPS, almacenamiento, ancho de banda Tamaño del bundle, número de nodos del DOM, peticiones por interacción
    Deep dive frecuente Caché, sharding, colas, consistencia Paginación, virtualización de listas, caché de peticiones, accesibilidad
    Trade-off estrella Consistencia frente a disponibilidad Renderizado en servidor frente a cliente, frescura frente a velocidad percibida
    Riesgo al prepararla Memorizar diagramas de empresas grandes Hablar de un framework concreto en vez del diseño

    Si vienes de Angular, ya practicas buena parte: dónde vive el estado, qué se renderiza en servidor, qué se carga en diferido. En el curso de Angular Moderno trabajamos signals y arquitectura de componentes, justo las piezas que te piden razonar.

    Plan de estudio de 3 semanas para preparar system design

    Tres semanas, una o dos horas al día. Yo empezaría por el proceso, no por la tecnología.

    Semana 1: fundamentos y guion. Caché, load balancing, replicación, sharding, colas y teorema CAP. Aprende la tabla de potencias de dos y los órdenes de latencia. Practica solo la fase de requisitos con cinco enunciados.

    Semana 2: diseños completos. Uno al día, cronometrado y en voz alta: acortador, feed, chat, notificaciones, rate limiter. Repasa patrones de deep dive como la arquitectura orientada a eventos o CQRS. Si es frontend, cambia dos por un autocompletado y un feed infinito.

    Semana 3: simulacros. Tres como mínimo, con otra persona o con un LLM de entrevistador. Graba uno y escúchalo: te oirás callado más tiempo del que crees.

    Errores que hacen suspender una entrevista de system design

    Suspende sobre todo el proceso, no el diagrama:

    1. Dibujar antes de preguntar.
    2. Soltar "aquí pongo Kafka" sin decir qué resuelve.
    3. Callarse: solo se evalúa lo que se oye.
    4. Aferrarse al primer diseño cuando cambian un requisito, que es una invitación a adaptarte.
    5. Quedarse sin tiempo para los cuellos de botella: un diseño sin "esto falla cuando…" suena a alguien que nunca operó un sistema en producción.

    El papel de la IA al preparar system design

    Como sparring, un LLM es útil: pídele que haga de entrevistador, que no te dé la solución, que cambie un requisito a mitad y que critique tus trade-offs.

    Como muleta durante la entrevista, no. Es deshonesto y te deja expuesto en cuanto te preguntan "¿por qué?" dos veces seguidas. Practicas con IA para no necesitarla en la entrevista. Para usarla con método fuera de ella, está el curso Construye con IA.

    Límites de este enfoque

    Memorizar diseños tiene techo. En un hilo de Hacker News de 2022, alguien contaba que un compañero suyo planteó una pregunta típica del libro System Design Interview, el candidato dio la respuesta perfecta y aun así al autor del hilo le quedaron dudas sobre su experiencia real. Uno respondió "Canned questions deserve canned answers". Otro defendió contratarlo y no penalizar la preparación, pero añadió: "If someone giving you a correct answer is concerning, just change the questions that you use". Eso es lo que pasa en la práctica: cambian un requisito y el diagrama memorizado no te salva.

    El framework rígido falla cuando la entrevista de system design es conversacional. Si el entrevistador te lleva a un componente en el minuto cinco, sigue su ritmo y usa las fases como lista de comprobación.

    Tres semanas no sustituyen la experiencia: el plan te enseña a expresar lo que sabes, no te da criterio sobre sistemas que nunca operaste.

    Cómo empezar hoy a preparar la entrevista de system design

    Haz un simulacro de 45 minutos esta semana. Elige un enunciado, pon el temporizador y diseña en voz alta empezando por preguntas, no por cajas. Si en el minuto 8 todavía no has dibujado nada, vas bien.

    Antes, cuida el filtro previo: un CV que pase el ATS y, si apuntas fuera, el trabajo remoto en USD.

    Preguntas frecuentes

    ¿Cuánto dura una entrevista de system design?

    Entre 45 y 60 minutos. Dedica los primeros 5-8 a requisitos y los últimos 5-7 a cuellos de botella; si son 45, recorta el deep dive.

    ¿Qué preguntas de system design son las más habituales?

    En backend, acortador de URLs, feed, chat, notificaciones y rate limiter. En frontend, autocompletado, feed infinito y editores colaborativos. Practícalas para entrenar el proceso, no para memorizar respuestas.

    ¿Se pide system design a perfiles junior?

    Es poco habitual. Aparece sobre todo en procesos para perfiles intermedios y senior, y la exigencia sube con el nivel.

    ¿Tengo que dar números exactos en las estimaciones?

    No. Se evalúa el orden de magnitud y la conclusión que sacas, por ejemplo que hace falta una caché. Redondea y di los supuestos en voz alta.

    ¿Puedo usar ChatGPT o Claude para preparar la entrevista?

    Sí, como entrevistador simulado que no te da la solución y te cambia requisitos. No como ayuda durante la entrevista real.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Arquitectura orientada a eventos en el frontend: 5 problemas

    Arquitectura orientada a eventos en el frontend: 5 problemas

    Pulsas "Cancelar pedido". El botón responde, sale un toast verde, la API devuelve 202 Accepted. Recargas la lista para comprobarlo y el pedido sigue ahí, en estado "Pagado", como si no hubieras hecho nada.

    Vuelves a pulsar. Ahora hay dos solicitudes de cancelación en una cola que no ves. Abres un ticket de soporte. Diez segundos después, el pedido aparece cancelado.

    Nadie ha roto nada. El backend migró a una arquitectura orientada a eventos y el frontend siguió programado como si cada petición devolviera la verdad al instante.

    En corto: con una arquitectura orientada a eventos en el backend, el frontend deja de recibir la verdad en la respuesta HTTP: le llega tarde, desordenada y a veces incompleta. Los cinco problemas típicos son la consistencia eventual visible, la UI optimista sin reconciliación, los eventos fuera de orden o duplicados, los huecos tras una reconexión y el acoplamiento al schema del backend. Se resuelven con versión por entidad, estados de sincronización explícitos y validación en el borde.

    ¿Qué cambia en el frontend con una arquitectura orientada a eventos?

    La arquitectura orientada a eventos es un estilo en el que los servicios se comunican publicando hechos ya ocurridos ("pedido cancelado") en lugar de llamarse entre sí, de modo que, para el frontend, cada escritura se confirma de forma asíncrona y el estado que lee converge con retraso.

    Tu POST ya no significa "hecho". Significa "recibido, ya veremos". Si el backend usa CQRS, el modelo de lectura se actualiza cuando el proyector procese el evento, como explico en cómo sincronizar el read model en CQRS.

    El lado servidor (idempotencia de consumidores, outbox, colas de mensajes fallidos) es otra historia. Aquí hablo de lo que le pasa a tu pantalla.

    Los 5 problemas de la arquitectura orientada a eventos en el frontend

    # Síntoma en la UI Causa Solución Coste o riesgo de la solución
    1 Guardo, recargo y mi cambio no está El read model aún no ha procesado el evento Devolver versión en la respuesta y esperar a verla (evento o polling acotado) Más lógica de espera; hace falta un timeout con salida clara
    2 La UI dice "hecho" y minutos después falló UI optimista sin estado pending ni rollback Estados pending / confirmed / failed y compensación visible Más estados que diseñar y testear
    3 Un dato vuelve a un valor antiguo Eventos fuera de orden o duplicados por WebSocket/SSE Versión por entidad: descartar todo evento con versión ≤ la actual El backend tiene que emitir una versión monotónica por entidad
    4 Dos pestañas muestran datos distintos Se cayó el socket y se perdieron eventos id: en SSE + resync con snapshot al reconectar Una petición extra en cada reconexión
    5 Un deploy del backend rompe una pantalla El cliente consume eventos de dominio crudos Eventos de integración pensados para el cliente + Zod en el borde Una capa más (BFF o traductor) que mantener

    Problema 1: consistencia eventual que el usuario sí ve

    La respuesta corta: no relances la lectura a ciegas; pide al backend la versión que generó tu escritura y espera a verla.

    El patrón roto es post().then(() => refetch()). Ese refetch llega antes que el proyector y lee el estado viejo. El usuario ve su cambio "deshecho".

    La garantía que necesitas se llama read-your-own-writes. Para dársela desde el cliente, la respuesta del comando debe incluir algo comparable: la versión resultante de la entidad.

    // La API responde 202 con la versión que asignó al aceptar el comando (el backend debe conocerla ya)
    type CommandAccepted = { orderId: string; expectedVersion: number };
    
    async function waitForVersion(
      { orderId, expectedVersion }: CommandAccepted,
      read: (id: string) => Promise<{ version: number }>,
      { attempts = 5, delayMs = 400 } = {},
    ): Promise<boolean> {
      for (let i = 0; i < attempts; i++) {
        const current = await read(orderId);
        if (current.version >= expectedVersion) return true;
        if (i < attempts - 1) await new Promise((r) => setTimeout(r, delayMs * (i + 1)));
      }
      return false; // no ha convergido: la UI lo dice, no lo esconde
    }
    

    Si ya tienes un stream de eventos abierto, no hagas polling: espera al evento con esa versión.

    Problema 2: UI optimista sin rollback

    La respuesta corta: una UI optimista sin estado pending no es optimista, es mentirosa.

    El debate es viejo. En el hilo de Hacker News sobre la UI optimista de Meteor, de mayo de 2015, un usuario lo planteó sin rodeos: "Isn't this just lying to the user?". Las respuestas del mismo hilo dan la salida: mostrar el cambio al instante, pero señalar cuándo está persistido, como los dos checks de WhatsApp.

    En event-driven el fallo puede llegar minutos después, como evento order.cancel_rejected, con el usuario ya en otra pantalla. Necesitas un estado de sincronización por entidad, no un booleano de loading.

    export type SyncState = 'pending' | 'confirmed' | 'failed';
    
    export interface OrderView {
      id: string;
      status: 'paid' | 'cancelled' | 'shipped';
      version: number;
      sync: SyncState;
      previous?: OrderView; // para revertir si el backend rechaza
    }
    

    pending se pinta distinto (opacidad, "Cancelando…"). failed revierte a previous y avisa con un mensaje que diga qué pasó y qué puede hacer el usuario. Eso es compensación visible: la UI admite que se adelantó.

    Problema 3: eventos fuera de orden o duplicados

    La respuesta corta: cada evento trae la versión de la entidad y el cliente ignora todo lo que no sea más nuevo que lo que ya tiene.

    Con varios productores o reintentos, puede llegarte la versión 4 de un pedido antes que la 3. Si aplicas por orden de llegada, el pedido "vuelve" a pagado.

    Un store con signals de Angular (estables desde Angular 17). La convergencia vive en apply:

    import { Injectable, computed, signal } from '@angular/core';
    
    @Injectable({ providedIn: 'root' })
    export class OrdersStore {
      private readonly byId = signal<Record<string, OrderView>>({});
      readonly orders = computed(() => Object.values(this.byId()));
    
      /** Aplica un evento confirmado del servidor. Idempotente y tolerante al desorden. */
      apply(e: { orderId: string; version: number; status: OrderView['status'] }) {
        this.byId.update((current) => {
          const prev = current[e.orderId];
          if (prev && prev.version >= e.version) return current; // viejo o duplicado
          return {
            ...current,
            [e.orderId]: { id: e.orderId, status: e.status, version: e.version, sync: 'confirmed' },
          };
        });
      }
    
      /** El backend rechazó el comando: vuelve al estado anterior y márcalo como fallido. */
      reject(orderId: string) {
        this.byId.update((c) => {
          const prev = c[orderId];
          if (!prev?.previous) return c;
          return { ...c, [orderId]: { ...prev.previous, sync: 'failed' } };
        });
      }
    
      markPending(orderId: string, status: OrderView['status']) {
        this.byId.update((c) => {
          const prev = c[orderId];
          if (!prev) return c;
          return { ...c, [orderId]: { ...prev, status, sync: 'pending', previous: prev.previous ?? prev } };
        });
      }
    }
    

    Fíjate en que el guard de versión ya cubre los duplicados de la misma entidad. El dedupe por eventId solo hace falta para eventos sin versión (notificaciones, contadores). Y si lo añades, acota el Set o crecerá sin límite en una pestaña abierta todo el día. Ojo: reject no tiene guard; en producción relaciona el rechazo con un commandId para que un cancel_rejected duplicado no revierta un intento posterior.

    Para un store convergente, signals bastan (si dudas, mira cuándo usar RxJS o signals en Angular). Los servicios con estado y signals los trabajo paso a paso en el curso de Angular Moderno.

    Problema 4: reconexión y huecos en el stream de eventos

    La respuesta corta: el stream nunca es completo; al reconectar, pide un snapshot y fusiónalo con el mismo guard de versión.

    Si el servidor envía id: en cada evento, EventSource guarda el último y, al reconectar, lo manda en la cabecera Last-Event-ID (está en la especificación de server-sent events del WHATWG) para que el servidor reenvíe lo perdido. Eso depende de que el servidor guarde histórico y de que ningún proxy se coma la cabecera. Es una optimización, no una garantía.

    type OrderSnapshot = { orderId: string; version: number; status: OrderView['status'] };
    
    export function connect(store: OrdersStore, loadSnapshot: () => Promise<OrderSnapshot[]>) {
      const es = new EventSource('/api/orders/stream');
    
      // 'open' se dispara en la conexión inicial y en cada reconexión
      es.addEventListener('open', async () => {
        const snapshot = await loadSnapshot(); // estado actual + versión de cada pedido
        snapshot.forEach((o) => store.apply(o)); // el guard descarta lo que ya es viejo
      });
    
      // Solo llegan aquí los mensajes enviados con "event: order"; sin ese campo van a 'message'
      es.addEventListener('order', (msg: MessageEvent<string>) => {
        const event = parseOrderEvent(msg.data); // ver problema 5
        if (!event) return;
        if (event.type === 'order.status_changed') store.apply(event);
        else store.reject(event.orderId); // order.cancel_rejected
      });
    
      es.addEventListener('error', () => {
        // CONNECTING: el navegador reintenta solo. CLOSED: no volverá; reconecta tú (sin Last-Event-ID: el snapshot cubre el hueco).
        if (es.readyState === EventSource.CLOSED) {
          setTimeout(() => connect(store, loadSnapshot), 3000);
        }
      });
    
      return es;
    }
    

    Snapshot y eventos pasan por el mismo apply. Da igual qué llegue primero: gana la versión más alta.

    Problema 5: acoplar la UI al schema interno del backend

    La respuesta corta: el frontend no debe consumir eventos de dominio crudos; necesita eventos de integración estables y validados al entrar.

    Los eventos de dominio cambian cuando cambia el modelo interno del servicio. Si tu componente lee event.payload.aggregate.lines[0].sku, cualquier refactor del backend rompe la pantalla en producción, sin error de compilación.

    Dos capas: un BFF o traductor que publique eventos pensados para el cliente (planos, versionados, solo lo que la UI pinta) y validación en el borde con Zod 4, para que un mensaje inesperado se descarte en vez de corromper el store.

    import { z } from 'zod';
    
    const OrderEvent = z.discriminatedUnion('type', [
      z.object({
        type: z.literal('order.status_changed'),
        eventId: z.string(),
        orderId: z.string(),
        version: z.number().int().nonnegative(),
        status: z.enum(['paid', 'cancelled', 'shipped']),
      }),
      z.object({
        type: z.literal('order.cancel_rejected'),
        eventId: z.string(),
        orderId: z.string(),
        version: z.number().int().nonnegative(),
        reason: z.string(),
      }),
    ]);
    export type OrderEventData = z.infer<typeof OrderEvent>;
    
    export function parseOrderEvent(raw: string): OrderEventData | null {
      let json: unknown;
      try {
        json = JSON.parse(raw);
      } catch {
        return null;
      }
      const result = OrderEvent.safeParse(json);
      if (!result.success) {
        console.warn('Evento descartado', result.error.issues);
        return null;
      }
      return result.data;
    }
    

    safeParse no lanza: te devuelve success y decides tú. Con discriminatedUnion, el resto del código recibe tipos estrechos según type. Si quieres llevar este patrón a todo el estado global, lo desarrollé en gestión de estado global con Zod y signals, y los schemas, transformaciones y errores de Zod los cubro a fondo en el curso de Zod para TypeScript.

    Cuándo NO usar estos patrones de arquitectura orientada a eventos en el frontend

    UI optimista en pagos, stock o cualquier acción irreversible. Si el usuario va a cerrar la pestaña creyendo que pagó, el pending bonito no basta. Ahí muestra "Procesando pago" y espera a la confirmación. El propio hilo de HN citado arriba separa preferencias de interfaz (optimismo sin problema) de facturación o mensajería (cuidado).

    Tiempo real cuando un refetch basta. Un panel de administración que se consulta cinco veces al día no necesita SSE ni resync. Un refetch al volver a la pestaña y un polling acotado tras cada comando resuelven casi todo con una fracción del código. Herramientas como las que comparo en httpResource vs TanStack Query ya traen revalidación al enfocar.

    Sin versión monotónica del backend, el guard no sirve. Comparar updatedAt entre máquinas con relojes distintos no es una versión. Si el backend no puede emitir una versión por entidad, negocia eso antes de escribir una línea de cliente.

    El BFF no es gratis. Para un solo frontend y un equipo pequeño, un mapper tipado en el cliente con Zod puede ser suficiente. El BFF compensa cuando hay varios clientes o el backend cambia más rápido que la UI.

    SSE sin HTTP/2 y con muchas pestañas. Según MDN, sin HTTP/2 el navegador limita a 6 las conexiones abiertas por dominio, y Chrome y Firefox lo marcaron como "Won't fix". Con siete pestañas de tu app, la séptima se queda colgada. Sirve con HTTP/2 o con una sola conexión compartida entre pestañas.

    Lo que puedes hacer hoy

    Abre el servicio que recibe eventos en tu app y busca una cosa: ¿cada mensaje trae versión por entidad y tu store la compara antes de aplicar? Si la respuesta es no, ese es tu primer cambio. Es la pieza que hace posibles las otras cuatro.

    Después, escribe el test que casi nadie escribe: aplica el evento versión 4, luego el versión 3, y comprueba que el estado sigue en 4. Si quieres montar esa batería con Jest y Testing Library en Angular, el curso de Testing en Angular cubre cómo testear servicios con estado y componentes que reaccionan a él.

    Preguntas frecuentes

    ¿La arquitectura orientada a eventos obliga a usar WebSockets en el frontend?

    No. El frontend puede seguir con HTTP y polling acotado por versión. WebSockets o SSE compensan cuando el usuario necesita ver cambios que no ha provocado él.

    ¿SSE o WebSockets para recibir eventos del backend?

    Si el flujo es solo del servidor al cliente, SSE es más simple: va sobre HTTP, reconecta solo y, si el servidor manda id: en cada evento, envía Last-Event-ID sin que escribas código. WebSockets tienen sentido cuando el cliente también emite muchos mensajes por el mismo canal, como en un chat o en edición colaborativa.

    ¿Cómo evito que un evento antiguo sobrescriba uno nuevo en el cliente?

    Pide al backend una versión monotónica por entidad en cada evento. En el store, descarta cualquier evento cuya versión sea menor o igual que la que ya tienes. Ese mismo guard resuelve también los duplicados de la misma entidad.

    ¿Qué hago si se pierden eventos mientras el socket estaba caído?

    Asume que siempre puede pasar. Al reconectar, pide un snapshot del estado con la versión de cada entidad y fusiónalo con el mismo guard que usas para los eventos. Last-Event-ID ayuda a recuperar lo perdido, pero depende de que el servidor guarde histórico.

    ¿Es mala práctica la UI optimista en una arquitectura orientada a eventos?

    No, siempre que tenga estados explícitos (pending, confirmed, failed) y una forma visible de revertir. Es mala práctica cuando la UI declara éxito antes de la confirmación en operaciones irreversibles, como pagos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Revocar JWT antes de que expire: 5 estrategias que funcionan

    Revocar JWT antes de que expire: 5 estrategias que funcionan

    Imagina que un usuario te escribe un domingo: le han robado el portátil con la sesión abierta y necesitas revocar su JWT ya. Entras al panel, pulsas "cerrar sesión en todos los dispositivos" y respiras.

    El botón borra sus refresh tokens de la base de datos. Pero el access token que vive en el portátil robado sigue firmado, sigue sin caducar y tu API lo sigue aceptando. Durante 24 horas, porque así configuraste el expiresIn.

    Ahí descubres que revocar JWT antes de que expiren no es una función que ya tengas. Es una decisión de arquitectura que no tomaste.

    En corto: un JWT no se puede borrar: su firma es válida hasta exp y el servidor no guarda nada que eliminar. Para revocar JWT de verdad necesitas access tokens cortos (5-15 min) y un poco de estado donde importa: refresh tokens revocables con rotación, una denylist por jti o una versión de token por usuario. Si necesitas cortar cualquier petición al segundo, no quieres JWT: quieres sesiones o introspección.

    ¿Qué significa revocar un JWT?

    Revocar un JWT es conseguir que el servidor rechace un token que todavía tiene una firma válida y un exp en el futuro. No se modifica el token, que ya está en manos del cliente. Lo que cambia es la regla que aplica el servidor al verificarlo.

    Un JWT firmado (RFC 7519) es autocontenido: la API comprueba la firma con una clave y lee los claims sin preguntar a nadie. Esa es su gracia y también su problema. Si no preguntas a nadie, nadie te puede decir que ese token ya no vale.

    Borrar el token del localStorage o la cookie solo lo quita de ese navegador. Por eso el "logout con JWT" que solo limpia el cliente no es un logout: es un olvido voluntario.

    Por qué invalidar un JWT es difícil: la discusión que no se acaba

    Invalidar un JWT es difícil porque verificarlo no consulta ningún estado: cualquier mecanismo de revocación obliga a reintroducir una consulta al servidor, que es justo lo que JWT prometía evitar.

    El artículo "Stop using JWT for sessions" (copia archivada) de 2016 se ha enviado a Hacker News más de quince veces, entre sus dos partes. El hilo con más actividad suma 248 puntos y 245 comentarios (consultado en octubre de 2026 vía la API de HN Algolia).

    En este comentario del hilo, un usuario resume el problema: invalidar obliga a que quien verifica vuelva a hablar con el backend de autenticación, justo lo que JWT prometía evitar. Su alternativa ni siquiera es JWT: tokens tradicionales cuya validez cachea 60 segundos en cada servidor de API, renovando la caché en segundo plano 30 segundos antes de que caduque.

    Es exactamente el compromiso que vas a ver en todas las estrategias: cada segundo de revocación más rápida lo pagas con estado y con latencia. Mi opinión: para una app SaaS típica, la combinación ganadora es access token de 10 minutos + refresh token opaco con rotación, y denylist solo para los casos graves.

    Estrategia 1: access tokens cortos y refresh token revocable

    La forma más barata de revocar JWT es que duren tan poco que no haga falta. Un access token de 10 minutos limita la ventana de un token robado a 10 minutos. El refresh token, que dura días, es opaco y vive en tu base de datos: ese sí lo puedes borrar.

    El código usa jose (API de la versión 6.x) para firmar y verificar:

    import { SignJWT, jwtVerify } from 'jose';
    import { randomUUID } from 'node:crypto';
    
    const secret = new TextEncoder().encode(process.env.JWT_SECRET!);
    
    export async function signAccessToken(userId: string, tokenVersion: number) {
      return new SignJWT({ ver: tokenVersion })
        .setProtectedHeader({ alg: 'HS256' })
        .setSubject(userId)
        .setJti(randomUUID())
        .setIssuedAt()
        .setExpirationTime('10m')
        .sign(secret);
    }
    

    El refresh token no debería ser un JWT. Es un string aleatorio (randomBytes(32).toString('base64url')) cuyo hash guardas en BD. Viaja en una cookie httpOnly, Secure y SameSite. Para el access token, la decisión es otra; la desmenucé en localStorage vs cookies.

    Al hacer logout borras la fila del refresh token; el access token vive, como mucho, 10 minutos más. Es la forma de revocar JWT que no añade ni una consulta por petición.

    Estrategia 2: JWT denylist por jti en Redis

    Cuando 10 minutos no son aceptables (cuenta comprometida, empleado despedido), necesitas una lista de tokens prohibidos. El claim jti (RFC 7519, sección 4.1.7) es el identificador único del token, y es justo lo que metes en la denylist.

    El truco está en el TTL: la entrada solo vive lo que le queda al token. Cuando caduca, la firma ya lo rechaza y Redis borra la clave. Sin cron jobs.

    import Redis from 'ioredis';
    
    const redis = new Redis(process.env.REDIS_URL!);
    
    export async function revokeAccessToken(jti: string, exp: number) {
      const ttl = exp - Math.floor(Date.now() / 1000);
      if (ttl > 0) await redis.set(`jwt:deny:${jti}`, '1', 'EX', ttl);
    }
    
    export async function isRevoked(jti: string) {
      return (await redis.exists(`jwt:deny:${jti}`)) === 1;
    }
    

    Y el middleware de Express que lo comprueba después de verificar la firma:

    import type { Request, Response, NextFunction } from 'express';
    import { jwtVerify } from 'jose';
    // `secret` es el mismo de signAccessToken
    
    export async function requireAuth(req: Request, res: Response, next: NextFunction) {
      const token = req.headers.authorization?.replace(/^Bearer /, '');
      if (!token) return res.sendStatus(401);
    
      try {
        const { payload } = await jwtVerify(token, secret, { algorithms: ['HS256'] });
        if (!payload.jti || (await isRevoked(payload.jti))) return res.sendStatus(401);
        res.locals.auth = payload;
        next();
      } catch {
        res.sendStatus(401);
      }
    }
    

    Fíjate en algorithms: ['HS256']: fijar el algoritmo evita aceptar tokens firmados con otro distinto al que esperas. Y payload llega tipado como JWTPayload genérico; validar los claims propios (ver, roles) con un schema es donde Zod te ahorra un as peligroso.

    Estrategia 3: versión de token para el logout de todos los dispositivos

    La denylist sirve para revocar un JWT concreto, pero con el portátil robado no sabes qué jti tiene el ladrón. Quieres invalidar todos los tokens del usuario de golpe.

    Para eso, cada usuario tiene un contador tokenVersion. Lo firmas dentro del token (el claim ver de la estrategia 1) y, al verificar, lo comparas con el valor actual. "Cerrar sesión en todos los dispositivos" es incrementar el contador.

    export async function logoutEverywhere(userId: string) {
      await redis.incr(`user:ver:${userId}`);
      // además, borra todos sus refresh tokens en BD
    }
    
    export async function isCurrentVersion(userId: string, ver: unknown) {
      // en producción: si la clave falta en Redis, lee el contador de BD y repuebla
      const current = Number((await redis.get(`user:ver:${userId}`)) ?? 0);
      return ver === current;
    }
    

    Y en requireAuth, justo después de la comprobación de la denylist, añade la línea que falta:

    if (!payload.sub || !(await isCurrentVersion(payload.sub, payload.ver))) return res.sendStatus(401);
    

    Sin esa línea, incrementar el contador no rechaza nada: los access tokens siguen vivos hasta su exp. Al firmar, tokenVersion sale de la misma clave: Number((await redis.get(`user:ver:${userId}`)) ?? 0).

    Guarda el contador en la BD y usa Redis como caché: si Redis pierde la clave, el contador vuelve a 0 y los tokens viejos resucitan.

    Una variante guarda un iat mínimo por usuario: se rechaza todo token emitido antes de esa fecha, sin añadir claims nuevos.

    Estrategia 4: refresh token rotation con detección de reutilización

    La rotación convierte el refresh token en uno de un solo uso: al canjearlo recibes uno nuevo y el anterior queda invalidado.

    La parte que casi nadie implementa es la detección de reutilización. El RFC 9700 (OAuth 2.0 Security BCP, enero de 2025) lo describe en su sección 4.14.2: si se presenta un refresh token ya invalidado, el servidor sabe que hay una copia en manos ajenas y, como no puede saber quién es quién, "will revoke the active refresh token". En la práctica, quemas la familia entera.

    import { createHash, randomBytes } from 'node:crypto';
    
    const sha256 = (t: string) => createHash('sha256').update(t).digest('hex');
    const THIRTY_DAYS = 30 * 24 * 60 * 60 * 1000;
    
    // refreshTokens: tu repositorio (Postgres con Prisma, Drizzle, SQL a pelo...)
    export async function rotateRefreshToken(presented: string) {
      const stored = await refreshTokens.findByHash(sha256(presented));
      if (!stored || stored.expiresAt < new Date()) throw new UnauthorizedError();
    
      // markUsed debe ser atómico y fallar si el token ya se usó o su familia está revocada:
      // UPDATE refresh_tokens SET used_at = now()
      // WHERE id = $1 AND used_at IS NULL
      //   AND family_id NOT IN (SELECT id FROM token_families WHERE revoked_at IS NOT NULL)
      const firstUse = await refreshTokens.markUsed(stored.id);
      if (!firstUse) {
        // reutilización detectada (o familia ya revocada)
        await refreshTokens.revokeFamily(stored.familyId); // UPDATE token_families SET revoked_at = now()
        throw new UnauthorizedError();
      }
    
      const next = randomBytes(32).toString('base64url');
      await refreshTokens.create({
        hash: sha256(next),
        userId: stored.userId,
        familyId: stored.familyId,
        expiresAt: new Date(Date.now() + THIRTY_DAYS),
      });
      return next;
    }
    

    Cada login empieza una familia nueva (familyId). La revocación vive en la familia, no en cada token: así, un token creado mientras otra petición quemaba la familia nace ya muerto. Da igual quién use primero el token robado, el atacante o el usuario: el segundo en llegar dispara la detección y la familia muere. Ojo: si el ladrón tiene la única copia, como en el portátil robado, nadie más presenta el token y la rotación no detecta nada. Para eso está la versión por usuario.

    Estrategia 5: tokens opacos e introspección (RFC 7662)

    Si tu requisito es "revocar y que la siguiente petición falle, siempre", deja de pelearte con JWT. El RFC 7662 define la introspección: la API envía el token al servidor de autorización y recibe un JSON con active: true o false.

    Es una consulta de red por petición, cacheable, como esos 60 segundos del comentarista de HN. Básicamente, una sesión con otro nombre.

    Comparativa: cómo revocar JWT según lo que necesitas

    La mejor estrategia depende de cuánto tiempo puedes tolerar un token robado: si son minutos, basta con tokens cortos; si tiene que ser inmediato, necesitas denylist, versión o introspección.

    Estrategia Latencia de revocación Coste por petición Estado necesario Limitación o riesgo
    Access corto + refresh en BD Hasta el exp del access (5-15 min) Ninguno extra Fila por refresh token La ventana del access token sigue abierta
    Denylist por jti Inmediata 1 lectura de Redis Una clave por token revocado, con TTL Si Redis cae, eliges entre rechazar a todos o aceptar revocados
    Versión de token por usuario Inmediata 1 lectura (Redis o BD) Un contador por usuario Es todo o nada: no revoca un dispositivo concreto
    Refresh rotation con familias En el siguiente refresh Ninguno extra (solo en /refresh) Historial de tokens por familia Pestañas que refrescan a la vez dan falsos positivos
    Opaco + introspección (RFC 7662) Inmediata (o el TTL de la caché) 1 llamada de red al servidor de auth Sesión completa en servidor Acopla cada API al servidor de autorización

    Límites de estos enfoques: cuándo no usar JWT

    Lo digo sin rodeos: si consultas Redis en cada petición para comprobar la denylist, has reinventado las sesiones, con un token más pesado y más piezas. Es justo la crítica del artículo de 2016. Si tu app es un monolito con un solo backend, una sesión en servidor con cookie es más simple y revoca de forma nativa; Better Auth te lo da hecho en TypeScript.

    Segundo: con access tokens cortos y nada más, la revocación nunca es instantánea. Un token robado funciona hasta 15 minutos, algo difícil de defender en banca, salud o paneles de administración.

    Tercero: en arquitecturas multi-servicio, el estado de revocación tiene que llegar a todos. Si cinco microservicios verifican el JWT por su cuenta, los cinco necesitan leer la denylist o la versión. Uno que se olvide es una puerta abierta.

    Y cuarto: la rotación tiene una trampa operativa. Dos pestañas que refrescan a la vez presentan el mismo token y la segunda parece un robo. Necesitas un periodo de gracia corto o serializar el refresh en el cliente, y eso no viene en ninguna librería por defecto.

    Un último apunte: todo lo que firmas en el token se congela hasta exp, permisos incluidos. Si le quitas a alguien el rol de admin, su access token lo seguirá diciendo hasta que caduque. El token dice bien quién eres; lo que puedes hacer cambia más a menudo, y por eso conviene separar autenticación y autorización: o consultas los permisos en el servidor en cada petición, o subes ver cada vez que cambian y el siguiente refresh trae los nuevos.

    Qué hacer hoy con tus JWT

    Abre tu configuración y busca el expiresIn de tus access tokens. Si pone 1d, 7d o no hay nada, ese es tu problema real, no la falta de denylist. Antes de pensar en cómo revocar JWT, bájalo a 10 minutos, saca el refresh token a una tabla con rotación y añade la versión por usuario para el botón de "cerrar sesión en todos los dispositivos".

    Este tipo de decisión es la que conviene dejar escrita en la spec antes de pedirle a un agente que genere el módulo de auth. Si no, la IA elige por ti un JWT de 7 días. Así lo trabajamos en el curso Construye con IA, y la metodología completa está en el libro de Spec-Driven Development.

    Preguntas frecuentes

    ¿Se puede revocar un JWT sin guardar nada en el servidor?

    No de forma inmediata. Sin estado en el servidor, lo único que limita un token es su exp, así que la única "revocación" posible es esperar a que caduque. Por eso se combinan access tokens cortos con un refresh token que sí vive en la base de datos.

    ¿Cuánto debe durar un access token JWT?

    Entre 5 y 15 minutos es el rango habitual en apps web: no satura el endpoint de refresh y un token robado sirve poco tiempo. Si necesitas menos de un minuto de exposición, usa sesiones o introspección.

    ¿Cómo hago logout con JWT correctamente?

    Borra el refresh token de la base de datos, limpia la cookie en el cliente y, si el riesgo lo justifica, añade el jti del access token actual a la denylist con TTL hasta su exp. Limpiar solo el cliente no invalida el token.

    ¿Qué pasa con la denylist si Redis se cae?

    Decídelo de antemano. Fallar cerrado rechaza toda petición autenticada mientras Redis no responda; fallar abierto acepta tokens quizá revocados. Un compromiso razonable: cerrado en operaciones sensibles, abierto en lecturas. El requireAuth de este post ya falla cerrado: si Redis lanza un error, el catch devuelve 401. Revisa también maxRetriesPerRequest y enableOfflineQueue de ioredis: por defecto reintenta y encola comandos mientras reconecta, y la petición se queda colgada en vez de fallar rápido.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Vercel Daemons: workers de colas junto a tu app Next.js

    Vercel Daemons: workers de colas junto a tu app Next.js

    Tu endpoint devuelve un 202 Accepted. El job entra en la cola. En local se procesa en dos segundos. En producción no se procesa nunca.

    No es un bug tuyo. Es el modelo de Vercel Functions, y es justo lo que viene a resolver Vercel Daemons: la función responde, la ejecución termina y el trabajo asíncrono que quedara colgando muere con ella.

    Por eso la arquitectura "seria" con Next.js en Vercel siempre ha tenido una pieza fuera: el worker de BullMQ o de Celery en Railway, Render, Fly o un VPS. Dos plataformas, dos facturas, dos sitios donde mirar logs.

    El 15 de octubre de 2026 Vercel anunció Vercel Daemons en beta pública. Y esa pieza puede volver al mismo proyecto.

    En corto: Vercel Daemons ejecuta contenedores que se quedan encendidos y sacan trabajo de una cola, una base de datos o un servicio externo, sin servidor HTTP. Se declaran con una entrada daemons en vercel.json, vercel.ts o vercel.toml, y Vercel mantiene las instancias que fijes por región. Compensa si tu worker es pequeño y estable; no, si necesitas autoescalado, previews o disco persistente.

    ¿Qué es Vercel Daemons?

    Vercel Daemons es un recurso de Vercel que ejecuta procesos de larga duración, empaquetados como contenedor desde un Dockerfile o Containerfile, que piden su propio trabajo en lugar de recibir peticiones. Corren sobre Fluid compute, la misma plataforma que las Vercel Functions, y se despliegan con tu app, en el mismo proyecto.

    La documentación oficial y el changelog del lanzamiento citan tres usos: consumidores de colas (Vercel Queues en modo poll, SQS, Kafka, Redis con BullMQ o Celery), workers de Temporal o Cadence que hacen long-poll de su cola de tareas, y runners de CI autoalojados (GitHub Actions, GitLab, CircleCI) que esperan jobs sin conexiones entrantes.

    La diferencia con una función es de dirección. Una función espera a que le llegue una petición. Un daemon sale a buscar el trabajo. Vercel lo resume en su guía de elección: las imágenes de contenedor cambian qué ejecuta una función; los Daemons cambian cómo se ejecuta un worker.

    Por qué un worker de BullMQ no funcionaba en Vercel

    No funcionaba porque BullMQ necesita un proceso vivo escuchando Redis, y una función de Vercel deja de existir cuando entrega la respuesta.

    No es teoría. En este hilo de la comunidad de Vercel (agosto de 2024), un developer describe el caso de la apertura: Next.js encola jobs de OpenAI con BullMQ, recibe un 202 y en producción nada se procesa.

    La respuesta del equipo de Vercel: las funciones detienen la ejecución cuando la respuesta se completa y el trabajo asíncrono pendiente se termina. Las alternativas que propusieron (waitUntil, streaming, más duración máxima) alargan la vida de la función, pero no la convierten en un proceso.

    waitUntil() y after() comparten el límite de duración de la función. Un worker de cola necesita un bucle infinito. Son modelos distintos.

    Ojo: tener el proceso vivo no arregla un worker que bloquea el event loop de Node. Con Daemons ese problema solo cambia de máquina.

    Cómo configurar Vercel Daemons: el ejemplo oficial con Celery

    Se configura con un Dockerfile en la carpeta del worker y una entrada daemons en el archivo de configuración de la raíz: vercel.json, vercel.ts o vercel.toml.

    Este es el ejemplo del changelog oficial: un worker de Celery, una instancia, en iad1 (Washington, D.C.), con el Dockerfile en worker/.

    {
      "$schema": "https://openapi.vercel.sh/vercel.json",
      "daemons": {
        "celery": {
          "root": "worker/",
          "entrypoint": "Dockerfile",
          "command": ["celery", "-A", "app", "worker", "--loglevel=info"],
          "instances": { "iad1": 1 }
        }
      }
    }
    

    Según la referencia de configuración:

    • root, entrypoint e instances son obligatorios. instances va de 0 a 100 por región.
    • command sustituye el ENTRYPOINT y el CMD de la imagen, sin pasar por una shell.
    • resources.requests.memory admite "1Gi", "2Gi" (por defecto), "4Gi" u "8Gi", con 1, 1, 2 o 4 vCPU.
    • terminationGracePeriodSeconds fija la espera tras el SIGTERM: 30 segundos por defecto, hasta 3.600.

    Un detalle que te ahorra un build fallido: el nombre del daemon solo admite minúsculas separadas por - o _. worker1 no vale.

    Un worker de BullMQ en TypeScript con Vercel Daemons

    En un proyecto Next.js con BullMQ, el worker vive en su propia carpeta con su Dockerfile, y Next.js solo encola.

    app/                  # tu Next.js de siempre
    workers/emails/
      .dockerignore
      Dockerfile
      package.json
      tsconfig.json
      src/schema.ts       # el contrato del job, solo importa zod
      src/worker.ts
    vercel.json
    

    El schema del job va en su propio archivo, sin efectos al cargarse:

    // workers/emails/src/schema.ts
    import { z } from 'zod';
    
    export const welcomeEmailSchema = z.object({
      userId: z.string(),
      to: z.email(),
    });
    
    export type WelcomeEmail = z.infer<typeof welcomeEmailSchema>;
    

    El worker cuida dos cosas: validar el payload antes de tocarlo y cerrar bien al recibir SIGTERM.

    // workers/emails/src/worker.ts
    import { Worker, type Job } from 'bullmq';
    import { Redis } from 'ioredis';
    import { welcomeEmailSchema, type WelcomeEmail } from './schema.js';
    
    // Sin REDIS_URL, ioredis conectaría a localhost en silencio y la instancia
    // se reiniciaría en bucle sin decir por qué
    const redisUrl = process.env.REDIS_URL;
    if (!redisUrl) throw new Error('REDIS_URL no está definida');
    
    // BullMQ exige maxRetriesPerRequest: null en las conexiones de los workers
    const connection = new Redis(redisUrl, {
      maxRetriesPerRequest: null,
    });
    
    async function sendWelcomeEmail(payload: WelcomeEmail) {
      // Aquí va tu proveedor de email. Debe ser idempotente:
      // el mismo job puede ejecutarse dos veces si la instancia se reinicia.
    }
    
    const worker = new Worker(
      'emails',
      async (job: Job) => {
        // Un payload mal formado falla aquí, no a mitad del envío
        const payload = welcomeEmailSchema.parse(job.data);
        await sendWelcomeEmail(payload);
      },
      { connection, concurrency: 5 },
    );
    
    worker.on('failed', (job, error) => {
      // stdout y stderr llegan a los Logs del proyecto en Vercel
      console.error(`Job ${job?.id} falló:`, error.message);
    });
    
    process.on('SIGTERM', async () => {
      // Deja de coger jobs nuevos y espera a que terminen los activos
      await worker.close();
      await connection.quit();
      process.exit(0);
    });
    

    Validar job.data no es un capricho: un job encolado hace tres deploys puede traer un formato que tu worker ya no espera. El schema vive en el worker y el Route Handler importa workers/emails/src/schema.ts (nunca worker.ts, que abriría una conexión a Redis al cargarse), porque el contexto de build del daemon no ve el resto del repo. La app de Next.js necesita también Zod 4 en su propio package.json (npm i zod@^4). En el curso de Zod trabajamos la validación de datos que llegan de fuera.

    El package.json del worker, con Zod 4 (z.email() no existe en Zod 3) e ioredis explícito:

    {
      "name": "emails-worker",
      "private": true,
      "type": "module",
      "scripts": { "build": "tsc" },
      "dependencies": { "bullmq": "^6.3.0", "ioredis": "^6.0.0", "zod": "^4.0.0" },
      "devDependencies": { "typescript": "^5.9.0", "@types/node": "^24.0.0" }
    }
    

    Y su tsconfig.json, para que npm run build deje el dist/worker.js que arranca la imagen:

    {
      "compilerOptions": {
        "target": "es2023",
        "module": "nodenext",
        "moduleResolution": "nodenext",
        "rootDir": "src",
        "outDir": "dist",
        "strict": true,
        "skipLibCheck": true
      }
    }
    

    Genera el package-lock.json con npm install dentro de workers/emails/: sin él, npm ci falla.

    El Dockerfile, basado en el quick start oficial (que usa node:24-slim), con un paso de build para compilar el TypeScript:

    FROM node:24-slim
    WORKDIR /app
    COPY package.json package-lock.json ./
    RUN npm ci
    COPY . .
    RUN npm run build && npm prune --omit=dev
    CMD ["node", "dist/worker.js"]
    

    Añade un .dockerignore con node_modules y dist. Sin él, COPY . . mete en la imagen el node_modules de tu máquina, y en Windows o Mac puede traer binarios que no sirven en linux/amd64.

    La misma imagen que corres en local es la que despliegas, la idea de los entornos reproducibles con Docker. Y la entrada en vercel.json, con más grace period para los emails en curso:

    {
      "$schema": "https://openapi.vercel.sh/vercel.json",
      "daemons": {
        "emails": {
          "root": "workers/emails/",
          "entrypoint": "Dockerfile",
          "instances": { "iad1": 1 },
          "resources": { "requests": { "memory": "1Gi" } },
          "terminationGracePeriodSeconds": 60
        }
      }
    }
    

    En Next.js solo cambia una línea: añade "workers" al exclude del tsconfig.json de la raíz, o next build intentará comprobar los tipos del worker con las dependencias de la app.

    Después, un Route Handler hace queue.add('welcome', { userId, to }) contra el mismo REDIS_URL, que llega a las dos piezas porque cada instancia recibe las variables del deployment.

    En local, vercel dev no arranca daemons: construye la imagen y córrela con docker run --env-file .env.local. Si tu Redis corre en local, usa host.docker.internal en vez de localhost dentro del contenedor.

    Vercel Functions vs Vercel Daemons vs un worker en Railway, Fly o VPS

    La elección depende de quién inicia el trabajo y de si necesitas escalar solo. Comparativa con lo que documenta Vercel a 20 de octubre de 2026:

    Criterio Vercel Functions + Cron Vercel Daemons (beta) Worker en Railway / Fly / VPS
    Quién inicia el trabajo Una petición HTTP o un cron El propio proceso (pull) El propio proceso (pull)
    Duración Limitada por invocación; waitUntil comparte el límite Proceso continuo Proceso continuo
    Escalado Automático Manual: instancias fijas por región, de 0 a 100 Según el proveedor
    Entornos Producción y previews Solo producción Los que montes
    Disco persistente No No (efímero) Depende del proveedor; en un VPS, sí
    Tráfico entrante Sí, es su razón de ser No acepta HTTP ni TCP entrante Sí
    Facturación La de Functions Active CPU desde 0,128 USD/h + memoria provisionada desde 0,0212 USD/GB-h (Pro) Otra cuenta, otra factura
    Limitación o riesgo principal Un job largo se corta al terminar la función Beta: sin autoescalado, sin previews, solo amd64 Dos plataformas que operar, logs y secretos repartidos

    La cifra que más importa es la memoria, porque se cobra por estar encendido, trabaje o no. Una instancia de 2 GiB encendida todo el mes (unas 730 horas) son unos 31 USD solo en memoria provisionada a la tarifa base de Pro (2 × 730 × 0,0212).

    La Active CPU se suma aparte y solo cuenta mientras tu código ejecuta. Las tarifas son "desde" y varían por región (precios de Vercel).

    Cuándo NO usar Vercel Daemons

    No uses Vercel Daemons si tu carga llega a picos y necesitas que los workers la sigan. En la beta no hay autoescalado: fijas las instancias en la configuración o en el dashboard, según la página de límites. Para picos, una cola serverless con funciones como consumidoras escala mejor.

    Tampoco encaja si dependes de las previews. Los daemons solo corren en producción: un cambio en el worker se prueba en local con Docker o directamente en producción.

    Más límites de la beta:

    • Sin almacenamiento persistente. El estado va a Vercel Blob o a una base de datos.
    • Monorepos con root directory en subcarpeta (por ejemplo apps/web) todavía no pueden añadir daemons.
    • Solo Linux amd64, hasta 8 GiB y 4 vCPU por instancia. La documentación no ofrece GPU: si la necesitas, sigue fuera.
    • Hobby se apaga al agotar la cuota hasta el mes siguiente. A 20 de octubre, la documentación habla de 10 horas de Active CPU y la página de precios de 5 horas más 420 GB-h: comprueba la cifra.

    Y el lock-in: el Dockerfile es portable; la orquestación (instancias por región, reinicios, logs) no.

    Vercel Daemons para agentes de IA y workers de Temporal

    Para agentes de IA, Vercel Daemons encaja porque un worker de Temporal que espera en long-poll, o un agente que espera al LLM, apenas consume Active CPU (el cifrado de las llamadas HTTPS sí cuenta, y la memoria se paga igual). Lo delicado es otro: una instancia puede pararse en cualquier momento y la documentación pide jobs idempotentes. Un agente que cobra una tarjeta a mitad de un paso necesita esa disciplina, no solo un sitio donde correr.

    Repasé esos patrones en la guía para desplegar agentes de LangChain en producción, y la arquitectura completa de un agente (tools, memoria, multiagente) está en el ebook gratuito El Developer Agéntico.

    Qué hacer con tu worker de colas hoy

    Mira tu worker actual y pregúntate si le bastan 1-2 instancias fijas. Si es así, no escribe en disco y no lo pruebas en previews, moverlo a Vercel Daemons te quita una plataforma entera de encima. Empieza por uno poco crítico, como el de emails, y deja los pesados donde están hasta que la beta madure.

    Si quieres ver cómo encaja esto en un producto completo, de la idea al despliegue, es lo que construimos en el curso Construye con IA.

    Preguntas frecuentes

    ¿Puedo usar BullMQ con Vercel Daemons?

    Sí. La documentación oficial cita BullMQ entre los consumidores soportados e incluye un daemon bullmq-worker de ejemplo. Necesitas un Redis accesible y su URL como variable de entorno de producción.

    ¿Cuánto cuesta Vercel Daemons?

    En Pro, Active CPU desde 0,128 USD por hora y memoria provisionada desde 0,0212 USD por GB-hora, según región. Durante la beta, Pro tiene una cuota por equipo de 16 vCPU y 32 GiB funcionando a la vez. Hobby incluye una cuota mensual y, al agotarla, se detienen los daemons.

    ¿Vercel Daemons funciona en preview deployments?

    No, durante la beta solo se ejecutan en producción. Para probar cambios, construye y corre la imagen en local con Docker, con las variables bajadas mediante vercel env pull.

    ¿Qué pasa con un job en curso cuando despliego una versión nueva?

    Vercel envía SIGTERM a las instancias anteriores y espera 30 segundos por defecto (hasta 3.600 con terminationGracePeriodSeconds). Tu worker debe dejar de aceptar trabajo y terminar el que tiene. En BullMQ, eso es worker.close().

    ¿Vercel Daemons sustituye a Vercel Functions?

    No. Las Functions siguen sirviendo el tráfico HTTP y los Daemons no aceptan tráfico entrante. En una app típica conviven: la función encola y el daemon procesa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Arquitectura orientada a eventos: qué se rompe y cuándo

    Arquitectura orientada a eventos: qué se rompe y cuándo

    Imagina el botón "Confirmar pedido" de una tienda online. Detrás, un endpoint hace cinco cosas seguidas: cobra, reserva stock, emite la factura, manda el email y avisa al almacén.

    Un viernes, el proveedor de email tarda ocho segundos en responder. El cliente ve un spinner, pulsa otra vez y paga dos veces. Nadie tocó el código de pagos. Lo rompió un email.

    Alguien propone pasar a una arquitectura orientada a eventos. Tiene razón a medias. Los eventos resuelven ese acoplamiento, pero traen duplicados, desorden y mensajes que nadie procesa nunca. Si no los ves venir, cambias un fallo ruidoso por uno silencioso.

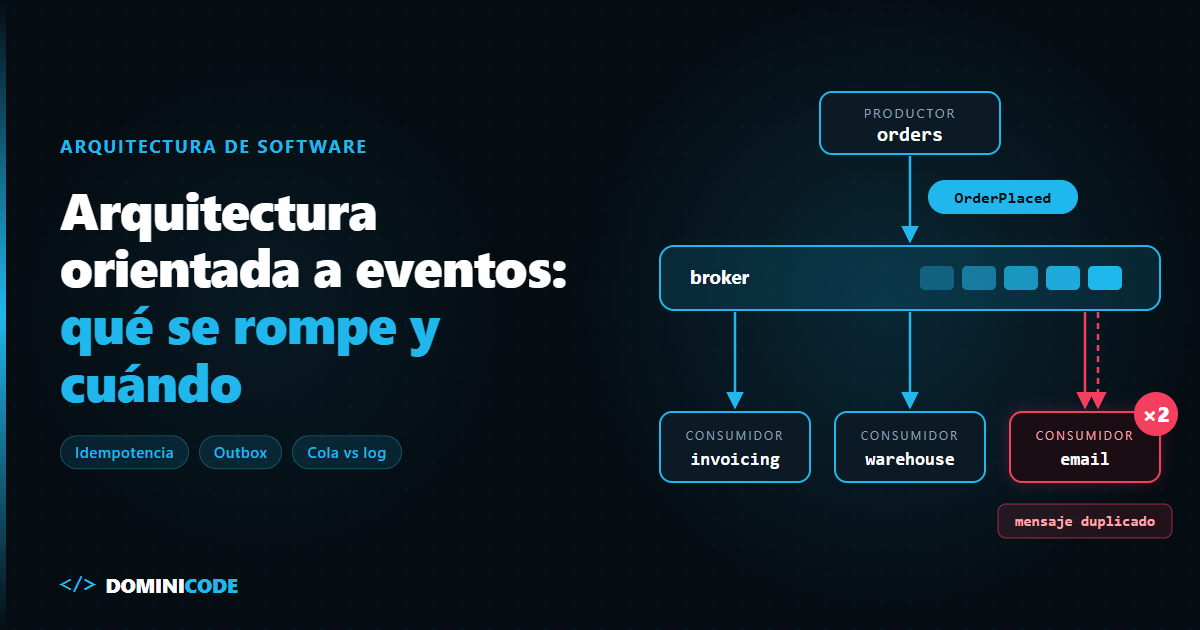
    En corto: la arquitectura orientada a eventos desacopla servicios porque el productor anuncia un hecho (OrderPlaced) y no decide quién reacciona. A cambio, tienes que diseñar para duplicados, orden por clave, mensajes envenenados y escrituras dobles. Úsala cuando varios consumidores independientes reaccionan al mismo hecho; evítala si necesitas respuesta inmediata o no puedes operar la infraestructura.

    ¿Qué es la arquitectura orientada a eventos?

    La arquitectura orientada a eventos (event-driven architecture, EDA) es un estilo en el que los servicios publican hechos que ya ocurrieron y otros servicios, que el emisor no conoce, deciden por su cuenta cómo reaccionar.

    No es "usar Kafka" ni "hacer cosas en segundo plano". Es mover la decisión de qué pasa después desde el productor hacia los consumidores.

    El problema de llamar servicios en cadena

    Encadenar llamadas síncronas suma latencias, multiplica la probabilidad de fallo y obliga a tocar el productor con cada feature nueva.

    Volvamos al pedido. Las cifras son un ejemplo ilustrativo inventado, no un benchmark:

    Paso síncrono Latencia (ejemplo) Si cae…
    Cobro (payments) 300 ms No hay pedido, correcto
    Reserva de stock (inventory) 120 ms Falla el pedido
    Factura (invoicing) 450 ms Falla el pedido ya cobrado
    Email de confirmación 800 ms Falla el pedido por un email
    Aviso al almacén (warehouse) 200 ms Falla el pedido
    Total 1.870 ms Cualquiera tumba todo

    Las latencias se suman: el usuario espera a toda la fila. La disponibilidad se multiplica: cinco servicios al 99 % en cadena dan un 95 % aproximado (0,99 elevado a 5). Has construido algo menos fiable que cualquiera de sus piezas.

    Y el problema que más duele: cada feature nueva toca al productor. ¿Marketing quiere puntos de fidelidad? Otro await en confirmOrder. ¿Analítica quiere registrar la conversión? Otro más.

    Con eventos, orders guarda el pedido y publica OrderPlaced. Facturación, email y almacén escuchan. Fidelidad se suscribe mañana sin que nadie toque orders.

    Eventos vs comandos vs queries

    Un evento cuenta algo que ya pasó. Un comando pide que algo pase. Una query pregunta. Confundirlos es una fuente de bugs habitual en una arquitectura orientada a eventos.

    Evento Comando Query
    Nombre En pasado: OrderPlaced Imperativo: ReserveStock Pregunta: GetOrderStatus
    Destinatarios Cero, uno o muchos, desconocidos Exactamente uno Exactamente uno
    ¿Se puede rechazar? No, ya ocurrió Sí Sí (error, no encontrado)
    ¿Cambia estado? Describe un cambio hecho Pide un cambio No
    Riesgo típico Nadie sabe quién reacciona Si el receptor cae, el emisor espera Latencia en cadena

    Martin Fowler describe en "What do you mean by Event-Driven?" la trampa del passive-aggressive command: el emisor espera que alguien actúe, pero lo envía como si fuera un evento.

    El síntoma está en el nombre: SendConfirmationEmailEvent. Eso no es un hecho, es una orden disfrazada. Si orders necesita que el email salga y lo comprueba, es un comando. El evento honesto es OrderPlaced, y el servicio de email decide que merece un correo.

    Asíncrono no es lo mismo que event-driven

    Puedes meter una cola entre orders e invoicing, publicar GenerateInvoice y procesarlo en segundo plano. Es asíncrono. No es arquitectura orientada a eventos.

    La pregunta práctica: ¿quién decidió la siguiente acción? Si orders decidió "ahora hay que facturar", tienes una cola de comandos, y cada paso nuevo se sigue añadiendo en orders. Si orders solo dijo "se confirmó un pedido" y invoicing decidió facturar, eso sí es event-driven.

    Ninguno es mejor por defecto. Cobrar no debería depender de que un oyente desconocido tenga ganas: ahí quieres un comando.

    Anatomía de un evento: sobre y payload

    Un evento tiene un sobre (envelope) con metadatos y un payload con los datos de negocio. La especificación CloudEvents (versión 1.0.2, la última publicada, de febrero de 2022) exige cuatro atributos: id, source, specversion y type, y obliga a que source + id sea único para cada evento distinto.

    Opcionales como time, subject o dataschema completan el resto; en la práctica, añade una extensión de correlación (correlationid; la spec solo admite minúsculas y dígitos en los nombres) para seguir un flujo entre servicios.

    Un evento thin lleva solo el orderId y obliga a consultar el resto. Uno fat lleva lo necesario para trabajar sin llamar de vuelta, pero convierte el payload en contrato público. Para ficheros grandes, como el PDF de la factura, usa claim-check: guarda el fichero y manda la referencia. Y nunca metas tokens de acceso en el mensaje: se loguean, se replican y se reprocesan meses después.

    Cola vs log vs router: dónde espera el evento

    Una cola reparte mensajes entre workers y los borra tras el ack; un log los conserva durante la retención y permite replay y orden por clave; un router los reparte a varias suscripciones sin guardar historia. Esta decisión condiciona más que el framework, y productos como RabbitMQ ofrecen más de un modelo:

    Cola Log Router
    Ejemplo SQS, colas clásicas de RabbitMQ Kafka, RabbitMQ Streams SNS, EventBridge
    Tras procesar Se borra tras el ack Se queda hasta que expira la retención Se entrega y no queda historia
    Reparto Competing consumers Cada consumer group lee todo con su offset Fan-out a suscripciones
    Replay No Sí, moviendo el offset Solo con archivo
    Orden Limitado (salvo FIFO) Por partición (misma clave, misma partición) No garantizado en general
    Limitación o riesgo Un consumidor nuevo no ve el pasado Paralelismo limitado por particiones Cada suscriptor necesita su cola y DLQ

    La introducción oficial de Kafka lo deja claro: los eventos no se borran tras consumirse, la retención se configura por topic, y los eventos con la misma clave van a la misma partición, que se lee en el orden de escritura.

    La contrapartida: dentro de un consumer group cada partición la lee un solo consumidor, así que los consumidores que sobren se quedan ociosos (Kafka: The Definitive Guide, cap. 4).

    Y no asumas que un archivo equivale a un log. EventBridge permite archivar y reproducir, pero la documentación de AWS avisa de que el replay no respeta necesariamente el orden de entrada: va por intervalos de un minuto.

    Mi opinión: para la tienda, router con una cola por consumidor es el punto de partida más barato. Pasa a un log cuando necesites replay real u orden estricto por pedido.

    Lo que se rompe en una arquitectura orientada a eventos

    Duplicados: necesitas un consumidor idempotente

    La mayoría de brokers de una arquitectura orientada a eventos entregan at-least-once: un mensaje puede llegar dos veces. Si el consumidor procesa, falla antes del ack y el broker reintenta, facturas dos veces.

    La solución es registrar el id del evento en la misma transacción que el efecto de negocio:

    type OrderPlaced = {
      specversion: '1.0';
      id: string;
      source: string;
      type: 'shop.order.placed';
      correlationid: string; // extensión CloudEvents: solo minúsculas y dígitos
      data: { orderId: string; total: number };
    };
    
    // Cliente genérico: adapta a pg, Prisma, Drizzle...
    interface Tx {
      query(sql: string, params: unknown[]): Promise<{ rowCount: number }>;
    }
    interface Db {
      transaction<T>(fn: (tx: Tx) => Promise<T>): Promise<T>;
    }
    
    export async function handleOrderPlaced(db: Db, event: OrderPlaced): Promise<void> {
      await db.transaction(async (tx) => {
        // SQL de Postgres: PRIMARY KEY (consumer, source, event_id)
        const inserted = await tx.query(
          `INSERT INTO processed_events (consumer, source, event_id)
           VALUES ($1, $2, $3)
           ON CONFLICT DO NOTHING`,
          ['invoicing', event.source, event.id],
        );
        if (inserted.rowCount === 0) return; // duplicado: ya está facturado
    
        await tx.query(
          `INSERT INTO invoices (order_id, total) VALUES ($1, $2)`,
          [event.data.orderId, event.data.total],
        );
      });
      // El ack al broker va después del commit, nunca antes.
    }
    

    La clave de deduplicación es source + id, no el correlation ID: un mismo flujo genera muchos eventos con el mismo correlation ID y descartarías todos menos el primero. Y si el efecto no vive en tu base de datos (un email, una API externa), la transacción no te protege: necesitas una clave de idempotencia en el proveedor.

    Orden: la clave de partición manda

    Si OrderCancelled llega antes que OrderPlaced, el almacén prepara un pedido cancelado. Publica todos los eventos de un pedido con la misma clave (orderId). Ojo si usas colas: SQS estándar no garantiza orden; necesitas una cola FIFO con MessageGroupId = orderId.

    Dos trampas: los timestamps de máquinas distintas no son fiables para ordenar, porque los relojes derivan. Y mandar un mensaje fallido a una cola de reintentos aparte rompe el orden, porque los siguientes eventos de esa clave pasan por delante.

    Poison messages: una DLQ que alguien vigila

    Un payload que tu código no sabe parsear fallará siempre. Pon un máximo de reintentos y manda lo que sobre a una dead letter queue. Pero una DLQ sin alertas es un cementerio.

    En el hilo "Ask HN: Has anyone fully embraced an event-driven architecture?", de agosto de 2021, un usuario con SNS + SQS describe su rutina: alertas cuando la DLQ crece o los mensajes llevan demasiado tiempo esperando, reenvío manual a la cola normal e investigación si vuelven a caer.

    Trazabilidad: sin correlation ID no hay debugging

    Con eventos no tienes un stack trace, tienes cinco servicios que reaccionaron en momentos distintos. En el mismo hilo, otro comentario lo resume: "invest as much as possible in a good logging solution, traceability, and just general things to make debugging easier. Come up with a way to replay events easily."

    Propaga el correlation ID del primer evento a todos los que derivan de él y loguéalo siempre.

    Patrón outbox: el problema de la escritura doble

    El patrón outbox (transactional outbox) consiste en guardar el evento en una tabla outbox dentro de la misma transacción que el cambio de negocio, para que un proceso aparte lo publique en el broker después: o se guardan los dos, o ninguno.

    Guardas el pedido y luego publicas OrderPlaced. Si el proceso muere en medio, tienes un pedido sin evento. Es el dual-write.

    El transactional outbox inserta el evento en una tabla outbox en la misma transacción que el pedido. Un relay la lee, por polling o con CDC (Debezium, por ejemplo), y publica.

    Ojo: el relay también puede publicar dos veces si cae antes de marcar el mensaje como enviado, así que el consumidor idempotente sigue siendo obligatorio.

    Lo detallo en cómo sincronizar el read model en CQRS; si CQRS te queda lejos, empieza por el patrón CQRS.

    Evolución de schema sin romper consumidores

    En una arquitectura orientada a eventos, el payload es una API pública. Añadir un campo opcional con valor por defecto es seguro; renombrar, borrar un campo obligatorio o cambiar el tipo suele romper a alguien. Los consumidores deben ser tolerant readers que ignoran campos desconocidos.

    Backward compatibility: un consumidor nuevo lee eventos viejos. Forward: un consumidor viejo lee eventos nuevos. Para replay de meses atrás necesitas compatibilidad hacia atrás transitiva: el schema nuevo tiene que leer todas las versiones anteriores, no solo la última.

    Un schema registry valida estructura, no significado: si total pasa de "con IVA" a "sin IVA" sin cambiar de tipo, no se entera. Quien llevó el equipo de schemas de Kafka en Uber lo dejó claro en HN: "We just did not accept breaking schema changes within the topic. Same as you would expect from any other public-facing API." Y si no queda otra: "If you absolutely have to break the schema, make a new topic with a new consumer and phase out the old."

    Por eso el contrato del evento (nombre, campos, semántica, versionado) se escribe antes que el productor. Es la lógica del libro de Spec-Driven Development: si el contrato no está escrito, cada consumidor inventa su interpretación.

    Cuándo NO usar una arquitectura orientada a eventos

    Los eventos no son una mejora gratuita sobre una llamada HTTP.

    Cuando necesitas respuesta inmediata. El cobro tiene que decir "pagado" o "rechazado" ahora. Eso es una llamada síncrona, con su clave de idempotencia para que un doble clic no cobre dos veces, no un evento que alguien procesará cuando pueda.

    Cuando necesitas una transacción conjunta. Si cobrar y reservar stock deben ocurrir juntos o no ocurrir, los eventos te empujan a sagas y compensaciones. Muchas veces bastaba una transacción en un monolito.

    Cuando el equipo no puede operar la infraestructura. Colas, DLQ, alertas, lag, replay: alguien tiene que vigilarlo a las tres de la mañana. En el hilo de HN, un comentario lo plantea en clave de microservicios: "Monolith is easier to handle. With microservices, any network connection could break…"

    Cuando solo hay un consumidor. Si OrderPlaced solo lo escucha facturación y nunca habrá otro, probablemente te basta un comando en una cola.

    Si te faltan conceptos de base como consistencia eventual o idempotencia, repasa los términos de system design.

    Por dónde empezar mañana

    Abre tu endpoint más largo y lista cada await posterior al guardado. Para cada uno: ¿tiene que terminar antes de responder al usuario? Los que respondan "no" y tengan más de un interesado son candidatos a evento. Empieza por uno: tu primera arquitectura orientada a eventos cabe en un solo consumidor idempotente con DLQ y alerta desde el primer día.

    Si construyes el producto entero con agentes, especificar contratos antes de pedir código es la misma disciplina que trabajamos en Construye con IA, de la idea al producto con Claude Code.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre un evento y un comando?

    Un evento describe algo que ya ocurrió, se nombra en pasado y puede tener muchos oyentes que el emisor no conoce. Un comando pide una acción a un destinatario concreto, que puede rechazarla. Si el emisor necesita que algo ocurra y lo comprueba, es un comando aunque lo llames evento.

    ¿Qué es un consumidor idempotente?

    Es un consumidor que produce el mismo resultado aunque reciba el mismo mensaje varias veces. Se implementa guardando el identificador único del evento (source más id) en la misma transacción que el efecto de negocio y descartando los que ya existen.

    ¿Cola o log: cuál elijo para eventos?

    Una cola reparte trabajo entre workers y borra el mensaje tras procesarlo. Un log como Kafka conserva los eventos durante la retención, deja que varios grupos lean lo mismo, permite replay y ordena por clave. Elige log si necesitas replay u orden por entidad; cola si solo necesitas repartir carga.

    ¿Para qué sirve el patrón outbox?

    Evita el dual-write: guardar en la base de datos y publicar en el broker no es atómico. El outbox inserta el evento en una tabla dentro de la misma transacción y un relay lo publica después. El relay puede duplicar, así que los consumidores deben ser idempotentes.

    ¿Asíncrono significa event-driven?

    No. Encolar un comando para procesarlo en segundo plano es asíncrono, pero el productor sigue decidiendo qué pasa después. Es event-driven cuando el productor solo anuncia un hecho y los consumidores deciden cómo reaccionar.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • AI software factory: qué es y por qué falla sin contrato

    AI software factory: qué es y por qué falla sin contrato

    El 6 de febrero de 2026 un equipo de tres personas de StrongDM publicó un manifiesto con dos reglas. La primera: el código no lo escriben humanos. La segunda: el código no lo revisan humanos.

    Al día siguiente el texto llegó a portada de Hacker News. Un comentario resumía la reacción de media sala: "I feel like I'm taking crazy pills". La otra media lo leía como el primer plano de una AI software factory de verdad.

    Casi nadie discutía qué modelo usaban. Discutían cómo sabes que funciona un software que ningún humano ha escrito ni leído.

    En corto: una AI software factory es un pipeline donde agentes de IA convierten especificaciones en software desplegado, y los humanos solo escriben specs y juzgan resultados. Lo que decide si funciona no es el modelo, sino el harness de verificación: tests, tipos, escenarios y gates de CI que el agente no puede manipular.

    ¿Qué es una AI software factory?

    Una AI software factory (fábrica de software con IA) es un sistema en el que agentes de IA escriben, prueban e integran código a partir de especificaciones, y donde la calidad la garantiza un sistema de verificación automatizado en lugar de la revisión humana línea a línea.

    StrongDM lo define en su propio manifiesto como "non-interactive development where specs + scenarios drive agents that write code": desarrollo no interactivo donde specs y escenarios dirigen a agentes que escriben código.

    Fíjate en lo que falta: el prompt. Nadie chatea con el agente. Hay una entrada (la spec), una salida (el software) y un control de calidad entre medias.

    ¿Quién usa el término AI software factory y qué hay detrás?

    Hoy el término lo usan cuatro actores: StrongDM y OpenAI para describir cómo producen software sin escribir código a mano, Dan Shapiro para su escala de autonomía, y Factory como marca comercial. Solo los dos primeros publican cómo verifican.

    Quién Qué afirma Evidencia Limitación o riesgo
    StrongDM (feb. 2026) Equipo de 3 personas desde julio de 2025; "code must not be written by humans" ni revisado por humanos Manifiesto propio, técnicas publicadas y análisis de Simon Willison Su regla práctica: si no gastas 1.000 USD en tokens al día por ingeniero, a tu fábrica le queda margen; no publican métricas de producto entregado
    Dan Shapiro (ene. 2026) Seis niveles de autonomía (0 a 5); el 5 es la "dark factory" Lo que ha visto en decenas de empresas No es una encuesta; los porcentajes son estimaciones del autor
    OpenAI, harness engineering (feb. 2026) Un producto interno en beta de alrededor de un millón de líneas en cinco meses, con cero código escrito a mano (InfoQ, The Neuron) Cifras autodeclaradas, repetidas por dos medios (lo analizo aquí) Lo hace el fabricante del modelo, con acceso y presupuesto que tu equipo no tiene
    Factory (antes Factory.ai) "Build Your Software Factory": agentes llamados Droids que trabajan desde terminal, Slack, Jira, Linear y CI Página comercial Es un producto; el término es su posicionamiento de marca

    Mi lectura: StrongDM y OpenAI describen cómo verifican, y eso es lo valioso. Factory describe dónde se ejecutan los agentes, que es lo fácil.

    Las piezas de una fábrica de software con IA

    Una fábrica de software con IA tiene cinco piezas, y solo una de ellas es el modelo.

    1. Specs. La entrada de la línea. Si es ambigua, el agente rellena huecos con lo más frecuente en su entrenamiento, no con lo que pide tu negocio. Es Spec-Driven Development sin humanos en medio; lo desarrollo en el libro de Spec-Driven Development.

    2. Agentes. Claude Code, Codex, Droids. La pieza más intercambiable.

    3. Harness de verificación. Tests, tipos estrictos, linters, tests estructurales de arquitectura y escenarios end-to-end. Según InfoQ, OpenAI impone los límites de arquitectura "through mechanical rules and structural tests". No los pide en el prompt.

    4. CI como gate. Nada llega a main sin pasar el harness.

    5. Revisión. En StrongDM la revisión humana desaparece y la sustituye una métrica que llaman satisfaction: de todas las trayectorias observadas en todos los escenarios, qué fracción probablemente satisface al usuario. En el resto del mundo, la revisión sigue siendo humana pero cambia de objeto: revisas el contrato, no cada diff.

    Por qué la verificación decide si una AI software factory funciona

    El cuello de botella de una AI software factory es la verificación, no la generación de código. Generar código ya es barato. Saber si es correcto sigue siendo caro.

    Si el mismo agente escribe el código y los tests, optimiza para que los tests pasen, no para que el software funcione. En el hilo de Hacker News sobre StrongDM, el usuario Zakodiac lo dijo sin rodeos: "agents will absolutely game your test suite".

    La respuesta de StrongDM es la idea más útil de todo su manifiesto: guardar los escenarios, a menudo, fuera del repositorio, como el holdout set de un modelo de machine learning. El agente nunca los ve, así que no puede adaptarse a ellos.

    En la práctica se parece a esto:

    # .github/workflows/factory-gate.yml
    name: factory-gate
    on: pull_request
    jobs:
      holdout:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v7
          # Los escenarios viven en otro repo, sin acceso de escritura para el agente
          - uses: actions/checkout@v7
            with:
              repository: acme/checkout-scenarios
              path: scenarios
              token: ${{ secrets.SCENARIOS_READ_TOKEN }}
          - run: npm ci && npm run typecheck && npm test
          - run: npx playwright install --with-deps
          - run: npx playwright test --config scenarios/playwright.config.ts
    

    Tipos y tests en el repo, y escenarios que el agente no puede leer ni editar. Si una capa falla, el PR no entra. Protege también el workflow con CODEOWNERS y protección de rama; si no, el agente puede editar el propio gate.

    Otro comentario del mismo hilo, de CuriouslyC, pone el límite donde toca: "Until we solve the validation problem, none of this stuff is going to be more than flexes."

    Por eso defiendo que la pieza central es un contrato: reglas de negocio expresadas como tipos, tests y escenarios, no como frases en un prompt. Lo explico paso a paso en el tutorial de harness engineering y en el método de revisión por contrato.

    En qué nivel de autonomía está la mayoría de equipos hoy

    Según Dan Shapiro, el 90 % de los developers que se llaman "AI-native" está en el nivel 2 de su escala de seis niveles, y casi todos tocan techo en el 3. No cita fuente ni método: es su observación tras ver "decenas de empresas", no un estudio. La escala, de enero de 2026, se inspira en la conducción autónoma:

    Nivel Analogía de Shapiro Qué hace el developer
    0 El Volvo de tus padres Escribe todo el código
    1 Control de carril Delega tareas pequeñas y aisladas
    2 Autopilot en autopista Programa en pareja con la IA, en flujo
    3 Waymo con conductor de seguridad La IA escribe; él revisa diffs ("your life is diffs")
    4 Robotaxi Escribe specs y planes; vuelve horas después a ver si pasan los tests
    5 Dark factory Una caja negra que convierte specs en software

    Mi opinión: el salto que paga es del 2 al 4, no del 4 al 5. En el nivel 4 sigues escribiendo la spec y juzgando el resultado, pero dejas de leer cada línea porque el harness lo hace por ti. Eso ya es una fábrica, y es el mismo salto que describo en los niveles de Spec-Driven Development. La dark factory completa es un caso extremo, no la meta por defecto. Si quieres ver el ciclo completo de contexto entre esos niveles, está en el post de SDLC context engineering.

    Cuándo NO montar una AI software factory

    Una AI software factory no es gratis ni universal. No la montaría en estos casos.

    Cuando no tienes tests ni tipos fiables. Si tu suite actual no detecta regresiones con humanos escribiendo el código, tampoco las detectará con agentes. Multiplicarás la velocidad de los errores. Primero el harness, después la fábrica.

    Cuando el trabajo consiste en descubrir qué hay que construir. Para validar su fábrica, StrongDM construyó réplicas de servicios con API pública documentada (Okta, Jira, Slack): ahí la spec ya existe. En el hilo de HN, softwaredoug lo señaló: "most development work involves discovering correctness, not writing to a fullproof spec (like cloning slack)". Si la spec no existe todavía, no hay nada que fabricar.

    Cuando el coste no cuadra. La guía de StrongDM habla de al menos 1.000 USD en tokens al día por ingeniero. Simon Willison lo traduce a unos 20.000 USD al mes por persona y admite que, a ese precio, el enfoque le resulta "far less interesting".

    Cuando un fallo es inaceptable y nadie lo revisa. Software de seguridad, pagos o salud. Un antiguo cliente de StrongDM escribió en el hilo que para un producto de seguridad central eso no era el "flex" que creían.

    Por dónde empezar con una fábrica de software con IA

    No montes la fábrica. Monta el contrato.

    Es el camino que sigo con el método de Revisión por Contrato (Contract Based Review Method), y cabe en cuatro pasos:

    1. Un Issue, una spec. Elige un módulo con reglas de negocio claras. Antes de que el agente escriba una línea, firma su spec: qué cambia, criterios de aceptación ejecutables y qué archivos puede tocar.
    2. Un harness que corre solo. Tipos, lint y tests en un bucle corto tras cada cambio, y el bucle largo en CI en cada PR. Si depende de que te acuerdes de lanzarlo, no es verificación.
    3. Un veredicto en lugar del diff. Un comando ejecuta cada criterio de la spec y comprueba que el agente no salió de su alcance. Lees ese veredicto, no el diff.
    4. Criterios fuera de su alcance. Protege la spec y el harness con CODEOWNERS y protección de rama, o mueve los escenarios a otro repo. Si el agente puede editar el gate, lo editará.

    Después deja que el agente implemente una feature entera sin que leas el diff, y mira solo el veredicto.

    Si pasa y el comportamiento es correcto, has subido un nivel. Si pasa y es incorrecto, has encontrado el agujero de tu contrato: la información más valiosa de tu semana.

    Si quieres empezar sin pagar nada, el ebook gratuito El Developer Agéntico cubre cómo construir agentes de IA, de la arquitectura a la seguridad y la evaluación.

    Ese recorrido, del Issue a una PR con veredicto, es el workshop SDD + Agentic Engineering: la spec como contrato, hooks y CI que corren solos, y un veredicto que comprueba cada criterio y el alcance del diff. Primero en un repo de práctica, después en el tuyo. Y si prefieres construir un producto completo con Claude Code aplicando estas ideas, está el curso Construye con IA: de la idea al producto.

    Preguntas frecuentes

    ¿Qué diferencia hay entre una AI software factory y usar Claude Code o Copilot?

    Usar un asistente es trabajo interactivo: tú pides, revisas y corriges en cada paso. Una AI software factory es no interactiva: los agentes trabajan a partir de una spec y un sistema automatizado decide si el resultado es aceptable, sin que nadie siga la sesión.

    ¿Qué es una dark factory en desarrollo de software?

    Es el nivel 5 de la escala de Dan Shapiro: un proceso donde las specs entran y el software sale sin desarrollo ni revisión humana en medio. El término viene de las fábricas industriales que funcionan con las luces apagadas porque no hay personas dentro.

    ¿Qué relación tiene una fábrica de software con IA con SDD?

    Spec-Driven Development aporta la entrada de la fábrica: specs precisas que el agente puede ejecutar sin interpretar. Sin SDD, el agente rellena los huecos de la spec con lo más frecuente en su entrenamiento. Con SDD, esas reglas se convierten en tipos, tests y escenarios que el harness comprueba.

    ¿Los agentes pueden escribir sus propios tests en una AI software factory?

    Pueden escribir tests unitarios, pero no deberían controlar la verificación final. Si el mismo agente escribe el código y todos los tests, tenderá a ajustar los tests al código. Los escenarios de aceptación deben vivir fuera de su alcance.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
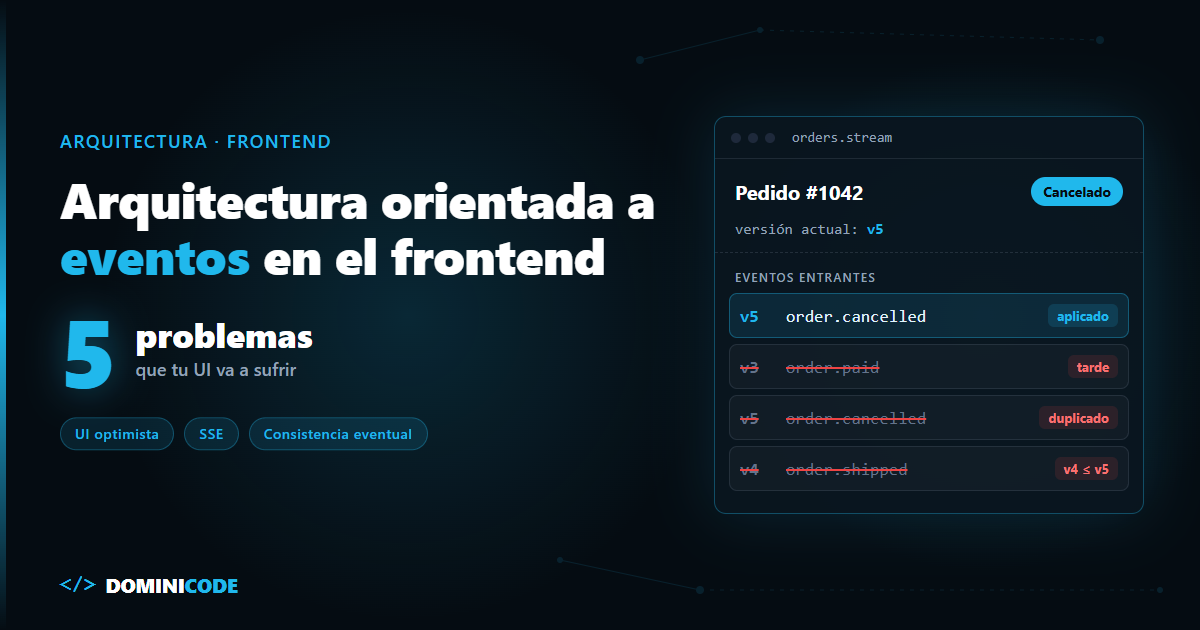
  • Feature flags: despliega código generado por IA sin miedo

    Feature flags: despliega código generado por IA sin miedo

    El 1 de agosto de 2012, Knight Capital acumuló en unos 45 minutos posiciones que acabaron costándole más de 460 millones de dólares. No fue un ataque ni un fallo de hardware. Fueron un despliegue incompleto y un feature flag mal gestionado: se reutilizó para activar código nuevo y, en el único servidor que no recibió ese código, despertó código que no se usaba desde 2003.

    Lo peor vino después: para arreglarlo, retiraron el código nuevo de los servidores donde sí funcionaba. Eso empeoró el problema.

    Hoy un agente te abre un PR de 900 líneas de código generado por IA en diez minutos. Los tests pasan. Y aun así no sabes cómo se comportará con tráfico real.

    En corto: mergea el código generado por IA a main detrás de un feature flag apagado por defecto, actívalo primero para tu equipo y luego por porcentaje de usuarios con un hash estable del userId. Si algo falla, apagas el flag en vez de hacer revert y redeploy. Y borras el flag y el camino viejo en cuanto llega al 100 %: a Knight lo hundieron un flag reutilizado, código muerto que nadie borró y un despliegue manual que nadie revisó.

    ¿Qué es un feature flag?

    Un feature flag es una condición en el código cuyo valor se decide en tiempo de ejecución, fuera del despliegue, y que permite activar o desactivar un comportamiento sin cambiar ni volver a desplegar el código.

    La clave es separar desplegar de liberar. Desplegar es poner el código en producción; liberar es que los usuarios lo ejecuten. Con un flag, lo primero lo hace tu pipeline y lo segundo lo decides tú.

    Pete Hodgson los clasifica en cuatro tipos en Feature Toggles, el artículo de referencia en martinfowler.com:

    Tipo Para qué sirve Vida esperada
    Release Ocultar código sin validar en producción Días o semanas; luego se borra
    Ops (kill switch) Apagar una función cara o frágil cuando el sistema sufre Casi siempre corta; algunos kill switches, años
    Experimento Comparar variantes A/B con métricas Lo que dure el experimento
    Permiso Dar acceso a planes premium o usuarios beta Años

    Para el código generado por IA interesa el de release, y Hodgson es tajante con su duración: "They should generally not stick around much longer than a week or two".

    Por qué el código generado por IA necesita feature flags

    El cuello de botella ya no es escribir código, es confiar en él. Un agente produce cambios más rápido de lo que tu equipo los valida, y hay comportamientos que solo descubres con tráfico real.

    Sin flags tienes dos salidas malas: una rama larga que acaba en un merge infernal, o liberar a todo el mundo a la vez. Ninguna escala cuando el agente abre cinco PR al día.

    Es el argumento de trunk-based development que vimos en cómo acelerar las entregas de los desarrolladores sénior: integrar pronto y en trozos pequeños. El flag hace seguro integrar código que aún no quieres que vea nadie.

    Criterio Revert + redeploy Feature flag Rama larga
    Cómo apagas el cambio Nuevo commit y pipeline completo Cambias un valor en el proveedor de flags No hace falta: nunca llegó a main
    Tiempo hasta apagar Lo que tarde tu CI/CD Lo que tarde en propagarse la configuración No aplica
    Exposición al activar 100 % de usuarios de golpe Equipo, luego 5 %, 25 %, 100 % 100 % de golpe al mergear
    Conflictos de merge Bajos Bajos Altos, crecen cada día
    Limitación / riesgo El revert puede no ser limpio si hubo migraciones o el cambio tocó varios servicios Deuda de flags, combinatoria de estados en tests, dependencia del proveedor El código no se prueba con tráfico real hasta el final; integración tardía

    El revert no siempre es la red de seguridad que parece: en Knight Capital, retirar el código nuevo activó el defectuoso en siete servidores más.

    Feature flags en TypeScript con OpenFeature

    OpenFeature es la forma de escribir feature flags en TypeScript sin casarte con un proveedor. Es una especificación abierta que la CNCF aceptó como proyecto incubating en diciembre de 2023: tu código habla con el SDK y el proveedor se enchufa detrás.

    El ejemplo está ejecutado con Node.js 24.16.0, @openfeature/server-sdk 1.23.0, @openfeature/core 1.12.0, tsx 4.23.15 y TypeScript 7.0.2 (tsc --noEmit sin errores). Usa TypedInMemoryProvider, porque en esta versión InMemoryProvider está marcado como @deprecated.

    Primero, el rollout por porcentaje. Math.random() < 0.05 es un error: el mismo usuario vería la función nueva en una petición y la vieja en la siguiente. Necesitas un hash estable.

    // rollout.ts
    import { createHash } from 'node:crypto';
    
    // Devuelve un "bucket" estable entre 0 y 99 para un usuario y un flag.
    // Mismo userId + mismo flag = mismo bucket, en cualquier proceso y en cualquier máquina.
    export function bucketOf(flagKey: string, userId: string): number {
      const digest = createHash('sha256').update(`${flagKey}:${userId}`).digest();
      return digest.readUInt32BE(0) % 100;
    }
    
    export function isInRollout(flagKey: string, userId: string, percentage: number): boolean {
      return bucketOf(flagKey, userId) < percentage;
    }
    

    El nombre del flag entra en el hash a propósito: si no, el mismo 5 % de usuarios se comería todos tus rollouts.

    Ahora el flag: siempre activo para el equipo, luego por porcentaje, y disabled: true como kill switch:

    // flags.ts
    import { OpenFeature, TypedInMemoryProvider, type EvaluationContext } from '@openfeature/server-sdk';
    import { isInRollout } from './rollout';
    
    const FLAG = 'new-checkout-ai';
    const TEAM = new Set(['ana@empresa.dev', 'luis@empresa.dev']);
    
    // Construye la configuración del flag: equipo interno + porcentaje + kill switch
    function buildFlags(percentage: number, killed: boolean) {
      return {
        [FLAG]: {
          variants: { on: true, off: false },
          defaultVariant: 'off',
          disabled: killed,
          contextEvaluator: (ctx: EvaluationContext) => {
            const userId = ctx.targetingKey;
            if (!userId) return 'off';
            if (TEAM.has(String(ctx.email))) return 'on';
            return isInRollout(FLAG, userId, percentage) ? 'on' : 'off';
          },
        },
      } as const;
    }
    
    const provider = new TypedInMemoryProvider(buildFlags(0, false));
    await OpenFeature.setProviderAndWait(provider);
    const client = OpenFeature.getClient();
    
    // Valor por defecto seguro: si algo falla, el código nuevo NO se ejecuta
    const SAFE_DEFAULT = false;
    
    async function share(): Promise<number> {
      let on = 0;
      for (let i = 0; i < 10_000; i++) {
        if (await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: `user-${i}` })) on++;
      }
      return on / 100;
    }
    
    console.log('1) Merge con el flag al 0 %');
    console.log('   equipo (ana):', await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: 'u-ana', email: 'ana@empresa.dev' }));
    console.log('   usuario externo:', await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: 'user-42' }));
    console.log(`   % de 10.000 usuarios con el flag: ${await share()} %`);
    
    provider.putConfiguration(buildFlags(5, false));
    const firstWave = new Set<string>();
    for (let i = 0; i < 10_000; i++) {
      if (await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: `user-${i}` })) firstWave.add(`user-${i}`);
    }
    console.log('2) Rollout al 5 %');
    console.log(`   % real: ${firstWave.size / 100} %`);
    const again = await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: [...firstWave][0] });
    console.log(`   ${[...firstWave][0]} vuelve a evaluar -> ${again} (estable)`);
    
    provider.putConfiguration(buildFlags(25, false));
    let kept = 0;
    for (const id of firstWave) if (await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: id })) kept++;
    console.log('3) Rollout al 25 %');
    console.log(`   % real: ${await share()} %`);
    console.log(`   usuarios del 5 % que siguen dentro: ${kept}/${firstWave.size}`);
    
    provider.putConfiguration(buildFlags(25, true));
    const details = await client.getBooleanDetails(FLAG, SAFE_DEFAULT, { targetingKey: [...firstWave][0], email: 'ana@empresa.dev' });
    console.log('4) Kill switch (disabled: true)');
    console.log(`   value=${details.value} reason=${details.reason}`);
    console.log(`   % real: ${await share()} %`);
    
    const missing = await client.getBooleanDetails('flag-que-no-existe', SAFE_DEFAULT, { targetingKey: 'user-1' });
    console.log('5) Flag inexistente');
    console.log(`   value=${missing.value} reason=${missing.reason} errorCode=${missing.errorCode}`);
    

    Salida real de npx tsx flags.ts:

    1) Merge con el flag al 0 %
       equipo (ana): true
       usuario externo: false
       % de 10.000 usuarios con el flag: 0 %
    2) Rollout al 5 %
       % real: 5.27 %
       user-0 vuelve a evaluar -> true (estable)
    3) Rollout al 25 %
       % real: 24.98 %
       usuarios del 5 % que siguen dentro: 527/527
    4) Kill switch (disabled: true)
       value=false reason=DISABLED
       % real: 0 %
    5) Flag inexistente
       value=false reason=ERROR errorCode=FLAG_NOT_FOUND
    

    Al subir del 5 % al 25 %, los 527 usuarios de la primera ola siguen dentro: nadie ve la función aparecer y desaparecer. El kill switch gana incluso al equipo interno (reason=DISABLED).

    Y si el flag no existe, el SDK no lanza: devuelve el valor por defecto con errorCode=FLAG_NOT_FOUND. Por eso el default es false, el camino viejo que ya funcionaba.

    Rollout gradual de código generado por IA: el flujo con agentes

    El rollout gradual convierte "lo despliego y rezo" en una serie de pasos pequeños con un botón de apagado en cada uno. Con agentes, el flujo queda así:

    1. El agente abre el PR con el código nuevo detrás de un flag apagado.
    2. Lo revisas igual: el código está en main. Aquí encaja la revisión por contrato.
    3. Mergeas el mismo día y tu pipeline de CI/CD despliega.
    4. Lo activas para el equipo interno.
    5. Subes a 5 %, 25 %, 50 % y 100 %, mirando métricas en cada paso.
    6. Estable al 100 %, el agente abre otro PR que borra el flag y el camino viejo.

    El paso 5 solo funciona si mides. Sin monitoreo en producción que separe métricas por variante, subir del 5 % al 25 % es fe, no datos.

    El paso 1 hay que pedirlo de forma explícita. Una regla en tu AGENTS.md como "todo cambio de comportamiento va detrás de un flag nuevo, apagado por defecto, con fecha de borrado" hace que ocurra siempre. Montar esas reglas y el harness del agente es lo que se trabaja en el workshop SDD + Agentic Engineering.

    El curso Construye con IA recorre el proceso completo, de la idea al producto desplegado con Claude Code.

    Lo que Knight Capital enseña sobre feature flags

    La lección no es "no uses flags". Es: nunca reutilices el nombre de un flag, borra el código muerto y no confíes en que el rollback sea inocuo. La orden de la SEC de octubre de 2013 lo documenta:

    • El código nuevo "repurposed a flag that was formerly used to activate the Power Peg code", sin uso desde 2003.
    • Un técnico no copió el código nuevo a uno de los ocho servidores, y nadie revisó el despliegue.
    • Ese servidor ejecutó el código viejo: 4 millones de ejecuciones en unos 45 minutos.
    • Desinstalar el código nuevo de los otros siete extendió el fallo a todos.

    En el hilo de Hacker News It's OK to hardcode feature flags, un usuario cuenta que una función nueva paralizó su app y una de las razones por las que tardaron tanto en arreglarlo fue que el responsable había quitado el flag remoto ese mismo día: "Redeploying takes time. Sometimes you want to disable something quick."

    En el mismo hilo, otro comentario resume el reverso: "leaving too many feature flags lying around can become serious debt". Las dos cosas son ciertas a la vez.

    Límites de los feature flags

    Los feature flags reducen el riesgo de liberar código, pero tienen su propio coste:

    Deuda de flags. Cada flag es un if con dos caminos que mantener; Hodgson habla de inventario con "carrying cost". Sin fecha de borrado se quedan para siempre: deuda técnica que además confunde al agente.

    Combinatoria en los tests. Con 10 flags booleanos activos hay 1.024 combinaciones. Testea los dos estados de cada flag y mantén pocos vivos a la vez.

    Dónde se evalúa. Si evalúas en el navegador, el código nuevo viaja en el bundle aunque el flag esté apagado. Cualquiera puede leerlo. Para funciones sensibles, evalúa en servidor o elimina el código en build.

    Latencia y caída del proveedor. Un proveedor remoto es una dependencia más. Si cae y no tiene caché, recibes el valor por defecto, y el kill switch tarda lo que tarde tu proveedor en propagar cambios.

    Los flags no sustituyen a los tests. Un flag limita a cuántos usuarios afecta un fallo, no evita el fallo. Las migraciones de base de datos tampoco se apagan con un flag: tienen que ser compatibles con los dos caminos.

    Por dónde empezar con feature flags

    Empieza por un solo flag de release en el próximo PR que te abra un agente. No necesitas un SaaS: OpenFeature con el provider en memoria para los tests y un provider que lea configuración externa en producción basta para separar desplegar de liberar.

    Ponle fecha de borrado el mismo día que lo creas: es lo que separa un flag útil de un Knight Capital en miniatura. Y si quieres que el agente parta de una especificación clara, el libro de Spec-Driven Development explica cómo definirla antes de escribir una línea.

    Preguntas frecuentes

    ¿Por qué no usar Math.random() para un rollout por porcentaje?

    Porque cada evaluación daría un resultado distinto y el mismo usuario vería la función nueva y la vieja alternándose. Un hash estable del userId y del nombre del flag asigna a cada usuario siempre el mismo bucket, y al subir el porcentaje los que ya estaban dentro siguen dentro.

    ¿Qué pasa si el proveedor de feature flags se cae?

    Con OpenFeature, la evaluación no lanza una excepción: si el provider no puede resolver el flag, devuelve el valor por defecto que pasaste en la llamada, con reason=ERROR y un errorCode. Muchos providers remotos sirven antes el último valor cacheado. Por eso el valor por defecto debe ser siempre el comportamiento antiguo y probado.

    ¿Qué diferencia hay entre un feature flag de release y un kill switch?

    Un flag de release oculta código nuevo mientras lo validas y se borra en una o dos semanas. Un kill switch es un flag de operaciones que sirve para apagar una función cara o frágil cuando el sistema sufre; casi siempre es temporal, aunque algunos se quedan años. En OpenFeature, disabled: true devuelve el valor por defecto con reason=DISABLED, incluso para el equipo interno.

    ¿Cuánto tiempo debe vivir un flag de release?

    Pete Hodgson recomienda que no pase de una o dos semanas. Al 100 % y estable, borra el flag y el camino viejo en un PR aparte.

    ¿Necesito LaunchDarkly o un SaaS para usar feature flags?

    No para empezar. Con OpenFeature escribes contra una API estándar y, si luego necesitas segmentación o auditoría, cambias de provider sin tocar las llamadas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Mutation testing en JavaScript: audita los tests de tu IA

    Mutation testing en JavaScript: audita los tests de tu IA

    Le pides al agente que escriba los tests del módulo de envíos. Todo en verde. La cobertura marca 100 % en líneas, ramas y funciones.

    Haces merge.

    Tres semanas después alguien cambia un >= por un > en la regla de envío gratis. Los pedidos de 50 € justos empiezan a pagar envío. Los tests siguen en verde y la cobertura, en 100 %.

    Nadie mintió. El agente escribió tests que ejecutan cada línea. Lo que no hizo fue comprobar que esas líneas hacen lo correcto. La cobertura no tiene forma de enterarse. El mutation testing en JavaScript, sí.

    En corto: la cobertura de código te dice qué líneas se ejecutaron durante los tests, no si algún test fallaría al romperlas. El mutation testing en JavaScript, con StrykerJS, introduce bugs pequeños en tu código y comprueba si algún test los detecta: el que sobrevive marca un test que no protegía nada. Es la forma más barata de auditar los tests que escribe un agente sin tener que leerlos todos.


    ¿Qué es el mutation testing?

    El mutation testing es una técnica que modifica el código de producción en pequeños puntos (cada cambio es un "mutante") y vuelve a pasar los tests para ver si alguno falla: si fallan, el mutante muere; si todo sigue en verde, el mutante sobrevive y has encontrado comportamiento que ningún test verifica.

    Los mutantes son bugs plausibles, no aleatorios. Los operadores de Stryker cambian a >= b por a > b, a + b por a - b, true por false, vacían un bloque o sustituyen una condición entera por true. Son los errores pequeños que se cuelan en un refactor sin que nadie los vea.

    El resultado se resume en el mutation score: mutantes detectados entre mutantes válidos, por cien. La documentación de métricas lo define así y separa los estados que verás en el informe:

    • Killed: al menos un test falló con el mutante activo.
    • Survived: todos los tests pasaron con el mutante activo.
    • No coverage: ningún test ejecuta ese código. No llega ni a probarse y cuenta como no detectado.
    • Timeout: el mutante provocó un bucle o una espera infinita. Cuenta como detectado.

    Por qué los tests generados por IA pasan y no prueban nada

    Los tests generados por IA fallan en lo mismo que los de un junior con prisa: ejecutan el código, pero sus asserts no comprometen nada. toBeDefined(), toBeTruthy(), toBeGreaterThanOrEqual(0), o un mock que se configura y luego se comprueba a sí mismo.

    El agente optimiza lo que le pides. Si le pides "tests que pasen" y "cobertura alta", te da las dos cosas. Ninguna de las dos garantiza que el test falle cuando el código está mal.

    Lo vimos desde otro ángulo en cómo blindar los tests para que Claude Code no los toque: proteger los tests del agente sirve de poco si los tests ya eran débiles cuando entraron.

    Cobertura de código Mutation score
    Qué mide Líneas, ramas y funciones ejecutadas por algún test Porcentaje de bugs sembrados que algún test detecta
    Qué no detecta Asserts débiles, tests sin expect útil, límites sin probar Mutantes equivalentes (cambios que no alteran el comportamiento)
    Coste Una ejecución de la suite con instrumentación Una ejecución de tests por cada mutante cubierto
    Herramienta en JS/TS @vitest/coverage-v8, Istanbul, Jest --coverage StrykerJS (@stryker-mutator/core + runner)
    Limitación / riesgo Da falsa seguridad: 100 % compatible con tests que no fallan nunca Lento en suites grandes y empuja a escribir tests para matar mutantes irrelevantes

    Tutorial de mutation testing con StrykerJS y Vitest en TypeScript

    Partimos de una función de seis líneas. El ejemplo está ejecutado con @stryker-mutator/core 10.0.0 y Vitest 4.1.11 (octubre de 2026). Más abajo explico por qué no Vitest 5.

    // src/envio.ts
    export function calcularEnvio(subtotal: number, esPremium: boolean): number {
      if (esPremium || subtotal >= 50) {
        return 0;
      }
      return 4.99;
    }
    

    Y este es el test "típico de agente". Pasa, y vitest run --coverage devuelve 100 % en statements, branches, functions y lines:

    // src/envio.spec.ts
    import { describe, it, expect } from 'vitest';
    import { calcularEnvio } from './envio';
    
    describe('calcularEnvio', () => {
      it('devuelve un coste de envío', () => {
        expect(calcularEnvio(20, false)).toBeDefined();
      });
    
      it('aplica envío gratis a partir de cierto importe', () => {
        expect(calcularEnvio(100, false)).toBe(0);
      });
    
      it('gestiona clientes premium', () => {
        expect(calcularEnvio(10, true)).toBeGreaterThanOrEqual(0);
      });
    });
    

    1. Instalar Stryker

    La vía oficial es el asistente, que pregunta por tu runner y genera la config (getting started):

    npm init stryker@latest
    

    Si prefieres hacerlo a mano, instala el core y el runner. El plugin no incluye Vitest: usa el que ya tienes en el proyecto.

    npm i -D @stryker-mutator/core @stryker-mutator/vitest-runner
    # Con Jest: npm i -D @stryker-mutator/core @stryker-mutator/jest-runner
    

    2. Configuración mínima

    Stryker busca stryker.config.{json,js,mjs,cjs} en la raíz (config file):

    // stryker.config.mjs
    // @ts-check
    /** @type {import('@stryker-mutator/api/core').PartialStrykerOptions} */
    const config = {
      testRunner: 'vitest', // con Jest: 'jest'
      mutate: ['src/**/*.ts', '!src/**/*.spec.ts'],
      reporters: ['clear-text', 'progress', 'html'],
      thresholds: { high: 80, low: 60, break: 70 },
    };
    export default config;
    

    Con Vitest, el runner ignora coverageAnalysis y usa siempre perTest: cada mutante solo ejecuta los tests que lo cubren. Es lo que lo hace viable.

    3. Ejecutar y leer el informe

    npx stryker run
    

    La consola muestra cada superviviente con su diff, y el informe HTML queda en reports/mutation/mutation.html. Resultado con el test del agente: 8 mutantes, 6 killed, 2 survived, mutation score 75 %. Con 100 % de cobertura.

    Los dos supervivientes:

    -     if (esPremium || subtotal >= 50) {
    +     if (esPremium || subtotal > 50) {
    
    -     if (esPremium || subtotal >= 50) {
    +     if (true) {
    

    El primero es el bug de la apertura: nadie prueba el límite de 50. El segundo es peor: si el envío fuera siempre gratis, ningún test se enteraría, porque toBeDefined() acepta un 0 igual que un 4,99.

    4. El test que mata a los dos

    describe('calcularEnvio', () => {
      it('cobra 4,99 por debajo de 50', () => {
        expect(calcularEnvio(49.99, false)).toBe(4.99);
      });
    
      it('el envío es gratis justo en 50', () => {
        expect(calcularEnvio(50, false)).toBe(0);
      });
    
      it('un cliente premium no paga envío aunque el pedido sea pequeño', () => {
        expect(calcularEnvio(10, true)).toBe(0);
      });
    });
    

    Mismo número de tests. Mutation score: 100 %, 8 de 8 killed. La diferencia es que cada assert afirma un valor concreto en un punto que importa. Es la misma disciplina que en TDD potenciado por IA: el test define el comportamiento, no lo acompaña.

    Cómo meter mutation testing en el flujo con agentes

    Lanzar Stryker sobre todo el repo en cada cambio no escala. Lo que funciona es acotar.

    Muta solo lo que cambió. --mutate acepta una lista de ficheros separada por comas, e incluso rangos de líneas (src/envio.ts:3-5). En una PR:

    CHANGED=$(git diff --name-only --diff-filter=d origin/main...HEAD -- 'src/*.ts' | { grep -v '\.spec\.ts$' || true; } | paste -sd, -)
    if [ -n "$CHANGED" ]; then npx stryker run --mutate "$CHANGED"; fi
    

    En GitHub Actions, haz el checkout con fetch-depth: 0; si no, origin/main no existe en el runner.

    Activa el modo incremental. Con --incremental, Stryker guarda resultados en reports/stryker-incremental.json y reutiliza los de mutantes cuyo código y tests no cambiaron (incremental). En la segunda ejecución del ejemplo el log dice "8 of 8 mutant result(s) are reused".

    Ojo: solo detecta cambios en ficheros mutados y de test; si actualizas dependencias, pasa --force.

    Pon un suelo en CI. thresholds.break hace que Stryker salga con código 1 si el score queda por debajo. Por defecto es null y nunca rompe el build (configuración). Empieza bajo y súbelo.

    Dale los supervivientes al agente. Aquí el mutation testing deja de ser una métrica y se vuelve un bucle de feedback:

    Stryker ha dejado estos mutantes vivos en src/envio.ts (diff abajo).
    Escribe o corrige tests que los maten. Reglas:
    - No toques el código de producción.
    - Cada assert compara contra un valor concreto, nunca toBeDefined/toBeTruthy.
    - Si un mutante no cambia el comportamiento observable, dímelo y no escribas test para él.
    

    La última regla importa más de lo que parece, y la explico abajo. Si quieres el sistema entero de verificación de código generado, sin leer cada línea, está en verificar código generado por IA sin leerlo todo, y lo trabajamos con proyectos reales en el workshop SDD + Agentic Engineering. Si estás empezando a delegar trabajo en agentes, el ebook gratuito El Developer Agéntico es el punto de partida.

    Cuándo NO usar mutation testing

    Lo recomiendo para módulos con lógica de negocio. No para todo.

    Es lento en suites grandes. Cada mutante es una ejecución de tests. En este comentario de Hacker News, un usuario de Stryker lo cuantifica: "a small-ish TS project where our normal test suite runs in 2 minutes or so takes about 20-25 with Stryker". Sobre el repo completo en cada push, no; sobre el diff, sí.

    Los mutantes equivalentes son ruido. Hay mutaciones que no cambian el comportamiento observable (por ejemplo, alterar un límite que el resto del código ya filtra). Sobreviven siempre y ningún test sensato las mata. Perseguir el 100 % te obliga a revisarlas a mano.

    Perseguir mutantes deforma los tests. Uncle Bob lo usó como rol de hardening en su harness y, como contamos en harness multiagente vs un solo agente, encontró bugs reales, pero el algoritmo empujaba al agente a hacer cosas tontas con tal de matar mutantes. Un agente con la orden "sube el score" acopla tests a detalles de implementación. Por eso el prompt de arriba le deja decir "este no".

    El runner también falla. Con Vitest 5, @stryker-mutator/vitest-runner 10.0.0 ejecuta cero tests por mutante y casi todo sale como Survived.

    Está documentado en el issue #6210 de stryker-js, abierto el 4 de septiembre de 2026: el autor reporta un score que cae de 47,36 con Vitest 4.1.11 a 2,96 con Vitest 5.0.0. El ejemplo de este post lo reproduce: 0 % con Vitest 5.0.3, 75 % con 4.1.11.

    A 10 de octubre de 2026 los PR del arreglo (#6214 y #6220) siguen abiertos. Si ves "Ran 0.00 tests per mutant", no te fíes del score.

    Por dónde empezar hoy

    Elige el módulo con más lógica de negocio que tu agente haya testeado en el último mes y hazle mutation testing en JavaScript con Stryker. Precios, permisos, cálculos de fechas. Solo ese fichero.

    Si sale por encima del 80 %, tus tests probablemente valen. Si sale al 40 % con cobertura del 95 %, acabas de medir cuánto te estaban diciendo los tests del agente.

    Los mutantes que sobreviven suelen apuntar a casos límite que nadie escribió. Para encontrarlos sin pensarlos uno a uno, el property-based testing con fast-check genera cientos de entradas por test.

    Hay errores que conviene que no lleguen ni a los tests: pasar un orderId donde va un userId. Esos los cierran los branded types en TypeScript.

    En testing en Angular con IA ya lo mencionábamos de pasada. Si trabajas en Angular, el curso de Testing en Angular con Jest y Testing Library cubre cómo escribir asserts que afirman comportamiento.

    Y si quieres montar el flujo completo con agentes, de la spec al test que mata mutantes, está en Construye con IA.

    Preguntas frecuentes

    ¿Qué diferencia hay entre cobertura de código y mutation score?

    La cobertura mide qué código se ejecuta durante los tests. El mutation score mide qué porcentaje de bugs introducidos a propósito detectan esos tests. Puedes tener 100 % de cobertura y 0 % de mutation score si ningún assert compara contra un valor concreto.

    ¿Stryker funciona con Jest y con Vitest?

    Sí. Para Jest instala @stryker-mutator/jest-runner y pon testRunner: 'jest'; para Vitest, @stryker-mutator/vitest-runner y testRunner: 'vitest'. En octubre de 2026 el runner de Vitest tiene un bug abierto con Vitest 5 (issue #6210), así que mantén Vitest 4 para mutation testing hasta que salga el arreglo.

    ¿Qué mutation score es bueno?

    Los umbrales por defecto de Stryker marcan 80 como alto y 60 como bajo. No hay una cifra universal: en lógica de negocio crítica apunta por encima de 80; en código de pegamento o UI, el esfuerzo de subirlo rara vez compensa.

    ¿Cómo hago que el mutation testing no tarde una eternidad?

    Muta solo los ficheros cambiados con --mutate, activa --incremental para reutilizar resultados entre ejecuciones y deja que el runner use análisis de cobertura perTest, que ejecuta solo los tests que tocan cada mutante.

    ¿Puedo pedirle al agente de IA que mate los mutantes supervivientes?

    Sí, y es el mejor uso. Pásale el diff de cada superviviente y prohíbele tocar el código de producción y usar asserts débiles. Déjale marcar mutantes equivalentes en vez de forzar tests absurdos para matarlos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Property-based testing en TypeScript: lo que la IA no prueba

    Property-based testing en TypeScript: lo que la IA no prueba

    Le pides al agente una función para dividir la cuenta de una cena entre varias personas. La escribe en diez segundos. Le pides los tests y también los escribe: 100 céntimos entre 2, 100 entre 3, 1.000 entre 7. Todo en verde.

    Incluso comprueba que la suma de las partes da el total.

    Hasta que alguien reparte 3 céntimos entre 5 personas y la función le dice a una de ellas que pague -1.

    Ese caso no lo eligió nadie. Los ejemplos los eligió el mismo que escribió el código y comparten sus puntos ciegos. El property-based testing en TypeScript ataca justo eso.

    En corto: el property-based testing no prueba ejemplos concretos, sino reglas que deben cumplirse para cualquier entrada, como "nadie paga una cantidad negativa".

    fast-check genera 100 entradas aleatorias por defecto y, si una rompe la regla, la reduce al contraejemplo más pequeño posible. Sirve para encontrar los casos límite que no eligió quien escribió el código, sea una persona o un agente de IA.


    ¿Qué es el property-based testing?

    El property-based testing es una técnica de testing en la que describes una propiedad que la función debe cumplir para todas las entradas válidas, y la librería genera cientos de entradas aleatorias para intentar romperla.

    La documentación de fast-check lo define así: una propiedad es una afirmación sobre la relación entre la entrada y la salida del código que debe cumplirse para todas las entradas.

    La diferencia con un test normal es quién elige los casos: aquí los elige un generador que no conoce tu implementación y no comparte tus suposiciones.

    La otra pieza es el shrinking. Cuando una entrada falla, fast-check no te devuelve un array de 400 elementos. Lo encoge hasta el caso más pequeño que sigue fallando.

    El bug que pasó los tests del agente

    Este es el código, tal como podría salir de cualquier asistente. Al menos trabaja en céntimos:

    // split.ts
    export function splitAmount(totalCents: number, people: number): number[] {
      const share = Math.round(totalCents / people);
      const shares = Array(people - 1).fill(share);
      const last = totalCents - share * (people - 1);
      return [...shares, last];
    }
    

    Y estos son sus tests:

    it('reparte a partes iguales', () => {
      expect(splitAmount(100, 2)).toEqual([50, 50]);
    });
    it('el último absorbe el redondeo', () => {
      expect(splitAmount(100, 3)).toEqual([33, 33, 34]);
    });
    it('la suma siempre cuadra', () => {
      const shares = splitAmount(1000, 7);
      expect(shares.reduce((a, b) => a + b, 0)).toBe(1000);
    });
    

    Tres tests, tres verdes. La suma cuadra siempre, porque el último se queda con lo que sobre. El fallo está en que Math.round puede redondear hacia arriba, y entonces lo que "sobra" para el último es negativo.

    Property-based testing en TypeScript con fast-check y Vitest

    El ejemplo está ejecutado con fast-check 4.10.2, @fast-check/vitest 0.5.0, Vitest 5.0.3 y Node 24 (octubre de 2026). El paquete @fast-check/vitest añade test.prop y it.prop encima de los de Vitest, y su paquete declara como peerDependency Vitest ^4.1.0 || ^5.0.0.

    npm i -D vitest fast-check @fast-check/vitest
    

    En vez de ejemplos, escribes las reglas del negocio:

    import { test, fc } from '@fast-check/vitest';
    import { expect } from 'vitest';
    import { splitAmount } from './split';
    
    const total = fc.integer({ min: 0, max: 1_000_000 }); // céntimos
    const people = fc.integer({ min: 1, max: 50 });
    
    test.prop([total, people])('la suma de las partes es el total', (t, n) => {
      const shares = splitAmount(t, n);
      expect(shares.reduce((a, b) => a + b, 0)).toBe(t);
    });
    
    test.prop([total, people])('nadie paga una cantidad negativa', (t, n) => {
      expect(Math.min(...splitAmount(t, n))).toBeGreaterThanOrEqual(0);
    });
    
    test.prop([total, people])('las partes difieren como mucho en 1 céntimo', (t, n) => {
      const shares = splitAmount(t, n);
      expect(Math.max(...shares) - Math.min(...shares)).toBeLessThanOrEqual(1);
    });
    

    fc.integer es un arbitrary: un generador de valores con restricciones. Hay uno para casi todo: fc.string(), fc.array(), fc.record(), fc.uuid(), fc.double().

    Esta es la salida real, recortada al primer fallo:

     ❯ src/split.prop.test.ts (3 tests | 2 failed) 13ms
       × nadie paga una cantidad negativa (with seed=1056875308) 7ms
       × las partes difieren como mucho en 1 céntimo (with seed=1864299458) 1ms
    
     FAIL  src/split.prop.test.ts > nadie paga una cantidad negativa (with seed=1056875308)
    Error: Property failed after 30 tests
    { seed: 1056875308, path: "29:2:4:0:0:1:0:4:3:1:1:0:5:2:1:1:0:1:3:0:2", endOnFailure: true }
    Counterexample: [3,5]
    Shrunk 20 time(s)
    
    Caused by: AssertionError: expected -1 to be greater than or equal to 0
    

    Fíjate en tres cosas. La propiedad que escribió el agente, la de la suma, pasa: era la única que se le ocurrió. El fallo apareció en el intento 30 y fast-check lo encogió 20 veces hasta [3,5]. Y splitAmount(3, 5) devuelve [1, 1, 1, 1, -1]: el bug cabe en una línea.

    La segunda propiedad también cayó, encogida hasta [2,4], que da [1, 1, 1, -1].

    Reproducir el fallo con seed y path

    Cada ejecución usa una semilla aleatoria distinta. Para que el fallo no se pierda, pasa la seed y el path del informe como parámetros:

    test.prop([total, people], {
      seed: 1056875308,
      path: '29:2:4:0:0:1:0:4:3:1:1:0:5:2:1:1:0:1:3:0:2',
      endOnFailure: true,
    })('nadie paga una cantidad negativa', (t, n) => { /* ... */ });
    

    Según la guía para leer los informes, path arranca directamente en el contraejemplo reducido y endOnFailure para en el primer fallo sin volver a encoger. En el ejemplo, con esos parámetros falla en el primer intento con [3,5].

    El fix reparte el resto céntimo a céntimo:

    export function splitAmount(totalCents: number, people: number): number[] {
      const base = Math.floor(totalCents / people);
      const remainder = totalCents % people;
      return Array.from({ length: people }, (_, i) => base + (i < remainder ? 1 : 0));
    }
    

    Las tres propiedades pasan. Y pasa algo revelador: el test de ejemplo [33, 33, 34] se rompe, porque ahora el resultado es [34, 33, 33]. Ese test no protegía una regla de negocio. Fijaba un detalle de implementación. Con numRuns: 1000 (el valor por defecto es 100, según el tipo Parameters de fast-check) las propiedades siguen en verde.

    Tests de ejemplo vs. property-based testing

    Tests de ejemplo Property-based testing
    Quién elige los casos Tú o el agente, con las mismas suposiciones que el código Un generador aleatorio con las restricciones que declares
    Qué cubre Los 3-5 casos escritos 100 entradas por defecto en cada ejecución, distintas cada vez
    Qué documenta Un caso concreto (100 / 3 → [33, 33, 34]) Una regla de negocio ("nadie paga negativo")
    Cómo depuras un fallo Lees el caso que escribiste Lees el contraejemplo encogido y lo reproduces con seed y path
    Coste Bajo de escribir y de ejecutar Pensar la propiedad cuesta más; ejecutar, unos milisegundos más
    Limitación o riesgo Solo encuentra los bugs que ya imaginaste Una propiedad débil pasa siempre y da falsa seguridad

    Seis propiedades que sirven en código real

    La pregunta que bloquea a todo el mundo es "¿qué propiedad escribo?". Casi siempre cae en una de estas:

    1. Round-trip. parse(serialize(x)) devuelve x. Con JSON.parse(JSON.stringify(o)) y fc.double(), fast-check encuentra -0, NaN, Infinity y -Infinity, que JSON convierte en 0 y null.
    2. Invariante. Algo que nunca cambia: el total cuadra, nadie paga negativo, el stock no baja de cero.
    3. Idempotencia. Aplicar dos veces da lo mismo que una: ordenar, normalizar un email, un slugify.
    4. Oráculo. Comparas tu versión optimizada con una implementación lenta pero obvia. Muy útil al refactorizar.
    5. Conmutatividad. El orden de entrada no cambia el resultado: aplicar dos descuentos, fusionar dos configuraciones.
    6. No lanza. Para cualquier entrada válida, la función devuelve algo y no explota. Es la propiedad más pobre, y aun así encuentra bugs.

    Cómo usar property-based testing con agentes de IA

    El cambio es pequeño y potente: no le pidas al agente "escribe tests para esta función". Pídele "escribe las propiedades que esta función debe cumplir para cualquier entrada, con fast-check". Obligarle a enunciar reglas le obliga a explicitar qué cree que hace el código, y ahí se ven las contradicciones.

    Mejor aún: escribe tú las propiedades antes que el código. Una propiedad es una especificación ejecutable, y es exactamente lo que necesita un agente para saber cuándo ha terminado. Es la lógica que enseño en el workshop de SDD + Agentic Engineering: el humano define el contrato y la máquina lo cumple.

    Si tus entradas ya tienen un esquema, conéctalo. Haz que el arbitrary genere objetos con fc.record y comprueba dentro de la propiedad que tu función acepta todo lo que el esquema de Zod valida.

    Existe zod-fast-check para derivar arbitraries del esquema, pero su última versión en npm (0.10.1) se publicó en 2023 y exige fast-check <4 y zod ^3: hoy no compensa instalarlo.

    Esto encaja con la idea de verificar el código generado por IA sin leerlo todo: no revisas línea a línea, revisas que las reglas se cumplan.

    Y complementa lo que contamos sobre testing de agentes con TDD y sobre validar código antes de hacer merge.

    Cuándo NO usar property-based testing

    Cuando no encuentras una propiedad que no sea la propia función. Si para comprobar el resultado tienes que reimplementar el algoritmo, estás comparando el bug consigo mismo. En código de pegamento (llamar a una API, mapear un DTO a otro) a menudo no hay propiedad interesante.

    En UI y efectos secundarios. Generar cientos de entradas contra una base de datos, una API de pago o un componente renderizado es lento y deja estado detrás. Existe testing basado en modelos para esto, pero el coste de montarlo sube mucho.

    Cuando dejas el azar suelto en CI. Cada ejecución usa otra semilla. Un fallo que aparece una vez y no vuelve es real, pero si no guardas la seed y el path lo pierdes. Fija la semilla al reproducir y convierte el contraejemplo en un test de ejemplo permanente.

    Cuando confías ciegamente en el shrinking. Es heurístico. Con las dos aserciones del ejemplo juntas en una sola propiedad, fast-check se quedó en [68630,4] (con otra semilla puede salir distinto) en vez de bajar a [2,4]. Una propiedad por regla da contraejemplos más limpios.

    La barrera de entrada también es real. En el hilo de Hacker News The sad state of property-based testing libraries, un usuario defiende que el shrinking es, cito, "90% of the value of PBT".

    Otro apunta que el problema de formación "is a very real and fundamental blocker" para adoptarlo en equipos.

    Empieza por una función de dinero

    Elige hoy la función de tu proyecto que toca importes, fechas o parseo de texto. Escribe una sola propiedad: la invariante que, si se rompe, le cuesta dinero a alguien. Ejecútala con test.prop.

    Si pasa, súbele numRuns. Si falla, acabas de encontrar el caso que nadie pensó, con su contraejemplo mínimo y su semilla para reproducirlo.

    Para saber si el resto de tus tests detecta algo, pásales mutation testing con Stryker. Y para que un id o un importe mal pasado no llegue ni a compilar, usa branded types en TypeScript.

    Y si estás construyendo producto con agentes, el curso Construye con IA recorre cómo poner estas redes de seguridad desde la idea hasta producción.

    Para el contexto de por qué validar las entradas en los bordes, repasa también la programación defensiva en TypeScript.

    Preguntas frecuentes

    ¿Qué diferencia hay entre property-based testing y fuzzing?

    Los dos generan entradas automáticamente. El fuzzing suele buscar cuelgues y excepciones, a menudo guiado por cobertura. El property-based testing comprueba reglas de negocio que tú declaras y reduce el fallo a un contraejemplo mínimo.

    ¿Cuántos casos genera fast-check por defecto?

    100 por propiedad y por ejecución, según la documentación del parámetro numRuns de fast-check 4.10.2. Puedes subirlo con { numRuns: 1000 } en las propiedades críticas, a costa de algo más de tiempo.

    ¿Sirve fast-check con Jest o solo con Vitest?

    fast-check funciona igual en JavaScript y en TypeScript, y con cualquier runner: fc.assert(fc.property(...)) lanza una excepción si la propiedad falla, y Jest o Mocha la tratan como un test fallido. @fast-check/vitest solo añade la sintaxis test.prop y muestra la semilla en el nombre del test.

    ¿Pueden los agentes de IA escribir buenas propiedades?

    Sí, si se lo pides explícitamente y revisas lo que proponen. El riesgo es que escriban propiedades débiles, como "devuelve un array", que pasan siempre. Revisar unas pocas reglas es más rápido que revisar decenas de ejemplos, y una regla débil se detecta leyéndola.

    ¿Los tests de propiedades sustituyen a los tests de ejemplo?

    No. Los ejemplos documentan casos concretos que un humano lee para entender la función. Las propiedades exploran el espacio de entradas. Cuando una propiedad encuentra un bug, guarda el contraejemplo como test de ejemplo para que no vuelva.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.