Category: Arquitectura de Software

  • Self-healing code en agentes TypeScript: el bucle que sí corrige

    Self-healing code en agentes TypeScript: el bucle que sí corrige

    El self-healing code en agentes de TypeScript es un patrón sencillo de describir y fácil de implementar mal. Te cuento primero cómo me enteré.

    Un agente mío se pasó tres minutos razonando una tarea, escribió ochenta líneas de TypeScript, llamó a la API interna y devolvió el objeto con userId donde el schema pedía id.

    Una palabra.

    El pipeline hizo lo que hacen todos: lanzó la excepción, abortó con código de salida 1 y me mandó un aviso para que abriera el editor y cambiara esa palabra a mano.

    Lo absurdo es que Zod ya sabía exactamente qué había fallado. Sabía el campo, el tipo recibido, el tipo esperado y la ruta dentro del objeto. Tenía el diagnóstico completo escrito en una estructura de datos. Y con todo eso en la mano, el sistema decidió despertar a un humano.

    Así que monté el bucle de autocorrección. Y durante dos semanas no funcionó, gastando el doble de llamadas al modelo, por un motivo que no vi hasta que abrí el objeto de error con el debugger.

    Resumen rápido:

    • El self-healing convierte el diagnóstico de un verificador determinista en el contexto del siguiente intento, en vez de escalar a un humano.
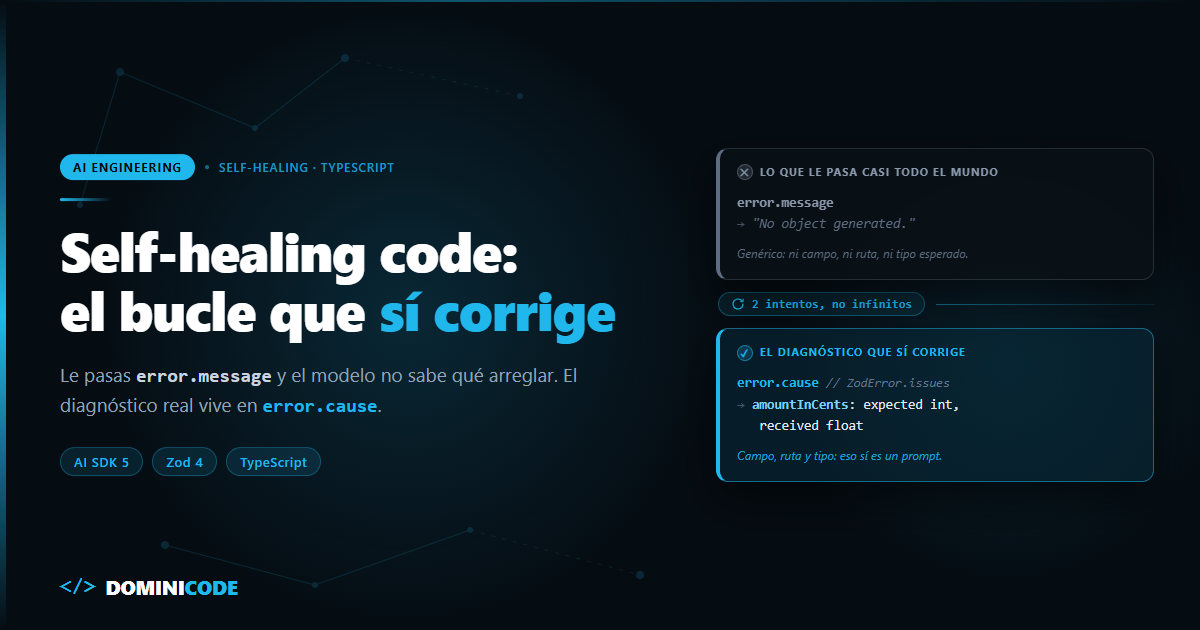
    • Si usas generateObject del Vercel AI SDK, el detalle del fallo no está en error.message — está en error.cause. Ese es el error que arruina la mayoría de implementaciones.
    • Techo de dos intentos totales, y cuenta intentos, no reintentos.
    • No todos los errores son curables: los de tipos y schema sí, los de credenciales o herramienta caída no.

    Qué es el self-healing code (y qué no es)

    El self-healing code es un patrón en el que el sistema que genera —código o datos estructurados— ejecuta un verificador determinista, captura el diagnóstico exacto del fallo y lo reinyecta como contexto en un reintento acotado, en lugar de tratar el fallo como terminal.

    La idea de fondo: el validador es el mejor prompt que vas a escribir en tu vida, porque es el único que describe el fallo con precisión de campo y sin ambigüedad.

    El bucle tiene cinco pasos:

    1. Generar. El modelo produce el objeto o el código.
    2. Verificar. Zod, tsc o el test runner dictaminan. Sin intervención humana y sin LLM de por medio: determinista.
    3. Extraer el diagnóstico real. Campo, ruta, tipo esperado, tipo recibido. Aquí es donde falla casi todo el mundo.
    4. Reinyectar. El diagnóstico vuelve como turno nuevo de la conversación, junto a la salida anterior.
    5. Acotar. Techo de intentos y salida limpia cuando se agota.

    Conviene separarlo de dos patrones vecinos con los que se confunde.

    No es un retry con backoff. El backoff reintenta lo mismo esperando que el mundo cambie: que se descongestione la red, que el proveedor se recupere. El self-healing reintenta algo distinto, porque le has añadido información que antes no estaba. Si reintentas idéntico un fallo de validación, el modelo suele reproducir el mismo error.

    No es un circuit breaker. El breaker existe para dejar de insistir cuando una herramienta externa lleva minutos caída; lo conté en circuit breaker para agentes IA. Son capas distintas: el breaker mira la salud de un servicio externo, el self-healing mira la forma de lo que devuelve el modelo. En un agente serio acaban conviviendo.

    Y una frontera más: este post va del bucle. De cómo validar y tipar la respuesta en sí ya escribí en cómo tipar las respuestas de una LLM con Zod y TypeScript. Si no tienes esa parte montada, empieza por ahí y vuelve.


    El error que hace que tu bucle de autocorrección no sirva de nada

    Aquí está lo que me costó dos semanas.

    Cuando usas generateObject del Vercel AI SDK y el modelo devuelve algo que no valida, el SDK lanza un NoObjectGeneratedError. La reacción natural es esta:

    catch (error: any) {
      prompt = `Tu respuesta anterior falló con este error: ${error.message}`;
    }
    

    Ese código se ejecuta sin romperse, el bucle gira, gastas otra llamada al modelo y parece que el patrón funciona.

    No funciona. El message de un NoObjectGeneratedError es genérico —del tipo "No object generated"— y no lleva el campo, ni el tipo esperado, ni la ruta. Le estás diciendo al modelo "lo has hecho mal" y esperando que adivine el qué.

    El detalle está en otras propiedades del error, documentadas en el propio AI SDK:

    • error.cause — el error subyacente real: el ZodError con sus issues, o el fallo de parseo de JSON.
    • error.text — el texto crudo que el modelo llegó a generar, que le permite ver su propia salida y compararla con el diagnóstico.
    • error.finishReason — si vale 'length', el JSON no es inválido por confusión del modelo: está truncado porque se acabaron los tokens. Reintentar con el mismo límite es tirar dinero; ahí toca subirlo o partir el schema.

    Ese último matiz es la diferencia entre un bucle que corrige y un bucle que solo encarece la factura.

    Hay un segundo fallo igual de común, y es de contexto. Si en el reintento reasignas el prompt en vez de acumular la conversación, el modelo recibe "tu respuesta anterior falló, corrígela" sin la tarea original y sin su propia salida. generateObject no guarda historial: cada llamada es independiente. El modelo no sabe qué tenía que generar ni qué generó. No hay nada que corregir.


    Implementación del bucle en TypeScript

    Con eso claro, el bucle queda así. Versiones: AI SDK 5 y Zod 4.

    import { generateObject, NoObjectGeneratedError } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    
    const PaymentConfigSchema = z.object({
      customerId: z.string().min(5).describe("ID del cliente, prefijo cus_"),
      amountInCents: z.number().int().positive().describe("Importe en céntimos, nunca decimal"),
      currency: z.enum(["EUR", "USD"]),
      maxPaymentRetries: z.number().int().min(1).max(5),
    });
    
    type PaymentConfig = z.infer<typeof PaymentConfigSchema>;
    
    // Intentos TOTALES, no reintentos: 2 = la primera llamada y una corrección.
    const MAX_ATTEMPTS = 2;
    
    export async function generateSelfHealingConfig(
      userRequirement: string,
    ): Promise<PaymentConfig> {
      const messages: Array<{ role: "user" | "assistant"; content: string }> = [
        { role: "user", content: `Genera la configuración de pago para: "${userRequirement}"` },
      ];
    
      for (let attempt = 1; attempt <= MAX_ATTEMPTS; attempt++) {
        try {
          const { object } = await generateObject({
            model: anthropic("claude-opus-5"),
            schema: PaymentConfigSchema,
            messages,
            // Clave: el maxRetries del SDK son reintentos de TRANSPORTE (429, 5xx)
            // y vale 2 por defecto. Sin ponerlo a 0, cada vuelta de este bucle
            // puede disparar hasta 3 peticiones HTTP: 6 llamadas en el peor caso.
            maxRetries: 0,
          });
          return object;
        } catch (error) {
          if (!NoObjectGeneratedError.isInstance(error)) throw error; // 401, red, bugs propios
    
          // Truncado por tokens: reintentar igual no arregla nada.
          if (error.finishReason === "length") {
            throw new Error(
              "[SELF-HEALING] Respuesta truncada por límite de tokens: súbelo o parte el schema.",
            );
          }
    
          if (attempt === MAX_ATTEMPTS) {
            throw new Error(
              `[SELF-HEALING] Sin corregir tras ${MAX_ATTEMPTS} intentos:\n${formatIssues(error.cause)}`,
            );
          }
    
          // El feedback útil: su salida + el diagnóstico concreto, como turno nuevo.
          messages.push({ role: "assistant", content: error.text ?? "(sin salida)" });
          messages.push({
            role: "user",
            content:
              `Tu respuesta no cumple el schema:\n${formatIssues(error.cause)}\n\n` +
              `Corrige ÚNICAMENTE esos campos y devuelve el objeto completo.`,
          });
        }
      }
    
      throw new Error("[SELF-HEALING] Bucle terminado sin resultado");
    }
    
    // El diagnóstico en tres líneas, no el volcado entero.
    function formatIssues(cause: unknown): string {
      if (cause instanceof z.ZodError) {
        return cause.issues
          .map((i) => `· ${i.path.join(".") || "(raíz)"}: ${i.message}`)
          .join("\n");
      }
      return cause instanceof Error ? cause.message : String(cause);
    }
    

    Tres decisiones que no son cosméticas.

    maxRetries: 0. Es la que más gente se salta. El maxRetries del AI SDK vale 2 por defecto y cubre fallos de transporte —408, 409, 429 y 5xx— con backoff exponencial. Son compatibles con este bucle, pero se multiplican: dos vueltas tuyas por tres peticiones suyas son seis llamadas donde creías tener dos. Si quieres backoff de red, ponlo tú fuera y controla el total.

    El error vuelve como turno de conversación. Al empujar la salida fallida como mensaje assistant y la corrección como user, el modelo ve su propio intento enfrentado al diagnóstico. Reasignar el prompt original pierde ese contraste — es el segundo fallo que veíamos arriba.

    formatIssues recorta. Un ZodError serializado entero son cientos de caracteres de ruido que pagas en cada vuelta. Las issues mapeadas a ruta: mensaje son las tres líneas que importan.

    Si quieres exprimir la parte del schema —.describe(), uniones discriminadas, enums en vez de strings abiertos— es lo que trabajo en el curso de Zod para TypeScript. Un schema bien diseñado reduce cuántas veces entras en este bucle, que sigue siendo el mejor ahorro disponible.


    Las tres reglas para que esto no se convierta en un bucle infinito caro

    1. Pásale el diagnóstico, no el volcado

    Cinco mil caracteres de stack trace con trazas internas de Node entierran la señal en ruido, y encima los pagas en cada vuelta. Ruta, mensaje y tipo esperado. Nada más.

    2. Techo estricto, y cuenta intentos, no esperanzas

    Dos intentos totales. Si un modelo actual no arregla un fallo de forma teniendo delante el error exacto, el problema casi nunca es el modelo: es un schema que pide algo que el contexto no contiene. El tercer intento no corrige, factura.

    El fallo más común es contar mal. Un for (let i = 1; i <= maxRetries; i++) con maxRetries = 2 da dos intentos totales, es decir, un solo reintento. Si querías dos correcciones, el bucle se te queda corto y no te enteras. Por eso arriba la constante se llama MAX_ATTEMPTS.

    Este techo vive dentro del límite global de pasos del agente, no lo sustituye: sobre eso escribí en el agentic loop en producción.

    3. Corrección quirúrgica, no regeneración

    Pide explícitamente que corrija solo los campos señalados. Si dejas que regenere el objeto entero, es habitual que arregle el campo roto y rompa otro que ya estaba bien — y con techo de dos intentos te quedas sin margen.


    Un oráculo por cada tipo de error

    Zod valida la forma de los datos en runtime. Es la primera capa, no la única: el patrón es idéntico cambiando quién emite el diagnóstico.

    Oráculo Qué detecta Qué le pasas al modelo
    Zod Salida estructurada que no cumple el schema issues mapeadas a ruta: mensaje
    tsc --noEmit Errores de tipos en el código generado Código de error, archivo, línea, tipo esperado vs recibido
    Vitest / Jest Errores de lógica de negocio Nombre del test y el diff esperado/recibido
    ESLint Estilo y patrones prohibidos Nada: esto se arregla con --fix, no con el modelo

    El compilador. Cuando el agente escribe código en vez de devolver datos, tsc --noEmit da diagnósticos con archivo, línea y tipos enfrentados. Un Type '{ userId: string }' is not assignable to type '{ id: string }' es la misma señal que un ZodError: precisa, accionable y gratis. Pásale las líneas del diagnóstico, no la salida completa del compilador — en un proyecto mediano son cientos de líneas y un solo error de tipos suele arrastrar diez mensajes derivados del mismo origen.

    Los tests. El compilador y Zod atrapan errores de forma; los tests atrapan errores de fondo. Un agente que ejecuta la suite, lee qué aserción falló y corrige antes de enseñarte nada es la versión completa del patrón. Es también donde el techo se vuelve innegociable: un agente iterando contra una suite en rojo sin límite es la forma más rápida que conozco de quemar presupuesto. Y hay una trampa propia de esta capa: ejecuta la suite entera antes de aceptar el parche, no solo el test que fallaba. Arreglar el test A rompiendo el B es un resultado muy común y, si solo miras A, lo das por bueno.

    Para montar el entorno donde ese ciclo corre aislado, escribí sobre el test harness para desarrollo con agentes. Y ese salto —de validar datos a montar el ciclo entero de generar, verificar y corregir— es el hilo del curso Construye con IA: de la idea al producto con Claude Code.

    Un apunte de arquitectura: el bucle queda más limpio si los fallos ya viajan como datos tipados en lugar de excepciones sueltas, algo que conté en cómo manejar errores en agentes de IA con TypeScript.


    Qué errores son curables y cuáles no

    Aplicar el bucle a todo es peor que no tenerlo. Esta es la tabla que uso para decidir:

    Tipo de fallo ¿Self-healing? Qué hacer
    Error de tipos (tsc) Sí Reinyectar diagnóstico, 1 reintento
    Schema de salida inválido Sí Reinyectar error.cause + la tarea original
    Aserción de test fallida Sí, con cuidado Reinyectar el diff y correr la suite completa
    Respuesta truncada (finishReason: 'length') No Subir el límite de salida o partir el schema
    Lint y formato No Determinista: --fix
    Tool externa 5xx o timeout No Circuit breaker, no reintento
    Credenciales, 401 No Abortar y escalar
    Requisito ambiguo No Humano en el bucle
    Operación con efectos ya aplicados No Idempotencia o compensación

    Ese último merece un párrafo. Si el primer intento escribió en base de datos o llamó a un endpoint de cobro, reintentar no es autocorregir: es duplicar. El bucle solo es seguro mientras la operación no haya salido de tu proceso. Valida primero, ejecuta después.

    Y hay un coste que conviene tener presente: cada vuelta añade la latencia completa de una llamada al modelo y paga de nuevo los tokens del contexto acumulado, que ahora incluye la salida fallida y el diagnóstico. En un flujo interactivo, a veces es mejor devolver el fallo rápido que hacer esperar el doble para acertar. Si quieres saber en qué se te va de verdad el presupuesto, medir el consumo de tokens del agente es el paso previo.


    Cuando el segundo intento también falla

    El techo implica que existe un camino de salida, y ese camino no puede ser una excepción sin contexto que alguien encuentre en un log tres días después.

    Lo que funciona: registrar el fallo con las cuatro piezas que lo hacen reproducible —la tarea original, la salida del modelo, el diagnóstico del verificador y el número de intentos consumidos— y encolarlo. Ese registro sirve para dos cosas distintas. La inmediata, que alguien lo resuelva. La útil a medio plazo, que la cola se convierte en tu mejor fuente de mejoras del schema: cuando ves tres fallos seguidos sobre el mismo campo, el problema no era el modelo.


    Por dónde empezar mañana

    Coge el punto de tu agente donde hoy salta una excepción de validación. Uno solo.

    Añade tres cosas: extrae el error real (error.cause, no error.message), formatéalo a ruta y mensaje, y devuélvelo como turno nuevo con techo de dos intentos y maxRetries: 0. Loguea cuántas veces entra en la segunda vuelta y cuántas sale con éxito.

    Ese ratio es el diagnóstico del diagnóstico. Si entra a menudo y se corrige, tienes un schema mejorable pero un bucle sano. Si entra mucho y no se corrige, tienes un schema imposible: le estás pidiendo al modelo un campo que nadie podría rellenar con el contexto que le das. Y si no entra casi nunca, enhorabuena — tu schema ya hace el trabajo y el bucle es solo la red.

    En Dominicode Labs es donde vamos rodando estos patrones sobre proyectos reales, con las métricas puestas.

    Los sistemas agénticos que aguantan en producción no son los que no se equivocan. Son los que tienen el diagnóstico a mano y saben devolvérselo al modelo antes de despertar a nadie.


    Preguntas frecuentes

    ¿Por qué mi agente no se corrige aunque le paso el error?

    La causa más común es pasar error.message en vez de error.cause. En un NoObjectGeneratedError del Vercel AI SDK, message es un texto genérico que no nombra el campo ni el tipo esperado; el diagnóstico útil vive en error.cause —el ZodError con sus issues— y la salida cruda del modelo en error.text. Con solo message, el bucle gasta llamadas sin darle al modelo nada con lo que corregir.

    ¿En qué se diferencia el self-healing code de un retry con backoff?

    En qué cambia entre un intento y el siguiente. El backoff reintenta la misma petición esperando que se recupere algo externo —red, proveedor, rate limit— y por eso funciona con fallos transitorios. El self-healing modifica la entrada: añade al contexto el diagnóstico que provocó el fallo. Ante un error de schema, el backoff solo repite el mismo error más despacio.

    ¿No reintenta ya generateObject por su cuenta con maxRetries?

    No de esta forma, y conviene ponerlo a 0. La opción maxRetries del AI SDK vale 2 por defecto y cubre fallos de transporte: errores de red y respuestas de API reintentables (408, 409, 429, 5xx) con backoff exponencial. Un fallo de validación de schema no entra ahí, se propaga como NoObjectGeneratedError. Si lo dejas por defecto, cada vuelta de tu bucle puede disparar hasta tres peticiones HTTP.

    ¿Cuántos intentos debería permitir?

    Dos totales: la llamada inicial y una corrección. Con el error exacto delante, un modelo actual corrige los fallos de forma en el primer reintento o no los corrige. Un tercero rara vez cambia el resultado y multiplica coste y latencia. Y cuenta intentos, no reintentos: un bucle i <= 2 da una sola corrección, y es donde más gente se equivoca al implementarlo.

    ¿Se puede hacer self-healing solo con el compilador, sin Zod?

    Sí, y son capas complementarias. tsc --noEmit cubre el código que el agente escribe; Zod cubre la salida estructurada que el modelo devuelve. Si tu agente genera archivos, el compilador es tu oráculo principal. Si devuelve objetos que tu aplicación consume, lo es Zod. Muchos agentes acaban usando los dos en puntos distintos del flujo.

    ¿Sirve para errores de lógica o solo para errores de tipos?

    Sirve para los de lógica, pero cambiando el oráculo: ahí el que dictamina es el test runner, y el diagnóstico que reinyectas es la aserción fallida con su diff esperado/recibido. La diferencia práctica es el riesgo. Un error de tipos tiene una única corrección posible; un test rojo admite varias, y alguna rompe otra cosa. Por eso en esta capa se ejecuta la suite completa antes de aceptar el parche.

    ¿Qué hago si el agente rompe otro test al arreglar el primero?

    Tratarlo como un fallo del intento, no como un éxito parcial. Si el criterio de aceptación es solo el test que fallaba, el bucle acepta parches que degradan el código. El criterio tiene que ser la suite entera en verde; si el parche pone A en verde y B en rojo, se descarta y se consume intento. Con techo de dos, eso normalmente significa escalar — que es la respuesta correcta.

    ¿Es seguro autocorregir una operación que ya escribió en base de datos?

    No. Si el intento fallido tuvo efectos externos, el reintento los duplica. El bucle es seguro mientras la operación no haya salido de tu proceso: valida primero, ejecuta después. Si el efecto ya ocurrió, lo que necesitas es idempotencia o compensación, no autocorrección.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Local-first con PGlite: Postgres en el navegador, ¿te toca?

    Abro una app de notas con IA, escribo una pregunta y espero.

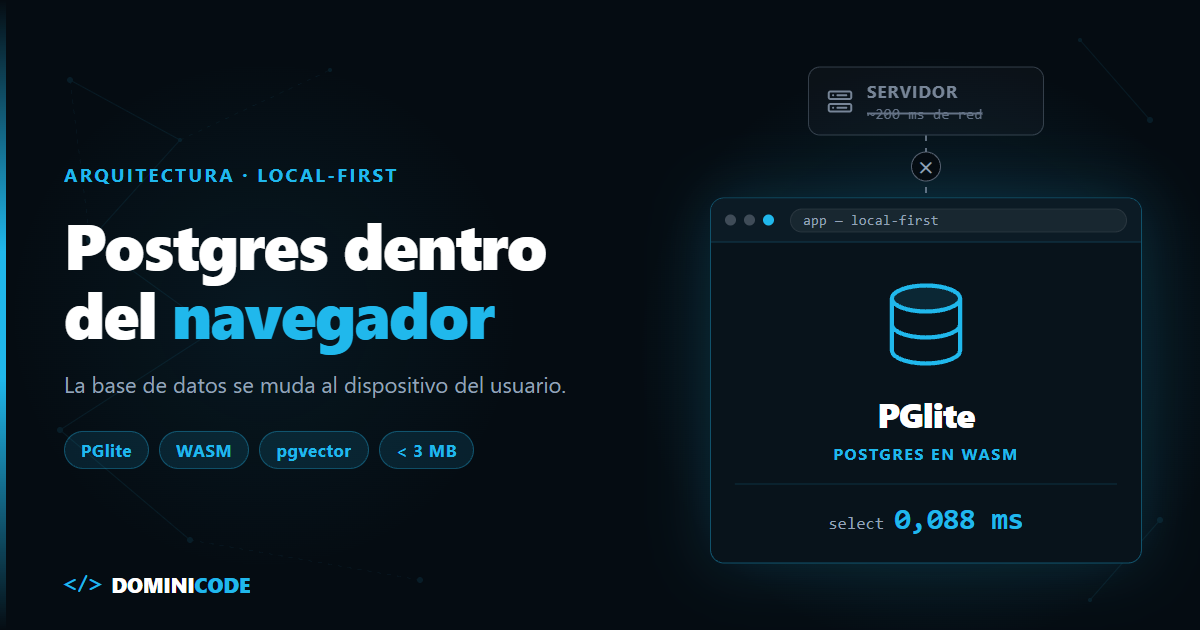
    No espero al modelo. Eso lo entiendo: el modelo piensa. Espero a que la app viaje al servidor para leer tres filas de mi propio historial, las traiga de vuelta y solo entonces monte el prompt. Doscientos milisegundos de red para leer datos que ya estaban en mi portátil.

    Ese es el patrón por defecto de casi todas las apps de IA que reviso. La arquitectura local-first le da la vuelta: la base de datos vive en el dispositivo del usuario, la app lee de ahí a velocidad de memoria, y el servidor pasa de ser la fuente de toda verdad a ser un destino de sincronización.

    Aquí va la tesis. Mover la base de datos al cliente no es una optimización: es un cambio de arquitectura que reparte de otra forma la latencia, el coste de tokens y la privacidad, y a cambio te devuelve tres problemas que en el servidor no tenías — una sola conexión, migraciones que corren en máquinas que no controlas, y un camino de escritura hacia el servidor que nadie te da hecho.

    Si terminas de leer sabiendo si te toca o no, el post ha cumplido.

    Qué es la arquitectura local-first

    Local-first es una arquitectura en la que la base de datos vive en el dispositivo del usuario: la aplicación lee y escribe siempre contra esa copia local, a velocidad de memoria, y el servidor deja de ser la fuente de toda verdad para convertirse en un destino de sincronización. La app funciona sin red por defecto, no como caso degradado.

    No es lo mismo que cachear. Una caché es una copia que aceleras y que puedes tirar; en local-first la copia local es donde de verdad ocurre todo, y la red es un detalle de implementación.

    Qué es PGlite y por qué no es "otra base de datos en el navegador"

    PGlite es Postgres compilado a WebAssembly y empaquetado como librería de TypeScript. Corre en el navegador, en Node.js y en Bun, sin dependencias externas y sin proceso servidor.

    La distinción que importa está en su propia documentación: "Unlike previous 'Postgres in the browser' projects, PGlite does not use a Linux virtual machine – it is simply Postgres in WASM."

    Eso no es marketing, es la decisión arquitectónica del proyecto. Los intentos anteriores emulaban una máquina Linux entera para arrancar encima un Postgres normal: pagabas el peso de un sistema operativo simulado para ejecutar un SELECT. PGlite elimina esa capa.

    Los números, para que no tengas que buscarlos:

    • PGlite pesa menos de 3 MB gzipped y corre Postgres compilado a WASM, sin máquina virtual Linux.
    • Persiste en memoria (efímero), en IndexedDB en el navegador, o en el sistema de ficheros en Node y Bun.
    • La versión actual de @electric-sql/pglite es la 0.5.8, publicada el 26 de agosto de 2026, y el plugin de sincronización @electric-sql/pglite-sync va por la 0.6.9.

    Retén ese "0.x". Vuelvo a ello más abajo.

    Qué gana una app de IA con arquitectura local-first

    Una app de IA gana tres cosas al pasar a local-first: latencia de microsegundos en lugar de un round-trip de red, menos tokens por turno porque filtras el contexto donde ya están los datos, y una garantía de privacidad real porque el historial no tiene por qué salir del dispositivo. Ninguno de los tres es "va más rápido" a secas.

    Latencia: microsegundos frente a un round-trip de red

    Los benchmarks oficiales, medidos en un MacBook Air M2 con PGlite en memoria, dan estos tiempos de ida y vuelta por operación: insert de una fila pequeña en 0,058 ms, select en 0,088 ms, update en 0,073 ms y delete en 0,145 ms.

    Compáralo con los 50-200 ms de una llamada HTTP a tu API y el cambio deja de ser cuantitativo: pasa a ser de diseño.

    Cuando leer cuesta microsegundos dejas de diseñar para minimizar consultas. Se acabó cachear tres pantallas por delante, montar endpoints agregados y pintar skeletons.

    Coste de tokens: RAG en el navegador con pgvector

    Este es el eje que más se subestima, y el que de verdad justifica local-first en una app de IA.

    El patrón habitual del chatbot es incómodo cuando lo miras de frente: mandas todo el historial al servidor en cada turno para que el backend reconstruya un contexto que ya estaba entero en el dispositivo del usuario. Pagas tokens por transportar información que no había salido de casa.

    Con un Postgres real en el cliente filtras el contexto en local —con SQL de verdad, joins y filtros por fecha— y mandas al modelo solo lo que importa. Y como PGlite soporta pgvector, ese filtro puede ser búsqueda semántica y no solo un WHERE:

    import { PGlite } from '@electric-sql/pglite'
    import { vector } from '@electric-sql/pglite-pgvector'
    
    const pg = new PGlite({
      extensions: { vector },
    })
    
    await pg.exec('CREATE EXTENSION IF NOT EXISTS vector;')
    

    La consulta por distancia de embeddings corre en el navegador y solo los cinco fragmentos relevantes viajan al modelo:

    SELECT id, content
    FROM chunks
    ORDER BY embedding <-> $1::vector
    LIMIT 5;
    

    Ese <-> es distancia euclídea; si tus embeddings vienen de OpenAI, lo habitual es coseno con <=>. Elige el operador que case con el índice que crees, no el del ejemplo que copiaste.

    Decidir qué entra en el contexto antes de escribir el primer prompt es justo el trabajo que hacemos en el curso de Construye con IA: el prompt no es el sistema, es la última capa.

    Si vienes de montar RAG en servidor, el contraste está en Búsqueda híbrida y embeddings en Supabase — misma técnica, distinto sitio. Y si aún dudas de si tu caso pide RAG, contexto o fine-tuning, esa decisión va antes que esta y la tienes en RAG vs fine-tuning vs contexto.

    Privacidad: los datos no salen del dispositivo

    En una app de notas es un argumento de venta. En salud, legal o finanzas es el requisito que decide si el proyecto existe.

    Con la base de datos en el cliente decides tú qué se sincroniza. Y puedes decidir que nada: si esa tabla no entra en ningún shape, el historial del usuario nunca toca tu infraestructura. Solo sale lo que mandas al modelo, y eso lo controlas con una consulta, no con una política de retención.

    Es la diferencia entre "prometemos que no miramos tus datos" y "no los tenemos".

    Pero ese modo máximo se paga dos secciones más abajo: sin copia en servidor no hay red de seguridad para las migraciones ni multi-dispositivo. Privacidad total y recuperación ante desastres son dos posiciones del mismo mando.

    Cómo queda la arquitectura: PGlite como fuente de verdad local

    PGlite es la fuente de verdad para la UI: la aplicación lee y escribe siempre contra la base local, nunca contra la red. El servidor mantiene su Postgres, que sigue siendo la fuente de verdad del negocio, y las escrituras llegan hasta él por un camino que montas tú. Ahora vuelvo a eso.

    Entre los dos, sincronización basada en shapes. Un shape es un subconjunto de una tabla: no te bajas messages entera, te bajas "los mensajes de las conversaciones de este usuario de los últimos 90 días". El cliente declara qué porción del mundo le interesa y el sync la mantiene al día.

    Y aquí va el matiz que decide presupuestos: ese sync va en una sola dirección. La documentación de pglite-sync no se esconde — "We don't yet support local writes being synced out, or conflict resolution" — y Electric lo remata: hace read-path sync, y no hace write-path sync.

    Traducido: el camino servidor → cliente te lo dan hecho. El camino cliente → servidor lo escribes tú. Cola de escrituras local, reintentos, orden, idempotencia y qué pintas mientras la escritura está en vuelo. Electric documenta cuatro patrones para eso, pero son patrones, no un paquete que instalas.

    Dos límites más de los shapes que conviene saber antes de diseñar: no se pueden sincronizar varios shapes sobre la misma tabla, porque una suscripción necesita poder tirar todos los datos y empezar de cero; y para garantizar consistencia transaccional los datos se agregan en memoria, lo que con shapes muy grandes se nota.

    Encima van las live queries del módulo @electric-sql/pglite/live: registras una consulta y los resultados se actualizan solos cuando cambian los datos, vengan del usuario o del sync. Sin polling y sin invalidación manual de caché.

    Ahí está el efecto secundario grande: desaparece la mitad de tu capa de gestión de estado. El estado del servidor deja de ser algo que cacheas a mano y pasa a ser una tabla que se actualiza. Esa reorganización de responsabilidades la traté en Clean Architecture en Frontend.

    Lo que se te rompe al llevar Postgres al navegador

    Llevar Postgres al navegador te devuelve seis problemas que en el servidor no tenías: una sola conexión, migraciones que corren en dispositivos ajenos, resolución de conflictos sin librería que la resuelva por ti, el peso de arranque, benchmarks que solo valen en memoria y una API todavía en 0.x. Esta es la sección que importa.

    Una sola conexión: el worker no es opcional

    La documentación lo dice sin adornos: "PGlite is single connection only". Y hay un segundo problema encima: si ejecutas PGlite en el hilo principal, bloqueas la UI.

    La solución oficial es el multi-tab worker: una única instancia de PGlite dentro de un Web Worker y una elección de líder que hace de proxy para las peticiones de todas las pestañas abiertas. Cuando la pestaña líder se cierra, se elige otra y se levanta una instancia nueva.

    El worker:

    // my-pglite-worker.js
    import { PGlite } from '@electric-sql/pglite'
    import { worker } from '@electric-sql/pglite/worker'
    
    worker({
      async init() {
        return new PGlite()
      },
    })
    

    Y el cliente:

    import { PGliteWorker } from '@electric-sql/pglite/worker'
    
    const pg = new PGliteWorker(
      new Worker(new URL('./my-pglite-worker.js', import.meta.url), {
        type: 'module',
      }),
    )
    

    Son quince líneas, pero no las trates como boilerplate. Tu base de datos vive ahora detrás de una frontera asíncrona con elección de líder, y eso condiciona cómo pruebas la app y qué ocurre en el segundo en que el usuario cierra la pestaña líder.

    Migraciones de esquema en dispositivos que no controlas

    En el servidor una migración es un evento: la lanzas, corre, se acabó. Hay una base de datos y tú tienes la llave.

    En local-first tienes N versiones del esquema repartidas por dispositivos ajenos. Un usuario abrió la app en marzo y no ha vuelto. Cuando vuelva, su base local está seis migraciones por detrás y esas seis tienen que aplicarse en orden, en su navegador, sin romperse a mitad.

    Esto es lo que se lleva por delante los planes de rollback: no puedes revertir una migración en 8.000 portátiles.

    La consecuencia práctica es que el esquema local evoluciona de forma aditiva casi siempre. Columnas nuevas, no renombradas. Tablas nuevas, no reestructuradas. Y una tabla de versión de esquema desde el día uno, antes de tener usuarios.

    La red de seguridad que sí funciona no es el rollback, es el reset. Si el servidor es la fuente de verdad del negocio, la base local es desechable: ante una migración que no aplica, la borras del dispositivo y vuelves a sincronizar los shapes desde cero. Es feo, tarda y hay que pintarlo bien, pero funciona.

    La letra pequeña: eso solo existe si hay copia en servidor. Si elegiste el modo máximo de privacidad, no hay de dónde resincronizar y cada migración es un disparo único sobre datos irrecuperables. Ahí el esquema aditivo deja de ser buena práctica y pasa a ser la única opción.

    Resolución de conflictos: aquí no hay magia

    Dos dispositivos offline. Los dos editan el mismo registro. Los dos recuperan la red.

    Sí existen librerías que deciden por ti: los CRDT de Yjs, Automerge o Loro convergen sin preguntarte. Pero convergen a una respuesta, no necesariamente a la que tu negocio considera correcta. Un CRDT te garantiza que dos dispositivos acaban iguales; no te garantiza que el saldo resultante sea el que el usuario esperaba. Esa decisión no la delegas.

    Tus opciones reales son tres: last write wins y perder ediciones en silencio, guardar ambas versiones y preguntar al usuario, o modelar los datos para que los conflictos sean estructuralmente imposibles — append-only, eventos en vez de estado, campos con un único dueño. La tercera es la buena, y es una decisión de modelado que tomas antes de escribir código.

    Su contrapartida: una base append-only crece sin techo, y eso choca con la pregunta que cierra este post — si los datos caben en el dispositivo. Compacta por antigüedad o materializa el estado cada N eventos, desde el principio.

    Un detalle que se olvida: lo que llega del sync es entrada externa y merece validarse como el body de una API. Un payload con un campo cambiado por una versión antigua del cliente puede corromper la base local del usuario, y ahí ya no tienes acceso para arreglarlo. Es el escenario exacto para el que trabajamos schemas en el curso de Zod: validar en la frontera, no confiar en el tipo.

    3 MB antes de que el usuario vea nada

    PGlite pesa menos de 3 MB gzipped, y es un coste de arranque real que pagas en el primer render.

    En una app que el usuario abre a diario se amortiza en el primer uso. En una landing con formulario es inaceptable. Cárgalo diferido, después del primer pintado, con un estado de "preparando" que no sea una pantalla en blanco.

    Los 0,058 ms son en memoria

    Aquí es donde muchos posts sobre PGlite venden humo, así que lo digo claro: los benchmarks de PGlite están medidos en memoria; en cuanto persistes a IndexedDB, la foto cambia.

    La propia documentación lo reconoce: "An fsync or flush to the underlying storage can be quite slow, particularly in the browser with IndexedDB for PGlite, or OPFS for wa-sqlite."

    Y es igual de honesta comparándose con SQLite en WASM: "wa-sqlite is faster than PGlite when run purely in memory", aunque "For single row CRUD inserts and updates, PGlite is faster then wa-sqlite", por usar Write-Ahead Log frente al rollback journal de SQLite.

    La doc avisa además de que comparar Postgres con SQLite es difícil y de que sus benchmarks son un punto de partida, no una sentencia.

    Traducción: sigue siendo órdenes de magnitud más rápido que la red, pero mide tus escrituras con persistencia activada antes de prometer nada.

    Sigue en 0.x

    @electric-sql/pglite está en la 0.5.8 y @electric-sql/pglite-sync en la 0.6.9. Pre-1.0 significa que la API puede moverse entre versiones menores.

    No es razón para descartarlo. Es razón para fijar la versión, leer los changelogs antes de actualizar y no esparcir PGlite por medio proyecto sin una capa propia delante.

    Cuándo NO usar local-first (y qué hacer en su lugar)

    La respuesta honesta es que a la mayoría de las apps no les toca.

    Tu situación Qué hacer
    App de IA de uso diario, con historial largo y propio de cada usuario Local-first con PGlite. Es tu caso.
    Datos sensibles que no deberían tocar tu servidor (salud, legal, finanzas) Local-first, y aquí es requisito, no optimización.
    Necesitas funcionar offline de verdad Local-first. No hay alternativa real.
    Datos compartidos que muchos usuarios editan a la vez Servidor. El coste de resolver conflictos se come la ganancia.
    Landing, e-commerce o cualquier app de sesión corta Servidor. 3 MB de arranque para dos consultas no sale.
    Necesitas consultar millones de filas que no caben en el cliente Servidor, con RAG clásico. Los shapes tienen un límite práctico.
    Equipo sin experiencia en sincronización de datos Servidor, hasta que el dolor justifique la curva.
    Tests de integración y CI que hoy levantan Docker con Postgres PGlite en Node o Bun. Sin migraciones ni sync, pero sigue siendo de una sola conexión.

    Esa última fila merece una nota. Aunque tu app no sea local-first, PGlite te sirve hoy en el pipeline: es un Postgres real, arranca en milisegundos y no necesita contenedor. Cambiar docker compose up por una instancia en memoria en tus tests es la puerta de entrada barata a esta tecnología. Con dos límites: al ser de una sola conexión ahí no vas a reproducir deadlocks, bloqueos entre sesiones ni el comportamiento de tu pool; y PGlite trae un catálogo concreto de extensiones, así que comprueba que las de tu esquema estén en la lista antes de tirar el Docker.

    Cómo decidir esto hoy, en diez minutos

    Responde a una sola pregunta: ¿los datos que tu IA necesita para responder son de un único usuario y caben en su dispositivo?

    Si es que sí, local-first con PGlite te saca el round-trip de red de la ruta crítica, te baja los tokens por turno y te da una historia de privacidad que tus competidores no pueden contar. Empieza por el worker, el esquema versionado, el camino de escritura y una estrategia de conflictos escrita antes de crear la primera tabla.

    Si es que no, quédate en el servidor y duerme tranquilo.

    Y si quieres ver este tipo de decisiones discutidas con proyectos reales delante, es lo que hacemos cada semana en Dominicode Labs.

    Preguntas frecuentes sobre local-first con PGlite

    ¿PGlite sustituye a mi Postgres del servidor?

    No. PGlite es un Postgres embebido de una sola conexión, pensado para vivir junto a la aplicación y no para servir a muchos clientes concurrentes. En una arquitectura local-first, PGlite es la fuente de verdad local del dispositivo y tu Postgres del servidor sigue siendo la del negocio: entre ambos hay sincronización —de servidor a cliente te la dan hecha, de cliente a servidor la montas tú—, no sustitución.

    ¿Puedo hacer RAG entero en el navegador con PGlite?

    Sí, siempre que el corpus sea del usuario y quepa en su dispositivo. PGlite soporta pgvector a través del paquete @electric-sql/pglite-pgvector, así que puedes guardar embeddings y hacer búsqueda por similitud en local sin que los documentos salgan del navegador. Lo que no puedes hacer en el cliente es RAG sobre un corpus corporativo de millones de documentos: eso sigue siendo trabajo de servidor.

    ¿Cuánto pesa PGlite y cómo afecta al arranque de la app?

    PGlite pesa menos de 3 MB gzipped. Se carga una vez y luego queda cacheado, pero es un coste real en el primer render, así que conviene cargarlo diferido después del primer pintado. En una app de uso diario se amortiza sin problema; en una página de sesión corta no compensa.

    ¿Qué pasa si el usuario abre la app en dos pestañas?

    PGlite admite una sola conexión, así que dos pestañas no pueden abrir dos instancias sobre la misma base de datos. La solución oficial es el multi-tab worker: una única instancia dentro de un Web Worker y una elección de líder que hace de proxy para todas las pestañas. Cuando la pestaña líder se cierra, se elige otra automáticamente y se levanta una instancia nueva.

    ¿Está listo para producción si sigue en 0.x?

    Depende de tu tolerancia a que la API cambie. @electric-sql/pglite está en la 0.5.8 y el plugin de sync en la 0.6.9, y pre-1.0 significa que puede haber cambios de API entre versiones menores. Hay proyectos en producción con PGlite, pero si entras, fija la versión exacta, lee los changelogs antes de cada actualización y aísla PGlite detrás de una capa propia para que un cambio de API no te toque cincuenta ficheros. Y si vas a hacer RAG en el navegador, mira el eslabón más verde de la cadena: el paquete de pgvector, @electric-sql/pglite-pgvector, va por la 0.0.9.

    ¿En qué se diferencia PGlite de IndexedDB o de SQLite en WASM?

    IndexedDB es un almacén clave-valor sin lenguaje de consultas: cualquier filtro o join lo escribes tú en JavaScript. SQLite compilado a WASM sí te da SQL y en memoria pura es más rápido que PGlite, pero es SQLite: otro dialecto y otras extensiones que las de tu servidor. PGlite es Postgres compilado a WASM sin máquina virtual Linux, así que ejecutas el mismo dialecto y un catálogo de extensiones que se solapa con el de tu servidor —pgvector incluida—, aunque no estén todas las de Postgres. En local-first, esa paridad es lo que evita mantener dos modelos de datos distintos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Arquitectura de código generado con IA: la Casa Winchester

    Arquitectura de código generado con IA: la Casa Winchester

    Hace tres semanas abrí un repo que llevaba cuatro meses construyendo casi entero con agentes. Buscaba una función para formatear fechas.

    Encontré tres.

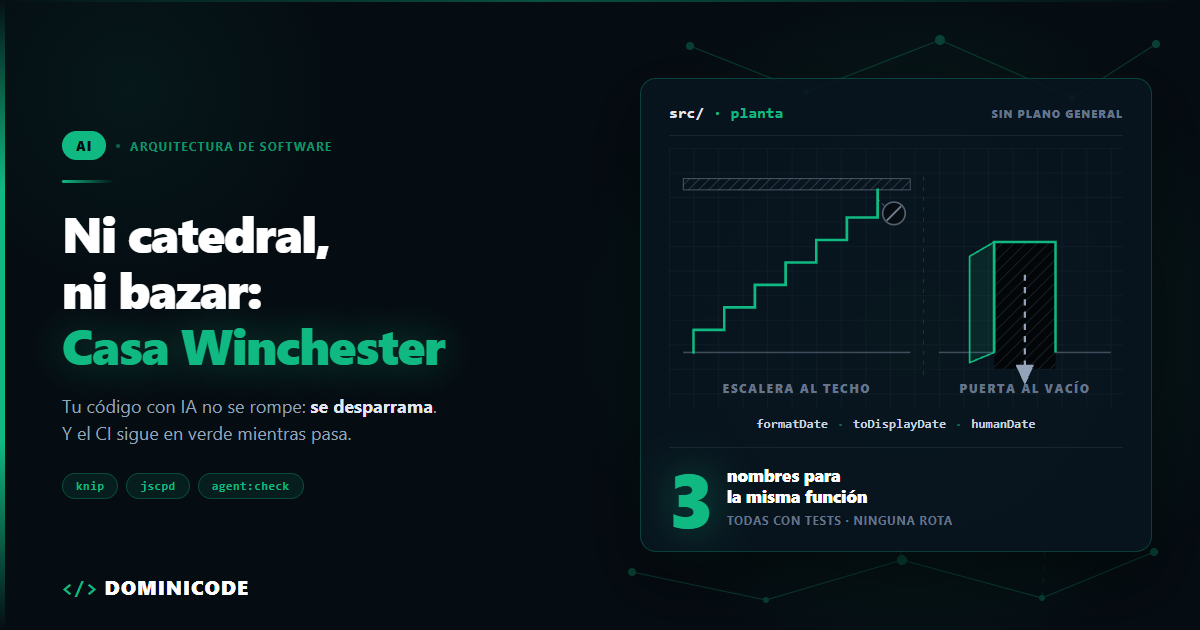
    formatDate en src/utils/date.ts. toDisplayDate en src/lib/format.ts. Y humanDate en src/shared/helpers/dates.ts. Las tres hacían lo mismo. Las tres estaban bien escritas. Las tres tenían tests. Ninguna estaba rota.

    Ese es el problema de la arquitectura de código generado con IA: no se rompe. Se desparrama. La arquitectura de código generado con IA es la forma que toma un repositorio cuando la mayor parte del código la escribe un agente y no una persona: cada pieza es correcta por separado, pero nadie sostiene el conjunto en la cabeza. El CI sigue verde mientras el repositorio se convierte en otra cosa.

    Se ha hablado mucho del "Deep Blue" — el término que se acuñó en el podcast Oxide and Friends, con crédito principal a Adam Leventhal y con Simon Willison en ese mismo episodio, que después lo difundió en su blog: esa mezcla de desánimo y vértigo existencial que sienten muchos developers ante los LLM. Este post no va de eso.

    Va de lo que le está pasando a tu repositorio ahora mismo, mientras tú lo miras.

    Qué es la Casa Winchester y por qué se parece a tu repo

    La Casa Winchester, en software, es el modelo que describe un repositorio construido a base de decisiones correctas tomadas de una en una, sin que nadie sostenga el plano general: cada pieza está bien hecha y el conjunto no tiene sentido. El nombre viene de una mansión real, y encaja con lo que produce hoy un agente de codificación.

    Sarah Winchester construyó durante décadas una mansión en San José, California. Sin arquitecto director y sin plano general. Cada obra se hacía bien: buena carpintería, buenos materiales, habitaciones perfectamente terminadas.

    El resultado tiene escaleras que acaban en el techo y puertas que abren al vacío.

    Ninguna decisión individual fue estúpida. Falló el conjunto. Nadie tenía en la cabeza la casa entera, así que nunca llegó a ser una casa: fue la suma de muchas obras correctas.

    Abre tu repo generado con agentes y busca ese patrón. No busques bugs. Busca escaleras que no llevan a ningún sitio.

    El tercer modelo: ni catedral ni bazar

    En 1997 Eric S. Raymond presentó La catedral y el bazar, el ensayo que definió los dos modelos con los que llevamos treinta años pensando el software. La catedral: planificada, cerrada, con arquitectos que controlan la forma. El bazar: abierto, caótico en la superficie, ordenado por muchos ojos mirando.

    Drew Breunig propuso en marzo de 2026 un tercero: la Casa Winchester. Su tesis es incómoda y precisa: "AI is making code cheap and kicking off a new era filled with idiosyncratic, sprawling, cobbled-together software".

    La clave no es que la IA escriba mal. Es esta otra frase suya: "Feedback hasn't gotten cheaper; the 'eyeballs' that guided the software developed by the bazaar haven't caught up to AI". El código bajó de precio. Todo lo demás —incluidos los ojos que Raymond puso en el centro del bazar— cuesta exactamente lo mismo que antes.

    Y remata: "There is only one source of feedback that moves at the speed of AI-generated code: yourself".

    Ahí está el problema entero. La revisión de un compañero, el diseño de una API, la discusión sobre si esto merece ser un módulo nuevo: todo eso sigue a velocidad humana. Lo único que se aceleró fue la producción.

    La entropía arquitectónica es la degradación progresiva de la forma de un repositorio —duplicación semántica, abstracciones sin uso, patrones incoherentes— sin que aparezca un solo fallo funcional. No es un problema de calidad de código: es un problema de caudal de feedback. Tu repo se desparrama porque el código llega más rápido de lo que nadie puede juzgarlo.

    Una catedral no se defiende sola: necesita a alguien mirando. El bazar tampoco, porque funcionaba gracias a que se leía despacio. Cuando el que escribe se acelera un orden de magnitud y el que lee sigue exactamente igual, no te queda ni catedral ni bazar. Te queda una casa con escaleras al techo.

    Las 4 señales de que tu arquitectura de código generado con IA ya es una Casa Winchester

    Esto no se detecta leyendo. Se detecta midiendo. Cuatro señales, cada una con su forma de verla hoy mismo.

    # Señal Cómo la mides
    1 La misma utilidad con tres nombres distintos Censo de exports con rg + jscpd
    2 Abstracciones con un solo consumidor Grafo de madge + in-degree
    3 Código muerto que nadie borra knip --reporter compact
    4 Patrones incoherentes entre sesiones Conteo de librerías rivales cruzado con git log

    1. La misma utilidad con tres nombres distintos

    Es la señal madre. El agente no encontró tu helper porque no estaba en su contexto, así que escribió otro. Correcto, con tests, y duplicado.

    # Censo de funciones exportadas: los duplicados semánticos saltan a la vista
    rg -o --no-filename 'export (?:async )?(?:function|const) (\w+)' -r '$1' src \
      | sort | uniq -c | sort -rn | head -30
    
    # Duplicación literal de bloques
    npx jscpd src --min-lines 5 --min-tokens 60 --reporters console
    

    El censo de nombres rinde más de lo que parece. Cuando ves formatDate, toDisplayDate y humanDate seguidos en la misma lista, el diagnóstico es inmediato.

    2. Abstracciones con un solo consumidor

    El agente te construye un UserRepository, un NotificationService y un PaymentGateway porque son buenas prácticas. Luego resulta que cada uno se usa exactamente desde un sitio.

    Una abstracción con un consumidor no es arquitectura. Es una capa de indirección que te cobra peaje cada vez que lees el código.

    npx madge --extensions ts,tsx --json src > deps.json
    

    Si tu repo usa path aliases (@/…), añade --ts-config tsconfig.json o madge no resolverá esos imports y el grafo saldrá incompleto — con lo que el in-degree te mentirá.

    Y un script de veinte líneas que cuenta cuántos módulos importan a cada módulo:

    // scripts/in-degree.mjs
    import { readFileSync } from 'node:fs'
    
    const graph = JSON.parse(readFileSync('deps.json', 'utf8'))
    const inDegree = new Map(Object.keys(graph).map((file) => [file, 0]))
    
    // Los tests no cuentan como consumidor: si el único importador de un módulo
    // es su test, ese módulo tiene cero consumidores de producción, no uno.
    for (const [file, deps] of Object.entries(graph)) {
      if (file.includes('.test.') || file.includes('.spec.')) continue
      for (const dep of deps) {
        inDegree.set(dep, (inDegree.get(dep) ?? 0) + 1)
      }
    }
    
    const suspects = [...inDegree]
      .filter(([file, count]) => count === 1 && !file.includes('.test.'))
      .map(([file]) => file)
      .sort()
    
    console.log(`Módulos con un único consumidor: ${suspects.length}`)
    console.log(suspects.join('\n'))
    

    Ejecútalo con node scripts/in-degree.mjs. Esa lista es tu deuda de indirección con nombres y apellidos.

    3. Código muerto que nadie borra

    Un agente borra cuando se lo pides. Nunca por iniciativa propia, porque borrar es arriesgado y su incentivo es que la tarea pase. Así que el código viejo se queda ahí, acumulándose y ensuciando el contexto de la siguiente sesión.

    npx knip --reporter compact
    

    knip te da ficheros, exports y dependencias que nadie usa. Apunta el número de hoy en algún sitio del repo. Si dentro de un mes ha subido, ya tienes tu métrica de entropía.

    4. Patrones incoherentes entre sesiones

    Esta es la más silenciosa. El módulo que escribiste en junio usa fetch a pelo. El de julio usa TanStack Query. El de agosto se trajo axios porque el agente decidió que era lo estándar.

    for p in "axios" "fetch(" "@tanstack/react-query" "HttpClient"; do
      printf "%-24s %s\n" "$p" "$(rg -l --fixed-strings "$p" src | wc -l)"
    done
    

    Si más de una fila devuelve un número mayor que cero, tienes dos maneras de hacer lo mismo conviviendo en el repo. Cruza el resultado con git log --diff-filter=A --format='%ad' --date=short -- <fichero> y verás que cada patrón corresponde a una tanda distinta de trabajo.

    Escaleras que dan al techo: por qué se degrada la arquitectura de código generado con IA

    Tres causas, y ninguna es "la IA escribe mal".

    El agente empieza cada sesión con amnesia parcial. No lee tu repo entero: lee lo que le cabe en la ventana y lo que sabe buscar — el mismo mecanismo que provoca el context drift. Si tu helper de fechas no aparece en esa muestra, para el agente no existe. Y lo que no existe, se escribe.

    Escribir se volvió más barato que entender. Esto siempre fue verdad, pero antes tecleabas tú, y el coste de escribir 200 líneas te empujaba a reutilizar. Esa fricción desapareció. Hoy reutilizar exige buscar, leer y decidir; crear exige una frase. El camino de menor resistencia lleva al código nuevo.

    El CI que ya tienes no ve nada de esto. Ningún test se pone rojo porque tengas tres formas de formatear fechas. Ningún linter falla porque una capa tenga un solo consumidor. Tus tests miden comportamiento; la entropía es un problema de forma. Es un punto ciego distinto del que conté en los 5 fallos del código generado por IA que un code review no puede ver: allí el diff esconde el fallo, aquí no hay fallo que esconder. Por eso el repo se degrada durante meses con el pipeline en verde.

    Aquí mucha gente responde con más proceso humano: más revisión, más reuniones de arquitectura. No funciona, y Breunig ya te dijo por qué: tú eres el único feedback que va a la velocidad del código, y tú no escalas.

    La respuesta tiene que ir a la misma velocidad que el problema. Es decir: automática.

    Guías y sensores: el plano que le falta al agente

    Birgitta Böckeler publicó el 2 de abril de 2026 en martinfowler.com un artículo sobre harness engineering con la formulación más clara que he leído del asunto. El harness engineering es la disciplina de diseñar todo lo que rodea al modelo —contexto, herramientas, verificaciones y bucles de corrección— para que el agente necesite menos supervisión humana. Su punto de partida: Agent = Model + Harness. El modelo no lo controlas. El arnés agéntico sí, y es tuyo entero.

    El arnés tiene dos mitades.

    Guías (feedforward). Fijan expectativas antes de que el agente actúe. Suben la probabilidad de que acierte a la primera. Documentación de arquitectura, convenciones, instrucciones de arranque.

    Sensores (feedback). Observan la salida después y permiten autocorrección. Böckeler insiste en un detalle que casi todo el mundo se salta: los sensores deben estar "optimised for LLM consumption" — mensajes que le digan al agente qué hacer, no solo qué falló.

    Y cada mitad puede ser computacional (determinista y rápida: tipos, lint, tests, build; milisegundos y resultado fiable) o inferencial (semántica: revisión por LLM, LLM-as-judge; más lenta, más cara y no determinista).

    Guías (antes de actuar) Sensores (después de actuar)
    Computacional (determinista, ms) Tipos, esquemas, plantillas, AGENTS.md con el mapa del repo tsc, ESLint, tests, knip, jscpd
    Inferencial (semántico, lento y caro) How-tos y ejemplos escritos para consumo del LLM Revisión por LLM en el PR, LLM-as-judge

    La conclusión que saco de su artículo es la parte que importa: ninguna mitad vale sola. Solo sensores y tienes un agente que repite siempre los mismos errores. Solo guías y tienes un agente que memoriza reglas sin enterarse nunca de si funcionaron.

    La guía: tu fichero de instrucciones no es un style guide

    El error más común en AGENTS.md o CLAUDE.md es llenarlo de preferencias de formato. Eso ya lo hace Prettier.

    La guía debe contener lo que el agente no puede deducir mirando un fichero suelto: dónde vive cada cosa, quién puede importar a quién y qué existe ya.

    MAPA DEL REPO — no crees carpetas de primer nivel sin preguntar
    
    - `src/domain/`  — tipos y reglas de negocio. No importa NADA de `src/infra/`.
    - `src/infra/`   — HTTP, DB, colas. Implementa los puertos de `src/domain/`.
    - `src/app/`     — casos de uso. Único sitio que orquesta domain + infra.
    - `src/shared/`  — fuente ÚNICA de fechas, dinero y formateo de strings.
    
    ANTES DE ESCRIBIR CUALQUIER UTILIDAD NUEVA
    
    Ejecuta esto y lee la salida. Si algo cubre el 80% del caso, extiéndelo:
    
        rg -n "export (async )?function" src/shared
    
    REGLAS DURAS
    
    - Una sola librería de fetching: `@tanstack/react-query`. Nada de `axios`.
    - No crees una abstracción con menos de dos consumidores reales.
    - Si un código sobra, bórralo. No lo comentes ni lo marques `@deprecated`.
    
    DEFINICIÓN DE "HE TERMINADO"
    
        pnpm agent:check
    

    Ese último bloque es la bisagra entre la guía y los sensores. Si tu definición de "terminado" es "el agente dijo que estaba", no tienes arnés: tienes fe.

    Si quieres un AGENTS.md ya escrito para copiar y adaptar, lo tienes entero en Revisión por Contrato, un ebook gratuito de 30 páginas donde desarrollo el contrato, el carril y el veredicto que le pones a un agente antes de dejarle tocar el repo.

    Fijar la forma antes de que exista el código es el mismo músculo que entrenas con Spec-Driven Development. Si quieres el método completo, lo desarrollo entero en el libro Spec Driven Development.

    Los sensores computacionales: que el agente se corrija solo

    Un único comando que el agente pueda ejecutar sin pedirte permiso:

    {
      "scripts": {
        "typecheck": "tsc --noEmit",
        "lint": "eslint . --max-warnings 0",
        "test": "vitest run",
        "dead": "knip --reporter compact",
        "dupes": "jscpd src --min-tokens 60 --threshold 1 --reporters console,threshold",
        "agent:check": "pnpm typecheck && pnpm lint && pnpm test && pnpm dead && pnpm dupes"
      }
    }
    

    knip y jscpd son los dos que faltan en casi todos los repos, y son justo los que detectan entropía en vez de bugs. jscpd con --threshold 1 sale con código 1 si la duplicación pasa del 1%, pero solo si añades el reporter threshold: el flag por sí solo no cambia el código de salida. Con los dos juntos, "hay algo duplicado" pasa de ser un texto en consola a una señal que el agente lee y sobre la que puede actuar.

    El sensor que más me ha servido es otro: convertir la dirección de dependencias en una regla de lint cuyo mensaje explique el arreglo.

    // eslint.config.js
    export default [
      {
        files: ['src/domain/**/*.ts'],
        rules: {
          'no-restricted-imports': ['error', {
            patterns: [{
              group: ['**/infra/**', 'axios', 'node:fs'],
              message:
                'domain/ no puede importar de infra/. Define un puerto (interfaz) en ' +
                'src/domain/ports/, impleméntalo en src/infra/ e inyéctalo desde el ' +
                'caso de uso en src/app/. No muevas el fichero: mueve la dependencia.',
            }],
          }],
        },
      },
    ]
    

    Fíjate en el mensaje. No dice "import restringido". Dice qué hacer, en qué orden y con qué carpetas. El agente lo lee, lo aplica y no te interrumpe. Eso es un sensor optimizado para consumo de LLM.

    Dos detalles que te ahorran un rato: export default en eslint.config.js exige "type": "module" en el package.json —o renombrar el fichero a eslint.config.mjs—, y si quieres bloquear también los import type de TypeScript necesitas @typescript-eslint/no-restricted-imports en vez de la regla core. La regla en sí no es más que Clean Architecture convertida en algo que el agente puede ejecutar.

    La misma lógica aplicada a la ejecución del agente la desarrollo en el post sobre guardrails para agentes con acceso a terminal y base de datos, y llevada a testear al propio agente en el de test harness para agentes de IA.

    Los sensores inferenciales: para lo que ningún linter ve

    Hay preguntas que ninguna regla determinista responde. ¿Esta función duplica algo que ya existe con otro nombre? ¿Esta abstracción tiene razón de ser? ¿Este módulo sigue el patrón del resto del repo?

    Eso es trabajo de un revisor LLM en el PR, con un prompt que pregunte por coherencia y no por corrección. La corrección ya la cubren los tipos y los tests. Lo que te falta es alguien que mire la casa entera. Cómo montarlo lo cuento en el post de agentic code review.

    Es más lento y no determinista, sí. Por eso va en el PR y no en cada guardado.

    Qué revisar en tu repo esta semana

    Cinco cosas, por orden. Ninguna te lleva más de una tarde.

    1. Saca tu línea base. Ejecuta npx knip y npx jscpd src hoy. Apunta los dos números en un fichero del repo con la fecha. Sin línea base no sabes si mejoras o empeoras.
    2. Abre tu AGENTS.md o CLAUDE.md. Si lo que hay dentro es un style guide, reescríbelo como mapa: dónde vive cada cosa y quién importa a quién.
    3. Añade agent:check al package.json y ponlo en la guía como definición literal de "he terminado".
    4. Convierte una regla de arquitectura en lint, con mensaje accionable. Una sola. La dirección de dependencias es la que más rinde.
    5. Aplica la regla de los dos consumidores. Coge la salida del script de in-degree, elige una abstracción que solo se use una vez y bórrala metiendo el código donde se usa. Vas a respirar mejor.

    La conclusión después de cuatro meses generando código con agentes es esta: el agente no tiene criterio arquitectónico, tiene contexto. Si tu criterio no está escrito en la guía y no lo verifica un sensor, para el agente no existe. Y lo que no existe se reinventa cada sesión con un nombre distinto.

    Sarah Winchester tenía dinero, buenos carpinteros y décadas por delante. Le faltó el plano. Tú tienes agentes que escriben más rápido de lo que nadie puede leer. El plano ya no es opcional.

    Si quieres ver el flujo completo funcionando — guías, sensores y agentes dentro de un arnés que aguanta — lo monto paso a paso en el curso Construye con IA: de la idea al producto con Claude Code. Y si prefieres trabajarlo sobre proyectos reales, eso pasa en Dominicode Labs.

    Preguntas frecuentes

    ¿Qué es la entropía arquitectónica en código generado con IA?

    Es la degradación de la forma de un repositorio sin que aparezca ningún fallo funcional: tres funciones que hacen lo mismo con nombres distintos, abstracciones con un único consumidor, código muerto que nadie borra y patrones que cambian según la sesión en que se escribió cada módulo. Se distingue de un bug en que ningún test la detecta: los tests miden comportamiento y la entropía es un problema de estructura. Se mide con herramientas de duplicación (jscpd), de código muerto (knip) y de grafo de dependencias (madge).

    ¿Esto no es simplemente deuda técnica de toda la vida?

    Misma familia, otra dinámica. La deuda técnica clásica la generas tú y la sientes al escribirla: sabes que estás tomando un atajo. Esta la genera un agente que hace las cosas bien en cada tarea individual, así que nunca hay atajo consciente ni sensación de deuda. Se acumula sin fricción y sin señal. Por eso hay que medirla, no intuirla.

    Si trabajo solo, ¿esto me afecta igual?

    Más. El modelo de la Casa Winchester describe precisamente proyectos personales donde el bucle de feedback se colapsa dentro de una sola cabeza. Sin nadie que revise, tu única defensa son los sensores automáticos. Un equipo grande al menos tiene pull requests con humanos delante; tú tienes exactamente lo que hayas automatizado.

    ¿Cuánto debe ocupar el fichero de instrucciones del agente?

    Corto y denso. Si pasa de una pantalla y media, el agente empieza a ignorar partes. Prioriza el mapa del repo, tres o cuatro reglas duras y el comando de verificación. Todo lo que se pueda comprobar con un linter, sácalo del fichero y ponlo como sensor: ahí sí se cumple siempre.

    ¿Los sensores inferenciales sustituyen al code review humano?

    No, lo reordenan. El revisor LLM absorbe el volumen y filtra lo obvio: duplicación, incoherencia de patrones, abstracciones sin uso. Tú te quedas con lo que exige criterio de producto y de negocio. Si intentas leer cada línea que produce un agente, vuelves al cuello de botella del que veníamos.

    Mi repo ya es una Casa Winchester. ¿Reescribo?

    No. Las reescrituras completas con agentes fallan por la misma razón que falló el repo original: mucho código y poco feedback. Congela primero — mete los sensores y la guía para que la entropía deje de crecer. Después ataca una zona por semana, empezando por las utilidades duplicadas: son las más baratas de unificar y las que más contexto sucio limpian para las sesiones siguientes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tests E2E autoreparables con Playwright: diagnostica, no parchees

    Tests E2E autoreparables con Playwright: diagnostica, no parchees

    El canal de Slack se llamaba #e2e-alerts. Llevaba cinco meses en silencio, y no porque no llegaran alertas: es que las once personas del equipo lo tenían silenciado.

    Ciento ochenta tests de Playwright. Entre veinte y cuarenta en rojo cada mañana. El ritual era mirar por encima, decir "es flaky" y relanzar el job.

    Cuando entré en ese proyecto me pidieron exactamente lo que estás pensando: montar tests E2E autoreparables, un agente que arreglara solo lo que se rompiera cada noche. Dije que no. Esa negativa es la mitad de este post.

    Antes de decir que no me senté a mirar por qué estaba rojo. Casi todo venía del mismo sitio: un refactor del design system que había renombrado clases CSS, y ciento y pico selectores apuntando a esas clases.

    Pero había un test distinto. El de pagar con código de descuento. Alguien lo había "arreglado" tres semanas antes cambiando getByRole('button', { name: 'Pagar pedido' }) por locator('button').nth(3).

    Verde. Precioso.

    El cuarto botón de esa página era "Seguir comprando". El de pagar llevaba nueve días deshabilitado para cualquier usuario que aplicara un descuento. Nueve días sin que nadie con un cupón pudiera pagar.

    El test lo sabía. Y una persona lo calló a mano en cuarenta segundos.

    Ahora imagina eso mismo, cien veces por semana, hecho por un agente que no firma nada y al que nadie revisa.

    Qué es un test E2E autoreparable (y qué no lo es)

    Aquí está la definición con la que trabajo:

    Un test E2E autoreparable es aquel que, cuando falla, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con evidencia adjunta. No es el que se modifica a sí mismo hasta ponerse verde.

    En inglés se conoce como self-healing test, y ahí está justo el malentendido: healing no significa que el test se reescriba solo.

    La diferencia no es de matiz. Es de propósito.

    Un test existe para emitir una señal: esto funciona, esto no. Si le das a un agente permiso para editar el test hasta que pase, has construido una máquina de decir "verde". Y una máquina de decir verde vale exactamente cero.

    El valor no está en el auto-arreglo. Está en el auto-diagnóstico. La parte cara de mantener una suite E2E no es escribir el parche —son tres caracteres en un locator—, es averiguar cuál de los cuarenta tests rojos merece un parche y cuáles están gritando que la aplicación se rompió.

    Eso es lo que un agente hace bien. Lo otro es lo que lo hace peligroso.

    No se rompe el test, se rompe el acoplamiento

    Los tests E2E no se degradan solos. Lo que se degrada es el contrato implícito entre tu test y el DOM.

    Escribiste .checkout__actions > button.btn-primary. Nadie firmó que esa clase fuera estable. Un martes alguien migró el botón a otro componente y tu test se enteró en producción.

    En las suites que he auditado, la inmensa mayoría de los rojos son fallos de localización, no de comportamiento: el elemento sigue ahí, hace lo mismo, y el test ya no sabe encontrarlo. Es mi impresión revisando proyectos, no un estudio —pero haz el recuento en tu propia suite y apuesto a que te sale parecido.

    Esa asimetría es la que hace viable un agente. Y también la que lo vuelve inútil si no distingue el resto.

    Antes del agente: locators de Playwright que se puedan reparar

    Si tus locators son frágiles, el agente no reduce la deuda. La automatiza.

    La estrategia de locators de Playwright está construida sobre lo que el usuario percibe, no sobre la implementación. Ese es el punto: un locator basado en rol accesible sobrevive a un refactor de estilos y muere cuando cambia lo que el usuario ve —que es justo cuando quieres que muera.

    // ❌ Se rompe con cualquier refactor de CSS. El agente no puede saber si es grave.
    await page.locator('.checkout__actions > button.btn-primary').click();
    
    // ✅ Se rompe solo cuando cambia lo que el usuario percibe.
    await page.getByRole('button', { name: 'Pagar pedido' }).click();
    await page.getByLabel('Código de descuento').fill('BLACKFRIDAY');
    await expect(page.getByTestId('order-summary')).toContainText('49,90 €');
    

    El orden que sigo es siempre el mismo: getByRole primero, getByLabel para formularios, y getByTestId solo cuando no hay semántica que agarrar —listas virtualizadas, tablas sin cabecera accesible, componentes de terceros.

    Y el atributo de test se declara en la config, no se improvisa por fichero:

    // playwright.config.ts
    import { defineConfig } from '@playwright/test';
    
    export default defineConfig({
      retries: 2,
      reporter: [['html', { open: 'never' }]],
      use: {
        testIdAttribute: 'data-test',
        trace: 'on-first-retry',
      },
    });
    

    Hay un efecto secundario que casi nadie cuenta: escribir los tests por rol accesible te obliga a que la aplicación tenga roles accesibles. Es la misma palanca que uso cuando pongo a un agente a auditar usabilidad con Playwright MCP. El árbol de accesibilidad deja de ser un extra de compliance y pasa a ser la API contra la que testeas.

    La traza es la única señal que el agente puede usar

    Sin traza, el agente lee un mensaje de timeout y adivina. Con traza, compara.

    Esa línea de la config —trace: 'on-first-retry'— es la que separa un diagnóstico de una alucinación. Playwright graba el reintento completo: acciones, peticiones de red, consola y snapshots del DOM antes y después de cada paso. El archivo se guarda dentro de test-results/ y se abre con npx playwright show-trace. La documentación del Trace Viewer explica el formato entero. Verificado con Playwright 1.63, la versión estable en septiembre de 2026.

    Un humano abre esa traza y ve la película. Un agente necesita algo más masticado, porque el DOM crudo de una app real son decenas de miles de tokens de ruido. En las dos páginas donde lo he medido, el árbol de accesibilidad ocupaba entre 2,5 y 28 veces menos que el HTML crudo.

    Lo que le doy es el árbol de accesibilidad en el momento del fallo, que es la misma abstracción sobre la que están escritos los locators. ariaSnapshot() está disponible desde Playwright 1.49; en versiones anteriores tendrás que serializar el árbol a mano.

    Aquí conviene ser honesto: Playwright 1.63 ya escribe por su cuenta un test-results/<test>/error-context.md con una sección # Page snapshot que contiene ese mismo árbol, así que una parte de esto la tienes gratis. El fixture sigue mereciendo la pena por lo que añade encima: la URL exacta del fallo, el nombrado que decides tú y los adjuntos visibles en el reporte HTML, que es lo que después consume el pipeline del agente.

    Este es el fixture:

    // tests/fixtures/diagnostico.ts
    import { test as base, expect } from '@playwright/test';
    
    export const test = base.extend<{ diagnostico: void }>({
      diagnostico: [
        async ({ page }, use, testInfo) => {
          await use();
    
          if (testInfo.status === testInfo.expectedStatus) return;
    
          // Árbol de accesibilidad real en el instante del fallo
          const real = await page.locator('body').ariaSnapshot();
          await testInfo.attach('aria-real.yml', { body: real, contentType: 'text/yaml' });
          await testInfo.attach('url-fallo.txt', { body: page.url(), contentType: 'text/plain' });
        },
        { auto: true },
      ],
    });
    
    export { expect };
    

    Con ese YAML adjunto en el reporte, el prompt del agente deja de ser "arregla este test" y pasa a ser una comparación: esperaba un button con nombre "Pagar pedido"; en el árbol real hay un button con nombre "Confirmar pedido" en la misma posición. Eso ya no es adivinar. Es diffear dos estructuras.

    Y si el elemento no aparece en el árbol bajo ningún nombre, el agente tiene que saber que eso significa algo completamente distinto.

    El triaje de un test E2E autoreparable: tres fallos distintos

    Esta es la sección que sostiene todo lo demás. Un agente que no separa estos tres casos te borra la señal de la suite entera.

    Tipo de fallo Evidencia que lo identifica Qué puede hacer el agente
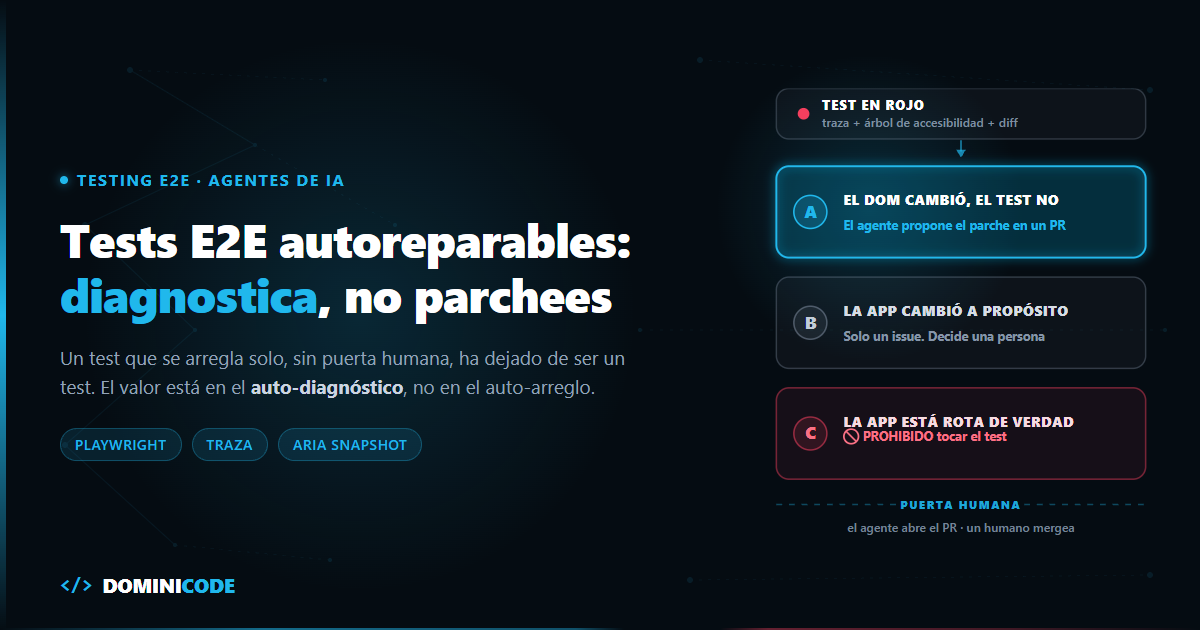
    A. El DOM cambió, el test no El elemento existe en el árbol con otro nombre, rol o posición. El commit sospechoso toca marcado o estilos. Fallan varios tests que comparten componente. Proponer el parche del locator en un PR. Es el único caso reparable.
    B. El comportamiento cambió a propósito El elemento ya no existe porque el flujo cambió: un paso nuevo, otra ruta, un campo eliminado. El commit toca lógica, no marcado. El fallo encaja con una feature reciente. Nada. Abre un issue con el diagnóstico y etiqueta al dueño de la feature. Actualizar ese test es una decisión de producto.
    C. La aplicación está rota El locator es correcto y el elemento está ahí, pero la acción falla, el estado final es otro o hay 500 en la traza de red. Suele caer un solo flujo crítico. Prohibido tocar el test. Escalar con la traza adjunta. El test está haciendo su trabajo.

    Las tres preguntas que resuelven casi todos los casos:

    ¿El commit tocó marcado o lógica? Un cambio en plantillas y estilos apunta a A. Un cambio en servicios, rutas o estado apunta a B o C.

    ¿Falla un test o fallan veinte? Veinte tests que comparten componente es A casi seguro. Uno solo, en el flujo de pago, con el resto en verde, es C hasta que se demuestre lo contrario.

    ¿El elemento existe con otro nombre o no existe? Existe con otro nombre → A. No aparece en el árbol → B o C, y el agente no decide cuál.

    Fíjate en que ninguna de las tres se responde mirando el test. Se responden cruzando la traza con el diff del commit. Por eso el agente necesita acceso al repositorio, y solo de lectura.

    El agente abre un PR. No commitea.

    El flujo que uso es aburrido, y por eso funciona.

    El job nocturno corre la suite. Si hay rojos, un segundo job lanza el agente con tres entradas: el reporte HTML con sus adjuntos, la traza de cada fallo y el diff de los commits desde el último run verde. Relanzar solo lo caído con npx playwright test --last-failed ahorra minutos de CI.

    El agente no ejecuta el navegador. Lee artefactos. Eso elimina de golpe toda la clase de problemas que aparecen cuando pones a un agente a conducir el navegador en vivo: esperas mal calculadas, referencias caducadas, estado que se le escapa.

    Su salida es una pull request con cuatro cosas: diagnóstico en prosa, clasificación A/B/C con la evidencia que la justifica, el diff del locator y la traza enlazada.

    Y una regla que no se negocia: un locator por test, un test por commit dentro del PR. Si el parche necesita tocar tres líneas para que pase, no es un parche de localización: es un cambio de comportamiento disfrazado. Se rechaza.

    Un humano mergea. Siempre.

    Esa puerta es el mismo mecanismo que describo en la revisión por contrato del código que genera la IA: el agente no gana el derecho a escribir en main por haber acertado ochenta veces seguidas. Si quieres el método entero, con las cláusulas y los límites escritos, está en el ebook gratuito de Revisión por Contrato.

    Los guardarraíles que impiden que la suite se convierta en teatro

    Tres guardarraíles bastan para que un agente de reparación no degrade la suite: que no toque asserts, un tope de cinco tests parcheados por PR y una métrica de bugs escapados a producción. Con eso vas servido.

    El agente no toca asserts. Solo locators y esperas. Un expect(...).toBeVisible() que muta a toBeHidden(), un toContainText con otro importe, un assert borrado: eso es cambiar la definición de correcto, y no es su trabajo. Lo hago cumplir con un check en CI que rechaza el PR si el diff cambia el matcher (toBeVisible, toContainText…) o el valor esperado. El locator que vive dentro de un expect(...) sí se puede tocar; la afirmación sobre qué es correcto, no.

    Tope de tests reparados por PR. Cinco. Si el agente quiere arreglar cuarenta, no ha encontrado cuarenta fallos de localización: ha encontrado un cambio estructural que necesita a una persona pensando diez minutos.

    La métrica que delata el desastre. Cuenta dos números cada mes: locators parcheados por el agente y bugs escapados a producción en flujos que la suite cubre. Si el primero sube y el segundo también, el agente no está manteniendo la suite. La está silenciando.

    Ese segundo número no sale de los tests. Sale de tener observabilidad de verdad, más allá del code review. Sin él pilotas a ciegas con un copiloto que te asegura que todo va bien.

    Un apunte de coste: los fallos de tipo B —comportamiento que cambió a propósito— se detectan mucho más barato una capa por debajo, en tests de componente. Si trabajas con Angular, ese nivel es el que cubro en el curso de Testing en Angular. Cuanto mejor sea tu capa de componente, menos ruido le llega al agente arriba.

    Qué hacer el lunes

    No montes el agente. Todavía no.

    Coge los diez tests que más han cambiado en los últimos tres meses según git log. Son tus diez tests más frágiles. Reescribe sus locators con getByRole y getByLabel, y activa trace: 'on-first-retry' en la config.

    Eso es una tarde. Y probablemente te baje el ruido más que cualquier agente.

    La semana siguiente, cuando algo se ponga rojo, abre la traza y clasifícalo a mano: A, B o C. Hazlo diez veces. Lo que aprendas en esas diez clasificaciones es literalmente el prompt del agente —y no lo puedes escribir antes de haberlo hecho tú.

    Cuando llegue el momento de montarlo, el patrón de agente que produce artefactos revisables en lugar de commits directos es el que enseño en Construye con IA, de la idea al producto con Claude Code.

    Y quédate con esto: el objetivo nunca fue tener la suite en verde. Era saber cuándo dejar de confiar en ella.

    Preguntas frecuentes

    ¿Qué es un test E2E autoreparable exactamente?

    Es un test que, al fallar, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con la evidencia adjunta. La palabra "autoreparable" describe el diagnóstico automático, no la escritura automática en la rama principal. Si el agente puede modificar el test hasta que pase sin que nadie lo apruebe, lo que tienes no es una suite que se cura sola: es una suite que ha dejado de informarte.

    ¿Por qué no dejar que el agente commitee el arreglo directamente si acierta casi siempre?

    Porque el coste del error no es simétrico. Cien parches correctos te ahorran unos minutos cada uno. Un solo parche incorrecto sobre un fallo de tipo C —la aplicación rota— borra la única señal que tenías de un bug en producción, y encima deja el CI en verde. Cuando ese bug aparezca, tu primer instinto será descartar el área que cubren los tests, precisamente porque estaban pasando.

    ¿Cómo distingue el agente entre un cambio de DOM y una regresión real?

    Cruzando tres evidencias: si el elemento sigue existiendo en el árbol de accesibilidad bajo otro nombre o rol, si el commit sospechoso tocó marcado o lógica, y si el fallo está aislado o afecta a varios tests que comparten componente. Elemento presente con otro nombre, más commit de marcado, más fallo en grupo, apunta a cambio de DOM. Elemento presente, locator correcto y acción que falla apunta a regresión, y ahí el agente no toca nada.

    ¿Sirve esto para tests flaky por timing y no por locators?

    Parcialmente. La traza deja ver si el fallo fue una espera insuficiente o una condición de carrera, y el agente puede proponer sustituir una espera fija por una aserción con reintento automático, que es la forma correcta de esperar en Playwright. Pero el flaky por datos compartidos entre tests o por estado sucio del entorno no se arregla en el test: se arregla aislando los datos de cada ejecución, y eso es trabajo de arquitectura, no de parche.

    ¿Cuánto cuesta esto en tokens si la suite es grande?

    Depende de qué le pases, y ahí está el truco. Si le mandas el DOM crudo de cada fallo, el coste se dispara y además el diagnóstico empeora por el ruido. Pasándole solo el árbol de accesibilidad recortado, la URL y el diff de los commits relevantes, el contexto por fallo se queda en unos pocos miles de tokens. El tope de cinco tests por PR funciona también como tope de gasto.

    ¿Puedo aplicar el mismo triaje sin agente, a mano?

    Sí, y deberías empezar por ahí. La tabla de A/B/C es una herramienta de proceso antes que de IA: obliga al equipo a justificar por escrito por qué un test rojo se convierte en verde. He visto equipos bajar el ruido de su suite a la mitad solo con esa regla y cero automatización. El agente acelera un criterio que ya funciona; no lo inventa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Evals deterministas para agentes de IA: testea datos, no frases

    Evals deterministas para agentes de IA: testea datos, no frases

    Un developer me enseñó su suite de tests para un agente de soporte. Tenía esta línea:

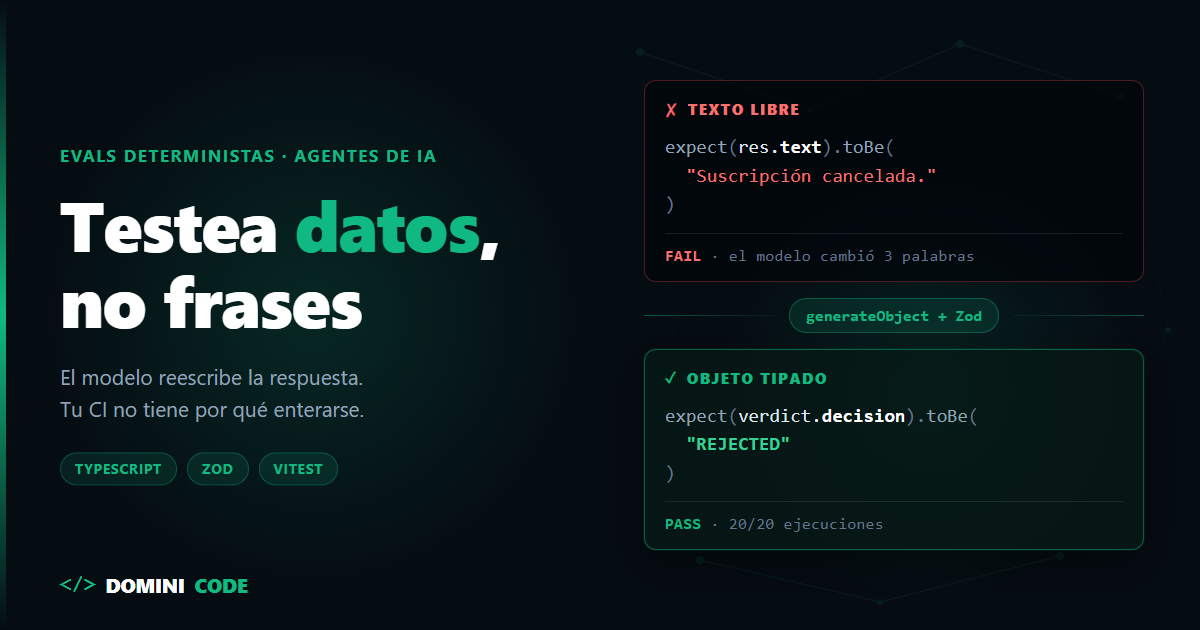
    expect(result.text).toBe("Tu suscripción ha sido cancelada con éxito.");
    

    En local pasó tres veces. Hizo push. En la cuarta ejecución en CI, el modelo contestó: "Hemos procesado la cancelación de tu suscripción correctamente."

    Pipeline en rojo. La suscripción se canceló. La tool correcta se llamó con el userId correcto. El agente hizo su trabajo y el test falló porque el modelo cambió tres palabras.

    Ese test no medía al agente. Medía la redacción de un modelo probabilístico, justo la parte que no controlas. La salida son los evals deterministas para agentes de IA: en vez de relajar la aserción hasta que ya no garantice nada, cambias lo que el agente devuelve.


    ¿Qué son los evals deterministas para agentes de IA?

    Un eval determinista es una comprobación cuyo resultado no depende de cómo redacte el modelo. El agente no devuelve una frase: devuelve un objeto tipado —un veredicto— y el test asierta de forma exacta sobre sus campos. Un decision que es un enum cerrado, un array de códigos de motivo, un identificador. Datos, no prosa. La misma clase de aserción que harías contra un endpoint REST.

    La diferencia con lo que la mayoría llama "eval" es el punto de aplicación. No estás puntuando una respuesta a posteriori con una rúbrica: estás rediseñando la interfaz del agente para que su decisión sea inspeccionable.

    Conviene marcar la frontera con dos cosas que ya conté por separado. El test harness para agentes de IA es el entorno: las tools falsas, el presupuesto de tokens que corta, el timeout real, la traza reproducible. Es el paso previo y es obligatorio. Este post va de lo otro: qué afirmas dentro de ese entorno.

    Y el function calling tipado con TypeScript valida la ENTRADA: los argumentos que el modelo manda a una tool, que en ai@7 viajan en inputSchema. Aquí hablamos de la SALIDA: el veredicto que emite el agente. Es la otra punta del mismo cable, y casi nadie tipa esa punta.


    Los dos callejones sin salida antes de llegar aquí

    Cuando el test de arriba se pone rojo hay dos salidas habituales, y las dos son peores que el problema: relajar la aserción hasta que deje de garantizar nada, o delegar el juicio en otro modelo.

    El primero es relajar la aserción. Un toContain, una expresión regular, un .toLowerCase().includes(). Queda así:

    expect(result.text.toLowerCase()).toContain("cancel");
    

    Verde. Y ahora ese test pasa también si el agente respondió "No puedo cancelar tu suscripción, contacta con soporte". Acabas de escribir una aserción que da verde cuando el agente hace exactamente lo contrario de lo que le pediste. Un test que no puede fallar en el caso que importa no es un test: es decoración en el pipeline.

    El segundo es montar un LLM-as-a-Judge para todo. Otro modelo lee la respuesta y decide si es correcta. Funciona, pero paga tres precios: es lento (una llamada extra por caso), es caro (y los evals se ejecutan por lotes, así que multiplica), y sobre todo hereda el no-determinismo que intentabas eliminar. Tu suite pasa a depender de que el juez opine igual el martes que el jueves. Y entonces tienes un segundo problema: quién calibra al juez.

    El juez tiene su sitio. Pero es el último recurso, no el primero. Antes de delegar una decisión en otro modelo, pregúntate si esa decisión se puede tipar. La mayoría de las veces se puede.

    Superficie de aserción Determinista Coste Cuándo usarla
    Texto libre con toBe o regex No Cero Nunca sobre la salida del modelo: o revienta con sinónimos o da verde con cualquier cosa
    Objeto tipado (generateObject + Zod) Sí en la aserción Cero extra Siempre que la salida sea una decisión, una clasificación, una extracción o un enrutado
    LLM-as-a-Judge No Alto, una llamada por caso Cuando la calidad es irreductiblemente textual: resúmenes, tono, redacción, código

    El giro: que la decisión sea un dato, no una frase

    Si quieres afirmar sobre la decisión del agente, haz que la decisión sea un campo.

    Con el AI SDK de Vercel eso es generateObject más un schema de Zod. Los ejemplos de este post corren con ai@7, zod@4 y Vitest 4, versiones de septiembre de 2026. El modelo deja de tener libertad de formato: o devuelve algo que valida contra el schema, o falla ruidosamente, que también es información útil.

    Un agente que revisa solicitudes de reembolso:

    // refund-agent.ts
    import { generateObject } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    import type { RefundTicket } from "./types";
    import { REFUND_POLICY_PROMPT } from "./prompts";
    
    const model = anthropic("claude-haiku-4-5-20251001");
    
    export const RefundVerdictSchema = z.object({
      decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
      reasonCodes: z
        .array(
          z.enum([
            "OUTSIDE_RETURN_WINDOW",
            "ITEM_DAMAGED_BY_CUSTOMER",
            "DUPLICATE_REQUEST",
            "OPEN_CHARGEBACK",
            "HIGH_VALUE_ORDER",
            "TRUSTED_CUSTOMER",
          ]),
        )
        .min(1),
      riskSignals: z.object({
        priorRefunds12m: z.number().int().min(0),
        daysSincePurchase: z.number().int().min(0),
      }),
      summary: z.string(),
    });
    
    export type RefundVerdict = z.infer<typeof RefundVerdictSchema>;
    
    export async function reviewRefund(ticket: RefundTicket): Promise<RefundVerdict> {
      const { object } = await generateObject({
        model,
        schema: RefundVerdictSchema,
        temperature: 0,
        instructions: REFUND_POLICY_PROMPT,
        prompt: JSON.stringify(ticket),
      });
    
      return object;
    }
    

    Fíjate en lo que acaba de pasar. reviewRefund ya no devuelve texto: devuelve RefundVerdict. Un tipo. Tu test vuelve a ser un test normal.

    Si ese veredicto es el paso final de un bucle con varias herramientas por medio, el schema es el punto de salida del bucle. Cómo montarlo con estado y reintentos lo desarrollé en el agentic loop en producción con TypeScript.

    Hasta aquí es lo que cuenta todo el mundo. Lo que casi nadie cuenta es que el schema puede estar bien tipado y ser una superficie de test pésima.


    Cómo diseñar el schema del veredicto: 5 reglas

    Esta es la parte que decide si tu suite aguanta seis meses o se convierte en ruido. Cinco reglas.

    1. Enums cerrados, nunca strings libres

    decision: z.string() valida perfectamente y no te sirve de nada. El modelo devolverá "rechazado", luego "Rechazado por política", luego "REJECT". Has movido el problema del texto de la respuesta al texto de un campo.

    // Mal: sigues asertando sobre prosa
    decision: z.string(),
    
    // Bien: el espacio de valores es finito y conocido
    decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
    

    Un enum cerrado tiene una propiedad que ningún string tiene: si el modelo quiere decir algo, solo puede decirlo de una manera. Ahí es donde toBe recupera el sentido.

    2. Códigos de motivo, no explicaciones

    Un veredicto que solo dice REJECTED te deja testear el qué, pero no el porqué. Y el porqué es donde viven las regresiones interesantes: el agente sigue rechazando el caso correcto, pero por el motivo equivocado. Eso es un bug que un test binario no ve.

    Por eso reasonCodes es un z.array(z.enum([...])) y no un z.array(z.string()). Con códigos puedes asertar la causa exacta. Con texto libre, vuelves al principio del post.

    Diseñar bien esa lista de códigos es trabajo de verdad: enums demasiado finos y el modelo elige mal entre opciones casi idénticas; demasiado gruesos y no distinguen nada. Empieza por los motivos que ya aparecen escritos en tu política de negocio.

    3. Los scores numéricos son la aserción más frágil que existe

    confidenceScore: z.number() es tentador. Y es una trampa.

    El modelo devuelve 0.82 hoy y 0.79 mañana con la misma entrada. Cualquier test que compare el valor exacto es un test que parpadea. Y cualquier umbral que escribas dentro del prompt —"si la confianza supera 0.8, aprueba"— es lógica de negocio metida en la parte no determinista del sistema.

    Dos reglas:

    • Si el score se queda, asierta rangos o umbrales, nunca el valor: expect(v.confidenceScore).toBeGreaterThan(0.7).
    • Mejor aún: saca el umbral del modelo y ponlo en tu código. Que el agente devuelva señales en bruto (priorRefunds12m, daysSincePurchase) y que la regla la aplique una función TypeScript pura.
    // route-verdict.ts — 100% determinista, testeable sin llamar al modelo
    export function routeVerdict(v: RefundVerdict): "AUTO" | "MANUAL_REVIEW" {
      const { priorRefunds12m, daysSincePurchase } = v.riskSignals;
    
      // El veredicto del agente manda: si pidió revisión humana, no la saltamos
      if (v.decision === "MANUAL_REVIEW") return "MANUAL_REVIEW";
      if (priorRefunds12m >= 3) return "MANUAL_REVIEW";
      if (daysSincePurchase > 30 && v.decision === "APPROVED") return "MANUAL_REVIEW";
    
      return "AUTO";
    }
    

    Cada umbral que mueves del prompt a una función es un test que pasa de probabilístico a exacto.

    4. Separa lo que se asierta de lo que se lee

    El schema puede —y suele— tener campos en texto libre. summary está ahí para que un humano entienda la decisión en el panel de revisión, y hace falta.

    La regla es que ese campo no se asierta jamás. Ni con toContain, ni con regex, ni "solo para comprobar que no viene vacío". Déjalo escrito en un comentario del propio schema, para que el siguiente developer no caiga en la tentación. Un schema tiene dos zonas: la contractual, sobre la que testeas, y la informativa, que solo se lee.

    5. Los campos opcionales fabrican tests frágiles

    En cuanto un campo permite undefined, tu test tiene que decidir qué significa eso. Y normalmente no lo decide: lo esquiva con un ?. y se queda verde por accidente.

    // Ambiguo: ¿no había motivos, o el modelo no los rellenó?
    reasonCodes: z.array(ReasonCode).optional(),
    
    // Explícito: el array siempre viene, y siempre con al menos un motivo
    reasonCodes: z.array(ReasonCode).min(1),
    

    Prefiere valores por defecto, arrays vacíos y uniones discriminadas antes que opcionalidad. Un undefined que atraviesa la suite entera sin que nadie lo asierte es un agujero con forma de test.

    Este tipo de diseño —enums, refinamientos, uniones discriminadas, z.infer para no duplicar tipos— es lo que trabajo paso a paso en el curso de Zod para TypeScript, porque aquí el schema no es validación defensiva: es la superficie de test de todo el sistema.


    El test que resulta

    Con el schema anterior, el eval en Vitest es aburrido. Ese es el objetivo: un test de agente de IA que se lee igual que cualquier otro test de tu suite.

    // refund-agent.eval.test.ts
    import { describe, it, expect } from "vitest";
    import { reviewRefund, type RefundVerdict } from "./refund-agent";
    import { routeVerdict } from "./route-verdict";
    import { lateRequestWithChargeback } from "./fixtures";
    
    describe("refund agent · casos obvios", () => {
      it("rechaza una solicitud fuera de plazo con chargeback abierto", async () => {
        const verdict = await reviewRefund(lateRequestWithChargeback);
    
        expect(verdict.decision).toBe("REJECTED");
        expect(verdict.reasonCodes).toContain("OPEN_CHARGEBACK");
        expect(verdict.reasonCodes).toContain("OUTSIDE_RETURN_WINDOW");
        expect(verdict.reasonCodes).not.toContain("TRUSTED_CUSTOMER");
      });
    });
    
    describe("routeVerdict · sin modelo", () => {
      it("escala a revisión manual con 3 reembolsos previos", () => {
        const verdict: RefundVerdict = {
          decision: "APPROVED",
          reasonCodes: ["TRUSTED_CUSTOMER"],
          riskSignals: { priorRefunds12m: 3, daysSincePurchase: 5 },
          summary: "",
        };
    
        expect(routeVerdict(verdict)).toBe("MANUAL_REVIEW");
      });
    });
    

    Dos detalles que importan.

    El toContain de aquí no es el toContain del callejón sin salida. Sobre un string comprueba subcadenas y da verde con cualquier ruido alrededor; sobre un array de enums comprueba pertenencia exacta a un conjunto cerrado. Misma función, garantías opuestas.

    Y el not.toContain vale tanto como el positivo. Un agente que rechaza el caso correcto pero marca al cliente como fiable está acertando por la razón equivocada, y ese es el fallo que se cuela a producción sin que nadie lo vea.

    Este test no se rompe si el modelo cambia la redacción del summary. Ni si cambia el orden de los motivos. Ni si actualizas a la siguiente versión del modelo y escribe más bonito. Solo se pone rojo cuando el agente decide distinto, que es exactamente lo que querías vigilar. Si quieres afinar el diseño de suites, fixtures y aislamiento de dependencias, ese músculo lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library: los ejemplos son de Angular, pero el diseño de suites y fixtures se traslada tal cual.


    Los límites de los evals deterministas en agentes de IA

    Toca ser honesto: el schema hace determinista la aserción, no el modelo.

    temperature: 0 reduce muchísimo la varianza, pero no la elimina. Entre el batching en el servidor, la aritmética en coma flotante y el enrutado interno de los modelos grandes, la misma entrada puede darte una decisión distinta. Menos que antes. No cero.

    La forma de convivir con eso es partir la suite en dos, y esta distinción es la que casi nadie hace.

    Casos obvios. El cliente pide el reembolso de un pedido de hace dos años con un chargeback abierto. Solo hay una respuesta razonable. Estos casos son tests binarios, corren siempre y bloquean el merge. Si uno falla, hay un bug: en el prompt, en el schema o en el modelo que acabas de actualizar.

    Casos de frontera. El pedido tiene 31 días y la política dice 30, pero el cliente lleva cinco años contigo. Aquí ni tú tienes una respuesta única. Estos casos no se testean como binarios: se miden como tasa de acierto. Ejecutas N veces y exiges un umbral de consistencia. Cinco ejecuciones es el mínimo que justifica el coste, no una muestra seria: si el caso importa de verdad, sube a veinte antes de fiarte de la tasa. Por qué N no es un número arbitrario lo desarrollé en evaluaciones automatizadas para agentes.

    // refund-agent.borderline.test.ts
    import { borderlineTicket } from "./fixtures";
    
    async function decisionCounts(runs: number, ticket: RefundTicket) {
      const results = await Promise.all(
        Array.from({ length: runs }, () => reviewRefund(ticket)),
      );
    
      return results.reduce<Record<string, number>>((acc, r) => {
        acc[r.decision] = (acc[r.decision] ?? 0) + 1;
        return acc;
      }, {});
    }
    
    it(
      "mantiene el caso frontera en revisión manual (4 de 5)",
      async () => {
        const counts = await decisionCounts(5, borderlineTicket);
        expect(counts.MANUAL_REVIEW ?? 0).toBeGreaterThanOrEqual(4);
      },
      60_000,
    );
    

    Meter los casos de frontera en la suite que bloquea el merge es la receta perfecta para que el equipo empiece a relanzar pipelines hasta que pasen. Y a partir de ese día los tests dejan de significar nada. Van en un job programado, con su propio umbral y su propia alerta cuando la tasa cae.

    Sí, esta suite cuesta dinero, porque llama al modelo de verdad. Por eso corre por lotes y no en cada push, mientras el test harness con tools falsas sigue corriendo en cada commit.


    Cuándo sí necesitas un LLM-as-a-Judge

    Cuando la calidad de la salida es irreductiblemente textual.

    Si tu agente escribe un resumen, redacta un email a un cliente o genera un módulo entero de código, no hay enum que capture "esto está bien". Ahí el juez —con rúbrica explícita, golden dataset versionado y calibración humana— es la herramienta correcta, y lo desarrollé entero en evals para código generado por IA.

    La regla de reparto es simple: si la decisión se puede tipar, típala; el juez es para lo que sobra después. En la mayoría de agentes de negocio, lo que sobra es mucho menos de lo que parece antes de sentarse a diseñar el schema.


    Por dónde empezar mañana

    Coge un agente. El que más te preocupe.

    Mira qué devuelve hoy. Si devuelve texto, escribe el schema del veredicto: un enum de decisión, un array de códigos de motivo, las señales numéricas en bruto y un summary que no vas a asertar nunca. Cambia la llamada a generateObject. Y mueve al menos un umbral del prompt a una función TypeScript.

    Después escribe cinco casos obvios. Cinco. Con eso ya tienes una red que detecta el día en que cambies de modelo y el agente empiece a aprobar lo que antes rechazaba, que es la regresión que de verdad cuesta dinero.

    Si todavía no tienes el agente sobre el que montar estos evals, el punto de partida es construir un agente de IA desde cero.

    Este tipo de decisión de diseño es lo que separa una demo de un producto que aguanta usuarios reales, y es el hilo que sigo en el curso Construye con IA: de la idea al producto con Claude Code.

    Deja de testear lo que el agente dice. Testea lo que el agente decide.


    Preguntas frecuentes

    ¿Qué es exactamente un eval determinista?

    Es una comprobación automática cuyo resultado no depende de cómo redacte el modelo. Se consigue haciendo que el agente devuelva un objeto tipado en lugar de texto y asertando sobre campos de valores cerrados, como enums o arrays de códigos. La aserción vuelve a ser exacta y repetible, igual que si testearas la respuesta de una API REST.

    ¿Con temperature 0 ya tengo determinismo garantizado?

    No. Reduce mucho la varianza, pero no la elimina, porque hay factores del lado del proveedor que no controlas, como el batching de peticiones o la aritmética en coma flotante. Lo que sí es determinista es tu aserción, y por eso los casos de frontera se miden como tasa de acierto sobre varias ejecuciones en lugar de como un test binario.

    ¿Puedo asertar sobre un campo de confianza numérico?

    Puedes, pero solo por rangos o umbrales, nunca por el valor exacto, porque el mismo caso te dará valores ligeramente distintos entre ejecuciones. La mejor opción es que el modelo devuelva las señales en bruto y que el umbral lo aplique una función de tu código, que sí puedes testear al cien por cien sin llamar al modelo.

    ¿En qué se diferencia esto de un test harness?

    El harness es el entorno de ejecución: las herramientas falsas, el presupuesto de tokens, el timeout y la traza. Responde a si el agente se salió de sus límites. Los evals deterministas son las aserciones que escribes dentro de ese entorno y responden a si el agente decidió lo correcto. Se montan en ese orden: primero el entorno, después las aserciones.

    ¿Estos tests corren en cada push?

    Los que no llaman al modelo, sí: el enrutado, los umbrales y toda la lógica pura alrededor del veredicto. Los que llaman al modelo de verdad cuestan dinero y tardan, así que van en un job programado sobre un conjunto reducido de casos, separando los obvios, que bloquean el merge, de los de frontera, que solo alertan cuando la tasa de acierto cae.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Desplegar agentes LangChain en producción sin perder el estado

    Desplegar agentes LangChain en producción sin perder el estado

    En local funcionaba perfecto.

    El agente respondía, llamaba a sus herramientas, escribía token a token en la terminal. Lo metí en un contenedor y lo subí. A los pocos días empecé a ver el mismo patrón en los logs: conversaciones cortadas a mitad, y usuarios que volvían y encontraban un agente sin memoria de nada.

    No había ningún error en el código del agente. El agente estaba bien. Lo que estaba mal era todo lo que hay entre el agente y el usuario.

    Y es que desplegar agentes LangChain en producción no se parece a desplegar una API REST. Una API REST responde en 200 milisegundos y no recuerda nada. Un agente tarda treinta segundos, mantiene la conexión abierta todo ese rato, guarda estado entre turnos y llama a servicios externos que fallan. Cuatro propiedades que rompen, una por una, las suposiciones sobre las que está construida tu infraestructura.

    Si todavía estás decidiendo la forma del agente —grafo de estados o bucle— eso lo desarrollé en LangGraph TypeScript: cuándo un grafo gana al while loop. Este post empieza donde acaba aquel: ya tienes el grafo, ahora hay que sacarlo del portátil.

    Todo el código está escrito contra langchain 1.5 y @langchain/langgraph 1.4, con @langchain/langgraph-checkpoint-postgres 1.0. Es importante que mires las versiones: la API de creación de agentes y la de streaming cambiaron en LangChain 1, y casi todos los tutoriales que vas a encontrar están escritos contra la anterior.

    Última revisión: 31 de agosto de 2026. Si LangGraph publica una 2.x, el PostgresSaver es lo primero que hay que volver a comprobar.


    Los 3 fallos al desplegar agentes LangChain en producción

    Los tres fallos que rompen un agente en producción son la conexión que corta el proxy, el estado que vive en RAM y la herramienta sin timeout. No son los que parecen, y son los que me han costado tiempo de verdad:

    # Fallo Por qué pasa
    1 La conexión se corta a mitad de respuesta El proxy cierra la conexión por inactividad: mientras el modelo "piensa" no viajan bytes
    2 El agente pierde la memoria El historial vivía en RAM y el contenedor se reinició o escaló a otra instancia
    3 Una herramienta se cuelga y arrastra al proceso Sin timeout ni cancelación, la petición queda colgada y la conexión SSE ocupando memoria

    Conviene desmontar un mito antes de seguir, porque lo he leído muchas veces: el bucle del agente no bloquea el event loop. El trabajo de un agente es esperar respuestas HTTP del modelo y de sus herramientas, así que es I/O, y Node o Bun siguen atendiendo peticiones mientras tanto. Lo que sí se te agota es otra cosa. La memoria que ocupa cada conexión abierta, el límite de concurrencia de tu plataforma, y los sockets que nadie cerró porque el cliente se fue sin avisar.


    El estado: sácalo de la RAM el primer día

    El estado de un agente LangGraph no puede vivir en una variable del proceso: en cuanto el contenedor se reinicia o escala, la conversación desaparece. Este es el arreglo con más retorno y el más barato de aplicar.

    Mientras el estado vive en memoria, tu agente recuerda hasta el próximo despliegue. Y como los reinicios no los decides tú —los decide el autoescalado, un health check o un deploy—, no es un riesgo teórico: pasa.

    La solución en LangGraph es un checkpointer, que guarda el estado del grafo después de cada paso en una base de datos externa:

    import { PostgresSaver } from "@langchain/langgraph-checkpoint-postgres";
    
    const checkpointer = PostgresSaver.fromConnString(process.env.DATABASE_URL!);
    
    // Solo la primera vez: crea las tablas que necesita el checkpointer.
    await checkpointer.setup();
    

    Ese setup() va en el paso de migraciones de tu despliegue, no en el arranque de cada instancia. Si lo dejas en el boot y levantas diez réplicas, tienes diez procesos creando las mismas tablas a la vez.

    A partir de ahí, cada conversación se identifica con un thread_id. El agente no "recuerda" nada en memoria: al recibir un turno nuevo, lee el estado de ese hilo desde Postgres, avanza y vuelve a escribirlo.

    Eso cambia una propiedad importante de tu servicio: pasa a ser reemplazable. Puedes matar el contenedor, desplegar una versión nueva o levantar diez réplicas detrás de un balanceador, y cualquiera de ellas puede continuar cualquier conversación, porque el estado no está en ninguna de ellas.


    El servidor: streaming que sobrevive al proxy

    El segundo problema es la conexión. Un agente tarda decenas de segundos en completar una respuesta, y durante buena parte de ese tiempo no manda ni un byte, porque está esperando al modelo o ejecutando una herramienta.

    Para un proxy —Nginx, Cloudflare, el balanceador de tu PaaS— una conexión abierta que no transmite nada es una conexión muerta, y la cierra.

    Así que hay tres cosas que hacer, y las tres se olvidan:

    • Enviar las cabeceras SSE inmediatamente, para que el proxy sepa que esto es un stream y no espere a tener el cuerpo entero.
    • Mandar un latido cada pocos segundos aunque no haya nada que decir, para que la conexión nunca esté inactiva.
    • Abortar el trabajo si el cliente se va, o seguirás pagando tokens de una respuesta que ya no lee nadie.
    import express from "express";
    import { createAgent } from "langchain";
    
    // Necesita @langchain/anthropic instalado y ANTHROPIC_API_KEY en el entorno.
    const agent = createAgent({
      model: "anthropic:claude-sonnet-5",
      tools: [buscarPedido], // la definimos más abajo
      checkpointer,          // el PostgresSaver de arriba
    });
    
    const app = express();
    app.use(express.json());
    
    app.post("/api/agent/chat", async (req, res) => {
      // El thread_id se valida contra el usuario autenticado: si no,
      // cualquiera puede leer la conversación de cualquier otro.
      const { threadId, message } = req.body;
    
      res.setHeader("Content-Type", "text/event-stream");
      res.setHeader("Cache-Control", "no-cache, no-transform");
      res.setHeader("Connection", "keep-alive");
      res.setHeader("X-Accel-Buffering", "no"); // que Nginx no acumule el stream
      res.flushHeaders();                       // sin esto, el proxy espera
    
      // Latido: mantiene viva la conexión frente al idle timeout del proxy.
      const heartbeat = setInterval(() => {
        if (res.writableEnded || res.destroyed) return;
        res.write(": ping\n\n");
      }, 15_000);
    
      // Si el cliente cierra la pestaña, se cancela el trabajo del agente.
      const controller = new AbortController();
      res.on("close", () => {
        clearInterval(heartbeat);
        controller.abort();
      });
    
      try {
        const stream = await agent.streamEvents(
          { messages: [{ role: "user", content: message }] },
          {
            version: "v3",
            configurable: { thread_id: threadId },
            signal: controller.signal,
          },
        );
    
        await Promise.all([
          (async () => {
            for await (const m of stream.messages) {
              for await (const token of m.text) {
                res.write(`data: ${JSON.stringify({ type: "token", text: token })}\n\n`);
              }
            }
          })(),
          (async () => {
            for await (const call of stream.toolCalls) {
              res.write(`data: ${JSON.stringify({ type: "tool", name: call.name })}\n\n`);
            }
          })(),
        ]);
    
        res.write("data: [DONE]\n\n");
      } catch (err) {
        if (!controller.signal.aborted) {
          res.write(`data: ${JSON.stringify({ type: "error" })}\n\n`);
        }
      } finally {
        clearInterval(heartbeat);
        res.end();
      }
    });
    
    // Cloud Run y casi cualquier PaaS inyectan PORT: no lo fijes a mano.
    app.listen(process.env.PORT ?? 3000);
    

    Dos detalles que merecen su párrafo.

    El version: "v3". Es la API de streaming con proyecciones tipadas, y aparece en langchain a partir de la 1.4.0. En vez de recibir un chorro plano de eventos y filtrar por nombre, iteras stream.messages para los tokens y stream.toolCalls para las herramientas, cada uno por su lado. Si copias un tutorial que usa version: "v2" y compara event.event === "on_chat_model_stream", estás escribiendo contra la API anterior.

    Un aviso que no vas a encontrar en esos tutoriales: LangChain la marca como experimental en su propia definición de tipos —"This v3 stream is experimental and its API may change in future releases"—. La uso igualmente porque la alternativa envejece peor, pero fija la versión en tu package.json y no la des por estable.

    El signal. RunnableConfig acepta un AbortSignal, y es lo que convierte el res.on("close") en una cancelación real en lugar de un simple return. Sin él, el cliente se va pero tu servidor sigue generando tokens contra la API del modelo hasta el final.

    Si vienes del stack de Vercel, el mismo problema con otras piezas lo resolví en streaming de respuestas de IA con NestJS y el Vercel AI SDK.


    Las herramientas: donde se cuelga todo

    El fallo que más veces he tenido que diagnosticar en producción no está en el modelo ni en el grafo. Está en una herramienta que llama a una API de terceros que ese día tarda cuarenta segundos en responder.

    Sin timeout propio, esa herramienta se lleva por delante la petición entera. El usuario ve un cursor parpadeando, la conexión sigue abierta consumiendo memoria, y tú no sabes en qué paso se quedó.

    La regla es simple: toda herramienta que salga a la red lleva su propio timeout, más corto que el de la petición completa, y devuelve un texto en lugar de reventar. Ésta es la buscarPedido que usa el agente de arriba:

    import { tool } from "langchain";
    import * as z from "zod";
    
    const buscarPedido = tool(
      async ({ id }) => {
        try {
          const res = await fetch(`${API}/pedidos/${id}`, {
            signal: AbortSignal.timeout(8_000), // esta tool falla en 8s o no falla
          });
          return JSON.stringify(await res.json());
        } catch {
          // El agente lee esto y decide: reintentar o admitir que no puede.
          return "El servicio de pedidos no respondió en 8 segundos.";
        }
      },
      {
        name: "buscar_pedido",
        description: "Busca un pedido por su identificador",
        schema: z.object({ id: z.string() }),
      },
    );
    

    Y que falle está bien. Un error controlado vuelve al agente como resultado de la herramienta, el modelo lo lee y puede reintentar o decir que no ha podido. Una herramienta colgada, en cambio, no le da ninguna información con la que trabajar: el agente se queda esperando y el usuario también.

    Si además quieres que la herramienta muera cuando el cliente cierra la pestaña, combina su propio timeout con el signal que le llega en el config: el AbortSignal.timeout por sí solo no escucha esa cancelación.

    Ese diseño de herramientas —contrato claro, fallo rápido y un error que el modelo pueda leer— es el que trabajo paso a paso en el curso Construye con IA con Claude Code.

    Cómo evitar que ese reintento se convierta en un bucle sin fin lo desarrollé en Agentic Loop en TypeScript. Y cómo probar todo esto en CI antes de que llegue a producción, en test harness para agentes de IA.


    Qué pasa de verdad cuando el contenedor se reinicia

    Aquí es donde casi todas las guías te dicen una verdad a medias. "Con un checkpointer no pierdes el estado" es cierto, pero conviene saber exactamente qué se salva y qué no.

    Si el contenedor muere mientras un agente está a mitad de una tarea:

    • Se conserva todo lo que ya estaba confirmado en el último checkpoint: los turnos anteriores, los resultados de las herramientas que ya terminaron y el estado del grafo hasta ese punto.
    • Se pierde el paso en vuelo. Los tokens que se estaban generando en ese momento no están en ninguna parte, y la conexión SSE del cliente se cae con el proceso.
    • No se reanuda solo. No hay nadie que retome la tarea al arrancar el contenedor nuevo. Y ojo con lo que significa "volver a llamar". El checkpoint se escribe por paso del grafo. Si el proceso murió justo después de que el modelo pidiera una herramienta, el estado guardado termina en un mensaje del asistente con tool_calls y ninguna respuesta. Mandar ahí un mensaje nuevo del usuario produce un 400 del proveedor, porque todo tool_use exige su tool_result. Antes de aceptar el turno siguiente hay que cerrar el paso pendiente de ese hilo.

    Esto tiene una consecuencia de diseño que hay que asumir pronto: el thread_id tiene que sobrevivir al navegador y estar atado al usuario. Que lo genere el cliente está bien; que el servidor se lo crea sin comprobar contra quién ha iniciado sesión, no. Y si el identificador solo vive en la memoria del navegador, un refresco lo pierde y la conversación se queda huérfana en la base de datos: existe, pero nadie sabe pedirla.

    Y si la tarea es larga de verdad —un informe que tarda diez minutos, un procesamiento por lotes—, el patrón correcto no es este. Es aceptar la petición, devolver un identificador y ejecutar el trabajo en una cola aparte, con el cliente consultando el progreso. Un agente detrás de una petición HTTP tiene sentido para conversación, no para trabajo de fondo.


    Empaquetar y desplegar agentes LangChain en producción

    Empaquetar un agente es un Dockerfile normal con un detalle que rompe builds: desde Bun 1.2 el lockfile por defecto es bun.lock, no bun.lockb.

    FROM oven/bun:1-alpine
    WORKDIR /app
    
    # Desde Bun 1.2 el lockfile por defecto es bun.lock (texto), no bun.lockb.
    COPY package.json bun.lock ./
    RUN bun install --frozen-lockfile --production
    
    COPY . .
    
    ENV NODE_ENV=production
    USER bun
    CMD ["bun", "run", "src/server.ts"]
    

    Si copias un Dockerfile de hace un par de años vas a ver COPY package.json bun.lockb ./, y con un proyecto actual esa línea falla porque ese archivo ya no existe.

    Y un .dockerignore al lado, que es el otro detalle que rompe builds:

    node_modules
    .git
    .env*
    

    Sin él, el COPY . . te mete el node_modules de tu portátil encima del que acabas de instalar dentro del contenedor, con binarios compilados para otra plataforma.

    Sobre dónde desplegarlo, lo único que importa de verdad es cuánto tiempo te dejan tener una conexión abierta:

    Plataforma Timeout por defecto Máximo Qué tienes que tocar
    Cloud Run 300 s (5 min) 3.600 s (60 min) Subir el timeout y fijar una instancia mínima para no pagar arranque en frío por conversación
    Render · Railway · Fly Idle timeout propio, más corto No es ilimitado El latido SSE: sin él la conexión cuenta como inactiva y la cortan

    Los números de Cloud Run salen de su documentación de timeouts. Para un agente conversacional con streaming, el valor de fábrica se queda corto en cuanto una herramienta se ralentiza.

    Y aquí hay una distinción que cuesta un incidente aprender: el latido no te salva del timeout de Cloud Run. El latido derrota los timeouts de inactividad, que es lo que aplican los PaaS. El de Cloud Run es duración máxima de la petición, y corta igual aunque estés emitiendo tokens sin parar. En todos los que he probado, además, ninguno mantiene una conexión abierta indefinidamente.

    Un agente en producción además habla con servicios externos, y ahí el problema deja de ser el deploy y pasa a ser el transporte y la autenticación. Eso lo cubrí en MCP en producción: lo que se rompe cuando tu server sale del portátil.


    No despliegues a ciegas

    En un backend clásico te basta con los errores HTTP. En un agente necesitas ver el árbol de decisiones: qué prompt se envió, qué herramienta se ejecutó, cuánto tardó y qué costó. Sin eso, "va lento" y "responde mal" son incidencias que no puedes investigar.

    No lo desarrollo aquí porque ya tiene su sitio. El planteamiento está en cómo monitorear agentes de IA en producción, la implementación en Langfuse paso a paso, y la parte que te va a llegar en la factura, en medir el consumo de tokens.


    Checklist antes de pulsar deploy

    1. El estado, fuera del proceso. Checkpointer con setup() ejecutado y thread_id generado y persistido por el cliente.
    2. El stream, blindado. flushHeaders(), latido cada 15 segundos y AbortSignal conectado al cierre de la conexión.
    3. Las herramientas, con timeout propio. Más corto que el de la petición, y que fallen con un error que el agente pueda leer.
    4. El timeout de la plataforma, subido. El de fábrica está pensado para APIs que responden rápido, no para agentes.
    5. Trazas desde el primer despliegue. No desde el primer incidente.

    Las arquitecturas de agentes que tengo funcionando, con sus fallos y lo que costó arreglarlos, las comparto cada semana en Dominicode Labs.

    Que un agente funcione en tu portátil es un experimento. Que sobreviva a un reinicio es ingeniería.


    Preguntas frecuentes

    ¿Cómo se despliega un agente LangChain en producción?

    Desplegar agentes LangChain en producción son cuatro decisiones, no una. Primera: sacar el estado del proceso con un checkpointer persistente —PostgresSaver sobre Postgres— para que cualquier réplica pueda continuar cualquier conversación. Segunda: servir la respuesta por SSE con flushHeaders(), un latido cada 15 segundos y un AbortSignal atado al cierre del cliente, para que ningún proxy corte el stream. Tercera: poner timeout propio a cada herramienta que salga a la red, más corto que el de la petición. Y cuarta: subir el timeout de la plataforma, que de fábrica está pensado para APIs que responden en milisegundos. El contenedor en sí es lo de menos.

    ¿Postgres o Redis para el checkpointer?

    Postgres por defecto. El estado de una conversación es un dato que quieres conservar, consultar y auditar más tarde, y Postgres te lo da sin trabajo extra. Redis tiene sentido cuando la latencia de lectura del estado empieza a notarse de verdad o cuando el historial es efímero y no te importa perderlo. Empezar por Redis "porque es más rápido" suele salir caro el día que necesitas saber qué le contestó el agente a un cliente hace tres semanas.

    Si el contenedor se reinicia a mitad de una tarea, ¿se reanuda sola?

    No. Se conserva el estado hasta el último checkpoint confirmado, pero el paso que estaba en vuelo se pierde y nadie retoma la tarea por su cuenta. La reanudación la dispara el cliente cuando vuelve a llamar con el mismo thread_id, siempre que el paso pendiente se cierre antes de mandar un mensaje nuevo. Si el hilo se quedó con una petición de herramienta sin responder, el proveedor devuelve un 400. Y si necesitas que el trabajo termine sí o sí aunque nadie esté mirando, eso no va en una petición HTTP: va en una cola.

    ¿SSE o WebSocket para un agente?

    SSE en la mayoría de casos. La comunicación de un agente conversacional es casi toda en un sentido —el servidor manda tokens— y SSE va sobre HTTP normal, así que atraviesa proxies y balanceadores sin configuración especial. La reconexión automática te la da EventSource, pero solo habla GET: con el endpoint POST de arriba consumes el stream con fetch y ReadableStream, y la reconexión la escribes tú. WebSocket compensa cuando de verdad necesitas un canal bidireccional con mucho tráfico del cliente hacia el servidor, y a cambio te complica el despliegue.

    ¿Cuánto timeout pongo en Cloud Run?

    El valor de fábrica son 5 minutos y el máximo son 60. Para un agente conversacional, subirlo a 10-15 minutos suele ser suficiente: cubre las respuestas largas y las herramientas lentas sin dejar conexiones zombis eternas. Ponerlo al máximo no es gratis, porque una conexión colgada ocupa una instancia durante todo ese tiempo.

    ¿Esto vale con otro modelo que no sea Claude?

    Sí. La arquitectura —checkpointer externo, streaming con latido, cancelación y timeouts por herramienta— es independiente del proveedor. Lo único que cambia es el identificador del modelo que le pasas a createAgent y el paquete de integración correspondiente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
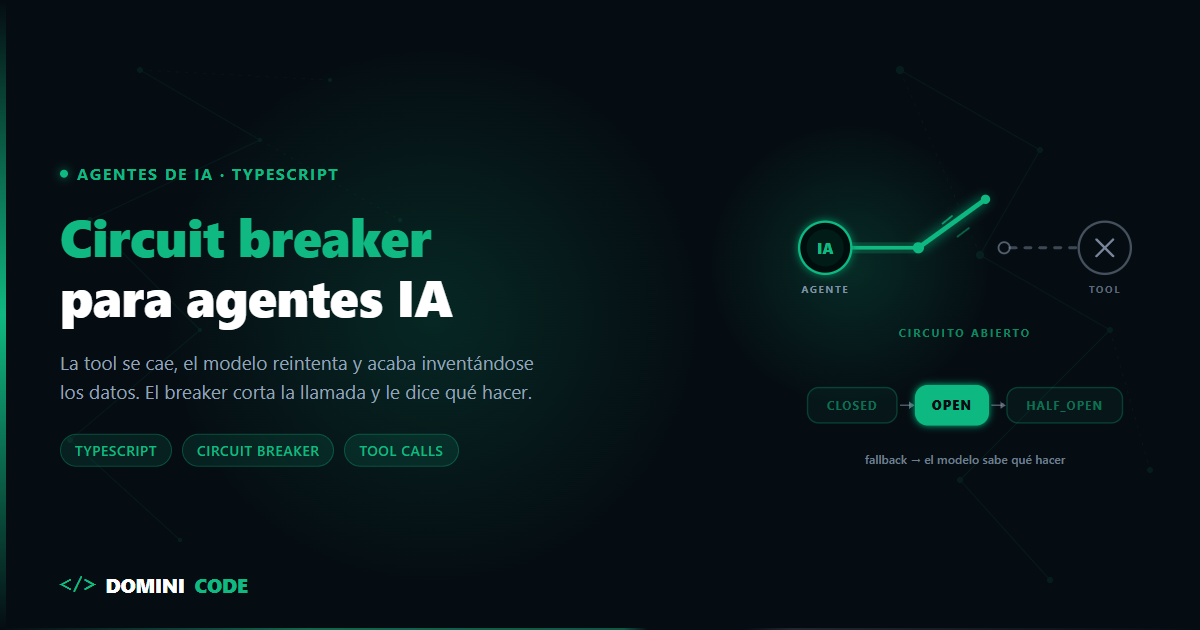
  • Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Un martes por la tarde, la API de búsqueda de un cliente empezó a devolver 500. Un despliegue suyo mal hecho: tres minutos de caída.

    El agente que consumía esa API estuvo cuarenta minutos haciendo tonterías caras.

    Primero reintentó. Normal. Luego, al ver que la herramienta seguía fallando, hizo lo que hacen los modelos cuando se les cierra una puerta: buscar otra. Llamó a una tool que no tocaba, cambió los parámetros "por si acaso" y en el paso 14 se inventó tres productos con sus precios.

    Faltaba un circuit breaker para agentes IA. El patrón es viejo — Michael Nygard lo describió en Release It! en 2007 para microservicios y Martin Fowler lo popularizó después — pero cuando en medio del reintento hay un LLM, cambia una pieza fundamental. Y esa pieza es la que casi nadie implementa.


    Qué es un circuit breaker para agentes IA

    Un circuit breaker para agentes IA es una máquina de estados que envuelve la ejecución de cada tool: cuenta los fallos de infraestructura dentro de una ventana de tiempo y, al superar un umbral, deja de llamar a la API y devuelve al modelo un resultado estructurado que le dice que esa herramienta no está disponible y qué debe hacer en su lugar.

    La diferencia con el circuit breaker clásico de microservicios está en quién recibe el corte. Allí el consumidor es código, que obedece un 503 y ejecuta su rama de fallback. Aquí el consumidor es un LLM, que interpreta el error y decide por su cuenta. Y si no se lo dices tú, lo que decide es reintentar o inventarse el dato.


    Los tres estados del circuit breaker en un agente

    El breaker es una máquina de estados que envuelve la ejecución de una herramienta.

    CLOSED. Todo pasa. Vas contando fallos en una ventana de tiempo. Si en los últimos 60 segundos hay 4 fallos de infraestructura, abres.

    OPEN. Rechazas sin llamar a la API. Esto es lo importante: el execute de la tool ni siquiera hace fetch. Devuelve en microsegundos. No hay timeout de 30 segundos, no hay latencia, no hay una API agonizante recibiendo más carga de la que ya no puede atender.

    HALF_OPEN. Pasado el tiempo de reset, dejas pasar una sola llamada de prueba. Si funciona, vuelves a CLOSED. Si falla, vuelves a OPEN y el contador de espera empieza otra vez. Ojo con esto en un agente: si dejas pasar todas las llamadas de un turno en half-open, el modelo puede lanzar tres tool calls en paralelo y le acabas metiendo tres peticiones a un servicio que se está levantando.

    Hasta aquí es idéntico a un microservicio. La diferencia empieza en lo que devuelves cuando el circuito está abierto.


    Qué devolver al modelo cuando el circuito está abierto

    Cuando un servicio A tiene el circuito abierto contra el servicio B, devuelve un 503 y quien lo consume es código. El código no negocia: ve el 503 y ejecuta la rama de fallback que escribiste.

    En un agente, quien recibe la respuesta de la tool es un modelo de lenguaje. Y un modelo de lenguaje sí negocia.

    Si le devuelves esto:

    { "error": "request failed" }
    

    El modelo va a reintentar. No porque sea tonto, sino porque no tiene ninguna forma de saber que existe un circuito y que está abierto. Desde su punto de vista una llamada ha fallado, y lo razonable ante una llamada que falla es intentarlo otra vez, quizá con otros parámetros.

    Has puesto un breaker que ahorra la petición HTTP pero no ahorra ni una sola iteración del loop ni un solo token. El agente sigue quemando pasos hasta agotar el presupuesto que le pusiste en stopWhen — si es que se lo pusiste, que de eso hablo en el post del agentic loop.

    El resultado de una tool es un canal de comunicación con el modelo. Es prompt. Úsalo como tal.

    {
      "ok": false,
      "toolUnavailable": true,
      "retryAfterSeconds": 27,
      "instruction": "La herramienta \"searchCatalog\" está fuera de servicio por fallos repetidos del proveedor. No vuelvas a llamarla durante los próximos 27 segundos: cualquier intento se rechazará sin llegar a la API. Usa \"searchCatalogSnapshot\" (catálogo cacheado de hace unas horas) y avisa en tu respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía stock en tiempo real, dile que ese dato no está disponible ahora. No lo estimes ni lo inventes."
    }
    

    Cuatro cosas, y las cuatro hacen falta:

    1. Qué herramienta está caída, por su nombre exacto — el mismo que ve en la definición de tools.
    2. Cuánto tiempo, en segundos concretos. Un "temporalmente" no le dice nada.
    3. La prohibición explícita de reintentar, con el motivo: no es que vaya a fallar, es que ni siquiera va a salir de tu servidor.
    4. Qué hacer en su lugar, en concreto. Y la orden de no inventarse lo que la API le habría dado, que es exactamente lo que hizo el agente de mi cliente en el paso 14.

    Y la alternativa que le ofreces tiene que existir de verdad en el toolset. Mandar al modelo a una herramienta que no le has dado es pedirle justo lo que intentas evitar: que se la invente.

    Añade también una línea al system prompt explicando el protocolo: "si una tool devuelve toolUnavailable: true, esa herramienta no está disponible en este turno; sigue las instrucciones del campo instruction y no la vuelvas a llamar". El modelo cumple bastante bien cuando la instrucción es específica y llega en el sitio donde toma la decisión.


    Qué errores abren el circuito de una tool (y cuáles no)

    Aquí es donde la mayoría de implementaciones se rompen, y se rompen hacia el lado peligroso: abriendo el circuito de una API que funciona perfectamente.

    Los 5xx cuentan. Los timeouts cuentan. Los errores de red cuentan. Los 429 cuentan también, porque cuando un servicio te dice que vas demasiado rápido, lo correcto es dejar de llamarlo un rato.

    Los 4xx de validación no cuentan nunca. Si el modelo manda { query: 42 } donde había que mandar un string, la API devuelve un 400 y eso no significa que la API esté rota. Significa que el modelo la está llamando mal. Si sumas ese 400 al contador, un modelo torpe con los argumentos te abre el circuito de un servicio sano — y a partir de ahí has convertido un problema de prompt en una caída de herramienta.

    Distinguir "la herramienta está rota" de "el modelo la está llamando mal" es la diferencia entre un breaker que te salva y uno que sabotea al agente.

    Error ¿Cuenta para abrir? Por qué
    5xx Sí El servicio está roto
    429 Sí Saturado: lo correcto es dejar de llamarlo un rato
    Timeout / AbortError Sí Sin timeout no hay fallo que contar, solo un agente esperando
    ECONNREFUSED, ECONNRESET, ENOTFOUND Sí La API no está ahí
    400, 422 Nunca El modelo mandó argumentos mal formados
    404 Nunca El recurso no existe; la API respondió bien
    409 Nunca Conflicto de estado, no caída
    Error desconocido No Ante la duda no penalizas: un falso positivo tumba una herramienta sana
    // tool-errors.ts
    export class ToolHttpError extends Error {
      constructor(readonly status: number, message: string) {
        super(message);
        this.name = "ToolHttpError";
      }
    }
    
    const NETWORK_ERRORS = /ECONNREFUSED|ECONNRESET|ETIMEDOUT|ENOTFOUND|EAI_AGAIN|fetch failed/i;
    
    export function isInfrastructureFailure(error: unknown): boolean {
      if (error instanceof ToolHttpError) {
        // 5xx: el servicio está roto. 429: saturado, y lo correcto es dejar de llamar.
        // 400, 404, 409, 422: los argumentos venían mal. Eso es el modelo, no la API.
        return error.status >= 500 || error.status === 429;
      }
    
      // AbortSignal.timeout() lanza un AbortError / TimeoutError
      if (error instanceof Error && (error.name === "AbortError" || error.name === "TimeoutError")) {
        return true;
      }
    
      if (error instanceof Error) {
        // Ojo con el runtime: en Bun el código de red viaja en error.cause.code,
        // no en el mensaje. Mirar solo message deja pasar un ECONNREFUSED.
        const code = (error as { cause?: { code?: string } }).cause?.code;
        if (code && NETWORK_ERRORS.test(code)) return true;
        return NETWORK_ERRORS.test(error.message);
      }
    
      // Ante la duda, no penalizas: un falso positivo tumba una herramienta sana
      return false;
    }
    

    La política de "ante la duda no cuenta" es deliberada. Un breaker que no abre cuando debía te cuesta unos reintentos. Un breaker que abre cuando no debía te deja al agente sin una herramienta buena durante medio minuto, y el modelo se pone creativo.

    La mitad de estos 4xx los evitas antes de que ocurran con schemas estrictos en la definición de la tool. Es el mismo trabajo de blindaje que vemos en el curso de Zod para TypeScript: si el argumento no valida, ni siquiera llega a salir una petición.


    Cómo implementar un circuit breaker en TypeScript

    Factory con estado en cierre, sin dependencias. Umbral de fallos, ventana deslizante, timeout de reset y una única prueba en half-open.

    // circuit-breaker.ts
    export type BreakerState = "CLOSED" | "OPEN" | "HALF_OPEN";
    
    export class CircuitOpenError extends Error {
      constructor(readonly toolName: string, readonly retryAfterMs: number) {
        super(`Circuito abierto para la herramienta "${toolName}"`);
        this.name = "CircuitOpenError";
      }
    }
    
    export interface BreakerOptions {
      name: string;
      failureThreshold?: number;
      windowMs?: number;
      resetTimeoutMs?: number;
      isFailure?: (error: unknown) => boolean;
      onStateChange?: (from: BreakerState, to: BreakerState) => void;
    }
    
    export function createCircuitBreaker({
      name,
      failureThreshold = 4,
      windowMs = 60_000,
      resetTimeoutMs = 30_000,
      isFailure = () => true, // ¡ojo! sobrescríbelo siempre con isInfrastructureFailure
      onStateChange = () => {},
    }: BreakerOptions) {
      let state: BreakerState = "CLOSED";
      let failures: number[] = [];
      let openedAt = 0;
      let probeInFlight = false;
    
      const transition = (next: BreakerState) => {
        if (next === state) return;
        onStateChange(state, next);
        state = next;
      };
    
      const currentState = (now: number): BreakerState => {
        if (state === "OPEN" && now - openedAt >= resetTimeoutMs) {
          transition("HALF_OPEN");
        }
        return state;
      };
    
      return {
        name,
        // getState() no es puro: dispara la transición OPEN -> HALF_OPEN. Si lo
        // polleas desde un exportador de métricas, la transición la provoca la
        // observabilidad y no el tráfico real.
        getState: () => currentState(Date.now()),
        getRetryAfterMs: () => Math.max(0, resetTimeoutMs - (Date.now() - openedAt)),
    
        async execute<T>(fn: () => Promise<T>): Promise<T> {
          const now = Date.now();
          const phase = currentState(now);
    
          if (phase === "OPEN") {
            throw new CircuitOpenError(name, resetTimeoutMs - (now - openedAt));
          }
    
          // En half-open solo pasa una petición: las demás siguen rechazadas
          if (phase === "HALF_OPEN" && probeInFlight) {
            // Espera corta a propósito: si la prueba en vuelo cierra el circuito, no
            // quieres haberle dicho al modelo que abandone la tool medio minuto
            throw new CircuitOpenError(name, 1_000);
          }
          if (phase === "HALF_OPEN") probeInFlight = true;
    
          try {
            const result = await fn();
            if (phase === "HALF_OPEN") {
              probeInFlight = false;
              failures = [];
              transition("CLOSED");
            }
            return result;
          } catch (error) {
            if (!isFailure(error)) {
              // No es culpa de la herramienta: no toca el contador
              if (phase === "HALF_OPEN") probeInFlight = false;
              throw error;
            }
    
            const failedAt = Date.now();
            failures = failures.filter((t) => failedAt - t < windowMs); // ventana deslizante
            failures.push(failedAt);
    
            if (phase === "HALF_OPEN" || failures.length >= failureThreshold) {
              openedAt = failedAt;
              probeInFlight = false;
              failures = [];
              transition("OPEN");
            }
            throw error;
          }
        },
      };
    }
    
    export type CircuitBreaker = ReturnType<typeof createCircuitBreaker>;
    

    Un fallo en half-open reabre directamente, sin esperar a acumular el umbral. Es intencionado: si la prueba falla, el servicio sigue caído y no hay nada que discutir.

    Ahora el wrapper que convierte la excepción en un resultado que el modelo entiende, integrado con la definición de tools del Vercel AI SDK:

    // with-breaker.ts
    import { tool } from "ai";
    import { z } from "zod";
    import { createCircuitBreaker, CircuitOpenError, type CircuitBreaker } from "./circuit-breaker";
    import { ToolHttpError, isInfrastructureFailure } from "./tool-errors";
    
    interface UnavailableInfo {
      toolName: string;
      retryAfterSeconds: number;
    }
    
    export function withBreaker<TArgs, TResult>(
      breaker: CircuitBreaker,
      onOpen: (info: UnavailableInfo) => Record<string, unknown>,
      execute: (args: TArgs) => Promise<TResult>,
    ) {
      return async (args: TArgs) => {
        try {
          return { ok: true, data: await breaker.execute(() => execute(args)) };
        } catch (error) {
          if (error instanceof CircuitOpenError) {
            return onOpen({
              toolName: error.toolName,
              retryAfterSeconds: Math.max(1, Math.ceil(error.retryAfterMs / 1000)),
            });
          }
          // Este fallo puede ser justo el que acaba de abrir el circuito: el modelo
          // tiene que enterarse ahora, no en la siguiente iteración
          if (breaker.getState() === "OPEN") {
            return onOpen({
              toolName: breaker.name,
              retryAfterSeconds: Math.max(1, Math.ceil(breaker.getRetryAfterMs() / 1000)),
            });
          }
    
          // Fallo puntual con el circuito cerrado: el modelo aún puede reintentar,
          // pero necesita saber qué falló para no repetir la misma llamada
          return { ok: false, error: error instanceof Error ? error.message : "Error desconocido" };
        }
      };
    }
    
    const searchBreaker = createCircuitBreaker({
      name: "searchCatalog",
      failureThreshold: 4,
      windowMs: 60_000,
      resetTimeoutMs: 30_000,
      isFailure: isInfrastructureFailure,
    });
    
    export const searchCatalog = tool({
      description: "Busca productos en el catálogo en tiempo real",
      inputSchema: z.object({ query: z.string().min(2) }),
      execute: withBreaker(
        searchBreaker,
        ({ toolName, retryAfterSeconds }) => ({
          ok: false,
          toolUnavailable: true,
          retryAfterSeconds,
          instruction:
            `La herramienta "${toolName}" está fuera de servicio por fallos repetidos del proveedor. ` +
            `No vuelvas a llamarla durante los próximos ${retryAfterSeconds} segundos: cualquier ` +
            `intento se rechazará sin llegar a la API. Usa "searchCatalogSnapshot" y avisa en tu ` +
            `respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía ` +
            `stock en tiempo real, dile que ese dato no está disponible ahora. No lo inventes.`,
        }),
        async ({ query }: { query: string }) => {
          const res = await fetch(`${process.env.CATALOG_API}/search?q=${encodeURIComponent(query)}`, {
            signal: AbortSignal.timeout(4_000),
          });
          if (!res.ok) throw new ToolHttpError(res.status, `Búsqueda falló con ${res.status}`);
          return res.json();
        },
      ),
    });
    

    Fíjate en el segundo if del catch: el fallo que abre el circuito también tiene que hablarle al modelo. Si esperas a la siguiente llamada para avisarle, has regalado una iteración entera del loop justo en el peor momento, el momento en que acabas de decidir que la herramienta está muerta.

    El ejemplo va sobre el AI SDK de Vercel 7, donde el schema de la tool se declara en inputSchema. Ese nombre existe desde la 5: si sigues en la 4.x el campo se llama parameters y el resto del wrapper no cambia.

    Fíjate también en el AbortSignal.timeout(4_000). Sin timeout explícito no hay breaker que valga: una petición colgada no genera un fallo que contar, genera un agente esperando. El timeout es lo que convierte "lento" en "fallido", y sin eso el patrón entero no arranca. Es el tipo de detalle que trato en programación defensiva en TypeScript.


    Un breaker por herramienta, nunca uno global

    Si la API de búsqueda está caída, la base de datos sigue respondiendo perfectamente. Un breaker global convierte un fallo parcial en una caída total del agente: pierdes cuatro herramientas sanas por culpa de una rota.

    Un registro por nombre de tool y listo:

    const breakers = new Map<string, CircuitBreaker>();
    
    export const breakerFor = (name: string, options: Partial<BreakerOptions> = {}): CircuitBreaker => {
      const existing = breakers.get(name);
      if (existing) return existing;
    
      const created = createCircuitBreaker({ name, isFailure: isInfrastructureFailure, ...options });
      breakers.set(name, created);
      return created;
    };
    

    Y una advertencia que cuesta una tarde de depuración: el estado del breaker tiene que vivir fuera de la petición. Si creas el breaker dentro del handler del chat, cada conversación arranca con el contador a cero y el patrón no protege absolutamente nada. Ámbito de módulo como mínimo. Si corres en serverless con varias instancias, el estado compartido va a Redis o cada instancia aprenderá por su cuenta que la API está caída — y pagarás el aprendizaje N veces.

    Y los umbrales no son iguales para todas: una API de pagos crítica aguanta 6 fallos antes de abrir, un scraper de enriquecimiento prescindible abre a los 2.


    El fallback: qué le das al modelo cuando no hay datos

    Tienes tres opciones, y elegir mal aquí desperdicia el breaker.

    Respuesta cacheada. El último snapshot bueno. Sirve para catálogos, listados y configuración. Obligatorio decirle al modelo que los datos son viejos y de cuándo son, para que lo declare en su respuesta.

    Herramienta degradada. Búsqueda local en vez de búsqueda semántica remota. Peor resultado, cero dependencia externa.

    Seguir sin el dato, declarándolo. La opción más honesta y la más infravalorada. El agente termina la tarea con la información que tiene y dice explícitamente qué no pudo comprobar. Mucho mejor que un dato inventado con toda la confianza del mundo.

    Y una cuarta que a veces es la correcta: parar y escalar al humano. Si la herramienta caída era imprescindible para la tarea, seguir es peor que rendirse. Igual que con los guardrails de ejecución, la decisión de frenar es parte del diseño, no un fallo.


    Cómo saber si tu breaker está bien calibrado

    Un breaker sin métricas es un valor mágico que alguien puso hace seis meses. Registra el cambio de estado con onStateChange y mira tres números:

    Aperturas por hora y por herramienta. Si una tool abre 5 veces por hora contra una API que su proveedor jura estar sana, tu umbral es demasiado bajo o estás contando 4xx que no deberías. Revisa el clasificador antes que el umbral.

    Tiempo total en OPEN. Es tu indisponibilidad real de esa capacidad. Si una herramienta pasa el 20% del día en OPEN, el problema ya no es el breaker: es el proveedor, y toca renegociarlo o buscar alternativa.

    Ratio de half-open que vuelven a abrir. El indicador de flapping. Por encima del 70% significa que tu resetTimeoutMs es demasiado corto y estás probando un servicio que aún no se ha levantado, gastando una llamada de tool en cada intento. Alarga el backoff de forma progresiva: 30s, 60s, 2 min. La versión de arriba usa un resetTimeoutMs fijo; para escalarlo, multiplícalo por el número de aperturas consecutivas antes de asignar openedAt.

    Y una cuarta que solo existe en agentes: qué hizo el modelo después de recibir el fallback. Loguea la siguiente tool call tras un toolUnavailable. Si el modelo vuelve a llamar a la herramienta caída, tu mensaje no está siendo lo bastante claro y toca reescribirlo. Los pasos que se ahorra el agente los ves directamente en el consumo de tokens por tarea.


    Por dónde empezar con el circuit breaker en tu agente

    Coge tu agente. Mira la tool que llama al servicio externo menos fiable — todos tenemos una. Ponle un timeout explícito, un breaker propio con isFailure que ignore los 4xx de validación, y un mensaje de fallback escrito para el modelo y no para tu log.

    Esa única herramienta es el 80% del beneficio. El resto es replicar el patrón.

    La idea de fondo: en un agente, cualquier mecanismo de defensa que no le hable al modelo se queda a medias. Puedes cortar la petición HTTP, pero si no le explicas al LLM qué ha pasado y qué esperas de él, el modelo rellenará el hueco con lo que se le ocurra. Y lo que se le ocurre suele ser caro.

    Esta forma de pensar la arquitectura — decidir antes de escribir código qué hace el sistema cuando algo falla — es exactamente el enfoque del curso Construye con IA: de la idea al producto. Y si quieres ver estos patrones montados sobre proyectos reales, con las métricas puestas y funcionando, en Dominicode Labs es donde los estamos rodando.


    Preguntas frecuentes

    ¿Qué diferencia hay entre un circuit breaker y un simple retry con backoff?

    El retry insiste; el breaker deja de insistir. Son complementarios: el backoff resuelve el fallo puntual dentro de una misma llamada, y el breaker resuelve el fallo sostenido a lo largo de muchas llamadas. Sin breaker, tu retry con backoff se ejecuta entero en cada una de las 14 iteraciones del agente contra un servicio que lleva minutos caído.

    ¿Cuántos fallos deben abrir el circuito de una tool?

    Entre 3 y 5 dentro de una ventana de 60 segundos funciona bien como punto de partida. Con umbral 1 o 2 abres por un pico transitorio; por encima de 8 el agente ya habrá gastado medio presupuesto de pasos antes de que el breaker reaccione. Ajústalo por criticidad: más tolerancia en herramientas imprescindibles, menos en las prescindibles.

    ¿Debe contar un error 400 de una tool para abrir el circuito?

    No. Un 400, un 404 o un 422 casi siempre significan que el modelo mandó argumentos mal formados, no que la API esté rota. Si los cuentas, acabas abriendo el circuito de un servicio sano por culpa del LLM y dejando al agente sin una herramienta que funcionaba. Cuentan los 5xx, los timeouts, los errores de red y los 429.

    ¿Dónde guardo el estado del breaker si mi agente corre en serverless?

    En un almacén compartido tipo Redis, con el nombre de la herramienta como clave. Si lo dejas en memoria de proceso, cada instancia fría descubre por su cuenta que el proveedor está caído y pagas ese descubrimiento tantas veces como instancias tengas. Para un servidor de larga vida, el ámbito de módulo basta.

    ¿El circuit breaker sustituye al límite de pasos del agente?

    No, resuelven cosas distintas. El límite de pasos acota cuánto puede trabajar el agente en total; el breaker impide que una herramienta rota consuma esos pasos sin aportar nada. Van juntos: el breaker devuelve el control rápido y con instrucciones, y el límite de pasos sigue siendo la red de seguridad final.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
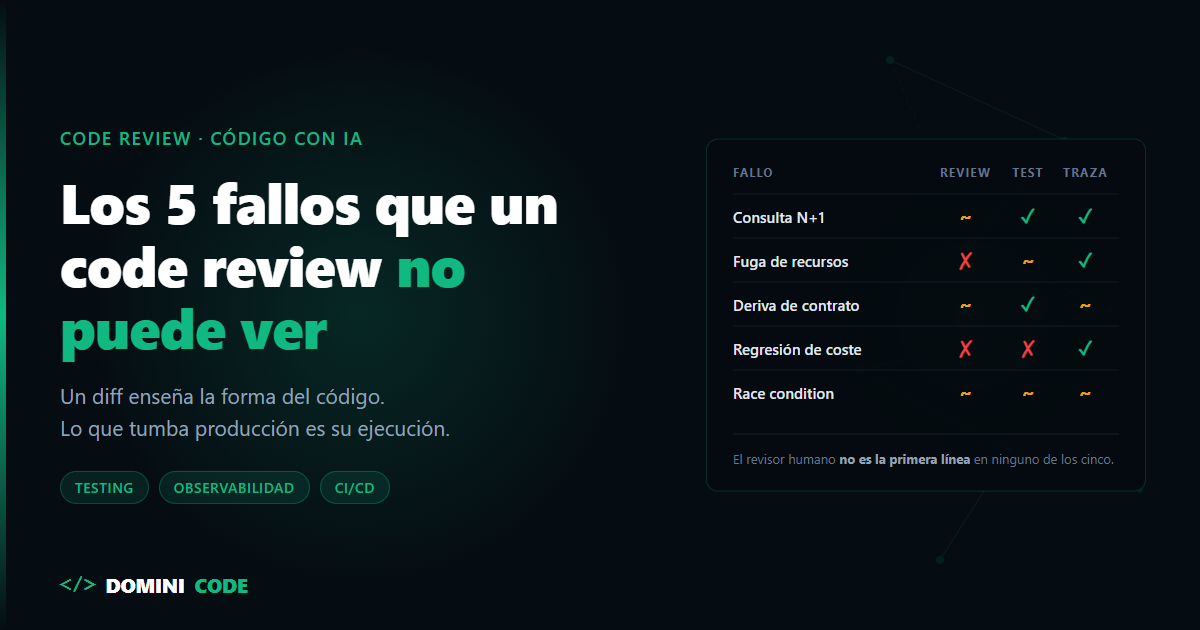
  • Los 5 fallos del código generado por IA que un code review no puede ver

    Los 5 fallos del código generado por IA que un code review no puede ver

    850 líneas. 14 archivos. Toda la capa de autenticación refactorizada con un asistente de IA.

    Dos seniors aprobaron el Pull Request. "LGTM, código muy limpio". Y lo era: nombres claros, funciones pequeñas, tipos correctos, cero warnings del linter.

    Diez minutos después del deploy, producción caída. El código abría una conexión nueva a PostgreSQL en cada petición y no la devolvía nunca. El pool se agotó, los 500 empezaron a caer en cascada y alguien tuvo que hacer rollback desde el móvil.

    Nadie hizo mal su trabajo en ese code review. El fallo simplemente no estaba en la pantalla que estaban mirando.

    Un diff te enseña la forma del código. Los fallos que tumban producción son de comportamiento: aparecen cuando el código se ejecuta, con concurrencia, con datos reales y repetido diez mil veces. Eso no se ve leyendo, se ve midiendo.

    Que no conviene fiarse de un código solo porque se lea bien ya lo conté en cómo garantizar la confiabilidad del código generado por IA. Este post no repite el aviso ni proclama que el code review haya muerto. Va de algo más operativo: qué clase de fallo caza cada capa de tu proceso, y cuál se te está colando porque lo estás buscando en el sitio equivocado.


    Los 5 fallos que un diff no puede mostrar

    No son fallos exóticos. Son los cinco que aparecen una y otra vez cuando el volumen de código generado sube y el tiempo de revisión no.

    1. La consulta N+1 encubierta

    El agente escribe un bucle que llama a un helper. El helper, tres archivos más allá, abre una consulta.

    En el diff ves await getUserProfile(id) dentro de un for. Una línea limpia, con buen nombre. Para verla como un problema tendrías que recordar qué hace ese helper por dentro y multiplicar mentalmente por el tamaño del array.

    En local, con 5 registros de prueba, vuela. En producción, con 4.000, son 4.000 consultas.

    2. La fuga de recursos

    Es el fallo de la historia de arriba y el más traicionero, porque lo que falta nunca aparece en un diff. Un diff enseña lo que se añadió; el bug está en la línea que no se escribió.

    // Se lee perfecto. Y en cada peticion abre una conexion que nadie cierra.
    export async function getInvoices(userId: string) {
      const client = new Client({ connectionString: process.env.DATABASE_URL });
      await client.connect();
      const { rows } = await client.query(
        "SELECT * FROM invoices WHERE user_id = $1",
        [userId],
      );
      return rows; // falta client.end() — y aqui no hay nada rojo que mirar
    }
    

    Lo mismo pasa con listeners que no se quitan, timers que no se limpian y streams que no se cierran. El código se lee bien porque está bien escrito. Solo está incompleto.

    3. La deriva de contrato

    El agente toca el endpoint y renombra un campo de la respuesta, o lo convierte de string a objeto. Actualiza el tipo en ese archivo, así que todo cuadra.

    Lo que no actualiza es el consumidor que vive en otro repositorio, o el móvil que lleva dos versiones sin actualizar. El fallo no está en ningún archivo: está entre dos. Y un revisor mirando un PR de un repo no tiene el otro delante.

    Contra esto, el tipado en tiempo de compilación no basta: hace falta validación en tiempo de ejecución en la frontera, que es justo lo que hace Zod cuando validas lo que entra y sale de cada servicio en lugar de confiar en el tipo declarado.

    4. La regresión de coste

    Este no produce ningún error. Todo funciona, los tests pasan en verde y el usuario no nota nada.

    Simplemente, la nueva versión hace tres llamadas al modelo donde antes hacía una, o manda el documento entero en el prompt donde antes mandaba un fragmento. El resultado es idéntico. La factura, el triple.

    Es el único de los cinco que no es un bug: es una decisión de implementación peor que la anterior. Ninguna aserción se pone roja por esto. Lo ves en la factura a fin de mes, o lo ves en la traza el mismo día.

    5. La race condition introducida "optimizando"

    El agente ve tres await seguidos y los convierte en un Promise.all. En el diff parece exactamente lo que quieres: menos latencia, código más idiomático.

    Salvo que dos de esas operaciones escribían sobre el mismo registro y el orden importaba. Con un usuario, nunca falla. Con doscientos concurrentes, falla una de cada cien veces y el bug tarda tres semanas en reproducirse.


    Qué capa caza cada fallo

    Aquí está el mapa. Es lo único que hay que llevarse del post:

    Fallo Code review Test automático Traza en producción Dónde se caza primero
    Consulta N+1 ⚠️ solo si conoces el helper ✅ asertando nº de queries ✅ evidente Test de integración
    Fuga de recursos ❌ no está en el diff ⚠️ solo repitiendo la llamada ✅ evidente Producción, en minutos
    Deriva de contrato ⚠️ si tienes ambos lados ✅ test de contrato ⚠️ tarde CI, con contract tests
    Regresión de coste ❌ invisible ❌ pasa en verde ✅ único sitio Traza / factura
    Race condition ⚠️ si la buscas ⚠️ flaky, poco fiable ⚠️ difícil de atribuir Test de concurrencia

    Léela por columnas y salta a la vista lo incómodo: el revisor humano no es la primera línea de defensa en ninguno de los cinco. En el mejor de los casos es un ⚠️ que depende de que la persona conozca ese helper concreto, tenga el otro repositorio en la cabeza o esté buscando específicamente esa clase de fallo a la línea 600 de 850.

    Eso no significa que el code review sobre. Significa que le estamos pidiendo el trabajo equivocado.


    El orden correcto (y por qué casi todos lo invierten)

    El proceso típico pone al humano primero: alguien lee el PR, lo aprueba, y entonces corre el CI y se despliega. Con código generado por IA ese orden está del revés, por una razón de economía muy simple: la atención humana es el recurso más caro y más escaso del equipo, y la máquina cuesta céntimos.

    Primero la máquina. Tests, linters, validación de contratos. Si un fallo tiene una aserción posible, esa aserción tiene que existir y correr antes de que nadie lea una línea. El caso del pool que tumbó producción se cazaba con esto:

    it("no deja conexiones abiertas al servir una petición", async () => {
      const before = pool.totalCount;
      await getInvoices("user-1");
      expect(pool.totalCount).toBe(before);
    });
    

    Ese test no lo escribe el agente por iniciativa propia: lo pides tú, porque conoces el fallo. Cómo repartir ese trabajo entre lo que escribes tú y lo que delegas está en TDD con IA: valida el código autogenerado antes de mergear, y hay una capa de revisión automática que puedes meter en el pipeline antes de la humana, explicada en cómo integrar revisiones de código con IA en tu CI/CD.

    Después la traza, como red. Para lo que nadie anticipó —y la regresión de coste es el ejemplo perfecto— la única capa que ve algo es la instrumentación en tiempo de ejecución. Si trabajas con LLMs, el árbol de llamadas y el coste por petición se trazan con las herramientas que repaso en observabilidad en LLMs.

    Y el humano al final, sobre otra pregunta. No "¿está bien escrito esto?" —eso ya lo contestaron el linter y los tests—, sino las tres que ninguna máquina responde:

    • ¿Este código debía existir? Buena parte de los PRs generados con IA resuelven un problema que no había que resolver así.
    • ¿Respeta las fronteras de arquitectura? Un agente cruza capas sin despeinarse si eso hace pasar el test.
    • ¿Cumple lo que dice la especificación?

    Esa tercera pregunta solo se puede contestar si existe una especificación escrita antes del código. Cuando el PR se revisa contra un spec.md, el review deja de ser una opinión sobre estilo y pasa a ser una comprobación con respuesta binaria — que es de lo que va el libro de Spec-Driven Development.

    Y si quieres el músculo de escribir las aserciones del punto 1 —las de verdad, las que fallan cuando algo se rompe y no cuando alguien renombra una variable—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library.


    Lo que puedes cambiar en el próximo PR

    1. Coge la tabla y localiza tu hueco. Casi todos los equipos tienen la columna de tests a medias y la de trazas vacía. Ese es el fallo que se te está colando.
    2. Convierte tu último incidente en una aserción. Si algo tumbó producción una vez, tiene que haber un test que se ponga rojo si vuelve. Uno por incidente, sin excepciones.
    3. Cambia la pregunta del review. Prohíbete comentar estilo. Solo arquitectura, fronteras y cumplimiento de la spec.

    En Dominicode Labs montamos este tipo de procesos de verificación para que la velocidad de la IA no se pague en incidentes de madrugada.

    Generar código rápido hoy es gratis. Lo caro sigue siendo saber si funciona — y eso no se lee en un diff.


    Preguntas frecuentes

    ¿Se puede revisar de verdad un PR de 850 líneas generado por IA?

    No con la atención que merece. La respuesta no es leer más rápido: es exigir que el PR llegue troceado y con la capa automática ya en verde. Un PR generado en cuarenta segundos no da derecho a una revisión de cuarenta segundos, así que o se parte en cambios pequeños o se revisa solo el subconjunto que toca arquitectura y contratos.

    ¿Un linter o un analizador estático caza estos cinco fallos?

    Parcialmente y solo dos. Las reglas estáticas detectan algunos patrones de recurso no cerrado dentro de un mismo archivo, pero no ven el N+1 escondido tras un helper, ni la deriva de contrato entre repositorios, ni el coste, ni la concurrencia. Un linter razona sobre el texto del programa; estos fallos existen únicamente cuando el programa corre.

    ¿Estos fallos son culpa de la IA o pasaban igual con código escrito a mano?

    Pasaban igual. Lo que cambia es el volumen y el ritmo: la misma tasa de fallo aplicada a diez veces más líneas, revisadas por el mismo número de personas en el mismo tiempo, da un resultado muy distinto. El proceso no se rompe porque la IA escriba peor, sino porque escribe más rápido de lo que nadie puede leer.

    Si aún no tengo observabilidad, ¿qué capa cubre el hueco mientras tanto?

    Los tests, pero eligiendo bien. Sin trazas pierdes la regresión de coste y la atribución de las races, así que compensa con aserciones sobre efectos medibles: número de consultas por operación, conexiones abiertas al terminar, número de llamadas al modelo. Son baratas, corren en CI y cubren tres de los cinco fallos hasta que instrumentes.

    ¿Merece la pena que la IA revise sus propios PRs?

    Como primera pasada sí, y sale muy rentable porque cuesta céntimos y no se cansa a la línea 600. Pero trátala como un linter semántico, no como un aprobador: comparte los puntos ciegos del modelo que escribió el código y tiende a validar lo que a ella misma le parece idiomático. La aprobación sigue siendo humana.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Nadie prueba un motor de avión montándolo en un aparato con pasajeros. Lo amarran a un banco de pruebas, le conectan sensores, le inducen fallos y miden qué aguanta. Si revienta, revienta en tierra.

    Con software tenemos el equivalente desde hace décadas y se llama test harness: el andamiaje que rodea al código bajo prueba, le inyecta entradas controladas y comprueba las salidas.

    Con agentes de IA, en cambio, la mayoría probamos en caliente. Lanzamos el agente contra una API real, miramos si el resultado "parece bien" y lo damos por bueno.

    El problema no es la pereza. Es que un agente rompe los tres supuestos sobre los que se construyó todo tu testing:

    • No es determinista: la misma entrada da salidas distintas.
    • Tiene efectos secundarios reales: escribe archivos, llama a APIs, toca bases de datos.
    • No tiene garantía de terminar: puede quedarse en bucle gastando dinero.

    Ya expliqué por qué un LLM por sí solo no es un producto y qué capas necesita alrededor para funcionar en producción. Este post va de la otra mitad del problema, la que casi nadie monta: el arnés que se ejecuta en CI, antes del deploy. Con código.


    Por qué un test unitario normal no sirve aquí

    Un test clásico es un contrato de tres líneas: preparas la entrada, ejecutas, comparas con el valor esperado.

    Con un agente, ese toEqual no existe. La respuesta correcta no es una cadena concreta, es cualquiera de un conjunto amplio de cadenas aceptables. Y si aun así escribes la aserción exacta, tendrás un test que pasa hoy y falla el martes sin que nadie haya tocado nada.

    De ahí sale la reacción habitual, que es la equivocada: dejar de testear el agente y testear solo las funciones puras que lo rodean. Los parsers, los formateadores, los validadores. Cosas que ya sabías hacer.

    Mientras tanto, lo que de verdad puede costarte dinero —el bucle, las llamadas a herramientas, el gasto— viaja a producción sin una sola comprobación.

    El arnés cambia la pregunta. En lugar de "¿ha respondido lo correcto?", que es un problema de evals, pregunta cosas que sí tienen respuesta binaria:

    • ¿Ha llamado a alguna herramienta que no tenía permitida?
    • ¿Se ha pasado del presupuesto de tokens que le di?
    • ¿Ha terminado dentro del tiempo límite?
    • ¿Ha intentado escribir fuera de su directorio temporal?
    • ¿Ha llamado 14 veces a la misma herramienta con los mismos argumentos?

    Eso son tests de verdad: deterministas, rápidos y rojos cuando algo se rompe.

       caso de prueba              TEST HARNESS                  veredicto
      ┌──────────────┐    ┌──────────────────────────────┐    ┌────────────┐
      │ entrada fija │───►│  tools falsas (sin red)      │───►│ PASS/FAIL  │
      │ estado fijo  │    │  presupuesto de tokens       │    │ trace.json │
      └──────────────┘    │  timeout + AbortSignal       │    └────────────┘
                          │  directorio efimero          │
                          └──────────────────────────────┘
    

    Las 3 piezas que hacen testeable a un agente

    1. Herramientas falsas, no red

    La regla es simple: en modo test, el agente no toca nada real. Ni base de datos, ni API de pagos, ni sistema de archivos fuera de un directorio temporal que destruyes al terminar.

    Y no basta con mockear la implementación. Hay que no exponer las herramientas no autorizadas: si el agente ve deleteUser en su lista de tools, tarde o temprano la llamará, y el error que quieres detectar en CI es precisamente ese. Un arnés que expone la herramienta y luego lanza una excepción llega tarde para razonar sobre el diseño, aunque salve los datos.

    Si necesitas ejecutar código generado de verdad —no simularlo—, ahí el aislamiento sube un nivel y toca contenedor: lo conté en Docker sandboxing para ejecutar código de IA de forma segura.

    2. Presupuesto de tokens y timeout que cortan de verdad

    Esta es la pieza que casi todo el mundo escribe mal.

    He visto docenas de arneses con un campo maxTokens en la configuración que no se comprueba en ningún sitio. Y timeouts implementados con Promise.race que devuelven el control al test pero dejan la ejecución corriendo por detrás, gastando tokens contra la API mientras el test ya ha dado verde.

    Un límite que no corta no es un límite: es un comentario.

    3. Traza reproducible

    El arnés graba cada paso: qué herramienta, con qué argumentos, cuánto tardó, cuánto costó. Un array de objetos serializado a JSON.

    Sirve para dos cosas. Para que un fallo en CI sea depurable sin volver a lanzar el agente. Y para escribir aserciones sobre el proceso, no sobre el texto final, que es donde está la señal útil: si el agente llegó al resultado correcto llamando siete veces a la misma consulta, eso es un bug aunque la salida sea perfecta.


    El arnés en TypeScript

    Vamos al código. Un arnés mínimo con presupuesto real, cancelación real y traza, sin dependencias más allá de Zod para validar los argumentos que el modelo envía a cada herramienta.

    Primero, los tipos y el registro de herramientas:

    import { z } from "zod";
    
    export interface HarnessConfig {
      maxTokens: number;
      timeoutMs: number;
      allowedTools: string[];
    }
    
    export interface TraceEntry {
      tool: string;
      args: unknown;
      durationMs: number;
      tokens: number;
    }
    
    /** Herramienta ya validada: el schema queda encapsulado dentro de `run`. */
    export interface HarnessTool {
      cost: number;
      run: (rawArgs: unknown) => Promise<unknown>;
    }
    
    export class BudgetExceededError extends Error {}
    
    /**
     * En el punto de definicion conservas el tipado completo del schema.
     * En el registro todas las tools comparten la misma firma, que es lo
     * que permite recorrerlas en bucle sin castings.
     */
    export function defineTool<S extends z.ZodType>(
      schema: S,
      cost: number,
      run: (args: z.infer<S>) => Promise<unknown>,
    ): HarnessTool {
      return { cost, run: (rawArgs) => run(schema.parse(rawArgs)) };
    }
    
    // Fixtures: nada de esto sale a la red.
    export const testTools: Record<string, HarnessTool> = {
      queryDatabase: defineTool(
        z.object({ table: z.string(), limit: z.number().max(100) }),
        320,
        async ({ table }) => ({ rows: [{ id: 1, table, name: "Fixture User" }] }),
      ),
      sendEmail: defineTool(
        z.object({ to: z.string().email(), body: z.string() }),
        90,
        async () => ({ delivered: true }),
      ),
    };
    

    Ahora el arnés. Fíjate en tres detalles: solo se construyen las herramientas permitidas, el presupuesto se comprueba antes de ejecutar cada llamada, y el temporizador se limpia siempre.

    export type HarnessStatus = "SUCCESS" | "TIMEOUT" | "BUDGET_EXCEEDED" | "FAILED";
    
    export interface HarnessResult {
      status: HarnessStatus;
      tokensUsed: number;
      durationMs: number;
      output: string | null;
      trace: TraceEntry[];
    }
    
    type ToolBox = Record<string, (args: unknown) => Promise<unknown>>;
    
    export async function runWithHarness(
      task: (tools: ToolBox, signal: AbortSignal) => Promise<string>,
      config: HarnessConfig,
    ): Promise<HarnessResult> {
      const startedAt = performance.now();
      const trace: TraceEntry[] = [];
      let tokensUsed = 0;
    
      // 1. Solo existen las tools autorizadas. El resto no se expone.
      const tools: ToolBox = {};
      for (const name of config.allowedTools) {
        const tool = testTools[name];
        // Un nombre desconocido es un error de configuracion del test: que reviente ya.
        if (!tool) throw new Error(`Tool desconocida en allowedTools: ${name}`);
    
        tools[name] = async (rawArgs: unknown) => {
          // 2. El presupuesto se comprueba ANTES de gastar.
          if (tokensUsed + tool.cost > config.maxTokens) {
            throw new BudgetExceededError(
              `Presupuesto agotado: ${tokensUsed} + ${tool.cost} > ${config.maxTokens}`,
            );
          }
          const t0 = performance.now();
          const result = await tool.run(rawArgs); // Zod valida dentro: si no cuadra, revienta
          tokensUsed += tool.cost;
          trace.push({
            tool: name,
            args: rawArgs,
            durationMs: Math.round(performance.now() - t0),
            tokens: tool.cost,
          });
          return result;
        };
      }
    
      // 3. Cancelacion real: la tarea recibe el signal y debe propagarlo al SDK.
      const controller = new AbortController();
      const timer = setTimeout(() => controller.abort(), config.timeoutMs);
    
      const finish = (status: HarnessStatus, output: string | null): HarnessResult => ({
        status,
        tokensUsed,
        durationMs: Math.round(performance.now() - startedAt),
        output,
        trace,
      });
    
      try {
        const output = await task(tools, controller.signal);
        return finish("SUCCESS", output);
      } catch (error) {
        if (controller.signal.aborted) return finish("TIMEOUT", null);
        if (error instanceof BudgetExceededError) return finish("BUDGET_EXCEEDED", null);
        return finish("FAILED", error instanceof Error ? error.message : String(error));
      } finally {
        clearTimeout(timer); // sin esto, el timer mantiene vivo el proceso al terminar
      }
    }
    

    Un aviso honesto sobre el punto 3: el AbortSignal solo cancela de verdad si tu tarea lo propaga al SDK del modelo y a cada fetch. Si lo ignoras, el arnés dará TIMEOUT y devolverá el control al test, pero la llamada seguirá viva por detrás y te la cobrarán igual. El signal no es decorativo: es el único mecanismo que corta el gasto.

    Y ahora sí, un test

    Con esto, probar el bucle del agente vuelve a ser testing normal:

    import { describe, expect, it } from "vitest";
    import { runWithHarness } from "./harness";
    
    describe("agente de facturación", () => {
      it("corta la ejecución al agotar el presupuesto", async () => {
        const result = await runWithHarness(
          async (tools) => {
            // Un agente en bucle: consulta la misma tabla sin parar.
            for (let i = 0; i < 20; i++) {
              await tools.queryDatabase({ table: "invoices", limit: 10 });
            }
            return "listo";
          },
          { maxTokens: 1_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.status).toBe("BUDGET_EXCEEDED");
        expect(result.tokensUsed).toBeLessThanOrEqual(1_000);
        expect(result.trace).toHaveLength(3); // 3 × 320 = 960; la cuarta no cabe
      });
    
      it("no expone las herramientas fuera del allowlist", async () => {
        const result = await runWithHarness(
          async (tools) => {
            if ("sendEmail" in tools) return "PELIGRO: tool disponible";
            return "ok";
          },
          { maxTokens: 5_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.output).toBe("ok");
      });
    });
    

    Deterministas, sin red, en milisegundos. Se pueden ejecutar en cada push sin pensar en la factura.

    Ese expect(result.trace).toHaveLength(3) es el tipo de aserción que solo puedes escribir si grabas la traza: comprueba el comportamiento del bucle, no el texto de salida.

    Si quieres afinar el diseño de tests y el aislamiento de dependencias externas —que es exactamente el músculo que necesitas aquí—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library. Y el uso de Zod para validar los argumentos que envía el modelo, con transformaciones y errores tipados, lo tienes en el curso de Zod para TypeScript.


    Qué encaja arriba y qué encaja abajo

    Tres piezas que se confunden todo el rato y conviene separar:

    Pieza Cuándo corre Qué responde
    Test harness En CI, en cada push ¿Se sale de los límites, del allowlist o del tiempo?
    Evals Por lotes, con casos reales ¿La calidad de las respuestas sube o baja?
    Agentic harness En producción, en cada ejecución ¿Cómo lo mantengo controlado con usuarios reales?

    El arnés de pruebas es el más barato de los tres y el que casi nadie tiene. Cuestión de horas montarlo, y atrapa la clase de fallo que más caro sale.

    Sobre el reparto de trabajo entre los tests que escribes tú y los que genera el agente, ya hay un post entero: adopta TDD para implementar pruebas efectivas con agentes de IA. Y sobre por qué la spec y la arquitectura no bastan sin esta capa debajo, también. Este post es la parte que faltaba: el código.

    Si trabajas con Spec-Driven Development, el encaje es directo. Los límites que escribes en la sección de NFRs del spec.md —presupuesto, latencia, herramientas permitidas— dejan de ser un párrafo y pasan a ser los argumentos de HarnessConfig. La especificación se vuelve ejecutable, que es de lo que va el libro de Spec-Driven Development.


    Lo que puedes montar esta semana

    1. Una lista blanca de herramientas por entorno. Que en test solo existan las que necesita el caso.
    2. Un presupuesto que corte. Comprobado antes de cada llamada, no después. Si tu maxTokens no aparece en ningún if, no existe.
    3. Una traza en JSON por ejecución. Y al menos un test que asierte sobre ella, no sobre el texto de salida.

    En Dominicode Labs montamos este tipo de arneses sobre agentes que corren horas sin supervisión.

    Deja de probar tus motores en pleno vuelo. Amárralos al banco, súbeles la presión hasta que rompan y arréglalos en tierra, que es donde sale barato.


    Preguntas frecuentes

    ¿Cómo se testea algo que no es determinista?

    No asertando sobre el texto de salida, sino sobre el comportamiento observable: qué herramientas llamó, con qué argumentos, cuántas veces, cuánto gastó y si terminó a tiempo. Todo eso sí es determinista y da un rojo claro cuando se rompe. La calidad de la respuesta es otra disciplina y se mide por lotes, no en cada push.

    ¿El test harness sustituye a los mocks de toda la vida?

    No, los usa. La diferencia es el alcance: un mock reemplaza una dependencia concreta, mientras que el arnés controla el entorno completo de la ejecución —qué herramientas existen, cuánto puede gastar, cuánto puede tardar y qué queda grabado—. Un mock por sí solo no impide que el agente entre en bucle.

    ¿Hay que llamar al modelo real en estos tests?

    No en los que corren en cada push: se ejecuta el bucle del agente con respuestas fijas, y eso vale para verificar límites, allowlist y control de flujo. Las ejecuciones con modelo real cuestan dinero y tardan, así que van en un job aparte, programado y sobre un conjunto reducido de casos.

    ¿Qué hago si el timeout salta pero el agente sigue gastando dinero?

    Es que estás cortando en el sitio equivocado. Promise.race devuelve el control al test pero no cancela nada: hay que crear un AbortController, pasar su signal a la tarea y propagarlo al SDK del modelo y a cada fetch. Si el SDK que usas no acepta señal de cancelación, el único corte real es aislar la ejecución en un proceso o contenedor aparte y matarlo.

    ¿Merece la pena montarlo si mi agente solo lee datos?

    Sí, por el gasto y por los bucles. Un agente de solo lectura no borra nada, pero puede repetir la misma consulta cuarenta veces y facturarte la broma entera. El presupuesto y la traza detectan ese patrón en CI, que es donde cuesta cero arreglarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • TDD con IA: valida el código autogenerado antes de mergear

    TDD con IA: valida el código autogenerado antes de mergear

    Revisé una Pull Request generada por un asistente de IA hace un par de semanas.

    El autor de la PR estaba fascinado: "Mira qué limpio quedó el algoritmo de descuentos por volumen. La IA lo escribió en 15 segundos".

    El código tenía nombres impecables, comentarios en JSDoc y tipado de TypeScript sin un solo error. Le faltaba lo único que sostiene el TDD con IA: tests.

    Escribí una prueba unitaria pasando una compra con descuento de cliente VIP combinado con un cupón del 100%. El sistema devolvió un saldo negativo donde la tienda terminaba debiéndole dinero al comprador.

    El modelo de IA no tenía mala intención: simplemente no sabía qué reglas de negocio proteger porque nadie se las había formulado como una prueba ejecutable.

    En la era de los asistentes de código, Test-Driven Development (TDD) no está muerto; es más indispensable que nunca. Aquí tienes el flujo exacto para combinar TDD con IA.


    El nuevo ciclo Red-Green-Refactor con Agentes de Código

    El ciclo clásico de TDD se transforma radicalmente cuando tienes un agente a tu lado:

    ┌─────────────────────────────────────────────────────────────┐
    │                 FLUJO TDD POTENCIADO POR IA                 │
    │                                                             │
    │  1. HUMANO (Diseño)  ──>  Escribe el Test Unitario (ROJO)   │
    │                                   │                         │
    │                                   ▼                         │
    │  2. AGENTE (Código)  ──>  Genera la Implementación (VERDE)  │
    │                                   │                         │
    │                                   ▼                         │
    │  3. DÚO (Calidad)    ──>  Refactoriza con Seguridad         │
    └─────────────────────────────────────────────────────────────┘
    

    En lugar de delegar el diseño a ciegas, el desarrollador asume el rol de arquitecto: define el contrato y los casos de borde en una prueba. El agente asume el trabajo pesado de implementar la sintaxis.


    Ejemplo Práctico: Implementando una lógica de negocio paso a paso

    Paso 1: Escribe el test en fallo (Rojo con Vitest)

    Antes de crear el archivo de lógica, defines el comportamiento esperado:

    // src/pricing/discount-calculator.spec.ts
    import { describe, it, expect } from 'vitest';
    import { calculateTotalWithDiscounts } from './discount-calculator';
    
    describe('calculateTotalWithDiscounts', () => {
      it('aplica descuento por volumen del 10% en compras mayores a $100', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 150, isVip: false, couponPercent: 0 });
        expect(total).toBe(135);
      });
    
      it('nunca devuelve un total negativo incluso con cupones acumulados', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 50, isVip: true, couponPercent: 120 });
        expect(total).toBe(0); // Regla de negocio crítica
      });
    });
    

    Al ejecutar bun test, el test falla inmediatamente porque la función ni siquiera existe.

    Paso 2: Pasa el test al agente como contrato ejecutable

    Invocas a tu agente de IA en la terminal con una instrucción cerrada:

    claude "Lee discount-calculator.spec.ts. Crea el archivo discount-calculator.ts con la implementación mínima necesaria para que los tests pasen en verde. Prohibido modificar el archivo de tests."
    

    Paso 3: El agente genera el código para poner el test en verde

    El agente analiza la firma de tipos esperada y las aserciones, generando la lógica requerida:

    // src/pricing/discount-calculator.ts
    export interface PricingOptions {
      subtotal: number;
      isVip: boolean;
      couponPercent: number;
    }
    
    export function calculateTotalWithDiscounts(options: PricingOptions): number {
      const { subtotal, isVip, couponPercent } = options;
      
      let discount = 0;
      if (subtotal > 100) discount += subtotal * 0.10;
      if (isVip) discount += subtotal * 0.05;
      if (couponPercent > 0) discount += subtotal * (couponPercent / 100);
    
      const finalTotal = subtotal - discount;
      return Math.max(0, finalTotal); // Respeta el caso de borde
    }
    

    El agente ejecuta el test runner de forma autónoma y confirma que la suite está en verde.


    Por qué este flujo recorta los bugs que llegan a producción

    1. Elimina la alucinación de requisitos: El modelo no tiene margen para inventar parámetros porque el test ya definió la interfaz y los valores esperados.
    2. Aislamiento de contexto: No necesitas explicar la arquitectura completa de tu empresa; solo entregas el archivo de prueba.
    3. Refactorización sin miedo: Si mañana quieres optimizar el rendimiento del algoritmo, puedes pedirle a la IA que lo refactorice sabiendo que cualquier regresión encenderá una alarma roja de inmediato.

    Que quede claro: esto no lleva los bugs a cero. Ningún flujo lo hace. Lo que hace es mover el error de "se descubre en producción tres semanas después" a "se descubre en el segundo en que el agente ejecuta la suite". Los fallos que se te escapan siguen siendo los casos que no se te ocurrió escribir.

    Para que el ciclo funcione, la suite tiene que correr en milisegundos, no en minutos: aquí tienes cómo montar pruebas unitarias ultrarrápidas con Vitest. Si el agente tarda 90 segundos en saber si acertó, el bucle rojo-verde deja de ser un bucle.

    En el curso de Testing en Angular con Jest y Testing Library enseñamos a estructurar suites de pruebas profesionales para frontend y backend preparadas para integrarse con flujos automatizados de CI/CD.

    Este enfoque de validación es también uno de los pilares centrales de nuestro libro de Spec-Driven Development (SDD).

    Para descargar pipelines de automatización con Vitest y plantillas de pruebas para agentes, visita Dominicode Labs.


    Qué hacer hoy con esto

    Para la próxima función o endpoint que vayas a programar:

    1. No escribas la implementación.
    2. Escribe primero dos tests unitarios en Vitest: uno para el caso feliz y otro para el caso borde más peligroso.
    3. Pásaselo a tu asistente de IA y pídele que escriba la función que los cumpla.

    Comprobarás dos cosas: que el primer diff llega mucho más cerca de lo que querías, y que las rondas de corrección se reducen a una o dos.

    Si además quieres que el agente derive los tests de una especificación en vez de escribirlos tú a mano, ese es el siguiente escalón: TDD y Spec-First aplicados al desarrollo con IA.


    Preguntas frecuentes

    ¿Por qué TDD es especialmente útil al programar con IA?

    Porque un test unitario actúa como una especificación matemática ejecutable. Los modelos de lenguaje responden con muchísima mayor precisión cuando tienen un criterio binario de éxito (el test pasa o falla) que cuando reciben instrucciones en lenguaje natural ambiguo.

    ¿Se debe permitir que la IA modifique los tests unitarios?

    No. Los tests unitarios deben ser diseñados y aprobados por el desarrollador. Si permites que la IA modifique los tests para que "pasen en verde", corres el riesgo de que relaje las aserciones y oculte errores de negocio.

    ¿Qué framework de tests es más rápido para iterar con agentes de IA?

    Vitest es actualmente la opción más recomendada en el ecosistema TypeScript por su velocidad de arranque instantánea, compatibilidad nativa con ESM y excelente integración en terminales CLI.

    ¿Puede la IA escribir también los tests en lugar del desarrollador?

    Puede escribir el andamiaje y los casos evidentes, pero no debe decidir qué se protege. Si el modelo escribe los tests y la implementación, ambos comparten el mismo malentendido y la suite en verde no demuestra nada. El desarrollador define los casos de borde; la IA rellena el resto.

    ¿Cuántos tests hacen falta antes de pasarle la tarea al agente?

    Dos suelen bastar para arrancar: el caso feliz y el caso de borde más caro si falla. Con eso el agente ya tiene una interfaz cerrada y un criterio binario de éxito. Ampliar la cobertura tiene más sentido después, cuando ya sabes por dónde se rompe la implementación real.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.