Tag: Spec Driven Development

  • Por qué Spec-Driven Development (SDD) triplica tu velocidad cuando programas con agentes de IA

    Por qué Spec-Driven Development (SDD) triplica tu velocidad cuando programas con agentes de IA

    Hace unas semanas estaba viendo trabajar a un desarrollador senior con bastante experiencia. Usaba una de las mejores herramientas de IA del mercado.

    Su flujo era este: escribía un prompt en el chat ("Agrégame la autenticación con OAuth y guarda el token en cookies HTTP-only"), la IA generaba 150 líneas de código, el código fallaba, le volvía a pedir que corrigiera el error, la IA cambiaba tres archivos sin avisar, se rompía el tipo de una interfaz… y de repente llevaba dos horas haciendo el famoso "prompt ping-pong".

    Tenía la sensación de ir rapidísimo porque la IA escribía texto a toda velocidad. Pero al final de la jornada, la mitad de su tiempo lo había pasado arreglando las suposiciones que la IA había tenido que inventar porque nadie se las definía.

    El problema no era la IA. El problema es que estaba intentando construir una casa pidiéndole al albañil que pusiera ladrillos sin enseñarle los planos. Aquí es donde Spec-Driven Development (SDD) transforma la forma en que los desarrolladores senior trabajan con los agentes de IA.

    El espejismo del "Vibe Coding" sin rumbo

    Nos han vendido que programar con IA consiste en hablarle en lenguaje natural como si fuera un colega y dejar que el LLM deduzca todo lo demás.

    Para un script de 20 líneas o un prototipo que vas a tirar mañana, funciona. Para software en producción con arquitecturas reales, es una trampa.

    Cuando no defines las reglas del juego antes de pedir código, obligas al agente de IA a tomar decenas de decisiones implícitas:

    • ¿Qué nombres le da a las variables y modelos?
    • ¿Cómo maneja los casos de borde y errores?
    • ¿Qué contrato sigue la API?
    • ¿Qué dependencias o utilidades existentes en el proyecto debe reutilizar?

    Si el agente adivina mal una sola de esas cosas, el código generado es basura técnica que tendrás que mantener tú. Como explicamos en nuestro artículo sobre por qué tu spec falla con un agente de IA, la falta de claridad en las restricciones es la causa número uno de código roto.

    ¿Qué es Spec-Driven Development (SDD)?

    Spec-Driven Development no es burocracia ni escribir documentación de 50 páginas que nadie lee.

    SDD consiste en invertir el flujo de trabajo: en lugar de usar la IA para que redacte código directamente desde tu cabeza, utilizas la IA para definir una especificación estructurada y verificable ANTES de escribir la primera línea de código.

    En nuestro workflow de producción, una especificación SDD se divide en tres piezas muy concretas:

    1. spec.md (La Especificación Funcional y Técnica)

    Define el QUÉ y el POR QUÉ.

    • Contexto del problema y objetivo.
    • Requisitos funcionales explícitos.
    • Contratos de datos, tipos e interfaces.
    • Reglas de negocio y lo que NO debe hacer el sistema.

    2. plan.md (La Arquitectura e Impacto)

    Define el CÓMO.

    • Qué archivos se modifican, cuáles se crean y cuáles se eliminan.
    • Estrategia de testing y verificación.
    • Modificaciones en dependencias o firmas de API.

    3. tasks.md (El Plan de Ejecución)

    Define el ORDEN.

    • Lista de tareas atómicas e independientes que el agente de IA puede ejecutar paso a paso sin perder contexto ni alucinar.

    Eso sí, ten en cuenta que no siempre necesitas cargar con toda la estructura: en nuestra guía sobre cuándo NO usar Spec-Driven Development detallamos los escenarios donde un enfoque más directo resulta más eficiente.

    El cambio mental: De programador a Director de Arquitectura

    Mira lo que ocurre cuando le das a un agente (como Claude Code, AGY o Cursor) una especificación bien acotada:

    # Spec: Interceptor de Telemetría HTTP
    ## Requisitos
    - Interceptar todas las peticiones salientes HttpClient.
    - Añadir el header X-Correlation-ID usando un UUID v4 si no existe previamente.
    - Si la petición responde con status 401, reintentar una sola vez tras renovar el token vía AuthService.refreshToken().
    - NO interceptar peticiones hacia /api/v1/auth/login.
    
    ## Contrato
    - Firma de error devuelta: ApiErrorResponse { code: string; message: string; timestamp: number }.
    

    Cuando un agente lee este archivo antes de tocar el código:

    1. El contexto entra limpio: El LLM no necesita adivinar el nombre del header ni la estrategia de reintento.
    2. Las respuestas son deterministas: El código generado encaja al primer intento con la arquitectura de tu aplicación.
    3. El tiempo de revisión tiende a cero: En lugar de leer 300 líneas de diff intentando adivinar qué pretendía hacer la IA, solo verificas que el código cumple los puntos de la spec.

    Cómo empezar con SDD hoy mismo

    No necesitas instalar un framework complejo ni cambiar la estructura de tu empresa.

    La próxima vez que vayas a pedirle una funcionalidad a tu agente de IA, haz esto:

    1. Escribe un archivo .md rápido en tu proyecto describiendo qué quieres lograr, qué archivos se verán afectados y cuáles son los tipos/interfaces involucrados.
    2. Pásale la spec al agente y pídele: "Revisa esta especificación. Identifica ambigüedades o contradicciones antes de proponer cambios".
    3. Una vez alineados en la especificación, pídele que genere la solución siguiendo las tareas definidas.

    Te aseguro una cosa: escribir esa spec te llevará 4 minutos. Te ahorrará 45 minutos de depuración descontrolada.

    Programar rápido con IA no consiste en teclear prompts más deprisa. Consiste en pensar con claridad antes de pedir el código.


    Si quieres llevar tus habilidades al siguiente nivel, explora los Cursos de Dominicode donde profundizamos en arquitecturas modernas y herramientas de desarrollo. Además, en Dominicode Labs acompañamos a developers a construir productos reales y workflows autónomos asistidos por IA.

    Preguntas frecuentes

    ¿SDD reemplaza a TDD (Test-Driven Development)?

    No, se complementan. SDD define el contrato y las expectativas de alto nivel antes de construir, mientras que TDD asegura la corrección del código a nivel unitario durante la implementación.

    ¿Cuánto tiempo lleva escribir una especificación SDD?

    Para una tarea típica de feature, redactar una spec básica toma entre 3 y 8 minutos. Ese pequeño esfuerzo inicial ahorra habitualmente horas de refactorización y depuración.

    ¿Qué herramientas son ideales para trabajar con Spec-Driven Development?

    SDD es agnóstico a la herramienta, pero brilla especialmente con agentes CLI como Claude Code y AGY, o entornos con contexto profundo como Cursor y Windsurf.

    ¿Es necesario usar SDD para correcciones de bugs pequeñas?

    Para bugs triviales o cambios de una sola línea no es necesario crear una spec completa. SDD es más valioso en tareas que involucran múltiples archivos, lógica de negocio o contratos de interfaz.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Un compañero me mandó el titular por Telegram a las siete de la mañana. Debajo, una sola línea: "¿Entonces pueden saber que este commit lo escribí con Claude Code?".

    Es la pregunta correcta. Y la respuesta corta es incómoda: hoy nadie te lo puede demostrar, porque el detector público de las marcas de agua de Claude todavía no existe.

    La respuesta larga es más interesante. Va de por qué estas marcas funcionan razonablemente bien sobre prosa y se deshacen casi solas dentro de un repositorio de código.

    La familia de marcas de agua más documentada en la literatura no es un carácter oculto ni un metadato: es un sesgo estadístico introducido durante la generación, en la elección misma de las palabras, que deja una firma detectable sin alterar el significado. Anthropic no ha confirmado que la suya funcione así. Solo dice que va "tejida dentro del propio texto".

    He leído la documentación entera. Esto es lo que dice, y lo que no.

    Documentación de Anthropic actualizada el 11 de agosto de 2026. Última revisión de este post: 12 de agosto de 2026.


    Qué ha anunciado Anthropic exactamente

    Cuatro hechos, sin adornos.

    1. Anthropic ha firmado el Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA sobre transparencia del contenido generado por IA. Esto no es marketing: es cumplimiento normativo.
    2. Los modelos Claude lanzados a partir del 2 de agosto de 2026 salen con marcado machine-readable desde el primer día. Para los modelos anteriores hay un periodo transitorio y Anthropic dice que está trabajando en incorporarlo.
    3. El alcance cubre Claude Platform (la API), Claude, Claude Code, Claude Cowork y Claude Tag, además de Claude servido desde AWS, Google Cloud y Microsoft Foundry. Se aplica en todo el mundo, no solo en la Unión Europea. Con una salvedad que conviene retener para más adelante: la marca en el texto sí viaja por esas tres nubes, pero los metadatos de procedencia firmados "puede que no estén soportados en todas las plataformas, según las funcionalidades que ofrezca cada una".
    4. La documentación no contempla ningún opt-out: el marcado se aplica a la salida de los modelos soportados, también cuando consumes la API.

    Que Claude Code aparezca escrito con todas las letras en esa lista es lo que hace que este post exista.

    Sobre el mecanismo, la documentación de Anthropic dice esto y nada más:

    "Teje una marca de agua imperceptible directamente en el propio texto. No la verás, y no cambia el significado, la calidad ni la legibilidad de la respuesta de Claude."
    ("…it weaves an imperceptible watermark directly into the text itself. You won't see it, and it doesn't change the meaning, quality, or readability of Claude's response.")

    Punto. No publican el algoritmo.


    Cómo se mete una marca de agua dentro de un texto

    La técnica estándar sesga la elección de tokens: en cada paso el modelo parte el vocabulario en una lista verde y una roja usando un hash secreto, y empuja suavemente la generación hacia la verde. El texto sigue siendo natural, pero contiene más tokens verdes de los que el azar explicaría.

    Aclaración previa: Anthropic no ha publicado su algoritmo. Lo que viene ahora es cómo funciona la familia de técnicas conocida en la literatura académica —sobre todo el trabajo de Kirchenbauer et al., "A Watermark for Large Language Models" (2023)—, no una descripción de lo que hace Claude por dentro.

    Lo explico porque es didáctico y porque es la familia plausible. No porque sea un dato confirmado.

    Un modelo de lenguaje no escribe palabras: escribe tokens. En cada paso genera un vector de logits, una puntuación para cada token del vocabulario, y de ahí sale la distribución de la que se muestrea el siguiente. Si nunca has visto por dentro cómo se trocea el texto, en Tokens en español: por qué cuestan un 26 % más que en inglés lo explico con ejemplos reales.

    La técnica clásica hace esto:

    1. Toma los últimos tokens generados y calcula un hash con una clave secreta.
    2. Usa ese hash como semilla para partir el vocabulario en dos: una lista verde y una lista roja.
    3. Suma un pequeño sesgo a los logits de la lista verde antes de muestrear.
    4. Repite en cada token.

    El texto resultante es perfectamente natural. Pero contiene muchos más tokens "verdes" de los que el azar justificaría. Quien tenga la clave recalcula las listas y saca un valor estadístico de confianza.

    La gracia del método es que el detector no necesita el modelo. Solo la clave y suficiente texto.

    Ahí está la palabra que lo condiciona todo: suficiente.


    Marca de agua no es lo mismo que detector de IA

    Un detector de IA adivina a partir del estilo; un detector de marca de agua busca una firma concreta que el propio modelo insertó. Son dos tecnologías distintas, con tasas de error distintas, y confundirlas es el error que más circula esta semana.

    Detector de IA Detector de watermark
    Analiza estilo Sí No
    Conoce la firma No Sí
    Necesita clave No Posiblemente
    Es probabilístico Sí Sí
    Identifica proveedor Difícil Potencialmente

    Un detector de IA clásico —los que llevan años suspendiendo a estudiantes por escribir demasiado bien— hace estadística sobre el estilo: perplejidad, longitud de frase, variedad léxica. Adivina. Un detector de watermark no adivina: busca una firma concreta que sabe que está ahí.

    Anthropic dice que "está trabajando para permitir que usuarios y terceros detecten las marcas de agua incrustadas de Claude y los metadatos de procedencia" y que publicará los detalles más adelante. Traducido: hoy no hay detector público de la marca de agua de Claude, ni fecha.

    De ahí sale la frase que más falta hace repetir esta semana: cualquier web que hoy te diga "este texto contiene el watermark de Claude" sin acceso al mecanismo de verificación de Anthropic, está vendiendo humo. Sin ese mecanismo no hay verificación posible. Hay marketing.


    El problema de la baja entropía cuando escribes código

    Una marca de agua estadística es más débil sobre código que sobre prosa porque el código tiene poca entropía: en cada punto hay muy pocas continuaciones válidas y casi ningún margen para elegir un token en lugar de otro equivalente.

    Y esto no me lo invento yo. Kirchenbauer et al. le dedican una sección entera del paper, titulada "A caveat: The difficulty of watermarking low-entropy sequences", y la abren así: "El texto de baja entropía crea dos problemas para el marcado. El primero: tanto humanos como máquinas producen terminaciones parecidas, si no idénticas, ante prompts de baja entropía, lo que hace imposible distinguir unas de otras."

    Lo que sí es inferencia mía es aplicárselo a Claude. Anthropic no ha publicado su algoritmo ni ninguna política específica sobre código.

    Una marca de agua estadística necesita libertad de elección. Si el modelo tiene veinte formas igual de válidas de continuar una frase, puede empujar hacia la lista verde sin que se note. En prosa esto sobra: "rápido" o "veloz", "por tanto" o "así que".

    El código no funciona así.

    Después de const user = await this.userService. hay dos o tres continuaciones razonables y el resto son errores de compilación. La entropía se hunde. El modelo no puede elegir un nombre de método "más verde" si el método se llama como se llama en la interfaz, y no puede reordenar los argumentos porque la firma es la que es.

    Cuanto más determinista es la salida, menos sitio hay donde esconder señal. Y el código es el texto más determinista que produce un modelo. Es la misma naturaleza probabilística que explico en por qué la IA se inventa cosas: ese margen de maniobra permite tanto la alucinación como la marca de agua. En código, el margen se estrecha.

    Añade que la mayoría de los diffs que revisas en un PR son de veinte o treinta líneas. Anthropic no da ningún umbral, pero sí reconoce el límite: un pasaje muy corto deja "demasiado poco texto para una señal fiable".

    El paper de Kirchenbauer sí da números. En sus experimentos detectan el 98,4 % de las generaciones al umbral z=4, que se alcanza a los 128 tokens. Y avisan, en la misma sección: "Las secuencias de alta entropía se detectan con relativamente pocos tokens, mientras que las de baja entropía requieren más tokens para ser detectadas."

    Junta las dos frases y verás por qué el número engaña. Ciento veintiocho tokens son del orden de diez o quince líneas de TypeScript, bastante menos que un commit cualquiera. Parece buena noticia para quien quiera detectarte. No lo es: ese 98,4 % está medido sobre prosa periodística, y el código es exactamente el material de baja entropía que, según los propios autores, necesita bastantes más tokens. Cuántos más, no lo dice nadie. Echa tú la cuenta con el tamaño de tus commits.


    Por qué tu flujo de trabajo real lava la marca

    Formatear, refactorizar, renombrar y revisar código altera la secuencia de tokens, y eso es lo que deshace una marca estadística sin que nadie se lo proponga.

    Separemos las dos mitades del argumento, porque solo una está documentada. La documentada: Anthropic dice que la marca puede dejar de detectarse si el texto "ha sido editado en profundidad, parafraseado, traducido o mezclado con otra escritura" ("heavily edited, paraphrased, translated, or mixed into other writing"). La mía: que tu flujo de trabajo normal, el de cualquier martes, cuenta como editar en profundidad.

    Conviene citar también la otra mitad, porque Anthropic la dice y casi nadie la está recogiendo: la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Es cierto y no contradice lo anterior. Copiar y pegar no toca la secuencia de tokens: la marca sigue ahí intacta. Lo que la rompe es cambiar el orden de esos tokens, y eso es precisamente lo que hacen el formateador, la extracción de método y el renombrado.

    Lee las dos frases otra vez y piensa en cómo trabajas de verdad con Claude Code a diario.

    Spec-Driven Development reduce la libertad del modelo

    Cuando trabajas con una spec detallada —nombres de tipos, contratos, estructura de carpetas, criterios de aceptación— no le pides al modelo que invente. Le pides que transcriba una decisión que ya tomaste tú.

    Si la marca funciona como creo —y esto sigue siendo inferencia mía—, cuanto más rigurosa sea la spec, menos libertad probabilística le queda al modelo y menos espacio hay donde incrustar señal. Un efecto secundario curioso de una metodología que adopté por razones completamente distintas, y que tienes desarrollada entera en el libro de Spec-Driven Development.

    El efecto Prettier

    Esto es más brutal todavía, y pasa cada día sin que lo pienses.

    Guardas el archivo y el formateador reparte los saltos de línea a su manera. Extraes un método. Renombras data por invoiceLines porque el nombre no decía nada. Mueves el bloque a otro archivo. El linter reordena los imports. Pasa por code review y alguien cambia tres cosas.

    Cada una de esas operaciones altera la secuencia de tokens. Y cualquier marca estadística de la familia que describí arriba depende, literalmente, del orden exacto de esos tokens. Que la de Claude funcione así es inferencia mía. Que editar en profundidad pueda dejarla indetectable lo dice Anthropic.

    No es que estés intentando borrar nada. Es que hacer bien tu trabajo la borra. Auditar y refactorizar lo que genera el asistente en lugar de aceptarlo tal cual es justo el flujo que enseño en Construye con IA, y resulta que además tiene este efecto colateral.


    Lo que sí aguanta: C2PA en los archivos que genera Claude

    Hay un caso donde la marca sí resiste: los archivos. Cuando Claude genera un .svg, .png o .jpg entra un segundo mecanismo: incrusta metadatos de procedencia firmados criptográficamente con el estándar C2PA, de la Coalition for Content Provenance and Authenticity. Anthropic no dice que esto sustituya a la marca del texto; dice que esos formatos llevan además procedencia.

    Otra liga. Una firma criptográfica no es probabilística: o valida o no valida. Y permite detectar si el archivo fue manipulado después.

    Y aquí está el contraste que más importa: la marca de agua del texto no la puede verificar nadie fuera de Anthropic, pero el C2PA sí se verifica ya hoy con herramientas públicas como c2patool o contentcredentials.org. Uno es una promesa; el otro funciona esta tarde.

    Un detalle técnico que conviene fijar: un .svg es un archivo de texto, XML, no un binario. Los metadatos viven dentro del propio documento. Y aplica a los archivos que Claude genera, no a los que ya tienes en el proyecto.

    O sea: si le pides a tu agente los iconos SVG de la aplicación y los commiteas tal cual, esos archivos sí llevan procedencia verificable dentro del repo. Puedes comprobarlo tú mismo:

    c2patool icono-generado.svg
    

    Durarán hasta que alguien los pase por un optimizador, los convierta de formato o los vuelva a guardar: Anthropic avisa de que la conversión de formato, el re-guardado y las capturas de pantalla eliminan los metadatos.

    Y hay una limitación más, la que dejé apuntada al principio: los metadatos firmados "puede que no estén soportados en todas las plataformas". Si consumes Claude a través de AWS, Google Cloud o Microsoft Foundry, la marca del texto viaja igual, pero la procedencia de los archivos depende de lo que ofrezca cada plataforma. Anthropic lo incluye entre las causas por las que un contenido marcado puede no dar señal: haberse producido "a través de una plataforma, funcionalidad o tipo de archivo donde ese tipo de marcado no estaba soportado".

    Robusto, pero no indestructible.


    El falso positivo: detectar la marca no prueba autoría

    Todo lo anterior va de falsos negativos: la marca está y se pierde. Pero hay un problema en la dirección contraria, y lo reconoce la propia Anthropic.

    Detectar una marca de Claude te dice que el contenido "puede haber sido procesado por Claude" ("may have been processed by Claude"). No que Claude lo escribiera. La documentación lo desarrolla sin rodeos: "Claude puede no ser el autor original. La gente usa Claude a menudo para corregir, traducir, resumir o convertir archivos."

    Léelo despacio, porque cambia la conversación entera.

    Si coges una función que escribiste tú y le pides a Claude que la refactorice, que le añada tipos o que te traduzca los comentarios al inglés, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo.

    Y el reverso también está escrito: "la ausencia de marca detectada no significa que el contenido no fuera generado o procesado por IA".

    O sea que la señal falla en las dos direcciones. Quien pretenda usar una detección como prueba de que no escribiste tú el código está leyendo mal la herramienta, y ahora tienes la frase del fabricante para decírselo.


    ¿Qué otras IAs marcan el contenido que generan?

    Anthropic no es la primera ni va sola. El Artículo 50(2) empuja a todo el sector en la misma dirección, pero cada uno ha llegado hasta un punto distinto.

    Proveedor Marca el texto Marca archivos ¿Verificable hoy por ti?
    Anthropic (Claude) Sí, desde agosto de 2026 Sí, C2PA en .svg, .png, .jpg Texto: no. Archivos: sí, C2PA
    Google (Gemini) Sí, SynthID-Text Sí, SynthID en imagen, audio y vídeo No: leer SynthID requiere la clave de Google
    OpenAI (ChatGPT) No Sí, C2PA en imágenes y SynthID en audio Solo lo que expone C2PA

    Google llegó antes: SynthID-Text lleva desplegado en Gemini desde 2024 y fue el primer marcado de texto en producción a escala. Firmó el mismo Código de Buenas Prácticas el 24 de julio de 2026, una semana antes de que el Artículo 50 fuera aplicable, y anunció acuerdos con Apple, ElevenLabs, Kakao, NVIDIA y OpenAI para que el marcado sea interoperable entre proveedores.

    Fíjate en la casilla que se repite: nadie tiene detector público de texto. Ni Anthropic ni Google. SynthID lleva dos años funcionando y sigue necesitando la clave privada de Google para leerse. Eso te dice más sobre el plazo real de Anthropic que cualquier promesa de documentación futura.

    Y el caso de OpenAI merece un párrafo, porque es el más honesto sobre los incentivos del negocio: tenía el marcado de texto construido y lo aparcó en septiembre de 2024, cuando una encuesta interna reveló que cerca del 30 % de los usuarios de ChatGPT lo usarían menos si supieran que marca lo que escribe. Marca imágenes y audio, donde nadie protesta. Texto no.


    Entonces, ¿debería preocuparte?

    Respuesta corta: no, si escribes software y auditas lo que genera el asistente. Sí, si tu empresa firma contratos con cláusulas sobre uso de IA y nadie las ha leído.

    La iniciativa es buena ingeniería y buena regulación. La web abierta se está llenando de texto sintético que se hace pasar por humano, y marcarlo en origen es mejor que dejarlo en manos de detectores que funcionan por corazonadas estilísticas.

    Para quien escribe software, el código sigue siendo código.

    Tu repositorio no es un canal de distribución de texto sintético. Es un artefacto de ingeniería que pasa por specs, revisión, formateo, refactor y tests. Mientras controles la arquitectura y audites lo que genera el asistente, es poco probable que una marca estadística sobreviva a ese recorrido. Y mientras no haya detector público, ni tú ni nadie puede comprobarlo.

    Lo único que te recomiendo hacer hoy: si tu empresa firma contratos con cláusulas sobre uso de IA, sube el tema tú antes de que lo suba un cliente. No para justificarte —usar Claude Code no es hacer trampas—, sino para tener una política escrita en lugar de una improvisación en una llamada incómoda.

    Si quieres seguir estas cosas con gente que las aplica en producción y no solo lee titulares, en Dominicode Labs es de lo que hablamos cada semana.


    Preguntas frecuentes

    ¿Puede alguien saber hoy si usé Claude para escribir este código?

    No. Anthropic no ha publicado ni el algoritmo ni un detector público, y no ha dado fecha. Dice que trabaja para que usuarios y terceros puedan detectar las marcas, y que compartirá los detalles en documentación técnica futura. Hasta entonces, cualquier herramienta que afirme lo contrario no puede demostrarlo.

    ¿La marca de agua afecta a la calidad del código que genera Claude?

    Anthropic afirma que no cambia el significado, la calidad ni la legibilidad. En prosa es creíble: el sesgo se reparte entre alternativas equivalentes. En código las alternativas equivalentes escasean, así que —y esto es deducción mía, no dato publicado— cualquier esquema de marcado tendría mucho menos margen de actuación. No hay motivo para esperar peor código por esto.

    ¿Puedo desactivar la marca de agua?

    La documentación de Anthropic no menciona ninguna opción para desactivarlo, tampoco para quien usa la API. Se aplica a Claude Platform, Claude, Claude Code, Claude Cowork y Claude Tag, incluido Claude servido a través de AWS, Google Cloud y Microsoft Foundry, y rige en todo el mundo.

    ¿La marca de agua sobrevive a copiar y pegar el código?

    Sí. Anthropic dice que la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Copiar y pegar no altera la secuencia de tokens, así que no hay motivo para que se pierda. Lo que sí puede romperla, según la propia documentación, es editar en profundidad, parafrasear, traducir o mezclar el texto con otra escritura.

    ¿Cómo compruebo si un archivo generado por Claude lleva metadatos C2PA?

    Con c2patool desde la terminal (c2patool archivo.svg) o subiendo el archivo a contentcredentials.org. Esto es lo único verificable hoy sin depender de Anthropic, y solo aplica a archivos .svg, .png y .jpg generados por Claude. Los metadatos desaparecen si conviertes el formato, vuelves a guardar el archivo o haces una captura de pantalla.

    ¿Afecta la marca de agua a quién es dueño del código que genera Claude?

    No. La marca es un mecanismo de transparencia sobre el origen del contenido, no un mecanismo de propiedad. La titularidad de lo que generas con Claude se rige por los términos de servicio de Anthropic y por el contrato que tengas con tu cliente o tu empresa, no por si el texto lleva firma estadística. Lo que sí conviene es que esa relación esté escrita antes de que alguien pregunte.

    ¿Los detectores de IA como GPTZero o Turnitin detectan la marca de agua de Claude?

    No. Son mecanismos distintos. Un detector convencional analiza el estilo y estima una probabilidad; no conoce ninguna firma y se equivoca a menudo en las dos direcciones. Un detector de watermark busca una señal concreta que sabe cómo se incrustó. Que un detector clásico marque tu texto como generado por IA no significa que haya encontrado la marca de Anthropic, porque no puede.

    Si detectan la marca, ¿significa que el código lo escribió Claude?

    No, y lo dice Anthropic: detectar una marca de Claude indica que el contenido "puede haber sido procesado por Claude", no que Claude lo escribiera. Si le pasas tu propio código para que lo refactorice o te lo traduzca, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo. Cualquiera que use una detección como prueba de que no escribiste tú el código está leyendo mal la señal.

    ¿Me afecta si no estoy en la Unión Europea?

    Sí. El marcado nace del Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA, pero Anthropic lo aplica globalmente. Dónde esté tu empresa no cambia nada.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Por qué tu spec falla con un agente de IA: 7 fallos y su arreglo

    Por qué tu spec falla con un agente de IA: 7 fallos y su arreglo

    La spec tenía 900 palabras, títulos bien puestos, listas numeradas y hasta un diagrama. El agente la leyó entera y construyó otra cosa.

    El dev que me la pasó estaba convencido de que el problema era el modelo. Probó con otro. Mismo resultado.

    Le hice una sola pregunta: cuando el agente termine, ¿qué comando ejecutas para saber si lo ha hecho bien?

    Silencio. No había ninguno.

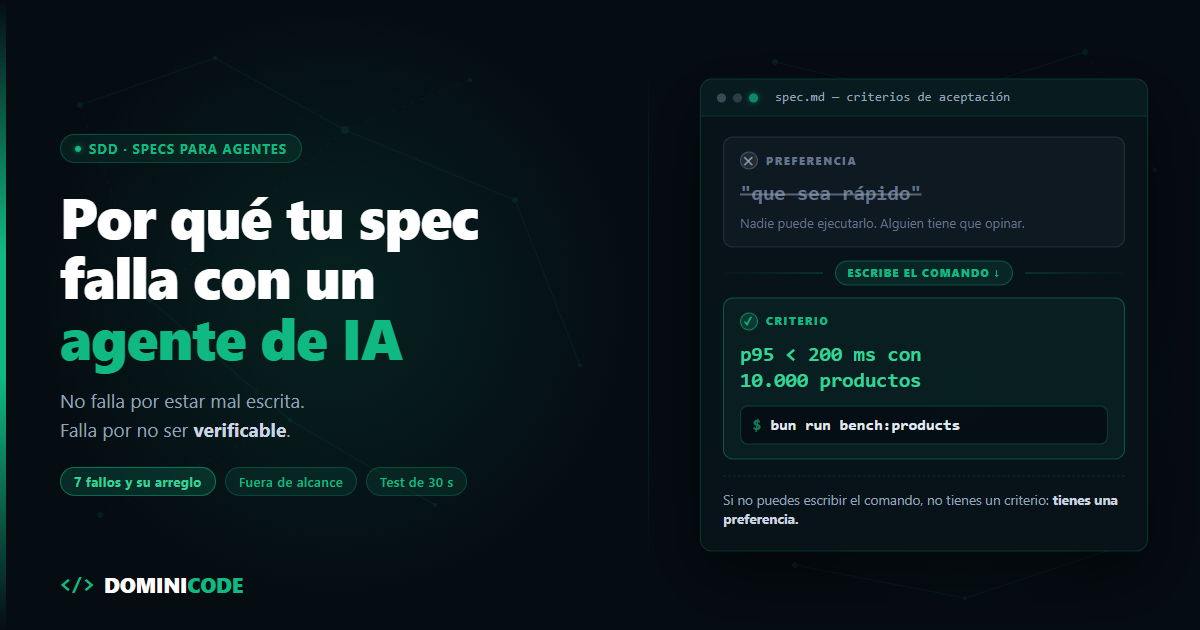
    Ese silencio es el diagnóstico completo. La mayoría de las specs que fallan —también las de quien ya aplica Spec-Driven Development a diario— no fallan por estar mal escritas. Fallan por no ser verificables. Y una spec que no se puede comprobar no es una especificación: es una carta de intenciones. Un agente no ejecuta intenciones.

    El SDD no consiste en redactar un documento bonito antes de programar — de eso hablé cuando expliqué por qué el Spec-Driven Development evita el caos. Consiste en escribir un contrato que una máquina pueda dar por cumplido o por incumplido, sin que tú tengas que opinar.

    Esto no es otro tutorial de redacción. Para la estructura desde cero ya tienes la anatomía de una spec para Claude Code. Esto es el diagnóstico de la spec que ya escribiste y no funcionó.

    Siete fallos, ordenados por lo que más veo. Los cinco primeros los detectas leyendo el documento. Los dos últimos, no.

    Busca tu síntoma: por qué tu spec falla con un agente de IA

    Lo que ves cuando el agente termina El fallo en la spec El arreglo
    Dice "está hecho" y no sabes si está hecho Criterios de éxito no comprobables Un comando debajo de cada criterio
    Hace las cosas como las hace todo el mundo, no como tu repo Ambigüedad sin marcar Señala el fichero que manda
    Toca ficheros que nadie le pidió No hay límites Sección "Fuera de alcance"
    Ignora la mitad de tus instrucciones técnicas Mezcla el qué con el cómo Cierra el qué, deja el cómo abierto
    catch vacíos y fallos que devuelven 200 Solo describe el camino feliz Tabla de estados de error
    Empieza bien y se desmadra a la mitad La spec es demasiado grande Pártela por unidad verificable
    Cumple la spec, pero la spec ya no es verdad Spec desactualizada Vive en el repo o se borra

    Fallo 1: criterios de éxito que nadie puede comprobar

    Un criterio de éxito es comprobable cuando existe un comando que lo declara cumplido o incumplido sin que nadie opine. Este es el fallo padre: los otros seis son variaciones suyas.

    Mira esta spec. La he leído con distintos nombres decenas de veces:

    ## Feature: listado de productos
    
    Endpoint para listar el catálogo.
    Tiene que ser rápido y soportar filtros.
    La respuesta debe ser consistente con el resto de la API.
    Gestionar bien los errores.
    

    Cuatro frases. Tres deseos y un título. ¿Rápido comparado con qué? ¿Consistente con cuál de los catorce endpoints que ya tienes? ¿Gestionar bien es devolver un 400 o un 422?

    Ninguna de esas preguntas la puede responder el agente ejecutando algo. Así que las responde inventando, y tú te enteras después.

    Ahora la misma feature escrita para que se pueda comprobar:

    ## Feature: GET /products
    
    ### Criterios de aceptación
    1. `GET /products?limit=20` devuelve 200 con
       `{ items: Product[], nextCursor: string | null }`.
    2. Paginación por cursor sobre `created_at DESC, id DESC`.
       `GET /products?cursor=<nextCursor>` devuelve la página siguiente
       sin repetir ni saltarse elementos. Nada de offset/limit.
    3. `limit` acepta 1-100, por defecto 20.
       Fuera de rango devuelve 400 con `{ code: 'INVALID_LIMIT' }`.
    4. p95 por debajo de 200 ms con 10.000 productos en tabla.
    
    ### Cómo se verifica
    - `bun test test/products.e2e.ts` en verde (cubre los puntos 1 a 3).
    - `bun run bench:products` imprime el p95 y sale con código 1
      si supera los 200 ms.
    

    La diferencia no es la longitud. Es que la segunda tiene una sección Cómo se verifica.

    "Que sea rápido" es un deseo. "Que GET /products responda por debajo de 200 ms de p95 con 10.000 registros, y aquí está el comando que lo mide" es un criterio. El primero obliga a que alguien juzgue. El segundo se cierra solo.

    Regla corta: debajo de cada criterio, el comando que lo prueba. Si no puedes escribir el comando, no tienes un criterio, tienes una preferencia.

    Y cuando el criterio es ejecutable pasa lo interesante: puedes delegar el ciclo entero —escribe, ejecuta, lee el fallo, corrige— en lugar de revisar cada iteración a mano. Es el flujo diario que describí en cómo usar Claude Code a diario, y depende por completo de que exista ese comando.

    Fallo 2: la ambigüedad la rellena el modelo, no tú

    Todo hueco de la spec se rellena. Siempre. La pregunta no es si el agente va a improvisar, es con qué.

    Y improvisa con lo más común de su entrenamiento: la mediana de internet. Tu repo no es la mediana de internet.

    Si tu API pagina por cursor y la spec solo dice "con paginación", el agente escribe offset y limit, porque es el patrón que domina en el código público con el que se entrenó. Si tu proyecto devuelve Result en vez de lanzar, escribirá try/catch. Si tus tests usan Testing Library, te meterá un TestBed clásico.

    Ninguno de esos es un error del modelo. Son la respuesta estadísticamente correcta a una pregunta que no hiciste.

    Aquí está el matiz que casi nadie aplica: la spec no tiene que decirlo todo. Tiene que decir dónde no se puede improvisar.

    Y la forma más barata de decirlo no es describir tu patrón en tres párrafos. Es apuntar al código que ya lo hace:

    ### Referencias obligatorias
    - Paginación: copia el patrón de `src/orders/orders.controller.ts` (solo lectura).
      Si hay conflicto entre este documento y ese fichero, manda el fichero.
    - Errores: usa los helpers de `src/common/http-errors.ts`.
      Prohibido lanzar `Error` pelado.
    
    ### Libre elección
    - Nombres internos, orden de los métodos, dónde partes los helpers.
      No preguntes por esto.
    

    Ese último bloque parece de relleno y no lo es. Marcar lo que sí es libre evita el otro extremo: el agente que se para cada dos minutos a preguntar cómo llamar a una variable.

    Tu trabajo no es documentar el proyecto entero dentro de la spec. Es marcar las tres o cuatro fronteras donde una decisión razonable sería, en tu repo, la decisión equivocada.

    Fallo 3: no dice qué NO hacer

    Los desastres que he visto con agentes casi nunca vienen de lo que el agente no hizo. Vienen de lo que hizo de más.

    Le pides un endpoint y te reformatea 40 ficheros porque detectó que el estilo era inconsistente. Le pides un filtro y te instala una librería de query building. Le pides un fix y "de paso" refactoriza el módulo de auth, que estaba feo.

    Todo eso es técnicamente razonable. Ninguna spec lo prohibía.

    Los límites son parte del contrato, no una nota al margen:

    ### Fuera de alcance
    - No tocar `src/auth/**` ni `src/orders/**`.
    - No añadir dependencias. La paginación sale del query builder
      que ya está en `src/common/pagination.ts`.
    - No crear migraciones. Si hace falta un índice, lo propones
      en el PR y paras.
    - No cambiar la forma de respuesta de endpoints existentes.
    - No reformatear ficheros que no toque la feature.
    

    Cinco líneas. Te ahorran la revisión de un diff de 40 ficheros donde lo que importa está en tres. Es, por cierto, uno de los patrones que aparece una y otra vez en los errores comunes al adoptar Claude Code: falta de guardarraíles, no falta de capacidad.

    No es opinión mía: las buenas prácticas oficiales de Claude Code lo dicen con todas las letras — las specs más útiles "nombran los ficheros e interfaces implicados, declaran qué queda fuera de alcance, y terminan con un paso de verificación end-to-end que demuestra que la feature funciona". Los tres primeros fallos de esta lista son exactamente esas tres cosas, en negativo.

    Fallo 4: la spec que ya decide la implementación

    Este falla al revés que los anteriores. No peca de vaga, peca de mandona.

    Crea un `ProductsCacheInterceptor` en `src/products/interceptors/`.
    Usa un `Map<string, { data: Product[]; ts: number }>` en memoria.
    TTL de 60 s, limpieza con un `setInterval` cada 30 s.
    La clave del Map es `JSON.stringify(req.query)`.
    

    Eso no es una spec. Es pseudocódigo con saltos de línea.

    Y tiene un agujero que probablemente no has visto: JSON.stringify(req.query) genera claves distintas para ?limit=20&cursor=x y ?cursor=x&limit=20. Son la misma petición. El agente puede implementar ese documento al pie de la letra, perfectamente, y aun así pegarle dos veces a la base de datos.

    La versión que sí es un contrato:

    ### Criterio
    Dos peticiones con los mismos parámetros a `GET /products` en menos de 60 s
    golpean la base de datos una sola vez, independientemente
    del orden de los parámetros en la query string.
    
    ### Cómo se verifica
    `bun test test/products.cache.e2e.ts` — el test espía el
    repositorio y afirma que solo hubo una query.
    
    ### Restricciones
    Sin dependencias nuevas. Sin Redis: todavía no está en infra.
    

    Fíjate en la paradoja. La versión que no dice cómo implementarlo es más exigente que la que lo dictaba línea a línea. La primera se puede cumplir y estar mal. La segunda no se puede fingir.

    Además, cuando cierras el cómo, cierras también las soluciones mejores que la tuya. Y en cachés, colas y consultas, el agente propone alternativas buenas más a menudo de lo que resulta cómodo admitir.

    Tú decides el qué observable. Él decide el cómo. El test decide quién tiene razón.

    Fallo 5: la spec solo describe el camino feliz

    Abre tu última spec y cuenta cuántas líneas hablan de qué pasa cuando algo falla. Lo normal es cero.

    Aquí está la trampa: el agente no deja el manejo de errores sin hacer. Lo inventa. Y su versión inventada suele ser un catch que loguea y sigue, o un 200 con array vacío cuando la base de datos no responde. Un endpoint que miente en lugar de fallar.

    Cuatro filas arreglan esto:

    Caso Respuesta Qué se loguea
    cursor malformado 400 INVALID_CURSOR warn, sin volcar el cursor entero
    limit fuera de 1-100 400 INVALID_LIMIT nada
    Timeout de la base de datos (>2 s) 503 DB_TIMEOUT error, con query y duración
    Fila de producto sin precio se excluye del listado warn con el id

    La última fila separa una spec escrita por alguien que ha estado de guardia de una escrita de memoria. Los datos sucios existen, y si no decides tú qué hacer con ellos, decide el agente.

    Dos minutos de escritura. Es lo que hay entre un endpoint y un endpoint que puedes dejar sin mirar.

    Los dos fallos que no ves leyendo la spec

    Los cinco anteriores se detectan releyendo el documento. Estos dos solo aparecen cuando comparas la spec con el repo y con el tamaño del trabajo.

    Fallo 6: la spec es demasiado grande

    La unidad de una spec no es la feature, es el paso verificable. Si la sección "Cómo se verifica" no cabe en cinco líneas, no tienes una spec: tienes tres disfrazadas de una.

    El síntoma es inconfundible: el agente empieza bien y se desmadra a la mitad, porque cada decisión que toma amplía la superficie de las siguientes.

    Partir el trabajo en unidades que se cierran una a una es, literalmente, la mitad del método que enseño en Construye con IA. La otra mitad es no volver a abrir una unidad ya cerrada.

    Fallo 7: la spec está desactualizada

    La spec dice que el endpoint devuelve items, el código lleva tres semanas devolviendo data. El agente no tiene forma de saber cuál manda. Unas veces sigue al documento y otras al código, y ninguna de las dos es una elección tuya.

    La regla que uso: la spec vive en el repo, entra en el mismo PR que el código, y cuando se contradicen gana el código. Entonces actualizas la spec o la borras. Una spec muerta es peor que no tener spec, porque es contexto con autoridad que resulta ser mentira.

    El test de 30 segundos: ¿tu spec es verificable?

    Una spec es verificable si responde a tres preguntas por escrito. No hace falta reescribir nada para saberlo. Coge la que ibas a pasarle al agente y hazle estas tres:

    1. ¿Qué comando prueba que está terminada?
    2. ¿Qué ficheros no puede tocar?
    3. ¿Qué pasa exactamente cuando falla?

    Si las tres tienen respuesta escrita en el documento, la spec funciona. Si falta una, ya sabes dónde está el bug — y no está en el modelo.

    Empieza hoy por la primera. Coge tus criterios de aceptación y escribe debajo de cada uno el comando que lo demuestra. Los que se queden sin comando, o los conviertes en algo medible o los sacas de la spec, porque no van a pasar de deseo.

    Todo el sistema —el contrato verificable, los límites, cómo partir el trabajo y cómo mantener la spec viva junto al código— es lo que ordené en SDD: Spec-Driven Development. Si este post te ha señalado tres fallos en tu documento, ahí tienes el método completo para que no vuelvan.

    Y si prefieres verlo sobre proyectos reales, con specs de gente que las está usando en producción, es una de las conversaciones habituales en Dominicode Labs.

    Preguntas frecuentes

    ¿Cómo sé si mi spec es verificable?

    Una spec es verificable si cada criterio de aceptación tiene debajo un comando que devuelve verde o rojo sin que nadie opine. Un test, un benchmark, un script de validación, un curl con la respuesta esperada.

    La prueba rápida: pásale la spec a alguien que no conozca el proyecto y pídele que te diga si está hecha sin abrir el código. Si necesita preguntarte algo, el agente también lo habría necesitado, solo que él no pregunta.

    ¿Qué hago con los criterios que no se pueden medir con un comando?

    Los conviertes en algo observable o los sacas de la spec. "Que la UI sea intuitiva" no es un criterio, pero "que el flujo de compra se complete en tres clics desde la ficha de producto y no haya ningún campo obligatorio sin marcar" sí lo es, y se comprueba con un test end-to-end.

    Cuando de verdad no se puede —criterios estéticos, tono de los textos, decisiones de marca— déjalo fuera de la spec y márcalo como revisión humana explícita. Lo que no puede pasar es que quede dentro como si el agente pudiera resolverlo.

    ¿Cuánto debe ocupar una spec para un agente de IA?

    No la mides en palabras, la mides en unidades verificables. Una spec debe cubrir un trozo de trabajo que se cierre con una tanda de comprobaciones y una revisión.

    Si la sección "Cómo se verifica" ocupa más de cinco líneas o mezcla áreas del sistema que no comparten test, pártela. Dos specs de 300 palabras funcionan mejor que una de 900.

    ¿La spec sustituye a los tests?

    No, los ordena. La spec dice qué tiene que ser cierto y el test lo comprueba en cada ejecución.

    En la práctica la relación es más estrecha de lo que parece: si los criterios de aceptación están bien escritos, los nombres de tus tests salen casi copiados de ellos. Cuando un criterio no se deja convertir en un nombre de test, casi siempre es que el criterio estaba vago.

    ¿Por qué el agente ignora partes de mi spec?

    Rara vez las ignora. Lo habitual es que las haya interpretado de una forma que a ti no se te ocurrió, porque estaban abiertas a más de una lectura.

    Revisa esas partes buscando dos cosas: adjetivos sin unidad ("rápido", "robusto", "limpio") y sustantivos que en tu proyecto tienen un significado propio ("paginación", "validación", "caché"). Son los dos sitios donde el modelo rellena con lo más común de su entrenamiento en lugar de con lo que hace tu repo.

    ¿Qué hago si el agente toca ficheros que nadie le pidió?

    Añade una sección "Fuera de alcance" a la spec y trátala como parte del contrato, no como una nota al margen. Cinco líneas bastan: qué directorios no se tocan, que no se añaden dependencias, que no se crean migraciones, que no se cambia la forma de respuesta de endpoints existentes y que no se reformatea nada que la feature no toque. Los desastres con agentes casi nunca vienen de lo que no hicieron, sino de lo que hicieron de más, y ninguna spec se lo prohibía.

    ¿La spec tiene que decir cómo implementar la feature?

    No, y decirlo suele empeorar el resultado. Una spec que dicta la implementación línea a línea se puede cumplir al pie de la letra y aun así estar mal, porque el agente reproduce también tus errores de diseño. Una spec que fija el comportamiento observable y el comando que lo verifica no se puede fingir. Tú decides el qué, el agente decide el cómo, y el test decide quién tenía razón.

    ¿Dónde guardo la spec y quién manda si contradice al código?

    En el repositorio, junto al código, y entra en el mismo pull request que la implementación. Fuera del repo se queda desactualizada en semanas y se convierte en contexto falso.

    Cuando spec y código se contradicen, manda el código y la spec se corrige o se borra en ese mismo momento. Déjalo escrito dentro del propio documento: es la línea que evita que el agente tenga que adivinar cuál de las dos fuentes es la buena.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cuándo NO usar Spec-Driven Development: 6 casos que te frenan

    Cuándo NO usar Spec-Driven Development: 6 casos que te frenan

    Escribí una spec de tres páginas —objetivo, contratos de datos, casos de error, criterios de aceptación— para una integración que no llegó a existir.

    A la mañana siguiente abrí la documentación de la API y descubrí que el endpoint sobre el que se apoyaba la mitad de mis decisiones no devolvía lo que yo daba por hecho. Tiré el documento entero.

    La spec no estaba mal escrita. Estaba escrita antes de tiempo.

    Escribí el libro de Spec-Driven Development. Lo uso casi todos los días y sigo pensando que es la diferencia entre dirigir a un agente y rezarle. Por eso mismo puedo decirte esto sin que suene a excusa: hay trabajo donde SDD no compensa, y confundir "el método funciona" con "el método aplica siempre" te cuesta más horas de las que te ahorra.

    Una spec es un seguro, y a veces la prima cuesta más que el siniestro

    Escribir una spec tiene dos costes.

    El obvio es el tiempo. Ese lo ves y lo aceptas, porque sabes que la vas a recuperar en el primer malentendido que no ocurre.

    El segundo no lo ve casi nadie: una spec fija decisiones. Ese es su trabajo. Y fijar decisiones es fantástico cuando tienes la información para tomarlas, y carísimo cuando no la tienes, porque conviertes una suposición en un contrato y luego construyes encima.

    Todo el debate se reduce a comparar dos cantidades: lo que cuesta el error que la spec previene, y lo que cuesta escribirla ahora, con la información que tienes ahora. Cuando el error es caro e irreversible, la prima es barata a cualquier precio. Cuando el error se arregla con un git revert y un café, estás pagando un seguro contra un rasguño.

    La regla, en una frase: no escribas una spec cuando el coste de deshacer el error sea menor que el coste de escribirla; escríbela siempre que el error no se deshaga con un comando.

    Si has llegado aquí sin el contexto previo, en Spec-Driven Development: evita el caos de la IA está el método entero. Este post es la otra mitad: los seis sitios donde estuve pagando de más hasta que aprendí a mirar la factura.

    1. Cuando todavía no sabes lo que quieres

    Una spec responde a "qué vamos a construir". Un spike responde a "¿esto es siquiera posible?".

    Son preguntas distintas, y la segunda no se contesta escribiendo. Se contesta ejecutando. Cuando estás evaluando si una librería aguanta tu caso, si esa API devuelve lo que promete o si el modelo entiende tus documentos, el código no es la implementación de la decisión: es el instrumento de medida.

    Especificar ahí es adivinar con formato de documento. Y un documento bien maquetado tiene un efecto raro sobre el cerebro: le da a una suposición el aspecto de un hecho.

    Lo que sí necesita un spike son guardarraíles, y son tres:

    1. Una pregunta concreta escrita antes de empezar ("¿puedo procesar 500 facturas en menos de un minuto con este proveedor?"). Si no sabes formularla, no es un spike, es procrastinación con IDE.
    2. Una caja de tiempo. Cuatro horas, un día. Lo que quieras, pero decidido antes.
    3. El compromiso de tirar el código. Rama aparte, sin tests, sin abstracciones. Es YAGNI aplicado al documento: no especifiques por si acaso.

    El peligro real de un spike nunca fue no tener spec. Es que el prototipo se quede. El prototipo demuestra, no se promociona.

    Cuando llega la respuesta, escribes la spec. La exploración no sustituye a la spec: la alimenta. Ese salto del prototipo que demuestra al producto que se sostiene es justo lo que trabajamos en Construye con IA.

    2. Cuando el cambio cabe en tu cabeza y git revert lo deshace

    Subir un timeout. Añadir un índice. Cambiar el copy de un botón. Un campo más en un formulario que ya existe.

    Un diff de veinte líneas, un archivo, reversible en un comando. Escribir spec.md + plan.md + tasks.md para eso no es rigor. Es ceremonia.

    Y la ceremonia hace un daño que no se contabiliza: enseña a todo el mundo —incluido tú— que el proceso es un trámite. En cuanto una spec se percibe como trámite, todas las specs pierden autoridad. También las que sí importaban.

    El test que uso es de tres preguntas. ¿Puedes describir el cambio completo en una frase, sin "y" ni "además"? ¿El diff cabe en una pantalla? ¿Deshacerlo es un comando? Tres síes: abre el editor y hazlo.

    3. Cuando el código no va a sobrevivir a la semana

    Un script para limpiar una tabla una vez. Un notebook para sacar un número que te ha pedido alguien. Un endpoint de debug que borras el viernes.

    Una spec sirve para que otra persona —o tú dentro de seis meses— entienda una decisión. Si no va a haber ni otra persona ni dentro de seis meses, el documento no tiene a quién servir. El criterio de aceptación es ejecutarlo y mirar el resultado.

    La trampa está en otro sitio: el código temporal tiene la mala costumbre de volverse permanente. En cuanto ese script se ejecuta una segunda vez, deja de ser desechable y entra en el caso contrario.

    Mi regla: si dudo, la escribo. La duda ya es la señal de que la tarea es más grande de lo que parecía. Y si escribir la spec te está costando de verdad, echa un vistazo a la anatomía de una spec, porque a lo mejor el problema no es la tarea, es que estás escribiendo cuarenta líneas donde bastaban seis.

    4. Los bugs no se especifican, se reproducen

    Un bug no es una funcionalidad que falta. Es una diferencia entre lo que el sistema hace y lo que ya estaba dicho que tenía que hacer.

    O sea: la especificación ya existe. La escribiste cuando construiste la feature, o vive implícita en el comportamiento que todo el mundo daba por bueno hasta el martes pasado. Escribir un documento nuevo para describir algo que ya está descrito es duplicar la verdad, no aclararla.

    El artefacto correcto es un test que falla.

    Reproduce, aísla, escribe el test en rojo, arréglalo, deja el test dentro. Ese test es la spec de ese bug, con una ventaja que ningún markdown te da: es ejecutable, y cuando envejece te avisa el CI. Si alguien vuelve a romper eso dentro de seis meses, se entera antes que tú. Cómo se combina eso con dejar que la IA escriba la implementación lo desarrollé en TDD y spec-first con IA.

    Hay dos excepciones. La primera: nadie sabe decirte cuál sería el comportamiento correcto. Eso no es un bug, es un requisito sin decidir disfrazado de bug, y sí se especifica. La segunda: sabes perfectamente qué tiene que pasar, pero el arreglo es más grande que el fallo —rehacer la caché, tocar el modelo de concurrencia, cambiar un contrato que ya consume alguien—. El test sigue siendo obligatorio, pero describe el síntoma, no el rediseño. Eso se especifica igual.

    5. Cuando el dominio cambia bajo tus pies

    Si el requisito muda cada semana, la spec envejece más rápido de lo que tardas en ejecutarla. Y entonces tienes dos verdades: el documento y el código.

    Cuando hay dos verdades, los humanos resuelven el conflicto solos: dejan de leer el documento. Molesto, pero se sobrevive.

    El problema es el agente. Un agente no distingue una spec vigente de una obsoleta. No tiene forma de saber que ese párrafo lo invalidó una llamada del jueves. La lee, la trata como fuente de verdad y construye encima con toda la seguridad del mundo.

    La salida no es abandonar el método, es acortar el alcance. Specs de una semana en vez de specs de un trimestre. Especifica la parte del dominio que ya está congelada y deja explícitamente marcado lo que sigue en discusión. Una sección de "esto todavía no está decidido" vale más que tres páginas de decisiones falsas.

    6. Cuando la spec se ha convertido en teatro

    El síntoma es fácil de reconocer: escribes la spec después de tener el código.

    Eso no es Spec-Driven Development. Es documentación retroactiva, que no tiene nada de malo salvo el nombre que le pongas. El valor de la spec está en el orden, no en el archivo. Si el código ya existe, el documento no puede cambiar ni una sola decisión, que era exactamente para lo que servía.

    Hay dos síntomas más. El primero: nadie la lee, y lo sabes porque nadie te ha discutido nunca una línea. El segundo: las specs se copian de la anterior cambiando los nombres.

    Cuando aparece cualquiera de los tres, el problema no es el método. Es que lo estás aplicando en tareas donde no aportaba, y la gente lo ha notado antes que tú.

    Cuándo usar Spec-Driven Development y cuándo no: la tabla

    Tipo de trabajo ¿Spec? Por qué
    Spike para saber si algo es viable No — pregunta y caja de tiempo El código es la investigación; la spec fijaría decisiones sin información
    Cambio pequeño y reversible No — el propio diff Revertirlo cuesta menos que documentarlo
    Bug reproducible No — un test en rojo El test fija el comportamiento y además lo vigila el CI
    Código que no sobrevive a la semana No — el propio código El documento no tiene a quién servir
    Spec escrita después del código No — llámalo documentación Ya no puede cambiar ninguna decisión, que era su único trabajo
    Requisito que cambia cada semana Corta y con caducidad La spec envejece más rápido de lo que se ejecuta
    Feature nueva en un producto vivo Sí Otra persona la va a tocar y el error se paga meses después
    Migración o cambio del modelo de datos Sí, siempre El error no se deshace con git
    Trabajo que cruza servicios o equipos Sí, siempre La spec es el punto de sincronización, no el papeleo
    Tarea que delegas entera a un agente Sí, siempre Lo que no escribas, lo rellena inventando
    Auth, pagos, datos personales Sí, siempre El coste del fallo no es técnico

    Bajar de artefacto no es dejar de pensar

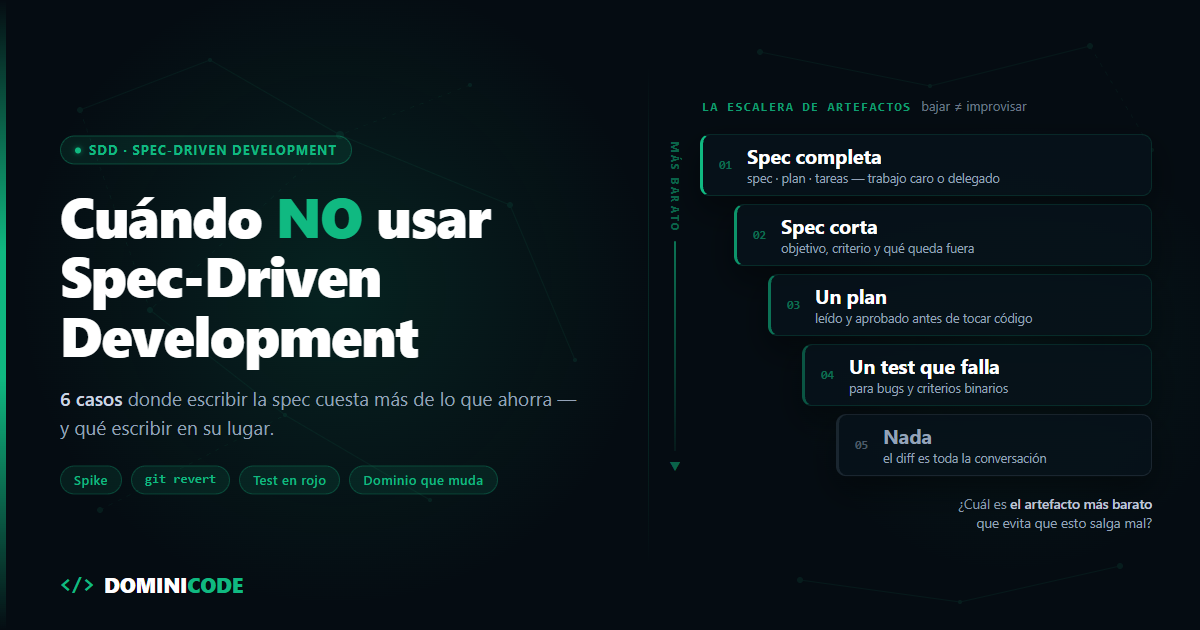
    La alternativa a una spec no es el caos: es un artefacto más barato. Hay cinco niveles, y solo el primero es una spec completa.

    1. Spec completa — spec, plan y tareas. Para trabajo caro, compartido o delegado entero.
    2. Spec corta — tres párrafos: objetivo, criterio de aceptación y qué queda fuera. El escalón que más uso.
    3. Un plan — el modo plan de Claude Code, leído y aprobado antes de que toque nada. Treinta segundos de lectura que evitan revisar un diff de novecientas líneas, como conté en cómo usar Claude Code a diario.
    4. Un test que falla — para bugs y para cualquier cosa con un criterio binario.
    5. Nada — y el diff es toda la conversación.

    La pregunta buena nunca fue "¿spec sí o spec no?". Es: ¿cuál es el artefacto más barato que evita que esto salga mal?

    Dónde Spec-Driven Development gana siempre

    La tabla ya dice dónde la spec no se discute: migraciones, modelo de dominio, auth, dinero. Nada de eso es nuevo. Lo que ha cambiado la ecuación, desde que los agentes de código empezaron a ejecutar tareas de varias horas sin supervisión, es la última fila: el trabajo que delegas entero a un agente.

    Antes la spec competía contra "lo hago yo, que ya me entiendo". Ahora compite contra revisar cuatrocientas líneas que alguien escribió interpretando lo que tú no llegaste a decir. Cuando delegas, cada hueco de la especificación se rellena con una invención plausible, y las invenciones plausibles son las más caras de detectar. Lo desarrollé en qué pasa cuando pides código sin spec.

    En ese escenario la spec deja de ser documentación. Es el prompt más caro que vas a escribir, y el único que se amortiza.

    Lo que haría yo mañana

    Coge la siguiente tarea de tu lista y hazte una sola pregunta antes de abrir el editor:

    Si esto sale mal, ¿cuánto cuesta deshacerlo?

    Si la respuesta es "un git revert", empieza a picar. Si la respuesta es "una migración de datos", "una llamada con otro equipo" o "un incidente en producción", escribe la spec antes de tocar una línea.

    No necesitas más criterio que ese. Los seis casos de este post son solo ejemplos de esas dos respuestas.

    El libro de Spec-Driven Development va justo de esto: hay un capítulo entero sobre la spec más corta que puedes escribir, además de las plantillas, el flujo con el agente y qué hacer cuando la spec y el código se separan. Si prefieres ver cómo lo aplica gente que ya lo tiene metido en su día a día, esa conversación pasa en Dominicode Labs.

    Saber cuándo no usar un método es la parte que nadie te enseña, y es la que separa aplicarlo de entenderlo.

    Preguntas frecuentes

    ¿Entonces Spec-Driven Development no sirve para proyectos pequeños?

    Sirve, pero el tamaño del proyecto no es la variable correcta. La variable es cuánto cuesta deshacer la tarea si sale mal y cuánta gente toca ese código. Un proyecto pequeño con una migración de datos y un cobro de por medio necesita spec. Un proyecto enorme donde vas a cambiar el texto de un botón, no. Y si dudas, escríbela: la duda suele significar que la tarea es más grande de lo que parecía.

    ¿Qué escribo en lugar de una spec cuando la tarea no la necesita?

    Bajas un escalón de artefacto, no bajas a cero. Hay cinco: spec completa, spec corta (objetivo, criterio de aceptación y qué queda fuera), un plan aprobado antes de tocar código, un test que falla, y nada. La mayoría del trabajo diario vive en los escalones dos y tres, no en el uno. La pregunta útil no es "¿spec sí o no?" sino cuál es el artefacto más barato que evita que eso salga mal.

    ¿Qué escribo en lugar de una spec cuando arreglo un bug?

    Un test que falla. Reproduce el fallo, aísla el caso mínimo, escribe el test en rojo, arregla el código y deja el test dentro del repositorio. Ese test cumple la misma función que una spec —fijar el comportamiento esperado— con dos ventajas: es ejecutable y el CI lo comprueba solo. La excepción es cuando nadie sabe cuál debería ser el comportamiento correcto; eso no es un bug, es un requisito sin decidir, y ese sí se especifica.

    ¿Puedo escribir la spec después de tener el código?

    Puedes, pero llámalo por su nombre: documentación. El valor de una spec está en el orden, porque su trabajo es cambiar decisiones antes de que se conviertan en código. Escrita después, no puede cambiar ninguna. Sirve para onboarding y para dejar constancia, y eso tiene su utilidad, pero no está gobernando nada.

    ¿Qué hago si los requisitos cambian cada semana?

    Acorta el alcance de la spec en lugar de abandonarla. Especifica solo la parte del dominio que ya está cerrada, marca de forma explícita lo que sigue en discusión y ponle caducidad al documento. El riesgo grande no es no tener spec, es tener una obsoleta: un agente no sabe distinguirla de una vigente y construirá encima con total seguridad.

    ¿Y si voy a delegar la tarea completa a un agente de código?

    Entonces escribe la spec aunque la tarea parezca pequeña. Cuando delegas, cada hueco que dejes sin especificar lo rellena el modelo con una suposición razonable, y esas suposiciones son las más difíciles de detectar revisando el diff. Ahí la spec no compite contra tu tiempo de escribir código: compite contra tu tiempo de revisar código ajeno, que siempre es más caro.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo explicar IA a tu jefe: 6 frases que acaban en tu sprint

    Cómo explicar IA a tu jefe: 6 frases que acaban en tu sprint

    La reunión duró cuarenta minutos. Al final, el director de producto lo cerró con una frase: "entonces montamos un agente que conteste con nuestra documentación y que no se invente nada, para el sprint que viene".

    Todo el mundo asintió. Yo también asentí, y ese fue mi error.

    En esa frase había tres proyectos distintos, un criterio de aceptación imposible de cumplir y una fecha. Lo que aprendí ese trimestre es que explicar IA a negocio no es un favor que le haces a tu jefe: es una tarea técnica que, si no haces, la pagas tú.

    Resumen rápido

    Explicar IA a negocio no consiste en corregir términos: consiste en convertir cada frase de la reunión en una decisión escrita antes de que llegue al sprint como alcance. Seis frases hacen casi todo el daño: "es solo un prompt", "necesitamos un agente", "entrénalo con nuestros datos", "que no alucine", "con IA iremos mucho más rápido" y "¿esto ya está en producción?". El método son cuatro pasos: traduce a decisión y no a definición, pon el tradeoff con números aunque sean aproximados, deja la decisión escrita y pelea el alcance en lugar de la palabra.

    El malentendido no se queda en la reunión: acaba en el alcance de tu sprint

    Cuando alguien de negocio usa mal un término técnico, tú y yo hacemos lo mismo: dejarlo pasar. No es el momento, se entiende por el contexto.

    El problema es que en proyectos de IA los términos no son adorno. Son alcance.

    "Agente" no describe una feature: describe un sistema con permisos y modos de fallo propios. "Que no alucine" no es un requisito: es una promesa que nadie puede firmar. Y las dos acaban redactadas como criterios de aceptación por alguien que no tenía por qué saber lo que esas dos palabras arrastran.

    Heredas el malentendido convertido en alcance. Y el alcance, a diferencia de la palabra, tiene fecha.

    Las definiciones limpias están en el diccionario de términos de IA y puedes mandar ahí a quien pregunte. Aquí van las seis frases y la factura que te llega cuando nadie las traduce.

    Traducir IA a negocio: las seis frases y lo que cuestan

    Estas son las seis frases que más veces he oído en reuniones de proyecto de IA, lo que cree quien las dice y la factura concreta que llega al sprint:

    Lo que dice Lo que cree que significa Lo que te llega al sprint
    "Es solo un prompt" Una frase bien escrita, medio día La estimación dividida entre tres
    "Necesitamos un agente" Un chat con botones Un sistema con permisos sobre datos reales
    "Entrénalo con nuestros datos" Que el modelo aprenda de sus PDF Semanas en el proyecto equivocado
    "Que no alucine" Un bug que se arregla Un criterio de aceptación que no cierra nunca
    "Con IA iremos mucho más rápido" El mismo trabajo en menos tiempo Fechas puestas sobre una cifra que nadie midió
    "¿Esto ya está en producción?" Si responde, está terminado Tú eres el sistema de evaluación, en tu tiempo

    "Es solo un prompt" — por qué la estimación se te va al triple

    Cree que el trabajo es redactar bien una instrucción. Medio día, uno si hay que probar variantes.

    El prompt es la pieza pequeña. Alrededor va el contexto que le pasas, las herramientas que puede llamar, qué ocurre cuando devuelve basura y cómo compruebas que la semana que viene sigue funcionando igual. Todo eso junto es lo que conté en por qué un LLM por sí solo no es un producto.

    El coste llega en la estimación: dijiste dos días pensando en la instrucción, y el ticket incluía en silencio todo lo demás. Cuando pides más tiempo, la conversación ya no es "el problema era más grande", es "¿por qué tardas el triple en escribir una frase?".

    "Necesitamos un agente" — qué te están pidiendo en realidad

    Cree que es un chat con botones que contesta en lenguaje natural.

    De verdad es un bucle que decide por su cuenta, llama herramientas y tiene permisos sobre sistemas reales. La distancia entre las dos cosas la desarrollé en IA generativa vs IA agéntica, y es la distancia entre dos presupuestos.

    El coste es que diste una estimación para un envoltorio de chat y te han pedido un sistema que actúa solo. Y "actúa" arrastra preguntas que no estaban en el ticket: sobre qué puede escribir, quién lo autoriza, cómo se detiene a mitad de ejecución, qué queda auditado.

    Ninguna cabe en el sprint que ya tenía fecha antes de que existieran.

    "Entrénalo con nuestros datos" — semanas en el proyecto equivocado

    Cree que toca fine-tuning: echarle los PDF de la empresa al modelo y que aprenda.

    Casi siempre lo que quiere es que el sistema busque en sus documentos antes de responder. Cuál toca en cada caso lo conté en RAG vs fine-tuning vs contexto.

    El coste son semanas en el proyecto equivocado. Y lo peor no es el tiempo: después nadie lo lee como un malentendido de alcance, se lee como que "la IA no funcionó" y que el que la montó fuiste tú.

    La versión hermana es "ponle memoria", que para quien lo dice significa acordarse de todo para siempre. Debajo hay ventana de contexto y coste por token. Si no sale antes, eliges arquitectura para sostener una expectativa que nadie revisó.

    "Que no alucine" — el criterio de aceptación que no cierra nunca

    Cree que es un bug: se abre ticket, se arregla, se cierra.

    Es consecuencia de cómo funciona el modelo. Se acota con límites de dominio, verificación y citas, y se reduce mucho. No se elimina. El porqué está en por qué la IA se inventa cosas.

    Este es el más caro de la lista por una razón concreta: se escribe. "El sistema no debe dar información incorrecta" aterriza tal cual como criterio de aceptación, y es una casilla que no vas a marcar nunca. No porque sea difícil: porque no se puede demostrar sobre entradas que no controlas. En la demo funciona y en la retro siguiente alguien trae un caso.

    Te quedas como responsable indefinido de algo que, por diseño, no tiene línea de meta.

    "Con IA iremos mucho más rápido" — la cifra que nadie midió

    Cree que es el mismo trabajo en menos tiempo.

    La IA mueve el cuello de botella: escribir código deja de ser lo caro, y especificar y revisar código que no escribiste pasan a serlo. Es lo que más ha cambiado en 15 años programando, y revisar es trabajo aunque no aparezca en ningún tablero.

    El coste son fechas puestas sobre una cifra que nadie midió. Nadie dice en voz alta "asumamos que iremos un 40% más rápido": se asume en silencio y aparece en el roadmap.

    Y cuando alguien lo mide en serio, el resultado incomoda. En el ensayo controlado de METR, 16 developers open-source experimentados resolvieron 246 tareas con y sin IA: creyeron que habían ido un 20 % más rápidos y en realidad tardaron un 19 % más. Cuidado con usar ese dato como arma, porque el propio METR lo da hoy por histórico —las herramientas eran de principios de 2025— y sirve justo para lo contrario de lo que parece: si los únicos que lo midieron con rigor ya no dan su número por vigente, nadie debería estar poniendo fechas sobre uno inventado.

    Sin medición no hay defensa: si el trimestre se cumple, la IA funcionó; si no, el equipo no la supo aprovechar. Lo único que rompe el bucle es llegar con números propios, y de eso va cómo medir la productividad en equipos que usan IA.

    "¿Esto ya está en producción?" — sin evals, el sistema de evaluación eres tú

    Cree que si responde bien en la demo, está terminado.

    Sin evals automáticos, que son los unit tests de un sistema con LLM, ni observabilidad, no sabes si funciona. Sabes que no ha explotado delante de ti todavía.

    El coste es el más silencioso de todos: tú eres el sistema de evaluación. Cada ajuste de prompt, cada versión nueva del modelo, cada caso raro que reporta un cliente pasa por tu criterio, a mano. Ese trabajo no está en ninguna planificación y crece con el uso: cuanto mejor le va al producto, más de tu tiempo se come mantenerlo respirando.

    Cómo explicar IA a tu jefe sin quedar de listo

    Tener razón no sirve de nada si la forma de decirlo te deja fuera de la conversación. Quien pide esto tiene su propia fecha encima. Cuatro cosas que funcionan.

    1. Traduce a decisión, no a definición. No expliques qué es un agente. Pregunta: "cuando dices agente, ¿quieres que actúe solo o que responda cuando le preguntan?". La definición no cambia nada; esa respuesta cambia el proyecto. Y la contesta él, así que la decisión sigue siendo suya.

    2. Pon el tradeoff con números, aunque sean aproximados. "Dos semanas si solo responde, seis si actúa solo" convierte un debate de palabras en una elección con precio. Da siempre rango y nunca una fecha suelta: la fecha se te queda pegada. Y si puedes, remata con la versión pequeña: "el día 12 tienes la que responde y cita fuentes; la que actúa sola es otra conversación". No estás negociando el alcance desde arriba, estás poniendo algo antes sobre la mesa. Con eso discute muchísima menos gente.

    3. Deja la decisión escrita. No hace falta un documento formal: dos líneas en el ticket o un correo con copia a los que estaban en la reunión. No es para tener razón después, sino para que el malentendido salga antes de escribir código. Si ahí pone "el sistema responde consultas, no ejecuta acciones sobre datos de cliente", quien lo lee contesta "espera, yo quería que ejecutara". Y te lo dice el martes, no en la demo del mes que viene. Ese es el argumento real para trabajar con especificaciones y la base del libro de Spec-Driven Development.

    4. No pelees la palabra, pelea el alcance. Da igual cómo lo llame. Lo que tiene que quedar fijado por escrito es qué hace, con qué permisos y qué pasa cuando falla. Esas tres cosas son el contrato; el término es decoración.

    Y si te toca opinar antes de que se apruebe el proyecto, ahí van cinco preguntas antes de aprobar un proyecto de IA.

    Explicar IA a negocio es parte de tu trabajo técnico

    Lo que cambió con la IA es el margen entre lo que negocio cree que pide y lo que hay que construir. Ese margen lo pagas tú en horas.

    Mañana, en la próxima reunión donde suelten una de estas seis frases, no la corrijas. Haz una pregunta que fuerce una decisión y escribe la respuesta en el ticket con las palabras de quien la dijo.

    Con eso dejas de heredar el malentendido. Y en un proyecto de IA, eso es la mitad del trabajo.

    Estas conversaciones, sobre proyectos reales, pasan cada semana en Dominicode Labs.

    Preguntas frecuentes

    ¿Cómo explico un proyecto de IA a mi jefe?

    No lo expliques: conviértelo en una decisión suya. Pregunta si el sistema tiene que actuar por su cuenta o solo responder cuando le preguntan, pon precio a cada opción en la misma frase ("dos semanas si solo responde, seis si actúa solo") y escribe la respuesta en el ticket con sus palabras. La definición no cambia nada; esa decisión cambia el proyecto entero.

    ¿No es el trabajo de mi jefe entender lo que pide?

    Entenderlo es su trabajo, sí, pero el coste de que no lo entienda cae en tu calendario, no en el suyo. Traducir hacia arriba no es un favor: es proteger tu propia estimación, y es una habilidad senior tan real como diseñar el sistema.

    ¿Cómo explico que "que no alucine" no es un requisito válido sin sonar a excusa?

    No discutas el requisito: propón otro que sí se pueda verificar. Cambia "no debe dar información incorrecta" por "toda respuesta cita el fragmento del que sale, y si la búsqueda no devuelve nada, el sistema responde que no lo sabe".

    Que eso último lo decida la búsqueda y no el modelo es lo que lo hace comprobable. Y añade la segunda mitad antes de que te la traigan ellos: sobre una lista fija de preguntas, alguien revisa que el fragmento citado sostenga la respuesta. Citar el documento correcto y tergiversarlo también es fallar.

    ¿Qué pregunto exactamente cuando alguien dice "necesitamos un agente"?

    Pregunta una sola cosa: "¿quieres que actúe por su cuenta o que responda cuando le preguntan?". Si contesta que actúe, encadena tres más: sobre qué sistemas puede escribir, quién lo autoriza y qué pasa cuando se equivoca. Esas cuatro respuestas son el alcance real.

    ¿Cómo sé si me están pidiendo fine-tuning o búsqueda sobre documentos?

    Pregunta qué pasa cuando el documento cambia. Si la respuesta es "tiene que responder con la versión nueva ya", están describiendo búsqueda sobre documentos, no entrenamiento. El fine-tuning ajusta cómo responde el modelo; si metes ahí información que cambia cada semana, te toca reentrenar cada semana.

    ¿Cómo estimo si negocio aún no ha decidido si el sistema actúa o solo responde?

    No estimes el proyecto: estima las dos versiones. Un rango para la que solo responde y otro para la que actúa sobre datos reales, con la diferencia en una línea. Así la fecha queda atada a esa decisión y no a tu velocidad.

    ¿Y si mi jefe se molesta cuando le matizo un término?

    No corrijas la palabra y ese roce casi nunca aparece. Lleva la conversación a qué hace el sistema, con qué permisos y qué ocurre cuando falla, y deja que él lo llame como quiera.

    Y si ya se ha molestado, no lo resuelvas en la reunión. Escríbele después el comportamiento que entendiste, con sus palabras, y pregúntale si es eso. Cuesta mucho ofenderse con alguien que te está confirmando lo que pediste.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo formar a tu equipo de desarrollo en IA en 6 semanas

    Cómo formar a tu equipo de desarrollo en IA en 6 semanas

    Cada vez que entro a dar una formación de IA a un equipo de desarrollo, hago la misma pregunta antes de encender el proyector: ¿qué no le dejáis hacer a la IA?

    Y casi siempre pasa lo mismo. Silencio. No un silencio incómodo: un silencio de gente que nunca se lo había planteado porque nadie se lo había preguntado.

    Formar a tu equipo de desarrollo en IA no consiste en repartir licencias ni en enseñar a escribir prompts: consiste en acordar por escrito qué se delega a la IA, cómo se revisa lo que genera y quién responde cuando falla. Eso es justo lo que ese silencio deja al descubierto.

    Al rato alguien contesta: "lo crítico lo revisamos bien". Pregunto qué es crítico. Salen tres definiciones distintas en la misma sala, y las tres personas llevan dos años trabajando en el mismo repositorio.

    Ahí está el problema entero. No es que el equipo no sepa usar la herramienta. Es que cada uno decide por su cuenta dónde termina la máquina y dónde empieza él.

    Comprar licencias no es formar a tu equipo de desarrollo en IA

    El patrón se repite en casi todas las empresas que me llaman. Dirección aprueba las licencias, se manda un email de anuncio, se hace una demo de una hora, y a partir de ahí "el equipo ya usa IA".

    Seis meses después sube la actividad. Más commits, más PRs, más líneas. Y nadie en esa organización sabe decir si el equipo va mejor o solo va más rápido cuesta abajo.

    Los datos del sector cuentan esa misma historia. El informe DORA 2025 sobre desarrollo asistido por IA, con casi 5.000 profesionales encuestados, encontró que el 90% ya usa IA en su trabajo y más del 80% cree que le hace más productivo.

    Pero un 30% reconoce tener poca o ninguna confianza en el código que esa IA genera. Trabajamos a diario con algo en lo que no confiamos.

    La encuesta a desarrolladores de Stack Overflow 2025 afina el diagnóstico: la frustración número uno, citada por el 66%, son las soluciones "casi correctas, pero no del todo". Y hay más gente que desconfía de la precisión de estas herramientas (45,7%) que gente que confía (32,7%).

    Lee eso otra vez con gorra de manager. El trabajo de tu equipo se ha desplazado a detectar lo casi-correcto. Eso no es una habilidad de herramienta. Es criterio.

    La conclusión más incómoda del informe DORA cabe en una frase suya: "AI doesn't fix a team; it amplifies what's already there". La IA no arregla un equipo, magnifica lo que ya había. Un equipo con estándares claros se vuelve más rápido y más consistente. Un equipo sin criterio compartido genera incoherencia a mayor velocidad y con mejor presentación.

    Por eso la adopción no es la competencia. El porcentaje de gente con la extensión instalada es una métrica de compras, no de ingeniería.

    Qué es exactamente "la parte de criterio" (en operativa, no en filosofía)

    Cuando digo criterio no hablo de sabiduría abstracta. Hablo de cuatro decisiones que alguien de tu equipo toma cada día, casi siempre sin acuerdo.

    Uno: qué se delega y qué no. Las tareas con dependencias de estado y decisiones encadenadas necesitan supervisión constante; las independientes y verificables se pueden lanzar en paralelo sin drama. Desarrollé esa separación en cómo clasificar tareas con IA en desarrollo de software, y es el primer acuerdo que debería tener un equipo por escrito.

    Dos: cómo se revisa código que no escribió un humano. Revisar el código de un compañero es revisar una intención que puedes preguntar. Revisar un diff generado es revisar una salida sin intención detrás. Menos estilo y naming, más "¿esto resuelve nuestro problema o uno parecido?".

    Tres: quién firma lo que sale a producción. Autoría y responsabilidad se han separado, y muchos equipos no lo han asumido. El modelo no está de guardia a las tres de la mañana. Si no hay un nombre humano pegado a ese despliegue, no hay dueño.

    Cuatro: qué haces cuando la propuesta funciona pero está mal. Este es el caso difícil. Pasa los tests, hace lo que pedía el ticket, y mete un patrón que dentro de cuatro meses te obliga a reescribir un módulo. Un dev con criterio lo rechaza aunque esté verde. Uno sin criterio lo mergea porque está verde.

    Decisión de criterio Síntoma cuando falta
    Qué se delega Cada dev tiene su umbral y la base de código parece escrita por cinco equipos
    Cómo se revisa Aprobaciones rápidas en diffs de 400 líneas que nadie ha leído entero
    Quién firma Cuando algo rompe, la primera frase es "eso lo generó la IA"
    Funciona pero está mal Deuda técnica nueva cada sprint, sin ninguna decisión que la haya causado

    Lo que la IA se ha llevado es la parte mecánica; escribí sobre ese desplazamiento en lo que cambió de verdad en el desarrollo con IA. Lo que queda es esta lista. Y esta lista es justo la que nadie está formando.

    El problema de los juniors: le has quitado su gimnasio

    Delegar a la IA el trabajo de bajo valor elimina justo las tareas con las que un junior se hacía senior. Es la parte de la que menos se habla y la que más me preocupa.

    El CRUD repetitivo, el test aburrido, el refactor pequeño, el bug tonto de dos horas: trabajo de bajo valor para la empresa y de altísimo valor para el que empezaba. Ahí aprendía un junior a leer un stack trace, a oler dónde rompe algo y a intuir por qué una decisión de ayer duele hoy.

    Si delegas ese bloque entero, el junior no se convierte en senior. Se convierte en revisor de algo que no sabe evaluar. Y un revisor sin criterio aprueba con una seguridad que asusta.

    No te digo que prohíbas la IA a los juniors: eso los deja fuera del mercado. Te digo que rediseñes por dónde entra el aprendizaje, con tres reglas que puedes implantar esta semana:

    • Primero a mano, después con IA. Elige dos o tres categorías de tarea (tests de lógica de negocio, consultas a base de datos) donde el junior hace la primera implementación sin asistente. A partir de la segunda, con lo que quiera. El objetivo no es sufrir: es tener un modelo mental propio contra el que comparar. Esto va por confianza, y la que lo hace cumplir de verdad es la regla siguiente.
    • Prohibido "no sé por qué funciona". Si no puede explicar el diff línea a línea en la revisión, no se mergea. Acótalo para que sobreviva al tercer mes: en los PRs que tocan lógica de negocio, y durante los primeros meses de cada junior. Un senior sentado en todos los PRs de todos los juniors no escala más allá de dos.
    • PR saboteado semanal. Un senior coge un PR generado con IA, le planta un fallo real (una condición invertida, un await que falta, un índice que se cae en la query nueva) y se lo pasa al junior. Tres condiciones para que esto no acabe siendo una novatada: el junior sabe que es un ejercicio y que hay un fallo, la rama vive fuera del flujo de merge para que nadie la apruebe por error, y al terminar se enseña el fallo aunque no lo haya encontrado. No se puntúa. Treinta minutos. Y una vez al mes se invierte: el junior sabotea y busca el senior. Es el ejercicio más barato y más eficaz que conozco para entrenar la mirada.

    Las tres cuestan tiempo de las personas más caras del equipo — cuenta unas 2 horas de senior por junior y semana. Es el precio real de que dentro de dos años tengas seniors.

    Y un cuarto movimiento que cambia el rol: que el junior escriba la especificación y la IA implemente. Deja de aprender tecleando y empieza a aprender decidiendo, que es donde está el valor ahora. Es la base de por qué el spec define hoy tu ventaja competitiva, y el método completo está en el libro de Spec-Driven Development.

    Si buscas algo que darle a un junior para que recorra ese camino por su cuenta, el curso Construye con IA va justo de eso: de la idea al producto decidiendo, no tecleando.

    Criterio compartido: el acuerdo que tu equipo debería tener escrito

    Un equipo donde cada dev tiene su propio umbral de delegación no tiene un problema de talento. Tiene un problema de varianza.

    Cinco personas razonables tomando cinco decisiones razonables distintas producen una base de código incoherente. Y eso no se detecta en el PR: se detecta seis meses después, cuando hay tres formas de hacer lo mismo y nadie sabe cuál es la buena.

    La solución no es un curso. Es un documento de una página que el equipo redacta y firma. Un acuerdo de uso de IA es ese documento: fija, por categoría de tarea, qué se delega al modelo, con qué nivel de revisión y quién tiene que dar el visto bueno. Cabe en esto:

    Categoría Regla Quién aprueba
    Qué se le pega al modelo Nunca secretos, credenciales ni datos reales de cliente: sintéticos o anonimizados. Solo herramientas aprobadas por la empresa Autor del PR
    Scaffolding, boilerplate, migraciones sin cambio de esquema Se delega completo Autor del PR
    Tests de lógica existente Se delega, revisión normal. El test tiene que fallar al menos una vez antes de aprobarse Autor del PR
    Refactor que cruza módulos o toca una API pública Se delega la implementación, el plan lo escribe un humano Autor + un revisor
    Auth, permisos, pagos, datos personales Se puede generar, revisión obligatoria de dos personas Owner del módulo
    Cambios de esquema en producción No se delega la decisión Tech lead
    Infra, pipelines de CI/CD y secretos No se delega la decisión Tech lead
    Dependencias nuevas La IA propone, un humano aprueba antes de que entre en el package.json Tech lead

    La fila de los tests es la que más gente se salta y la que más caro sale: un test generado certifica el comportamiento actual, bug incluido. Si rompes a mano lo que prueba y sigue en verde, ese test no vale nada.

    Tres reglas al pie del documento que valen más que la tabla:

    1. Toda excepción se justifica en una línea dentro del PR. Una línea, no un ensayo.
    2. Quien abre el PR responde del código, lo haya escrito él o no. La tabla dice quién aprueba; la responsabilidad no se reparte.
    3. El acuerdo se revisa cada trimestre. Si crece a ocho páginas, nadie lo lee y deja de existir.

    Métetelo en el repositorio, no en Confluence. En el CONTRIBUTING.md, en el CLAUDE.md o en el AGENTS.md, donde lo lean el equipo y los agentes. Y protege con CODEOWNERS las rutas críticas, pero acuérdate de activar en la rama principal la regla "Require review from Code Owners": sin esa casilla, CODEOWNERS sugiere revisores y no bloquea nada. Con la casilla puesta, el acuerdo deja de depender de la memoria de nadie un viernes a las siete.

    Y si quieres el punto de partida, este es el bloque que pego yo en el repo:

    # Acuerdo de uso de IA — v1
    Revisión: cada trimestre. Si crece a 8 páginas, deja de existir.
    
    | Categoría | Regla | Quién aprueba |
    |---|---|---|
    | Qué se le pega al modelo | Nunca secretos ni datos reales de cliente | Autor del PR |
    | Scaffolding, boilerplate, migraciones sin cambio de esquema | Se delega completo | Autor del PR |
    | Tests de lógica existente | Se delega. Debe fallar una vez antes de aprobarse | Autor del PR |
    | Refactor que cruza módulos o toca API pública | El plan lo escribe un humano | Autor + revisor |
    | Auth, permisos, pagos, datos personales | Revisión de dos personas | Owner del módulo |
    | Cambios de esquema en producción | No se delega la decisión | Tech lead |
    | Infra, CI/CD y secretos | No se delega la decisión | Tech lead |
    | Dependencias nuevas | La IA propone, un humano aprueba | Tech lead |
    
    1. Toda excepción se justifica en una línea dentro del PR.
    2. Quien abre el PR responde del código, lo haya escrito él o no.
    3. Nada se mergea si el autor no lo puede explicar línea a línea.
    

    Facilitar esa redacción con el equipo delante —y que salga en una sesión, no en tres meses de hilo de Slack— es la mitad del trabajo de una formación en IA para equipos de desarrollo. El documento no vale por lo que dice: vale porque lo escribieron ellos.

    Cómo medir si la formación en IA de tu equipo sirvió de algo

    La formación funcionó si el equipo converge: si ante el mismo ticket da menos respuestas distintas que antes de empezar. Lo que no sirve es medir líneas de código o PRs mergeados — con IA esas dos suben aunque el equipo esté empeorando. Ya conté qué medir en un equipo que usa IA en lugar de eso.

    Para evaluar la formación en concreto uso una medida que no vas a encontrar en ningún dashboard, porque me la inventé yo: la dispersión de criterio, es decir, cuántas respuestas distintas da tu equipo cuando le preguntas qué delegaría de un mismo ticket. Se mide así.

    Coges cinco tickets reales del backlog y preguntas a cada dev, por escrito y en anónimo, si los delegaría enteros, en parte o nada. Anotas el reparto antes de empezar. Seis semanas después repites el ejercicio con cinco tickets distintos pero del mismo perfil: si repites los mismos, lo que mides es si se acuerdan del acuerdo que firmaron, no si tienen criterio.

    Mira cuánta gente coincide en la opción mayoritaria de cada ticket. Si en la primera ronda el equipo se reparte entre las tres opciones y en la segunda ocho de cada diez coinciden, la formación funcionó. Si sigue repartido, has pagado una charla.

    Un detalle que evita el autoengaño: mete entre los cinco un ticket que ya salió mal en producción por haberlo delegado. Ese te dice si el equipo converge hacia el criterio bueno o simplemente converge hacia el que habla más alto en las reuniones.

    Añade tres indicadores de salud que ya deberías estar mirando: ciclos de revisión por PR, defectos que llegan a producción y tiempo de recuperación cuando algo rompe. El último es el más revelador, porque un equipo que no entiende el código que desplegó tarda muchísimo en arreglarlo.

    Y una métrica que no debes usar jamás: porcentaje de código generado por IA. Es vanidad pura y encima incentiva justo lo contrario de lo que quieres.

    Plan de 6 semanas para formar a tu equipo de desarrollo en IA

    Nada de trimestres ni de planes estratégicos: esto empieza el lunes. Seis semanas, una o dos sesiones por semana, y cada semana cierra con un entregable — diagnóstico, borrador del acuerdo, acuerdo firmado en el repo y segunda medición de dispersión.

    Semana Qué haces Entregable
    1 Diagnóstico, sin formación. Cada dev trae el PR más grande del último mes que se aprobó en menos de diez minutos, y se lee en voz alta en una sesión de 60 min. Se anotan de paso los términos donde el equipo no coincide Foto real del punto de partida, glosario común y medición inicial de dispersión
    2-4 Criterio en vivo. Dos sesiones semanales revisando PRs reales del repo, no ejemplos de juguete. Cada sesión añade una línea al acuerdo Borrador del acuerdo de uso de IA
    3 Arranca en paralelo la pista de juniors (primero a mano, PR saboteado) y sigue corriendo hasta el final Rutina semanal instalada
    5 Se cierra y se firma el acuerdo v1. Se mete en el repo y se cablea lo automatizable: bloquear PRs que tocan package.json sin aprobación del tech lead, límite de tamaño de diff, y el check de que la línea de justificación está en la descripción del PR Acuerdo v1 en producción
    6 Segunda medición de dispersión y retro Comparativa antes/después

    Coste total: entre 8 y 10 sesiones en seis semanas, alrededor de hora y media por persona y semana. Ese es el número que necesitas para venderlo hacia arriba.

    Las semanas 2, 3 y 4 deciden el resultado. Es donde el equipo discute casos concretos con el código delante y donde salen los desacuerdos que llevaban meses enterrados. Si te saltas esa parte y das teoría, acabas con gente que recita buenas prácticas y sigue mergeando lo que no entiende.

    Fíjate en que no hay ninguna semana de vocabulario. Si el 90% del equipo ya usa IA a diario, dedicar cinco días a explicar qué es una ventana de contexto es formación para un equipo que no tienes: los términos salen solos en la sesión de diagnóstico, y ahí se anotan.

    Si prefieres no llevar esto tú solo, es exactamente el trabajo que hago con equipos internos: seis semanas, adaptadas al stack real y con el acuerdo saliendo de los PRs del propio repo. Así funciona una formación para tu equipo.

    Por dónde empiezas el lunes

    Reúne al equipo cuarenta y cinco minutos, pon tres tickets reales encima de la mesa y que cada uno diga qué delegaría de cada uno. No pidas opiniones generales: vas a ver la dispersión en directo, y ese reparto es tu punto de partida.

    La herramienta se compra en una tarde. El criterio se acuerda, se escribe y se revisa. Esa diferencia es todo lo que separa a un equipo que usa IA de un equipo que la aprovecha.

    Preguntas frecuentes

    ¿Cuánto tiempo necesita un equipo para formarse en IA de verdad?

    Seis semanas para tener criterio compartido y un acuerdo escrito funcionando. La parte técnica pura son entre 8 y 24 horas según el nivel, pero sin las sesiones de revisión sobre código real el conocimiento no se convierte en práctica de equipo.

    ¿Sirve este plan para un equipo de 3 personas? ¿Y para 40?

    Para 3 sí, comprimido: las semanas 2, 3 y 4 se hacen en dos. Por debajo de 3 el acuerdo no aporta gran cosa, porque no hay varianza que reducir.

    Por encima de 15 no funciona en una sola sala: se hace por squad, cada uno redacta su acuerdo y luego se consolidan las reglas comunes en el repositorio raíz.

    ¿Debo prohibir la IA a los juniors hasta que tengan más nivel?

    No, eso los deja fuera del mercado y además la usarán igual sin que te enteres. Lo que sí funciona es acotar dónde la usan: que hagan la primera implementación de ciertas categorías de tarea sin asistente, y que no mergeen nada que no sepan explicar línea a línea.

    ¿Quién es responsable si el código generado por IA rompe producción?

    Quien abrió el pull request. La autoría del código y la responsabilidad sobre él se separaron, y la única forma de que un sistema siga funcionando es que la responsabilidad se quede pegada a un nombre humano. Escríbelo en el acuerdo del equipo antes de que ocurra el primer incidente.

    ¿Cómo justifico ante dirección invertir en formación si ya pagamos las licencias?

    Con la diferencia entre adopción y resultado. La licencia demuestra que la gente usa la herramienta; no dice nada sobre defectos en producción, ciclos de revisión ni tiempo de recuperación. Lleva esos tres números a la reunión junto con la medición de dispersión de criterio y la conversación cambia de tono.

    ¿Qué hago si un dev senior se niega a usar IA?

    Escúchale primero, porque su objeción suele ser de calidad y suele tener parte de razón. Después conviértelo en el dueño de la parte de revisión del acuerdo: la gente que desconfía escribe las mejores reglas de control, y así deja de ser un bloqueo para ser una garantía.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
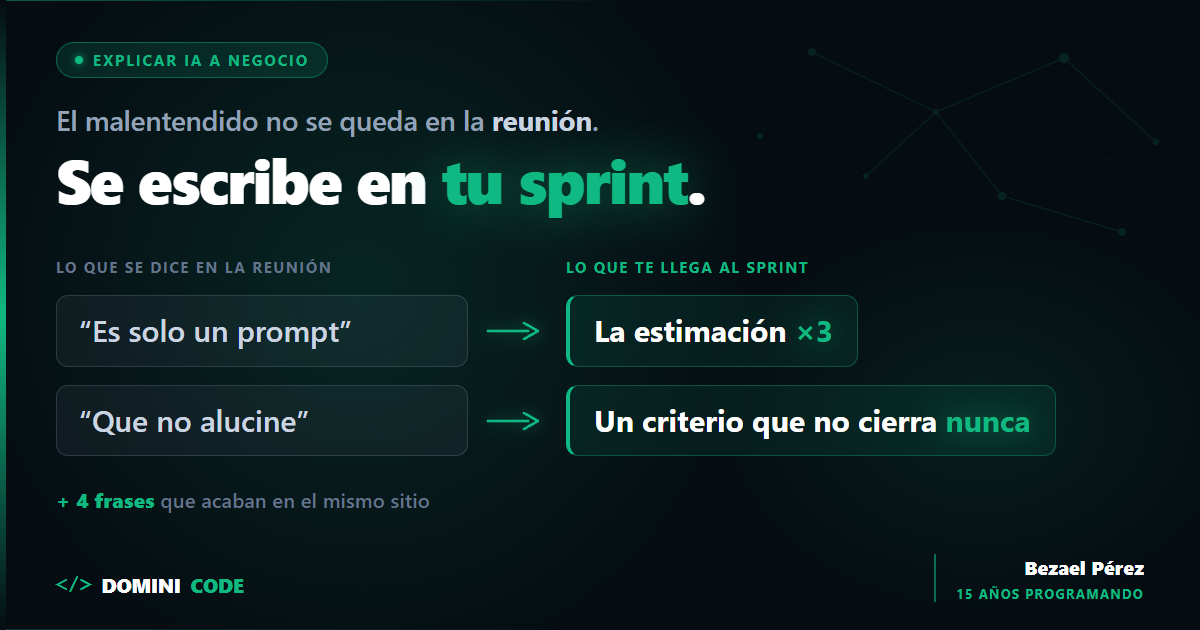
  • Llevo 15 años programando: esto es lo que cambió con la IA

    Llevo 15 años programando: esto es lo que cambió con la IA

    Hace quince años, construir una funcionalidad significaba abrir un archivo en blanco y teclear cada línea hasta que compilaba. Cuando me atascaba, Stack Overflow. Cuando Stack Overflow fallaba, la documentación. Cuando la documentación mentía, prueba y error durante horas. Así aprendí el oficio y así trabajé la primera mitad de mi carrera.

    Esta mañana he construido un módulo completo sin teclear una sola línea de implementación a mano.

    Llevo quince años en esto y he visto pasar muchas modas. El desarrollo de software con IA no es una más. Es lo único que ha cambiado de raíz cómo hago mi trabajo. Pero no por la razón que casi todo el mundo repite en LinkedIn.

    Lo que ha cambiado no son las herramientas. Es el rol.

    Ya no me pagan por escribir código. Me pagan por decidir qué código debe existir, especificarlo bien y verificar que lo que se ha escrito es correcto. El tecleo —la parte que durante quince años fue la mayor parte del oficio— se ha vuelto la parte barata.

    Y si quieres la definición limpia, esta es la mía: el desarrollo de software con IA es la práctica de construir software delegando la escritura del código a modelos y agentes, mientras el developer se reserva las tres decisiones que siguen siendo suyas —qué construir, cómo debe encajar y si lo generado es correcto—.


    De escribir código a orquestarlo: así se programa con IA hoy

    Antes, un día productivo se medía en líneas. Hoy se mide en decisiones acertadas.

    La sesión de esta mañana fue así: abrí un documento, describí qué quería —el comportamiento, los límites, los casos que no debía tocar—, se lo pasé a un agente y me fui a por café. Cuando volví, había un diff de trescientas líneas esperándome.

    Mi trabajo empezó ahí. Leerlo entero. Cuestionar tres decisiones. Rechazar una. Aprobar el resto.

    No escribí la implementación. La orquesté.

    Si tuviera que resumir el cambio en una tabla, sería esta:

    Antes Ahora
    Unidad de medida Líneas escritas Decisiones acertadas
    Cuello de botella Teclear rápido y conocer la API Especificar con precisión
    Habilidad clave Saber escribir código Saber leer y revisar código
    Riesgo principal Bugs por descuido Deuda por código que nadie entendió
    Tu rol Autor Director y revisor

    Y ese cambio no fue de un día para otro. Fue una escalera. Primero el autocompletado —GitHub Copilot en 2021—, que adivinaba el final de la línea. Después el chat, ChatGPT y compañía, al que le pegabas un error y te devolvía una respuesta plausible. Y ahora el agente autónomo, del estilo de Claude Code o Cursor, que lee tu repo, ejecuta comandos, mira la salida y decide el siguiente paso sin ti. Si todavía andas en el primer escalón, la guía de Agentes de IA es el mejor sitio para entender qué hace distinto al último.

    Esa forma de trabajar en bucle —delegar, observar, corregir, repetir— tiene su propia disciplina, y la desarrollé entera en Loop Engineering: la evolución del desarrollo con IA. Porque diseñar bien ese bucle es hoy más determinante que elegir el modelo de moda.


    El cuello de botella del desarrollo de software con IA se movió: ahora está en especificar

    Durante años, el cuello de botella era teclear rápido y conocer la API de memoria. El que escribía más limpio y más rápido ganaba.

    Hoy el cuello de botella es otro: describir con precisión lo que quieres.

    Un agente hace lo que le pides al pie de la letra, no lo que querías decir. Todo lo que no especificas, lo inventa. Y lo inventa con una seguridad que asusta.

    Por eso el trabajo de más valor ya no es escribir la función. Es escribir la especificación de la función: el resultado esperado, los límites, los casos borde, lo que queda explícitamente fuera del alcance.

    Esto no es teoría. Es la metodología que uso a diario y la que documenté entera en el libro de Spec-Driven Development: especificar primero, delegar después. Si quieres el porqué antes que el cómo, lo cuento en Spec-Driven Development: la forma de evitar el caos con la IA.

    El developer que sabe redactar una buena especificación multiplica su trabajo. El que sigue tratando al agente como un buscador —"hazme esto"— se pasa el día corrigiendo basura.


    Lo que NO ha cambiado (y por qué el senior vale más que nunca)

    Aquí está la parte incómoda para los que venden que la IA ya programa sola.

    Nada de esto elimina al developer con criterio. Lo hace imprescindible.

    Un agente escribe trescientas líneas en dos minutos. Pero no sabe si esas trescientas líneas encajan en tu arquitectura. No sabe si van a ser un infierno de mantener dentro de un año. No sabe si acaba de duplicar una lógica que ya existía en otro módulo. El agente optimiza para que el criterio de parada se cumpla, no para que el sistema siga vivo dentro de dos años.

    Ese juicio sigue siendo tuyo.

    Y no es una manía mía de señor mayor. El informe DORA 2025 de Google Cloud, hecho con cerca de 5.000 profesionales de todo el mundo, encontró que el 90% ya usa IA en su trabajo y más del 80% dice que le ha subido la productividad. Pero un 30% reconoce tener poca o ninguna confianza en el código que esa IA genera.

    Ahí tienes la foto exacta del oficio hoy: casi todos delegamos, casi nadie firma a ciegas. Esa distancia entre "lo uso todos los días" y "no me fío" es, literalmente, la descripción de tu nuevo puesto de trabajo.

    Y ojo con confundir velocidad con progreso. Generar código rápido no es lo mismo que avanzar rápido. Un diff de trescientas líneas que nadie entiende no es velocidad, es deuda con intereses. Por eso "más rápido" y "mejor" no son la misma métrica, y desarrollé cómo distinguirlas en Cómo medir la productividad de un equipo con IA.

    Hay tres cosas que la IA no ha tocado, y son exactamente las que definen a un buen ingeniero:

    • El criterio. Saber qué construir y, sobre todo, qué no construir.
    • La arquitectura. Decidir cómo encajan las piezas para que el sistema aguante el paso del tiempo.
    • Saber leer código. Porque revisar es la nueva forma de escribir. Un diff que no entiendes es un diff que no puedes aprobar.

    Lo diré claro: hoy saber leer código importa más que saber escribirlo. Escribir lo hace la máquina. Leerlo, entenderlo y detectar dónde se ha equivocado sigue siendo humano.


    Al que no se adapta no lo sustituye la IA

    El miedo que oigo en cada charla es siempre el mismo: "¿La IA me va a quitar el trabajo?".

    No. Pero un developer que orquesta, especifica y revisa bien va a hacer el trabajo de tres que siguen tecleando línea a línea. Y las empresas lo van a notar en la nómina antes de lo que crees.

    No te sustituye la IA. Te sustituye el compañero que sabe usarla.

    La brecha ya no está entre el que programa y el que no. Está entre el que ha movido su trabajo hacia arriba en la cadena —del tecleo a la decisión— y el que sigue midiendo su día en líneas escritas a mano, orgulloso de un esfuerzo que la máquina hace gratis.

    Esa segunda persona no está en peligro por la IA. Está en peligro por negarse a cambiar de rol.


    Qué puedes hacer hoy

    Si llevas años programando y sientes que el suelo se mueve, tienes razón. Se mueve. Pero a tu favor, si haces el cambio a tiempo.

    Deja de medir tu jornada en líneas escritas. Empieza a medirla en decisiones acertadas, especificaciones claras y diffs bien revisados.

    Coge mañana una tarea aburrida y acotada —migrar un módulo, añadir tests a un servicio— y en vez de teclearla, especifícala y delégala. Luego siéntate a revisar el resultado como revisarías el pull request de un junior brillante pero despistado. Ahí, en esa revisión, es donde vas a hacer tu trabajo de senior a partir de ahora.

    Ese es el músculo nuevo. Y como todo músculo, se entrena.

    Si quieres ver este flujo completo montado de principio a fin —de la idea a un producto funcionando, especificando y delegando de verdad— es exactamente lo que construimos en el curso Construye con IA. Y si prefieres hacer el cambio acompañado, con proyectos reales y gente que ya está en esto, te espero en Dominicode Labs.

    El código dejó de ser el trabajo. El criterio para dirigirlo es el trabajo. Muévete hacia ahí.


    Preguntas frecuentes

    ¿La IA va a reemplazar a los programadores?

    No a los programadores con criterio. La IA reemplaza el tecleo, que era la parte mecánica del oficio, no el juicio. Un agente escribe código muy rápido, pero no decide qué construir, no diseña una arquitectura que aguante el tiempo ni sabe si su propia solución es mantenible. Lo que sí ocurre es que un developer que sabe orquestar, especificar y revisar hace el trabajo de varios que siguen escribiendo cada línea a mano. El riesgo no es la IA: es no adaptarse a usarla.

    ¿Necesito seguir aprendiendo a programar si la IA escribe el código?

    Sí, y hoy más que nunca. La IA escribe código, pero alguien tiene que leerlo, entenderlo y decidir si es correcto. No puedes aprobar un diff que no comprendes ni detectar un fallo de arquitectura si no sabes cómo debería estar construido. Saber programar deja de ser una habilidad de producción y pasa a ser una habilidad de criterio y revisión. Sin esa base, delegar en un agente es apostar a ciegas.

    ¿Por dónde empiezo a programar con IA?

    Por una tarea real, aburrida y acotada, no por un proyecto ambicioso. Coge algo que sepas hacer a mano en media hora —migrar un módulo, añadir tests, actualizar una dependencia—, escríbele una especificación clara al agente en lugar de un "hazme esto" y luego revisa el resultado línea a línea. Cuando eso te salga limpio, sube el listón. Trabajar primero la especificación y después delegar es la base de la metodología Spec-Driven Development, y es el orden que evita el caos.

    ¿Qué habilidades necesita hoy un developer?

    Tres que la IA no cubre. Criterio para decidir qué construir y qué no. Arquitectura para que las piezas encajen y el sistema sobreviva al paso del tiempo. Y capacidad de leer código ajeno —ahora, código generado— para revisarlo y aprobarlo con confianza. A eso se suma una habilidad nueva: saber especificar con precisión lo que quieres, porque todo lo que no le dices al agente, se lo inventa. El tecleo rápido ya no está en la lista.

    ¿Sigue haciendo falta un developer senior si la IA programa sola?

    Más que antes. La IA baja el coste de escribir código, lo que multiplica la cantidad de código que se genera y, con él, la superficie donde algo puede salir mal. Alguien tiene que poner criterio arquitectónico, revisar lo que produce el agente y frenar las decisiones que optimizan por cerrar la tarea a costa de la mantenibilidad. Ese trabajo es exactamente el de un senior. La IA no elimina ese rol: lo hace el más valioso del equipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
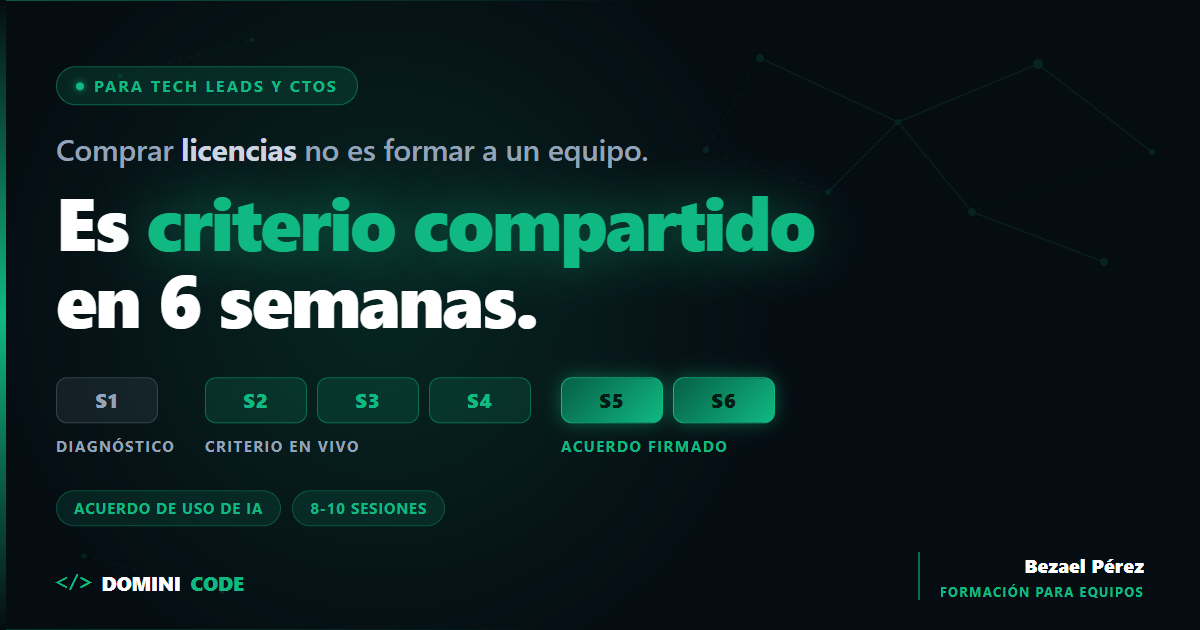
  • Spec-Driven Development (SDD): Evita el caos de la IA

    Spec-Driven Development (SDD): Evita el caos de la IA

    Hace unos meses un cliente me llamó desesperado. Habían decidido usar Cursor y Claude Code para acelerar el desarrollo de su nueva aplicación. El primer día escribieron 5.000 líneas de código y estaban maravillados con la velocidad.

    El segundo día, nada compilaba.

    El tercer día, la IA empezó a sobreescribir funciones previas, a alucinar APIs inexistentes y a meter bugs en bucle. Habían creado un monstruo de código spaghetti en tiempo récord.

    El problema no era la IA. El problema era que nadie le había dicho exactamente qué construir.

    Hoy te quiero explicar qué es Spec-Driven Development (SDD), la metodología de diseño que utilizo a diario para dar directrices claras a las IAs y evitar el caos en el código.


    El peligro de programar por "vibe coding"

    Cuando te sientas ante un editor como Cursor y le tiras prompts rápidos tipo "añade autenticación" o "agrega este formulario", estás haciendo vibe coding. La IA asume la arquitectura por su cuenta, inventa nombres de variables y adivina el modelo de datos.

    Esto funciona para landing pages sencillas, pero en proyectos reales produce tres efectos desastrosos:

    1. Código redundante: La IA vuelve a escribir funciones que ya existían porque no sabe dónde encontrarlas.
    2. APIs rotas: Se inventa endpoints que no coinciden con tu backend.
    3. Pérdida de control: El desarrollador deja de entender cómo funciona el sistema, convirtiéndose en un espectador pasivo.

    La solución no es dar mejores prompts conversacionales. La solución es dar especificaciones estructuradas.


    La regla de oro de SDD: Diseña antes de codificar

    La metodología Spec-Driven Development (SDD) establece que nunca debes dejar que un agente de IA escriba código hasta que haya aprobado un documento de diseño claro.

    Antes de tocar el teclado, debes estructurar tres archivos en la carpeta de especificaciones de tu proyecto:

    1. spec.md (La Especificación)

    Define la visión del producto, las reglas de negocio, los casos de uso y la arquitectura de datos. Responde al QUÉ se va a construir.

    2. plan.md (El Plan Técnico)

    Detalla la estrategia técnica paso a paso. Divide el desarrollo en fases incrementales y lógicas (por ejemplo, definir primero el esquema de base de datos antes de hacer la UI). Responde al CÓMO se va a construir.

    3. tasks.md (La Lista de Tareas)

    Una lista TODO detallada con tareas unitarias y autocontenidas. Cada tarea debe ser tan pequeña que la IA pueda completarla en una sola iteración y validarla con un test.


    El Flujo de Trabajo con tu Copiloto

    Una vez que tienes estos archivos, tu rol cambia de programador interactivo a director técnico:

    1. Le entregas el spec.md y el plan.md al agente de IA (ej: Claude Code).
    2. Le pides que lea las especificaciones y empiece a resolver la primera tarea del tasks.md.
    3. El agente implementa la tarea, corre los tests correspondientes y te avisa cuando está lista.
    4. Marcas la tarea como completada y pasas a la siguiente.

    Con este flujo, la IA no tiene que adivinar nada. Trabaja con un contrato de éxito claro y documentado.

    Este enfoque de ingeniería de software es el que trato en profundidad en mi libro de SDD: Spec-Driven Development, indispensable para cualquier desarrollador que quiera escalar sus desarrollos con IA en bucles agénticos u organizados. Además, es la metodología de base que aplicamos en todas las lecciones del curso de Construye con IA.


    Conclusión: La IA es el ejecutor, tú eres el arquitecto

    Delegar la escritura de código es seguro, pero delegar la arquitectura es un suicidio técnico. Al adoptar Spec-Driven Development, mantienes el control absoluto del diseño de tu software, reduces las alucinaciones de la IA a cero y multiplicas tu velocidad de desarrollo real.

    Si quieres aprender a estructurar tus specs y debatir sobre metodologías de ingeniería agéntica con otros desarrolladores senior, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué diferencia hay entre SDD y TDD?

    TDD (Test-Driven Development) se enfoca en escribir los tests unitarios antes que el código para guiar la implementación. SDD (Spec-Driven Development) va un paso más allá y exige redactar la especificación funcional y el plan técnico arquitectónico antes de escribir los tests o el código. Ambas metodologías se complementan perfectamente.

    ¿Por qué las especificaciones reducen las alucinaciones de la IA?

    Los LLMs tienden a alucinar cuando no tienen suficiente contexto o cuando las instrucciones son ambiguas. Un documento spec.md acota el espacio de decisiones que la IA debe tomar, forzándola a ceñirse a las reglas de negocio y arquitecturas declaradas en el archivo.

    ¿Cuánto tiempo toma escribir las especificaciones?

    Escribir un spec.md básico para una nueva feature suele tomar entre 15 y 30 minutos. Aunque parece un paso extra, te ahorra horas de depuración de código spaghetti mal estructurado por la IA en fases posteriores.

    ¿Se puede aplicar SDD a proyectos legacy o ya existentes?

    Sí. Al trabajar con código legacy, el primer paso es documentar el estado actual del componente afectado en un archivo de contexto (context.md) y redactar el spec.md detallando únicamente los cambios y adiciones a realizar, guiando a la IA sobre la base ya existente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • SDD 2026: por qué el spec define tu ventaja competitiva

    SDD 2026: por qué el spec define tu ventaja competitiva

    Un cliente me mandó su proyecto hace tres semanas. Llevaba dos meses usando Claude Code todos los días. El repositorio tenía 340 archivos. Tenía features. Tenía tests. El código compilaba.

    Y no tenía ni idea de qué hacía el sistema.

    Me preguntó: “¿Por qué cada vez que añado algo nuevo, rompo tres cosas que ya funcionaban?” La respuesta era visible desde el primer git log: llevaba dos meses pidiéndole a la IA que generara código sin decirle nunca qué estaba construyendo realmente. Cada prompt era una instrucción táctica. Nunca había una visión. Nunca un mapa.

    Eso es Spec-Driven Development (SDD) al revés. Y en 2026, con agentes que pueden escribir mil líneas en minutos, la diferencia entre los dos modos es la diferencia entre un producto y un desastre con tests.


    La IA no necesita que seas más rápido. Necesita que seas más claro.

    La narrativa que se vende sobre el desarrollo con IA es esta: “ahora puedes construir el doble de rápido”. Es verdad. El problema es que construir el doble de rápido sin dirección no te lleva antes a destino — te lleva el doble de lejos en la dirección equivocada.

    Los agentes de IA son ejecutores extraordinariamente potentes con cero criterio arquitectónico propio. Claude Code, GitHub Copilot, Cursor, cualquiera — siguen instrucciones. Si las instrucciones son vagas, el output es coherente localmente e incoherente globalmente. Cada archivo tiene sentido en sí mismo. El sistema entero no tiene sentido como conjunto.

    El spec no es documentación. No es burocracia. Es la única forma de darle a un agente de IA el contexto suficiente para que sus decisiones locales sean coherentes con la visión global.

    Sin spec, el agente está adivinando constantemente. Y adivina bien, frase a frase. Pero adivinar bien frase a frase no produce un párrafo con sentido — produce contenido que parece correcto y no lleva a ningún lado.


    Qué es SDD y por qué no es lo que crees

    Spec-Driven Development no es escribir documentación antes de programar. Eso es lo que la mayoría imagina y por lo que lo descartan: “ya tengo suficiente trabajo sin añadir Word docs al proceso”.

    SDD es una metodología de tres artefactos que define qué construyes, cómo lo construyes y en qué orden lo construyes — antes de que un solo agente escriba una sola línea de código.

    Los tres artefactos son:

    spec.md — el qué. La especificación estructurada del sistema. Tiene seis secciones fijas: Visión, Usuarios, Funcionalidades, Flujos, Arquitectura, NFRs. En total, tres o cuatro páginas que responden a la pregunta que ningún agente puede responder por ti: qué problema resuelves exactamente, para quién, y qué significa “hecho” en este proyecto.

    plan.md — el cómo. El plan técnico por fases. No divide el trabajo en tareas sueltas — divide el trabajo en capas que tienen sentido en secuencia. Primero el dominio, después la infraestructura, después la UI. No al revés. El plan.md es el documento que evita que empieces por la pantalla de login cuando el sistema de autenticación aún no existe.

    tasks.md — el orden. La lista de tareas ordenada para TDD. Cada tarea define qué test escribes primero y qué código lo hace pasar. El tasks.md convierte el plan en commits atómicos verificables. Cuando un agente ejecuta una tarea del tasks.md, el resultado es predecible: un test verde y un incremento de funcionalidad real.

    Estos tres documentos no tardan tres días en escribirse. Con el skill /dominicode-sdd-spec-creator en Claude Code (disponible para miembros de Dominicode Labs), la estructura completa se genera en minutos a partir de una descripción del proyecto. Lo que tarda tiempo es pensar — y ese tiempo es exactamente el que te ahorra deuda técnica después.


    Antes vs después: el mismo proyecto, dos formas de empezar

    Hace unos meses construí un sistema de gestión de contenido para automatizar la publicación en múltiples canales. El proyecto tenía integraciones con tres APIs externas, lógica de colas, transformaciones de formato y un dashboard de seguimiento.

    Sin SDD (como lo hubiera hecho en 2022): Habría abierto el editor, creado una carpeta src/, y empezado por la parte que más me apetecía — probablemente el dashboard. A las dos semanas tendría un dashboard bonito conectado a datos hardcodeados, una integración con una API que funcionaba en happy path, y ninguna certeza de cómo conectar las piezas. Cada decisión técnica habría sido local, sin visión del sistema completo.

    Con SDD: Antes de escribir código, escribí el spec.md. La sección de Flujos me forzó a pensar en qué pasa cuando una API falla en mitad de una publicación — algo que no habría considerado hasta toparme con el bug en producción. La sección de NFRs me hizo definir qué latencia máxima era aceptable para el sistema de colas. La sección de Arquitectura me hizo elegir entre evento-driven y polling antes de escribir nada — no a mitad del proyecto cuando cambiar de dirección cuesta semanas.

    El spec.md tardó dos horas. El plan.md, una hora más. El tasks.md, otra hora.

    Cuatro horas de especificación que eliminaron tres semanas de refactoring posterior.

    Cuando empecé a usar Claude Code en el proyecto, el agente tenía el spec.md en el contexto. Cada decisión técnica que tomaba era coherente con la arquitectura definida. No porque el LLM sea mágicamente más inteligente con un documento — sino porque el documento le daba información que de otra forma no tenía.


    El spec como brújula del agente

    Este es el cambio de mentalidad que más cuesta hacer: el spec no es para ti. Es para el agente.

    Cuando llevas quince años programando, tu cabeza tiene el contexto del proyecto. Sabes por qué elegiste ese patrón. Sabes qué módulo toca qué. Sabes los trade-offs que hiciste en la semana dos. Ese contexto vive en tu cabeza y lo das por supuesto.

    El agente no tiene nada de eso. Sin contexto explícito, cada sesión empieza desde cero. Cada prompt es una petición descontextualizada si no le das el marco. Sin spec, el agente responde a lo que le preguntas — no a lo que necesitas construir.

    Con el spec.md en contexto, el agente puede hacer preguntas que de otra forma no haría: “esta funcionalidad que me pides entra en conflicto con el flujo de usuario número tres que está en el spec — ¿quieres cambiar el flujo o ajustar la funcionalidad?”. Esa pregunta vale más que mil líneas de código generado sin contexto.

    Esta es exactamente la lógica detrás del libro Spec-Driven Development — no es un manual de documentación, es una metodología diseñada para que el agente tenga suficiente contexto para tomar decisiones correctas sin que tú estés micromanageando cada prompt.


    Por qué el spec te protege del vibe coding

    El vibe coding no es programar con IA. Es programar con IA sin criterio. Hay developers que publican proyectos enteros generados en un fin de semana. Impresionante en superficie. Inutilizable en producción.

    El problema del vibe coding no es la velocidad — es la ausencia de coherencia acumulada. Cada prompt genera código coherente con el prompt anterior, pero nadie garantiza que el sistema resultante sea coherente con la intención original. A las cuatro horas de vibe coding, el proyecto tiene forma de algo pero no tiene diseño. Tiene features pero no tiene arquitectura.

    Lo que se acumula en silencio no es código malo — es deuda técnica agéntica. El tipo de deuda que no se ve en los tests porque los tests también los generó el agente sin un contrato claro de qué probar. El tipo de deuda que explota cuando intentas añadir la feature número veinte sobre una base que asumió implícitamente cosas que nunca se definieron.

    Para entender por qué la arquitectura de tus agentes necesita un spec detrás, te recomiendo el post sobre agentic harness: por qué la spec y la arquitectura no bastan.

    SDD es el antídoto no porque ralentice el desarrollo. Lo acelera — pero acelera el desarrollo en la dirección correcta. La spec es el contrato que el agente respeta en cada iteración. El plan es la secuencia que evita que construyas la décima planta antes de los cimientos. El tasks.md son los commits que puedes revisar, aprobar y revertir si algo no cuadra.

    Con SDD, el vibe coding se convierte en agile coding con contexto — velocidad de agente, criterio de arquitecto.


    Cómo empezar con SDD en Claude Code hoy

    Si tienes Claude Code y quieres aplicar SDD en tu próximo proyecto, el proceso es directo:

    1. Describe tu proyecto en lenguaje natural — qué construyes, para quién, qué problema resuelve.
    2. Ejecuta el skill /dominicode-sdd-creator — genera spec.md, plan.md y tasks.md en pocos minutos (disponible en Dominicode Labs).
    3. Revisa el spec antes de tocar código — es el momento de pensar, no después.
    4. Añade el spec.md al contexto de Claude Code con @spec.md al inicio de cada sesión de desarrollo — la documentación oficial de Claude Code explica cómo gestionar el contexto entre sesiones.
    5. Trabaja el tasks.md en secuencia — un task, un test, un commit.

    El skill no reemplaza tu pensamiento. Te obliga a pensar antes de que sea costoso cambiar de dirección.

    El post sobre SDD Creator, la herramienta CLI muestra exactamente cómo se genera la estructura automáticamente.

    Si quieres ver cómo se aplica esto en un proyecto real de principio a fin — desde la spec inicial hasta el deploy — es exactamente lo que trabajamos en el curso Construye con IA: no tutoriales sueltos de herramientas, sino el proceso completo de construir un producto con IA de forma que funcione en producción.


    El spec como ventaja competitiva real

    Hay algo que nadie dice sobre SDD en 2026 y que merece decirse.

    En un mundo donde cualquier developer puede generar código a gran velocidad con IA, la diferencia competitiva no está en quién genera más rápido. Está en quién sabe exactamente qué construir y por qué.

    El spec es donde vive esa ventaja. No en el prompt. No en la elección del modelo. En la claridad con la que defines el problema antes de que empiece la ejecución.

    Los developers que entienden esto ya no compiten con los que “usan IA para programar más rápido”. Son una categoría diferente: developers que combinan criterio técnico con capacidad de ejecución agéntica. El spec es la expresión concreta de ese criterio.

    Dentro de doce meses, los equipos que hayan integrado SDD en su workflow tendrán bases de código mantenibles, documentación generada como efecto colateral del proceso, y la capacidad de incorporar nuevos agentes o nuevos developers sin que el proyecto colapse. Los que sigan con vibe coding habrán reescrito el proyecto tres veces.


    FAQ

    ¿SDD no es simplemente documentación con otro nombre?

    No. La documentación describe lo que existe. El spec define lo que va a existir — antes de que exista. La diferencia no es semántica: la documentación se escribe después y siempre está desactualizada. El spec se escribe antes y guía la implementación. Si el spec y el código divergen durante el desarrollo, es señal de que hay una decisión técnica que tomar conscientemente — no de que el documento esté equivocado.

    ¿Cuánto tiempo tarda escribir el spec de un proyecto real?

    Depende del proyecto. Para un MVP de funcionalidad acotada, entre dos y cuatro horas. Para un sistema con múltiples integraciones y flujos complejos, un día. El punto de referencia útil: si el spec tarda más de un día en escribirse, es señal de que el proyecto no está suficientemente definido para empezar a construirlo — y ese es el momento exacto en que el spec te está salvando, no ralentizando.

    ¿Se puede aplicar SDD a proyectos que ya existen?

    Sí, pero el proceso es diferente. En proyectos existentes, el spec se usa para nuevas features o para refactorizaciones significativas. El ejercicio de escribir el spec de un módulo existente es también un audit implícito: si no puedes escribir el spec del módulo, es porque el módulo no tiene diseño coherente. El spec revela la deuda técnica que el código oculta.

    ¿SDD funciona con cualquier agente de IA o solo con Claude Code?

    La metodología es agnóstica al agente. Spec.md, plan.md y tasks.md son documentos markdown que cualquier LLM puede usar como contexto. El skill /dominicode-sdd-spec-creator está diseñado para Claude Code y disponible en Dominicode Labs, pero los artefactos que genera son compatibles con cualquier entorno. Lo importante no es la herramienta — es el hábito de definir antes de ejecutar.

    ¿Qué pasa cuando el spec cambia durante el desarrollo? ¿No es todo ese trabajo en vano?

    El spec cambia. Siempre cambia. Y eso es una funcionalidad, no un fallo. Cuando el spec cambia, tienes un documento que actualizar — y esa actualización fuerza una decisión consciente sobre el impacto del cambio en la arquitectura, los flujos y las tareas pendientes. Sin spec, el cambio ocurre de forma invisible: alguien pide algo diferente, el agente lo implementa, y nadie sabe qué asunciones antiguas quedan rotas. Con spec, el cambio es visible y gestionable.

    ¿Es SDD compatible con metodologías ágiles?

    Completamente. SDD no impone un ciclo de desarrollo — impone un hábito de especificación antes de ejecución. Dentro de un sprint de dos semanas, el spec de las features del sprint se escribe al inicio. El plan.md define el orden de implementación dentro del sprint. El tasks.md genera los tickets concretos. SDD convierte el backlog en artefactos ejecutables para agentes, no en listas de deseos sin criterio técnico.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • El Harness: por qué la spec y la arquitectura no son suficientes

    El Harness: por qué la spec y la arquitectura no son suficientes

    Mi workflow completo: de idea a producto en producción con IA

    Hace un año tardaba 2-3 semanas en tener algo desplegado desde una idea nueva.

    Hoy tardo 2-3 días.

    No porque use mejores modelos. Porque cambié el workflow.

    Acá está el proceso completo, sin omitir nada.


    Fase 1 — Captura (30 minutos)

    Antes de abrir el editor, abro un documento en blanco y respondo tres preguntas:

    1. ¿Qué problema concreto resuelve esto?
    2. ¿Quién lo va a usar y en qué contexto exacto?
    3. ¿Qué tiene que funcionar sí o sí para que sea útil desde el día uno?

    Solo eso. Sin pensar en tech stack. Sin pensar en arquitectura.

    Si no puedo responder las tres en 30 minutos, la idea no está lista para construirse.


    Fase 2 — Spec (1-2 horas)

    Con las respuestas anteriores, genero la spec técnica.

    La spec tiene 6 secciones: Visión, Usuarios, Funcionalidades, Flujos, Arquitectura y NFRs.

    No la escribo yo desde cero. La genero con un agente que toma mis respuestas de la Fase 1 como input.

    Luego la reviso y ajusto lo que el agente asumió mal.

    El output: un documento de 2-3 páginas que define qué se construye, para quién, y cómo debe comportarse.


    Fase 3 — Plan técnico (30 minutos)

    Con la spec lista, otro agente genera el plan de implementación.

    No “empieza a codear”. Define:

    • Las fases del proyecto en orden
    • Qué necesita estar listo antes de cada fase
    • Los riesgos técnicos por módulo

    Reviso el plan. Lo ajusto si algo no tiene sentido. Firma.


    Fase 4 — Implementación (el grueso)

    Aquí entra Claude Code.

    No le doy el prompt “hazme la app”. Le doy la spec + el plan + el task específico a implementar en esa sesión.

    Un task. Una sesión. Un output verificable.

    Si el task es “implementar autenticación con GitHub OAuth”, eso es todo lo que hace esa sesión.

    Al final de cada sesión, verifico que lo que se construyó cumple el criterio de aceptación de la spec.

    Si no lo cumple, corrijo antes de avanzar. No acumulo deuda de contexto.


    Fase 5 — Deploy y validación (1-2 horas)

    Deploy con el stack que use el proyecto (Railway, Vercel, Supabase).

    Luego muestro el producto a 2-3 personas del perfil objetivo y les hago una sola pregunta:

    “¿Qué haría que esto fuera indispensable para ti?”

    No “¿te gusta?” ni “¿qué mejorarías?”.

    Esa pregunta específica te da el siguiente ciclo de iteración o te dice que pivotes.


    Lo que hace que este workflow funcione no es la IA.

    Es que la IA nunca opera sin contexto estructurado.

    Cada agente recibe exactamente lo que necesita para hacer su parte. Nada más. Nada menos.

    Sin eso, la IA improvisa. Y cuando improvisa, construye lo que interpreta, no lo que necesitas.


    Si quieres ver este workflow ejecutado en vivo sobre un proyecto real — Stripe webhook receiver + Supabase, desde la spec hasta el deploy — eso es exactamente lo que hacemos el 9 de julio.

    workshop.dominicode.com