Tag: Spec Driven Development

  • GitHub Spec Kit con Claude Code: specs que el agente cumple

    GitHub Spec Kit con Claude Code: specs que el agente cumple

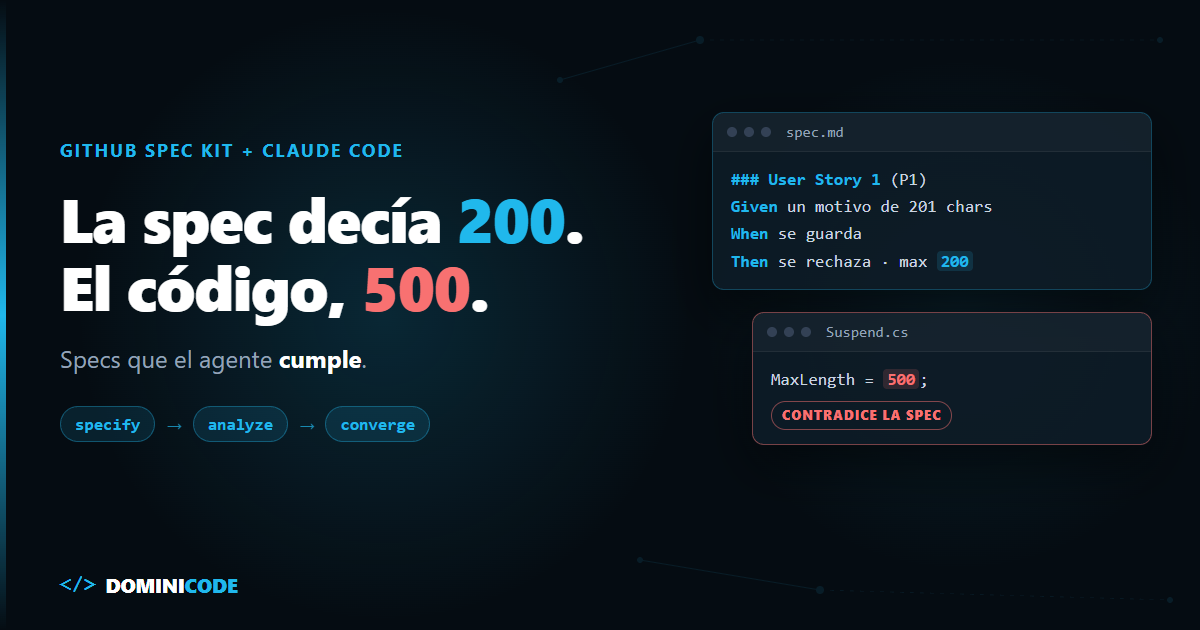
    La spec decía 200 caracteres. El código dice 500.

    En septiembre de 2026, un developer abrió el issue #4383 en el repo de Spec Kit. Había hecho todo bien: constitution, specify, plan, tasks, implement, usando GitHub Spec Kit con Claude Code. El PRD fijaba en 200 la longitud máxima de dos campos. spec.md lo decía. data-model.md también: SuspendReason nvarchar(200).

    Y Claude implementó SuspendReasonMaxLength = 500.

    Nadie le había dado mal la regla al agente. La regla se había perdido por el camino: tasks.md mencionaba el límite de un campo y no el del otro. Para el campo sin límite, el agente puso uno por su cuenta.

    En corto: GitHub Spec Kit no impide que Claude Code contradiga tu spec, pero hace visible dónde se rompe el hilo. Su plantilla te obliga a escribir historias priorizadas que se prueban por separado, escenarios Given/When/Then, requisitos numerados y criterios medibles. Sus comandos clarify, checklist, analyze y converge detectan las contradicciones antes de implementar y después.

    ¿Qué es GitHub Spec Kit?

    GitHub Spec Kit es un toolkit open source de GitHub que instala en tu agente de código (Claude Code, Copilot, Codex y otros) un proceso de Spec-Driven Development con plantillas y comandos que van de la especificación al plan, las tareas, el código y la verificación.

    No es un modelo ni un servicio. Es un CLI en Python (specify) que copia plantillas Markdown y skills a tu proyecto. Todo lo demás lo hace el agente siguiendo esas instrucciones.

    Va rápido. La última release cuando escribo esto es la v1.3.2, del 6 de noviembre de 2026, y el repo pasa de 148.000 estrellas (dato de la API de GitHub, 7 de noviembre de 2026).

    Los tres errores que hacen que el agente contradiga la spec

    Un agente contradice una spec por tres motivos que el formato de Spec Kit ataca de frente: la ambigüedad, la falta de slices verticales y los criterios de aceptación débiles.

    El resto de fallos lo tienes en los siete fallos de una spec que rompen a un agente de IA, y lo de los slices, en el post sobre spec global y slices verticales en un proyecto greenfield.

    La tesis es simple: un agente no contradice una spec por rebeldía. La contradice cuando la spec deja un hueco y él lo rellena. Spec Kit no hace al agente más obediente. Te deja menos huecos que rellenar.

    Cómo instalar GitHub Spec Kit en Claude Code

    Necesitas Python 3.11+, uv y Claude Code instalado. La página de la integración con Claude da la clave claude:

    uv tool install specify-cli
    specify init mi-proyecto --integration claude
    cd mi-proyecto
    

    En un proyecto que ya existe, la guía de proyectos existentes indica specify init --here --force --integration claude. Haz commit antes: --force puede sobrescribir archivos en las rutas que gestiona Spec Kit.

    Spec Kit instala sus comandos como skills en .claude/skills/speckit-<comando>/SKILL.md. En el chat de Claude Code se invocan con guion:

    /speckit-constitution Prioriza la exactitud fiscal y los tests de integración.
    /speckit-specify Exportación trimestral de facturas para la gestoría.
    /speckit-clarify
    /speckit-plan Next.js, Postgres y generación del CSV en el servidor.
    /speckit-checklist
    /speckit-tasks
    /speckit-analyze
    /speckit-implement
    /speckit-converge
    

    Si ves /speckit.specify con punto en la documentación, es la notación genérica: en Claude Code va con guion.

    El formato de spec de Spec Kit, sección a sección

    La plantilla spec-template.md tiene tres secciones obligatorias (User Scenarios & Testing, Requirements y Success Criteria), una condicional (Key Entities, si la feature maneja datos) y una sección final de Assumptions. Así se mapea cada error a un mecanismo concreto:

    Error en la spec Mecanismo de Spec Kit Qué lo detecta
    Ambigüedad Marcadores [NEEDS CLARIFICATION: …] (máximo 3 por spec) y sección Assumptions /speckit-clarify: hasta 5 preguntas y las respuestas se escriben en spec.md
    Sin slices verticales User stories con prioridad (P1, P2, P3) y un Independent Test cada una /speckit-tasks agrupa las tareas por historia
    Criterios débiles Escenarios Given/When/Then y Success Criteria medibles (SC-001…) /speckit-checklist, "unit tests for English"
    Spec, plan y tareas que no cuadran Requisitos numerados FR-001… para trazar cada uno /speckit-analyze, de solo lectura
    Código que no cumple la spec spec.md, plan.md y tasks.md como referencia /speckit-converge añade tareas por lo que falta
    Principios del proyecto ignorados .specify/memory/constitution.md /speckit-analyze marca cualquier conflicto con la constitución como CRITICAL

    Fuente: plantillas y comandos en templates/commands/, consultados el 7 de noviembre de 2026.

    La plantilla exige que cada historia sea "INDEPENDENTLY TESTABLE": si implementas solo una, sigues teniendo un MVP viable. Es un slice vertical con otro nombre.

    Ejemplo: de spec mala a spec en formato Spec Kit

    Caso: un SaaS de facturación para autónomos. Los usuarios quieren mandar sus facturas a la gestoría cada trimestre sin descargarlas una a una.

    La spec que suele llegar al agente:

    # Exportación para la gestoría
    
    Añadir exportación de facturas para la gestoría.
    Tiene que ser rápida y fácil de usar.
    Formato CSV o Excel.
    Opción de enviarlo por email automáticamente.
    Gestionar bien los errores.
    

    Cada línea es un hueco. "Rápida" no se puede medir. "CSV o Excel" deja la decisión al agente. "Gestionar bien los errores" no dice qué es un error. Y no hay orden: el agente puede empezar por el envío automático, la parte más difícil, sin que exista la exportación básica.

    La misma spec en el formato de Spec Kit:

    # Feature Specification: Exportación trimestral para la gestoría
    
    **Status**: Draft
    
    ## User Scenarios & Testing *(mandatory)*
    
    ### User Story 1 - Descargar el CSV del trimestre (Priority: P1)
    
    El autónomo elige un trimestre y descarga un CSV con todas sus
    facturas emitidas en ese periodo.
    
    **Why this priority**: sin esto no hay nada que enviar. Es el
    mínimo que ya ahorra el trabajo manual.
    
    **Independent Test**: con 3 facturas en el T2 y 1 en el T3,
    exportar el T2 devuelve un CSV con exactamente 3 filas.
    
    **Acceptance Scenarios**:
    
    1. **Given** un usuario con 3 facturas emitidas en el T2 de 2026,
       **When** exporta el T2 de 2026, **Then** descarga un CSV con
       3 filas y las columnas número, fecha, NIF del cliente, base
       imponible, tipo de IVA, cuota de IVA y total.
    2. **Given** una factura rectificativa en el T2, **When** exporta
       el T2, **Then** la rectificativa aparece con importes negativos.
    3. **Given** un trimestre sin facturas, **When** lo exporta,
       **Then** ve el mensaje "No hay facturas en este trimestre"
       y no se descarga ningún archivo.
    
    ---
    
    ### User Story 2 - Enviar el CSV al email de la gestoría (Priority: P2)
    
    El autónomo guarda el email de su gestoría y envía el CSV del
    trimestre con un botón.
    
    **Why this priority**: elimina el paso de adjuntar el archivo,
    pero depende de que la US1 funcione.
    
    **Independent Test**: con un email de gestoría guardado, pulsar
    "Enviar" genera un único email con el CSV del trimestre adjunto.
    
    **Acceptance Scenarios**:
    
    1. **Given** un email de gestoría guardado, **When** pulsa
       "Enviar T2", **Then** se envía un email con el CSV adjunto
       y el envío queda registrado con fecha y destinatario.
    2. **Given** que el T2 ya se envió, **When** pulsa "Enviar T2"
       otra vez, **Then** se le pide confirmación antes de reenviar.
    
    ---
    
    ### User Story 3 - Envío automático al cerrar el trimestre (Priority: P3)
    
    [...]
    
    ### Edge Cases
    
    - ¿Qué pasa con una factura con fecha del último día del trimestre
      a las 23:59 en otra zona horaria?
    - ¿Qué pasa si el email de la gestoría rebota?
    
    ## Requirements *(mandatory)*
    
    ### Functional Requirements
    
    - **FR-001**: System MUST incluir solo facturas emitidas, nunca
      borradores.
    - **FR-002**: System MUST asignar el trimestre por la fecha de
      emisión, no por la fecha de cobro.
    - **FR-003**: System MUST usar [NEEDS CLARIFICATION: ¿separador
      decimal coma o punto? Depende del programa de la gestoría].
    - **FR-004**: System MUST NOT modificar ninguna factura al exportar.
    
    ### Key Entities
    
    - **Factura**: número, fecha de emisión, cliente, base, IVA, total.
    - **Envío**: trimestre, destinatario, fecha y archivo enviado.
    
    ## Success Criteria *(mandatory)*
    
    ### Measurable Outcomes
    
    - **SC-001**: un usuario con 500 facturas en un trimestre obtiene
      el CSV en menos de 5 segundos.
    - **SC-002**: la suma de la columna total del CSV coincide al
      céntimo con el total facturado del trimestre en la app.
    
    ## Assumptions
    
    - La exportación a Excel queda fuera de esta versión.
    - Las facturas recibidas (gastos) no entran en esta feature.
    

    Fíjate en lo que cambió. El orden ya no es cosa del agente: P1 se puede terminar, probar y desplegar sin tocar P2. "Rápida" ahora es SC-001, con un número. "CSV o Excel" se convirtió en una decisión escrita en Assumptions. Y lo que de verdad no sabes, el separador decimal, queda marcado en vez de inventado.

    Ojo: una spec mejor no habría evitado por sí sola el bug del issue #4383. Allí la spec ya decía 200; el límite se perdió al pasar a tasks.md. Lo que lo atrapa es una restricción escrita como escenario (Given un motivo de 201 caracteres, When se guarda, Then se rechaza) más un comando que compare el código con ella. Un escenario se convierte en un test que falla, y un test que falla no deja pasar un 500 donde ponía 200.

    Cómo detecta Spec Kit las contradicciones antes de implementar

    Spec Kit detecta las contradicciones con cuatro comandos: clarify y checklist revisan la spec, analyze cruza spec, plan y tareas antes de implementar, y converge compara el código con los tres después. Es justo el punto donde falló el issue: algo se perdió entre spec.md y el código.

    /speckit-clarify revisa la spec por categorías y te hace como máximo cinco preguntas, de una en una, con opciones cerradas o respuestas de cinco palabras como mucho. Cada respuesta se escribe en spec.md. Pásalo antes de plan: es más barato resolver el separador decimal ahí que en un PR.

    /speckit-checklist genera lo que el propio comando llama "Unit Tests for English": comprueba si los requisitos están completos, son claros y no se contradicen. No prueba el código. Prueba la spec.

    /speckit-analyze cruza spec.md, plan.md y tasks.md y saca una tabla de hallazgos con severidad. Es estrictamente de solo lectura: no toca ningún archivo. Y la constitución manda: según el propio comando, un conflicto con ella es "automatically CRITICAL" y se arregla cambiando la spec, el plan o las tareas, no el principio.

    /speckit-converge va después de implementar. Compara el código con los tres artefactos y añade a tasks.md el trabajo que falta, sin tocar el código. Repites implement y converge hasta que el comando informa Converged.

    El issue #4383 acabó en un cambio a la plantilla de tasks. Desde el PR #4430, fusionado el 8 de septiembre de 2026, el comando pide citar literalmente en cada tarea las restricciones de campo de data-model.md: longitudes máximas, nullables, enums, reglas de validación. Aun así, el bot del repo, que clasificó el issue como "likely valid, needs reproduction", avisa de que el arreglo es solo de prompt y de que distintos agentes pueden seguir parafraseando las restricciones en vez de citarlas. Por eso no te fíes de un solo comando: analyze antes de implementar y converge después.

    La constitución: lo que ningún feature puede saltarse

    /speckit-constitution escribe .specify/memory/constitution.md, que se crea una vez por proyecto. La plantilla trae huecos para cinco principios, con ejemplos como "Test-First (NON-NEGOTIABLE)".

    Para el SaaS de facturas, uno de los principios sería este:

    ### I. Exactitud fiscal (NON-NEGOTIABLE)
    Los importes se calculan en céntimos enteros, nunca en coma flotante.
    Toda exportación tiene un test que compara su suma con el total del sistema.
    

    Ese principio no vive en ninguna spec concreta. Vive por encima de todas. Si mañana un plan propone calcular con number de JavaScript, analyze debería marcarlo como CRITICAL antes de que se escriba una línea.

    Spec Kit, un spec.md propio u OpenSpec

    No todo proyecto necesita Spec Kit:

    Criterio GitHub Spec Kit spec.md propio OpenSpec
    Instalación uv + Python 3.11+ Ninguna npm (Node 22.12+), Homebrew o script
    Formato de spec Plantilla fija: user stories P1-P3, Given/When/Then, FR, SC El que tú decidas Requisitos y escenarios en Markdown, por cambio
    Detección de contradicciones clarify, checklist, analyze, converge Depende de tu disciplina y tus prompts /opsx:verify en el perfil ampliado
    Specs a largo plazo Una carpeta por feature en specs/ Lo que mantengas a mano openspec/specs/ vivas; los cambios se archivan y las actualizan
    Limitación o riesgo Mucho Markdown y ceremonia; las specs por feature envejecen Nada te obliga a escribir criterios medibles Menos puertas de calidad; su README llama a Spec Kit "Thorough but heavyweight"

    Fuentes: README de Spec Kit, README de OpenSpec, consultados el 7 de noviembre de 2026. Si ya usas OpenSpec, tienes el paso a paso en cómo integrar OpenSpec con Claude Code.

    Mi opinión: el formato es lo mejor del paquete y te lo puedes llevar sin el CLI. Si copias la plantilla a tu spec.md propio, ya ganas la mitad; la otra mitad, analyze y converge, es lo que justifica instalarlo en proyectos medianos o grandes.

    Cuándo NO usar Spec Kit

    Para cambios pequeños. El proceso completo genera spec, plan, tareas, checklists y varios artefactos más. Para un bug de tres líneas es ceremonia pura. En este hilo de Hacker News, a raíz del análisis de Birgitta Böckeler sobre Kiro, Spec Kit y Tessl, un usuario contaba que lo dejó porque "Always made it too complex, and at some point it wasn't worth correcting it anymore". Para bugs, Spec Kit tiene ahora una extensión aparte (specify extension add bug); úsala en vez de pasar el bug por el flujo de features.

    Cuando esperas que la spec garantice el resultado. En el mismo hilo, otro usuario cuenta que usó Spec Kit con Claude Code durante dos semanas. Tras unos diez días de flujo, tenía tests fallando y un build que no salía. En el siguiente proyecto dejó de lado parte del flujo: montó sus propios comandos por sprint y revisaba cada sprint antes de seguir. Ese comentario es de octubre de 2025, antes de converge, pero la lección no caduca: la spec reduce los huecos, no sustituye la revisión.

    Cuando tus specs tienen que vivir años. Spec Kit crea una carpeta por feature. Si la feature 009 cambia lo que definió la 001, nada fusiona las dos automáticamente. Es lo que se preguntaba en el issue #620, "How to keep specs consistent and up-to-date with spec-kit?". Existe una guía para hacer evolucionar specs, pero el mantenimiento sigue siendo tuyo.

    Cuando no vas a leer lo que genera. Una spec sin revisar es un prompt vago convertido en Markdown largo; el README pide ejecutar los comandos de uno en uno y revisar cada resultado.

    Por dónde empezar a escribir specs para agentes de IA con Spec Kit

    Coge la última feature que le pediste a Claude Code y reescribe su spec con la plantilla: dos o tres historias con prioridad, un Independent Test por historia, escenarios Given/When/Then y al menos un criterio con número. Después pasa /speckit-clarify y mira qué te pregunta. Esas preguntas son los huecos que el agente iba a rellenar por ti.

    Si quieres el método completo detrás de este formato, está en el libro Spec-Driven Development. Y si prefieres verlo aplicado de la idea al producto con Claude Code, es lo que hacemos en el curso Construye con IA. Para la parte de revisar lo que genera el agente contra la spec, el workshop SDD + Agentic Engineering va justo de eso.

    Preguntas frecuentes

    ¿Cómo se instala GitHub Spec Kit en Claude Code?

    Con uv tool install specify-cli y specify init mi-proyecto --integration claude (en un repo existente, specify init --here --force --integration claude). Necesitas Python 3.11+, uv y Claude Code.

    ¿Los comandos de Spec Kit se escriben /speckit.specify o /speckit-specify?

    En Claude Code, /speckit-specify, con guion: Spec Kit los instala como skills en .claude/skills/. La documentación de referencia usa /speckit.specify como notación genérica, y cada agente tiene su propia forma de invocarlos.

    ¿Qué diferencia hay entre /speckit-clarify y /speckit-analyze?

    clarify resuelve dudas de la spec antes del plan y escribe las respuestas en spec.md. analyze cruza spec, plan y tareas después de tasks y no modifica ningún archivo.

    ¿Cómo se escriben criterios de aceptación para un agente de IA con Spec Kit?

    Con escenarios Given/When/Then en cada user story y Success Criteria numerados (SC-001…) con una cifra. Cada escenario fija un estado inicial, una acción y un resultado comprobable; cada criterio, un número que un test puede medir, como "menos de 5 segundos con 500 facturas". Si no se puede comprobar con un test, no es un criterio de aceptación: es un hueco que el agente rellenará por su cuenta.

    ¿Cuántos [NEEDS CLARIFICATION] puede tener una spec de Spec Kit?

    Como máximo tres. El comando specify está escrito para suponer con criterio y anotar esas suposiciones en Assumptions, y para marcar solo las decisiones críticas sin un valor razonable por defecto: alcance, seguridad o experiencia de usuario.

    ¿Spec Kit sirve para proyectos existentes o solo para empezar de cero?

    Sirve para los dos, pero en un proyecto existente no genera specs del comportamiento que ya tienes: empiezan con la siguiente feature que definas.

    ¿Puedo usar el formato de Spec Kit sin instalar el CLI?

    Sí. La plantilla templates/spec-template.md es Markdown público en el repo. Copiarla a tu propio spec.md te da las historias priorizadas, Given/When/Then, FR y SC. Lo que pierdes son los comandos que comprueban la coherencia entre spec, plan, tareas y código.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • De ticket a PR con Claude Code: escribe la spec primero

    De ticket a PR con Claude Code: escribe la spec primero

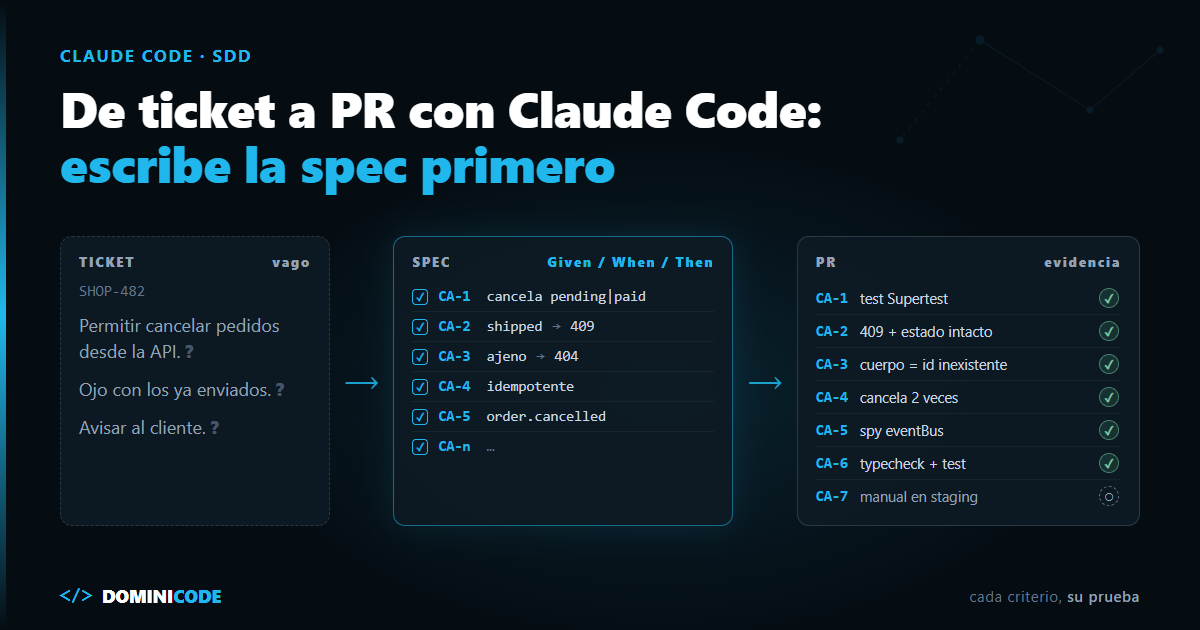
    Te asignan un ticket. Tres líneas. "Permitir cancelar pedidos desde la API. Ojo con los ya enviados. Avisar al cliente."

    Quieres cerrarlo rápido, así que lo pegas tal cual en Claude Code. Veinte minutos después tienes endpoint, tests y PR. Y el revisor empieza el interrogatorio. ¿Qué pasa si cancelo dos veces? ¿Quién dijo que había que reembolsar?

    Nadie lo dijo. El agente rellenó los huecos del ticket con suposiciones razonables. Y razonable no es lo mismo que acordado.

    El flujo de ticket a PR con Claude Code no se rompe al generar código. Se rompe antes: al traducir el ticket a algo que el agente pueda cerrar y un revisor comprobar.

    En corto: para ir de ticket a PR con Claude Code, convierte primero el ticket en una spec de una página con alcance cerrado y criterios Given/When/Then. Cada criterio lleva al lado el test, el comando o la comprobación manual que lo demuestra. El agente implementa contra esa lista y el PR mapea cada criterio a su evidencia.

    ¿Qué es una spec de ticket?

    Una spec de ticket es un documento de una página que traduce un ticket a un alcance cerrado y a criterios de aceptación verificables, cada uno ligado al test, comando o comprobación que demuestra que se cumple.

    No es la spec de un proyecto entero: no tiene visión, usuarios ni arquitectura. Vive en un repo que ya existe y su único trabajo es cerrar las preguntas que el ticket deja abiertas.

    Por qué el ticket tal cual no sirve para ir de ticket a PR con Claude Code

    Un ticket es una conversación a medias. Asume contexto que el agente no tiene: qué significa "enviado" en tu modelo, qué códigos HTTP usa el equipo o si "avisar" es un email o un evento.

    En el hilo de Hacker News "Spec-Driven Development: The Waterfall Strikes Back" (noviembre de 2025, 191 comentarios), un usuario lo resume así: el agile no mató la especificación, la dejó "split across hundreds to thousands of randomly filled Jira tickets". Esa es exactamente la materia prima con la que trabajas.

    En el mismo hilo, el autor del artículo lo ve de otra forma: dice que SDD no le aporta nada porque ya usa plan mode antes de implementar. Mezcla dos cosas. Plan mode decide cómo se construye. La spec fija qué cuenta como terminado. Un plan sin criterios externos siempre está de acuerdo consigo mismo.

    Cómo convertir un ticket en una spec: el ejemplo completo

    Un ticket se convierte en spec en cuatro pasos: lista las preguntas que no contesta, resuelve con el código las que son técnicas, lleva las de producto a quien abrió el ticket y escribe el alcance y los criterios Given/When/Then con su verificación al lado.

    Vamos con un caso. Es un ejemplo inventado, con la forma de los tickets reales: una API en TypeScript que ya existe, con tests en Vitest y Supertest, un eventBus interno y un servicio de notificaciones que escucha eventos.

    El ticket "antes":

    SHOP-482 — Cancelar pedidos
    Permitir cancelar pedidos desde la API. Ojo con los ya enviados.
    Avisar al cliente.
    

    Antes de escribir una línea de spec, lista las preguntas que el ticket no contesta. En este caso salen seis: quién puede cancelar, en qué estados, qué responde si ya está enviado, qué pasa si cancelas dos veces, qué significa "avisar" y si hay reembolso.

    Cuatro las resuelve el código: enum de estados, formato común de errores y notificaciones que ya escuchan el bus. Dos son de producto y se preguntan a quien abrió el ticket. Respuesta (inventada): solo cancela el dueño, y el reembolso va en otro ticket.

    El agente puede ayudarte a encontrar las preguntas. No puede contestar las de producto.

    La spec "después":

    # SHOP-482 — Cancelar un pedido desde la API
    
    ## Contexto
    Ticket: SHOP-482. El cliente puede cancelar un pedido propio que aún no ha salido del almacén.
    
    ## Alcance
    Dentro:
    - Endpoint POST /orders/:id/cancel en src/orders/
    - Transición de estado pending | paid -> cancelled
    - Publicar el evento order.cancelled en el eventBus existente
    
    Fuera:
    - Reembolsos (SHOP-483)
    - Plantillas de email (las gestiona notifications, no se tocan)
    - Panel de administración
    
    ## Decisiones tomadas
    - Solo el dueño del pedido puede cancelar (confirmado con producto)
    - Pedido de otro usuario: 404, no 403, para no revelar que existe
    - Cancelar un pedido ya cancelado no es un error: es idempotente
    
    ## Criterios de aceptación
    CA-1 Given un pedido "pending" o "paid" del usuario autenticado
         When llama a POST /orders/:id/cancel
         Then responde 200, status = "cancelled" y cancelledAt tiene fecha
         Verificación: test "cancela un pedido pendiente o pagado"
    
    CA-2 Given un pedido "shipped"
         When llama a POST /orders/:id/cancel
         Then responde 409 con code ORDER_ALREADY_SHIPPED y el estado no cambia
         Verificación: test "rechaza cancelar un pedido enviado"
    
    CA-3 Given un pedido de otro usuario
         When llama a POST /orders/:id/cancel
         Then responde 404 con el mismo cuerpo que un id inexistente
         Verificación: test "no revela pedidos ajenos"
    
    CA-4 Given un pedido ya "cancelled"
         When llama a POST /orders/:id/cancel de nuevo
         Then responde 200 con el mismo cuerpo y no publica un segundo evento
         Verificación: test "cancelar es idempotente"
    
    CA-5 Given un pedido "pending" o "paid" del usuario autenticado
         When lo cancela
         Then se publica exactamente un evento order.cancelled con orderId y userId
         Verificación: test "publica order.cancelled una vez" (spy sobre eventBus.publish)
    
    CA-6 Given el resto de la API
         When se ejecuta la suite completa
         Then ningún contrato existente cambia
         Verificación: npm run typecheck && npm test
    
    CA-7 Given staging con el servicio de notificaciones activo
         When se cancela un pedido de prueba
         Then el cliente recibe el email de cancelación
         Verificación: manual, en staging
    
    ## Restricciones del repo
    - Seguir el patrón de src/orders/routes/pay.ts (validación + servicio + error común)
    - No tocar src/notifications/ ni las migraciones
    
    ## Preguntas abiertas
    (vacío: si hay algo aquí, no se implementa)
    

    "Avisar al cliente" pasó a ser un evento (CA-5) más una comprobación manual (CA-7), y "ojo con los ya enviados", un 409 con código de error. El reembolso, que nadie había mencionado, quedó fuera por escrito.

    Si quieres la lista de por qué una spec falla aunque parezca completa, la tienes en por qué tu spec falla con un agente de IA. No la repito aquí.

    Plantilla de spec para un ticket

    La estructura del ejemplo sirve para casi cualquier ticket acotado en un repo existente:

    Sección Qué responde Señal de que está mal
    Contexto Qué problema resuelve, en una frase, con el id del ticket Ocupa más de tres líneas
    Alcance (dentro / fuera) Qué archivos o módulos se tocan y qué no El "fuera" está vacío
    Decisiones tomadas Las preguntas del ticket ya contestadas, y por quién Hay decisiones de producto que tomó el agente
    Criterios de aceptación Given/When/Then numerados, con su verificación Un criterio sin test, comando ni paso manual
    Restricciones del repo Qué patrón copiar y qué no tocar No nombra ningún archivo real
    Preguntas abiertas Lo que falta por decidir Tiene algo y aun así se implementa

    Lo que no está escrito como excluido, el agente lo considera negociable.

    Esta forma de trabajar, con specs pequeñas y criterios numerados, es la que desarrollo con calma en el libro de Spec-Driven Development.

    Criterios de aceptación Given/When/Then: cada uno con su prueba

    Given/When/Then obliga a escribir estado de partida, acción y resultado observable. Y lo observable se puede comprobar.

    La regla: si no puedes escribir al lado de un criterio cómo se verifica, el criterio no está terminado.

    Criterio Cómo se verifica
    CA-1 cancela pendiente o pagado Test de integración con Supertest
    CA-2 rechaza enviado Test que comprueba 409 y estado intacto
    CA-3 no revela ajenos Test que compara el cuerpo con el de un id inexistente
    CA-4 idempotente Test que cancela dos veces y cuenta eventos
    CA-5 publica evento Spy sobre eventBus.publish
    CA-6 sin regresiones npm run typecheck && npm test
    CA-7 email al cliente Comprobación manual en staging

    No todo se automatiza, como CA-7. Un criterio manual declarado es honesto; uno olvidado es un bug con fecha de llegada.

    El bloque de CLAUDE.md para trabajar con specs

    No necesitas un CLAUDE.md nuevo. Necesitas una sección que le diga al agente cómo comportarse cuando la tarea viene con spec. El archivo completo, con su plantilla, está en CLAUDE.md para proyectos. Esta es solo la parte de SDD:

    ## Trabajo con specs (SDD)
    
    - Si la tarea menciona una spec en specs/, léela entera antes de abrir otros archivos.
    - Empieza en plan mode. El plan indica, para cada CA-n, qué archivo cambia y qué test lo cubre.
    - No modifiques archivos fuera de la sección "Alcance". Si hace falta, para y pregunta.
    - Si la spec contradice el código, no lo resuelvas tú: anótalo en "Preguntas abiertas" y para.
    - Escribe primero los tests de cada CA-n y comprueba que fallan.
    - No des la tarea por terminada sin que pasen: npm run typecheck && npm test
    - La descripción del PR lista cada CA-n con su evidencia o con "manual: pendiente".
    

    Lo dice la propia documentación de Claude Code: Claude trata el CLAUDE.md como contexto, no como configuración obligatoria. Lo seguirá casi siempre. Si necesitas que sea siempre, la guía de buenas prácticas recomienda un hook Stop que devuelva a Claude al trabajo hasta que pase el typecheck (con un tope de bloqueos configurable).

    De la spec al PR en Claude Code: cinco pasos

    Con la spec en specs/shop-482-cancelar-pedido.md, el recorrido es corto. Todo lo que sigue está en la documentación oficial de Claude Code, consultada en noviembre de 2026: flujos de trabajo comunes, modos de permiso y buenas prácticas.

    1. Explora sin editar. Arranca en plan mode con claude --permission-mode plan. En este modo Claude lee archivos y ejecuta comandos para explorar, pero no edita el código hasta que apruebes un plan. Pídele que lea la spec y localice el enum de estados, pay.ts y el eventBus. Si el repo es nuevo para ti, entender un repositorio con Claude Code cubre esta fase a fondo.

    2. Pide un plan que cite los criterios. Sigue en plan mode (o pulsa Shift+Tab hasta ver ⏸ plan mode on, o empieza el prompt con /plan) y pide un plan donde cada CA-n tenga archivo y test. Con Ctrl+G abres el plan en tu editor y lo corriges antes de aprobar. Si falta un criterio, no apruebes.

    3. Tests primero, luego código. Pide los tests de CA-1 a CA-5 y comprueba que fallan por la razón correcta. Después, la implementación.

    4. Verifica contra la spec, no contra el plan. Ejecuta los comandos de CA-6 y pide a un subagente que compare el diff con la spec y marque los criterios sin test, un patrón que propone la guía oficial.

    5. Abre el PR con la tabla. Basta con pedirle a Claude que cree el PR; si lo hace con gh pr create, Claude Code enlaza la sesión al PR y luego la recuperas con claude --from-pr <número>. Si prefieres controlarlo tú, escribe la descripción en un archivo y usa gh pr create --draft --title "SHOP-482: cancelar pedidos" --body-file pr.md.

    La descripción del PR no resume los cambios. Mapea:

    ## SHOP-482 — Cancelar pedidos
    Spec: specs/shop-482-cancelar-pedido.md
    
    | CA | Evidencia |
    |----|-----------|
    | CA-1 | test "cancela un pedido pendiente o pagado" (verde) |
    | CA-2 | test "rechaza cancelar un pedido enviado" (verde) |
    | CA-3 | test "no revela pedidos ajenos" (verde) |
    | CA-4 | test "cancelar es idempotente" (verde) |
    | CA-5 | test "publica order.cancelled una vez" (verde) |
    | CA-6 | typecheck y suite completa en verde |
    | CA-7 | manual: pendiente de QA en staging |
    
    Fuera de alcance: reembolsos (SHOP-483).
    

    El revisor ya no lee el diff adivinando qué hace: comprueba cada criterio y busca lo que falta. Es la idea de la revisión por contrato del código de agentes.

    Ramas, commits y conflictos con git merecen su propio post. Y si quieres encadenar todo desde Jira hasta el deploy, el pipeline está en automatizar el proceso de desarrollo con IA.

    ¿Cuánto se tarda de ticket a PR con Claude Code?

    Para un ticket acotado como este, una hora es un presupuesto razonable. No es una medición: es un reparto orientativo para saber cuándo te estás pasando en una fase.

    Fase Presupuesto orientativo Si te pasas, suele significar
    Leer el ticket y sacar preguntas 10 min El ticket esconde una decisión de producto
    Escribir la spec y los criterios 15 min El ticket es en realidad dos tickets
    Explorar el repo en plan mode 10 min No hay un patrón claro que copiar
    Revisar y aprobar el plan 5 min Los criterios son ambiguos
    Tests e implementación 10 min El alcance creció por el camino
    Verificar y abrir el PR 10 min Algún criterio no tenía forma real de comprobarse

    Dos tercios del tiempo, 40 de los 60 minutos, se van antes de que el agente edite nada. Es al revés de lo habitual: el tiempo se gasta en decidir, no en rehacer el PR.

    Límites de este método

    No sirve para tickets que esconden una decisión de producto grande. Si al listar preguntas descubres que nadie sabe qué tiene que pasar, la spec no lo arregla. Te obliga a verlo antes, pero el ticket vuelve a producto.

    Los criterios verifican lo que escribiste, no lo que olvidaste. Si nadie pensó en la concurrencia (dos cancelaciones a la vez), el PR saldrá con todas las filas en verde y el bug dentro. La tabla da trazabilidad, no completitud.

    El CLAUDE.md no obliga a nada. Si tu repo tiene carpetas que no se pueden tocar nunca, eso va en una regla de permisos o en un hook, no en una frase.

    No todo ticket necesita spec. Un cambio de texto, un bump de dependencia o un prototipo de UI que vas a tirar no compensan el ritual. Los casos están en cuándo no usar Spec-Driven Development. Y si lo que tienes delante es reestructurar código existente sin cambiar comportamiento, el enfoque es otro: refactorizar código legacy con SDD y Claude Code.

    Tu próximo ticket, en una hoja

    No cambies todo tu flujo. Coge el próximo ticket que te asignen y, antes de abrir Claude Code, escribe sus preguntas abiertas y cinco criterios Given/When/Then con su verificación al lado. Solo eso.

    El código no mejora porque el modelo sea más listo. Mejora porque por fin sabe qué significa "terminado".

    Si quieres practicar este recorrido completo con un proyecto real de principio a fin, es lo que hacemos en el curso Construye con IA: de la idea al producto con Claude Code. Y si tu problema es revisar lo que genera el agente con criterios y un harness, eso lo trabajamos en el workshop SDD + Agentic Engineering.

    Preguntas frecuentes

    ¿Quién escribe la spec del ticket, el dev o el agente?

    Los dos, con papeles distintos. El agente es bueno encontrando las preguntas que el ticket no contesta y proponiendo criterios a partir del código. El dev decide, y las decisiones de producto las cierra quien abrió el ticket. Si nadie la lee antes de implementar, la spec solo documenta las suposiciones del agente.

    ¿La spec va en el PR o se queda en el ticket?

    En el repo, dentro del PR. Así viaja con el código, el revisor la tiene al lado del diff y queda en el historial de git. En el ticket basta con un enlace al archivo. Si discrepan, manda la spec.

    ¿Qué hago si a mitad de implementación descubro que la spec estaba mal?

    Para, corrige la spec y vuelve a plan mode. No dejes que el agente lo arregle "sobre la marcha" en el código, porque entonces la spec y el PR cuentan dos historias distintas. Si es técnico, anótalo en "Decisiones tomadas"; si es de producto, vuelve a preguntar.

    ¿Necesito una spec si ya uso plan mode?

    Sí, porque resuelven cosas distintas. Plan mode decide cómo se construye; la spec fija qué cuenta como terminado. Un plan sin criterios externos siempre está de acuerdo consigo mismo: el agente lo escribe y luego lo cumple. Con la spec, el plan tiene que citar cada CA-n con su archivo y su test, y lo que falte se ve antes de aprobar.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • AI software factory: qué es y por qué falla sin contrato

    AI software factory: qué es y por qué falla sin contrato

    El 6 de febrero de 2026 un equipo de tres personas de StrongDM publicó un manifiesto con dos reglas. La primera: el código no lo escriben humanos. La segunda: el código no lo revisan humanos.

    Al día siguiente el texto llegó a portada de Hacker News. Un comentario resumía la reacción de media sala: "I feel like I'm taking crazy pills". La otra media lo leía como el primer plano de una AI software factory de verdad.

    Casi nadie discutía qué modelo usaban. Discutían cómo sabes que funciona un software que ningún humano ha escrito ni leído.

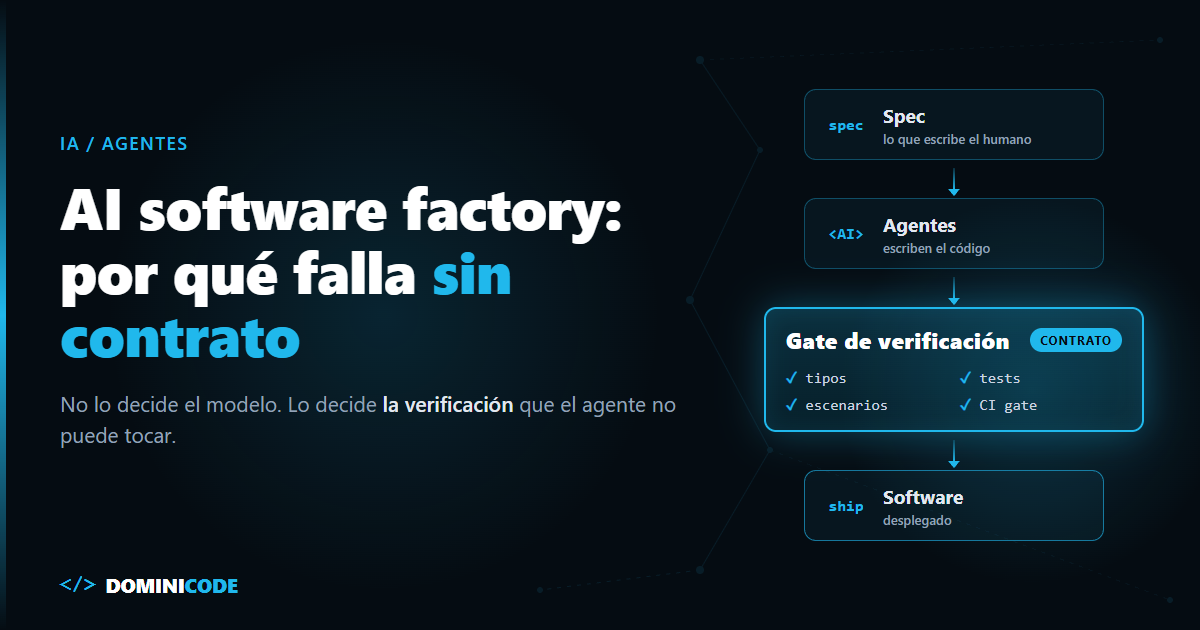
    En corto: una AI software factory es un pipeline donde agentes de IA convierten especificaciones en software desplegado, y los humanos solo escriben specs y juzgan resultados. Lo que decide si funciona no es el modelo, sino el harness de verificación: tests, tipos, escenarios y gates de CI que el agente no puede manipular.

    ¿Qué es una AI software factory?

    Una AI software factory (fábrica de software con IA) es un sistema en el que agentes de IA escriben, prueban e integran código a partir de especificaciones, y donde la calidad la garantiza un sistema de verificación automatizado en lugar de la revisión humana línea a línea.

    StrongDM lo define en su propio manifiesto como "non-interactive development where specs + scenarios drive agents that write code": desarrollo no interactivo donde specs y escenarios dirigen a agentes que escriben código.

    Fíjate en lo que falta: el prompt. Nadie chatea con el agente. Hay una entrada (la spec), una salida (el software) y un control de calidad entre medias.

    ¿Quién usa el término AI software factory y qué hay detrás?

    Hoy el término lo usan cuatro actores: StrongDM y OpenAI para describir cómo producen software sin escribir código a mano, Dan Shapiro para su escala de autonomía, y Factory como marca comercial. Solo los dos primeros publican cómo verifican.

    Quién Qué afirma Evidencia Limitación o riesgo
    StrongDM (feb. 2026) Equipo de 3 personas desde julio de 2025; "code must not be written by humans" ni revisado por humanos Manifiesto propio, técnicas publicadas y análisis de Simon Willison Su regla práctica: si no gastas 1.000 USD en tokens al día por ingeniero, a tu fábrica le queda margen; no publican métricas de producto entregado
    Dan Shapiro (ene. 2026) Seis niveles de autonomía (0 a 5); el 5 es la "dark factory" Lo que ha visto en decenas de empresas No es una encuesta; los porcentajes son estimaciones del autor
    OpenAI, harness engineering (feb. 2026) Un producto interno en beta de alrededor de un millón de líneas en cinco meses, con cero código escrito a mano (InfoQ, The Neuron) Cifras autodeclaradas, repetidas por dos medios (lo analizo aquí) Lo hace el fabricante del modelo, con acceso y presupuesto que tu equipo no tiene
    Factory (antes Factory.ai) "Build Your Software Factory": agentes llamados Droids que trabajan desde terminal, Slack, Jira, Linear y CI Página comercial Es un producto; el término es su posicionamiento de marca

    Mi lectura: StrongDM y OpenAI describen cómo verifican, y eso es lo valioso. Factory describe dónde se ejecutan los agentes, que es lo fácil.

    Las piezas de una fábrica de software con IA

    Una fábrica de software con IA tiene cinco piezas, y solo una de ellas es el modelo.

    1. Specs. La entrada de la línea. Si es ambigua, el agente rellena huecos con lo más frecuente en su entrenamiento, no con lo que pide tu negocio. Es Spec-Driven Development sin humanos en medio; lo desarrollo en el libro de Spec-Driven Development.

    2. Agentes. Claude Code, Codex, Droids. La pieza más intercambiable.

    3. Harness de verificación. Tests, tipos estrictos, linters, tests estructurales de arquitectura y escenarios end-to-end. Según InfoQ, OpenAI impone los límites de arquitectura "through mechanical rules and structural tests". No los pide en el prompt.

    4. CI como gate. Nada llega a main sin pasar el harness.

    5. Revisión. En StrongDM la revisión humana desaparece y la sustituye una métrica que llaman satisfaction: de todas las trayectorias observadas en todos los escenarios, qué fracción probablemente satisface al usuario. En el resto del mundo, la revisión sigue siendo humana pero cambia de objeto: revisas el contrato, no cada diff.

    Por qué la verificación decide si una AI software factory funciona

    El cuello de botella de una AI software factory es la verificación, no la generación de código. Generar código ya es barato. Saber si es correcto sigue siendo caro.

    Si el mismo agente escribe el código y los tests, optimiza para que los tests pasen, no para que el software funcione. En el hilo de Hacker News sobre StrongDM, el usuario Zakodiac lo dijo sin rodeos: "agents will absolutely game your test suite".

    La respuesta de StrongDM es la idea más útil de todo su manifiesto: guardar los escenarios, a menudo, fuera del repositorio, como el holdout set de un modelo de machine learning. El agente nunca los ve, así que no puede adaptarse a ellos.

    En la práctica se parece a esto:

    # .github/workflows/factory-gate.yml
    name: factory-gate
    on: pull_request
    jobs:
      holdout:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v7
          # Los escenarios viven en otro repo, sin acceso de escritura para el agente
          - uses: actions/checkout@v7
            with:
              repository: acme/checkout-scenarios
              path: scenarios
              token: ${{ secrets.SCENARIOS_READ_TOKEN }}
          - run: npm ci && npm run typecheck && npm test
          - run: npx playwright install --with-deps
          - run: npx playwright test --config scenarios/playwright.config.ts
    

    Tipos y tests en el repo, y escenarios que el agente no puede leer ni editar. Si una capa falla, el PR no entra. Protege también el workflow con CODEOWNERS y protección de rama; si no, el agente puede editar el propio gate.

    Otro comentario del mismo hilo, de CuriouslyC, pone el límite donde toca: "Until we solve the validation problem, none of this stuff is going to be more than flexes."

    Por eso defiendo que la pieza central es un contrato: reglas de negocio expresadas como tipos, tests y escenarios, no como frases en un prompt. Lo explico paso a paso en el tutorial de harness engineering y en el método de revisión por contrato.

    En qué nivel de autonomía está la mayoría de equipos hoy

    Según Dan Shapiro, el 90 % de los developers que se llaman "AI-native" está en el nivel 2 de su escala de seis niveles, y casi todos tocan techo en el 3. No cita fuente ni método: es su observación tras ver "decenas de empresas", no un estudio. La escala, de enero de 2026, se inspira en la conducción autónoma:

    Nivel Analogía de Shapiro Qué hace el developer
    0 El Volvo de tus padres Escribe todo el código
    1 Control de carril Delega tareas pequeñas y aisladas
    2 Autopilot en autopista Programa en pareja con la IA, en flujo
    3 Waymo con conductor de seguridad La IA escribe; él revisa diffs ("your life is diffs")
    4 Robotaxi Escribe specs y planes; vuelve horas después a ver si pasan los tests
    5 Dark factory Una caja negra que convierte specs en software

    Mi opinión: el salto que paga es del 2 al 4, no del 4 al 5. En el nivel 4 sigues escribiendo la spec y juzgando el resultado, pero dejas de leer cada línea porque el harness lo hace por ti. Eso ya es una fábrica, y es el mismo salto que describo en los niveles de Spec-Driven Development. La dark factory completa es un caso extremo, no la meta por defecto. Si quieres ver el ciclo completo de contexto entre esos niveles, está en el post de SDLC context engineering.

    Cuándo NO montar una AI software factory

    Una AI software factory no es gratis ni universal. No la montaría en estos casos.

    Cuando no tienes tests ni tipos fiables. Si tu suite actual no detecta regresiones con humanos escribiendo el código, tampoco las detectará con agentes. Multiplicarás la velocidad de los errores. Primero el harness, después la fábrica.

    Cuando el trabajo consiste en descubrir qué hay que construir. Para validar su fábrica, StrongDM construyó réplicas de servicios con API pública documentada (Okta, Jira, Slack): ahí la spec ya existe. En el hilo de HN, softwaredoug lo señaló: "most development work involves discovering correctness, not writing to a fullproof spec (like cloning slack)". Si la spec no existe todavía, no hay nada que fabricar.

    Cuando el coste no cuadra. La guía de StrongDM habla de al menos 1.000 USD en tokens al día por ingeniero. Simon Willison lo traduce a unos 20.000 USD al mes por persona y admite que, a ese precio, el enfoque le resulta "far less interesting".

    Cuando un fallo es inaceptable y nadie lo revisa. Software de seguridad, pagos o salud. Un antiguo cliente de StrongDM escribió en el hilo que para un producto de seguridad central eso no era el "flex" que creían.

    Por dónde empezar con una fábrica de software con IA

    No montes la fábrica. Monta el contrato.

    Es el camino que sigo con el método de Revisión por Contrato (Contract Based Review Method), y cabe en cuatro pasos:

    1. Un Issue, una spec. Elige un módulo con reglas de negocio claras. Antes de que el agente escriba una línea, firma su spec: qué cambia, criterios de aceptación ejecutables y qué archivos puede tocar.
    2. Un harness que corre solo. Tipos, lint y tests en un bucle corto tras cada cambio, y el bucle largo en CI en cada PR. Si depende de que te acuerdes de lanzarlo, no es verificación.
    3. Un veredicto en lugar del diff. Un comando ejecuta cada criterio de la spec y comprueba que el agente no salió de su alcance. Lees ese veredicto, no el diff.
    4. Criterios fuera de su alcance. Protege la spec y el harness con CODEOWNERS y protección de rama, o mueve los escenarios a otro repo. Si el agente puede editar el gate, lo editará.

    Después deja que el agente implemente una feature entera sin que leas el diff, y mira solo el veredicto.

    Si pasa y el comportamiento es correcto, has subido un nivel. Si pasa y es incorrecto, has encontrado el agujero de tu contrato: la información más valiosa de tu semana.

    Si quieres empezar sin pagar nada, el ebook gratuito El Developer Agéntico cubre cómo construir agentes de IA, de la arquitectura a la seguridad y la evaluación.

    Ese recorrido, del Issue a una PR con veredicto, es el workshop SDD + Agentic Engineering: la spec como contrato, hooks y CI que corren solos, y un veredicto que comprueba cada criterio y el alcance del diff. Primero en un repo de práctica, después en el tuyo. Y si prefieres construir un producto completo con Claude Code aplicando estas ideas, está el curso Construye con IA: de la idea al producto.

    Preguntas frecuentes

    ¿Qué diferencia hay entre una AI software factory y usar Claude Code o Copilot?

    Usar un asistente es trabajo interactivo: tú pides, revisas y corriges en cada paso. Una AI software factory es no interactiva: los agentes trabajan a partir de una spec y un sistema automatizado decide si el resultado es aceptable, sin que nadie siga la sesión.

    ¿Qué es una dark factory en desarrollo de software?

    Es el nivel 5 de la escala de Dan Shapiro: un proceso donde las specs entran y el software sale sin desarrollo ni revisión humana en medio. El término viene de las fábricas industriales que funcionan con las luces apagadas porque no hay personas dentro.

    ¿Qué relación tiene una fábrica de software con IA con SDD?

    Spec-Driven Development aporta la entrada de la fábrica: specs precisas que el agente puede ejecutar sin interpretar. Sin SDD, el agente rellena los huecos de la spec con lo más frecuente en su entrenamiento. Con SDD, esas reglas se convierten en tipos, tests y escenarios que el harness comprueba.

    ¿Los agentes pueden escribir sus propios tests en una AI software factory?

    Pueden escribir tests unitarios, pero no deberían controlar la verificación final. Si el mismo agente escribe el código y todos los tests, tenderá a ajustar los tests al código. Los escenarios de aceptación deben vivir fuera de su alcance.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Cómo presupuestar un proyecto de software cuando usas IA

    Cómo presupuestar un proyecto de software cuando usas IA

    Te escribe un posible cliente: quiere un portal de reservas para su clínica, con pagos online y conectado a la agenda que ya usa. Y remata: "Como ahora programas con IA, saldrá bastante más barato, ¿no?".

    Hace un año habrías estimado unas 150 horas. Ahora el agente genera un CRUD en diez minutos. La tentación es partir las horas por la mitad y cerrar el trato.

    Saber cómo presupuestar un proyecto de software en este contexto es la diferencia entre cobrar lo que vale y pagar de tu bolsillo cada imprevisto. Porque la mitad del código no es la mitad del proyecto.

    En corto: la IA abarata escribir código, pero no abarata entender el problema, decidir, revisar, integrar con los sistemas del cliente, probar, desplegar ni mantener. Si descuentas horas a ciegas, cobras de menos y te quedas con todo el riesgo. Presupuesta por entregable y por riesgo, con una tarifa mínima calculada y un alcance cerrado, no por horas de tecleo.

    ¿Qué es un presupuesto de software y qué incluye?

    Un presupuesto de software es un compromiso de precio y alcance: qué vas a entregar, con qué criterio de aceptación, en qué plazo, por cuánto dinero y qué pasa cuando algo cambia.

    No es una estimación de horas. La estimación es tu cálculo interno; el presupuesto es lo que firmas. Y lo que firmas cubre todo lo que puede salir mal, aunque la IA abarate algunas tareas. Incluye alcance, entregables, exclusiones, hitos de pago y una regla para los cambios.

    Por qué la IA no abarata el proyecto entero

    La IA acelera la parte del trabajo que más se ve: teclear. Y deja casi igual la que más tiempo consume en un proyecto con cliente real: averiguar qué quiere, decidir cómo hacerlo y demostrar que funciona.

    Además, ni siquiera la parte de código se acelera tanto como crees. En el estudio de METR publicado en julio de 2025, 16 developers experimentados resolvieron 246 issues reales de sus repositorios. Con IA tardaron un 19% más. Antes de empezar esperaban ir un 24% más rápido y, al terminar, seguían creyendo que habían ganado un 20% (paper en arXiv).

    El estudio tiene límites que el propio METR enumera: muestra pequeña, repositorios grandes que conocían a fondo y herramientas de principios de 2025. De hecho, METR cree que ya no refleja la situación actual: en su continuación de febrero de 2026 cree probable que hoy la IA sí acelere, aunque con datos débiles (los detalles, en el post sobre el estudio METR de productividad con IA). Para presupuestar, la lección sigue en pie: tu sensación de velocidad no es un dato. En un precio cerrado, cada hora mal descontada sale de tu margen.

    Cómo presupuestar un proyecto de software paso a paso

    El método tiene seis pasos:

    1. Calcula tu tarifa mínima por hora.
    2. Divide el proyecto en entregables con tallas.
    3. Marca qué acelera la IA y qué no.
    4. Añade el colchón de riesgo.
    5. Cobra por hitos.
    6. Cierra el alcance y cobra los cambios aparte.

    Todas las cifras que siguen son un ejemplo inventado para ilustrar el cálculo, no datos de mercado. Sustitúyelas por las tuyas.

    Paso 1: calcula tu tarifa mínima por hora

    Tu tarifa mínima es lo que necesitas facturar por cada hora vendible para cubrir gastos y sueldo objetivo; por debajo de ella, pierdes dinero aunque el cliente esté contento.

    Ejemplo: quieres ingresar 36.000 USD al año antes de impuestos y tu negocio gasta 6.000 USD (equipo, software, suscripciones de IA, gestoría, seguros). Necesitas 42.000 USD.

    Trabajas 45 semanas de 40 horas: 1.800 horas. No todas se facturan: ventas, administración y formación se comen tiempo. Con un 60% facturable te quedan 1.080 horas. 42.000 / 1.080 = 38,89 USD. Redondea hacia arriba: 40 USD/h es tu suelo, no tu precio.

    Si tu tarifa por hora como developer está por debajo, ningún método te salva. En cómo pasar de consumir tutoriales a facturar con código tienes el marco para elegir qué proyectos aceptar.

    Paso 2: divide el proyecto en entregables con tallas

    No estimes "el portal". Estima piezas que el cliente pueda ver y aceptar. Asigna a cada una una talla: S (hasta 6 h), M (7-12 h), L (13-24 h) y XL (más de 24 h). Si algo sale XL, pártelo o trátalo como riesgo.

    Paso 3: marca qué acelera la IA y qué no

    Repasa cada entregable y pregúntate qué parte es escribir código conocido. Boilerplate, CRUD, formularios, tests de casos claros y plantillas de email se aceleran. Descubrimiento, decisiones de arquitectura, integración con sistemas del cliente, QA, despliegue y reuniones, apenas.

    Y añade una tarea que antes no existía: revisar lo que genera la IA. Si no la presupuestas, la haces gratis. Un método para que esa revisión sea rápida y verificable es la Revisión por Contrato.

    Este es el ejemplo completo del portal de reservas. Las horas con IA son un supuesto del ejemplo, no una medición:

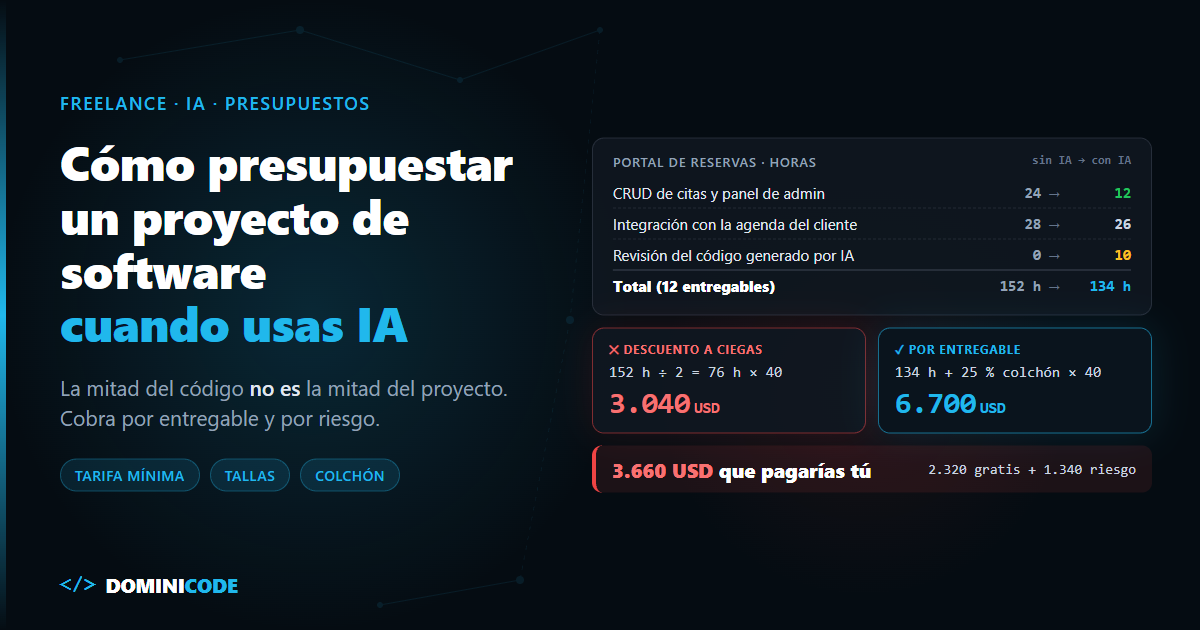
    Entregable Talla (con IA) Horas sin IA Horas con IA Nota
    Descubrimiento y especificación L 16 16 Hablar con el cliente no se acelera
    Modelo de datos y arquitectura M 8 8 Decisión tuya, la IA solo propone
    Autenticación y roles M 12 8 Patrón conocido
    CRUD de citas y panel de administración M 24 12 Boilerplate puro: donde más ahorra
    Integración con la agenda actual del cliente XL 28 26 API sin documentar: el riesgo real
    Pasarela de pago M 12 10 Webhooks y casos límite a mano
    Notificaciones por email S 6 3 Plantillas
    Tests automatizados M 12 8 Los casos los decides tú
    Revisión del código generado por IA M 0 10 Tarea nueva
    QA con el cliente y correcciones L 16 16 Depende del cliente, no de ti
    Despliegue, CI y monitorización M 8 7 Poco código, mucha configuración
    Reuniones y gestión M 10 10 Igual que siempre
    Total 152 134 18 h menos (11,8%)

    La IA "escribe la mitad del código", pero el proyecto baja un 11,8% en este supuesto. Si hubieras partido las 152 horas por la mitad, habrías presupuestado 76 horas: 3.040 USD. El trabajo real con IA son 134 horas: 5.360 USD sin colchón.

    Pasar de idea a producto con un agente sin perder el control de estas fases es lo que trabajamos en el curso Construye con IA.

    Paso 4: añade el colchón de riesgo

    Añade un colchón sobre las horas con IA, mayor cuanto más incierto sea el proyecto. En el ejemplo, un 25% por la integración XL: 134 × 1,25 = 167,5 horas. A 40 USD/h, el presupuesto es 6.700 USD.

    Compáralo con los 3.040 USD del descuento a ciegas: la diferencia son 3.660 USD: 2.320 de trabajo que harías gratis seguro (5.360 − 3.040) y 1.340 de riesgo que asumirías sin cobrarlo.

    Paso 5: cobra por hitos

    Liga cada pago a un entregable aceptado, no a una fecha. En el ejemplo: 30% a la firma (2.010 USD), 40% con la versión de pruebas funcionando (2.680 USD) y 30% en la aceptación final (2.010 USD). Total: 6.700 USD. Si el cliente desaparece a mitad, no has trabajado gratis.

    Paso 6: cierra el alcance y cobra los cambios aparte

    El precio fijo solo funciona con un alcance escrito: qué entra, qué no entra y cómo se acepta cada pieza. Eso es una especificación, y es lo que trabajamos en el workshop SDD + Agentic Engineering: la misma spec que guía al agente sirve de contrato con el cliente.

    Todo lo que esté fuera de ese documento es un cambio y se presupuesta aparte. Sin esa regla, el colchón se gasta en peticiones nuevas.

    Precio fijo, por horas o por valor: cuál elegir

    Si el alcance se puede escribir, cobra a precio fijo por entregable: es el único modelo en el que el ahorro de la IA se queda en tu margen. Cobra por horas solo el descubrimiento o lo que no tenga alcance claro.

    Precio fijo Por horas Por valor
    Qué cobras Entregables cerrados Tiempo trabajado Parte del resultado para el negocio
    Efecto de la IA El ahorro real es tu margen El ahorro se lo queda el cliente Irrelevante para el precio
    Encaja cuando El alcance se puede escribir El alcance no está claro El impacto se puede medir
    Limitación / riesgo Si estimas mal, pierdes tú Te penaliza ser rápido; el cliente discute cada hora Difícil de vender y de medir en un MVP

    Mi opinión: para un freelance que trabaja con IA, el precio fijo por entregable con cambios aparte es el modelo por defecto. Es el único donde ser más rápido te beneficia a ti.

    El debate es anterior a la IA. En un hilo de Hacker News de 2013 sobre precio fijo frente a horas, un usuario escribía: "Something that use to take me 10 hours to design may now take me 2 hours. Should I discount the knowledge and skill it took to learn that?".

    Otro describía su modelo: precio fijo según el alcance inicial y facturación aparte para soporte y para "additions to scope or changes that occur after sign-offs" (comentario).

    La IA ha añadido un giro. En un comentario de diciembre de 2025, un developer que arreglaba apps generadas con IA explicaba que esos trabajos están mal pagados porque el cliente espera que "mostly everything is now done" y que tú, con IA a tu disposición, solo escribas "a better magic prompt". Esa expectativa es la que tu presupuesto tiene que desmontar.

    Qué responder cuando el cliente pregunta por qué no es más barato

    Esta respuesta está lista para copiar y adaptar:

    "Uso IA, y por eso este presupuesto ya es más ajustado. Pero la IA acelera escribir código, que es solo una parte. No acelera entender tu negocio, integrar con tu agenda actual, probar con tus datos ni desplegar con garantías. Y todo lo que genera lo reviso yo, porque el responsable de que funcione sigo siendo yo.

    Te doy un precio cerrado por entregables: si surge un imprevisto, lo asumo yo. Solo se presupuestan aparte los cambios de alcance."

    El argumento clave es el último: con precio cerrado, el riesgo lo asumes tú, y eso tiene un precio.

    Límites de presupuestar así

    Este método para presupuestar un proyecto de software no elimina la incertidumbre; tiene cuatro límites.

    La estimación sigue siendo incierta. El cono de incertidumbre de Steve McConnell y Construx sitúa el error de una estimación en fase de concepto inicial entre 0,25x y 4x del resultado real, y aun así lo presenta como el mejor caso: "results can easily be worse". Con una definición de producto aprobada, el rango baja a 0,5x-2x. Por eso no se presupuesta sin especificación.

    Los proyectos legacy rompen las tallas. Sin tests ni documentación, la IA ayuda poco y estimar por entregable es adivinar. Cobra primero un diagnóstico por horas y presupuesta después.

    Hay clientes que no saben lo que quieren. Con ellos el precio fijo es una trampa: vende primero un descubrimiento pagado y cierra el precio cuando el alcance esté escrito.

    El colchón no cubre un cambio de alcance. El 25% está para imprevistos de lo pactado, no para funcionalidades nuevas. Si los mezclas, regalas trabajo. Y si el proyecto incluye agentes de IA en producción, calcula también su coste de fallo: está explicado en cuánto cuesta de verdad un agente que falla.

    Por dónde empezar a presupuestar un proyecto de software

    En tu próximo presupuesto, añade una fila de revisión del código generado y otra de colchón, y separa por escrito el alcance de los cambios. Si quieres que esa especificación sea sólida, el libro de Spec-Driven Development explica cómo escribirla. Y si buscas más fuentes de ingreso, repasa las tres vías para ganar dinero en internet.

    La IA te hace más rápido escribiendo. Cobra por el resultado y por el riesgo que asumes, no por lo rápido que escribes.

    Preguntas frecuentes

    ¿Debo cobrar menos si uso IA para programar?

    No necesariamente. La IA reduce el tiempo de escribir código, no el de descubrimiento, integración, QA ni despliegue, y añade revisión. Aplica el ahorro solo donde sea real.

    ¿Cómo calculo mi tarifa por hora como developer freelance?

    Suma tu ingreso objetivo anual y tus gastos del negocio, y divide entre tus horas facturables reales. En el ejemplo del post: 42.000 USD entre 1.080 horas da 38,89 USD, que se redondea a una tarifa mínima de 40 USD/h.

    ¿Es mejor presupuestar a precio fijo o por horas?

    Con un alcance escrito, el precio fijo por entregables suele ser mejor para quien trabaja con IA, porque el ahorro se convierte en margen. Si el alcance no está claro, cobra el descubrimiento por horas.

    ¿Cuánto colchón de imprevistos debo añadir a un presupuesto de software?

    No hay un porcentaje universal: el colchón crece con la incertidumbre del proyecto. El ejemplo del post usa un 25% por una integración sin documentar. Si el alcance es muy incierto, no cierres precio todavía: vende primero un descubrimiento pagado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Refactorizar código legacy con IA: el método SDD en brownfield

    Refactorizar código legacy con IA: el método SDD en brownfield

    El fichero se llamaba pricing.ts, tenía 1.100 líneas y un comentario en la línea 3 que decía // NO TOCAR — hablar con Javi antes. Javi se había ido de la empresa en 2021.

    Cero tests. Cero documentación. Y toda la facturación pasando por ahí.

    Hice lo que hace todo el mundo la primera vez que intenta refactorizar código legacy con IA: se lo pegué entero a Claude Code y le pedí que lo dejara limpio. Me devolvió algo precioso. Funciones puras, nombres decentes, 300 líneas en vez de 1.100.

    Y roto para los pedidos que acumulaban cupón y descuento de socio a la vez.

    El agente no alucinó nada. Hizo exactamente lo que le pedí. Le pedí arreglar un código cuya intención nadie le había explicado, porque nadie la sabía.

    Esa es la tesis de este post: en legacy la spec no describe la feature que quieres, describe el comportamiento que ya tienes. Y por eso el primer artefacto no es spec.md, son los tests de caracterización.

    Por qué refactorizar código legacy con IA falla sin tests

    Refactorizar código legacy con IA usando SDD consiste en invertir el ciclo habitual: primero tests de caracterización que congelan el comportamiento observable, después una spec que documenta lo que el sistema ya hace, y solo entonces plan y tasks.

    El motivo es simple. Un modelo lee código y ve perfectamente qué hace. Lo que no puede ver es qué debería hacer.

    En un proyecto nuevo eso da igual, porque la intención está en tu cabeza y la escribes tú. Es lo que hacemos cuando arrancamos un greenfield con slices verticales: la spec va delante porque describe algo que todavía no existe.

    En legacy la intención está enterrada bajo seis años de parches de viernes por la tarde. Y ahí aparece el problema real: ningún modelo distingue una regla de negocio rara de un bug que lleva años tolerándose.

    En mi pricing.ts había un Math.floor donde cualquiera pondría Math.round. Claude lo "arregló". Llevaba ahí desde 2019 porque el departamento financiero quería redondear siempre a favor del cliente.

    Eso no es un bug. Es un requisito no escrito. Y el agente no tenía forma humana de saberlo.

    Los antipatrones de este escenario los desarrollé en los 5 errores fatales al refactorizar legacy con IA, así que no los repito. El método positivo empieza invirtiendo el orden.

    Spec greenfield Spec brownfield
    Qué describe Lo que quieres construir Lo que ya hace el sistema
    Fuente de verdad Tu criterio de producto El código en producción
    Primer artefacto spec.md Tests de caracterización
    Criterio de éxito Cumple los casos de uso nuevos No cambia ninguna salida observable
    Ambigüedad Se resuelve preguntando Se resuelve ejecutando
    Riesgo principal Construir lo que no toca Romper lo que ya funcionaba

    En greenfield el ciclo es spec → plan → tasks → código. En brownfield es tests → spec → plan → tasks → código. La spec sigue existiendo, pero llega en segundo lugar: hasta que no ejecutas el módulo no sabes qué escribir en ella.

    Paso 0 — Acota el blast radius antes de abrir el editor

    La regla que más refactors me ha salvado: si no puedes escribir en una línea qué NO vas a tocar, no empieces.

    Escribe estas cuatro cosas antes de nada:

    • Dentro: src/pricing.ts y sus dos helpers.
    • Fuera: el modelo de datos, los endpoints, la UI de checkout.
    • Consumidores: quién importa esto. Lanza un rg sobre el repo y pega la lista tal cual.
    • Contrato público: las funciones exportadas que otros usan. Esas firmas no se tocan.

    Ese último punto es el que hace el trabajo acotable: si la frontera del módulo se mueve, ya no es un refactor, es un rediseño.

    Paso 1 — Arqueología asistida: el agente lee, no escribe

    Aquí Claude Code es brutalmente bueno, y es la parte que casi nadie usa. El agente tiene prohibido cambiar una sola línea.

    El prompt que uso, más o menos literal:

    Lee src/pricing.ts. No propongas mejoras ni refactorices nada.
    
    Produce docs/legacy/pricing-observado.md con:
    1. Cada rama de decisión del módulo, con la condición exacta que la activa.
    2. Las entradas: tipos reales, no los declarados. Marca los que en la práctica
       llegan como null o undefined.
    3. Las salidas: forma del retorno en cada rama.
    4. Efectos secundarios: I/O, escrituras, logs, mutación de argumentos, lecturas
       de Date/Math.random o de variables globales.
    5. Una sección "Comportamientos sospechosos": cosas que parecen bugs.
       NO las arregles. Solo lístalas con número de línea.
    6. Una sección "Preguntas que no puedo responder leyendo el código".
    

    Las secciones 5 y 6 son el oro: una lista lo que el agente habría "arreglado" solo, la otra lo que tienes que ir a preguntarle a un humano o a los logs de producción.

    En pricing.ts la sección 6 tenía nueve preguntas. Siete las resolví mirando datos reales. Dos las resolvió el responsable de facturación en cinco minutos. Ese día no escribí código y fue el día más productivo del refactor.

    Paso 2 — Tests de caracterización: congela el comportamiento, incluso el feo

    Un test de caracterización no comprueba que el código sea correcto. Comprueba que sigue haciendo lo mismo. En TDD el test va delante y define lo deseable; aquí va detrás y define lo existente.

    Aunque lo existente sea horrible.

    // pricing.characterization.test.ts
    import { describe, it, expect } from 'vitest'
    import { calcularPrecioFinal } from '../src/pricing'
    
    // Casos capturados de pedidos reales de producción, anonimizados.
    const CASOS = [
      { nombre: 'base sin descuentos', pedido: { subtotal: 100, cupon: null, pais: 'ES', socio: false } },
      { nombre: 'cupon y socio acumulados', pedido: { subtotal: 100, cupon: 'VIP10', pais: 'ES', socio: true } },
      { nombre: 'cupon caducado', pedido: { subtotal: 100, cupon: 'OLD20', pais: 'ES', socio: false } },
      { nombre: 'pais sin IVA', pedido: { subtotal: 100, cupon: null, pais: 'US', socio: false } },
      { nombre: 'decimales feos', pedido: { subtotal: 1234.56, cupon: 'VIP10', pais: 'ES', socio: true } },
      { nombre: 'subtotal cero', pedido: { subtotal: 0, cupon: 'VIP10', pais: 'ES', socio: true } },
    ] as const
    
    // CONGELADO: el caso 'decimales feos' devuelve un céntimo de menos por el
    // Math.floor de pricing.ts:412. Se arregla DESPUÉS del refactor, en un
    // commit propio. Ver LEG-14.
    describe('calcularPrecioFinal — caracterización', () => {
      it.each(CASOS)('$nombre', ({ pedido }) => {
        expect(calcularPrecioFinal(pedido)).toMatchSnapshot()
      })
    })
    

    Fíjate en lo que no hay: ningún valor esperado escrito a mano. El snapshot lo genera la primera ejecución. Tú no decides la salida correcta, la registras.

    El término viene de Working Effectively with Legacy Code (Michael Feathers, 2004), y en Vitest 5 lo implementas con toMatchSnapshot().

    Después abres el fichero de snapshots y lo lees entero. Ahí aparecen las sorpresas y ahí apuntas los // CONGELADO:. Cada uno es un ticket futuro, no una excusa para tocar nada ahora.

    Y sí, congelas el bug a propósito. Si arreglas comportamiento y estructura en el mismo commit, cuando algo falle en producción no sabrás cuál de las dos cosas lo rompió.

    Paso 3 — La spec brownfield

    Ahora, y solo ahora, escribes la spec. Con los tests en verde delante deja de ser un ejercicio de memoria, y las secciones que importan no son las de un proyecto nuevo:

    # Spec — Refactor de pricing
    
    ## Comportamiento observado
    Documentado en docs/legacy/pricing-observado.md.
    Congelado en pricing.characterization.test.ts (6 casos).
    
    ## Contrato público (NO cambia)
    calcularPrecioFinal(pedido: Pedido): Precio
    - Devuelve `total` en céntimos como number. No se migra a bigint en este refactor.
    - Nunca lanza: ante entrada inválida devuelve { total: 0, error: string }.
    
    ## Efectos secundarios actuales
    - Escribe en la tabla pricing_audit. SE MANTIENE.
    - Lee process.env.TAX_MODE en caliente. SE MANTIENE, se aísla en config.ts.
    - Muta el objeto `pedido` recibido. SE ELIMINA: ningún consumidor depende de
      ello, verificado en los 4 call sites.
    
    ## Deuda congelada a propósito
    - LEG-14: redondeo con Math.floor en la línea 412.
    - LEG-15: cupón caducado devuelve descuento 0 en vez de error.
    
    ## Fuera de alcance
    Modelo de datos, endpoints, UI de checkout, migración a bigint.
    
    ## Criterio de aceptación
    Los 6 tests de caracterización pasan sin modificar sus snapshots.
    El test de equivalencia legacy/refactor pasa en las 72 combinaciones.
    

    Es corta a propósito. Y es lo que le das al agente en cada task, no el fichero de 1.100 líneas.

    El formato completo lo tienes en el libro de Spec-Driven Development. Para el esqueleto uso el skill dominicode-sdd-creator, que genera spec.md + plan.md + tasks.md; el contenido brownfield lo pones tú, porque sale de los tests.

    Si dudas de cuánta ceremonia merece el módulo, el criterio está en los tres niveles de SDD. Un refactor de legacy con dinero de por medio es nivel alto, sin discusión.

    Paso 4 — Plan por fases, tasks pequeñas, un commit verde cada una

    El plan de un refactor brownfield tiene siempre la misma forma:

    1. Aislar. Extraer funciones puras sin cambiar la lógica. Copiar, no reescribir.
    2. Tipar los bordes. Con los tipos reales del paso 1, no los declarados.
    3. Sustituir por partes. La implementación nueva convive con la vieja mientras dure.
    4. Borrar el legacy. Cuando la equivalencia lleve dos semanas en verde.

    La fase 3 es la que necesita andamio. Copia el original a pricing.legacy.ts, deja pricing.ts para la implementación nueva, y este es todo el andamio:

    // pricing.equivalence.test.ts
    import { describe, it, expect } from 'vitest'
    import { calcularPrecioFinal as legacy } from '../src/pricing.legacy'
    import { calcularPrecioFinal as refactor } from '../src/pricing'
    
    const subtotales = [0, 9.99, 100, 1234.56]
    const cupones = [null, 'VIP10', 'OLD20']
    const paises = ['ES', 'US', 'DE']
    const socios = [true, false]
    
    describe('legacy vs refactor — equivalencia', () => {
      for (const subtotal of subtotales) {
        for (const cupon of cupones) {
          for (const pais of paises) {
            for (const socio of socios) {
              const pedido = { subtotal, cupon, pais, socio }
              it(`${subtotal} / ${cupon ?? 'sin cupon'} / ${pais} / socio=${socio}`, () => {
                expect(refactor(pedido)).toEqual(legacy(pedido))
              })
            }
          }
        }
      }
    })
    

    72 combinaciones que el agente ejecuta solo cada vez que cierra una task. Y ojo: si el test sale intermitente no tienes un problema de refactor, tienes un Date.now() o un Math.random() sin inyectar. Arréglalo antes de seguir.

    Regla de tamaño de task: si el diff no lo puedes leer entero en diez minutos, pártela. El límite no lo pone el agente, lo pone tu capacidad de revisar lo que produjo — que es el verdadero cuello de botella de trabajar con agentes.

    Paso 5 — Qué haces cuando un test se pone rojo

    Un test de caracterización en rojo tiene tres causas. Míralas en este orden.

    Uno: el refactor rompió algo. Nueve de cada diez veces, por mi experiencia. Revierte la task, no la parchees: el diff es pequeño precisamente para que revertir sea barato.

    Dos: el refactor arregló un bug sin querer. Pasa más de lo que parece y es una trampa. Revierte igual y arréglalo en su propio commit, con su snapshot actualizado. Un cambio de comportamiento colado dentro de un refactor pasa desapercibido en la review casi siempre.

    Tres: el test no era determinista. Fechas, aleatoriedad, orden de un Object.keys, zona horaria. Eso no es caracterización, es ruido. Arréglalo en el test o inyecta la dependencia.

    La regla que resume el paso 5 entero: un refactor nunca cambia comportamiento, y un cambio de comportamiento nunca se llama refactor. Commits distintos, PRs distintas, riesgos distintos.

    Este bucle es el mismo que aplico en TDD potenciado por IA, solo que en legacy los tests no los escribes para diseñar: los escribes para tener permiso a tocar.

    Cómo empezar a refactorizar legacy con Claude Code el lunes

    Coge el fichero que todo el mundo evita en tu repo. No lo refactorices. Haz solo esto, y no tardas más de una hora.

    Escribe en una línea qué entra y qué queda fuera. Lanza a Claude Code el prompt de arqueología del paso 1 en modo lectura. Y escribe cinco tests de caracterización con los casos que ya te sabes de memoria, porque son los que se rompen cada trimestre.

    El lunes no refactorizas nada. El martes ya puedes, y con red.

    Cuando quieras montar la verificación en serio — el AGENTS.md, los carriles del agente y los criterios que se comprueban solos — está en el ebook gratuito de Revisión por Contrato. Y el ciclo completo de idea a producto con Claude Code ejecutando tasks es el recorrido del curso Construye con IA.

    El código legacy no da miedo por antiguo. Da miedo porque no sabes qué hace. Y eso se arregla escribiendo tests, no reescribiendo código.

    Preguntas frecuentes

    ¿Qué es un test de caracterización y en qué se diferencia de un test unitario normal?

    Un test unitario afirma que el código hace lo correcto. Un test de caracterización afirma que sigue haciendo lo mismo que antes, sea correcto o no. No lo escribes a mano: ejecutas el módulo con entradas reales y registras la salida en un snapshot. Su único trabajo es ponerse rojo cuando el refactor cambia una salida observable.

    ¿Merece la pena congelar un comportamiento que sé que es un bug?

    Sí, siempre. Si arreglas el bug en el mismo commit en el que reestructuras el código y algo revienta en producción, no podrás distinguir cuál de las dos cosas lo rompió. Congélalo con un comentario que explique la sospecha y su ticket, y arréglalo después en un commit propio donde el cambio de snapshot sea la parte visible de la pull request.

    ¿Cuánto código legacy le puedo dar a Claude Code de una vez?

    Menos del que cabe. El límite útil no es la ventana de contexto, es lo que tú puedes verificar después. Yo trabajo módulo a módulo y en cada task le paso la spec brownfield y los tests, no el fichero original. Una vez documentado el comportamiento en el paso 1, ese documento sustituye al código fuente como contexto.

    ¿Puedo saltarme los tests de caracterización si el módulo ya está tipado con TypeScript estricto?

    No. Los tipos garantizan la forma del dato, no el valor. Un refactor que cambia Math.floor por Math.round, que invierte el orden de dos descuentos o que redondea antes en vez de después compila perfecto, pasa el type-check y factura mal. Los tipos protegen el contrato; los tests de caracterización protegen el comportamiento.

    ¿Y si el módulo legacy no se puede ejecutar de forma aislada?

    Entonces esa es tu primera task, y no es refactorizar. Si no puedes invocar la función sin levantar media aplicación, lo que falta es una costura: inyectar la base de datos, el reloj y las llamadas HTTP para poder ejecutarla con entradas controladas. Feathers lo llama seam. Hasta que no consigues ejecutar el módulo con entradas que tú decides, no hay tests de caracterización posibles ni refactor seguro.

    ¿Sirve este método si el módulo legacy no está en TypeScript?

    Sí, el orden no cambia. Lo único que necesitas es un runner con snapshots: pytest con syrupy en Python, ApprovalTests en Java o C#, o el propio Vitest si es JavaScript sin tipar. Lo que sí cambia es el paso de tipar los bordes: sin tipos estáticos pierdes la red del compilador y el peso recae entero sobre los tests de caracterización, así que conviene capturar más casos de los que capturarías en TypeScript.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • SDLC context engineering: arregla el ciclo, no el prompt

    SDLC context engineering: arregla el ciclo, no el prompt

    El mismo agente. El mismo modelo. Prácticamente el mismo prompt.

    En uno de mis repositorios la tarea salió a la primera. En el otro, el agente se inventó un helper que no existía y escribió los tests con una librería que ese proyecto abandonó hace más de un año.

    No falló el modelo. Falló todo lo que había alrededor del modelo.

    Y eso que hay alrededor tiene nombre: SDLC context engineering. Tu ciclo de desarrollo es la fábrica del contexto que consume el agente, y si la fábrica va mal, da igual cómo escribas el prompt.

    El primer repositorio tiene un CLAUDE.md con las convenciones escritas, una carpeta de decisiones de arquitectura y un índice del contenido previo que el agente puede consultar. El segundo tiene un README viejo y el resto vive en mi cabeza.

    Y ahí está el problema: cuando el contexto vive en tu cabeza, el agente tiene que adivinarlo. Adivinar, en un modelo de lenguaje, se llama alucinar.

    Por eso llevo meses insistiendo en lo mismo: el prompt no es la unidad de contexto. Puedes escribir el prompt más elaborado del mundo, con sus tres adjetivos y su frase en mayúsculas, que si la información que necesita el agente no existe en ningún sitio legible, no va a aparecer porque tú se lo pidas con más énfasis.

    El contexto no se escribe en el prompt. Se fabrica antes, en tu ciclo de desarrollo.

    Opero Dominicode solo: cursos, libros, una plataforma y un canal. No tengo un equipo que rellene los huecos por mí, así que los huecos los tengo que cerrar en el proceso. De ahí sale la idea que más ha cambiado mi forma de trabajar en el último año:

    Tu SDLC no es un proceso para humanos. Es la cadena de montaje que fabrica el contexto que consumen tus agentes.


    Qué es el SDLC context engineering

    El SDLC context engineering es tratar tu ciclo de vida del software como el sistema que fabrica el contexto que consumen tus agentes de IA.

    Cada una de las cinco fases —requisitos, diseño, implementación, code review y documentación— deja de producir artefactos para humanos y pasa a producir artefactos que una máquina puede leer, verificar y ejecutar: una spec con límites, un esquema de validación, una suite de tests como gate, un diff acotado y contexto versionado en el repositorio.

    La diferencia con el prompt engineering es de capa. El prompt engineering optimiza la instrucción de un turno. El SDLC context engineering optimiza la información que esa instrucción tiene disponible, y esa información la produce tu proceso, no tú en el momento de escribir.


    Qué cambia cuando el que lee el proceso es una máquina

    Cuando el que lee tu proceso es una máquina cambia el destinatario de cada artefacto: deja de valer lo que un humano completa con conocimiento implícito y solo cuenta lo que cabe en la ventana de contexto.

    El ciclo de vida clásico producía artefactos para personas: un ticket de tres líneas, la foto de una pizarra, un hilo de Slack, una reunión de refinamiento.

    Todo eso funciona con humanos por una razón que casi nunca decimos en voz alta: una persona rellena los huecos con conocimiento implícito. Sabe que en este proyecto los servicios van en esa carpeta. Sabe que ese campo del modelo está deprecado aunque siga ahí. Y, sobre todo, sabe a quién preguntar cuando algo no cuadra.

    Un agente no tiene a quién preguntar. Solo tiene lo que le entre por la ventana de contexto.

    Así que cada fase de tu ciclo tiene dos versiones posibles: la que produce algo para un humano y la que produce algo que una máquina puede leer, verificar y ejecutar.

    # Fase del ciclo Artefacto para humanos Artefacto para agentes
    1 Requisitos Ticket de 3 líneas spec.md con límites explícitos
    2 Diseño Diagrama en una pizarra Contratos ejecutables que validan
    3 Implementación "En mi máquina funciona" Tests como gate de salida
    4 Code review "A mí me parece bien" Diff acotado + auditor automático
    5 Documentación Wiki de hace tres años Contexto versionado en el repositorio

    La columna de la derecha es tu context engineering. No es un documento aparte que escribes el viernes por la tarde: es el residuo natural de un ciclo bien montado.

    Vamos fase por fase.


    1. Requisitos: del ticket de tres líneas al spec.md

    Qué falla: un ticket ambiguo no le da al agente lo único que de verdad necesita. Y no es la descripción de la funcionalidad: son los límites.

    Esta es la frase que más repito y la que más discusión genera: el alcance no es lo que el agente tiene que hacer, es lo que el agente no puede tocar.

    Un agente al que le pides "añade validación al formulario de registro" y no le dices nada más, se expande. Toca el modelo de datos porque le pareció que hacía falta. Refactoriza el componente de al lado porque estaba feo. Añade una dependencia. Y cuando abres el diff, tienes once archivos modificados y ninguna forma rápida de saber cuáles querías.

    Una spec no necesita ser larga. Una página con cuatro bloques:

    • Contratos de datos. La forma exacta de lo que entra y lo que sale.
    • Archivos afectados. Las rutas concretas que se pueden tocar.
    • Fuera de alcance. Lo que no se toca, escrito explícitamente.
    • Criterio de terminado. Qué comando tiene que pasar en verde.

    Con esos cuatro bloques, una spec entera te cabe en la pantalla:

    # Spec — Validación del formulario de registro
    
    ## Contratos
    - Entrada: { email: string, password: string, acceptedTerms: boolean }
    - Salida: { ok: true } | { ok: false, errors: FieldError[] }
    
    ## Archivos afectados
    - src/features/auth/register-form.tsx
    - src/features/auth/register.schema.ts
    
    ## Fuera de alcance
    - No tocar el modelo de usuario ni las migraciones
    - No añadir dependencias nuevas
    - No refactorizar componentes vecinos
    
    ## Terminado cuando
    - `bun test src/features/auth` pasa en verde
    - `tsc --noEmit` sin errores
    

    Ese tercer bloque es el que mejor retorno da de todo el documento, y es el que casi nunca veo escrito.

    Improvisar aquí no sale gratis, y el coste se puede calcular turno a turno: lo hice en la factura del vibe coding. Si tus specs ya existen pero el agente sigue desviándose, el problema suele estar en uno de estos 7 fallos. Y si quieres saber hasta dónde llevar el enfoque, están los tres niveles de Spec-Driven Development.

    La metodología completa, con las plantillas que uso a diario, está en el libro de Spec-Driven Development.


    2. Diseño: del diagrama en la pizarra a contratos ejecutables

    Qué falla: si la forma de tus datos vive dispersa por el código, el agente inventa propiedades. Y las inventa con una seguridad absoluta, porque estadísticamente user.email es un campo muy razonable aunque en tu proyecto se llame user.contactAddress.

    La solución no es documentar los tipos en un wiki. Es que la definición y la verificación sean el mismo artefacto.

    Un esquema de validación —Zod 4 en el ecosistema TypeScript, pero el principio vale para cualquier stack— hace tres cosas a la vez:

    • Describe la forma de los datos en un sitio único y localizable.
    • La comprueba en ejecución, así que si la descripción miente, algo se rompe y te enteras.
    • Genera el tipo con z.infer, así que la definición y la verificación salen del mismo artefacto y se actualizan a la vez.

    Esa segunda parte es la que lo convierte en contexto fiable. Un diagrama puede quedarse obsoleto en silencio durante dos años. Un esquema que se ejecuta, no: cuando un campo obligatorio cambia de tipo o desaparece, revienta y te enteras.

    Con un matiz que conviene saber, porque es donde la gente se confía: por defecto z.object() descarta las claves que no conoce en lugar de fallar. Si la API empieza a devolver campos nuevos, tu esquema los tira sin decir nada. Para que esa deriva también haga ruido necesitas z.strictObject(). El esquema te protege del campo que falta; del campo que sobra, solo si se lo pides.

    Y no confundas una cosa con la otra: los tipos de TypeScript desaparecen al compilar y no validan nada en ejecución. Evitan bugs antes de desplegar, que no es poco, pero el que comprueba lo que entra de verdad por la API es el esquema.

    Estos patrones —esquemas como contrato, inferencia de tipos y validación en los bordes— son los que desarrollo en el curso de Zod para TypeScript.

    La otra mitad del diseño es el acceso. En vez de pegar el esquema de tu base de datos dentro del prompt cada mañana, expones la fuente y dejas que el agente la consulte cuando la necesite. Eso es lo que resuelven los servidores de Model Context Protocol: el contexto deja de ser algo que copias y pasa a ser algo que se consulta.

    Eso sí, cada servidor que conectas mete sus definiciones de herramientas en la ventana. MCP cambia copiar por consultar, no elimina el coste de contexto: conecta los que uses, no los que tengas.


    3. Implementación: del "en mi máquina funciona" al gate de salida

    Qué falla: preguntarle al agente si ha terminado.

    Te va a decir que sí. No porque mienta, sino porque no tiene forma de saberlo: está evaluando su propio trabajo con exactamente el mismo contexto con el que lo escribió. Si le faltaba una pieza para escribirlo bien, le sigue faltando para revisarlo.

    Necesitas una señal que venga de fuera del modelo. Y la señal más barata que existe es un código de salida.

    El bucle que uso:

    1. El agente escribe primero el test que falla.
    2. Escribe el código mínimo para que pase.
    3. El pipeline ejecuta tipado, tests y lint. Si sale 0, la tarea entra en la cola de revisión. Si no, el agente recibe el error y corrige sin que yo intervenga.

    El gate no tiene que ser un pipeline entero. Un script que encadene los tres comandos ya sirve: si devuelve 0, la tarea pasa; si no, el agente recibe el error y sigue solo.

    {
      "scripts": {
        "gate": "tsc --noEmit && bun test && bun run lint"
      }
    }
    

    Lo importante no es que sea TDD de manual. Es que la condición de parada la decide un proceso externo y no una frase del agente. Mientras la puerta de calidad seas tú leyendo la terminal, no has automatizado nada: solo has cambiado de sitio el cuello de botella.

    El flujo completo de validar código generado antes de mergear lo desarrollé en TDD con IA. Y si lo que quieres es probar al propio agente en CI —no solo al código que produce— eso es un test harness, que es una pieza distinta.

    Y ojo con el nivel de la suite, porque aquí hay un efecto perverso: unos tests flojos no son neutros. Le dan al agente permiso para dar por terminado un trabajo a medias, con la ventaja de que ahora el sello de aprobado es automático.


    4. Code review: del "a mí me parece bien" al diff acotado

    Qué falla: el volumen. Un agente produce en veinte minutos más código del que puedes revisar con atención en una tarde.

    Y aquí hay una trampa que cuesta ver: la calidad de tu code review se decide en la fase 1, no en la fase 4. Un diff de once archivos es muy difícil de auditar bien, y la razón por la que toca once archivos es que la spec no dijo cuáles no tocar. Cuando el alcance está escrito, el diff sale acotado solo, y revisarlo pasa de ser una tarde a ser un rato.

    Con el diff ya acotado, la revisión se reparte en dos filtros:

    • El automático, primero. Tipado, tests, lint y un auditor que mire el diff antes que tú. Lo que no pasa esos gates no llega a tus ojos. Cómo montarlo en el pipeline lo detallé en revisiones de código con IA en CI/CD.
    • El tuyo, después, y solo para lo que la máquina no puede ver. Que la abstracción elegida sea la correcta. Que no haya duplicado algo que ya existía. Que el error se maneje donde tiene sentido y no donde resultaba cómodo.

    Esa segunda lista es más larga de lo que parece, y hay fallos del código generado por IA que un code review directamente no ve. Los tests cubren la corrección. Tú cubres el criterio.

    El checklist que uso para auditar diffs generados por IA antes de mergear está en el ebook gratuito Revisión por Contrato.


    5. Documentación: del wiki muerto al contexto versionado

    Qué falla: guardar la arquitectura en herramientas que el agente no puede abrir.

    El contexto tiene que vivir en el repositorio, al lado del código y bajo control de versiones, en cuatro capas de artefactos de contexto para agentes que hacen cosas distintas:

    • CLAUDE.md o AGENTS.md en la raíz. Convenciones, comandos de build, qué no se toca. AGENTS.md es un formato abierto supervisado por la Agentic AI Foundation, bajo la Linux Foundation, y lo usan ya más de 60.000 proyectos open source. Es lo primero que lee el agente al arrancar y lo que evita la mayoría de los "esto no va aquí".
    • docs/adr/ con decisiones de arquitectura. Markdown ligero que explica por qué se decidió algo, no solo qué se decidió. Sin el porqué, el agente deshace tus decisiones creyendo que mejora el código.
    • Un índice consultable del conocimiento previo. Para que pueda buscar en lo que ya existe sin que le metas el proyecto entero en la ventana.
    • Un mapa de dependencias del repositorio. Qué depende de qué. Es la diferencia entre un agente que cambia una función y otro que sabe qué se rompe al cambiarla, y va de graph engineering.

    Con una advertencia importante, porque es el error clásico de quien descubre esto: más contexto no es mejor contexto. Llenar la ventana de documentación irrelevante degrada las respuestas igual que no tener nada, solo que gastando más. Cómo estructurar esa memoria para que sume está en context engineering aplicado a agentes, y qué pasa cuando la conversación se alarga demasiado, en context drift.


    La regla del eslabón más débil de tu SDLC

    La regla del eslabón más débil dice que tu ciclo rinde lo que rinda su fase peor: da igual lo bien que hagas las otras cuatro, el resultado del agente lo marca la fase rota.

    Por eso esta es la parte práctica, la que decide por dónde empezar mañana:

    • Specs impecables sin gate de tests: el agente escribe muy rápido algo que nadie valida.
    • Tests excelentes con tickets ambiguos: validas a la perfección la funcionalidad equivocada.
    • Todo bien montado y el conocimiento en tu cabeza: cada mañana empiezas de cero.

    Así que no empieces por la fase que más te apetece, que suele ser la que ya haces bien. Empieza por la que te está costando dinero ahora mismo. Este diagnóstico lo resuelve en un minuto:

    Lo que te pasa con el agente Fase que tienes rota
    Se sale del alcance y toca archivos que no debía 1. Requisitos
    Inventa campos, funciones o rutas que no existen 2. Diseño
    Dice que ha terminado y no funciona 3. Implementación
    Los diffs son tan grandes que no los revisas 4. Code review
    Repite errores que ya corregiste la semana pasada 5. Documentación

    Ese último síntoma es el más frecuente y el que más gente confunde con un problema de memoria del modelo. No lo es. Es que la corrección se quedó en el chat en vez de acabar en un archivo del repositorio.


    Lo que no debes hacer

    Documentarlo todo.

    Es la reacción típica cuando alguien entiende esta idea: se pasa un fin de semana escribiendo un CLAUDE.md de cuarenta secciones y una carpeta de ADRs preciosa. Tres meses después, la mitad ya no es verdad.

    Y contexto desactualizado es peor que no tener contexto, porque el agente lo obedece. Un archivo que dice que los servicios van en una carpeta que ya no existe no es un documento inútil: es una instrucción activa para hacerlo mal.

    La regla que aplico: si no lo vas a mantener, no lo escribas. Es preferible un archivo de quince líneas verdaderas que uno de doscientas donde no sabes cuáles siguen siéndolo.

    Tampoco todo proyecto necesita este aparato montado. Hay casos concretos en los que el enfoque de spec te frena, y conviene reconocerlos antes de meter ceremonia donde no hace falta.


    Los 3 cambios para tu próximo ticket

    No hace falta rehacer la metodología de tu equipo. En la próxima tarea que delegues:

    1. Escribe el "fuera de alcance". Una línea diciendo qué archivos no debe tocar el agente. Es el cambio con mejor retorno de esta lista.
    2. Pon un gate automático. Aunque sea solo tsc --noEmit y los tests. Que la respuesta a "¿ha terminado?" la dé un código de salida y no una frase.
    3. Mueve una convención de tu cabeza al repositorio. Una. La que más veces has tenido que repetirle al agente esta semana.

    Con esos tres, el siguiente prompt que escribas tiene muchas más probabilidades de salir a la primera sin que le cambies ni una palabra. Porque no habrás mejorado el prompt: habrás mejorado la fábrica que lo alimenta. Eso es SDLC context engineering.

    El flujo completo, de la idea al producto con herramientas agénticas, lo enseño paso a paso en el curso Construye con IA con Claude Code.

    Y si quieres ver los artefactos reales —specs, gates y archivos de contexto de proyectos que están en producción— eso es lo que compartimos cada semana en Dominicode Labs.

    Deja de buscar el prompt mágico. Arregla la fase que tienes rota y el contexto se arregla solo.


    Preguntas frecuentes

    ¿Qué es exactamente el SDLC context engineering?

    Es tratar tu ciclo de vida del software como el sistema que fabrica el contexto de tus agentes de IA. En lugar de escribir prompts cada vez más largos, haces que cada fase del ciclo —requisitos, diseño, implementación, revisión y documentación— deje un artefacto que una máquina pueda leer y verificar: una spec con límites, un esquema de validación, una suite de tests, un diff acotado y contexto versionado en el repositorio.

    ¿Esto no es lo mismo que el prompt engineering?

    No, y la diferencia es de escala. El prompt engineering trabaja sobre la instrucción concreta que escribes en un turno. El context engineering trabaja sobre la información que esa instrucción tiene disponible, y esa información la produce tu proceso, no tú en el momento de escribir. Un buen prompt sobre un ciclo roto sigue dando resultados malos, solo que con mejor redacción.

    ¿Por dónde empiezo si tengo las cinco fases mal?

    Por el síntoma que estés sufriendo ahora, no por el orden numérico. Si el agente se sale del alcance, empieza por la spec. Si inventa campos que no existen, por los contratos de datos. Si dice que ha terminado y no funciona, por el gate de tests. La cadena rinde lo que rinda su fase peor, así que arreglar la que más te está costando da más retorno que mejorar la que ya funciona.

    ¿Hace falta usar Spec-Driven Development para esto?

    No es obligatorio, pero la fase de requisitos es la que más impacto tiene sobre las otras cuatro, y SDD es la forma más ordenada de resolverla. Puedes empezar con algo mucho más ligero: una línea de "fuera de alcance" en el ticket ya cambia el comportamiento del agente. Y hay casos concretos en los que el enfoque de spec te frena en vez de ayudarte, así que conviene reconocerlos antes de montar ceremonia.

    ¿Cuánto contexto es demasiado contexto?

    El que no puedas mantener actualizado. Un archivo de contexto que ya no refleja la realidad no es neutro: el agente lo obedece y hace las cosas mal con total seguridad. La medida correcta no es cuántas páginas tienes, sino cuántas líneas puedes garantizar que siguen siendo ciertas hoy. Además, llenar la ventana de contexto irrelevante degrada las respuestas y encarece cada turno.

    ¿Qué documentación para agentes de IA hace falta de verdad en un repositorio?

    Cuatro capas y nada más: un CLAUDE.md o AGENTS.md en la raíz con convenciones y comandos, una carpeta docs/adr/ con el porqué de las decisiones de arquitectura, un índice consultable del conocimiento previo y un mapa de dependencias del repositorio. Todo versionado junto al código. Lo que no esté en el repositorio, el agente no lo puede abrir.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
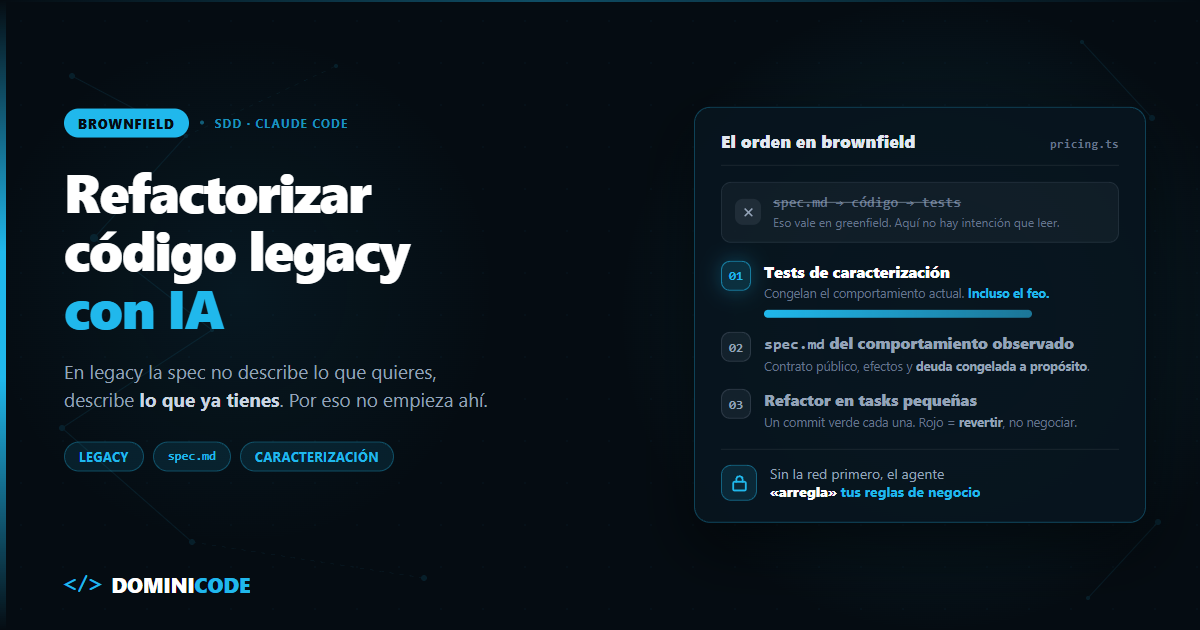
  • La factura del vibe coding: improvisar con un agente sale 7 veces más caro

    La factura del vibe coding: improvisar con un agente sale 7 veces más caro

    "Añade suscripciones con Stripe, cupones de descuento y control de acceso por roles."

    Un prompt. Diecisiete palabras. El agente arrancó con entusiasmo: creó catorce archivos, instaló tres dependencias que no hacían falta, inventó un esquema de base de datos incompatible con el que ya existía y, hacia el paso dieciocho, se puso a arreglar errores de compilación que había provocado él mismo seis pasos antes.

    Cuarenta y cinco minutos después, git reset --hard. Salía más a cuenta tirarlo todo que rescatarlo.

    Esa historia —el vibe coding en estado puro— la hemos vivido todos, y siempre se cuenta igual: en tiempo perdido y en frustración. Nadie mira la otra columna.

    Lo que nadie miró ese día fue la factura. Y es la parte más fácil de calcular, la más incómoda de ver y la que convence a un jefe en treinta segundos, que es más de lo que ha conseguido nunca el argumento de "escribir la spec es buena práctica".

    De qué es SDD, qué lleva dentro un spec.md y cómo se genera el plan.md no voy a hablar aquí: está en por qué Spec-Driven Development triplica tu velocidad. Este post hace una sola cosa: poner precio a improvisar.


    La factura no crece con los turnos: crece con su cuadrado

    Aquí está la parte que casi nadie tiene interiorizada, y sin ella todo el cálculo parece exagerado.

    Un agente no manda tu último mensaje: manda toda la conversación otra vez, en cada turno. Lo que escribiste al principio, la salida de aquel grep, el test que falló en el turno 3. Todo, cada vez.

    Si cada turno añade d tokens al contexto y la sesión dura n turnos, lo que pagas no es n × d. Es esto:

    total = n · base  +  d · n · (n − 1) / 2
                         └──────┬─────────┘
                         el término que te mata
    

    Ese segundo término es cuadrático. En cristiano: duplicar los turnos de una sesión no duplica la factura, la multiplica por casi cuatro. El mecanismo, con la instrumentación para medirlo en tu propio agente, lo desglosé en medir el consumo de tokens de un agente.

    Y ahora la pregunta que conecta las dos mitades del post: ¿qué hace una especificación, exactamente?

    Reduce n.

    No hace al modelo más listo ni al código más bonito. Solo elimina turnos: los de explorar el repositorio a ciegas, los de elegir una librería y cambiarla, los de deshacer, los de arreglar lo que rompió al deshacer. Y como la factura va con el cuadrado de los turnos, quitar turnos por delante es la palanca más potente que existe.


    Las dos sesiones, en números

    Cojamos la sesión de Stripe de arriba y su versión con spec. Mismo modelo, mismo repositorio, misma persona.

    Los supuestos, sobre la mesa antes que los resultados:

    • 6.000 tokens de base por turno: system prompt, definiciones de herramientas, archivos abiertos.
    • 6.000 tokens que se añaden en cada turno: el diff, la salida del test, lo que devuelve cada herramienta.
    • La spec ocupa 2.500 tokens y se paga en todos los turnos, porque viaja en el contexto entera.
    • 18 turnos improvisando, 6 con la spec delante.
    • Precio de entrada: 5 $ por millón de tokens.
    Vibe coding Con spec
    Turnos 18 6
    Base por turno 6.000 8.500 (incluye la spec)
    Tokens de input acumulados 1.026.000 141.000
    Coste de entrada 5,13 $ 0,71 $

    Siete veces. Y no por un truco: los 141.000 son el 13,7 % de 1.026.000, así que el ahorro es del 86 %.

    Fíjate en el detalle que hace daño: los 2.500 tokens de la spec, multiplicados por los seis turnos, suman 15.000 tokens de sobrecoste. Un solo turno tardío de la sesión improvisada —el turno 18, con todo el historial detrás— cuesta 108.000. La especificación se paga siete veces con evitar un único turno al final.

    Estos números son un modelo, no una medición de laboratorio: salen de aplicar la fórmula de arriba a los supuestos declarados. Cambia los tuyos y cambiarán los resultados. Lo que no cambia es la forma de la curva, porque el término cuadrático no depende del precio: si el ratio de turnos es 3 a 1, el ratio de coste ronda 7 a 1 pagues lo que pagues — y llega a 8 a 1 si no cuentas lo que ocupa la propia spec.


    De dónde salen los doce turnos que te ahorras

    No son turnos imaginarios. Son estos, y los reconocerás todos:

    • Reconocimiento. Sin spec, el agente abre archivos "por si acaso" para deducir tu arquitectura. Con la spec, ya sabe qué toca y qué no.
    • Decisiones que tú deberías haber tomado. Elige una librería, la instala, no encaja, la quita. Tres turnos que se resolvían con una línea en el documento.
    • Marcha atrás. Descubre en el turno 12 que el esquema de base de datos no cuadra con lo que ya existe y rehace lo del turno 5.
    • Parches sobre parches. Arregla un error de compilación creando otro, porque ya no recuerda la restricción del primer mensaje.

    Los dos últimos tienen la peor propiedad de todas: son los turnos más caros de la sesión, porque ocurren al final, cuando el contexto ya pesa. En una sesión de 18 turnos, los seis últimos se llevan más de la mitad de la factura.

    Ojo con la conclusión fácil, eso sí: una spec ambigua o incompleta no ahorra nada, porque el agente vuelve a decidir por su cuenta y los turnos regresan. Por qué una especificación falla y qué la hace inservible lo conté en por qué tu spec falla con un agente de IA.

    Y hay un caso en el que este cálculo se da la vuelta: cuando el trabajo es tan pequeño que escribir la spec cuesta más turnos que hacerlo. Los seis escenarios donde no compensa están en cuándo NO usar Spec-Driven Development.


    Cómo medir esto en tu repositorio esta semana

    No hace falta creerme. Tienes los datos en tu historial:

    1. Cuenta los turnos de tus últimas cinco sesiones con el agente. Solo el número, nada más.
    2. Sepáralas en dos montones: las que empezaron con un documento delante y las que empezaron con una frase.
    3. Aplica la fórmula con tu base y tu delta reales, que los saca la instrumentación del post de consumo de tokens en media hora.
    4. Multiplica por sesiones al mes. Ahí es donde el número deja de ser una curiosidad y pasa a ser una cifra de la que hablar en una reunión.

    Si además pagas por suscripción y no por API, el cálculo sigue valiendo: no cambia la factura, cambia cuántas sesiones te caben antes de tocar el límite de uso.

    El flujo completo —de la idea a la spec, y de la spec al agente ejecutando por fases— lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code, y como referencia de consulta está el libro de Spec-Driven Development.

    Una última pieza, porque es la que cierra el círculo: el agente no puede dar una tarea por terminada porque "el código parece correcto". Necesita un test que devuelva 0, y para eso hacen falta suites rápidas y fiables — que es lo que trabajo en el curso de Testing en Angular con Jest y Testing Library. Sin esa comprobación, los turnos de marcha atrás vuelven por la puerta de atrás y con ellos la factura.

    En Dominicode Labs trabajamos así todos los proyectos de la comunidad.

    Escribir la especificación no es burocracia ni buena práctica de manual. Son 2.500 tokens que te ahorran un millón.


    Preguntas frecuentes

    ¿El prompt caching no se come todo este ahorro?

    Lo reduce, no lo elimina. La caché abarata el reenvío del historial ya visto, así que el término cuadrático pasa a costar una fracción — pero solo mientras el prefijo se mantenga idéntico. Y una sesión improvisada es justo la que peor lo mantiene: cada marcha atrás reescribe contexto anterior e invalida la caché a partir de ahí. Con caché el 8 a 1 se estrecha; la dirección no cambia.

    ¿Cuántos tokens puede ocupar la spec para que siga saliendo a cuenta?

    Muchos más de los que vas a escribir. La spec se suma a la base y por tanto cuesta tokens × turnos; un turno tardío evitado cuesta base + delta × (n−1). Con los supuestos de este post, una spec de 10.000 tokens en una sesión de seis turnos sale por 60.000, todavía por debajo de lo que costaba aquel turno 18 en solitario. El límite práctico no es económico: es que una spec larga se lee peor y decide peor.

    ¿Y si trabajo con suscripción en vez de pagar por token?

    El coste cambia de moneda, no desaparece. Con tarifa plana pagas en cuota de uso y en tiempo de espera: la misma sesión cuadrática te consume el límite antes y te deja mirando el reloj. La ventaja de medirlo en tokens es que es la única unidad que no depende de la tarifa que tengas contratada.

    Si la spec está mal escrita, ¿ahorra igual?

    No, y este es el fallo más común. Una spec con huecos —sin decir qué queda fuera de alcance, sin contratos de datos, sin nombrar los archivos que se tocan— devuelve las decisiones al modelo, y con ellas vuelven los turnos de exploración y marcha atrás. Una especificación ambigua tiene el coste de escribirla y ninguno de sus beneficios.

    ¿Merece la pena para un cambio de veinte líneas?

    No. Para un bug acotado o un ajuste de copy, el trabajo cabe en dos o tres turnos y ahí el término cuadrático no ha despegado todavía: la spec es sobrecoste puro. Este cálculo empieza a inclinarse a partir de las sesiones largas, que son precisamente las que hoy nadie planifica.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
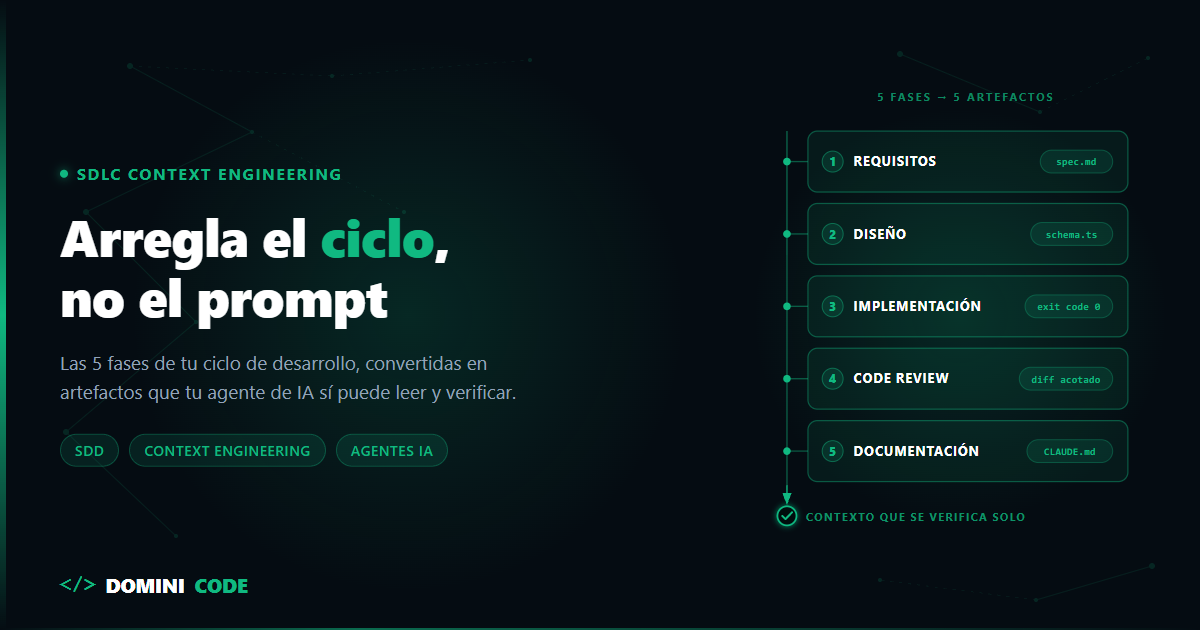
  • Roadmap del developer con IA: de junior a fullstack agentic

    Roadmap del developer con IA: de junior a fullstack agentic

    En 2011 mi trabajo diario como programador consistía en memorizar la sintaxis de jQuery, lidiar con los bugs de Internet Explorer 8 y escribir bucles for a mano.

    Si en aquel momento alguien me hubiera dicho que 15 años después un modelo de lenguaje escribiría un algoritmo completo en dos segundos, habría pensado que la profesión de programador iba a desaparecer de la faz de la tierra.

    La realidad ha sido muy distinta, y por eso el roadmap del developer con IA no se parece en nada al de hace cinco años: programar no ha muerto, pero el acto de mecanografiar código se ha convertido en un commodity.

    El desarrollador que solo sabe traducir un ticket de Jira a líneas de JavaScript está en una posición vulnerable. En cambio, el perfil que está multiplicando su valor en el mercado es el Fullstack Agentic Developer: el profesional que diseña la arquitectura, establece los contratos y dirige un ejército de agentes de IA para construir productos en tiempo récord.

    Aquí tienes la hoja de ruta clara para hacer esa transición.


    La Evolución del Perfil: De Codificador a Director de Agentes

    ┌─────────────────────────────────────────────────────────────┐
    │               EVOLUCIÓN DEL ROL DE DEVELOPER                │
    │                                                             │
    │  AYER (Programador Tradicional)                            │
    │  [Escribir sintaxis] ──> [Recordar APIs] ──> [Debug manual] │
    │                                                             │
    │  HOY & MAÑANA (Agentic Developer)                           │
    │  [Diseñar Specs] ──> [Dirigir Agentes/MCP] ──> [TDD & CI]   │
    └─────────────────────────────────────────────────────────────┘
    

    La ventaja competitiva ya no es recordar de memoria los parámetros de un método de array. Tu valor reside en tu criterio técnico para decidir qué construir, con qué arquitectura y bajo qué límites de seguridad.


    Las 4 Habilidades Indispensables para los Próximos 3 Años

    1. Spec-Driven Development (SDD) y Diseño de Contratos

    Tu capacidad para redactar especificaciones técnicas precisas (spec.md) determinará la calidad del software que generen tus agentes. Si no sabes definir límites de dominio, flujos de datos y escenarios WHEN/THEN, los modelos alucinarán y perderás horas corrigiendo código basura.

    Es la habilidad con más retorno de las cuatro. Si empiezas hoy, empieza por aquí: Spec-Driven Development con agentes de IA.

    2. Fundamentos Sólidos de Arquitectura y Tipado Estricto

    Para evaluar si el código generado por un agente es seguro para producción necesitas dominar:

    • Clean Architecture y separación de capas (Domain, Application, Infrastructure).
    • TypeScript estricto, tipos discriminados y esquemas de validación en runtime con Zod.
    • Patrones de concurrencia y diseño de bases de datos relacionales.

    3. Testing Automatizado y Validación Determinista (TDD)

    La IA es probabilística; el software de producción debe ser determinista. La única forma de desplegar a producción sin miedo es contar con suites de pruebas automatizadas con Vitest o Jest que actúen como un guardián implacable ante cualquier regresión.

    4. Orquestación de Agentes, Herramientas y Protocolos MCP

    Aprender a conectar agentes CLI (como Claude Code) con bases de datos, APIs de terceros y herramientas de terminal mediante el Model Context Protocol (MCP) y la creación de custom skills (SKILL.md).

    El salto de nivel aquí está en dejar de escribir prompts y empezar a construir herramientas: cómo crear skills y subagentes personalizados para que tu flujo diario se ejecute solo.


    La Hoja de Ruta (Roadmap) Paso a Paso

    FASE 1: Fundamentos Modernos
    ├── TypeScript 5+ Estricto (Satisfies, Discriminated Unions, Generics)
    ├── Frameworks Reactivos (Angular Signals / Next.js 16 App Router)
    └── Validación de Esquemas con Zod
    
    FASE 2: Red de Seguridad y Metodología
    ├── TDD con Vitest / Jest (Escribir tests antes de generar código)
    └── Flujo SDD (Spec ➔ Plan ➔ Tasks versionados en Git)
    
    FASE 3: Operaciones Agénticas
    ├── Dominio de agentes CLI (Claude Code, Cursor, terminal tools)
    ├── Creación de Custom Skills y Subagentes especializados
    └── Conexión de servidores MCP para acceso a bases de datos y APIs
    
    FASE 4: Producción y Negocio
    ├── Despliegues Serverless, Edge Functions y bases de datos relacionales
    └── Entrega continua (CI/CD) con validación automática de agentes
    

    Para recorrer este camino con proyectos prácticos de extremo a extremo, en el curso Construye con IA: De la Idea al Producto con Claude Code te guiamos paso a paso en la transición hacia el desarrollo agentico.

    Si buscas una comunidad activa donde compartimos arquitecturas reales, plantillas de agentes y debates técnicos semanales, únete a Dominicode Labs.

    También puedes seguir todos nuestros tutoriales y directos gratuitos en el Canal de YouTube de Dominicode.


    Qué hacer hoy con esto

    Elige un proyecto personal o una tarea pequeña de tu trabajo.

    No intentes escribir cada línea de código a mano por nostalgia, ni tampoco le pidas a la IA que haga todo sin supervisión.

    Asume el rol de arquitecto: redacta la especificación, diseña los tests de validación y delega la implementación sintáctica a tu agente. Ese es el nuevo estándar de la ingeniería de software.


    Preguntas frecuentes

    ¿Los agentes de IA van a sustituir a los desarrolladores juniors?

    No van a sustituir a los desarrolladores, pero sí sustituirán el modelo tradicional de trabajo junior basado exclusivamente en escribir sintaxis básica. Los juniors que adopten metodologías estructuradas (SDD, TDD) y aprendan a orquestar agentes avanzarán mucho más rápido hacia niveles senior.

    ¿Por qué aprender TypeScript y testing si la IA puede escribir el código?

    Porque la IA comete errores sutiles y alucinaciones. Sin conocimientos profundos de TypeScript y testing automatizado, no tendrás el criterio técnico necesario para auditar el código generado ni detectar fallos antes de que lleguen a producción.

    ¿Qué es un Servidor MCP (Model Context Protocol)?

    Es un estándar abierto desarrollado por Anthropic que permite a los asistentes de IA conectarse de forma segura con herramientas locales, bases de datos (Postgres, SQLite), repositorios Git y APIs de servicios externos.

    ¿Cuánto se tarda en recorrer este roadmap?

    Depende del punto de partida, pero las cuatro fases no son secuenciales en el tiempo: puedes empezar a escribir specs y tests la semana que viene mientras sigues consolidando fundamentos. Lo que no funciona es saltar a la Fase 3 sin las dos primeras, porque sin criterio técnico no puedes auditar lo que el agente produce.

    ¿Hace falta ser senior para trabajar con agentes de código?

    No, pero sí hace falta saber leer código mejor de lo que lo escribes. Un junior que domina testing y sabe redactar una especificación clara saca más partido a un agente que un senior que le pide código a ciegas y acepta el diff sin revisarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso. OpenSpec es un framework open source de spec-driven development creado por Fission-AI que guarda lo acordado — propuesta, diseño, tareas y spec — en archivos Markdown versionados dentro del repo, para que Claude Code los lea antes de tocar código. En esta guía lo instalamos, lo inicializamos con openspec init y recorremos el flujo OPSX completo sobre un proyecto que ya existe.


    OpenSpec no es OpenAPI: la diferencia en una tabla

    Comparten cuatro letras y nada más.

    OpenSpec OpenAPI
    Qué es Framework de spec-driven development para asistentes de código Especificación para describir APIs REST
    Quién lo mantiene Fission-AI OpenAPI Initiative (Linux Foundation)
    Formato Markdown dentro del repo YAML o JSON
    Para qué sirve Que un agente implemente lo acordado Que un cliente sepa llamar a tu API

    Si has llegado buscando Swagger, este no es tu post.


    Cómo instalar OpenSpec para Claude Code (y el error de scope de npm)

    OpenSpec se instala como CLI global. Requiere Node.js 20.19.0 o superior, y la versión actual es la 1.8.0.

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto: openspec a secas es la versión 0.0.0 publicada el 9 de abril de 2019, sin relación alguna con el framework y sin una sola actualización desde entonces. Es el fallo más repetido en tutoriales, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Qué crea openspec init en un proyecto con Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Qué poner en openspec/config.yaml (y por qué no es opcional)

    openspec/config.yaml es el archivo donde defines el schema por defecto, el contexto del proyecto y las reglas por artefacto. No es documentación que el agente abre si le apetece: es entrada del modelo. La doc oficial lo dice sin rodeos — "When generating any artifact, your context and rules are injected into the AI prompt".

    Sus claves de nivel superior son cuatro:

    Clave Para qué
    schema El schema por defecto de los artefactos
    context La información de tu proyecto. Aparece en todos los artefactos
    rules Restricciones por artefacto. Solo aparecen en el artefacto que coincide
    operations Guía opcional para apply y archive

    Ese matiz de context y rules importa: el contexto viaja siempre, las reglas solo cuando toca. Así que lo que quieras que el agente tenga presente en cada decisión va en context.

    Dedica cinco minutos a describir de verdad tres cosas ahí: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear. El detalle de cada clave está en la doc de customization.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    El flujo OPSX paso a paso en Claude Code

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y consolida lo implementado en openspec/specs/, que es la fuente de verdad del proyecto — "Specs are the source of truth — they describe how your system currently behaves". A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    Los otros dos del perfil por defecto

    /opsx:update revisa los artefactos de planificación de un cambio y los mantiene coherentes entre sí, en cualquier dirección: si editas el diseño, la propuesta se ajusta.

    /opsx:sync fusiona las delta specs en openspec/specs/ sin archivar el cambio. Útil cuando quieres consolidar antes de cerrar.

    Los extendidos, y por qué /opsx:verify no te va a funcionar todavía

    Aquí está el detalle que hace perder media hora a mucha gente: el perfil por defecto no trae verify.

    El perfil core son los seis de arriba — propose, explore, apply, update, sync, archive. Los extendidos son otros seis: /opsx:new, /opsx:continue, /opsx:ff, /opsx:verify, /opsx:bulk-archive y /opsx:onboard. Si escribes /opsx:verify recién instalado, no autocompleta y no pasa nada.

    Para activarlos:

    openspec config profile   # selecciona el perfil ampliado
    openspec update           # aplica los cambios en el proyecto
    

    Con el perfil ampliado activo, /opsx:verify contrasta la implementación contra la spec. No es un test runner: es la comprobación de que no se ha colado nada que nadie pidió y de que no falta nada que sí se pidió.

    Empieza por los seis del perfil core. Los extendidos los necesitarás cuando tengas el ciclo rodado y lleves varios cambios a la vez.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Una delta spec es una spec que describe solo lo que cambia — lo añadido, lo modificado y lo eliminado — en vez de redescribir el sistema entero. Es lo que hace viable OpenSpec en un proyecto que ya existe.

    Así se ve una:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - GIVEN el listado de productos cargado
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ### Requirement: Paginación del listado
    El listado DEBE conservar el filtro activo al cambiar de página.
    

    Dos cosas que conviene saber antes de copiar esto. Las etiquetas son literales y no se traducen: ADDED, MODIFIED, REMOVED, Requirement:, Scenario: y GIVEN/WHEN/THEN van en inglés aunque el cuerpo esté en español. Y solo incluyes las secciones que uses — si el cambio no elimina nada, no dejes un ## REMOVED Requirements vacío.

    Sobre los escenarios: es vocabulario Gherkin, pero en Markdown plano. Sin ficheros .feature, sin Cucumber, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development.

    Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto. La lista completa está en la tabla de herramientas soportadas, que cubre más de treinta.


    Cómo migrar del flujo antiguo de OpenSpec al flujo OPSX

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano: ejecuta openspec update, que regenera los ficheros de skills y comandos para las herramientas que tengas configuradas.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Dos avisos antes de que te lances. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Por qué no me funciona el comando /opsx:verify?

    Porque no viene en el perfil por defecto. OpenSpec usa el perfil core, que trae seis comandos: propose, explore, apply, update, sync y archive. El comando verify pertenece al perfil ampliado, junto a new, continue, ff, bulk-archive y onboard. Para activarlo ejecuta openspec config profile y después openspec update.

    ¿Qué comandos trae OpenSpec por defecto?

    El perfil core incluye seis: propose para generar la propuesta, explore para planificar sin compromiso, apply para implementar, update para mantener coherentes los artefactos de planificación, sync para fusionar las delta specs en openspec/specs/ y archive para cerrar el cambio.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es ejecutar openspec update en el proyecto, que regenera skills y comandos, en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Hace unas semanas abrí un repo mío de febrero. Fui a la carpeta specs/. Ahí seguía todo: spec.md, plan.md, tasks.md.

    El spec.md describía tres endpoints. El código tenía once.

    La spec no estaba mal escrita. Estaba muerta. Cinco meses sin tocarla mientras el código crecía por su cuenta. Y lo peor es que todo funcionaba: los tests pasaban, el deploy iba, nadie se enteró de nada.

    Yo llevaba meses diciendo que hacía SDD. No lo hacía. Hay tres niveles de Spec-Driven Development y yo estaba en el primero convencido de estar en el segundo.

    Esto no va de qué es SDD. Va de diagnóstico: en qué nivel estás de verdad y a cuál te conviene subir. Que no siempre es el de arriba.

    El test de los 30 segundos: borra la carpeta specs/

    Antes de leer nada más, hazte esta pregunta.

    Si borras la carpeta specs/ de tu proyecto ahora mismo, ¿se rompe algo del pipeline?

    Si la respuesta es no —si el build sigue verde, los tests pasan y el deploy sale— entonces tu spec es un documento, no un artefacto de ingeniería. Eres spec-first. Da igual lo bien escrita que esté. Da igual que tengas constitution.md y siete plantillas.

    Nada que se pueda borrar sin consecuencias forma parte del sistema.

    Y ojo, que esto no es un insulto. Spec-first es un nivel legítimo y para la mitad de tus proyectos es exactamente el que necesitas. El problema no es estar ahí. El problema es estar ahí creyendo que estás dos escalones más arriba, y por tanto confiando en garantías que no tienes.

    Qué son los tres niveles de rigor de especificación

    Deepak Babu Piskala publicó el 30 de enero de 2026 el preprint Spec-Driven Development: From Code to Contract in the Age of AI Coding Assistants (arXiv:2602.00180, cs.SE). Es el primer sitio donde he visto puesto por escrito, con nombres, lo que la mayoría hacemos por intuición.

    El paper define tres niveles de rigor de especificación: spec-first, spec-anchored y spec-as-source. Lo único que cambia entre ellos es cuánta autoridad tiene la spec sobre el código — el eje de su primera figura se llama literalmente increasing specification authority.

    No son fases de madurez que haya que recorrer. Son opciones, y cada una tiene un coste.

    Nivel La spec es… ¿Quién escribe el código? ¿Qué pasa con el drift? Es tu nivel si…
    Spec-first Un briefing inicial Tú o el agente al arrancar; después, solo tú Ocurre en silencio, nadie se entera Prototipos, features puntuales, exploración
    Spec-anchored Un contrato vivo Tú, con la spec como referencia obligatoria Lo detecta el CI si lo automatizas; si no, rot La mayoría de sistemas en producción
    Spec-as-source El único artefacto que un humano edita Nadie. Se genera No existe por construcción Automoción, embebidos, dominios certificados

    Spec-first: la spec guía el arranque

    Definición del paper: la especificación se escribe antes de programar para guiar la implementación inicial.

    Ahí está la palabra clave: inicial. La spec hace su trabajo en el minuto cero y después su vida útil se acaba. El agente genera el código, tú lo revisas, y desde ese momento el código es la única fuente de verdad.

    El paper es explícito: spec-first funciona en desarrollo inicial de features con asistentes de IA, y en prototipos y features de usar y tirar.

    Es donde está casi todo el mundo que usa Claude Code o Cursor con un spec.md delante. Y para mucho de lo que hacemos, está perfecto. Escribes la spec, el agente construye, tú corriges, sigues adelante. Es el flujo que enseño en el curso de Construye con IA para ir de idea a producto sin caos.

    El fallo no es usar spec-first. El fallo es usar spec-first en un sistema que va a vivir tres años y con cuatro personas tocándolo.

    Spec-anchored: la spec vive con el código

    Definición del paper: la especificación se mantiene junto al código durante todo el ciclo de vida del sistema.

    Y aquí viene la frase que a mí me hizo replantearme cosas. El paper llama a spec-anchored el punto óptimo para la mayoría de sistemas en producción, porque te da los beneficios de documentación clara y requisitos verificables sin exigir que el código se genere entero.

    Traducido: tienes las garantías sin renunciar a escribir código.

    El riesgo de este nivel tiene nombre propio en el paper: specification rot. La podredumbre de la especificación, que aparece cuando los equipos no actualizan las specs a medida que el código cambia. Exactamente lo que le pasó a mi repo de febrero.

    Y la solución que propone el paper no es disciplina. Es automatización: los tests imponen la alineación entre spec y código, con escenarios BDD funcionando como tests automáticos que corren en cada commit.

    Esa es la diferencia real entre los dos primeros niveles. No es cuánto cuidas la spec. Es si la alineación depende de tu voluntad o de un check que falla el build.

    Spec-as-source: la spec es el código

    Definición del paper: la especificación es el único artefacto que los humanos editan directamente. El código se genera enteramente a partir de la spec.

    La regla operativa que da el paper es tajante: si quieres cambiar la funcionalidad, cambias la spec y regeneras. Nunca editas el código generado directamente.

    El drift desaparece. No se gestiona, no se detecta: no puede existir. Como el código se regenera en lugar de editarse a mano, spec y código están siempre alineados por construcción.

    Suena a futuro lejano. No lo es, y esto es lo que más me sorprendió del paper.

    Spec-as-source ya existe. Y una parte ya la haces

    Hay una idea instalada de que spec-as-source es hacia dónde vamos cuando los LLM sean lo bastante buenos.

    Falso. El paper lo desmonta con una frase: spec-as-source ya es práctica estándar en dominios con generación de código bien definida, y pone dos ejemplos. Uno es generar código embebido certificado desde modelos de Simulink. En la capa de control, el ingeniero rara vez escribe a mano el C que acaba en la ECU: escribe el modelo, y el generador produce el C.

    El otro ejemplo del paper es generar los stubs de servidor desde un openapi.yaml.

    Eso también es spec-as-source. Y llevas años haciéndolo sin llamarlo así: editas el contrato, regeneras, nunca tocas a mano lo generado. Es exactamente la regla del nivel tres.

    La diferencia es qué generas. Ahí generas el andamio. Nadie ha certificado un generador para la lógica de negocio.

    Entonces, ¿por qué no puedes hacer lo mismo con la lógica de tu app de Next.js?

    Porque, según el paper, spec-as-source solo es práctico hoy en dominios donde esa confianza está establecida. El paper no entra en por qué, pero la respuesta no está en el modelo: está en el toolchain. Generadores cualificados bajo norma, trazabilidad auditable y décadas de proceso detrás.

    Tu lógica de negocio no tiene eso. No porque la IA no dé la talla, sino porque no hay un organismo que responda cuando el código generado la líe en producción.

    Así que spec-as-source completo no es tu nivel hoy si haces web. Y no pasa nada. Perseguirlo con las herramientas actuales es la forma más rápida de acabar con el peor de los dos mundos: código generado que nadie entiende y una spec que tampoco es la fuente real de verdad.

    Qué cuesta subir de spec-first a spec-anchored

    Este es el salto que sí te interesa. Y es más barato de lo que parece, porque no va de escribir más documentación. Va de cerrar el bucle.

    El paper describe un flujo de cuatro fases: Specify → Plan → Implement → Validate.

    La mayoría hacemos tres. Especificamos, planificamos, implementamos, y en cuanto la feature funciona nos vamos a la siguiente. Validate se queda sin hacer. Y para mí, Validate es la fase que convierte spec-first en spec-anchored.

    En un proyecto normal de TypeScript, el salto son tres movimientos concretos.

    Uno: los criterios de aceptación de la spec dejan de ser prosa y pasan a ser tests. Cada comportamiento descrito en la spec tiene un test que lo verifica. Si la spec dice que un usuario sin permisos recibe un 403, hay un test que lo comprueba. Si no puedes escribir ese test, tu spec no era verificable — que es uno de los motivos por los que una spec falla con un agente de IA aunque esté impecablemente redactada.

    Dos: los contratos se validan contra la implementación. El paper lista aquí las herramientas por categoría: OpenAPI y Swagger, GraphQL SDL o Protocol Buffers para las specs de API, y Pact o Specmatic para contract testing. Tu openapi.yaml deja de ser documentación y pasa a ser el árbitro. Si el backend devuelve un campo que el contrato no declara, falla.

    Tres: eso corre en CI y rompe el build.

    # .github/workflows/ci.yml
    on: [push, pull_request]
    
    jobs:
      spec-alignment:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v5
          - run: npm ci
          - run: npm run test:contract     # implementación vs openapi.yaml
          - run: npm run test:acceptance   # escenarios derivados de la spec
    

    Ese bloque es la frontera entre los dos niveles. El día que alguien añade un endpoint sin tocar el contrato, el build se pone rojo antes de que llegue a review. La alineación deja de depender de que te acuerdes.

    Sobre el retorno de esto, el paper documenta un caso de estudio de microservicios API-first con OpenAPI y Specmatic con una reducción del 75% en el tiempo de ciclo de integración. Es un caso concreto del paper, no una media del sector, y conviene leerlo como lo que es: una señal de dónde está el valor, no una promesa.

    La parte incómoda es que este salto se apoya en tener una cultura de testing decente. Si tu suite de tests es frágil, spec-anchored no te va a salvar: vas a tener dos cosas rotas en vez de una. Arregla primero los tests — y si tu stack es Angular, esa base la trabajo entera con Jest y Testing Library en el curso de Testing en Angular, que es la misma disciplina en cualquier proyecto de TypeScript.

    El fallo que sobrevive a todos los niveles

    Hay una trampa que no se arregla subiendo de nivel, y el paper la nombra sin anestesia: los tests de spec que pasan no garantizan software correcto si las specs están mal.

    Falsa confianza. Para mí es el fallo más caro de los cuatro que lista el paper —junto a la sobre-especificación, la podredumbre de la spec y convertir las specs en burocracia— porque los otros tres se notan y este no.

    Tienes el CI verde, el contrato validado, los escenarios BDD pasando. Y estás construyendo con enorme rigor exactamente lo que el negocio no pidió.

    Por eso el paper reformula el rol del developer: pasamos de programar a mano a orquestar especificaciones, revisar salidas de IA y centrarnos en el diseño de alto nivel. Si tu spec es mala, subir de nivel solo automatiza el error y le pone un sello de calidad encima.

    La regla de oro del Spec-Driven Development: usa el mínimo rigor

    El paper cierra con un marco de decisión que merece la pena tener a mano. SDD aporta valor cuando hay asistencia de IA de por medio, requisitos complejos, sistemas de vida larga, varios mantenedores, generación de código viable o integración complicada. Y hay que saltárselo en prototipos desechables, trabajo en solitario de vida corta, código exploratorio o CRUD simple con requisitos evidentes.

    Que es básicamente lo que ya defendí en su día al hablar de cuándo no usar Spec-Driven Development, y me alegra ver que el paper llega a la misma conclusión.

    Porque el principio rector que se lleva el paper, y el que yo me he apuntado, es este:

    Usa el mínimo nivel de rigor de especificación que elimine la ambigüedad en tu contexto.

    Subir de nivel no es mejor. Es más caro. Spec-anchored en un script que vas a borrar en dos semanas no es madurez profesional, es ceremonia. Y spec-first en la plataforma que factura no es agilidad, es deuda con fecha de vencimiento.

    Lo que puedes hacer hoy, en diez minutos: coge tu proyecto más importante y aplícale el test de los 30 segundos. Borra mentalmente la carpeta specs/. Si no se rompe nada y ese proyecto va a vivir más de seis meses con más de una persona tocándolo, ya sabes cuál es tu siguiente PR. No es escribir más spec. Es añadir el check que la vuelve obligatoria.

    Si quieres el método completo —cómo redactar specs que un agente ejecuta sin inventarse la mitad y cómo mantenerlas vivas sin que se conviertan en burocracia— lo desarrollo entero en el libro de Spec-Driven Development. Y en Dominicode Labs tienes los proyectos donde esto está montado tal cual lo uso en producción, con el CI incluido.

    Preguntas frecuentes

    ¿Cuáles son los tres niveles de Spec-Driven Development?

    Spec-first, spec-anchored y spec-as-source. En spec-first la spec guía la implementación inicial y después puede quedar obsoleta. En spec-anchored la spec se mantiene junto al código durante todo el ciclo de vida y hay tests que verifican la alineación. En spec-as-source la spec es el único artefacto que edita un humano y el código se genera entero a partir de ella. Los definió Deepak Babu Piskala en el preprint arXiv:2602.00180.

    ¿Spec-first significa que lo estoy haciendo mal?

    No. Spec-first es un nivel legítimo y el paper lo recomienda explícitamente para prototipos, features de usar y tirar y desarrollo inicial con asistentes de IA. El problema aparece cuando aplicas spec-first a un sistema de vida larga y asumes garantías de trazabilidad que ese nivel no te da.

    ¿Cómo sé si mi spec está viva o solo bien escrita?

    Comprueba si algo del pipeline depende de ella. Si puedes borrar la spec y el build sigue verde, la spec es documentación. Una spec viva rompe algo cuando desaparece o cuando el código se desvía de ella, porque hay tests o validaciones de contrato que la usan como referencia.

    ¿Necesito Cucumber o BDD para ser spec-anchored?

    No obligatoriamente. El paper menciona los frameworks BDD (Cucumber, SpecFlow, Behave) como la forma habitual de que los escenarios se conviertan en tests automáticos, pero lo que define el nivel es que exista una verificación automática de la alineación, no la herramienta concreta. Con contract testing sobre OpenAPI usando Pact o Specmatic ya cumples el requisito.

    ¿Spec-as-source llegará algún día al desarrollo web?

    En parte ya llegó: generar los stubs de servidor desde un openapi.yaml es el ejemplo de spec-as-source que el propio paper pone, y es desarrollo web. Lo que no ha llegado es la lógica de negocio, y el cuello de botella no es la capacidad del modelo sino la confianza en el generador. En automoción y embebidos spec-as-source ya es práctica estándar desde hace años con Simulink o SCADE, y una de las razones es que esos generadores están cualificados bajo norma y auditados.

    Si mis tests de spec pasan, ¿está el software correcto?

    No. El paper lo advierte de forma directa: que los tests de spec pasen no garantiza que el software sea correcto si las propias specs son incorrectas. Verificar que cumples la spec y validar que la spec era la adecuada son dos problemas distintos, y el segundo sigue siendo humano.

    ¿Merece la pena spec-anchored si trabajo solo?

    Depende de la vida del proyecto, no del tamaño del equipo. El paper desaconseja SDD en trabajo en solitario de vida corta, pero si eres solo tú manteniendo algo durante años, el "otro mantenedor" eres tú dentro de ocho meses sin recordar nada. Ahí el contrato en CI te protege igual que protegería a un equipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.