Tag: MCP

  • Claude Code: Effort, Models, Tools y Context para developers

    Claude Code: Effort, Models, Tools y Context para developers

    La primera vez que abrí Claude Code, lo traté como un chat más inteligente. Le pegaba código, le pedía que lo arreglara, copiaba la respuesta. Funcionaba, pero lo estaba usando como una versión cara de Stack Overflow.

    Tardé tres semanas en entender que Claude Code no es un chatbot. Es un agente que ejecuta herramientas reales en tu sistema, que puede leer tu repositorio entero, que tiene niveles de razonamiento configurables y que toma decisiones en cadena sin que tú intervengas en cada paso.

    Cuando lo entendí así, cambió todo.

    Este post es lo que me hubiera gustado leer antes de empezar. No es un tutorial de instalación — asume que ya lo tienes corriendo. Es una explicación honesta de los cuatro conceptos que determinan si Claude Code trabaja para ti o contra ti: Effort, Models, Tools y Context.


    Effort — el nivel de razonamiento que decides gastar

    Cuando Claude Code procesa una tarea, no siempre piensa igual de profundo. Puedes configurar cuánto razonamiento aplica desde la UI de Claude Code o mediante la opción de esfuerzo en la configuración. Los niveles son cuatro: low, medium, high y max.

    Esto no es marketing. Es la diferencia entre gastar dos segundos y gastar dos minutos en una misma pregunta, con respuestas radicalmente distintas.

    Low — cuando la velocidad importa más que la precisión

    Con low, Claude Code responde rápido y sin profundizar demasiado. Es útil para tareas mecánicas y predecibles: renombrar variables, formatear código, generar boilerplate que ya tienes en mente pero no quieres teclear.

    Si le pides "añade un método toString() a esta clase", no necesita razonar sobre arquitectura. low es suficiente.

    Medium — el nivel por defecto para trabajo diario

    medium es lo que usas el 80% del tiempo. Hay razonamiento real, considera contexto, pero no entra en análisis profundo de consecuencias. Funciona bien para refactoring moderado, explicaciones técnicas, generación de tests unitarios para funciones simples.

    Es el equilibrio entre velocidad y calidad que necesitas en un flujo de trabajo normal.

    High — cuando el error cuesta caro

    Aquí Claude Code empieza a razonar sobre consecuencias. Evalúa múltiples opciones antes de decidir, considera casos borde, analiza impacto en el resto del sistema.

    Úsalo cuando toques código crítico: un servicio de autenticación, la lógica de pagos, una migración de base de datos, un cambio arquitectural en el core de la aplicación. El tiempo extra que tarda se justifica con la reducción de errores no detectados.

    Max — análisis exhaustivo, sin atajos

    max activa el razonamiento más profundo disponible. Claude Code descompone el problema en partes, considera múltiples estrategias, evalúa trade-offs explícitamente.

    Esto no es para trabajo diario. Es para cuando necesitas que te ayude a diseñar la arquitectura de un módulo nuevo, cuando tienes un bug imposible de reproducir que llevas días persiguiendo, o cuando vas a tomar una decisión técnica con consecuencias a largo plazo.

    El coste es tiempo y tokens. La ganancia es profundidad real.

    Regla práctica: empieza con medium. Si la respuesta no llega al nivel que necesitas, sube un nivel. No uses max por defecto — no tiene sentido pagar el coste de razonamiento exhaustivo para añadir un campo en un formulario.


    Models — cuál elegir y por qué importa

    Claude Code tiene acceso a varios modelos bajo el capó. No todos son iguales en velocidad, coste ni capacidad. Elegir mal aquí es tirar dinero o tirar tiempo.

    A junio de 2026, los modelos disponibles en Claude Code son:

    Claude Haiku 4.5 — velocidad máxima, coste mínimo

    Haiku es el modelo pequeño. Responde en segundos, cuesta muy poco por token, y es más que suficiente para tareas de bajo peso cognitivo: completar líneas de código, responder preguntas de documentación, generar snippets concretos que ya tienes pensados.

    En un workflow agentic donde Claude Code ejecuta decenas de llamadas encadenadas (leer archivos, buscar patrones, escribir logs), Haiku hace el trabajo de las subtareas sin disparar el coste.

    Claude Sonnet 4.6 — el modelo de trabajo diario

    Sonnet es el punto dulce. Más capaz que Haiku en razonamiento y contexto largo, más rápido y barato que Opus, suficientemente potente para el 90% de las tareas de un developer.

    Refactoring complejo, generación de tests con lógica no trivial, debugging asistido, implementación de features completas — Sonnet lo maneja bien. Si no sabes cuál usar, empieza aquí.

    Claude Opus 4.8 — para problemas difíciles

    Opus es el modelo grande. Más lento, más caro, y considerablemente más capaz cuando el problema requiere razonamiento profundo, comprensión de contexto muy largo o análisis de consecuencias en sistemas complejos.

    No lo uses para tareas rutinarias. Sí lo uses cuando estés diseñando una arquitectura nueva, cuando el problema tiene múltiples dependencias que hay que razonar en paralelo, o cuando los outputs de Sonnet no son suficientemente precisos para tu caso.

    Claude Fable 5 — el modelo más potente

    Fable es el frontier model de Anthropic. Capacidades extendidas de razonamiento, mejor manejo de contexto muy largo y mayor precisión en tareas de alta complejidad. En Claude Code aparece como opción para las tareas más exigentes.

    Úsalo con criterio: el coste es significativamente mayor. Tiene sentido cuando diseñas sistemas críticos, cuando necesitas que el modelo razone sobre un codebase completo de miles de archivos, o cuando el nivel de precisión que necesitas no lo alcanza Opus.

    La decisión práctica: para trabajo diario usa Sonnet. Para subtareas rápidas y repetitivas dentro de un agente, Haiku. Para decisiones técnicas importantes o problemas difíciles, Opus o Fable. El modelo correcto no es el más potente — es el que resuelve el problema con el menor coste posible.


    Tools — las herramientas built-in que hacen a Claude Code un agente real

    Aquí está la diferencia fundamental entre Claude Code y un chatbot: Claude Code tiene herramientas que ejecuta de verdad en tu sistema. No simula leer archivos — los lee. No describe cómo haría una búsqueda — la hace.

    Estas son las herramientas principales y para qué sirve cada una:

    Herramienta Qué hace
    Read Lee el contenido de un archivo del filesystem. Claude ve exactamente lo que hay en el archivo, con números de línea.
    Edit Modifica un fragmento concreto de un archivo existente. Solo envía el diff, no reescribe todo el archivo.
    Write Crea un archivo nuevo o sobreescribe uno completo. Más costoso que Edit — úsalo solo cuando el cambio afecta a todo el archivo.
    Bash Ejecuta comandos de shell reales en tu sistema. Tests, builds, git, scripts, cualquier cosa que harías en terminal.
    Glob Busca archivos por patrón (**/*.ts, src/**/*.spec.ts). Útil para que Claude Code entienda la estructura del proyecto antes de actuar.
    Grep Busca contenido dentro de archivos por expresión regular. Para localizar dónde se usa una función, qué archivos importan un módulo, qué tests cubren una clase.
    WebSearch Hace búsquedas web reales. Útil cuando necesita documentación actualizada, información sobre versiones recientes o validar datos externos.
    WebFetch Descarga y procesa el contenido de una URL concreta. Para leer documentación oficial, specs de una API, changelog de una librería.
    Agent Lanza un subagente — una instancia paralela de Claude Code que ejecuta una subtarea de forma independiente. Arquitectura agentic en acción.
    TodoRead / TodoWrite Gestiona una lista de tareas interna de la sesión. Claude Code se auto-organiza las tareas que tiene pendientes en una tarea compleja.

    Lo que hace potente a este conjunto no es ninguna herramienta por sí sola — es la combinación. Claude Code lee la estructura del proyecto con Glob, localiza el código relevante con Grep, lo lee con Read, lo modifica con Edit, y ejecuta los tests con Bash. Todo en secuencia, sin que tú intervengas en cada paso.

    Este es el flujo que hace que una instrucción como "refactoriza el módulo de autenticación para que use el nuevo interceptor HTTP" produzca cambios reales en diez archivos distintos, con los tests pasando al final.

    La referencia completa de todas las herramientas y sus parámetros está en la documentación oficial de Claude Code.

    Si quieres ver cómo encajan estas herramientas con el resto del stack IA, en Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo analizo exactamente eso.

    Si te interesa construir workflows agenticos más avanzados con Claude Code — desde la idea hasta un producto deployado — el curso Construye con IA: De la Idea al Producto con Claude y Specs cubre exactamente eso: cómo orquestar estas herramientas para que Claude Code trabaje con autonomía real.


    Context — cómo sabe Claude Code dónde está y qué importa

    El contexto es el factor más subestimado de Claude Code. Puedes tener el modelo correcto, el nivel de esfuerzo correcto y todas las herramientas disponibles — si Claude Code no entiende el contexto de tu proyecto, los outputs serán genéricos.

    @files y @folders — lo que le pones delante

    En la interfaz de Claude Code puedes mencionar archivos o carpetas con @. Cuando escribes @src/app/auth/auth.service.ts, Claude Code lee ese archivo y lo incluye directamente en el contexto de la conversación antes de procesar tu instrucción.

    Con @src/app/auth/ incluyes toda la carpeta. Claude Code procesa los archivos relevantes y construye una comprensión del módulo antes de actuar.

    Esto no es solo "adjuntar archivos". Es darle a Claude Code el mapa del territorio antes de pedirle que navegue.

    @url — documentación externa en tiempo real

    @url le permite a Claude Code leer el contenido de una URL y usarlo como contexto. Si necesitas que siga la documentación oficial de Angular v22 antes de modificar tu código de routing, puedes darle la URL del changelog y él la procesa.

    Esto elimina el problema clásico de los LLMs con conocimiento desactualizado. Si la librería sacó una versión nueva hace dos semanas, puedes darle la fuente actualizada directamente.

    CLAUDE.md — la memoria persistente del proyecto

    El archivo CLAUDE.md en la raíz de tu proyecto es la forma de darle a Claude Code instrucciones permanentes que se cargan en cada sesión.

    Aquí defines las convenciones del proyecto: cómo nombrar archivos, qué patrones arquitecturales seguís, qué comandos son los válidos, qué herramientas externas usáis, qué NO debe tocar sin confirmación explícita. Un CLAUDE.md bien escrito hace que Claude Code se comporte como un developer que conoce las reglas del equipo desde el primer día.

    No es opcional. Es la diferencia entre un agente que trabaja contigo y uno que trabaja en paralelo a ti sin coordinación.

    Memoria entre sesiones

    Por defecto, cada sesión de Claude Code empieza sin memoria de conversaciones anteriores. El contexto no persiste automáticamente.

    La forma correcta de manejar esto es el CLAUDE.md: las decisiones técnicas importantes, las convenciones acordadas, las restricciones del proyecto — todo lo que necesita persistir va ahí. No en el historial de conversación.

    Para proyectos más complejos, puedes estructurar archivos adicionales de contexto (specs, planes, documentos de arquitectura) y referenciarlos con @ al inicio de cada sesión. Es un flujo de trabajo, no una feature automática.

    En Dominicode Labs tenemos proyectos reales donde aplicamos exactamente esta estructura — con los archivos de contexto organizados para que Claude Code mantenga coherencia a lo largo de semanas de desarrollo.


    Cuatro hábitos para usar Claude Code como un agente real

    Claude Code no es difícil. Pero usarlo bien requiere entender que no es un chatbot avanzado — es un agente con herramientas reales, niveles de razonamiento configurables, múltiples modelos con características distintas, y un sistema de contexto que tú controlas.

    Elegir el modelo correcto para cada tarea, configurar el esfuerzo según lo que está en juego, dejar que las tools hagan el trabajo sin microgestionar cada paso, y mantener un CLAUDE.md que le dé continuidad al proyecto — esos cuatro hábitos son la diferencia entre usarlo como un buscador caro y usarlo como un colaborador técnico real.

    El siguiente paso es construir algo con él. No un script de prueba — un flujo de trabajo real donde Claude Code gestione decisiones en cadena. Si quieres ver ese proceso desde el principio, el curso Construye con IA: De la Idea al Producto con Claude y Specs parte exactamente de aquí.


    FAQ — Preguntas frecuentes sobre Claude Code

    ¿Claude Code funciona con cualquier lenguaje de programación?

    Sí. Claude Code no está limitado a ningún stack. Funciona igual con TypeScript, Python, Go, Rust, Java o cualquier lenguaje que puedas ejecutar desde terminal. Las herramientas como Bash, Glob y Grep operan sobre el filesystem, no sobre el lenguaje. Lo que sí varía es la calidad del output según el lenguaje — para TypeScript y Python la precisión es especialmente alta porque son los lenguajes más representados en el entrenamiento.

    ¿Cuál es la diferencia real entre Sonnet y Opus para trabajo diario?

    En la práctica, para el 90% de las tareas cotidianas no notarás diferencia en calidad. Sí notarás diferencia en velocidad y coste. Opus tarda más y consume más tokens. La diferencia se hace evidente en problemas complejos con mucho contexto: cuando le das un módulo de 3.000 líneas y le pides que entienda las dependencias implícitas antes de refactorizar, Opus razona más profundo. Para añadir un endpoint nuevo a una API que ya funciona, Sonnet es suficiente.

    ¿Cómo evito que Claude Code modifique archivos que no debe tocar?

    Con el CLAUDE.md. Puedes definir explícitamente qué archivos o carpetas son de solo lectura, qué operaciones requieren confirmación explícita tuya antes de ejecutarse, y qué convenciones debe respetar siempre. Claude Code en modo interactivo ya solicita confirmación antes de ejecutar operaciones destructivas — y con autoApproveEdits: false en tu settings.json puedes reforzar ese control para cualquier edición de archivos.

    ¿Claude Code puede trabajar en proyectos con múltiples repositorios?

    Sí, pero con matices. Claude Code opera desde el directorio donde lo lanzas y puede leer rutas relativas o absolutas fuera de él si tienes los permisos correctos. Para proyectos monorepo o arquitecturas con múltiples repos relacionados, la práctica recomendada es lanzarlo desde la raíz del monorepo y gestionar el contexto con @carpetas específicas para cada subtarea. Si trabajas con Angular en un monorepo, el curso de Angular Moderno cubre la estructura de proyectos que mejor se integra con flujos agenticos.

    ¿Cuánto contexto puede manejar Claude Code en una sesión?

    Depende del modelo. Los modelos actuales de Claude tienen ventanas de contexto de 200.000 tokens, lo que equivale a varios cientos de miles de líneas de código. En la práctica, el límite operativo es antes: a partir de cierto volumen, la calidad del razonamiento empieza a degradarse aunque técnicamente quepa más. La buena práctica es ser selectivo con el contexto que cargas — usar @ para incluir solo los archivos relevantes para la tarea actual, no volcar el repositorio entero en cada sesión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Automatizar el proceso de desarrollo con IA: de Jira al deploy

    Automatizar el proceso de desarrollo con IA: de Jira al deploy

    Hace tres meses le propuse a un cliente algo que le sonó a ciencia ficción: que el agente iba a leer el ticket de Jira, implementar la feature, abrir el navegador para testearla, hacer el code review y crear el PR en GitHub. Que él solo tendría que revisar y aprobar.

    Su respuesta fue "sí, claro". Con la misma energía con la que alguien te dice "ajá" cuando no te está escuchando.

    Lo puse en marcha. En la primera semana el agente cerró cuatro tickets de forma autónoma. El quinto lo paré yo a mitad porque se estaba inventando un requisito que no estaba en el ticket. Ajusté el prompt. El sexto salió limpio.

    Esto no es el futuro. Es lo que puedes montar hoy con Claude Code, el MCP de Jira, el MCP de Chrome y un CLAUDE.md bien escrito. Y en este post te cuento exactamente cómo funciona el pipeline para automatizar el proceso de desarrollo con IA de principio a fin.

    Un pipeline agentico de desarrollo es un flujo automatizado donde un agente de IA ejecuta de forma autónoma los pasos de implementación, testing y revisión de código a partir de un ticket, reduciendo la intervención humana al momento de aprobar el resultado.

    El problema con el workflow de desarrollo tradicional

    El ciclo habitual de un developer en un equipo tiene un patrón claro: leer el ticket, entender el contexto del código, implementar, escribir el test manual en el navegador, hacer el PR, esperar el code review, corregir los comentarios, mergear, rezar para que el CI pase.

    Cada uno de esos pasos tiene rozamiento. Cambios de contexto. Interrupciones. El developer senior pasa entre un 20% y un 30% de su tiempo en tareas que no son escribir código: leer tickets, crear PRs, hacer reviews de código propio.

    Con agentes, ese porcentaje puede recortarse a la mitad.

    No estoy hablando de reemplazar al developer. Estoy hablando de eliminar la fricción mecánica para que el developer se quede con las decisiones que importan.

    El pipeline completo: de Jira al deploy en seis pasos

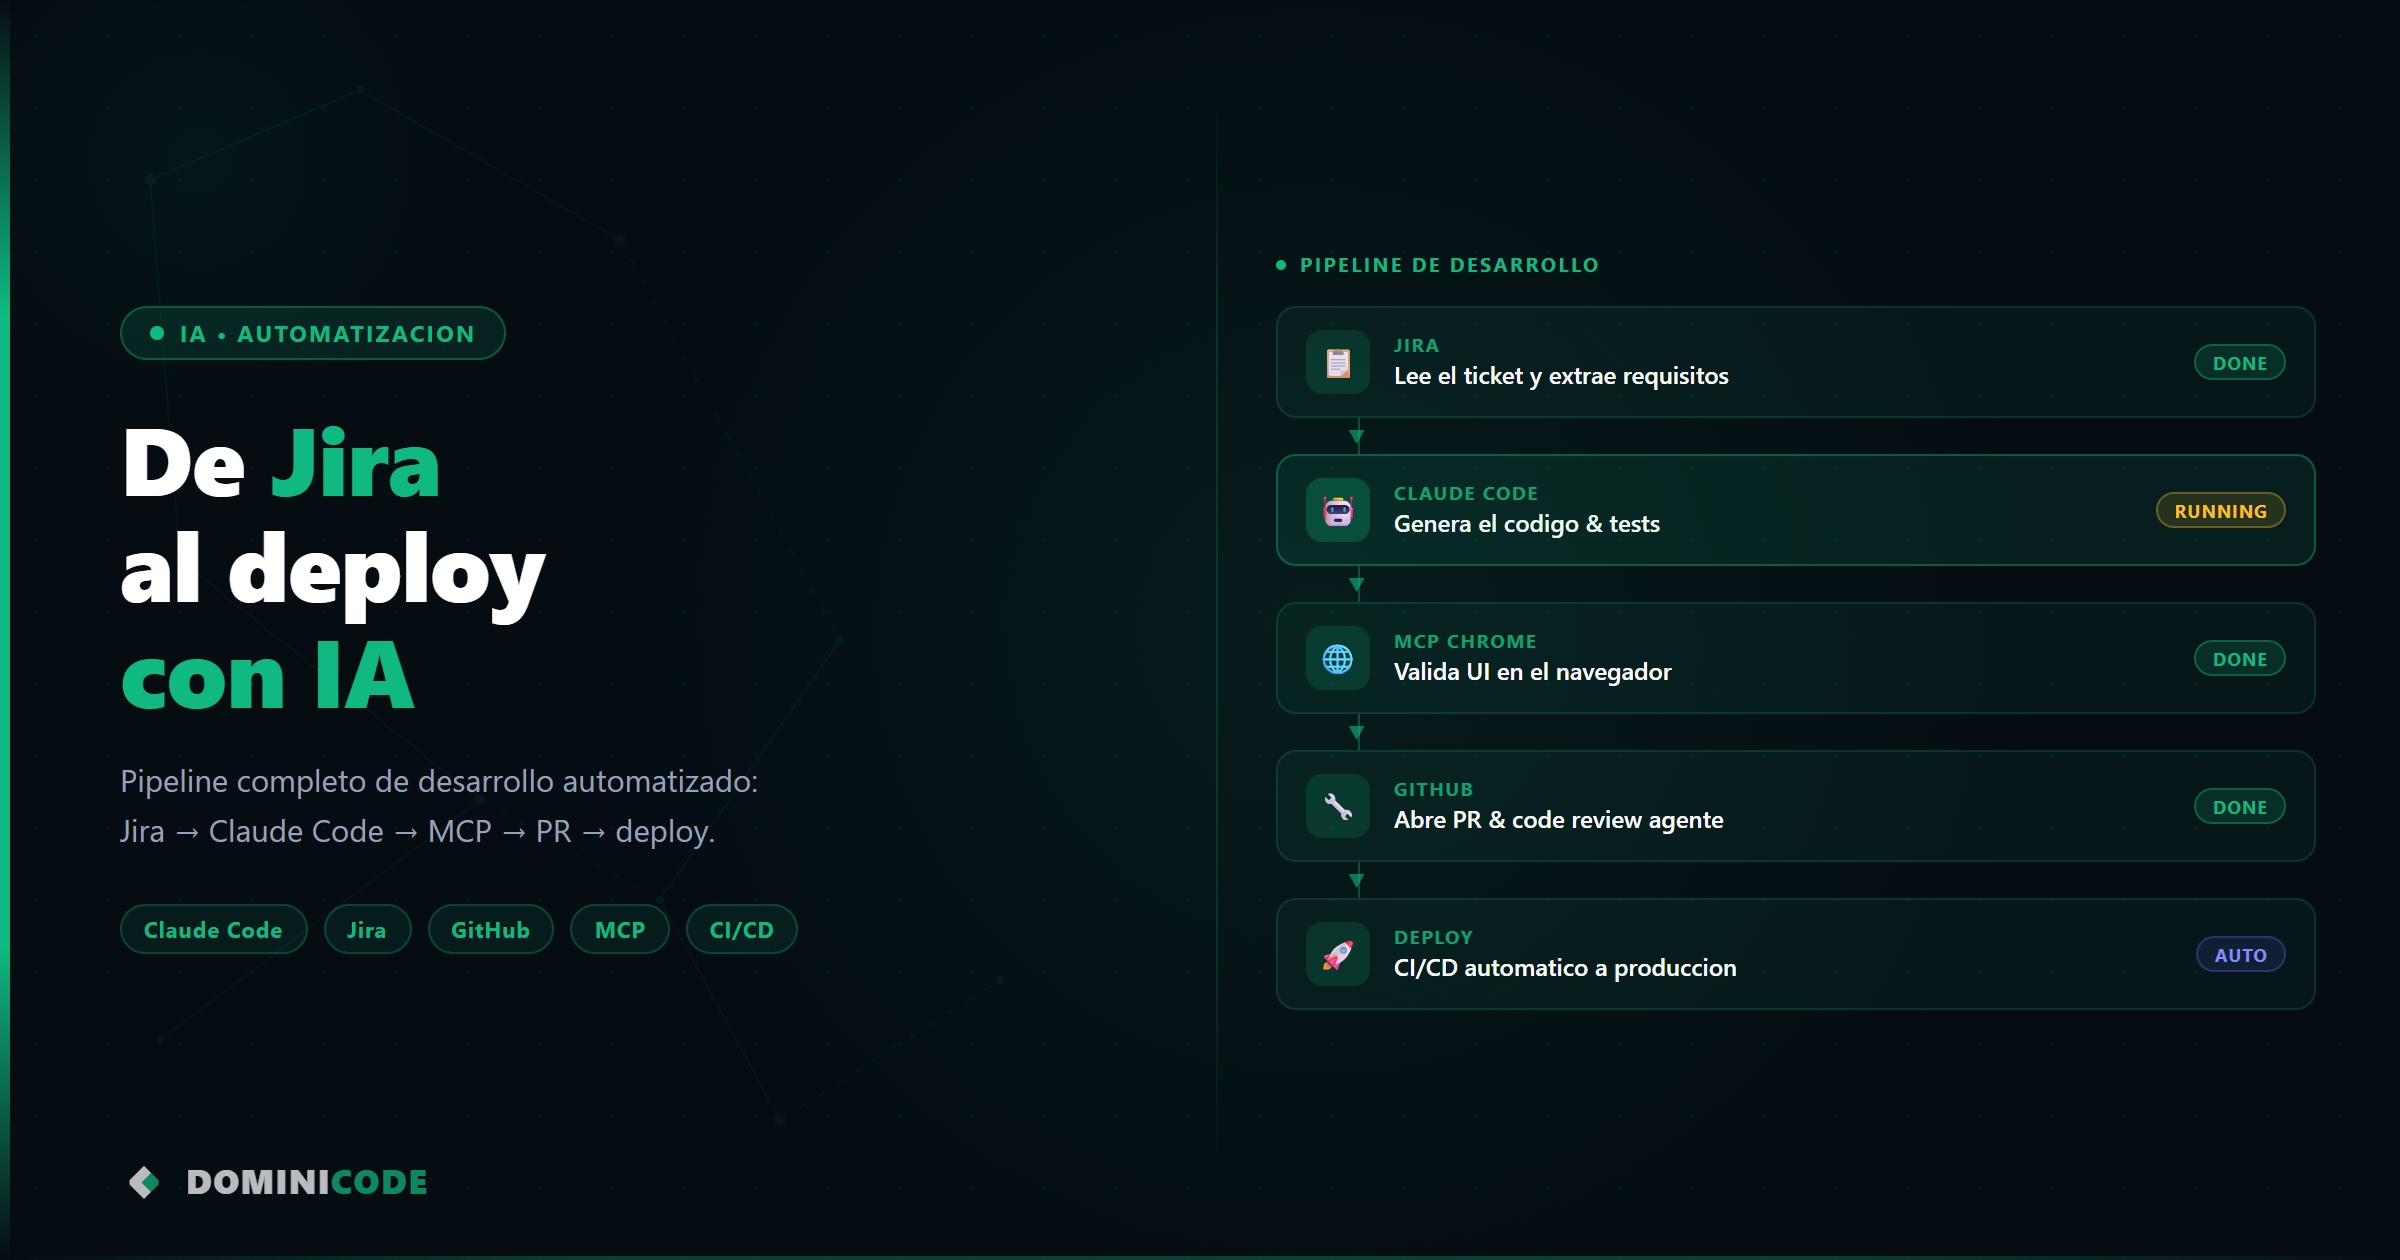
    Así es el flujo que tengo montado:

    [Ticket Jira]
         ↓
    [Claude Code lee ticket via MCP Jira]
         ↓
    [Lee CLAUDE.md + contexto del proyecto]
         ↓
    [Implementa la feature o bug fix]
         ↓
    [MCP Chrome: abre navegador, navega, verifica]
         ↓
    [/code-review: detecta problemas antes del merge]
         ↓
    [Crea PR en GitHub con descripción del ticket]
         ↓
    [CI/CD se dispara tras el merge]
         ↓
    [Deploy a producción]
    

    El developer entra en el paso de revisar el PR. Todo lo anterior lo hace el agente.

    Paso 1: leer el ticket de Jira

    Claude Code tiene acceso al MCP de Jira. Cuando invocas el agente con el ID del ticket, extrae la descripción, los criterios de aceptación, el tipo de tarea y cualquier comentario relevante.

    # Invocar el agente con un ticket específico
    claude "Lee el ticket PROJ-412 de Jira e implementa la tarea"
    

    El agente extrae:

    • Descripción de la tarea
    • Criterios de aceptación (los usará para el testing)
    • Labels y tipo (bug, feature, refactor)
    • Comentarios con contexto adicional

    Si los criterios de aceptación están mal escritos o son ambiguos, el agente lo detecta y puede preguntar antes de implementar. Ese comportamiento se configura en el CLAUDE.md del proyecto.

    Paso 2: leer el contexto del proyecto con CLAUDE.md

    El CLAUDE.md es la memoria del agente sobre tu proyecto. Antes de escribir una sola línea de código, Claude Code lee este archivo para entender:

    • Convenciones de nomenclatura
    • Arquitectura del proyecto (qué hace cada capa)
    • Comandos para correr tests y el servidor local
    • Patrones prohibidos o recomendados
    • Cómo se estructuran los PRs en este equipo

    Un CLAUDE.md bien escrito transforma al agente de "asistente genérico" a "developer que conoce el proyecto". La diferencia entre los dos es enorme en producción.

    # CLAUDE.md — ejemplo mínimo
    
    ## Arquitectura
    - Feature modules en `src/features/<nombre>/`
    - Services solo en la capa de aplicación, nunca en componentes
    - Todos los efectos secundarios pasan por el store (NgRx)
    
    ## Comandos importantes
    - Dev server: `bun run dev`
    - Tests: `bun run test`
    - Build: `bun run build`
    
    ## Convenciones de PR
    - Título: `[PROJ-XXX] descripción breve`
    - Descripción: resumen del ticket + cambios técnicos + steps to test
    

    Si quieres ver cómo construir un CLAUDE.md completo para un proyecto real, en el curso Construye con IA lo hago desde cero con un proyecto en TypeScript.

    Paso 3: implementar la feature

    Claude Code implementa la tarea. Lee los archivos relevantes, sigue las convenciones del CLAUDE.md, escribe los tests unitarios si el proyecto los requiere y ejecuta el servidor local para verificar que compila sin errores.

    Aquí es donde el contexto importa más que el modelo. Un agente con buen contexto (CLAUDE.md + ticket detallado) implementa con una tasa de acierto mucho más alta que uno que empieza desde cero.

    El agente también puede hacer preguntas aclaratorias antes de implementar si detecta ambigüedad. Ese comportamiento se configura así en el CLAUDE.md:

    ## Comportamiento del agente
    - Si los criterios de aceptación son ambiguos, pregunta antes de implementar
    - No inventes requisitos que no estén en el ticket
    - Si necesitas crear un nuevo módulo, describe la estructura antes de crearla
    

    Paso 4: testing en el navegador con el MCP de Chrome

    Este es el paso que más sorprende a los developers cuando lo ven por primera vez.

    El MCP de Chrome (servidor MCP que usa Playwright por debajo para controlar el navegador) le da a Claude Code control total: abrir URLs, hacer clic en elementos, rellenar formularios, tomar screenshots, leer el contenido del DOM, verificar mensajes de error en consola.

    El agente usa los criterios de aceptación del ticket como guión de testing. Si el ticket dice "el usuario debe poder filtrar la tabla por fecha y ver solo los registros del rango seleccionado", el agente:

    1. Abre la app en localhost:4200
    2. Navega a la sección de la tabla
    3. Selecciona un rango de fechas
    4. Verifica que los registros mostrados coinciden con el filtro
    5. Toma un screenshot del resultado
    6. Revisa la consola del navegador para detectar errores
    // API de Playwright que ejecuta el servidor MCP internamente
    await page.goto('http://localhost:4200/dashboard/reports');
    await page.click('[data-testid="date-filter"]');
    await page.fill('[data-testid="date-from"]', '2026-01-01');
    await page.fill('[data-testid="date-to"]', '2026-01-31');
    await page.click('[data-testid="apply-filter"]');
    
    const rows = await page.$$('[data-testid="table-row"]');
    // Verifica que todos los rows tienen fechas dentro del rango
    

    Si algo falla, el agente lo reporta, corrige el código y vuelve a ejecutar el test. Es un loop de implementar → testear → corregir que el developer antes hacía manualmente.

    Referencia: Playwright — documentación oficial de automatización de navegadores.

    Paso 5: code review automático antes del PR

    Antes de crear el PR, el agente ejecuta /code-review — un slash command de Claude Code que analiza todos los cambios del diff:

    • Detecta problemas de seguridad (inputs sin sanitizar, secrets hardcodeados)
    • Verifica que se siguen las convenciones del proyecto
    • Revisa cobertura de casos edge
    • Detecta código duplicado o patrones que el equipo tiene como prohibidos

    Si el code review detecta problemas críticos, el agente los corrige antes de crear el PR. Si son sugerencias menores, las incluye como comentarios en la descripción del PR para que el reviewer humano las evalúe.

    Tengo un post completo sobre cómo configurar el agentic code review con Claude Code si quieres profundizar en esa parte del pipeline.

    Paso 6: crear el PR y disparar el CI/CD

    El agente crea el PR en GitHub con:

    • Título siguiendo la convención del proyecto (extraído del ticket)
    • Descripción generada del ticket: contexto, criterios de aceptación, cambios técnicos
    • Screenshot del testing en navegador como evidencia visual
    • Checklist de testing para el reviewer
    # El agente ejecuta esto internamente
    gh pr create \
      --title "[PROJ-412] Filtro por fecha en tabla de reportes" \
      --body "$(cat pr-description.md)" \
      --base main
    

    Cuando el developer aprueba el PR y hace el merge, el CI/CD se dispara automáticamente. GitHub Actions corre los tests, valida el build y despliega a producción. El agente ya no interviene en este paso — el pipeline de CI/CD es responsabilidad del equipo de infraestructura.

    Lo que el developer sigue haciendo

    Dejar claro este punto porque es importante: el agente no reemplaza al developer. El developer hace tres cosas:

    1. Escribir tickets con criterios de aceptación claros. Esto es ahora la habilidad más valiosa. Un ticket ambiguo produce código ambiguo.
    2. Revisar y aprobar el PR. El agente implementa, pero el developer decide si el resultado es correcto.
    3. Mantener el CLAUDE.md actualizado. Las convenciones del proyecto, la arquitectura, los patrones — el agente es tan bueno como el contexto que le das.

    El rol evoluciona de "el que escribe el código" a "el que define qué construir y valida que se construyó bien". Que es, paradójicamente, donde está el valor real de un developer senior.

    En Dominicode Labs estamos implementando este pipeline en proyectos reales con la comunidad — si quieres ver el setup completo con errores incluidos, es donde lo hacemos en directo.

    Cómo empezar a automatizar tu proceso de desarrollo con IA

    No montes el pipeline completo de golpe. Empieza con esto:

    1. Escribe un CLAUDE.md sólido para tu proyecto
    2. Instala el MCP de GitHub en Claude Code
    3. Prueba crear un PR automático desde un cambio pequeño
    4. Añade el MCP de Chrome y testea un flujo simple en el navegador
    5. Conecta Jira cuando los pasos anteriores funcionen de forma estable

    El pipeline completo lleva tiempo afinar. El valor llega antes de tenerlo completo.


    Preguntas frecuentes

    ¿El MCP de Chrome funciona con cualquier framework frontend (React, Vue, Angular)?
    Sí. El MCP de Chrome opera sobre el navegador real, no sobre el framework. No le importa si la app está en Angular, React o Vue — interactúa con el DOM resultante. Solo necesitas que la app esté corriendo en un servidor local accesible.

    ¿Qué pasa si los criterios de aceptación del ticket están mal escritos o son incompletos?
    El agente intentará inferir la intención, pero si la ambigüedad es suficientemente alta, puede preguntar antes de implementar o implementar algo que no era lo esperado. La calidad del output del agente es directamente proporcional a la calidad del input (el ticket). Invertir en escribir buenos tickets es la palanca más subestimada de este pipeline.

    ¿Se puede usar este pipeline sin Jira? ¿Con Linear, GitHub Issues u otras herramientas?
    Sí. Claude Code tiene MCPs para Linear, Asana y GitHub Issues. El principio es el mismo: el agente lee el ticket desde la fuente, extrae los criterios de aceptación y los usa como guión de implementación y testing. La integración específica depende del MCP disponible para cada herramienta.

    ¿Es seguro dejar que el agente tenga acceso a la base de datos o a servicios externos durante el testing?
    No. El testing del agente debe hacerse contra un entorno de desarrollo o staging, nunca contra producción ni contra una base de datos con datos reales. El CLAUDE.md debe especificar explícitamente contra qué entorno corre el agente y qué permisos tiene. El principio de mínimos privilegios aplica igual para agentes que para cualquier proceso automatizado.

    ¿Cuánto tiempo lleva montar este pipeline desde cero?
    El pipeline mínimo (CLAUDE.md + MCP GitHub + PR automático) puede estar funcionando en un día. El pipeline completo con MCP de Jira, MCP de Chrome y code review automático lleva entre una semana y dos de ajuste para que funcione de forma estable en un proyecto real. La mayor parte del tiempo se va en escribir un CLAUDE.md completo y en afinar los prompts para que el agente entienda las convenciones del proyecto.


    Si quieres aprender a construir con IA desde cero hasta producción, echa un vistazo al curso Construye con IA.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • MCP server para empresas: por qué necesitas el tuyo en 2026

    MCP server para empresas: por qué necesitas el tuyo en 2026

    Un cliente llega a tu empresa con su propio agente de IA. Ha construido workflows con Claude, con GPT-4o, con lo que sea. Quiere que ese agente use tu plataforma — consultar datos, lanzar acciones, integrarse con lo que tú ya tienes.

    Tu equipo responde: “Tenemos una API REST. Aquí está la documentación.”

    El cliente asiente, se va, y dos semanas después vuelve con una lista de preguntas sobre autenticación, rate limits y por qué el agente no entiende el schema de tu respuesta. Tu equipo dedica tres sprints a construir un wrapper custom. El cliente queda satisfecho. Pero el siguiente cliente viene con el mismo problema. Y el siguiente.

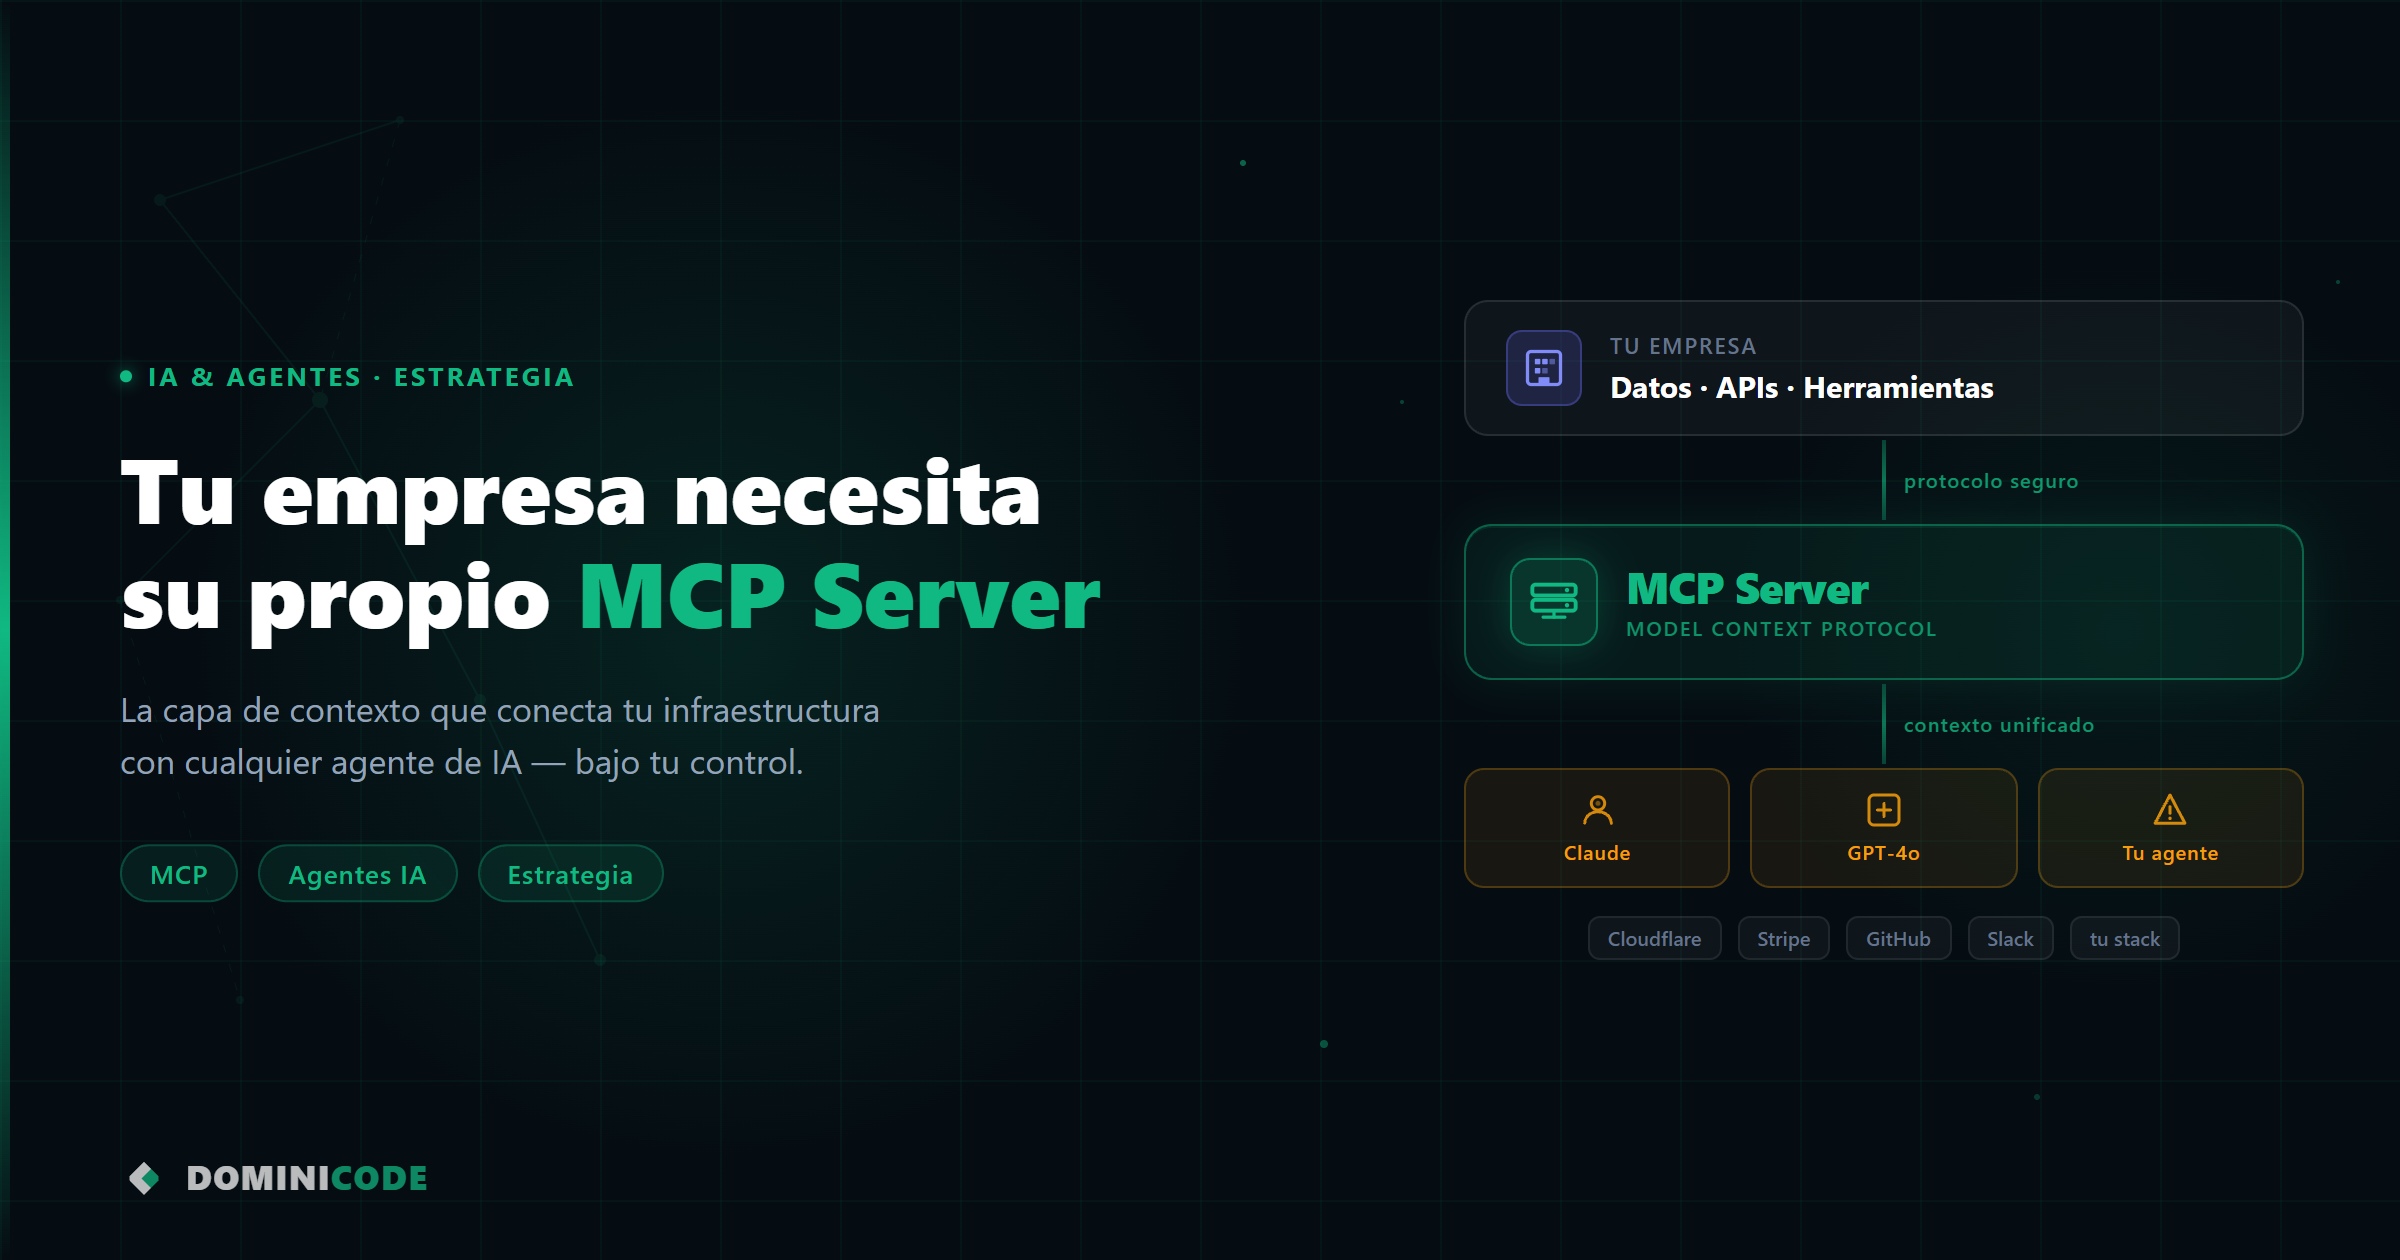
    Ese es el problema que un MCP server para empresas resuelve de raíz.


    Qué es MCP y por qué importa ahora

    Si ya leíste MCP explicado para developers: conecta Claude a tus herramientas, tienes el contexto técnico. El resumen ejecutivo es este: MCP (Model Context Protocol) es el protocolo abierto que estandariza cómo los agentes de IA se comunican con herramientas y servicios externos. Lo creó Anthropic en noviembre de 2024. En menos de 18 meses alcanzó 97 millones de descargas mensuales del SDK.

    OpenAI lo adoptó en marzo de 2025. Microsoft en mayo, durante el Microsoft Build. La Agentic AI Foundation — con Anthropic, OpenAI, Google, AWS y Cloudflare como cofundadores — lo recibió bajo la Linux Foundation en diciembre de 2025. Ya no es el protocolo de Anthropic. Es el estándar del sector.

    Forrester predice que el 30% de los vendors de software empresarial lanzarán su propio MCP server en 2026. Si tu empresa tiene una API, ese porcentaje incluye a tu competencia. Puedes ver el listado oficial de MCP servers en el repositorio de la especificación.


    El problema de las integraciones N×M que un MCP server resuelve

    Antes de MCP, el problema era sencillo de enunciar e imposible de escalar: cada cliente que quería conectar su agente de IA a tu servicio necesitaba una integración custom. Tú necesitabas mantenerla. Ellos necesitaban documentarla para cada LLM que usaran.

    Un cliente con Claude, otro con GPT, otro con Gemini. Tres integraciones. Cinco clientes, quince integraciones. La complejidad crece de forma cuadrática.

    MCP colapsa esa matriz. Un server, muchos clientes. Cualquier agente compatible con MCP — Claude, Cursor, tu herramienta interna — puede usar tu servidor sin que tú ni tu cliente escriban una línea de código de integración adicional.


    Empresas con MCP server en producción: Stripe, Cloudflare, GitHub

    No es teoría. Hay empresas que ya tienen MCP servers en producción y que están redefiniendo cómo sus clientes interactúan con ellas.

    Cloudflare expone toda su API — más de 2.500 endpoints de Workers, R2, D1, DNS y Zero Trust — a través de un MCP server con solo dos herramientas: search() y execute(). Un agente puede desplegar un Worker, configurar un dominio o gestionar reglas de acceso sin que un humano abra el dashboard. Cloudflare no creó una integración por cada herramienta de IA. Creó un punto de entrada único.

    Stripe tiene un MCP server que permite a los agentes inspeccionar clientes, suscripciones, pagos y disputas. El caso de uso es claro: un agente de soporte o de análisis financiero puede consultar el estado de una transacción directamente, sin que alguien tenga que entrar al dashboard o llamar a la API manualmente.

    GitHub expone issues, pull requests y búsqueda de código. Los agentes de desarrollo — como Claude Code — pueden abrir issues, revisar PRs o buscar en el código base directamente desde el contexto de trabajo del desarrollador.

    Notion, Linear, Sentry, Asana y Atlassian convergen en el mismo patrón: un servidor MCP alojado en su propia infraestructura, protegido por OAuth, que cualquier agente compatible puede usar sin configuración adicional.

    El patrón que se está convirtiendo en referencia de la industria es el que estableció Cloudflare: un MCP server remoto alojado en Workers, expuesto como endpoint público, autenticado con OAuth. Stripe, Linear y Sentry siguieron exactamente ese camino.


    MCP server vs API REST: la diferencia que importa

    Dimensión API REST MCP Server
    Consumidor Un programador (o su código) Un agente de IA de forma autónoma
    Autodescripción Documentación externa (OpenAPI, etc.) Nombre, descripción y schema integrados
    Integración por cliente Una por LLM / plataforma Una sola, vale para todos los clientes MCP
    Mantenimiento N adaptadores en paralelo Un único punto de entrada
    Compatibilidad Depende del cliente Cualquier agente que soporte MCP

    La diferencia no está en el transporte HTTP — está en quién consume y cómo lo hace.


    Por qué esto es una ventaja competitiva, no solo una feature técnica

    Aquí está la tesis central de este post: exponer tu servicio como MCP server no es una integración más. Es posicionarte en la capa de infraestructura de los agentes de IA.

    En los próximos dos o tres años, los workflows empresariales se van a orquestar mediante agentes. Esos agentes van a conectarse con los servicios que estén disponibles en su ecosistema. Si tu empresa no está accesible vía MCP, tus clientes van a usar el servicio de tu competidor que sí lo está. No porque sea técnicamente superior — sino porque es el que el agente puede usar sin fricción.

    Piénsalo como los plugins de ChatGPT en 2023, pero con el soporte de toda la industria detrás y un estándar real. O como tener presencia en el App Store en 2010 — todavía temprano, todavía diferenciador.

    Las ventajas concretas son estas:

    1. Distribución sin esfuerzo de integración. Cualquier agente MCP-compatible puede usar tu server el día que lo publicas. Sin SDK propio. Sin documentación de integración por plataforma.

    2. Reducción drástica del coste de integración. Mantener un único MCP server en lugar de N adaptadores custom elimina la mayor parte del trabajo de integración. En la práctica, organizaciones que han estandarizado en MCP reportan reducciones superiores al 60% frente a conectores custom independientes.

    3. Posicionamiento como infraestructura. Los servicios que se convierten en infraestructura para otros tienen una tasa de churn históricamente baja. Si los workflows de tus clientes dependen de tu MCP server, la barrera de salida sube.

    4. Acceso al ecosistema de agentes sin inversión en partnerships. Cuando Cursor, Claude Code o cualquier nuevo cliente MCP busque herramientas disponibles, tu server ya estará ahí. No necesitas acuerdos con Anthropic ni con OpenAI para aparecer en su ecosistema.

    5. Datos de uso más ricos. Un MCP server te dice exactamente qué operaciones realizan los agentes de tus clientes, con qué frecuencia, con qué parámetros. Eso es señal de producto que una API tradicional no te da con la misma granularidad.

    6. Velocidad de adopción por parte de clientes técnicos. Los developers y los equipos de ingeniería que ya trabajan con agentes van a evaluar tu producto por si tiene MCP server. Es una señal de que entiendes el ecosistema en el que operan.


    Cuándo tiene sentido construirlo — y cuándo no

    No todo servicio necesita un MCP server hoy. Tiene sentido si se cumplen al menos dos de estas condiciones:

    • Tu API ya tiene clientes externos que la integran en sus workflows.
    • Tus clientes son developers o equipos técnicos que trabajan con agentes de IA.
    • Tienes operaciones discretas y definibles — acciones que un agente puede invocar con claridad.
    • Tu competencia ya está evaluando o construyendo el suyo.

    No tiene sentido si tu producto es puramente transaccional sin lógica de negocio expuesta, si tus clientes no tienen ninguna adopción de IA aún, o si tu API no está estabilizada. Un MCP server mal diseñado puede crear más fricción que eliminarla.

    La clave es pensar en términos de herramientas, no de endpoints. Un MCP server no expone rutas HTTP — expone acciones con nombre, descripción y schema de parámetros que un LLM puede entender sin documentación adicional.


    El momento es ahora, no en 2027

    En 12 meses, tener un MCP server no será una ventaja competitiva. Será la línea de base. Como tener una API REST en 2015 o estar en el App Store en 2012. Los que entraron antes construyeron workflows y convenciones que son difíciles de desplazar.

    El patrón de adopción de MCP sigue exactamente la curva que siguieron los SDKs de OAuth, los webhooks y las APIs GraphQL. Primero una empresa pionera. Luego los líderes del sector. Luego todos. El mercado está en la segunda fase.

    Si estás construyendo un producto con IA o evaluando cómo posicionar tu servicio en el ecosistema de agentes, en el curso Construye con IA trabajamos exactamente este tipo de decisiones arquitectónicas: desde la idea hasta el producto, con las herramientas que el sector ya usa en producción.


    Cómo empezar sin un proyecto completo

    El punto de entrada mínimo no es construir un MCP server completo. Es identificar las tres o cinco operaciones de tu API que más valor aportarían a un agente externo.

    Para Stripe, son: consultar cliente, listar pagos, ver disputa. Para Cloudflare, son: buscar recurso, ejecutar acción. Para tu empresa, probablemente sean las mismas operaciones que ya documentas como “casos de uso principales” en tu developer portal.

    El SDK oficial de MCP en TypeScript y Python tiene menos de 200 líneas para un servidor funcional. El coste de entrada es bajo. El coste de no entrar ahora es más alto de lo que parece.

    Si quieres explorar esto con más profundidad junto a otros developers que ya están construyendo con agentes, en Dominicode Labs tenemos recursos, proyectos y conversaciones activas sobre arquitectura MCP en producción.


    FAQ

    ¿Es MCP solo para empresas grandes como Stripe o Cloudflare?

    No. El SDK es open source, la implementación mínima es trivial y los casos de uso más interesantes están en productos medianos con APIs bien definidas. Las empresas grandes lo lanzaron antes porque tienen más exposición pública, no porque sea técnicamente más accesible para ellas. Una startup con una API limpia puede tener un MCP server en producción en días.

    ¿MCP funciona con todos los modelos de IA, no solo con Claude?

    Sí. Aunque MCP lo desarrolló Anthropic, OpenAI lo adoptó en abril de 2025 y Microsoft en julio de 2025. Hoy es un estándar de la industria bajo la Agentic AI Foundation (Linux Foundation). Cualquier cliente que implemente el protocolo — Claude, GPT, Cursor, tu agente interno — puede consumir tu MCP server sin cambios en el servidor.

    ¿Qué diferencia hay entre un MCP server y una API REST normal?

    Una API REST expone endpoints que un humano (o un código que alguien escribió) llama con parámetros concretos. Un MCP server expone herramientas con nombre, descripción semántica y schema de parámetros que un LLM puede interpretar, seleccionar y usar de forma autónoma dentro de un workflow. La diferencia no es en el transporte — es en que el consumidor es un modelo de lenguaje, no un programador.

    ¿Hay riesgos de seguridad al exponer un MCP server?

    Los mismos riesgos que tiene cualquier API expuesta: autenticación, autorización, rate limiting y auditoría. El patrón de referencia de la industria (Cloudflare, Stripe) usa OAuth 2.0 con tokens de acceso limitados al scope que el usuario autoriza. El MCP server no añade superficie de ataque nueva — la gestiona con el mismo modelo que ya usan las APIs modernas. Lo importante es no exponer herramientas destructivas sin confirmación explícita del usuario.

    ¿Necesito cambiar toda mi arquitectura para tener un MCP server?

    No. El MCP server es una capa adicional, no un reemplazo. Tu API REST sigue funcionando igual. El MCP server actúa como un adaptador que traduce las herramientas del protocolo a llamadas a tu API existente. En la mayoría de los casos es una capa delgada de 200-500 líneas de TypeScript o Python sobre lo que ya tienes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo automatizar usabilidad con agentes de IA en tu app

    Cómo automatizar usabilidad con agentes de IA en tu app

    Un cliente me enseñó su aplicación de onboarding hace unos meses. Cinco pasos. Diseño limpio. Todo funcional en los tests.

    La tasa de abandono era del 68% en el paso tres.

    Revisamos los tests de integración: pasaban todos. El formulario enviaba datos correctamente. La validación funcionaba. El CI estaba en verde. Y aun así, casi siete de cada diez usuarios salían del flujo antes de terminar.

    El problema no era que la aplicación no funcionara. Era que nadie había auditado cómo se usaba.

    Ahí está la diferencia que muchos developers no distinguen hasta que lo ven en métricas reales: una cosa es que el código haga lo que debe, y otra muy distinta es que el usuario pueda usarlo sin fricción. La primera la resuelves con tests. La segunda la resuelves con automatizar usabilidad con agentes de IA — que es exactamente lo que vamos a ver aquí.

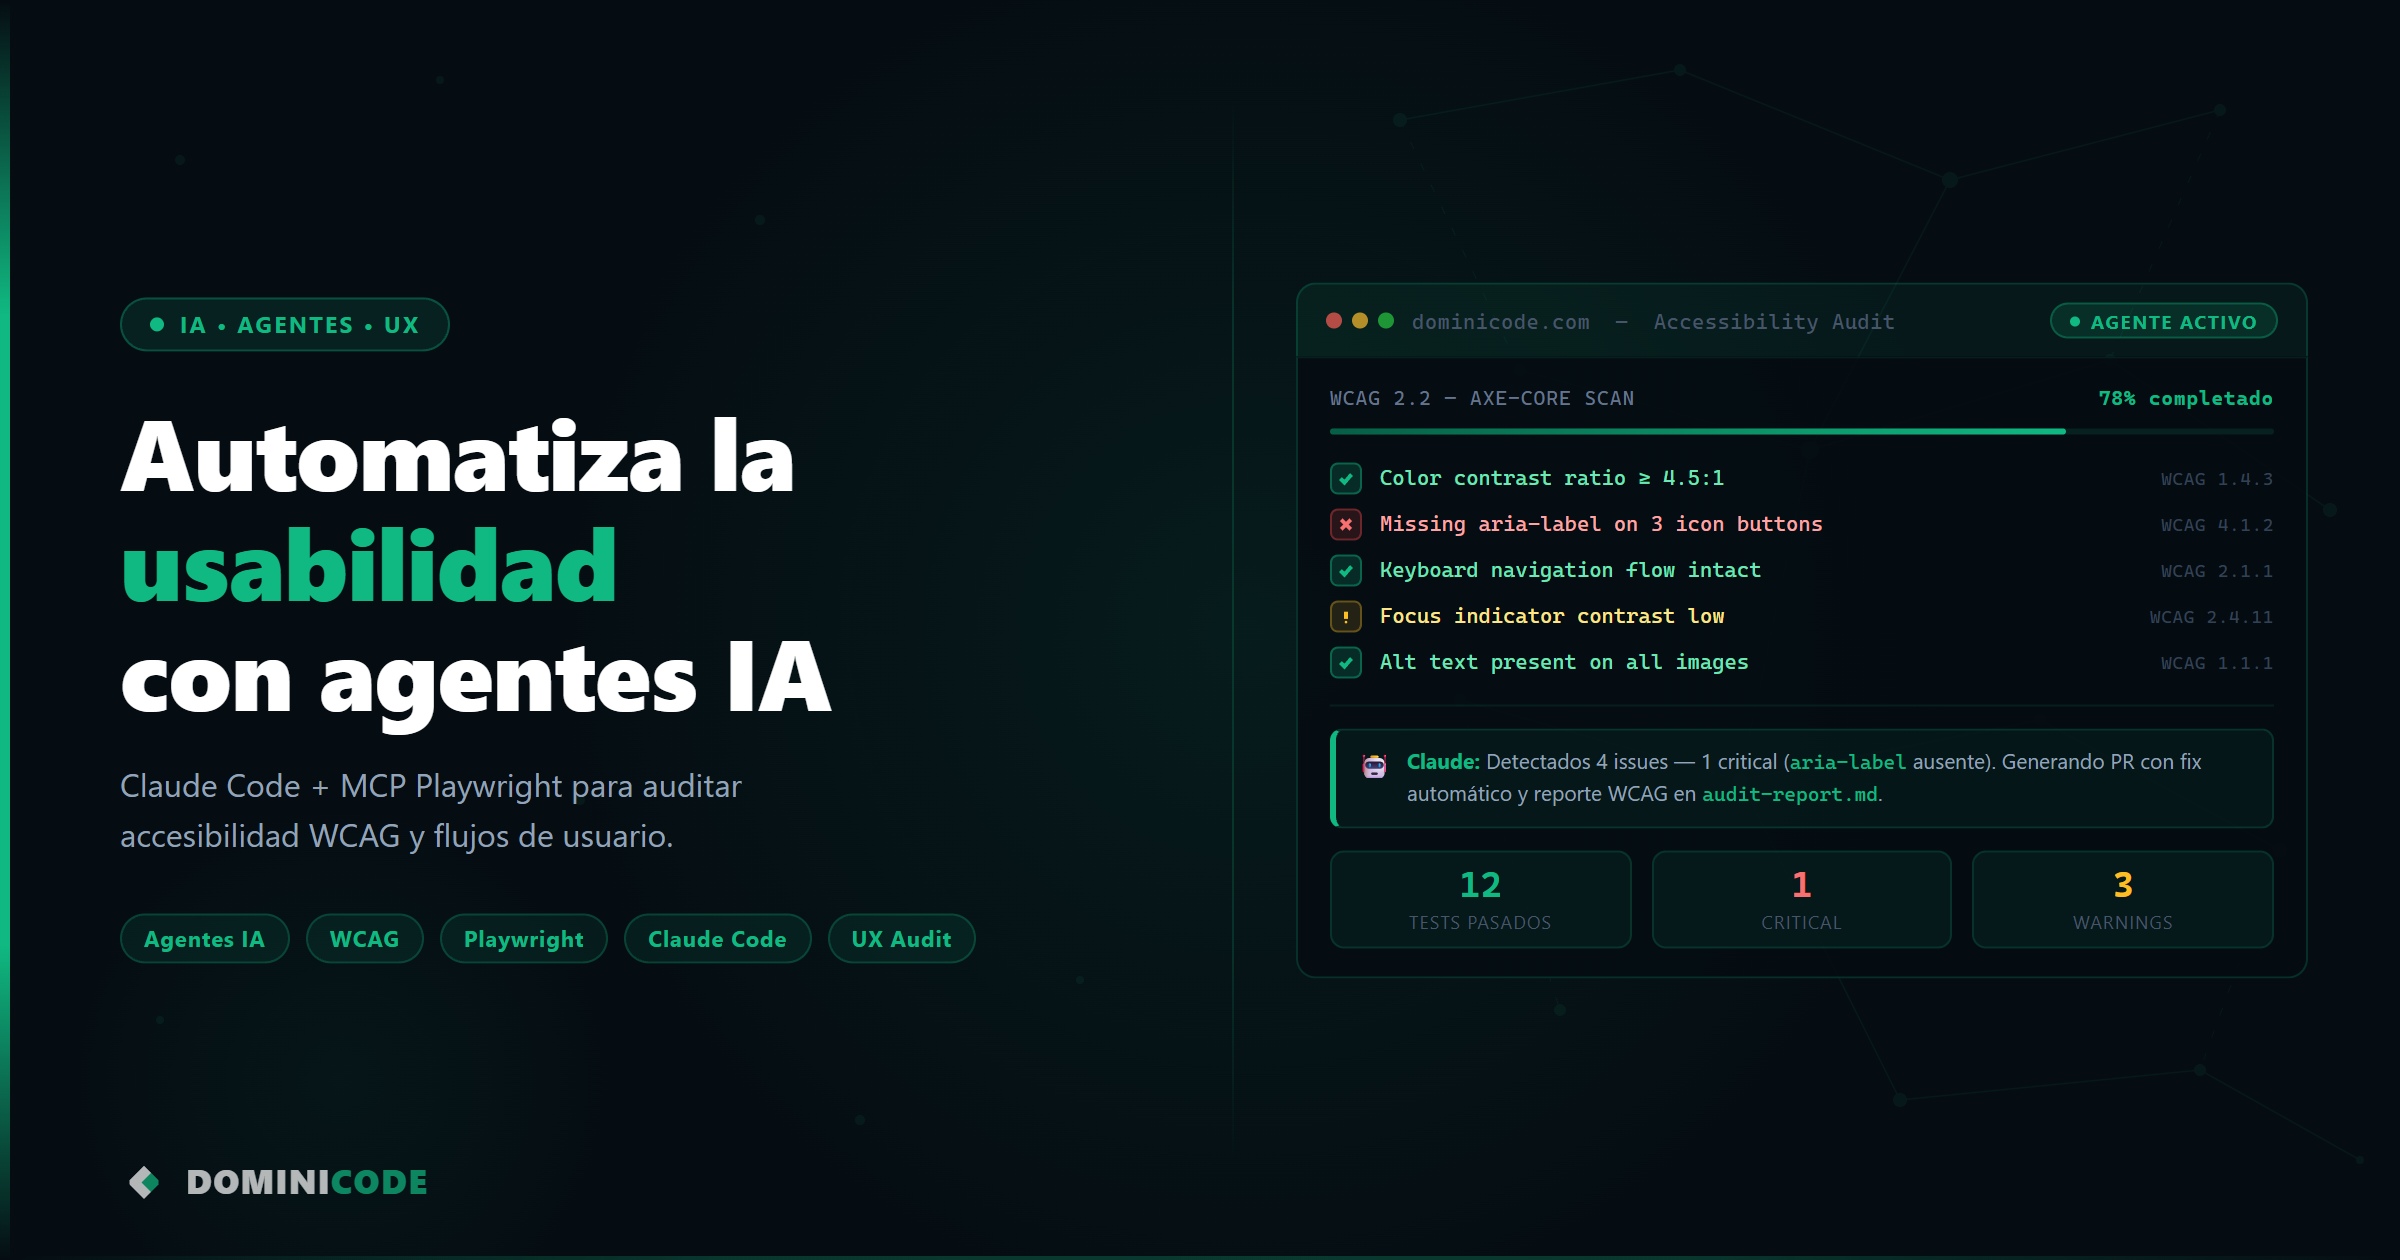
    Automatizar usabilidad con agentes de IA consiste en delegar la auditoría de accesibilidad, flujos de usuario y fricciones de interfaz a un agente — como Claude Code con MCP de Playwright — que controla el navegador de forma programática, navega flujos reales y genera un reporte estructurado de hallazgos sin intervención manual.


    Testing funcional vs. testing de usabilidad

    Un test funcional pregunta: ¿el botón de "Enviar" llama a la función correcta?

    Un test de usabilidad pregunta: ¿el usuario sabe que tiene que hacer clic ahí? ¿Lo ve? ¿Entiende qué va a pasar después?

    Son preguntas distintas y se responden con herramientas distintas.

    Los tests funcionales los escribes tú, los corre un CI, comprueban comportamiento esperado. Eso ya lo sabes hacer. Lo que un agente de IA aporta es la capacidad de navegar tu aplicación como si fuera un usuario — explorar rutas no documentadas, detectar elementos sin etiquetas accesibles, medir cuánto tarda en responder una pantalla, o identificar que un campo de error aparece debajo del scroll y el usuario nunca lo ve.

    No te reemplaza un test de usabilidad con personas reales. Pero te da un nivel de auditoría automatizada que antes no existía — y que tú nunca harías manualmente en cada PR. Si quieres ver cómo encaja esto en un pipeline completo de desarrollo, tienes la explicación en el post sobre automatizar el proceso de desarrollo con IA.


    Qué puede detectar un agente

    Cuando conectas Claude Code con el MCP de Playwright o Chrome DevTools, el agente puede controlar el navegador de forma programática. Eso significa que puede:

    • Navegar a cualquier ruta de tu aplicación
    • Hacer clic en elementos, rellenar formularios, desplazarse por la página
    • Leer el DOM y el árbol de accesibilidad (el que usa un lector de pantalla)
    • Medir tiempos de respuesta entre interacciones
    • Ejecutar axe-core para detectar violaciones WCAG
    • Capturar screenshots en cada paso del flujo
    • Generar un reporte estructurado con los hallazgos

    Lo que un agente detecta bien:

    1. Accesibilidad técnica: imágenes sin alt, botones sin aria-label, contraste insuficiente entre texto y fondo, formularios sin etiquetas asociadas, skip navigation ausente, foco de teclado atrapado en un componente modal.
    2. Fricciones estructurales: mensajes de error fuera del viewport, campos obligatorios que no se identifican como tales hasta el submit, pasos de onboarding que no guardan el progreso si el usuario recarga.
    3. Performance percibida: cuánto tarda en aparecer el primer elemento interactivo después de una navegación, si hay loaders sin indicación de progreso, si el layout shift hace que el usuario haga clic en el elemento equivocado.
    4. Cobertura de flujos: si una ruta de error (credenciales incorrectas, sesión expirada, red caída) termina en una pantalla sin instrucciones claras.

    Cómo configurar el agente para automatizar la auditoría de usabilidad

    La combinación que funciona en producción: Claude Code + MCP de Playwright.

    Para instalarlo: npx @playwright/mcp@latest. Una vez activo en tu configuración de Claude Code, el agente tiene acceso a las herramientas de control del navegador sin que escribas una línea de Playwright.

    El MCP de Playwright expone herramientas al agente para controlar el navegador: browser_navigate, browser_click, browser_type, browser_snapshot, browser_evaluate. Claude puede encadenar esas herramientas para ejecutar flujos completos.

    Un ejemplo de instrucción al agente para auditar el onboarding de una app:

    ## Tarea: Auditoría de usabilidad — flujo de onboarding
    
    URL base: http://localhost:4200
    
    Flujo a auditar:
    1. Navega a /register
    2. Rellena el formulario con datos válidos: nombre, email, contraseña
    3. Haz clic en "Crear cuenta"
    4. Completa los pasos del onboarding hasta llegar al dashboard
    
    En cada paso:
    - Captura un screenshot
    - Extrae el árbol de accesibilidad del contenido principal
    - Identifica elementos interactivos sin aria-label o sin texto visible
    - Mide el tiempo hasta que el siguiente paso es interactivo
    - Detecta si hay mensajes de error o advertencia y si son visibles sin scroll
    
    Al terminar, genera un reporte en formato JSON con esta estructura:
    {
      "paso": string,
      "url": string,
      "tiempo_carga_ms": number,
      "violaciones_accesibilidad": [],
      "fricciones_detectadas": [],
      "screenshot": string
    }
    

    El agente ejecuta eso de forma autónoma. Navega, interactúa, observa, y vuelve con un reporte estructurado.


    Accesibilidad automática con axe-core

    Para violaciones WCAG, la integración más sólida es axe-core. El agente puede ejecutarlo sobre cualquier página activa en el navegador mediante browser_evaluate:

    // Si axe-core no está en el bundle de la app, inyectarlo primero:
    // await page.addScriptTag({ url: 'https://cdn.jsdelivr.net/npm/axe-core/axe.min.js' });
    
    // Ejecutar la auditoría en el contexto de la página
    const results = await axe.run();
    return {
      violaciones: results.violations.map(v => ({
        impacto: v.impact,
        descripcion: v.description,
        elementos: v.nodes.map(n => n.target)
      }))
    };
    

    Lo que devuelve axe-core son violaciones categorizadas por impacto: critical, serious, moderate, minor. El agente puede filtrar solo las críticas, agregar el selector del elemento afectado, y generar una lista accionable para el developer.

    Esto detecta cosas como:

    • Contraste de color insuficiente (ratio menor a 4.5:1 para texto normal)
    • Imágenes sin atributo alt o con alt vacío en imágenes informativas
    • Elementos <div> y <span> usados como botones sin rol ARIA
    • Formularios sin <label> asociado o con placeholder como único identificador
    • Encabezados fuera de jerarquía (<h4> después de <h2> sin <h3>)

    Esta es una de las capacidades que trabajamos en detalle en el curso Construye con IA: cómo delegar auditorías estructuradas al agente para que el developer se centre en las decisiones de producto, no en el checklist técnico.


    El reporte de hallazgos

    Un agente que navega y detecta problemas no sirve de nada si los hallazgos terminan en un log de consola que nadie lee.

    El formato que mejor funciona para integrar en un workflow de desarrollo es un JSON estructurado que puedas convertir en un issue de GitHub, una tarea en Linear, o un comentario en un PR.

    Estructura mínima de reporte que el agente genera:

    {
      "auditoria": {
        "fecha": "2026-06-17",
        "url_base": "https://app.ejemplo.com",
        "flujo": "onboarding",
        "duracion_total_ms": 8420
      },
      "resumen": {
        "violaciones_criticas": 3,
        "violaciones_serias": 7,
        "fricciones_detectadas": 4,
        "pasos_con_retraso": 2
      },
      "hallazgos": [
        {
          "paso": "registro",
          "tipo": "accesibilidad",
          "impacto": "critical",
          "descripcion": "Campo de contraseña sin label asociado. Solo usa placeholder.",
          "selector": "#password-input",
          "referencia_wcag": "1.3.1"
        },
        {
          "paso": "paso-2-perfil",
          "tipo": "friccion",
          "impacto": "serious",
          "descripcion": "Mensaje de validación aparece 280px por debajo del campo en mobile. No visible sin scroll.",
          "selector": ".validation-message",
          "screenshot": "paso-2-error-state.png"
        }
      ]
    }
    

    Este reporte lo puedes consumir directamente en tu pipeline de CI, enviarlo a un webhook de Slack, o procesarlo con otro agente que abra los issues correspondientes.


    Agentes IA vs Lighthouse

    Capacidad Lighthouse Agente IA + MCP Playwright
    Métricas de rendimiento (LCP, CLS, FID) ✅ ❌
    Accesibilidad estática (axe-core) ✅ ✅ más granular
    Flujos interactivos multipaso ❌ ✅
    Estados de error y modales ❌ ✅
    Reporte adaptado al contexto del proyecto ❌ ✅ JSON estructurado
    Requiere código de automatización ❌ ❌ lenguaje natural
    Integración en CI/CD ✅ ✅

    Lighthouse mide el estado de una página en un instante. Un agente mide cómo un usuario real la recorre.


    Lo que el agente no puede hacer

    Esto es importante. Un agente mide lo que puede observar en el DOM y en el comportamiento de la interfaz. No puede medir lo que ocurre dentro del usuario.

    No detecta:

    • Frustración emocional. Si el flujo es técnicamente correcto pero genera ansiedad porque el lenguaje es frío o las instrucciones son ambiguas, el agente no lo sabe.
    • Preferencias estéticas. El contraste puede pasar el ratio WCAG y aun así resultar incómodo visualmente en contextos específicos.
    • Contexto cultural. Un ícono que es intuitivo para un usuario europeo puede no serlo para un usuario latinoamericano. El agente no tiene ese mapa cultural.
    • Carga cognitiva subjetiva. Puede detectar que hay ocho campos en un formulario, pero no puede decirte si eso es demasiado para tu audiencia específica.
    • Microcopy y confianza. El texto de un CTA puede ser técnicamente legible y aun así no generar suficiente confianza para que el usuario haga clic.

    Esas decisiones siguen siendo tuyas — o del diseñador, o del researcher de UX. Lo que el agente elimina es el trabajo de auditoría técnica repetitiva que de otra forma no harías en cada ciclo de desarrollo.


    Cómo integrarlo en tu workflow

    El patrón que funciona sin complicar el pipeline:

    1. Local, bajo demanda: el developer lanza la auditoría sobre la rama antes de abrir el PR. El agente revisa el flujo afectado por el cambio.
    2. En CI, sobre entornos de preview: cada PR despliega a un entorno de preview (Vercel, Netlify, Railway), y el agente audita ese entorno de forma automática antes del merge.
    3. Semanal, sobre producción: un job programado lanza la auditoría completa sobre la app en producción y genera un reporte que llega al equipo.

    El tercer nivel es el más valioso a largo plazo: detecta regresiones de accesibilidad que se cuelan en producción sin que nadie las vea en los tests unitarios.

    El paso de code review automático antes del PR — que complementa esta auditoría de usabilidad — lo explico en detalle en el post sobre agentic code review con Claude Code.

    Si quieres ver cómo construir este tipo de pipelines con agentes desde cero, en Dominicode Labs tenemos proyectos completos que aplican exactamente este enfoque — desde la configuración del MCP hasta la generación del reporte final.


    FAQ

    ¿Necesito conocer Playwright para esto?
    No necesitas escribir código Playwright. El MCP abstrae las herramientas de control del navegador y el agente las usa directamente. Basta con que describas el flujo que quieres auditar en lenguaje natural.

    ¿axe-core cubre todos los criterios WCAG?
    Cubre los criterios que son detectables automáticamente — menos de la mitad de los criterios de WCAG 2.1. El resto requiere evaluación humana. Pero ese 30-40% incluye los problemas más comunes y los más graves.

    ¿El agente puede auditar aplicaciones con autenticación?
    Sí. Puedes darle al agente las credenciales de una cuenta de prueba, o configurar el MCP para que arranque el navegador con una sesión ya autenticada. El agente navega como un usuario real, incluyendo el flujo de login.

    ¿Qué diferencia hay entre esto y Lighthouse?
    Lighthouse audita métricas de performance, SEO básico y accesibilidad en un snapshot estático. Un agente con MCP de Playwright puede auditar flujos interactivos completos — formularios multipaso, modales, estados de error, interacciones con el teclado — y generar reportes adaptados a tu contexto específico, no a un checklist genérico.

    ¿Puedo usar esto con cualquier framework frontend?
    Sí. El agente interactúa con el navegador, no con el framework. Funciona igual con Angular, React, Vue o cualquier app renderizada en el cliente o en el servidor.

    La próxima vez que un cliente te muestre métricas de abandono con todos los tests en verde, ya sabes qué está pasando — y cómo resolverlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • MCP explicado para developers: conecta Claude a tus herramientas

    MCP explicado para developers: conecta Claude a tus herramientas

    Hace unos meses estaba trabajando con Claude Code en un proyecto con Supabase. Quería que el agente pudiese consultar la base de datos, leer el schema, revisar los registros. Lo normal cuando construyes algo de verdad.

    El problema: Claude no podía llegar a Supabase por sí solo. Necesitaba que yo le pasase el contexto a mano — copiar y pegar schema, copiar y pegar queries, copiar y pegar resultados. El LLM hacía el trabajo intelectual, pero la conexión a las herramientas era un cuello de botella manual y frustrante.

    Eso era la vida antes de MCP (Model Context Protocol).

    Hoy, con el servidor MCP de Supabase configurado en Claude Code, el agente puede leer tablas, ejecutar queries y revisar logs sin que yo mueva un dedo. La diferencia no es pequeña. Es el salto entre un asistente que responde preguntas y un agente que trabaja de verdad.


    El problema que MCP viene a resolver

    Antes de MCP, si querías conectar un LLM a una herramienta externa — GitHub, una base de datos, Slack, tu sistema de archivos — tenías que construir esa integración desde cero para cada caso.

    Cada proveedor de LLM tenía su forma de hacer “function calling”. OpenAI tenía la suya. Anthropic tenía la suya. Google tenía la suya. Y cada herramienta que querías conectar necesitaba código custom adaptado a ese proveedor específico.

    El resultado: ecosistemas fragmentados. Integraciones que había que reescribir al cambiar de modelo. Código duplicado en cada proyecto. Y una fricción enorme para cualquier developer que quisiese construir algo más allá del chat básico.

    MCP es la respuesta a ese problema. Un protocolo único, abierto y estandarizado para que cualquier LLM se comunique con cualquier herramienta. Escribe el servidor una vez. Funciona con cualquier cliente compatible.


    Qué es MCP exactamente

    Model Context Protocol es un protocolo abierto — especificación pública, SDK con licencia MIT — creado por Anthropic en noviembre de 2024 y adoptado por la industria. Define cómo los LLMs se comunican con herramientas y fuentes de datos externas.

    La arquitectura tiene dos piezas:

    1. Cliente MCP — la aplicación host que aloja al LLM (Claude Code, Claude Desktop). Es quien inicia la conexión, gestiona qué servidores están disponibles y enruta las llamadas del modelo a las herramientas.
    2. Servidor MCP — el servicio que expone las herramientas. Puede ser Supabase, GitHub, tu sistema de archivos, Notion, Slack, o cualquier cosa que hayas construido tú mismo.

    El flujo de una interacción con MCP es el siguiente:

    1. El usuario hace una petición a Claude: “¿Cuántos usuarios se registraron esta semana?”
    2. Claude detecta que necesita datos de la base de datos.
    3. La aplicación host enruta la llamada al servidor MCP de Supabase.
    4. El servidor ejecuta la query y devuelve los resultados.
    5. Claude recibe la respuesta y continúa la conversación con datos reales.

    Todo esto ocurre dentro de la misma sesión, de forma transparente para el usuario. La especificación completa del protocolo está disponible en modelcontextprotocol.io, mantenida como estándar abierto.


    MCP vs Function Calling: la diferencia que importa

    Si llevas tiempo trabajando con LLMs probablemente conoces el concepto de function calling — la capacidad de un modelo de invocar funciones definidas por el developer.

    La confusión es comprensible. MCP y function calling resuelven el mismo problema superficialmente. Pero hay una diferencia fundamental:

    Criterio Function Calling MCP
    Compatibilidad Propietario por proveedor Protocolo abierto
    Portabilidad Reescribir al cambiar de modelo Un servidor, cualquier cliente
    Mantenimiento Código duplicado por proveedor Único punto de actualización
    Adopción Fragmentada Claude Code, Cursor y más

    Function calling es propietario. La especificación de cómo defines una función para OpenAI no es la misma que para Anthropic. Si cambias de modelo, reescribes las integraciones.

    MCP es el estándar universal. El servidor MCP que escribas hoy para conectar Claude a tu base de datos funciona también con cualquier otro cliente MCP que aparezca mañana. El servidor no sabe ni le importa qué LLM hay al otro lado.

    Es la diferencia entre construir sobre propietario y construir sobre estándar. La misma diferencia que existe entre HTTP y el protocolo interno de un servicio concreto.

    Si estás construyendo herramientas que los LLMs van a usar en producción, MCP es la apuesta correcta. Es la razón por la que en el curso Construye con IA trabajamos con MCP desde el principio — no porque sea lo más nuevo, sino porque es lo que tiene sentido en un stack real.


    Casos de uso reales para developers

    Supabase MCP. Claude puede leer el schema de tu base de datos, ejecutar queries, revisar los logs de error, inspeccionar las políticas RLS. Cuando estás debuggeando un problema en producción, tener al agente con acceso directo a la base de datos no es un lujo — es lo que separa minutos de horas.

    GitHub MCP. Claude puede leer Pull Requests, crear issues, revisar el historial de commits, comentar en code reviews. Si trabajas en un equipo o gestionas un proyecto open source, esto te cambia el flujo de trabajo.

    Filesystem MCP. Claude puede leer y escribir archivos en tu proyecto directamente. Esto es lo que usa Claude Code por defecto — el acceso al sistema de archivos es un servidor MCP. Cuando le dices a Claude “edita este archivo”, hay un servidor MCP detrás gestionando esa operación.

    Notion o Confluence MCP. Claude puede leer tu documentación, buscar en tus notas, actualizar páginas. Útil si tienes tu spec o tus decisiones de arquitectura en Notion y quieres que el agente las tenga en contexto sin tener que copiarlas manualmente.

    Slack MCP. Claude puede leer canales, buscar mensajes, enviar notificaciones. Si construyes pipelines de automatización, esto es la pieza que conecta el agente con tu equipo.

    El patrón es siempre el mismo: en lugar de que tú seas el intermediario entre el LLM y la herramienta, el protocolo gestiona esa conexión. Tu rol pasa de “copy-paste operator” a alguien que define qué herramientas el agente puede usar y con qué permisos.


    Cómo configurar un servidor MCP en Claude Code

    La parte práctica. Hay dos formas de configurar servidores MCP en Claude Code:

    Opción 1 — Configuración global (claudedesktopconfig.json) Esta configuración aplica a todas tus sesiones de Claude Code. El archivo vive en:

    • macOS: ~/Library/Application Support/Claude/claudedesktopconfig.json
    • Windows: %APPDATA%\Claude\claudedesktopconfig.json

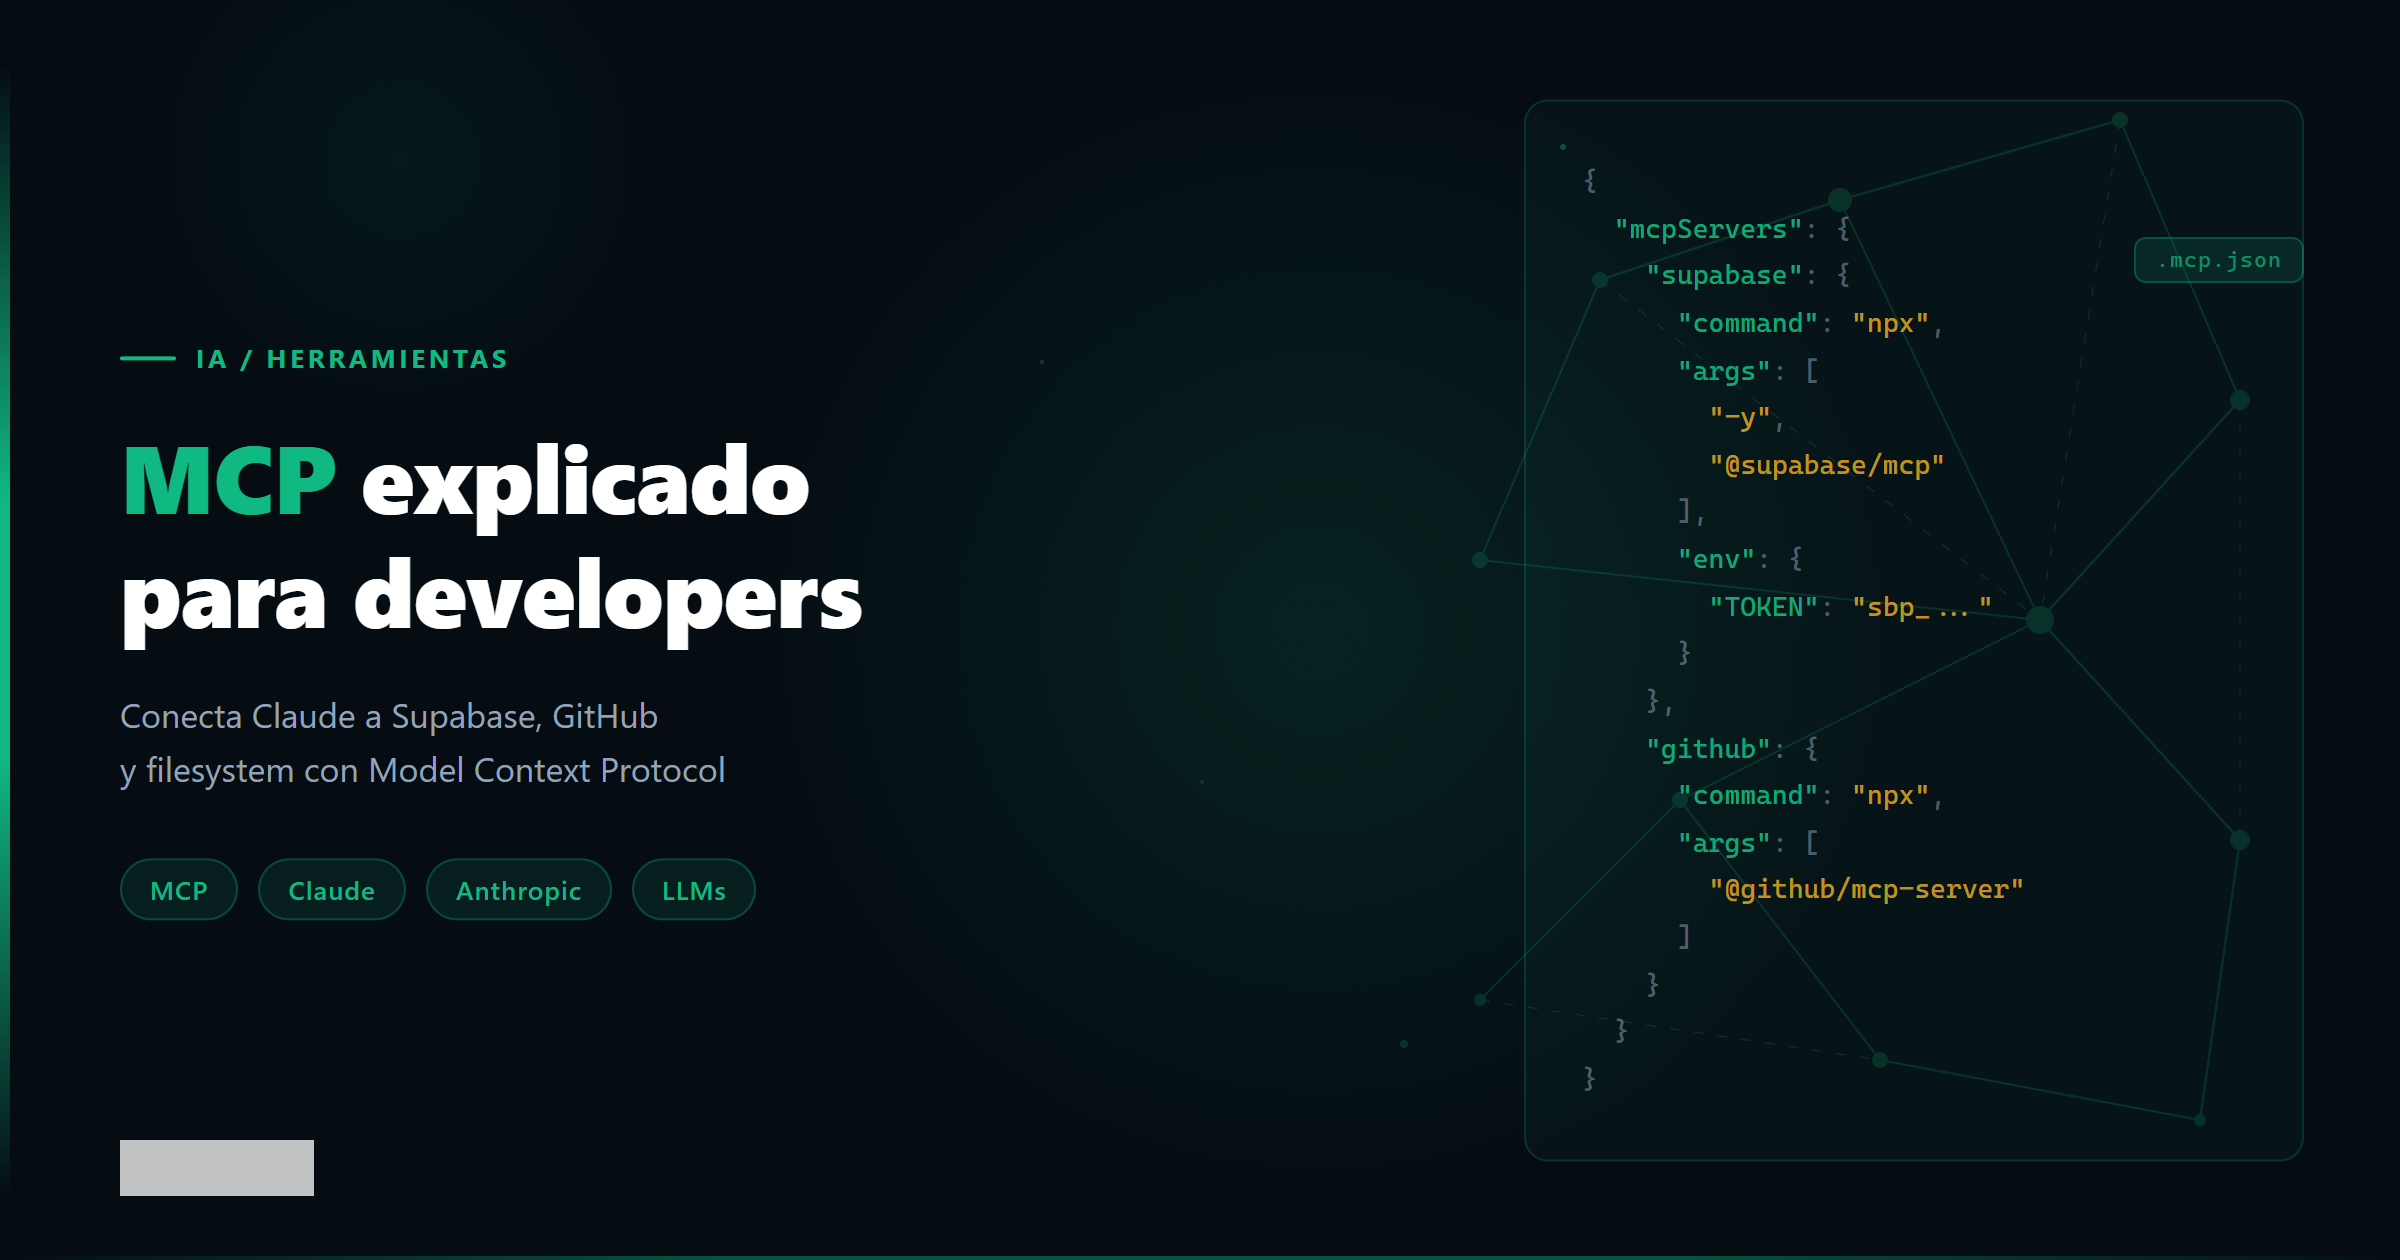
    Opción 2 — Configuración por proyecto (.mcp.json) Un archivo .mcp.json en la raíz de tu proyecto. Solo aplica a ese proyecto. Es la opción que recomiendo — el contexto de las herramientas debe ser específico al proyecto, no global.

    Ejemplo práctico: MCP de filesystem

    {
      "mcpServers": {
        "filesystem": {
          "command": "npx",
          "args": [
            "-y",
            "@modelcontextprotocol/server-filesystem",
            "/Users/bezael/projects/mi-proyecto"
          ]
        }
      }
    }

    Con esto configurado, Claude puede leer y modificar archivos dentro de la ruta que especifiques. No tiene acceso a nada fuera de ese directorio — los permisos los defines tú.

    Ejemplo: MCP de Supabase

    {
      "mcpServers": {
        "supabase": {
          "command": "npx",
          "args": ["-y", "@supabase/mcp-server-supabase@latest"],
          "env": {
            "SUPABASE_URL": "https://tu-proyecto.supabase.co",
            "SUPABASE_SERVICE_ROLE_KEY": "tu-service-role-key"
          }
        }
      }
    }

    Una vez que reinicias Claude Code con esta configuración, el agente tiene acceso a tu base de datos. Puedes pedirle que revise el schema, que ejecute una query, que busque errores en los logs.

    Qué ocurre cuando Claude usa una herramienta MCP

    Por defecto, Claude Code te muestra cada llamada MCP antes de ejecutarla. Verás algo como:

    Tool call: filesystem.read_file
    Arguments: { "path": "/src/components/UserCard.tsx" }

    Puedes aprobarla, rechazarla o configurar permisos permanentes por servidor. El flujo de trabajo es transparente — no hay caja negra.

    Esto conecta directamente con lo que explico en el post sobre Context Engineering para proyectos de IA: el contexto que tiene el agente determina la calidad de sus decisiones. MCP es una de las palancas más directas para darle al agente contexto real, no simulado.


    El ecosistema MCP hoy

    La adopción ha sido rápida. Hoy existen servidores MCP oficiales o comunitarios para:

    • Supabase, PostgreSQL, SQLite
    • GitHub, GitLab, Linear
    • Notion, Confluence, Obsidian
    • Slack, Discord
    • AWS, Google Cloud
    • Playwright (para automatizar navegadores)
    • Docker
    • Y decenas más

    El registro de servidores MCP crece cada semana. Si la herramienta que necesitas no tiene servidor MCP todavía, puedes construir el tuyo — el SDK oficial de Anthropic para TypeScript y Python hace que crear un servidor MCP básico sea trabajo de pocas horas.


    Por dónde empezar hoy

    Si nunca has configurado un servidor MCP, el camino más corto es este:

    1. Abre Claude Code en un proyecto real tuyo.
    2. Crea un archivo .mcp.json en la raíz con el servidor de filesystem apuntando a tu directorio de trabajo.
    3. Reinicia Claude Code.
    4. Pídele que liste los archivos del proyecto, que lea un componente específico, que analice la estructura.

    No necesitas construir nada. Solo configurar. En menos de 10 minutos tienes un agente que trabaja con el contexto real de tu proyecto en lugar de con lo que tú le describes.

    Si todavía no tienes configurado el contexto base de tu proyecto, el post sobre cómo estructurar tu CLAUDE.md es el punto de partida — MCP y CLAUDE.md son complementarios, no alternativos.

    El siguiente paso natural es conectar tu base de datos si usas Supabase, o GitHub si gestionas un repositorio con actividad. Cada servidor MCP que añades amplía lo que el agente puede hacer sin intervención tuya.

    Y si quieres entender la arquitectura completa — no solo el protocolo MCP sino todo el sistema que lo rodea, de la spec al producto funcionando — eso es exactamente lo que cubrimos en el curso Construye con IA. Si quieres explorar esto con otros developers y ver proyectos reales con MCP en acción, en Dominicode Labs revisamos este tipo de proyectos regularmente.


    FAQ

    ¿MCP es solo para Claude o funciona con otros LLMs?

    MCP es un protocolo abierto — no es propietario de Anthropic en el sentido de que solo funcione con Claude. Otros clientes MCP compatibles pueden usar los mismos servidores. La apuesta de Anthropic fue precisamente crear un estándar que la industria pudiese adoptar, no una ventaja competitiva cerrada. Hoy el ecosistema está centrado en Claude Code y Claude Desktop, pero la adopción por parte de otros clientes está creciendo.

    ¿Es seguro darle acceso a Claude a mi base de datos o sistema de archivos?

    Depende de cómo lo configures. El servidor MCP de filesystem solo puede acceder a las rutas que tú especifiques — no tiene acceso a toda tu máquina. Con Supabase, usas la service role key, que tiene permisos amplios, por lo que hay que ser cuidadoso con qué operaciones permites. Por defecto Claude Code te muestra cada llamada MCP antes de ejecutarla. La regla general: mínimo privilegio — dale al servidor MCP exactamente los permisos que necesita, no más.

    ¿Necesito saber TypeScript o Python para usar MCP?

    Para usar servidores MCP existentes, no. Solo necesitas editar un archivo JSON de configuración y tener Node.js instalado (para los servidores que usan npx). Para construir tu propio servidor MCP, el SDK oficial de Anthropic está disponible en TypeScript y Python, y el punto de partida es sencillo — un servidor básico son menos de 50 líneas.

    ¿Cuál es la diferencia entre MCP y un plugin de ChatGPT?

    Los plugins de ChatGPT fueron un intento propietario de conectar LLMs a herramientas externas, y OpenAI los deprecó en 2024. MCP es un protocolo abierto, no una feature de un producto específico. La diferencia práctica: un servidor MCP que construyas hoy puede ser usado por cualquier cliente MCP compatible mañana. Un plugin de ChatGPT solo funcionaba con ChatGPT, con las restricciones y cambios que OpenAI decidiera unilateralmente.

    ¿MCP reemplaza completamente el function calling tradicional?

    No exactamente. Function calling sigue siendo el mecanismo subyacente — MCP lo usa internamente. Lo que MCP añade es la capa de estandarización: define cómo se describen las herramientas, cómo se comunica el cliente con el servidor, cómo se gestionan los errores. Es más una capa de protocolo sobre function calling que un reemplazo.


    *Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.*

  • Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo

    Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo

    El problema no es que falten herramientas para construir agentes de IA. Es que sobran.

    Hace unos meses, en una sesión de Dominicode Labs, me preguntaron cuál era el stack IA agéntica 2026 que recomendaba. Empecé a responder y me di cuenta de que tenía una respuesta para cada capa — pero no tenía una respuesta integrada. Llevo varios proyectos agénticos en producción en Dominicode y cada semana aparece un nuevo framework, un nuevo modelo, un nuevo “estándar imprescindible”.

    Qué modelo. Qué framework de orquestación. Qué hacer con la memoria. Cómo trazar lo que hace el agente. Dónde desplegarlo. Cada capa tiene sus propias opciones, sus propias compensaciones y su propio ecosistema de hype que no para de generar nuevas herramientas.

    Este post es mi respuesta integrada: el stack que yo uso, por qué elegí cada pieza y qué descarto con criterio. No es una lista de todas las herramientas que existen. Es una guía con tesis clara sobre qué funciona en producción cuando construyes con TypeScript, para un proyecto real, sin un equipo de 20 personas.


    Cómo pensar en el stack agéntico: capas, no herramientas

    Antes de hablar de herramientas específicas, el marco que uso para evaluar cualquier stack agéntico. Hay cinco capas y cada una resuelve un problema diferente:

    1. Modelo — el LLM que razona y toma decisiones
    2. Framework de agente — el runtime que envuelve el agentic loop
    3. Memoria y contexto — dónde vive la información entre sesiones y entre agentes
    4. Observabilidad — cómo ves qué está haciendo el agente
    5. Deployment — dónde corre el sistema en producción

    La mayoría de los posts sobre herramientas de IA mezclan estas capas y crean confusión. LangChain no compite con Claude — compite con el SDK de Anthropic. Langfuse no compite con Pinecone — resuelven problemas en capas completamente distintas.

    Cuando tienes claro qué capa resuelve cada herramienta, la decisión se vuelve mucho más simple. Si no tienes claro aún qué es el agentic loop y cómo funciona, empieza por aquí antes de elegir el stack.


    Capa 1: El modelo — quién razona

    La decisión más importante del stack y la que más gente toma al revés: eligen el modelo por el benchmark, no por el comportamiento en producción con herramientas.

    Los benchmarks de razonamiento abstracto no predicen bien si un modelo va a gestionar correctamente el agentic loop: respetar los límites de las herramientas, detectar cuándo ha completado el objetivo, no inventarse argumentos para las tool calls, pedir confirmación cuando tiene ambigüedad.

    Mi ranking para sistemas agénticos en 2026, basado en uso real:

    Claude Sonnet (Anthropic) — mi elección principal. La familia Claude 4.x lidera en comportamiento agéntico: sigue instrucciones complejas del sistema prompt con más fidelidad que los competidores, gestiona bien contextos de 200k tokens, y tiene el menor índice de “tool hallucination” — inventarse argumentos para herramientas que no existen o llamar a herramientas con parámetros incorrectos. Para proyectos donde el agente tiene acceso a herramientas reales con consecuencias (escritura a disco, llamadas a APIs, base de datos), esta fidelidad importa.

    Gemini 2.5 Pro (Google) — segunda opción para tareas de análisis. Tiene una ventana de contexto de 1M tokens que es genuinamente útil cuando el agente necesita procesar documentos grandes. El razonamiento es sólido. La API tiene más latencia que Anthropic en llamadas con herramientas. Lo uso puntualmente para tareas de análisis de documentos extensos, no como backbone de un sistema agéntico.

    GPT-4o (OpenAI) — bueno, pero no es mi primera elección para agentes. Excelente en tareas de generación pura. En agentic loops de más de 15 iteraciones, he visto más context drift que con Claude. Para proyectos que ya tienen infraestructura en el ecosistema OpenAI, es perfectamente válido.

    Llama 3.x local (Meta) — para casos específicos, no como base. Los modelos locales tienen su lugar: privacidad total, sin costos por token, sin latencia de red. Pero para sistemas agénticos complejos, la diferencia en calidad de razonamiento con los modelos de frontera es demasiado grande hoy. Los uso para tareas de clasificación simple o cuando los datos no pueden salir del entorno.

    La conclusión práctica: empieza con Claude Sonnet. Si los costos escalan y la tarea lo permite, evalúa migrar partes del sistema a modelos más baratos para subtareas que no requieren razonamiento complejo.


    Capa 2: El framework de agente — quién orquesta el loop

    Aquí está la decisión que más polémica genera, porque hay muchas opciones y cada una tiene su comunidad apasionada.

    Mi posición es clara: el framework que elijas debería desaparecer de tu código. Si tu lógica de negocio está mezclada con abstracciones del framework, tienes un problema de arquitectura, no de elección de herramienta.

    Vercel AI SDK — mi elección para TypeScript

    Para proyectos TypeScript, el Vercel AI SDK es el estándar más sólido hoy. Tiene tres propiedades que importan:

    Primero, la abstracción es mínima. generateText, streamText, generateObject — funciones que hacen lo que dicen, con un tipo de retorno predecible. Puedes leer el código del SDK y entender qué ocurre.

    Segundo, es agnóstico al proveedor. El mismo código funciona con Claude, GPT-4o y Gemini. Cambias el adaptador, no la lógica. En un año donde los modelos evolucionan rápido, esto no es un detalle menor.

    Tercero, tiene soporte nativo para tool use, streaming de respuestas y generateObject con schemas Zod — lo que significa que puedes hacer que el modelo devuelva JSON tipado sin analizadores de texto frágiles.

    import { generateText } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";


    const result = await generateText({ model: anthropic("claude-sonnet-4-6"), // verifica el modelo vigente en docs.anthropic.com/models tools: { readFile: { description: "Lee el contenido de un archivo del proyecto", parameters: z.object({ path: z.string() }), execute: async ({ path }) => fs.readFile(path, "utf-8"), }, }, messages: [{ role: "user", content: userQuery }], maxSteps: 15, // límite de iteraciones del loop });

    El parámetro maxSteps es el límite de iteraciones del agentic loop. No lo omitas nunca. Un agente sin límite de pasos en producción es un bug esperando a ocurrir.

    LangGraph — cuando necesitas flujos con estado y ramificaciones

    LangGraph (de LangChain) resuelve un problema diferente: orquestación de flujos donde el camino de ejecución no es lineal. Si tienes un sistema donde el agente puede ir por diferentes ramas según el resultado de un paso anterior, donde necesitas estado persistente entre sesiones, o donde hay handoffs entre múltiples agentes con condiciones complejas — LangGraph tiene primitivas para eso.

    No es mi primera elección para proyectos simples porque añade complejidad conceptual. Pero para sistemas multi-agente con lógica de routing elaborada, es genuinamente más potente que construir esa lógica a mano.

    SDK de Anthropic directo — para control total

    Cuando necesito control máximo sobre cada llamada a la API, uso el SDK de Anthropic directamente. Sin abstracciones intermedias. El agentic loop lo implemento yo, con la lógica exacta que necesito.

    Esto es lo que haría si estuviera construyendo el loop desde cero con el SDK directo — el mismo patrón que cubro en detalle en el curso Construye con IA:

    import Anthropic from "@anthropic-ai/sdk";


    const client = new Anthropic();

    async function runAgentLoop(userMessage: string, tools: Tool[]) { const messages: Anthropic.MessageParam[] = [ { role: "user", content: userMessage }, ];

    let iterations = 0; const maxIterations = 20;

    while (iterations < maxIterations) { const response = await client.messages.create({ model: "claude-sonnet-4-6", // verifica en docs.anthropic.com/models max_tokens: 4096, tools, messages, });

    // Si el modelo no llama a ninguna herramienta, ha terminado if (response.stop_reason === "end_turn") { return extractTextResponse(response); }

    // Procesa las tool calls y añade los resultados al contexto const toolResults = await executeToolCalls(response.content); messages.push({ role: "assistant", content: response.content }); messages.push({ role: "user", content: toolResults });

    iterations++; }

    throw new Error(Agente excedió el límite de ${maxIterations} iteraciones); }

    Lo que no uso: CrewAI, AutoGen, AgentGPT ni la mayoría de frameworks Python-first para proyectos TypeScript. No porque sean malos — CrewAI tiene ideas interesantes sobre roles y colaboración entre agentes — sino porque añadir Python al stack cuando ya tienes TypeScript es complejidad operacional que no se justifica en la mayoría de casos. Si tu equipo es Python, la ecuación cambia.


    Capa 3: MCP — el protocolo que está cambiando todo

    El Model Context Protocol (MCP) merece su propio apartado porque no es un framework de agentes. Es un estándar de comunicación — el equivalente a REST para que los agentes consuman herramientas y contexto de fuentes externas de forma estandarizada.

    Antes de MCP, cada herramienta que querías darle a un agente requería código de integración específico. Con MCP, una herramienta bien construida se puede conectar a cualquier agente que soporte el protocolo — Claude Code, Cursor, tu propio agente custom.

    Las implicaciones son grandes: en lugar de construir integraciones punto a punto, construyes servidores MCP reutilizables. Ya existe un ecosistema de servidores MCP públicos para GitHub, bases de datos, sistemas de archivos, APIs populares.

    // Un servidor MCP mínimo con el SDK oficial
    import { Server } from "@modelcontextprotocol/sdk/server/index.js";
    import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
    import { ListToolsRequestSchema } from "@modelcontextprotocol/sdk/types.js";


    const server = new Server( { name: "dominicode-tools", version: "1.0.0" }, { capabilities: { tools: {} } } );

    server.setRequestHandler(ListToolsRequestSchema, async () => ({ tools: [ { name: "get_post_metrics", description: "Obtiene métricas de un post del blog por slug", inputSchema: { type: "object", properties: { slug: { type: "string" } }, required: ["slug"], }, }, ], }));

    const transport = new StdioServerTransport(); await server.connect(transport);

    En 2026, si construyes herramientas para agentes y no las expones como servidores MCP, estás construyendo para un solo cliente. El ecosistema ya se está moviendo en esta dirección — Anthropic, OpenAI, Google y la mayoría de los frameworks de agentes tienen soporte nativo para MCP.


    Capa 4: Memoria y contexto persistente

    El problema de la memoria en agentes agénticos tiene tres dimensiones distintas y cada una necesita una solución diferente.

    Memoria conversacional (corto plazo) — el historial de mensajes de la sesión actual. La gestión correcta es mantenerlo en el contexto de la llamada al LLM. El truco está en la truncación inteligente: cuando el contexto se acerca al límite, no cortes los mensajes más antiguos a ciegas — resume las iteraciones antiguas y mantén los más recientes completos.

    Memoria semántica (búsqueda por similaridad) — para cuando el agente necesita recuperar información relevante de una base de conocimiento grande. Las opciones que uso:

    • pgvector — extensión de PostgreSQL. Si ya tienes Postgres en el stack (y probablemente lo tienes), añadir pgvector es añadir una extensión. No necesitas otra base de datos. Para la mayoría de proyectos con menos de diez millones de embeddings, pgvector es suficiente y elimina complejidad operacional.
    • Pinecone — la opción gestionada cuando el volumen es grande o quieres zero-ops. Más caro, más simple. Para proyectos en fases tempranas con presupuesto ajustado, pgvector primero.
    • Supabase pgvector — pgvector sobre Supabase. La que uso en proyectos nuevos porque ya tengo Supabase en el stack para auth y database.

    Memoria episódica (estado entre sesiones) — lo que el agente recuerda de sesiones anteriores con un usuario específico. Esto no es búsqueda vectorial: es estado estructurado que guardas en una tabla normal. El patrón que funciona es guardar un JSON con los hechos relevantes del usuario o proyecto y cargarlo al inicio de cada sesión como parte del system prompt.

    // Carga el estado de memoria al inicio de la sesión
    async function buildSystemPromptWithMemory(userId: string): Promise<string> {
      const memory = await db.query<UserMemory>(
        "SELECT facts FROM agent_memory WHERE user_id = $1",
        [userId]
      );


    const memoryContext = memory.rows[0]?.facts ? \n\nContexto previo del usuario:\n${JSON.stringify(memory.rows[0].facts, null, 2)} : "";

    return Eres un asistente técnico de Dominicode.${memoryContext}; }


    Capa 5: Observabilidad — ver lo que hace el agente

    Sin observabilidad, un agente en producción es una caja negra que factura. Ya hay un post completo en este blog sobre cómo instrumentar tus agentes con Langfuse y OpenTelemetry, así que aquí voy directo a las decisiones de stack:

    Langfuse — la elección por defecto. Open source, autohospedable, SDK para TypeScript con integración nativa en el Vercel AI SDK. Con un experimental_telemetry en la llamada tienes trazas completas:

    const result = await generateText({
      model: anthropic("claude-sonnet-4-6"), // verifica el modelo vigente en docs.anthropic.com/models
      messages,
      tools,
      experimental_telemetry: { // en Vercel AI SDK v4+ puede ser telemetry sin el prefijo
        isEnabled: true,
        metadata: { userId, sessionId, operationType: "support-agent" },
      },
    });

    OpenTelemetry GenAI — si ya tienes infraestructura OTEL en la empresa, las semantic conventions para IA generativa te permiten integrar las trazas de tus agentes en Grafana, Datadog o Honeycomb sin añadir otra plataforma.

    Helicone — proxy sin código si necesitas observabilidad inmediata sin instrumentar. Un cambio de base URL y tienes dashboards. Útil para proyectos donde no puedes tocar el código de integración.


    Capa 6: Deployment — dónde vive el agente en producción

    Las opciones razonables en 2026, con criterio claro sobre cuándo usar cada una:

    Railway — mi primera opción para agentes con estado o procesos de larga duración. Soporta WebSockets, procesos persistentes y tiene buena DX con Docker. Para agentes que necesitan mantener conexiones abiertas o procesar en background, Railway es más natural que Vercel.

    Vercel — ideal para agentes stateless que responden a webhooks o peticiones HTTP. La integración con el Vercel AI SDK es perfecta — maxDuration hasta 300 segundos en planes Pro es suficiente para la mayoría de las respuestas agénticas. Para workflows que duran minutos, necesitas otra opción.

    Cloudflare Workers + Durable Objects — la opción de mayor rendimiento para agentes edge. Durable Objects resuelve el problema de estado en entornos serverless de forma elegante. La curva de aprendizaje es mayor, pero el resultado en latencia y coste a escala es difícil de igualar.

    Docker + VPS — cuando necesitas control total, costos predecibles a escala media y no quieres depender de plataformas específicas. Es lo que uso para los agentes internos de Dominicode que corren de forma continua.

    Una regla práctica: si el agente responde en menos de 30 segundos y no necesita estado entre llamadas, serverless es suficiente. Si el agente trabaja durante minutos, mantiene conexiones o necesita acceso a recursos locales, necesitas un proceso persistente.


    Mi stack en Dominicode: la versión concreta

    Sin rodeos. Esto es exactamente lo que uso:

    Capa Herramienta Por qué
    Modelo principal Claude Sonnet (Anthropic) Mejor comportamiento en agentic loops, 200k contexto
    Modelo para análisis Gemini 2.5 Pro Contexto 1M para documentos grandes
    Runtime Bun Arranque más rápido, compatibilidad TS nativa, fetch nativo
    Framework de agente Vercel AI SDK Tipado TS sólido, agnóstico al proveedor, maxSteps nativo
    Herramientas custom MCP servers propios Reutilizables entre agentes, estándar abierto
    Memoria semántica Supabase + pgvector Postgres ya en el stack, zero overhead operacional
    Memoria episódica Postgres (tabla JSON) No necesita búsqueda vectorial, estado estructurado
    Observabilidad Langfuse cloud Open source, free tier generoso, integración VAISDK
    Deployment (agentes web) Vercel Integración natural con el SDK
    Deployment (procesos) Railway + Docker Agentes de larga duración, procesos internos
    Validación Zod Schemas para tool inputs y outputs tipados

    La parte que más me preguntan es el runtime: por qué Bun y no Node. La respuesta corta: en scripts de agentes que arrancan y terminan frecuentemente, la diferencia de arranque es perceptible. El soporte nativo de TypeScript elimina el paso de transpilación en scripts de herramientas. Y fetch nativo sin polyfills simplifica el código de integración con APIs externas.


    Lo que descarto y por qué

    LangChain (la librería base) — demasiada abstracción sobre abstracciones. El problema no es que sea mala herramienta: es que cuando algo falla en un agente LangChain, la pila de herencia de clases hace que depurar sea más difícil que si hubieras implementado el loop a mano. LangGraph tiene más sentido para flujos complejos, pero la librería base la evito.

    AutoGen (Microsoft) — interesante para investigación, inconsistente en producción. El modelo de conversación entre agentes es elegante en teoría, pero en proyectos reales he visto bucles de conversación que consumen tokens sin converger. Puede mejorar, pero hoy no lo usaría para un sistema que atiende usuarios reales.

    Pinecone como primera opción — no porque sea malo, sino porque pgvector en Postgres elimina una dependencia externa para la mayoría de los casos de uso. Cuando el volumen de embeddings supere los diez millones o necesites búsquedas en milisegundos a escala muy alta, Pinecone tiene sentido. Antes, no.

    Modelos locales como backbone — la brecha de calidad con los modelos de frontera es demasiado grande para sistemas agénticos complejos. Para clasificación de intenciones sencillas o filtros de moderación, tiene sentido. Para el loop principal de un agente que toma decisiones consecuentes, no lo haría hoy.


    El stack no es el problema

    La decisión de stack importa — pero menos de lo que sugiere el volumen de contenido que se publica sobre herramientas de IA cada semana.

    He visto proyectos con el stack perfecto que fallaban en producción por falta de observabilidad. He visto proyectos con stacks “incorrectos” que funcionaban perfectamente porque el equipo entendía qué estaba haciendo.

    El stack es el entorno. Lo que importa es entender cómo funciona el agentic loop, cómo diseñar herramientas que el modelo pueda usar de forma predecible, y cómo instrumentar el sistema para ver qué ocurre cuando algo falla.

    Si quieres construir esto desde cero con criterio — desde el primer loop hasta el sistema completo en producción — en el curso Construye con IA cubrimos exactamente estas decisiones: qué stack elegir para cada tipo de proyecto, cómo estructurar el código para que sea mantenible, y cómo pasar de prototipo a sistema que funciona cuando no estás mirando.

    Y si quieres el marco metodológico para especificar el sistema antes de escribir una línea de código — evitar construir el agente equivocado — el libro de Spec-Driven Development es la guía que yo sigo antes de abrir el editor.


    Y si al montar el stack te queda la duda de fondo de dónde acaba la automatización y empieza la agencia real, la definición operativa está en qué es un agente de IA de verdad.

    FAQ — Preguntas frecuentes sobre el stack de IA agéntica

    ¿Qué framework de agentes es mejor en 2026: Vercel AI SDK, LangGraph o el SDK directo de Anthropic?

    Depende de la complejidad del sistema. Para la mayoría de proyectos TypeScript con flujos lineales, el Vercel AI SDK ofrece el mejor equilibrio entre abstracción mínima y productividad: tipado sólido, soporte nativo para tool use y streaming, y compatibilidad con múltiples proveedores. LangGraph añade valor cuando el flujo tiene ramificaciones complejas, estado persistente entre pasos o múltiples agentes con routing condicional. El SDK directo de Anthropic tiene sentido cuando necesitas control total sobre cada llamada o cuando las abstracciones intermedias ocultan comportamiento que necesitas ver.

    ¿Necesito una base de datos vectorial para construir un agente?

    No necesariamente. La memoria vectorial solo es necesaria cuando el agente necesita recuperar información relevante de un corpus grande de documentos. Si el agente trabaja con un contexto fijo que cabe en la ventana de contexto del modelo (y con 200k tokens de Claude, cabe mucho), no necesitas embeddings ni búsqueda vectorial. Cuando el corpus supera lo que cabe en contexto, empieza por pgvector en Postgres antes de añadir Pinecone u otra base de datos vectorial externa.

    ¿Qué es MCP y por qué debería importarme en 2026?

    El Model Context Protocol es un estándar abierto que define cómo los agentes de IA consumen herramientas y contexto de fuentes externas. Su importancia práctica: en lugar de construir integraciones específicas para cada agente que quieras conectar a una herramienta, construyes un servidor MCP una vez y cualquier agente compatible puede usarlo. Claude Code, Cursor y la mayoría de los IDEs con IA ya soportan MCP. Si construyes herramientas para agentes hoy, exponerlas como servidores MCP multiplica su utilidad sin trabajo adicional.

    ¿Puedo usar Python para construir el stack agéntico si ya soy developer Python?

    Sí, y tiene sentido si Python es tu lenguaje principal. El ecosistema de agentes en Python es más maduro en algunos aspectos: LangChain, AutoGen, CrewAI y la mayoría de frameworks de referencia nacieron en Python. Lo que pierdes en TypeScript: algunas integraciones no tienen SDK Python equivalente al mismo nivel de calidad. Lo que ganas: ecosistema de ML más rico y más documentación de referencia. La decisión debe estar en el lenguaje que dominas, no en el que tiene más hype.

    ¿Cómo elijo entre Railway y Vercel para desplegar un agente?

    La regla práctica: si el agente responde a peticiones HTTP en menos de 60 segundos y no necesita mantener estado entre llamadas, Vercel Functions es suficiente y más simple. Si el agente trabaja en procesos de larga duración (más de un minuto), necesita WebSockets, mantiene conexiones persistentes, o accede a recursos locales del servidor, Railway con un contenedor Docker es la opción correcta. Cloudflare Workers + Durable Objects es la tercera opción para máxima performance edge cuando el coste a escala importa.

    ¿Qué herramienta de observabilidad recomendarías empezar primero?

    Langfuse. El plan gratuito en cloud cubre 50.000 observaciones al mes, la integración con el Vercel AI SDK es de una línea de código (el parámetro experimental_telemetry), y si en algún momento necesitas privacidad total de los datos, puedes autohospedarlo con Docker. Si ya tienes infraestructura OpenTelemetry en la empresa, las semantic conventions GenAI de OTEL te permiten integrar sin añadir otra plataforma.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
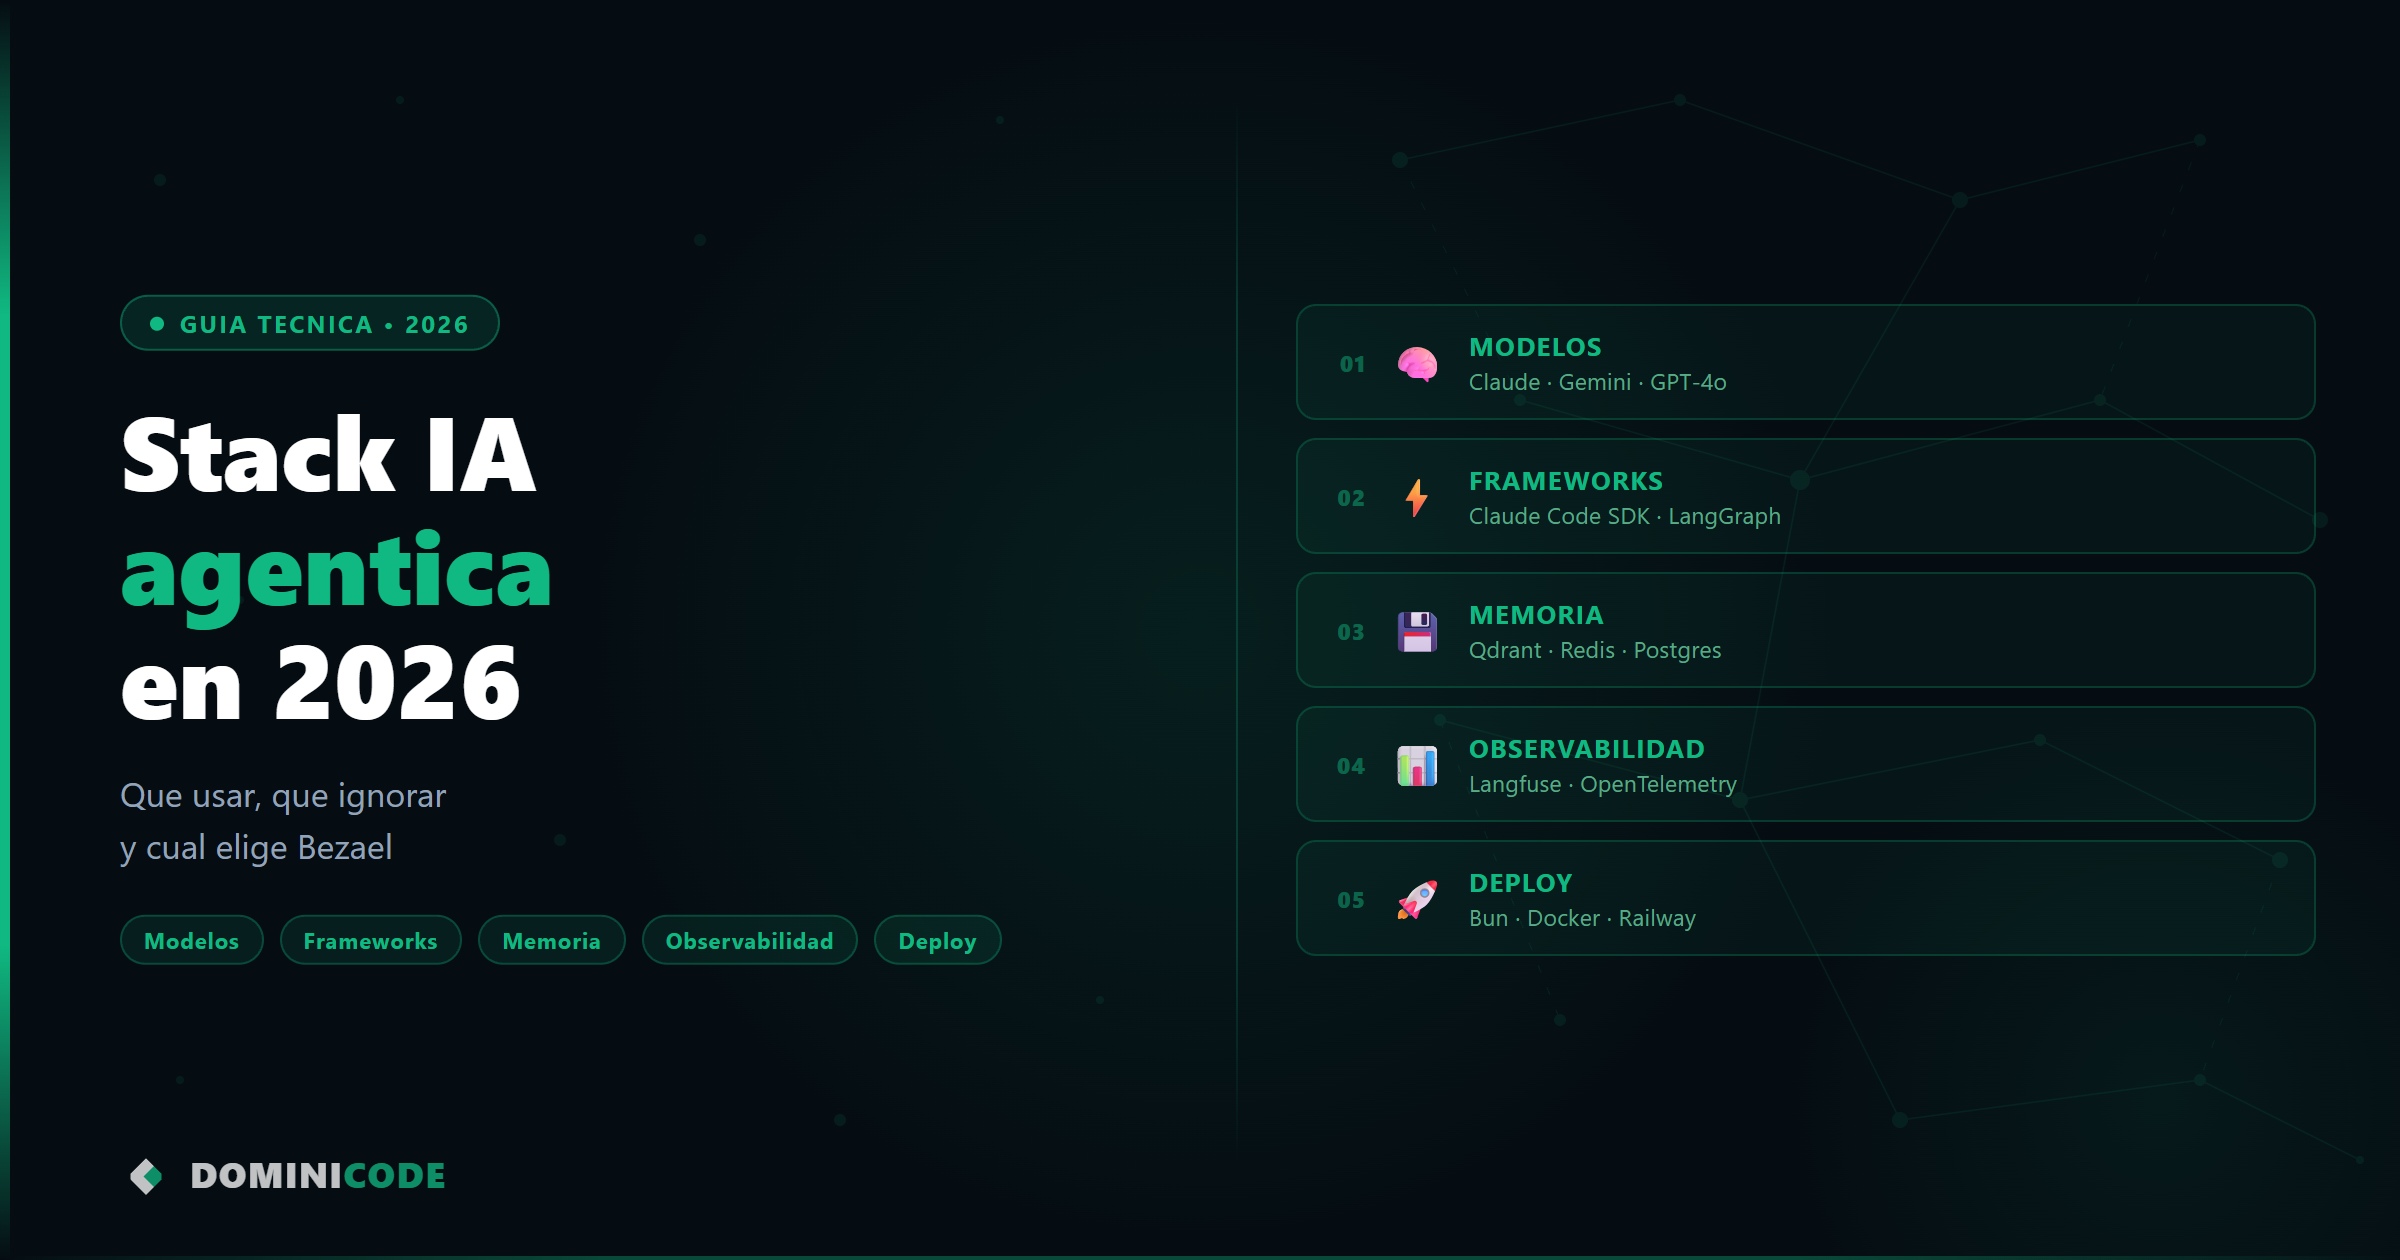
  • Cómo crear un MCP Server para integrar LLMs con seguridad

    Cómo crear un MCP Server para integrar LLMs con seguridad

    MCP servers explicados: qué son, para qué sirven y cómo crear el tuyo

    Entender los MCP servers explicados: qué son, para qué sirven y cómo crear el tuyo es importante si quieres conectar un LLM con datos y acciones de tu infraestructura sin abrir una caja negra insegura. El Model Context Protocol (MCP) busca estandarizar esa capa: separa el razonamiento del modelo de la ejecución real que hace tu código.

    Documentación y recursos oficiales:

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Un MCP Server expone Resources (solo lectura), Tools (acciones ejecutables) y Prompts (templates) para clientes LLM.
    • La comunicación puede ser por stdio (local) o SSE/HTTP (remoto) manteniendo credenciales en el servidor.
    • Empieza con capacidades de solo lectura; exige confirmación humana para escrituras peligrosas.
    • Implementa autenticación, rate limiting y auditoría con trace IDs para producción.

    Introducción

    Un MCP Server es un proceso ligero (local o remoto) que expone al cliente de IA tres tipos de capacidades bien definidas: Resources (solo lectura), Tools (acciones ejecutables) y Prompts (templates). El cliente (por ejemplo Claude Desktop, Cursor, Windsurf, o un agente en n8n) descubre esas capacidades y decide cuándo invocarlas. La comunicación suele usar stdio para ejecuciones locales o SSE/HTTP para conexiones remotas. Crucial: las credenciales y el acceso real permanecen en tu servidor; el LLM no las recibe.

    Resumen rápido (lectores con prisa)

    MCP es un protocolo para separar razonamiento (LLM) de ejecución (tu infra).

    Expone Resources (lectura), Tools (acciones) y Prompts (templates) para clientes LLM.

    Transporte: stdio local o SSE/HTTP remoto; credenciales se quedan en el servidor.

    Útil para integrar múltiples clientes LLM con una capa única, segura y versionable.

    Qué es un MCP Server

    Un MCP Server publica capacidades que los clientes LLM pueden descubrir y usar en tiempo de ejecución. Las capacidades son:

    • Resources: datos de solo lectura (esquemas, logs resumidos, métricas).
    • Tools: acciones ejecutables con entradas definidas por esquema.
    • Prompts: plantillas que combinan contextos y recursos relevantes.

    Por qué usar MCP en vez de una API ad-hoc

    • Estándar único: el mismo servidor puede trabajar con múltiples clientes LLM sin reescribir integraciones.
    • Seguridad mejorada: las credenciales no viajan en prompts.
    • Descubrimiento dinámico: el cliente lista herramientas y recursos disponibles en tiempo de ejecución.

    Arquitectura mínima de un MCP Server

    • Transporte: stdio (local) o SSE/HTTP (remoto).
    • Registro de capabilities: lista de tools/resources que el servidor publica.
    • Handlers: funciones que ejecutan las herramientas y devuelven contenido estructurado.
    • Logging/auditoría: registros de llamadas, inputs y outputs con firma/trace-id.

    Ejemplo práctico (Node.js + TypeScript)

    Instalación y preparación

    mkdir mi-mcp-server && cd mi-mcp-server
    npm init -y
    npm install @modelcontextprotocol/sdk
    npm install -D typescript @types/node
    npx tsc --init

    Ejemplo mínimo: src/index.ts

    import { Server } from "@modelcontextprotocol/sdk/server/index.js";
    import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
    import { ListToolsRequestSchema, CallToolRequestSchema } from "@modelcontextprotocol/sdk/types.js";
    import os from "os";
    
    const server = new Server({name:"mi-mcp", version:"0.1.0"}, {capabilities:{tools:{}}});
    
    server.setRequestHandler(ListToolsRequestSchema, async ()=>({
      tools: [{ name: "get_system_info", description: "Info SO y memoria", inputSchema: { type: "object", properties: {}, required: [] } }]
    }));
    
    server.setRequestHandler(CallToolRequestSchema, async (req)=>{
      if (req.params.name === "get_system_info") {
        return { content: [{ type:"text", text: JSON.stringify({ platform: os.platform(), totalMemory: os.totalmem() }, null, 2) }] };
      }
      throw new Error("tool-not-found");
    });
    
    await server.connect(new StdioServerTransport());
    console.error("MCP server listo");

    Compila con npx tsc y ejecuta node dist/index.js. Para clientes como Claude Desktop registra el comando en su config (paths en macOS/Windows según documentación del cliente).

    Qué exponer (y qué no)

    Empieza por recursos de solo lectura y herramientas inofensivas:

    • Recursos: esquemas de DB, logs resumidos, métricas con paginación.
    • Tools (lectura): consultas parametrizadas que devuelven resultados limitados.
    • Prompts: plantillas que pre-cargan recursos relevantes.

    Evita al principio: comandos de escritura (DROP, DELETE), accesos de shell indiscriminados, o cualquier endpoint que pueda cambiar estado sin confirmación humana. Implementa siempre un flujo de validación humana para acciones críticas.

    Producción: seguridad y operativa

    • Autenticación y autorización: el servidor debe gestionar credenciales y validar cada petición con roles.
    • Rate limiting y cuotas: evita que un prompt malicioso dispare herramientas repetidamente.
    • Auditoría inmutable: registra request/response con trace IDs, timestamps y hashes del prompt.
    • Testing: mocks para tools y tests end-to-end con clientes (stdio y SSE).
    • Paginación y resumido: no envíes logs enteros; ofrece ventanas y resúmenes para preservar tokens.

    Casos de uso reales y prácticas recomendadas

    • Integración con n8n: usa el MCP Server como puente para disparar workflows desde lenguaje natural sin exponer credenciales a la interfaz.
    • Revisión de PRs automatizada: expón diffs y reglas como recursos; la tool devuelve checklist y reportes en Markdown.
    • Soporte operador: diagnóstico de infra mediante logs resumidos y herramientas read-only que recogen métricas.

    Registra y versiona tus prompts y esquemas del MCP en el repo; trátalos como código crítico.

    Conclusión

    Los MCP servers explicados aquí son la pieza que convierte LLMs en componentes confiables dentro de una plataforma técnica. No es magia: es disciplina. Empieza pequeño (solo lectura), instrumenta todo, exige confirmación humana para escrituras y versiona los prompts. Si lo haces bien, tendrás agentes que razonan con seguridad y una única capa mantenible que conecta IA con tus sistemas.

    Mención: Dominicode Labs

    Para equipos que exploran automatización y agentes como parte de su plataforma técnica, puede ser útil revisar trabajos y prototipos en Dominicode Labs. Es una referencia contextual para enfoques de integración y experimentación práctica.

    FAQ

    ¿Qué diferencia a un MCP Server de una API tradicional?

    Un MCP Server define un estándar para que clientes LLM descubran y llamen capacidades (Resources, Tools, Prompts). Mantiene credenciales y lógica de ejecución en el servidor, evitando que se incrusten en prompts como suele pasar con APIs ad-hoc.

    ¿Cómo se comunican el cliente LLM y el MCP Server?

    La comunicación común es por stdio para ejecuciones locales o mediante SSE/HTTP para conexiones remotas. El cliente consulta las capabilities y llama handlers definidos por el servidor.

    ¿Qué precauciones de seguridad debo implementar?

    Implementa autenticación y autorización por roles, rate limiting, auditoría inmutable con trace IDs y validation humana para acciones que modifican estado.

    ¿Puedo exponer herramientas de escritura si las requisito?

    Sí, pero siempre detrás de controles estrictos: confirmación humana, autorización granular, pruebas y registros completos. Evita exponer inicialmente comandos destructivos.

    ¿Cómo se versionan prompts y esquemas?

    Registra y versiona prompts y esquemas en el repositorio del proyecto como parte del código crítico; aplica revisiones, pruebas y despliegues controlados.

    ¿Qué formatos de respuesta soportan las tools?

    Las tools devuelven contenido estructurado (por ejemplo objetos JSON con bloques de tipo texto o markdown). El SDK y el spec del MCP describen los schemas esperados.

    ¿Cuál es el transporte recomendado para producción?

    Para local, stdio es simple y seguro. Para entornos distribuidos, SSE/HTTP ofrece mayor flexibilidad; la elección depende de latencia, despliegue y requisitos de auditoría.

  • Implementación del Model Context Protocol en Angular 21

    Implementación del Model Context Protocol en Angular 21

    Hacer post sobre los MCPs de angular 21

    Tiempo estimado de lectura: 6 min

    • MCP estandariza cómo los agentes de IA leen, razonan y proponen cambios en repositorios Angular 21.
    • Orden de inspectores (list_projects → get_best_practices → search_documentation → find_examples → onpush_zoneless_migration) minimiza cambios destructivos.
    • MCP exige trazabilidad: cada recomendación debe incluir referencia a la documentación oficial y reglas del proyecto.
    • Integración práctica: CI/pipelines y IDEs deben ejecutar inspectores antes de ofrecer o aplicar cambios.
    • Riesgos reales: reduce alucinaciones pero no elimina límites del análisis estático; requiere revisión humana.

    Introducción

    Hacer post sobre los MCPs de angular 21 empieza por entender que no hablamos de una feature menor: hablamos de cómo los agentes de IA leerán, razonan y propondrán cambios en tu código sin romper la arquitectura. En Angular 21, donde Signals, Standalone Components y la migración zoneless son la norma, el Model Context Protocol (MCP) pasa de ser un extra a una herramienta de gobernanza técnica indispensable.

    Resumen rápido (lectores con prisa)

    Qué es: Un protocolo que estandariza cómo los modelos de lenguaje interactúan con repositorios para descubrir topología, consultar documentación y aplicar reglas antes de sugerir cambios.

    Cuándo usarlo: En monorepos, pipelines automatizados y entornos donde agentes de IA pueden proponer cambios en código base (migraciones, refactors, PRs).

    Por qué importa: Evita propuestas que compilan pero introducen deuda técnica; garantiza trazabilidad y reglas específicas por versión.

    Cómo funciona (resumen): Ejecuta inspectores en orden (list_projects → get_best_practices → search_documentation → find_examples → onpush_zoneless_migration) y adjunta referencias oficiales a cada recomendación.

    Por qué importa ahora

    Angular 21 consolida patrones que rompen supuestos antiguos: la inyección por constructor deja paso a inject(), la reactividad local se orienta a Signals y zone.js tiende a desaparecer. Un LLM no contextualizado propondrá soluciones que compilan pero introducen deuda técnica. El MCP asegura que el agente primero lea la topología y las reglas del proyecto y luego proponga —no al revés.

    Componentes del flujo MCP en Angular 21

    • Descubrimiento de topología: el agente usa Nx para mapear aplicaciones, librerías y dependencias mediante list_projects.
    • Inyección de prácticas por versión: get_best_practices detecta la versión y aplica reglas (p. ej. evitar NgModules cuando no proceden).
    • Validación documental en tiempo real: search_documentation consulta angular.dev antes de afirmar APIs o signaturas.
    • Ejemplos concretos y actualizados: find_examples recupera implementaciones modernas (Signals, inject(), formularios reactivos).
    • Coaching contextual: ai_tutor ajusta el nivel técnico según el rol del usuario.
    • Auditoría zoneless: onpush_zoneless_migration analiza compatibilidad al eliminar zone.js.

    Ejemplo práctico (flujo mínimo aplicable)

    1) Ejecuta list_projects: el agente devuelve el mapa del monorepo con apps y librerías.

    2) Ejecuta get_best_practices: se cargan reglas específicas para Angular 21 (uso de Signals, restricciones sobre RxJS local).

    3) Pide search_documentation para la API concreta (p. ej. Signals API).

    4) Solicita find_examples para ver implementaciones validadas.

    5) Si el objetivo es migrar, corre onpush_zoneless_migration y compila la lista de refactorizaciones.

    Este orden evita que el agente proponga cambios destructivos en zonas equivocadas del repo.

    Casos de uso concretos y recomendaciones

    • Revisiones automáticas de PR: integra MCP en pipelines de CI para que el agente haga una pre-auditoría. Usa n8n o tu runner de CI para ejecutar los inspectores en cada PR.
    • Onboarding y documentación viva: ai_tutor puede generar guías de cambios y checklist de migración adaptados al repositorio. Útil para equipos nuevos que deben adoptar Signals y patrones zoneless.
    • Auditorías zoneless: no confíes en una única ejecución. Los detectores estáticos identifican patrones vulnerables (suscripciones sin limpieza, efectos colaterales) pero requieren revisión humana en casos límite.

    Criterio técnico que debes aplicar

    • Nunca concedas permisos de escritura antes de ejecutar list_projects y get_best_practices.
    • Exige trazabilidad: cada recomendación debe venir con la referencia a la documentación oficial (angular.dev).
    • Valida migraciones zoneless con pruebas E2E y monitoreo en staging; los cambios en detección de cambios pueden aparecer solo en escenarios complejos.
    • Mantén una “zona de seguridad” en la que la IA puede proponer cambios no destructivos (documentación, tests, refactorizaciones no críticas) y otra donde solo humanos aprueban (cambios en librerías compartidas, infraestructuras críticas).

    Integración con herramientas (práctico)

    • IDEs con IA: plug-ins que implementen MCP deben ejecutar inspectores antes de ofrecer snippets.
    • Automatización: orquesta inspectores con n8n para que cada PR dispare una auditoría RAG (Read-Only).
    • Registro y auditoría: guarda outputs de inspectores (mapa de topología, reglas aplicadas, fragmentos de doc) junto al PR para trazabilidad histórica.

    Riesgos y límites reales

    MCP reduce alucinaciones, no las elimina totalmente. Hay límites del análisis estático: efectos en tiempo de ejecución, race conditions y casos complejos de detección de cambios pueden escapar. Además, dar permisos de escritura sin límites en monorepos empresariales sigue siendo una superficie de riesgo alta.

    Conclusión (lo que ganas)

    Hacer post sobre los MCPs de angular 21 no es solo hablar de una integración técnica; es establecer un contrato de confianza entre IA y equipo. Con MCP, los agentes dejan de ser generadores indiscriminados y pasan a ser asistentes que conocen tu repo, tus reglas y tus límites. Implementados con disciplina (orden de inspectores, trazabilidad y revisión humana), los MCPs reducen deuda técnica, aceleran migraciones y convierten la IA en parte fiable del flujo de desarrollo.

    Dominicode Labs

    Para equipos que orquestan agentes y pipelines, una referencia práctica de investigación y experimentación es Dominicode Labs. Integrar MCP con flujos de trabajo y pruebas reproducibles ayuda a mantener trazabilidad y mejorar la adopción de prácticas zoneless.

    FAQ

    ¿Qué es exactamente un MCP?

    Un Model Context Protocol (MCP) es un conjunto de inspectores y flujos estandarizados que permiten a modelos de lenguaje interactuar con un repositorio de forma gobernada: descubrir topología, cargar reglas de práctica por versión y validar documentación antes de generar cambios.

    ¿Cuándo debo ejecutar inspectores en mi flujo?

    Siempre antes de conceder permisos de escritura a un agente: al menos ejecutar list_projects y get_best_practices. Para migraciones, añadir search_documentation, find_examples y onpush_zoneless_migration.

    ¿Cómo garantiza el MCP que no se rompa la arquitectura?

    No lo garantiza por completo, pero reduce riesgos al exigir que el agente conozca la topología y las reglas específicas del proyecto antes de proponer cambios. Además obliga a adjuntar referencias y un plan de refactorización verificable.

    ¿Qué referencias documentales se deben adjuntar a las recomendaciones?

    Las referencias deben ser enlaces a la documentación oficial pertinente en angular.dev (por ejemplo la Signals API) y, cuando corresponda, recursos técnicos como repositorios oficiales (p. ej. zone.js).

    ¿Puede un MCP eliminar la necesidad de revisión humana?

    No. MCP reduce alucinaciones y añade trazabilidad, pero las decisiones críticas (cambios en librerías compartidas, infraestructuras) deben seguir pasando por revisión humana.

    ¿Cómo integrar MCP en CI con n8n?

    Orquesta los inspectores como pasos en la pipeline: cada PR dispara un flujo de RAG (Read-Only) en el que list_projects y get_best_practices se ejecutan primero, seguidos por validaciones documentales y generación de un reporte adjunto al PR. Una opción práctica es usar n8n para encadenar esos inspectores.

    ¿Qué precauciones tomar en migraciones zoneless?

    Validar compatibilidad con onpush_zoneless_migration, ejecutar pruebas E2E en staging y monitorizar cambios en detección de cambios. No confiar exclusivamente en análisis estático: casos de race conditions y efectos en tiempo de ejecución requieren supervisión humana.

  • Cuándo usar WebMCP y MCP: diferencias y criterios técnicos

    Cuándo usar WebMCP y MCP: diferencias y criterios técnicos

    Cuándo usar WebMCP y MCP: diferencias, casos de uso y criterio técnico

    Tiempo estimado de lectura: 5 min

    • Idea clave: MCP expone datos y herramientas de forma programática; WebMCP aporta semántica de UI para agentes en navegador.
    • Idea clave: Si la tarea vive en datos/APIs usa MCP; si vive en la interfaz web y necesita lógica visual, añade WebMCP.
    • Idea clave: La mayoría de flujos reales cruzan ambas capas; diseñar límites, autorización y auditoría evita inconsistencias.
    • Idea clave: Evita usar WebMCP como scraping del DOM o exponer operaciones sensibles solo vía WebMCP.

    Introducción

    Cuándo usar WebMCP y MCP es la pregunta que aparece en equipos de producto y arquitectura tras el anuncio de la vista previa de WebMCP. No es una elección técnica trivial: ambos protocolos resuelven capas distintas del mismo problema. Elegir el adecuado requiere entender la responsabilidad que vive la tarea del agente: datos o interfaz.

    Referencias útiles: Anthropic — documentación general, Claude (Anthropic)

    Resumen rápido (lectores con prisa)

    MCP es el protocolo para exponer datos y herramientas a modelos en backends y servicios automatizados. WebMCP añade semántica sobre la UI en el navegador para que agentes entiendan acciones y flujos visuales. Usa MCP para operaciones centradas en datos/APIs; usa WebMCP cuando la tarea requiere comprensión de la interfaz.

    Cuándo usar WebMCP y MCP: el criterio básico

    MCP (Model Context Protocol) y WebMCP no son intercambiables. Cada uno atiende una capa distinta:

    • MCP es el protocolo de contexto y herramientas pensado para exponer datos y capacidades de manera programática a modelos. Funciona en backends, pipelines y servicios automatizados.
    • WebMCP es una capa específica para navegador que añade semántica a la UI: explica qué hace cada elemento, qué secuencias son válidas y qué intenciones soporta la interfaz.

    Regla simple: si la tarea “vive” en datos y APIs, usa MCP. Si la tarea “vive” en la interfaz web y requiere comprender lógica visual o flujos humanos, añade WebMCP. La mayoría de flujos reales cruzan ambas capas; entonces ambos protocolos deben coexistir en la arquitectura.

    ¿Qué problema resuelve cada uno?

    MCP

    • Acceso programático a recursos: bases de datos, APIs, servicios internos.
    • Orquestación de herramientas y ejecución de operaciones sin interfaz (CI, backend, bots).
    • Reutilización: un mismo MCP sirve a agentes en CLI, servidores y apps.

    WebMCP

    • Traducción de UI a semántica: campos, opciones, relaciones de pasos.
    • Desambiguación de acciones visuales que el DOM por sí solo no comunica (¿este botón envía o guarda? ¿este panel es lectura o edición?).
    • Permite que un agente interactúe de forma segura con la experiencia de producto sin “adivinar” intenciones.

    Piensa en MCP como el sistema central de información y herramientas; WebMCP es el manual semántico de la tienda que obliga al agente a seguir los caminos definidos por el equipo de producto.

    Casos de uso concretos

    MCP es la opción cuando:

    • El agente debe crear eventos en calendarios corporativos, leer CRM, actualizar inventarios o ejecutar jobs en un pipeline.
    • Automatizas procesos en n8n, Airflow o sistemas de backend donde la UI no existe.
    • Necesitas consistencia de datos y gobernanza centralizada (auditoría, permisos, logs).

    WebMCP encaja cuando:

    • El agente necesita completar formularios complejos dentro de tu app SaaS (onboarding, configuración avanzada).
    • El producto es la UI y quieres que agentes de navegador ejecuten acciones sin romper flujos o introducir comportamientos no contemplados.
    • Quieres exponer ayuda contextual, tooltips y secuencias válidas para que el agente no interprete el DOM de forma errónea.

    Ejemplo real: “Programar una reunión”

    MCP se usa para consultar calendarios, proponer franjas y crear el evento en el backend. WebMCP se usa para verificar y ajustar preferencias visuales del usuario en el panel de configuración del calendario dentro del sitio (zona horaria específica, visibilidad de invitados).

    Arquitectura práctica: cómo combinarlos

    No se trata de elegir uno u otro, sino de diseñar límites claros:

    1. Define los contratos MCP — qué operaciones y datos expone el backend (endpoints, credenciales, scopes).
    2. Publica una capa WebMCP que mapea componentes UI a acciones seguras y semánticas (ej. checkout.submit, profile.update).
    3. Diseña autorización cruzada: acciones WebMCP deben validar permisos contra MCP antes de ejecutar cambios críticos.
    4. Registra y audita: todo cambio iniciado por WebMCP que afecte datos sensibles pasa por MCP para persistencia y trazabilidad.

    Esto evita dos errores frecuentes: agentes que manipulan la UI sin persistir cambios en backend, y agentes que modifican datos sin respetar la UX (rompiendo expectativas de usuario).

    Checklist de arquitectura antes de implementar

    • ¿La tarea requiere acceso a datos centralizados o a la UI? (MCP vs WebMCP)
    • ¿Tienes contratos claros y versionados en MCP? (endpoints, scopes, rate limits)
    • ¿Has documentado la semántica UI en WebMCP? (acciones autorizadas, flujos válidos)
    • ¿Existe validación cruzada entre WebMCP y MCP para evitar inconsistencias?
    • ¿Se auditan todas las acciones ejecutadas por agentes en una capa centralizada?

    Riesgos y anti-patrones

    • Tratar WebMCP como atajo para “scraping” del DOM. Sin semántica declarada, el agente va a fallar con cambios menores de UI.
    • Exponer operaciones sensibles solo vía WebMCP sin pasar por MCP: pérdida de control y trazabilidad.
    • Diseñar agentes que dependen de un único protocolo cuando las tareas cruzan capas; eso genera fragilidad.

    Conclusión técnica

    Cuándo usar WebMCP y MCP no es una disputa de protocolos: es diseño de responsabilidades. MCP administra datos y herramientas de forma agnóstica al entorno; WebMCP aporta la semántica que convierte interfaces humanas en elementos ejecutables y seguros para agentes. Diseña ambos desde el inicio cuando tus agentes deben operar en el mundo real: la combinación adecuada reduce errores, mejora la experiencia del usuario y protege los invariantes del sistema.

    Para equipos interesados en experimentar con patrones de integración entre agentes, UI y backend, una continuación natural es explorar prototipos y guías prácticas en Dominicode Labs. Allí se pueden encontrar ejemplos de contratos MCP y mapeos WebMCP aplicables a flujos reales.

    FAQ

    ¿Qué es MCP y para qué sirve?

    MCP (Model Context Protocol) es un protocolo para exponer contexto, datos y operaciones a modelos de forma programática. Sirve para orquestar herramientas, acceder a recursos y ejecutar operaciones en backend sin depender de la UI.

    ¿Qué es WebMCP y cuándo debería usarlo?

    WebMCP es una capa semántica para navegador que describe la intención y el comportamiento de elementos de UI. Debes usarlo cuando agentes en el navegador necesiten entender flujos visuales, acciones permitidas y relaciones entre campos.

    ¿Puedo usar solo WebMCP para todo?

    No. WebMCP no reemplaza la necesidad de un backend bien gobernado. Exponer operaciones sensibles únicamente vía WebMCP lleva a pérdida de gobernanza y trazabilidad. WebMCP y MCP deben coexistir según las responsabilidades.

    ¿Cómo debo gestionar permisos entre WebMCP y MCP?

    Diseña validaciones cruzadas: cualquier acción iniciada desde WebMCP que afecte datos sensibles debe validar permisos contra MCP antes de persistir. Mantén contratos claros y scopes en MCP para control centralizado.

    ¿Qué errores debo evitar al diseñar agentes que interactúan con la UI?

    Evita depender del scraping del DOM sin semántica, exponer operaciones críticas solo en la capa de UI y diseñar agentes acoplados a un único protocolo cuando la tarea cruza capas.

    ¿Dónde encuentro documentación adicional sobre protocolos y agentes?

    Consulta la documentación oficial de proveedores y recursos sobre diseño de agentes y contratos API. En este artículo se citaron las guías de Anthropic — documentación general y la página de Claude (Anthropic) como puntos de partida.

  • Cómo optimizar Agentes y Skills en Claude Code para un mejor rendimiento

    Cómo optimizar Agentes y Skills en Claude Code para un mejor rendimiento

    entender Agentes vs Skills, en Claude code, trade-offs de los agentes, y los trade-offs de los modelos

    ¿Quieres que tu sistema con Claude deje de comportarse como un aprendiz despistado y empiece a trabajar como un equipo bien entrenado? entender Agentes vs Skills, en Claude code, trade-offs de los agentes, y los trade-offs de los modelos es el primer paso. No es filosofía; es diseño técnico que decide costes, latencia y confiabilidad.

    En una frase: una Skill es una herramienta; un Agente es quien decide cuándo y cómo usarla. En Claude Code (y en el Model Context Protocol) esa diferencia no es semántica: define el control flow, la observabilidad y la estrategia de modelo.

    Resumen rápido (lectores con prisa)

    Qué es: Skill = función stateless y determinista; Agente = sistema que orquesta Skills con loop de razonamiento.

    Cuándo usarlo: Skill para flujos deterministas; Agente para tareas multi-step y adaptativas.

    Por qué importa: determina latencia, coste, observabilidad y riesgo de loops.

    Cómo funciona (alto nivel): Agente observa, planifica, invoca Skills y verifica; Skills exponen APIs claras (MCP/HTTP).

    Tiempo estimado de lectura

    Tiempo estimado de lectura: 5 min

    Ideas clave

    • Skills son funciones deterministas y stateless; expónlas como APIs claras.
    • Agentes orquestan Skills y gestionan objetivo, memoria y reintentos.
    • Los agentes añaden latencia, coste e indeterminismo; requieren guardrails y observabilidad.
    • Elige modelo por trade-off: Haiku (rápido/barato), Sonnet (equilibrio), Opus (máxima calidad).
    • Patrón híbrido recomendado: router ligero → Skills directas → Agentes especializados → guardrails y tracing.

    Tabla de contenidos

    Introducción

    ¿Quieres que tu sistema con Claude deje de comportarse como un aprendiz despistado y empiece a trabajar como un equipo bien entrenado? entender Agentes vs Skills, en Claude code, trade-offs de los agentes, y los trade-offs de los modelos es el primer paso. No es filosofía; es diseño técnico que decide costes, latencia y confiabilidad.

    Agentes vs Skills: la distinción que evita catástrofes

    Skills = funciones puntuales, deterministas y stateless.

    Skills

    • readFile(path), runSQL(query), sendSlack(channel, text).
    • Implementadas como código tradicional (JS/Python) y expuestas al modelo con una firma clara (MCP/HTTP).
    • No razonan. Ejecutan.

    Agentes

    • Mantienen objetivo, memoria y loop de razonamiento (Observe → Plan → Act → Verify).
    • Un Agente puede invocar múltiples Skills, evaluar resultados, reintentar o escalar a humano.
    • En Claude Code, el Agente es la instancia del modelo que ejecuta el bucle y usa las Skills ofrecidas por el runtime.

    Técnicamente: Skills son APIs; Agentes son sistemas de control y decisión que consumen esas APIs.

    Por qué importa: trade-offs de los agentes

    Autonomía suena bien hasta que el Agente se vuelve caro o tóxico. Estos son los efectos prácticos que deberías medir.

    Latencia multiplicada

    Cada paso del bucle agrega llamadas al modelo y a Skills. Una tarea que toma 2s con una Skill directa puede tardar 15–30s con un Agente que valida y reintenta. Para workflows interactivos eso mata la UX.

    Riesgo de loops infinitos

    Si no limitas iteraciones o detectas patrones repetitivos, el Agente puede intentar la misma corrección 1000 veces. Resultado: facturas de API astronómicas y procesos bloqueados.

    Indeterminismo e idempotencia perdida

    Un Agente puede resolver la misma tarea de maneras distintas. Eso da flexibilidad ante casos abiertos, pero complica testing, CI/CD y auditoría. Necesitas validaciones basadas en propiedades (constraints) en lugar de resultados fijos.

    Observabilidad y debugging costosos

    Debuguear un flow agéntico exige trazas por cada llamada LLM ↔ Skill, snapshots de memoria y métricas de confianza. Sin esto, los fallos solo se detectan cuando el usuario se queja.

    Mitigaciones prácticas:

    • Limitar pasos y tiempo por tarea (timeouts cognitivos).
    • Implementar detección de retries repetidos y bloqueo.
    • Validación post-acción (tests automáticos, checksums, schema validation).
    • Escalada a humano cuando la confianza baja.

    Trade-offs de los modelos: elegir Sonnet, Haiku u Opus

    No todos los modelos sirven para todo. Aquí el criterio es coste versus capacidad de razonamiento.

    Claude 3.5 Sonnet — el equilibrio

    • Pros: razonamiento sólido, buen manejo de Tool Use y generación de código.
    • Contras: coste y latencia moderados.
    • Uso: cerebro del Agente para planificación y edición de código.

    Claude 3 Haiku — router / executor barato

    • Pros: rápido y barato.
    • Contras: menos capaz en razonamiento profundo; mayor riesgo de alucinación en tareas complejas.
    • Uso: clasificación, enrutamiento, pre-filtros, resumen rápido o conversión simple.

    Claude 3 Opus — máxima calidad (cuando el coste no importa)

    • Pros: razonamiento profundo y menor tasa de error en zero-shot.
    • Contras: latencia y coste altos.
    • Uso: análisis crítico donde la calidad es la prioridad absoluta.

    Arquitectura recomendada: híbrida. Usa Haiku como router inicial; Sonnet para agentes especializados; Opus solo en batches o tareas off-line costosas.

    Patrón de despliegue práctico (claude-code + MCP)

    1. Router (Haiku): decide si la petición necesita Skill directa o Agente Sonnet.

    2. Skill directa: ejecutar si el flujo es determinista (p. ej. ETL, queries, envíos).

    3. Agente Sonnet: para tareas multi-step (refactor, investigación, remediación).

    4. Guardrails: límites de iteración, chequeos de schema, registros de decisión.

    5. Observabilidad: tracing por etapa (LLM prompt/responses, llamadas Skill, costos).

    Para referencia del runtime y la integración con Skills revisa la documentación de Claude Code en el portal de Anthropic (y el repositorio de ejemplo).

    Criterio final para un Tech Lead

    Decide según tres preguntas:

    • ¿Es el flujo determinista? Usa una Skill.
    • ¿Requiere adaptación y varios pasos? Construye un Agente.
    • ¿Cuál es el SLA de latencia y el presupuesto de coste? Selecciona Haiku/Sonnet/Opus acorde al ROI.

    No es magia: es ingeniería de trade-offs. Un Agente bien diseñado reduce intervención humana y aumenta alcance, pero exige observabilidad, límites y selección cuidadosa de modelo. En Dominicode tratamos Agentes como infraestructura: medimos, protegemos y versionamos. Haz lo mismo y tu Claude Code dejará de improvisar y empezará a producir.

    Dominicode Labs

    Si trabajas con automatización, agentes o workflows, puedes encontrar recursos adicionales y experimentos en Dominicode Labs. Es un complemento práctico para aplicar patrones de despliegue, guardrails y observabilidad en proyectos reales.

    FAQ

    ¿Cuándo debería preferir una Skill sobre un Agente?

    Usa una Skill cuando el flujo sea determinista, idempotente y pueda representarse como una API con firma clara (por ejemplo ETL, consultas, envíos). Las Skills reducen latencia y coste y facilitan testing y CI/CD.

    ¿Cómo mitigo el riesgo de loops infinitos en un Agente?

    Implementa límites de iteración, timeouts cognitivos y detección de patrones de retry repetidos. Añade reglas que bloqueen acciones cuando se superan umbrales y escalamiento a humano cuando la confianza sea baja.

    ¿Qué observabilidad mínima necesito para un Agente en producción?

    Traza cada llamada LLM ↔ Skill, snapshots de memoria relevantes y métricas de confianza/decisión. Registra costos por etapa para analizar trade-offs de latencia y gasto.

    ¿Cómo selecciono entre Haiku, Sonnet y Opus?

    Elige según coste vs capacidad de razonamiento: Haiku para routing y tareas simples; Sonnet como cerebro del Agente para planificación y edición; Opus para análisis crítico donde la calidad justifica el coste.

    ¿Qué prácticas recomiendan para validar acciones de un Agente?

    Usa validación post-acción: tests automáticos, checksums y validación de esquema. Implementa constraints que verifiquen propiedades del resultado más que un valor exacto.

    ¿Debo versionar Skills y Agentes por separado?

    Sí. Trata Skills como infra y versiona sus APIs. Versiona Agentes por su política de decisión, prompts y memoria para poder reproducir y auditar comportamientos en producción.