Tag: LLM

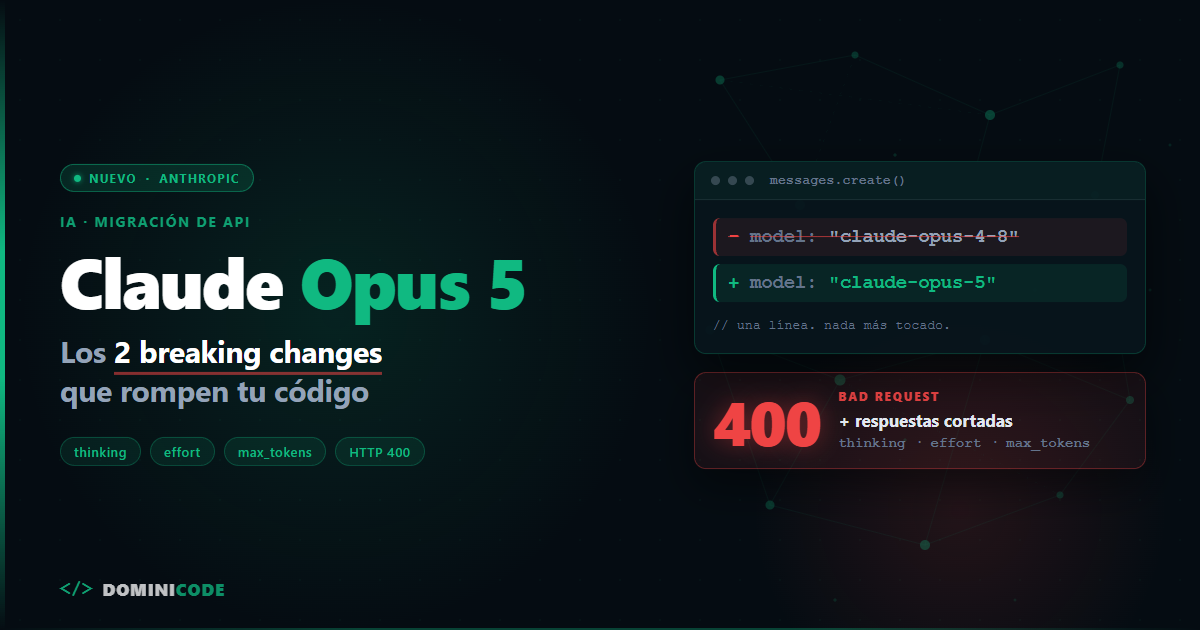
  • Claude Opus 5: los 2 breaking changes que rompen tu código

    Claude Opus 5: los 2 breaking changes que rompen tu código

    Cambias una línea. Un campo model dentro de un JSON. Diez segundos de trabajo, deploy a staging, a otra cosa.

    Veinte minutos después el endpoint de resúmenes devuelve textos cortados a mitad de frase. Y una ruta concreta —la de análisis largo, la que más te importa— devuelve 400 sin que hayas tocado nada más.

    No es un bug de Anthropic. Eres tú, migrando a Claude Opus 5 como si fuera un cambio de versión menor.

    No lo es. Y el problema es que casi todo lo que vas a leer estos días sobre este modelo son tablas de benchmarks. El titular es que cuesta la mitad que Fable 5. La letra pequeña es que si no tocas dos parámetros, tu aplicación empieza a devolver respuestas cortadas y errores 400.

    Este post va de la letra pequeña.


    Qué es Claude Opus 5 y qué cambia respecto a Opus 4.8

    Claude Opus 5 es el modelo más capaz de Anthropic, disponible desde el 24 de julio de 2026 con el identificador de API claude-opus-5, sin sufijo de fecha. Cuesta $5 por millón de tokens de entrada y $25 de salida —el mismo precio que Opus 4.8— y trae dos breaking changes respecto a la generación anterior: el thinking viene activado por defecto y desactivarlo deja de ser compatible con los niveles de effort xhigh y max.

    Atributo Claude Opus 5 Claude Opus 4.8
    ID de API claude-opus-5 claude-opus-4-8
    Precio entrada / salida $5 / $25 por millón $5 / $25 por millón
    Fast mode (solo API de Anthropic) $10 / $50 por millón —
    Thinking al omitir el parámetro Adaptativo, activado Desactivado
    Qué cubre max_tokens Thinking + respuesta Solo la respuesta
    Effort por defecto en la API high —
    thinking: disabled + xhigh/max HTTP 400 Válido
    Mínimo para prompt caching 512 tokens 1024 tokens
    Ventana de contexto 1M tokens (defecto y máximo) —
    Salida máxima 128K tokens —
    Rate limits Cubo propio Pool combinado Opus 4.x

    Está disponible en Claude.ai, Claude Code, Claude Cowork, la API de Anthropic, Amazon Bedrock (anthropic.claude-opus-5), Google Cloud y Microsoft Foundry. Es el modelo por defecto en Claude Max y el más potente disponible en Claude Pro. Los datos de esta tabla están contrastados con la documentación oficial de Anthropic.


    Los benchmarks de Claude Opus 5, en treinta segundos

    Sí, los números son buenos. Los despacho rápido porque no son el tema.

    En CursorBench 3.2, a máximo effort, Claude Opus 5 se queda a un 0,5% del pico de Fable 5 —a la mitad de coste por tarea—. En ARC-AGI 3 triplica la puntuación del siguiente mejor modelo. En Frontier-Bench v0.1 más que dobla el rendimiento de Opus 4.8. Los tres resultados salen de las cifras publicadas por Anthropic.

    No es el mejor en todo: sigue por detrás de Mythos 5 en tareas de ciberseguridad ofensiva. Y Anthropic lo describe como su modelo mejor alineado hasta la fecha, con la menor tasa de comportamiento engañoso.

    Si vienes de Claude Opus 4.8, pagas lo mismo por token por un modelo bastante mejor. Con un matiz que casi nadie menciona: Opus 5 piensa por defecto y escribe más largo, así que gasta más tokens por tarea. Misma tarifa no significa misma factura. Y si estabas pagando el premium de Fable 5 por tareas de agente, ahí sí: Anthropic mide la mitad de coste por tarea.

    Perfecto. Ahora la parte que rompe cosas.


    Breaking change 1 de Claude Opus 5: el thinking viene activado por defecto

    En Claude Opus 5, omitir el parámetro thinking ejecuta thinking adaptativo; en Opus 4.8 y 4.7 omitirlo significaba no razonar. Este es el cambio que corta tus respuestas a mitad de frase.

    Antes, el silencio equivalía a "no razones, contéstame". Ahora el silencio es un sí.

    Y aquí viene la parte que duele: max_tokens es un tope duro sobre thinking más texto de respuesta, juntos. No son dos presupuestos separados.

    Si tenías max_tokens ajustado al milímetro para tu respuesta —y todo el que ha optimizado costes lo tiene ajustado al milímetro— el modelo se gasta parte de ese presupuesto razonando y la respuesta se corta.

    Este código funcionaba perfectamente ayer:

    import Anthropic from "@anthropic-ai/sdk";
    const client = new Anthropic();
    
    // Opus 4.8 — omitir "thinking" = sin razonamiento; 1024 tokens íntegros para la respuesta
    const res = await client.messages.create({
      model: "claude-opus-4-8",
      max_tokens: 1024,
      messages: [{ role: "user", content: prompt }],
    });
    

    Cambias el model a claude-opus-5 y esos 1024 tokens ahora se reparten entre razonamiento y respuesta. Nadie te avisa: no hay error, solo un texto que termina a media frase.

    Tienes dos salidas. La buena:

    // Opus 5 — thinking explícito y presupuesto con margen
    const res = await client.messages.create({
      model: "claude-opus-5",
      max_tokens: 8192, // cubre thinking + respuesta
      thinking: { type: "adaptive", display: "summarized" },
      output_config: { effort: "medium" },
      messages: [{ role: "user", content: prompt }],
    });
    

    Y la que replica el comportamiento anterior:

    thinking: { type: "disabled" }
    

    Cuidado con esa segunda, porque tiene trampa. Es exactamente el breaking change número dos.

    Sobre display: los tokens de razonamiento en crudo no se devuelven nunca. El valor por defecto es "omitted". Si pones "summarized" recibes un resumen legible del razonamiento, útil para logs y para depurar por qué el modelo llegó a donde llegó.


    Breaking change 2: desactivar el thinking en Opus 5 está capado a effort high

    Esta es la que devuelve 400.

    En Opus 5 la escala completa de effort es low, medium, high, xhigh y max. El valor por defecto de la API es high.

    Combinar thinking: { type: "disabled" } con effort xhigh o max devuelve HTTP 400. En Opus 4.8 esa combinación era perfectamente válida.

    // Válido en Opus 4.8 — error 400 en Opus 5
    const res = await client.messages.create({
      model: "claude-opus-5",
      max_tokens: 4096,
      thinking: { type: "disabled" },
      output_config: { effort: "xhigh" }, // 400
      messages: [{ role: "user", content: prompt }],
    });
    

    Y ahora el detalle que hace que esto sea peligroso de verdad: la validación es por petición. No hay un chequeo global al arrancar. Puedes tener veinte llamadas funcionando con thinking desactivado y effort high, y que la veintiuna —la que sube a xhigh para el caso difícil— se rechace. Las anteriores funcionando no te protegen de nada.

    Traducido: cualquier ruta de tu código que desactive el thinking hay que auditarla antes de migrar, no después. Búscalo con un grep por "disabled" y revisa qué effort viaja en cada una de esas peticiones.

    Mi recomendación es no mantener esa ruta. En lugar de desactivar el thinking, bájalo a effort medium con thinking activado:

    // Sustituto recomendado para las rutas que antes desactivaban thinking
    thinking: { type: "adaptive" },
    output_config: { effort: "medium" },
    

    En Opus 5 los niveles low y medium rinden inusualmente bien. La intuición de "menos effort, peor respuesta" que traías de la generación anterior ya no aplica igual: prueba medium antes de asumir que necesitas high.

    Con un matiz, para que nadie me lea en diagonal: para coding y trabajo agéntico, Anthropic recomienda arrancar en xhigh y bajar solo donde tus evals demuestren que la calidad aguanta. Lo de medium es el sustituto de las rutas que antes desactivaban el thinking, no un consejo para bajarle el effort a tu agente de coding. Y si al bajarlo compruebas que la tarea nunca necesitó Opus, Claude Sonnet 5 cubre buena parte de ese terreno por bastante menos dinero.


    El tercer sitio donde revienta: el rechazo que llega con un 200

    Este no está en la lista oficial de breaking changes, pero te va a tirar producción igual.

    Los clasificadores de seguridad pueden declinar una petición. Cuando lo hacen, la API devuelve HTTP 200 con stop_reason: "refusal". No es un error. Tu try/catch no lo captura, tu retry no se dispara, tu monitorización no lo ve.

    Y content llega vacío: un array sin bloques. Así que este patrón —el que escribe todo el mundo la primera vez— revienta con un TypeError:

    const res = await client.messages.create({ /* ... */ });
    const text = res.content[0].text; // 💥 TypeError: content llega vacío
    

    La corrección son cuatro líneas:

    const res = await client.messages.create({ /* ... */ });
    
    if (res.stop_reason === "refusal") {
      logger.warn("Petición declinada por los clasificadores", { requestId: res.id });
      return fallbackResponse();
    }
    
    const text = res.content.find((b) => b.type === "text")?.text ?? "";
    

    Dos datos más que ayudan aquí. Un rechazo que llega antes de emitir output no se factura, aunque sí consume rate limit. Y si no quieres montar el fallback a mano, Anthropic tiene un parámetro fallbacks en modo "default" (con el beta header server-side-fallback-2026-07-01) que reencamina la petición rechazada a otro modelo dentro de la misma llamada: los rechazos de categoría ciber caen a Opus 4.8.

    Comprueba stop_reason antes de leer content. Siempre. Con este modelo y con el siguiente.


    Dos cambios de comportamiento que te van a sorprender

    Escribe respuestas más largas por defecto. Y bajar el effort no lo arregla —es un eje distinto—. Si necesitas respuestas breves, pídelo en el prompt de forma explícita: límite de palabras, formato, o ambos.

    Verifica su propio trabajo sin que se lo pidas. Esta es la importante, porque invierte una buena práctica de prompting que era válida hasta la semana pasada.

    Todos tenemos system prompts con alguna variante de "revisa tu respuesta antes de contestar". En Opus 5 esas instrucciones provocan verificación excesiva: más tokens, más latencia, misma calidad. La solución no es reescribirlas con mejor redacción. Es borrarlas.

    Con la delegación en subagentes el ajuste es distinto. Opus 5 delega más que Opus 4.8 por defecto, así que los empujones que añadiste para forzarla ahora sobran. Pero aquí no basta con borrar: la recomendación de Anthropic es poner límites —en qué escenarios se delega, o cuántos subagentes como máximo—. Pasas de empujar a acotar.

    Es la parte contraintuitiva del oficio: mantener un system prompt no es acumular reglas, es borrarlas cuando el modelo ya no las necesita. Es exactamente el criterio que trabajo en el curso Construye con IA, donde el prompt se trata como código con mantenimiento, no como un texto que se escribe una vez y se olvida.


    Lo que mejora en Claude Opus 5 sin que toques nada

    El mínimo de prompt caching baja a 512 tokens. En Opus 4.8 eran 1024, y el umbral está en la documentación de prompt caching. Prompts de sistema que antes se quedaban justo por debajo del umbral y no cacheaban, ahora sí cachean, sin cambiar una línea de código.

    Si tienes muchas llamadas cortas y repetitivas, revisa la factura la semana que viene: puede bajar sola. Y si aún no tienes el caching bien montado, la mecánica completa está en Prompt Caching en Claude: reduce tu factura de API un 90%.

    Otros dos datos que conviene tener a mano: la ventana de contexto es de 1M tokens —es a la vez el valor por defecto y el máximo— con 128K tokens de salida. Y los rate limits de Opus 5 son un cubo separado del pool combinado de Opus 4.x: al migrar tráfico no heredas tu cuota anterior. Si mueves un volumen serio, comprueba límites antes del despliegue y no el lunes por la mañana con todo el tráfico encima.


    Cómo migrar a Claude Opus 5 en 4 pasos

    Cuatro pasos, en este orden:

    1. Grep por "disabled" en todas tus llamadas al thinking. Cada resultado, con su effort al lado. Si hay xhigh o max, es un 400 esperándote.
    2. Revisa tus max_tokens. Todo lo que esté ajustado al límite de la respuesta necesita margen para el thinking, o cambia a thinking: { type: "disabled" } con effort high como máximo.
    3. Comprueba stop_reason antes de leer content. Cuatro líneas.
    4. Borra las instrucciones de auto-verificación de tus system prompts. No las reescribas. Y en las de delegación, cambia el empujón por un límite: cuándo se delega y cuántos subagentes como máximo.

    Media hora de trabajo. Y a cambio: te acercas a la inteligencia frontera de Fable 5 por la mitad de coste por tarea.

    Si quieres ver este tipo de migraciones aplicadas sobre proyectos reales —con los prompts, el código y los errores que salen por el camino— es lo que hacemos en Dominicode Labs, y voy publicando los análisis modelo a modelo en el canal de YouTube.

    El precio lo pone Anthropic. Los 400 los pones tú.


    Preguntas frecuentes sobre Claude Opus 5

    ¿Cuánto cuesta Claude Opus 5?

    $5 por millón de tokens de entrada y $25 por millón de tokens de salida, exactamente el mismo precio que tenía Opus 4.8. Fable 5 cuesta $10/$50, así que Opus 5 se acerca a esa franja de inteligencia frontera por la mitad. Existe un fast mode disponible únicamente en la API de Anthropic que cuesta el doble: $10/$50. En suscripciones, es el modelo por defecto de Claude Max y el más potente disponible en Claude Pro.

    ¿Qué se rompe al migrar de Opus 4.8 a Claude Opus 5?

    Dos cosas concretas. Primera: el parámetro thinking ahora viene activado por defecto, y como max_tokens es un tope duro sobre thinking más respuesta juntos, los presupuestos ajustados provocan respuestas cortadas a mitad de frase. Segunda: thinking: { type: "disabled" } combinado con effort xhigh o max devuelve un error 400, cuando en Opus 4.8 esa combinación era válida. A eso conviene sumar una tercera comprobación: los rechazos de los clasificadores llegan como HTTP 200 con stop_reason: "refusal", no como error.

    ¿Cómo desactivo el thinking en Claude Opus 5?

    Con thinking: { type: "disabled" }, pero solo puedes hacerlo hasta effort high. Si envías esa configuración con xhigh o max, la petición se rechaza con un 400. Y ojo: la validación se hace petición a petición, así que una llamada posterior que suba el effort se rechazará aunque todas las anteriores hayan funcionado. En la mayoría de casos compensa más bajar a effort medium con el thinking activado, porque en Opus 5 los niveles low y medium rinden bastante mejor de lo que esperarías.

    ¿Sigo necesitando el «revisa tu respuesta antes de contestar» en mis prompts?

    No, y además es contraproducente. Opus 5 verifica su propio trabajo sin que se lo pidas, así que esas instrucciones provocan verificación excesiva: gastas más tokens y añades latencia sin ganar calidad. La recomendación es borrarlas, no reescribirlas. Con la delegación en subagentes el ajuste es distinto: los empujones para forzarla sobran, pero Anthropic recomienda sustituirlos por un límite explícito —en qué escenarios se delega y cuántos subagentes como máximo—, porque Opus 5 delega más que Opus 4.8 por defecto.

    ¿Hay que cambiar algo para aprovechar el prompt caching en Opus 5?

    Nada. El mínimo de tokens necesario para cachear baja de 1024 a 512, así que los prompts que antes eran demasiado cortos para entrar en caché ahora cachean automáticamente, sin tocar código. Si tu carga de trabajo son muchas llamadas cortas con un system prompt repetido, es probable que la factura baje sola tras migrar.

    ¿Puedo mover todo mi tráfico de Opus 4.x a Opus 5 de golpe?

    Técnicamente sí, pero revisa los rate limits antes. Los límites de Opus 5 son un cubo separado del pool combinado de Opus 4.x, de modo que al migrar no heredas la cuota que ya tenías asignada. Si mueves un volumen alto sin comprobarlo, puedes empezar a recibir throttling con un código que hasta ese momento no lo veía nunca.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • IA generativa vs IA agéntica: la diferencia que decide tu stack

    IA generativa vs IA agéntica: la diferencia que decide tu stack

    Hace unas semanas un CTO me escribió para que le ayudara a "medir el retorno de la IA" en su equipo. Doce developers, doce licencias, una factura mensual que ya se notaba en la hoja de gastos.

    Le pregunté qué hacían exactamente con ellas.

    "Autocompletar. Y a veces le preguntan cosas al chat."

    Ahí estaba todo. Ese equipo no tenía un problema de retorno: tenía un problema de categoría. Estaban pagando IA generativa y esperando resultados de IA agéntica.

    Y la diferencia entre IA generativa vs IA agéntica no es una discusión de nomenclatura para ponentes de conferencia. Es la decisión que determina qué compras, cuánto pagas cada mes y qué trabajo puedes delegar de verdad.

    En 2026, seguir describiendo el trabajo de un programador con IA como "IA generativa" es señal de llevar dos años de retraso.


    Resumen rápido

    • IA generativa es un sistema que produce un artefacto (texto, código, JSON) a partir de un prompt y termina ahí: no ejecuta nada, no verifica nada, no conserva estado.
    • IA agéntica es un sistema que recibe un objetivo en lugar de un prompt, tiene acceso a herramientas y repite el ciclo observar → decidir → actuar → verificar hasta cumplir un criterio de parada.
    • El modelo puede ser el mismo. Lo que cambia es la capa que lo envuelve: herramientas, permisos y criterio de parada.
    • Regla de decisión: si existe una señal automática de verdad (tests, typecheck, build, lint) que diga si el trabajo está bien hecho, es territorio de agente. Si el único verificador eres tú leyendo, es territorio de prompt.
    • Coste: un agente consume unas 4 veces más tokens que un chat; un sistema multi-agente, unas 15 (Anthropic, junio 2025).

    Lo que compraste no era generativa: era autocompletado caro

    El equipo de ese CTO usaba la IA exactamente igual que en 2023. Escribir media línea, aceptar la sugerencia gris. Abrir un chat, pegar un stack trace, copiar la respuesta de vuelta al editor.

    Eso funciona. Ahorra minutos. Pero el trabajo sigue siendo tuyo: tú lees el repo, tú decides, tú ejecutas, tú verificas si la respuesta era correcta, tú vuelves a preguntar cuando no lo era.

    La IA hace la parte fácil —escribir texto plausible— y tú te quedas con el bucle completo. Con doce licencias, lo que compras es doce veces la parte fácil.

    El salto de productividad real no está en generar mejor código. Está en dejar de ser tú quien cierra el bucle.


    ¿Qué es la IA generativa? Tú pides, ella escupe

    La IA generativa es un sistema que produce un artefacto a partir de un prompt y termina ahí. Entra un prompt, sale texto, código, un JSON, un diagrama. Se acabó.

    No tiene estado. No sabe qué hay en tu repositorio salvo lo que le pegas. No sabe si su respuesta compiló. No sabe si el test pasó. No puede saberlo, porque no ejecuta nada.

    Eso no es un defecto. Es el diseño. Y para tareas de un solo salto es imbatible: latencia de segundos, coste de céntimos, resultado inmediato.

    Un regex complejo. El mensaje de un commit a partir de un diff. Explicar qué demonios hace esa función de 2019 que nadie toca. Convertir un objeto de ejemplo en una interfaz de TypeScript.

    En todos esos casos, montar un agente es como contratar una mudanza para llevar una caja de zapatos al piso de arriba.


    ¿Qué es la IA agéntica? Lee, decide, ejecuta y vuelve

    La IA agéntica es un sistema que recibe un objetivo en lugar de un prompt, tiene acceso a herramientas y permiso para usarlas. Aquí el contrato cambia por completo.

    El agente lee ficheros. Ejecuta comandos. Mira la salida. Decide el siguiente paso a partir de lo que ha visto, no de lo que tú le contaste. Y repite hasta que se cumple un criterio de parada.

    Ese mecanismo tiene nombre y lo desmonté pieza a pieza en Agentic loop: el mecanismo detrás de los agentes de IA.

    Ese ciclo —observar, decidir, actuar, verificar, repetir— es todo el asunto. Lo he desarrollado a fondo en Loop Engineering: la evolución definitiva del desarrollo con IA, porque diseñar bien ese bucle es hoy más determinante que elegir modelo.

    Fíjate en que el modelo puede ser exactamente el mismo. Claude generando texto en una web y Claude arreglando un test en tu CI son el mismo peso de red neuronal. Lo que cambia es lo que hay alrededor: las herramientas que le das, los permisos que aceptas, la señal que le dice si ha terminado.

    Un LLM solo no es un agente, igual que un motor no es un coche. Esa capa que lo envuelve —el harness— es la que hace el trabajo, y lo expliqué en detalle en El Agentic Harness: por qué un LLM por sí solo no es un producto.

    La prueba práctica para distinguirlas: pídele algo cuyo resultado no puedas predecir sin ejecutar código. "Arregla el test que falla en CI" no lo resuelve un chat, por bueno que sea el modelo. Requiere leer el log, formular una hipótesis, tocar el código y volver a ejecutar. Eso es un agente o no es nada.

    Si vienes de cero con esto, la guía definitiva de Agentes de IA cubre los fundamentos y lo dejas para después de este.


    IA generativa o IA agéntica: cuál usar en cada tarea

    Esta es la asignación que uso a diario: a la izquierda la tarea, a la derecha la categoría que la resuelve con el menor coste y la menor latencia.

    Tarea Generativa o agéntica Por qué
    Escribir un regex o una query SQL puntual Generativa Salida única, la verificas tú en cinco segundos
    Redactar el mensaje de un commit Generativa El contexto está en el diff, no hay bucle que cerrar
    Explicar una función o un fichero legacy que no entiendes Generativa Necesitas comprensión, no cambios en disco
    Renombrar un concepto de dominio en 40 archivos Agéntica Hay que leer el repo, decidir caso a caso y comprobar que compila — no es el rename del IDE: cambian nombres, strings, rutas y documentación
    Arreglar un test en rojo que puedes reproducir en local Agéntica Requiere hipótesis, ejecución y reintento con la salida real
    Migrar un módulo de RxJS a Signals Agéntica Cambios encadenados con verificación continua vía tests
    Generar mocks o datos de ejemplo Generativa Un salto, coste mínimo, no toca disco
    Subir una dependencia mayor con breaking changes Agéntica El error aparece al ejecutar, no al leer
    Escribir la primera versión de un componente aislado Generativa Lo revisas tú de un vistazo; el bucle no aporta

    El patrón se ve solo: si existe una señal automática de verdad —tests, typecheck, build, lint— que diga si el trabajo está bien hecho, es territorio de agente. Si el único verificador eres tú leyendo, es territorio de prompt.


    El error caro: meter un agente donde bastaba un prompt

    Este es el fallo que más veo desde que los agentes se pusieron de moda. Y sale caro en cuatro dimensiones.

    Coste. Un agente no hace una llamada al modelo: hace decenas. Anthropic publicó las cifras de su sistema de investigación multi-agente en junio de 2025: los agentes consumen unas 4 veces más tokens que una interacción de chat, y los sistemas multi-agente unas 15 veces más. Está medido en tareas de investigación, pero el orden de magnitud se traslada. Cuando delegas a un agente algo que resolvía un prompt, estás multiplicando la factura por un trabajo idéntico.

    Latencia. El chat te responde en segundos. El agente tarda minutos porque lee, ejecuta, falla, reintenta. Para una tarea de treinta segundos, esa espera es una pérdida neta de tiempo, no una ganancia.

    No determinismo. Con un prompt, si la respuesta no te gusta, la descartas y ya está. Con un agente, cada ejecución toma un camino distinto: puede tocar archivos que no esperabas, reescribir un test en lugar de arreglar el código o "resolver" el fallo borrando la aserción que molestaba. Dos ejecuciones del mismo objetivo rara vez producen el mismo diff.

    Superficie de fallo. Un chat solo puede equivocarse en el texto. Un agente con permisos de escritura y shell puede equivocarse en tu disco, en tu historial de git y en tu base de datos de desarrollo. Cada herramienta que le das es potencia y es riesgo, en la misma proporción.

    Resumido en una tabla:

    Dimensión Prompt (generativa) Agente (agéntica)
    Coste Una llamada al modelo Decenas de llamadas: ~4x tokens, ~15x si es multi-agente
    Latencia Segundos Minutos: lee, ejecuta, falla, reintenta
    Determinismo Descartas la respuesta y repites Cada ejecución toma un camino distinto
    Superficie de fallo El texto que devuelve Tu disco, tu historial de git, tu base de datos de desarrollo

    Mi regla, sin matices: si puedes verificar el resultado leyéndolo en menos de un minuto, no necesitas un agente.


    Cómo migrar tu flujo de una a otra en 3 pasos

    Si hoy vives en el chat y quieres pasar al bucle, no empieces instalando frameworks. Empieza por aquí.

    1. Cierra el bucle de verificación antes de dar un solo permiso

    Un agente sin forma de comprobar su propio trabajo es un generador de texto con acceso a tu disco. Es la peor combinación posible.

    Antes de delegar nada, asegúrate de que existe un comando que responde sí o no:

    # El criterio de parada del agente: un comando que responde sí o no
    npm test && npx tsc --noEmit && npm run lint
    

    Ese comando es el criterio de parada. Si tu proyecto no tiene tests que corran rápido y en verde, tu primer trabajo agéntico es conseguirlos —y si trabajas con Angular y andas flojo ahí, el curso de Testing en Angular con Jest y Testing Library resuelve justo esa base.

    Sin señal de verdad no hay agente. Hay ruleta.

    2. Escribe la especificación, no el prompt

    Un prompt describe una petición. Una especificación describe un resultado esperado, sus límites y qué queda fuera del alcance.

    La diferencia importa porque el agente va a tomar cientos de microdecisiones que tú no vas a supervisar. Todo lo que no esté escrito lo va a inventar.

    Es la metodología que uso a diario y la que documenté entera en el libro de Spec-Driven Development: especificar primero, delegar después. Cambia el resultado más que cambiar de modelo.

    3. Empieza por una tarea aburrida, acotada y reversible

    Nada de "refactoriza la arquitectura". Elige algo que te lleve entre veinte y cuarenta minutos a mano, con criterio de éxito objetivo y sobre una rama nueva.

    Migrar un módulo. Añadir tests a un servicio. Actualizar una dependencia. Ejecuta, revisa el diff completo, mide cuánto ha tardado y cuánto has tenido que corregir.

    Si quieres ver ese primer trabajo delegado en la terminal, lo hago paso a paso con Claude Code.

    Sube el listón solo cuando esa tarea salga limpia dos veces seguidas. Y cuando llegue el momento de elegir herramientas de verdad, tengo mi criterio completo en Stack IA agéntica en 2026: qué usar, qué ignorar y cuál elijo.


    La pregunta que resuelve el 90% de las decisiones

    No memorices la tabla. Quédate con una sola pregunta antes de abrir cualquier herramienta:

    ¿Existe una señal automática que diga si el trabajo está bien hecho?

    Si existe, delega el bucle: es trabajo de agente. Si no existe, el bucle eres tú, y lo que necesitas es un buen prompt y tus ojos encima.

    Esa pregunta te ahorra factura y sustos.

    Si quieres ver el bucle completo montado de principio a fin —del objetivo a un producto funcionando, con especificaciones, herramientas y verificación— es exactamente lo que construimos en el curso Construye con IA. Y si prefieres hacerlo acompañado, con proyectos reales y gente que ya está en esto, te espero en Dominicode Labs.


    Preguntas frecuentes

    ¿Cuál es la diferencia entre IA generativa e IA agéntica?

    La IA generativa produce un artefacto a partir de un prompt y ahí termina: no ejecuta código, no verifica su propia salida y no conserva estado entre peticiones. La IA agéntica recibe un objetivo, dispone de herramientas para leer ficheros y ejecutar comandos, y repite el ciclo observar, decidir, actuar y verificar hasta cumplir un criterio de parada. El modelo subyacente puede ser el mismo en ambos casos; lo que cambia es la capa que lo envuelve. La prueba práctica para distinguirlas es pedir algo cuyo resultado no puedas predecir sin ejecutar código: eso solo lo resuelve un agente.

    ¿La IA agéntica sustituye a la IA generativa?

    No. La agéntica se construye encima de la generativa: el modelo que razona dentro del agente es el mismo tipo de modelo que responde en un chat. Lo que cambia es la capa que lo envuelve, con herramientas, permisos y un criterio de parada. En un flujo de trabajo real conviven las dos, y la mayoría de tus interacciones diarias seguirán siendo generativas porque son más rápidas y más baratas.

    ¿Cuánto más caro sale usar un agente en vez de un chat?

    Entre 4 y 15 veces más en consumo de tokens. Según los datos publicados por Anthropic en junio de 2025, un agente consume alrededor de 4 veces más tokens que una interacción de chat, y un sistema multi-agente unas 15 veces más. La cifra exacta depende del modelo y de la tarea, pero el orden de magnitud es ese: el agente solo compensa cuando la tarea es suficientemente valiosa como para justificar el gasto.

    ¿Un chat con acceso a herramientas ya es un agente?

    Solo si cierra el bucle. Ejecutar una búsqueda web y devolverte el resultado sigue siendo un salto único. Un agente encadena decisiones: usa la salida de una herramienta para elegir la siguiente acción, evalúa si ha cumplido el objetivo y reintenta cuando no. Si el sistema no puede reintentar por su cuenta a partir de lo que ha observado, es un chat con extras.

    ¿Necesito un framework de agentes para empezar?

    No al principio. Los asistentes de terminal actuales — Claude Code, Codex CLI, Gemini CLI — ya traen el bucle implementado, y con eso cubres la mayoría de tareas de desarrollo diario. El framework empieza a tener sentido cuando construyes un agente propio para un producto: cuando necesitas orquestar varios pasos, persistir estado entre ejecuciones o exponer herramientas específicas de tu dominio.

    ¿Qué tareas no delegaría hoy a un agente?

    Tres tipos. Las que no tienen verificación automática, porque no hay forma de saber si acertó sin revisarlo todo a mano. Las irreversibles: migraciones sobre datos de producción, borrados, despliegues sin rollback. Y las decisiones de arquitectura, porque un agente optimiza para que el criterio de parada se cumpla, no para que el sistema siga siendo mantenible dentro de dos años. Esa parte todavía es tuya.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
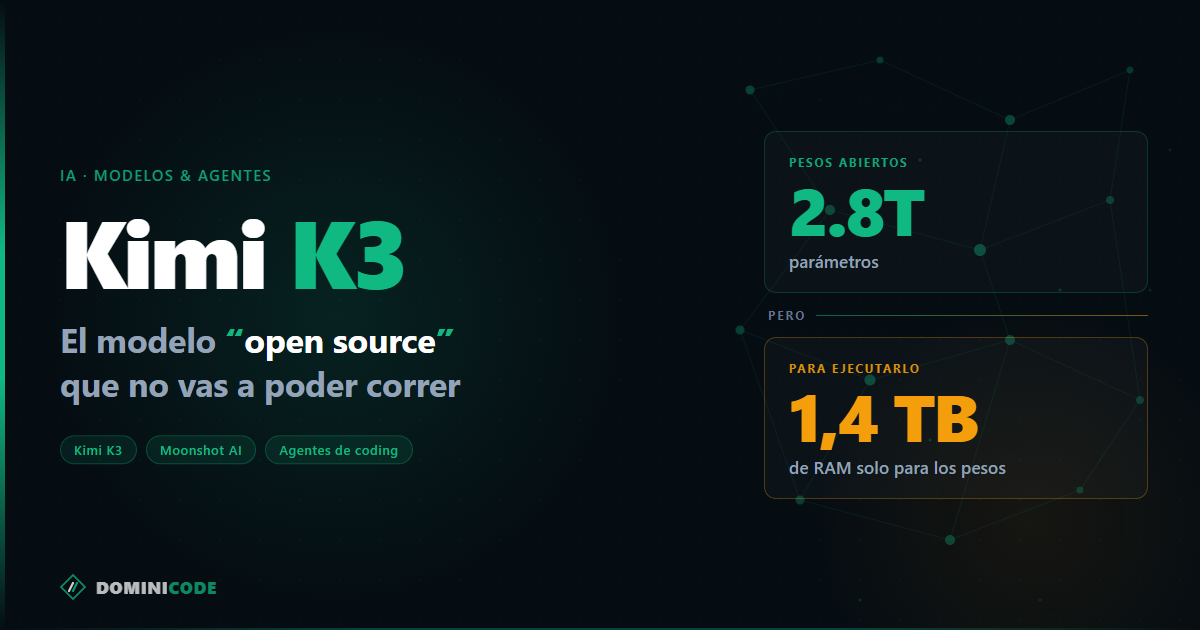
  • Kimi K3: el modelo “open source” que no vas a poder correr

    Kimi K3: el modelo “open source” que no vas a poder correr

    El 16 de julio de 2026, por la mañana, me llegaron cuatro mensajes casi idénticos. Todos decían alguna versión de lo mismo: "Bezael, ha salido Kimi K3, ¿esto lo puedo bajar y correrlo en local?".

    Entiendo la ilusión. Moonshot AI lo anunció como el mayor modelo open source del mundo. Y "open source" en la cabeza de cualquier developer significa una cosa muy concreta: lo descargo, lo pongo en mi máquina, dejo de pagar tokens.

    Con este no.

    Kimi K3 tiene 2.8 billones de parámetros. Los pesos son abiertos, sí. Pero abrir los pesos de un modelo de ese tamaño es como regalarte los planos de un portaaviones. Técnicamente lo tienes todo. Prácticamente no lo vas a construir en el garaje.

    Así que la pregunta interesante no es "¿supera a Fable 5?". Esa la contesta cualquier tabla de benchmarks y encima se queda obsoleta en tres semanas. La pregunta que sí te cambia el mes es: ¿me conviene mover mi agente de coding a K3, y a partir de cuándo?

    Vamos con eso.

    ¿Qué es Kimi K3?

    Kimi K3 es el modelo de lenguaje que Moonshot AI (Pekín) lanzó el 16 de julio de 2026. Tiene 2.8 billones de parámetros con pesos abiertos, entrada multimodal de imagen y una ventana de contexto de 1M tokens, con razonamiento siempre activo y sin modo rápido. Moonshot lo distribuye en dos variantes: K3 Max, orientada a chat y agentes, y K3 Swarm Max, para paralelismo a gran escala.

    En el índice independiente de Artificial Analysis, Kimi K3 puntúa 57 y ocupa el puesto #4 de 187 modelos evaluados en el corte de julio de 2026. Ese índice se recalcula cada pocas semanas y tanto la puntuación como el puesto se mueven, así que trata la cifra como una foto fechada, no como una constante. Su precio de API es de $3 por millón de tokens de entrada y $15 por millón de salida, con cache hit a $0.30.

    Hasta ahí la ficha. Lo interesante empieza cuando la cruzas con lo que necesitas tú.

    El "open source" de 2.8T no significa lo que crees

    Haz la cuenta conmigo, porque es aritmética de servilleta y te ahorra la tarde.

    2.8 billones de parámetros. Aun cuantizando agresivamente a 4 bits —medio byte por parámetro— necesitas del orden de 1,4 TB de memoria solo para tener los pesos residentes. Sin contar el KV cache, que con una ventana de 1M tokens no es precisamente pequeño.

    Tu Mac con 128 GB de RAM unificada no entra. Ni el doble. Ni el de tu amigo el del homelab con dos 4090.

    Estás hablando de un rack. De órdenes de magnitud por encima de lo que un dev individual —o una startup pequeña— monta para inferencia propia.

    Entonces, ¿qué gana el mundo con que los pesos sean abiertos? Gana algo real, pero indirecto: cualquier proveedor puede servirlo, nadie te encierra en una única API, y el precio tiende a bajar por competencia entre hosts. Eso es valioso. Pero no es soberanía local. Es no depender de un solo vendor.

    Si lo que buscabas era de verdad correr modelos en tu máquina, esa es otra conversación y la tengo escrita aparte: los mejores modelos de IA para ejecutar en local en 2026. Ahí sí hay opciones que caben en tu hardware.

    Para K3 vas a pagar tokens igual que con cualquier modelo cerrado. La forma más rápida de probarlo sin abrirte cuenta en Moonshot es a través de un router; te expliqué el mecanismo completo en qué es OpenRouter y para qué sirve.

    Kimi K3: qué está verificado y qué es marketing de Moonshot

    Aquí voy a ser quisquilloso a propósito, porque el 90% de lo que se ha publicado sobre él estos días mezcla las dos categorías sin avisarte.

    Lo verificado en fuentes independientes (ficha de Kimi K3 en OpenRouter y Artificial Analysis):

    • Kimi K3 se lanzó el 16 de julio de 2026, desarrollado por Moonshot AI (Pekín).
    • Kimi K3 tiene 2.8T parámetros con pesos abiertos y es multimodal con entrada de imagen.
    • Kimi K3 ofrece una ventana de contexto de 1M tokens.
    • Kimi K3 razona siempre: a día de hoy no existe una versión "rápida sin pensar".
    • El precio de Kimi K3 es de $3 por 1M de tokens de entrada y $15 por 1M de salida, con cache hit a $0.30 (un 90% menos).
    • Kimi K3 obtiene 57 en el Artificial Analysis Intelligence Index, puesto #4 de 187 modelos. La media de modelos comparables está en 31.
    • OpenRouter advierte en la ficha del modelo de que la capacidad upstream de Kimi K3 está limitada y son frecuentes los errores 429.

    Lo que dice el fabricante y no está auditado:

    • SWE-bench Verified 76.8%, Terminal-Bench 2.1 en 88.3, FrontierSWE 81.2.
    • Un Coding Index de 76.24 que lo pondría por encima de Fable 5 — dato que circula de terceros y que aún no aparece en la ficha oficial de Artificial Analysis.
    • Las dos variantes, K3 Max y K3 Swarm Max, las anuncia Moonshot y las recogen los medios, pero no aparecen diferenciadas en la ficha de OpenRouter.

    Y aquí una que no está sin confirmar, sino directamente refutada. Moonshot afirma que K3 compite con Fable 5 y supera a Opus 4.8 y a GPT-5.6. Coge el mismo índice independiente que la propia Moonshot cita y mira la tabla completa:

    Modelo Intelligence Index
    Claude Fable 5 59.9
    GPT-5.6 Sol 58.9
    Kimi K3 57
    Claude Opus 4.8 56

    Lo de superar a Opus 4.8 es cierto. Lo de superar a GPT-5.6 es falso: queda casi dos puntos por debajo de Sol. Y "competir con Fable 5" es defendible si por competir entendemos quedarse a tres puntos, que para un modelo de pesos abiertos es una noticia enorme — pero no es lo mismo que empatar.

    Que quede claro: puesto #4 de 187 no se regala y K3 no es humo. Lo que digo es que las cifras de coding, que son las que más te importan a ti, son hoy marketing sin auditar. Trátalas como hipótesis a validar en tu repo, no como hechos.

    El mercado, en cambio, se lo creyó de golpe: según la prensa financiera, el lanzamiento tumbó acciones de semiconductores y le valió el apodo de "segundo shock DeepSeek".

    El coste real de Kimi K3: el impuesto de la verbosidad

    Este es el dato que más me llamó la atención, y está publicado en la misma ficha de Artificial Analysis que todo el mundo cita para el ranking — pero que casi nadie lee hasta el final.

    Kimi K3 consumió 130 millones de tokens de salida para completar el Intelligence Index. La media de los modelos evaluados es de 63M. La propia ficha lo califica de "very verbose".

    Multiplica: 130M × $15 por millón. Son casi 2.000 dólares de output solo para pasar una batería de evaluación.

    Ahí está el punto. El precio de lista de un modelo no es su coste. Su coste es el precio de lista multiplicado por lo que le da la gana escribir.

    K3 razona siempre, y razona largo: algo más del doble que la media. Haz la traducción a dinero — un modelo de $15/1M que emite 2,06 veces los tokens de la media te sale, en la práctica, como uno de ~$31.

    Sigue estando por debajo de Fable 5 a ~$50. Pero la distancia real es la mitad de la que sugiere la tabla de precios:

    Modelo Output / 1M tokens
    Fable 5 ~$50
    Kimi K3 $15
    GLM-5.2 $3.52
    DeepSeek V4 Pro $0.87

    Parece que K3 está en un punto dulce. Y puede que lo esté. Pero esa tabla es engañosa mientras no le añadas la columna que casi nadie mira: tokens emitidos por tarea resuelta. Artificial Analysis publica el agregado de su índice; lo que ningún benchmark publica es ese número para tus tareas.

    Y ojo con el consuelo del cache: el descuento del 90% a $0.30 juega a favor de K3 en agentes, donde reenvías el mismo contexto una y otra vez. Pero aplica a la entrada, no a la salida. Y tu problema con este modelo es la salida.

    ¿Cuándo conviene migrar tu agente de coding a Kimi K3?

    Te conviene mirarlo en serio si:

    • Trabajas con repos grandes de verdad y el millón de tokens de contexto te ahorra la gimnasia de trocear y resumir. Ahí sí compensa.
    • Haces agentic de horizonte largo, con sesiones de muchos pasos, y el razonamiento permanente reduce las veces que el agente se descarrila a mitad de tarea.
    • Estás pagando facturas de cuatro cifras con un frontier caro, y una reducción de coste por token —aun con la verbosidad descontada— te sale a cuenta.
    • Te importa la portabilidad. Pesos abiertos significa que si mañana un proveedor sube precios, te llevas la carga a otro. Eso es apalancamiento real de negociación.

    No te molestes si:

    • Necesitas latencia estable en producción hoy. Los 429 que advierte OpenRouter no son teóricos: la demanda obligó a Moonshot a parar nuevas suscripciones por saturación de GPUs a los pocos días del lanzamiento. Un agente que falla una de cada siete llamadas no es un agente, es una lotería.
    • Tu caso son tareas cortas y bien acotadas. Vas a pagar razonamiento que no necesitas en cada llamada, sin opción de apagarlo.
    • Ya tienes un harness afinado alrededor de otro modelo.

    Y este último es el punto que más me duele repetir: cambiar de modelo casi nunca es donde está tu ganancia. Lo desarrollé entero en por qué el harness agéntico, no el LLM, es el producto. Tus prompts, tus herramientas, tu gestión de contexto y tus validaciones pesan más en el resultado final que dos puntos de diferencia en un índice.

    Si tu agente falla porque le das mal el contexto, K3 va a fallar igual. Solo que escribiendo más y cobrándotelo.

    Es exactamente lo que trabajamos en el curso de Construye con IA: de la idea al producto con Claude Code — montar el sistema alrededor del modelo, para que el día que salga el siguiente K3 puedas cambiarlo en una línea de configuración y seguir con tu vida.

    Veredicto: ¿merece la pena Kimi K3 hoy?

    Kimi K3 es genuinamente bueno. Puesto #4 de 187 en un índice independiente no se regala, y el precio frente a la gama alta occidental es agresivo de verdad.

    Pero no es el modelo que vas a correr en tu máquina, y su coste real está por encima de lo que sugiere su precio de lista. Dos cosas que el anuncio no te dice.

    Mi posición hoy: lo evalúo, no lo migro. Si dependes de coding en producción, espera a dos señales concretas antes de mover nada: que Artificial Analysis publique el Coding Index en su ficha oficial, y que la capacidad upstream se estabilice. Escribo esto la semana del lanzamiento (20 de julio de 2026); si llegas a este post más tarde, comprueba ambas antes de darlas por pendientes.

    Comparar contra la otra familia frontier también ayuda a calibrar: tienes los números de la de OpenAI en la guía práctica de GPT-5.6 vía API.

    Cómo decidirlo con tus propios datos en una hora

    No te fíes de mi veredicto ni del anuncio de Moonshot. Mide:

    1. Coge diez tareas reales de tu backlog — no de un benchmark. Tareas que ya sabes resolver, para poder juzgar el resultado.
    2. Pásalas por tu modelo actual y por K3, con el mismo harness y los mismos prompts.
    3. Apunta tres columnas por tarea: tokens de salida, coste total y si la tarea quedó resuelta o no.
    4. Compara coste por tarea resuelta, no precio por millón de tokens. Es la única cifra que decide.

    Ese número tuyo vale más que todos los benchmarks del anuncio juntos. Y va a haber sorpresas en las dos direcciones.

    Ese blindaje empieza incluso antes del harness: si escribes la especificación de lo que quieres construir, el modelo pasa a ser una pieza intercambiable. Es la tesis completa del libro de Spec-Driven Development.

    Si haces el experimento, comparte los resultados en Dominicode Labs — estamos juntando mediciones reales de la comunidad, que es exactamente el dato que ningún benchmark publica.

    Preguntas frecuentes sobre Kimi K3

    ¿Qué es Kimi K3?
    Kimi K3 es el modelo de lenguaje de Moonshot AI lanzado el 16 de julio de 2026. Tiene 2.8 billones de parámetros con pesos abiertos, ventana de contexto de 1M tokens, entrada multimodal de imagen y razonamiento permanente. Puntúa 57 en el Artificial Analysis Intelligence Index, puesto #4 de 187 modelos.

    ¿Kimi K3 es realmente open source?
    Los pesos de Kimi K3 son abiertos, pero eso no equivale a poder ejecutarlo. Con 2.8T parámetros, la barrera de hardware lo deja fuera del alcance de cualquier developer o startup pequeña. El beneficio real de esos pesos abiertos es que cualquier proveedor puede servir el modelo: evita el lock-in de vendor y presiona el precio a la baja, pero no da soberanía local.

    ¿Puedo ejecutar Kimi K3 en local?
    En la práctica, no. Con 2.8T parámetros necesitas del orden de 1,4 TB de memoria solo para los pesos, incluso cuantizando a 4 bits. Eso es infraestructura de datacenter, no de escritorio. Los pesos son abiertos, pero eso beneficia a quien pueda servirlos, no a tu portátil.

    ¿Cuánto cuesta Kimi K3?
    $3 por millón de tokens de entrada y $15 por millón de salida, con los cache hits a $0.30 (un 90% de descuento). Ojo: por su verbosidad, el coste efectivo por tarea suele quedar bastante por encima de lo que sugiere esa tarifa.

    ¿Kimi K3 es mejor que Fable 5 para programar?
    Moonshot lo afirma y circula un Coding Index de 76.24 que lo situaría por encima. Ese dato viene de terceros y todavía no aparece en la ficha oficial de Artificial Analysis. En inteligencia general sí hay dato auditado, y no respalda la afirmación: Fable 5 puntúa 59.9 y Kimi K3, 57. En coding concretamente, trátalo como hipótesis hasta que se confirme.

    ¿Cuál es la diferencia entre K3 Max y K3 Swarm Max?
    Según Moonshot, K3 Max está orientado a chat y flujos agénticos convencionales, mientras que K3 Swarm Max está pensado para ejecución paralela a gran escala. Para un agente de coding individual, tu variante es K3 Max.

    ¿Por qué Kimi K3 sale más caro de lo que dice su precio?
    Porque razona siempre y razona largo. Kimi K3 emitió 130M tokens de salida completando el Intelligence Index de Artificial Analysis, frente a una media de 63M — algo más del doble. A $15 por millón de salida, esa verbosidad sitúa el coste efectivo en torno a los $31 por millón. El precio de lista de un modelo no es su coste: su coste es el precio de lista por lo que decide escribir.

    ¿Por qué me devuelve errores 429?
    OpenRouter avisa en la propia ficha del modelo de que la capacidad upstream está limitada tras el lanzamiento. Si lo llevas a producción, necesitas reintentos con backoff y un modelo de fallback configurado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
    Analizo lanzamientos como este en detalle en el canal de YouTube de Dominicode.

  • Guía de Modelos: Los mejores LLMs para correr en local

    Guía de Modelos: Los mejores LLMs para correr en local

    La primera vez que abres Hugging Face, te abrumas. Hay cientos de miles de modelos subidos. Nombres crípticos como Qwen2.5-Coder-7B-Instruct-Q4_K_M.gguf o DeepSeek-R1-Distill-Llama-8B llenan la pantalla de descargas.

    ¿Cuál de todos ellos deberías bajar?

    Si descargas el equivocado, tu ordenador tardará diez segundos en responder cada palabra o, peor aún, la IA empezará a alucinar código absurdo. Correr modelos de IA en local de forma eficiente requiere elegir el modelo adecuado para tu hardware. Como vimos en nuestro post anterior, configurar tu entorno de hardware para LLMs locales es el paso inicial antes de elegir tu modelo de uso diario.

    Hoy te quiero enseñar la guía definitiva con las mejores familias de modelos libres que puedes ejecutar hoy mismo localmente, en qué tareas destaca cada uno y cómo dimensionar su tamaño según tu memoria RAM.


    Las 5 mejores familias de modelos locales

    A día de hoy, el ecosistema de código abierto se ha consolidado en torno a cinco grandes opciones que cubren todas las necesidades de desarrollo y automatización:

    1. Qwen 2.5 Coder (7B y 32B) — El Rey de la Programación

    Desarrollado por Alibaba, es el mejor modelo del mundo para desarrollo de software local en 2026. Su variante de 7B parámetros es tan rápida y precisa que puede correr en cualquier portátil, mientras que el modelo de 32B rivaliza directamente con GPT-4o en generación de código.

    • Ideal para: Autocompletado en IDEs (Cursor/VS Code), refactorizaciones de código y escritura de scripts.

    2. Llama 3 (8B y 70B) — El estándar multipropósito

    El modelo de Meta es la base del ecosistema. Cuenta con un excelente soporte para múltiples idiomas, sigue instrucciones complejas con mucha precisión y está altamente integrado en todos los frameworks de desarrollo.

    • Ideal para: Chatbots generales, análisis de texto, tareas RAG (búsqueda sobre tus documentos locales) y soporte al cliente.

    3. DeepSeek-R1 Distilled (8B y 32B) — Razonamiento avanzado (o1/o3-style)

    Estos modelos han sido entrenados para "pensar antes de hablar". Muestran su cadena de razonamiento y son excepcionales resolviendo problemas lógicos complejos, matemáticas y planificación de arquitectura.

    • Ideal para: Resolver bugs difíciles, planificar especificaciones funcionales y analizar flujos lógicos en bucle.

    4. Mistral & Nemo (7B y 12B) — Ligero y compatible con Herramientas

    La empresa francesa Mistral AI destaca por crear modelos extremadamente compactos con un excelente soporte para la llamada de funciones (Tool Calling).

    • Ideal para: Agentes autónomos (como Hermes Agent) que necesitan interactuar con APIs externas y ejecutar comandos de consola de forma rápida y segura.

    5. Gemma 2 (2B y 9B) — La opción eficiente de Google

    Google ha diseñado una arquitectura muy eficiente que exprime la memoria al máximo. Su modelo de 2B parámetros es perfecto para dispositivos móviles o portátiles antiguos, mientras que la versión de 9B destaca en fluidez de redacción.

    • Ideal para: Dispositivos con recursos limitados (computadores de 16GB de RAM o menos).

    El Secreto del Rendimiento Local: La Cuantización

    No puedes descargar un modelo en su formato original de flotantes (FP16) y esperar que corra en tu ordenador. Ocuparía demasiada memoria. Un modelo de 7B parámetros sin optimizar requeriría más de 14GB de VRAM solo para cargarse en memoria.

    Para solucionar esto, utilizamos cuantización.

    La cuantización consiste en comprimir los pesos del modelo (reduciendo la precisión matemática de 16 bits a 4 u 8 bits).

    El sweet spot indiscutible para la mayoría de desarrolladores es el formato Q4_K_M (cuantización a 4 bits). Reduce el peso en disco del modelo en un 70% (un modelo de 7B pasa de pesar 14GB a ocupar solo 4.5GB en disco) a cambio de una pérdida de precisión matemática prácticamente imperceptible para el usuario.


    Guía rápida de Sizing de memoria RAM/VRAM

    Antes de iniciar cualquier descarga, verifica este mapa de recursos para saber qué modelo puede digerir tu máquina:

    • 16GB de RAM/VRAM: Puedes correr de forma fluida modelos cuantizados de 7B u 8B parámetros (como Qwen 2.5 Coder 7B o Llama 3 8B).
    • 32GB de RAM/VRAM: El entorno perfecto para modelos medianos de 12B a 14B parámetros, o versiones muy optimizadas de modelos de 32B.
    • 64GB de RAM/VRAM o superior: Puedes correr modelos masivos de 32B y 70B parámetros (como Qwen 32B o Llama 70B) que te darán respuestas al nivel de las mejores IAs de pago de la nube.

    Esta lógica de calibración de hardware y selección de modelos locales es la base de las infraestructuras de desarrollo que montamos en el curso de Construye con IA y que llevamos a su máximo rendimiento en el nuevo curso de Hermes Agent.


    Conclusión: Descarga con estrategia

    No descargues el modelo más grande solo porque tiene mejores números en los benchmarks. Un modelo de 7B corriendo a 50 tokens por segundo en tu GPU local siempre te dará una mejor experiencia de desarrollo que un modelo de 70B que satura tu memoria y responde a 1 token por segundo. Encuentra tu equilibrio de hardware, aplica cuantización a 4 bits y monta un entorno de IA local eficiente.

    Si quieres compartir benchmarks de rendimiento de modelos locales en tu propia máquina y conocer qué setups usa nuestra comunidad, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué significa el sufijo "Instruct" en los modelos de Hugging Face?

    Los modelos marcados como "Instruct" han sido entrenados específicamente para seguir instrucciones de los usuarios y mantener conversaciones. Los modelos "Base" o nativos solo sirven para completar texto y no son aptos para interfaces de chat o asistentes de código directo.

    ¿Cuál es la diferencia entre los formatos GGUF y safetensors?

    GGUF es un formato contenedor diseñado por el ecosistema de llama.cpp para correr modelos en CPU y GPU locales compartiendo la memoria RAM de forma eficiente. Safetensors es el formato nativo utilizado principalmente por runtimes de Python (como PyTorch o Hugging Face transformers) para entrenamiento e inferencia en tarjetas gráficas dedicadas.

    ¿Se pueden mezclar modelos locales con APIs en la nube?

    Sí. Herramientas de orquestación como Hermes Agent permiten configurar setups híbridos. Puedes configurar tu agente para que use un modelo de código local ultra-rápido (como Qwen 2.5 Coder 7B) para autocompletados y delegue las tareas de planificación complejas a APIs externas como Claude 3.5 Sonnet.

    ¿Los modelos locales pueden dañar mi hardware?

    No. Correr modelos locales consumirá el 100% de los recursos de tu GPU/CPU durante la inferencia, lo que aumentará la temperatura de los componentes y activará los ventiladores de tu máquina. Es un comportamiento totalmente normal bajo cargas de trabajo pesadas de computación.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • OpenRouter: Qué es, para qué sirve y por qué lo necesitas

    OpenRouter: Qué es, para qué sirve y por qué lo necesitas

    Si estás construyendo una aplicación o un agente autónomo de IA, tu archivo de configuración de claves de API probablemente se parezca a una pesadilla. Tienes un token de facturación para OpenAI, otro para Anthropic, otro para los modelos de Google, y quizás una cuenta en un hosting de GPUs externas para los modelos de código abierto.

    Facturas fragmentadas, SDKs de código distintos y un dolor de cabeza constante cada vez que un proveedor sube los precios o sufre una caída de servicio.

    Hay una forma mucho más inteligente de gestionar esto.

    Hoy te quiero explicar qué es openrouter y para qué sirve, y por qué se ha convertido en la herramienta de backend indispensable para cualquier desarrollador de inteligencia artificial moderna.


    ¿Qué es OpenRouter?

    OpenRouter (disponible en openrouter.ai) es un enrutador y pasarela de API unificada para modelos de lenguaje. Actúa como un intermediario o agregador: tú te conectas a OpenRouter con una única clave de API y, a cambio, ellos te dan acceso a cientos de modelos distintos de múltiples proveedores de forma instantánea.

    En lugar de registrarte en Anthropic, OpenAI, Google Cloud, Meta y DeepSeek por separado, solo te registras en OpenRouter, cargas saldo en una sola cuenta y consumes los modelos que necesites pagando estrictamente por el uso de tokens.


    ¿Para qué sirve OpenRouter en el día a día?

    Si eres desarrollador de software o integras IA en tus flujos de negocio, OpenRouter resuelve cuatro problemas de infraestructura masivos:

    1. Unificación de SDKs (API compatible con OpenAI)

    No necesitas aprender a usar la librería de Anthropic o los formatos específicos de Google. OpenRouter utiliza el formato estándar de la API de OpenAI. Para cambiar de modelo, solo tienes que cambiar una string de texto en tu llamada, sin tocar una sola línea de código. Como vimos en nuestro análisis de Qwen 3.7 y OpenRouter, esto te permite cambiar de modelo en caliente para aprovechar el contexto extendido y las capacidades de razonamiento.

    2. Acceso a Modelos Propietarios y Open-Source

    En la misma plataforma conviven los gigantes de pago (como GPT-4o o Gemini 1.5 Pro) junto con las versiones de código abierto servidas a alta velocidad (como Qwen 2.5 Coder o DeepSeek-R1). Esto te permite experimentar con docenas de variantes en segundos.

    3. Redundancia y Fallbacks

    Si la API oficial de Anthropic se cae o sufre congestión, puedes configurar tu código para que OpenRouter derive la petición automáticamente a un modelo equivalente (como GPT-4o) de forma transparente para el usuario final, garantizando que tu aplicación nunca deje de responder.

    4. Control de Costes y Estadísticas

    La plataforma ofrece un panel visual increíblemente detallado que te muestra qué modelos están consumiendo más recursos, cuántos tokens envías en la fase de contexto y la latencia promedio de cada proveedor.


    Cómo implementarlo en tus Agentes Autónomos

    Integrar OpenRouter en frameworks agénticos como Hermes es sumamente sencillo. Al ser compatible con la especificación de OpenAI, basta con apuntar el base_url del cliente al endpoint unificado:

    import OpenAI from "openai";
    
    const client = new OpenAI({
      baseURL: "https://openrouter.ai/api/v1",
      apiKey: "tu_token_de_openrouter_aqui",
    });
    
    async function main() {
      const completion = await client.chat.completions.create({
        model: "anthropic/claude-3.5-sonnet", // Cambia a "qwen/qwen-2.5-coder-32b" cuando quieras
        messages: [
          { role: "user", content: "Escribe una función de ordenamiento en TypeScript." }
        ],
      });
    
      console.log(completion.choices[0].message.content);
    }
    main();
    

    Este enfoque híbrido y unificado es la infraestructura de base que montamos en el curso de Construye con IA para desarrollar productos escalables, y el que explotamos en producción para conectar canales de comunicación automatizados en el nuevo curso de Hermes Agent.


    Conclusión: La API definitiva para Developers

    No pierdas el tiempo gestionando contratos de facturación individuales ni peleando con diferentes SDKs. Al adoptar OpenRouter en tus desarrollos de inteligencia artificial, simplificas tu código a una única conexión, blindas tu aplicación contra caídas de proveedores y tienes la libertad de elegir el modelo idóneo para cada tarea con un solo cambio de configuración.

    Si estás utilizando OpenRouter en producción y quieres optimizar el consumo de tus tokens en tareas agénticas complejas, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿OpenRouter cobra alguna comisión por encima del precio del modelo?

    No. OpenRouter ofrece los modelos a los precios de coste oficiales de los proveedores (e incluso más baratos en algunos modelos de código abierto debido a acuerdos de volumen con servidores de hosting de inferencia como Together o Fireworks). Su modelo de negocio se basa en la agregación y volumen de tráfico.

    ¿Qué sucede con la privacidad de mis datos al usar OpenRouter?

    OpenRouter actúa como un proxy de transporte. Tus prompts viajan encriptados a través de su API hacia el proveedor del modelo seleccionado. La plataforma no almacena las conversaciones de tus usuarios a menos que actives explícitamente los logs en tu panel de configuración para depuración de errores.

    ¿Se pueden usar herramientas (Tool Calling) a través de OpenRouter?

    Sí. OpenRouter soporta el paso de herramientas (tools) y la llamada de funciones nativas para todos los modelos que lo admitan de forma nativa en su arquitectura (como las familias de Claude, GPT, Llama y Qwen).

    ¿Es seguro usar OpenRouter para aplicaciones de producción masivas?

    Sí, es una infraestructura robusta utilizada por miles de aplicaciones y startups en producción a nivel global. Al contar con endpoints optimizados y soporte para conmutación por error (fallbacks), suele ofrecer una estabilidad incluso superior a la de conectarse directamente a un único proveedor.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Clasificar tareas con IA: guía de supervivencia para developers

    Clasificar tareas con IA: guía de supervivencia para developers


    status: borrador
    title: "Clasificar tareas con IA: guía de supervivencia para developers"
    slug: clasificar-tareas-con-ia-desarrollo-software
    excerpt: "Aprende a clasificar tareas con IA en desarrollo de software. Descubre cómo dividir tareas seriales y paralelas para programar de forma profesional sin bugs."
    keywords:

    • clasificar tareas con IA
    • tareas seriales vs paralelas software
    • desarrollo guiado por IA
    • agentes de inteligencia artificial

    El martes pasado perdí cuatro horas intentando que Claude Code (v0.2.0, corriendo con el modelo Claude 3.5 Sonnet) reescribiera un módulo de pagos entero de un solo golpe. El resultado fue un bucle infinito de errores de tipado en TypeScript que me enseñó la importancia de clasificar tareas con IA antes de ponerme a tirar código.

    Si tratas a un LLM como a un junior todoterreno sin entender qué puede resolver en paralelo y qué requiere tu intervención directa, vas a perder más tiempo depurando que programando. Para construir software real con inteligencia artificial, necesitas dividir tu backlog bajo un criterio muy simple: estructura mental vs. ejecución de código.

    Aprender a clasificar tareas con IA es lo que separa a los programadores que sufren de "vibe coding hangover" de los que construyen aplicaciones mantenibles y escalables en producción.


    ¿Por qué debes clasificar tareas con IA?

    Cuando automatizas flujos con agentes, la mayoría de los desarrolladores cometen el error de meter todo en una gran cadena secuencial. No entienden cómo fluyen los datos y la memoria dentro de un modelo de lenguaje.

    Los LLMs tienen una ventana de contexto limitada y, a medida que la conversación se alarga, sufren de pérdida de atención. Si el modelo comete un pequeño error en el paso 1 y continúas la secuencia sin corregirlo, ese error se propaga y amplifica en los pasos 2, 3 y 4.

    Por eso, separar las tareas no es una cuestión de organización escolar: es una necesidad de arquitectura técnica para evitar que el contexto del modelo se contamine.


    Tareas seriales vs. paralelas: El cuello de botella del contexto

    Para delegar a la IA de forma óptima, debes entender la diferencia entre dos tipos de flujos de trabajo:

    A. Tareas Seriales (Secuenciales)

    Son aquellas donde cada paso depende estrictamente del resultado del paso anterior. No puedes avanzar si el paso previo no está validado.

    • Ejemplo: Diseñar un backend con NestJS. No puedes escribir los controladores ni los queries del ORM hasta que la estructura de tablas SQL esté completamente definida y validada.
    • Workflow: Exigen pasos secuenciales cortos con validaciones humanas intermedias. Necesitas un modelo integrado en tu IDE (como Cursor o Claude Code) operando con supervisión activa. Tú guías el flujo, pruebas cada paso en local y decides el siguiente movimiento.

    B. Tareas Paralelas (Independientes)

    Son tareas independientes que no comparten estado entre sí y se pueden ejecutar en entornos aislados de forma simultánea.

    • Ejemplo: Traducir archivos i18n de traducción, documentar funciones utilitarias independientes o escribir tests unitarios de Jest para componentes que no tienen acoplamiento entre sí.
    • Workflow: Este es el territorio ideal de los agentes autónomos que corren en segundo plano. Puedes lanzar múltiples llamadas paralelas a la API y resolver el backlog en segundos mientras tú te enfocas en diseñar la lógica del negocio.

    A continuación, puedes ver una comparativa clara de cómo enfocar cada tipo de tarea:

    Característica Tareas Seriales (Secuenciales) Tareas Paralelas (Independientes)
    Dependencia Alta (Paso B necesita el output de A) Nula o muy baja (Módulos aislados)
    Workflow de IA Interactivo (Human-in-the-loop) Agentes autónomos en background
    Ejemplo práctico Depuración de bugs complejos, diseño de APIs Escribir tests unitarios, documentación
    Riesgo de desvío Alto (los errores de contexto se acumulan) Bajo (tareas acotadas y repetitivas)
    Intervención humana Constante (validación paso a paso) Al inicio (spec) y al final (code review)

    Cómo clasificar tareas con IA: lo que delegas y lo que no

    La IA es un ejecutor brutal de especificaciones cerradas. Si le das reglas claras y un entorno acotado, escribirá código mejor y más rápido que tú. Esto es lo que llamamos el "desarrollo guiado por IA".

    Para flujos secuenciales complejos, la clave está en fragmentar el código. No le pidas al modelo "escribe el endpoint de cobro con Stripe entero". En su lugar, fragméntalo en una secuencia controlada:

    // Paso 1: Pídele que defina la interfaz de datos estrictamente
    interface PaymentPayload {
      amount: number;
      currency: 'USD' | 'EUR';
      token: string;
    }
    
    // Paso 2: Una vez validada la interfaz, pídele implementar el validador
    function validatePayment(payload: PaymentPayload): boolean {
      return payload.amount > 0 && payload.token.length > 0;
    }
    

    Qué delegar a la IA (Ejecución y Boilerplate)

    • Scaffolding: Configuración de herramientas, setup de linters, inicialización de módulos.
    • Refactoring menor: Traducir funciones, migrar código JavaScript legacy a TypeScript clásico.
    • Tests y Documentación: Tareas repetitivas que consumen tiempo y tienen baja ambigüedad.

    Qué NUNCA debes delegar al modelo (Criterio y Dirección)

    • Decisiones de arquitectura: Decidir si tu base de datos debe ser relacional, si necesitas microservicios, o qué abstracción introducir hoy para no bloquear el desarrollo en 6 meses. La IA optimiza a nivel local, pero no ve a largo plazo.
    • Comprensión del negocio: Qué le importa realmente al usuario y qué tradeoffs valen la pena asumir.

    Para evitar que tu proyecto se desvíe, yo utilizo una metodología de diseño de especificaciones antes de tocar código. En el Libro SDD (Leanpub) explico cómo escribir especificaciones claras que los modelos de lenguaje entienden a la perfección y ejecutan a la primera.


    El loop humano: Tú eres el compilador final

    La automatización no significa que el programador desaparezca. Al contrario, la evolución natural del programador tradicional, como vimos en nuestro post sobre loop engineering y la evolución de la IA, exige que pases de escribir código a orquestar sistemas que escriben código.

    Tu rol ya no es picar código sin parar. Tu trabajo es diseñar la especificación, configurar los límites de los agentes (como las directivas en la documentación de Claude Code de Anthropic), y actuar como el control de calidad senior que decide qué entra a producción y qué se descarta.

    Esto es parte de lo que explico en mi artículo sobre el stack de IA agentica en 2026, donde analizamos cómo los ingenieros senior multiplican su productividad manejando subagentes independientes para tareas aisladas.

    Si quieres dominar este flujo y aprender a estructurar proyectos reales que funcionen con agentes y Claude Code, te recomiendo revisar el Curso "Construye con IA" en Udemy. Es el paso a paso exacto que yo sigo para lanzar productos sin perder la cabeza con bugs infinitos.

    Empieza hoy por lo básico: abre tu backlog y etiqueta cada tarea pendiente. Sabrás exactamente cuándo colaborar en vivo, cuándo lanzar un agente en background y cuándo apagar la pantalla y pensar tú solo.

    También puedes unirte a Dominicode Labs para acceder a herramientas, experimentos y una comunidad de desarrolladores seniors que están construyendo el futuro del software con inteligencia artificial aplicada de verdad.


    Preguntas frecuentes

    ¿Cómo clasificar tareas con IA en seriales o paralelas?

    Pregúntate si el output de un paso es obligatorio para que el siguiente empiece a procesarse. Si la respuesta es sí (como definir el esquema SQL antes de escribir el ORM), la tarea es serial y secuencial. Si las tareas pueden ejecutarse en entornos independientes sin afectarse mutuamente (como escribir tests de archivos diferentes), son paralelas.

    ¿Por qué los modelos de IA fallan en las tareas seriales largas?

    A medida que el prompt y la conversación se alargan, el modelo sufre de pérdida de atención (needle in a haystack) y alucinaciones. Si el paso 1 tiene un pequeño error de interpretación, ese error se arrastra y amplifica en los pasos siguientes, destruyendo el resultado final. La clave es fragmentar el proceso en prompts individuales.

    ¿Se puede automatizar al 100% el desarrollo de software con agentes de IA?

    No en aplicaciones de producción complejas. Los agentes actuales destacan implementando código bajo especificaciones acotadas. Sin embargo, la toma de decisiones de negocio, el diseño de la arquitectura general y la integración de APIs de terceros siguen requiriendo la supervisión y validación de un programador humano experimentado.

    ¿Qué herramientas son mejores para ejecutar tareas paralelas con LLMs?

    Para flujos paralelos de volumen (como traducción o análisis de código masivo), las APIs de Claude o OpenAI conectadas a scripts locales son la opción más rápida y económica. Para desarrollo interactivo en local y tareas seriales complejas que requieren explorar el workspace, herramientas como Claude Code o entornos basados en agentes autónomos son ideales.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Hermes Agent + oMLX: Inferencia local en Apple Silicon

    Hermes Agent + oMLX: Inferencia local en Apple Silicon

    Cuando buscas privacidad absoluta al construir tus herramientas y automatizaciones agénticas, la respuesta siempre es correr todo en tu propia máquina. Sin embargo, en macOS, levantar un agente de IA y conectarlo a un modelo local suele traducirse en dos problemas: o el modelo responde de forma desesperantemente lenta, o devora toda la memoria unificada y tu Mac se congele. Como vimos en nuestra guía de hardware y modelos para LLMs locales, correr modelos de gran escala exige un balance fino de memoria.

    La solución requiere un matrimonio arquitectónico perfecto.

    Hoy te quiero enseñar cómo configurar Hermes Agent con oMLX, combinando el mejor plano de control agéntico con el servidor de inferencia nativo más rápido y eficiente para los procesadores Apple Silicon.


    El Plano de Control se une al Plano de Inferencia

    Como analizamos en nuestra guía de las 4 capas de la IA local, un agente autónomo no debe cargar los pesos del modelo por su cuenta. Necesita un servidor especializado que le sirva las respuestas.

    Para un desarrollador en macOS, la combinación de Hermes Agent y oMLX es el estándar de oro actual:

    • Hermes Agent como Plano de Control: Aporta el bucle de auto-aprendizaje, la persistencia de conversaciones en SQLite, la ejecución de herramientas seguras en contenedores y las integraciones multicanal (Telegram, Notion, Slack).
    • oMLX como Plano de Inferencia: Aporta velocidad bruta de generación Metal-accelerated, continuous batching (para procesar llamadas concurrentes de múltiples sub-agentes) y un sistema de caché de contexto optimizado.

    Al estar desacoplados, tu agente interactúa con oMLX de forma transparente utilizando la API estándar compatible con OpenAI.


    Paso 1: Levantar el Servidor oMLX en macOS

    oMLX requiere Apple Silicon (M1 o posterior) y macOS 15+. Puedes instalar la cómoda aplicación de barra de menú notarizada o levantar el servidor de consola desde el repositorio oficial de oMLX clonado.

    Para inicializar oMLX en producción local con soporte de caché SSD y concurrencia optimizada, ejecuta el siguiente comando en tu terminal:

    omlx serve \
      --model-dir ~/models \
      --paged-ssd-cache-dir ~/.omlx/cache \
      --hot-cache-max-size 20% \
      --max-concurrent-requests 8 \
      --api-key local-dev-key
    

    Este servidor arrancará de forma local en http://127.0.0.1:8000/v1 y expondrá tu modelo (por ejemplo, Mistral-7B-Instruct-MLX-4bit) listo para ser consumido.


    Paso 2: Configurar Hermes Agent para apuntar a oMLX

    Para conectar Hermes a tu servidor oMLX, puedes usar el asistente interactivo ejecutando hermes model en tu consola y seleccionando la opción Custom endpoint.

    O si lo prefieres, puedes editar directamente tu archivo de configuración en ~/.hermes/config.yaml:

    model:
      default: Mistral-7B-Instruct-MLX-4bit
      provider: custom
      base_url: http://127.0.0.1:8000/v1
      context_length: 128000
    
    custom_providers:
      - name: local-omlx
        base_url: http://127.0.0.1:8000/v1
        models:
          Mistral-7B-Instruct-MLX-4bit:
            context_length: 128000
    
    terminal:
      backend: local
      timeout: 180
    

    Configuración de seguridad ante pre-procesamientos largos:

    Cuando utilizas contextos masivos de código en local, el servidor de inferencia puede tomarse algunos minutos para procesar todo el prompt inicial (fase de prefill).

    Para evitar que Hermes corte la conexión por timeout mientras oMLX está procesando el contexto largo, asegúrate de configurar estas variables en tu archivo ~/.hermes/.env:

    HERMES_STREAM_READ_TIMEOUT=1800
    HERMES_API_TIMEOUT=1800
    

    Este nivel de sintonía fina técnica es el que te permite correr flujos de trabajo profesionales sin caídas de red, y es el estándar de infraestructura que enseñamos en profundidad tanto en el curso de Construye con IA como en el nuevo curso de Hermes Agent.


    Conclusión: Privacidad real a la velocidad del silicio

    Al orquestar tus tareas autónomas con Hermes Agent y procesar toda la inferencia local con oMLX bajo la GPU de tu Mac, consigues una soberanía de datos absoluta. Tus contraseñas, código propietario y conversaciones nunca viajan a servidores de terceros, y disfrutas de la máxima aceleración de hardware que Apple Silicon puede ofrecer.

    Si quieres compartir tus configuraciones de hardware locales y ver cómo conectamos estos agentes locales a integraciones web de producción, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Por qué la combinación Hermes + oMLX es más rápida que usar Ollama en Mac?

    Ollama utiliza llama.cpp como motor por debajo, el cual es excelente en optimizar el tiempo hasta el primer token (TTFT) para chats cortos. Sin embargo, oMLX utiliza el framework nativo de Apple (MLX) que aprovecha la arquitectura de memoria unificada al máximo, ofreciendo una velocidad de generación sostenida mucho mayor en contextos largos y procesamiento de código.

    ¿Qué hace el parámetro –hot-cache-max-size 20% en oMLX?

    Indica al servidor qué porcentaje de la memoria RAM unificada de tu Mac puede reservarse para mantener en caliente los tokens de contexto de conversaciones recientes. El resto de contextos inactivos se moverán automáticamente al disco de estado sólido (SSD) para liberar espacio físico de GPU.

    ¿Puedo utilizar llamadas a herramientas (Tool Calling) en local?

    Sí. oMLX implementa parsers de herramientas nativos para las familias de modelos más populares (Qwen, Llama y Mistral). La condición clave es que el chat template del modelo descargado de Hugging Face sea compatible con el paso de la variable tools.

    ¿Cómo sé si mi Mac es compatible con esta configuración?

    Requiere un ordenador Mac con procesador Apple Silicon (M1, M2, M3, M4 o sus variantes Pro/Max/Ultra) y sistema operativo macOS 15 o posterior. Se recomienda contar con un mínimo de 16GB de memoria unificada, siendo el sweet spot para modelos grandes contar con 32GB o 64GB de RAM.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • oMLX: El servidor de inferencia definitivo para Apple Silicon

    oMLX: El servidor de inferencia definitivo para Apple Silicon

    Comprar un Mac con memoria unificada de Apple Silicon para correr modelos locales es una de las mejores inversiones que puede hacer un desarrollador hoy en día. Sin embargo, resulta frustrante ver cómo gran parte de esa memoria se satura de inmediato al cargar contextos masivos de código en tu IDE o al ejecutar agentes autónomos de forma continuada.

    El problema no es de tu Mac. Es de la capa de servicio de inferencia.

    Llama.cpp y Ollama son herramientas excelentes y versátiles, pero no están diseñadas para exprimir al 100% las capacidades específicas del silicio de Apple a nivel de gestión de memoria profunda.

    Hoy te quiero explicar cómo configurar oMLX en Mac, un servidor de inferencia de código abierto diseñado exclusivamente para Apple Silicon que promete cambiar las reglas del juego de la IA local mediante técnicas avanzadas de cache de contexto y rendimiento óptimo.


    ¿Qué es oMLX y por qué importa en Mac?

    oMLX (disponible en su web oficial omlx.ai) es una capa de servicio de inferencia de alto rendimiento construida directamente sobre MLX, el framework de aprendizaje automático de código abierto desarrollado por Apple para aceleración de Metal.

    A diferencia de usar scripts de Python directos de MLX o de usar loaders tradicionales, oMLX funciona como un servicio robusto en segundo plano (con una cómoda interfaz en la barra de menús de macOS) que expone APIs totalmente compatibles con OpenAI y Anthropic.

    Pero su verdadero valor diferencial radica en cómo soluciona el cuello de botella de la memoria mediante el Tiered KV Caching (Caché de Claves-Valores en Dos Niveles).


    La magia del Tiered KV Caching

    Cuando utilizas un agente de IA (como tu IDE con autocompletado o un bot autónomo), el modelo pasa la mayor parte del tiempo procesando el mismo contexto repetidamente (los archivos de tu proyecto, el historial de la conversación, etc.). Esto llena la memoria VRAM de claves y valores (KV Cache).

    Si tu contexto es de 32k tokens, una gran parte de tu valiosa memoria unificada se consume únicamente en recordar la conversación, dejándote sin espacio para correr modelos más grandes de 14B o 32B parámetros.

    Como vimos en nuestra guía de hardware y modelos para LLMs locales en 2026, la velocidad y capacidad están limitadas por la VRAM. oMLX soluciona esto de forma brillante:

    • Caché Caliente (RAM): Mantiene los tokens de contexto más recientes y activos en la memoria ultrarrápida del sistema.
    • Caché Frío (SSD): Mueve los prefijos y contextos más antiguos o inactivos a tu disco de estado sólido (SSD) local.

    Cuando vuelves a interactuar con el agente en el mismo contexto, oMLX restaura la caché del SSD al instante sin necesidad de que la GPU tenga que re-computar todo el prompt desde cero. Esto reduce la latencia de respuesta (Time to First Token) a prácticamente cero y libera Gigabytes de memoria unificada.


    Características clave para Desarrolladores

    Si estás construyendo tus propios agentes o quieres optimizar tus herramientas locales, oMLX aporta ventajas que Ollama o Llama.cpp aún no implementan de forma tan integrada para Apple Silicon:

    1. Continuous Batching (Procesamiento continuo por lotes): Permite procesar múltiples peticiones entrantes de forma paralela en la GPU sin bloquear los hilos. Es ideal si tienes varios sub-agentes trabajando en segundo plano.
    2. API Dual Compatible: Expone endpoints idénticos a los de OpenAI y Anthropic. Puedes cambiar tu proveedor del SDK de Claude o GPT apuntándolo a tu servidor local de oMLX y todo seguirá funcionando sin tocar una línea de código.
    3. Gestión Visual: La aplicación nativa de macOS te permite monitorizar el uso de memoria Metal en tiempo real, descargar modelos directamente desde Hugging Face y gestionar logs sin tocar la terminal.

    Cómo conectar tus Agentes a oMLX

    Para empezar a utilizarlo en tus pipelines de desarrollo, solo debes seguir estos pasos:

    1. Instala el servidor descargando la app de oMLX en GitHub o vía Homebrew.
    2. Descarga tu modelo de código preferido (ejemplo: Qwen/Qwen2.5-Coder-7B-Instruct-MLX).
    3. El servidor web local se iniciará automáticamente expuesto en el puerto http://localhost:8000.

    A partir de ahí, puedes integrarlo en cualquier framework agéntico o en tu propio entorno local de desarrollo. Esta es exactamente la filosofía que discutimos y ponemos en práctica en el curso de Construye con IA para maximizar la velocidad de ejecución y minimizar costes.


    Conclusión: Diseña para el Hardware Local

    Correr IA local no es solo cuestión de descargar modelos, sino de entender cómo interactúan con el silicio de tu máquina. Al aprovechar herramientas optimizadas como oMLX, transformas tu Mac en un nodo de procesamiento de alta velocidad capaz de gestionar agentes autónomos multitarea sin pestañear.

    Si estás experimentando con oMLX y quieres optimizar la configuración de tus modelos locales de desarrollo en macOS, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Cuál es la diferencia entre MLX y oMLX?

    MLX es el framework de operaciones matemáticas y deep learning desarrollado por Apple (equivalente a PyTorch o TensorFlow). oMLX es un servidor de inferencia de producción y una interfaz de usuario construida encima de MLX para que puedas servir modelos y comsumirlos a través de APIs web sin necesidad de escribir scripts de consola.

    ¿Qué modelos son compatibles con oMLX?

    oMLX es compatible con cualquier modelo disponible en formato MLX (que suelen publicarse en Hugging Face bajo cuentas como mlx-community). Esto incluye familias populares como Llama 3, Qwen 2.5 Coder, Mistral y Phi-3.

    ¿Cómo ayuda el Tiered KV Caching a los agentes de IA?

    Los agentes de IA envían constantemente todo el contexto de sus herramientas y el historial en cada petición. oMLX guarda este contexto inactivo en el SSD de tu Mac y solo carga en la RAM el contexto activo actual. Al no tener que volver a procesar miles de palabras previas en la GPU, la respuesta del agente es inmediata y consume mucha menos memoria.

    ¿Se puede usar oMLX en Windows o Linux?

    No. oMLX está construido específicamente sobre el framework MLX de Apple, el cual utiliza la API de Metal y la arquitectura de memoria unificada exclusiva de los procesadores Apple Silicon (M1, M2, M3, M4, etc.). Para Windows o Linux con GPUs Nvidia o AMD, debes seguir utilizando herramientas como Ollama o vLLM.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qwen 3.7: El nuevo gigante de razonamiento que cambia las reglas

    Qwen 3.7: El nuevo gigante de razonamiento que cambia las reglas

    Cuando pensamos en modelos de razonamiento avanzado y agentes autónomos capaces de operar durante horas, la mente siempre nos viaja a Silicon Valley. Nos imaginamos los laboratorios de OpenAI en San Francisco o las oficinas de Anthropic. Como vimos en nuestra guía de mejores modelos de IA para correr en local, Qwen destaca en programación local, pero sus capacidades propietarias en la nube van mucho más allá.

    Sin embargo, el verdadero competidor a batir hoy en día en lógica pura y desarrollo de software viene de Hangzhou.

    Alibaba Cloud ha dado un golpe de autoridad con el lanzamiento de su nueva familia insignia: Qwen 3.7.

    Hoy te quiero contar qué hace especial a Qwen 3.7, por qué su modelo de razonamiento Max está poniendo en aprietos a Claude 3.5 Sonnet y cómo puedes integrarlo hoy mismo en tus pipelines de desarrollo.


    La familia Qwen 3.7: Max y Plus

    Presentada oficialmente en la cumbre tecnológica de Alibaba, la serie Qwen 3.7 introduce una arquitectura optimizada para la toma de decisiones lógicas en entornos complejos. El lanzamiento se ha estructurado en torno a dos variantes principales:

    • Qwen 3.7-Max: Un modelo de texto puro centrado en razonamiento matemático, generación de código complejo y resolución de tareas autónomas de largo recorrido (long-horizon autonomous tasks). Cuenta con una ventana de contexto colosal de 1 millón de tokens.
    • Qwen 3.7-Plus: Un modelo multimodal nativo que integra visión y texto, optimizado para la interacción autónoma con interfaces gráficas de usuario (GUI), automatización de navegación web y tareas de diseño visual.

    A diferencia de las versiones anteriores, Qwen 3.7 es de código cerrado (proprietario) por ahora. No puedes descargar sus pesos para correrlos en local, pero sus capacidades como motor de backend de agentes justifican plenamente pagar por su API.


    ¿Por qué importa Qwen 3.7 para tus Agentes de IA?

    Si estás construyendo pipelines agénticos con frameworks como Hermes, sabes que el principal cuello de botella de los modelos tradicionales es la falta de consistencia lógica en planes de muchos pasos. La IA tiende a desviarse del objetivo o a cometer errores de sintaxis a medida que la conversación se alarga.

    Qwen 3.7 soluciona esto a tres niveles clave:

    1. Memoria de contexto masiva: Su ventana de 1M de tokens te permite pasarle repositorios enteros de código o historiales comerciales completos sin tener que recurrir a complejas técnicas de fragmentación o RAG restrictivos.
    2. Razonamiento profundo integrado: Al igual que los modelos o1/o3, Qwen 3.7-Max calcula silenciosamente sus rutas lógicas antes de emitir la primera palabra, reduciendo los errores lógicos en refactorizaciones de código a niveles ínfimos.
    3. Continuous execution: Está especialmente entrenado para interactuar con herramientas externas mediante MCP (Model Context Protocol), respondiendo de forma ultra-consistente ante llamadas repetidas de base de datos o consolas.

    Cómo conectar Qwen 3.7 a Hermes Agent

    Aunque los pesos son cerrados, la gran ventaja es que puedes consumir la API de Qwen 3.7-Max a través de proveedores compatibles con la interfaz de OpenAI, como OpenRouter o Fireworks AI.

    Para usar Qwen 3.7 como el motor cerebral de tu agente Hermes en segundo plano, solo debes configurar tu archivo ~/.hermes/config.yaml apuntando al endpoint del router:

    model:
      default: qwen/qwen-3.7-max
      provider: custom
      base_url: https://openrouter.ai/api/v1
      context_length: 1000000
    
    custom_providers:
      - name: openrouter-qwen
        base_url: https://openrouter.ai/api/v1
        models:
          qwen/qwen-3.7-max:
            context_length: 1000000
    

    Y asegurar que tu archivo .env local contenga el token de autenticación de OpenRouter para autorizar las consultas:

    OPENROUTER_API_KEY=tu_token_de_acceso_privado
    

    Con esta configuración, tu agente operará con la potencia de uno de los mejores LLMs del mercado actual, delegando la inferencia pesada a la nube por una fracción del coste de otros proveedores propietarios.

    Este enfoque híbrido (agente local + cerebro en la nube) es la arquitectura de producción que defendemos en el curso de Construye con IA y la que llevamos a cabo para automatizar flujos complejos en el nuevo curso de Hermes Agent.


    Conclusión: La IA ya no es monopolio de Occidente

    El lanzamiento de Qwen 3.7 demuestra que la brecha de rendimiento entre las corporaciones de Silicon Valley y los gigantes asiáticos se ha cerrado por completo. Para tareas lógicas pesadas y desarrollo de software, evaluar alternativas como Qwen 3.7-Max es obligatorio si quieres mantener la máxima velocidad de ejecución al coste de API más bajo.

    Si estás experimentando con Qwen 3.7 en tus herramientas y quieres debatir sus resultados con otros desarrolladores senior de nuestra comunidad, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qwen 3.7 tendrá versiones de código abierto (open-weights) en el futuro?

    Alibaba tiene un historial sólido de publicar versiones open-source (Qwen-Coder, Qwen-Instruct) meses después del lanzamiento de sus APIs de pago insignia. Aunque a día de hoy Qwen 3.7-Max y Plus son cerrados, es altamente probable que veamos variantes destiladas de menor tamaño (como 7B o 14B) publicadas en Hugging Face en los próximos meses.

    ¿Qué coste tiene la API de Qwen 3.7 en comparación con Claude 3.5 Sonnet?

    Históricamente, los precios de API de Alibaba Cloud y sus distribuidores autorizados en OpenRouter son extremadamente competitivos, situándose habitualmente a una fracción del coste por millón de tokens en comparación con los precios oficiales de Anthropic o OpenAI para modelos del mismo rango de rendimiento.

    ¿Qué ventajas aporta Qwen 3.7-Plus en la automatización de interfaces (GUI)?

    Qwen 3.7-Plus está entrenado con capacidades avanzadas de visual grounding (localización de coordenadas en pantalla). Esto significa que al pasarle una captura de pantalla de una aplicación web, el modelo puede identificar con precisión matemática dónde debe hacer clic o qué campo de texto debe rellenar un agente de navegación web autónomo.

    ¿Se puede usar la ventana de contexto de 1 millón de tokens en OpenRouter?

    Sí. OpenRouter soporta y adapta los límites de contexto declarados por el proveedor oficial de Alibaba. Sin embargo, recuerda que enviar contextos masivos de cientos de miles de tokens aumentará proporcionalmente el coste de la consulta y la latencia inicial de respuesta (TTFT) debido al volumen de datos a pre-procesar.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Las 4 capas de la IA Local: Evita errores comunes

    Las 4 capas de la IA Local: Evita errores comunes

    Cuando un desarrollador decide meterse en el mundo de la IA local, lo primero que suele hacer es clonar tres repositorios distintos de GitHub, descargar un modelo desde Hugging Face y cruzar los dedos.

    A los diez minutos, algo falla y escribe frustrado en un foro: "Ayuda, Hermes Agent no soporta archivos GGUF" o "¿Ollama es compatible con LangChain?".

    Es un error clásico. Ocurre porque la industria avanza tan rápido que no nos ha dado tiempo a trazar un mapa conceptual de lo que estamos construyendo. Mezclar las capas de abstracción en tu servidor te llevará a diagnósticos erróneos y a un código insostenible. Puedes consultar nuestro post sobre cómo configurar oMLX en Mac para ver cómo operan de forma desacoplada las capas de inferencia y agente.

    Hoy te quiero enseñar las 4 capas de la IA local que debes dominar para estructurar tus proyectos de forma profesional y entender qué herramienta hace qué en tu máquina.


    El Mapa del Stack de IA Local

    Para evitar dolores de cabeza, debes entender que un entorno de inteligencia artificial local se compone de cuatro capas independientes y bien delimitadas:

    ┌─────────────────────────────────────────┐
    │ 1. AGENTE / ORQUESTADOR (Hermes Agent)  │  <-- Controla la lógica y flujo
    └─────────────────────────────────────────┘
                         │  (Habla vía API HTTP / JSON)
                         ▼
    ┌─────────────────────────────────────────┐
    │ 2. SERVIDOR DE INFERENCIA / SERVING     │  <-- Expone endpoints OpenAI/Anthropic
    │    (oMLX, Ollama, llama.cpp, vLLM)       │
    └─────────────────────────────────────────┘
                         │  (Compila y optimiza para el chip)
                         ▼
    ┌─────────────────────────────────────────┐
    │ 3. RUNTIME ENGINE (MLX, TensorRT-LLM)   │  <-- Gestiona el hardware (GPU/Metal)
    └─────────────────────────────────────────┘
                         │  (Lee los bytes binarios)
                         ▼
    ┌─────────────────────────────────────────┐
    │ 4. FORMATO DE PESOS (GGUF, safetensors) │  <-- Los archivos del modelo (.bin)
    └─────────────────────────────────────────┘
    

    Capa 1: El Agente / Orquestador (El Cerebro Lógico)

    Aquí es donde viven herramientas como Hermes Agent, LangChain o LlamaIndex. Esta capa no sabe matemáticas de tensores, no lee archivos de pesos binarios ni sabe qué es una GPU.

    • Su función: Orquestar la conversación, manejar la persistencia de sesiones en SQLite, gestionar el historial de prompts y llamar a herramientas externas mediante MCP (Model Context Protocol).
    • Cómo se comunica: Es 100% API-céntrico. Solo le importa hablar con un puerto web (como http://localhost:8000) que le devuelva texto en formato compatible con OpenAI o Anthropic.

    Capa 2: El Servidor de Inferencia (El Gestor de Tráfico)

    Aquí encontramos a oMLX, Ollama, LM Studio o vLLM. Su trabajo es actuar como puente entre el protocolo web del agente y los motores de bajo nivel del hardware.

    • Su función: Exponer los endpoints HTTP compatibles (/v1/chat/completions), gestionar las colas de peticiones entrantes (continuous batching), optimizar el uso de memoria RAM y administrar las cachés de claves y valores (KV cache).

    Capa 3: El Runtime Engine (El Acelerador de Hardware)

    El motor de bajo nivel matemático. Aquí están MLX (el framework oficial de Apple), ONNX Runtime, TensorRT-LLM de Nvidia o la librería core de llama.cpp.

    • Su función: Traducir las operaciones lógicas de la red neuronal a comandos nativos de tu hardware específico (núcleos CUDA de Nvidia o aceleración Metal en los chips Apple Silicon M1/M2/M3/M4).

    Capa 4: El Formato de Pesos (Los Datos)

    La capa más baja. Los archivos binarios reales descargados de Hugging Face en formatos como MLX, GGUF, safetensors u ONNX. Son simplemente las matrices de números y coeficientes del modelo (por ejemplo, Qwen 2.5 Coder o Llama 3).


    Por qué esta distinción te salvará la vida

    Cuando entiendes este mapa, te das cuenta de que la pregunta: "¿Hermes Agent soporta modelos GGUF?" no tiene sentido.

    Hermes es formato-agnóstico a nivel de pesos. A Hermes no le importa si tu modelo es un archivo GGUF o una carpeta MLX. A Hermes solo le importa que el Servidor de Inferencia (como Ollama o oMLX) le exponga un puerto compatible. Si el servidor lee GGUF y responde HTTP, Hermes funcionará sin cambiar una línea de código.

    Este enfoque modular y arquitectónico es clave para construir sistemas escalables. Es la filosofía que defendemos en el libro de SDD: Spec-Driven Development para estructurar el desarrollo antes de codificar, y la que aplicamos para conectar microservicios locales en el curso de Construye con IA y en el nuevo curso de Hermes Agent.


    Conclusión: Diseña con desacoplamiento

    No ates tu lógica agéntica a un formato de archivo o a un hardware concreto. Al separar el plano de control (Hermes) del plano de inferencia (oMLX/Ollama), puedes cambiar de modelo, escalar tu servidor a una máquina con GPU dedicada en Linux o correr localmente en tu Mac sin tener que reescribir una sola línea del comportamiento de tu agente de IA.

    Si quieres debatir sobre la arquitectura óptima de IA local para tu equipo y resolver dudas de infraestructura, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Por qué Hermes Agent no carga directamente los pesos del modelo?

    Para mantener la eficiencia y el desacoplamiento. Cargar pesos de modelos de miles de millones de parámetros requiere optimizaciones extremas de memoria GPU a bajo nivel. Delegar esto a servidores dedicados (como oMLX o vLLM) permite que Hermes se concentre únicamente en la lógica de control, la orquestación de herramientas y el flujo de la conversación.

    ¿Qué formatos de pesos debo usar en Mac con Apple Silicon?

    Para obtener el máximo rendimiento nativo en procesadores Apple Silicon, se recomienda utilizar el formato MLX servido por herramientas como oMLX. Si buscas portabilidad o usas hardware variado, el formato GGUF servido por Ollama o llama.cpp es la alternativa estándar.

    ¿Cómo se comunican el Agente y el Servidor de Inferencia?

    Se comunican a través del protocolo HTTP utilizando formatos de petición y respuesta compatibles con la API de OpenAI o Anthropic. Esto significa que el agente simplemente envía un JSON con los mensajes y el servidor le devuelve el texto generado (habitualmente en modo streaming).

    ¿Puedo cambiar el servidor de inferencia sin alterar mi agente?

    Sí. Al estar desacoplados mediante APIs estándar, puedes cambiar tu backend de inferencia local de oMLX en Mac a vLLM en un servidor Linux en la nube simplemente actualizar la URL base en el archivo de configuración del agente (config.yaml), sin alterar sus habilidades ni su lógica operativa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.