Tag: LLM

  • Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    El 3 de agosto Alibaba presentó Qwen3.8-Max. Me senté a leer el anuncio para sacar dos párrafos y pasar a otra cosa: modelo nuevo, ficha técnica, precio, siguiente.

    Me quedé atascado en la tabla de benchmarks.

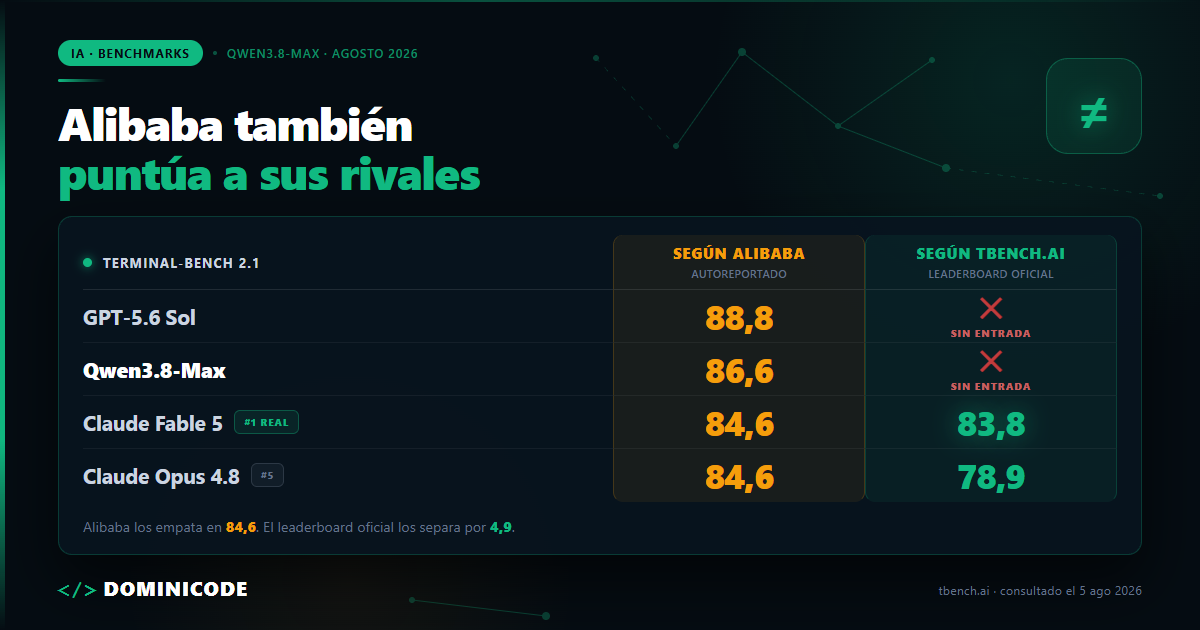
    No por sus números, sino por los de los demás. En esa tabla Alibaba no solo se puntúa a sí misma: puntúa también a Claude Opus 4.8, a Claude Fable 5 y a GPT-5.6 Sol. Cuatro filas, cuatro modelos, un único autor de las mediciones.

    Abrí el leaderboard oficial de Terminal-Bench 2.1 para cruzar las cifras. Y ahí dejó de ser una ficha técnica.

    Los cuatro modelos de la tabla de Alibaba —incluidos los tres que no son suyos— puntúan por encima del número 1 del leaderboard independiente. Dos de ellos ni siquiera tienen entrada en ese leaderboard.

    Hay una explicación legítima para esto y la doy entera más abajo, antes de cualquier conclusión. No es fraude. Pero tampoco es un ranking, aunque tenga forma de ranking.

    El contexto general —el leaderboard completo de agosto y por qué una cifra autoreportada y una medida no valen lo mismo— lo dejé escrito en Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen. Este post es el caso concreto: qué es Qwen3.8-Max, cuánto cuesta y qué haces con él a partir de hoy.

    ¿Qué es Qwen3.8-Max? 2,4 billones de parámetros y un dato que falta

    Qwen3.8-Max es un modelo MoE —mixture of experts— con 2,4 billones de parámetros totales (2,4 × 10¹², lo que en inglés se escribe 2.4T). Es multimodal de entrada: acepta texto, imagen y vídeo, y devuelve texto.

    Hasta aquí, la ficha. Ahora lo interesante. En un MoE, el número que de verdad predice coste y latencia no es el total, sino cuántos parámetros se activan por token. Los agregadores llevan días repitiendo "95B activos" como si estuviera en el anuncio.

    Fui a buscarlo y no está: Alibaba publica el total, no los activos. Tampoco lo he encontrado en ningún material primario del lanzamiento, y ninguno de los agregadores que repiten los 95B enlaza a dónde lo sacó.

    No digo que sea falso. Digo que no lo puedo verificar y que se está citando un número de segunda mano como si fuera de primera.

    Que el dato más repetido del lanzamiento sea justo el que no puedo confirmar dice bastante de cómo viaja la información técnica en las primeras 72 horas de un modelo.

    El contexto de Qwen3.8-Max: 1M de titular, 983K reales

    El titular es "1 millón de tokens de contexto". Los límites reales de la API son estos:

    Modo Entrada máxima Salida máxima
    Normal 991K tokens 131K tokens
    Con thinking activado 983K tokens 131K tokens

    No es una trampa: nadie te vende "991K de contexto". Pero si llenas la ventana hasta el borde, esos tokens que desaparecen al activar el razonamiento son los que revientan una ejecución larga a las tres de la mañana.

    Diseña contra 983K, no contra 1M. El límite que importa es el peor, no el del titular.

    Cuánto cuesta Qwen3.8-Max: $2 de entrada y $6 de salida

    Precios de lista por millón de tokens:

    Concepto Precio por millón
    Entrada $2,00
    Salida $6,00
    Lectura de caché implícita $0,25

    Franja media del mercado, no gama alta. Y el dato que casi nadie mira es el tercero: la lectura de caché a $0,25 es un 87,5% menos que la tarifa de entrada.

    Un agente que arrastra el mismo system prompt y los mismos ficheros durante veinte turnos paga la mayor parte de su factura a $0,25, no a $2. Calcula con esa tarifa o te sobrará presupuesto por el lado equivocado. La comparativa de precios de agosto de 2026 con el resto de modelos ya está publicada; aquí no la repito.

    Sobre disponibilidad, un matiz que cambia la decisión: está en API alojada y los pesos abiertos están prometidos para "la semana que viene" desde el 3 de agosto, así que aún no existen. Un modelo con pesos prometidos no es un modelo con pesos. Con Qwen3.7 analicé la generación anterior; aquí al menos hay promesa y plazo. Sigue siendo una promesa.

    Los benchmarks de Qwen3.8-Max según Alibaba

    Estas son las cifras del anuncio de lanzamiento de Alibaba, tal como las reproducen dos fuentes independientes que coinciden entre sí. No he podido confirmar la URL del anuncio original, así que no te la enlazo y prefiero decirlo en voz alta. Todas ellas, sin excepción, son mediciones reportadas por Alibaba:

    Benchmark Qwen3.8-Max (autoreportado por Alibaba)
    Terminal-Bench 2.1 86,6
    SWE-bench Pro 67,7
    DeepSWE 1.1 56,6
    PaperBench 93,0
    CoWorkBench 74,8
    WideSearch 81,9
    GPQA Diamond 92,6
    IFBench 82,8
    MRCR v2 (256K) 92,9
    MMMU-Pro 82,3
    OSWorld-Verified 86,1
    OmniDocBench 1.5 92,1
    Video-MME (con subtítulos) 90,4

    Ninguna de estas cifras ha sido reproducida por un tercero independiente a 7 de agosto de 2026.

    He dejado solo la columna de Qwen. En el anuncio, la fila de Terminal-Bench trae tres modelos más.

    Es una tabla fuerte, sobre todo en multimodal: 82,3 en MMMU-Pro y 86,1 en OSWorld-Verified con entrada de imagen y vídeo a $2 el millón es una combinación que casi nadie ofrece.

    El problema no está en esta tabla. Está en la fila de Terminal-Bench 2.1, donde Alibaba añadió a la competencia.

    Qwen3.8-Max frente a tbench.ai: el cruce fila a fila

    Esto es lo que publicó Alibaba en esa fila, junto a lo que dice el leaderboard público de tbench.ai consultado el 5 de agosto de 2026:

    Modelo Según Alibaba Según tbench.ai Puesto Harness + effort Diferencia
    GPT-5.6 Sol 88,8 sin entrada — — —
    Qwen3.8-Max 86,6 sin entrada — — —
    Claude Fable 5 84,6 83,8 #1 Claude Code, xhigh +0,8
    Claude Opus 4.8 84,6 78,9 #5 Claude Code, high +5,7

    Hay tres cosas en esa tabla y ninguna salta a la primera.

    Uno. Los cuatro valores de la columna de Alibaba superan el 83,8 que es el primer puesto del leaderboard independiente. En la tabla del anuncio, el líder real del ranking público queda empatado en tercer puesto.

    Dos. Alibaba empata a Opus 4.8 con Fable 5 en 84,6. En la medición independiente esos dos modelos están separados por 4,9 puntos. No es solo que las cifras sean más altas: es que el orden entre los rivales también cambia.

    Tres. Los dos modelos que encabezan la tabla son justo los que no tienen entrada oficial. GPT-5.6 Sol no aparece en el leaderboard —y el 88,8 que le asigna Alibaba tampoco coincide con el 89,5 que circula por los agregadores, otra cifra sin fuente que ya repasé en el post hermano—. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%): entre diez y trece puntos por debajo del 88,8 del anuncio. Y Qwen3.8-Max tampoco está: se anunció el 3 de agosto, dos días antes de esa consulta.

    Un número que nadie externo ha reproducido no es mejor ni peor. Es un número sin contraste.

    Por qué los números de Alibaba pueden ser correctos y no comparables

    Hay una razón técnica por la que las cuatro cifras pueden ser correctas sin ser comparables, y la doy antes de mi conclusión porque cambia el veredicto.

    Terminal-Bench 2.1 no puntúa modelos sueltos. Puntúa modelo + harness + effort: el modelo, el agente que lo envuelve y cuánto cómputo se le permite gastar por tarea. Por eso cada fila del leaderboard oficial dice "Claude Code + Fable 5, xhigh" y no simplemente "Fable 5".

    Si Alibaba corrió el benchmark con su propio harness y su propia configuración de esfuerzo, sus números pueden ser correctos y a la vez no comparables con los de tbench.ai. Un harness más agresivo sube a todos los modelos de la tabla, incluidos los ajenos. Eso explicaría por qué las cuatro cifras están por encima del líder oficial.

    No hay fraude en eso. Es una medición distinta de una cosa distinta.

    El problema es de presentación, y es real: una tabla con forma de ranking, que mezcla tu medición con la de tus competidores y llega al lector sin harness ni effort al lado, se va a leer como si fuera el leaderboard. Porque se parece al leaderboard.

    Es lo que enseño en Construye con IA: montar la evaluación antes que el modelo, porque el número que te sale es del sistema entero y el modelo es solo una de sus piezas. Cambia el andamiaje y cambias el número sin tocar el modelo.

    Es también el patrón que analicé con Kimi K3. La coincidencia no está en el país de origen: está en que ningún fabricante espera a que un tercero le mida antes de lanzar.

    Entonces, ¿te conviene Qwen3.8-Max?

    Sí para multimodal barato, no para agentes de terminal en producción. El criterio que lo decide es uno solo: separa lo comprobable de lo reportado.

    Comprobable hoy: $2 y $6 por millón, caché a $0,25, 983K de entrada real con thinking, 131K de salida, entrada de texto, imagen y vídeo, y disponibilidad por API. Con eso ya decides un piloto.

    Reportado y sin contraste: el 86,6 de Terminal-Bench, el 67,7 de SWE-bench Pro y el resto de la tabla. Sirven como hipótesis de trabajo, no como criterio de compra.

    Si trabajas con documentos, capturas o vídeo —OCR, análisis de UI, pipelines de contenido—, es candidato serio y su precio lo hace barato de probar. Si buscas un agente de terminal para producción, yo esperaría: los pesos no están, no hay medición independiente y sí hay opciones ya medidas.

    Lo que puedes hacer esta semana, en dos horas: elige tres tareas de tu backlog que ya sepas resolver, ejecútalas con tu agente actual y con Qwen3.8-Max detrás, y compara tiempo, turnos y factura. Tres tareas tuyas te dicen más que trece benchmarks ajenos.

    Eso solo funciona si el criterio de "terminado" está escrito antes de empezar, que es toda la lógica del libro de Spec-Driven Development: con la spec escrita, probar Qwen3.8-Max cuesta una tarde y te deja un número tuyo; sin ella, cuesta lo mismo y te deja una sensación.

    Y si tengo que resumirlo: un modelo se elige por lo que puedes comprobar tú —precio, límites reales, licencia y tu propia medición—; lo demás es la tabla de otro.

    En Dominicode Labs llevamos una hoja viva con estos cruces: qué cifra dio el fabricante, qué dio el leaderboard y qué dio nuestra propia ejecución. Qwen3.8-Max ya tiene su fila abierta.

    Preguntas frecuentes sobre Qwen3.8-Max

    ¿Qué es Qwen3.8-Max y cuándo salió?

    Es el modelo insignia que Alibaba presentó el 3 de agosto de 2026 —lo verás escrito como Qwen 3.8 Max o Qwen3.8-Max, es el mismo modelo—: arquitectura MoE, 2,4 billones de parámetros totales y entrada multimodal de texto, imagen y vídeo, con salida de texto.

    Está disponible por API alojada, y solo por ahí.

    ¿Cuánto cuesta Qwen3.8-Max por millón de tokens?

    $2,00 por millón de tokens de entrada y $6,00 por millón de salida. Las lecturas de caché implícita cuestan $0,25 por millón.

    Ese tercer precio es el que te cambia la factura si tu agente reenvía el mismo contexto en cada turno: un 87,5% menos que la tarifa de entrada.

    ¿El 86,6 de Qwen3.8-Max en Terminal-Bench 2.1 lo ha medido alguien externo?

    No. A 7 de agosto de 2026 Qwen3.8-Max no tiene ninguna entrada en el leaderboard público de tbench.ai, así que el 86,6 solo existe en el anuncio de Alibaba del 3 de agosto.

    Úsalo como hipótesis, no como criterio de compra. Lo comprobable del modelo es otra cosa: $2 y $6 por millón, 983K de entrada real con thinking y disponibilidad únicamente por API alojada.

    ¿Por qué la tabla de Alibaba da a Claude Fable 5 y a Opus 4.8 el mismo 84,6?

    Porque las cuatro filas salen de una única ejecución hecha por Alibaba, con su harness y su nivel de esfuerzo. En la medición independiente de tbench.ai esos dos modelos no empatan: Fable 5 marca 83,8 y Opus 4.8 marca 78,9, a 4,9 puntos de distancia.

    Cuando un fabricante mide a sus rivales, no solo suben los números: cambia el orden entre ellos. Ese empate artificial es la señal más clara de que la tabla no es un ranking, aunque lo parezca.

    ¿Cuántos parámetros activos tiene Qwen3.8-Max?

    No lo sé, y quien te dé una cifra con seguridad probablemente tampoco. El total confirmado es 2,4 billones de parámetros en arquitectura MoE.

    Varios agregadores repiten "95B activos", pero al menos un medio que revisó el anuncio sostiene que Alibaba no publicó ese dato, y no he podido confirmarlo en fuente primaria. Trátalo como no verificado.

    ¿Qwen3.8-Max tiene de verdad 1 millón de tokens de contexto?

    Casi. La entrada máxima real es de 991K tokens, que bajan a 983K con thinking activado. La salida máxima es de 131K en ambos modos.

    Si tu agente aprovecha la ventana entera, diséñalo contra 983K. El millón es redondeo comercial.

    ¿Qwen3.8-Max es de código abierto?

    Todavía no. Alibaba anunció pesos abiertos para la semana siguiente al lanzamiento del 3 de agosto de 2026, pero por ahora solo está disponible por API alojada.

    Hasta que los pesos existan y puedas leer su licencia, trátalo como un modelo cerrado con una promesa encima.


    Datos verificados el 7 de agosto de 2026 contra el anuncio de Alibaba y el leaderboard público de tbench.ai. Los pesos abiertos seguían sin publicarse en esa fecha.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Un compañero me mandó el titular por Telegram a las siete de la mañana. Debajo, una sola línea: "¿Entonces pueden saber que este commit lo escribí con Claude Code?".

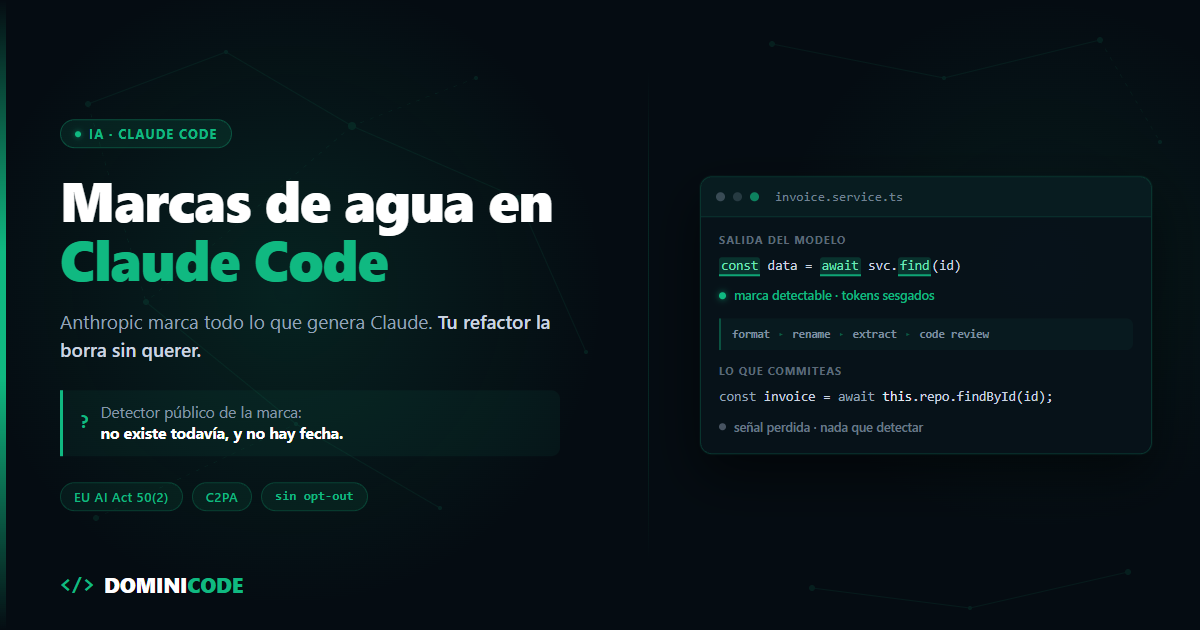
    Es la pregunta correcta. Y la respuesta corta es incómoda: hoy nadie te lo puede demostrar, porque el detector público de las marcas de agua de Claude todavía no existe.

    La respuesta larga es más interesante. Va de por qué estas marcas funcionan razonablemente bien sobre prosa y se deshacen casi solas dentro de un repositorio de código.

    La familia de marcas de agua más documentada en la literatura no es un carácter oculto ni un metadato: es un sesgo estadístico introducido durante la generación, en la elección misma de las palabras, que deja una firma detectable sin alterar el significado. Anthropic no ha confirmado que la suya funcione así. Solo dice que va "tejida dentro del propio texto".

    He leído la documentación entera. Esto es lo que dice, y lo que no.

    Documentación de Anthropic actualizada el 11 de agosto de 2026. Última revisión de este post: 12 de agosto de 2026.


    Qué ha anunciado Anthropic exactamente

    Cuatro hechos, sin adornos.

    1. Anthropic ha firmado el Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA sobre transparencia del contenido generado por IA. Esto no es marketing: es cumplimiento normativo.
    2. Los modelos Claude lanzados a partir del 2 de agosto de 2026 salen con marcado machine-readable desde el primer día. Para los modelos anteriores hay un periodo transitorio y Anthropic dice que está trabajando en incorporarlo.
    3. El alcance cubre Claude Platform (la API), Claude, Claude Code, Claude Cowork y Claude Tag, además de Claude servido desde AWS, Google Cloud y Microsoft Foundry. Se aplica en todo el mundo, no solo en la Unión Europea. Con una salvedad que conviene retener para más adelante: la marca en el texto sí viaja por esas tres nubes, pero los metadatos de procedencia firmados "puede que no estén soportados en todas las plataformas, según las funcionalidades que ofrezca cada una".
    4. La documentación no contempla ningún opt-out: el marcado se aplica a la salida de los modelos soportados, también cuando consumes la API.

    Que Claude Code aparezca escrito con todas las letras en esa lista es lo que hace que este post exista.

    Sobre el mecanismo, la documentación de Anthropic dice esto y nada más:

    "Teje una marca de agua imperceptible directamente en el propio texto. No la verás, y no cambia el significado, la calidad ni la legibilidad de la respuesta de Claude."
    ("…it weaves an imperceptible watermark directly into the text itself. You won't see it, and it doesn't change the meaning, quality, or readability of Claude's response.")

    Punto. No publican el algoritmo.


    Cómo se mete una marca de agua dentro de un texto

    La técnica estándar sesga la elección de tokens: en cada paso el modelo parte el vocabulario en una lista verde y una roja usando un hash secreto, y empuja suavemente la generación hacia la verde. El texto sigue siendo natural, pero contiene más tokens verdes de los que el azar explicaría.

    Aclaración previa: Anthropic no ha publicado su algoritmo. Lo que viene ahora es cómo funciona la familia de técnicas conocida en la literatura académica —sobre todo el trabajo de Kirchenbauer et al., "A Watermark for Large Language Models" (2023)—, no una descripción de lo que hace Claude por dentro.

    Lo explico porque es didáctico y porque es la familia plausible. No porque sea un dato confirmado.

    Un modelo de lenguaje no escribe palabras: escribe tokens. En cada paso genera un vector de logits, una puntuación para cada token del vocabulario, y de ahí sale la distribución de la que se muestrea el siguiente. Si nunca has visto por dentro cómo se trocea el texto, en Tokens en español: por qué cuestan un 26 % más que en inglés lo explico con ejemplos reales.

    La técnica clásica hace esto:

    1. Toma los últimos tokens generados y calcula un hash con una clave secreta.
    2. Usa ese hash como semilla para partir el vocabulario en dos: una lista verde y una lista roja.
    3. Suma un pequeño sesgo a los logits de la lista verde antes de muestrear.
    4. Repite en cada token.

    El texto resultante es perfectamente natural. Pero contiene muchos más tokens "verdes" de los que el azar justificaría. Quien tenga la clave recalcula las listas y saca un valor estadístico de confianza.

    La gracia del método es que el detector no necesita el modelo. Solo la clave y suficiente texto.

    Ahí está la palabra que lo condiciona todo: suficiente.


    Marca de agua no es lo mismo que detector de IA

    Un detector de IA adivina a partir del estilo; un detector de marca de agua busca una firma concreta que el propio modelo insertó. Son dos tecnologías distintas, con tasas de error distintas, y confundirlas es el error que más circula esta semana.

    Detector de IA Detector de watermark
    Analiza estilo Sí No
    Conoce la firma No Sí
    Necesita clave No Posiblemente
    Es probabilístico Sí Sí
    Identifica proveedor Difícil Potencialmente

    Un detector de IA clásico —los que llevan años suspendiendo a estudiantes por escribir demasiado bien— hace estadística sobre el estilo: perplejidad, longitud de frase, variedad léxica. Adivina. Un detector de watermark no adivina: busca una firma concreta que sabe que está ahí.

    Anthropic dice que "está trabajando para permitir que usuarios y terceros detecten las marcas de agua incrustadas de Claude y los metadatos de procedencia" y que publicará los detalles más adelante. Traducido: hoy no hay detector público de la marca de agua de Claude, ni fecha.

    De ahí sale la frase que más falta hace repetir esta semana: cualquier web que hoy te diga "este texto contiene el watermark de Claude" sin acceso al mecanismo de verificación de Anthropic, está vendiendo humo. Sin ese mecanismo no hay verificación posible. Hay marketing.


    El problema de la baja entropía cuando escribes código

    Una marca de agua estadística es más débil sobre código que sobre prosa porque el código tiene poca entropía: en cada punto hay muy pocas continuaciones válidas y casi ningún margen para elegir un token en lugar de otro equivalente.

    Y esto no me lo invento yo. Kirchenbauer et al. le dedican una sección entera del paper, titulada "A caveat: The difficulty of watermarking low-entropy sequences", y la abren así: "El texto de baja entropía crea dos problemas para el marcado. El primero: tanto humanos como máquinas producen terminaciones parecidas, si no idénticas, ante prompts de baja entropía, lo que hace imposible distinguir unas de otras."

    Lo que sí es inferencia mía es aplicárselo a Claude. Anthropic no ha publicado su algoritmo ni ninguna política específica sobre código.

    Una marca de agua estadística necesita libertad de elección. Si el modelo tiene veinte formas igual de válidas de continuar una frase, puede empujar hacia la lista verde sin que se note. En prosa esto sobra: "rápido" o "veloz", "por tanto" o "así que".

    El código no funciona así.

    Después de const user = await this.userService. hay dos o tres continuaciones razonables y el resto son errores de compilación. La entropía se hunde. El modelo no puede elegir un nombre de método "más verde" si el método se llama como se llama en la interfaz, y no puede reordenar los argumentos porque la firma es la que es.

    Cuanto más determinista es la salida, menos sitio hay donde esconder señal. Y el código es el texto más determinista que produce un modelo. Es la misma naturaleza probabilística que explico en por qué la IA se inventa cosas: ese margen de maniobra permite tanto la alucinación como la marca de agua. En código, el margen se estrecha.

    Añade que la mayoría de los diffs que revisas en un PR son de veinte o treinta líneas. Anthropic no da ningún umbral, pero sí reconoce el límite: un pasaje muy corto deja "demasiado poco texto para una señal fiable".

    El paper de Kirchenbauer sí da números. En sus experimentos detectan el 98,4 % de las generaciones al umbral z=4, que se alcanza a los 128 tokens. Y avisan, en la misma sección: "Las secuencias de alta entropía se detectan con relativamente pocos tokens, mientras que las de baja entropía requieren más tokens para ser detectadas."

    Junta las dos frases y verás por qué el número engaña. Ciento veintiocho tokens son del orden de diez o quince líneas de TypeScript, bastante menos que un commit cualquiera. Parece buena noticia para quien quiera detectarte. No lo es: ese 98,4 % está medido sobre prosa periodística, y el código es exactamente el material de baja entropía que, según los propios autores, necesita bastantes más tokens. Cuántos más, no lo dice nadie. Echa tú la cuenta con el tamaño de tus commits.


    Por qué tu flujo de trabajo real lava la marca

    Formatear, refactorizar, renombrar y revisar código altera la secuencia de tokens, y eso es lo que deshace una marca estadística sin que nadie se lo proponga.

    Separemos las dos mitades del argumento, porque solo una está documentada. La documentada: Anthropic dice que la marca puede dejar de detectarse si el texto "ha sido editado en profundidad, parafraseado, traducido o mezclado con otra escritura" ("heavily edited, paraphrased, translated, or mixed into other writing"). La mía: que tu flujo de trabajo normal, el de cualquier martes, cuenta como editar en profundidad.

    Conviene citar también la otra mitad, porque Anthropic la dice y casi nadie la está recogiendo: la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Es cierto y no contradice lo anterior. Copiar y pegar no toca la secuencia de tokens: la marca sigue ahí intacta. Lo que la rompe es cambiar el orden de esos tokens, y eso es precisamente lo que hacen el formateador, la extracción de método y el renombrado.

    Lee las dos frases otra vez y piensa en cómo trabajas de verdad con Claude Code a diario.

    Spec-Driven Development reduce la libertad del modelo

    Cuando trabajas con una spec detallada —nombres de tipos, contratos, estructura de carpetas, criterios de aceptación— no le pides al modelo que invente. Le pides que transcriba una decisión que ya tomaste tú.

    Si la marca funciona como creo —y esto sigue siendo inferencia mía—, cuanto más rigurosa sea la spec, menos libertad probabilística le queda al modelo y menos espacio hay donde incrustar señal. Un efecto secundario curioso de una metodología que adopté por razones completamente distintas, y que tienes desarrollada entera en el libro de Spec-Driven Development.

    El efecto Prettier

    Esto es más brutal todavía, y pasa cada día sin que lo pienses.

    Guardas el archivo y el formateador reparte los saltos de línea a su manera. Extraes un método. Renombras data por invoiceLines porque el nombre no decía nada. Mueves el bloque a otro archivo. El linter reordena los imports. Pasa por code review y alguien cambia tres cosas.

    Cada una de esas operaciones altera la secuencia de tokens. Y cualquier marca estadística de la familia que describí arriba depende, literalmente, del orden exacto de esos tokens. Que la de Claude funcione así es inferencia mía. Que editar en profundidad pueda dejarla indetectable lo dice Anthropic.

    No es que estés intentando borrar nada. Es que hacer bien tu trabajo la borra. Auditar y refactorizar lo que genera el asistente en lugar de aceptarlo tal cual es justo el flujo que enseño en Construye con IA, y resulta que además tiene este efecto colateral.


    Lo que sí aguanta: C2PA en los archivos que genera Claude

    Hay un caso donde la marca sí resiste: los archivos. Cuando Claude genera un .svg, .png o .jpg entra un segundo mecanismo: incrusta metadatos de procedencia firmados criptográficamente con el estándar C2PA, de la Coalition for Content Provenance and Authenticity. Anthropic no dice que esto sustituya a la marca del texto; dice que esos formatos llevan además procedencia.

    Otra liga. Una firma criptográfica no es probabilística: o valida o no valida. Y permite detectar si el archivo fue manipulado después.

    Y aquí está el contraste que más importa: la marca de agua del texto no la puede verificar nadie fuera de Anthropic, pero el C2PA sí se verifica ya hoy con herramientas públicas como c2patool o contentcredentials.org. Uno es una promesa; el otro funciona esta tarde.

    Un detalle técnico que conviene fijar: un .svg es un archivo de texto, XML, no un binario. Los metadatos viven dentro del propio documento. Y aplica a los archivos que Claude genera, no a los que ya tienes en el proyecto.

    O sea: si le pides a tu agente los iconos SVG de la aplicación y los commiteas tal cual, esos archivos sí llevan procedencia verificable dentro del repo. Puedes comprobarlo tú mismo:

    c2patool icono-generado.svg
    

    Durarán hasta que alguien los pase por un optimizador, los convierta de formato o los vuelva a guardar: Anthropic avisa de que la conversión de formato, el re-guardado y las capturas de pantalla eliminan los metadatos.

    Y hay una limitación más, la que dejé apuntada al principio: los metadatos firmados "puede que no estén soportados en todas las plataformas". Si consumes Claude a través de AWS, Google Cloud o Microsoft Foundry, la marca del texto viaja igual, pero la procedencia de los archivos depende de lo que ofrezca cada plataforma. Anthropic lo incluye entre las causas por las que un contenido marcado puede no dar señal: haberse producido "a través de una plataforma, funcionalidad o tipo de archivo donde ese tipo de marcado no estaba soportado".

    Robusto, pero no indestructible.


    El falso positivo: detectar la marca no prueba autoría

    Todo lo anterior va de falsos negativos: la marca está y se pierde. Pero hay un problema en la dirección contraria, y lo reconoce la propia Anthropic.

    Detectar una marca de Claude te dice que el contenido "puede haber sido procesado por Claude" ("may have been processed by Claude"). No que Claude lo escribiera. La documentación lo desarrolla sin rodeos: "Claude puede no ser el autor original. La gente usa Claude a menudo para corregir, traducir, resumir o convertir archivos."

    Léelo despacio, porque cambia la conversación entera.

    Si coges una función que escribiste tú y le pides a Claude que la refactorice, que le añada tipos o que te traduzca los comentarios al inglés, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo.

    Y el reverso también está escrito: "la ausencia de marca detectada no significa que el contenido no fuera generado o procesado por IA".

    O sea que la señal falla en las dos direcciones. Quien pretenda usar una detección como prueba de que no escribiste tú el código está leyendo mal la herramienta, y ahora tienes la frase del fabricante para decírselo.


    ¿Qué otras IAs marcan el contenido que generan?

    Anthropic no es la primera ni va sola. El Artículo 50(2) empuja a todo el sector en la misma dirección, pero cada uno ha llegado hasta un punto distinto.

    Proveedor Marca el texto Marca archivos ¿Verificable hoy por ti?
    Anthropic (Claude) Sí, desde agosto de 2026 Sí, C2PA en .svg, .png, .jpg Texto: no. Archivos: sí, C2PA
    Google (Gemini) Sí, SynthID-Text Sí, SynthID en imagen, audio y vídeo No: leer SynthID requiere la clave de Google
    OpenAI (ChatGPT) No Sí, C2PA en imágenes y SynthID en audio Solo lo que expone C2PA

    Google llegó antes: SynthID-Text lleva desplegado en Gemini desde 2024 y fue el primer marcado de texto en producción a escala. Firmó el mismo Código de Buenas Prácticas el 24 de julio de 2026, una semana antes de que el Artículo 50 fuera aplicable, y anunció acuerdos con Apple, ElevenLabs, Kakao, NVIDIA y OpenAI para que el marcado sea interoperable entre proveedores.

    Fíjate en la casilla que se repite: nadie tiene detector público de texto. Ni Anthropic ni Google. SynthID lleva dos años funcionando y sigue necesitando la clave privada de Google para leerse. Eso te dice más sobre el plazo real de Anthropic que cualquier promesa de documentación futura.

    Y el caso de OpenAI merece un párrafo, porque es el más honesto sobre los incentivos del negocio: tenía el marcado de texto construido y lo aparcó en septiembre de 2024, cuando una encuesta interna reveló que cerca del 30 % de los usuarios de ChatGPT lo usarían menos si supieran que marca lo que escribe. Marca imágenes y audio, donde nadie protesta. Texto no.


    Entonces, ¿debería preocuparte?

    Respuesta corta: no, si escribes software y auditas lo que genera el asistente. Sí, si tu empresa firma contratos con cláusulas sobre uso de IA y nadie las ha leído.

    La iniciativa es buena ingeniería y buena regulación. La web abierta se está llenando de texto sintético que se hace pasar por humano, y marcarlo en origen es mejor que dejarlo en manos de detectores que funcionan por corazonadas estilísticas.

    Para quien escribe software, el código sigue siendo código.

    Tu repositorio no es un canal de distribución de texto sintético. Es un artefacto de ingeniería que pasa por specs, revisión, formateo, refactor y tests. Mientras controles la arquitectura y audites lo que genera el asistente, es poco probable que una marca estadística sobreviva a ese recorrido. Y mientras no haya detector público, ni tú ni nadie puede comprobarlo.

    Lo único que te recomiendo hacer hoy: si tu empresa firma contratos con cláusulas sobre uso de IA, sube el tema tú antes de que lo suba un cliente. No para justificarte —usar Claude Code no es hacer trampas—, sino para tener una política escrita en lugar de una improvisación en una llamada incómoda.

    Si quieres seguir estas cosas con gente que las aplica en producción y no solo lee titulares, en Dominicode Labs es de lo que hablamos cada semana.


    Preguntas frecuentes

    ¿Puede alguien saber hoy si usé Claude para escribir este código?

    No. Anthropic no ha publicado ni el algoritmo ni un detector público, y no ha dado fecha. Dice que trabaja para que usuarios y terceros puedan detectar las marcas, y que compartirá los detalles en documentación técnica futura. Hasta entonces, cualquier herramienta que afirme lo contrario no puede demostrarlo.

    ¿La marca de agua afecta a la calidad del código que genera Claude?

    Anthropic afirma que no cambia el significado, la calidad ni la legibilidad. En prosa es creíble: el sesgo se reparte entre alternativas equivalentes. En código las alternativas equivalentes escasean, así que —y esto es deducción mía, no dato publicado— cualquier esquema de marcado tendría mucho menos margen de actuación. No hay motivo para esperar peor código por esto.

    ¿Puedo desactivar la marca de agua?

    La documentación de Anthropic no menciona ninguna opción para desactivarlo, tampoco para quien usa la API. Se aplica a Claude Platform, Claude, Claude Code, Claude Cowork y Claude Tag, incluido Claude servido a través de AWS, Google Cloud y Microsoft Foundry, y rige en todo el mundo.

    ¿La marca de agua sobrevive a copiar y pegar el código?

    Sí. Anthropic dice que la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Copiar y pegar no altera la secuencia de tokens, así que no hay motivo para que se pierda. Lo que sí puede romperla, según la propia documentación, es editar en profundidad, parafrasear, traducir o mezclar el texto con otra escritura.

    ¿Cómo compruebo si un archivo generado por Claude lleva metadatos C2PA?

    Con c2patool desde la terminal (c2patool archivo.svg) o subiendo el archivo a contentcredentials.org. Esto es lo único verificable hoy sin depender de Anthropic, y solo aplica a archivos .svg, .png y .jpg generados por Claude. Los metadatos desaparecen si conviertes el formato, vuelves a guardar el archivo o haces una captura de pantalla.

    ¿Afecta la marca de agua a quién es dueño del código que genera Claude?

    No. La marca es un mecanismo de transparencia sobre el origen del contenido, no un mecanismo de propiedad. La titularidad de lo que generas con Claude se rige por los términos de servicio de Anthropic y por el contrato que tengas con tu cliente o tu empresa, no por si el texto lleva firma estadística. Lo que sí conviene es que esa relación esté escrita antes de que alguien pregunte.

    ¿Los detectores de IA como GPTZero o Turnitin detectan la marca de agua de Claude?

    No. Son mecanismos distintos. Un detector convencional analiza el estilo y estima una probabilidad; no conoce ninguna firma y se equivoca a menudo en las dos direcciones. Un detector de watermark busca una señal concreta que sabe cómo se incrustó. Que un detector clásico marque tu texto como generado por IA no significa que haya encontrado la marca de Anthropic, porque no puede.

    Si detectan la marca, ¿significa que el código lo escribió Claude?

    No, y lo dice Anthropic: detectar una marca de Claude indica que el contenido "puede haber sido procesado por Claude", no que Claude lo escribiera. Si le pasas tu propio código para que lo refactorice o te lo traduzca, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo. Cualquiera que use una detección como prueba de que no escribiste tú el código está leyendo mal la señal.

    ¿Me afecta si no estoy en la Unión Europea?

    Sí. El marcado nace del Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA, pero Anthropic lo aplica globalmente. Dónde esté tu empresa no cambia nada.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    El 26 de julio publiqué una comparativa entre Opus 5, GPT-5.6 y Kimi K3. Diez días después me senté a completarla con los que faltaban: Grok 4.5, Claude Fable 5 y DeepSeek V4 Flash.

    No llegué a escribir esa actualización.

    Me atasqué en el primer paso, el más tonto: abrir el leaderboard oficial de Terminal-Bench 2.1 y copiar las cifras que todo ranking de modelos para programar de agosto de 2026 da por buenas.

    Buena parte de esas cifras no está ahí. No es que estén desactualizadas: es que no aparecen. Ni con ese número, ni en ese puesto.

    Así que este post no es la lista de los tres modelos que me faltaban. Es lo que encontré mientras la buscaba. Si lo que quieres es qué modelo usar para qué trabajo según el coste real por tarea, eso está entero en Opus 5 vs GPT-5.6 vs Kimi K3, la comparativa base que este post completa.

    El leaderboard oficial de Terminal-Bench 2.1, sin intermediarios

    Qué es Terminal-Bench 2.1 y qué puntúa en realidad

    Terminal-Bench 2.1 es un benchmark que mide si un sistema de IA completa tareas reales de desarrollo dentro de una terminal —instalar dependencias, ejecutar los tests, arreglar lo que falla—, no si el modelo escribe código elegante. Cada fila del leaderboard puntúa tres cosas a la vez: el modelo, el harness (el agente que lo envuelve: Claude Code, Codex, Terminus 2, Cursor CLI) y el effort (cuánto cómputo se le permite gastar por tarea). Cambia cualquiera de las tres y cambia el número.

    Esto es lo que hay en el leaderboard público de Terminal-Bench, consultado el 5 de agosto de 2026. Corto en la fila 11 por espacio:

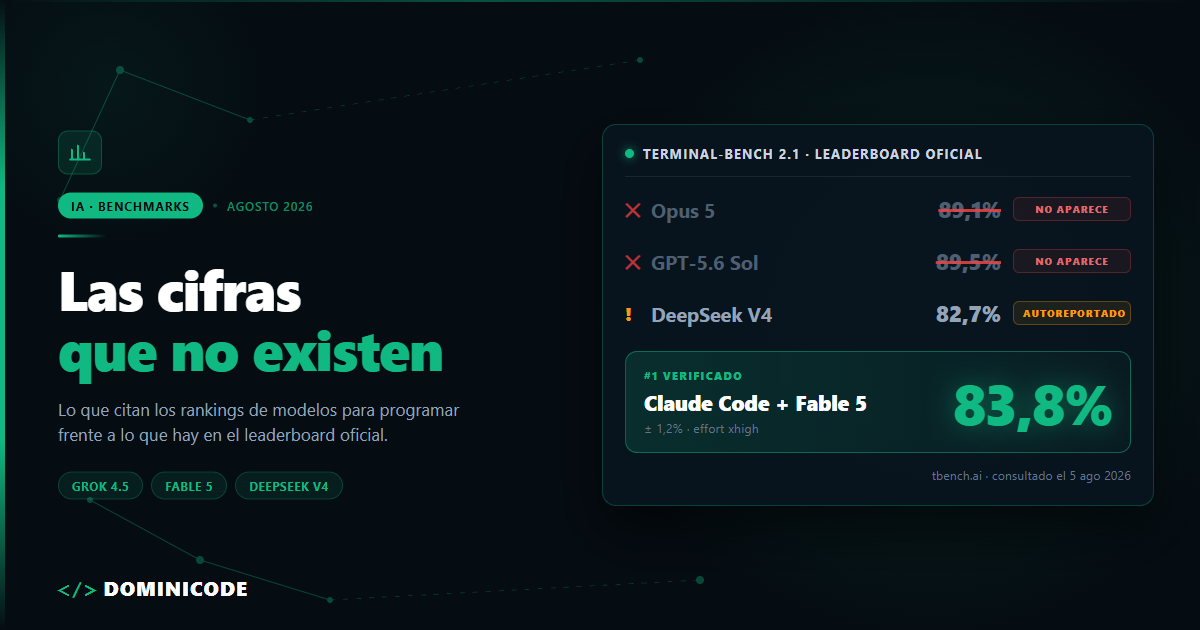
    # Agente + modelo Score Effort
    1 Claude Code + Fable 5 83,8% ± 1,2% xhigh
    2 Codex + GPT-5.5 83,1% xhigh
    3 Terminus 2 + Fable 5 80,4% high
    4 Cursor CLI + Grok 4.5 79,3% high
    5 Claude Code + Opus 4.8 78,9% high
    6 Codex + GPT-5.6 Terra 78,4% max
    7 Terminus 2 + GPT-5.5 78,0% xhigh
    8 mini-SWE-agent + Muse Spark 1.1 76,2% xhigh
    9 Codex + GPT-5.6 Luna 75,7% max
    10 Claude Code + Sonnet 5 74,6% high
    11 Terminus 2 + Gemini 3 Pro 73,9% high

    Lee la segunda columna otra vez. No dice "modelo". Dice agente y modelo. Y la última añade el effort.

    Ahora mira lo que no está.

    Claude Opus 5 no aparece. El Opus de esa lista es el 4.8, con 78,9%. Llevo semanas viendo circular un "Opus 5: 89,1% en Terminal-Bench 2.1" por blogs agregadores y no he encontrado de dónde sale. No digo que sea falso: digo que no está en la fuente oficial, que no lo puedo verificar y que quien lo publicó tampoco enlazó a nada.

    "GPT-5.6 Sol, 89,5%" tampoco aparece. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%), ambas por debajo de GPT-5.5 en Codex, que marca 83,1%. En la única medición pública que conozco, la 5.6 no supera a la 5.5 programando en terminal.

    Kimi K3 tampoco aparece. Eso no lo convierte en mal modelo —sigo pensando lo que escribí en si te conviene Kimi K3 para tu agente—, solo significa que ahí no hay ejecución publicada. Y el 88,3 que reporta Moonshot es autoreportado, exactamente igual que el de DeepSeek que verás más abajo.

    Un benchmark ausente no es un suspenso. Es un dato que no existe. Y un dato que no existe no se cita.

    Por qué el mismo modelo puntúa distinto: el harness pesa tanto como el modelo

    El mismo modelo cambia de puesto según el agente que lo envuelve: Fable 5 saca 83,8% con Claude Code y 80,4% con Terminus 2. Esos 3,4 puntos son toda la distancia entre el puesto 1 y el puesto 3 del leaderboard.

    Vuelve a la tabla y búscalo dos veces. Está ahí.

    Lo que separa esas dos filas es el andamiaje que rodea al modelo, no el modelo. GPT-5.5 hace lo mismo: 83,1% en Codex, 78,0% en Terminus 2.

    Por eso "cuál es el mejor modelo para programar" es una pregunta mal formulada. Terminal-Bench no puntúa modelos, puntúa sistemas.

    Es la idea que sostiene todo lo que enseño en Construye con IA: el resultado sale del sistema completo, no del modelo que eliges en un desplegable. Cuando alguien te cuenta que su equipo va más rápido "porque usa X modelo", casi siempre lo que cambió fue el harness.

    Cuánto cuesta Grok 4.5 de verdad: el precio se dobla a partir de 200K tokens

    Grok 4.5 es el mejor situado de los tres que faltaban: puesto 4 del leaderboard de Terminal-Bench 2.1 con Cursor CLI y 79,3%, por delante de Opus 4.8 y de las dos variantes medidas de GPT-5.6. Este es el que peor llevo haberme dejado fuera en julio.

    En el Intelligence Index de Artificial Analysis marca 54 puntos en el corte del 5 de agosto de 2026. No te doy su puesto, y el motivo es el propio post: en la comparativa de julio yo mismo publiqué 58,9 para GPT-5.6 Sol y 57 para Kimi K3 en ese mismo índice. Con esos números, 54 no es un cuarto puesto.

    Es una puntuación. El puesto depende del corte y del subconjunto de modelos que estés mirando, y por eso no vale como argumento.

    El titular comercial es 500K de contexto a $2 el millón. Es cierto a medias, y la mitad falsa está en la documentación de xAI:

    Tamaño del prompt Entrada / millón Salida / millón
    Menos de 200K tokens $2 $6
    200K tokens o más $4 $12

    El precio se dobla exactamente cuando empiezas a usar el contexto por el que compraste el modelo.

    Con un agente que acumula ficheros, salidas de tests y logs, cruzar los 200K no es un caso raro: es el martes por la tarde. Y no lo cruzas tú de forma consciente, lo cruza el agente a mitad de sesión.

    La parte buena: el input cacheado cuesta $0,50 por millón, un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4. Si tu agente reenvía el mismo contexto en cada turno —y casi todos lo hacen—, el ahorro real está ahí, no en la tarifa de lista.

    En el Coding Agent Index de Artificial Analysis, Grok 4.5 saca 76 en el harness de Grok Build, empatado con GPT-5.5 en Codex y justo por debajo de Fable 5 en Claude Code. Otra vez modelo y harness moviéndose juntos.

    Ficha rápida: 500K de contexto, knowledge cutoff el 1 de febrero de 2026, disponible como grok-4.5 en Grok Build, en Cursor para todos los planes y en la consola de xAI.

    DeepSeek V4 Flash 0731: barato de verdad, medido por ellos mismos

    Salió el 31 de julio con pesos abiertos y licencia MIT, la misma categoría de modelo abierto que repasé en el ranking de LLM locales de 2026. MoE disperso, 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    $0,14 de entrada y $0,28 de salida por millón. Con cache-hit, $0,0028. Fable 5 cuesta más de 70 veces más por token de entrada: eso no es una diferencia de gama, es otra categoría de decisión.

    En el Intelligence Index marca 50 puntos, cifra seria para lo que cuesta.

    Ahora la parte incómoda, que es el motivo por el que este modelo está en el post.

    DeepSeek reporta 82,7 en Terminal-Bench 2.1 —subiendo 20,9 puntos desde el 61,8 de su Preview— y 54,4 en DeepSWE. Con 82,7 entraría tercero en el leaderboard de Terminal-Bench 2.1, a cuatro décimas de GPT-5.5 en Codex (83,1%) y por detrás de Fable 5 (83,8%).

    Esa cifra es autoreportada por DeepSeek en su propia tabla y no aparece en el leaderboard oficial de tbench.ai.

    No acuso a nadie de mentir. Señalo una distinción que muchos rankings borran sin avisar: un número autoreportado y uno medido de forma independiente no valen lo mismo, aunque los dos lleven decimal.

    El fabricante corre el benchmark en sus condiciones, con su harness y su criterio de cuándo parar.

    No hay nada ilegítimo en eso. Simplemente no es comparable con una entrada verificada, y mezclar las dos cosas en la misma tabla es lo que convierte una comparativa en marketing.

    Si vas a probar DeepSeek V4 Flash, pruébalo por el precio y la licencia MIT, que son hechos comprobables. No por el 82,7.

    Y recuerda que el precio por token no es el gasto: un modelo barato que necesita el doble de turnos para cerrar la misma tarea sale caro, un efecto que desarrollé en por qué sube el coste de los subagentes al cambiar de modelo.

    Cuánto cuesta Fable 5: lidera el leaderboard y su tarifa miente a su favor

    Fable 5 es el número 1 real: 83,8% ± 1,2% con Claude Code y effort xhigh. GA desde el 9 de junio de 2026, 1M de contexto, 128k de salida máxima.

    También es el más caro por bastante: $10 de entrada y $50 de salida por millón, según la documentación de Anthropic. Adaptive thinking siempre activo —no se puede apagar— y una latencia que su propia doc califica de "slower".

    El dato que casi nadie cita es este: Fable 5 usa el tokenizer que llegó con Opus 4.7, y el mismo texto produce alrededor de un 30% más de tokens que en modelos anteriores a esa versión. Es el mismo mecanismo que expliqué con el sobrecoste de escribir en español: la tarifa por millón no se mueve, pero el número de millones sí.

    Haz la cuenta. Frente a un modelo con el tokenizer viejo, sus $10 se comportan como $13 y sus $50 como $65 sobre el mismo texto.

    Su coste efectivo es peor que su tarifa de lista. Es la tesis del post de julio otra vez: el precio que pagas no es el que aparece en la página de pricing.

    Mythos 5: recomendado en rankings, imposible de contratar

    Mythos 5 tiene las mismas specs y el mismo precio que Fable 5. Y da igual, porque no lo puedes usar: no hay alta self-serve, es por invitación dentro de Project Glasswing, orientado a ciberseguridad defensiva.

    Aun así lo he visto en varias listas de "mejores modelos para programar de agosto de 2026", con su fila, su precio y su recomendación de uso, como si bastara una tarjeta.

    Cuando un ranking te recomienda un producto que no está a la venta, ya sabes cuánto lo ha probado quien lo escribió.

    Precios por millón de tokens en agosto de 2026: las cifras que sí puedes comprobar

    Estos son los precios de lista publicados por cada proveedor a 5 de agosto de 2026, en dólares por millón de tokens:

    Modelo Entrada / millón Salida / millón Contexto
    Claude Fable 5 $10 $50 1M
    Claude Opus 5 $5 $25 1M
    GPT-5.6 Sol $5 $30 1,05M
    Claude Sonnet 5 $3 ($2 intro hasta el 31 ago 2026) $15 ($10 intro) 1M
    Kimi K3 $3 $15 1M
    Grok 4.5 (prompt < 200K) $2 $6 500K
    Grok 4.5 (prompt ≥ 200K) $4 $12 500K
    DeepSeek V4 Flash 0731 $0,14 $0,28 1M

    Una nota de honestidad, porque predico con el ejemplo o no predico: al recopilar esto me encontré a Grok 4.5 con 54 puntos presentado como cuarto y a DeepSeek V4 Flash con 50 presentado como tercero. Las dos cosas no pueden ser ciertas a la vez.

    Son cortes distintos de un índice que se recalcula constantemente. Por eso en este post doy puntuaciones y fechas, y no puestos: el puesto caduca antes de que le des a publicar.

    Cómo verificar un ranking de modelos para programar en 3 filtros

    Abre el ranking que tengas a mano ahora mismo y pásale tres filtros.

    1. Busca el enlace a la fuente. Si la cifra no apunta a un leaderboard o a una doc oficial, trátala como rumor.
    2. Comprueba si el número es autoreportado. Un score en la web del fabricante y uno en tbench.ai no son la misma clase de dato.
    3. Mira si nombra el harness y el effort. Si dice "Fable 5: 83,8%" sin decir Claude Code y xhigh, quien lo escribió no ha leído la tabla que cita.

    Te quedará mucho menos ranking del que tenías. Bien.

    Y una decisión práctica que sí puedo defender: elige el modelo al final, no al principio. Define primero qué tarea automatizas, con qué agente y con qué criterio de "terminado". Es la lógica del libro de Spec-Driven Development, y aquí se nota más que en ningún sitio: con la spec escrita, cambiar de modelo es una variable de entorno y una medición; sin ella, es fe.

    Mi conclusión cabe en una frase: no existe el mejor modelo para programar, existe el mejor sistema, y el único número que decide tu caso es el que midas tú.

    En Dominicode Labs hacemos justo eso: pasar los modelos nuevos por tareas reales, con la factura y los logs delante, antes de meterlos en producción.

    Preguntas frecuentes sobre los modelos para programar de agosto de 2026

    ¿Qué modelo lidera el leaderboard de Terminal-Bench 2.1 en agosto de 2026?

    En el leaderboard oficial de Terminal-Bench 2.1 el primer puesto es Claude Code con Fable 5 (83,8%), seguido de Codex con GPT-5.5 (83,1%). Fíjate en que ambos resultados nombran un agente y un nivel de esfuerzo, no solo un modelo.

    El mismo Fable 5 baja a 80,4% con Terminus 2. Liderar un leaderboard no es lo mismo que ser el modelo que te conviene: si lo que buscas es la recomendación por tipo de trabajo —agente largo, repo grande, volumen alto—, está desarrollada en Opus 5 vs GPT-5.6 vs Kimi K3.

    ¿Cuánto cuesta realmente Grok 4.5?

    $2 de entrada y $6 de salida por millón de tokens mientras el prompt se mantenga por debajo de 200K tokens. A partir de 200K, la tarifa pasa a $4 y $12: se dobla.

    El input cacheado cuesta $0,50 por millón: un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4 de los prompts largos. Ahí está el ahorro real en un agente que reenvía el mismo contexto en cada turno.

    ¿Es fiable el 82,7 de DeepSeek V4 en Terminal-Bench 2.1?

    Es una cifra autoreportada por DeepSeek en su propia tabla, no una entrada verificada del leaderboard oficial de tbench.ai. Ahí no aparece.

    Eso no significa que sea falsa: significa que no ha pasado por una medición independiente y que no es comparable con la tabla oficial. Lo comprobable de ese modelo es su precio ($0,14 / $0,28 por millón) y su licencia MIT con pesos abiertos.

    ¿Por qué Claude Opus 5 no aparece en el leaderboard de Terminal-Bench 2.1?

    Porque no hay una ejecución publicada de Opus 5 en el leaderboard oficial. El Opus que sí figura es el 4.8, con 78,9% usando Claude Code.

    Las cifras de "Opus 5 al 89,1%" que circulan por blogs agregadores no están en la fuente primaria y no he podido verificarlas. Ausencia de resultado no equivale a mal resultado: equivale a que no hay medición pública.

    ¿Merece la pena Fable 5 a $10 / $50 por millón?

    Sale a cuenta cuando un fallo del modelo te cuesta más de una hora de revisión humana; para volumen alto de tareas repetitivas, casi nunca.

    Hay además un matiz que empeora el cálculo: Fable 5 usa el tokenizer introducido con Opus 4.7, que genera alrededor de un 30% más de tokens sobre el mismo texto que los modelos anteriores a esa versión. Su coste efectivo es peor que su tarifa.

    ¿Qué diferencia hay entre un score autoreportado y uno del leaderboard oficial?

    Un score autoreportado lo ejecuta el propio fabricante, con su harness, su nivel de esfuerzo y su criterio de cuándo dar una tarea por terminada. Uno del leaderboard oficial lo ejecuta un tercero con condiciones fijas e iguales para todos.

    Los dos llevan decimales y parecen el mismo tipo de dato, pero no son comparables. Mezclarlos en la misma tabla, sin marcar cuál es cuál, es lo que convierte una comparativa en marketing.

    ¿DeepSeek V4 Flash es de código abierto?

    Tiene pesos abiertos y licencia MIT desde el 31 de julio de 2026. Es un MoE disperso con 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    La licencia y el precio ($0,14 de entrada y $0,28 de salida por millón) son los dos hechos comprobables del modelo. Su 82,7 en Terminal-Bench 2.1 no lo es: es autoreportado.

    ¿Puedo usar Claude Mythos 5 en mi proyecto?

    No, salvo que tengas invitación. Comparte specs y precio con Fable 5, pero solo está disponible dentro de Project Glasswing, orientado a ciberseguridad defensiva, y no tiene alta self-serve.

    Si lo ves recomendado en un ranking de modelos para programar, ese ranking no lo ha probado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Agentes de voz en tiempo real: la latencia es el producto

    Agentes de voz en tiempo real: la latencia es el producto

    Un cliente me pidió una demo de un asistente telefónico para reservas. La monté en un fin de semana: transcripción con Whisper, un LLM para razonar, un TTS decente para responder. En mis pruebas funcionaba. Entendía todo, respondía bien, la voz sonaba natural.

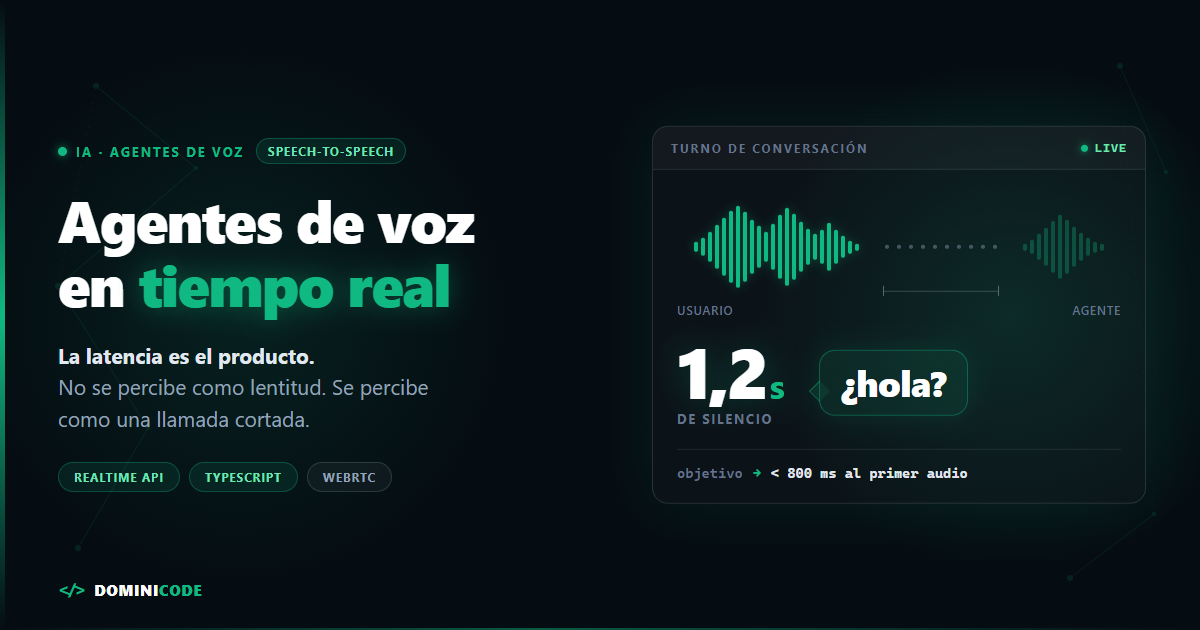
    Se la enseñé por teléfono a alguien de su equipo. Preguntó por una mesa para el sábado. Silencio. Y entonces hizo lo que hace cualquiera cuando no le contestan: dijo "¿hola?".

    Ese "¿hola?" me enseñó lo único que de verdad importa al construir agentes de voz en tiempo real: el agente no había fallado. Había tardado 1,2 segundos en empezar a hablar. Y 1,2 segundos, en una conversación, no se perciben como lentitud. Se perciben como que la llamada se ha cortado.

    La latencia no es una métrica que optimizas al final. Es el producto.

    Qué es un agente de voz en tiempo real

    Un agente de voz en tiempo real es un sistema que escucha al usuario, decide qué responder y contesta hablando, todo dentro de la misma conversación y sin pasar por turnos escritos. Se diferencia de un chatbot en que el canal es audio continuo, y de un asistente de voz clásico en que quien decide es un LLM con acceso a herramientas, no un árbol de intenciones.

    Se construye de dos maneras: encadenando reconocimiento de voz (STT), modelo de lenguaje (LLM) y síntesis de voz (TTS), o con un modelo speech-to-speech nativo que recibe audio y emite audio. La diferencia entre las dos no está en lo bonita que suena la voz. Está en la latencia, y en cuánta información sobrevive por el camino.

    El listón lo puso la evolución, no OpenAI

    Hay un dato que explica por qué 1,2 segundos rompen la ilusión. Un estudio publicado en PNAS por Stivers y su equipo midió los huecos entre turnos en conversaciones reales de diez lenguas, de comunidades indígenas tradicionales a lenguas mayoritarias.

    El resultado fue incómodamente uniforme. La moda del hueco entre que uno termina de preguntar y el otro empieza a responder cae entre 0 y +200 ms en todas las lenguas estudiadas, con una moda global de 0 ms y una mediana entre lenguas de +100 ms. Las diferencias entre unas lenguas y otras caben en un margen de 250 ms respecto a la media global.

    Piensa en lo que implica. Nadie escucha una pregunta, la entiende, formula la respuesta y la articula en 200 milisegundos. No da tiempo. Lo que hacemos los humanos es predecir: empezamos a construir la respuesta mucho antes de que el otro termine.

    Tu agente no predice. Espera. Y ese hueco es exactamente donde la gente cuelga.

    Este es el presupuesto de latencia con el que trabajo cuando monto uno de estos. No son cifras de ningún benchmark: es la repartición que me funciona para no pasarme del umbral.

    Tramo Objetivo Qué lo dispara
    Detección de fin de turno (VAD) 200-500 ms silence_duration_ms alto, eagerness: "low"
    Primer token del modelo 200-400 ms contexto largo sin caché, modelo grande
    Primer audio de salida 100-300 ms TTS sin streaming
    Red y jitter 50-200 ms WebSocket en móvil, sin buffer adaptativo
    Total percibido por debajo de 800 ms por encima de 1 s el usuario dice "¿hola?"

    Por qué el pipeline encadenado suena mal en un agente de voz

    El diseño por defecto del developer que viene de chatbots de texto es el pipeline encadenado: STT → LLM → TTS. Es el que se entiende y el que puedes montar con tres proveedores que ya conoces.

    Tiene dos problemas de fondo que no se arreglan cambiando de proveedor.

    El primero es que las latencias suman. Cada etapa tiene su propio tiempo hasta el primer byte, y ninguna empieza hasta que la anterior le da algo con lo que trabajar. Puedes tener un STT rápido, un LLM rápido y un TTS rápido, y aun así un conjunto lento, porque mides cada pieza aislada mientras el usuario mide la cadena entera.

    Se mitiga con streaming agresivo — transcripciones parciales al modelo, tokens al TTS según salen — pero eso convierte tu pipeline en un problema de concurrencia, no en tres llamadas HTTP.

    El segundo es peor, porque no se arregla con ingeniería. El texto intermedio es un cuello de botella de información.

    Cuando alguien dice "no…" con duda, alargando la vocal, y cuando dice "No." tajante, tu STT te entrega la misma palabra. Has tirado a la basura el tono, la vacilación, el énfasis, la prisa, el enfado. Toda la información que un humano usa para decidir cómo responder desaparece antes de que el modelo la vea. Después le pides al TTS que reconstruya emoción a partir de texto plano, y suena a lo que es: una reconstrucción.

    Esto no mata el pipeline encadenado. Lo coloca en su sitio: es la arquitectura correcta para transcribir audio por lotes y extraer datos — una nota de voz, una reunión grabada, un mensaje asíncrono. Ahí Whisper sigue siendo excelente, y lo conté en detalle en captura y procesamiento de audio en Angular usando Whisper.

    Lo que no puedes es coger la arquitectura de transcripción por lotes y esperar que sostenga una conversación.

    Qué cambia con speech-to-speech en un agente de voz

    El modelo speech-to-speech elimina el viaje de ida y vuelta por el texto. Entra audio, sale audio, y el mismo modelo que entiende es el que habla.

    La consecuencia técnica es que la prosodia sobrevive. El modelo no lee una transcripción de lo que dijiste: procesa el audio, con sus pausas y su entonación, igual que procesa cualquier otra modalidad. Si te resulta raro que un modelo "escuche", la idea general está en qué es un modelo multimodal: el audio también acaba siendo tokens.

    La consecuencia práctica es que desaparecen dos saltos de red y dos colas de espera.

    A cambio pierdes flexibilidad. No puedes cambiar la voz sin cambiar de modelo, no tienes un punto intermedio en texto donde auditar lo que el agente está a punto de decir, y estás casado con un proveedor. Es un trade-off real, y hay negocios regulados donde ese checkpoint de texto no es negociable.

    Pero si tu producto es una conversación, la conversación gana.

    Los cuatro problemas de un agente de voz en producción

    Aquí es donde la demo del fin de semana se separa del producto.

    Barge-in: el agente tiene que callarse

    Cuando el usuario empieza a hablar mientras el agente habla, el agente debe cortar. Inmediatamente. Un agente que termina su frase mientras tú le hablas encima resulta insoportable en tres segundos.

    El detalle sucio es que cancelar la respuesta no basta. Al cortar, el servidor cree que ha dicho todo el audio que generó, pero el usuario solo ha oído lo que le dio tiempo a reproducirse. Si no corriges esa divergencia, el historial de la conversación contiene frases que el usuario nunca escuchó, y el modelo seguirá razonando como si las hubiera dicho.

    Por eso existe conversation.item.truncate: le dices al servidor en qué milisegundo exacto se quedó el audio realmente reproducido. Y ese milisegundo tiene que venir de tu reproductor, no de los bytes que has recibido del socket. Recibir no es reproducir. Este es el bug número uno de todo el que monta esto por primera vez.

    Detección de turno: saber cuándo ha terminado de hablar

    El VAD por volumen — silencio durante X milisegundos, luego respondo — funciona bien hasta que alguien dice "quiero reservar para… espera que mire… el sábado". Ese "espera que mire" incluye una pausa, y tu agente entra a saco a media frase.

    La Realtime API de OpenAI ofrece dos modos: server_vad, que trocea por silencio con parámetros de threshold, prefix_padding_ms y silence_duration_ms, y semantic_vad, que usa un modelo para estimar la probabilidad de que hayas terminado y ajusta el timeout de forma dinámica, controlado con eagerness (low, auto/medium, high).

    La regla práctica: eagerness: "low" cuando el usuario tiene que pensar o recordar datos, high cuando son respuestas cortas de sí/no. Esto se nota más en el resultado final que cambiar de modelo.

    Transporte: WebSocket no es la respuesta por defecto

    La documentación oficial es clara. WebRTC para clientes de navegador y móvil que capturan o reproducen audio directamente. WebSocket cuando tu servidor ya recibe audio crudo de un pipeline de medios o de una centralita. SIP para telefonía.

    La razón de fondo es que WebRTC trae de fábrica lo que en WebSocket tendrías que construir tú: control de jitter, adaptación a pérdida de paquetes, cancelación de eco. En una wifi doméstica no notarás la diferencia. En 4G en movimiento, sí — y es justo el escenario donde vive un agente de voz de verdad.

    Desde el navegador, el flujo recomendado pasa por tu backend: el cliente genera la oferta SDP, tu servidor la reenvía a https://api.openai.com/v1/realtime/calls con la configuración de sesión y devuelve la respuesta. Nunca expongas la API key en el cliente; para eso están los secretos efímeros de /v1/realtime/client_secrets.

    Coste: el audio se paga como audio

    Muchos proyectos se caen justo aquí, después de la demo. Precios oficiales consultados el 31 de julio de 2026, por millón de tokens:

    Modelo Audio entrada Audio entrada cacheada Audio salida
    gpt-realtime-2.1 $32,00 $0,40 $64,00
    gpt-realtime-2.1-mini $10,00 $0,30 $20,00
    gemini-3.1-flash-live-preview $3,00 (~$0,005/min) — $12,00 (~$0,018/min)

    Lo interesante no es la cifra absoluta, es la comparación dentro del mismo modelo. gpt-realtime-2.1 cobra $4,00 por millón de tokens de texto de entrada y $32,00 por millón de tokens de audio de entrada. Ocho veces más por el mismo millón de tokens, solo por la modalidad.

    El otro número que deberías tener tatuado: el audio de entrada cacheado cuesta $0,40 frente a $32,00. Ochenta veces menos. En una conversación larga, donde cada turno reenvía todo el contexto anterior, el caché deja de ser una optimización y pasa a ser la diferencia entre un producto viable y uno que no. Si nunca has mirado de cerca cómo se cuentan los tokens y por qué el idioma influye en la factura, escribí sobre ello en tokens en español y el coste del tokenizador.

    El modelo mini cuesta exactamente 3,2 veces menos en audio no cacheado, tanto de entrada como de salida. Para el 80% de los agentes de voz reales — reservas, soporte de primer nivel, cualificación de leads — es más que suficiente.

    El código: una sesión realtime de verdad

    Esto es Node/Bun con TypeScript, a nivel de protocolo. Lo pongo así a propósito: los SDKs te esconden justo las partes que necesitas entender.

    import WebSocket from "ws";
    import { z } from "zod";
    
    // Tus dos piezas: el reproductor de audio del cliente y tu API de negocio.
    declare const player: {
      enqueue(chunk: Buffer): void;
      stop(): void;
      playedMs(): number; // ms realmente reproducidos al usuario
    };
    declare const reservas: { buscar(q: unknown): Promise<unknown> };
    
    const MODEL = "gpt-realtime-2.1";
    
    const ws = new WebSocket(`wss://api.openai.com/v1/realtime?model=${MODEL}`, {
      headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
    });
    
    const send = (event: Record<string, unknown>) => ws.send(JSON.stringify(event));
    
    ws.on("open", () => {
      send({
        type: "session.update",
        session: {
          type: "realtime",
          instructions:
            "Eres el asistente de reservas de Bar Nostrum. Frases cortas. " +
            "Nunca leas listas largas en voz alta: ofrece dos opciones como mucho.",
          audio: {
            input: {
              // OJO: format es un objeto, no la cadena "pcm16" de la beta antigua.
              format: { type: "audio/pcm", rate: 24000 },
              turn_detection: {
                type: "semantic_vad",
                eagerness: "low",         // el usuario tiene que recordar fechas
                interrupt_response: true, // permite barge-in
              },
            },
            output: { voice: "cedar" },
          },
          tools: [
            {
              type: "function",
              name: "buscar_disponibilidad",
              description: "Consulta mesas libres para una fecha y nº de comensales.",
              parameters: {
                type: "object",
                properties: {
                  fecha: { type: "string", description: "Formato YYYY-MM-DD" },
                  comensales: { type: "integer" },
                },
                required: ["fecha", "comensales"],
              },
            },
          ],
        },
      });
    });
    

    Ahora el bucle de eventos. Fíjate en player.playedMs(): ese es el punto donde casi todo el mundo se equivoca.

    let currentItemId: string | null = null;
    
    ws.on("message", async (raw) => {
      const event = JSON.parse(raw.toString());
    
      switch (event.type) {
        // El usuario habla mientras el agente habla → barge-in
        case "input_audio_buffer.speech_started": {
          if (!currentItemId) break;
    
          // Defensivo: con interrupt_response:true el servidor ya cancela solo.
          // Lo dejo por si algún día bajas a server_vad sin interrupción.
          send({ type: "response.cancel" });
          send({
            type: "conversation.item.truncate",
            item_id: currentItemId,
            content_index: 0,
            // CLAVE: lo que el usuario ha OÍDO, no lo que has recibido del socket.
            audio_end_ms: player.playedMs(),
          });
          player.stop();
          currentItemId = null;
          break;
        }
    
        case "response.output_audio.delta": {
          currentItemId = event.item_id;
          player.enqueue(Buffer.from(event.delta, "base64"));
          break;
        }
    
        case "response.function_call_arguments.done": {
          await handleToolCall(event.call_id, event.arguments);
          break;
        }
    
        case "response.done": {
          currentItemId = null;
          break;
        }
      }
    });
    

    Y la tool call, que es donde esto deja de ser una demo:

    const BuscarDisponibilidad = z.object({
      fecha: z.iso.date(),
      comensales: z.number().int().min(1).max(20),
    });
    
    async function handleToolCall(callId: string, rawArgs: string) {
      // 1. Valida SIEMPRE. El modelo alucina argumentos igual que alucina texto.
      const parsed = BuscarDisponibilidad.safeParse(JSON.parse(rawArgs));
      if (!parsed.success) {
        return sendToolOutput(callId, { error: "argumentos_invalidos" });
      }
    
      // 2. Si la tool tarda, habla antes de que el silencio se note.
      const filler = setTimeout(() => {
        send({
          type: "response.create",
          response: {
            // CLAVE: out-of-band. Sin esto, cuando la tool resuelva lanzarás un
            // segundo response.create mientras el relleno sigue generando audio.
            conversation: "none",
            instructions:
              "Di una frase muy corta indicando que estás consultando. " +
              "No inventes el resultado.",
          },
        });
      }, 400);
    
      const mesas = await reservas.buscar(parsed.data);
      clearTimeout(filler);
    
      sendToolOutput(callId, mesas);
    }
    
    function sendToolOutput(callId: string, output: unknown) {
      send({
        type: "conversation.item.create",
        item: {
          type: "function_call_output",
          call_id: callId,
          output: JSON.stringify(output),
        },
      });
      send({ type: "response.create" });
    }
    

    Ese setTimeout de 400 ms resuelve el silencio incómodo. Mientras la tool consulta tu API, el agente dice "déjame que lo mire" y luego encadena con el resultado. Es lo que hace un humano al teléfono, y sin ello cualquier consulta que tarde más de medio segundo se siente como una caída.

    La validación con Zod no es opcional. Los argumentos de una tool call son texto generado por un modelo, y tratarlos como datos de confianza es la misma clase de error que confiar en el body de una petición HTTP sin validarlo. Si quieres afinar esa capa, la trabajo a fondo en el curso de Zod para validación en TypeScript.

    Si prefieres abstracción, el SDK de agentes de OpenAI para JavaScript expone RealtimeAgent, RealtimeSession y un helper backgroundResult para tools largas. El diseño de herramientas es el mismo que expliqué en el servidor de herramientas con el Agent SDK de Anthropic.

    Cuándo NO usar un agente de voz

    La voz se está metiendo en sitios donde estorba.

    No uses voz cuando el usuario tenga que dar datos exactos y largos: un IBAN, un email, una referencia alfanumérica. Deletrear "bezael arroba dominicode punto com" por teléfono es peor experiencia que un input de texto, siempre.

    No uses voz cuando el resultado sea una lista para comparar. La voz es un canal estrictamente serial: no puedes escanear, ni volver atrás, ni ver tres precios a la vez.

    No uses voz cuando el error sea caro e irreversible. Confirmar una transferencia bancaria con un VAD que puede cortarte a media frase es pedir un incidente.

    La voz gana en tres escenarios: cuando las manos están ocupadas, cuando el input es abierto y ambiguo — describir un problema es más rápido hablando que rellenando diez campos — y cuando el canal ya es voz porque el usuario ha llamado por teléfono.

    Si tu caso no encaja en ninguno, un formulario gana. Y un formulario cuesta cero dólares por millón de tokens.

    Qué hacer hoy

    Ese número —los milisegundos hasta que el agente empieza a hablar— es tu producto. El prompt, la voz y las funcionalidades solo importan si está por debajo del umbral en el que la gente deja de sentir que habla con una máquina rota. Así lo mido:

    1. Monta una sesión realtime mínima con una sola tool enganchada.
    2. Instrumenta dos marcas de tiempo: input_audio_buffer.speech_stopped y el primer response.output_audio.delta.
    3. Mide 20 turnos con tu red real y tu dispositivo real. En localhost todo va rápido.
    4. Si la mediana pasa de 800 ms, ataca en este orden: caché de audio de entrada, gpt-realtime-2.1-mini, WebRTC en lugar de WebSocket, y frase de relleno para las tools lentas.
    5. Vuelve a medir. Repite hasta que nadie diga "¿hola?".

    Si quieres construir esto con método en lugar de a golpe de prueba y error, es el enfoque que enseño en Construye con IA: de la idea al producto con Claude Code. Y si prefieres no pelearte con esto en solitario, en Dominicode Labs es donde desmontamos este tipo de arquitecturas entre developers que están construyendo cosas parecidas.

    Preguntas frecuentes

    ¿Merece la pena todavía el pipeline STT → LLM → TTS?

    Sí, pero para otro problema. Es la arquitectura correcta cuando necesitas un checkpoint de texto auditable, cuando quieres cambiar de proveedor de voz sin tocar el resto, o cuando el trabajo es transcripción y análisis por lotes en lugar de conversación. Para una conversación en tiempo real, un modelo speech-to-speech nativo te ahorra saltos de red y conserva la información prosódica que el texto intermedio destruye.

    ¿WebSocket o WebRTC para un agente de voz en tiempo real?

    La documentación de OpenAI recomienda WebRTC para clientes de navegador y móvil que capturan o reproducen audio directamente, WebSocket cuando tu servidor ya recibe audio crudo de un pipeline de medios, y SIP para telefonía. La diferencia se nota sobre todo en redes móviles: WebRTC trae control de jitter, adaptación a pérdida de paquetes y cancelación de eco de serie.

    ¿Cuánto cuesta un agente de voz con IA?

    A 31 de julio de 2026, gpt-realtime-2.1 cuesta $32 por millón de tokens de audio de entrada y $64 de salida; el modelo mini, $10 y $20. Gemini publica precios por minuto para gemini-3.1-flash-live-preview: unos $0,005 por minuto de audio de entrada y $0,018 de salida. La clave del coste real no es el precio de lista sino el caché: en el modelo grande, el audio de entrada cacheado baja de $32 a $0,40 por millón.

    ¿Cómo evito que el agente corte al usuario cuando hace una pausa para pensar?

    Usa detección de turno semántica en lugar de VAD por volumen. semantic_vad estima con un modelo la probabilidad de que el usuario haya terminado, en lugar de contar milisegundos de silencio, y ajusta el timeout dinámicamente. Con eagerness: "low" das más margen, que es lo que quieres cuando el usuario tiene que recordar una fecha o un dato.

    ¿Puedo usar Claude para un agente de voz en tiempo real?

    No como modelo speech-to-speech nativo: los modelos de Anthropic aceptan texto e imagen como entrada y devuelven texto, no audio. Ahora bien, como cerebro de un pipeline encadenado con STT y TTS externos funcionan muy bien — Fable 5 para el trabajo más exigente, Opus 5 y Sonnet 5 para el grueso, y Haiku 4.5 cuando la latencia manda por encima de todo. Es la opción sólida si necesitas ese checkpoint de texto intermedio o si ya tienes tus herramientas montadas sobre el Agent SDK de Anthropic. Para latencia conversacional pura, hoy la vía nativa pasa por los modelos realtime de OpenAI o Gemini Live.

    ¿Cuánta latencia es aceptable en un agente de voz?

    Por debajo de 800 ms desde que el usuario deja de hablar hasta que el agente emite el primer audio. A partir de un segundo la gente deja de percibirlo como lentitud y empieza a percibirlo como una llamada cortada. El estudio de Stivers y su equipo en PNAS muestra que en las diez lenguas analizadas los hablantes minimizan el silencio entre turnos, con una moda global de 0 ms y una mediana de +100 ms.

    ¿Se puede conectar un agente de voz a una centralita o a un número de teléfono?

    Sí. Para telefonía la vía es SIP: la Realtime API acepta conexiones SIP además de WebRTC y WebSocket, y proveedores como Twilio o Telnyx enrutan el número hacia tu sesión. Si tu pipeline de medios ya te entrega audio crudo en el servidor, WebSocket también sirve. WebRTC está pensado para clientes de navegador y móvil.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tokens en español: por qué cuestan un 26 % más que en inglés

    Tokens en español: por qué cuestan un 26 % más que en inglés

    Hace unas semanas revisé el consumo de API de un agente de soporte. Sonnet, 25.000 conversaciones al mes, prompts cortos, nada exótico. El equipo había estimado el coste a mano antes de lanzar y la factura llegó cerca de un 26 % por encima.

    Estuvimos media hora buscando la llamada duplicada. No había llamada duplicada.

    El problema eran los tokens en español. No porque un token en español cueste más —el precio por token es idéntico—, sino porque necesitas más tokens para decir exactamente lo mismo.

    Y la parte incómoda es por qué necesitas más. La respuesta cómoda es "el español es más largo". Esa respuesta no llega a explicar ni la mitad de lo que pasa.

    Lo medí.

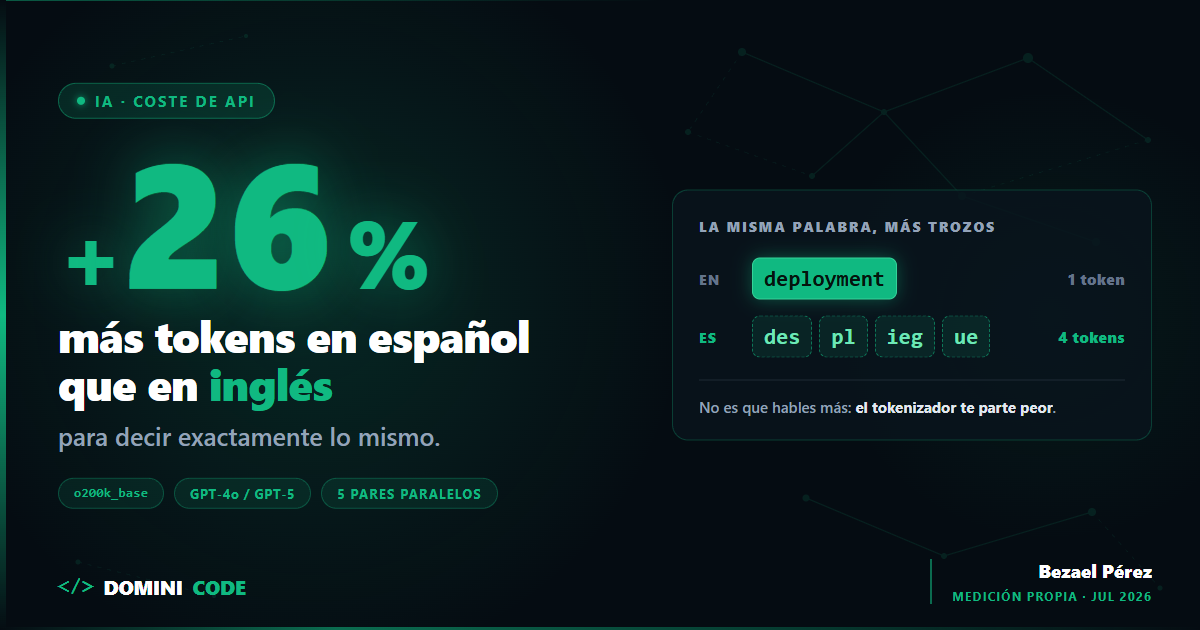
    La respuesta corta: el español consume un 26,0 % más de tokens que el inglés para transmitir el mismo mensaje, medido sobre cinco pares de textos paralelos con o200k_base (GPT-4o / GPT-5). Unos 10 puntos vienen de que el español usa más palabras; el resto, de que el tokenizador parte cada palabra española en más trozos. El precio por token es idéntico en los dos idiomas: lo que cambia es cuántos necesitas.

    Medí los tokens en español de cinco textos reales

    Cogí cinco textos del tipo que de verdad mandas a un modelo en producción y escribí la versión española y la inglesa de cada uno, con el mismo significado y el mismo registro. Nada de traducciones infladas: pares paralelos.

    Luego los pasé en local por o200k_base, el tokenizador de la familia GPT-4o / GPT-5.

    Tabla 1 — Sobrecoste de tokens del español frente al inglés en cinco pares de textos paralelos, medidos con o200k_base. Medición propia de Dominicode, julio de 2026.

    Tipo de texto Tokens EN Tokens ES Sobrecoste ES vs EN
    System prompt de agente 74 86 +16,2 %
    Documentación técnica 62 85 +37,1 %
    Mensaje de un usuario (soporte) 65 73 +12,3 %
    Fragmento de base de conocimiento (RAG) 67 93 +38,8 %
    Prompt de tarea de desarrollo 55 70 +27,3 %
    Total 323 407 +26,0 %

    El español consume un 26,0 % más de tokens que el inglés para decir exactamente lo mismo. No es una anécdota: es un multiplicador que se aplica a cada llamada de tu aplicación, todos los días.

    Y fíjate en la dispersión, porque ahí está la parte accionable: el mensaje de un usuario se hincha un 12,3 %; un fragmento de base de conocimiento, un 38,8 %. Tres veces más de castigo según el tipo de texto.

    No es que hables más. Es que te parten peor.

    Descompongo ese +26 % en sus dos factores:

    • Palabras: 290 en inglés → 319 en español = +10,0 %
    • Tokens por palabra: 1,114 en inglés → 1,276 en español = +14,5 %. O sin decimales, por si se lee mejor: 111 tokens por cada 100 palabras inglesas frente a 128 por cada 100 españolas.

    Y los dos factores se multiplican, no se suman: 1,10 × 1,145 = 1,26. Ahí está el +26 % completo.

    Traducido: de los 26 puntos de sobrecoste, solo unos 10 vienen de que el español use más palabras. El resto viene de que cada palabra española se rompe en más trozos.

    Esto no es una queja sobre el idioma, es ingeniería. El vocabulario de un tokenizador BPE se construye por estadística sobre un corpus mayoritariamente inglés, así que las secuencias frecuentes en inglés se quedan con las plazas buenas: una palabra inglesa común entra entera en un token y su equivalente española entra a trozos. Súmale que el español conjuga y deriva mucho más, y cada variante es una cadena distinta que el tokenizador no tiene memorizada.

    Eso explica también la dispersión de la tabla. Los dos que menos se inflan son el mensaje de usuario (+12,3 %) y el system prompt (+16,2 %): frases cortas, vocabulario común y terminología técnica que el tokenizador reconoce igual en los dos idiomas. Los que más se inflan son la documentación (+37,1 %) y los fragmentos de RAG (+38,8 %), que llevan prosa española de verdad, con subordinadas y nominalizaciones largas de las de "-ción" y "-miento". La regla práctica: cuanta más prosa explicativa, más sobrecoste.

    El sobrecoste del español baja de +44 % a +26 %

    Pasé los mismos cinco pares por cl100k_base, el tokenizador antiguo de GPT-3.5 y GPT-4: 323 tokens en inglés y 465 en español. Un +44,0 %.

    De +44 % a +26 % en una generación de tokenizador. El vocabulario de o200k_base es más grande y menos anglocéntrico. Pero son dos medidas, no una ley: bajó una vez, no des por hecho que baje siempre. Lo que sí puedes dar por hecho es que si en 2023 tomaste una decisión de arquitectura basada en lo que costaba el español, ese número está caduco.

    Metodología y límites de la medición

    Medición hecha por Bezael Pérez (Dominicode) en julio de 2026: cinco pares de textos paralelos español/inglés —system prompt de agente, documentación técnica, mensaje de soporte, fragmento de RAG y prompt de tarea de desarrollo—, tokenizados en local con o200k_base y cl100k_base. Totales: 323 tokens en inglés frente a 407 en español con o200k_base, y 465 con cl100k_base.

    Cada proveedor usa su propio tokenizador. Anthropic no publica el suyo: la única fuente fiable para contar tokens de Claude es su endpoint count_tokens — y Anthropic la llama estimación, no medida exacta.

    Así que los porcentajes de arriba son de la familia OpenAI (o200k_base), no de Claude. La dirección del efecto es la misma en todos los modelos comerciales, pero el número exacto varía según proveedor y tipo de texto. Anthropic lo admite en su propia página de precios: un token son "aproximadamente 4 caracteres o 0,75 palabras en inglés", y el recuento exacto "varía según el idioma".

    Con Claude hay además un detalle que cambia los números absolutos, avisado en esa misma página: los modelos de la generación 4.7 en adelante —Opus 5 y Sonnet 5 incluidos— usan un tokenizador nuevo que produce alrededor de un 30 % más de tokens que los anteriores para el mismo texto. Se nota en sus estimaciones: el millón de tokens de Opus 5 son ~555.000 palabras en inglés, y en Opus 4.6 eran ~750.000.

    Así que no copies la cifra de este post. Mídela. Es gratis y te cuento cómo abajo.

    Dónde se paga el sobrecoste de tokens en español: factura, contexto y latencia

    1. La factura: cuánto cuesta el sobrecoste al mes

    Tabla 2 — Precios oficiales de la API de Anthropic por millón de tokens, en USD (consultados el 30 de julio de 2026).

    Modelo Entrada ($/M tokens) Salida ($/M tokens)
    Claude Opus 5 $5 $25
    Claude Sonnet 5 $3 $15
    Claude Haiku 4.5 $1 $5

    Ojo a la fecha con Sonnet 5: los $3 / $15 son la tarifa estándar que entra el 1 de septiembre de 2026; hasta el 31 de agosto rige el lanzamiento de $2 / $10, un tercio más barato. Calculo con la estándar porque es la que pagarás cuando esto lleve unos meses en producción.

    Vuelvo al agente del principio: Sonnet 5 a tarifa estándar, 25.000 conversaciones al mes, 1.500 tokens de entrada y 300 de salida por conversación. El modelo responde en el idioma en el que le escriben, así que cuando el usuario escribe en español la salida también se hincha un 26 %.

    • En inglés: entrada 37,5 M × $3 = $112,50 · salida 7,5 M × $15 = $112,50 → $225/mes
    • En español (+26 % en entrada y en salida): entrada 47,25 M × $3 = $141,75 · salida 9,45 M × $15 = $141,75 → $283,50/mes

    Diferencia: $58,50 al mes. $702 al año. Por escribir en el idioma de tus usuarios. El +26 % va aquí como aproximación, por lo que ya expliqué: el tokenizador de Claude no es público.

    A esta escala es asumible. Multiplícalo por diez y ya es una decisión de producto.

    2. La ventana de contexto

    Opus 5 y Sonnet 5 tienen 1 millón de tokens de ventana de contexto. Y ojo con la cuenta, porque aquí el 26 % se da la vuelta: si cada texto te cuesta un 26 % más de tokens, en ese millón te cabe un 21 % menos de contenido (1 ÷ 1,26 = 0,79). Con fragmentos de base de conocimiento, que se hinchan un 38,8 %, la pérdida sube al 28 %.

    En un RAG eso no es una curiosidad académica: es recall —y si todavía estás decidiendo entre RAG y fine-tuning, el idioma entra en la ecuación de coste. Con el mismo presupuesto de contexto inyectas menos fragmentos por consulta.

    Menos evidencia recuperada para la misma pregunta es exactamente la situación en la que un modelo empieza a rellenar huecos, que es el mecanismo que expliqué en por qué la IA se inventa cosas.

    Y antes de que la solución sea "pues meto más": llenar la ventana tampoco es gratis en calidad. Va de eso la regla del 60 % en gestión de contexto.

    3. La latencia

    Un modelo emite los tokens de salida de uno en uno, a un ritmo más o menos fijo. Si tu respuesta en español necesita un 26 % más de tokens, tarda un 26 % más en terminar.

    Ojo con dónde lo notas, porque es fácil confundirse: si haces streaming, el primer token llega igual de rápido —eso lo manda el prefill de la entrada, no la longitud de la salida—, y lo que se alarga es la respuesta completa. Sin streaming, el usuario se come el 26 % entero mirando el cursor parpadear. Y si detrás hay un agente que encadena cinco llamadas, ese 26 % se acumula en cada paso.

    Qué hacer con esto (sin escribir peor español)

    Mide, no estimes. El endpoint count_tokens de Anthropic es gratis. Solo lo limitan las peticiones por minuto de tu tier: 2.000 en Start, 4.000 en Build, 8.000 en Scale.

    import Anthropic from "@anthropic-ai/sdk"
    
    const client = new Anthropic()
    
    const systemEs = "Eres un agente de soporte…"   // tu system prompt real
    const systemEn = "You are a support agent…"     // el mismo, en inglés
    
    async function contar(system: string) {
      const res = await client.messages.countTokens({
        model: "claude-opus-5",
        system,
        messages: [{ role: "user", content: "ping" }],
      })
      return res.input_tokens
    }
    
    console.log(await contar(systemEs), await contar(systemEn))
    

    El "ping" está ahí porque messages es obligatorio; al ser idéntico en las dos llamadas, la diferencia sale limpia. Quince minutos y dejas de discutir con estimaciones.

    El system prompt en inglés, el contenido del usuario en español. El system prompt se repite en cada llamada y tu usuario nunca lo lee. Traducirlo al inglés te quita tokens de encima en todas.

    Pero pon el número antes de comprar la idea. Mi system prompt de prueba baja de 86 a 74 tokens: por 25.000 conversaciones al mes son $0,90 con Sonnet 5. Con un system prompt realista de 2.000 tokens, unos $21 al mes. Con caché, una décima parte de eso. Es una optimización real, pero es de un dígito o dos de dólares — no la vendas como el arreglo.

    Y no es gratis. Si lo traduces, fija el idioma de salida de forma explícita —"Always respond in Spanish, regardless of the language of these instructions"— en vez de dejar que el modelo lo infiera del mensaje. Si dentro tienes few-shots, cuidado: los ejemplos arrastran el idioma de salida tanto como la instrucción. Y deja en español cualquier texto que el modelo tenga que devolver literal —mensajes fijos, disclaimers, nombres de producto—, o te lo traducirá a su manera. Después de tocar el system prompt, vuelve a pasar tus evals.

    Prompt caching. Esta es la palanca de verdad. Si el system prompt y el contexto fijo se repiten entre llamadas, cachéalos: una lectura de caché cuesta 0,1× el precio de entrada, un 90 % menos. Ataca justo la parte repetida, la que paga el 26 % una y otra vez sin cambiar una coma, y por eso rinde un orden de magnitud más que traducir nada. Lo desarrollé entero en prompt caching con la API de Claude. Orden de prioridades: primero cachea, después piensa en el idioma.

    Vigila lo que inyectas en cada consulta. Los fragmentos de base de conocimiento son lo que más se hincha (+38,8 %) y van en cada petición; la documentación técnica le sigue (+37,1 %). Si trabajas con specs, esto te toca de lleno: una spec es documentación técnica que entra en el contexto en cada iteración. Una razón más para escribirlas cortas y estructuradas, como insisto en el libro de Spec-Driven Development.

    Lo que NO debes hacer: escribir peor español para ahorrar tokens. Nada de abreviar, quitar tildes o telegrafiar los prompts como un SMS de 2004. El ahorro es de céntimos, y transliterar o mutilar el texto es justo lo contrario de lo que recomiendan los propios proveedores, que piden enviarlo en su escritura nativa. Si necesitas gastar menos: cachea, elige un modelo más pequeño para la tarea, reduce el número de llamadas o mueve la carga a un modelo local, donde el sobrecoste del español deja de facturarse por token y pasa a ser tiempo de GPU.

    Cómo medir tus tokens en español hoy mismo

    Abre tu system prompt de producción. El real, el que ya está desplegado.

    1. Copia tu system prompt tal cual está desplegado.
    2. Pásalo por count_tokens y anota input_tokens.
    3. Traduce ese mismo prompt al inglés sin recortar contenido.
    4. Pásalo otra vez y anota el segundo número.
    5. Resta, divide por el valor en inglés y multiplica por tus llamadas mensuales y por el precio de entrada de tu modelo.

    En quince minutos tienes tu número, no el mío.

    La mayoría descubre que su problema no era el idioma: era que no estaban cacheando nada. Ese diagnóstico solo aparece cuando mides.

    Si quieres el flujo completo para llevar una idea a producto con Claude Code —y salir con instrumentación, no con intuiciones—, es lo que trabajo en Construye con IA: de la idea al producto con Claude Code. Y si prefieres verlo sobre proyectos reales, con gente peleándose con las mismas facturas, eso pasa cada semana en Dominicode Labs.

    Preguntas frecuentes sobre los tokens en español

    ¿Cuánto más cuesta escribir prompts en español que en inglés?

    En mi medición con o200k_base sobre cinco pares de textos paralelos, un 26,0 % más de tokens para decir lo mismo: 323 en inglés frente a 407 en español.

    El rango va de +12,3 % (mensaje de un usuario) a +38,8 % (fragmento de RAG): el tipo de texto importa tanto como el idioma.

    ¿Es porque el español es más largo?

    Solo en parte, y los dos factores se multiplican, no se suman: un +10,0 % de palabras (290 → 319) por un +14,5 % de tokens por palabra (1,114 → 1,276) sale 1,10 × 1,145 = 1,26. El factor grande es el segundo.

    La causa es el tokenizador, no la verborrea: su vocabulario se entrenó sobre un corpus mayoritariamente inglés, y lo que no está bien representado ahí se fragmenta.

    ¿Cuántos tokens es una palabra en español?

    1,276 tokens por palabra de media en mi medición con o200k_base, frente a 1,114 en inglés. O sin decimales: unos 128 tokens por cada 100 palabras españolas y 111 por cada 100 inglesas.

    Es una media sobre texto real de producción: sube en prosa explicativa y baja en textos cargados de terminología inglesa, que el tokenizador ya conoce.

    ¿Qué tipo de texto se encarece más al escribirlo en español?

    Los fragmentos de base de conocimiento para RAG (+38,8 %) y la documentación técnica (+37,1 %). El que menos, los mensajes que escriben los propios usuarios (+12,3 %).

    La diferencia está en la densidad de jerga inglesa: cuanto más técnico es el texto, más tokens comparte el español con el inglés y menos se infla.

    ¿Cómo cuento los tokens en español que consume Claude?

    Con el endpoint count_tokens de la API de Anthropic, disponible en el SDK oficial como client.messages.countTokens(). Es gratis y solo lo limitan las peticiones por minuto de tu tier: 2.000 en Start, 4.000 en Build, 8.000 en Scale.

    Es además la única fuente oficial, porque Anthropic no publica su tokenizador. Ni siquiera ella es exacta: Anthropic advierte de que el conteo es una estimación y puede desviarse ligeramente del consumo real. Cualquier cifra calculada con o200k_base o cl100k_base es una aproximación de otro proveedor.

    ¿Debo escribir mis prompts en inglés para ahorrar dinero?

    El system prompt puedes traducirlo: se repite en cada llamada, nadie lo lee y los modelos responden en español perfectamente aunque las instrucciones estén en inglés. Pero mide el ahorro antes de moverlo, porque suele ser de un dígito o dos de dólares al mes, y desaparece casi entero si ya estás cacheando.

    El contenido del usuario, no lo toques. Y no traduzcas tu base de conocimiento al inglés solo por coste sin medir antes qué le pasa a la calidad de las respuestas. Antes de eso activa prompt caching: ahorra un 90 % en la parte repetida y no cambia nada de tu producto.

    ¿Este sobrecoste va a desaparecer?

    Se está reduciendo: los mismos cinco pares dan +44,0 % con cl100k_base (GPT-3.5 / GPT-4) y +26,0 % con o200k_base (GPT-4o / GPT-5), porque los vocabularios nuevos son más grandes y menos anglocéntricos.

    Pero no lo tomes como una tendencia garantizada. Son dos medidas, no una ley, y hay contraejemplos: los modelos Claude de la generación 4.7 en adelante usan un tokenizador nuevo que produce alrededor de un 30 % más de tokens que los anteriores para el mismo texto. Vuelve a medir cada vez que cambies de modelo.

    ¿Afecta el idioma a la ventana de contexto?

    Sí, y es el coste que menos se vigila. Cuidado con la cuenta, porque el porcentaje se invierte: en 1 millón de tokens —el que traen Opus 5 y Sonnet 5— cabe un 21 % menos de contenido si está en español, porque un +26 % de tokens por texto equivale a 1 ÷ 1,26 de contenido por ventana. Con fragmentos de RAG (+38,8 %) la pérdida es del 28 %.

    En un RAG eso significa menos fragmentos recuperados por consulta con el mismo presupuesto de contexto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
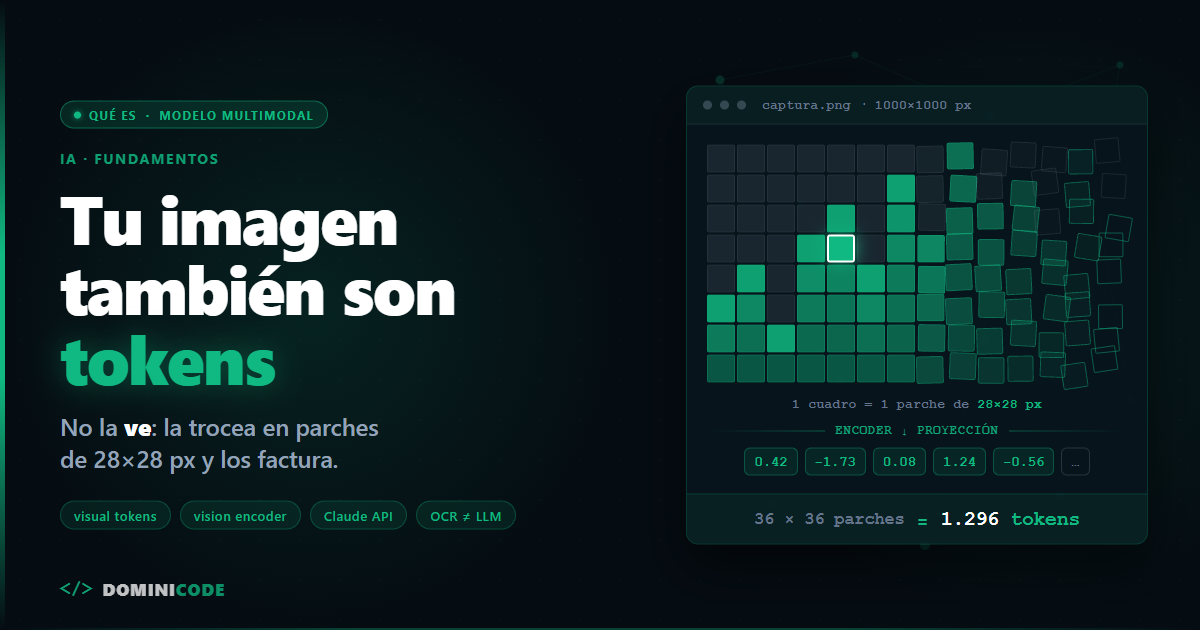
  • Qué es un modelo multimodal: tu imagen también son tokens

    Qué es un modelo multimodal: tu imagen también son tokens

    Hace unas semanas metí un pantallazo de un dashboard de facturación en una llamada a la API y le pedí al modelo el total del mes.

    Me devolvió una cifra. Redonda, con su símbolo de euro, con toda la seguridad del mundo.

    Estaba mal. No un poco mal: mal de otro trimestre.

    Mi primer reflejo fue culpar al OCR. Craso error, porque ahí no había ningún OCR. Y ese fue el momento en el que entendí que llevaba meses usando un modelo multimodal sin tener ni idea de lo que pasaba entre mi fetch y la respuesta.

    El modelo no leyó mi dashboard. Lo convirtió en tokens y predijo qué números encajaban ahí.


    Qué es un modelo multimodal

    Un modelo multimodal es un modelo de IA que acepta más de un tipo de entrada —texto, imagen, audio o vídeo— porque convierte todas esas entradas a vectores del mismo espacio y las procesa con un único transformer. No hay un "módulo de visión" que mira y luego le cuenta al modelo lo que hay: todo acaba siendo la misma sopa de números, y el modelo sigue haciendo lo único que sabe hacer, predecir el siguiente token.

    Lo esencial, antes de entrar en detalle:

    • Entrada no es salida. Que un modelo acepte imágenes no significa que las genere. Claude entiende imágenes; no las produce ni las edita.
    • Se factura por parches. Claude trocea la imagen en bloques de 28×28 px y cobra cada bloque como un visual token.
    • El coste es de prompt. Una captura de 1000×1000 px son 1.296 tokens de entrada antes de que el modelo escriba una palabra.
    • El conteo es aproximado. La documentación de Anthropic lo admite: los conteos de objetos y las coordenadas no son exactos.

    Cómo funciona: tu imagen no entra como imagen, entra como tokens

    Un modelo multimodal procesa una imagen en tres pasos: un encoder la trocea en parches y convierte cada parche en un vector, una capa de proyección lleva esos vectores a la misma dimensionalidad que los embeddings de texto, y el transformer los mezcla con los tokens de tu prompt como si fueran palabras. Si ya tienes claro que la IA no piensa, predice, es una extensión bastante elegante de la misma idea.

    Un LLM de texto tiene un tokenizador: parte tu string en trozos y a cada trozo le asigna un vector de N dimensiones. Ese vector es lo que come el transformer.

    Un modelo multimodal añade una pieza delante: un encoder por cada modalidad. Para imagen suele ser un Vision Transformer que trocea el bitmap en parches cuadrados y convierte cada parche en un vector. Para audio, algo equivalente sobre el espectrograma.

    Después viene el truco de todo esto: una capa de proyección que traduce esos vectores a la misma dimensionalidad que los embeddings de texto. Pasada esa capa, el transformer los procesa con la misma maquinaria: no hay una ruta especial para lo visual. El vector del parche 47 de tu JPEG y el de la palabra "factura" son vecinos en el mismo espacio, aunque el modelo sepa perfectamente cuál vino de dónde.

    Anthropic lo documenta de forma literal: Claude ve las imágenes en parches de 28×28 píxeles y a cada parche lo llama visual token. No es una metáfora divulgativa, es la unidad de facturación.

    El detalle que rompe la intuición: la secuencia final es una lista plana donde los tokens de la imagen y los de tu prompt están mezclados, atendiéndose unos a otros con el mismo mecanismo de atención de siempre.

    No hay un ojo. Hay una secuencia más larga.

    Y ojo con la confusión que cuesta dinero en reuniones de producto: que un modelo acepte imágenes no significa que las genere. Claude entiende imágenes, no las produce ni las edita. Gemini y la familia GPT sí generan, con endpoints y precios propios. Cuando alguien proponga "usar IA multimodal", pregunta si habla de entrada o de salida.


    El código: mandar una imagen de verdad

    Así se envía una imagen a Claude con el SDK oficial de TypeScript. Fíjate en el orden: la imagen antes del texto, porque la propia documentación de Anthropic recomienda esa estructura.

    import Anthropic from "@anthropic-ai/sdk";
    import { readFile } from "node:fs/promises";
    
    const anthropic = new Anthropic(); // lee ANTHROPIC_API_KEY del entorno
    
    const imageData = (await readFile("factura.jpg")).toString("base64");
    
    const message = await anthropic.messages.create({
      model: "claude-opus-5",
      max_tokens: 16000, // el thinking va dentro de este tope: no lo dejes corto
      messages: [
        {
          role: "user",
          content: [
            {
              type: "image",
              source: {
                type: "base64",
                media_type: "image/jpeg",
                data: imageData,
              },
            },
            {
              type: "text",
              text: "Extrae total, fecha y NIF. Devuelve JSON. Si un campo no es legible, null.",
            },
          ],
        },
      ],
    });
    
    console.log(message.usage.input_tokens); // aquí está la factura de verdad
    

    Si la imagen ya vive en una URL pública, te ahorras el base64:

    // sustituye el bloque de imagen del array content por este
    const imageBlock: Anthropic.ImageBlockParam = {
      type: "image",
      source: { type: "url", url: "https://ejemplo.com/factura.jpg" },
    };
    

    Loguea usage.input_tokens desde el primer día. Es la diferencia entre una demo bonita y saber lo que te va a costar en producción.

    Y ese null del prompt no es adorno: cuando el modelo te devuelve JSON extraído de un píxel borroso, necesitas un esquema que valide antes de que ese dato toque tu base de datos. Es el patrón que trabajo en el curso de Zod: el modelo propone, el schema dispone.


    Cuánto cuesta una imagen en un modelo multimodal

    Una imagen cuesta ⌈ancho / 28⌉ × ⌈alto / 28⌉ visual tokens en la API de Claude. Es aritmética pública y simple, y aun así aquí es donde se tuercen la mayoría de los proyectos multimodales: nadie hace la cuenta antes.

    Los modelos de Claude 4.7 en adelante están en el tier de alta resolución (borde largo máximo 2576 px, tope de 4.784 visual tokens); los anteriores, en el estándar (1568 px, 1.568 tokens). Si te pasas, la imagen se reescala antes de procesarse.

    Estas son las cifras que publica la documentación oficial de visión de Anthropic:

    Imagen Tier estándar Tier alta resolución
    200×200 px 64 tokens 64 tokens
    1000×1000 px 1.296 tokens 1.296 tokens
    1920×1080 px 1.560 tokens (reescalada a 1456×819) 2.691 tokens
    3840×2160 px (4K) 1.560 tokens (reescalada) 4.784 tokens (reescalada a 2576×1449)

    Traduce eso a dinero. Con Opus 5 a 5 $ por millón de tokens de entrada (precios de julio de 2026), mil capturas de 1000×1000 salen por unos 6,48 $ y mil capturas en 4K por unos 23,92 $. La cuenta la puedes rehacer tú: 1.296 × 5 / 1.000.000 × 1.000.

    Parece barato hasta que lo multiplicas por un agente que itera catorce veces sobre la misma pantalla.

    Con audio pasa lo mismo en otra escala. Gemini documenta 32 tokens por segundo, o sea 1.920 tokens por minuto. Una reunión de una hora son unos 115.000 tokens de entrada antes de que el modelo escriba una sola palabra.

    Tres consecuencias prácticas:

    1. Redimensiona antes de subir. Mandar un 4K cuando el texto se lee perfectamente a 1200 px es tirar tokens y latencia a la basura.
    2. En conversaciones de varios turnos, usa la Files API. Con base64 el payload entero viaja otra vez en cada turno, porque el historial se reenvía completo. Con file_id subes una vez y referencias. Ojo: hoy va por anthropic.beta.files.upload y hay que pasar betas: ["files-api-2025-04-14"].
    3. La imagen infla el prompt, no la respuesta. Ese coste es todo de entrada y el modelo lo digiere antes del primer token. La latencia sube aunque respondas tres líneas.

    Dónde falla un modelo multimodal (y falla más de lo que crees)

    Un modelo multimodal alucina con imágenes por el mismo motivo por el que la IA se inventa cosas con texto: no hay un módulo de verdad, hay una distribución de probabilidad. La diferencia es que con una imagen mala el modelo tiene menos señal y más margen para rellenar con lo plausible.

    Mi dashboard fue justo eso. Cifras pequeñas, reescaladas, con poco contraste. El modelo generó el número que estadísticamente encajaba en ese hueco.

    La documentación de Anthropic reconoce los límites sin maquillaje. Con imágenes de baja calidad, rotadas o de menos de 200 píxeles, alucina. Los conteos de objetos son aproximados. Las coordenadas, también. Y no puede determinar si una imagen fue generada por IA: si se lo preguntas, se inventa la respuesta.

    Léelo otra vez: el conteo es aproximado. Si tu caso de uso es "cuántos palés hay en esta foto" y tu negocio depende de esa cifra, tienes un problema de arquitectura, no de prompt.

    Sobre el OCR: un modelo multimodal entiende un documento con layout raro, tablas torcidas o manuscritos mucho mejor que Tesseract. Pero un OCR clásico es determinista y trazable. El modelo puede darte dos respuestas distintas para la misma imagen, y si le pides coordenadas te las da aproximadas, nunca como una región verificable contra el original. En un pipeline de compliance eso es inaceptable.

    Modelo multimodal OCR clásico (Tesseract, Textract)
    Layout variable, manuscritos, fotos malas Muy bueno Malo
    Misma imagen → misma salida No garantizado Sí
    Trazabilidad de dónde salió el dato No la da Sí, con bounding boxes
    Coste Por visual token, escala con la resolución Plano o por página
    Entiende el contenido ("¿este ticket es de comida?") Sí No
    Apto para compliance sin revisión humana No Sí

    Cuándo usar un modelo multimodal y cuándo es un martillo caro

    Mi regla, después de comerme varias facturas de API sin necesidad:

    Si el dato ya existe en forma estructurada, no le mandes la foto. Si tienes el PDF con capa de texto, extrae el texto. Si tienes la API del dashboard, llama a la API. Mandar una captura de algo que podías consultar en JSON es la forma más cara de leer un número.

    Usa multimodal cuando la información vive en la disposición visual y no en el contenido. Un ticket arrugado fotografiado de noche. Un diagrama en una pizarra. El screenshot de una UI rota que un usuario manda por soporte. Ahí la alternativa no es un parser peor: es que no hay alternativa.

    Y vigílalo dentro del bucle agéntico. Si montas un agente que navega e interpreta pantallas, cada iteración multiplica el coste visual. Esa distinción entre IA generativa e IA agéntica importa mucho más cuando cada paso arrastra 2.700 tokens de imagen.

    Y si lo que necesitas es buscar entre miles de imágenes en vez de razonar sobre una, ya no quieres un modelo generativo: quieres embeddings multimodales e índice vectorial. Lo tienes montado paso a paso en el pipeline multimodal con Gemini Embedding 2.

    La decisión que va antes —si tu problema es de búsqueda, de RAG o de fine-tuning— la desmenucé aquí.


    Lo que puedes hacer hoy

    Coge la funcionalidad multimodal que tengas en marcha o en el backlog y haz una sola cosa: calcula sus visual tokens con la fórmula, multiplícalos por tu volumen mensual real y compáralo con lo que cuesta resolverlo sin imagen.

    En más casos de los que esperas descubrirás que ibas a pagar por interpretar un pantallazo de un dato que ya tenías en una tabla. En el resto tendrás el número exacto para defender el proyecto delante de quien firma.

    Los modelos multimodales no son magia ni son un timo. Son un canal de entrada más, con su precio por parche y su margen de error. Trátalos como lo que son: una dependencia cara. Mídela antes de casarte con ella.

    Cómo encaja esto en un producto completo —qué resuelve el modelo y qué resuelve código normal— lo trabajo de principio a fin en Construye con IA. Y si prefieres discutirlo con gente que está construyendo lo mismo esta semana, estamos en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es un modelo multimodal en una frase?

    Un modelo que acepta varios tipos de entrada —texto, imagen, audio, vídeo— porque los convierte todos a vectores del mismo espacio antes de procesarlos. En la práctica, para el desarrollador significa una sola cosa: tu imagen entra en el prompt como tokens, cuesta como tokens y se factura como tokens.

    ¿Un modelo multimodal "ve" la imagen como una persona?

    No. Trocea el bitmap en parches, convierte cada parche en un vector y los intercala con los tokens de tu prompt. No hay percepción: hay una secuencia de números sobre la que se aplica atención. Por eso describe con precisión una escena compleja y a la vez falla contando cuatro objetos.

    ¿Cuántos tokens cuesta enviar una imagen?

    Depende de la resolución y del proveedor. En la API de Claude son ⌈ancho / 28⌉ × ⌈alto / 28⌉ visual tokens, con reescalado automático si superas el límite del modelo: 1000×1000 px son 1.296 tokens y un 4K llega al tope de 4.784 en el tier de alta resolución. Son cifras aproximadas de la documentación oficial, así que loguea usage.input_tokens en vez de fiarte de una estimación.

    ¿Es mejor un modelo multimodal que un OCR clásico?

    Para documentos con layout variable, manuscritos o fotos malas, casi siempre sí. Para pipelines que necesitan determinismo, trazabilidad y coste plano, no. Muchos sistemas serios usan los dos, con el modelo actuando solo sobre lo que el OCR no resuelve.

    ¿Los modelos multimodales también generan imágenes?

    No todos. Aceptar imágenes como entrada y producirlas como salida son capacidades distintas. Claude entiende imágenes pero no las genera ni las edita, según su propia documentación. Gemini y la familia GPT sí tienen generación, con endpoints y precios propios. Confirma cuál de las dos necesitas antes de planificar la feature.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo evaluar un proyecto de IA: cinco preguntas antes de aprobar

    Cómo evaluar un proyecto de IA: cinco preguntas antes de aprobar

    Un responsable de operaciones entra en la reunión con la frase ya montada: "queremos un agente para las devoluciones".

    Primera pregunta del árbol. ¿Los pasos son siempre los mismos, y en el mismo orden?

    Sí. Salvo cuando el importe supera cierto umbral.

    Fin del árbol. En la pregunta uno.

    Lo que necesitaba era un workflow con una excepción. Y estaba presupuestando diez veces eso.

    Esto es lo que no sale en la diapositiva de nadie que venga a venderte algo, y es el fondo de cómo evaluar un proyecto de IA: el resultado más frecuente de hacerlo bien es descubrir que no hacía falta un agente. No es falta de ambición. Es lo que hace que el proyecto siga vivo dentro de dos años.

    Y hay un motivo egoísta para que te importe aunque tú no firmes ningún presupuesto: la decisión mala la acabas implementando tú.

    Si lo que buscas es el vocabulario —qué es un agente y qué no—, está entero en esta guía. Aquí no definimos nada. Aquí decidimos, y le ponemos precio a cada decisión.


    Resumen rápido

    • Cinco preguntas, en orden, y se para en la primera que aplique. No es un cuestionario: es un árbol.
    • Cada peldaño que subes multiplica el coste. La gracia está en pararse en el más bajo que resuelve el problema.
    • En IA el éxito es lo que dispara el coste: se paga por uso, así que si la herramienta gusta, la factura sube con ella.

    Cómo evaluar un proyecto de IA: el árbol de cinco preguntas

    Evaluar un proyecto de IA es recorrer estas cinco preguntas en orden y parar en la primera que aplique:

    1. ¿Los pasos son siempre los mismos, y en el mismo orden? Si sí, es un workflow, no un agente.
    2. ¿Basta con leer y escribir texto, sin tocar ningún otro sistema? Si sí, basta un chat con buen contexto.
    3. ¿Hay que decidir sobre la marcha según lo que se encuentre? Si no, workflow otra vez.
    4. Si se equivoca, ¿se puede deshacer? Si no, agente con una persona aprobando cada acción con consecuencias.
    5. ¿Puedes medir si lo ha hecho bien? Si no, todavía no va a producción.

    Cada peldaño que superas multiplica el coste, así que evaluar bien un proyecto de IA consiste en pararse en el escalón más bajo que resuelve el problema.

    La decisión se toma casi siempre al revés. Alguien quiere hacer algo con IA y después busca dónde encajarlo. Así es como acabas pagando la flexibilidad de un agente para ejecutar cinco pasos que nunca cambian.

    El árbol invierte el orden. Primero el problema, después la herramienta. Y así es como se ve cuando lo pones en una hoja, que es la forma en que de verdad se usa en una reunión:

      1. ¿Los pasos son siempre los mismos,
         y en el mismo orden?
           └─ SÍ → workflow. No agente.
           ↓ NO
    
      2. ¿Basta con leer y escribir texto,
         sin tocar ningún otro sistema?
           └─ SÍ → un chat con buen contexto.
           ↓ NO
    
      3. ¿Hay que decidir sobre la marcha
         según lo que se encuentre?
           └─ NO → workflow otra vez.
           ↓ SÍ
    
      4. Si se equivoca, ¿se puede deshacer?
           └─ NO → agente, pero con una
                    persona aprobando todo
                    lo que tenga consecuencias.
           ↓ SÍ
    
      5. ¿Puedes medir si lo ha hecho bien?
           └─ NO → todavía no va a producción.
           ↓ SÍ
    
         → Adelante. Empieza con los permisos
           mínimos y ábrelos según se los gane.
    

    Ninguna de las cinco es técnica: se contestan describiendo el proceso. Vamos una a una, con el precio de quedarse en cada peldaño al lado. Porque el árbol no va de arquitectura. Va de dinero.


    Uno. ¿Los pasos son siempre los mismos y en el mismo orden?

    Si la respuesta es sí, ya has terminado. No necesitas un agente: necesitas un workflow.

    Más barato, más rápido, auditable, y no improvisa. Cuando falla, el informe de incidencia cabe en una línea: falló el paso tres. Eso también es dinero, porque nadie factura horas reconstruyendo qué pasó.

    Esta pregunta se salta por una razón muy humana: describir un proceso como "variable" suena mejor que describirlo como "cinco pasos y una excepción". Pero el caso de las devoluciones es el típico, no la anomalía. Los pasos son fijos salvo un caso, y ese salvo se convierte en el argumento para presupuestar un sistema entero.

    Un if no es variedad. Es un if.

    Y aquí está el multiplicador que hace que esta pregunta valga tanto dinero: un agente que da quince vueltas en lugar de tres no cuesta cinco veces más. Cuesta bastante más, porque el coste no crece con el número de vueltas, sino con la suma de todas las anteriores: cada una reenvía el contexto completo. Un workflow ejecuta los pasos que escribiste y para.

    Muchos candidatos a agente son procesos que pueden escribirse tal cual, y los desmenucé en cómo automatizar tu proceso de desarrollo con IA.

    Lo que pagas aquí: ingeniería una vez, ejecución predecible. Es el único escalón donde la factura no depende de que la herramienta guste.


    Dos. ¿Basta con leer y escribir texto, sin tocar ningún otro sistema?

    Si es que sí, te sobra con un chat con buen contexto. Súmale tus documentos y ya está.

    Redactar, resumir, reformular, clasificar. Nada de eso toca un sistema ni necesita permisos, y montarlo es cuestión de días.

    Lo que se subestima aquí no es la capacidad. Es la latencia.

    Un asistente que tarda ocho segundos sirve perfectamente para redactar un informe. El mismo asistente delante de un cliente al teléfono es inaceptable. La calidad es idéntica; el uso, imposible. Y un agente multiplica esa espera por el número de vueltas: lo que en un chat son ocho segundos, en un agente pueden ser dos minutos.

    Regla que uso siempre: si hay una persona esperando, la latencia es un requisito, no un detalle. Si el proceso corre de madrugada, da igual lo que tarde.

    Lo que pagas aquí: sube con el número de personas, no con la complejidad. Es el escalón que menos sorpresas da.


    Tres. ¿Hay que decidir sobre la marcha según lo que se encuentre?

    Si es que no, workflow otra vez.

    Esta pregunta existe porque hay procesos que tocan varios sistemas —por eso pasaron la dos— pero donde el orden sigue estando escrito de antemano. Leer un correo, extraer datos, meterlos en el CRM, avisar por Slack. Toca cuatro cosas. No decide ninguna.

    El error de asignación es carísimo y se repite: mover datos de un sitio a otro no necesita un modelo eligiendo el siguiente paso. Necesita una automatización de las de siempre, con IA solo en el hueco donde hace falta criterio.

    El árbol decide un proyecto entero. Cuando lo que tienes delante es un backlog y no un presupuesto, la unidad cambia: se decide tarea por tarea, y eso está en cómo clasificar tareas de desarrollo para delegarlas a la IA.

    Lo que pagas aquí: lo mismo que en la uno, más las ramas que hay que mantener. Sigue siendo el barato.


    Cuatro. Si se equivoca, ¿se puede deshacer?

    Si la respuesta es no, la respuesta tampoco es "no lo hagas". Es: agente sí, pero con una persona aprobando cada acción con consecuencias.

    Sin excepciones. Y sin renegociarlo a la baja tres semanas después porque aprobar es un incordio.

    Pagar, contratar, publicar, borrar, escribir a clientes reales, migrar datos de producción. Ninguna de esas se deshace con un ctrl+Z, y todas tienen un coste que ya no es de infraestructura: es de reputación, de contrato o de nómina.

    La parte que no aparece en ninguna hoja de cálculo: esa persona es un coste recurrente y no escala. Revisar el diez por ciento de las salidas es viable con cien casos al día e imposible con diez mil. El proveedor absorbe el volumen sin despeinarse. Quien lo vigila, no.

    Y si el proyecto solo sale a cuenta cuando quitas al humano de en medio, entonces no sale a cuenta. Eso es información valiosa, y llega gratis si haces la pregunta antes de firmar.

    Lo que pagas aquí: el modelo por las vueltas, más el tiempo de quien aprueba. Este es el peldaño donde el presupuesto cambia de orden de magnitud, no de porcentaje.


    Cinco. ¿Puedes medir si lo ha hecho bien?

    Si es que no, no lo pongas en producción todavía.

    No porque vaya a salir mal desde el primer día. Al revés: va a salir bien, porque los pilotos salen bien.

    El problema llega después. Sin forma de medir no vas a saber si empeora, y va a empeorar: cambias de modelo, cambia el tipo de casos que llegan, alguien toca un prompt. Todo eso ocurre sin que salte ninguna alarma, porque no hay alarma.

    Medir son dos cosas y hacen falta las dos. Una señal automática que diga si la ejecución fue correcta. Y la traza de qué decidió el sistema y con qué información, que es lo que te deja reconstruir un incidente en vez de opinar sobre él — la lista de qué guardar de cada ejecución la tienes en este repaso de observabilidad para agentes.

    Decidir qué salida es aceptable antes de construir, en lugar de parchearlo cuando ya ha explotado, es el trabajo que describo en el libro de Spec-Driven Development. No es burocracia: es lo que hace que la pregunta cinco tenga respuesta el día que la haces.

    Lo que pagas aquí: todo lo anterior más la infraestructura de medir. Y esa no se va nunca, porque es la que sostiene el resto.

    Si llegas al final del árbol, adelante. Un agente es la respuesta correcta y merece la pena. Empieza con los permisos mínimos y ábrelos según se los gane.


    Dónde te paras y qué pagas

    Cada parada del árbol tiene un perfil de coste distinto, y esa es la información que falta en casi todos los presupuestos:

    Dónde se para el árbol Lo que pagas de verdad
    Pregunta 1 → workflow Ingeniería una vez. Ejecución predecible
    Pregunta 2 → chat con contexto Por conversación. Sube con las personas
    Pregunta 3 → workflow otra vez Igual que 1, más ramas que mantener
    Pregunta 4 → agente con aprobación Modelo × vueltas + tiempo de quien aprueba
    Pregunta 5 → agente instrumentado Todo lo anterior + medir, para siempre

    Esta tabla es la razón de que el orden de las preguntas no sea decorativo.

    Anthropic lo dice sin rodeos en Building effective agents (diciembre de 2024): la recomendación es buscar siempre la solución más simple posible, y eso "puede significar no construir sistemas agénticos en absoluto". Es la empresa que te cobra por vuelta diciéndote que des menos vueltas.


    Cuánto cuesta un proyecto de IA: la cuenta que casi nadie hace

    Un proyecto de IA no se paga por licencia: se paga por uso. Un taxímetro, no un abono.

    En el software al que estás acostumbrado, el usuario número mil sale casi gratis. Aquí no: cada respuesta rehace un cálculo entero, y ese cálculo cuesta dinero.

    De ahí sale la frase que te va a servir en cualquier reunión de presupuesto: en IA, el éxito es lo que dispara el coste. Si la herramienta gusta y la usa todo el mundo, la factura sube en la misma proporción. Al revés de lo que espera un director financiero.

    Así que la cuenta es esta, y se hace antes: coste por consulta × número de consultas al mes, con el escenario de que la herramienta guste.

    Un piloto de diez personas y una implantación de dos mil no se diferencian en dos veces. Se diferencian en dos órdenes de magnitud. Y dos detalles estropean cualquier estimación hecha a ojo: lo que sale se cobra varias veces más caro que lo que entra —está en las tarifas públicas de Anthropic y en las de cualquier otro proveedor—, y una conversación larga cuesta más que la suma de sus mensajes, porque cada turno reenvía todo lo anterior.

    Esa asimetría entre lo que entra y lo que sale, con los números de coste al lado, la desglosé en IA generativa vs IA agéntica.

    El piloto es el diez por ciento del trabajo aunque parezca el noventa

    Un piloto se monta en semanas y sale bien: casos elegidos, gente motivada y alguien vigilando de cerca.

    Producción es otra cosa. Aparecen los casos raros, los usos que nadie previó, el mantenimiento de la base de conocimiento y la factura de verdad. Y aparece el punto que más proyectos entierra: quién se ocupa de esto dentro de un año. El piloto lo llevó alguien con ilusión en un rato libre. Producción necesita un dueño en el organigrama.

    Piloto Producción
    Casos Elegidos a mano Los que lleguen, incluidos los raros
    Usuarios Motivados y avisados Todos, y sin leer las instrucciones
    Supervisión Alguien mirando de cerca Una revisión semanal que hay que asignar
    Coste Casi ruido Coste por consulta × volumen real
    Dueño Quien tuvo la idea Una persona en el organigrama

    La regla, dura a propósito: si al terminar el piloto no sabes decir quién lo mantiene, cuánto costará al volumen real y quién lo revisa cada semana, el piloto no ha terminado. Ha terminado la parte divertida.

    Cómo evaluar un proyecto de IA cuando no hay un "antes" que medir

    Empieza por procesos donde puedas medir el antes. Es la regla que evita la mayoría de los disgustos, y se entiende sola: si no sabes cuánto tardabais en tramitar una devolución antes de la IA, tampoco vas a poder demostrar que ahora tardáis menos. Y sin eso, la renovación del presupuesto se decide por sensaciones.

    Cuidado con lo que eliges medir, porque lo que midas es lo que vas a conseguir. Si mides volumen tendrás volumen: más documentos generados, más tickets cerrados y ninguna certeza de que algo haya mejorado. Qué métricas dicen la verdad lo desarrollé en cómo medir la productividad de equipos que usan IA.


    Por qué te importa aunque tú no firmes nada

    Este árbol es cosa de quien firma. Por eso te importa a ti.

    Cuando alguien aprueba un agente para un proceso de cinco pasos fijos, tú eres quien pasa los seis meses siguientes intentando que un sistema no determinista se comporte de forma determinista. Vas a montar guardrails para forzar un orden que cabía en un switch. Vas a depurar ejecuciones que no se repiten. Vas a explicar por qué sube la factura.

    Todo eso era evitable en la pregunta uno, en una reunión de veinte minutos a la que probablemente no te invitaron.

    La jugada es sencilla: haz tú las cinco preguntas, en voz alta, antes de que se decida nada. No hace falta ser quien firma para ser quien pregunta.

    Y cuando la decisión ya está tomada y lo que te llega es una frase de reunión, el trabajo es traducirla antes de que se convierta en alcance: cómo explicar IA a tu jefe y las seis frases que acaban en tu sprint.

    Y si quieres contrastar el árbol antes de usarlo, esa conversación pasa cada semana en Dominicode Labs, con gente que ya tiene estos sistemas corriendo.

    Y si quieres el recorrido de idea a producto con este criterio aplicado desde el primer día, es el camino del curso Construye con IA.


    Lo único que tienes que hacer hoy

    Coge el proyecto de IA que ya está aprobado. Ese, no el que viene.

    Y contesta la pregunta uno: ¿los pasos son siempre los mismos y en el mismo orden?

    Si la respuesta empieza por "sí, salvo cuando…", ese salvo es la conversación que tienes que provocar esta semana. Porque casi siempre es un if, y estás pagando por un sistema que decide para no tener que escribirlo.

    El árbol sale de un libro que estoy terminando, El mapa de la inteligencia artificial: 120 conceptos para gente que decide sin escribir código. Mientras tanto, esos conceptos colocados por zonas —y estas cinco preguntas en formato imprimible— los tienes gratis en el mapa desplegable.

    Imprímelo y déjalo en la sala de reuniones. Mejor aún: pásaselo a quien te aprueba el presupuesto. Ahí es donde de verdad hace su trabajo.


    Preguntas frecuentes

    ¿Cómo se evalúa si un proyecto de IA merece la pena?

    Con un árbol de cinco preguntas que se recorre en orden y se detiene en la primera que aplique: si los pasos son siempre los mismos, si basta con leer y escribir texto, si hay que decidir sobre la marcha, si el error es reversible y si puedes medir el resultado. Cada peldaño que subes multiplica el coste y el riesgo, así que evaluar bien es pararse en el escalón más bajo que resuelve el problema.

    ¿Cuándo compensa pagar por un agente y cuándo basta con un workflow?

    Un agente solo justifica su precio cuando el camino cambia según lo que el sistema encuentra durante la ejecución, y pagar flexibilidad para un proceso fijo es el error más caro de esta lista. Si los pasos están fijados de antemano, un workflow es más barato, más rápido y auditable. Si el trabajo se agota en leer y escribir texto sin tocar otros sistemas, un chat con buen contexto y tus documentos resuelve el caso en días.

    ¿Por qué la primera pregunta ahorra tanto dinero?

    Porque corta los proyectos más caros antes de que existan. Un agente que da quince vueltas en lugar de tres multiplica la factura, y cada vuelta reenvía todo el contexto anterior, así que el coste no crece con el número de pasos sino con la suma de todos los anteriores. Cuando el proceso es fijo salvo una excepción, pagas por una decisión que se toma miles de veces y siempre sale igual.

    ¿Cuánto cuesta realmente un proyecto de IA?

    No se paga por licencia, se paga por uso: la cuenta correcta es coste por consulta multiplicado por consultas al mes, calculada con el escenario de que la herramienta guste. Un piloto de diez personas y una implantación de dos mil se separan en dos órdenes de magnitud, no en dos veces. Súmale lo que casi nunca se presupuesta: quien revisa, el mantenimiento de la base de conocimiento y el dueño del sistema.

    ¿Por qué un piloto que funciona no garantiza que el proyecto funcione?

    Porque el piloto se hace con casos elegidos, gente motivada y alguien vigilando de cerca. En producción aparecen los casos raros, los usos que nadie previó, los límites de las APIs y la supervisión semanal. Lo que no escala no es la infraestructura, que el proveedor absorbe sin inmutarse: es la parte humana de revisar, mantener y decidir.

    ¿Qué hago si no puedo medir si el sistema lo hace bien?

    No lo pones en producción todavía. Sin una señal que diga si una ejecución fue correcta no vas a enterarte de que el sistema empeora, y va a empeorar en cuanto cambie el modelo, cambien los casos o alguien toque un prompt. Antes de subirlo necesitas dos cosas: una comprobación automática del resultado y la traza de qué decidió el sistema con qué información.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
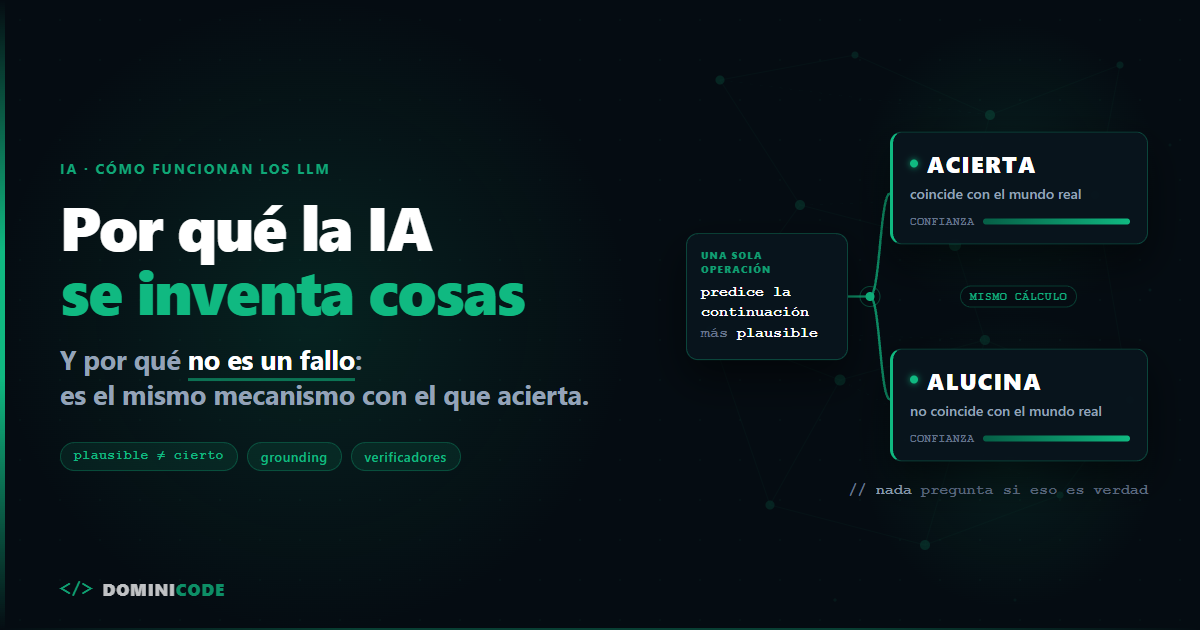
  • Por qué la IA se inventa cosas — y por qué no es un fallo

    Por qué la IA se inventa cosas — y por qué no es un fallo

    Le pides las tres sentencias más relevantes sobre un asunto. Te devuelve tres: tribunal, número, año, en el formato exacto en que se citan estas cosas.

    Dos existen.

    La tercera no. Y es indistinguible de las otras dos.

    No está peor escrita. No lleva una nota al pie que diga "esta me la he inventado". No hay cambio de tono, ni duda, ni titubeo. Tiene la misma pinta de ser verdad que las otras dos.

    Y aquí está lo que casi nadie cuenta cuando explica por qué la IA se inventa cosas: no falló nada. El sistema hizo exactamente lo mismo que hace cuando acierta.

    Esto no es un ejercicio teórico. El 22 de junio de 2023, el juez P. Kevin Castel impuso una sanción de 5.000 dólares —solidariamente a dos abogados y a su despacho— en el caso Mata v. Avianca, nº 1:22-cv-01461 del Distrito Sur de Nueva York (678 F. Supp. 3d 443). Habían presentado un escrito con seis sentencias inventadas de principio a fin, con citas internas a resoluciones que tampoco existen.

    Lo mejor viene ahora: uno de ellos le preguntó a ChatGPT si esos casos eran reales. Respondió que sí, y añadió que podían encontrarse en Westlaw, LexisNexis y el Federal Reporter.

    Y aquí está el detalle que casi nadie cuenta: el juez no sancionó por el error. Escribió que usar una herramienta de IA no tiene "nada de intrínsecamente impropio". Sancionó porque, después de que la parte contraria y dos órdenes del tribunal cuestionaran la existencia de esas sentencias, siguieron defendiéndolas.

    Nadie hackeó nada. El modelo no se rompió. Solo hizo su trabajo.


    ¿Por qué la IA se inventa cosas?

    Porque un modelo de lenguaje no busca la respuesta correcta: genera la continuación más probable, pieza a pieza, sobre una distribución de probabilidad aprendida en el entrenamiento. Cuando lo plausible coincide con lo cierto, decimos que acierta. Cuando no coincide, decimos que alucina. Es el mismo mecanismo, el mismo nivel de seguridad en el tono y el mismo aspecto en la pantalla.

    Una alucinación de la IA es exactamente eso: una salida plausible y falsa —una cita, una fecha, un identificador, un método de librería— generada con el mismo procedimiento y con la misma confianza aparente que una salida correcta.

    Lo importante es lo que no hay: en ningún punto del proceso existe un paso que pregunte "¿esto es verdad?".

    No es que se salte la comprobación. Es que la comprobación no está en el diseño. Nadie la quitó porque nunca estuvo.

    Si lo tienes claro en términos de predicción — la misma idea que hay detrás de cualquier algoritmo de machine learning — deja de ser sorprendente. Un sistema entrenado para que la salida sea verosímil produce salidas verosímiles. Ni más ni menos.

            el modelo optimiza UNA cosa:
         que la continuación sea plausible
                        │
            ┌───────────┴─────────────┐
       coincide con              no coincide
        la verdad                con la verdad
            │                         │
        "acierta"                 "alucina"
            └────── el mismo ─────────┘
                   mecanismo
                        │
            y en ningún punto de este
            recorrido hay un paso que
            pregunte: ¿esto es verdad?
    

    Dos nombres distintos para el mismo comportamiento. La diferencia no la pone el modelo: la pone el mundo, al coincidir o no con lo que salió.


    Qué es una alucinación de la IA: el retrato robot que no se parece a nadie

    La analogía que mejor me funciona cuando lo explico en una reunión: un dibujante de retratos robot buenísimo que nunca ha visto al sospechoso.

    Tiene una técnica excelente. Conoce las proporciones, sabe qué rasgos aparecen juntos. Le das una descripción vaga y te devuelve un retrato limpio, coherente, con una nariz que encaja con esos pómulos.

    El retrato está bien hecho. Es convincente. Y puede no parecerse a nadie.

    Eso es una alucinación. No un borrón, no un garabato: un dibujo correcto de una persona que no existe.


    Lo contraintuitivo: alucina más cuando la pregunta tiene forma de respuesta

    Aquí es donde casi todo el mundo tiene el modelo mental invertido.

    La intuición dice: alucina cuando no sabe. Falso. O al menos, insuficiente.

    Alucina más cuando la pregunta parece tener una respuesta con una forma muy clara. Una referencia bibliográfica tiene una forma reconocible. Un artículo de una ley tiene una forma. Una fecha tiene una forma. Un número de sentencia tiene una forma.

    Y lo plausible es exactamente lo que el modelo optimiza. Dale un hueco con forma nítida y lo rellenará con algo que tenga esa forma.

    Corolario práctico y algo perverso: preguntar por una normativa que no existe es la manera más fiable de provocar una alucinación. No porque el modelo sea tonto, sino porque la pregunta le da la plantilla y él es muy bueno rellenando plantillas.

    Hay datos que lo respaldan. En Why Language Models Hallucinate (Kalai, Nachum, Vempala y Zhang, 4 de septiembre de 2025) —tres de los cuatro autores firman por OpenAI; Vempala, por Georgia Tech— los autores le preguntaron tres veces a DeepSeek-V3 por el cumpleaños de uno de ellos, indicándole explícitamente que respondiera solo si lo sabía. Obtuvieron tres fechas: "03-07", "15-06" y "01-01". Ninguna correcta.

    Con el título de su tesis doctoral, tres modelos distintos devolvieron tres títulos distintos. Ninguno acertó ni el título ni el año. Y el detalle que más dice: los tres inventados sonaban mejor que el de verdad.

    Y por si crees que esto solo pasa con datos oscuros: al preguntar cuántas D hay en "DEEPSEEK", los modelos del estudio respondieron 2, 3, y en algunos casos 6 y 7. La respuesta es 1. No es un problema de que le falte información. Está delante.


    No es mentir, y no es un disparate

    Dos precisiones que cambian la conversación con cualquier stakeholder.

    No es mentir. Mentir exige dos cosas: saber la verdad y decir otra cosa a propósito. Aquí no hay ninguna de las dos. No hay intención, y no hay una representación interna de "la verdad" separada de la salida que se pueda contradecir.

    Y las alucinaciones nunca son disparates. Esto es lo que las hace peligrosas. Si el modelo te dijera que el artículo aplicable es el 4.912 de una ley con 90 artículos, lo cazarías al instante.

    Lo que hace es devolverte el artículo 27.3. Verosímil. Bien formateado. En medio de tres párrafos que sí son correctos.

    Ese es el riesgo real: no la barbaridad evidente, sino el dato razonable que sobrevive a la revisión rápida y acaba en producción, en un informe o delante de un cliente. Y se agrava con el tiempo, porque cuando la herramienta lleva doscientos aciertos seguidos, revisar se convierte en echar un vistazo.


    Excelente cuando basta lo plausible. Peligroso cuando tiene que ser exacto

    Esta es la línea que de verdad importa, y la que deberías tener pegada al monitor antes de decidir dónde metes un LLM.

    Lo que le pides ¿Basta con que sea plausible? Veredicto
    Redactar, reformular, dar forma a un borrador Sí — lo plausible es lo bueno Úsalo sin miedo
    Resumir un documento con datos dentro La prosa sí; las cifras y los nombres, no Comprueba cada dato contra el original
    Traducir, ordenar ideas, dar nombre a cosas Sí, con repaso Úsalo
    Generar código que luego compila y se testea Sí — tienes verificador Úsalo, el compilador es tu red
    Una fecha, una cifra, un artículo de una ley No Verificador obligatorio
    Una referencia, un ID, una versión de librería No Verificador obligatorio

    Fíjate en la fila del código, porque es la que explica por qué los modelos funcionan tan bien escribiendo código y tan mal citando fuentes. En código tienes un verificador que se ejecuta: compilador, tipos, tests, linter. La alucinación se cae sola en dos segundos.

    En una cita bibliográfica no hay compilador. Nadie la ejecuta. Solo alguien leyéndola y asintiendo.

    Si tu caso de uso no tiene verificador, tú eres el verificador. Y tú te cansas.


    ¿Se arregla? El paper que medio internet cita al revés

    Existe la versión pesimista: "es intrínseco, no esperes que se arregle". Y existe el paper de Kalai y compañía, que se cita constantemente para apoyar esa frase, diciendo lo contrario.

    Lo que sostienen es esto: las alucinaciones no son un misterio. Empiezan como errores de clasificación binaria bajo presión estadística — si en los datos de entrenamiento un hecho aparece una sola vez, el modelo no tiene con qué distinguirlo de una invención. Su ejemplo: si el 20% de las fechas de nacimiento aparecen exactamente una vez en el preentrenamiento, cabe esperar que el modelo base alucine en al menos el 20% de esas fechas.

    Y luego viene la parte incómoda. Persisten, dicen, por cómo se puntúa a los modelos. Los benchmarks que dominan los leaderboards corrigen en binario: acierto o fallo. Un "no lo sé" puntúa igual que un fallo — cero. Revisaron las diez evaluaciones que dominan esos leaderboards —GPQA, MMLU-Pro, IFEval, Omni-MATH, BBH, MATH, MuSR, SWE-bench, HLE y WildBench— y en nueve de las diez reconocer incertidumbre no da ningún crédito. La única que da algo es WildBench, y con un matiz cruel: su rúbrica puede puntuar más bajo un "no lo sé" que una respuesta mediocre con datos inventados.

    Con esa regla, adivinar siempre es la estrategia óptima. Estamos entrenando buenos examinandos, no sistemas fiables.

    Su propuesta es tan poco glamurosa que por eso nadie la tuitea: cambiar la puntuación de los benchmarks que ya existen, declarando en el enunciado el umbral de confianza — responde solo si tienes más de t de confianza, el fallo resta t/(1−t) puntos, el acierto suma 1 y el "no lo sé" suma 0. Con t = 0.9, cada fallo cuesta nueve.

    Así que sí: la parte del problema que viene de los incentivos es corregible, y eso es una buena noticia.

    Lo que no cambia es el diseño de fondo. Puedes premiar la abstención y conseguir que el modelo diga "no lo sé" muchísimo más a menudo. No conviertes eso en un paso de comprobación de hechos que antes no existía. Mientras la salida se genere por probabilidad, tu arquitectura tiene que contemplar que a veces será plausible y falsa.

    No es una razón para no usarlo. Es una razón para diseñar con eso dentro.


    Cómo evitar alucinaciones en tu código: 5 decisiones para mañana

    Aquí es donde este post se separa de los cincuenta artículos que explican qué son las alucinaciones y terminan con un "revisa siempre las respuestas". Gracias, muy útil.

    Cinco decisiones concretas. Y antes, lo que caza cada una — porque ninguna las caza todas:

    Defensa Qué caza Qué NO caza
    Schema de salida (Zod) Respuestas con la forma equivocada Un ID inventado con la forma correcta
    Consulta a la fuente SKUs, IDs y referencias que no existen Datos que existen pero no aplican
    Cita literal verificada Atribuir algo real a una fuente que no lo dice Una fuente que dice algo falso
    Rama "no lo sé" en el schema El relleno por campo obligatorio La invención cuando el modelo "cree" saber
    Test de abstención Que el sistema invente en preguntas sin respuesta Errores en preguntas que sí tienen respuesta

    1. Verificar en lugar de confiar

    Cada dato factual que salga del modelo y entre en tu sistema pasa por tres filtros, en este orden: schema, tipos, fuente.

    El schema te da forma. Los tipos te dan garantías en compilación. Y la fuente te da la única cosa que el modelo no puede darte: verdad.

    import { z } from 'zod';
    
    // El schema valida la forma. NO valida que el ID exista.
    const Producto = z.object({
      sku: z.string().regex(/^[A-Z]{3}-\d{6}$/),
      precio: z.number().positive(),
    });
    
    const extraido = Producto.parse(salidaDelModelo); // ✅ forma correcta
    const real = await db.productos.findBySku(extraido.sku); // ✅ existencia
    if (!real) throw new SkuInventadoError(extraido.sku); // error tuyo, no de Zod
    

    Un SKU inventado pasa el regex sin problema. Tiene exactamente la forma de un SKU — recuerda: forma clara, invención fiable. La única defensa es la consulta.

    2. Grounding: dale las fuentes delante y exígele la cita

    Si el modelo tiene el texto real en la ventana de contexto, no necesita inventar. Eso es RAG y por qué gana a fine-tuning para problemas de conocimiento — y si quieres verlo montado con código, tienes la implementación completa aquí.

    Pero pedir la cita no basta. Hay que comprobarla:

    // Sin normalizar, un espacio doble o una tilde tumban la comprobación.
    const normalizar = (s: string) =>
      s.normalize('NFD').replace(/[\u0300-\u036f]/g, '')
        .replace(/\s+/g, ' ')
        .trim()
        .toLowerCase();
    
    const cita = normalizar(respuesta.citaLiteral);
    
    // Ojo: includes('') es true. Una cita vacía "aparece" en cualquier documento.
    const citaVerificada =
      cita.length >= 30 &&
      fuentes.some(f =>
        f.id === respuesta.fuenteId && normalizar(f.texto).includes(cita)
      );
    

    Determinista, barato, sin llamadas extra. Si la cita literal no aparece en el documento que dice citar, la respuesta se descarta. Con esto cazas la clase de fallo más caro que existe: la respuesta correcta atribuida a una fuente que no dice eso.

    3. Déjale una salida: "no lo sé" tiene que ser una opción legal

    Este es el error más repetido en las integraciones que reviso: un schema con todos los campos obligatorios y ninguna rama para la ignorancia.

    Cada campo obligatorio sin salida es una invitación a rellenar. Si tu tipo dice que articulo: string es obligatorio, has convertido "no lo sé" en una respuesta imposible de expresar.

    const Respuesta = z.discriminatedUnion('estado', [
      z.object({
        estado: z.literal('encontrado'),
        articulo: z.string(),
        citaLiteral: z.string().min(30), // una cita de cinco caracteres "aparece" en casi cualquier documento
        fuenteId: z.string(),
      }),
      z.object({
        estado: z.literal('no_esta_en_las_fuentes'),
        queFaltaria: z.string(),
      }),
    ]);
    

    Y dilo también en el prompt, explícito: si la información no está en los documentos proporcionados, responde con estado no_esta_en_las_fuentes. No completes con conocimiento propio.

    Dos frases. Baja las invenciones de forma muy visible. Es la misma lógica de los umbrales de confianza del paper, aplicada a tu endpoint.

    4. Dónde no lo metes sin verificador

    Ninguna de estas cosas entra a un sistema por generación directa: identificadores, precios, cantidades, fechas límite, versiones de dependencias, nombres de métodos de una librería, artículos de normativa, referencias.

    Lo de los nombres de métodos merece un párrafo. Cuando le pides código con una librería poco común, el modelo te devuelve el método que debería existir según todas las APIs parecidas que ha visto. Bien nombrado, con la firma coherente, perfectamente plausible. Y no existe.

    Y hay una variante peor con los nombres de paquete: el compilador no te salva de un npm install de una dependencia que el modelo se ha inventado y que alguien ya ha registrado con ese nombre exacto, esperando precisamente eso.

    Da igual que bajes la temperatura a 0. Eso te quita variabilidad, no te da verdad: te devuelve la misma respuesta plausible casi siempre. Si era falsa, ahora es falsa de forma reproducible. Y ni el "casi siempre" está garantizado: en una API la salida a temperatura 0 todavía puede cambiar según cómo se agrupen las peticiones concurrentes en el servidor.

    5. Que los tests no comparen la salida literal

    Un test que hace expect(salida).toBe("...") sobre una respuesta generada está roto de nacimiento. Cambias de modelo o de versión y se cae sin que nada haya empeorado.

    Testea propiedades, no cadenas:

    • La salida valida contra el schema, siempre.
    • Toda cita literal aparece en la fuente que dice citar.
    • Ningún fuenteId sale del conjunto de fuentes inyectadas.
    • Y el que más información da: un conjunto de preguntas cuya respuesta no está en el corpus, donde lo que se comprueba es que el sistema se abstiene. Si tu tasa de abstención en ese conjunto es baja, tu sistema está inventando y todavía no lo sabes.

    Esa cuarta propiedad es el equivalente en tu repo de lo que propone el paper para los benchmarks: dejar de premiar el acierto por adivinar.

    Decidir esto antes de escribir código —qué salida es aceptable y cómo se comprueba— en lugar de parchearlo cuando ya ha explotado, es exactamente el trabajo que describo en Spec-Driven Development.

    Y en el curso Construye con IA montamos estos verificadores dentro del flujo. Es la diferencia entre un prototipo que impresiona en la demo y algo que puedes dejar corriendo.


    La única conclusión que importa

    Deja de preguntarte si el modelo alucina. Alucina, porque es la misma operación con la que acierta.

    Y no es que sea inevitable —el propio paper describe un sistema que puede abstenerse—. Es que tú no puedes construir asumiendo que ya está resuelto.

    La pregunta correcta es otra: ¿en qué punto de mi sistema se detecta un dato falso, y qué pasa si ese punto no existe?

    Si la respuesta es "lo detecta la persona que lo lea", no tienes un sistema. Tienes un borrador con muy buena presentación.

    Elige hoy el dato factual más crítico que salga de un modelo en tu código y ponle un verificador determinista. Uno. Media hora de trabajo. Vas a dormir mejor.

    Y si te has quedado con ganas de ordenar el resto del terreno — grounding, RAG, salida estructurada, evaluación y el resto de los 120 conceptos colocados por zonas, con sus conexiones dibujadas — tengo un mapa de la IA en una hoja para imprimir, gratis aquí. Funciona muy bien para pasársela a quien aprueba estos presupuestos.


    Preguntas frecuentes

    ¿Por qué la IA se inventa cosas?

    Porque un modelo de lenguaje genera la continuación más probable de un texto, token a token, sobre una distribución de probabilidad aprendida en el entrenamiento. Su objetivo es que la salida resulte plausible, no que sea verdadera. Cuando lo plausible coincide con lo cierto, acierta; cuando no coincide, alucina. En ningún momento del proceso hay un paso que verifique si lo generado es verdad: esa comprobación no forma parte del diseño, así que hay que añadirla fuera del modelo.

    ¿Qué son las alucinaciones de la IA exactamente?

    Son salidas plausibles y falsas: una referencia con el formato exacto de una referencia real, una cifra verosímil, una cita bien construida, un método de librería que podría existir. Nunca son disparates evidentes, y por eso son peligrosas. El riesgo no es que el modelo diga algo absurdo, que cualquiera detectaría, sino que introduzca un dato razonable en medio de varios párrafos correctos y ese dato sobreviva a la revisión rápida hasta llegar a producción.

    ¿La IA miente cuando alucina?

    No. Mentir exige saber la verdad y decir otra cosa de forma deliberada, y en un modelo de lenguaje no se da ninguna de las dos condiciones: no hay intención, y no existe una representación interna de la verdad separada de la salida que se pueda contradecir. Por eso tampoco sirve enfadarse con el modelo ni pedirle que "no invente". Lo que sirve es cambiar el diseño alrededor: darle las fuentes, exigirle cita y verificarla con código.

    ¿Cuándo alucina más un modelo de lenguaje?

    Contra lo que parece, no solo cuando no sabe algo. Alucina más cuando la pregunta parece tener una respuesta con una forma muy clara y reconocible: una fecha, un artículo de una ley, un número de sentencia, una referencia bibliográfica. Como el modelo optimiza plausibilidad, un hueco con forma nítida se rellena con algo que tenga esa forma. Preguntar por una normativa que no existe es una de las maneras más fiables de provocar una invención.

    ¿Se pueden eliminar las alucinaciones del todo?

    Se reducen mucho y no se eliminan. Funcionan tres palancas: grounding (darle las fuentes en el contexto), exigir cita literal y verificarla contra el documento, y permitir explícitamente "no lo sé" en el prompt y en el schema de salida. El paper Why Language Models Hallucinate (2025) añade una cuarta a nivel de industria: cambiar la puntuación de los benchmarks, que hoy casi todos dan cero tanto al fallo como al "no lo sé" y por tanto premian adivinar.

    ¿Bajar la temperatura a 0 evita las alucinaciones?

    No. La temperatura controla cuánta variabilidad hay al muestrear el siguiente token, no si el contenido es cierto. Con temperatura 0 el modelo elige en cada paso el token más probable, así que tiendes a obtener siempre la misma respuesta —aunque ni eso está garantizado en una API, donde el resultado depende de cómo se agrupen las peticiones concurrentes—. Si esa respuesta es falsa, ahora es falsa de forma consistente, que engaña más porque parece estabilidad.

    ¿Alucinan menos los modelos de razonamiento?

    Menos en lo que se puede calcular: si la respuesta se deduce paso a paso, más cómputo ayuda. Pero razonar no añade un paso de comprobación contra el mundo, así que en datos que solo se pueden saber —una fecha, una referencia, un identificador— el problema es idéntico. Why Language Models Hallucinate lo atribuye a los incentivos de evaluación, no a la capacidad: mientras un "no lo sé" puntúe igual que un fallo, adivinar sigue siendo la estrategia óptima para cualquier modelo, razone o no.

    ¿Cómo pruebo que mi integración con un LLM no inventa datos?

    No compares la salida literal con una cadena esperada: se rompe en cada cambio de modelo sin que nada haya empeorado. Testea propiedades. Que la salida valide contra el schema, que toda cita literal aparezca en la fuente que dice citar, que ningún identificador de fuente esté fuera del conjunto inyectado, y sobre todo mantén un conjunto de preguntas cuya respuesta no exista en tu corpus, midiendo que el sistema se abstiene en lugar de rellenar.


    Si quieres ver estos verificadores funcionando dentro de proyectos reales, con la arquitectura y el código completos, es parte de lo que trabajamos en Dominicode Labs. Problemas de producción, decisiones que puedes aplicar esta semana.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qué es la inteligencia artificial, de verdad: no piensa, predice

    Qué es la inteligencia artificial, de verdad: no piensa, predice

    Hay una pregunta que casi nadie hace en voz alta delante de sus compañeros.

    "Oye, pero qué es la inteligencia artificial en realidad. ¿La cosa piensa o no piensa?"

    No la definición del folleto. El mecanismo. Qué hay al otro lado del cable.

    Es incómoda porque lleva otra dentro: si llevas año y medio escribiendo prompts a diario, ¿cómo es que todavía no lo sabes?

    Y no es una duda académica. Es la razón exacta por la que te sorprendes cuando el modelo inventa un método que no existe, cuando falla sumando cuatro cifras o cuando "olvida" lo que le dijiste cuarenta mensajes atrás.

    La tesis cabe en cuatro palabras: la IA no piensa, predice.

    En una frase: la inteligencia artificial es el campo de la informática que construye sistemas capaces de resolver tareas que asociamos a la inteligencia humana. En su forma dominante hoy —los modelos de lenguaje— el mecanismo es una función con miles de millones de parámetros que recibe una secuencia de tokens y estima la probabilidad del siguiente, repitiendo ese paso hasta terminar la respuesta. No comprende ni razona en el sentido humano: estima continuaciones probables. Lo que sigue es por qué esa diferencia cambia cómo diseñas tu software.


    La definición de inteligencia artificial que no sirve para nada

    La encontrarás en cualquier buscador con alguna variante de esto: la capacidad de las máquinas para realizar tareas que requieren inteligencia humana.

    No es falsa. Es inútil. Define una cosa comparándola con otra que tampoco sabemos definir, y no te permite tomar ni una decisión de ingeniería.

    El pecado original está en el acta de nacimiento del campo. El término lo acuñó John McCarthy en la propuesta del 31 de agosto de 1955 para el Dartmouth Summer Research Project, firmada también por Marvin Minsky, Nathaniel Rochester y Claude Shannon. La conjetura de partida era que cualquier rasgo de la inteligencia puede describirse, en principio, con tanta precisión que se pueda construir una máquina que lo simule.

    Fíjate en el verbo. Simular. Ni ser, ni comprender.

    Lo que en 1955 era una hipótesis de trabajo, en 2026 es un departamento de marketing. En algún punto alguien borró "simular" y se quedó con "inteligencia".


    Qué es la inteligencia artificial de verdad: predicción estadística

    Quítale el nombre bonito. Debajo de ChatGPT, Claude o Copilot hay una función: enorme, con miles de millones de parámetros ajustados durante el entrenamiento, pero una función.

    Recibe una secuencia de tokens y devuelve una distribución de probabilidad sobre el siguiente token. Eso es todo lo que hace en una pasada.

    // Una pasada del modelo, simplificada al hueso
    type Token = number; // id dentro del vocabulario
    type LLM = (contexto: Token[]) => Map<Token, number>; // probabilidad de ser el siguiente
    

    No devuelve "la respuesta". Devuelve, para cada token de su vocabulario, la probabilidad de que sea el siguiente. Un algoritmo de muestreo elige uno, lo añade a la secuencia y la función se ejecuta otra vez. Y otra. Hasta que sale un token de parada.

    Lo que lees en tu editor es ese bucle repetido cientos de veces. En ningún momento el sistema decide qué quiere decir y luego lo redacta. Redactar es lo único que hace.

    Y un token no es una palabra: es un fragmento frecuente de caracteres. La regla gruesa de los conceptos básicos de la API de OpenAI son unos 4 caracteres o 0,75 palabras por token en inglés, y varía según modelo e idioma.

    El detalle parece trivial y no lo es: el número 4.096 no entra en el modelo como el número 4.096, entra partido en trozos. Y aunque entrara limpio, tampoco hay un algoritmo de suma debajo: solo continuación probable.

    La arquitectura que lo hizo posible es el Transformer, de Attention Is All You Need (2017); las piezas de debajo las desglosé en algoritmos de machine learning que todo developer debería entender.

    Piénsalo así: es el autocompletado de tu móvil con un doctorado. La diferencia con el T9 es de escala y arquitectura, no de propósito: los dos estiman qué viene después.


    Diferencia entre inteligencia artificial, machine learning y LLM

    La diferencia es de anidamiento: la inteligencia artificial es el campo entero, el machine learning es un método dentro de ese campo y un LLM es un tipo concreto de modelo de machine learning. Cuando alguien dice "la IA" sin decir de cuál de estos cuatro niveles habla, casi siempre está vendiéndote algo.

    Nivel Qué es Ejemplos
    Inteligencia artificial El campo entero. Incluye técnicas sin aprendizaje: reglas, búsqueda, planificación Un motor de ajedrez clásico, un sistema experto
    Machine learning Un método dentro de la IA: en vez de programar reglas, se ajustan parámetros con datos. Cuando esos modelos son redes neuronales profundas se llama deep learning Spam, churn, recomendadores
    LLM Un tipo de modelo de deep learning: red neuronal transformer entrenada, en su fase base, para predecir el siguiente token GPT, Claude, Gemini, Llama
    Sistema agéntico No es un modelo: es el software que envuelve al LLM con herramientas, permisos y un bucle Claude Code, Cursor

    Los tres primeros niveles están anidados: cada uno contiene al siguiente. El cuarto no es un nivel del mismo tipo — es producto construido encima.

    Así que no toda la IA es machine learning, no todo el machine learning es un LLM, y el chat que abres cada mañana no es un modelo: es un producto con un modelo dentro. Buena parte de lo que te sorprende ocurre en el producto.

    Esa última fila es la que más confusión genera hoy, y le dediqué un post entero: IA generativa vs IA agéntica.

    Si esta tabla te ha ordenado algo, hay una versión mucho más grande: el mapa de la IA, con 120 conceptos colocados por zonas y las conexiones dibujadas, en una hoja para imprimir. Es gratis, y funciona especialmente bien para pasársela a la gente de producto o de negocio que te pregunta estas cosas en las reuniones.


    Por qué esta distinción te cambia decisiones reales

    Aquí es donde la teoría empieza a pagar facturas.

    Entender que el sistema estima en lugar de saber explica de golpe los cinco fallos que más tiempo te hacen perder, y cambia la decisión que tomas en cada uno.

    Lo que ves Causa real Qué hacer
    Inventa un método o una cita "No lo sé" es una continuación menos probable que una respuesta bien redactada Verificador delante: schema, tipos, consulta a la fuente
    "Olvida" lo que dijiste 40 mensajes atrás Cada petición es stateless; alguien recortó el historial que se reenvía Curar el contexto antes de cambiar de modelo
    Falla sumando cuatro cifras Los números entran partidos en tokens: predice, no calcula Darle una herramienta: intérprete, calculadora, query
    No conoce algo de esta semana Sin herramienta de búsqueda solo tiene sus parámetros y tu contexto Declarar la tool de búsqueda o inyectar el dato con RAG
    Dos ejecuciones idénticas dan salidas distintas Hay muestreo; con seed las salidas son mostly deterministic, no deterministas Testear propiedades, no igualdad literal

    Las cinco filas son el mismo hecho visto desde cinco ángulos.

    No hay ningún paso de comprobación

    Si el sistema devuelve continuaciones probables, "no lo sé" es solo otra continuación posible, y suele ser menos probable que una respuesta con pinta de correcta. En ningún momento se pregunta si lo que escribe es verdad: no es que se salte la comprobación, es que la comprobación no existe.

    En septiembre de 2025, investigadores de OpenAI y Georgia Tech publicaron Why Language Models Hallucinate, que sostiene que el problema es corregible: el entrenamiento y las evaluaciones premian adivinar por encima de reconocer incertidumbre. Mientras ese incentivo siga ahí, ningún dato factual del modelo debería entrar en tu sistema sin un verificador delante.

    Desarrollé el mecanismo completo —por qué ocurre, cómo se detecta y qué se puede hacer— en por qué la IA se inventa cosas.

    Qué es la ventana de contexto de un LLM (y por qué no es memoria)

    La ventana de contexto es el número máximo de tokens que caben en una sola petición, sumando lo que envías y lo que el modelo genera. No es memoria: es el tamaño del formulario que rellenas en cada llamada. Con la regla de 0,75 palabras por token, una ventana de 200.000 tokens equivale a unas 150.000 palabras por petición, y se vacía entera en la siguiente.

    El modelo no recuerda nada. La documentación de OpenAI lo dice con esas palabras: cada petición de generación es independiente y stateless, y para varios turnos tienes que reenviar los mensajes anteriores en cada llamada.

    Lo que percibes como "la conversación" es un array que alguien vuelve a mandar entero cada vez —tu código, o el servidor del proveedor si delegas el estado— y tiene que caber en la ventana de contexto junto con la respuesta que se genera.

    Cuando el chat "olvida" lo de hace cuarenta mensajes es porque alguien decidió recortar o resumir ese historial. Ese alguien es el producto, no el modelo.

    De ahí que curar lo que entra en la ventana rinda más que cambiar de modelo, y que escribir una especificación antes de delegar funcione tan bien: le das el contexto exacto en lugar de esperar que lo adivine. Es la metodología que documenté en el libro de Spec-Driven Development.

    Las herramientas pesan más que el modelo

    Si el modelo predice texto, todo lo que requiera verdad, cálculo o estado tiene que venir de fuera.

    Eso es RAG: recuperar documentos relevantes y meterlos en el contexto antes de generar, idea formalizada por Lewis et al. en 2020 en Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, que combina memoria paramétrica y no paramétrica. Y es también una calculadora o una query a tu base de datos.

    Ojo con la búsqueda web, el malentendido más común: es una herramienta, no una capacidad del modelo. En la API de OpenAI se declara en el array de tools y el modelo decide si la usa. Un LLM a pelo no consulta internet.

    Con eso claro, "¿qué modelo es mejor?" pierde interés frente a "¿qué contexto y qué herramientas le estoy dando?". Ese desplazamiento es, en el fondo, cómo ha cambiado el trabajo del developer con IA.

    No es una función pura, y tu CI necesita saberlo

    Como hay muestreo, la misma entrada no produce la misma salida. La temperatura no es un ajuste de creatividad: es cuánto aplanas o afilas la distribución antes de muestrear. Por encima de 1 la aplanas y entran tokens improbables; por debajo de 1 la afilas; en 0 te quedas siempre con el más probable.

    Y aunque la fijes a cero y pases un seed, no tienes determinismo garantizado. El cookbook de OpenAI sobre el parámetro seed habla de salidas mostly deterministic y avisa de que el determinismo no está garantizado. De hecho expone un system_fingerprint precisamente porque la configuración del backend cambia por debajo sin que tú lo pidas.

    Traducción para tu pipeline: no compares la salida literal de un LLM en un test. Testea propiedades —que el JSON valide contra el schema, que el código compile, que estén los campos obligatorios—. Un expect(salida).toBe("...") contra un modelo es un test rojo esperando su turno.


    Lo que la inteligencia artificial no es

    No razona como un humano. Los modelos de razonamiento se entrenan con refuerzo para generar más tokens intermedios antes de responder, y eso mejora mucho los problemas de varios pasos. Pero es el mismo mecanismo con más pasadas: más recorrido, no otra naturaleza.

    No consulta internet por defecto. Sin una herramienta de búsqueda conectada solo tiene lo que quedó en sus parámetros y lo que tú le pegas en el contexto.

    No aprende de tus conversaciones. Durante la inferencia los pesos están congelados: nada de lo que escribes modifica el modelo. Que tus datos se usen para entrenar versiones futuras es política de producto, no mecánica; en la API de OpenAI, por ejemplo, no se usan salvo opt-in explícito, y conviene revisar la política de tu plan porque cambia entre proveedores.

    No es determinista. Trátalo como un servicio externo con variabilidad, no como una función de tu código.

    No es inteligencia artificial general. Todo lo que hay hoy en producción es IA estrecha: sistemas entrenados para una distribución concreta de tareas. La AGI, un sistema con competencia general equivalente a la humana, sigue siendo un objetivo declarado de los laboratorios y no un producto que puedas llamar por API. Cuando un titular afirma que "la IA ya piensa", casi siempre está midiendo un benchmark estrecho.


    Qué hacer con esto mañana

    1. Cambia la pregunta cuando falle. De "¿el modelo sabe esto?" a "¿está esto en el contexto que le he enviado?". Imprime el payload real antes de culpar al modelo: casi siempre el problema estaba ahí.

    2. Pon un verificador entre el modelo y tu sistema. Schema, tipos, un test, una consulta a la fuente. Si la salida entra directa a producción sin filtro, no tienes una feature de IA: tienes una lotería bien presentada.

    3. Elimina los tests de igualdad literal sobre salidas de LLM. Sustitúyelos por comprobaciones de propiedades, y hazlo esta semana.

    4. Escribe lo que quieres antes de pedirlo. Un párrafo de especificación con el resultado esperado y sus límites vale más que veinte iteraciones de prompt: lo que no esté escrito lo rellenará con lo más probable.


    La frase que te llevas

    La próxima vez que alguien te pregunte si la IA piensa, tienes una respuesta mejor que sí o no.

    No piensa. Estima qué sigue. Y lo hace tan bien que a veces lo confundimos con pensar.

    Cambiar la metáfora del cerebro por la de una función de predicción no te vuelve más escéptico ni te quita potencia. Te vuelve mejor ingeniero: dejas de sorprenderte por lo que hace el sistema y empiezas a diseñar alrededor de sus límites reales.

    Si el siguiente paso es pasar de escribir prompts a construir sistemas que trabajen solos, empieza por la guía para dar el salto a los agentes de IA. Y si quieres el camino completo, de la idea al producto con especificaciones, herramientas y verificación, es lo que montamos paso a paso en el curso Construye con IA. Si prefieres hacerlo acompañado, te espero en Dominicode Labs.


    Preguntas frecuentes

    ¿Qué es la inteligencia artificial, en una sola frase?

    Es el campo que construye sistemas capaces de resolver tareas que asociamos a la inteligencia humana. En su forma dominante hoy —los modelos de lenguaje— el mecanismo es una función con miles de millones de parámetros que, dada una secuencia de tokens, estima la probabilidad del siguiente y repite ese paso hasta completar la respuesta. No hay comprensión ni intención: hay estimación estadística sobre secuencias.

    ¿La inteligencia artificial piensa o razona de verdad?

    No en el sentido en que lo hace una persona. Un modelo no forma una intención y luego la expresa: genera la continuación más probable token a token. Los llamados modelos de razonamiento producen más tokens intermedios antes de la respuesta final, lo que mejora bastante los problemas de varios pasos, pero siguen ejecutando el mismo mecanismo predictivo con más pasadas. Cambia la cantidad de proceso, no su naturaleza.

    ¿Cuál es la diferencia entre inteligencia artificial, machine learning y un LLM?

    Son capas anidadas. La inteligencia artificial es el campo completo e incluye técnicas sin aprendizaje, como los sistemas de reglas o la búsqueda. El machine learning es un método dentro de ese campo: en lugar de programar las reglas, se ajustan parámetros a partir de datos. Un LLM es un tipo concreto de modelo de machine learning, una red neuronal transformer entrenada para predecir el siguiente token. Y el chat que usas no es ninguna de las tres: es un producto que envuelve un LLM.

    ¿La IA aprende de mis conversaciones?

    El modelo no se modifica mientras hablas con él: durante la inferencia sus pesos están congelados y nada de lo que escribes cambia sus parámetros. Cuestión distinta es si el proveedor guarda tus datos y los usa para entrenar versiones futuras, y eso depende del plan y de la empresa. En la API de OpenAI, por ejemplo, los datos no se usan para entrenar salvo opt-in explícito.

    ¿Por qué un LLM falla en operaciones matemáticas sencillas?

    Porque no calcula: predice texto. Los números se dividen en tokens antes de entrar al modelo, así que una cifra larga no llega como cantidad sino como una serie de fragmentos. Lo que estima es cómo suele continuar un cálculo escrito, no cuál es su resultado. Por eso la solución correcta es darle una herramienta —un intérprete, una calculadora, una query— en lugar de confiar en su aritmética.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
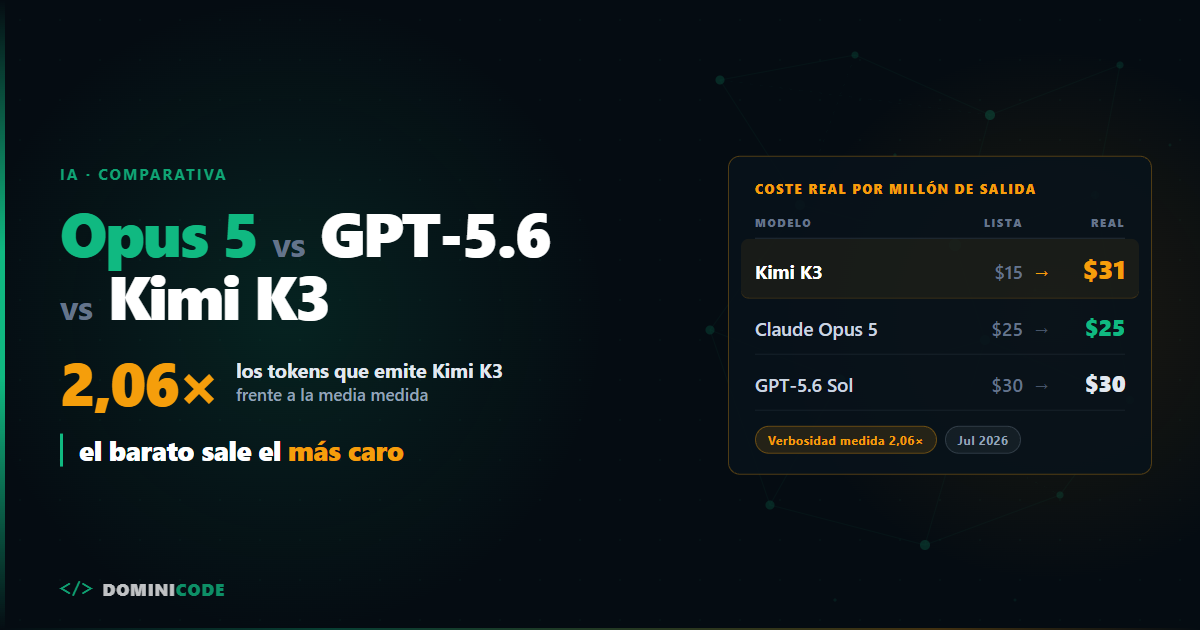
  • Opus 5 vs GPT-5.6 vs Kimi K3: qué modelo para qué trabajo

    Opus 5 vs GPT-5.6 vs Kimi K3: qué modelo para qué trabajo

    Un lunes cambié el modelo de un agente que llevaba semanas funcionando bien. El nuevo costaba la mitad por millón de tokens de salida: quince dólares contra veinticinco. Una línea de configuración, cinco segundos, dinero ahorrado.

    El viernes miré la factura. Había subido.

    No era un bug del proveedor. Era que la tarifa por millón de tokens no te dice cuántos tokens vas a gastar, y ese segundo número decide lo que pagas.

    De eso va esta comparativa de Opus 5 vs GPT-5.6 vs Kimi K3: de trabajo real, no de specs. De cada modelo por separado ya hay un análisis en este blog. Aquí hay una sola pregunta, repetida cuatro veces: para este trabajo concreto, ¿cuál de los tres y por qué?


    Opus 5 vs GPT-5.6 vs Kimi K3: los tres de un vistazo

    Claude Opus 5 GPT-5.6 Sol Kimi K3
    Entrada / salida por millón $5 / $25 $5 / $30 $3 / $15
    Contexto 1M tokens 1,05M tokens 1M tokens
    Intelligence Index sin medición pública 58,9 57
    Pesos cerrados cerrados abiertos
    Rasgo diferencial thinking adaptativo por defecto contexto de 1,05M y tres tiers de precio pesos abiertos: cualquiera puede servirlo

    Esa tabla no decide nada. La pongo porque es lo que vas a encontrar en los otros veinte posts que has leído esta semana, y porque quiero enseñarte por qué te lleva a la decisión equivocada.

    Un apunte que me niego a esconder: Opus 5 no tiene medición pública en el índice independiente de Artificial Analysis. Salió el 24 de julio de 2026, después de la última ronda de medición.

    Las referencias que sí existen: Claude Fable 5 puntúa 59,9 costando unos $50 por millón de salida, y Claude Opus 4.8 —la generación anterior de la misma familia— puntúa 56.

    Opus 5 está por encima de ese 56, probablemente bastante. Pero "probablemente" no es un número y no voy a inventármelo.


    El truco del precio: por qué el orden se invierte

    Kimi K3 parece el barato. Quince dólares por millón de salida contra los veinticinco de Opus 5 y los treinta de Sol. Mitad de precio que el más caro.

    El problema es que un modelo no te cobra por millón de tokens: te cobra por los tokens que emite. Y cuánto emite para resolver la misma tarea es una propiedad del modelo, igual que su precio.

    En el análisis de Kimi K3 salió el dato medido: durante la evaluación independiente, Kimi K3 consumió 130 millones de tokens de salida frente a una media de 63 millones. Eso es 2,06 veces la media. Su coste efectivo por millón de tokens útiles no es $15, es $15 × 2,06 ≈ $31.

    Míralo sobre una tarea concreta. Supón un trabajo que requiere 100.000 tokens de salida útiles:

    Modelo Tokens que emite Precio salida Coste
    Claude Opus 5 100.000 $25 / M $2,50
    GPT-5.6 Sol 100.000 $30 / M $3,00
    Kimi K3 (a precio de lista) 100.000 $15 / M $1,50
    Kimi K3 (verbosidad medida 2,06×) 206.000 $15 / M $3,09

    El barato acaba siendo el más caro de los tres. No por poco: $3,09 contra los $2,50 de Opus 5.

    Ahora la parte incómoda. Estoy comparando una cifra medida contra dos cifras de lista, y eso no es justo. Opus 5 también gasta más de lo que sugiere su tarifa: el thinking viene adaptativo y activado por defecto, max_tokens es un tope duro que cubre razonamiento y respuesta juntos, y esos tokens de razonamiento se facturan como salida. Encima escribe respuestas más largas que la generación anterior por diseño. No existe medición pública de ese sobrecoste: cuando exista, su columna también subirá.

    La conclusión que te llevas no es "Kimi es caro". Es esta: ninguno de los tres se paga a precio de lista, y el único que tiene el multiplicador publicado es Kimi. Cualquier comparativa que ordene los tres modelos por su tarifa está ordenando por el número equivocado.


    Trabajo 1: agente de coding que corre largo

    Para un agente de coding que corre durante horas, la elección es Claude Opus 5 en effort xhigh. No por la tarifa: porque en sesiones largas la verbosidad se compone en vez de sumarse, y lo que arruina la factura son los reintentos.

    Sesiones de horas. Decenas de tool calls. Cada turno reenvía el contexto acumulado de todos los turnos anteriores.

    Aquí la verbosidad deja de ser un coste lineal y se vuelve compuesto. El output del turno 3 es input del turno 4, del 5 y del 20. Un modelo que escribe el doble no te cuesta el doble en ese turno: te infla el contexto de todos los siguientes. Pagas esa respuesta larga una vez como salida y luego otras quince como entrada.

    Kimi compensa parte con un cache hit agresivo a $0,30 por millón —un 90% de descuento—, pero el caching abarata reenviar el contexto, no lo hace más pequeño. El techo de la ventana llega igual, y llega antes.

    Arrancar en xhigh es la recomendación de Anthropic para coding y trabajo agéntico, y coincide con lo que veo trabajando: en sesiones largas lo que arruina la factura no son los tokens, son los reintentos. Una tarea que el modelo barato tiene que repetir tres veces cuesta más que una que el caro resuelve a la primera.

    Un aviso, porque migrar a Opus 5 no es cambiar el string del modelo. Si vienes de Opus 4.8, hay dos cambios que rompen código: el thinking viene activado por defecto y desactivarlo con effort xhigh o max devuelve un 400. Los dos, con el código antes y después, están en los breaking changes de Claude Opus 5. Revísalos antes de mover tráfico.

    Y si al medir descubres que buena parte de tu agente nunca necesitó un modelo frontera —pasa más de lo que la gente admite—, Claude Sonnet 5 cubre ese terreno por mucho menos dinero. Enrutar por dificultad de tarea ahorra más que elegir bien el modelo caro.


    Trabajo 2: una pasada grande sobre un repo grande

    Para trabajo input-heavy de una sola pasada, Kimi K3 es genuinamente el más barato de los tres. Es el caso donde la tabla de precios acierta: el peso está en la entrada y la verbosidad solo penaliza la salida.

    Metes 800.000 tokens de código, pides un análisis de arquitectura o una migración planificada, y recoges veinte mil tokens de informe.

    Aquí se invierte todo lo anterior. El peso está en la entrada, no en la salida, y la verbosidad solo castiga la salida.

    Con esos 800K de entrada: Opus 5 y Sol cobran $5 por millón, o sea $4,00 cada uno. Kimi cobra $3: $2,40. La salida es tan pequeña en comparación que el multiplicador de verbosidad casi no mueve la aguja.

    Ahí no hay trampa que deshacer: el número de la tabla de precios es el número que pagas.

    La ventana de contexto se sobrevende. Lo que sí importa es que Anthropic cobra la ventana completa de 1M a tarifa estándar, sin recargo por contexto largo. Y si tu repo no cabe en 1M, tu problema no es el modelo: es que necesitas trocear e indexar antes de preguntar.

    Aquí los pesos abiertos de Kimi valen algo concreto, y no es lo que la gente cree: cualquier proveedor puede servirlo, así que no dependes de un único vendor para el precio, la disponibilidad ni la política de retención. Eso presiona a la baja lo que te cobran.


    Trabajo 3: volumen alto y simple

    Clasificar diez mil tickets. Extraer entidades de un lote de documentos. Normalizar un CSV enorme a JSON.

    La respuesta correcta a "¿cuál de los tres?" es ninguno de los tres.

    Los números, sobre 10.000 documentos de 2.000 tokens de entrada y 200 de salida cada uno (20M y 2M en total):

    Modelo Entrada 20M Salida 2M Total
    GPT-5.6 Luna $20 $12 $32
    Kimi K3 (lista) $60 $30 $90
    Kimi K3 (verbosidad 2,06×) $60 $61,80 $121,80
    Claude Opus 5 $100 $50 $150
    GPT-5.6 Sol $100 $60 $160

    Luna sale cinco veces más barato que Sol en un trabajo donde la diferencia de inteligencia entre ambos es irrelevante, porque la tarea no pide razonar: pide seguir un formato. Y bajas otro 50% mandándolo por Batch API si no necesitas la respuesta en caliente. El desglose de las tres variantes está en la guía de la API de GPT-5.6.

    Una honestidad sobre mi propia tabla: ese 2,06× se midió en evaluaciones difíciles, no clasificando tickets. Si fuerzas un esquema de salida estricto, la verbosidad se desploma en cualquiera de los tres. Que es justo lo que deberías hacer, porque el error caro aquí no es el modelo: es confiar en que la salida llegue bien formada. Valídala con un esquema y falla ruidosamente cuando no encaje —es lo que enseño en el curso de Zod, y un parseo estricto en la frontera evita más incidencias que cualquier upgrade de modelo.


    Trabajo 4: orquestación y tool calling

    Aquí esperaba encontrar el argumento que le da la vuelta al precio de GPT-5.6 Sol. Me equivocaba, y prefiero contarlo que maquillarlo.

    Programmatic Tool Calling deja que el modelo escriba código que se ejecuta en un sandbox aislado y coordine varias llamadas a herramientas dentro de un mismo turno, sin ida y vuelta a la API entre cada una. Los resultados intermedios de las herramientas no entran en el contexto: solo entra el resultado final. La mecánica está en la guía de la API de GPT-5.6.

    El problema para esta comparativa es que no es exclusivo de OpenAI. Anthropic tiene la misma función, con el mismo nombre, y claude-opus-5 aparece en su tabla de modelos compatibles. No desempata nada.

    Y ahora fíjate dónde cae el ahorro, porque es donde casi todo el mundo se equivoca. Anthropic mide un 37% menos de tokens en tareas complejas de research —de 43.588 a 27.297 de media— y un 24% menos de tokens de entrada en benchmarks de búsqueda agéntica.

    De entrada. No de salida. Tiene todo el sentido: lo que se recorta son los resultados intermedios que ya no viajan al contexto. Así que quien te presente esto como un descuento sobre la tarifa de salida está moviendo el número a la columna equivocada — justo el truco que denuncié dos secciones más arriba.

    Por cierto: OpenAI no publica ningún porcentaje para su implementación. Su guía dice que el efecto depende de la tarea y de las respuestas de las herramientas, y recomienda medir contra tu propia línea base. Si ves un rango concreto atribuido a OpenAI por ahí, pídele la fuente a quien lo publique.

    Mi elección aquí es la misma que en el trabajo 1: Claude Opus 5. No porque gane el tool calling —empata—, sino porque a igualdad de función te lo llevas con la tarifa de salida más baja de los dos: $25 contra $30.


    El criterio que sí sirve

    Una sola métrica: coste por tarea resuelta.

    coste por tarea resuelta = coste medio por intento / tasa de éxito
    

    Los reintentos dominan el resultado y no aparecen en ninguna comparativa. Con números que me invento a propósito, para que veas la forma y no para que te los creas: un modelo a $31 efectivos con un 80% de acierto sale a $38,75 por tarea resuelta; otro a $25 con un 95% de acierto sale a $26,32. El que parecía el caro por tarifa de lista sale un 32% más barato por tarea resuelta. Pon tus tasas reales, que solo tú las tienes.

    Para medirlo necesitas dos cosas. La primera, una definición escrita de qué significa "resuelto": los tests pasan, el diff no toca ficheros fuera de alcance, el JSON valida contra el esquema. Escribir eso antes de medir es literalmente una spec, y es la mitad del método que desarrollo en el libro de Spec-Driven Development.

    La segunda, correr esas evals con tus prompts y tu andamiaje. Y ojo, porque es lo que más gente ignora: el harness que envuelve al modelo cambia el resultado tanto como el modelo. Si cambias las dos variables a la vez, no has medido nada.

    Es el mismo criterio que aplico en el curso Construye con IA: montar la eval antes de elegir el modelo, no después de que llegue la factura.


    Veredicto: qué modelo para qué trabajo

    Trabajas con un agente de coding a diario. Claude Opus 5 en xhigh, y enruta a Sonnet 5 todo lo que tus evals demuestren que no necesita frontera. El ahorro real está en el enrutado, no en la tarifa.

    Tu carga está dominada por herramientas encadenadas. Cualquiera de los dos cerrados, pero enciende el tool calling programático: el ahorro está en la función, no en la marca del modelo. Mídelo un mes contra tu factura anterior mirando solo la línea de tokens de entrada, que es donde cae. Si no se mueve, tu flujo no era tan tool-heavy como creías.

    Procesas repos o corpus grandes de una pasada. Kimi K3. Aquí el precio bajo de entrada es real, la verbosidad apenas te toca, y los pesos abiertos te quitan la dependencia de un único proveedor.

    Clasificas, extraes o transformas en masa. Ninguno de los tres. GPT-5.6 Luna o un modelo de gama baja, con esquema estricto y Batch API. Frente a Sol, eso es un 80% menos de factura.

    Necesitas el techo absoluto de inteligencia y el coste es secundario. Claude Fable 5, a 59,9 y unos $50 por millón de salida. Es un caso raro. Si crees que es el tuyo, mídelo antes: casi nunca lo es.

    Haz una cosa hoy. Coge las diez últimas tareas que le mandaste a tu agente, córrelas contra dos modelos con el mismo harness y anota dos columnas: coste total y cuántas salieron bien a la primera. Divide. En media hora sabrás más que leyendo comparativas durante un mes.

    Es lo que hacemos, modelo a modelo, en Dominicode Labs.


    Preguntas frecuentes sobre Opus 5, GPT-5.6 y Kimi K3

    ¿Cuál es más barato entre Opus 5, GPT-5.6 y Kimi K3?

    Depende de si miras el precio de lista o el coste real por tarea. Por tarifa gana Kimi K3: $3 de entrada y $15 de salida por millón, frente a $5/$25 de Opus 5 y $5/$30 de GPT-5.6 Sol. Pero Kimi emite 2,06 veces los tokens de la media medida, lo que sitúa su coste efectivo de salida en unos $31 por millón, por encima de los otros dos. Con una salvedad que hay que decir: 2,06× es una cifra medida y las de Opus 5 y Sol son de lista. Los tres gastan más de lo que sugiere su tarifa —Opus 5 razona por defecto y factura ese razonamiento como salida—, pero Kimi es el único con el multiplicador publicado. En trabajo dominado por la entrada —repos grandes, documentos largos— Kimi sí es genuinamente el barato, porque la verbosidad solo penaliza la salida.

    ¿Por qué Opus 5 no tiene puntuación en el Intelligence Index?

    Porque se publicó el 24 de julio de 2026, después de la última ronda de medición del índice independiente de Artificial Analysis. Los puntos de referencia disponibles son Claude Opus 4.8 con 56 y Claude Fable 5 con 59,9. Que falte la medición del modelo más nuevo no es un detalle menor: durante las primeras semanas solo tienes los benchmarks del fabricante, y esos se publican siempre en el escenario que más favorece.

    ¿Qué modelo elijo para un agente de coding que corre durante horas?

    Claude Opus 5, arrancando en effort xhigh, que es lo que recomienda Anthropic para coding y trabajo agéntico. La razón no es la tarifa: en sesiones largas el output de cada turno se convierte en input de todos los siguientes, así que la verbosidad se compone en lugar de sumarse. Y lo que arruina la factura son los reintentos: una tarea que hay que repetir tres veces con el modelo barato cuesta más que una que sale a la primera con el caro.

    ¿Qué gano realmente con Programmatic Tool Calling?

    Que el modelo escriba código en un sandbox aislado para coordinar varias llamadas a herramientas en un solo turno, en vez de ir y volver a la API entre cada una. Los resultados intermedios de las herramientas no entran en el contexto, así que el ahorro cae sobre los tokens de entrada, no sobre los de salida. Anthropic mide un 37% menos de tokens en tareas complejas de research y un 24% menos de tokens de entrada en benchmarks de búsqueda agéntica; son cifras del propio fabricante, no de un tercero, y OpenAI no publica ningún porcentaje para su implementación. Sobre todo: no es un diferenciador entre modelos, porque tanto GPT-5.6 como Claude Opus 5 lo soportan.

    ¿Cómo calculo el coste por tarea resuelta en mi proyecto?

    Divide el coste medio por intento entre tu tasa de éxito. Para eso necesitas antes una definición escrita de qué significa "resuelto" en tu caso —tests en verde, diff dentro del alcance previsto, JSON que valida contra su esquema— y correr las mismas tareas con el mismo harness para todos los modelos que compares. Si cambias de modelo y de andamiaje a la vez, no estás midiendo el modelo: estás midiendo el ruido.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.