Tag: JavaScript

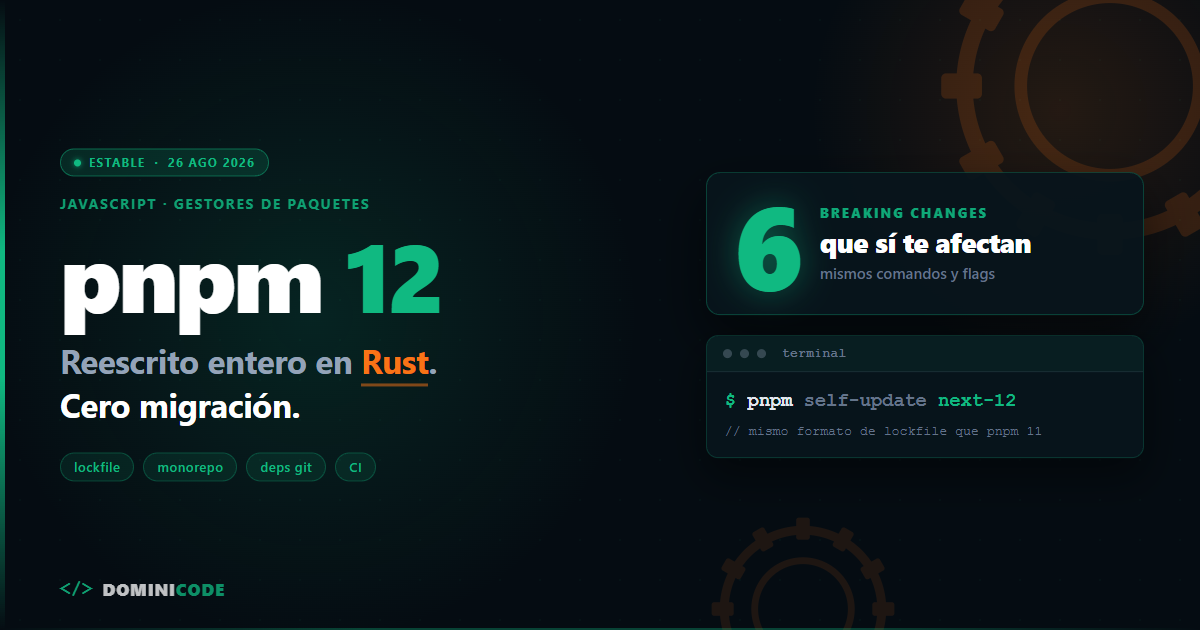
  • pnpm 12 en Rust: los 6 breaking changes que sí te afectan

    pnpm 12 en Rust: los 6 breaking changes que sí te afectan

    Antes de que llegue pnpm 12, un ejemplo de por qué lo vas a querer: un lockfile que instala perfecto en tu portátil y revienta en el runner de CI.

    La traza no ayuda mucho: git@github.com: Permission denied (publickey). Y en tu package.json solo pone "is-positive": "kevva/is-positive".

    Tu máquina tiene claves SSH. El runner no. pnpm resolvió por SSH porque podía, lo grabó así en el lockfile, y el runner se topó con una URL que no puede abrir.

    pnpm 12 arregla eso. Y la forma en que lo arregla dice bastante de cómo está construida esta versión.

    Qué es pnpm 12: una reescritura en Rust que, a propósito, no te pide migrar nada

    pnpm 12.0 salió estable el 26 de agosto de 2026. Es pnpm reescrito entero en Rust.

    Del anuncio oficial de pnpm 12.0, publicado el 26 de agosto de 2026:

    It is a rewrite of pnpm in Rust, and it is deliberately not a migration: the commands, flags, settings, and lockfile format of pnpm 11 all carry over.

    Lee otra vez la parte de deliberately not a migration, porque en el ecosistema JavaScript esa frase es rara. Aquí una major suele traducirse en un sábado peleándote con el build, un codemod que no cubre tu caso y tres dependencias transitivas que ya no compilan.

    En pnpm 12 no. Mismos comandos, mismos flags, mismos settings y el mismo formato de lockfile que pnpm 11. El cambio está debajo: el lenguaje en el que corre la herramienta, no el contrato que tienes con ella.

    Es el mismo movimiento que ya vimos con TypeScript y su compilador en Go: reescribir el motor en un lenguaje nativo sin tocar la superficie que usa el desarrollador. Cuando la API pública no se mueve, la reescritura deja de ser un riesgo y pasa a ser una actualización.

    Dicho esto, "no es una migración" no significa "no cambia nada". Entre el anuncio de la 12.0 y el documento What's different in pnpm 12 hay seis diferencias respecto a pnpm 11 que conviene revisar antes de meterlo en el pipeline.

    Cómo instalar pnpm 12 hoy

    El tag latest de npm sigue apuntando a pnpm 11. Para pnpm 12 tienes que pedir el tag next-12 de forma explícita:

    # Si ya tienes pnpm instalado
    pnpm self-update next-12
    

    Si vienes de otro gestor, el paquete es el mismo con el tag distinto:

    npm install -g pnpm@next-12
    

    pnpm 12 se distribuye como binario nativo compilado desde Rust, y hay vías de instalación que no pasan por npm. Si tu imagen de CI instala pnpm por script, revisa que apunte al tag correcto y no a latest, o seguirás en 11 sin enterarte.

    Los 6 breaking changes de pnpm 12 que sí te van a afectar

    Estos son los seis, y a quién afectan de verdad:

    # Qué cambia en pnpm 12 Te afecta si… Qué hacer
    1 Las dependencias git resuelven por su URL HTTPS canónica; nunca se graba una URL SSH en el lockfile Tienes deps de GitHub, GitLab o Bitbucket en package.json Re-resolverlas una vez con pnpm update <paquete>
    2 Los settings desconocidos de pnpm-workspace.yaml se reportan en vez de ignorarse Tienes pnpm-workspace.yaml, y sobre todo si pinneas la versión de pnpm Corregir las erratas antes de actualizar
    3 Los ciclos de dependencias se cortan siempre en el mismo punto → lockfiles byte-idénticos Tu monorepo tiene librerías internas que se referencian entre sí Nada: es ganancia neta (2–3× en resolución de peers)
    4 Con packageImportMethod: auto, en Linux se prueba hardlink antes que reflink Tu CI corre en Linux sobre btrfs Nada: instala más rápido. En ext4 no cambia
    5 engineStrict sigue aristas, no subárboles Usas engineStrict y tienes paquetes incompatibles colgando de optionalDependencies Verificar que el install sigue pasando
    6 --resolution-only deja de existir y se rechaza con error Lo usas en scripts de package.json o en workflows de CI Sustituir por pnpm peers check

    1. Las dependencias git son identidades, no transportes

    Este es el que más gente va a notar, y es el problema del CI que abre el post.

    Hasta ahora, la URL con la que declarabas una dependencia de GitHub también decidía cómo se descargaba. En pnpm 12 los specifiers de GitHub, GitLab y Bitbucket resuelven por su URL HTTPS canónica. Estas cuatro formas son ahora exactamente la misma dependencia:

    kevva/is-positive
    github:kevva/is-positive
    git+https://github.com/kevva/is-positive.git
    git+ssh://git@github.com/kevva/is-positive.git
    

    Y lo importante: pnpm nunca graba una URL SSH para esos hosts en el lockfile. Un lockfile generado en tu máquina, con tus claves cargadas, instala en un runner que no tiene ninguna.

    ¿Y los repos privados por SSH? Siguen funcionando, pero la reescritura se configura en Git, no en el specifier:

    git config --global url."git@github.com:".insteadOf https://github.com/
    

    pnpm delega en git, así que la regla se aplica sola a todas sus operaciones.

    Un aviso importante: pnpm no reescribe por su cuenta las entradas que ya están en tu lockfile, porque el lockfile es el registro de lo que hay que instalar. Las URLs SSH heredadas de pnpm 11 siguen ahí hasta que re-resuelvas esas dependencias una vez con pnpm update <paquete>.

    Si en tu equipo existe la regla no escrita de "el lockfile lo regenera quien lo tenga configurado", esto te devuelve horas.

    2. Los settings desconocidos en pnpm-workspace.yaml ya no se ignoran

    Antes, una clave mal escrita se descartaba en silencio y tú te quedabas convencido de que la configuración estaba aplicada. En pnpm 12 se reporta, con sugerencia de corrección. Y si tienes una versión de pnpm pinneada en el proyecto, la instalación falla.

    # pnpm-workspace.yaml
    packages:
      - "packages/*"
    
    # Erratas como esta ya no pasan desapercibidas
    packageImportMetod: hardlink
    

    Prepárate para descubrir que llevas meses con un setting que nunca hizo nada.

    3. Los ciclos se rompen siempre en el mismo sitio

    Los grafos de dependencias cíclicas ahora se canonicalizan. Desde la v12.0.0-rc.5, pnpm corta el ciclo en un punto fijo en lugar de donde se lo encuentre la instalación, y ordena los miembros de cada ciclo por package id.

    La consecuencia práctica es que dos instalaciones del mismo proyecto producen lockfiles byte-idénticos. Se acabaron los diffs fantasma en las pull requests.

    Como efecto secundario, en workspaces con muchos ciclos la resolución de peers va 2–3 veces más rápida, consume alrededor de un 25% menos de memoria y el lockfile se encoge bastante al desaparecer variantes duplicadas de peers.

    Si mantienes un monorepo con varias librerías internas que se referencian entre sí —el escenario típico de un workspace Angular como los que montamos en el curso de Angular Moderno—, este es el cambio que más vas a notar en el reloj.

    Con packageImportMethod: auto, pnpm clonaba primero. Ahora en Linux prueba el hardlink antes que el reflink. En macOS se mantiene el clone-first.

    En btrfs esto reduce aproximadamente a la mitad el tiempo que una instalación pasa materializando node_modules desde un store caliente. En ext4 no cambia nada: ahí el clonado nunca estuvo soportado y auto ya hacía hardlink.

    5. engineStrict sigue aristas, no subárboles

    Con engineStrict activado, la instalación falla si un paquete incompatible se alcanza por una arista de dependencies normal de un paquete que sí se está instalando, aunque todo ese subárbol cuelgue de una entrada de optionalDependencies. Lo que no cambia: un paquete al que solo se llega por aristas opcionales —o a través de otro que ya se saltó— se sigue saltando igual que en pnpm 11.

    Traducción: proyectos que instalaban en pnpm 11 porque el paquete problemático quedaba escondido bajo una opcional, ahora fallan. Es más correcto, pero puede sorprenderte en el primer install después de actualizar.

    6. --resolution-only ya no existe

    pnpm 12 rechaza el flag con un error. El sustituto es un comando propio:

    # pnpm 11
    pnpm install --resolution-only
    
    # pnpm 12
    pnpm peers check
    

    Busca --resolution-only en los scripts de tu package.json y en los workflows de CI antes de actualizar. Es un grep de diez segundos que te ahorra un pipeline en rojo.

    Las novedades de pnpm 12 que de verdad usarás

    La estrella no es una cifra de rendimiento, es un cambio de rol: pnpm ahora provisiona otros gestores de paquetes. npm, Yarn Classic, Yarn Berry, Yarn 6 (yarnpkg/zpm) y Bun.

    pnx yarn@4 install
    pnx npm@11 ci
    pnx node@22
    

    pnx ejecuta uno de ellos para un solo comando. Y si lo quieres permanente:

    pnpm shim add yarn
    

    Eso enlaza un yarn que ejecuta lo que pinnee el proyecto en el que estés. En la misma línea, los global bins son conscientes del proyecto: un Node.js, un Deno o un Bun instalados globalmente pueden seguir la versión que fija el proyecto actual, controlado por el setting globalShims.

    Si mantienes varios repos con runtimes distintos, esto se come de un bocado buena parte de la razón por la que tienes nvm. Y si estás valorando mover backend a Bun, ya conté dónde Bun reemplaza a Node.js de verdad y dónde no.

    El resto del cambiario, en corto:

    • Registry revisions. Artefactos de reemplazo identificados por SHA-512 y anotados como revision: N en el lockfile. Sirve para servir artefactos parcheados sin bump de versión.
    • pnpm init pinnea la última release de pnpm, no la que estás corriendo.
    • Aprobación por lotes en staged publishing con pnpm stage approve.
    • audit.ignorePrune. Con el setting activo, pnpm audit --fix borra de tu lista de ignorados las GHSA que ya no aparecen en el informe, para que no se te acumulen advisories de dependencias que ya ni existen.
    • Los comandos globales se niegan a correr bajo sudo y devuelven ERR_PNPM_SUDO_NOT_SUPPORTED.
    • hooks.filterLog queda deprecado. Si lo usas en tu .pnpmfile.cjs, tienes trabajo pendiente.
    • Caché remota de side-effects: proof of concept, opt-in. No la metas en producción todavía.

    Y un fix pequeño con impacto grande si trabajas en contenedores: cuando ningún directorio por encima del proyecto acepta hardlinks, el store se crea dentro del propio proyecto, en node_modules/.pnpm-store.

    Eso arregla los entornos sandbox y containerizados que hasta ahora fallaban sin explicación clara —justo el tipo de fricción que intentas eliminar cuando montas entornos de desarrollo reproducibles con dev containers.

    Checklist para actualizar a pnpm 12 sin sustos

    Media hora, en este orden:

    1. Busca --resolution-only en scripts y workflows. Sustitúyelo por pnpm peers check.
    2. Actualiza en una rama: pnpm self-update next-12 y después un pnpm install en limpio.
    3. Lee los avisos de pnpm-workspace.yaml. Si aparecen settings desconocidos, corrígelos ahora que solo avisan.
    4. Re-resuelve las dependencias git una vez: pnpm update <paquete> por cada dependencia de GitHub, GitLab o Bitbucket. pnpm no reescribe esas entradas por su cuenta —el lockfile es el registro de lo que hay que instalar—, así que un install normal te deja las URLs SSH heredadas de pnpm 11 donde estaban. Revisa el diff: ahí sí deben desaparecer.
    5. Si usas engineStrict, comprueba que el install sigue pasando; el criterio por aristas es más estricto que antes.
    6. Corre la suite completa en CI con el lockfile nuevo antes de mergear. Un lockfile byte-idéntico solo vale de algo si tus tests confirman que el árbol resultante es el que esperabas, y esa disciplina de pipeline es la misma que trabajamos en el curso de Testing en Angular con Jest y Testing Library.

    Si los seis pasos pasan, ya estás en pnpm 12.

    ¿Merece la pena actualizar a pnpm 12 ya?

    La noticia no es que pnpm sea ahora más rápido. La noticia es que un equipo ha reescrito una herramienta entera en otro lenguaje y ha decidido que el coste de esa decisión lo pagan ellos, no tú.

    Eso es una postura de diseño, y merece copiarse. La próxima vez que reescribas un módulo interno, pregúntate cuánto de tu refactor es mejora real y cuánto es trabajo que le estás pasando a quien lo consume.

    Actualiza en una rama esta semana. Si tienes dependencias git en el package.json, el cambio del punto 1 te paga la actualización él solo.

    Yo voy a pasarlo esta semana por los repos de Labs, con el checklist de arriba y sin tocar el lockfile de pnpm 11 más de lo imprescindible. Contaré qué se rompió —si es que se rompe algo— en Dominicode Labs, que es donde vamos pasando estas herramientas por proyectos reales antes de decidir qué entra en el stack y qué se queda fuera.


    Preguntas frecuentes sobre pnpm 12

    ¿Puedo instalar pnpm 12 con pnpm self-update a secas?

    No. El tag latest de npm sigue apuntando a pnpm 11, así que un self-update normal te deja donde estabas. Tienes que pedir el tag de forma explícita con pnpm self-update next-12, o instalar pnpm@next-12 desde npm si vienes de otro gestor.

    ¿Tengo que regenerar el lockfile al pasar a pnpm 12?

    El formato de lockfile de pnpm 11 se mantiene, así que el tuyo sigue siendo válido. Ahora bien, si tienes dependencias git de GitHub, GitLab o Bitbucket, te interesa re-resolverlas una vez con pnpm update <paquete>: pnpm no reescribe solo las entradas ya escritas, así que las URLs SSH heredadas de pnpm 11 siguen ahí hasta que se lo pidas. Cuando desaparecen, el lockfile pasa a ser instalable en cualquier runner de CI. También lo notarás en workspaces con muchos ciclos, donde el lockfile se encoge al eliminarse variantes duplicadas de peers.

    ¿Qué hago si mi CI usa --resolution-only?

    Sustitúyelo por pnpm peers check. El flag --resolution-only ya no existe en pnpm 12 y la ejecución termina con error, así que el pipeline se te va a rojo en el primer build si no lo cambias antes de actualizar.

    ¿Cuánto se gana de rendimiento con pnpm 12?

    Depende del proyecto, y solo hay cifras oficiales para dos escenarios concretos. En workspaces con muchos ciclos, la resolución de peers va entre 2 y 3 veces más rápida y consume alrededor de un 25% menos de memoria. En Linux sobre btrfs, priorizar hardlink frente a reflink reduce aproximadamente a la mitad el tiempo de materializar node_modules; en ext4 no cambia. Cualquier otra cifra espectacular que veas circulando por blogs de terceros no está en el anuncio oficial, así que trátala como no verificada hasta que la midas en tu propio repositorio.

    ¿Qué cambia en pnx con pnpm 12?

    pnx no es un comando nuevo: es el alias de pnpm dlx —descarga un paquete del registro, lo ejecuta y no lo deja instalado— y ya existía antes de la 12. Lo que cambia en pnpm 12 es a qué apunta cuando nombras un gestor de paquetes o un runtime. Desde la v12.0.0-rc.6, pnx yarn@4 install, pnx npm@11 ci o pnx node@22 te dan la herramienta de verdad y no el paquete npm que comparte su nombre: en npm, yarn se queda en Classic, Yarn 4 se publica como @yarnpkg/cli-dist y Yarn 6 no está. Si la quieres permanente, pnpm shim add yarn enlaza un yarn que respeta la versión que pinnee cada proyecto.

    ¿Es seguro meter pnpm 12 en producción ya?

    La 12.0 es una release estable y mantiene comandos, flags, settings y formato de lockfile de pnpm 11, así que la superficie de riesgo es baja. Repasa los seis breaking changes en una rama antes de mergear y deja fuera la caché remota de side-effects, que es un proof of concept opt-in y no está pensada todavía para pipelines críticos.

    ¿Por qué mi lockfile de pnpm falla en CI con Permission denied (publickey)?

    Porque el lockfile grabó una URL SSH para una dependencia de git y el runner de CI no tiene claves SSH cargadas. Ocurre cuando quien generó el lockfile sí las tenía: pnpm 11 resolvía por SSH porque podía y lo dejaba escrito. pnpm 12 lo corta de raíz al resolver los specifiers de GitHub, GitLab y Bitbucket por su URL HTTPS canónica, de modo que nunca graba una URL SSH para esos hosts. Para arreglar un lockfile ya existente no basta con actualizar: re-resuelve esas dependencias una vez con pnpm update <paquete>, porque pnpm no reescribe por su cuenta las entradas que ya están escritas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Optimización extrema de rendimiento y consumo de memoria en Next.js 16

    Optimización extrema de rendimiento y consumo de memoria en Next.js 16

    Hace unos meses recibí una llamada de emergencia de un equipo que acababa de desplegar su aplicación de comercio electrónico construida sobre Next.js. El servidor Node.js en producción colapsaba cada 4 horas con el temible mensaje FATAL ERROR: Reached heap limit Allocation failed - JavaScript heap out of memory.

    Su solución temporal era programar un reinicio automático del contenedor Docker cada 3 horas. Un parche espantoso para disimular un problema de arquitectura grave.

    El equipo culpaba a Node.js y a los servidores de Vercel. Pero al auditar el perfil de memoria, descubrimos que los desarrolladores estaban reteniendo objetos gigantescos en la caché de Server Components y desbordando la memoria durante la hidratación de datos.

    Next.js 16 introduce avances masivos en la gestión de memoria y compilación, pero si no entiendes cómo funciona su motor bajo el capó, es ridículamente fácil introducir memory leaks en producción.

    El espejismo de los Server Components sin estado

    Existe el mito de que los React Server Components (RSC) son inmunes a las fugas de memoria porque se ejecutan en el servidor y solo envían HTML/JSON al cliente.

    La realidad es que en el servidor, cada petición HTTP mantiene en memoria el árbol de renderizado del componente hasta que se completa la respuesta. Si dentro de un Server Component:

    • Suscribes escuchadores de eventos globales que no se destruyen.
    • Almacenas buffers de imágenes o respuestas API masivas en variables fuera de la función del componente.
    • Abres conexiones de base de datos dentro del render sin un pool reutilizable.

    Estás acumulando megabytes de basura retenida en la memoria Heap de Node.js en cada petición de usuario.

    Como ya explicamos en nuestro análisis detallado sobre la reducción de memoria en builds de Next.js, separar la memoria del compilador de la memoria en tiempo de ejecución es el primer paso para diagnosticar estos fallos.

    3 Estrategias para Optimizar Next.js 16 en Producción

    1. Gestión Inteligente de Caché de Datos (unstable_cache & PPR)

    En Next.js 16, la caché de peticiones debe configurarse explícitamente utilizando etiquetas de revalidación (revalidateTag) en lugar de almacenar respuestas masivas en memoria global:

    import { unstable_cache } from 'next/cache';
    
    export const getProductoDestacado = unstable_cache(
      async (id: string) => {
        // Consulta limpia a la base de datos
        return await db.producto.findUnique({ where: { id } });
      },
      ['producto-destacado-key'],
      {
        revalidate: 3600, // Revalida cada hora en segundo plano
        tags: ['productos']
      }
    );
    

    2. Configurar Límites de Memoria en Turbopack y Node.js

    Para evitar que el proceso de build agote la RAM de tu servidor de integración continua (CI/CD) o contenedor de producción, configura los flags de memoria de forma estricta en tu package.json:

    {
      "scripts": {
        "dev": "next dev --turbo",
        "build": "NODE_OPTIONS='--max-old-space-size=4096' next build"
      }
    }
    

    3. Evitar el "Waterfall" en Renderizado Asíncrono

    Uno de los fallos de rendimiento más comunes en Server Components es ejecutar peticiones await secuenciales cuando podrían resolverse en paralelo:

    // ❌ MAL: Peticiones en cascada (waterfall), triplica el tiempo de respuesta y retención en memoria
    const usuario = await getUsuario(id);
    const pedidos = await getPedidos(id);
    const metricas = await getMetricas(id);
    
    // ✅ BIEN: Ejecución en paralelo con Promise.all
    const [usuario, pedidos, metricas] = await Promise.all([
      getUsuario(id),
      getPedidos(id),
      getMetricas(id)
    ]);
    

    Al aplicar programación defensiva en TypeScript, garantizas que cualquier fallo dentro de Promise.all sea capturado sin dejar promesas colgadas en el event loop.

    Monitoreo y Diagnóstico de Memoria

    Para auditar el consumo real de tu aplicación en desarrollo o staging:

    1. Ejecuta el servidor con el inspector habilitado: node --inspect node_modules/.bin/next start.
    2. Abre Chrome DevTools (chrome://inspect) y toma una instantánea del Heap (Heap Snapshot).
    3. Filtra por clases retenidas (Closure, System / Context) para identificar qué Server Components no están siendo liberados por el recolector de basura (Garbage Collector).

    Como destacamos en nuestras guías de graph engineering, mapear las dependencias entre módulos es la forma más limpia de aislar fugas de memoria.


    Optimizar el rendimiento en Next.js 16 no requiere magia; requiere disciplina en la gestión de datos asíncronos y una configuración adecuada de los límites de memoria.

    Si quieres dominar el desarrollo fullstack moderno con Next.js y arquitecturas de alto rendimiento, descubre los Cursos de Dominicode. Y si buscas resolver desafíos complejos de producción en comunidad con otros desarrolladores senior, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué mi build de Next.js se queda congelado consumiendo 100% de CPU?

    Suele deberse a la importación masiva de módulos con dependencias circulares o al procesamiento de imágenes gigantescas durante la generación estática (SSG). Limitar el número de páginas pre-renderizadas en build mediante generateStaticParams dinámico soluciona el problema.

    ¿Qué diferencia hay entre revalidatePath y revalidateTag?

    revalidatePath purga toda la caché asociada a una URL específica. revalidateTag es mucho más eficiente porque purga de forma quirúrgica solo los datos que comparten una etiqueta concreta en todo el proyecto, sin invalidar otras secciones de la página.

    ¿Cómo afecta el uso de middleware al rendimiento en Next.js?

    El Middleware se ejecuta en el Edge Runtime antes de cada petición. Si realizas llamadas pesadas a APIs o consultas directas a bases de datos dentro del middleware, añadirás latencia a todas las rutas de tu aplicación. Mantén el middleware ultraligero (solo para redirecciones y lectura de headers/cookies).

    ¿Es recomendable usar next/image para todas las imágenes?

    Sí. El componente next/image optimiza automáticamente el formato (WebP/AVIF), ajusta las dimensiones según la pantalla del cliente y evita desplazamientos de diseño (Cumulative Layout Shift – CLS), reduciendo drásticamente la carga de memoria en el navegador.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Construyendo sitios web ultrarrápidos con Astro y Server Islands: Cero JS por defecto

    Construyendo sitios web ultrarrápidos con Astro y Server Islands: Cero JS por defecto

    Hace unos meses analicé la landing page de un cliente que ofrecía un producto SaaS. Habían construido la web utilizando un marco de trabajo de aplicación de página única (SPA) completo.

    Para renderizar un titular estático, una lista de precios y tres testimonios de clientes, el navegador del usuario tenía que descargar, descompilar y ejecutar 480 KB de JavaScript. En conexiones móviles 4G, el tiempo hasta que la página se volvía interactiva (Time to Interactive) superaba los 5.5 segundos. El resultado en Google Lighthouse era un doloroso 44/100.

    Perdían el 30% de los visitantes antes de que la página terminara de cargar.

    Al refactorizar el sitio hacia Astro y aprovechar la nueva funcionalidad de Server Islands, redujimos el bundle de JavaScript cliente para la estructura estática a 0 KB, logrando una puntuación de 100/100 en Core Web Vitals en el primer intento.

    La paradoja de enviar JavaScript para renderizar HTML

    Durante la última década, la industria del desarrollo web cometió un error colectivo: asumir que cualquier sitio web moderno debía empaquetarse dentro de una aplicación de React o Angular que se ejecuta íntegramente en el navegador del usuario.

    El resultado ha sido la degradación del rendimiento web:

    • El navegador descarga megabytes de JavaScript para crear nodos de DOM que podrían haber sido enviados directamente como HTML estático.
    • La CPU del dispositivo móvil se satura ejecutando hidratación de estado.
    • Los motores de búsqueda e intenciones de búsqueda sufren retardos de indexación.

    Astro invirtió este modelo con su filosofía "Zero JavaScript by default" (Cero JavaScript por defecto). Astro renderiza todo el componente a HTML estático en el servidor y solo envía JavaScript al cliente si especificas explícitamente una isla interactiva (Islands Architecture).

    ¿Qué son las Server Islands en Astro?

    La arquitectura de islas tradicional permitía incrustar componentes interactivos cliente (React, Vue, Svelte) dentro de una página estática usando directivas como client:load o client:visible.

    Sin embargo, las Server Islands introducen un avance superior: permiten posponer la renderización de un componente dinámico de servidor sin bloquear la carga estática inicial de la página.

    ┌─────────────────────────────────────────────────────────┐
    │ HTML Estático enviado de inmediato (TTFB ultra bajo)     │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ Hero Section + Menú + Testimonios (HTML Puro)       │ │
    │ └─────────────────────────────────────────────────────┘ │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ <AvatarUsuario server:defer /> (Server Island)      │ │
    │ │  └─► Renderiza fallback estático instantáneo        │ │
    │ │  └─► Se sustituye en segundo plano por HTML del srv  │ │
    │ └─────────────────────────────────────────────────────┘ │
    └─────────────────────────────────────────────────────────┘
    

    Ejemplo de uso de Server Island en Astro

    Imagina un blog de alta velocidad donde la mayor parte del contenido es estático, pero deseas mostrar el avatar personalizado del usuario autenticado en la barra superior.

    ---
    // src/pages/posts/[slug].astro
    import Layout from '../layouts/Layout.astro';
    import AvatarUsuario from '../components/AvatarUsuario.astro';
    import ContenidoPost from '../components/ContenidoPost.astro';
    
    const { slug } = Astro.params;
    ---
    
    <Layout title="Post de Blog Ultrarrápido">
      <header style="display: flex; justify-content: space-between;">
        <Logo />
        <!-- La Server Island no bloquea la carga de la página estática -->
        <AvatarUsuario server:defer>
          <!-- Fallback mientras el servidor procesa la sesión -->
          <div slot="fallback" class="avatar-skeleton"></div>
        </AvatarUsuario>
      </header>
    
      <main>
        <ContenidoPost slug={slug} />
      </main>
    </Layout>
    

    Al cargar la página:

    1. El servidor entrega HTML puro súper rápido (la estructura completa del artículo y la plantilla).
    2. El cliente ve la página cargada de forma instantánea con el skeleton del avatar.
    3. Astro ejecuta en segundo plano el componente <AvatarUsuario /> en el servidor y reemplaza el fallback con el HTML dinámico parseado sin necesidad de descargar una pesada librería cliente.

    Como vimos al comparar el consumo en tiempo de compilación con Next.js y Turbopack, utilizar la arquitectura correcta para cada tipo de proyecto es la decisión de rendimiento más rentable.

    Tipado Defensivo y Colecciones de Contenido

    Astro integra Content Collections, un sistema basado en Zod que valida en tiempo de compilación que todos tus archivos Markdown o MDX cumplan exactamente con la estructura de tipos definida.

    // src/content/config.ts
    import { defineCollection, z } from 'astro:content';
    
    const postsCollection = defineCollection({
      type: 'content',
      schema: z.object({
        title: z.string(),
        description: z.string().max(160),
        pubDate: z.date(),
        author: z.string().default('Bezael Pérez'),
        tags: z.array(z.string()),
      }),
    });
    
    export const collections = { posts: postsCollection };
    

    Al aplicar programación defensiva en TypeScript, garantizas que ningún artículo con metadatos defectuosos rompa la generación estática de tu sitio web.

    Además, mantener aisladas las dependencias de tus componentes siguiendo principios de graph engineering permite reutilizar componentes de React o Vue dentro de Astro de manera impecable.


    Astro y sus Server Islands representan la convergencia perfecta entre la velocidad extrema del HTML estático y la flexibilidad de la web dinámica moderna.

    Si quieres dominar el desarrollo web moderno, optimización de rendimiento y arquitectura frontend, explora los Cursos de Dominicode. Y si buscas construir sitios web y productos de alto impacto junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿En qué se diferencia una Server Island de un Server Component de React?

    Los Server Components de React requieren que toda la aplicación comparta el modelo de hidratación y empaquetado de React. Las Server Islands de Astro son agnósticas al framework: puedes usar componentes en Astro puro, React, Vue, Svelte o Solid, y se reemplazan de forma asíncrona mediante un fragmento de HTML ligero sin cargar el runtime del framework si no es necesario.

    ¿Puedo seguir usando componentes interactivos de React en Astro?

    Sí. Puedes importar cualquier componente de React, Vue o Svelte en Astro. Para habilitar la interactividad cliente en un componente específico, solo añades la directiva de hidratación correspondiente, como client:visible (se hidrata solo cuando el usuario hace scroll hasta él) o client:idle (se hidrata cuando el navegador está inactivo).

    ¿Server Islands requiere una plataforma de despliegue en servidor (SSR)?

    Para que las Server Islands funcionen procesando peticiones dinámicas en segundo plano, tu proyecto Astro debe desplegarse con un adaptador SSR (Server-Side Rendering) en plataformas como Vercel, Netlify, Cloudflare Workers o un contenedor Docker con Node.js/Bun.

    ¿Astro es adecuado para aplicaciones web complejas con paneles de administración?

    Astro es imbatible para sitios web centrados en contenido, blogs, e-commerce, documentación y landing pages. Para paneles de administración interactivos con estado denso en cliente (dashboards complejos), combinar Astro para las páginas públicas con un framework como Next.js, Angular o React para el panel privado es una excelente estrategia de arquitectura.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Gestión de estado global sin dolor combinando Zod y Signals en aplicaciones modernas

    Gestión de estado global sin dolor combinando Zod y Signals en aplicaciones modernas

    Hace un par de años audité una aplicación enterprise en React y TypeScript que utilizaba Redux Toolkit. Para gestionar el estado de 6 pantallas principales, el equipo había tenido que escribir más de 3.500 líneas de código entre actions, reducers, selectors y Middlewares de Thunk.

    Lo grave no era la cantidad de archivos. Lo grave era que cuando el backend cambiaba un campo opcional de la API sin avisar, el store de Redux aceptaba el objeto corrupto y la aplicación explotaba páginas más tarde con el temible Cannot read properties of undefined.

    Habían creado un sistema complejo que no ofrecía ninguna protección real en tiempo de ejecución.

    La combinación de Zod (validación de esquemas) y Signals (reactividad de grano fino) se ha convertido en el estándar moderno para eliminar el dolor de la gestión de estado global en aplicaciones frontend.

    El problema de las librerías de estado tradicionales

    Durante años creímos que para gestionar el estado de una aplicación web necesitábamos un contenedor monolítico global con patrones de inmutabilidad estrictos.

    Ese enfoque sufría tres defectos estructurales:

    1. Verbosidad extrema: Escribir decenas de funciones de selección y mutación para actualizar una simple propiedad de usuario.
    2. Re-renderizados innecesarios: Si un componente escuchaba un objeto de estado global grande, cualquier cambio menor provocaba el re-renderizado del árbol de UI completo.
    3. Ceguera en la frontera API: Asumir que la respuesta del backend coincide al 100% con los tipos de TypeScript sin validar los datos entrantes.

    Como destacamos en nuestro artículo sobre programación defensiva en TypeScript, las interfaces de TypeScript desaparecen al transpilar, por lo que confiar solo en tipos en tiempo de compilación es una trampa.

    La Arquitectura Zod + Signals

    La solución moderna consiste en aplicar la validación de esquemas en la frontera de entrada (HTTP) y gestionar la reactividad atómica mediante Signals (disponibles de forma nativa en Angular, Preact, SolidJS o mediante librerías ultraligeras como @preact/signals en React).

    ┌─────────────────────────────────────────────────────────┐
    │ Respuesta API HTTP (JSON sin confiar)                   │
    │  └─► Validacion en tiempo de ejecucion con Zod Schema   │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Estado Reactivo Atómico (Signals)                │
    │     │  └─► signal(), computed()                         │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Componentes de UI (Actualización Quirúrgica)         │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    

    1. Definición del Esquema Zod y Tipado Automático

    import { z } from 'zod';
    
    // 1. Esquema con validación estricta en tiempo de ejecución
    export const UserStateSchema = z.object({
      id: z.string().uuid(),
      email: z.string().email(),
      nombre: z.string().min(2),
      rol: z.enum(['ADMIN', 'USER', 'GUEST']),
      preferencias: z.object({
        tema: z.enum(['light', 'dark']).default('dark'),
      }),
    });
    
    // Inferir el tipo de TypeScript automáticamente
    export type UserState = z.infer<typeof UserStateSchema>;
    

    2. Store Reactivo basado en Signals

    import { signal, computed } from '@preact/signals-react';
    import { UserStateSchema, UserState } from './user.schema';
    
    // State atómico inicial
    export const usuarioSignal = signal<UserState | null>(null);
    export const estaAutenticadoSignal = computed(() => usuarioSignal.value !== null);
    export const esAdminSignal = computed(() => usuarioSignal.value?.rol === 'ADMIN');
    
    // Acción de actualización con validación Zod defensiva
    export function setUsuarioConValidacion(rawData: unknown) {
      const parseResult = UserStateSchema.safeParse(rawData);
    
      if (!parseResult.success) {
        console.error('Payload de API inválido:', parseResult.error.format());
        // Se evita corromper el estado global con datos inválidos
        return false;
      }
    
      // Se asigna únicamente si la validación es 100% exitosa
      usuarioSignal.value = parseResult.data;
      return true;
    }
    

    Beneficios en Aplicaciones de Producción

    1. Re-renderizados quirúrgicos: Al consumir esAdminSignal en un botón de administración, solo ese botón se re-evalúa cuando el rol cambia. El resto de la UI permanece intacta sin necesidad de memoizaciones manuales (useMemo, React.memo).
    2. Cero corrupción de estado: Si la API devuelve un campo mal formateado, Zod detiene la propagación en la frontera HTTP antes de que afecte a la reactividad de la aplicación.
    3. Escalabilidad de código: Eliminas más del 70% del boilerplate de Redux/MobX, creando un código limpio que tanto los desarrolladores como los asistentes de IA pueden refactorizar sin riesgo.

    Al estructurar los módulos de estado siguiendo los principios de graph engineering, consigues una separación clara entre la lógica de datos y los componentes de presentación.

    Y si estás desarrollando en Angular, ten en cuenta el constante ciclo de releases de Angular donde los Signals y los Signal Forms se han integrado como el estándar nativo del framework.


    Simplificar la gestión de estado combinando la solidez de Zod con la velocidad de los Signals permite construir interfaces mantenibles, reactivas y blindadas ante fallos de producción.

    Si quieres dominar el desarrollo frontend moderno y las mejores prácticas de arquitectura con TypeScript, explora los Cursos de Dominicode. Y si quieres construir aplicaciones reales junto a otros desarrolladores senior, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Puedo usar Zod con otras librerías de estado como Zustand o Pinia?

    Sí. Zod es una librería de validación agnóstica al framework. Puedes usar ZodSchema.parse() dentro de las acciones de Zustand, Pinia, Redux o cualquier otra librería para validar los datos antes de guardarlos en el store.

    ¿Qué diferencia hay entre la reactividad de Signals y los Observables de RxJS?

    Los Signals están optimizados para la reactividad síncrona de UI con evaluación perezosa y seguimiento automático de dependencias. RxJS está diseñado para la coordinación de eventos asíncronos en el tiempo (peticiones HTTP, WebSockets, timers). En aplicaciones modernas, se usan Signals para el estado del componente y RxJS para streams asíncronos.

    ¿Zod añade demasiado peso al bundle del cliente?

    No. Zod es una librería ultraligera (menos de 12 KB gzippeado) y soporta tree-shaking, por lo que solo se empaquetan en el cliente los métodos y validadores que utilices explícitamente en tu código.

    ¿Cómo persiste el estado basado en Signals entre recargas de página?

    Puedes crear un efecto reactivo que sincronice automáticamente el valor del Signal con localStorage o sessionStorage cada vez que el Signal cambia, parseando los datos con Zod al restaurar la sesión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Entornos de desarrollo reproducibles con Docker y Dev Containers: Adiós al ‘en mi máquina funciona’

    Entornos de desarrollo reproducibles con Docker y Dev Containers: Adiós al ‘en mi máquina funciona’

    Hace un año incorporamos a un desarrollador senior a un proyecto que integraba microservicios en Node.js 22, utilidades en Python 3.12, PostgreSQL con la extensión pgvector y colas de tareas en Redis.

    El proceso de Onboarding para que el nuevo desarrollador pudiera ejecutar la aplicación en su portátil local duró dos días completos.

    Hubo conflictos de versiones entre NVM, diferencias en el compilador de C++ para binarios nativos en macOS M3 frente a Windows, e incompatibilidades de variables de entorno. Durante esos dos días, dos ingenieros senior tuvieron que detener su trabajo para hacer pair programming y desatascar la instalación.

    Dos semanas después configuramos Dev Containers (.devcontainer/devcontainer.json).

    Cuando se sumó el siguiente desarrollador al equipo, clonó el repositorio, abrió VS Code / Cursor, hizo clic en "Reopen in Container", y en 3 minutos y 40 segundos tenía la aplicación corriendo con la base de datos poblada y todos los linters configurados.

    Tener entornos de desarrollo reproducibles con Docker no es una preferencia cosmética; es la diferencia entre un equipo acelerado y una pesadilla de soporte técnico interno.

    ¿Qué son los Dev Containers y por qué superan a Docker Compose?

    Durante años intentamos solucionar el problema de las versiones en local usando docker-compose.yml.

    Aunque Docker Compose resolvía la ejecución de servicios de fondo (bases de datos o cachés), el código fuente principal seguía ejecutándose en el sistema operativo del anfitrión (Host OS). Tu editor de código utilizaba los binarios de Node.js o Python instalados en tu máquina local, lo que provocaba discrepancias en el intellisense, formatos de línea y extensiones del IDE.

    La especificación Dev Containers (estandarizada por la Development Containers Specification de la Linux Foundation) va un paso más allá: mueve todo el entorno de desarrollo (incluyendo el servidor del editor, terminal, extensiones y compiladores) dentro de un contenedor de Docker aislado.

    ┌─────────────────────────────────────────────────────────┐
    │ Máquina Anfitriona (macOS / Windows / Linux)            │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ Editor de Código (VS Code / Cursor Client UI)       │ │
    │ └──────────────────────────┬──────────────────────────┘ │
    │                            │ SSH / Socket RPC           │
    │ ┌──────────────────────────▼──────────────────────────┐ │
    │ │ Contenedor Docker (Linux Debian/Ubuntu)             │ │
    │ │ ┌─────────────────────────────────────────────────┐ │ │
    │ │ │ VS Code Server + Extensiones + Linters           │ │ │
    │ │ ├─────────────────────────────────────────────────┤ │ │
    │ │ │ Node.js 22 + Python 3.12 + TypeScript + Bun     │ │ │
    │ │ ├─────────────────────────────────────────────────┤ │ │
    │ │ │ Código Fuente Montado + PostgreSQL + Redis       │ │ │
    │ │ └─────────────────────────────────────────────────┘ │ │
    │ └─────────────────────────────────────────────────────┘ │
    └─────────────────────────────────────────────────────────┘
    

    Configuración Paso a Paso de un Dev Container Profesional

    Para convertir cualquier proyecto en un entorno reproducible, solo necesitas crear una carpeta .devcontainer en la raíz del repositorio con los siguientes dos archivos.

    1. .devcontainer/docker-compose.yml

    version: '3.8'
    
    services:
      app:
        build:
          context: .
          dockerfile: Dockerfile
        volumes:
          - ..:/workspace:cached
        command: sleep infinity
        network_mode: service:db
    
      db:
        image: pgvector/pgvector:pg16
        environment:
          POSTGRES_DB: dev_db
          POSTGRES_USER: dev_user
          POSTGRES_PASSWORD: dev_password
        ports:
          - "5432:5432"
    

    2. .devcontainer/devcontainer.json

    {
      "name": "Dominicode Fullstack Dev Environment",
      "dockerComposeFile": "docker-compose.yml",
      "service": "app",
      "workspaceFolder": "/workspace",
      "customizations": {
        "vscode": {
          "settings": {
            "editor.formatOnSave": true,
            "editor.defaultFormatter": "esbenp.prettier-vscode",
            "typescript.tsdk": "node_modules/typescript/lib"
          },
          "extensions": [
            "dbaeumer.vscode-eslint",
            "esbenp.prettier-vscode",
            "eamodio.gitlens",
            "biomejs.biome"
          ]
        }
      },
      "remoteUser": "node",
      "postCreateCommand": "bun install"
    }
    

    Ventajas Clave para Equipos de Desarrollo e IA

    1. Onboarding en 1 Clic: Cualquier nuevo desarrollador (o agente de IA que opere en entornos remotos) puede levantar un workspace 100% funcional sin instalar dependencias globales en su máquina.
    2. Homogeneización de herramientas: Todo el equipo comparte exactamente la misma versión de Node.js, TypeScript y linters. Nadie puede subir código formateado con reglas distintas.
    3. Aislamiento Total: Puedes trabajar simultáneamente en dos proyectos que utilicen versiones totalmente incompatibles de bases de datos o ejecutables de sistema sin que interfieran entre sí.

    Como analizamos en nuestra guía sobre cómo formar a tu equipo de desarrollo en IA, estandarizar los entornos de trabajo es el primer paso para acelerar la adopción de herramientas avanzadas.

    Al escribir código dentro del contenedor, sigues aplicando principios de programación defensiva en TypeScript, con la tranquilidad de que las validaciones de tipo en tiempo de ejecución se comportarán exactamente igual en local y en integración continua.

    Además, mantener aislados los límites de dependencias de tus servicios facilita aplicar estrategias de graph engineering para mapear tu arquitectura.


    Decir adiós al "en mi máquina funciona" es posible. Adoptar Dev Containers eleva la madurez de tu ingeniería de software y ahorra cientos de horas de soporte innecesario.

    Si quieres dominar las mejores prácticas de DevOps, arquitectura y desarrollo moderno con TypeScript, explora los Cursos de Dominicode. Y si quieres colaborar en proyectos reales junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Afecta el rendimiento de lectura de disco al usar Dev Containers en macOS o Windows?

    En macOS y Windows, Docker ejecuta una máquina virtual ligera. Para garantizar una velocidad de lectura de archivos óptima en los volúmenes de código fuente, la especificación usa montajes con flag :cached o tecnologías como VirtioFS en macOS, ofreciendo un rendimiento prácticamente idéntico al nativo.

    ¿Puedo usar Dev Containers si programo en Cursor o WebStorm?

    Sí. Cursor soporta la especificación Dev Containers de forma nativa al estar basado en VS Code. JetBrains (WebStorm, IntelliJ) también ofrece soporte completo para Dev Containers a través de su arquitectura de desarrollo remoto.

    ¿Qué ocurre con mis credenciales de Git y claves SSH?

    Dev Containers reenvía automáticamente el agente SSH (SSH Agent Forwarding) y las credenciales de Git de tu máquina anfitriona al interior del contenedor. Puedes hacer git commit y git push desde la terminal del contenedor usando tus claves privadas de forma segura sin copiarlas dentro de la imagen.

    ¿Dev Containers es útil para proyectos pequeños de un solo desarrollador?

    Absolutamente. Además de evitar contaminar tu sistema operativo con decenas de versiones globales de bases de datos o servicios, te permite formatear tu portátil o cambiar de equipo informático y retomar exactamente el mismo estado de desarrollo en minutos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Cómo escribir y publicar tu propio libro técnico en Amazon KDP siendo programador

    Durante años pensé que para publicar un libro de programación necesitabas ser contratado por una gran editorial técnica, enviar propuestas durante meses y aceptar que te pagaran un miserable 8% de regalías un año después de escribirlo.

    Cuando publiqué mis primeros libros técnicos de forma autodidacta usando Markdown y los subí directamente a Amazon KDP (Kindle Direct Publishing), me di cuenta de lo equivocado que estaba.

    Publicar un libro técnico no solo te reporta ingresos pasivos mes a mes. Es la mayor carta de presentación posible para tu carrera como desarrollador: te posiciona de inmediato como un referente en tu tecnología, abre puertas para consultorías de alto valor y multiplica tu autoridad profesional.

    Si sabes programar y has resuelto problemas reales en producción, ya tienes todo lo necesario para escribir y publicar tu propio libro técnico.

    Por qué escribir un libro en la era de la IA

    Con la proliferación de contenido generado automáticamente en internet, el valor de la voz de un desarrollador senior con experiencia real ha aumentado drásticamente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, el valor del mercado ya no está en escupir código sintácticamente correcto, sino en la capacidad de estructurar sistemas, explicar decisiones de arquitectura y enseñar soluciones probadas en batalla.

    Un libro técnico bien empaquetado transmite la experiencia práctica que un desarrollador busca cuando quiere aprender un framework sin perder semanas probando tutoriales desactualizados.

    El Stack del Desarrollador Escritor

    Olvídate de Microsoft Word o Indesign. Como programadores, nuestro entorno de trabajo habitual es ideal para redactar libros técnicos:

    ┌─────────────────────────────────────────────────────────┐
    │ Redacción en Markdown (VS Code / Claude Code)           │
    │  └─► Control de versiones con Git & GitHub             │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Compilación de formatos (Pandoc / CSS / HTML)     │
    │     │  └─► Salida: PDF (Imprenta) + EPUB (Kindle)      │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Distribución Directa (Amazon KDP + Leanpub)          │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Redacción: Archivos .md organizados por capítulos en Git.
    2. Control de Código: Fragmentos de código reales probados con tests unitarios en el mismo repositorio.
    3. Formateo Automatizado: Scripts en CLI (usando Pandoc, PrinceXML o Puppeteer) para compilar el Markdown a PDF listo para impresión y EPUB para lectores digitales.

    El flujo de trabajo: De la idea a las regalías en Amazon

    1. Validación rápida (Validar antes de escribir 300 páginas)

    Antes de redactar el libro completo, escribe una tabla de contenidos detallada y publica un primer borrador o guía en plataformas como Leanpub o Gumroad. Si los primeros desarrolladores compran la versión preliminar, tienes luz verde.

    2. Estructuración pedagógica

    Un buen libro técnico no es una documentación de API traducida. Es una ruta estructurada de aprendizaje. Al igual que en nuestra metodología para formar a un equipo de desarrollo en IA en 6 semanas, debes ir de lo conceptual a lo práctico con proyectos reales paso a paso.

    3. Portada y formateo de Amazon KDP

    En Amazon KDP la portada es el 50% de la conversión. Diseña una portada limpia, con alto contraste y tipografía profesional. Asegúrate de ajustar las sangrías y márgenes de corte (bleed) según las especificaciones de Amazon si vas a ofrecer versión en papel (Paperback/Hardcover).

    4. Regalías y Estrategia de Precio

    Amazon KDP ofrece hasta un 70% de regalías en versión Kindle digital y un 60% en versión física de tapa blanda. Establecer tu precio entre $9.99 y $24.99 en digital suele ofrecer el mejor equilibrio entre volumen de ventas e ingresos netos.


    Publicar tu primer libro técnico es un proyecto de fin de semana acelerado que pagará dividendos durante años en tu carrera.

    Si te interesa profundizar en la creación de productos técnicos y modelos de ingresos para desarrolladores, explora los Cursos de Dominicode. Y si quieres rodearte de creadores y builders que están lanzando sus propias herramientas y publicaciones, únete a Dominicode Labs.

    Preguntas frecuentes

    ¿Necesito pedir ISBN antes de publicar en Amazon KDP?

    No. Amazon KDP te proporciona un código ASIN gratuito para libros digitales y un ISBN gratuito para las versiones impresas dentro de su plataforma. Si deseas vender el mismo formato físico en librerías externas, puedes comprar tu propio ISBN.

    ¿Cuánto tiempo lleva escribir un libro técnico de 150 páginas?

    Con una estructura clara y dedicando de 4 a 6 horas semanales, un desarrollador puede completar un libro técnico enfocado en 6 u 8 semanas.

    ¿Puedo usar asistentes de IA para ayudarme a redactar el libro?

    Sí, herramientas como Claude Code son excelentes para estructurar esquemas de capítulos, sugerir ejercicios prácticos y revisar la gramática de tus explicaciones. No obstante, el valor principal debe provenir de tus ejemplos de código y experiencia real.

    ¿Qué diferencia hay entre publicar en KDP e ir con una editorial como O'Reilly o Packt?

    Ir con una editorial tradicional te ofrece prestigio de marca, pero el proceso tarda entre 9 y 18 meses y solo recibes entre el 8% y el 15% de regalías. En KDP publicas de forma instantánea, mantienes el 100% de los derechos y conservas hasta el 70% de los ingresos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Cómo construir micro-SaaS rentables operando como solo developer asistido por IA

    Hace tres años, lanzar un producto de software como servicio (SaaS) requería un equipo entero. Necesitabas un desarrollador frontend, un ingeniero backend, un diseñador UI/UX, un especialista en bases de datos, un responsable de QA y un copywriter para las landing pages. Si intentabas hacerlo todo solo, tardabas 9 meses en sacar una versión alfa.

    Hoy, la combinación de stack moderno (Next.js, Supabase, Stripe) y agentes de desarrollo acelerados con IA me permite operar múltiples líneas de negocio en solitario.

    Construir micro-SaaS rentables siendo solo developer asistido por IA ya no es una fantasía de hackers de fin de semana. Es el modelo de negocio más eficiente para ingenieros senior que quieren crear independencia financiera acumulando ingresos recurrentes (MRR) sin la sobrecarga de gestionar personal.

    El cambio de paradigma: Del equipo tradicional al "Solo Builder" con IA

    Un micro-SaaS es una herramienta de software hiperenfocada que resuelve un problema específico para un nicho bien definido. No buscas levantar rondas de capital riesgo ni contratar a 50 empleados. Buscas un producto que facture entre 2,000 $ y 15,000 $ al mes con costes operativos mínimos.

    Antes de la IA, el cuello de botella del solo builder era la falta de horas en el día. Tenías que pasar de escribir código backend a configurar pipelines de CI/CD, diseñar thumbnails u redactar emails de venta.

    Con agentes de IA especializados (como Claude Code, AGY o subagentes configurados en tu entorno):

    • Delegas el formateo de componentes, la generación de tests y el código boilerplate.
    • Redactas copys persuasionales para tus páginas de captación en minutos.
    • Automatizas las tareas repetitivas de mantenimiento y atención al cliente.

    Como planteamos en nuestro análisis sobre si la IA va a sustituir a los programadores, la ventaja competitiva ha dejado de estar en picar código a mano y ha pasado a la capacidad de orquestar soluciones de producto completas.

    El Stack Tecnológico del Solo Developer en 2026

    Para operar un micro-SaaS sin morir en el intento, tu arquitectura debe ser ultraligera y requerir cero mantenimiento de servidores:

    ┌─────────────────────────────────────────────────────────┐
    │ Frontend & Rendering: Next.js / Astro / TailwindCSS     │
    │  └─► Desplegado en Vercel o Netlify (Cero DevOps)       │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Backend & Data: Supabase / PostgreSQL / Hono      │
    │     │  └─► Auth, DB, Edge Functions y Vector Search    │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Pagos & Facturación: Stripe / Lemon Squeezy         │
    │  │  └─► Subscripciones recurrentes y webhooks           │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    
    1. Frontend: Next.js o Astro para maquetación e hidratación ultrarrápida.
    2. Base de Datos & Auth: Supabase o Neon sobre PostgreSQL. Te proporciona autenticación, base de datos relacional y storage sin gestionar servidores.
    3. Monetización: Stripe para gestionar suscripciones recurrentes, pagos en un clic y portales de clientes automáticos.
    4. Asistente de Desarrollo: Claude Code y subagentes integrados para generar tareas, refactorizar módulos y escribir especificaciones antes de codificar.

    Las 3 Reglas de Oro para Construir Micro-SaaS Rentables

    1. Valida el problema antes de escribir código

    El error número uno de los desarrolladores es encerrarse a programar durante 3 meses para descubrir que nadie quiere pagar por el producto. Crea una landing page simple, comparte la propuesta en redes o comunidades técnicas y verifica si hay intención de pago real.

    Como explicamos en nuestra guía sobre cuándo NO usar Spec-Driven Development, en fases muy tempranas de exploración debes priorizar la velocidad de aprendizaje sobre arquitecturas sobre-diseñadas.

    2. Controla los costes de tokens e infraestructura de IA

    Si tu micro-SaaS incluye funcionalidades basadas en LLMs (ej. resúmenes automáticos, asistentes RAG o generación de imágenes), diseña la arquitectura pensando en los márgenes de beneficio.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, elegir el modelo adecuado para cada tarea (usando modelos ligeros como Haiku o Flash para tareas simples y modelos avanzados para razonamiento complejo) es la diferencia entre tener un margen del 80% o perder dinero en cada registro.

    3. Automatiza la retención y el soporte desde el día 1

    Como desarrollador en solitario, tu activo más valioso es tu tiempo. Configura secuencias de onboarding por email automáticas y asistentes de soporte basados en documentación para resolver las dudas más frecuentes sin intervención manual.


    Construir micro-SaaS rentables te da la libertad de trabajar en tus propios términos, aplicando tu experiencia técnica en productos que aportan valor real a tus clientes.

    Si quieres aprender las mejores técnicas de desarrollo frontend, backend y arquitectura con IA, explora los Cursos de Dominicode. Y si quieres unirte a una comunidad privada de creadores que están construyendo y facturando con sus propios proyectos de software, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿Cuánto dinero se necesita para lanzar un micro-SaaS?

    Gracias al tier gratuito de plataformas como Vercel, Supabase, GitHub y Stripe, el coste inicial de infraestructura para lanzar un micro-SaaS es prácticamente cero dólares al mes. Tus únicos gastos iniciales son el nombre de dominio (unos 10 $/año) y tu suscripción a herramientas de IA.

    ¿Cuánto tiempo lleva desarrollar un MVP (Producto Mínimo Viable)?

    Usando el stack recomendado y apoyándote en asistentes de IA para el código repetitivo, un desarrollador senior puede construir y lanzar un MVP funcional en 2 a 4 semanas trabajando a tiempo parcial.

    ¿Cómo competir contra grandes empresas siendo un solo developer?

    Tu ventaja es la agilidad y el enfoque de nicho. Una gran empresa no puede dedicar recursos a resolver un problema específico de 5,000 $ de MRR para una industria concreta. Tú puedes construir una solución a medida, ofrecer una atención cercana y adaptar el producto en horas sin pasar por comités de aprobación.

    ¿Se pueden vender estos micro-SaaS en el futuro?

    Sí. Existe un mercado secundario enorme en plataformas como Acquire.com o Flippa donde inversores compran micro-SaaS validados y rentables por múltiplos de 3x a 5x de sus ingresos anuales (ARR).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Pruebas unitarias ultrarrápidas con Vitest en proyectos de frontend e IA

    Pruebas unitarias ultrarrápidas con Vitest en proyectos de frontend e IA

    Hace un tiempo audité el repositorio de un proyecto en React y TypeScript que contaba con una suite de 400 pruebas unitarias en Jest. Cada vez que lanzabas npm test, tardaba 4 minutos y 15 segundos en completar la ejecución.

    Los desarrolladores habían dejado de ejecutar los tests en local. Su flujo de trabajo era hacer git push y esperar a que el servidor de integración continua (CI) les dijera 10 minutos después si habían roto algo.

    La fricción era enorme.

    Cuando reemplazamos Jest por Vitest y optimizamos el entorno de DOM con happy-dom, la misma suite de 400 tests pasó de tardar 4 minutos a completarse en 7.8 segundos.

    En la era del desarrollo acelerado con IA, tener un feedback loop de testing instantáneo no es un lujo; es el único pilar que te permite iterar rápido sin destruir producción.

    El problema de Jest en proyectos modernos (Vite / ESM)

    Jest fue el rey indiscutible de las pruebas en JavaScript durante casi una década. Sin embargo, su arquitectura arrastra decisiones de diseño pasadas:

    • Utiliza transformadores pesados en Babel/ts-jest que recompilan todo tu código TypeScript en CommonJS antes de ejecutar cada test.
    • La emulación del DOM con jsdom consume gigabytes de memoria Heap en proyectos medianos.
    • La ejecución en Watch mode rehace trabajo redundante de empaquetado.

    Vitest aprovecha la arquitectura moderna de Vite y esm.sh: usa el mismo pipeline de transformación de tu aplicación en desarrollo, comparte la configuración de alias e importaciones y aprovecha hilos de ejecución paralelos en Node.js de forma nativa.

    Configuración de Vitest para Frontend e IA

    Instalar Vitest en un proyecto moderno requiere un archivo de configuración mínimo (vitest.config.ts):

    import { defineConfig } from 'vitest/config';
    
    export default defineConfig({
      test: {
        environment: 'happy-dom', // Mucho más rápido y ligero que jsdom
        globals: true,
        setupFiles: ['./src/test/setup.ts'],
        include: ['src/**/*.{test,spec}.ts'],
        coverage: {
          provider: 'v8',
          reporter: ['text', 'json', 'html'],
        },
      },
    });
    

    Cómo mockear llamadas a Modelos de IA (LLMs) sin gastar tokens

    Cuando pruebas código que interactúa con APIs de IA (como Anthropic Claude, OpenAI o Vercel AI SDK), jamás debes realizar peticiones HTTP reales dentro de tus tests unitarios. Lanzarías la factura de tokens por las nubes y harías que tus tests sean no deterministas.

    Ejemplo de Mockeo Limpio con vi.mock()

    import { describe, it, expect, vi } from 'vitest';
    import { procesarRespuestaIA } from './ai-processor';
    
    // 1. Mockear la librería cliente de IA
    vi.mock('@anthropic-ai/sdk', () => {
      return {
        Anthropic: vi.fn().mockImplementation(() => ({
          messages: {
            create: vi.fn().mockResolvedValue({
              content: [{ type: 'text', text: 'Respuesta mockeada de prueba' }],
            }),
          },
        })),
      };
    });
    
    describe('Procesador de IA', () => {
      it('debe transformar la respuesta de la IA en una estructura válida', async () => {
        const resultado = await procesarRespuestaIA('Prompt de prueba');
        
        expect(resultado.ok).toBe(true);
        expect(resultado.texto).toBe('Respuesta mockeada de prueba');
      });
    });
    

    Al aplicar programación defensiva en TypeScript, garantizas que tus mocks cumplan exactamente con los contratos de tipos de las librerías originales.

    3 Principios para Suites de Test Ultrarrápidas

    1. Usa happy-dom en lugar de jsdom: happy-dom implementa las APIs del navegador necesarias para componentes de UI ocupando un 70% menos de memoria y ejecutando tests hasta 3 veces más rápido.
    2. Aísla las capas de tu aplicación: Separa los tests de unidades puras (funciones de dominio y utilidades) de los tests de componentes de UI. Al igual que recomendamos en nuestra guía sobre graph engineering, mantener fronteras claras evita inicializaciones innecesarias.
    3. No intentes testearlo todo: En nuestro análisis sobre cuándo NO usar Spec-Driven Development, recordamos que el objetivo de las pruebas es dar confianza en cambios de producción, no alcanzar el 100% de cobertura en código trivial sin valor de negocio.

    La velocidad de ejecución de tus pruebas unitarias determina el ritmo al que tu equipo puede innovar y refactorizar con seguridad.

    Si quieres aprender a construir pipelines de testing modernos e integraciones con IA, descubre los Cursos de Dominicode. Y si quieres colaborar en proyectos reales de alto nivel con desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Es dificil migrar una suite existente de Jest a Vitest?

    No. Vitest incluye compatibilidad casi al 100% con las APIs de Jest (describe, it, expect, jest.fn() -> vi.fn()). En la mayoría de los proyectos basta con sustituir la importación y la configuración de jest.config.js por vitest.config.ts.

    ¿Se pueden ejecutar tests de Vitest en modo Watch continuo durante el desarrollo?

    Sí. El modo Watch de Vitest es uno de sus puntos más fuertes: gracias al HMR de Vite, solo reejecuta en milisegundos los tests directamente afectados por el archivo que acabas de modificar en tu editor.

    ¿Cómo pruebo componentes que utilizan hooks o reactividad de framework?

    Vitest se integra perfectamente con @testing-library/react, @testing-library/angular o @testing-library/vue, permitiéndote probar la interacción del usuario con componentes de UI usando la misma sintaxis que ya conoces.

    ¿Vitest funciona en proyectos que no usan Vite como empaquetador principal?

    Sí. Aunque Vitest brilla especialmente en proyectos basados en Vite (como Nuxt, Astro, SvelteKit o React con Vite), puede configurarse y funcionar perfectamente en cualquier proyecto de Node.js o TypeScript independiente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • La arquitectura moderna de Angular en 2026: Cómo los Signals y Signal Forms cambiaron el juego

    La arquitectura moderna de Angular en 2026: Cómo los Signals y Signal Forms cambiaron el juego

    Hace un par de años revisé una aplicación empresarial desarrollada en Angular 14. Tenía más de 80 componentes. Para sincronizar dos campos de un formulario y calcular un total dinámico, el equipo había montado un laberinto de BehaviorSubject, combineLatest, operadores de RxJS como distinctUntilChanged y tuberías async por todas partes.

    Cualquier cambio menor requería tocar 4 archivos distintos. Los desarrolladores pasaban más tiempo luchando contra fugas de memoria por suscripciones no canceladas que construyendo funcionalidades de negocio.

    Cuando refactorizamos esa misma aplicación a las versiones modernas de Angular basándonos en Signals y Signal Forms, eliminamos el 45% del boilerplate y la velocidad de renderizado en el navegador se disparó.

    Angular ha cambiado radicalmente. Si sigues programando en Angular como lo hacías en 2020, te estás perdiendo la mayor revolución de usabilidad en la historia del framework.

    El problema histórico: RxJS en la capa de UI

    RxJS es una librería extraordinaria para manejar eventos asíncronos complejos como websockets, streams de datos o cancelación de peticiones HTTP.

    Sin embargo, usar RxJS para gestionar el estado reactivo simple dentro de un componente de UI era una mala decisión forzada por las limitaciones del framework anterior:

    • Tenías que lidiar con la subscripción y desuscripción explícita (takeUntilDestroyed, async pipe).
    • Zone.js tenía que comprobar el árbol completo de componentes ante cualquier evento, provocando ciclos de detección de cambios innecesarios.
    • La sintaxis resultaba verbosa y confusa para desarrolladores que venían de otros ecosistemas.

    Con el rápido ciclo de releases de Angular, el equipo del framework ha introducido un modelo reactivo síncrono, directo y ultrarrápido: los Signals.

    El nuevo paradigma: Grafo Reactivo con Signals

    En la arquitectura moderna de Angular, la reactividad síncrona dentro del componente se gestiona mediante tres primitivas fundamentales:

    1. signal() (Estado primario)

    Representa un valor reactivo mutable. Al modificar su valor, Angular sabe exactamente qué nodo del DOM depende de él y actualiza únicamente ese elemento.

    const cantidad = signal<number>(1);
    const precioUnitario = signal<number>(25);
    

    2. computed() (Estado derivado)

    Calcula automáticamente un nuevo valor en función de otros signals. Es perezoso (lazy) y memoriza su resultado (memoized), por lo que solo se reevalúa cuando uno de sus signals dependientes cambia.

    const total = computed(() => cantidad() * precioUnitario());
    

    3. effect() (Efectos secundarios)

    Se ejecuta cuando los signals leídos en su interior cambian.

    • Regla de oro de arquitectura: Jamás uses effect() para modificar otro signal o para lógica de negocio. Reservalo exclusivamente para sincronización externa (ej. guardar en localStorage, emitir eventos a librerías de terceros o analytics).

    Como recalcamos en nuestras guías de programación defensiva en TypeScript, tipar de forma estricta los valores de tus signals previene errores de estado en tiempo de ejecución.

    Signal Forms y Zoneless: El salto definitivo

    Dos de las piezas más esperadas en el ecosistema moderno son la integración de Signal Forms y el soporte nativo para aplicaciones Zoneless (sin Zone.js).

    Zoneless Angular

    Al basar la UI en Signals, Angular ya no necesita Zone.js para "mono-patrullar" los eventos del navegador (clicks, timers, peticiones HTTP). El framework sabe con precisión quirúrgica qué componente y qué nodo del DOM ha cambiado. El resultado es un consumo de memoria mínimo y un arranque instantáneo.

    El rol actual de RxJS

    RxJS no ha muerto ni va a desaparecer. La regla de arquitectura actual es sencilla:

    • Estado de UI y componentes: Usa 100% Signals (signal, computed, input, output).
    • Eventos asíncronos complejos y HTTP: Usa RxJS (HttpClient, debounceTime, switchMap) y conviértelo a Signal en la frontera del componente mediante toSignal().
    // Integración perfecta: RxJS hacia la API, Signal hacia la plantilla
    readonly usuarios = toSignal(this.userService.getUsuarios(), { initialValue: [] });
    

    La arquitectura moderna de Angular es más limpia, más rápida de aprender y infinitamente más fácil de mantener que en versiones anteriores.

    Si quieres dominar el desarrollo frontend moderno y la integración con herramientas de IA, descubre los Cursos de Dominicode. Y si quieres aplicar estas arquitecturas en proyectos reales de producción, te invitamos a sumarte a Dominicode Labs.

    Preguntas frecuentes

    ¿Debo migrar todos mis BehaviorSubject a Signals inmediatamente?

    No es necesario hacer una migración destructiva de golpe. Puedes mantener tu capa de servicios en RxJS e ir adoptando toSignal() y signal() en la capa de componentes de forma progresiva.

    ¿Cuándo debo usar RxJS en lugar de Signals?

    Utiliza RxJS cuando necesites coordinar múltiples eventos asíncronos en el tiempo (por ejemplo, autocompletados con debounceTime, polling periódico, cancelación de peticiones anteriores con switchMap o gestión de WebSockets).

    ¿Cómo afecta el uso de Signals al SEO y SSR en Angular?

    Los Signals mejoran el rendimiento de Server-Side Rendering (SSR) y Hydration ya que reducen la sobrecarga de evaluación de cambios en el servidor y permiten una hidratación parcial ultrarrápida en el cliente.

    ¿Qué versión de Angular se recomienda para trabajar con Signals de forma estable?

    Signals se introdujo como developer preview en Angular 16 y alcanzó estabilidad en Angular 17/18. Para contar con APIs maduras como input(), output(), model() y Signal Forms se recomienda usar Angular 19/20+.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Clean Architecture en Frontend: Cómo estructurar tus aplicaciones para sobrevivir a la era de la IA

    Clean Architecture en Frontend: Cómo estructurar tus aplicaciones para sobrevivir a la era de la IA

    Hace unos meses audité una aplicación de un cliente que tenía más de 50 componentes. Cuando abrí el archivo de un simple formulario de checkout, me encontré con 750 líneas de código: llamadas directas a fetch, manipulación de tokens de autenticación, formateo de fechas, cálculo de impuestos y renderizado visual de botones. Todo apretado en el mismo sitio.

    El cliente me decía frustrado: "Intentamos usar agentes de IA para añadir un nuevo método de pago y el agente rompe la aplicación entera cada vez".

    El problema no era la herramienta de IA. El problema es que los modelos de lenguaje necesitan fronteras claras para no perderse. Cuando mezclas UI, estado y lógica de negocio en una bola de barro, obligas a la IA a interpretar miles de líneas irrelevantes para hacer un cambio trivial.

    Clean Architecture en frontend no es un capricho teórico. Es la única forma de construir aplicaciones mantenibles que tanto los humanos como los agentes de IA puedan modificar sin romper producción.

    El problema del espagueti en la capa de presentación

    Durante años nos enseñaron que organizar una app frontend consistía en crear carpetas como /components, /services y /utils.

    Esa estructura por "tipo de archivo" suele degenerar en componentes gigantescos que contienen:

    • Lógica de UI (animaciones, estados de modales, hovers).
    • Lógica de Negocio (validación de carritos, cálculo de descuentos, reglas de usuario).
    • Lógica de Infraestructura (llamadas a la API HTTP, almacenamiento en localStorage).

    Cuando un agente de IA intenta refactorizar o añadir una funcionalidad a un componente así, el resultado son alucinaciones, código duplicado y efectos secundarios inesperados. Como demostramos en nuestro post sobre programación defensiva en TypeScript, la falta de contratos claros es la causa principal de fallos silenciosos.

    Las 3 Capas de Clean Architecture en Frontend

    Para que una aplicación frontend sea desacoplada y amigable para el desarrollo asistido por IA, debemos dividir el proyecto en tres capas concéntricas con reglas de dependencia estrictas:

    ┌─────────────────────────────────────────────────────────┐
    │ Presentación (React / Angular / Vue Components)         │
    │  └─► Llaman a Casos de Uso                             │
    │     ┌───────────────────────────────────────────────────┐
    │     │ Dominio (Entities, Use Cases, Interfaces Repos)   │
    │     │  └─► Cero dependencias externas o de UI           │
    │     └───────────────────────────────────────────────────┘
    │  ┌──────────────────────────────────────────────────────┐
    │  │ Infraestructura (HTTP Repositories, LocalStorage)    │
    │  │  └─► Implementan las Interfaces del Dominio          │
    │  └──────────────────────────────────────────────────────┘
    └─────────────────────────────────────────────────────────┘
    

    1. Capa de Dominio (El Corazón de tu App)

    Contiene las Entidades y los Casos de Uso pura lógica de TypeScript.

    • Regla de oro: No importa qué framework estés usando. La capa de dominio NO debe importar nada de React, Angular, Vue o librerías HTTP.
    • Ejemplo: CalcularDescuentoUseCase, UsuarioEntity, CarritoInterface.

    2. Capa de Infraestructura (Conexiones Externas)

    Implementa las interfaces definidas por el dominio para interactuar con APIs externas, bases de datos o servicios del navegador.

    • Ejemplo: UserHttpRepository que implementa UserRepository, clientes Axios/Fetch, adaptores de localStorage.

    3. Capa de Presentación (Vista e Interacción)

    Se limita a pintar los datos y capturar eventos del usuario. Sus componentes invocan los Casos de Uso y reaccionan al estado presentado.

    • Ejemplo: Componentes visuales, señales/hooks de estado UI, botones, maquetación.

    Por qué esta arquitectura multiplica la velocidad de la IA

    Cuando tu aplicación sigue Clean Architecture, trabajar con asistentes como Claude Code o Cursor se vuelve ridículamente eficiente:

    1. Prompting aislado: Si necesitas cambiar una regla de negocio (ej. "los clientes VIP tienen un 15% de descuento en lugar del 10%"), solo le pides a la IA que modifique el archivo CalcularDescuentoUseCase.ts. La IA no toca ni un solo archivo de UI.
    2. Generación automática de Tests: Probar un Caso de Uso puro de TypeScript no requiere renderizar componentes ni simular el DOM (jsdom/happy-dom). La IA puede escribir y validar 20 unit tests puramente lógicos en 5 segundos.
    3. Sustitución de UI sin riesgo: Puedes pedirle a un agente de IA que rediseñe un componente visual entero desde cero, sabiendo que la lógica de negocio subyacente permanecerá intacta.

    Como explicamos al analizar el graph engineering, proporcionarle a la IA un mapa claro de dependencias previene que introduzca acoplamientos indeseados.

    Y recuerda: aunque Clean Architecture aporta enormes beneficios en apps de tamaño mediano y grande, en nuestra guía sobre cuándo NO usar Spec-Driven Development analizamos los casos de uso donde soluciones más simples resultan más recomendables.


    Separar las responsabilidades de tu código no es solo una buena práctica de ingeniería; es la mejor inversión para escalar aplicaciones en la era de los agentes autónomos.

    Si quieres aprender a diseñar arquitecturas robustas y escalables desde cero, échale un vistazo a los Cursos de Dominicode. Y si quieres construir proyectos complejos en un entorno colaborativo de alto nivel, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿No añade Clean Architecture demasiada sobrecarga de archivos en proyectos pequeños?

    Para proyectos tipo "landing page" o prototipos simples de pocas semanas, Clean Architecture puede resultar excesiva. Sin embargo, para aplicaciones que van a vivir en producción durante años o mantenidas por equipos, el ahorro en mantenimiento compensa con creces la estructura inicial.

    ¿Dónde encaja la gestión de estado (Redux, NgRx, Zustand, Signals)?

    La gestión de estado vive en la capa de Presentación/UI. Los stores o señales consumen los Casos de Uso del Dominio y exponen el estado procesado a los componentes visuales.

    ¿Cómo interactúa el Dominio con las llamadas a la API sin importar HTTP Client?

    El Dominio define una interfaz abstracta (ej. export interface UserRepository { getById(id: string): Promise<User>; }). La Capa de Infraestructura implementa esa interfaz con llamadas HTTP reales mediante inyección de dependencias.

    ¿Por qué los agentes de IA entienden mejor la Clean Architecture?

    Porque los límites de responsabilidad están definidos a nivel de carpetas y contratos. La IA no tiene que adivinar dónde termina la lógica de interfaz y dónde empieza la validación de negocio.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.