Tag: JavaScript

  • Event loop de Node: por qué tu agente de IA se bloquea

    Event loop de Node: por qué tu agente de IA se bloquea

    El agente llevaba cuarenta segundos streameando tokens sin cortes. Tool call, chunk, tool call, chunk. Perfecto. Hasta que dejó de responder.

    No hubo excepción ni error en consola. El proceso seguía vivo, la conexión seguía abierta, pero pasaron seis segundos sin que saliera un token más. El cliente que consumía el streaming asumió que el agente había muerto y cortó la conexión.

    No fue un timeout de red ni un capricho del LLM. Fue el event loop de Node haciendo lo que tiene que hacer: ejecutar, en orden, una sola cosa a la vez. Esa "una cosa" era un JSON.parse() de una respuesta de herramienta de 30MB — y mientras corría, nada más en el proceso podía avanzar: ni el siguiente chunk del stream, ni la siguiente tool call.

    Si construyes agentes en Node o TypeScript y no entiendes el event loop por dentro, esto te va a pasar. No es una posibilidad remota: es casi garantizado en cuanto metes trabajo síncrono pesado en el proceso que gestiona streaming y llamadas concurrentes a un LLM.

    En corto: el event loop de Node es el mecanismo de un solo hilo que decide, en fases fijas (timers, pending callbacks, poll, check, close callbacks), qué callback se ejecuta a continuación — nunca dos a la vez. Un agente de IA en Node se bloquea cuando metes trabajo síncrono pesado (un JSON.parse() enorme, un regex con backtracking catastrófico, cifrado síncrono) en el mismo proceso que debería atender el siguiente chunk de streaming o la siguiente tool call. La solución no es "más async/await": es sacar ese trabajo del hilo principal con worker_threads o particionarlo.

    ¿Qué es el event loop de Node?

    El event loop de Node es el bucle de un solo hilo que ejecuta tu código JavaScript, atiende callbacks y delega el trabajo de I/O a libuv, la librería en C que implementa la asincronía de la plataforma.

    Node ejecuta JavaScript en un único hilo — el call stack solo puede tener una función corriendo a la vez. Lo que parece "concurrencia" (leer un archivo, una petición HTTP, esperar al LLM) no lo hace ese hilo: lo delega a libuv, que usa el sistema operativo y, para algunas operaciones, un pool de hilos interno.

    Cuando el trabajo termina, libuv encola el callback para que el hilo principal lo ejecute cuando le toque.

    La palabra clave es "cuando le toque". El event loop decide ese turno recorriendo fases fijas, una y otra vez, mientras el proceso siga vivo.

    Las fases del event loop (y qué las bloquea)

    Cada vuelta del loop pasa por estas fases, en este orden. La documentación oficial de Node las describe así:

    Fase Qué ejecuta Qué la bloquea
    Timers Callbacks de setTimeout() y setInterval() cuyo umbral ya venció Cualquier callback anterior que tarde más que el timer programado
    Pending callbacks Callbacks de I/O diferidos (p. ej. errores TCP tipo ECONNREFUSED) Trabajo síncrono pesado en la fase anterior que retrasa la llegada aquí
    Poll Recupera eventos de I/O nuevos y ejecuta casi todos sus callbacks; aquí Node espera si no hay nada más que hacer Un callback de I/O que hace trabajo síncrono en vez de delegar y devolver el control
    Check Callbacks de setImmediate(), tras la fase de poll Cualquier callback de poll que no suelte el hilo
    Close callbacks Eventos de cierre, como socket.on('close', ...) Casi nunca — es la fase más ligera

    process.nextTick() no es una fase del loop: su cola se vacía después de cada operación, sin importar la fase, y antes de la cola de microtasks de las Promises. Encadenarlo de forma recursiva puede "matar de hambre" al loop y evitar que llegue a poll — riesgo que documenta la propia guía de Node.

    Dato para quien ya conocía esto: desde libuv 1.45.0 (Node 20), los timers corren después de poll en cada vuelta, no antes como en versiones previas, con una excepción solo en la primera vuelta, por compatibilidad.

    Microtasks vs macrotasks: quién corre primero

    setTimeout, setImmediate y los callbacks de I/O son macrotasks: cada uno corre en su fase. Las Promises son microtasks: su cola se vacía completa entre cada macrotask, y process.nextTick() tiene prioridad incluso sobre esa cola.

    Fuera de un callback de I/O, el orden entre setTimeout(fn, 0) y setImmediate() no está garantizado — depende de cuánto tarde el proceso en arrancar. Dentro de uno sí lo está, porque ya veniste de la fase de poll y check es la siguiente parada:

    const fs = require('node:fs');
    
    fs.readFile(__filename, () => {
      setTimeout(() => console.log('timeout'), 0);
      setImmediate(() => console.log('immediate'));
      Promise.resolve().then(() => console.log('promise'));
      process.nextTick(() => console.log('nextTick'));
    });
    
    // orden garantizado aquí: nextTick, promise, immediate, timeout
    

    Esto no es trivia de entrevista. Es lo que determina si tu agente procesa el siguiente evento a tiempo o lo deja esperando en cola.

    Por qué tu agente de IA se cuelga a mitad de un streaming

    Un loop agéntico en Node hace, en el mismo proceso, tres cosas que compiten por el mismo hilo: recibe chunks del stream del LLM, ejecuta tool calls y a veces atiende varias conversaciones a la vez. Si metes ahí una operación síncrona pesada, todo lo demás espera.

    Los tres culpables más comunes:

    • JSON.parse() de payloads enormes. Un resultado de herramienta con miles de filas puede tardar cientos de milisegundos en parsear, y ese tiempo es tiempo sin avance del stream. La guía oficial "Don't Block the Event Loop" confirma que JSON.parse() y JSON.stringify() son costosas sobre estructuras grandes.
    • Regex con backtracking catastrófico. Si validas los argumentos de una tool call con un regex mal escrito, un input adversarial puede volverlo exponencial — la misma guía lo señala como vector de ReDoS.
    • Cifrado síncrono. Las variantes Sync de node:crypto bloquean el hilo principal; las asíncronas delegan al pool de libuv. Esa diferencia es la que hay entre un agente que responde y uno que se congela.

    Esto no es hipotético. En el issue #75882 de OpenClaw — una gateway de agentes en Node 22 — el event loop se quedó estancado entre 10 y 170+ segundos, con un pico registrado de eventLoopDelayMaxMs=171798.7. El reportante lo atribuye a trabajo síncrono y locks de archivo al guardar sesión, sin que el issue confirme la causa exacta.

    Lo que sí es un hecho documentado es el resultado: mensajes de WhatsApp sin respuesta y sesiones colgadas más de 594 segundos. El síntoma no era "el LLM tardó" — era el hilo único, ocupado en otra cosa.

    La solución no es cambiar de lenguaje. Es sacar el trabajo pesado del hilo principal:

    import { Worker } from 'node:worker_threads';
    
    function parseToolResultInWorker(raw: string): Promise<unknown> {
      return new Promise((resolve, reject) => {
        const worker = new Worker('./json-parser.worker.js', { workerData: raw });
        worker.once('message', (result) => { worker.terminate(); resolve(result); });
        worker.once('error', (err) => { worker.terminate(); reject(err); });
      });
    }
    

    Validar los argumentos de una tool call con un schema declarativo, en vez de un regex a mano, elimina el riesgo de ReDoS de raíz — es el tipo de validación que cubrimos en el curso de Zod para TypeScript: defines el shape, Zod hace el parseo.

    Si ya usas streaming por SSE, esta arquitectura con Hono y Bun muestra cómo mantener vivo el flujo de chunks. Y si el loop crece, compara el while loop clásico contra un grafo de estados con LangGraph: un grafo no arregla el bloqueo, pero obliga a aislar cada paso — y eso facilita detectar cuál bloquea.

    Cuando ese JSON.parse() lo escribió un agente y no tú, revisarlo antes de aceptar el PR importa más — es justo el chequeo que cubre el método Revisión por Contrato: qué debe cumplir el código antes de fiarte de que "compila y pasa los tests".

    Cuándo el event loop NO es tu problema

    Entender el event loop no convierte cada lentitud en un problema de hilo bloqueado. Hay al menos tres casos donde pelear con el single thread es la respuesta equivocada:

    1. La latencia es del proveedor del LLM, no de tu proceso. Si el modelo tarda 3 segundos en devolver el primer token, eso es I/O de red esperando respuesta externa — el loop está libre mientras espera. Optimizar tu código no acelera la infraestructura de OpenAI o Anthropic.
    2. Necesitas paralelismo real de CPU, no solo no bloquear. Generar embeddings de miles de documentos no se arregla con async/await — un solo hilo sigue siendo un solo hilo. Ahí la respuesta es worker_threads, un cluster de procesos, o un servicio aparte.
    3. El cuello de botella es una dependencia con bindings síncronos por diseño. Si tu persistencia hace locks de archivo entre sesiones concurrentes, como en el issue de OpenClaw, el fix no es "entender mejor el loop": es cambiar de estrategia de persistencia.

    Confundir estos casos con "necesito entender mejor el event loop" es la forma más común de perder una tarde sin resolver nada.

    Qué hacer hoy

    Busca en tu agente cualquier JSON.parse(), .sync( o regex sobre datos del LLM o de una tool call. Si puede tardar más de unos milisegundos, sácalo del hilo principal con worker_threads, o mide primero con perf_hooks.monitorEventLoopDelay() antes de reescribir nada.

    Si construyes tu propio agente de producción, en Construye con IA trabajamos estas decisiones de arquitectura antes de que se conviertan en un incidente. Y en Dominicode Labs discutimos patrones de producción como este cada semana.

    Preguntas frecuentes

    ¿Node.js es de un solo hilo, entonces no puede hacer nada en paralelo?

    Tu código corre en un solo hilo, pero Node delega I/O (red, disco, algo de crypto) a libuv, que usa un pool de hilos internamente — eso da concurrencia, no paralelismo real de CPU. Para paralelismo de verdad hacen falta worker_threads, procesos separados o un servicio externo.

    ¿process.nextTick() es lo mismo que una promesa (microtask)?

    No. Ambos corren antes que el siguiente macrotask, pero process.nextTick() tiene prioridad: su cola se vacía primero, y solo después la de microtasks de las Promises. Abusarlo de forma recursiva puede impedir que el loop llegue nunca a poll.

    ¿Cómo detecto en producción que mi agente está bloqueando el event loop?

    Usa perf_hooks.monitorEventLoopDelay(), incluido en Node, para medir el delay real sin instrumentación externa — si el max o el p99 se disparan al procesar resultados grandes, ahí está la pista. Clinic.js o un flame graph con --prof dan el detalle de qué función es la culpable.

    ¿worker_threads resuelve todos los problemas de bloqueo en un agente?

    No todos. Resuelve el trabajo de CPU pesado y determinista (parseo, validación, cifrado). No resuelve la latencia de red hacia el LLM, ni bugs donde una promesa nunca se resuelve y el agente queda colgado — eso es un problema de diseño del loop agéntico, no del event loop de Node.

    ¿Bun o Deno tienen el mismo problema de event loop que Node?

    El modelo de un solo hilo ejecutando JavaScript es el mismo en los tres runtimes. Cambia la implementación de I/O: Node usa libuv en todas las plataformas; Bun tiene su propia capa sobre epoll en Linux y kqueue en macOS, y solo recurre a libuv en Windows. Deno, por su parte, delega la parte async en Tokio. Pero un JSON.parse() gigante bloquea el hilo principal igual en los tres.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo funcionan los hooks de React por dentro: Fiber y orden

    Cómo funcionan los hooks de React por dentro: Fiber y orden

    El PR venía con una nota: "optimización menor". Dentro, un useState movido dentro de un if, porque ese estado solo hacía falta si el usuario era admin. Tenía su lógica: para qué reservar memoria de algo que el 95% de la gente no usa.

    El lint saltó. El autor lo silenció con un // eslint-disable-next-line. Dos días después la app reventó: Rendered fewer hooks than expected.

    Entender cómo funcionan los hooks de React por dentro no es curiosidad académica: es lo que vuelve evidente esa regla. Porque "no llames hooks dentro de condicionales" la obedece todo el mundo sin saber por qué existe, y una regla que obedeces por fe acabas rompiéndola.

    No es un capricho del equipo de React. Es la consecuencia directa de dónde está guardado tu estado.

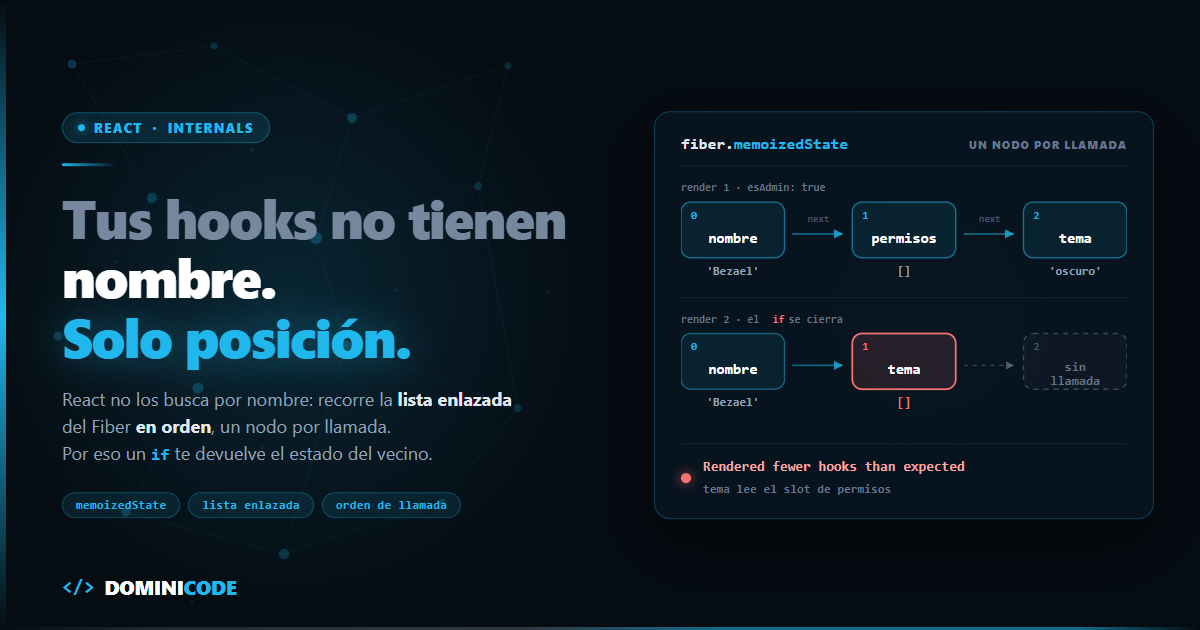
    En corto: tu estado no vive en la función del componente, vive en el nodo Fiber que React mantiene por cada instancia montada, dentro de una lista enlazada que cuelga del campo memoizedState. React no guarda el nombre de cada hook: recorre esa lista en orden, un nodo por llamada. Si el orden cambia entre renders, React entrega el estado equivocado a la llamada equivocada.


    ¿Qué es un hook de React por dentro?

    Un hook es una entrada de una lista enlazada asociada a un nodo Fiber: un objeto de cinco campos —memoizedState, baseState, baseQueue, queue y next— que React crea en el primer render y recupera por posición en todos los siguientes.

    No es una metáfora. Es el tipo literal, tal cual está en packages/react-reconciler/src/ReactFiberHooks.js:

    export type Hook = {
      memoizedState: any,
      baseState: any,
      baseQueue: Update<any, any> | null,
      queue: any,
      next: Hook | null,
    };
    

    Y en el mismo fichero, un comentario que ahorra media hora de lectura: "Hooks are stored as a linked list on the fiber's memoizedState field."

    Ojo con la trampa de nombres. En el Fiber, memoizedState apunta al primer hook de la lista. En cada Hook, memoizedState guarda el valor de ese hook concreto. Mismo nombre, dos niveles distintos.

    Un Fiber es el objeto que React mantiene por cada elemento del árbol —componente, nodo del DOM o fragmento— y que guarda su estado, el trabajo pendiente y su posición en el árbol; React 16 lo introdujo en 2017 para poder pausar, abandonar y reanudar el renderizado. Con su puntero alternate al Fiber del render anterior, es lo que sobrevive entre renders. Tu componente solo se ejecuta y muere.

    Por qué el orden de llamada de los hooks de React lo es todo

    Si React guarda los hooks en una lista y no guarda nombres, solo le queda una manera de saber cuál te toca: contar.

    La forma más rápida de que haga clic es escribir la versión de juguete. Ojo — es una simplificación pedagógica: React usa una lista enlazada por Fiber, no un array global. La identidad por posición, en cambio, funciona igual.

    // useState casero. React usa una lista enlazada por Fiber, no un array global:
    // esto es una simplificación para ver el mecanismo del orden.
    let hooks = [];
    let cursor = 0;
    
    function useState(initialValue) {
      const index = cursor; // esta llamada se queda con esta posición
      cursor++;             // la siguiente cogerá la siguiente
    
      if (!(index in hooks)) {
        hooks[index] = initialValue; // primer render: monta
      }
    
      const setState = (next) => {
        // igual que basicStateReducer en React: si es función, la aplica
        hooks[index] = typeof next === 'function' ? next(hooks[index]) : next;
        render();
      };
    
      return [hooks[index], setState];
    }
    
    function render() {
      cursor = 0;  // el cursor vuelve a cero al empezar cada render
      Component(); // tu componente: React lo vuelve a ejecutar
    }
    

    La línea que importa es cursor = 0: el array persiste, el cursor se reinicia. La identidad de cada hook es su posición en la secuencia de llamadas.

    Ahora mete un condicional en medio:

    function Perfil({ esAdmin }) {
      const [nombre, setNombre] = useState('Bezael');   // índice 0
    
      if (esAdmin) {
        const [permisos] = useState([]);                // índice 1 ... a veces
      }
    
      const [tema, setTema] = useState('oscuro');       // índice 1 o 2, según el día
    }
    

    Primer render con esAdmin: true: se montan tres hooks. nombre en 0, permisos en 1, tema en 2.

    El usuario pierde el rol. Segundo render con esAdmin: false: solo hay dos llamadas, así que tema lee el índice 1 — donde estaba permisos. Durante ese render tu string 'oscuro' es un array vacío, y al terminar el componente React ve que sobraba un hook en la lista y revienta con Rendered fewer hooks than expected: el error del PR de arriba.

    El caso caro es el que no altera el conteo — un if/else con un useState en cada rama. Mismo número de llamadas, ningún error, valor equivocado. React no puede echar en falta lo que no falta.

    Las comprobaciones que sí tiene viven en la propia lista. En updateWorkInProgressHook, si pides un hook que no existía antes:

    throw new Error('Rendered more hooks than during the previous render.');
    

    Y al terminar el render, si faltan hooks respecto a la lista previa, salta el otro: "Rendered fewer hooks than expected. This may be caused by an accidental early return statement." En desarrollo hay además un aviso que compara la secuencia hook a hook: "React has detected a change in the order of Hooks called by…".

    Los tres mensajes que vas a ver, y qué significa cada uno:

    Mensaje Cuándo salta Qué lo causó Dónde vive
    Rendered more hooks than during the previous render. Durante el render Este render pide un hook que el anterior no tenía: el if se abrió updateWorkInProgressHook
    Rendered fewer hooks than expected. This may be caused by an accidental early return statement. Al terminar el render Faltan llamadas respecto a la lista previa: un return temprano o un if que se cerró finishRenderingHooks
    React has detected a change in the order of Hooks called by... Solo en __DEV__ Mismo número de hooks, distinto orden: compara la secuencia hook a hook aviso de desarrollo
    (ninguno) Nunca El caso peligroso: el tipo de hook coincide y el valor se corrompe en silencio —

    Esa última fila es la que importa. Los tres errores son el caso amable.

    No fue un accidente que luego hubo que justificar: fue una decisión discutida en público. El RFC de Hooks lo abrió Sebastian Markbåge en octubre de 2018, y Dan Abramov dedicó un artículo entero a las alternativas descartadas, Why Do React Hooks Rely on Call Order? (13 de diciembre de 2018). Sobre identificar hooks por nombre en vez de por posición, escribió:

    "With this proposal, any time you add a new state variable inside a custom Hook, you risk breaking any components that use it (directly or transitively) because they might already use the same name for their own state variables."

    Y sobre por qué tampoco compensaba arreglarlo con más lint: "But if we have to lint anyway, what problem did we solve?".

    Ese es el trueque: React se traga una regla incómoda a cambio de que los custom hooks compongan sin colisiones de nombres.

    Mount y update son dos funciones distintas

    Segunda pieza: useState no es una función. Son dos.

    React no importa useState desde el reconciler. Lo lee de un dispatcher, un objeto que apunta a una implementación u otra según el momento. La línea vive en renderWithHooks, la función que envuelve la ejecución de tu componente:

    ReactSharedInternals.H =
      current === null || current.memoizedState === null
        ? HooksDispatcherOnMount
        : HooksDispatcherOnUpdate;
    

    mountState crea el nodo: reserva el hook, guarda el valor inicial en memoizedState y baseState, monta la cola y ata el dispatch. Ahí está, de paso, por qué el lazy initializer se ejecuta una sola vez: el typeof initialState === 'function' vive dentro de mountStateImpl, y a esa rama no vuelves nunca. updateState no crea nada: recupera el hook por posición y calcula el valor procesando su cola con basicStateReducer.

    El montaje son estas líneas:

    function mountWorkInProgressHook(): Hook {
      const hook: Hook = {
        memoizedState: null, baseState: null,
        baseQueue: null, queue: null, next: null,
      };
    
      if (workInProgressHook === null) {
        // This is the first hook in the list
        currentlyRenderingFiber.memoizedState = workInProgressHook = hook;
      } else {
        // Append to the end of the list
        workInProgressHook = workInProgressHook.next = hook;
      }
      return workInProgressHook;
    }
    

    Hay más dispatchers. Uno es ContextOnlyDispatcher: el famoso "Invalid hook call" no es una comprobación mágica, es que el puntero apunta a un objeto cuyos métodos, salvo use y readContext, solo saben lanzar errores.

    Colas de actualización y comparación de dependencias

    Cuando llamas a setState no pasa casi nada: React crea un objeto Update, lo mete en una cola circular colgada de hook.queue.pending y programa trabajo. El valor nuevo se calcula durante el render.

    Pero hay un atajo que explica un comportamiento confuso. En dispatchSetStateInternal, si la cola está vacía React calcula el estado siguiente antes de renderizar y compara:

    const eagerState = lastRenderedReducer(currentState, action);
    update.hasEagerState = true;
    update.eagerState = eagerState;
    if (is(eagerState, currentState)) {
      // Fast path. We can bail out without scheduling React to re-render.
      enqueueConcurrentHookUpdateAndEagerlyBailout(fiber, queue, update);
      return false;
    }
    

    Por eso setCount(count) con el mismo valor no siempre provoca un render: el atajo solo aplica si la cola estaba vacía. Si ya había algo pendiente, React renderiza igual. Y aun cuando el atajo entra, la documentación avisa de que React puede necesitar ejecutar tu componente una vez antes de saltarse a los hijos.

    La comparación de dependencias de useEffect, useMemo y useCallback es aún más simple. areHookInputsEqual recorre el array posición a posición:

    for (let i = 0; i < prevDeps.length && i < nextDeps.length; i++) {
      if (is(nextDeps[i], prevDeps[i])) {
        continue;
      }
      return false;
    }
    return true;
    

    Ese is viene de shared/objectIs, que es Object.is. Superficial, elemento a elemento, sin recursión. Un objeto literal nuevo en cada render nunca pasa el test, porque Object.is({}, {}) es false. Ahí está la causa de casi todos los "mi efecto se dispara en bucle": un objeto o un array creado en el cuerpo del componente y metido tal cual en el array de dependencias.

    Y ojo con la salida fácil: validar ese objeto tampoco lo estabiliza — cada parse devuelve una referencia nueva. Lo que estabiliza es depender de primitivas (user.id, no user), y para eso necesitas tener escrito el contrato de esos datos: es lo que trabajo en el curso de Zod.

    El stale closure: el bug que no es un bug

    Un stale closure es una función que sobrevive al render en el que nació y sigue leyendo las props y el estado de aquella ejecución concreta, no los actuales. Con el modelo mental montado, el clásico se explica solo:

    function Contador() {
      const [count, setCount] = useState(0);
    
      useEffect(() => {
        const id = setInterval(() => {
          console.log(count);  // siempre 0
          setCount(count + 1); // siempre 0 + 1
        }, 1000);
        return () => clearInterval(id);
      }, []); // el array vacío congela el render nº 1
    }
    

    La callback capturó el count del primer render. No es una referencia a "el estado": es una constante de aquella ejecución de la función. El Fiber avanza; esa closure no.

    No es una rareza, es un roce de diseño que la comunidad llevó al repositorio. En el issue "Design decision: why do we need the stale closure problem in the first place?", abierto por Sébastien Lorber en septiembre de 2019, el argumento era este:

    "Coupling the dependencies of the closure and the conditions to trigger effect re-execution does not make much sense to me."

    Tardó años, pero React acabó dándole parte de razón. Las tres salidas, de más vieja a más nueva:

    1. Updater funcional: setCount(c => c + 1). React aplica tu función sobre el estado real durante el render, no sobre la copia congelada.
    2. Ref: guardas el valor en un useRef y lees ref.current dentro del intervalo.
    3. useEffectEvent, estable desde React 19.2: saca del efecto la parte que lee lo último, sin que ese valor entre en las dependencias.

    useState, useRef y useMemo: la misma caja, distinto contrato

    Los tres guardan cosas en hook.memoizedState. Lo que cambia es qué guardan y quién avisa a React.

    Qué hay en hook.memoizedState Cuándo cambia ¿Provoca render? Límite / riesgo real
    useState El valor y una queue con pending, lastRenderedReducer y lastRenderedState Al procesar la cola durante el render Sí — dispatchSetState programa trabajo Lees un snapshot del render actual, no "el estado ahora". Origen de casi todos los stale closures
    useRef El objeto {current: initialValue}, creado una vez y devuelto siempre Cuando mutas .current, al instante No — React ni se entera Si la UI depende de ese valor, no se repinta. Leerlo en el render rompe la pureza
    useMemo La tupla [valor, deps] Si areHookInputsEqual da false No Es una pista, no una garantía: React puede descartar el cache
    useCallback La tupla [callback, deps] Igual que useMemo No Estabiliza la referencia, no el contenido: sigue capturando los valores de su render

    useRef y useState son la misma caja con distinto contrato frente al render. Y la última columna es la que más cuesta: memorizar no es gratis. mountMemo guarda un array por hook y updateMemo recorre las dependencias en cada render. Si el cálculo cuesta menos que comparar sus dependencias, useMemo te hace la app más lenta y más difícil de leer.

    Los custom hooks de React no tienen magia

    Un custom hook es una función que llama a hooks. Punto. No hay registro, no hay instancia, no hay contexto propio.

    function useUsuario(id) {
      const [datos, setDatos] = useState(null);   // ocupa la siguiente posición libre
      const [cargando, setCargando] = useState(true);
      useEffect(() => { /* ... */ }, [id]);
      return { datos, cargando };
    }
    

    Esos tres hooks se insertan en la lista del componente que llama, en el punto exacto de la secuencia donde estaba la llamada. El cursor no distingue entre "hooks míos" y "hooks del custom hook". Por eso componen sin colisiones: las llamadas a función forman un árbol, y un árbol se recorre en orden.

    Y por eso la regla sube hacia arriba: si metes un if dentro de un custom hook, rompes el orden de todos los componentes que lo usan aunque su código se vea impecable. Para la parte de tipos, lo desmonté aparte en cómo tipar props, hooks y contextos en TypeScript.

    Render y commit: dos fases, y solo una toca el DOM

    La fase de render ejecuta tu función, recorre la lista de hooks y calcula el árbol nuevo. Es interrumpible: React puede empezarla, abandonarla y rehacerla con otra prioridad. Por eso tu componente tiene que ser puro — si escribes en una variable externa durante el render, esa escritura puede ocurrir dos veces o ninguna. Strict Mode ejecuta tu componente dos veces en desarrollo —y monta, desmonta y vuelve a montar los efectos— a propósito para sacar a la luz ese tipo de bug. La fase de commit aplica los cambios al DOM y ejecuta los efectos, y esa no se interrumpe.

    El batching vive entre las dos. Desde React 18, con createRoot, React agrupa todas las actualizaciones antes de renderizar vengan de donde vengan. Dan Abramov lo dejó escrito en la discusión del Working Group de React 18:

    "Until React 18, we only batched updates during the React event handlers. Updates inside of promises, setTimeout, native event handlers, or any other event were not batched in React by default."

    Tres setState dentro de un fetch().then() daban tres renders en React 17. Hoy dan uno. Cómo se coloca ese trabajo en la cola del navegador está en cómo los microtasks afectan a la renderización.

    Contrástalo con el otro modelo mental del frontend actual: un signal guarda el valor en el propio objeto y notifica a quien lo lee; un hook lo guarda en el Fiber y obliga a reejecutar el componente entero. Comparé ambos en cómo funcionan los Signals en Angular 22 y React 19, y esa reactividad granular llevada a producción es la base del curso de Angular Moderno.

    Lo que este modelo mental NO te resuelve

    Es un detalle de implementación, y cambia. Nada de lo que has leído es API pública. Campos como baseQueue, lanes o revertLane llegaron con el modo concurrente y se han movido de sitio más de una vez. Sirve para razonar y depurar; no escribas código que dependa de ello.

    Saber los internals no arregla un useEffect mal planteado. Entender areHookInputsEqual te dice por qué tu efecto se dispara en bucle. No te dice que ese efecto no debería existir. La mayoría de los que reviso son estado derivado que debería calcularse en el render. El array de dependencias es el síntoma, no la enfermedad.

    El React Compiler cambia parte del cálculo. Desde la versión 1.0 estable, del 7 de octubre de 2025, el compilador inserta la memoización en tiempo de build y tu intuición sobre "cuándo compensa un useMemo" deja de aplicarse igual. Ojo con el entusiasmo: la guía oficial recomienda "leaving existing memoization in place (removing it can change compilation output)". El orden de llamada, en cambio, no lo toca — se apoya en él, porque necesita que cumplas las reglas para poder optimizar.

    Qué hacer con esto hoy

    Abre el componente más grande que tengas y cuenta sus hooks. Luego, hook a hook: ¿este valor necesita provocar un render, o me vale un useRef? ¿Este useMemo cuesta más que comparar sus dependencias? ¿Este efecto lee algo del pasado sin darse cuenta? Veinte minutos, y te va a quitar código.

    La próxima vez que alguien proponga meter un hook dentro de un if "porque tiene sentido", ya no tienes que apelar a la autoridad del lint. Le enseñas el cursor y se acabó la discusión.

    Publico desmontajes así cada semana en el canal de YouTube, y el material largo con proyectos completos vive en Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué no puedo llamar a un hook dentro de un if?

    Porque React no identifica los hooks por su nombre, sino por su posición en la secuencia de llamadas. Los guarda en una lista enlazada colgada del campo memoizedState del Fiber y la recorre en orden en cada render.

    Si un condicional hace que una llamada aparezca en un render y no en el siguiente, las posiciones posteriores se desplazan y cada hook recibe el estado del de al lado. React lanza "Rendered more hooks than during the previous render" o "Rendered fewer hooks than expected" en parte de estos casos, pero no en todos: algunos te corrompen el valor en silencio.

    ¿Dónde guarda React el estado de useState exactamente?

    En el nodo Fiber del componente, no en la función. Cada Fiber tiene un campo memoizedState que apunta al primer hook de una lista enlazada, y cada hook es un objeto con los campos memoizedState, baseState, baseQueue, queue y next.

    El valor actual de tu useState vive en el memoizedState de su hook; las actualizaciones pendientes, en una cola circular dentro de queue.pending.

    ¿Qué es un stale closure en React y cómo lo evito?

    Es una función que sobrevive a su render y sigue viendo los valores de props y estado del momento en que se creó. El caso típico es un setInterval dentro de un useEffect con dependencias vacías: la callback capturó el estado del primer render y no lo ve cambiar nunca.

    Tienes tres salidas: la forma funcional de actualizar (setCount(c => c + 1)), un useRef cuyo .current mantienes al día, o useEffectEvent, estable desde React 19.2.

    ¿Cuál es la diferencia real entre useRef y useState?

    La misma caja con distinto contrato. useState guarda el valor y una cola de actualizaciones, y llamar a su setter programa un render. useRef guarda un objeto { current: valor } que React crea una sola vez y devuelve idéntico en todos los renders: mutar .current es instantáneo y React ni se entera.

    Usa useRef para lo que no debe repintar la pantalla y useState para lo que la UI tiene que reflejar.

    ¿Qué es React Fiber?

    Es la arquitectura interna del reconciliador de React desde la versión 16 (2017). Cada elemento del árbol —componente, nodo del DOM, fragmento— tiene su propio objeto Fiber que guarda su estado, el trabajo pendiente y sus punteros al resto del árbol.

    Su razón de ser es que el renderizado se pueda interrumpir: React puede empezar a construir un árbol, abandonarlo a medias y rehacerlo con otra prioridad. El campo memoizedState de cada Fiber es donde cuelga la lista enlazada de hooks de ese componente.

    ¿Por qué mi useEffect se ejecuta en bucle infinito?

    Casi siempre porque una de sus dependencias es un objeto, un array o una función que creas en el cuerpo del componente. React compara las dependencias con areHookInputsEqual, que recorre el array posición a posición usando Object.is: superficial, sin recursión.

    Object.is({}, {}) es false, así que un literal nuevo en cada render nunca pasa el test, el efecto vuelve a ejecutarse, cambia el estado, provoca otro render y vuelta a empezar. Saca el valor fuera del componente, memorízalo, o pregúntate si ese efecto debería existir.

    ¿Qué significa el error "Invalid hook call"?

    Que llamaste a un hook cuando el dispatcher activo era ContextOnlyDispatcher: un objeto cuyos métodos, salvo use y readContext, solo saben lanzar ese error. No hay detección mágica, hay un puntero apuntando al sitio equivocado.

    Pasa en tres situaciones: llamar al hook fuera de un componente o custom hook, tener dos copias de React en el árbol de dependencias, o una desincronización entre react y react-dom.

    ¿Puedo confiar en estos internals para escribir código?

    No. Nada de esto es API pública y el reconciler se reescribe cada pocas versiones: para escribir código, la fuente sigue siendo la documentación oficial y el plugin de ESLint.

    El valor de conocer los internals es otro: depurar más rápido, entender los mensajes de error y dejar de obedecer las reglas por fe.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • timingSafeEqual: por qué comparar secretos con === te delata

    timingSafeEqual: por qué comparar secretos con === te delata

    Escribí una función de comparación byte a byte. Sin ramas, sin salida temprana, acumulando las diferencias con un OR bit a bit.

    La medí con un millón de iteraciones. La desviación salió plana. Tiempo constante en JavaScript, pensé. Di la librería por buena, quité el crypto.timingSafeEqual que tenía puesto de parche y seguí con otra cosa.

    Meses después, perfilando algo que no tenía nada que ver, vi las primeras llamadas a esa función en la traza. Tardaban lo que no tenían que tardar. No un poco más: otra escala.

    Ahí entendí lo que había medido en realidad. Mi benchmark ejecutaba la versión que V8 había optimizado después de miles de llamadas.

    El atacante mide la primera.

    Ese es todo el problema, y no tiene arreglo dentro del lenguaje: no puedes escribir código de tiempo constante en JavaScript puro. No porque tu algoritmo esté mal. Porque V8 tiene permiso para reescribirlo. El código que tú escribes no es el código que se ejecuta, y en criptografía esa diferencia tiene nombre: vulnerabilidad.

    El ataque de temporización, en treinta segundos

    Un ataque de temporización es una técnica de canal lateral que deduce un secreto midiendo cuánto tarda el servidor en rechazarlo: no lee el token, cronometra el rechazo. Una comparación en tiempo constante es la que tarda lo mismo pase lo que pase con los datos, falle el primer byte o el último. Los === de JavaScript no lo son.

    Cuando escribes secret === input, V8 no compara letra por letra desde el principio. Toma varios atajos antes.

    Primero mira si los dos operandos son el mismo objeto en memoria: misma dirección, true inmediato. Si los dos son strings internalizadas y las direcciones no coinciden, devuelve false sin leer un solo byte — para eso sirve internalizar.

    Si no hay atajo entra en la comparación lenta, y ahí el orden real es: longitudes distintas, false inmediato; si las dos tienen el hash ya calculado y no coincide, false inmediato; y si sobrevive a eso, compara el primer carácter antes siquiera de aplanar las cadenas. Está tal cual en String::SlowEquals y SlowEqualsNonThinSameLength, en src/objects/string.cc.

    Solo entonces recorre el resto, y no byte a byte: por bloques, con memcmp o con SIMD, saliendo en cuanto un bloque no cuadra.

    Esa cadena de salidas tempranas es la fuga. Un token con la longitud mal se rechaza antes que uno con la longitud bien. Uno que falla el primer carácter se rechaza antes que uno que lo acierta. La diferencia es de nanosegundos y el ruido de red se la come, pero el ruido de red es aleatorio y la señal no. Con suficientes muestras, la media separa las dos poblaciones.

    Se filtra la longitud. Se filtra el prefijo. Bloque a bloque, se reconstruye el secreto.

    El arreglo que todos escribimos

    Esta función la hemos escrito todos. Yo el primero.

    function unsafeEqual(a, b) {
      if (a.length !== b.length) return false;
      let diff = 0;
      for (let i = 0; i < a.length; i++) {
        diff |= a.charCodeAt(i) ^ b.charCodeAt(i);
      }
      return diff === 0;
    }
    

    Sin salida temprana. Sin ramas dentro del bucle. Un acumulador que junta todas las diferencias y se revisa una sola vez al final.

    En C esto se acerca bastante al tiempo constante. En JavaScript, no.

    Y es justo el código que un agente de IA te escribe sin pestañear si le pides "una comparación segura contra ataques de temporización". Pasa todos los tests que se te ocurran.

    Los tests comprueban el valor devuelto, y aquí el valor devuelto siempre es correcto. El fallo vive en una dimensión que ningún expect mira.

    Si eso te suena al problema que tienes ahora mismo con el código que generas, escribí un ebook gratuito sobre cómo revisar por contrato lo que produce un agente: Revisión por Contrato.

    Por qué V8 rompe tu comparación en tiempo constante: cuatro mecanismos

    Cada uno basta por sí solo para tumbar la garantía.

    1. Tu función se ejecuta en cuatro motores distintos

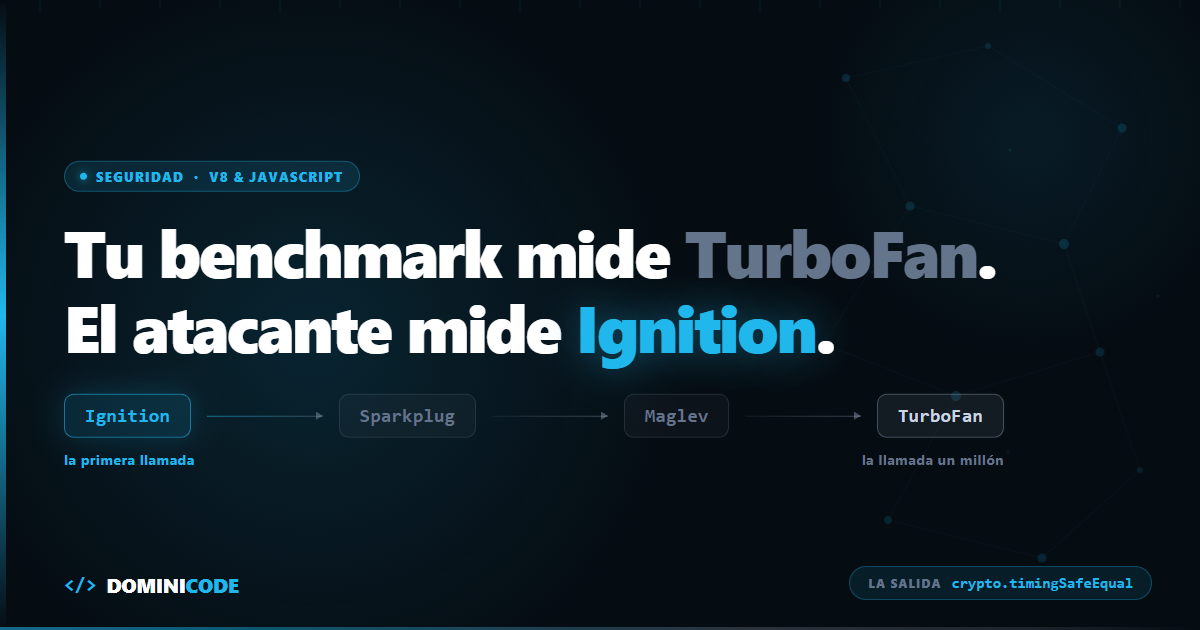
    V8 no tiene un compilador. Tiene cuatro niveles y va promocionando tu función entre ellos según cuántas veces la llames: Ignition interpreta el bytecode, Sparkplug compila sin optimizar, Maglev (en Chrome desde la M117, finales de 2023) optimiza rápido y razonablemente bien, y TurboFan optimiza despacio y muy bien. Los cuatro niveles están documentados en el blog oficial de V8.

    Nivel Qué hace Cuándo entra Quién lo mide
    Ignition Interpreta el bytecode Primera llamada El atacante
    Sparkplug Compila sin optimizar Unas pocas llamadas El atacante
    Maglev Optimiza rápido Cientos de llamadas A veces el atacante
    TurboFan Optimiza despacio y muy bien Miles de llamadas Solo tu benchmark

    La misma función, con el mismo input, tarda cosas distintas según en qué nivel esté cuando la llamas. Y tú no controlas cuándo sube de nivel.

    Aquí está la trampa del benchmark. Un millón de iteraciones deja la función en TurboFan mucho antes de terminar el bucle. Estás midiendo el estado final, que es exactamente el único estado que el atacante no ve.

    El primer login del día, el primer webhook después de un despliegue, la primera petición a una lambda fría: todo eso es Ignition. Y en Ignition el perfil temporal de tu bucle es otro.

    2. La desoptimización la dispara el dato de entrada

    TurboFan optimiza especulando. Ha visto que i siempre es un entero pequeño y que a y b siempre llegan como strings de un byte, así que genera código máquina que da eso por hecho y mete una comprobación barata por si acaso.

    Cuando la comprobación falla, V8 tira la versión optimizada y vuelve al intérprete. Eso es la desoptimización, y tiene un coste que se nota.

    Lo importante no es el coste. Es quién lo dispara: el dato de entrada. Un input con una forma que TurboFan no esperaba desoptimiza la función. El primer token con un carácter fuera de ASCII entra como string de dos bytes, la comprobación falla y la función se vuelve al intérprete. Un input de la forma habitual, no.

    Comparación que se desoptimiza según los datos es comparación con temporización dependiente del secreto. Que es justo lo que intentabas evitar.

    3. SMI, HeapNumber y la frontera que no ves

    V8 guarda los enteros pequeños como valor inmediato dentro del propio puntero. Los llama SMI, small integer, y son gratis. El resto de números van al heap como objetos: un HeapNumber.

    Cruzar esa frontera reserva memoria. Reservar memoria cuesta. Y si tu acumulador o tus índices se salen del rango según los datos que entran, el coste de tu función depende de los datos que entran.

    Puedes forzar la aritmética a int32 con | 0 o con Math.imul, y ayuda de verdad. Pero seamos precisos con lo que consigues: int32 no es SMI. Con pointer compression el rango SMI es de 31 bits, así que un int32 suficientemente grande sigue acabando en el heap. Es una costumbre que funciona porque este motor, en esta versión, se comporta así. No es una garantía del lenguaje.

    No es la primera vez que el motor decide por ti cosas que dabas por sentadas. Ya lo conté con structuredClone frente a JSON.parse(JSON.stringify()): el resultado parece el mismo hasta que dejas de mirar solo el resultado.

    4. El recolector de basura no hace ruido aleatorio

    Cualquier asignación puede disparar una pausa de GC. Concatenar una cadena, crear un array intermedio, salirte del rango SMI.

    La asignación correlaciona con los datos. La pausa correlaciona con la asignación. Por transitividad, la pausa correlaciona con los datos.

    Ese es el peor tipo de ruido: el que tiene estructura. Se promedia y aparece la señal.

    Si quieres entender cuándo el motor retiene memoria que creías liberada, lo desarrollé aquí: closures, scope chains y garbage collection.

    El tiempo no está en el contrato de ECMAScript

    La especificación de ECMAScript define qué resultado produce tu código. No define cuánto tarda. El tiempo de ejecución no aparece en el contrato del lenguaje por ninguna parte. Puedes comprobarlo tú mismo: la spec no dice nada sobre cuánto puede tardar una operación.

    Un motor puede hacer literalmente lo que le dé la gana con tu función mientras el valor devuelto sea el correcto. Puede interpretarla, compilarla, recompilarla, reordenar operaciones, eliminar el bucle si demuestra que el resultado no cambia, cachear, especular, desoptimizar. Todo eso es conforme a la spec.

    Pedirle tiempo constante a JavaScript es pedirle una garantía que el lenguaje nunca prometió.

    No es un bug de V8. Es que estás usando la herramienta equivocada.

    Es el mismo espejismo que con los tipos. TypeScript te garantiza tipos en compilación, y la gente asume que eso vale también en runtime, hasta que llega el primer JSON de una API externa y revienta algo tres capas más abajo. Por eso se valida en el límite con Zod: porque la garantía de compilación no es la garantía de ejecución. Con el tiempo pasa igual, solo que aquí no hay Zod que valga.

    Cómo comparar secretos de forma segura en Node y en el navegador

    Hay una sola respuesta y no la escribes tú: delega la comparación en código nativo y haz que lo que comparas no guarde relación con el secreto. En Node es crypto.timingSafeEqual; en el navegador, HMAC doble con crypto.subtle.sign.

    Entorno Primitiva nativa Qué usar
    Node · Deno · Bun crypto.timingSafeEqual HMAC doble + timingSafeEqual
    Cloudflare Workers crypto.subtle.timingSafeEqual (extensión no estándar) La nativa, o HMAC doble si quieres portabilidad
    Navegador Ninguna HMAC doble con crypto.subtle.sign
    Otros edge (solo Web Crypto) Ninguna HMAC doble con crypto.subtle.sign

    En Node: tiempo constante de verdad con crypto.timingSafeEqual

    Está en el core desde Node 6.6.0, implementado en C++ y fuera del alcance del JIT. Trabaja con Buffer, TypedArray o DataView, y acepta ArrayBuffer desde Node 15.

    Y tiene un detalle que casi todo el mundo se salta: lanza si las longitudes difieren (ERR_CRYPTO_TIMING_SAFE_EQUAL_LENGTH). O sea, la longitud sigue filtrándose. Si comparas directamente el token del usuario contra el tuyo, has tapado la fuga de prefijo y has dejado abierta la de longitud.

    La forma correcta es el HMAC doble:

    import { createHmac, randomBytes, timingSafeEqual } from 'node:crypto';
    
    const key = randomBytes(32); // clave efímera del proceso
    
    export function safeEqual(a, b) {
      // createHmac().update() lanza ERR_INVALID_ARG_TYPE con cualquier otra cosa
      if (typeof a !== 'string' || typeof b !== 'string') return false;
    
      const ha = createHmac('sha256', key).update(a).digest();
      const hb = createHmac('sha256', key).update(b).digest();
      return timingSafeEqual(ha, hb);
    }
    

    Aquí pasan dos cosas.

    Los digests siempre miden 32 bytes, vengan de un token de 8 caracteres o de 800. La longitud deja de filtrarse y timingSafeEqual no lanza nunca.

    Y como la clave es aleatoria y vive solo en este proceso, el atacante no puede relacionar lo que mide con el secreto. No sabe qué digest produce su input, así que no puede ir ajustándolo byte a byte. La señal deja de tener sentido aunque la capture entera.

    En el navegador: no existe timingSafeEqual

    El estándar Web Crypto no expone ninguna primitiva de comparación en tiempo constante: no está en crypto.subtle y no hay equivalente. Algún runtime la añade por su cuenta —Cloudflare Workers trae timingSafeEqual en crypto.subtle como extensión no estándar—, pero eso no te sirve en el navegador y no es portable.

    La respuesta es el mismo patrón, con crypto.subtle.sign:

    const raw = crypto.getRandomValues(new Uint8Array(32));
    const enc = new TextEncoder();
    
    const keyPromise = crypto.subtle.importKey(
      'raw',
      raw,
      { name: 'HMAC', hash: 'SHA-256' },
      false,
      ['sign']
    );
    
    export async function safeEqual(a, b) {
      const key = await keyPromise;
    
      const ha = new Uint8Array(await crypto.subtle.sign('HMAC', key, enc.encode(a)));
      const hb = new Uint8Array(await crypto.subtle.sign('HMAC', key, enc.encode(b)));
    
      let diff = 0;
      for (let i = 0; i < ha.length; i++) diff |= ha[i] ^ hb[i];
      return diff === 0;
    }
    

    Fíjate en que la clave se genera una vez, no en cada llamada.

    Y fíjate en el bucle del final. Es el mismo bucle de unsafeEqual con el que abría el post, el que acabo de decirte que no vale. Aquí sí vale.

    No porque el bucle haya mejorado —sigue a merced de Ignition, de Maglev y de lo que V8 decida en la próxima versión—, sino porque ya no compara nada que el atacante pueda perseguir. El arreglo nunca estuvo en el bucle. Estaba en lo que le metes.

    La regla de arriba del todo

    Si el secreto lo guarda el servidor, compáralo en el servidor.

    La mayoría de estas comparaciones no tenían que estar en el cliente. El navegador es un sitio raro para validar un token que el navegador ya tiene en la mano.

    Y la regla sincera

    No escribas criptografía. Usa lo que ya existe. Si tienes que escribirla, léete antes el Cryptography Coding Standard, que lleva años recogiendo exactamente este tipo de trampas.

    Este post no es para que escribas una comparación mejor. Es para que entiendas por qué la tuya no lo era.

    El patrón, más allá de la criptografía

    Esto se generaliza, y por eso me interesa tanto.

    Cada vez que tu razonamiento depende de cómo se ejecuta el código y no de qué devuelve, estás apostando contra el optimizador.

    El optimizador no firmó ese trato. Cambia en cada versión del motor, sin avisarte, sin notas de migración y sin romper un solo test. Tu suite sigue verde mientras la propiedad de la que dependías se evapora.

    Vale para el tiempo constante, para el micro-benchmark que justificó una refactorización, para el orden de evaluación del que alguien acabó fiándose, para el "esto no asigna memoria". La única defensa es hacer explícitas las propiedades de las que dependes en vez de asumirlas. De eso va la programación defensiva en TypeScript: escribir código que no confía en lo que nadie te ha prometido por escrito.

    Hoy mismo puedes hacer una cosa. Busca en tu código todos los === y todos los .equals() que comparan tokens, firmas de webhook, claves de API o códigos de un solo uso. Sustitúyelos por HMAC doble más timingSafeEqual. Es media hora.

    Y si quieres seguir bajando a este nivel de detalle con otros devs a los que también les divierte, esa conversación pasa en Dominicode Labs.

    Preguntas frecuentes

    ¿Esto es un bug de V8?

    No, y la mejor forma de verlo es preguntarse cómo sería el arreglo. Para garantizarte tiempo constante, V8 tendría que renunciar a promocionar funciones entre niveles, a especular sobre tipos y a desoptimizar cuando falla la especulación: tendría que dejar de ser un motor rápido para que tu comparación de tokens tarde siempre lo mismo. Ningún motor va a hacer ese cambio, ni debería. La optimización adaptativa es la razón por la que JavaScript es viable en servidor. El tiempo constante hay que buscarlo fuera del JIT, no pedirle al JIT que se apague.

    ¿Pasa lo mismo en Bun y en Deno?

    Sí, y por la misma razón. Deno usa V8, así que es idéntico. Bun usa JavaScriptCore, que también tiene varios niveles de compilación con su propio intérprete, su JIT base y sus optimizadores. Cambian los nombres, no el problema. Los tres implementan node:crypto, así que timingSafeEqual está disponible en los tres; eso sí, no des por hecho que los casos límite, como qué ocurre exactamente con longitudes distintas, se comportan igual en todos. Con el patrón de HMAC doble esa diferencia deja de afectarte.

    ¿Sirve Object.freeze, %NeverOptimizeFunction o compilar a WebAssembly?

    Object.freeze congela la forma de un objeto, no la estrategia de compilación: no tiene nada que ver. %NeverOptimizeFunction solo existe con --allow-natives-syntax, o sea, no es código que puedas desplegar. WASM sí es una opción más seria, porque eliminas el JIT especulativo sobre tipos dinámicos y ganas control real sobre la representación de los datos, pero tampoco es una garantía formal: la spec de WebAssembly no promete tiempo constante, y por debajo sigue habiendo un compilador y una CPU con cachés. Es mejor. No es demostrable.

    ¿Me afecta si solo comparo contraseñas hasheadas con bcrypt?

    Ahí estás cubierto, aunque no por el motivo que parece. La comparación final depende de la librería: el paquete nativo bcrypt la hace en C++, y bcryptjs, que es JavaScript puro, usa un safeStringCompare que es palabra por palabra el unsafeEqual del principio de este post. Da igual cuál uses. Lo que se compara en bcrypt no es el secreto: es un hash derivado con un coste deliberadamente alto, y el atacante no controla esos bytes ni puede ajustarlos a ciegas. Sin control sobre lo que se compara no hay ataque adaptativo, que es exactamente el argumento del HMAC doble. El problema aparece cuando la comparación es directa: tokens de sesión, claves de API, firmas de webhook, códigos OTP, tokens de reset de contraseña.

    ¿Y si lo mido yo mismo con performance.now() para salir de dudas?

    No vas a llegar a ninguna conclusión útil por ahí. Los navegadores redondean el reloj a propósito, como mitigación contra ataques de canal lateral tipo Spectre, así que tu instrumento es peor que la señal que buscas. Y aunque midieras con precisión perfecta, volverías a caer en la trampa original: tras unas cuantas iteraciones estás midiendo el nivel optimizado, no el que ve el atacante.

    ¿Cómo sé si mi comparación es vulnerable de verdad?

    Cambia la pregunta. Demostrar que una comparación es explotable requiere análisis estadístico serio, y no conseguir demostrarlo no prueba nada. Aplica un criterio binario en la revisión de código: ¿este === tiene a un lado un valor que controla el usuario y al otro un secreto del servidor? Si la respuesta es sí, se cambia. No hace falta medir nada. Cuesta menos arreglarlo que discutir si era explotable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Streaming SSE con Hono y Bun: la API de tu agente de IA

    Streaming SSE con Hono y Bun: la API de tu agente de IA

    El endpoint funcionaba. El agente respondía. El usuario veía una ruleta girando veintidós segundos y luego, de golpe, un muro de texto.

    Lo peor no fue la espera: abrió la misma pregunta en tres pestañas porque creyó que se había colgado. Tres ejecuciones del agente, tres facturas de tokens, una respuesta leída.

    Lo reescribí usando streaming SSE con Hono y Bun. Y el arreglo de fondo no fue técnico, fue conceptual: yo devolvía la respuesta de un agente como si fuera un JSON. Un agente no devuelve un resultado. Un agente transcurre. Piensa, llama a una herramienta, se equivoca, reintenta.

    Si tu API no transmite ese transcurso, el usuario solo ve una ruleta y saca sus propias conclusiones.

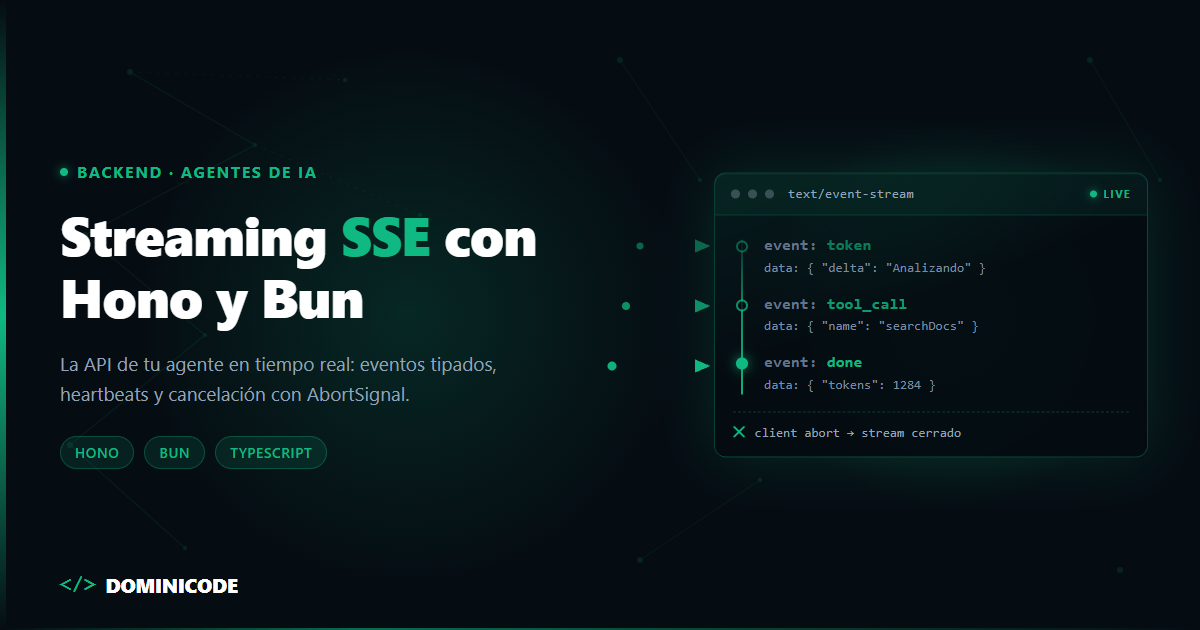
    Para exponer un agente por HTTP con salida en tiempo real, usa el helper streamSSE de hono/streaming sobre Bun: emite eventos con nombre (token, tool_call, error, done) en lugar de texto plano, propaga la desconexión del cliente a un AbortSignal con stream.onAbort() para dejar de gastar tokens, y manda un comentario SSE (: ping) cada 15-20 segundos para que ningún proxy corte la conexión. Todo el código de este post está verificado ejecutándolo contra Hono 4.13.7 sobre Bun 1.3.


    SSE no está deprecado: lo que se deprecó fue el transporte HTTP+SSE de MCP

    Son dos capas distintas y solo se deprecó una. Si vienes de mi post sobre montar un MCP Server en producción con Streamable HTTP y auth, su primer titular dice que SSE está deprecado, y ahora te propongo construir una API con SSE. No hay contradicción.

    Lo que se deprecó es el transporte HTTP+SSE del protocolo MCP —el de dos endpoints, uno GET para abrir el canal y otro POST para enviar, definido en la revisión 2024-11-05—, sustituido por Streamable HTTP en la 2025-03-26 y reclasificado formalmente como Deprecated en la 2026-07-28. Eso decide cómo hablan entre sí un cliente MCP y un servidor MCP.

    Server-Sent Events, el mecanismo del navegador, no está deprecado en absoluto. La especificación vigente de MCP —revisión 2026-07-28— sigue construida sobre él: el servidor responde a cada petición con un único objeto JSON o con un stream de Server-Sent Events, y el cliente está obligado a aceptar text/event-stream. En el registro oficial de features deprecadas la única entrada de transporte sigue siendo HTTP+SSE transport, deprecado en 2025-03-26, con Streamable HTTP como ruta de migración. Cambió la coreografía de endpoints, no el formato del stream. Aquí no implementamos MCP: construimos tu propia API para tu propio frontend.


    Por qué SSE y no WebSockets para un agente

    Porque el flujo de un agente es unidireccional: el usuario manda una pregunta y luego solo escucha. Abrir un canal bidireccional para eso es pagar complejidad por una dirección que nunca usas.

    Server-Sent Events (SSE) es el estándar web que permite a un servidor enviar un flujo de mensajes al cliente sobre una única conexión HTTP abierta, en texto plano y con el formato event: / data: / id:. Es unidireccional por diseño: el cliente abre la conexión y a partir de ahí solo recibe.

    La diferencia práctica está en lo que tienes que operar después del primer despliegue.

    SSE WebSockets
    Dirección Servidor → cliente Bidireccional
    Protocolo HTTP normal, respuesta larga Upgrade a ws://
    Proxies, CDN y balanceadores Pasa como cualquier respuesta HTTP Necesitan soporte explícito de upgrade
    Reconexión Automática en el navegador, con Last-Event-ID La implementas tú
    Autenticación Tus cookies o headers de siempre (con fetch) Handshake aparte, token en query
    Estado en el servidor Ninguno: es una request más Conexiones vivas que gestionar
    Depuración curl -N y lo lees Herramienta específica

    Elige WebSockets cuando el cliente tenga que interrumpir, corregir o hablar durante la generación: audio en vivo, edición colaborativa. Para un chat de agente con herramientas, SSE gana por aburrimiento operativo.


    Streaming SSE con Hono y Bun: el endpoint en veinte líneas

    El helper vive en hono/streaming y su firma es streamSSE(c, callback, onError?). Dentro del callback recibes un objeto de stream y escribes eventos con writeSSE().

    import { Hono } from 'hono'
    import { streamSSE } from 'hono/streaming'
    
    const app = new Hono()
    
    app.post('/agent', (c) =>
      streamSSE(c, async (stream) => {
        await stream.writeSSE({
          event: 'tool_call',
          data: JSON.stringify({ name: 'search_docs' }),
          id: '1',
        })
        await stream.writeSSE({ event: 'token', data: JSON.stringify({ text: 'Hola' }), id: '2' })
        await stream.writeSSE({ event: 'done', data: '{}' })
      })
    )
    
    export default { port: 3000, fetch: app.fetch }
    

    Ese export default { port, fetch } no es de Hono: es el contrato de Bun.serve. Bun arranca el servidor con bun run index.ts, sin adaptador ni servidor HTTP intermedio, y empuja cada chunk al socket según lo produces — que es justo lo que necesita un stream.

    El objeto que acepta writeSSE es { data, event?, id?, retry? }, con data como string o Promise<string>. Hono pone por ti Content-Type: text/event-stream, Cache-Control: no-cache, Connection: keep-alive y Transfer-Encoding: chunked. Lo tienes documentado en el streaming helper de Hono.

    Lo que sale por el cable, verificado con curl -N, es exactamente esto:

    event: tool_call
    data: {"name":"search_docs"}
    id: 1
    
    event: token
    data: {"text":"Hola"}
    id: 2
    
    event: done
    data: {}
    

    Hono encaja aquí porque es un router sobre Web Standards: no te obliga a envolver la respuesta en abstracciones propias, y eso importa cuando lo que devuelves es un stream y no un objeto. La comparativa completa está en Hono vs NestJS vs Express.

    Si tu stack es NestJS, el mismo problema se resuelve de otra forma y lo cubrí aparte en streaming de respuestas de IA con NestJS y el Vercel AI SDK: allí el SDK gestiona el protocolo por ti sobre la Response nativa. Aquí el contrato de eventos lo defines tú, que es justo lo que quiero que controles.


    Eventos con significado, no un chorro de texto

    El error que veo en casi todas las implementaciones: mandar solo data: <trozo de texto> y que el cliente concatene. Con eso el frontend no puede renderizar estados, solo puede pintar letras.

    Un agente tiene fases visibles para el usuario. Dale un nombre a cada una.

    event data (JSON) Qué hace el cliente
    token {"text":"…"} Concatena en la burbuja de respuesta
    tool_call {"name":"search_docs","args":{…}} Muestra "Buscando en la documentación…"
    tool_result {"name":"search_docs","ok":true,"ms":412} Cierra el indicador de herramienta
    error {"code":"RATE_LIMIT","message":"…"} Pinta el fallo y ofrece reintentar
    done {"usage":{"input":812,"output":344}} Cierra el stream y guarda la conversación

    Ese contrato es una API pública aunque viva dentro de tu repo. Si mañana renombras tool_call a toolCall, rompes el frontend en producción sin que ningún compilador te avise: entre servidor y cliente solo viaja texto.

    Por eso defino el contrato como un discriminated union validado con Zod y lo importo en los dos lados. El servidor lo usa para serializar, el cliente para parsear. Si un evento no encaja con el schema, lo descartas y lo registras en lugar de romper el render. Es el patrón que enseño en el curso de Zod para validación y transformación de datos en TypeScript, aplicado al borde más frágil de una app de IA.

    Un detalle del formato: writeSSE parte tu data por saltos de línea y emite una línea data: por cada trozo. Con JSON.stringify no te afecta, porque produce una sola línea. Con texto crudo multilínea, sí.


    Cancelación: el usuario cierra la pestaña y tú sigues pagando

    Cuando el cliente se desconecta, Hono marca stream.aborted = true y dispara los listeners registrados con stream.onAbort(). Ese es el enganche para abortar el trabajo del agente.

    Aquí está el detalle que casi nadie cuenta, y lo verifiqué ejecutándolo: escribir en un stream muerto no lanza ninguna excepción. El write interno de Hono captura el error y sigue como si nada. Si tu bucle espera un try/catch para enterarse de la desconexión, va a seguir llamando al modelo hasta terminar la respuesta entera. Y la vas a pagar.

    app.post('/agent', (c) =>
      streamSSE(c, async (stream) => {
        const ac = new AbortController()
        stream.onAbort(() => ac.abort()) // el cliente se fue: corta el trabajo
    
        const agent = runAgent({ prompt: await c.req.json(), signal: ac.signal })
    
        for await (const chunk of agent) {
          if (stream.aborted) return // guardia explícita: no confíes en que write falle
          await stream.writeSSE({ event: 'token', data: JSON.stringify({ text: chunk }) })
        }
    
        await stream.writeSSE({ event: 'done', data: '{}' })
      })
    )
    

    Dos mecanismos, y quieres los dos. onAbort propaga la cancelación hacia abajo —al SDK del modelo, a tu fetch de herramientas, a la query de base de datos— porque casi todo el ecosistema acepta un AbortSignal. La guardia if (stream.aborted) return corta el bucle en el siguiente ciclo aunque la librería de turno ignore la señal.

    En mi prueba, con un cliente que abortaba a mitad de stream, onAbort se disparó en el mismo tick en que el bucle vio aborted = true, y el AbortSignal del agente quedó abortado.

    Hay un detalle propio de Bun que conviene conocer: onAbort depende de que el runtime cancele el ReadableStream de la respuesta, y Hono todavía arrastra una función isOldBunVersion() que considera antigua cualquier versión que empiece por 1.1, 1.0 o 0.. En esas escucha c.req.raw.signal para abortar el stream a mano. De Bun 1.2 en adelante funciona el camino nativo y no tienes que hacer nada.

    Esto es la contrapartida natural del agentic loop en producción con TypeScript: allí pones el techo de pasos para que el agente no se dispare solo, aquí pones el interruptor para que no siga corriendo cuando ya no hay nadie escuchando.


    Heartbeats: por qué tu stream muere a los sesenta segundos

    Porque los proxies inversos, los balanceadores y los CDN cierran conexiones que llevan demasiado tiempo sin transmitir bytes. En Nginx son los 60 segundos de proxy_read_timeout, su valor por defecto. Un agente pensando o esperando a una herramienta lenta produce exactamente ese silencio.

    La solución cabe en una línea. SSE define que toda línea que empieza por : es un comentario y el cliente la ignora:

    const beat = setInterval(() => {
      if (!stream.aborted) void stream.write(': ping\n\n')
    }, 15_000)
    
    stream.onAbort(() => clearInterval(beat))
    // y clearInterval(beat) también al terminar bien
    

    Y hay una segunda mitad que casi nadie configura: aunque mandes el heartbeat perfecto, un proxy con buffering activo va acumulando los eventos y entregándolos a golpes, así que el usuario sigue sin ver nada en tiempo real. Se desactiva con una cabecera, y la propia especificación de MCP la recomienda: los servidores SHOULD incluir X-Accel-Buffering: no al abrir un stream SSE, porque sin ella "los proxies pueden acumular mensajes antes de enviarlos al cliente".

    c.header('X-Accel-Buffering', 'no')
    

    Verificado en el cable: el ping viaja, no genera ningún evento en el cliente y mantiene la conexión con tráfico. Elige un intervalo por debajo del timeout de tu proxy: 15 segundos es seguro contra los 60 de proxy_read_timeout. En PaaS el corte llega antes y no lo decides tú — los timeouts de Render, Railway y Fly los desgloso en desplegar agentes LangChain en producción.

    Aprovecha también retry: al emitir { data: '…', retry: 3000 } le dices al navegador cuánto esperar antes de reconectar. Y si numeras los eventos con id, el navegador reenvía el último en la cabecera Last-Event-ID al reconectar, así que puedes reanudar en vez de empezar de cero. Eso solo aplica cuando el cliente es EventSource, y ahí viene el siguiente problema.


    El cliente: por qué EventSource se te queda corto

    Porque EventSource solo hace peticiones GET y no admite body ni headers personalizados. Para un agente necesitas mandar el prompt, el historial y un Authorization: o metes la conversación entera en la query string, o cambias de herramienta.

    Cambias de herramienta. fetch con un lector de stream y un parser de veinte líneas:

    async function* readSSE(res: Response) {
      const reader = res.body!.getReader()
      const decoder = new TextDecoder()
      let buffer = ''
    
      while (true) {
        const { done, value } = await reader.read()
        if (done) break
        buffer += decoder.decode(value, { stream: true })
    
        let sep: number
        while ((sep = buffer.indexOf('\n\n')) !== -1) {
          const raw = buffer.slice(0, sep)
          buffer = buffer.slice(sep + 2)
    
          let event = 'message'
          let id: string | undefined
          const data: string[] = []
          for (const line of raw.split('\n')) {
            if (line.startsWith(':')) continue // heartbeat
            if (line.startsWith('event:')) event = line.slice(6).trim()
            else if (line.startsWith('data:')) data.push(line.slice(5).replace(/^ /, ''))
            else if (line.startsWith('id:')) id = line.slice(3).trim()
          }
          if (data.length) yield { event, id, data: data.join('\n') }
        }
      }
    }
    

    Dos cosas se rompen si las improvisas. Los eventos llegan agrupados o partidos: en mi prueba el primer chunk traía dos eventos completos juntos, así que hay que bufferear y cortar por línea en blanco, nunca asumir un chunk igual a un evento. Y decoder.decode(value, { stream: true }) no es opcional: sin ese flag, un carácter multibyte partido entre dos chunks llega corrupto. En español eso es cualquier acento.

    El precio de dejar EventSource es que pierdes la reconexión automática y el Last-Event-ID. Si los necesitas, los implementas tú guardando el último id recibido y reenviándolo al reintentar. Cancelar, en cambio, es trivial: pasa un AbortController al fetch y llama a abort() cuando el usuario pulse "parar" o el componente se desmonte. Eso dispara todo el camino de cancelación de la sección anterior.


    El error a mitad de stream: ya enviaste un 200 OK

    Cuando el agente falla en el segundo 12, las cabeceras salieron hace 12 segundos. No hay un 500 que devolver. El fallo tiene que viajar dentro del stream, como un evento más.

    Hono lo contempla con el tercer argumento de streamSSE:

    app.post('/agent', (c) =>
      streamSSE(
        c,
        async (stream) => {
          // ...el agente...
        },
        async (err, stream) => {
          logger.error({ err }, 'agent stream failed')
          await stream.writeSSE({
            event: 'error',
            data: JSON.stringify({ code: 'AGENT_FAILED', message: 'No he podido completar la respuesta.' }),
          })
        }
      )
    )
    

    Dos avisos que solo se descubren mirando la respuesta cruda, y los comprobé.

    El primero: si pasas el tercer argumento a streamSSE, además de tu handler Hono emite automáticamente su propio evento error con el message de la excepción en crudo. Tu cliente recibirá dos eventos error por un solo fallo. Trátalo: quédate con el primero y descarta el resto hasta el cierre. Sin onError, en cambio, Hono no manda nada al cliente y la excepción se queda en un console.error del servidor.

    El segundo es de seguridad. Ese mensaje automático es el texto real de la excepción y va tal cual al navegador. Si tu error trae una URL interna, un nombre de tabla o un fragmento de credencial, acabas de filtrarlo. Lanza errores con mensajes ya saneados, o envuelve el cuerpo del handler en tu propio try/catch y nunca dejes que la excepción llegue al helper.

    Revisar este tipo de detalle en el código que genera un agente es lo que trabajo en el ebook gratuito Revisión por Contrato: un modelo te escribe este endpoint en treinta segundos, te devuelve el camino feliz impecable y te deja estos dos fallos intactos.


    Qué puedes montar hoy

    Coge tu endpoint de agente actual, el que devuelve un JSON al final, y cámbiale tres cosas: envuélvelo en streamSSE, emite token / tool_call / done en vez de un objeto final, y engancha stream.onAbort() a un AbortController que pases hacia abajo.

    Con eso dejas de pagar respuestas que nadie lee. El resto —heartbeats, reconexión, validación con Zod— lo añades cuando el primero se sostenga.

    Si quieres el flujo completo de idea a producto construyendo con agentes, lo enseño paso a paso en el curso Construye con IA.


    Preguntas frecuentes

    ¿SSE está deprecado en 2026?

    No. Lo que se deprecó fue el transporte HTTP+SSE del protocolo MCP, sustituido por Streamable HTTP en la revisión 2025-03-26. Server-Sent Events como mecanismo web sigue vigente y es estándar; en la revisión vigente 2026-07-28 Streamable HTTP lo sigue usando para la parte de streaming, respondiendo con Content-Type: text/event-stream. Son capas distintas: una es la coreografía de endpoints de MCP, otra es el formato del stream.

    ¿Cómo detecto en Hono que el cliente cerró la pestaña?

    Con stream.onAbort(callback) para reaccionar, y con la propiedad stream.aborted para comprobarlo dentro de tu bucle. Lo importante es no confiar en que la escritura falle: el write de Hono captura el error internamente y no lanza nada, así que un bucle sin la guardia if (stream.aborted) seguirá llamando al modelo y generando coste después de que el usuario se haya ido.

    ¿Puedo usar EventSource para llamar a mi endpoint de agente?

    Solo si tu endpoint es GET y no necesitas headers personalizados, porque EventSource no admite ni body ni Authorization. Para un agente al que le mandas prompt e historial, lo práctico es fetch con un parser propio del stream. Pierdes la reconexión automática y el manejo de Last-Event-ID, y si los necesitas los implementas tú guardando el último id recibido.

    ¿Cada cuánto debo mandar un heartbeat en un stream SSE?

    Cada 15 o 20 segundos, siempre por debajo del timeout de inactividad de tu proxy o balanceador — 60 segundos es el valor típico de Nginx. Se envía como un comentario SSE: una línea que empieza por dos puntos seguida de una línea en blanco, que el cliente ignora sin generar ningún evento. Recuerda limpiar el setInterval tanto al terminar bien como en onAbort.

    ¿Cómo devuelvo un error si ya envié las cabeceras con 200 OK?

    Emitiendo un evento error dentro del propio stream, porque el código de estado ya viajó. En Hono usas el tercer argumento de streamSSE. Ten en cuenta que Hono añade además su propio evento error con el mensaje crudo de la excepción, así que tu cliente recibirá dos, y conviene sanear los mensajes que lanzas para no filtrar detalles internos.

    ¿SSE o WebSockets para una app de chat con IA?

    SSE, salvo que el cliente necesite hablar durante la generación. El flujo de un chat con agente es una pregunta y luego solo escuchar, y SSE viaja sobre HTTP normal: atraviesa proxies y CDN sin configuración especial, reutiliza tu autenticación y no deja estado de conexión que gestionar. WebSockets compensa cuando hay audio bidireccional o interrupciones en vivo.


    Si quieres ver este endpoint construido en directo, con el agente conectado y midiendo la cancelación en tiempo real, lo publico en el canal de YouTube de Dominicode.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • React 19.3: la release para borrar código, no para escribirlo

    React 19.3: la release para borrar código, no para escribirlo

    Hace un mes revisé el repo de un cliente. Una app de e-commerce, React, tres años de vida, gente competente detrás.

    Busqué isMounted en el proyecto. Diecinueve resultados. Busqué wrapperRef. Once. Y en el package.json, una librería de animación de 40 KB que solo se usaba para hacer un fade entre dos pantallas.

    Ninguna de las tres es un error. Son workarounds: código que existe porque React no daba la primitiva y alguien lo resolvió con lo que había.

    React 19.3 salió estable en npm el 9 de septiembre de 2026 y es, sobre todo, una release para borrar ese tipo de código. El problema de un workaround es que se queda para siempre, y cada dev nuevo del equipo asume que así es como se hace.

    No trae un paradigma nuevo. Trae dos APIs que salen de experimental —View Transitions y Fragment Refs—, una nueva, browser(), y un ajuste en Server Components. Cada una sustituye un apaño concreto que llevas años arrastrando. Vamos una por una, con lo que se borra en cada caso.

    En resumen: React 19.3 (react@19.3.0 y react-dom@19.3.0, publicados en npm el 9 de septiembre de 2026) estabiliza View Transitions y Fragment Refs, estrena browser() en react-dom, permite renderizar un Context directamente desde un Server Component y mejora el soporte de Trusted Types. No documenta ningún breaking change.

    Cambio Estado en 19.3 Se importa de Qué código elimina
    <ViewTransition> Estable (era experimental) react Librería de animación para transiciones de página y enter/exit de listas
    addTransitionType() Nueva react Estado de dirección pasado por props hasta el componente animado
    Fragment con ref Estable (era experimental) react El <div> wrapper que solo existía para colgar un ref, y el cloneElement
    browser() Nueva react-dom El trío useState + useEffect + flag mounted
    Context en Server Components Nuevo — El componente 'use client' que solo renderizaba el Provider
    Trusted Types Nuevo react-dom Sanitizado manual de TrustedHTML / TrustedScript

    View Transitions en React 19.3: borra la librería de animación

    <ViewTransition> ya no es experimental. Se importa de react y envuelve el trozo del árbol que quieres animar.

    import { ViewTransition, useState, startTransition } from 'react';
    
    export default function Component() {
      const [showItem, setShowItem] = useState(false);
      return (
        <>
          <button onClick={() => { startTransition(() => { setShowItem(prev => !prev); }); }}>
            {showItem ? 'âž–' : 'âž•'}
          </button>
          {showItem && (
            <ViewTransition>
              <Video video={videos[0]} />
            </ViewTransition>
          )}
        </>
      );
    }
    

    No hay animate, no hay variants, no hay AnimatePresence. Envuelves y ya. Por debajo React se apoya en la View Transition API del navegador.

    Hay cuatro formas de activarlo, según lo que pase en el árbol:

    • enter — se añade un ViewTransition al árbol.
    • exit — se elimina.
    • update — cambian sus hijos, sea contenido o style.
    • share — un ViewTransition con nombre desaparece en un sitio y aparece en otro.

    Cada tipo tiene su prop del mismo nombre —enter, exit, update, share— y su event prop: onEnter, onExit, onUpdate, onShare. Y existe además default, que fija la animación de los tipos que no declares: es lo que te permite apagarlos todos de golpe con default="none".

    Y ahora la regla que te va a costar media hora si no la lees: un setState normal no dispara la animación. Solo se activa dentro de una Transition: startTransition, useTransition, useDeferredValue o una navegación de Suspense.

    No es un detalle de implementación, es la decisión de diseño central: React no anima por si acaso, anima cuando tú marcas el cambio como transición. Si tu <ViewTransition> no hace nada, mira el setState antes que el CSS.

    Segundo detalle: la direccionalidad. El caso clásico —un carrusel que debe animar distinto según vayas hacia delante o hacia atrás— se resuelve con addTransitionType, otra función nueva de react:

    import { addTransitionType, startTransition } from 'react';
    
    function nextSlide() {
      startTransition(() => {
        addTransitionType('next');
        setCurrentSlide(c => c + 1);
      });
    }
    

    Etiquetas la transición y luego la consumes en CSS con :active-view-transition-type(next), o mapeas tipo → animación directamente en el componente:

    <ViewTransition
      enter={{ 'next': 'from-right', 'previous': 'from-left' }}
      exit={{ 'next': 'to-left', 'previous': 'to-right' }}
    >
      <Page />
    </ViewTransition>
    

    Ese mapa { tipo: animación } sustituye al estado de dirección que antes mantenías, pasabas por props hasta el componente animado y traducías a variants. Ahora vive donde ocurre la navegación.

    Y cuando dentro hay un Suspense, la doc recomienda animar solo el cambio de fallback a contenido y no todo lo que se mueva por debajo:

    <ViewTransition update="auto" default="none">
      <Suspense fallback={<Fallback />}>
        <Component />
      </Suspense>
    </ViewTransition>
    

    Qué borras: las transiciones de página y los enter/exit de listas y modales. Ojo, no digo que desinstales tu librería de animación mañana: los gestos, los drags, los springs físicos y las animaciones interrumpibles siguen siendo territorio de Framer Motion o GSAP. Pero si la instalaste para hacer un fade entre rutas —que es la mayoría de los casos que veo en revisiones— ya no la necesitas.


    Fragment Refs en React 19.3: un ref sin el <div> wrapper

    Fragment Refs permiten pasar un ref a un <Fragment> y recibir un FragmentInstance que opera sobre los hijos de primer nivel sin añadir ningún nodo al DOM. Son estables desde React 19.3.

    Es el cambio más pequeño de la release y probablemente el que más veces al mes te va a ahorrar un mal rato.

    Fragment ahora acepta ref. Te devuelve un FragmentInstance que opera sobre los hijos de primer nivel, sin meter un nodo extra en el DOM.

    Los métodos disponibles son estos:

    Categoría Métodos
    Eventos addEventListener, removeEventListener, dispatchEvent
    Foco focus() (en profundidad, depth-first), focusLast(), blur()
    Observers observeUsing(observer), unobserveUsing(observer)
    Layout y DOM getClientRects(), getRootNode(), compareDocumentPosition(otherNode), scrollIntoView(options)

    Un componente InView que antes exigía envolver los hijos en un div —con el consiguiente estropicio si el padre era un grid o un flex— ahora se escribe así:

    import { Fragment, useRef, useLayoutEffect } from 'react';
    
    export default function InView({ onChange, children }) {
      const fragmentRef = useRef(null);
    
      useLayoutEffect(() => {
        const visibleElements = new Set();
        const observer = new IntersectionObserver((entries) => {
          entries.forEach(e => {
            if (e.isIntersecting) visibleElements.add(e.target);
            else visibleElements.delete(e.target);
          });
          onChange(visibleElements.size > 0);
        });
        const fragmentInstance = fragmentRef.current;
        fragmentInstance.observeUsing(observer);
        return () => { fragmentInstance.unobserveUsing(observer); };
      }, [onChange]);
    
      return <Fragment ref={fragmentRef}>{children}</Fragment>;
    }
    

    Fíjate en observeUsing: le pasas el observer y él se encarga de suscribir a cada hijo. No iteras children, no clonas elementos, no pides refs a los hijos.

    Para accesibilidad, mover el foco al primer elemento enfocable de un grupo se queda en dos líneas:

    import { Fragment, useRef, useEffect } from 'react';
    
    function Component() {
      const fragmentRef = useRef(null);
    
      useEffect(() => {
        const fragmentInstance = fragmentRef.current;
        fragmentInstance.focus();
      }, []);
    
      return (
        <Fragment ref={fragmentRef}>
          {posts.map(post => (
            <Heading key={post.id}>{post.title}</Heading>
          ))}
        </Fragment>
      );
    }
    

    Qué borras: los wrappers de layout que no pintan nada y el cloneElement con ref que usabas para llegar a los hijos. Es el mismo tipo de deuda que genera el props drilling en React: estructura que existe para transportar algo, no para representar nada.


    use(browser()) en React 19.3: borra el flag mounted

    browser() es una función nueva de react-dom que, consumida con use(browser()), suspende en el servidor y no suspende en el cliente: marca un componente como client-only sin useState ni useEffect.

    Es el cambio más discreto de la release y el que más código muerto elimina en una app con SSR.

    El patrón que todos hemos escrito mil veces: un componente necesita window, Intl, localStorage o cualquier cosa que solo existe en el navegador, así que montas el ritual de useState(false) + useEffect(() => setMounted(true), []) + if (!mounted) return null.

    React 19.3 mete browser() en react-dom. Se consume con use() y su comportamiento cabe en una línea: suspende en el servidor y no suspende en el cliente.

    import { Suspense, use } from 'react';
    import { browser } from 'react-dom';
    
    function TimeZone() {
      use(browser());
      const timeZone = new Intl.DateTimeFormat().resolvedOptions().timeZone;
      return <p>{timeZone}</p>;
    }
    
    export default function App() {
      return (
        <>
          <p>Your current time zone is:</p>
          <Suspense fallback="Loading...">
            <TimeZone />
          </Suspense>
        </>
      );
    }
    

    Tres líneas de estado sustituidas por una. Y el fallback deja de ser null para pasar a ser un Suspense de verdad, que es lo que debería haber sido siempre.

    Además se puede llamar condicionalmente, cosa que no es habitual en las APIs de React:

    function TimeZone({ defaultValue }) {
      if (defaultValue) return <p>{defaultValue}</p>;
      use(browser());
      const localTimeZone = new Intl.DateTimeFormat().resolvedOptions().timeZone;
      return <p>{localTimeZone}</p>;
    }
    

    Y dentro de tus propios hooks, que es donde se pone interesante:

    function useBrowserQuery(query, options) {
      if (options.initialData === undefined) use(browser());
      return useQuery(query, options);
    }
    

    Ahí acabas de mover una decisión de renderizado —"esto solo puede resolverse en cliente"— del componente a la capa de datos. El componente ya no sabe nada del entorno.

    Requisito: necesitas un Suspense por encima. Sin él no funciona. Si todavía tratas Suspense como un spinner y no como una herramienta de orquestación, aquí lo desarrollo: fetching paralelo en Next.js con Suspense y Promise.all.


    Context en Server Components: borra el Provider intermedio

    Desde React 19.3, un Server Component puede importar un Context definido en un módulo 'use client' y renderizarlo directamente, sin un componente Provider intermedio.

    Si trabajas con RSC conoces el peaje. Para pasar datos del servidor al árbol de cliente había que crear un componente 'use client' cuya única razón de existir era renderizar el Provider:

    // user-context.js  ('use client')
    export const UserContext = createContext(null);
    export function UserProvider({ currentUser, children }) {
      return <UserContext value={currentUser}>{children}</UserContext>;
    }
    
    // server-component.js
    import { UserProvider } from './user-context';
    export async function Layout({ children }) {
      const currentUser = await getCurrentUser();
      return <UserProvider currentUser={currentUser}>{children}</UserProvider>;
    }
    

    Ahora el Server Component importa el Context directamente de su módulo 'use client' y lo renderiza:

    // user-context.js  ('use client')
    export const UserContext = createContext(null);
    
    // server-component.js
    import { UserContext } from './user-context';
    export async function Layout({ children }) {
      const currentUser = await getCurrentUser();
      return <UserContext value={currentUser}>{children}</UserContext>;
    }
    

    Un fichero menos y, sobre todo, una capa de indirección menos. Si estás montando esto en producción, escribí sobre las decisiones reales de React Server Components que hay detrás de esa frontera server/client: este cambio elimina uno de los puntos de fricción que mencionaba allí.


    Otros cambios de React 19.3: Trusted Types, rendimiento y renombrados

    Tres cosas más que no dan para post pero que conviene saber.

    Trusted Types. React ya no coerciona a string los valores TrustedHTML, TrustedScript y TrustedScriptURL: los pasa tal cual para que el navegador valide la política. Si sirves con Content-Security-Policy: require-trusted-types-for 'script', esto cierra una vía de XSS basado en DOM que antes tenías que tapar tú.

    Rendimiento. Dos cambios, sin cifras publicadas y sin que yo me las invente: las Transitions se renderizan de forma independiente en vez de enredarse en un único render, así que una Transition lenta ya no bloquea a otras que no tienen nada que ver; y las actualizaciones que vienen de eventos de resize se agrupan hasta el siguiente frame. Si tu app tiene layout reactivo al viewport, lo notarás sin tocar nada.

    Renombrados y fixes. useActionState pasa a hablar de "action state" en vez de "form state". Y hay arreglos que probablemente expliquen algún bug que archivaste como "cosas raras": useDeferredValue quedándose con el valor viejo, useSyncExternalStore perdiendo mutaciones, useEffectEvent roto dentro de forwardRef y memo, y la propagación de context en los fallbacks de Suspense.


    ¿Merece la pena actualizar a React 19.3 hoy?

    La nota de release oficial de React 19.3 no documenta ningún breaking change. La instalación es esta:

    npm install react@19.3 react-dom@19.3
    

    Aviso para quien llegue desde los sandboxes de la doc: ahí verás versiones 19.3.0-canary-*. Esas son del entorno de la documentación, no la instrucción de instalación. La estable es 19.3.0.

    Mi recomendación: actualiza y no migres nada todavía. Primero mide cuánto código muerto tienes. Es un ejercicio de veinte minutos y te da la lista de la compra.

    Yo lo hago con un agente: le pido a Claude Code que barra el repo buscando los tres patrones —flags de mounted, wrappers que solo existen para un ref y animaciones de ruta hechas con librería— y que me devuelva un inventario con ubicación y coste, no un PR. Que el agente haga el inventario y la decisión la tomes tú es justo lo que enseño en el curso Construye con IA: de la idea al producto con Claude Code.

    Y si además sigues el ecosistema Angular, merece la pena comparar cómo resuelve cada framework lo mismo. Lo desarrollé en el post sobre Signals en Angular 22 frente a React 19. React 19.3 refuerza esa dirección: el modelo de reactividad no se toca, lo que mejora es qué puedes expresar sin escribir infraestructura.


    Por dónde empezar a migrar a React 19.3

    Abre tu proyecto y busca mounted. Solo eso.

    Cada resultado es un componente que tarda un render extra en aparecer, que probablemente hace flash en producción y que existe porque React no tenía forma de decir "esto es client-only". Ahora la tiene. Ese es el mejor punto de entrada a React 19.3 porque el cambio es local, no rompe nada y se ve en el primer render.

    Cuando termines con esos, ve a por los <div> wrapper. Y deja las transiciones de página para el final, que son las más divertidas y las que más tiempo te van a comer.

    En Dominicode Labs estamos probando estas APIs sobre proyectos reales y compartiendo lo que funciona y lo que no. Y si prefieres verlo en vídeo, lo iré contando en el canal de Dominicode a medida que lo lleve a producción.


    Preguntas frecuentes sobre React 19.3

    ¿React 19.3 rompe algo si actualizo desde 19.2?

    La nota de release de React 19.3 no documenta ningún breaking change. La actualización es npm install react@19.3 react-dom@19.3 y las APIs nuevas son aditivas: ViewTransition y addTransitionType no estaban en la API estable —vivían en los builds experimentales—, browser() es nueva, y que Fragment acepte ref no cambia el comportamiento de los Fragment que ya tienes. Aun así, actualiza en una rama y pasa tu suite de tests: la release incluye arreglos en useDeferredValue, useSyncExternalStore y useEffectEvent, y si tu código dependía sin saberlo del comportamiento defectuoso, ahí es donde lo vas a notar.

    ¿Por qué mi ViewTransition no anima nada?

    Casi siempre por lo mismo: el cambio de estado no está dentro de una Transition. <ViewTransition> solo se activa con startTransition, useTransition, useDeferredValue o una navegación de Suspense. Un setState normal actualiza el DOM sin animar. Antes de tocar el CSS, comprueba que el setState que provoca el cambio está envuelto en una Transition.

    ¿Puedo usar View Transitions de React 19.3 con Next.js o React Router?

    Sí, porque <ViewTransition> es un componente de react y no depende del router. La condición es que el cambio de estado ocurra dentro de una Transition, y las navegaciones de los routers modernos ya lo hacen. Lo que no obtienes automáticamente es la direccionalidad: para animar distinto hacia delante y hacia atrás tienes que llamar tú a addTransitionType('next') dentro del startTransition que dispara la navegación.

    ¿Fragment Refs sustituyen a los refs normales?

    No. Un ref normal apunta a un nodo del DOM y eso sigue siendo lo correcto cuando ese nodo existe. Fragment Refs resuelven el caso en el que necesitas operar sobre un conjunto de hijos y no hay un elemento común que los envuelva, o lo hay solo porque lo metiste tú para colgar el ref. El FragmentInstance que recibes trabaja sobre los hijos de primer nivel: registra eventos, mueve el foco con focus() y focusLast(), conecta un IntersectionObserver o un ResizeObserver con observeUsing(), mide con getClientRects() y hace scroll con scrollIntoView().

    ¿use(browser()) elimina todos los useEffect de mi app?

    No, solo un patrón concreto: el de marcar un componente como client-only. browser() se importa de react-dom, suspende en el servidor y no suspende en el cliente, así que sustituye al trío useState + useEffect + flag mounted. Necesita un Suspense por encima para funcionar. Los efectos que sincronizan con sistemas externos —suscripciones, listeners, integraciones con librerías no-React— siguen siendo useEffect.

    ¿Necesito un framework con Server Components para aprovechar React 19.3?

    Para nada. View Transitions, Fragment Refs y use(browser()) funcionan en cualquier aplicación React; browser() cobra especial sentido si haces SSR, pero no exige RSC. Lo que sí requiere una configuración con Server Components es la mejora de Context, que permite a un Server Component importar un Context definido en un módulo 'use client' y renderizarlo directamente, sin el componente Provider intermedio.

    ¿Cómo instalo React 19.3 y por qué veo versiones canary en la documentación?

    Se instala con npm install react@19.3 react-dom@19.3. Las versiones 19.3.0-canary-* que aparecen en los sandboxes interactivos de react.dev pertenecen al entorno de la propia documentación y no son la instrucción de instalación. En npm, react@19.3.0 y react-dom@19.3.0 son estables desde el 9 de septiembre de 2026.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • htmx 4: qué rompe, qué gana y por qué npm te sigue dando la 2

    htmx 4: qué rompe, qué gana y por qué npm te sigue dando la 2

    Ves el hilo en Hacker News: htmx 4 released. Vas a tu proyecto, corres npm update htmx.org, arrancas el servidor.

    No pasa nada. Sigues en la 2.0.10.

    No es tu lockfile. No es la caché de npm. Es una decisión: el equipo publicó htmx 4.0.0 el 28 de agosto de 2026 bajo el dist-tag next, no bajo latest. Y no piensa moverla hasta principios de 2027.

    El motivo lo dicen ellos con todas las letras: "we do not want to force-upgrade users who are relying on non-versioned CDN URLs for htmx". Miles de páginas apuntan a una URL de CDN sin versión. Cambiar latest sería reescribir el runtime de todas esas páginas de golpe, sin que nadie hubiera tocado un commit.

    Y ahí está lo interesante de esta release, que no va de features.

    Cuando el propio equipo decide no empujarte su major, te está diciendo dos cosas. La primera: rompe lo suficiente como para no fiarse. La segunda, la que te sirve hoy: tienes meses para prepararte, no horas.

    Dos frases de contexto por si no usas htmx. Es la librería que trae HTML del servidor y lo intercambia dentro del DOM usando atributos en el markup, en lugar de mantener un árbol de componentes en el cliente. Es el modelo opuesto al de Angular o React: tu estado vive en el servidor y el navegador solo pega parches de HTML.

    Vamos a lo que cambia.


    Cómo instalar htmx 4 hoy (y por qué npm te da la 2.0.10)

    A día de hoy el dist-tag latest de npm sigue apuntando a htmx 2.0.10, y next apunta a htmx 4.0.0. Por eso npm install htmx.org te instala la 2 aunque htmx 4 lleve publicada desde el 28 de agosto de 2026.

    Todo convive en el mismo paquete:

    npm install htmx.org          # te instala 2.0.10
    npm install htmx.org@next     # te instala 4.0.0
    npm install htmx.org@4.0.0    # explícito, el que yo usaría
    

    Y antes de tocar nada, la herramienta que el equipo publicó junto a la release:

    npx htmx.org@4.0.0 upgrade-check -- ./templates
    

    npx htmx.org@4.0.0 upgrade-check -- ./templates escanea tus plantillas y te marca los atributos eliminados o renombrados. Tarda segundos y te da el tamaño real del problema, que es exactamente lo que necesitas antes de decidir nada.

    La 2.x, por cierto, tiene soporte indefinido. No hay reloj corriendo.


    Cambio 1: la herencia de atributos ahora se pide por escrito

    En htmx 2, un atributo puesto en un padre lo heredaban todos los hijos. Era cómodo hasta que dejaba de serlo, y entonces aparecían hx-disinherit y hx-inherit para apagar y encender esa magia a mano.

    En htmx 4 no se hereda nada salvo que lo digas, con el sufijo :inherited:

    <div hx-confirm:inherited="Are you sure?">
        <button hx-delete="/item/1">Delete</button>
    </div>
    

    Sin ese sufijo, el botón no pregunta nada. Borra.

    Consecuencia directa: hx-disinherit y hx-inherit desaparecen, porque ya no hay nada que desheredar.

    Si necesitas la herencia implícita de htmx 2 mientras migras, htmx.config.implicitInheritance = true la devuelve. A diferencia de fetch(), este cambio sí tiene marcha atrás.

    Este es el cambio que más plantillas rompe, y rompe de la peor manera posible: no lanza errores. Deja de hacer cosas. Tu confirmación desaparece, tu indicador de carga desaparece, tu hx-target heredado deja de aplicarse y el swap aterriza en otro sitio. Todo con la consola limpia.

    Es el mismo patrón que analicé cuando Starlight 0.42 rompió el menú móvil en silencio: los breaking changes que te cuestan dinero no son los que revientan el build, son los que pasan los tests y llegan a producción con la UI medio muerta.


    Cambio 2: fetch() nativo y adiós a XMLHttpRequest

    htmx 4 reescribe todo el motor de peticiones sobre la API nativa fetch() y elimina XMLHttpRequest. Es el único cambio de la major que no se puede revertir por configuración, y la doc es tajante: "All requests use the native fetch() API. This cannot be reverted."

    El motor de peticiones entero está reescrito sobre fetch(). Lo que se lleva por delante:

    • Todos los eventos htmx:xhr:* desaparecen. Cualquier cosa colgada de ellos deja de dispararse.
    • El timeout por defecto pasa a ser de 60 segundos (60000 ms). En htmx 2 era ilimitado. Si tienes un endpoint de informes que tarda dos minutos, en htmx 4 muere solo.

    Ese timeout es de los cambios que más me gustan. Y de los que más incidentes van a provocar la primera semana: un default sano que rompe justo el caso raro que nadie documentó.

    Se revierte con una línea: htmx.config.defaultTimeout = 0.


    Cambio 3: todos los eventos se renombran

    htmx 4 unifica los nombres bajo el patrón htmx:phase:action — fase, acción y, si hace falta, subacción, separadas por dos puntos:

    htmx 2 htmx 4
    htmx:beforeRequest htmx:before:request
    htmx:afterRequest htmx:after:request
    htmx:beforeSwap htmx:before:swap
    htmx:afterSwap htmx:after:swap
    htmx:configRequest htmx:config:request
    htmx:responseError htmx:response:error

    Además, varios errores colapsan en uno: htmx:sendError, htmx:swapError, htmx:targetError y htmx:timeout pasan todos a ser htmx:error. Y los eventos de validación (htmx:validation:*) desaparecen.

    Si tienes una capa de logging o de telemetría colgada de estos eventos, esta es la parte mecánica de la migración: tediosa, pero visible y buscable.


    Otros breaking changes de htmx 4 que no salen en el titular

    Además de la herencia, fetch() y los eventos, htmx 4 trae cinco cambios menores que rompen en silencio.

    Ahora se swapea casi todo. htmx 4 hace swap de todas las respuestas HTTP menos 204 y 304. En htmx 2, los 4xx y 5xx no swapeaban.

    Esto es excelente si devuelves HTML de validación con un 422: se acabó pelearse con la librería para pintar errores de formulario. Y es una bomba si tu 500 devuelve la página de error completa de tu framework, porque ahora esa página entera se te mete dentro del <div> del target. Si necesitas el comportamiento de htmx 2 mientras migras, htmx.config.noSwap = [204, 304, '4xx', '5xx'] lo restaura.

    hx-delete ya no incluye los inputs del formulario que lo envuelve. En htmx 2, cualquier petición que no fuera GET arrastraba los valores del formulario asociado, así que hx-delete se comportaba como hx-post. En htmx 4 la regla excluye también a DELETE, y pasa a comportarse como hx-get: no manda nada. Si dependías de eso:

    <button hx-delete="/item/1" hx-include="closest form">Delete</button>
    

    El historial ya no cachea en localStorage. Al pulsar atrás, htmx hace una petición de red real y swapea en <body> o en [hx-history-elt]. Si quieres el cacheo de antes, hay una extensión hx-history-cache que usa sessionStorage.

    El orden de los swaps out-of-band se invierte. Ahora el contenido principal swapea primero y los OOB después, en orden de documento. Si tenías scripts que asumían el orden contrario, se van a ejecutar contra un DOM distinto.

    Los selectores con espacios en hx-trigger necesitan comillas simples: from:'closest form', target:'.a, .b'.

    Y dos más: el modificador queue de hx-trigger se elimina en favor de hx-sync="this:queue all", y las extensiones ya no se activan con hx-ext — incluyes el script y listo.


    La tabla de atributos eliminados (y el baile peligroso)

    Eliminado Reemplazo
    hx-disable hx-ignore
    hx-disabled-elt hx-disable
    hx-vars hx-vals con prefijo js:
    hx-params evento htmx:config:request
    hx-prompt extensión hx-prompt
    hx-ext incluir el script directamente
    hx-disinherit — (la herencia ya es explícita)
    hx-inherit — (la herencia ya es explícita)
    hx-request hx-config
    hx-history — (ya no hay caché en localStorage)

    Mira las dos primeras filas juntas, porque ahí hay una trampa preciosa.

    hx-disable pasa a llamarse hx-ignore. Y hx-disabled-elt pasa a llamarse… hx-disable. El orden en que hagas ese find & replace decide si tu migración funciona o si conviertes todos tus hx-disable viejos en algo que significa otra cosa.

    Primero hx-disable → hx-ignore. Después hx-disabled-elt → hx-disable. Al revés chocan: el segundo paso renombraría a hx-ignore los hx-disable que acabas de crear.

    Y ancla la búsqueda al nombre exacto del atributo (hx-disable= o la regex \bhx-disable\b). Con un replace de texto plano, el primer paso entra también dentro de hx-disabled-elt y te lo deja como hx-ignored-elt, que no existe. Nadie te avisa.

    Es el tipo de detalle que no se ve en una revisión de PR de 400 líneas de plantillas. Lo mismo que pasaba con los 6 breaking changes de pnpm 12 que sí te afectan: las majors no se rompen en el cambio grande que sale en el anuncio, se rompen en la línea 7 de la tabla de migración.


    Novedades de htmx 4: hx-status, hx-partial y morphing nativo

    htmx 4 añade tres capacidades que en htmx 2 exigían JavaScript o extensiones: hx-status, <hx-partial> y morphing nativo. Porque no todo es pagar el peaje.

    hx-status: comportamiento por código de estado. Acepta código exacto (404), comodín de un dígito (50x) y de rango (5xx), con claves swap:, target:, select:, push:, replace: y transition::

    <form hx-post="/save"
          hx-status:422="swap:innerHTML target:#errors select:#validation-errors"
          hx-status:5xx="swap:none push:false">
    </form>
    

    Esto resuelve de raíz el problema que planteaba antes: los 422 pintan errores donde tú digas y los 5xx no ensucian nada. Es la respuesta declarativa a lo que en htmx 2 era un htmx:beforeSwap con un if dentro.

    <hx-partial>: varios targets desde una sola respuesta. La alternativa a hx-swap-oob, cada bloque con su target y su swap:

    <hx-partial hx-target="#messages" hx-swap="beforeend">
        <div>New message</div>
    </hx-partial>
    <hx-partial hx-target="#count">
        <span>5</span>
    </hx-partial>
    

    Morphing nativo. Nuevos estilos de swap innerMorph y outerMorph con el algoritmo idiomorph, dentro del core: "morph swaps using the idiomorph algorithm. Better for preserving state in complex UIs". Se acabó cargar la extensión para que un swap no te reinicie el foco del input.

    Y una lista rápida de lo demás:

    • Atributos nuevos: hx-action (con hx-method opcional), hx-query (petición QUERY con parámetros en el body), hx-config, hx-ignore y hx-validate.
    • Swaps nuevos: textContent y delete, más los alias before/after/prepend/append.
    • Scroll con sintaxis distinta: hx-swap="innerHTML show:top showTarget:#other" donde antes ponías show:#other:top.

    El core viene además con un paquete de extensiones oficiales agrupadas por propósito:

    • Streaming: hx-sse, hx-ws, hx-multipart.
    • UX: hx-live, hx-pending, hx-prompt, hx-browser-indicator.
    • Rendimiento: hx-preload, hx-history-cache, hx-ptag.
    • Swaps: hx-download, hx-head, hx-targets, hx-upsert.
    • Seguridad: hx-csp.
    • Compatibilidad: htmx-2-compat y hx-alpine-compat.

    Y un bundle htmax.js que empaqueta htmx con las más usadas.

    Esa última categoría, compatibilidad, es la que convierte esta migración en algo realista.


    htmx-2-compat: la vía sensata

    Existe una extensión oficial, htmx-2-compat, que restaura los defaults y los nombres de eventos de htmx 2. Lo que no te devuelve es el motor: las peticiones siguen saliendo por fetch() y los htmx:xhr:* no vuelven de ninguna manera.

    Eso cambia por completo la estrategia. No tienes que elegir entre quedarte en la 2 o reescribir 300 plantillas en un sprint. Puedes:

    1. Subir a htmx 4.
    2. Cargar htmx-2-compat y comprobar qué sigue funcionando igual y qué no.
    3. Ir apagando comportamientos viejos uno a uno, en PRs pequeños, con la app en producción todo el rato.

    Es la diferencia entre una migración y un rewrite.

    Con una condición que no es negociable: necesitas tests que verifiquen el HTML que llega y dónde aterriza. Sin eso, quitar comportamientos de compatibilidad es dar palos de ciego, porque los fallos de htmx 4 son silenciosos casi siempre. Esta es exactamente la mentalidad que trabajo en mi curso de Testing: los tests no están para demostrar que el código funciona, están para permitirte cambiarlo. El framework da igual; el criterio de qué merece un test, no.


    ¿Debo migrar a htmx 4 ahora?

    Tu situación Qué hacer
    Proyecto htmx 2 en producción, estable Corre upgrade-check, guarda el informe, no migres aún
    Proyecto nuevo que empiezas esta semana Empieza en htmx.org@4.0.0 directamente
    Usas URL de CDN sin versión Fíjala a una versión concreta hoy, antes de 2027
    Tienes hx-disable o hx-disabled-elt en plantillas Anota el orden del rename ahora, mientras lo tienes fresco
    No usas htmx Quédate con la decisión del dist-tag, que es lo valioso

    Lo que yo haría esta semana

    Corre esto y guarda la salida en el repo:

    npx htmx.org@4.0.0 upgrade-check -- ./templates
    

    Ya está. No migres hoy. Lo que necesitas ahora es un número: cuántos atributos tuyos están en esa lista. Con ese número decides en enero si es una tarde o un trimestre, y lo decides con datos en vez de con la sensación que te dejó un hilo de Hacker News.

    Y quédate con la lección de fondo, que sirve para cualquier dependencia de tu package.json: latest no significa "la última versión". Significa "la versión que el equipo se atreve a darte por defecto". Cuando esas dos cosas se separan durante seis meses, la distancia entre ellas es el mapa de todo lo que rompe.


    Preguntas frecuentes sobre htmx 4

    ¿Puedo instalar htmx 4 hoy?

    Sí. Está publicada como 4.0.0 desde el 28 de agosto de 2026, solo que bajo el dist-tag next en lugar de latest. Instálala con npm install htmx.org@next o, mejor, fijando la versión con npm install htmx.org@4.0.0 para que no te cambie bajo los pies cuando publiquen la siguiente preview.

    ¿Cuándo pasa htmx 4 a ser la versión latest?

    El equipo ha dicho que htmx 4 tomará el tag latest en algún momento de principios de 2027. La razón de esperar es no forzar la actualización a quienes cargan htmx desde una URL de CDN sin versión, que se actualizarían de golpe sin haber tocado su código.

    ¿Cuánto rompe htmx 4 mi proyecto de verdad?

    Depende de cuántos atributos eliminados uses, y eso lo puedes medir hoy con npx htmx.org@4.0.0 upgrade-check -- ./templates. Los tres focos de dolor son la herencia de atributos, que ahora exige el sufijo :inherited; los eventos, que se renombran todos al patrón htmx:fase:acción; y el swap de respuestas 4xx y 5xx, que antes no ocurría y ahora sí.

    ¿htmx 2 deja de tener soporte cuando la 4 sea latest?

    No. El equipo mantiene la rama 2.x con soporte indefinido. No hay una fecha de fin de vida anunciada, así que quedarte en htmx 2 es una decisión válida y no una deuda técnica con cuenta atrás.

    ¿Merece la pena migrar ya?

    Si arrancas un proyecto nuevo, sí: empieza directamente en la 4 y te ahorras la migración entera. Si tienes algo en producción, la vía razonable es subir a la 4 con la extensión htmx-2-compat, que restaura los defaults de htmx 2, y desactivar comportamientos viejos poco a poco en vez de reescribir todas las plantillas de una vez.

    ¿Qué gano si migro, aparte de estar al día?

    Tres cosas concretas: hx-status, que te deja definir swap, target y select por código de respuesta de forma declarativa; el elemento <hx-partial>, que apunta a varios elementos desde una sola respuesta sin hx-swap-oob; y el morphing con idiomorph integrado en el core mediante los swaps innerMorph y outerMorph, sin extensión externa.


    Si prefieres ver este tipo de análisis en vídeo, con el proyecto delante, lo publico en el canal de YouTube de Dominicode.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Astro 7.3: el candado que bloqueaba tus tests E2E en preview

    Astro 7.3: el candado que bloqueaba tus tests E2E en preview

    Actualizas Astro. Lanzas la suite de Playwright. Un servidor de preview arranca bien y los demás se caen con un error que no habla de tus tests: habla de un lockfile.

    Tú no habías puesto ningún lockfile. Y el commit de esa noche no tocaba nada de testing.

    Ese error tiene una historia detrás, y la historia no va de ti. Va de los agentes de IA.

    Astro 7.3.0 se publicó el 3 de septiembre de 2026 con tres cambios pequeños: el flag --ignore-lock llega a astro preview, el logger de runtime de Astro se pasa a los image services y cache providers custom, y @astrojs/cloudflare 14.3.0 incorpora un helper finalize() para worker entrypoints propios. No hay breaking changes. Ninguno de los tres cambia lo que puedes construir con Astro; los tres cambian cuánto tiempo pierdes cuando algo se rompe.

    Todo lo que cuento aquí sale de las notas oficiales de la release de Astro 7.3, del changelog de astro 7.3.0, del changelog de @astrojs/cloudflare y de la referencia de CLI de Astro.

    Vamos con el primero, que es el que más gente va a notar hoy mismo.


    --ignore-lock llega a astro preview: el arreglo que se nota en el CI

    astro preview levanta un servidor sobre tu build de producción. Es contra ese servidor contra el que corren tus tests E2E, porque probar contra astro dev es probar otra cosa: otro pipeline, otros assets, otro comportamiento.

    Desde Astro 7.2, ese comando escribe un lockfile en .astro/preview.json — el mismo mecanismo que astro dev usa en .astro/dev.json desde Astro 7.0. Un servidor de preview por proyecto y punto: si intentas levantar el segundo, no arranca.

    Astro 7.3 devuelve la escotilla:

    npx astro preview --port 4322 --ignore-lock
    

    El flag se salta la comprobación del lockfile y te deja arrancar tantos servidores de preview como quieras sobre el mismo proyecto, cada uno en su puerto. En Playwright, que es el caso de uso que el propio equipo de Astro menciona en las notas, se traduce en esto:

    // playwright.config.ts
    import { defineConfig } from '@playwright/test';
    
    export default defineConfig({
      webServer: [
        {
          command: 'npx astro preview --port 4321 --ignore-lock',
          url: 'http://localhost:4321',
          reuseExistingServer: !process.env.CI,
        },
        {
          command: 'npx astro preview --port 4322 --ignore-lock',
          url: 'http://localhost:4322',
          reuseExistingServer: !process.env.CI,
        },
      ],
    });
    

    Hay un detalle que conviene leer dos veces. Las notas oficiales avisan de que estas instancias corren de forma independiente, así que están pensadas para servidores rápidos y de usar y tirar, no para los que gestionas con astro preview stop o astro preview status. Traducido: si los arrancas a mano, los matas a mano. Dentro de Playwright da igual, porque el teardown del webServer se encarga.

    Y un aviso que no está en el anuncio de la release pero sí en la referencia del CLI: --ignore-lock no se puede combinar con --background ni con --force, porque los dos dependen del lockfile. Si los juntas, Astro lanza un error.

    Lo que convierte eso en un problema real: Astro activa el modo background por su cuenta cuando detecta que quien ejecuta el comando es un agente de IA. Traducido: si lanzas la suite desde dentro de una sesión de Claude Code o de Cursor, tu --ignore-lock puede petar sin que hayas escrito --background en ninguna parte.

    La salida está documentada y es una variable de entorno:

    ASTRO_PREVIEW_BACKGROUND=0 npx astro preview --port 4322 --ignore-lock
    

    Si lanzas Playwright desde tu terminal, esto no te afecta. Si lo lanza un agente por ti, ponla en el webServer y te ahorras el segundo día de depuración.

    Y hay un segundo escenario, menos obvio y más frecuente de lo que parece: no necesitas dos suites en paralelo para chocar con el candado. Basta con que algo ya lo tenga cogido. Un preview huérfano de la ejecución anterior. O tu agente de IA, que dejó uno levantado en segundo plano mientras trabajaba.

    Esto último no es hipotético, y aquí es donde la release se pone interesante.


    El candado no lo pusieron por ti

    Astro 7 introdujo el lockfile en astro dev con un motivo explícito, y lo dicen ellos con todas las letras en su blog: para que los agentes de IA no levantaran servidores de desarrollo duplicados del mismo proyecto sin darse cuenta. Un problema que hace tres años no existía.

    La secuencia completa es esta:

    Versión Qué pasó
    Astro 7.0 Llega el lockfile a astro dev para frenar servidores duplicados de agentes de IA
    Astro 7.1 Se añade --ignore-lock a astro dev para quien sí quiere varios a propósito
    Astro 7.2 El lockfile se extiende a astro preview, pero sin escotilla
    Astro 7.3 --ignore-lock llega también a astro preview

    Si te interesa el contexto de dónde salió todo esto, lo conté cuando salió la major en el repaso de novedades de Astro v7.

    Aquí está la lección, y va mucho más allá de Astro.

    Tus herramientas están empezando a poner defaults pensados para un agente, no para ti. El lockfile es una decisión sensata cuando quien ejecuta el comando es un modelo que no recuerda si ya levantó el servidor hace diez minutos. Es una decisión molesta cuando quien lo ejecuta eres tú, con un playwright.config.ts delante y muy claro lo que quieres.

    Astro lo ha resuelto bien: default seguro para el agente, flag explícito para el humano. Pero el patrón se va a repetir en todo tu stack, y la próxima vez a lo mejor no te dan el flag el mismo trimestre.

    Por eso insisto tanto en esto cuando trabajo con agentes en el curso de Construye con IA: tienes que saber qué procesos deja vivos tu agente. No porque vaya a romper nada grave, sino porque el día que tu CI falle por un lockfile vas a perder dos horas buscando el bug en tu código.

    Y ya que estamos en testing: el E2E es la capa cara. Casi todo lo que quieres verificar debería estar cubierto más abajo, donde una prueba cuesta milisegundos — lo desarrollé en pruebas unitarias ultrarrápidas con Vitest.


    El logger de runtime llega a los image services y a los cache providers

    Segundo cambio. Menos vistoso, y sin embargo es el que arregla un problema de higiene real.

    Si mantienes un image service custom —el típico wrapper sobre Cloudinary, imgproxy o tu propio CDN— hasta ahora tu única forma de avisar de algo era console.warn(). Con la consecuencia obvia: ese warning se escupía siempre. Ignoraba el nivel de log del proyecto, ignoraba --silent y ensuciaba la salida del build igual en local que en CI.

    En Astro 7.3, los image services reciben el logger de Astro como argumento adicional en transform():

    import type { LocalImageService } from 'astro';
    
    const service: LocalImageService = {
      // ...
      async transform(inputBuffer, transform, imageConfig, logger) {
        logger.warn(`No se pudo optimizar "${transform.src}". Se devuelve sin tocar.`);
        return { data: inputBuffer, format: 'png' };
      },
    };
    

    Y los cache providers lo reciben dentro del contexto que se pasa a onRequest():

    import type { CacheProvider } from 'astro';
    
    const provider: CacheProvider = {
      name: 'my-cache',
      async onRequest({ request, url, logger }, next) {
        logger.warn(`Caché omitida en ${url.pathname}: la respuesta define una cookie.`);
        return next();
      },
      // ...
    };
    

    El servicio Sharp integrado y el provider memoryCache() ya están migrados. Sharp lo usa para avisar de formatos de origen raros o no soportados; memoryCache(), para avisar de respuestas que se salta y de fallos en la revalidación en segundo plano.

    La ganancia no es que ahora "haya logs". Es que tus warnings viajan por el mismo canal que los de Astro y respetan la configuración del proyecto. Si mantienes una integración propia, es un cambio de dos líneas.

    Y sí, esto entra de lleno en la conversación de rendimiento: el image service es una de las piezas que decide el peso real de tus páginas, igual que las Server Islands que analicé en sitios web ultrarrápidos con Astro.


    finalize() en @astrojs/cloudflare: el bug silencioso de las cookies

    Tercer cambio, el más de nicho y el más peligroso de los tres si te toca.

    Va para quien despliega en Cloudflare con un worker entrypoint propio en lugar del que genera el adapter. Ese pipeline manual funciona, pero se salta un paso: aplicar las cookies y los defaults de caché del CDN de Cloudflare a la respuesta que devuelve astro/fetch.

    Un bug de esos que no rompe el build. Simplemente un día descubres que las cookies de sesión no llegan.

    @astrojs/cloudflare 14.3.0, publicada el 3 de septiembre de 2026 —el mismo día que Astro 7.3—, añade finalize() para cerrar ese hueco. Recibe el FetchState y la respuesta del pipeline, y devuelve la respuesta ya con las cookies y la caché aplicadas:

    // src/worker.ts
    import { astro, FetchState } from 'astro/fetch';
    import { cf, finalize } from '@astrojs/cloudflare/fetch';
    
    export default {
      async fetch(request: Request, env: Env, context: ExecutionContext) {
        const state = new FetchState(request);
        const asset = await cf(state, env, context);
        if (asset) return asset;
    
        return finalize(state, await astro(state));
      },
    };
    

    Si usas Hono, no tienes que hacer nada: el middleware @astrojs/cloudflare/hono aplica esas cabeceras por su cuenta.

    El resto de la release te ahorra tiempo. Esta te ahorra un incidente.


    ¿Te toca actualizar a Astro 7.3?

    No hay breaking changes, así que la pregunta no es si puedes, es si ganas algo.

    Tu situación Qué hacer Por qué
    Tienes E2E con Playwright sobre astro preview Actualiza hoy Es la diferencia entre una suite que arranca y una que muere en el webServer
    Trabajas a diario con un agente de IA en el proyecto Actualiza hoy Dejas de pelearte con él por el mismo lockfile
    Mantienes un image service o cache provider custom Actualiza y cambia dos líneas Tus warnings pasan a respetar el nivel de log y --silent
    Despliegas en Cloudflare con worker entrypoint propio Sube @astrojs/cloudflare a 14.3.0 finalize() te quita el bug silencioso de las cookies
    Sitio estático, sin E2E, sin adapter Actualiza sin prisa No hay riesgo, pero tampoco premio

    Si vienes de la rama 6.x, el salto que de verdad cambió cómo se construye con Astro no es este: fue el de Server Islands y Actions en 6.2. Astro 7.3 es mantenimiento fino sobre esa base.


    Lo que yo haría esta semana

    Abre tu playwright.config.ts y mira si el command del webServer llama a astro preview. Si es que sí, añade --ignore-lock y actualiza. Son treinta segundos y te ahorras el día en que el CI falle por un lockfile que tú no pusiste.

    El resto puede esperar al próximo sprint.

    Pero quédate con la idea de fondo, porque vale más que los tres cambios juntos: tu tooling ha empezado a asumir que quien escribe los comandos es un agente. Los defaults se están moviendo hacia ahí. Cuando algo se rompa de forma rara en tu pipeline, esa es la primera hipótesis que deberías poner sobre la mesa, y ya no la última.

    De esto discutimos bastante en Dominicode Labs, porque casi todos los que estamos metiendo agentes en el flujo diario nos hemos comido alguna versión de este mismo problema.


    Preguntas frecuentes

    ¿Qué hace exactamente –ignore-lock en astro preview?

    Se salta la comprobación del lockfile que Astro 7.2 añadió a astro preview, de modo que puedes tener varios servidores de preview del mismo proyecto corriendo a la vez en puertos distintos. El flag ya existía en astro dev desde Astro 7.1; la 7.3 lo lleva también a preview.

    ¿Por qué astro preview –ignore-lock me da error?

    Porque --ignore-lock no se puede combinar con --background ni con --force: las dos opciones dependen del lockfile, así que Astro lanza un error. Y cuando Astro detecta que el comando lo ejecuta un agente de IA, activa el modo background automáticamente, aunque tú no hayas pasado --background. Si te ocurre, desactiva ese automatismo con la variable de entorno ASTRO_PREVIEW_BACKGROUND=0 delante del comando.

    ¿Por qué existe ese lockfile si nadie lo pidió?

    Porque Astro 7 lo introdujo para que los agentes de IA no levantaran servidores duplicados del mismo proyecto sin darse cuenta. Es un default pensado para un ejecutor que no recuerda si ya arrancó el servidor hace diez minutos, y por eso convive mal con flujos donde tú quieres varios servidores a propósito.

    ¿Los servidores lanzados con –ignore-lock se gestionan con astro preview stop?

    No. Las notas oficiales avisan de que esas instancias corren de forma independiente y están pensadas para servidores rápidos y de usar y tirar, no para los que administras con astro preview stop o astro preview status. Si los arrancas a mano, los cierras a mano; dentro de Playwright se encarga el teardown del webServer.

    ¿Tengo que tocar mi image service custom para aprovechar el logger?

    Solo si quieres. El cambio es aditivo: el logger llega como argumento adicional en transform() y dentro del contexto de onRequest() en los cache providers, así que tu código actual sigue funcionando. Cambiar console.warn() por logger.warn() es lo que hace que tus avisos respeten el nivel de log configurado y el flag --silent.

    ¿Necesito llamar a finalize() si uso Hono en Cloudflare?

    No. El middleware @astrojs/cloudflare/hono aplica esas cabeceras automáticamente. finalize() está pensado para quien monta un worker entrypoint propio sobre astro/fetch y necesita aplicar a mano las cookies y los defaults de caché del CDN de Cloudflare.

    ¿En qué versión de @astrojs/cloudflare está finalize()?

    En @astrojs/cloudflare 14.3.0, publicada el 3 de septiembre de 2026 junto a Astro 7.3. El adapter se versiona aparte de astro: subir astro a 7.3 no actualiza el adapter, tienes que subir los dos paquetes.

    ¿Hay breaking changes al actualizar a Astro 7.3?

    No. Es una release menor de mantenimiento sobre la 7.2: un flag nuevo, un logger que se propaga a APIs de extensión y un helper añadido en @astrojs/cloudflare 14.3. La actualización del adapter de Cloudflare va aparte de la de astro, así que revisa que subes las dos si estás en ese escenario.


    Si prefieres ver este tipo de análisis en vídeo, con el proyecto delante, lo publico en el canal de YouTube de Dominicode.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Starlight 0.42: menos JavaScript, menú móvil roto en silencio

    Starlight 0.42: menos JavaScript, menú móvil roto en silencio

    El viernes actualicé la documentación de un proyecto interno a Starlight 0.42. npx @astrojs/upgrade, build en verde, Lighthouse un punto mejor. Cerré el portátil.

    El lunes un compañero me pasa una captura desde el móvil. El menú abría perfecto. Pero el botón se quedaba gris. Nuestro color de marca al abrir el menú había desaparecido.

    Nada había fallado. Ese es el problema. El CSS no lanza errores: cuando un selector deja de coincidir con algo, se calla y sigue. El build no te avisa, los tests no lo ven y tú te enteras cuando alguien abre el sitio en un teléfono.

    El anuncio oficial de la release vende una paradoja simpática —menos JavaScript y más JavaScript a la vez— y para los detalles te remite al CHANGELOG. Este post es el CHANGELOG explicado, con el CSS concreto que tienes que cambiar.

    El titular es "menos JavaScript". La letra pequeña es que si tocaste el menú móvil con CSS o JS propio, la 0.42 te lo rompe sin decir nada.


    La paradoja de Starlight 0.42: "un 100 % más de JavaScript"

    El chiste es del propio anuncio y tiene truco. Hay dos JavaScript distintos aquí y el post oficial los mezcla a propósito.

    Uno es el JavaScript que va dentro del paquete de npm. Ese sube: Starlight ha dejado de publicar TypeScript y ahora distribuye JavaScript compilado.

    El otro es el JavaScript que llega al navegador de quien lee tu documentación. Ese baja: el menú móvil ya no necesita JS para funcionar.

    Build-time contra runtime. Son cosas distintas y confundirlas es el error clásico al leer notas de release. Con la 0.42 en la mano, un sitio Starlight medio sigue enviando entre 3 y 13 veces menos JavaScript al usuario final que herramientas comparables: MkDocs, Sphinx, VitePress, Nextra, GitBook o Docusaurus.

    Es la misma lógica que ya movía a Astro con las server islands: decidir con precisión qué se ejecuta en el servidor y qué viaja al cliente, en vez de mandarlo todo y confiar. Astro lleva varias releases insistiendo en lo mismo, desde que server islands y actions se estabilizaron en la 6.2.


    Por qué Starlight publicaba TypeScript y por qué ha parado

    Hay una rareza de los proyectos Astro que mucha gente no conoce: puedes publicar archivos .ts directamente en npm y funcionan cuando alguien los instala. Sin build step. Genial para prototipar rápido, y así se venía publicando Starlight desde el principio.

    El coste aparecía en tu proyecto, no en el suyo.

    Si haces typecheck con tsc, TypeScript revisa cualquier .ts que encuentre importado, incluso dentro de node_modules. Así que acababas comprobando el código fuente de Starlight. Y no con la configuración del paquete, sino con la tuya. En algunos casos el rendimiento de tipos en el editor también se resentía. En una base de código del tamaño de Starlight, esos problemas se acumulan.

    La 0.42 compila sus fuentes y distribuye JavaScript más archivos de declaración (.d.ts). El resultado esperable es un typecheck más rápido en tu máquina — y más aún cuando aterrice el compilador de TypeScript escrito en Go.

    Detalle que conviene tener claro: un .d.ts describe tipos en tiempo de compilación y desaparece en tiempo de ejecución. No valida nada.

    La validación de verdad ya la estás usando aunque no te hayas fijado: el frontmatter de tus páginas lo comprueba Starlight con esquemas de Zod durante el build. Y si tu sitio además tiene formularios o endpoints, ahí hace falta el mismo tipo de esquema pero ejecutándose en runtime. Tipos y validación resuelven problemas distintos, aunque la gente los meta en el mismo saco.


    La Popover API: por qué el menú móvil deja de necesitar tu JavaScript

    Aquí está el cambio de fondo.

    Antes, el menú móvil era una máquina de estados escrita a mano: un custom element <starlight-menu-button> que escuchaba clics, cambiaba aria-expanded en el botón y ponía un atributo en el <body>. Si el JavaScript no llegaba a ejecutarse, no había menú.

    Y hay más razones de las que la gente cree para que el JavaScript no se ejecute. La red se cae a medias. Otro script peta antes y se lleva por delante el resto del bundle. Una extensión del navegador se mete por medio. Alguien lo tiene desactivado. En un sitio de documentación —que muchas veces es la primera vez que alguien te ve— eso es una puerta cerrada.

    La 0.42 delega ese estado en la Popover API del navegador. El menú abre aunque tu JavaScript nunca llegue.

    Menos código propio, más primitiva nativa. Es la dirección correcta.

    Pero ojo con la consecuencia: si el estado ya no vive en un atributo del botón, tu CSS no tiene a qué agarrarse.


    Los 3 breaking changes de Starlight 0.42, en una tabla

    Starlight 0.42 rompe tres cosas y solo tres. Esta es la traducción directa de código viejo a código nuevo:

    Qué desaparece Reemplazo en 0.42 A quién afecta
    <starlight-menu-button> y aria-expanded .sl-menu-button y .sl-menu-button:has(~ :popover-open) Estilos, temas o component overrides que apuntaban al botón del menú móvil
    body[data-mobile-menu-expanded] body:has(sl-sidebar-pane:popover-open) CSS o JS propio que reaccionaba a la apertura del menú
    Opción tagline en astro.config Sin reemplazo: se borra Configs que la declararon (nunca hizo nada)

    Si ninguna de las tres filas aparece en tu código, la actualización es transparente. Si aparece alguna, las tres secciones siguientes son tuyas.


    Breaking change 1: el botón del menú móvil

    El botón ya no va envuelto en el custom element <starlight-menu-button> y ya no usa aria-expanded. Ahora apuntas al botón con la clase .sl-menu-button y lees el estado abierto con la pseudo-clase :popover-open.

    Así estaba tu CSS antes:

    /* Antes: Starlight 0.41 y anteriores */
    starlight-menu-button button {
      border-radius: 999px;
      background: var(--sl-color-gray-6);
    }
    
    starlight-menu-button[aria-expanded="true"] button {
      background: var(--dc-brand);
      color: var(--sl-color-white);
    }
    

    Y así queda en la 0.42:

    /* Después: Starlight 0.42 */
    .sl-menu-button {
      border-radius: 999px;
      background: var(--sl-color-gray-6);
    }
    
    /* El estado abierto lo expone el navegador en el panel, no en el botón.
       Seleccionas el botón que tiene un popover abierto como hermano. */
    .sl-menu-button:has(~ :popover-open) {
      background: var(--dc-brand);
      color: var(--sl-color-white);
    }
    

    Fíjate en lo que ha cambiado de verdad. No es un nombre de clase: es de quién es el estado.

    Antes el estado estaba en el botón, porque lo escribía JavaScript. Ahora está en el panel, porque lo gestiona el navegador. Por eso el selector nuevo tiene que ser relacional: :has() con ~ :popover-open significa "este botón, cuando un hermano posterior suyo está abierto".


    Breaking change 2: adiós a data-mobile-menu-expanded

    El atributo data-mobile-menu-expanded que Starlight añadía al <body> mientras el menú estaba abierto ya no existe. Si lo usabas para ocultar una barra flotante, bloquear el scroll o apagar una animación, ese bloque de CSS ha dejado de aplicarse.

    /* Antes */
    body[data-mobile-menu-expanded] .dc-cta-flotante {
      display: none;
    }
    
    /* Después */
    body:has(sl-sidebar-pane:popover-open) .dc-cta-flotante {
      display: none;
    }
    

    Si además tenías JavaScript propio reaccionando al menú, el cambio te ahorra código. Antes tocaba vigilar un atributo:

    // Antes: espiar el atributo que ponía Starlight
    const boton = document.querySelector('starlight-menu-button button');
    
    new MutationObserver(() => {
      const abierto = boton.getAttribute('aria-expanded') === 'true';
      document.body.classList.toggle('menu-abierto', abierto);
    }).observe(boton, { attributeFilter: ['aria-expanded'] });
    

    Ahora el navegador te lo cuenta él solo con un evento nativo:

    // Después: el panel es el popover y emite un evento toggle
    const panel = document.querySelector('sl-sidebar-pane[popover]');
    
    panel?.addEventListener('toggle', (event) => {
      const abierto = event.newState === 'open';
      document.body.classList.toggle('menu-abierto', abierto);
    });
    

    Un MutationObserver menos en tu sitio. Esa es la parte buena de apoyarse en primitivas del navegador: el código que borras no puede fallar.


    Breaking change 3: la opción tagline ya no existe

    Se elimina de la configuración. Nunca se llegó a usar para nada, así que no hay reemplazo: la borras de tu astro.config y listo. Si no la quitas, la validación de config te lo dirá.


    Requisitos mínimos y navegadores que se caen

    Starlight 0.42 exige Astro v7.2.10 o superior. Si usas @astrojs/markdown-satteri, necesitas 0.4.0 o superior. Si sigues con @astrojs/markdown-remark, 7.3.0 o superior.

    Si tu sitio todavía está en Astro v6, el salto grande no es este release, es el anterior: repasa primero las novedades de Astro v7 y hazlo en un PR aparte. Actualizar dos majors en el mismo commit es la forma más rápida de perder la tarde.

    Y hay una lista de navegadores que dejan de tener soporte oficial:

    Navegador Versión mínima soportada
    Chromium 116 (agosto de 2023)
    Safari 17.0 (septiembre de 2023)
    Firefox 125 (abril de 2024)

    No es un capricho, pero tampoco es el mínimo exacto de la API. Firefox 125 y Safari 17.0 son justo las versiones donde aterrizó la Popover API. En Chromium llegó antes, en la 114, así que ahí Starlight se ha guardado dos versiones de margen. Y en iPhone no hay sorpresa: el Safari de iOS la soporta desde la misma 17.0 que el de escritorio.

    El precio de apoyarse en el navegador es aceptar su calendario. Mira tus analíticas antes de decidir: en un sitio de documentación técnica, ese tráfico suele redondear a cero.


    Lo que mejora sin que hagas nada

    Dos cosas llegan gratis con la actualización.

    Rendimiento. La última versión de Sätteri —el motor de Markdown y MDX de Astro escrito en Rust, que llegó en Astro 6.4 y es el motor por defecto desde Astro 7— les ha permitido optimizar componentes y plugins de Markdown, y reducir el número de dependencias de Starlight. El procesado de datos del sidebar es ahora hasta 1.400 veces más rápido, y eso se nota de verdad en sitios con sidebars grandes o muy anidados.

    Ojo con un detalle que no es opcional. Sätteri no ejecuta plugins de remark ni de rehype: tiene su propio sistema de plugins mdast y hast, y no hay fallback automático.

    Y aquí no eliges tú. Como es el motor por defecto de Astro 7, y la 0.42 exige Astro v7.2.10 o superior, la actualización te lo puede cambiar sola. Si tu pipeline depende de remark o rehype, tienes que quedarte explícitamente en @astrojs/markdown-remark 7.3.0 o superior. Compruébalo antes de lanzar el upgrade, no después.

    Accesibilidad. El menú móvil atrapa el foco mientras está abierto, para que no puedas tabular hacia la página que queda escondida debajo. Detrás está el criterio de éxito WCAG 2.4.11, «Focus Not Obscured (Minimum)»: el elemento con el foco no puede quedar tapado por lo que hay encima. Se agradece en viewports pequeños o con mucho zoom. Llegó en la 0.41.3, así que si vienes de la última 0.41.x ya lo tienes. Si esto lo habías parcheado tú a mano, bórralo: ahora hay dos implementaciones peleándose por el foco.


    Cómo actualizar a Starlight 0.42 paso a paso

    1. Comprueba que estás en Astro v7. Starlight 0.42 exige Astro v7.2.10 o superior. Si vienes de Astro v6, haz ese salto antes y en un PR aparte.

    2. Busca lo que se va a romper. Cuatro grep antes de tocar nada:

      grep -rn "starlight-menu-button" src/
      grep -rn "data-mobile-menu-expanded" src/
      grep -rn "aria-expanded" src/styles/
      grep -rn "tagline" astro.config.*
      

      Cada resultado es una línea que hay que migrar. Si no aparece nada, actualiza tranquilo.

    3. Actualiza. Un solo comando sube Starlight, Astro y el resto de integraciones a la vez:

      npx @astrojs/upgrade
      
    4. Migra el CSS y el JS con la tabla de equivalencias de más arriba: .sl-menu-button, .sl-menu-button:has(~ :popover-open) y body:has(sl-sidebar-pane:popover-open).

    5. Abre el sitio en un móvil de verdad y toca el botón del menú. No en el simulador de Chrome: en un teléfono. Es el único sitio donde estos tres breaking changes se manifiestan.

    Este tipo de migración quirúrgica —buscar patrones muertos, cambiarlos y verificar— es exactamente lo que un agente hace bien si le das el CHANGELOG y los selectores concretos. Es el flujo que enseño en Construye con IA: contexto preciso primero, ejecución después.


    La conclusión que te llevas

    Un release que quita JavaScript casi siempre mueve el estado a otro sitio. Y el CSS que apuntaba al estado viejo no se queja: se apaga. Es el mismo patrón que en los breaking changes de pnpm 12: la nota de release vende el titular y el trabajo real está tres párrafos más abajo.

    Si mantienes un sitio con Starlight, haz hoy los cuatro grep de arriba antes de actualizar. Tardas menos de lo que has tardado en leer este post, y te ahorras la captura de un compañero el lunes por la mañana.

    En Dominicode Labs trabajamos este tipo de migraciones sobre proyectos reales, con el diff delante en vez de con el anuncio de marketing. Y el anuncio original, por si quieres la versión oficial, está en el blog de Astro.


    Preguntas frecuentes

    ¿Cómo actualizo a Starlight 0.42?

    Ejecuta npx @astrojs/upgrade, que sube Starlight, Astro y el resto de integraciones a la vez. Antes de lanzarlo, busca en tu proyecto starlight-menu-button, data-mobile-menu-expanded, aria-expanded en tus estilos y tagline en astro.config: cada coincidencia es una línea que hay que migrar. Necesitas Astro v7.2.10 o superior. Después, abre el sitio en un móvil real y comprueba el botón del menú.

    ¿Starlight 0.42 envía más o menos JavaScript al navegador?

    Menos. El "100 % más de JavaScript" del anuncio se refiere al paquete de npm, que ahora se distribuye compilado a JavaScript en lugar de TypeScript. Lo que llega al navegador de quien lee tu documentación baja, porque el menú móvil se apoya en la Popover API nativa en vez de en código propio. Un sitio Starlight medio sigue enviando entre 3 y 13 veces menos JavaScript al usuario final que MkDocs, Sphinx, VitePress, Nextra, GitBook o Docusaurus.

    ¿Por qué ha dejado de aplicarse mi CSS del menú móvil tras actualizar?

    Porque el botón ya no va envuelto en el custom element <starlight-menu-button> y ya no usa el atributo aria-expanded. Cualquier selector construido sobre esos dos elementos deja de coincidir con nada y el navegador lo ignora en silencio. La migración es apuntar al botón con .sl-menu-button y leer el estado abierto con .sl-menu-button:has(~ :popover-open).

    ¿Por qué el selector nuevo usa :has() en lugar de una clase en el botón?

    Porque el estado ha cambiado de dueño. Antes lo escribía JavaScript en el botón; ahora lo gestiona el navegador en el panel del menú, que es el elemento popover. Para estilar el botón según ese estado necesitas un selector relacional: :has(~ :popover-open) significa "este botón, cuando un hermano posterior suyo está abierto". Para el <body>, el equivalente del antiguo data-mobile-menu-expanded es body:has(sl-sidebar-pane:popover-open).

    ¿Qué versiones mínimas necesito para actualizar a Starlight 0.42?

    Astro v7.2.10 o superior. Si usas @astrojs/markdown-satteri, 0.4.0 o superior. Si usas @astrojs/markdown-remark, 7.3.0 o superior. El comando npx @astrojs/upgrade se encarga de subir Starlight, Astro y el resto de integraciones a la vez.

    ¿Debería preocuparme por los navegadores que pierden soporte?

    Depende de tus analíticas, pero casi nunca. Se cae el soporte oficial de Chromium anterior a la 116 (agosto de 2023), Safari anterior a 17.0 (septiembre de 2023) y Firefox anterior a 125. Son los mínimos que exige la Popover API. En documentación técnica ese tráfico suele ser residual; míralo antes de bloquear la actualización por si acaso.

    ¿Qué hago si tenía JavaScript propio escuchando la apertura del menú?

    Bórralo y escucha el evento nativo. El panel es el popover, así que un panel.addEventListener('toggle', ...) con event.newState === 'open' te da lo mismo que antes conseguías con un MutationObserver sobre aria-expanded, con la mitad de código y sin depender de detalles internos de Starlight.

    ¿Y la opción tagline de la configuración?

    Se ha eliminado y no tiene reemplazo, porque nunca se llegó a usar. Bórrala de tu astro.config al actualizar.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Bun 1.4.1: tu bundle de zod pesa un 79% menos sin tocar código

    Bun 1.4.1: tu bundle de zod pesa un 79% menos sin tocar código

    Hace unas semanas abrí el análisis de bundle de un backend que despliego como ejecutable compilado desde hace dos años. Hono, Postgres, validación con zod. Nada exótico.

    Lo que me llamó la atención no fue el tamaño total, fue el reparto. Zod se llevaba una porción absurda para los cuatro schemas que usaba de verdad.

    La explicación estaba en un await import() dinámico enterrado en un módulo de rutas. Ese import funcionaba como un muro: el bundler no podía mirar al otro lado, así que metía el módulo entero por si acaso.

    Bun 1.4.1 tira ese muro. El número que publica el equipo de Bun es exactamente el que me interesaba: zod pasa de 375,3 KB a 77,3 KB. Un 79% menos sin tocar una línea de código de aplicación.

    El titular fácil de esta release es "202 issues cerrados". Ese no es el titular. El titular es que el bundler de Bun ha dejado de ser su eslabón flojo.

    Bun 1.4.1 se publicó el 4 de septiembre de 2026 y su cambio principal está en el bundler: bun build ya hace tree-shaking a través de import() dinámico y de export * as. Medido por el equipo de Bun sobre librerías reales, zod 4.5 baja de 375,3 KB a 77,3 KB (79% menos), effect 3.22 de 369,1 KB a 163,6 KB (56% menos) y fp-ts 2.16 de 21,8 KB a 3,2 KB (85% menos). En el runtime llegan HTTP/2 y HTTP/1.1 en el mismo puerto de Bun.serve(), Bun.write() con streaming a disco y crypto.argon2(). Se actualiza con bun upgrade, y las notas no anuncian ningún breaking change: son 202 issues cerrados sobre la 1.4.0.

    Todas las cifras de este post salen de las notas oficiales de la release de Bun v1.4.1.


    Tree-shaking a través de import() dinámico: el gran cambio de Bun 1.4.1

    Hasta ahora un import dinámico era una frontera para el bundler: sabía que el módulo existía, pero no qué se usaba de él, así que la única opción segura era incluirlo entero.

    Mira este caso, sacado de las notas de la release:

    // is.ts exports isNumber, isOdd, and isEven
    const { isOdd } = await import("./is");
    console.log(isOdd(3));
    

    Antes, ese import() arrastraba isNumber e isEven al bundle aunque nadie las llamara nunca. Ahora Bun analiza el destructuring y solo entra isOdd.

    Parece un detalle de juguete. Multiplícalo por una librería con cientos de exports y entiendes el 79% menos de zod.

    Y ahí está lo interesante: los patrones de carga perezosa que usábamos para "no cargar la validación hasta que haga falta" llevaban años penalizándonos. Cargábamos tarde, sí, pero cargábamos todo.

    En el curso de Zod para TypeScript trabajo justo esa parte: componer schemas por módulo en lugar de un barrel gigante que el bundler tiene que adivinar.

    export * as: el otro sitio donde se escondía el peso

    El segundo sitio donde Bun 1.4.1 recorta peso es más silencioso: los re-exports.

    export * as algo from "./modulo" es el re-export de namespace: agrupas un módulo entero bajo un nombre y lo sacas por tu index.ts. Cómodo para importar, veneno para el tamaño final.

    Bun 1.4.1 optimiza ese re-export. El resultado con fp-ts 2.16: de 21,8 KB a 3,2 KB. Un 85% menos.

    Si tus barrels reexportan con export * as —y en arquitectura por features es habitual agrupar así—, este cambio te afecta aunque no lo hayas pedido. Si solo usas export * plano, mide antes de celebrar.

    Code splitting y ejecutables que arrancan antes

    El code splitting también mejora. El dashboard de Medusa pasa de 349 a 245 archivos JS generados: menos peticiones, menos overhead y menos coste de arranque en el navegador.

    Y en builds de navegador con --splitting, Bun ahora emite module preloading, así que los chunks se piden en paralelo en lugar de en cascada.

    La parte que más me sorprendió está en los ejecutables compilados: arrancan alrededor de un 20% más rápido, con el bytecode más compacto según el equipo de Bun. El caso que usan de ejemplo es Claude Code: de 397 ms a 318 ms de arranque, y la instalación baja de 376 MB a 207 MB.

    Ochenta milisegundos escasos suenan a nada hasta que recuerdas cuántas veces al día lanzas tu CLI favorita. Y fíjate en el detalle: Claude Code, el ejemplo que usa Bun para medirse, está compilado con Bun. Si vives en la terminal con herramientas así —el flujo que enseño en Construye con IA—, ese 20% lo notas en la fricción, no en el benchmark.

    Bun.serve() con HTTP/2 y HTTP/1.1 en el mismo puerto

    En el runtime, Bun 1.4.1 trae dos cambios que afectan a código real: HTTP/2 en Bun.serve() y Bun.write() con streaming a disco.

    El primero es un flag:

    Bun.serve({
      tls: { key, cert },
      http2: true,
      fetch(req) {
        return new Response("hi");
      },
    });
    

    Sin proxy delante, sin segundo servidor, sin decidir de antemano qué protocolo habla tu cliente.

    Si todavía estás en la pregunta anterior a esta —por qué Bun y no Node—, la respuesta larga la escribí en Bun reemplazando a Node.js en backend TypeScript. Aquí doy por hecho que ya la tienes resuelta.

    El segundo cambio: Bun.write() hace streaming a disco en vez de bufferizar en memoria.

    await Bun.write("./big.tar.gz", await fetch(url)); // => bytes escritos
    await Bun.write("./out.txt", readableStream); // antes escribía "[object ReadableStream]"
    

    En una descarga de 128 MiB, el pico de RSS baja de 161 MB a 13 MB. Ese primer ejemplo es el patrón que todos escribimos alguna vez para guardar un archivo remoto, y hasta hoy cargaba el archivo entero en RAM antes de tocar el disco.

    La segunda línea es directamente un bug arreglado: pasar un ReadableStream escribía el texto "[object ReadableStream]" en tu fichero. Si tienes archivos corruptos en producción con ese contenido exacto, ya sabes de dónde venían.

    También hay pause(), resume() y la propiedad isPaused en el WebSocket cliente, que es la pieza que faltaba para hacer backpressure decente:

    import { createWriteStream } from "node:fs";
    
    const file = createWriteStream("./feed.ndjson");
    const socket = new WebSocket("wss://example.com/feed");
    
    socket.addEventListener("message", (event) => {
      if (!file.write(event.data)) {
        socket.pause();
        file.once("drain", () => socket.resume());
      }
    });
    

    Sin eso, un feed rápido y un disco lento acababan siempre en el mismo sitio: memoria creciendo hasta que algo revienta.

    Memoria y detalles que se notan a las tres de la mañana

    La memoria en reposo baja. Un SSR de Next.js pasa de 222 MB a 142 MB una vez terminada la carga. En un contenedor con límite de 256 MB, eso es la diferencia entre dormir tranquilo y recibir alertas de OOM.

    Ojo con la lectura fácil de este tipo de cifras: lo mismo pasó con el 90% menos de memoria de Next.js 16.3, donde el número era real pero no era el de todo el mundo.

    En Buffer hay dos mejoras concretas, y quiero ser preciso porque esto se lee por ahí como "Buffer 9x más rápido": son 9,2x en writeFloatLE() y 7,2x en writeUInt8(). Métodos específicos, no la clase entera.

    AsyncLocalStorage va unas 2x más rápido y ya no asigna memoria en cada await. Si tienes tracing o contexto de request atravesando toda la aplicación, esto lo estabas pagando en cada salto asíncrono.

    Y llegan crypto.argon2() y crypto.argon2Sync(). Bun ya hasheaba con argon2id desde Bun.password; lo nuevo es tenerlo en la API de crypto, que es lo que te ahorra reescribir el módulo de auth cuando portas código de Node.

    Todos los números de Bun 1.4.1, en una tabla

    Caso medido Antes Bun 1.4.1 Mejora
    Bundle de zod 4.5 375,3 KB 77,3 KB 79% menos
    Bundle de effect 3.22 369,1 KB 163,6 KB 56% menos
    export * as con fp-ts 2.16 21,8 KB 3,2 KB 85% menos
    Archivos JS del dashboard de Medusa 349 245 30% menos
    Arranque de Claude Code 397 ms 318 ms 20% menos
    Instalación de Claude Code 376 MB 207 MB 45% menos
    Pico de RSS al descargar 128 MiB 161 MB 13 MB 92% menos
    Memoria en reposo de un SSR de Next.js 222 MB 142 MB 36% menos
    Buffer.writeFloatLE() 2,85 ns 0,31 ns 9,2x
    Buffer.writeUInt8() 2,24 ns 0,31 ns 7,2x

    Fuente: notas de la release de Bun v1.4.1.

    bun install --offline: es para tu CI, no para ti

    Dos flags nuevos en bun install.

    --offline falla si algo no está en caché. Cero red, sin excusas. --prefer-offline es la versión suave: usa la caché y se salta el refetch de metadatos, pero baja lo que falte.

    Los mismos valores viven en bunfig.toml:

    # bunfig.toml
    [install]
    offline = true       # equivale a --offline
    # prefer = "offline" # equivale a --prefer-offline
    

    --offline en local te va a molestar. En CI, con la caché restaurada antes del install, convierte un fallo de red del registry en un error reproducible en lugar de un build rojo aleatorio a las once de la noche.

    Y para monorepos, los workspaces admiten paquetes con node_modules autocontenidos:

    {
      "workspaces": {
        "packages": ["apps/*"],
        "selfContained": ["apps/desktop"]
      }
    }
    

    Útil cuando una app del monorepo se distribuye sola —un binario de escritorio, un contenedor— y necesita sus dependencias dentro, no hoisted arriba del todo.

    Si vienes de otro gestor, el movimiento de fondo es el mismo en todo el ecosistema: velocidad y builds reproducibles. Lo analicé cuando salió pnpm 12 reescrito en Rust.

    ¿Merece la pena actualizar a Bun 1.4.1? Qué migrar hoy y qué no

    Bun 1.4.1 no es una revolución. Es una release de consolidación, y el bloque del bundler es lo único que justifica que la instales esta semana.

    Tu situación Qué hacer con Bun 1.4.1 Por qué
    Compilas frontend o librerías con bun build Actualiza hoy La ganancia de tamaño es gratis y se mide en diez minutos
    Distribuyes ejecutables con bun build --compile Actualiza hoy 20% menos de arranque y 45% menos de instalación sin tocar código
    Bun solo ejecuta tu servidor Actualiza sin prisa HTTP/2 y menos RSS no arreglan nada que hoy funcione
    Estás en Node y te funciona No migres Una release no justifica cambiar de runtime en producción

    La primera fila es la que tiene premio inmediato: actualizas, relanzas el build y comparas el tamaño. Diez minutos. La tercera puede esperar al próximo sprint, porque HTTP/2 en el mismo puerto y menos RSS están muy bien, pero no arreglan nada que hoy funcione.

    Y no migres de Node a Bun solo por esta release. Si Node te sirve, esto no cambia la ecuación. Lo que cambia es que el argumento "el bundler de Bun todavía no está maduro" ya no se sostiene.

    Mi orden de trabajo esta semana es este: actualizar, lanzar el build, medir el bundle antes y después, y revisar dónde teníamos import() dinámicos puestos como optimización que en realidad no optimizaban nada.

    Ese ejercicio de medir antes y después es de lo que más discutimos en Dominicode Labs, porque casi siempre aparece algo que llevaba años ahí sin que nadie lo mirara.


    Preguntas frecuentes

    ¿Tengo que cambiar código para ganar el 79% menos de zod?

    No. La optimización ocurre al empaquetar, no al escribir: actualizas Bun, vuelves a lanzar bun build y el bundle sale más pequeño. Lo único que conviene revisar es si tus import() dinámicos destructuran lo que usan de verdad, porque cuanto más explícito seas al importar, más trabajo puede hacer el bundler.

    ¿El tree-shaking a través de import() dinámico funciona fuera de Bun?

    No. Es una optimización del bundler de Bun, no del lenguaje ni de TypeScript, así que el beneficio solo llega cuando el build lo hace bun build. Ejecutar tu aplicación con Bun pero empaquetar con otro bundler no te da estos números.

    ¿HTTP/2 en Bun.serve() necesita TLS?

    Sí en la práctica: el ejemplo oficial de la release configura tls junto a http2: true, que es el escenario normal para HTTP/2 en internet. Lo nuevo no es soportar el protocolo, es que HTTP/2 y HTTP/1.1 conviven en el mismo puerto, sin levantar dos servidores ni decidir por adelantado qué habla el cliente.

    ¿Cómo actualizo a Bun 1.4.1 y hay breaking changes?

    Con bun upgrade, y las notas de la release no anuncian ningún breaking change: es una versión de consolidación que cierra 202 issues sobre la 1.4.0. Si compilas con bun build, el orden sensato es actualizar, relanzar el build y comparar el tamaño antes y después.

    ¿bun install –offline sirve para CI?

    Sí, es su mejor uso: restauras la caché de Bun al principio del job y lanzas bun install --offline, de modo que si falta algo el build falla ahí y no a mitad del pipeline. Si prefieres algo menos estricto, --prefer-offline se salta el refetch de metadatos pero descarga lo que no esté en caché.

    ¿Merece la pena migrar de Node a Bun solo por esta release?

    No. Una release no justifica una migración de runtime en un proyecto que ya está en producción y funciona. Lo que sí merece la pena es probar bun build como bundler aunque ejecutes con Node: esa prueba cuesta una tarde y te da datos de tu proyecto en lugar de benchmarks ajenos.


    Si quieres ver este tipo de análisis en vídeo, con el proyecto delante y midiendo en directo, lo publico en el canal de YouTube de Dominicode.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
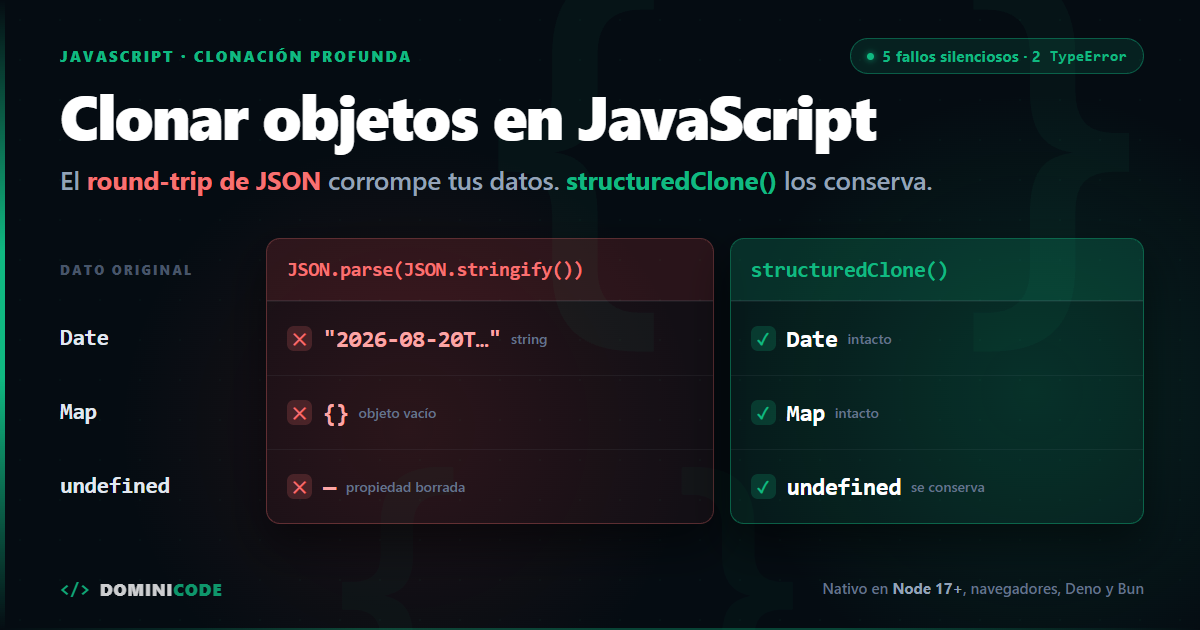
  • Clonar objetos en JavaScript: structuredClone vs JSON.parse

    Clonar objetos en JavaScript: structuredClone vs JSON.parse

    Clonar objetos en JavaScript parece trivial hasta que te llaman de urgencia un viernes por la tarde.

    Me pasó hace un par de años con una pasarela de reservas. El bug era esquivo: cuando un usuario editaba una reserva antes de pagar, la fecha del check-in cambiaba sola. Otras veces el sistema reventaba con date.toISOString is not a function.

    El culpable era una línea en un reducer. Arreglarlo costó cinco minutos. Encontrarlo, dos días.

    const updatedState = JSON.parse(JSON.stringify(currentState));
    

    El desarrollador quería una copia profunda (deep clone) para no mutar el estado. Pero JSON.stringify() convirtió todas las fechas Date en cadenas de texto, borró las propiedades con valor undefined, vació los Map y transformó los NaN en null.

    La respuesta corta: para clonar un objeto en JavaScript en profundidad, usa structuredClone(obj). Es una función global nativa que copia el objeto y todo su contenido anidado conservando Date, Map, Set, RegExp, BigInt, ArrayBuffer y las referencias circulares. No hay que instalar nada: está disponible en los navegadores como Baseline desde marzo de 2022 y en Node.js desde la 17.0.0, además de Deno y Bun.

    Durante una década, el round-trip de JSON fue el parche habitual porque el lenguaje no tenía API nativa de clonación profunda. Hoy la tiene, y mantener el hack es un riesgo que ya no hace falta correr.

    Las 7 cosas que JSON.parse(JSON.stringify()) le hace a tus datos

    El formato JSON nació para intercambiar datos por red. Nunca se diseñó para serializar estructuras de datos vivas en memoria. Solo conoce seis tipos: string, number, boolean, null, array y objeto plano. Todo lo demás se degrada o desaparece.

    Al pasar un objeto por JSON.stringify() y devolverlo con JSON.parse() ocurren siete cosas: cinco corrompen los datos en silencio y dos lanzan un TypeError que al menos te avisa.

    Dato original Tras JSON.parse(JSON.stringify()) Con structuredClone()
    new Date("2026-08-20") "2026-08-20T00:00:00.000Z" — string Date intacto
    { prop: undefined } {} — la propiedad desaparece { prop: undefined }
    { total: NaN } { total: null } NaN
    new Set([1, 2, 3]) {} — objeto vacío Set intacto
    new Map([["k", "v"]]) {} — objeto vacío Map intacto
    123n — BigInt TypeError: Do not know how to serialize a BigInt 123n
    Referencia circular TypeError: Converting circular structure to JSON referencia conservada

    Las dos últimas filas son las buenas: fallan ruidosamente y te enteras en el acto. El peligro real son las cinco primeras, porque la aplicación sigue funcionando mientras tus entidades de negocio pierden sus tipos.

    Y el compilador tampoco te va a avisar: JSON.parse() devuelve any, así que TypeScript sigue creyendo que checkIn es un Date mucho después de que haya dejado de serlo. Es justo el hueco que cubre la programación defensiva en TypeScript: el tipo estático no valida nada en tiempo de ejecución.

    Qué es structuredClone() y cómo funciona

    structuredClone() crea una copia profunda e independiente de un valor: modificar el clon no afecta al original a ninguna profundidad.

    Utiliza el algoritmo de clonación estructurada (structured clone algorithm), el mismo estándar que usa el navegador para transferir datos de forma segura entre la ventana principal y los Web Workers o IndexedDB. Por eso entiende de tipos: no serializa a texto, copia estructura.

    Es una de esas APIs que ya no tienes que comprobar al mover código entre runtimes, porque la comparten todos — algo que agradeces cuando comparas Bun frente a Node.js en backend TypeScript y quieres que el mismo código corra en los dos.

    const original = {
      id: 101,
      createdAt: new Date(),
      tags: new Set(["typescript", "angular", "ia"]),
      metadata: new Map([["source", "web"]]),
      config: { retries: 3 },
    };
    
    // Clonación profunda nativa
    const clon = structuredClone(original);
    
    clon.tags.add("nuevo-tag");
    clon.config.retries = 10;
    
    // El original permanece intacto, y con sus tipos
    console.log(original.tags.has("nuevo-tag")); // false
    console.log(original.createdAt instanceof Date); // true
    console.log(clon.metadata instanceof Map); // true
    

    Qué NO puede clonar structuredClone()

    El algoritmo está diseñado para clonar datos, no comportamiento ni recursos del sistema operativo.

    1. Funciones y métodos. Clonar { fn: () => {} } lanza una DOMException con name: "DataCloneError". Las funciones capturan closures y no pueden duplicarse de forma determinista.
    2. Nodos del DOM. No puedes clonar un HTMLElement — para eso existe element.cloneNode(true). Tampoco Promise, WeakMap ni WeakSet.
    3. Instancias de clase. Cualquiera, incluso con un solo método. Se clonan sus propiedades de datos, pero el clon llega como objeto plano, sin prototipo.
    class Reserva {
      constructor(public id: number, public checkIn: Date) {}
      estaVencida(): boolean { return this.checkIn < new Date(); }
    }
    
    const original = new Reserva(101, new Date("2026-01-01"));
    const clon = structuredClone(original);
    
    clon.checkIn instanceof Date; // true  — el dato sobrevive
    clon instanceof Reserva;      // false — el prototipo no
    clon.constructor.name;        // "Object"
    clon.estaVencida();           // TypeError: clon.estaVencida is not a function
    
    // Si necesitas la instancia de vuelta, recoloca el prototipo a mano:
    const clonReal = Object.assign(
      Object.create(Reserva.prototype),
      structuredClone({ ...original }),
    );
    
    clonReal instanceof Reserva; // true
    

    Cuando te ves haciendo ese baile a menudo, el problema no es structuredClone(): es que estás mezclando estado y comportamiento en la misma estructura. Separar la entidad de datos del servicio que la opera es uno de los criterios que desarrollo en patrones de diseño avanzados en TypeScript.

    Hay dos pérdidas más, menos conocidas y más traicioneras:

    1. Getters y setters. El clon no hereda el getter, hereda su resultado. structuredClone() lo ejecuta una vez y guarda el valor como propiedad normal.
    2. Símbolos. Un Symbol como valor lanza DataCloneError. Como clave, desaparece del clon sin decir nada.
    const producto = {
      precioBase: 100,
      get precioConIva() { return this.precioBase * 1.21; },
      [Symbol("interno")]: "no viaja",
    };
    
    const clon = structuredClone(producto);
    
    clon.precioConIva;                         // 121 — valor congelado, ya no es un getter
    clon.precioBase = 200;
    clon.precioConIva;                         // 121 — no se recalcula
    Object.getOwnPropertySymbols(clon).length; // 0   — la clave Symbol desapareció
    

    Lo mismo aplica a las propiedades no enumerables y a Object.freeze(): no viajan. El clon siempre sale descongelado.

    ¿structuredClone() es más lento que JSON.parse(JSON.stringify())?

    Sí, y conviene decirlo en voz alta porque casi ningún post lo menciona: con objetos planos sin tipos especiales, structuredClone() viene a ser el doble de lento que el round-trip de JSON.

    La razón es que JSON.parse lleva más de una década optimizado en C++ dentro de V8, mientras que el algoritmo de clonación estructurada tiene que inspeccionar el tipo de cada valor para decidir cómo copiarlo. Esa inspección es justo lo que estás comprando.

    No te doy una cifra por operación a propósito: la medí tres veces sobre el mismo objeto en la misma máquina y el ratio se movió entre 1,5× y 2,2× según el tamaño del payload y la corrida. Mídelo en tu caso si te importa, con tu objeto real. El código para hacerlo cabe en cinco líneas.

    Ahora bien, hablamos de fracciones de milisegundo por cada centenar de objetos. Si eso es tu cuello de botella, el problema no es el clonado: es que estás clonando cientos de objetos en el camino crítico. Cambiar corrección por medio milisegundo es un mal negocio, y el único escenario donde JSON gana de verdad es cuando ya sabes que tu payload es JSON puro porque acaba de llegar de un fetch().

    structuredClone() vs lodash cloneDeep: cuándo sigues necesitando la librería

    structuredClone() sustituye a cloneDeep() en la mayoría de casos y te ahorra la dependencia. Pero no en todos:

    • Clases y prototipos. cloneDeep() conserva el prototipo: el clon de new Pedido() sigue siendo un Pedido con sus métodos. structuredClone() no, porque el algoritmo de clonación estructurada no recorre ni duplica la cadena de prototipos.
    • Funciones dentro del objeto. cloneDeep() copia la referencia. structuredClone() lanza DataCloneError y aborta el clonado entero.
    • Getters, setters y descriptores. Tampoco se duplican: una propiedad de solo lectura sale de lectura y escritura en el clon.
    • Símbolos. structuredClone() los rechaza.

    En sentido contrario, structuredClone() cubre cosas que cloneDeep no: BigInt, ArrayBuffer, Blob y las referencias circulares sin trucos.

    La regla que uso: si tu estado son datos —el caso normal en una arquitectura con Signals o un store inmutable—, structuredClone() y fuera la dependencia. Si tu estado son instancias con comportamiento, no clones: replantea el modelo.

    Si tu arquitectura se apoya en inmutabilidad —un store de Signals, un reducer, cualquier cosa que compare por referencia—, structuredClone() encaja de forma natural, porque el estado debe ser datos puros. En el curso de Angular Moderno hay módulos enteros dedicados a montar esa arquitectura con Signals sin mutaciones accidentales.

    Clonar no es validar

    structuredClone() garantiza que el clon tiene los mismos tipos que el original. No que el original sea correcto.

    Si el objeto viene de una API, de localStorage o de un formulario, clonarlo solo te da dos copias del mismo problema. Un Date que en realidad era el string "2026-13-45" seguirá siendo basura después de clonarlo. Valida en el borde, clona dentro del dominio.

    Y aquí hay un detalle que casi nadie aprovecha: parse() de Zod no te devuelve el objeto que le pasaste, sino uno nuevo reconstruido campo a campo. La validación ya te está dando una copia.

    import { z } from "zod";
    
    const ReservaSchema = z.object({
      id: z.number().int().positive(),
      checkIn: z.coerce.date(),            // string ISO → Date real
      tags: z.array(z.string()).default([]),
    });
    
    const payload = await fetch("/api/reservas/101").then((r) => r.json());
    
    // Zod valida, convierte tipos y devuelve un objeto NUEVO
    const reserva = ReservaSchema.parse(payload);
    
    reserva.checkIn instanceof Date; // true — z.coerce.date() lo reconstruyó
    reserva !== payload;             // true — ya es una copia
    reserva.tags !== payload.tags;   // true — también los arrays anidados
    
    // structuredClone() solo hace falta para la SIGUIENTE copia
    const borrador = structuredClone(reserva);
    borrador.tags.push("editado");
    
    reserva.tags.length;  // 1 — el validado no se toca
    borrador.tags.length; // 2
    

    Si estás llamando a structuredClone(payload) justo después de schema.parse(payload), estás clonando dos veces. Los patrones de contrato y coerción los desgloso en el curso de Zod para TypeScript, y el montaje completo hasta el store está en gestión de estado global con Zod y Signals.

    Tu tarea para hoy en el repositorio

    Abre el editor y haz una búsqueda global:

    JSON.parse(JSON.stringify(
    

    Si encuentras coincidencias:

    1. Reemplázalas por structuredClone(obj). Ganas soporte inmediato para fechas, sets, maps y referencias circulares sin dependencias externas.
    2. Si la llamada empieza a lanzar DataCloneError, no lo tapes con un try/catch. Acabas de descubrir que había funciones en ese objeto y que el hack de JSON te las estaba borrando en silencio.
    3. Desinstala lo que ya no necesitas. Si arrastrabas lodash solo por cloneDeep, tienes una dependencia menos en el bundle.
    4. Blinda el cambio con un test. Una aserción de referencia detecta la regresión el día que alguien vuelva a meter el hack.
    it("no muta el estado original al clonar", () => {
      const original = { checkIn: new Date("2026-01-01"), tags: new Set(["web"]) };
      const clon = structuredClone(original);
    
      clon.tags.add("editado");
    
      expect(original.tags.has("editado")).toBe(false);
      expect(clon.checkIn).not.toBe(original.checkIn); // referencia distinta
      expect(clon.checkIn).toEqual(original.checkIn);  // mismo valor
    });
    

    Cómo montar estas suites en proyectos reales lo tienes en el curso de Testing en Angular y TypeScript.

    En Dominicode Labs revisamos código real de los miembros y cazamos justo este tipo de patrón obsoleto: el que no rompe nada hasta que rompe todo.

    El código moderno no consiste en instalar más paquetes. Consiste en conocer lo que el lenguaje ya trae y usarlo con criterio.


    Preguntas frecuentes sobre clonar objetos en JavaScript

    ¿Cómo clono un objeto en JavaScript sin modificar el original?

    Usa structuredClone(objeto). Devuelve una copia profunda e independiente: modificar el clon no afecta al original, ni siquiera en propiedades anidadas a cualquier profundidad. Si solo necesitas copiar el primer nivel y todos los valores son primitivos, el spread { ...objeto } es suficiente y más rápido, pero con objetos anidados el spread copia referencias compartidas y acabarás mutando el original sin darte cuenta.

    ¿Por qué JSON.parse(JSON.stringify()) rompe mis datos?

    Porque JSON es un formato de intercambio por red, no de serialización de memoria, y solo conoce seis tipos: string, number, boolean, null, array y objeto plano. Todo lo demás se degrada o desaparece. Los Date se convierten en cadenas de texto, las propiedades con valor undefined se eliminan, los NaN pasan a null, y los Map y Set quedan como objetos vacíos porque su contenido vive en slots internos que JSON.stringify() no sabe leer. Ninguna de esas cinco pérdidas lanza un error: tu aplicación sigue corriendo con los datos ya corrompidos.

    ¿structuredClone() funciona en Node.js?

    Sí, como función global y sin importar nada, desde Node.js 17.0.0. También está en Deno y en Bun. En navegadores es Baseline desde marzo de 2022, así que ya no necesitas polyfill salvo que tengas que soportar versiones anteriores a esa fecha, donde la alternativa es el paquete @ungap/structured-clone.

    ¿Por qué structuredClone() lanza DataCloneError?

    Porque el objeto contiene algo que el algoritmo no sabe copiar: casi siempre una función, un símbolo o un nodo del DOM escondido en alguna propiedad anidada. El algoritmo clona datos, no comportamiento, y una función captura su ámbito léxico, que no se puede duplicar de forma determinista. El mensaje no te da la ruta hasta la propiedad culpable, así que la vía rápida es ir clonando por capas hasta aislarla.

    ¿structuredClone() conserva las clases y sus métodos?

    No. La cadena de prototipos no se recorre ni se duplica, así que el clon de una instancia de clase conserva sus propiedades de datos pero llega como objeto plano, sin métodos y con constructor.name igual a Object. Lo peligroso es que esto no lanza ningún error: el fallo aparece más tarde, cuando alguien llama a un método que ya no existe. Si necesitas la instancia completa, clona solo los datos y reconstruye con new MiClase(datos), o añade un método clone() propio a la clase.

    ¿Sigo necesitando lodash cloneDeep?

    Solo si clonas instancias de clase y necesitas conservar el prototipo, si el objeto contiene funciones, o si dependes de getters, setters y descriptores de propiedad. Para datos puros, structuredClone() cubre más tipos que cloneDeep —incluidos BigInt y las referencias circulares— sin añadir un solo byte a tu bundle.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.