Tag: Anthropic Claude

  • Coste de subagentes: por qué sube al cambiar de modelo

    Coste de subagentes: por qué sube al cambiar de modelo

    Cambié el modelo de mi pipeline de research y la factura del día siguiente no cuadraba.

    No había tocado el código. Ni un prompt nuevo, ni una tool nueva. Solo el identificador del modelo en una variable de entorno.

    Mi primera sospecha fue el precio por token. No era eso.

    Era que el modelo nuevo delegaba más. El mismo prompt de orquestación, palabra por palabra, lanzaba más subagentes por tarea. Y ese es el problema: el coste de los subagentes no se fija una vez y queda escrito en tu repo.

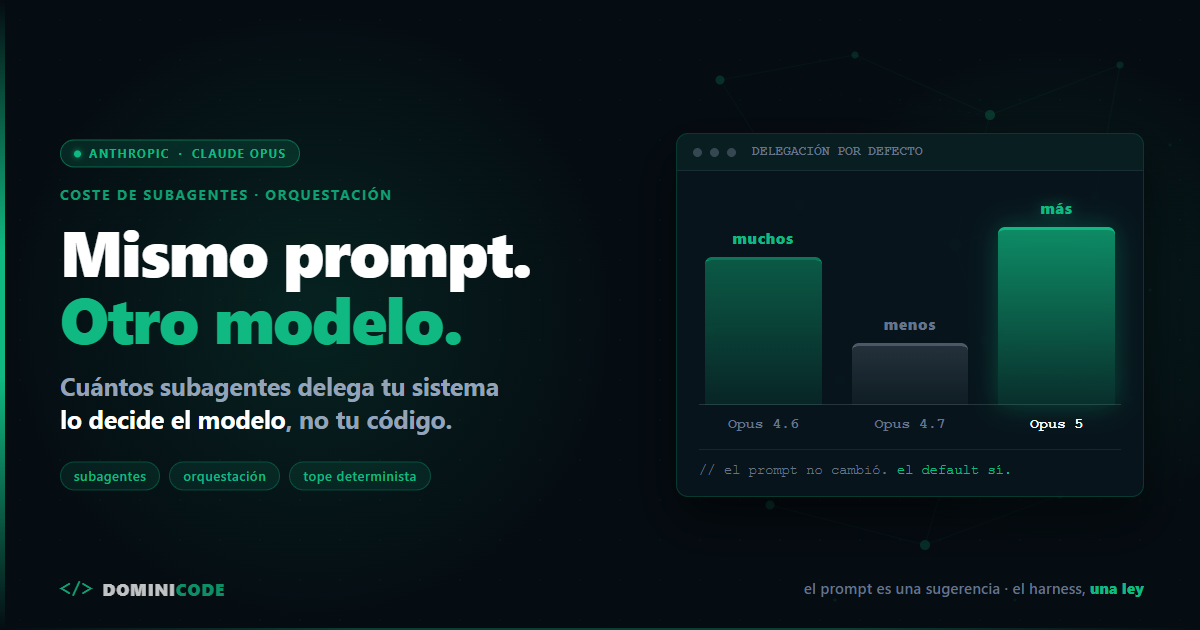
    El número de subagentes que lanza tu sistema no lo decides solo tú. Lo decide en parte el modelo: cuántos subagentes delega por defecto es una propiedad del modelo, no de tu código, y cambió en las tres últimas generaciones de Claude Opus — 4.6 lanzaba muchos, 4.7 menos, y Opus 5 vuelve a delegar más que los anteriores. Por eso tu factura puede subir sin que toques una línea.

    Un aviso antes de seguir: si lo que estás decidiendo es si montar varios agentes o quedarte con uno, este no es tu post. Esa pregunta la respondí entera en cuándo usar multi-agente sin orquestador. Aquí doy por hecho que ya tienes subagentes corriendo. Voy a otra cosa: tu ajuste está atado a un modelo que ya no existe.

    Cuántos subagentes delega Claude Opus 4.6, 4.7 y 5 por defecto

    Esto es lo que documenta Anthropic en su guía de migración de modelos sobre el comportamiento por defecto al delegar:

    Modelo Comportamiento por defecto al delegar
    Claude Opus 4.6 Lanzaba muchos subagentes
    Claude Opus 4.7 Tiende a lanzar menos subagentes que 4.6
    Claude Opus 5 Delega en subagentes más fácilmente que los modelos anteriores

    Fuente: documentación de Anthropic sobre Claude Opus 4.6, 4.7 y 5, consultada en julio de 2026.

    Arriba, abajo, y otra vez arriba.

    Tres versiones, tres defaults distintos. Y ninguno aparece en tu diff, en tu changelog ni en tu suite de tests.

    Sobre Opus 5 Anthropic es literal: la delegación "compensa en tramos de trabajo grandes y genuinamente independientes, pero multiplica coste y tiempo cuando se aplica a tareas pequeñas".

    Multiplica. No suma.

    Un cambio de modelo tiene dos tipos de consecuencias: las que rompen la llamada y ves en el primer deploy —de esas hablé en los 2 breaking changes de Claude Opus 5— y las que no rompen nada. Estas segundas son peores, porque el sistema sigue funcionando. Solo cuesta más y tarda más.

    Por qué el coste de los subagentes se dispara: los ajustes se acumulan

    Piensa en lo que hiciste cuando tu modelo delegaba poco.

    Le empujaste. Escribiste algo del tipo "si la tarea toca más de tres ficheros, reparte el trabajo entre varios subagentes". Funcionó, lo dejaste ahí y pasaste a otra cosa.

    Esa frase sigue en tu prompt.

    La escribiste contra un modelo que iba parado. Ahora se la dices a uno que ya corre solo. Empujar a alguien quieto y empujar a alguien lanzado no dan el mismo resultado, y esa es la situación de casi todos los sistemas de agentes que reviso.

    El prompt de orquestación es la capa que más rápido envejece y la que menos gente revisa. Si tienes montado el patrón coordinador que expliqué en cómo orquestar subagentes de IA, el coordinador es donde vive esta deuda: ahí siguen las instrucciones que compensaban algo que ya no hay que compensar.

    Los ajustes de prompt no se reemplazan al cambiar de modelo. Se acumulan sobre el nuevo default.

    La recomendación de Anthropic va en dos direcciones: dar guía explícita sobre qué escenarios justifican delegar, o poner topes deterministas a cuántos agentes se pueden lanzar. Este es el bloque de guía que ellos mismos proponen, traducido:

    Delega en un subagente solo para tareas grandes que sean genuinamente
    independientes y paralelizables, como una investigación amplia en muchos
    ficheros. No delegues trabajo que puedas terminar tú en un puñado de
    llamadas a herramientas, y no uses subagentes para verificar o revisar
    tu propio trabajo. Si un subagente puede completar la tarea, usa uno en
    vez de varios, y mantén bajos los recuentos de lanzamiento.
    

    Fíjate en la frase del medio. Ahí está el cambio más caro.

    El caso más caro: el subagente que verifica

    No uses subagentes para verificar o revisar tu propio trabajo.

    Hace un año eso era lo contrario de lo que recomendábamos casi todos, yo incluido: un subagente con contexto limpio revisaba la salida del principal y pillaba lo que el autor no veía. Funcionaba.

    Con Opus 5 esa misma instrucción es gasto.

    Anthropic documenta que Opus 5 verifica su propio trabajo sin que se lo pidas. Y va más lejos: si tu prompt lleva instrucciones explícitas del tipo "incluye un paso final de verificación" o "usa un subagente para verificar", hay que quitarlas, porque provocan sobre-verificación. Quitarlas reduce tokens desperdiciados sin pérdida de calidad.

    Eliminar instrucciones baja el coste y no empeora el resultado.

    Lo mismo con el auto-chequeo. La indicación es no pedirle re-chequeos que ya hace, y eso invierte una de las best practices de prompting más repetidas de los últimos años.

    El patrón escritor-verificador no está muerto: Anthropic dice también que Opus 5 coordina equipos de subagentes bien, con pocos casos de agentes que se pisan el trabajo entre ellos. Lo que cambia no es el patrón, es el reflejo.

    La línea es esta: sobra que el modelo se revise a sí mismo dos veces; no sobra un control independiente sobre el trabajo de otro. Una puerta antes de mergear, un revisor de seguridad, un validador de contrato. Eso no es sobre-verificación, es una barrera, y las barreras no se quitan porque el modelo haya mejorado.

    Un verificador independiente sobre un entregable grande sigue teniendo sentido. Enganchado por defecto a cada tarea pequeña, revisando lo que el modelo ya revisó solo, duplica el coste de los subagentes a cambio de nada.

    Y otra vez Anthropic: para cargas sensibles al coste, limita la delegación.

    Lo único estable: el tope determinista

    Un prompt es una sugerencia que el modelo pondera junto a todo lo que hay en su contexto. Un tope en el harness es un número.

    Si el default del modelo se mueve y tu tope no, tu coste tiene techo.

    Por eso el sitio donde escribes "máximo tres subagentes por tarea" importa más que la frase. En el prompt es una preferencia. En el código que rodea al modelo es una ley. La misma distinción que explico en por qué un LLM por sí solo no es un producto: el modelo propone, el harness decide qué se ejecuta.

    Dónde vive ese número depende de cuánto harness tuyo haya. Si el bucle lo escribes tú —API directa o SDK—, el tope es un contador en la función que lanza subagentes y no hay más discusión. Si trabajas dentro de una herramienta de terceros no tienes esa función, pero casi siempre tienes tres palancas: qué subagentes existen como definición, un hook que intercepte la llamada que los lanza —como los hooks de Claude Code— y el log. Si tu plataforma no te da ninguna de las tres, asúmelo: tu único control es el prompt, y entonces el número de la factura no lo decides tú.

    Cuatro topes de subagentes que no dependen del modelo

    El mecanismo aguanta cualquier generación; el número que metes dentro, no. Ese lo revisas tú, con el log delante.

    • Contador de lanzamientos por tarea. El spawn número N+1 se rechaza, sin negociación.
    • Presupuesto de tokens por ejecución. Cuando se agota, se corta y se devuelve lo que haya.
    • Profundidad máxima de anidamiento. Un subagente que lanza subagentes es donde se va el presupuesto sin aparecer en ninguna traza. Si tu harness permite anidar, el límite es 1 salvo que puedas justificar lo contrario. Y si defines los subagentes como ficheros, como en Claude Code, la lista de herramientas de cada uno es donde se decide quién puede delegar y quién no.
    • Timeout por rama. El subagente colgado también cuesta, sobre todo en latencia.

    El tope tiene un precio y conviene decirlo. Si el modelo iba a repartir bien un trabajo de verdad paralelizable, el rechazo número N+1 le corta el plan por la mitad. Por eso el tope no puede ser solo un throw: define qué pasa después. Lo razonable es degradar, no abortar — el trabajo que iba a delegar lo hace en línea, más lento y más barato, y el log registra que el tope saltó. Un tope que convierte un sobrecoste visible en un resultado truncado silencioso es peor que no tener tope.

    Y el tope solo protege del exceso. Si el próximo modelo vuelve a delegar poco —y ya ha pasado— nunca llega a saltar, y lo que notas es peor cobertura, no peor factura. El log es lo que te dice si el número hay que subirlo, bajarlo o dejarlo en paz.

    Cuántos agentes puede lanzar tu sistema es una decisión de arquitectura y se toma antes de escribir el código, no cuando llega la factura. Es el fondo de lo que cuento en el libro de Spec-Driven Development: lo que no está en la spec lo acaba decidiendo el modelo por ti.

    Qué revisar hoy en tu prompt de orquestación: checklist en 5 pasos

    1. Busca en tu prompt de orquestación las frases que empujan a delegar. Las escribiste contra un modelo concreto. Si ese modelo ya no es el que corre, bórralas o reescríbelas.
    2. Busca las instrucciones de verificación que el modelo se aplica a sí mismo. "Verifica al final", "usa un subagente para revisar tu trabajo", "comprueba tu respuesta". Si estás en Opus 5, quítalas y mide antes y después. Lo que no tocas es el control independiente: si tienes una puerta que valida el entregable de otro agente antes de que salga, se queda donde está.
    3. Loguea cuántos subagentes se lanzan por tarea. Media y percentil 95. Sin ese número no tienes el problema medido, tienes una intuición — va de eso cómo monitorear agentes de IA en producción.
    4. Pon un tope duro en el harness, aunque lo pongas alto. La primera vez que salte te contará algo que no sabías.
    5. Anota contra qué modelo está afinado tu prompt. Modelo y fecha, dos líneas en el repo. Eso convierte el futuro "esto ya no va igual" en "esto se afinó contra 4.7".

    El resumen cabe en una frase: el prompt es una recomendación, el harness es una ley. Todo lo que quieras que sobreviva al próximo modelo, escríbelo en el segundo.

    En Dominicode Labs revisamos configuraciones reales de producción, con sus facturas delante.

    Preguntas frecuentes sobre el coste de los subagentes

    ¿Cuántos subagentes debería lanzar mi sistema por tarea?

    Los menos que resuelvan la tarea. La guía de Anthropic es explícita: si un subagente puede completar el trabajo, usa uno en vez de varios y mantén bajos los recuentos de lanzamiento.

    No hay número universal, pero sí un punto de partida razonable: tope de 3 lanzamientos por tarea y profundidad de anidamiento 1 —un subagente no lanza subagentes—, y a partir de ahí subes solo cuando el log demuestre que hacía falta. Mide el tuyo antes de opinar sobre él.

    ¿Por qué subió el coste de los subagentes si no cambié nada del código?

    Porque el comportamiento por defecto al delegar es una propiedad del modelo y cambia entre versiones. Claude Opus 4.6 lanzaba muchos subagentes, Opus 4.7 tiende a lanzar menos que 4.6 y Opus 5 delega más fácilmente que los anteriores. Cambiar el identificador del modelo en una variable de entorno cambia ese default sin tocar una línea de tu sistema.

    ¿Hay que quitar el subagente verificador de mi orquestador?

    Si corres sobre Claude Opus 5, sí en su forma refleja. Anthropic recomienda eliminar las instrucciones explícitas del tipo "usa un subagente para verificar": el modelo ya verifica su propio trabajo y esas frases provocan sobre-verificación, así que quitarlas reduce tokens desperdiciados sin pérdida de calidad.

    Un verificador independiente sobre un entregable grande sigue teniendo sentido; enganchado a cada tarea pequeña, no. Para las instrucciones de auto-chequeo dentro del propio prompt —el clásico "revisa tu respuesta antes de contestar"— el detalle está en los 2 breaking changes de Claude Opus 5.

    ¿Sigue siendo válido el patrón escritor-verificador?

    Sí como patrón de coordinación. Anthropic documenta que Opus 5 coordina equipos de subagentes bien, con pocos casos de agentes que se pisan el trabajo entre ellos. Lo que deja de tener sentido es el verificador reflejo: un subagente revisando cada tarea pequeña que el modelo ya ha revisado solo.

    ¿El tope de subagentes va en el prompt o en el código?

    En el código. Un tope en el prompt es una sugerencia que el modelo pondera junto a su comportamiento por defecto; en el harness se cumple siempre, sea cual sea el modelo. El prompt sirve para la guía cualitativa —qué escenarios justifican delegar—, no para el límite duro.

    ¿El default de delegación también cambia entre versiones de otros proveedores?

    El comportamiento por defecto al delegar es una propiedad de cada modelo, no del proveedor, así que asumir que se mantiene estable entre versiones es mala idea con cualquiera. Los datos de este post proceden de la documentación de Anthropic sobre Claude Opus 4.6, 4.7 y 5, que lo recoge de forma explícita; si trabajas con otro proveedor, búscalo en su guía de migración antes de dar tu ajuste por bueno, y si no lo documenta, con más razón pon el tope en el harness: lo que no está escrito puede cambiar igual, solo que sin avisarte.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude API: Crash Course para developers con TypeScript

    Claude API: Crash Course para developers con TypeScript

    Hace unos meses un developer me escribió frustrado. Llevaba dos días intentando integrar Claude en su app. No le funcionaba el streaming, no entendía por qué sus respuestas llegaban cortadas, y había probado tres ejemplos distintos de Stack Overflow que usaban versiones diferentes del SDK.

    El problema no era la API. Era que había empezado por el medio.

    Esta es la Claude API introducción que yo habría querido tener al principio: sin rodeos, con código real, y con el orden correcto para entender qué está pasando antes de que algo falle.

    Qué es la Claude API y por qué te importa

    Claude es el modelo de lenguaje de Anthropic. La API te da acceso directo a ese modelo desde tu código: puedes enviarle mensajes, pedirle que razone, que use herramientas externas, que responda en streaming o que procese imágenes.

    La diferencia respecto a ChatGPT para developers es principalmente la calidad del razonamiento en tareas de código complejas y el system prompt — Claude lo sigue con una precisión que cambia cómo construyes agentes.

    Setup: API key y SDK

    Primero necesitas una cuenta en console.anthropic.com. Una vez dentro, ve a API Keys y genera una nueva clave. Guárdala — no la vuelves a ver.

    Instala el SDK oficial con npm o Bun:

    npm install @anthropic-ai/sdk
    # o con Bun
    bun add @anthropic-ai/sdk
    

    Guarda la clave en una variable de entorno. Nunca en el código:

    # .env
    ANTHROPIC_API_KEY=sk-ant-...
    

    Tu primera llamada en TypeScript

    Este es el "Hello World" de la Claude API. Sin clases, sin abstracción, directo al grano:

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic({
      apiKey: process.env.ANTHROPIC_API_KEY,
    });
    
    async function main() {
      const response = await client.messages.create({
        model: "claude-sonnet-4-6",
        max_tokens: 1024,
        messages: [
          {
            role: "user",
            content: "Explica qué es un closure en JavaScript en 2 líneas.",
          },
        ],
      });
    
      console.log(response.content[0].type === "text" ? response.content[0].text : "");
    }
    
    main();
    

    Eso es todo. Ejecutas esto y tienes una respuesta de Claude en tu terminal.

    Lo que necesitas entender de la estructura:

    • model — qué versión de Claude usas (más sobre esto abajo)
    • max_tokens — límite de tokens en la respuesta (no el total de la conversación)
    • messages — array de turnos de conversación con role: "user" o role: "assistant"

    Los conceptos que no puedes ignorar

    Modelos disponibles

    Anthropic tiene tres familias activas:

    Modelo Cuándo usarlo
    claude-sonnet-4-6 El equilibrio perfecto: velocidad + calidad. Mi default para casi todo.
    claude-haiku-4-5 Más rápido y barato. Bueno para tareas simples o llamadas en volumen.
    claude-opus-4-8 El más potente. Para tareas de razonamiento complejo donde el coste no es el problema.

    Si estás empezando, usa claude-sonnet-4-6. No pienses más.

    System prompt vs User message

    El system es la personalidad y las instrucciones permanentes de Claude. El user es lo que cambia en cada turno.

    const response = await client.messages.create({
      model: "claude-sonnet-4-6",
      max_tokens: 1024,
      system: "Eres un reviewer de código senior. Responde siempre en español. Sé directo y señala el problema antes de proponer la solución.",
      messages: [
        {
          role: "user",
          content: "Revisa esta función: function add(a, b) { return a - b; }",
        },
      ],
    });
    

    El system prompt es donde ocurre la mayor parte de la magia cuando construyes agentes. Si quieres ver cómo llevamos esto a proyectos reales con Claude Code, en el curso Construye con IA cubrimos exactamente eso: de la idea al producto con agentes que siguen instrucciones de producción.

    Tokens: lo que cuesta dinero

    Un token es aproximadamente 0,75 palabras en inglés (algo menos en español). La API te cobra por input_tokens (lo que envías) y output_tokens (lo que Claude responde).

    Después de cada llamada puedes ver el uso:

    console.log(response.usage);
    // { input_tokens: 48, output_tokens: 312 }
    

    max_tokens limita la respuesta, no la llamada completa. Si pones max_tokens: 100 y la respuesta necesita 200 tokens, Claude cortará el texto a mitad. Es uno de los errores más comunes al empezar.

    ¿Cómo implementar streaming con la Claude API en TypeScript?

    Sin streaming, esperas a que Claude termine de generar toda la respuesta antes de recibirla. Con streaming, recibes los tokens a medida que se generan — igual que ves escribir a Claude en el chat web.

    Para UX en tiempo real, el streaming no es opcional. Es lo que distingue una app que se siente viva de una que "se congela" tres segundos antes de mostrar algo. En los proyectos de agentes que construimos en Labs, migrar de llamada síncrona a streaming eliminó la necesidad de un loader — los usuarios percibieron la respuesta como inmediata sin que cambiáramos nada más.

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic({
      apiKey: process.env.ANTHROPIC_API_KEY,
    });
    
    async function streamResponse() {
      const stream = await client.messages.create({
        model: "claude-sonnet-4-6",
        max_tokens: 1024,
        stream: true,
        messages: [
          {
            role: "user",
            content: "Escribe un test unitario en TypeScript para una función que suma dos números.",
          },
        ],
      });
    
      for await (const event of stream) {
        if (
          event.type === "content_block_delta" &&
          event.delta.type === "text_delta"
        ) {
          process.stdout.write(event.delta.text);
        }
      }
    
      console.log("\n--- Stream completado ---");
    }
    
    streamResponse();
    

    El loop for await itera sobre los eventos del stream. El tipo que te importa es content_block_delta con delta.type === "text_delta" — ahí está el texto.

    ¿Qué es el tool use en Claude API y cómo funciona?

    Tool use (o function calling) permite que Claude llame a funciones definidas por ti. Claude decide cuándo usarlas y con qué argumentos. Tú ejecutas la función y le devuelves el resultado.

    El siguiente ejemplo define una herramienta get_weather ficticia:

    const response = await client.messages.create({
      model: "claude-sonnet-4-6",
      max_tokens: 1024,
      tools: [
        {
          name: "get_weather",
          description: "Obtiene el tiempo actual para una ciudad.",
          input_schema: {
            type: "object",
            properties: {
              city: {
                type: "string",
                description: "El nombre de la ciudad.",
              },
            },
            required: ["city"],
          },
        },
      ],
      messages: [
        {
          role: "user",
          content: "¿Qué tiempo hace en Madrid ahora mismo?",
        },
      ],
    });
    
    // Si Claude quiere usar la herramienta, el stop_reason será "tool_use"
    if (response.stop_reason === "tool_use") {
      const toolUse = response.content.find((b) => b.type === "tool_use");
      console.log("Claude quiere llamar a:", toolUse?.name);
      console.log("Con argumentos:", toolUse?.input);
      // Aquí ejecutarías la función real y devolverías el resultado a Claude
    }
    

    Esto es la base de cualquier agente. Claude no ejecuta código — tú lo ejecutas y le informas del resultado. El loop de razonamiento lo controla Claude; la ejecución la controlas tú. Si quieres ver cómo este patrón escala a un pipeline completo — desde un ticket de Jira hasta el deploy —, tienes el ejemplo en el post sobre automatizar el proceso de desarrollo con IA.

    Errores comunes al empezar

    Rate limits. La API tiene límites por minuto tanto en requests como en tokens. Si los golpeas, recibes un 429. Solución: exponential backoff o usar Haiku para prototipos de alto volumen.

    Context window agotado. Cada modelo tiene un límite de tokens totales en conversación (input + output). Sonnet 4.6 tiene 200K tokens de context window — es enorme, pero si metes archivos enteros en cada llamada, lo llenas. Sé selectivo con lo que incluyes en el contexto.

    Formato de mensajes incorrecto. El array messages debe alternar user y assistant. No puedes tener dos mensajes de user seguidos sin un assistant entre medias. Eso devuelve un error 400.

    max_tokens demasiado bajo. Si la respuesta se corta, sube max_tokens. El valor por defecto no existe — es un parámetro obligatorio. Empieza con 1024 y ajusta según lo que necesites.

    Variables de entorno no cargadas. Si ves AuthenticationError, casi siempre es que ANTHROPIC_API_KEY no está disponible en el proceso. Verifica con console.log(process.env.ANTHROPIC_API_KEY) antes de depurar nada más.

    Qué explorar después

    Una vez tienes la llamada básica y el streaming funcionando, estos son los siguientes pasos lógicos:

    Vision. Puedes enviar imágenes en el array content y Claude las analiza. Útil para screenshots, diagramas, facturas.

    Embeddings. Anthropic no tiene embeddings propios en la API, pero Claude funciona muy bien combinado con embeddings de OpenAI o Cohere para búsqueda semántica.

    Batch API. Para procesar cientos de prompts sin necesidad de respuesta en tiempo real. Hasta un 50% más barato que llamadas individuales.

    Workbench de Anthropic. En console.anthropic.com tienes un playground para probar prompts, comparar modelos y ver el uso de tokens antes de escribir una sola línea de código. Es la herramienta que más uso al diseñar system prompts.

    Multiturno real. Construir una conversación que mantenga contexto entre turnos requiere gestionar el array messages manualmente — añadir cada respuesta de Claude como role: "assistant" y cada input del usuario como role: "user". No hay estado en la API.

    Si quieres ver tool use aplicado a un workflow de code review automático antes de un PR, tienes el flujo completo en el post sobre agentic code review con Claude Code.

    Si tuvieras que elegir solo un área para explorar después del streaming, elige Vision — es el salto de ROI más rápido y el que más impacto tiene en una demo.


    FAQ

    ¿Necesito tarjeta de crédito para empezar?
    Sí. Anthropic requiere un método de pago para activar la API, pero tiene un tier de prueba con crédito gratuito. Puedes hacer cientos de llamadas de desarrollo sin pagar nada en los primeros días.

    ¿Cuál es la diferencia entre la API de Claude y Claude.ai?
    Claude.ai es el producto de consumo (el chat web). La API es el acceso programático al modelo. Tienen facturación y cuentas separadas. Una suscripción a Claude.ai no te da acceso a la API.

    ¿Cuánto cuesta en producción?
    Depende del modelo y el volumen. Claude Sonnet 4.6 está alrededor de $3 por millón de input tokens y $15 por millón de output tokens — verifica siempre en anthropic.com/pricing antes de hacer estimaciones de arquitectura, los precios se actualizan con cada generación de modelo.

    ¿Puedo usar la API en el frontend directamente?
    Técnicamente sí, pero nunca deberías. La API key quedaría expuesta en el cliente. Siempre llama a la API desde un backend o un serverless function que tú controlas.

    ¿Qué pasa si Claude no termina la respuesta y stop_reason no es end_turn?
    Si stop_reason es max_tokens, la respuesta se cortó por el límite que pusiste. Si es tool_use, Claude quiere ejecutar una herramienta. Si es stop_sequence, alcanzó una secuencia de parada que definiste. Valida siempre stop_reason en producción.


    Si quieres ver todo esto aplicado en un proyecto real — no en ejemplos de tutorial sino en un producto con usuarios — en Dominicode Labs tenemos el código de los proyectos que construimos en directo, incluyendo agentes con tool use y streaming. Es donde llevamos la teoría a producción.

    Y si prefieres el formato video con más ejemplos en directo, en el canal de YouTube de Dominicode cubrimos estas integraciones con frecuencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Implementación efectiva con Plan Mode en Claude Code

    Implementación efectiva con Plan Mode en Claude Code

    Plan Mode primero, código después: el workflow que cambia cómo trabajas con Claude Code

    Tiempo estimado de lectura: 5 min

    • Plan Mode obliga a auditar y planear antes de ejecutar cambios en código.
    • Workflow en tres fases: análisis, refinamiento y ejecución; cada fase reduce riesgo y scope de impacto.
    • Activa Plan Mode en cambios multiplataforma, código heredado o integraciones de librerías arquitectónicas.
    • Mide efectividad por integración sin rollback, estabilidad en CI y ahorro de horas en debugging.

    Plan Mode primero, código después es la regla que separa entregas limpias de correcciones interminables. Activa Plan Mode, deja que Claude analice el repositorio y produzca un plan antes de que toque una sola línea de código. Esa inversión de diez minutos evita horas de debugging por decisiones implícitas.

    Resumen rápido (lectores con prisa)

    Plan Mode obliga a auditar y planear cambios antes de codificar. Úsalo cuando el cambio implica múltiples archivos, código heredado o librerías que afectan la arquitectura. Workflow: análisis, refinamiento y ejecución. Mide por integración sin rollback y estabilidad en CI.

    Plan Mode primero, código después: qué es y por qué importa

    Plan Mode es un modo de sesión en Claude Code que obliga al agente a auditar el código existente, mapear dependencias y proponer una secuencia de cambios verificable antes de implementar. Se activa con Shift+Tab en sesiones interactivas de Claude Code; la documentación oficial lo describe como un flujo que prioriza planificación sobre ejecución (https://docs.anthropic.com/en/docs/agents-and-tools/claude-code/overview y https://www.anthropic.com/claude).

    ¿Por qué importa? Porque los errores de diseño no son fallos de sintaxis: son decisiones implícitas que se propagan. Implementar primero amplifica esos errores. Planear primero los expone cuando aún cuestan cero cambios.

    Cómo funciona el workflow (práctico y repetible)

    El workflow consta de tres fases claras: análisis, refinamiento y ejecución. No son sugerencias; son pasos que los equipos efectivos repiten cuando integran agentes en su proceso.

    1) Análisis inicial (activar Plan Mode)

    Activa Plan Mode (Shift+Tab). Describe el objetivo como contrato, no como receta. Ejemplo: “Aísla la lógica de autenticación para pruebas unitarias sin DB” en vez de “usa repositorio para auth”. Deja que Claude liste archivos relevantes, dependencias directas y riesgos.

    2) Revisión y refinamiento (iterar sobre el plan)

    Lee el plan: archivos a tocar, orden propuesto, efectos secundarios y tests necesarios. Corrige límites de dominio si hace falta. Esa iteración es barata: texto, no commits. Aquí se define el alcance real y se evitan sorpresas de integración.

    3) Aprobación e implementación (ejecutar con control)

    Aprobas el plan y Claude implementa en el orden validado. Cada cambio es acotado, con tests adjuntos y notas de diseño. Si algo rompe, el impacto está limitado al módulo que se aprobó, no a toda la base de código.

    Ejemplo real de uso en migración

    Meta: migrar API REST a tRPC por módulos.

    Spec

    • Módulo A: AuthService (sin dependencias).
    • Módulo B: UserService (depende de A).
    • Módulo C: Billing (depende de B).

    Con Plan Mode, Claude devuelve: archivos a crear/modificar por módulo, tipos DTO esperados, tests unitarios y orden de merges. Implementación ocurre por sesión por módulo. Resultado: integraciones predecibles y rollback sencillo.

    Cuándo activar Plan Mode (criterio técnico)

    Activa Plan Mode cuando:

    • El cambio afecta múltiples archivos o contracts públicos.
    • Trabajas en código heredado que no conoces.
    • Vas a integrar una librería que afecta la arquitectura (auth, DB, infra).
    • La tarea es una refactorización o migración.

    No lo actives cuando:

    • El cambio es un ajuste pequeño en un único archivo.
    • Creas un archivo nuevo con una spec cerrada.
    • Resuelves un typo o validación trivial.

    El criterio es simple: a mayor riesgo arquitectónico, mayor valor del plan previo.

    Reglas prácticas para que Plan Mode funcione

    • Siempre comienza con CLAUDE.md actualizado. El agente leerá convenciones y patrones prohibidos antes de planear (si tu repo lo tiene, intégralo; si no, crea uno).
    • Exige que el plan incluya: archivos modificados, orden de cambios, tests a ejecutar y riesgos conocidos.
    • Valida el plan tú, un peer o el tech lead; las aprobaciones humanas reducen regresiones.
    • Mantén las sesiones acotadas: una sesión = un módulo. Evita planos globales indefinidos.

    Métricas que importan (no solo LOC/hora)

    Mide efectividad por:

    • Tiempo hasta integración sin rollback.
    • Número de handoffs con correcciones arquitectónicas.
    • Cobertura y estabilidad en CI tras cada merge.
    • Tiempo invertido en revisión del plan vs. horas ahorradas en debugging.

    Un plan de 10 minutos que evita 2 horas de corrección es ROI directo.

    Riesgos y límites honestos

    Plan Mode reduce errores, no elimina la necesidad de juicio humano. Si la spec es ambigua, Claude producirá una implementación ambigua más rápido. El agente no reemplaza decisiones críticas de diseño, trade-offs de rendimiento o consideraciones legales de seguridad. Su fuerza está en ejecutar lo que tú especificas mejor y antes de que toque escribir código.

    Conclusión

    Adoptar “Plan Mode primero, código después” cambia la métrica del equipo: de velocidad de salida a resiliencia de la plataforma. Si quieres que Claude Code deje de ser un generador de parches y pase a ser un colaborador técnico confiable, exige un plan. Haz que piense antes de tocar tu repo.

    Para equipos que exploran workflows, integraciones y automatización avanzada, consulta Dominicode Labs como continuación lógica del enfoque: recursos y experimentos centrados en agentes y productividad técnica.

    FAQ

    ¿Qué es Plan Mode?

    Plan Mode es un modo de sesión en Claude Code que obliga al agente a auditar el código existente, mapear dependencias y proponer una secuencia de cambios verificable antes de implementar.

    ¿Cuándo debo activarlo?

    Actívalo cuando el cambio afecta múltiples archivos, trabajas en código heredado, o integras librerías que afectan la arquitectura. Para cambios pequeños y aislados no es necesario.

    ¿Qué debe incluir un plan mínimo?

    El plan debe listar archivos a modificar, orden de cambios, tests a ejecutar y riesgos conocidos. También conviene indicar límites de dominio y criterios de aceptación.

    ¿Cómo reduce el riesgo en migraciones?

    Al definir el alcance y el orden de merge por módulo, limita el blast radius y facilita rollbacks. Permite validar la integración por partes con tests adjuntos.

    ¿Plan Mode reemplaza la revisión humana?

    No. Plan Mode reduce errores estructurales, pero las aprobaciones humanas siguen siendo necesarias para decisiones críticas y trade-offs no técnicos.

    ¿Qué métricas debe rastrear mi equipo?

    Tiempo hasta integración sin rollback, número de handoffs con correcciones arquitectónicas, cobertura y estabilidad en CI, y la relación entre tiempo de planificación y horas ahorradas en debugging.

  • Cómo optimizar Agentes y Skills en Claude Code para un mejor rendimiento

    Cómo optimizar Agentes y Skills en Claude Code para un mejor rendimiento

    entender Agentes vs Skills, en Claude code, trade-offs de los agentes, y los trade-offs de los modelos

    ¿Quieres que tu sistema con Claude deje de comportarse como un aprendiz despistado y empiece a trabajar como un equipo bien entrenado? entender Agentes vs Skills, en Claude code, trade-offs de los agentes, y los trade-offs de los modelos es el primer paso. No es filosofía; es diseño técnico que decide costes, latencia y confiabilidad.

    En una frase: una Skill es una herramienta; un Agente es quien decide cuándo y cómo usarla. En Claude Code (y en el Model Context Protocol) esa diferencia no es semántica: define el control flow, la observabilidad y la estrategia de modelo.

    Resumen rápido (lectores con prisa)

    Qué es: Skill = función stateless y determinista; Agente = sistema que orquesta Skills con loop de razonamiento.

    Cuándo usarlo: Skill para flujos deterministas; Agente para tareas multi-step y adaptativas.

    Por qué importa: determina latencia, coste, observabilidad y riesgo de loops.

    Cómo funciona (alto nivel): Agente observa, planifica, invoca Skills y verifica; Skills exponen APIs claras (MCP/HTTP).

    Tiempo estimado de lectura

    Tiempo estimado de lectura: 5 min

    Ideas clave

    • Skills son funciones deterministas y stateless; expónlas como APIs claras.
    • Agentes orquestan Skills y gestionan objetivo, memoria y reintentos.
    • Los agentes añaden latencia, coste e indeterminismo; requieren guardrails y observabilidad.
    • Elige modelo por trade-off: Haiku (rápido/barato), Sonnet (equilibrio), Opus (máxima calidad).
    • Patrón híbrido recomendado: router ligero → Skills directas → Agentes especializados → guardrails y tracing.

    Tabla de contenidos

    Introducción

    ¿Quieres que tu sistema con Claude deje de comportarse como un aprendiz despistado y empiece a trabajar como un equipo bien entrenado? entender Agentes vs Skills, en Claude code, trade-offs de los agentes, y los trade-offs de los modelos es el primer paso. No es filosofía; es diseño técnico que decide costes, latencia y confiabilidad.

    Agentes vs Skills: la distinción que evita catástrofes

    Skills = funciones puntuales, deterministas y stateless.

    Skills

    • readFile(path), runSQL(query), sendSlack(channel, text).
    • Implementadas como código tradicional (JS/Python) y expuestas al modelo con una firma clara (MCP/HTTP).
    • No razonan. Ejecutan.

    Agentes

    • Mantienen objetivo, memoria y loop de razonamiento (Observe → Plan → Act → Verify).
    • Un Agente puede invocar múltiples Skills, evaluar resultados, reintentar o escalar a humano.
    • En Claude Code, el Agente es la instancia del modelo que ejecuta el bucle y usa las Skills ofrecidas por el runtime.

    Técnicamente: Skills son APIs; Agentes son sistemas de control y decisión que consumen esas APIs.

    Por qué importa: trade-offs de los agentes

    Autonomía suena bien hasta que el Agente se vuelve caro o tóxico. Estos son los efectos prácticos que deberías medir.

    Latencia multiplicada

    Cada paso del bucle agrega llamadas al modelo y a Skills. Una tarea que toma 2s con una Skill directa puede tardar 15–30s con un Agente que valida y reintenta. Para workflows interactivos eso mata la UX.

    Riesgo de loops infinitos

    Si no limitas iteraciones o detectas patrones repetitivos, el Agente puede intentar la misma corrección 1000 veces. Resultado: facturas de API astronómicas y procesos bloqueados.

    Indeterminismo e idempotencia perdida

    Un Agente puede resolver la misma tarea de maneras distintas. Eso da flexibilidad ante casos abiertos, pero complica testing, CI/CD y auditoría. Necesitas validaciones basadas en propiedades (constraints) en lugar de resultados fijos.

    Observabilidad y debugging costosos

    Debuguear un flow agéntico exige trazas por cada llamada LLM ↔ Skill, snapshots de memoria y métricas de confianza. Sin esto, los fallos solo se detectan cuando el usuario se queja.

    Mitigaciones prácticas:

    • Limitar pasos y tiempo por tarea (timeouts cognitivos).
    • Implementar detección de retries repetidos y bloqueo.
    • Validación post-acción (tests automáticos, checksums, schema validation).
    • Escalada a humano cuando la confianza baja.

    Trade-offs de los modelos: elegir Sonnet, Haiku u Opus

    No todos los modelos sirven para todo. Aquí el criterio es coste versus capacidad de razonamiento.

    Claude 3.5 Sonnet — el equilibrio

    • Pros: razonamiento sólido, buen manejo de Tool Use y generación de código.
    • Contras: coste y latencia moderados.
    • Uso: cerebro del Agente para planificación y edición de código.

    Claude 3 Haiku — router / executor barato

    • Pros: rápido y barato.
    • Contras: menos capaz en razonamiento profundo; mayor riesgo de alucinación en tareas complejas.
    • Uso: clasificación, enrutamiento, pre-filtros, resumen rápido o conversión simple.

    Claude 3 Opus — máxima calidad (cuando el coste no importa)

    • Pros: razonamiento profundo y menor tasa de error en zero-shot.
    • Contras: latencia y coste altos.
    • Uso: análisis crítico donde la calidad es la prioridad absoluta.

    Arquitectura recomendada: híbrida. Usa Haiku como router inicial; Sonnet para agentes especializados; Opus solo en batches o tareas off-line costosas.

    Patrón de despliegue práctico (claude-code + MCP)

    1. Router (Haiku): decide si la petición necesita Skill directa o Agente Sonnet.

    2. Skill directa: ejecutar si el flujo es determinista (p. ej. ETL, queries, envíos).

    3. Agente Sonnet: para tareas multi-step (refactor, investigación, remediación).

    4. Guardrails: límites de iteración, chequeos de schema, registros de decisión.

    5. Observabilidad: tracing por etapa (LLM prompt/responses, llamadas Skill, costos).

    Para referencia del runtime y la integración con Skills revisa la documentación de Claude Code en el portal de Anthropic (y el repositorio de ejemplo).

    Criterio final para un Tech Lead

    Decide según tres preguntas:

    • ¿Es el flujo determinista? Usa una Skill.
    • ¿Requiere adaptación y varios pasos? Construye un Agente.
    • ¿Cuál es el SLA de latencia y el presupuesto de coste? Selecciona Haiku/Sonnet/Opus acorde al ROI.

    No es magia: es ingeniería de trade-offs. Un Agente bien diseñado reduce intervención humana y aumenta alcance, pero exige observabilidad, límites y selección cuidadosa de modelo. En Dominicode tratamos Agentes como infraestructura: medimos, protegemos y versionamos. Haz lo mismo y tu Claude Code dejará de improvisar y empezará a producir.

    Dominicode Labs

    Si trabajas con automatización, agentes o workflows, puedes encontrar recursos adicionales y experimentos en Dominicode Labs. Es un complemento práctico para aplicar patrones de despliegue, guardrails y observabilidad en proyectos reales.

    FAQ

    ¿Cuándo debería preferir una Skill sobre un Agente?

    Usa una Skill cuando el flujo sea determinista, idempotente y pueda representarse como una API con firma clara (por ejemplo ETL, consultas, envíos). Las Skills reducen latencia y coste y facilitan testing y CI/CD.

    ¿Cómo mitigo el riesgo de loops infinitos en un Agente?

    Implementa límites de iteración, timeouts cognitivos y detección de patrones de retry repetidos. Añade reglas que bloqueen acciones cuando se superan umbrales y escalamiento a humano cuando la confianza sea baja.

    ¿Qué observabilidad mínima necesito para un Agente en producción?

    Traza cada llamada LLM ↔ Skill, snapshots de memoria relevantes y métricas de confianza/decisión. Registra costos por etapa para analizar trade-offs de latencia y gasto.

    ¿Cómo selecciono entre Haiku, Sonnet y Opus?

    Elige según coste vs capacidad de razonamiento: Haiku para routing y tareas simples; Sonnet como cerebro del Agente para planificación y edición; Opus para análisis crítico donde la calidad justifica el coste.

    ¿Qué prácticas recomiendan para validar acciones de un Agente?

    Usa validación post-acción: tests automáticos, checksums y validación de esquema. Implementa constraints que verifiquen propiedades del resultado más que un valor exacto.

    ¿Debo versionar Skills y Agentes por separado?

    Sí. Trata Skills como infra y versiona sus APIs. Versiona Agentes por su política de decisión, prompts y memoria para poder reproducir y auditar comportamientos en producción.

  • Cómo crear un plugin para Anthropic Claude usando MCP

    Cómo crear un plugin para Anthropic Claude usando MCP

    Crear tu primer plugin para Anthropic Claude (Claude Code)

    Crear tu primer plugin para Anthropic Claude (Claude Code) no es magia. Es arquitectura. En vez de «pegar texto en el prompt», vas a exponer funciones ejecutables que Claude puede invocar como herramientas reales. Aquí tienes una guía práctica, técnica y directa para hacerlo funcionar en minutos.

    Tiempo estimado de lectura: 5 min

    • Convierte prompts en herramientas: expón funciones (tools) que Claude invoca mediante MCP en lugar de meter contexto en el prompt.
    • Implementa un servidor MCP: el servidor genera schemas automáticamente y maneja llamadas desde Claude (ej.: FastMCP en Python).
    • Seguridad y fiabilidad: docstrings claros, timeouts, manejo de errores y principio de menor privilegio son imprescindibles.
    • Observabilidad y versionado: registra llamadas, latencias y versiona schemas para evitar rupturas en producción.
    • Integración: estas tools pueden orquestarse en n8n u otros workflows como nodos reutilizables.

    Introducción

    Un “plugin” en Claude es, en realidad, Tool Use o Function Calling via Model Context Protocol (MCP). No le estás metiendo código al modelo: le das una API estructurada y el modelo decide cuándo llamarla. Tu servidor ejecuta la lógica real (Python/TS/Go) y el modelo actúa como cliente que conoce las herramientas disponibles mediante un schema.

    Resumen rápido (lectores con prisa)

    Qué es: Exponer funciones ejecutables (tools) que Claude puede invocar vía MCP.

    Cuándo usarlo: Cuando necesites que el asistente consulte sistemas externos, ejecute acciones o maneje datos sin inflar el prompt.

    Por qué importa: Permite acciones deterministas, auditables y seguras desde un asistente LLM.

    Cómo funciona: El modelo selecciona una tool, genera parámetros según el schema y llama al servidor MCP; el servidor responde con texto estructurado.

    ¿Qué es un “plugin” en Claude?

    Conceptualmente:

    • Claude = cliente que conoce las herramientas disponibles mediante un schema.
    • MCP = protocolo que negocia llamadas entre Claude y tu servicio (stdio, HTTP, WebSocket).
    • Tu servidor = el plugin: código real que ejecuta la lógica (Python/TS/Go).

    No le estás metiendo código al modelo. Le das una API estructurada y el modelo decide cuándo llamarla.

    ¿Qué necesitas y por qué importa?

    ¿Por qué hacerlo? Porque así conviertes un asistente en un agente capaz de:

    • consultar bases de datos internas,
    • ejecutar comprobaciones de infra,
    • automatizar workflows en n8n,

    sin inundar el prompt con contexto ni exponer credenciales en texto.

    Requisitos mínimos:

    Código mínimo: servidor MCP en Python

    Este ejemplo expone una tool que verifica el estado HTTP de una URL usando FastMCP. Copia, ajusta y ejecuta.

    from mcp.server.fastmcp import FastMCP
    import httpx
    
    mcp = FastMCP("WebChecker")
    
    @mcp.tool()
    async def check_website_status(url: str) -> str:
        """
        Verifica el estado HTTP de una URL.
        Args:
          url: URL completa (ej: https://dominicode.com)
        Returns:
          Mensaje con código y razón, o error legible.
        """
        try:
            async with httpx.AsyncClient(timeout=5.0) as client:
                r = await client.get(url, follow_redirects=True)
                return f"Status: {r.status_code} - {r.reason_phrase}"
        except Exception as e:
            return f"Error: {str(e)}"
    
    if __name__ == "__main__":
        mcp.run()

    FastMCP genera automáticamente el schema de la tool a partir de los type hints y docstrings. No escribes JSON a mano.

    Registrar el plugin en Claude Desktop / CLI

    Para que Claude vea tu servidor local, añade una entrada en la configuración de Claude Desktop:

    – macOS/Linux: ~/Library/Application Support/Claude/claude_desktop_config.json
    – Windows: %APPDATA%\Claude\claude_desktop_config.json

    Ejemplo:

    {
      "mcpServers": {
        "web-checker": {
          "command": "python",
          "args": ["/ruta/absoluta/a/server.py"]
        }
      }
    }

    Reinicia Claude. Deberías ver el servidor activo (icono de enchufe).

    Flujo de ejecución (Thinking Loop)

    Cuando pides: “Claude, comprueba si dominicode.com responde”, sucede:

    1. Claude detecta necesidad de herramienta.
    2. Selecciona check_website_status.
    3. Genera parámetros (url).
    4. Llama al plugin vía MCP.
    5. El plugin responde con texto estructurado.
    6. Claude formatea la respuesta humana.

    Todo ordenado, trazable y auditable.

    Buenas prácticas imprescindibles

    Docstrings son contratos

    Escribe docstrings claros. El modelo usa esa información para construir la llamada. Ambigüedad = invocación errónea.

    Errores controlados

    Nunca dejes que tu plugin haga crash. Captura excepciones y devuelve mensajes legibles. Si tu proceso muere, Claude pierde acceso a todo ese servidor.

    Timeouts defensivos

    Usa timeouts explícitos (ej. httpx timeout=5s). No querrás procesos colgados.

    Principio de menor privilegio

    No implementes tools como exec_shell(cmd) a la ligera. Restringe rutas, usuarios y operaciones. Si necesitas ejecutar comandos, envuelve y valida cada input.

    Observabilidad

    Loguea prompts recibidos, respuestas, latencias y costes. Traza cada call LLM ↔ tool. Para infra, añade métricas que permitan alertas (ERRORES, RETRIES, LATENCIA).

    Gestión de versiones

    Versiona schemas y tools. Cambiar la firma de una función sin versionado rompe agentes y workflows en producción.

    Escalada humana

    Si el agente entra en loop o baja de confianza, define una regla clara: cortar, crear ticket y notificar a un responsable.

    Integración con workflows y n8n

    Estas tools son bloques reutilizables. Úsalas como nodos en n8n o como pasos en un orquestador de agentes. Por ejemplo:

    • Nodo n8n invoca tu API plugin para obtener estado.
    • Resultado condicional dispara un PR automático o un Slack alert.

    Recursos y lectura adicional

    Cierre operativo

    Crear un plugin para Claude Code es convertir una idea en una API que el modelo puede invocar de forma determinista. No es magia; es ingeniería de interfaces. Empieza con una tool pequeña, aplícala en un workflow y añade observabilidad. Si lo haces bien, tu Claude dejará de hablar y empezará a actuar.

    Esto no acaba aquí: construye la siguiente tool, versiona el schema y orquesta esas tools con un agente. Tu siguiente despliegue será la prueba.

    Dominicode Labs

    Si quieres prototipar y validar pipelines de agentes y automatizaciones, revisa Dominicode Labs. Es una continuación natural para integrar tools, pruebas y orquestación en entornos de trabajo técnico.

    FAQ

    ¿Qué diferencia hay entre un plugin y poner contexto en el prompt?

    ¿Qué diferencia hay entre un plugin y poner contexto en el prompt?

    Un plugin expone funciones ejecutables con schemas; el modelo invoca esas funciones. Poner contexto en el prompt implica enviar datos y lógica de forma textual, sin capacidad de ejecución externa ni trazabilidad.

    ¿Qué es MCP?

    ¿Qué es MCP?

    MCP (Model Context Protocol) es el protocolo que negocia llamadas entre el modelo y tu servicio (stdio, HTTP, WebSocket), permitiendo que el modelo conozca y llame herramientas.

    ¿Por qué usar docstrings en lugar de JSON manual?

    ¿Por qué usar docstrings en lugar de JSON manual?

    Frameworks como FastMCP generan schemas automáticamente a partir de type hints y docstrings, reduciendo errores y manteniendo documentación y contratos sincronizados.

    ¿Cómo manejo errores para que Claude no pierda acceso?

    ¿Cómo manejo errores para que Claude no pierda acceso?

    Captura excepciones, devuelve mensajes legibles y usa timeouts defensivos. No permitas que el proceso principal haga crash; implementa reinicios supervisados y health checks.

    ¿Qué precauciones de seguridad debo tomar?

    ¿Qué precauciones de seguridad debo tomar?

    Aplica principio de menor privilegio, valida y sanitiza inputs, restringe rutas y comandos, y evita exponer credenciales en texto plano.

    ¿Puedo integrar estas tools en n8n?

    ¿Puedo integrar estas tools en n8n?

    Sí. Usa las tools como nodos o llamadas API desde n8n; el resultado puede condicionar flujos, crear PRs o enviar alertas en Slack.

    ¿Dónde encuentro ejemplos y documentación?

    ¿Dónde encuentro ejemplos y documentación?

    Consulta MCP repo, Anthropic Developer Docs y los Claude Code examples.