Tag: Agentes IA

  • Tests E2E con IA: el agente navega, el código verifica

    Tests E2E con IA: el agente navega, el código verifica

    El viernes a las seis alguien renombra un data-testid en el botón de pagar. Nadie toca la lógica. El lunes la pipeline está en rojo: catorce tests E2E fallan por un atributo que ningún usuario ve.

    Así que pruebas lo contrario. Montas tests E2E con IA: le das el navegador a un agente y le pides "compra el teclado". Da verde. Y el pedido nunca se creó: el agente vio un spinner, lo interpretó como éxito y siguió.

    Entre esos dos fallos está la pregunta. Si dejas que el modelo decida también si el test pasa, has cambiado un test frágil por uno que no sabes si miente.

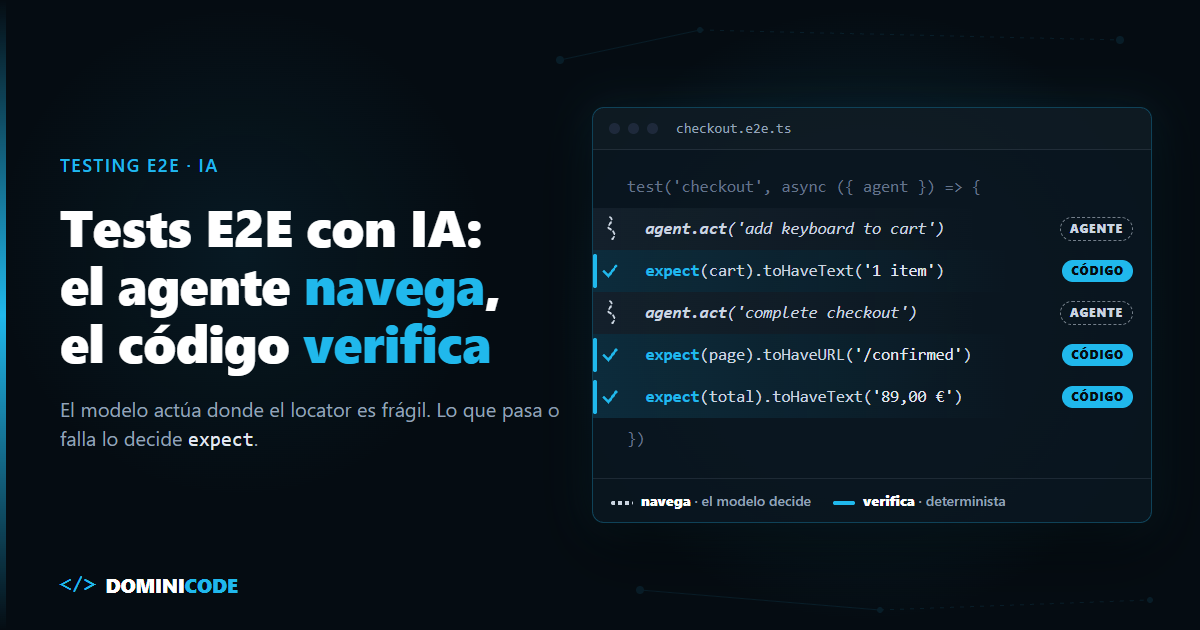
    En corto: en los tests E2E con IA el agente solo debería actuar donde el locator es frágil; la verificación tiene que seguir siendo código determinista. El framework open source e2e de Tester Army está diseñado así: graba los pasos del agente que una aserción posterior confirma y los reproduce sin llamar al modelo hasta que la app cambia. Lo crítico va con expect, no con agent.assert.

    ¿Qué son los tests E2E con IA?

    Un test E2E con IA es un test de extremo a extremo en el que un modelo de lenguaje decide las acciones (clics, formularios, navegación) a partir de un objetivo en lenguaje natural, en lugar de seguir una secuencia fija de selectores.

    La diferencia con Playwright clásico es dónde vive el conocimiento de la interfaz. En un script, en tus locators. Con un agente, en el modelo, que lee el árbol de accesibilidad en cada ejecución.

    Eso resuelve la fragilidad y abre dos problemas: coste y no determinismo.

    Cómo funciona e2e de Tester Army: intención, grabación y replay

    e2e combina pasos de agente (agent.act), aserciones semánticas y locators deterministas, y reproduce sin modelo los pasos del agente que una comprobación posterior confirmó.

    e2e es el framework open source (Apache-2.0) de Tester Army. A 15 de octubre de 2026 tiene unas 10.700 estrellas en GitHub y va por la versión 0.21.1. El README avisa: está en desarrollo hacia 1.0 y la API y la config pueden cambiar entre versiones menores.

    Un test mezcla tres tipos de paso, según la documentación de conceptos:

    Paso API ¿Llama al modelo?
    Objetivo agent.act() Sí, salvo que la caché lo reproduzca
    Aserción semántica agent.assert(), agent.waitFor(), agent.extract() Sí, nunca desde caché
    Locator screen + expect No

    La clave está en la primera fila. Según la doc de caché, cuando un agent.act() va seguido de una comprobación que pasa, el runner guarda sus acciones en .e2e/cache/. En la siguiente ejecución las repite localizando cada control por rol, nombre y test id (los mismos locators que enseño en el curso de Testing en Angular con Jest y Testing Library), y comprueba que la pantalla acaba igual. Si cuadra, termina sin modelo. Si la UI cambió, el agente retoma desde la pantalla actual.

    Fíjate en la condición: solo se graba lo que algo verificó después. Un act sin comprobación detrás queda como unconfirmed. Sin verificación no hay replay: el framework te empuja a escribirla.

    Y un test sin pasos de agente no necesita modelo. Puedes empezar con locators puros y meter agent.act() solo donde duele.

    Tutorial: tu primer test E2E con IA con npx e2e init

    Necesitas Node.js 24.8 o superior (22.22.3 en la rama 22). En Windows, dentro de WSL. En el directorio de tu app:

    npx e2e init
    

    El asistente pregunta motor (Web con Playwright o Mobile para iOS/Android) y proveedor de modelo: una suscripción, una API key o un modelo local. Hay opción None para tests sin IA. Escribe e2e.config.ts y un test de ejemplo que no llama al modelo.

    Ahora un checkout de tienda. Es un ejemplo del patrón, no un proyecto real:

    // tests/checkout.e2e.ts
    import { test } from '@e2e-dev/web';
    import { expect } from 'e2e';
    
    test('un cliente compra con la tarjeta de prueba', async ({ app, agent, screen, browser }) => {
      await app.open('/products/teclado-mecanico');
    
      // AGENTE: variantes, drawer del carrito, banners... la parte frágil
      await agent.act('add the keyboard to the cart');
      await expect(screen.getByRole('status')).toHaveText('1 item');
    
      // AGENTE: formulario de pago que UX cambia cada sprint
      await agent.act('complete checkout with the test card {card}', {
        params: { card: '4242 4242 4242 4242' },
      });
    
      // DETERMINISTA: lo que el negocio necesita que sea verdad
      await expect(browser).toHaveURL('/checkout/confirmation');
      await expect(screen.getByRole('heading', 'Order confirmed')).toBeVisible();
      await expect(screen.getByTestId('order-total')).toHaveText('89,00 €');
    
      // SEMÁNTICO: lo que no merece un locator
      await agent.assert('the page shows an estimated delivery date');
    });
    
    npx e2e run tests/checkout.e2e.ts
    

    El agente navega donde más cambia el DOM. Cada act es un objetivo atómico seguido de un expect, como pide la doc, para que el replay lo grabe. URL, título y total los comprueba código.

    Es el enfoque contrario al de agentes que diagnostican tests de Playwright ya escritos. Allí el script es la fuente de verdad y la IA interviene cuando se rompe. Aquí la intención es la fuente de verdad y el script es una grabación desechable. Coinciden en lo importante: la IA no toca los asserts.

    La trampa: agent.assert no es un assert

    agent.assert() se lee como una aserción, pero un modelo recibe la frase y un snapshot de texto de la pantalla y emite un veredicto. Puede fallar con ASSERTION_FAILED o con ASSERTION_INCONCLUSIVE si no tiene evidencia. Y nunca se reproduce desde caché: es una llamada al modelo en cada ejecución.

    Mi regla: si un bug en esa línea te cuesta dinero o un ticket de soporte, va con expect. Total, estado del pedido, URL, mensaje de error. agent.assert queda para lo difuso: que un texto generado tenga sentido, que un gráfico suba (vision: true).

    La propia doc lo dice: cuando el texto exacto importa, usa un locator.

    Playwright vs e2e vs Tester Army: comparativa de tests E2E con IA

    Playwright puro e2e (open source) Tester Army (SaaS)
    Cómo escribes el test Código con locators Locators + agent.act() Lenguaje natural, sin código
    Coste por ejecución Solo infra Modelo en la primera pasada y al cambiar la UI (en CI, solo si commiteas .e2e/cache/); asserts semánticos siempre Por runs: 99 $/mes (250) o 299 $/mes (1.000); 5 runs gratis
    Determinismo Total Total en expect y replay; agent.assert no Depende del agente
    Auth, OTP, infra Tú Tú (los Secret no llegan al modelo) Incluido: cuentas de test, OAuth, OTP
    Dónde corre Tu CI Tu CI + tu proveedor de modelo Su nube
    Límite o riesgo Selectores frágiles Pre-1.0, telemetría activa por defecto Dependes de un tercero; cifras de clientes autodeclaradas

    Sobre esa última celda: según Tester Army, Novu redujo a la mitad sus tests flaky y Juno pasó de 501 a 791 PRs mergeadas en un mes. Son casos de sus propios clientes. Señal, no benchmark.

    Lo que se discute en Hacker News

    En el Launch HN de TesterArmy (junio de 2026) un usuario lo planteó así: "E2E tests are now quick to write due to LLMs, and are then deterministic AND cheap to run". Y preguntaba cuánto cuesta en tokens tener un agente en cada test.

    Otro preguntó directamente si cacheaban los pasos para no llamar al LLM en ejecuciones posteriores. El fundador respondió que cacheaban la trayectoria del agente, pero todavía no el test completo: querían al agente en el bucle, más como un QA manual que como un script.

    El replay sin modelo de e2e es la respuesta a esa objeción, y es el argumento del Show HN de e2e de octubre. Aun así, un comentario pregunta por qué no usar Gherkin con Cucumber y que un agente escriba las step definitions.

    Cuándo NO usar tests E2E con IA

    Si necesitas una API estable. e2e está antes de 1.0. Una actualización puede cambiar las claves de la caché y obligarte a regrabar.

    Si tu CI va cargado. El issue #1144 documenta que la espera del estado final se fija al grabar: un paso grabado en una máquina tranquila puede fallar con REPLAY_STALE bajo --strict-cache al reproducirse con varios workers, aunque el estado acabe apareciendo. Hay un PR con el arreglo, el #1154, sin mergear a 15 de octubre.

    Si no controlas el coste en CI. e2e init mete .e2e/cache/ en el .gitignore y en CI la caché es de solo lectura: si no commiteas las grabaciones, cada pipeline arranca sin caché y paga modelo en cada act. Y si las commiteas, una grabación que deja de reproducirse no falla: el agente toma el paso y cada CI paga hasta que alguien la regraba. Usa --strict-cache en CI para enterarte.

    Si tus datos no pueden salir. El modelo ve el árbol de accesibilidad y capturas enmascaradas. La doc de seguridad avisa de lo que puede filtrarse: vídeos, command.log y valores no declarados como secreto. Con datos reales, modelo local o nada de agente.

    Si no has revisado la telemetría. El CLI envía uso anónimo por defecto, sin contenido de tests ni credenciales. Se desactiva con npx e2e telemetry disable o E2E_TELEMETRY_DISABLED=1.

    Por dónde empezar con tests E2E con IA

    Coge el test que más se rompe de tu suite. No el más importante: el más frágil. Sustituye solo la navegación que falla por un agent.act() y deja todos los expect como estaban. La guía de migración desde Playwright explica cómo convivir con tu suite archivo a archivo. Si en la segunda ejecución el replay pasa sin llamar al modelo, commitea .e2e/cache/ para que CI también lo reproduzca. Ahí has ganado.

    Si te preocupa qué verificar cuando el código lo escribe un agente, es el tema del workshop SDD + Agentic Engineering y de cómo verificar código generado por IA sin leerlo todo.

    Si tu app usa agentes en el navegador en producción, lee también por qué los agentes de IA en el navegador se rompen.

    Preguntas frecuentes

    ¿Qué diferencia hay entre agent.act y agent.assert?

    agent.act ejecuta un objetivo, y sus acciones se reproducen sin modelo si una comprobación posterior pasó. agent.assert juzga la pantalla con un modelo en cada ejecución. El primero ahorra mantenimiento; el segundo añade coste y no determinismo.

    ¿Los tests E2E con IA necesitan un modelo en cada ejecución?

    No en e2e. Los pasos act verificados se reproducen desde la caché mientras la app no cambie (en CI, solo si commiteas la carpeta .e2e/cache/), y los tests sin pasos de agente no usan modelo. Las aserciones semánticas sí lo llaman siempre.

    ¿e2e sustituye a Playwright?

    No. Su motor web, @e2e-dev/web, usa Playwright con Chromium, Firefox y WebKit. Añade encima objetivos en lenguaje natural, caché de replay y aserciones semánticas.

    ¿Puedo usar e2e con un modelo local?

    Sí. Admite suscripciones, API keys vía AI SDK y endpoints compatibles con OpenAI, incluidos servidores locales. Es la opción si no quieres que el árbol de accesibilidad salga hacia un proveedor externo.

    ¿Qué es Tester Army y en qué se diferencia de e2e?

    Tester Army es la plataforma SaaS: tests en lenguaje natural sin código, cuentas de test con OAuth y OTP, ejecución en PRs y por calendario, alertas en Slack y MCP para Claude Code, Codex y Cursor. e2e es el framework open source que corre en tu repo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Branded types en TypeScript: que la IA no cruce tus ids

    Branded types en TypeScript: que la IA no cruce tus ids

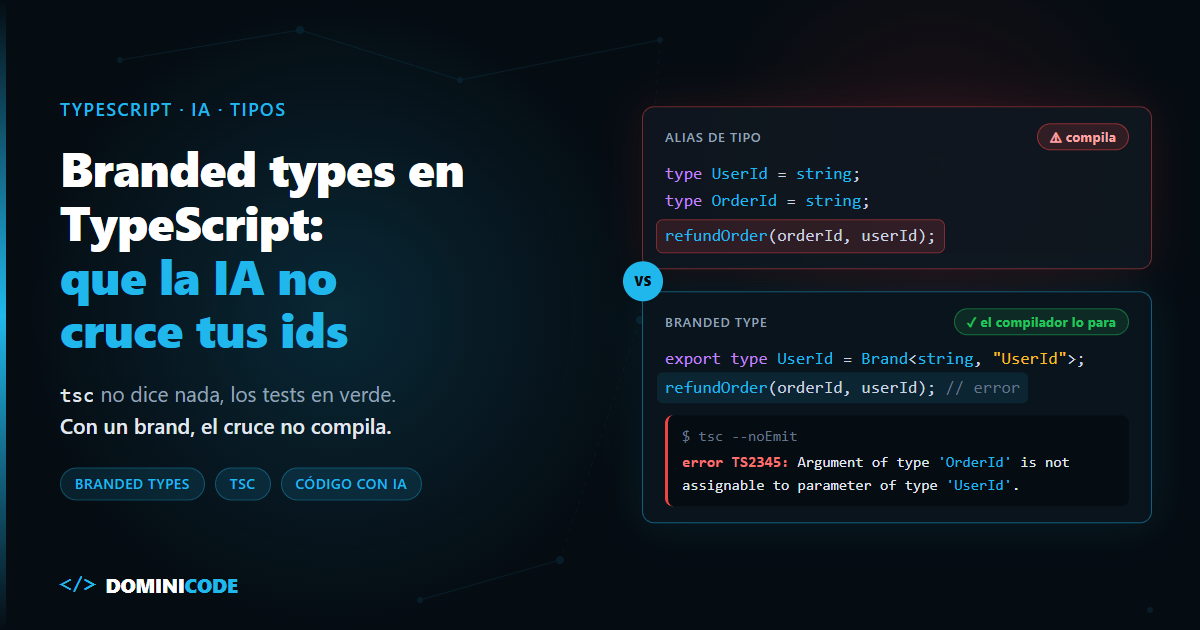
    Le pides al agente un endpoint en TypeScript para reembolsar un pedido. Lo escribe en segundos: busca el pedido, comprueba que pertenece al usuario y llama a refundOrder(orderId, userId).

    La firma de la función es refundOrder(userId, orderId). Los argumentos van al revés.

    tsc no dice nada, los tests en verde. Los dos son string, los dos empiezan por tres letras y un guion bajo, y para TypeScript son exactamente lo mismo. El bug llega a producción y lo encuentra un cliente que no recibe su dinero. Los branded types en TypeScript existen para que ese error no compile.

    En corto: un branded type es un string o un number con una etiqueta que solo existe en el sistema de tipos, de modo que UserId y OrderId dejan de ser intercambiables. El compilador rechaza el cruce de argumentos sin coste en runtime. Es una de las defensas más baratas contra un error frecuente en código generado por IA: pasar un valor con la misma forma en la posición equivocada.

    Por qué TypeScript acepta un orderId donde va un userId

    TypeScript usa tipado estructural: dos tipos son compatibles si tienen la misma forma, da igual cómo se llamen. Un alias como type UserId = string no crea un tipo nuevo, solo le pone un nombre a string.

    Este código compila sin un solo aviso:

    type UserId = string;
    type OrderId = string;
    
    declare function refundOrder(userId: UserId, orderId: OrderId): void;
    
    const userId: UserId = "usr_8f2k";
    const orderId: OrderId = "ord_91xa";
    
    refundOrder(orderId, userId); // compila: los dos son string
    

    El nombre del alias da una falsa sensación de seguridad. Lees UserId en la firma y asumes que el compilador lo vigila. No lo hace.

    Con código humano el riesgo ya existe. Con código generado es peor: el agente rellena argumentos por posición y por nombre parecido, y nadie relee cada llamada. La disciplina que antes ponía el equipo en el code review ahora tiene que ponerla el compilador.

    Es la misma idea que recorre cómo verificar código generado por IA sin leerlo todo: mover comprobaciones de la cabeza del revisor a una herramienta.

    ¿Qué son los branded types en TypeScript?

    Un branded type es un tipo primitivo intersectado con una propiedad fantasma que solo existe en tiempo de compilación, lo que hace que dos valores con la misma forma en runtime sean incompatibles para el compilador.

    Es la forma de simular tipado nominal en un lenguaje estructural. En conceptos avanzados de TypeScript aparece en un párrafo; aquí va el detalle que necesitas para usarlo en producción.

    Hay dos variantes habituales.

    Variante 1: la propiedad __brand

    type UserId = string & { __brand: "UserId" };
    

    Funciona y se entiende a la primera. El problema es que __brand parece una propiedad real: sale en el autocompletado del editor y id.__brand compila. En runtime vale undefined, porque nadie la ha asignado nunca. Un agente que ve esa propiedad en las sugerencias puede acabar usándola.

    Variante 2: unique symbol

    declare const brand: unique symbol;
    type Brand<T, B extends string> = T & { readonly [brand]: B };
    
    export type UserId = Brand<string, "UserId">;
    export type OrderId = Brand<string, "OrderId">;
    

    El símbolo se declara pero no se exporta, así que nadie fuera del módulo puede escribir id[brand]. La etiqueta queda invisible en el uso normal. Es la variante más sólida para código compartido.

    Cómo crear valores: constructor con validación, no as

    Un branded type no se puede asignar desde un string normal. Hay que crearlo, y ese es justo el punto donde se decide si sirve para algo:

    export function toUserId(raw: string): UserId {
      if (!/^usr_[a-z0-9]+$/.test(raw)) throw new Error(`UserId no válido: ${raw}`);
      return raw as UserId;
    }
    
    export function toOrderId(raw: string): OrderId {
      if (!/^ord_[a-z0-9]+$/.test(raw)) throw new Error(`OrderId no válido: ${raw}`);
      return raw as OrderId;
    }
    
    const userId = toUserId("usr_8f2k");
    const orderId = toOrderId("ord_91xa");
    
    refundOrder(userId, orderId); // ok
    refundOrder(orderId, userId); // error
    refundOrder("usr_8f2k", orderId); // error: string sin marca
    

    Esto es lo que devuelve tsc --noEmit con TypeScript 7.0.2, copiado tal cual. Las posiciones (línea,columna) son las del archivo completo, que incluye las declaraciones de arriba:

    src/branded.ts(23,13): error TS2345: Argument of type 'OrderId' is not assignable to parameter of type 'UserId'.
      Type 'OrderId' is not assignable to type '{ readonly [brand]: "UserId"; }'.
        Types of property '[brand]' are incompatible.
          Type '"OrderId"' is not assignable to type '"UserId"'.
    src/branded.ts(24,13): error TS2345: Argument of type 'string' is not assignable to parameter of type 'UserId'.
      Type 'string' is not assignable to type '{ readonly [brand]: "UserId"; }'.
    

    Fíjate en el as dentro del constructor. Es el único as legítimo: vive en un sitio, detrás de una validación. El patrón es el de "parse, don't validate" que se explica en programación defensiva en TypeScript: validas una vez en la frontera y el tipo garantiza el resto del recorrido.

    El riesgo real es el as repartido por el código. Cuando un agente se encuentra un error de tipos, una de sus salidas favoritas es "usr_8f2k" as UserId en la línea que falla. Compila, y el brand ya no protege nada. Por eso conviene una regla de lint o de revisión: as UserId solo dentro de toUserId.

    Zod 4: .brand() con validación incluida

    Si ya validas con Zod, no necesitas escribir los constructores a mano. Zod 4 tiene .brand(), que añade la etiqueta al tipo inferido:

    import { z } from "zod";
    
    const UserIdSchema = z.string().regex(/^usr_[a-z0-9]+$/).brand<"UserId">();
    const OrderIdSchema = z.string().regex(/^ord_[a-z0-9]+$/).brand<"OrderId">();
    
    type UserId = z.infer<typeof UserIdSchema>;
    type OrderId = z.infer<typeof OrderIdSchema>;
    
    declare function refundOrder(userId: UserId, orderId: OrderId): void;
    
    const userId = UserIdSchema.parse("usr_8f2k");
    const orderId = OrderIdSchema.parse("ord_91xa");
    
    refundOrder(userId, orderId); // ok
    refundOrder(orderId, userId); // error
    

    El error que da el compilador:

    src/zod.ts(15,13): error TS2345: Argument of type 'string & $brand<"OrderId">' is not assignable to parameter of type 'string & $brand<"UserId">'.
      Type 'string & $brand<"OrderId">' is not assignable to type '$brand<"UserId">'.
        Types of property '[$brand]' are incompatible.
          Property 'UserId' is missing in type '{ OrderId: true; }' but required in type '{ UserId: true; }'.
    

    La documentación oficial de Zod deja claro que el brand es "a static-only construct": .parse() devuelve el mismo string de siempre.

    Por defecto solo se marca el tipo de salida; desde Zod 4.2 un segundo genérico ("in", "out", "inout") cambia esa dirección. La ventaja es que validación y tipo salen del mismo schema.

    En el curso de Zod se trabaja este patrón de schemas en la frontera, y en el blog tienes cómo Zod resuelve la validación en runtime.

    Segundo caso de uso: céntimos vs euros

    Los branded types también separan unidades: un number en euros y otro en céntimos tienen la misma forma y un factor 100 de diferencia, y es el cruce que más dinero cuesta.

    type Cents = Brand<number, "Cents">;
    type Euros = Brand<number, "Euros">;
    
    const toCents = (euros: Euros): Cents => Math.round(euros * 100) as Cents;
    
    declare function charge(amount: Cents): void;
    
    const price = 19.99 as Euros;
    charge(price); // error
    charge(toCents(price)); // ok
    
    src/money.ts(12,8): error TS2345: Argument of type 'Euros' is not assignable to parameter of type 'Cents'.
      Type 'Euros' is not assignable to type '{ readonly [brand]: "Cents"; }'.
        Types of property '[brand]' are incompatible.
          Type '"Euros"' is not assignable to type '"Cents"'.
    

    Ojo con la aritmética: toCents(price) + toCents(price) devuelve number, no Cents. El brand se pierde en cada operación, así que necesitas funciones como addCents(a, b): Cents si quieres mantenerlo.

    Branded types vs alias vs clase: comparativa

    Criterio Alias (type UserId = string) Branded type (unique symbol) Zod .brand() Clase con campo #private
    Detecta userId ↔ orderId No Sí Sí Sí
    Coste en runtime Ninguno Ninguno El del .parse() Un objeto por valor
    Serializa a JSON tal cual Sí Sí, pero pierde el brand Sí, pero pierde el brand Sale como { "value": "…" }; necesitas toJSON para un string
    Encaja con ORMs y librerías Directo Hace falta convertir en la frontera Hace falta parsear en la frontera Hay que envolver y desenvolver
    Validación del valor No La que escribas en el constructor Incluida en el schema La que escribas en el constructor
    Limitación / riesgo Falsa sensación de seguridad Un as suelto lo anula Acopla tus tipos de dominio a Zod Una clase sin campo privado es estructural también

    La última celda no es teórica. Dos clases UserId y OrderId con solo readonly value: string son intercambiables para TypeScript; compilado con 7.0.2, la asignación pasa sin error. En cuanto añades un miembro privado (un #tag de JavaScript o un private tag de TypeScript), el compilador las separa.

    Límites de los branded types

    No existen en runtime. Bun ejecuta TypeScript sin comprobar tipos, igual que el type stripping de Node. Si tu CI no ejecuta tsc --noEmit, el brand no protege nada.

    JSON los borra. JSON.parse devuelve any, y const back: UserId = copy.id compila sin protestar. Todo lo que entra por red, base de datos o cola tiene que pasar otra vez por toUserId o por el schema.

    Fricción con ORMs y librerías. Prisma, Drizzle o tu cliente HTTP devuelven string. O conviertes en la capa de acceso a datos, o acabas con as por todas partes, que es peor que no tener brand.

    as lo rompe. Ningún tipo sobrevive a "lo-que-sea" as UserId. Con agentes que escriben cientos de líneas por sesión, esto exige una regla explícita en tu AGENTS.md y en la revisión. Cómo convertir esas reglas en un contrato que se comprueba al revisar está en el método Revisión por Contrato.

    Cuesta DX. Mensajes de error más largos, más funciones constructoras y más conversiones. En un script de 200 líneas no compensa. En un dominio con dinero, permisos o varios tipos de id, sí.

    Tipado nominal en TypeScript: lo que se discute en la comunidad

    El tipado nominal es una de las peticiones más antiguas a TypeScript. El issue #202 del repositorio de TypeScript, "Support some non-structural (nominal) type matching", sigue abierto desde julio de 2014 con casi 500 comentarios (498 en octubre de 2026). Los branded types son el parche de la comunidad mientras tanto.

    En el hilo de Hacker News sobre branded types (mayo de 2024, 144 comentarios) hay dos posturas que conviene leer. Un usuario lo resume como "Really ugly way to avoid something already solved by named parameters and/or namespacing".

    Otro explica que su equipo prefiere alias simples y asume que la consecuencia es "an extra level of vigilance and discipline in PR reviews, or else implicit trust in one another".

    Esa segunda frase es la clave del debate en 2026. La confianza implícita entre compañeros funciona en un equipo pequeño. Con un agente generando código, esa confianza no existe, y la vigilancia en el PR es justo lo que no escala.

    Por dónde empezar con branded types en TypeScript

    No brandees todo. Empieza por los tipos donde un cruce cuesta dinero o seguridad: ids de entidades distintas que viajan juntos en la misma firma, y cantidades con unidad (céntimos, segundos, milisegundos).

    Crea un Brand<T, B> con unique symbol, un constructor validado por tipo y una regla que prohíba as fuera de esos constructores. Añade tsc --noEmit al CI. Y dale esa regla al agente por escrito, no confíes en que la deduzca: es el tipo de contrato que se trabaja en el workshop de SDD + Agentic Engineering.

    Los tipos cierran los errores de forma; los de valor los cazan los tests. Para comprobar que esos tests valen, usa mutation testing con Stryker, y para generar las entradas que no se te ocurren, property-based testing con fast-check.

    El ejemplo de este post está compilado con TypeScript 7.0.2 y Zod 4.6.5.

    Preguntas frecuentes

    ¿TypeScript tiene tipado nominal?

    No. TypeScript es estructural: dos tipos con la misma forma son compatibles. La petición de tipado nominal sigue abierta en el issue #202 desde 2014; mientras tanto, los branded types y las clases con miembros privados son las dos formas de simularlo.

    ¿Los branded types tienen coste en runtime?

    No. La etiqueta solo existe en el sistema de tipos y desaparece al compilar. El único coste es el de la validación que pongas en el constructor, que pagarías igualmente si validas en la frontera.

    ¿Qué diferencia hay entre __brand y unique symbol?

    Con __brand la etiqueta aparece en el autocompletado y id.__brand compila aunque en runtime valga undefined. Con un unique symbol no exportado, nadie fuera del módulo puede acceder a la etiqueta. Para código compartido, unique symbol es más limpio.

    ¿Sirven los template literal types en lugar de los branded types?

    Para ids con prefijo, sí: type UserId = `usr_${string}` rechaza un `ord_${string}` en la misma posición. No sirven para unidades, porque un number en céntimos y otro en euros no tienen prefijo que los distinga.

    ¿Cómo evito que un agente de IA rompa los branded types con as?

    Escribe la regla en tu AGENTS.md (as UserId solo dentro de toUserId) y búscala en la revisión con un grep o una regla de lint. El agente tiende a resolver errores de tipos con as; si no se lo prohíbes explícitamente, lo hará.

    ¿Zod .brand() valida algo en runtime?

    La validación la hacen las reglas del schema, como .regex(), o el propio tipo, como z.uuid(). El .brand() por sí mismo solo cambia el tipo inferido; según la documentación de Zod, no afecta al resultado de .parse().

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Claude Code Remote Control: tu sesión local desde el móvil

    Claude Code Remote Control: tu sesión local desde el móvil

    Son las siete de la tarde. Claude Code lleva cuarenta minutos migrando una suite de tests y le quedan otros tantos. Tienes que salir.

    Ya sabes lo que va a pasar. A los diez minutos de cerrar la puerta, el agente se parará en un prompt de permisos para un comando que no está en tu allowlist. Y se quedará ahí, esperando, con el trabajo a medias.

    Hasta ahora la salida era abrir SSH desde el móvil, engancharte a un tmux y pelearte con un teclado de 6 pulgadas. Claude Code Remote Control convierte ese apaño en una función oficial: la sesión sigue en tu PC y tú la conduces desde el teléfono.

    En corto: Claude Code Remote Control conecta la app de Claude (iOS y Android) o claude.ai/code a una sesión que se ejecuta en tu máquina, para aprobar permisos, mandar mensajes y revisar el progreso desde fuera. Se activa con claude remote-control, claude --remote-control o /remote-control, y requiere un plan Pro, Max, Team o Enterprise. Si tu PC va a estar apagado, lo que necesitas es una sesión en la nube.

    ¿Qué es Claude Code Remote Control?

    Claude Code Remote Control es la función que expone una sesión local de Claude Code a claude.ai/code y a la app móvil de Claude, para manejarla desde otro dispositivo mientras el código, las herramientas y los archivos siguen en tu ordenador.

    La documentación oficial de Remote Control (consultada en octubre de 2026) la describe como una ventana a esa sesión local. Tus servidores MCP y tu configuración siguen disponibles, y la conversación se sincroniza entre terminal, navegador y móvil.

    La consecuencia práctica: tu ordenador tiene que seguir encendido y el proceso claude tiene que seguir vivo.

    Cómo activar Claude Code Remote Control

    Hay tres formas de arrancarlo desde la CLI:

    # Modo servidor: espera conexiones y muestra URL + QR (barra espaciadora)
    claude remote-control --name "migracion-tests"
    
    # Sesión interactiva normal, también accesible desde el móvil
    claude --remote-control "migracion-tests"   # alias: --rc
    
    # Dentro de una sesión ya abierta (conserva el historial)
    /remote-control                              # alias: /rc
    

    El subcomando claude remote-control llegó en la versión 2.1.51, según el CHANGELOG oficial. En el móvil abres la app de Claude, entras en la pestaña Code y eliges la sesión, o escaneas el QR de la terminal.

    En modo servidor, --spawn worktree da su propio git worktree a cada sesión que abras bajo demanda, para que no se pisen archivos (requiere un repo git; la sesión creada al arrancar se queda en el directorio actual), y --capacity limita las sesiones concurrentes (32 por defecto).

    Para conectar todas tus sesiones automáticamente, pon remoteControlAtStartup: true en ~/.claude/settings.json. En el .claude/settings.json del repo ese true se ignora, y con razón.

    Requisitos: planes y cuenta

    Remote Control solo funciona con una suscripción de claude.ai: Pro, Max, Team o Enterprise. Con API key no. En Team y Enterprise, además, un Owner tiene que activar el toggle en la configuración de administración.

    Tampoco funciona con Bedrock, Google Cloud Agent Platform o Microsoft Foundry, con ANTHROPIC_BASE_URL apuntando a un gateway o proxy, ni con CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC o DISABLE_GROWTHBOOK activos. El token de larga duración de claude setup-token tampoco sirve: necesitas claude auth login.

    En el móvil necesitas la app de Claude con la misma cuenta y organización que en la terminal. No hay una app aparte de Claude Code: todo vive en la pestaña Code.

    Qué puedes hacer desde el móvil

    Desde el móvil puedes aprobar o rechazar permisos, responder preguntas, mandar mensajes, adjuntar archivos, ver el diff, parar subagentes y cambiar el modo de permisos. Lo que resuelve el problema de las siete de la tarde son las notificaciones push. En /config activas Push when actions required para permisos y preguntas, y Push when Claude decides para que avise al terminar una tarea larga. También puedes pedirlo en el prompt: notify me when the tests finish.

    Los prompts de permisos y las preguntas de AskUserQuestion se quedan abiertos hasta que respondes. Otros diálogos reenviados se cierran a los cinco minutos por defecto (ajustable con dialogExpiry).

    Puedes elegir los modos Manual, Accept edits, Plan y Auto, pero no Bypass permissions. Me parece la decisión correcta: si no estás delante, no deberías poder quitarle todos los frenos al agente.

    Si no tienes claro qué comandos dejar en la allowlist, en hooks vs permissions en Claude Code explico dónde va cada guardarraíl. Con Remote Control esa decisión pesa más: cada prompt te llega al bolsillo.

    Qué sale de tu máquina y qué no

    Tu sesión local solo hace peticiones HTTPS salientes y nunca abre puertos de entrada. Se registra en la API de Anthropic, que enruta los mensajes entre el móvil y tu terminal sobre TLS, con credenciales de vida corta.

    Se queda en tu máquina la ejecución de comandos y el acceso a archivos. Sale la transcripción (tus mensajes, las respuestas de Claude y la actividad de herramientas), que se guarda en servidores de Anthropic mientras Remote Control está conectado.

    Ojo: la actividad de herramientas forma parte de esa transcripción. Si el agente hace cat de un .env, asume que esa salida queda guardada en Anthropic mientras estés conectado, además de en tu historial local de ~/.claude/projects/. Antes de salir, niega la lectura de .env con una regla deny o un hook. Las organizaciones con Zero Data Retention o configuración HIPAA no pueden activarlo, y el ajuste disableRemoteControl lo apaga del todo.

    Si quieres más control, activa Trusted Devices (en beta): exige dispositivos registrados y un inicio de sesión de menos de 18 horas.

    Claude Code Remote Control vs sesión en la nube vs SSH + tmux

    La diferencia clave es dónde se ejecuta el trabajo. Remote Control conduce tu sesión local. Una sesión en la nube corre en una máquina virtual aislada de Anthropic y sigue viva con el portátil cerrado.

    Criterio Remote Control Sesión en la nube SSH + tmux
    Dónde se ejecuta Tu PC VM aislada de Anthropic Tu PC o servidor
    ¿PC encendido? Sí, con claude vivo No Sí
    MCP y herramientas locales Disponibles Solo lo del entorno cloud Disponibles
    Cómo se activa /remote-control claude.ai/code o claude --cloud Servidor SSH + cliente móvil
    Origen del código Tu checkout local Tu rama remota de GitHub Tu checkout local
    Planes Pro, Max, Team, Enterprise Pro, Max, Team; Enterprise con asientos premium o Chat + Claude Code Cualquiera, incluso API key
    Limitación o riesgo Transcripción guardada en Anthropic; si el PC se apaga, se para Clonar y hacer push requieren GitHub (sin él sube un bundle local, pero no puede hacer push de vuelta); consume tus límites; la VM se recicla tras inactividad Puerto SSH expuesto (salvo VPN o túnel); sin push de la app

    Un detalle que confunde: claude --cloud "tarea" clona tu remoto de GitHub en la rama actual, no tu checkout local, así que haz push antes. Para traer una sesión cloud a tu terminal, usa claude --teleport. Y --cloud no mueve la sesión que ya tienes abierta: crea una nueva.

    Si quieres que el trabajo se lance solo, sin ti, eso ya son Claude Code Routines, que corren en esa misma infraestructura cloud.

    Un caso real: la tarea larga que apruebas desde la calle

    Vuelvo a la migración de las siete. Con lo que dice la documentación, este es el flujo que recomiendo:

    1. Antes de salir, escribe /remote-control migracion-tests en la sesión abierta.
    2. Comprueba que Push when actions required está activo en /config.
    3. Añade al prompt que te avise cuando pasen todos los tests.
    4. Cuando llegue un permiso, léelo entero. Si es un rm o un git push, recházalo y escribe qué quieres en su lugar.

    Si la tarea no necesita tu entorno local, lanza claude --cloud y cierra el portátil. Delegar lo largo y reservar tu atención para las decisiones es justo lo que trabajamos en Construye con IA.

    Cuándo NO usar Claude Code Remote Control

    Tu máquina es el punto único de fallo. Si el portátil se queda sin batería o cierras la terminal, la sesión se cae. En modo servidor, tras unos 10 minutos sin red el proceso sale. Para horas sin supervisión, la nube es más honesta.

    La reconexión todavía da guerra. El issue #34255 de anthropics/claude-code, abierto desde marzo de 2026 con más de 70 comentarios, describe conexiones con la app de iOS que se caen en silencio. Su autor, que lo reportó sobre la v2.1.76, indica "Connection typically drops after 15-60 minutes of use" y que tenía que volver al teclado para reconectar. La documentación actual dice que reconecta sola; yo no le confiaría una entrega crítica sin probarlo en tu red.

    No todos los comandos funcionan desde el móvil. /plugin y /resume son solo locales, y /model o /effort piden el valor como argumento.

    No es para código que no puede salir de tu red. La ejecución es local, pero la transcripción pasa por Anthropic. Con Zero Data Retention, ni siquiera está disponible.

    Cómo empezar hoy con Claude Code Remote Control

    Una sola recomendación: antes de tu próxima tarea larga, haz una prueba de diez minutos. Ejecuta /remote-control, activa las dos opciones de push, sal de la habitación y aprueba un permiso desde el móvil. Si aguanta en tu red, ya tienes el hábito. Si se cae, para lo largo te toca la nube.

    Y si lo que te frena es no fiarte de lo que aprobaste desde el sofá, el problema no es Remote Control: es cómo revisas el código del agente. Eso trabajamos en el workshop SDD + Agentic Engineering. Para el resto del día a día, aquí tienes mi flujo con Claude Code.

    Preguntas frecuentes

    ¿Qué diferencia hay entre Remote Control y Claude Code en la web?

    Remote Control conduce una sesión que se ejecuta en tu ordenador, con tus archivos y tus servidores MCP. Claude Code en la web (claude.ai/code) también lanza sesiones en la nube, que corren en una máquina virtual de Anthropic y siguen activas con tu PC apagado. Ambas se ven en la misma interfaz; cambia dónde se ejecuta el código.

    ¿Puedo usar Claude Code Remote Control con una API key?

    No. Exige iniciar sesión con una suscripción de claude.ai (Pro, Max, Team o Enterprise). Si tienes ANTHROPIC_API_KEY en el entorno, Claude Code te avisa y no conecta. Tampoco funciona con proveedores de terceros como Bedrock.

    ¿Remote Control abre algún puerto en mi máquina?

    No. La sesión local solo hace peticiones HTTPS salientes a la API de Anthropic. Es la gran diferencia frente a exponer SSH. A cambio, la transcripción se guarda en servidores de Anthropic mientras está conectada.

    ¿Qué pasa si mi portátil se suspende durante una sesión remota?

    Claude Code se reconecta cuando la máquina vuelve a estar online. Si cierras el proceso claude, la sesión queda offline, pero no la pierdes. Si la abriste con /remote-control o claude --remote-control, recupérala con claude --continue o claude --resume. Si era un servidor claude remote-control que paraste con Ctrl+C, ejecuta claude remote-control --continue en el mismo directorio durante unas cuatro horas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Feature flags: despliega código generado por IA sin miedo

    Feature flags: despliega código generado por IA sin miedo

    El 1 de agosto de 2012, Knight Capital acumuló en unos 45 minutos posiciones que acabaron costándole más de 460 millones de dólares. No fue un ataque ni un fallo de hardware. Fueron un despliegue incompleto y un feature flag mal gestionado: se reutilizó para activar código nuevo y, en el único servidor que no recibió ese código, despertó código que no se usaba desde 2003.

    Lo peor vino después: para arreglarlo, retiraron el código nuevo de los servidores donde sí funcionaba. Eso empeoró el problema.

    Hoy un agente te abre un PR de 900 líneas de código generado por IA en diez minutos. Los tests pasan. Y aun así no sabes cómo se comportará con tráfico real.

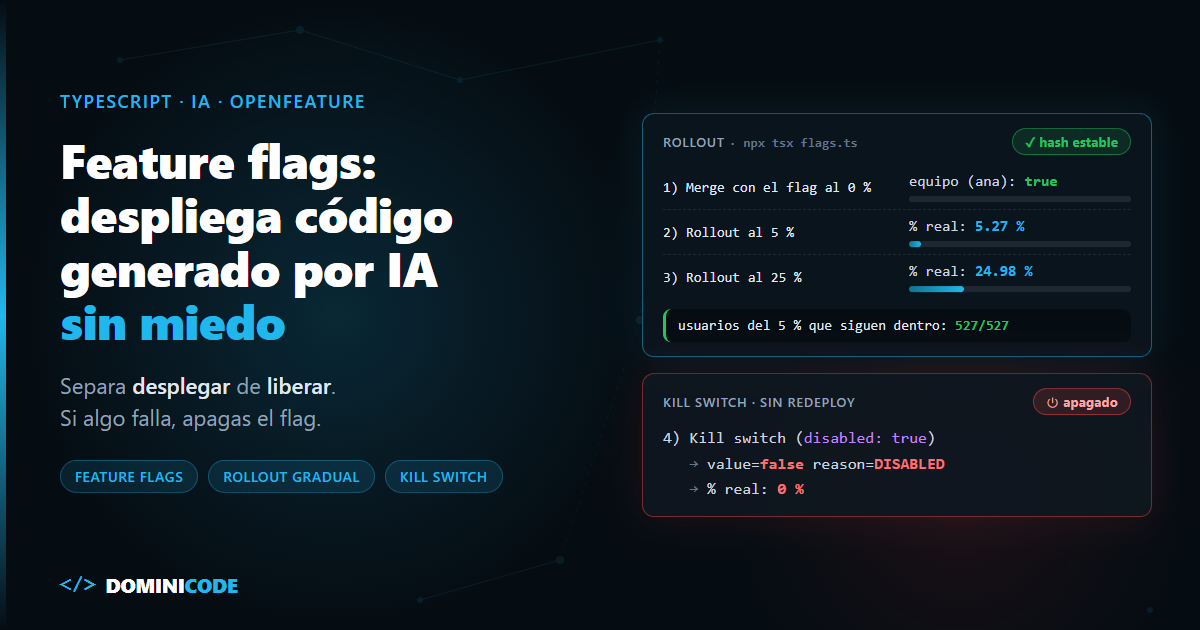
    En corto: mergea el código generado por IA a main detrás de un feature flag apagado por defecto, actívalo primero para tu equipo y luego por porcentaje de usuarios con un hash estable del userId. Si algo falla, apagas el flag en vez de hacer revert y redeploy. Y borras el flag y el camino viejo en cuanto llega al 100 %: a Knight lo hundieron un flag reutilizado, código muerto que nadie borró y un despliegue manual que nadie revisó.

    ¿Qué es un feature flag?

    Un feature flag es una condición en el código cuyo valor se decide en tiempo de ejecución, fuera del despliegue, y que permite activar o desactivar un comportamiento sin cambiar ni volver a desplegar el código.

    La clave es separar desplegar de liberar. Desplegar es poner el código en producción; liberar es que los usuarios lo ejecuten. Con un flag, lo primero lo hace tu pipeline y lo segundo lo decides tú.

    Pete Hodgson los clasifica en cuatro tipos en Feature Toggles, el artículo de referencia en martinfowler.com:

    Tipo Para qué sirve Vida esperada
    Release Ocultar código sin validar en producción Días o semanas; luego se borra
    Ops (kill switch) Apagar una función cara o frágil cuando el sistema sufre Casi siempre corta; algunos kill switches, años
    Experimento Comparar variantes A/B con métricas Lo que dure el experimento
    Permiso Dar acceso a planes premium o usuarios beta Años

    Para el código generado por IA interesa el de release, y Hodgson es tajante con su duración: "They should generally not stick around much longer than a week or two".

    Por qué el código generado por IA necesita feature flags

    El cuello de botella ya no es escribir código, es confiar en él. Un agente produce cambios más rápido de lo que tu equipo los valida, y hay comportamientos que solo descubres con tráfico real.

    Sin flags tienes dos salidas malas: una rama larga que acaba en un merge infernal, o liberar a todo el mundo a la vez. Ninguna escala cuando el agente abre cinco PR al día.

    Es el argumento de trunk-based development que vimos en cómo acelerar las entregas de los desarrolladores sénior: integrar pronto y en trozos pequeños. El flag hace seguro integrar código que aún no quieres que vea nadie.

    Criterio Revert + redeploy Feature flag Rama larga
    Cómo apagas el cambio Nuevo commit y pipeline completo Cambias un valor en el proveedor de flags No hace falta: nunca llegó a main
    Tiempo hasta apagar Lo que tarde tu CI/CD Lo que tarde en propagarse la configuración No aplica
    Exposición al activar 100 % de usuarios de golpe Equipo, luego 5 %, 25 %, 100 % 100 % de golpe al mergear
    Conflictos de merge Bajos Bajos Altos, crecen cada día
    Limitación / riesgo El revert puede no ser limpio si hubo migraciones o el cambio tocó varios servicios Deuda de flags, combinatoria de estados en tests, dependencia del proveedor El código no se prueba con tráfico real hasta el final; integración tardía

    El revert no siempre es la red de seguridad que parece: en Knight Capital, retirar el código nuevo activó el defectuoso en siete servidores más.

    Feature flags en TypeScript con OpenFeature

    OpenFeature es la forma de escribir feature flags en TypeScript sin casarte con un proveedor. Es una especificación abierta que la CNCF aceptó como proyecto incubating en diciembre de 2023: tu código habla con el SDK y el proveedor se enchufa detrás.

    El ejemplo está ejecutado con Node.js 24.16.0, @openfeature/server-sdk 1.23.0, @openfeature/core 1.12.0, tsx 4.23.15 y TypeScript 7.0.2 (tsc --noEmit sin errores). Usa TypedInMemoryProvider, porque en esta versión InMemoryProvider está marcado como @deprecated.

    Primero, el rollout por porcentaje. Math.random() < 0.05 es un error: el mismo usuario vería la función nueva en una petición y la vieja en la siguiente. Necesitas un hash estable.

    // rollout.ts
    import { createHash } from 'node:crypto';
    
    // Devuelve un "bucket" estable entre 0 y 99 para un usuario y un flag.
    // Mismo userId + mismo flag = mismo bucket, en cualquier proceso y en cualquier máquina.
    export function bucketOf(flagKey: string, userId: string): number {
      const digest = createHash('sha256').update(`${flagKey}:${userId}`).digest();
      return digest.readUInt32BE(0) % 100;
    }
    
    export function isInRollout(flagKey: string, userId: string, percentage: number): boolean {
      return bucketOf(flagKey, userId) < percentage;
    }
    

    El nombre del flag entra en el hash a propósito: si no, el mismo 5 % de usuarios se comería todos tus rollouts.

    Ahora el flag: siempre activo para el equipo, luego por porcentaje, y disabled: true como kill switch:

    // flags.ts
    import { OpenFeature, TypedInMemoryProvider, type EvaluationContext } from '@openfeature/server-sdk';
    import { isInRollout } from './rollout';
    
    const FLAG = 'new-checkout-ai';
    const TEAM = new Set(['ana@empresa.dev', 'luis@empresa.dev']);
    
    // Construye la configuración del flag: equipo interno + porcentaje + kill switch
    function buildFlags(percentage: number, killed: boolean) {
      return {
        [FLAG]: {
          variants: { on: true, off: false },
          defaultVariant: 'off',
          disabled: killed,
          contextEvaluator: (ctx: EvaluationContext) => {
            const userId = ctx.targetingKey;
            if (!userId) return 'off';
            if (TEAM.has(String(ctx.email))) return 'on';
            return isInRollout(FLAG, userId, percentage) ? 'on' : 'off';
          },
        },
      } as const;
    }
    
    const provider = new TypedInMemoryProvider(buildFlags(0, false));
    await OpenFeature.setProviderAndWait(provider);
    const client = OpenFeature.getClient();
    
    // Valor por defecto seguro: si algo falla, el código nuevo NO se ejecuta
    const SAFE_DEFAULT = false;
    
    async function share(): Promise<number> {
      let on = 0;
      for (let i = 0; i < 10_000; i++) {
        if (await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: `user-${i}` })) on++;
      }
      return on / 100;
    }
    
    console.log('1) Merge con el flag al 0 %');
    console.log('   equipo (ana):', await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: 'u-ana', email: 'ana@empresa.dev' }));
    console.log('   usuario externo:', await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: 'user-42' }));
    console.log(`   % de 10.000 usuarios con el flag: ${await share()} %`);
    
    provider.putConfiguration(buildFlags(5, false));
    const firstWave = new Set<string>();
    for (let i = 0; i < 10_000; i++) {
      if (await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: `user-${i}` })) firstWave.add(`user-${i}`);
    }
    console.log('2) Rollout al 5 %');
    console.log(`   % real: ${firstWave.size / 100} %`);
    const again = await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: [...firstWave][0] });
    console.log(`   ${[...firstWave][0]} vuelve a evaluar -> ${again} (estable)`);
    
    provider.putConfiguration(buildFlags(25, false));
    let kept = 0;
    for (const id of firstWave) if (await client.getBooleanValue(FLAG, SAFE_DEFAULT, { targetingKey: id })) kept++;
    console.log('3) Rollout al 25 %');
    console.log(`   % real: ${await share()} %`);
    console.log(`   usuarios del 5 % que siguen dentro: ${kept}/${firstWave.size}`);
    
    provider.putConfiguration(buildFlags(25, true));
    const details = await client.getBooleanDetails(FLAG, SAFE_DEFAULT, { targetingKey: [...firstWave][0], email: 'ana@empresa.dev' });
    console.log('4) Kill switch (disabled: true)');
    console.log(`   value=${details.value} reason=${details.reason}`);
    console.log(`   % real: ${await share()} %`);
    
    const missing = await client.getBooleanDetails('flag-que-no-existe', SAFE_DEFAULT, { targetingKey: 'user-1' });
    console.log('5) Flag inexistente');
    console.log(`   value=${missing.value} reason=${missing.reason} errorCode=${missing.errorCode}`);
    

    Salida real de npx tsx flags.ts:

    1) Merge con el flag al 0 %
       equipo (ana): true
       usuario externo: false
       % de 10.000 usuarios con el flag: 0 %
    2) Rollout al 5 %
       % real: 5.27 %
       user-0 vuelve a evaluar -> true (estable)
    3) Rollout al 25 %
       % real: 24.98 %
       usuarios del 5 % que siguen dentro: 527/527
    4) Kill switch (disabled: true)
       value=false reason=DISABLED
       % real: 0 %
    5) Flag inexistente
       value=false reason=ERROR errorCode=FLAG_NOT_FOUND
    

    Al subir del 5 % al 25 %, los 527 usuarios de la primera ola siguen dentro: nadie ve la función aparecer y desaparecer. El kill switch gana incluso al equipo interno (reason=DISABLED).

    Y si el flag no existe, el SDK no lanza: devuelve el valor por defecto con errorCode=FLAG_NOT_FOUND. Por eso el default es false, el camino viejo que ya funcionaba.

    Rollout gradual de código generado por IA: el flujo con agentes

    El rollout gradual convierte "lo despliego y rezo" en una serie de pasos pequeños con un botón de apagado en cada uno. Con agentes, el flujo queda así:

    1. El agente abre el PR con el código nuevo detrás de un flag apagado.
    2. Lo revisas igual: el código está en main. Aquí encaja la revisión por contrato.
    3. Mergeas el mismo día y tu pipeline de CI/CD despliega.
    4. Lo activas para el equipo interno.
    5. Subes a 5 %, 25 %, 50 % y 100 %, mirando métricas en cada paso.
    6. Estable al 100 %, el agente abre otro PR que borra el flag y el camino viejo.

    El paso 5 solo funciona si mides. Sin monitoreo en producción que separe métricas por variante, subir del 5 % al 25 % es fe, no datos.

    El paso 1 hay que pedirlo de forma explícita. Una regla en tu AGENTS.md como "todo cambio de comportamiento va detrás de un flag nuevo, apagado por defecto, con fecha de borrado" hace que ocurra siempre. Montar esas reglas y el harness del agente es lo que se trabaja en el workshop SDD + Agentic Engineering.

    El curso Construye con IA recorre el proceso completo, de la idea al producto desplegado con Claude Code.

    Lo que Knight Capital enseña sobre feature flags

    La lección no es "no uses flags". Es: nunca reutilices el nombre de un flag, borra el código muerto y no confíes en que el rollback sea inocuo. La orden de la SEC de octubre de 2013 lo documenta:

    • El código nuevo "repurposed a flag that was formerly used to activate the Power Peg code", sin uso desde 2003.
    • Un técnico no copió el código nuevo a uno de los ocho servidores, y nadie revisó el despliegue.
    • Ese servidor ejecutó el código viejo: 4 millones de ejecuciones en unos 45 minutos.
    • Desinstalar el código nuevo de los otros siete extendió el fallo a todos.

    En el hilo de Hacker News It's OK to hardcode feature flags, un usuario cuenta que una función nueva paralizó su app y una de las razones por las que tardaron tanto en arreglarlo fue que el responsable había quitado el flag remoto ese mismo día: "Redeploying takes time. Sometimes you want to disable something quick."

    En el mismo hilo, otro comentario resume el reverso: "leaving too many feature flags lying around can become serious debt". Las dos cosas son ciertas a la vez.

    Límites de los feature flags

    Los feature flags reducen el riesgo de liberar código, pero tienen su propio coste:

    Deuda de flags. Cada flag es un if con dos caminos que mantener; Hodgson habla de inventario con "carrying cost". Sin fecha de borrado se quedan para siempre: deuda técnica que además confunde al agente.

    Combinatoria en los tests. Con 10 flags booleanos activos hay 1.024 combinaciones. Testea los dos estados de cada flag y mantén pocos vivos a la vez.

    Dónde se evalúa. Si evalúas en el navegador, el código nuevo viaja en el bundle aunque el flag esté apagado. Cualquiera puede leerlo. Para funciones sensibles, evalúa en servidor o elimina el código en build.

    Latencia y caída del proveedor. Un proveedor remoto es una dependencia más. Si cae y no tiene caché, recibes el valor por defecto, y el kill switch tarda lo que tarde tu proveedor en propagar cambios.

    Los flags no sustituyen a los tests. Un flag limita a cuántos usuarios afecta un fallo, no evita el fallo. Las migraciones de base de datos tampoco se apagan con un flag: tienen que ser compatibles con los dos caminos.

    Por dónde empezar con feature flags

    Empieza por un solo flag de release en el próximo PR que te abra un agente. No necesitas un SaaS: OpenFeature con el provider en memoria para los tests y un provider que lea configuración externa en producción basta para separar desplegar de liberar.

    Ponle fecha de borrado el mismo día que lo creas: es lo que separa un flag útil de un Knight Capital en miniatura. Y si quieres que el agente parta de una especificación clara, el libro de Spec-Driven Development explica cómo definirla antes de escribir una línea.

    Preguntas frecuentes

    ¿Por qué no usar Math.random() para un rollout por porcentaje?

    Porque cada evaluación daría un resultado distinto y el mismo usuario vería la función nueva y la vieja alternándose. Un hash estable del userId y del nombre del flag asigna a cada usuario siempre el mismo bucket, y al subir el porcentaje los que ya estaban dentro siguen dentro.

    ¿Qué pasa si el proveedor de feature flags se cae?

    Con OpenFeature, la evaluación no lanza una excepción: si el provider no puede resolver el flag, devuelve el valor por defecto que pasaste en la llamada, con reason=ERROR y un errorCode. Muchos providers remotos sirven antes el último valor cacheado. Por eso el valor por defecto debe ser siempre el comportamiento antiguo y probado.

    ¿Qué diferencia hay entre un feature flag de release y un kill switch?

    Un flag de release oculta código nuevo mientras lo validas y se borra en una o dos semanas. Un kill switch es un flag de operaciones que sirve para apagar una función cara o frágil cuando el sistema sufre; casi siempre es temporal, aunque algunos se quedan años. En OpenFeature, disabled: true devuelve el valor por defecto con reason=DISABLED, incluso para el equipo interno.

    ¿Cuánto tiempo debe vivir un flag de release?

    Pete Hodgson recomienda que no pase de una o dos semanas. Al 100 % y estable, borra el flag y el camino viejo en un PR aparte.

    ¿Necesito LaunchDarkly o un SaaS para usar feature flags?

    No para empezar. Con OpenFeature escribes contra una API estándar y, si luego necesitas segmentación o auditoría, cambias de provider sin tocar las llamadas.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • API keys y agente de IA: cómo evitar que tu key se filtre

    API keys y agente de IA: cómo evitar que tu key se filtre

    Viernes por la tarde. Un test de integración falla con un 401 y le pides a tu agente de IA que lo arregle. Hace lo que haría cualquier developer con prisa: comprobar si las API keys están cargadas.

    Ejecuta un env. La salida entera, con tu key de Anthropic, la de Stripe y el token de GitHub, entra en el contexto y queda en el transcript de la sesión. Luego, para que el test pase, escribe la key en un fixture. Revisas el diff en diagonal, commit y push.

    Nadie ha hecho nada malicioso. No hubo prompt injection ni atacante. Solo una cadena de cuatro pasos donde ninguno parecía grave.

    En corto: las API keys se escapan de un agente de IA por cinco vías: lectura del .env, salida de terminal, código hardcodeado, commit y chat. Ninguna defensa cubre las cinco: combina reglas de lectura del agente, sandbox o limpieza del entorno, secretos inyectados en runtime, gitleaks en pre-commit y push protection. Y si una key se filtra, revócala antes de tocar el historial de git.

    ¿Qué es una fuga de secretos con un agente de IA?

    Una fuga de secretos con un agente de IA es cualquier camino por el que una credencial pasa de su sitio seguro a un lugar que no controlas: el contexto del modelo, un transcript guardado en disco, un log, el código fuente o el historial de git.

    No hace falta que acabe en GitHub: en cuanto entra en el contexto, viaja al proveedor del modelo y queda en el historial de la sesión.

    El problema tiene cifras. El informe State of Secrets Sprawl 2026 de GitGuardian, publicado en marzo de 2026, contó 28,65 millones de secretos nuevos en commits públicos de GitHub durante 2025, un 34 % más que el año anterior.

    Según el informe State of Secrets Sprawl 2026 de GitGuardian, los commits asistidos por Claude Code filtraron secretos en un 3,2 % de los casos, frente al 1,5 % de base en GitHub público. Y hallaron 24.008 secretos en ficheros de configuración de MCP.

    Ojo: GitGuardian vende escáneres de secretos y no publica la metodología de esa comparación.

    Las cinco vías por las que una API key sale de tu máquina

    Cada vía por la que se filtran las API keys de un agente de IA tiene su defensa, y cada defensa tiene un agujero.

    Vía de fuga Defensa concreta Limitación o riesgo
    1. El agente lee .env y el valor entra en el contexto permissions.deny con Read(./.env) y Read(./.env.*) No cubre grep -r ni scripts de Python o Node que abren el fichero por su cuenta
    2. La key aparece en la salida de terminal (env, printenv, logs, stack traces) Sandbox con credentials en deny o mask, o CLAUDE_CODE_SUBPROCESS_ENV_SCRUB=1 El sandbox no funciona en Windows nativo; el scrub deja GITHUB_TOKEN; tu propio código puede seguir logueando headers
    3. El agente hardcodea la key en código o en un fixture Secretos inyectados en runtime (op run) y revisión del diff Si la key existe en el entorno, el agente puede copiarla igual
    4. Commit y push gitleaks en pre-commit + push protection de GitHub Falsos negativos con keys troceadas; ambos se pueden saltar
    5. Tú pegas la key en el chat Disciplina, y keys con scope mínimo y límite de gasto Ninguna herramienta te protege de ti mismo

    Proteger .env en Claude Code: qué bloquea permissions.deny y qué no

    La primera capa es decirle a Claude Code qué no puede leer, como en el ejemplo de la referencia de settings:

    {
      "permissions": {
        "deny": [
          "Read(./.env)",
          "Read(./.env.*)",
          "Read(./secrets/**)"
        ]
      }
    }
    

    Si tienes un .claudeignore, bórralo: la doc de permisos dice que no tiene ningún efecto y que hay que pasar sus entradas a reglas Read de deny.

    El matiz que casi nadie lee: mucha gente da por hecho que denegar Read no impide un cat .env. En versiones recientes, la doc (consultada en octubre de 2026) dice otra cosa: el deny de Read y Edit se aplica a los comandos de Bash que Claude Code reconoce, como cat, head, tail, sed y tee, y a las redirecciones.

    No cubre comandos que leen ficheros sin nombrarlos, como grep -r pattern ., ni un script de Python o Node que abre el fichero por su cuenta. Para eso, la doc remite al sandbox, que restringe a nivel de sistema operativo.

    Si quieres lógica propia, como bloquear todo comando con printenv, eso va en un hook PreToolUse. Cuándo usar cada pieza lo explica hooks vs permissions en Claude Code.

    Sandbox y limpieza del entorno: la key fuera del alcance del shell

    La vía 2 es la más traicionera: la key no está en un fichero que puedas denegar, sino en las variables de entorno que heredan los comandos.

    En el issue #80153 de anthropics/claude-code, quien lo reporta cuenta que un agente autónomo ejecutó un comando compuesto con un env suelto en medio. El entorno entero acabó en el transcript y hubo que rotar unas diez credenciales.

    La doc del sandbox es explícita: por defecto, los comandos sandboxed heredan las variables de entorno de Claude Code, "incluidos los secretos". Para evitarlo tienes sandbox.credentials:

    {
      "sandbox": {
        "enabled": true,
        "credentials": {
          "files": [
            { "path": "~/.aws/credentials", "mode": "deny" }
          ],
          "envVars": [
            { "name": "ANTHROPIC_API_KEY", "mode": "deny" },
            { "name": "STRIPE_SECRET_KEY", "mode": "deny" }
          ]
        }
      }
    }
    

    Con deny, la variable desaparece antes de cada comando. Con mask, el comando ve un marcador y el proxy pone el valor real solo hacia hosts permitidos; exige terminación TLS.

    Dos avisos de la doc: no hay lista de credenciales por defecto, solo se protege lo que declaras. Y credentials afecta solo a Bash sandboxed. Para limpiar credenciales de todos los subprocesos, incluidos hooks y servidores MCP por stdio, usa CLAUDE_CODE_SUBPROCESS_ENV_SCRUB=1. Ojo: detecta las credenciales por el nombre o la forma del valor, y deja GITHUB_TOKEN y GH_TOKEN a propósito para que gh siga funcionando. Para quitarlas, añádelas como deny en sandbox.credentials.

    Que la API key no viva en el disco del repo

    Todo lo anterior es de Claude Code. Si alternas con Codex o Cursor, necesitas una capa independiente del agente: que el .env no contenga secretos.

    Con la CLI de 1Password, el .env guarda referencias en lugar de valores:

    # .env — solo referencias, se puede leer sin miedo
    ANTHROPIC_API_KEY="op://dev/anthropic/credential"
    STRIPE_SECRET_KEY="op://dev/stripe/secret_key"
    
    # Los valores reales existen solo mientras dura el proceso
    op run --env-file="./.env" -- npm run test:integration
    

    Si el agente lee ese .env, ve rutas op://, no secretos. Doppler o dotenvx resuelven lo mismo con otro modelo; elige uno y no mezcles.

    Y no olvides tu carpeta de configuración. En el hilo de Hacker News sobre usar Bubblewrap para aislar el .env, con 187 puntos, Simon Willison avisó de que ~/.claude contiene los transcripts de todas tus sesiones anteriores, que pueden incluir datos sensibles. Si una key pasó por el chat, sigue ahí.

    gitleaks en pre-commit y push protection: la red cuando todo falla

    Las capas anteriores reducen la probabilidad. Esta reduce el daño: si la key llega al commit, no sale de tu máquina.

    La prueba: un repo vacío con gitleaks 8.30.1 como hook de pre-commit y una key de Anthropic falsa, con formato realista, dentro de un fixture de test. El hook:

    #!/bin/sh
    # .githooks/pre-commit — bloquea el commit si hay secretos en staging
    gitleaks git --pre-commit --staged --redact --no-banner -v
    

    Git no lee .githooks/ por su cuenta. Actívalo una vez por clon:

    # Activa la carpeta de hooks del repo
    git config core.hooksPath .githooks
    chmod +x .githooks/pre-commit
    

    Salida real al intentar el commit (sin marcas de tiempo):

    Finding:     const apiKey = 'REDACTED'
    Secret:      REDACTED
    RuleID:      anthropic-api-key
    Entropy:     5.453328
    File:        src/client.test.ts
    Line:        4
    Fingerprint: src/client.test.ts:anthropic-api-key:4
    
    INF 0 commits scanned.
    INF scanned ~308 bytes (308 bytes) in 173ms
    WRN leaks found: 1
    

    El commit no se creó. Usa siempre --redact: sin él, gitleaks imprime la key, y si el commit lo lanza el agente, la metes en el contexto por otra puerta.

    Si usas el framework pre-commit, esta es la configuración del README de gitleaks, con la versión actualizada a la 8.30.1. El hook gitleaks ya ejecuta --redact por defecto:

    repos:
      - repo: https://github.com/gitleaks/gitleaks
        rev: v8.30.1
        hooks:
          - id: gitleaks
    

    Última línea: GitHub. Según la doc de push protection, la protección para usuarios viene activada por defecto y bloquea pushes con secretos a repositorios públicos. La protección a nivel de repositorio viene desactivada y requiere GitHub Secret Protection: en tus repos privados, por defecto, nadie para el push.

    Qué hacer si una API key se filtra: revoca primero

    El instinto es borrar el commit. Orden equivocado: la guía de GitHub para eliminar datos sensibles dice que el primer paso es revocar o rotar el secreto.

    Limpiar el historial no basta: el commit sigue accesible en clones, forks, vistas cacheadas por SHA y pull requests. Y GitGuardian encontró que más del 64 % de los secretos válidos de 2022 seguían funcionando en enero de 2026.

    En los primeros minutos:

    1. Revoca la key en el panel del proveedor y genera una nueva.
    2. Revisa el uso de la key comprometida en ese periodo.
    3. Actualiza la key nueva en tu gestor de secretos, no en el .env.
    4. Solo entonces limpia el historial con git-filter-repo (2.47 o superior, con --sensitive-data-removal).

    Para acotar el daño, usa keys con alcance mínimo y límite de gasto. En Anthropic, los workspaces admiten keys propias y un límite de gasto mensual. Una key de desarrollo para el agente, en su workspace y con tope bajo, convierte una fuga en una molestia.

    Límites de este enfoque

    Ninguna capa es hermética. Esto es lo que no resuelven.

    gitleaks tiene falsos negativos. En el mismo repo de prueba, la key troceada en dos literales concatenados (prefix + '...') dio este resultado: no leaks found y commit creado. Las reglas buscan patrones, no entienden el código.

    Todo hook se puede saltar. git commit --no-verify omite el pre-commit, y el README de gitleaks documenta SKIP=gitleaks. Un agente con permiso para ejecutar git puede hacerlo para cumplir la tarea.

    El sandbox no llega a todas partes. Funciona en macOS, Linux y WSL2, no en Windows nativo, y si no puede arrancar, por defecto los comandos se ejecutan sin sandbox; activa sandbox.failIfUnavailable si prefieres que falle. Los servidores MCP locales, los hooks y tus comandos con ! corren fuera de él. Un servidor MCP es una dependencia más; trátalo como cualquier paquete de npm que instalas.

    El agente necesita algunas keys. Si ejecuta tests de integración, la key tiene que existir. Lo realista es una key de desarrollo limitada, no una de producción bien escondida.

    No cubre un ataque deliberado. Si un documento malicioso ordena al agente exfiltrar credenciales, el problema es otro: lo cubre el post sobre inyección indirecta de prompts.

    Y si piensas filtrar comandos peligrosos con una lista negra, la blocklist típica deja pasar 16 de 20 casos.

    Por dónde empezar con las API keys y tu agente de IA

    Para proteger tus API keys del agente de IA con veinte minutos, en este orden: gitleaks en pre-commit con --redact, reglas Read de deny para .env en ~/.claude/settings.json (con .env en subcarpetas, usa Read(**/.env) y Read(**/.env.*)), y la key del agente en un workspace propio con límite de gasto.

    op run, sandbox y limpieza del entorno van en la segunda tanda. La idea es una: no confíes en que el agente no mire; haz que no haya nada que ver.

    El ebook gratuito El Developer Agéntico dedica una parte a la seguridad de agentes. En el curso Construye con IA llevas Claude Code a un producto completo.

    Y si te preocupa revisar lo que escribe el agente antes de que llegue a main, de eso va el workshop SDD + Agentic Engineering.

    Preguntas frecuentes

    ¿Basta con añadir .env al .gitignore?

    No. Evita que el fichero entre en git, pero no que el agente lo lea, que la key salga en un log o que la copie a un fichero versionado, como un fixture.

    ¿Read(./.env) en deny impide que Claude Code ejecute cat .env?

    Según la doc de Claude Code (octubre de 2026), sí: el deny de Read cubre comandos que Claude Code reconoce, como cat, head o tail. No cubre grep -r ni scripts que abren el fichero por su cuenta; para eso está el sandbox.

    ¿gitleaks detecta todas las API keys?

    No. Busca patrones conocidos y alta entropía. En una prueba real, una key de Anthropic troceada en dos literales pasó sin aviso. Es una red, no una garantía.

    ¿Push protection de GitHub está activada por defecto?

    Para usuarios, sí, pero solo bloquea pushes a repositorios públicos. A nivel de repositorio viene desactivada y requiere GitHub Secret Protection.

    ¿Qué hago primero si el agente ha subido una key a GitHub?

    Revocarla y generar una nueva. Limpiar el historial va después: borrar el commit no invalida la key, y sigue accesible en clones y forks.

    ¿Esto sirve para Codex o Cursor?

    Los permisos y el sandbox son de Claude Code. El resto sirve igual: op run, gitleaks, push protection y keys con scope mínimo y límite de gasto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code Chrome: que el agente compruebe la UI que toca

    Claude Code Chrome: que el agente compruebe la UI que toca

    El agente termina. Te dice que ha refactorizado el formulario de registro, que los tipos compilan y que los tests unitarios pasan. "Listo".

    Abres localhost:3000. El botón de enviar no hace nada. En la consola hay un TypeError en rojo que nadie ha leído, porque nadie ha abierto la página.

    Ese hueco es el que cierra Claude Code Chrome: la integración que deja al agente abrir tu app en un navegador real, hacer clic, leer la consola y enseñarte lo que ha visto antes de cerrar la tarea. Sin ella, "listo" significa "compila". Con ella, puede significar "lo he probado".

    En corto: Claude Code se conecta a Chrome o Edge mediante la extensión Claude in Chrome y se activa con claude --chrome o con /chrome. El agente puede navegar por tu app en local, interactuar con ella, leer errores de consola y peticiones de red, hacer capturas y grabar GIF. Úsalo para verificar mientras desarrollas, no como sustituto de tu suite E2E en CI.

    ¿Qué es la integración de Claude Code con Chrome?

    La integración de Claude Code con Chrome es una conexión entre la CLI (o la extensión de VS Code) y la extensión de navegador Claude in Chrome que da al agente herramientas para controlar pestañas de tu navegador real mientras programa.

    Según la documentación oficial de Claude Code con Chrome (consultada en octubre de 2026), las acciones se ejecutan en una ventana visible y en tiempo real. Claude abre pestañas nuevas, las agrupa en un grupo ligado a tu sesión y comparte el estado de login de tu navegador.

    Esa última frase es la que importa. Volveremos a ella en los riesgos.

    Cómo activar Claude Code Chrome: requisitos y comandos

    Instala la extensión, inicia sesión con /login y arranca con claude --chrome. Estos son los requisitos que lista la documentación:

    Requisito Detalle según la doc oficial
    Navegador Chrome o Edge. También detecta la extensión en Brave, Arc, Vivaldi y Opera
    Extensión Claude in Chrome 1.0.36 o posterior, desde la Chrome Web Store
    Plan Plan directo de Anthropic: Pro, Max, Team o Enterprise
    Autenticación Sesión con /login. Con API key o token de claude setup-token queda desactivada aunque pases --chrome
    No soportado WSL y proveedores de terceros como Amazon Bedrock, Google Cloud Agent Platform o Microsoft Foundry (necesitas una cuenta de claude.ai aparte)
    # Sesión con el navegador conectado
    claude --chrome
    
    # Dentro de la sesión: estado, permisos, reconectar o elegir navegador
    /chrome
    

    Funciona cuando /chrome muestra "Status: Enabled" y "Extension: Installed". Desde ese panel puedes marcar Enabled by default, aunque la doc avisa de que aumenta el consumo de contexto porque las herramientas del navegador quedan siempre cargadas. En VS Code, el gesto es escribir @browser seguido de la tarea.

    Si la extensión no aparece a la primera, reinicia Chrome: la primera activación instala un archivo de native messaging host que el navegador solo lee al arrancar.

    Qué puede hacer Claude Code en Chrome

    Con Claude Code Chrome tienes todo lo que necesitas para verificar una UI: navegar, hacer clic, escribir, leer y documentar.

    La doc oficial enumera depuración leyendo errores de consola y estado del DOM, verificación de diseño, pruebas de formularios y flujos de usuario, subida de archivos, capturas guardadas en disco y grabación de GIF. El artículo de ayuda de Claude in Chrome añade que lee la salida de la consola, incluidos errores, peticiones de red y estado del DOM.

    Para la lista exacta de herramientas en tu versión, ejecuta /mcp, selecciona claude-in-chrome y entra en View tools. Esa es la fuente de verdad, por encima de cualquier post.

    Cómo hacer que Claude Code verifique la UI antes de decir "listo"

    Para que Claude Code verifique la UI, pide el cambio y la comprobación en el mismo prompt: qué URL abrir, qué flujo recorrer, qué errores de consola reportar y qué evidencia guardar. La tarea no termina cuando el código compila; termina cuando el agente ha visto la pantalla.

    Con el servidor de desarrollo corriendo en otra terminal y la sesión arrancada con claude --chrome, pide el cambio y la verificación en el mismo prompt, con criterios concretos:

    Cambia la validación del formulario de registro: email obligatorio
    y password de mínimo 12 caracteres.
    
    Cuando termines, abre localhost:3000/registro, envía el formulario
    vacío y luego con un password de 5 caracteres. Comprueba que salen
    los mensajes de error correctos. Revisa la consola y dime solo los
    errores o warnings nuevos. Guarda en disco una captura del estado
    final. No digas "listo" hasta haber hecho todo esto.
    

    Dos detalles salen directamente de la documentación. Primero, recomienda decirle a Claude qué patrones buscar en la consola en lugar de pedirle toda la salida, porque los logs pueden ser muy verbosos. "Errores nuevos tras el cambio" es útil; "lee la consola" quema contexto.

    Segundo, las capturas en disco y los GIF dejan evidencia revisable. Un GIF del flujo adjunto a la PR dice más que "lo he probado". Ojo: guardar capturas en disco requiere Claude Code v2.1.211 o posterior; antes, la opción no escribía el archivo.

    Para que sea la norma, escríbelo en tu CLAUDE.md como parte de la definición de terminado de cualquier cambio de UI. Es la misma lógica que trabajamos en el curso Construye con IA: el agente no se autoaprueba, demuestra. Y si necesitas pasos deterministas que no dependan de la memoria del modelo, los hooks de Claude Code son la capa para eso.

    Claude Code Chrome frente a tests E2E con Playwright

    No compiten. Claude Code Chrome es verificación asistida mientras desarrollas; Playwright es una suite que se ejecuta igual en cada commit.

    Criterio Claude Code + Chrome Tests E2E con Playwright
    Cuándo se usa En local, justo después del cambio En CI, en cada push o PR
    Navegador Tu Chrome real, con tus sesiones Navegador aislado y reproducible
    Qué se prueba Lo que el agente decide a partir de tu prompt Lo que fija el código del test
    Repetibilidad Baja: cada ejecución puede recorrer la app distinto Alta
    Coste de empezar Un prompt Escribir y mantener specs
    Limitación / riesgo Actúa con tus cookies; no sirve como gate de regresión No detecta lo que nadie escribió como test

    En el hilo de Hacker News sobre el lanzamiento de Claude in Chrome, un usuario comentó que en sus primeras pruebas a Claude le resultaba más fácil de manejar que los servidores MCP de Playwright para QA web puntual, pero que no estaba pensado para E2E. También le pareció bastante más lento que otras extensiones de navegador con IA para tareas web generales. Es una impresión individual de diciembre de 2025, no un benchmark, pero encaja con la tabla.

    Si buscas la otra mitad, la suite que vive en CI y se repara cuando cambia la UI, la tienes en tests E2E autoreparables con Playwright. Y si trabajas con Angular, la base de testing que no depende de ningún agente está en el curso de Testing en Angular con Jest y Testing Library.

    Mi opinión: usa Chrome para que el agente no te entregue nada sin mirarlo, y convierte en test de Playwright cada flujo que hayas tenido que verificar más de dos veces.

    Límites y riesgos de Claude Code con Chrome

    Los riesgos de Claude Code Chrome vienen todos de lo mismo: trabaja en tu navegador, no en uno de laboratorio.

    Tu sesión real, con tus cuentas iniciadas. Claude puede acceder a cualquier sitio en el que ya estés autenticado. El artículo de uso seguro de Claude in Chrome recomienda un perfil de navegador separado sin cuentas sensibles y avisa del prompt injection: instrucciones maliciosas ocultas en contenido web. Los clasificadores lo reducen, pero el riesgo no es cero.

    En el mismo hilo de HN, otro usuario contó que Claude Code, al no encontrar una operación en la CLI ni en la API pública, abrió la app en Chrome, tomó sus tokens de las cookies y llamó con curl a la API privada.

    Para verificar localhost, usa un perfil de Chrome solo para desarrollo.

    Los GIF lo graban todo. La doc advierte de que la grabación captura todo lo visible, incluidos datos de cuenta en páginas con sesión iniciada. Revísala antes de pegarla en una PR pública.

    Los permisos son por sitio y no siempre los controlas tú. Se heredan de la extensión y se gestionan en su configuración. En el issue #99007 de anthropics/claude-code, un usuario reporta que en subdominios internos de su empresa cada acción, capturas incluidas, pedía aprobación y no existía la opción de permitir siempre. Según su análisis, la extensión clasifica ciertos dominios como de aprobación obligatoria, y ni tus reglas de Claude Code ni el modo auto lo cambian. En un staging corporativo puede bloquearte.

    Un alert() congela al agente. Según el troubleshooting oficial, los diálogos modales de JavaScript (alert, confirm, prompt) bloquean los eventos del navegador e impiden que Claude reciba comandos. Hay que cerrarlos a mano y decirle que continúe. Si tu app usa confirm() para borrar, ese flujo no lo recorre solo.

    Además, ante un login o un CAPTCHA Claude se pausa y te pide que lo resuelvas tú, y en sesiones largas el service worker de la extensión puede quedarse inactivo y cortar la conexión. El patrón general de por qué los agentes fallan en el navegador está en agentes de IA en el navegador: por qué se rompen.

    Cómo empezar hoy con Claude Code Chrome

    Crea un perfil de Chrome solo para desarrollo, instala la extensión y añade una línea a tu CLAUDE.md: ningún cambio de UI se da por terminado sin abrir la página en local, recorrer el flujo afectado y reportar los errores nuevos de consola.

    Una línea que convierte "compila" en "lo he visto funcionar". Si quieres ver flujos así en vídeo, los publico en el canal de YouTube de Dominicode.

    Preguntas frecuentes

    ¿Qué necesito para usar Claude Code con Chrome?

    Chrome o Edge (Claude Code también detecta la extensión en Brave, Arc, Vivaldi u Opera, aunque el centro de ayuda de Claude in Chrome no los da como soportados), la extensión Claude in Chrome 1.0.36 o posterior, Claude Code y un plan directo de Anthropic (Pro, Max, Team o Enterprise), con la sesión iniciada mediante /login. Con una API key o un token de claude setup-token, la integración queda desactivada.

    ¿Cómo activo Chrome en Claude Code?

    Arranca con claude --chrome o ejecuta /chrome dentro de la sesión. Ese comando también sirve para ver el estado, gestionar permisos, reconectar la extensión y activarla por defecto. En VS Code, escribe @browser seguido de la tarea.

    ¿Sustituye Claude Code Chrome a mis tests E2E con Playwright?

    No. Chrome sirve para que el agente verifique lo que acaba de cambiar, en tu navegador real. Playwright ejecuta la misma suite de forma reproducible en CI y bloquea regresiones. Usa los dos.

    ¿Por qué Claude deja de responder en el navegador?

    Lo más habitual, según la documentación, es un diálogo alert, confirm o prompt abierto en la página. Ciérralo a mano y dile que continúe. Si no es eso, pídele una pestaña nueva o ejecuta /chrome y elige "Reconnect extension".


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Anthropic Scion: por qué dejó git y qué te enseña a ti

    Anthropic Scion: por qué dejó git y qué te enseña a ti

    En mayo de 2026, el monorepo de Anthropic recibía unos 2.500 merges al día. En septiembre recibía más de 30.000.

    Casi todos los clientes del repo eran ya agentes y jobs automáticos. Y en algún punto de esa curva, git dejó de ser una herramienta y pasó a ser un problema de infraestructura.

    El 13 de octubre de 2026, Anthropic publicó cómo lo resolvió: Anthropic Scion, un sistema de control de versiones propio que sustituye a git en su monorepo. El titular que más circuló fue "Anthropic abandona git". Es verdad, pero no es lo interesante.

    Lo interesante es dónde se rompió primero. No fue el código. Fue todo lo que pasa después de escribirlo.

    En corto: Anthropic sustituyó git por Scion, un control de versiones centralizado propio, porque su monorepo pasó de 2.500 a más de 30.000 merges diarios, con agentes como clientes principales. La propia Anthropic dice que Scion no sirve como reemplazo general de git. La lección para ti no es cambiar de herramienta: es que, cuando los agentes escriben el código, el cuello de botella se mueve a la integración y a la revisión.

    ¿Qué es Anthropic Scion?

    Anthropic Scion es el sistema de control de versiones centralizado que Anthropic construyó para sustituir a git en su monorepo, diseñado para clientes que siempre están online —sobre todo agentes y jobs de CI— y en el que el servidor, no el cliente, crea los commits y hace los merges.

    Viene acompañado de Antique, su herramienta de code review. Lo construyó un equipo de 7 personas y la migración duró 5 meses, según el post de ingeniería de Anthropic. Por debajo, mover una referencia (lo que en git sería actualizar una rama) es un compare-and-swap sobre una fila de Spanner: por eso los commits no necesitan locks.

    Por qué Anthropic dejó git en su monorepo

    La respuesta corta: usaban git como si fuera centralizado, y git está diseñado para lo contrario.

    Git asume que cada developer tiene una copia completa, trabaja offline y sincroniza de vez en cuando. Anthropic tenía casi todos sus clientes siempre conectados: agentes y jobs. El diseño distribuido, que es la gran virtud de git, jugaba en su contra.

    Las cifras que publica Anthropic lo dejan claro:

    Métrica (fuente: Anthropic, oct 2026) Valor
    Merges diarios en mayo 2026 ~2.500
    Merges diarios en septiembre 2026 más de 30.000
    Historial de main casi 100 GB
    Working copy comprimida más de 25 GB
    Checkouts al día solo para CI ~25 millones
    Tráfico git diario con un fetch ingenuo más de 600 PB
    Mirrors internos de git en el pico varios cientos

    Ya usaban shallow clones y sparse checkouts. No bastaba.

    Git vs Anthropic Scion: dos modelos de control de versiones

    Scion no es "un git más rápido". Es otro modelo, más cercano a SVN o Perforce que a git.

    Git Scion
    Modelo Distribuido, pensado para trabajar offline Centralizado, clientes siempre online
    Dónde se crean commits y merges En el cliente; luego push En el servidor; no existe push
    Copia del repo Cada clon tiene la historia completa (o parte, con shallow/sparse) No existe copia completa en ningún sitio, ni siquiera en el servidor
    Working copy Necesaria para trabajar (salvo repos bare) Opcional, sparse o virtualizada
    Coste de un commit Local y barato; lo que crece con el repo es sincronizar (clone, fetch, checkout) Se crea en el servidor; el coste escala con el cambio, no con el repo
    Para quién sirve Prácticamente cualquier equipo y proyecto Monorepos enormes con decenas de miles de ingenieros o enjambres de agentes
    Limitación o riesgo A escala de agentes masiva exige mirrors, cachés y mantenimiento de packfiles Sin conexión no trabajas; no es open source; adoptarlo obliga a migrar review, code search y CI

    Según Anthropic, el resultado: una huella de infraestructura unas 200 veces menor que la de los mirrors de git, checkouts de CI en segundos en vez de minutos y un 25% de la CPU de CI liberada.

    La merge queue clásica no aguanta el volumen de los agentes

    Según Anthropic, una merge queue clásica no aguanta 30.000 merges al día: prescindieron de ella y movieron la validación a testing post-merge y pre-deploy. Esta es la parte que sí te afecta.

    Anthropic lo escribe sin rodeos: "A proper merge queue, for example, doesn't make much sense at agent scale." (Una merge queue como tal, por ejemplo, no tiene mucho sentido a escala de agentes.)

    Una merge queue serializa los cambios: prueba cada uno contra el estado más reciente de main antes de integrarlo. Con 30.000 merges al día, esa cola es un embudo. Su respuesta fue prescindir del lock global, que no lograron replicar a esa escala, invertir en testing post-merge y pre-deploy, y dejar que Claude arregle los conflictos.

    Esa decisión solo es segura si tus tests son buenos de verdad. Un test que pasa siempre no protege nada. Por eso, antes de mover validación a post-merge, merece la pena medir la calidad real de tu suite, por ejemplo con mutation testing con Stryker, y proteger los tests para que el agente no los modifique cuando le estorban.

    Revisar la intención, no cada línea

    Revisar la intención es comprobar que el cambio hace lo que debía hacer, en vez de leer cada línea que escribió el agente. Es el segundo cambio, y el más incómodo.

    Anthropic cuenta que sus ingenieros tuvieron que decirle "no" a Claude a menudo durante el proyecto. Claude proponía escaneos lineales del log de commits en lugar de consultar la herramienta de review, o añadía validación sobre-defensiva después de una revisión adversarial. La conclusión del equipo: ahora revisan la intención del cambio, no cada línea.

    No es revisar menos. Es revisar otra cosa: tener escrito qué debe hacer el cambio y comprobar que lo hace.

    Es exactamente la idea detrás de la revisión por contrato del código generado por agentes: defines el contrato antes, y revisas contra él. Y empieza por darle al agente contexto estable sobre tu proyecto, con un buen AGENTS.md para Claude Code.

    Si quieres empezar gratis, el ebook El Developer Agéntico es el punto de partida para construir agentes de IA con criterio: herramientas, memoria, seguridad, permisos y evaluación.

    Si quieres llevarlo a un flujo completo, es lo que trabajamos en el workshop SDD + Agentic Engineering: especificación, harness y revisión de lo que produce el agente.

    Lo que dice Hacker News: ¿es git o es el monorepo?

    El hilo de Hacker News superó los 940 comentarios. La respuesta corta a la pregunta del título: técnicamente, buena parte del problema es el monorepo; lo que forzó el cambio fue el volumen. El escepticismo fue bastante sano.

    La crítica técnica más repetida: el problema no es git, es el monorepo. zmmmmm lo planteó directamente, y bob1029 fue más lejos: "This article doesn't do a very good job of convincing me that git is technically incapable of handling the described workload." (Este artículo no consigue convencerme de que git sea técnicamente incapaz de manejar esa carga.)

    tancop lo resumió en una línea: "So it's a SVN/Perforce style server based VCS with a more modern design." (O sea, un VCS basado en servidor al estilo SVN/Perforce con un diseño más moderno.)

    kburman apuntó al coste oculto: "I suspect we'll see a lot more reinvention of the wheel, even at smaller startups, as AI makes writing code significantly cheaper. […] Whether maintaining all that custom software turns out to be equally cheap is another question." (Sospecho que veremos mucha más reinvención de la rueda, incluso en startups pequeñas, porque la IA abarata escribir código. Si mantener todo ese software a medida resulta igual de barato es otra cuestión.)

    Y duttish hizo la pregunta que más me importa: "Every time I stop reviewing the code from Claude I later find janky crap. […] how are they avoiding the janky crap?" (Cada vez que dejo de revisar el código de Claude, después encuentro chapuzas. ¿Cómo las evitan ellos?)

    Mi opinión: la crítica de que "es el monorepo" tiene razón técnica, pero no cambia la lección. Lo que forzó el rediseño fue el volumen de cambios. Y la pregunta de duttish tiene respuesta: no dejas de revisar, cambias qué revisas. Revisar la intención sin un contrato escrito suele acabar en chapuzas.

    Cuándo NO te sirve el enfoque de Anthropic Scion

    La propia Anthropic lo dice claro: "Scion is by no means a suitable replacement for git for general use." (Scion no es, en absoluto, un reemplazo adecuado de git para uso general.)

    Estas son las limitaciones que reconoce:

    1. Solo tiene sentido a una escala que casi nadie tiene. Monorepos enormes, con decenas de miles de ingenieros o enjambres de agentes. Si tu repo cabe en un portátil, git te sobra.
    2. Su presupuesto de tokens no es el tuyo. Anthropic reconoce que lo que gasta en tokens para uso interno supera con mucho lo que cualquier otra empresa querría gastar de forma realista. Parte de su manera de trabajar se apoya en ese gasto, y tú no partes de ahí.
    3. Adoptarlo es migrar todo el ciclo. No cambias solo el VCS: cambias review, code search y CI. Anthropic construyó Antique y el resto del ecosistema a la vez.
    4. No es open source. No puedes instalarlo. Anthropic dice que quiere compartir las ideas con GitHub, GitLab y la comunidad git, no el producto.

    Qué hacer con tu flujo de trabajo esta semana

    No necesitas Anthropic Scion. Necesitas que tu flujo aguante el volumen de cambios que tus agentes ya pueden generar.

    Haz esta prueba:

    1. Cuenta cuántos PRs abrieron tus agentes este mes y el anterior.
    2. Mide cuánto tardó cada uno en llegar a main.
    3. Si el tiempo de espera crece más rápido que el número de PRs, tu cuello de botella ya no es escribir código: es integrar y revisar.
    4. Empieza por escribir la intención antes de pedir el cambio y revisa contra ella. Si quieres el método completo para trabajar con especificaciones, está en el libro Spec-Driven Development. Y si quieres verlo aplicado de la idea al producto con Claude Code, en el curso Construye con IA.

    Preguntas frecuentes

    ¿Anthropic ha abandonado git?

    Solo en su monorepo interno. Anthropic lo sustituyó por Scion en ese monorepo porque los merges pasaron de unos 2.500 diarios en mayo de 2026 a más de 30.000 en septiembre. La propia empresa dice que Scion no es un reemplazo de git para uso general.

    ¿Anthropic Scion es open source?

    No. Anthropic no lo libera como open source. Su intención declarada es compartir las ideas de diseño con GitHub, GitLab y la comunidad de git.

    ¿Debería dejar de usar git?

    No. Scion está pensado para monorepos enormes con decenas de miles de ingenieros o enjambres de agentes, y exige migrar review, code search y CI. Para casi cualquier equipo, git sigue siendo la opción correcta; lo que sí conviene revisar es tu proceso de integración y revisión.

    ¿Qué es Antique?

    Antique es la herramienta de code review que Anthropic construyó junto a Scion. Forma parte del mismo ecosistema que también incluye code search e IAM de source control.

    ¿Qué es Claude Mythos Preview en esta historia?

    Un snapshot interno temprano de Claude Mythos Preview reescribió el pipeline de ingesta de git a Scion sin más instrucciones, según Anthropic. El resultado usaba 20 veces menos memoria y era 4 veces más rápido, preservando las invariantes implícitas de orden de ingesta y de estructuras de datos.

    ¿Por qué Anthropic no usa una merge queue clásica?

    Porque, según Anthropic, una merge queue como tal no tiene mucho sentido a escala de agentes, y no lograron replicar el lock global del repositorio que es estándar en la industria. En su lugar invierten en testing automático post-merge y pre-deploy, y Claude arregla los conflictos entre cambios concurrentes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
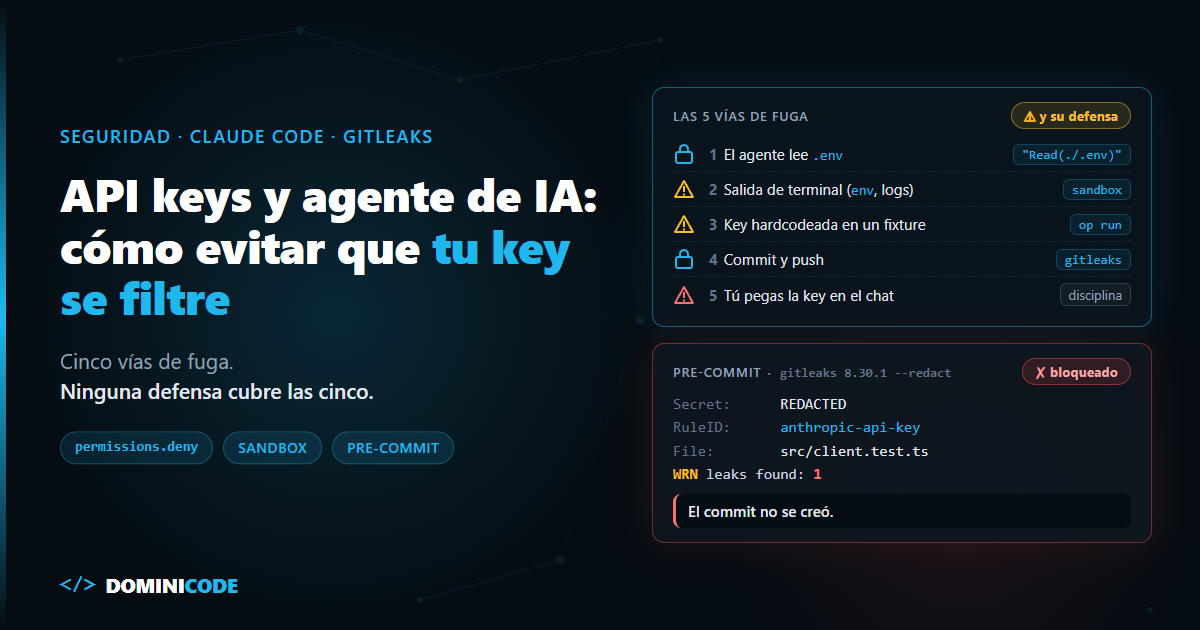
  • Mutation testing en JavaScript: audita los tests de tu IA

    Mutation testing en JavaScript: audita los tests de tu IA

    Le pides al agente que escriba los tests del módulo de envíos. Todo en verde. La cobertura marca 100 % en líneas, ramas y funciones.

    Haces merge.

    Tres semanas después alguien cambia un >= por un > en la regla de envío gratis. Los pedidos de 50 € justos empiezan a pagar envío. Los tests siguen en verde y la cobertura, en 100 %.

    Nadie mintió. El agente escribió tests que ejecutan cada línea. Lo que no hizo fue comprobar que esas líneas hacen lo correcto. La cobertura no tiene forma de enterarse. El mutation testing en JavaScript, sí.

    En corto: la cobertura de código te dice qué líneas se ejecutaron durante los tests, no si algún test fallaría al romperlas. El mutation testing en JavaScript, con StrykerJS, introduce bugs pequeños en tu código y comprueba si algún test los detecta: el que sobrevive marca un test que no protegía nada. Es la forma más barata de auditar los tests que escribe un agente sin tener que leerlos todos.


    ¿Qué es el mutation testing?

    El mutation testing es una técnica que modifica el código de producción en pequeños puntos (cada cambio es un "mutante") y vuelve a pasar los tests para ver si alguno falla: si fallan, el mutante muere; si todo sigue en verde, el mutante sobrevive y has encontrado comportamiento que ningún test verifica.

    Los mutantes son bugs plausibles, no aleatorios. Los operadores de Stryker cambian a >= b por a > b, a + b por a - b, true por false, vacían un bloque o sustituyen una condición entera por true. Son los errores pequeños que se cuelan en un refactor sin que nadie los vea.

    El resultado se resume en el mutation score: mutantes detectados entre mutantes válidos, por cien. La documentación de métricas lo define así y separa los estados que verás en el informe:

    • Killed: al menos un test falló con el mutante activo.
    • Survived: todos los tests pasaron con el mutante activo.
    • No coverage: ningún test ejecuta ese código. No llega ni a probarse y cuenta como no detectado.
    • Timeout: el mutante provocó un bucle o una espera infinita. Cuenta como detectado.

    Por qué los tests generados por IA pasan y no prueban nada

    Los tests generados por IA fallan en lo mismo que los de un junior con prisa: ejecutan el código, pero sus asserts no comprometen nada. toBeDefined(), toBeTruthy(), toBeGreaterThanOrEqual(0), o un mock que se configura y luego se comprueba a sí mismo.

    El agente optimiza lo que le pides. Si le pides "tests que pasen" y "cobertura alta", te da las dos cosas. Ninguna de las dos garantiza que el test falle cuando el código está mal.

    Lo vimos desde otro ángulo en cómo blindar los tests para que Claude Code no los toque: proteger los tests del agente sirve de poco si los tests ya eran débiles cuando entraron.

    Cobertura de código Mutation score
    Qué mide Líneas, ramas y funciones ejecutadas por algún test Porcentaje de bugs sembrados que algún test detecta
    Qué no detecta Asserts débiles, tests sin expect útil, límites sin probar Mutantes equivalentes (cambios que no alteran el comportamiento)
    Coste Una ejecución de la suite con instrumentación Una ejecución de tests por cada mutante cubierto
    Herramienta en JS/TS @vitest/coverage-v8, Istanbul, Jest --coverage StrykerJS (@stryker-mutator/core + runner)
    Limitación / riesgo Da falsa seguridad: 100 % compatible con tests que no fallan nunca Lento en suites grandes y empuja a escribir tests para matar mutantes irrelevantes

    Tutorial de mutation testing con StrykerJS y Vitest en TypeScript

    Partimos de una función de seis líneas. El ejemplo está ejecutado con @stryker-mutator/core 10.0.0 y Vitest 4.1.11 (octubre de 2026). Más abajo explico por qué no Vitest 5.

    // src/envio.ts
    export function calcularEnvio(subtotal: number, esPremium: boolean): number {
      if (esPremium || subtotal >= 50) {
        return 0;
      }
      return 4.99;
    }
    

    Y este es el test "típico de agente". Pasa, y vitest run --coverage devuelve 100 % en statements, branches, functions y lines:

    // src/envio.spec.ts
    import { describe, it, expect } from 'vitest';
    import { calcularEnvio } from './envio';
    
    describe('calcularEnvio', () => {
      it('devuelve un coste de envío', () => {
        expect(calcularEnvio(20, false)).toBeDefined();
      });
    
      it('aplica envío gratis a partir de cierto importe', () => {
        expect(calcularEnvio(100, false)).toBe(0);
      });
    
      it('gestiona clientes premium', () => {
        expect(calcularEnvio(10, true)).toBeGreaterThanOrEqual(0);
      });
    });
    

    1. Instalar Stryker

    La vía oficial es el asistente, que pregunta por tu runner y genera la config (getting started):

    npm init stryker@latest
    

    Si prefieres hacerlo a mano, instala el core y el runner. El plugin no incluye Vitest: usa el que ya tienes en el proyecto.

    npm i -D @stryker-mutator/core @stryker-mutator/vitest-runner
    # Con Jest: npm i -D @stryker-mutator/core @stryker-mutator/jest-runner
    

    2. Configuración mínima

    Stryker busca stryker.config.{json,js,mjs,cjs} en la raíz (config file):

    // stryker.config.mjs
    // @ts-check
    /** @type {import('@stryker-mutator/api/core').PartialStrykerOptions} */
    const config = {
      testRunner: 'vitest', // con Jest: 'jest'
      mutate: ['src/**/*.ts', '!src/**/*.spec.ts'],
      reporters: ['clear-text', 'progress', 'html'],
      thresholds: { high: 80, low: 60, break: 70 },
    };
    export default config;
    

    Con Vitest, el runner ignora coverageAnalysis y usa siempre perTest: cada mutante solo ejecuta los tests que lo cubren. Es lo que lo hace viable.

    3. Ejecutar y leer el informe

    npx stryker run
    

    La consola muestra cada superviviente con su diff, y el informe HTML queda en reports/mutation/mutation.html. Resultado con el test del agente: 8 mutantes, 6 killed, 2 survived, mutation score 75 %. Con 100 % de cobertura.

    Los dos supervivientes:

    -     if (esPremium || subtotal >= 50) {
    +     if (esPremium || subtotal > 50) {
    
    -     if (esPremium || subtotal >= 50) {
    +     if (true) {
    

    El primero es el bug de la apertura: nadie prueba el límite de 50. El segundo es peor: si el envío fuera siempre gratis, ningún test se enteraría, porque toBeDefined() acepta un 0 igual que un 4,99.

    4. El test que mata a los dos

    describe('calcularEnvio', () => {
      it('cobra 4,99 por debajo de 50', () => {
        expect(calcularEnvio(49.99, false)).toBe(4.99);
      });
    
      it('el envío es gratis justo en 50', () => {
        expect(calcularEnvio(50, false)).toBe(0);
      });
    
      it('un cliente premium no paga envío aunque el pedido sea pequeño', () => {
        expect(calcularEnvio(10, true)).toBe(0);
      });
    });
    

    Mismo número de tests. Mutation score: 100 %, 8 de 8 killed. La diferencia es que cada assert afirma un valor concreto en un punto que importa. Es la misma disciplina que en TDD potenciado por IA: el test define el comportamiento, no lo acompaña.

    Cómo meter mutation testing en el flujo con agentes

    Lanzar Stryker sobre todo el repo en cada cambio no escala. Lo que funciona es acotar.

    Muta solo lo que cambió. --mutate acepta una lista de ficheros separada por comas, e incluso rangos de líneas (src/envio.ts:3-5). En una PR:

    CHANGED=$(git diff --name-only --diff-filter=d origin/main...HEAD -- 'src/*.ts' | { grep -v '\.spec\.ts$' || true; } | paste -sd, -)
    if [ -n "$CHANGED" ]; then npx stryker run --mutate "$CHANGED"; fi
    

    En GitHub Actions, haz el checkout con fetch-depth: 0; si no, origin/main no existe en el runner.

    Activa el modo incremental. Con --incremental, Stryker guarda resultados en reports/stryker-incremental.json y reutiliza los de mutantes cuyo código y tests no cambiaron (incremental). En la segunda ejecución del ejemplo el log dice "8 of 8 mutant result(s) are reused".

    Ojo: solo detecta cambios en ficheros mutados y de test; si actualizas dependencias, pasa --force.

    Pon un suelo en CI. thresholds.break hace que Stryker salga con código 1 si el score queda por debajo. Por defecto es null y nunca rompe el build (configuración). Empieza bajo y súbelo.

    Dale los supervivientes al agente. Aquí el mutation testing deja de ser una métrica y se vuelve un bucle de feedback:

    Stryker ha dejado estos mutantes vivos en src/envio.ts (diff abajo).
    Escribe o corrige tests que los maten. Reglas:
    - No toques el código de producción.
    - Cada assert compara contra un valor concreto, nunca toBeDefined/toBeTruthy.
    - Si un mutante no cambia el comportamiento observable, dímelo y no escribas test para él.
    

    La última regla importa más de lo que parece, y la explico abajo. Si quieres el sistema entero de verificación de código generado, sin leer cada línea, está en verificar código generado por IA sin leerlo todo, y lo trabajamos con proyectos reales en el workshop SDD + Agentic Engineering. Si estás empezando a delegar trabajo en agentes, el ebook gratuito El Developer Agéntico es el punto de partida.

    Cuándo NO usar mutation testing

    Lo recomiendo para módulos con lógica de negocio. No para todo.

    Es lento en suites grandes. Cada mutante es una ejecución de tests. En este comentario de Hacker News, un usuario de Stryker lo cuantifica: "a small-ish TS project where our normal test suite runs in 2 minutes or so takes about 20-25 with Stryker". Sobre el repo completo en cada push, no; sobre el diff, sí.

    Los mutantes equivalentes son ruido. Hay mutaciones que no cambian el comportamiento observable (por ejemplo, alterar un límite que el resto del código ya filtra). Sobreviven siempre y ningún test sensato las mata. Perseguir el 100 % te obliga a revisarlas a mano.

    Perseguir mutantes deforma los tests. Uncle Bob lo usó como rol de hardening en su harness y, como contamos en harness multiagente vs un solo agente, encontró bugs reales, pero el algoritmo empujaba al agente a hacer cosas tontas con tal de matar mutantes. Un agente con la orden "sube el score" acopla tests a detalles de implementación. Por eso el prompt de arriba le deja decir "este no".

    El runner también falla. Con Vitest 5, @stryker-mutator/vitest-runner 10.0.0 ejecuta cero tests por mutante y casi todo sale como Survived.

    Está documentado en el issue #6210 de stryker-js, abierto el 4 de septiembre de 2026: el autor reporta un score que cae de 47,36 con Vitest 4.1.11 a 2,96 con Vitest 5.0.0. El ejemplo de este post lo reproduce: 0 % con Vitest 5.0.3, 75 % con 4.1.11.

    A 10 de octubre de 2026 los PR del arreglo (#6214 y #6220) siguen abiertos. Si ves "Ran 0.00 tests per mutant", no te fíes del score.

    Por dónde empezar hoy

    Elige el módulo con más lógica de negocio que tu agente haya testeado en el último mes y hazle mutation testing en JavaScript con Stryker. Precios, permisos, cálculos de fechas. Solo ese fichero.

    Si sale por encima del 80 %, tus tests probablemente valen. Si sale al 40 % con cobertura del 95 %, acabas de medir cuánto te estaban diciendo los tests del agente.

    Los mutantes que sobreviven suelen apuntar a casos límite que nadie escribió. Para encontrarlos sin pensarlos uno a uno, el property-based testing con fast-check genera cientos de entradas por test.

    Hay errores que conviene que no lleguen ni a los tests: pasar un orderId donde va un userId. Esos los cierran los branded types en TypeScript.

    En testing en Angular con IA ya lo mencionábamos de pasada. Si trabajas en Angular, el curso de Testing en Angular con Jest y Testing Library cubre cómo escribir asserts que afirman comportamiento.

    Y si quieres montar el flujo completo con agentes, de la spec al test que mata mutantes, está en Construye con IA.

    Preguntas frecuentes

    ¿Qué diferencia hay entre cobertura de código y mutation score?

    La cobertura mide qué código se ejecuta durante los tests. El mutation score mide qué porcentaje de bugs introducidos a propósito detectan esos tests. Puedes tener 100 % de cobertura y 0 % de mutation score si ningún assert compara contra un valor concreto.

    ¿Stryker funciona con Jest y con Vitest?

    Sí. Para Jest instala @stryker-mutator/jest-runner y pon testRunner: 'jest'; para Vitest, @stryker-mutator/vitest-runner y testRunner: 'vitest'. En octubre de 2026 el runner de Vitest tiene un bug abierto con Vitest 5 (issue #6210), así que mantén Vitest 4 para mutation testing hasta que salga el arreglo.

    ¿Qué mutation score es bueno?

    Los umbrales por defecto de Stryker marcan 80 como alto y 60 como bajo. No hay una cifra universal: en lógica de negocio crítica apunta por encima de 80; en código de pegamento o UI, el esfuerzo de subirlo rara vez compensa.

    ¿Cómo hago que el mutation testing no tarde una eternidad?

    Muta solo los ficheros cambiados con --mutate, activa --incremental para reutilizar resultados entre ejecuciones y deja que el runner use análisis de cobertura perTest, que ejecuta solo los tests que tocan cada mutante.

    ¿Puedo pedirle al agente de IA que mate los mutantes supervivientes?

    Sí, y es el mejor uso. Pásale el diff de cada superviviente y prohíbele tocar el código de producción y usar asserts débiles. Déjale marcar mutantes equivalentes en vez de forzar tests absurdos para matarlos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
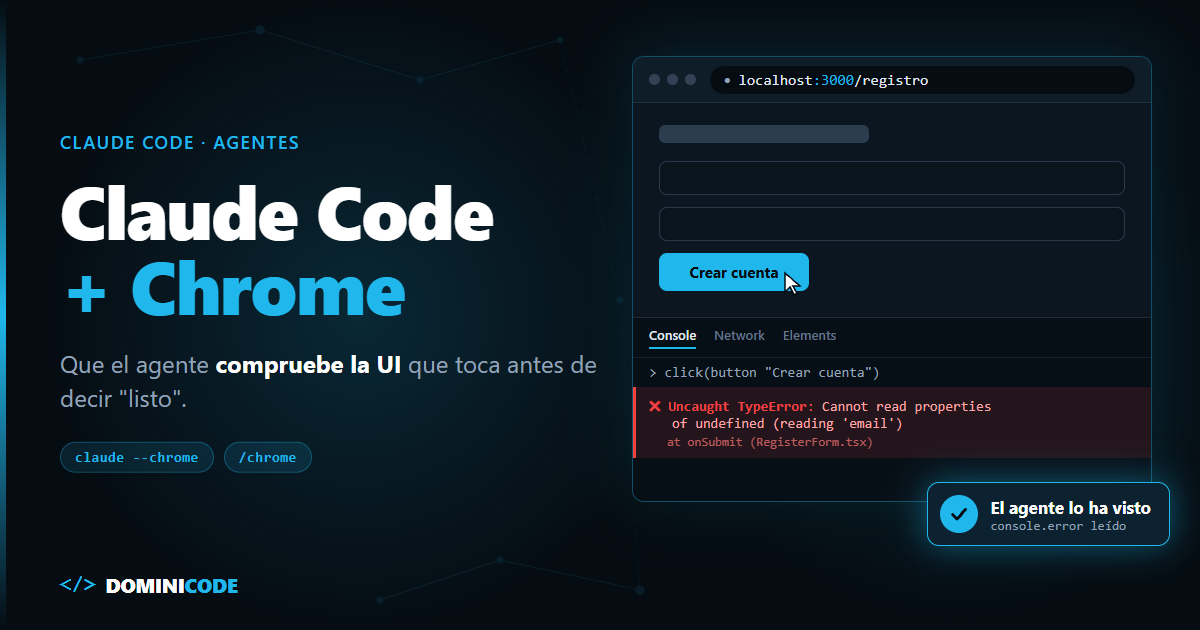
  • Property-based testing en TypeScript: lo que la IA no prueba

    Property-based testing en TypeScript: lo que la IA no prueba

    Le pides al agente una función para dividir la cuenta de una cena entre varias personas. La escribe en diez segundos. Le pides los tests y también los escribe: 100 céntimos entre 2, 100 entre 3, 1.000 entre 7. Todo en verde.

    Incluso comprueba que la suma de las partes da el total.

    Hasta que alguien reparte 3 céntimos entre 5 personas y la función le dice a una de ellas que pague -1.

    Ese caso no lo eligió nadie. Los ejemplos los eligió el mismo que escribió el código y comparten sus puntos ciegos. El property-based testing en TypeScript ataca justo eso.

    En corto: el property-based testing no prueba ejemplos concretos, sino reglas que deben cumplirse para cualquier entrada, como "nadie paga una cantidad negativa".

    fast-check genera 100 entradas aleatorias por defecto y, si una rompe la regla, la reduce al contraejemplo más pequeño posible. Sirve para encontrar los casos límite que no eligió quien escribió el código, sea una persona o un agente de IA.


    ¿Qué es el property-based testing?

    El property-based testing es una técnica de testing en la que describes una propiedad que la función debe cumplir para todas las entradas válidas, y la librería genera cientos de entradas aleatorias para intentar romperla.

    La documentación de fast-check lo define así: una propiedad es una afirmación sobre la relación entre la entrada y la salida del código que debe cumplirse para todas las entradas.

    La diferencia con un test normal es quién elige los casos: aquí los elige un generador que no conoce tu implementación y no comparte tus suposiciones.

    La otra pieza es el shrinking. Cuando una entrada falla, fast-check no te devuelve un array de 400 elementos. Lo encoge hasta el caso más pequeño que sigue fallando.

    El bug que pasó los tests del agente

    Este es el código, tal como podría salir de cualquier asistente. Al menos trabaja en céntimos:

    // split.ts
    export function splitAmount(totalCents: number, people: number): number[] {
      const share = Math.round(totalCents / people);
      const shares = Array(people - 1).fill(share);
      const last = totalCents - share * (people - 1);
      return [...shares, last];
    }
    

    Y estos son sus tests:

    it('reparte a partes iguales', () => {
      expect(splitAmount(100, 2)).toEqual([50, 50]);
    });
    it('el último absorbe el redondeo', () => {
      expect(splitAmount(100, 3)).toEqual([33, 33, 34]);
    });
    it('la suma siempre cuadra', () => {
      const shares = splitAmount(1000, 7);
      expect(shares.reduce((a, b) => a + b, 0)).toBe(1000);
    });
    

    Tres tests, tres verdes. La suma cuadra siempre, porque el último se queda con lo que sobre. El fallo está en que Math.round puede redondear hacia arriba, y entonces lo que "sobra" para el último es negativo.

    Property-based testing en TypeScript con fast-check y Vitest

    El ejemplo está ejecutado con fast-check 4.10.2, @fast-check/vitest 0.5.0, Vitest 5.0.3 y Node 24 (octubre de 2026). El paquete @fast-check/vitest añade test.prop y it.prop encima de los de Vitest, y su paquete declara como peerDependency Vitest ^4.1.0 || ^5.0.0.

    npm i -D vitest fast-check @fast-check/vitest
    

    En vez de ejemplos, escribes las reglas del negocio:

    import { test, fc } from '@fast-check/vitest';
    import { expect } from 'vitest';
    import { splitAmount } from './split';
    
    const total = fc.integer({ min: 0, max: 1_000_000 }); // céntimos
    const people = fc.integer({ min: 1, max: 50 });
    
    test.prop([total, people])('la suma de las partes es el total', (t, n) => {
      const shares = splitAmount(t, n);
      expect(shares.reduce((a, b) => a + b, 0)).toBe(t);
    });
    
    test.prop([total, people])('nadie paga una cantidad negativa', (t, n) => {
      expect(Math.min(...splitAmount(t, n))).toBeGreaterThanOrEqual(0);
    });
    
    test.prop([total, people])('las partes difieren como mucho en 1 céntimo', (t, n) => {
      const shares = splitAmount(t, n);
      expect(Math.max(...shares) - Math.min(...shares)).toBeLessThanOrEqual(1);
    });
    

    fc.integer es un arbitrary: un generador de valores con restricciones. Hay uno para casi todo: fc.string(), fc.array(), fc.record(), fc.uuid(), fc.double().

    Esta es la salida real, recortada al primer fallo:

     ❯ src/split.prop.test.ts (3 tests | 2 failed) 13ms
       × nadie paga una cantidad negativa (with seed=1056875308) 7ms
       × las partes difieren como mucho en 1 céntimo (with seed=1864299458) 1ms
    
     FAIL  src/split.prop.test.ts > nadie paga una cantidad negativa (with seed=1056875308)
    Error: Property failed after 30 tests
    { seed: 1056875308, path: "29:2:4:0:0:1:0:4:3:1:1:0:5:2:1:1:0:1:3:0:2", endOnFailure: true }
    Counterexample: [3,5]
    Shrunk 20 time(s)
    
    Caused by: AssertionError: expected -1 to be greater than or equal to 0
    

    Fíjate en tres cosas. La propiedad que escribió el agente, la de la suma, pasa: era la única que se le ocurrió. El fallo apareció en el intento 30 y fast-check lo encogió 20 veces hasta [3,5]. Y splitAmount(3, 5) devuelve [1, 1, 1, 1, -1]: el bug cabe en una línea.

    La segunda propiedad también cayó, encogida hasta [2,4], que da [1, 1, 1, -1].

    Reproducir el fallo con seed y path

    Cada ejecución usa una semilla aleatoria distinta. Para que el fallo no se pierda, pasa la seed y el path del informe como parámetros:

    test.prop([total, people], {
      seed: 1056875308,
      path: '29:2:4:0:0:1:0:4:3:1:1:0:5:2:1:1:0:1:3:0:2',
      endOnFailure: true,
    })('nadie paga una cantidad negativa', (t, n) => { /* ... */ });
    

    Según la guía para leer los informes, path arranca directamente en el contraejemplo reducido y endOnFailure para en el primer fallo sin volver a encoger. En el ejemplo, con esos parámetros falla en el primer intento con [3,5].

    El fix reparte el resto céntimo a céntimo:

    export function splitAmount(totalCents: number, people: number): number[] {
      const base = Math.floor(totalCents / people);
      const remainder = totalCents % people;
      return Array.from({ length: people }, (_, i) => base + (i < remainder ? 1 : 0));
    }
    

    Las tres propiedades pasan. Y pasa algo revelador: el test de ejemplo [33, 33, 34] se rompe, porque ahora el resultado es [34, 33, 33]. Ese test no protegía una regla de negocio. Fijaba un detalle de implementación. Con numRuns: 1000 (el valor por defecto es 100, según el tipo Parameters de fast-check) las propiedades siguen en verde.

    Tests de ejemplo vs. property-based testing

    Tests de ejemplo Property-based testing
    Quién elige los casos Tú o el agente, con las mismas suposiciones que el código Un generador aleatorio con las restricciones que declares
    Qué cubre Los 3-5 casos escritos 100 entradas por defecto en cada ejecución, distintas cada vez
    Qué documenta Un caso concreto (100 / 3 → [33, 33, 34]) Una regla de negocio ("nadie paga negativo")
    Cómo depuras un fallo Lees el caso que escribiste Lees el contraejemplo encogido y lo reproduces con seed y path
    Coste Bajo de escribir y de ejecutar Pensar la propiedad cuesta más; ejecutar, unos milisegundos más
    Limitación o riesgo Solo encuentra los bugs que ya imaginaste Una propiedad débil pasa siempre y da falsa seguridad

    Seis propiedades que sirven en código real

    La pregunta que bloquea a todo el mundo es "¿qué propiedad escribo?". Casi siempre cae en una de estas:

    1. Round-trip. parse(serialize(x)) devuelve x. Con JSON.parse(JSON.stringify(o)) y fc.double(), fast-check encuentra -0, NaN, Infinity y -Infinity, que JSON convierte en 0 y null.
    2. Invariante. Algo que nunca cambia: el total cuadra, nadie paga negativo, el stock no baja de cero.
    3. Idempotencia. Aplicar dos veces da lo mismo que una: ordenar, normalizar un email, un slugify.
    4. Oráculo. Comparas tu versión optimizada con una implementación lenta pero obvia. Muy útil al refactorizar.
    5. Conmutatividad. El orden de entrada no cambia el resultado: aplicar dos descuentos, fusionar dos configuraciones.
    6. No lanza. Para cualquier entrada válida, la función devuelve algo y no explota. Es la propiedad más pobre, y aun así encuentra bugs.

    Cómo usar property-based testing con agentes de IA

    El cambio es pequeño y potente: no le pidas al agente "escribe tests para esta función". Pídele "escribe las propiedades que esta función debe cumplir para cualquier entrada, con fast-check". Obligarle a enunciar reglas le obliga a explicitar qué cree que hace el código, y ahí se ven las contradicciones.

    Mejor aún: escribe tú las propiedades antes que el código. Una propiedad es una especificación ejecutable, y es exactamente lo que necesita un agente para saber cuándo ha terminado. Es la lógica que enseño en el workshop de SDD + Agentic Engineering: el humano define el contrato y la máquina lo cumple.

    Si tus entradas ya tienen un esquema, conéctalo. Haz que el arbitrary genere objetos con fc.record y comprueba dentro de la propiedad que tu función acepta todo lo que el esquema de Zod valida.

    Existe zod-fast-check para derivar arbitraries del esquema, pero su última versión en npm (0.10.1) se publicó en 2023 y exige fast-check <4 y zod ^3: hoy no compensa instalarlo.

    Esto encaja con la idea de verificar el código generado por IA sin leerlo todo: no revisas línea a línea, revisas que las reglas se cumplan.

    Y complementa lo que contamos sobre testing de agentes con TDD y sobre validar código antes de hacer merge.

    Cuándo NO usar property-based testing

    Cuando no encuentras una propiedad que no sea la propia función. Si para comprobar el resultado tienes que reimplementar el algoritmo, estás comparando el bug consigo mismo. En código de pegamento (llamar a una API, mapear un DTO a otro) a menudo no hay propiedad interesante.

    En UI y efectos secundarios. Generar cientos de entradas contra una base de datos, una API de pago o un componente renderizado es lento y deja estado detrás. Existe testing basado en modelos para esto, pero el coste de montarlo sube mucho.

    Cuando dejas el azar suelto en CI. Cada ejecución usa otra semilla. Un fallo que aparece una vez y no vuelve es real, pero si no guardas la seed y el path lo pierdes. Fija la semilla al reproducir y convierte el contraejemplo en un test de ejemplo permanente.

    Cuando confías ciegamente en el shrinking. Es heurístico. Con las dos aserciones del ejemplo juntas en una sola propiedad, fast-check se quedó en [68630,4] (con otra semilla puede salir distinto) en vez de bajar a [2,4]. Una propiedad por regla da contraejemplos más limpios.

    La barrera de entrada también es real. En el hilo de Hacker News The sad state of property-based testing libraries, un usuario defiende que el shrinking es, cito, "90% of the value of PBT".

    Otro apunta que el problema de formación "is a very real and fundamental blocker" para adoptarlo en equipos.

    Empieza por una función de dinero

    Elige hoy la función de tu proyecto que toca importes, fechas o parseo de texto. Escribe una sola propiedad: la invariante que, si se rompe, le cuesta dinero a alguien. Ejecútala con test.prop.

    Si pasa, súbele numRuns. Si falla, acabas de encontrar el caso que nadie pensó, con su contraejemplo mínimo y su semilla para reproducirlo.

    Para saber si el resto de tus tests detecta algo, pásales mutation testing con Stryker. Y para que un id o un importe mal pasado no llegue ni a compilar, usa branded types en TypeScript.

    Y si estás construyendo producto con agentes, el curso Construye con IA recorre cómo poner estas redes de seguridad desde la idea hasta producción.

    Para el contexto de por qué validar las entradas en los bordes, repasa también la programación defensiva en TypeScript.

    Preguntas frecuentes

    ¿Qué diferencia hay entre property-based testing y fuzzing?

    Los dos generan entradas automáticamente. El fuzzing suele buscar cuelgues y excepciones, a menudo guiado por cobertura. El property-based testing comprueba reglas de negocio que tú declaras y reduce el fallo a un contraejemplo mínimo.

    ¿Cuántos casos genera fast-check por defecto?

    100 por propiedad y por ejecución, según la documentación del parámetro numRuns de fast-check 4.10.2. Puedes subirlo con { numRuns: 1000 } en las propiedades críticas, a costa de algo más de tiempo.

    ¿Sirve fast-check con Jest o solo con Vitest?

    fast-check funciona igual en JavaScript y en TypeScript, y con cualquier runner: fc.assert(fc.property(...)) lanza una excepción si la propiedad falla, y Jest o Mocha la tratan como un test fallido. @fast-check/vitest solo añade la sintaxis test.prop y muestra la semilla en el nombre del test.

    ¿Pueden los agentes de IA escribir buenas propiedades?

    Sí, si se lo pides explícitamente y revisas lo que proponen. El riesgo es que escriban propiedades débiles, como "devuelve un array", que pasan siempre. Revisar unas pocas reglas es más rápido que revisar decenas de ejemplos, y una regla débil se detecta leyéndola.

    ¿Los tests de propiedades sustituyen a los tests de ejemplo?

    No. Los ejemplos documentan casos concretos que un humano lee para entender la función. Las propiedades exploran el espacio de entradas. Cuando una propiedad encuentra un bug, guarda el contraejemplo como test de ejemplo para que no vuelva.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
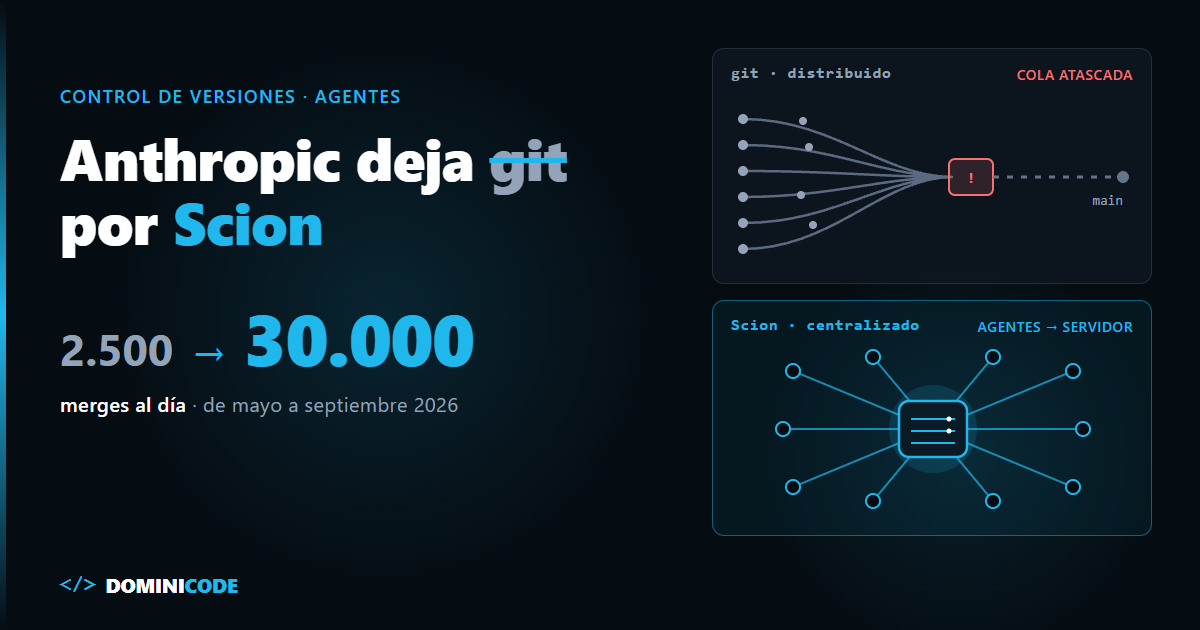
  • GTM Engineer: qué es y por qué un developer puede ocuparlo

    GTM Engineer: qué es y por qué un developer puede ocuparlo

    Abre una oferta de GTM Engineer y lee los requisitos: SQL, Python, APIs, n8n, saber meter un LLM dentro de un flujo de datos. Parece un puesto de backend. Ahora mira el departamento: ventas.

    Casi ningún developer tiene ese título en el radar. Lo buscan equipos comerciales que se han dado cuenta de algo incómodo: su embudo ya no es un equipo de personas con hojas de cálculo. Es software. Y el software que nadie diseña se rompe.

    Según el análisis de Bloomberry que veremos más abajo, la mayoría de quienes ocupan hoy ese puesto vienen de ventas (SDR/BDR) y el perfil técnico es el más raro. Saben de embudos, no de reintentos ni de rate limits. Tú tienes justo lo que les falta.

    En corto: un GTM Engineer construye el sistema que encuentra, enriquece y puntúa clientes potenciales: pipelines de datos cuyo output son reuniones de venta. Las ofertas piden SQL o Python en un 38% de los casos y n8n en un 28%, según el análisis de Bloomberry sobre unas 1.000 ofertas. Un developer con IA y automatización ya tiene la mitad técnica del perfil; lo que le falta es entender por qué una empresa compra.

    ¿Qué es un GTM Engineer?

    Un GTM Engineer es el perfil técnico que convierte el trabajo comercial manual (buscar empresas, completar datos, decidir a quién escribir) en un sistema automatizado de datos, APIs e IA.

    GTM viene de go-to-market: todo lo que hace una empresa para llegar al cliente y venderle. Clay, la herramienta que más se asocia al rol, define la disciplina en su guía de GTM engineering (abril de 2026) como "the practice of building automated revenue systems using AI, data enrichment, and workflow automation".

    Clay vende la herramienta del rol, así que léelo con cautela. Pero la definición es correcta.

    Qué hace un GTM Engineer en el día a día

    Un GTM Engineer reparte la semana entre cinco trabajos:

    • Señales: detectar que una empresa contrata, levanta ronda o cambia de stack.
    • Enriquecer: completar datos preguntando a varios proveedores en cascada.
    • Puntuar: decidir con un LLM si la empresa encaja.
    • Orquestar: conectar CRM, Slack y webhooks con n8n o Zapier.
    • Higiene: duplicados, rebotes y entregabilidad.

    Quita el vocabulario comercial y queda lo de siempre: colas, APIs con límites, reintentos y deduplicación.

    Qué piden las ofertas de GTM Engineer: los datos y su letra pequeña

    Las ofertas de GTM Engineer piden sobre todo herramientas de automatización (Zapier en el 39%, n8n en el 28%) y, en algo más de un tercio, SQL o Python (38% cada uno).

    El análisis más citado es el de Henley Wing Chiu en Bloomberry: unas 1.000 ofertas de GTM Engineer, publicado el 3 de octubre de 2025 y actualizado el 25 de enero de 2026.

    Dato Cifra Letra pequeña
    Ofertas que piden SQL 38% Python, también 38%. La mayoría no exige programar
    Ofertas que citan n8n 28% Zapier aparece en el 39%
    Herramienta más popular del rol Clay Sin porcentaje en ofertas; aparece en más del 90% de los perfiles de GTM Engineer analizados
    Salario en ofertas con rango público 127.500 USD/año El cuerpo lo llama mediana y el encabezado, media. Sobre todo EE. UU.
    Crecimiento de ofertas 2024→2025 +205% Suma GTM Engineer y RevOps, enero-septiembre de cada año

    Esa última fila es la que más se cita mal. La metodología de Bloomberry dice textualmente que compara GTM Engineers y RevOps combinados. Medio internet repite el 205% como si fuera solo GTM Engineer.

    Casi todo lo que se publica sobre el rol viene de quien vende herramientas para él. Lee las cifras como dirección, no como promesa. Y el 38% dice algo útil: la mayoría no te pide ser ingeniero de software, pero las ofertas que sí lo piden son las que mejor encajan contigo.

    GTM Engineer vs RevOps, SDR y developer clásico

    La diferencia entre un GTM Engineer y RevOps es quién construye y quién gobierna: RevOps mantiene el proceso, el CRM y los informes; el GTM Engineer construye sistemas nuevos que traen datos de fuera.

    SDR RevOps GTM Engineer Developer clásico
    Qué produce Conversaciones y reuniones Procesos, CRM limpio, informes Sistemas que generan pipeline Producto y features
    Herramienta central Secuenciador, LinkedIn CRM Clay, n8n, APIs, LLM Repo, CI/CD
    Cómo se mide Reuniones agendadas Calidad del dato, previsión Reuniones conseguidas por el sistema Entregas, incidencias
    Código No Poco Variable: de no-code a Python Siempre
    Limitación o riesgo No escala Se queda en mantenimiento El título está inflado: muchas ofertas son operaciones con otro nombre No conoce el embudo

    La frontera no está clara ni para quien trabaja en ello. En este hilo de la comunidad RevGenius (abril de 2026), una usuaria plantea que los dos puestos ya se han fundido en responsabilidades y resultados. Otro participante le responde que GTM Engineer es RevOps con otro nombre, más carga y menos sueldo. En Hacker News el escepticismo es más seco: en un comentario de agosto de 2026, un usuario cuenta que acaba de descubrir el término y que le suena a que, si usas Claude Code para X, ya puedes llamarlo X engineering.

    Mi lectura: el título está inflado, pero el trabajo que hay debajo, cuando la oferta pide código, es real.

    Por qué un developer con IA puede ocupar el hueco del GTM Engineer

    Un developer puede ocupar el puesto de GTM Engineer porque lo que se rompe en estos sistemas a escala es exactamente lo que un developer sabe arreglar.

    Un flujo no-code funciona con 200 filas. Con 20.000 aparecen duplicados, límites de API, reintentos que disparan el gasto y un LLM que inventa datos. Idempotencia, errores, coste por llamada y tests: eso no se aprende en un curso de ventas.

    Me pasó sin buscarlo. Para el lanzamiento de un workshop monté dos piezas encima de MailerLite: un panel que mide cada hora cuánta gente hay en cada paso del embudo (ebook, webinar, lista de espera, reto) y un script que sube los correos como borradores con los enlaces ya etiquetados. Un cron, una API con límites y un JSON. En otra empresa, eso es trabajo de GTM Engineer.

    Si ya montas agentes y flujos en n8n, el salto es corto. Lo que llevas tiempo practicando en Agentic Engineering o en la ruta de dev a AI Engineer es la mitad técnica del perfil.

    Un lead scoring con LLM que puedes montar hoy

    El corazón del rol, sin pagar ninguna herramienta: una lista de dominios, el LLM lee cada web y la puntúa contra tu cliente ideal. Con Bun, el SDK de Anthropic y Zod para no fiarte del JSON que devuelve el modelo:

    // score-leads.ts — bun add @anthropic-ai/sdk zod
    // bun run score-leads.ts leads.txt   (un dominio por línea)
    import Anthropic from "@anthropic-ai/sdk";
    import { z } from "zod";
    
    const ICP = `Vendemos formación en IA para equipos de desarrollo.
    Encaja: empresa de software de 20 a 500 personas que esté contratando developers.`;
    
    const Score = z.object({
      fit: z.number().int().min(0).max(10),
      reason: z.string(),
      hook: z.string(), // vacío si la web no da nada concreto
    });
    
    const client = new Anthropic(); // lee ANTHROPIC_API_KEY
    const model = process.env.MODEL ?? "claude-haiku-5-5";
    const domains = (await Bun.file(Bun.argv[2] ?? "leads.txt").text())
      .split("\n").map((l) => l.trim()).filter(Boolean);
    
    async function pageText(domain: string): Promise<string> {
      const res = await fetch(`https://${domain}`, { signal: AbortSignal.timeout(10_000) });
      if (!res.ok) throw new Error(`HTTP ${res.status}`);
      return (await res.text())
        .replace(/<script[\s\S]*?<\/script>|<style[\s\S]*?<\/style>/g, "")
        .replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").slice(0, 6000);
    }
    
    const rows = [];
    for (const domain of [...new Set(domains)]) {
      try {
        const msg = await client.messages.create({
          model, max_tokens: 2000,
          messages: [{ role: "user", content:
            `Cliente ideal:\n${ICP}\n\nTexto de la web de ${domain}:\n${await pageText(domain)}\n\n` +
            `Responde SOLO con JSON: {"fit": 0-10, "reason": "por qué", ` +
            `"hook": "algo concreto de SU web, o cadena vacía si no hay nada"}` }],
        });
        const raw = msg.content.find((b) => b.type === "text")?.text ?? "{}";
        const parsed = Score.parse(JSON.parse(raw.slice(raw.indexOf("{"), raw.lastIndexOf("}") + 1)));
        rows.push({ domain, ...parsed });
      } catch (e) {
        rows.push({ domain, fit: -1, reason: `error: ${(e as Error).message.split("\n")[0]}`, hook: "" });
      }
    }
    
    rows.sort((a, b) => b.fit - a.fit);
    console.table(rows);
    await Bun.write("scored.json", JSON.stringify(rows, null, 2));
    

    El modelo por defecto es Haiku porque la documentación de Anthropic lo recomienda para clasificación de alto volumen; cámbialo con la variable MODEL.

    Fíjate en dos detalles. El hook se pide de su web, y si no hay nada, vacío: así el LLM no inventa el dato que delata un email automatizado. Y el Score.parse convierte un JSON mal formado en un error controlado, no en una fila corrupta en tu CRM. Validar con schemas cualquier dato que no controlas, como la salida de un LLM, es la base del curso de Zod.

    Cuando funcione con 20 dominios, pásalo a n8n. La edición community es gratuita y self-hosted; si no la tienes, aquí explicamos cómo levantar n8n en local con Docker:

    1. Schedule Trigger: cada lunes a las 8:00.
    2. Google Sheets: lee los dominios nuevos.
    3. HTTP Request: descarga la web.
    4. Basic LLM Chain (con el modelo de Anthropic): el mismo prompt, con salida JSON.
    5. IF: fit >= 7.
    6. CRM (HubSpot o el tuyo): crea o actualiza la empresa con reason y hook.
    7. Slack: te avisa con los cinco mejores del día.

    El paso 8 no existe a propósito: el email lo manda una persona. En Hermes Agent para captar leads tienes una variante donde busca un agente.

    Cuándo NO te conviene ser GTM Engineer

    No te conviene si buscas un puesto de ingeniería con otro nombre y no filtras ofertas. Muchas "GTM Engineer" son operaciones con una tabla de Clay y un secuenciador. Filtra por las que piden SQL, Python o APIs.

    No te conviene si no aceptas que te midan en reuniones, no en PRs. Tu trabajo depende de cosas que no controlas: el producto, el precio o el comercial que llama. A algunos devs eso les motiva. A otros les quema en tres meses.

    No te conviene automatizar el envío. El envío masivo sin revisión es como se quema un dominio. Y en la Unión Europea el email comercial no solicitado tiene reglas; en España, la LSSI es estricta. Revísalas antes de enviar nada desde este flujo.

    Y no esperes el salario de la tabla: es de ofertas de Estados Unidos. Fuera de ahí, el rol está mucho menos medido.

    El primer paso para probar el rol de GTM Engineer

    Apunta 20 dominios de empresas a las que te gustaría venderles algo, o donde te gustaría trabajar. Pásales el script. Cuenta cuántos hook salen vacíos.

    Ese número te dice cuánto vale de verdad la personalización con IA. Si quieres llevar ese prototipo a un producto con agentes, en el ebook gratuito El Developer Agéntico está la arquitectura completa: tools, memoria y orquestación.

    Un GTM Engineer no escribe más emails. Construye el sistema que decide a quién merece la pena escribir.

    Preguntas frecuentes

    ¿Qué significa GTM en GTM Engineer?

    GTM son las siglas de go-to-market: todo lo que hace una empresa para llegar al cliente y venderle. Un GTM Engineer trabaja en la parte técnica de ese proceso, sobre todo en outbound: encontrar empresas, enriquecer sus datos y decidir a quién contactar.

    ¿Un GTM Engineer necesita saber programar?

    No siempre. Según el análisis de Bloomberry, SQL y Python aparecen cada uno en el 38% de las ofertas, así que la mayoría no lo exige. Pero las ofertas que lo piden son las más técnicas, y ahí un developer tiene ventaja clara.

    ¿Cuál es la diferencia entre un GTM Engineer y RevOps?

    RevOps mantiene el proceso comercial: CRM, informes y previsiones. El GTM Engineer construye sistemas nuevos que traen datos de fuera y los convierten en oportunidades. Muchas empresas mezclan los dos.

    ¿Cuánto gana un GTM Engineer?

    En las ofertas con rango público que analizó Bloomberry, la cifra central es de 127.500 dólares al año, sobre todo en Estados Unidos. No hay un dato equivalente fiable para España ni Latinoamérica, así que no la uses como referencia local.

    ¿Cómo empiezo a construir sistemas así con IA?

    Empieza por un caso pequeño, como el lead scoring de este post, y valida cada salida del modelo. Si quieres un recorrido de idea a producto con Claude Code, el curso Construye con IA sigue ese proceso paso a paso, y en el canal de YouTube de Dominicode hay más ejemplos de automatización con IA.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.