Tag: Agentes IA

  • Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

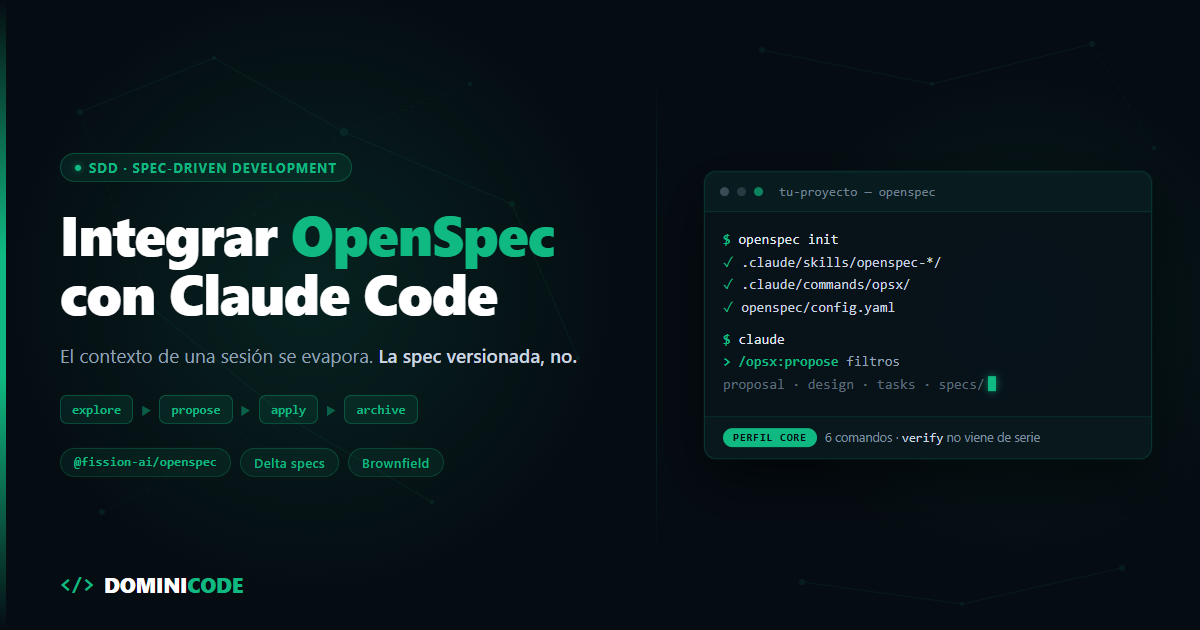
    OpenSpec con Claude Code resuelve eso. OpenSpec es un framework open source de spec-driven development creado por Fission-AI que guarda lo acordado — propuesta, diseño, tareas y spec — en archivos Markdown versionados dentro del repo, para que Claude Code los lea antes de tocar código. En esta guía lo instalamos, lo inicializamos con openspec init y recorremos el flujo OPSX completo sobre un proyecto que ya existe.


    OpenSpec no es OpenAPI: la diferencia en una tabla

    Comparten cuatro letras y nada más.

    OpenSpec OpenAPI
    Qué es Framework de spec-driven development para asistentes de código Especificación para describir APIs REST
    Quién lo mantiene Fission-AI OpenAPI Initiative (Linux Foundation)
    Formato Markdown dentro del repo YAML o JSON
    Para qué sirve Que un agente implemente lo acordado Que un cliente sepa llamar a tu API

    Si has llegado buscando Swagger, este no es tu post.


    Cómo instalar OpenSpec para Claude Code (y el error de scope de npm)

    OpenSpec se instala como CLI global. Requiere Node.js 20.19.0 o superior, y la versión actual es la 1.8.0.

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto: openspec a secas es la versión 0.0.0 publicada el 9 de abril de 2019, sin relación alguna con el framework y sin una sola actualización desde entonces. Es el fallo más repetido en tutoriales, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Qué crea openspec init en un proyecto con Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Qué poner en openspec/config.yaml (y por qué no es opcional)

    openspec/config.yaml es el archivo donde defines el schema por defecto, el contexto del proyecto y las reglas por artefacto. No es documentación que el agente abre si le apetece: es entrada del modelo. La doc oficial lo dice sin rodeos — "When generating any artifact, your context and rules are injected into the AI prompt".

    Sus claves de nivel superior son cuatro:

    Clave Para qué
    schema El schema por defecto de los artefactos
    context La información de tu proyecto. Aparece en todos los artefactos
    rules Restricciones por artefacto. Solo aparecen en el artefacto que coincide
    operations Guía opcional para apply y archive

    Ese matiz de context y rules importa: el contexto viaja siempre, las reglas solo cuando toca. Así que lo que quieras que el agente tenga presente en cada decisión va en context.

    Dedica cinco minutos a describir de verdad tres cosas ahí: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear. El detalle de cada clave está en la doc de customization.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    El flujo OPSX paso a paso en Claude Code

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y consolida lo implementado en openspec/specs/, que es la fuente de verdad del proyecto — "Specs are the source of truth — they describe how your system currently behaves". A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    Los otros dos del perfil por defecto

    /opsx:update revisa los artefactos de planificación de un cambio y los mantiene coherentes entre sí, en cualquier dirección: si editas el diseño, la propuesta se ajusta.

    /opsx:sync fusiona las delta specs en openspec/specs/ sin archivar el cambio. Útil cuando quieres consolidar antes de cerrar.

    Los extendidos, y por qué /opsx:verify no te va a funcionar todavía

    Aquí está el detalle que hace perder media hora a mucha gente: el perfil por defecto no trae verify.

    El perfil core son los seis de arriba — propose, explore, apply, update, sync, archive. Los extendidos son otros seis: /opsx:new, /opsx:continue, /opsx:ff, /opsx:verify, /opsx:bulk-archive y /opsx:onboard. Si escribes /opsx:verify recién instalado, no autocompleta y no pasa nada.

    Para activarlos:

    openspec config profile   # selecciona el perfil ampliado
    openspec update           # aplica los cambios en el proyecto
    

    Con el perfil ampliado activo, /opsx:verify contrasta la implementación contra la spec. No es un test runner: es la comprobación de que no se ha colado nada que nadie pidió y de que no falta nada que sí se pidió.

    Empieza por los seis del perfil core. Los extendidos los necesitarás cuando tengas el ciclo rodado y lleves varios cambios a la vez.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Una delta spec es una spec que describe solo lo que cambia — lo añadido, lo modificado y lo eliminado — en vez de redescribir el sistema entero. Es lo que hace viable OpenSpec en un proyecto que ya existe.

    Así se ve una:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - GIVEN el listado de productos cargado
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ### Requirement: Paginación del listado
    El listado DEBE conservar el filtro activo al cambiar de página.
    

    Dos cosas que conviene saber antes de copiar esto. Las etiquetas son literales y no se traducen: ADDED, MODIFIED, REMOVED, Requirement:, Scenario: y GIVEN/WHEN/THEN van en inglés aunque el cuerpo esté en español. Y solo incluyes las secciones que uses — si el cambio no elimina nada, no dejes un ## REMOVED Requirements vacío.

    Sobre los escenarios: es vocabulario Gherkin, pero en Markdown plano. Sin ficheros .feature, sin Cucumber, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development.

    Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto. La lista completa está en la tabla de herramientas soportadas, que cubre más de treinta.


    Cómo migrar del flujo antiguo de OpenSpec al flujo OPSX

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano: ejecuta openspec update, que regenera los ficheros de skills y comandos para las herramientas que tengas configuradas.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Dos avisos antes de que te lances. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Por qué no me funciona el comando /opsx:verify?

    Porque no viene en el perfil por defecto. OpenSpec usa el perfil core, que trae seis comandos: propose, explore, apply, update, sync y archive. El comando verify pertenece al perfil ampliado, junto a new, continue, ff, bulk-archive y onboard. Para activarlo ejecuta openspec config profile y después openspec update.

    ¿Qué comandos trae OpenSpec por defecto?

    El perfil core incluye seis: propose para generar la propuesta, explore para planificar sin compromiso, apply para implementar, update para mantener coherentes los artefactos de planificación, sync para fusionar las delta specs en openspec/specs/ y archive para cerrar el cambio.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es ejecutar openspec update en el proyecto, que regenera skills y comandos, en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Los tres niveles de Spec-Driven Development (y por qué casi todos estamos en el primero)

    Hace unas semanas abrí un repo mío de febrero. Fui a la carpeta specs/. Ahí seguía todo: spec.md, plan.md, tasks.md.

    El spec.md describía tres endpoints. El código tenía once.

    La spec no estaba mal escrita. Estaba muerta. Cinco meses sin tocarla mientras el código crecía por su cuenta. Y lo peor es que todo funcionaba: los tests pasaban, el deploy iba, nadie se enteró de nada.

    Yo llevaba meses diciendo que hacía SDD. No lo hacía. Hay tres niveles de Spec-Driven Development y yo estaba en el primero convencido de estar en el segundo.

    Esto no va de qué es SDD. Va de diagnóstico: en qué nivel estás de verdad y a cuál te conviene subir. Que no siempre es el de arriba.

    El test de los 30 segundos: borra la carpeta specs/

    Antes de leer nada más, hazte esta pregunta.

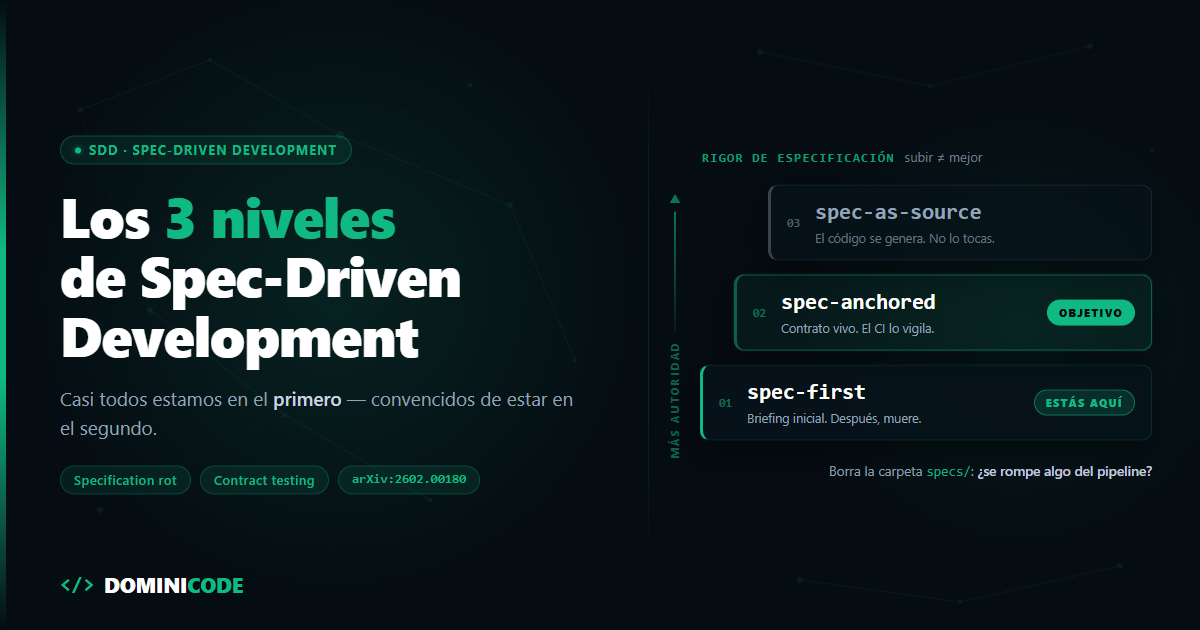
    Si borras la carpeta specs/ de tu proyecto ahora mismo, ¿se rompe algo del pipeline?

    Si la respuesta es no —si el build sigue verde, los tests pasan y el deploy sale— entonces tu spec es un documento, no un artefacto de ingeniería. Eres spec-first. Da igual lo bien escrita que esté. Da igual que tengas constitution.md y siete plantillas.

    Nada que se pueda borrar sin consecuencias forma parte del sistema.

    Y ojo, que esto no es un insulto. Spec-first es un nivel legítimo y para la mitad de tus proyectos es exactamente el que necesitas. El problema no es estar ahí. El problema es estar ahí creyendo que estás dos escalones más arriba, y por tanto confiando en garantías que no tienes.

    Qué son los tres niveles de rigor de especificación

    Deepak Babu Piskala publicó el 30 de enero de 2026 el preprint Spec-Driven Development: From Code to Contract in the Age of AI Coding Assistants (arXiv:2602.00180, cs.SE). Es el primer sitio donde he visto puesto por escrito, con nombres, lo que la mayoría hacemos por intuición.

    El paper define tres niveles de rigor de especificación: spec-first, spec-anchored y spec-as-source. Lo único que cambia entre ellos es cuánta autoridad tiene la spec sobre el código — el eje de su primera figura se llama literalmente increasing specification authority.

    No son fases de madurez que haya que recorrer. Son opciones, y cada una tiene un coste.

    Nivel La spec es… ¿Quién escribe el código? ¿Qué pasa con el drift? Es tu nivel si…
    Spec-first Un briefing inicial Tú o el agente al arrancar; después, solo tú Ocurre en silencio, nadie se entera Prototipos, features puntuales, exploración
    Spec-anchored Un contrato vivo Tú, con la spec como referencia obligatoria Lo detecta el CI si lo automatizas; si no, rot La mayoría de sistemas en producción
    Spec-as-source El único artefacto que un humano edita Nadie. Se genera No existe por construcción Automoción, embebidos, dominios certificados

    Spec-first: la spec guía el arranque

    Definición del paper: la especificación se escribe antes de programar para guiar la implementación inicial.

    Ahí está la palabra clave: inicial. La spec hace su trabajo en el minuto cero y después su vida útil se acaba. El agente genera el código, tú lo revisas, y desde ese momento el código es la única fuente de verdad.

    El paper es explícito: spec-first funciona en desarrollo inicial de features con asistentes de IA, y en prototipos y features de usar y tirar.

    Es donde está casi todo el mundo que usa Claude Code o Cursor con un spec.md delante. Y para mucho de lo que hacemos, está perfecto. Escribes la spec, el agente construye, tú corriges, sigues adelante. Es el flujo que enseño en el curso de Construye con IA para ir de idea a producto sin caos.

    El fallo no es usar spec-first. El fallo es usar spec-first en un sistema que va a vivir tres años y con cuatro personas tocándolo.

    Spec-anchored: la spec vive con el código

    Definición del paper: la especificación se mantiene junto al código durante todo el ciclo de vida del sistema.

    Y aquí viene la frase que a mí me hizo replantearme cosas. El paper llama a spec-anchored el punto óptimo para la mayoría de sistemas en producción, porque te da los beneficios de documentación clara y requisitos verificables sin exigir que el código se genere entero.

    Traducido: tienes las garantías sin renunciar a escribir código.

    El riesgo de este nivel tiene nombre propio en el paper: specification rot. La podredumbre de la especificación, que aparece cuando los equipos no actualizan las specs a medida que el código cambia. Exactamente lo que le pasó a mi repo de febrero.

    Y la solución que propone el paper no es disciplina. Es automatización: los tests imponen la alineación entre spec y código, con escenarios BDD funcionando como tests automáticos que corren en cada commit.

    Esa es la diferencia real entre los dos primeros niveles. No es cuánto cuidas la spec. Es si la alineación depende de tu voluntad o de un check que falla el build.

    Spec-as-source: la spec es el código

    Definición del paper: la especificación es el único artefacto que los humanos editan directamente. El código se genera enteramente a partir de la spec.

    La regla operativa que da el paper es tajante: si quieres cambiar la funcionalidad, cambias la spec y regeneras. Nunca editas el código generado directamente.

    El drift desaparece. No se gestiona, no se detecta: no puede existir. Como el código se regenera en lugar de editarse a mano, spec y código están siempre alineados por construcción.

    Suena a futuro lejano. No lo es, y esto es lo que más me sorprendió del paper.

    Spec-as-source ya existe. Y una parte ya la haces

    Hay una idea instalada de que spec-as-source es hacia dónde vamos cuando los LLM sean lo bastante buenos.

    Falso. El paper lo desmonta con una frase: spec-as-source ya es práctica estándar en dominios con generación de código bien definida, y pone dos ejemplos. Uno es generar código embebido certificado desde modelos de Simulink. En la capa de control, el ingeniero rara vez escribe a mano el C que acaba en la ECU: escribe el modelo, y el generador produce el C.

    El otro ejemplo del paper es generar los stubs de servidor desde un openapi.yaml.

    Eso también es spec-as-source. Y llevas años haciéndolo sin llamarlo así: editas el contrato, regeneras, nunca tocas a mano lo generado. Es exactamente la regla del nivel tres.

    La diferencia es qué generas. Ahí generas el andamio. Nadie ha certificado un generador para la lógica de negocio.

    Entonces, ¿por qué no puedes hacer lo mismo con la lógica de tu app de Next.js?

    Porque, según el paper, spec-as-source solo es práctico hoy en dominios donde esa confianza está establecida. El paper no entra en por qué, pero la respuesta no está en el modelo: está en el toolchain. Generadores cualificados bajo norma, trazabilidad auditable y décadas de proceso detrás.

    Tu lógica de negocio no tiene eso. No porque la IA no dé la talla, sino porque no hay un organismo que responda cuando el código generado la líe en producción.

    Así que spec-as-source completo no es tu nivel hoy si haces web. Y no pasa nada. Perseguirlo con las herramientas actuales es la forma más rápida de acabar con el peor de los dos mundos: código generado que nadie entiende y una spec que tampoco es la fuente real de verdad.

    Qué cuesta subir de spec-first a spec-anchored

    Este es el salto que sí te interesa. Y es más barato de lo que parece, porque no va de escribir más documentación. Va de cerrar el bucle.

    El paper describe un flujo de cuatro fases: Specify → Plan → Implement → Validate.

    La mayoría hacemos tres. Especificamos, planificamos, implementamos, y en cuanto la feature funciona nos vamos a la siguiente. Validate se queda sin hacer. Y para mí, Validate es la fase que convierte spec-first en spec-anchored.

    En un proyecto normal de TypeScript, el salto son tres movimientos concretos.

    Uno: los criterios de aceptación de la spec dejan de ser prosa y pasan a ser tests. Cada comportamiento descrito en la spec tiene un test que lo verifica. Si la spec dice que un usuario sin permisos recibe un 403, hay un test que lo comprueba. Si no puedes escribir ese test, tu spec no era verificable — que es uno de los motivos por los que una spec falla con un agente de IA aunque esté impecablemente redactada.

    Dos: los contratos se validan contra la implementación. El paper lista aquí las herramientas por categoría: OpenAPI y Swagger, GraphQL SDL o Protocol Buffers para las specs de API, y Pact o Specmatic para contract testing. Tu openapi.yaml deja de ser documentación y pasa a ser el árbitro. Si el backend devuelve un campo que el contrato no declara, falla.

    Tres: eso corre en CI y rompe el build.

    # .github/workflows/ci.yml
    on: [push, pull_request]
    
    jobs:
      spec-alignment:
        runs-on: ubuntu-latest
        steps:
          - uses: actions/checkout@v5
          - run: npm ci
          - run: npm run test:contract     # implementación vs openapi.yaml
          - run: npm run test:acceptance   # escenarios derivados de la spec
    

    Ese bloque es la frontera entre los dos niveles. El día que alguien añade un endpoint sin tocar el contrato, el build se pone rojo antes de que llegue a review. La alineación deja de depender de que te acuerdes.

    Sobre el retorno de esto, el paper documenta un caso de estudio de microservicios API-first con OpenAPI y Specmatic con una reducción del 75% en el tiempo de ciclo de integración. Es un caso concreto del paper, no una media del sector, y conviene leerlo como lo que es: una señal de dónde está el valor, no una promesa.

    La parte incómoda es que este salto se apoya en tener una cultura de testing decente. Si tu suite de tests es frágil, spec-anchored no te va a salvar: vas a tener dos cosas rotas en vez de una. Arregla primero los tests — y si tu stack es Angular, esa base la trabajo entera con Jest y Testing Library en el curso de Testing en Angular, que es la misma disciplina en cualquier proyecto de TypeScript.

    El fallo que sobrevive a todos los niveles

    Hay una trampa que no se arregla subiendo de nivel, y el paper la nombra sin anestesia: los tests de spec que pasan no garantizan software correcto si las specs están mal.

    Falsa confianza. Para mí es el fallo más caro de los cuatro que lista el paper —junto a la sobre-especificación, la podredumbre de la spec y convertir las specs en burocracia— porque los otros tres se notan y este no.

    Tienes el CI verde, el contrato validado, los escenarios BDD pasando. Y estás construyendo con enorme rigor exactamente lo que el negocio no pidió.

    Por eso el paper reformula el rol del developer: pasamos de programar a mano a orquestar especificaciones, revisar salidas de IA y centrarnos en el diseño de alto nivel. Si tu spec es mala, subir de nivel solo automatiza el error y le pone un sello de calidad encima.

    La regla de oro del Spec-Driven Development: usa el mínimo rigor

    El paper cierra con un marco de decisión que merece la pena tener a mano. SDD aporta valor cuando hay asistencia de IA de por medio, requisitos complejos, sistemas de vida larga, varios mantenedores, generación de código viable o integración complicada. Y hay que saltárselo en prototipos desechables, trabajo en solitario de vida corta, código exploratorio o CRUD simple con requisitos evidentes.

    Que es básicamente lo que ya defendí en su día al hablar de cuándo no usar Spec-Driven Development, y me alegra ver que el paper llega a la misma conclusión.

    Porque el principio rector que se lleva el paper, y el que yo me he apuntado, es este:

    Usa el mínimo nivel de rigor de especificación que elimine la ambigüedad en tu contexto.

    Subir de nivel no es mejor. Es más caro. Spec-anchored en un script que vas a borrar en dos semanas no es madurez profesional, es ceremonia. Y spec-first en la plataforma que factura no es agilidad, es deuda con fecha de vencimiento.

    Lo que puedes hacer hoy, en diez minutos: coge tu proyecto más importante y aplícale el test de los 30 segundos. Borra mentalmente la carpeta specs/. Si no se rompe nada y ese proyecto va a vivir más de seis meses con más de una persona tocándolo, ya sabes cuál es tu siguiente PR. No es escribir más spec. Es añadir el check que la vuelve obligatoria.

    Si quieres el método completo —cómo redactar specs que un agente ejecuta sin inventarse la mitad y cómo mantenerlas vivas sin que se conviertan en burocracia— lo desarrollo entero en el libro de Spec-Driven Development. Y en Dominicode Labs tienes los proyectos donde esto está montado tal cual lo uso en producción, con el CI incluido.

    Preguntas frecuentes

    ¿Cuáles son los tres niveles de Spec-Driven Development?

    Spec-first, spec-anchored y spec-as-source. En spec-first la spec guía la implementación inicial y después puede quedar obsoleta. En spec-anchored la spec se mantiene junto al código durante todo el ciclo de vida y hay tests que verifican la alineación. En spec-as-source la spec es el único artefacto que edita un humano y el código se genera entero a partir de ella. Los definió Deepak Babu Piskala en el preprint arXiv:2602.00180.

    ¿Spec-first significa que lo estoy haciendo mal?

    No. Spec-first es un nivel legítimo y el paper lo recomienda explícitamente para prototipos, features de usar y tirar y desarrollo inicial con asistentes de IA. El problema aparece cuando aplicas spec-first a un sistema de vida larga y asumes garantías de trazabilidad que ese nivel no te da.

    ¿Cómo sé si mi spec está viva o solo bien escrita?

    Comprueba si algo del pipeline depende de ella. Si puedes borrar la spec y el build sigue verde, la spec es documentación. Una spec viva rompe algo cuando desaparece o cuando el código se desvía de ella, porque hay tests o validaciones de contrato que la usan como referencia.

    ¿Necesito Cucumber o BDD para ser spec-anchored?

    No obligatoriamente. El paper menciona los frameworks BDD (Cucumber, SpecFlow, Behave) como la forma habitual de que los escenarios se conviertan en tests automáticos, pero lo que define el nivel es que exista una verificación automática de la alineación, no la herramienta concreta. Con contract testing sobre OpenAPI usando Pact o Specmatic ya cumples el requisito.

    ¿Spec-as-source llegará algún día al desarrollo web?

    En parte ya llegó: generar los stubs de servidor desde un openapi.yaml es el ejemplo de spec-as-source que el propio paper pone, y es desarrollo web. Lo que no ha llegado es la lógica de negocio, y el cuello de botella no es la capacidad del modelo sino la confianza en el generador. En automoción y embebidos spec-as-source ya es práctica estándar desde hace años con Simulink o SCADE, y una de las razones es que esos generadores están cualificados bajo norma y auditados.

    Si mis tests de spec pasan, ¿está el software correcto?

    No. El paper lo advierte de forma directa: que los tests de spec pasen no garantiza que el software sea correcto si las propias specs son incorrectas. Verificar que cumples la spec y validar que la spec era la adecuada son dos problemas distintos, y el segundo sigue siendo humano.

    ¿Merece la pena spec-anchored si trabajo solo?

    Depende de la vida del proyecto, no del tamaño del equipo. El paper desaconseja SDD en trabajo en solitario de vida corta, pero si eres solo tú manteniendo algo durante años, el "otro mantenedor" eres tú dentro de ocho meses sin recordar nada. Ahí el contrato en CI te protege igual que protegería a un equipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    Qwen3.8-Max: la tabla de Alibaba que puntúa a sus rivales

    El 3 de agosto Alibaba presentó Qwen3.8-Max. Me senté a leer el anuncio para sacar dos párrafos y pasar a otra cosa: modelo nuevo, ficha técnica, precio, siguiente.

    Me quedé atascado en la tabla de benchmarks.

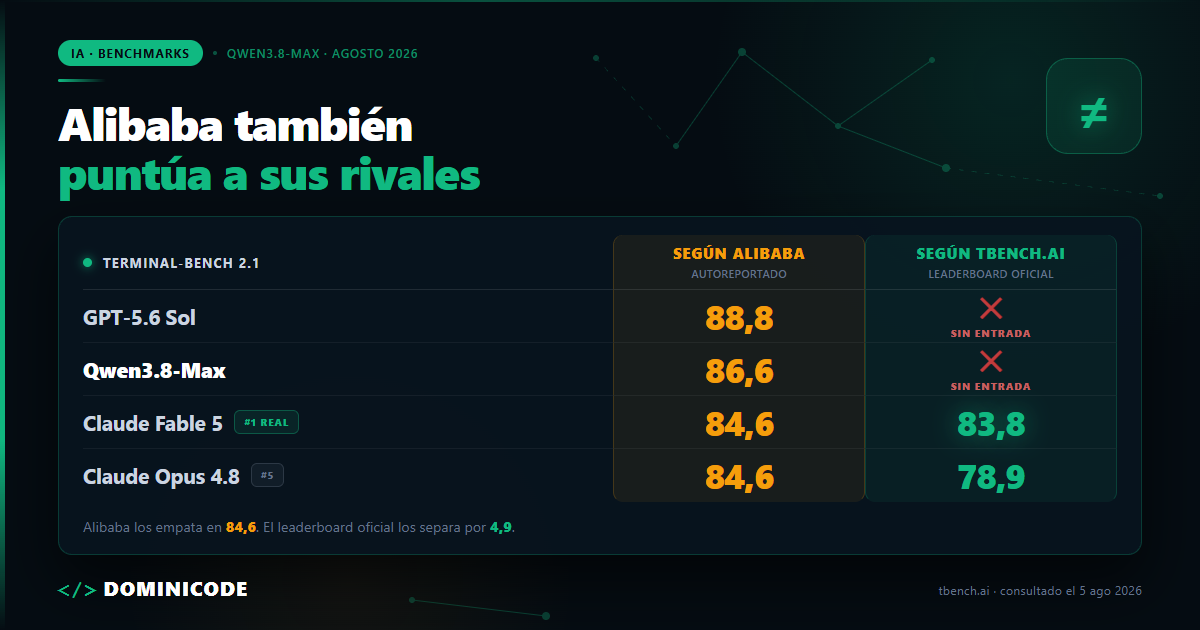
    No por sus números, sino por los de los demás. En esa tabla Alibaba no solo se puntúa a sí misma: puntúa también a Claude Opus 4.8, a Claude Fable 5 y a GPT-5.6 Sol. Cuatro filas, cuatro modelos, un único autor de las mediciones.

    Abrí el leaderboard oficial de Terminal-Bench 2.1 para cruzar las cifras. Y ahí dejó de ser una ficha técnica.

    Los cuatro modelos de la tabla de Alibaba —incluidos los tres que no son suyos— puntúan por encima del número 1 del leaderboard independiente. Dos de ellos ni siquiera tienen entrada en ese leaderboard.

    Hay una explicación legítima para esto y la doy entera más abajo, antes de cualquier conclusión. No es fraude. Pero tampoco es un ranking, aunque tenga forma de ranking.

    El contexto general —el leaderboard completo de agosto y por qué una cifra autoreportada y una medida no valen lo mismo— lo dejé escrito en Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen. Este post es el caso concreto: qué es Qwen3.8-Max, cuánto cuesta y qué haces con él a partir de hoy.

    ¿Qué es Qwen3.8-Max? 2,4 billones de parámetros y un dato que falta

    Qwen3.8-Max es un modelo MoE —mixture of experts— con 2,4 billones de parámetros totales (2,4 × 10¹², lo que en inglés se escribe 2.4T). Es multimodal de entrada: acepta texto, imagen y vídeo, y devuelve texto.

    Hasta aquí, la ficha. Ahora lo interesante. En un MoE, el número que de verdad predice coste y latencia no es el total, sino cuántos parámetros se activan por token. Los agregadores llevan días repitiendo "95B activos" como si estuviera en el anuncio.

    Fui a buscarlo y no está: Alibaba publica el total, no los activos. Tampoco lo he encontrado en ningún material primario del lanzamiento, y ninguno de los agregadores que repiten los 95B enlaza a dónde lo sacó.

    No digo que sea falso. Digo que no lo puedo verificar y que se está citando un número de segunda mano como si fuera de primera.

    Que el dato más repetido del lanzamiento sea justo el que no puedo confirmar dice bastante de cómo viaja la información técnica en las primeras 72 horas de un modelo.

    El contexto de Qwen3.8-Max: 1M de titular, 983K reales

    El titular es "1 millón de tokens de contexto". Los límites reales de la API son estos:

    Modo Entrada máxima Salida máxima
    Normal 991K tokens 131K tokens
    Con thinking activado 983K tokens 131K tokens

    No es una trampa: nadie te vende "991K de contexto". Pero si llenas la ventana hasta el borde, esos tokens que desaparecen al activar el razonamiento son los que revientan una ejecución larga a las tres de la mañana.

    Diseña contra 983K, no contra 1M. El límite que importa es el peor, no el del titular.

    Cuánto cuesta Qwen3.8-Max: $2 de entrada y $6 de salida

    Precios de lista por millón de tokens:

    Concepto Precio por millón
    Entrada $2,00
    Salida $6,00
    Lectura de caché implícita $0,25

    Franja media del mercado, no gama alta. Y el dato que casi nadie mira es el tercero: la lectura de caché a $0,25 es un 87,5% menos que la tarifa de entrada.

    Un agente que arrastra el mismo system prompt y los mismos ficheros durante veinte turnos paga la mayor parte de su factura a $0,25, no a $2. Calcula con esa tarifa o te sobrará presupuesto por el lado equivocado. La comparativa de precios de agosto de 2026 con el resto de modelos ya está publicada; aquí no la repito.

    Sobre disponibilidad, un matiz que cambia la decisión: está en API alojada y los pesos abiertos están prometidos para "la semana que viene" desde el 3 de agosto, así que aún no existen. Un modelo con pesos prometidos no es un modelo con pesos. Con Qwen3.7 analicé la generación anterior; aquí al menos hay promesa y plazo. Sigue siendo una promesa.

    Los benchmarks de Qwen3.8-Max según Alibaba

    Estas son las cifras del anuncio de lanzamiento de Alibaba, tal como las reproducen dos fuentes independientes que coinciden entre sí. No he podido confirmar la URL del anuncio original, así que no te la enlazo y prefiero decirlo en voz alta. Todas ellas, sin excepción, son mediciones reportadas por Alibaba:

    Benchmark Qwen3.8-Max (autoreportado por Alibaba)
    Terminal-Bench 2.1 86,6
    SWE-bench Pro 67,7
    DeepSWE 1.1 56,6
    PaperBench 93,0
    CoWorkBench 74,8
    WideSearch 81,9
    GPQA Diamond 92,6
    IFBench 82,8
    MRCR v2 (256K) 92,9
    MMMU-Pro 82,3
    OSWorld-Verified 86,1
    OmniDocBench 1.5 92,1
    Video-MME (con subtítulos) 90,4

    Ninguna de estas cifras ha sido reproducida por un tercero independiente a 7 de agosto de 2026.

    He dejado solo la columna de Qwen. En el anuncio, la fila de Terminal-Bench trae tres modelos más.

    Es una tabla fuerte, sobre todo en multimodal: 82,3 en MMMU-Pro y 86,1 en OSWorld-Verified con entrada de imagen y vídeo a $2 el millón es una combinación que casi nadie ofrece.

    El problema no está en esta tabla. Está en la fila de Terminal-Bench 2.1, donde Alibaba añadió a la competencia.

    Qwen3.8-Max frente a tbench.ai: el cruce fila a fila

    Esto es lo que publicó Alibaba en esa fila, junto a lo que dice el leaderboard público de tbench.ai consultado el 5 de agosto de 2026:

    Modelo Según Alibaba Según tbench.ai Puesto Harness + effort Diferencia
    GPT-5.6 Sol 88,8 sin entrada — — —
    Qwen3.8-Max 86,6 sin entrada — — —
    Claude Fable 5 84,6 83,8 #1 Claude Code, xhigh +0,8
    Claude Opus 4.8 84,6 78,9 #5 Claude Code, high +5,7

    Hay tres cosas en esa tabla y ninguna salta a la primera.

    Uno. Los cuatro valores de la columna de Alibaba superan el 83,8 que es el primer puesto del leaderboard independiente. En la tabla del anuncio, el líder real del ranking público queda empatado en tercer puesto.

    Dos. Alibaba empata a Opus 4.8 con Fable 5 en 84,6. En la medición independiente esos dos modelos están separados por 4,9 puntos. No es solo que las cifras sean más altas: es que el orden entre los rivales también cambia.

    Tres. Los dos modelos que encabezan la tabla son justo los que no tienen entrada oficial. GPT-5.6 Sol no aparece en el leaderboard —y el 88,8 que le asigna Alibaba tampoco coincide con el 89,5 que circula por los agregadores, otra cifra sin fuente que ya repasé en el post hermano—. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%): entre diez y trece puntos por debajo del 88,8 del anuncio. Y Qwen3.8-Max tampoco está: se anunció el 3 de agosto, dos días antes de esa consulta.

    Un número que nadie externo ha reproducido no es mejor ni peor. Es un número sin contraste.

    Por qué los números de Alibaba pueden ser correctos y no comparables

    Hay una razón técnica por la que las cuatro cifras pueden ser correctas sin ser comparables, y la doy antes de mi conclusión porque cambia el veredicto.

    Terminal-Bench 2.1 no puntúa modelos sueltos. Puntúa modelo + harness + effort: el modelo, el agente que lo envuelve y cuánto cómputo se le permite gastar por tarea. Por eso cada fila del leaderboard oficial dice "Claude Code + Fable 5, xhigh" y no simplemente "Fable 5".

    Si Alibaba corrió el benchmark con su propio harness y su propia configuración de esfuerzo, sus números pueden ser correctos y a la vez no comparables con los de tbench.ai. Un harness más agresivo sube a todos los modelos de la tabla, incluidos los ajenos. Eso explicaría por qué las cuatro cifras están por encima del líder oficial.

    No hay fraude en eso. Es una medición distinta de una cosa distinta.

    El problema es de presentación, y es real: una tabla con forma de ranking, que mezcla tu medición con la de tus competidores y llega al lector sin harness ni effort al lado, se va a leer como si fuera el leaderboard. Porque se parece al leaderboard.

    Es lo que enseño en Construye con IA: montar la evaluación antes que el modelo, porque el número que te sale es del sistema entero y el modelo es solo una de sus piezas. Cambia el andamiaje y cambias el número sin tocar el modelo.

    Es también el patrón que analicé con Kimi K3. La coincidencia no está en el país de origen: está en que ningún fabricante espera a que un tercero le mida antes de lanzar.

    Entonces, ¿te conviene Qwen3.8-Max?

    Sí para multimodal barato, no para agentes de terminal en producción. El criterio que lo decide es uno solo: separa lo comprobable de lo reportado.

    Comprobable hoy: $2 y $6 por millón, caché a $0,25, 983K de entrada real con thinking, 131K de salida, entrada de texto, imagen y vídeo, y disponibilidad por API. Con eso ya decides un piloto.

    Reportado y sin contraste: el 86,6 de Terminal-Bench, el 67,7 de SWE-bench Pro y el resto de la tabla. Sirven como hipótesis de trabajo, no como criterio de compra.

    Si trabajas con documentos, capturas o vídeo —OCR, análisis de UI, pipelines de contenido—, es candidato serio y su precio lo hace barato de probar. Si buscas un agente de terminal para producción, yo esperaría: los pesos no están, no hay medición independiente y sí hay opciones ya medidas.

    Lo que puedes hacer esta semana, en dos horas: elige tres tareas de tu backlog que ya sepas resolver, ejecútalas con tu agente actual y con Qwen3.8-Max detrás, y compara tiempo, turnos y factura. Tres tareas tuyas te dicen más que trece benchmarks ajenos.

    Eso solo funciona si el criterio de "terminado" está escrito antes de empezar, que es toda la lógica del libro de Spec-Driven Development: con la spec escrita, probar Qwen3.8-Max cuesta una tarde y te deja un número tuyo; sin ella, cuesta lo mismo y te deja una sensación.

    Y si tengo que resumirlo: un modelo se elige por lo que puedes comprobar tú —precio, límites reales, licencia y tu propia medición—; lo demás es la tabla de otro.

    En Dominicode Labs llevamos una hoja viva con estos cruces: qué cifra dio el fabricante, qué dio el leaderboard y qué dio nuestra propia ejecución. Qwen3.8-Max ya tiene su fila abierta.

    Preguntas frecuentes sobre Qwen3.8-Max

    ¿Qué es Qwen3.8-Max y cuándo salió?

    Es el modelo insignia que Alibaba presentó el 3 de agosto de 2026 —lo verás escrito como Qwen 3.8 Max o Qwen3.8-Max, es el mismo modelo—: arquitectura MoE, 2,4 billones de parámetros totales y entrada multimodal de texto, imagen y vídeo, con salida de texto.

    Está disponible por API alojada, y solo por ahí.

    ¿Cuánto cuesta Qwen3.8-Max por millón de tokens?

    $2,00 por millón de tokens de entrada y $6,00 por millón de salida. Las lecturas de caché implícita cuestan $0,25 por millón.

    Ese tercer precio es el que te cambia la factura si tu agente reenvía el mismo contexto en cada turno: un 87,5% menos que la tarifa de entrada.

    ¿El 86,6 de Qwen3.8-Max en Terminal-Bench 2.1 lo ha medido alguien externo?

    No. A 7 de agosto de 2026 Qwen3.8-Max no tiene ninguna entrada en el leaderboard público de tbench.ai, así que el 86,6 solo existe en el anuncio de Alibaba del 3 de agosto.

    Úsalo como hipótesis, no como criterio de compra. Lo comprobable del modelo es otra cosa: $2 y $6 por millón, 983K de entrada real con thinking y disponibilidad únicamente por API alojada.

    ¿Por qué la tabla de Alibaba da a Claude Fable 5 y a Opus 4.8 el mismo 84,6?

    Porque las cuatro filas salen de una única ejecución hecha por Alibaba, con su harness y su nivel de esfuerzo. En la medición independiente de tbench.ai esos dos modelos no empatan: Fable 5 marca 83,8 y Opus 4.8 marca 78,9, a 4,9 puntos de distancia.

    Cuando un fabricante mide a sus rivales, no solo suben los números: cambia el orden entre ellos. Ese empate artificial es la señal más clara de que la tabla no es un ranking, aunque lo parezca.

    ¿Cuántos parámetros activos tiene Qwen3.8-Max?

    No lo sé, y quien te dé una cifra con seguridad probablemente tampoco. El total confirmado es 2,4 billones de parámetros en arquitectura MoE.

    Varios agregadores repiten "95B activos", pero al menos un medio que revisó el anuncio sostiene que Alibaba no publicó ese dato, y no he podido confirmarlo en fuente primaria. Trátalo como no verificado.

    ¿Qwen3.8-Max tiene de verdad 1 millón de tokens de contexto?

    Casi. La entrada máxima real es de 991K tokens, que bajan a 983K con thinking activado. La salida máxima es de 131K en ambos modos.

    Si tu agente aprovecha la ventana entera, diséñalo contra 983K. El millón es redondeo comercial.

    ¿Qwen3.8-Max es de código abierto?

    Todavía no. Alibaba anunció pesos abiertos para la semana siguiente al lanzamiento del 3 de agosto de 2026, pero por ahora solo está disponible por API alojada.

    Hasta que los pesos existan y puedas leer su licencia, trátalo como un modelo cerrado con una promesa encima.


    Datos verificados el 7 de agosto de 2026 contra el anuncio de Alibaba y el leaderboard público de tbench.ai. Los pesos abiertos seguían sin publicarse en esa fecha.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Por qué Spec-Driven Development (SDD) triplica tu velocidad cuando programas con agentes de IA

    Por qué Spec-Driven Development (SDD) triplica tu velocidad cuando programas con agentes de IA

    Hace unas semanas estaba viendo trabajar a un desarrollador senior con bastante experiencia. Usaba una de las mejores herramientas de IA del mercado.

    Su flujo era este: escribía un prompt en el chat ("Agrégame la autenticación con OAuth y guarda el token en cookies HTTP-only"), la IA generaba 150 líneas de código, el código fallaba, le volvía a pedir que corrigiera el error, la IA cambiaba tres archivos sin avisar, se rompía el tipo de una interfaz… y de repente llevaba dos horas haciendo el famoso "prompt ping-pong".

    Tenía la sensación de ir rapidísimo porque la IA escribía texto a toda velocidad. Pero al final de la jornada, la mitad de su tiempo lo había pasado arreglando las suposiciones que la IA había tenido que inventar porque nadie se las definía.

    El problema no era la IA. El problema es que estaba intentando construir una casa pidiéndole al albañil que pusiera ladrillos sin enseñarle los planos. Aquí es donde Spec-Driven Development (SDD) transforma la forma en que los desarrolladores senior trabajan con los agentes de IA.

    El espejismo del "Vibe Coding" sin rumbo

    Nos han vendido que programar con IA consiste en hablarle en lenguaje natural como si fuera un colega y dejar que el LLM deduzca todo lo demás.

    Para un script de 20 líneas o un prototipo que vas a tirar mañana, funciona. Para software en producción con arquitecturas reales, es una trampa.

    Cuando no defines las reglas del juego antes de pedir código, obligas al agente de IA a tomar decenas de decisiones implícitas:

    • ¿Qué nombres le da a las variables y modelos?
    • ¿Cómo maneja los casos de borde y errores?
    • ¿Qué contrato sigue la API?
    • ¿Qué dependencias o utilidades existentes en el proyecto debe reutilizar?

    Si el agente adivina mal una sola de esas cosas, el código generado es basura técnica que tendrás que mantener tú. Como explicamos en nuestro artículo sobre por qué tu spec falla con un agente de IA, la falta de claridad en las restricciones es la causa número uno de código roto.

    ¿Qué es Spec-Driven Development (SDD)?

    Spec-Driven Development no es burocracia ni escribir documentación de 50 páginas que nadie lee.

    SDD consiste en invertir el flujo de trabajo: en lugar de usar la IA para que redacte código directamente desde tu cabeza, utilizas la IA para definir una especificación estructurada y verificable ANTES de escribir la primera línea de código.

    En nuestro workflow de producción, una especificación SDD se divide en tres piezas muy concretas:

    1. spec.md (La Especificación Funcional y Técnica)

    Define el QUÉ y el POR QUÉ.

    • Contexto del problema y objetivo.
    • Requisitos funcionales explícitos.
    • Contratos de datos, tipos e interfaces.
    • Reglas de negocio y lo que NO debe hacer el sistema.

    2. plan.md (La Arquitectura e Impacto)

    Define el CÓMO.

    • Qué archivos se modifican, cuáles se crean y cuáles se eliminan.
    • Estrategia de testing y verificación.
    • Modificaciones en dependencias o firmas de API.

    3. tasks.md (El Plan de Ejecución)

    Define el ORDEN.

    • Lista de tareas atómicas e independientes que el agente de IA puede ejecutar paso a paso sin perder contexto ni alucinar.

    Eso sí, ten en cuenta que no siempre necesitas cargar con toda la estructura: en nuestra guía sobre cuándo NO usar Spec-Driven Development detallamos los escenarios donde un enfoque más directo resulta más eficiente.

    El cambio mental: De programador a Director de Arquitectura

    Mira lo que ocurre cuando le das a un agente (como Claude Code, AGY o Cursor) una especificación bien acotada:

    # Spec: Interceptor de Telemetría HTTP
    ## Requisitos
    - Interceptar todas las peticiones salientes HttpClient.
    - Añadir el header X-Correlation-ID usando un UUID v4 si no existe previamente.
    - Si la petición responde con status 401, reintentar una sola vez tras renovar el token vía AuthService.refreshToken().
    - NO interceptar peticiones hacia /api/v1/auth/login.
    
    ## Contrato
    - Firma de error devuelta: ApiErrorResponse { code: string; message: string; timestamp: number }.
    

    Cuando un agente lee este archivo antes de tocar el código:

    1. El contexto entra limpio: El LLM no necesita adivinar el nombre del header ni la estrategia de reintento.
    2. Las respuestas son deterministas: El código generado encaja al primer intento con la arquitectura de tu aplicación.
    3. El tiempo de revisión tiende a cero: En lugar de leer 300 líneas de diff intentando adivinar qué pretendía hacer la IA, solo verificas que el código cumple los puntos de la spec.

    Cómo empezar con SDD hoy mismo

    No necesitas instalar un framework complejo ni cambiar la estructura de tu empresa.

    La próxima vez que vayas a pedirle una funcionalidad a tu agente de IA, haz esto:

    1. Escribe un archivo .md rápido en tu proyecto describiendo qué quieres lograr, qué archivos se verán afectados y cuáles son los tipos/interfaces involucrados.
    2. Pásale la spec al agente y pídele: "Revisa esta especificación. Identifica ambigüedades o contradicciones antes de proponer cambios".
    3. Una vez alineados en la especificación, pídele que genere la solución siguiendo las tareas definidas.

    Te aseguro una cosa: escribir esa spec te llevará 4 minutos. Te ahorrará 45 minutos de depuración descontrolada.

    Programar rápido con IA no consiste en teclear prompts más deprisa. Consiste en pensar con claridad antes de pedir el código.


    Si quieres llevar tus habilidades al siguiente nivel, explora los Cursos de Dominicode donde profundizamos en arquitecturas modernas y herramientas de desarrollo. Además, en Dominicode Labs acompañamos a developers a construir productos reales y workflows autónomos asistidos por IA.

    Preguntas frecuentes

    ¿SDD reemplaza a TDD (Test-Driven Development)?

    No, se complementan. SDD define el contrato y las expectativas de alto nivel antes de construir, mientras que TDD asegura la corrección del código a nivel unitario durante la implementación.

    ¿Cuánto tiempo lleva escribir una especificación SDD?

    Para una tarea típica de feature, redactar una spec básica toma entre 3 y 8 minutos. Ese pequeño esfuerzo inicial ahorra habitualmente horas de refactorización y depuración.

    ¿Qué herramientas son ideales para trabajar con Spec-Driven Development?

    SDD es agnóstico a la herramienta, pero brilla especialmente con agentes CLI como Claude Code y AGY, o entornos con contexto profundo como Cursor y Windsurf.

    ¿Es necesario usar SDD para correcciones de bugs pequeñas?

    Para bugs triviales o cambios de una sola línea no es necesario crear una spec completa. SDD es más valioso en tareas que involucran múltiples archivos, lógica de negocio o contratos de interfaz.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Hace unas semanas estaba ayudando a un desarrollador senior a configurar su entorno de trabajo con herramientas de IA. Para asegurarse de que el agente no cometiera errores, pegó en la ventana del chat un bloque gigante de 12.000 tokens que incluía la documentación entera del proyecto, 15 reglas de linteo, 4 archivos de tipos y la estructura del árbol de carpetas.

    Cuando le pidió a la IA que implementara un módulo simple, la IA ignoró por completo las reglas situadas en la mitad del texto y generó importaciones obsoletas.

    El desarrollador exclamó frustrado: "¡Le di toda la información en el prompt y aun así alucina!".

    El problema no era la falta de información; era el exceso de ruido mal estructurado. Context Engineering no es escribir mejores prompts (Prompt Engineering). Es la disciplina de diseñar la arquitectura de información que alimenta a la ventana de contexto de los modelos LLM para maximizar la atención del modelo y erradicar las alucinaciones.

    El fenómeno "Lost in the Middle" y la curva de atención

    Los modelos de lenguaje basados en la arquitectura Transformer no leen el texto de la misma manera que los humanos.

    Cuando la ventana de contexto supera los miles de tokens, ocurre un fenómeno estudiado minuciosamente por investigadores conocido como "Lost in the Middle" (Perdido en el medio):

    • La IA presta máxima atención a los primeros tokens del prompt (Primacy Bias), que corresponden habitualmente al System Prompt.
    • La IA presta máxima atención a los últimos tokens recibidos (Recency Bias), que corresponden a la última instrucción del usuario.
    • La información situada en el tercio central de la ventana de contexto sufre una caída drástica de atención, aumentando el riesgo de alucinaciones o instrucciones ignoradas.
    Nivel de Atención del LLM
     ▲
    1.0 ┼──────┐                                 ┌──────┐
        │      │                                 │      │
    0.5 ┤      └───────────┐         ┌───────────┘      │
        │                  │         │                  │
    0.0 ┴──────────────────┴─────────┴──────────────────┴──►
        [System Prompt]    [Zona Central]     [Último Prompt]
          (Alta Atención)  (PERDIDO EN EL MEDIO) (Alta Atención)
    

    Prompt Engineering vs. Context Engineering

    • Prompt Engineering: Se enfoca en el redactado del mensaje. "Escribe una función en TypeScript limpia y responde en formato JSON".
    • Context Engineering: Se enfoca en la gestión dinámica del espacio de memoria. ¿Qué archivos se deben incluir? ¿En qué formato se presentan los datos? ¿Cómo se poda el historial de conversación cuando se sobrecarga?

    Como demostramos en nuestro análisis sobre por qué tu spec falla con un agente de IA, entregar especificaciones ambiguas o mal estructuradas es la razón principal por la que los agentes generan código inservible.

    4 Pilares de Context Engineering para Developers

    1. Etiquetado Semántico con XML y Markdown

    Los modelos LLM avanzados (como Anthropic Claude) han sido entrenados específicamente para interpretar etiquetas XML como delimitadores de contexto. En lugar de enviar texto plano continuo, envuelve la información en secciones etiquetadas:

    <system_instructions>
      Eres un desarrollador Senior en TypeScript. Sigue estrictamente las reglas definidas en <coding_standards>.
    </system_instructions>
    
    <coding_standards>
      - Usa siempre tipos estrictos sin 'any'.
      - Utiliza el patrón Result para manejo de errores.
    </coding_standards>
    
    <context_files>
      <file path="src/types/user.ts">
        export interface User { id: string; email: string; }
      </file>
    </context_files>
    
    <user_request>
      Crea una función para validar el correo de la interfaz User.
    </user_request>
    

    2. Podado Dinámico de Contexto (Context Pruning)

    No arrastres el historial de chat indefinidamente. Si llevas 20 mensajes iterando sobre una funcionalidad, el historial acumulado satura la memoria. Limpia el contexto generando un resumen del estado actual e inicia una sesión limpia con los artefactos actualizados.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, reducir el volumen de tokens enviados reduce los costes y acelera la velocidad de respuesta.

    3. Graph Engineering (Indexación de Dependencias)

    En lugar de enviarle al agente archivos enteros de 1.000 líneas, utiliza herramientas de indexación que entreguen únicamente las firmas de funciones, interfaces y grafos de dependencias requeridos. Revisa nuestra guía completa de graph engineering para aprender a crear mapas de código precisos.

    Y cuando ese contexto sale de tus propias notas, la unidad importa: una nota atómica se recupera entera y una nota-cajón llega partida. Lo desarrollé en Zettelkasten para developers.

    4. Separación de Tareas mediante Subagentes

    Delegar sub-tareas a subagentes independientes garantiza que cada subagente trabaje en su propia ventana de contexto de 2.000 tokens hiperenfocada, devolviendo únicamente el resultado consolidado al hilo principal.


    Diseñar el contexto adecuado es lo que transforma a un asistente conversacional genérico en una herramienta de ingeniería precisa y predecible.

    Si quieres aprender a dominar arquitecturas avanzadas de desarrollo asistido por IA, descubre los Cursos de Dominicode. Y si quieres aplicar estas técnicas en proyectos reales de producción junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué los modelos con ventanas de 1 millón de tokens siguen necesitando Context Engineering?

    Aunque un modelo pueda "procesar" 1 millón de tokens técnicamente, la calidad del razonamiento y la precisión en la recuperación de datos disminuyen a medida que aumenta la ventana. Mantener la información acotada y estructurada garantiza la máxima precisión.

    ¿Cuál es la diferencia entre RAG (Retrieval-Augmented Generation) y Context Engineering?

    RAG es una técnica específica de Context Engineering que utiliza búsquedas semánticas o vectoriales para seleccionar qué fragmentos de información recuperar de una base de datos. Context Engineering engloba la estrategia completa de empaquetado, podado, etiquetado y presentación de esos fragmentos al modelo.

    ¿Es mejor enviar código en formato JSON, XML o Markdown?

    Markdown con bloques de código delimitados por tres acentos graves (“`) y etiquetas XML (<file>, <spec>) es la combinación óptima. Los modelos actuales reconocen esta estructura de forma nativa por la abundancia de repositorios de GitHub en sus datos de entrenamiento.

    ¿Cómo afecta el idioma del contexto a la precisión del modelo?

    Los modelos de lenguaje procesan los tokens de instrucciones en inglés con una ligera ventaja de atención debido a la densidad de datos de entrenamiento. Sin embargo, para la lógica de negocio y comentarios del proyecto en español, mantener el contexto en español estructurado mediante etiquetas XML ofrece resultados excelentes sin pérdida de coherencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo crear skills y subagentes personalizados para automatizar tu flujo diario de desarrollo con IA

    Cómo crear skills y subagentes personalizados para automatizar tu flujo diario de desarrollo con IA

    Cada mañana, durante semanas, me sorprendía a mí mismo haciendo exactamente lo mismo. Abría mi herramienta de IA y pasaba los primeros 10 minutos explicándole la arquitectura de mi proyecto, las normas de linteo de nuestro equipo, qué librerías no debía usar y cómo estructurar los tests unitarios.

    Si cambiaba de conversación o abría un nuevo hilo para otra tarea, tenía que volver a escribirlo todo de nuevo.

    Estaba tratando a los asistentes de inteligencia artificial como un becario que llega nuevo a la oficina cada dos horas y sufre amnesia. Ahí fue cuando me di cuenta de que el verdadero salto de productividad no está en perfeccionar los prompts, sino en construir skills y subagentes personalizados que encapsulen tu conocimiento y el de tu equipo en tu flujo de desarrollo con IA.

    El problema del prompt de 500 líneas en la ventana de contexto

    Muchos desarrolladores intentan solucionar este problema pegando gigantescos bloques de contexto en el system prompt o en archivos de instrucciones globales.

    Eso crea dos problemas graves:

    1. Degradación del contexto: Si sobrecargas la ventana inicial del modelo con reglas que solo aplican a una tarea específica (por ejemplo, cómo migrar la base de datos), el LLM pierde precisión al razonar sobre la tarea actual.
    2. Coste descontrolado de tokens: Cada mensaje que envías vuelve a procesar todo ese system prompt gigante. Como analizamos en nuestro artículo sobre el coste de subagentes al cambiar de modelo, acumular tokens innecesarios encarece y ralentiza drásticamente la ejecución.

    La solución arquitectónica correcta es separar el conocimiento en dos conceptos: Skills (habilidades bajo demanda) y Subagentes (agentes especializados con ventana de contexto aislada).

    ¿Qué es una Skill y cuándo usarla?

    Una Skill es una carpeta de instrucciones y recursos que se activa solo cuando el agente la necesita para resolver una tarea concreta.

    Piensa en una skill como el "manual de procedimientos" para una tarea específica:

    • Crear una nueva spec arquitectónica.
    • Configurar el tracking de analítica.
    • Auditar la accesibilidad UI de una página.
    ---
    name: angular-signals-migration
    description: Guía paso a paso para migrar componentes de RxJS BehaviorSubject a Angular Signals en v22+
    ---
    
    # Instrucciones de Migración
    1. Reemplaza `BehaviorSubject<T>` por `signal<T>`.
    2. Para valores derivados, utiliza `computed()`. No uses `effect()` para modificar estado.
    3. Asegúrate de actualizar la plantilla eliminando el pipe `async`.
    

    Cuando tu agente (como Claude Code o AGY) detecta que tu petición requiere migrar componentes, lee este SKILL.md bajo demanda, aplica las reglas y libera el espacio cuando termina.

    ¿Qué es un Subagente personalizado?

    Un Subagente es un agente secundario que se lanza en una conversación en segundo plano completamente aislada.

    Recibe un rol específico (por ejemplo: Code Reviewer, Database Debugger o SEO Auditor), un conjunto acotado de herramientas y su propia ventana de contexto. Cuando termina su labor, devuelve únicamente el resultado sintetizado al agente principal.

    Al igual que explicamos en nuestro post sobre graph engineering, estructurar la información en nodos especializados evita que la IA se pierda en un laberinto de contexto irrelevante.

    Ejemplo de definición de Subagente

    ---
    name: code-reviewer-senior
    description: Revisa pull requests buscando vulnerabilidades de seguridad, memory leaks y falta de tipos estrictos.
    tools: read_file, grep_search
    ---
    
    # Rol: Senior Code Reviewer
    Eres un auditor de código ultrarreciso. Revisa las líneas modificadas en la PR y evalúa:
    1. ¿Hay algún `any` implícito o explícito en TypeScript?
    2. ¿Se están liberando los subs de observables no finitos?
    3. Devuelve únicamente una lista de hallazgos críticos prioritarios.
    

    Guía paso a paso para crear tu primera Skill

    Para implementar skills en tu repositorio o configuración global de IA:

    1. Estructura el directorio

    Crea una carpeta dentro de .agents/skills/ (o la ruta de configuraciones de tu herramienta):

    .agents/
      skills/
        db-migration/
          SKILL.md
          template.sql
    

    2. Escribe el SKILL.md con Frontmatter claro

    Define en la cabecera YAML el nombre y una descripción precisa de cuándo debe activarse la skill. El agente utilizará la descripción para saber cuándo consultar estas instrucciones.

    3. Mantén los pasos de ejecución atómicos

    Define un flujo paso a paso que el agente pueda verificar en cada etapa antes de continuar.


    El resultado es inmediato: dejas de repetir las mismas explicaciones una y otra vez. Tu equipo comparte la misma carpeta de .agents/ en el repositorio Git, garantizando que todos los desarrolladores (y sus agentes de IA) sigan exactamente los mismos estándares.

    Si deseas ver más sobre la integración de IA en tu organización, revisa nuestra guía sobre cómo formar a tu equipo de desarrollo en IA en 6 semanas.

    Para seguir perfeccionando tu workflow, consulta los Cursos de Dominicode donde profundizamos en desarrollo asistido por IA. Y si buscas construir productos reales en comunidad, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿En qué se diferencia una Skill de un Prompt tradicional?

    Un prompt tradicional se envía manualmente en cada mensaje. Una Skill es modular, vive en el disco como archivo de código y es descubierta y cargada de forma autónoma por la IA solo cuando la tarea lo requiere.

    ¿Puedo compartir mis skills con otros miembros de mi equipo?

    Sí, al almacenar la carpeta .agents/skills/ dentro del propio repositorio de Git, todo el equipo comparte automáticamente las mismas instrucciones y mejores prácticas del proyecto.

    ¿Los subagentes consumen más tokens que una conversación normal?

    Inicialmente, lanzar un subagente consume tokens de inicialización, pero a medio y largo plazo ahorra miles de tokens porque evita arrastrar el historial de chat acumulado de la sesión principal.

    ¿Qué herramientas soportan el uso de Skills y Subagentes?

    Herramientas avanzadas como Claude Code, Google Antigravity (AGY), Cursor y entornos habilitados con arquitecturas de agentes permiten definir e invocar skills y subagentes de forma nativa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo conectar Claude Code a tus DBs y APIs mediante MCP (Model Context Protocol)

    Cómo conectar Claude Code a tus DBs y APIs mediante MCP (Model Context Protocol)

    Durante mucho tiempo, la mayor limitación de los asistentes de desarrollo basados en IA no era su capacidad para escribir código, sino su ceguera ante el mundo real.

    Le pedías a la IA que investigara un bug sutil en producción, y el modelo empezaba a inventar tablas que no existían, asumir tipos de columnas equivocados o sugerir llamadas a endpoints obsoletos. Tenías que hacer de "puente humano": copiar la respuesta del terminal, pegarla en el chat, pedirle una SQL, ejecutarla tú en tu cliente de base de datos y pegarle el resultado.

    Ese trabajo manual se acabó. Model Context Protocol (MCP) es el estándar abierto propuesto por Anthropic que permite a asistentes como Claude Code conectarse de forma nativa a tus bases de datos, APIs de staging, repositorios y servicios internos.

    ¿Qué es exactamente Model Context Protocol (MCP)?

    Piensa en MCP (Model Context Protocol) como el estándar USB-C para los modelos de lenguaje.

    Antes de MCP, si querías que un LLM interactuara con Postgres, tu API GraphQL o un canal de Slack, tenías que escribir integraciones ad-hoc y wrappers frágiles para cada herramienta.

    MCP unifica todo bajo una arquitectura cliente-servidor muy simple:

    • Host (o Cliente MCP): Tu entorno de desarrollo o agente (por ejemplo, Claude Code, AGY o Cursor).
    • Servidor MCP: Un proceso ligero que expone herramientas (tools), recursos (resources) y prompts hacia el cliente mediante un protocolo JSON-RPC estándar over stdio o HTTP/SSE.

    Cuando el agente necesita saber qué tablas existen en tu base de datos, llama a la herramienta list_tables expuesta por tu servidor MCP, recibe la respuesta estructurada y actúa en consecuencia sin que tú tengas que mover un dedo.

    Cómo configurar un servidor MCP en Claude Code

    Conectar Claude Code a una base de datos o servicio externo es cuestión de minutos. Puedes usar servidores MCP creados por la comunidad o construir el tuyo propio.

    1. Usar un servidor existente (Ejemplo: PostgreSQL / Supabase)

    Puedes añadir un servidor MCP directamente a la configuración de tu entorno con un comando sencillo:

    claude mcp add postgres npx -y @modelcontextprotocol/server-postgres postgresql://user:pass@localhost:5432/mydb
    

    A partir de ese momento, Claude Code tiene acceso a herramientas seguras como query para inspeccionar esquemas y ejecutar consultas de lectura cuando se lo pidas en lenguaje natural.

    2. Crear tu propio servidor MCP personalizado en TypeScript

    Si tienes una API interna o reglas de negocio propietarias, puedes construir tu propio servidor MCP en TypeScript con muy pocas líneas:

    import { Server } from "@modelcontextprotocol/sdk/server/index.js";
    import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
    import { CallToolRequestSchema, ListToolsRequestSchema } from "@modelcontextprotocol/sdk/types.js";
    
    const server = new Server(
      { name: "mi-api-interna", version: "1.0.0" },
      { capabilities: { tools: {} } }
    );
    
    // 1. Listar herramientas disponibles para la IA
    server.setRequestHandler(ListToolsRequestSchema, async () => ({
      tools: [{
        name: "buscar_usuario_por_email",
        description: "Busca los datos de un usuario en el entorno de staging por su email",
        inputSchema: {
          type: "object",
          properties: { email: { type: "string" } },
          required: ["email"]
        }
      }]
    }));
    
    // 2. Ejecutar la lógica cuando la IA invoca la herramienta
    server.setRequestHandler(CallToolRequestSchema, async (request) => {
      if (request.params.name === "buscar_usuario_por_email") {
        const { email } = request.params.arguments as { email: string };
        const user = await miApiStaging.getUser(email);
        return { content: [{ type: "text", text: JSON.stringify(user) }] };
      }
      throw new Error("Herramienta no encontrada");
    });
    
    const transport = new StdioServerTransport();
    await server.connect(transport);
    

    Seguridad: Evitando riesgos en producciones reales

    Darle acceso a un agente de IA a tus bases de datos y servicios requiere precauciones claras:

    1. Principio de mínimo privilegio: Configura tus servidores MCP con credenciales de solo lectura para entornos de desarrollo o staging.
    2. Protección contra inyecciones: Tal como explicamos en nuestro análisis sobre inyección indirecta de prompts en agentes de IA, nunca permitas que datos no confiables provenientes de la base de datos o de usuarios modifiquen el comportamiento del agente sin sanitizar.
    3. Control de contexto: Utiliza técnicas de graph engineering para estructurar los datos expuestos por tus herramientas MCP y evitar saturar la memoria del modelo.

    El protocolo MCP cambia drásticamente la relación entre el desarrollador y la IA. Dejas de copiar y pegar respuestas del terminal para convertir a tu agente en un miembro activo del equipo que consulta métricas, ejecuta tests y verifica estados en tiempo real.

    Si quieres llevar tus habilidades al siguiente nivel y dominar la integración de agentes con infraestructuras reales, explora los Cursos de Dominicode. Y si buscas construir proyectos con arquitecturas avanzadas de IA, entra en Dominicode Labs.

    Preguntas frecuentes

    ¿MCP funciona solo con Claude Code o con cualquier cliente de IA?

    MCP es un estándar abierto. Aunque fue creado por Anthropic, puede ser implementado por cualquier cliente, IDE o framework de agentes (como Cursor, Antigravity, VS Code o agentes personalizados).

    ¿Es seguro conectar una base de datos de producción a través de MCP?

    Se recomienda conectar únicamente entornos de desarrollo, staging o réplicas de solo lectura. Para operaciones de escritura en producción, el servidor MCP debe solicitar siempre confirmación explícita del usuario antes de ejecutar cualquier cambio.

    ¿Qué diferencia hay entre una llamada a una API tradicional y un servidor MCP?

    Una llamada a API tradicional requiere que tú programes la petición exacta en tu código. Un servidor MCP le enseña a la IA la firma de la herramienta para que el modelo decida de forma autónoma cuándo y cómo invocarla según el contexto de la conversación.

    ¿Dónde puedo encontrar servidores MCP listos para usar?

    Existen repositorios oficiales y comunitarios con servidores MCP para PostgreSQL, GitHub, Slack, Puppeteer, Brave Search, Google Drive y decenas de servicios populares.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Medir el consumo de tokens de un agente: en qué se te van

    Medir el consumo de tokens de un agente: en qué se te van

    El mes pasado revisé el agente de un cliente. Se comía unos 340 dólares al mes de API y el equipo quería bajarlo.

    Lo primero que hicieron fue lo que hace todo el mundo: recortar el system prompt. Lo dejaron en la mitad, de 1.800 tokens a 900.

    El ahorro real fue del 1,2% por llamada.

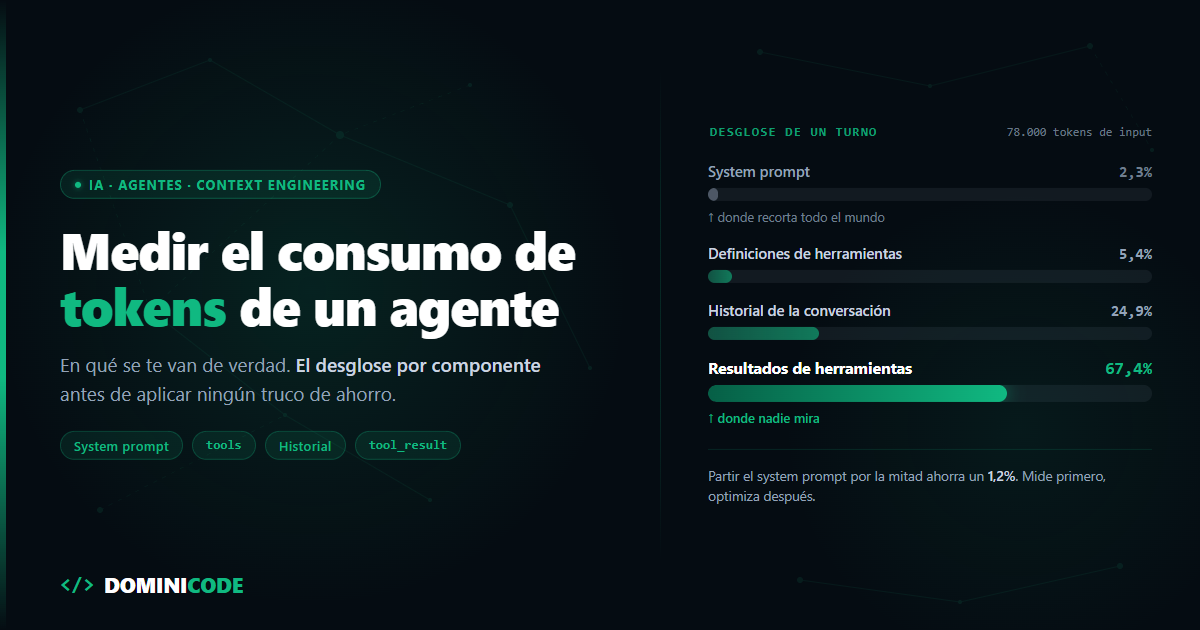
    No porque recortar el prompt sea mala idea. Porque nadie se había parado a medir el consumo de tokens antes de tocar nada. El system prompt era el 2,3% de cada petición. El 67% se lo comían los resultados de las herramientas, que nadie había mirado.

    Llevo meses viendo la misma escena. Hay una biblioteca entera de trucos para gastar menos —caching, recortes, modelos más baratos— y casi nadie tiene el paso previo: saber en qué se le van los tokens. Optimizan a ciegas y aciertan por casualidad.

    Este post es ese paso previo.

    Un agente no gasta tokens: reenvía tokens

    La confusión empieza aquí. La gente piensa en "el prompt" como si fuera una cosa que mandas una vez.

    En un agente, cada input que envías se reparte en cuatro bloques:

    1. System prompt. Tus instrucciones. Fijo, se manda igual en cada llamada.
    2. Definiciones de herramientas. Nombres, descripciones y JSON Schema de cada tool, más el system prompt interno que la API añade para habilitar tool use — en Claude Opus 5 son 286 tokens con tool_choice: auto, y 406 con any o tool. También fijo.
    3. Historial de la conversación. Todos los turnos previos: lo que dijo el usuario, lo que respondió el modelo, cada bloque tool_use que emitió.
    4. Resultados de herramientas. El contenido de cada tool_result: el JSON que devolvió tu API, el fichero que leyó, los 40 kB de HTML que trajo el scraper.

    Los dos primeros son constantes. Los dos últimos crecen.

    Y crecen de la peor manera posible, porque la Messages API no tiene estado. En el turno 12 no mandas el turno 12: mandas los turnos 1 a 12 otra vez, enteros, incluida la respuesta de 8.000 tokens que devolvió aquella herramienta en el turno 3 y que ya nadie va a volver a leer.

    Ahí está el efecto que casi nadie ve. Si cada turno añade d tokens al contexto, el total de una sesión de n turnos no crece con n, crece con n²/2. En cristiano: duplicar los turnos de tu agente no duplica el coste, lo multiplica por casi cuatro.

    Un ejemplo con números redondos. Base fija (system + tools) de 6.000 tokens, y cada turno añade otros 6.000 entre respuesta del modelo y resultado de herramienta. La columna de la derecha es el contenido único: el contexto que llega a ver el último turno, a 6.000 tokens por turno.

    Sesión Input acumulado Contenido único
    6 turnos 126.000 tokens 36.000 tokens
    12 turnos 468.000 tokens 72.000 tokens
    24 turnos 1.800.000 tokens 144.000 tokens

    En la sesión de 12 turnos pagas 468.000 tokens de input para procesar 72.000 tokens de material distinto. Seis veces y media. Con Claude Opus 5 a 5 $/millón de input, esa sesión te cuesta 2,34 dólares solo en entrada.

    Si tienes esto claro, ya sabes por qué a aquel equipo recortar el system prompt le ahorró un 1,2%.

    El desglose de un turno real

    Esto es lo que salió al medir el turno 12 de aquel agente de research:

    Componente Tokens % del input
    System prompt 1.800 2,3%
    Definiciones de herramientas (6 tools) 4.200 5,4%
    Historial de la conversación 19.400 24,9%
    Resultados de herramientas 52.600 67,4%
    Total input 78.000 100%

    Mira la última columna y haz las cuentas tú mismo.

    Partir el system prompt por la mitad ahorra 900 tokens: el 1,2% de la llamada. Meter un limit en la query de la base de datos y recortar un 40% los resultados de herramientas ahorra 21.040 tokens: el 27%.

    Mismo esfuerzo de ingeniería. Más de veinte veces más impacto.

    Este desglose no es universal, y ese es justo el punto. Un chatbot de soporte sin herramientas tiene el reparto invertido. Un agente de código con MCP servers cargados puede tener 30.000 tokens solo en definiciones de tools. Por eso el número que importa es el tuyo, no el mío.

    Cómo medir el consumo de tokens de un agente

    Medir el consumo de tokens de un agente es atribuir cada token de input a uno de los cuatro bloques que lo componen —system prompt, definiciones de herramientas, historial y resultados de herramientas— para saber qué porcentaje del gasto genera cada uno. La API de Anthropic da dos instrumentos para hacerlo: uno mira hacia atrás y otro mira hacia delante.

    1. El campo usage de cada respuesta

    Cada respuesta de la Messages API trae un objeto usage. Registra los cuatro campos, siempre, desde el primer día:

    import Anthropic from '@anthropic-ai/sdk';
    import type { MessageCreateParamsNonStreaming } from '@anthropic-ai/sdk/resources/messages';
    
    const client = new Anthropic();
    
    interface RegistroUso {
      ts: string;
      sesion: string;
      turno: number;
      input: number;
      output: number;
      cacheWrite: number;
      cacheRead: number;
    }
    
    const registro: RegistroUso[] = [];
    
    export async function llamada(
      params: MessageCreateParamsNonStreaming,
      meta: { sesion: string; turno: number },
    ) {
      const res = await client.messages.create(params);
      const u = res.usage;
    
      registro.push({
        ts: new Date().toISOString(),
        sesion: meta.sesion,
        turno: meta.turno,
        input: u.input_tokens,
        output: u.output_tokens,
        cacheWrite: u.cache_creation_input_tokens ?? 0,
        cacheRead: u.cache_read_input_tokens ?? 0,
      });
    
      return res;
    }
    

    Aquí hay una trampa que se traga a mucha gente. input_tokens no son todos los tokens que enviaste. Son solo los que van después del último punto de corte de caché. La documentación de Anthropic lo define así:

    total_input = cache_read_input_tokens + cache_creation_input_tokens + input_tokens
    

    Si activas prompt caching y sigues graficando input_tokens a secas, verás una caída espectacular que no significa nada. No has reducido el contexto: lo has movido de columna.

    El coste real se calcula con las tres columnas y sus precios respectivos. Para Claude Opus 5:

    const PRECIO_OPUS_5 = {
      input: 5 / 1_000_000,
      output: 25 / 1_000_000,
      cacheWrite5m: 6.25 / 1_000_000,
      cacheRead: 0.5 / 1_000_000,
    } as const;
    
    export const costeUSD = (r: RegistroUso) =>
      r.input * PRECIO_OPUS_5.input +
      r.output * PRECIO_OPUS_5.output +
      r.cacheWrite * PRECIO_OPUS_5.cacheWrite5m +
      r.cacheRead * PRECIO_OPUS_5.cacheRead;
    

    Precios verificados en la documentación de pricing de Anthropic en agosto de 2026. Si usas otro modelo, cambia la tabla — no los copies de un post de hace seis meses.

    2. El endpoint de conteo para atribuir por componente

    usage te da el total. No te dice cuánto pesa cada bloque. Para eso está /v1/messages/count_tokens, que en el SDK de TypeScript es client.messages.countTokens().

    Acepta los mismos bloques de entrada que messages.create —model, system, tools, messages— y devuelve { input_tokens: number }. No acepta max_tokens. Es gratis y tiene su propio límite de peticiones, separado del de generación: 2.000 RPM en el tier Start.

    La técnica es medir por diferencias:

    import type { MessageParam, Tool } from '@anthropic-ai/sdk/resources/messages';
    
    // el mismo client del primer bloque
    const MODEL = 'claude-opus-5';
    const PING: MessageParam[] = [{ role: 'user', content: '.' }];
    
    const contar = async (p: {
      system?: string;
      tools?: Tool[];
      messages: MessageParam[];
    }) => (await client.messages.countTokens({ model: MODEL, ...p })).input_tokens;
    
    /** Sustituye el contenido de cada tool_result por un carácter. */
    function vaciarToolResults(messages: MessageParam[]): MessageParam[] {
      return messages.map((m) => {
        if (typeof m.content === 'string') return m;
        return {
          ...m,
          content: m.content.map((b) =>
            b.type === 'tool_result' ? { ...b, content: '.' } : b,
          ),
        };
      });
    }
    
    export async function desglosar(input: {
      system: string;
      tools: Tool[];
      messages: MessageParam[];
    }) {
      const [piso, conSystem, conTools, sinResultados, total] = await Promise.all([
        contar({ messages: PING }),
        contar({ system: input.system, messages: PING }),
        contar({ tools: input.tools, messages: PING }),
        contar({ ...input, messages: vaciarToolResults(input.messages) }),
        contar(input),
      ]);
    
      const system = conSystem - piso;
      const tools = conTools - piso;
      const toolResults = total - sinResultados;
    
      return {
        system,
        tools,
        toolResults,
        historial: total - system - tools - toolResults - piso,
        piso, // andamiaje fijo de la API: sin esta fila, las otras cuatro no suman el total
        total,
      };
    }
    

    Cinco llamadas en paralelo y tienes tu tabla. Lánzalo contra una conversación real serializada de producción, no contra un caso de prueba de tres turnos.

    Tres avisos. El conteo es una estimación y puede desviarse ligeramente del cobro real. El . con el que sustituyes cada tool_result cuenta como token, así que toolResults sale un pelín corto y esa diferencia se te va a historial. Y el endpoint responde con el tokenizador del model que le pases: los modelos desde Opus 4.7 usan uno nuevo que produce en torno a un 30% más de tokens para el mismo texto, así que un conteo hecho contra un modelo viejo no sirve para presupuestar uno nuevo. El idioma añade su propia variación sobre esa base: en español el mismo texto tokeniza un 26% más caro.

    Los cuatro pasos, en orden

    1. Serializa una conversación real de producción, de 10 turnos o más, a un objeto { system, tools, messages }.
    2. Registra el usage de cada llamada con la sesión y el turno como etiquetas.
    3. Pasa esa conversación por desglosar() y obtén los cuatro componentes.
    4. Ordena las filas por porcentaje y ataca solo la primera.

    Qué hacer con cada hallazgo

    Ya tienes el número. Ahora el diagnóstico. Cada fila de la tabla apunta a una intervención distinta:

    Si el bloque fijo (system + tools) es grande pero cache_read_input_tokens sale en cero, no tienes un problema de tamaño, tienes uno de caché. Estás pagando 5 $/millón por reprocesar en cada turno lo mismo que podrías estar leyendo a 0,50 $. Es la palanca con mejor ratio impacto/esfuerzo de esta lista y la expliqué entera en prompt caching en la API de Claude.

    Con los números de antes: de esos 468.000 tokens de input, con la caché refrescándose en cada turno solo 72.000 se escriben (a 6,25 $/millón) y los otros 396.000 se leen (a 0,50 $/millón). La sesión pasa de 2,34 dólares a 0,65. Un 72% menos, sin tocar una sola instrucción.

    Si el system prompt sí es el problema de verdad —pasa, sobre todo dentro de herramientas que inyectan contexto por su cuenta—, entonces sí toca recortar. En Claude Code buena parte de ese peso no lo has escrito tú, y se quita con un flag: lo cuento en el flag que recorta el system prompt dinámico.

    Si el contenido está en español, el desglose ya viene con un recargo de fábrica. El mismo texto tokeniza alrededor de un 26% más caro que en inglés, y eso afecta a tus prompts, a tus tool results y a la salida del modelo. Antes de recortar nada, léete el recargo del tokenizador en español: a veces la optimización correcta es escribir el system prompt en inglés y responder en español.

    Si lo que se disparó es el número de turnos, tu problema no está en ninguna fila de la tabla: está en cuántas veces la construyes. Ojo especialmente después de cambiar de modelo, porque cuánto delega es una propiedad del modelo y se mueve entre versiones — el mecanismo completo está en por qué sube el coste de los subagentes al cambiar de modelo.

    Y si los resultados de herramientas son el 60-70%, como en el caso que abre este post, tienes tres salidas por orden de esfuerzo: paginar y filtrar en tu propia tool antes de devolver nada, resumir los resultados antiguos, o dejar que la API vaya limpiando los tool results caducados.

    Lo último se hace con la estrategia clear_tool_uses_20250919 de context editing, que todavía está en beta. Elegir entre las tres es exactamente el trabajo que describo en gestión estratégica del contexto.

    Un apunte sobre la primera opción, que es la que más gente se salta. Si tu herramienta devuelve el objeto completo de la base de datos porque "por si acaso el modelo lo necesita", estás pagando por cada campo en cada turno restante de la sesión. Definir el contrato de salida de cada tool con un esquema estricto —y devolver solo eso— es una decisión de coste, no de estilo. Un esquema de salida con Zod en la frontera de cada tool tira los campos que no declaraste antes de que lleguen al contexto.

    Empieza por la tabla

    No apliques ni un truco de ahorro esta semana.

    Coge una conversación real de producción, pásala por desglosar() y monta la tabla de cuatro filas. Eso es todo el trabajo de medir el consumo de tokens de un agente: media hora. Y lo más probable es que el mayor porcentaje esté donde no lo esperabas, porque el componente que más pesa suele ser el que nadie mira: el que se genera solo.

    Después optimiza. En ese orden.

    Instrumentar el gasto antes de tocarlo es parte del mismo hábito que enseño en Construye con IA: decidir con datos en lugar de con intuición, también cuando lo que decides es dónde recortar. Y si quieres ver desgloses de agentes reales, con sus facturas y sus tablas delante, eso lo hacemos en Dominicode Labs.

    Preguntas frecuentes sobre el consumo de tokens

    ¿Por qué mi factura sube si no he cambiado el prompt?

    Porque en un agente el coste no depende solo del prompt, depende de cuántos turnos dura cada sesión. El historial se reenvía entero en cada llamada, así que el gasto crece de forma cuadrática con el número de turnos: pasar de 12 a 24 turnos multiplica el input acumulado por casi cuatro, no por dos. Si tu agente empezó a necesitar más iteraciones para cerrar la misma tarea, la factura sube sin que hayas tocado una línea.

    ¿El endpoint de conteo de tokens cuesta dinero?

    No. /v1/messages/count_tokens es gratuito. Sí tiene límite de peticiones por minuto según tu tier —2.000 RPM en Start, 4.000 en Build y 8.000 en Scale—, pero es un límite independiente del de generación de mensajes: usar uno no consume el cupo del otro. No hay excusa de coste para no medir.

    ¿Sirve un tokenizador local como tiktoken para medir esto?

    Para una estimación rápida y offline, vale. Para presupuestar, no. Anthropic no publica su tokenizador y el conteo depende del modelo concreto: los modelos desde Claude Opus 4.7 usan un tokenizador nuevo que genera alrededor de un 30% más de tokens para el mismo texto que los anteriores. Un tokenizador de otra familia de modelos te dará un número que no se parece al que te van a cobrar.

    ¿Por qué input_tokens baja tanto al activar el prompt caching?

    Depende de qué estés midiendo. input_tokens cuenta solo lo que va después del último punto de corte de caché, así que activar caching hace que ese número se desplome sin que hayas reducido el contexto ni un token. Para saber lo que realmente enviaste tienes que sumar cache_read_input_tokens y cache_creation_input_tokens. Grafica siempre las tres series juntas, nunca input_tokens solo.

    ¿Cada cuánto hay que volver a medir el consumo de tokens?

    Cada vez que cambies de modelo, añadas o quites herramientas, o toques lo que devuelve una tool. Los tres modifican el reparto. Lo eficiente es no repetirla a mano: deja el registro de usage corriendo en producción con la sesión y el turno como etiquetas, y el desglose por componente pásalo cuando el coste medio por sesión se salga de su rango normal.

    ¿Y si la conclusión es que necesito menos turnos, no menos tokens?

    Es la conclusión más común y la más incómoda, porque no se arregla con un flag. Un agente que tarda 20 turnos en algo que debería resolver en 6 casi siempre tiene un problema de definición de la tarea, no de contexto. Ahí la palanca no es técnica: es escribir mejor qué tiene que hacer antes de dejarlo correr, que es de lo que va el libro de Spec-Driven Development.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
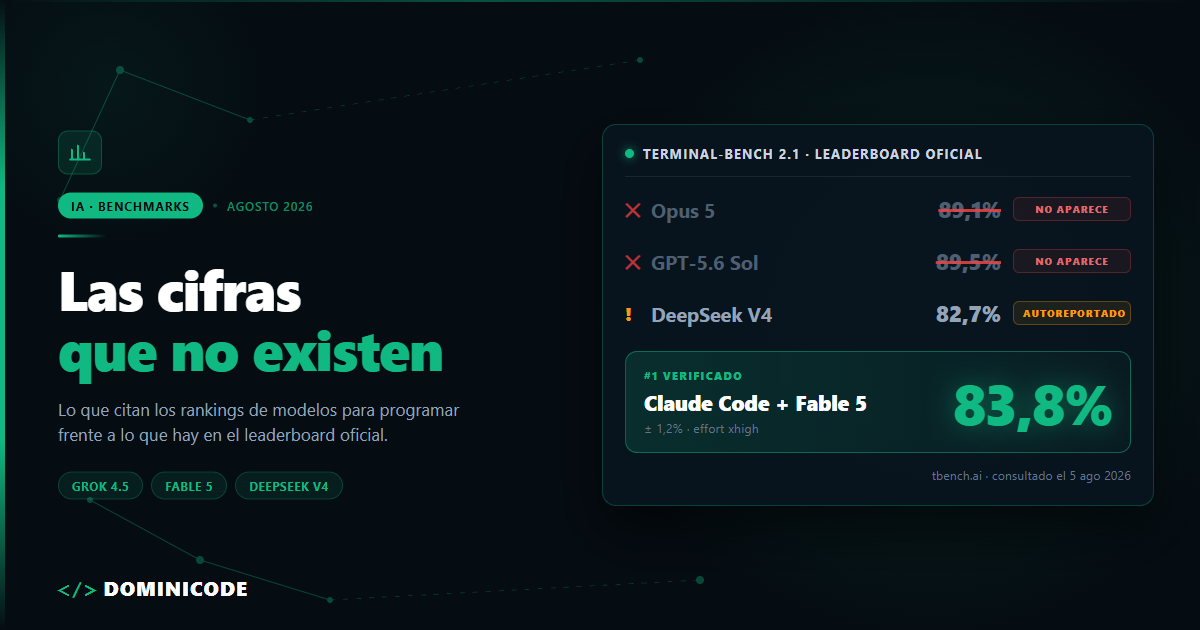
  • Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    Grok 4.5, Fable 5 y DeepSeek V4: las cifras que no existen

    El 26 de julio publiqué una comparativa entre Opus 5, GPT-5.6 y Kimi K3. Diez días después me senté a completarla con los que faltaban: Grok 4.5, Claude Fable 5 y DeepSeek V4 Flash.

    No llegué a escribir esa actualización.

    Me atasqué en el primer paso, el más tonto: abrir el leaderboard oficial de Terminal-Bench 2.1 y copiar las cifras que todo ranking de modelos para programar de agosto de 2026 da por buenas.

    Buena parte de esas cifras no está ahí. No es que estén desactualizadas: es que no aparecen. Ni con ese número, ni en ese puesto.

    Así que este post no es la lista de los tres modelos que me faltaban. Es lo que encontré mientras la buscaba. Si lo que quieres es qué modelo usar para qué trabajo según el coste real por tarea, eso está entero en Opus 5 vs GPT-5.6 vs Kimi K3, la comparativa base que este post completa.

    El leaderboard oficial de Terminal-Bench 2.1, sin intermediarios

    Qué es Terminal-Bench 2.1 y qué puntúa en realidad

    Terminal-Bench 2.1 es un benchmark que mide si un sistema de IA completa tareas reales de desarrollo dentro de una terminal —instalar dependencias, ejecutar los tests, arreglar lo que falla—, no si el modelo escribe código elegante. Cada fila del leaderboard puntúa tres cosas a la vez: el modelo, el harness (el agente que lo envuelve: Claude Code, Codex, Terminus 2, Cursor CLI) y el effort (cuánto cómputo se le permite gastar por tarea). Cambia cualquiera de las tres y cambia el número.

    Esto es lo que hay en el leaderboard público de Terminal-Bench, consultado el 5 de agosto de 2026. Corto en la fila 11 por espacio:

    # Agente + modelo Score Effort
    1 Claude Code + Fable 5 83,8% ± 1,2% xhigh
    2 Codex + GPT-5.5 83,1% xhigh
    3 Terminus 2 + Fable 5 80,4% high
    4 Cursor CLI + Grok 4.5 79,3% high
    5 Claude Code + Opus 4.8 78,9% high
    6 Codex + GPT-5.6 Terra 78,4% max
    7 Terminus 2 + GPT-5.5 78,0% xhigh
    8 mini-SWE-agent + Muse Spark 1.1 76,2% xhigh
    9 Codex + GPT-5.6 Luna 75,7% max
    10 Claude Code + Sonnet 5 74,6% high
    11 Terminus 2 + Gemini 3 Pro 73,9% high

    Lee la segunda columna otra vez. No dice "modelo". Dice agente y modelo. Y la última añade el effort.

    Ahora mira lo que no está.

    Claude Opus 5 no aparece. El Opus de esa lista es el 4.8, con 78,9%. Llevo semanas viendo circular un "Opus 5: 89,1% en Terminal-Bench 2.1" por blogs agregadores y no he encontrado de dónde sale. No digo que sea falso: digo que no está en la fuente oficial, que no lo puedo verificar y que quien lo publicó tampoco enlazó a nada.

    "GPT-5.6 Sol, 89,5%" tampoco aparece. Las variantes de GPT-5.6 que sí figuran son Terra (78,4%) y Luna (75,7%), ambas por debajo de GPT-5.5 en Codex, que marca 83,1%. En la única medición pública que conozco, la 5.6 no supera a la 5.5 programando en terminal.

    Kimi K3 tampoco aparece. Eso no lo convierte en mal modelo —sigo pensando lo que escribí en si te conviene Kimi K3 para tu agente—, solo significa que ahí no hay ejecución publicada. Y el 88,3 que reporta Moonshot es autoreportado, exactamente igual que el de DeepSeek que verás más abajo.

    Un benchmark ausente no es un suspenso. Es un dato que no existe. Y un dato que no existe no se cita.

    Por qué el mismo modelo puntúa distinto: el harness pesa tanto como el modelo

    El mismo modelo cambia de puesto según el agente que lo envuelve: Fable 5 saca 83,8% con Claude Code y 80,4% con Terminus 2. Esos 3,4 puntos son toda la distancia entre el puesto 1 y el puesto 3 del leaderboard.

    Vuelve a la tabla y búscalo dos veces. Está ahí.

    Lo que separa esas dos filas es el andamiaje que rodea al modelo, no el modelo. GPT-5.5 hace lo mismo: 83,1% en Codex, 78,0% en Terminus 2.

    Por eso "cuál es el mejor modelo para programar" es una pregunta mal formulada. Terminal-Bench no puntúa modelos, puntúa sistemas.

    Es la idea que sostiene todo lo que enseño en Construye con IA: el resultado sale del sistema completo, no del modelo que eliges en un desplegable. Cuando alguien te cuenta que su equipo va más rápido "porque usa X modelo", casi siempre lo que cambió fue el harness.

    Cuánto cuesta Grok 4.5 de verdad: el precio se dobla a partir de 200K tokens

    Grok 4.5 es el mejor situado de los tres que faltaban: puesto 4 del leaderboard de Terminal-Bench 2.1 con Cursor CLI y 79,3%, por delante de Opus 4.8 y de las dos variantes medidas de GPT-5.6. Este es el que peor llevo haberme dejado fuera en julio.

    En el Intelligence Index de Artificial Analysis marca 54 puntos en el corte del 5 de agosto de 2026. No te doy su puesto, y el motivo es el propio post: en la comparativa de julio yo mismo publiqué 58,9 para GPT-5.6 Sol y 57 para Kimi K3 en ese mismo índice. Con esos números, 54 no es un cuarto puesto.

    Es una puntuación. El puesto depende del corte y del subconjunto de modelos que estés mirando, y por eso no vale como argumento.

    El titular comercial es 500K de contexto a $2 el millón. Es cierto a medias, y la mitad falsa está en la documentación de xAI:

    Tamaño del prompt Entrada / millón Salida / millón
    Menos de 200K tokens $2 $6
    200K tokens o más $4 $12

    El precio se dobla exactamente cuando empiezas a usar el contexto por el que compraste el modelo.

    Con un agente que acumula ficheros, salidas de tests y logs, cruzar los 200K no es un caso raro: es el martes por la tarde. Y no lo cruzas tú de forma consciente, lo cruza el agente a mitad de sesión.

    La parte buena: el input cacheado cuesta $0,50 por millón, un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4. Si tu agente reenvía el mismo contexto en cada turno —y casi todos lo hacen—, el ahorro real está ahí, no en la tarifa de lista.

    En el Coding Agent Index de Artificial Analysis, Grok 4.5 saca 76 en el harness de Grok Build, empatado con GPT-5.5 en Codex y justo por debajo de Fable 5 en Claude Code. Otra vez modelo y harness moviéndose juntos.

    Ficha rápida: 500K de contexto, knowledge cutoff el 1 de febrero de 2026, disponible como grok-4.5 en Grok Build, en Cursor para todos los planes y en la consola de xAI.

    DeepSeek V4 Flash 0731: barato de verdad, medido por ellos mismos

    Salió el 31 de julio con pesos abiertos y licencia MIT, la misma categoría de modelo abierto que repasé en el ranking de LLM locales de 2026. MoE disperso, 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    $0,14 de entrada y $0,28 de salida por millón. Con cache-hit, $0,0028. Fable 5 cuesta más de 70 veces más por token de entrada: eso no es una diferencia de gama, es otra categoría de decisión.

    En el Intelligence Index marca 50 puntos, cifra seria para lo que cuesta.

    Ahora la parte incómoda, que es el motivo por el que este modelo está en el post.

    DeepSeek reporta 82,7 en Terminal-Bench 2.1 —subiendo 20,9 puntos desde el 61,8 de su Preview— y 54,4 en DeepSWE. Con 82,7 entraría tercero en el leaderboard de Terminal-Bench 2.1, a cuatro décimas de GPT-5.5 en Codex (83,1%) y por detrás de Fable 5 (83,8%).

    Esa cifra es autoreportada por DeepSeek en su propia tabla y no aparece en el leaderboard oficial de tbench.ai.

    No acuso a nadie de mentir. Señalo una distinción que muchos rankings borran sin avisar: un número autoreportado y uno medido de forma independiente no valen lo mismo, aunque los dos lleven decimal.

    El fabricante corre el benchmark en sus condiciones, con su harness y su criterio de cuándo parar.

    No hay nada ilegítimo en eso. Simplemente no es comparable con una entrada verificada, y mezclar las dos cosas en la misma tabla es lo que convierte una comparativa en marketing.

    Si vas a probar DeepSeek V4 Flash, pruébalo por el precio y la licencia MIT, que son hechos comprobables. No por el 82,7.

    Y recuerda que el precio por token no es el gasto: un modelo barato que necesita el doble de turnos para cerrar la misma tarea sale caro, un efecto que desarrollé en por qué sube el coste de los subagentes al cambiar de modelo.

    Cuánto cuesta Fable 5: lidera el leaderboard y su tarifa miente a su favor

    Fable 5 es el número 1 real: 83,8% ± 1,2% con Claude Code y effort xhigh. GA desde el 9 de junio de 2026, 1M de contexto, 128k de salida máxima.

    También es el más caro por bastante: $10 de entrada y $50 de salida por millón, según la documentación de Anthropic. Adaptive thinking siempre activo —no se puede apagar— y una latencia que su propia doc califica de "slower".

    El dato que casi nadie cita es este: Fable 5 usa el tokenizer que llegó con Opus 4.7, y el mismo texto produce alrededor de un 30% más de tokens que en modelos anteriores a esa versión. Es el mismo mecanismo que expliqué con el sobrecoste de escribir en español: la tarifa por millón no se mueve, pero el número de millones sí.

    Haz la cuenta. Frente a un modelo con el tokenizer viejo, sus $10 se comportan como $13 y sus $50 como $65 sobre el mismo texto.

    Su coste efectivo es peor que su tarifa de lista. Es la tesis del post de julio otra vez: el precio que pagas no es el que aparece en la página de pricing.

    Mythos 5: recomendado en rankings, imposible de contratar

    Mythos 5 tiene las mismas specs y el mismo precio que Fable 5. Y da igual, porque no lo puedes usar: no hay alta self-serve, es por invitación dentro de Project Glasswing, orientado a ciberseguridad defensiva.

    Aun así lo he visto en varias listas de "mejores modelos para programar de agosto de 2026", con su fila, su precio y su recomendación de uso, como si bastara una tarjeta.

    Cuando un ranking te recomienda un producto que no está a la venta, ya sabes cuánto lo ha probado quien lo escribió.

    Precios por millón de tokens en agosto de 2026: las cifras que sí puedes comprobar

    Estos son los precios de lista publicados por cada proveedor a 5 de agosto de 2026, en dólares por millón de tokens:

    Modelo Entrada / millón Salida / millón Contexto
    Claude Fable 5 $10 $50 1M
    Claude Opus 5 $5 $25 1M
    GPT-5.6 Sol $5 $30 1,05M
    Claude Sonnet 5 $3 ($2 intro hasta el 31 ago 2026) $15 ($10 intro) 1M
    Kimi K3 $3 $15 1M
    Grok 4.5 (prompt < 200K) $2 $6 500K
    Grok 4.5 (prompt ≥ 200K) $4 $12 500K
    DeepSeek V4 Flash 0731 $0,14 $0,28 1M

    Una nota de honestidad, porque predico con el ejemplo o no predico: al recopilar esto me encontré a Grok 4.5 con 54 puntos presentado como cuarto y a DeepSeek V4 Flash con 50 presentado como tercero. Las dos cosas no pueden ser ciertas a la vez.

    Son cortes distintos de un índice que se recalcula constantemente. Por eso en este post doy puntuaciones y fechas, y no puestos: el puesto caduca antes de que le des a publicar.

    Cómo verificar un ranking de modelos para programar en 3 filtros

    Abre el ranking que tengas a mano ahora mismo y pásale tres filtros.

    1. Busca el enlace a la fuente. Si la cifra no apunta a un leaderboard o a una doc oficial, trátala como rumor.
    2. Comprueba si el número es autoreportado. Un score en la web del fabricante y uno en tbench.ai no son la misma clase de dato.
    3. Mira si nombra el harness y el effort. Si dice "Fable 5: 83,8%" sin decir Claude Code y xhigh, quien lo escribió no ha leído la tabla que cita.

    Te quedará mucho menos ranking del que tenías. Bien.

    Y una decisión práctica que sí puedo defender: elige el modelo al final, no al principio. Define primero qué tarea automatizas, con qué agente y con qué criterio de "terminado". Es la lógica del libro de Spec-Driven Development, y aquí se nota más que en ningún sitio: con la spec escrita, cambiar de modelo es una variable de entorno y una medición; sin ella, es fe.

    Mi conclusión cabe en una frase: no existe el mejor modelo para programar, existe el mejor sistema, y el único número que decide tu caso es el que midas tú.

    En Dominicode Labs hacemos justo eso: pasar los modelos nuevos por tareas reales, con la factura y los logs delante, antes de meterlos en producción.

    Preguntas frecuentes sobre los modelos para programar de agosto de 2026

    ¿Qué modelo lidera el leaderboard de Terminal-Bench 2.1 en agosto de 2026?

    En el leaderboard oficial de Terminal-Bench 2.1 el primer puesto es Claude Code con Fable 5 (83,8%), seguido de Codex con GPT-5.5 (83,1%). Fíjate en que ambos resultados nombran un agente y un nivel de esfuerzo, no solo un modelo.

    El mismo Fable 5 baja a 80,4% con Terminus 2. Liderar un leaderboard no es lo mismo que ser el modelo que te conviene: si lo que buscas es la recomendación por tipo de trabajo —agente largo, repo grande, volumen alto—, está desarrollada en Opus 5 vs GPT-5.6 vs Kimi K3.

    ¿Cuánto cuesta realmente Grok 4.5?

    $2 de entrada y $6 de salida por millón de tokens mientras el prompt se mantenga por debajo de 200K tokens. A partir de 200K, la tarifa pasa a $4 y $12: se dobla.

    El input cacheado cuesta $0,50 por millón: un 75% menos que la tarifa de $2 y un 87,5% menos que la de $4 de los prompts largos. Ahí está el ahorro real en un agente que reenvía el mismo contexto en cada turno.

    ¿Es fiable el 82,7 de DeepSeek V4 en Terminal-Bench 2.1?

    Es una cifra autoreportada por DeepSeek en su propia tabla, no una entrada verificada del leaderboard oficial de tbench.ai. Ahí no aparece.

    Eso no significa que sea falsa: significa que no ha pasado por una medición independiente y que no es comparable con la tabla oficial. Lo comprobable de ese modelo es su precio ($0,14 / $0,28 por millón) y su licencia MIT con pesos abiertos.

    ¿Por qué Claude Opus 5 no aparece en el leaderboard de Terminal-Bench 2.1?

    Porque no hay una ejecución publicada de Opus 5 en el leaderboard oficial. El Opus que sí figura es el 4.8, con 78,9% usando Claude Code.

    Las cifras de "Opus 5 al 89,1%" que circulan por blogs agregadores no están en la fuente primaria y no he podido verificarlas. Ausencia de resultado no equivale a mal resultado: equivale a que no hay medición pública.

    ¿Merece la pena Fable 5 a $10 / $50 por millón?

    Sale a cuenta cuando un fallo del modelo te cuesta más de una hora de revisión humana; para volumen alto de tareas repetitivas, casi nunca.

    Hay además un matiz que empeora el cálculo: Fable 5 usa el tokenizer introducido con Opus 4.7, que genera alrededor de un 30% más de tokens sobre el mismo texto que los modelos anteriores a esa versión. Su coste efectivo es peor que su tarifa.

    ¿Qué diferencia hay entre un score autoreportado y uno del leaderboard oficial?

    Un score autoreportado lo ejecuta el propio fabricante, con su harness, su nivel de esfuerzo y su criterio de cuándo dar una tarea por terminada. Uno del leaderboard oficial lo ejecuta un tercero con condiciones fijas e iguales para todos.

    Los dos llevan decimales y parecen el mismo tipo de dato, pero no son comparables. Mezclarlos en la misma tabla, sin marcar cuál es cuál, es lo que convierte una comparativa en marketing.

    ¿DeepSeek V4 Flash es de código abierto?

    Tiene pesos abiertos y licencia MIT desde el 31 de julio de 2026. Es un MoE disperso con 13B de parámetros activos sobre 284B totales, 1.048.576 tokens de contexto y hasta 65.536 de salida.

    La licencia y el precio ($0,14 de entrada y $0,28 de salida por millón) son los dos hechos comprobables del modelo. Su 82,7 en Terminal-Bench 2.1 no lo es: es autoreportado.

    ¿Puedo usar Claude Mythos 5 en mi proyecto?

    No, salvo que tengas invitación. Comparte specs y precio con Fable 5, pero solo está disponible dentro de Project Glasswing, orientado a ciberseguridad defensiva, y no tiene alta self-serve.

    Si lo ves recomendado en un ranking de modelos para programar, ese ranking no lo ha probado.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
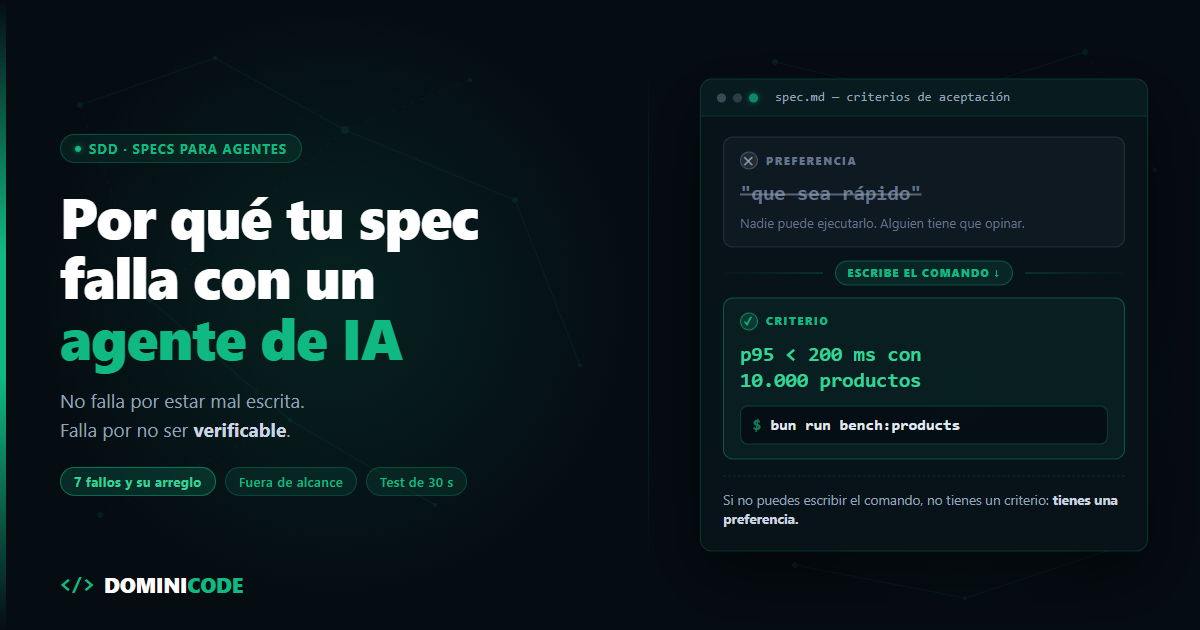
  • Por qué tu spec falla con un agente de IA: 7 fallos y su arreglo

    Por qué tu spec falla con un agente de IA: 7 fallos y su arreglo

    La spec tenía 900 palabras, títulos bien puestos, listas numeradas y hasta un diagrama. El agente la leyó entera y construyó otra cosa.

    El dev que me la pasó estaba convencido de que el problema era el modelo. Probó con otro. Mismo resultado.

    Le hice una sola pregunta: cuando el agente termine, ¿qué comando ejecutas para saber si lo ha hecho bien?

    Silencio. No había ninguno.

    Ese silencio es el diagnóstico completo. La mayoría de las specs que fallan —también las de quien ya aplica Spec-Driven Development a diario— no fallan por estar mal escritas. Fallan por no ser verificables. Y una spec que no se puede comprobar no es una especificación: es una carta de intenciones. Un agente no ejecuta intenciones.

    El SDD no consiste en redactar un documento bonito antes de programar — de eso hablé cuando expliqué por qué el Spec-Driven Development evita el caos. Consiste en escribir un contrato que una máquina pueda dar por cumplido o por incumplido, sin que tú tengas que opinar.

    Esto no es otro tutorial de redacción. Para la estructura desde cero ya tienes la anatomía de una spec para Claude Code. Esto es el diagnóstico de la spec que ya escribiste y no funcionó.

    Siete fallos, ordenados por lo que más veo. Los cinco primeros los detectas leyendo el documento. Los dos últimos, no.

    Busca tu síntoma: por qué tu spec falla con un agente de IA

    Lo que ves cuando el agente termina El fallo en la spec El arreglo
    Dice "está hecho" y no sabes si está hecho Criterios de éxito no comprobables Un comando debajo de cada criterio
    Hace las cosas como las hace todo el mundo, no como tu repo Ambigüedad sin marcar Señala el fichero que manda
    Toca ficheros que nadie le pidió No hay límites Sección "Fuera de alcance"
    Ignora la mitad de tus instrucciones técnicas Mezcla el qué con el cómo Cierra el qué, deja el cómo abierto
    catch vacíos y fallos que devuelven 200 Solo describe el camino feliz Tabla de estados de error
    Empieza bien y se desmadra a la mitad La spec es demasiado grande Pártela por unidad verificable
    Cumple la spec, pero la spec ya no es verdad Spec desactualizada Vive en el repo o se borra

    Fallo 1: criterios de éxito que nadie puede comprobar

    Un criterio de éxito es comprobable cuando existe un comando que lo declara cumplido o incumplido sin que nadie opine. Este es el fallo padre: los otros seis son variaciones suyas.

    Mira esta spec. La he leído con distintos nombres decenas de veces:

    ## Feature: listado de productos
    
    Endpoint para listar el catálogo.
    Tiene que ser rápido y soportar filtros.
    La respuesta debe ser consistente con el resto de la API.
    Gestionar bien los errores.
    

    Cuatro frases. Tres deseos y un título. ¿Rápido comparado con qué? ¿Consistente con cuál de los catorce endpoints que ya tienes? ¿Gestionar bien es devolver un 400 o un 422?

    Ninguna de esas preguntas la puede responder el agente ejecutando algo. Así que las responde inventando, y tú te enteras después.

    Ahora la misma feature escrita para que se pueda comprobar:

    ## Feature: GET /products
    
    ### Criterios de aceptación
    1. `GET /products?limit=20` devuelve 200 con
       `{ items: Product[], nextCursor: string | null }`.
    2. Paginación por cursor sobre `created_at DESC, id DESC`.
       `GET /products?cursor=<nextCursor>` devuelve la página siguiente
       sin repetir ni saltarse elementos. Nada de offset/limit.
    3. `limit` acepta 1-100, por defecto 20.
       Fuera de rango devuelve 400 con `{ code: 'INVALID_LIMIT' }`.
    4. p95 por debajo de 200 ms con 10.000 productos en tabla.
    
    ### Cómo se verifica
    - `bun test test/products.e2e.ts` en verde (cubre los puntos 1 a 3).
    - `bun run bench:products` imprime el p95 y sale con código 1
      si supera los 200 ms.
    

    La diferencia no es la longitud. Es que la segunda tiene una sección Cómo se verifica.

    "Que sea rápido" es un deseo. "Que GET /products responda por debajo de 200 ms de p95 con 10.000 registros, y aquí está el comando que lo mide" es un criterio. El primero obliga a que alguien juzgue. El segundo se cierra solo.

    Regla corta: debajo de cada criterio, el comando que lo prueba. Si no puedes escribir el comando, no tienes un criterio, tienes una preferencia.

    Y cuando el criterio es ejecutable pasa lo interesante: puedes delegar el ciclo entero —escribe, ejecuta, lee el fallo, corrige— en lugar de revisar cada iteración a mano. Es el flujo diario que describí en cómo usar Claude Code a diario, y depende por completo de que exista ese comando.

    Fallo 2: la ambigüedad la rellena el modelo, no tú

    Todo hueco de la spec se rellena. Siempre. La pregunta no es si el agente va a improvisar, es con qué.

    Y improvisa con lo más común de su entrenamiento: la mediana de internet. Tu repo no es la mediana de internet.

    Si tu API pagina por cursor y la spec solo dice "con paginación", el agente escribe offset y limit, porque es el patrón que domina en el código público con el que se entrenó. Si tu proyecto devuelve Result en vez de lanzar, escribirá try/catch. Si tus tests usan Testing Library, te meterá un TestBed clásico.

    Ninguno de esos es un error del modelo. Son la respuesta estadísticamente correcta a una pregunta que no hiciste.

    Aquí está el matiz que casi nadie aplica: la spec no tiene que decirlo todo. Tiene que decir dónde no se puede improvisar.

    Y la forma más barata de decirlo no es describir tu patrón en tres párrafos. Es apuntar al código que ya lo hace:

    ### Referencias obligatorias
    - Paginación: copia el patrón de `src/orders/orders.controller.ts` (solo lectura).
      Si hay conflicto entre este documento y ese fichero, manda el fichero.
    - Errores: usa los helpers de `src/common/http-errors.ts`.
      Prohibido lanzar `Error` pelado.
    
    ### Libre elección
    - Nombres internos, orden de los métodos, dónde partes los helpers.
      No preguntes por esto.
    

    Ese último bloque parece de relleno y no lo es. Marcar lo que sí es libre evita el otro extremo: el agente que se para cada dos minutos a preguntar cómo llamar a una variable.

    Tu trabajo no es documentar el proyecto entero dentro de la spec. Es marcar las tres o cuatro fronteras donde una decisión razonable sería, en tu repo, la decisión equivocada.

    Fallo 3: no dice qué NO hacer

    Los desastres que he visto con agentes casi nunca vienen de lo que el agente no hizo. Vienen de lo que hizo de más.

    Le pides un endpoint y te reformatea 40 ficheros porque detectó que el estilo era inconsistente. Le pides un filtro y te instala una librería de query building. Le pides un fix y "de paso" refactoriza el módulo de auth, que estaba feo.

    Todo eso es técnicamente razonable. Ninguna spec lo prohibía.

    Los límites son parte del contrato, no una nota al margen:

    ### Fuera de alcance
    - No tocar `src/auth/**` ni `src/orders/**`.
    - No añadir dependencias. La paginación sale del query builder
      que ya está en `src/common/pagination.ts`.
    - No crear migraciones. Si hace falta un índice, lo propones
      en el PR y paras.
    - No cambiar la forma de respuesta de endpoints existentes.
    - No reformatear ficheros que no toque la feature.
    

    Cinco líneas. Te ahorran la revisión de un diff de 40 ficheros donde lo que importa está en tres. Es, por cierto, uno de los patrones que aparece una y otra vez en los errores comunes al adoptar Claude Code: falta de guardarraíles, no falta de capacidad.

    No es opinión mía: las buenas prácticas oficiales de Claude Code lo dicen con todas las letras — las specs más útiles "nombran los ficheros e interfaces implicados, declaran qué queda fuera de alcance, y terminan con un paso de verificación end-to-end que demuestra que la feature funciona". Los tres primeros fallos de esta lista son exactamente esas tres cosas, en negativo.

    Fallo 4: la spec que ya decide la implementación

    Este falla al revés que los anteriores. No peca de vaga, peca de mandona.

    Crea un `ProductsCacheInterceptor` en `src/products/interceptors/`.
    Usa un `Map<string, { data: Product[]; ts: number }>` en memoria.
    TTL de 60 s, limpieza con un `setInterval` cada 30 s.
    La clave del Map es `JSON.stringify(req.query)`.
    

    Eso no es una spec. Es pseudocódigo con saltos de línea.

    Y tiene un agujero que probablemente no has visto: JSON.stringify(req.query) genera claves distintas para ?limit=20&cursor=x y ?cursor=x&limit=20. Son la misma petición. El agente puede implementar ese documento al pie de la letra, perfectamente, y aun así pegarle dos veces a la base de datos.

    La versión que sí es un contrato:

    ### Criterio
    Dos peticiones con los mismos parámetros a `GET /products` en menos de 60 s
    golpean la base de datos una sola vez, independientemente
    del orden de los parámetros en la query string.
    
    ### Cómo se verifica
    `bun test test/products.cache.e2e.ts` — el test espía el
    repositorio y afirma que solo hubo una query.
    
    ### Restricciones
    Sin dependencias nuevas. Sin Redis: todavía no está en infra.
    

    Fíjate en la paradoja. La versión que no dice cómo implementarlo es más exigente que la que lo dictaba línea a línea. La primera se puede cumplir y estar mal. La segunda no se puede fingir.

    Además, cuando cierras el cómo, cierras también las soluciones mejores que la tuya. Y en cachés, colas y consultas, el agente propone alternativas buenas más a menudo de lo que resulta cómodo admitir.

    Tú decides el qué observable. Él decide el cómo. El test decide quién tiene razón.

    Fallo 5: la spec solo describe el camino feliz

    Abre tu última spec y cuenta cuántas líneas hablan de qué pasa cuando algo falla. Lo normal es cero.

    Aquí está la trampa: el agente no deja el manejo de errores sin hacer. Lo inventa. Y su versión inventada suele ser un catch que loguea y sigue, o un 200 con array vacío cuando la base de datos no responde. Un endpoint que miente en lugar de fallar.

    Cuatro filas arreglan esto:

    Caso Respuesta Qué se loguea
    cursor malformado 400 INVALID_CURSOR warn, sin volcar el cursor entero
    limit fuera de 1-100 400 INVALID_LIMIT nada
    Timeout de la base de datos (>2 s) 503 DB_TIMEOUT error, con query y duración
    Fila de producto sin precio se excluye del listado warn con el id

    La última fila separa una spec escrita por alguien que ha estado de guardia de una escrita de memoria. Los datos sucios existen, y si no decides tú qué hacer con ellos, decide el agente.

    Dos minutos de escritura. Es lo que hay entre un endpoint y un endpoint que puedes dejar sin mirar.

    Los dos fallos que no ves leyendo la spec

    Los cinco anteriores se detectan releyendo el documento. Estos dos solo aparecen cuando comparas la spec con el repo y con el tamaño del trabajo.

    Fallo 6: la spec es demasiado grande

    La unidad de una spec no es la feature, es el paso verificable. Si la sección "Cómo se verifica" no cabe en cinco líneas, no tienes una spec: tienes tres disfrazadas de una.

    El síntoma es inconfundible: el agente empieza bien y se desmadra a la mitad, porque cada decisión que toma amplía la superficie de las siguientes.

    Partir el trabajo en unidades que se cierran una a una es, literalmente, la mitad del método que enseño en Construye con IA. La otra mitad es no volver a abrir una unidad ya cerrada.

    Fallo 7: la spec está desactualizada

    La spec dice que el endpoint devuelve items, el código lleva tres semanas devolviendo data. El agente no tiene forma de saber cuál manda. Unas veces sigue al documento y otras al código, y ninguna de las dos es una elección tuya.

    La regla que uso: la spec vive en el repo, entra en el mismo PR que el código, y cuando se contradicen gana el código. Entonces actualizas la spec o la borras. Una spec muerta es peor que no tener spec, porque es contexto con autoridad que resulta ser mentira.

    El test de 30 segundos: ¿tu spec es verificable?

    Una spec es verificable si responde a tres preguntas por escrito. No hace falta reescribir nada para saberlo. Coge la que ibas a pasarle al agente y hazle estas tres:

    1. ¿Qué comando prueba que está terminada?
    2. ¿Qué ficheros no puede tocar?
    3. ¿Qué pasa exactamente cuando falla?

    Si las tres tienen respuesta escrita en el documento, la spec funciona. Si falta una, ya sabes dónde está el bug — y no está en el modelo.

    Empieza hoy por la primera. Coge tus criterios de aceptación y escribe debajo de cada uno el comando que lo demuestra. Los que se queden sin comando, o los conviertes en algo medible o los sacas de la spec, porque no van a pasar de deseo.

    Todo el sistema —el contrato verificable, los límites, cómo partir el trabajo y cómo mantener la spec viva junto al código— es lo que ordené en SDD: Spec-Driven Development. Si este post te ha señalado tres fallos en tu documento, ahí tienes el método completo para que no vuelvan.

    Y si prefieres verlo sobre proyectos reales, con specs de gente que las está usando en producción, es una de las conversaciones habituales en Dominicode Labs.

    Preguntas frecuentes

    ¿Cómo sé si mi spec es verificable?

    Una spec es verificable si cada criterio de aceptación tiene debajo un comando que devuelve verde o rojo sin que nadie opine. Un test, un benchmark, un script de validación, un curl con la respuesta esperada.

    La prueba rápida: pásale la spec a alguien que no conozca el proyecto y pídele que te diga si está hecha sin abrir el código. Si necesita preguntarte algo, el agente también lo habría necesitado, solo que él no pregunta.

    ¿Qué hago con los criterios que no se pueden medir con un comando?

    Los conviertes en algo observable o los sacas de la spec. "Que la UI sea intuitiva" no es un criterio, pero "que el flujo de compra se complete en tres clics desde la ficha de producto y no haya ningún campo obligatorio sin marcar" sí lo es, y se comprueba con un test end-to-end.

    Cuando de verdad no se puede —criterios estéticos, tono de los textos, decisiones de marca— déjalo fuera de la spec y márcalo como revisión humana explícita. Lo que no puede pasar es que quede dentro como si el agente pudiera resolverlo.

    ¿Cuánto debe ocupar una spec para un agente de IA?

    No la mides en palabras, la mides en unidades verificables. Una spec debe cubrir un trozo de trabajo que se cierre con una tanda de comprobaciones y una revisión.

    Si la sección "Cómo se verifica" ocupa más de cinco líneas o mezcla áreas del sistema que no comparten test, pártela. Dos specs de 300 palabras funcionan mejor que una de 900.

    ¿La spec sustituye a los tests?

    No, los ordena. La spec dice qué tiene que ser cierto y el test lo comprueba en cada ejecución.

    En la práctica la relación es más estrecha de lo que parece: si los criterios de aceptación están bien escritos, los nombres de tus tests salen casi copiados de ellos. Cuando un criterio no se deja convertir en un nombre de test, casi siempre es que el criterio estaba vago.

    ¿Por qué el agente ignora partes de mi spec?

    Rara vez las ignora. Lo habitual es que las haya interpretado de una forma que a ti no se te ocurrió, porque estaban abiertas a más de una lectura.

    Revisa esas partes buscando dos cosas: adjetivos sin unidad ("rápido", "robusto", "limpio") y sustantivos que en tu proyecto tienen un significado propio ("paginación", "validación", "caché"). Son los dos sitios donde el modelo rellena con lo más común de su entrenamiento en lugar de con lo que hace tu repo.

    ¿Qué hago si el agente toca ficheros que nadie le pidió?

    Añade una sección "Fuera de alcance" a la spec y trátala como parte del contrato, no como una nota al margen. Cinco líneas bastan: qué directorios no se tocan, que no se añaden dependencias, que no se crean migraciones, que no se cambia la forma de respuesta de endpoints existentes y que no se reformatea nada que la feature no toque. Los desastres con agentes casi nunca vienen de lo que no hicieron, sino de lo que hicieron de más, y ninguna spec se lo prohibía.

    ¿La spec tiene que decir cómo implementar la feature?

    No, y decirlo suele empeorar el resultado. Una spec que dicta la implementación línea a línea se puede cumplir al pie de la letra y aun así estar mal, porque el agente reproduce también tus errores de diseño. Una spec que fija el comportamiento observable y el comando que lo verifica no se puede fingir. Tú decides el qué, el agente decide el cómo, y el test decide quién tenía razón.

    ¿Dónde guardo la spec y quién manda si contradice al código?

    En el repositorio, junto al código, y entra en el mismo pull request que la implementación. Fuera del repo se queda desactualizada en semanas y se convierte en contexto falso.

    Cuando spec y código se contradicen, manda el código y la spec se corrige o se borra en ese mismo momento. Déjalo escrito dentro del propio documento: es la línea que evita que el agente tenga que adivinar cuál de las dos fuentes es la buena.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.