Category: TypeScript

  • Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Circuit breaker para agentes IA: la tool cae y el modelo inventa

    Un martes por la tarde, la API de búsqueda de un cliente empezó a devolver 500. Un despliegue suyo mal hecho: tres minutos de caída.

    El agente que consumía esa API estuvo cuarenta minutos haciendo tonterías caras.

    Primero reintentó. Normal. Luego, al ver que la herramienta seguía fallando, hizo lo que hacen los modelos cuando se les cierra una puerta: buscar otra. Llamó a una tool que no tocaba, cambió los parámetros "por si acaso" y en el paso 14 se inventó tres productos con sus precios.

    Faltaba un circuit breaker para agentes IA. El patrón es viejo — Michael Nygard lo describió en Release It! en 2007 para microservicios y Martin Fowler lo popularizó después — pero cuando en medio del reintento hay un LLM, cambia una pieza fundamental. Y esa pieza es la que casi nadie implementa.


    Qué es un circuit breaker para agentes IA

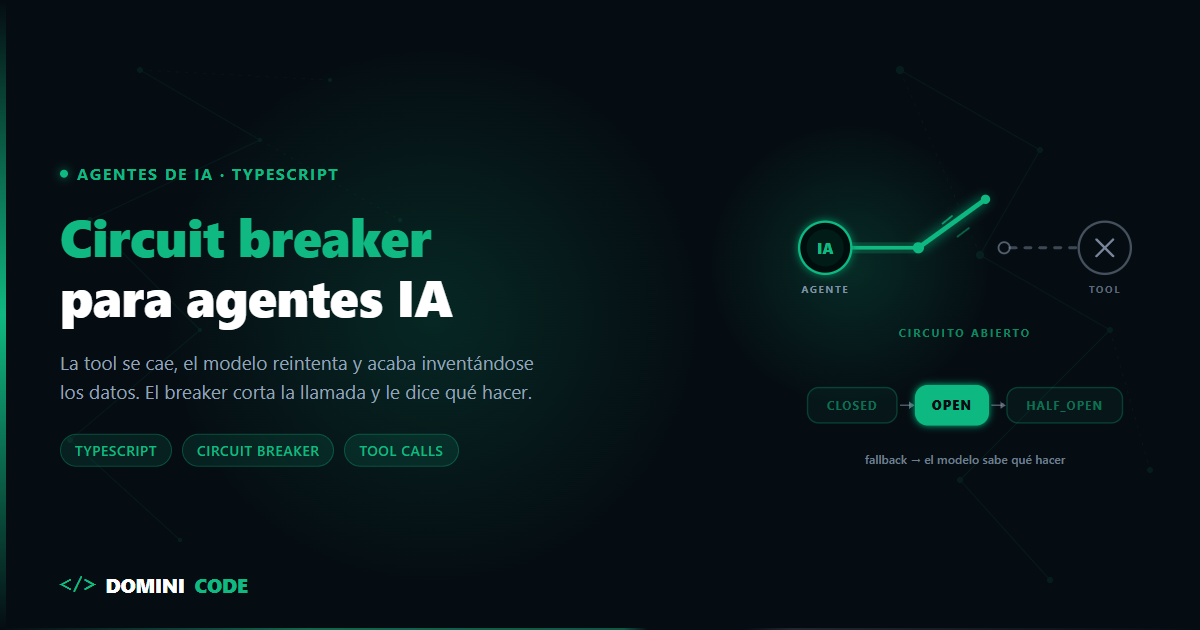
    Un circuit breaker para agentes IA es una máquina de estados que envuelve la ejecución de cada tool: cuenta los fallos de infraestructura dentro de una ventana de tiempo y, al superar un umbral, deja de llamar a la API y devuelve al modelo un resultado estructurado que le dice que esa herramienta no está disponible y qué debe hacer en su lugar.

    La diferencia con el circuit breaker clásico de microservicios está en quién recibe el corte. Allí el consumidor es código, que obedece un 503 y ejecuta su rama de fallback. Aquí el consumidor es un LLM, que interpreta el error y decide por su cuenta. Y si no se lo dices tú, lo que decide es reintentar o inventarse el dato.


    Los tres estados del circuit breaker en un agente

    El breaker es una máquina de estados que envuelve la ejecución de una herramienta.

    CLOSED. Todo pasa. Vas contando fallos en una ventana de tiempo. Si en los últimos 60 segundos hay 4 fallos de infraestructura, abres.

    OPEN. Rechazas sin llamar a la API. Esto es lo importante: el execute de la tool ni siquiera hace fetch. Devuelve en microsegundos. No hay timeout de 30 segundos, no hay latencia, no hay una API agonizante recibiendo más carga de la que ya no puede atender.

    HALF_OPEN. Pasado el tiempo de reset, dejas pasar una sola llamada de prueba. Si funciona, vuelves a CLOSED. Si falla, vuelves a OPEN y el contador de espera empieza otra vez. Ojo con esto en un agente: si dejas pasar todas las llamadas de un turno en half-open, el modelo puede lanzar tres tool calls en paralelo y le acabas metiendo tres peticiones a un servicio que se está levantando.

    Hasta aquí es idéntico a un microservicio. La diferencia empieza en lo que devuelves cuando el circuito está abierto.


    Qué devolver al modelo cuando el circuito está abierto

    Cuando un servicio A tiene el circuito abierto contra el servicio B, devuelve un 503 y quien lo consume es código. El código no negocia: ve el 503 y ejecuta la rama de fallback que escribiste.

    En un agente, quien recibe la respuesta de la tool es un modelo de lenguaje. Y un modelo de lenguaje sí negocia.

    Si le devuelves esto:

    { "error": "request failed" }
    

    El modelo va a reintentar. No porque sea tonto, sino porque no tiene ninguna forma de saber que existe un circuito y que está abierto. Desde su punto de vista una llamada ha fallado, y lo razonable ante una llamada que falla es intentarlo otra vez, quizá con otros parámetros.

    Has puesto un breaker que ahorra la petición HTTP pero no ahorra ni una sola iteración del loop ni un solo token. El agente sigue quemando pasos hasta agotar el presupuesto que le pusiste en stopWhen — si es que se lo pusiste, que de eso hablo en el post del agentic loop.

    El resultado de una tool es un canal de comunicación con el modelo. Es prompt. Úsalo como tal.

    {
      "ok": false,
      "toolUnavailable": true,
      "retryAfterSeconds": 27,
      "instruction": "La herramienta \"searchCatalog\" está fuera de servicio por fallos repetidos del proveedor. No vuelvas a llamarla durante los próximos 27 segundos: cualquier intento se rechazará sin llegar a la API. Usa \"searchCatalogSnapshot\" (catálogo cacheado de hace unas horas) y avisa en tu respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía stock en tiempo real, dile que ese dato no está disponible ahora. No lo estimes ni lo inventes."
    }
    

    Cuatro cosas, y las cuatro hacen falta:

    1. Qué herramienta está caída, por su nombre exacto — el mismo que ve en la definición de tools.
    2. Cuánto tiempo, en segundos concretos. Un "temporalmente" no le dice nada.
    3. La prohibición explícita de reintentar, con el motivo: no es que vaya a fallar, es que ni siquiera va a salir de tu servidor.
    4. Qué hacer en su lugar, en concreto. Y la orden de no inventarse lo que la API le habría dado, que es exactamente lo que hizo el agente de mi cliente en el paso 14.

    Y la alternativa que le ofreces tiene que existir de verdad en el toolset. Mandar al modelo a una herramienta que no le has dado es pedirle justo lo que intentas evitar: que se la invente.

    Añade también una línea al system prompt explicando el protocolo: "si una tool devuelve toolUnavailable: true, esa herramienta no está disponible en este turno; sigue las instrucciones del campo instruction y no la vuelvas a llamar". El modelo cumple bastante bien cuando la instrucción es específica y llega en el sitio donde toma la decisión.


    Qué errores abren el circuito de una tool (y cuáles no)

    Aquí es donde la mayoría de implementaciones se rompen, y se rompen hacia el lado peligroso: abriendo el circuito de una API que funciona perfectamente.

    Los 5xx cuentan. Los timeouts cuentan. Los errores de red cuentan. Los 429 cuentan también, porque cuando un servicio te dice que vas demasiado rápido, lo correcto es dejar de llamarlo un rato.

    Los 4xx de validación no cuentan nunca. Si el modelo manda { query: 42 } donde había que mandar un string, la API devuelve un 400 y eso no significa que la API esté rota. Significa que el modelo la está llamando mal. Si sumas ese 400 al contador, un modelo torpe con los argumentos te abre el circuito de un servicio sano — y a partir de ahí has convertido un problema de prompt en una caída de herramienta.

    Distinguir "la herramienta está rota" de "el modelo la está llamando mal" es la diferencia entre un breaker que te salva y uno que sabotea al agente.

    Error ¿Cuenta para abrir? Por qué
    5xx Sí El servicio está roto
    429 Sí Saturado: lo correcto es dejar de llamarlo un rato
    Timeout / AbortError Sí Sin timeout no hay fallo que contar, solo un agente esperando
    ECONNREFUSED, ECONNRESET, ENOTFOUND Sí La API no está ahí
    400, 422 Nunca El modelo mandó argumentos mal formados
    404 Nunca El recurso no existe; la API respondió bien
    409 Nunca Conflicto de estado, no caída
    Error desconocido No Ante la duda no penalizas: un falso positivo tumba una herramienta sana
    // tool-errors.ts
    export class ToolHttpError extends Error {
      constructor(readonly status: number, message: string) {
        super(message);
        this.name = "ToolHttpError";
      }
    }
    
    const NETWORK_ERRORS = /ECONNREFUSED|ECONNRESET|ETIMEDOUT|ENOTFOUND|EAI_AGAIN|fetch failed/i;
    
    export function isInfrastructureFailure(error: unknown): boolean {
      if (error instanceof ToolHttpError) {
        // 5xx: el servicio está roto. 429: saturado, y lo correcto es dejar de llamar.
        // 400, 404, 409, 422: los argumentos venían mal. Eso es el modelo, no la API.
        return error.status >= 500 || error.status === 429;
      }
    
      // AbortSignal.timeout() lanza un AbortError / TimeoutError
      if (error instanceof Error && (error.name === "AbortError" || error.name === "TimeoutError")) {
        return true;
      }
    
      if (error instanceof Error) {
        // Ojo con el runtime: en Bun el código de red viaja en error.cause.code,
        // no en el mensaje. Mirar solo message deja pasar un ECONNREFUSED.
        const code = (error as { cause?: { code?: string } }).cause?.code;
        if (code && NETWORK_ERRORS.test(code)) return true;
        return NETWORK_ERRORS.test(error.message);
      }
    
      // Ante la duda, no penalizas: un falso positivo tumba una herramienta sana
      return false;
    }
    

    La política de "ante la duda no cuenta" es deliberada. Un breaker que no abre cuando debía te cuesta unos reintentos. Un breaker que abre cuando no debía te deja al agente sin una herramienta buena durante medio minuto, y el modelo se pone creativo.

    La mitad de estos 4xx los evitas antes de que ocurran con schemas estrictos en la definición de la tool. Es el mismo trabajo de blindaje que vemos en el curso de Zod para TypeScript: si el argumento no valida, ni siquiera llega a salir una petición.


    Cómo implementar un circuit breaker en TypeScript

    Factory con estado en cierre, sin dependencias. Umbral de fallos, ventana deslizante, timeout de reset y una única prueba en half-open.

    // circuit-breaker.ts
    export type BreakerState = "CLOSED" | "OPEN" | "HALF_OPEN";
    
    export class CircuitOpenError extends Error {
      constructor(readonly toolName: string, readonly retryAfterMs: number) {
        super(`Circuito abierto para la herramienta "${toolName}"`);
        this.name = "CircuitOpenError";
      }
    }
    
    export interface BreakerOptions {
      name: string;
      failureThreshold?: number;
      windowMs?: number;
      resetTimeoutMs?: number;
      isFailure?: (error: unknown) => boolean;
      onStateChange?: (from: BreakerState, to: BreakerState) => void;
    }
    
    export function createCircuitBreaker({
      name,
      failureThreshold = 4,
      windowMs = 60_000,
      resetTimeoutMs = 30_000,
      isFailure = () => true, // ¡ojo! sobrescríbelo siempre con isInfrastructureFailure
      onStateChange = () => {},
    }: BreakerOptions) {
      let state: BreakerState = "CLOSED";
      let failures: number[] = [];
      let openedAt = 0;
      let probeInFlight = false;
    
      const transition = (next: BreakerState) => {
        if (next === state) return;
        onStateChange(state, next);
        state = next;
      };
    
      const currentState = (now: number): BreakerState => {
        if (state === "OPEN" && now - openedAt >= resetTimeoutMs) {
          transition("HALF_OPEN");
        }
        return state;
      };
    
      return {
        name,
        // getState() no es puro: dispara la transición OPEN -> HALF_OPEN. Si lo
        // polleas desde un exportador de métricas, la transición la provoca la
        // observabilidad y no el tráfico real.
        getState: () => currentState(Date.now()),
        getRetryAfterMs: () => Math.max(0, resetTimeoutMs - (Date.now() - openedAt)),
    
        async execute<T>(fn: () => Promise<T>): Promise<T> {
          const now = Date.now();
          const phase = currentState(now);
    
          if (phase === "OPEN") {
            throw new CircuitOpenError(name, resetTimeoutMs - (now - openedAt));
          }
    
          // En half-open solo pasa una petición: las demás siguen rechazadas
          if (phase === "HALF_OPEN" && probeInFlight) {
            // Espera corta a propósito: si la prueba en vuelo cierra el circuito, no
            // quieres haberle dicho al modelo que abandone la tool medio minuto
            throw new CircuitOpenError(name, 1_000);
          }
          if (phase === "HALF_OPEN") probeInFlight = true;
    
          try {
            const result = await fn();
            if (phase === "HALF_OPEN") {
              probeInFlight = false;
              failures = [];
              transition("CLOSED");
            }
            return result;
          } catch (error) {
            if (!isFailure(error)) {
              // No es culpa de la herramienta: no toca el contador
              if (phase === "HALF_OPEN") probeInFlight = false;
              throw error;
            }
    
            const failedAt = Date.now();
            failures = failures.filter((t) => failedAt - t < windowMs); // ventana deslizante
            failures.push(failedAt);
    
            if (phase === "HALF_OPEN" || failures.length >= failureThreshold) {
              openedAt = failedAt;
              probeInFlight = false;
              failures = [];
              transition("OPEN");
            }
            throw error;
          }
        },
      };
    }
    
    export type CircuitBreaker = ReturnType<typeof createCircuitBreaker>;
    

    Un fallo en half-open reabre directamente, sin esperar a acumular el umbral. Es intencionado: si la prueba falla, el servicio sigue caído y no hay nada que discutir.

    Ahora el wrapper que convierte la excepción en un resultado que el modelo entiende, integrado con la definición de tools del Vercel AI SDK:

    // with-breaker.ts
    import { tool } from "ai";
    import { z } from "zod";
    import { createCircuitBreaker, CircuitOpenError, type CircuitBreaker } from "./circuit-breaker";
    import { ToolHttpError, isInfrastructureFailure } from "./tool-errors";
    
    interface UnavailableInfo {
      toolName: string;
      retryAfterSeconds: number;
    }
    
    export function withBreaker<TArgs, TResult>(
      breaker: CircuitBreaker,
      onOpen: (info: UnavailableInfo) => Record<string, unknown>,
      execute: (args: TArgs) => Promise<TResult>,
    ) {
      return async (args: TArgs) => {
        try {
          return { ok: true, data: await breaker.execute(() => execute(args)) };
        } catch (error) {
          if (error instanceof CircuitOpenError) {
            return onOpen({
              toolName: error.toolName,
              retryAfterSeconds: Math.max(1, Math.ceil(error.retryAfterMs / 1000)),
            });
          }
          // Este fallo puede ser justo el que acaba de abrir el circuito: el modelo
          // tiene que enterarse ahora, no en la siguiente iteración
          if (breaker.getState() === "OPEN") {
            return onOpen({
              toolName: breaker.name,
              retryAfterSeconds: Math.max(1, Math.ceil(breaker.getRetryAfterMs() / 1000)),
            });
          }
    
          // Fallo puntual con el circuito cerrado: el modelo aún puede reintentar,
          // pero necesita saber qué falló para no repetir la misma llamada
          return { ok: false, error: error instanceof Error ? error.message : "Error desconocido" };
        }
      };
    }
    
    const searchBreaker = createCircuitBreaker({
      name: "searchCatalog",
      failureThreshold: 4,
      windowMs: 60_000,
      resetTimeoutMs: 30_000,
      isFailure: isInfrastructureFailure,
    });
    
    export const searchCatalog = tool({
      description: "Busca productos en el catálogo en tiempo real",
      inputSchema: z.object({ query: z.string().min(2) }),
      execute: withBreaker(
        searchBreaker,
        ({ toolName, retryAfterSeconds }) => ({
          ok: false,
          toolUnavailable: true,
          retryAfterSeconds,
          instruction:
            `La herramienta "${toolName}" está fuera de servicio por fallos repetidos del proveedor. ` +
            `No vuelvas a llamarla durante los próximos ${retryAfterSeconds} segundos: cualquier ` +
            `intento se rechazará sin llegar a la API. Usa "searchCatalogSnapshot" y avisa en tu ` +
            `respuesta final de que los precios pueden estar desactualizados. Si el usuario pedía ` +
            `stock en tiempo real, dile que ese dato no está disponible ahora. No lo inventes.`,
        }),
        async ({ query }: { query: string }) => {
          const res = await fetch(`${process.env.CATALOG_API}/search?q=${encodeURIComponent(query)}`, {
            signal: AbortSignal.timeout(4_000),
          });
          if (!res.ok) throw new ToolHttpError(res.status, `Búsqueda falló con ${res.status}`);
          return res.json();
        },
      ),
    });
    

    Fíjate en el segundo if del catch: el fallo que abre el circuito también tiene que hablarle al modelo. Si esperas a la siguiente llamada para avisarle, has regalado una iteración entera del loop justo en el peor momento, el momento en que acabas de decidir que la herramienta está muerta.

    El ejemplo va sobre el AI SDK de Vercel 7, donde el schema de la tool se declara en inputSchema. Ese nombre existe desde la 5: si sigues en la 4.x el campo se llama parameters y el resto del wrapper no cambia.

    Fíjate también en el AbortSignal.timeout(4_000). Sin timeout explícito no hay breaker que valga: una petición colgada no genera un fallo que contar, genera un agente esperando. El timeout es lo que convierte "lento" en "fallido", y sin eso el patrón entero no arranca. Es el tipo de detalle que trato en programación defensiva en TypeScript.


    Un breaker por herramienta, nunca uno global

    Si la API de búsqueda está caída, la base de datos sigue respondiendo perfectamente. Un breaker global convierte un fallo parcial en una caída total del agente: pierdes cuatro herramientas sanas por culpa de una rota.

    Un registro por nombre de tool y listo:

    const breakers = new Map<string, CircuitBreaker>();
    
    export const breakerFor = (name: string, options: Partial<BreakerOptions> = {}): CircuitBreaker => {
      const existing = breakers.get(name);
      if (existing) return existing;
    
      const created = createCircuitBreaker({ name, isFailure: isInfrastructureFailure, ...options });
      breakers.set(name, created);
      return created;
    };
    

    Y una advertencia que cuesta una tarde de depuración: el estado del breaker tiene que vivir fuera de la petición. Si creas el breaker dentro del handler del chat, cada conversación arranca con el contador a cero y el patrón no protege absolutamente nada. Ámbito de módulo como mínimo. Si corres en serverless con varias instancias, el estado compartido va a Redis o cada instancia aprenderá por su cuenta que la API está caída — y pagarás el aprendizaje N veces.

    Y los umbrales no son iguales para todas: una API de pagos crítica aguanta 6 fallos antes de abrir, un scraper de enriquecimiento prescindible abre a los 2.


    El fallback: qué le das al modelo cuando no hay datos

    Tienes tres opciones, y elegir mal aquí desperdicia el breaker.

    Respuesta cacheada. El último snapshot bueno. Sirve para catálogos, listados y configuración. Obligatorio decirle al modelo que los datos son viejos y de cuándo son, para que lo declare en su respuesta.

    Herramienta degradada. Búsqueda local en vez de búsqueda semántica remota. Peor resultado, cero dependencia externa.

    Seguir sin el dato, declarándolo. La opción más honesta y la más infravalorada. El agente termina la tarea con la información que tiene y dice explícitamente qué no pudo comprobar. Mucho mejor que un dato inventado con toda la confianza del mundo.

    Y una cuarta que a veces es la correcta: parar y escalar al humano. Si la herramienta caída era imprescindible para la tarea, seguir es peor que rendirse. Igual que con los guardrails de ejecución, la decisión de frenar es parte del diseño, no un fallo.


    Cómo saber si tu breaker está bien calibrado

    Un breaker sin métricas es un valor mágico que alguien puso hace seis meses. Registra el cambio de estado con onStateChange y mira tres números:

    Aperturas por hora y por herramienta. Si una tool abre 5 veces por hora contra una API que su proveedor jura estar sana, tu umbral es demasiado bajo o estás contando 4xx que no deberías. Revisa el clasificador antes que el umbral.

    Tiempo total en OPEN. Es tu indisponibilidad real de esa capacidad. Si una herramienta pasa el 20% del día en OPEN, el problema ya no es el breaker: es el proveedor, y toca renegociarlo o buscar alternativa.

    Ratio de half-open que vuelven a abrir. El indicador de flapping. Por encima del 70% significa que tu resetTimeoutMs es demasiado corto y estás probando un servicio que aún no se ha levantado, gastando una llamada de tool en cada intento. Alarga el backoff de forma progresiva: 30s, 60s, 2 min. La versión de arriba usa un resetTimeoutMs fijo; para escalarlo, multiplícalo por el número de aperturas consecutivas antes de asignar openedAt.

    Y una cuarta que solo existe en agentes: qué hizo el modelo después de recibir el fallback. Loguea la siguiente tool call tras un toolUnavailable. Si el modelo vuelve a llamar a la herramienta caída, tu mensaje no está siendo lo bastante claro y toca reescribirlo. Los pasos que se ahorra el agente los ves directamente en el consumo de tokens por tarea.


    Por dónde empezar con el circuit breaker en tu agente

    Coge tu agente. Mira la tool que llama al servicio externo menos fiable — todos tenemos una. Ponle un timeout explícito, un breaker propio con isFailure que ignore los 4xx de validación, y un mensaje de fallback escrito para el modelo y no para tu log.

    Esa única herramienta es el 80% del beneficio. El resto es replicar el patrón.

    La idea de fondo: en un agente, cualquier mecanismo de defensa que no le hable al modelo se queda a medias. Puedes cortar la petición HTTP, pero si no le explicas al LLM qué ha pasado y qué esperas de él, el modelo rellenará el hueco con lo que se le ocurra. Y lo que se le ocurre suele ser caro.

    Esta forma de pensar la arquitectura — decidir antes de escribir código qué hace el sistema cuando algo falla — es exactamente el enfoque del curso Construye con IA: de la idea al producto. Y si quieres ver estos patrones montados sobre proyectos reales, con las métricas puestas y funcionando, en Dominicode Labs es donde los estamos rodando.


    Preguntas frecuentes

    ¿Qué diferencia hay entre un circuit breaker y un simple retry con backoff?

    El retry insiste; el breaker deja de insistir. Son complementarios: el backoff resuelve el fallo puntual dentro de una misma llamada, y el breaker resuelve el fallo sostenido a lo largo de muchas llamadas. Sin breaker, tu retry con backoff se ejecuta entero en cada una de las 14 iteraciones del agente contra un servicio que lleva minutos caído.

    ¿Cuántos fallos deben abrir el circuito de una tool?

    Entre 3 y 5 dentro de una ventana de 60 segundos funciona bien como punto de partida. Con umbral 1 o 2 abres por un pico transitorio; por encima de 8 el agente ya habrá gastado medio presupuesto de pasos antes de que el breaker reaccione. Ajústalo por criticidad: más tolerancia en herramientas imprescindibles, menos en las prescindibles.

    ¿Debe contar un error 400 de una tool para abrir el circuito?

    No. Un 400, un 404 o un 422 casi siempre significan que el modelo mandó argumentos mal formados, no que la API esté rota. Si los cuentas, acabas abriendo el circuito de un servicio sano por culpa del LLM y dejando al agente sin una herramienta que funcionaba. Cuentan los 5xx, los timeouts, los errores de red y los 429.

    ¿Dónde guardo el estado del breaker si mi agente corre en serverless?

    En un almacén compartido tipo Redis, con el nombre de la herramienta como clave. Si lo dejas en memoria de proceso, cada instancia fría descubre por su cuenta que el proveedor está caído y pagas ese descubrimiento tantas veces como instancias tengas. Para un servidor de larga vida, el ámbito de módulo basta.

    ¿El circuit breaker sustituye al límite de pasos del agente?

    No, resuelven cosas distintas. El límite de pasos acota cuánto puede trabajar el agente en total; el breaker impide que una herramienta rota consuma esos pasos sin aportar nada. Van juntos: el breaker devuelve el control rápido y con instrucciones, y el límite de pasos sigue siendo la red de seguridad final.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • httpResource vs TanStack Query: cuál usar en Angular 22

    httpResource vs TanStack Query: cuál usar en Angular 22

    Un dev me escribió hace tres semanas con una captura de su package.json. Proyecto Angular 22 recién creado, dos días de vida, y ya tenía @tanstack/angular-query-experimental dentro.

    Le pregunté por qué. Respuesta: "en React siempre lo uso".

    Ese es el 80% de las discusiones de httpResource vs TanStack Query que veo por ahí: no son decisiones, son inercias. El resto viene del extremo contrario. Alguien leyó en un hilo que "httpResource no cachea", cerró la pestaña y descartó la API estándar de Angular sin llegar a preguntarse qué caché necesitaba de verdad su aplicación.

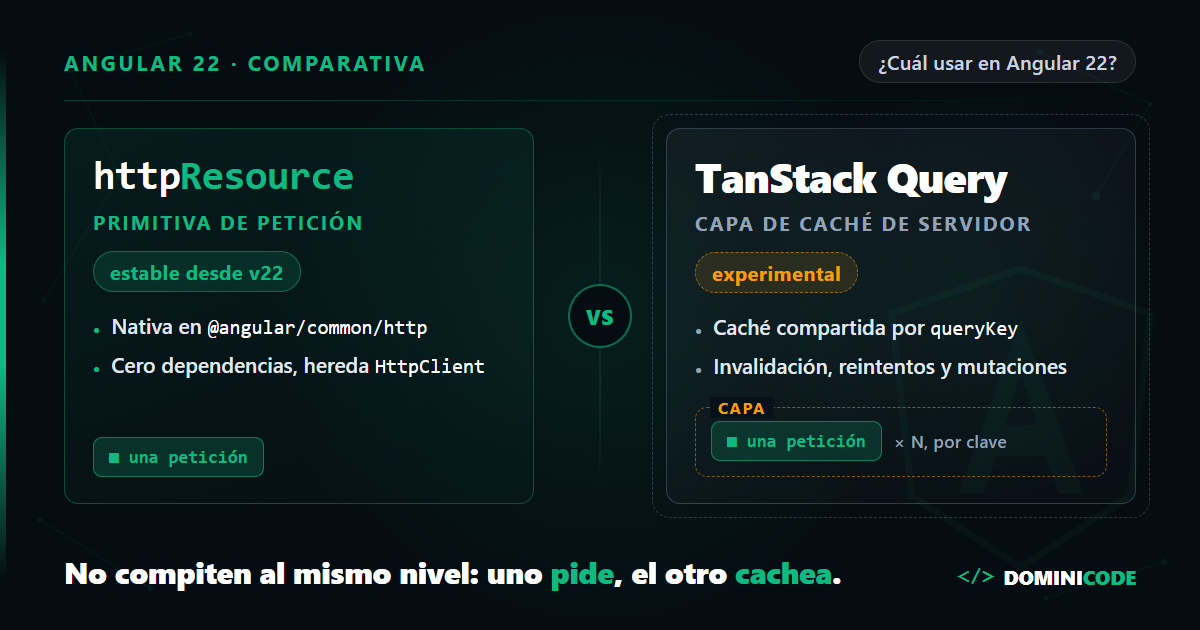
    Las dos posturas fallan por el mismo motivo: comparan dos cosas que no juegan en la misma liga.

    Este post no es un tutorial. Si buscas el cómo, ya publiqué la guía de la Resource API en Angular 22 y la de httpResource con señales. Aquí vamos a lo otro: qué eliges, por qué, y qué te va a costar.

    httpResource vs TanStack Query: la respuesta corta

    Usa httpResource por defecto en Angular 22. Es la API estándar, es estable desde la v22.0, no añade dependencias y hereda todo el ecosistema de HttpClient. Cambia a TanStack Query solo cuando necesites una caché de servidor compartida entre componentes con invalidación por clave, mutaciones optimistas o scroll infinito, y estés dispuesto a asumir que su adaptador de Angular se llama literalmente @tanstack/angular-query-experimental.

    Esa es la decisión. El resto del post explica por qué, con la letra pequeña que casi nadie te cuenta.

    La diferencia real: petición reactiva vs caché de estado de servidor

    httpResource es una primitiva de petición reactiva. Le das una función que construye una URL a partir de señales, y la petición se vuelve a lanzar sola cuando esas señales cambian. Vive dentro del grafo reactivo de Angular como un nodo más. Su unidad de trabajo es una petición atada a un estado.

    TanStack Query es otra cosa. Es una capa de caché de estado de servidor. Su unidad de trabajo no es la petición: es la clave. Cuando escribes queryKey: ['products', filtro], estás diciendo "estos datos existen en la aplicación bajo este identificador". A partir de ahí llegan la deduplicación de peticiones en vuelo, la invalidación cruzada, el stale-while-revalidate y las mutaciones optimistas. Todo eso son consecuencias de tener una clave y un almacén global, no de saber hacer un GET.

    Por eso la pregunta "¿cuál es mejor?" lleva casi siempre a la respuesta equivocada. Es como comparar fetch con Redis. Uno trae datos; el otro decide quién los tiene, cuándo caducan y a quién hay que avisar.

    La pregunta correcta es esta: ¿tu aplicación tiene un problema de caché de servidor, o solo tiene peticiones que dependen de un estado?

    Cinco pantallas CRUD con filtros y un detalle no tienen problema de caché. Un dashboard donde ocho componentes distintos leen el mismo listado, donde una mutación en un modal tiene que refrescar tres widgets y donde el usuario espera ver el cambio antes de que responda el servidor, sí lo tiene.

    El mismo caso resuelto con httpResource

    Lista de productos con filtro reactivo. Esta es la versión con la API estándar.

    import { Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    
    type Product = { id: string; name: string; price: number };
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isLoading()) {
          <p>Cargando…</p>
        } @else if (products.error()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.value(); track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      readonly query = signal('');
    
      readonly products = httpResource<Product[]>(
        () => `/api/products?q=${encodeURIComponent(this.query())}`,
        { defaultValue: [] },
      );
    }
    

    Cero dependencias. Cero providers. El HttpResourceRef te expone value, status, error, headers, statusCode, progress e isLoading como señales, más los métodos hasValue() y reload().

    Hay un detalle que se pasa por alto: la documentación oficial aclara que si hay una petición pendiente cuando cambia la dependencia, el resource cancela la anterior antes de lanzar la nueva. El caso del input que escribe rápido está resuelto de fábrica.

    Si quieres validar la respuesta, tienes la opción parse con Zod o Valibot. Y como usa HttpClient por debajo, tus interceptors de auth, de reintentos y de logging siguen aplicando sin tocar nada. Este patrón, con la arquitectura de señales completa alrededor, es lo que trabajo a fondo en el curso de Angular Moderno.

    El mismo caso resuelto con TanStack Query

    Mismo componente, otra filosofía. Primero el provider en el arranque.

    import { provideHttpClient } from '@angular/common/http';
    import { provideTanStackQuery, QueryClient } from '@tanstack/angular-query-experimental';
    
    bootstrapApplication(AppComponent, {
      providers: [provideHttpClient(), provideTanStackQuery(new QueryClient())],
    });
    

    Y el componente:

    import { Component, inject, signal } from '@angular/core';
    import { HttpClient } from '@angular/common/http';
    import { lastValueFrom } from 'rxjs';
    import {
      injectQuery,
      injectMutation,
      QueryClient,
    } from '@tanstack/angular-query-experimental';
    
    type Product = { id: string; name: string; price: number };
    type NewProduct = Omit<Product, 'id'>;
    
    @Component({
      selector: 'app-products',
      template: `
        <input [value]="query()" (input)="query.set($any($event.target).value)" />
    
        @if (products.isPending()) {
          <p>Cargando…</p>
        } @else if (products.isError()) {
          <p>No se pudo cargar el catálogo</p>
        } @else {
          <ul>
            @for (product of products.data() ?? []; track product.id) {
              <li>{{ product.name }} — {{ product.price }} €</li>
            }
          </ul>
        }
      `,
    })
    export class ProductsComponent {
      private readonly http = inject(HttpClient);
      private readonly queryClient = inject(QueryClient);
    
      readonly query = signal('');
    
      readonly products = injectQuery(() => ({
        queryKey: ['products', this.query()],
        queryFn: () =>
          lastValueFrom(
            this.http.get<Product[]>(`/api/products?q=${encodeURIComponent(this.query())}`),
          ),
      }));
    
      readonly createProduct = injectMutation(() => ({
        mutationFn: (product: NewProduct) =>
          lastValueFrom(this.http.post<Product>('/api/products', product)),
        onSuccess: () => {
          this.queryClient.invalidateQueries({ queryKey: ['products'] });
        },
      }));
    }
    

    Fíjate en lo que aparece y en lo que desaparece.

    Aparece el queryKey: ese array es la identidad de los datos en toda la aplicación. Si otros seis componentes montan la misma clave, hay una sola petición y una sola copia en memoria. Y aparece invalidateQueries, la pieza que httpResource no tiene: un componente puede invalidar datos que él nunca pidió.

    Desaparece la simplicidad. Tienes un provider global, un queryFn que devuelve promesas (de ahí el lastValueFrom para puentear el observable de HttpClient) y un vocabulario nuevo que todo el equipo tiene que aprender.

    Tabla comparativa: httpResource vs TanStack Query en Angular 22

    Solo celdas verificadas contra la documentación y los tipos publicados de ambos proyectos, a septiembre de 2026: Angular 22.1.4 y @tanstack/angular-query-experimental 5.102.8.

    Criterio httpResource (Angular 22) TanStack Query (adaptador Angular)
    Estabilidad Estable desde v22.0 Experimental: breaking changes en releases minor y patch
    Dependencias Ninguna, viene en @angular/common/http @tanstack/angular-query-experimental, que arrastra @tanstack/query-core
    Caché compartida entre componentes No Sí, por queryKey
    Deduplicación de peticiones en vuelo No entre instancias; cancela su propia petición anterior Sí, por clave
    Invalidación por clave No queryClient.invalidateQueries({ queryKey })
    Stale-while-revalidate Conserva el valor anterior mientras recarga, pero no hay política de caducidad ni refetch en segundo plano Sí, con staleTime y refetch en segundo plano
    Reintentos automáticos No incluidos (las opciones son parse, defaultValue, injector, equal y debugName) Sí, tres reintentos por defecto con backoff exponencial
    Mutaciones y updates optimistas Fuera de alcance por diseño injectMutation con invalidación en onSuccess
    Paginación infinita A mano injectInfiniteQuery
    Devtools de datos Sin panel de caché propio; los nodos aparecen en el signal graph de Angular DevTools vía debugName withDevtools() desde el subpath /devtools
    Interceptors de HttpClient Siempre, usa HttpClient por debajo Solo si el queryFn usa HttpClient
    Testing HttpTestingController estándar provideTanStackQuery en TestBed, QueryClient nuevo por spec, retry: false, y requiere Angular ≥ 19
    SSR / hydration Entra en el transfer cache de provideClientHydration Sin guía de SSR propia para Angular; expone injectIsRestoring
    Versión mínima de Angular 22 para la versión estable 16 (19 para la integración de testing)

    Dónde httpResource se queda corto de verdad

    No voy a defender la API estándar más allá de lo que aguanta. Hay cuatro escenarios en los que httpResource te deja escribiendo infraestructura a mano.

    Caché compartida entre componentes. Si el header, la sidebar y la tabla montan tres httpResource contra /api/user, son tres peticiones. No hay almacén común. Puedes subir el resource a un servicio con providedIn: 'root' y compartirlo, claro, pero eso ya es tu caché artesanal, con tus reglas de caducidad escritas por ti y mantenidas por ti.

    Invalidación cruzada tras una mutación. Guardas un producto en un modal y necesitas refrescar el listado, el contador del carrito y el widget de novedades. Con httpResource toca llamar a reload() en cada uno, lo que obliga al modal a conocer a esos tres. Es acoplamiento, y escala mal.

    Paginación infinita. Acumular páginas, saber si hay siguiente, mantener el scroll. injectInfiniteQuery te lo da resuelto. A mano son varias tardes y unos cuantos bugs sutiles.

    Actualizaciones optimistas con rollback. Pintar el cambio antes de que responda el servidor y deshacerlo limpio si falla es un problema de gestión de estado, no de HTTP.

    Y añado una limitación que no es un defecto sino una decisión de diseño: la documentación de Angular es explícita en que hay que evitar httpResource para mutaciones tipo POST o PUT, y usar directamente HttpClient. httpResource lee; no escribe.

    Dónde TanStack Query te sale caro

    Empecemos por lo que está escrito en su propia web, palabra por palabra:

    "This library is currently in an experimental stage. This means that breaking changes will happen in minor AND patch releases."

    Léelo otra vez, porque no es la típica etiqueta beta de adorno. Es el equipo de TanStack diciéndote que un patch puede romperte la capa de datos. Y no es un aviso antiguo: sigue ahí, en la documentación del adaptador de Angular, con el paquete en la versión 5.102.8. El "experimental" está en el nombre del paquete que vas a escribir en tu package.json.

    En una prueba de concepto da igual. En una aplicación de empresa que va a vivir cinco años y que mantendrá otro equipo, eso significa fijar la versión, leerte cada changelog y aceptar que una parte crítica de tu arquitectura evoluciona a un ritmo que tú no controlas.

    El segundo coste es más sutil: te sales del ecosistema de HttpClient. Los interceptors de Angular solo se aplican si tu queryFn usa HttpClient. En cuanto alguien del equipo escribe un queryFn con fetch porque le resulta más cómodo, esa petición se salta el interceptor de auth, el de reintentos y el de trazas. Y no falla en desarrollo: falla el día que caduca un token en producción.

    Ese mismo salto te afecta al testing. httpResource se testea con HttpTestingController, igual que cualquier otra llamada de tu aplicación. Con TanStack Query montas provideTanStackQuery en el TestBed, creas un QueryClient limpio en cada spec, desactivas los reintentos para que los fallos no tarden tres backoffs y esperas a whenStable(). Se puede, está documentado, pero es una capa más que mantener. Si quieres el enfoque completo de testing en Angular moderno, lo tienes en el curso de Testing en Angular con Jest y Testing Library.

    Y el tercer coste es el SSR. httpResource usa HttpClient, así que se beneficia del transfer cache de la hidratación sin que hagas nada. El adaptador de Angular de TanStack Query no publica hoy una guía de SSR equivalente a la de React.

    Veredicto: el árbol de decisión

    Me mojo.

    Por defecto, httpResource. En un proyecto Angular 22 nuevo, empieza con la API estándar. Es estable, no amplía tu superficie de dependencias, integra con interceptors, testing y SSR, y cubre el 80% de los casos reales: listados, detalles, filtros, buscadores. Si hoy dudas, esta es tu respuesta.

    TanStack Query cuando se cumplen las tres condiciones a la vez:

    1. Varios componentes independientes consumen los mismos datos de servidor y quieres una única fuente en memoria.
    2. Necesitas invalidación cruzada tras mutaciones, scroll infinito o updates optimistas, y ya has calculado lo que cuesta escribir todo eso a mano.
    3. Aceptas el riesgo de breaking changes en versiones patch y vas a fijar la versión exacta.

    Si falla una sola de las tres, no lo metas.

    Y la opción que casi nadie considera: los dos. No son excluyentes. Puedes servir el grueso de tus pantallas con httpResource y reservar TanStack Query para el módulo de dashboard donde de verdad existe un problema de caché compartida. Aísla la decisión en una zona del código en lugar de casarte con ella en toda la aplicación.

    Lo que no vale es lo que hacía el dev del package.json: instalarlo el primer día porque en React lo usabas. Angular 22 no es React. El grafo de señales que llegó con la v22 ya te da reactividad de primera clase, y esa es justo la pieza que TanStack Query tuvo que inventar en el mundo de los hooks.

    Qué hacer hoy

    Abre tu proyecto y cuenta cuántos componentes distintos piden el mismo endpoint. Solo eso.

    Si el número es cero o uno, no tienes un problema de caché de servidor: tienes peticiones reactivas, y httpResource te sobra para resolverlas. Si el número es tres o más, y además hay mutaciones que deben refrescar varias vistas a la vez, ahí sí te has ganado el derecho a meter una dependencia externa en la capa de datos.

    Ese conteo tarda diez minutos y vale más que cualquier hilo de discusión en X.

    En Dominicode Labs trabajamos este tipo de decisiones de arquitectura sobre proyectos reales, no sobre ejemplos de listas de tareas. Y si prefieres verlo en vídeo, en el canal de YouTube publico cada semana contenido de Angular moderno e IA aplicada al desarrollo.

    Preguntas frecuentes

    ¿Qué es mejor en Angular 22, httpResource o TanStack Query?

    httpResource es la mejor opción por defecto en Angular 22: es la API estándar, es estable desde la versión 22.0, no añade dependencias y hereda los interceptors, el testing y el transfer cache de HttpClient. TanStack Query solo compensa cuando varios componentes independientes consumen los mismos datos y necesitas invalidación por clave, mutaciones optimistas o scroll infinito. No resuelven el mismo problema: httpResource es una primitiva de petición reactiva y TanStack Query es una capa de caché de estado de servidor.

    ¿httpResource cachea las peticiones?

    No, y ese malentendido origina la mitad de las discusiones sobre el tema. httpResource no mantiene un almacén de datos por clave: lanza la petición cuando cambian las señales de las que depende y expone el resultado como señal. Si necesitas que varios componentes compartan la misma copia en memoria, tienes que construir esa caché tú, por ejemplo elevando el resource a un servicio raíz, o usar una librería que ya la traiga resuelta.

    ¿Puedo usar httpResource y TanStack Query en la misma aplicación?

    Sí, y en muchos proyectos es la decisión más sensata. Nada impide resolver el grueso de las pantallas con la API estándar de Angular y reservar TanStack Query para el módulo concreto que tiene un problema real de caché compartida e invalidación cruzada. Así limitas la superficie de la dependencia externa a una zona del código, en lugar de extenderla por toda la base.

    ¿Es seguro usar el adaptador de Angular de TanStack Query en producción?

    Sí, siempre que fijes la versión exacta, revises el changelog antes de cada actualización y tengas tests que cubran la capa de datos. El riesgo está declarado en su propia documentación: habrá cambios que rompan en versiones minor y también en versiones patch. Si el proyecto lo va a mantener otro equipo dentro de dos años, piénsalo dos veces.

    ¿Los interceptors de HttpClient funcionan con TanStack Query?

    Solo si la función de la query usa HttpClient por debajo. Si alguien la escribe con fetch o con axios porque le resulta más cómodo, esa petición se salta los interceptors de autenticación, reintentos y trazas de Angular, y el problema aparecerá en producción y no en desarrollo. Si adoptas la librería, conviene dejar por escrito en el equipo que toda petición pasa por HttpClient.

    ¿Sirve httpResource para POST y PUT?

    No, y no es una limitación sino una decisión de diseño. La documentación de Angular recomienda de forma explícita evitar httpResource para mutaciones y usar directamente las APIs de HttpClient. httpResource está pensado para leer datos de forma reactiva; escribir es otro problema, con otro ciclo de vida y otros requisitos de control de errores.

    ¿Qué versión de Angular necesito para cada opción?

    httpResource es estable desde Angular 22.0 y vive en el paquete de HTTP común, así que no tienes que instalar nada. El adaptador de TanStack Query declara compatibilidad desde Angular 16 en adelante, aunque su propia guía de testing avisa de que esa integración requiere Angular 19 o superior, porque las versiones anteriores no soportan PendingTasks.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Human in the loop: tu agente no puede esperar en un await

    Human in the loop: tu agente no puede esperar en un await

    El mensaje llegó a Slack a las 19:42: «El agente quiere reembolsar 38 pagos por 4.120 €. ¿Apruebas?».

    La responsable de soporte de mi cliente, Marta, lo leyó a las 23:10, desde el sofá, y pulsó el botón verde. No pasó nada.

    Bueno, esa noche no pasó nada. Al día siguiente pasó tres veces de más.

    El human in the loop de aquel agente eran catorce líneas: una llamada a Slack y un await esperando la respuesta. En local funcionaba precioso. En producción, la función serverless se había muerto tres horas antes de que nadie pulsara nada, con la conversación entera en memoria.

    El arreglo de urgencia fue relanzar el agente con «el usuario ya aprobó los reembolsos» metido en el prompt. El modelo volvió a planificar desde cero, esta vez encontró 41 pagos fallidos en vez de 38 — habían entrado tres nuevos por la noche — y reembolsó los 41.

    El humano había aprobado 38. El agente ejecutó 41. Y nadie podía decir qué se aprobó exactamente, porque la propuesta solo había existido en la RAM de un proceso muerto.

    Eso no es un bug. Es lo que pasa cuando tratas la aprobación humana como un if.


    Qué es el human in the loop: la aprobación es asíncrona, tu loop no

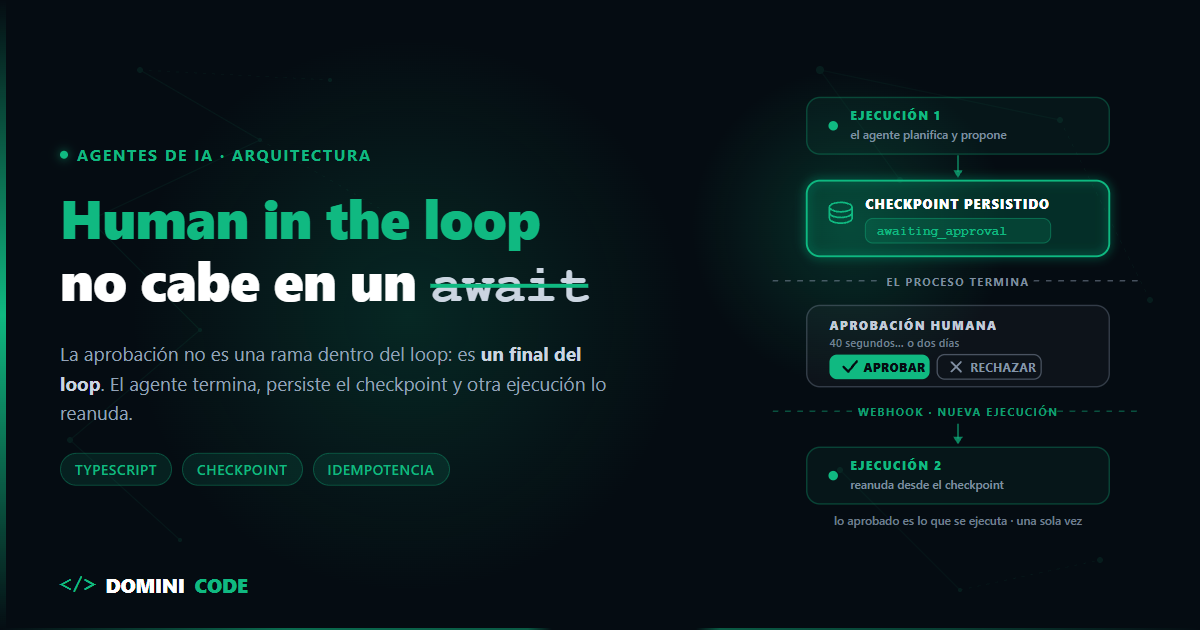
    El human in the loop (HITL) en un agente de IA es el patrón por el que el agente detiene su ejecución antes de una acción irreversible —mover dinero, enviar emails, borrar datos, desplegar— y solo continúa cuando una persona la aprueba, la edita o la rechaza. La diferencia entre que funcione y que no está en dónde ocurre esa pausa: no dentro del bucle, sino al final de una ejecución que termina y de otra que la retoma.

    El agentic loop es una función: el modelo piensa, pide una herramienta, tú la ejecutas, le devuelves el resultado, repites. Todo dentro de la misma llamada, con el array de mensajes creciendo en memoria.

    Meter una aprobación humana ahí parece trivial. Un if antes de ejecutar, una notificación, y esperas.

    El problema es lo que hay al otro lado de esa espera: una persona. Y en lo que llevo medido, una persona tarda entre cuarenta segundos y dos días. Tu proceso no aguanta ni lo primero.

    Se muere por el timeout de la función serverless. Se muere porque despliegas. Se muere por un reinicio del contenedor, por un OOM, porque el usuario cerró la pestaña y tu handler se canceló. Un await de seis horas no es una espera: es una apuesta a que nada se reinicie en seis horas.

    Y en el caso improbable de que sobreviva, tienes un proceso vivo con la conversación completa en memoria, sin hacer absolutamente nada, ocupando RAM y una conexión abierta. Multiplícalo por doscientas aprobaciones pendientes un lunes por la mañana.

    Hay un tercer problema, y es el que acaba en una reunión incómoda: si el estado vive en memoria, no existe. Nadie puede responder a «¿qué aprobó exactamente Marta el jueves a las 23:10?».

    Así que la regla de diseño es esta: la aprobación humana no es una rama dentro del loop, es un final del loop. El agente termina su ejecución devolviendo un estado «esperando decisión». Una ejecución nueva y distinta, disparada por el webhook de aprobación, lo retoma donde se quedó.

    Un punto de aprobación es una frontera de proceso. Todo lo demás sale de ahí.


    Qué acciones necesitan aprobación humana: los tres niveles de riesgo

    Antes de suspender nada hay que decidir qué merece suspenderse. Y aquí casi todo el mundo se pasa de frenada.

    Un agente que pregunta cuarenta veces al día se desactiva solo. Peor todavía: no se desactiva, y el humano aprende a pulsar «Aprobar» sin leer. Un botón que se pulsa siempre no es un control, es un ritual.

    Clasifica cada herramienta en tres niveles:

    Nivel Ejemplos ¿Aprobación?
    Read-only Buscar pedidos, leer un fichero, consultar saldo Nunca. Ni una sola vez
    Reversible Crear un borrador, etiquetar, abrir un PR, escribir en staging No, pero deja rastro y ten un deshacer
    Irreversible Reembolsar, enviar email, borrar registros, desplegar, publicar Sí, salvo por debajo de un umbral

    El matiz que lo cambia todo: el riesgo no está en la herramienta, está en los argumentos. sendEmail a un destinatario es soporte normal; a doce mil, es una campaña que nadie autorizó. refundPayments de 3 € es ruido; de 4.120 € es una conversación.

    Y el lote es una decisión, no treinta y ocho. Si tu tool reembolsa de uno en uno, el agente pedirá permiso treinta y ocho veces y habrás construido el autoclick con tus propias manos. La herramienta que se aprueba recibe el lote entero y el umbral se calcula sobre el total.

    Por eso la política de aprobación es una función del input, no un booleano en la definición de la tool:

    // tool-policy.ts
    export type RiskLevel = "read_only" | "reversible" | "irreversible";
    export type ApprovalMode = "auto" | "human";
    
    export interface ToolPolicy<TInput> {
      risk: RiskLevel;
      approval: (input: TInput) => ApprovalMode;
    }
    
    const definePolicy = <TInput>(policy: ToolPolicy<TInput>): ToolPolicy<TInput> => policy;
    
    export const toolPolicies = {
      searchOrders: definePolicy<{ status: string }>({
        risk: "read_only",
        approval: () => "auto",
      }),
      draftRefundReport: definePolicy<{ orderIds: string[] }>({
        risk: "reversible",
        approval: () => "auto",
      }),
      refundPayments: definePolicy<{ orderIds: string[]; totalCents: number }>({
        risk: "irreversible",
        // El umbral mira el lote entero, no el pago suelto.
        approval: ({ orderIds, totalCents }) =>
          totalCents > 5_000 || orderIds.length > 1 ? "human" : "auto",
      }),
      sendEmail: definePolicy<{ to: string[]; subject: string }>({
        risk: "irreversible",
        approval: ({ to }) => (to.length > 1 ? "human" : "auto"),
      }),
      deleteCustomers: definePolicy<{ ids: string[] }>({
        risk: "irreversible",
        approval: () => "human",
      }),
    } as const;
    
    export function approvalModeFor(toolName: string, input: unknown): ApprovalMode {
      const policy = toolPolicies[toolName as keyof typeof toolPolicies];
      // Fail-closed: una tool que no está en el mapa NO se ejecuta sola.
      // El día que alguien añada una herramienta y olvide la política, el
      // agente preguntará de más. Ese es el fallo barato.
      if (!policy) return "human";
      return (policy.approval as (input: unknown) => ApprovalMode)(input);
    }
    

    El cast de la última línea es el precio de tener un mapa heterogéneo. Lo pago en un único punto del sistema y no en cada herramienta, que es justo el reparto que quiero.

    Los umbrales no son constantes de por vida. Empieza pidiendo aprobación de todo lo irreversible, y a las tres semanas, con el registro de decisiones delante, súbelos donde el humano lleve treinta aprobaciones seguidas sin rechazar ni una. Si un umbral nunca se ha movido, es que nadie está mirando.

    Y si al terminar la clasificación resulta que todo requiere aprobación, no tienes un agente: tienes un formulario caro. Eso significa que le has dado herramientas que no debía tener, y el arreglo está antes, en el perímetro de ejecución, como conté en guardrails para agentes con acceso a terminal y base de datos.

    Esta tabla, además, se escribe antes que el código. Qué es irreversible en tu dominio es una decisión de producto, no de implementación, y va en la spec junto al resto de reglas del sistema — es literalmente uno de los apartados que defiendo en el libro de Spec-Driven Development.


    Cómo interrumpir y reanudar un agente de IA sin perder el estado

    Ahora el núcleo. El loop tiene que poder terminar a mitad de un turno y volver a arrancar horas después como si nada.

    Declaro las herramientas sin función de ejecución: el modelo puede pedirlas, pero quien decide si se ejecutan soy yo, en mi código. Ese es el punto de control.

    // agent-run.ts
    import { generateText, type ModelMessage, type JSONValue } from "ai";
    import { approvalModeFor } from "./tool-policy";
    import { buildPreview, type ApprovalPreview } from "./preview";
    import { checkpoints } from "./checkpoints";
    import { executeTool } from "./execute-tool";
    // model, SYSTEM_PROMPT y toolSchemas salen de tu configuración del agente.
    // executeTool: (call: PendingCall, opts?: { idempotencyKey?: string }) => Promise<JSONValue>
    import { model, SYSTEM_PROMPT, toolSchemas } from "./config";
    
    export interface PendingCall {
      toolCallId: string;
      toolName: string;
      input: unknown;
    }
    
    export interface PendingApproval extends PendingCall {
      approvalId: string;
      preview: ApprovalPreview;
      requestedAt: string;
      expiresAt: string;
    }
    
    export type AgentOutcome =
      | { status: "completed"; text: string }
      | { status: "awaiting_approval"; runId: string; approval: PendingApproval }
      | { status: "already_resolved" }
      | { status: "exhausted"; stepsUsed: number };
    
    const MAX_STEPS = 12;
    
    // El shape exacto del resultado de tool depende de tu SDK.
    // Este es el de AI SDK 5+; en 4.x era { type: "tool-result", result }.
    export const toolResult = (call: PendingCall, value: JSONValue) => ({
      type: "tool-result" as const,
      toolCallId: call.toolCallId,
      toolName: call.toolName,
      output: { type: "json" as const, value },
    });
    
    export async function runAgent(
      runId: string,
      initial: ModelMessage[],
      stepsUsed = 0,
    ): Promise<AgentOutcome> {
      const messages = [...initial];
    
      for (let step = stepsUsed; step < MAX_STEPS; step++) {
        const turn = await generateText({ model, system: SYSTEM_PROMPT, messages, tools: toolSchemas });
        messages.push(...turn.response.messages);
    
        if (turn.toolCalls.length === 0) return { status: "completed", text: turn.text };
    
        const results: ReturnType<typeof toolResult>[] = [];
    
        for (const [index, call] of turn.toolCalls.entries()) {
          // En AI SDK 4.x los argumentos viajan en call.args, no en call.input
          if (approvalModeFor(call.toolName, call.input) === "auto") {
            results.push(toolResult(call, await executeTool(call)));
            continue;
          }
    
          // Hay una llamada que necesita un humano. El turno se acaba aquí.
          // Las llamadas que quedaban detrás NO se ejecutan, pero necesitan
          // un resultado: el protocolo exige responder a todas las tool calls.
          const deferred = turn.toolCalls.slice(index + 1).map((rest) =>
            toolResult(rest, {
              ok: false,
              deferred: true,
              instruction:
                "No se ejecutó: el turno se detuvo esperando una aprobación humana. " +
                "Si sigue siendo necesaria, vuelve a pedirla después.",
            }),
          );
    
          const approval: PendingApproval = {
            ...call,
            approvalId: crypto.randomUUID(),
            preview: await buildPreview(call),
            requestedAt: new Date().toISOString(),
            expiresAt: new Date(Date.now() + 24 * 60 * 60 * 1000).toISOString(),
          };
    
          await checkpoints.save({
            runId,
            messages,
            partialResults: [...results, ...deferred],
            approval,
            stepsUsed: step + 1, // el presupuesto no se reinicia al reanudar
          });
    
          return { status: "awaiting_approval", runId, approval };
        }
    
        messages.push({ role: "tool", content: results });
      }
    
      return { status: "exhausted", stepsUsed: MAX_STEPS };
    }
    

    Fíjate en el bloque deferred, que es la parte que casi nadie ve venir. Cuando el modelo pide tres herramientas en el mismo turno y la segunda necesita aprobación, no puedes limitarte a guardar y salir: los proveedores exigen que cada tool call tenga su resultado antes de continuar la conversación. Si dejas una huérfana, al reanudar te comes un 400 y no entiendes por qué — el AI SDK tiene hasta un error con nombre propio para esto, MissingToolResultsError.

    El checkpoint guarda tres cosas y las tres hacen falta: los mensajes hasta ese punto, los resultados parciales del turno a medias, y la llamada pendiente con su preview. Eso es todo el agente, serializado. En Postgres, en una tabla con run_id, approval_id, status y un jsonb.

    El resto de la función que expone esto por HTTP es aburrido a propósito: si el status es awaiting_approval, mandas la notificación y devuelves un 202. La petición termina. El proceso puede morirse tranquilo. Y el presupuesto de pasos sigue siendo tuyo, exactamente igual que en el agentic loop en producción.

    Esto es, con otros nombres, lo que hacen los frameworks. LangGraph lo llama interrupts: la función interrupt() congela el grafo, el checkpointer persiste el estado y se reanuda con new Command({ resume }) sobre el mismo thread_id.

    El AI SDK trae tool approvals, y aquí hay que fijarse en dos cosas. La primera, dónde se declara: toolApproval no va dentro de la tool, va como opción de generateText, streamText o del ToolLoopAgent, en un mapa indexado por nombre de herramienta. Cada política recibe el input tipado y devuelve 'user-approval', undefined si no aplica, o un { type: 'denied', reason }. La segunda, la versión: esa API llegó en la v7 y no existe en la 5, que es contra la que está escrito el código de este post.

    Enfoque Cómo se pausa Dónde vive el estado Qué te sigue tocando a ti
    Propio (este post) El loop devuelve awaiting_approval y la API un 202 Tabla agent_runs en Postgres, columna jsonb Todo, pero sin sorpresas
    LangGraph interrupt() congela el grafo en el nodo Checkpointer (memoria, Postgres, SQLite) Caducidad, idempotencia y el mensaje de rechazo
    AI SDK v7 toolApproval deja la tool pendiente Lo persistes tú Dónde guardas los mensajes y qué haces al reanudar

    Úsalos si te encajan — pero ninguno responde por ti dónde vive el checkpoint, quién limpia los que nadie aprobó y qué le cuentas al modelo cuando la respuesta es que no. Si prefieres modelar todo esto como estados explícitos, el enfoque de grafo de estados frente al loop clásico resuelve bastante bien la parte de la máquina de estados.

    Los ejemplos de este post están escritos y verificados en septiembre de 2026 contra AI SDK 5 y LangGraph JS; si estás en AI SDK 4.x, los argumentos viajan en call.args y el resultado en result en vez de output.


    Qué debe ver el humano: sin datos, la aprobación es una firma

    «El agente quiere borrar 1.204 clientes. ¿Apruebas?» no es una pregunta. Es un trámite.

    Nadie puede aprobar eso de verdad, porque no hay nada que evaluar. Y si no hay nada que evaluar, el humano no está decidiendo: está firmando.

    El payload de aprobación tiene que llevar lo suficiente para decir que no:

    // preview.ts
    export interface ApprovalPreview {
      title: string;          // "Reembolsar 38 pagos — 4.120,00 €"
      rationale: string;      // por qué el agente cree que hay que hacerlo
      impact: string[];       // efectos concretos, contados
      payload: unknown;       // exactamente lo que se va a ejecutar, sin resumir
      sample: unknown[];      // 5 filas afectadas, para oler el error
      reversible: boolean;
      precondition: { name: string; value: string | number }; // se revalida al reanudar
    }
    

    Cuatro reglas, y la primera es innegociable.

    El preview lo genera tu código, no el modelo. Si el resumen que lee el humano lo escribe el mismo LLM cuya acción estás supervisando, has montado un control donde el vigilado redacta el informe. Y si esa tool call llegó por una inyección de prompt en un email que el agente leyó, el resumen viene envenenado igual — el mismo problema que trato en tácticas defensivas contra inyección de prompts. El texto lo compone tu función a partir de los argumentos y de una consulta real a tu base de datos.

    Números, no adverbios. «Varios registros» no se puede aprobar. «1.204 registros, de los cuales 6 tienen facturas emitidas este trimestre» se aprueba o se rechaza en cuatro segundos.

    Una muestra. Cinco filas de las que van a cambiar. Es donde el humano detecta que el filtro estaba mal, y le cuesta una consulta barata a tu API.

    Una precondición y una caducidad. Guarda el número que justificaba la acción — 38 pagos fallidos — y vuelve a comprobarlo al reanudar. Una aprobación de hace seis horas puede estar aprobando un mundo que ya no existe: si ahora hay 41, no ejecutas, vuelves a preguntar. Exactamente el fallo que le costó tres reembolsos de más a mi cliente.


    Idempotencia: reanudar el agente sin ejecutar la acción dos veces

    Persistir el estado abre la puerta al segundo problema del día: el botón se puede pulsar dos veces. Y se pulsa. El humano da doble clic, el webhook de Slack reintenta porque tu 200 tardó, alguien reenvía el enlace por WhatsApp.

    Necesitas dos capas, porque cada una tapa un agujero distinto.

    La primera es un compare-and-swap en la base de datos. No leas el checkpoint y luego lo actualices: reclámalo en una sola sentencia atómica.

    UPDATE agent_runs
       SET status = 'resuming', resolved_at = now()
     WHERE run_id = $1
       AND approval_id = $2
       AND status = 'awaiting_approval'
    RETURNING checkpoint;
    

    Si devuelve cero filas, alguien te ganó la carrera. No es un error: es el sistema funcionando. Devuelves un 200 idempotente y te callas.

    Y ponle un timeout también al estado resuming: si el proceso se muere justo después de reclamar el checkpoint, esa fila se queda ahí para siempre y el job de caducidad, que solo mira awaiting_approval, no la va a rescatar nunca.

    // resume.ts
    export type Decision =
      | { type: "approved"; approvedBy: string }
      | { type: "approved_with_changes"; approvedBy: string; input: unknown }
      | { type: "rejected"; approvedBy: string; reason: string };
    
    export async function resumeRun(
      runId: string,
      approvalId: string,
      decision: Decision,
    ): Promise<AgentOutcome> {
      const claimed = await checkpoints.claim(runId, approvalId);
      if (!claimed) return { status: "already_resolved" };
    
      const { messages, partialResults, approval, stepsUsed } = claimed;
    
      if (decision.type === "rejected") {
        const denial = toolResult(approval, buildDenialResult(approval, decision));
        return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, denial] }], stepsUsed);
      }
    
      const input =
        decision.type === "approved_with_changes" ? decision.input : approval.input;
    
      // El payload lleva horas en la base de datos y vuelve a entrar por la puerta.
      // Se valida otra vez contra el schema de la tool, como si viniera de fuera.
      const parsed = toolSchemas[approval.toolName as keyof typeof toolSchemas].inputSchema.parse(input);
    
      // La precondición que vio el humano tiene que seguir siendo verdad
      const still = await checkPrecondition(approval.preview.precondition);
      if (!still.ok) return requestApprovalAgain(runId, approval, still.current);
    
      // idempotencyKey = approvalId: si esto se ejecuta dos veces, el proveedor
      // devuelve el mismo resultado en lugar de mover el dinero otra vez
      const output = await executeTool({ ...approval, input: parsed }, { idempotencyKey: approvalId });
    
      const result = toolResult(approval, {
        ok: true,
        approvedBy: decision.approvedBy,
        executedInput: parsed, // lo que se ejecutó de verdad, no lo que se pidió
        data: output,
      });
    
      return runAgent(runId, [...messages, { role: "tool", content: [...partialResults, result] }], stepsUsed);
    }
    

    La segunda capa es la idempotencia aguas abajo. El compare-and-swap te protege del doble clic, pero no del proceso que se cae justo entre mover el dinero y escribir en la base de datos que lo movió. Para eso la acción tiene que ser idempotente en el otro extremo: la clave de idempotencia de Stripe, una restricción única en la tabla de efectos, un INSERT ... ON CONFLICT DO NOTHING. Usa el approvalId como clave y el reintento devuelve el mismo resultado en lugar de un segundo reembolso. Y no es casualidad que el expiresAt de la aprobación sean 24 horas: Stripe purga las claves de idempotencia a partir de las 24 horas de antigüedad, así que una aprobación que sobreviviera a esa ventana perdería justo la red que la protegía.

    Y ojo con el parse de esa función, que parece decorativo y no lo es. Ese payload salió de tu proceso hace ocho horas, ha dormido en una base de datos y vuelve por un endpoint público. Tratarlo como dato de confianza porque «lo generamos nosotros» es el tipo de suposición que valido siempre en frontera, con el enfoque de schemas del curso de Zod para TypeScript.


    Qué le devuelves al modelo cuando el humano dice que no

    Aquí es donde se cae la mitad de las implementaciones que he revisado.

    Devuelven esto:

    { "error": "denied" }
    

    Y el modelo hace lo que hace un modelo ante una puerta cerrada: buscar otra. Reintenta con parámetros distintos, parte el borrado en dos llamadas de 600 registros, o directamente redacta una respuesta final diciendo que los reembolsos se han procesado correctamente. Un rechazo que parece un fallo técnico se lee como un fallo técnico.

    El resultado de una tool es prompt. Escríbelo como tal:

    {
      "ok": false,
      "approvalDenied": true,
      "toolName": "refundPayments",
      "deniedBy": "marta@cliente.com",
      "reason": "12 de los 38 pagos son de un lote que ya se reembolsó manualmente el viernes.",
      "instruction": "Un humano ha rechazado esta acción. No vuelvas a llamar a \"refundPayments\" en esta conversación, ni con otros parámetros, ni en lotes más pequeños, ni a través de otra herramienta. No intentes conseguir el mismo efecto por otra vía. Explica al usuario qué ibas a hacer, cuál fue el motivo del rechazo, y termina el turno sin ejecutar nada más."
    }
    

    Cuatro ingredientes y los cuatro son necesarios:

    1. Que fue una persona, no un error de red. Cambia por completo la interpretación.
    2. El motivo en lenguaje humano. Es información nueva y real que el modelo no tenía.
    3. La prohibición de buscar rutas alternativas, dicha de forma explícita. Sin esta línea, el modelo trocea la acción y lo vuelve a intentar.
    4. Qué hacer ahora. Terminar y reportar. Si no le das salida, se inventa una.

    Y existe un tercer estado que casi nadie modela: aprobado con cambios. El humano no rechaza, edita — baja el reembolso a 26 pagos y aprueba. En ese caso, el resultado que devuelves debe llevar el executedInput real, porque si el modelo cree que se ejecutaron 38 va a escribirle al usuario que se reembolsaron 38. La verdad de lo que pasó viaja en el resultado de la tool o no viaja.

    Añade también una línea al system prompt describiendo el protocolo: «si el resultado de una herramienta trae approvalDenied: true, esa acción está vetada para el resto de la conversación; sigue el campo instruction y no busques alternativas». El modelo obedece bastante bien cuando la instrucción es específica y llega en el momento en que toma la decisión.


    Cómo implementar human in the loop hoy en tu agente

    No montes el sistema entero. Coge la herramienta más peligrosa de tu agente — todos sabemos cuál es — y hazle tres cosas esta tarde.

    Sácala del execute automático. Haz que tu loop, al llegar a ella, guarde los mensajes y la llamada pendiente en una tabla y devuelva un 202. Y escribe el resultado de rechazo como si fuera un prompt, porque lo es.

    Con eso ya tienes lo importante: un agente que puede quedarse esperando sin estar vivo.

    La idea de fondo es la misma que con cualquier mecanismo de defensa en un agente: si no le hablas al modelo, no lo estás controlando, solo lo estás frenando. Y un modelo frenado sin explicaciones busca la puerta de al lado.

    Decidir todo esto antes de escribir el código — qué es irreversible, quién aprueba, qué pasa cuando la respuesta es no — es el método que enseño en el curso Construye con IA: de la idea al producto.

    Y si prefieres verlo funcionando antes que leerlo, en Dominicode Labs estamos rodando estos checkpoints sobre proyectos reales, con la tabla de aprobaciones y el audit trail puestos.


    Preguntas frecuentes

    ¿Qué es human in the loop en un agente de IA?

    Human in the loop (HITL) es el patrón por el que un agente de IA detiene su ejecución antes de realizar una acción irreversible y solo continúa cuando una persona la aprueba, la edita o la rechaza. En una implementación correcta la pausa no es un await: el agente termina su ejecución guardando un checkpoint con los mensajes y la llamada pendiente, y una ejecución nueva, disparada por la decisión del humano, lo reanuda desde ahí. Aplica a mover dinero, enviar emails masivos, borrar registros, desplegar y publicar.

    ¿Puedo implementar human in the loop con un simple await hasta que el humano responda?

    Solo si el humano contesta en segundos y tu proceso es de larga vida. En cuanto la aprobación puede tardar minutos, el await deja de ser una espera y pasa a ser una apuesta: un despliegue, un timeout de la función serverless o un reinicio del contenedor se llevan por delante todo el estado del agente. Además pagas RAM y una conexión abierta por cada aprobación pendiente. La alternativa correcta es terminar la ejecución, persistir el checkpoint y reanudar con una ejecución nueva.

    ¿Qué acciones de un agente deben requerir aprobación humana?

    Las irreversibles, y dentro de ellas solo las que superan un umbral. Todo lo de solo lectura va sin aprobación siempre; lo reversible va sin aprobación pero con registro y con una forma de deshacer; lo irreversible — mover dinero, enviar emails, borrar, desplegar, publicar — pide permiso. El umbral se calcula sobre los argumentos, no sobre la herramienta: un reembolso de 3 € y uno de 4.000 € usan la misma tool y no tienen el mismo riesgo.

    ¿Dónde guardo el estado del agente mientras espera la aprobación?

    En un almacén duradero fuera del proceso: una tabla en Postgres con run_id, approval_id, status y una columna jsonb con los mensajes, los resultados parciales del turno y la llamada pendiente. Redis sirve si tiene persistencia y si el TTL es mayor que el tiempo máximo de aprobación, pero para acciones que mueven dinero quieres una tabla auditable donde consultar meses después quién aprobó qué.

    ¿Qué pasa si nadie aprueba nunca la acción del agente?

    Que se te llena la base de datos de agentes zombis, así que la caducidad forma parte del diseño. Pon un expiresAt en cada aprobación, y un job que cierre las vencidas devolviendo al modelo un resultado de expiración con la misma estructura que el rechazo — para que el agente pueda cerrar la conversación explicando qué quedó sin hacer. Si un tipo de aprobación caduca de forma sistemática, el problema no es el TTL: es que estás pidiendo permiso para algo que a nadie le importa.

    ¿Cómo evito que el agente ejecute dos veces si la aprobación llega duplicada?

    Con dos capas. La primera es reclamar el checkpoint con un UPDATE ... WHERE status = 'awaiting_approval' RETURNING, en una sola sentencia atómica: si devuelve cero filas, otro ya lo reanudó y no ejecutas nada. La segunda es hacer idempotente la acción en el otro extremo, usando el approvalId como clave de idempotencia o como restricción única, porque el compare-and-swap no te salva si el proceso se cae justo después de mover el dinero y antes de registrarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Guardrails para agentes: probé la blocklist típica y pasan 16 de 20

    Guardrails para agentes: probé la blocklist típica y pasan 16 de 20

    La primera semana que le das a un agente acceso a tu terminal te sientes invencible.

    Le pides que instale una dependencia, ejecute los tests, cree una rama y arregle un bug. Y lo hace, mientras tú haces otra cosa.

    Después llega la pregunta incómoda: ¿qué pasa exactamente si se equivoca?

    Casi todo el mundo responde igual. Ha metido en el System Prompt una frase del tipo "por favor, nunca ejecutes comandos destructivos", y con eso duerme tranquilo. Eso no es una barrera: un modelo es probabilístico y esa frase compite con todo lo demás que hay en el contexto. Que el LLM no puede ser su propia barrera de seguridad ya lo desarrollé en guardrails y tácticas defensivas contra inyección de prompts, así que aquí lo doy por sabido.

    Este post va del siguiente paso, el que casi nadie audita: el que sí escribió código de defensa y cree que con eso está cubierto.

    Porque hay un guardrail concreto que escribimos todos, que parece serio, que da mucha tranquilidad y que no aguanta ni una reordenación de flags. Vamos a romperlo con un test que puedes ejecutar tú.


    El guardrail que todos escribimos

    Es este, con pequeñas variaciones. Una lista de patrones peligrosos y un interceptor delante del ejecutor de herramientas:

    const FORBIDDEN_PATTERNS = [
      /rm\s+(-rf|-fr|\*)/i,
      /git\s+push\s+.*(--force|-f)/i,
      /git\s+reset\s+--hard/i,
      /drop\s+table/i,
      /chmod\s+777/i,
      /curl\s+.*\|\s*(bash|sh)/i,
    ];
    
    const blocked = (cmd: string) => FORBIDDEN_PATTERNS.some(p => p.test(cmd));
    

    Tiene buena pinta. Cubre el rm -rf de los titulares, el force push, el DROP TABLE y el clásico curl | bash.

    Ahora vamos a medirlo.


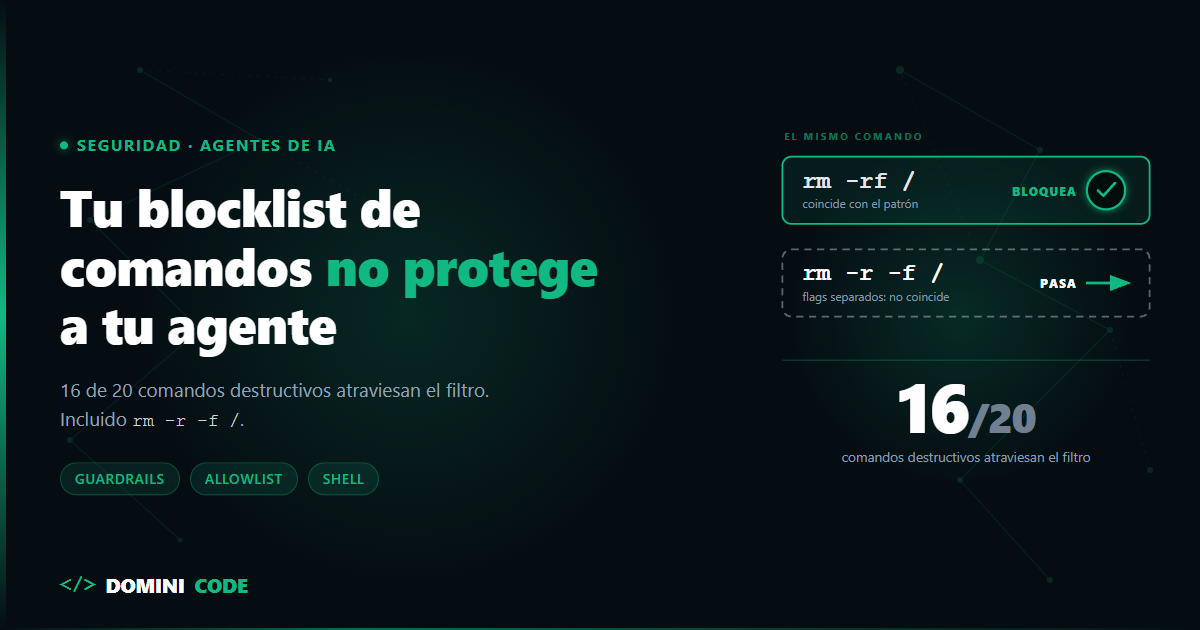
    El test: 16 de 20 comandos destructivos pasan

    Le pasé a ese filtro 20 comandos que ningún agente debería poder ejecutar sobre tu máquina. Este es el resultado completo:

    Comando ¿Lo detiene?
    rm -rf / Bloqueado
    rm -r -f / Pasa
    rm -Rf ~/proyecto Bloqueado
    rm --recursive --force / Pasa
    rm -f -r . Pasa
    find . -delete Pasa
    find . -exec rm {} + Pasa
    git clean -fdx Pasa
    > package.json Pasa
    cat /dev/null > .env Pasa
    dd if=/dev/zero of=/dev/sda Pasa
    git reset --hard HEAD~5 Bloqueado
    DROP TABLE users Bloqueado
    drop/**/table users Pasa
    TRUNCATE TABLE users Pasa
    DELETE FROM users Pasa
    mv proyecto /dev/null Pasa
    $(echo rm) -rf / Pasa
    npm run deploy:prod Pasa
    chmod -R 777 / Pasa

    Cuatro bloqueados, dieciséis dentro. Y fíjate en la segunda fila, porque resume el problema entero:

    rm -rf / está bloqueado. rm -r -f / pasa.

    Es el mismo comando. Borra exactamente lo mismo. Lo único que cambia es que los flags van separados, y el modelo no necesita saber que existe un filtro para escribirlo así: es una forma perfectamente normal de escribir ese comando.

    La última fila es igual de reveladora. El patrón /chmod\s+777/ espera que el 777 venga justo detrás de chmod, así que chmod -R 777 / —que es peor, porque es recursivo— no lo toca.

    Aquí tienes el test entero para que lo corras contra tu propia lista antes de seguir leyendo:

    const destructivos = [
      "rm -rf /", "rm -r -f /", "rm -Rf ~/proyecto", "rm --recursive --force /",
      "rm -f -r .", "find . -delete", "find . -exec rm {} +", "git clean -fdx",
      "> package.json", "cat /dev/null > .env", "dd if=/dev/zero of=/dev/sda",
      "git reset --hard HEAD~5", "DROP  TABLE users", "drop/**/table users",
      "TRUNCATE TABLE users", "DELETE FROM users", "mv proyecto /dev/null",
      "$(echo rm) -rf /", "npm run deploy:prod", "chmod -R 777 /",
    ];
    
    const pasan = destructivos.filter(c => !blocked(c));
    console.log(`${pasan.length}/${destructivos.length} pasan el filtro`);
    console.log(pasan);
    

    Y hay un segundo efecto, menos grave pero muy revelador: el patrón del force push bloquea git push --force-with-lease, que es precisamente la variante segura. Una blocklist no solo deja pasar lo peligroso; también prohíbe cosas correctas, y eso es lo que te acaba empujando a desactivarla.


    El fallo no son los patrones. Es la arquitectura

    La tentación, al ver esa tabla, es añadir patrones. Meter -r -f, meter find, meter TRUNCATE.

    No sirve. Puedes pasarte una tarde ampliando la lista y mañana el agente encontrará la forma número veintidós, porque una shell tiene infinitas maneras de expresar la misma destrucción: flags separados, flags largos, alias, sustitución de comandos, redirecciones, herramientas distintas que hacen lo mismo.

    Esto tiene nombre desde hace décadas en seguridad: enumerating badness, enumerar lo malo. Y siempre pierde, porque el conjunto de lo peligroso es infinito y el de lo permitido es finito.

    La inversión es la solución completa:

      BLOCKLIST              ALLOWLIST
      ─────────              ─────────
      permite por defecto    deniega por defecto
      enumera lo malo        enumera lo bueno
      conjunto infinito      conjunto finito
      falla abierta          falla cerrada
    

    Con una allowlist, el comando número veintidós que no habías previsto no se ejecuta, porque no está en la lista. Ese es el único diseño en el que un olvido tuyo no se convierte en un incidente.


    El chequeo de rutas también se cae

    El mismo middleware suele traer una validación de rutas parecida a esta:

    if (path.startsWith("/") || path.includes("..")) return BLOQUEADO;
    

    Falla en las dos direcciones. Estas rutas pasan:

    • C:\Windows\System32 — una ruta absoluta de Windows no empieza por /.
    • ~/.ssh/id_rsa — la expande la shell después de tu comprobación.

    Y a la vez bloquea src/../lib/x.ts, que es una ruta legítima dentro del proyecto.

    El arreglo es no razonar sobre el texto de la ruta, sino resolverla y comprobar dónde acaba:

    import path from "node:path";
    
    const ROOT = path.resolve(process.env.AGENT_WORKSPACE!);
    
    export function dentroDelWorkspace(candidata: string): boolean {
      const destino = path.resolve(ROOT, candidata);
      return destino === ROOT || destino.startsWith(ROOT + path.sep);
    }
    

    Con eso, ../../etc/passwd y /etc/passwd quedan fuera —los dos resuelven a un destino que no cuelga de ROOT— mientras que src/../lib/x.ts entra sin problema. La comprobación deja de depender de cómo esté escrita la ruta.

    Un aviso: si tu agente puede crear enlaces simbólicos, resuélvelos también (fs.realpath) antes de comparar. Un symlink dentro del workspace apuntando fuera se salta la comprobación de arriba.


    Las 4 capas que sí sostienen la capa de ejecución

    En orden, de más a menos importante.

    1. Allowlist de comandos, denegar por defecto

    Define qué puede ejecutar el agente, no qué no puede. Empieza por lo que de verdad necesita a diario —tests, linter, build, git status, git diff— y ve añadiendo cuando algo se bloquee de forma legítima.

    La forma práctica de arrancar: registra durante una semana todo lo que el agente intenta ejecutar sin bloquear nada, y monta la allowlist a partir de esa lista real. Casi siempre son menos de treinta comandos.

    Si usas un agente CLI, esto normalmente ya existe en su configuración: reglas de permiso allow / deny / ask y modos de permisos. Revisa el tuyo con una pregunta concreta: ¿hay alguna regla comodín tipo Bash(*) que anule a todas las demás? Si la hay, tu allowlist es decorativa.

    2. Confinamiento por ruta resuelta

    El agente trabaja dentro de un directorio y solo dentro de él. Con la función de arriba, y aplicada a todas las herramientas que tocan disco: leer, escribir, mover y borrar. Confinar solo la escritura deja abierta la exfiltración de .env y de tus claves.

    3. Puerta humana para lo irreversible

    Lo que no se puede deshacer no se automatiza: git push, migraciones, escrituras en base de datos de producción, despliegues, borrados. El criterio no es "peligroso" sino "¿puedo revertirlo en un minuto?". Es el mismo principio de mínimo privilegio que desarrollé al hablar de inyección indirecta de prompts en agentes, aplicado aquí a la shell.

    Montar esa puerta bien tiene su propia arquitectura —clasificar las tools por riesgo, persistir el estado mientras se espera y no ejecutar dos veces al reanudar—, y la desarrollo en arquitectura human in the loop en TypeScript.

    4. Aislamiento: que el radio del fallo sea pequeño

    Las tres capas anteriores fallan alguna vez. La cuarta decide cuánto duele.

    Dale a cada tarea su propia rama y su propio directorio de trabajo, y un contenedor cuando la tarea toque dependencias o servicios. Si algo sale mal, borras el directorio y no has perdido nada. Cómo montar el aislamiento fuerte con contenedores lo detallé en Docker sandboxing para ejecutar código de IA.


    El middleware corregido

    Juntando las piezas, el interceptor queda así:

    import path from "node:path";
    
    const COMANDOS_PERMITIDOS = new Set([
      "npm", "pnpm", "bun", "node", "tsc", "eslint", "prettier", "vitest", "jest",
    ]);
    
    const SUBCOMANDOS_GIT = new Set(["status", "diff", "log", "add", "commit", "branch", "checkout"]);
    
    const IRREVERSIBLES = new Set(["push", "reset", "clean", "rebase"]);
    
    const ROOT = path.resolve(process.env.AGENT_WORKSPACE!);
    
    type Decision =
      | { tipo: "ejecutar" }
      | { tipo: "preguntar"; motivo: string }
      | { tipo: "denegar"; motivo: string };
    
    export function decidir(argv: string[], rutas: string[] = []): Decision {
      for (const r of rutas) {
        const destino = path.resolve(ROOT, r);
        if (destino !== ROOT && !destino.startsWith(ROOT + path.sep)) {
          return { tipo: "denegar", motivo: `La ruta "${r}" queda fuera del workspace.` };
        }
      }
    
      const [binario, sub] = argv;
    
      if (binario === "git") {
        if (IRREVERSIBLES.has(sub)) return { tipo: "preguntar", motivo: `git ${sub} no es reversible.` };
        if (SUBCOMANDOS_GIT.has(sub)) return { tipo: "ejecutar" };
        return { tipo: "denegar", motivo: `git ${sub} no está en la allowlist.` };
      }
    
      if (COMANDOS_PERMITIDOS.has(binario)) return { tipo: "ejecutar" };
    
      return { tipo: "denegar", motivo: `"${binario}" no está en la allowlist.` };
    }
    

    Tres detalles que hacen que esto funcione y la versión anterior no:

    Recibe argv, no un string. Nada de analizar una línea de shell con expresiones regulares. Si construyes el comando como array de argumentos y lo ejecutas sin shell (execFile en lugar de exec), desaparecen de golpe la sustitución de comandos, las redirecciones y el encadenado con ; o &&. La mitad de las evasiones de la tabla de arriba dejan de existir.

    Devuelve tres estados, no un booleano. ejecutar, preguntar y denegar. Sin el estado intermedio acabas ampliando la allowlist con cosas irreversibles solo para no tener que confirmar cada vez.

    Deniega por defecto. El return final es una denegación. Lo que no previste no se ejecuta.

    Y cuando bloquees, devuélvele al agente el motivo en texto, no una excepción: el modelo lo lee y busca otra vía en lugar de dejar la tarea a medias.

    Para los parámetros estructurados que llegan a una herramienta o a la base de datos, la validación de schema con Zod es la pieza que cierra el círculo, y los patrones de contrato están en el curso de Zod para TypeScript. El criterio general de dónde poner las validaciones —y dónde no— lo tienes en programación defensiva en TypeScript.


    El guardrail más barato: acotar antes de empezar

    Todo lo anterior actúa cuando el agente ya está trabajando. Es más barato reducir lo que puede intentar.

    Cuando escribes un spec.md que fija qué archivos entran en la tarea y qué queda fuera, el agente deja de tener motivos para acercarse al resto del repositorio. No sustituye a los guardrails —una especificación no es un control de seguridad— pero baja mucho la frecuencia con la que se activan.

    La metodología completa está en el libro de Spec-Driven Development, y el flujo práctico con agentes CLI en el curso Construye con IA: de la idea al producto con Claude Code.


    Checklist para esta semana

    1. Corre el test de arriba contra tu propia blocklist. Diez minutos. Si pasa más de la mitad, ya sabes en qué punto estás.
    2. Busca el comodín. Abre la configuración de permisos de tu agente y comprueba si hay una regla que permita todo. Suele estar puesta desde el primer día y olvidada.
    3. Ejecuta sin shell. Cambia exec por execFile con argv. Es el cambio con mejor relación esfuerzo/resultado de toda la lista.
    4. Confina por ruta resuelta, en lectura y en escritura.

    En Dominicode Labs revisamos arquitecturas agénticas reales y compartimos las configuraciones de permisos que aguantan en producción.

    La autonomía de verdad no es darle libertad total al modelo. Es construirle un sitio donde equivocarse salga barato.


    Preguntas frecuentes

    ¿Por qué una lista de comandos prohibidos no basta para proteger a un agente?

    Porque enumera un conjunto infinito. Una shell puede expresar la misma acción destructiva de muchas formas —flags separados, flags largos, otra herramienta que hace lo mismo, sustitución de comandos— y tu lista solo cubre las que se te ocurrieron. En la prueba de este post, dieciséis de veinte comandos destructivos atraviesan una blocklist de aspecto razonable, incluido rm -r -f /, que es el mismo comando del ejemplo con los flags separados.

    ¿Cómo confino a un agente a la carpeta del proyecto?

    Resolviendo cada ruta con path.resolve() contra la raíz del workspace y comprobando que el resultado sigue colgando de esa raíz. No compruebes el texto de la ruta: startsWith("/") no detecta rutas absolutas de Windows ni el ~ que expande la shell, y includes("..") bloquea rutas internas legítimas. Si el agente puede crear symlinks, resuélvelos con fs.realpath antes de comparar.

    ¿Una allowlist no me va a estar frenando todo el rato?

    Los primeros días sí, y es la señal de que funciona. La forma de reducirlo es construirla con datos: registra una semana de comandos reales del agente y parte de ahí. Suelen ser menos de treinta. Y ten un estado intermedio de "preguntar" para lo irreversible: sin él acabarás metiendo en la allowlist cosas que no deberían estar solo para dejar de confirmar.

    ¿Necesito Docker para esto o me basta con una rama aislada?

    Depende de qué pueda romper la tarea. Una rama con su propio directorio de trabajo protege tu código y hace que tirar el trabajo cueste un segundo, pero comparte tu máquina, tus variables de entorno y tu red. Si la tarea instala dependencias, ejecuta código que no has leído o toca servicios, necesitas el aislamiento del contenedor.

    ¿Dónde pongo el guardrail: en la herramienta o en el agente?

    En la herramienta, siempre. Un control que vive en el prompt, en el nombre de la tool o en su descripción es una sugerencia que el modelo puede ignorar. El guardrail tiene que estar en el código que ejecuta la acción, de forma que ni siquiera un agente que decida saltárselo pueda hacerlo. Si el control se puede desactivar escribiendo texto, no es un control.

  • MCP en producción: lo que se rompe cuando tu server sale del portátil

    MCP en producción: lo que se rompe cuando tu server sale del portátil

    Tu MCP server funciona. Lo lanzas por stdio, tu agente lo ve, las tools responden.

    Y entonces alguien pregunta lo obvio: ¿y si lo usamos desde el resto del equipo?

    Ahí es donde la cosa deja de parecerse a lo que montaste. Porque un server local por stdio es un proceso hijo hablando por una tubería: sin red, sin autenticación, sin concurrencia, sin nada que se pueda caer a medias. En cuanto lo expones por HTTP, todo eso aparece de golpe — y encima el protocolo ha cambiado justo en las piezas que te afectan.

    Si todavía no tienes el server montado, empieza por construir un agente y su MCP server paso a paso, y para registrarlo en tu entorno tienes claude mcp add explicado con sus scopes. Este post empieza donde acaban esos dos: el día que ese server deja de ser tuyo.

    Van seis cosas, todas verificables contra la especificación.


    1. SSE está deprecado. El transporte es Streamable HTTP

    Si has leído tutoriales de MCP del último año y medio, muchos te dicen que para salir a red uses SSE (Server-Sent Events) con dos endpoints.

    No lo hagas. El transporte HTTP+SSE está deprecado desde la revisión 2025-03-26 del protocolo, y la revisión 2026-07-28 lo reclasifica formalmente como Deprecated bajo la nueva política de ciclo de vida, con la instrucción explícita de migrar a Streamable HTTP. El SDK de TypeScript ya marca SSEClientTransport como @deprecated.

    La diferencia práctica: SSE usaba dos endpoints (uno para abrir el stream, otro para mandar mensajes). Streamable HTTP usa uno solo, que gestiona las dos direcciones. Menos superficie, menos estado que coordinar y mucho menos que explicarle a tu balanceador.

    Lo bueno es que esto no depende de si migras a la v2 o no: la deprecación de SSE es anterior y aplica igual. Si tu server remoto habla SSE, ya vas con retraso.


    2. Ya no hay sesiones — y eso te simplifica el escalado

    Este es el cambio que más agradece la infraestructura.

    La revisión 2026-07-28 elimina las sesiones a nivel de protocolo y la cabecera Mcp-Session-Id del transporte Streamable HTTP. Y va más allá: elimina también el handshake initialize/notifications/initialized. Cada petición viaja ahora con su versión de protocolo y las capacidades del cliente dentro de _meta.

    Traducido a lo que te importa un lunes por la mañana: desaparecen las sticky sessions. Puedes poner un round-robin normal delante de N réplicas y ya está. Si alguna vez has peleado con un balanceador intentando que un cliente vuelva siempre a la misma instancia, esta es la razón para mirar la v2.

    El matiz importante: si tu server necesitaba estado entre llamadas, ahora no lo guardas en la sesión. La spec dice que los servidores que necesiten estado entre llamadas usen handles explícitos, acuñados por el servidor y pasados como argumentos normales de una tool. Es decir: el estado deja de ser magia del transporte y pasa a ser parte de tu contrato de datos, visible y tipado.

    También aparece un server/discover que los servidores deben implementar para anunciar versiones soportadas, capacidades e identidad.


    3. Un stream que se rompe pierde la petición

    Esta es la que más te va a doler si no la ves venir, y es la menos comentada.

    La revisión 2026-07-28 elimina la resumibilidad del stream y la reentrega de mensajes: fuera la cabecera Last-Event-ID y fuera los IDs de evento SSE. Lo que dice la spec es directo: si el stream de respuesta se corta, la petición en vuelo se pierde, y el cliente debe reemitirla como una petición nueva con un ID nuevo.

    Piensa en lo que significa eso con una tool que cobra una suscripción, crea un usuario o lanza un despliegue. Un corte de red a mitad y el cliente reintenta. Si tu tool no es idempotente, acabas de cobrar dos veces.

    En local esto no existía. Una tubería stdio no se corta a medias. En red, sí.

    Lo que hay que hacer es lo de siempre en sistemas distribuidos, solo que ahora te toca a ti aplicarlo en la capa de tools:

    • Toda tool con efectos secundarios necesita una clave de idempotencia que venga en los argumentos, no generada dentro.
    • Separa lectura de escritura. Las de lectura pueden reintentarse alegremente; las de escritura, solo con la clave.
    • Registra el resultado por clave y, si llega repetida, devuelve el resultado guardado en lugar de volver a ejecutar.

    En la práctica son unas pocas líneas delante de tu lógica:

    const ArgsSchema = z.object({
      idempotencyKey: z.string().uuid().describe("Identificador único de este intento"),
      usuarioId: z.string(),
      plan: z.enum(["pro", "team"]),
    });
    
    async function cambiarPlan(args: unknown) {
      const { idempotencyKey, usuarioId, plan } = ArgsSchema.parse(args);
    
      const previo = await store.get(idempotencyKey);
      if (previo) return previo;               // el reintento no vuelve a cobrar
    
      const resultado = await facturacion.cambiarPlan(usuarioId, plan);
      await store.set(idempotencyKey, resultado, { ttlSegundos: 86_400 });
      return resultado;
    }
    

    La clave llega en los argumentos, no se genera dentro: si la generaras tú, cada reintento traería una distinta y no servirían de nada.

    Ese criterio de qué se automatiza y qué no —lo reversible frente a lo irreversible— es el mismo que aplico a los permisos de un agente, y lo desarrollé en inyección indirecta de prompts en agentes.


    4. Autenticación: tu server pasa a ser un resource server de OAuth 2.1

    En local no hay autenticación porque no hace falta: el proceso es tuyo. En red hace falta, y MCP no se la inventa: se apoya en OAuth 2.1.

    El modelo mental que conviene fijar: tu MCP server es un resource server, no un servidor de autorización. Valida tokens y sirve recursos. No emite tokens ni loguea a nadie. Eso es de otro.

    Las piezas:

    • Metadatos de recurso protegido. Tu server publica /.well-known/oauth-protected-resource, un JSON que declara su identificador, los servidores de autorización en los que confía, los scopes que soporta y los métodos de bearer que acepta. Es lo que permite a un cliente descubrir a dónde ir a pedir el token:

      {
        "resource": "https://mcp.tudominio.com",
        "authorization_servers": ["https://auth.tudominio.com"],
        "scopes_supported": ["mcp:read", "mcp:write"],
        "bearer_methods_supported": ["header"]
      }
      
    • El parámetro resource. El cliente lo manda en la petición de autorización y en la de token. Es el mecanismo que impide que un token acuñado para tu server sirva en otro distinto.

    • Registro de cliente. La revisión 2026-07-28 deprecia el Dynamic Client Registration en favor de los Client ID Metadata Documents, aunque DCR sigue disponible por compatibilidad. También pide validar el parámetro iss de la respuesta de autorización contra el emisor registrado antes de canjear el código, y que las credenciales persistidas se indexen por emisor y no se reutilicen con otro servidor de autorización.

    Si vas a exponer un server a terceros, esta sección es la que decide si te lo pueden usar las empresas o no. El caso de negocio de tener el tuyo lo desarrollé en MCP server para empresas.


    5. Observabilidad: el logging del protocolo se va, entra OpenTelemetry

    La revisión 2026-07-28 deprecia las features de Roots, Sampling y Logging. Siguen funcionando durante la ventana de deprecación —que la política fija en un mínimo de doce meses— pero las implementaciones nuevas no deberían adoptarlas.

    Para el logging, la migración que sugiere la propia spec es explícita: escribir a stderr (en stdio) o usar OpenTelemetry.

    Y la spec te lo pone fácil, porque documenta la propagación de contexto de trazas de OpenTelemetry sobre las claves _meta: traceparent, tracestate y baggage. Eso significa que puedes correlacionar la traza de tu backend con la llamada del agente que la originó, que es justo lo que echas de menos la primera vez que un tool call falla en producción y no sabes de qué conversación venía.


    6. El caché que te ahorra tokens (y casi nadie configura)

    Este es el que da alegrías y no cuesta nada.

    La revisión 2026-07-28 exige los campos ttlMs y cacheScope en los resultados de tools/list, prompts/list, resources/list, resources/read y resources/templates/list, mediante una nueva interfaz CacheableResult. ttlMs es una pista de frescura en milisegundos para que el cliente cachee y deje de sondear; cacheScope ("public" o "private") controla si un intermediario compartido puede cachear la respuesta.

    Y hay un detalle pequeño con consecuencias grandes: la spec dice que los servidores deberían devolver las tools de tools/list en un orden determinista, explícitamente para permitir el caché del lado del cliente y mejorar los aciertos de caché de prompt del LLM.

    Piénsalo un segundo. La lista de tools va al principio del contexto. Si tu server la devuelve en orden distinto en cada petición, estás invalidando el prefijo cacheado del prompt en cada llamada y pagando entrada completa cada vez. Ordenar un array te sale gratis.


    Y una que no viene de la spec: la deriva de esquemas

    Esto no es un cambio del protocolo, es el fallo que más veo en servers reales.

    El patrón habitual define el esquema dos veces: una con Zod para validar en ejecución, y otra a mano como JSON Schema en la respuesta de tools/list. Dos fuentes de verdad para el mismo contrato.

    El día que añades un campo y solo tocas una, el resultado no es un error: es peor. El modelo lee un contrato y tu servidor valida otro, así que el agente manda llamadas perfectamente razonables que tu server rechaza. Y como el fallo llega como un error de validación, parece culpa del modelo.

    La regla: el JSON Schema que publicas tiene que derivarse del esquema que valida, nunca escribirse en paralelo. Un solo sitio donde cambiar las cosas.

    Los patrones para modelar y derivar contratos con Zod los vemos en el curso de Zod para TypeScript. Y si vas a definir las tools antes de escribirlas —que es lo que evita justo esta clase de deriva— la metodología está en el libro de Spec-Driven Development.


    Checklist antes de exponerlo

    1. Transporte: Streamable HTTP, un solo endpoint. Si tienes SSE, tienes deuda.
    2. Idempotencia: clave en los argumentos para toda tool con efectos secundarios, y resultado guardado por clave.
    3. Sin sesiones: nada de sticky sessions; el estado entre llamadas viaja como handle explícito en los argumentos.
    4. Auth: /.well-known/oauth-protected-resource publicado y validación del parámetro resource en los tokens.
    5. Trazas: propaga traceparent por _meta y manda las trazas a tu colector.
    6. Caché: ttlMs y cacheScope en los listados, y tools/list siempre en el mismo orden.
    7. Un solo esquema: el JSON Schema publicado, derivado del validador.

    El flujo completo de diseñar herramientas para agentes y llevarlas a producción es lo que enseño en el curso Construye con IA: de la idea al producto con Claude Code.

    En Dominicode Labs tengo servidores MCP corriendo para infraestructura, analítica y publicación, y comparto ahí las configuraciones que aguantan.

    Montar un MCP server es una tarde. Exponerlo es un sistema distribuido. La diferencia entre las dos cosas son estas siete líneas.


    Preguntas frecuentes

    ¿Tengo que migrar mi MCP server a la v2 ya?

    Para el protocolo, no: hablar la revisión nueva es opt-in y la v1 sigue soportada. Pero la deprecación de SSE es anterior e independiente de la v2 —viene de la revisión 2025-03-26— así que si tu server remoto habla SSE, eso sí conviene cambiarlo aunque no toques nada más. Lo que sí trae la v2 y compensa de verdad es quitarte las sticky sessions.

    ¿Qué diferencia hay entre SSE y Streamable HTTP en un MCP server?

    SSE usaba dos endpoints: uno para mantener abierto el stream de servidor a cliente y otro para que el cliente enviara mensajes. Streamable HTTP usa un único endpoint que gestiona ambas direcciones. Menos piezas que coordinar, menos configuración en el balanceador y menos estado que mantener vivo entre peticiones.

    Si desaparecen las sesiones, ¿dónde guardo el estado entre llamadas?

    En los argumentos de la tool. La spec indica que los servidores que necesiten estado entre llamadas usen handles explícitos acuñados por el propio servidor y pasados como parámetros normales. Deja de ser un implícito del transporte y pasa a formar parte del contrato de datos, que es más fácil de depurar y de tipar.

    ¿Por qué mis tools tienen que ser idempotentes en un server remoto?

    Porque la revisión 2026-07-28 elimina la reentrega de mensajes y la resumibilidad del stream. Si la conexión se corta, la petición en vuelo se pierde y el cliente debe reemitirla como una petición nueva. Sin clave de idempotencia, una tool que cobra o crea algo lo haría dos veces. En local, con stdio, este escenario no existe.

    ¿Mi MCP server tiene que emitir tokens de autenticación?

    No. Tu server es un resource server: valida tokens y sirve recursos, nunca emite tokens ni autentica usuarios. De eso se encarga un servidor de autorización aparte. Lo que sí publica tu server es /.well-known/oauth-protected-resource, para que los clientes descubran en qué servidor de autorización pedir el token y con qué scopes.

  • El impuesto oculto de los frameworks de IA no existe: medí lo que mandan

    El impuesto oculto de los frameworks de IA no existe: medí lo que mandan

    Hay una frase que se repite en cada hilo sobre frameworks de IA: "te inyectan miles de tokens de prompts ocultos que tú no has escrito".

    La he leído decenas de veces. Nunca con un número al lado.

    Así que la medí. Levanté un endpoint falso que se hace pasar por la API de Anthropic, apunté a él el SDK oficial, el Vercel AI SDK y LangChain, y guardé el cuerpo exacto de la petición HTTP que cada uno manda por el cable.

    El resultado no es el que esperaba, y probablemente tampoco es el que esperas tú.


    Cómo lo medí

    La idea es simple: si quieres saber qué manda una librería, no leas su código. Ponte en medio.

    import http from "node:http";
    
    const capturas = [];
    const server = http.createServer((req, res) => {
      let body = "";
      req.on("data", c => (body += c));
      req.on("end", () => {
        capturas.push(body);                  // esto es lo que se manda de verdad
        res.writeHead(200, { "content-type": "application/json" });
        res.end(JSON.stringify({
          id: "msg_x", type: "message", role: "assistant", model: "claude-opus-5",
          content: [{ type: "text", text: "ok" }],
          stop_reason: "end_turn", stop_sequence: null,
          usage: { input_tokens: 1, output_tokens: 1 },
        }));
      });
    });
    await new Promise(r => server.listen(0, r));
    const BASE = `http://127.0.0.1:${server.address().port}`;
    

    Después, cada librería apuntando a BASE con la misma tarea: un mensaje de sistema idéntico, la misma pregunta y —en la segunda tanda— la misma herramienta.

    Versiones medidas: @anthropic-ai/sdk 0.120.0, ai 7.0.77 con @ai-sdk/anthropic 4.0.41, y langchain 1.5.10 con @langchain/anthropic 1.5.8. Los números son de estas versiones; si lees esto dentro de seis meses, vuelve a correrlo.


    Resultado 1: nadie inyecta un prompt oculto

    Primera tanda, sin herramientas. Mensaje de sistema de 47 caracteres, escrito por mí.

    Librería Cuerpo total Campo system
    SDK oficial de Anthropic 194 B 47 B
    LangChain (modelo directo) 210 B 47 B
    Vercel AI SDK 246 B 74 B

    LangChain manda exactamente mis 47 caracteres. Ni uno más. El SDK oficial, lo mismo.

    Vercel AI SDK manda 74 en vez de 47, y esos 27 caracteres de diferencia no son prosa: es que envuelve el string en la forma de bloques de contenido, [{"type":"text","text":"…"}]. Estructura, no instrucciones.

    Y ahora el dato que cierra el asunto. Repetí la prueba con el agente prefabricado de LangChain —el createAgent que viene de fábrica, justo la abstracción que se supone que te llena el contexto de basura— y el campo system de la petición venía así:

    system = 0 bytes
    

    Vacío. El agente prefabricado de LangChain no manda ningún prompt de sistema que tú no hayas puesto.

    Sea cual sea el origen de la leyenda de los "1.500 tokens ocultos", no describe estas librerías en 2026.


    Resultado 2: donde sí se paga es en los esquemas

    Segunda tanda, misma tarea pero declarando una herramienta: get_weather, con un solo parámetro string y su descripción.

    Librería Cuerpo total system tools
    SDK oficial de Anthropic 393 B 47 B 213 B
    LangChain (agente prefabricado) 436 B 0 B 299 B
    Vercel AI SDK 556 B 74 B 294 B

    Aquí sí hay diferencia, y no está donde la buscaba todo el mundo: está en cómo cada librería serializa el esquema de la herramienta.

    El SDK oficial manda el JSON Schema que tú escribiste, tal cual: 213 bytes. Vercel AI SDK y LangChain lo generan a partir de tu esquema de Zod, y el resultado es más verboso: 294 y 299 bytes. Un 38% y un 40% más para describir exactamente la misma función.

    En el total de la petición: 393 bytes contra 556 del Vercel AI SDK. Un 41% más.


    Qué significan de verdad 163 bytes

    Aquí es donde hay que ser honesto en las dos direcciones.

    En una llamada, no significa nada. 163 bytes son unos 40 tokens. Si tu agente hace diez peticiones al día, esta discusión es irrelevante y deberías dedicar el rato a otra cosa.

    Pero no escala como una constante, escala con tus herramientas. El 40% no es de la petición: es del bloque de esquemas. Un agente serio no tiene una tool, tiene quince o veinte. Ese bloque va en cada turno del bucle, no una vez por conversación. Y si el prefijo de tu prompt cambia entre peticiones, además pierdes los aciertos de caché.

    Así que el número que importa no es el mío: es el tuyo. Coge tu agente real, con tus tools reales, y mide el bloque tools de una petición. Si te sale un bloque de 6 KB repitiéndose en veinte turnos, ahí tienes una conversación que merece la pena. Cómo desglosar en qué se te va la factura lo conté en medir el consumo de tokens de un agente, y el efecto de cambiar de modelo con ese mismo contexto, en el coste de los subagentes.

    Y la palanca real, una vez lo has medido, no es quitar el framework: es tener menos herramientas y mejor descritas. Ese criterio lo desarrollé al montar un servidor de herramientas para tu agente sin MCP.


    Entonces, ¿framework o código directo?

    Si has llegado hasta aquí esperando que te diga que quites el framework, malas noticias: el argumento de los tokens no sostiene esa decisión. La diferencia existe, es medible y es pequeña comparada con lo que de verdad decide.

    Lo que sí decide:

    Depurabilidad. Cuando un agente falla en producción necesitas ver el mensaje exacto que salió. Con el SDK directo pones un console.log en la llamada. Con capas por encima, tienes que aprender dónde mirar. No es imposible —el arnés de esta prueba son cuarenta líneas— pero es trabajo.

    Retraso frente a la API. Los proveedores sacan capacidades nuevas constantemente. Con el SDK directo las usas el mismo día. Con una capa intermedia, esperas a que la abstraiga. Este es, en mi experiencia, el coste real de un framework, y no aparece en ninguna tabla de bytes.

    Acoplamiento de tu dominio. Si la lógica de decisión de tu negocio vive dentro de las clases de un tercero, no eres dueño de tu arquitectura. Esto es lo mismo que llevamos treinta años diciendo de los ORM y de los frameworks de UI, y aplica igual.

    Y en la otra dirección: hay problemas donde un grafo de estados expresa cosas que un while no expresa bien —ramificaciones, reanudar tras una pausa humana, estado explícito entre pasos—. Si tu bucle ya se está llenando de banderas, esa es la señal.

    Si lo que quieres es el bucle explícito bien hecho, con control de pasos y detección de estancamiento, está entero en Agentic Loop en TypeScript.


    Mide el tuyo antes de opinar

    El arnés completo cabe en un archivo. Levanta el servidor de arriba, apunta tu cliente a BASE en lugar de a la API real, lanza una petición representativa y mira el cuerpo:

    const cuerpo = capturas.pop();
    const j = JSON.parse(cuerpo);
    
    console.log("total  :", cuerpo.length, "bytes");
    console.log("system :", (j.system ? JSON.stringify(j.system).length : 0), "bytes");
    console.log("tools  :", (j.tools ? JSON.stringify(j.tools).length : 0), "bytes");
    console.log("mensajes:", JSON.stringify(j.messages).length, "bytes");
    

    Cuatro líneas y dejas de discutir de oídas. Y si el bloque de esquemas te sorprende, el sitio donde arreglarlo es el diseño de tus contratos: los patrones de Zod para que un esquema diga lo justo están en el curso de Zod para TypeScript.

    Definir esas interfaces antes de escribir el agente es lo que evita acabar con veinte tools que nadie recuerda para qué son, y es la metodología del libro de Spec-Driven Development. El flujo completo con agentes CLI lo enseño en el curso Construye con IA.

    En Dominicode Labs comparto las mediciones reales de los agentes que tengo corriendo.

    La conclusión que me llevo no es "framework sí" ni "framework no". Es que llevábamos dos años repitiendo un número que nadie había comprobado, y que el sitio donde de verdad se te va el contexto —los esquemas de tus herramientas— no sale en ningún hilo.


    Preguntas frecuentes

    ¿Es verdad que LangChain inyecta prompts ocultos en cada petición?

    En las versiones medidas para este post, no. Con langchain 1.5.10 y @langchain/anthropic 1.5.8, tanto el modelo directo como el agente prefabricado mandan en el campo system exactamente lo que tú pones — y el agente prefabricado, cuando no le das mensaje de sistema, manda ese campo vacío. La afirmación de los "miles de tokens ocultos" no describe estas versiones.

    ¿Cuánto overhead añade entonces un framework?

    En la prueba, con una sola herramienta declarada: el bloque tools pasó de 213 bytes con el SDK oficial a 294 con Vercel AI SDK y 299 con LangChain, un 38% y un 40% más. En el cuerpo total de la petición, 393 bytes frente a 556. La diferencia viene de generar el JSON Schema a partir de Zod, que sale más verboso que un esquema escrito a mano.

    ¿Cómo mido el overhead de mi propio agente?

    Levanta un servidor HTTP local que responda con la forma de respuesta del proveedor, apunta tu cliente a esa URL con la opción baseURL, lanza una petición representativa y mide la longitud del cuerpo por campos: system, tools y messages. Son unas cuarenta líneas y te da el dato exacto de tu caso, que es el único que importa.

    ¿Merece la pena quitar el framework para ahorrar tokens?

    Casi nunca. La diferencia medida es real pero pequeña frente a otras decisiones. Si vas a quitarlo, que sea por depurabilidad, por no ir con retraso respecto a las capacidades nuevas de la API o por no acoplar tu lógica de negocio a un tercero. El ahorro de tokens es el peor de los argumentos disponibles.

    ¿Por qué el bloque de tools pesa más que el prompt de sistema?

    Porque describe una interfaz completa: nombre, descripción, tipos de cada parámetro, cuáles son obligatorios y las descripciones de cada campo. Y porque se manda en cada turno del bucle agéntico, no una vez por conversación. Con quince o veinte herramientas, ese bloque es la mayor parte del contexto fijo que pagas en cada llamada.

  • LangGraph TypeScript: cuándo un grafo gana al while loop

    LangGraph TypeScript: cuándo un grafo gana al while loop

    Tenía un agente que revisaba pull requests. Cincuenta líneas de TypeScript, un while, tres tools. Funcionaba.

    Hasta que un PR tocó el módulo de autenticación y el agente hizo lo correcto: parar y pedir aprobación humana. El problema es que "parar" significaba dejar un proceso de Node vivo esperando un webhook que llegó dieciocho horas después. El proceso ya no existía. El contexto tampoco.

    Reinicié. Volvió a analizar el PR desde cero, volvió a gastar tokens, volvió a pedir aprobación. Mi loop no tenía un bug: tenía un límite arquitectónico.

    LangGraph TypeScript existe para ese límite exacto. Y lo adoptas sin comprar la casa entera para usar el garaje.

    LangGraph es la librería de orquestación de agentes de LangChain, disponible para TypeScript y Python, que modela un agente como un grafo de estados: los nodos son funciones que reciben y devuelven estado, las aristas deciden qué nodo va después, y un checkpointer persiste el estado tras cada paso. Ese checkpointer es lo que permite pausar una ejecución hoy y reanudarla dentro de tres días, en otra máquina.

    El loop explícito resuelve la mayoría de los agentes

    Empecemos por lo incómodo: en los proyectos que he tocado, la gran mayoría de los agentes no necesitan un framework de orquestación. Necesitan esto.

    type ToolCall = { id: string; name: string; args: unknown };
    type Msg =
      | { role: "user" | "assistant" | "system"; content: string }
      | { role: "assistant"; content: string; toolCalls: ToolCall[] }
      | { role: "tool"; toolCallId: string; content: string };
    
    export async function agente(prompt: string): Promise<string> {
      const messages: Msg[] = [{ role: "user", content: prompt }];
      let turno = 0;
    
      while (turno++ < 10) {
        const res = await llm.complete(messages);
    
        if (!res.toolCalls?.length) return res.content;
    
        messages.push({
          role: "assistant",
          content: res.content,
          toolCalls: res.toolCalls,
        });
    
        for (const call of res.toolCalls) {
          const tool = tools[call.name];
          // El nombre de la tool lo elige el modelo. Si alucina uno, se lo devuelves
          // como error para que se corrija, en vez de reventar a mitad de ejecución.
          const salida = tool
            ? await tool(call.args)
            : `Error: la herramienta "${call.name}" no existe.`;
          messages.push({ role: "tool", toolCallId: call.id, content: salida });
        }
      }
    
      throw new Error("Límite de turnos alcanzado");
    }
    

    Eso es un agente. Lo depuras con console.log, lo entiendes entero en treinta segundos y no tiene una capa de orquestación que pueda romperte en la siguiente minor.

    Yo defiendo este loop, y lo he defendido por escrito: en multi-agente sin orquestador explico por qué la mayoría de los sistemas "multi-agente" son un for con buen marketing. Sigo pensando lo mismo.

    El loop no falla por complejidad. Falla por duración.

    Cuándo usar LangGraph en vez de un while loop

    Usa LangGraph cuando tu agente cumpla al menos uno de estos tres síntomas. Si no cumple ninguno, quédate con el while. El punto de inflexión no es "mi agente hace muchas cosas": es uno de estos tres, y basta con uno.

    1. El estado tiene que sobrevivir al proceso. Si tu agente vive más que un request HTTP —minutos, horas, días— el array messages en memoria es una bomba de relojería. Un deploy, un reinicio, un pod que se recicla, y perdiste la ejecución.
    2. La ramificación es real, no cosmética. Un if dentro del loop está bien. Pero cuando el camino A y el camino B tienen pasos distintos, reintentos distintos y puntos de salida distintos, el loop se convierte en un árbol de condicionales que nadie quiere tocar.
    3. Un humano tiene que decidir en mitad de la ejecución. No al principio ni al final. En mitad. Y puede tardar un día en contestar.
    while loop explícito LangGraph (StateGraph)
    Estado entre pasos Array en memoria Campos tipados con reducers
    Sobrevive a un reinicio No Sí, con checkpointer
    Pausar y reanudar Lo escribes tú interrupt() + Command({ resume })
    Ramificación if anidados addConditionalEdges tipado
    Depuración console.log Inspección del grafo y del checkpoint
    Dependencias Ninguna @langchain/langgraph + @langchain/core
    Coste de entrada Cero Una tarde por tramo migrado

    Si no tienes ninguno de los tres, cierra esta pestaña y quédate con tu loop. Hablo en serio. Ese es justamente el argumento que defiendo en el stack de IA agéntica que uso: la capa de orquestación es la última que deberías añadir, no la primera.

    Un apunte de vocabulario, porque genera confusión real: aquí "grafo" significa grafo de orquestación —qué nodo se ejecuta después de cuál—. No tiene nada que ver con el grafo de recuperación del que hablé en qué es graph engineering, que va de qué código llega al contexto del modelo. Misma palabra, dos capas distintas del sistema.

    El estado primero, el grafo después

    En LangGraph el estado no es un detalle de implementación: es el contrato. Y en la v1 —@langchain/langgraph 1.4.10, agosto de 2026— se declara con StateSchema, aceptando esquemas de Zod campo a campo.

    import {
      StateSchema,
      MessagesValue,
      ReducedValue,
    } from "@langchain/langgraph";
    import { z } from "zod";
    
    const RevisionState = new StateSchema({
      messages: MessagesValue,
      pr: z.string(),
      riesgo: z.enum(["bajo", "alto"]).default("bajo"),
      hallazgos: new ReducedValue(z.array(z.string()).default(() => []), {
        reducer: (actual: string[], nuevo: string[]) => actual.concat(nuevo),
      }),
      aprobado: z.boolean().default(false),
    });
    
    type Revision = typeof RevisionState.State;
    

    Fíjate en ReducedValue. Esa es la pieza que no tiene equivalente limpio en el loop: define cómo se combinan las actualizaciones de un campo. Los nodos devuelven trozos de estado y el reducer decide si se sobrescriben o se acumulan. Sin eso, dos nodos que escriben en hallazgos se pisan.

    Y sí, es Zod de verdad: .default(), .enum(), refinamientos. El estado del agente es un contrato de datos como cualquier otro, y aquí es donde se nota tenerlos bien tipados — es el mismo músculo que entreno en el curso de Zod para TypeScript.

    Verás mucho tutorial con Annotation.Root({ ... }). Sigue funcionando y sigue compilando, pero es la sintaxis anterior. Si empiezas hoy, empieza con StateSchema.

    Nodos, aristas y la decisión que el loop no sabe expresar

    Un nodo es una función que recibe el estado y devuelve un trozo de estado. Nada más.

    import {
      StateGraph, START, END, MemorySaver, interrupt, Command,
    } from "@langchain/langgraph";
    
    async function analizar(state: Revision) {
      const tocaAuth = state.pr.includes("auth");
      return {
        hallazgos: ["Cobertura de tests: 62%"],
        riesgo: tocaAuth ? ("alto" as const) : ("bajo" as const),
      };
    }
    
    async function aprobarAuto(_state: Revision) {
      return { aprobado: true };
    }
    
    function enrutar(state: Revision): "aprobarAuto" | "revisionHumana" {
      return state.riesgo === "alto" ? "revisionHumana" : "aprobarAuto";
    }
    
    const grafo = new StateGraph(RevisionState)
      .addNode("analizar", analizar)
      .addNode("aprobarAuto", aprobarAuto)
      .addNode("revisionHumana", revisionHumana)
      .addEdge(START, "analizar")
      .addConditionalEdges("analizar", enrutar, ["aprobarAuto", "revisionHumana"])
      .addEdge("aprobarAuto", END)
      .addEdge("revisionHumana", END)
      .compile({ checkpointer: new MemorySaver() });
    

    addConditionalEdges recibe el nodo origen, la función que decide y la lista de destinos posibles. Esa lista no es decorativa: es lo que hace que el enrutado sea tipado y que el grafo sea inspeccionable antes de ejecutarlo.

    Y ahí está compile({ checkpointer }). Esa línea es la que justifica todo lo demás. Sin checkpointer tienes un runner de funciones con sintaxis rara. Con checkpointer tienes una máquina de estados que se puede pausar y reanudar.

    MemorySaver es para desarrollo —vive en RAM y muere con el proceso—. Para producción usa los checkpointers persistentes, que van en paquetes aparte: @langchain/langgraph-checkpoint-postgres (1.0.4) o @langchain/langgraph-checkpoint-sqlite (1.0.3).

    Human-in-the-loop en LangGraph: la funcionalidad que justifica el cambio

    El human-in-the-loop en LangGraph se implementa con interrupt(): el nodo lanza la pausa, el grafo guarda el estado en el checkpointer y la ejecución termina. Cuando llega la respuesta humana, se reanuda con Command({ resume }) sobre el mismo thread_id.

    Aquí es donde mi PR de las dieciocho horas deja de ser un problema.

    type PeticionRevision = {
      pr: string;
      hallazgos: string[];
      pregunta: string;
    };
    
    async function revisionHumana(state: Revision) {
      const decision = interrupt<PeticionRevision, { aprobado: boolean }>({
        pr: state.pr,
        hallazgos: state.hallazgos,
        pregunta: "Este PR toca auth. ¿Lo apruebas?",
      });
    
      return { aprobado: decision.aprobado };
    }
    

    Cuando la ejecución llega a interrupt(), el grafo persiste el estado exacto y para. No bloquea un proceso: termina. El estado queda guardado bajo un thread_id.

    const config = { configurable: { thread_id: "pr-482" } };
    
    await grafo.invoke({ pr: "feat/auth-refresh-token" }, config);
    
    const pausa = await grafo.getState(config);
    console.log(pausa.next);                          // [ 'revisionHumana' ]
    console.log(pausa.tasks[0]?.interrupts[0]?.value); // el payload de la pregunta
    
    // Horas o días después, otro proceso, otro deploy:
    const final = await grafo.invoke(
      new Command({ resume: { aprobado: true } }),
      config
    );
    console.log(final.aprobado); // true
    

    Léelo otra vez. El segundo invoke puede ocurrir en otra máquina, la semana siguiente, después de tres despliegues. El grafo continúa donde estaba: analizar no se vuelve a ejecutar y no gastas otra vez esos tokens.

    Eso, en el loop, no lo montas en un rato. Escribes tu propio serializador de estado, tu propio registro de "en qué paso iba" y tu propia lógica de reanudación. Es decir: escribes un checkpointer peor.

    Tres avisos que cuestan tiempo:

    1. El nodo que contiene el interrupt() sí se re-ejecuta entero al reanudar. El grafo no repite los nodos anteriores, pero este arranca otra vez desde su primera línea. Si pones un INSERT, un webhook o un cobro antes de la llamada, ocurre dos veces. Todo efecto secundario va después del interrupt(), nunca antes.
    2. No envuelvas interrupt() en un try/catch: señaliza la pausa con una excepción y te la comerías.
    3. Lo que le pasas debe ser serializable a JSON.

    Esto es la versión LangGraph del patrón. Si quieres la arquitectura completa —clasificar las tools por riesgo, persistir el checkpoint, garantizar la idempotencia al reanudar y qué devolverle al modelo cuando el humano dice que no—, la desarrollo entera en arquitectura human in the loop en TypeScript.

    Cuándo NO montar el grafo de estados en LangGraph

    No lo montes porque el proyecto "va a crecer". Móntalo cuando tengas uno de los tres síntomas delante.

    Y no confundas esto con adoptar el ecosistema entero. Ya dejé claro mi veredicto sobre la librería base en el stack de IA agéntica que uso: demasiada abstracción sobre abstracciones. LangGraph es otra cosa. Es una máquina de estados con persistencia, y puedes usarla sin tocar el resto.

    Un detalle actual que evita un error frecuente: el prebuilt createReactAgent de @langchain/langgraph/prebuilt está marcado como deprecado. Se movió al paquete langchain como createAgent. Si sigues un tutorial de hace un año, vas a copiar un import obsoleto.

    Y antes de dibujar un solo nodo, escribe qué estados existen y qué transiciones son legales. Un grafo mal pensado es peor que un loop, porque además parece serio. Esa disciplina de definir el contrato antes de escribir la implementación es la misma que defiendo en el libro de Spec-Driven Development, y aquí paga doble.

    Qué hacer con esto hoy

    Abre tu agente y busca una sola cosa: un punto donde la ejecución tenga que sobrevivir a un reinicio. Una aprobación, una espera larga, un proceso por lotes que tarda horas.

    Si no lo encuentras, tu loop está bien. Cierra el editor.

    Si lo encuentras, no reescribas el agente entero. Extrae solo ese tramo a un StateGraph con checkpointer, deja el resto como está y quédate con las tools intactas. Migrar un tramo cuesta una tarde. Migrar por moda cuesta un trimestre.

    Si quieres ver este tipo de decisiones tomadas en proyectos reales —cuándo meter un framework y cuándo no—, es justo lo que trabajo en Construye con IA, y en Dominicode Labs montamos estos grafos con el código completo delante.

    Preguntas frecuentes

    ¿Cuándo usar LangGraph en vez de un while loop?

    Cuando la ejecución tenga que sobrevivir al proceso, cuando la ramificación tenga pasos y salidas realmente distintas, o cuando un humano deba decidir en mitad del flujo. Con uno solo de esos tres basta. Si tu agente empieza y termina dentro del mismo request, el while explícito es mejor opción: se depura con console.log y no tiene una capa de orquestación que se rompa en la siguiente minor. LangGraph no gana por complejidad, gana por duración.

    ¿Necesito un checkpointer para usar interrupt() en LangGraph?

    Sí, y no es opcional. interrupt() funciona persistiendo el estado del grafo y terminando la ejecución. Sin un checkpointer en compile() no hay dónde guardar ese estado, así que no hay nada que reanudar. En desarrollo te vale MemorySaver; en producción necesitas uno con almacenamiento real, o perderás las pausas en cada despliegue.

    ¿StateSchema con Zod sustituye a Annotation.Root en LangGraph TypeScript?

    Es la forma actual de declarar el estado y la que deberías usar en código nuevo. Annotation.Root sigue exportándose y sigue compilando, así que no tienes que migrar nada con prisa. La diferencia práctica es que con StateSchema reutilizas esquemas de Zod que probablemente ya tienes en el proyecto, con sus default() y sus validaciones, en lugar de aprender una segunda sintaxis solo para el estado del grafo.

    ¿Qué checkpointer uso en producción con LangGraph JS?

    MemorySaver viene en el paquete principal pero guarda en RAM: sirve para tests y ejemplos, no para producción. Los checkpointers persistentes van en paquetes aparte, @langchain/langgraph-checkpoint-postgres y @langchain/langgraph-checkpoint-sqlite. Si ya tienes Postgres en el stack, esa es la respuesta fácil, porque el estado del agente pasa a ser una tabla más que respaldas y auditas como cualquier otra.

    ¿Puedo migrar mi while loop a LangGraph sin reescribir las tools?

    Sí, y es la vía que recomiendo. Las tools son funciones con un esquema de entrada; no les afecta quién las llama. Lo que cambia es el orquestador: el bucle pasa a ser nodos y aristas, y el array de mensajes pasa a ser un campo del estado. Puedes migrar un solo tramo del flujo —el que necesita pausarse— y dejar el resto del agente exactamente como está.

    ¿Necesito LangChain para usar LangGraph en TypeScript?

    No. @langchain/langgraph declara @langchain/core como peer dependency —de ahí salen los tipos de mensajes y modelos— pero no requiere el paquete langchain ni sus cadenas y abstracciones: una instalación limpia trae @langchain/core, langgraph-checkpoint y langgraph-sdk, y ahí se acaba. Puedes montar un StateGraph llamando dentro de tus nodos al SDK del proveedor que ya uses. Un nodo es una función asíncrona: lo que hagas dentro es cosa tuya.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Context Drift: por qué tu agente se vuelve tonto en la iteración 15

    Context Drift: por qué tu agente se vuelve tonto en la iteración 15

    El agente empieza como un ingeniero senior.

    Analiza el problema con precisión quirúrgica. Propone una arquitectura impecable. Modifica los primeros módulos con código limpio y bien tipado.

    Pero llega la iteración 14.

    De repente olvida la regla que le pusiste en el primer mensaje. Inventa funciones auxiliares que ya existen. Borra código que él mismo escribió hace cinco minutos. Y para resolver un fallo de compilación, entra en pánico y sugiere reescribir la mitad del proyecto.

    No se ha vuelto tonto de golpe. Está sufriendo Context Drift: el mismo modelo, con las mismas instrucciones, deja de prestarles atención porque el historial las ha sepultado bajo miles de tokens de basura.

    Y aquí va lo importante: esto no se arregla con un modelo mejor ni con una ventana más grande. Se arregla en el bucle.


    Por qué el fallo aparece en la iteración 15 y no en la 3

    Que un modelo reparte su atención de forma desigual —mucha al principio del prompt, mucha al final, poca en el medio— ya lo conoces. Y si no, lo tienes explicado con detalle en Context Engineering: cómo estructurar la memoria de tus agentes de IA. Este post no va de eso.

    Va de lo que pasa cuando ese efecto se combina con un bucle que se ejecuta solo.

    En una conversación normal tú controlas lo que entra. En un agentic loop no: cada iteración inyecta la salida de una herramienta sin que nadie la lea. Y esas salidas son enormes. Un npm test, un git diff, un grep sobre un monorepo o un schema de base de datos rondan fácil los 4.000 tokens cada uno.

    Supón un agente con 2.000 tokens de system prompt y 3.000 de especificación. Eso es lo que de verdad tiene que respetar: 5.000 tokens fijos de instrucciones.

    Iteración Salidas de herramientas acumuladas Total en ventana Peso de tus instrucciones
    3 12.000 tokens 17.000 29 %
    8 32.000 tokens 37.000 14 %
    15 60.000 tokens 65.000 8 %

    Tus reglas no han desaparecido: siguen ahí, íntegras, en el token 1. Lo que ha cambiado es que ahora compiten contra sesenta mil tokens de ruido reciente que el modelo también considera relevante.

    [System prompt + spec: 5.000 tokens] ──► Alta atención
    
    [Log 1: salida de grep]        ──┐
    [Log 2: test runner completo]    ├── Zona de dilución
    [Log 3: schema SQL entero]      ──┘
    
    [Instrucción final] ──────────────────► Alta atención
    

    El 92 % de lo que el modelo está leyendo en la iteración 15 es material que ya no sirve para nada. Ahí es donde empieza a alucinar.


    Las 3 técnicas para eliminar el Context Drift

    1. Poda de salidas de herramientas

    Nunca devuelvas al contexto la salida completa de un comando.

    Si un test runner ejecutó 120 tests y falló uno, el agente necesita saber tres cosas:

    • El estado general (FAILED).
    • El nombre del test que falló.
    • Las 10 líneas relevantes del stack trace.

    Los otros 3.000 tokens de tests en verde son ruido puro: encarecen la factura y compiten por la atención del modelo. Poda en el tool handler, antes de que ese texto llegue al historial. No le pidas al modelo que lo ignore, porque no puede.

    Si quieres ver cuánto te está costando esto de verdad, en medir el consumo de tokens de un agente desgloso en qué se te van realmente.

    2. El patrón scratchpad: memoria en disco, no en el chat

    El peor sitio para guardar el estado de un proyecto es el historial del chat. Es volátil, crece sin control y no puedes consultarlo sin arrastrarlo entero.

    El patrón robusto es obligar al agente a mantener un archivo en disco —scratch/state.md— como única fuente de la verdad. En cada paso clave lo actualiza:

    • Tareas completadas.
    • Tareas pendientes.
    • Decisiones técnicas tomadas y descartadas.

    Cuando el contexto conversacional se ensucia, tiras la conversación entera y arrancas otra pidiéndole que lea ese archivo. El agente recupera todo su foco por unos cientos de tokens en vez de sesenta mil.

    Esta es la versión mínima y sin dependencias del asunto. Si necesitas memoria entre sesiones, perfiles de usuario o recuperación semántica, el terreno está mapeado en implementación de memoria en agentes de IA. Pero empieza por el archivo de texto: resuelve más de lo que parece.

    3. Compactación rodante del historial

    En lugar de acumular treinta mensajes, sustituye el tramo intermedio por un resumen sintético y conserva intactos el system prompt y los últimos turnos.

    Suena trivial, y tiene dos trampas que revientan la petición en producción: cortar un mensaje de resultado de herramienta separándolo de la llamada que lo produjo, y romper la alternancia de roles que exigen algunas APIs.

    export type Role = "system" | "user" | "assistant" | "tool";
    
    export interface AgentMessage {
      role: Role;
      content: string;
    }
    
    /**
     * Sustituye el tramo intermedio del historial por un resumen.
     * Preserva el system prompt y los ultimos `keepLastTurns` mensajes.
     */
    export function compactContext(
      messages: AgentMessage[],
      keepLastTurns = 6,
    ): AgentMessage[] {
      if (keepLastTurns < 1) {
        throw new RangeError("keepLastTurns debe ser >= 1");
      }
    
      const hasSystem = messages[0]?.role === "system";
      const head = hasSystem ? messages.slice(0, 1) : [];
      const body = hasSystem ? messages.slice(1) : messages;
    
      if (body.length <= keepLastTurns) return messages;
    
      // Un mensaje `tool` sin la llamada que lo genero es un 400 en la API.
      // Retrocedemos el corte hasta que deje de apuntar a un resultado huerfano.
      let cut = body.length - keepLastTurns;
      while (cut > 0 && body[cut].role === "tool") cut--;
    
      const middle = body.slice(0, cut);
      if (middle.length === 0) return messages;
    
      const summary: AgentMessage = {
        role: "user",
        content:
          `[RESUMEN DE PASOS ANTERIORES] Se ejecutaron ${middle.length} operaciones ` +
          `de inspeccion y validacion. El estado real esta en scratch/state.md; ` +
          `los mensajes siguientes son la fase activa.`,
      };
    
      return [...head, summary, ...body.slice(cut)];
    }
    

    Dos notas para llevarlo a producción:

    • Si tu proveedor exige alternancia estricta de roles, comprueba que body[cut] no sea otro mensaje de usuario. Si lo es, fusiona el resumen con él en vez de insertarlo aparte.
    • El resumen genérico es un punto de partida, no el final. En cuanto puedas, genera ese texto con una llamada barata a un modelo pequeño que resuma los pasos reales: qué se intentó, qué falló y por qué. Un resumen que dice "se ejecutaron 12 operaciones" evita la saturación, pero no conserva el aprendizaje.

    El coste oculto de compactar (y por qué no debes hacerlo cada turno)

    Aquí es donde mucha gente se pega el tiro en el pie.

    La caché de prompts de los proveedores funciona por prefijo: se reutiliza el principio del prompt mientras siga siendo idéntico. Cuando compactas, reescribes justo esa parte del historial, así que la petición siguiente se paga entera a precio completo, sin descuento de caché.

    Si compactas cada turno, pierdes más de lo que ahorras: tendrás menos tokens, pero pagados todos a tarifa plena y con la caché reconstruyéndose sin parar.

    La regla práctica que uso:

    1. Poda siempre, en cada llamada a herramienta. Eso no toca el prefijo cacheado, porque afecta a lo que todavía no ha entrado.
    2. Compacta por lotes, cuando cruzas un umbral (por ejemplo, el 60 % de la ventana) o cuando termina una fase completa de trabajo.
    3. Nunca compactes a mitad de una subtarea. Espera al cambio de fase: es cuando el resumen sale bien y cuando el corte de caché duele menos.

    Por qué Spec-Driven Development resuelve el 80 % del problema

    El Context Drift no es solo un problema de memoria; es un problema de ambigüedad inicial.

    Si no le das al agente una especificación cerrada en un spec.md, tiene que deducir qué hacer sobre la marcha. Y deducir cuesta tokens: exploración, preguntas, archivos abiertos por si acaso, callejones sin salida. Todo eso acaba en el historial y satura la ventana con material que ni siquiera hacía falta.

    Con Spec-Driven Development el alcance está delimitado desde el primer segundo: el agente sabe qué archivos puede tocar y qué queda fuera. Menos exploración es, literalmente, menos drift.

    Es el método que enseño en profundidad en el curso Construye con IA: de la idea al producto con Claude Code y que tienes explicado paso a paso en el libro de Spec-Driven Development.

    Y si además validas con esquemas de Zod todo lo que entra y sale de tus herramientas, cortas el otro vector de degradación: datos deformados que el agente arrastra durante veinte iteraciones sin que nadie los detecte. Cómo blindar esos contratos lo tienes en el curso de Zod para TypeScript.


    Lo que puedes aplicar hoy

    1. Poda los logs. Limita la salida de cada herramienta y resume los errores antes de inyectarlos.
    2. Externaliza la memoria. Guarda el progreso en un archivo en disco en lugar de confiar en el historial.
    3. Compacta por fases, no por turnos. Y mira el impacto en la caché antes de darlo por bueno.

    En Dominicode Labs diseñamos arquitecturas de agentes que ejecutan tareas de horas sin desviarse del objetivo.

    El punto fijo al que volver cuando el contexto ya derivó son tus propias notas, siempre que estén escritas para recuperarse sueltas: Zettelkasten para developers.

    Tener una ventana de contexto gigante no es una excusa para ser descuidado con lo que metes dentro. La diferencia entre un prototipo frágil y un sistema agéntico de producción no está en el modelo: está en qué le dejas leer en la iteración 15.


    Preguntas frecuentes

    ¿Cada cuántas iteraciones conviene compactar el historial de un agente?

    No lo ates a un número de iteraciones, átalo a un umbral de ocupación de la ventana y a los cambios de fase. Compactar al cruzar el 60 % de la ventana, o al terminar una subtarea completa, funciona mejor que hacerlo cada N turnos: el resumen sale más limpio y no partes el trabajo por la mitad.

    ¿Compactar el contexto invalida la caché de prompts y encarece la factura?

    Sí. La caché funciona por prefijo idéntico, así que al reescribir el tramo intermedio del historial la siguiente petición se paga completa. Por eso conviene compactar por lotes en lugar de cada turno: podar la salida de las herramientas antes de que entren al historial reduce tokens sin tocar el prefijo ya cacheado.

    ¿Qué diferencia hay entre compactar el historial y reiniciar la conversación?

    Compactar conserva el hilo conversacional y sustituye lo antiguo por un resumen; reiniciar tira todo y arranca de cero leyendo el archivo de estado. Compactar es más fácil de aplicar en mitad de una tarea. Reiniciar limpia mejor, pero solo es viable si el estado real vive en disco y no en el chat.

    ¿Cómo distingo un context drift de un fallo del modelo?

    Por la reproducibilidad. Coge la petición que falló, arranca una conversación nueva con el system prompt, el estado actual y esa única instrucción, y vuelve a lanzarla. Si con el contexto limpio sale bien, no era el modelo: era el historial. Si falla igual, el problema está en tus instrucciones o en la propia tarea.

    ¿Sirve de algo esto si uso un modelo con ventana de un millón de tokens?

    Sirve más, no menos. La ventana grande solo amplía cuánta basura cabe antes de que la petición reviente, pero la atención se sigue diluyendo y el coste por llamada crece con todo lo que arrastras. Una ventana grande es margen de maniobra, no un sustituto de la gestión del contexto.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Nadie prueba un motor de avión montándolo en un aparato con pasajeros. Lo amarran a un banco de pruebas, le conectan sensores, le inducen fallos y miden qué aguanta. Si revienta, revienta en tierra.

    Con software tenemos el equivalente desde hace décadas y se llama test harness: el andamiaje que rodea al código bajo prueba, le inyecta entradas controladas y comprueba las salidas.

    Con agentes de IA, en cambio, la mayoría probamos en caliente. Lanzamos el agente contra una API real, miramos si el resultado "parece bien" y lo damos por bueno.

    El problema no es la pereza. Es que un agente rompe los tres supuestos sobre los que se construyó todo tu testing:

    • No es determinista: la misma entrada da salidas distintas.
    • Tiene efectos secundarios reales: escribe archivos, llama a APIs, toca bases de datos.
    • No tiene garantía de terminar: puede quedarse en bucle gastando dinero.

    Ya expliqué por qué un LLM por sí solo no es un producto y qué capas necesita alrededor para funcionar en producción. Este post va de la otra mitad del problema, la que casi nadie monta: el arnés que se ejecuta en CI, antes del deploy. Con código.


    Por qué un test unitario normal no sirve aquí

    Un test clásico es un contrato de tres líneas: preparas la entrada, ejecutas, comparas con el valor esperado.

    Con un agente, ese toEqual no existe. La respuesta correcta no es una cadena concreta, es cualquiera de un conjunto amplio de cadenas aceptables. Y si aun así escribes la aserción exacta, tendrás un test que pasa hoy y falla el martes sin que nadie haya tocado nada.

    De ahí sale la reacción habitual, que es la equivocada: dejar de testear el agente y testear solo las funciones puras que lo rodean. Los parsers, los formateadores, los validadores. Cosas que ya sabías hacer.

    Mientras tanto, lo que de verdad puede costarte dinero —el bucle, las llamadas a herramientas, el gasto— viaja a producción sin una sola comprobación.

    El arnés cambia la pregunta. En lugar de "¿ha respondido lo correcto?", que es un problema de evals, pregunta cosas que sí tienen respuesta binaria:

    • ¿Ha llamado a alguna herramienta que no tenía permitida?
    • ¿Se ha pasado del presupuesto de tokens que le di?
    • ¿Ha terminado dentro del tiempo límite?
    • ¿Ha intentado escribir fuera de su directorio temporal?
    • ¿Ha llamado 14 veces a la misma herramienta con los mismos argumentos?

    Eso son tests de verdad: deterministas, rápidos y rojos cuando algo se rompe.

       caso de prueba              TEST HARNESS                  veredicto
      ┌──────────────┐    ┌──────────────────────────────┐    ┌────────────┐
      │ entrada fija │───►│  tools falsas (sin red)      │───►│ PASS/FAIL  │
      │ estado fijo  │    │  presupuesto de tokens       │    │ trace.json │
      └──────────────┘    │  timeout + AbortSignal       │    └────────────┘
                          │  directorio efimero          │
                          └──────────────────────────────┘
    

    Las 3 piezas que hacen testeable a un agente

    1. Herramientas falsas, no red

    La regla es simple: en modo test, el agente no toca nada real. Ni base de datos, ni API de pagos, ni sistema de archivos fuera de un directorio temporal que destruyes al terminar.

    Y no basta con mockear la implementación. Hay que no exponer las herramientas no autorizadas: si el agente ve deleteUser en su lista de tools, tarde o temprano la llamará, y el error que quieres detectar en CI es precisamente ese. Un arnés que expone la herramienta y luego lanza una excepción llega tarde para razonar sobre el diseño, aunque salve los datos.

    Si necesitas ejecutar código generado de verdad —no simularlo—, ahí el aislamiento sube un nivel y toca contenedor: lo conté en Docker sandboxing para ejecutar código de IA de forma segura.

    2. Presupuesto de tokens y timeout que cortan de verdad

    Esta es la pieza que casi todo el mundo escribe mal.

    He visto docenas de arneses con un campo maxTokens en la configuración que no se comprueba en ningún sitio. Y timeouts implementados con Promise.race que devuelven el control al test pero dejan la ejecución corriendo por detrás, gastando tokens contra la API mientras el test ya ha dado verde.

    Un límite que no corta no es un límite: es un comentario.

    3. Traza reproducible

    El arnés graba cada paso: qué herramienta, con qué argumentos, cuánto tardó, cuánto costó. Un array de objetos serializado a JSON.

    Sirve para dos cosas. Para que un fallo en CI sea depurable sin volver a lanzar el agente. Y para escribir aserciones sobre el proceso, no sobre el texto final, que es donde está la señal útil: si el agente llegó al resultado correcto llamando siete veces a la misma consulta, eso es un bug aunque la salida sea perfecta.


    El arnés en TypeScript

    Vamos al código. Un arnés mínimo con presupuesto real, cancelación real y traza, sin dependencias más allá de Zod para validar los argumentos que el modelo envía a cada herramienta.

    Primero, los tipos y el registro de herramientas:

    import { z } from "zod";
    
    export interface HarnessConfig {
      maxTokens: number;
      timeoutMs: number;
      allowedTools: string[];
    }
    
    export interface TraceEntry {
      tool: string;
      args: unknown;
      durationMs: number;
      tokens: number;
    }
    
    /** Herramienta ya validada: el schema queda encapsulado dentro de `run`. */
    export interface HarnessTool {
      cost: number;
      run: (rawArgs: unknown) => Promise<unknown>;
    }
    
    export class BudgetExceededError extends Error {}
    
    /**
     * En el punto de definicion conservas el tipado completo del schema.
     * En el registro todas las tools comparten la misma firma, que es lo
     * que permite recorrerlas en bucle sin castings.
     */
    export function defineTool<S extends z.ZodType>(
      schema: S,
      cost: number,
      run: (args: z.infer<S>) => Promise<unknown>,
    ): HarnessTool {
      return { cost, run: (rawArgs) => run(schema.parse(rawArgs)) };
    }
    
    // Fixtures: nada de esto sale a la red.
    export const testTools: Record<string, HarnessTool> = {
      queryDatabase: defineTool(
        z.object({ table: z.string(), limit: z.number().max(100) }),
        320,
        async ({ table }) => ({ rows: [{ id: 1, table, name: "Fixture User" }] }),
      ),
      sendEmail: defineTool(
        z.object({ to: z.string().email(), body: z.string() }),
        90,
        async () => ({ delivered: true }),
      ),
    };
    

    Ahora el arnés. Fíjate en tres detalles: solo se construyen las herramientas permitidas, el presupuesto se comprueba antes de ejecutar cada llamada, y el temporizador se limpia siempre.

    export type HarnessStatus = "SUCCESS" | "TIMEOUT" | "BUDGET_EXCEEDED" | "FAILED";
    
    export interface HarnessResult {
      status: HarnessStatus;
      tokensUsed: number;
      durationMs: number;
      output: string | null;
      trace: TraceEntry[];
    }
    
    type ToolBox = Record<string, (args: unknown) => Promise<unknown>>;
    
    export async function runWithHarness(
      task: (tools: ToolBox, signal: AbortSignal) => Promise<string>,
      config: HarnessConfig,
    ): Promise<HarnessResult> {
      const startedAt = performance.now();
      const trace: TraceEntry[] = [];
      let tokensUsed = 0;
    
      // 1. Solo existen las tools autorizadas. El resto no se expone.
      const tools: ToolBox = {};
      for (const name of config.allowedTools) {
        const tool = testTools[name];
        // Un nombre desconocido es un error de configuracion del test: que reviente ya.
        if (!tool) throw new Error(`Tool desconocida en allowedTools: ${name}`);
    
        tools[name] = async (rawArgs: unknown) => {
          // 2. El presupuesto se comprueba ANTES de gastar.
          if (tokensUsed + tool.cost > config.maxTokens) {
            throw new BudgetExceededError(
              `Presupuesto agotado: ${tokensUsed} + ${tool.cost} > ${config.maxTokens}`,
            );
          }
          const t0 = performance.now();
          const result = await tool.run(rawArgs); // Zod valida dentro: si no cuadra, revienta
          tokensUsed += tool.cost;
          trace.push({
            tool: name,
            args: rawArgs,
            durationMs: Math.round(performance.now() - t0),
            tokens: tool.cost,
          });
          return result;
        };
      }
    
      // 3. Cancelacion real: la tarea recibe el signal y debe propagarlo al SDK.
      const controller = new AbortController();
      const timer = setTimeout(() => controller.abort(), config.timeoutMs);
    
      const finish = (status: HarnessStatus, output: string | null): HarnessResult => ({
        status,
        tokensUsed,
        durationMs: Math.round(performance.now() - startedAt),
        output,
        trace,
      });
    
      try {
        const output = await task(tools, controller.signal);
        return finish("SUCCESS", output);
      } catch (error) {
        if (controller.signal.aborted) return finish("TIMEOUT", null);
        if (error instanceof BudgetExceededError) return finish("BUDGET_EXCEEDED", null);
        return finish("FAILED", error instanceof Error ? error.message : String(error));
      } finally {
        clearTimeout(timer); // sin esto, el timer mantiene vivo el proceso al terminar
      }
    }
    

    Un aviso honesto sobre el punto 3: el AbortSignal solo cancela de verdad si tu tarea lo propaga al SDK del modelo y a cada fetch. Si lo ignoras, el arnés dará TIMEOUT y devolverá el control al test, pero la llamada seguirá viva por detrás y te la cobrarán igual. El signal no es decorativo: es el único mecanismo que corta el gasto.

    Y ahora sí, un test

    Con esto, probar el bucle del agente vuelve a ser testing normal:

    import { describe, expect, it } from "vitest";
    import { runWithHarness } from "./harness";
    
    describe("agente de facturación", () => {
      it("corta la ejecución al agotar el presupuesto", async () => {
        const result = await runWithHarness(
          async (tools) => {
            // Un agente en bucle: consulta la misma tabla sin parar.
            for (let i = 0; i < 20; i++) {
              await tools.queryDatabase({ table: "invoices", limit: 10 });
            }
            return "listo";
          },
          { maxTokens: 1_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.status).toBe("BUDGET_EXCEEDED");
        expect(result.tokensUsed).toBeLessThanOrEqual(1_000);
        expect(result.trace).toHaveLength(3); // 3 × 320 = 960; la cuarta no cabe
      });
    
      it("no expone las herramientas fuera del allowlist", async () => {
        const result = await runWithHarness(
          async (tools) => {
            if ("sendEmail" in tools) return "PELIGRO: tool disponible";
            return "ok";
          },
          { maxTokens: 5_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.output).toBe("ok");
      });
    });
    

    Deterministas, sin red, en milisegundos. Se pueden ejecutar en cada push sin pensar en la factura.

    Ese expect(result.trace).toHaveLength(3) es el tipo de aserción que solo puedes escribir si grabas la traza: comprueba el comportamiento del bucle, no el texto de salida.

    Si quieres afinar el diseño de tests y el aislamiento de dependencias externas —que es exactamente el músculo que necesitas aquí—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library. Y el uso de Zod para validar los argumentos que envía el modelo, con transformaciones y errores tipados, lo tienes en el curso de Zod para TypeScript.


    Qué encaja arriba y qué encaja abajo

    Tres piezas que se confunden todo el rato y conviene separar:

    Pieza Cuándo corre Qué responde
    Test harness En CI, en cada push ¿Se sale de los límites, del allowlist o del tiempo?
    Evals Por lotes, con casos reales ¿La calidad de las respuestas sube o baja?
    Agentic harness En producción, en cada ejecución ¿Cómo lo mantengo controlado con usuarios reales?

    El arnés de pruebas es el más barato de los tres y el que casi nadie tiene. Cuestión de horas montarlo, y atrapa la clase de fallo que más caro sale.

    Sobre el reparto de trabajo entre los tests que escribes tú y los que genera el agente, ya hay un post entero: adopta TDD para implementar pruebas efectivas con agentes de IA. Y sobre por qué la spec y la arquitectura no bastan sin esta capa debajo, también. Este post es la parte que faltaba: el código.

    Si trabajas con Spec-Driven Development, el encaje es directo. Los límites que escribes en la sección de NFRs del spec.md —presupuesto, latencia, herramientas permitidas— dejan de ser un párrafo y pasan a ser los argumentos de HarnessConfig. La especificación se vuelve ejecutable, que es de lo que va el libro de Spec-Driven Development.


    Lo que puedes montar esta semana

    1. Una lista blanca de herramientas por entorno. Que en test solo existan las que necesita el caso.
    2. Un presupuesto que corte. Comprobado antes de cada llamada, no después. Si tu maxTokens no aparece en ningún if, no existe.
    3. Una traza en JSON por ejecución. Y al menos un test que asierte sobre ella, no sobre el texto de salida.

    En Dominicode Labs montamos este tipo de arneses sobre agentes que corren horas sin supervisión.

    Deja de probar tus motores en pleno vuelo. Amárralos al banco, súbeles la presión hasta que rompan y arréglalos en tierra, que es donde sale barato.


    Preguntas frecuentes

    ¿Cómo se testea algo que no es determinista?

    No asertando sobre el texto de salida, sino sobre el comportamiento observable: qué herramientas llamó, con qué argumentos, cuántas veces, cuánto gastó y si terminó a tiempo. Todo eso sí es determinista y da un rojo claro cuando se rompe. La calidad de la respuesta es otra disciplina y se mide por lotes, no en cada push.

    ¿El test harness sustituye a los mocks de toda la vida?

    No, los usa. La diferencia es el alcance: un mock reemplaza una dependencia concreta, mientras que el arnés controla el entorno completo de la ejecución —qué herramientas existen, cuánto puede gastar, cuánto puede tardar y qué queda grabado—. Un mock por sí solo no impide que el agente entre en bucle.

    ¿Hay que llamar al modelo real en estos tests?

    No en los que corren en cada push: se ejecuta el bucle del agente con respuestas fijas, y eso vale para verificar límites, allowlist y control de flujo. Las ejecuciones con modelo real cuestan dinero y tardan, así que van en un job aparte, programado y sobre un conjunto reducido de casos.

    ¿Qué hago si el timeout salta pero el agente sigue gastando dinero?

    Es que estás cortando en el sitio equivocado. Promise.race devuelve el control al test pero no cancela nada: hay que crear un AbortController, pasar su signal a la tarea y propagarlo al SDK del modelo y a cada fetch. Si el SDK que usas no acepta señal de cancelación, el único corte real es aislar la ejecución en un proceso o contenedor aparte y matarlo.

    ¿Merece la pena montarlo si mi agente solo lee datos?

    Sí, por el gasto y por los bucles. Un agente de solo lectura no borra nada, pero puede repetir la misma consulta cuarenta veces y facturarte la broma entera. El presupuesto y la traza detectan ese patrón en CI, que es donde cuesta cero arreglarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Construyendo sitios web ultrarrápidos con Astro y Server Islands: Cero JS por defecto

    Construyendo sitios web ultrarrápidos con Astro y Server Islands: Cero JS por defecto

    Hace unos meses analicé la landing page de un cliente que ofrecía un producto SaaS. Habían construido la web utilizando un marco de trabajo de aplicación de página única (SPA) completo.

    Para renderizar un titular estático, una lista de precios y tres testimonios de clientes, el navegador del usuario tenía que descargar, descompilar y ejecutar 480 KB de JavaScript. En conexiones móviles 4G, el tiempo hasta que la página se volvía interactiva (Time to Interactive) superaba los 5.5 segundos. El resultado en Google Lighthouse era un doloroso 44/100.

    Perdían el 30% de los visitantes antes de que la página terminara de cargar.

    Al refactorizar el sitio hacia Astro y aprovechar la nueva funcionalidad de Server Islands, redujimos el bundle de JavaScript cliente para la estructura estática a 0 KB, logrando una puntuación de 100/100 en Core Web Vitals en el primer intento.

    La paradoja de enviar JavaScript para renderizar HTML

    Durante la última década, la industria del desarrollo web cometió un error colectivo: asumir que cualquier sitio web moderno debía empaquetarse dentro de una aplicación de React o Angular que se ejecuta íntegramente en el navegador del usuario.

    El resultado ha sido la degradación del rendimiento web:

    • El navegador descarga megabytes de JavaScript para crear nodos de DOM que podrían haber sido enviados directamente como HTML estático.
    • La CPU del dispositivo móvil se satura ejecutando hidratación de estado.
    • Los motores de búsqueda e intenciones de búsqueda sufren retardos de indexación.

    Astro invirtió este modelo con su filosofía "Zero JavaScript by default" (Cero JavaScript por defecto). Astro renderiza todo el componente a HTML estático en el servidor y solo envía JavaScript al cliente si especificas explícitamente una isla interactiva (Islands Architecture).

    ¿Qué son las Server Islands en Astro?

    La arquitectura de islas tradicional permitía incrustar componentes interactivos cliente (React, Vue, Svelte) dentro de una página estática usando directivas como client:load o client:visible.

    Sin embargo, las Server Islands introducen un avance superior: permiten posponer la renderización de un componente dinámico de servidor sin bloquear la carga estática inicial de la página.

    ┌─────────────────────────────────────────────────────────┐
    │ HTML Estático enviado de inmediato (TTFB ultra bajo)     │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ Hero Section + Menú + Testimonios (HTML Puro)       │ │
    │ └─────────────────────────────────────────────────────┘ │
    │ ┌─────────────────────────────────────────────────────┐ │
    │ │ <AvatarUsuario server:defer /> (Server Island)      │ │
    │ │  └─► Renderiza fallback estático instantáneo        │ │
    │ │  └─► Se sustituye en segundo plano por HTML del srv  │ │
    │ └─────────────────────────────────────────────────────┘ │
    └─────────────────────────────────────────────────────────┘
    

    Ejemplo de uso de Server Island en Astro

    Imagina un blog de alta velocidad donde la mayor parte del contenido es estático, pero deseas mostrar el avatar personalizado del usuario autenticado en la barra superior.

    ---
    // src/pages/posts/[slug].astro
    import Layout from '../layouts/Layout.astro';
    import AvatarUsuario from '../components/AvatarUsuario.astro';
    import ContenidoPost from '../components/ContenidoPost.astro';
    
    const { slug } = Astro.params;
    ---
    
    <Layout title="Post de Blog Ultrarrápido">
      <header style="display: flex; justify-content: space-between;">
        <Logo />
        <!-- La Server Island no bloquea la carga de la página estática -->
        <AvatarUsuario server:defer>
          <!-- Fallback mientras el servidor procesa la sesión -->
          <div slot="fallback" class="avatar-skeleton"></div>
        </AvatarUsuario>
      </header>
    
      <main>
        <ContenidoPost slug={slug} />
      </main>
    </Layout>
    

    Al cargar la página:

    1. El servidor entrega HTML puro súper rápido (la estructura completa del artículo y la plantilla).
    2. El cliente ve la página cargada de forma instantánea con el skeleton del avatar.
    3. Astro ejecuta en segundo plano el componente <AvatarUsuario /> en el servidor y reemplaza el fallback con el HTML dinámico parseado sin necesidad de descargar una pesada librería cliente.

    Como vimos al comparar el consumo en tiempo de compilación con Next.js y Turbopack, utilizar la arquitectura correcta para cada tipo de proyecto es la decisión de rendimiento más rentable.

    Tipado Defensivo y Colecciones de Contenido

    Astro integra Content Collections, un sistema basado en Zod que valida en tiempo de compilación que todos tus archivos Markdown o MDX cumplan exactamente con la estructura de tipos definida.

    // src/content/config.ts
    import { defineCollection, z } from 'astro:content';
    
    const postsCollection = defineCollection({
      type: 'content',
      schema: z.object({
        title: z.string(),
        description: z.string().max(160),
        pubDate: z.date(),
        author: z.string().default('Bezael Pérez'),
        tags: z.array(z.string()),
      }),
    });
    
    export const collections = { posts: postsCollection };
    

    Al aplicar programación defensiva en TypeScript, garantizas que ningún artículo con metadatos defectuosos rompa la generación estática de tu sitio web.

    Además, mantener aisladas las dependencias de tus componentes siguiendo principios de graph engineering permite reutilizar componentes de React o Vue dentro de Astro de manera impecable.


    Astro y sus Server Islands representan la convergencia perfecta entre la velocidad extrema del HTML estático y la flexibilidad de la web dinámica moderna.

    Si quieres dominar el desarrollo web moderno, optimización de rendimiento y arquitectura frontend, explora los Cursos de Dominicode. Y si buscas construir sitios web y productos de alto impacto junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿En qué se diferencia una Server Island de un Server Component de React?

    Los Server Components de React requieren que toda la aplicación comparta el modelo de hidratación y empaquetado de React. Las Server Islands de Astro son agnósticas al framework: puedes usar componentes en Astro puro, React, Vue, Svelte o Solid, y se reemplazan de forma asíncrona mediante un fragmento de HTML ligero sin cargar el runtime del framework si no es necesario.

    ¿Puedo seguir usando componentes interactivos de React en Astro?

    Sí. Puedes importar cualquier componente de React, Vue o Svelte en Astro. Para habilitar la interactividad cliente en un componente específico, solo añades la directiva de hidratación correspondiente, como client:visible (se hidrata solo cuando el usuario hace scroll hasta él) o client:idle (se hidrata cuando el navegador está inactivo).

    ¿Server Islands requiere una plataforma de despliegue en servidor (SSR)?

    Para que las Server Islands funcionen procesando peticiones dinámicas en segundo plano, tu proyecto Astro debe desplegarse con un adaptador SSR (Server-Side Rendering) en plataformas como Vercel, Netlify, Cloudflare Workers o un contenedor Docker con Node.js/Bun.

    ¿Astro es adecuado para aplicaciones web complejas con paneles de administración?

    Astro es imbatible para sitios web centrados en contenido, blogs, e-commerce, documentación y landing pages. Para paneles de administración interactivos con estado denso en cliente (dashboards complejos), combinar Astro para las páginas públicas con un framework como Next.js, Angular o React para el panel privado es una excelente estrategia de arquitectura.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.