Category: TypeScript

  • Neon vs Supabase: comparación técnica honesta (2026)

    Neon vs Supabase: comparación técnica honesta (2026)

    Hace unos meses estaba arrancando un proyecto nuevo. Stack limpio, decisiones por tomar. Y en cuestión de minutos tuve el debate de siempre en el canal de decisiones técnicas: ¿Neon o Supabase?

    Los dos son Postgres. Los dos tienen free tier. Los dos aparecen en casi cualquier lista de "stack moderno para SaaS". Y los dos hacen cosas completamente distintas.

    Este post es la Neon vs Supabase comparación técnica que me hubiera ahorrado dos horas de lectura de docs.


    Qué es cada uno en una línea

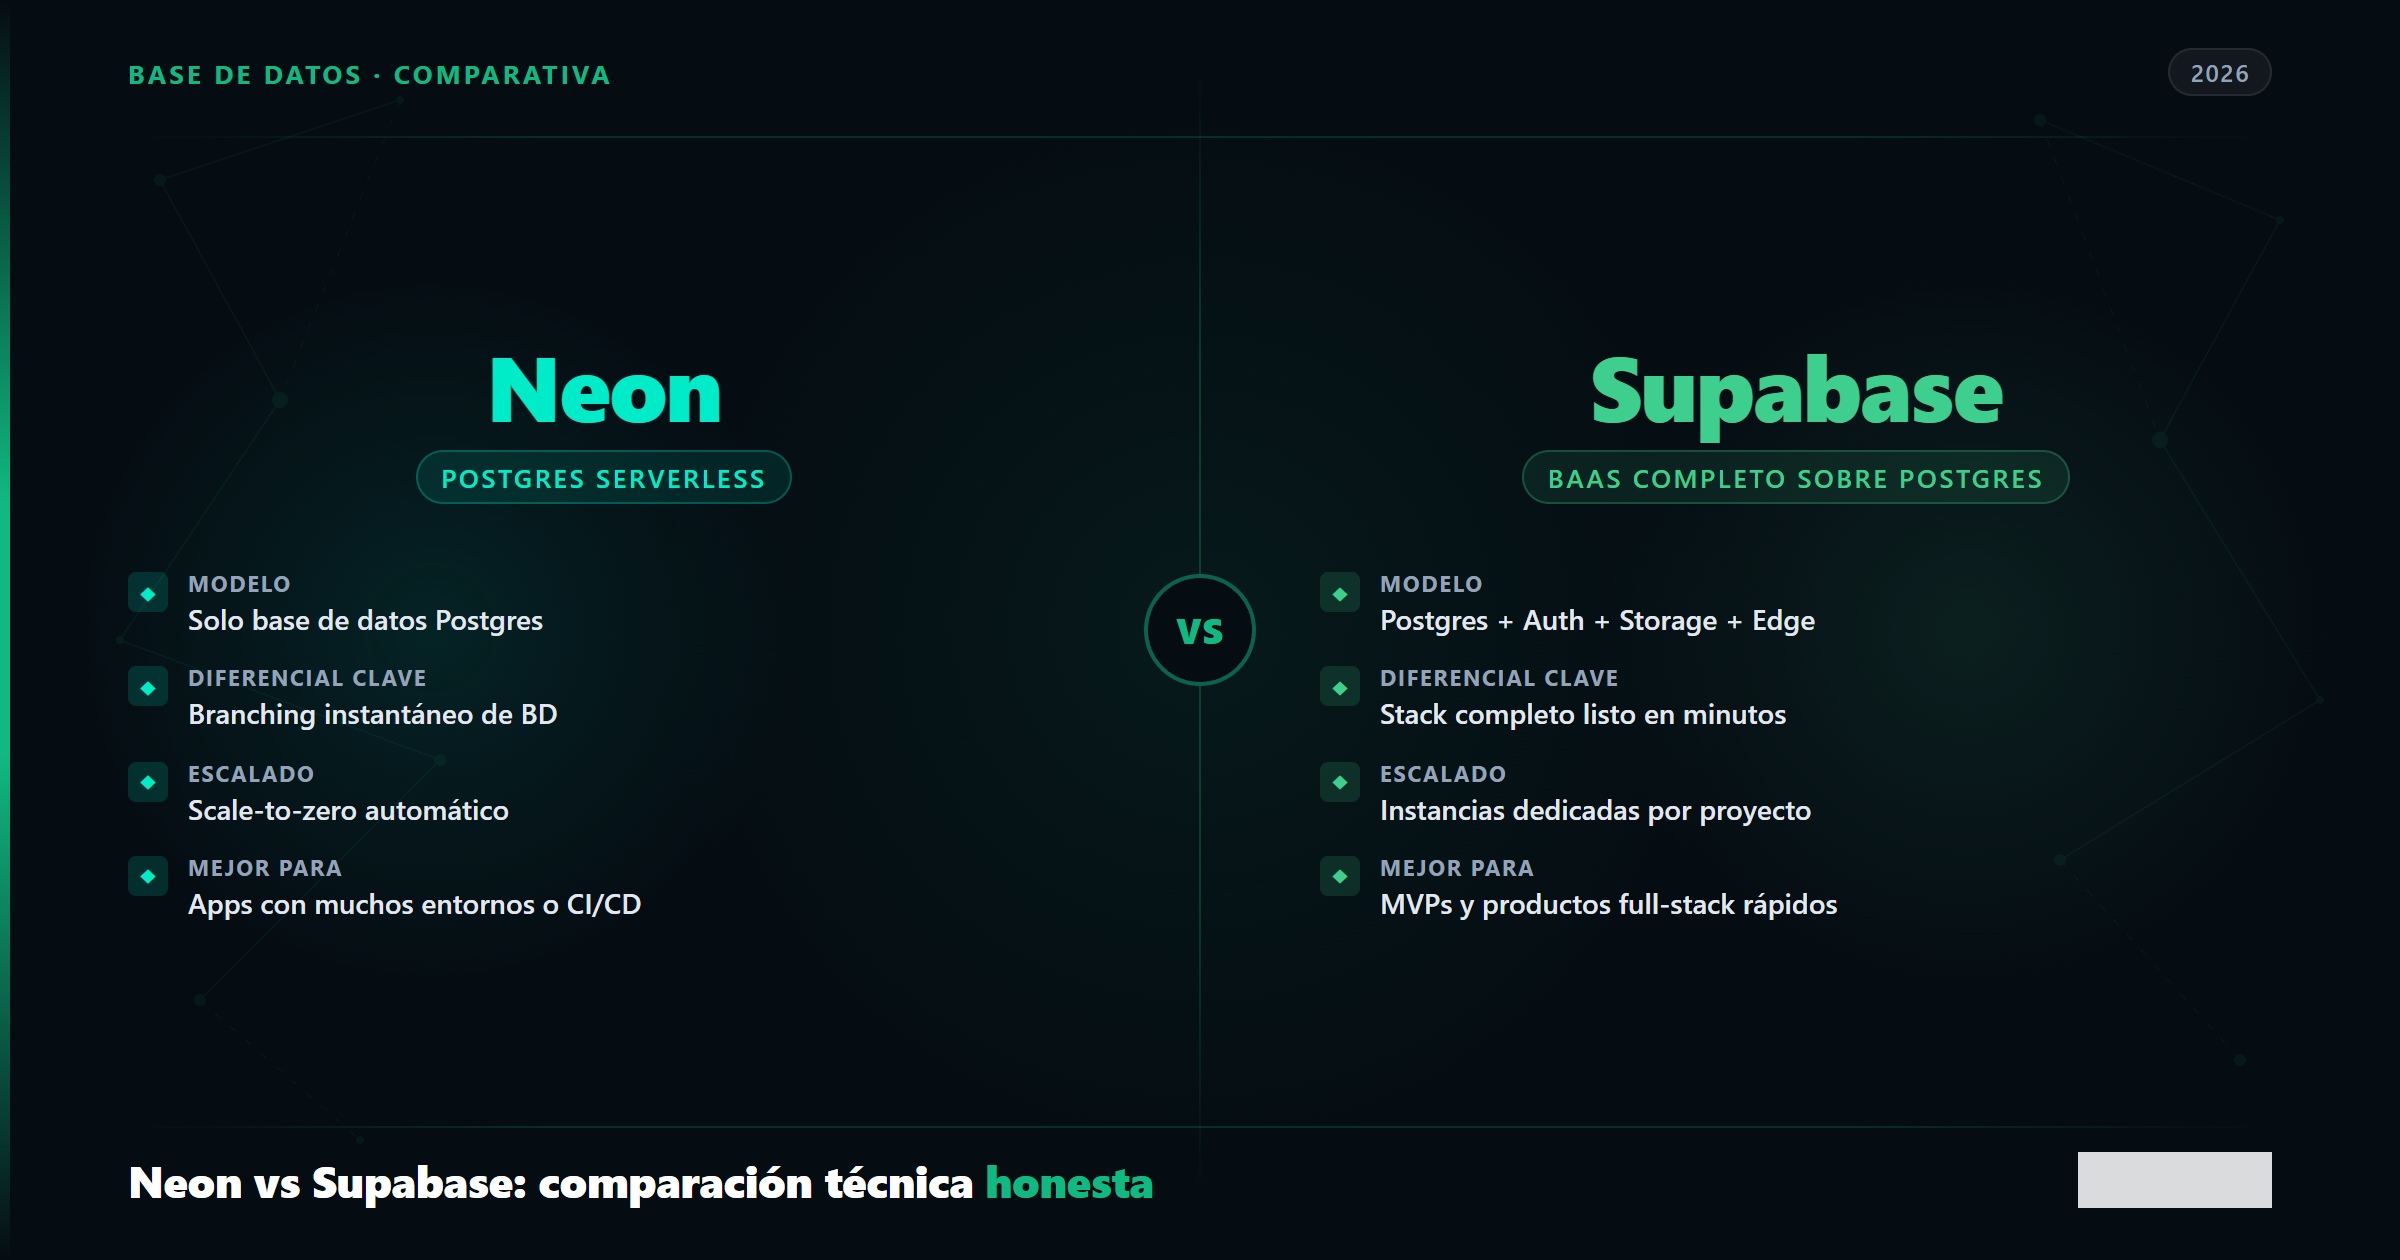
    Neon: Postgres serverless puro con branching de base de datos y scale-to-zero.

    Supabase: Plataforma BaaS construida sobre Postgres — incluye Auth, Storage, Realtime y Edge Functions en un solo sitio.

    La diferencia de fondo: Neon es una base de datos. Supabase es un backend completo que usa Postgres como motor.


    Tabla comparativa

    Criterio Neon Supabase
    Tipo Postgres serverless BaaS completo sobre Postgres
    Scale-to-zero Sí, nativo No en producción (pausa en free tier)
    Branching de DB Sí, copy-on-write instantáneo Solo Pro+ (beta); provisiona DB nueva + migraciones
    Auth nativo No Sí (JWT, OAuth, Magic Link)
    Storage nativo No Sí (S3-compatible)
    Realtime No Sí (WebSockets sobre Postgres)
    Edge Functions No Sí (Deno runtime)
    Free tier DB 0.5 GB, 100 CU-h 500 MB, pausa tras 7 días idle
    Plan de pago Desde ~$19/mes (usage-based) $25/mes (Pro, todo incluido)
    ORM compatible Cualquiera (Drizzle, Prisma, pg) Cliente JS/TS propio + cualquier ORM
    Tipado auto-generado Via ORM Sí, con supabase gen types
    Adquirida por Databricks (2025, ~$1B) Independiente

    Arquitectura de Neon vs Supabase: la diferencia que más importa

    Neon separa compute y storage. Cuando no hay peticiones, el compute se apaga solo — y cuando llega la primera query, arranca en milisegundos. El storage usa copy-on-write, lo que hace que crear una rama de base de datos sea instantáneo y casi sin coste.

    Supabase no funciona así. Tu base de datos corre en una instancia dedicada. Si estás en el free tier, Supabase pausa el proyecto tras 7 días sin actividad. En Pro, la instancia corre siempre — pagas compute 24/7 aunque tu app esté durmiendo.

    Para proyectos en producción con tráfico real, esto no es necesariamente un problema. Para proyectos con muchos entornos (staging, feature branches, demos de clientes), la diferencia de coste es brutal.


    Branching: por qué Neon gana en CI/CD

    Esta es la feature que más me ha cambiado el flujo de trabajo.

    Con Neon puedes crear una rama de base de datos por PR. Misma estructura, mismos datos (o un subconjunto). La rama vive mientras dura el PR y desaparece al hacer merge. No hay que mantener un entorno de staging contaminado con datos de otras features. Si tienes un pipeline con code review automático antes del merge, tienes el flujo completo en el post sobre agentic code review con Claude Code.

    # Crear una rama de DB para una PR concreta
    neon branches create --name feature/payment-refactor --parent main
    

    Supabase también tiene branching, pero funciona diferente: aprovisiona una base de datos nueva, ejecuta tus migraciones y carga el seed. Es más lento y consume más recursos. Para un equipo pequeño o un proyecto personal, puede ser suficiente. Para un pipeline de CI/CD que crea y destruye entornos constantemente, Neon gana por goleada.


    SDK y DX: dos filosofías distintas

    Supabase tiene un cliente JS/TS que abstrae casi todo. Queries, auth, storage, realtime — todo desde el mismo objeto.

    // Supabase: cliente unificado con tipado auto-generado
    import { createClient } from '@supabase/supabase-js'
    import type { Database } from './database.types' // generado con supabase gen types
    
    const supabase = createClient<Database>(
      process.env.SUPABASE_URL!,
      process.env.SUPABASE_ANON_KEY!
    )
    
    const { data, error } = await supabase
      .from('products')
      .select('id, name, price')
      .eq('active', true)
    

    Neon apuesta por Postgres nativo. Usas tu ORM de siempre — Drizzle, Prisma, o pg directo — contra un connection string estándar. Sin abstracciones propias, sin vendor lock-in de cliente.

    // Neon: Drizzle sobre el driver serverless de Neon
    import { neon } from '@neondatabase/serverless'
    import { drizzle } from 'drizzle-orm/neon-http'
    import { products } from './schema'
    import { eq } from 'drizzle-orm'
    
    const sql = neon(process.env.DATABASE_URL!)
    const db = drizzle(sql)
    
    const activeProducts = await db
      .select({ id: products.id, name: products.name, price: products.price })
      .from(products)
      .where(eq(products.active, true))
    

    Si ya tienes un ORM configurado en tu proyecto, migrar a Neon es cambiar el connection string. Con Supabase, el cliente propio es más cómodo para proyectos nuevos pero añade una dependencia específica a la plataforma.


    Precios Neon vs Supabase: cuándo cada modelo tiene sentido

    Neon (usage-based):

    • Free: $0 — 100 CU-horas, 0.5 GB storage
    • Launch: ~$19/mes — $0.106/CU-hora, $0.35/GB storage
    • Scale: desde ~$701/mes — con SLA e HIPAA incluidos

    Supabase (plataforma flat + overages):

    • Free: $0 — 500 MB DB, 50K MAU, 1 GB storage (pausa tras 7 días idle)
    • Pro: $25/mes — 8 GB DB, 100K MAU, Auth + Storage + Edge Functions incluidos
    • Team: $599/mes — SSO, SOC 2

    Para un proyecto con tráfico irregular o muchos entornos temporales, el modelo de Neon puede salir significativamente más barato. Para un SaaS en crecimiento que necesita Auth + Storage + DB y quiere una sola factura, el Pro de Supabase a $25 es imbatible en relación precio/funcionalidad.

    Precios verificados en junio 2026. Consulta las páginas oficiales de Neon y Supabase para tarifas actualizadas — los modelos usage-based cambian con frecuencia.


    Cuándo elegir Neon

    • Quieres Postgres puro sin opiniones sobre tu stack de auth o storage.
    • Tu pipeline de CI/CD se beneficia de tener una rama de DB por PR.
    • Tienes cargas de trabajo variables o intermitentes — el scale-to-zero te ahorra dinero real.
    • Ya tienes Drizzle o Prisma configurado y no quieres añadir un cliente propio.
    • Estás construyendo agentes de IA que necesitan provisionar bases de datos efímeras. La arquitectura serverless de Neon (y el respaldo de Databricks) la convierte en la opción natural para cargas de trabajo agénticas — incluidos los pipelines donde el agente lee un ticket, implementa y despliega de forma autónoma, como los que explico en el post sobre automatizar el proceso de desarrollo con IA.

    Cuándo elegir Supabase

    • Necesitas Auth desde el día uno — OAuth, magic link, JWT — sin montar Clerk ni Auth.js.
    • Tu proyecto necesita file storage y no quieres gestionar un bucket S3 por tu cuenta.
    • Quieres Realtime (subscripciones en tiempo real) sin añadir Redis ni WebSockets propios.
    • Valoras tener un solo proveedor para DB + Auth + Storage con una sola factura.
    • El free tier te basta para empezar y no te molesta que el proyecto se pause tras 7 días idle.

    Edge cases que nadie menciona

    Supabase no hace scale-to-zero en producción. Esto es intencionado — una instancia siempre activa garantiza latencia consistente. Pero si tienes 10 entornos de staging o un proyecto que duerme la mayor parte del tiempo, estás pagando compute en vacío.

    Neon no tiene Auth ni Storage nativos. Si los necesitas, tienes que añadirlos tú: Clerk, Better Auth, Auth.js para autenticación; Cloudflare R2, AWS S3 o Uploadthing para ficheros. No es un problema técnico, pero sí es trabajo de integración que con Supabase viene resuelto de fábrica.

    El branching de Supabase requiere CLI y configuración previa. No es tan plug-and-play como en Neon. Si quieres branching en Supabase, necesitas tener migraciones bien organizadas desde el principio.


    FAQ

    ¿Puedo usar Drizzle con Supabase?
    Sí. Supabase es Postgres estándar — puedes conectar cualquier ORM con el connection string del proyecto. El cliente propio de Supabase es opcional, no obligatorio.

    ¿Neon tiene Realtime o Auth?
    No de forma nativa. Puedes añadir LISTEN/NOTIFY de Postgres para eventos básicos, pero no hay un sistema de auth ni storage integrado. Para eso necesitas otra capa.

    ¿El scale-to-zero de Neon afecta a producción?
    Depende de tu configuración. El cold start de Neon suele estar por debajo de 500ms en condiciones normales. Para la mayoría de apps es aceptable. Si tienes requisitos de latencia muy estrictos, puedes configurar un mínimo de compute activo en el plan de pago.

    ¿Qué pasa con la adquisición de Neon por Databricks?
    Databricks compró Neon en 2025 por aproximadamente $1B. La apuesta es que los agentes de IA van a necesitar provisionar bases de datos efímeras a escala. Para el usuario, de momento se traduce en mejoras de precios — el storage bajó de $1.75 a $0.35/GB-mes. El roadmap a largo plazo aún está por verse.

    ¿Puedo migrar de Supabase a Neon (o al revés) más adelante?
    La base de datos en sí migra sin problema — es Postgres estándar en los dos casos. El trabajo real está en reemplazar el cliente de Supabase (auth, storage, realtime) si decides cambiar. Si usas Drizzle o Prisma desde el principio, cambiar el connection string es trivial.


    La decisión no es técnica en el fondo — es de qué quieres gestionar tú y qué quieres que gestione la plataforma. Si quieres Postgres puro con control total y branching en CI/CD, Neon. Si quieres un backend completo sin ensamblar piezas, Supabase.

    Ninguna de las dos es la respuesta correcta en abstracto. Ambas son la respuesta correcta para el problema adecuado.

    Si en tu proyecto estás usando IA para construir features o automatizar flujos, en el curso Construye con IA trabajamos exactamente con este tipo de decisiones de arquitectura — desde la elección de herramientas hasta el producto en producción.

    Si quieres profundizar en cómo tomar este tipo de decisiones de arquitectura en proyectos reales — con IA en el loop — en Dominicode Labs tenemos proyectos completos con el stack detallado y la justificación técnica detrás de cada decisión.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude API: Crash Course para developers con TypeScript

    Claude API: Crash Course para developers con TypeScript

    Hace unos meses un developer me escribió frustrado. Llevaba dos días intentando integrar Claude en su app. No le funcionaba el streaming, no entendía por qué sus respuestas llegaban cortadas, y había probado tres ejemplos distintos de Stack Overflow que usaban versiones diferentes del SDK.

    El problema no era la API. Era que había empezado por el medio.

    Esta es la Claude API introducción que yo habría querido tener al principio: sin rodeos, con código real, y con el orden correcto para entender qué está pasando antes de que algo falle.

    Qué es la Claude API y por qué te importa

    Claude es el modelo de lenguaje de Anthropic. La API te da acceso directo a ese modelo desde tu código: puedes enviarle mensajes, pedirle que razone, que use herramientas externas, que responda en streaming o que procese imágenes.

    La diferencia respecto a ChatGPT para developers es principalmente la calidad del razonamiento en tareas de código complejas y el system prompt — Claude lo sigue con una precisión que cambia cómo construyes agentes.

    Setup: API key y SDK

    Primero necesitas una cuenta en console.anthropic.com. Una vez dentro, ve a API Keys y genera una nueva clave. Guárdala — no la vuelves a ver.

    Instala el SDK oficial con npm o Bun:

    npm install @anthropic-ai/sdk
    # o con Bun
    bun add @anthropic-ai/sdk
    

    Guarda la clave en una variable de entorno. Nunca en el código:

    # .env
    ANTHROPIC_API_KEY=sk-ant-...
    

    Tu primera llamada en TypeScript

    Este es el "Hello World" de la Claude API. Sin clases, sin abstracción, directo al grano:

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic({
      apiKey: process.env.ANTHROPIC_API_KEY,
    });
    
    async function main() {
      const response = await client.messages.create({
        model: "claude-sonnet-4-6",
        max_tokens: 1024,
        messages: [
          {
            role: "user",
            content: "Explica qué es un closure en JavaScript en 2 líneas.",
          },
        ],
      });
    
      console.log(response.content[0].type === "text" ? response.content[0].text : "");
    }
    
    main();
    

    Eso es todo. Ejecutas esto y tienes una respuesta de Claude en tu terminal.

    Lo que necesitas entender de la estructura:

    • model — qué versión de Claude usas (más sobre esto abajo)
    • max_tokens — límite de tokens en la respuesta (no el total de la conversación)
    • messages — array de turnos de conversación con role: "user" o role: "assistant"

    Los conceptos que no puedes ignorar

    Modelos disponibles

    Anthropic tiene tres familias activas:

    Modelo Cuándo usarlo
    claude-sonnet-4-6 El equilibrio perfecto: velocidad + calidad. Mi default para casi todo.
    claude-haiku-4-5 Más rápido y barato. Bueno para tareas simples o llamadas en volumen.
    claude-opus-4-8 El más potente. Para tareas de razonamiento complejo donde el coste no es el problema.

    Si estás empezando, usa claude-sonnet-4-6. No pienses más.

    System prompt vs User message

    El system es la personalidad y las instrucciones permanentes de Claude. El user es lo que cambia en cada turno.

    const response = await client.messages.create({
      model: "claude-sonnet-4-6",
      max_tokens: 1024,
      system: "Eres un reviewer de código senior. Responde siempre en español. Sé directo y señala el problema antes de proponer la solución.",
      messages: [
        {
          role: "user",
          content: "Revisa esta función: function add(a, b) { return a - b; }",
        },
      ],
    });
    

    El system prompt es donde ocurre la mayor parte de la magia cuando construyes agentes. Si quieres ver cómo llevamos esto a proyectos reales con Claude Code, en el curso Construye con IA cubrimos exactamente eso: de la idea al producto con agentes que siguen instrucciones de producción.

    Tokens: lo que cuesta dinero

    Un token es aproximadamente 0,75 palabras en inglés (algo menos en español). La API te cobra por input_tokens (lo que envías) y output_tokens (lo que Claude responde).

    Después de cada llamada puedes ver el uso:

    console.log(response.usage);
    // { input_tokens: 48, output_tokens: 312 }
    

    max_tokens limita la respuesta, no la llamada completa. Si pones max_tokens: 100 y la respuesta necesita 200 tokens, Claude cortará el texto a mitad. Es uno de los errores más comunes al empezar.

    ¿Cómo implementar streaming con la Claude API en TypeScript?

    Sin streaming, esperas a que Claude termine de generar toda la respuesta antes de recibirla. Con streaming, recibes los tokens a medida que se generan — igual que ves escribir a Claude en el chat web.

    Para UX en tiempo real, el streaming no es opcional. Es lo que distingue una app que se siente viva de una que "se congela" tres segundos antes de mostrar algo. En los proyectos de agentes que construimos en Labs, migrar de llamada síncrona a streaming eliminó la necesidad de un loader — los usuarios percibieron la respuesta como inmediata sin que cambiáramos nada más.

    import Anthropic from "@anthropic-ai/sdk";
    
    const client = new Anthropic({
      apiKey: process.env.ANTHROPIC_API_KEY,
    });
    
    async function streamResponse() {
      const stream = await client.messages.create({
        model: "claude-sonnet-4-6",
        max_tokens: 1024,
        stream: true,
        messages: [
          {
            role: "user",
            content: "Escribe un test unitario en TypeScript para una función que suma dos números.",
          },
        ],
      });
    
      for await (const event of stream) {
        if (
          event.type === "content_block_delta" &&
          event.delta.type === "text_delta"
        ) {
          process.stdout.write(event.delta.text);
        }
      }
    
      console.log("\n--- Stream completado ---");
    }
    
    streamResponse();
    

    El loop for await itera sobre los eventos del stream. El tipo que te importa es content_block_delta con delta.type === "text_delta" — ahí está el texto.

    ¿Qué es el tool use en Claude API y cómo funciona?

    Tool use (o function calling) permite que Claude llame a funciones definidas por ti. Claude decide cuándo usarlas y con qué argumentos. Tú ejecutas la función y le devuelves el resultado.

    El siguiente ejemplo define una herramienta get_weather ficticia:

    const response = await client.messages.create({
      model: "claude-sonnet-4-6",
      max_tokens: 1024,
      tools: [
        {
          name: "get_weather",
          description: "Obtiene el tiempo actual para una ciudad.",
          input_schema: {
            type: "object",
            properties: {
              city: {
                type: "string",
                description: "El nombre de la ciudad.",
              },
            },
            required: ["city"],
          },
        },
      ],
      messages: [
        {
          role: "user",
          content: "¿Qué tiempo hace en Madrid ahora mismo?",
        },
      ],
    });
    
    // Si Claude quiere usar la herramienta, el stop_reason será "tool_use"
    if (response.stop_reason === "tool_use") {
      const toolUse = response.content.find((b) => b.type === "tool_use");
      console.log("Claude quiere llamar a:", toolUse?.name);
      console.log("Con argumentos:", toolUse?.input);
      // Aquí ejecutarías la función real y devolverías el resultado a Claude
    }
    

    Esto es la base de cualquier agente. Claude no ejecuta código — tú lo ejecutas y le informas del resultado. El loop de razonamiento lo controla Claude; la ejecución la controlas tú. Si quieres ver cómo este patrón escala a un pipeline completo — desde un ticket de Jira hasta el deploy —, tienes el ejemplo en el post sobre automatizar el proceso de desarrollo con IA.

    Errores comunes al empezar

    Rate limits. La API tiene límites por minuto tanto en requests como en tokens. Si los golpeas, recibes un 429. Solución: exponential backoff o usar Haiku para prototipos de alto volumen.

    Context window agotado. Cada modelo tiene un límite de tokens totales en conversación (input + output). Sonnet 4.6 tiene 200K tokens de context window — es enorme, pero si metes archivos enteros en cada llamada, lo llenas. Sé selectivo con lo que incluyes en el contexto.

    Formato de mensajes incorrecto. El array messages debe alternar user y assistant. No puedes tener dos mensajes de user seguidos sin un assistant entre medias. Eso devuelve un error 400.

    max_tokens demasiado bajo. Si la respuesta se corta, sube max_tokens. El valor por defecto no existe — es un parámetro obligatorio. Empieza con 1024 y ajusta según lo que necesites.

    Variables de entorno no cargadas. Si ves AuthenticationError, casi siempre es que ANTHROPIC_API_KEY no está disponible en el proceso. Verifica con console.log(process.env.ANTHROPIC_API_KEY) antes de depurar nada más.

    Qué explorar después

    Una vez tienes la llamada básica y el streaming funcionando, estos son los siguientes pasos lógicos:

    Vision. Puedes enviar imágenes en el array content y Claude las analiza. Útil para screenshots, diagramas, facturas.

    Embeddings. Anthropic no tiene embeddings propios en la API, pero Claude funciona muy bien combinado con embeddings de OpenAI o Cohere para búsqueda semántica.

    Batch API. Para procesar cientos de prompts sin necesidad de respuesta en tiempo real. Hasta un 50% más barato que llamadas individuales.

    Workbench de Anthropic. En console.anthropic.com tienes un playground para probar prompts, comparar modelos y ver el uso de tokens antes de escribir una sola línea de código. Es la herramienta que más uso al diseñar system prompts.

    Multiturno real. Construir una conversación que mantenga contexto entre turnos requiere gestionar el array messages manualmente — añadir cada respuesta de Claude como role: "assistant" y cada input del usuario como role: "user". No hay estado en la API.

    Si quieres ver tool use aplicado a un workflow de code review automático antes de un PR, tienes el flujo completo en el post sobre agentic code review con Claude Code.

    Si tuvieras que elegir solo un área para explorar después del streaming, elige Vision — es el salto de ROI más rápido y el que más impacto tiene en una demo.


    FAQ

    ¿Necesito tarjeta de crédito para empezar?
    Sí. Anthropic requiere un método de pago para activar la API, pero tiene un tier de prueba con crédito gratuito. Puedes hacer cientos de llamadas de desarrollo sin pagar nada en los primeros días.

    ¿Cuál es la diferencia entre la API de Claude y Claude.ai?
    Claude.ai es el producto de consumo (el chat web). La API es el acceso programático al modelo. Tienen facturación y cuentas separadas. Una suscripción a Claude.ai no te da acceso a la API.

    ¿Cuánto cuesta en producción?
    Depende del modelo y el volumen. Claude Sonnet 4.6 está alrededor de $3 por millón de input tokens y $15 por millón de output tokens — verifica siempre en anthropic.com/pricing antes de hacer estimaciones de arquitectura, los precios se actualizan con cada generación de modelo.

    ¿Puedo usar la API en el frontend directamente?
    Técnicamente sí, pero nunca deberías. La API key quedaría expuesta en el cliente. Siempre llama a la API desde un backend o un serverless function que tú controlas.

    ¿Qué pasa si Claude no termina la respuesta y stop_reason no es end_turn?
    Si stop_reason es max_tokens, la respuesta se cortó por el límite que pusiste. Si es tool_use, Claude quiere ejecutar una herramienta. Si es stop_sequence, alcanzó una secuencia de parada que definiste. Valida siempre stop_reason en producción.


    Si quieres ver todo esto aplicado en un proyecto real — no en ejemplos de tutorial sino en un producto con usuarios — en Dominicode Labs tenemos el código de los proyectos que construimos en directo, incluyendo agentes con tool use y streaming. Es donde llevamos la teoría a producción.

    Y si prefieres el formato video con más ejemplos en directo, en el canal de YouTube de Dominicode cubrimos estas integraciones con frecuencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Observabilidad en LLMs: traza, mide y depura tus agentes de IA

    Observabilidad en LLMs: traza, mide y depura tus agentes de IA

    El equipo había estado tres semanas construyendo un agente de soporte técnico. Funcionaba bien en local. Lo lanzaron a producción un lunes por la mañana.

    El viernes tenían una factura de $1.200 en tokens, tres tickets de clientes con respuestas completamente inventadas y ninguna pista de en qué paso del flujo había empezado a fallar todo.

    El agente había estado corriendo. Respondiendo. Consumiendo. Pero nadie podía ver qué estaba pasando dentro.

    Ese es el problema que resuelve la observabilidad en LLMs — el conjunto de técnicas que permite registrar, medir y analizar cada paso de un agente de IA en producción: los prompts enviados, las herramientas invocadas, los tokens consumidos y los errores producidos. Si estás construyendo cualquier cosa con IA en producción, necesitas entenderla antes de que te pase lo mismo.


    El problema real: los LLMs son cajas negras que facturan

    Con una API REST tradicional tienes un contrato claro: envías una petición, recibes una respuesta, mides el tiempo, logueas el error. La traza es determinista.

    Con un LLM, el contrato se rompe. Puedes enviar el mismo prompt dos veces y recibir respuestas distintas. Un agente puede invocar herramientas en un orden diferente al esperado. El modelo puede alucinarse con un dato en el paso 3 de 7 y tú solo ves el resultado final — correcto en formato, incorrecto en contenido.

    Sin observabilidad, estás volando a ciegas. Y en producción, volar a ciegas con un LLM significa costos impredecibles, degradación silenciosa de calidad y bugs que no aparecen en ningún test.


    Los tres pilares de la observabilidad en LLMs

    La observabilidad clásica tiene tres dimensiones. En el mundo de los LLMs, cada una significa algo distinto.

    Trazas (Traces)

    Una traza registra el camino completo de una ejecución: qué prompt se envió, qué herramientas se llamaron, en qué orden, con qué inputs y qué outputs. En un agente con múltiples pasos, una traza te muestra el árbol completo de decisiones — no solo el resultado final.

    Es la diferencia entre saber que tu agente “falló” y saber exactamente en qué llamada a qué herramienta empezó a descarrilarse.

    Métricas

    Latencia por llamada, costo en tokens (input + output), tasa de éxito de herramientas, número de reintentos. Estas métricas agregadas te dicen si tu sistema está degradándose con el tiempo o si hay un prompt específico que consume diez veces más tokens que los demás.

    Logs estructurados

    No los logs de consola que escribes para depurar en local. Logs que capturen el contexto completo de cada ejecución: qué usuario lanzó la petición, qué versión del prompt se usó, qué modelo, qué temperatura. Logs que puedas consultar después cuando alguien reporte un comportamiento extraño hace 48 horas.


    Herramientas de observabilidad LLM en 2026

    Cinco herramientas que cualquier developer que construye con IA debería conocer:

    Herramienta Tipo Self-hosted Stack ideal Plan gratuito
    Langfuse SDK + plataforma ✅ Sí Cualquier API 50k obs/mes
    LangSmith Plataforma ❌ No LangChain Sí (limitado)
    Helicone Proxy ❌ No Multi-proveedor Sí
    Arize Phoenix Análisis offline ✅ Sí Evaluación por lotes Open source
    OpenTelemetry GenAI Estándar ✅ Sí Stacks OTEL existentes Open source

    Langfuse — El estándar open source. Puedes autohospedarlo o usar su cloud. Tiene SDK para TypeScript, Python e integración nativa con LangChain, Vercel AI SDK y llamadas directas a la API de Anthropic u OpenAI. Es la opción que recomiendo si quieres control total sobre tus datos.

    LangSmith — El producto de LangChain. Excelente si ya usas LangChain en tu stack, pero te ata al ecosistema. Para proyectos con llamadas directas a la API, Langfuse gana en flexibilidad.

    Helicone — Proxy que se pone delante de cualquier llamada a la mayoría de proveedores LLM (OpenAI, Anthropic, Azure, LiteLLM y otros). Configuración en dos minutos, observabilidad inmediata. Ideal para proyectos donde no puedes tocar el código de integración o quieres monitoreo rápido sin instrumentación.

    Arize Phoenix — Enfocado en evaluación y análisis offline. Útil cuando quieres analizar lotes de ejecuciones para detectar problemas de calidad sistemáticos, no solo monitoreo en tiempo real.

    Semantic conventions for generative AI systems (OTel GenAI) — El estándar OTEL para IA lleva trazas de LLMs al stack de observabilidad que ya tienes (Grafana, Datadog, Honeycomb). Si tu empresa ya tiene infraestructura OTEL, esta es la forma de integrar los LLMs sin añadir otra herramienta.


    Implementación real con TypeScript y Langfuse

    Suficiente teoría. Esto es cómo lo implementas en un proyecto TypeScript.

    Primero, instala el SDK (versión actual: langfuse@3.x):

    npm install langfuse
    

    Inicializa el cliente una sola vez en tu aplicación — en un módulo singleton si usas NestJS, en un archivo de configuración si es un script:

    import Langfuse from "langfuse";
    
    export const langfuse = new Langfuse({
      publicKey: process.env.LANGFUSE_PUBLIC_KEY!,
      secretKey: process.env.LANGFUSE_SECRET_KEY!,
      baseUrl: "https://cloud.langfuse.com", // o tu instancia autohospedada
    });
    

    Ahora instrumenta una llamada a Claude. El patrón es siempre el mismo: creas una traza, creas una generación dentro de esa traza, ejecutas la llamada y registras el resultado:

    import Anthropic from "@anthropic-ai/sdk";
    import { langfuse } from "./langfuse-client";
    
    const client = new Anthropic();
    
    async function generateSupportResponse(
      userMessage: string,
      userId: string
    ): Promise<string> {
      // Abre la traza — representa toda la operación de negocio
      const trace = langfuse.trace({
        name: "support-response",
        userId,
        metadata: { channel: "web" },
      });
    
      // Crea una generación — representa una sola llamada al LLM
      const generation = trace.generation({
        name: "claude-response",
        model: "claude-sonnet-4-6",
        input: [{ role: "user", content: userMessage }],
      });
    
      try {
        const response = await client.messages.create({
          model: "claude-sonnet-4-6",
          max_tokens: 1024,
          messages: [{ role: "user", content: userMessage }],
        });
    
        const outputText =
          response.content[0].type === "text" ? response.content[0].text : "";
    
        // Registra la respuesta y el uso de tokens
        generation.end({
          output: outputText,
          usage: {
            input: response.usage.input_tokens,
            output: response.usage.output_tokens,
          },
        });
    
        return outputText;
      } catch (error) {
        // Registra errores también — son datos cruciales
        generation.end({
          level: "ERROR",
          statusMessage: error instanceof Error ? error.message : "Unknown error",
        });
        throw error;
      } finally {
        // Vacía el buffer antes de cerrar el proceso
        await langfuse.shutdownAsync();
      }
    }
    

    Para un agente con múltiples pasos — por ejemplo, uno que busca en una base de datos antes de responder — anidas spans dentro de la traza:

    async function agentWithToolCall(query: string, userId: string) {
      const trace = langfuse.trace({
        name: "agent-with-tools",
        userId,
        input: { query },
      });
    
      // Span para la búsqueda en base de datos
      const searchSpan = trace.span({
        name: "database-search",
        input: { query },
      });
    
      const searchResults = await searchDatabase(query);
    
      searchSpan.end({
        output: { resultCount: searchResults.length },
      });
    
      // Generación con los resultados como contexto
      const generation = trace.generation({
        name: "synthesis",
        model: "claude-sonnet-4-6",
        input: buildPromptWithContext(query, searchResults),
      });
    
      const response = await callClaude(query, searchResults);
    
      generation.end({ output: response });
      trace.update({ output: { response } });
      await langfuse.shutdownAsync();
    
      return response;
    }
    

    Con esto, cada ejecución queda registrada en Langfuse con su árbol completo de spans. Puedes ver exactamente cuánto tardó la búsqueda, cuántos tokens consumió la síntesis y qué prompt produjo esa respuesta que el cliente reportó como incorrecta.

    Es exactamente este tipo de arquitectura observable la que construimos en el curso Construye con IA — desde el primer agente hasta el sistema completo en producción, con trazabilidad desde el día uno.


    Los errores que aparecen cuando no tienes observabilidad

    Estos son los tres problemas que he visto repetirse en proyectos sin observabilidad — y que solo se detectan cuando ya han causado daño:

    Alucinaciones no detectadas. El agente responde con confianza. El formato es correcto. El dato está mal. Sin trazas, nunca sabes en qué paso del flujo el modelo inventó algo. Con trazas, identificas el prompt exacto que produce el problema y lo corriges.

    Latencias ocultas. El endpoint responde en 8 segundos. No sabes si el problema está en la llamada al LLM, en la búsqueda vectorial o en el postprocesado. Las métricas por span te dicen exactamente dónde está el cuello de botella.

    Costos fuera de control. Un prompt mal diseñado puede consumir 10x más tokens que uno equivalente. Sin métricas de uso por operación, solo ves la factura de fin de mes. Con observabilidad, detectas el problema en el primer día de producción.


    Por dónde empezar si ya tienes un proyecto en marcha

    No tienes que instrumentar todo de golpe. El orden que funciona:

    1. Añade Langfuse o Helicone a la llamada al LLM más crítica de tu sistema.
    2. Registra siempre: modelo, versión del prompt, userId, tokens usados.
    3. Cuando detectes un comportamiento inesperado, usa las trazas para reproducirlo.
    4. Una vez que el patrón funciona, extiéndelo al resto de llamadas.

    La observabilidad no es una feature opcional que añades al final. Es la infraestructura que te permite iterar sobre tus prompts con datos reales — no con intuición.

    Si quieres construir sistemas con IA desde cero con buenas prácticas de producción integradas desde el principio, en Dominicode Labs tenemos proyectos y recursos donde trabajamos exactamente esto junto a otros developers hispanohablantes.


    FAQ — Preguntas frecuentes sobre LLM Observability

    ¿Qué diferencia hay entre observabilidad en LLMs y logging tradicional?

    El logging tradicional captura eventos discretos: errores, requests, respuestas. La observabilidad en LLMs captura el flujo completo de razonamiento de un agente: qué herramientas invocó, en qué orden, con qué contexto, y cómo cada paso influyó en el resultado final. La diferencia es la misma que entre saber que tu avión aterrizó tarde y saber exactamente en qué tramo de la ruta perdió tiempo.

    ¿Necesito observabilidad si solo uso un LLM para tareas sencillas como resúmenes de texto?

    Si está en producción y lo usa más de un usuario, sí. Incluso para tareas aparentemente sencillas, la observabilidad te da visibilidad sobre costos (¿cuánto estoy gastando por resumen?), calidad (¿hay inputs que producen respuestas malas consistentemente?) y latencia (¿hay prompts que tardan 5x más que otros?). El esfuerzo de instrumentar una sola llamada es de menos de 20 líneas de código.

    ¿Langfuse es mejor que LangSmith?

    Depende de tu stack. Si usas LangChain, LangSmith es la integración más natural. Si haces llamadas directas a la API de Anthropic u OpenAI, o usas el Vercel AI SDK, Langfuse tiene mejor soporte, es open source y puedes autohospedarlo. Para proyectos donde los datos son sensibles y no quieres enviarlos a un tercero, Langfuse self-hosted es la única opción razonable.

    ¿Cómo gestiono la observabilidad en un agente con múltiples LLMs y herramientas?

    Usando el modelo de trazas jerárquicas: una traza por operación de negocio, spans para cada herramienta o paso intermedio, y generaciones para cada llamada al LLM. Langfuse, LangSmith y Arize Phoenix soportan este modelo de forma nativa. La clave es diseñar las trazas pensando en qué preguntas querrás responder cuando algo falle — no en lo que es fácil de capturar.

    ¿Cuánto cuesta implementar observabilidad con Langfuse?

    Langfuse Cloud tiene un plan gratuito generoso (50.000 observaciones al mes en la fecha de publicación de este post). Para proyectos con volumen alto, puedes autohospedarlo en tu propia infraestructura con Docker — el costo es solo el del servidor. LangSmith y Helicone tienen también niveles gratuitos, pero con menos control sobre los datos.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Novedades de Angular v22: todo lo que cambia en esta versión

    Novedades de Angular v22: todo lo que cambia en esta versión

    Un compañero me preguntó la semana pasada: “¿Merece la pena actualizar ya a Angular v22?”.

    Le respondí lo mismo que le diría a ti: las novedades de Angular v22 no son parches ni renombrados. Son APIs nuevas que reemplazan patrones que llevan años instalados en nuestra cabeza — y varias de ellas pasan a ser estables en esta versión. Si llevas tiempo esperando que Angular se parezca a lo que promete ser, v22 es esa versión.

    Afecta cómo gestionas estado asíncrono, cómo escribes formularios, cómo arranca la detección de cambios y cómo declaras componentes. Todo a la vez. En una sola versión.

    Este post es el mapa. Si quieres ir al detalle de alguna feature concreta, tienes posts específicos linkados donde corresponde.

    ¿Qué es Angular v22? Angular v22 es la versión que consolida las Signal APIs como estándar principal del framework. Introduce la Resource API estable (resource(), rxResource()), el nuevo decorator @Service(), Signal Forms experimental, y avanza en zoneless como camino recomendado para proyectos nuevos. Es la versión con más cambios de fondo desde que Angular adoptó standalone components.


    Qué cambia de raíz en Angular v22

    Antes de ver las APIs una a una, hay una idea central que explica casi todo lo que trae v22:

    Angular se está moviendo hacia un modelo completamente basado en Signals, sin Zones y sin boilerplate innecesario.

    Eso no es nuevo como dirección. Lo que es nuevo en v22 es que varias piezas de ese puzzle pasan a ser estables o por lo menos usables en producción experimental. Ya no es solo teoría.

    Patrón anterior vs equivalente en Angular v22

    Patrón anterior Equivalente en Angular v22
    HttpClient.get().subscribe() httpResource() (experimental)
    Subject + switchMap resource() / rxResource() (estables)
    new FormControl() Signal Forms formField() (experimental)
    @Injectable({ providedIn: 'root' }) @Service() (estable)
    ChangeDetectionStrategy.Default ChangeDetectionStrategy.Eager
    standalone: true explícito Default desde v22 — ya no hace falta
    allowSignalWrites: true en effect Eliminado — ya no necesario

    Resource API en Angular v22: gestión de estado asíncrono sin subscribe

    La novedad más importante de Angular v22 en el día a día son las tres APIs de Resource. resource() y rxResource() pasan a ser estables:

    resource() — async state sin subscribe

    resource() es la forma nativa de Angular para manejar operaciones asíncronas reactivas. Defines un loader con una Promise y el framework gestiona loading, error y datos por ti.

    import { resource, signal } from '@angular/core';
    

    @Component({ ... })

    export class ProductListComponent {

    categoryId = signal(1);

    products = resource({

    request: () => this.categoryId(),

    loader: ({ request }) =>

    fetch(/api/products?category=${request}).then(r => r.json())

    });

    }

    En el template:

    @if (products.status() === 'loading') {
    

    <p>Cargando...</p>

    }

    @if (products.status() === 'resolved') {

    @for (product of products.value(); track product.id) {

    <li>{{ product.name }}</li>

    }

    }

    Los estados posibles son strings literales: 'idle', 'loading', 'reloading', 'resolved', 'error', 'local'. No hay enum. No uses ResourceStatus.Loading — no existe así.

    rxResource() — cuando el backend habla en Observables

    Si tienes servicios que devuelven Observables (la mayoría de los proyectos reales), usa rxResource(). La clave es que el parámetro se llama stream, no loader:

    import { rxResource } from '@angular/core/rxjs-interop';
    

    @Component({ ... })

    export class OrdersComponent {

    userId = signal(42);

    orders = rxResource({

    request: () => this.userId(),

    stream: ({ request }) => this.ordersService.getByUser(request)

    });

    }

    La diferencia con resource() es solo el parámetro: loader para Promises, stream para Observables. El resto del comportamiento es idéntico.

    httpResource() — HTTP reactivo sin HttpClient.get().pipe(...)

    httpResource() es la versión experimental especializada en HTTP — úsala con precaución en producción. El primer argumento siempre es una función, nunca un string directo.

    import { httpResource } from '@angular/core';
    

    @Component({ ... })

    export class UserProfileComponent {

    userId = signal(1);

    user = httpResource<User>(() => /api/users/${this.userId()});

    }

    Requiere provideHttpClient() en tu configuración. Devuelve un HttpResourceRef que expone .value(), .status(), .statusCode() y .headers() como signals.

    Si quieres profundidad en las tres APIs, tengo un post dedicado: Resource API en Angular 22: el fin del subscribe() manual.


    linkedSignal() estable: el signal derivado que puedes escribir

    linkedSignal() resuelve un problema concreto que no tenía solución limpia hasta ahora: quieres un signal que se inicialice (y se resetee) a partir de otro signal, pero que también puedas modificar manualmente.

    Ejemplo clásico: una lista de items y un item seleccionado que vuelve al primero cuando cambia la lista.

    import { signal, linkedSignal } from '@angular/core';
    

    @Component({ ... })

    export class ItemSelectorComponent {

    items = signal(['Angular', 'React', 'Vue']);

    selectedItem = linkedSignal(() => this.items()[0]);

    }

    Cuando items cambia, selectedItem vuelve automáticamente al primer elemento. Pero puedes escribir en selectedItem en cualquier momento:

    this.selectedItem.set('React'); // funciona

    Con un computed() no puedes hacer eso. Con un signal() normal perderías el vínculo con items. linkedSignal() es la pieza que faltaba entre los dos.


    debounced() experimental: búsquedas sin setTimeout manual

    debounced() es una API experimental de Angular v22 para manejar valores con delay configurable. No devuelve un Signal — devuelve un Resource, así que se lee con .value() y .status(), igual que resource().

    Es ideal para barras de búsqueda donde no quieres disparar una petición por cada tecla. Al ser experimental, la firma exacta puede cambiar antes de estabilizarse — consulta siempre la documentación oficial de angular.dev antes de usarla en producción.


    Signal Forms experimental: formularios basados en Signals

    Angular v22 introduce Signal Forms como API experimental. No reemplaza a Reactive Forms todavía — no está pensado para producción sin asumir el riesgo de breaking changes — pero marca la dirección clara hacia la que van los formularios en Angular.

    La premisa es eliminar el FormBuilder, los FormGroup y los valueChanges basados en Observables. Todo como signals.

    Es la feature que más puede cambiar antes de estabilizarse, así que úsala con precaución en proyectos reales y estate pendiente a las release notes.


    effect() ya no necesita allowSignalWrites

    Pequeño pero importante: a partir de v22, escribir en un signal dentro de un effect() está permitido por defecto. La opción allowSignalWrites está deprecada y no debes usarla.

    Antes (v21 y anteriores):

    // v21 — necesitabas esto:
    

    effect(() => {

    this.count.set(this.source() * 2);

    }, { allowSignalWrites: true });

    Ahora (v22):

    // v22 — simplemente funciona:
    

    effect(() => {

    this.count.set(this.source() * 2);

    });

    Si tienes código con allowSignalWrites: true, no se rompe todavía. Pero el compilador te avisará que está deprecated. Es uno de esos cambios que limpias en 10 minutos con un find & replace.


    ChangeDetectionStrategy.Eager y el adiós definitivo a Default

    Angular v22 introduce ChangeDetectionStrategy.Eager como el nuevo nombre para la estrategia de detección de cambios que antes se llamaba Default.

    ChangeDetectionStrategy.Default pasa a ser un alias deprecated de Eager. Si tienes componentes sin estrategia explícita, no se rompen, pero la nomenclatura oficial cambia:

    // Antes (sigue funcionando, pero deprecated el nombre):
    

    @Component({

    changeDetection: ChangeDetectionStrategy.Default

    })

    // Ahora (lo correcto en v22):

    @Component({

    changeDetection: ChangeDetectionStrategy.Eager

    })

    En la práctica, para componentes nuevos lo relevante sigue siendo usar OnPush cuando sea posible y avanzar hacia zoneless. Eager es el fallback explícito cuando necesitas el comportamiento clásico por nombre, no por omisión.


    Zoneless en Angular v22: cómo funciona y cuándo usarlo en producción

    Zone.js ha sido la pieza más criticada del runtime de Angular desde que existe. En v22 el modo zoneless avanza significativamente como alternativa estable para proyectos nuevos.

    Sin Zone.js, Angular solo ejecuta detección de cambios cuando se lo dices explícitamente: a través de signals, events, o marcando el componente como sucio manualmente. El resultado son aplicaciones más predecibles, más fáciles de depurar y más rápidas en la mayoría de los escenarios.

    Para activarlo en una app nueva:

    // main.ts
    

    bootstrapApplication(AppComponent, {

    providers: [

    provideExperimentalZonelessChangeDetection()

    ]

    });

    En el Curso de Angular Moderno cubrimos la arquitectura zoneless con Signals desde cero — actualizado a v22.


    standalone: true ya no es necesario

    A partir de v22, standalone es el default. No necesitas escribir standalone: true en ningún componente nuevo:

    // v21 y anteriores — necesitabas declararlo:
    

    @Component({

    standalone: true,

    selector: 'app-product-card',

    ...

    })

    // v22 — standalone por defecto, sin declaración:

    @Component({

    selector: 'app-product-card',

    ...

    })

    Solo necesitas standalone: false si quieres un componente que NO sea standalone — que es el caso raro ahora.


    Nuevo decorator @Service() en Angular v22: para qué sirve

    Si llevas tiempo usando inject() en lugar de constructor injection, este cambio te va a gustar.

    Angular v22 introduce @Service() como alternativa directa a @Injectable({ providedIn: 'root' }). Sin opciones, sin configuración — declaras la clase como servicio y Angular la provee en root automáticamente.

    // Antes
    

    @Injectable({ providedIn: 'root' })

    export class AuthService {

    private http = inject(HttpClient);

    }

    // Angular v22

    @Service()

    export class AuthService {

    private http = inject(HttpClient);

    }

    Un detalle importante: @Service() solo funciona con inject(). Si intentas usar constructor injection con @Service(), obtendrás un error — el decorator asume el modelo de inyección funcional. Si necesitas constructor injection o configuración avanzada como providedIn: 'platform', sigue usando @Injectable.

    Es coherente con la dirección que lleva el framework desde que inject() llegó — alejarse del constructor como único punto de entrada de dependencias.


    Angular v22: tabla completa de features estables y experimentales

    Feature Estado en v22 Para producción
    resource() Estable Sí
    rxResource() Estable Sí
    linkedSignal() Estable Sí
    @Service() Estable Sí
    standalone: true default Estable Sí
    allowSignalWrites deprecated Estable Quitar el flag
    ChangeDetectionStrategy.Eager Estable Sí
    httpResource() Experimental Con precaución
    debounced() Experimental Con precaución
    Signal Forms Experimental No recomendado aún
    Zoneless Developer preview Proyectos nuevos

    Cómo migrar a Angular v22 desde Angular 20 o 21: guía paso a paso

    No necesitas migrar todo a la vez. Esta es la secuencia que tiene más sentido:

    • Elimina allowSignalWrites: true de tus effects. Es trivial y lo haces en un PR.
    • Adopta linkedSignal() donde tengas signals que dependen de otros y se resetean. Los encontrarás fácilmente.
    • Migra a @Service() en servicios simples que ya usen inject(). La ganancia es inmediata en legibilidad.
    • Empieza a usar resource() en componentes nuevos en lugar de switchMap + HttpClient.get(). No tienes que migrar los existentes de golpe.
    • Experimenta con zoneless en un proyecto nuevo o en un módulo aislado.
    • Deja Signal Forms para más adelante hasta que estabilice.

    Si quieres ir más al fondo en cómo funciona el testing de estos nuevos patrones, tengo el Curso de Testing en Angular actualizado con Jest y Testing Library — resource() y linkedSignal() cambian cómo se escriben los tests de componentes.


    FAQ — Preguntas frecuentes sobre Angular v22

    ¿Es Angular v22 compatible con Angular v19 o v20?

    La migración de v19/v20 a v22 es incremental. Las APIs nuevas son aditivas — no rompen el código existente. standalone: true sigue funcionando aunque ya no sea necesario. ChangeDetectionStrategy.Default sigue siendo un alias válido aunque deprecated. Puedes actualizar con ng update y adoptar las nuevas APIs a tu ritmo sin necesidad de reescribir nada de golpe.

    ¿httpResource() reemplaza a HttpClient en Angular v22?

    No. HttpClient no desaparece en v22 y sigue siendo la opción recomendada para lógica HTTP compleja. httpResource() es una alternativa más ergonómica para casos concretos: cuando tienes un signal como parámetro reactivo de la petición y quieres gestionar loading/error automáticamente. Para interceptores custom, peticiones en paralelo o manejo avanzado de headers, HttpClient con RxJS sigue siendo la herramienta correcta. Además, httpResource() es experimental en v22, así que no es recomendable adoptarlo masivamente en proyectos en producción todavía.

    ¿Qué diferencia hay entre resource() y httpResource()?
    resource() es genérico: acepta cualquier función que devuelva una Promise como loader. httpResource() está especializado en HTTP y usa internamente HttpClient, por lo que respeta interceptores, el provideHttpClient() configurado y expone metadatos de la respuesta como .statusCode() y .headers(). Para llamadas HTTP simples con parámetros reactivos, httpResource() es más cómodo. Para lógica asíncrona que no sea HTTP, resource() es la opción.
    ¿Signal Forms reemplaza a Reactive Forms en v22?

    No. Signal Forms es experimental en v22 y no está pensado para reemplazar Reactive Forms todavía. Reactive Forms sigue siendo la opción estable y recomendada para formularios complejos en producción. Signal Forms marca la dirección futura del framework — formularios completamente basados en signals sin FormBuilder ni valueChanges — pero antes de considerarla lista para producción necesita que la API se estabilice, cosa que no ocurre en v22.

    ¿Puedo usar zoneless ya en producción con Angular v22?

    Depende del proyecto. Para proyectos nuevos que uses signals de forma consistente, zoneless es viable — el equipo de Angular lo recomienda como el camino a seguir. Para proyectos existentes que mezclan Zone.js con código legacy que depende del ciclo de detección de cambios automático, la migración requiere más cuidado. En v22 el modo zoneless sigue marcado como “experimental” en el nombre del provider (provideExperimentalZonelessChangeDetection()), aunque en la práctica es bastante estable para proyectos nuevos bien estructurados.

    ¿linkedSignal() es lo mismo que computed() con posibilidad de escritura?

    Conceptualmente se parecen, pero con una diferencia clave: linkedSignal() tiene dependencia reactiva sobre otro signal para su valor inicial y para resetearse automáticamente cuando ese signal cambia. computed() es de solo lectura — no puedes escribir en él. signal() es escribible pero no tiene vínculo reactivo con otros signals. linkedSignal() combina los dos comportamientos: se actualiza cuando cambia su fuente y también acepta escrituras manuales, lo que lo hace ideal para estados que tienen un “valor por defecto reactivo” pero que el usuario puede sobrescribir.

    ¿Para qué sirve @Service() y cuándo no usarlo?
    @Service() es el nuevo decorator de Angular v22 que simplifica la declaración de servicios singleton en root. Equivale a @Injectable({ providedIn: 'root' }) pero sin configuración. Solo funciona con inject() — si intentas constructor injection con @Service(), obtendrás un error. Úsalo en servicios simples que ya sigan el patrón de inject(). Si necesitas providedIn: 'platform', providedIn: 'any' u otras opciones avanzadas, sigue usando @Injectable con su configuración completa.


    Si estás construyendo con IA en tu día a día como developer, el curso Construye con IA te muestra cómo integrar Claude Code en tu flujo de trabajo real con proyectos Angular y TypeScript.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
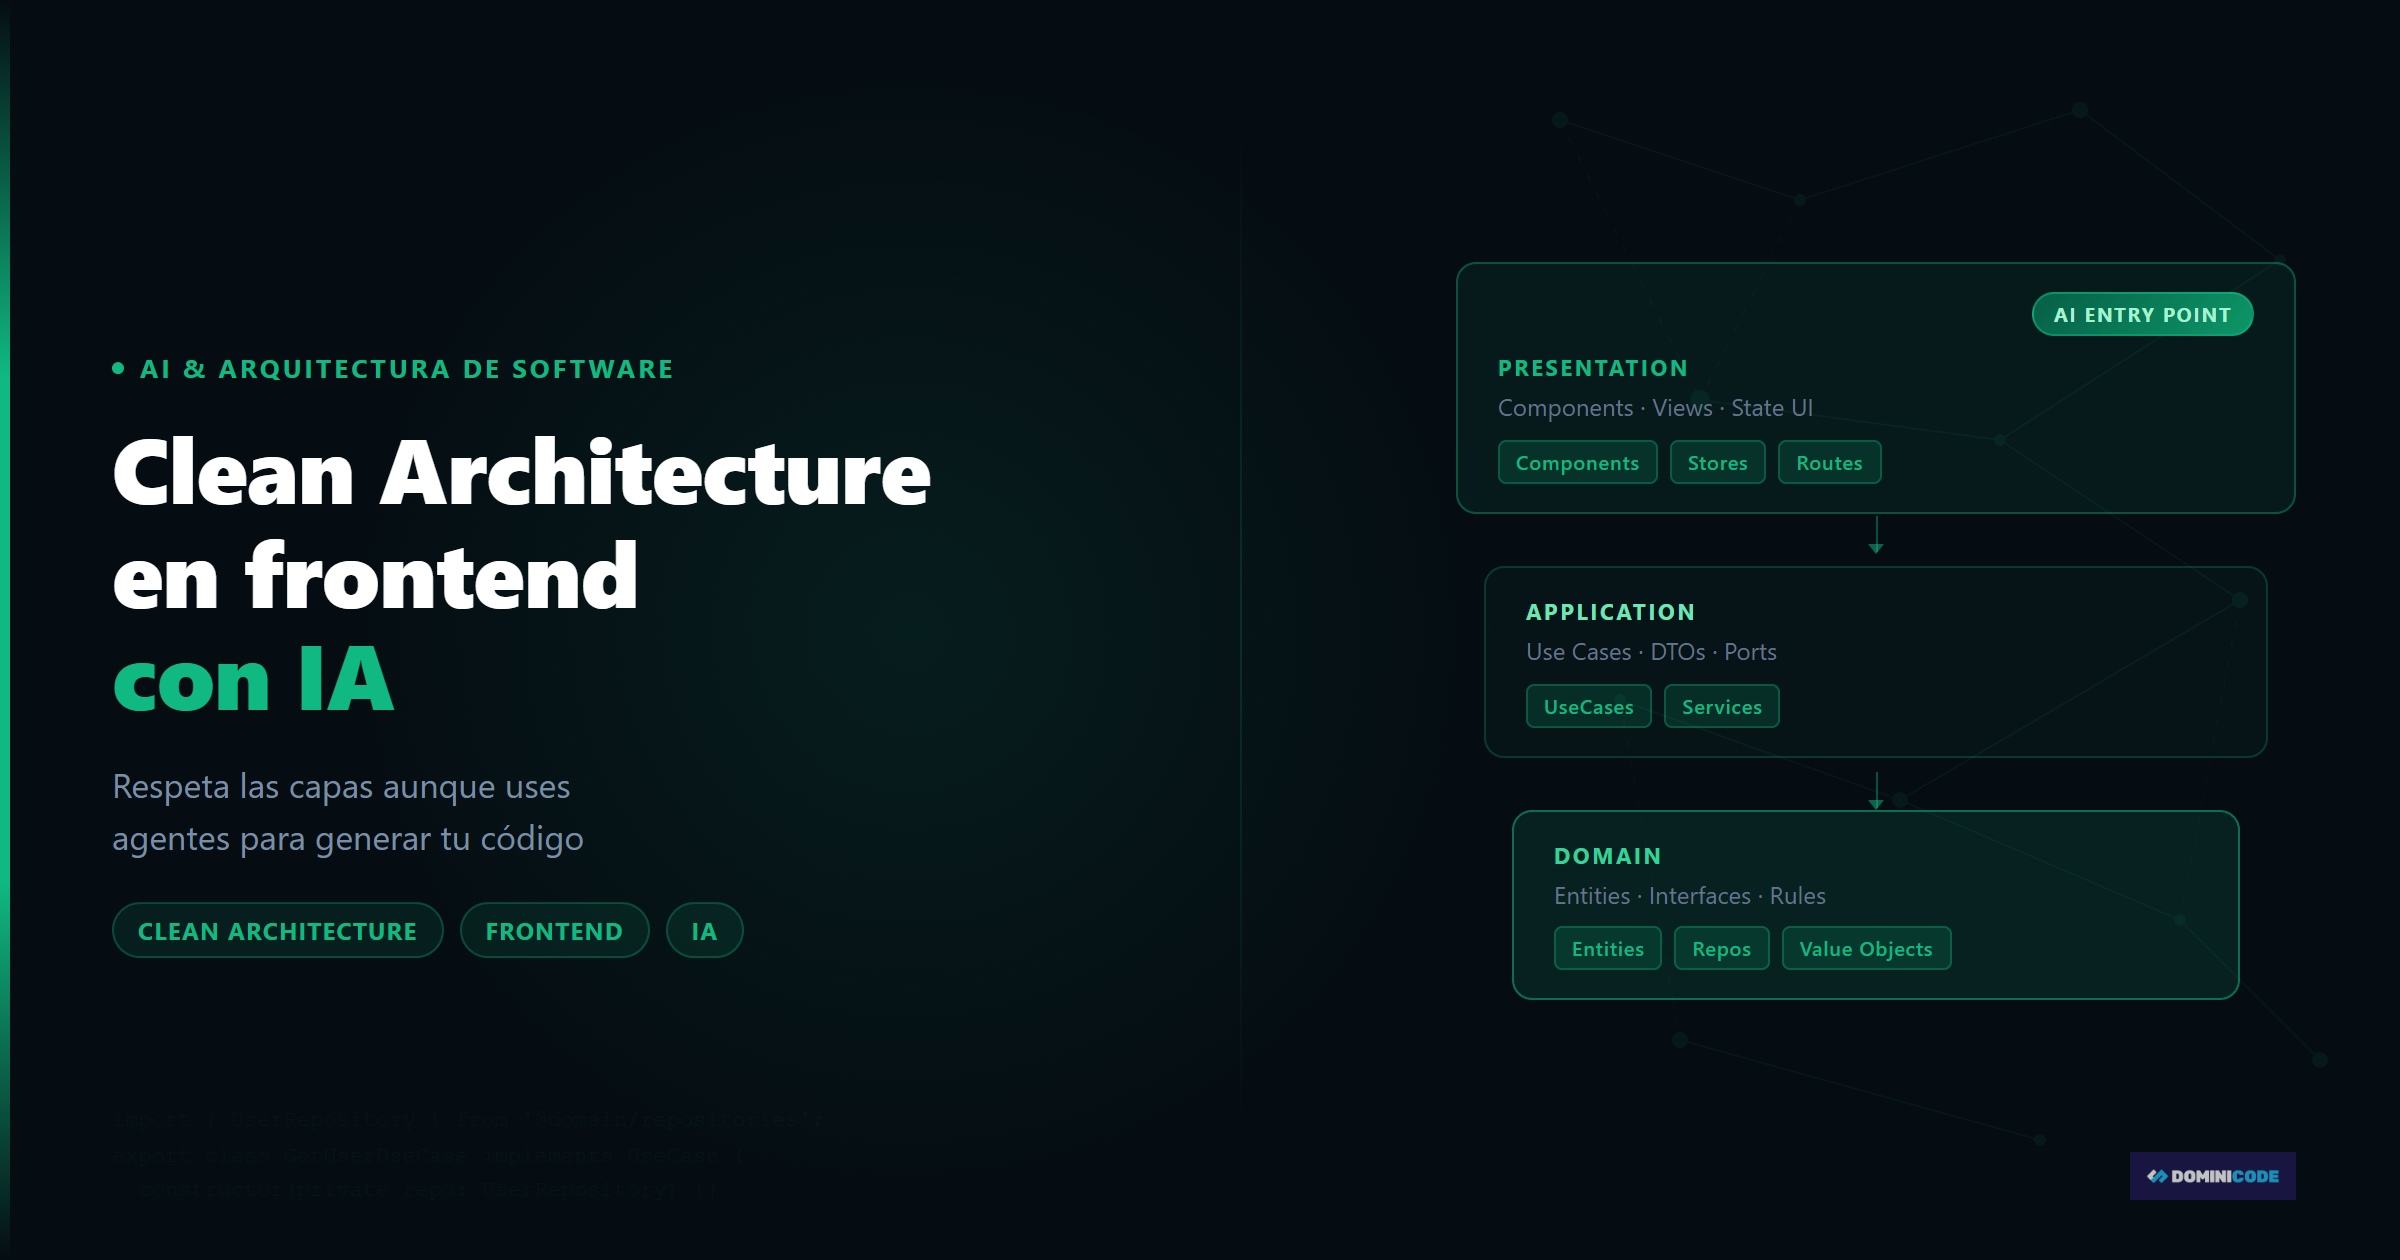
  • Clean Architecture en frontend con IA: respeta las capas

    Clean Architecture en frontend con IA: respeta las capas

    Le pedí a un agente que generara la feature de listado de productos para un proyecto frontend.

    Veinte segundos después tenía el código listo. Funcionaba. Los datos aparecían en pantalla.

    Y entonces abrí el componente y vi esto:

    // ProductListComponent.tsx — lo que el agente generó sin contexto
    const ProductListComponent = () => {
      const [products, setProducts] = useState([]);
    
      useEffect(() => {
        fetch("https://api.myapp.com/products")
          .then(res => res.json())
          .then(data => setProducts(data));
      }, []);
    
      return <ul>{products.map(p => <li key={p.id}>{p.name}</li>)}</ul>;
    };

    Una llamada HTTP directamente en el componente. Sin interface. Sin use case. Sin repository. Sin manejo de errores. La lógica de negocio mezclada con la presentación, exactamente lo que llevaba seis meses evitando en ese proyecto.

    El agente no hizo lo que yo quería. Hizo lo que era más rápido de generar.

    Ese es el problema real cuando usas IA en un proyecto con clean architecture frontend: la IA optimiza para el camino más corto, no para el más correcto. Y sin guía, el camino más corto siempre es el spaghetti.

    (Los ejemplos de este post usan TypeScript 5.4 con Angular 19 / React 18 como referencia, y Claude Code en su versión de 2026. El CLAUDE.md y los principios aplican igualmente a Cursor y GitHub Copilot.)

    Por qué la IA destroza la arquitectura si la dejas sola

    Clean Architecture en frontend no es difícil de entender. Es difícil de sostener.

    Cualquier developer senior entiende la separación de capas. El problema es que cuando el equipo crece, cuando hay presión de tiempo, cuando alguien nuevo entra al proyecto — las capas se erosionan. Un fetch aquí, una lógica de transformación allá directamente en el componente.

    La IA acelera exactamente este problema.

    Los LLMs aprenden de código real que existe en internet. Y el código real que existe en internet está lleno de llamadas HTTP en componentes, lógica de negocio en controllers, transformaciones de datos sin tipado. Los modelos han visto millones de ejemplos de ese código. Lo reproducen con total confianza porque estadísticamente es el patrón más frecuente.

    Si no le dices al agente qué arquitectura sigue tu proyecto, asumirá que no tienes ninguna.

    Las capas que importan en frontend

    Clean Architecture en frontend es un patrón de organización de código que divide la aplicación en tres capas independientes (Domain, Data, Presentation) con una regla de dependencia estricta: las capas externas dependen de las internas, nunca al revés.

    En frontend, estas tres capas se pueden modelar de forma clara — independientemente de si usas Angular, React o Vue:

    Domain — El núcleo. Aquí viven las entities (los modelos de negocio), los use cases (la lógica que define qué puede hacer el sistema) y los ports (las interfaces que definen contratos sin implementación concreta).

    Data — La capa de acceso a datos. Repositories (implementaciones concretas de los ports), DTOs (los objetos que llegan de la API tal como los devuelve el servidor), y adapters/mappers (la transformación de DTO a entity).

    Presentation — Lo que el usuario ve. Componentes, páginas, ViewModels (la forma específica en que la presentación necesita los datos), y el estado de UI.

    La regla de dependencia es simple: las capas externas dependen de las internas. La Presentation conoce el Domain. El Data implementa los contratos del Domain. El Domain no sabe que existe ninguna de las otras dos.

    Presentation → Domain ← Data

    El componente no habla con la API. Habla con un use case. El use case habla con un repository port. El repository concrete habla con la API y transforma los datos antes de devolverlos.

    Eso es lo que el agente rompió cuando puso el fetch directamente en el componente.

    Dónde la IA puede ayudarte más en Clean Architecture

    La IA es extraordinariamente buena en el trabajo más aburrido de Clean Architecture.

    Crear interfaces de repositorios. Generar mappers entre DTOs y entities. Escribir use cases que siguen un patrón uniforme. Crear tests unitarios de use cases que no tienen dependencias externas. Esas son tareas repetitivas, con patrones claros, donde el agente brilla.

    Y son exactamente las tareas que los developers saltamos “para ir más rápido” y que luego generan deuda técnica durante meses.

    Tarea de Clean Architecture IA sin contexto IA con contexto
    Generar entity con validación Genera clase plana sin contratos Sigue el patrón de entity existente
    Crear repository port (interface) Puede saltárselo e ir a la implementación Crea interface primero, luego implementación
    Escribir adapter/mapper DTO → Entity Transforma inline en el componente Crea mapper en capa Data con tipos explícitos
    Implementar use case Mezcla lógica de UI con lógica de negocio Separa correctamente, inyecta el port
    Manejo de errores en Data layer Try/catch en el componente Manejo en el repository, domain errors tipados
    Test de use case Test de integración con API real Unit test con mock del repository port

    La diferencia entre las dos columnas no es el modelo. Es el contexto que le das.

    Cómo darle contexto al agente para que respete la arquitectura

    Hay tres mecanismos que uso y que funcionan en producción.

    1. Estructura de carpetas que documenta la arquitectura

    Si tu estructura de carpetas refleja las capas, el agente las ve antes de generar código. Cuando lee el proyecto antes de actuar, el patrón es obvio:

    src/
    ├── domain/
    │   ├── entities/
    │   │   └── product.entity.ts
    │   ├── use-cases/
    │   │   └── get-products.use-case.ts
    │   └── ports/
    │       └── product.repository.port.ts
    ├── data/
    │   ├── repositories/
    │   │   └── product.repository.ts
    │   ├── dtos/
    │   │   └── product.dto.ts
    │   └── mappers/
    │       └── product.mapper.ts
    └── presentation/
        ├── components/
        │   └── product-list/
        └── view-models/
            └── product-list.vm.ts

    Un agente que lee esta estructura sabe dónde va cada pieza. La carpeta es la arquitectura documentada.

    2. CLAUDE.md con reglas de arquitectura

    Si usas Claude Code, el archivo CLAUDE.md en la raíz del proyecto es leído automáticamente antes de que el agente actúe. Es tu oportunidad de definir las reglas del juego:

    # Arquitectura del proyecto
    
    Este proyecto sigue Clean Architecture con tres capas:
    
    ## Reglas de dependencia (OBLIGATORIAS)
    - Los componentes en presentation/ NUNCA importan directamente de data/
    - Los componentes solo usan use cases de domain/use-cases/
    - Los use cases solo conocen ports de domain/ports/, nunca implementaciones concretas
    - Todo acceso a API externo va en data/repositories/, nunca en componentes ni use cases
    
    ## Antes de generar código nuevo
    1. Si es lógica de negocio → crea use case en domain/use-cases/
    2. Si es acceso a datos → crea o modifica el repository en data/repositories/
    3. Si es transformación de datos → crea mapper en data/mappers/
    4. Si el port no existe → créalo en domain/ports/ antes de la implementación
    
    ## Naming conventions
    - Entities: *.entity.ts
    - Use cases: get-products.use-case.ts (verbo + sustantivo)
    - Ports: product.repository.port.ts
    - DTOs: product.dto.ts
    - Mappers: product.mapper.ts

    Esto no es opcional. Es la diferencia entre un agente que genera spaghetti y uno que genera código que encaja en tu arquitectura.

    3. Prompt con diagrama de capas

    Cuando pides una feature específica, incluye siempre la capa donde debe vivir:

    Necesito implementar la feature "obtener lista de productos" siguiendo la arquitectura del proyecto.
    
    Genera en este orden:
    1. ProductDTO en data/dtos/ (tal como viene de la API)
    2. ProductEntity en domain/entities/ (modelo de negocio limpio)
    3. ProductMapper en data/mappers/ (transforma DTO → Entity)
    4. IProductRepository port en domain/ports/ (interface del contrato)
    5. ProductRepository en data/repositories/ (implementación concreta que usa fetch)
    6. GetProductsUseCase en domain/use-cases/ (orquesta el repositorio, devuelve entities)
    
    El componente ya existe — no lo modifiques. Solo genera las capas de dominio y datos.

    Ejemplo práctico: de DTO a Use Case con el agente

    Así es como queda el código cuando el agente tiene contexto. Le pedí exactamente las piezas del ejemplo anterior con el CLAUDE.md activo:

    // domain/entities/product.entity.ts
    export interface ProductEntity {
      id: string;
      name: string;
      price: number;
      inStock: boolean;
    }
    
    // data/dtos/product.dto.ts
    export interface ProductDTO {
      id: string;
      nombre: string;         // la API devuelve en español
      precio_eur: number;     // con otro nombre
      stock: number;          // número, no boolean
    }
    
    // data/mappers/product.mapper.ts
    import { ProductDTO } from "../dtos/product.dto";
    import { ProductEntity } from "../../domain/entities/product.entity";
    
    export const toProductEntity = (dto: ProductDTO): ProductEntity => ({
      id: dto.id,
      name: dto.nombre,
      price: dto.precio_eur,
      inStock: dto.stock > 0,
    });
    
    // domain/ports/product.repository.port.ts
    import { ProductEntity } from "../entities/product.entity";
    
    export interface IProductRepository {
      getAll(): Promise<ProductEntity[]>;
      getById(id: string): Promise<ProductEntity | null>;
    }
    
    // data/repositories/product.repository.ts
    import { IProductRepository } from "../../domain/ports/product.repository.port";
    import { ProductEntity } from "../../domain/entities/product.entity";
    import { ProductDTO } from "../dtos/product.dto";
    import { toProductEntity } from "../mappers/product.mapper";
    
    export class ProductRepository implements IProductRepository {
      private readonly baseUrl = "https://api.myapp.com";
    
      async getAll(): Promise<ProductEntity[]> {
        const response = await fetch(`${this.baseUrl}/products`);
        if (!response.ok) throw new Error(`HTTP ${response.status}`);
        const dtos: ProductDTO[] = await response.json();
        return dtos.map(toProductEntity);
      }
    
      async getById(id: string): Promise<ProductEntity | null> {
        const response = await fetch(`${this.baseUrl}/products/${id}`);
        if (response.status === 404) return null;
        if (!response.ok) throw new Error(`HTTP ${response.status}`);
        const dto: ProductDTO = await response.json();
        return toProductEntity(dto);
      }
    }
    
    // domain/use-cases/get-products.use-case.ts
    import { IProductRepository } from "../ports/product.repository.port";
    import { ProductEntity } from "../entities/product.entity";
    
    export class GetProductsUseCase {
      constructor(private readonly productRepository: IProductRepository) {}
    
      async execute(): Promise<ProductEntity[]> {
        // El use case no tiene try/catch — delega el manejo de errores al repository.
        // Los errores de infraestructura suben como excepciones; la capa de presentación decide cómo mostrarlos.
        return this.productRepository.getAll();
      }
    }

    El componente ahora solo necesita instanciar el use case e invocar execute(). No sabe que existe una API. No sabe el formato de los DTOs. No hace transformaciones. Solo le habla al dominio.

    Eso es Clean Architecture aplicada. Y el agente lo generó todo en un solo turno porque sabía exactamente dónde iba cada pieza.

    Dónde la IA falla aunque tengas contexto

    El CLAUDE.md no es una bala de plata.

    Hay situaciones donde el agente ignora las reglas o las interpreta de forma inesperada. Las más comunes:

    Features cross-capa sin spec previa. Si le pides “añade filtros al listado de productos”, el agente puede añadir el estado del filtro en el use case (lógica de UI en el dominio), en la URL de la API directamente, o en el componente — sin pasar por el use case. La feature es compleja y el agente toma atajos.

    Refactorizaciones de archivos existentes. Al modificar código que ya existe y que no sigue la arquitectura, el agente tiende a preservar el patrón existente en lugar de corregirlo. Si el archivo ya tiene un fetch en el componente y le pides que añada una funcionalidad, lo más probable es que añada otro fetch.

    Código sin tests previos. Sin tests que fallen cuando se rompe la arquitectura, el agente no recibe feedback negativo cuando viola las capas. El código compila, parece correcto, y el problema solo aparece cuando otro developer intenta extender la feature meses después.

    La solución a los tres casos es la misma: spec primero, código después.

    La hoja de ruta correcta: SDD + IA

    Lo que marca la diferencia no es qué agente usas. Es si empiezas con una especificación o si vas directo al código.

    Cuando escribes la spec primero — qué entities existen, qué use cases necesita la feature, qué contratos definen los ports — el agente tiene un mapa. No adivina la arquitectura. La sigue porque está documentada antes de que genere la primera línea.

    Spec-Driven Development (SDD) es exactamente esta metodología: especificar antes de implementar, usar la spec como contrato entre el developer y el agente. He documentado todo el proceso — con plantillas, ejemplos y el flujo completo — en el Libro SDD. Si tu proyecto tiene problemas de arquitectura cuando usas IA, el libro es el punto de partida más directo que tengo para darte.

    Si quieres entender primero cómo funciona el bucle interno del agente — el ciclo percibir-razonar-actuar que subyace a todo esto — el post sobre el agentic loop y la guía sobre qué es un Agentic Engineer completan el contexto antes de aplicarlo a tu arquitectura.

    El flujo práctico es este:

    1. Escribe la spec: entities, use cases, ports, contratos
    2. Configura CLAUDE.md con las reglas de arquitectura
    3. Pide al agente que genere una capa a la vez, en orden
    4. Review: ¿la implementación respeta la spec?
    5. Añade tests que fallen si alguien rompe las capas
    6. Itera

    Cada paso reduce el espacio de decisión del agente. Y reducir el espacio de decisión es reducir el riesgo de que genere spaghetti.

    Si quieres ver este flujo aplicado a proyectos reales — desde la spec hasta el producto funcionando — el curso Construye con IA cubre exactamente esto: cómo trabajar con agentes de IA respetando la arquitectura, con ejemplos en TypeScript y el proceso completo desde idea hasta código en producción.

    FAQ — Preguntas frecuentes

    ¿Clean Architecture en frontend es sobreingeniería para proyectos pequeños?

    Depende del criterio de “pequeño”. Si el proyecto va a crecer, va a tener más de un developer tocando el código o va a ser mantenido más de seis meses, Clean Architecture paga su coste desde el primer mes. El problema no es la arquitectura en sí — es implementarla de forma rígida cuando no añade valor. Para un script de 200 líneas o un prototipo desechable, no la necesitas. Para cualquier producto real, la separación de capas es lo que permite que la IA ayude en lugar de crear deuda.

    ¿Funciona el mismo enfoque con Cursor, GitHub Copilot o cualquier otro agente?

    Sí. El CLAUDE.md es específico de Claude Code, pero el principio es universal: cualquier agente que pueda leer el contexto del proyecto antes de generar código va a producir mejores resultados. En Cursor usas archivos .cursor/rules/*.mdc (la convención actual desde 2025; .cursorrules sigue funcionando por retrocompatibilidad). En GitHub Copilot puedes añadir instrucciones en el repositorio o en el prompt. La estructura de carpetas funciona con todos porque es parte del contexto que el agente lee automáticamente cuando explora el proyecto.

    ¿Cómo testeo que la arquitectura se está respetando?

    La forma más efectiva es con import constraints a nivel de build o linting. En proyectos TypeScript puedes usar eslint-plugin-boundaries para definir reglas de qué capas pueden importar de cuáles. Cuando el agente viola la arquitectura, el linter falla antes de que el código llegue a revisión. Es la red de seguridad que hace que el enfoque sea sostenible en equipos o en proyectos donde usas IA intensivamente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Resource API en Angular 22: el fin del subscribe() manual

    Resource API en Angular 22: el fin del subscribe() manual

    Revisé hace poco un componente de Angular que cargaba una lista de productos. Contaba los observables con los dedos: un BehaviorSubject para la categoría seleccionada, un switchMap hacia HttpClient, un catchError para los fallos, un takeUntilDestroyed para no dejar suscripciones vivas, y al final, un async pipe en el template.

    Todo correcto. Todo necesario. Y todo código que explica exactamente lo mismo que cualquier otro componente de carga de datos en la aplicación. La Resource API de Angular 22 resuelve exactamente este problema.

    Ese patrón tiene quince años. Angular 22 tiene la respuesta definitiva.

    Qué es la Resource API y por qué existe

    La Resource API es el mecanismo nativo de Angular para gestionar operaciones asíncronas dentro del sistema de Signals. No es una librería de terceros, no es un wrapper sobre RxJS: es la pieza que faltaba para que el modelo reactivo de Angular estuviera completo.

    La idea central es sencilla: tienes un signal que representa un parámetro (un ID, un filtro, una página), y quieres que Angular haga automáticamente el fetch cuando ese parámetro cambia. Sin subscribe, sin pipe, sin gestión manual del ciclo de vida.

    En Angular 22 el ecosistema completo se compone de tres APIs:

    • resource() — fetch genérico con Promise. Estable en v22.
    • rxResource() — puente para servicios basados en Observable. Estable en v22.
    • httpResource() — wrapper declarativo sobre HttpClient. Experimental en v22.

    El matiz de los estados de estabilidad importa. resource() y rxResource() ya son API pública con garantías de compatibilidad. httpResource() sigue marcado como experimental — la API puede cambiar. Para producción crítica, ten eso en cuenta.

    resource(): el punto de entrada

    Usa resource() cuando el origen de datos es una Promise o una función fetch directa. El parámetro reactivo se define en params, y la función que carga los datos en loader.

    import { ChangeDetectionStrategy, Component, signal, resource } from '@angular/core';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @switch (productos.status()) { @case ('loading') { <p>Cargando...</p> } @case ('reloading') { <p>Actualizando...</p> } @case ('error') { <p>Error: {{ productos.error() }}</p> } @default { @if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } } } <button (click)="categoria.set(categoria() + 1)">Siguiente</button> <button (click)="productos.reload()">Recargar</button> `, }) export class CatalogoComponent { categoria = signal(1);

    productos = resource<Producto[], { cat: number }>({ params: () => ({ cat: this.categoria() }), loader: ({ params, abortSignal }) => fetch(/api/products?category=${params.cat}, { signal: abortSignal }) .then(r => r.json()), }); }

    Dos errores que verás en código antiguo o en tutoriales desactualizados:

    • El campo se llama params, no request. Eso era la API experimental anterior.
    • Los estados son strings literales: 'loading', 'reloading', 'error'… ResourceStatus no es un enum TypeScript nativo — es un objeto de constantes (as const), así que se compara con strings literales, no con ResourceStatus.Loading.

    Cuando categoria cambia, Angular cancela el fetch anterior (usando el abortSignal que recibe el loader) y lanza uno nuevo. El ciclo de vida completo, gestionado sin escribir una sola línea de cleanup.

    rxResource(): para servicios que devuelven Observables

    La mayoría de proyectos Angular tienen servicios basados en HttpClient que devuelven Observable. Migrar todo a fetch puro no es viable ni deseable.

    rxResource() es el puente. En lugar de loader, usa stream, que devuelve un Observable.

    import { ChangeDetectionStrategy, Component, signal, inject } from '@angular/core';
    import { rxResource } from '@angular/core/rxjs-interop';
    import { HttpClient } from '@angular/common/http';
    

    interface Producto { id: number; nombre: string; }

    @Component({ selector: 'app-catalogo-rx', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (productos.isLoading()) { <p>Cargando...</p> } @else if (productos.hasValue()) { <ul> @for (p of productos.value(); track p.id) { <li>{{ p.nombre }}</li> } </ul> } `, }) export class CatalogoRxComponent { private http = inject(HttpClient); categoria = signal(1);

    productos = rxResource({ params: () => ({ cat: this.categoria() }), stream: ({ params }) => this.http.get<Producto[]>(/api/products?category=${params.cat}), }); }

    Dos puntos que generan confusión frecuente:

    • El import correcto es @angular/core/rxjs-interop, no @angular/core.
    • El método se llama stream, no loader. Los ejemplos de versiones experimentales anteriores usaban loader, de ahí la confusión.

    httpResource(): la opción declarativa

    httpResource() va un paso más allá: elimina la necesidad de declarar un servicio intermedio para casos de fetching simple. Lo declaras directamente en el componente.

    import { ChangeDetectionStrategy, Component, signal } from '@angular/core';
    import { httpResource } from '@angular/common/http';
    

    interface User { id: number; name: string; }

    @Component({ selector: 'app-user-profile', changeDetection: ChangeDetectionStrategy.OnPush, template: ` @if (user.isLoading()) { <p>Cargando...</p> } @else if (user.error()) { <p>Error al cargar el perfil</p> } @else if (user.hasValue()) { <p>{{ user.value()?.name }}</p> } `, }) export class UserProfileComponent { userId = signal(1);

    user = httpResource<User>(() => /api/user/${this.userId()}); }

    httpResource() expone dos signals exclusivos que no tienen resource() ni rxResource():

    • .statusCode() — el código HTTP de la respuesta (200, 404, 500…)
    • .headers() — las cabeceras de la respuesta

    Ambas son señales independientes de .status(), que sigue siendo el estado del ciclo de vida del recurso. Confundir .status() con .statusCode() es el error más frecuente al empezar con esta API.

    Para respuestas que no son JSON:

    // Texto plano
    const readme = httpResource.text(() => /docs/readme.md);
    

    // Binario const avatar = httpResource.blob(() => /api/user/${this.userId()}/avatar);

    Requiere provideHttpClient() en el bootstrap. Usa HttpClient e interceptores por debajo, así que tus interceptores de autenticación siguen funcionando sin cambiar nada.

    Recuerda que httpResource() sigue marcado como experimental en v22. Para proyectos con requisitos estrictos de estabilidad de API, usa rxResource() con tu servicio HttpClient habitual hasta que se estabilice.

    Cuándo usar cada uno

    No es una decisión complicada si tienes claros los criterios:

    | Situación | API recomendada | |—|—| | Fetch puro o API externa directa | resource() | | Tienes servicios con Observable existentes | rxResource() | | Fetching simple sin servicio intermedio (experimental) | httpResource() | | Necesitas el status code HTTP como signal | httpResource() |

    Las tres APIs comparten la misma superficie de lectura: .value(), .isLoading(), .error(), .hasValue(), .status(), .reload(). Cambiar de una a otra es mínimamente invasivo.

    Validación del dato en runtime

    El genérico de TypeScript solo existe en tiempo de compilación. Si el backend devuelve algo inesperado, httpResource() no lanzará ningún error — simplemente tendrás un objeto mal tipado en runtime.

    La opción parse existe exactamente para este caso:

    import { z } from 'zod';
    

    const UserSchema = z.object({ id: z.number(), name: z.string(), });

    user = httpResource( () => /api/user/${this.userId()}, { parse: UserSchema.parse } );

    Si el dato del backend no cumple el schema, el resource entra en estado 'error' automáticamente. Sin try/catch manual, sin runtime silencioso. Si quieres profundizar en cómo construir schemas robustos con Zod para este tipo de validación, el curso de Zod para TypeScript cubre exactamente estos patrones de producción.

    Lo que cambia en tu arquitectura

    La Resource API no elimina los servicios Angular — los reorganiza. Sigues necesitando servicios para encapsular lógica de negocio compleja, componer múltiples endpoints, o compartir estado entre componentes. Lo que elimina es el boilerplate de gestión de ciclo de vida en los componentes que simplemente cargan y muestran datos.

    Un componente que antes necesitaba un servicio, tres operadores RxJS y un takeUntilDestroyed ahora expresa la misma intención en diez líneas. La lógica no desaparece — se mueve al lugar correcto.

    Si quieres el cuadro completo — Signals, Resource API, Signal Forms, Zoneless y todo lo que llegó en v22 — el curso Angular Moderno tiene el módulo M10 dedicado íntegramente a Resource API con ejemplos sobre el proyecto ShopFlow.

    Qué hacer hoy

    Identifica en tu proyecto los componentes que tienen este patrón: signal o BehaviorSubject como parámetro, switchMap hacia HttpClient, y async pipe en el template.

    Esos son tus candidatos para migrar a rxResource(). No necesitas reescribir los servicios. Solo cambias la forma en que el componente consume el Observable.

    Empieza por un componente de solo lectura — uno que carga datos y no tiene formularios complejos. Comprueba que .status() en el template te da todo lo que necesitabas del loading$ que tenías antes.

    Si funciona ahí, tienes el patrón. El resto de la migración es repetirlo.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre resource() y httpResource() en Angular 22? resource() acepta cualquier función que devuelva una Promise — puedes usarlo con fetch, con SDKs externos, o con cualquier operación asíncrona. httpResource() es un wrapper declarativo sobre HttpClient que además expone el status code HTTP y las cabeceras como signals independientes. La diferencia clave: httpResource() sigue siendo experimental en v22; resource() es API estable.

    ¿Puedo usar rxResource() si tengo servicios que devuelven Observables? Sí. rxResource() está diseñado exactamente para ese caso. En lugar de loader, defines un stream que devuelve un Observable. Tus servicios existentes no cambian — solo cambia cómo el componente los consume.

    ¿La Resource API reemplaza completamente RxJS en Angular? No. RxJS sigue siendo útil para transformaciones complejas de streams, operadores avanzados y casos donde necesitas combinar múltiples fuentes. La Resource API reemplaza el patrón subscribe/unsubscribe para carga de datos HTTP en componentes — no todos los casos de uso reactivo.

    ¿Qué ocurre con los datos en caché cuando cambia el signal de parámetros? Cuando el signal de params cambia, el resource entra en estado 'reloading' (no 'loading'). El valor anterior sigue disponible en .value() durante la recarga. Esto permite mostrar datos obsoletos mientras llegan los nuevos, en lugar de mostrar un spinner que vacía la UI. Es el comportamiento por defecto — no necesitas configurarlo.

    ¿Funciona la Resource API con Angular SSR? Sí. httpResource() usa HttpClient internamente, que ya tiene soporte de transferencia de estado para SSR. Con resource() y rxResource() necesitas gestionar tú mismo la transferencia de estado si el servidor precarga datos. La integración más limpia con SSR actualmente es a través de httpResource() o rxResource() con un servicio que use TransferState.

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode. Ha migrado proyectos Angular en producción desde v2 hasta v22.
    Sources:

  • Construye un agente de IA en TypeScript: stack mínimo para 2026

    Construye un agente de IA en TypeScript: stack mínimo para 2026

    El stack mínimo para un agente de IA en TypeScript en 2026

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Anthropic SDK + Zod + tsx + dotenv es la combinación práctica para agentes en producción: observabilidad, tipado y control.
    • Zod como frontera: declara schemas de herramientas, valida args y convierte a JSON Schema para pasar al modelo.
    • Bucle explícito: orquesta tool-calls en un único proceso, limita iteraciones y registra cada uso.
    • No es minimalismo estético: es técnica operativa para que el equipo pueda depurar y reparar a cualquier hora.
    • Escala solo cuando métricas y requisitos lo exijan: añade memoria, orquestadores o trazas distribuidas según necesidad.

    Tabla de contenidos

    El stack mínimo propuesto es una combinación práctica y limitada de dependencias enfocadas a reducir superficie de fallo, mantener trazabilidad y controlar consumo de tokens: Anthropic SDK para el motor, Zod para contratos, tsx para ejecución TypeScript rápida y dotenv para gestionar secretos.

    Resumen rápido (lectores con prisa)

    Stack: Anthropic SDK + Zod + tsx + dotenv. Usa Zod para declarar y validar schemas de herramientas, convierte Zod a JSON Schema para pasárselo al modelo y orquesta tool-calls en un bucle explícito. Añade PostgreSQL+pgvector, orquestadores o trazas solo cuando lo exijan métricas y requisitos.

    tsx + dotenv — entorno y secretos

    tsx te permite ejecutar TypeScript directamente en Node sin compilar manualmente. En desarrollo y CI rápidos esto reduce ciclos de retroalimentación.

    dotenv mantiene las claves fuera del repo: ANTHROPIC_API_KEY, DATABASE_URL, etc. Ambos son higiene operativa, no glamour.

    Anthropic SDK — motor cognitivo directo

    Usa el SDK oficial: Anthropic SDK. Evita enrutadores genéricos que suavizan diferencias entre modelos y esconden comportamientos de tool-calling. Anthropic devuelve explícitamente cuándo el modelo quiere invocar una herramienta; tú ejecutas la función y devuelves el resultado, con control total del flujo.

    Zod — contrato entre texto probabilístico y tipos

    Zod es la frontera. Define los schemas de herramientas y valida los argumentos que el modelo genera. Convierte Zod a JSON Schema con zod-to-json-schema para declarar las herramientas al modelo. Resultado: menor tasa de alucinaciones en tool_use y errores tipo detectables y manejables.

    Por qué este stack vence en producción (ejemplos técnicos)

    1) Trazabilidad total

    Cuando el modelo pide usar una herramienta, el SDK devuelve nombre + args. Antes de ejecutar, haces schema.safeParse(args). Si falla, capturas el error, lo loggeas y agregas ese fallo al historial que reenvías al modelo. No hay retries automáticos “mágicos” que oculten la causa.

    2) Menor latencia y coste

    Un único proceso que orquesta tool-calls evita encadenados innecesarios. Si cada handoff fuera otra llamada LLM, multiplicas tokens y TTFT. Con un loop explícito controlas el número máximo de iteraciones y evitas bucles de cortesía.

    3) Menos superficie de bugs

    Las capas extra (framework + adaptadores) introducen incompatibilidades y reintentos implícitos. Tener cuatro dependencias estables reduce puntos de falla.

    El patrón de implementación: el loop explícito

    Escribes un bucle claro. Pseudodiagrama:

    1. Inicializar cliente Anthropic con la API key desde dotenv.
    2. Preparar mensajes (system + user + tool_history).
    3. Llamar a client.messages.create(…) con tool definitions derivadas de Zod.
    4. Si respuesta es texto → devolver.
    5. Si respuesta es tool_use → validar con Zod; si válido ejecutar función; añadir resultado al historial; repetir.

    Ese flujo se implementa en 30–80 líneas y es 100% controlable. No es necesario heredar de clases ni integrar callbacks crípticos.

    Validación práctica y contratos: ejemplo de herramientas

    Define una tool con Zod:

    - ticketId: z.string().regex(/^[A-Z]+-\d+$/)
    - includeComments: z.boolean().default(false)

    Convierte esto a JSON Schema y pásalo a Anthropic. Cuando el LLM devuelva args, safeParse te dice inmediatamente si se puede ejecutar. Si no, devuelves el error al modelo como contexto y le pides corrección. Ese patrón reduce las llamadas inválidas y mejora la seguridad.

    Qué no cubre este stack y cuándo añadir componentes

    • Memoria de largo plazo: integra PostgreSQL + pgvector si necesitas retrieval persistente.
    • Flujos empresariales largos (days/weeks): añade un orquestador (n8n o LangGraph) para persistencia de estado y control de aprobaciones humanas.
    • Observabilidad distribuida: añade OpenTelemetry o similar si tu cluster requiere trazas correlacionadas a escala.

    Empieza simple; añade estas piezas solo con datos que demuestren necesidad.

    Reglas operativas antes de desplegar

    • Nunca expongas una herramienta sin Zod schema.
    • Registra cada tool_use y su validación. Logs estructurados; no texto plano.
    • Limita iteraciones del loop por petición (por ejemplo, max 5 reintentos).
    • Implementa el patrón Result (ok/error) en todas las funciones ejecutadas por el agente.

    Conclusión práctica

    El stack mínimo para un agente de IA en TypeScript en 2026 devuelve poder al equipo de ingeniería: trazabilidad, tipos y control operativo. Para la mayoría de agentes productivos —consultas a APIs, limpieza de datos, consultas SQL parametrizadas— esta pila es suficiente y más fiable que una montaña de frameworks. Escala solo cuando las métricas (latencia, coste por token, fallos en producción) y los requisitos (memoria, durabilidad) lo exijan. Así evitas añadir complejidad por moda y mantienes un sistema que puedas entender, auditar y mejorar.

    Dominicode Labs

    Para quienes construyen agentes y workflows, una referencia útil y complementaria sobre prácticas operativas y plantillas de integración está disponible en Dominicode Labs. Considera consultarlo como continuación lógica al patrón de loop explícito y validación con Zod.

    Y si has llegado aquí buscando el «cómo» sin tener resuelto el «qué», empieza por ahí: antes de construirlo, qué es un agente de IA y en qué se diferencia de un workflow con un LLM dentro.

    FAQ

    ¿Por qué usar Anthropic SDK en vez de adaptadores genéricos?

    Porque el SDK oficial expone el comportamiento nativo del modelo (por ejemplo, tool_use) sin abstracciones que oculten diferencias entre modelos. Esto permite un control más preciso sobre cuándo y cómo ejecutar herramientas.

    ¿Cuál es el papel exacto de Zod en este stack?

    Zod define los schemas de las herramientas y valida los argumentos generados por el modelo. Convertir esos schemas a JSON Schema permite declararlos al modelo y reducir llamadas inválidas y alucinaciones en tool_use.

    ¿Necesito tsx en producción?

    tsx facilita ciclos de desarrollo y CI al evitar compilación manual. En producción puedes seguir usándolo o compilar, según tu pipeline; la recomendación es usarlo para reducir fricción durante desarrollo y pruebas.

    ¿Cómo reducir costes de tokens con este patrón?

    Orquesta tool-calls en un único proceso, limita iteraciones del loop y evita encadenar llamadas LLM por cada handoff. Controlar explícitamente el número de iteraciones reduce tokens enviados y latencia.

    ¿Cuándo añadir bases de datos y vectores (pgvector)?

    Añade PostgreSQL + pgvector cuando necesites retrieval persistente y la memoria a corto plazo del agente no sea suficiente para tus casos de uso.

    ¿Qué límites de seguridad operativa aplicar al expositor de herramientas?

    Nunca expongas una herramienta sin schema Zod, registra cada tool_use con logs estructurados, limita reintentos y aplica validaciones estrictas (Result ok/error) en todas las funciones ejecutadas por el agente.

  • Implementación de Generics para Wrappers de IA en TypeScript

    Implementación de Generics para Wrappers de IA en TypeScript

    Generics para wrappers de IA en TypeScript

    Tiempo estimado de lectura: 4 min

    • Evita desincronización: usa un wrapper genérico withAI<T>() para enlazar firma TypeScript y validación Zod.
    • Zod‑first: Zod en runtime + z.infer en TypeScript ofrece validación práctica frente al type erasure.
    • Autodocumentación y registros: genera descripciones básicas y registra prompt, rawResponse y resultado de Zod.
    • Operación segura: define límites de reintentos y métricas; en sistemas críticos separa intención (LLM) de efecto (máquina de estado).

    Generics para wrappers de IA en TypeScript: si vas a exponer funciones de negocio a agentes, necesitas una forma segura y mantenible de hacerlo. En las primeras líneas: usar generics y Zod evita duplicar contratos y convierte la exposición de funciones en un proceso reproducible y tipado. Aquí explico por qué funciona, cómo implementarlo y qué decisiones arquitectónicas debes tomar.

    Resumen rápido (lectores con prisa)

    Patrón Zod‑first: pasa un esquema Zod al wrapper y usa z.infer<…> para que TypeScript infiera tipos. El wrapper genérico withAI<T> enlaza la firma de la función con el esquema, validando en runtime y detectando incompatibilidades en compilación.

    Úsalo cuando expongas funciones a LLMs o agentes; mejora seguridad estática, validación runtime y trazabilidad.

    Por qué necesitas Generics para wrappers de IA en TypeScript

    Exponer una función como herramienta para un LLM suele generar cuatro elementos repetitivos: descripción, esquema de validación, bindings del SDK y la ejecución. Ese boilerplate se desincroniza con el tiempo: la firma cambia, el esquema no, y el error aparece en producción, no en el IDE.

    La solución es un wrapper genérico —withAI<T>()— que capture la firma de la función mediante tipos TypeScript y reciba un esquema Zod en runtime. Zod vive en ejecución; TypeScript no. Esta combinación (TypeScript + Zod) te da lo mejor de ambos mundos: seguridad estática y validación runtime.

    Limitación real: type erasure y la decisión Zod‑first

    TypeScript suprime tipos en runtime (type erasure). No puedes inspeccionar en ejecución que un parámetro se llama userId y es string. Por eso hay dos rutas:

    • Extraer metadatos en build time (AST/JSDoc) — viable pero compleja.
    • Patrón Zod‑first — práctico y fiable: pasas un esquema Zod al wrapper, Zod valida en runtime y TypeScript infiere tipos con z.infer<…>.

    Recomiendo Zod‑first. Es simple, robusto y encaja con flujos CI/CD.

    Implementación: withAI<T> paso a paso

    Idea: recibir la función original, su esquema Zod y devolver una herramienta lista para el SDK de IA (p. ej. Vercel AI SDK https://sdk.vercel.ai/docs). El genérico obliga a coherencia entre firma y esquema.

    Ejemplo reducido

    import { z } from 'zod';
    import { tool } from 'ai'; // Vercel AI SDK
    
    export function withAI>(
      fn: T,
      schema: z.ZodType<Parameters<T>[0]>,
      description?: string
    ) {
      const autoDesc = description ?? generateDescription(fn.name, schema);
    
      return tool({
        description: autoDesc,
        parameters: schema,
        execute: async (args) => {
          // args ya validado por Zod cuando el SDK integra la validación
          return await fn(args as Parameters<T>[0]);
        },
      });
    }
    

    Claves:

    • Parameters<T>[0] enlaza el tipo esperado del primer argumento de fn con el esquema.
    • Si la firma de fn cambia y el esquema no, TypeScript marcará el error en compilación.
    • tool() es una abstracción; adapta al SDK que uses (Vercel, OpenAI, etc.).

    Autodocumentación práctica

    El wrapper puede generar una descripción básica a partir del nombre de la función y las claves del esquema. No es NLP mágico, pero reduce trabajo manual y mejora la señal hacia el modelo.

    function generateDescription(name: string, schema: z.ZodTypeAny) {
      const readable = name.replace(/([A-Z])/g, ' $1').trim().toLowerCase();
      const params = schema instanceof z.ZodObject ? Object.keys(schema.shape).join(', ') : 'input object';
      return `Use this tool to ${readable}. Parameters: ${params}.`;
    }
    

    Para funciones críticas, proporciona siempre una descripción manual y ejemplos de uso. Puedes enriquecer la doc con ejemplos JSON y constraints — los modelos modernos respetan instrucciones claras (ver Structured Outputs de OpenAI: https://platform.openai.com/docs/guides/structured-outputs).

    Buenas prácticas operativas

    • Valida con .safeParse() en agentes que puedan autocorregirse; usa .parse() para endpoints que deban fallar rápido.
    • Registra siempre: prompt, rawResponse, resultado de Zod (error.flatten()), la herramienta invocada y contexto. Sin esto, los postmortems son inútiles.
    • Mide: tasa de validación fallida, latencia de autocorrección, reintentos por prompt y degradaciones a humano.
    • Define límites: si tras N reintentos no hay corrección, encola para revisión humana. Evita loops que consuman tokens/requests.

    Trade‑offs y decisiones arquitectónicas

    • Autogeneración vs. precisión: la descripción automática agiliza pero no sustituye documentación humana para casos sensibles.
    • Structured Outputs + generateObject (OpenAI) reducen errores de formato, pero no reemplazan validaciones semánticas (p. ej. rangos, signos). Zod sigue siendo necesario.
    • En sistemas críticos, deja que el LLM decida la herramienta, pero que una máquina de estado (n8n, XState) controle la ejecución final; así separas intención y efecto.

    Ejemplo completo: patrón en producción

    1. Define la función pura:

    async function getOrder(args: { orderId: string }) { /* ... */ }

    2. Define esquema Zod:

    const OrderSchema = z.object({ orderId: z.string().uuid() });

    3. Envuelve:

    const getOrderTool = withAI(getOrder, OrderSchema, 'Obtiene estado de un pedido por ID');

    4. Registra y mide cada llamada. Si Zod falla, serializa error.flatten() y envíalo al LLM para autocorrección o al equipo de soporte.

    Conclusión

    Generics para wrappers de IA en TypeScript no es un truco académico: es una medida práctica para escalar agentes sin introducir deuda técnica. El patrón Zod‑first con withAI<T> convierte la exposición de funciones en una operación segura, rastreable y testeable. Si tu agente escribe en bases de datos, llama APIs facturadas o ejecuta efectos críticos, aplica este patrón hoy: te evitará errores que sólo descubres en producción.

    Para equipos que diseñan flujos de agentes y workflows relacionados con automatización e IA aplicada, puede ser útil revisar trabajos y herramientas experimentales. Más recursos y experimentos están disponibles en Dominicode Labs.

    FAQ


    ¿Qué es exactamente el patrón Zod‑first?

    Es la práctica de definir esquemas de validación con Zod en runtime y usar z.infer<…> para que TypeScript derive los tipos, evitando depender de metadatos de tipos en ejecución.


    ¿Cuándo debo usar safeParse() vs parse()?

    Usa safeParse() cuando el agente pueda autocorregirse o cuando quieras manejar errores sin lanzar. Usa parse() en endpoints que deban fallar rápido y propagar excepciones.


    ¿Cómo detecta TypeScript desalineaciones entre firma y esquema?

    El wrapper genérico usa tipos como Parameters<T>[0]. Si la firma de la función cambia y el esquema suministrado no coincide, TypeScript emitirá un error en compilación por incompatibilidad de tipos.


    ¿Qué hacer si Zod falla de forma recurrente?

    Registra el resultado de error.flatten(), envía el fallo al LLM para autocorrección o encola el caso para revisión humana si supera N reintentos. Mide la tasa de validación fallida para priorizar correcciones.


    ¿Puedo usar este patrón con otros SDKs además de Vercel?

    Sí. tool() en el ejemplo es una abstracción; adapta la forma de registrar parámetros, validar y ejecutar según el SDK (Vercel, OpenAI u otros).


    ¿Cómo debo registrar errores y métricas?

    Registra prompt, rawResponse, resultado de Zod (error.flatten()), herramienta invocada, contexto y métricas como latencia y reintentos. Estos datos son esenciales para postmortems y mejoras iterativas.

  • Angular 22: Implicaciones técnicas y coste real de migrar en 2026

    Angular 22: Implicaciones técnicas y coste real de migrar en 2026

    Angular 22 vs el resto: lo que nadie te dice sobre migrar en 2026

    Tiempo estimado de lectura: 4 min

    • Modernización estructural: Zoneless por defecto, Signals y Control Flow nativo cambian la forma de detectar cambios y escribir templates.
    • Contextos de ventaja: Angular 22 aporta coherencia en equipos grandes y proyectos de larga vida útil; no es la opción por defecto para prototipado rápido.
    • Coste real de migración: incluye trabajo manual de refactor y coste de formación; planifica recursos y tiempo (ej. 3–6 meses para monorepos medianos).
    • Testing y despliegue: migrar a Jest + Angular Testing Library es parte crítica del plan; usa despliegues canarios y métricas para validar.

    Buscar Angular 22 vs el resto: lo que nadie te dice sobre migrar en 2026 no es una charla de café. Es una decisión de arquitectura con consecuencias inmediatas en costes, ritmo de desarrollo y mantenimiento. Angular 22 ya no es el framework “pesado” que recuerdas. Pero esa modernización trae costes de migración reales y decisiones estratégicas que no aparecen en la documentación oficial.

    Resumen rápido (lectores con prisa)

    Angular 22 introduce Zoneless por defecto, Signals y Control Flow nativo en templates. Mejora TTI y reduce renders innecesarios. Es una buena opción para equipos grandes y proyectos de larga duración; la migración requiere refactor y formación. Incluye la migración del stack de testing a Jest + Angular Testing Library como parte del plan.

    Angular 22 vs el resto: lo que cambia y por qué importa

    Zoneless por defecto

    Se abandona Zone.js. La detección de cambios pasa de ser global e impulsiva a ser controlada y granular. Resultado: TTI más bajo y menos renders innecesarios.

    Signals como primitivo de reactividad

    Reactividad sin subscriptions masivas. Signals reduce la boilerplate de RxJS para estado local y mejora predictibilidad.

    Control Flow nativo en templates (@if, @for)

    El compilador procesa control de flujo a nivel de AST, lo que incrementa rendimiento y legibilidad.

    Traducido: Angular ya compite en métricas de rendimiento con frameworks “reactivos” como Solid o con Vue, pero manteniendo un conjunto de herramientas integradas (DI, routing, forms) que otros frameworks dejan al ecosistema.

    Comparativa honesta: cuándo Angular gana y cuándo no

    Angular no es la mejor opción por defecto. Es la mejor opción para ciertos contextos.

    • Si ganas con opinión y consistencia: equipos de >10 devs, código con vida útil >3 años, requisitos de accesibilidad y compliance, Angular aporta coherencia y reduce decisiones ad-hoc.
    • Si priorizas libertad y prototipado rápido: React o Vue siguen siendo más ágiles. Next.js / Nuxt dominan en SSR/Server Components y experiencia híbrida contenido-aplicación.

    Arquitectura

    Angular = opinado; React = flexible; Vue = progresivo.

    Reactividad

    Angular = Signals; React = Hooks/Virtual DOM; Vue = Composition API.

    SSR y SEO

    Next.js/Nuxt > Angular Universal (mejora pero no centro de innovación).

    Mantenimiento en equipos grandes

    Angular > React (por la opinión y patrones forzados).

    Lo que nadie te cuenta sobre el coste real de migrar

    Hay dos costes que muchos subestiman.

    1) Coste técnico (trabajo manual)

    Actualizar con el CLI es el viaje fácil. El trabajo duro es refactorizar: pasar de NgModules a Standalone Components, reescribir flujos con Signals, adaptar templates a Control Flow nativo. Eso no se hace con sed. Es trabajo de diseño con pruebas y revisiones de arquitectura.

    2) Coste de conocimiento (formación)

    Si tu equipo maneja Angular 8–12 y nunca siguió la evolución, la migración se convierte en un proceso de aprendizaje. No es solo código; es cambiar patrones mentales.

    Estimación práctica: para un monorepo mediano (~50–100 paquetes) con Angular legacy, planifica entre 3–6 meses de esfuerzo de ingeniería + formación (una squad dedicada en paralelo). Para apps pequeñas, 2–4 semanas si controlas las dependencias.

    Testing: la parte que obliga a modernizar

    Karma y Jasmine están oficialmente deprecados. Seguir con ellos en 2026 equivale a cargar deuda técnica que ralentiza CI. El estándar actual es Jest + Angular Testing Library: tests por comportamiento, más rápidos y menos frágiles ante refactors.

    Si vas a migrar, incluye la migración del stack de testing en el plan. No lo dejes para “después”; las pruebas son el talón de Aquiles de cualquier transición grande.

    Plan de migración (práctico y priorizado)

    1. Auditoría de superficie: identifica paquetes que usan NgModules, transformadores de compilador o dependencias tightly-coupled.
    2. Formación y pilot: entrena 2–3 leads en Standalone + Signals. Ejecuta un pilot migrando un módulo crítico.
    3. Reescritura incremental: migrar componentes a Standalone, adaptar servicios a nuevo DI y sustituir RxJS local por Signals donde aplique.
    4. Testing first: antes de cambiar templates, adapta tests a Jest + Testing Library.
    5. Despliegue canario: canary en producción para un subset de usuarios. Monitorea TTI, errores y coste de CI.
    6. Feedback loop: métricas + sesiones de code review para homogeneizar patrones.

    Formación recomendada (práctica)

    Si tu equipo necesita acelerar la adopción, dos recursos útiles y prácticos:

    Ambos cubren desde conceptos arquitectónicos hasta patrones aplicables en migraciones reales.

    Conclusión: criterio para decidir en 2026

    Angular 22 es una opción sólida cuando necesitas previsibilidad, escalabilidad y uniformidad. No es una moda; es una apuesta por la ingeniería predecible. Pero la migración exige plan, formación y disciplina. Si tu prioridad es velocidad de lanzamiento inmediata y equipo pequeño, otras opciones siguen siendo más prácticas. Si en cambio trabajas en dominios donde la UI es infraestructura con vida útil larga —migrar a Angular 22 tiene sentido y trae beneficios tangibles: menos renders innecesarios, menos deuda y mejores métricas de rendimiento.

    Migrar no es solo actualizar dependencias. Es reescribir la forma en que piensas la UI. Hazlo con criterio.

    FAQ

    ¿Qué es Zoneless en Angular 22?

    Zoneless significa que Angular deja de depender de Zone.js para la detección de cambios. La detección se vuelve más controlada y granular, lo que reduce renders innecesarios y mejora TTI.

    ¿Qué son Signals y cuándo conviene usarlos?

    Signals son un primitivo de reactividad que permiten manejar estado local sin la sobrecarga de subscriptions masivas. Conviene usarlos para reducir boilerplate y mejorar la predictibilidad del estado local.

    ¿Cuánto tiempo toma migrar un monorepo mediano?

    Estimación práctica indicada en el artículo: para un monorepo mediano (~50–100 paquetes) planifica entre 3–6 meses de esfuerzo de ingeniería + formación con una squad dedicada en paralelo.

    ¿Por qué migrar el stack de testing ahora?

    Karma y Jasmine están deprecados; mantenerlos añade deuda técnica y ralentiza CI. Migrar a Jest + Angular Testing Library hace los tests más rápidos y menos frágiles ante refactors, y debe formar parte del plan de migración.

    ¿Qué partes deben pilotearse primero?

    Pilotear un módulo crítico con leads formados en Standalone + Signals es la recomendación: forma 2–3 leads y ejecuta un pilot antes de reescrituras a gran escala.

    ¿Angular 22 mejora SEO comparado con Next.js?

    En SSR y SEO Next.js/Nuxt suelen ofrecer una experiencia más avanzada; Angular Universal ha mejorado pero no es el centro de innovación en este espacio.

  • Usa el sistema de tipos de TypeScript como documentación para IA

    Usa el sistema de tipos de TypeScript como documentación para IA

    El type system de TypeScript como documentación para tu agente de IA

    Tiempo estimado de lectura: 4 min

    • El type system actúa como contrato para agentes IA: reduce ambigüedad y alucinaciones.
    • Proveer tipos reales al modelo mejora la integración: interfaces y uniones limitan las soluciones válidas.
    • Prácticas recomendadas: evita any, usa uniones discriminadas, y documenta intenciones clave con JSDoc.
    • Aplica en sistemas críticos: APIs públicas, lógica financiera, workflows y automations en producción.

    El type system de TypeScript como documentación para tu agente de IA funciona mejor que mil parrafadas: le das al modelo un contrato, no una novela. Si quieres que Claude, GPT o cualquier agente genere código real y alineado con tu arquitectura, empieza por entregarle los tipos —no descripciones— y observa cómo las alucinaciones desaparecen.

    ¿Por qué? Porque un tipo es una restricción matemática. Un LLM con contexto tipado no puede inventar propiedades, estados o firmas que no existen.

    Resumen rápido (lectores con prisa)

    Qué: Usa el type system de TypeScript como contrato para agentes IA.

    Cuándo: En APIs públicas, lógica crítica y workflows en producción.

    Por qué importa: Reduce alucinaciones y errores de integración.

    Cómo: Pega las interfaces, enums y tipos en el prompt y obliga al agente a cumplir firmas y uniones discriminadas.

    Qué cambia en tu flujo de trabajo

    Los modelos de lenguaje predicen tokens; no “entienden” tus necesidades de negocio. Cuando les ofreces solo lenguaje natural, abrazan convenciones comunes y rellenan huecos con suposiciones populares. Resultado: código que “parece” correcto pero falla en integrarse con tu stack.

    Si en cambio inyectas las interfaces, enums y tipos de tu proyecto, reduces drásticamente el espacio de soluciones válidas. El agente no elige entre cien estructuras posibles: respeta la tuya.

    No es teoría. Es práctica:

    • Tipos explícitos delimitan estados válidos ('pending' | 'completed' | 'failed').
    • Relaciones entre interfaces exponen dependencias y claves foráneas.
    • Uniones discriminadas fuerzan el manejo correcto de errores y casos límite.

    Fuentes prácticas: documentación oficial de TypeScript, guías de APIs y plataformas de agentes como OpenAI o Anthropic.

    Ejemplo práctico: deja de explicar, pega el tipo

    Imagina que quieres delegar la lógica de cambio de estado de pedidos.

    Sin tipos: “Crea una función para actualizar el estado de un pedido”. El modelo inventa estados. Problema.

    Con tipos reales:

    type OrderStatus = 'pending' | 'confirmed' | 'dispatched' | 'delivered' | 'refunded';
    
    interface Order {
      id: string;
      status: OrderStatus;
      customerId: string;
      updatedAt: string; // ISO UTC
    }
    
    type UpdateOrderStatusResult = 
      | { success: true; order: Order }
      | { success: false; error: 'ORDER_NOT_FOUND' | 'INVALID_TRANSITION' };

    Pega esto en el prompt o en el contexto del agente (Cursor, GitHub Copilot, flujos custom via API) y pide: “Implementa updateOrderStatus que valide transiciones y devuelva UpdateOrderStatusResult”. Ahora el agente debe cumplir la firma. No habrá processing fantasmas ni retornos desordenados.

    Reglas prácticas para construir el contexto tipado

    1. Evita any como si fuera veneno

    any es una puerta abierta a alucinaciones.

    2. Prefiere uniones discriminadas sobre booleans dispersos

    Las banderas (isLoading, isError) permiten estados imposibles; una unión no.

    3. Añade JSDoc breve cuando la intención no sea obvia

    Ejemplo: /** Fecha en UTC. No convertir a local. */

    4. Expone las relaciones

    Usa referencias: invoice.orderId: Order['id']. El agente lo interpreta como clave foránea.

    5. Incluye los tipos de retorno claros (Result/Either)

    Obliga a manejar errores, no a ignorarlos.

    Herramientas que usan este enfoque

    Herramientas que usan este enfoque: n8n para orquestación, GitHub Copilot y Cursor en editores. También puedes integrar directamente archivos .d.ts en el contexto de la llamada a la API.

    ¿Cuándo aplicar Type-Driven Development con agentes?

    Úsalo cuando la consistencia importa: APIs públicas, lógica financiera, workflows críticos, transformaciones de datos y automations en producción. Evítalo solo en prototipos tempranos donde los modelos de datos cambian cada dos días.

    No confundas disciplina con burocracia: diseñar tipos claros al principio acelera todo lo demás. Es una inversión que reduce revisiones manuales y bugs silenciosos.

    Resultado esperado y próximos pasos

    Si empiezas hoy, el cambio es tangible: menos iteraciones, menos PRs arreglando supuestos imposibles y, sobre todo, código que entra en tu base sin romper contratos. El tipo es el contrato. El agente es el implementador.

    Haz esto ahora: copia el archivo de tipos relevante (o el fragmento clave) en el prompt de tu agente, pide una implementación concreta y compara el PR generado con lo que haría un desarrollador. Notarás dos cosas: consistencia y menos errores lógicos. Si trabajas con n8n, añade los tipos a los nodos o workflows para que los agentes que automatan tareas respeten tus contratos.

    No acaba aquí: diseña un checklist de tipos antes de delegar, prueba un par de endpoints y verás cómo el modelo deja de “inventar”. ¿Quieres un checklist listo para usar? Haz esto primero: pega tu index.d.ts en el prompt y pide al agente “Genera tests unitarios que verifiquen las transiciones permitidas”. Verás la diferencia al instante.

    Si quieres profundizar con proyectos y experimentos, revisa también los recursos y experimentos de Dominicode Labs. Es un buen complemento para validar patrones de Type-Driven Development aplicados a agentes y workflows antes de llevarlos a producción.

    FAQ

    ¿Por qué usar tipos en lugar de solo lenguaje natural?

    Porque los tipos actúan como restricciones matemáticas que reducen el espacio de soluciones válidas. Forzan al agente a no inventar propiedades o estados que no existen.

    ¿Qué tipos debo compartir primero?

    Empieza por los tipos que definen estados y contratos públicos: DTOs, modelos de entidad y tipos de retorno de API. Luego añade relaciones y uniones discriminadas.

    ¿Cómo evito que el agente ignore los tipos?

    Entrega los tipos en el contexto del prompt y pide explícitamente que la implementación cumpla las firmas. Usa ejemplos de tests o resultados (Result/Either) para que el agente devuelva formas esperadas.

    ¿Qué herramientas facilitan este flujo?

    Editores y orquestadores que soportan contexto tipado: Cursor, GitHub Copilot y plataformas de orquestación como n8n.

    ¿Es útil en prototipos rápidos?

    En prototipos muy tempranos donde los modelos de datos cambian constantemente, puede ser una carga. Para prototipos más avanzados o cuando la estructura es estable, sí acelera la integración.

    ¿Cómo manejar cambios de tipos en producción?

    Versiona tus tipos y mantén contratos retrocompatibles siempre que sea posible. Añade migraciones y tests que verifiquen transiciones permitidas entre versiones.

    ¿Debo incluir ejemplos de datos junto a los tipos?

    Sí. Ejemplos concretos ayudan al agente a mapear tipos a estructuras reales y generan pruebas útiles para validar implementaciones.