Le pedí a Claude que escribiera los tests de un componente de login. Me devolvió 14 tests. Todos verdes. El CI pasó sin problema.
Dos semanas después, un bug llegó a producción. El formulario aceptaba contraseñas vacías si el campo estaba touched pero sin valor. Ninguno de esos 14 tests lo detectó.
Los tests no fallaron porque el bug no existía para ellos. Los tests comprobaban que el componente existía, que el formulario se renderizaba, que el método onSubmit() se llamaba. No comprobaban el comportamiento. Eran tests de que el código había sido escrito, no de que el código hacía lo correcto.
Este es el problema número uno del testing en Angular con IA: la IA genera tests que pasan, no tests que protegen.
El problema real de los tests generados por IA
Cuando le das a un modelo un componente Angular y le pides “escribe los tests”, le estás pidiendo que haga ingeniería inversa de tu implementación. Y eso es exactamente lo que hace.
Lee el código. Ve que hay un loginForm con dos controles. Ve que hay un método onSubmit(). Ve que hay un AuthService. Y escribe tests que verifican que esas cosas existen y se llaman entre sí.
El resultado son tests acoplados a la implementación, no al comportamiento. Si renombras onSubmit() a handleSubmit(), los tests fallan. Si cambias el nombre de una variable interna, los tests fallan. Pero si introduces un bug lógico — como que el formulario se envíe con campos vacíos — los tests siguen verdes.
Esto no es un fallo del modelo. Es un fallo del prompt. Le preguntaste lo que no debías preguntar.
Sin contexto del comportamiento esperado, la IA no tiene forma de saber qué casos importan. No sabe cuándo debería bloquearse el submit. No sabe qué errores deben mostrarse. Así que copia lo que ve: la implementación.
El cambio de mentalidad que lo arregla todo
No le pidas a la IA que escriba tests. Pídele que te ayude a pensar qué testear.
Son dos tareas completamente distintas. La primera produce código. La segunda produce criterios. Y los criterios son lo que hace que un test sea útil.
Un test útil parte de una pregunta: “¿qué debería pasar cuando X?” No de “¿qué hace este código?”
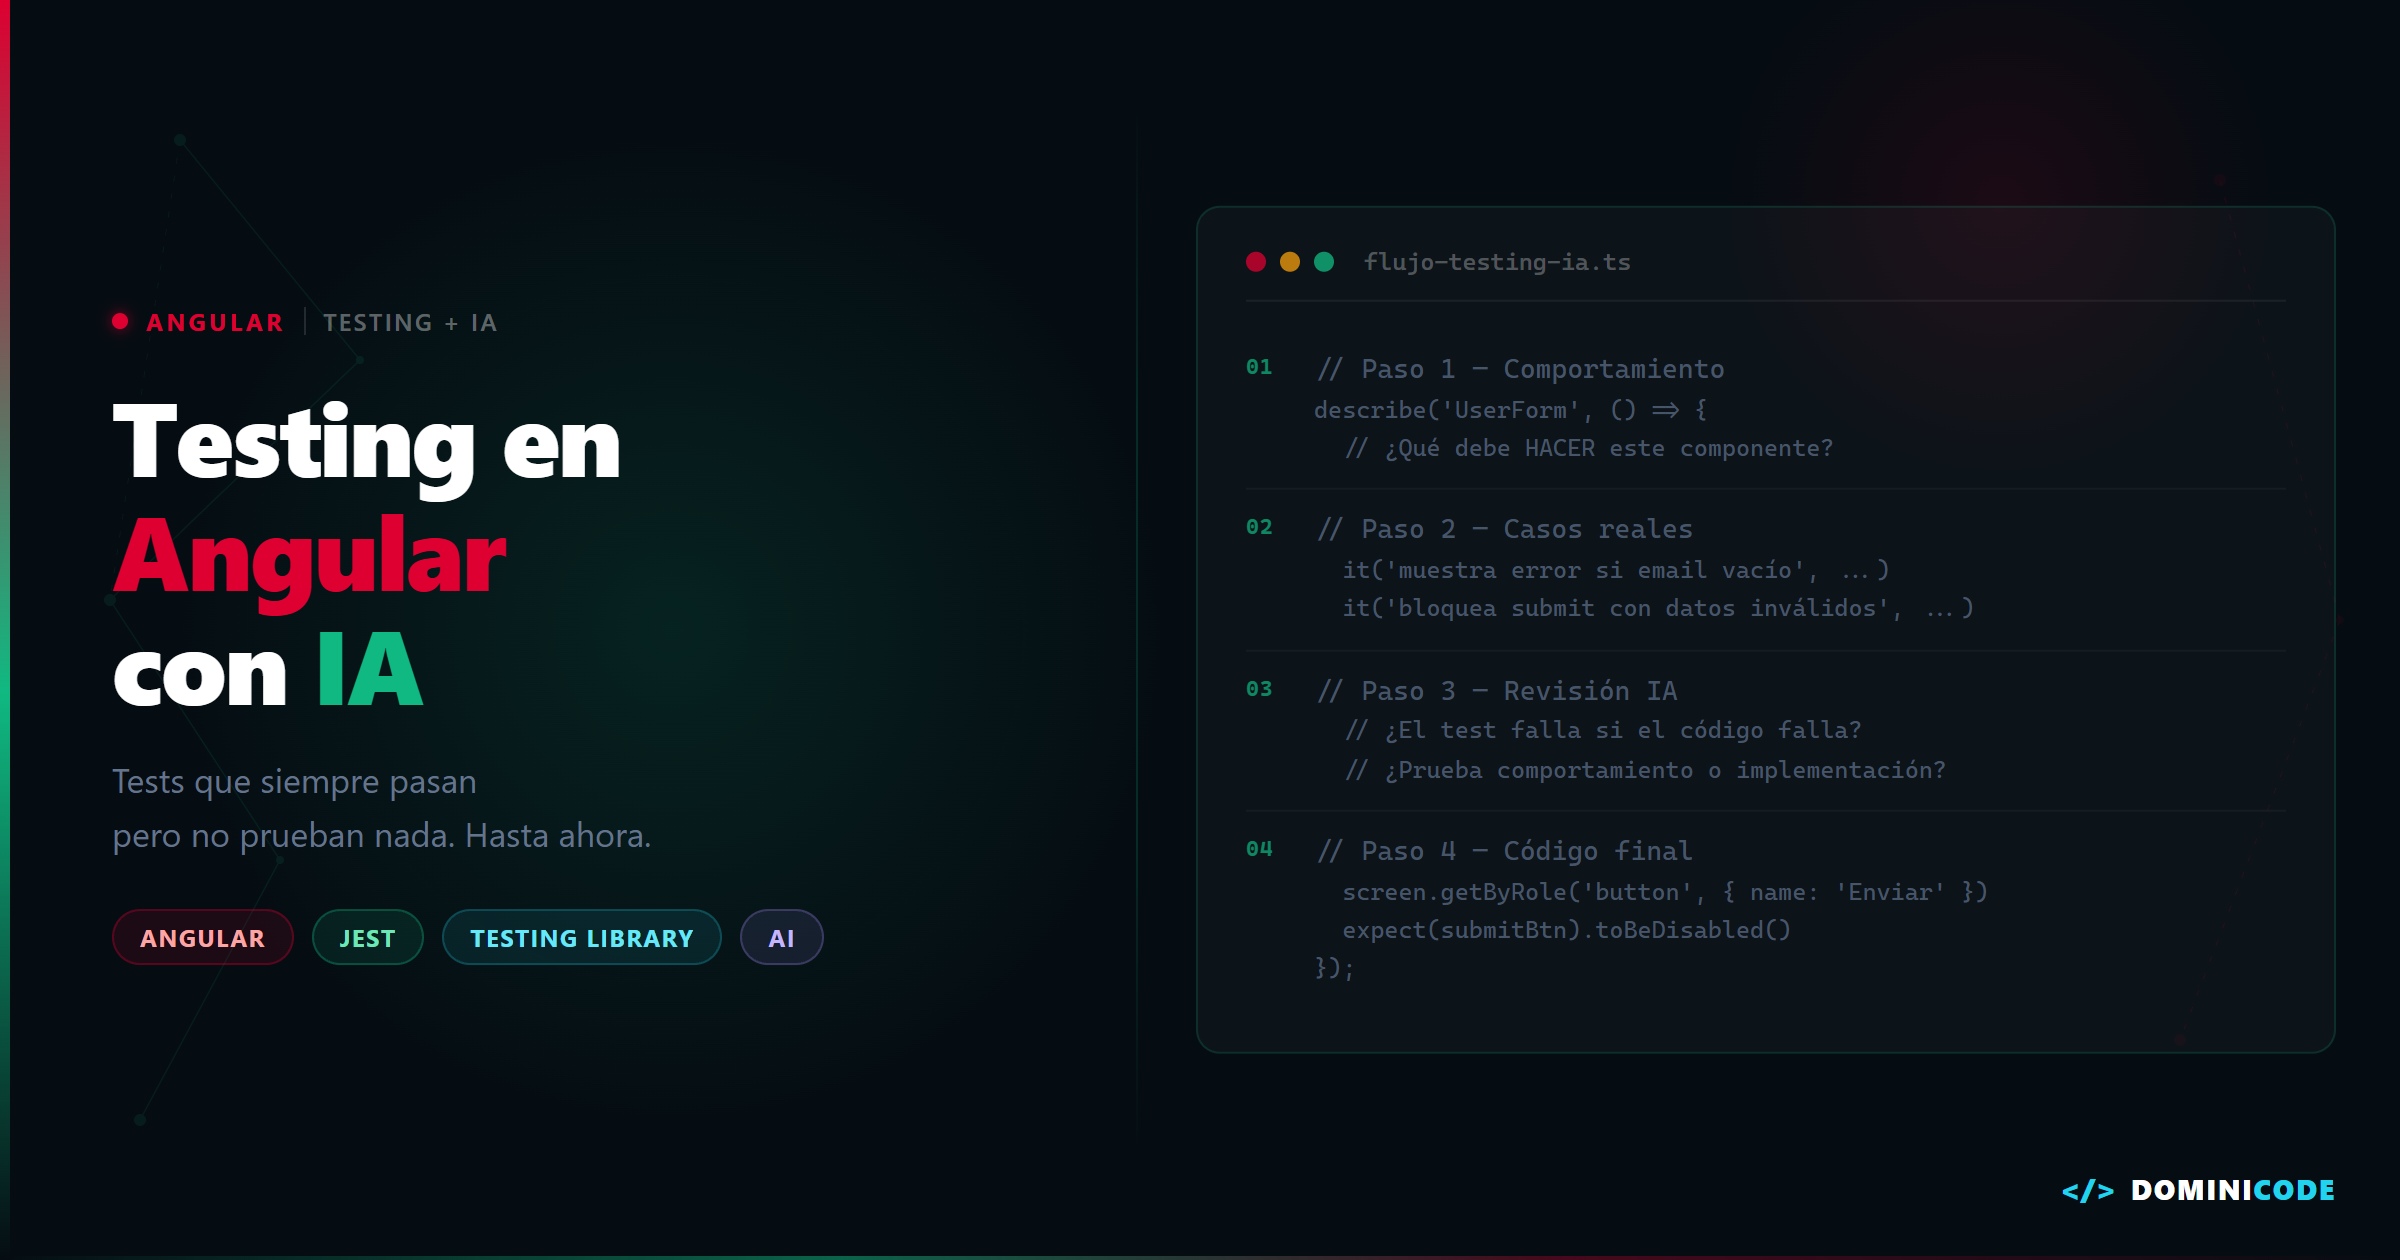
El flujo correcto es este:
- Describe el comportamiento, no el código. No copies el componente en el prompt. Describe qué hace desde fuera. Qué ve el usuario. Qué espera. Qué debe pasar si hace algo incorrecto.
- Pídele que liste los casos de test. Solo los casos, sin código todavía.
- Revisa y aprueba esa lista. Añades los que faltan. Eliminas los redundantes. Este paso es el más valioso de todo el flujo — y es el que la mayoría de devs salta.
- Pide el código de test para cada caso. Con Jest y Testing Library, una vez que los criterios están claros.
Ejemplo práctico con Angular 22
Este es el componente. Un formulario de login con Reactive Forms en Angular 22:
// login.component.ts
import { Component, inject, signal } from '@angular/core';
import { FormBuilder, ReactiveFormsModule, Validators } from '@angular/forms';
import { Router } from '@angular/router';
import { firstValueFrom } from 'rxjs';
import { AuthService } from '../services/auth.service';

@Component({
  selector: 'app-login',
  standalone: true,
  imports: [ReactiveFormsModule],
  template: `
    <form [formGroup]="form" (ngSubmit)="onSubmit()">
      <input formControlName="email" type="email" placeholder="Email" />
      <input formControlName="password" type="password" placeholder="Contraseña" />
      @if (errorMessage()) {
        <p class="error">{{ errorMessage() }}</p>
      }
      <button type="submit" [disabled]="form.invalid || isLoading()">
        {{ isLoading() ? 'Cargando...' : 'Entrar' }}
      </button>
    </form>
  `
})
export class LoginComponent {
  private fb = inject(FormBuilder);
  private auth = inject(AuthService);
  private router = inject(Router);

  form = this.fb.group({
    email: ['', [Validators.required, Validators.email]],
    password: ['', Validators.required]
  });

  errorMessage = signal('');
  isLoading = signal(false);

  async onSubmit() {
    if (this.form.invalid) return;
    this.isLoading.set(true);
    this.errorMessage.set('');
    try {
      await firstValueFrom(this.auth.login(this.form.value as { email: string; password: string }));
      this.router.navigate(['/dashboard']);
    } catch (err: any) {
      if (err.status === 401) {
        this.errorMessage.set('Credenciales incorrectas');
      }
    } finally {
      this.isLoading.set(false);
    }
  }
}
El prompt malo que genera tests inútiles:
"Escribe los tests para este componente Angular."El prompt bueno, siguiendo el flujo de cuatro pasos:
"Tengo un componente de login en Angular 22 con Reactive Forms.
El comportamiento esperado es:
- El botón está deshabilitado si el formulario es inválido o si está cargando
- Al enviar credenciales válidas, se llama a AuthService.login()
- Si AuthService lanza un error 401, se muestra 'Credenciales incorrectas'
- Si tiene éxito, el router navega a /dashboard

Lista primero los casos de test. Sin código todavía."
Y estos son los tests resultantes con Jest y Testing Library para Angular:
// login.component.spec.ts
import { render, screen } from '@testing-library/angular';
import userEvent from '@testing-library/user-event';
import { LoginComponent } from './login.component';
import { AuthService } from '../services/auth.service';
import { provideRouter } from '@angular/router';
import { of, throwError } from 'rxjs';

describe('LoginComponent', () => {
  const mockAuthService = { login: jest.fn() };

  async function setup() {
    await render(LoginComponent, {
      providers: [
        { provide: AuthService, useValue: mockAuthService },
        provideRouter([{ path: 'dashboard', component: {} as any }])
      ]
    });
    return userEvent.setup();
  }

  beforeEach(() => jest.clearAllMocks());

  it('deshabilita el botón cuando el formulario está vacío', async () => {
    await setup();
    expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
  });

  it('deshabilita el botón con email inválido aunque haya contraseña', async () => {
    const user = await setup();
    await user.type(screen.getByPlaceholderText('Email'), 'no-es-email');
    await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
    expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
  });

  it('habilita el botón con credenciales válidas', async () => {
    const user = await setup();
    await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
    await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
    expect(screen.getByRole('button', { name: /entrar/i })).not.toBeDisabled();
  });

  it('llama a AuthService.login al hacer submit con datos válidos', async () => {
    mockAuthService.login.mockReturnValue(of({}));
    const user = await setup();
    await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
    await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
    await user.click(screen.getByRole('button', { name: /entrar/i }));
    expect(mockAuthService.login).toHaveBeenCalledWith({
      email: 'user@test.com',
      password: '123456'
    });
  });

  it('muestra mensaje de error cuando el servicio responde 401', async () => {
    mockAuthService.login.mockReturnValue(throwError(() => ({ status: 401 })));
    const user = await setup();
    await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
    await user.type(screen.getByPlaceholderText('Contraseña'), 'wrong');
    await user.click(screen.getByRole('button', { name: /entrar/i }));
    expect(await screen.findByText('Credenciales incorrectas')).toBeInTheDocument();
  });
});
La clave está en userEvent.type en lugar de fireEvent.input — con Reactive Forms en Angular, solo userEvent actualiza el FormControl correctamente en el entorno de test. Y el mock usa of({}) y throwError() de RxJS porque AuthService.login() devuelve un Observable.
Esto es exactamente el enfoque que trabajamos en el curso de Testing en Angular con Jest y Testing Library: probar comportamiento, no implementación.
Tests de servicios con IA: qué mockear y cómo describirlo
Los servicios son donde más fácil es equivocarse al usar IA para testing.
El error más común: pedirle a la IA que mockee el propio servicio para testearlo. Si mockeas AuthService en el test de AuthService, estás probando el mock, no el servicio.
Lo que debes describirle a la IA es esto:
"Tengo un AuthService en Angular 22 que inyecta HttpClient.
El método login() hace POST a /api/auth/login con email y password.
Devuelve un Observable<User>. En caso de error HTTP lo relanza tal cual.
Escribe los tests usando provideHttpClient() + provideHttpClientTesting() y HttpTestingController.
No mockees el servicio. Mockea solo el HttpClient."
Con ese prompt, la IA sabe exactamente qué nivel de la pila debe sustituir:
// auth.service.spec.ts
import { TestBed } from '@angular/core/testing';
import { HttpTestingController, provideHttpClientTesting } from '@angular/common/http/testing';
import { provideHttpClient } from '@angular/common/http';
import { AuthService } from './auth.service';

describe('AuthService', () => {
  let service: AuthService;
  let httpMock: HttpTestingController;

  beforeEach(() => {
    TestBed.configureTestingModule({
      providers: [AuthService, provideHttpClient(), provideHttpClientTesting()]
    });
    service = TestBed.inject(AuthService);
    httpMock = TestBed.inject(HttpTestingController);
  });

  afterEach(() => httpMock.verify());

  it('hace POST a /api/auth/login con las credenciales', () => {
    const credentials = { email: 'user@test.com', password: '123456' };
    service.login(credentials).subscribe();
    const req = httpMock.expectOne('/api/auth/login');
    expect(req.request.method).toBe('POST');
    expect(req.request.body).toEqual(credentials);
    req.flush({ id: 1, email: 'user@test.com' });
  });

  it('devuelve el usuario cuando el servidor responde con éxito', () => {
    const mockUser = { id: 1, email: 'user@test.com' };
    let result: any;
    service.login({ email: 'user@test.com', password: '123456' })
      .subscribe(user => (result = user));
    httpMock.expectOne('/api/auth/login').flush(mockUser);
    expect(result).toEqual(mockUser);
  });

  it('relanza el error HTTP cuando el servidor responde 401', () => {
    let error: any;
    service.login({ email: 'user@test.com', password: 'wrong' })
      .subscribe({ error: err => (error = err) });
    httpMock.expectOne('/api/auth/login').flush(
      { message: 'Unauthorized' },
      { status: 401, statusText: 'Unauthorized' }
    );
    expect(error.status).toBe(401);
  });
});
La clave está en la instrucción: “mockea solo el HttpClient”. Esa precisión es lo que separa un prompt que genera tests útiles de uno que genera ruido.
Si quieres ver cómo aplicar este patrón a servicios más complejos — con interceptores, state management y Signals — en el curso de Angular Moderno tienes la arquitectura base sobre la que todo esto encaja.
Lo que la IA no puede hacer por ti
La IA puede generar el código de test más rápido de lo que tú lo escribirías. No puede decirte qué casos importan en tu dominio de negocio.
No sabe que en tu aplicación una contraseña vacía tiene un tratamiento especial. No sabe que hay un edge case cuando el usuario tiene sesión expirada y reintenta. No sabe que el botón de carga es crítico porque en producción la red va lenta y los usuarios hacen doble click.
Ese conocimiento solo lo tienes tú. Tu trabajo es trasladarlo al prompt antes de pedir código. La IA amplifica lo que le das — si le das una descripción de comportamiento, amplifica eso. Si le das solo el código de implementación, amplifica eso.
El flujo de cuatro pasos no es burocracia. Es el mínimo para que la IA genere tests que protejan algo.
Si quieres llevar esta forma de trabajar más lejos — combinando especificaciones previas al código con IA para que los tests sean parte del diseño — eso es lo que construimos en el curso Construye con IA: de la Idea al Producto. Y si quieres acceso a los proyectos completos con suites de tests reales, los encontrarás en Dominicode Labs.
FAQ
¿Puedo usar cualquier modelo de IA o Claude es el mejor para esto?
El flujo de cuatro pasos funciona con cualquier modelo — Claude, GPT-4o, Gemini. La calidad del output depende mucho más de la calidad del prompt que del modelo. Dicho esto, Claude tiene ventaja en identificar casos borde cuando describes comportamientos complejos con muchas condiciones.
¿La IA puede generar tests TDD, es decir, antes de escribir el componente?
Sí, y es el flujo ideal. Describes el comportamiento, pides los casos, apruebas la lista, pides el código de test — y luego le pides que implemente el componente para que esos tests pasen. Es TDD asistido por IA, y es especialmente potente para componentes nuevos.
¿Testing Library o Spectator para Angular?
Testing Library porque te obliga a pensar en términos de comportamiento desde el principio. getByRole, getByPlaceholderText, findByText — todas esas queries buscan lo que el usuario ve, no lo que el código tiene internamente. Spectator facilita demasiado el acceso directo a la instancia del componente, lo que lleva a tests acoplados a implementación.
¿Cómo sé si un test generado por IA es bueno?
Una heurística sencilla: introduce manualmente el bug más obvio en el componente y corre los tests. Si los tests siguen verdes, no valen nada. Por ejemplo, en el componente de login, pon if (true) return; al principio de onSubmit() — si el test de “llama a AuthService.login” sigue pasando, ese test no prueba nada. Esta técnica se llama mutation testing.
¿Vale la pena testear componentes de presentación puros?
Depende de la complejidad. Un componente que solo muestra datos sin lógica condicional no necesita tests exhaustivos. Pero si tiene lógica de visualización — mostrar un badge según el estado, calcular clases CSS condicionalmente — esa lógica sí merece tests. Pregúntale a la IA: “¿qué comportamientos condicionales tiene este template que merecen ser testados?”
*Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.*