Category: TDD

  • Tests E2E autoreparables con Playwright: diagnostica, no parchees

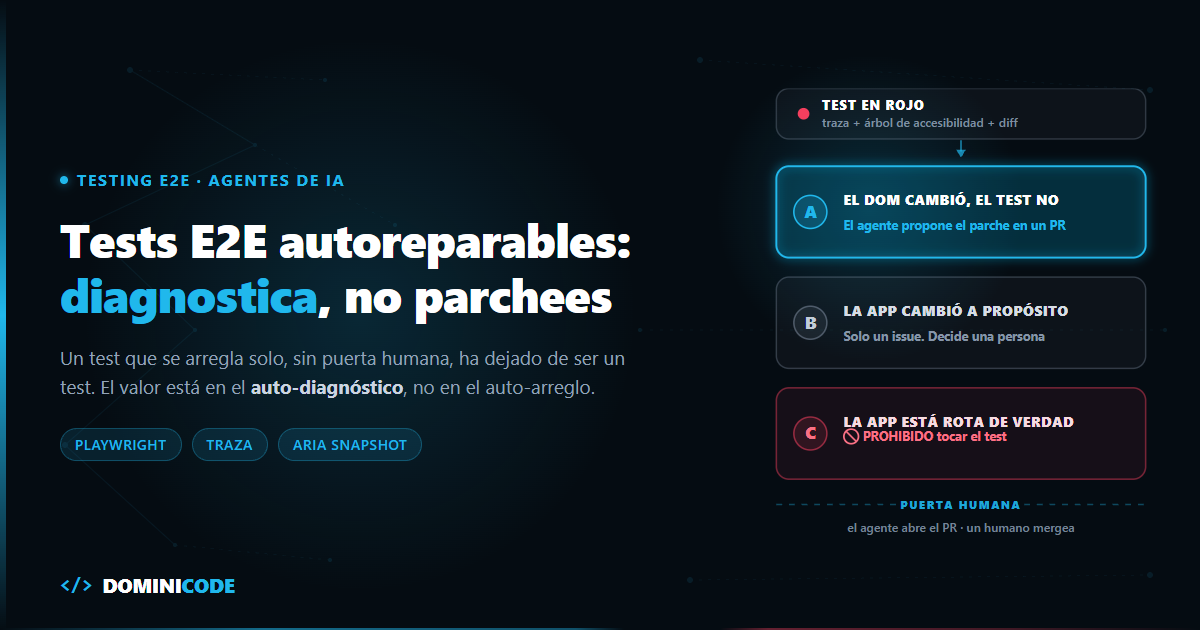
    Tests E2E autoreparables con Playwright: diagnostica, no parchees

    El canal de Slack se llamaba #e2e-alerts. Llevaba cinco meses en silencio, y no porque no llegaran alertas: es que las once personas del equipo lo tenían silenciado.

    Ciento ochenta tests de Playwright. Entre veinte y cuarenta en rojo cada mañana. El ritual era mirar por encima, decir "es flaky" y relanzar el job.

    Cuando entré en ese proyecto me pidieron exactamente lo que estás pensando: montar tests E2E autoreparables, un agente que arreglara solo lo que se rompiera cada noche. Dije que no. Esa negativa es la mitad de este post.

    Antes de decir que no me senté a mirar por qué estaba rojo. Casi todo venía del mismo sitio: un refactor del design system que había renombrado clases CSS, y ciento y pico selectores apuntando a esas clases.

    Pero había un test distinto. El de pagar con código de descuento. Alguien lo había "arreglado" tres semanas antes cambiando getByRole('button', { name: 'Pagar pedido' }) por locator('button').nth(3).

    Verde. Precioso.

    El cuarto botón de esa página era "Seguir comprando". El de pagar llevaba nueve días deshabilitado para cualquier usuario que aplicara un descuento. Nueve días sin que nadie con un cupón pudiera pagar.

    El test lo sabía. Y una persona lo calló a mano en cuarenta segundos.

    Ahora imagina eso mismo, cien veces por semana, hecho por un agente que no firma nada y al que nadie revisa.

    Qué es un test E2E autoreparable (y qué no lo es)

    Aquí está la definición con la que trabajo:

    Un test E2E autoreparable es aquel que, cuando falla, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con evidencia adjunta. No es el que se modifica a sí mismo hasta ponerse verde.

    En inglés se conoce como self-healing test, y ahí está justo el malentendido: healing no significa que el test se reescriba solo.

    La diferencia no es de matiz. Es de propósito.

    Un test existe para emitir una señal: esto funciona, esto no. Si le das a un agente permiso para editar el test hasta que pase, has construido una máquina de decir "verde". Y una máquina de decir verde vale exactamente cero.

    El valor no está en el auto-arreglo. Está en el auto-diagnóstico. La parte cara de mantener una suite E2E no es escribir el parche —son tres caracteres en un locator—, es averiguar cuál de los cuarenta tests rojos merece un parche y cuáles están gritando que la aplicación se rompió.

    Eso es lo que un agente hace bien. Lo otro es lo que lo hace peligroso.

    No se rompe el test, se rompe el acoplamiento

    Los tests E2E no se degradan solos. Lo que se degrada es el contrato implícito entre tu test y el DOM.

    Escribiste .checkout__actions > button.btn-primary. Nadie firmó que esa clase fuera estable. Un martes alguien migró el botón a otro componente y tu test se enteró en producción.

    En las suites que he auditado, la inmensa mayoría de los rojos son fallos de localización, no de comportamiento: el elemento sigue ahí, hace lo mismo, y el test ya no sabe encontrarlo. Es mi impresión revisando proyectos, no un estudio —pero haz el recuento en tu propia suite y apuesto a que te sale parecido.

    Esa asimetría es la que hace viable un agente. Y también la que lo vuelve inútil si no distingue el resto.

    Antes del agente: locators de Playwright que se puedan reparar

    Si tus locators son frágiles, el agente no reduce la deuda. La automatiza.

    La estrategia de locators de Playwright está construida sobre lo que el usuario percibe, no sobre la implementación. Ese es el punto: un locator basado en rol accesible sobrevive a un refactor de estilos y muere cuando cambia lo que el usuario ve —que es justo cuando quieres que muera.

    // ❌ Se rompe con cualquier refactor de CSS. El agente no puede saber si es grave.
    await page.locator('.checkout__actions > button.btn-primary').click();
    
    // ✅ Se rompe solo cuando cambia lo que el usuario percibe.
    await page.getByRole('button', { name: 'Pagar pedido' }).click();
    await page.getByLabel('Código de descuento').fill('BLACKFRIDAY');
    await expect(page.getByTestId('order-summary')).toContainText('49,90 €');
    

    El orden que sigo es siempre el mismo: getByRole primero, getByLabel para formularios, y getByTestId solo cuando no hay semántica que agarrar —listas virtualizadas, tablas sin cabecera accesible, componentes de terceros.

    Y el atributo de test se declara en la config, no se improvisa por fichero:

    // playwright.config.ts
    import { defineConfig } from '@playwright/test';
    
    export default defineConfig({
      retries: 2,
      reporter: [['html', { open: 'never' }]],
      use: {
        testIdAttribute: 'data-test',
        trace: 'on-first-retry',
      },
    });
    

    Hay un efecto secundario que casi nadie cuenta: escribir los tests por rol accesible te obliga a que la aplicación tenga roles accesibles. Es la misma palanca que uso cuando pongo a un agente a auditar usabilidad con Playwright MCP. El árbol de accesibilidad deja de ser un extra de compliance y pasa a ser la API contra la que testeas.

    La traza es la única señal que el agente puede usar

    Sin traza, el agente lee un mensaje de timeout y adivina. Con traza, compara.

    Esa línea de la config —trace: 'on-first-retry'— es la que separa un diagnóstico de una alucinación. Playwright graba el reintento completo: acciones, peticiones de red, consola y snapshots del DOM antes y después de cada paso. El archivo se guarda dentro de test-results/ y se abre con npx playwright show-trace. La documentación del Trace Viewer explica el formato entero. Verificado con Playwright 1.63, la versión estable en septiembre de 2026.

    Un humano abre esa traza y ve la película. Un agente necesita algo más masticado, porque el DOM crudo de una app real son decenas de miles de tokens de ruido. En las dos páginas donde lo he medido, el árbol de accesibilidad ocupaba entre 2,5 y 28 veces menos que el HTML crudo.

    Lo que le doy es el árbol de accesibilidad en el momento del fallo, que es la misma abstracción sobre la que están escritos los locators. ariaSnapshot() está disponible desde Playwright 1.49; en versiones anteriores tendrás que serializar el árbol a mano.

    Aquí conviene ser honesto: Playwright 1.63 ya escribe por su cuenta un test-results/<test>/error-context.md con una sección # Page snapshot que contiene ese mismo árbol, así que una parte de esto la tienes gratis. El fixture sigue mereciendo la pena por lo que añade encima: la URL exacta del fallo, el nombrado que decides tú y los adjuntos visibles en el reporte HTML, que es lo que después consume el pipeline del agente.

    Este es el fixture:

    // tests/fixtures/diagnostico.ts
    import { test as base, expect } from '@playwright/test';
    
    export const test = base.extend<{ diagnostico: void }>({
      diagnostico: [
        async ({ page }, use, testInfo) => {
          await use();
    
          if (testInfo.status === testInfo.expectedStatus) return;
    
          // Árbol de accesibilidad real en el instante del fallo
          const real = await page.locator('body').ariaSnapshot();
          await testInfo.attach('aria-real.yml', { body: real, contentType: 'text/yaml' });
          await testInfo.attach('url-fallo.txt', { body: page.url(), contentType: 'text/plain' });
        },
        { auto: true },
      ],
    });
    
    export { expect };
    

    Con ese YAML adjunto en el reporte, el prompt del agente deja de ser "arregla este test" y pasa a ser una comparación: esperaba un button con nombre "Pagar pedido"; en el árbol real hay un button con nombre "Confirmar pedido" en la misma posición. Eso ya no es adivinar. Es diffear dos estructuras.

    Y si el elemento no aparece en el árbol bajo ningún nombre, el agente tiene que saber que eso significa algo completamente distinto.

    El triaje de un test E2E autoreparable: tres fallos distintos

    Esta es la sección que sostiene todo lo demás. Un agente que no separa estos tres casos te borra la señal de la suite entera.

    Tipo de fallo Evidencia que lo identifica Qué puede hacer el agente
    A. El DOM cambió, el test no El elemento existe en el árbol con otro nombre, rol o posición. El commit sospechoso toca marcado o estilos. Fallan varios tests que comparten componente. Proponer el parche del locator en un PR. Es el único caso reparable.
    B. El comportamiento cambió a propósito El elemento ya no existe porque el flujo cambió: un paso nuevo, otra ruta, un campo eliminado. El commit toca lógica, no marcado. El fallo encaja con una feature reciente. Nada. Abre un issue con el diagnóstico y etiqueta al dueño de la feature. Actualizar ese test es una decisión de producto.
    C. La aplicación está rota El locator es correcto y el elemento está ahí, pero la acción falla, el estado final es otro o hay 500 en la traza de red. Suele caer un solo flujo crítico. Prohibido tocar el test. Escalar con la traza adjunta. El test está haciendo su trabajo.

    Las tres preguntas que resuelven casi todos los casos:

    ¿El commit tocó marcado o lógica? Un cambio en plantillas y estilos apunta a A. Un cambio en servicios, rutas o estado apunta a B o C.

    ¿Falla un test o fallan veinte? Veinte tests que comparten componente es A casi seguro. Uno solo, en el flujo de pago, con el resto en verde, es C hasta que se demuestre lo contrario.

    ¿El elemento existe con otro nombre o no existe? Existe con otro nombre → A. No aparece en el árbol → B o C, y el agente no decide cuál.

    Fíjate en que ninguna de las tres se responde mirando el test. Se responden cruzando la traza con el diff del commit. Por eso el agente necesita acceso al repositorio, y solo de lectura.

    El agente abre un PR. No commitea.

    El flujo que uso es aburrido, y por eso funciona.

    El job nocturno corre la suite. Si hay rojos, un segundo job lanza el agente con tres entradas: el reporte HTML con sus adjuntos, la traza de cada fallo y el diff de los commits desde el último run verde. Relanzar solo lo caído con npx playwright test --last-failed ahorra minutos de CI.

    El agente no ejecuta el navegador. Lee artefactos. Eso elimina de golpe toda la clase de problemas que aparecen cuando pones a un agente a conducir el navegador en vivo: esperas mal calculadas, referencias caducadas, estado que se le escapa.

    Su salida es una pull request con cuatro cosas: diagnóstico en prosa, clasificación A/B/C con la evidencia que la justifica, el diff del locator y la traza enlazada.

    Y una regla que no se negocia: un locator por test, un test por commit dentro del PR. Si el parche necesita tocar tres líneas para que pase, no es un parche de localización: es un cambio de comportamiento disfrazado. Se rechaza.

    Un humano mergea. Siempre.

    Esa puerta es el mismo mecanismo que describo en la revisión por contrato del código que genera la IA: el agente no gana el derecho a escribir en main por haber acertado ochenta veces seguidas. Si quieres el método entero, con las cláusulas y los límites escritos, está en el ebook gratuito de Revisión por Contrato.

    Los guardarraíles que impiden que la suite se convierta en teatro

    Tres guardarraíles bastan para que un agente de reparación no degrade la suite: que no toque asserts, un tope de cinco tests parcheados por PR y una métrica de bugs escapados a producción. Con eso vas servido.

    El agente no toca asserts. Solo locators y esperas. Un expect(...).toBeVisible() que muta a toBeHidden(), un toContainText con otro importe, un assert borrado: eso es cambiar la definición de correcto, y no es su trabajo. Lo hago cumplir con un check en CI que rechaza el PR si el diff cambia el matcher (toBeVisible, toContainText…) o el valor esperado. El locator que vive dentro de un expect(...) sí se puede tocar; la afirmación sobre qué es correcto, no.

    Tope de tests reparados por PR. Cinco. Si el agente quiere arreglar cuarenta, no ha encontrado cuarenta fallos de localización: ha encontrado un cambio estructural que necesita a una persona pensando diez minutos.

    La métrica que delata el desastre. Cuenta dos números cada mes: locators parcheados por el agente y bugs escapados a producción en flujos que la suite cubre. Si el primero sube y el segundo también, el agente no está manteniendo la suite. La está silenciando.

    Ese segundo número no sale de los tests. Sale de tener observabilidad de verdad, más allá del code review. Sin él pilotas a ciegas con un copiloto que te asegura que todo va bien.

    Un apunte de coste: los fallos de tipo B —comportamiento que cambió a propósito— se detectan mucho más barato una capa por debajo, en tests de componente. Si trabajas con Angular, ese nivel es el que cubro en el curso de Testing en Angular. Cuanto mejor sea tu capa de componente, menos ruido le llega al agente arriba.

    Qué hacer el lunes

    No montes el agente. Todavía no.

    Coge los diez tests que más han cambiado en los últimos tres meses según git log. Son tus diez tests más frágiles. Reescribe sus locators con getByRole y getByLabel, y activa trace: 'on-first-retry' en la config.

    Eso es una tarde. Y probablemente te baje el ruido más que cualquier agente.

    La semana siguiente, cuando algo se ponga rojo, abre la traza y clasifícalo a mano: A, B o C. Hazlo diez veces. Lo que aprendas en esas diez clasificaciones es literalmente el prompt del agente —y no lo puedes escribir antes de haberlo hecho tú.

    Cuando llegue el momento de montarlo, el patrón de agente que produce artefactos revisables en lugar de commits directos es el que enseño en Construye con IA, de la idea al producto con Claude Code.

    Y quédate con esto: el objetivo nunca fue tener la suite en verde. Era saber cuándo dejar de confiar en ella.

    Preguntas frecuentes

    ¿Qué es un test E2E autoreparable exactamente?

    Es un test que, al fallar, dispara un agente que investiga la traza de ejecución, clasifica la causa y propone un parche revisable con la evidencia adjunta. La palabra "autoreparable" describe el diagnóstico automático, no la escritura automática en la rama principal. Si el agente puede modificar el test hasta que pase sin que nadie lo apruebe, lo que tienes no es una suite que se cura sola: es una suite que ha dejado de informarte.

    ¿Por qué no dejar que el agente commitee el arreglo directamente si acierta casi siempre?

    Porque el coste del error no es simétrico. Cien parches correctos te ahorran unos minutos cada uno. Un solo parche incorrecto sobre un fallo de tipo C —la aplicación rota— borra la única señal que tenías de un bug en producción, y encima deja el CI en verde. Cuando ese bug aparezca, tu primer instinto será descartar el área que cubren los tests, precisamente porque estaban pasando.

    ¿Cómo distingue el agente entre un cambio de DOM y una regresión real?

    Cruzando tres evidencias: si el elemento sigue existiendo en el árbol de accesibilidad bajo otro nombre o rol, si el commit sospechoso tocó marcado o lógica, y si el fallo está aislado o afecta a varios tests que comparten componente. Elemento presente con otro nombre, más commit de marcado, más fallo en grupo, apunta a cambio de DOM. Elemento presente, locator correcto y acción que falla apunta a regresión, y ahí el agente no toca nada.

    ¿Sirve esto para tests flaky por timing y no por locators?

    Parcialmente. La traza deja ver si el fallo fue una espera insuficiente o una condición de carrera, y el agente puede proponer sustituir una espera fija por una aserción con reintento automático, que es la forma correcta de esperar en Playwright. Pero el flaky por datos compartidos entre tests o por estado sucio del entorno no se arregla en el test: se arregla aislando los datos de cada ejecución, y eso es trabajo de arquitectura, no de parche.

    ¿Cuánto cuesta esto en tokens si la suite es grande?

    Depende de qué le pases, y ahí está el truco. Si le mandas el DOM crudo de cada fallo, el coste se dispara y además el diagnóstico empeora por el ruido. Pasándole solo el árbol de accesibilidad recortado, la URL y el diff de los commits relevantes, el contexto por fallo se queda en unos pocos miles de tokens. El tope de cinco tests por PR funciona también como tope de gasto.

    ¿Puedo aplicar el mismo triaje sin agente, a mano?

    Sí, y deberías empezar por ahí. La tabla de A/B/C es una herramienta de proceso antes que de IA: obliga al equipo a justificar por escrito por qué un test rojo se convierte en verde. He visto equipos bajar el ruido de su suite a la mitad solo con esa regla y cero automatización. El agente acelera un criterio que ya funciona; no lo inventa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Evals deterministas para agentes de IA: testea datos, no frases

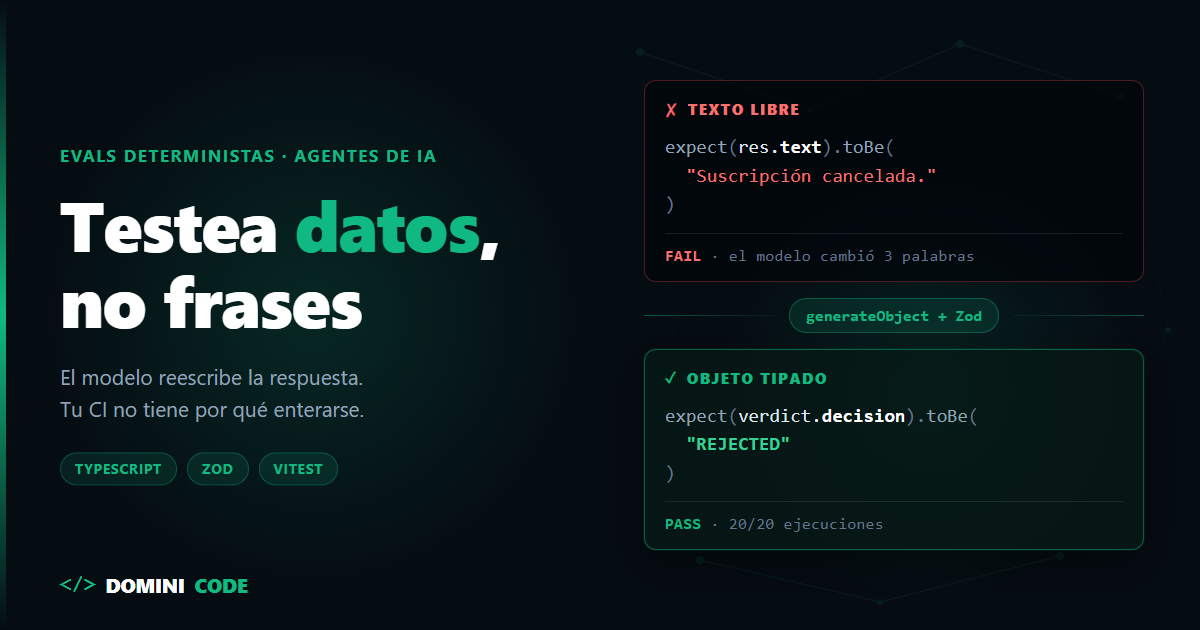
    Evals deterministas para agentes de IA: testea datos, no frases

    Un developer me enseñó su suite de tests para un agente de soporte. Tenía esta línea:

    expect(result.text).toBe("Tu suscripción ha sido cancelada con éxito.");
    

    En local pasó tres veces. Hizo push. En la cuarta ejecución en CI, el modelo contestó: "Hemos procesado la cancelación de tu suscripción correctamente."

    Pipeline en rojo. La suscripción se canceló. La tool correcta se llamó con el userId correcto. El agente hizo su trabajo y el test falló porque el modelo cambió tres palabras.

    Ese test no medía al agente. Medía la redacción de un modelo probabilístico, justo la parte que no controlas. La salida son los evals deterministas para agentes de IA: en vez de relajar la aserción hasta que ya no garantice nada, cambias lo que el agente devuelve.


    ¿Qué son los evals deterministas para agentes de IA?

    Un eval determinista es una comprobación cuyo resultado no depende de cómo redacte el modelo. El agente no devuelve una frase: devuelve un objeto tipado —un veredicto— y el test asierta de forma exacta sobre sus campos. Un decision que es un enum cerrado, un array de códigos de motivo, un identificador. Datos, no prosa. La misma clase de aserción que harías contra un endpoint REST.

    La diferencia con lo que la mayoría llama "eval" es el punto de aplicación. No estás puntuando una respuesta a posteriori con una rúbrica: estás rediseñando la interfaz del agente para que su decisión sea inspeccionable.

    Conviene marcar la frontera con dos cosas que ya conté por separado. El test harness para agentes de IA es el entorno: las tools falsas, el presupuesto de tokens que corta, el timeout real, la traza reproducible. Es el paso previo y es obligatorio. Este post va de lo otro: qué afirmas dentro de ese entorno.

    Y el function calling tipado con TypeScript valida la ENTRADA: los argumentos que el modelo manda a una tool, que en ai@7 viajan en inputSchema. Aquí hablamos de la SALIDA: el veredicto que emite el agente. Es la otra punta del mismo cable, y casi nadie tipa esa punta.


    Los dos callejones sin salida antes de llegar aquí

    Cuando el test de arriba se pone rojo hay dos salidas habituales, y las dos son peores que el problema: relajar la aserción hasta que deje de garantizar nada, o delegar el juicio en otro modelo.

    El primero es relajar la aserción. Un toContain, una expresión regular, un .toLowerCase().includes(). Queda así:

    expect(result.text.toLowerCase()).toContain("cancel");
    

    Verde. Y ahora ese test pasa también si el agente respondió "No puedo cancelar tu suscripción, contacta con soporte". Acabas de escribir una aserción que da verde cuando el agente hace exactamente lo contrario de lo que le pediste. Un test que no puede fallar en el caso que importa no es un test: es decoración en el pipeline.

    El segundo es montar un LLM-as-a-Judge para todo. Otro modelo lee la respuesta y decide si es correcta. Funciona, pero paga tres precios: es lento (una llamada extra por caso), es caro (y los evals se ejecutan por lotes, así que multiplica), y sobre todo hereda el no-determinismo que intentabas eliminar. Tu suite pasa a depender de que el juez opine igual el martes que el jueves. Y entonces tienes un segundo problema: quién calibra al juez.

    El juez tiene su sitio. Pero es el último recurso, no el primero. Antes de delegar una decisión en otro modelo, pregúntate si esa decisión se puede tipar. La mayoría de las veces se puede.

    Superficie de aserción Determinista Coste Cuándo usarla
    Texto libre con toBe o regex No Cero Nunca sobre la salida del modelo: o revienta con sinónimos o da verde con cualquier cosa
    Objeto tipado (generateObject + Zod) Sí en la aserción Cero extra Siempre que la salida sea una decisión, una clasificación, una extracción o un enrutado
    LLM-as-a-Judge No Alto, una llamada por caso Cuando la calidad es irreductiblemente textual: resúmenes, tono, redacción, código

    El giro: que la decisión sea un dato, no una frase

    Si quieres afirmar sobre la decisión del agente, haz que la decisión sea un campo.

    Con el AI SDK de Vercel eso es generateObject más un schema de Zod. Los ejemplos de este post corren con ai@7, zod@4 y Vitest 4, versiones de septiembre de 2026. El modelo deja de tener libertad de formato: o devuelve algo que valida contra el schema, o falla ruidosamente, que también es información útil.

    Un agente que revisa solicitudes de reembolso:

    // refund-agent.ts
    import { generateObject } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    import type { RefundTicket } from "./types";
    import { REFUND_POLICY_PROMPT } from "./prompts";
    
    const model = anthropic("claude-haiku-4-5-20251001");
    
    export const RefundVerdictSchema = z.object({
      decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
      reasonCodes: z
        .array(
          z.enum([
            "OUTSIDE_RETURN_WINDOW",
            "ITEM_DAMAGED_BY_CUSTOMER",
            "DUPLICATE_REQUEST",
            "OPEN_CHARGEBACK",
            "HIGH_VALUE_ORDER",
            "TRUSTED_CUSTOMER",
          ]),
        )
        .min(1),
      riskSignals: z.object({
        priorRefunds12m: z.number().int().min(0),
        daysSincePurchase: z.number().int().min(0),
      }),
      summary: z.string(),
    });
    
    export type RefundVerdict = z.infer<typeof RefundVerdictSchema>;
    
    export async function reviewRefund(ticket: RefundTicket): Promise<RefundVerdict> {
      const { object } = await generateObject({
        model,
        schema: RefundVerdictSchema,
        temperature: 0,
        instructions: REFUND_POLICY_PROMPT,
        prompt: JSON.stringify(ticket),
      });
    
      return object;
    }
    

    Fíjate en lo que acaba de pasar. reviewRefund ya no devuelve texto: devuelve RefundVerdict. Un tipo. Tu test vuelve a ser un test normal.

    Si ese veredicto es el paso final de un bucle con varias herramientas por medio, el schema es el punto de salida del bucle. Cómo montarlo con estado y reintentos lo desarrollé en el agentic loop en producción con TypeScript.

    Hasta aquí es lo que cuenta todo el mundo. Lo que casi nadie cuenta es que el schema puede estar bien tipado y ser una superficie de test pésima.


    Cómo diseñar el schema del veredicto: 5 reglas

    Esta es la parte que decide si tu suite aguanta seis meses o se convierte en ruido. Cinco reglas.

    1. Enums cerrados, nunca strings libres

    decision: z.string() valida perfectamente y no te sirve de nada. El modelo devolverá "rechazado", luego "Rechazado por política", luego "REJECT". Has movido el problema del texto de la respuesta al texto de un campo.

    // Mal: sigues asertando sobre prosa
    decision: z.string(),
    
    // Bien: el espacio de valores es finito y conocido
    decision: z.enum(["APPROVED", "REJECTED", "MANUAL_REVIEW"]),
    

    Un enum cerrado tiene una propiedad que ningún string tiene: si el modelo quiere decir algo, solo puede decirlo de una manera. Ahí es donde toBe recupera el sentido.

    2. Códigos de motivo, no explicaciones

    Un veredicto que solo dice REJECTED te deja testear el qué, pero no el porqué. Y el porqué es donde viven las regresiones interesantes: el agente sigue rechazando el caso correcto, pero por el motivo equivocado. Eso es un bug que un test binario no ve.

    Por eso reasonCodes es un z.array(z.enum([...])) y no un z.array(z.string()). Con códigos puedes asertar la causa exacta. Con texto libre, vuelves al principio del post.

    Diseñar bien esa lista de códigos es trabajo de verdad: enums demasiado finos y el modelo elige mal entre opciones casi idénticas; demasiado gruesos y no distinguen nada. Empieza por los motivos que ya aparecen escritos en tu política de negocio.

    3. Los scores numéricos son la aserción más frágil que existe

    confidenceScore: z.number() es tentador. Y es una trampa.

    El modelo devuelve 0.82 hoy y 0.79 mañana con la misma entrada. Cualquier test que compare el valor exacto es un test que parpadea. Y cualquier umbral que escribas dentro del prompt —"si la confianza supera 0.8, aprueba"— es lógica de negocio metida en la parte no determinista del sistema.

    Dos reglas:

    • Si el score se queda, asierta rangos o umbrales, nunca el valor: expect(v.confidenceScore).toBeGreaterThan(0.7).
    • Mejor aún: saca el umbral del modelo y ponlo en tu código. Que el agente devuelva señales en bruto (priorRefunds12m, daysSincePurchase) y que la regla la aplique una función TypeScript pura.
    // route-verdict.ts — 100% determinista, testeable sin llamar al modelo
    export function routeVerdict(v: RefundVerdict): "AUTO" | "MANUAL_REVIEW" {
      const { priorRefunds12m, daysSincePurchase } = v.riskSignals;
    
      // El veredicto del agente manda: si pidió revisión humana, no la saltamos
      if (v.decision === "MANUAL_REVIEW") return "MANUAL_REVIEW";
      if (priorRefunds12m >= 3) return "MANUAL_REVIEW";
      if (daysSincePurchase > 30 && v.decision === "APPROVED") return "MANUAL_REVIEW";
    
      return "AUTO";
    }
    

    Cada umbral que mueves del prompt a una función es un test que pasa de probabilístico a exacto.

    4. Separa lo que se asierta de lo que se lee

    El schema puede —y suele— tener campos en texto libre. summary está ahí para que un humano entienda la decisión en el panel de revisión, y hace falta.

    La regla es que ese campo no se asierta jamás. Ni con toContain, ni con regex, ni "solo para comprobar que no viene vacío". Déjalo escrito en un comentario del propio schema, para que el siguiente developer no caiga en la tentación. Un schema tiene dos zonas: la contractual, sobre la que testeas, y la informativa, que solo se lee.

    5. Los campos opcionales fabrican tests frágiles

    En cuanto un campo permite undefined, tu test tiene que decidir qué significa eso. Y normalmente no lo decide: lo esquiva con un ?. y se queda verde por accidente.

    // Ambiguo: ¿no había motivos, o el modelo no los rellenó?
    reasonCodes: z.array(ReasonCode).optional(),
    
    // Explícito: el array siempre viene, y siempre con al menos un motivo
    reasonCodes: z.array(ReasonCode).min(1),
    

    Prefiere valores por defecto, arrays vacíos y uniones discriminadas antes que opcionalidad. Un undefined que atraviesa la suite entera sin que nadie lo asierte es un agujero con forma de test.

    Este tipo de diseño —enums, refinamientos, uniones discriminadas, z.infer para no duplicar tipos— es lo que trabajo paso a paso en el curso de Zod para TypeScript, porque aquí el schema no es validación defensiva: es la superficie de test de todo el sistema.


    El test que resulta

    Con el schema anterior, el eval en Vitest es aburrido. Ese es el objetivo: un test de agente de IA que se lee igual que cualquier otro test de tu suite.

    // refund-agent.eval.test.ts
    import { describe, it, expect } from "vitest";
    import { reviewRefund, type RefundVerdict } from "./refund-agent";
    import { routeVerdict } from "./route-verdict";
    import { lateRequestWithChargeback } from "./fixtures";
    
    describe("refund agent · casos obvios", () => {
      it("rechaza una solicitud fuera de plazo con chargeback abierto", async () => {
        const verdict = await reviewRefund(lateRequestWithChargeback);
    
        expect(verdict.decision).toBe("REJECTED");
        expect(verdict.reasonCodes).toContain("OPEN_CHARGEBACK");
        expect(verdict.reasonCodes).toContain("OUTSIDE_RETURN_WINDOW");
        expect(verdict.reasonCodes).not.toContain("TRUSTED_CUSTOMER");
      });
    });
    
    describe("routeVerdict · sin modelo", () => {
      it("escala a revisión manual con 3 reembolsos previos", () => {
        const verdict: RefundVerdict = {
          decision: "APPROVED",
          reasonCodes: ["TRUSTED_CUSTOMER"],
          riskSignals: { priorRefunds12m: 3, daysSincePurchase: 5 },
          summary: "",
        };
    
        expect(routeVerdict(verdict)).toBe("MANUAL_REVIEW");
      });
    });
    

    Dos detalles que importan.

    El toContain de aquí no es el toContain del callejón sin salida. Sobre un string comprueba subcadenas y da verde con cualquier ruido alrededor; sobre un array de enums comprueba pertenencia exacta a un conjunto cerrado. Misma función, garantías opuestas.

    Y el not.toContain vale tanto como el positivo. Un agente que rechaza el caso correcto pero marca al cliente como fiable está acertando por la razón equivocada, y ese es el fallo que se cuela a producción sin que nadie lo vea.

    Este test no se rompe si el modelo cambia la redacción del summary. Ni si cambia el orden de los motivos. Ni si actualizas a la siguiente versión del modelo y escribe más bonito. Solo se pone rojo cuando el agente decide distinto, que es exactamente lo que querías vigilar. Si quieres afinar el diseño de suites, fixtures y aislamiento de dependencias, ese músculo lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library: los ejemplos son de Angular, pero el diseño de suites y fixtures se traslada tal cual.


    Los límites de los evals deterministas en agentes de IA

    Toca ser honesto: el schema hace determinista la aserción, no el modelo.

    temperature: 0 reduce muchísimo la varianza, pero no la elimina. Entre el batching en el servidor, la aritmética en coma flotante y el enrutado interno de los modelos grandes, la misma entrada puede darte una decisión distinta. Menos que antes. No cero.

    La forma de convivir con eso es partir la suite en dos, y esta distinción es la que casi nadie hace.

    Casos obvios. El cliente pide el reembolso de un pedido de hace dos años con un chargeback abierto. Solo hay una respuesta razonable. Estos casos son tests binarios, corren siempre y bloquean el merge. Si uno falla, hay un bug: en el prompt, en el schema o en el modelo que acabas de actualizar.

    Casos de frontera. El pedido tiene 31 días y la política dice 30, pero el cliente lleva cinco años contigo. Aquí ni tú tienes una respuesta única. Estos casos no se testean como binarios: se miden como tasa de acierto. Ejecutas N veces y exiges un umbral de consistencia. Cinco ejecuciones es el mínimo que justifica el coste, no una muestra seria: si el caso importa de verdad, sube a veinte antes de fiarte de la tasa. Por qué N no es un número arbitrario lo desarrollé en evaluaciones automatizadas para agentes.

    // refund-agent.borderline.test.ts
    import { borderlineTicket } from "./fixtures";
    
    async function decisionCounts(runs: number, ticket: RefundTicket) {
      const results = await Promise.all(
        Array.from({ length: runs }, () => reviewRefund(ticket)),
      );
    
      return results.reduce<Record<string, number>>((acc, r) => {
        acc[r.decision] = (acc[r.decision] ?? 0) + 1;
        return acc;
      }, {});
    }
    
    it(
      "mantiene el caso frontera en revisión manual (4 de 5)",
      async () => {
        const counts = await decisionCounts(5, borderlineTicket);
        expect(counts.MANUAL_REVIEW ?? 0).toBeGreaterThanOrEqual(4);
      },
      60_000,
    );
    

    Meter los casos de frontera en la suite que bloquea el merge es la receta perfecta para que el equipo empiece a relanzar pipelines hasta que pasen. Y a partir de ese día los tests dejan de significar nada. Van en un job programado, con su propio umbral y su propia alerta cuando la tasa cae.

    Sí, esta suite cuesta dinero, porque llama al modelo de verdad. Por eso corre por lotes y no en cada push, mientras el test harness con tools falsas sigue corriendo en cada commit.


    Cuándo sí necesitas un LLM-as-a-Judge

    Cuando la calidad de la salida es irreductiblemente textual.

    Si tu agente escribe un resumen, redacta un email a un cliente o genera un módulo entero de código, no hay enum que capture "esto está bien". Ahí el juez —con rúbrica explícita, golden dataset versionado y calibración humana— es la herramienta correcta, y lo desarrollé entero en evals para código generado por IA.

    La regla de reparto es simple: si la decisión se puede tipar, típala; el juez es para lo que sobra después. En la mayoría de agentes de negocio, lo que sobra es mucho menos de lo que parece antes de sentarse a diseñar el schema.


    Por dónde empezar mañana

    Coge un agente. El que más te preocupe.

    Mira qué devuelve hoy. Si devuelve texto, escribe el schema del veredicto: un enum de decisión, un array de códigos de motivo, las señales numéricas en bruto y un summary que no vas a asertar nunca. Cambia la llamada a generateObject. Y mueve al menos un umbral del prompt a una función TypeScript.

    Después escribe cinco casos obvios. Cinco. Con eso ya tienes una red que detecta el día en que cambies de modelo y el agente empiece a aprobar lo que antes rechazaba, que es la regresión que de verdad cuesta dinero.

    Este tipo de decisión de diseño es lo que separa una demo de un producto que aguanta usuarios reales, y es el hilo que sigo en el curso Construye con IA: de la idea al producto con Claude Code. En Dominicode Labs están los schemas y las suites completas de los agentes que corremos en producción, con sus casos de frontera y sus umbrales reales.

    Deja de testear lo que el agente dice. Testea lo que el agente decide.


    Preguntas frecuentes

    ¿Qué es exactamente un eval determinista?

    Es una comprobación automática cuyo resultado no depende de cómo redacte el modelo. Se consigue haciendo que el agente devuelva un objeto tipado en lugar de texto y asertando sobre campos de valores cerrados, como enums o arrays de códigos. La aserción vuelve a ser exacta y repetible, igual que si testearas la respuesta de una API REST.

    ¿Con temperature 0 ya tengo determinismo garantizado?

    No. Reduce mucho la varianza, pero no la elimina, porque hay factores del lado del proveedor que no controlas, como el batching de peticiones o la aritmética en coma flotante. Lo que sí es determinista es tu aserción, y por eso los casos de frontera se miden como tasa de acierto sobre varias ejecuciones en lugar de como un test binario.

    ¿Puedo asertar sobre un campo de confianza numérico?

    Puedes, pero solo por rangos o umbrales, nunca por el valor exacto, porque el mismo caso te dará valores ligeramente distintos entre ejecuciones. La mejor opción es que el modelo devuelva las señales en bruto y que el umbral lo aplique una función de tu código, que sí puedes testear al cien por cien sin llamar al modelo.

    ¿En qué se diferencia esto de un test harness?

    El harness es el entorno de ejecución: las herramientas falsas, el presupuesto de tokens, el timeout y la traza. Responde a si el agente se salió de sus límites. Los evals deterministas son las aserciones que escribes dentro de ese entorno y responden a si el agente decidió lo correcto. Se montan en ese orden: primero el entorno, después las aserciones.

    ¿Estos tests corren en cada push?

    Los que no llaman al modelo, sí: el enrutado, los umbrales y toda la lógica pura alrededor del veredicto. Los que llaman al modelo de verdad cuestan dinero y tardan, así que van en un job programado sobre un conjunto reducido de casos, separando los obvios, que bloquean el merge, de los de frontera, que solo alertan cuando la tasa de acierto cae.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Los 5 fallos del código generado por IA que un code review no puede ver

    Los 5 fallos del código generado por IA que un code review no puede ver

    850 líneas. 14 archivos. Toda la capa de autenticación refactorizada con un asistente de IA.

    Dos seniors aprobaron el Pull Request. "LGTM, código muy limpio". Y lo era: nombres claros, funciones pequeñas, tipos correctos, cero warnings del linter.

    Diez minutos después del deploy, producción caída. El código abría una conexión nueva a PostgreSQL en cada petición y no la devolvía nunca. El pool se agotó, los 500 empezaron a caer en cascada y alguien tuvo que hacer rollback desde el móvil.

    Nadie hizo mal su trabajo en ese code review. El fallo simplemente no estaba en la pantalla que estaban mirando.

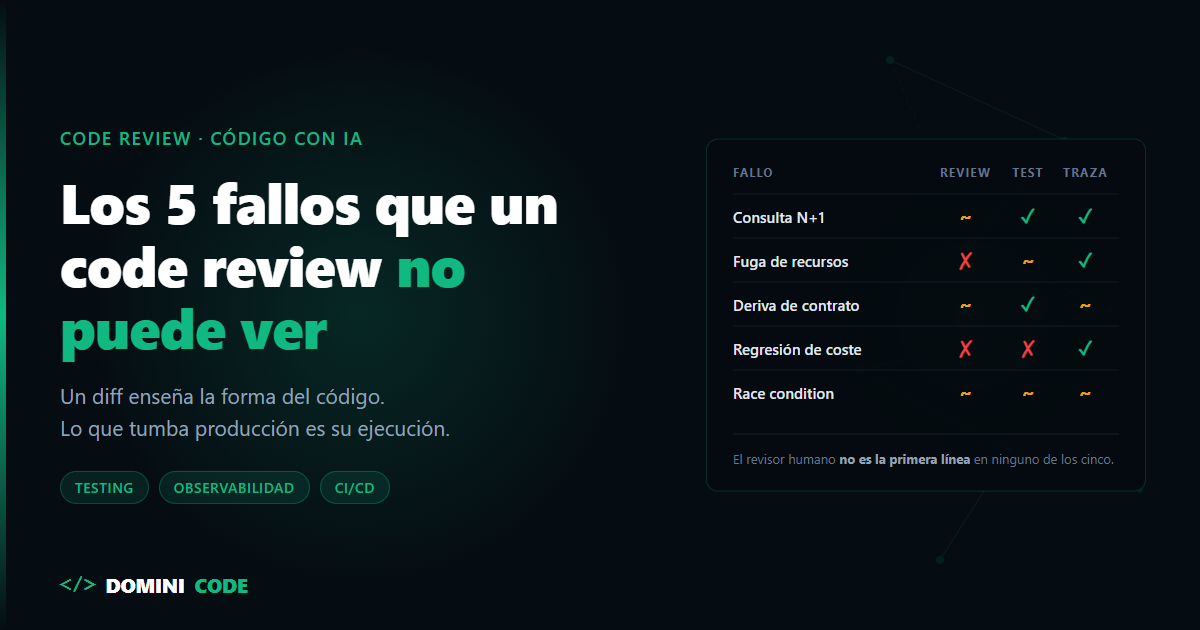
    Un diff te enseña la forma del código. Los fallos que tumban producción son de comportamiento: aparecen cuando el código se ejecuta, con concurrencia, con datos reales y repetido diez mil veces. Eso no se ve leyendo, se ve midiendo.

    Que no conviene fiarse de un código solo porque se lea bien ya lo conté en cómo garantizar la confiabilidad del código generado por IA. Este post no repite el aviso ni proclama que el code review haya muerto. Va de algo más operativo: qué clase de fallo caza cada capa de tu proceso, y cuál se te está colando porque lo estás buscando en el sitio equivocado.


    Los 5 fallos que un diff no puede mostrar

    No son fallos exóticos. Son los cinco que aparecen una y otra vez cuando el volumen de código generado sube y el tiempo de revisión no.

    1. La consulta N+1 encubierta

    El agente escribe un bucle que llama a un helper. El helper, tres archivos más allá, abre una consulta.

    En el diff ves await getUserProfile(id) dentro de un for. Una línea limpia, con buen nombre. Para verla como un problema tendrías que recordar qué hace ese helper por dentro y multiplicar mentalmente por el tamaño del array.

    En local, con 5 registros de prueba, vuela. En producción, con 4.000, son 4.000 consultas.

    2. La fuga de recursos

    Es el fallo de la historia de arriba y el más traicionero, porque lo que falta nunca aparece en un diff. Un diff enseña lo que se añadió; el bug está en la línea que no se escribió.

    // Se lee perfecto. Y en cada peticion abre una conexion que nadie cierra.
    export async function getInvoices(userId: string) {
      const client = new Client({ connectionString: process.env.DATABASE_URL });
      await client.connect();
      const { rows } = await client.query(
        "SELECT * FROM invoices WHERE user_id = $1",
        [userId],
      );
      return rows; // falta client.end() — y aqui no hay nada rojo que mirar
    }
    

    Lo mismo pasa con listeners que no se quitan, timers que no se limpian y streams que no se cierran. El código se lee bien porque está bien escrito. Solo está incompleto.

    3. La deriva de contrato

    El agente toca el endpoint y renombra un campo de la respuesta, o lo convierte de string a objeto. Actualiza el tipo en ese archivo, así que todo cuadra.

    Lo que no actualiza es el consumidor que vive en otro repositorio, o el móvil que lleva dos versiones sin actualizar. El fallo no está en ningún archivo: está entre dos. Y un revisor mirando un PR de un repo no tiene el otro delante.

    Contra esto, el tipado en tiempo de compilación no basta: hace falta validación en tiempo de ejecución en la frontera, que es justo lo que hace Zod cuando validas lo que entra y sale de cada servicio en lugar de confiar en el tipo declarado.

    4. La regresión de coste

    Este no produce ningún error. Todo funciona, los tests pasan en verde y el usuario no nota nada.

    Simplemente, la nueva versión hace tres llamadas al modelo donde antes hacía una, o manda el documento entero en el prompt donde antes mandaba un fragmento. El resultado es idéntico. La factura, el triple.

    Es el único de los cinco que no es un bug: es una decisión de implementación peor que la anterior. Ninguna aserción se pone roja por esto. Lo ves en la factura a fin de mes, o lo ves en la traza el mismo día.

    5. La race condition introducida "optimizando"

    El agente ve tres await seguidos y los convierte en un Promise.all. En el diff parece exactamente lo que quieres: menos latencia, código más idiomático.

    Salvo que dos de esas operaciones escribían sobre el mismo registro y el orden importaba. Con un usuario, nunca falla. Con doscientos concurrentes, falla una de cada cien veces y el bug tarda tres semanas en reproducirse.


    Qué capa caza cada fallo

    Aquí está el mapa. Es lo único que hay que llevarse del post:

    Fallo Code review Test automático Traza en producción Dónde se caza primero
    Consulta N+1 ⚠️ solo si conoces el helper ✅ asertando nº de queries ✅ evidente Test de integración
    Fuga de recursos ❌ no está en el diff ⚠️ solo repitiendo la llamada ✅ evidente Producción, en minutos
    Deriva de contrato ⚠️ si tienes ambos lados ✅ test de contrato ⚠️ tarde CI, con contract tests
    Regresión de coste ❌ invisible ❌ pasa en verde ✅ único sitio Traza / factura
    Race condition ⚠️ si la buscas ⚠️ flaky, poco fiable ⚠️ difícil de atribuir Test de concurrencia

    Léela por columnas y salta a la vista lo incómodo: el revisor humano no es la primera línea de defensa en ninguno de los cinco. En el mejor de los casos es un ⚠️ que depende de que la persona conozca ese helper concreto, tenga el otro repositorio en la cabeza o esté buscando específicamente esa clase de fallo a la línea 600 de 850.

    Eso no significa que el code review sobre. Significa que le estamos pidiendo el trabajo equivocado.


    El orden correcto (y por qué casi todos lo invierten)

    El proceso típico pone al humano primero: alguien lee el PR, lo aprueba, y entonces corre el CI y se despliega. Con código generado por IA ese orden está del revés, por una razón de economía muy simple: la atención humana es el recurso más caro y más escaso del equipo, y la máquina cuesta céntimos.

    Primero la máquina. Tests, linters, validación de contratos. Si un fallo tiene una aserción posible, esa aserción tiene que existir y correr antes de que nadie lea una línea. El caso del pool que tumbó producción se cazaba con esto:

    it("no deja conexiones abiertas al servir una petición", async () => {
      const before = pool.totalCount;
      await getInvoices("user-1");
      expect(pool.totalCount).toBe(before);
    });
    

    Ese test no lo escribe el agente por iniciativa propia: lo pides tú, porque conoces el fallo. Cómo repartir ese trabajo entre lo que escribes tú y lo que delegas está en TDD con IA: valida el código autogenerado antes de mergear, y hay una capa de revisión automática que puedes meter en el pipeline antes de la humana, explicada en cómo integrar revisiones de código con IA en tu CI/CD.

    Después la traza, como red. Para lo que nadie anticipó —y la regresión de coste es el ejemplo perfecto— la única capa que ve algo es la instrumentación en tiempo de ejecución. Si trabajas con LLMs, el árbol de llamadas y el coste por petición se trazan con las herramientas que repaso en observabilidad en LLMs.

    Y el humano al final, sobre otra pregunta. No "¿está bien escrito esto?" —eso ya lo contestaron el linter y los tests—, sino las tres que ninguna máquina responde:

    • ¿Este código debía existir? Buena parte de los PRs generados con IA resuelven un problema que no había que resolver así.
    • ¿Respeta las fronteras de arquitectura? Un agente cruza capas sin despeinarse si eso hace pasar el test.
    • ¿Cumple lo que dice la especificación?

    Esa tercera pregunta solo se puede contestar si existe una especificación escrita antes del código. Cuando el PR se revisa contra un spec.md, el review deja de ser una opinión sobre estilo y pasa a ser una comprobación con respuesta binaria — que es de lo que va el libro de Spec-Driven Development.

    Y si quieres el músculo de escribir las aserciones del punto 1 —las de verdad, las que fallan cuando algo se rompe y no cuando alguien renombra una variable—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library.


    Lo que puedes cambiar en el próximo PR

    1. Coge la tabla y localiza tu hueco. Casi todos los equipos tienen la columna de tests a medias y la de trazas vacía. Ese es el fallo que se te está colando.
    2. Convierte tu último incidente en una aserción. Si algo tumbó producción una vez, tiene que haber un test que se ponga rojo si vuelve. Uno por incidente, sin excepciones.
    3. Cambia la pregunta del review. Prohíbete comentar estilo. Solo arquitectura, fronteras y cumplimiento de la spec.

    En Dominicode Labs montamos este tipo de procesos de verificación para que la velocidad de la IA no se pague en incidentes de madrugada.

    Generar código rápido hoy es gratis. Lo caro sigue siendo saber si funciona — y eso no se lee en un diff.


    Preguntas frecuentes

    ¿Se puede revisar de verdad un PR de 850 líneas generado por IA?

    No con la atención que merece. La respuesta no es leer más rápido: es exigir que el PR llegue troceado y con la capa automática ya en verde. Un PR generado en cuarenta segundos no da derecho a una revisión de cuarenta segundos, así que o se parte en cambios pequeños o se revisa solo el subconjunto que toca arquitectura y contratos.

    ¿Un linter o un analizador estático caza estos cinco fallos?

    Parcialmente y solo dos. Las reglas estáticas detectan algunos patrones de recurso no cerrado dentro de un mismo archivo, pero no ven el N+1 escondido tras un helper, ni la deriva de contrato entre repositorios, ni el coste, ni la concurrencia. Un linter razona sobre el texto del programa; estos fallos existen únicamente cuando el programa corre.

    ¿Estos fallos son culpa de la IA o pasaban igual con código escrito a mano?

    Pasaban igual. Lo que cambia es el volumen y el ritmo: la misma tasa de fallo aplicada a diez veces más líneas, revisadas por el mismo número de personas en el mismo tiempo, da un resultado muy distinto. El proceso no se rompe porque la IA escriba peor, sino porque escribe más rápido de lo que nadie puede leer.

    Si aún no tengo observabilidad, ¿qué capa cubre el hueco mientras tanto?

    Los tests, pero eligiendo bien. Sin trazas pierdes la regresión de coste y la atribución de las races, así que compensa con aserciones sobre efectos medibles: número de consultas por operación, conexiones abiertas al terminar, número de llamadas al modelo. Son baratas, corren en CI y cubren tres de los cinco fallos hasta que instrumentes.

    ¿Merece la pena que la IA revise sus propios PRs?

    Como primera pasada sí, y sale muy rentable porque cuesta céntimos y no se cansa a la línea 600. Pero trátala como un linter semántico, no como un aprobador: comparte los puntos ciegos del modelo que escribió el código y tiende a validar lo que a ella misma le parece idiomático. La aprobación sigue siendo humana.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Test harness para agentes de IA: el banco de pruebas que te falta en CI

    Nadie prueba un motor de avión montándolo en un aparato con pasajeros. Lo amarran a un banco de pruebas, le conectan sensores, le inducen fallos y miden qué aguanta. Si revienta, revienta en tierra.

    Con software tenemos el equivalente desde hace décadas y se llama test harness: el andamiaje que rodea al código bajo prueba, le inyecta entradas controladas y comprueba las salidas.

    Con agentes de IA, en cambio, la mayoría probamos en caliente. Lanzamos el agente contra una API real, miramos si el resultado "parece bien" y lo damos por bueno.

    El problema no es la pereza. Es que un agente rompe los tres supuestos sobre los que se construyó todo tu testing:

    • No es determinista: la misma entrada da salidas distintas.
    • Tiene efectos secundarios reales: escribe archivos, llama a APIs, toca bases de datos.
    • No tiene garantía de terminar: puede quedarse en bucle gastando dinero.

    Ya expliqué por qué un LLM por sí solo no es un producto y qué capas necesita alrededor para funcionar en producción. Este post va de la otra mitad del problema, la que casi nadie monta: el arnés que se ejecuta en CI, antes del deploy. Con código.


    Por qué un test unitario normal no sirve aquí

    Un test clásico es un contrato de tres líneas: preparas la entrada, ejecutas, comparas con el valor esperado.

    Con un agente, ese toEqual no existe. La respuesta correcta no es una cadena concreta, es cualquiera de un conjunto amplio de cadenas aceptables. Y si aun así escribes la aserción exacta, tendrás un test que pasa hoy y falla el martes sin que nadie haya tocado nada.

    De ahí sale la reacción habitual, que es la equivocada: dejar de testear el agente y testear solo las funciones puras que lo rodean. Los parsers, los formateadores, los validadores. Cosas que ya sabías hacer.

    Mientras tanto, lo que de verdad puede costarte dinero —el bucle, las llamadas a herramientas, el gasto— viaja a producción sin una sola comprobación.

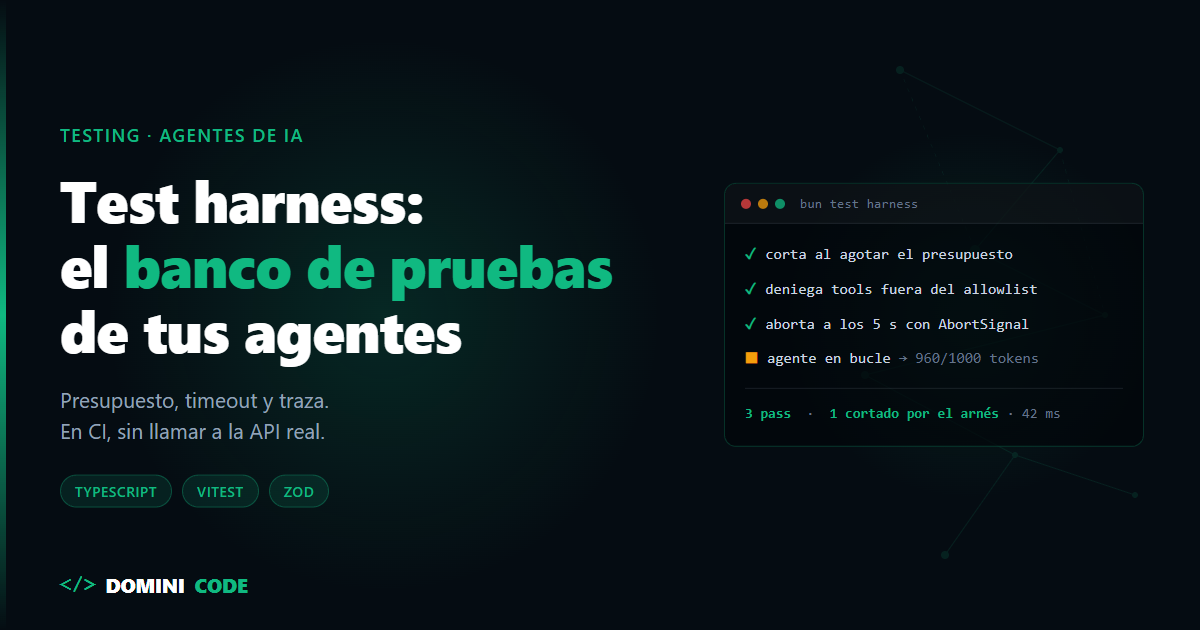
    El arnés cambia la pregunta. En lugar de "¿ha respondido lo correcto?", que es un problema de evals, pregunta cosas que sí tienen respuesta binaria:

    • ¿Ha llamado a alguna herramienta que no tenía permitida?
    • ¿Se ha pasado del presupuesto de tokens que le di?
    • ¿Ha terminado dentro del tiempo límite?
    • ¿Ha intentado escribir fuera de su directorio temporal?
    • ¿Ha llamado 14 veces a la misma herramienta con los mismos argumentos?

    Eso son tests de verdad: deterministas, rápidos y rojos cuando algo se rompe.

       caso de prueba              TEST HARNESS                  veredicto
      ┌──────────────┐    ┌──────────────────────────────┐    ┌────────────┐
      │ entrada fija │───►│  tools falsas (sin red)      │───►│ PASS/FAIL  │
      │ estado fijo  │    │  presupuesto de tokens       │    │ trace.json │
      └──────────────┘    │  timeout + AbortSignal       │    └────────────┘
                          │  directorio efimero          │
                          └──────────────────────────────┘
    

    Las 3 piezas que hacen testeable a un agente

    1. Herramientas falsas, no red

    La regla es simple: en modo test, el agente no toca nada real. Ni base de datos, ni API de pagos, ni sistema de archivos fuera de un directorio temporal que destruyes al terminar.

    Y no basta con mockear la implementación. Hay que no exponer las herramientas no autorizadas: si el agente ve deleteUser en su lista de tools, tarde o temprano la llamará, y el error que quieres detectar en CI es precisamente ese. Un arnés que expone la herramienta y luego lanza una excepción llega tarde para razonar sobre el diseño, aunque salve los datos.

    Si necesitas ejecutar código generado de verdad —no simularlo—, ahí el aislamiento sube un nivel y toca contenedor: lo conté en Docker sandboxing para ejecutar código de IA de forma segura.

    2. Presupuesto de tokens y timeout que cortan de verdad

    Esta es la pieza que casi todo el mundo escribe mal.

    He visto docenas de arneses con un campo maxTokens en la configuración que no se comprueba en ningún sitio. Y timeouts implementados con Promise.race que devuelven el control al test pero dejan la ejecución corriendo por detrás, gastando tokens contra la API mientras el test ya ha dado verde.

    Un límite que no corta no es un límite: es un comentario.

    3. Traza reproducible

    El arnés graba cada paso: qué herramienta, con qué argumentos, cuánto tardó, cuánto costó. Un array de objetos serializado a JSON.

    Sirve para dos cosas. Para que un fallo en CI sea depurable sin volver a lanzar el agente. Y para escribir aserciones sobre el proceso, no sobre el texto final, que es donde está la señal útil: si el agente llegó al resultado correcto llamando siete veces a la misma consulta, eso es un bug aunque la salida sea perfecta.


    El arnés en TypeScript

    Vamos al código. Un arnés mínimo con presupuesto real, cancelación real y traza, sin dependencias más allá de Zod para validar los argumentos que el modelo envía a cada herramienta.

    Primero, los tipos y el registro de herramientas:

    import { z } from "zod";
    
    export interface HarnessConfig {
      maxTokens: number;
      timeoutMs: number;
      allowedTools: string[];
    }
    
    export interface TraceEntry {
      tool: string;
      args: unknown;
      durationMs: number;
      tokens: number;
    }
    
    /** Herramienta ya validada: el schema queda encapsulado dentro de `run`. */
    export interface HarnessTool {
      cost: number;
      run: (rawArgs: unknown) => Promise<unknown>;
    }
    
    export class BudgetExceededError extends Error {}
    
    /**
     * En el punto de definicion conservas el tipado completo del schema.
     * En el registro todas las tools comparten la misma firma, que es lo
     * que permite recorrerlas en bucle sin castings.
     */
    export function defineTool<S extends z.ZodType>(
      schema: S,
      cost: number,
      run: (args: z.infer<S>) => Promise<unknown>,
    ): HarnessTool {
      return { cost, run: (rawArgs) => run(schema.parse(rawArgs)) };
    }
    
    // Fixtures: nada de esto sale a la red.
    export const testTools: Record<string, HarnessTool> = {
      queryDatabase: defineTool(
        z.object({ table: z.string(), limit: z.number().max(100) }),
        320,
        async ({ table }) => ({ rows: [{ id: 1, table, name: "Fixture User" }] }),
      ),
      sendEmail: defineTool(
        z.object({ to: z.string().email(), body: z.string() }),
        90,
        async () => ({ delivered: true }),
      ),
    };
    

    Ahora el arnés. Fíjate en tres detalles: solo se construyen las herramientas permitidas, el presupuesto se comprueba antes de ejecutar cada llamada, y el temporizador se limpia siempre.

    export type HarnessStatus = "SUCCESS" | "TIMEOUT" | "BUDGET_EXCEEDED" | "FAILED";
    
    export interface HarnessResult {
      status: HarnessStatus;
      tokensUsed: number;
      durationMs: number;
      output: string | null;
      trace: TraceEntry[];
    }
    
    type ToolBox = Record<string, (args: unknown) => Promise<unknown>>;
    
    export async function runWithHarness(
      task: (tools: ToolBox, signal: AbortSignal) => Promise<string>,
      config: HarnessConfig,
    ): Promise<HarnessResult> {
      const startedAt = performance.now();
      const trace: TraceEntry[] = [];
      let tokensUsed = 0;
    
      // 1. Solo existen las tools autorizadas. El resto no se expone.
      const tools: ToolBox = {};
      for (const name of config.allowedTools) {
        const tool = testTools[name];
        // Un nombre desconocido es un error de configuracion del test: que reviente ya.
        if (!tool) throw new Error(`Tool desconocida en allowedTools: ${name}`);
    
        tools[name] = async (rawArgs: unknown) => {
          // 2. El presupuesto se comprueba ANTES de gastar.
          if (tokensUsed + tool.cost > config.maxTokens) {
            throw new BudgetExceededError(
              `Presupuesto agotado: ${tokensUsed} + ${tool.cost} > ${config.maxTokens}`,
            );
          }
          const t0 = performance.now();
          const result = await tool.run(rawArgs); // Zod valida dentro: si no cuadra, revienta
          tokensUsed += tool.cost;
          trace.push({
            tool: name,
            args: rawArgs,
            durationMs: Math.round(performance.now() - t0),
            tokens: tool.cost,
          });
          return result;
        };
      }
    
      // 3. Cancelacion real: la tarea recibe el signal y debe propagarlo al SDK.
      const controller = new AbortController();
      const timer = setTimeout(() => controller.abort(), config.timeoutMs);
    
      const finish = (status: HarnessStatus, output: string | null): HarnessResult => ({
        status,
        tokensUsed,
        durationMs: Math.round(performance.now() - startedAt),
        output,
        trace,
      });
    
      try {
        const output = await task(tools, controller.signal);
        return finish("SUCCESS", output);
      } catch (error) {
        if (controller.signal.aborted) return finish("TIMEOUT", null);
        if (error instanceof BudgetExceededError) return finish("BUDGET_EXCEEDED", null);
        return finish("FAILED", error instanceof Error ? error.message : String(error));
      } finally {
        clearTimeout(timer); // sin esto, el timer mantiene vivo el proceso al terminar
      }
    }
    

    Un aviso honesto sobre el punto 3: el AbortSignal solo cancela de verdad si tu tarea lo propaga al SDK del modelo y a cada fetch. Si lo ignoras, el arnés dará TIMEOUT y devolverá el control al test, pero la llamada seguirá viva por detrás y te la cobrarán igual. El signal no es decorativo: es el único mecanismo que corta el gasto.

    Y ahora sí, un test

    Con esto, probar el bucle del agente vuelve a ser testing normal:

    import { describe, expect, it } from "vitest";
    import { runWithHarness } from "./harness";
    
    describe("agente de facturación", () => {
      it("corta la ejecución al agotar el presupuesto", async () => {
        const result = await runWithHarness(
          async (tools) => {
            // Un agente en bucle: consulta la misma tabla sin parar.
            for (let i = 0; i < 20; i++) {
              await tools.queryDatabase({ table: "invoices", limit: 10 });
            }
            return "listo";
          },
          { maxTokens: 1_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.status).toBe("BUDGET_EXCEEDED");
        expect(result.tokensUsed).toBeLessThanOrEqual(1_000);
        expect(result.trace).toHaveLength(3); // 3 × 320 = 960; la cuarta no cabe
      });
    
      it("no expone las herramientas fuera del allowlist", async () => {
        const result = await runWithHarness(
          async (tools) => {
            if ("sendEmail" in tools) return "PELIGRO: tool disponible";
            return "ok";
          },
          { maxTokens: 5_000, timeoutMs: 5_000, allowedTools: ["queryDatabase"] },
        );
    
        expect(result.output).toBe("ok");
      });
    });
    

    Deterministas, sin red, en milisegundos. Se pueden ejecutar en cada push sin pensar en la factura.

    Ese expect(result.trace).toHaveLength(3) es el tipo de aserción que solo puedes escribir si grabas la traza: comprueba el comportamiento del bucle, no el texto de salida.

    Si quieres afinar el diseño de tests y el aislamiento de dependencias externas —que es exactamente el músculo que necesitas aquí—, lo trabajo a fondo en el curso de Testing en Angular con Jest y Testing Library. Y el uso de Zod para validar los argumentos que envía el modelo, con transformaciones y errores tipados, lo tienes en el curso de Zod para TypeScript.


    Qué encaja arriba y qué encaja abajo

    Tres piezas que se confunden todo el rato y conviene separar:

    Pieza Cuándo corre Qué responde
    Test harness En CI, en cada push ¿Se sale de los límites, del allowlist o del tiempo?
    Evals Por lotes, con casos reales ¿La calidad de las respuestas sube o baja?
    Agentic harness En producción, en cada ejecución ¿Cómo lo mantengo controlado con usuarios reales?

    El arnés de pruebas es el más barato de los tres y el que casi nadie tiene. Cuestión de horas montarlo, y atrapa la clase de fallo que más caro sale.

    Sobre el reparto de trabajo entre los tests que escribes tú y los que genera el agente, ya hay un post entero: adopta TDD para implementar pruebas efectivas con agentes de IA. Y sobre por qué la spec y la arquitectura no bastan sin esta capa debajo, también. Este post es la parte que faltaba: el código.

    Si trabajas con Spec-Driven Development, el encaje es directo. Los límites que escribes en la sección de NFRs del spec.md —presupuesto, latencia, herramientas permitidas— dejan de ser un párrafo y pasan a ser los argumentos de HarnessConfig. La especificación se vuelve ejecutable, que es de lo que va el libro de Spec-Driven Development.


    Lo que puedes montar esta semana

    1. Una lista blanca de herramientas por entorno. Que en test solo existan las que necesita el caso.
    2. Un presupuesto que corte. Comprobado antes de cada llamada, no después. Si tu maxTokens no aparece en ningún if, no existe.
    3. Una traza en JSON por ejecución. Y al menos un test que asierte sobre ella, no sobre el texto de salida.

    En Dominicode Labs montamos este tipo de arneses sobre agentes que corren horas sin supervisión.

    Deja de probar tus motores en pleno vuelo. Amárralos al banco, súbeles la presión hasta que rompan y arréglalos en tierra, que es donde sale barato.


    Preguntas frecuentes

    ¿Cómo se testea algo que no es determinista?

    No asertando sobre el texto de salida, sino sobre el comportamiento observable: qué herramientas llamó, con qué argumentos, cuántas veces, cuánto gastó y si terminó a tiempo. Todo eso sí es determinista y da un rojo claro cuando se rompe. La calidad de la respuesta es otra disciplina y se mide por lotes, no en cada push.

    ¿El test harness sustituye a los mocks de toda la vida?

    No, los usa. La diferencia es el alcance: un mock reemplaza una dependencia concreta, mientras que el arnés controla el entorno completo de la ejecución —qué herramientas existen, cuánto puede gastar, cuánto puede tardar y qué queda grabado—. Un mock por sí solo no impide que el agente entre en bucle.

    ¿Hay que llamar al modelo real en estos tests?

    No en los que corren en cada push: se ejecuta el bucle del agente con respuestas fijas, y eso vale para verificar límites, allowlist y control de flujo. Las ejecuciones con modelo real cuestan dinero y tardan, así que van en un job aparte, programado y sobre un conjunto reducido de casos.

    ¿Qué hago si el timeout salta pero el agente sigue gastando dinero?

    Es que estás cortando en el sitio equivocado. Promise.race devuelve el control al test pero no cancela nada: hay que crear un AbortController, pasar su signal a la tarea y propagarlo al SDK del modelo y a cada fetch. Si el SDK que usas no acepta señal de cancelación, el único corte real es aislar la ejecución en un proceso o contenedor aparte y matarlo.

    ¿Merece la pena montarlo si mi agente solo lee datos?

    Sí, por el gasto y por los bucles. Un agente de solo lectura no borra nada, pero puede repetir la misma consulta cuarenta veces y facturarte la broma entera. El presupuesto y la traza detectan ese patrón en CI, que es donde cuesta cero arreglarlo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • TDD con IA: valida el código autogenerado antes de mergear

    TDD con IA: valida el código autogenerado antes de mergear

    Revisé una Pull Request generada por un asistente de IA hace un par de semanas.

    El autor de la PR estaba fascinado: "Mira qué limpio quedó el algoritmo de descuentos por volumen. La IA lo escribió en 15 segundos".

    El código tenía nombres impecables, comentarios en JSDoc y tipado de TypeScript sin un solo error. Le faltaba lo único que sostiene el TDD con IA: tests.

    Escribí una prueba unitaria pasando una compra con descuento de cliente VIP combinado con un cupón del 100%. El sistema devolvió un saldo negativo donde la tienda terminaba debiéndole dinero al comprador.

    El modelo de IA no tenía mala intención: simplemente no sabía qué reglas de negocio proteger porque nadie se las había formulado como una prueba ejecutable.

    En la era de los asistentes de código, Test-Driven Development (TDD) no está muerto; es más indispensable que nunca. Aquí tienes el flujo exacto para combinar TDD con IA.


    El nuevo ciclo Red-Green-Refactor con Agentes de Código

    El ciclo clásico de TDD se transforma radicalmente cuando tienes un agente a tu lado:

    ┌─────────────────────────────────────────────────────────────┐
    │                 FLUJO TDD POTENCIADO POR IA                 │
    │                                                             │
    │  1. HUMANO (Diseño)  ──>  Escribe el Test Unitario (ROJO)   │
    │                                   │                         │
    │                                   ▼                         │
    │  2. AGENTE (Código)  ──>  Genera la Implementación (VERDE)  │
    │                                   │                         │
    │                                   ▼                         │
    │  3. DÚO (Calidad)    ──>  Refactoriza con Seguridad         │
    └─────────────────────────────────────────────────────────────┘
    

    En lugar de delegar el diseño a ciegas, el desarrollador asume el rol de arquitecto: define el contrato y los casos de borde en una prueba. El agente asume el trabajo pesado de implementar la sintaxis.


    Ejemplo Práctico: Implementando una lógica de negocio paso a paso

    Paso 1: Escribe el test en fallo (Rojo con Vitest)

    Antes de crear el archivo de lógica, defines el comportamiento esperado:

    // src/pricing/discount-calculator.spec.ts
    import { describe, it, expect } from 'vitest';
    import { calculateTotalWithDiscounts } from './discount-calculator';
    
    describe('calculateTotalWithDiscounts', () => {
      it('aplica descuento por volumen del 10% en compras mayores a $100', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 150, isVip: false, couponPercent: 0 });
        expect(total).toBe(135);
      });
    
      it('nunca devuelve un total negativo incluso con cupones acumulados', () => {
        const total = calculateTotalWithDiscounts({ subtotal: 50, isVip: true, couponPercent: 120 });
        expect(total).toBe(0); // Regla de negocio crítica
      });
    });
    

    Al ejecutar bun test, el test falla inmediatamente porque la función ni siquiera existe.

    Paso 2: Pasa el test al agente como contrato ejecutable

    Invocas a tu agente de IA en la terminal con una instrucción cerrada:

    claude "Lee discount-calculator.spec.ts. Crea el archivo discount-calculator.ts con la implementación mínima necesaria para que los tests pasen en verde. Prohibido modificar el archivo de tests."
    

    Paso 3: El agente genera el código para poner el test en verde

    El agente analiza la firma de tipos esperada y las aserciones, generando la lógica requerida:

    // src/pricing/discount-calculator.ts
    export interface PricingOptions {
      subtotal: number;
      isVip: boolean;
      couponPercent: number;
    }
    
    export function calculateTotalWithDiscounts(options: PricingOptions): number {
      const { subtotal, isVip, couponPercent } = options;
      
      let discount = 0;
      if (subtotal > 100) discount += subtotal * 0.10;
      if (isVip) discount += subtotal * 0.05;
      if (couponPercent > 0) discount += subtotal * (couponPercent / 100);
    
      const finalTotal = subtotal - discount;
      return Math.max(0, finalTotal); // Respeta el caso de borde
    }
    

    El agente ejecuta el test runner de forma autónoma y confirma que la suite está en verde.


    Por qué este flujo recorta los bugs que llegan a producción

    1. Elimina la alucinación de requisitos: El modelo no tiene margen para inventar parámetros porque el test ya definió la interfaz y los valores esperados.
    2. Aislamiento de contexto: No necesitas explicar la arquitectura completa de tu empresa; solo entregas el archivo de prueba.
    3. Refactorización sin miedo: Si mañana quieres optimizar el rendimiento del algoritmo, puedes pedirle a la IA que lo refactorice sabiendo que cualquier regresión encenderá una alarma roja de inmediato.

    Que quede claro: esto no lleva los bugs a cero. Ningún flujo lo hace. Lo que hace es mover el error de "se descubre en producción tres semanas después" a "se descubre en el segundo en que el agente ejecuta la suite". Los fallos que se te escapan siguen siendo los casos que no se te ocurrió escribir.

    Para que el ciclo funcione, la suite tiene que correr en milisegundos, no en minutos: aquí tienes cómo montar pruebas unitarias ultrarrápidas con Vitest. Si el agente tarda 90 segundos en saber si acertó, el bucle rojo-verde deja de ser un bucle.

    En el curso de Testing en Angular con Jest y Testing Library enseñamos a estructurar suites de pruebas profesionales para frontend y backend preparadas para integrarse con flujos automatizados de CI/CD.

    Este enfoque de validación es también uno de los pilares centrales de nuestro libro de Spec-Driven Development (SDD).

    Para descargar pipelines de automatización con Vitest y plantillas de pruebas para agentes, visita Dominicode Labs.


    Qué hacer hoy con esto

    Para la próxima función o endpoint que vayas a programar:

    1. No escribas la implementación.
    2. Escribe primero dos tests unitarios en Vitest: uno para el caso feliz y otro para el caso borde más peligroso.
    3. Pásaselo a tu asistente de IA y pídele que escriba la función que los cumpla.

    Comprobarás dos cosas: que el primer diff llega mucho más cerca de lo que querías, y que las rondas de corrección se reducen a una o dos.

    Si además quieres que el agente derive los tests de una especificación en vez de escribirlos tú a mano, ese es el siguiente escalón: TDD y Spec-First aplicados al desarrollo con IA.


    Preguntas frecuentes

    ¿Por qué TDD es especialmente útil al programar con IA?

    Porque un test unitario actúa como una especificación matemática ejecutable. Los modelos de lenguaje responden con muchísima mayor precisión cuando tienen un criterio binario de éxito (el test pasa o falla) que cuando reciben instrucciones en lenguaje natural ambiguo.

    ¿Se debe permitir que la IA modifique los tests unitarios?

    No. Los tests unitarios deben ser diseñados y aprobados por el desarrollador. Si permites que la IA modifique los tests para que "pasen en verde", corres el riesgo de que relaje las aserciones y oculte errores de negocio.

    ¿Qué framework de tests es más rápido para iterar con agentes de IA?

    Vitest es actualmente la opción más recomendada en el ecosistema TypeScript por su velocidad de arranque instantánea, compatibilidad nativa con ESM y excelente integración en terminales CLI.

    ¿Puede la IA escribir también los tests en lugar del desarrollador?

    Puede escribir el andamiaje y los casos evidentes, pero no debe decidir qué se protege. Si el modelo escribe los tests y la implementación, ambos comparten el mismo malentendido y la suite en verde no demuestra nada. El desarrollador define los casos de borde; la IA rellena el resto.

    ¿Cuántos tests hacen falta antes de pasarle la tarea al agente?

    Dos suelen bastar para arrancar: el caso feliz y el caso de borde más caro si falla. Con eso el agente ya tiene una interfaz cerrada y un criterio binario de éxito. Ampliar la cobertura tiene más sentido después, cuando ya sabes por dónde se rompe la implementación real.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Tests unitarios lentos: el número de Vitest que casi nadie mira

    Tests unitarios lentos: el número de Vitest que casi nadie mira

    Nuestro job de tests en CI tardaba doce minutos clavados. Setecientos siete ficheros, cuatro mil cuatrocientos tests. Nadie lo cuestionaba: una suite grande tarda, y punto.

    Hoy lo hemos dejado en seis minutos y quince segundos. Sin borrar un solo test, sin runners más caros, sin paralelizar nada. Solo cambiando qué entorno arranca cada fichero.

    Y lo interesante no es el 48 % que nos ahorramos. Es que llevábamos meses con tests unitarios lentos mirando el número equivocado.

    El número equivocado es el total. El total te dice que tienes un problema, pero no te dice dónde se va el tiempo. Y sin el dónde, optimizar es tirar cosas a la pared: cambias el entorno, subes los threads, añades runners, y a veces sale bien y a veces sale peor y nunca sabes por qué.

    Vitest te da el dónde al final de cada ejecución. Lo tienes impreso en tu terminal ahora mismo.


    Resumen rápido

    • El total del Duration te dice que tienes tests unitarios lentos, no dónde se va el tiempo. El desglose sí.
    • environment es la suma del arranque de cada fichero entre todos los workers, no el wall-clock del run. Compáralo contra tests, nunca contra Duration.
    • En nuestra suite: 803,6 s de environment contra 156 s de tests. Cinco veces más en montar el escenario que en ejecutarlo.
    • La causa: environment: 'jsdom' global para 707 ficheros, de los que solo 208 tocan el DOM.
    • El fix: dos proyectos de Vitest, la extensión decide el entorno. .test.ts a node, .test.tsx a DOM. 12m → 6m 15s en CI.
    • Shardear no arregla esto: algo más de la mitad del tiempo es coste fijo de arranque, y cada shard lo vuelve a pagar entero.

    Tests unitarios lentos: el desglose que Vitest imprime y nadie lee

    Debajo del Duration hay un paréntesis con seis campos: transform, setup, collect, tests, environment y prepare.

    En nuestro caso, los dos que importan salían así:

    Duration  106.31s (transform …, setup …, collect …, tests 156.00s, environment 803.60s, prepare …)
    

    Recorto los campos que no vienen al caso. Fíjate en la contradicción aparente: el run entero duró 106 segundos, pero dice que gastó 803 en environment.

    No es un bug. environment es la suma del arranque de cada fichero entre todos los workers, no el wall-clock del run. La suite corre en dieciséis workers y cada uno monta su propio entorno por fichero. La cifra que ves es la suma de todos ellos, así que puede ser más de siete veces mayor que el reloj de pared.

    La regla de lectura del desglose de Vitest es comparar acumulado contra acumulado: environment contra tests, nunca contra Duration. Duration es wall-clock; los otros dos son tiempos sumados entre ficheros y workers.

    Y ahí el número deja de ser abstracto: 803,6 segundos montando el escenario contra 156 ejecutando los tests. Cinco veces más en preparar que en actuar.

    Cuando environment multiplica varias veces a tests, el problema no son los tests lentos: es el arranque del entorno.


    707 ficheros arrancando un navegador, 208 usándolo

    El origen estaba en una línea del config: environment: 'jsdom', global, para los 707 ficheros.

    Conté los que tocaban el DOM de verdad. Eran 208. Los 499 restantes —parsers, cálculo de precios, mapeo de rutas de API, validadores— montaban un navegador falso entero para no usarlo jamás.

    Ese es el gasto que estábamos pagando cinco veces sobre el trabajo real. No era un problema de rendimiento del emulador. Era que la mitad larga de la suite no necesitaba emulador ninguno.

    La solución fue partir la suite en dos proyectos de Vitest con una regla que cabe en una frase: la extensión decide el entorno.

    El config, con Vitest 4.1.10 (julio de 2026). La clave test.projects sustituyó a workspace en Vitest 3.2, así que en versiones anteriores esto no aplica:

    // vitest.config.ts
    import { defineConfig } from 'vitest/config'
    import react from '@vitejs/plugin-react'
    
    export default defineConfig({
      test: {
        projects: [
          {
            // Lógica pura: node pelado. Sin plugins, sin setup, sin DOM.
            test: {
              name: 'unit',
              environment: 'node',
              include: ['src/**/*.test.ts'],
            },
          },
          {
            // Componentes: DOM emulado + testing-library.
            plugins: [react()],
            test: {
              name: 'dom',
              environment: 'jsdom',
              include: ['src/**/*.test.tsx'],
              setupFiles: ['./src/test/setup-dom.ts'],
            },
          },
        ],
      },
    })
    

    Elegir la extensión como criterio no es cosmético. Con globs por carpeta o por sufijo (*.spec.ts y *.component.spec.ts) te toca mantener un exclude, porque el primer patrón se traga los ficheros del segundo y esos tests se ejecutan dos veces, una de ellas en el entorno equivocado y fallando por un motivo que parece un bug de tu código.

    .test.ts y .test.tsx no se solapan nunca. Cero exclude, cero ambigüedad, y una regla que un compañero nuevo entiende sin preguntar: si tu test importa JSX, es .tsx y tiene DOM.

    Si trabajas en Angular la idea es idéntica desde que Vitest es el runner por defecto. Cambian los globs, no el razonamiento.

    Después dimos el segundo paso: cambiar una palabra en el proyecto dom, de jsdom a happy-dom. En un A/B aislado sobre esos 208 ficheros, 48,9 s → 34,9 s. Unos catorce segundos. Útil, pero un orden de magnitud por debajo de lo que dio separar los entornos.

    La comparativa completa entre los dos emuladores, con benchmark y las APIs que le faltan a cada uno, la tengo aparte en el post sobre happy-dom o jsdom.

    El resultado de las dos cosas juntas:

    Ámbito Antes Después Δ
    Job Test en CI 12m 00s 6m 15s −48 %
    Suite local (16 cores) 106,3 s 46,0 s −57 %
    environment (acumulado entre ficheros) 803,6 s 137 s −83 %
    Ficheros / tests 707 / 4.400 707 / 4.400 sin cambios

    Mismos tests. Mismas aserciones. Misma cobertura.


    El efecto secundario: dos tests que llevaban meses mintiendo

    Al cambiar el entorno, dos tests empezaron a fallar.

    Y tenían razón.

    El patrón era este, y lo he visto en todos los proyectos en los que he entrado:

    vi.spyOn(global, 'fetch')
      .mockResolvedValueOnce(ok(productos))
      .mockResolvedValueOnce(ok(stock))
    

    Parece un mock. No lo es.

    vi.spyOn(global, 'fetch') sin implementación envuelve la función original y sigue llamándola. Lo único que intercepta son las respuestas que has encolado con mockResolvedValueOnce. Y esa cola se agota: la primera llamada recibe productos, la segunda stock, y la tercera sale a la red de verdad.

    Nuestro componente hacía tres llamadas.

    Llevaba meses pidiendo datos a localhost:3000 desde el runner de CI. jsdom se lo tragaba en silencio y el test seguía en verde. Con happy-dom la petición real quedó a la vista, y ahí aparecieron los 401.

    El arreglo son cuatro líneas, y es la clase de cosa que debería estar en el setup de cualquier suite:

    // setup-dom.ts
    import { beforeEach, vi } from 'vitest'
    
    beforeEach(() => {
      vi.spyOn(global, 'fetch').mockRejectedValue(new Error('fetch sin mockear'))
    })
    

    Un default que revienta. Si un test necesita una respuesta, la encola encima; si se le olvida una llamada, el test falla con un mensaje que dice exactamente qué pasó, en vez de irse a internet a buscar suerte.

    Añade también restoreMocks: true en el config: mockRejectedValue en un beforeEach no vacía la cola de ...Once que haya dejado el test anterior, y esa cola sobrante es una fuga entre tests igual de silenciosa que la que acabas de tapar.

    Yo esto ya no lo discuto: un test que llega a la red no es un test unitario, es una apuesta. Es lento, es flaky, y depende del firewall del runner. Diseñar los mocks para que el hueco falle ruidosamente en vez de degradar en silencio es la mitad del trabajo de testear bien, y es la parte que más tiempo dedico a explicar en el curso de Testing en Angular.

    Nadie planea encontrar estos bugs. Aparecen cuando tocas los cimientos.


    ¿Merece la pena shardear los tests unitarios? Los números dijeron que no

    Nos dio un 27 % a cambio de cuatro runners, cuando el cálculo ingenuo prometía un 60 %. El motivo es que en unitarios la mayor parte del tiempo es arranque compartido, y repartirlo no lo divide: lo multiplica. Así llegamos ahí.

    Semanas antes habíamos partido la suite de E2E en shards concurrentes y el wall-clock se había desplomado. Fue de esas victorias que te dejan con ganas de repetir.

    Así que la pregunta era obvia: si funcionó con E2E, ¿por qué no con los unitarios?

    Los números decían que sí. De los 375 segundos del job, solo 31 eran setup —checkout, pnpm install, build de las librerías internas—, un 8 %. Con un overhead fijo tan bajo, repartir en tres debería habernos dejado en torno a los dos minutos y medio. Una mejora del orden del 60 %.

    Abrimos el PR, lo lanzamos, y esto es lo que salió:

    Job Tiempo
    Test (1) 4m 19s
    Test (2) 4m 32s ← wall-clock
    Test (3) 3m 57s
    Test (otros paquetes) 1m 38s

    375 s → 272 s. Un 27 %, a cambio de cuatro runners en vez de uno.

    Volvimos al desglose, que es lo que había que haber hecho antes de escribir el PR:

    Ámbito Ficheros Tiempo de tests
    Job completo 707 333 s
    Un shard 236 226 s

    Léelo despacio. Un tercio de los ficheros tarda el 68 % de lo que tardan todos.

    Si ajustas una recta T(n) = F + n·v con esos dos puntos, sale un coste fijo F de unos 172 segundos y una pendiente de 0,23 segundos por fichero. Traducido: de los 333 segundos, algo más de la mitad es peaje que pagas antes de ejecutar un solo test. Solo unos 160 dependen de cuántos ficheros tengas.

    Y aquí toca ser honesto con el método: dos puntos y dos incógnitas significa que la recta pasa por ambos por construcción. Es aritmética, no un perfilado. Te da el orden de magnitud del reparto entre lo fijo y lo variable, que es justo lo que necesitas para decidir, pero no lo cites como si fuera una medida.

    Ese coste fijo es transform más importación del grafo de dependencias, en frío, sin caché de Vite en el runner. Y cada shard lo paga entero, otra vez, desde cero.

    Con 3 shards pagas ese peaje tres veces. Con 6, seis. No hace falta el modelo para verlo: el shard más rápido de los tres, con 236 ficheros en vez de 707, todavía tardó 3m 57s. Por muchos runners que enchufes, el suelo se queda en unos cuatro minutos.

    La lección de E2E no transfería, y visto desde aquí es evidente. En Playwright cada test es trabajo independiente de navegador: repartir divide de verdad. En unitarios, la mayor parte del tiempo es arranque compartido, y repartir trabajo compartido no lo divide, lo multiplica.

    El sharding no era la palanca. La palanca era eliminar los ~172 segundos de coste fijo que cada shard vuelve a pagar entero.


    El PR sigue abierto, y creo que así está bien

    El PR #36 no está mergeado ni cerrado. Un 27 % por 4x runners es un trade flojo, y las tres opciones siguen sobre la mesa:

    • Cerrarlo. Los cien segundos no compensan cuadruplicar el consumo de CI ni la complejidad de un job matricial.
    • Bajarlo a 2 shards. Menos ganancia, la mitad de coste, y sospecho que el punto donde la curva todavía compensa.
    • Aparcarlo y atacar el coste fijo. Cachear node_modules/.vite entre runs, si esa caché existe en tu setup, porque hoy se reconstruye en frío cada vez. Si funciona, mejora los tres escenarios a la vez, incluido el de un solo runner.

    La tercera es la que tiene mejor pinta, y precisamente por eso no quiero decidirla con la misma prisa con la que abrimos el PR. Primero medir el arranque en caliente, después decidir.


    Qué hacer hoy si tienes tests unitarios lentos

    1. Lanza tus tests y mira el paréntesis del final. Solo eso.
    2. Compara environment con tests. Los dos son sumas acumuladas entre ficheros, así que la división tiene sentido. Si environment es el doble de tests, ya sabes dónde está tu problema, y no es donde llevas semanas buscándolo.
    3. Cuenta cuántos ficheros importan JSX o tocan document de verdad. En nuestro caso eran 208 de 707. En el tuyo probablemente sea una proporción parecida, porque un catálogo, un carrito o un dashboard tienen mucha más lógica que pintura.
    4. Separa por extensión. .test.ts a node, .test.tsx a DOM. Veinte minutos de trabajo, cero riesgo, ningún test tocado.

    La tesis de todo esto no es "usa happy-dom" ni "shardea tus tests". Es que medir el coste correcto —no el tiempo total, sino en qué se va— convierte una optimización a ciegas en un cambio de config de veinte líneas. El mismo desglose que nos quitó seis minutos nos evitó después tirar cuatro runners a un problema que no era de paralelismo.

    Y que de vez en cuando, al levantar los cimientos, encuentras un test que llevaba meses saliendo a internet sin que nadie se enterara.

    Si quieres ver este tipo de decisiones tomadas sobre proyectos reales, con los runs y los números delante en vez de con opiniones, es lo que hacemos en Dominicode Labs.


    Preguntas frecuentes sobre tests unitarios lentos

    ¿Por qué mis tests unitarios son lentos si cada test tarda milisegundos?

    Casi siempre porque el tiempo no se va en ejecutar los tests, sino en preparar el entorno de cada fichero. En nuestra suite, el desglose de Vitest daba 803,6 segundos acumulados en environment frente a 156 en tests: cinco veces más en montar el escenario que en actuar. Mientras esa proporción esté desequilibrada, optimizar aserciones o subir el número de threads no te va a dar nada: estarías acelerando la parte pequeña.

    ¿Qué significa environment en el resumen de Vitest?

    Es el tiempo dedicado a instanciar el entorno de test (jsdom, happy-dom o node) para cada fichero, sumado entre todos los workers. Es tiempo acumulado entre ficheros y workers, no wall-clock, y por eso puede ser mucho mayor que el Duration total: nosotros teníamos 803,6 segundos de environment en un run de 106,3 segundos corriendo sobre dieciséis workers. La comparación que tiene sentido es environment contra tests, porque ambas cifras están acumuladas de la misma forma.

    ¿Cómo separo los tests que necesitan DOM de los que no en Vitest?

    Con test.projects en vitest.config.ts: un proyecto con environment: 'node' para la lógica pura y otro con DOM emulado, plugin del framework y setupFiles para los tests de componente. Lo que mejor nos ha funcionado es decidir por extensión, .test.ts contra .test.tsx, porque son globs que no se solapan y no necesitas exclude. Si separas por carpeta o por sufijo compuesto, un mismo fichero puede caer en los dos proyectos y ejecutarse dos veces, una de ellas en el entorno equivocado.

    ¿Merece la pena shardear los tests unitarios en CI?

    Depende de qué proporción de tu tiempo sea coste fijo de arranque, y hay que medirlo antes de abrir el PR. En nuestro caso, tres shards dieron un 27 % de mejora a cambio de cuatro runners, cuando el cálculo ingenuo prometía un 60 %. El motivo es que cada shard vuelve a pagar entero el transform y la importación del grafo de dependencias, así que ese coste no se reparte, se multiplica. Con E2E la historia es distinta porque cada test es trabajo independiente de navegador y repartir sí divide.

    ¿Por qué vi.spyOn(global, 'fetch') no mockea mis llamadas?

    Porque spyOn sin implementación envuelve la función original y sigue llamándola. Solo intercepta las respuestas que hayas encolado con mockResolvedValueOnce, y esa cola se agota: en cuanto tu código hace una llamada más de las que encolaste, esa petición sale a la red de verdad. El arreglo es poner siempre un default que falle, con vi.spyOn(global, 'fetch').mockRejectedValue(new Error('fetch sin mockear')) en el setup, y encolar las respuestas concretas encima en cada test.

    ¿Esto aplica igual en Angular?

    Sí, y desde Angular 21 y 22 aún más, porque Vitest pasó a ser el runner por defecto y el entorno DOM dejó de ser una decisión implícita del builder de Karma. Cambian los globs, que serán .spec.ts con algún criterio propio para distinguir tests de componente de tests de servicio, pero el diagnóstico es idéntico: mira el desglose de environment, cuenta cuántos specs necesitan document y manda el resto a node.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
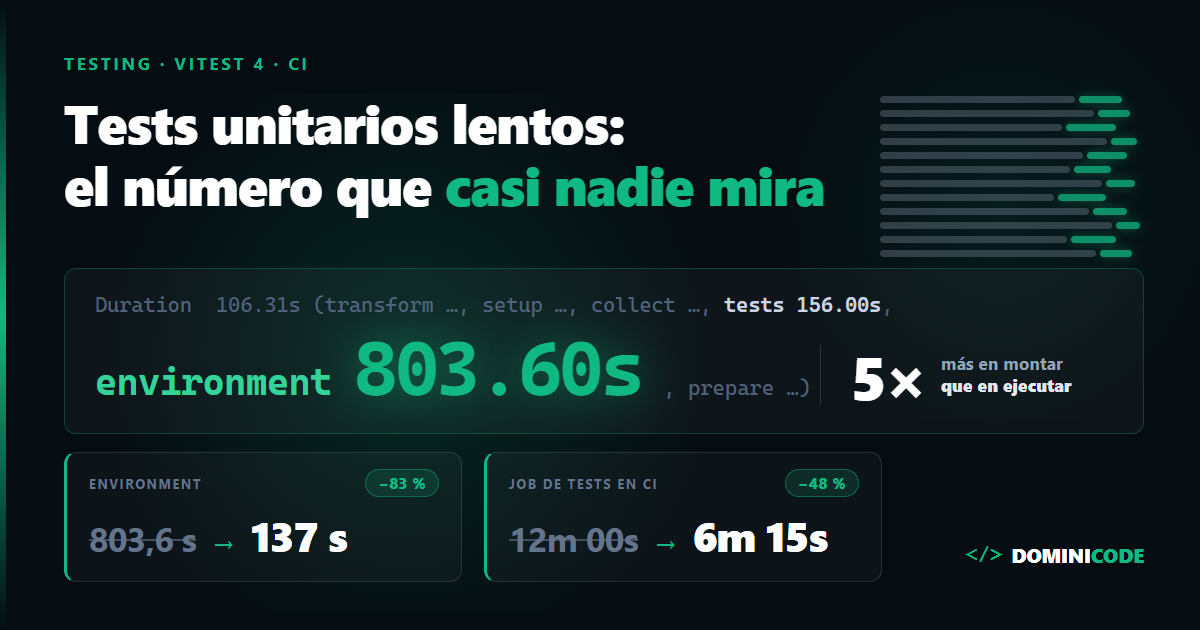
  • happy-dom o jsdom: qué entorno DOM elegir en tests unitarios

    happy-dom o jsdom: qué entorno DOM elegir en tests unitarios

    Cambié a happy-dom la mitad de la suite que toca el DOM, un martes por la mañana. Era la última pieza de un cambio que dejó el job de CI en 6m 15s, desde los doce minutos que tardaba esa misma mañana. Me sentí muy listo.

    Dos semanas después, un componente de lazy loading llegó roto a producción. El test seguía en verde. Lo ejecuté cincuenta veces y cincuenta veces me dijo que todo estaba bien.

    El problema no era el test. Era el suelo sobre el que corría. Elegir entre happy-dom o jsdom no es una micro-optimización de CI: es decidir qué mentiras está autorizada a contarte tu suite.

    Con jsdom, ResizeObserver no existe. El test revienta con un error escandaloso, instalas un mock, el mock dispara el callback y el test comprueba algo de verdad. Con happy-dom, ResizeObserver sí existe: es una clase que se instancia sin quejarse y cuyos tres métodos están vacíos por dentro. El callback no se llama jamás.

    Mi setup tenía una guarda del tipo if (typeof window.ResizeObserver === 'undefined') para instalar el mock. Con happy-dom esa condición no se cumplía nunca. El mock no se instalaba. El test verificaba el vacío.


    Resumen rápido

    • En tests unitarios, el runner (Vitest, Jest) no es el entorno. El entorno es la librería que emula el navegador debajo: jsdom, happy-dom o ninguna.
    • Vitest arranca por defecto en node, sin DOM. Jest también. El DOM siempre lo pides tú.
    • En mi benchmark, happy-dom resultó 1,77x más rápido que jsdom (mediana de 5 pares A/B, rango 1,45x–1,96x), no las 5x-10x que circulan por ahí.
    • Ninguno de los dos tiene motor de layout. getBoundingClientRect() devuelve ceros en ambos. Cambiar de entorno no arregla eso.
    • happy-dom cubre más superficie de API moderna que jsdom (matchMedia, showModal, scrollIntoView), pero incluye stubs mudos que fingen existir.
    • Regla: node por defecto, happy-dom para tests de componente, jsdom fichero a fichero cuando algo se rompa. Se mezclan en el mismo proyecto.

    El runner no es el entorno

    Esta confusión cuesta tardes enteras.

    Cuando escribes environment: 'jsdom', Vitest instancia un window completo por cada fichero de test y lo inyecta en el contexto global antes de importar tu código. El runner orquesta. El entorno es quien finge ser un navegador.

    Y por defecto no hay ninguno: Vitest arranca en node por defecto, sin document ni window. Jest hace lo mismo desde la versión 27, y desde la 28 ni siquiera trae jsdom — hay que instalar jest-environment-jsdom a mano.

    Angular es el caso más traicionero. Desde que Vitest se convirtió en el test runner por defecto en Angular 21, el builder @angular/build:unit-test detecta qué tienes instalado: si encuentra happy-dom lo usa, y si no, cae a jsdom. Basta con que alguien añada happy-dom al package.json por cualquier motivo para que toda tu suite cambie de suelo sin que nadie toque un fichero de configuración.

    Si vienes de Karma, ese cambio de suelo es la parte que menos se cuenta y más duele. Lo desarrollé en Vitest en Angular 22: por qué Karma ya no es el default.


    Qué es jsdom y qué es happy-dom, sin marketing

    jsdom es la implementación de referencia. Se publicó por primera vez en noviembre de 2011: casi quince años de historia y la base sobre la que se ha testeado medio ecosistema JavaScript. Su norma es la fidelidad a la especificación: si algo está implementado, se comporta como en el navegador; si no puede implementarlo bien, prefiere no implementarlo. Su documentación deja layout y navegación explícitamente fuera de alcance. Versión actual: 29.1.1, del 30 de abril de 2026. Nada nuevo desde entonces.

    happy-dom es un emulador con otra prioridad: arrancar rápido y cubrir lo que los frameworks modernos usan de verdad. Versión 20.11.1, del 22 de julio de 2026, con nueve versiones publicadas entre el 3 de junio y esa fecha.

    En disco: jsdom instala 25 MB y 21 dependencias directas; happy-dom, 19 MB y 7. La diferencia real es mucho menor de lo que sugieren las comparativas que verás por ahí.


    Benchmark happy-dom vs jsdom: lo medí en vez de citarlo

    Circulan cifras de "5x-10x más rápido" que nadie respalda. Monté la prueba, y publico los datos crudos para que puedas comprobar cada división.

    Metodología — benchmark ejecutado por Bezael Pérez (Dominicode) el 24 de julio de 2026:

    Carga 50 ficheros × 3 tests con DOM real: listas de 100 nodos, eventos con dispatchEvent, 200 mutaciones de clases y atributos
    Protocolo 5 pares de ejecuciones alternando A/B (jsdom, happy-dom, jsdom, happy-dom…) para anular la deriva de carga de la máquina
    CPU Intel i7-11700K, 16 hilos, 32 GB RAM, Windows 11
    Runtime Node 24.16.0
    Runner Vitest 4.1.10
    Entornos jsdom 29.1.1 · happy-dom 20.11.1

    Datos crudos. Tiempo total de suite, par a par:

    Par jsdom happy-dom Ventaja
    1 26,47 s 14,93 s 1,77x
    2 21,94 s 15,11 s 1,45x
    3 26,90 s 15,77 s 1,71x
    4 15,70 s 8,56 s 1,83x
    5 16,27 s 8,31 s 1,96x

    La ventaja de happy-dom es 1,77x, la mediana de esos cinco ratios.

    Ojo con un detalle que despista, porque yo mismo tropecé con él: la mediana de los tiempos de jsdom (21,94 s) dividida entre la mediana de los de happy-dom (14,93 s) da 1,47x. Pero esas dos medianas salen de pares distintos —la primera del par 2, la segunda del par 1— y dividirlas mezcla ejecuciones que no compartieron condiciones de máquina. En un diseño A/B emparejado, el estimador correcto es el ratio dentro de cada par, y su mediana es 1,77x.

    Con ese mismo criterio, el resto de métricas:

    Métrica jsdom (mediana) happy-dom (mediana) Ventaja por par
    Tiempo total de suite 21,94 s 14,93 s 1,77x
    Ejecución pura de los tests 4,29 s 1,74 s 2,5x
    Arranque del entorno (acumulado) 235,6 s 119,0 s 2,2x

    Y ahora el dato que de verdad cambia decisiones. Segunda suite, 50 ficheros con un único expect(1 + 1).toBe(2), que aísla el coste de levantar el entorno:

    Entorno Tiempo total Arranque por fichero
    node 1,55 s ~0,2 ms
    happy-dom 4,20 s ~0,75 s
    jsdom 7,71 s ~1,55 s

    Las dos tablas no miden lo mismo y no debes cruzarlas: el arranque acumulado de la primera incluye montar y desmontar un documento con cientos de nodos por fichero, con los 16 hilos saturados; la segunda mide levantar un DOM vacío. Compara cada tabla consigo misma.

    Dicho eso, léelo dos veces. Pasar de jsdom a happy-dom te da 1,8x. Pasar de jsdom a ningún DOM te da 5x.

    La optimización más rentable de tu suite no es cambiar de emulador. Es dejar de cargar un emulador en los tests que no tocan el DOM: reducers, servicios, validadores, utilidades puras. Esos no necesitan window, y probablemente son el 70% de tu suite.


    Dónde te rompe cada uno: qué APIs faltan en jsdom y en happy-dom

    Ejecuté el mismo fichero de sondeo en los dos entornos. Esto es lo que devolvió, no lo que dice la documentación:

    API jsdom 29.1.1 happy-dom 20.11.1
    getBoundingClientRect() todo a 0 todo a 0
    offsetWidth / offsetTop 0 0
    getComputedStyle() con estilos inline correcto correcto
    window.matchMedia no existe sí
    Element.scrollIntoView no existe sí
    document.elementFromPoint no existe sí
    dialog.showModal() no existe sí
    CSS.supports no existe sí
    navigator.clipboard no existe sí
    ResizeObserver no existe stub que nunca dispara
    IntersectionObserver no existe stub que nunca dispara
    canvas.getContext('2d') null, o real con el paquete canvas null, sin alternativa
    Element.animate (WAAPI) no existe no existe
    Custom elements y Shadow DOM sí sí

    Un matiz sobre dialog: jsdom sí define el constructor HTMLDialogElement, pero showModal, show y close no están en el prototipo. No es que lancen una excepción propia: es que 'showModal' in dialog devuelve false.

    Tres conclusiones incómodas.

    Una: el relato de "jsdom es más completo" es falso tal y como se cuenta. En superficie de API moderna gana happy-dom. jsdom sigue sin matchMedia en 2026, probablemente el mock más copiado y pegado de la historia del frontend.

    Dos: ninguno tiene layout. Si tu test necesita que getBoundingClientRect() devuelva algo distinto de cero, cambiar de entorno no te salva.

    Tres, la que me costó el susto: happy-dom prefiere un stub silencioso a un fallo ruidoso. Este es su ResizeObserver real, tal cual está en el repositorio:

    export default class ResizeObserver {
      public observe(): void {
        // TODO: Not implemented
      }
      public unobserve(): void {
        // TODO: Not implemented
      }
      public disconnect(): void {
        // TODO: Not implemented
      }
    }
    

    IntersectionObserver sigue el mismo patrón: guarda el callback en el constructor y expone un takeRecords() que devuelve siempre un array vacío, pero observe() tiene el cuerpo igual de hueco. Tu código lo instancia, llama a observe(), no pasa nada y el test sigue adelante. Un fallo ruidoso cuesta diez minutos. Uno silencioso cuesta un incidente.

    En lo fundamental son gemelos: probé validación de formularios, sanitización de input[type=number], ciclo de vida de custom elements, <template>, orden de propagación capture/bubble, resolución de URLs relativas y parseo de HTML mal formado. Resultado idéntico en ambos. Para el 95% de los tests de componente da exactamente igual cuál uses.


    Cómo se configuran, y cómo se mezclan

    Lo que casi nadie cuenta: no tienes que elegir uno para todo el proyecto. Con Vitest 4 defines proyectos por glob.

    // vitest.config.ts
    import { defineConfig } from 'vitest/config'
    
    export default defineConfig({
      test: {
        projects: [
          {
            test: {
              name: 'unit',
              environment: 'node',
              include: ['src/**/*.spec.ts'],
              exclude: ['src/**/*.component.spec.ts'],
            },
          },
          {
            test: {
              name: 'dom',
              environment: 'happy-dom',
              include: ['src/**/*.component.spec.ts'],
            },
          },
        ],
      },
    })
    

    Ese exclude no es decorativo. Sin él, src/**/*.spec.ts también captura los *.component.spec.ts, cada test de componente se ejecuta dos veces —una en node y otra en happy-dom— y la ejecución en node falla con un expected 'undefined' to be 'object' que parece un bug de tu componente y no lo es.

    Y cuando un fichero suelto necesite jsdom, lo declaras en la primera línea. Ese comentario gana a la configuración del proyecto:

    // @vitest-environment jsdom
    import { it, expect } from 'vitest'
    
    it('corre en jsdom aunque el proyecto use happy-dom', () => {
      expect(window.navigator.userAgent).toContain('jsdom')
    })
    

    Lo he verificado ejecutándolo: ese fichero arranca en jsdom mientras el resto de la suite sigue en happy-dom. Un solo test lento no justifica frenar los otros mil.

    En Angular la palanca es distinta, porque el builder elige por ti según lo que esté instalado. Lo robusto es no depender de esa autodetección: apunta la opción runnerConfig del builder a un vitest.config.ts con environment fijado explícitamente, y así da igual lo que aparezca en el package.json. Si prefieres la vía rápida, deja instalado solo uno de los dos:

    # alternativa: fuerza jsdom eliminando la otra opción
    npm uninstall happy-dom && npm install -D jsdom
    

    Y añade esto a tu fichero de setup para que los observers dejen de mentirte:

    // test-setup.ts
    import { vi, beforeEach } from 'vitest'
    
    class ResizeObserverMock {
      constructor(private cb: (entries: unknown[], obs: unknown) => void) {}
      observe = vi.fn((target: Element) =>
        this.cb([{ target, contentRect: target.getBoundingClientRect() }], this))
      unobserve = vi.fn()
      disconnect = vi.fn()
    }
    
    class IntersectionObserverMock {
      constructor(private cb: (entries: unknown[], obs: unknown) => void) {}
      observe = vi.fn((target: Element) => this.cb([{ target, isIntersecting: true }], this))
      unobserve = vi.fn()
      disconnect = vi.fn()
      takeRecords = vi.fn(() => [])
    }
    
    beforeEach(() => {
      vi.stubGlobal('ResizeObserver', ResizeObserverMock)
      vi.stubGlobal('IntersectionObserver', IntersectionObserverMock)
    })
    

    Dos clases, no una. Un mock compartido que emite { isIntersecting: true } para ambos revienta en cuanto un componente responsive lee entries[0].contentRect.width, porque esa propiedad no existe en la entry: TypeError: Cannot read properties of undefined. Cada observer tiene su forma de entry y hay que respetarla.

    Y fíjate en el otro detalle: asigno siempre, sin comprobar antes si existe. Esa comprobación es exactamente lo que me llevó a producción con un test verde y un componente roto.


    La regla para elegir entre happy-dom o jsdom

    Cinco pasos, en este orden. Los aplico tal cual.

    1. node por defecto. Si el test no toca document, no cargues DOM. Ahí está el 5x, no en la comparativa de emuladores.
    2. happy-dom para tests de componente. Casi el doble de rápido y con más API moderna cubierta. Es la elección por defecto en 2026.
    3. Nunca uses guardas del tipo if (typeof window.X === 'function') en el setup. Sobrescribe siempre los observers con mocks que disparen.
    4. jsdom fichero a fichero, no suite entera. ¿Un test necesita canvas real o un comportamiento de spec que happy-dom aproxima mal? // @vitest-environment jsdom en la línea 1 y sigues.
    5. Si necesitas layout de verdad, ningún emulador sirve. Posiciones reales, scroll real, capturas visuales: eso es Browser Mode de Vitest, estable desde la 4.0, con Playwright debajo. Más lento, y el único sitio donde esos tests significan algo.

    La excepción que invierte los pasos 2 y 4: si mantienes una librería de componentes que consumen otros, empieza en jsdom. Ahí prefieres un fallo ruidoso a una aproximación cómoda, porque el coste de un falso verde no lo pagas tú.

    Razonar sobre el entorno antes que sobre el aserto es la columna vertebral del curso de Testing en Angular, donde monto la suite desde cero decidiendo qué corre en node, qué en DOM emulado y qué en navegador real. Y si lo que te falta es la base del framework antes de entrar a testearlo, esa parte la cubro en el curso de Angular Moderno.


    Lo que puedes hacer hoy

    Abre tu vitest.config.ts y mira qué environment tienes a nivel global para tus tests unitarios.

    Si es jsdom o happy-dom para toda la suite, acabas de encontrar tu mayor ganancia de tiempo del trimestre: sepáralo en dos proyectos y manda a node todo lo que no toque document. Diez minutos de trabajo.

    Después añade el mock de los observers al setup. Porque el test que más te va a costar en tu carrera no es el que falla: es el que pasa por el motivo equivocado.

    Si quieres seguir tirando del hilo, tengo publicado Testing en Angular con IA: tests que protegen de verdad, donde ataco el mismo problema desde el otro lado. Y si prefieres verlo montado sobre un proyecto real y con gente a la que preguntar, te espero en Dominicode Labs.


    Preguntas frecuentes sobre happy-dom y jsdom

    ¿Qué es más rápido, happy-dom o jsdom?

    happy-dom. En el benchmark que ejecuté en Dominicode en julio de 2026 con Vitest 4.1.10, sobre 50 ficheros con manipulación real de DOM y cinco pares de ejecuciones alternadas, happy-dom resultó 1,77x más rápido que jsdom en mediana, con un rango de 1,45x a 1,96x. En ejecución pura de operaciones DOM la ventaja sube a 2,5x y en arranque del entorno es de 2,2x. Las cifras de "5x o 10x" que circulan no se corresponden con lo que mide una suite real. La ganancia grande está en no cargar ningún DOM: el entorno node fue 5 veces más rápido que jsdom en la misma máquina.

    ¿Merece la pena migrar de jsdom a happy-dom?

    Depende de dónde esté tu cuello de botella, y casi nunca está donde crees. Si tu suite tarda diez minutos, migrar a happy-dom te deja en unos seis: real, pero no transformador. Antes de eso, mira cuántos de tus tests cargan un DOM sin necesitarlo, porque mover esos a environment: 'node' da una mejora del orden de 5x en esa parte de la suite y no tiene ningún riesgo de compatibilidad. Mi recomendación es hacerlo en ese orden: primero separa node de DOM, después cambia el emulador y, si algún fichero se rompe, pásalo a jsdom con el comentario // @vitest-environment jsdom en lugar de revertir la migración entera.

    ¿Cuál usa Vitest por defecto?

    Ninguno de los dos. El valor por defecto de test.environment en Vitest es node, sin window ni document. Para tener DOM debes instalar jsdom o happy-dom y declararlo en vitest.config.ts o con el comentario // @vitest-environment en la cabecera del fichero. Jest se comporta igual: su entorno por defecto es node y desde Jest 28 hay que instalar jest-environment-jsdom como paquete aparte.

    ¿Qué entorno DOM usa Angular con Vitest?

    El builder @angular/build:unit-test detecta automáticamente qué tienes instalado: prefiere happy-dom si está presente y cae a jsdom si no. Conviene saberlo porque implica que añadir happy-dom al package.json por cualquier motivo cambia el entorno de toda la suite sin que nadie modifique la configuración. Si quieres un comportamiento predecible, fija environment de forma explícita en el fichero de configuración al que apunta la opción runnerConfig del builder, en vez de confiar en la autodetección.

    ¿Por qué mi test falla con "ResizeObserver is not defined"?

    Porque estás en jsdom, que no implementa ResizeObserver ni IntersectionObserver: la propiedad no existe en window. La solución es añadir un mock en el fichero de setup, con una clase distinta para cada uno, porque sus entries tienen forma diferente: contentRect en el de resize e isIntersecting en el de intersection. Ojo con el matiz: en happy-dom esas clases sí existen, pero sus métodos están vacíos y el callback no se ejecuta nunca. Si tu mock está protegido por una comprobación de existencia, en happy-dom no se instalará y tu test pasará sin comprobar nada.

    ¿Puedo usar happy-dom y jsdom en el mismo proyecto?

    Sí, y es la mejor estrategia. Con Vitest 4 defines varios proyectos en test.projects, cada uno con su environment y su glob de ficheros. Cuida los globs: si un proyecto incluye src/**/*.spec.ts y otro src/**/*.component.spec.ts, los ficheros de componente caen en los dos y se ejecutan por duplicado, así que necesitas un exclude en el primero. Además, el comentario // @vitest-environment jsdom en la primera línea de un fichero tiene prioridad sobre la configuración del proyecto, así que puedes mantener toda la suite en happy-dom y mover a jsdom solo los ficheros que lo necesiten. No hay que migrar en bloque.

    ¿Con cuál funciona getBoundingClientRect?

    Con ninguno. Ni jsdom ni happy-dom incorporan motor de layout, así que getBoundingClientRect(), offsetWidth y offsetTop devuelven cero en los dos. La documentación de jsdom lo declara explícitamente fuera de alcance. Si tu test depende de posiciones o tamaños reales, la única salida es un navegador de verdad: Browser Mode de Vitest, estable desde la 4.0, con Playwright por debajo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
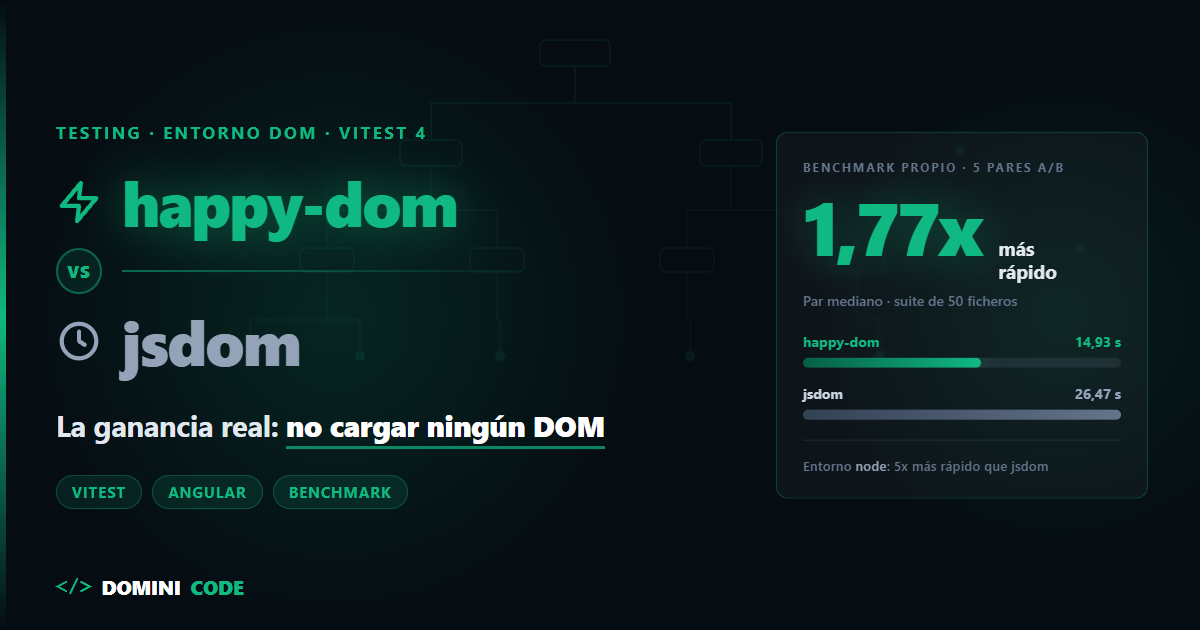
  • Vitest en Angular 22: por qué Karma ya no es el default

    Vitest en Angular 22: por qué Karma ya no es el default

    Son las 11 de la noche. Hay un commit pendiente de mergear y el pipeline de CI acaba de arrancar.

    Primero levanta el contenedor. Después Chrome headless. Karma detecta los specs, los compila y — casi dos minutos después de tu push — arranca la primera suite.

    Multiplica esos dos minutos por cada PR del día, por cada rebase, por ese "se me olvidó un punto y coma" que te obliga a repetir el ciclo entero.

    No es una exageración. Es el ritual diario de cualquier equipo Angular con Karma en producción. Por eso Vitest en Angular 22 dejó de ser una curiosidad de nicho: es ya el camino que recomienda el propio equipo de Angular.


    Por qué Karma se queda atrás

    Karma no es lento porque esté mal hecho. Es lento porque hace algo que en 2026 ya no tiene sentido: lanzar un navegador real — Chrome, o el que hayas configurado — para ejecutar cada suite de tests.

    Arrancar un navegador tiene un coste. Inicializar el motor de renderizado, cargar las extensiones de test, compilar el bundle con la configuración heredada de karma.conf.js… todo eso pasa antes de que se ejecute el primer expect().

    Y luego está la ejecución. Karma corre las suites de forma secuencial por defecto. Si tienes 40 archivos de spec, esperas a que terminen uno detrás de otro.

    Yo he trabajado en proyectos donde levantar el entorno de Karma tardaba varios minutos, antes de correr un solo test útil. Multiplica eso por cada push a un pipeline que corre veinte veces al día y tienes un cuello de botella silencioso que nadie cuestiona porque "siempre ha sido así".

    Vitest cambia la premisa completa. En lugar de un navegador real, corre en un proceso de Node.js y simula el DOM con una librería de emulación — arranca en milisegundos, no en segundos. Y ejecuta los archivos de test en paralelo por defecto, no de forma secuencial.

    No hace falta inventar un benchmark con un múltiplo llamativo para explicar esto. La diferencia cualitativa ya es suficiente: uno lanza un navegador, el otro no.


    Vitest nativo en Angular 22: lo que es default y lo que no

    Desde Angular 21, Vitest es el framework de testing por defecto para proyectos nuevos creados con ng new. Angular 22 mantiene ese default. Aquí hay que ser preciso, porque el estado real tiene matices que se pierden en los titulares.

    Si generas un proyecto hoy con el CLI — tal y como lo hacemos desde cero en el curso de Angular Moderno —, Vitest ya viene configurado. No instalas nada, no tocas angular.json.

    Karma, por otro lado, sigue soportado oficialmente. No ha sido eliminado ni deprecado. Sigue siendo una opción válida y documentada si tienes un proyecto existente y decides quedarte con él.

    Lo que sí está marcado como experimental es otra cosa distinta: migrar un proyecto existente de Karma a Vitest. La documentación oficial de Angular lo dice sin rodeos: "Migrating an existing project to Vitest is considered experimental".

    Esa distinción importa. Vitest de fábrica en un proyecto nuevo es el camino estándar y recomendado. El proceso de migración de un proyecto legacy con Karma es lo que todavía se etiqueta como experimental. No son lo mismo, y confundirlos te hace tomar decisiones equivocadas sobre cuándo migrar.

    El builder detrás de todo esto se llama @angular/build:unit-test, y se configura en el target test de tu angular.json:

    {
      "projects": {
        "mi-proyecto": {
          "architect": {
            "test": {
              "builder": "@angular/build:unit-test"
            }
          }
        }
      }
    }
    

    Requiere el sistema de compilación application, que ya es el default en cualquier proyecto nuevo. Sus valores por defecto son "tsConfig": "tsconfig.spec.json" y "buildTarget": "::development" — no necesitas escribirlos a mano salvo que quieras cambiarlos.

    ¿Y el DOM? Vitest corre tus tests en un entorno Node.js, no en un navegador. Para simular document, window y el resto de la API del navegador usa una librería de emulación. El Angular CLI detecta automáticamente happy-dom si lo tienes instalado; si no, cae a jsdom como fallback.


    Cómo migrar un proyecto existente

    Si tu proyecto ya existe y corre sobre Karma, migrar no es instantáneo, pero tampoco es una reescritura. Son cinco pasos:

    1. Instala las dependencias: npm install --save-dev vitest jsdom
    2. Cambia el builder del target test en angular.json a @angular/build:unit-test
    3. Revisa tu karma.conf.js en busca de configuraciones custom y trasládalas a un vitest.config.ts
    4. Elimina karma.conf.js y src/test.ts, y desinstala los paquetes de Karma (karma, karma-chrome-launcher, karma-coverage, karma-jasmine, etc.)
    5. Opcional: si necesitas correr tests en un navegador real (modo browser), instala @vitest/browser-playwright y añade "browsers": ["chromium"] en la configuración

    Ahora el gotcha que rompe configuraciones cuando nadie lo espera.

    Con el builder viejo de Karma, podías meter tus opciones de build — polyfills, assets, estilos — directamente dentro del target test. Era cómodo, y casi nadie se paraba a pensar si estaba bien hecho.

    El builder nuevo, @angular/build:unit-test, no soporta eso. Si las opciones de build que necesitas para tus tests son distintas de las de tu configuración normal de desarrollo, tienes que sacarlas de ahí y crear una configuración de build dedicada — normalmente un target development separado que el builder de test referencia.

    Si tu proyecto tenía cualquier personalización de polyfills o assets dentro del target test, este es exactamente el punto donde la migración "automática" deja de serlo.


    El schematic que automatiza parte del trabajo

    Angular no te deja solo con los cinco pasos manuales. Existe un schematic que hace la parte mecánica de convertir sintaxis Jasmine a Vitest:

    ng generate @schematics/angular:refactor-jasmine-vitest --project mi-proyecto --add-imports
    

    Convierte automáticamente patrones como fit/fdescribe a it.only/describe.only, spyOn a vi.spyOn, jasmine.any a expect.any, y otras conversiones de sintaxis equivalentes.

    Opciones útiles: --project <nombre> para apuntar a un proyecto específico del workspace, --include <path> para limitar el alcance, --add-imports para que añada los imports explícitos de Vitest que necesites, y --browser-mode si estás migrando hacia modo browser.

    Ahora la parte honesta, porque prometerte una migración 100% automática sería mentirte.

    El schematic no instala dependencias — eso lo haces tú a mano. No migra polyfills ni assets — ese es el gotcha del punto anterior, y sigue siendo tu responsabilidad. Y en escenarios de spies complejos — mocks anidados, spies sobre spies, configuraciones de retorno encadenadas — hace su mejor esfuerzo, pero necesitas revisar el resultado a mano.

    Trátalo como un primer pase que te ahorra la mayor parte del trabajo mecánico, no como un botón de "migrar y olvidar".

    Si además ya usas IA para generar o revisar tus tests — algo que cubrimos en testing en Angular con IA —, dale el resultado del schematic a tu agente y pídele que revise específicamente los spies antes de dar la migración por terminada.


    Mapa de equivalencias: de Jasmine/Jest a Vitest

    Necesidad Jasmine/Jest Vitest
    Función simulada jest.fn() / jasmine.createSpy vi.fn()
    Espiar método jest.spyOn() vi.spyOn()
    Mockear módulo jest.mock() vi.mock()
    Import real en mock parcial jest.requireActual() vi.importActual()
    Timers falsos jest.useFakeTimers() vi.useFakeTimers()
    Restaurar mocks jest.clearAllMocks() vi.clearAllMocks()
    Matcher jasmine.any jasmine.any(Type) expect.any(Type)

    Fíjate en el patrón: casi todo lo que cambia empieza con jest. o jasmine. y pasa a vi.. Es el mocking y el motor de ejecución lo que cambia, no la forma de pensar tus tests.

    Los matchers de aserciones — toBe, toEqual, toContain, toThrow, resolves, rejects — funcionan prácticamente igual en Vitest. Si ya sabes escribir un expect() en Jasmine o Jest, sabes escribir uno en Vitest. La curva de aprendizaje no está en las aserciones, está en el mocking.

    Esto es justo lo que no cambia con el motor: los patrones de Testing Library (render, screen, userEvent) y la filosofía de testing por comportamiento en lugar de por implementación.

    Eso es exactamente lo que cubrimos en el curso de Testing en Angular con Jest y Testing Library: sea cual sea el motor de tu proyecto — Jest hoy, Vitest mañana —, cómo piensas un test de comportamiento no cambia.


    Testing zoneless con Vitest

    Angular 22 empuja fuerte hacia zoneless. Y eso cambia también cómo escribes tus tests.

    Con Zone.js, después de simular una interacción — un click, un input — a veces tenías que llamar fixture.detectChanges() manualmente para forzar que Angular actualizara la vista antes de tu expect().

    En modo zoneless no hay Zone.js escuchando cada tarea async para disparar la detección de cambios. En su lugar, usas await fixture.whenStable() para esperar a que el ciclo de detección de cambios asíncrono termine:

    it('actualiza el contador al hacer click', async () => {
      const fixture = TestBed.createComponent(ContadorComponent);
      fixture.nativeElement.querySelector('button').click();
    
      await fixture.whenStable();
    
      expect(fixture.nativeElement.textContent).toContain('1');
    });
    

    Es un cambio pequeño en la sintaxis pero grande en la intención: pasas de forzar la detección de cambios a esperar a que el propio sistema te diga que está estable. Es la misma filosofía que estamos viendo en otras piezas de v22, como Signal Forms — otra API que va madurando y sobre la que conviene ser precisos respecto a qué está ya estable y qué sigue en evolución.


    Karma vs Vitest en Angular 22, cara a cara

    Karma Vitest
    Arranque de suite Lanza un navegador real (Chrome u otro) Corre en Node.js, simula el DOM con happy-dom o jsdom
    Ejecución Secuencial por defecto Paralela por defecto
    Configuración karma.conf.js, heredada de webpack vitest.config.ts, integrada con el builder de Angular
    Estado en Angular 22 Soportado oficialmente, sigue siendo válido Default para proyectos nuevos; migrar proyectos existentes es experimental

    La tesis

    Cambiar de Karma a Vitest no es "un test runner más rápido". Es Angular alineando su tooling de testing con el ecosistema Vite y ESM que ya domina el resto del frontend — y quitándose de encima una dependencia que llevaba años siendo el cuello de botella silencioso de cualquier pipeline: un navegador real corriendo en CI.

    Si estás empezando un proyecto hoy, no tienes nada que decidir — Vitest ya viene puesto. Si tienes un proyecto existente con Karma, tienes una decisión real que tomar, y ahora sabes exactamente qué parte de esa migración es estándar y cuál sigue siendo experimental.

    Repasamos el resto de las novedades de v22 — de las que Vitest es solo una pieza — en el post de novedades de Angular v22. Y si quieres ver cómo aplicamos estos patrones en proyectos reales de producción, en Dominicode Labs es donde compartimos ese trabajo con la comunidad.


    Preguntas frecuentes sobre Vitest en Angular 22

    ¿Vitest reemplaza completamente a Karma en Angular 22?

    Reemplaza a Karma como default para proyectos nuevos, pero no lo elimina. Karma sigue soportado oficialmente y sigue siendo una opción documentada y válida si tienes un proyecto existente que prefieres no migrar todavía.

    ¿Necesito instalar plugins de terceros como Analog para usar Vitest en Angular 22?

    No. El soporte de Vitest está integrado directamente en el Angular CLI a través del builder @angular/build:unit-test. No necesitas ningún plugin de terceros para el flujo estándar — solo instalar vitest y jsdom (o happy-dom) como dependencias de desarrollo.

    ¿Cómo migro mis tests de Jasmine a Vitest automáticamente?

    Con el schematic ng generate @schematics/angular:refactor-jasmine-vitest, que convierte automáticamente la sintaxis de spies, matchers y bloques fit/fdescribe. No es una migración 100% automática: no instala dependencias, no migra polyfills ni assets, y los spies complejos necesitan revisión manual.

    ¿Qué le pasa a mis configuraciones de build al migrar de Karma a Vitest?

    Si tu configuración de build para tests (polyfills, assets, estilos) era distinta de tu configuración normal de desarrollo, no puedes moverla dentro del target test como hacías con Karma. El nuevo builder no lo soporta — tienes que crear una configuración de build dedicada, por ejemplo un target development separado.

    ¿Vitest funciona con testing zoneless en Angular 22?

    Sí, y de hecho es donde más se nota el cambio de paradigma: en lugar de llamar fixture.detectChanges() manualmente tras una interacción, usas await fixture.whenStable() para esperar el ciclo de detección de cambios asíncrono.

    ¿Debería migrar mi proyecto existente a Vitest hoy mismo?

    Si tu suite de tests es grande y crítica para producción, pruébalo primero en una rama o en un proyecto secundario antes de tocar el repo principal — la documentación oficial etiqueta esta migración como experimental. Depende, en última instancia, de tu tolerancia al riesgo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Testing en Angular con IA: tests que protegen de verdad

    Testing en Angular con IA: tests que protegen de verdad

    Le pedí a Claude que escribiera los tests de un componente de login. Me devolvió 14 tests. Todos verdes. El CI pasó sin problema.

    Dos semanas después, un bug llegó a producción. El formulario aceptaba contraseñas vacías si el campo estaba touched pero sin valor. Ninguno de esos 14 tests lo detectó.

    Los tests no fallaron porque el bug no existía para ellos. Los tests comprobaban que el componente existía, que el formulario se renderizaba, que el método onSubmit() se llamaba. No comprobaban el comportamiento. Eran tests de que el código había sido escrito, no de que el código hacía lo correcto.

    Este es el problema número uno del testing en Angular con IA: la IA genera tests que pasan, no tests que protegen.


    El problema real de los tests generados por IA

    Cuando le das a un modelo un componente Angular y le pides “escribe los tests”, le estás pidiendo que haga ingeniería inversa de tu implementación. Y eso es exactamente lo que hace.

    Lee el código. Ve que hay un loginForm con dos controles. Ve que hay un método onSubmit(). Ve que hay un AuthService. Y escribe tests que verifican que esas cosas existen y se llaman entre sí.

    El resultado son tests acoplados a la implementación, no al comportamiento. Si renombras onSubmit() a handleSubmit(), los tests fallan. Si cambias el nombre de una variable interna, los tests fallan. Pero si introduces un bug lógico — como que el formulario se envíe con campos vacíos — los tests siguen verdes.

    Esto no es un fallo del modelo. Es un fallo del prompt. Le preguntaste lo que no debías preguntar.

    Sin contexto del comportamiento esperado, la IA no tiene forma de saber qué casos importan. No sabe cuándo debería bloquearse el submit. No sabe qué errores deben mostrarse. Así que copia lo que ve: la implementación.


    El cambio de mentalidad que lo arregla todo

    No le pidas a la IA que escriba tests. Pídele que te ayude a pensar qué testear.

    Son dos tareas completamente distintas. La primera produce código. La segunda produce criterios. Y los criterios son lo que hace que un test sea útil.

    Un test útil parte de una pregunta: “¿qué debería pasar cuando X?” No de “¿qué hace este código?”

    El flujo correcto es este:

    1. Describe el comportamiento, no el código. No copies el componente en el prompt. Describe qué hace desde fuera. Qué ve el usuario. Qué espera. Qué debe pasar si hace algo incorrecto.
    2. Pídele que liste los casos de test. Solo los casos, sin código todavía.
    3. Revisa y aprueba esa lista. Añades los que faltan. Eliminas los redundantes. Este paso es el más valioso de todo el flujo — y es el que la mayoría de devs salta.
    4. Pide el código de test para cada caso. Con Jest y Testing Library, una vez que los criterios están claros.

    Ejemplo práctico con Angular 22

    Este es el componente. Un formulario de login con Reactive Forms en Angular 22:

    // login.component.ts
    import { Component, inject, signal } from '@angular/core';
    import { FormBuilder, ReactiveFormsModule, Validators } from '@angular/forms';
    import { Router } from '@angular/router';
    import { firstValueFrom } from 'rxjs';
    import { AuthService } from '../services/auth.service';
    
    @Component({
      selector: 'app-login',
      standalone: true,
      imports: [ReactiveFormsModule],
      template: `
        <form [formGroup]="form" (ngSubmit)="onSubmit()">
          <input formControlName="email" type="email" placeholder="Email" />
          <input formControlName="password" type="password" placeholder="Contraseña" />
          @if (errorMessage()) {
            <p class="error">{{ errorMessage() }}</p>
          }
          <button type="submit" [disabled]="form.invalid || isLoading()">
            {{ isLoading() ? 'Cargando...' : 'Entrar' }}
          </button>
        </form>
      `
    })
    export class LoginComponent {
      private fb = inject(FormBuilder);
      private auth = inject(AuthService);
      private router = inject(Router);
    
      form = this.fb.group({
        email: ['', [Validators.required, Validators.email]],
        password: ['', Validators.required]
      });
    
      errorMessage = signal('');
      isLoading = signal(false);
    
      async onSubmit() {
        if (this.form.invalid) return;
        this.isLoading.set(true);
        this.errorMessage.set('');
        try {
          await firstValueFrom(this.auth.login(this.form.value as { email: string; password: string }));
          this.router.navigate(['/dashboard']);
        } catch (err: any) {
          if (err.status === 401) {
            this.errorMessage.set('Credenciales incorrectas');
          }
        } finally {
          this.isLoading.set(false);
        }
      }
    }

    El prompt malo que genera tests inútiles:

    "Escribe los tests para este componente Angular."

    El prompt bueno, siguiendo el flujo de cuatro pasos:

    "Tengo un componente de login en Angular 22 con Reactive Forms.
    El comportamiento esperado es:
    - El botón está deshabilitado si el formulario es inválido o si está cargando
    - Al enviar credenciales válidas, se llama a AuthService.login()
    - Si AuthService lanza un error 401, se muestra 'Credenciales incorrectas'
    - Si tiene éxito, el router navega a /dashboard
    
    Lista primero los casos de test. Sin código todavía."

    Y estos son los tests resultantes con Jest y Testing Library para Angular:

    // login.component.spec.ts
    import { render, screen } from '@testing-library/angular';
    import userEvent from '@testing-library/user-event';
    import { LoginComponent } from './login.component';
    import { AuthService } from '../services/auth.service';
    import { provideRouter } from '@angular/router';
    import { of, throwError } from 'rxjs';
    
    describe('LoginComponent', () => {
      const mockAuthService = { login: jest.fn() };
    
      async function setup() {
        await render(LoginComponent, {
          providers: [
            { provide: AuthService, useValue: mockAuthService },
            provideRouter([{ path: 'dashboard', component: {} as any }])
          ]
        });
        return userEvent.setup();
      }
    
      beforeEach(() => jest.clearAllMocks());
    
      it('deshabilita el botón cuando el formulario está vacío', async () => {
        await setup();
        expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
      });
    
      it('deshabilita el botón con email inválido aunque haya contraseña', async () => {
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'no-es-email');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        expect(screen.getByRole('button', { name: /entrar/i })).toBeDisabled();
      });
    
      it('habilita el botón con credenciales válidas', async () => {
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        expect(screen.getByRole('button', { name: /entrar/i })).not.toBeDisabled();
      });
    
      it('llama a AuthService.login al hacer submit con datos válidos', async () => {
        mockAuthService.login.mockReturnValue(of({}));
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), '123456');
        await user.click(screen.getByRole('button', { name: /entrar/i }));
        expect(mockAuthService.login).toHaveBeenCalledWith({
          email: 'user@test.com',
          password: '123456'
        });
      });
    
      it('muestra mensaje de error cuando el servicio responde 401', async () => {
        mockAuthService.login.mockReturnValue(throwError(() => ({ status: 401 })));
        const user = await setup();
        await user.type(screen.getByPlaceholderText('Email'), 'user@test.com');
        await user.type(screen.getByPlaceholderText('Contraseña'), 'wrong');
        await user.click(screen.getByRole('button', { name: /entrar/i }));
        expect(await screen.findByText('Credenciales incorrectas')).toBeInTheDocument();
      });
    });

    La clave está en userEvent.type en lugar de fireEvent.input — con Reactive Forms en Angular, solo userEvent actualiza el FormControl correctamente en el entorno de test. Y el mock usa of({}) y throwError() de RxJS porque AuthService.login() devuelve un Observable.

    Esto es exactamente el enfoque que trabajamos en el curso de Testing en Angular con Jest y Testing Library: probar comportamiento, no implementación.


    Tests de servicios con IA: qué mockear y cómo describirlo

    Los servicios son donde más fácil es equivocarse al usar IA para testing.

    El error más común: pedirle a la IA que mockee el propio servicio para testearlo. Si mockeas AuthService en el test de AuthService, estás probando el mock, no el servicio.

    Lo que debes describirle a la IA es esto:

    "Tengo un AuthService en Angular 22 que inyecta HttpClient.
    El método login() hace POST a /api/auth/login con email y password.
    Devuelve un Observable<User>. En caso de error HTTP lo relanza tal cual.
    Escribe los tests usando provideHttpClient() + provideHttpClientTesting() y HttpTestingController.
    No mockees el servicio. Mockea solo el HttpClient."

    Con ese prompt, la IA sabe exactamente qué nivel de la pila debe sustituir:

    // auth.service.spec.ts
    import { TestBed } from '@angular/core/testing';
    import { HttpTestingController, provideHttpClientTesting } from '@angular/common/http/testing';
    import { provideHttpClient } from '@angular/common/http';
    import { AuthService } from './auth.service';
    
    describe('AuthService', () => {
      let service: AuthService;
      let httpMock: HttpTestingController;
    
      beforeEach(() => {
        TestBed.configureTestingModule({
          providers: [AuthService, provideHttpClient(), provideHttpClientTesting()]
        });
        service = TestBed.inject(AuthService);
        httpMock = TestBed.inject(HttpTestingController);
      });
    
      afterEach(() => httpMock.verify());
    
      it('hace POST a /api/auth/login con las credenciales', () => {
        const credentials = { email: 'user@test.com', password: '123456' };
        service.login(credentials).subscribe();
        const req = httpMock.expectOne('/api/auth/login');
        expect(req.request.method).toBe('POST');
        expect(req.request.body).toEqual(credentials);
        req.flush({ id: 1, email: 'user@test.com' });
      });
    
      it('devuelve el usuario cuando el servidor responde con éxito', () => {
        const mockUser = { id: 1, email: 'user@test.com' };
        let result: any;
        service.login({ email: 'user@test.com', password: '123456' })
          .subscribe(user => (result = user));
        httpMock.expectOne('/api/auth/login').flush(mockUser);
        expect(result).toEqual(mockUser);
      });
    
      it('relanza el error HTTP cuando el servidor responde 401', () => {
        let error: any;
        service.login({ email: 'user@test.com', password: 'wrong' })
          .subscribe({ error: err => (error = err) });
        httpMock.expectOne('/api/auth/login').flush(
          { message: 'Unauthorized' },
          { status: 401, statusText: 'Unauthorized' }
        );
        expect(error.status).toBe(401);
      });
    });

    La clave está en la instrucción: “mockea solo el HttpClient”. Esa precisión es lo que separa un prompt que genera tests útiles de uno que genera ruido.

    Si quieres ver cómo aplicar este patrón a servicios más complejos — con interceptores, state management y Signals — en el curso de Angular Moderno tienes la arquitectura base sobre la que todo esto encaja.


    Lo que la IA no puede hacer por ti

    La IA puede generar el código de test más rápido de lo que tú lo escribirías. No puede decirte qué casos importan en tu dominio de negocio.

    No sabe que en tu aplicación una contraseña vacía tiene un tratamiento especial. No sabe que hay un edge case cuando el usuario tiene sesión expirada y reintenta. No sabe que el botón de carga es crítico porque en producción la red va lenta y los usuarios hacen doble click.

    Ese conocimiento solo lo tienes tú. Tu trabajo es trasladarlo al prompt antes de pedir código. La IA amplifica lo que le das — si le das una descripción de comportamiento, amplifica eso. Si le das solo el código de implementación, amplifica eso.

    El flujo de cuatro pasos no es burocracia. Es el mínimo para que la IA genere tests que protejan algo.

    Si quieres llevar esta forma de trabajar más lejos — combinando especificaciones previas al código con IA para que los tests sean parte del diseño — eso es lo que construimos en el curso Construye con IA: de la Idea al Producto. Y si quieres acceso a los proyectos completos con suites de tests reales, los encontrarás en Dominicode Labs.


    FAQ

    ¿Puedo usar cualquier modelo de IA o Claude es el mejor para esto?

    El flujo de cuatro pasos funciona con cualquier modelo — Claude, GPT-4o, Gemini. La calidad del output depende mucho más de la calidad del prompt que del modelo. Dicho esto, Claude tiene ventaja en identificar casos borde cuando describes comportamientos complejos con muchas condiciones.

    ¿La IA puede generar tests TDD, es decir, antes de escribir el componente?

    Sí, y es el flujo ideal. Describes el comportamiento, pides los casos, apruebas la lista, pides el código de test — y luego le pides que implemente el componente para que esos tests pasen. Es TDD asistido por IA, y es especialmente potente para componentes nuevos.

    ¿Testing Library o Spectator para Angular?

    Testing Library porque te obliga a pensar en términos de comportamiento desde el principio. getByRole, getByPlaceholderText, findByText — todas esas queries buscan lo que el usuario ve, no lo que el código tiene internamente. Spectator facilita demasiado el acceso directo a la instancia del componente, lo que lleva a tests acoplados a implementación.

    ¿Cómo sé si un test generado por IA es bueno?

    Una heurística sencilla: introduce manualmente el bug más obvio en el componente y corre los tests. Si los tests siguen verdes, no valen nada. Por ejemplo, en el componente de login, pon if (true) return; al principio de onSubmit() — si el test de “llama a AuthService.login” sigue pasando, ese test no prueba nada. Esta técnica se llama mutation testing.

    ¿Vale la pena testear componentes de presentación puros?

    Depende de la complejidad. Un componente que solo muestra datos sin lógica condicional no necesita tests exhaustivos. Pero si tiene lógica de visualización — mostrar un badge según el estado, calcular clases CSS condicionalmente — esa lógica sí merece tests. Pregúntale a la IA: “¿qué comportamientos condicionales tiene este template que merecen ser testados?”


    *Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.*

  • Adopta TDD para implementar pruebas efectivas con agentes de IA

    Adopta TDD para implementar pruebas efectivas con agentes de IA

    Testing en la era de los agentes — TDD + agents, qué tests escribir tú vs cuáles el agente, snapshot testing inteligente

    Tiempo estimado de lectura: 5 min

    Ideas clave:

    • Usa tests como especificación (Test-Driven Prompting) y pide al agente implementar hasta que el test pase.
    • Los humanos deben definir contratos y tests críticos; los agentes pueden generar unit tests, edge cases y boilerplate bajo supervisión.
    • Cambia snapshots textuales por evaluaciones semánticas (LLM-judge) para reducir fragilidad.
    • Implementa un pipeline two-speed con sandboxes efímeros y telemetría sobre prompts y evaluaciones.

    Tabla de contenidos

    Introducción

    Testing en la era de los agentes — TDD + agents, qué tests escribir tú vs cuáles el agente, snapshot testing inteligente debe aparecer en tu playbook desde hoy. Si vas a dejar que un agente (Claude Code, Aider, Cursor u otros) escriba código en tu repo, tienes que reordenar qué pruebas son autoritativas, cuáles automatizas y cómo evitas cobertura falsa.

    Aquí está la estrategia práctica y accionable: cómo usar TDD como especificación, qué pruebas deben ser humanas, cuáles delegar a la IA, y cómo evolucionar los snapshots desde diffs frágiles a evaluaciones semánticas.

    Resumen rápido (lectores con prisa)

    Test-Driven Prompting aplica TDD a agentes: escribe el test como especificación y pide al agente implementar hasta que pase. Usa humanos para contratos, integración crítica y regresiones reales; delega unit tests deterministas y generación de edge cases al agente. Reemplaza snapshots textuales por una evaluación semántica (LLM-judge) que decide si un cambio es cosmético o funcional.

    Test-Driven Prompting: TDD + agents, qué tests escribir tú vs cuáles el agente

    Test-Driven Prompting es TDD adaptado a agentes. Escribes el test primero —no como un ejercicio de documentación, sino como la especificación no ambigua— y pides al agente que implemente hasta que el test pase. El test se convierte en el prompt más estricto que existe.

    Beneficios inmediatos:

    • El agente no improvisa requisitos; el test define el contrato.
    • Evitas cambios colaterales porque la suite actúa como guardrail.
    • La revisión humana se traslada de “¿funciona?” a “¿es esto sostenible y seguro?”.

    Pero atención: si el agente escribe la implementación y el test, obtendrás tautologías. Por eso la división de responsabilidades es crítica.

    División práctica: qué escribe el humano y qué el agente

    Lo que debe escribir el humano (no delegues)

    • Tests de integración críticos: pagos, auth, sincronización entre servicios. Requieren contexto de negocio y pruebas contra fallos reales.
    • Flujos E2E y guiones de usuario (Playwright, Cypress): definen la experiencia que no puede ser inferida por el agente. Playwright / Cypress
    • Tests de regresión con historial real: errores de producción documentados como tests que no pueden ser reinterpretados.
    • Setup de entornos y fixtures confiables: seeds de DB, contratos de mock globales.

    Lo que el agente puede generar (con supervisión)

    • Tests unitarios para funciones puras: transformaciones deterministas, utilidades, algoritmos puros.
    • Generación de edge cases y fuzzing estructurado: inputs nulos, límites, arrays extremos.
    • Boilerplate de mocks simples y factories (bajo reglas estrictas definidas por humanos).

    Pauta de revisión

    Cualquier test con mocking complejo (p. ej. jest.mock con comportamiento dinámico) debe pasar revisión manual antes de merge. Los LLMs tienden a “alucinar” APIs de mocking o a asumir comportamiento de librerías.

    Snapshot testing inteligente: de fragilidad a semántica

    Cómo funciona

    Los snapshots textuales mueren rápidos en repos de ritmo alto. La alternativa es snapshot testing inteligente: comparar semánticamente en lugar de por texto.

    Cómo funciona:

    • Generas snapshot tradicional (DOM/JSON).
    • Si cambia, un módulo de evaluación semántica (LLM-as-a-Judge) recibe: snapshot antiguo, snapshot nuevo y una rúbrica.
    • El modelo decide si el cambio es cosmético (aprobable) o funcional (falla y requiere revisión).

    Aplicaciones

    • UI: detectar si un botón cambió de estilo (aprobable) vs desapareció el control de envío (fallo).
    • APIs: admitir la adición de campos no utilizados por clientes y bloquear cambios en campos requeridos.

    Herramientas/ideas

    Construir un servicio interno que use un modelo de evaluación (ej. GPT-4o / Claude avanzado) y registre justificaciones estructuradas para auditoría.

    Pipeline recomendado y consideraciones operativas

    1. Golden Dataset de tests

    Golden Dataset de tests: 20–50 casos representativos versionados en Git. Sirve como baseline para evaluar cambios de spec.

    2. Two-speed CI

    • Cada PR: ejecución determinista rápida (linters, unit tests generados por agente, AST checks).
    • Merge/main: evaluación semántica completa (LLM-judge, snapshots semánticos).

    3. Sandbox seguro para deterministas

    Sandbox seguro para deterministas: ejecuta tests en contenedores efímeros sin red ni credenciales. Usa Firecracker o gVisor para aislamiento si ejecutas código generado automáticamente.

    4. Métricas y guardrails

    • Pass rate determinista por PR.
    • Delta semántico medio por cambio de spec.
    • Flakiness score (casos inestables entre ejecuciones).
    • Cost per eval (tokens, tiempo).

    Integración de herramientas de observabilidad: Promptfoo para orquestación local de evals, LangSmith para tracing, Braintrust para gestión de datasets.

    Checklist mínimo antes de confiar en un agente

    • Tests críticos escritos por humanos y en el repo.
    • Golden Dataset versionado y ejecutable en CI.
    • Sandbox efímero con timeouts y sin acceso a prod.
    • Reglas claras de qué puede commitear el agente automáticamente.
    • LLM-judge configurado para snapshots y revisiones semánticas.
    • Telemetría: registro de prompts, respuestas, tokens y justificación del juez.

    Conclusión: el rol del Tech Lead

    Testing en la era de los agentes no elimina la responsabilidad humana; la traslada a la definición de contratos, gobernanza y métricas. El Tech Lead debe decidir qué pruebas son la fuente de verdad, cómo se auditan las decisiones del agente y cuándo intervenir manualmente. Si tratas los tests como especificaciones inmutables y habilitas snapshots semánticos, los agentes dejan de ser generadores de ruido y pasan a ser máquinas de productividad que se pueden gobernar.

    Dominicode Labs

    Para equipos que exploran evaluaciones semánticas y pipelines con agentes, Dominicode Labs ofrece recursos y patrones reproducibles para integrar LLM-judges y sandboxes en CI. Considera esta referencia como una continuación práctica de las ideas descritas arriba.

    FAQ

    ¿Qué es Test-Driven Prompting?

    Test-Driven Prompting aplica la práctica de escribir tests como especificaciones antes de implementar. El test actúa como el prompt más estricto para el agente y define el contrato que debe cumplirse.

    ¿Qué pruebas nunca debo delegar a un agente?

    No delegues tests de integración críticos (pagos, auth), flujos E2E, tests de regresión con historial real y el setup de entornos/fixtures. Estos requieren contexto de negocio y control humano.

    ¿Cómo funcionan los snapshots semánticos?

    Los snapshots semánticos usan un módulo de evaluación (LLM-judge) que recibe el snapshot antiguo, el nuevo y una rúbrica, y decide si el cambio es cosmético o funcional, registrando justificación para auditoría.

    ¿Qué debo incluir en un Golden Dataset?

    Un Golden Dataset incluye 20–50 casos representativos, versionados en Git y ejecutables en CI. Sirve como baseline para validar cambios de especificación.

    ¿Cómo aislar el código generado automáticamente?

    Ejecuta código en contenedores efímeros sin red ni credenciales, aplica timeouts y usa tecnologías como Firecracker o gVisor para aislamiento.

    ¿Qué métricas seguir para confiar en un agente?

    Sigue métricas como pass rate determinista por PR, delta semántico medio por cambio de spec, flakiness score y cost per eval (tokens, tiempo). Complementa con telemetría de prompts y decisiones del juez.