Category: Spec Driven Development

  • Por qué tu spec falla con un agente de IA: 7 fallos y su arreglo

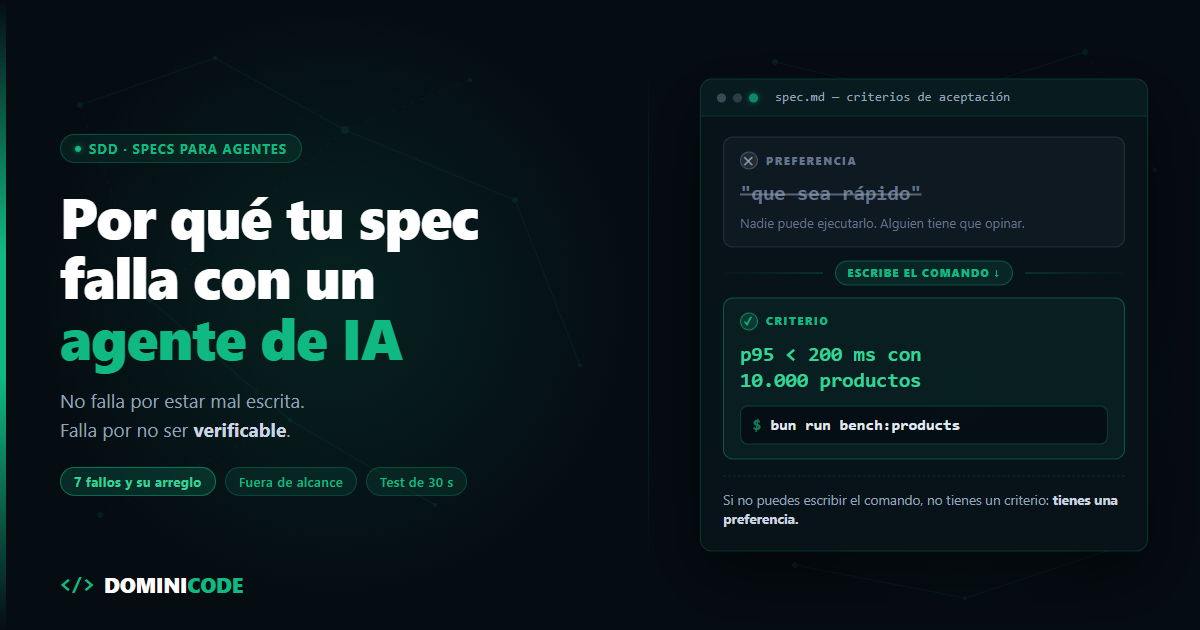
    Por qué tu spec falla con un agente de IA: 7 fallos y su arreglo

    La spec tenía 900 palabras, títulos bien puestos, listas numeradas y hasta un diagrama. El agente la leyó entera y construyó otra cosa.

    El dev que me la pasó estaba convencido de que el problema era el modelo. Probó con otro. Mismo resultado.

    Le hice una sola pregunta: cuando el agente termine, ¿qué comando ejecutas para saber si lo ha hecho bien?

    Silencio. No había ninguno.

    Ese silencio es el diagnóstico completo. La mayoría de las specs que fallan —también las de quien ya aplica Spec-Driven Development a diario— no fallan por estar mal escritas. Fallan por no ser verificables. Y una spec que no se puede comprobar no es una especificación: es una carta de intenciones. Un agente no ejecuta intenciones.

    El SDD no consiste en redactar un documento bonito antes de programar — de eso hablé cuando expliqué por qué el Spec-Driven Development evita el caos. Consiste en escribir un contrato que una máquina pueda dar por cumplido o por incumplido, sin que tú tengas que opinar.

    Esto no es otro tutorial de redacción. Para la estructura desde cero ya tienes la anatomía de una spec para Claude Code. Esto es el diagnóstico de la spec que ya escribiste y no funcionó.

    Siete fallos, ordenados por lo que más veo. Los cinco primeros los detectas leyendo el documento. Los dos últimos, no.

    Busca tu síntoma: por qué tu spec falla con un agente de IA

    Lo que ves cuando el agente termina El fallo en la spec El arreglo
    Dice "está hecho" y no sabes si está hecho Criterios de éxito no comprobables Un comando debajo de cada criterio
    Hace las cosas como las hace todo el mundo, no como tu repo Ambigüedad sin marcar Señala el fichero que manda
    Toca ficheros que nadie le pidió No hay límites Sección "Fuera de alcance"
    Ignora la mitad de tus instrucciones técnicas Mezcla el qué con el cómo Cierra el qué, deja el cómo abierto
    catch vacíos y fallos que devuelven 200 Solo describe el camino feliz Tabla de estados de error
    Empieza bien y se desmadra a la mitad La spec es demasiado grande Pártela por unidad verificable
    Cumple la spec, pero la spec ya no es verdad Spec desactualizada Vive en el repo o se borra

    Fallo 1: criterios de éxito que nadie puede comprobar

    Un criterio de éxito es comprobable cuando existe un comando que lo declara cumplido o incumplido sin que nadie opine. Este es el fallo padre: los otros seis son variaciones suyas.

    Mira esta spec. La he leído con distintos nombres decenas de veces:

    ## Feature: listado de productos
    
    Endpoint para listar el catálogo.
    Tiene que ser rápido y soportar filtros.
    La respuesta debe ser consistente con el resto de la API.
    Gestionar bien los errores.
    

    Cuatro frases. Tres deseos y un título. ¿Rápido comparado con qué? ¿Consistente con cuál de los catorce endpoints que ya tienes? ¿Gestionar bien es devolver un 400 o un 422?

    Ninguna de esas preguntas la puede responder el agente ejecutando algo. Así que las responde inventando, y tú te enteras después.

    Ahora la misma feature escrita para que se pueda comprobar:

    ## Feature: GET /products
    
    ### Criterios de aceptación
    1. `GET /products?limit=20` devuelve 200 con
       `{ items: Product[], nextCursor: string | null }`.
    2. Paginación por cursor sobre `created_at DESC, id DESC`.
       `GET /products?cursor=<nextCursor>` devuelve la página siguiente
       sin repetir ni saltarse elementos. Nada de offset/limit.
    3. `limit` acepta 1-100, por defecto 20.
       Fuera de rango devuelve 400 con `{ code: 'INVALID_LIMIT' }`.
    4. p95 por debajo de 200 ms con 10.000 productos en tabla.
    
    ### Cómo se verifica
    - `bun test test/products.e2e.ts` en verde (cubre los puntos 1 a 3).
    - `bun run bench:products` imprime el p95 y sale con código 1
      si supera los 200 ms.
    

    La diferencia no es la longitud. Es que la segunda tiene una sección Cómo se verifica.

    "Que sea rápido" es un deseo. "Que GET /products responda por debajo de 200 ms de p95 con 10.000 registros, y aquí está el comando que lo mide" es un criterio. El primero obliga a que alguien juzgue. El segundo se cierra solo.

    Regla corta: debajo de cada criterio, el comando que lo prueba. Si no puedes escribir el comando, no tienes un criterio, tienes una preferencia.

    Y cuando el criterio es ejecutable pasa lo interesante: puedes delegar el ciclo entero —escribe, ejecuta, lee el fallo, corrige— en lugar de revisar cada iteración a mano. Es el flujo diario que describí en cómo usar Claude Code a diario, y depende por completo de que exista ese comando.

    Fallo 2: la ambigüedad la rellena el modelo, no tú

    Todo hueco de la spec se rellena. Siempre. La pregunta no es si el agente va a improvisar, es con qué.

    Y improvisa con lo más común de su entrenamiento: la mediana de internet. Tu repo no es la mediana de internet.

    Si tu API pagina por cursor y la spec solo dice "con paginación", el agente escribe offset y limit, porque es el patrón que domina en el código público con el que se entrenó. Si tu proyecto devuelve Result en vez de lanzar, escribirá try/catch. Si tus tests usan Testing Library, te meterá un TestBed clásico.

    Ninguno de esos es un error del modelo. Son la respuesta estadísticamente correcta a una pregunta que no hiciste.

    Aquí está el matiz que casi nadie aplica: la spec no tiene que decirlo todo. Tiene que decir dónde no se puede improvisar.

    Y la forma más barata de decirlo no es describir tu patrón en tres párrafos. Es apuntar al código que ya lo hace:

    ### Referencias obligatorias
    - Paginación: copia el patrón de `src/orders/orders.controller.ts` (solo lectura).
      Si hay conflicto entre este documento y ese fichero, manda el fichero.
    - Errores: usa los helpers de `src/common/http-errors.ts`.
      Prohibido lanzar `Error` pelado.
    
    ### Libre elección
    - Nombres internos, orden de los métodos, dónde partes los helpers.
      No preguntes por esto.
    

    Ese último bloque parece de relleno y no lo es. Marcar lo que sí es libre evita el otro extremo: el agente que se para cada dos minutos a preguntar cómo llamar a una variable.

    Tu trabajo no es documentar el proyecto entero dentro de la spec. Es marcar las tres o cuatro fronteras donde una decisión razonable sería, en tu repo, la decisión equivocada.

    Fallo 3: no dice qué NO hacer

    Los desastres que he visto con agentes casi nunca vienen de lo que el agente no hizo. Vienen de lo que hizo de más.

    Le pides un endpoint y te reformatea 40 ficheros porque detectó que el estilo era inconsistente. Le pides un filtro y te instala una librería de query building. Le pides un fix y "de paso" refactoriza el módulo de auth, que estaba feo.

    Todo eso es técnicamente razonable. Ninguna spec lo prohibía.

    Los límites son parte del contrato, no una nota al margen:

    ### Fuera de alcance
    - No tocar `src/auth/**` ni `src/orders/**`.
    - No añadir dependencias. La paginación sale del query builder
      que ya está en `src/common/pagination.ts`.
    - No crear migraciones. Si hace falta un índice, lo propones
      en el PR y paras.
    - No cambiar la forma de respuesta de endpoints existentes.
    - No reformatear ficheros que no toque la feature.
    

    Cinco líneas. Te ahorran la revisión de un diff de 40 ficheros donde lo que importa está en tres. Es, por cierto, uno de los patrones que aparece una y otra vez en los errores comunes al adoptar Claude Code: falta de guardarraíles, no falta de capacidad.

    No es opinión mía: las buenas prácticas oficiales de Claude Code lo dicen con todas las letras — las specs más útiles "nombran los ficheros e interfaces implicados, declaran qué queda fuera de alcance, y terminan con un paso de verificación end-to-end que demuestra que la feature funciona". Los tres primeros fallos de esta lista son exactamente esas tres cosas, en negativo.

    Fallo 4: la spec que ya decide la implementación

    Este falla al revés que los anteriores. No peca de vaga, peca de mandona.

    Crea un `ProductsCacheInterceptor` en `src/products/interceptors/`.
    Usa un `Map<string, { data: Product[]; ts: number }>` en memoria.
    TTL de 60 s, limpieza con un `setInterval` cada 30 s.
    La clave del Map es `JSON.stringify(req.query)`.
    

    Eso no es una spec. Es pseudocódigo con saltos de línea.

    Y tiene un agujero que probablemente no has visto: JSON.stringify(req.query) genera claves distintas para ?limit=20&cursor=x y ?cursor=x&limit=20. Son la misma petición. El agente puede implementar ese documento al pie de la letra, perfectamente, y aun así pegarle dos veces a la base de datos.

    La versión que sí es un contrato:

    ### Criterio
    Dos peticiones con los mismos parámetros a `GET /products` en menos de 60 s
    golpean la base de datos una sola vez, independientemente
    del orden de los parámetros en la query string.
    
    ### Cómo se verifica
    `bun test test/products.cache.e2e.ts` — el test espía el
    repositorio y afirma que solo hubo una query.
    
    ### Restricciones
    Sin dependencias nuevas. Sin Redis: todavía no está en infra.
    

    Fíjate en la paradoja. La versión que no dice cómo implementarlo es más exigente que la que lo dictaba línea a línea. La primera se puede cumplir y estar mal. La segunda no se puede fingir.

    Además, cuando cierras el cómo, cierras también las soluciones mejores que la tuya. Y en cachés, colas y consultas, el agente propone alternativas buenas más a menudo de lo que resulta cómodo admitir.

    Tú decides el qué observable. Él decide el cómo. El test decide quién tiene razón.

    Fallo 5: la spec solo describe el camino feliz

    Abre tu última spec y cuenta cuántas líneas hablan de qué pasa cuando algo falla. Lo normal es cero.

    Aquí está la trampa: el agente no deja el manejo de errores sin hacer. Lo inventa. Y su versión inventada suele ser un catch que loguea y sigue, o un 200 con array vacío cuando la base de datos no responde. Un endpoint que miente en lugar de fallar.

    Cuatro filas arreglan esto:

    Caso Respuesta Qué se loguea
    cursor malformado 400 INVALID_CURSOR warn, sin volcar el cursor entero
    limit fuera de 1-100 400 INVALID_LIMIT nada
    Timeout de la base de datos (>2 s) 503 DB_TIMEOUT error, con query y duración
    Fila de producto sin precio se excluye del listado warn con el id

    La última fila separa una spec escrita por alguien que ha estado de guardia de una escrita de memoria. Los datos sucios existen, y si no decides tú qué hacer con ellos, decide el agente.

    Dos minutos de escritura. Es lo que hay entre un endpoint y un endpoint que puedes dejar sin mirar.

    Los dos fallos que no ves leyendo la spec

    Los cinco anteriores se detectan releyendo el documento. Estos dos solo aparecen cuando comparas la spec con el repo y con el tamaño del trabajo.

    Fallo 6: la spec es demasiado grande

    La unidad de una spec no es la feature, es el paso verificable. Si la sección "Cómo se verifica" no cabe en cinco líneas, no tienes una spec: tienes tres disfrazadas de una.

    El síntoma es inconfundible: el agente empieza bien y se desmadra a la mitad, porque cada decisión que toma amplía la superficie de las siguientes.

    Partir el trabajo en unidades que se cierran una a una es, literalmente, la mitad del método que enseño en Construye con IA. La otra mitad es no volver a abrir una unidad ya cerrada.

    Fallo 7: la spec está desactualizada

    La spec dice que el endpoint devuelve items, el código lleva tres semanas devolviendo data. El agente no tiene forma de saber cuál manda. Unas veces sigue al documento y otras al código, y ninguna de las dos es una elección tuya.

    La regla que uso: la spec vive en el repo, entra en el mismo PR que el código, y cuando se contradicen gana el código. Entonces actualizas la spec o la borras. Una spec muerta es peor que no tener spec, porque es contexto con autoridad que resulta ser mentira.

    El test de 30 segundos: ¿tu spec es verificable?

    Una spec es verificable si responde a tres preguntas por escrito. No hace falta reescribir nada para saberlo. Coge la que ibas a pasarle al agente y hazle estas tres:

    1. ¿Qué comando prueba que está terminada?
    2. ¿Qué ficheros no puede tocar?
    3. ¿Qué pasa exactamente cuando falla?

    Si las tres tienen respuesta escrita en el documento, la spec funciona. Si falta una, ya sabes dónde está el bug — y no está en el modelo.

    Empieza hoy por la primera. Coge tus criterios de aceptación y escribe debajo de cada uno el comando que lo demuestra. Los que se queden sin comando, o los conviertes en algo medible o los sacas de la spec, porque no van a pasar de deseo.

    Todo el sistema —el contrato verificable, los límites, cómo partir el trabajo y cómo mantener la spec viva junto al código— es lo que ordené en SDD: Spec-Driven Development. Si este post te ha señalado tres fallos en tu documento, ahí tienes el método completo para que no vuelvan.

    Y si prefieres verlo sobre proyectos reales, con specs de gente que las está usando en producción, es una de las conversaciones habituales en Dominicode Labs.

    Preguntas frecuentes

    ¿Cómo sé si mi spec es verificable?

    Una spec es verificable si cada criterio de aceptación tiene debajo un comando que devuelve verde o rojo sin que nadie opine. Un test, un benchmark, un script de validación, un curl con la respuesta esperada.

    La prueba rápida: pásale la spec a alguien que no conozca el proyecto y pídele que te diga si está hecha sin abrir el código. Si necesita preguntarte algo, el agente también lo habría necesitado, solo que él no pregunta.

    ¿Qué hago con los criterios que no se pueden medir con un comando?

    Los conviertes en algo observable o los sacas de la spec. "Que la UI sea intuitiva" no es un criterio, pero "que el flujo de compra se complete en tres clics desde la ficha de producto y no haya ningún campo obligatorio sin marcar" sí lo es, y se comprueba con un test end-to-end.

    Cuando de verdad no se puede —criterios estéticos, tono de los textos, decisiones de marca— déjalo fuera de la spec y márcalo como revisión humana explícita. Lo que no puede pasar es que quede dentro como si el agente pudiera resolverlo.

    ¿Cuánto debe ocupar una spec para un agente de IA?

    No la mides en palabras, la mides en unidades verificables. Una spec debe cubrir un trozo de trabajo que se cierre con una tanda de comprobaciones y una revisión.

    Si la sección "Cómo se verifica" ocupa más de cinco líneas o mezcla áreas del sistema que no comparten test, pártela. Dos specs de 300 palabras funcionan mejor que una de 900.

    ¿La spec sustituye a los tests?

    No, los ordena. La spec dice qué tiene que ser cierto y el test lo comprueba en cada ejecución.

    En la práctica la relación es más estrecha de lo que parece: si los criterios de aceptación están bien escritos, los nombres de tus tests salen casi copiados de ellos. Cuando un criterio no se deja convertir en un nombre de test, casi siempre es que el criterio estaba vago.

    ¿Por qué el agente ignora partes de mi spec?

    Rara vez las ignora. Lo habitual es que las haya interpretado de una forma que a ti no se te ocurrió, porque estaban abiertas a más de una lectura.

    Revisa esas partes buscando dos cosas: adjetivos sin unidad ("rápido", "robusto", "limpio") y sustantivos que en tu proyecto tienen un significado propio ("paginación", "validación", "caché"). Son los dos sitios donde el modelo rellena con lo más común de su entrenamiento en lugar de con lo que hace tu repo.

    ¿Qué hago si el agente toca ficheros que nadie le pidió?

    Añade una sección "Fuera de alcance" a la spec y trátala como parte del contrato, no como una nota al margen. Cinco líneas bastan: qué directorios no se tocan, que no se añaden dependencias, que no se crean migraciones, que no se cambia la forma de respuesta de endpoints existentes y que no se reformatea nada que la feature no toque. Los desastres con agentes casi nunca vienen de lo que no hicieron, sino de lo que hicieron de más, y ninguna spec se lo prohibía.

    ¿La spec tiene que decir cómo implementar la feature?

    No, y decirlo suele empeorar el resultado. Una spec que dicta la implementación línea a línea se puede cumplir al pie de la letra y aun así estar mal, porque el agente reproduce también tus errores de diseño. Una spec que fija el comportamiento observable y el comando que lo verifica no se puede fingir. Tú decides el qué, el agente decide el cómo, y el test decide quién tenía razón.

    ¿Dónde guardo la spec y quién manda si contradice al código?

    En el repositorio, junto al código, y entra en el mismo pull request que la implementación. Fuera del repo se queda desactualizada en semanas y se convierte en contexto falso.

    Cuando spec y código se contradicen, manda el código y la spec se corrige o se borra en ese mismo momento. Déjalo escrito dentro del propio documento: es la línea que evita que el agente tenga que adivinar cuál de las dos fuentes es la buena.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cuándo NO usar Spec-Driven Development: 6 casos que te frenan

    Cuándo NO usar Spec-Driven Development: 6 casos que te frenan

    Escribí una spec de tres páginas —objetivo, contratos de datos, casos de error, criterios de aceptación— para una integración que no llegó a existir.

    A la mañana siguiente abrí la documentación de la API y descubrí que el endpoint sobre el que se apoyaba la mitad de mis decisiones no devolvía lo que yo daba por hecho. Tiré el documento entero.

    La spec no estaba mal escrita. Estaba escrita antes de tiempo.

    Escribí el libro de Spec-Driven Development. Lo uso casi todos los días y sigo pensando que es la diferencia entre dirigir a un agente y rezarle. Por eso mismo puedo decirte esto sin que suene a excusa: hay trabajo donde SDD no compensa, y confundir "el método funciona" con "el método aplica siempre" te cuesta más horas de las que te ahorra.

    Una spec es un seguro, y a veces la prima cuesta más que el siniestro

    Escribir una spec tiene dos costes.

    El obvio es el tiempo. Ese lo ves y lo aceptas, porque sabes que la vas a recuperar en el primer malentendido que no ocurre.

    El segundo no lo ve casi nadie: una spec fija decisiones. Ese es su trabajo. Y fijar decisiones es fantástico cuando tienes la información para tomarlas, y carísimo cuando no la tienes, porque conviertes una suposición en un contrato y luego construyes encima.

    Todo el debate se reduce a comparar dos cantidades: lo que cuesta el error que la spec previene, y lo que cuesta escribirla ahora, con la información que tienes ahora. Cuando el error es caro e irreversible, la prima es barata a cualquier precio. Cuando el error se arregla con un git revert y un café, estás pagando un seguro contra un rasguño.

    La regla, en una frase: no escribas una spec cuando el coste de deshacer el error sea menor que el coste de escribirla; escríbela siempre que el error no se deshaga con un comando.

    Si has llegado aquí sin el contexto previo, en Spec-Driven Development: evita el caos de la IA está el método entero. Este post es la otra mitad: los seis sitios donde estuve pagando de más hasta que aprendí a mirar la factura.

    1. Cuando todavía no sabes lo que quieres

    Una spec responde a "qué vamos a construir". Un spike responde a "¿esto es siquiera posible?".

    Son preguntas distintas, y la segunda no se contesta escribiendo. Se contesta ejecutando. Cuando estás evaluando si una librería aguanta tu caso, si esa API devuelve lo que promete o si el modelo entiende tus documentos, el código no es la implementación de la decisión: es el instrumento de medida.

    Especificar ahí es adivinar con formato de documento. Y un documento bien maquetado tiene un efecto raro sobre el cerebro: le da a una suposición el aspecto de un hecho.

    Lo que sí necesita un spike son guardarraíles, y son tres:

    1. Una pregunta concreta escrita antes de empezar ("¿puedo procesar 500 facturas en menos de un minuto con este proveedor?"). Si no sabes formularla, no es un spike, es procrastinación con IDE.
    2. Una caja de tiempo. Cuatro horas, un día. Lo que quieras, pero decidido antes.
    3. El compromiso de tirar el código. Rama aparte, sin tests, sin abstracciones. Es YAGNI aplicado al documento: no especifiques por si acaso.

    El peligro real de un spike nunca fue no tener spec. Es que el prototipo se quede. El prototipo demuestra, no se promociona.

    Cuando llega la respuesta, escribes la spec. La exploración no sustituye a la spec: la alimenta. Ese salto del prototipo que demuestra al producto que se sostiene es justo lo que trabajamos en Construye con IA.

    2. Cuando el cambio cabe en tu cabeza y git revert lo deshace

    Subir un timeout. Añadir un índice. Cambiar el copy de un botón. Un campo más en un formulario que ya existe.

    Un diff de veinte líneas, un archivo, reversible en un comando. Escribir spec.md + plan.md + tasks.md para eso no es rigor. Es ceremonia.

    Y la ceremonia hace un daño que no se contabiliza: enseña a todo el mundo —incluido tú— que el proceso es un trámite. En cuanto una spec se percibe como trámite, todas las specs pierden autoridad. También las que sí importaban.

    El test que uso es de tres preguntas. ¿Puedes describir el cambio completo en una frase, sin "y" ni "además"? ¿El diff cabe en una pantalla? ¿Deshacerlo es un comando? Tres síes: abre el editor y hazlo.

    3. Cuando el código no va a sobrevivir a la semana

    Un script para limpiar una tabla una vez. Un notebook para sacar un número que te ha pedido alguien. Un endpoint de debug que borras el viernes.

    Una spec sirve para que otra persona —o tú dentro de seis meses— entienda una decisión. Si no va a haber ni otra persona ni dentro de seis meses, el documento no tiene a quién servir. El criterio de aceptación es ejecutarlo y mirar el resultado.

    La trampa está en otro sitio: el código temporal tiene la mala costumbre de volverse permanente. En cuanto ese script se ejecuta una segunda vez, deja de ser desechable y entra en el caso contrario.

    Mi regla: si dudo, la escribo. La duda ya es la señal de que la tarea es más grande de lo que parecía. Y si escribir la spec te está costando de verdad, echa un vistazo a la anatomía de una spec, porque a lo mejor el problema no es la tarea, es que estás escribiendo cuarenta líneas donde bastaban seis.

    4. Los bugs no se especifican, se reproducen

    Un bug no es una funcionalidad que falta. Es una diferencia entre lo que el sistema hace y lo que ya estaba dicho que tenía que hacer.

    O sea: la especificación ya existe. La escribiste cuando construiste la feature, o vive implícita en el comportamiento que todo el mundo daba por bueno hasta el martes pasado. Escribir un documento nuevo para describir algo que ya está descrito es duplicar la verdad, no aclararla.

    El artefacto correcto es un test que falla.

    Reproduce, aísla, escribe el test en rojo, arréglalo, deja el test dentro. Ese test es la spec de ese bug, con una ventaja que ningún markdown te da: es ejecutable, y cuando envejece te avisa el CI. Si alguien vuelve a romper eso dentro de seis meses, se entera antes que tú. Cómo se combina eso con dejar que la IA escriba la implementación lo desarrollé en TDD y spec-first con IA.

    Hay dos excepciones. La primera: nadie sabe decirte cuál sería el comportamiento correcto. Eso no es un bug, es un requisito sin decidir disfrazado de bug, y sí se especifica. La segunda: sabes perfectamente qué tiene que pasar, pero el arreglo es más grande que el fallo —rehacer la caché, tocar el modelo de concurrencia, cambiar un contrato que ya consume alguien—. El test sigue siendo obligatorio, pero describe el síntoma, no el rediseño. Eso se especifica igual.

    5. Cuando el dominio cambia bajo tus pies

    Si el requisito muda cada semana, la spec envejece más rápido de lo que tardas en ejecutarla. Y entonces tienes dos verdades: el documento y el código.

    Cuando hay dos verdades, los humanos resuelven el conflicto solos: dejan de leer el documento. Molesto, pero se sobrevive.

    El problema es el agente. Un agente no distingue una spec vigente de una obsoleta. No tiene forma de saber que ese párrafo lo invalidó una llamada del jueves. La lee, la trata como fuente de verdad y construye encima con toda la seguridad del mundo.

    La salida no es abandonar el método, es acortar el alcance. Specs de una semana en vez de specs de un trimestre. Especifica la parte del dominio que ya está congelada y deja explícitamente marcado lo que sigue en discusión. Una sección de "esto todavía no está decidido" vale más que tres páginas de decisiones falsas.

    6. Cuando la spec se ha convertido en teatro

    El síntoma es fácil de reconocer: escribes la spec después de tener el código.

    Eso no es Spec-Driven Development. Es documentación retroactiva, que no tiene nada de malo salvo el nombre que le pongas. El valor de la spec está en el orden, no en el archivo. Si el código ya existe, el documento no puede cambiar ni una sola decisión, que era exactamente para lo que servía.

    Hay dos síntomas más. El primero: nadie la lee, y lo sabes porque nadie te ha discutido nunca una línea. El segundo: las specs se copian de la anterior cambiando los nombres.

    Cuando aparece cualquiera de los tres, el problema no es el método. Es que lo estás aplicando en tareas donde no aportaba, y la gente lo ha notado antes que tú.

    Cuándo usar Spec-Driven Development y cuándo no: la tabla

    Tipo de trabajo ¿Spec? Por qué
    Spike para saber si algo es viable No — pregunta y caja de tiempo El código es la investigación; la spec fijaría decisiones sin información
    Cambio pequeño y reversible No — el propio diff Revertirlo cuesta menos que documentarlo
    Bug reproducible No — un test en rojo El test fija el comportamiento y además lo vigila el CI
    Código que no sobrevive a la semana No — el propio código El documento no tiene a quién servir
    Spec escrita después del código No — llámalo documentación Ya no puede cambiar ninguna decisión, que era su único trabajo
    Requisito que cambia cada semana Corta y con caducidad La spec envejece más rápido de lo que se ejecuta
    Feature nueva en un producto vivo Sí Otra persona la va a tocar y el error se paga meses después
    Migración o cambio del modelo de datos Sí, siempre El error no se deshace con git
    Trabajo que cruza servicios o equipos Sí, siempre La spec es el punto de sincronización, no el papeleo
    Tarea que delegas entera a un agente Sí, siempre Lo que no escribas, lo rellena inventando
    Auth, pagos, datos personales Sí, siempre El coste del fallo no es técnico

    Bajar de artefacto no es dejar de pensar

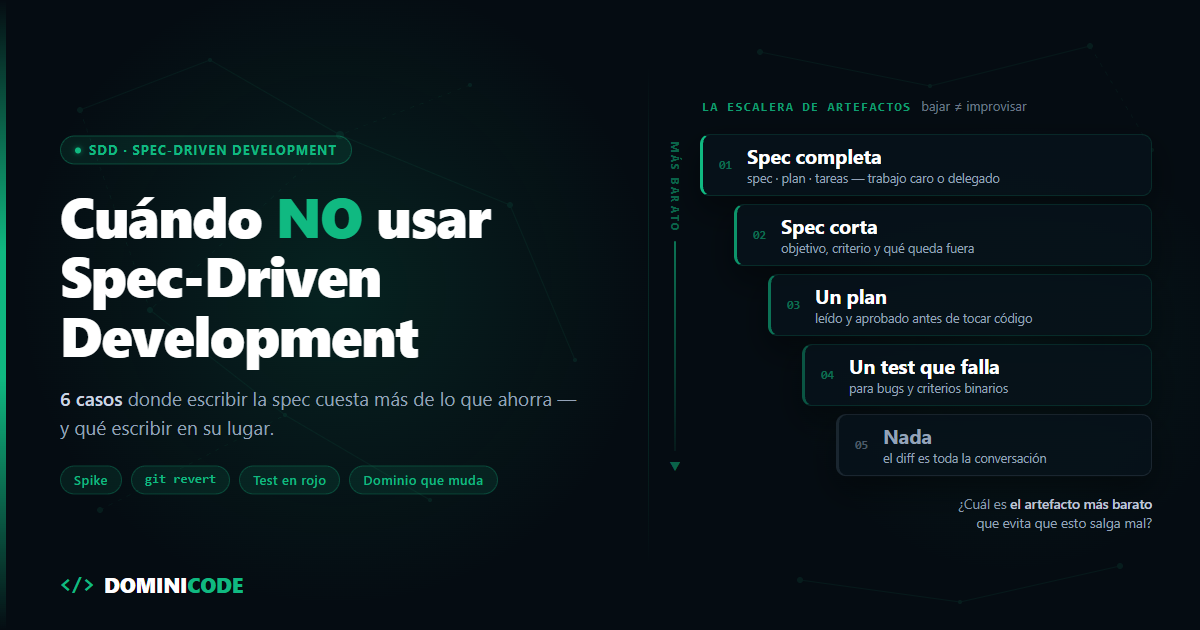
    La alternativa a una spec no es el caos: es un artefacto más barato. Hay cinco niveles, y solo el primero es una spec completa.

    1. Spec completa — spec, plan y tareas. Para trabajo caro, compartido o delegado entero.
    2. Spec corta — tres párrafos: objetivo, criterio de aceptación y qué queda fuera. El escalón que más uso.
    3. Un plan — el modo plan de Claude Code, leído y aprobado antes de que toque nada. Treinta segundos de lectura que evitan revisar un diff de novecientas líneas, como conté en cómo usar Claude Code a diario.
    4. Un test que falla — para bugs y para cualquier cosa con un criterio binario.
    5. Nada — y el diff es toda la conversación.

    La pregunta buena nunca fue "¿spec sí o spec no?". Es: ¿cuál es el artefacto más barato que evita que esto salga mal?

    Dónde Spec-Driven Development gana siempre

    La tabla ya dice dónde la spec no se discute: migraciones, modelo de dominio, auth, dinero. Nada de eso es nuevo. Lo que ha cambiado la ecuación, desde que los agentes de código empezaron a ejecutar tareas de varias horas sin supervisión, es la última fila: el trabajo que delegas entero a un agente.

    Antes la spec competía contra "lo hago yo, que ya me entiendo". Ahora compite contra revisar cuatrocientas líneas que alguien escribió interpretando lo que tú no llegaste a decir. Cuando delegas, cada hueco de la especificación se rellena con una invención plausible, y las invenciones plausibles son las más caras de detectar. Lo desarrollé en qué pasa cuando pides código sin spec.

    En ese escenario la spec deja de ser documentación. Es el prompt más caro que vas a escribir, y el único que se amortiza.

    Lo que haría yo mañana

    Coge la siguiente tarea de tu lista y hazte una sola pregunta antes de abrir el editor:

    Si esto sale mal, ¿cuánto cuesta deshacerlo?

    Si la respuesta es "un git revert", empieza a picar. Si la respuesta es "una migración de datos", "una llamada con otro equipo" o "un incidente en producción", escribe la spec antes de tocar una línea.

    No necesitas más criterio que ese. Los seis casos de este post son solo ejemplos de esas dos respuestas.

    El libro de Spec-Driven Development va justo de esto: hay un capítulo entero sobre la spec más corta que puedes escribir, además de las plantillas, el flujo con el agente y qué hacer cuando la spec y el código se separan. Si prefieres ver cómo lo aplica gente que ya lo tiene metido en su día a día, esa conversación pasa en Dominicode Labs.

    Saber cuándo no usar un método es la parte que nadie te enseña, y es la que separa aplicarlo de entenderlo.

    Preguntas frecuentes

    ¿Entonces Spec-Driven Development no sirve para proyectos pequeños?

    Sirve, pero el tamaño del proyecto no es la variable correcta. La variable es cuánto cuesta deshacer la tarea si sale mal y cuánta gente toca ese código. Un proyecto pequeño con una migración de datos y un cobro de por medio necesita spec. Un proyecto enorme donde vas a cambiar el texto de un botón, no. Y si dudas, escríbela: la duda suele significar que la tarea es más grande de lo que parecía.

    ¿Qué escribo en lugar de una spec cuando la tarea no la necesita?

    Bajas un escalón de artefacto, no bajas a cero. Hay cinco: spec completa, spec corta (objetivo, criterio de aceptación y qué queda fuera), un plan aprobado antes de tocar código, un test que falla, y nada. La mayoría del trabajo diario vive en los escalones dos y tres, no en el uno. La pregunta útil no es "¿spec sí o no?" sino cuál es el artefacto más barato que evita que eso salga mal.

    ¿Qué escribo en lugar de una spec cuando arreglo un bug?

    Un test que falla. Reproduce el fallo, aísla el caso mínimo, escribe el test en rojo, arregla el código y deja el test dentro del repositorio. Ese test cumple la misma función que una spec —fijar el comportamiento esperado— con dos ventajas: es ejecutable y el CI lo comprueba solo. La excepción es cuando nadie sabe cuál debería ser el comportamiento correcto; eso no es un bug, es un requisito sin decidir, y ese sí se especifica.

    ¿Puedo escribir la spec después de tener el código?

    Puedes, pero llámalo por su nombre: documentación. El valor de una spec está en el orden, porque su trabajo es cambiar decisiones antes de que se conviertan en código. Escrita después, no puede cambiar ninguna. Sirve para onboarding y para dejar constancia, y eso tiene su utilidad, pero no está gobernando nada.

    ¿Qué hago si los requisitos cambian cada semana?

    Acorta el alcance de la spec en lugar de abandonarla. Especifica solo la parte del dominio que ya está cerrada, marca de forma explícita lo que sigue en discusión y ponle caducidad al documento. El riesgo grande no es no tener spec, es tener una obsoleta: un agente no sabe distinguirla de una vigente y construirá encima con total seguridad.

    ¿Y si voy a delegar la tarea completa a un agente de código?

    Entonces escribe la spec aunque la tarea parezca pequeña. Cuando delegas, cada hueco que dejes sin especificar lo rellena el modelo con una suposición razonable, y esas suposiciones son las más difíciles de detectar revisando el diff. Ahí la spec no compite contra tu tiempo de escribir código: compite contra tu tiempo de revisar código ajeno, que siempre es más caro.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Spec-Driven Development (SDD): Evita el caos de la IA

    Spec-Driven Development (SDD): Evita el caos de la IA

    Hace unos meses un cliente me llamó desesperado. Habían decidido usar Cursor y Claude Code para acelerar el desarrollo de su nueva aplicación. El primer día escribieron 5.000 líneas de código y estaban maravillados con la velocidad.

    El segundo día, nada compilaba.

    El tercer día, la IA empezó a sobreescribir funciones previas, a alucinar APIs inexistentes y a meter bugs en bucle. Habían creado un monstruo de código spaghetti en tiempo récord.

    El problema no era la IA. El problema era que nadie le había dicho exactamente qué construir.

    Hoy te quiero explicar qué es Spec-Driven Development (SDD), la metodología de diseño que utilizo a diario para dar directrices claras a las IAs y evitar el caos en el código.


    El peligro de programar por "vibe coding"

    Cuando te sientas ante un editor como Cursor y le tiras prompts rápidos tipo "añade autenticación" o "agrega este formulario", estás haciendo vibe coding. La IA asume la arquitectura por su cuenta, inventa nombres de variables y adivina el modelo de datos.

    Esto funciona para landing pages sencillas, pero en proyectos reales produce tres efectos desastrosos:

    1. Código redundante: La IA vuelve a escribir funciones que ya existían porque no sabe dónde encontrarlas.
    2. APIs rotas: Se inventa endpoints que no coinciden con tu backend.
    3. Pérdida de control: El desarrollador deja de entender cómo funciona el sistema, convirtiéndose en un espectador pasivo.

    La solución no es dar mejores prompts conversacionales. La solución es dar especificaciones estructuradas.


    La regla de oro de SDD: Diseña antes de codificar

    La metodología Spec-Driven Development (SDD) establece que nunca debes dejar que un agente de IA escriba código hasta que haya aprobado un documento de diseño claro.

    Antes de tocar el teclado, debes estructurar tres archivos en la carpeta de especificaciones de tu proyecto:

    1. spec.md (La Especificación)

    Define la visión del producto, las reglas de negocio, los casos de uso y la arquitectura de datos. Responde al QUÉ se va a construir.

    2. plan.md (El Plan Técnico)

    Detalla la estrategia técnica paso a paso. Divide el desarrollo en fases incrementales y lógicas (por ejemplo, definir primero el esquema de base de datos antes de hacer la UI). Responde al CÓMO se va a construir.

    3. tasks.md (La Lista de Tareas)

    Una lista TODO detallada con tareas unitarias y autocontenidas. Cada tarea debe ser tan pequeña que la IA pueda completarla en una sola iteración y validarla con un test.


    El Flujo de Trabajo con tu Copiloto

    Una vez que tienes estos archivos, tu rol cambia de programador interactivo a director técnico:

    1. Le entregas el spec.md y el plan.md al agente de IA (ej: Claude Code).
    2. Le pides que lea las especificaciones y empiece a resolver la primera tarea del tasks.md.
    3. El agente implementa la tarea, corre los tests correspondientes y te avisa cuando está lista.
    4. Marcas la tarea como completada y pasas a la siguiente.

    Con este flujo, la IA no tiene que adivinar nada. Trabaja con un contrato de éxito claro y documentado.

    Este enfoque de ingeniería de software es el que trato en profundidad en mi libro de SDD: Spec-Driven Development, indispensable para cualquier desarrollador que quiera escalar sus desarrollos con IA en bucles agénticos u organizados. Además, es la metodología de base que aplicamos en todas las lecciones del curso de Construye con IA.


    Conclusión: La IA es el ejecutor, tú eres el arquitecto

    Delegar la escritura de código es seguro, pero delegar la arquitectura es un suicidio técnico. Al adoptar Spec-Driven Development, mantienes el control absoluto del diseño de tu software, reduces las alucinaciones de la IA a cero y multiplicas tu velocidad de desarrollo real.

    Si quieres aprender a estructurar tus specs y debatir sobre metodologías de ingeniería agéntica con otros desarrolladores senior, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué diferencia hay entre SDD y TDD?

    TDD (Test-Driven Development) se enfoca en escribir los tests unitarios antes que el código para guiar la implementación. SDD (Spec-Driven Development) va un paso más allá y exige redactar la especificación funcional y el plan técnico arquitectónico antes de escribir los tests o el código. Ambas metodologías se complementan perfectamente.

    ¿Por qué las especificaciones reducen las alucinaciones de la IA?

    Los LLMs tienden a alucinar cuando no tienen suficiente contexto o cuando las instrucciones son ambiguas. Un documento spec.md acota el espacio de decisiones que la IA debe tomar, forzándola a ceñirse a las reglas de negocio y arquitecturas declaradas en el archivo.

    ¿Cuánto tiempo toma escribir las especificaciones?

    Escribir un spec.md básico para una nueva feature suele tomar entre 15 y 30 minutos. Aunque parece un paso extra, te ahorra horas de depuración de código spaghetti mal estructurado por la IA en fases posteriores.

    ¿Se puede aplicar SDD a proyectos legacy o ya existentes?

    Sí. Al trabajar con código legacy, el primer paso es documentar el estado actual del componente afectado en un archivo de contexto (context.md) y redactar el spec.md detallando únicamente los cambios y adiciones a realizar, guiando a la IA sobre la base ya existente.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.

  • Loop Engineering: La evolución definitiva del desarrollo con IA

    Loop Engineering: La evolución definitiva del desarrollo con IA

    En 2021 instalé la primera beta de GitHub Copilot. Recuerdo la sensación de pulsar la tecla Tab y ver cómo el editor completaba una línea de código entera o sugería una función trivial. En aquel momento, parecía magia negra.

    Hoy, esa magia me parece prehistórica.

    El autocompletado de código y los asistentes de chat interactivos han dejado de ser el estado del arte. El desarrollo de software ha entrado en una fase más profunda: la era de Loop Engineering.

    Hoy te quiero explicar el viaje evolutivo que nos ha traído hasta aquí y por qué diseñar bucles de ejecución autónomos es la habilidad definitiva que diferenciará a los desarrolladores senior en los próximos años. En mi post anterior vimos cómo implementar este bucle agéntico de auto-aprendizaje con Hermes Agent, pero hoy nos enfocaremos en la filosofía de desarrollo.


    La Curva Evolutiva del Código con IA

    Para entender dónde estamos hoy, debemos analizar las cuatro iteraciones que ha vivido la inteligencia artificial aplicada a la programación:

    Iteración 1: El Tabulador Pasivo (Autocomplete)

    Es la era de GitHub Copilot clásico. La IA actúa como un autocompletado avanzado que predice los siguientes caracteres basándose en el contexto del archivo actual. Tú sigues sentado frente al teclado, picando código línea por línea, y la IA simplemente te ahorra pulsaciones.

    Iteración 2: El Asistente conversacional (Chat)

    La llegada de ChatGPT. Aquí el flujo pasa de la línea al bloque. El desarrollador copia un trozo de código roto, lo pega en una ventana de chat y le pide a la IA que lo arregle o añada tests. La IA devuelve el código corregido y el humano tiene que copiarlo, pegarlo de vuelta y probar si funciona.

    Iteración 3: El Desarrollo Agéntico interactivo (Cursor / Claude Code)

    El software empieza a tomar acción. La IA ya no solo te da texto: tiene herramientas. Puede leer tus archivos locales, realizar búsquedas, proponer planes y escribir código directamente en tu editor. Herramientas como Claude Code o Cursor actúan como un junior a tu lado que ejecuta órdenes en caliente, pero siguen requiriendo que estés frente a la pantalla validando y guiando cada paso.

    Iteración 4: Loop Engineering (Automatización autónoma)

    Aquí el desarrollador deja de programar de forma interactiva. En su lugar, diseña un bucle agéntico (agentic loop) cerrado. El desarrollador define una especificación de entrada y unas reglas de éxito claras.

    El agente ejecuta el plan, corre los tests, lee los errores de compilación, corrige su propio código en bucle y se auto-mejora sin que tú tengas que intervenir. Ese salto —de una IA que solo genera texto a una que actúa y verifica— es la diferencia entre IA generativa e IA agéntica, y es la que decide qué stack montas.


    ¿Por qué Loop Engineering es el fin del "Vibe Coding"?

    El vibe coding (sentarse a tirar prompts a un chat esperando que la IA cree tu app por arte de magia) tiene un límite claro: la complejidad. En proyectos reales, la primera propuesta de la IA casi nunca funciona a la primera. Requiere iteración.

    En el paradigma de Loop Engineering, tu trabajo ya no es guiar a la IA paso a paso. Tu trabajo es estructurar el entorno para que la IA se guíe a sí misma de forma segura:

    1. Definir especificaciones robustas: Antes de escribir una sola línea de código, necesitas definir la arquitectura en un documento claro. Este es el principio que defiendo en mi libro de SDD: Spec-Driven Development para dar a los agentes la directriz exacta de éxito.
    2. Entornos de Sandbox: Crear sandboxes seguros de Docker donde el agente pueda compilar y romper cosas sin peligro.
    3. Evals y Tests automatizados: El bucle necesita saber si ha tenido éxito. Si tus tests están bien diseñados, el agente puede correrlos en bucle hasta que todos pasen a verde.

    El desarrollador como Ingeniero de Bucles

    El futuro de nuestra profesión no es picar código rápido; es diseñar los sistemas que pican código.

    Un Ingeniero de Bucles (Loop Engineer) no le dice a la IA: "escribe esta función". Le dice: "este es el repositorio, este es el bug en producción, estas son las reglas de seguridad y este es el test que debe pasar. Llámame cuando el test esté en verde o si encuentras un bloqueo insalvable".

    Esta transición es exactamente la que aplicamos en el curso de Construye con IA para automatizar procesos de negocio complejos, y la que llevamos a su máximo exponente con herramientas de larga duración en el nuevo [curso de Agentes IA Autónomos en Producción con Hermes Agent]([ENLACE PENDIENTE]).


    Conclusión: Deja de picar código, diseña los bucles

    El autocompletado te hace un 20% más rápido. Un chat te ahorra un 40% del tiempo de investigación. Pero un bucle agéntico autónomo que trabaja en segundo plano te da un apalancamiento infinito.

    Si quieres debatir con otros desarrolladores senior sobre cómo diseñar estos pipelines de automatización y el futuro de nuestra profesión, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Qué es exactamente el Loop Engineering?

    Loop Engineering es la práctica de diseñar, estructurar y optimizar entornos de software cerrados donde los agentes de IA operan en bucles autónomos (planificar → codificar → probar → depurar) para resolver problemas de desarrollo complejos sin supervisión humana constante.

    ¿Cuál es la diferencia entre desarrollo agéntico y Loop Engineering?

    El desarrollo agéntico interactivo (como usar Cursor) requiere la supervisión constante de un humano que lee las propuestas de la IA y aprueba sus cambios paso a paso. Loop Engineering automatiza ese proceso delegando la iteración (las correcciones de compilación y pruebas de bugs) a un bucle de ejecución autónomo en segundo plano.

    ¿Qué rol juegan las especificaciones en el Loop Engineering?

    El agente de IA necesita saber cuándo ha completado la tarea de forma correcta. Un documento de especificaciones técnicas (Spec) bien estructurado actúa como el "contrato de éxito" que el agente utiliza para auto-evaluar sus propuestas de código en cada iteración del bucle.

    ¿Cómo puedo empezar a aplicar Loop Engineering hoy?

    Puedes empezar estructurando tus proyectos bajo el enfoque TDD (Desarrollo Guiado por Pruebas). Si creas tests unitarios claros antes de invocar a tu agente (como Claude Code), puedes configurarlo para que ejecute el comando de pruebas de forma recurrente y no detenga su ejecución hasta que todas las pruebas pasen con éxito.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
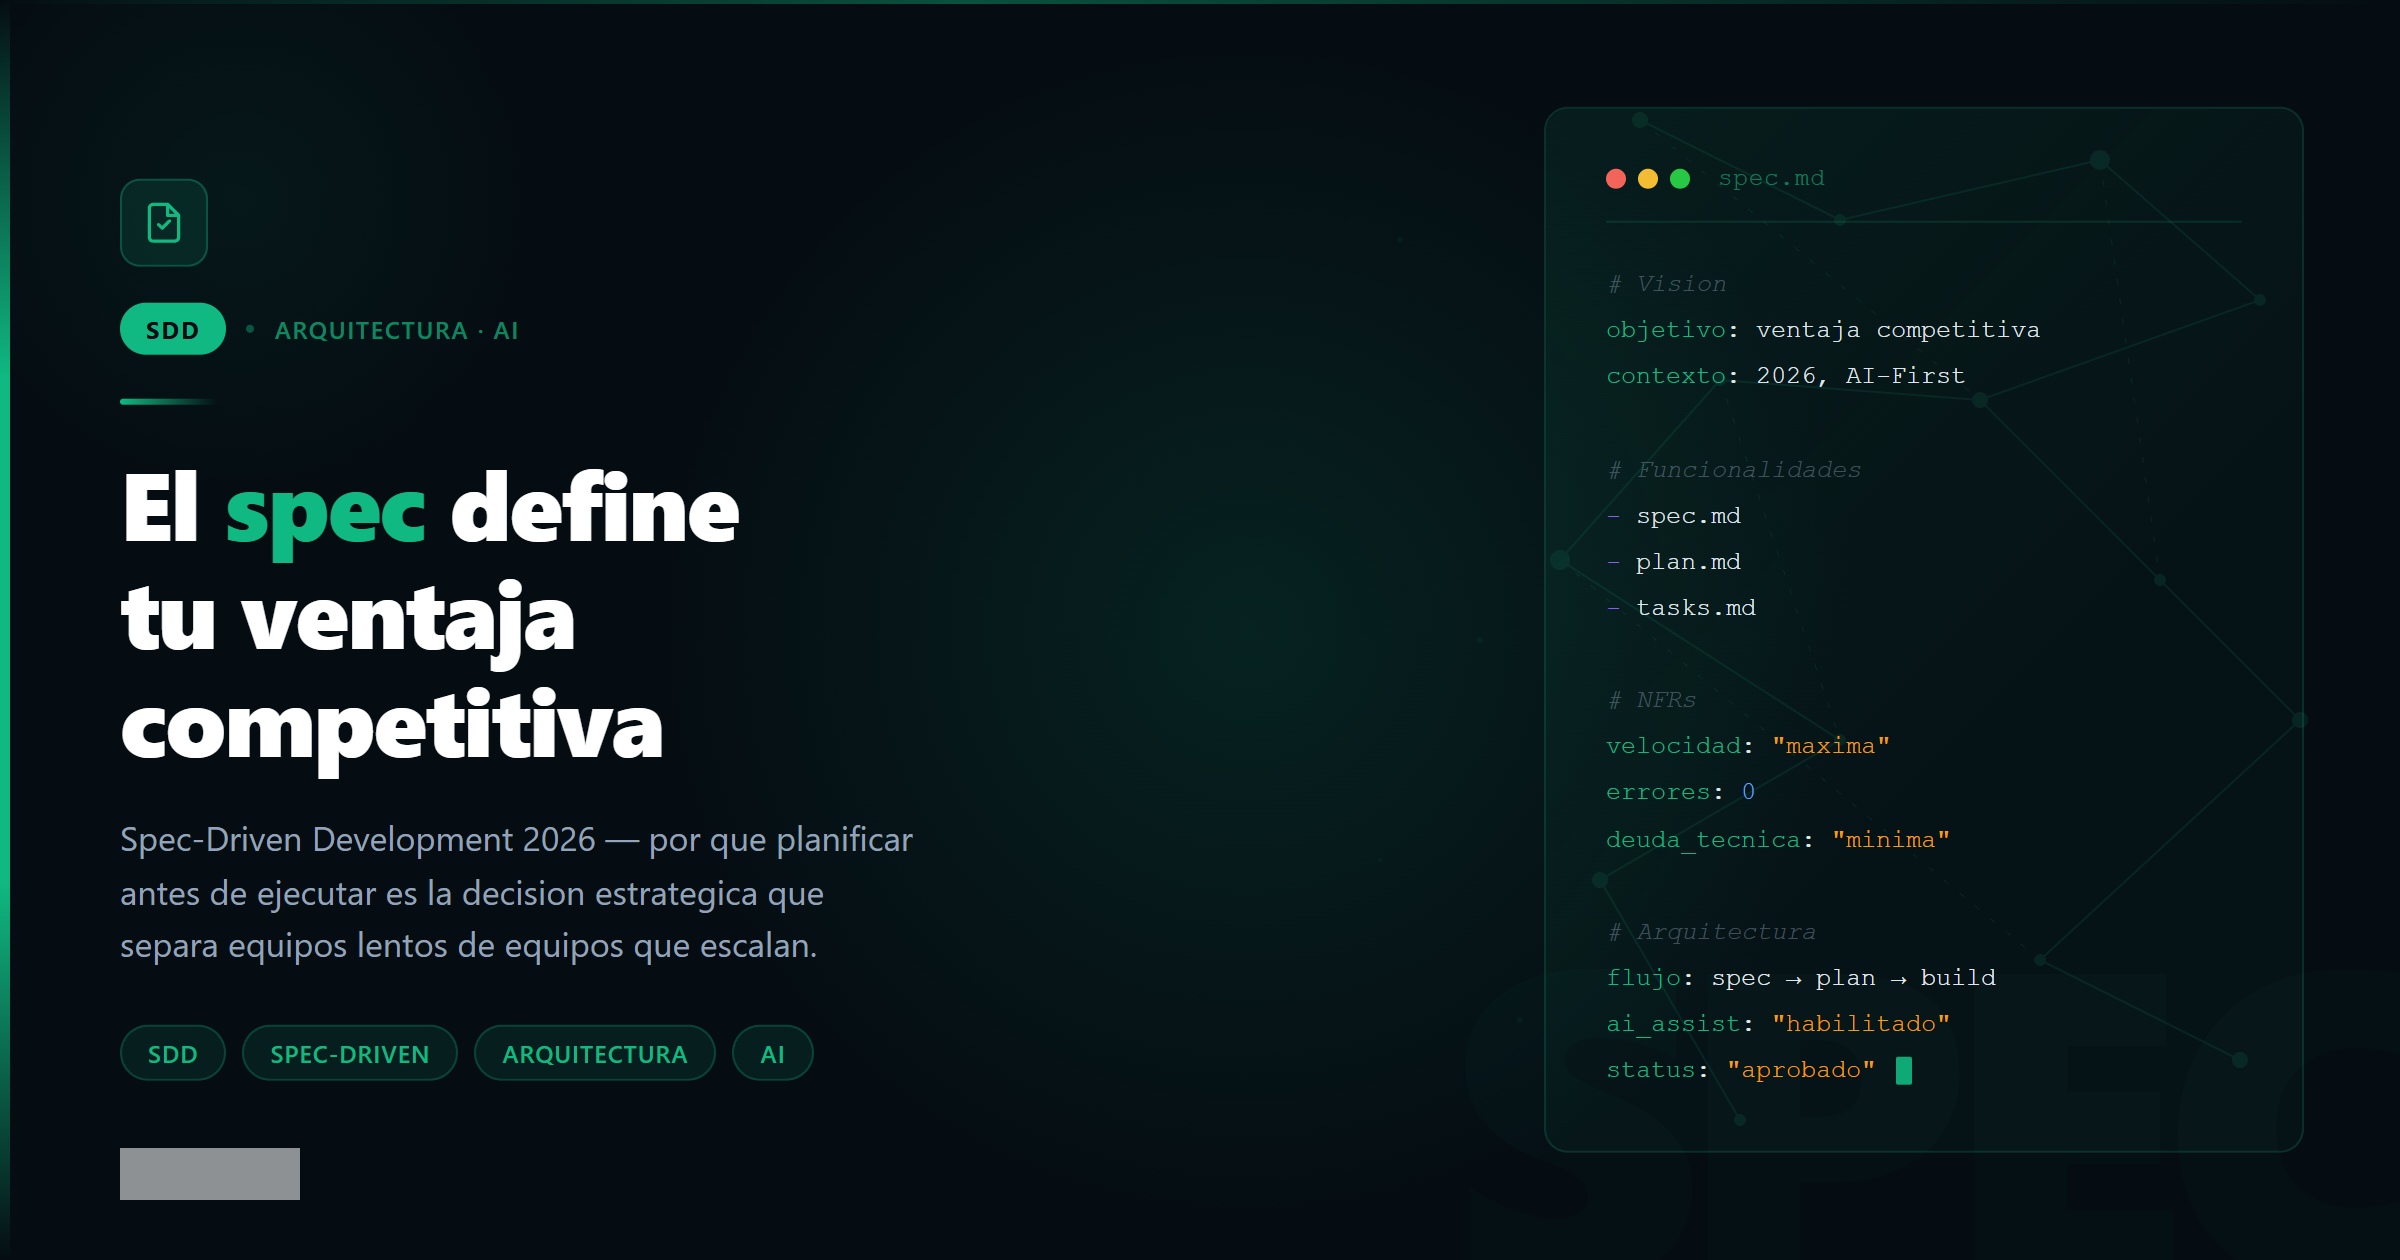
  • SDD 2026: por qué el spec define tu ventaja competitiva

    SDD 2026: por qué el spec define tu ventaja competitiva

    Un cliente me mandó su proyecto hace tres semanas. Llevaba dos meses usando Claude Code todos los días. El repositorio tenía 340 archivos. Tenía features. Tenía tests. El código compilaba.

    Y no tenía ni idea de qué hacía el sistema.

    Me preguntó: “¿Por qué cada vez que añado algo nuevo, rompo tres cosas que ya funcionaban?” La respuesta era visible desde el primer git log: llevaba dos meses pidiéndole a la IA que generara código sin decirle nunca qué estaba construyendo realmente. Cada prompt era una instrucción táctica. Nunca había una visión. Nunca un mapa.

    Eso es Spec-Driven Development (SDD) al revés. Y en 2026, con agentes que pueden escribir mil líneas en minutos, la diferencia entre los dos modos es la diferencia entre un producto y un desastre con tests.


    La IA no necesita que seas más rápido. Necesita que seas más claro.

    La narrativa que se vende sobre el desarrollo con IA es esta: “ahora puedes construir el doble de rápido”. Es verdad. El problema es que construir el doble de rápido sin dirección no te lleva antes a destino — te lleva el doble de lejos en la dirección equivocada.

    Los agentes de IA son ejecutores extraordinariamente potentes con cero criterio arquitectónico propio. Claude Code, GitHub Copilot, Cursor, cualquiera — siguen instrucciones. Si las instrucciones son vagas, el output es coherente localmente e incoherente globalmente. Cada archivo tiene sentido en sí mismo. El sistema entero no tiene sentido como conjunto.

    El spec no es documentación. No es burocracia. Es la única forma de darle a un agente de IA el contexto suficiente para que sus decisiones locales sean coherentes con la visión global.

    Sin spec, el agente está adivinando constantemente. Y adivina bien, frase a frase. Pero adivinar bien frase a frase no produce un párrafo con sentido — produce contenido que parece correcto y no lleva a ningún lado.


    Qué es SDD y por qué no es lo que crees

    Spec-Driven Development no es escribir documentación antes de programar. Eso es lo que la mayoría imagina y por lo que lo descartan: “ya tengo suficiente trabajo sin añadir Word docs al proceso”.

    SDD es una metodología de tres artefactos que define qué construyes, cómo lo construyes y en qué orden lo construyes — antes de que un solo agente escriba una sola línea de código.

    Los tres artefactos son:

    spec.md — el qué. La especificación estructurada del sistema. Tiene seis secciones fijas: Visión, Usuarios, Funcionalidades, Flujos, Arquitectura, NFRs. En total, tres o cuatro páginas que responden a la pregunta que ningún agente puede responder por ti: qué problema resuelves exactamente, para quién, y qué significa “hecho” en este proyecto.

    plan.md — el cómo. El plan técnico por fases. No divide el trabajo en tareas sueltas — divide el trabajo en capas que tienen sentido en secuencia. Primero el dominio, después la infraestructura, después la UI. No al revés. El plan.md es el documento que evita que empieces por la pantalla de login cuando el sistema de autenticación aún no existe.

    tasks.md — el orden. La lista de tareas ordenada para TDD. Cada tarea define qué test escribes primero y qué código lo hace pasar. El tasks.md convierte el plan en commits atómicos verificables. Cuando un agente ejecuta una tarea del tasks.md, el resultado es predecible: un test verde y un incremento de funcionalidad real.

    Estos tres documentos no tardan tres días en escribirse. Con el skill /dominicode-sdd-spec-creator en Claude Code (disponible para miembros de Dominicode Labs), la estructura completa se genera en minutos a partir de una descripción del proyecto. Lo que tarda tiempo es pensar — y ese tiempo es exactamente el que te ahorra deuda técnica después.


    Antes vs después: el mismo proyecto, dos formas de empezar

    Hace unos meses construí un sistema de gestión de contenido para automatizar la publicación en múltiples canales. El proyecto tenía integraciones con tres APIs externas, lógica de colas, transformaciones de formato y un dashboard de seguimiento.

    Sin SDD (como lo hubiera hecho en 2022): Habría abierto el editor, creado una carpeta src/, y empezado por la parte que más me apetecía — probablemente el dashboard. A las dos semanas tendría un dashboard bonito conectado a datos hardcodeados, una integración con una API que funcionaba en happy path, y ninguna certeza de cómo conectar las piezas. Cada decisión técnica habría sido local, sin visión del sistema completo.

    Con SDD: Antes de escribir código, escribí el spec.md. La sección de Flujos me forzó a pensar en qué pasa cuando una API falla en mitad de una publicación — algo que no habría considerado hasta toparme con el bug en producción. La sección de NFRs me hizo definir qué latencia máxima era aceptable para el sistema de colas. La sección de Arquitectura me hizo elegir entre evento-driven y polling antes de escribir nada — no a mitad del proyecto cuando cambiar de dirección cuesta semanas.

    El spec.md tardó dos horas. El plan.md, una hora más. El tasks.md, otra hora.

    Cuatro horas de especificación que eliminaron tres semanas de refactoring posterior.

    Cuando empecé a usar Claude Code en el proyecto, el agente tenía el spec.md en el contexto. Cada decisión técnica que tomaba era coherente con la arquitectura definida. No porque el LLM sea mágicamente más inteligente con un documento — sino porque el documento le daba información que de otra forma no tenía.


    El spec como brújula del agente

    Este es el cambio de mentalidad que más cuesta hacer: el spec no es para ti. Es para el agente.

    Cuando llevas quince años programando, tu cabeza tiene el contexto del proyecto. Sabes por qué elegiste ese patrón. Sabes qué módulo toca qué. Sabes los trade-offs que hiciste en la semana dos. Ese contexto vive en tu cabeza y lo das por supuesto.

    El agente no tiene nada de eso. Sin contexto explícito, cada sesión empieza desde cero. Cada prompt es una petición descontextualizada si no le das el marco. Sin spec, el agente responde a lo que le preguntas — no a lo que necesitas construir.

    Con el spec.md en contexto, el agente puede hacer preguntas que de otra forma no haría: “esta funcionalidad que me pides entra en conflicto con el flujo de usuario número tres que está en el spec — ¿quieres cambiar el flujo o ajustar la funcionalidad?”. Esa pregunta vale más que mil líneas de código generado sin contexto.

    Esta es exactamente la lógica detrás del libro Spec-Driven Development — no es un manual de documentación, es una metodología diseñada para que el agente tenga suficiente contexto para tomar decisiones correctas sin que tú estés micromanageando cada prompt.


    Por qué el spec te protege del vibe coding

    El vibe coding no es programar con IA. Es programar con IA sin criterio. Hay developers que publican proyectos enteros generados en un fin de semana. Impresionante en superficie. Inutilizable en producción.

    El problema del vibe coding no es la velocidad — es la ausencia de coherencia acumulada. Cada prompt genera código coherente con el prompt anterior, pero nadie garantiza que el sistema resultante sea coherente con la intención original. A las cuatro horas de vibe coding, el proyecto tiene forma de algo pero no tiene diseño. Tiene features pero no tiene arquitectura.

    Lo que se acumula en silencio no es código malo — es deuda técnica agéntica. El tipo de deuda que no se ve en los tests porque los tests también los generó el agente sin un contrato claro de qué probar. El tipo de deuda que explota cuando intentas añadir la feature número veinte sobre una base que asumió implícitamente cosas que nunca se definieron.

    Para entender por qué la arquitectura de tus agentes necesita un spec detrás, te recomiendo el post sobre agentic harness: por qué la spec y la arquitectura no bastan.

    SDD es el antídoto no porque ralentice el desarrollo. Lo acelera — pero acelera el desarrollo en la dirección correcta. La spec es el contrato que el agente respeta en cada iteración. El plan es la secuencia que evita que construyas la décima planta antes de los cimientos. El tasks.md son los commits que puedes revisar, aprobar y revertir si algo no cuadra.

    Con SDD, el vibe coding se convierte en agile coding con contexto — velocidad de agente, criterio de arquitecto.


    Cómo empezar con SDD en Claude Code hoy

    Si tienes Claude Code y quieres aplicar SDD en tu próximo proyecto, el proceso es directo:

    1. Describe tu proyecto en lenguaje natural — qué construyes, para quién, qué problema resuelve.
    2. Ejecuta el skill /dominicode-sdd-creator — genera spec.md, plan.md y tasks.md en pocos minutos (disponible en Dominicode Labs).
    3. Revisa el spec antes de tocar código — es el momento de pensar, no después.
    4. Añade el spec.md al contexto de Claude Code con @spec.md al inicio de cada sesión de desarrollo — la documentación oficial de Claude Code explica cómo gestionar el contexto entre sesiones.
    5. Trabaja el tasks.md en secuencia — un task, un test, un commit.

    El skill no reemplaza tu pensamiento. Te obliga a pensar antes de que sea costoso cambiar de dirección.

    El post sobre SDD Creator, la herramienta CLI muestra exactamente cómo se genera la estructura automáticamente.

    Si quieres ver cómo se aplica esto en un proyecto real de principio a fin — desde la spec inicial hasta el deploy — es exactamente lo que trabajamos en el curso Construye con IA: no tutoriales sueltos de herramientas, sino el proceso completo de construir un producto con IA de forma que funcione en producción.


    El spec como ventaja competitiva real

    Hay algo que nadie dice sobre SDD en 2026 y que merece decirse.

    En un mundo donde cualquier developer puede generar código a gran velocidad con IA, la diferencia competitiva no está en quién genera más rápido. Está en quién sabe exactamente qué construir y por qué.

    El spec es donde vive esa ventaja. No en el prompt. No en la elección del modelo. En la claridad con la que defines el problema antes de que empiece la ejecución.

    Los developers que entienden esto ya no compiten con los que “usan IA para programar más rápido”. Son una categoría diferente: developers que combinan criterio técnico con capacidad de ejecución agéntica. El spec es la expresión concreta de ese criterio.

    Dentro de doce meses, los equipos que hayan integrado SDD en su workflow tendrán bases de código mantenibles, documentación generada como efecto colateral del proceso, y la capacidad de incorporar nuevos agentes o nuevos developers sin que el proyecto colapse. Los que sigan con vibe coding habrán reescrito el proyecto tres veces.


    FAQ

    ¿SDD no es simplemente documentación con otro nombre?

    No. La documentación describe lo que existe. El spec define lo que va a existir — antes de que exista. La diferencia no es semántica: la documentación se escribe después y siempre está desactualizada. El spec se escribe antes y guía la implementación. Si el spec y el código divergen durante el desarrollo, es señal de que hay una decisión técnica que tomar conscientemente — no de que el documento esté equivocado.

    ¿Cuánto tiempo tarda escribir el spec de un proyecto real?

    Depende del proyecto. Para un MVP de funcionalidad acotada, entre dos y cuatro horas. Para un sistema con múltiples integraciones y flujos complejos, un día. El punto de referencia útil: si el spec tarda más de un día en escribirse, es señal de que el proyecto no está suficientemente definido para empezar a construirlo — y ese es el momento exacto en que el spec te está salvando, no ralentizando.

    ¿Se puede aplicar SDD a proyectos que ya existen?

    Sí, pero el proceso es diferente. En proyectos existentes, el spec se usa para nuevas features o para refactorizaciones significativas. El ejercicio de escribir el spec de un módulo existente es también un audit implícito: si no puedes escribir el spec del módulo, es porque el módulo no tiene diseño coherente. El spec revela la deuda técnica que el código oculta.

    ¿SDD funciona con cualquier agente de IA o solo con Claude Code?

    La metodología es agnóstica al agente. Spec.md, plan.md y tasks.md son documentos markdown que cualquier LLM puede usar como contexto. El skill /dominicode-sdd-spec-creator está diseñado para Claude Code y disponible en Dominicode Labs, pero los artefactos que genera son compatibles con cualquier entorno. Lo importante no es la herramienta — es el hábito de definir antes de ejecutar.

    ¿Qué pasa cuando el spec cambia durante el desarrollo? ¿No es todo ese trabajo en vano?

    El spec cambia. Siempre cambia. Y eso es una funcionalidad, no un fallo. Cuando el spec cambia, tienes un documento que actualizar — y esa actualización fuerza una decisión consciente sobre el impacto del cambio en la arquitectura, los flujos y las tareas pendientes. Sin spec, el cambio ocurre de forma invisible: alguien pide algo diferente, el agente lo implementa, y nadie sabe qué asunciones antiguas quedan rotas. Con spec, el cambio es visible y gestionable.

    ¿Es SDD compatible con metodologías ágiles?

    Completamente. SDD no impone un ciclo de desarrollo — impone un hábito de especificación antes de ejecución. Dentro de un sprint de dos semanas, el spec de las features del sprint se escribe al inicio. El plan.md define el orden de implementación dentro del sprint. El tasks.md genera los tickets concretos. SDD convierte el backlog en artefactos ejecutables para agentes, no en listas de deseos sin criterio técnico.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
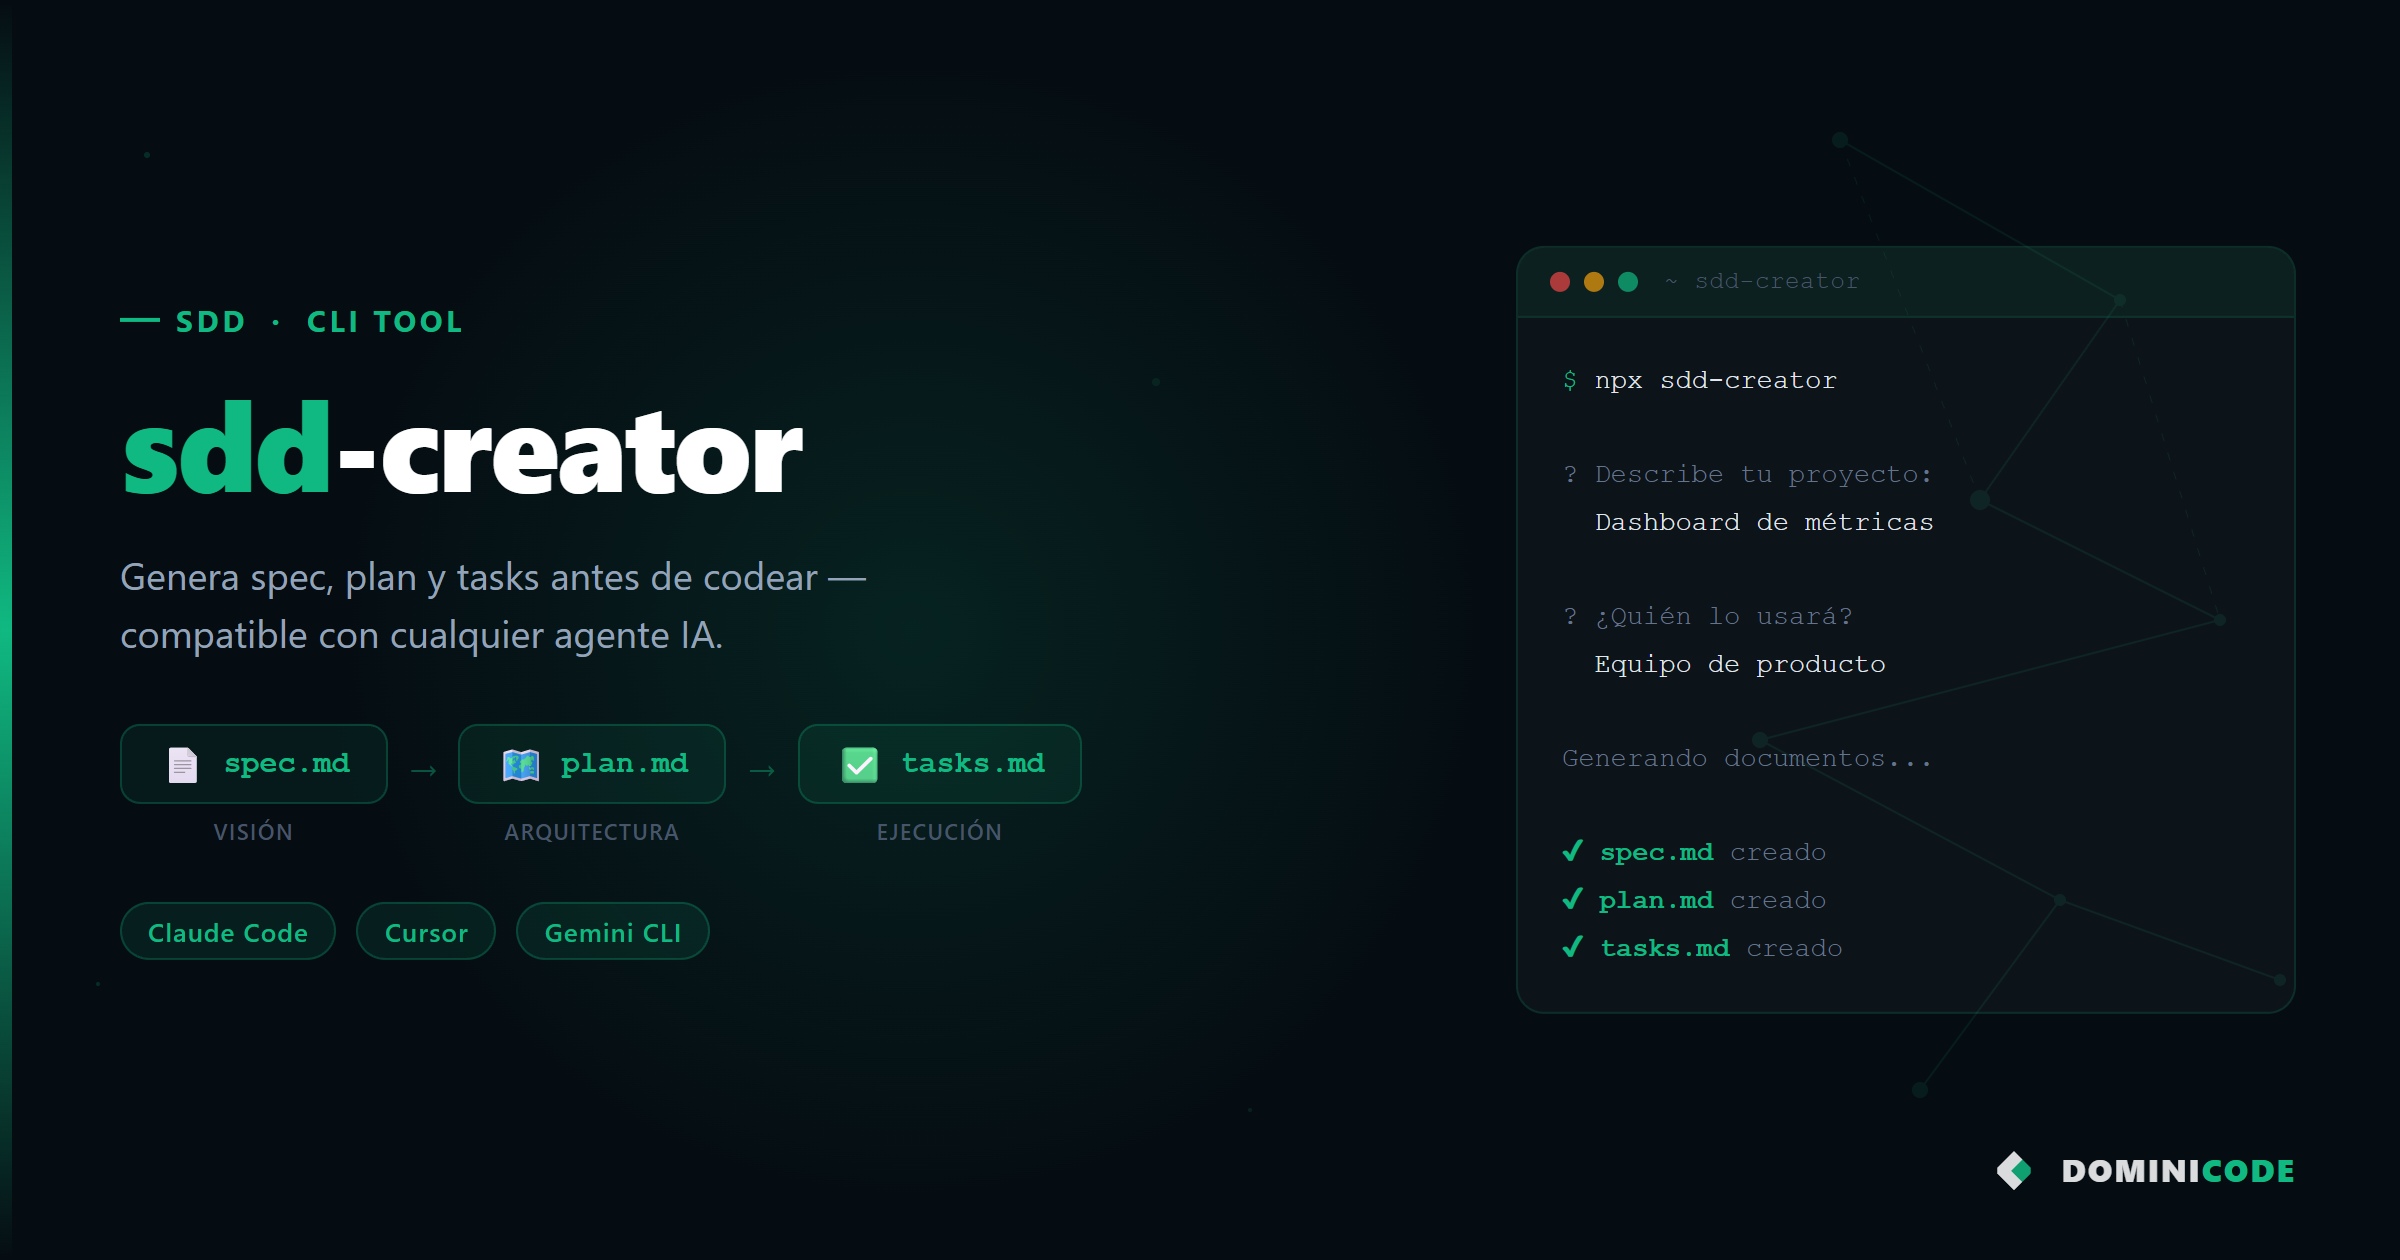
  • sdd-creator: genera spec, plan y tasks con cualquier agente IA

    sdd-creator: genera spec, plan y tasks con cualquier agente IA

    Llevaba tres horas implementando un sistema de autenticación con JWT cuando me di cuenta de que no había especificado nada.

    ¿El token debía expirar en la sesión o persistir entre reinicios? ¿Qué pasaba cuando el refresh token vencía estando el usuario activo? ¿El endpoint de logout invalidaba en servidor o solo limpiaba el cliente?

    Yo respondí esas preguntas sobre la marcha. Sin coherencia, sin registro de decisiones. El código resultó funcional pero arquitectónicamente un desastre.

    Eso no es un problema del agente. Es un problema de proceso. Para eso existe sdd-creator.


    El problema de codear sin especificar

    Los agentes de IA son extremadamente buenos ejecutando instrucciones. También son extremadamente buenos ejecutando instrucciones mal definidas — y el resultado es lo que imaginas.

    Cuando le das a Claude Code o a Cursor un prompt del tipo “implementa login con JWT”, el agente toma decisiones. Muchas. Las toma rápido, sin preguntarte, porque así trabajan. El output es código funcional que responde a una interpretación del problema, no necesariamente a tu interpretación.

    El fallo no está en la IA. Está en que nunca estableciste qué querías exactamente.

    Spec-Driven Development (SDD) resuelve esto con una premisa simple: antes de generar código, genera el spec. Un documento que responde qué hace la feature, por qué existe, quién la usa, qué flujos cubre y bajo qué criterios está terminada.

    El problema es que hacer bien un spec lleva disciplina. Y cuando tienes el agente abierto y las ganas de construir, la tentación de saltártelo es enorme.


    Qué es sdd-creator y cómo funciona

    sdd-creator es un skill para agentes de IA que impone el proceso de especificación antes de ejecutar cualquier implementación. No es un generador de documentos — es un interrogador. El agente no escribe código hasta que el spec esté completo y confirmado.

    A diferencia de pedirle directamente al agente que “genere un spec libre”, sdd-creator impone siempre las mismas 6 secciones y bloquea la implementación hasta recibir confirmación explícita. Sin esa estructura, los specs se convierten en párrafos de texto libre que el agente interpreta como quiere.

    El flujo tiene siete pasos:

    1. Describes el feature o proyecto que quieres construir
    2. sdd-creator detecta la complejidad (LOW / MEDIUM / HIGH)
    3. Te hace una entrevista interactiva — te pregunta lo que no especificaste
    4. Genera spec.md con 6 secciones estructuradas
    5. Espera tu confirmación antes de continuar
    6. Genera plan.md con las decisiones técnicas y la planificación por fases
    7. Genera tasks.md con las tareas ordenadas para TDD — y solo entonces empieza la implementación

    El repositorio está en GitHub: bezael/sdd-creator — MIT, v1.2.0.

    Si quieres entender la metodología detrás con más profundidad, el libro SDD cubre los principios completos, con patrones reales de proyectos en producción.


    Instalación

    Una sola línea:

    npx skills@latest add bezael/sdd-creator

    El CLI detecta tu herramienta y copia el skill al directorio correcto automáticamente. Como referencia, los directorios destino son:

    • Claude Code: ~/.claude/skills/
    • Cursor: .cursor/rules/ del proyecto

    No hay configuración adicional. No hay API keys. No hay dependencias de runtime. El skill vive como un archivo de instrucciones que el agente carga en contexto cuando lo invocas.

    Para instalación manual o integración con otros agentes, consulta la documentación oficial de Claude Code o los docs de tu herramienta.


    Tutorial paso a paso — feature de login con JWT

    Vamos con un ejemplo concreto. Tienes una app NestJS y quieres implementar autenticación con JWT. Sin sdd-creator, abres el agente y escribes: “implementa autenticación con JWT”. Con sdd-creator, el proceso es diferente.

    Paso 1 — Invoca el skill

    En Claude Code o en Cursor, activa sdd-creator. Luego describe tu feature:

    Quiero implementar un sistema de autenticación con JWT para una API NestJS.
    Incluye registro, login, refresh de token y logout.

    Paso 2 — La entrevista interactiva

    sdd-creator detecta complejidad media y empieza a preguntarte:

    • ¿El token de acceso expira en cuánto tiempo?
    • ¿El refresh token se invalida en servidor o solo en cliente?
    • ¿El endpoint de logout invalida todos los dispositivos activos o solo el actual?
    • ¿La app requiere rate limiting en los endpoints de auth?
    • ¿Los usuarios pueden tener múltiples sesiones simultáneas?

    Preguntas incómodas. Preguntas que el agente habría respondido solo — con su mejor criterio — si no le hubieras forzado a preguntarte.

    Paso 3 — Confirmas el spec.md

    El agente genera el spec.md completo. Lo revisas, corriges lo que no cuadra, y confirmas. Solo entonces avanza.

    Paso 4 — plan.md y tasks.md

    sdd-creator genera el plan técnico (decisiones de arquitectura, librerías, estructura de módulos) y la lista de tareas ordenadas para TDD. Primero los tests de los casos de error — token expirado, credenciales inválidas, refresh token revocado. Luego el código que los hace pasar.

    Resultado: el agente implementa exactamente lo que especificaste. Sin sorpresas. Sin decisiones implícitas. Sin “lo hice así porque parecía razonable”.


    Los 3 archivos que genera

    spec.md — La especificación en 6 secciones

    La estructura es fija e invariable:

    1. Visión — qué problema resuelve y por qué existe esta feature
    2. Usuarios — quién la usa y cuáles son sus necesidades reales
    3. Funcionalidades — qué puede hacer el sistema (listado concreto)
    4. Flujos — cómo se comporta el sistema en los escenarios principales
    5. Arquitectura — cómo está organizado técnicamente
    6. NFRs — requisitos no funcionales: performance, seguridad, disponibilidad

    La estructura fija es deliberada. Cuando el spec siempre tiene las mismas 6 secciones, puedes revisarlo en segundos y saber exactamente qué falta. Un spec libre en prosa no tiene esa propiedad.

    Si quieres ver cómo aplicar estas 6 secciones en un proyecto greenfield completo, este post sobre SDD con slices verticales lo cubre en detalle.

    plan.md — Las decisiones técnicas

    El plan responde: ¿cómo vamos a construir esto? Librerías seleccionadas y por qué. Estructura de módulos. Fases de implementación. Dependencias entre componentes. Riesgos identificados.

    No es un documento académico — es el registro de las decisiones que tomarías antes de empezar, aunque fueran en tu cabeza. Externalizar ese razonamiento tiene valor: el agente lo usa como referencia durante la implementación, y tú lo usas para hacer review.

    tasks.md — La lista ordenada para TDD

    Las tareas están ordenadas para Test-Driven Development. Los tests de los contratos del sistema van primero. El código que los satisface, después. Cada tarea es atómica — una sola responsabilidad, verificable por sí sola.

    Cuando tienes esta lista, puedes darle una tarea al agente y pedirle que haga solo esa. Sin divagar. Sin añadir “mejoras” que no pediste. La tarea acotada, con su test, con su criterio de aceptación.

    Esta es exactamente la forma de trabajar que desarrollamos en el curso Construye con IA — de la idea al producto real, con agentes IA y sin perder el control del código.


    Cuándo NO usar sdd-creator

    sdd-creator añade valor cuando el problema tiene suficiente complejidad para merecer una especificación. Hay casos donde el overhead no compensa:

    • Scripts de un solo uso: automatizaciones de 20-30 líneas que se ejecutan una vez y se descartan
    • Prototipos desechables: experimentos para validar si algo es técnicamente posible, sin intención de iterar sobre el código
    • Hotfixes triviales: corregir un typo, cambiar un color, ajustar un literal de texto

    La regla práctica: si el feature va a producción y va a ser mantenido, usa sdd-creator. Si es exploración o descarte, ve directo al código.


    Compatible con cualquier agente de IA

    sdd-creator no está atado a un agente específico. Funciona con todos los entornos de desarrollo con IA más usados:

    Agente Tipo de integración Directorio
    Claude Code Skills nativo ~/.claude/skills/
    Cursor Rules .cursor/rules/ del proyecto
    Codex CLI (OpenAI) AGENTS.md / system prompt Configuración de proyecto
    Gemini CLI System prompt Configuración de proyecto
    Aider Contexto personalizado .aider.conf.yml
    Continue config.json .continue/

    El formato MIT también significa que puedes adaptarlo a tu equipo. Si tienes convenciones de nomenclatura propias, o secciones adicionales en tus specs, puedes forkear el repositorio y ajustarlo.


    FAQ

    ¿Qué es sdd-creator?

    sdd-creator es un skill para agentes de IA que implementa el flujo de Spec-Driven Development. Cuando lo activas, el agente no escribe código directamente — primero te hace una entrevista para entender el problema, luego genera tres documentos estructurados (spec.md, plan.md, tasks.md), y solo después implementa. Es la diferencia entre darle instrucciones a un agente y darle una especificación.

    ¿Con qué agentes de IA funciona sdd-creator?

    Con Claude Code, Cursor, Codex CLI (OpenAI), Gemini CLI, Aider y Continue. El skill es un archivo de instrucciones, no una integración específica — cualquier agente que soporte archivos de contexto puede usarlo. La instalación varía: en Claude Code se copia a ~/.claude/skills/, en Cursor va a .cursor/rules/.

    ¿Cuánto tiempo lleva generar la spec con sdd-creator?

    Entre 5 y 20 minutos, dependiendo de la complejidad del feature. Una feature simple puede especificarse en 5 minutos. Una feature con múltiples flujos, integraciones externas y requisitos de seguridad puede tomar 20. Ese tiempo es siempre menor que el que cuesta refactorizar código que el agente implementó sin especificación.

    ¿Es sdd-creator compatible con proyectos legacy?

    Sí. SDD no requiere empezar desde cero — puedes aplicarlo feature a feature sobre una base de código existente. El spec refleja las restricciones reales del sistema existente: qué puedes cambiar, qué no, y qué deuda técnica tienes que tener en cuenta durante la implementación.

    ¿Puedo usar sdd-creator en equipos?

    Sí, y es donde más valor aporta. El spec.md generado es el contrato de la feature — cualquier miembro del equipo puede revisarlo, cuestionarlo y aprobarlo antes de que empiece la implementación. Elimina el “yo entendí que…” de las reuniones de review.


    Ahora, cuando tengo el agente abierto y las ganas de construir, lo primero que activo es sdd-creator. Los 15 minutos de spec se pagan solos. Esas tres horas de JWT no se van a repetir.

    Si quieres ver cómo SDD encaja en el ciclo completo de desarrollo con IA — desde la idea hasta el producto desplegado — en Dominicode Labs tienes acceso a proyectos reales donde aplicamos este flujo de principio a fin.

    Por Bezael Pérez — Fundador de Dominicode.

  • Las 4 habilidades que definen al programador en la era de la IA

    Las 4 habilidades que definen al programador en la era de la IA

    Un cliente me llamó a las 11 de la noche. Me dijo que su equipo llevaba tres semanas con Claude Code y que la productividad se había disparado. Más código por sprint. Menos bugs. Entregas más rápidas.

    Pero había un problema.

    "Bezael, el equipo construye muy rápido. El problema es que construye muy rápido la cosa equivocada."

    Tres semanas generando código con IA. Código correcto, bien estructurado, con tests. Y un producto que no resolvía lo que el cliente necesitaba.

    Ese es el nuevo riesgo para el programador en la era de la IA. No que la IA te reemplace escribiendo código. Sino que la velocidad de producción amplifique el coste de tomar decisiones equivocadas. Antes tardabas un mes en construir algo mal. Ahora tardas tres días.

    Lo que separa a los developers que avanzan de los que se atascan no son sus habilidades técnicas. Son cuatro habilidades del programador en la era de la IA que ningún LLM puede suplir.


    Las habilidades del programador en la era de la IA que este post desarrolla son cuatro: entender el problema real antes de escribir una línea, comunicar la solución a stakeholders no técnicos, especificar con precisión lo que el agente debe construir, y negociar trade-offs cuando los requisitos chocan. Son las habilidades que la IA no puede ejecutar por ti — y las que determinan si su velocidad se convierte en ventaja o en ruido.


    Por qué el código ya no es el cuello de botella del programador en la era IA

    Durante veinte años el cuello de botella en el desarrollo de software fue escribir el código. Encontrar developers. Escalar equipos. Mantener la velocidad.

    Eso ha cambiado.

    Hoy un developer con Claude Code puede producir en un día lo que antes llevaba una semana. Los agentes no se cansan, no tienen bloqueos creativos, y no discuten sobre si usar tabs o spaces. El Stack Overflow Developer Survey 2025 documenta que más del 75% de developers ya usa o planea usar herramientas de IA en su flujo de trabajo — el cambio está aquí.

    Pero los agentes hacen exactamente lo que les pides. Ni más, ni menos. Y si lo que les pides es impreciso, ambiguo, o directamente equivocado, producen código impecable que resuelve el problema equivocado.

    El cuello de botella se ha desplazado. Ya no está en escribir. Está en pensar.


    Habilidad 1: Entender el problema real antes de abrir el editor

    Esta es la más subestimada y la que más dinero cuesta cuando falla.

    Un cliente te dice: "Necesitamos un dashboard con métricas en tiempo real." Un developer técnico abre el editor y empieza a pensar en WebSockets, en qué charting library usar, en cómo estructurar el backend.

    Un developer con criterio hace una pregunta primero: "¿Para qué vas a usar ese dashboard? ¿Quién lo mira y qué decisión toma a partir de lo que ve?"

    Esa pregunta cambia todo.

    A veces el dashboard en tiempo real que pedían era en realidad un email diario con tres métricas. A veces era un CSV que se cargaba en Excel. A veces ni siquiera era un problema de visualización — era un problema de que nadie en la empresa sabía qué datos tenía disponibles.

    Con IA esto se vuelve crítico. Porque ahora la velocidad de producción es tan alta que el coste de empezar en la dirección equivocada es enorme. Construyes tres features completas en el tiempo que antes tardabas en escribir media. Si las tres están mal orientadas, has quemado tres veces más tiempo que antes.

    La habilidad de entender el problema real — no el síntoma que te describen, sino la causa raíz que lo genera — es la que protege todo lo demás.

    No se aprende con más cursos de programación. Se aprende haciendo preguntas incómodas antes de escribir una línea.


    Habilidad 2: Comunicar la solución a quien no es técnico

    El código más elegante del mundo no vale nada si nadie en la empresa entiende qué resuelve ni por qué importa.

    Esto ha sido siempre un problema para los developers. Pero con IA se vuelve más urgente, porque ahora eres capaz de construir cosas más complejas, más rápido, con más capas de abstracción. Y cuanto más complejo es lo que construyes, más difícil es explicarlo a quien toma las decisiones de negocio.

    La comunicación técnica a stakeholders no técnicos no es "simplificar para que lo entienda un niño". Es traducir impacto.

    Un stakeholder no necesita entender cómo funciona una cola de mensajes asíncrona. Necesita entender que gracias a esa cola, el sistema puede procesar diez mil pedidos en paralelo sin que ningún usuario espere más de dos segundos. Eso sí lo entiende. Y eso sí cambia cómo percibe el valor de lo que has construido.

    Esta habilidad también protege tu trabajo. Si tu contribución es invisible para quien decide los presupuestos, eres vulnerable. Si puedes hacer visible el impacto técnico en términos de negocio, eres indispensable.

    Practica esto: después de cada feature que entregues, escribe en dos frases qué problema de negocio resuelve y qué habría pasado sin ella. Si no puedes hacerlo, tienes un problema antes de que alguien externo lo detecte.

    Hay un ejercicio que funciona muy bien para esto: antes de la próxima reunión de sprint, prepara una explicación de lo que estás construyendo en menos de 60 segundos, sin usar términos técnicos. Si necesitas más tiempo o tienes que recurrir al jargon, la feature aún no está suficientemente clara en tu cabeza. Esa claridad — la que te permite explicarla en voz alta — es exactamente la que también necesitas para especificarla bien para un agente.

    Esta habilidad se conecta directamente con la siguiente. Un developer que no puede explicar lo que construye a un humano tampoco puede especificarlo con precisión para una máquina.


    Habilidad 3: Especificar con precisión lo que el agente debe construir

    Esta es la habilidad nueva. La que no existía como tal hace tres años y que ahora es central.

    Los agentes de IA son ejecutores extraordinarios de instrucciones precisas. Son ejecutores pésimos de instrucciones vagas.

    "Construye un sistema de autenticación" puede producir cualquier cosa desde un JWT básico hasta un sistema OAuth completo con múltiples proveedores y gestión de sesiones. El agente hará algo. Y lo que haga puede ser técnicamente correcto y completamente inadecuado para tu contexto.

    Especificar bien significa definir:

    1. Qué hace el sistema — comportamiento concreto, no intención abstracta
    2. Qué NO hace — los límites son tan importantes como las funcionalidades
    3. Bajo qué restricciones — tecnología, rendimiento, compatibilidad, seguridad
    4. Cómo se valida que está correcto — criterios de aceptación verificables

    Si quieres entender mejor el perfil completo del developer que trabaja con agentes en producción, el post sobre qué es un Agentic Engineer cubre ese rol con detalle. La especificación es su primer requisito.

    Llevo varios años aplicando una metodología para esto que llamo Spec-Driven Development. La idea es que antes de que el agente escriba una línea, tienes un documento que responde esas cuatro preguntas. No un documento largo ni burocrático — uno preciso. El Libro SDD documenta este proceso completo, desde cómo estructurar la especificación hasta cómo convertirla en tareas que un agente puede ejecutar sin desviarse.

    La diferencia entre un developer que especifica bien y uno que no lo hace no se mide en velocidad. Se mide en cuánto código hay que tirar a la basura al final de cada sprint.


    Habilidad 4: Negociar trade-offs cuando los requisitos chocan

    Los requisitos siempre chocan. Siempre.

    "Quiero que sea seguro, rápido, barato, flexible y que esté listo para el martes." No puedes tener las cinco cosas. Nunca has podido. Pero antes la conversación sobre qué sacrificar era más lenta porque construir era más lento. Ahora, con la velocidad que da la IA, la presión para tomarlo todo aumenta.

    Un developer que sabe negociar trade-offs no es el que cede ante la presión del cliente. Es el que hace explícito el coste de cada decisión y ayuda a quien decide a entender qué están eligiendo realmente.

    "Si priorizamos velocidad de lanzamiento, el sistema no va a escalar bien por encima de diez mil usuarios. Podemos lanzar en dos semanas con esa limitación asumida, o lanzar en seis semanas con una arquitectura que aguante cien mil. ¿Qué es más importante ahora mismo para el negocio?"

    Esa conversación requiere que el developer entienda el negocio suficientemente bien como para hacer la pregunta correcta. Requiere que sepa comunicar la implicación técnica en términos de impacto. Y requiere que tenga la seguridad de plantear la conversación antes de que los problemas aparezcan en producción.

    Con agentes de IA esto se vuelve más delicado porque la velocidad de implementación hace que sea tentador no tener esa conversación. "Lo construimos rápido, si no funciona lo cambiamos." Pero cambiar una decisión arquitectural después de que cuatro features dependen de ella no es barato, aunque la IA escriba el código.

    En el curso Construye con IA dedicamos una parte específica a cómo estructurar estas conversaciones antes de empezar a generar código — porque los errores más costosos no son de sintaxis, son de dirección.


    Las habilidades del programador que la IA no puede reemplazar

    La IA escribe código. Lo depura. Lo refactoriza. Lo documenta. Lo testea.

    No puede entrar a una reunión y detectar que lo que el cliente pide en realidad responde a un miedo que no ha verbalizado. No puede leer el contexto político de una organización para entender por qué un requisito existe. No puede mirar los ojos de un stakeholder y saber que cuando dice "necesitamos esto para el viernes" en realidad está diciendo "si esto no sale el viernes, me cuesta el trabajo".

    Esas lecturas son humanas. Y en un entorno donde el código se genera en segundos, son el verdadero diferencial.

    Los developers que van a crecer en los próximos años no son los que más saben de LLMs. Son los que combinan criterio técnico con las habilidades de comunicación, especificación y negociación que hacen que ese criterio tenga impacto.


    El developer que va a sobrevivir a la IA

    No es el que sabe más frameworks.

    No es el que tiene mejores prompts para Claude.

    Es el que puede entrar en una sala con personas técnicas y no técnicas, entender lo que realmente está en juego, definir con precisión lo que hay que construir, y explicar con claridad por qué ciertas cosas no se pueden tener al mismo tiempo.

    Este cambio de rol — de ejecutar tareas a tomar decisiones con criterio — es lo que ya analizamos en profundidad en el post sobre el programador que se convierte en product builder. Las cuatro habilidades de este post son el motor que hace posible ese salto.

    La IA amplifica la velocidad de ejecución. Las cuatro habilidades de las que hablamos hoy amplifican la calidad de las decisiones. Y en software, las decisiones siempre cuestan más que el código.

    En Dominicode Labs trabajamos estos temas con developers que están construyendo con IA en proyectos reales — no ejercicios de academia, sino productos con usuarios, deadlines, y stakeholders que necesitan respuestas los lunes por la mañana.

    Si quieres empezar hoy, elige la habilidad que sabes que tienes más floja de las cuatro y pasa esta semana ejerciéndola deliberadamente. Una conversación con un stakeholder. Un documento de especificación antes de abrir el editor. Una pregunta incómoda que no has hecho todavía.

    El código lo escribe la IA. El criterio lo pones tú.


    Preguntas frecuentes

    ¿Estas habilidades sustituyen al conocimiento técnico profundo?
    No, lo complementan. Sin base técnica sólida no puedes especificar bien ni negociar trade-offs con conocimiento de causa. Lo que cambia es que el conocimiento técnico ya no es suficiente por sí solo — necesitas combinarlo con estas capacidades para que tenga impacto real. Un developer que solo sabe programar pero no puede comunicar ni especificar ni negociar tiene cada vez menos diferencial frente a un agente de IA.

    ¿Cómo se aprende a especificar para agentes de IA si nunca lo he hecho?
    Empieza por escribir, antes de cualquier tarea, un documento de dos párrafos: uno con lo que el sistema debe hacer y uno con lo que no debe hacer. Con ese ejercicio simple ya estás especificando. A medida que lo practiques, irás añadiendo restricciones, criterios de aceptación y contexto. La metodología Spec-Driven Development es un marco más completo para esto, documentado en el Libro SDD.

    ¿Estas habilidades son más importantes para freelancers que para developers en empresa?
    Son importantes en los dos contextos, pero de formas distintas. El freelance que no sabe comunicar ni negociar pierde clientes. El developer en empresa que no sabe hacer estas cosas se queda estancado en roles de ejecución y ve cómo los que ascienden son los que saben tener las conversaciones difíciles. En ambos casos, la consecuencia de no desarrollarlas es la misma: invisibilidad.

    ¿La velocidad que da la IA no hace que estos trade-offs sean menos importantes porque "se puede cambiar todo fácilmente"?
    Es una trampa común. Sí, la IA acelera la implementación. Pero hay decisiones — de arquitectura, de modelo de datos, de contratos de API — que una vez tomadas son costosas de cambiar aunque el código lo escriba un agente.

    Si tu base de datos está mal modelada, reescribir las queries con IA no resuelve el problema. El coste de las malas decisiones estructurales no ha bajado con la IA.

    Lo que ha bajado es el coste de implementar la decisión, buena o mala. Eso amplifica el impacto de decidir bien tanto como el de decidir mal.

    ¿Existe algún perfil técnico donde estas habilidades no importan?
    Si trabajas en investigación pura, en open source sin usuarios directos, o en roles muy especializados de bajo nivel donde el contacto con stakeholders es mínimo, el peso relativo de estas habilidades es menor. Pero para la mayoría de developers que trabajan en productos, servicios o consultoría — que es la mayoría — estas cuatro capacidades son cada vez más determinantes para el crecimiento profesional.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
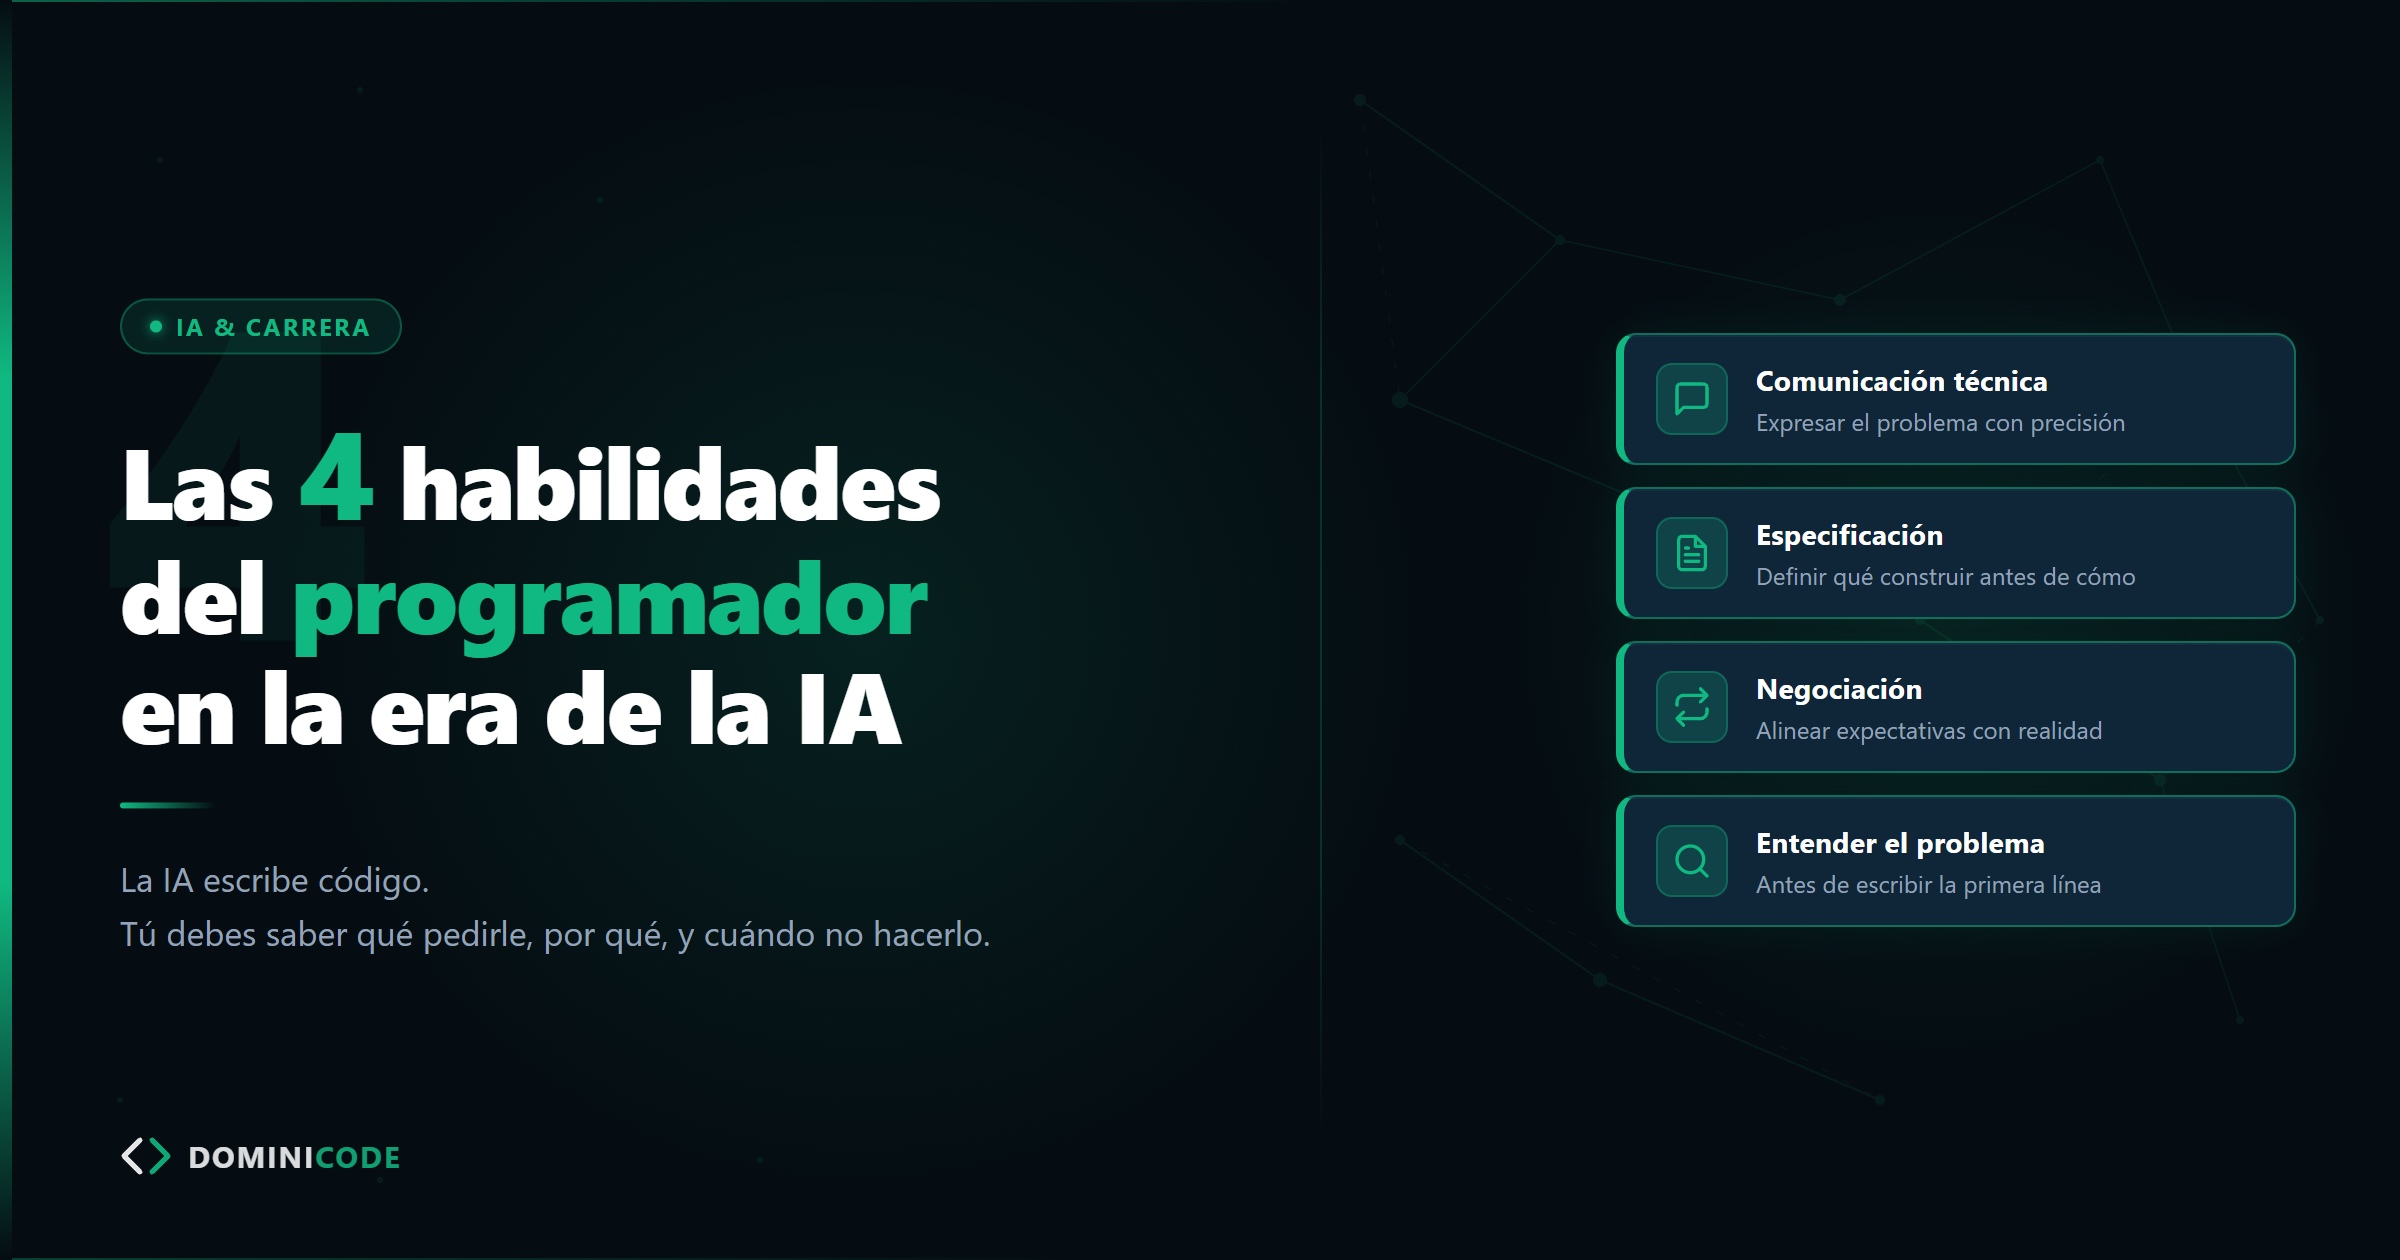
  • Proyecto greenfield con SDD: spec global + slices verticales

    Proyecto greenfield con SDD: spec global + slices verticales

    Hace unas semanas un developer del canal me contó lo que había pasado en su último proyecto.

    Seis horas. Eso tardó en planificar un proyecto greenfield con SDD usando slices verticales. Tenía un spec global, features bien definidas, tareas granulares. Parecía perfecto.

    Ejecutó el primer slice con su agente IA. La app funcionaba. Autenticación, flujo de datos, navegación — todo correcto.

    Y era completamente gris. Sin estilos. Sin diseño. Una interfaz que parecía sacada de 1998.

    No había especificado nada sobre la UI en su spec. Ni colores, ni componentes, ni sistema de diseño. El agente hizo exactamente lo que se le pidió: implementar la lógica. Y lo hizo bien.

    El problema no era el agente. Era el spec.

    El error que nadie te dice sobre SDD en proyectos nuevos

    Spec-Driven Development (SDD) es una metodología en la que cada feature comienza con un documento de especificación estructurado — el spec — antes de escribir código. El spec define qué hace la feature, cómo se ve, y qué criterios debe cumplir para considerarse completa.

    Cuando descubres SDD, la primera intuición es clara: especifica todo antes de escribir una línea de código. Visión, usuarios, funcionalidades, arquitectura, flujos.

    Y esa intuición es correcta… pero incompleta.

    Hay dos errores que se cometen casi siempre en un proyecto greenfield con SDD:

    El primero es intentar especificar el proyecto completo antes de tocar el teclado. Un spec monolítico de 40 páginas que detalla hasta la última feature antes de que exista una sola línea de código. Es atractivo. Se siente seguro. Y casi siempre es un error.

    El segundo es lo que le pasó a ese developer: especificar las features en términos de lógica y flujos, pero olvidar que las features tienen una cara visible. Que los usuarios las ven. Que el diseño no es una capa que se añade al final — es parte de la feature.

    Ambos errores llevan al mismo resultado: rediseño tardío, deuda técnica, y la sensación de que SDD no funciona cuando el problema real es la estrategia, no la metodología.


    La estructura que sí funciona: spec global ligero + slices con UI

    La solución tiene dos capas. Una sesión corta de spec global que define las reglas del juego, y luego un ciclo de feature-por-feature donde cada spec incluye explícitamente la UI.

    Capa 1: El spec global ligero

    Este documento no especifica features. Especifica el contexto en el que todas las features van a vivir. Se hace una sola vez, en una sola sesión, y no debería tomar más de 45 minutos.

    # Spec Global — [Nombre del proyecto]
    _Versión: 1.0 | Fecha: YYYY-MM-DD_
    
    ## Visión
    [Una sola frase que describe qué es el producto y para quién.]
    
    ## Stack técnico
    - Frontend: Angular 22 con Signals
    - Backend: NestJS + Supabase
    - Estilos: Tailwind CSS v4
    - Testing: Jest + Testing Library
    
    ## Sistema de diseño
    - Librería de componentes: Angular Material / PrimeNG / custom
    - Paleta de colores: primario #1A73E8, fondo #F8FAFC, texto #0F172A
    - Tipografía: Inter, base 16px
    - Espaciado: escala de 4px (4, 8, 12, 16, 24, 32, 48...)
    - Breakpoints: sm 640px / md 768px / lg 1024px / xl 1280px
    
    ## Convenciones de arquitectura
    - Estructura: feature-based (cada feature es un módulo independiente)
    - Estado global: NgRx Signal Store
    - Llamadas HTTP: Resource API (Angular 22)
    - Validación: Zod en schemas compartidos
    
    ## Decisiones técnicas ya tomadas
    - Autenticación: Supabase Auth (no reinventar)
    - Despliegue: Vercel (frontend) + Railway (backend)
    - No usar: Redux clásico, Class Components, módulos NgModule legacy
    
    ## Features planificadas (sin detallar)
    1. Autenticación
    2. Dashboard principal
    3. Gestión de proyectos
    4. Reportes
    

    Eso es todo. No más. El spec global no detalla cómo funciona cada feature — solo establece las reglas que todas van a respetar.

    Lo más importante de ese documento son las secciones de sistema de diseño y convenciones de arquitectura. Son el contrato que el agente va a respetar en cada feature. Si no las defines aquí, las decide él — y probablemente no va a coincidir con lo que tienes en la cabeza.

    Capa 2: El spec de cada feature — con sección UI obligatoria

    Aquí está el cambio que lo transforma todo. Cuando vas a implementar una feature, escribes su spec detallado en ese momento, no antes. Y ese spec siempre incluye una sección de UI/UX.

    # Feature 1: Autenticación
    _Contexto: spec global v1.0 | Estado: en implementación_
    
    ## Qué hace
    Permite al usuario crear cuenta, iniciar sesión y recuperar contraseña.
    Usa Supabase Auth. No hay lógica de autenticación propia.
    
    ## Flujos principales
    1. Registro: email + contraseña → verificación por email → redirect a dashboard
    2. Login: email + contraseña → redirect a dashboard (o a la ruta que intentaba visitar)
    3. Recuperación: email → link con token → nueva contraseña → login
    
    ## UI/UX (obligatorio)
    - Layout: columna centrada, max-width 400px, padding 24px
    - Componentes a usar: InputField, Button, Alert — todos del sistema de diseño global
    - Estados visuales a implementar:
      - Loading: botón con spinner, campos desactivados
      - Error: Alert rojo con mensaje específico (no "algo salió mal")
      - Éxito: redirect inmediato, sin pantalla intermedia
    - Mobile first: el form debe funcionar bien en 320px
    - No inventar componentes nuevos — usar los del spec global
    
    ## Criterios de aceptación
    - [ ] El usuario puede registrarse con email válido
    - [ ] El usuario recibe email de verificación
    - [ ] El usuario puede iniciar sesión y llega al dashboard
    - [ ] Los estados de loading y error son visibles
    - [ ] El form es usable en móvil
    
    ## Lo que NO hace esta feature
    - No maneja OAuth (Twitter, Google) — queda para v2
    - No maneja roles de usuario — eso es responsabilidad del dashboard
    

    La sección UI/UX no es opcional. Es donde especificas exactamente qué tiene que ver el usuario cuando interactúa con esta feature. Si la omites, el agente tomará esa decisión por ti, y probablemente tomará la decisión más rápida, no la más correcta.


    Spec total upfront vs spec incremental — la comparativa real

    La tentación de escribir el spec completo del proyecto antes de arrancar tiene sentido desde afuera. La realidad es diferente.

    Spec total upfront Spec incremental (global ligero + features)
    Tiempo inicial 2-3 días o más 45 min (spec global) — hasta 20× más rápido para arrancar
    Riesgo Alto — cambias de opinión cuando ves el código real Bajo — ajustas cada feature antes de implementarla
    UI/UX Probablemente omitida o abstracta Concreta en cada feature, con contexto real
    Consistencia Dependes de que el spec inicial fuera perfecto El spec global garantiza coherencia entre features
    Deuda de redesign Alta — aparece cuando el 80% del código ya existe Baja — se elimina en cada ciclo de validación visual
    Útil con agentes IA Solo si el agente tiene memoria perfecta (no la tiene) Sí — cada prompt incluye contexto concreto y actualizado

    El spec incremental no significa improvisación. Significa que el contexto que tienes cuando implementas la feature 4 es mejor que el que tenías antes de escribir una sola línea de código. Y ese contexto — los componentes que ya existen, las decisiones que ya se tomaron, los problemas que ya aparecieron — enriquece el spec de la siguiente feature.

    Este enfoque es una variación de la Vertical Slice Architecture documentada por Jimmy Bogard, aplicada al contexto de specs con agentes IA.

    El rediseño tardío no ocurre porque el spec sea incremental. Ocurre porque no hay spec en absoluto.


    El ciclo de trabajo en un proyecto greenfield SDD

    El flujo que funciona es simple, y se repite para cada feature:

    1. Escribe el spec de esa feature (con sección UI incluida)
    2. Dáselo al agente como contexto completo
    3. Implementa
    4. Valida visualmente antes de marcar como hecho
    5. Usa lo aprendido para enriquecer el spec de la siguiente feature

    El paso 4 es crítico y muchos lo saltan. Validar visualmente significa abrir el navegador, probar el flujo como lo haría un usuario real, y confirmar que los estados de loading, error y éxito se ven como los especificaste. No basta con que los tests pasen.

    Si en el paso 4 descubres que algo no se ve bien, arréglalo antes de avanzar. El coste de arreglar un componente mal implementado en la feature 1 es mínimo. El coste de arreglar el mismo patrón cuando ya está repetido en las features 1, 3, 5 y 7 es considerable.


    Lo que cambia cuando tienes el spec global

    El spec global tiene un efecto que no es obvio hasta que lo usas en producción.

    Cuando llegas a la feature 4, el agente tiene contexto. Sabe que los inputs van con Tailwind, que el estado global es NgRx Signal Store, que los errores se muestran con el componente Alert del sistema de diseño. Si estás usando Angular 22, también puedes aprovechar la Resource API para centralizar las llamadas HTTP en el spec desde el principio — sin que el agente invente su propio patrón. No lo tienes que repetir en cada prompt.

    Y cuando llega alguien nuevo al proyecto — o cuando tú mismo vuelves al código tres meses después — entiende en 10 minutos las decisiones que se tomaron y por qué.

    Eso no lo da el código. Lo da el spec.

    Si quieres profundizar en la metodología completa, en el libro de Spec-Driven Development tienes el framework completo: cómo estructurar specs, cómo trabajar con agentes IA de forma efectiva, y los patrones que se usan en proyectos reales de producción.


    La UI no es una capa. Es un contrato.

    El error del developer que me escribió no fue usar SDD. Fue asumir que SDD significa especificar todo el proyecto antes de arrancar.

    SDD significa especificar lo suficiente, en el momento correcto, con el nivel de detalle correcto. El spec global define el campo de juego. El spec de cada feature define las reglas de ese momento.

    Y la UI no es una capa que se añade al final. Es parte del contrato de cada feature.

    Si quieres ver este flujo en acción — desde el spec hasta el commit — en el curso Construye con IA: De la Idea al Producto aplicamos exactamente esta metodología: spec global, slices verticales, validación visual antes de avanzar. Con agentes IA reales, en proyectos que no son de juguete.

    Y si prefieres el formato comunidad, en Dominicode Labs compartimos los specs reales de los proyectos que construimos juntos — con las decisiones que se tomaron y las que se descartaron.

    El spec no te quita velocidad. Te quita el coste de arreglar lo que nadie especificó.


    FAQ

    ¿Cuánto tiempo debería tardar el spec global de un proyecto real?

    Entre 30 y 60 minutos. Si tardas más, estás especificando features en el spec global, y eso no es su función. El spec global define el contexto y las reglas. Las features se detallan una a una cuando llega su turno.

    ¿Es obligatoria la sección UI/UX en el spec de cada feature?

    En proyectos con interfaz visible, sí. Si estás construyendo una API sin frontend, la sección UI/UX no aplica, pero deberías incluir una sección de contratos de API: endpoints, tipos de respuesta, códigos de error. El principio es el mismo: especifica todo lo que el agente necesita para no tomar decisiones que tú deberías tomar.

    ¿Cómo manejo las features que dependen de otras que aún no están implementadas?

    En el spec de la feature con dependencia, añades una sección “Asunciones” que documenta qué esperas de las features previas. Si la feature A aún no existe, especificas el contrato que A debería cumplir — y cuando implementes A, ese contrato ya está documentado. Es una forma de diseño by contract que funciona muy bien con agentes.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
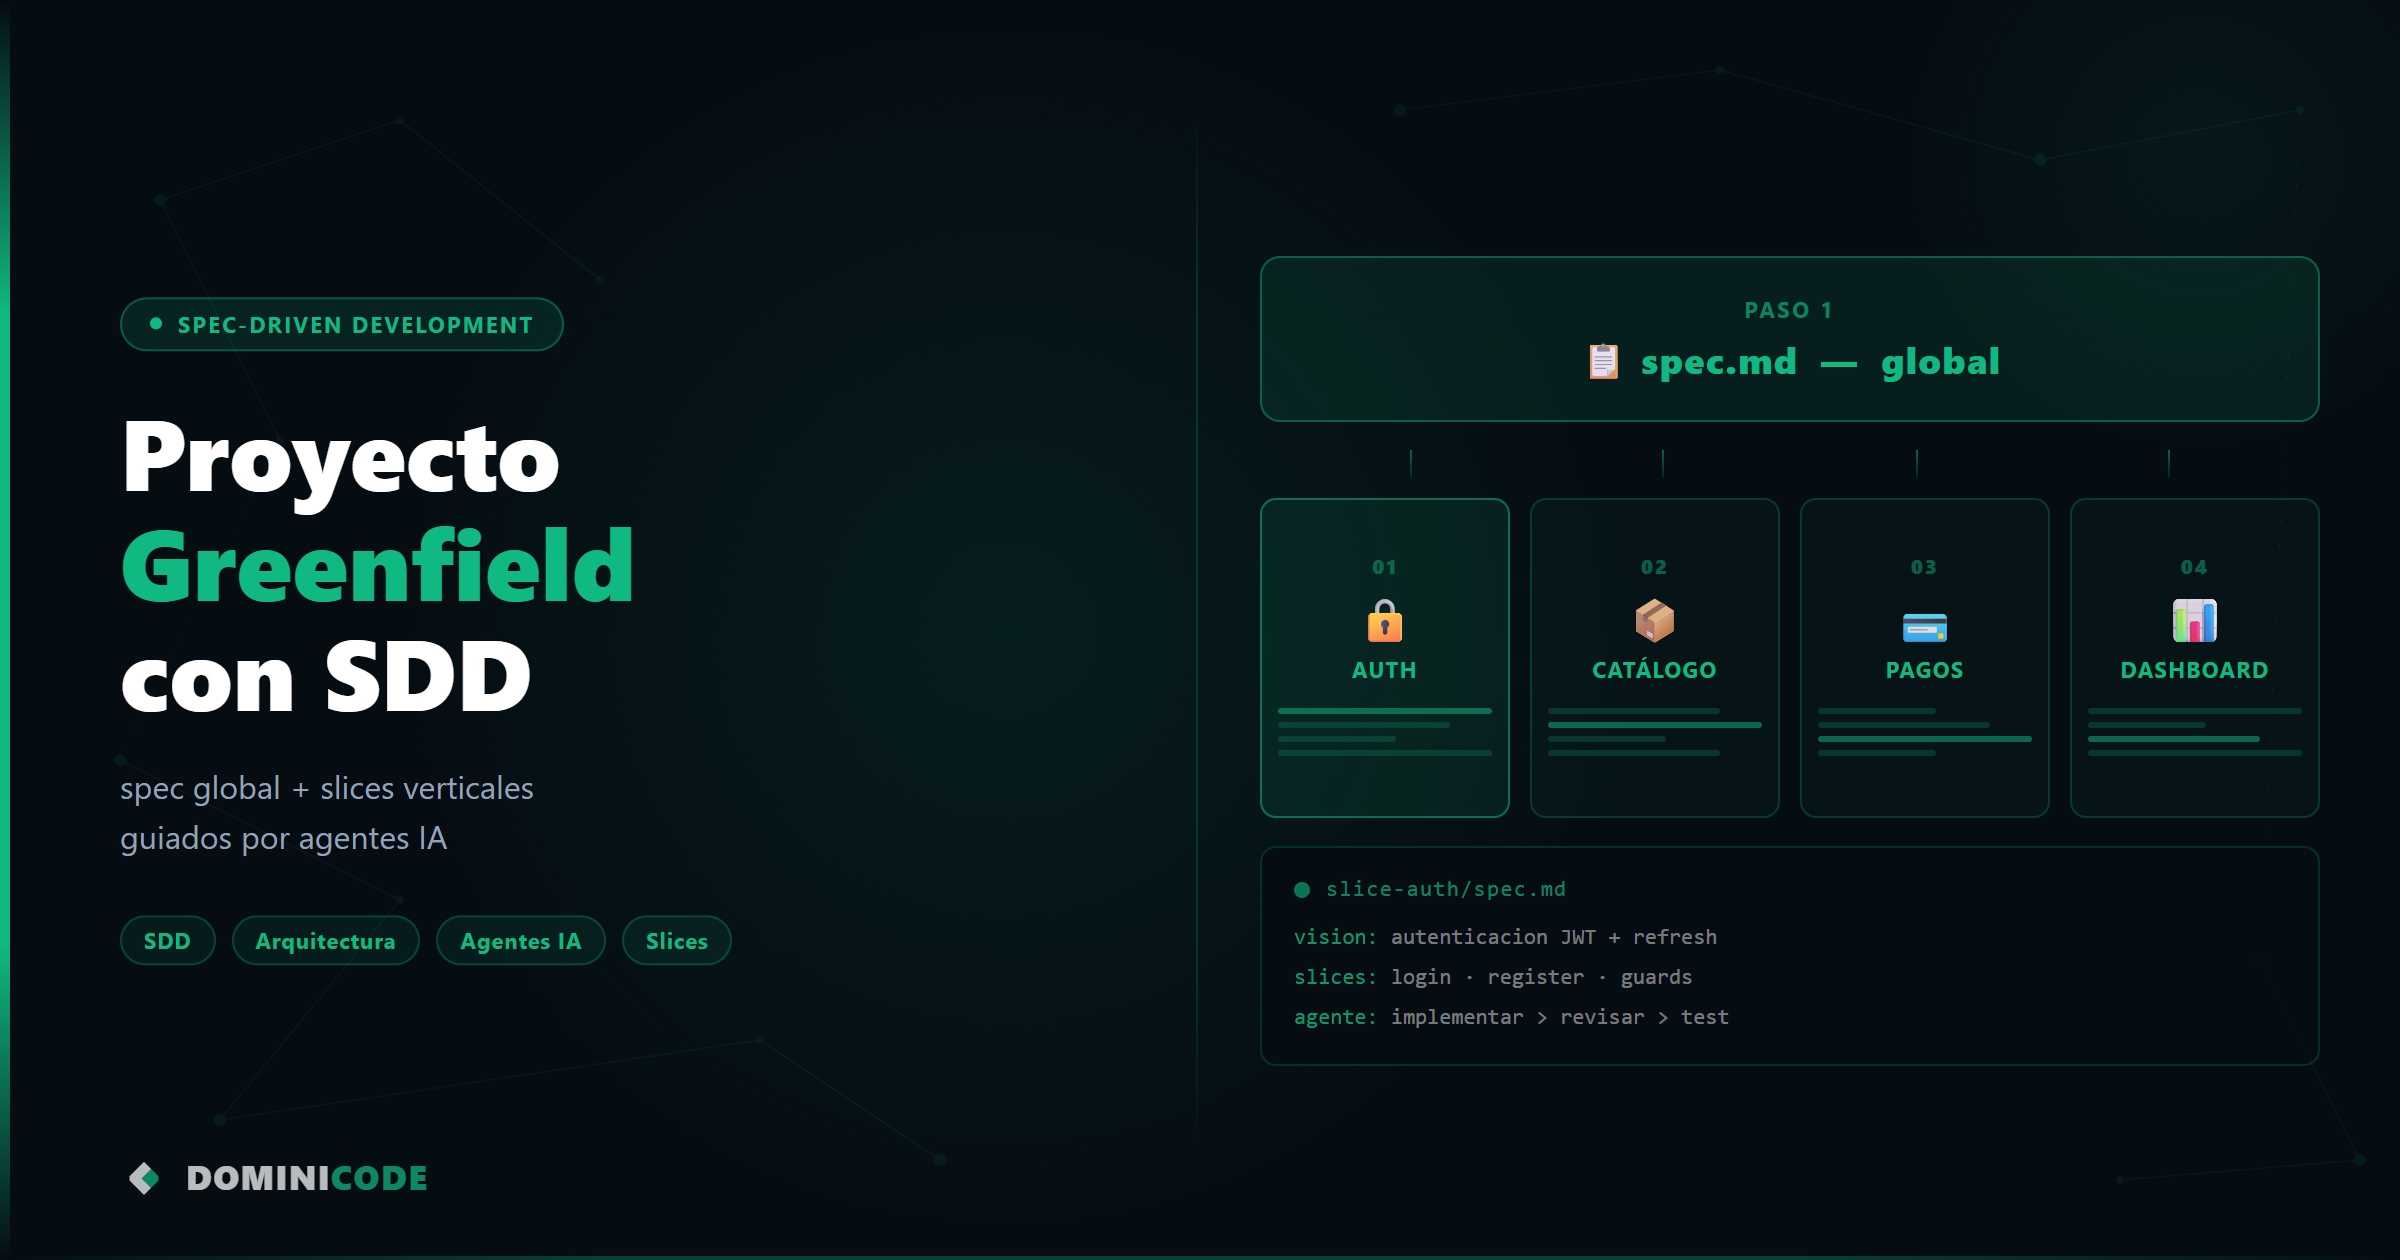
  • Cómo construir un producto de software desde cero usando IA

    Cómo construir un producto de software desde cero usando IA

    Cómo construyo un producto de software desde cero usando IA (mi proceso real)

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Construir un producto con IA es un proceso disciplinado: define el problema, escribe una spec como única fuente de verdad y deja que un agente implemente bajo revisión.
    • Spec‑Driven Development (SDD) es la columna vertebral: spec.md debe contener stack, modelado de datos, contratos API, reglas de negocio y casos de aceptación.
    • Uso un agente en terminal (Claude Code) para implementar desde el repo leyendo la spec; interactúo revisando diffs y actualizando la spec cuando cambia el comportamiento.
    • Pipelines: tests, linters y CI antes de merge; deploy en Vercel para front o infra reproducible para backend.

    Construir un producto de software desde cero usando IA no es “pedir código al chat”. Es un proceso disciplinado: idea → spec con SDD → código con Claude Code → deploy. Aquí tienes mi walkthrough real, probado en proyectos que pasaron de prototipo a producción sin incendiar la base de código.

    Resumen rápido (lectores con prisa)

    Qué es: Un proceso disciplinado que usa Spec‑Driven Development (SDD) como única fuente de verdad y un agente en terminal (Claude Code) para ejecutar la implementación bajo revisión humana.

    Cuándo usarlo: Para productos escalables y mantenibles donde la coherencia arquitectónica y la gestión de deuda técnica importan.

    Por qué importa: Evita ambigüedades, reduce deuda técnica y permite iteraciones rápidas sin romper coherencia del sistema.

    Cómo funciona: Define problema → escribe spec.md detallada → ejecuta al agente que lee el repo y la spec → revisa diffs → tests/CI → deploy.

    1) Del problema a la frontera del producto (no a la idea vaga)

    La diferencia entre una idea y un producto es la frontera: cuándo, quién, condiciones y consecuencias. Define el problema en 3–5 oraciones concretas. Quién sufre, cuándo ocurre, qué le frustra hoy y qué mediremos para saber si la solución funciona.

    Usa IA aquí como auditor: hazle preguntas para descubrir supuestos y casos edge. Pero no le pidas código aún. Resultado: una descripción del problema que cualquier dev pueda leer en frío y entender.

    2) Escribir la spec: Spec‑Driven Development (SDD)

    SDD es la columna vertebral. Antes de una sola línea de código:

    • Crea spec.md en el repo. Será la única fuente de verdad.
    • Incluye stack exacto (ej.: Next.js 16, React 19, Tailwind 4).
    • Modelado de datos: tablas, campos, relaciones, índices y restricciones.
    • Contratos API: endpoints, payloads, respuestas, errores y códigos HTTP.
    • Reglas de negocio claras: qué está permitido y qué nunca.
    • Casos de prueba de aceptación (no tests automatizados, sino escenarios).

    La spec elimina ambigüedad. Si algo no está en la spec, no existe para el agente.

    Recurso práctico: Spec-Driven Development

    3) Implementación con Claude Code (agente en terminal)

    Claude Code vive en la terminal, lee archivos y puede ejecutar comandos. No es un chat: es un agente con acceso al repo.

    Flujo estándar

    1. git init + estructura base según spec.md.
    2. Llamada inicial al agente con instrucción precisa:
    Claude Code (Anthropic).
    3. Reviso los diffs que propone como si fueran PRs. Aprobación explícita o feedback.
    4. Si hay cambio de comportamiento, actualizo spec.md y pido refactor.

    Regla innegociable: nunca corregir código sin actualizar la spec. Corrige la spec, suprime la ambigüedad, manda refactor. Así el agente aprende reglas permanentes del proyecto.

    Ejemplo de prompt maestro (simplificado): “Contexto: repo vacío, spec.md adjunto. Tarea: implementar la API de autenticación según spec. Antes de modificar, lista ambigüedades. Compara con stack y patrones del repo.”

    4) Tests, CI y deploy

    El código sigue buenas prácticas: tests unitarios básicos, linters y pipelines en GitHub Actions. Deploy en Vercel para front o en un VPS/Cloud con infra reproducible para backend.

    Pipeline típico:

    • PR generado por agente → revisión humana → GitHub Actions (lint, test) → merge → deploy.

    Cuando necesito añadir features: actualizo spec.md, ejecuto al agente con el repo y la spec actualizada. El contexto persistente evita “olvidos” que generan deuda técnica.

    Buenas prácticas operativas (evitan dolor después)

    • Versiona spec.md. Cada cambio debe tener justificación y número de versión.
    • Usa ejemplos concretos en la spec (payloads de ejemplo, respuestas de error).
    • Limita el scope por iteración. Un sprint = 1–2 features bien especificadas.
    • Rechaza cambios grandes mediante parches rápidos: si la spec cambia radicalmente, crea una rama de arquitectura.
    • Mantén un humano con criterio técnico revisando cada PR del agente.

    Cuándo usar este proceso (y cuándo no)

    Úsalo si necesitas un producto escalable, con datos complejos o que deba mantenerse en el tiempo. No lo burocratices para un script de 100 líneas o un prototipo desechable: ahí el prompt‑driven rápido sigue siendo válido.

    Esto no es un truco mágico: es disciplina. La IA ejecuta, pero la arquitectura y el criterio técnico siguen en tus manos. Si mantienes la spec como la fuente única de verdad y tratas al agente como un colaborador que trabaja sobre ese contrato, podrás iterar rápido sin destruir la coherencia del sistema. Esto es solo la base: la próxima iteración debe cubrir cómo redactar specs resistentes y ejemplos prácticos de prompts maestro para Claude Code.

    Si trabajas en automatización, agentes o workflows, este enfoque encaja con iniciativas prácticas de investigación y experimentación de herramientas y procesos. Sigue explorando en Dominicode Labs como continuación lógica para prototipado y validación de pipelines con agentes.

    FAQ

    ¿Qué es Spec‑Driven Development (SDD)?

    SDD es un marco donde una spec.md actúa como la única fuente de verdad para el desarrollo. Define stack, modelos de datos, contratos API, reglas de negocio y casos de aceptación antes de escribir código.

    ¿Por qué usar un agente en terminal como Claude Code?

    Porque puede leer el repo, ejecutar comandos y proponer cambios como si fueran PRs. Esto permite automatizar implementaciones repetibles mientras el humano revisa y guía el resultado.

    ¿Qué debe contener spec.md?

    Debe incluir stack exacto, modelado de datos (tablas, campos, relaciones), contratos API (endpoints, payloads, respuestas y errores), reglas de negocio y casos de aceptación con ejemplos concretos.

    ¿Cómo se gestionan los cambios de comportamiento?

    Actualiza spec.md y crea un refactor controlado. Nunca corrijas código sin primero cambiar la spec. Esto mantiene la coherencia y enseña al agente las reglas permanentes del proyecto.

    ¿Cuándo no aplicar este proceso?

    No lo burocratices para scripts pequeños o prototipos desechables (por ejemplo, un script de ~100 líneas). En esos casos, un enfoque prompt‑driven rápido es más eficiente.

    ¿Qué herramientas de CI/Deploy recomiendas?

    Usa pipelines en GitHub Actions para lint y tests, y Vercel para frontends. Para backends, despliega en VPS/Cloud con infraestructura reproducible según la spec.

  • Cómo mejorar la calidad del código con Spec-Driven Development

    Cómo mejorar la calidad del código con Spec-Driven Development

    Spec-Driven Development en la práctica: del prompt al código mantenible — Un walkthrough real mostrando cómo una buena spec cambia la calidad del output de Claude Code o Cursor. Caso antes/después

    Tiempo estimado de lectura: 6 min

    • Ideas clave:
    • Una spec técnica reduce la ambigüedad en prompts y convierte salidas generativas en contratos verificables.
    • Sin spec, los LLMs tienden a producir código rápido pero frágil y con deuda técnica.
    • Una spec mínima (stack, artefactos, contratos, edge cases) es suficiente para outputs reproducibles y testeables.
    • Integra specs en CI/PR para automatizar comprobaciones y mantener control humano sobre arquitectura.

    Spec-Driven Development en la práctica: del prompt al código mantenible — esto no es una etiqueta elegante. Es la diferencia entre código que sobrevive y código que tendrás que reescribir dentro de tres sprints. Si usas Claude Code, Cursor o cualquier herramienta generativa, sin una spec clara estás empujando decisiones arquitectónicas a un modelo estadístico.

    En estas primeras líneas: definimos el problema, mostramos un caso antes/después y entregamos una receta práctica para que tu equipo obtenga salidas reproducibles y revisables por humanos.

    Resumen rápido (lectores con prisa)

    Qué es: Una spec técnica es un documento corto que define stack, artefactos, contratos de datos y criterios de aceptación.

    Cuándo usarla: Antes de pedirle a un LLM que genere código o acciones automáticas; imprescindible para features que afectan arquitectura o seguridad.

    Por qué importa: Reduce ambigüedad, limita el espacio de decisión del modelo y convierte output en un contrato auditables y testeable.

    Cómo funciona: Provee stack y contratos (ej. Zod schemas, tipos TS, API contracts) que el agente implementa exactamente, produciendo artefactos modulares y testeables.

    Por qué una spec cambia todo

    Los LLMs son excelentes en patrones, no en contexto de producto. Cuando reciben un prompt abierto, generan la solución más probable según su entrenamiento: ejemplos de tutoriales y antipatrón comunes. Esa es la razón por la que el output suele ser rápido pero frágil.

    Una especificación técnica (spec) reduce el “espacio de probabilidad” del modelo. Le das:

    • el stack exacto,
    • las restricciones arquitectónicas,
    • los contratos de datos,
    • y los criterios de aceptación/edge cases.

    Con esa entrada, herramientas como Cursor o Claude dejan de improvisar y comienzan a implementar un contrato.

    Walkthrough real: formulario de registro en Next.js

    Escenario: crear un registro de usuario con validación Zod y Server Actions (Next.js App Router). Te muestro el antes y el después, sin adornos.

    Antes — Prompt conversacional (vibe coding)

    Prompt enviado al modelo:

    “Crea un formulario de registro en Next.js con email, password y confirmación. Conéctalo a la API.”

    Salida típica:

    • Un solo archivo RegisterForm.tsx con JSX, estado useState y fetch mezclados.
    • Validación DIY con regex.
    • Manejo de errores = console.log.
    • Tipos débiles (any o sin tipos).
    • No hay tests ni contractos reutilizables.

    Resultado: funciona en local. Falla en producción. Es deuda técnica con firma.

    Después — Prompt con spec (Spec-Driven Development)

    Antes de preguntar al modelo, escribes spec-auth-register.md y lo adjuntas.

    Fragmento de spec:

    # Spec: Registro de usuario
    Stack: Next.js App Router, React Hook Form, Zod
    Outputs: 3 archivos
      - src/lib/validations/auth.ts (registerSchema)
      - src/actions/auth.actions.ts (Server Action) -> devuelve { success: boolean; error?: string }
      - src/components/auth/RegisterForm.tsx
    UI: usar useTransition para isPending; mostrar errores por campo; redirigir a /dashboard en éxito.
    Edge cases: handling de timeouts, duplicados, validación server-side.
    

    Prompt al modelo:

    “Lee @spec-auth-register.md e implementa exactamente los archivos descritos, respetando tipos y contratos.”

    Salida típica con spec:

    • registerSchema en auth.ts (Zod) reutilizable en cliente y servidor.
    • Server Action tipada que devuelve { success, error }.
    • Componente de presentación que usa React Hook Form y solo hace binding.
    • Estados de UI y manejo de errores explícito.
    • Código modular, testeable y legible.

    La diferencia es clara: la spec obliga al modelo a ceñirse a un contrato verificable. Lo que se genera se puede code-reviewar, testear e integrar.

    Plantilla mínima de spec que funciona

    No necesitas escribir una novela. Esta plantilla (portable en .specs/feature.md) es suficiente:

    1. Contexto de negocio (1-2 líneas).
    2. Stack y restricciones (libraries permitidas/prohibidas).
    3. Artefactos esperados (files + path).
    4. Contratos de datos (TS interfaces o Zod schemas).
    5. Estados UI y criterios de aceptación.
    6. Edge cases y métricas de éxito.

    Incluye URLs útiles en la spec para librerías: Zod, OWASP para seguridad, documentación de Cursor si lo usas.

    Integración práctica en el flujo de trabajo

    • Guarda specs en .specs/ y referencia el archivo en el prompt (Cursor soporta @Files).
    • Automatiza comprobaciones básicas con linters/CI: que exista un schema Zod, que acciones devuelvan un tipo estándar, que tests unitarios pasen.
    • Añade una regla en code review: si el cambio viene de un agente, el PR debe acompañar la spec original y un ADR si la modificación afecta arquitectura.
    • No olvides observabilidad y testing: cada tool o action generada debe tener tests unitarios independientes del LLM.

    Conclusión: la IA ejecuta, el ingeniero decide

    Spec-Driven Development no elimina la IA; la pone en su lugar. En lugar de confiar en la creatividad del modelo, confías en el criterio técnico del equipo para dirigirlo. Los equipos que adoptan specs claras convierten a Claude Code y Cursor en herramientas productivas en lugar de fuentes de deuda técnica. Implementar specs no es una carga extra: es la inversión que transforma prototipos de IA en software mantenible y auditable.

    La siguiente pieza en esta serie mostrará ejemplos de specs reales y scripts de CI que validan la conformidad automática entre spec y código.

    Para continuidad con iniciativas de automatización y prácticas de ingeniería aplicadas a IA, revisa recursos adicionales y experimentos en Dominicode Labs. Estos materiales complementan la adopción de specs y proporcionan plantillas y scripts para integrar comprobaciones automatizadas en CI/PR.

    FAQ


    ¿Qué es una spec técnica y cuánto debe medir?

    Una spec técnica es un documento conciso que define contexto, stack, artefactos requeridos, contratos de datos y criterios de aceptación. Suele medir entre 1 y 2 páginas; la clave es ser suficiente para convertir decisiones arquitectónicas en reglas ejecutables.


    ¿Qué diferencia hay entre una spec y una historia de usuario?

    Una historia de usuario describe el problema de negocio y la necesidad. La spec técnica traduce esa necesidad en artefactos técnicos concretos (files, tipos, contratos, edge cases) que un agente o desarrollador implementará.


    ¿Qué herramientas debo pedir en la spec para validación de datos?

    Especifica la librería (por ejemplo, Zod), el archivo donde residirá el schema y el contrato de retorno esperado para server actions. Indica validación client/server y casos límite relevantes.


    ¿Cómo integro specs en CI?

    Automatiza comprobaciones que verifiquen la presencia de schemas Zod, la firma de acciones y tests unitarios mínimos. Añade una regla en PRs que requiera la spec original cuando cambios provengan de un agente.


    ¿Qué hacer si el LLM ignora la spec?

    Ajusta el prompt para referenciar explícitamente la spec (ej. @spec-auth-register.md), valida output contra tests automatizados y rechaza cambios que no cumplan contratos en CI. Mantén revisión humana obligatoria para PRs generados por agentes.