Category: Claude Code

  • Claude Opus 4.8: novedades para desarrolladores (Claude Code, Effort Control y más)

    Claude Opus 4.8: novedades para desarrolladores (Claude Code, Effort Control y más)

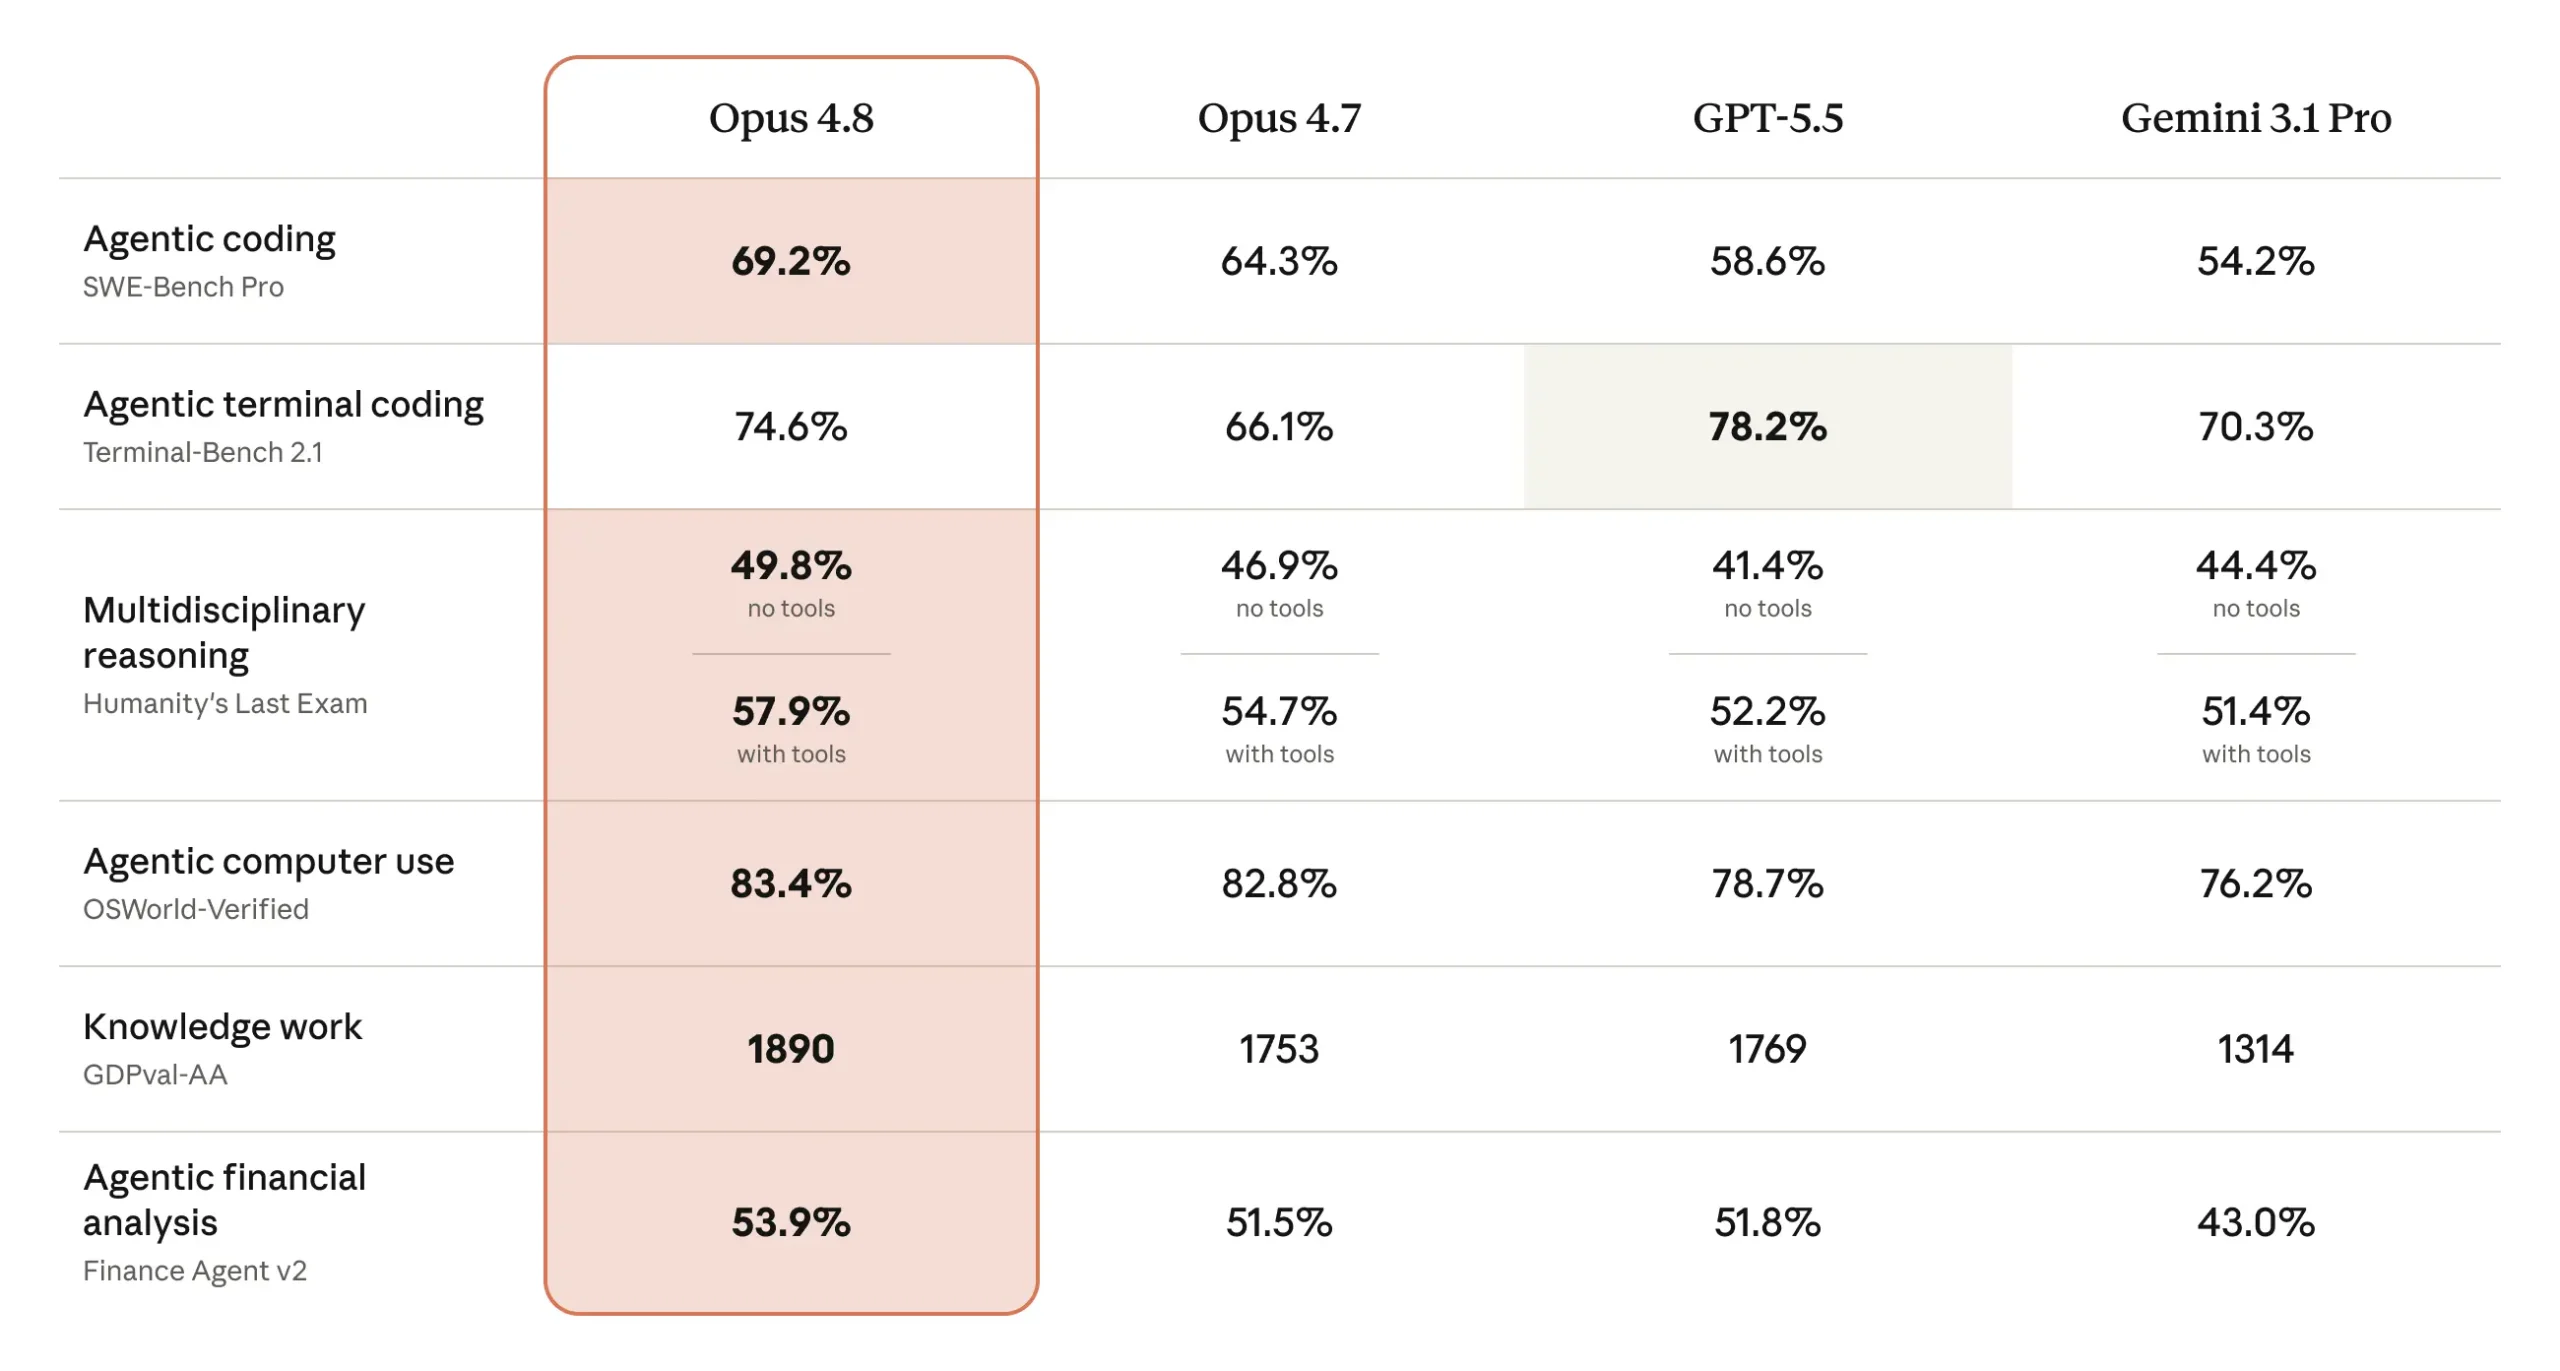
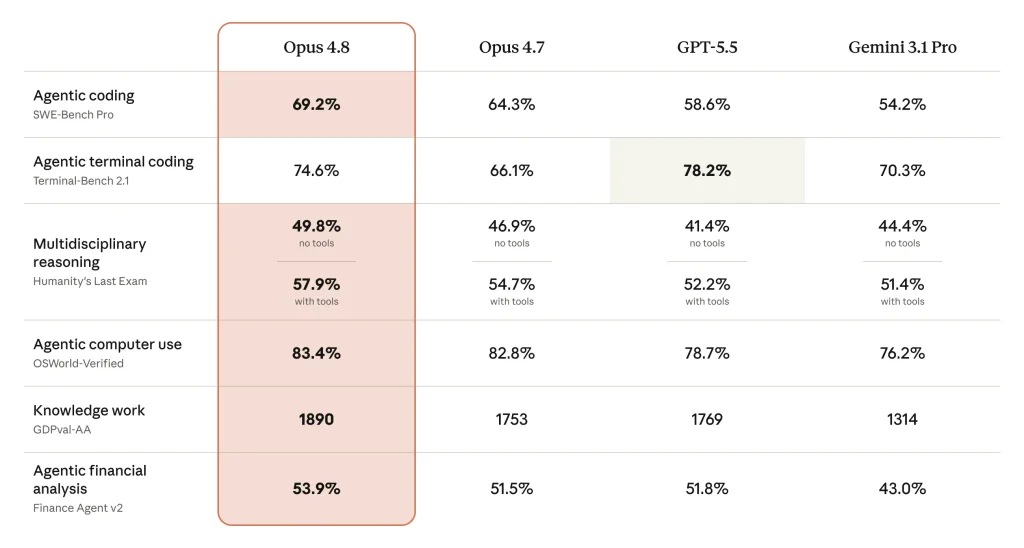
    Anthropic acaba de lanzar Claude Opus 4.8, y ellos mismos lo describen como una mejora “modesta” sobre Opus 4.7. Es una descripción honesta, pero engañosa: las mejoras de calidad de vida son justo las que más se notan cuando trabajas con esto todos los días.

    En este artículo voy directo a lo que importa si programas: qué cambia de verdad, qué es marketing, y cómo encaja en un flujo de trabajo serio.
    Qué es Opus 4.8 en una frase

    Opus 4.8 reemplaza a 4.7 dentro de la misma familia de modelos. Mismo precio, pero más fiable y con mejor criterio cuando trabaja en modo agente. El identificador del modelo en la API es claude-opus-4-8.

    La jugada interesante de este lanzamiento no es el modelo en solitario, sino lo que Anthropic construyó alrededor de él. Vamos por partes.

    1. Dynamic Workflows en Claude Code

    Esta es la novedad grande, y de momento está en research preview.

    Claude Code ahora puede planificar una tarea de gran tamaño, lanzar cientos de subagentes en paralelo dentro de una misma sesión, verificar sus propios resultados y recién entonces reportarte. El ejemplo que pone Anthropic es ambicioso: migraciones de código a escala de cientos de miles de líneas, desde el arranque hasta el merge, usando tu propia suite de tests como criterio de aceptación.

    El detalle a tener en cuenta: esta capacidad está disponible en los planes Enterprise, Team y Max. Si estás en otro plan, no la tendrás todavía.

    Para quien delega tareas largas, este es el cambio con más potencial a medio plazo.

    2. Effort Control: tú decides cuánto piensa

    Ahora puedes elegir el nivel de “esfuerzo” del modelo desde un control junto al selector de modelo.

    • Más esfuerzo: razona más profundo y entrega mejores respuestas.
    • Menos esfuerzo: responde más rápido y consume menos de tus límites de uso.

    Por defecto viene en high. Por encima tienes la opción “extra” —que en Claude Code corresponde a xhigh— y “max”. La recomendación oficial es usar “extra” para tareas difíciles y flujos asíncronos largos. A diferencia de Dynamic Workflows, Effort Control está disponible en todos los planes.

    3. Un modelo más honesto (menos bugs silenciosos)

    Esta es, para mí, la mejora que más se nota en el día a día del código.

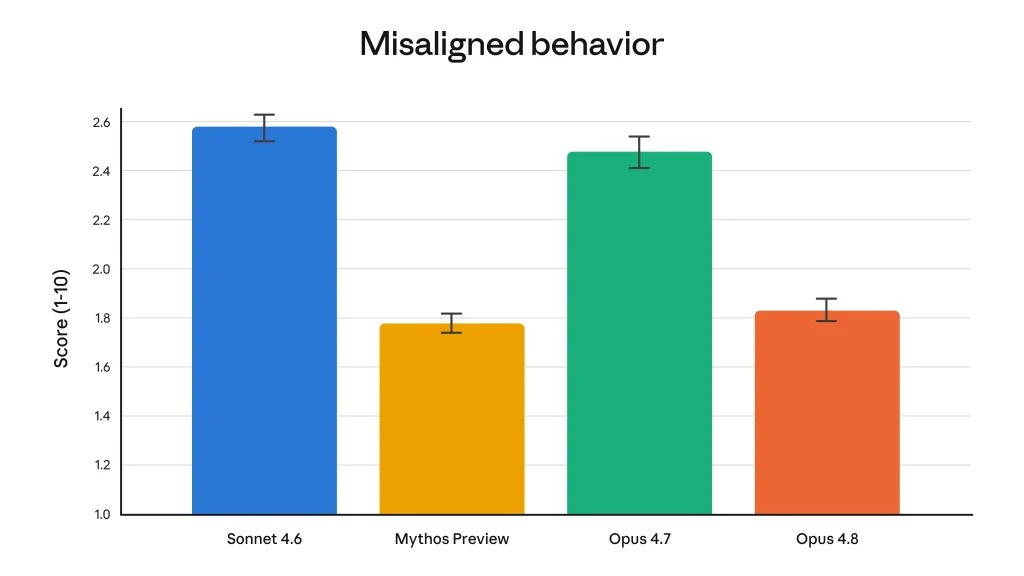
    Anthropic entrenó el modelo para que no cante victoria sin evidencia. El dato concreto: Opus 4.8 tiene aproximadamente cuatro veces menos probabilidad que su predecesor de dejar pasar un fallo —en código que él mismo escribió— sin señalártelo.

    Traducido: menos “ya está listo” cuando en realidad no lo está. Si delegas tramos grandes de trabajo, esa honestidad te ahorra horas de revisión y depuración.

    Novedad para quien construye sobre la API

    Si desarrollas agentes sobre la API, hay un cambio silencioso pero práctico: la Messages API ahora acepta entradas de tipo system dentro del array de mensajes. Esto te permite actualizar las instrucciones de Claude a mitad de una tarea —permisos, presupuesto de tokens, contexto del entorno— sin romper el prompt cache ni tener que colarlo como un turno de usuario. Para harnesses de agentes que corren de forma autónoma, limpia bastante la arquitectura.

    Precios y velocidad

    Opus 4.8 mantiene el precio de 4.7:

    • Modo regular: 5 USD por millón de tokens de entrada, 25 USD por millón de salida.
    • Modo fast: 10 USD por millón de entrada, 50 USD por millón de salida, a 2,5× la velocidad. Anthropic indica que este modo fast es alrededor de tres veces más barato que en modelos anteriores.

    En resumen: mejor modelo, mismo costo. Difícil quejarse de eso.
    Mi opinión: no es un salto generacional, y está bien

    Seamos claros: Opus 4.8 no te va a volar la cabeza. Es una mejora de calidad de vida, no un cambio de generación. Pero precisamente por eso se siente: el mejor criterio agéntico y la honestidad encajan a la perfección con un flujo de Spec-Driven Development (SDD).

    Si el modelo respeta mejor el spec, se atreve a frenar cuando el plan no cuadra y no te miente con un “terminé” falso, entonces puedes delegar tramos más grandes con menos revisión manual. Esa es la dirección que importa: el desarrollador como director de la IA, no como su competidor.

    Conclusión

    Claude Opus 4.8 no es un titular espectacular, pero es una actualización sólida para quien vive dentro de Claude Code. Dynamic Workflows y la honestidad extra del modelo son lo que de verdad vale la pena, y el Effort Control le da un control fino que se agradece.

    Si trabajas con SDD y Claude Code, este lanzamiento te toca de lleno. En las próximas semanas haré un experimento práctico combinando Dynamic Workflows con specs bien definidas; lo compartiré por aquí.

    ¿Ya probaste Opus 4.8? ¿Qué tarea grande le tirarías primero a los Dynamic Workflows? Cuéntame en los comentarios.
  • Aprende a convertirte en AI Engineer en 2026

    Aprende a convertirte en AI Engineer en 2026

    De dev a AI Engineer: qué necesitas aprender en 2026

    Tiempo estimado de lectura: 3 min

    Ideas clave

    • Prompt Engineering como contrato tipado y versionable para reducir alucinaciones.
    • Tool Calling y agentes: definir herramientas con responsabilidades únicas y schemas JSON.
    • RAG en producción usando embeddings, chunking y pgvector para memoria privada eficiente.
    • LLMOps con tracing y LLM-evaluadores para medir costes y alucinaciones.

    Introducción

    Buscar De dev a AI Engineer: qué necesitas aprender en 2026 ya no es curiosidad de fin de semana; es una decisión profesional con impacto directo en tu carrera. Si vienes de React, Angular o NestJS, tienes la base técnica. Lo que falta es reaprender cómo estructurar sistemas cuando la lógica principal es probabilística y depende de modelos externos.

    En las siguientes líneas encontrarás un roadmap concreto, orientado a ingenieros web/backend, con prioridades prácticas, enlaces a documentación útil y criterios para decidir qué aprender primero.

    Resumen rápido (lectores con prisa)

    Prompt Engineering: diseñar prompts como artefactos versionables que produzcan salidas tipadas y validables.

    Tool Calling / Agentes: definir herramientas con schemas JSON y orquestar invocaciones desde un Agent Loop.

    RAG: almacenar embeddings por chunk (pgvector), recuperar top-k y re-rankear antes de inyectar contexto.

    LLMOps: traza sesiones, registra tokens y usa un LLM evaluador para medir pertinencia y alucinaciones.

    De dev a AI Engineer: qué necesitas aprender en 2026 (roadmap concreto)

    No te doy una lista genérica. Te doy cuatro pilares con tareas prácticas y recursos.

    1) Prompt Engineering estructurado — De texto a contrato

    • Qué aprender: diseñar prompts como artefactos versionables: system prompts, ejemplos (few-shot), y salidas tipadas.
    • Práctica concreta: escribe prompts que devuelvan JSON con un esquema Zod; automatiza tests que validen esos esquemas en CI.
    • Por qué importa: reduce alucinaciones y permite integrar respuestas en pipelines sin parsing frágil.
    • Recurso: Vercel AI SDK para integrar outputs tipados en TypeScript.

    2) Tool Calling y diseño de agentes — Orquesta, no suplentes

    • Qué aprender: definir herramientas (APIs) como JSON-schema que el LLM puede invocar (function/tool calling).
    • Práctica concreta: implementa un Agent Loop mínimo en NestJS:
      • Enviar mensaje + herramientas (schemas) al LLM.
      • Si respuesta indica tool_use, validar args y ejecutar el Service correspondiente.
      • Devolver tool_result y repetir hasta end_turn.
    • Criterio: cada herramienta = responsabilidad única (no “herramienta dios”).
    • Recurso: Anthropic Tool Use

    3) RAG (Retrieval-Augmented Generation) avanzado — Memoria privada usable

    • Qué aprender: embeddings, chunking semántico, re-ranking y vectores en producción.
    • Práctica concreta: usa pgvector sobre PostgreSQL para empezar; implementa pipeline:
      • Normaliza y chunkea documentos.
      • Genera embeddings por chunk.
      • Recupera top-k por similitud y re-rankea por señal de negocio antes de inyectar al prompt.
    • Criterio: prioriza latencia y coste. Evita enviar “todo” en cada petición.
    • Recurso: pgvector

    4) LLMOps y Evaluaciones — Operar lo no determinista

    • Qué aprender: tracing por sesión, LLM-as-a-judge y métricas de negocio.
    • Práctica concreta: registra cada interacción (tokens, latencia, tools invocadas). Configura un job que use un LLM evaluador para puntuar respuestas por pertinencia y alucinaciones.
    • Herramientas: Langfuse para trazabilidad, LangSmith para visualización.
    • Métricas clave: coste por sesión, iteraciones por solicitud, p95 latencia por tool, tasa de fallos por tool.

    Stack técnico recomendado (práctico y defendible)

    Si trabajas en TypeScript, prioriza estos componentes (con orden de adopción):

    1. SDKs oficiales

    Recomendación: Anthropic/OpenAI — aprende sus modelos, límites y formatos de tool-calling.

    2. Backend

    Recomendación: NestJS — implementa providers para LLM, ToolRegistry y AgentService.

    3. Vector DB inicial

    Recomendación: pgvector + PostgreSQL; escala a Pinecone/Qdrant si el volumen lo exige.

    4. Orquestación y workflows

    Recomendación: n8n para pipelines asíncronos y conectores empresariales.

    5. Observabilidad

    Recomendación: Langfuse o LangSmith para tracing y análisis de coste.

    Evita caer en frameworks que abstraen demasiado al principio. Aprende la API real: sabes más cuanto menos le pidas al framework que haga por ti.

    Errores que vas a cometer (y cómo evitarlos)

    • No versionar prompts: guarda prompts junto al código y pruébalos.
    • Herramientas multifunción: separa responsabilidades y aplica autorización por herramienta.
    • No medir tokens: integra métricas de coste desde el primer día.
    • Tests ausentes: mockea LLMs y valida esquemas de salida en CI.

    Prioridad de aprendizaje (3 pasos rápidos)

    1. Practica Tool Calling con un mini-proyecto en NestJS: define 4 herramientas y un Agent Loop.
    2. Implementa RAG con pgvector para un dominio de 100 documentos. Mide latencia y coste.
    3. Añade tracing (Langfuse) y un evaluador LLM que puntúe respuestas en lotes.

    Conclusión

    Convertirse en AI Engineer en 2026 no implica abandonar lo que ya sabes. Implica extender tu disciplina: convertir prompts en contratos, convertir respuestas probabilísticas en flujos controlados y operar sistemas con métricas reales. Si dominas eso, liderarás la integración de IA en producto, no sólo la experimentación.

    Dominicode Labs

    Para equipos que implementan agentes, RAG y pipelines de observabilidad, un siguiente paso natural es consolidar prácticas en proyectos pilotos y reproducibles. Una opción para explorar experimentos y plantillas es Dominicode Labs, que puede servir como repositorio de referencia para workflows y pruebas de concepto.

    FAQ

    ¿Qué es Prompt Engineering estructurado?

    Diseñar prompts como artefactos versionables que incluyan system prompts, ejemplos (few-shot) y produzcan salidas tipadas. El objetivo es generar respuestas que se puedan validar automáticamente (por ejemplo, JSON con esquema Zod).

    ¿Cómo funciona Tool Calling y por qué usarlo?

    Se definen herramientas con schemas JSON que el LLM puede invocar. Un Agent Loop envía mensajes y herramientas al LLM; si el LLM indica uso de herramienta, se validan los argumentos, se ejecuta el servicio y se devuelve el resultado, repitiendo hasta finalizar.

    ¿Por qué usar pgvector para RAG?

    pgvector sobre PostgreSQL permite comenzar con una solución integrada para embeddings y búsquedas vectoriales. Es práctica para dominios iniciales antes de escalar a Pinecone o Qdrant.

    ¿Qué incluye LLMOps en producción?

    Tracing por sesión, registrar tokens, latencia y tools invocadas; configurar jobs que usen un LLM evaluador para puntuar respuestas por pertinencia y alucinaciones; y medir métricas como coste por sesión y p95 latencia por tool.

    ¿Qué stack priorizar si trabajo en TypeScript?

    Prioriza SDKs oficiales (Anthropic/OpenAI), backend en NestJS, pgvector + PostgreSQL, orquestación con n8n y observabilidad con Langfuse o LangSmith.

    ¿Cuáles son los primeros proyectos prácticos recomendados?

    Tres pasos rápidos: (1) mini-proyecto en NestJS para Tool Calling con 4 herramientas y un Agent Loop; (2) implementar RAG con pgvector para ~100 documentos; (3) añadir tracing y un evaluador LLM para puntuar respuestas.

  • Cómo montar un segundo cerebro con Claude Code para gestión del conocimiento

    Cómo montar un segundo cerebro con Claude Code para gestión del conocimiento

    Como montar un segundo cerebro con Claude code

    Si buscas cómo montar un segundo cerebro con Claude Code, aquí tienes una estrategia técnica, reproducible y orientada a equipos que trabajan con código. No es magia: es arquitectura. Trata tus notas como código fuente, versiona todo en Git y deja que Claude Code razone sobre Markdown estructurado para capturar, recuperar y sintetizar conocimiento técnico.

    Documentación de referencia: Claude Code. Para ingesta automatizada, n8n.

    Resumen rápido (lectores con prisa)

    Qué es: Un repositorio de Markdown gestionado por Claude Code que actúa como segundo cerebro técnico.

    Cuándo usarlo: Cuando quieras operar conocimiento técnico como código, con control de versiones, búsqueda semántica y automatización.

    Por qué importa: Reduce fricción entre captura y reutilización, mejora durabilidad y facilita síntesis automatizada.

    Cómo funciona (esencial): Notas en Markdown con frontmatter, indexadas por búsqueda semántica local, gobernadas por un archivo CLAUDE.md y accionadas por un agente CLI.

    Ideas clave

    • Texto plano + Git: durabilidad, portabilidad y trazabilidad.
    • Metadatos estructurados: frontmatter obligatorio para búsquedas precisas y ahorro de tokens.
    • Claude Code como motor activo: agente CLI que crea, etiqueta, sintetiza y propone cambios (PRs).
    • Ingesta automatizada: usar n8n para pipelines que conviertan señales (Slack, GitHub, newsletters) en notas Markdown.

    Tabla de contenidos

    Como montar un segundo cerebro con Claude code: diseño y principios

    El objetivo es simple: minimizar la fricción entre capturar ideas y convertirlas en artefactos reutilizables (ADRs, snippets, post-mortems). Tres principios guían el diseño:

    • Texto plano y Git: durabilidad y portabilidad.
    • Metadatos estructurados: permiten búsquedas precisas sin cargar todo el repositorio.
    • Agente CLI como motor activo: Claude Code actúa (crea, etiqueta, sintetiza) en lugar de solo devolver resultados.

    La propuesta técnica es un repositorio local de Markdown, indexado por una búsqueda semántica local y gobernado por reglas en un archivo CLAUDE.md. Claude Code usa ese contexto para operar de forma coherente.

    Estructura del repositorio (parámetros prácticos)

    Adapta el método PARA (Projects, Areas, Resources, Archives) con convenciones claras. Una topología sugerida:

    /knowledge-base
    /01-projects
    /02-areas
    /03-resources
    /04-archives
    CLAUDE.md

    Adaptación del método PARA

    • Archivos Markdown (.md) con YAML frontmatter en la cabecera.
    • Nombres de archivo semánticos: 2026-04-migracion-postgres.md o auth-use-cases-login.md.
    • Limita el tamaño de archivos (ideal < 1.5k palabras por nota) para mantener la relevancia en búsquedas semánticas.

    Ejemplo de frontmatter

    —
    title: Rate limiting en Express con Redis
    date: 2025-04-10
    tags: [backend, nodejs, redis, performance]
    status: active
    —

    El frontmatter permite a Claude filtrar sin leer todo el contenido y reduce consumo de tokens.

    CLAUDE.md: memoria persistente y reglas del agente

    CLAUDE.md es la gobernanza del segundo cerebro. Define el rol del agente, las reglas de ingestión, los comandos permitidos y las prioridades de búsqueda.

    Contenido mínimo recomendado:

    • Rol (ej. “Actúa como gestor de conocimiento técnico”).
    • Reglas de escritura (frontmatter obligatorio, plantillas).
    • Reglas de búsqueda (usar Semantic Search antes de cargar archivos completos).
    • Protocolos de modificación (p. ej. “Mostrar PR antes de borrar”).

    Con esto, cada sesión arranca con el mismo contrato operativo, evitando decisiones erráticas del modelo.

    Flujos de trabajo operativos (ejemplos reales)

    Algunos flujos operativos que funcionan en equipos técnicos:

    1) Ingesta rápida (post-reunión)

    • Acción: pega el texto bruto en la terminal.
    • Prompt: “Extrae decisiones, riesgos y tareas; crea /01-projects/migracion-postgres.md con frontmatter y lista de tasks.”
    • Resultado: nota creada, etiquetada y commiteada.

    2) Búsqueda semántica y recuperación

    Prompt: “Busca soluciones documentadas para latencia en queries SQL en los últimos 12 meses y sintetiza los patrones comunes.” Claude usa Semantic Search para limitar los archivos que carga y devuelve una síntesis accionable.

    3) Generación de ADRs

    Prompt: “Lee notas con tags #arquitectura y #microservicios, encuentra trade-offs recurrentes y genera un primer borrador de ADR con pros/cons y migración paso a paso.”

    4) Mantenimiento automatizado

    Prompt: “Lista archivos en /03-resources sin tags; propone tags automáticos y muestra la diff antes de aplicar.”

    Orquestación externa: n8n para captura y pipelines

    Para entradas automáticas (Slack, GitHub stars, newsletters), crea workflows en n8n que:

    • Extraigan el contenido.
    • Conviertan a Markdown con frontmatter básico.
    • Guarden en /03-resources o /01-projects.

    Así tu segundo cerebro se alimenta sin intervención manual y Claude tiene material fresco al iniciar la sesión.

    Consideraciones operativas y limitaciones

    • Costos y tokens: obliga al agente a usar Semantic Search local antes de enviar datos al modelo para ahorrar tokens.
    • Context window: evita pedir que el agente “lea todo”; diseña prompts que recuperen subsets relevantes.
    • Seguridad: el repositorio puede contener notas sensibles. Aplica cifrado o repositorios privados; controla accesos.
    • Evolución: revisa periódicamente las convenciones en CLAUDE.md y actualiza plantillas.

    Integración con flujo de trabajo real (CI / PRs)

    Siempre que Claude genere cambios significativos:

    • Crea un branch y un PR automático.
    • Ejecuta CI (tests, linters, SCA) en un entorno aislado (VM/Container).
    • Usa n8n o pipelines para devolver resultados al CLI y permitir que Claude revise y corrija si es necesario.

    Esto evita merges automáticos sin validación humana.

    Conclusión y primer paso accionable

    Cómo montar un segundo cerebro con Claude code no es un truco de productividad: es una decisión de arquitectura que convierte notas en activos reutilizables. Empieza hoy con estos tres pasos:

    1. crea la topología PARA en un repositorio Git,
    2. añade frontmatter obligatorio y un CLAUDE.md con reglas básicas,
    3. prueba un flujo de ingesta simple (reunión → nota creada por Claude).

    Luego automatiza la captación con n8n y define tu política de PR/CI. Haz esto y tu conocimiento dejará de ser un archivo muerto: se convertirá en una base de decisión viva y accionable.

    Eso es la infraestructura: dónde viven las notas y quién las gobierna. Lo que escribes dentro de cada archivo decide si el agente las recupera enteras o partidas por la mitad, y de eso va Zettelkasten para developers.

    Mención: Dominicode Labs

    Para complementar flujos de trabajo y pruebas de concepto relacionadas con automatización y agentes, considera explorar recursos prácticos y experimentos en Dominicode Labs. Es una continuación lógica para equipos que buscan implementar pipelines y agentes en entornos reales.

    FAQ

    ¿Qué formato deben tener las notas?

    Archivos Markdown con YAML frontmatter en la cabecera. Nombres semánticos y notas cortas (ideal < 1.5k palabras).

    ¿Por qué usar frontmatter?

    El frontmatter permite filtrar y priorizar sin cargar todo el contenido, reduciendo consumo de tokens y haciendo las búsquedas más precisas.

    ¿Cómo ahorro tokens al usar Claude?

    Obliga al agente a ejecutar Semantic Search localmente y solo enviar al modelo los archivos más relevantes; evita pedidos que “lean todo” el repositorio.

    ¿Qué hace CLAUDE.md?

    Es el contrato operativo: define el rol del agente, reglas de ingestión, plantillas, comandos permitidos y protocolos de PR/edición.

    ¿Qué rol juega n8n en esta arquitectura?

    n8n orquesta ingestas automáticas (Slack, GitHub, newsletters): extrae contenido, genera Markdown con frontmatter y lo guarda en las carpetas correspondientes del repositorio.

    ¿Cómo integro cambios de Claude en mi flujo de Git?

    Claude debe crear branches y PRs automáticos; la CI ejecuta tests/linters y se evita el merge automático sin validación humana.

  • Comparativa de Claude Code y Cursor para desarrolladores en 2026

    Comparativa de Claude Code y Cursor para desarrolladores en 2026

    Claude Code vs Cursor en 2026: cuándo usar cada uno — Comparativa honesta basada en flujos reales

    Tiempo estimado de lectura: 4 min

    • Claude Code es la herramienta de maquinaria: automatización, pipelines y transformaciones en lote.
    • Cursor es el artesano: edición visual, diffs en contexto y pair programming asistido por IA.
    • Asignar la tarea a la interfaz correcta reduce fricción: uso CLI/agents para procesos reproducibles y el IDE para juicios semánticos.

    Claude Code vs Cursor en 2026: cuándo usar cada uno — eso no es una discusión de modelos, es una discusión de interfaz y fricción. Ambas herramientas sirven a la misma ambición (hacerte más productivo), pero en 2026 la diferencia práctica está en qué tipo de trabajo quieres sacar de tu cabeza y poner en piloto automático. En este artículo comparo Claude Code (CLI/headless) y Cursor (IDE visual) basándome en flujos reales: refactors masivos, creación de features y debugging en producción. No hay benchmarks sintéticos; hay decisiones que rompen builds o liberan producto.

    Resumen rápido (lectores con prisa)

    Claude Code: CLI para automatización, pipelines y transforms en lote. Cursor: IDE visual para edición interactiva, diffs en contexto y pair programming. Usa Claude Code para reproducibilidad y escala; usa Cursor para juicios semánticos y cambios que requieren inspección visual.

    Claude Code vs Cursor en 2026: resumen rápido

    – Claude Code (CLI): pensado para automatización, pipelines, scripts y trabajo en lote. Ideal para orquestar agentes sin interfaz gráfica, ejecutar transforms en monorepos y procesar logs pesados. (paquete npm: paquete npm, Anthropic: Anthropic)

    – Cursor (IDE): pensado para el trabajo artesanal dentro del editor. Contexto visual, diffs en vivo, edición interactiva y pair programming asistido por IA. (Cursor)

    Ambas pueden usar modelos avanzados; la ganancia real viene de asignar a cada herramienta la tarea que mejor gestiona su interfaz.

    1) Features nuevas: scaffolding y lógica inicial

    Cuando arrancas una funcionalidad, necesitas dos cosas: rapidez para generar boilerplate y control para validar decisiones arquitectónicas.

    Usa Cursor si…

    • tu feature es UI/UX, componentes React/Next/Angular o cambios que requieren vista simultánea de varios archivos.
    • Cursor muestra el diff en contexto, te permite aceptar cambios parciales y mantener el control línea a línea. Es pair programming con atajos.

    Usa Claude Code si…

    • vas a generar servicios backend desde un esquema: scripts que lean un SQL/JSON Schema, generen controladores, tests y terraform en lote.
    • Un workflow típico: un script Bash alimenta Claude con el esquema y crea un PR con estructura inicial, lista para revisión. No abres centenares de archivos; revisas el PR.

    Ejemplo (flujo Claude Code): un comando que toma un esquema y produce controladores, ejecutado desde CI o local en terminal, sin interfaz gráfica interrumpida.

    2) Refactors masivos y migraciones

    Aquí se gana o se pierde integridad del sistema.

    Claude Code brilla cuando…

    • necesitas migraciones sistemáticas: buscar patrones con ast-grep, encadenar transformaciones con sed/perl/jq y delegar la modificación a un agente que produzca PRs.
    • Es fire-and-forget, reproducible y fácil de auditar.

    Cursor es la opción segura cuando…

    • el refactor toca lógica de dominio y contratos implícitos. Necesitas validar cada cambio con pruebas y juicio humano.
    • Cursor te permite intervenir en cada paso con contexto visual.

    Regla práctica: si puedes expresar la transformación como patrón AST y confiar en pruebas automatizadas, usa Claude Code. Si la transformación requiere juicio semántico sobre reglas de negocio, usa Cursor.

    3) Debugging: local vs infra

    – Cursor es superior para errores locales: reproduces, el IDE captura stacktrace, envía contexto al asistente y te marca la línea problemática. El ciclo es inmediato y visual.

    – Claude Code es la herramienta natural para logs y debugging infra: conecta por SSH, procesa gigas de logs con pipelines (cat error.log | claude --print "resume patrón de errores") y no rompe tu máquina local. Ideal para memory leaks, dumps o análisis de trazas distribuidas.

    Integración práctica (hooks y CI)

    No es “usar uno u otro”; es asignar tareas. Ejemplos concretos:

    • Revisor automático de PRs: Claude Code integrado en un job de CI o hook pre-push con Husky. El agente valida patrones y marca “Missing Tests”.
    • Patch iterativo de UI: Cursor para proponer cambios, revisar visualmente y aceptar commits parciales.

    Tabla de decisión rápida

    Escenario Recomendación
    Componentes UI y revisión visual Cursor
    Migraciones masivas (monorepo) Claude Code
    Debugging local (reproducción en IDE) Cursor
    Análisis de logs/infra remota Claude Code
    Scaffolding backend/infra as code Claude Code
    Refactors de lógica de negocio crítica Cursor

    Riesgos y buenas prácticas

    • Tokens y coste: cualquier workflow que pase megabytes de código a un LLM necesita filtrado (excluir node_modules, builds, package-lock.json) y paginar el contexto.
    • Contexto parcial: Claude Code trabaja con lo que le das. Añade tests y fixtures para reducir falsos positivos.
    • Auditoría: versiona prompts y scripts en el repo. Revisa los PRs generados por agentes como revisas cualquier patch humano.

    Conclusión clara

    No es una elección excluyente. Cursor es el artesano: detalle, iteración y control. Claude Code es la maquinaria: automatización, pipelines y transformaciones en lote. En 2026 los equipos más efectivos combinan ambos: Cursor para diseñar y verificar, Claude Code para escalar y ejecutar. Tu criterio técnico consiste en decidir, a diario, qué tipo de fricción quieres eliminar y cuál quieres mantener para no romper la base de código.

    Para equipos interesados en explorar workflows, agentes y automatización aplicados a ingeniería, consulta Dominicode Labs como continuación lógica para experimentar con pipelines reproducibles y hooks de CI.

    FAQ

    ¿Cuándo debo elegir Claude Code sobre Cursor?

    Elige Claude Code para tareas reproducibles y en lote: migraciones sistemáticas, scaffolding backend desde esquemas y análisis de logs a escala.

    ¿Cuándo es mejor Cursor?

    Cursor es mejor para cambios que requieren inspección visual, diffs en contexto y juicios semánticos sobre lógica de negocio o UX.

    ¿Puedo usar ambos en el mismo flujo?

    Sí. Un enfoque práctico es usar Cursor para diseñar y verificar, y Claude Code para ejecutar y escalar los pasos repetibles mediante CI y hooks.

    ¿Cómo gestiono el riesgo de exponer código sensible a modelos?

    Filtra el input (excluir node_modules, builds y lockfiles), paginate el contexto y mantén tests/fixtures para validar salidas antes de aplicar cambios.

    ¿Qué herramientas concretas se mencionan para migraciones y hooks?

    Se mencionan ast-grep para patrones AST y Husky para hooks de pre-push. También se refiere al paquete de Claude Code en paquete npm y a Anthropic.

    ¿Qué prácticas de auditoría recomiendan?

    Versiona prompts y scripts en el repo, revisa PRs generados por agentes como revisas cualquier patch humano y registra cambios automatizados en CI para trazabilidad.

    ¿Dónde puedo probar Cursor y Claude Code?

    Cursor se encuentra en Cursor. Claude Code y recursos relacionados están disponibles via paquete npm y Anthropic.

  • Cómo construir un agente de IA con NestJS y Claude API

    Cómo construir un agente de IA con NestJS y Claude API

    Cómo construir un agente de IA con NestJS + Claude API

    Tiempo estimado de lectura: 4 min

    • Separar cliente LLM, registro de herramientas y loop de agente para modularidad y pruebas.
    • Herramientas como contratos JSON-schema y validación antes de ejecución.
    • Agent loop controlado: límites de iteraciones, métricas y manejo de errores normalizado.
    • Producción: no bloquear peticiones HTTP, usar SSE/WebSockets y proteger PII y costes.
    • Observabilidad y testing: trazas por sesión, mocks para provider y canary releases.

    Introducción

    Saber cómo construir un agente de IA con NestJS + Claude API es lo que separa una demo interesante de una pieza de infraestructura que puedas mantener en producción. En este artículo encontrarás la arquitectura, decisiones técnicas y patrones que realmente importan cuando implementas tool-calling de Claude dentro de un backend modular y tipado como NestJS.

    Un agente no es un chatbot: es un bucle de decisión. Recibe objetivo, decide herramientas, ejecuta, observa resultados y vuelve a razonar hasta resolver la tarea o agotar límites.

    Resumen rápido (lectores con prisa)

    Qué: Un agente es un bucle de decisión que orquesta llamadas a herramientas externas desde un LLM.

    Cuándo: Cuando necesitas que un LLM interactúe con sistemas externos (DB, APIs, logs) de forma controlada.

    Por qué importa: Permite trazabilidad, testing y control de costes frente a soluciones ad-hoc.

    Cómo: Separando un provider LLM, un registro de herramientas con schemas JSON y un agente que controla el loop y límites.

    Cómo construir un agente de IA con NestJS + Claude API: arquitectura y flujo

    Ese bucle —Agent Loop— obliga a diseñar responsabilidades claras. El agente recibe un objetivo, decide qué herramienta usar, ejecuta esa herramienta, observa el resultado y repite hasta resolver la tarea o agotar límites.

    Arquitectura mínima recomendada:

    • Proveedor del cliente LLM (Anthropic) como Provider de NestJS.
    • Registro dinámico de herramientas (ToolRegistryService) que mapea nombres/JSON-schema a métodos de servicios.
    • Motor de ejecución (AgentService) que orquesta el loop y gestiona historial, stop reasons y seguridad.

    Referencias: NestJS Docs y Anthropic Tool Use

    Capa 1 — AnthropicProvider: el cliente como dependencia inyectable

    Nunca newees el cliente de Anthropic en controladores o servicios. Crea un provider que se inyecte y centralice la lógica del cliente.

    • Lee ANTHROPIC_API_KEY mediante ConfigService.
    • Envuelve lógica de retries, backoff y métricas (tokens usados, latencia).
    • Permite mockear en tests unitarios.

    Ejemplo conceptual: el provider expone sendMessage(payload) que encapsula anthropic.messages.create() y normaliza la respuesta (stop_reason, content, tool_call).

    Beneficio: centralizas control de coste y modelo (p. ej. cambiar de Claude 3.5 a otro modelo sin tocar el resto).

    Capa 2 — ToolRegistry: herramientas como contratos JSON y servicios

    Claude espera herramientas descritas por JSON-schema. En el backend conviene modelarlas y validar antes de ejecutar.

    • Definir cada herramienta con nombre, descripción y schema (tipado TypeScript).
    • Mapear cada herramienta a un método de servicio inyectable (p. ej. UsersService.getById, LogsService.append).
    • Implementar granularidad: una herramienta = una responsabilidad.

    Diseño práctico:

    • ToolRegistryService mantiene un mapa { toolName -> { schema, executor } }.
    • executor(args) valida los args contra el schema y ejecuta el método correspondiente en try/catch.

    Así el agent loop no necesita switches gigantes; resuelve métodos dinámicamente.

    Capa 3 — AgentService: el bucle, stop_reasons y límites

    El AgentService orquesta el loop de decisión, mantiene el historial y aplica límites y políticas de seguridad.

    Patrón del Agent Loop

    1. Construir messages + tools (esquemas) y llamar a Anthropic.
    2. Leer stop_reason:
      • end_turn: devolver respuesta final.
      • tool_use: extraer tool_name y arguments.
    3. Ejecutar herramienta vía ToolRegistryService y añadir tool_result al historial.
    4. Repetir hasta end_turn o alcanzar un límite de iteraciones.

    Normas prácticas

    • Límite de iteraciones (p. ej. max 5) para evitar bucles y costes excesivos.
    • Cada iteración registra métricas: tokens, latencia, herramienta invocada.
    • Normaliza errores: si la herramienta falla, devuelve { error: 'timeout' } a Claude, no throws.

    Producción: latencia, UX y seguridad

    Al pasar a producción hay que priorizar experiencia de usuario, seguridad y observabilidad.

    Latencia y UX

    • No bloquees la petición HTTP principal. Emite progreso con SSE o WebSockets: “Pensando…”, “Consultando DB…”.
    • Opcional: respuesta rápida + notificación cuando el resultado final esté listo (webhook / push).

    Seguridad y validación

    • Valida argumentos de herramientas con class-validator/schema JSON antes de ejecutar.
    • Logs sensibles: evita enviar secrets o PII a la API de Claude.
    • Rate limits y circuit breakers en el provider para proteger tu backend y controlar facturación.

    Observabilidad

    Traza cada sesión como un árbol de spans: requests al LLM, ejecuciones de herramientas, errores.

    Integra herramientas de visualización y trazabilidad como Langfuse o LangSmith para visualizar flujos y coste por sesión.

    Testing y despliegue

    • Mockea el AnthropicProvider y el ToolRegistryService en tests unitarios.
    • Tests de integración: entorno con Claude sandbox o replay de respuestas deterministas.
    • Canary releases: habilita el agente en subset de usuarios antes de producir a toda la base.

    Coste y gobernanza

    • Mide tokens por iteración; extrapola a coste por sesión.
    • Define políticas: cuándo permitir tool-calling (p. ej. solo usuarios verificados) y límites diarios.

    Qué evitar (errores comunes)

    • Herramientas “dios” que hacen todo: dificultan autorización y testing.
    • Dejar excepciones sin capturar: provoca loops rotos y mala UX.
    • No auditar llamadas: sin trazabilidad no sabrás por qué el agente falló o costó tanto.

    Cierre práctico

    Construir un agente con NestJS + Claude API no es magia, es disciplina arquitectónica. Si abstraes el cliente, modelas herramientas como contratos y controlas el bucle con límites, obtienes un sistema escalable, testeable y seguro.

    En el siguiente artículo veremos ejemplos concretos de ToolRegistryService y patrones para emitir progreso en SSE desde NestJS para mejorar la experiencia del usuario.

    Dominicode Labs

    Para continuidad en temas de automatización y agentes, consulta recursos adicionales en Dominicode Labs. Es una fuente útil para patrones, ejemplos y plantillas prácticas que complementan esta arquitectura.

    FAQ

    ¿Qué es un agente de IA en este contexto?

    Un agente es un bucle de decisión que recibe un objetivo, decide qué herramienta invocar, ejecuta esa herramienta, observa el resultado y repite hasta completar la tarea o agotar límites.

    ¿Por qué usar un provider para Anthropic?

    Un provider centraliza la configuración del cliente (API key, retries, métricas), facilita el mock en tests y permite cambiar de modelo o proveedor sin modificar la lógica de negocio.

    ¿Cómo se describen las herramientas?

    Las herramientas se describen con nombre, descripción y un JSON-schema (tipado TypeScript). Se valida la entrada antes de ejecutar y se mapea a funciones/executors inyectables.

    ¿Qué es stop_reason y cómo se maneja?

    stop_reason indica la acción del LLM: end_turn para respuesta final o tool_use para invocar una herramienta. El agente interpreta y actúa según ese valor.

    ¿Cómo se asegura la producción respecto a latencia?

    No bloquear la petición HTTP principal; usar SSE o WebSockets para emitir progreso. También considerar respuestas rápidas con notificación posterior y aplicar límites de iteraciones para controlar latencia y coste.

    ¿Qué pruebas son recomendables?

    Mockear el provider y el registry en tests unitarios; usar sandbox o replays deterministas en integración; ejecutar canary releases antes de un despliegue completo.

  • Comparativa técnica de Agentic Harness: Claude Code, Cursor y más

    Comparativa técnica de Agentic Harness: Claude Code, Cursor y más

    Agentic Harness comparado — Claude Code vs Cursor vs Codex CLI vs Aider vs Cline

    Tiempo estimado de lectura: 6 min

    • Un agentic harness convierte un LLM en un actor sobre tu repo: necesita contexto eficiente, aplicación segura de cambios y bucles de verificación.
    • Elige la herramienta según dominio: Cursor para UI y revisión visual, Aider para refactors y auditabilidad, Claude Code para pipelines, Cline para acceso a infra, Codex/Copilot CLI para utilidades tácticas.
    • Prioriza: context slicing (RAG/AST), rollback y trazabilidad, integración CI/CD, permisos/extensibilidad y observabilidad.
    • Gobernanza: define qué puede hacer el agente sin revisión, qué debe proponer como PR y cómo auditar acciones.

    El desarrollo asistido por IA dejó de ser un experimento cuando los equipos empezaron a pedir algo concreto: no sólo sugerencias, sino ejecución fiable. Aquí tienes un análisis técnico y accionable de Agentic Harness comparado — Claude Code vs Cursor vs Codex CLI vs Aider vs Cline, pensado para Tech Leads y equipos reales que deben decidir estrategia, integraciones y límites de autonomía.

    Resumen rápido (lectores con prisa)

    Un agentic harness es la capa que permite a un LLM operar sobre un repositorio con seguridad y trazabilidad.

    Úsalo cuando necesites ejecutar cambios repetibles, verificables y revertibles — no sólo sugerencias.

    Elige según dominio: UI (Cursor), refactor/legacy (Aider), pipelines/infra (Claude Code), acceso a infra interna (Cline).

    Prioriza RAG/AST para contexto, commits/diffs para trazabilidad y bucles de tests para verificación.

    Agentic Harness comparado — por qué importa y qué debes exigirle

    Un agentic harness no es un plugin bonito: es la capa que convierte un LLM en un actor capaz de operar sobre tu repo. A nivel técnico debe resolver tres problemas simultáneos:

    • Resolución de contexto: indexación del repo + selección de snippets relevantes (RAG, AST-aware slicing).
    • Aplicación segura de cambios: diffs atómicos, commits, PRs y rollback.
    • Bucle de verificación: pruebas, linters y reintentos automáticos leyendo stderr/exit codes.

    Si la herramienta que evalúas no cubre esas tres piezas de forma explícita, la estás usando como un asistente, no como un agente.

    Resumen rápido de cada harness

    Cursor — editor visual AI-first

    Cursor es un fork de VS Code que trae IA integrada a la experiencia del editor. Su valor es UX: Composer permite editar múltiples archivos en contexto y previsualizar diffs antes de aplicar. Técnica clave: contexto calculado desde archivos abiertos y navegación del cursor, útil para producción de features frontend donde la verificación visual es crítica. URL: Cursor

    Cuándo elegirlo: equipos Full Stack que quieren control visual y revisión humana inmediata. Fricción: migración de editor.

    Claude Code — CLI para razonamiento extendido

    Claude Code (Anthropic) es un CLI pensado para ejecución en terminal. Diseñado para Claude 3.7 con extended thinking, ejecuta bucles autónomos: corre tests, inspecciona logs y corrige iterativamente. Técnica clave: integración terminal-native y capacidad de manejar workflows en CI/CD. URL: Claude Code docs

    Cuándo elegirlo: backend, infra y pipelines automatizados donde no necesitas UI pero sí razonamiento arquitectónico.

    Aider — control Git como seguridad

    Aider es Open Source y opera en CLI con filosofía “Git-first”: cada cambio satisfactorio produce un commit automático. Técnica clave: mapeo del repo vía AST para minimizar el contexto enviado al modelo y trazabilidad total mediante commits. URL: Aider

    Cuándo elegirlo: repos grandes, legacy codebases y equipos que exigen revertibilidad y auditoría precisa.

    Cline — extensión VS Code con MCP

    Cline implementa MCP (Model Context Protocol) y permite que el agente consulte servicios externos (DBs, docs internas) antes de escribir código. Técnica clave: permisos explícitos por acción y extensibilidad mediante MCP. URL: Cline

    Cuándo elegirlo: organizaciones con infra y APIs internas que quieren que el agente actúe con contexto real y seguro.

    Codex CLI / Copilot CLI — utilidades tácticas

    Herramientas como Codex CLI o Copilot CLI están enfocadas en traducir NL a comandos de terminal. Útiles para scripting y tareas puntuales, no para refactorizaciones autónomas: carecen del bucle iterativo sobre el repo. Recurso: Codex (OpenAI)

    Cuándo elegirlo: tareas de DevOps ad-hoc, scripting, comandos complejos — no para “delega la refactorización”.

    Criterios técnicos para elegir

    1. Context slicing: ¿la herramienta usa RAG o análisis AST para minimizar tokens? Si no, pagarás tokens y recibirás ruido.
    2. Rollback y trazabilidad: commits automáticos + mensajes generados por IA (Aider) vs diffs aprobados por UI (Cursor). Decide si prefieres control humano o commits automáticos.
    3. Integración CI/CD: ¿el harness puede operar en pipelines sin UI y corregir builds? Claude Code brilla aquí.
    4. Extensibilidad y permisos: MCP (Cline) permite consultas reales a infra interna; obligatorio si necesitas que el agente lea DBs o docs privadas.
    5. Observabilidad y métricas: tokens, fallos de parseo, reintentos y coste por sesión. Sin métricas no puedes gobernar autonomía.

    Ejemplos prácticos

    • Refactorización de API en un monorepo grande: usa Aider por AST-mapping + commits automáticos. Revertir es simple y el contexto es eficiente.
    • Corregir fallo en CI que rompe build: lanza Claude Code en la pipeline; ejecutará tests, leerá logs y propondrá patches iterativos.
    • Añadir componente UI y actualizar rutas: Cursor acelera al mostrar previews y permitir aceptar diffs por pantalla.
    • Integración con servicio interno (consulta de esquema DB antes de generar ORM): Cline + MCP para consultas reales antes de generar código.

    Recomendación práctica para equipos

    No hay una sola herramienta “mejor”. La arquitectura razonable es híbrida:

    • Cursor para trabajo de producto diario y revisión rápida.
    • Aider para refactors críticos y control de cambios.
    • Claude Code en pipelines automatizados y tareas de infra.
    • Cline cuando necesites que el agente hable con infra interna.
    • Codex/Copilot CLI para utilidades puntuales de scripting.

    Antes de adoptar, define: qué puede hacer el agente sin revisión humana, qué debe proponer como PR, y cómo auditarás cada acción (logs, commits, approvals). Sin estas reglas, la herramienta genera ruido o riesgos.

    Recursos y lecturas

    Si vas a integrar agentes en producción, no lo hagas por moda. Prepara contexto (CLAUDE.md / AGENTS.md / memory files), define límites y selecciona el harness según el dominio: UI, infra, refactor o integración con sistemas internos. Así, la IA deja de ser un “showroom” y pasa a ser una herramienta medible y auditable.

    Como continuación lógica para equipos que diseñan flujos de agentes y gobernanza técnica, consulta los experimentos y recursos de Dominicode Labs. Allí encontrarás guías prácticas para implementar context slicing, auditoría de commits y métricas de observabilidad en flujos con agentes.

    FAQ

    ¿Qué es exactamente un agentic harness?

    Es la capa que permite a un modelo de lenguaje operar sobre un repositorio con procesos definidos: resolución de contexto, aplicación segura de cambios y bucle de verificación mediante tests/linters.

    ¿Cuándo debo usar Aider en lugar de Cursor?

    Usa Aider para refactors en repos grandes o legacy donde necesitas commits automáticos y trazabilidad. Usa Cursor cuando la experiencia visual y la revisión humana inmediata son prioritarias (UI, previews, aceptación de diffs).

    ¿Claude Code reemplaza un CI tradicional?

    No necesariamente. Claude Code facilita la automatización y el razonamiento en pipelines (ejecutar tests, leer logs, proponer parches), pero suele integrarse con CI/CD existente como una herramienta para corregir y iterar en builds.

    ¿Qué es MCP y por qué importa con Cline?

    MCP es el Model Context Protocol: permite que el agente consulte servicios externos (DBs, docs internas) antes de escribir código. Es crítico si el agente necesita contexto real y permisos explícitos para interactuar con infra interna.

    ¿Puedo usar Codex/Copilot CLI para refactorizaciones?

    No son la mejor opción para refactorizaciones autónomas. Están pensados para traducir lenguaje natural a comandos de terminal y scripting; carecen del bucle iterativo y la gestión de diffs sobre el repo que requieren refactors complejos.

    ¿Cómo audito las acciones de un agente?

    Define trazabilidad mediante commits/diffs, logs de sesión, métricas de tokens y reintentos. Decide qué acciones requieren aprobación humana vs commit automático y conserva archivos de contexto (CLAUDE.md / AGENTS.md / memory files) para replicabilidad.

  • Cómo construir un subagente en Claude Code para revisión de PRs

    Cómo construir un subagente en Claude Code para revisión de PRs

    Cómo construir tu primer subagente en Claude Code — Tutorial paso a paso con un caso útil: por ejemplo, un agente revisor de PRs o generador de tests

    Tiempo estimado de lectura: 4 min

    • Patrón práctico: contexto acotado + reglas estrictas + output accionable para integrar IA en pipelines.
    • Dos casos: revisor de PRs (diff) y generador de tests (por archivo).
    • Implementación: scripts CLI que usan Claude Code, prompts versionados y hooks/CI para automatizar.
    • Precauciones: controlar tokens, contexto parcial y mantener revisión humana para decisiones críticas.
    Entender cómo construir tu primer subagente en Claude Code — Tutorial paso a paso con un caso útil: por ejemplo, un agente revisor de PRs o generador de tests, es el salto práctico entre usar IA como chat y convertirla en un componente automatizado de tu pipeline de desarrollo. Aquí tienes un tutorial accionable, sin humo: código, prompts y reglas para que funcione de verdad.

    Resumen rápido (lectores con prisa)

    Un subagente es un script que envía contexto limitado (diff o archivo) a Claude Code con un prompt versionado. Úsalo cuando la tarea sea repetitiva y pueda expresarse con reglas claras. La clave: reducir contexto, reglas estrictas y automatizar en hooks/CI.

    Cómo construir tu primer subagente en Claude Code — paso a paso

    Requisitos mínimos

    • Node.js y npm.
    • Cuenta y credenciales de Anthropic (Claude Code).
    • Repositorio Git con cambios en una rama distinta a main.

    Instalación rápida

    Instala la CLI de Claude Code y autentica:

    # macOS, Linux o WSL
    curl -fsSL https://claude.ai/install.sh | bash
    # Windows (PowerShell)
    irm https://claude.ai/install.ps1 | iex
    
    claude auth login
    

    (Referencia: guía de instalación oficial de Claude Code)

    1. Define el System Prompt (qué puede y qué no puede hacer)

    El System Prompt es la barrera entre ruido y valor. Guarda uno en la raíz: .claude-reviewer-prompt.md.

    Contenido recomendado:

    Eres un Staff Engineer realizando una revisión de código.
    Recibirás un `git diff`. Tu objetivo es identificar problemas críticos.
    
    Reglas:
    1. Ignora formato y estilo (linters ya hacen eso).
    2. Busca: vulnerabilidades, condiciones de carrera, mutaciones de estado no controladas y complejidad innecesaria.
    3. Si hay nueva lógica sin tests, marca "Missing Tests" como error crítico.
    4. Responde en Markdown. Si todo está correcto, responde solo: "✅ Código limpio. Listo para PR."
    

    Sé explícito: lo que no está en las reglas, está fuera del subagente.

    2. Script que orquesta el subagente (claude-pr-review.sh)

    Extrae el diff y pásalo al modelo. Crea /scripts/claude-pr-review.sh:

    #!/bin/bash
    DIFF=$(git diff main...HEAD -- ':!**/package-lock.json' ':!**/dist/**')
    
    if [ -z "$DIFF" ]; then
      echo "No hay cambios para revisar."
      exit 0
    fi
    
    PROMPT=$(cat .claude-reviewer-prompt.md)
    
    claude -p "$PROMPT
    
    Aquí tienes el diff:
    \`\`\`diff
    $DIFF
    \`\`\`"
    

    Notas:

    • Excluye archivos generados para ahorrar tokens (-- ':!path').
    • claude --print muestra la respuesta en terminal; puedes redirigirla a un archivo.

    3. Variante: generador de tests por archivo

    Mismo patrón, distinto input. Crea /scripts/claude-gen-tests.sh:

    #!/bin/bash
    FILE_PATH=$1
    if [ ! -f "$FILE_PATH" ]; then
      echo "Archivo no encontrado: $FILE_PATH"
      exit 1
    fi
    
    claude -p "Actúa como SDET especializado en TypeScript.
    Genera tests unitarios con Jest para el siguiente archivo. Usa mocking donde aplique. Devuelve solo el código del test.
    
    Archivo:
    $(cat $FILE_PATH)" > "${FILE_PATH%.*}.test.ts"
    

    El resultado es un punto de partida. No lo aceptes ciegamente: revisa los mocks y aserciones.

    4. Integración práctica: Hooks y CI

    Un script manual se olvida. Integra el revisor en un hook pre-push (Husky) o como job en CI.

    Ejemplo Husky (.husky/pre-push):

    #!/bin/sh
    ./scripts/claude-pr-review.sh || exit 1
    

    Si detecta un problema crítico, el script puede devolver exit 1 y bloquear el push.

    En CI, ejecuta el script y falla el job si el output contiene palabras clave (ej. “Missing Tests” o “Error crítico”).

    5. Limitaciones y buenas prácticas

    • Coste de tokens: pasar un diff enorme puede ser caro. Filtra archivos irrelevantes. Regla práctica: apunta a menos de ~20k tokens por invocación.
    • Contexto parcial: el subagente solo ve lo que le das (diff o archivo). Los falsos positivos aparecen cuando la lógica depende de archivos no incluidos.
    • No es reemplazo de humanos: automatiza lo repetitivo; deja decisiones arquitectónicas a desarrolladores senior.
    • Versiona prompts y scripts: audítalos como cualquier herramienta crítica.

    6. Decisión rápida: cuándo usar un subagente local

    Usa subagentes locales si:

    • La tarea es repetitiva y repite reglas claras (seguridad simple, checklists de arquitectura).
    • Tienes un disparador claro (push, PR, commit).
    • Puedes limitar el contexto para controlar coste y precisión.

    Evítalos cuando:

    • Requieres análisis de arquitectura completa de un monorepo.
    • Necesitas pruebas end-to-end dependientes de infra externa.

    Conclusión (y lo que sigue)

    El patrón es simple y poderoso: reduce ruido dando contexto acotado y reglas firmes. Implementa el revisor y el generador de tests como base, obsérvalos un par de semanas, afina el prompt y automatiza su ejecución en hooks o CI. Esto no acaba aquí: un subagente bien definido se convierte en una pieza de infraestructura que reduce fricción y libera criterio humano para lo que realmente importa.

    Dominicode Labs

    Para equipos que investigan automatización y agentes en pipelines, puede ser útil explorar recursos y experimentos adicionales en Dominicode Labs. Considera esto como una continuación lógica para prototipar y versionar subagentes en un entorno experimental controlado.

    FAQ

    ¿Qué es un subagente en este contexto?

    Un subagente es un componente automatizado que envía contexto específico (por ejemplo, un git diff o el contenido de un archivo) a un modelo (Claude Code) junto con un prompt versionado y reglas, para producir output accionable usado en pipelines de desarrollo.

    ¿Cómo protejo credenciales y datos sensibles?

    Almacena credenciales en entornos seguros (secrets en CI, variables de entorno en el sistema) y evita pasar archivos que contengan secretos en los diffs enviados al modelo. Versiona prompts pero no incluyas secretos en ellos.

    ¿Cuándo el subagente debe fallar un push?

    Haz que falle cuando detecte errores críticos claramente definidos en el prompt (por ejemplo, “Missing Tests” o “Error crítico”). Mantén una lista pequeña y precisa de condiciones que realmente justifiquen bloquear un push.

    ¿Cómo controlo el coste de tokens?

    Filtra archivos irrelevantes, limita el tamaño del diff y prioriza invocaciones por carpeta o por cambios significativos. Regla práctica: apunta a menos de ~20k tokens por invocación.

    ¿Puedo usar otros modelos o proveedores?

    Sí. El patrón (contexto acotado + reglas estrictas + output accionable) es agnóstico al proveedor. Ajusta comandos y prompts según la API/CLI del proveedor seleccionado.

    ¿Cómo versiono y audito prompts?

    Guarda prompts en el repositorio (por ejemplo, .claude-reviewer-prompt.md) y trata los cambios como código: revisiones, PRs y registro de cambios. Audítalos como cualquier herramienta crítica operativa.

  • Cómo Crear una Especificación Técnica Efectiva para Claude

    Cómo Crear una Especificación Técnica Efectiva para Claude

    ¿Quieres convertir una idea brillante en un plan técnico que no se desmorone en la primera integración?

    Tiempo estimado de lectura: 6 min

    • Empieza por el porqué: describir el valor antes de pedir diseño técnico.
    • Documenta y estructura: volcado de contexto organizado en secciones claras.
    • Limita y pide artefactos: define stack, restricciones y solicita outputs machine-readable.
    • Itera con pruebas: divide en fases, genera tests y checklist de aceptación desde el inicio.

    Introducción

    Poca gente habla de esto en voz alta: usar a Claude sin método es como dar un GPS a alguien que no sabe leer mapas. Te lleva rápido. Te deja en medio de la nada.

    Descubrí algo curioso trabajando con equipos: los proyectos con mejor documentación no son los más lentos. Son los que sobreviven. Y con IA, la supervivencia depende de tu habilidad para traducir intuiciones en contratos técnicos claros. Claude puede ser el mejor compañero para eso —si sabes cómo pedirle las cosas.

    Esto no es un manual académico. Es un plan para usar Claude y salir del “hacer que funcione” hacia “hacer que dure”.

    Resumen rápido (lectores con prisa)

    Qué es: método para convertir intuiciones en especificaciones técnicas usando Claude.

    Cuándo usarlo: cuando las decisiones afectan contratos, seguridad o arquitectura.

    Por qué importa: reduce ambigüedad, acelera integración y baja la deuda técnica.

    Cómo funciona: estructura el prompt, define stack y límites, pide artefactos machine-readable y tests en fases.

    Guía paso a paso

    1) Empieza por el porqué, no por el cómo

    No le sueltes al modelo: “Hazme el CRUD.” Suéltale: “Esto existe porque…”

    Explica el negocio en 3–5 frases. Quién usa el producto. Qué métricas importan. Qué es un éxito y qué es un fallo. Claude necesita entender el valor antes de diseñar la estructura. Si no sabe el porqué, propondrá soluciones bonitas que no resuelven nada real.

    2) Brain dump: vacía la cabeza en orden

    Haz un volcado de contexto. Todo. Usuarios, roles, integraciones, datos sensibles, presupuestos, deadlines. Todo en bruto. Luego organízalo en secciones:

    • Objetivo del producto.
    • Requisitos no negociables.
    • Integraciones externas.
    • Restricciones de coste o tiempo.

    Si no lo pones por escrito, la IA lo “olvidará” cuando la conversación crezca. La ventana de contexto es grande, pero limitada. La spec fija el rumbo.

    3) Define límites claros: el terreno de juego

    Un LLM sin límites propone arquitectura épica. Kubernetes para un formulario. Event Sourcing para un blog. Fija el stack y las reglas: Next.js o Angular, Postgres o Mongo, monolito o microservicios. Di lo que está permitido y lo que está prohibido.

    Esto no es control por control. Es evitar decisiones peligrosas. Cuanto más concreto seas, más útiles serán las propuestas de Claude.

    4) Usa a Claude como auditor: Red Teaming

    Hazle preguntas desagradables. Pídele que rompa el diseño.

    “Si la base de datos recibe 10k req/s, ¿qué falla?”

    “¿Qué pasa si el OAuth provider devuelve 500 por 30 segundos?”

    “Describe tres formas en que esto puede ser explotado.”

    Pedir a Claude que actúe como Staff Engineer es oro. Suele encontrar cuellos de botella y escenarios que no ves en la primera pasada.

    5) Pide un Plan Técnico Estructurado (no un ensayo)

    No le pidas “un diseño”. Pide un plan accionable y dividido en entregables. Que incluya:

    • Arquitectura general (componentes y responsabilidades).
    • Modelos de datos (tablas o colecciones, relaciones).
    • Contratos de API (endpoints, métodos, payloads).
    • Reglas de seguridad y manejo de secretos.
    • Estrategia de testing y despliegue.
    • Checklist de aceptación.

    Exige formatos concretos: interfaces TypeScript, OpenAPI, diagramas Mermaid. Claude los produce con disciplina si se lo pides.

    6) Prompt maestro: estructura rígida para resultados deterministas

    Empaqueta la solicitud final con bloques semánticos. Ejemplo sencillo que Claude entiende bien:

    <contexto_negocio>
    Resumen del problema en 3–5 frases.
    </contexto_negocio>

    <stack_requerido>
    Frontend: Next.js 14. Backend: Node 20. DB: PostgreSQL 15.
    </stack_requerido>

    <restricciones>
    Monolito. No sugerir microservicios. Cumplir GDPR.
    </restricciones>

    <output_esperado>
    Markdown con: arquitectura, modelos TypeScript, OpenAPI y Mermaid.
    </output_esperado>

    Sí: usa algo parecido. Claude procesa estructura. Evita “hazme algo bueno” y usa “hazme esto exacto”.

    7) Itera en pequeños pasos: divide para conquistar

    No le pidas “termina todo en un prompt”. Divide el plan en fases:

    • Fase 1: Modelo de datos y contratos.
    • Fase 2: Endpoints principales + seguridad.
    • Fase 3: Estrategia de despliegue y observabilidad.

    Aprueba cada fase antes de avanzar. Así mantienes coherencia y controlas la complejidad.

    8) Genera pruebas desde el principio

    Pide a Claude que escriba tests de aceptación junto al contrato. Un endpoint sin test es un contrato sin firma.

    Solicita ejemplos de payloads válidos e inválidos. Solicita tests automáticos que fallen si no cumples las reglas. Así la implementación se vuelve una verificación automática del plan.

    9) Convierte la spec en artefactos machine-readable

    No dejes todo en texto. Pide:

    • OpenAPI / Swagger.
    • Esquema DB (SQL o Prisma).
    • Interfaces TypeScript.
    • Mermaid para diagramas.

    Estos artefactos alimentan la fase de implementación y reducen la ambigüedad cuando uses Copilot o agentes de coding.

    10) Añade reglas de guardia: políticas y anti-patrones

    Incluye en la spec lo que NO se debe hacer. Ejemplos útiles:

    • No exponer tokens en el frontend.
    • No usar dependencias sin CVE review.
    • Todas las APIs deben ser idempotentes.
    • Tiempo máximo de respuesta: 500ms en endpoints críticos.

    La IA responde bien a instrucciones negativas si las formulas claras.

    11) Implantación práctica: .cursorrules y SPEC.md

    Pon la spec en el repo. No escondas nada en Google Docs. Dos archivos mínimos:

    • SPEC.md: objetivo, reglas, contratos, checklist de aceptación.
    • .cursorrules (o el archivo que tu herramienta use): reglas automáticas consumibles por agentes.

    Que la spec sea la primera lectura del modelo cada vez que se genere código.

    12) Checklist de revisión para PRs generados por IA

    No es lo mismo revisar un PR humano que uno generado por IA. Usa una checklist específica:

    • ¿Respeta la spec? (sí/no)
    • ¿Hay tests que cubren casos límite?
    • ¿Se siguen convenciones de seguridad?
    • ¿Hay duplicación innecesaria de lógica?
    • ¿Los nombres reflejan la intención del dominio?

    Si falla cualquiera, rechaza y pide reescritura a la IA con referencia a la sección exacta de SPEC.md.

    13) Historias reales (sin fantasías)

    Equipo A: arrancó sin spec. 10 librerías distintas, 3 sistemas de auth, un pico y nada funcionó. Reescritura completa en 3 semanas.

    Equipo B: escribió spec en 2 días, usó Claude para generar contratos y tests. Demo en 48 horas. Integración estable en producción. ¿Qué prefieres?

    14) Cuándo no usar Claude para esto

    Claude es excelente en diseño. No lo necesitas para:

    • Tiny fixes en funciones locales.
    • Tests unitarios triviales.
    • Autocompletado en IDE (usa Copilot si quieres velocidad inline).

    Usa Claude cuando la decisión impacte contratos, seguridad o arquitectura.

    15) Plantilla mínima de SPEC.md (pégala ya)

    Pon esto en la raíz del repo. No la copies palabra por palabra sin adaptar. Pero hazlo.

    – Título y objetivo en una frase.

    – Stack aprobado (y versiones).

    – Reglas arquitectónicas innegociables (3).

    – Interfaces/contratos principales.

    – Criterios de aceptación (tests que deben pasar).

    – Política de secretos.

    – Responsables y permisos de cambio.

    Hazlo ahora. No mañana.

    16) Metáfora que pega y no falla

    La spec es la brújula. Claude es el marinero diestro. Sin brújula, el marinero navega. Rápido. Pero a la deriva. Con la brújula, llega al puerto. A salvo.

    17) Urgencia real: la deuda técnica no perdona

    Cada PR aceptado sin spec es una deuda invisible. Se acumula. Multiplica el coste de cada iteración futura. Actuar ahora es barato. Reescribir después es caro.

    CTA: hazlo en 60 minutos

    Abre el repo. Crea SPEC.md con las seis secciones mínimas que te di.

    Si quieres, te doy la plantilla lista para pegar. Respóndeme con “Quiero la plantilla” y te la envío ahora mismo.

    Esto no acaba aquí. Si quieres, te enseño:

    • Un prompt maestro listo para Claude.
    • Un SPEC.md completo para un proyecto típico (Next.js + PostgreSQL).
    • Un .cursorrules ejemplo para que la spec sea leída por agentes.

    Dime cuál quieres y te lo mando. Tus commits lo agradecerán. Y dentro de seis meses, tu equipo también.

    Si quieres recursos y experimentos prácticos sobre automatización, agentes y workflows, revisa Dominicode Labs. Es una continuación lógica para quienes aplican estas prácticas en repos reales y pipelines de integración continua.

    FAQ

    ¿Qué debe contener la sección “Objetivo del producto” en SPEC.md?

    Respuesta

    Debe resumir en una frase el problema que se resuelve, los usuarios principales, y las métricas que determinan éxito o fallo. Manténlo en 2–3 líneas claras.

    ¿Cómo estructuro un prompt maestro para Claude?

    Respuesta

    Usa bloques semánticos: contexto negocio, stack requerido, restricciones y output esperado. Entrega ejemplos concretos y formatos de salida (TypeScript, OpenAPI, Mermaid).

    ¿Qué artefactos machine-readable son prioritarios?

    Respuesta

    Prioriza OpenAPI, esquema de BD (SQL/Prisma) e interfaces TypeScript. Estos permiten plug-and-play con herramientas de generación y tests automáticos.

    ¿Cuándo debo usar Claude vs Copilot?

    Respuesta

    Usa Copilot para autocompletado y fixes locales. Usa Claude para diseño, contratos, análisis de riesgos y generación de artefactos estructurados que guían implementaciones.

    ¿Qué incluir en la checklist de PRs generados por IA?

    Respuesta

    Incluye verificación de spec, cobertura de tests (casos límite), cumplimiento de reglas de seguridad y ausencia de duplicación. Si falla cualquiera, rechaza el PR.

    ¿Cómo integrar .cursorrules en el flujo CI?

    Respuesta

    Añádelo al repo raíz y configura el pipeline para validar que la spec se carga antes de generar artefactos. Automatiza checks que garanticen que los agents leen .cursorrules en cada run.

  • Errores comunes al adoptar Claude Code en equipos de desarrollo

    Errores comunes al adoptar Claude Code en equipos de desarrollo

    Errores comunes al adoptar Claude Code en un equipo

    Tiempo estimado de lectura: 4 min

    • Onboarding: enseñar la herramienta no es suficiente; hay que enseñar el paradigma de agentes autónomos.
    • Spec-First: ejecutar cambios sin especificaciones claras genera deuda y decisiones inventadas por el agente.
    • Costes y contexto: control de iteraciones, reglas permissions.deny y límites para evitar facturas y pérdida de foco.
    • Guardrails operativos: PR gating, auditoría y human-in-the-loop previenen cambios destructivos.

    Los primeros días de uso no muestran los verdaderos errores comunes al adoptar Claude Code en un equipo. Aparecen cuando el agente empieza a operar a escala: facturas inesperadas, PRs que compilan pero rompen la arquitectura, y bucles que consumen tokens hasta que alguien corta la ejecución. Si vas a introducir Claude Code en tu flujo, entiende esto desde la primera semana.

    Claude Code no es un autocompletador: es un agente de terminal. Lee archivos, ejecuta comandos y modifica el repositorio. Esa autonomía multiplica la productividad—y los riesgos—si no impones disciplina.

    Resumen rápido (lectores con prisa)

    Claude Code es un agente autónomo que puede leer, ejecutar y modificar un repositorio. Úsalo cuando tengas specs claros y boundaries operativos. Controla contexto y costes; automatiza tareas repetitivas, pero requiere revisión humana para cambios de arquitectura y acciones destructivas.

    Errores comunes al adoptar Claude Code en un equipo: lecciones aprendidas

    1) Onboarding enfocado en la herramienta y no en el paradigma

    Error: enseñar “cómo instalar la CLI” y asumir que el equipo sabe usar un agente autónomo. Resultado: uso ineficiente o delegación total.

    Solución práctica:

    • Onboarder por paradigma: sesiones que enseñen “qué preguntar”, “qué no delegar” y cómo interpretar salidas de la IA.
    • Política obligatoria: cualquier PR generado por Claude pasa por revisión humana con checklist (seguridad, tests, dependencias).
    • Define tareas delegables: por ejemplo, generación de tests unitarios a partir de interfaces, refactorizaciones pequeñas bajo spec, o scaffolding de componentes que ya respetan convenciones.

    Referencia útil: documentación de Claude Code en Anthropic

    2) Lanzar prompts sin specs (Spec-First)

    Error: pedir “implementa autenticación” en la raíz del repo. El agente inventa ORM, mezcla infra y dominio, y produce deuda.

    Solución práctica:

    • Escribe specs antes de ejecutar la CLI: feature-auth.md que incluya interfaces TypeScript, endpoints, casos de error, y tests esperados.
    • Invocación por referencia: claude "Implementa lo descrito en feature-auth.md; respeta interfaces y pruebas".
    • Mantén un CONVENTIONS.md o .claude/instructions.md con reglas de estilo, librerías permitidas y antipatrones a evitar.

    Esto convierte al agente en un ejecutor de decisiones, no en un arquitecto improvisado.

    3) Ignorar costos y permitir bucles infinitos

    Error: ejecutar Claude en la raíz de un monorepo o dejar que itere tests sin límite. Token-cost + ejecuciones = facturas altas y uso indiscriminado.

    Solución práctica:

    • Abre Claude Code en la carpeta del paquete en el que trabajas, no en la raíz del monorepo.
    • Claude Code no tiene .claudeignore. Para que no lea carpetas pesadas o sensibles, usa reglas deny en .claude/settings.json. Ejemplo:
    {
      "permissions": {
        "deny": [
          "Read(./dist/**)",
          "Read(./logs/**)",
          "Read(./*.sqlite)",
          "Read(./.env)"
        ]
      }
    }
    
    • Imponer límites en el prompt: "Si los tests no pasan después de 3 intentos, detén la ejecución y reporta errores con stack traces".
    • Monitorización y alertas: trackea consumo de tokens y costes con dashboards; define budgets por equipo y bloquea continuaciones si se supera el umbral.

    4) Saturar la ventana de contexto (Lost in the Middle)

    Error: dar al agente el repo entero para “entender el proyecto”. El modelo pierde foco—más contexto = peor señal en el medio. Documentado en Lost in the Middle.

    Solución práctica:

    • Contexto quirúrgico: navega al directorio relevante antes de invocar la CLI. Alimenta al agente con fragmentos semánticos (interfaces, esquema DB, tests relacionados), no con 50 controladores.
    • Usa grafos de dependencia o resúmenes (README de módulo, esquema ER, list of public APIs) para que el agente comprenda impacto sin leer todo el código.
    • Divide tareas grandes en sesiones pequeñas y contractuales con outputs claros entre ellas.

    Controles operativos y guardrails que funcionan

    • PR gating: cualquier cambio propuesto por Claude debe pasar por pipeline CI que incluya lint, tests y políticas SCA (software composition analysis).
    • Auditoría: almacenar hashes del contexto inyectado y logs de comandos ejecutados para auditoría forense.
    • Human-in-the-loop para acciones destructivas: merges automáticos solo si cambios son triviales (docs, comentarios). Para código, siempre revisión humana.
    • Backstop de seguridad: sanitiza PII antes de permitir lectura por el agente.

    Conclusión breve y accionable

    Claude Code acelera trabajos repetitivos y eleva la productividad, pero no sustituye la disciplina de ingeniería. La herramienta amplifica lo que ya existe: si tu arquitectura es modular y tienes specs y tests, el agente te hará avanzar más rápido. Si tu repo es un monolito sin reglas, el agente producirá deuda técnica en modo turbo.

    Implementa Spec-First, controla el contexto que das, limita iteraciones y monitoriza costes. Si sigues esos principios, convertirás a Claude Code en un multiplicador de valor en vez de un generador de problemas.

    Para equipos que diseñan workflows y guardrails para agentes, recursos prácticos y experimentos están disponibles en Dominicode Labs. Estos materiales complementan políticas de PR gating, auditoría y límites de coste descritos arriba, sirviendo como punto de partida para pruebas internas.

    FAQ

    ¿Por qué no basta enseñar la CLI para integrar Claude Code?

    Enseñar la CLI cubre cómo ejecutar la herramienta, pero no enseña el paradigma de agentes autónomos: qué delegar, cómo formular prompts seguros y cómo interpretar acciones que modifican el repo. Sin ese contexto, el equipo tiende a delegar decisiones arquitectónicas a la IA o a usarla de forma ineficiente.

    ¿Qué significa Spec-First y cómo se aplica?

    Spec-First es la práctica de definir interfaces, endpoints, casos de error y tests antes de ejecutar el agente. Se aplica mediante documentos como feature-auth.md y convención de invocación que referencia ese spec; así el agente ejecuta decisiones ya tomadas, no inventa arquitectura.

    ¿Cómo evito facturas inesperadas por bucles del agente?

    Impone límites en el prompt (por ejemplo, máximo 3 intentos de test), usa reglas permissions.deny para que no lea carpetas pesadas y monitoriza consumo de tokens con dashboards y budgets por equipo. Bloquea continuaciones automáticas si se supera el umbral.

    ¿Existe .claudeignore en Claude Code?

    No. Claude Code no lee ningún archivo .claudeignore, así que crearlo no protege nada. Para impedir que lea carpetas pesadas o sensibles (dist, logs, .env), usa reglas deny como Read(./dist/**) en .claude/settings.json.

    ¿Cómo limitar el contexto que le doy a Claude Code?

    Proporciona contexto quirúrgico: archivos relevantes (interfaces, esquema DB, tests relacionados), resúmenes de módulo y grafos de dependencia. Divide tareas grandes en sesiones pequeñas para evitar que el agente lea un monolito entero.

    ¿Cuándo debe intervenir un humano en el flujo de trabajo?

    Siempre que el cambio afecte arquitectura, dependencias críticas, seguridad o datos sensibles, debe haber revisión humana. Merges automáticos pueden permitirse solo para cambios triviales como documentación o comentarios.

  • Agentic Coding: Automatizando el Ciclo de Desarrollo con IA

    Agentic Coding: Automatizando el Ciclo de Desarrollo con IA

    Qué es el Agentic coding?

    Tiempo estimado de lectura: 4 min

    Ideas clave

    • Agentic coding es un paradigma donde un agente de IA recibe un objetivo de alto nivel y ejecuta el ciclo completo de implementación.
    • Combina planificación, uso de herramientas y un bucle de retroalimentación que incluye tests y correcciones iterativas.
    • Funciona bien para scaffolding, pruebas y tareas repetitivas; requiere documentación, TDD y revisión humana para evitar riesgos.


    Qué es el Agentic coding? Es el paradigma en el que un agente de IA recibe un objetivo de alto nivel y ejecuta el ciclo completo de implementación: planifica subtareas, escribe y modifica archivos, ejecuta tests y se autocorrige hasta cumplir el criterio de éxito. No es autocompletar: es automatizar el flujo de trabajo de desarrollo con bucles de razonamiento y acción.

    Resumen rápido (lectores con prisa)

    Agentic coding transforma LLMs en agentes que planifican, usan herramientas (editar archivos, ejecutar comandos, llamar APIs) y se corrigen mediante un bucle de feedback con tests. Es útil para scaffolding, pruebas y tareas repetitivas, pero requiere documentación, TDD y revisión humana por riesgos de seguridad, coherencia y alucinaciones.

    Qué es el Agentic coding? — definición y componentes técnicos

    Técnicamente, un sistema agéntico combina tres capacidades:

    • Planificación: el modelo descompone una tarea compleja en pasos ejecutables antes de tocar código.
    • Uso de herramientas (tool use): el agente puede leer/editar archivos, ejecutar comandos en la terminal, abrir el navegador o llamar APIs externas.
    • Bucle de retroalimentación (feedback loop): ejecuta tests o builds, analiza fallos (stack traces) y corrige el código iterativamente.

    Esa combinación transforma al LLM de generador de texto en un motor de ejecución: piensa, actúa, verifica, corrige. Ejemplo real: pedir “añade rate limiting al endpoint /api/auth y crea tests unitarios” y recibir, tras múltiples ejecuciones, un PR con código que pasa el pipeline de CI (o al menos repite intentos hasta que los tests locales pasan).

    Herramientas y ecosistema (URLs)

    Las herramientas que ya incorporan capacidades agénticas o facilitan su adopción son relevantes para entender el estado práctico del Agentic coding:

    Estas herramientas muestran dos enfoques: editores/CLI que actúan dentro del flujo de desarrollo, y orquestadores que integran agentes en pipelines y automatizaciones.

    Limitaciones prácticas y riesgos técnicos

    El Agentic coding funciona, pero con condiciones. No es una panacea.

    1. Context window y coherencia arquitectónica

    Los agentes pierden visión global en repositorios grandes. La ventana de contexto de los LLMs mejora, pero no sustituye el conocimiento arquitectónico humano. Técnicas como RAG (retrieval-augmented generation) ayudan a indexar documentación, pero no garantizan decisiones coherentes a nivel sistema.

    2. Seguridad y dependencias

    Un agente optimiza la entrega de la tarea, no la seguridad. Puede introducir dependencias vulnerables o atajos que rompen principios de Clean Architecture. La revisión humana sigue siendo obligatoria antes del merge.

    3. Alucinaciones técnicas

    Los modelos pueden generar llamadas a APIs inexistentes o usar firmas obsoletas. Sin ejecución automática de tests y análisis estático, esas alucinaciones pasan desapercibidas.

    4. Escalabilidad y mantenimiento

    Generar cambios rápidos aumenta la deuda técnica si no se adoptan reglas de estilo, ADRs o documentación que orienten al agente.

    Buenas prácticas para adoptar Agentic coding

    Si vas a integrar agentes en tu flujo, aplica estas reglas mínimas:

    • Documenta el contexto: RULES.md, guías de estilo y ADRs reducen ambigüedad y guían las decisiones del agente.
    • Adopta TDD como protocolo de interacción: escribir tests primero ofrece un criterio de éxito claro para el agente y reduce la supervisión humana.
    • Modula y desacopla: los agentes funcionan mejor en componentes pequeños; refactoriza monolitos antes de delegar tareas significativas.
    • Pipelines de CI como árbitro: ejecuta builds y análisis estático automáticamente en cada PR generado por un agente.
    • Revisión humana con checklist: seguridad, licencias de dependencias y arquitectura deben validarse manualmente antes del merge.

    Cuándo usar y cuándo no usar agentes

    Usa agentes para:

    • Scaffolding y generación de pruebas.
    • Refactorizaciones locales y tareas repetitivas.
    • Automatizar revisiones preliminares de PRs o generar PRs iniciales para revisión humana.

    Evítalos en:

    • Decisiones arquitectónicas críticas.
    • Código con requisitos regulatorios o de seguridad estrictos.
    • Repositorios legacy masivos sin documentación ni tests.

    Conclusión

    Qué es el Agentic coding? Es la evolución de la IA desde asistente pasivo a actor autónomo en el ciclo de desarrollo. Ofrece un multiplicador de productividad si se integra con disciplina: documentación explícita, tests como contrato de aceptación, CI robusto y revisión humana en los puntos críticos. Mal usado acelera la deuda técnica; bien usado multiplica la capacidad del equipo.

    Si exploras integración de agentes, pipelines y automatización en equipos de ingeniería, puede resultar útil revisar recursos y experimentos prácticos. Una continuación lógica para equipos interesados en estos temas es Dominicode Labs, que agrupa proyectos y guías sobre automatización e IA aplicada en flujos de desarrollo.


    FAQ


    ¿Qué distingue al Agentic coding de un asistente de autocompletar?

    Agentic coding implica que el agente planifique, ejecute cambios en archivos, ejecute tests y se autocorrija mediante bucles de feedback. Un autocompletador solo sugiere fragmentos de texto o código sin ejecutar ni verificar el resultado.

    ¿Qué componentes técnicos hacen falta para un agente agéntico?

    Planificación de tareas, capacidad de usar herramientas (editar archivos, ejecutar comandos, llamar APIs) y un bucle de retroalimentación con tests o builds son los componentes esenciales.

    ¿Cuáles son los riesgos principales al usar agentes?

    Riesgos clave: pérdida de coherencia arquitectónica en repositorios grandes, introducción de dependencias inseguras, alucinaciones técnicas y aumento de deuda si no hay reglas y documentación.

    ¿Cómo debo preparar un repo antes de delegar a un agente?

    Documenta contexto y reglas (RULES.md, ADRs), añade tests y adopta TDD, modula componentes y habilita pipelines de CI para validar PRs generados por agentes.

    ¿Qué herramientas son relevantes hoy para Agentic coding?

    Herramientas representativas incluyen Cursor — editor con modo Composer, Aider, Cognition.ai, OpenHands, n8n, OpenAI (APIs de LLM) y Anthropic (Claude).

    ¿Los agentes pueden reemplazar la revisión humana?

    No. La revisión humana sigue siendo obligatoria para validar seguridad, licencias y decisiones arquitectónicas críticas antes del merge.

    ¿Qué prácticas reducen alucinaciones técnicas?

    Practicas que ayudan: adoptar TDD, ejecutar tests y análisis estático en CI automáticamente, usar RAG para documentar contexto y contar con reglas y ADRs que guíen al agente.