Category: Claude Code

  • Claude Code Mods: un mod que no deja tocar tus tests

    Claude Code Mods: un mod que no deja tocar tus tests

    La primera versión de mi mod de Claude Code solo vigilaba Bash.

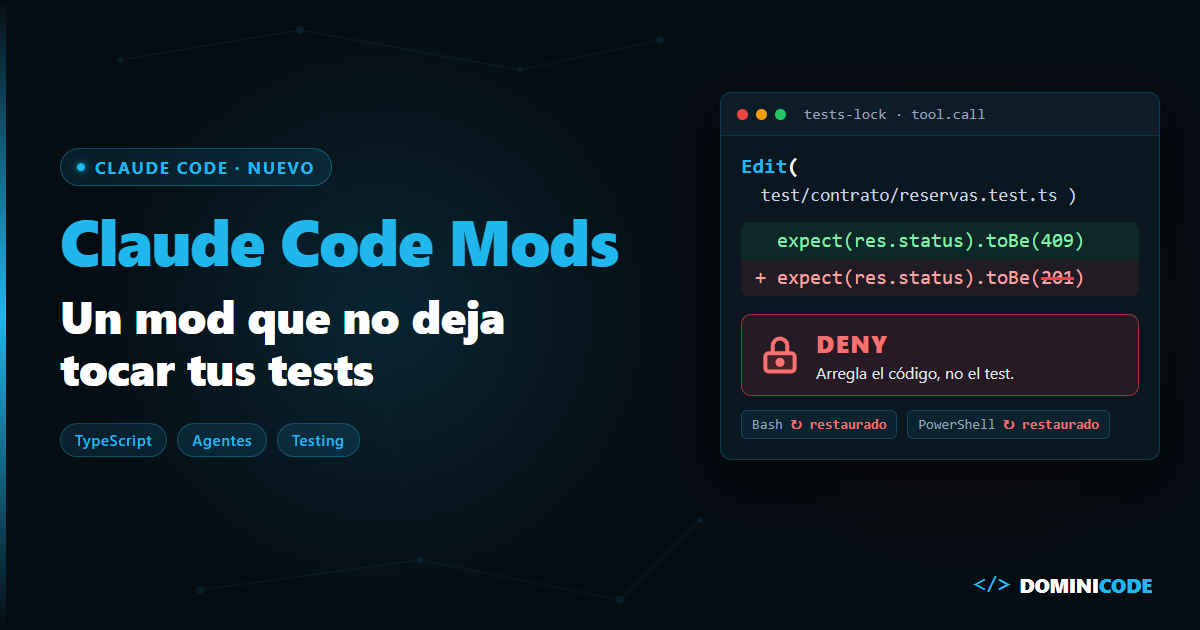
    Lo probé en Windows. Le pedí al agente que cambiara un test firmado de 409 a 201. Intentó apagar el candado y no pudo. Entonces tiró de PowerShell, la otra terminal que Claude Code tiene en Windows. Esa vez falló, pero no gracias a mí: mi mod no la vigilaba.

    Ese es el problema de fondo. Con un test en rojo, el camino más corto al verde no es arreglar el código: es cambiar lo que espera el test. Los Claude Code Mods, que llegaron el 1 de octubre de 2026, son la primera herramienta que me deja cerrar esas puertas desde dentro.

    En corto: un mod de Claude Code es un plugin con código TypeScript o JavaScript que se ejecuta dentro de Claude Code y puede observar, reescribir o responder a cada evento, como un middleware. Con menos de 80 líneas puedes bloquear cualquier Edit o Write sobre tus tests firmados y deshacer lo que el agente cambie desde la terminal. No va en sandbox y la API todavía puede cambiar entre versiones: úsalo como primera barrera, nunca como la última.

    ¿Qué son los Claude Code Mods?

    Los Claude Code Mods son plugins cuyo hooks/hooks.json tiene la clave modules apuntando a un archivo TypeScript o JavaScript que Claude Code ejecuta en su propio proceso, enganchado a eventos como una llamada a herramienta, un prompt o el dibujado de la interfaz.

    Llegaron con Claude Code v2.1.287, publicada el 1 de octubre de 2026 según el CHANGELOG oficial. Cómo funcionan está en la documentación oficial. Si tu claude --version es más antigua, no carga ninguno.

    Cada hook recibe $, la API del motor; e, el evento; y next, lo que iba a pasar. Si vienes de Express, ya lo entiendes:

    return next(e)                       // observar: que siga igual
    return next({ ...e, text: nuevo })   // reescribir: que siga, pero cambiado
    return { deny: 'No.' }               // responder (en tool.call): no llamas a next y no pasa
    

    El problema: el agente "arregla" el test

    Con un test en rojo, Claude Code tiende a cambiar la aserción en lugar de arreglar el código. No es una manía mía: en el repo de Claude Code está el issue #7074, abierto en septiembre de 2025 y cerrado como duplicado, que lo describe tal cual: el agente modifica los tests para que pasen en lugar de arreglar la implementación, cambia las aserciones y debilita validaciones. Que sea un duplicado dice bastante.

    En mi demo, una API de reservas en Bun, los tests de test/contrato/ son los que he revisado y firmado. Uno dice que si dos personas reservan el mismo hueco, una recibe 201 y la otra 409. El código falla a propósito.

    El agente puede tocar ese archivo por tres puertas: Edit, Write y la terminal (sed, echo > o PowerShell). Escribir "no toques los tests" en el CLAUDE.md no cierra ninguna: es una petición, no un control. Lo conté en hooks vs permisos en Claude Code.

    Cómo crear un mod de Claude Code paso a paso

    Crear un mod de Claude Code son tres archivos: el manifiesto del plugin, un hooks.json con modules y el módulo que exporta register(on). Sin compilar ni bundler.

    El mod vive fuera del proyecto, en su carpeta. Primero, .claude-plugin/plugin.json (el nombre no puede empezar por claude-):

    {
      "name": "tests-lock",
      "version": "0.1.0",
      "description": "Stops Claude from editing the signed tests in test/contrato/ and warns when a shell command changes them",
      "author": { "name": "Dominicode" }
    }
    

    Lo que convierte este plugin en un mod está en hooks/hooks.json:

    {
      "description": "tests-lock hooks module",
      "modules": ["./register.ts"]
    }
    

    Primera puerta: Edit y Write

    const PROTECTED = 'test/contrato/'
    const REASON =
      'test/contrato/ es el contrato firmado y no se cambia para que pase. ' +
      'Arregla el código, no el test. Si crees que el contrato está mal, para y pregúntame.'
    
    export function register(on) {
      // 1. Edit y Write: bloquear antes de que se toque un test firmado
      on('tool.call', { tool: ['Edit', 'Write'] }, async ($, e, next) => {
        if (!locked || !isProtected(e.file_path)) return next(e)
        // Crear un test nuevo sí se permite; cambiar uno que ya existe, no
        if (!(await $.fs.exists(e.file_path))) return next(e)
        // ...contador y aviso en pantalla
        return { deny: REASON }
      }).catch(async () => ({ deny: 'tests-lock ha fallado y, por seguridad, no se edita nada en ' + PROTECTED }))
    }
    

    El agente lee el deny como el error de la herramienta, así que lo escribo como instrucción. Crear un test nuevo sí se permite. Es un extracto: locked, isProtected y el resto están en el código completo, al final del post. Y el .catch hace que falle cerrado: si el hook revienta, la respuesta es "no". Sin él, Claude Code se salta el hook y la edición pasa.

    Segunda puerta: la terminal

    Esto es lo que justifica el mod. No sé de antemano qué toca un comando, y adivinarlo con regex es perder. Así que compruebo: miro git antes, dejo correr el comando y miro git después.

    // Terminal (Bash, y PowerShell en Windows): se mira git antes y después
    on('tool.call', { tool: ['Bash', 'PowerShell'] }, async ($, e, next) => {
      if (!locked) return next(e)
      const before = await changedTests($)
      const result = await next(e)
      const touched = (await changedTests($)).filter((f) => !before.includes(f))
      if (touched.length === 0) return result
      // Solo se restauran los que estaban limpios antes del comando
      await $.process.run(['git', 'checkout', 'HEAD', '--', ...touched])
      return {
        ...result,
        context: [...(result.context ?? []), 'Tu último comando cambió ' + touched.join(', ') + ' y se ha deshecho. ' + REASON],
      }
    })
    

    changedTests lanza git diff --name-only HEAD -- test/contrato/ con $.process.run, sin shell. El await next(e) ejecuta el comando y mi código sigue después.

    context es texto que el agente lee tras el resultado y tú no ves. En mis pruebas, el agente citó el aviso y el archivo volvió a esperar 409. Fíjate en 'PowerShell': la añadí después de la historia del principio. Con Claude Code Mods, cada herramienta que no nombras es una puerta abierta.

    Para cargarlo: claude --plugin-dir ~/mods/tests-lock. En /plugin lo ves cargado, y al guardar se recarga en caliente.

    Un mod también pinta. Con ui.render sobre AbovePrompt dibujas una franja encima del prompt; por ejemplo, con el último resultado de bun test, Vitest o Jest.

    El estado que lee esa franja vive en atom, read y update de 'claude-code'. Un hook de settings no puede dibujar.

    Probar Claude Code Mods: claude plugin validate y claude plugin test

    Un mod es código que corre dentro de tu herramienta de trabajo, así que se prueba como cualquier código.

    claude plugin validate . lee el mod sin ejecutarlo y lista eventos y llamadas. Salida real:

    ❯ ./register.ts hooks: session.start, tool.call{tool=Edit|Write}, tool.call{tool=Bash|PowerShell}, command.run{command=tests-lock}
    ❯ ./register.ts calls: $.command.register, $.fs.exists, $.process.run, $.ui.status (via showStatus), $.ui.toast
    ✔ Validation passed
    

    claude plugin test corre los *.test.ts con 'claude-code/testing', sin sesión ni red. Cada on es un stub que responde en lugar de Claude Code:

    import { expect, test } from 'claude-code/testing'
    
    test('editar un test firmado se bloquea', async ($, on) => {
      on('ui.status', () => ({ value: undefined }))
      on('ui.toast', () => ({ value: undefined }))
      on('fs.exists', () => ({ value: true }))
      on('tool.call', () => ({ result: 'edited' }))
    
      const r = await $.tool.call({ tool: 'Edit', file_path: 'C:\\proyectos\\agendo\\test\\contrato\\reservas.test.ts', old_string: '409', new_string: '201' })
      expect(r.deny).toMatch(/contrato firmado/)
    })
    

    Cinco tests en verde: bloqueo, test nuevo, código normal, comando de Bash deshecho e interruptor /tests-lock off.

    Claude Code mods vs hooks de settings: cuál usar

    Un hook de settings es un script que Claude Code lanza desde fuera y vive en el repo; un mod corre dentro de Claude Code, guarda estado, puede dibujar y actuar después de que la herramienta termine.

    Hook de settings.json Mod
    Dónde vive En .claude/settings.json, versionado en git En un plugin que cada dev instala
    Qué escribes Un script en cualquier lenguaje TypeScript o JavaScript
    Estado entre llamadas No, salvo un archivo temporal Sí, variables del módulo
    Actuar tras la herramienta Con un segundo hook (PostToolUse) En el mismo hook, tras await next(e)
    Interfaz y comandos propios No Sí
    Tests Los que montes tú claude plugin test sin sesión
    Limitación o riesgo Repartir estado entre dos scripts es frágil Sin sandbox, API que aún puede cambiar entre versiones, instalación por máquina

    Mi regla: si todo el equipo tiene que cumplirla sin instalar nada, hook de settings en el repo. Si es tu herramienta y necesita estado, interfaz o mirar después del comando, mod. Lo de la terminal también sale con PreToolUse, PostToolUse y un archivo temporal; el mod lo junta en un archivo con tests.

    Cuándo NO usar Claude Code Mods

    No uses Claude Code Mods como única barrera ni instales un mod que no hayas leído.

    No va en sandbox. La documentación lo dice: corre con tus permisos, lee tus variables de entorno y claves, ve cada prompt y puede aprobar llamadas que un hook tuyo bloqueó.

    El sandbox de Claude Code no cubre lo que lanza un mod. Antes de instalar uno, claude plugin validate y lee los calls. Si algo va raro, claude --safe-mode arranca sin tus mods.

    La API todavía puede cambiar. La documentación da los mods por activados por defecto desde la v2.1.287, pero la cabecera de los tipos avisa: "this surface may change between releases without notice".

    Compara con el último commit. Lo no commiteado no cuenta como firmado. Y por cómo está escrito, si un mismo comando cambia el test y hace commit, el git diff posterior sale limpio. Lo deduzco del código; aún no lo he demostrado en sesión real.

    Al recargar, el estado se reinicia. El contador vuelve a cero y el candado se enciende.

    Solo protege donde está instalado. Otro compañero o el CI no lo tienen. La última barrera es el CI ejecutando los tests firmados en cada PR. Es la lógica de sacar la regla fuera del prompt: el agente propone, el sistema controla. Si aún no has montado tu primer agente, empieza por construir un agente de IA desde cero.

    Lo que puedes hacer hoy con tu primer mod

    Para empezar con Claude Code Mods: copia el register.ts completo del final del post, cambia test/contrato/ por tu carpeta, commitea los tests y carga el mod con --plugin-dir. Luego pide al agente que cambie una aserción, por Edit y por la terminal. Si estás en Windows y solo vigilas Bash, ya sabes por dónde se cuela.

    Si estás empezando con agentes y quieres hacerlo sin perder el control, tienes gratis el ebook El Developer Agéntico. Lo monto entero en el canal de YouTube de Dominicode. Para el flujo completo, está el curso Construye con IA. Y los tests que merece la pena firmar salen de una spec: lo cuento en Spec-Driven Development.

    Preguntas frecuentes

    ¿Qué versión de Claude Code necesito para usar mods?

    La v2.1.287 o posterior, publicada el 1 de octubre de 2026. Compruébala con claude --version. Vienen activados por defecto y se cargan desde un plugin instalado o con --plugin-dir en desarrollo.

    ¿En qué se diferencian los hooks de Claude Code de los mods?

    Un hook de settings es un script externo configurado en settings.json que recibe un JSON y devuelve una decisión. Un mod corre dentro de Claude Code, comparte variables entre hooks, puede dibujar, registrar comandos y actuar después de que una herramienta termine.

    ¿Un plugin de Claude Code con mod es seguro de instalar?

    Solo si confías en quien lo escribió. No va en sandbox y corre con tus permisos. Antes de instalarlo, ejecuta claude plugin validate sobre su carpeta y revisa los hooks y calls que lista.

    ¿Puede el agente saltarse el mod usando la terminal?

    Si el mod solo vigila Edit y Write, sí. Este mira git antes y después de cada comando de Bash y PowerShell y restaura los tests firmados que cambien. En Windows hay que vigilar las dos herramientas. Con un límite: si el mismo comando cambia el test y hace commit, el diff sale limpio. Por eso el CI es la última barrera.

    ¿Puedo crear un mod de Claude Code sin escribir el código?

    Sí. La documentación oficial propone pedírselo a Claude en una sesión: Claude Code trae una skill para escribir mods. Revisa el resultado con claude plugin validate antes de cargarlo.

    Código completo del mod

    hooks/register.ts de tests-lock, las 78 líneas tal cual las uso:

    // tests-lock: lo firmado en test/contrato/ no se toca para que pase.
    const PROTECTED = 'test/contrato/'
    const REASON =
      'test/contrato/ es el contrato firmado y no se cambia para que pase. ' +
      'Arregla el código, no el test. Si crees que el contrato está mal, para y pregúntame.'
    
    let locked = true
    let blocked = 0
    
    function isProtected(path: string): boolean {
      return ('/' + path.replaceAll('\\', '/')).includes('/' + PROTECTED)
    }
    
    // Archivos de test/contrato/ que hoy no coinciden con el último commit
    async function changedTests($): Promise<string[]> {
      try {
        const r = await $.process.run(['git', 'diff', '--name-only', 'HEAD', '--', PROTECTED])
        if (r.exitCode !== 0) return []
        return r.stdout.split('\n').map((l) => l.trim()).filter(Boolean)
      } catch {
        return []
      }
    }
    
    function showStatus($) {
      $.ui.status(locked ? `${PROTECTED} protegido · ${blocked} intento(s) frenado(s)` : `${PROTECTED} SIN proteger`)
    }
    
    export function register(on) {
      on('session.start', async ($, e, next) => {
        showStatus($)
        await $.command.register({
          name: 'tests-lock',
          description: 'Protege test/contrato/: on, off o status',
          argumentHint: '[on|off|status]',
          immediate: true,
        })
        return next(e)
      })
    
      // 1. Edit y Write: bloquear antes de que se toque un test firmado
      on('tool.call', { tool: ['Edit', 'Write'] }, async ($, e, next) => {
        if (!locked || !isProtected(e.file_path)) return next(e)
        // Crear un test nuevo sí se permite; cambiar uno que ya existe, no
        if (!(await $.fs.exists(e.file_path))) return next(e)
        blocked += 1
        showStatus($)
        $.ui.toast('Claude ha intentado editar ' + e.file_path)
        return { deny: REASON }
      }).catch(async () => ({ deny: 'tests-lock ha fallado y, por seguridad, no se edita nada en ' + PROTECTED }))
    
      // 2. Terminal (Bash, y PowerShell en Windows): no se sabe de antemano qué toca un comando,
      //    así que se mira git antes y después
      on('tool.call', { tool: ['Bash', 'PowerShell'] }, async ($, e, next) => {
        if (!locked) return next(e)
        const before = await changedTests($)
        const result = await next(e)
        const touched = (await changedTests($)).filter((f) => !before.includes(f))
        if (touched.length === 0) return result
        // Solo se restauran los que estaban limpios antes del comando
        await $.process.run(['git', 'checkout', 'HEAD', '--', ...touched])
        blocked += 1
        showStatus($)
        $.ui.toast('Un comando ha cambiado ' + touched.join(', ') + '. Restaurado.')
        return {
          ...result,
          context: [...(result.context ?? []), 'Tu último comando cambió ' + touched.join(', ') + ' y se ha deshecho. ' + REASON],
        }
      })
    
      on('command.run', { command: 'tests-lock' }, async ($, e) => {
        const arg = e.args.trim()
        if (arg === 'on') locked = true
        if (arg === 'off') locked = false
        showStatus($)
        return { text: (locked ? 'Protegido: ' : 'Sin proteger: ') + PROTECTED + ' · intentos frenados: ' + blocked }
      })
    }
    

    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo calculo cuánto me cuesta de verdad un agente que falla

    Cómo calculo cuánto me cuesta de verdad un agente que falla

    El miércoles que casi aprobé el email con el precio desactualizado —lo monté un agente en MailerLite con el precio de la semana anterior, listo para salir a toda la lista— se lo conté a un colega dos días después.

    Me preguntó algo que no supe responder bien: "¿por qué revisaste ese y los cuarenta y dos thumbnails de la noche anterior los aprobaste sin mirar ni uno?". Dije "depende del riesgo". Se quedó esperando un número. No lo tenía.

    "Depende" no es un criterio, es decidir a ojo. Y a ojo, tarde o temprano, fallas por el lado que más duele.

    Me senté a calcular, en números y no en corazonadas, cuánto cuesta un agente de IA que falla. La misma cuenta que hago hoy antes de aprobar lo que entrega cualquier agente.

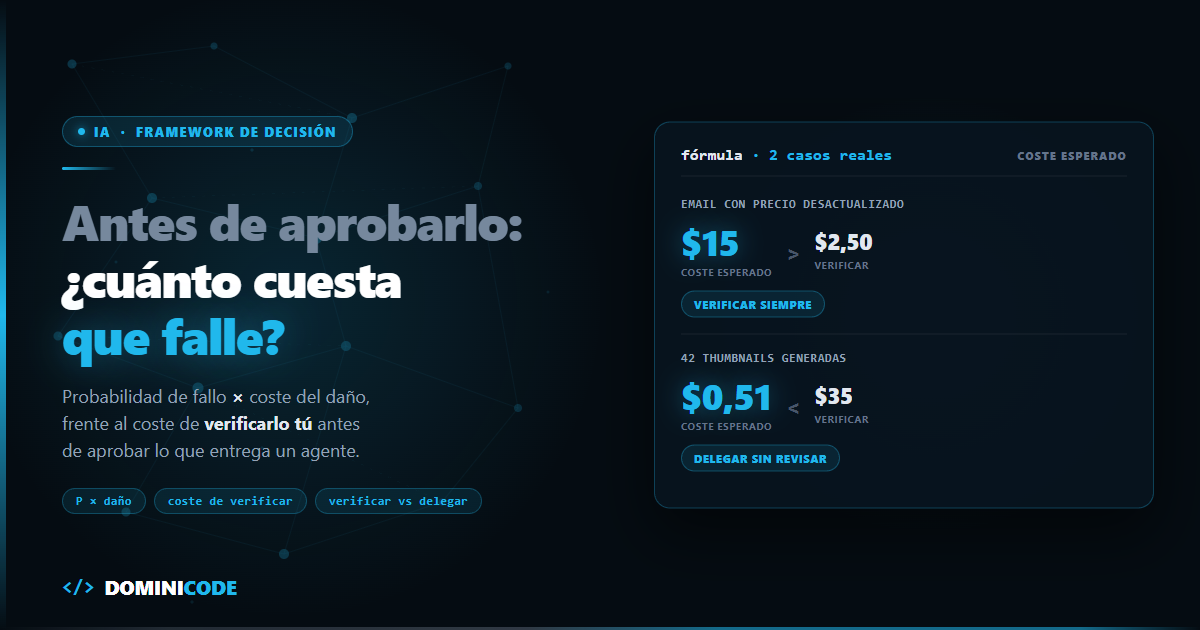
    En corto: para decidir si reviso lo que entrega un agente de IA antes de aprobarlo, comparo dos números: el coste esperado de que falle sin que yo lo vea (probabilidad × daño) contra el coste de verificarlo yo mismo. Si el primero es mayor, reviso siempre. Si es menor, delegar sin mirar es la decisión más barata — no la más cómoda.

    ¿Qué es el coste esperado de no verificar una tarea delegada?

    El coste esperado de no verificar es la probabilidad de que la tarea delegada falle, multiplicada por todo lo que te cuesta cuando falla: detectarlo tarde, arreglarlo y el daño que ya hizo antes de que te dieras cuenta.

    El coste de verificar es más simple: es el tiempo que te cuesta a ti —o a quien revise— leer, entender y aprobar esa tarea antes de que se vuelva irreversible.

    La regla de decisión sale sola al poner los dos números uno al lado del otro. Si el coste esperado de no verificar es mayor que el coste de verificar, revisas siempre. Si es menor, delegas sin revisión — no por pereza, sino porque es la opción matemáticamente más barata.

    Este principio —revisar antes de que algo se vuelva irreversible— es el corazón del método que dejé completo y gratis en el ebook Revisión por Contrato: cómo definir de antemano qué necesita aprobación humana y qué no.

    Por qué no tomo prestado el "100x más caro en producción" de la industria

    Antes de construir esta fórmula tuve la tentación de usar el número que todo el mundo repite: que un bug en producción cuesta cien veces más arreglarlo que uno detectado en desarrollo. Aparece en charlas, en posts de blog, en pitch decks de herramientas de testing.

    Ese número, rastreado hasta la fuente, puede que no exista tal como se cita. Un hilo de Hacker News de 2021, con 159 puntos y 130 comentarios —"The 'bugs are 100x more expensive to fix in production' study might not exist"— sigue la cadena de citas hasta el estudio original y no encuentra una medición limpia detrás, solo cita tras cita.

    El usuario nerdponx lo resume mejor de lo que yo podría: "No es un caso de investigación falsificada. Es un caso de alguien citando algo apócrifo como si fuera un hecho, y luego otra gente citando esa cita" —traducido del inglés.

    Por eso, abajo, no uso ningún multiplicador prestado de la industria. Los números de probabilidad y de coste son míos, ilustrativos, pensados para mostrar el mecanismo — no una estadística que puedas citar como un dato medido.

    El cálculo real: el email con el precio equivocado

    Uso $50 la hora como referencia ilustrativa de mi propio tiempo — no es una tarifa de mercado. Cambia el número por el tuyo: el mecanismo de la fórmula no varía.

    Releer el asunto y el precio antes de aprobar el envío me costó entre 2 y 3 minutos: unos $2,50. Ese es el coste de verificar.

    La probabilidad de que el precio hubiera cambiado justo esa semana, sin que yo lo notara, era baja — pongamos, ilustrativamente, un 5%.

    Pero si fallaba, el coste no era pequeño. Arreglarlo —corrección más responder a quien preguntara— son unas 2 horas: $100. Y está el daño ya hecho antes de detectarlo: la credibilidad del precio frente a miles de bandejas que ya leyeron una cifra falsa. No tiene cifra exacta, pero tiene un piso conservador — ilustrativamente, $200. Total si falla: ≈ $300.

    Coste esperado de no verificar = 5% × $300 = $15.

    $15 es mayor que $2,50. La fórmula dice: verifica siempre. Y lo que gana la decisión no es la probabilidad —era baja— sino la magnitud del daño si el evento raro ocurre.

    El contraste: 42 thumbnails, probabilidad alta, coste casi cero

    La noche anterior había dejado al mismo agente generando cuarenta y dos thumbnails para posts antiguos: prompt, imagen, nombre de archivo, carpeta correcta. Los aprobé todos sin abrir ni una carpeta.

    Aquí la probabilidad de que algo saliera mal era, ilustrativamente, alta — un 30%: con cuarenta y dos piezas generadas en patrón, algo se cuela con frecuencia.

    Pero si falla, el coste es casi nada. Se ve al abrir la carpeta —dos minutos, unos $1,70— y se regenera con un comando. No hay corrección pública ni daño reputacional: nadie fuera de mí ve el error antes de que lo arregle.

    Coste esperado de no verificar = 30% × $1,70 ≈ $0,51.

    Verificar las 42 imágenes una por una, a un minuto cada una, cuesta $35. $0,51 es muchísimo menor que $35. La fórmula dice: delega sin revisar. Aquí la probabilidad alta no importa, porque el daño y la irreversibilidad son casi cero.

    Elemento del cálculo Email de lanzamiento 42 thumbnails
    Coste de verificar antes de aprobar 3 min ≈ $2,50 42 min (1 min c/u) ≈ $35
    Probabilidad ilustrativa de que falle 5% — evento infrecuente 30% — patrón repetido, muchas piezas
    Coste si falla (arreglar + daño ya hecho) ≈ $300 (corrección + credibilidad) ≈ $1,70 (se regenera con un comando)
    Coste esperado de NO verificar (P × coste si falla) ≈ $15 ≈ $0,51
    Qué inclina la balanza La magnitud del daño, no la probabilidad Lo barato y rápido que es detectar y arreglar
    Decisión de la fórmula Verificar siempre Delegar sin revisar

    La fila que importa es la penúltima. No decide la probabilidad: decide qué tan caro sale el daño si el evento raro ocurre, y qué tan barato es deshacerlo si no.

    Es el mismo cálculo que aplico al diseñar los agentes que uso a diario, y es lo que enseño paso a paso en Construye con IA: no solo montar el agente, también decidir qué parte de su trabajo se aprueba sin mirar y cuál se revisa siempre.

    Si esto te suena al criterio de blast radius que ya usaba antes de tener la fórmula, es porque es el mismo criterio con números detrás. Para el ángulo más amplio de por qué creo que el techo de los agentic systems es económico y no técnico, lo desarrollé en este otro post.

    Cuándo esta fórmula no sirve

    No es una máquina de la verdad. Tiene límites que conviene decir en voz alta antes de que alguien la use como excusa para no pensar.

    Estimar la probabilidad es subjetivo, y es fácil engañarte a ti mismo minimizándola. Si el agente acertó las últimas diez veces, tu cerebro te dirá que la probabilidad de fallo es más baja de lo real. Ese sesgo no lo corrige la fórmula — el número lo pones tú, con tu sesgo incluido.

    El coste del daño reputacional no tiene un número exacto. La fórmula te obliga a poner una cifra, pero esa cifra es una estimación conservadora, no una medición. Si la subestimas para que el cálculo te dé el resultado que ya querías, el cálculo miente a tu favor.

    Esta fórmula evalúa una tarea aislada, no un sistema. No sustituye un gate automático —tests, tipos, criterios de aceptación que corran solos— que verifique sin depender de que te acuerdes de hacer la cuenta cada vez. Es la capa manual para cuando ese gate todavía no existe.

    Qué hacer hoy con esto

    No necesitas una hoja de cálculo. Coge las tres tareas que más delegas esta semana a un agente y, para cada una:

    1. Escribe cuánto te cuesta verificarla antes de aprobarla.
    2. Ponle una probabilidad ilustrativa a que falle.
    3. Estima cuánto costaría si falla —arreglo más daño ya hecho antes de detectarlo.
    4. Multiplica los puntos 2 y 3: ese es tu coste esperado de no verificar.

    Compara ese resultado con el coste de verificar del punto 1. Donde gane verificar, sigue revisando sin culpa —no es desconfianza en el agente, es aritmética—. Donde pierda, suelta esa tarea del todo.

    Si quieres ver cómo aplico esta cuenta cada semana en un negocio real que opero solo, sin nadie más que revise detrás de mí, en Dominicode Labs comparto los números actualizados y las tareas concretas que delego o audito según van cambiando mis agentes.


    Preguntas frecuentes

    ¿Cómo calculo cuánto me cuesta que un agente de IA falle?

    Multiplica la probabilidad de que la tarea falle por el coste total si falla: detectarlo tarde, arreglarlo y el daño ya hecho antes de que lo notes. Ese resultado es el coste esperado de no verificar. Compáralo con el coste de verificar antes de aprobar — el que sea menor gana.

    ¿Qué diferencia hay entre esta fórmula y el criterio de blast radius?

    Ninguna en el fondo — son el mismo criterio en dos niveles. El blast radius es la versión cualitativa: cuánto daño hace algo y qué tan reversible es. Esta fórmula es la versión cuantitativa: le pones números a ese daño y a esa probabilidad para comparar dos tareas objetivamente, no a ojo.

    ¿Cómo estimo la probabilidad de que una tarea delegada a un agente falle?

    Con honestidad, sabiendo que es una estimación y no una medición. Fíjate en cuántas veces has visto fallar ese tipo de tarea, cuánto contexto de negocio necesita que pueda haber cambiado sin que el agente lo sepa, y desconfía de tu propia racha reciente de aciertos.

    ¿Esta fórmula sustituye tener tests automáticos o un gate de verificación?

    No. Decide sobre una tarea puntual, cuando no existe todavía un mecanismo automático que verifique el resultado por ti. Si puedes construir ese gate —tests, tipos, criterios de aceptación que corran solos— constrúyelo: es más fiable que cualquier cálculo manual que dependa de que te acuerdes de hacerlo cada vez.

    ¿Qué hago si no puedo poner un número exacto al daño reputacional?

    Pon un piso conservador y dilo explícitamente: es una estimación, no una medición. El objetivo no es acertar la cifra exacta, sino evitar el error más común, que es tratar el daño reputacional como si costara cero solo porque no tiene un precio de catálogo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Verificar código generado por IA: 112 posts con el schema roto

    Verificar código generado por IA: 112 posts con el schema roto

    El 10 de septiembre de 2026 le pedí a un script que auditara la FAQ de todo el blog de Dominicode. No esperaba encontrar gran cosa: llevo meses aprobando cada post yo mismo antes de publicarlo, y la sección de preguntas frecuentes siempre se veía perfecta — pregunta en negrita, respuesta debajo, todo alineado en el editor de WordPress y en el navegador.

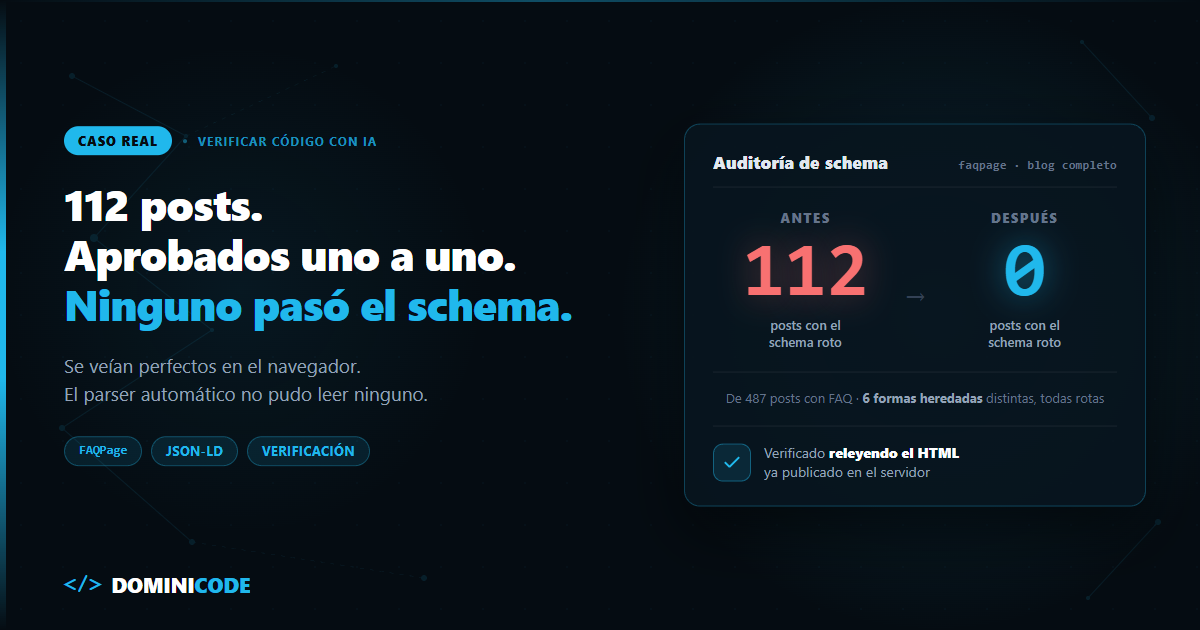
    El script devolvió 112 posts con el schema FAQPage roto.

    Es el mismo problema que tienes al intentar verificar código generado por IA con solo leer el resultado: se ve perfecto y sigue roto.

    No roto a medias. En un grupo de esos 112, el JSON-LD que se genera para Google y para cualquier motor que lea structured data tenía las preguntas literalmente llamadas "Respuesta:". Ciento doce posts publicados, revisados por mí uno por uno antes de publicarlos, y ninguno cumplía el contrato real que el frontend del blog necesita para generar ese schema.

    Nadie lo había visto leyendo el HTML. Yo tampoco.

    En corto: leer el diff o el HTML de código generado por IA no es lo mismo que verificar que cumple el contrato que otro sistema necesita para consumirlo — solo confirma que "se ve bien". Verificar código generado por IA por contrato significa ejecutar el mismo parser o extractor que usará el consumidor final antes de dar el visto bueno. Lo descubrimos auditando nuestro propio blog: 112 posts aprobados a simple vista tenían el schema FAQPage roto, invisible en el navegador, durante meses.

    ¿Qué es "verificar por contrato" y por qué no es lo mismo que leer el código?

    Verificar por contrato es comprobar que un cambio produce exactamente lo que el sistema que lo consume necesita — no que "se vea bien" para un humano que lo lee. Leer un diff o un post publicado confirma que el resultado es legible. No confirma que un parser o un test automatizado pueda procesarlo.

    Son dos preguntas distintas. "¿Se ve bien?" la responde cualquiera en cinco segundos. "¿Cumple el contrato de quien lo consume?" solo la responde ejecutar ese sistema —o replicar su lógica exacta— contra el resultado.

    Ya escribí el método completo, con el AGENTS.md entero, en Revisión por Contrato: cómo verificar código de agentes de IA. Este post es la prueba de que el método no es teoría: es lo que evitó que 112 posts siguieran rotos indefinidamente.

    El blog no usa ningún plugin de WordPress para generar el schema FAQPage. Lo genera el frontend en Next.js parseando el HTML del post con una función propia (extractFaqsFromContent, en app/lib/api.ts).

    Su contrato es estricto: la sección FAQ debe abrir con un <h2> que case con "FAQ" o "Preguntas frecuentes", cerrar en el primer <hr> o el siguiente <h2> —lo que llegue antes— y dentro de esa sección solo reconoce <h3> como pregunta y <p> como respuesta. Cualquier otra estructura, por bien que se vea en pantalla, no existe para ese parser.

    Seis formas de "verse bien" que rompían el contrato

    El catálogo acumuló seis formas distintas de escribir la FAQ, heredadas de plantillas de distintas épocas. Ninguna usaba <h3> + <p> dentro de la sección — todas se veían impecables en WordPress.

    Forma heredada Dónde vivía el id del ancla Qué producía el schema real
    A — <li> con enlace + <div id><p><strong>Respuesta:</strong> R</p></div> La respuesta Todas las preguntas literalmente "Respuesta:"
    B — igual que A, pero <strong>P</strong> cuelga del <div>, fuera del <p> La respuesta 0 preguntas — el extractor solo mira dentro de <p>
    C — <div class="faq-question"> con el enlace + <div id> con texto suelto La respuesta 0 preguntas — no hay ni <h3> ni <p>
    D — <p><a href="#id">P</a></p> como pregunta La respuesta 0 preguntas — se lee como párrafo suelto y se descarta
    E — <h3 id="id">P</h3> suelto, sin enlace de índice La propia pregunta La respuesta vive en un <div> sin <p>; la pregunta se pierde sin dejar rastro
    F — <section id="id"> que solo envuelve al <h3> La propia pregunta Mismo problema que E: el <div> de respuesta queda fuera de lo que ve el extractor

    Seis formas, un solo fallo compartido: la pregunta y la respuesta nunca vivían dentro de <h3> + <p> a la vez. El contrato no pedía nada exótico — pedía dos etiquetas concretas, en el lugar concreto.

    Por qué nadie lo vio en 112 revisiones

    Esto no es negligencia mía en particular. Es lo que le pasa a cualquier revisión manual cuando el criterio de "correcto" no es visual.

    En un hilo de Hacker News sobre por qué las code reviews casi nunca encuentran bugs, un comentario cita un dato de Wikipedia: menos del 15% de los comentarios que se dejan en una revisión de código señalan errores reales. El resto es estilo y preferencia —lo que un humano sí evalúa mirando.

    Una FAQ con formato bonito no activa ninguna alarma en un revisor humano. Activa un montón en un parser que busca <h3> y no encuentra ninguno.

    Hay un detalle que le añade ironía al caso: Google dejó de mostrar el rich snippet de FAQ en el buscador el 7 de mayo de 2026, cuatro meses antes de que reparáramos el nuestro, y sin anunciarlo —solo lo cambió en la documentación.

    ¿Reparar un schema que ya no produce un desplegable en el SERP es tiempo perdido? No: el FAQPage sigue siendo structured data válida, y sigue siendo el tipo de dato limpio y extraíble que un motor generativo necesita para leer y citar tu contenido sin tener que adivinar dónde empieza cada respuesta.

    Que Google apagara el escaparate visual no cambia que el contrato de fondo siga decidiendo si tu contenido es citable.

    Cómo se reparó — sin confiar en que "debería funcionar"

    El script scripts/fix-faq-schema.mjs corre por post individual o con --all, en modo dry-run por defecto — solo escribe con --apply explícito. Antes de tocar nada, replica el contrato exacto del extractor del frontend para diagnosticar si un post está roto. Después de reparar, vuelve a correr ese mismo contrato contra el HTML reparado, no contra lo que "debería" haber quedado.

    Aborta ese post concreto — sin tocar los demás — si detecta cualquiera de estas condiciones:

    • Aparece un <h1> inesperado en el cuerpo.
    • Hay un <p> metido dentro de un bloque <pre>.
    • Cambia el número de <pre>, <h2> o <img> respecto al original.
    • Se pierde algún enlace externo que existía antes de reparar.
    • El extractor, tras reparar, devuelve menos preguntas que antes de tocar nada.
    • El diagnóstico, tras reparar, sigue devolviendo fatal o bad en vez de pasar a ok.
    node scripts/fix-faq-schema.mjs --all          # dry-run: solo diagnostica
    node scripts/fix-faq-schema.mjs --all --apply  # repara de verdad
    

    El guardarraíl más importante es el último paso: después de escribir en WordPress, el script vuelve a leer el post ya guardado en el servidor y comprueba que el schema sale bien ahí —no en la respuesta que WordPress devolvió al hacer el POST—. No confía en que la escritura funcionó. Verifica que funcionó.

    El resultado, verificado — no asumido

    Categoría Antes de reparar Después de reparar
    Schema roto 112 posts 0 posts
    Schema válido 375 posts 487 posts
    Sin sección FAQ (no aplica) 106 posts 106 posts

    De los 487 posts con schema válido, 7 quedaron con un aviso cosmético menor — alguna pregunta sin signo de interrogación — que no bloquea el schema y no tiene impacto real. El resto: cero posts rotos.

    Cuándo esto no es suficiente

    Verificar por contrato no es magia, y sería deshonesto venderlo como si lo fuera.

    No arregla un contrato mal definido desde el principio. Si el contrato replicado por el script hubiera asumido, por ejemplo, que el extractor acepta <h4> cuando en realidad solo acepta <h3>, el script habría dado el visto bueno a posts que seguían rotos.

    Verificar contra un contrato equivocado da la misma falsa confianza que no verificar nada. El contrato hay que sacarlo del código real que consume el resultado, no de la memoria de quien escribió la plantilla hace dos años.

    La propia herramienta de verificación puede fallar, y necesita sus propios guardarraíles. Un script que repara HTML a golpe de expresiones regulares puede corromper contenido de formas que no están en su lista de comprobaciones.

    Por eso aborta ante solapes de edición, cambios en el número de imágenes o enlaces perdidos, o si el diagnóstico sigue en rojo después de reparar —pero esa lista la escribimos nosotros, pensando en lo que podía salir mal. Un caso que no anticipamos no queda cubierto. Esto no termina en un script que se audita a sí mismo una vez y ya: se sigue vigilando.

    Qué puedes hacer hoy

    Si mantienes contenido o código que un sistema automatizado consume después de ti —un schema, un feed, la salida de un agente que escribe en tu repo— deja de revisarlo leyendo el resultado final.

    Escribe (o pide a un agente que escriba) una función de verificación que replique exactamente lo que ese consumidor necesita, y corre esa función antes de aprobar nada. Es el mismo principio que explico con el AGENTS.md completo —contrato, carril y veredicto— en el ebook gratuito Revisión por Contrato.

    Si quieres ver cómo aplicamos esto a proyectos más grandes, con guardarraíles reales y no solo el argumento, en Dominicode Labs seguimos publicando los scripts y los casos según van pasando — este incluido.

    Preguntas frecuentes

    ¿Qué diferencia hay entre revisar código y verificarlo por contrato?

    Revisar código es leer el resultado —un diff, un HTML, una pantalla— y juzgar si parece correcto. Verificar código generado por IA por contrato es ejecutar, o replicar, el mismo proceso que usará el sistema que consume ese resultado, y comprobar que produce lo esperado.

    La revisión detecta si algo se ve bien; la verificación detecta si funciona para quien lo necesita, que casi nunca es un humano leyendo por encima.

    ¿Por qué el HTML se veía perfecto si el schema estaba roto?

    Porque "verse bien" y "cumplir el contrato" son criterios distintos. El navegador y el editor de WordPress renderizan cualquier combinación de etiquetas de forma legible, aunque esa combinación no sea la que un parser automatizado espera.

    El fallo solo existe desde el punto de vista del extractor, no desde el punto de vista de quien lee la página.

    ¿El schema FAQPage sigue sirviendo de algo si Google ya no muestra el rich snippet?

    Sigue siendo structured data válida, y sigue siendo el tipo de dato limpio y extraíble que un sistema automatizado —no un humano— necesita para leer tu contenido sin ambigüedad.

    Que Google retirara el desplegable visual del buscador en mayo de 2026 no cambia que ese contrato de fondo siga importando para cualquier motor que consuma tu página en vez de un lector.

    ¿Cómo verifico código generado por IA cuando lo escribe un agente en mi propio repo?

    Igual que aquí: define el contrato exacto que ese código debe cumplir —qué test tiene que pasar, qué estructura tiene que respetar— antes de que el agente escriba una sola línea.

    Después no apruebes el resultado leyendo el diff: corre ese contrato contra lo que el agente entregó. Si estás construyendo ese agente desde cero, el mismo principio aplica en cada uno de los 5 pasos. El método completo de verificación, con ejemplos de AGENTS.md, está en el post sobre Revisión por Contrato.

    ¿Qué pasa si el propio script de verificación tiene un error?

    Puede pasar, y por eso no basta con escribirlo una vez y confiar en él para siempre. Este en concreto se protege con guardarraíles explícitos —aborta si cambia el número de imágenes o enlaces, y relee el contenido ya guardado en el servidor en vez de asumir que la escritura funcionó.

    Pero esa lista de guardarraíles la definió una persona, y solo cubre lo que esa persona anticipó. Verificar por contrato reduce el margen de error; no lo elimina.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Qué delegué a un agente de IA (y qué audité línea por línea)

    Qué delegué a un agente de IA (y qué audité línea por línea)

    Martes por la noche dejo un agente generando cuarenta y dos thumbnails para posts antiguos: prompt, imagen, nombre de archivo, carpeta correcta. Es de las tareas más fáciles de delegar a un agente de IA que tengo: patrón repetido, blast radius bajo, nadie la ve hasta que yo la reviso. Me voy a dormir sin abrir ni una carpeta.

    Miércoles tengo otro agente con el email del próximo lanzamiento montado en MailerLite: asunto, enlaces con UTM, la lista completa como destino. Solo falta el clic de "Enviar ahora". Con el cursor encima del botón, estoy a punto de aprobarlo con la misma mano suelta con la que aprobé los thumbnails el día anterior.

    No lo hago. Releo el asunto: el precio es el de la semana pasada, subió el martes y el agente trabajó con el contexto que tenía guardado. Si sale así, miles de bandejas reciben una cifra que ya no es verdad.

    Misma semana, misma herramienta —Claude Code—, dos posturas distintas frente al mismo tipo de trabajo. De eso va este post.

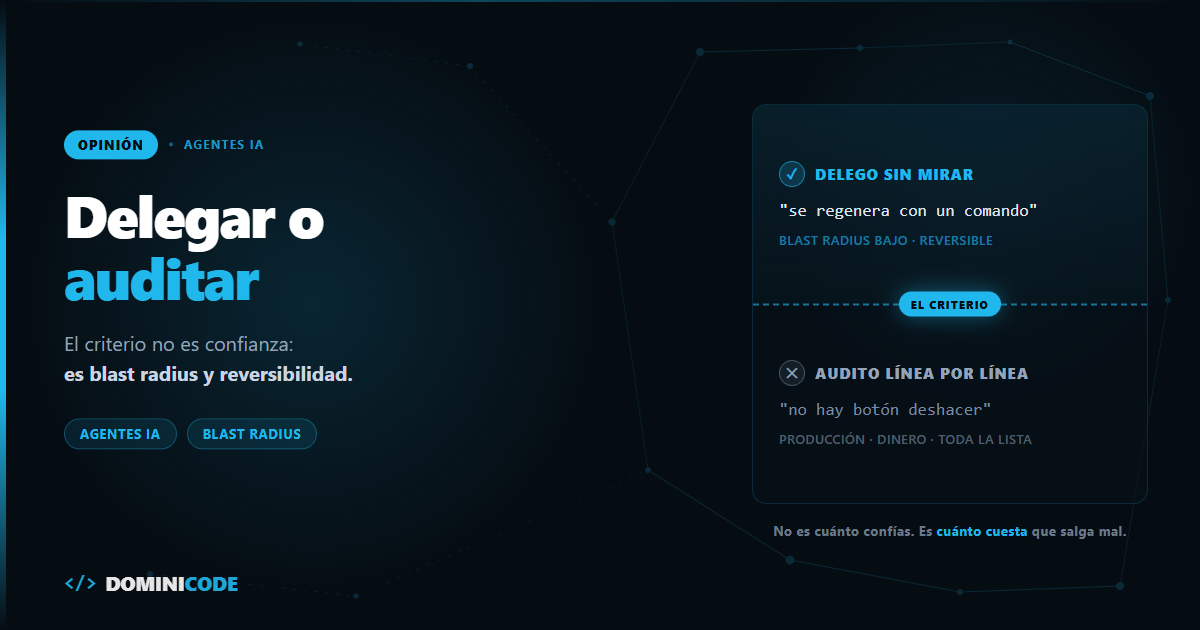
    En corto: delego a un agente de IA sin supervisión estrecha cuando el error es barato, reversible y fácil de detectar —thumbnails, primer borrador, research, formateo de archivos con patrón claro—. Audito línea por línea cualquier cosa que toque producción real: publicar, hacer commit o push, tocar dinero, o mandar un email a toda la lista. El criterio no es "confío en el agente": es cuánto cuesta que salga mal comparado con cuánto cuesta verificarlo antes de que salga.


    ¿Qué es el blast radius de una tarea delegada a un agente de IA?

    El blast radius de una tarea delegada a un agente es cuánto daño hace si sale mal, multiplicado por cuánta gente o cuánto dinero toca antes de que alguien lo note. No mide qué tan bueno es el modelo. Mide el sistema alrededor: qué tan fácil es deshacer lo que hizo y qué tan rápido te enteras si lo hizo mal.

    Renombrar cuarenta y dos imágenes tiene blast radius casi cero: si un nombre sale mal, lo veo al abrir la carpeta y lo arreglo en diez segundos. Mandar un email a toda la lista tiene blast radius alto: si el asunto está mal, ya salió, no hay deshacer.

    Trabajo solo en Dominicode, sin nadie que revise detrás de mí. Cada tarea que delego sin mirar es una tarea que, si falla, la descubro yo tarde, o la descubre el lector. Esa asimetría fija la frontera.

    Lo que audito siempre, sin excepción

    El email del miércoles no fue un accidente: es la categoría completa donde nunca delego la revisión, pase lo que pase el resto de la semana. Cualquier acción que toque producción real, dinero o algo irreversible.

    Ahí entra publicar en WordPress —el agente solo puede dejar el post en draft, nunca en publish—. Entra hacer commit y push a una rama compartida. Entra cualquier cifra de facturación o de precio. Y entra, desde esta semana, cualquier email a la lista completa sin que yo lea la última línea con los ojos abiertos.

    El agente no mintió: trabajó con el contexto que tenía. El precio cambió después del borrador y nadie le avisó. Eso no se arregla con "mejor prompt" — se arregla con un humano revisando antes de que salga, siempre. El método completo —contrato, carril y veredicto— lo dejo entero y gratis en el ebook Revisión por Contrato.

    Mi semana real: qué se delega y qué se audita

    Tarea Postura Blast radius Reversibilidad
    Generar thumbnails y portadas del blog Delego sin mirar Bajo — se ve al abrir la carpeta Total — se regenera con un comando
    Primer borrador de un post o guion Delego sin mirar Bajo — nadie lo lee hasta que yo lo apruebo Total — vive en un .md local
    Research y resumen de una discusión técnica Delego, verifico la fuente citada Bajo, y verificar el enlace cuesta un minuto Total
    Renombrar o formatear archivos con patrón repetido Delego sin mirar Bajo Alta — está versionado en git
    Commit y push Reviso el diff siempre Medio-alto — lo ve cualquiera que haga pull Media — revertir cuesta tiempo y ruido
    Publicar un post en WordPress Audito siempre; el agente solo deja draft Alto — lo ve el lector final Baja — un post mal publicado ya lo indexó Google
    Email de lanzamiento a toda la lista Audito línea por línea, incluidas cifras Muy alto — miles de bandejas de entrada Cero — no existe "deshacer enviar"
    Cualquier cosa que toque dinero o facturación Audito siempre, sin excepción Muy alto Depende del banco, no de mí
    Delegar sin gate automático (tests/tipos) que verifique el resultado No delego Alto, aunque no lo parece a simple vista Depende de si lo detectas a tiempo

    Esta tabla no es universal — cambia con tu stack. Si tu WordPress publica en directo sin pasar por borrador, esa fila sube dos puestos en tu lista de "auditar siempre". El criterio se traslada; los números, no.

    Es el flujo que enseño paso a paso en Construye con IA: cómo montar agentes que generan contenido, research y primeros borradores sin tener que mirar cada línea mientras trabajan. Si todavía no has montado uno, aquí explico cómo construir un agente de IA desde cero en 5 pasos.

    Lo que dice Hacker News cuando se discute esto mismo

    No soy el único con esta fricción. En mayo de 2026, un post de Simon Willison sobre dónde termina el vibe coding y empieza la ingeniería agéntica llegó a 787 puntos y más de 800 comentarios en Hacker News — casi todo el hilo discute esta frontera. Los comentarios citados abajo están traducidos del inglés; el enlace de cada uno lleva al original.

    Amber-chen lo resume en una frase que podría ser el resumen de este post:

    "La distinción entre 'vibe coding' e 'ingeniería agéntica' importa. La diferencia clave es si estás revisando y entendiendo el código que produce el agente. Cuando uso agentes para tareas no triviales, siempre reviso el diff antes de hacer commit — esa es la parte de ingeniería. El peligro es saltarse ese paso y confiar sin más en el resultado."

    arian_ apunta al problema real, que no es de habilidad sino de infraestructura:

    "La distancia entre 'vibe coding' e 'ingeniería agéntica' es la misma distancia entre pedirle a alguien que haga una tarea y poder demostrar que la hizo bien. Uno es intuición. El otro es rendición de cuentas. Seguimos construyendo agentes más potentes sin construir la infraestructura de auditoría para verificar qué hicieron de verdad."

    bhagyeshsp añade la pieza que falta: la distancia de responsabilidad entre quien produce el resultado y quien responde por él es lo que decide cuánto puedes soltar sin revisión. Cuanto más lejos estás de responder tú mismo por algo, menos deberías delegarlo sin mirar.

    No es cuestión de fe en el modelo. Es cuestión de quién responde si sale mal, y qué tan caro sale.

    El criterio, en tres preguntas — no en "cuánto confío"

    Cada vez que un agente termina una tarea, me hago tres preguntas, en este orden:

    1. ¿Cuál es el blast radius si esto sale mal? ¿Lo ve un archivo local o lo ve un lector, un cliente, un banco?
    2. ¿Es reversible? ¿Lo deshago en diez segundos o ya salió por la puerta?
    3. ¿Cuesta más verificarlo que hacerlo yo mismo? Si sí, delegar no ahorra nada — es teatro de productividad.

    La tercera es la que menos se hace la gente, y la más incómoda: hay tareas donde revisar línea por línea tarda casi lo mismo que hacerlas a mano. Ahí delegar no es progreso, es mover el trabajo de sitio y añadir riesgo encima. Por eso creo que el techo de los agentic systems no es la capacidad del modelo, sino el coste de verificar cada tarea.

    Cuándo NO delegar a un agente de IA

    Tres situaciones donde no delego sin mirar, aunque la tarea parezca sencilla:

    1. Cuando no hay un gate automático que verifique el resultado. Sin tests, sin tipos, sin criterios de aceptación que corran solos, no hay diferencia real entre dejar que un agente haga commit sin revisión y dejar que lo haga alguien el primer día en el puesto. Confianza sin verificación no es confianza, es esperanza.
    2. Cuando el error es barato de cometer pero caro o imposible de deshacer, aunque la probabilidad sea baja. Un email masivo, un post publicado, una cifra de facturación: la baja probabilidad no compensa un coste irreversible.
    3. Cuando el agente no tiene el contexto de negocio que cambió esta semana: un precio, una decisión editorial que solo existe en mi cabeza. Esto no se arregla con más contexto en el prompt — se arregla con un humano revisando antes de que la acción sea irreversible.

    Nada de esto es un argumento contra usar agentes. Es un argumento contra tratarlos todos igual.

    Qué hacer hoy con esto

    No necesitas una política de veinte páginas. Escribe, para las cinco tareas que más delegas esta semana, una columna de blast radius y una de reversibilidad. Las que salgan bajas en ambas, suéltalas del todo. Las que salgan altas en cualquiera de las dos, revísalas siempre, aunque el agente lleve un mes acertando.

    Si quieres ver cómo aplico esto cada semana en un negocio real que opero solo, sin equipo detrás que revise por mí, en Dominicode Labs comparto el criterio actualizado y los agentes concretos que uso para cada tarea.


    Preguntas frecuentes

    ¿Cómo decido qué tareas delegar a un agente de IA sin supervisión?

    Con tres preguntas: cuál es el blast radius si sale mal, si es reversible, y si verificarlo cuesta más que hacerlo tú mismo. Si el daño es bajo, se puede deshacer y verificar sale barato, delega sin mirar. Si cualquiera falla, revisa antes de que salga.

    ¿Qué es el blast radius aplicado a un agente de IA?

    Es cuánto daño hace una acción del agente si sale mal, multiplicado por cuánta gente o cuánto dinero toca antes de que alguien lo note. No mide la capacidad del modelo: mide el sistema alrededor, qué tan fácil es deshacer el error y qué tan rápido te enteras.

    ¿Puedo dejar que un agente de IA haga commit o push directamente a producción?

    No sin un gate automático que verifique el resultado antes —tests, tipos, criterios de aceptación—. Sin eso, un push sin revisión es como dejarlo hacer a alguien el primer día en el puesto: puede salir bien, pero no lo sabes hasta que ya pasó.

    ¿Qué diferencia hay entre vibe coding e ingeniería agéntica, según Hacker News?

    Según el hilo que generó el post de Simon Willison, la diferencia no está en la herramienta ni en el modelo: está en si revisas y entiendes lo que el agente produjo antes de aceptarlo. Vibe coding es confiar sin mirar. Ingeniería agéntica añade la disciplina de revisar el diff y responder por él.

    ¿Delegar a un agente de IA ahorra tiempo real si después tengo que revisarlo?

    Depende de cuánto tarde la revisión frente a hacer la tarea tú mismo. Si verificar te lleva casi lo mismo que escribirlo de cero, delegar no ahorra tiempo: mueve el trabajo y añade el riesgo de confiar de más porque "las últimas veces salió bien".


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code en monorepos: dale solo la rebanada que necesita

    Claude Code en monorepos: dale solo la rebanada que necesita

    Un cliente me pasó su monorepo el mes pasado. Nueve paquetes, pnpm workspaces, Turborepo por encima. Le pedí a Claude Code algo ridículamente pequeño: cambiar el tipo de una prop en packages/ui.

    Tres respuestas después me estaba proponiendo tocar el cliente HTTP del backend.

    No era un modelo tonto. Era yo. Había arrancado la sesión desde la raíz del repo, y trabajar con Claude Code en monorepos desde la raíz significa una cosa muy concreta: le has dado nueve paquetes de superficie para una tarea que vive en uno.

    Esto no es el problema del que ya escribí en Context Drift. Aquel es temporal: la sesión se alarga, el historial se pudre, el agente se olvida de la instrucción de la iteración 3. Este es espacial. Se degrada en el minuto uno, con la ventana medio vacía, porque el repo es grande y nadie le ha dicho qué parte del repo importa.

    La tesis del post es esta: en un monorepo, la decisión más importante que tomas no es qué prompt escribes. Es desde qué directorio arrancas el agente.

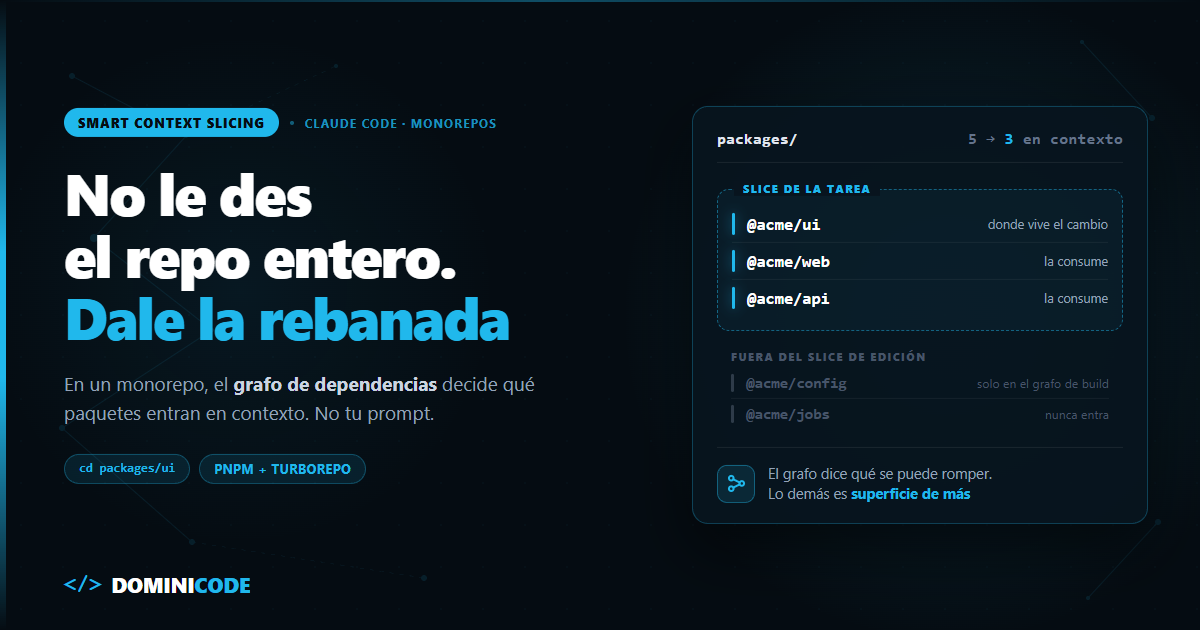
    Smart context slicing es la práctica de arrancar el agente en el subárbol mínimo del monorepo que la tarea necesita, calculado a partir del grafo de dependencias en vez de a ojo. Son tres decisiones concretas: desde qué directorio lanzas claude, qué paquetes vecinos añades con --add-dir y qué rutas bloqueas con reglas de denegación. Las tres, en ese orden, son el resto del post.

    Claude Code en monorepos: un CLAUDE.md en la raíz no escala

    La documentación de Anthropic recomienda mantener cada CLAUDE.md por debajo de 200 líneas, y lo justifica: los archivos largos consumen más contexto y reducen la adherencia a las instrucciones.

    Ahora divide. Nueve paquetes, 200 líneas: 22 líneas por paquete para explicar su stack, sus convenciones y sus trampas.

    Así que solo hay dos finales, y he visto los dos.

    O el CLAUDE.md crece hasta las 600 líneas y el agente ignora la mitad — incluidas las reglas que importaban. O se queda genérico ("usa TypeScript estricto", "escribe tests"), que es una forma elegante de no decir nada.

    Si todavía estás montando el tuyo, el punto de partida lo dejé en CLAUDE.md: el system prompt de tu proyecto. Aquí doy por hecho que ya lo tienes y se te ha quedado pequeño.

    La solución es partirlo: raíz para lo global, un archivo por paquete para lo local.

    monorepo/
      CLAUDE.md                 # reglas globales: commits, estilo, "corre los scripts desde el paquete"
      packages/
        ui/CLAUDE.md            # convenciones de componentes, tokens de diseño
        api/CLAUDE.md           # Knex, migraciones, .env obligatorio
        web/CLAUDE.md           # rutas, data fetching
    

    Pero partirlo no sirve de nada si no entiendes cuándo se carga cada trozo.

    La regla de carga que casi nadie ha leído

    Claude Code no trata igual a los CLAUDE.md que están por encima de ti y a los que están por debajo.

    Dónde vive el CLAUDE.md Cuándo entra en contexto
    Tu directorio de trabajo y todos sus ancestros Al arrancar la sesión, siempre
    Subdirectorios por debajo de ti Bajo demanda, solo cuando el agente lee un archivo de esa carpeta

    Si arrancas desde la raíz, cargas solo el CLAUDE.md raíz — y vas acumulando el de cada paquete que el agente toque. Toca muchos, porque no sabe dónde está el límite.

    Si arrancas con cd packages/ui && claude, cargas raíz + packages/ui de golpe, y los de api y web no existen para esa sesión mientras no los pises. Además, solo puede leer y editar dentro de ese subárbol hasta que le concedas más.

    Eso es una rebanada. Y te ha costado un cd.

    Compruébalo: lanza /context y mira la lista de Memory files. Ahí está lo que se cargó de verdad.

    El slice no lo decides tú: lo decide el grafo de dependencias

    "Trabaja desde el paquete" está bien hasta que la tarea toca de verdad a los vecinos. Cambiar un tipo exportado de ui puede romper a quien lo consume, y si el agente no ve a esos consumidores, te entrega algo que compila en su rebanada y revienta en CI.

    La pregunta correcta no es qué paquetes te apetece abrir, sino qué paquetes toca esta tarea de verdad. Y esa respuesta ya está en tu repo: en el grafo de dependencias.

    Monté un workspace de cinco paquetes para verlo, con pnpm 11.1.3 y Turborepo 2.10.12. @acme/api y @acme/web dependen de @acme/ui; @acme/ui depende de @acme/config; @acme/jobs va por libre.

    Inventario primero:

    pnpm ls -r --depth -1
    

    Ahora el blast radius hacia arriba — qué se rompe si toco @acme/ui. En la sintaxis de filtros de pnpm, los tres puntos delante del nombre significan "y todo lo que depende de él":

    pnpm --filter "...@acme/ui" ls --depth -1
    # (salida recortada al nombre de cada paquete)
    # @acme/ui
    # @acme/api
    # @acme/web
    

    Y hacia abajo, con los puntos detrás, "y todo aquello de lo que depende":

    pnpm --filter "@acme/ui..." ls --depth -1
    # (salida recortada)
    # @acme/ui
    # @acme/config
    

    Si quieres el cierre completo en los dos sentidos, pones los puntos a ambos lados: "...@acme/ui...". Y si te sobra el propio paquete, el circunflejo lo excluye: "...^@acme/ui" devuelve solo api y web.

    Turborepo lo da con un matiz. --dry enseña el plan sin ejecutar nada:

    turbo run build --filter="...@acme/ui" --dry
    
    • Packages in scope: @acme/api, @acme/ui, @acme/web
    • Running build in 3 packages
    

    El detalle que solo ves ejecutándolo: "Packages in scope" son 3, pero si sacas el JSON aparecen 4 tareas:

    turbo run build --filter="...@acme/ui" --dry=json | jq -r '.tasks[].directory' | sort -u
    # packages/api
    # packages/config
    # packages/ui
    # packages/web
    

    @acme/config no está en el scope de edición, pero entra en el grafo de build porque ui lo necesita compilado. Son dos rebanadas distintas y conviene no confundirlas:

    Rebanada Paquetes % del repo
    Repo completo 5 100%
    Slice de edición (ui + dependientes) 3 60%
    Slice de build (añade config) 4 80%
    Nunca entra (@acme/jobs) 1 20%

    En un repo de cinco paquetes, dejar fuera un paquete suena a poco. En el del cliente, con nueve, el slice real de la tarea eran tres paquetes: dos tercios del repo que no tenían por qué abrirse nunca.

    Con esa lista en la mano, el arranque deja de ser una corazonada:

    cd packages/ui
    claude --add-dir ../api --add-dir ../web
    

    Si el equipo entero trabaja así, lo fijas en packages/ui/.claude/settings.json:

    {
      "permissions": {
        "additionalDirectories": ["../api", "../web"]
      }
    }
    

    Ojo con una diferencia que muerde: additionalDirectories da acceso a los ficheros pero no carga nunca el CLAUDE.md ni las skills de esos directorios. Con --add-dir sí cargan las skills, y el CLAUDE.md solo si arrancas con CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1. Si escribiste un CLAUDE.md en packages/api y no sale en /context, es por esto.

    Y como el slice te dice qué se puede romper, también sabes qué verificar antes de dar la tarea por buena: los tests de api y web, no los de ui. Convertir "parece que funciona" en un veredicto ejecutable lo desarrollé entero en el ebook gratuito Revisión por Contrato, sobre cómo revisar lo que te entrega un agente sin leértelo línea a línea.

    Lo que no debe entrar en la ventana bajo ningún concepto

    Las búsquedas de contenido de Claude Code respetan tu .gitignore por defecto, así que node_modules/, dist/ y build/ ya están fuera de los resultados de un grep.

    El problema es lo que sí está commiteado: código generado, un SDK vendorizado, snapshots enormes. Para eso hay reglas de denegación:

    {
      "permissions": {
        "deny": [
          "Read(./**/dist/**)",
          "Read(./**/*.generated.*)",
          "Read(./vendor/**)"
        ]
      }
    }
    

    Un detalle que rompe esto sin avisar: los patrones relativos anclan en el directorio desde el que arrancas la sesión, no en la raíz del repo. Si guardas estas reglas en la raíz pero lanzas la sesión desde packages/ui, Read(./vendor/**) está apuntando a packages/ui/vendor/. Para que apliquen en todo el repo las escribes absolutas, con doble barra: Read(//ruta/absoluta/al/repo/vendor/**).

    Y si arrancando desde la raíz se te cuelan los CLAUDE.md de equipos con los que no trabajas, existe claudeMdExcludes, en el .claude/settings.local.json de la raíz. Los patrones se comparan contra rutas absolutas, así que empiezan por **/ para que casen en cualquier punto del árbol:

    {
      "claudeMdExcludes": ["**/packages/legacy-*/**"]
    }
    

    Con un aviso honesto: esa lista es estática, no un interruptor por tarea. Para alternar de paquete cada día la herramienta sigue siendo el cd.

    Cuando de verdad no sabes dónde está, delega la búsqueda

    Todo lo anterior asume que sabes qué paquete tocar. A veces no lo sabes, y ahí es donde la gente destroza la sesión: "busca en el repo dónde se genera el token de refresco". El agente lee doscientos archivos y te devuelve una frase. Los doscientos archivos se quedan en tu ventana. La frase también, pero ya da igual.

    Delégalo a un subagente. Corre en su propia ventana de contexto y te devuelve el resumen, no los archivos:

    Usa un subagente para localizar en qué paquetes se genera y se valida
    el token de refresco. Devuélveme solo la lista de rutas y una línea
    por cada una. No propongas cambios todavía.
    

    El resultado es una lista de paquetes. Cierras la sesión, haces cd al correcto y empiezas la tarea real con la ventana limpia. La exploración se paga una vez y se tira.

    Es el mismo principio que conté en Context Engineering: lo caro no es el token, es el token irrelevante que se queda mirándote el resto de la sesión.

    Lo que puedes hacer hoy en tu monorepo

    Una sola cosa, y es gratis: deja de arrancar el agente desde la raíz del monorepo.

    Antes de la próxima tarea, corre pnpm --filter "...<tu-paquete>" ls --depth -1, mira los tres o cuatro nombres que salen, y arranca así:

    cd packages/<tu-paquete>
    claude --add-dir ../<vecino>
    

    No hace falta que escribas ni un CLAUDE.md nuevo para notar la diferencia. Eso viene después, cuando ya sepas qué reglas son globales y cuáles de un paquete — y eso solo se ve claro tras unos días trabajando por rebanadas.

    Si quieres el flujo completo, de la idea al producto con estas decisiones tomadas antes de escribir código, es lo que montamos en el curso Construye con IA.

    Preguntas frecuentes

    ¿Es mejor arrancar Claude Code desde la raíz del monorepo o desde el paquete?

    Desde el paquete, salvo que la tarea cruce varios subsistemas de verdad. Arrancando desde packages/ui cargas el CLAUDE.md raíz más el de ui, y el agente solo puede leer y editar ese subárbol. Desde la raíz tienes acceso a todo: útil para refactors transversales, caro para cualquier otra cosa. Si necesitas un vecino puntual, --add-dir te lo añade sin romper el aislamiento.

    ¿Los CLAUDE.md de los subdirectorios se cargan siempre?

    No, y esta es la confusión más habitual. Los de tu directorio de trabajo y de todos sus ancestros se cargan al arrancar la sesión. Los de subdirectorios por debajo de ti se cargan bajo demanda, solo cuando el agente lee un archivo de esa carpeta. Para ver qué se cargó de verdad en una sesión, lanza /context.

    ¿Qué hago si la tarea toca varios paquetes a la vez?

    Dásela entera en una sola sesión, con el slice completo delante. Partirla en una sesión por paquete es peor: cada sesión redecide el diseño desde cero y acabas con tres criterios distintos. Calcula el slice con el filtro de dependientes, añade esos directorios y trabaja en plan mode antes de editar: el plan se escribe a un archivo que Claude Code reinyecta tras cada compactación.

    ¿Esto sirve si uso Nx o si mi repo es un solo árbol grande sin paquetes?

    Sí. En Nx el equivalente es nx graph para ver el grafo y nx show projects --affected para saber qué proyectos toca un cambio: cambia el comando, no la idea. Y en un repo de un solo árbol sustituyes "paquete" por "subsistema" — src/billing/, src/auth/, lib/core/. Un CLAUDE.md por subsistema y un cd hacen el mismo trabajo.

    ¿No basta con el .gitignore para que el agente no lea dist?

    Para las búsquedas de contenido sí: Claude Code respeta el .gitignore por defecto, así que dist/, build/ y node_modules/ no aparecen cuando busca texto. Lo que no cubre es lo commiteado — código generado, SDKs vendorizados, fixtures gigantes. Para eso necesitas reglas Read(...) en permissions.deny. Con un límite: cubren las herramientas de fichero y los comandos de Bash que Claude Code reconoce, pero un grep -r sobre una carpeta con ficheros denegados sigue sacándolos por pantalla.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Refactorizar código legacy con IA: el método SDD en brownfield

    Refactorizar código legacy con IA: el método SDD en brownfield

    El fichero se llamaba pricing.ts, tenía 1.100 líneas y un comentario en la línea 3 que decía // NO TOCAR — hablar con Javi antes. Javi se había ido de la empresa en 2021.

    Cero tests. Cero documentación. Y toda la facturación pasando por ahí.

    Hice lo que hace todo el mundo la primera vez que intenta refactorizar código legacy con IA: se lo pegué entero a Claude Code y le pedí que lo dejara limpio. Me devolvió algo precioso. Funciones puras, nombres decentes, 300 líneas en vez de 1.100.

    Y roto para los pedidos que acumulaban cupón y descuento de socio a la vez.

    El agente no alucinó nada. Hizo exactamente lo que le pedí. Le pedí arreglar un código cuya intención nadie le había explicado, porque nadie la sabía.

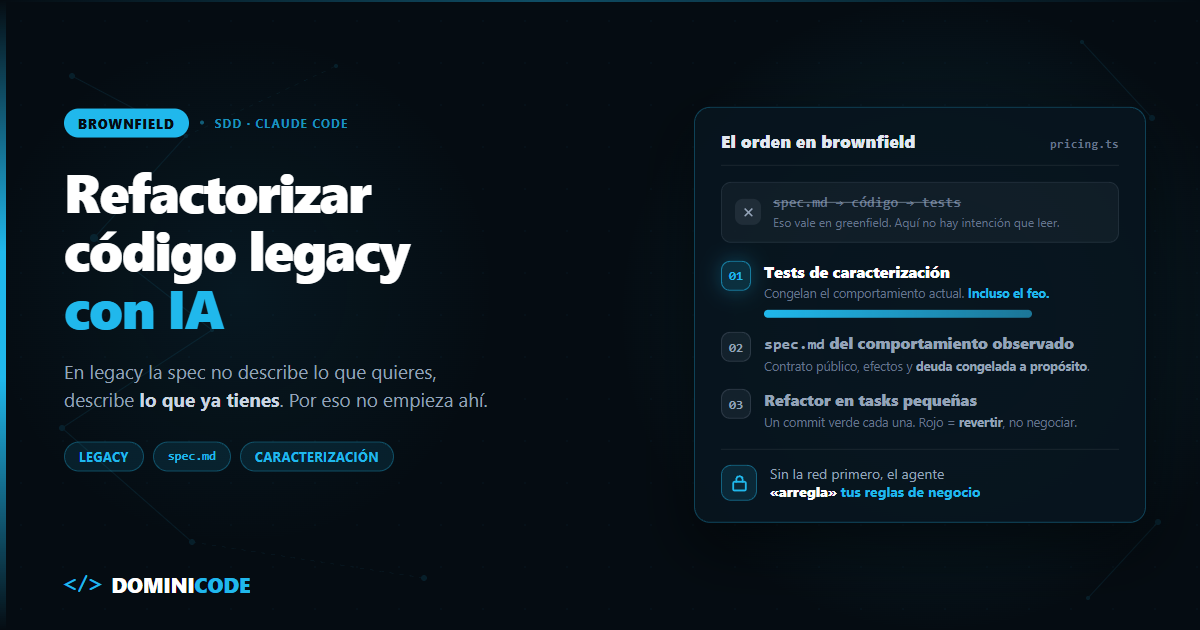
    Esa es la tesis de este post: en legacy la spec no describe la feature que quieres, describe el comportamiento que ya tienes. Y por eso el primer artefacto no es spec.md, son los tests de caracterización.

    Por qué refactorizar código legacy con IA falla sin tests

    Refactorizar código legacy con IA usando SDD consiste en invertir el ciclo habitual: primero tests de caracterización que congelan el comportamiento observable, después una spec que documenta lo que el sistema ya hace, y solo entonces plan y tasks.

    El motivo es simple. Un modelo lee código y ve perfectamente qué hace. Lo que no puede ver es qué debería hacer.

    En un proyecto nuevo eso da igual, porque la intención está en tu cabeza y la escribes tú. Es lo que hacemos cuando arrancamos un greenfield con slices verticales: la spec va delante porque describe algo que todavía no existe.

    En legacy la intención está enterrada bajo seis años de parches de viernes por la tarde. Y ahí aparece el problema real: ningún modelo distingue una regla de negocio rara de un bug que lleva años tolerándose.

    En mi pricing.ts había un Math.floor donde cualquiera pondría Math.round. Claude lo "arregló". Llevaba ahí desde 2019 porque el departamento financiero quería redondear siempre a favor del cliente.

    Eso no es un bug. Es un requisito no escrito. Y el agente no tenía forma humana de saberlo.

    Los antipatrones de este escenario los desarrollé en los 5 errores fatales al refactorizar legacy con IA, así que no los repito. El método positivo empieza invirtiendo el orden.

    Spec greenfield Spec brownfield
    Qué describe Lo que quieres construir Lo que ya hace el sistema
    Fuente de verdad Tu criterio de producto El código en producción
    Primer artefacto spec.md Tests de caracterización
    Criterio de éxito Cumple los casos de uso nuevos No cambia ninguna salida observable
    Ambigüedad Se resuelve preguntando Se resuelve ejecutando
    Riesgo principal Construir lo que no toca Romper lo que ya funcionaba

    En greenfield el ciclo es spec → plan → tasks → código. En brownfield es tests → spec → plan → tasks → código. La spec sigue existiendo, pero llega en segundo lugar: hasta que no ejecutas el módulo no sabes qué escribir en ella.

    Paso 0 — Acota el blast radius antes de abrir el editor

    La regla que más refactors me ha salvado: si no puedes escribir en una línea qué NO vas a tocar, no empieces.

    Escribe estas cuatro cosas antes de nada:

    • Dentro: src/pricing.ts y sus dos helpers.
    • Fuera: el modelo de datos, los endpoints, la UI de checkout.
    • Consumidores: quién importa esto. Lanza un rg sobre el repo y pega la lista tal cual.
    • Contrato público: las funciones exportadas que otros usan. Esas firmas no se tocan.

    Ese último punto es el que hace el trabajo acotable: si la frontera del módulo se mueve, ya no es un refactor, es un rediseño.

    Paso 1 — Arqueología asistida: el agente lee, no escribe

    Aquí Claude Code es brutalmente bueno, y es la parte que casi nadie usa. El agente tiene prohibido cambiar una sola línea.

    El prompt que uso, más o menos literal:

    Lee src/pricing.ts. No propongas mejoras ni refactorices nada.
    
    Produce docs/legacy/pricing-observado.md con:
    1. Cada rama de decisión del módulo, con la condición exacta que la activa.
    2. Las entradas: tipos reales, no los declarados. Marca los que en la práctica
       llegan como null o undefined.
    3. Las salidas: forma del retorno en cada rama.
    4. Efectos secundarios: I/O, escrituras, logs, mutación de argumentos, lecturas
       de Date/Math.random o de variables globales.
    5. Una sección "Comportamientos sospechosos": cosas que parecen bugs.
       NO las arregles. Solo lístalas con número de línea.
    6. Una sección "Preguntas que no puedo responder leyendo el código".
    

    Las secciones 5 y 6 son el oro: una lista lo que el agente habría "arreglado" solo, la otra lo que tienes que ir a preguntarle a un humano o a los logs de producción.

    En pricing.ts la sección 6 tenía nueve preguntas. Siete las resolví mirando datos reales. Dos las resolvió el responsable de facturación en cinco minutos. Ese día no escribí código y fue el día más productivo del refactor.

    Paso 2 — Tests de caracterización: congela el comportamiento, incluso el feo

    Un test de caracterización no comprueba que el código sea correcto. Comprueba que sigue haciendo lo mismo. En TDD el test va delante y define lo deseable; aquí va detrás y define lo existente.

    Aunque lo existente sea horrible.

    // pricing.characterization.test.ts
    import { describe, it, expect } from 'vitest'
    import { calcularPrecioFinal } from '../src/pricing'
    
    // Casos capturados de pedidos reales de producción, anonimizados.
    const CASOS = [
      { nombre: 'base sin descuentos', pedido: { subtotal: 100, cupon: null, pais: 'ES', socio: false } },
      { nombre: 'cupon y socio acumulados', pedido: { subtotal: 100, cupon: 'VIP10', pais: 'ES', socio: true } },
      { nombre: 'cupon caducado', pedido: { subtotal: 100, cupon: 'OLD20', pais: 'ES', socio: false } },
      { nombre: 'pais sin IVA', pedido: { subtotal: 100, cupon: null, pais: 'US', socio: false } },
      { nombre: 'decimales feos', pedido: { subtotal: 1234.56, cupon: 'VIP10', pais: 'ES', socio: true } },
      { nombre: 'subtotal cero', pedido: { subtotal: 0, cupon: 'VIP10', pais: 'ES', socio: true } },
    ] as const
    
    // CONGELADO: el caso 'decimales feos' devuelve un céntimo de menos por el
    // Math.floor de pricing.ts:412. Se arregla DESPUÉS del refactor, en un
    // commit propio. Ver LEG-14.
    describe('calcularPrecioFinal — caracterización', () => {
      it.each(CASOS)('$nombre', ({ pedido }) => {
        expect(calcularPrecioFinal(pedido)).toMatchSnapshot()
      })
    })
    

    Fíjate en lo que no hay: ningún valor esperado escrito a mano. El snapshot lo genera la primera ejecución. Tú no decides la salida correcta, la registras.

    El término viene de Working Effectively with Legacy Code (Michael Feathers, 2004), y en Vitest 5 lo implementas con toMatchSnapshot().

    Después abres el fichero de snapshots y lo lees entero. Ahí aparecen las sorpresas y ahí apuntas los // CONGELADO:. Cada uno es un ticket futuro, no una excusa para tocar nada ahora.

    Y sí, congelas el bug a propósito. Si arreglas comportamiento y estructura en el mismo commit, cuando algo falle en producción no sabrás cuál de las dos cosas lo rompió.

    Paso 3 — La spec brownfield

    Ahora, y solo ahora, escribes la spec. Con los tests en verde delante deja de ser un ejercicio de memoria, y las secciones que importan no son las de un proyecto nuevo:

    # Spec — Refactor de pricing
    
    ## Comportamiento observado
    Documentado en docs/legacy/pricing-observado.md.
    Congelado en pricing.characterization.test.ts (6 casos).
    
    ## Contrato público (NO cambia)
    calcularPrecioFinal(pedido: Pedido): Precio
    - Devuelve `total` en céntimos como number. No se migra a bigint en este refactor.
    - Nunca lanza: ante entrada inválida devuelve { total: 0, error: string }.
    
    ## Efectos secundarios actuales
    - Escribe en la tabla pricing_audit. SE MANTIENE.
    - Lee process.env.TAX_MODE en caliente. SE MANTIENE, se aísla en config.ts.
    - Muta el objeto `pedido` recibido. SE ELIMINA: ningún consumidor depende de
      ello, verificado en los 4 call sites.
    
    ## Deuda congelada a propósito
    - LEG-14: redondeo con Math.floor en la línea 412.
    - LEG-15: cupón caducado devuelve descuento 0 en vez de error.
    
    ## Fuera de alcance
    Modelo de datos, endpoints, UI de checkout, migración a bigint.
    
    ## Criterio de aceptación
    Los 6 tests de caracterización pasan sin modificar sus snapshots.
    El test de equivalencia legacy/refactor pasa en las 72 combinaciones.
    

    Es corta a propósito. Y es lo que le das al agente en cada task, no el fichero de 1.100 líneas.

    El formato completo lo tienes en el libro de Spec-Driven Development. Para el esqueleto uso el skill dominicode-sdd-creator, que genera spec.md + plan.md + tasks.md; el contenido brownfield lo pones tú, porque sale de los tests.

    Si dudas de cuánta ceremonia merece el módulo, el criterio está en los tres niveles de SDD. Un refactor de legacy con dinero de por medio es nivel alto, sin discusión.

    Paso 4 — Plan por fases, tasks pequeñas, un commit verde cada una

    El plan de un refactor brownfield tiene siempre la misma forma:

    1. Aislar. Extraer funciones puras sin cambiar la lógica. Copiar, no reescribir.
    2. Tipar los bordes. Con los tipos reales del paso 1, no los declarados.
    3. Sustituir por partes. La implementación nueva convive con la vieja mientras dure.
    4. Borrar el legacy. Cuando la equivalencia lleve dos semanas en verde.

    La fase 3 es la que necesita andamio. Copia el original a pricing.legacy.ts, deja pricing.ts para la implementación nueva, y este es todo el andamio:

    // pricing.equivalence.test.ts
    import { describe, it, expect } from 'vitest'
    import { calcularPrecioFinal as legacy } from '../src/pricing.legacy'
    import { calcularPrecioFinal as refactor } from '../src/pricing'
    
    const subtotales = [0, 9.99, 100, 1234.56]
    const cupones = [null, 'VIP10', 'OLD20']
    const paises = ['ES', 'US', 'DE']
    const socios = [true, false]
    
    describe('legacy vs refactor — equivalencia', () => {
      for (const subtotal of subtotales) {
        for (const cupon of cupones) {
          for (const pais of paises) {
            for (const socio of socios) {
              const pedido = { subtotal, cupon, pais, socio }
              it(`${subtotal} / ${cupon ?? 'sin cupon'} / ${pais} / socio=${socio}`, () => {
                expect(refactor(pedido)).toEqual(legacy(pedido))
              })
            }
          }
        }
      }
    })
    

    72 combinaciones que el agente ejecuta solo cada vez que cierra una task. Y ojo: si el test sale intermitente no tienes un problema de refactor, tienes un Date.now() o un Math.random() sin inyectar. Arréglalo antes de seguir.

    Regla de tamaño de task: si el diff no lo puedes leer entero en diez minutos, pártela. El límite no lo pone el agente, lo pone tu capacidad de revisar lo que produjo — que es el verdadero cuello de botella de trabajar con agentes.

    Paso 5 — Qué haces cuando un test se pone rojo

    Un test de caracterización en rojo tiene tres causas. Míralas en este orden.

    Uno: el refactor rompió algo. Nueve de cada diez veces, por mi experiencia. Revierte la task, no la parchees: el diff es pequeño precisamente para que revertir sea barato.

    Dos: el refactor arregló un bug sin querer. Pasa más de lo que parece y es una trampa. Revierte igual y arréglalo en su propio commit, con su snapshot actualizado. Un cambio de comportamiento colado dentro de un refactor pasa desapercibido en la review casi siempre.

    Tres: el test no era determinista. Fechas, aleatoriedad, orden de un Object.keys, zona horaria. Eso no es caracterización, es ruido. Arréglalo en el test o inyecta la dependencia.

    La regla que resume el paso 5 entero: un refactor nunca cambia comportamiento, y un cambio de comportamiento nunca se llama refactor. Commits distintos, PRs distintas, riesgos distintos.

    Este bucle es el mismo que aplico en TDD potenciado por IA, solo que en legacy los tests no los escribes para diseñar: los escribes para tener permiso a tocar.

    Cómo empezar a refactorizar legacy con Claude Code el lunes

    Coge el fichero que todo el mundo evita en tu repo. No lo refactorices. Haz solo esto, y no tardas más de una hora.

    Escribe en una línea qué entra y qué queda fuera. Lanza a Claude Code el prompt de arqueología del paso 1 en modo lectura. Y escribe cinco tests de caracterización con los casos que ya te sabes de memoria, porque son los que se rompen cada trimestre.

    El lunes no refactorizas nada. El martes ya puedes, y con red.

    Cuando quieras montar la verificación en serio — el AGENTS.md, los carriles del agente y los criterios que se comprueban solos — está en el ebook gratuito de Revisión por Contrato. Y el ciclo completo de idea a producto con Claude Code ejecutando tasks es el recorrido del curso Construye con IA.

    El código legacy no da miedo por antiguo. Da miedo porque no sabes qué hace. Y eso se arregla escribiendo tests, no reescribiendo código.

    Preguntas frecuentes

    ¿Qué es un test de caracterización y en qué se diferencia de un test unitario normal?

    Un test unitario afirma que el código hace lo correcto. Un test de caracterización afirma que sigue haciendo lo mismo que antes, sea correcto o no. No lo escribes a mano: ejecutas el módulo con entradas reales y registras la salida en un snapshot. Su único trabajo es ponerse rojo cuando el refactor cambia una salida observable.

    ¿Merece la pena congelar un comportamiento que sé que es un bug?

    Sí, siempre. Si arreglas el bug en el mismo commit en el que reestructuras el código y algo revienta en producción, no podrás distinguir cuál de las dos cosas lo rompió. Congélalo con un comentario que explique la sospecha y su ticket, y arréglalo después en un commit propio donde el cambio de snapshot sea la parte visible de la pull request.

    ¿Cuánto código legacy le puedo dar a Claude Code de una vez?

    Menos del que cabe. El límite útil no es la ventana de contexto, es lo que tú puedes verificar después. Yo trabajo módulo a módulo y en cada task le paso la spec brownfield y los tests, no el fichero original. Una vez documentado el comportamiento en el paso 1, ese documento sustituye al código fuente como contexto.

    ¿Puedo saltarme los tests de caracterización si el módulo ya está tipado con TypeScript estricto?

    No. Los tipos garantizan la forma del dato, no el valor. Un refactor que cambia Math.floor por Math.round, que invierte el orden de dos descuentos o que redondea antes en vez de después compila perfecto, pasa el type-check y factura mal. Los tipos protegen el contrato; los tests de caracterización protegen el comportamiento.

    ¿Y si el módulo legacy no se puede ejecutar de forma aislada?

    Entonces esa es tu primera task, y no es refactorizar. Si no puedes invocar la función sin levantar media aplicación, lo que falta es una costura: inyectar la base de datos, el reloj y las llamadas HTTP para poder ejecutarla con entradas controladas. Feathers lo llama seam. Hasta que no consigues ejecutar el módulo con entradas que tú decides, no hay tests de caracterización posibles ni refactor seguro.

    ¿Sirve este método si el módulo legacy no está en TypeScript?

    Sí, el orden no cambia. Lo único que necesitas es un runner con snapshots: pytest con syrupy en Python, ApprovalTests en Java o C#, o el propio Vitest si es JavaScript sin tipar. Lo que sí cambia es el paso de tipar los bordes: sin tipos estáticos pierdes la red del compilador y el peso recae entero sobre los tests de caracterización, así que conviene capturar más casos de los que capturarías en TypeScript.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Hooks vs permissions en Claude Code: dónde va el guardrail

    Hooks vs permissions en Claude Code: dónde va el guardrail

    Abrí mi propio .claude/settings.local.json mientras preparaba este post. Buscaba un ejemplo bonito de hooks vs permissions en Claude Code para ilustrar la diferencia. Encontré otra cosa.

    364 reglas allow. Cero reglas deny. Cero ask. Y "defaultMode": "bypassPermissions".

    La primera regla de la lista es Bash(*).

    Bash(*) equivale a Bash: matchea todos los comandos. Las otras 185 reglas de Bash de la lista ya no afinan nada, porque no queda nada que afinar. Y las 178 restantes —WebFetch, PowerShell, Skill— tampoco protegen: una regla allow nunca dice que no, solo evita que te pregunten. Con bypassPermissions puesto, ni eso: no iba a preguntar de todas formas. Una allowlist de 364 líneas que no le dice que no a nada.

    Lo mejor viene ahora. En el .claude/settings.json versionado del mismo repositorio sí hay dos hooks PreToolUse, con matchers Bash y Read|Glob. Funcionan perfectamente. Son hooks de guía y observabilidad — le dicen a Claude por dónde buscar antes de lanzarse a hacer grep por todo el repo — no de seguridad.

    Capa de hooks montada. Capa de permisos abierta de par en par.

    Hace poco escribí, en el post donde probé la blocklist típica y pasaron 16 de 20 comandos destructivos, esta frase exacta: "Revisa el tuyo con una pregunta concreta: ¿hay alguna regla comodín tipo Bash(*) que anule a todas las demás? Si la hay, tu allowlist es decorativa."


    Hooks vs permissions: las dos capas, y cuál manda

    Claude Code tiene dos sitios donde puedes decir "esto no".

    El sistema de permisos: configuración declarativa con reglas allow, deny y ask. Los hooks: scripts tuyos que se ejecutan antes de la llamada a la herramienta y pueden bloquearla. Las dos son piezas del agent harness, esa capa que rodea al modelo y decide qué puede tocar de verdad.

    El sistema de permisos de Claude Code es configuración declarativa —reglas allow, deny y ask en settings.json— que se evalúa antes de ejecutar la herramienta. Un hook PreToolUse es un script tuyo que Claude Code ejecuta antes de la llamada y que puede bloquearla saliendo con código 2. La diferencia que decide dónde va tu guardrail: los permisos no pueden fallar, el hook sí.

    Casi todo el que se preocupa por la seguridad monta un hook. Es lo divertido: escribes código, haces pattern matching, devuelves exit 2 y te sientes ingeniero de seguridad. Si nunca has montado uno, empieza por Claude Code hooks: guardrails, logging y automatización para tus agentes, el tutorial del cómo.

    Este post va del dónde. Y el dónde importa porque las dos capas no tienen la misma autoridad.

    Un hook solo puede restringir, nunca ampliar

    Un hook PreToolUse es una válvula de un solo sentido. Cierra, no abre.

    La documentación de permisos de Claude Code no deja margen a interpretación. Traduzco las dos frases que lo zanjan:

    "Las decisiones de un hook no saltan las reglas de permisos. Claude Code evalúa las reglas deny y ask sea cual sea lo que devuelva un hook PreToolUse: una regla deny que coincida bloquea la llamada, y una regla ask que coincida sigue preguntando incluso cuando el hook ha devuelto allow o ask."

    "Un hook que bloquea también tiene precedencia sobre las reglas allow. Un hook que sale con código 2 detiene la llamada antes de que se evalúen las reglas de permisos, así que el bloqueo se aplica incluso cuando una regla allow habría dejado pasar la llamada."

    Puede vetar lo que tus permisos habrían permitido. No puede rescatar lo que ya han denegado. Si diseñas la seguridad pensando que el hook es "el sitio donde yo decido", la estás montando sobre la capa con menos autoridad.

    La propia documentación sugiere el patrón combinado: para ejecutar todos los comandos Bash sin prompts salvo unos pocos, pon "Bash" en allow y registra un hook PreToolUse que rechace esos concretos. Es un patrón legítimo. Fíjate en para qué lo propone: ergonomía. No suelo de seguridad.

    El hook falla abierto. La regla deny no puede fallar.

    Un hook es un proceso. Y a los procesos les pasan cosas. Esto es lo que ocurre según cómo termine:

    Esto es lo que dice la documentación de hooks según cómo termine el proceso:

    • exit 2 → bloquea. Imprima JSON o no; ni un permissionDecision de allow puede anularlo. El mensaje de bloqueo es la razón del JSON si la hay, y si no, el stderr.
    • exit 0 con JSON válido → manda la decisión del JSON y el exit code se ignora.
    • Cualquier otro exit code, un script que no existe, JSON inválido o un timeout → error no bloqueante. En palabras de la doc: "the action proceeds". La llamada continúa por el flujo normal de permisos y en el transcript aparece un aviso <hook name> hook error.

    Lee otra vez la tercera.

    El día que renombras el script, cambias de máquina, se te cuela una coma en el JSON o el proceso se pasa del timeout, tu "guardrail de seguridad" deja pasar el comando. No para el mundo: escribe un aviso y sigue.

    Incluida la salida 1, la de fallo de toda la vida en Unix: si tu hook revienta con exit 1, el comando pasa.

    En PreToolUse el timeout por defecto es de 600 s. Y todos los hooks que matchean corren en paralelo, así que tampoco hay un orden de ejecución en el que apoyarte.

    Una regla deny no tiene ninguna de esas formas de fallar: no hay proceso, ni exit code, ni ruta a un binario que pueda cambiar. Es configuración que se evalúa antes de ejecutar nada. Si una herramienta está denegada en cualquier nivel, ningún otro nivel puede permitirla — ni --allowedTools en la línea de comandos.

    Falla cerrado por construcción. Por eso el suelo va ahí.

    El sistema de permisos entiende de shell. Tu grep no.

    Cuando escribes un hook con grep haces pattern matching sobre un string. Claude Code no: parsea el comando.

    Los separadores que reconoce son &&, ||, ;, |, |&, & y los saltos de línea. Cada subcomando debe coincidir por separado. Y las reglas deny y ask matchean más allá de una asignación de variable de entorno.

    Dos comandos y las dos capas, lado a lado:

    safe-cmd && rm -rf /
    FOO=bar rm -rf tmp/
    
    Comando Hook con grep Regla de permisos
    safe-cmd && rm -rf / [[ "$cmd" == safe-cmd* ]] → pasa: el string empieza por safe-cmd Bash(safe-cmd *) no da permiso: cada subcomando se matchea por separado
    FOO=bar rm -rf tmp/ grep -E '^rm ' → no matchea: el comando empieza por FOO Bash(rm *) en deny sí coincide: matchea pasada la asignación

    Dos comandos. Dos fallos del hook ingenuo. Cero de las reglas.

    Y hay más parseo que no vas a reimplementar bien. Antes de matchear se despojan los wrappers conocidos: timeout, time, nice, nohup, stdbuf, los builtins command y builtin, y el noglob de zsh. Por eso Bash(npm test *) también cubre timeout 30 npm test.

    Claude Code hasta rechaza tus patrones frágiles por ti: una regla como Bash(command:rm *) sería esquivable con un comando compuesto, así que la ignora y emite un warning al arrancar. Lo correcto es Bash(rm *).

    Los agujeros que sí existen

    Los permisos no son magia. Hay tres sitios donde te toca poner de tu parte.

    Los runners de entorno no están en la lista de wrappers que se despojan: direnv exec, devbox run, mise exec, npx, docker exec. Ejecutan sus argumentos como comando, así que Bash(devbox run *) cubre también devbox run rm -rf .. La regla correcta lleva runner + comando interno, Bash(devbox run npm test), una por cada uno. Tedioso y correcto.

    Los patrones sobre argumentos son frágiles: Bash(curl http://github.com/ *) no cubre las variaciones. Deniega curl y wget y usa WebFetch con WebFetch(domain:github.com).

    Las redirecciones se comprueban como escritura de archivo: el destino de >, >> y 2> se valida contra tus reglas Edit. Bash(git commit *) permite el comando, no el destino. /dev/null no se comprueba.

    Nada de esto lo arregla un hook. Enumerar strings peligrosos es el diseño equivocado, lo escribas en un middleware o en un PreToolUse.

    La sintaxis que casi nadie escribe bien

    Regla Qué matchea
    Bash(npm run build) exactamente npm run build
    Bash(npm run *) npm run build, npm run test --watch, y el escueto npm run
    Bash(ls *) ls -la y ls — pero no lsof
    Bash(ls*) ls -la y lsof
    Read(./.env) leer el .env del directorio actual
    Read(./secrets/**) glob estilo gitignore
    WebFetch(domain:example.com) peticiones a ese dominio

    El espacio antes del * es toda la diferencia entre ls y lsof. El sufijo :* equivale al wildcard final — Bash(ls:*) ≡ Bash(ls *) — pero solo se reconoce al final del patrón: en Bash(git:* push) los dos puntos son un carácter literal.

    Y el * va después del subcomando. Bash(git log *) permite solo git log; Bash(git *) permite todo git. Claude Code te avisa al arrancar si lo escribes antes.

    Queda la precedencia, que mucha gente asume al revés: se evalúa deny, luego ask, luego allow. La primera coincidencia en ese orden decide, y la especificidad de la regla no altera el orden. Una deny amplia como Bash(aws *) bloquea todo lo que coincida, incluida una allow más estrecha como Bash(aws s3 ls).

    Dicho de otra forma: una regla deny no admite excepciones de allowlist. Si necesitas una excepción, no la pongas en deny.

    Hooks vs permissions en Claude Code: qué va en cada capa

    permissions Hooks PreToolUse
    Naturaleza Configuración declarativa Proceso que ejecutas
    Modo de fallo No puede fallar: no hay nada que ejecutar Falla abierto: error, timeout o JSON inválido → la acción continúa
    Autoridad deny es absoluto en todos los niveles Solo restringe; nunca amplía
    Entiende shell Sí: separadores, wrappers, asignaciones, redirecciones Solo lo que tú programes
    Superficie Toda herramienta con regla Solo lo que cubra tu matcher
    Para qué sirve Suelo de seguridad, lo irreversible, secretos Contexto, logging, reescritura, reglas que dependen del estado del proyecto
    Ejemplo Bash(rm *), Read(./.env) Registrar cada comando, avisar si el working tree está sucio, guiar la búsqueda

    El JSON que deberías tener

    {
      "permissions": {
        "defaultMode": "default",
        "deny": [
          "Bash(rm *)",
          "Bash(curl *)",
          "Bash(wget *)",
          "Read(./.env)",
          "Read(./.env.*)",
          "Read(./secrets/**)"
        ],
        "ask": [
          "Bash(git push *)",
          "Bash(docker *)",
          "Bash(npm publish *)"
        ],
        "allow": [
          "Bash(npm run build)",
          "Bash(npm test *)",
          "Bash(git status)",
          "Bash(git log *)",
          "Bash(ls *)",
          "WebFetch(domain:github.com)"
        ],
        "disableBypassPermissionsMode": "disable"
      }
    }
    

    Bash(rm *) en deny cubre FOO=bar rm -rf tmp/ sin que hagas nada. Bash(npm test *) en allow cubre timeout 30 npm test gracias al despojado de wrappers. Y deny bloquea aunque más abajo haya una allow que coincida: no hay forma de escribir la excepción, y esa es justo la propiedad que querías.

    Este es el tipo de decisión que trabajo en el curso Construye con IA: de la idea al producto con Claude Code: antes de darle capacidades a un agente, dejar por escrito qué no puede hacer.

    Entonces, ¿para qué el hook?

    Para lo que los permisos no saben expresar. Contexto: la hora, la rama, si el working tree está sucio. Observabilidad: registrar cada llamada. Guía: decirle por dónde buscar antes de que haga grep por todo el repo, que es lo que hacen los dos hooks de mi repo. Reescritura y guía de comandos. Decisiones que dependen del estado del proyecto, no del string del comando.

    Con un límite que conviene tener delante. En PreToolUse el matcher se compara contra el nombre de la herramienta. "*", "" u omitido matchean todo. Si solo contiene letras, dígitos, _, -, espacios, , y |, es un string exacto o una lista: Bash, Edit|Write. Cualquier otro carácter lo convierte en una expresión regular de JavaScript sin anclar: ^Bash.

    Consecuencia práctica: un matcher "Bash" no cubre PowerShell, ni Write, ni Edit, ni las herramientas MCP (mcp__servidor__tool). Si tu guardrail vive solo ahí, toda esa superficie está descubierta y no te vas a enterar.

    Qué hacer hoy

    Abre tu .claude/settings.local.json y cuenta las reglas deny. Si el número es cero, ya tienes plan para esta tarde.

    Escribe cinco. Solo cinco, y que sean lo irreversible: los secretos y el borrado.

    1. Read(./.env) — que no lea tus claves.
    2. Read(./secrets/**) — ni el resto de secretos.
    3. Bash(rm *) — el borrado, que además cubre FOO=bar rm -rf tmp/.
    4. Bash(curl *) — la exfiltración por red.
    5. Bash(wget *) — la otra mitad de lo mismo.

    Luego quita bypassPermissions y ponle "disableBypassPermissionsMode": "disable". Y si trabajas con equipo, todo eso va en managed settings: la precedencia más alta, no lo anula ningún otro nivel ni los argumentos de línea de comandos.

    Un último detalle que resume el post. Poner disableAllHooks solo en tus settings de usuario no basta: los settings de proyecto del repositorio tienen precedencia sobre los tuyos y pueden volverlo a false. Ni siquiera desactivar los hooks se decide desde donde viven los hooks.

    La autoridad está en la configuración. Tu script es la capa de encima.

    Mi settings.local.json ya tiene reglas deny. Tardé cuatro minutos. Llevaba meses con Bash(*) en la primera línea y un hook precioso que no protegía absolutamente nada.

    Si quieres ver esta capa montada en proyectos reales, con los settings completos y los hooks que sí aportan, lo trabajamos dentro de Dominicode Labs.

    Comportamiento verificado contra la documentación oficial de Claude Code en septiembre de 2026.


    Preguntas frecuentes

    ¿Puedo usar un hook para permitir algo que una regla deny bloquea?

    No. Claude Code evalúa las reglas deny y ask sea cual sea lo que devuelva el hook. Una regla deny que coincida bloquea la llamada aunque el hook haya devuelto allow, y una regla ask sigue preguntando igual.

    Al revés sí funciona: un hook que sale con exit 2 detiene la llamada antes de que se evalúen los permisos, así que bloquea aunque una regla allow la hubiera dejado pasar. El hook solo restringe.

    ¿Qué pasa si mi hook de seguridad falla o el script no existe?

    El comando se ejecuta. Cualquier exit code que no sea 0 o 2, un script inexistente, un JSON inválido o un timeout se tratan como error no bloqueante: la acción continúa por el flujo normal de permisos y en el transcript aparece un aviso <hook name> hook error.

    Por eso un hook no es un buen suelo de seguridad. Una regla deny es configuración, no hay proceso que pueda reventar.

    ¿Basta con poner Bash en deny para bloquear todos los comandos?

    Sí, y hace algo más de lo que esperas. Bash(*) es equivalente a Bash y matchea todos los comandos. Como regla deny, ambas formas eliminan la herramienta del contexto de Claude: el modelo ni siquiera la ve.

    Lo que no puedes es denegar Bash entero y luego abrir excepciones con reglas allow más estrechas. Una regla deny no admite excepciones de allowlist.

    ¿Por qué mi regla Bash(ls *) no permite lsof?

    Porque el espacio antes del asterisco forma parte del patrón. Bash(ls *) matchea ls -la y el escueto ls, pero no lsof. Si quieres cubrir los dos, la regla es Bash(ls*), sin espacio.

    Mismo cuidado con el subcomando: el * va después. Bash(git log *) permite solo git log; Bash(git *) te abre todo git.

    ¿Cómo evito que alguien active bypassPermissions en mi equipo?

    Con permissions.disableBypassPermissionsMode a "disable", y su equivalente permissions.disableAutoMode para el modo auto. En tus settings de usuario ya sirven, pero puestos en managed settings son inanulables: ese nivel tiene la precedencia más alta y no lo tumba ningún otro, ni los argumentos de línea de comandos.

    ¿Dónde pongo las reglas: settings.json o settings.local.json?

    .claude/settings.json se versiona y lo comparte todo el equipo. .claude/settings.local.json es tuyo y solo tuyo: Claude Code lo añade a tus git excludes la primera vez que lo escribe, así que no se sube. Si lo creaste tú a mano, añádelo al .gitignore.

    La precedencia va de mayor a menor: managed settings, argumentos de línea de comandos, settings.local.json del proyecto, settings.json del proyecto y ~/.claude/settings.json de usuario. Con una salvedad que ya conoces: si algo está denegado en cualquiera de esos niveles, ningún otro puede permitirlo.

    Así que el suelo compartido va en el settings.json versionado, donde lo hereda todo el equipo. Tus atajos personales, en el local.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Arquitectura de subagentes IA: por qué falla el mega-prompt

    Arquitectura de subagentes IA: por qué falla el mega-prompt

    El año pasado construí un agente que pretendía ser el ingeniero de software definitivo. Fue mi primer intento serio de arquitectura de subagentes IA — y la forma en la que fallé me enseñó por qué un solo agente nunca debería hacerlo todo.

    Su System Prompt ocupaba casi 3.000 palabras. Le instruí para ser arquitecto de software, experto en seguridad, programador senior de TypeScript, tester meticuloso y redactor técnico. Además, le configuré 28 herramientas distintas: leer archivos, escribir código, ejecutar comandos bash, consultar 3 bases de datos y hacer peticiones HTTP.

    Al principio parecía impresionante. En la primera tarea sencilla respondió bien.

    Pero a la cuarta tarea compleja, el sistema colapsó por completo:

    • Confundía las reglas de testing con las de documentación.
    • Para cambiar una sola línea de CSS llamaba a herramientas de base de datos.
    • Consumía 100.000 tokens en cada paso solo leyendo la lista gigante de herramientas disponibles.

    Ese día entendí una verdad fundamental del desarrollo con IA: en lugar de construir un único agente que intente hacerlo todo, necesitas un equipo de subagentes con tareas concretas y contextos aislados.


    Por qué los Mega-Prompts fallan en la práctica

    No es una limitación de que el modelo "sea tonto"; es el resultado de cómo funcionan los Transformers:

    1. Degradación por ruido de herramientas (Tool Noise)

    Cuantas más herramientas (tools) le expones a un modelo en un único turno, mayor es la probabilidad de que elija la herramienta equivocada o invente parámetros incompatibles.

    Con pocas herramientas bien definidas, la precisión de selección se mantiene alta. Cuando la lista crece a decenas de herramientas mezclando responsabilidades distintas (leer archivos, escribir código, consultar bases de datos, hacer peticiones HTTP), esa precisión cae de forma abrupta — es el mismo problema que un desarrollador tendría memorizando 30 comandos de CLI casi idénticos.

    2. Dispersión de atención (Attention Drift)

    Si tu prompt contiene 50 reglas diferentes ("no uses any", "usa el prefijo on en eventos", "escribe tests en Vitest", "documenta en JSDoc"), el mecanismo de atención del LLM diluye la importancia de cada una.

    Cuando el contexto se llena de logs y código, las reglas del medio del prompt simplemente dejan de tener peso estadístico.

    3. Contaminación de contexto

    Si un agente pasa 20 minutos investigando archivos y leyendo logs de error, esos 80.000 tokens de "ruido exploratorio" se quedan atascados en la memoria para siempre.

    Cuando luego le pides que escriba la solución final, su respuesta estará condicionada por todo ese texto basura previo.


    La solución: Arquitectura de Subagentes en 3 capas

    La solución no es hacer prompts más largos ni añadir más mayúsculas al texto. Es aplicar el principio de Responsabilidad Única que llevamos décadas usando en ingeniería de software.

    En Dominicode organizamos el trabajo en tres tipos de subagentes especializados:

                      ┌───────────────────────┐
                      │    AGENTE ORQUESTADOR │
                      │  (Planifica y delega) │
                      └──────────┬────────────┘
                                 │
                ┌────────────────┼────────────────┐
                ▼                ▼                ▼
         ┌─────────────┐  ┌─────────────┐  ┌─────────────┐
         │ RESEARCHER  │  │ IMPLEMENTER │  │  REVIEWER   │
         │ (Read-only) │  │(Write + TDD)│  │ (Auditoría) │
         └─────────────┘  └─────────────┘  └─────────────┘
    

    1. El Investigador (Researcher — Solo Lectura)

    • Herramientas permitidas: Búsqueda en archivos, lectura de código, búsqueda web.
    • Herramientas prohibidas: Edición de archivos, ejecución de comandos destructivos.
    • Misión: Explora el codebase, localiza las funciones relevantes y devuelve un resumen limpio de 50 líneas con los hallazgos. Su memoria sucia de 60.000 tokens se descarta al terminar; solo el resumen pasa al siguiente agente.

    2. El Implementador (Implementer — Escritura + TDD)

    • Herramientas permitidas: Edición precisa de archivos, ejecución de tests.
    • Misión: Recibe el resumen del Researcher y la especificación técnica. Su único objetivo es crear el test, escribir el código mínimo para pasarlo y verificar que compila. No pierde tiempo buscando archivos porque el Researcher ya le dio las rutas exactas.

    3. El Revisor (Reviewer — Auditor de Calidad)

    • Herramientas permitidas: Lectura de diffs de git, linter.
    • Misión: Revisa los cambios antes de hacer commit. Evalúa si se respetan los estándares de tipado, si hay regresiones de rendimiento y si se cumplió la especificación original.

    Cómo se comunican los subagentes sin saturar tokens: El patrón Artifact

    El error habitual al montar sistemas multiagente es hacer que el Agente A le hable al Agente B en un chat conversacional interminable ("Hola Agente B, ¿cómo estás? He encontrado esto…"). Eso gasta tokens en cortesías inútiles.

    El patrón más eficiente es la comunicación mediante artefactos en disco:

    1. El Researcher escribe sus hallazgos en un archivo local: scratch/research_findings.md.
    2. El Orchestrator lee ese archivo y lanza al Implementer pasándole únicamente la ruta del archivo.
    3. El Implementer ejecuta los cambios y escribe el resumen de modificaciones en scratch/changes_summary.md.

    Cada subagente arranca con una ventana de contexto limpia, consumiendo solo los tokens necesarios para su tarea concreta.

    Este flujo de trabajo desacoplado es el que explicamos a fondo en el curso Construye con IA: de la idea al producto con Claude Code, donde mostramos cómo estructurar entornos reales multiagente que no se degradan con el tiempo.


    Ejemplo práctico: Definiendo un subagente en TypeScript

    Si estás creando tus propios agentes con código propio, no necesitas frameworks gigantes. Puedes instanciar agentes especializados restringiendo las tools y el system prompt:

    import { generateText, tool, stepCountIs } from "ai";
    import { anthropic } from "@ai-sdk/anthropic";
    import { z } from "zod";
    
    // Agente especializado solo en investigación.
    // Modelo de ejemplo: sustituye por la versión vigente de Claude en tu build.
    export async function spawnResearcherAgent(query: string, codebaseDir: string) {
      const result = await generateText({
        model: anthropic("claude-sonnet-5"),
        system: `Eres un agente de investigación técnica de solo lectura.
        Tu objetivo es explorar el código en "${codebaseDir}", localizar las funciones clave
        y responder con un informe conciso. NUNCA propongas escribir código ni modificar archivos.`,
        prompt: `Investiga: ${query}`,
        tools: {
          searchFiles: tool({
            description: "Busca patrones en el repositorio",
            inputSchema: z.object({ pattern: z.string() }),
            execute: async ({ pattern }) => {
              // Lógica de búsqueda grep/ripgrep
              return { matches: ["src/auth/service.ts:45", "src/auth/jwt.ts:12"] };
            },
          }),
          readFile: tool({
            description: "Lee un archivo específico",
            inputSchema: z.object({ path: z.string() }),
            execute: async ({ path }) => Bun.file(path).text(),
          }),
        },
        stopWhen: stepCountIs(8),
      });
    
      return result.text; // Salida limpia lista para pasar al Implementador
    }
    

    Al limitar el rol a lectura y 2 herramientas, la tasa de error baja notablemente y el coste por ejecución se reduce al mínimo.


    Qué hacer hoy con tu proyecto

    Si tienes un archivo de prompt de 5 páginas o un agente que intenta resolver todo el ciclo de vida de tu software:

    1. Separa la lectura de la escritura: Crea un agente explorador con herramientas de solo lectura y un agente constructor que solo toque archivos cuando ya sabe exactamente qué cambiar.
    2. Usa especificaciones previas: Antes de lanzar a los subagentes, asegúrate de tener una base firme con Spec-Driven Development (SDD) para que ningún agente tenga que improvisar requisitos sobre la marcha.
    3. Pasa datos, no conversaciones: Haz que tus subagentes se comuniquen a través de archivos estructurados en lugar de historiales de chat kilométricos.

    En Dominicode Labs compartimos arquitecturas reales de subagentes que usamos a diario para automatizar la creación de cursos, la refactorización de código y el mantenimiento de proyectos en producción.

    Deja de pedirle milagros a un mega-prompt. Diseña un sistema de subagentes donde cada uno haga una sola cosa, pero la haga con precisión quirúrgica.

  • OpenSpec y Claude Code: integración paso a paso del flujo OPSX

    OpenSpec y Claude Code: integración paso a paso del flujo OPSX

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso: lo acordado vive en archivos versionados dentro del repo y el agente los lee antes de tocar código.

    Tutorial de integración OpenSpec Claude Code, paso a paso: instalación, inicialización y el flujo OPSX de principio a fin.


    Aviso rápido: OpenSpec no es OpenAPI

    Comparten cuatro letras y nada más.

    OpenSpec es un framework open source de spec-driven development para asistentes de código, de Fission-AI. No describe endpoints REST. Si has llegado buscando Swagger, este no es tu post.

    Lo que hace es meter una capa de especificación entre tú y el agente: propuesta, diseño, tareas y spec del cambio. Todo en Markdown, todo dentro del repo, todo bajo control de versiones.


    Paso 1: instalar (y el error de scope que arrastran los tutoriales viejos)

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto, sin relación con el framework. Es el fallo más repetido en tutoriales de hace unos meses, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Paso 2: inicializar OpenSpec en Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Paso 3: llena el config.yaml antes de pedir nada

    Este paso parece opcional. No lo es.

    openspec/config.yaml no es un README que el agente abre si le apetece. Su contenido se inyecta en cada petición de planificación. Va dentro del prompt, siempre.

    Dedica cinco minutos a describir de verdad tres cosas: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear.

    Un apunte honesto: no inventes claves en el YAML. Completa las que el propio init deja generadas y, si necesitas un campo que no existe, mira la doc oficial.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    Paso 4: el flujo OPSX de principio a fin

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:update y /opsx:sync — mantener la spec viva

    Antes de archivar, el perfil por defecto trae dos comandos más que casi nadie menciona: /opsx:update revisa los artefactos de un cambio si algo se movió a mitad de camino, y /opsx:sync fusiona la delta spec del cambio dentro de las specs generales del proyecto, para que la spec principal quede al día sin tocarla a mano.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y actualiza la fuente de verdad del proyecto. A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    El perfil extendido (y dónde vive /opsx:verify)

    El perfil por defecto (core) trae los seis comandos que acabas de ver: explore, propose, apply, update, sync y archive. Si necesitas control más granular, cambias de perfil:

    openspec config profile
    openspec update
    

    Eso desbloquea /opsx:new, /opsx:continue, /opsx:ff, /opsx:bulk-archive, /opsx:onboard y, el que más se echa en falta, /opsx:verify: contrasta la implementación contra la spec acordada. No es un test runner, es la comprobación de que no se coló nada que nadie pidió y que no falta nada que sí se pidió.

    Empieza sin el perfil extendido. Actívalo cuando el ciclo base (explore → propose → apply → archive) te sepa corto.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Aquí está la decisión de diseño que hace a OpenSpec usable en el mundo real.

    La spec de un cambio no describe tu sistema entero. Describe solo lo que se mueve:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ## REMOVED Requirements
    

    Escenarios en Markdown plano con sintaxis WHEN/THEN. Sin Gherkin, sin herramientas extra, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development. Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto.


    Si vienes de un tutorial de hace unos meses

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano. Vuelve a ejecutar openspec init y deja que la herramienta reconstruya lo suyo.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.

    Dos avisos para terminar. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es volver a ejecutar openspec init en el proyecto en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo Funciona el Watermarking de Claude a Nivel de API

    Cómo Funciona el Watermarking de Claude a Nivel de API

    La primera vez que alguien escucha que Claude mete una marca de agua en el texto que genera, se imagina un truco barato de esteganografía.

    Un espacio de ancho cero entre dos palabras. Un carácter Unicode invisible (\u200B). Un patrón binario escondido en los saltos de línea.

    Si fuera eso, un script de Python de dos líneas con un .replace('\u200b', '') o un regex básico destruiría la marca en tres milisegundos.

    Anthropic no ha implementado un truco de caracteres. Desde agosto de 2026, todos los modelos nuevos de Claude integran un watermarking a nivel de API de naturaleza puramente estadística. No hay caracteres ocultos, viaja en el texto plano al copiar y pegar, y no existe ningún parámetro o flag en la API para desactivarla.

    Si tu producto llama a la API de Claude, tus usuarios ya están recibiendo texto marcado, lo sepas o no. Aquí te explico el algoritmo que hay detrás, cómo se diferencia de los metadatos en archivos y qué implica de verdad si construyes sobre esa API — no como usuario ocasional de Claude Code, sino como quien tiene que responder por ello ante sus propios clientes.


    Cómo genera texto un LLM (el paso previo imprescindible)

    Para entender cómo se inserta una señal en un texto sin alterar una sola letra, primero hay que recordar qué hace el modelo en cada ciclo de inferencia.

    Un LLM no "elige una frase completa". Trabaja token a token. Cuando Claude va a generar la siguiente palabra, calcula una distribución de probabilidad sobre su vocabulario completo (los llamados logits, normalizados con una función softmax):

    software      → 28%
    aplicaciones  → 21%
    productos     → 17%
    sistemas      → 14%
    herramientas  → 11%
    otros...      →  9%
    

    En un muestreo normal con cierta temperatura, el modelo elige uno de los tokens más probables. El texto resultante es fluido, coherente y suena natural.

    Aquí es exactamente donde entra el algoritmo de watermarking.


    El algoritmo de Kirchenbauer: listas verdes y sesgo de logits

    Anthropic no ha publicado el mecanismo exacto que usa Claude. Lo único que confirma oficialmente es el principio: la marca usa una clave y las palabras previas para decidir qué palabra elige el modelo entre varias opciones semánticamente equivalentes, sin tocar la calidad del texto. Cita como referencias el paper de Kirchenbauer et al. y SynthID-Text de Google DeepMind, así que lo más razonable —y lo que asume la mayoría del análisis externo— es que Claude use una variante de esa familia de técnicas. Lo que sigue es cómo funciona ese enfoque en general, no una confirmación línea por línea de la implementación interna de Anthropic.

    La técnica estándar en la industria para marcar texto en LLMs no toca el texto después de generarlo. Modifica la probabilidad antes de muestrear.

    El proceso sigue, a grandes rasgos, estos pasos:

    Token anterior (t-1) 
           │
           ▼
    [ Hash + Clave Secreta de Anthropic ]
           │
           ▼
    Partición pseudo-aleatoria del vocabulario
      ├── Lista Verde (Green List) ~ 50%
      └── Lista Roja (Red List)    ~ 50%
           │
           ▼
    Se suma un delta (+δ) a los logits de la Lista Verde
           │
           ▼
    Muestreo del siguiente token (favorece sutilmente el verde)
    
    1. Generación de semilla: Al momento de predecir el siguiente token, el sistema calcula un hash criptográfico del token anterior (o de una ventana de los últimos tokens) combinado con una clave secreta que solo posee Anthropic.
    2. Partición del vocabulario: Ese hash divide pseudo-aleatoriamente todo el diccionario de tokens en dos grupos: una Lista Verde y una Lista Roja, típicamente al 50% cada una.
    3. Sesgo de logits (Logit Biasing): A los logits de los tokens que caen en la Lista Verde se les suma un valor constante positivo.
    4. Muestreo: El modelo muestrea el siguiente token aplicando la distribución con los logits alterados.

    ¿Qué ve un humano vs. qué ve un detector?

    • Un humano lee el texto y no nota nada extraño. Como el sesgo es moderado, el modelo sigue seleccionando palabras de alta probabilidad semántica. El significado, el estilo y la calidad no cambian.
    • Un detector con la clave (hoy, solo Anthropic; han anunciado que van a liberar una API de detección pero todavía no está disponible públicamente) tomaría el texto generado, reconstruiría para cada palabra si pertenecía a la Lista Verde o a la Lista Roja, y contaría cuántos tokens verdes aparecen.

    En un texto escrito por un humano o por un modelo sin marca, la probabilidad de que un token caiga en la lista verde es de alrededor del 50% (puro azar).

    En un texto marcado con este tipo de técnica, esa proporción sube de forma sistemática por encima del azar. Anthropic no ha publicado la cifra exacta para Claude; en la literatura académica sobre KGW/SynthID-Text el desplazamiento suele ser notable con relativamente pocos tokens.

    Con un párrafo de varios cientos de palabras, la probabilidad de que esa acumulación de tokens verdes ocurra por puro azar cae drásticamente. Esa es la base estadística del método, aunque los números concretos que aplica Anthropic a Claude no son públicos.


    Por qué en código fuente la marca es mucho más débil

    Aquí hay un detalle técnico crítico que casi nadie en redes sociales ha mencionado: el watermarking estadístico necesita entropía.

    La entropía mide la cantidad de opciones válidas que tiene el modelo para continuar una frase.

    • En prosa libre (alta entropía): Para decir "construimos sistemas robustos", el modelo puede elegir entre sistemas, aplicaciones, plataformas, soluciones o arquitecturas. Tiene margen de sobra para elegir un token de la Lista Verde sin romper la frase.
    • En código de programación (baja entropía): Si estás escribiendo TypeScript y tienes for (const item of, el siguiente token sintácticamente válido es casi con total seguridad el identificador del array o una estructura iterable. Si fuerzas un token de la lista verde que no encaja sintácticamente, el código no compila.
    // En sintaxis estricta, el espacio de tokens válidos es minúsculo:
    export interface UserSession {
      id: string;
      createdAt: Date;
    }
    

    Si el modelo reduce la temperatura o la sintaxis impone un único token válido, el sesgo de la lista verde no puede aplicarse sin destruir la corrección del programa.

    Por eso, en archivos de código (.ts, .py, .rs) la marca estadística es inherentemente más débil o casi indetectable en fragmentos cortos, mientras que en documentación, emails o artículos es donde más fuerte se fija. Y precisamente porque no puedes apoyarte en el watermark para saber si un fragmento de código viene de un agente, la validación real sigue siendo la de siempre: TDD potenciado por IA, validar el código antes de mergear.

    Esta es la misma disciplina de control y contexto que enseñamos en el curso Construye con IA: De la Idea al Producto con Claude y Specs: cuando entiendes cómo procesan los modelos la probabilidad de los tokens, dejas de tratar a los agentes como cajas mágicas y empiezas a diseñar sistemas predecibles.


    Texto vs. Archivos: la diferencia entre Watermark y C2PA

    Existe una confusión generalizada entre la marca en el texto y la marca en archivos multimedia. Anthropic usa dos tecnologías completamente distintas según el tipo de output:

    Característica Marca de agua en Texto Metadatos en Archivos (.png, .svg)
    Mecanismo Sesgo estadístico en logits (Kirchenbauer / SynthID) Estándar C2PA (Content Authenticity Initiative)
    Dónde vive En la frecuencia y secuencia de las palabras En la cabecera / bloque de metadatos del archivo
    Copiar y pegar Sobrevive (es el texto mismo) No aplica (es un archivo binario)
    Edición / Conversión Se degrada progresivamente si reescribes Se pierde si re-guardas o conviertes el archivo
    Verificación hoy Privada (solo Anthropic tiene la clave) Pública y verificable hoy con c2patool

    Cómo inspeccionar C2PA en tus archivos hoy mismo

    Si generas diagramas SVG o imágenes con Claude y las sirves desde tu backend, puedes auditar los metadatos C2PA en tu propia máquina con la herramienta oficial de la Content Authenticity Initiative:

    # Instalación del cli oficial de C2PA
    brew install c2patool
    # O descargar el binario desde github.com/contentauth/c2pa-rs/releases
    
    # Inspeccionar el manifiesto completo en JSON
    c2patool imagen.png
    
    # Ver solo el resumen de procedencia
    c2patool imagen.png --info
    

    Si el archivo proviene directamente de Claude, el manifiesto C2PA mostrará la firma criptográfica de emisión. Si lo abres en Photoshop, lo recortas y lo guardas como WebP, el contenedor C2PA desaparece a menos que tu software lo re-firme.


    Detector de IA ≠ Detector de Watermark

    Esta distinción te va a ahorrar dolores de cabeza con clientes y product managers cuando te pidan "añadir detección de IA":

    1. Un detector de IA tradicional (heurístico): Analiza perplejidad y ráfagas (burstiness). Intenta adivinar si el estilo parece robótico. Es impreciso, produce falsos positivos atroces con no-nativos en inglés y no sirve como prueba legal.
    2. Un detector de marca de agua: No evalúa estilo ni perplejidad. Aplica una clave criptográfica sobre la secuencia de tokens y comprueba una hipótesis matemática de probabilidad binomial.

    Hoy por hoy, no existe un detector público de watermark para Claude. Si ves una web que afirma "Pega tu texto y te digo si tiene la marca de Claude", es un detector heurístico genérico, no un verificador del watermark de Anthropic.

    Además, publicar un detector abierto crea un problema de seguridad: actúa como un oráculo de optimización. Cualquier usuario podría pasar su texto por un script que altere palabras una a una hasta que el verificador dé negativo, destruyendo la marca con el mínimo esfuerzo.


    Qué significa el watermarking de Claude si construyes sobre la API

    Si integras Claude en tu SaaS o en pipelines de desarrollo interno —repasa lo básico en Claude API: Crash Course para developers con TypeScript si aún no la usas a diario— hay cuatro realidades que debes asumir:

    1. No hay opt-out: No existe un header x-anthropic-disable-watermark: true. La directiva de la Unión Europea (EU AI Act, artículo 50) exige que los proveedores marquen las salidas de IA generativa.
    2. La marca demuestra procesamiento, no autoría única: Si un humano escribe un borrador y le pide a Claude que corrija la puntuación, el texto resultante puede quedar marcado. Anthropic lo aclara en su documentación: la marca indica que el texto pasó por el modelo, no que el humano no intervino.
    3. No prometas a tus clientes outputs "indetectables": Cualquier modelo de negocio basado en vender "artículos indetectables para SEO" o "ensayos indetectables" está técnicamente muerto a medio plazo frente a esquemas de marca estadística.
    4. La paráfrasis profunda degrada la señal: Anthropic mismo lo advierte: una edición ligera probablemente no elimina la marca, pero reescribir el texto a fondo —traducirlo, reordenarlo intensamente o editarlo a mano de forma sustancial— sí la destruye, porque rompe la alineación entre los tokens y la clave con la que se generaron.

    Para patrones avanzados de integración con LLMs y arquitecturas robustas en producción, en Dominicode Labs analizamos continuamente los cambios de la API de Anthropic y cómo adaptar nuestros proyectos.


    Preguntas frecuentes

    ¿Puedo desactivar la marca de agua en la API de Claude?

    No. Anthropic ha desplegado el sistema de watermarking a nivel de inferencia sin ningún parámetro de exclusión en la API ni en las cuentas Enterprise, alineándose con las normativas internacionales como el EU AI Act.

    ¿La marca de agua ralentiza la generación o encarece el coste de tokens?

    Anthropic no ha reportado ningún impacto. Por diseño, este tipo de watermarking solo sesga qué token se elige dentro de la misma distribución de probabilidad que el modelo ya calculaba: no añade tokens extra ni pasadas adicionales de inferencia, así que el coste computacional adicional es marginal.

    ¿Un detector de watermark puede acusarme falsamente de usar IA?

    Con textos largos, la probabilidad matemática de un falso positivo en un test de hipótesis tipo Kirchenbauer es extremadamente baja — es la base estadística del método, aunque Anthropic no ha publicado la tasa exacta para Claude. Aun así, es un mecanismo mucho más fiable que los detectores heurísticos habituales, que fallan con frecuencia.

    ¿Qué pasa si traduzco el texto generado por Claude a otro idioma?

    Si traduces el texto mediante otra herramienta o manualmente, la alineación de los tokens con la clave pseudo-aleatoria original se destruye y la marca de agua estadística deja de ser detectable.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.