Category: Claude Code

  • Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    Integrar OpenSpec con Claude Code: el flujo OPSX paso a paso

    El lunes le pedí a Claude Code que añadiera paginación a un listado. Lo hizo bien.

    El miércoles abrí una sesión nueva en el mismo proyecto y le pedí un filtro. Se inventó otra forma de paginar, distinta a la del lunes, y reescribió la que ya funcionaba.

    No fue culpa del modelo. El contexto de Claude Code vive en la sesión: cierras la terminal y se evapora.

    OpenSpec con Claude Code resuelve eso. OpenSpec es un framework open source de spec-driven development creado por Fission-AI que guarda lo acordado — propuesta, diseño, tareas y spec — en archivos Markdown versionados dentro del repo, para que Claude Code los lea antes de tocar código. En esta guía lo instalamos, lo inicializamos con openspec init y recorremos el flujo OPSX completo sobre un proyecto que ya existe.


    OpenSpec no es OpenAPI: la diferencia en una tabla

    Comparten cuatro letras y nada más.

    OpenSpec OpenAPI
    Qué es Framework de spec-driven development para asistentes de código Especificación para describir APIs REST
    Quién lo mantiene Fission-AI OpenAPI Initiative (Linux Foundation)
    Formato Markdown dentro del repo YAML o JSON
    Para qué sirve Que un agente implemente lo acordado Que un cliente sepa llamar a tu API

    Si has llegado buscando Swagger, este no es tu post.


    Cómo instalar OpenSpec para Claude Code (y el error de scope de npm)

    OpenSpec se instala como CLI global. Requiere Node.js 20.19.0 o superior, y la versión actual es la 1.8.0.

    npm install -g @fission-ai/openspec@latest
    

    Fíjate bien en el scope, porque esto:

    # ❌ NO es OpenSpec
    npm install -g openspec
    

    instala otro paquete distinto: openspec a secas es la versión 0.0.0 publicada el 9 de abril de 2019, sin relación alguna con el framework y sin una sola actualización desde entonces. Es el fallo más repetido en tutoriales, y luego pasas media hora preguntándote por qué openspec init no hace lo que dice la documentación.

    Instala siempre el paquete con scope @fission-ai/.


    Qué crea openspec init en un proyecto con Claude Code

    Desde la raíz del repo:

    cd tu-proyecto
    openspec init
    

    El init te pregunta qué herramienta usas. Selecciona Claude Code.

    Y aquí el detalle que casi nadie explica bien: para Claude Code te crea las dos cosas.

    .claude/skills/openspec-*/SKILL.md    ← una skill por cada acción del flujo
    .claude/commands/opsx/<id>.md         ← los slash commands
    openspec/config.yaml                  ← la configuración del proyecto
    

    Las skills las carga Claude Code solo, sin que tú hagas nada. Los comandos son la puerta de entrada manual cuando quieres disparar una fase concreta. No eliges entre unas y otros: conviven.

    El config.yaml guarda además tus preferencias entre ejecuciones de init y update. Si mañana actualizas OpenSpec, no te vuelve a preguntar todo.


    Qué poner en openspec/config.yaml (y por qué no es opcional)

    openspec/config.yaml es el archivo donde defines el schema por defecto, el contexto del proyecto y las reglas por artefacto. No es documentación que el agente abre si le apetece: es entrada del modelo. La doc oficial lo dice sin rodeos — "When generating any artifact, your context and rules are injected into the AI prompt".

    Sus claves de nivel superior son cuatro:

    Clave Para qué
    schema El schema por defecto de los artefactos
    context La información de tu proyecto. Aparece en todos los artefactos
    rules Restricciones por artefacto. Solo aparecen en el artefacto que coincide
    operations Guía opcional para apply y archive

    Ese matiz de context y rules importa: el contexto viaja siempre, las reglas solo cuando toca. Así que lo que quieras que el agente tenga presente en cada decisión va en context.

    Dedica cinco minutos a describir de verdad tres cosas ahí: el stack real con sus versiones, las convenciones que sigues (naming, estructura de carpetas, patrón de tests) y lo que está prohibido en el proyecto — esa librería que ya migraste, ese patrón que odias.

    La diferencia se nota en la primera propuesta. Con el config vacío recibes una propuesta genérica de manual. Con el config bien puesto recibes una que usa tus carpetas, tus nombres y tu forma de testear. El detalle de cada clave está en la doc de customization.

    Es la misma lógica que trabajamos en el curso Construye con IA: el resultado de un agente depende mucho menos del prompt del momento que del contexto estable que le dejaste montado antes.


    El flujo OPSX paso a paso en Claude Code

    En Claude Code los comandos van con dos puntos: /opsx:<id>. Este detalle importa y ahora verás por qué.

    /opsx:explore — pensar sin comprometerte

    /opsx:explore
    

    Fase de planificación pura. Exploras el problema, discutes enfoques, descartas caminos. No genera artefactos ni te ata a nada.

    Es el comando que más se omite en los tutoriales y el que más rentabilidad da. Cuando saltas directo a propose, el agente propone algo — y lo propone bien argumentado, con lo cual te lo crees. En explore es donde descubres que el problema real era otro, antes de tener cuatro archivos que revisar.

    /opsx:propose — generar la propuesta

    /opsx:propose añadir filtros por categoría al listado de productos
    

    Aquí se materializa el trabajo:

    openspec/changes/<nombre-del-cambio>/
    ├── proposal.md    ← qué se va a hacer y por qué
    ├── design.md      ← cómo, a nivel técnico
    ├── tasks.md       ← el desglose ejecutable
    └── specs/         ← la delta spec del cambio
    

    Y ahora tu parte: leerlo. Este es el punto exacto donde el flujo funciona o no funciona. Corriges asunciones, ajustas el diseño, partes tareas demasiado grandes. Cuesta minutos ahora y ahorra horas después.

    /opsx:apply — implementar contra la spec

    /opsx:apply
    

    El agente implementa tarea por tarea, referenciando la spec acordada. La diferencia con pedirle código a pelo es que ya no hay margen de interpretación.

    /opsx:archive — cerrar el cambio

    /opsx:archive
    

    Mueve el cambio a openspec/changes/archive/ y consolida lo implementado en openspec/specs/, que es la fuente de verdad del proyecto — "Specs are the source of truth — they describe how your system currently behaves". A partir de ahí eso ya no es un cambio pendiente: es cómo funciona tu sistema.

    Los otros dos del perfil por defecto

    /opsx:update revisa los artefactos de planificación de un cambio y los mantiene coherentes entre sí, en cualquier dirección: si editas el diseño, la propuesta se ajusta.

    /opsx:sync fusiona las delta specs en openspec/specs/ sin archivar el cambio. Útil cuando quieres consolidar antes de cerrar.

    Los extendidos, y por qué /opsx:verify no te va a funcionar todavía

    Aquí está el detalle que hace perder media hora a mucha gente: el perfil por defecto no trae verify.

    El perfil core son los seis de arriba — propose, explore, apply, update, sync, archive. Los extendidos son otros seis: /opsx:new, /opsx:continue, /opsx:ff, /opsx:verify, /opsx:bulk-archive y /opsx:onboard. Si escribes /opsx:verify recién instalado, no autocompleta y no pasa nada.

    Para activarlos:

    openspec config profile   # selecciona el perfil ampliado
    openspec update           # aplica los cambios en el proyecto
    

    Con el perfil ampliado activo, /opsx:verify contrasta la implementación contra la spec. No es un test runner: es la comprobación de que no se ha colado nada que nadie pidió y de que no falta nada que sí se pidió.

    Empieza por los seis del perfil core. Los extendidos los necesitarás cuando tengas el ciclo rodado y lleves varios cambios a la vez.


    Delta specs: por qué esto sirve en un proyecto que ya existe

    Una delta spec es una spec que describe solo lo que cambia — lo añadido, lo modificado y lo eliminado — en vez de redescribir el sistema entero. Es lo que hace viable OpenSpec en un proyecto que ya existe.

    Así se ve una:

    ## ADDED Requirements
    
    ### Requirement: Filtrado por categoría
    El listado DEBE permitir filtrar productos por categoría.
    
    #### Scenario: Usuario selecciona una categoría
    - GIVEN el listado de productos cargado
    - WHEN el usuario selecciona la categoría "Audio"
    - THEN el listado muestra solo productos de esa categoría
    
    ## MODIFIED Requirements
    
    ### Requirement: Paginación del listado
    El listado DEBE conservar el filtro activo al cambiar de página.
    

    Dos cosas que conviene saber antes de copiar esto. Las etiquetas son literales y no se traducen: ADDED, MODIFIED, REMOVED, Requirement:, Scenario: y GIVEN/WHEN/THEN van en inglés aunque el cuerpo esté en español. Y solo incluyes las secciones que uses — si el cambio no elimina nada, no dejes un ## REMOVED Requirements vacío.

    Sobre los escenarios: es vocabulario Gherkin, pero en Markdown plano. Sin ficheros .feature, sin Cucumber, sin plugins.

    Piensa en la alternativa: especificar entera una aplicación con tres años de historia para poder añadir un filtro. No lo hace nadie, y por eso la mayoría de intentos de SDD en brownfield mueren en la segunda semana. Con deltas, la unidad de trabajo es el cambio, no el sistema.

    Si quieres el marco completo detrás de esto — cómo se escribe una spec que un agente pueda ejecutar sin rellenar huecos por su cuenta — lo desarrollo en el libro de Spec-Driven Development.

    Y para el reverso de la moneda, ya escribí sobre por qué una spec falla con un agente de IA.


    La sintaxis cambia según la herramienta

    Dato práctico que ahorra confusión cuando copias comandos de un tutorial grabado con otro editor:

    Herramienta Sintaxis
    Claude Code /opsx:propose
    Cursor /opsx-propose
    GitHub Copilot /opsx-propose
    Amazon Q @opsx-propose
    Codex $openspec-propose

    Mismo flujo, distinto prefijo. Si el comando no autocompleta en tu editor, casi siempre es esto. La lista completa está en la tabla de herramientas soportadas, que cubre más de treinta.


    Cómo migrar del flujo antiguo de OpenSpec al flujo OPSX

    El flujo pre-OPSX está muerto. Pasó de fases cerradas a acciones, y la traducción es esta:

    Antes Ahora
    /openspec:proposal /opsx:propose
    openspec/project.md openspec/config.yaml
    changes/active/ openspec/changes/

    Si tienes un proyecto con la estructura antigua, no lo migres a mano: ejecuta openspec update, que regenera los ficheros de skills y comandos para las herramientas que tengas configuradas.


    Qué hacer hoy con esto

    Abre un proyecto que ya tengas — uno real, con código feo dentro — y no empieces por una feature grande.

    Instala, ejecuta openspec init, dedica cinco minutos de verdad al config.yaml y lanza un /opsx:explore sobre el próximo cambio pequeño que tenías pendiente. Sigue hasta /opsx:archive. Media hora, un ciclo completo.

    Dos avisos antes de que te lances. Esto no sustituye a revisar el código: sustituye a discutir el mismo diseño tres veces. Y no todo cambio merece el ciclo completo — un fix de dos líneas no necesita una propuesta, y sobre eso escribí en cuándo NO usar spec-driven development.

    Si quieres ver este flujo aplicado a proyectos completos, con los casos donde se rompe y cómo se arregla, lo trabajamos dentro de Dominicode Labs.

    Lo que vas a notar no es velocidad. Es que la siguiente sesión de Claude Code arranca sabiendo lo que se decidió en la anterior. Eso es lo que compras aquí.


    Preguntas frecuentes

    ¿OpenSpec es lo mismo que OpenAPI?

    No. OpenSpec es un framework open source de spec-driven development para asistentes de código, creado por Fission-AI. OpenAPI es una especificación para describir APIs REST. Comparten cuatro letras y nada más.

    ¿Por qué mi instalación de OpenSpec no funciona?

    Lo más probable es que hayas instalado el paquete equivocado. El comando correcto es npm install -g @fission-ai/openspec@latest, con el scope @fission-ai. El paquete llamado openspec a secas es otro proyecto distinto, y es el error que arrastran muchos tutoriales antiguos.

    ¿OpenSpec sirve en un proyecto que ya existe o solo en proyectos nuevos?

    Sirve en proyectos existentes, y esa es su mejor característica. La spec de cada cambio es una delta: solo describe lo que se añade, se modifica o se elimina, con las secciones ADDED, MODIFIED y REMOVED Requirements. No necesitas especificar tu sistema entero para empezar.

    ¿Se puede usar OpenSpec con Cursor o Copilot en vez de Claude Code?

    Sí. El flujo es el mismo y lo que cambia es el prefijo de los comandos. Claude Code usa /opsx:propose con dos puntos, Cursor y Copilot usan /opsx-propose con guion, Amazon Q usa @opsx-propose y Codex usa $openspec-propose. Lo seleccionas al ejecutar openspec init.

    ¿Puedo saltarme el comando explore e ir directo a propose?

    Puedes, pero es donde más gente pierde tiempo. El comando explore es la fase de planificación sin compromiso y sirve para descartar enfoques antes de generar propuesta, diseño, tareas y spec. Si vas directo a propose, acabas revisando cuatro artefactos de una solución que quizá resuelve el problema equivocado.

    ¿Por qué no me funciona el comando /opsx:verify?

    Porque no viene en el perfil por defecto. OpenSpec usa el perfil core, que trae seis comandos: propose, explore, apply, update, sync y archive. El comando verify pertenece al perfil ampliado, junto a new, continue, ff, bulk-archive y onboard. Para activarlo ejecuta openspec config profile y después openspec update.

    ¿Qué comandos trae OpenSpec por defecto?

    El perfil core incluye seis: propose para generar la propuesta, explore para planificar sin compromiso, apply para implementar, update para mantener coherentes los artefactos de planificación, sync para fusionar las delta specs en openspec/specs/ y archive para cerrar el cambio.

    ¿Qué hago si seguí un tutorial con el flujo antiguo de OpenSpec?

    Ese flujo ya no es válido. El comando /openspec:proposal pasó a /opsx:propose, el archivo openspec/project.md pasó a openspec/config.yaml y la carpeta changes/active/ pasó a openspec/changes/. Lo más limpio es ejecutar openspec update en el proyecto, que regenera skills y comandos, en lugar de renombrar archivos a mano.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Marcas de agua en Claude Code: ¿pueden detectar tu código?

    Un compañero me mandó el titular por Telegram a las siete de la mañana. Debajo, una sola línea: "¿Entonces pueden saber que este commit lo escribí con Claude Code?".

    Es la pregunta correcta. Y la respuesta corta es incómoda: hoy nadie te lo puede demostrar, porque el detector público de las marcas de agua de Claude todavía no existe.

    La respuesta larga es más interesante. Va de por qué estas marcas funcionan razonablemente bien sobre prosa y se deshacen casi solas dentro de un repositorio de código.

    La familia de marcas de agua más documentada en la literatura no es un carácter oculto ni un metadato: es un sesgo estadístico introducido durante la generación, en la elección misma de las palabras, que deja una firma detectable sin alterar el significado. Anthropic no ha confirmado que la suya funcione así. Solo dice que va "tejida dentro del propio texto".

    He leído la documentación entera. Esto es lo que dice, y lo que no.

    Documentación de Anthropic actualizada el 11 de agosto de 2026. Última revisión de este post: 12 de agosto de 2026.


    Qué ha anunciado Anthropic exactamente

    Cuatro hechos, sin adornos.

    1. Anthropic ha firmado el Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA sobre transparencia del contenido generado por IA. Esto no es marketing: es cumplimiento normativo.
    2. Los modelos Claude lanzados a partir del 2 de agosto de 2026 salen con marcado machine-readable desde el primer día. Para los modelos anteriores hay un periodo transitorio y Anthropic dice que está trabajando en incorporarlo.
    3. El alcance cubre Claude Platform (la API), Claude, Claude Code, Claude Cowork y Claude Tag, además de Claude servido desde AWS, Google Cloud y Microsoft Foundry. Se aplica en todo el mundo, no solo en la Unión Europea. Con una salvedad que conviene retener para más adelante: la marca en el texto sí viaja por esas tres nubes, pero los metadatos de procedencia firmados "puede que no estén soportados en todas las plataformas, según las funcionalidades que ofrezca cada una".
    4. La documentación no contempla ningún opt-out: el marcado se aplica a la salida de los modelos soportados, también cuando consumes la API.

    Que Claude Code aparezca escrito con todas las letras en esa lista es lo que hace que este post exista.

    Sobre el mecanismo, la documentación de Anthropic dice esto y nada más:

    "Teje una marca de agua imperceptible directamente en el propio texto. No la verás, y no cambia el significado, la calidad ni la legibilidad de la respuesta de Claude."
    ("…it weaves an imperceptible watermark directly into the text itself. You won't see it, and it doesn't change the meaning, quality, or readability of Claude's response.")

    Punto. No publican el algoritmo.


    Cómo se mete una marca de agua dentro de un texto

    La técnica estándar sesga la elección de tokens: en cada paso el modelo parte el vocabulario en una lista verde y una roja usando un hash secreto, y empuja suavemente la generación hacia la verde. El texto sigue siendo natural, pero contiene más tokens verdes de los que el azar explicaría.

    Aclaración previa: Anthropic no ha publicado su algoritmo. Lo que viene ahora es cómo funciona la familia de técnicas conocida en la literatura académica —sobre todo el trabajo de Kirchenbauer et al., "A Watermark for Large Language Models" (2023)—, no una descripción de lo que hace Claude por dentro.

    Lo explico porque es didáctico y porque es la familia plausible. No porque sea un dato confirmado.

    Un modelo de lenguaje no escribe palabras: escribe tokens. En cada paso genera un vector de logits, una puntuación para cada token del vocabulario, y de ahí sale la distribución de la que se muestrea el siguiente. Si nunca has visto por dentro cómo se trocea el texto, en Tokens en español: por qué cuestan un 26 % más que en inglés lo explico con ejemplos reales.

    La técnica clásica hace esto:

    1. Toma los últimos tokens generados y calcula un hash con una clave secreta.
    2. Usa ese hash como semilla para partir el vocabulario en dos: una lista verde y una lista roja.
    3. Suma un pequeño sesgo a los logits de la lista verde antes de muestrear.
    4. Repite en cada token.

    El texto resultante es perfectamente natural. Pero contiene muchos más tokens "verdes" de los que el azar justificaría. Quien tenga la clave recalcula las listas y saca un valor estadístico de confianza.

    La gracia del método es que el detector no necesita el modelo. Solo la clave y suficiente texto.

    Ahí está la palabra que lo condiciona todo: suficiente.


    Marca de agua no es lo mismo que detector de IA

    Un detector de IA adivina a partir del estilo; un detector de marca de agua busca una firma concreta que el propio modelo insertó. Son dos tecnologías distintas, con tasas de error distintas, y confundirlas es el error que más circula esta semana.

    Detector de IA Detector de watermark
    Analiza estilo Sí No
    Conoce la firma No Sí
    Necesita clave No Posiblemente
    Es probabilístico Sí Sí
    Identifica proveedor Difícil Potencialmente

    Un detector de IA clásico —los que llevan años suspendiendo a estudiantes por escribir demasiado bien— hace estadística sobre el estilo: perplejidad, longitud de frase, variedad léxica. Adivina. Un detector de watermark no adivina: busca una firma concreta que sabe que está ahí.

    Anthropic dice que "está trabajando para permitir que usuarios y terceros detecten las marcas de agua incrustadas de Claude y los metadatos de procedencia" y que publicará los detalles más adelante. Traducido: hoy no hay detector público de la marca de agua de Claude, ni fecha.

    De ahí sale la frase que más falta hace repetir esta semana: cualquier web que hoy te diga "este texto contiene el watermark de Claude" sin acceso al mecanismo de verificación de Anthropic, está vendiendo humo. Sin ese mecanismo no hay verificación posible. Hay marketing.


    El problema de la baja entropía cuando escribes código

    Una marca de agua estadística es más débil sobre código que sobre prosa porque el código tiene poca entropía: en cada punto hay muy pocas continuaciones válidas y casi ningún margen para elegir un token en lugar de otro equivalente.

    Y esto no me lo invento yo. Kirchenbauer et al. le dedican una sección entera del paper, titulada "A caveat: The difficulty of watermarking low-entropy sequences", y la abren así: "El texto de baja entropía crea dos problemas para el marcado. El primero: tanto humanos como máquinas producen terminaciones parecidas, si no idénticas, ante prompts de baja entropía, lo que hace imposible distinguir unas de otras."

    Lo que sí es inferencia mía es aplicárselo a Claude. Anthropic no ha publicado su algoritmo ni ninguna política específica sobre código.

    Una marca de agua estadística necesita libertad de elección. Si el modelo tiene veinte formas igual de válidas de continuar una frase, puede empujar hacia la lista verde sin que se note. En prosa esto sobra: "rápido" o "veloz", "por tanto" o "así que".

    El código no funciona así.

    Después de const user = await this.userService. hay dos o tres continuaciones razonables y el resto son errores de compilación. La entropía se hunde. El modelo no puede elegir un nombre de método "más verde" si el método se llama como se llama en la interfaz, y no puede reordenar los argumentos porque la firma es la que es.

    Cuanto más determinista es la salida, menos sitio hay donde esconder señal. Y el código es el texto más determinista que produce un modelo. Es la misma naturaleza probabilística que explico en por qué la IA se inventa cosas: ese margen de maniobra permite tanto la alucinación como la marca de agua. En código, el margen se estrecha.

    Añade que la mayoría de los diffs que revisas en un PR son de veinte o treinta líneas. Anthropic no da ningún umbral, pero sí reconoce el límite: un pasaje muy corto deja "demasiado poco texto para una señal fiable".

    El paper de Kirchenbauer sí da números. En sus experimentos detectan el 98,4 % de las generaciones al umbral z=4, que se alcanza a los 128 tokens. Y avisan, en la misma sección: "Las secuencias de alta entropía se detectan con relativamente pocos tokens, mientras que las de baja entropía requieren más tokens para ser detectadas."

    Junta las dos frases y verás por qué el número engaña. Ciento veintiocho tokens son del orden de diez o quince líneas de TypeScript, bastante menos que un commit cualquiera. Parece buena noticia para quien quiera detectarte. No lo es: ese 98,4 % está medido sobre prosa periodística, y el código es exactamente el material de baja entropía que, según los propios autores, necesita bastantes más tokens. Cuántos más, no lo dice nadie. Echa tú la cuenta con el tamaño de tus commits.


    Por qué tu flujo de trabajo real lava la marca

    Formatear, refactorizar, renombrar y revisar código altera la secuencia de tokens, y eso es lo que deshace una marca estadística sin que nadie se lo proponga.

    Separemos las dos mitades del argumento, porque solo una está documentada. La documentada: Anthropic dice que la marca puede dejar de detectarse si el texto "ha sido editado en profundidad, parafraseado, traducido o mezclado con otra escritura" ("heavily edited, paraphrased, translated, or mixed into other writing"). La mía: que tu flujo de trabajo normal, el de cualquier martes, cuenta como editar en profundidad.

    Conviene citar también la otra mitad, porque Anthropic la dice y casi nadie la está recogiendo: la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Es cierto y no contradice lo anterior. Copiar y pegar no toca la secuencia de tokens: la marca sigue ahí intacta. Lo que la rompe es cambiar el orden de esos tokens, y eso es precisamente lo que hacen el formateador, la extracción de método y el renombrado.

    Lee las dos frases otra vez y piensa en cómo trabajas de verdad con Claude Code a diario.

    Spec-Driven Development reduce la libertad del modelo

    Cuando trabajas con una spec detallada —nombres de tipos, contratos, estructura de carpetas, criterios de aceptación— no le pides al modelo que invente. Le pides que transcriba una decisión que ya tomaste tú.

    Si la marca funciona como creo —y esto sigue siendo inferencia mía—, cuanto más rigurosa sea la spec, menos libertad probabilística le queda al modelo y menos espacio hay donde incrustar señal. Un efecto secundario curioso de una metodología que adopté por razones completamente distintas, y que tienes desarrollada entera en el libro de Spec-Driven Development.

    El efecto Prettier

    Esto es más brutal todavía, y pasa cada día sin que lo pienses.

    Guardas el archivo y el formateador reparte los saltos de línea a su manera. Extraes un método. Renombras data por invoiceLines porque el nombre no decía nada. Mueves el bloque a otro archivo. El linter reordena los imports. Pasa por code review y alguien cambia tres cosas.

    Cada una de esas operaciones altera la secuencia de tokens. Y cualquier marca estadística de la familia que describí arriba depende, literalmente, del orden exacto de esos tokens. Que la de Claude funcione así es inferencia mía. Que editar en profundidad pueda dejarla indetectable lo dice Anthropic.

    No es que estés intentando borrar nada. Es que hacer bien tu trabajo la borra. Auditar y refactorizar lo que genera el asistente en lugar de aceptarlo tal cual es justo el flujo que enseño en Construye con IA, y resulta que además tiene este efecto colateral.


    Lo que sí aguanta: C2PA en los archivos que genera Claude

    Hay un caso donde la marca sí resiste: los archivos. Cuando Claude genera un .svg, .png o .jpg entra un segundo mecanismo: incrusta metadatos de procedencia firmados criptográficamente con el estándar C2PA, de la Coalition for Content Provenance and Authenticity. Anthropic no dice que esto sustituya a la marca del texto; dice que esos formatos llevan además procedencia.

    Otra liga. Una firma criptográfica no es probabilística: o valida o no valida. Y permite detectar si el archivo fue manipulado después.

    Y aquí está el contraste que más importa: la marca de agua del texto no la puede verificar nadie fuera de Anthropic, pero el C2PA sí se verifica ya hoy con herramientas públicas como c2patool o contentcredentials.org. Uno es una promesa; el otro funciona esta tarde.

    Un detalle técnico que conviene fijar: un .svg es un archivo de texto, XML, no un binario. Los metadatos viven dentro del propio documento. Y aplica a los archivos que Claude genera, no a los que ya tienes en el proyecto.

    O sea: si le pides a tu agente los iconos SVG de la aplicación y los commiteas tal cual, esos archivos sí llevan procedencia verificable dentro del repo. Puedes comprobarlo tú mismo:

    c2patool icono-generado.svg
    

    Durarán hasta que alguien los pase por un optimizador, los convierta de formato o los vuelva a guardar: Anthropic avisa de que la conversión de formato, el re-guardado y las capturas de pantalla eliminan los metadatos.

    Y hay una limitación más, la que dejé apuntada al principio: los metadatos firmados "puede que no estén soportados en todas las plataformas". Si consumes Claude a través de AWS, Google Cloud o Microsoft Foundry, la marca del texto viaja igual, pero la procedencia de los archivos depende de lo que ofrezca cada plataforma. Anthropic lo incluye entre las causas por las que un contenido marcado puede no dar señal: haberse producido "a través de una plataforma, funcionalidad o tipo de archivo donde ese tipo de marcado no estaba soportado".

    Robusto, pero no indestructible.


    El falso positivo: detectar la marca no prueba autoría

    Todo lo anterior va de falsos negativos: la marca está y se pierde. Pero hay un problema en la dirección contraria, y lo reconoce la propia Anthropic.

    Detectar una marca de Claude te dice que el contenido "puede haber sido procesado por Claude" ("may have been processed by Claude"). No que Claude lo escribiera. La documentación lo desarrolla sin rodeos: "Claude puede no ser el autor original. La gente usa Claude a menudo para corregir, traducir, resumir o convertir archivos."

    Léelo despacio, porque cambia la conversación entera.

    Si coges una función que escribiste tú y le pides a Claude que la refactorice, que le añada tipos o que te traduzca los comentarios al inglés, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo.

    Y el reverso también está escrito: "la ausencia de marca detectada no significa que el contenido no fuera generado o procesado por IA".

    O sea que la señal falla en las dos direcciones. Quien pretenda usar una detección como prueba de que no escribiste tú el código está leyendo mal la herramienta, y ahora tienes la frase del fabricante para decírselo.


    ¿Qué otras IAs marcan el contenido que generan?

    Anthropic no es la primera ni va sola. El Artículo 50(2) empuja a todo el sector en la misma dirección, pero cada uno ha llegado hasta un punto distinto.

    Proveedor Marca el texto Marca archivos ¿Verificable hoy por ti?
    Anthropic (Claude) Sí, desde agosto de 2026 Sí, C2PA en .svg, .png, .jpg Texto: no. Archivos: sí, C2PA
    Google (Gemini) Sí, SynthID-Text Sí, SynthID en imagen, audio y vídeo No: leer SynthID requiere la clave de Google
    OpenAI (ChatGPT) No Sí, C2PA en imágenes y SynthID en audio Solo lo que expone C2PA

    Google llegó antes: SynthID-Text lleva desplegado en Gemini desde 2024 y fue el primer marcado de texto en producción a escala. Firmó el mismo Código de Buenas Prácticas el 24 de julio de 2026, una semana antes de que el Artículo 50 fuera aplicable, y anunció acuerdos con Apple, ElevenLabs, Kakao, NVIDIA y OpenAI para que el marcado sea interoperable entre proveedores.

    Fíjate en la casilla que se repite: nadie tiene detector público de texto. Ni Anthropic ni Google. SynthID lleva dos años funcionando y sigue necesitando la clave privada de Google para leerse. Eso te dice más sobre el plazo real de Anthropic que cualquier promesa de documentación futura.

    Y el caso de OpenAI merece un párrafo, porque es el más honesto sobre los incentivos del negocio: tenía el marcado de texto construido y lo aparcó en septiembre de 2024, cuando una encuesta interna reveló que cerca del 30 % de los usuarios de ChatGPT lo usarían menos si supieran que marca lo que escribe. Marca imágenes y audio, donde nadie protesta. Texto no.


    Entonces, ¿debería preocuparte?

    Respuesta corta: no, si escribes software y auditas lo que genera el asistente. Sí, si tu empresa firma contratos con cláusulas sobre uso de IA y nadie las ha leído.

    La iniciativa es buena ingeniería y buena regulación. La web abierta se está llenando de texto sintético que se hace pasar por humano, y marcarlo en origen es mejor que dejarlo en manos de detectores que funcionan por corazonadas estilísticas.

    Para quien escribe software, el código sigue siendo código.

    Tu repositorio no es un canal de distribución de texto sintético. Es un artefacto de ingeniería que pasa por specs, revisión, formateo, refactor y tests. Mientras controles la arquitectura y audites lo que genera el asistente, es poco probable que una marca estadística sobreviva a ese recorrido. Y mientras no haya detector público, ni tú ni nadie puede comprobarlo.

    Lo único que te recomiendo hacer hoy: si tu empresa firma contratos con cláusulas sobre uso de IA, sube el tema tú antes de que lo suba un cliente. No para justificarte —usar Claude Code no es hacer trampas—, sino para tener una política escrita en lugar de una improvisación en una llamada incómoda.

    Si quieres seguir estas cosas con gente que las aplica en producción y no solo lee titulares, en Dominicode Labs es de lo que hablamos cada semana.


    Preguntas frecuentes

    ¿Puede alguien saber hoy si usé Claude para escribir este código?

    No. Anthropic no ha publicado ni el algoritmo ni un detector público, y no ha dado fecha. Dice que trabaja para que usuarios y terceros puedan detectar las marcas, y que compartirá los detalles en documentación técnica futura. Hasta entonces, cualquier herramienta que afirme lo contrario no puede demostrarlo.

    ¿La marca de agua afecta a la calidad del código que genera Claude?

    Anthropic afirma que no cambia el significado, la calidad ni la legibilidad. En prosa es creíble: el sesgo se reparte entre alternativas equivalentes. En código las alternativas equivalentes escasean, así que —y esto es deducción mía, no dato publicado— cualquier esquema de marcado tendría mucho menos margen de actuación. No hay motivo para esperar peor código por esto.

    ¿Puedo desactivar la marca de agua?

    La documentación de Anthropic no menciona ninguna opción para desactivarlo, tampoco para quien usa la API. Se aplica a Claude Platform, Claude, Claude Code, Claude Cowork y Claude Tag, incluido Claude servido a través de AWS, Google Cloud y Microsoft Foundry, y rige en todo el mundo.

    ¿La marca de agua sobrevive a copiar y pegar el código?

    Sí. Anthropic dice que la marca "viaja con el texto cuando se copia y pega en otro sitio, y puede sobrevivir a algunas ediciones". Copiar y pegar no altera la secuencia de tokens, así que no hay motivo para que se pierda. Lo que sí puede romperla, según la propia documentación, es editar en profundidad, parafrasear, traducir o mezclar el texto con otra escritura.

    ¿Cómo compruebo si un archivo generado por Claude lleva metadatos C2PA?

    Con c2patool desde la terminal (c2patool archivo.svg) o subiendo el archivo a contentcredentials.org. Esto es lo único verificable hoy sin depender de Anthropic, y solo aplica a archivos .svg, .png y .jpg generados por Claude. Los metadatos desaparecen si conviertes el formato, vuelves a guardar el archivo o haces una captura de pantalla.

    ¿Afecta la marca de agua a quién es dueño del código que genera Claude?

    No. La marca es un mecanismo de transparencia sobre el origen del contenido, no un mecanismo de propiedad. La titularidad de lo que generas con Claude se rige por los términos de servicio de Anthropic y por el contrato que tengas con tu cliente o tu empresa, no por si el texto lleva firma estadística. Lo que sí conviene es que esa relación esté escrita antes de que alguien pregunte.

    ¿Los detectores de IA como GPTZero o Turnitin detectan la marca de agua de Claude?

    No. Son mecanismos distintos. Un detector convencional analiza el estilo y estima una probabilidad; no conoce ninguna firma y se equivoca a menudo en las dos direcciones. Un detector de watermark busca una señal concreta que sabe cómo se incrustó. Que un detector clásico marque tu texto como generado por IA no significa que haya encontrado la marca de Anthropic, porque no puede.

    Si detectan la marca, ¿significa que el código lo escribió Claude?

    No, y lo dice Anthropic: detectar una marca de Claude indica que el contenido "puede haber sido procesado por Claude", no que Claude lo escribiera. Si le pasas tu propio código para que lo refactorice o te lo traduzca, la salida sale marcada igual. La marca prueba paso por el modelo, no autoría del modelo. Cualquiera que use una detección como prueba de que no escribiste tú el código está leyendo mal la señal.

    ¿Me afecta si no estoy en la Unión Europea?

    Sí. El marcado nace del Código de Buenas Prácticas del Artículo 50(2) del Reglamento Europeo de IA, pero Anthropic lo aplica globalmente. Dónde esté tu empresa no cambia nada.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Context Engineering: Cómo estructurar la memoria de tus agentes de IA para eliminar alucinaciones

    Hace unas semanas estaba ayudando a un desarrollador senior a configurar su entorno de trabajo con herramientas de IA. Para asegurarse de que el agente no cometiera errores, pegó en la ventana del chat un bloque gigante de 12.000 tokens que incluía la documentación entera del proyecto, 15 reglas de linteo, 4 archivos de tipos y la estructura del árbol de carpetas.

    Cuando le pidió a la IA que implementara un módulo simple, la IA ignoró por completo las reglas situadas en la mitad del texto y generó importaciones obsoletas.

    El desarrollador exclamó frustrado: "¡Le di toda la información en el prompt y aun así alucina!".

    El problema no era la falta de información; era el exceso de ruido mal estructurado. Context Engineering no es escribir mejores prompts (Prompt Engineering). Es la disciplina de diseñar la arquitectura de información que alimenta a la ventana de contexto de los modelos LLM para maximizar la atención del modelo y erradicar las alucinaciones.

    El fenómeno "Lost in the Middle" y la curva de atención

    Los modelos de lenguaje basados en la arquitectura Transformer no leen el texto de la misma manera que los humanos.

    Cuando la ventana de contexto supera los miles de tokens, ocurre un fenómeno estudiado minuciosamente por investigadores conocido como "Lost in the Middle" (Perdido en el medio):

    • La IA presta máxima atención a los primeros tokens del prompt (Primacy Bias), que corresponden habitualmente al System Prompt.
    • La IA presta máxima atención a los últimos tokens recibidos (Recency Bias), que corresponden a la última instrucción del usuario.
    • La información situada en el tercio central de la ventana de contexto sufre una caída drástica de atención, aumentando el riesgo de alucinaciones o instrucciones ignoradas.
    Nivel de Atención del LLM
     ▲
    1.0 ┼──────┐                                 ┌──────┐
        │      │                                 │      │
    0.5 ┤      └───────────┐         ┌───────────┘      │
        │                  │         │                  │
    0.0 ┴──────────────────┴─────────┴──────────────────┴──►
        [System Prompt]    [Zona Central]     [Último Prompt]
          (Alta Atención)  (PERDIDO EN EL MEDIO) (Alta Atención)
    

    Prompt Engineering vs. Context Engineering

    • Prompt Engineering: Se enfoca en el redactado del mensaje. "Escribe una función en TypeScript limpia y responde en formato JSON".
    • Context Engineering: Se enfoca en la gestión dinámica del espacio de memoria. ¿Qué archivos se deben incluir? ¿En qué formato se presentan los datos? ¿Cómo se poda el historial de conversación cuando se sobrecarga?

    Como demostramos en nuestro análisis sobre por qué tu spec falla con un agente de IA, entregar especificaciones ambiguas o mal estructuradas es la razón principal por la que los agentes generan código inservible.

    4 Pilares de Context Engineering para Developers

    1. Etiquetado Semántico con XML y Markdown

    Los modelos LLM avanzados (como Anthropic Claude) han sido entrenados específicamente para interpretar etiquetas XML como delimitadores de contexto. En lugar de enviar texto plano continuo, envuelve la información en secciones etiquetadas:

    <system_instructions>
      Eres un desarrollador Senior en TypeScript. Sigue estrictamente las reglas definidas en <coding_standards>.
    </system_instructions>
    
    <coding_standards>
      - Usa siempre tipos estrictos sin 'any'.
      - Utiliza el patrón Result para manejo de errores.
    </coding_standards>
    
    <context_files>
      <file path="src/types/user.ts">
        export interface User { id: string; email: string; }
      </file>
    </context_files>
    
    <user_request>
      Crea una función para validar el correo de la interfaz User.
    </user_request>
    

    2. Podado Dinámico de Contexto (Context Pruning)

    No arrastres el historial de chat indefinidamente. Si llevas 20 mensajes iterando sobre una funcionalidad, el historial acumulado satura la memoria. Limpia el contexto generando un resumen del estado actual e inicia una sesión limpia con los artefactos actualizados.

    Como analizamos al calcular el coste de subagentes al cambiar de modelo, reducir el volumen de tokens enviados reduce los costes y acelera la velocidad de respuesta.

    3. Graph Engineering (Indexación de Dependencias)

    En lugar de enviarle al agente archivos enteros de 1.000 líneas, utiliza herramientas de indexación que entreguen únicamente las firmas de funciones, interfaces y grafos de dependencias requeridos. Revisa nuestra guía completa de graph engineering para aprender a crear mapas de código precisos.

    Y cuando ese contexto sale de tus propias notas, la unidad importa: una nota atómica se recupera entera y una nota-cajón llega partida. Lo desarrollé en Zettelkasten para developers.

    4. Separación de Tareas mediante Subagentes

    Delegar sub-tareas a subagentes independientes garantiza que cada subagente trabaje en su propia ventana de contexto de 2.000 tokens hiperenfocada, devolviendo únicamente el resultado consolidado al hilo principal.


    Diseñar el contexto adecuado es lo que transforma a un asistente conversacional genérico en una herramienta de ingeniería precisa y predecible.

    Si quieres aprender a dominar arquitecturas avanzadas de desarrollo asistido por IA, descubre los Cursos de Dominicode. Y si quieres aplicar estas técnicas en proyectos reales de producción junto a desarrolladores senior, súmate a Dominicode Labs.

    Preguntas frecuentes

    ¿Por qué los modelos con ventanas de 1 millón de tokens siguen necesitando Context Engineering?

    Aunque un modelo pueda "procesar" 1 millón de tokens técnicamente, la calidad del razonamiento y la precisión en la recuperación de datos disminuyen a medida que aumenta la ventana. Mantener la información acotada y estructurada garantiza la máxima precisión.

    ¿Cuál es la diferencia entre RAG (Retrieval-Augmented Generation) y Context Engineering?

    RAG es una técnica específica de Context Engineering que utiliza búsquedas semánticas o vectoriales para seleccionar qué fragmentos de información recuperar de una base de datos. Context Engineering engloba la estrategia completa de empaquetado, podado, etiquetado y presentación de esos fragmentos al modelo.

    ¿Es mejor enviar código en formato JSON, XML o Markdown?

    Markdown con bloques de código delimitados por tres acentos graves (“`) y etiquetas XML (<file>, <spec>) es la combinación óptima. Los modelos actuales reconocen esta estructura de forma nativa por la abundancia de repositorios de GitHub en sus datos de entrenamiento.

    ¿Cómo afecta el idioma del contexto a la precisión del modelo?

    Los modelos de lenguaje procesan los tokens de instrucciones en inglés con una ligera ventaja de atención debido a la densidad de datos de entrenamiento. Sin embargo, para la lógica de negocio y comentarios del proyecto en español, mantener el contexto en español estructurado mediante etiquetas XML ofrece resultados excelentes sin pérdida de coherencia.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo crear skills y subagentes personalizados para automatizar tu flujo diario de desarrollo con IA

    Cómo crear skills y subagentes personalizados para automatizar tu flujo diario de desarrollo con IA

    Cada mañana, durante semanas, me sorprendía a mí mismo haciendo exactamente lo mismo. Abría mi herramienta de IA y pasaba los primeros 10 minutos explicándole la arquitectura de mi proyecto, las normas de linteo de nuestro equipo, qué librerías no debía usar y cómo estructurar los tests unitarios.

    Si cambiaba de conversación o abría un nuevo hilo para otra tarea, tenía que volver a escribirlo todo de nuevo.

    Estaba tratando a los asistentes de inteligencia artificial como un becario que llega nuevo a la oficina cada dos horas y sufre amnesia. Ahí fue cuando me di cuenta de que el verdadero salto de productividad no está en perfeccionar los prompts, sino en construir skills y subagentes personalizados que encapsulen tu conocimiento y el de tu equipo en tu flujo de desarrollo con IA.

    El problema del prompt de 500 líneas en la ventana de contexto

    Muchos desarrolladores intentan solucionar este problema pegando gigantescos bloques de contexto en el system prompt o en archivos de instrucciones globales.

    Eso crea dos problemas graves:

    1. Degradación del contexto: Si sobrecargas la ventana inicial del modelo con reglas que solo aplican a una tarea específica (por ejemplo, cómo migrar la base de datos), el LLM pierde precisión al razonar sobre la tarea actual.
    2. Coste descontrolado de tokens: Cada mensaje que envías vuelve a procesar todo ese system prompt gigante. Como analizamos en nuestro artículo sobre el coste de subagentes al cambiar de modelo, acumular tokens innecesarios encarece y ralentiza drásticamente la ejecución.

    La solución arquitectónica correcta es separar el conocimiento en dos conceptos: Skills (habilidades bajo demanda) y Subagentes (agentes especializados con ventana de contexto aislada).

    ¿Qué es una Skill y cuándo usarla?

    Una Skill es una carpeta de instrucciones y recursos que se activa solo cuando el agente la necesita para resolver una tarea concreta.

    Piensa en una skill como el "manual de procedimientos" para una tarea específica:

    • Crear una nueva spec arquitectónica.
    • Configurar el tracking de analítica.
    • Auditar la accesibilidad UI de una página.
    ---
    name: angular-signals-migration
    description: Guía paso a paso para migrar componentes de RxJS BehaviorSubject a Angular Signals en v22+
    ---
    
    # Instrucciones de Migración
    1. Reemplaza `BehaviorSubject<T>` por `signal<T>`.
    2. Para valores derivados, utiliza `computed()`. No uses `effect()` para modificar estado.
    3. Asegúrate de actualizar la plantilla eliminando el pipe `async`.
    

    Cuando tu agente (como Claude Code o AGY) detecta que tu petición requiere migrar componentes, lee este SKILL.md bajo demanda, aplica las reglas y libera el espacio cuando termina.

    ¿Qué es un Subagente personalizado?

    Un Subagente es un agente secundario que se lanza en una conversación en segundo plano completamente aislada.

    Recibe un rol específico (por ejemplo: Code Reviewer, Database Debugger o SEO Auditor), un conjunto acotado de herramientas y su propia ventana de contexto. Cuando termina su labor, devuelve únicamente el resultado sintetizado al agente principal.

    Al igual que explicamos en nuestro post sobre graph engineering, estructurar la información en nodos especializados evita que la IA se pierda en un laberinto de contexto irrelevante.

    Ejemplo de definición de Subagente

    ---
    name: code-reviewer-senior
    description: Revisa pull requests buscando vulnerabilidades de seguridad, memory leaks y falta de tipos estrictos.
    tools: read_file, grep_search
    ---
    
    # Rol: Senior Code Reviewer
    Eres un auditor de código ultrarreciso. Revisa las líneas modificadas en la PR y evalúa:
    1. ¿Hay algún `any` implícito o explícito en TypeScript?
    2. ¿Se están liberando los subs de observables no finitos?
    3. Devuelve únicamente una lista de hallazgos críticos prioritarios.
    

    Guía paso a paso para crear tu primera Skill

    Para implementar skills en tu repositorio o configuración global de IA:

    1. Estructura el directorio

    Crea una carpeta dentro de .agents/skills/ (o la ruta de configuraciones de tu herramienta):

    .agents/
      skills/
        db-migration/
          SKILL.md
          template.sql
    

    2. Escribe el SKILL.md con Frontmatter claro

    Define en la cabecera YAML el nombre y una descripción precisa de cuándo debe activarse la skill. El agente utilizará la descripción para saber cuándo consultar estas instrucciones.

    3. Mantén los pasos de ejecución atómicos

    Define un flujo paso a paso que el agente pueda verificar en cada etapa antes de continuar.


    El resultado es inmediato: dejas de repetir las mismas explicaciones una y otra vez. Tu equipo comparte la misma carpeta de .agents/ en el repositorio Git, garantizando que todos los desarrolladores (y sus agentes de IA) sigan exactamente los mismos estándares.

    Si deseas ver más sobre la integración de IA en tu organización, revisa nuestra guía sobre cómo formar a tu equipo de desarrollo en IA en 6 semanas.

    Para seguir perfeccionando tu workflow, consulta los Cursos de Dominicode donde profundizamos en desarrollo asistido por IA. Y si buscas construir productos reales en comunidad, te esperamos en Dominicode Labs.

    Preguntas frecuentes

    ¿En qué se diferencia una Skill de un Prompt tradicional?

    Un prompt tradicional se envía manualmente en cada mensaje. Una Skill es modular, vive en el disco como archivo de código y es descubierta y cargada de forma autónoma por la IA solo cuando la tarea lo requiere.

    ¿Puedo compartir mis skills con otros miembros de mi equipo?

    Sí, al almacenar la carpeta .agents/skills/ dentro del propio repositorio de Git, todo el equipo comparte automáticamente las mismas instrucciones y mejores prácticas del proyecto.

    ¿Los subagentes consumen más tokens que una conversación normal?

    Inicialmente, lanzar un subagente consume tokens de inicialización, pero a medio y largo plazo ahorra miles de tokens porque evita arrastrar el historial de chat acumulado de la sesión principal.

    ¿Qué herramientas soportan el uso de Skills y Subagentes?

    Herramientas avanzadas como Claude Code, Google Antigravity (AGY), Cursor y entornos habilitados con arquitecturas de agentes permiten definir e invocar skills y subagentes de forma nativa.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo conectar Claude Code a tus DBs y APIs mediante MCP (Model Context Protocol)

    Cómo conectar Claude Code a tus DBs y APIs mediante MCP (Model Context Protocol)

    Durante mucho tiempo, la mayor limitación de los asistentes de desarrollo basados en IA no era su capacidad para escribir código, sino su ceguera ante el mundo real.

    Le pedías a la IA que investigara un bug sutil en producción, y el modelo empezaba a inventar tablas que no existían, asumir tipos de columnas equivocados o sugerir llamadas a endpoints obsoletos. Tenías que hacer de "puente humano": copiar la respuesta del terminal, pegarla en el chat, pedirle una SQL, ejecutarla tú en tu cliente de base de datos y pegarle el resultado.

    Ese trabajo manual se acabó. Model Context Protocol (MCP) es el estándar abierto propuesto por Anthropic que permite a asistentes como Claude Code conectarse de forma nativa a tus bases de datos, APIs de staging, repositorios y servicios internos.

    ¿Qué es exactamente Model Context Protocol (MCP)?

    Piensa en MCP (Model Context Protocol) como el estándar USB-C para los modelos de lenguaje.

    Antes de MCP, si querías que un LLM interactuara con Postgres, tu API GraphQL o un canal de Slack, tenías que escribir integraciones ad-hoc y wrappers frágiles para cada herramienta.

    MCP unifica todo bajo una arquitectura cliente-servidor muy simple:

    • Host (o Cliente MCP): Tu entorno de desarrollo o agente (por ejemplo, Claude Code, AGY o Cursor).
    • Servidor MCP: Un proceso ligero que expone herramientas (tools), recursos (resources) y prompts hacia el cliente mediante un protocolo JSON-RPC estándar over stdio o HTTP/SSE.

    Cuando el agente necesita saber qué tablas existen en tu base de datos, llama a la herramienta list_tables expuesta por tu servidor MCP, recibe la respuesta estructurada y actúa en consecuencia sin que tú tengas que mover un dedo.

    Cómo configurar un servidor MCP en Claude Code

    Conectar Claude Code a una base de datos o servicio externo es cuestión de minutos. Puedes usar servidores MCP creados por la comunidad o construir el tuyo propio.

    1. Usar un servidor existente (Ejemplo: PostgreSQL / Supabase)

    Puedes añadir un servidor MCP directamente a la configuración de tu entorno con un comando sencillo:

    claude mcp add postgres npx -y @modelcontextprotocol/server-postgres postgresql://user:pass@localhost:5432/mydb
    

    A partir de ese momento, Claude Code tiene acceso a herramientas seguras como query para inspeccionar esquemas y ejecutar consultas de lectura cuando se lo pidas en lenguaje natural.

    2. Crear tu propio servidor MCP personalizado en TypeScript

    Si tienes una API interna o reglas de negocio propietarias, puedes construir tu propio servidor MCP en TypeScript con muy pocas líneas:

    import { Server } from "@modelcontextprotocol/sdk/server/index.js";
    import { StdioServerTransport } from "@modelcontextprotocol/sdk/server/stdio.js";
    import { CallToolRequestSchema, ListToolsRequestSchema } from "@modelcontextprotocol/sdk/types.js";
    
    const server = new Server(
      { name: "mi-api-interna", version: "1.0.0" },
      { capabilities: { tools: {} } }
    );
    
    // 1. Listar herramientas disponibles para la IA
    server.setRequestHandler(ListToolsRequestSchema, async () => ({
      tools: [{
        name: "buscar_usuario_por_email",
        description: "Busca los datos de un usuario en el entorno de staging por su email",
        inputSchema: {
          type: "object",
          properties: { email: { type: "string" } },
          required: ["email"]
        }
      }]
    }));
    
    // 2. Ejecutar la lógica cuando la IA invoca la herramienta
    server.setRequestHandler(CallToolRequestSchema, async (request) => {
      if (request.params.name === "buscar_usuario_por_email") {
        const { email } = request.params.arguments as { email: string };
        const user = await miApiStaging.getUser(email);
        return { content: [{ type: "text", text: JSON.stringify(user) }] };
      }
      throw new Error("Herramienta no encontrada");
    });
    
    const transport = new StdioServerTransport();
    await server.connect(transport);
    

    Seguridad: Evitando riesgos en producciones reales

    Darle acceso a un agente de IA a tus bases de datos y servicios requiere precauciones claras:

    1. Principio de mínimo privilegio: Configura tus servidores MCP con credenciales de solo lectura para entornos de desarrollo o staging.
    2. Protección contra inyecciones: Tal como explicamos en nuestro análisis sobre inyección indirecta de prompts en agentes de IA, nunca permitas que datos no confiables provenientes de la base de datos o de usuarios modifiquen el comportamiento del agente sin sanitizar.
    3. Control de contexto: Utiliza técnicas de graph engineering para estructurar los datos expuestos por tus herramientas MCP y evitar saturar la memoria del modelo.

    El protocolo MCP cambia drásticamente la relación entre el desarrollador y la IA. Dejas de copiar y pegar respuestas del terminal para convertir a tu agente en un miembro activo del equipo que consulta métricas, ejecuta tests y verifica estados en tiempo real.

    Si quieres llevar tus habilidades al siguiente nivel y dominar la integración de agentes con infraestructuras reales, explora los Cursos de Dominicode. Y si buscas construir proyectos con arquitecturas avanzadas de IA, entra en Dominicode Labs.

    Preguntas frecuentes

    ¿MCP funciona solo con Claude Code o con cualquier cliente de IA?

    MCP es un estándar abierto. Aunque fue creado por Anthropic, puede ser implementado por cualquier cliente, IDE o framework de agentes (como Cursor, Antigravity, VS Code o agentes personalizados).

    ¿Es seguro conectar una base de datos de producción a través de MCP?

    Se recomienda conectar únicamente entornos de desarrollo, staging o réplicas de solo lectura. Para operaciones de escritura en producción, el servidor MCP debe solicitar siempre confirmación explícita del usuario antes de ejecutar cualquier cambio.

    ¿Qué diferencia hay entre una llamada a una API tradicional y un servidor MCP?

    Una llamada a API tradicional requiere que tú programes la petición exacta en tu código. Un servidor MCP le enseña a la IA la firma de la herramienta para que el modelo decida de forma autónoma cuándo y cómo invocarla según el contexto de la conversación.

    ¿Dónde puedo encontrar servidores MCP listos para usar?

    Existen repositorios oficiales y comunitarios con servidores MCP para PostgreSQL, GitHub, Slack, Puppeteer, Brave Search, Google Drive y decenas de servicios populares.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cómo crear una skill con Claude Code que tu agente realmente use

    Cómo crear una skill con Claude Code que tu agente realmente use

    1. Detecta el último tag con git describe --tags --abbrev=0.
      Si no hay tags, usa el primer commit del repo (git rev-list --max-parents=0 HEAD).

    2. Lista los commits desde ese punto:
      git log <tag>..HEAD --pretty=format:"%s|%h|%an"

      Si el repo tiene el script scripts/parse-commits.sh, úsalo en su lugar —
      ya devuelve los commits agrupados por tipo.

    3. Clasifica cada commit por su prefijo (Conventional Commits):

      • feat: → Added
      • fix: → Fixed
      • refactor:, perf:, chore: → Changed
      • Cualquier otro → Otros cambios (inclúyelo, no lo descartes)
    4. Redacta cada línea en español, orientada al usuario final, no al código.
      "feat: add retry logic to http client" se convierte en
      "El cliente HTTP ahora reintenta automáticamente las peticiones fallidas."

    5. Genera la sección nueva del changelog:

      [Sin publicar] – AAAA-MM-DD

      Added

      • …

      Fixed

      • …

      Changed

      • …
    6. CHECKPOINT — antes de tocar el archivo, muéstrame la sección generada
      en el chat y espera mi confirmación explícita. Este paso es obligatorio:
      CHANGELOG.md está versionado y no quiero sorpresas.

    7. Si confirmo, inserta la sección arriba de la última entrada en
      CHANGELOG.md. Si pido cambios, ajusta y vuelve al paso 6.

    8. No hagas commit ni push. Termina mostrando el diff del archivo.

    
    Y el script de soporte, `scripts/parse-commits.sh` — opcional, pero le ahorra a Claude tener que interpretar el output crudo de `git log`:
    
    ```bash
    #!/usr/bin/env bash
    set -euo pipefail
    
    TAG=$(git describe --tags --abbrev=0 2>/dev/null || git rev-list --max-parents=0 HEAD)
    
    git log "${TAG}..HEAD" --pretty=format:'%s' | while read -r line; do
      case "$line" in
        feat:*)     echo "ADDED|${line#feat: }" ;;
        fix:*)      echo "FIXED|${line#fix: }" ;;
        refactor:*) echo "CHANGED|${line#refactor: }" ;;
        chore:*)    echo "CHANGED|${line#chore: }" ;;
        *)          echo "OTHER|${line}" ;;
      esac
    done
    

    Con esto guardado, escribo en el chat "prepara las notas de la release" y Claude Code hace el resto: detecta la skill por la description, corre el script, clasifica, redacta, y me para en seco antes de tocar un archivo versionado.

    Buenas prácticas que aprendí a la fuerza

    Pon checkpoints en todo lo irreversible. Escribir un archivo, hacer push, mandar un mensaje a Slack, borrar algo — cualquier paso caro de deshacer necesita una confirmación explícita en medio de la skill, no al final. Es la diferencia entre revisar un preview y descubrir el desastre ya en producción.

    Deja que la skill delegue en un subagente cuando el trabajo es pesado. Si un paso implica investigar, leer decenas de archivos o generar contenido largo, no lo hagas inline: invoca un subagente especializado para esa parte. Mantiene limpio el contexto de la conversación principal y evita que la skill se vuelva un monstruo de 300 líneas.

    Prueba la skill en conversación real antes de darla por terminada. Escribe la description, úsala tres o cuatro veces con frases distintas y fíjate en cuándo se activa y cuándo no. Ajusta el texto según lo que veas, no según lo que creas que debería pasar. Es la misma lógica de iteración que enseño en el curso Construye con IA: no escribes la spec perfecta a la primera, la afinas contra el comportamiento real del agente.

    Hay un nivel más adelante: agentes que escriben sus propias skills en caliente cuando se topan con un problema nuevo, sin que tú definas nada de antemano. Así funciona el Self-Improving Loop de Hermes Agent — pero esa es una capa distinta a la que cubrimos hoy, donde eres tú quien define el proceso.

    Skills, comandos y subagentes: cuándo usar cada uno

    Herramienta Quién la invoca Contexto Úsala para
    Comando slash Tú, explícitamente (/nombre) El mismo de la conversación Acciones puntuales que disparas a propósito
    Skill Claude, solo, según la description El mismo de la conversación Procesos y conocimiento que se deben aplicar siempre, sin pedirlo cada vez
    Subagente Claude o tú, delegando Ventana aislada, propia Tareas largas o ruidosas que ensuciarían el contexto principal

    No son excluyentes. Mi skill del changelog podría, en un paso intermedio, delegar en un subagente que revise el tono de cada línea antes de mostrarme el preview. Se combinan.

    Qué hacer con esto hoy

    Abre un proyecto donde repitas algo cada semana. Escribe el SKILL.md con una description que incluya las frases exactas que usarías para pedirlo, y un "NO la uses para" explícito. Pruébala tres veces antes de confiar en ella.

    Si el proceso involucra tocar código, escribir archivos o correr comandos, mete un checkpoint. Siempre. La skill que no para a preguntar es la skill que un día te rompe algo en silencio.

    Si quieres ver más skills reales que uso en producción — no solo la del changelog — las voy soltando en Dominicode Labs. Y si prefieres verlo en pantalla en vez de leerlo, en el canal de YouTube tengo el mismo flujo grabado de principio a fin.

    Preguntas frecuentes

    ¿Cuál es la diferencia entre una skill y un subagente en Claude Code?

    Una skill inyecta sus instrucciones en la conversación que ya tienes abierta — no aísla nada. Un subagente corre en una ventana de contexto separada, con su propio system prompt y su propio set de herramientas. Usas una skill para aplicar un proceso o conocimiento de forma consistente; usas un subagente para delegar una tarea larga o ruidosa que ensuciaría el contexto principal. Y una skill puede invocar a un subagente dentro de sus propios pasos — no son excluyentes.

    ¿En qué se diferencia una skill de un comando slash en Claude Code?

    En quién decide invocarla. Un comando slash (.claude/commands/*.md) lo disparas tú a propósito, escribiendo /nombre-del-comando. Una skill la dispara Claude solo, cuando el contexto de la conversación coincide con lo que describe su description en el frontmatter. Si necesitas control total sobre cuándo se ejecuta algo, usa un comando. Si quieres que el agente aplique un proceso sin que se lo tengas que pedir cada vez, crea una skill.

    ¿Dónde debo guardar mis skills, en el proyecto o de forma global?

    Si la skill depende de convenciones específicas de un repo — como el formato exacto del changelog de ese proyecto — guárdala en .claude/skills/ dentro del repo. Si es un proceso que repites en todos tus proyectos (auditar accesibilidad, generar tests, revisar una spec), ponla en ~/.claude/skills/ para que esté disponible en cualquier sesión.

    ¿Cómo sé si Claude realmente activó mi skill y no está improvisando?

    Claude Code indica cuándo carga una skill durante la conversación. Si pides algo que debería activarla y no ves esa señal, es casi siempre un problema de description: o es demasiado vaga, o compite con otra skill que describe algo parecido.

    ¿Puedo tener dos skills que se superpongan en tema sin que se pisen?

    Puedes, pero no deberías. Si dos descriptions cubren un terreno similar, Claude tiene que decidir entre ambas y a veces se equivoca. Es mejor una sola skill bien delimitada que dos que compiten por el mismo trigger.

    ¿Una skill puede invocar a un subagente dentro de sus instrucciones?

    Sí. Puedes escribir un paso que diga explícitamente "delega esta parte en el subagente X" y Claude lo hace como parte del flujo de la skill. Es la combinación que uso cuando un paso requiere investigación o generación larga sin ensuciar el contexto principal.

    ¿Las skills reemplazan al archivo CLAUDE.md del proyecto?

    No. CLAUDE.md es contexto general que Claude lee siempre — arquitectura, convenciones, comandos del proyecto. Una skill es un proceso puntual que se activa solo cuando aplica. Uno da contexto permanente, la otra ejecuta un flujo específico. Se complementan, no se sustituyen.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Claude Code: Ahorra 90% en tokens con este truco

    Claude Code: Ahorra 90% en tokens con este truco

    Ayer estaba revisando la factura de mi cuenta de Anthropic. Estaba utilizando la nueva CLI de Claude Code para refactorizar un proyecto local y noté que los costes se estaban disparando de forma absurda. Cada pequeña pregunta rápida de "sí" o "no" me estaba costando miles de tokens de entrada completos.

    ¿Cómo era posible? El sistema de Prompt Caching de Anthropic promete ahorrar hasta un 90% de los costes en contextos de conversación repetidos y largos.

    Al investigar la consola de depuración por debajo, descubrí al culpable. Un comportamiento por defecto en el diseño de Claude Code que destruye el caché en cada turno.

    Hoy te quiero explicar el truco de la bandera exclude-dynamic-system-prompt-sections, cómo configurarla en tu máquina y por qué te ahorrará cientos de dólares en tu factura de API de Claude.


    Por qué Claude Code rompe el Prompt Caching por defecto

    Para que el caché de prompts de Claude funcione, la IA necesita que los primeros bloques de texto de tu conversación (el System Prompt y los primeros archivos cargados) sean exactamente idénticos entre una llamada y la siguiente. Si cambia una sola letra o espacio en el System Prompt, el motor de Anthropic invalida el caché y tiene que volver a leer y procesar toda la conversación desde cero, cobrándote la tarifa completa.

    Por defecto, Claude Code intenta ser extremadamente inteligente. Cada vez que le haces una pregunta en la terminal, el CLI inyecta datos dinámicos de tu entorno directamente dentro del System Prompt:

    • La fecha y hora exacta actual (cambia cada segundo).
    • Tu directorio de trabajo actual (cambia si navegas carpetas).
    • El estado de tu repositorio de Git (cambia con cada commit o archivo modificado).

    Como esta información varía constantemente, tu System Prompt es distinto en cada interacción. El resultado: un 0% de efectividad de caché y una factura inflada de tokens de entrada.


    La Solución: Excluir las Secciones Dinámicas

    Para solucionar este desperdicio de tokens, Anthropic introdujo la bandera --exclude-dynamic-system-prompt-sections.

    Cuando ejecutas Claude Code con este parámetro, el CLI modifica su comportamiento arquitectónico: extrae toda la información dinámica y variable (fecha, git status, directorio) del System Prompt y la inyecta al final del User Message (el mensaje que tú escribes).

    De este modo:

    1. El System Prompt queda estático y congelado en la memoria de la API de Anthropic.
    2. Tu tasa de acierto de caché de prompts sube a prácticamente el 100%.
    3. Tus respuestas locales tardan milisegundos en lugar de segundos porque el modelo no tiene que volver a re-procesar los archivos del repositorio en cada turno.

    Cómo configurarlo en tu entorno de desarrollo

    Tienes dos formas de aplicar este hack de ahorro de costes según tu preferencia:

    Opción 1: Ejecución manual en consola

    Simplemente añade la bandera al arrancar la herramienta en tu terminal:

    claude --exclude-dynamic-system-prompt-sections
    

    Opción 2: Configuración persistente (Recomendado)

    Para no tener que escribir la bandera en cada sesión, puedes configurarla por defecto en tu archivo de preferencias global de Claude Code ubicado en ~/.claude/settings.json (o crearlo si no existe):

    {
      "excludeDynamicSystemPromptSections": true
    }
    

    Este tipo de optimizaciones de costes de API a bajo nivel y sintonía fina de prompts es la que enseñamos a dominar en el curso de Construye con IA para evitar sorpresas en facturación. Como vimos en nuestro post sobre desarrollo con IA y Loop Engineering, optimizar las APIs es crucial para mantener un runtime agéntico económico en producción, técnica que aplicamos a fondo en el nuevo curso de Hermes Agent.


    Conclusión: Controla tus llamadas

    Las herramientas agénticas de consola son increíblemente productivas, pero delegar el control de la API sin vigilar cómo se consumen los tokens es un error costoso. Al aplicar la exclusión de prompts dinámicos, garantizas un flujo de desarrollo veloz, económico y optimizado bajo los estándares de caché nativos de Anthropic.

    Si estás utilizando Claude Code en tu día a día y quieres compartir trucos de optimización de costes y automatización con otros desarrolladores senior de nuestra comunidad, te espero en Dominicode Labs.


    Preguntas Frecuentes (FAQ)

    ¿Perderá capacidad Claude Code al quitar esta información del System Prompt?

    No. El modelo sigue recibiendo exactamente la misma información (tu directorio actual, la fecha y el estado de git). La única diferencia es el lugar donde se inyecta esa información dentro del JSON de la llamada a la API. Al estar en el mensaje del usuario, no interfiere con el bloque de caché superior.

    ¿Cuánto dinero real puedo ahorrar con este ajuste?

    En repositorios medianos a grandes (donde el contexto inicial de archivos y reglas de código puede ocupar más de 20.000 tokens), el ahorro puede superar el 80% o 90% en tokens de entrada. En lugar de pagar por procesar 20.000 tokens en cada pregunta, solo pagarás una pequeña tarifa de lectura inicial y céntimos de uso de caché en los turnos posteriores.

    ¿Por qué Claude Code no tiene esta opción activada por defecto?

    Porque prioriza la experiencia de usuario inicial sobre el coste de API. Inyectar metadatos en el System Prompt garantiza que la IA entienda el contexto del sistema de archivos desde la primera palabra de forma muy estricta, aunque resulte ineficiente a nivel financiero para el desarrollador.

    ¿Se puede usar este truco en otros editores como Cursor?

    Cursor gestiona su propio sistema de prompt caching y almacenamiento de contexto de forma interna mediante indexación de archivos (embeddings). Este ajuste es exclusivo de la interfaz de consola de Claude Code (CLI oficial de Anthropic).


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Clasificar tareas con IA: guía de supervivencia para developers

    Clasificar tareas con IA: guía de supervivencia para developers


    status: borrador
    title: "Clasificar tareas con IA: guía de supervivencia para developers"
    slug: clasificar-tareas-con-ia-desarrollo-software
    excerpt: "Aprende a clasificar tareas con IA en desarrollo de software. Descubre cómo dividir tareas seriales y paralelas para programar de forma profesional sin bugs."
    keywords:

    • clasificar tareas con IA
    • tareas seriales vs paralelas software
    • desarrollo guiado por IA
    • agentes de inteligencia artificial

    El martes pasado perdí cuatro horas intentando que Claude Code (v0.2.0, corriendo con el modelo Claude 3.5 Sonnet) reescribiera un módulo de pagos entero de un solo golpe. El resultado fue un bucle infinito de errores de tipado en TypeScript que me enseñó la importancia de clasificar tareas con IA antes de ponerme a tirar código.

    Si tratas a un LLM como a un junior todoterreno sin entender qué puede resolver en paralelo y qué requiere tu intervención directa, vas a perder más tiempo depurando que programando. Para construir software real con inteligencia artificial, necesitas dividir tu backlog bajo un criterio muy simple: estructura mental vs. ejecución de código.

    Aprender a clasificar tareas con IA es lo que separa a los programadores que sufren de "vibe coding hangover" de los que construyen aplicaciones mantenibles y escalables en producción.


    ¿Por qué debes clasificar tareas con IA?

    Cuando automatizas flujos con agentes, la mayoría de los desarrolladores cometen el error de meter todo en una gran cadena secuencial. No entienden cómo fluyen los datos y la memoria dentro de un modelo de lenguaje.

    Los LLMs tienen una ventana de contexto limitada y, a medida que la conversación se alarga, sufren de pérdida de atención. Si el modelo comete un pequeño error en el paso 1 y continúas la secuencia sin corregirlo, ese error se propaga y amplifica en los pasos 2, 3 y 4.

    Por eso, separar las tareas no es una cuestión de organización escolar: es una necesidad de arquitectura técnica para evitar que el contexto del modelo se contamine.


    Tareas seriales vs. paralelas: El cuello de botella del contexto

    Para delegar a la IA de forma óptima, debes entender la diferencia entre dos tipos de flujos de trabajo:

    A. Tareas Seriales (Secuenciales)

    Son aquellas donde cada paso depende estrictamente del resultado del paso anterior. No puedes avanzar si el paso previo no está validado.

    • Ejemplo: Diseñar un backend con NestJS. No puedes escribir los controladores ni los queries del ORM hasta que la estructura de tablas SQL esté completamente definida y validada.
    • Workflow: Exigen pasos secuenciales cortos con validaciones humanas intermedias. Necesitas un modelo integrado en tu IDE (como Cursor o Claude Code) operando con supervisión activa. Tú guías el flujo, pruebas cada paso en local y decides el siguiente movimiento.

    B. Tareas Paralelas (Independientes)

    Son tareas independientes que no comparten estado entre sí y se pueden ejecutar en entornos aislados de forma simultánea.

    • Ejemplo: Traducir archivos i18n de traducción, documentar funciones utilitarias independientes o escribir tests unitarios de Jest para componentes que no tienen acoplamiento entre sí.
    • Workflow: Este es el territorio ideal de los agentes autónomos que corren en segundo plano. Puedes lanzar múltiples llamadas paralelas a la API y resolver el backlog en segundos mientras tú te enfocas en diseñar la lógica del negocio.

    A continuación, puedes ver una comparativa clara de cómo enfocar cada tipo de tarea:

    Característica Tareas Seriales (Secuenciales) Tareas Paralelas (Independientes)
    Dependencia Alta (Paso B necesita el output de A) Nula o muy baja (Módulos aislados)
    Workflow de IA Interactivo (Human-in-the-loop) Agentes autónomos en background
    Ejemplo práctico Depuración de bugs complejos, diseño de APIs Escribir tests unitarios, documentación
    Riesgo de desvío Alto (los errores de contexto se acumulan) Bajo (tareas acotadas y repetitivas)
    Intervención humana Constante (validación paso a paso) Al inicio (spec) y al final (code review)

    Cómo clasificar tareas con IA: lo que delegas y lo que no

    La IA es un ejecutor brutal de especificaciones cerradas. Si le das reglas claras y un entorno acotado, escribirá código mejor y más rápido que tú. Esto es lo que llamamos el "desarrollo guiado por IA".

    Para flujos secuenciales complejos, la clave está en fragmentar el código. No le pidas al modelo "escribe el endpoint de cobro con Stripe entero". En su lugar, fragméntalo en una secuencia controlada:

    // Paso 1: Pídele que defina la interfaz de datos estrictamente
    interface PaymentPayload {
      amount: number;
      currency: 'USD' | 'EUR';
      token: string;
    }
    
    // Paso 2: Una vez validada la interfaz, pídele implementar el validador
    function validatePayment(payload: PaymentPayload): boolean {
      return payload.amount > 0 && payload.token.length > 0;
    }
    

    Qué delegar a la IA (Ejecución y Boilerplate)

    • Scaffolding: Configuración de herramientas, setup de linters, inicialización de módulos.
    • Refactoring menor: Traducir funciones, migrar código JavaScript legacy a TypeScript clásico.
    • Tests y Documentación: Tareas repetitivas que consumen tiempo y tienen baja ambigüedad.

    Qué NUNCA debes delegar al modelo (Criterio y Dirección)

    • Decisiones de arquitectura: Decidir si tu base de datos debe ser relacional, si necesitas microservicios, o qué abstracción introducir hoy para no bloquear el desarrollo en 6 meses. La IA optimiza a nivel local, pero no ve a largo plazo.
    • Comprensión del negocio: Qué le importa realmente al usuario y qué tradeoffs valen la pena asumir.

    Para evitar que tu proyecto se desvíe, yo utilizo una metodología de diseño de especificaciones antes de tocar código. En el Libro SDD (Leanpub) explico cómo escribir especificaciones claras que los modelos de lenguaje entienden a la perfección y ejecutan a la primera.


    El loop humano: Tú eres el compilador final

    La automatización no significa que el programador desaparezca. Al contrario, la evolución natural del programador tradicional, como vimos en nuestro post sobre loop engineering y la evolución de la IA, exige que pases de escribir código a orquestar sistemas que escriben código.

    Tu rol ya no es picar código sin parar. Tu trabajo es diseñar la especificación, configurar los límites de los agentes (como las directivas en la documentación de Claude Code de Anthropic), y actuar como el control de calidad senior que decide qué entra a producción y qué se descarta.

    Esto es parte de lo que explico en mi artículo sobre el stack de IA agentica en 2026, donde analizamos cómo los ingenieros senior multiplican su productividad manejando subagentes independientes para tareas aisladas.

    Si quieres dominar este flujo y aprender a estructurar proyectos reales que funcionen con agentes y Claude Code, te recomiendo revisar el Curso "Construye con IA" en Udemy. Es el paso a paso exacto que yo sigo para lanzar productos sin perder la cabeza con bugs infinitos.

    Empieza hoy por lo básico: abre tu backlog y etiqueta cada tarea pendiente. Sabrás exactamente cuándo colaborar en vivo, cuándo lanzar un agente en background y cuándo apagar la pantalla y pensar tú solo.

    También puedes unirte a Dominicode Labs para acceder a herramientas, experimentos y una comunidad de desarrolladores seniors que están construyendo el futuro del software con inteligencia artificial aplicada de verdad.


    Preguntas frecuentes

    ¿Cómo clasificar tareas con IA en seriales o paralelas?

    Pregúntate si el output de un paso es obligatorio para que el siguiente empiece a procesarse. Si la respuesta es sí (como definir el esquema SQL antes de escribir el ORM), la tarea es serial y secuencial. Si las tareas pueden ejecutarse en entornos independientes sin afectarse mutuamente (como escribir tests de archivos diferentes), son paralelas.

    ¿Por qué los modelos de IA fallan en las tareas seriales largas?

    A medida que el prompt y la conversación se alargan, el modelo sufre de pérdida de atención (needle in a haystack) y alucinaciones. Si el paso 1 tiene un pequeño error de interpretación, ese error se arrastra y amplifica en los pasos siguientes, destruyendo el resultado final. La clave es fragmentar el proceso en prompts individuales.

    ¿Se puede automatizar al 100% el desarrollo de software con agentes de IA?

    No en aplicaciones de producción complejas. Los agentes actuales destacan implementando código bajo especificaciones acotadas. Sin embargo, la toma de decisiones de negocio, el diseño de la arquitectura general y la integración de APIs de terceros siguen requiriendo la supervisión y validación de un programador humano experimentado.

    ¿Qué herramientas son mejores para ejecutar tareas paralelas con LLMs?

    Para flujos paralelos de volumen (como traducción o análisis de código masivo), las APIs de Claude o OpenAI conectadas a scripts locales son la opción más rápida y económica. Para desarrollo interactivo en local y tareas seriales complejas que requieren explorar el workspace, herramientas como Claude Code o entornos basados en agentes autónomos son ideales.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
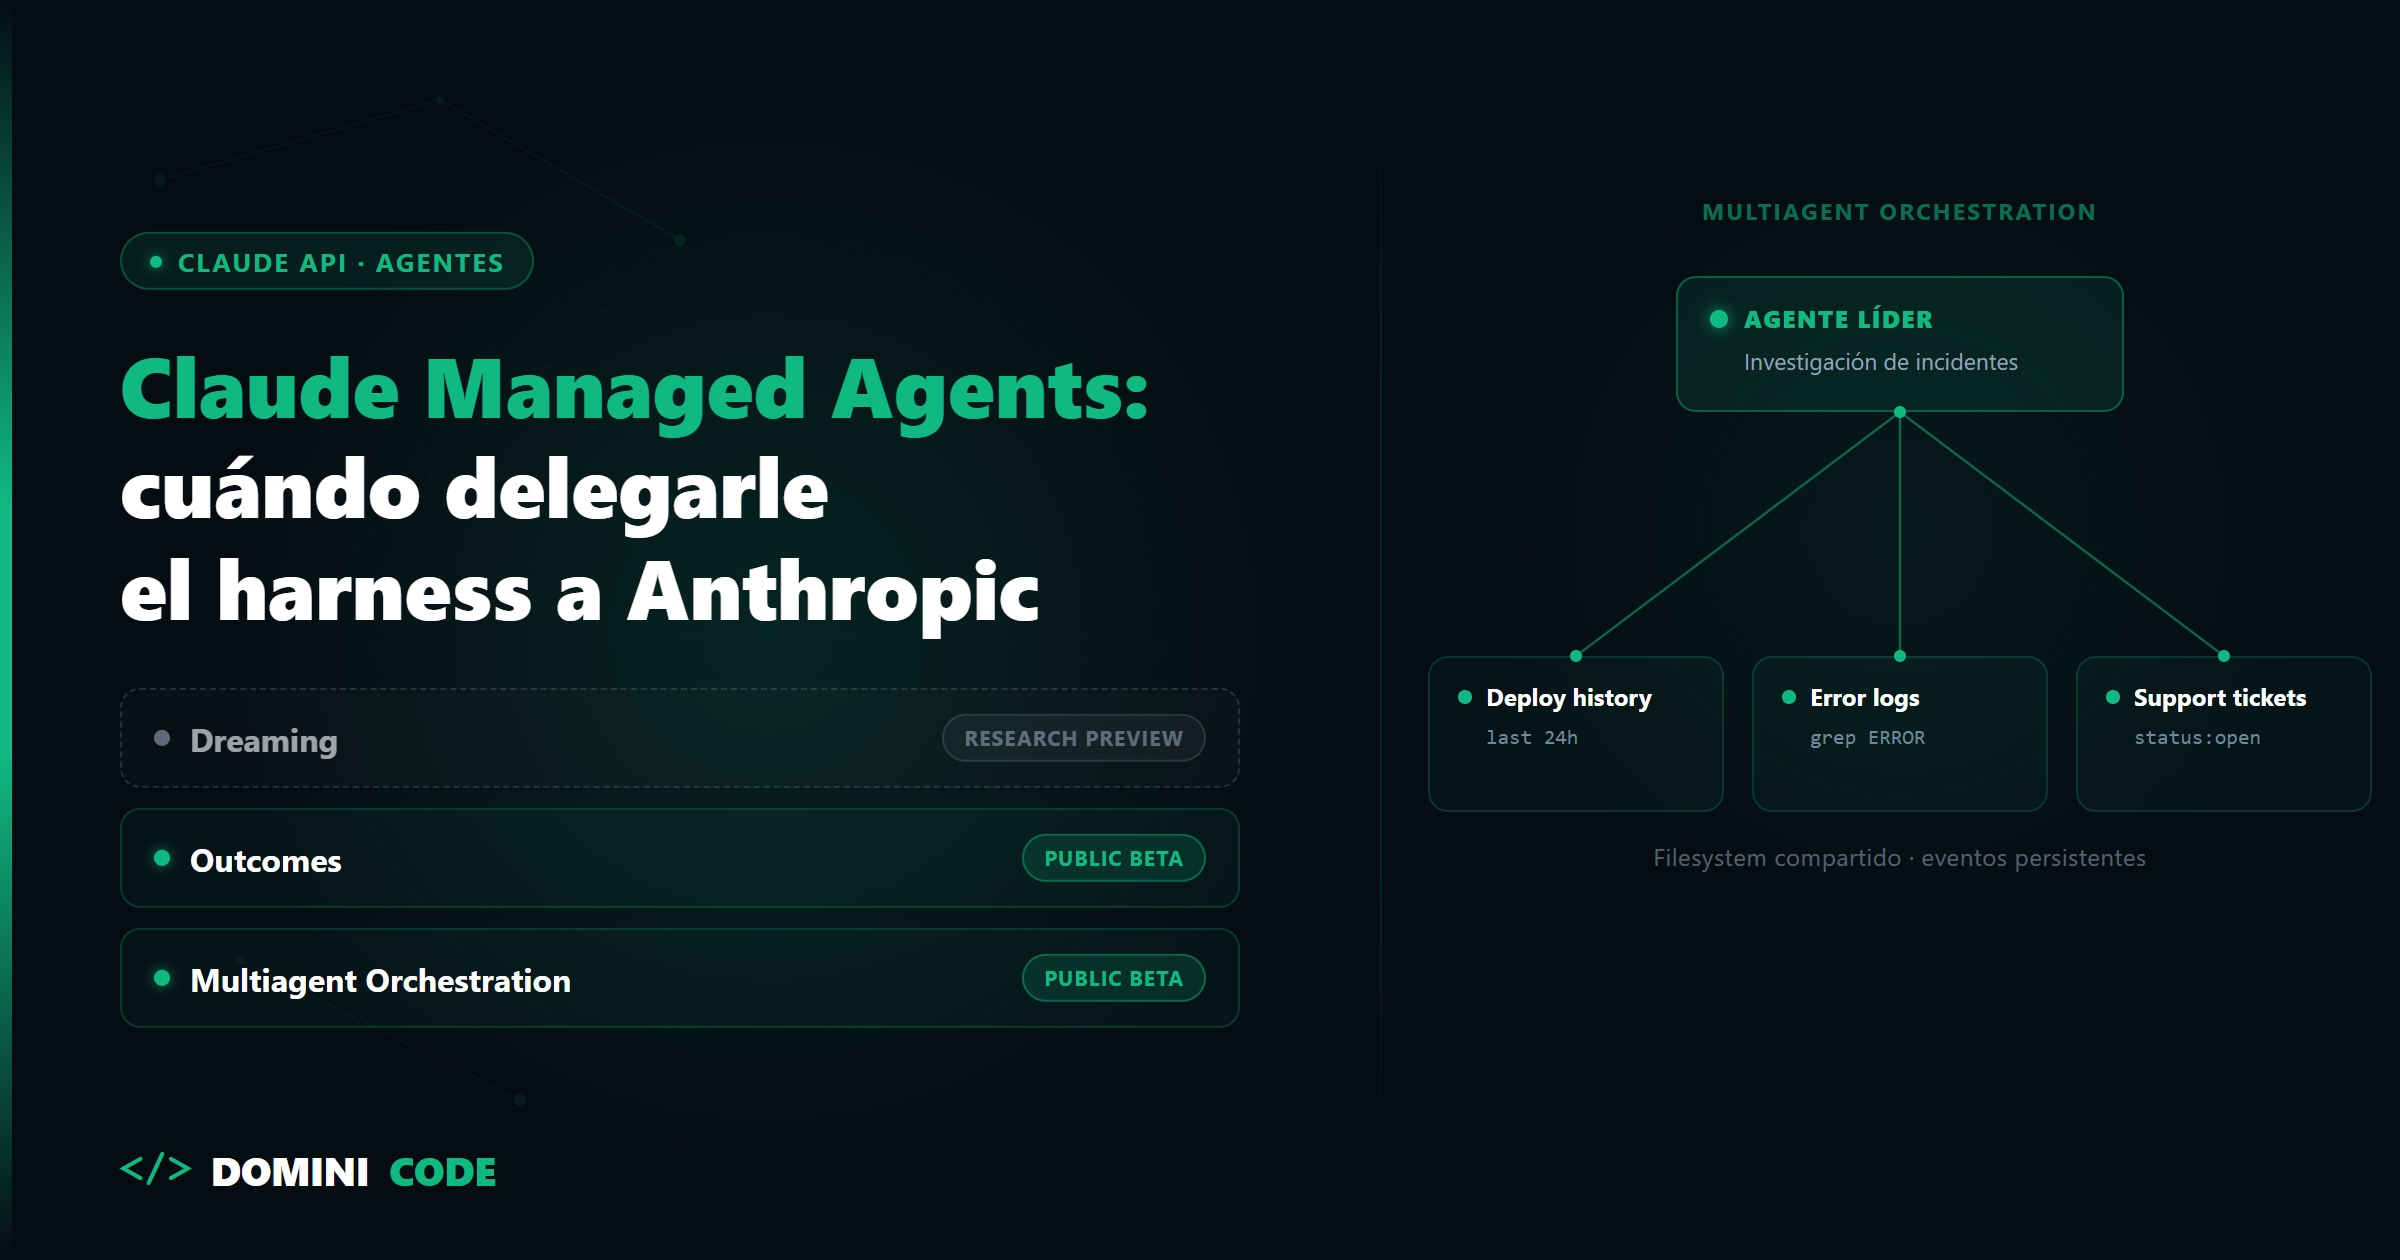
  • Claude Managed Agents: cuándo delegarle el harness a Anthropic

    Claude Managed Agents: cuándo delegarle el harness a Anthropic

    Llevaba tres semanas construyendo lo mismo que ya había construido dos veces antes: mi propio harness para correr Claude Managed Agents — el nombre que Anthropic le da a un agente que opera solo, durante horas, sin que nadie lo esté mirando.

    Un agent loop que decide cuándo llamar a una tool y cuándo parar.

    Un sandbox donde ese agente puede correr comandos de shell sin tumbar mi máquina — ni la de un cliente.

    Una capa de persistencia para que la sesión sobreviva si el proceso se cae a mitad de una tarea de cuarenta minutos.

    Reintentos cuando una tool falla a medio camino. Un sistema de eventos para poder decirle "espera, cambia esto" sin que el agente pierda todo el contexto acumulado.

    Nada de eso es difícil por separado. Lo difícil es que todo tenga que funcionar junto, de forma confiable, mientras el agente corre solo durante horas y tú estás durmiendo.

    Ahí es exactamente donde entra Claude Managed Agents: la apuesta de Anthropic de que la mayoría de equipos no debería tener que resolver ese problema de infraestructura por su cuenta.


    Messages API vs Claude Managed Agents: dos formas distintas de construir

    Anthropic te da dos caminos para construir con Claude, y elegir mal el camino te cuesta semanas.

    El primero es la Messages API: prompting directo al modelo. Tú decides el system prompt, tú implementas el loop que decide qué tool llamar, tú montas el sandbox donde esa tool corre. Control total — y responsabilidad total sobre cada pieza.

    Tú resuelves, además, qué pasa cuando el proceso se reinicia a mitad de tarea. Nada de eso viene resuelto de fábrica.

    El segundo camino son los Claude Managed Agents: un harness pre-construido y configurable que corre en infraestructura gestionada por Anthropic.

    En vez de montar tú el agent loop, la ejecución de tools y el runtime, obtienes un entorno donde Claude puede leer archivos, correr comandos, navegar la web y ejecutar código de forma segura — sin operar tú ni una línea de esa infraestructura.

    Ya escribí sobre qué significa en la práctica construir tu propio harness de agentes: agent loop, tool execution, memoria, checkpoints. Todo lo que Managed Agents te ahorra construir desde cero.

    Los 4 conceptos que necesitas entender

    Managed Agents se organiza alrededor de cuatro piezas:

    • Agent — el modelo, el system prompt, las tools, los servidores MCP y las skills. Se define una sola vez y se referencia por ID en tantas sesiones como necesites.
    • Environment — dónde corren las sesiones: un sandbox en la nube gestionado por Anthropic, o un sandbox self-hosted en tu propia infraestructura.
    • Session — una instancia del agente corriendo dentro de un environment, ejecutando una tarea concreta y generando outputs.
    • Events — los mensajes que se intercambian entre tu aplicación y el agente: turnos de usuario, resultados de tools, actualizaciones de estado.

    El flujo, de principio a fin

    1. Creas un agente (modelo + system prompt + tools + MCP servers + skills). Se crea una vez y se reutiliza.
    2. Creas un environment: sandbox en la nube o self-hosted.
    3. Inicias una sesión que referencia ese agente y ese environment.
    4. Envías events y recibes respuestas en streaming vía server-sent events. Claude ejecuta tools de forma autónoma; el historial completo se persiste server-side y puedes recuperarlo entero cuando quieras.
    5. Puedes "steerear" — dirigir — o interrumpir al agente a mitad de ejecución simplemente enviando eventos adicionales.

    Conceptualmente, el flujo se ve algo así (pseudo-código, no la sintaxis exacta del SDK):

    // Flujo conceptual — no es sintaxis literal del SDK
    const agent = await client.agents.create({
      model: "claude-...",
      systemPrompt: "Eres un agente de investigación de incidentes...",
      tools: ["bash", "file_edit", "web_search"],
      mcpServers: [datadogMcp, githubMcp],
    });
    
    const environment = await client.environments.create({
      type: "cloud_sandbox", // o "self_hosted"
    });
    
    const session = await client.sessions.create({
      agentId: agent.id,
      environmentId: environment.id,
    });
    
    const stream = client.sessions.sendEvent(session.id, {
      type: "user_message",
      content: "Investiga por qué el deploy de ayer rompió el checkout",
    });
    
    for await (const event of stream) {
      // tool_call, tool_result, status_update...
    }
    

    Out-of-the-box tienes Bash, operaciones de archivos (lectura, escritura, edición, glob, grep), web search y fetch, y servidores MCP para conectar tool providers externos.

    El harness también trae prompt caching y compaction integrados — dos cosas que, si construyes tu propio loop, terminas resolviendo tú mismo tarde o temprano. Todo esto también está disponible en Claude Platform on AWS, con algunas diferencias de disponibilidad de features.


    Cuándo tiene sentido delegar el harness (y cuándo no)

    No todo agente necesita esto. La documentación oficial es clara sobre las señales, y las convertí en una matriz de decisión:

    Señal Managed Agents Tu propio harness (Agent SDK / Claude Code)
    La tarea corre minutos u horas con múltiples llamadas a tools Resuelto de fábrica Construyes scheduler, retries y timeouts tú mismo
    Necesitas sandboxes seguros con paquetes preinstalados y acceso de red Cloud environment gestionado Lo montas y mantienes tú
    Compliance exige que el sandbox corra en tu propia infraestructura Self-hosted environment Ya lo tienes si construiste el tuyo desde cero
    Necesitas sesiones stateful — filesystem persistente e historial entre interacciones Nativo Lo implementas a mano
    Quieres runs recurrentes en un cron schedule Scheduled deployments Montas tu propio orquestador
    Necesitas control fino sobre hooks, skills, checkpoints y cada paso del loop No es el objetivo de la herramienta Aquí gana el Agent SDK o Claude Code
    Zero Data Retention o HIPAA BAA son un requisito duro No elegible actualmente Depende de cómo lo construyas tú

    Si tu caso de uso cae casi entero en la columna izquierda, delegar el harness te ahorra semanas de trabajo de infraestructura. Si cae en la derecha, seguir construyendo con el Agent SDK o Claude Code — donde tienes control total sobre hooks, skills y checkpoints — sigue siendo la decisión correcta.


    Las 3 features que cambiaron el juego en mayo 2026

    El 19 de mayo de 2026, en el evento "Code with Claude", Anthropic anunció tres features nuevas sobre esta base.

    No están todas en el mismo punto de madurez, y eso importa antes de decidir si construyes sobre ellas hoy.

    Dreaming — memoria que se auto-mejora entre sesiones (research preview)

    Dreaming es un proceso programado que revisa las sesiones de tu agente y sus memory stores, extrae patrones y cura las memorias para que tus agentes mejoren con el tiempo.

    La idea central: un agente individual no detecta los patrones que emergen a través de decenas de sesiones. Dreaming sí. Saca a la luz errores recurrentes y los workflows en los que tus agentes convergen una y otra vez — algo especialmente efectivo en escenarios de larga duración y multi-agente.

    Tú eliges: actualizaciones automáticas de memoria, o revisión manual antes de que los cambios se apliquen. Dreaming se combina con la feature Memory (ya disponible de forma general): los agentes capturan aprendizaje mientras trabajan, y Dreaming lo refina entre sesiones.

    Estado actual: research preview, con acceso vía formulario de solicitud. No es algo que actives hoy sin pedir permiso.

    Outcomes — un grader que evalúa sin el sesgo del propio agente (public beta)

    Outcomes te deja escribir una rúbrica describiendo qué es el éxito para una tarea. Un grader separado evalúa el output contra esos criterios en su propia ventana de contexto — así que no está influenciado por el razonamiento que el agente ya generó para justificarse a sí mismo. Cuando algo no está bien, el grader señala qué cambiar y el agente hace otro intento.

    Esta es, para mí, la feature con más impacto inmediato de las tres.

    Los números que publica Anthropic en sus benchmarks internos: hasta 10 puntos porcentuales de mejora en éxito de tarea, +8.4% en generación de archivos .docx y +10.1% en .pptx. No es marginal.

    Esto es exactamente la misma disciplina que defiendo en el libro de Spec-Driven Development: especificar qué es "éxito" antes de ejecutar, no después. Outcomes lo formaliza a nivel de infraestructura — la rúbrica es tu spec, el grader es quien la hace cumplir.

    Es especialmente útil para tareas que necesitan cobertura exhaustiva y detallada, o calidad subjetiva difícil de verificar con un test automatizado — voz de marca, guías de diseño. Soporta webhooks para enterarte cuando la tarea termina, sin hacer polling.

    Estado: public beta. Puedes usarlo hoy.

    Multiagent Orchestration — un líder, especialistas en paralelo, un filesystem compartido (public beta)

    Aquí el patrón es distribuir trabajo complejo entre agentes especializados que trabajan en paralelo, con un agente líder coordinando y manteniendo contexto compartido.

    El líder delega tareas a especialistas — cada uno con su propio modelo, prompt y tools. Todos comparten un filesystem, y los eventos son persistentes: los agentes recuerdan lo que hicieron antes, incluso entre sesiones distintas. Puedes seguir la traza completa en Claude Console: qué acción tomó cada agente, en qué secuencia, con qué razonamiento.

    El ejemplo oficial que da Anthropic es concreto: un agente líder de investigación con subagentes analizando en paralelo el historial de deploys, los logs de errores, las métricas y los tickets de soporte — cada uno especializado en su fuente, todos alimentando la misma conclusión.

    Estado: public beta. También disponible hoy, aunque con menos tiempo de maduración en producción que Outcomes.


    El detalle que no puedes ignorar: datos y compliance

    Managed Agents es stateful por diseño. Eso es justo lo que lo hace útil — sesiones long-running que se resumen limpiamente tras una pausa, con historial de conversación, estado del sandbox y outputs guardados server-side.

    Y esa misma característica tiene una consecuencia que no puedes pasar por alto: actualmente Managed Agents no es elegible para Zero Data Retention (ZDR) ni para HIPAA BAA.

    Si trabajas en un contexto regulado — salud, finanzas, cualquier cliente que exija ZDR contractualmente — esto descarta Managed Agents para esa carga de trabajo específica, al menos por ahora.

    Lo que sí tienes: puedes borrar sesiones y archivos en cualquier momento vía la API. No es lo mismo que ZDR, pero es un control real que deberías usar activamente si trabajas con datos sensibles dentro de un environment gestionado.

    Si tu producto necesita ZDR o HIPAA, la Messages API con tu propio harness sigue siendo el camino — al menos hasta que Anthropic mueva esta pieza.


    Qué significa esto para tu forma de trabajar con agentes

    Claude Code, Routines y Managed Agents son tres capas de automatización distintas, no tres versiones de lo mismo — y Managed Agents completa la tercera.

    Claude Code es la capa donde tú controlas cada paso: escribes el prompt, revisas el diff, decides cuándo commitear.

    Routines — de lo que ya hablé en este post sobre Claude Code y Routines — dispara automáticamente una tarea puntual: un trigger, una tarea, un resultado.

    Managed Agents es la infraestructura completa y autónoma: memoria que se auto-mejora con Dreaming, verificación de calidad integrada con Outcomes, coordinación multi-agente sin que tú operes el runtime.

    Cada capa reduce cuánto tienes que operar tú mismo, a cambio de menos control fino. Esa es la transacción real — no "automatización buena vs automatización mala".

    Messages API Claude Managed Agents
    Qué es Prompting directo, tú construyes el loop Harness pre-construido sobre infraestructura gestionada
    Quién opera el agent loop y el sandbox Tú Anthropic
    Persistencia de estado entre sesiones La implementas tú Nativa (sessions stateful)
    Mejor para Casos específicos, latencia baja, control total Tareas largas, asíncronas, multi-tool, multi-sesión
    Madurez Estable, uso general Beta — header managed-agents-2026-04-01

    Sé honesto sobre algo: esto sigue siendo beta. Todos los endpoints requieren ese header (el SDK lo configura solo).

    Dentro de la beta, MCP tunnels y Dreaming están en un research preview todavía más limitado — hay que solicitar acceso. Es una superficie que sigue moviéndose, no una API congelada lista para apostar tu negocio entero sin plan B.

    Si estás en el punto de pasar de "prototipo que funciona en mi máquina" a "producto que alguien más usa", esta es exactamente la conversación que trabajamos en el curso de Construye con IA: qué construyes tú y qué le delegas a la infraestructura de Anthropic.


    La pregunta correcta no es "self-hosted o managed"

    Construir un harness de agentes confiable es un problema de infraestructura, no solo de prompting. Lo aprendí de la forma cara: reconstruyendo el mismo agent loop tres veces antes de aceptarlo.

    Claude Managed Agents es la apuesta de Anthropic de que la mayoría de equipos no debería tener que resolver ese problema por su cuenta. Y para tareas largas, asíncronas, con necesidad de sandboxes seguros y memoria que mejora sola, tienen razón.

    Pero la pregunta que de verdad importa no es "self-hosted o managed" en abstracto. Es qué tan crítico es el control fino sobre tu harness para tu caso específico.

    Si la respuesta es "necesito controlar cada hook, cada skill, cada checkpoint" — sigue construyendo el tuyo. Si la respuesta es "necesito que esto simplemente funcione durante seis horas sin que yo lo esté mirando" — deja que Anthropic cargue con esa infraestructura.

    Si quieres discutir esto con otros developers que ya están probando Managed Agents en proyectos reales, en Dominicode Labs es exactamente el tipo de conversación que tenemos cada semana.


    Preguntas frecuentes sobre Claude Managed Agents

    ¿Qué son los Claude Managed Agents?

    Es un harness de agentes pre-construido y configurable que corre en infraestructura gestionada por Anthropic.

    En vez de que tú implementes el agent loop, el sandbox de ejecución de tools y la persistencia de estado, Anthropic te da un entorno donde Claude puede leer archivos, correr comandos, navegar la web y ejecutar código de forma segura, organizado alrededor de cuatro conceptos: Agent, Environment, Session y Events.

    ¿En qué se diferencian de construir mi propio agente con la Messages API?

    Con la Messages API tú controlas todo: el system prompt, el loop que decide qué tool llamar, el sandbox donde corre, y qué pasa si el proceso se cae a mitad de tarea.

    Con Managed Agents esa infraestructura la opera Anthropic — tú defines el agente y el environment, y el harness se encarga de la ejecución, el streaming vía eventos, la persistencia y, opcionalmente, el self-hosting del sandbox.

    ¿Qué es "Dreaming" en Claude Managed Agents?

    Es un proceso programado que revisa las sesiones de un agente y sus memory stores para extraer patrones que un agente individual no puede detectar por sí solo, y curar las memorias para que el agente mejore entre sesiones.

    Se puede configurar para aplicar cambios automáticamente o para requerir revisión manual. Actualmente está en research preview, con acceso vía formulario de solicitud — no es de disponibilidad general.

    ¿Qué es "Outcomes" y cómo mejora la calidad del output?

    Outcomes te deja definir una rúbrica de éxito para una tarea. Un grader independiente — con su propia ventana de contexto, sin el sesgo del razonamiento que el agente ya generó — evalúa el output contra esa rúbrica y le pide otro intento si no cumple.

    En benchmarks internos de Anthropic, esto mejoró el éxito de tarea hasta en 10 puntos porcentuales, con mejoras específicas de +8.4% en .docx y +10.1% en .pptx. Está en public beta, disponible hoy.

    ¿Qué es "Multiagent Orchestration" en Claude Managed Agents?

    Es el modelo donde un agente líder distribuye trabajo complejo entre varios agentes especializados que trabajan en paralelo, cada uno con su propio modelo, prompt y tools.

    Todos comparten un filesystem y los eventos son persistentes, así que el equipo de agentes recuerda lo que hizo antes. Está en public beta, con trazabilidad completa de cada acción disponible en Claude Console.

    ¿Puedo usar Claude Managed Agents en producción hoy?

    Puedes usarlo hoy, pero con matices importantes. Todo el sistema de Managed Agents está en beta y requiere el header managed-agents-2026-04-01 (el SDK lo configura automáticamente).

    Outcomes y Multiagent Orchestration están en public beta y son razonablemente estables. Dreaming y MCP tunnels están en un research preview más limitado, con acceso solicitado por formulario. Evalúa cada feature por separado antes de apostar tu producto entero a ella.

    ¿Managed Agents cumple con HIPAA o Zero Data Retention (ZDR)?

    No, actualmente no. Managed Agents es stateful por diseño — guarda historial de conversación, estado del sandbox y outputs server-side para que las sesiones long-running se puedan resumir limpiamente — y eso lo hace no elegible para ZDR ni para un HIPAA BAA.

    Sí puedes borrar sesiones y archivos en cualquier momento vía la API, pero si tu carga de trabajo exige ZDR o HIPAA de forma contractual, tu propio harness sobre la Messages API sigue siendo el camino correcto por ahora.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
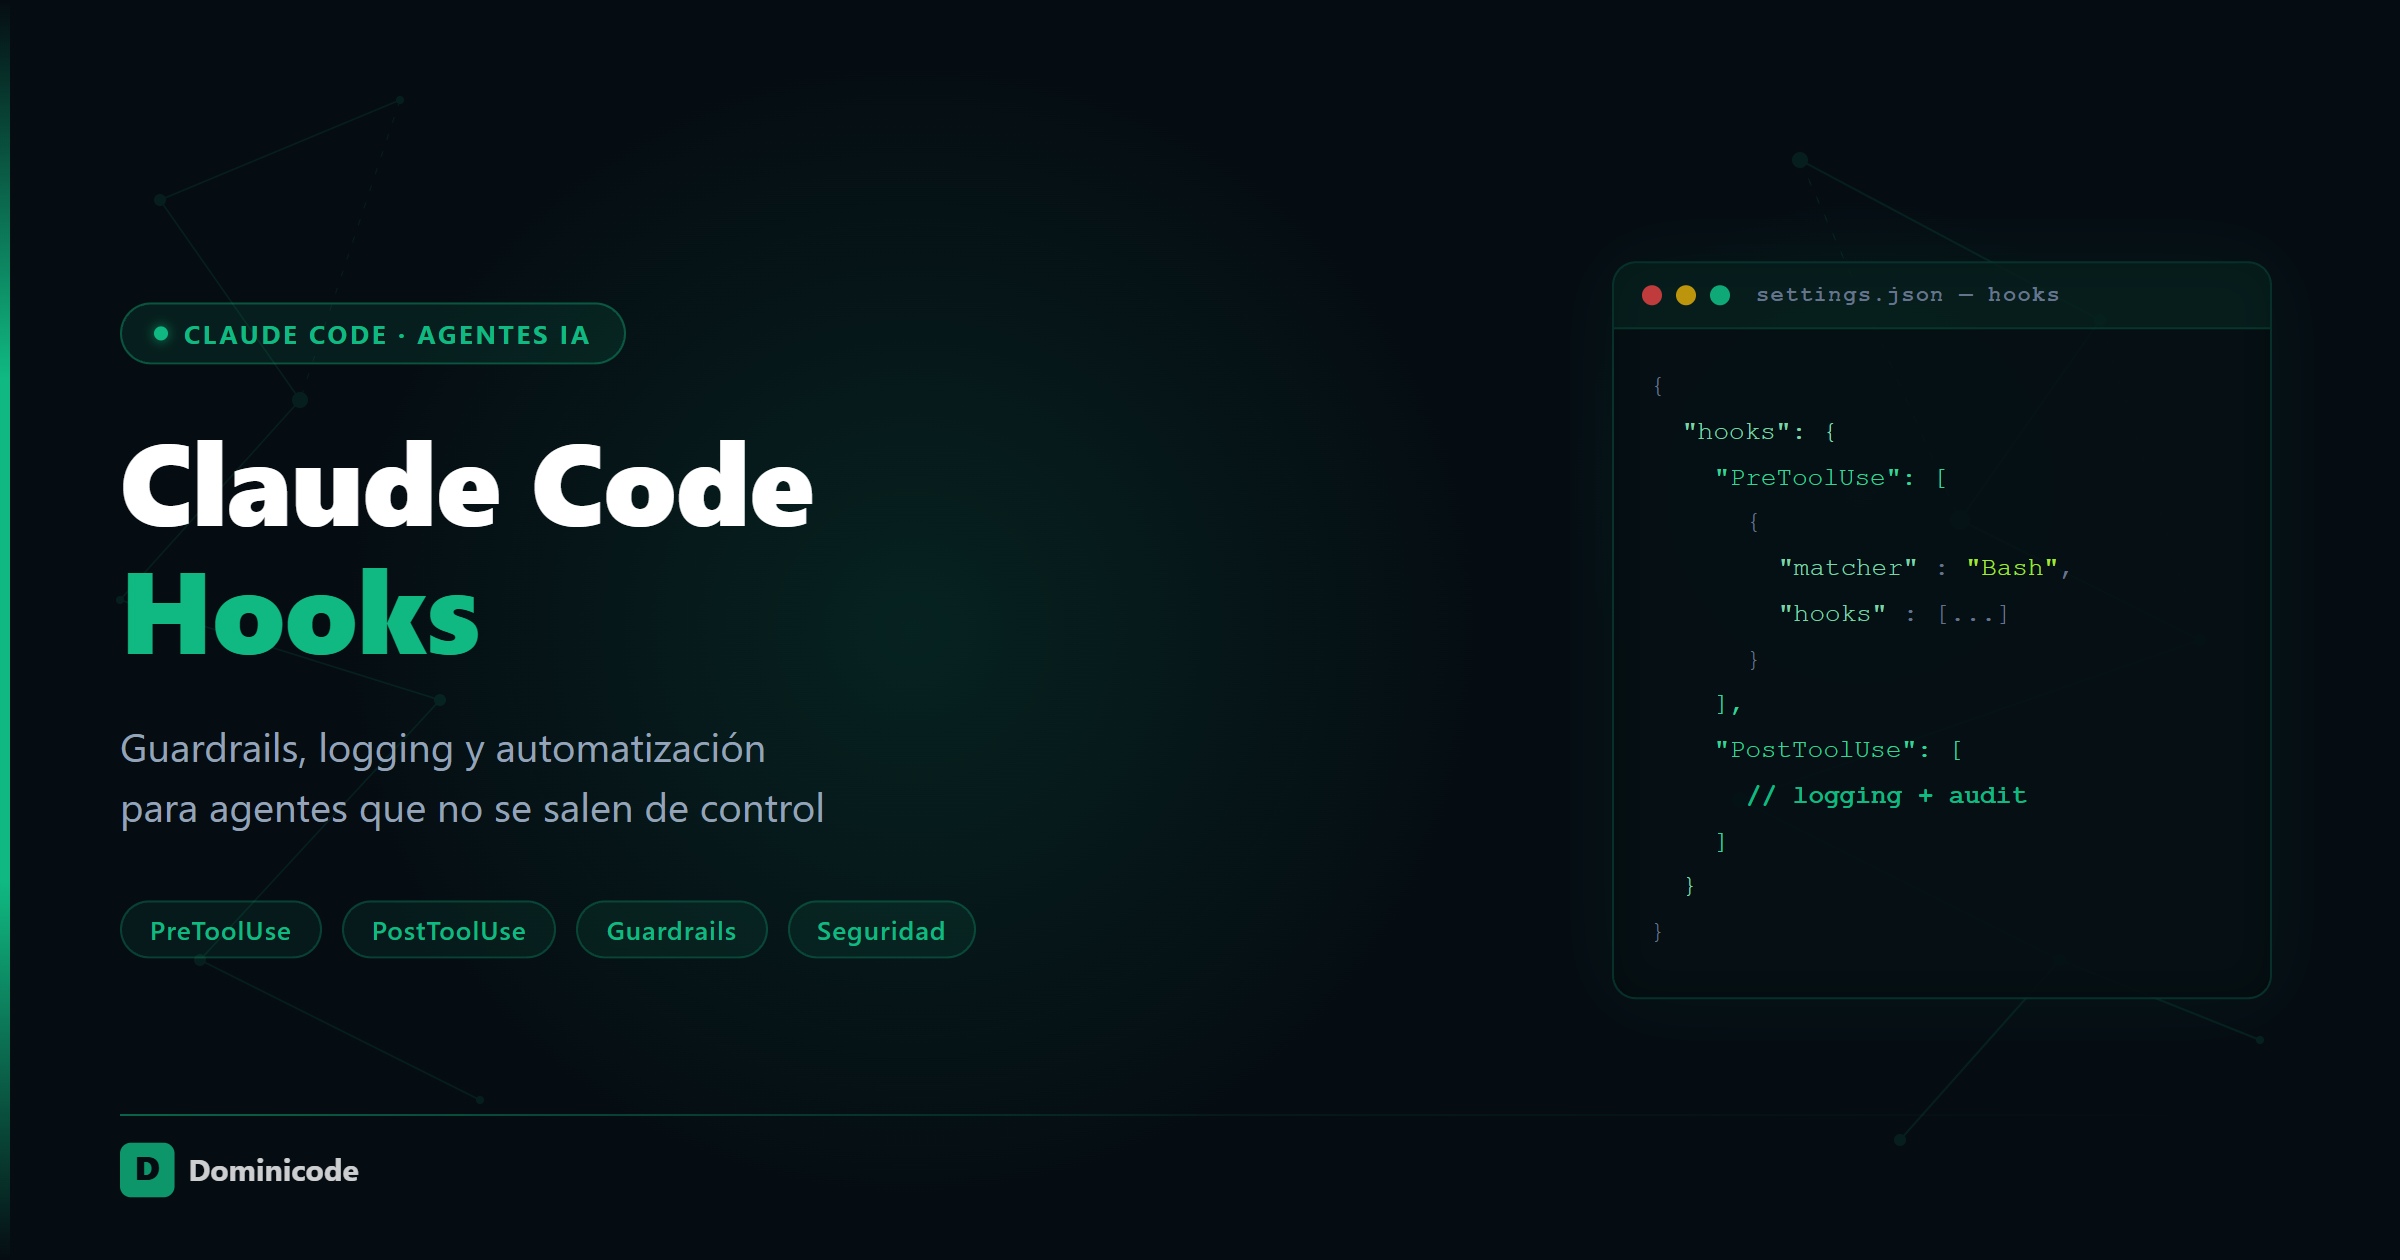
  • Claude Code hooks: guardrails, logging y automatización para tus agentes

    Claude Code hooks: guardrails, logging y automatización para tus agentes

    Hook PreToolUse para Bash: bloquea rm -rf y loguea todo

    set -euo pipefail

    Leer el JSON de entrada desde stdin

    INPUT=$(cat)

    Extraer el comando que Claude quiere ejecutar

    COMMAND=$(echo "$INPUT" | jq -r '.tool_input.command // ""')

    Timestamp para el log

    TIMESTAMP=$(date -u +"%Y-%m-%dT%H:%M:%SZ")
    LOG_FILE="${CLAUDE_PROJECT_DIR:-$HOME}/.claude/bash-audit.log"

    Loguear el comando (siempre, antes de cualquier decisión)

    echo "[$TIMESTAMP] CMD: $COMMAND" >> "$LOG_FILE"

    Patrones peligrosos que bloqueamos sin excepciones

    BLOCKED_PATTERNS=(
    "rm -rf /"
    "rm -rf ~"
    "rm -rf *"
    "rm -rf ."
    ":(){ :|:& };:"
    "dd if=/dev/zero"
    "> /dev/sda"
    "mkfs."
    )

    for PATTERN in "${BLOCKED_PATTERNS[@]}"; do
    if echo "$COMMAND" | grep -qE "$PATTERN"; then
    echo "[$TIMESTAMP] BLOCKED: $COMMAND" >> "$LOG_FILE"
    echo "Comando bloqueado por hook de seguridad: patrón destructivo detectado ('$PATTERN')" >&2
    exit 2
    fi
    done

    Todo bien — salida silenciosa, flujo normal

    exit 0

    
    Ahora la configuración en `.claude/settings.json`:
    
    ```json
    {
      "hooks": {
        "PreToolUse": [
          {
            "matcher": "Bash",
            "hooks": [
              {
                "type": "command",
                "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/bash-guard.sh",
                "timeout": 10
              }
            ]
          }
        ]
      }
    }
    

    Dale permisos de ejecución al script:

    chmod +x .claude/hooks/bash-guard.sh
    

    A partir de aquí, cada vez que Claude intente ejecutar un comando Bash, el hook se dispara primero. Si detecta un patrón peligroso, Claude recibe el mensaje de error en stderr y no ejecuta nada. Si todo está limpio, el agente continúa sin ninguna interrupción visible.

    El archivo bash-audit.log crece con cada comando ejecutado. En una sesión de trabajo normal con un agente activo, ese log te cuenta la historia completa de lo que hizo Claude — sin tener que scrollear el historial de conversación.


    Añadir una notificación cuando el agente termina

    Si lanzas tareas largas y quieres saber cuándo terminan sin estar mirando la pantalla, el hook Stop es lo que necesitas.

    {
      "hooks": {
        "Stop": [
          {
            "hooks": [
              {
                "type": "command",
                "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/notify-done.sh",
                "timeout": 5
              }
            ]
          }
        ]
      }
    }
    
    #!/bin/bash
    # .claude/hooks/notify-done.sh
    # Notificación de escritorio cuando Claude termina una tarea
    
    # En macOS
    if command -v osascript &> /dev/null; then
      osascript -e 'display notification "Claude ha terminado la tarea" with title "Claude Code"'
    fi
    
    # En Linux con notify-send
    if command -v notify-send &> /dev/null; then
      notify-send "Claude Code" "El agente ha terminado la tarea"
    fi
    
    exit 0
    

    El hook Stop no tiene matcher porque no hay herramientas que filtrar — aplica siempre que Claude decide parar. Si necesitas que Claude continúe trabajando hasta que se cumpla alguna condición (por ejemplo, todos los tests en verde), haz que el script devuelva exit 2 y escribe en stdout un JSON con {"hookSpecificOutput": {"additionalContext": "Los tests aún fallan. Corrígelos antes de terminar."}} para que Claude sepa qué debe hacer a continuación. El stderr en Stop hooks no interrumpe el flujo.


    Cuándo usar hooks, cuándo CLAUDE.md y cuándo sub-agentes

    Esta es la pregunta que más se repite cuando alguien empieza a añadir capas de control a sus agentes.

    Usa CLAUDE.md para instrucciones de comportamiento en lenguaje natural: convenciones de código, qué herramientas preferir, cómo formatear los commits. Es lo primero que Claude lee. Es contexto, no control.

    Usa hooks cuando necesitas una garantía técnica que no dependa de que Claude interprete bien una instrucción. Un rm -rf bloqueado por un hook es un rm -rf bloqueado, siempre, independientemente de cómo estaba redactado el prompt. Un rm -rf "prohibido" en CLAUDE.md es una sugerencia que Claude puede ignorar bajo presión de contexto.

    Usa sub-agentes cuando necesitas razonamiento sobre una situación: revisar si el código generado cumple los requisitos de arquitectura, validar que una migración de base de datos es correcta antes de ejecutarla, resumir los resultados de diez herramientas en paralelo. Los sub-agentes piensan. Los hooks no necesitan pensar — esa es su ventaja.

    La regla general: hooks para lo que debe ser determinista, sub-agentes para lo que requiere juicio.


    Preguntas frecuentes

    ¿Los hooks se ejecutan con cada mensaje del usuario o solo cuando Claude usa herramientas?

    Depende del tipo de hook. PreToolUse y PostToolUse solo se disparan cuando Claude invoca una herramienta — no con cada mensaje de texto. UserPromptSubmit se dispara con cada mensaje enviado, antes de que Claude lo procese. Stop se dispara cuando Claude decide terminar, no cuando el usuario escribe algo.

    ¿Puedo tener hooks diferentes para proyectos distintos?

    Sí. Los hooks en .claude/settings.json (dentro del proyecto) solo aplican a ese proyecto. Los hooks en ~/.claude/settings.json aplican a todos tus proyectos. Si hay configuraciones en ambos archivos, se combinan. En caso de conflicto en el mismo evento, la configuración más específica (proyecto) tiene precedencia.

    ¿Un hook puede modificar lo que Claude va a hacer, no solo bloquearlo?

    Sí, en PreToolUse. Puedes devolver por stdout un JSON con hookSpecificOutput.updatedInput para reemplazar los argumentos que Claude iba a usar. Por ejemplo, si Claude quiere ejecutar rm -rf build, puedes interceptarlo y devolver rm -rf build/ (con trailing slash) para que solo borre el contenido del directorio, no el directorio en sí. Esta capacidad es poderosa — úsala con cuidado.

    ¿Hay alguna forma de ver qué hooks están activos en mi sesión?

    Sí. Escribe /hooks en el prompt de Claude Code y se abre una vista en el navegador con todos los hooks configurados, organizados por evento, con su matcher y tipo de handler. Es de solo lectura, pero es la forma más rápida de auditar qué está activo.

    ¿Los hooks se pueden desactivar sin borrarlos?

    Sí. Añade "disableAllHooks": true en cualquiera de los archivos de settings. Solo los settings de usuario y proyecto pueden desactivar hooks definidos en esos mismos niveles — los hooks de configuración administrada (managed settings) requieren intervención del administrador.

    ¿Hay límite en cuántos hooks puedo configurar?

    No hay un límite documentado en el número de hooks. Sí hay un timeout por hook (por defecto 600 segundos para comandos, 30 para prompts). Si un hook supera el timeout, se cancela como error no bloqueante (igual que un exit 1) — el flujo continúa pero el hook no tuvo efecto.


    Lo que cambia cuando añades hooks a tu workflow

    La primera semana que empecé a usar hooks en mis propios agentes, lo que más me sorprendió no fue la seguridad — fue la visibilidad.

    El archivo de log de comandos Bash me reveló patrones que no había visto antes. Claude ejecutaba con frecuencia ciertos comandos que yo no esperaba. Algunos eran ineficientes. Uno de ellos era potencialmente problemático en un contexto de CI. Sin el log, nunca me habría enterado.

    Los hooks no solo protegen tu sistema. Te dan información real sobre cómo trabaja el agente — y esa información es la que necesitas para mejorar tus prompts, tu CLAUDE.md y tu arquitectura de agentes con el tiempo.

    Si estás construyendo algo serio con Claude Code — más de un agente, un workflow automatizado, código que toca producción —, los hooks no son opcionales. Son la diferencia entre un agente que funciona y uno en el que confías.

    Si quieres ver cómo encajan los hooks dentro de un sistema de agentes más completo — con sub-agentes, routines y MCP — en el curso Construye con IA cubrimos el stack completo desde la idea hasta el producto, incluyendo cómo estructurar los guardrails de seguridad para workflows que corren sin supervisión constante.

    Y si prefieres un entorno donde experimentar con otros developers que están construyendo lo mismo, en Dominicode Labs compartimos proyectos, configuraciones y workflows reales cada semana.


    Bezael Pérez — Developer senior, fundador de Dominicode. Lleva 15+ años construyendo software y los últimos años construyendo con IA. Escribe sobre arquitectura de agentes, Angular moderno y cómo pasar de idea a producto sin caos.