Termina la tarde. Has cerrado tres issues con el agente abierto todo el día. Has escrito poco código a mano, has visto diffs aparecer en segundos y tienes la sensación de haber volado.
Ahora una pregunta incómoda: ¿cuánto habrías tardado sin IA? No lo sabes. Así que contestas con lo que sentiste.
El estudio METR sobre productividad con IA es el experimento que se atrevió a contestar esa pregunta con un reloj en lugar de con una encuesta. Y el reloj no dijo lo que sintieron los developers.
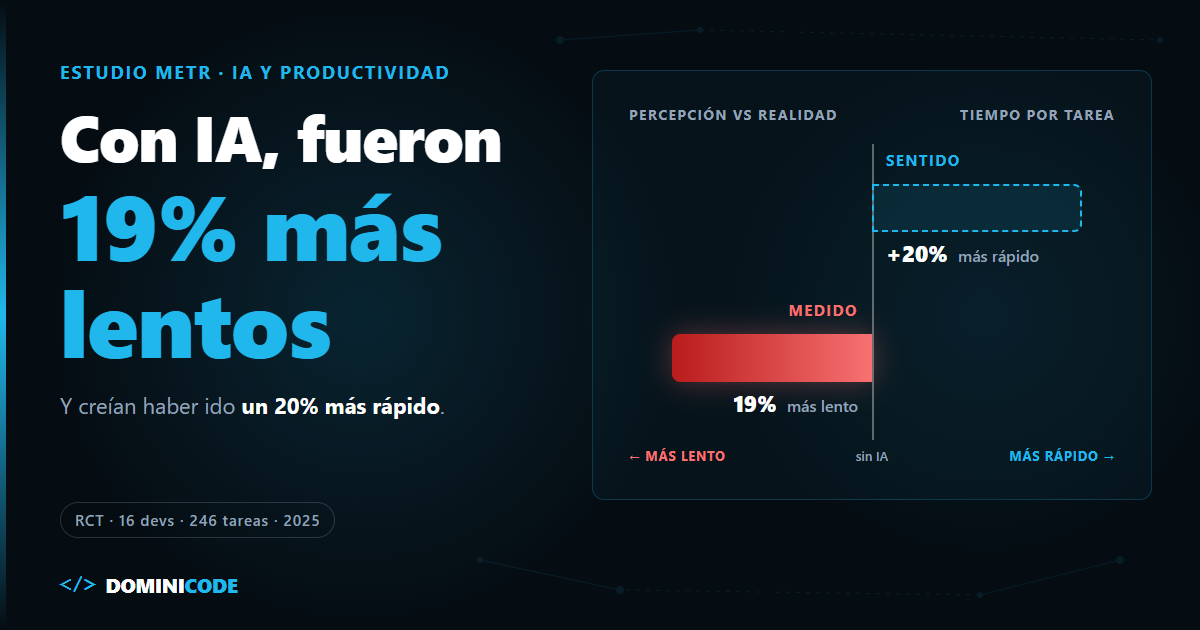
En corto: en el estudio de METR (julio de 2025), 16 developers experimentados tardaron un 19% más en sus tareas cuando podían usar IA, pero al terminar estimaron que habían ido un 20% más rápido. El hallazgo útil no es "la IA ralentiza", es que tu percepción de velocidad no es una medida fiable. Si no mides el tiempo hasta el cambio terminado, no sabes si la IA te está ayudando.
Qué midió exactamente el estudio METR sobre productividad con IA
El estudio METR es un ensayo controlado aleatorizado (RCT) que midió cuánto tardan developers expertos en resolver issues reales de sus propios repositorios cuando se les permite o se les prohíbe usar IA, tarea a tarea.
El diseño importa más que el titular. METR reclutó a 16 developers con años de contribuciones en proyectos open source maduros, de una media de más de 22.000 estrellas y más de un millón de líneas de código. Cada uno trajo su lista de issues reales: 246 tareas en total, de unas dos horas de media. Cada tarea se asignaba al azar a "IA permitida" o "IA prohibida", y se les pagaba 150 dólares por hora. Los datos están en el paper en arXiv y en el post de METR del 10 de julio de 2025.
La herramienta principal fue Cursor Pro con Claude 3.5/3.7 Sonnet, los modelos punteros de febrero a junio de 2025. Antes de empezar, se pidió a todo el mundo que predijera el resultado:
| Quién | Qué esperaba o estimó | Fuente |
|---|---|---|
| Developers, antes de empezar | 24% menos de tiempo con IA | arXiv 2507.09089 |
| Expertos en economía | 39% menos de tiempo | arXiv 2507.09089 |
| Expertos en machine learning | 38% menos de tiempo | arXiv 2507.09089 |
| Developers, después de terminar | 20% menos de tiempo | arXiv 2507.09089 |
| Resultado medido | 19% más de tiempo (IC: +2% a +39%) | METR, feb. 2026 |
| Limitación | 16 personas, repos que conocían a fondo, herramientas de principios de 2025 | METR, jul. 2025 |
Fíjate en la cuarta fila: es lo que estimaron después de trabajar con y sin IA. Ni la experiencia directa corrigió la impresión. Entre lo que sintieron y lo que marcó el reloj hay casi 40 puntos.
Por qué la IA hace más lentos a developers expertos (en ese contexto)
La brecha aparece porque la IA elimina fricción visible, como teclear y buscar sintaxis, y añade fricción invisible: escribir prompts, esperar, revisar y descartar.
El paper analiza 20 factores posibles y encuentra evidencia de que cinco contribuyen a la ralentización:
- Exceso de optimismo sobre lo útil que sería la IA, que lleva a usarla también donde no compensa.
- Alta familiaridad con el repositorio. Estos developers ya sabían dónde tocar; la IA les aportaba menos.
- Repositorios grandes y complejos, donde el modelo rinde peor.
- Baja fiabilidad de la salida. Aceptaron menos del 44% de las generaciones de código.
- Contexto implícito del repositorio: convenciones, decisiones históricas y requisitos que no están escritos en ningún sitio.
Las grabaciones de pantalla cuentan el resto: con IA, menos tiempo programando y buscando información, y más escribiendo prompts, esperando y revisando. Solo revisar y limpiar lo generado se llevó en torno al 9% del tiempo.
Encaja con algo que ya defendí en el blog: el cuello de botella al programar con IA es verificar, no escribir. METR le pone número. El código llega rápido; lo caro es decidir si sirve.
El hilo de Hacker News sobre el estudio pasó de 480 comentarios. Los debates más repetidos: la curva de aprendizaje (según el paper, solo el 44% de los participantes había usado Cursor antes, aunque más del 90% tenía experiencia haciendo prompts a LLMs), el tamaño de la muestra y si el resultado aguantaría con agentes más recientes.
Qué NO demuestra el estudio (y qué dijo METR en 2026)
El estudio METR no demuestra que la IA ralentice a la mayoría de developers: demuestra que, en un contexto concreto, la percepción de velocidad se separó de la velocidad real.
El propio METR lo deja escrito: no afirma que la IA no acelere a la mayoría de developers, ni que los modelos próximos no vayan a acelerar a estos mismos developers, ni que no existan formas de usar mejor las herramientas actuales para conseguir aceleración en ese mismo contexto. Usar el 19% como eslogan anti-IA es leer el paper al revés.
En febrero de 2026, METR publicó una actualización con un segundo experimento de finales de 2025: 57 developers, 143 repositorios y más de 800 tareas. Los datos brutos apuntan a una aceleración: un -18% de tiempo estimado en los developers del estudio original y un -4% en los nuevos, aunque ambos intervalos de confianza incluyen la posibilidad de ralentización.
Lo revelador: METR considera esos datos una señal poco fiable. Algunos developers no participaban, y entre un 30% y un 50% no enviaban ciertas tareas, porque no querían hacerlas sin IA, así que las tareas donde más ayuda se quedaban fuera.
Además bajaron el pago de 150 a 50 dólares por hora y no podían medir bien a quien usa varios agentes a la vez. Concluyen que probablemente los developers van más rápido a principios de 2026 que en 2025, y están rediseñando el experimento.
Lo que sí sigue en pie es la lección metodológica: el propio METR recuerda que las aceleraciones autodeclaradas pueden ser muy poco fiables. Esa parte no caduca con el siguiente modelo. Es la misma distancia que separa un benchmark de tu repositorio, como cuento en qué mide de verdad un benchmark de IA programando.
Cómo medir tu propia productividad real con IA
Tu productividad real con IA es el tiempo desde que empiezas una tarea hasta que el cambio está fusionado y no genera retrabajo, no el tiempo que tarda en aparecer el diff.
No puedes replicar un RCT tú solo, pero sí dejar de fiarte de la sensación. Durante dos semanas, haz lo que METR pidió a sus participantes: antes de cada tarea, escribe cuánto crees que tardarás con y sin IA, y tira una moneda para decidir si la usas. Anota:
| Qué registras | Cuándo | Por qué importa |
|---|---|---|
| Estimación sin IA y con IA | Antes de empezar | Es tu predicción, la que METR demostró sesgada |
| Con o sin IA (moneda) | Antes de empezar | Evita que elijas la IA solo para lo fácil |
| Tiempo hasta PR listo para revisión | Al abrir el PR | El dato que normalmente sientes |
| Tiempo hasta merge | Al fusionar | Incluye las rondas de revisión |
| Retrabajo en los 7 días siguientes | Una semana después | Captura el "casi correcto" que se coló |
| Tu estimación de aceleración | Al cerrar la tarea | Compárala con el reloj |
| Limitación | — | Con 20 o 30 tareas el ruido es grande; tómalo como señal, no como verdad |
Si lo que tienes que medir es un equipo y no a ti, el enfoque cambia: tendencias en el tiempo en lugar de una moneda por tarea. Lo explico en cómo medir la productividad en equipos que usan IA.
No buscas un número exacto. Buscas en qué tipo de tarea se separan tu sensación y tu reloj: quizá la IA te ahorra horas en código nuevo y aislado y te las quita en el módulo que conoces de memoria.
Cómo cerrar la brecha entre sentirte rápido y serlo
La brecha se cierra reduciendo el tiempo de revisión y descarte, no generando más código más deprisa.
Lo que METR señala como causa dicta el remedio. Si el modelo falla por contexto implícito, escríbelo antes de pedir código: un contrato de cinco líneas con el comportamiento esperado, los casos límite y lo que no puede tocar. Es la base del Spec-Driven Development, y es justo lo que convierte una salida "casi correcta" en una que puedes aceptar o rechazar en un minuto.
Antes de escribir código, inspecciona AuthService y el middleware actual.
Propón un plan para devolver 401 en tokens ausentes o inválidos, sin cambiar el
flujo de refresh ni los permisos de rutas internas. Después escribe los tests
que cubran esos casos. No modifiques archivos fuera de auth/ sin preguntarme.
Si la salida es poco fiable, encoge el cambio hasta que puedas revisarlo sin cruzar los dedos. Para no leer cada línea, apóyate en técnicas para verificar código generado por IA sin leerlo todo. Y para detectar el error que compila pero no hace lo que debe, no hay atajo: necesitas los fundamentos que explico en las habilidades que definen al programador en la era de la IA.
El retrabajo también es seguridad. Veracode probó más de 100 modelos y encontró que el 45% de las muestras de código generado no superaba sus pruebas de seguridad e introducía vulnerabilidades del OWASP Top 10. Es el estudio de un proveedor de seguridad, no la tasa de tu repo, pero explica por qué el "ya está" del agente no es el final de la tarea. Si quieres ver cómo montamos ese flujo de punta a punta, el curso Construye con IA lo aplica de la idea al producto.
Límites de este enfoque
Medir tu propia brecha tiene tres límites: pocas tareas dan mucho ruido, el tiempo no mide calidad ni cansancio, y los datos de 2025 no describen las herramientas de hoy.
El primero es estadístico. Con pocas decenas de tareas, la varianza entre tareas aplasta cualquier diferencia pequeña. Ni siquiera METR, con 246 tareas, obtuvo un intervalo estrecho: el 19% va de +2% a +39%. Tu experimento personal te dará intuiciones, no conclusiones.
El segundo es que el tiempo no lo es todo. Una tarea con IA puede tardar lo mismo y cansarte menos, o dejar más tests. METR mide tiempo hasta completar, no calidad a largo plazo ni carga cognitiva. Si solo optimizas el cronómetro, puedes castigar una herramienta que te hace mejor trabajo.
El tercero: los datos de 2025 ya no describen las herramientas de hoy. Lo que no ha cambiado es lo poco que vale preguntarte cómo te sentiste.
Tu siguiente paso: diez tareas y una moneda
Elige tus próximas diez tareas. Antes de cada una, apunta tu estimación y tira la moneda. Al final, compara tu sensación con tu reloj. Lo que descubras te dirá dónde merece la pena la IA en tu proyecto, y dónde solo te hace sentir rápido.
Si quieres entender qué hace un agente por dentro y construir el tuyo sin perder el control, el ebook gratuito El Developer Agéntico es un buen punto de partida.
Preguntas frecuentes
¿Qué es el estudio de METR sobre productividad con IA?
Es un ensayo controlado aleatorizado publicado en julio de 2025 en el que 16 developers experimentados resolvieron 246 issues reales de sus repositorios open source. Cada tarea se asignaba al azar a usar o no IA. Con IA tardaron un 19% más.
¿Por qué los developers creían ir más rápido si tardaban más?
Porque la IA elimina el esfuerzo más visible, teclear y buscar sintaxis, y lo sustituye por esperar, escribir prompts y revisar salidas, que se perciben menos como trabajo. Por eso estimaron un 20% de aceleración tras terminar.
¿El estudio de METR sigue siendo válido en 2026?
Como medida de las herramientas actuales, no. Usó Cursor Pro con Claude 3.5/3.7 Sonnet, y en febrero de 2026 METR reconoció que probablemente los developers ya van más rápido con IA. Como prueba de que la sensación no mide la velocidad, sigue vigente.
¿Cómo sé si la IA me hace más productivo a mí?
Registra durante dos semanas tu estimación previa, decide al azar si usas IA y mide el tiempo hasta el merge y el retrabajo posterior. Compara las estimaciones con el reloj en lugar de fiarte de la sensación.
Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
Leave a Reply