Tag: Vibe coding

  • Usar IA para programar: los 4 errores de mis primeros 3 meses

    Usar IA para programar: los 4 errores de mis primeros 3 meses

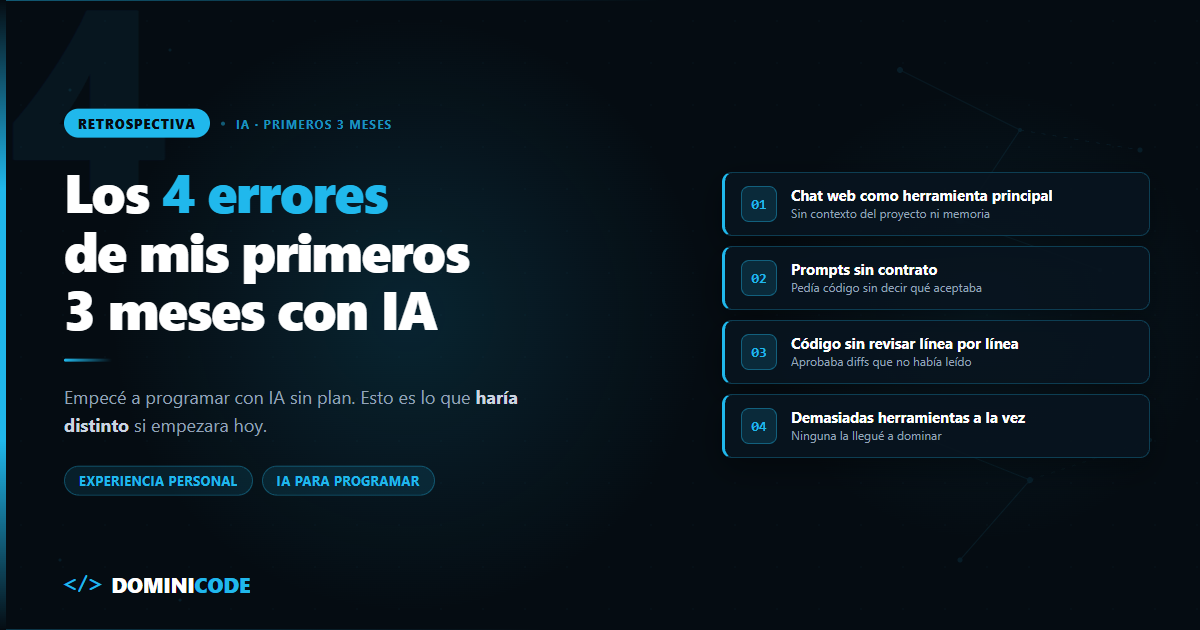
    Hace tres meses, en junio de 2026, hice merge de un endpoint generado por ChatGPT dentro de Kursar sin leerlo línea por línea. Compilaba. Los dos tests que traía pasaban — los había escrito la misma IA que escribió el endpoint. Lo aprobé un jueves a las diez de la noche porque tenía prisa.

    Quince días después, ese endpoint dejó pasar un payload que no debía. Tuve que revertir un commit en producción a las once de la noche sin saber qué línea lo había roto — nunca la había leído.

    Ese fue el momento en que entendí que empezar a usar IA para programar no es un problema de qué herramienta eliges primero. Es un problema de qué hábitos construyes en las primeras semanas. Y yo construí los equivocados.

    En corto: en mis primeros tres meses usando IA para programar cometí cuatro errores caros: chat web como herramienta principal, prompts sin contrato, código sin revisar línea por línea, y demasiadas herramientas probadas a la vez. Si empezara hoy, instalaría una sola herramienta agéntica, escribiría el contexto antes que el prompt, y no aprobaría nada que no hubiera leído yo mismo.

    ¿Qué es revisar código por contrato?

    Revisar código por contrato es comprobar que lo que generó la IA cumple una lista explícita de condiciones —qué debe hacer, qué no debe romper, con qué se valida— antes de aceptarlo. No es leer por encima para ver si "se ve bien": es fijar el contrato antes de escribir el prompt, no después de leer la respuesta. Ya escribí sobre este método completo en Revisar código generado por IA: el método Revisión por Contrato; aquí va la versión resumida de por qué me costó tan caro no aplicarlo desde el día uno.

    En el mes uno yo no hacía esto. Escribía un prompt sin contrato y aprobaba lo que volviera si compilaba:

    // Mes uno: sin contrato
    "Mejora este endpoint de pagos"
    
    // Ahora: con contrato
    "Modifica solo el endpoint POST /payments.
    No cambies la firma de la función ni el schema de respuesta.
    El monto debe seguir validándose con Zod antes de llamar al proveedor.
    Si el proveedor devuelve error, reintenta máximo 2 veces con backoff."
    

    El contrato lo inventé después de romper algo en producción, que es la forma más cara de aprenderlo.

    Los cuatro errores que más me costaron

    No los cometí por descuido. Los cometí porque nadie me dijo que el problema no era la herramienta, sino el orden en que construía el hábito de usarla.

    Hábito Cómo empecé (mes 1) Qué cambié Coste que me hubiera ahorrado
    Herramienta principal Chat web genérico (ChatGPT), copiar y pegar código a mano CLI agéntica que lee el repo completo (Claude Code) Semanas reescribiendo contexto a mano en cada prompt
    Cómo pedía las cosas "Mejora este código", "arregla este bug" Prompt con contrato: qué debe cumplir, qué no debe tocar, con qué se valida Una noche entera revirtiendo un commit que rompió un flujo en producción
    Revisión antes de aceptar Merge si compilaba y pasaban los tests que la propia IA había escrito Diff línea por línea + criterios de aceptación que escribo yo antes de pedir el código El bug de producción del endpoint que abre este post
    Herramientas probadas Cinco en paralelo la primera semana (Copilot, Cursor, ChatGPT, Claude web, Codeium) Una sola herramienta, mínimo dos o tres semanas antes de evaluar otra Casi un mes sin dominar ninguna a fondo

    No soy el único al que le pasó esto. En el hilo de Hacker News "The AI coding trap" hay un comentario que lo resume mejor que yo: "if you yolo your way through a build without thought, it will collapse". Otro añade algo que se aplica directo a mi endpoint: la deuda técnica generada por código de IA sin revisar "isn't paid down, it's being added to".

    Eso es exactamente lo que pasó con mis dos primeros meses: no estaba pagando deuda, la estaba acumulando cada vez que aprobaba un diff sin leerlo.

    La ruta que seguiría si empezara hoy

    Si tuviera que borrar los tres meses y empezar de nuevo, este es el orden exacto, no una lista de buenas intenciones:

    1. Instala una herramienta agéntica de terminal antes que una extensión de autocompletado. Necesitas ver cómo razona sobre el repo completo, no solo qué te autocompleta línea a línea. A mí lo que me cambió el flujo fue Claude Code — en el curso Construye con IA parto de cero con esta misma herramienta, sin dar por hecho nada.
    2. Escribe el contexto antes que el prompt. Qué archivos puede tocar, qué no debe romper, con qué criterio se valida. Un prompt sin contrato produce una solución genérica para un problema que no era genérico.
    3. No apruebes un diff sin leerlo, ni una sola vez, en las primeras semanas. Es el hábito más caro de perder y el más barato de mantener desde el día uno.
    4. Escribe tú los criterios de aceptación antes de pedir el código. No dejes que la misma IA que escribió la función te diga si la función está bien — ese fue mi error con los tests del endpoint. Este marco lo dejé completo en Revisar código generado por IA: el método Revisión por Contrato, justo para no repetir mi error.
    5. Comprométete con una sola herramienta dos o tres semanas antes de evaluar otra. Cambiar cada dos días es la forma más cara de no aprender ninguna a fondo.

    Lo que la IA todavía no te resuelve

    Nada de esto convierte a la IA en un sustituto de tu criterio. Dos límites reales, no teóricos, con los que me sigo topando:

    • No conoce las restricciones de negocio que nadie escribió en ningún sitio. La decisión de arquitectura que tomaste hace dos años por una razón que ya nadie recuerda. Te va a dar una solución "correcta" en el vacío, y ese vacío es exactamente donde vive la mayoría de los bugs de producción.
    • No sustituye la revisión de seguridad. Secretos hardcodeados, dependencias inseguras, patrones peligrosos como eval o deserialización sin validar pasan la revisión superficial precisamente porque el código generado se ve profesional — y el código que se ve profesional es el que menos se revisa a fondo.

    Si tu flujo de trabajo depende de que la IA nunca se equivoque, no tienes un flujo de trabajo. Tienes una apuesta.

    Qué haría hoy, literalmente

    Si hoy tuviera que empezar de cero, esto es lo que haría antes de escribir una sola línea de código con ayuda de IA: instalar una sola herramienta agéntica, escoger una tarea pequeña y real de mi propio repo, escribir el contrato antes del prompt, y leer el diff completo antes de aprobar nada.

    No es una lista de deseos. Es lo que hago ahora, después de pagar el precio de no hacerlo en el mes uno.

    Si prefieres no reconstruir esto a partir de tus propios errores, en Construye con IA parto contigo de la idea al producto con Claude Code, con estos mismos hábitos desde la primera clase. Si ya tienes el hábito y quieres dar el siguiente paso, construir un agente de IA desde cero es la ruta lógica. Y si prefieres tener con quién comentar los errores mientras los cometes, en Dominicode Labs compartimos esto cada semana con gente que está exactamente en este punto.

    Preguntas frecuentes

    ¿Por dónde empezar a usar IA para programar si nunca lo he hecho?

    Empieza por una sola herramienta agéntica de terminal, no por el chat web. Elige una tarea pequeña y real de un proyecto que ya conozcas —no un tutorial de juguete— y practica el hábito de escribir el contrato antes del prompt y leer el diff completo antes de aprobar nada.

    ¿Qué herramienta de IA debería instalar primero?

    Depende de si trabajas sobre todo desde la terminal o desde el editor, pero para ver el repo completo y razonar sobre varios archivos a la vez, una CLI agéntica como Claude Code te enseña el hábito correcto desde el primer día. El chat web genérico está bien para preguntas puntuales, pero no para tu flujo de trabajo principal.

    ¿Es seguro dejar que la IA escriba código en producción?

    Es seguro si tú revisas cada diff con criterios definidos antes de aprobarlo, y no lo es si el criterio es "compiló" o "los tests pasaron" cuando esos tests también los escribió la IA. El riesgo no está en usar IA, está en saltarte la revisión por prisa.

    ¿Cuánto tiempo se tarda en tener un flujo de trabajo sólido con IA?

    A mí me tomó tres meses y un incidente en producción para dejar de improvisar. Si defines el contrato desde el primer día y te comprometes con una sola herramienta en vez de probar cinco a la vez, puedes llegar a un flujo sólido en dos o tres semanas.

    ¿Vale la pena seguir usando el chat web en vez de una herramienta agéntica?

    Para preguntas sueltas o para pensar en voz alta sobre un problema, sí. Para escribir código que vas a mergear en un repo real, no: pierdes el contexto del proyecto en cada mensaje y terminas pegando código a mano, que fue exactamente mi primer error.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Cuándo usar vibe coding: la frontera exacta donde deja de servir

    Cuándo usar vibe coding: la frontera exacta donde deja de servir

    Hace unas semanas un amigo me enseñó una app que había montado en un fin de semana.

    Sin spec. Sin tests. Sin AGENTS.md. Sin una sola de las cosas que yo llevo un año contando por aquí. Prompt, ver qué sale, prompt otra vez. Puro vibe coding.

    Y funcionaba. Bien, además.

    Me tocó quedarme callado, que es una postura que recomiendo más a menudo de lo que se practica.

    Y me obligó a replantearme cuándo usar vibe coding y cuándo no, porque la respuesta que yo daba no explicaba lo que estaba viendo.

    Porque el problema de este debate es que casi siempre lo plantea alguien que necesita que el otro lado esté equivocado. Y no lo está. La gente que hace vibe coding y dice que le funciona no miente ni se engaña: le funciona de verdad. Lo que pasa es que no ha llegado todavía al sitio donde deja de funcionar, y ese sitio no está donde la mayoría cree.

    Así que vamos con las dos partes. Primero por qué tienen razón. Después dónde exactamente se acaba.

    Lo que el vibe coding acierta y ningún método te da

    Tres cosas, y las tres son reales.

    Cuando no sabes lo que quieres, escribir una especificación es adivinar. Es el fallo que más veo en la gente que se toma en serio lo de las specs: escribe cuarenta líneas de criterios de aceptación sobre un producto que todavía no ha visto funcionando. Eso no es rigor, es ficción con formato. Muchas veces la forma más rápida de saber qué quieres es tener algo delante y odiarlo.

    Casi todo lo que generas así está pensado para tirarse, y está bien. La ceremonia sobre código desechable es coste puro. Si vas a borrar la carpeta entera el lunes, todo lo que gastes en hacerla mantenible es dinero quemado. Ahí el vibe coding no es una versión relajada del método: es objetivamente la decisión correcta.

    Y la velocidad cambia qué problemas te atreves a atacar. Esto es lo que menos se dice y lo que más importa. Cuando probar una idea cuesta cuarenta minutos en vez de dos días, pruebas ideas que antes ni te planteabas. Eso no lo da ninguna metodología, y quien lo ha probado no va a volver atrás por un post. Yo tampoco volvería.

    Ojo, que velocidad de exploración y coste no son lo mismo: improvisar con un agente sobre algo que sí va a existir sale unas 7 veces más caro en turnos. Lo que el vibe coding abarata es descubrir qué quieres, no construirlo.

    Con lo cual, si tu argumento contra el vibe coding es "así no se hacen las cosas", no tienes un argumento. Tienes una preferencia estética.

    Qué es el vibe coding (y la mitad de la frase que se cortó)

    El vibe coding es generar código conversando con un modelo sin revisar lo que produce: describes lo que quieres, ejecutas el resultado y, si funciona, sigues sin leer el diff.

    El término lo acuñó Andrej Karpathy en febrero de 2025, en un tuit que ya es historia de esta profesión: "hay un nuevo tipo de programación que llamo vibe coding, en el que te entregas del todo a las vibras, abrazas las exponenciales y olvidas que el código existe" (en el original: "There's a new kind of coding I call 'vibe coding', where you fully give in to the vibes, embrace exponentials, and forget that the code even exists").

    Esa mitad la ha leído todo el mundo. La otra, que va unas líneas más abajo en el mismo mensaje, casi nadie:

    "It's not too bad for throwaway weekend projects, but still quite amusing."

    No está mal para proyectos desechables de fin de semana — y sigue teniendo su gracia.

    El término no llegó sin instrucciones de uso. Llegó con el rango de validez escrito al lado, en el mismo tuit. Lo que pasó después es que la industria se quedó con el eslogan y tiró la letra pequeña, que es lo que hace la industria con todo.

    Y hay una segunda parte, de octubre de 2025. Karpathy publicó nanochat, unas 8.000 líneas que cubren el pipeline entero de entrenar un modelo pequeño.

    Le preguntaron cuánto de ese código había escrito a mano y contestó que está "basically entirely hand-written (with tab autocomplete)". A mano, con autocompletado y poco más. Probó agentes de Claude y de Codex varias veces y su conclusión fue que no funcionaban lo bastante bien, posiblemente porque ese repositorio está demasiado lejos de la distribución de datos con la que se entrenaron.

    No es un arrepentimiento ni una retractación, y quien lo venda así te está vendiendo humo. Es un tipo que sabe en qué casilla está trabajando cada vez.

    Ahí está el matiz que se pierde en la discusión de siempre: el vibe coding no es una postura moral que adoptas y defiendes en Twitter. Es una técnica con un rango. El debate útil no es si es bueno o malo. Es dónde está el borde.

    Cuándo usar vibe coding: la frontera no la marca el tamaño

    Aquí es donde casi todo el mundo se equivoca de línea, yo el primero durante bastante tiempo.

    La frontera no es "prototipo contra producción", porque nadie sabe dónde está esa raya. Tampoco es el número de líneas, ni si tiene base de datos, ni si lo has desplegado. Todo eso son síntomas.

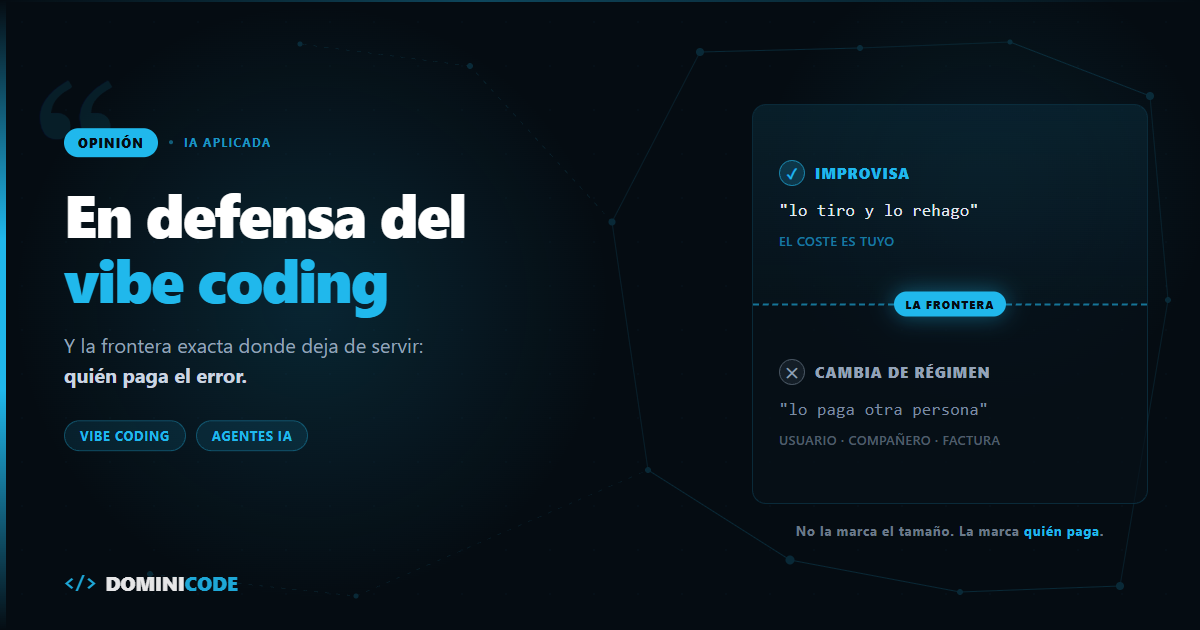
    La frontera es esta: quién paga el error.

    Situación ¿Quién paga el error? Régimen
    Prototipo que borras el lunes Tú Vibe coding puro, cero ceremonia
    Herramienta interna de un solo usuario Tú Vibe coding + carril mínimo
    Repo que va a mantener otra persona Tu compañero Contrato de 4 líneas + verificación
    Usuarios reales o datos que no puedes rehacer El usuario Verificación en cada cambio
    Migraciones, cobros, credenciales, borrados Todos Fuera del carril: nunca improvisado

    Mientras el peor caso posible sea "lo tiro y lo rehago", el vibe coding es la mejor herramienta que tienes y cualquier ceremonia que le añadas es coste. Improvisa todo lo que quieras. Yo lo hago.

    En el momento en que el peor caso incluye a otra persona — un usuario que pierde datos, un compañero que va a mantener esto el año que viene, una factura que sale mal, una tabla de la que ya no puedes hacer rollback — cambiaste de régimen. Aunque el código sea exactamente el mismo. Aunque lo hayas escrito igual de rápido.

    Lo que cambia no es la calidad del código. Es que el coste de descubrir un fallo dejó de ser tuyo.

    Y date cuenta de una cosa: esa frontera puede cruzarse el día 3 de un proyecto de cien líneas y no cruzarse nunca en uno de veinte mil. No tiene nada que ver con el tamaño.

    Por qué cruzas la frontera sin enterarte

    Ahora el problema de verdad, que no es el vibe coding.

    Es que nadie cruza esa frontera un martes por la mañana, conscientemente, diciendo "vale, esto ya es producción, voy a cambiar de forma de trabajar".

    Se cruza sola. Un amigo que lo prueba. Un dominio que compras porque ya que estás. El primer usuario que no eres tú. Un compañero que abre el repo para tocar una cosa pequeña. Ninguno de esos días parece nada.

    El vibe coding no es una decisión que tomas y revocas. Es un estado por defecto que se queda.

    El día 1 es una técnica excelente. El día 90 es una herencia, y la recibe alguien — muchas veces tú mismo, con el contexto ya evaporado.

    Lo peor es que el sistema no te avisa, porque no hay nada que avise. No se pone nada en rojo. No falla ningún comando, entre otras cosas porque no hay comandos.

    Todo sigue funcionando exactamente igual hasta el día que no, y ese día ya arrastras noventa jornadas de decisiones que nadie escribió en ningún sitio. Es el mecanismo exacto por el que un proyecto con IA se rompe sin que nadie lo decida: la arquitectura acaba pareciendo una Casa Winchester, con habitaciones que no llevan a ninguna parte, escaleras que dan al techo, y ni un solo día en el que alguien decidiera construirlas.

    "Ya, pero los modelos van a mejorar"

    Este es el argumento con el que se cierra el 90% de estas conversaciones, y es el más equivocado de todos.

    Un modelo mejor amplía el rango del vibe coding en tamaño, no en criticidad.

    Te va a dejar improvisar ocho mil líneas donde hoy improvisas ochocientas. No te va a decir cuáles de esas ocho mil son correctas, ni quién paga si una no lo es. La confianza no es un subproducto de la fluidez: son dos ejes distintos, y solo estamos avanzando por uno.

    De hecho, cuanto mejor es el modelo, más rápido cruzas la frontera sin enterarte — porque el resultado se parece cada vez más a algo terminado. Un prototipo que se ve regular te recuerda solo lo que es. Un prototipo impecable no te recuerda nada.

    Y si tu problema es raro, el modelo mejor tampoco te salva. Justo eso es lo que le pasó a Karpathy con nanochat: cuanto más lejos estás de lo que todo el mundo ha escrito ya, menos te ayudan los agentes. La media no cubre tu caso.

    Vibe coding vs Spec-Driven Development: lo que hacemos mal los del método

    Toca la parte incómoda para mí, porque el vibe coding no creció solo. Creció porque la alternativa se presentó fatal.

    Specs de cuarenta páginas para un CRUD. Plantillas con doce secciones obligatorias. Gente pidiendo un documento de diseño para cambiar el color de un botón. Si tu método le impone eso a alguien que quiere probar una idea un sábado, esa persona vuelve al vibe coding y hace bien.

    El peso del método tiene que ser proporcional al coste del error, no al tamaño del código. Un contrato de cuatro líneas para algo que toca dinero. Cero líneas para algo que vas a borrar el lunes. Todo lo demás, en medio. Ese criterio —cuánto método aplicar y dónde— es la mitad del libro de Spec-Driven Development.

    Cuando alguien te dice que el Spec-Driven Development es lento, casi siempre está describiendo con precisión el SDD mal aplicado, que efectivamente lo es. Yo mismo tengo escritos los seis casos en los que no compensa aplicarlo, y no es un gesto de falsa modestia: es que un método que no dice dónde no sirve es una religión.

    La propuesta: no dejes de vibe codear

    No te voy a pedir que cambies tu forma de trabajar. Va a sonar raro viniendo de mí, pero es que no hace falta.

    Sigue improvisando. Sigue sin escribir la spec cuando no sabes lo que quieres. Lo único que te pido es que le pongas al proyecto dos cosas que se ejecutan solas y que tardan una tarde en existir:

    Un carril — cuatro líneas diciendo qué no se toca: migraciones, despliegue, dependencias, credenciales. Y un veredicto — los comandos que ya tienes hoy, aunque solo sean el build y el type checker, puestos en un sitio donde el agente los ejecute después de cada cambio.

    Así de literal es. Nueve líneas en AGENTS.md:

    ## No se toca sin permiso
    - Migraciones y esquema de base de datos
    - Configuración de despliegue
    - Dependencias nuevas
    - Credenciales y variables de entorno
    
    ## Verificación después de cada cambio
    - `npm run build`
    - `npx tsc --noEmit`
    

    Improvisa todo lo que quieras dentro de ese carril. Eso sigue siendo vibe coding, con la misma velocidad y la misma libertad. La única diferencia es quién se entera de que cruzaste la línea: ahora es el sistema, no tú a las tres de la mañana de un martes.

    Eso es lo que llamo Revisión por Contrato, y no es lo contrario del vibe coding. Es lo que le permite durar más de un fin de semana.

    La pregunta que cierra el debate

    Cuando termines lo próximo que generes, hazte esta:

    Si esto falla el martes a las tres de la mañana, ¿quién se entera y quién lo paga?

    Si la respuesta es "yo, y lo tiro", cierra este post y vibe codea tranquilo. Lo digo en serio: estás usando la herramienta correcta y cualquiera que te diga lo contrario te está vendiendo algo.

    Si la respuesta incluye a alguien que no eres tú, entonces ya no estás haciendo vibe coding. Estás haciendo producción sin verificación y llamándolo vibe coding, que es una cosa bastante distinta y con muchísima peor prensa.

    Y a partir de ahí ya no discutimos de metodología. Discutimos de cómo se llaman las cosas.

    Si quieres el carril y el veredicto montados, sin escribirlos desde cero, están enteros en el ebook gratuito de Revisión por Contrato — treinta páginas y ningún coste. Y si lo que te interesa es ver dónde termina exactamente la improvisación y empieza el método sobre un proyecto real, ese es el recorrido de Construye con IA: de la idea al producto con Claude Code.

    Preguntas frecuentes

    ¿Cuándo usar vibe coding y cuándo no?

    Úsalo mientras el peor caso posible de un fallo sea "lo tiro y lo rehago". Prototipos, pruebas de concepto, herramientas internas de un solo usuario, cualquier cosa que vayas a borrar. Deja de usarlo tal cual en el momento en que el coste de un error lo pague otra persona: un usuario, un cliente, o el compañero que herede el repositorio. La frontera no la marca el número de líneas ni si está desplegado, sino quién paga el fallo.

    ¿El vibe coding sirve para producción?

    No como técnica única. Puedes seguir generando código de forma improvisada en producción siempre que el proyecto tenga dos cosas que no dependan de ti: límites declarados sobre lo que el agente no toca y comandos de verificación que se ejecuten en cada cambio. Sin eso, lo que tienes no es vibe coding en producción, es producción sin verificación.

    ¿Karpathy dijo que el vibe coding era solo para proyectos desechables?

    En el tuit original de febrero de 2025 donde acuñó el término escribió que "no está mal para proyectos desechables de fin de semana". Nunca lo presentó como un método general de desarrollo. Además, cuando publicó nanochat en octubre de 2025 —unas 8.000 líneas de código de entrenamiento de modelos— explicó que estaba escrito prácticamente a mano y que los agentes que probó no le resultaron útiles en ese repositorio, posiblemente por estar demasiado fuera de la distribución de datos habitual.

    ¿No arreglarán esto los modelos cuando sean mejores?

    Un modelo mejor amplía cuánto código puedes improvisar, no cuánta confianza tienes en él. Son dos ejes distintos. De hecho, cuanto mejor es el resultado, más fácil es cruzar sin enterarte la línea entre prototipo y sistema del que depende alguien, porque un prototipo impecable ya no se parece a un prototipo.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • La factura del vibe coding: improvisar con un agente sale 7 veces más caro

    La factura del vibe coding: improvisar con un agente sale 7 veces más caro

    "Añade suscripciones con Stripe, cupones de descuento y control de acceso por roles."

    Un prompt. Diecisiete palabras. El agente arrancó con entusiasmo: creó catorce archivos, instaló tres dependencias que no hacían falta, inventó un esquema de base de datos incompatible con el que ya existía y, hacia el paso dieciocho, se puso a arreglar errores de compilación que había provocado él mismo seis pasos antes.

    Cuarenta y cinco minutos después, git reset --hard. Salía más a cuenta tirarlo todo que rescatarlo.

    Esa historia —el vibe coding en estado puro— la hemos vivido todos, y siempre se cuenta igual: en tiempo perdido y en frustración. Nadie mira la otra columna.

    Lo que nadie miró ese día fue la factura. Y es la parte más fácil de calcular, la más incómoda de ver y la que convence a un jefe en treinta segundos, que es más de lo que ha conseguido nunca el argumento de "escribir la spec es buena práctica".

    De qué es SDD, qué lleva dentro un spec.md y cómo se genera el plan.md no voy a hablar aquí: está en por qué Spec-Driven Development triplica tu velocidad. Este post hace una sola cosa: poner precio a improvisar.


    La factura no crece con los turnos: crece con su cuadrado

    Aquí está la parte que casi nadie tiene interiorizada, y sin ella todo el cálculo parece exagerado.

    Un agente no manda tu último mensaje: manda toda la conversación otra vez, en cada turno. Lo que escribiste al principio, la salida de aquel grep, el test que falló en el turno 3. Todo, cada vez.

    Si cada turno añade d tokens al contexto y la sesión dura n turnos, lo que pagas no es n × d. Es esto:

    total = n · base  +  d · n · (n − 1) / 2
                         └──────┬─────────┘
                         el término que te mata
    

    Ese segundo término es cuadrático. En cristiano: duplicar los turnos de una sesión no duplica la factura, la multiplica por casi cuatro. El mecanismo, con la instrumentación para medirlo en tu propio agente, lo desglosé en medir el consumo de tokens de un agente.

    Y ahora la pregunta que conecta las dos mitades del post: ¿qué hace una especificación, exactamente?

    Reduce n.

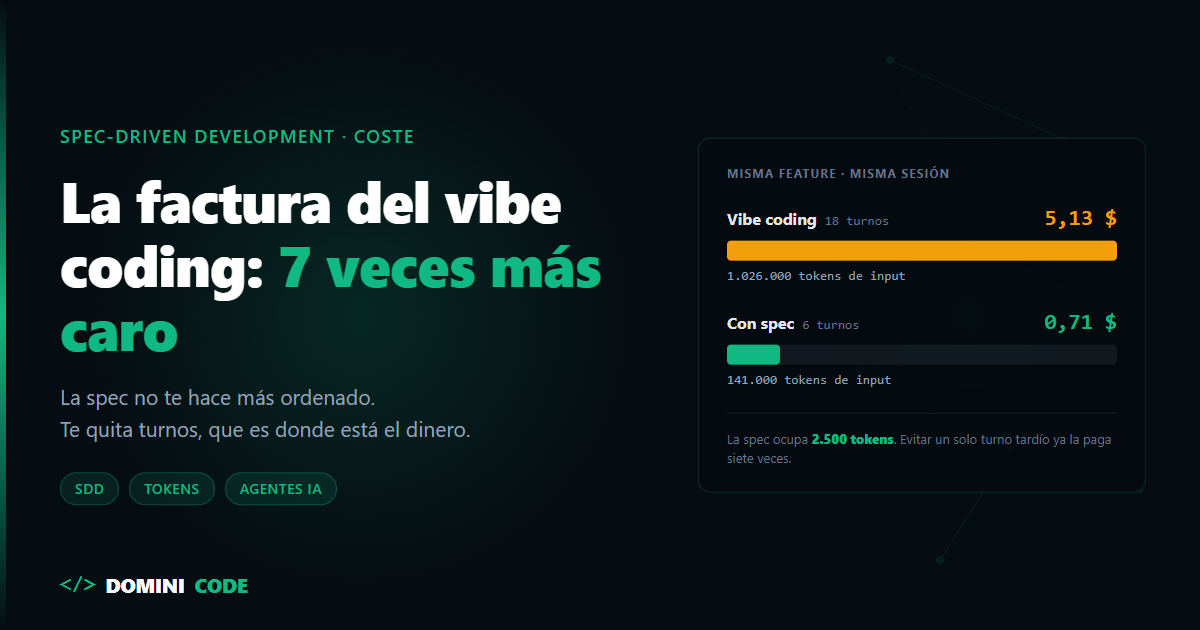
    No hace al modelo más listo ni al código más bonito. Solo elimina turnos: los de explorar el repositorio a ciegas, los de elegir una librería y cambiarla, los de deshacer, los de arreglar lo que rompió al deshacer. Y como la factura va con el cuadrado de los turnos, quitar turnos por delante es la palanca más potente que existe.


    Las dos sesiones, en números

    Cojamos la sesión de Stripe de arriba y su versión con spec. Mismo modelo, mismo repositorio, misma persona.

    Los supuestos, sobre la mesa antes que los resultados:

    • 6.000 tokens de base por turno: system prompt, definiciones de herramientas, archivos abiertos.
    • 6.000 tokens que se añaden en cada turno: el diff, la salida del test, lo que devuelve cada herramienta.
    • La spec ocupa 2.500 tokens y se paga en todos los turnos, porque viaja en el contexto entera.
    • 18 turnos improvisando, 6 con la spec delante.
    • Precio de entrada: 5 $ por millón de tokens.
    Vibe coding Con spec
    Turnos 18 6
    Base por turno 6.000 8.500 (incluye la spec)
    Tokens de input acumulados 1.026.000 141.000
    Coste de entrada 5,13 $ 0,71 $

    Siete veces. Y no por un truco: los 141.000 son el 13,7 % de 1.026.000, así que el ahorro es del 86 %.

    Fíjate en el detalle que hace daño: los 2.500 tokens de la spec, multiplicados por los seis turnos, suman 15.000 tokens de sobrecoste. Un solo turno tardío de la sesión improvisada —el turno 18, con todo el historial detrás— cuesta 108.000. La especificación se paga siete veces con evitar un único turno al final.

    Estos números son un modelo, no una medición de laboratorio: salen de aplicar la fórmula de arriba a los supuestos declarados. Cambia los tuyos y cambiarán los resultados. Lo que no cambia es la forma de la curva, porque el término cuadrático no depende del precio: si el ratio de turnos es 3 a 1, el ratio de coste ronda 7 a 1 pagues lo que pagues — y llega a 8 a 1 si no cuentas lo que ocupa la propia spec.


    De dónde salen los doce turnos que te ahorras

    No son turnos imaginarios. Son estos, y los reconocerás todos:

    • Reconocimiento. Sin spec, el agente abre archivos "por si acaso" para deducir tu arquitectura. Con la spec, ya sabe qué toca y qué no.
    • Decisiones que tú deberías haber tomado. Elige una librería, la instala, no encaja, la quita. Tres turnos que se resolvían con una línea en el documento.
    • Marcha atrás. Descubre en el turno 12 que el esquema de base de datos no cuadra con lo que ya existe y rehace lo del turno 5.
    • Parches sobre parches. Arregla un error de compilación creando otro, porque ya no recuerda la restricción del primer mensaje.

    Los dos últimos tienen la peor propiedad de todas: son los turnos más caros de la sesión, porque ocurren al final, cuando el contexto ya pesa. En una sesión de 18 turnos, los seis últimos se llevan más de la mitad de la factura.

    Ojo con la conclusión fácil, eso sí: una spec ambigua o incompleta no ahorra nada, porque el agente vuelve a decidir por su cuenta y los turnos regresan. Por qué una especificación falla y qué la hace inservible lo conté en por qué tu spec falla con un agente de IA.

    Y hay un caso en el que este cálculo se da la vuelta: cuando el trabajo es tan pequeño que escribir la spec cuesta más turnos que hacerlo. Los seis escenarios donde no compensa están en cuándo NO usar Spec-Driven Development.


    Cómo medir esto en tu repositorio esta semana

    No hace falta creerme. Tienes los datos en tu historial:

    1. Cuenta los turnos de tus últimas cinco sesiones con el agente. Solo el número, nada más.
    2. Sepáralas en dos montones: las que empezaron con un documento delante y las que empezaron con una frase.
    3. Aplica la fórmula con tu base y tu delta reales, que los saca la instrumentación del post de consumo de tokens en media hora.
    4. Multiplica por sesiones al mes. Ahí es donde el número deja de ser una curiosidad y pasa a ser una cifra de la que hablar en una reunión.

    Si además pagas por suscripción y no por API, el cálculo sigue valiendo: no cambia la factura, cambia cuántas sesiones te caben antes de tocar el límite de uso.

    El flujo completo —de la idea a la spec, y de la spec al agente ejecutando por fases— lo enseño paso a paso en el curso Construye con IA: de la idea al producto con Claude Code, y como referencia de consulta está el libro de Spec-Driven Development.

    Una última pieza, porque es la que cierra el círculo: el agente no puede dar una tarea por terminada porque "el código parece correcto". Necesita un test que devuelva 0, y para eso hacen falta suites rápidas y fiables — que es lo que trabajo en el curso de Testing en Angular con Jest y Testing Library. Sin esa comprobación, los turnos de marcha atrás vuelven por la puerta de atrás y con ellos la factura.

    En Dominicode Labs trabajamos así todos los proyectos de la comunidad.

    Escribir la especificación no es burocracia ni buena práctica de manual. Son 2.500 tokens que te ahorran un millón.


    Preguntas frecuentes

    ¿El prompt caching no se come todo este ahorro?

    Lo reduce, no lo elimina. La caché abarata el reenvío del historial ya visto, así que el término cuadrático pasa a costar una fracción — pero solo mientras el prefijo se mantenga idéntico. Y una sesión improvisada es justo la que peor lo mantiene: cada marcha atrás reescribe contexto anterior e invalida la caché a partir de ahí. Con caché el 8 a 1 se estrecha; la dirección no cambia.

    ¿Cuántos tokens puede ocupar la spec para que siga saliendo a cuenta?

    Muchos más de los que vas a escribir. La spec se suma a la base y por tanto cuesta tokens × turnos; un turno tardío evitado cuesta base + delta × (n−1). Con los supuestos de este post, una spec de 10.000 tokens en una sesión de seis turnos sale por 60.000, todavía por debajo de lo que costaba aquel turno 18 en solitario. El límite práctico no es económico: es que una spec larga se lee peor y decide peor.

    ¿Y si trabajo con suscripción en vez de pagar por token?

    El coste cambia de moneda, no desaparece. Con tarifa plana pagas en cuota de uso y en tiempo de espera: la misma sesión cuadrática te consume el límite antes y te deja mirando el reloj. La ventaja de medirlo en tokens es que es la única unidad que no depende de la tarifa que tengas contratada.

    Si la spec está mal escrita, ¿ahorra igual?

    No, y este es el fallo más común. Una spec con huecos —sin decir qué queda fuera de alcance, sin contratos de datos, sin nombrar los archivos que se tocan— devuelve las decisiones al modelo, y con ellas vuelven los turnos de exploración y marcha atrás. Una especificación ambigua tiene el coste de escribirla y ninguno de sus beneficios.

    ¿Merece la pena para un cambio de veinte líneas?

    No. Para un bug acotado o un ajuste de copy, el trabajo cabe en dos o tres turnos y ahí el término cuadrático no ha despegado todavía: la spec es sobrecoste puro. Este cálculo empieza a inclinarse a partir de las sesiones largas, que son precisamente las que hoy nadie planifica.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Clasificar tareas con IA: guía de supervivencia para developers

    Clasificar tareas con IA: guía de supervivencia para developers


    status: borrador
    title: "Clasificar tareas con IA: guía de supervivencia para developers"
    slug: clasificar-tareas-con-ia-desarrollo-software
    excerpt: "Aprende a clasificar tareas con IA en desarrollo de software. Descubre cómo dividir tareas seriales y paralelas para programar de forma profesional sin bugs."
    keywords:

    • clasificar tareas con IA
    • tareas seriales vs paralelas software
    • desarrollo guiado por IA
    • agentes de inteligencia artificial

    El martes pasado perdí cuatro horas intentando que Claude Code (v0.2.0, corriendo con el modelo Claude 3.5 Sonnet) reescribiera un módulo de pagos entero de un solo golpe. El resultado fue un bucle infinito de errores de tipado en TypeScript que me enseñó la importancia de clasificar tareas con IA antes de ponerme a tirar código.

    Si tratas a un LLM como a un junior todoterreno sin entender qué puede resolver en paralelo y qué requiere tu intervención directa, vas a perder más tiempo depurando que programando. Para construir software real con inteligencia artificial, necesitas dividir tu backlog bajo un criterio muy simple: estructura mental vs. ejecución de código.

    Aprender a clasificar tareas con IA es lo que separa a los programadores que sufren de "vibe coding hangover" de los que construyen aplicaciones mantenibles y escalables en producción.


    ¿Por qué debes clasificar tareas con IA?

    Cuando automatizas flujos con agentes, la mayoría de los desarrolladores cometen el error de meter todo en una gran cadena secuencial. No entienden cómo fluyen los datos y la memoria dentro de un modelo de lenguaje.

    Los LLMs tienen una ventana de contexto limitada y, a medida que la conversación se alarga, sufren de pérdida de atención. Si el modelo comete un pequeño error en el paso 1 y continúas la secuencia sin corregirlo, ese error se propaga y amplifica en los pasos 2, 3 y 4.

    Por eso, separar las tareas no es una cuestión de organización escolar: es una necesidad de arquitectura técnica para evitar que el contexto del modelo se contamine.


    Tareas seriales vs. paralelas: El cuello de botella del contexto

    Para delegar a la IA de forma óptima, debes entender la diferencia entre dos tipos de flujos de trabajo:

    A. Tareas Seriales (Secuenciales)

    Son aquellas donde cada paso depende estrictamente del resultado del paso anterior. No puedes avanzar si el paso previo no está validado.

    • Ejemplo: Diseñar un backend con NestJS. No puedes escribir los controladores ni los queries del ORM hasta que la estructura de tablas SQL esté completamente definida y validada.
    • Workflow: Exigen pasos secuenciales cortos con validaciones humanas intermedias. Necesitas un modelo integrado en tu IDE (como Cursor o Claude Code) operando con supervisión activa. Tú guías el flujo, pruebas cada paso en local y decides el siguiente movimiento.

    B. Tareas Paralelas (Independientes)

    Son tareas independientes que no comparten estado entre sí y se pueden ejecutar en entornos aislados de forma simultánea.

    • Ejemplo: Traducir archivos i18n de traducción, documentar funciones utilitarias independientes o escribir tests unitarios de Jest para componentes que no tienen acoplamiento entre sí.
    • Workflow: Este es el territorio ideal de los agentes autónomos que corren en segundo plano. Puedes lanzar múltiples llamadas paralelas a la API y resolver el backlog en segundos mientras tú te enfocas en diseñar la lógica del negocio.

    A continuación, puedes ver una comparativa clara de cómo enfocar cada tipo de tarea:

    Característica Tareas Seriales (Secuenciales) Tareas Paralelas (Independientes)
    Dependencia Alta (Paso B necesita el output de A) Nula o muy baja (Módulos aislados)
    Workflow de IA Interactivo (Human-in-the-loop) Agentes autónomos en background
    Ejemplo práctico Depuración de bugs complejos, diseño de APIs Escribir tests unitarios, documentación
    Riesgo de desvío Alto (los errores de contexto se acumulan) Bajo (tareas acotadas y repetitivas)
    Intervención humana Constante (validación paso a paso) Al inicio (spec) y al final (code review)

    Cómo clasificar tareas con IA: lo que delegas y lo que no

    La IA es un ejecutor brutal de especificaciones cerradas. Si le das reglas claras y un entorno acotado, escribirá código mejor y más rápido que tú. Esto es lo que llamamos el "desarrollo guiado por IA".

    Para flujos secuenciales complejos, la clave está en fragmentar el código. No le pidas al modelo "escribe el endpoint de cobro con Stripe entero". En su lugar, fragméntalo en una secuencia controlada:

    // Paso 1: Pídele que defina la interfaz de datos estrictamente
    interface PaymentPayload {
      amount: number;
      currency: 'USD' | 'EUR';
      token: string;
    }
    
    // Paso 2: Una vez validada la interfaz, pídele implementar el validador
    function validatePayment(payload: PaymentPayload): boolean {
      return payload.amount > 0 && payload.token.length > 0;
    }
    

    Qué delegar a la IA (Ejecución y Boilerplate)

    • Scaffolding: Configuración de herramientas, setup de linters, inicialización de módulos.
    • Refactoring menor: Traducir funciones, migrar código JavaScript legacy a TypeScript clásico.
    • Tests y Documentación: Tareas repetitivas que consumen tiempo y tienen baja ambigüedad.

    Qué NUNCA debes delegar al modelo (Criterio y Dirección)

    • Decisiones de arquitectura: Decidir si tu base de datos debe ser relacional, si necesitas microservicios, o qué abstracción introducir hoy para no bloquear el desarrollo en 6 meses. La IA optimiza a nivel local, pero no ve a largo plazo.
    • Comprensión del negocio: Qué le importa realmente al usuario y qué tradeoffs valen la pena asumir.

    Para evitar que tu proyecto se desvíe, yo utilizo una metodología de diseño de especificaciones antes de tocar código. En el Libro SDD (Leanpub) explico cómo escribir especificaciones claras que los modelos de lenguaje entienden a la perfección y ejecutan a la primera.


    El loop humano: Tú eres el compilador final

    La automatización no significa que el programador desaparezca. Al contrario, la evolución natural del programador tradicional, como vimos en nuestro post sobre loop engineering y la evolución de la IA, exige que pases de escribir código a orquestar sistemas que escriben código.

    Tu rol ya no es picar código sin parar. Tu trabajo es diseñar la especificación, configurar los límites de los agentes (como las directivas en la documentación de Claude Code de Anthropic), y actuar como el control de calidad senior que decide qué entra a producción y qué se descarta.

    Esto es parte de lo que explico en mi artículo sobre el stack de IA agentica en 2026, donde analizamos cómo los ingenieros senior multiplican su productividad manejando subagentes independientes para tareas aisladas.

    Si quieres dominar este flujo y aprender a estructurar proyectos reales que funcionen con agentes y Claude Code, te recomiendo revisar el Curso "Construye con IA" en Udemy. Es el paso a paso exacto que yo sigo para lanzar productos sin perder la cabeza con bugs infinitos.

    Empieza hoy por lo básico: abre tu backlog y etiqueta cada tarea pendiente. Sabrás exactamente cuándo colaborar en vivo, cuándo lanzar un agente en background y cuándo apagar la pantalla y pensar tú solo.

    También puedes unirte a Dominicode Labs para acceder a herramientas, experimentos y una comunidad de desarrolladores seniors que están construyendo el futuro del software con inteligencia artificial aplicada de verdad.


    Preguntas frecuentes

    ¿Cómo clasificar tareas con IA en seriales o paralelas?

    Pregúntate si el output de un paso es obligatorio para que el siguiente empiece a procesarse. Si la respuesta es sí (como definir el esquema SQL antes de escribir el ORM), la tarea es serial y secuencial. Si las tareas pueden ejecutarse en entornos independientes sin afectarse mutuamente (como escribir tests de archivos diferentes), son paralelas.

    ¿Por qué los modelos de IA fallan en las tareas seriales largas?

    A medida que el prompt y la conversación se alargan, el modelo sufre de pérdida de atención (needle in a haystack) y alucinaciones. Si el paso 1 tiene un pequeño error de interpretación, ese error se arrastra y amplifica en los pasos siguientes, destruyendo el resultado final. La clave es fragmentar el proceso en prompts individuales.

    ¿Se puede automatizar al 100% el desarrollo de software con agentes de IA?

    No en aplicaciones de producción complejas. Los agentes actuales destacan implementando código bajo especificaciones acotadas. Sin embargo, la toma de decisiones de negocio, el diseño de la arquitectura general y la integración de APIs de terceros siguen requiriendo la supervisión y validación de un programador humano experimentado.

    ¿Qué herramientas son mejores para ejecutar tareas paralelas con LLMs?

    Para flujos paralelos de volumen (como traducción o análisis de código masivo), las APIs de Claude o OpenAI conectadas a scripts locales son la opción más rápida y económica. Para desarrollo interactivo en local y tareas seriales complejas que requieren explorar el workspace, herramientas como Claude Code o entornos basados en agentes autónomos son ideales.


    Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.
  • Vibe coding sin sistema: por qué tu proyecto con IA se rompe

    Vibe coding sin sistema: por qué tu proyecto con IA se rompe

    La primera semana fue increíble.

    Abriste Claude Code, describiste la idea a grandes rasgos, y el proyecto arrancó. En dos horas tenías rutas funcionando. En cuatro tenías la autenticación. En un día, un prototipo que podías enseñar. Sentiste que habías desbloqueado algo — que la IA era la ventaja que llevabas buscando.

    La segunda semana empezaron las grietas. Añadiste una feature nueva y rompiste una que ya funcionaba. Pediste al modelo que corrigiera el bug y generó código con una convención de nombres distinta a la del resto del proyecto. Abriste el archivo equivocado porque en una sesión le pusiste un nombre y en otra, otro.

    La tercera semana dejaste de entender tu propio proyecto.

    Esto no es un problema de la IA. Es el resultado predecible del vibe coding sin sistema — y hay una salida que no implica empezar desde cero.


    El ciclo que reconocerás si llevas más de dos semanas con IA

    El vibe coding tiene un patrón muy concreto. Arranca con energía, avanza rápido, y luego se convierte en deuda que nadie quiere pagar.

    Semana 1 — La euforia del prototipo. El modelo genera código que funciona. Tú describes lo que quieres, él lo construye. Cada sesión termina con algo nuevo encima de la mesa. Sientes que puedes construir cualquier cosa.

    Semana 2 — Los primeros síntomas. Añadir una feature empieza a costar más de lo esperado. El modelo genera código que no encaja del todo con lo que ya existe — naming diferente, estructura diferente, patrones distintos. Cada sesión nueva es ciega respecto a las decisiones de la anterior.

    Semana 3 — El colapso. El proyecto tiene capas que se contradicen entre sí. No puedes explicarle a nadie la arquitectura — ni siquiera a la IA que lo construyó. Cada sesión nueva te exige re-explicar el contexto desde cero. Y cuando lo haces, el modelo entiende una versión diferente de lo que tienes.

    Aquí hay dos salidas que la mayoría elige: abandonar el proyecto o empezar desde cero con la promesa de “esta vez lo haré mejor”. Ninguna funciona porque el problema no es el punto de partida. Es la ausencia de sistema.


    Por qué el vibe coding escala mal

    Por defecto, la IA no carga el estado de sesiones anteriores. Aunque herramientas como Claude Projects permiten persistir algo de contexto entre conversaciones, ese contexto no es estructurado — no sabe que decidiste usar repositorios en lugar de servicios directos, ni recuerda que el módulo de usuarios tiene una estructura específica, ni que descartaste la opción B el martes porque tenía un problema de concurrencia.

    Lo que el modelo construye en cada sesión es una respuesta razonable al contexto que le das en ese momento. Sin especificación, sin arquitectura documentada, sin contexto persistente, ese contexto siempre es incompleto. Y el modelo completa los huecos con sus propias suposiciones — razonables para un proyecto genérico, incorrectas para el tuyo.

    El resultado es código construido sobre arena. Cada sesión añade una capa nueva que puede o no ser compatible con lo que ya existe. Con el tiempo, la incoherencia se acumula hasta que el proyecto es incomprensible — no porque sea complejo, sino porque nadie tomó decisiones explícitas.

    Esto no es un defecto del modelo. Es una consecuencia directa de cómo usamos el modelo.


    Los 3 síntomas de que tu proyecto está en modo vibe

    Antes de hablar de la solución, vale la pena identificar dónde estás. Estos tres síntomas aparecen en orden: si tienes los tres, el proyecto ya necesita intervención.

    Naming inconsistente entre archivos. Un archivo se llama user-service.ts, otro usersService.ts, otro UserManager.ts. Las variables que representan el mismo concepto tienen nombres distintos según la sesión en que se crearon. El proyecto habla idiomas distintos en cada carpeta.

    Tests que no prueban lo que dicen. Los tests existen — el modelo siempre los genera cuando se los pides — pero prueban el código tal como fue escrito en ese momento, no el comportamiento que el sistema debería tener. Cuando el código cambia, los tests se rompen de formas que no esperabas. O peor: siguen en verde porque prueban implementación, no contrato.

    No puedes explicar la arquitectura de tu propio proyecto. Este es el síntoma definitivo. Si le preguntas al modelo “¿cuál es la arquitectura de este proyecto?” y la respuesta que genera no coincide con lo que tienes, tienes un problema de contexto. Si tú mismo no puedes describir en dos párrafos cómo fluyen los datos de principio a fin, el proyecto ya está en modo vibe terminal.

    Si reconoces los tres, no significa que tengas que tirar el código. Significa que tienes que añadir lo que falta: sistema.


    El sistema que reemplaza al vibe

    Pasar del vibe coding al desarrollo con sistema no es abandonar la IA. Es usarla de forma diferente — con estructura que la hace más efectiva, no más lenta.

    El sistema tiene cuatro piezas. No son opcionales entre sí.

    1. Spec antes de código (SDD)

    La especificación no es un documento burocrático. Es la respuesta a: ¿qué estoy construyendo exactamente, para quién, y cómo fluye la información?

    Con Spec-Driven Development, la spec se escribe antes de abrir el editor. No porque sea una regla, sino porque un modelo que recibe una spec bien escrita genera código diez veces más coherente que uno al que le describes la idea de viva voz. La spec define los contratos. El modelo los implementa. El espacio de decisión se reduce y el output es predecible.

    2. Contexto persistente (CLAUDE.md)

    El CLAUDE.md en la raíz del proyecto es el system prompt que Claude Code lee al inicio de cada sesión. Contiene el stack, las convenciones de naming, las restricciones explícitas y el estado actual del proyecto. No es documentación — es la memoria estructurada que el modelo necesita para ser consistente. En otros entornos como Cursor o Windsurf, el concepto equivalente existe con distintos nombres (.cursor/rules/, AGENTS.md).

    Sin este archivo, cada sesión es ciega. Con él, cada sesión arranca desde el mismo punto de partida. Las decisiones tomadas en día 1 siguen vigentes en día 30. Aquí tienes cómo estructurar este archivo paso a paso si quieres implementarlo hoy.

    3. Tareas pequeñas (chunking)

    “Implementa el sistema de autenticación completo” es el tipo de prompt que genera código plausible pero incoherente con tu proyecto. El modelo toma demasiadas decisiones implícitas porque el scope es demasiado amplio.

    La regla es: una tarea por sesión, un contrato por tarea. En lugar de pedir la autenticación completa, pides el esquema de usuario, luego el endpoint de login, luego el middleware de validación. Cuatro sesiones. Cuatro piezas que encajan porque cada una tiene un contexto explícito y un alcance controlado.

    4. Validación continua

    Al final de cada sesión, pides al modelo un resumen: qué se implementó, qué decisiones se tomaron, qué queda pendiente. Ese resumen va a un session-log.md con fecha. La sesión siguiente empieza con ese log como contexto. No empiezas desde cero — empiezas desde donde lo dejaste.

    El context engineering es la disciplina que une estas cuatro piezas. No es un concepto teórico — es la práctica concreta de gestionar qué información recibe el modelo en cada momento.


    Cómo hacer la transición sin empezar desde cero

    Este es el punto donde la mayoría para: “mi proyecto ya es un caos, tendría que reescribirlo todo”. No.

    La transición tiene cinco pasos y los puedes empezar hoy con el código que tienes.

    Paso 1 — Audita lo que existe. Antes de añadir nada, entiende el estado real del proyecto. Pídele al modelo que lea tu estructura de carpetas y te describa la arquitectura que ve. Compara esa descripción con lo que creías que habías construido. La brecha entre las dos es tu deuda de contexto.

    Paso 2 — Genera la spec retroactiva. No necesitas escribir la spec desde cero — puedes generarla a partir del código existente. Dale al modelo el contexto actual y pídele que genere una spec de lo que existe: entidades, contratos, flujos. Esa spec se convierte en la verdad oficial del proyecto, no el código.

    Paso 3 — Crea el CLAUDE.md. Con la spec en mano, crea el archivo de contexto persistente. Incluye el stack real (no el ideal), las convenciones que ya están en el código aunque no estuvieran documentadas, y las restricciones que te habría gustado tener desde el principio. Esto es lo que normaliza el naming y la estructura en todas las sesiones futuras.

    Paso 4 — Divide lo que queda en tareas pequeñas. El backlog de features pendientes deja de ser una lista de ideas y pasa a ser una lista de contratos. Cada tarea tiene una descripción concreta: qué recibe, qué devuelve, cómo interactúa con lo existente. El modelo implementa contratos, no ideas.

    Paso 5 — Valida antes de seguir. Antes de añadir la siguiente feature, escribe o genera los tests del contrato de la feature actual. No para cubrir el código — para verificar el comportamiento. Si el test falla cuando cambias algo que no debería afectarlo, el test te está diciendo que el contrato no estaba claro.

    Son cinco pasos que se pueden hacer en una tarde si el proyecto no es demasiado grande. El resultado no es un proyecto perfecto — es un proyecto con el que puedes volver a trabajar con confianza.


    La diferencia que importa en producción

    El vibe coding no es malo. Es la herramienta correcta para el momento incorrecto.

    Para validar una idea en 48 horas, el vibe coding es insuperable. Para construir algo que tendrás que mantener en semanas 4, 8 y 16, es un problema en espera de ocurrir.

    La diferencia entre un developer que usa IA con efectividad y uno que acaba atascado no es el modelo que usan, ni el IDE, ni los prompts. Es si tienen sistema o no. Si cada sesión nueva añade coherencia al proyecto o añade caos.

    El sistema no frena la velocidad de la IA. La mantiene en el tiempo.

    Si quieres ver esto aplicado en proyectos reales — desde la spec inicial hasta el producto funcionando, con CLAUDE.md, SDD y Claude Code — el curso Construye con IA: de la idea al producto cubre exactamente ese flujo. Y si quieres trabajar la transición con proyectos concretos y feedback en comunidad, en Dominicode Labs hacemos exactamente eso.


    FAQ

    ¿El vibe coding sirve para algo?

    Sí, y mucho. El vibe coding es la herramienta perfecta para prototipar ideas rápido — para validar si algo es técnicamente posible, para hacer demos, para explorar una API que no conoces. El problema no es el vibe coding en sí, sino usarlo para construir algo que vas a mantener durante semanas o meses. En ese contexto, la ausencia de sistema convierte la velocidad inicial en deuda que pagas después con intereses.

    ¿Cuándo está bien improvisar?

    Siempre que el objetivo sea explorar, no construir. Si abres una sesión nueva para entender cómo funciona un nuevo framework, para probar una librería, o para validar si tu idea de arquitectura tiene sentido — improvisa sin culpa. El momento en que decides que algo va a producción o que tendrás que volver a ello en una semana, el sistema tiene que entrar.

    ¿Tengo que empezar desde cero si mi proyecto ya es un caos?

    No. La spec retroactiva y el CLAUDE.md te permiten añadir estructura al código existente sin reescribirlo. El código puede quedarse como está mientras añades el sistema que le da coherencia hacia adelante. Lo que sí tendrás que hacer es tomar las decisiones que no tomaste al principio — naming, arquitectura, convenciones — y documentarlas. Eso es trabajo que tarda horas, no semanas.

    ¿El sistema con IA hace el desarrollo más lento?

    La percepción de velocidad que da el vibe coding es real — pero es velocidad a corto plazo. El sistema hace que la semana 3 sea igual de rápida que la semana 1, porque el contexto no se degrada. Sin sistema, la velocidad cae semana a semana conforme la deuda de contexto se acumula. Quien usa sistema tiene el mismo ritmo en el sprint 8 que en el sprint 1. Quien usa vibe coding puro, no.

    ¿Qué es lo primero que debo hacer si reconozco los síntomas?

    Crea el CLAUDE.md. Puedes tenerlo en quince minutos: descripción del proyecto, stack real con versiones, convenciones de naming que ya existen en el código (aunque estén implícitas), y las tres o cuatro restricciones que te habría gustado tener desde el principio. Ese archivo solo ya reduce la inconsistencia en las sesiones futuras. El resto del sistema puedes añadirlo gradualmente.

    ¿En qué se diferencia el vibe coding del agentic engineering?

    El vibe coding es un flujo de trabajo donde el developer describe ideas y el modelo decide cómo implementarlas. El agentic engineering es una disciplina donde el developer diseña el sistema — la spec, el contexto, los contratos, los límites — y delega la implementación de forma controlada. La diferencia no es la IA que usas sino quién toma las decisiones de diseño: tú o el modelo.


    *Por Bezael Pérez — Developer senior con más de 15 años de experiencia y fundador de Dominicode.*

  • Cómo garantizar la confiabilidad del código generado por IA

    Cómo garantizar la confiabilidad del código generado por IA

    Vibe Coding: la trampa del 84%

    Tiempo estimado de lectura: 3 min

    Ideas clave

    • El 84% de desarrolladores usa IA a diario, pero solo el 29% confía en el código generado — la brecha es riesgo operativo.
    • Los LLMs generan código verosímil pero frágil: happy-paths, alucinaciones de API y antipatrones a escala.
    • Auditoría práctica: validar dependencias, exigir sad-paths desde el prompt, tests humanos para edge cases, auditar queries y requerir métricas.
    • Aplicar Zero Trust: checklist de confianza y CI que impida merges sin cobertura e instrumentación.

    Introducción

    Vibe Coding: la trampa del 84% no es un titular sensacionalista: es una advertencia práctica. El 84% de los desarrolladores usa IA diariamente, pero solo el 29% confía en el código que obtiene. Esa brecha no es una estadística; es un agujero por donde entra la deuda técnica, la fuga de datos y las regresiones en caliente. (Fuente: Stack Overflow Developer Survey 2024)

    Este artículo te da un marco operativo: cómo revisar, auditar y —sobre todo— confiar en código generado por modelos de lenguaje sin que la velocidad mate la fiabilidad.

    Resumen rápido (lectores con prisa)

    Los LLMs generan código verosímil pero no garantizan manejo de errores ni adaptación al dominio. Valida dependencias, exige sad-paths desde el prompt, escribe tests humanos para edge cases y exige métricas y trazas antes de mergear.

    Vibe Coding: la trampa del 84% — por qué sucede y qué rompe

    El problema no es que la IA escriba mala sintaxis. Es que escribe código verosímil. Y lo verosímil engaña al ojo. Un LLM predice tokens; no entiende tu dominio, tus SLAs ni tu topología de datos. Eso genera tres fallos constantes:

    • Happy-path en serie: el código funciona cuando todo va bien. No maneja latencias, timeouts o datos corruptos.
    • Alucinaciones de API: métodos que “suenan” correctos pero no existen en tu versión de la librería.
    • Antipatrones a escala: consultas N+1, bloqueos por locks mal usados, o rutas críticas sin instrumentación.

    Aceptar ese output sin auditoría es como aceptar un merge request sin tests: rápido, pero peligroso.

    Auditoría práctica: pasos que aplicas hoy mismo

    Cambia tu rol: con IA, no recibes código; recibes la propuesta de un “junior hiperproductivo”. Revíalo como tal.

    1) Valida dependencias antes de instalar

    • No copies imports sin comprobar. Busca la API en la documentación oficial.
    • Consulta npm para fecha de publicación y descargas.
    • Ejecuta npm audit tras añadir paquetes y antes de mergear. Herramienta: docs.npmjs.com/cli/v9/commands/npm-audit

    2) Obliga el Sad Path desde el prompt

    • No pidas solo “la función”. Pide manejo de fallos, retries y logging contextual.
    • Prompt débil: “Genera una función que llame a la API de pagos”
    • Prompt fuerte:
      "Genera una función que llame a la API de pagos. Incluye:
       - timeout y retry con backoff exponencial,
       - logging con requestId y contexto,
       - pruebas de unidad para timeouts y respuestas 5xx,
       - no devolver datos sensibles en la respuesta."

    3) Tests: el humano decide los edge cases

    • No dejes que la IA escriba tanto la función como los tests críticos.
    • Define tú los casos límite y las aserciones. La IA puede generar mocks y el setup repetitivo.
    • Cubre: inputs inválidos, latencias extremas, concurrencia (race conditions) y fallos de autenticación.

    4) Base de datos: audita las queries antes de producción

    • Habilita logging de queries en dev y revisa el número de hits por operación.
    • Verifica índices para columnas filtradas.
    • Comprueba serialización de objetos para no exponer campos sensibles.

    5) Métricas y observabilidad como contrato

    • Exige que cualquier cambio generado incluya: métricas (latencia, error rate), trazas correlacionadas y logs estructurados.
    • Si el PR no contiene instrumentación mínima, reviértelo.

    Checklist de confianza (Zero Trust aplicado)

    • [ ] Prompts que exigen Sad Path y límites de recursos.
    • [ ] Dependencias verificadas y npm audit limpio.
    • [ ] Tests escritos por humanos para edge cases críticos.
    • [ ] Logging y tracing incluidos en el cambio.
    • [ ] Revisión de queries e índices en DB.
    • [ ] Branch aislado y CI que rechaza merge sin cobertura mínima.

    Cuándo delegar y cuándo no

    Usa IA para acelerar tareas repetitivas y de bajo riesgo:

    • Boilerplate, DTOs, validaciones simples, plantillas de tests, conversiones de sintaxis.

    No delegues a la IA decisiones de criterio:

    • Modelado de dominio, reglas de autorización, diseño de esquemas, SLAs o decisiones que impacten seguridad y privacidad.

    Cierre directo

    La diferencia entre el 84% que usa IA y el 29% que confía en ella no es tecnología: es proceso y criterio. Si tu equipo aprende a auditar como si cada PR viniera de un “junior sin contexto”, reducirás fallos graves sin renunciar a la velocidad.

    La IA debe ahorrar tipeo; no debe asumir la responsabilidad arquitectónica. Haz que ese sea tu contrato interno hoy.

    Una continuación práctica y recursos relacionados están disponibles en Dominicode Labs, donde se publican frameworks y workflows para auditoría y observabilidad integrables en equipos que usan IA.

    FAQ

    ¿Por qué no confiar de entrada en código generado por IA?

    Porque los LLMs generan código verosímil sin comprender tu dominio, SLAs o topología de datos. Ese código puede funcionar en happy-paths pero fallar en latencia, datos corruptos o versiones de librerías.

    ¿Qué preguntas agregar al prompt para obtener código más fiable?

    Exige manejo de fallos, retries con backoff, timeouts, logging contextual (requestId), pruebas unitarias para errores 5xx y restricciones sobre datos sensibles.

    ¿Cómo validar dependencias antes de instalarlas?

    Comprueba la API en la documentación oficial, revisa fecha de publicación y descargas en npm y ejecuta npm audit tras añadir paquetes y antes de mergear.

    ¿Qué tests deben escribir los humanos?

    Los humanos deben definir y escribir tests para edge cases críticos: inputs inválidos, latencias extremas, condiciones de carrera y fallos de autenticación. La IA puede generar mocks y setups repetitivos.

    ¿Qué instrumentación mínima exigir en un PR?

    Métricas de latencia y tasa de error, trazas correlacionadas y logs estructurados. Si el PR no contiene instrumentación mínima, debería revertirse.

    ¿Cuándo es apropiado delegar tareas a la IA?

    Para tareas repetitivas y de bajo riesgo: boilerplate, DTOs, validaciones simples, plantillas de tests y conversiones de sintaxis. No para modelado de dominio, reglas de autorización, diseño de esquemas o decisiones que afecten seguridad y privacidad.

  • Identificando problemas de vibe coding en equipos empresariales

    Identificando problemas de vibe coding en equipos empresariales

    Problemas de vibe coding para equipos empresariales (2026)

    Tiempo estimado de lectura: 4 min

    • Vibe coding —iterar con un LLM hasta que el código “parece funcionar”— acelera entrega pero genera deuda técnica opaca.
    • Cinco problemas concretos: código huérfano, erosión arquitectónica, riesgos de seguridad en la cadena de suministro, degradación del criterio técnico y sobrecarga en code review.
    • La solución no es prohibir la IA: es imponer controles técnicos y procesos (Design-First, ADRs, testing liderado por humanos, CI/CD restrictivo, verificación de dependencias y rotación de ownership).
    • Permitir vibe coding solo en prototipos desechables, scripts aislados o mocks; evitarlo en autenticación, transacciones y caminos con implicaciones regulatorias.
    ¿Tu repositorio funciona hoy y nadie lo entiende mañana? Los problemas de vibe coding para equipos empresariales (2026) son eso: soluciones rápidas que se convierten en deuda técnica silenciosa. Para Tech Leads, Arquitectos y CTOs, esto ya no es una discusión teórica. Es mantenimiento que se vuelve imposible, incidentes que aparecen a horas raras y una superficie de ataque que crece sin control.

    Resumen rápido (lectores con prisa)

    Vibe coding: iterar con LLMs hasta que el bloque “parece funcionar”. Útil para prototipos; peligroso en código de producción. Obliga a controles: diseño previo, ADRs, testing liderado por humanos, CI/CD restrictivo y validación de dependencias. Evitar en caminos críticos.

    Problemas de vibe coding para equipos empresariales (2026): diagnóstico rápido

    1) Código huérfano: funciona, pero nadie lo mantiene

    La IA entrega un módulo que pasa tests básicos. Nadie lo escribió línea por línea. Nadie puede explicar el flujo en un incidente P1. Eso aumenta el tiempo de resolución dramáticamente: lo que se ahorró en desarrollo se pierde multiplicado en debugging.

    Ejemplo realista: un endpoint de autenticación generado que falla ante tokens caducados en escenarios de reintentos — el path feliz funciona, el resto no. Resultado: latencia, errores y horas de on-call.

    2) Erosión arquitectónica: soluciones locales que rompen el todo

    Los modelos no tienen una visión sistémica del repo. Producen utilidades reinventadas, acoplan capas y rompen contratos explícitos. Cuando varios devs usan prompts distintos, el cóctel es un monolito fragmentado con estilos y anti-patterns mezclados.

    3) Seguridad y cadena de suministro: vulnerabilidades sutiles

    No es solo SQL injection. Son flujos de autorización incompletos, validaciones omitidas en edge cases y dependencias “sugeridas” que están obsoletas o son inexistentes. La comunidad de seguridad ya documentó riesgos de typosquatting y abuso de paquetes; automatizar la adopción de dependencias sin verificación amplifica ese vector (ver OWASP).

    4) Degradación del criterio técnico

    Delegar la implementación en prompts empobrece el aprendizaje. Juniors que se vuelven “prompteadores” no construyen modelos mentales sobre complejidad, rendimiento o diseño de sistemas. A la larga, el activo más valioso —criterio técnico— se erosiona.

    5) Code review convertido en cuello de botella

    Revisar código generado exige más contexto y tiempo. Los patrones de error humano son predecibles; las soluciones de LLM son impecables sintácticamente pero opacas conceptualmente. Los leads pasan de decidir arquitectura a auditar toneladas de PRs.

    Cómo mitigar sin renunciar a la IA

    Prohibir la IA no es opción. Las empresas competitivas aplican control, no veto. Aquí un set de medidas prácticas y verificables.

    • Design-First: define contratos, diagramas y contratos de datos antes de cualquier generación. La IA implementa; no diseña.
    • ADRs obligatorios: cualquier módulo generado con complejidad no trivial debe acompañarse de un Architecture Decision Record. Plantilla y ejemplo: Plantilla y ejemplo
    • Testing humano-led (BDD): el desarrollador define casos, edge cases y aserciones. La IA genera el boilerplate de tests, no la lógica de cobertura.
    • CI/CD restrictivo: integra análisis estático y políticas que bloqueen PRs con saltos bruscos de complejidad ciclomática o inclusión de paquetes no verificados. Herramientas como Semgrep ayudan a automatizar reglas.
    • Verificación de dependencias fuera del flujo PR: antes de aceptar librerías sugeridas por un LLM, pásalas por un proceso de validación de licencias y reputación. Sigue guías de NIST sobre desarrollo seguro.
    • Pares y rotación de ownership: obliga a que otro ingeniero entienda y firme el ADR antes del merge. Pair-programming para integración crítica.
    • Entrenamiento deliberado: formación interna en diseño, debugging profundo y análisis de performance. No atajos educativos.

    Límites claros: cuándo permitir vibe coding y cuándo no

    Permite vibe coding en prototipos desechables, scripts aislados o generación de mocks. Evítalo en autenticación, transacciones, migraciones de estado y cualquier camino con implicaciones regulatorias o legales.

    Conclusión: la IA potencia, pero el criterio no se automatiza

    Los problemas de vibe coding para equipos empresariales (2026) no son culpa de las herramientas. Son consecuencia de adoptarlas sin procesos. La diferencia entre un equipo que escala con IA y uno que se ahoga en deuda técnica está en una palabra: criterio. No lo externalices. Defínelo, mídelo y exige documentación. La IA hará el trabajo pesado; los humanos deben seguir decidiendo qué trabajo merece hacerse.

    Apúntate al newsletter de Dominicode para la siguiente entrega: hablaremos de políticas concretas de CI/CD y reglas Semgrep para detectar “sospecha de generación automática” en PRs.

    Encuentra una continuación práctica y recursos experimentales en Dominicode Labs. Allí publicamos plantillas de ADR, reglas Semgrep y ejemplos de pipelines seguros que complementan este artículo.

    FAQ

    ¿Qué es exactamente “vibe coding”?

    Es el patrón de trabajo donde un desarrollador itera con un modelo de lenguaje (Copilot, Claude, Cursor u otros) hasta que el código “parece funcionar”, sin aplicar diseño previo ni verificación humana exhaustiva.


    ¿En qué escenarios es aceptable usar IA para generar código?

    Aceptable en prototipos desechables, scripts aislados y generación de mocks. No es recomendable en autenticación, transacciones, migraciones de estado o caminos con implicaciones regulatorias.


    ¿Cómo se evita que las dependencias sugeridas por LLM introduzcan riesgo?

    Implementando un proceso de validación de dependencias fuera del flujo PR que verifique licencias, reputación y coincidencia con políticas internas antes de su aceptación.


    ¿Qué debe incluir un ADR cuando el código fue generado por IA?

    Descripción de la decisión, alternativas consideradas, riesgos identificados, responsables y link al módulo generado. La plantilla recomendada se puede consultar en Plantilla y ejemplo.


    ¿Cómo cambia el proceso de code review con uso intensivo de LLMs?

    Requiere más contexto en las revisiones, énfasis en arquitectura y pruebas, y posibles políticas de pares y rotación de ownership para asegurar que otro ingeniero pueda explicar y mantener el código.


    ¿Qué herramientas ayudan a automatizar políticas que mitiguen vibe coding?

    Herramientas de análisis estático y reglas en CI/CD (por ejemplo, Semgrep), y procesos de verificación de dependencias siguiendo guías como las de NIST.